다중 조건 검색MultiConIR질문 분해Query DecompositionTypeSafeJev팬아웃임베딩Qwen3-EmbeddingBGE-M3RRF순서 민감성한국어 검색RAG한국어 검색 스택실측 벤치마크
조건이 둘, 셋이 되면 — 질문을 쪼개는 검색과 Jev의 조건별 판정, 한국어 실측 (한국어 검색 스택 10편)
8편이 풀지 못한 숙제가 있었습니다. 'AWS 보안 글', 'Claude Code에서 MCP를 쓰는 글'처럼 두 주제를 모두 만족해야 하는 질문입니다. 이 글은 조건 1개·2개·3개짜리 한국어 질문 52개와 조건 순서만 바꾼 쌍둥이 질문 40개로, 조건이 늘 때 검색이 어떻게 무너지는지와 그것을 어떻게 막는지를 쟀습니다. 질문을 한 번에 임베딩하면 nDCG@10이 조건 1개 0.940에서 2개 0.519, 3개 0.387로 떨어졌습니다. 질문을 조건별로 쪼개 따로 찾고 합치기만 해도 3개에서 0.592로 버텼고, 그 후보를 Jev가 판정하면 2개와 3개 모두 0.725였습니다. Jev는 한 호출에 질문을 여러 개 받으므로 조건마다 따로 물어도 조건 하나당 토큰 90개, 지연 2ms만 늘었고, 어느 조건이 빠졌는지까지 알려 줬습니다. 의외의 발견도 있었습니다. 판정할 문장 자체가 바뀌는 탓에 'Jev 한 질문'이 조건 순서에 가장 민감했고, 조건별로 묻자 그 흔들림이 사라졌습니다. Jev 9,544회 호출에 0.27달러. 인터랙티브 4개와 삽화 7장.
8편에서 질문을 다섯 종류로 나눠 BM25·임베딩·Jev·코드를 제자리에 배치했을 때, 한 종류만은 설계안이 오라클에 크게 졌습니다. 'AWS 보안 글', 'Claude Code에서 MCP를 쓰는 글'처럼 두 주제를 모두 다뤄야 하는 질문이었습니다. 제외 질문의 '빼고'나 날짜 질문의 '4월'처럼 눈에 띄는 표지가 없어서 평범한 질문으로 분류됐고, 후보 10개만 판정받아 0.502에 머물렀습니다. 후보 40개를 보면 0.625였습니다.
이 약점은 우리만의 것이 아닙니다. Lu 등의 MultiConIR(EMNLP 2025 Findings, arXiv:2503.08046)는 조건이 여러 개 붙은 질문으로 검색기와 리랭커를 시험해, 조건이 늘수록 대부분이 크게 무너지고, 조건을 질문의 어느 위치에 두느냐에 따라 결과가 흔들린다 고 보고했습니다. GPT-4o만이 그 붕괴를 견뎠습니다.
그래서 이번에는 조건 수를 1, 2, 3으로 늘려 가며 세 가지를 쟀습니다. 얼마나 무너지나. 질문을 쪼개면 얼마나 막아지나. 그리고 Jev의 고유 기능, 즉 한 호출에 질문 여러 개 를 쓰면 무엇이 달라지나.
1
조건 하나마다 반 토막
한 번에 임베딩하면 nDCG가 조건 1개 0.940, 2개 0.519, 3개 0.387. MultiConIR의 붕괴가 한국어에서 그대로 재현된다.
2
쪼개서 찾고, 판정으로 거른다
조건별로 따로 찾아 합치면(공짜) 3개에서 0.592. 그 후보를 Jev가 판정하면 2개·3개 모두 0.725. 카테고리 조건은 8편대로 코드에.
3
조건별로 물으면 흔들리지 않고, 이유도 말한다
조건마다 질문을 따로 넣어도 조건 하나당 토큰 90개·지연 2ms. 순서를 바꿔도 결과가 거의 같고(겹침 0.955), 어느 조건이 빠졌는지 확률로 보인다.
1부. 실험 설계
질문 52개 + 쌍둥이 40개
문서는 1~9편과 같은 블로그·뉴스 589건입니다. 질문은 조건 수로 나눴습니다.
조건 수
예시
개수
1개
RAG 글 · 보안 글 · Claude Code 글
12
2개
보안과 AWS를 함께 다룬 글 · Git과 에이전트를 함께 다룬 글
20
3개 (주제 셋)
Git, Claude Code, 에이전트를 모두 다룬 글
7
3개 (주제 둘 + 카테고리)
Git과 Claude Code를 함께 다룬 튜토리얼 · RAG와 에이전트를 함께 다룬 특집 글
13
조건 2·3개짜리 40개에는 조건 순서만 바꾼 쌍둥이 를 하나씩 만들었습니다. '보안과 AWS를 함께 다룬 글'에는 'AWS와 보안을 함께 다룬 글', 'RAG와 에이전트를 함께 다룬 특집 글'에는 '특집 글 중에서 에이전트와 RAG를 함께 다룬 것'. 같은 질문이므로 좋은 검색이라면 같은 답을 내야 합니다. 정답은 8·9편과 같은 기준(태그 또는 제목·요약의 정확한 용어)으로, 모든 조건에 해당하는 글 전부입니다.
질문을 쪼개는 일, 그리고 프롬프트 한 줄의 교훈
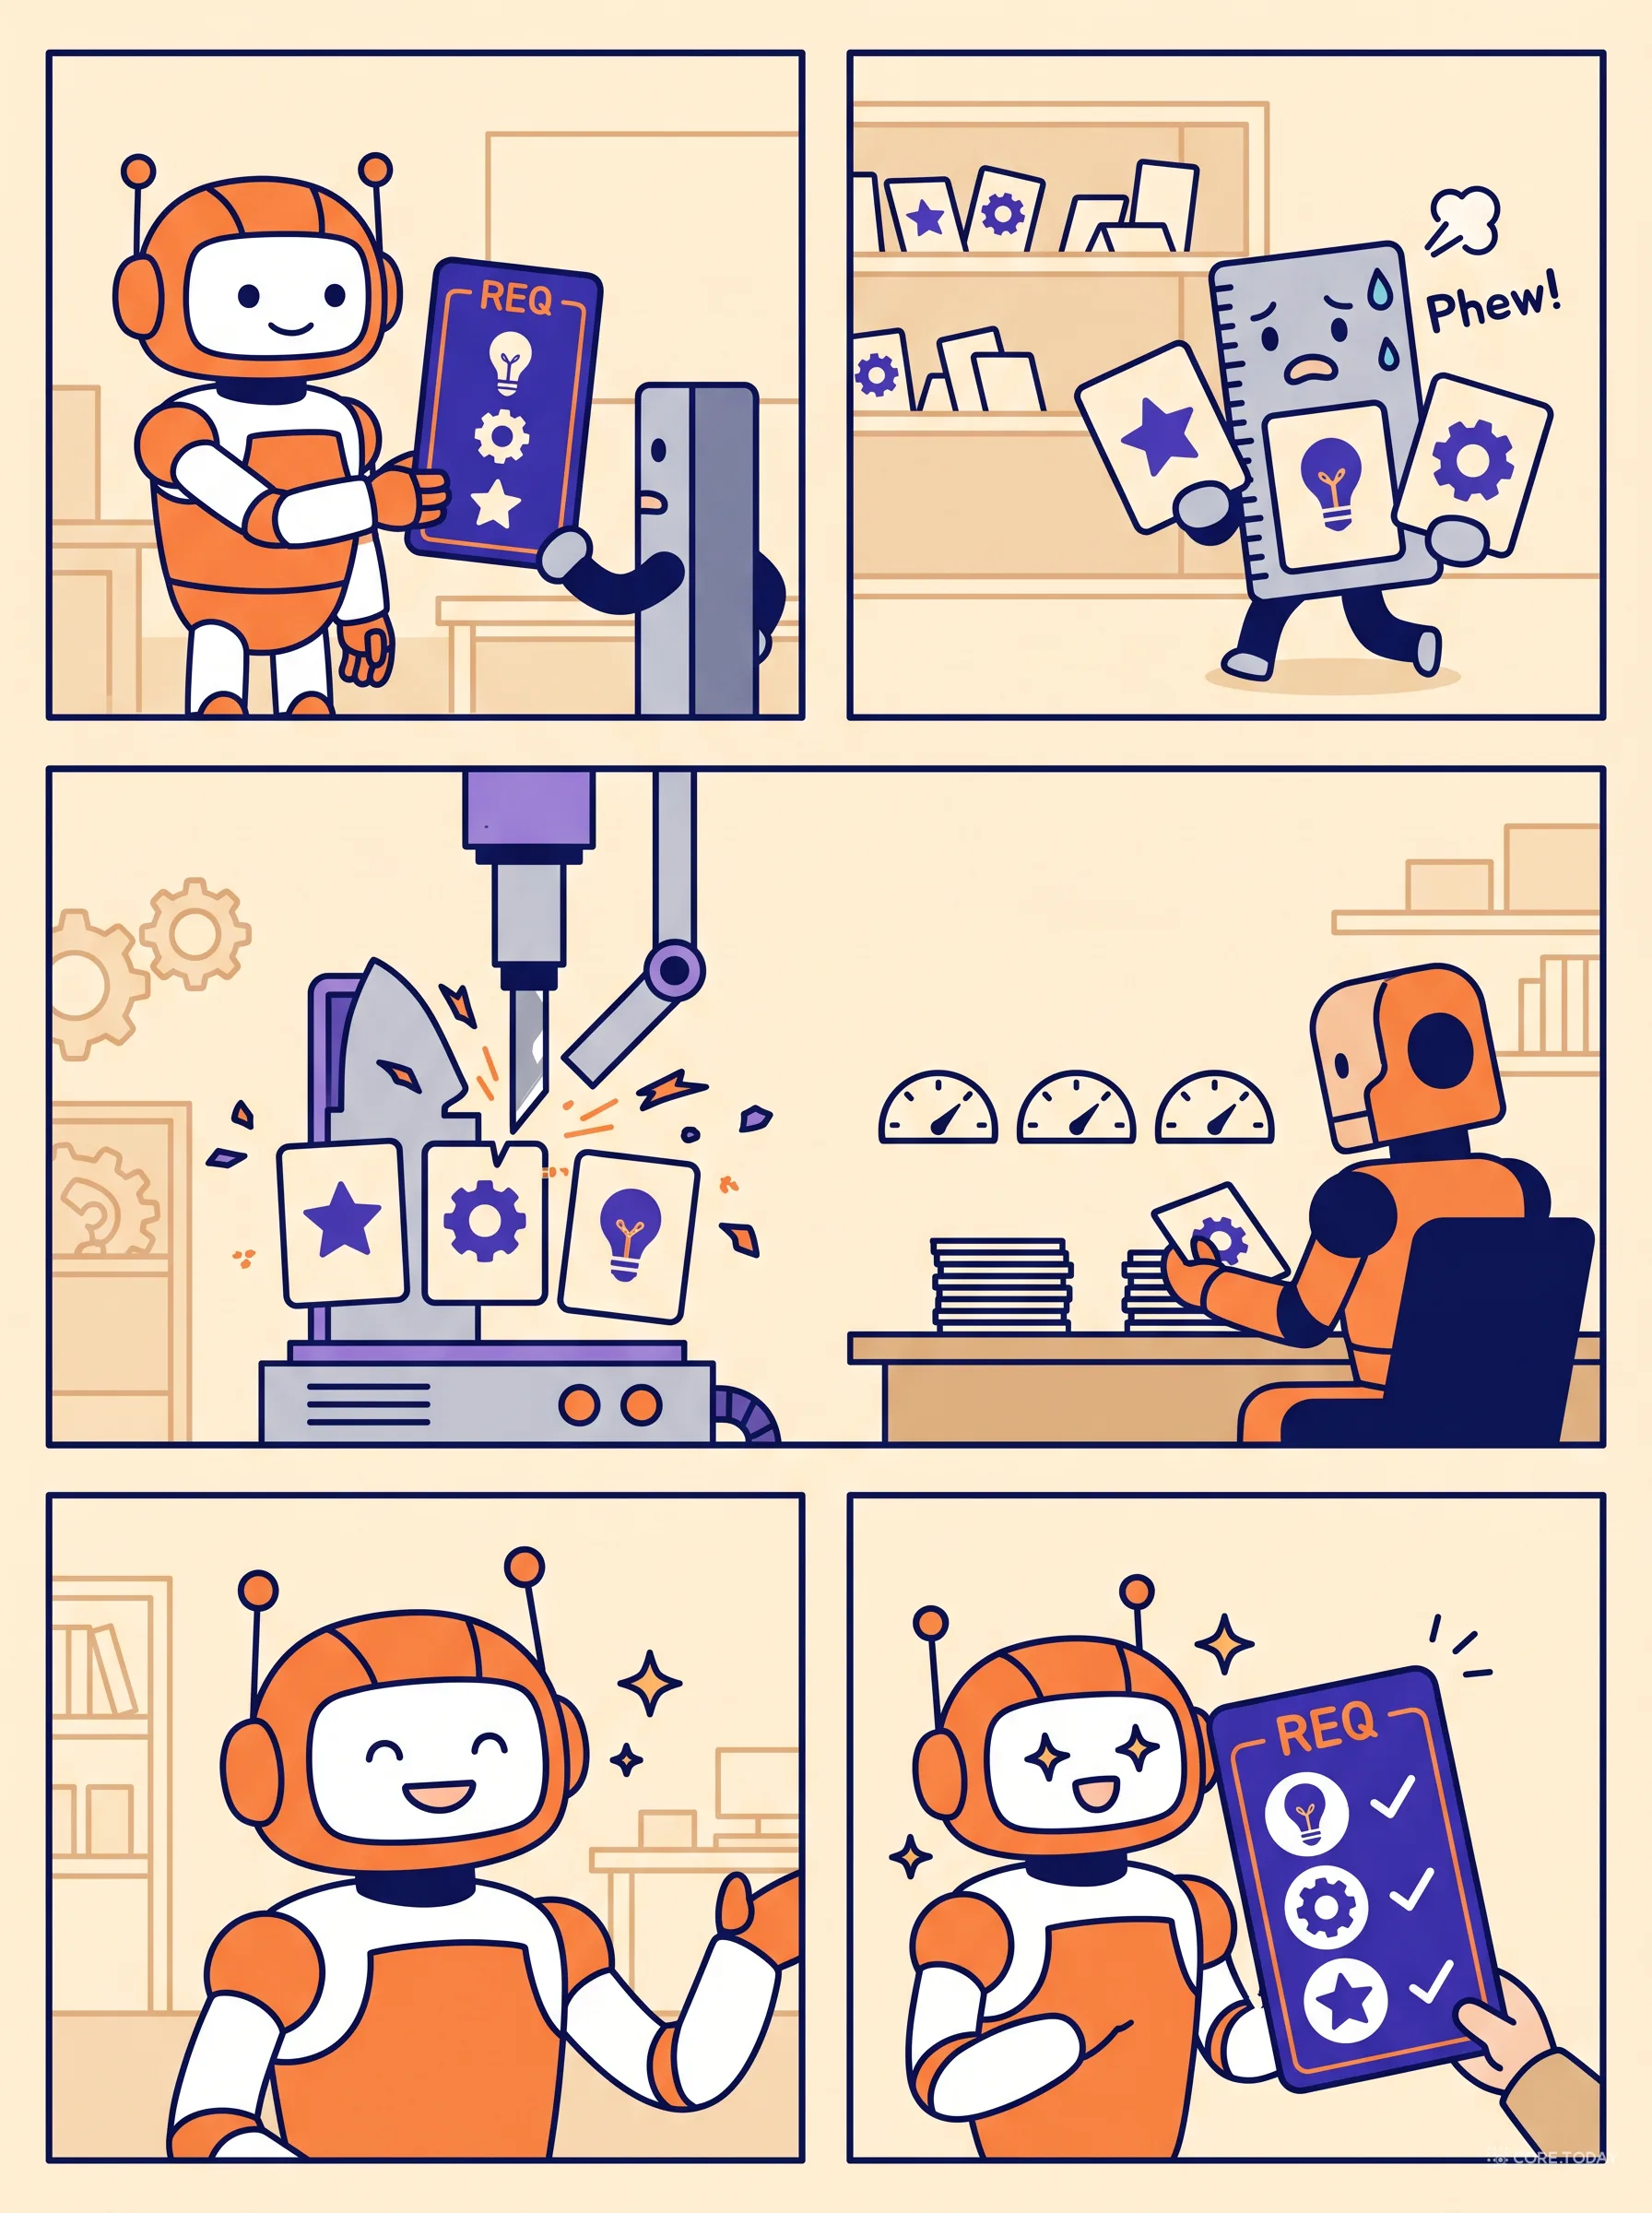
조건별로 찾으려면 질문을 조건 목록으로 나눠야 합니다. 9편처럼 로컬 LLM(qwen3.8)에 맡겼습니다. 첫 프롬프트는 "주제 조건은 짧게, 글 종류 조건은 '카테고리:종류'로 쓰라"였는데, 결과가 엉망이었습니다. 'RAG 글'에서 '카테고리:기술'을, 'AWS 글'에서 '카테고리:글'을 지어냈습니다. 92개 중 정답과 일치한 것은 55개(60%)였습니다. 프롬프트에 "질문이 종류를 직접 말한 경우에만 카테고리 조건을 만들고, '글'은 조건이 아니다"를 넣자 90개(98%) 가 맞았습니다. 분해 모델은 형식을 알려 주면 그 형식을 채우려 듭니다. 없는 것은 만들지 말라고 명시해야 합니다.
질문 문장 전체를 Qwen3-8B로 임베딩하면 조건 1개에서 0.940으로 훌륭하다가, 2개에서 0.519, 3개에서 0.387입니다. 하이브리드도 같습니다(0.954 → 0.515 → 0.396). 이유는 1부의 그림 그대로입니다. 임베딩은 문장을 점 하나로 만듭니다. '보안과 AWS'는 보안 쪽 점과 AWS 쪽 점의 중간 어딘가가 되고, 그 근처에는 두 주제를 함께 다룬 글뿐 아니라 보안만 다룬 글, AWS만 다룬 글이 뒤섞여 있습니다. 상위 10개 중 정답 비율이 조건 1개 92%에서 2개 38%, 3개 25%로 떨어집니다.
버팀 1: 쪼개서 찾기만 해도
조건마다 따로 찾아 RRF로 합치면 2개에서 0.602, 3개에서 0.592로 버팁니다. 특히 '주제 둘 + 카테고리' 질문에서 0.401 → 0.672로 크게 올랐는데, 카테고리 조건을 임베딩이 아니라 코드로 걸렀기 때문입니다(8편의 교훈). 반면 '조건별 유사도의 최솟값'은 주제 셋 질문에서 0.167로 무너졌습니다. 세 주제 모두와 '적당히' 가까운 글, 즉 아무 주제도 깊게 다루지 않는 일반론 글이 위로 올라왔습니다. 쪼갠 뒤 합치는 방식도 중요합니다. 순위의 합(RRF)은 안정적이고, 최솟값은 위험했습니다.
버팀 2: 쪼갠 후보를 판정
같은 'Jev 한 질문'이라도 후보를 어디서 받느냐가 결정적이었습니다.
Jev 한 질문이 받는 후보 40개
조건 2개
조건 3개
조건 3개 후보 재현율
질문 한 번에 찾은 후보 (8편 방식)
0.706
0.577
69%
조건별로 찾은 후보
0.725
0.725
90%
조건 3개에서 후보 재현율이 69%에서 90%로 오르자 판정 결과가 0.577에서 0.725로 올랐습니다. 8편과 9편에 이어 세 번째로 같은 결론입니다. 판정 모델의 점수는 후보가 정한다. 다중 조건에서는 조건별로 찾는 것이 후보를 넓히는 가장 확실한 방법입니다.
이 표의 셋째 열은 꼭 짚고 넘어가야 합니다. 조건 1개 질문은 정답의 73%가 제목·요약에 주제가 드러나 있지만(Jev의 조건별 확률이 모두 0.5 이상인 비율), 조건 2개 이상이면 30% 안팎입니다. 정답의 상당수가 필자가 붙인 태그로만 두 주제를 갖고 있다는 뜻입니다. 요약만 보는 어떤 검색도 그 글을 '두 주제를 모두 다룬 글'로 알아볼 수 없습니다. 그래서 이 글의 다중 조건 점수는 모든 방법에 대해 실제보다 낮고, 절대값보다 방법 사이의 차이로 읽어야 합니다.
Jev 특집에서 소개한 기능 하나가 이 문제에 꼭 맞습니다. Jev는 한 호출에 질문을 여러 개 받고, TypeSafe는 "질문을 더해도 응답 시간은 거의 변하지 않는다"고 말합니다. 그렇다면 '조건을 모두 만족하나'를 한 문장으로 묻는 대신, 조건마다 따로 물어 한 번에 받을 수 있습니다.
TypeSafe의 말은 사실이었습니다. 조건별 질문 2개짜리 호출은 평균 654토큰·중위 0.236초, 3개짜리는 742토큰·0.238초. 질문 하나가 늘 때마다 토큰 88개, 지연 2ms입니다.
품질은 어땠을까요? 조건별 확률을 최솟값으로 합친 방식은 조건 2개 0.708, 3개 0.720으로 '한 질문'(0.725, 0.725)과 거의 같았습니다. 조건 1개에서는 1.000으로 한 질문(0.973)보다 높았고, '주제 둘 + 카테고리'에서는 0.856으로 가장 높았습니다. 곱으로 합치면 조금 낮았습니다(3개 0.663). 확률 셋을 곱하면 하나만 애매해도 크게 깎이기 때문입니다.
점수보다 더 큰 차이는 설명 입니다. 'RAG, MCP, 에이전트를 모두 다룬 글'을 골라 보면 맨 위 문서도 RAG와 MCP 확률이 0.1 아래입니다. 한 질문 방식은 그 문서에 0.35를 주고 끝나지만, 조건별 방식은 '에이전트는 0.99, RAG와 MCP는 바닥'이라고 말합니다. 시스템은 이 정보로 "세 가지를 모두 다룬 글은 찾지 못했습니다. 에이전트와 MCP를 다룬 글은 이렇습니다"라고 정직하게 답할 수 있습니다. 주제 셋 질문 7개 중 요약 기준으로 세 조건을 모두 만족하는 글이 하나라도 있는 질문은 57%뿐이었습니다.
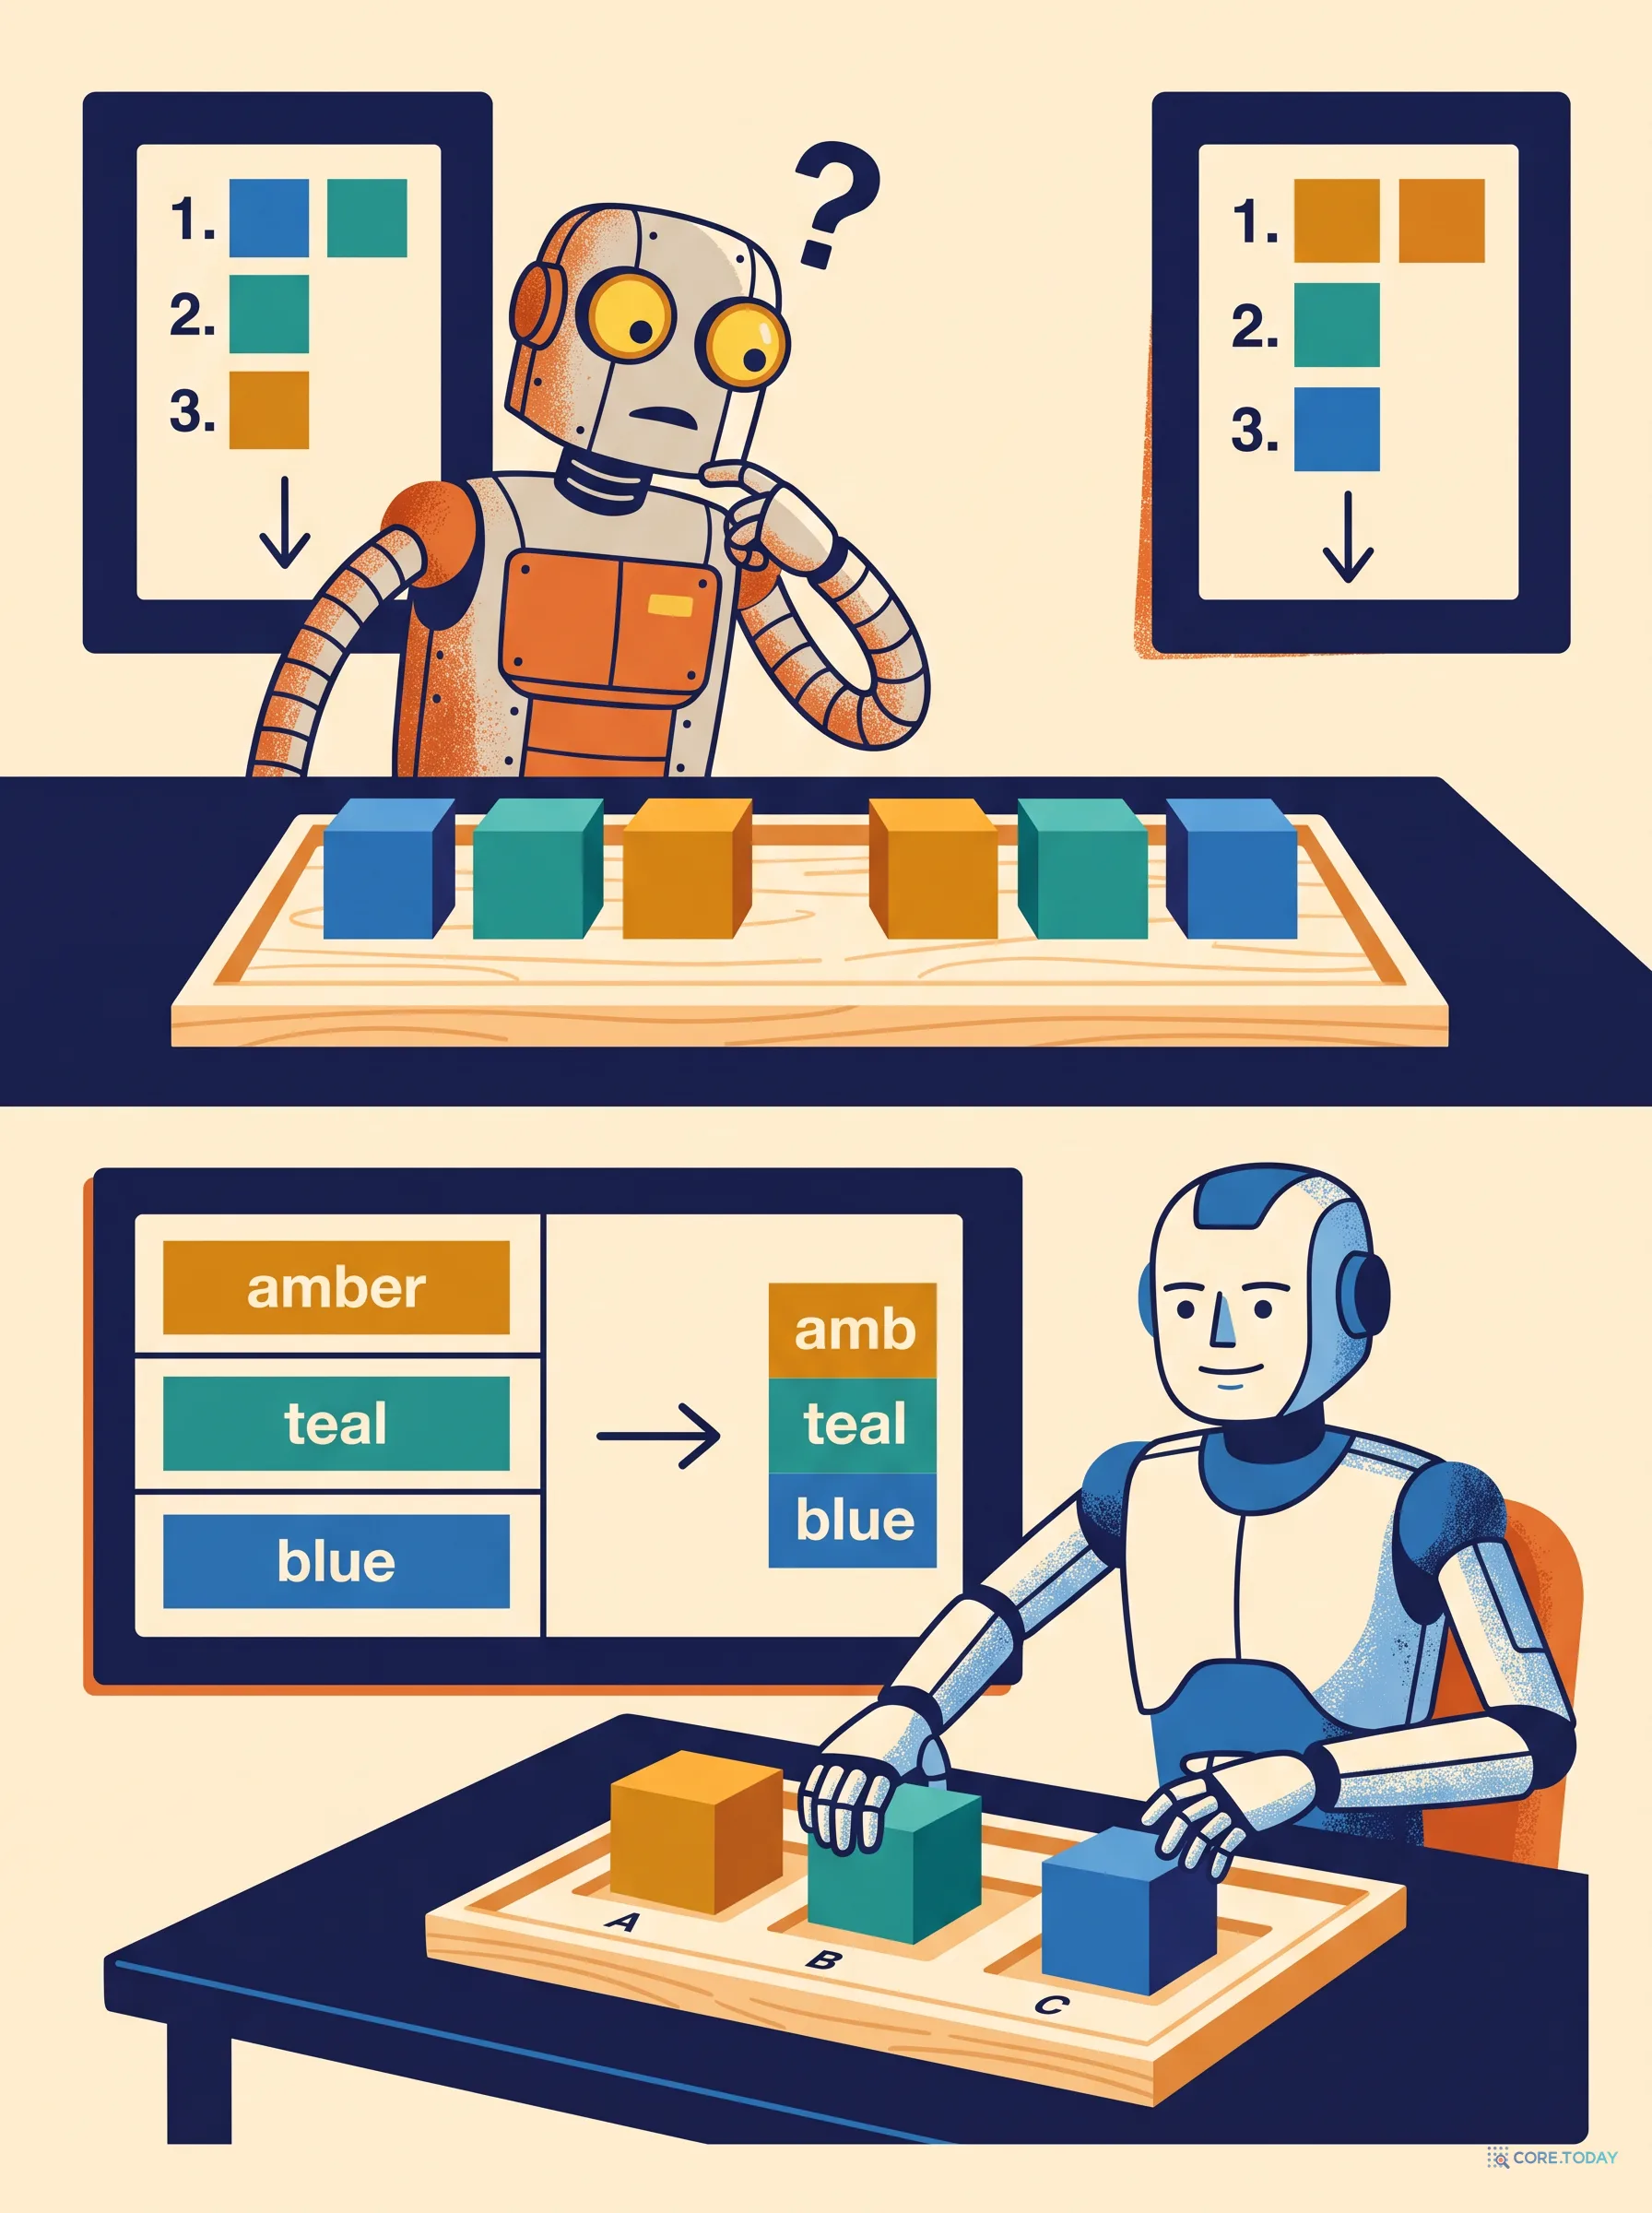
가장 뜻밖의 결과는 여기서 나왔습니다. 조건 순서만 바꾼 쌍둥이 질문 40쌍에서 상위 10개가 얼마나 겹치는지 쟀더니, 'Jev 한 질문'이 가장 흔들렸습니다(겹침 0.857). 임베딩(0.918)보다도 민감했습니다.
이유는 두 겹입니다. 'Jev 한 질문'은 질문 문장으로 후보를 모으고, 같은 질문 문장으로 판정합니다. 순서가 바뀌면 후보가 조금 바뀌고, 판정할 문장도 바뀝니다. 특히 '특집 글 중에서 에이전트와 RAG를 함께 다룬 것'처럼 문장 구조가 달라지면 판정 확률도 달라집니다. MultiConIR가 말한 '조건 위치에 대한 민감성'은 판정 모델에도 있었던 것입니다.
조건별 질문은 0.955까지 안정됩니다. 조건을 먼저 목록으로 나누면 순서와 무관하게 같은 질문들이 Jev에 들어가기 때문입니다. 남은 흔들림은 후보를 모을 때 원래 질문 문장의 검색 결과도 섞기 때문이고, 일부는 분해 결과가 다르게 나온 2쌍에서 왔습니다. 조건별로 찾아 RRF로 합치는 공짜 방법은 0.980으로 가장 안정적이었습니다. 처방은 모델이 아니라 질문을 다루는 방식 에 있었습니다.
5부. 설계: 쪼개고, 넓히고, 조건별로 묻는다
① 조건 나누기
LLM으로 질문을 조건 목록으로 나눈다. "질문에 없는 조건은 만들지 마라"를 반드시 명시(60% → 98%)
② 카테고리·날짜는 코드
글 종류·작성일처럼 필드에 있는 조건은 메타데이터로 거른다(8편)
③ 주제 조건은 따로 찾아 합치기
조건마다 하이브리드 검색, 원래 질문 검색과 함께 RRF로 합쳐 후보 40개. 조건 3개에서 후보 재현율 69% → 90%
④ 한 호출에 두 가지 질문
후보마다 원래 질문 한 문장 + 조건별 질문을 한 번에 넣는다. 순위는 한 질문 확률(또는 조건별 최솟값), 설명과 '답 없음' 판단은 조건별 확률로
④에서 두 가지를 한 호출에 넣는 이유는 비용이 거의 같기 때문입니다. 이 실험에서는 비교를 위해 따로 호출했지만, 실제로는 조건 3개 + 한 질문 = 질문 4개를 한 호출에 넣어도 토큰은 800개 안팎, 지연은 0.24초 안팎일 것입니다. 질문 1만 건에 후보 40개씩이면 약 13달러입니다.
8편의 설계안에 붙이면 '두 주제 함께' 가족의 점수가 0.502(후보 10개 판정)에서 이 글의 방식으로 0.7 안팎까지 오를 것으로 보입니다. 정확한 값은 8편과 이 글의 질문 세트가 달라 직접 비교하지 않았습니다.
다중 조건 정답의 다수는 요약에 보이지 않습니다. 2부의 표처럼 조건 2개 이상 정답 중 요약에 조건이 다 드러난 것은 30% 안팎입니다. 이 비율 자체를 Jev의 조건별 판정으로 쟀으므로, Jev에 유리한 쪽으로 기울었을 수 있습니다. 절대 점수보다 방법 간 차이로 읽어 주세요.
주제 셋 질문은 7개뿐입니다. 589건 안에서 세 주제의 교집합이 3건 이상인 조합이 이것밖에 없었습니다. 그 행의 수치는 흔들릴 수 있습니다.
분해 프롬프트는 결과를 보고 한 번 고쳤습니다. 첫 프롬프트의 실패(60%)를 보고 고친 것이므로, 98%는 낙관적인 값입니다.
'Jev 둘 다'는 두 번 호출해 곱한 값입니다. 한 호출에 함께 넣었을 때 질문끼리 영향을 주는지는 재지 않았습니다.
Jev는 jev-latest(1.13), 2026년 10월 초 기준입니다. 이 실험의 Jev 호출은 9,544회, 입력 650만 토큰, 약 0.27달러였습니다.
출처
Xuan Lu 외, "MultiConIR: Towards multi-condition Information Retrieval", EMNLP 2025 Findings, arXiv:2503.08046 — "대부분의 검색기와 리랭커가 질문이 복잡해질수록 크게 무너진다", 조건 위치에 대한 민감성, GPT-4o와의 격차
TypeSafe AI 문서: 소개 · 한 호출 여러 질문(팬아웃), jev-1.13, 입력 100만 토큰당 $0.042