TypeSafeJevSystem One리랭커NoulChoice확률 보정임베딩 비교Qwen3-EmbeddingBGE-M3한국어 검색RAG제로샷 분류Ollama한국어 검색 스택실측 벤치마크
임베딩 다섯과 판정 모델 하나 — TypeSafe Jev를 한국어 검색 파이프라인에 세워 보다 (한국어 검색 스택 6편)
지난 특집에서 TypeSafe의 Jev를 '글자를 포기한 모델'이라고 소개했습니다. 벡터도 문장도 내놓지 않고, 상태와 질문을 받아 확률이 붙은 결정만 돌려주는 모델입니다. 그렇다면 임베딩 모델과 비교할 수 있을까요? 같은 자리에 놓으면 안 됩니다. 임베딩은 '문서 100만 개 중 어디를 볼까'를 정하고, Jev는 '이 열 장 중 어느 것이 답인가'를 판정합니다. 이 글은 그 자리를 정확히 나눈 뒤, 1~5편의 한국어 코퍼스(589건, 질문 85개)로 Jev를 검색 파이프라인의 세 자리에 세워 실측했습니다. 리랭커로는 8B 임베딩의 상위 10개를 0.889에서 0.929로 올렸고(같은 자리에서 568M 크로스 인코더는 0.864로 떨어뜨렸습니다), 한국어 지시문이 영어보다 조금 더 좋았고, 확률은 대체로 보정돼 있었고, 4,213번 호출에 0.16달러가 들었습니다. 반면 카테고리 분류에서는 임베딩 이웃 투표가 이겼습니다. 인터랙티브 5개와 삽화 10장.
TypeSafe AI의 Jev 는 지난 특집 「글자를 포기한 모델」에서 자세히 다뤘습니다. ChatGPT를 만든 사람이 2년 스텔스 끝에 내놓은 이 모델은 글을 쓰지 않습니다. 상태(state)와 타입이 정해진 질문(Noul·Choice·Score)을 받아 확률이 붙은 결정을 돌려줍니다. 입력 100만 토큰에 0.042달러, 출력은 무료, 응답은 0.2~0.5초.
독자 몇 분이 물었습니다. "Jev를 임베딩 모델과 비교해 주세요." 그런데 Jev는 임베딩을 만들지 않습니다. 벡터가 없으니 코사인도 없고, 100만 개 문서를 미리 색인해 둘 수도 없습니다. 임베딩 모델과 Jev를 같은 자리에 놓고 비교하는 것은 지도와 심판을 비교하는 것 입니다. 지도는 어디를 봐야 할지 알려 주고, 심판은 눈앞의 후보 중 무엇이 맞는지 판정합니다.
그래서 이 글은 비교의 자리를 먼저 나눕니다. 검색 파이프라인에는 Jev가 설 수 있는 자리가 셋 있습니다.
자리
임베딩 모델이 하는 일
Jev가 할 수 있는 일
이 글의 실험
① 1차 검색
문서 전체를 벡터로 만들어 두고 질문 벡터와 가까운 것을 찾는다. 수백만 건, 밀리초
못 한다. 벡터가 없다. 문서 전체를 매번 상태에 넣을 수 없다
없음. 1~4편의 결론을 그대로 쓴다
② 리랭킹
바이 인코더라 정밀도가 낮다. 보통 크로스 인코더(2편)에 넘긴다
후보 하나하나에 "이 문서가 질문에 답하는가?"를 묻는다(Noul). 또는 열 장을 한 상태에 넣고 "어느 것이 가장 잘 답하나"를 묻는다(Choice)
1~2부. bge-reranker-v2-m3와 정면 비교
③ 분류·라우팅
가까운 이웃의 라벨을 투표한다(kNN). 라벨이 있어야 한다
카테고리 설명만 주고 고르게 한다(Choice, 제로샷). confidence로 애매한 것을 걸러낸다
4부. 블로그 카테고리 558건
실험 데이터는 1~5편과 같습니다. 코어닷투데이 블로그·뉴스 589건, 한국어 질문 85개(사람 바꿔쓰기 22 + LLM 바꿔쓰기 45 + 키워드 18). 1차 검색은 1편의 Qwen3-Embedding-8B(로컬 Ollama)이고, Jev는 jev-latest(1.13) API를 그대로 호출했습니다. 전부 한국어이고, 번역하지 않았습니다. TypeSafe 문서가 "CJK는 영어만큼 잘 처리되지 않으니 직접 테스트하라"고 경고한 바로 그 조건입니다.
1부. 리랭커 자리: 같은 열 장을 누가 더 잘 고르나
2편의 반전을 기억하실 겁니다. 8B 임베딩이 고른 상위 10개를 568M 크로스 인코더(bge-reranker-v2-m3)가 다시 정렬하자 nDCG@10이 0.889에서 0.864로 떨어졌습니다. 1차가 이미 강하면 작은 리랭커는 해가 됐습니다. 같은 열 장을 Jev에 줬습니다.
쌍별 Noul: "이 문서가 질문에 답하는가?"
질문 하나와 후보 문서 하나를 상태에 넣고 Noul 질문을 하나 붙였습니다. TypeSafe의 리랭킹 쿡북이 쓰는 형식 그대로입니다.
{"model":"jev-latest","state":{"query":"울산 지역에서 청년 일자리와 관련해 최근 추진된 사업은?","candidate_document":"지역주도형 청년취업 지원사업 추진\n…"},"questions":{"relevant":{"type":"noul","instructions":"Does the candidate document answer or directly address the query?","criteria":{"true":"The document is about the same specific topic the query asks for","false":"The document is only loosely related or about a different topic"}}}}
후보 10개의 Noul 값으로 내림차순 정렬하면 리랭킹이 끝납니다. 85개 질문 × 10 = 850회 호출, 8개 병렬로 30초.
1차 검색 → 리랭커
리랭킹 전
bge-reranker-v2-m3
Jev Noul (영어 지시문)
Jev Noul (한국어 지시문)
Qwen3-8B 벡터 단독 (nDCG@10)
0.889
0.864
0.929
0.933
정답이 1등
80.0%
76.5%
89.4%
90.6%
BM25 + Qwen3-8B RRF (nDCG@10)
0.794
0.857
0.925
—
BM25 단독 (nDCG@10, 천장 Recall@10 = 0.698)
0.616
0.677
0.695
—
세 가지가 보입니다.
첫째, 강한 1차 검색을 Jev는 해치지 않고 올렸습니다. 크로스 인코더가 0.889를 0.864로 떨어뜨린 그 열 장에서 Jev는 0.929를 냈고, 정답이 1등인 비율은 80%에서 89%로 올랐습니다. 2편의 결론 "1차가 강하면 리랭커가 해칠 수 있다"는 568M 크로스 인코더에 대한 결론이었고, 판정 모델에는 해당하지 않았습니다.
둘째, 약한 1차 검색은 거의 완전히 복구했습니다. RRF로 0.794까지 떨어진 순위를 0.925로, BM25 단독의 0.616을 천장(0.698) 바로 아래인 0.695까지 올렸습니다. 후보 안에 정답이 있으면 Jev는 거의 항상 그것을 찾아 올렸습니다.
셋째, 한국어 지시문이 영어 지시문보다 조금 나았습니다 (0.929 → 0.933, 정답 1등 89.4% → 90.6%). TypeSafe 문서는 영어가 주 학습 언어라고 하고, 실제로 지시문을 영어로 쓰는 것이 관례입니다. 그런데 상태(문서와 질문)가 한국어일 때는 지시문도 한국어로 맞추는 쪽이 조금 좋았습니다. 차이는 작아서(85개 중 1개 질문 차이) 잡음일 수 있지만, 방향이 '영어가 낫다'는 아니었습니다.
Jev가 크로스 인코더와 다른 점 하나는 출력이 점수가 아니라 확률 이라는 것입니다. bge-reranker의 출력은 순서를 매기는 데는 쓰지만 "0.7이면 70% 확률로 관련 있다"고 읽을 수 없습니다. Jev의 Noul은 그렇게 읽으라고 만들어진 값입니다. 정말 그런지 850쌍으로 재 봤습니다.
0.7 아래 구간에는 정답이 거의 없고(0~14%), 0.8~0.9에서 52%, 0.9 이상에서 86%였습니다. 모양은 맞고 중간이 조금 과대 확신입니다. 다만 우리의 '정답'은 질문당 문서 하나(시리즈는 몇 개)만 표시한 것이어서, 실제로는 관련 있는데 표시되지 않은 문서가 중간 구간에 들어 있을 수 있습니다. 이 차트는 Jev의 보정을 과소평가 하는 쪽으로 치우쳐 있습니다.
실무적으로 중요한 것은 이것입니다. 크로스 인코더 점수로는 "몇 점 아래는 버린다"는 임계값을 데이터마다 다시 찾아야 하지만, Noul 값으로는 "0.7 아래는 LLM에 넘기지 않는다"를 그대로 쓸 수 있고, 그 임계값이 대략 그 의미를 지킵니다. TypeSafe의 RAG 쿡북이 관련도 0.45 미만 제외, 근거 0.55 이상 채택 같은 임계값을 쓰는 이유입니다.
2부. 한꺼번에 묻기: 열 장을 한 상태에
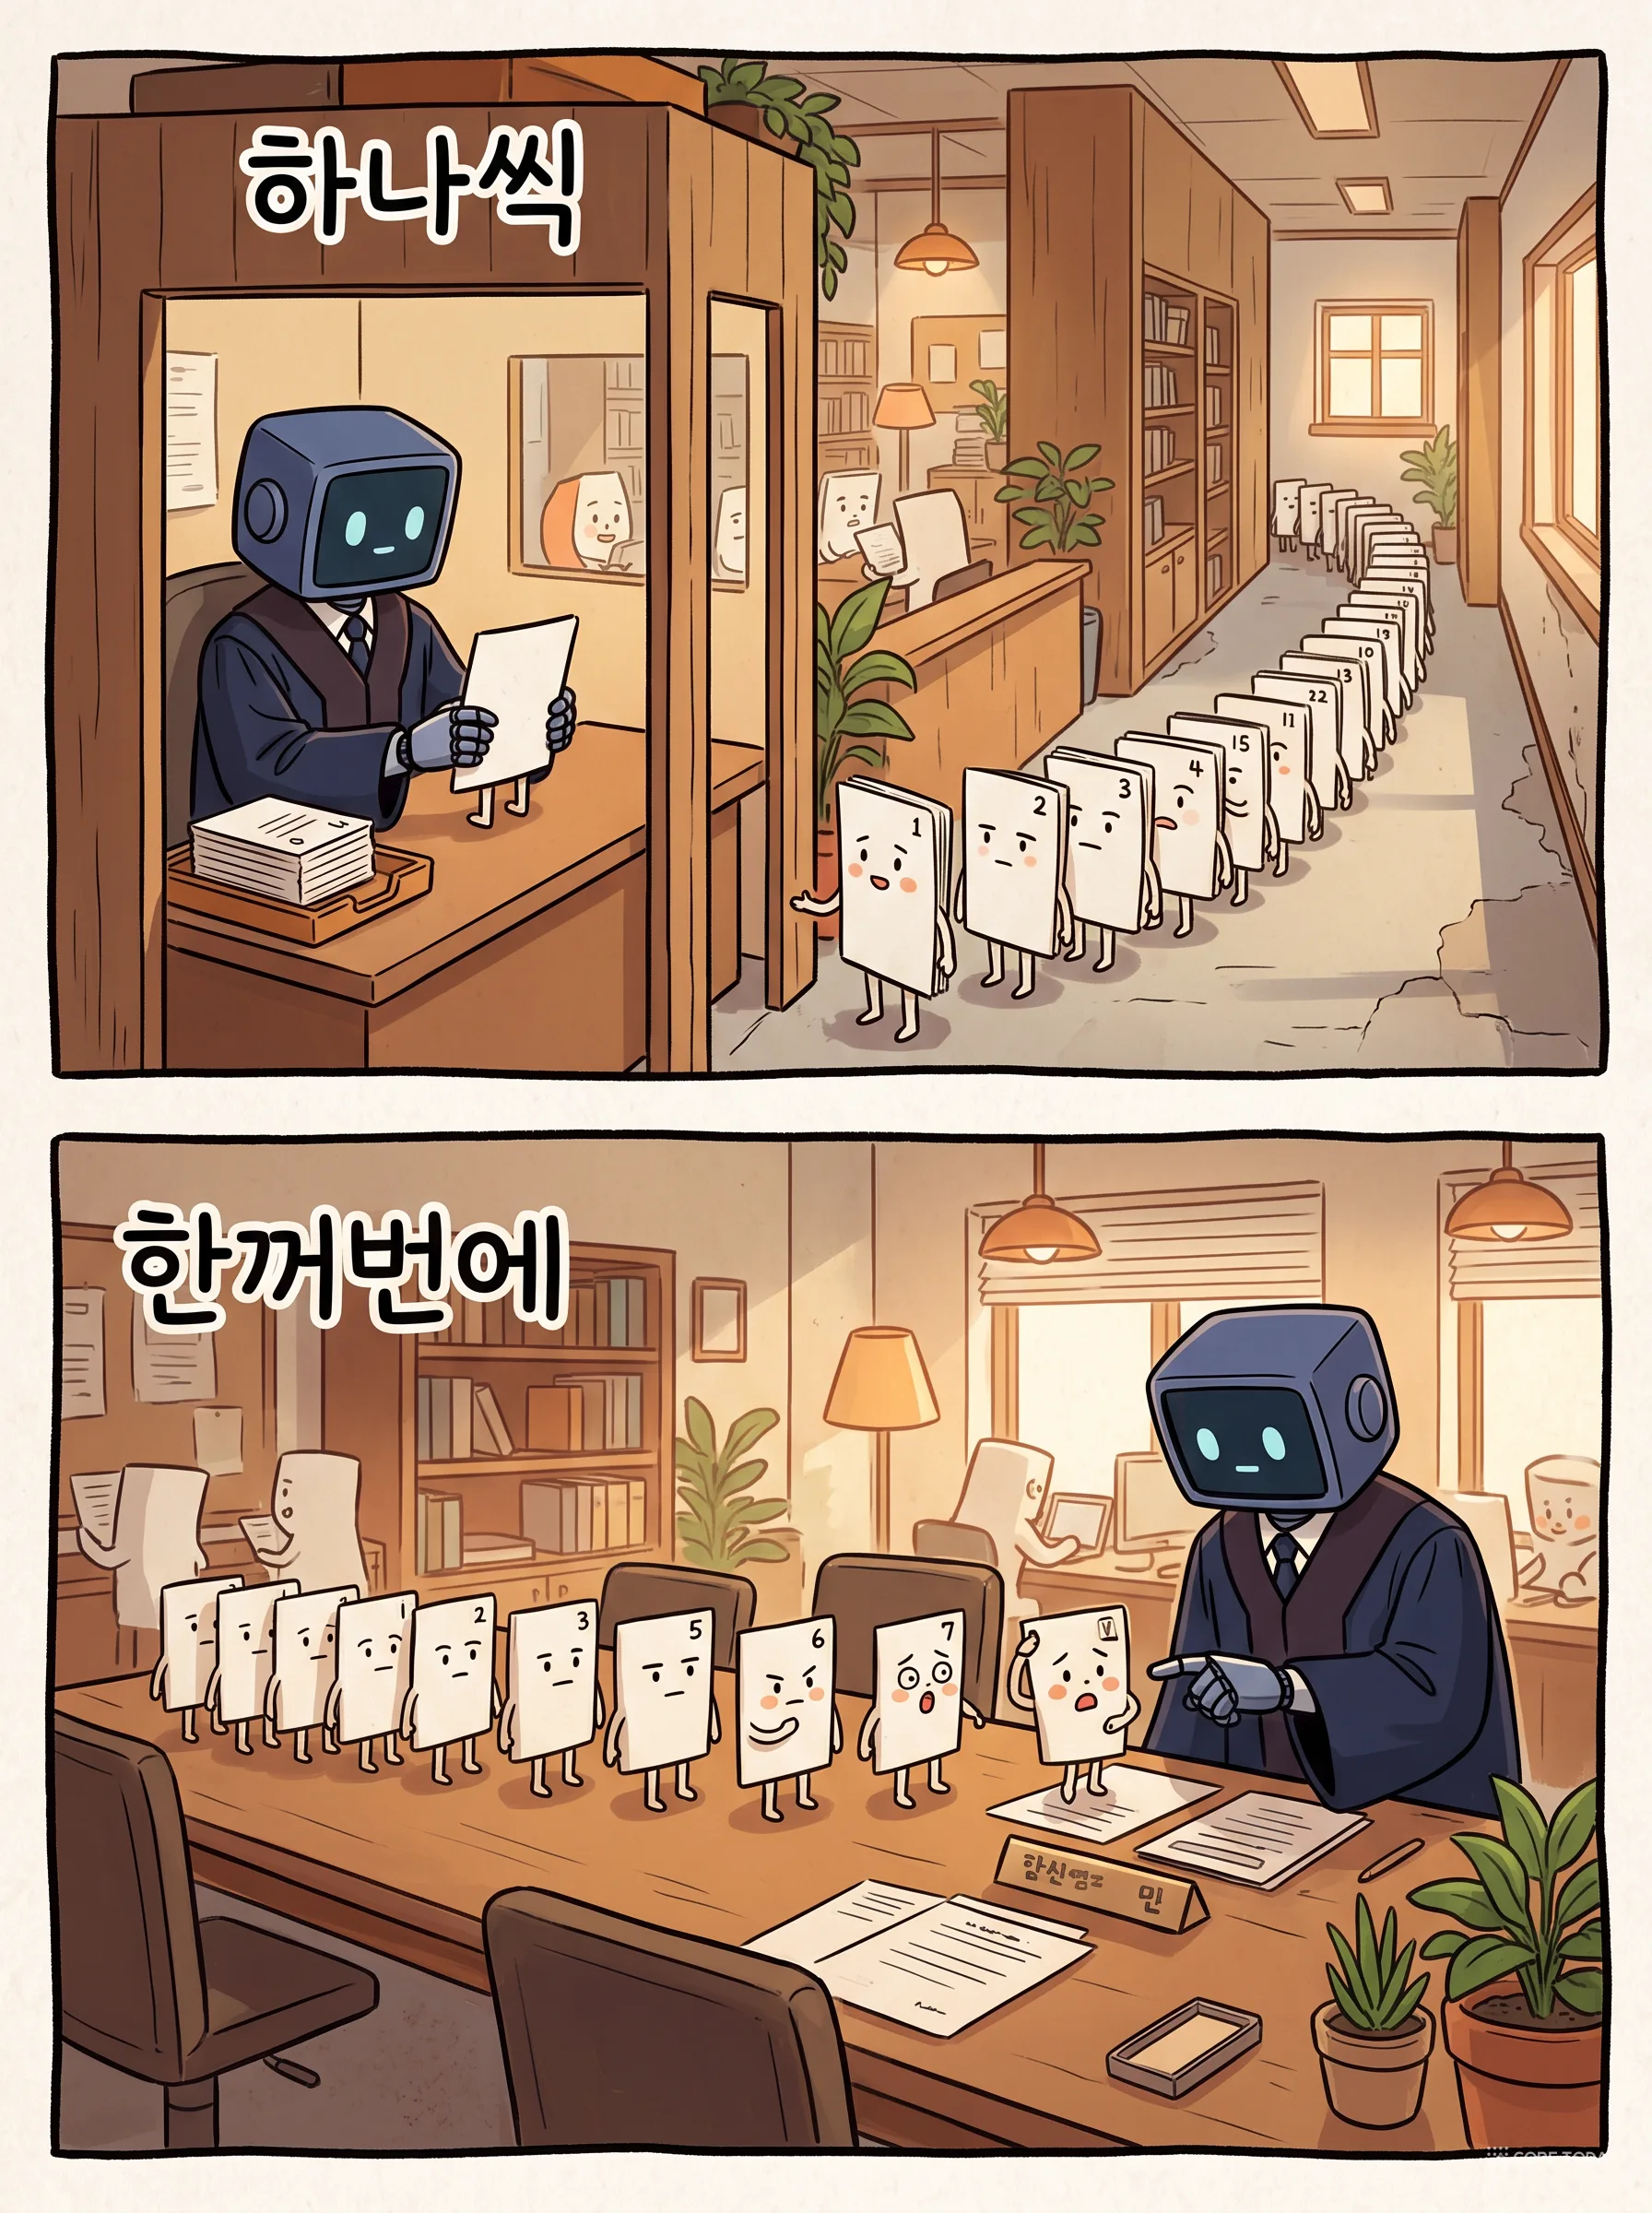
쌍별 Noul은 질문당 10회 호출입니다. 빠르고 싸지만(30초, 0.03달러) 호출 수가 많습니다. Jev의 다른 방식은 후보 열 장을 D01~D10으로 이름 붙여 하나의 상태 에 넣고, "어느 문서가 질문에 가장 잘 답하나"를 Choice로 한 번 묻는 것입니다. Choice는 선택지마다 확률을 돌려주므로, 그 확률 분포가 곧 순위입니다. TypeSafe의 '줄 단위 검색' 쿡북이 쓰는 방식입니다.
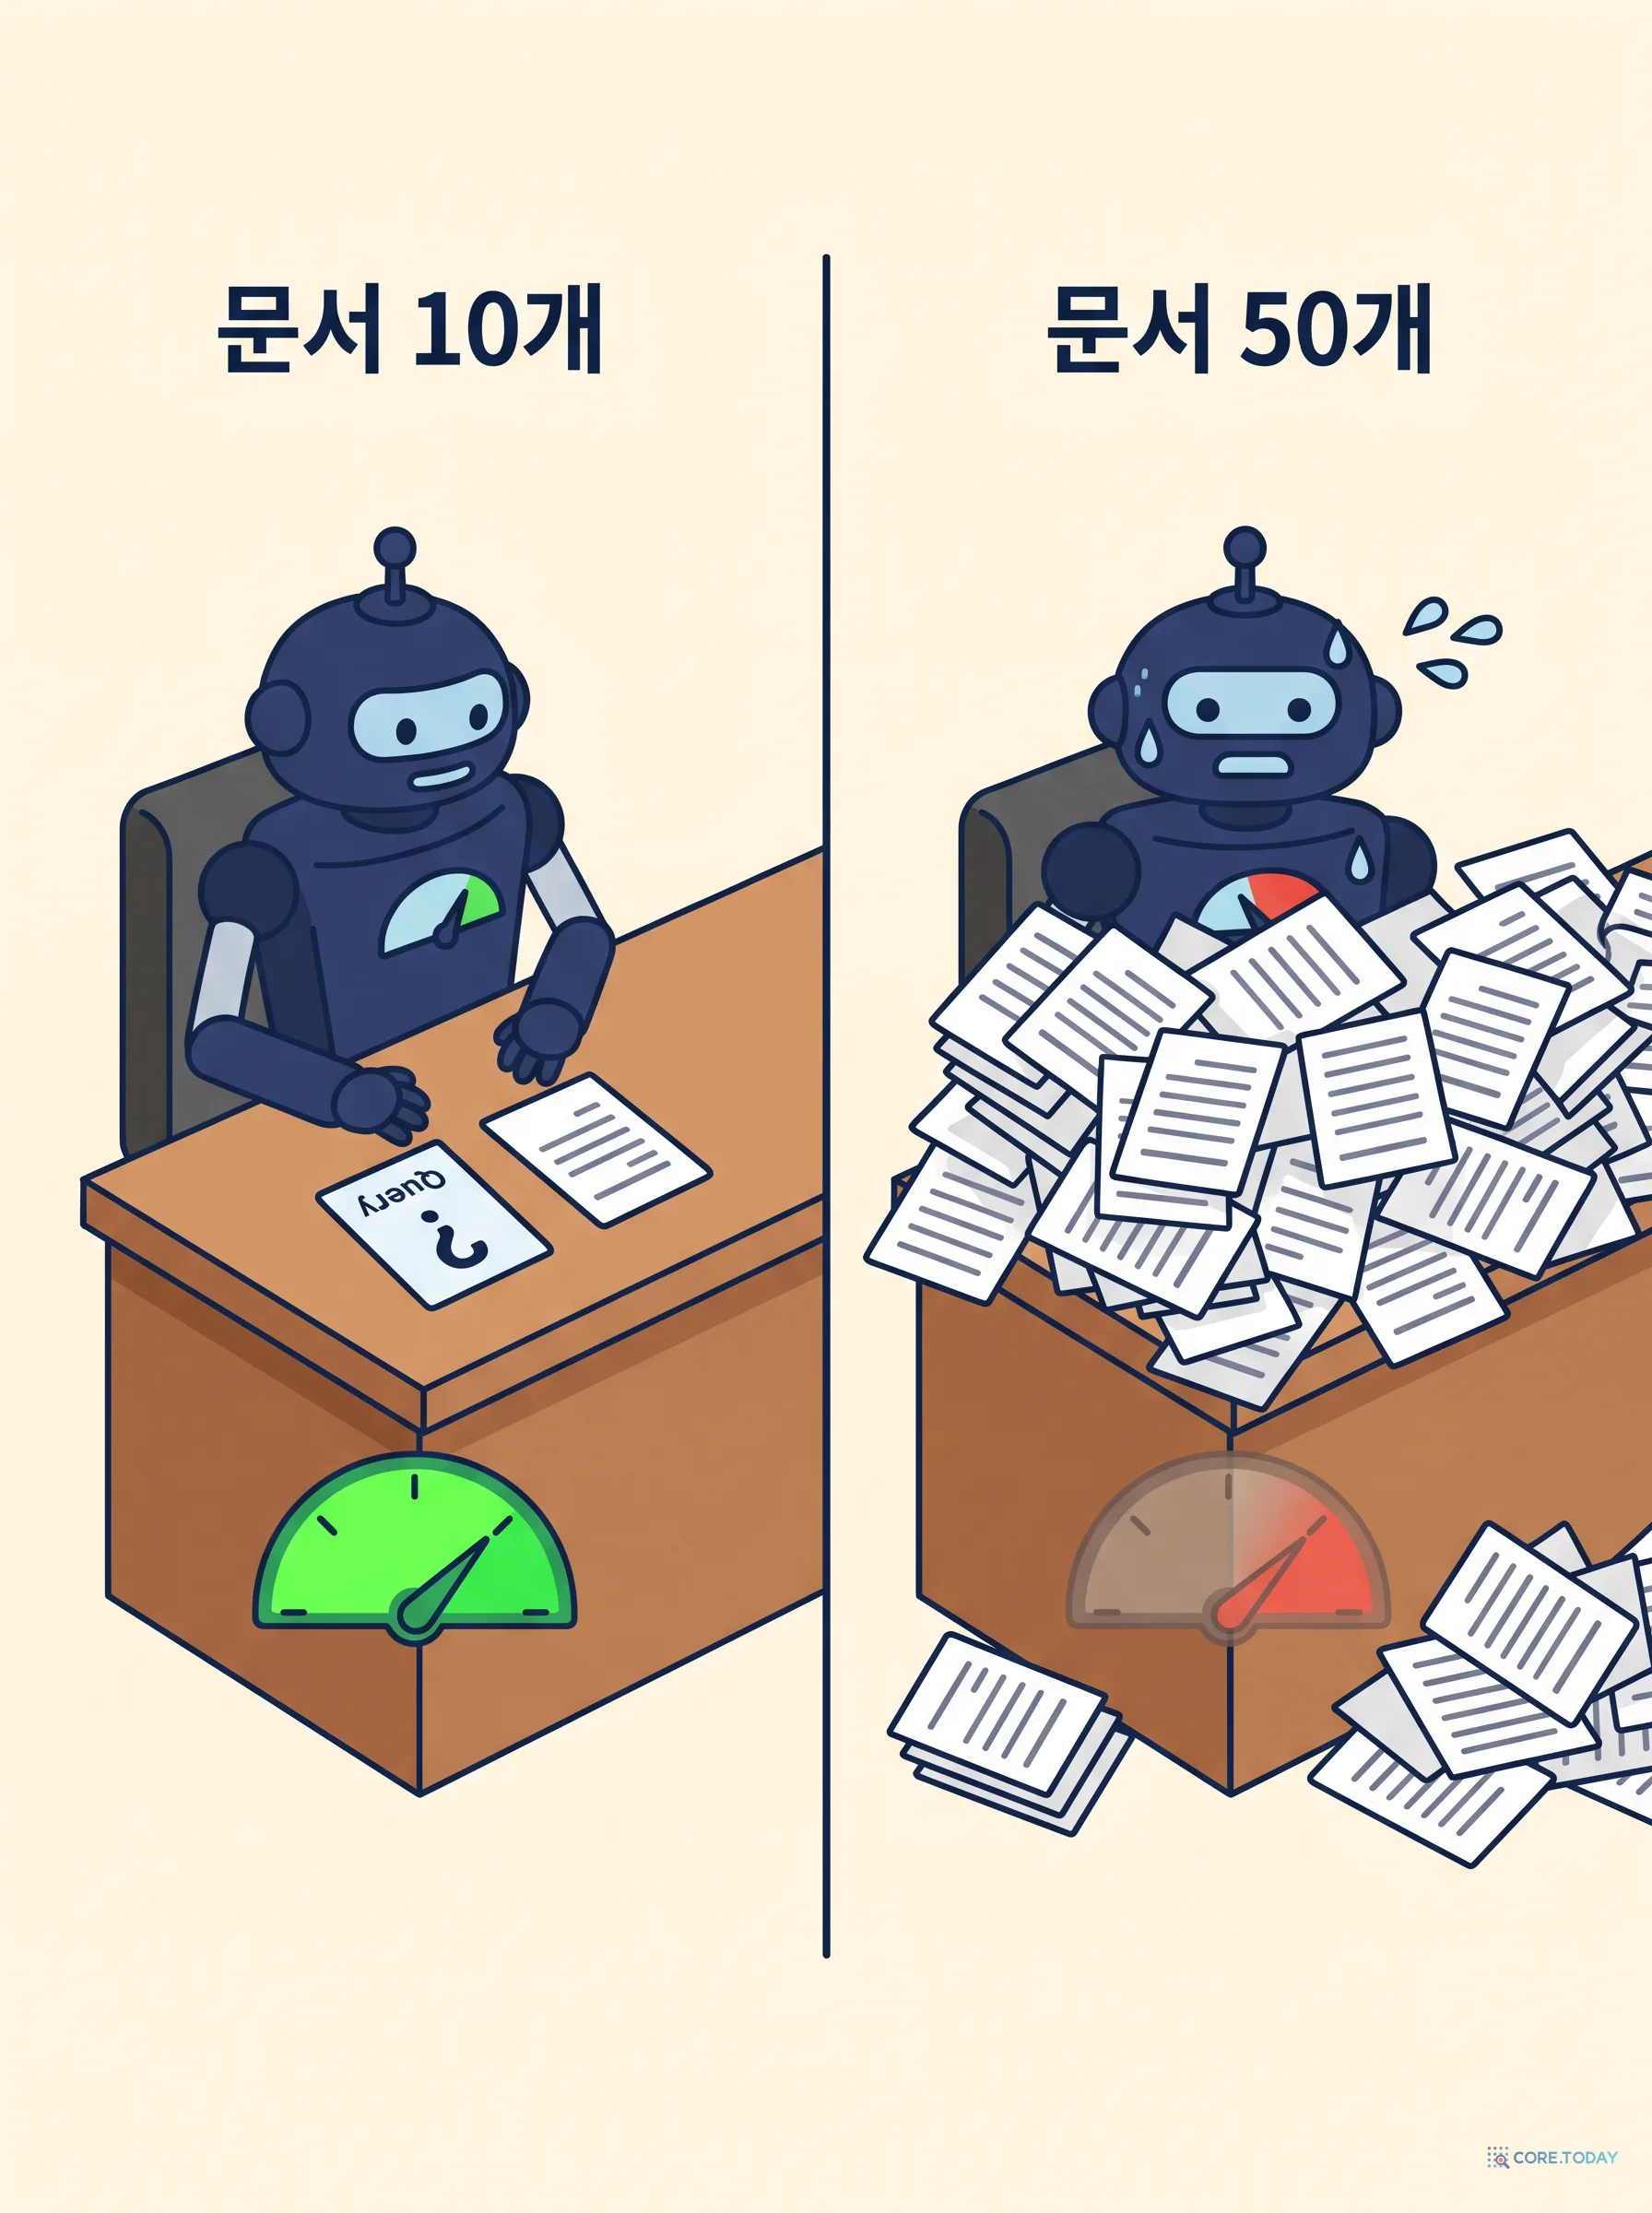
여기에 실험을 하나 더 얹었습니다. Jev의 공개 문서에는 「Jev 1.13의 들쭉날쭉함(jaggedness)」이라는 페이지가 있고, 그중 하나가 "결정과 무관한 내용으로 상태가 커지면 정확도가 떨어진다" 입니다. 그래서 상위 10개에 무관한 문서 20개, 40개를 무작위로 섞어 30개, 50개짜리 상태로도 물었습니다.
열 장을 한 번에 물어도 쌍별과 거의 같은 품질에 토큰은 60%입니다. 그리고 예상과 반대로, 무관한 문서 40개를 섞었을 때 점수가 올랐습니다. 왜일까요. 이 실험의 '무관 문서'는 주제가 완전히 다른 글(도커 튜토리얼과 청년 일자리 공고처럼)이어서, Choice의 확률 질량을 0 근처로 빨아들이는 대조군이 됐고, 남은 질량이 진짜 후보 사이에서 더 선명하게 갈린 것으로 보입니다. TypeSafe 문서가 경고한 위험은 '비슷한데 틀린' 내용 이 많을 때이고, 그것은 이 실험이 잰 것이 아닙니다. 상태가 커지면 비용은 정직하게 늡니다(10,033토큰, 쌍별의 2.5배).
이 글의 모든 Jev 호출을 합치면 4,213회, 입력 376만 토큰, 출력 18만 토큰(무료)이었고 0.158달러 가 들었습니다. 중위 지연 0.25초, 95% 지연 0.36초(서울에서 8개 병렬). 리랭커 세 방식을 여러분의 트래픽으로 계산해 보세요.
비교의 요점은 비용이 아니라 운영 입니다. 질문 하나를 리랭킹하는 데 Jev는 0.0002달러, 자체 크로스 인코더는 API 비용 0(서버 비용 별도), LLM API는 0.02달러쯤입니다. 하루 1만 질문이면 Jev가 월 5달러, LLM이 월 540달러입니다. 그러나 GPU 서버가 이미 있는 팀에게 크로스 인코더는 공짜에 가깝고, 없는 팀에게 Jev는 서버 없이 리랭커를 갖는 가장 싼 길입니다.
4부. 분류 자리: 판정 모델 대 이웃 투표
임베딩이 검색 외에 가장 많이 쓰이는 곳이 분류입니다. 라벨 붙은 문서를 벡터로 만들어 두고, 새 문서의 가장 가까운 이웃 k개의 라벨을 투표합니다(kNN). Jev의 방식은 다릅니다. 카테고리 설명을 Choice의 선택지로 주고 고르게 합니다. 라벨 데이터가 없어도 됩니다.
블로그 글 558건(기술 236·특집 111·인사이트 100·뉴스 64·튜토리얼 47)의 제목과 요약만 주고 카테고리를 맞히게 했습니다. 정답은 필자가 붙인 카테고리입니다.
방법
전체 정확도
기술
특집
인사이트
뉴스
튜토리얼
Jev Choice (제로샷, 설명 5줄)
63.4%
64%
69%
28%
88%
92%
Qwen3-8B 5-NN (라벨 557개 사용)
69.0%
73%
69%
34%
97%
89%
BGE-M3 5-NN
72.6%
80%
68%
42%
92%
87%
Qwen3-4B 5-NN
67.7%
76%
53%
38%
92%
89%
이번에는 임베딩이 이겼습니다. BGE-M3 이웃 투표 72.6%, Jev 제로샷 63.4%. 단서가 둘 있습니다. 첫째, 조건이 다릅니다. 이웃 투표는 필자의 라벨 557개를 보고 투표한 것이고, Jev는 카테고리 설명 다섯 줄만 봤습니다. 라벨이 없는 새 도메인이라면 kNN은 시작조차 못 합니다. 둘째, 이 블로그의 카테고리는 필자가 그때그때 붙인 것이어서 '기술'과 '특집'과 '인사이트'의 경계가 원래 흐릿합니다. Jev의 오류 대부분이 기술→특집(65건), 인사이트→특집(51건)이었고, 경계가 분명한 뉴스와 튜토리얼은 잘 맞혔습니다. 라벨의 문제인지 모델의 문제인지는 이 데이터로 가릴 수 없습니다.
그리고 Jev만 가진 것이 하나 있습니다. confidence. 확신이 높은 절반(중앙값 0.83 이상)의 정확도는 76.1%, 낮은 절반은 50.4%였습니다. 낮은 절반만 사람이 보면 전체 검수량이 반으로 줄고, 놓치는 오류도 줄어듭니다. TypeSafe 문서의 '신뢰도 게이트 라우팅' 패턴이 이것이고, kNN에는 이 값이 없습니다(이웃 투표 비율로 흉내 낼 수는 있습니다).
Qwen3-Embedding 4B 또는 8B(1편), 1,024차원으로 잘라(3편) HNSW에(4편). 정확한 용어가 중요한 도메인이면 잘 쪼갠 BM25(5편)를 낮은 가중치로 RRF(2편). 수백만 건에서 후보 20~50개. Jev는 여기 못 온다.
리랭킹 · Jev 또는 크로스 인코더
후보 10~50개를 다시 정렬. 이 글의 실측에서 Jev Noul은 강한 1차를 해치지 않고(0.889→0.929) 약한 1차를 복구했다(0.794→0.925). GPU 서빙이 있으면 Qwen3-Reranker급 크로스 인코더, 없으면 Jev. 한국어 상태면 지시문도 한국어로.
문턱 · Noul 임계값
Jev의 확률이 대략 보정돼 있으므로 "0.7 미만은 LLM에 넘기지 않는다"를 그대로 쓴다. 후보 전부가 문턱 아래면 '답 없음'으로 처리. 크로스 인코더 점수로는 이 문턱을 데이터마다 다시 찾아야 한다.
분류·라우팅 · 라벨이 있으면 kNN, 없으면 Jev
라벨이 수백 개 있으면 BGE-M3 이웃 투표가 이 데이터에서 9%p 앞섰다. 라벨이 없거나 카테고리가 자주 바뀌면 Jev 제로샷 + confidence 게이트. 확신 낮은 절반만 사람이 본다.
생성 · LLM
문턱을 넘은 3~5개만 넘긴다. 여기서 비로소 글을 쓰는 모델이 등장한다.
지난 특집의 결론은 "Jev는 더 똑똑한 것이 아니라 같은 똑똑함을 다른 가격표로 파는 것"이었습니다. 이 글의 실측은 그 문장에 한 줄을 보탭니다. 검색 파이프라인에서 Jev의 자리는 임베딩의 자리가 아니라 크로스 인코더의 자리이고, 그 자리에서 한국어로도 제 몫을 했습니다. 그리고 그 몫은 확률이라는 형태로 나와서, 다음 단계가 코드로 분기할 수 있습니다.