TypeSafeJevRAG환각근거 검증faithfulness임베딩 한계부정NLI크로스 인코더LLM-as-judgeQwen3-EmbeddingBGE-M3Ollama한국어 검색 스택실측 벤치마크
임베딩은 '아니다'를 못 읽는다 — Jev를 RAG 환각 검문소에 세우다 (한국어 검색 스택 7편)
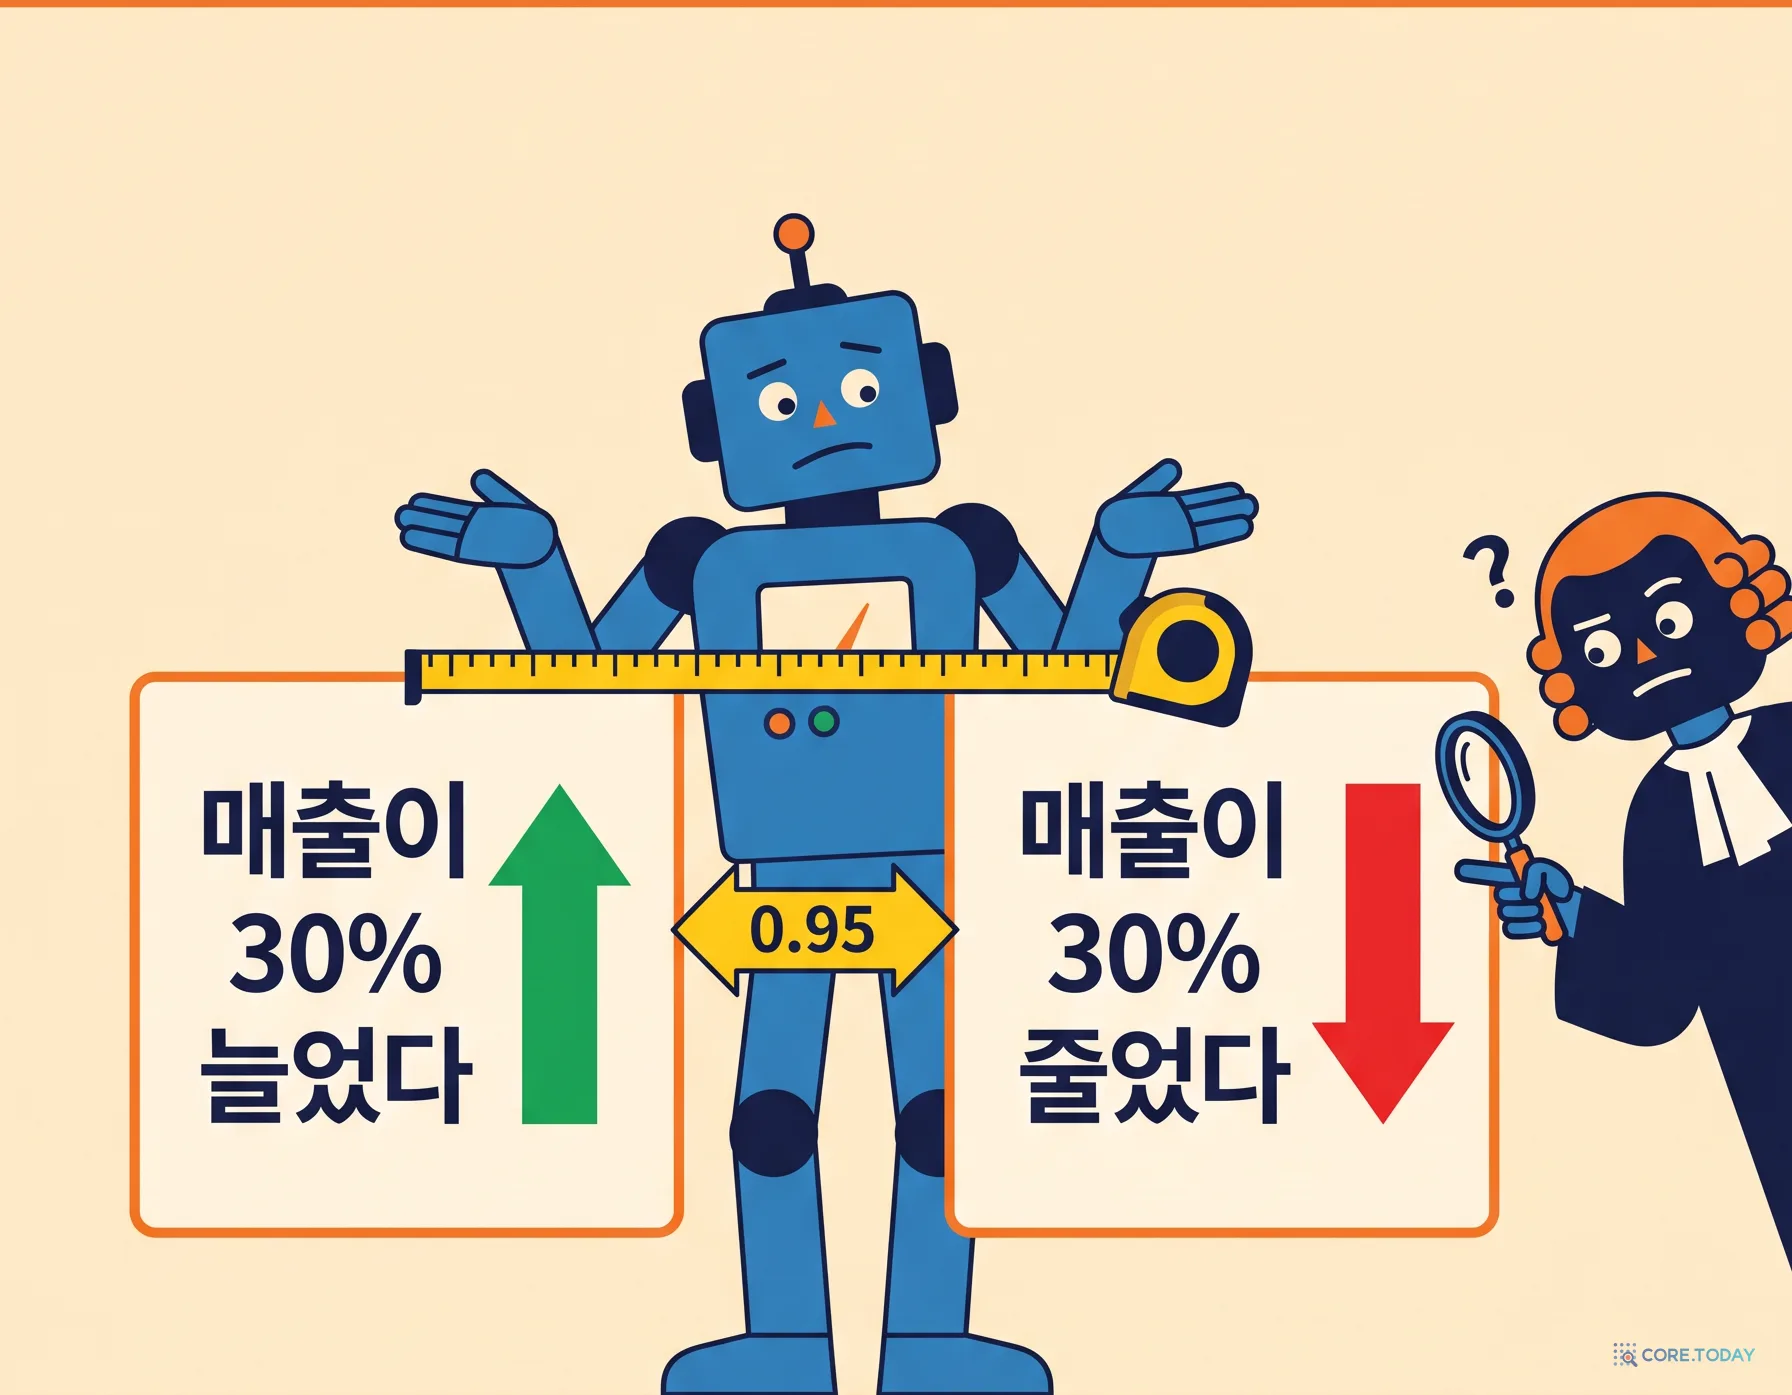
임베딩 모델은 '매출이 30% 늘었다'와 '매출이 30% 줄었다'를 거의 같은 문장으로 봅니다. 검색에는 맞는 판단이지만, RAG 답변의 마지막 관문에서는 치명적입니다. 이 글은 6편에 이어 TypeSafe의 Jev를 한국어 검색 파이프라인의 새 자리, 답변 뒤의 '환각 검문소'에 세웁니다. 이 블로그 문단 87개로 참 주장 257개와 숫자·방향·주체를 바꾸거나 없는 사실을 덧붙인 거짓 주장 344개를 만들고, 임베딩 둘·크로스 인코더·NLI 모델·로컬 LLM 둘·Jev에게 같은 601쌍을 판정시켰습니다. 참 주장의 90%를 통과시키는 임계값에서 BGE-M3 코사인은 숫자를 바꾼 거짓의 3%만 잡았고, Jev는 100%를 잡았습니다(AUROC 0.995). 0.3B NLI 모델이 의외의 복병이었고(0.959), 숫자를 1만 바꿔도 잡던 Jev는 문서의 숫자로 계산해야 하는 주장에서 약해졌습니다. 601번 검문에 0.021달러. 인터랙티브 7개와 삽화 8장.
LG AI Research의 K-EXAONE 236B 가 AIME 2025 수학 벤치마크에서 92.8% 를 기록하며 GPT-o3-mini(92.5%)를 넘었다.
주장 B
LG AI Research의 K-EXAONE 236B 가 AIME 2025 수학 벤치마크에서 92.8% 를 기록하며 GPT-o3-mini(92.5%)에 밀렸다.
A는 이 블로그의 한 문단에 그대로 있는 문장이고, B는 로컬 LLM에게 '주장의 방향만 뒤집어라'라고 시켜 만든 거짓 문장입니다. RAG 시스템이 B를 답으로 내놓으면 그것이 환각 입니다. 근거 문서를 줬는데도 문서에 없는 말을 한 것이니까요.
이제 두 주장을 근거 문단과 함께 심판들에게 보여 줬습니다. 1편에서 한국어 검색 1등이었던 Qwen3-Embedding-8B는 A에 1.000, B에 0.994를 줬습니다. BGE-M3는 1.000와 0.962. 2편의 크로스 인코더 리랭커는 1.000와 0.999. 세 모델 모두에게 A와 B는 사실상 같은 문장입니다. 반면 TypeSafe의 Jev는 A에 0.98, B에 0.01를 줬습니다.
이것은 임베딩 모델의 결함이 아닙니다. 임베딩은 "무엇에 관한 문장인가" 를 재도록 만들어진 자입니다. A와 B는 같은 것에 관한 문장이 맞습니다. 다만 RAG의 마지막 관문에서 필요한 질문은 그것이 아니라 "이 문장이 저 문서에 뒷받침되는가" 이고, 그 질문에는 다른 도구가 필요합니다.
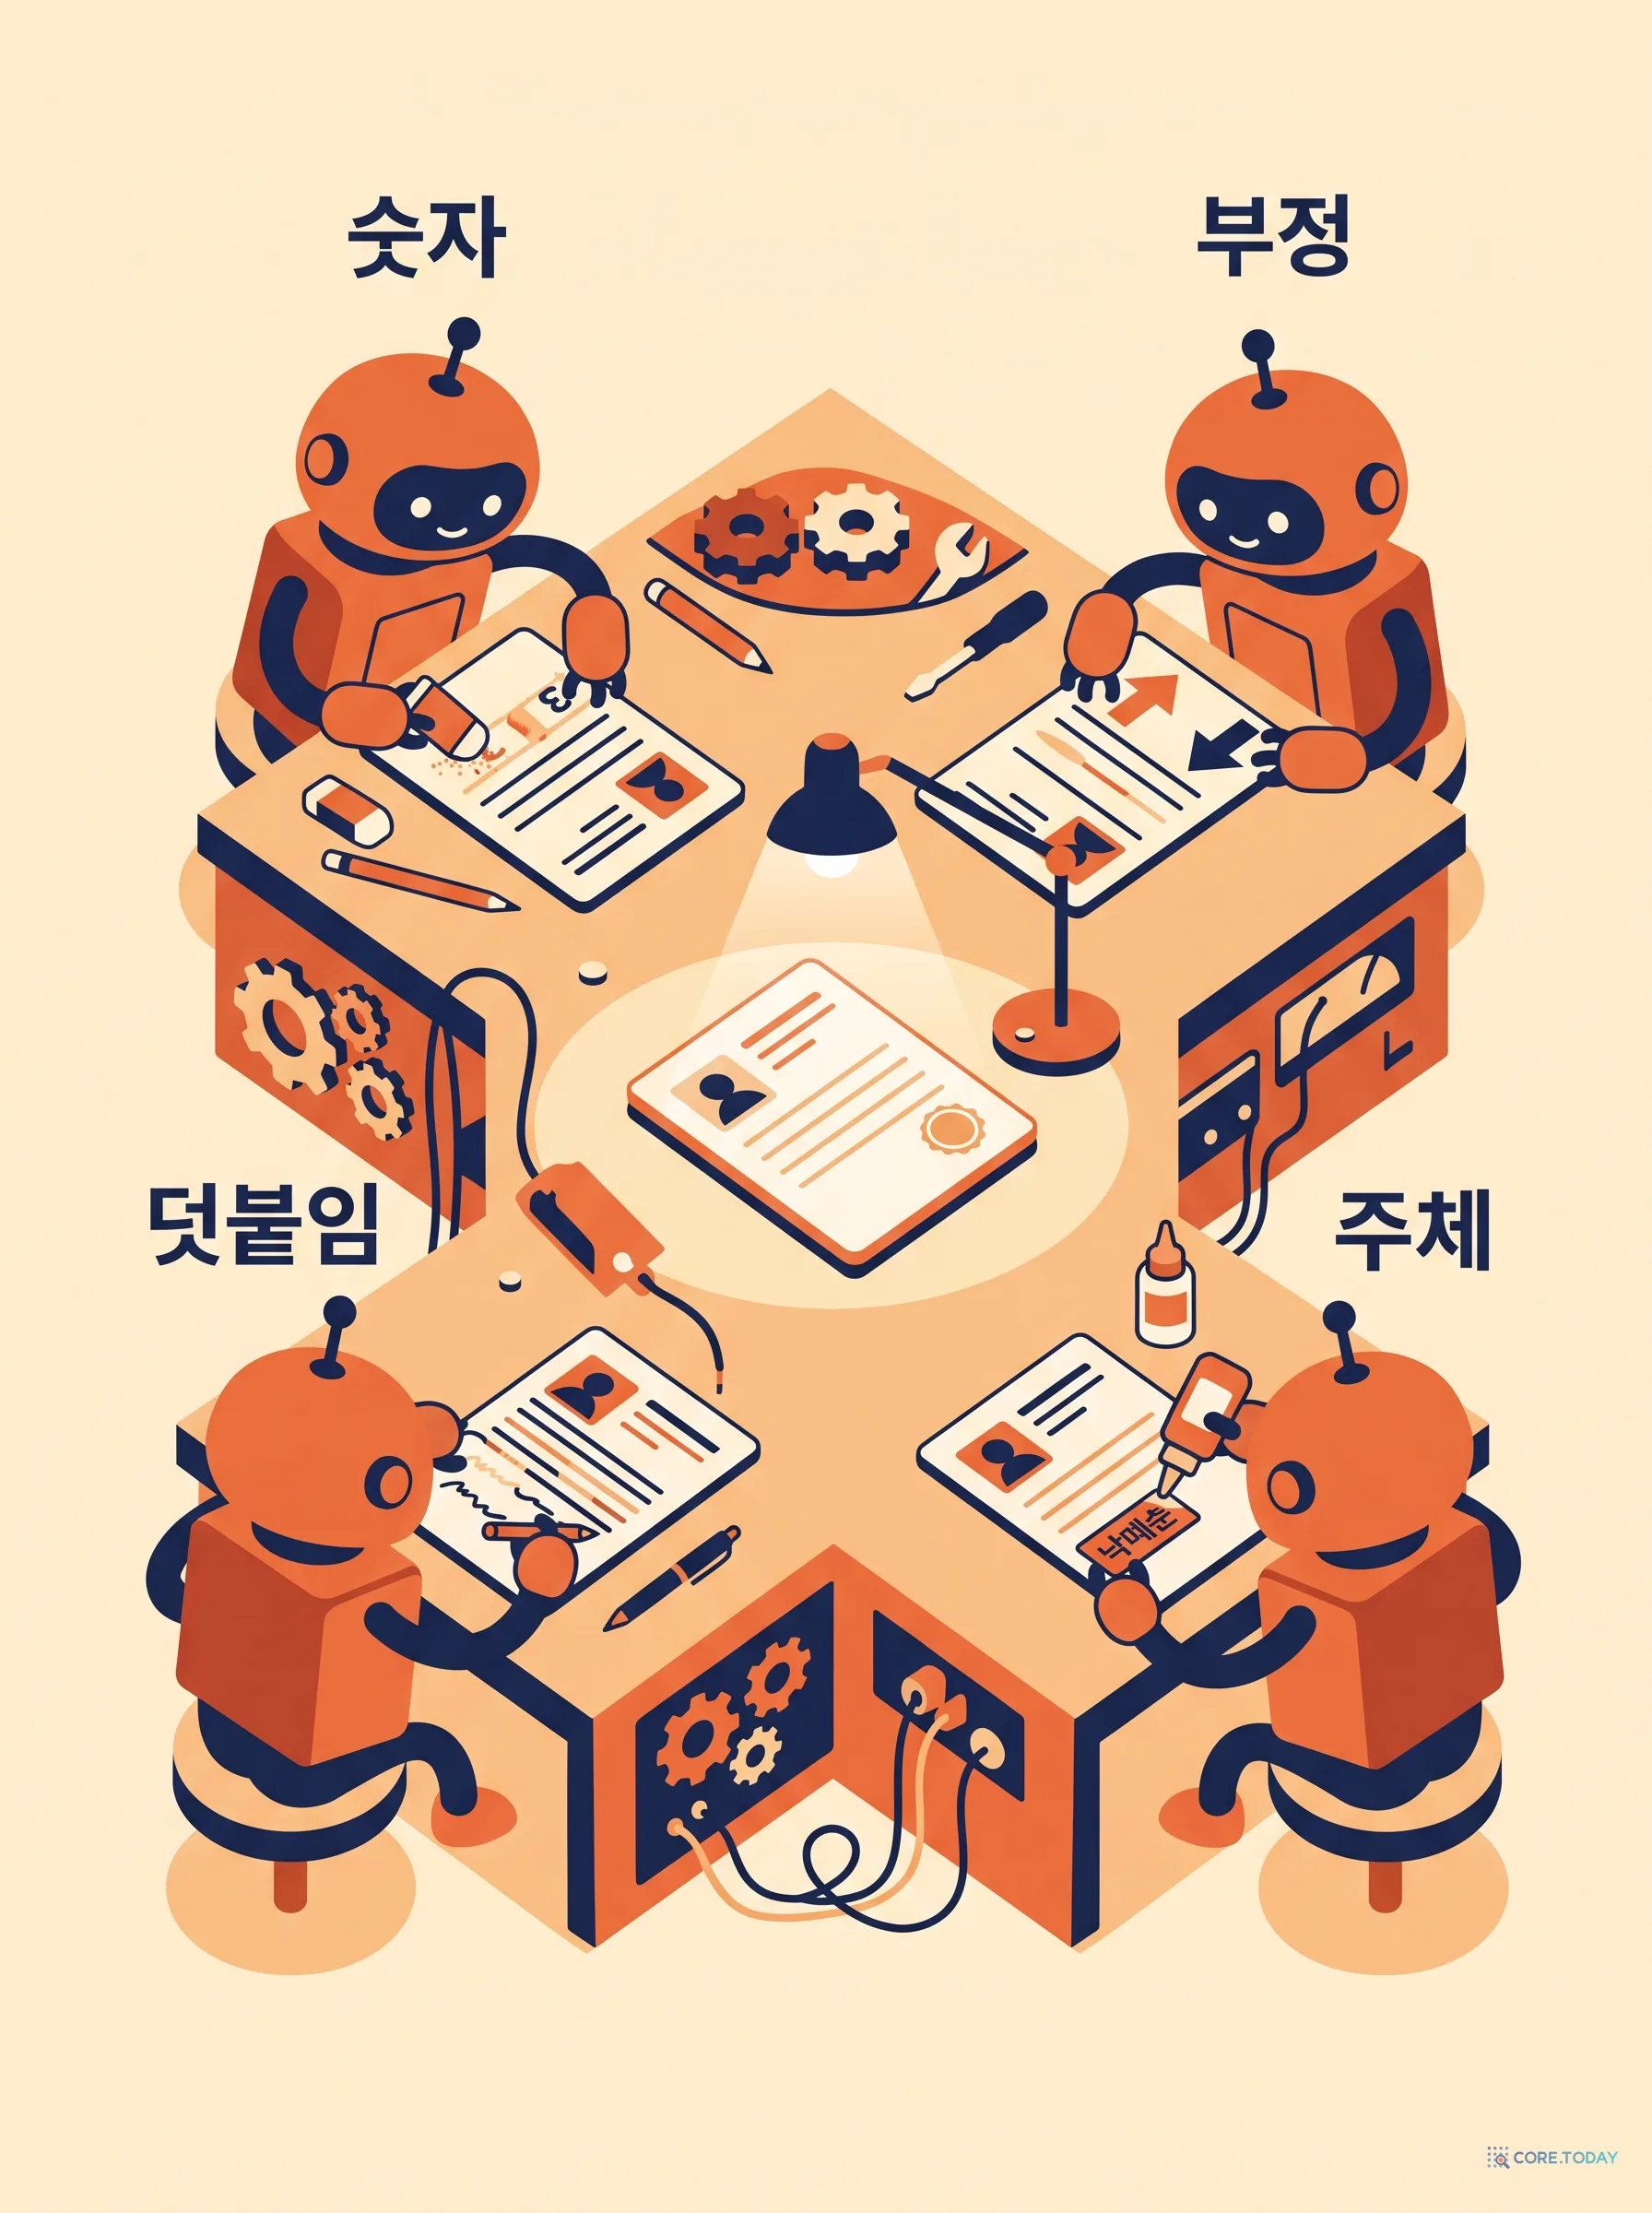
이 글은 6편에 이어 Jev를 한국어 검색 파이프라인의 새 자리, 답변 뒤의 검문소 에 세웁니다. 이 블로그 문단 87개로 참 주장 257개와 네 가지로 비튼 거짓 주장 344개를 만들고, 임베딩 둘·크로스 인코더·NLI 모델·로컬 LLM 둘·Jev에게 같은 601쌍을 판정시켰습니다. 전부 한국어이고, 정답은 구성상 확정되어 있습니다.
1부. 왜 자로는 '아니다'를 못 재나
유사도와 함의는 다른 질문이다
1편에서 임베딩 모델을 이렇게 설명했습니다. 문장을 수천 차원의 점으로 바꾸고, 두 점의 코사인으로 "얼마나 비슷한가"를 잰다. 모델은 대조 학습 으로 훈련됩니다. 같은 주제의 질문과 문서는 가깝게, 다른 주제는 멀게. 그 훈련에서 "매출이 30% 늘었다"와 "매출이 30% 줄었다"는 한 번도 서로 밀어내야 할 쌍으로 등장하지 않습니다. 둘 다 '매출 30% 변화'에 관한 문장이고, 검색 관점에서는 둘 다 같은 질문의 정답 후보입니다.
이 현상은 측정된 지 오래됐습니다. Weller 등의 NevIR(EACL 2024)은 부정 하나만 다른 문서 쌍으로 검색 모델을 시험했는데, 최신 모델 대부분이 무작위 순위와 같거나 그보다 못했습니다. 크로스 인코더가 가장 나았고 바이 인코더(우리가 쓰는 임베딩)와 희소 신경 모델이 꼴찌였습니다. 2편의 리랭커가 이 글에서 임베딩보다 나은 이유이자, 그래도 충분하지 않은 이유입니다.
?
검색이 묻는 것
이 문서가 이 질문과 같은 것에 관한가. 방향·숫자·주체가 달라도 '같은 것에 관한' 문서는 정답 후보다. 임베딩과 리랭커는 이 질문에 답하도록 훈련됐다.
!
검문소가 묻는 것
이 주장의 모든 사실이 저 문서에 있는가. 숫자 하나, 화살표 방향 하나가 다르면 답은 '아니오'다. 이것은 함의(entailment) 판정이고, 별도의 모델이 필요하다.
→
이 글의 실험
같은 쌍을 두 부류의 모델에 주고, 검색용 모델이 어디까지 검문소 노릇을 하는지, 판정 모델이 얼마나 더 잘하는지, 그 값이 얼마인지 잰다.
검문소의 계보
RAG 답변의 근거 검증은 요약 분야에서 먼저 정리됐습니다. Laban 등의 SummaC(TACL 2021)는 자연어 추론(NLI) 모델을 문장 단위로 잘라 적용해 요약의 사실 불일치를 잡았고, RAG 평가 프레임워크 Ragas(2023)는 답변을 주장 단위로 쪼갠 뒤 각 주장이 문맥에 뒷받침되는지를 LLM에게 물어 '충실도(faithfulness)'를 계산합니다. Tang 등의 MiniCheck(EMNLP 2024)는 그 판정을 770M짜리 작은 모델로 GPT-4 수준까지 끌어올려 비용을 400분의 1로 낮췄습니다.
즉 검문소의 설계는 이미 정해져 있습니다. 답변을 주장으로 쪼개고, 주장마다 "근거에 있는가"를 판정한다. 남은 질문은 그 판정을 누가, 얼마에, 얼마나 정확하게 하느냐입니다. 이 글은 그 판정 자리의 후보를 한국어로 줄 세웁니다.
2부. 실험 설계: 참 셋, 거짓 넷
문단 87개, 주장 601개
근거 문서는 이 블로그 글 본문에서 뽑은 문단입니다. 숫자가 셋 이상, 영문 고유명사가 하나 이상 들어 있는 220~520자 문단을 글마다 하나씩 100개 골랐고(1~6편의 요약문 코퍼스보다 사실이 조밀해야 비틀 거리가 있습니다), 그중 참고문헌 목록처럼 문장이 아닌 것 13개를 뺀 87개를 썼습니다. 문단마다 주장 일곱 개를 만들었습니다(일부 문단은 문장이 하나뿐이거나 주체 바꾸기가 실패해 여섯 개).
규칙으로 원문장의 숫자 하나를 바꿈(연도 ±1~3, 정수 ×0.4~3, 소수 ×0.5~2)
모순
87
거짓 · 방향 뒤집음
LLM이 숫자·주체는 두고 주장 방향만 반대로(늘었다→줄었다, 가능→불가능)
모순
87
거짓 · 주체 바꿈
LLM이 모델명·회사·사람을 같은 부류의 다른 이름으로
모순
83
거짓 · 없는 사실 덧붙임
LLM이 문단 주제와 관련 있지만 문단에 없는 구체적 사실을 지어냄
언급 없음
87
숫자 바꾸기만 규칙으로 한 이유가 있습니다. Jev 문서는 산술과 날짜를 약점으로 명시합니다. 규칙으로 만들면 '연도를 1년 틀린 경우'처럼 정확히 무엇이 바뀌었는지 알 수 있어, 약점이 어디서 시작되는지 볼 수 있습니다. 나머지 셋은 LLM이 만들고 필자가 표본을 검수했습니다. 완벽하지는 않습니다. 4부의 탐색기에서 실제 쌍을 직접 볼 수 있습니다.
심판 열 명
같은 601쌍(문단, 주장)을 아래 심판에게 줬습니다. 전부 "이 주장이 문서에 뒷받침되는가"를 점수 하나로 내게 했고, 점수의 뜻은 모델마다 다릅니다.
다국어 NLI 모델(27개 언어 273만 쌍 + XNLI 학습, 한국어 XNLI 정확도 0.792). SummaC 계열의 정석
qwen3.8 (로컬 대형 LLM)
"뒷받침 여부 + 확신 0~100"을 JSON으로
Ollama 로컬, 온도 0
LLM-as-judge의 대표. 6편에서 질문을 만들던 그 모델
qwen3:8b (로컬 소형 LLM)
위와 같음
Ollama 로컬
싼 LLM 판정이 어디까지 되는지
비교 기준은 두 가지입니다. AUROC 는 참 주장에 거짓보다 높은 점수를 줄 확률로, 임계값과 무관한 순위 능력입니다. 적발률 은 실무 기준입니다. 참 주장의 90%를 통과시키는 임계값을 심판마다 따로 잡고(참 주장 점수의 하위 10% 지점), 그 임계값에서 거짓 주장의 몇 %가 걸리는지 셉니다. 검문소는 참을 너무 많이 막으면 쓸모가 없으므로, '참 90% 통과'를 고정하고 거짓 적발을 비교하는 것이 공정합니다.
3부. 결과: 누가 무엇을 잡았나
먼저 큰 그림입니다. 아래 표는 심판마다 '참 주장(원문 복사 제외)의 90%를 통과시키는 임계값'을 잡고, 그 임계값에서 네 가지 거짓 주장이 얼마나 걸리는지를 보여 줍니다. 원문을 그대로 복사한 참 주장은 임베딩에 코사인 1.0을 주는 자명한 경우라 임계값 계산에서 뺐습니다. 실제 RAG 답변은 바꿔 쓴 문장이니까요.
세 줄로 요약하면 이렇습니다.
임베딩 코사인은 검문소가 못 됩니다. BGE-M3를 문단과 통째로 비교하면 AUROC 0.570, 동전 던지기와 다르지 않습니다. 문단의 문장 중 가장 가까운 것과 비교하는 유리한 조건을 줘도 0.863이고, 참 90%를 통과시키는 임계값에서 숫자를 바꾼 거짓은 3%, 방향을 뒤집은 거짓은 34%만 걸립니다. 1편의 한국어 1등 Qwen3-Embedding-8B도 같습니다(숫자 2%, 부정 17%). 유일하게 잘 잡는 것은 '없는 사실 덧붙임'(91%)인데, 그것은 문장 자체가 달라서 유사도가 떨어지기 때문입니다.
크로스 인코더는 절반쯤 됩니다. bge-reranker-v2-m3는 가장 가까운 문장과 비교할 때 AUROC 0.916, 부정은 87%까지 잡습니다. NevIR의 관찰(크로스 인코더가 바이 인코더보다 부정에 강하다)이 한국어에서도 재현됐습니다. 그러나 숫자 바꿈 70%, 주체 바꿈 65%에서 멈추고, 점수가 1.0에 붙어 버려 임계값을 잡기가 어렵습니다.
함의를 배운 모델만 검문소가 됩니다. 0.3B짜리 다국어 NLI 모델(mDeBERTa)이 AUROC 0.959로 크로스 인코더를 크게 앞섰고, Jev는 0.995(한국어 지시문 0.996)로 네 유형을 사실상 전부 잡았습니다. 로컬 LLM 판정은 qwen3.8(로컬 대형)이 AUROC 0.994(숫자 100%, 부정 99%, 주체 96%, 덧붙임 100%)로 Jev에 가까웠고, qwen3:8b(소형)은 0.466로 동전 던지기보다 못했습니다. 소형 모델은 거의 모든 주장에 '뒷받침된다'고 답했습니다(거짓 적발 11%). 다만 대형 LLM 판정도 확신도를 0~100으로 '말한' 값이라 보정된 확률이 아니고(거의 전부 100), 호출당 2.1초가 걸렸습니다.
NLI 모델의 선전은 이 실험에서 가장 실용적인 발견 중 하나입니다. 무료이고 CPU에서 돌고 한국어를 압니다. 다만 두 가지가 다릅니다. 첫째, 임계값이 0.092입니다. 바꿔 쓴 참 주장에 '함의 확률 9%'를 주는 일이 흔해서, 순위는 맞아도 확률로 읽을 수 없습니다. 둘째, 주체를 바꾼 거짓에서 86%로 다른 유형보다 약합니다. 'GPT-4에 따르면'과 '논문에 따르면'의 차이를 함의 모델은 자주 놓칩니다.
점 하나가 주장 하나
이 산점도가 이 글의 그림입니다. 가로축(임베딩 코사인)에서는 참(초록)과 숫자·부정·주체를 바꾼 거짓(빨강·주황·노랑)이 0.9~1.0 사이 같은 자리에 포개져 있고, 세로축(Jev)에서는 참이 0.9 위에, 거짓이 0.1 아래에 갈립니다. 가로축을 크로스 인코더나 NLI로 바꾸면 거짓이 조금씩 왼쪽으로 흩어지기 시작하고, LLM 판정으로 바꾸면 Jev와 비슷한 모양이 됩니다. 보라색(없는 사실 덧붙임)만 임베딩에서도 왼쪽으로 밀려 있습니다.
Jev 문서는 산술과 날짜를 약점으로 명시합니다. 6편의 독자 중에도 "숫자를 바꾸면 못 잡지 않겠느냐"고 물은 분이 있었습니다. 그래서 숫자 바꿈은 규칙으로 만들었고, 결과는 100% 적발이었습니다. 연도를 1년 틀린 것도, 소수점 둘째 자리를 바꾼 것도 전부 잡았습니다.
여기서 멈추지 않고 더 밀어 봤습니다. 아래 위젯의 첫 탭은 숫자를 딱 1만 올린 주장(87개)과 단위만 바꾼 주장(%↔배, 억↔만, GB↔MB 등 30개)입니다. 둘째 탭은 실제 검문소 조건인 '문단 다섯 개짜리 상태'(정답 하나에 무관한 문단 넷), 셋째 탭은 문서의 숫자로 계산 해야만 참·거짓이 갈리는 주장입니다.
숫자 +1도 100%, 의미 있는 단위 바꿈도 100% 잡았습니다. 문서가 밝힌 약점은 '숫자를 못 읽는다'가 아니라 '계산을 못 한다'였고, 셋째 탭이 그 경계를 보여 줍니다. 계산이 맞는 주장 40개와 틀린 주장 40개에서 Jev의 AUROC는 0.810, 같은 임계값에서 참 통과 5%, 거짓 적발 100%였습니다. 참 주장 평균 0.54, 거짓 평균 0.25로 둘이 가까워졌습니다. 같은 주장을 로컬 LLM(qwen3.8)에 주면 AUROC 0.613(참 정확 60%, 거짓 정확 62%)입니다. 흥미로운 것은 실패의 모양입니다. Jev는 계산이 필요한 주장에 확신을 주지 않았습니다. 참 주장은 대부분 0.4~0.8, 거짓 주장은 0~0.5에 흩어져 있어서, 검문소 임계값(0.91)에서는 둘 다 '보류'가 됩니다. 반면 사고를 끈 로컬 LLM은 같은 주장에 확신도 100으로 답하고 열에 넷을 틀렸습니다. 모르는 것을 모른다고 하는 실패와, 모르면서 단언하는 실패는 검문소에서 값이 다릅니다. 계산이 섞인 주장은 코드로 숫자를 먼저 꺼내 검산하고, Jev에는 '계산 전 숫자가 문서에 있는가'만 묻는 편이 맞습니다. 문단 다섯 개짜리 상태에서는 AUROC 0.998로 문단 하나일 때(0.995)와 차이가 없었습니다. 토큰은 호출당 853에서 1650로 늘었지만 지연은 0.24초로 그대로였습니다.
슬라이더를 움직여 보면 검문소의 본질이 보입니다. Jev를 고르고 임계값을 0.5에서 0.9 사이 어디에 두어도 결과가 거의 같습니다. 참은 0.9 위, 거짓은 0.1 아래에 있어서 그 사이가 텅 비어 있기 때문입니다. 임베딩 코사인을 고르면 어떤 임계값에서도 참과 거짓이 함께 움직입니다. NLI를 고르면 순위는 좋지만 임계값을 0.1 근처까지 내려야 참 주장이 살아납니다. '임계값을 어디에 두느냐'가 고민거리가 아닌 심판이 좋은 심판입니다.
4부. 확률과 세 갈래
6편의 보정 차트에는 단서가 붙어 있었습니다. 정답을 질문당 하나만 표시해서 '관련 있는데 표시 안 된' 문서가 중간 구간을 흐렸을 수 있다는 것. 이번 데이터는 정답이 구성상 확정되어 있어 그 단서가 없습니다.
결과는 양극입니다. 601쌍 중 330쌍이 0.1 아래(실제 참 0%), 240쌍이 0.9 위(실제 참 99%)입니다. 중간 구간(0.6~0.9)에는 21쌍뿐이고 그중 19개가 참이었습니다. Jev가 망설인 경우가 적었고, 망설인 곳에서는 대략 확률만큼 맞았습니다.
Choice 혼동 행렬은 더 흥미롭습니다. 숫자·방향·주체를 바꾼 거짓은 '모순'으로(86/87, 86/87, 76/83), 없는 사실을 덧붙인 거짓은 '언급 없음'으로(73/87) 갈랐습니다. '언급 없음'이어야 할 것을 '모순'이라 한 11건을 하나씩 읽어 보면 열에 여덟은 생성 LLM이 지시를 어긴 경우였습니다. '없는 사실을 덧붙이라'고 했는데 문서의 숫자나 이름을 바꿔 버린 것입니다(48회를 45회로, GHCR을 Docker Hub로, 2005년을 2008년으로). Jev가 맞고 데이터가 틀린 것입니다.
실제 쌍을 보며
몇 개만 넘겨 보시면 이 데이터의 결이 보입니다. 원문 그대로인 참 주장에는 임베딩과 크로스 인코더가 1.00을 주고 Jev도 0.95 안팎을 줍니다. 그 문장의 숫자 하나가 바뀌면 임베딩은 0.99, 크로스 인코더는 0.98쯤을 유지하고 Jev는 0.02로 떨어집니다. 바꿔 쓴 참 주장에서는 반대로 임베딩이 0.85~0.9로 내려오는데 Jev는 0.9 위에 그대로 있습니다. 검문소에 필요한 것은 '표현이 얼마나 비슷한가'가 아니라 '사실이 같은가'이고, 두 축이 다르다는 것을 이 탐색기가 보여 줍니다.
이 실험의 Jev 검문 601건은 입력 0.51M 토큰, 0.021달러였습니다(출력 무료). 문단 다섯 개짜리 상태로 다시 돌린 601건은 0.99M 토큰, 0.042달러. 8 병렬로 보냈을 때 벽시계 22.4초, 호출당 중위 0.25초입니다. 비교를 위해 로컬 LLM 판정의 호출당 시간도 쟀습니다. qwen3.8은 호출당 평균 2.1초, qwen3:8b는 0.4초(둘 다 M 시리즈 맥, 사고 끔, 순차)입니다. Jev의 0.25초와 비교하면 8배입니다. 아래 계산기에 여러분의 트래픽을 넣어 보세요.
6부. 파이프라인에 붙이는 법
검문소는 검색 파이프라인의 맨 끝, 답변이 사용자에게 나가기 직전에 섭니다. 6편의 그림에 한 칸을 더하면 이렇습니다.
1차 검색
임베딩(1편) + BM25(5편) → RRF(2편). 후보 50~100개. 여기서 놓치면 검문소도 못 살린다
리랭킹
크로스 인코더 또는 Jev Noul(6편) → 상위 5~10개를 LLM에 근거로 전달
생성
LLM이 근거를 보고 답변 초안을 쓴다. 문장 단위로 쪼개거나, 처음부터 주장 목록을 JSON으로 받는다
검문소
주장마다 Jev에 (근거, 주장)을 넣고 Noul + Choice를 한 호출로 받는다. '모순'은 삭제, '언급 없음'은 재검색 또는 "확인되지 않음" 표시, 통과한 주장만 내보낸다
핵심은 세 갈래 처리입니다. 확률 하나로는 "틀렸다"와 "모른다"를 못 가릅니다. 근거와 모순 되는 주장은 지워야 하지만, 근거에 없는 주장은 다른 문서를 더 찾아보면 참일 수 있습니다. Choice 한 번이면 이 둘이 갈리고, Jev는 한 호출에 질문 여럿을 받으므로 추가 비용이 거의 없습니다.
python
import json, urllib.request
defgate(document: str, claim: str, key: str) -> dict:
body = {
"state": {"document": document, "claim": claim},
"model": "jev-latest",
"questions": {
"supported": {
"type": "noul",
"instructions": "이 주장은 문서에 의해 온전히 뒷받침되는가? 주장의 모든 사실(숫자·이름·변화 방향)이 문서에 그대로 있어야 한다.",
"criteria": {
"true": "문서가 주장의 내용을 같은 숫자·같은 주체·같은 방향으로 말하고 있다",
"false": "주장이 문서와 모순되거나, 숫자나 주체가 다르거나, 문서에 없는 내용을 말한다",
},
},
"relation": {
"type": "choice",
"instructions": "문서와 주장의 관계는?",
"criteria": {
"supported": "문서가 주장을 그대로 뒷받침한다",
"contradicted": "문서가 주장과 모순된다(숫자·주체·방향이 다르다)",
"not_mentioned": "문서에 없는 내용이라 확인할 수 없다",
},
},
},
}
req = urllib.request.Request(
"https://api.typesafe.ai/v1/systemone",
data=json.dumps(body, ensure_ascii=False).encode(),
headers={"Authorization": f"Bearer {key}", "Content-Type": "application/json"},
)
r = json.load(urllib.request.urlopen(req, timeout=30))
a = r["answers"]
return {"p_supported": a["supported"]["noul"], "relation": a["relation"]["choice"],
"confidence": a["relation"]["confidence"]}
# 답변의 주장마다 호출 (병렬 가능)# verdict = gate(passage, claim, JEV_KEY)# if verdict["relation"] == "contradicted": 삭제# elif verdict["relation"] == "not_mentioned": 재검색 또는 '확인되지 않음' 표시# elif verdict["p_supported"] >= 0.7: 통과
이 코드가 이 글의 실험 코드와 같습니다. 지시문과 기준은 한국어 그대로이고, 위의 임계값 0.91은 이 데이터에서 참 주장의 90%를 통과시키는 값입니다. 여러분의 문서에서는 다시 재야 합니다. 다만 Jev 출력은 확률이므로 "0.7이면 대략 열에 일곱은 참"이라는 뜻이 어느 데이터에서나 대체로 지켜집니다(4부). 임계값을 옮기는 것이 아니라 '얼마나 엄격할지'를 정하는 일이 됩니다.
거짓 주장의 세 종류는 LLM이 만들었습니다. 부정·주체·덧붙임은 qwen3.8이 생성했고 필자가 표본만 검수했습니다. 생성 모델의 문체가 참 주장(바꿔 쓰기)과 거짓 주장에 같이 묻어 있으므로, 문체로 참·거짓을 가르는 지름길은 없습니다. 반대로 LLM이 지시를 어긴 쌍(예: '없는 사실'이라 했는데 모순되는 문장)이 몇 개 섞여 있고, 그 경우 Jev의 '오답'이 실은 정답일 수 있습니다.
비틀기는 한 문장에 하나씩입니다. 실제 환각은 여러 사실이 섞인 긴 문장에서 하나만 틀리는 식이고, 두 문서의 내용을 섞는 식이기도 합니다. 이 실험은 그 조합을 재지 않았습니다.
참 90% 통과 규칙은 필자가 정한 것입니다. 다른 운영점(참 95%, 99%)에서는 순위가 바뀔 수 있습니다. 위젯의 슬라이더로 직접 확인할 수 있습니다.
NLI 모델은 하나만 썼습니다. 더 큰 NLI 모델이나 MiniCheck 계열의 전용 사실 검증 모델은 한국어 지원이 불확실해 넣지 않았습니다. 0.3B로 AUROC 0.959가 나왔으니 더 큰 모델은 더 좁혀 올 가능성이 큽니다.
문단은 이 블로그의 글이고 한국어 기술 문서입니다. 법률·의료·재무 문서, 표와 수식이 많은 문서에서는 다를 수 있습니다. 특히 계산이 필요한 주장(3부 셋째 탭)이 많은 도메인이라면 검문소 설계를 다시 해야 합니다.
검문소는 검색을 대신하지 못합니다. 근거 문서가 애초에 틀렸거나 검색이 못 찾았으면 검문소도 틀린 근거에 대해 '뒷받침됨'을 줍니다. 1~5편이 먼저이고, 이 글은 그 위의 마지막 칸입니다.
출처
Orion Weller, Dawn Lawrie, Benjamin Van Durme, "NevIR: Negation in Neural Information Retrieval", EACL 2024, arXiv:2305.07614 — "대부분의 검색 모델이 부정을 고려하지 않아 무작위 순위와 같거나 못하다", 크로스 인코더 > 후기 상호작용 > 바이 인코더·희소
Liyan Tang, Philippe Laban, Greg Durrett, "MiniCheck: Efficient Fact-Checking of LLMs on Grounding Documents", EMNLP 2024, arXiv:2404.10774 — 770M 모델이 GPT-4 정확도, 비용 400분의 1, LLM-AggreFact 벤치마크
Philippe Laban, Tobias Schnabel, Paul N. Bennett, Marti A. Hearst, "SummaC: Re-Visiting NLI-based Models for Inconsistency Detection in Summarization", TACL 2022, arXiv:2111.09525 — 문장 단위 NLI 집계
Shahul Es, Jithin James, Luis Espinosa-Anke, Steven Schockaert, "RAGAS: Automated Evaluation of Retrieval Augmented Generation", 2023, arXiv:2309.15217 — 주장 분해 + 문맥 검증으로 충실도 계산
TypeSafe AI 문서: 소개 · 모델 제원(jev-1.13, $0.042/M 입력, 출력 무료, CJK 주의) · Noul/Choice 프리미티브 · 들쭉날쭉함(산술·날짜 약점)