RAG한국어 검색KURE-v2late interactionColBERTMaxSim다중 벡터임베딩Qwen3-EmbeddingBGE-M3MTEBPLAID재랭커하이브리드 검색
문서를 한 점으로 누르지 않는다 — KURE-v2와 한국어 late interaction 검색 (RAG 특집 7편)
154M 파라미터짜리 한국어 검색 모델이 MTEB 한국어 검색 9과제 평균에서 7.6B·27B 단일 벡터 모델을 앞섰다. 비결은 크기가 아니라 비교 방식이다. 문서 전체를 벡터 하나로 누르는 대신 토큰마다 128차원 벡터를 남겨 두고, 질의 토큰마다 가장 잘 맞는 문서 토큰을 찾아 더한다(MaxSim). 2026년 8월 29일 공개된 KURE-v2는 이 late interaction 방식을 한국어·영어에 적용한 첫 본격 모델이다. 이 특집은 단일 벡터가 무엇을 잃는지, 조사·형태소·영한 혼용이 많은 한국어에서 토큰 단위 비교가 왜 유리할 수 있는지, 평균 1위 뒤에 숨은 과제별 승패, 문서마다 벡터 수백 개를 저장하는 대가와 그것을 1.7GB로 줄이는 법, 그리고 Qwen3 임베딩과 공정하게 비교하는 실험 설계를 위젯 5종으로 따라간다. 결론은 3편과 같다 — 기본은 하이브리드, late interaction은 고가치 한국어 질의에만.
2026년 8월 29일, 고려대학교 NLP&AI 연구실이 한국어 검색 임베딩 모델 KURE의 두 번째 판을 공개했다. 저장소의 리더보드 첫 줄은 이렇다.
0.8160
KURE-v2 · MTEB 한국어 검색 9과제 평균 nDCG@10 (154M)
0.7826
Qwen3-Embedding-8B · 같은 9과제 (7.6B)
0.7667
microsoft/harrier-oss-v1-27b (27B)
49배
KURE-v2와 Qwen3-8B의 파라미터 수 차이
파라미터가 49분의 1인 모델이 평균에서 앞섰다. 이런 표를 보면 두 가지 반응이 나온다. "한국어 특화 모델이니까"라는 반응과 "리더보드는 리더보드일 뿐"이라는 반응. 둘 다 반은 맞다. 그러나 둘 다 이 표에서 정말 중요한 것을 놓친다. KURE-v2는 다른 모델들과 문서를 비교하는 방식 자체가 다르다.
다른 모델들은 문서 하나를 벡터 하나로 만든다. 1,024차원이든 4,096차원이든, 문서 전체가 한 점이 된다. KURE-v2는 문서의 토큰마다 128차원 벡터를 하나씩 남겨 둔다. 400토큰짜리 문서면 벡터 400개다. 질의도 마찬가지로 토큰마다 벡터가 된다. 그리고 비교할 때는 질의의 토큰 하나하나가 문서의 토큰 중 가장 잘 맞는 것을 찾아 그 점수를 더한다. 이 방식을 late interaction이라 부르고, 그 점수 함수를 MaxSim이라 부른다.
이 글은 그 방식이 무엇이고, 왜 한국어에서 유리할 수 있으며, 무엇을 대가로 치르고, 우리 데이터에서 어떻게 검증해야 하는지를 다룬다. 시리즈 앞 편들과의 연결은 분명하다. 3편이 "질문마다 다른 검색기"를 말했다면, 이 글은 한국어 팀의 검색기 선택지에 새로 들어온 후보 하나를 해부한다.
📚
RAG 특집 시리즈 7편.1편은 검색을 수행하는 에이전트(Agentic Search), 2편은 최소 충분 증거 집합, 3편은 질의별 검색기·생성기 라우팅, 4편은 파싱과 자가 수정 인덱스, 5편은 GraphRAG의 다변화, 6편은 멀티모달 문서 검색을 다뤘다. 이 글은 한국어 검색기 자체를 다룬다. 이어서 8편 보안과 총정리가 남았다.
🗺️
1장 — 단일 벡터의 대가: 문서 전체를 한 점으로
2장 — Late interaction: 토큰을 남겨 두고 나중에 비교한다 (MaxSim 실험실 위젯)
3장 — 왜 한국어에서 토큰 단위 비교가 유리할 수 있나
4장 — KURE-v2: 무엇이 공개됐나
5장 — 결과: 평균이 아니라 과제별로 (리더보드 탐색기 위젯)
6장 — 운영: 문서마다 벡터 수백 개 (인덱스 계산기 위젯)
7장 — Qwen3와 공정하게 비교하기 (실험 체크리스트 위젯)
8장 — 라우터의 관점: 고가치 한국어 질의에만 (스택 진단 위젯)
9장 — 우리 시스템에 넣는 순서
10장 — 한계와 반론
마무리 — 압축하지 않는다는 선택
지금 대부분의 RAG가 쓰는 dense 검색은 이렇게 돌아간다. 임베딩 모델이 문서를 읽고 벡터 하나를 낸다. 질의도 벡터 하나가 된다. 두 벡터의 코사인 유사도가 점수다. 빠르고 단순하고, HNSW 같은 근사 최근접 탐색 인덱스가 잘 발달해 있어서 수백만 문서도 밀리초에 뒤진다.
이 방식의 대가는 압축이다. 문서가 무슨 말을 하든, 몇 가지 주제를 담든, 어떤 고유명사와 숫자가 있든, 전부 한 점으로 눌린다. 이 압축이 어디서 문제가 되는지는 세 가지 상황에서 뚜렷하다.
긴 문서
3,000토큰짜리 규정 문서에 열 개 조항이 있다. 벡터 하나는 열 조항의 평균이다. 질의가 그중 한 조항을 정확히 겨눠도, 평균은 그 조항과 그리 가깝지 않다.
그래서 청크를 잘게 자른다 — 그러면 이번엔 조항 사이의 참조가 끊긴다.
고유명사·숫자·코드
“KS B 0221”이나 “2026-03-15 고시”처럼 정확히 그 문자열이 중요한 질의에서, 의미 벡터는 비슷한 다른 코드와 구분을 잘 못 한다.
그래서 BM25를 같이 쓴다 — 하이브리드가 표준이 된 이유.
설명 불가
점수 0.71이 나왔다. 왜 0.71인지는 알 수 없다. 어느 단어가 맞았고 어느 단어가 빠졌는지가 압축 과정에서 사라진다.
그래서 리랭커를 뒤에 붙인다 — 질의와 문서를 함께 읽는 cross-encoder가 다시 판단한다.
세 카드의 아래 줄을 보면 흥미롭다. 단일 벡터의 약점마다 덧붙이는 부품이 있다 — 청킹, BM25, 리랭커. 우리 블로그가 Advanced RAG 7가지 기법에서 정리한 것이 대체로 이 부품들이다. 잘 작동한다. 그러나 전부 "압축의 손실을 뒤에서 메우는" 장치라는 점은 같다.
late interaction은 다른 질문을 던진다. 처음부터 압축하지 않으면 어떻게 되는가.
이 발상은 2020년 스탠퍼드의 Khattab과 Zaharia가 ColBERT라는 이름으로 내놓았다. 이름의 뜻이 곧 원리다 — Contextualized Late Interaction over BERT. 질의와 문서를 각각 BERT에 통과시키되 마지막에 한 점으로 모으지 않고, 토큰별 벡터를 그대로 둔다. 그리고 상호작용(비교)을 나중에 한다.
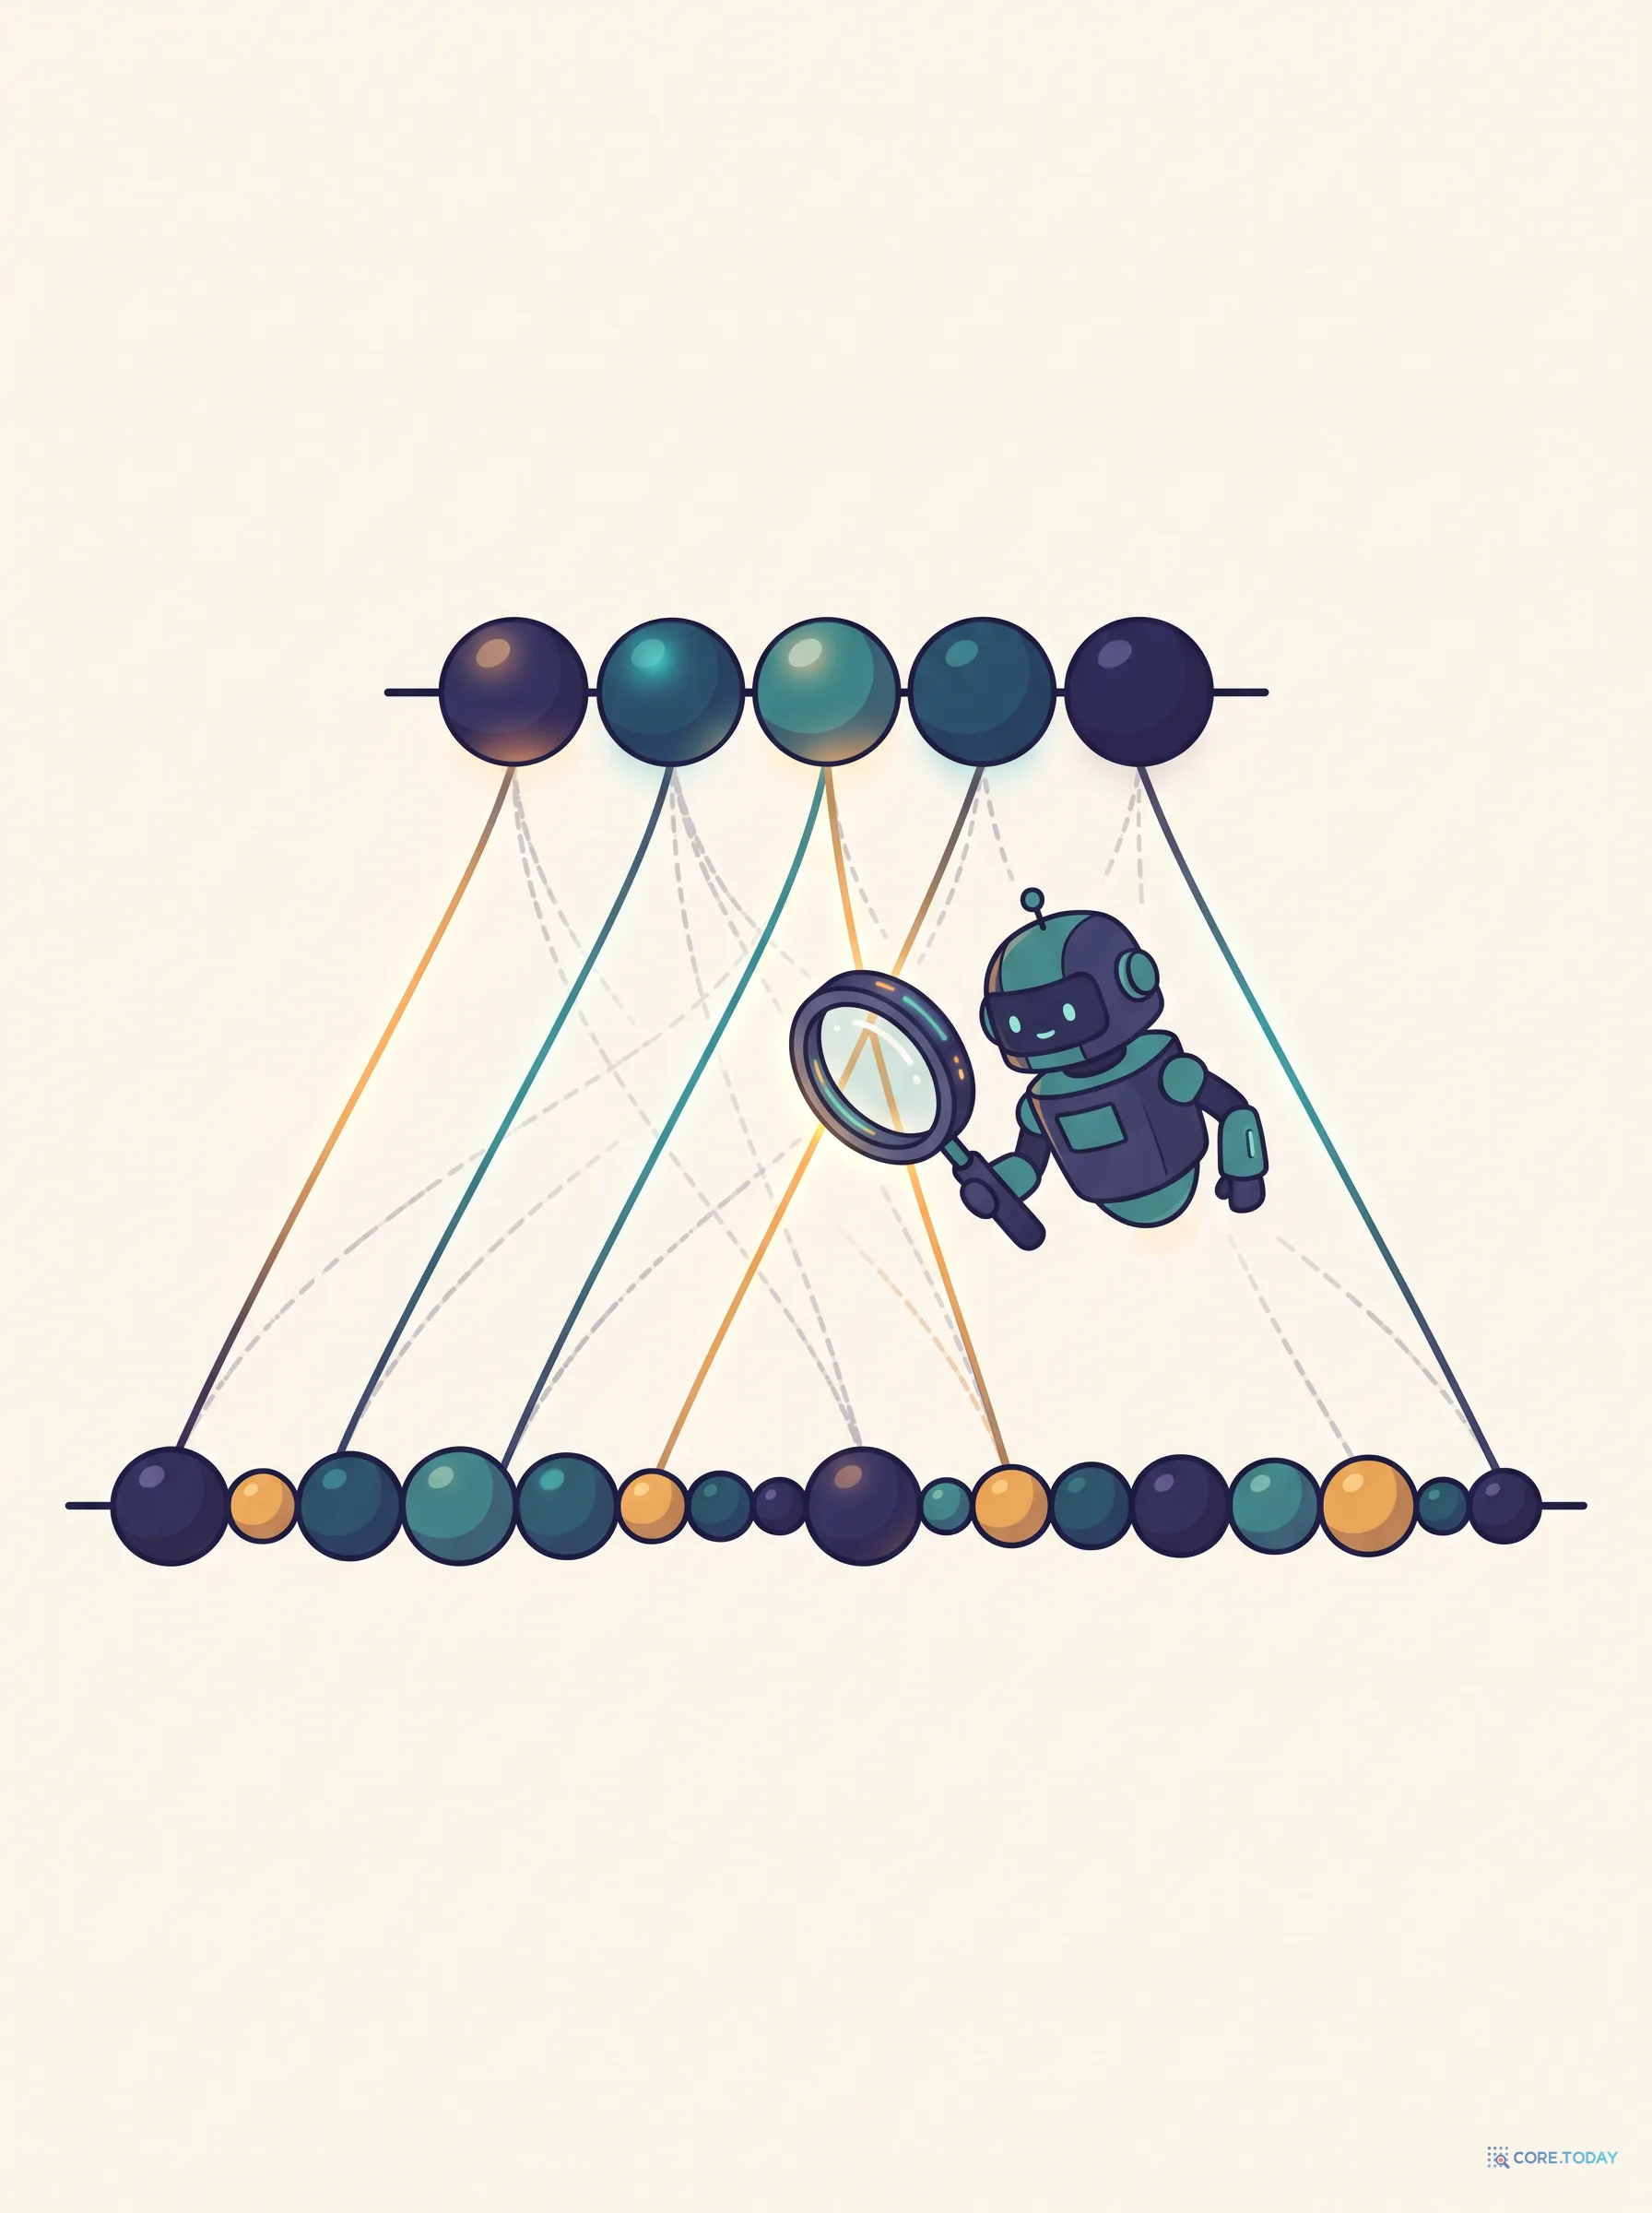
비교 함수는 단순하다. 질의 토큰 하나를 잡고, 문서의 모든 토큰과 내적을 계산해 최댓값을 취한다. 이것을 질의 토큰마다 반복해 합산한다. 그래서 MaxSim이다.
MaxSim · ColBERT (Khattab & Zaharia, 2020)
score(q, d) = Σi ∈ 질의 토큰maxj ∈ 문서 토큰 ( qi · dj )
# 질의 토큰 i마다 → 문서에서 가장 잘 맞는 토큰 j 하나를 찾아 그 점수를 더한다# 문서 토큰은 색인 시점에 미리 계산해 저장 (질의 시점엔 질의 토큰만 인코딩)
수식보다 예시가 빠르다. 아래 실험실에서 같은 한국어 질의를 두 방식으로 비교해 보자.
위젯에서 확인할 것은 두 가지다. 첫째, 단일 벡터에서 1위였던 문서가 MaxSim에서는 3위로 내려가고, 반대로 표현이 달라서 밀렸던 문서가 1위로 올라온다. '키오스크'가 '단말기'에, '재부팅'이 '재시작'에 토큰 단위로 짝을 찾았기 때문이다. 둘째, MaxSim 분해표에서 붉은 줄 — 짝을 못 찾은 질의 토큰 — 이 그대로 보인다. 단일 벡터의 점수 하나로는 절대 알 수 없는 정보다.
이 방식이 dense 단일 벡터와 BM25 사이 어디쯤에 있는지도 분명해진다. BM25처럼 토큰 단위로 맞추되, BM25와 달리 토큰이 문맥화된 벡터라 '재부팅'과 '재시작'이 짝이 된다. dense처럼 의미를 보되, dense와 달리 어느 토큰이 맞았는지가 남는다. 그래서 late interaction 진영은 종종 이것을 "하이브리드 검색이 하려던 일을 모델 하나가 한다"고 설명한다.
물론 대가가 있다. 문서마다 벡터가 토큰 수만큼 생긴다. 이 문제는 6장에서 다룬다. 먼저 이 방식이 한국어에서 특별히 의미 있는 이유부터 보자.
late interaction의 이득은 언어를 가리지 않는다. 그러나 한국어에는 이 방식이 특히 잘 맞을 만한 이유가 몇 가지 있다. 미리 적어 두면, 아래는 한국어의 언어적 특성에서 나온 설명 가설이지 KURE 저장소가 실험으로 하나하나 증명한 결과는 아니다. 5장의 과제별 결과가 이 가설과 어디서 맞고 어디서 어긋나는지를 함께 봐야 한다.
3.1 조사와 어미가 단어에 붙어 있다
"키오스크가", "키오스크를", "키오스크에서는" — 영어라면 the kiosk 하나로 끝날 것이 한국어에서는 조사에 따라 문자열이 달라진다. 단일 벡터 모델도 서브워드 토크나이저 덕분에 어간을 공유하긴 하지만, 문서 전체를 평균 낼 때 이 정보는 희석된다. 토큰 단위 비교에서는 '키오스크' 서브워드가 질의와 문서에서 직접 짝이 된다. 조사가 무엇이든 상관없다.
3.2 띄어쓰기가 불규칙하다
"재부팅절차", "재부팅 절차", "재 부팅 절차"가 전부 실제 문서에 나온다. BM25는 이것을 다른 토큰으로 본다. 단일 벡터는 평균 속에 묻는다. 서브워드 단위 MaxSim은 '재부팅'과 '절차'가 어떻게 띄어 있든 각각의 조각이 짝을 찾는다.
기술 문서, 논문, 계약서, 심지어 보도자료에도 "POS 단말기", "API 키 발급", "SLA 위반 시"처럼 영문 용어가 한국어 문장 안에 박혀 있다. 질의는 "포스기 오류"라고 한국어로 들어온다. 단일 벡터 모델이 다국어를 지원해도, 문서 전체를 평균 낼 때 영문 토큰과 한글 토큰의 관계는 흐려진다. late interaction에서는 '포스'와 'POS'가 문맥화된 토큰 벡터로 직접 짝을 찾는다. KURE-v2가 처음부터 한국어·영어 이중언어로 학습된 이유가 여기 있다.
3.4 숫자·고유명사와 의미를 동시에 봐야 한다
"제12조 제3항"과 "제13조 제2항"은 의미 벡터로는 거의 같고, 문자열로는 다르다. 행정·법령·공고 문서에서 이런 질의가 많다. MaxSim은 '12'와 '3'이 각각 짝을 찾아야 점수가 오르므로 단일 벡터보다 숫자에 민감하고, 동시에 '조'와 '항'의 의미도 본다. 다만 이것도 서브워드 분할과 학습 데이터에 달린 문제라 5장의 법령 과제(LawIRKo) 결과를 보면 생각보다 단순하지 않다.
3.5 긴 문서를 자르기 어렵다
공고문·조례·보고서는 한 문서가 수천 토큰이고 조항끼리 서로 참조한다. 잘게 자르면 참조가 끊기고, 안 자르면 단일 벡터가 평균이 된다. late interaction은 문서를 8,192토큰까지 통째로 넣어도 질의 토큰이 문서의 해당 부분만 골라 짝을 찾는다. 5장에서 이 가설은 가장 뚜렷하게 확인된다(MLDR 과제).
기반 모델이 SKT의 A.X-Encoder-base다. 다국어 모델을 한국어로 미세조정한 v1과 달리, 한국어 인코더 위에서 시작했다. 154M이라는 크기가 여기서 온다. late interaction의 질의 인코딩이 가벼운 이유이기도 하다(6장의 13.8ms).
instruction prefix가 없다. Qwen3 임베딩은 "Given a web search query, retrieve relevant passages"류의 지시문을 질의 앞에 붙여야 성능이 오른다. KURE-v2는 그냥 질의를 넣는다. 운영에서는 이 차이가 의외로 크다 — 과제별로 프롬프트를 관리할 필요가 없고, 7장의 공정한 비교에서도 조건 하나가 줄어든다.
증류가 들어갔다. 지도 학습 단계에서 재랭커의 점수 분포를 KL 발산으로 따라가게 했다. 리랭커가 "왜 이 문서가 더 관련 있는지"를 아는 것을 검색기에 옮긴 셈이다. 저장소는 비지도 학습만 한 버전(KURE-v2-unsupervised)도 함께 공개했는데, 5장에서 이 둘의 차이가 이 모델의 성능이 어디서 오는지를 알려 준다.
5. 결과 — 평균이 아니라 과제별로
이 글의 첫 표로 돌아가자. 평균 nDCG@10 0.8160. 이 숫자 하나로 "KURE-v2를 쓰자"고 결정하면 안 되는 이유를 아래 위젯이 보여 준다.
첫 번째 탭의 아홉 과제를 하나씩 보면 그림이 갈린다.
과제
KURE-v2
Qwen3-Emb-8B
차이
무엇을 재나
MultiLongDocRetrieval
0.7159
0.5046
+0.211
긴 문서 검색
AutoRAGRetrieval
0.9718
0.8276
+0.144
금융·공공·의료·법률·커머스 실무 문서
SQuADKorV1
0.9846
0.9063
+0.078
위키 독해형
MIRACL (약 150만 문서)
0.7237
0.6783
+0.045
대규모 위키
Belebele (ko-ko)
0.9660
0.9824
−0.016
웹·뉴스 문단 독해
MrTidy
0.5974
0.6187
−0.021
위키 오픈 도메인 (bge-m3가 0.6471로 1위)
Ko-StrategyQA
0.8070
0.8363
−0.029
다중 홉 추론형
PublicHealthQA
0.8229
0.8721
−0.049
보건·의료
LawIRKo
0.7550
0.8171
−0.062
법령·판례
KURE-v2가 크게 이기는 곳은 긴 문서와 실무 문서다. MLDR의 격차 0.211은 아홉 과제 중 압도적이다. 3.5절의 가설 — 긴 문서를 한 점으로 누르는 대가 — 이 그대로 숫자로 나타난다. AutoRAG는 금융·공공·의료·법률·커머스 실무 문서로 구성된 과제인데, 코어닷투데이가 다루는 공고·보도자료·행정 문서와 성격이 가장 가깝다.
Qwen3-8B가 이기는 곳은 추론과 전문 도메인이다. 다중 홉 추론(Ko-StrategyQA), 보건(PublicHealthQA), 법령(LawIRKo)에서 8B 단일 벡터가 앞선다. 특히 법령에서 6pt 차이는 3.4절의 가설("숫자와 의미를 동시에")이 순진했음을 보여 준다. 법령 검색은 조항 번호 매칭보다 법률 개념의 이해가 좌우하고, 그것은 7.6B 모델의 세계 지식이 154M 인코더보다 나은 영역이다.
bge-m3가 1위인 과제도 있다. MrTidy에서 2년 된 568M 다국어 모델이 KURE-v2와 Qwen3-8B를 다 이긴다. 리더보드 평균 13위 모델이다. 과제별로 보지 않으면 절대 모를 사실이다.
두 번째 탭의 평균표에서도 두 가지를 읽어야 한다. 하나는 late interaction 두 모델(KURE-v2, colbert-ko-en-v2)이 7.6B~27B 단일 벡터를 평균에서 앞선다는 것 — 구조의 힘이다. 다른 하나는 같은 구조인 KURE-v2-unsupervised가 0.728로 bge-m3 아래라는 것 — 지도 학습과 증류가 없으면 late interaction이라도 평범하다. 구조가 자리를 만들고, 한국어 학습 데이터가 점수를 만든다.
⚠️
이 표를 읽을 때의 단서. 저장소는 late interaction 모델을 PyLate 2.18.16과 PLAID 인덱스로 직접 평가했고, 단일 벡터 모델은 가능한 경우 공식 MTEB 결과를 썼다고 밝힌다. 즉 두 진영의 평가 코드가 다르다. 재현 가능한 결과 파일이 공개돼 있어 방향은 믿을 수 있지만, 소수점 둘째 자리의 차이를 근거로 결정하지는 말아야 한다. 그리고 이 표는 코어닷투데이의 공고·보도자료·행정·의정 문서에서 같은 순위가 나온다는 뜻이 아니다 — 7장.
이제 대가를 계산할 차례다. 단일 벡터 인덱스는 문서 수 × 차원이다. late interaction 인덱스는 문서 수 × 토큰 수 × 128이다. 400토큰짜리 문서라면 1,024차원 단일 벡터의 50배 저장 공간이다. 이것이 ColBERT가 2020년에 나오고도 2026년까지 주류가 되지 못한 이유다.
KURE 저장소가 이 문제를 정면으로 다룬 것이 이 공개의 실무적 가치다. 9개 평가 코퍼스 전체를 대상으로 압축 방식별 인덱스 크기와 정확도를 쟀다.
구성
인덱스 크기
nDCG@10
비고
전수 스캔 (압축 없음)
24.2 GB
0.8160
기준
토큰 풀링 ×2
12.5 GB
0.8160
인접 토큰을 계층적으로 합침 — 손실 없이 절반
PLAID (4-bit 잔차)
9.1 GB
0.8160
후보 생성 인덱스. 고정형(삽입 어려움)
BinaryIVF
2.2 GB
0.8160
해밍 거리로 후보 → 정밀 MaxSim 재채점
토큰 풀링 ×3 + 1-bit 양자화
1.7 GB
0.8097
가장 작다. nDCG 0.006 손실
비교: 단일 벡터 HNSW (8B·4B급)
7.0~25.4 GB
0.77~0.78
차원이 크면 단일 벡터도 작지 않다
마지막 줄이 이 표의 반전이다. Qwen3-Embedding-8B의 기본 차원은 4,096이다. 문서 수가 같을 때 4,096차원 fp32 단일 벡터 인덱스는 128차원 토큰 벡터를 풀링·양자화한 것보다 크다. "다중 벡터는 인덱스가 크다"는 상식은 128차원 × 압축이라는 조건에서는 뒤집힌다.
속도도 마찬가지다. 저자들의 하드웨어(A100 80GB 1장)에서 KURE-v2의 질의 인코딩은 13.8ms, 8B 단일 벡터는 38~40ms였다. 처리량은 MUVERA를 제외한 모든 구성에서 44~57 QPS로, 8B 단일 벡터의 약 25 QPS의 두 배다. 154M 인코더가 가볍기 때문이다.
위젯에서 문서 수를 30만 건 넘게 올리면 경고가 뜬다. 저장소의 권고 그대로다 — 큰 컬렉션에서는 전수 스캔이 아니라 후보를 생성하는 인덱스(PLAID 또는 BinaryIVF)를 쓰라. 약 150만 문서인 MIRACL에서 BinaryIVF는 p95 지연 38ms를 냈다. 원리는 두 단계다. 먼저 이진화한 토큰 벡터의 해밍 거리로 후보 문서를 빠르게 좁히고, 그 후보 안에서만 정밀 MaxSim을 계산한다. 1편의 결론("인덱스로 후보를 좁히고 그 안에서 고해상도 도구를 쓴다")과 같은 구조가 검색기 내부에도 있는 셈이다.
운영자가 알아야 할 차이가 하나 더 있다. PLAID는 인덱스를 고정한다. 새 문서를 넣으려면 재구축에 가깝다. 매일 공고가 들어오는 코퍼스라면 BinaryIVF나 풀링+양자화 쪽이 운영하기 쉽고, 4편의 선택적 인덱스 수정과도 궁합이 맞는다.
🔧
이 수치는 저자들의 조건이다. A100 80GB 1장, AMD EPYC 7513 2개, RAM 1.2TB, 그리고 MTEB 9개 코퍼스. 우리 서버·우리 코퍼스에서 같은 QPS가 나온다는 보장은 없다. 특히 HNSW 단일 벡터 인덱스는 구현(FAISS·pgvector·OpenSearch)에 따라 크기와 속도가 크게 다르다. 7장의 체크리스트 중 “같은 하드웨어에서 다시 재라”가 이 때문이다.
이제 결정의 순간이다. 우리 데이터에서 KURE-v2를 쓸 것인가, Qwen3 계열을 쓸 것인가, 둘 다인가. 리더보드는 답을 주지 않는다. 우리 데이터로 재야 한다. 그러려면 먼저 비교 대상의 성격을 정확히 알아야 한다.
7.1 Qwen3 Embedding·Reranker
2025년 6월 공개된 Qwen3 Embedding 시리즈는 현재 다국어 임베딩의 사실상 기준선이다. 임베딩과 재랭커 각각 0.6B·4B·8B 세 크기, 입력 32K 토큰, 100개 이상 언어, Apache 2.0. 두 가지 특징이 비교 설계에 영향을 준다.
instruction-aware. 과제·언어·도메인에 맞춘 지시문을 질의 앞에 붙이면 성능이 오른다. 붙이지 않고 비교하면 Qwen3에 불리하고, 붙이고 비교하면 그 사실을 적어야 한다.
MRL(Matryoshka) 차원 조절. 0.6B는 1,024, 4B는 2,560, 8B는 4,096차원이 기본이지만 더 작은 차원으로 잘라 쓸 수 있다. 6장의 인덱스 크기 비교는 이 조건을 고정해야 의미가 있다.
7.2 권장 비교군
역할
1차 후보
왜 이 자리인가
가벼운 Dense 검색
Qwen3-Embedding-0.6B
기본 경로. 1,024차원, CPU에서도 돌아간다
균형형 Dense 검색
Qwen3-Embedding-4B
추론·전문 도메인 과제에서 0.6B보다 확실히 낫고 8B보다 싸다
기존 다국어 기준선
BGE-M3 또는 KURE-v1
지금 운영 중일 가능성이 높은 모델. “바꿀 가치가 있나”의 기준점
한국어 고정밀 검색
KURE-v2
긴 문서·실무 문서·영한 혼용에서 이득. 고가치 질의 경로 후보
가벼운 재랭커
Qwen3-Reranker-0.6B
기본 경로의 재랭커
고정밀 재랭커
Qwen3-Reranker-4B
어려운 질의만. 3편의 추론형 재랭커는 그 위 실험 단계
멀티모달
Qwen3-VL-Embedding / Reranker
6편의 페이지·표·스크린샷 검색
7.3 같은 출발선
비교 실험이 오염되는 방식은 정해져 있다. 아래 체크리스트에서 항목을 하나씩 꺼 보면 그 방식이 나온다.
세 가지 치명 항목을 다시 적어 둔다. 같은 청킹 — late interaction은 긴 청크를 더 잘 버티므로 한쪽만 짧게 자르면 결과가 뒤집힌다. 같은 전처리 — 4편의 문서 객체를 그대로 두 인덱스에 넣는다. 우리 질의 — MTEB 9과제는 남의 데이터다. 실제 질의 로그에서 200문항 이상을 뽑아 정답 문서를 다는 것이 이 실험의 절반이다.
그리고 순서가 중요하다. 재랭커 없이 먼저 잰다. 재랭커가 검색기의 차이를 덮기 때문이다. 재랭커 없는 Recall@10이 검색기 자체의 차이이고, 같은 재랭커를 붙였을 때의 차이가 "재랭커가 메우지 못하는 차이"다. 후자가 작으면 싼 쪽을 쓰면 되고, 크면 그 차이가 나는 질의를 3편의 라우터로 골라내 비싼 쪽에 보낸다.
3편의 결론은 "모든 질의에 같은 검색기를 쓰지 말라"였다. 이 글의 결론은 그 결론의 한국어 판이다. late interaction은 강력하지만 모든 질의에 켤 이유가 없다.
5장의 과제별 결과가 라우팅의 근거다. 짧은 뉴스 문단 독해(Belebele)나 보건 FAQ(PublicHealthQA)에서는 단일 벡터가 이미 충분하거나 더 낫다. 긴 문서(MLDR)와 실무 문서(AutoRAG)에서 격차가 크다. 그러니 질의가 긴 문서의 특정 부분을 겨누거나, 영한 혼용 용어를 담거나, 고유명사·품번의 정확한 매칭이 필요할 때 late interaction 경로로 보내고, 나머지는 하이브리드 단일 벡터로 처리한다.
위젯의 조합을 여러 번 바꿔 보면 판정이 대체로 한 방향으로 수렴한다. 기본은 BM25 + Qwen3 임베딩 하이브리드에 0.6B 재랭커. KURE-v2는 긴 문서·영한 혼용·정확 매칭 조건에서 상위 경로로 붙는다. 3개 언어 이상이면 KURE-v2의 범위(한·영)를 벗어나므로 Qwen3 4B로 간다. 100만 건이 넘으면 후보 생성 인덱스가 필수다.
이 구조는 1편의 라우팅 표에서 "② Agentic Search"가 차지한 자리와 같다. 기본 경로가 실패한 질의를 처리하는 상위 경로. 다만 이번에는 도구가 아니라 검색기가 바뀐다. 3편의 8경로 표에 넣는다면 "어려운 의미·논리 검색 → Multi-vector + Reranker" 줄이 바로 이 자리다.
9. 우리 시스템에 넣는 순서
1
실패 질의부터 분류한다. 지금의 하이브리드 검색이 놓친 질의를 모아 “긴 문서 안의 특정 부분 / 영한 혼용 / 정확 매칭 / 추론형”으로 나눈다. 앞의 셋이 많으면 late interaction의 후보 데이터이고, 추론형이 많으면 검색기보다 재랭커와 3편의 라우팅이 먼저다.
2
4편의 문서 객체에서 같은 청크를 뽑는다. 청킹·전처리를 두 모델에 동일하게 공급하는 것이 7장 체크리스트의 첫 항목이다. late interaction 쪽은 청크를 더 길게 잡고 싶은 유혹이 있지만, 비교 단계에서는 참는다.
3
PyLate로 KURE-v2 인덱스를 만든다. 처음에는 코퍼스 일부(수만 건)로 전수 스캔 인덱스를 만들어 정확도만 잰다. 규모를 키울 때 PLAID(고정 코퍼스)나 BinaryIVF(갱신 잦은 코퍼스)로 옮긴다. 인덱스 크기는 6장 계산기로 미리 어림한다.
4
재랭커 없이 먼저, 그다음 같은 재랭커로. Recall@10·nDCG@10을 두 번 잰다. 두 결과의 차이가 곧 “KURE-v2 경로가 필요한 질의의 비율”이다.
5
라우팅 규칙을 정한다. 4단계에서 KURE-v2만 맞힌 질의의 공통점(문서 길이, 영문 용어 포함, 품번 패턴)을 규칙이나 작은 분류기로 만든다. 이 규칙이 3편의 라우터에 들어가는 한 줄이 된다.
6
우리 하드웨어에서 지연·QPS를 다시 잰다. 13.8ms와 44~57 QPS는 A100 조건이다. CPU 서빙이라면 풀링×3+1-bit 인덱스와 후보 수 제한으로 예산 안에 넣는다.
10. 한계와 반론
10.1 저장소가 스스로 밝힌 것
서빙 수치는 특정 하드웨어(A100 80GB 1장, EPYC 7513 2개, RAM 1.2TB)와 9개 MTEB 코퍼스 조건에서 측정됐다.
late interaction 모델과 단일 벡터 모델의 평가 코드가 다르다(PyLate+PLAID 직접 평가 vs 공식 MTEB 결과).
큰 코퍼스에서는 전수 스캔이 아니라 후보 생성 인덱스를 써야 한다 — 즉 정확도 표의 0.8160은 전수 스캔 기준이며, 운영 구성에서는 0.8097(풀링×3+1-bit)이나 후보 생성의 근사 손실을 감안해야 한다.
10.2 이 특집이 덧붙이는 반론
한·영 이중언어라는 경계. 일본어·중국어 문서가 섞이는 코퍼스, 또는 다국적 고객의 문의라면 KURE-v2는 후보가 아니다. Qwen3의 100개 언어가 그 자리다.
추론형 질의에서는 크기가 이긴다. Ko-StrategyQA·LawIRKo·PublicHealthQA의 결과는 분명하다. 법률 개념이나 의학 지식이 필요한 질의에서 154M 인코더는 7.6B의 세계 지식을 대신하지 못한다. late interaction은 매칭의 해상도를 올리지 이해의 깊이를 올리지 않는다.
신생 기반 모델. A.X-Encoder-base는 bge-m3나 Qwen3만큼 널리 검증된 인코더가 아니다. 특정 도메인의 어휘(의료 약어, 제조 품번 체계)에서 서브워드 분할이 이상하게 되면 MaxSim의 이득이 사라질 수 있다. 우리 도메인의 토크나이징 결과를 한 번은 눈으로 봐야 한다.
인덱스 운영의 복잡도. 단일 벡터 HNSW는 pgvector·OpenSearch·Milvus 어디에나 있다. 다중 벡터 인덱스는 PyLate·Vespa·일부 벡터 DB에서만 지원되고, 갱신·삭제·필터링(ACL, 날짜) 같은 운영 기능이 단일 벡터만큼 성숙하지 않다. 특히 8편의 보안 요구(ACL을 검색 전에 적용)를 다중 벡터 인덱스에서 어떻게 구현할지는 별도 검토가 필요하다.
리더보드 과적합. MTEB 한국어 9과제는 공개된 평가셋이고, 모델 개발자들이 그것을 보며 학습 데이터를 고른다. 이것은 KURE만의 문제가 아니라 모든 리더보드의 문제다. 그래서 7장의 “우리 질의 200문항”이 선택이 아니라 필수다.
이 글은 154M이 7.6B를 이겼다는 표로 시작했다. 그 표의 진짜 내용은 크기가 아니라 선택이었다. 문서를 한 점으로 누르지 않겠다는 선택. 토큰을 남겨 두고, 질의가 들어왔을 때 비로소 토큰끼리 짝을 찾겠다는 선택.
이 선택은 한국어에서 특별히 값어치가 있다. 조사와 어미가 붙고, 띄어쓰기가 흔들리고, 영문 용어가 한글 문장에 박히고, 공고문 한 장이 수천 토큰인 언어. 그 특성 하나하나가 "평균 내면 사라지는 것"들이다. 5장의 과제별 결과는 이 직관이 긴 문서와 실무 문서에서는 크게 맞고, 추론과 전문 지식이 필요한 곳에서는 크기가 여전히 이긴다는 것을 보여 줬다.
그래서 결론은 시리즈의 다른 편들과 같은 모양이다. 새 기본값이 아니라 새 선택지다. 기본 경로는 하이브리드 단일 벡터로 두고, 긴 문서·영한 혼용·정확 매칭이 필요한 고가치 한국어 질의만 late interaction 경로로 보낸다. 그리고 그 경계선은 리더보드가 아니라 우리 질의 200문항이 긋는다.
다음 편은 이 모든 검색 구조가 공유하는 취약점으로 간다. 문서 하나로 '최신 정보'를 위장하는 공격, 여러 문서에 논리를 분산하는 공격, 코드 예제 하나로 취약점을 퍼뜨리는 공격. 8편은 RAG 보안이 왜 출처 신뢰성 문제로 확대되는지를 다룬다.
참고자료
모델과 저장소
고려대학교 NLP&AI Lab. KURE: Korea University Retrieval Embedding models.github.com/nlpai-lab/KURE — KURE-v2 공개(2026-08-29), MTEB(kor, v2) 검색 리더보드, 서빙 효율 실험
Chen, J. et al. BGE M3-Embedding: Multi-Lingual, Multi-Functionality, Multi-Granularity Text Embeddings.arXiv:2402.03216 (2024)
Late interaction의 계보
Khattab, O. & Zaharia, M. ColBERT: Efficient and Effective Passage Search via Contextualized Late Interaction over BERT. SIGIR 2020, arXiv:2004.12832 — MaxSim의 원전
Santhanam, K. et al. ColBERTv2: Effective and Efficient Retrieval via Lightweight Late Interaction. NAACL 2022, arXiv:2112.01488 — 잔차 압축
Santhanam, K. et al. PLAID: An Efficient Engine for Late Interaction Retrieval. CIKM 2022, arXiv:2205.09707 — 중심점 필터·가지치기·정밀 재채점
Chaffin, A. & Sourty, R. PyLate: Flexible Training and Retrieval for Late Interaction Models. CIKM 2025, arXiv:2508.03555 · github.com/lightonai/pylate — KURE-v2의 학습·평가·서빙 라이브러리
출처와 수치에 대하여. 리더보드 평균·과제별 nDCG@10·서빙 효율 수치는 KURE 저장소와 KURE-v2 모델 카드(2026년 9월 기준)에서 그대로 옮겼다. 저장소는 QPS를 44~57, 모델 카드는 43~55로 적고 있어 본문은 저장소 값을 썼다. 라이선스는 저장소가 MIT, 모델 카드가 Apache-2.0으로 표기가 다르다는 점을 그대로 적었다. 위젯 ‘MaxSim 실험실’의 토큰 분할과 유사도 값은 설명용 예시이며 KURE-v2의 실제 출력이 아니다. 위젯 ‘인덱스 계산기’는 저장소의 압축 비율을 사용자 입력에 곱한 어림값이다. 위젯 ‘스택 진단’의 판정은 코어닷투데이의 실무 규칙이다. 3장의 한국어 특성 논의는 설명 가설이며 저장소가 실험으로 개별 검증한 결과가 아니다. 삽화는 코어닷투데이가 생성했다. 권장 비교군 표는 이 특집 시리즈의 기획 원고를 바탕으로 정리했다.