마트료시카 임베딩Matryoshka Representation LearningMRL벡터 차원 축소Qwen3-EmbeddingNomic Embed적응형 검색Adaptive Retrieval벡터 DB 저장 비용양자화Ollama한국어 검색 스택튜토리얼
마트료시카 임베딩 — 벡터를 앞에서부터 잘라도 되는 이유와, 잘랐을 때 실제로 남는 것 (한국어 검색 스택 3편)
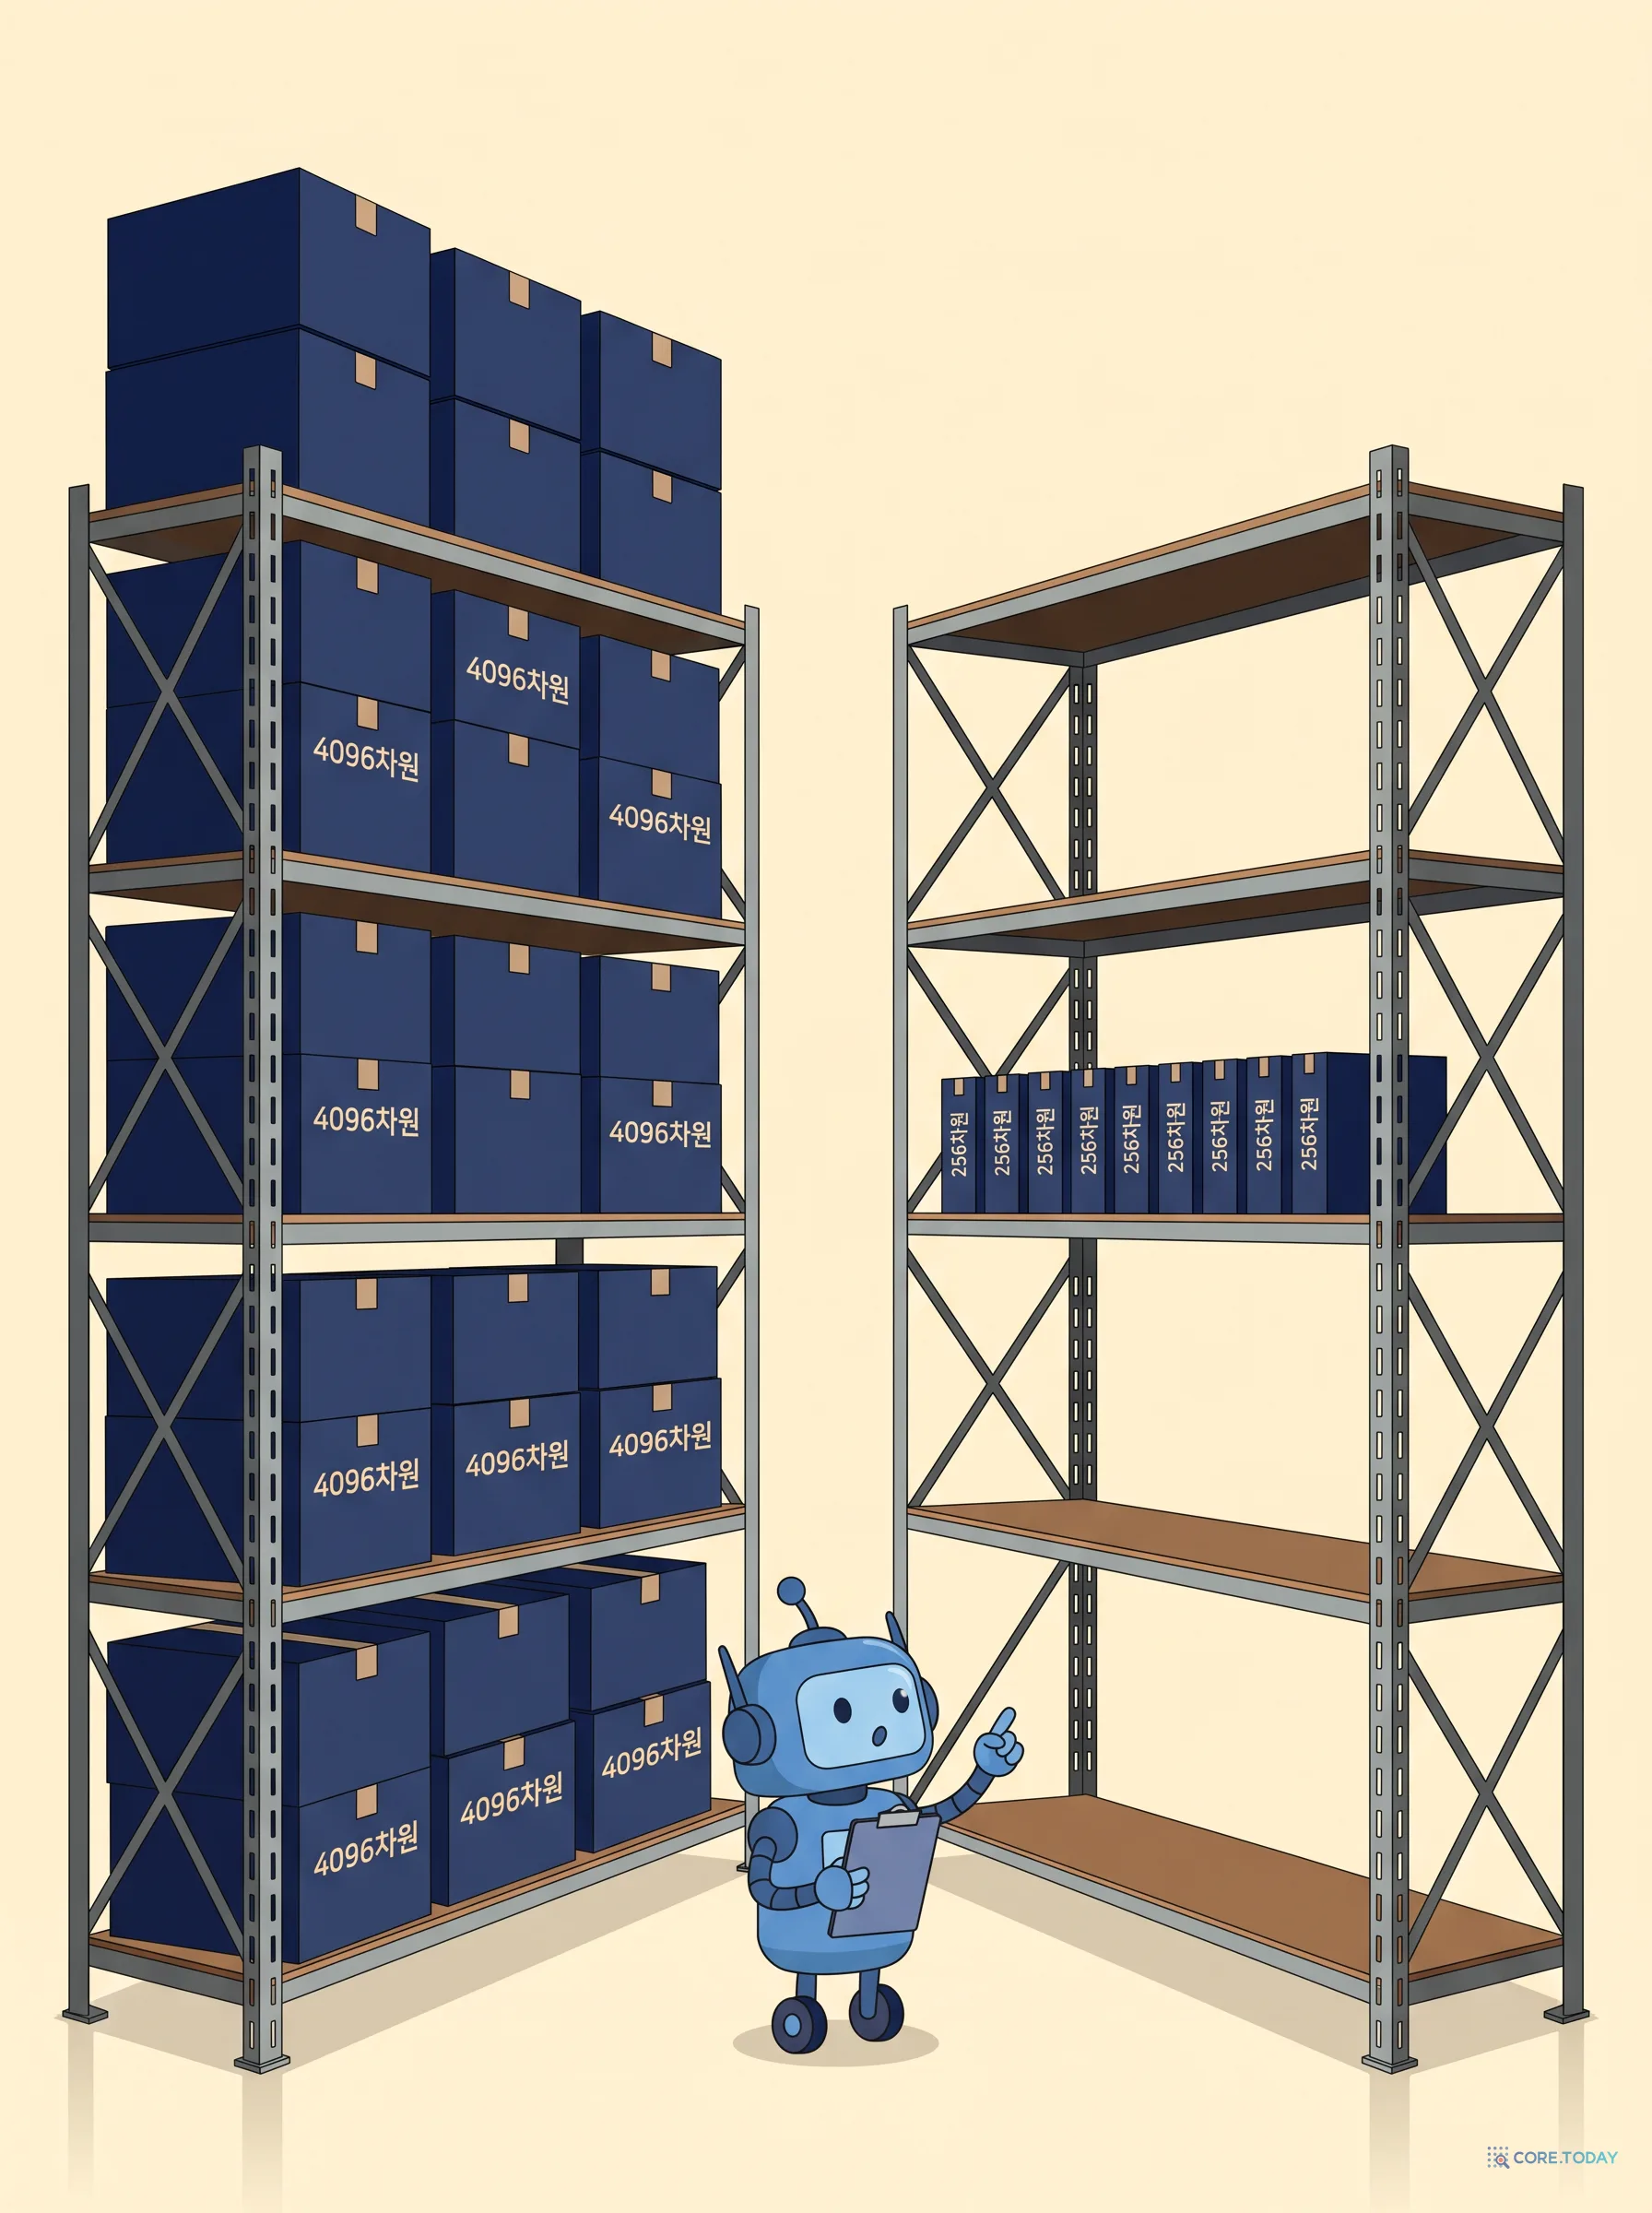
Qwen3-Embedding-8B의 벡터는 숫자 4,096개입니다. 5,000만 청크를 float32로 저장하면 벡터만 819GB입니다. 그런데 이 벡터의 앞 256개만 남기고 나머지를 버려도 검색 품질의 93%가 남는다면? 그것이 마트료시카 임베딩입니다. 2022년 논문 「Matryoshka Representation Learning」이 제안하고 OpenAI text-embedding-3, Nomic v2, Qwen3 Embedding이 채택한 이 기법은 '중요한 정보를 벡터의 앞쪽에 몰아넣도록' 학습해, 러시아 인형처럼 큰 벡터 안에 작은 벡터가 들어 있게 만듭니다. 이 글은 원리를 장난감 모형으로 손에 잡히게 설명하고, 같은 한국어 코퍼스로 Qwen3 4B·8B와 Nomic v2를 32차원까지 잘라 가며 잰 실측 곡선, 저장 비용 계산기, 그리고 '짧게 걸러서 길게 고르는' 두 단계 적응형 검색이 전체 차원의 품질을 얼마나 되찾는지를 보여 줍니다. 인터랙티브 4개와 삽화 7장.
1편에서 가장 좋은 점수를 낸 Qwen3-Embedding-8B는 문장 하나를 숫자 4,096개로 바꿉니다. float32면 16KB입니다. 문서 청크 5,000만 개면 벡터만 819GB이고, HNSW 인덱스의 그래프까지 얹으면 1TB를 넘습니다. 원문 메모가 Nomic v2의 256차원을 눈여겨본 이유가 이것이었습니다. 768차원 3KB가 256차원 1KB가 되면, 5,000만 개에서 100GB가 사라집니다.
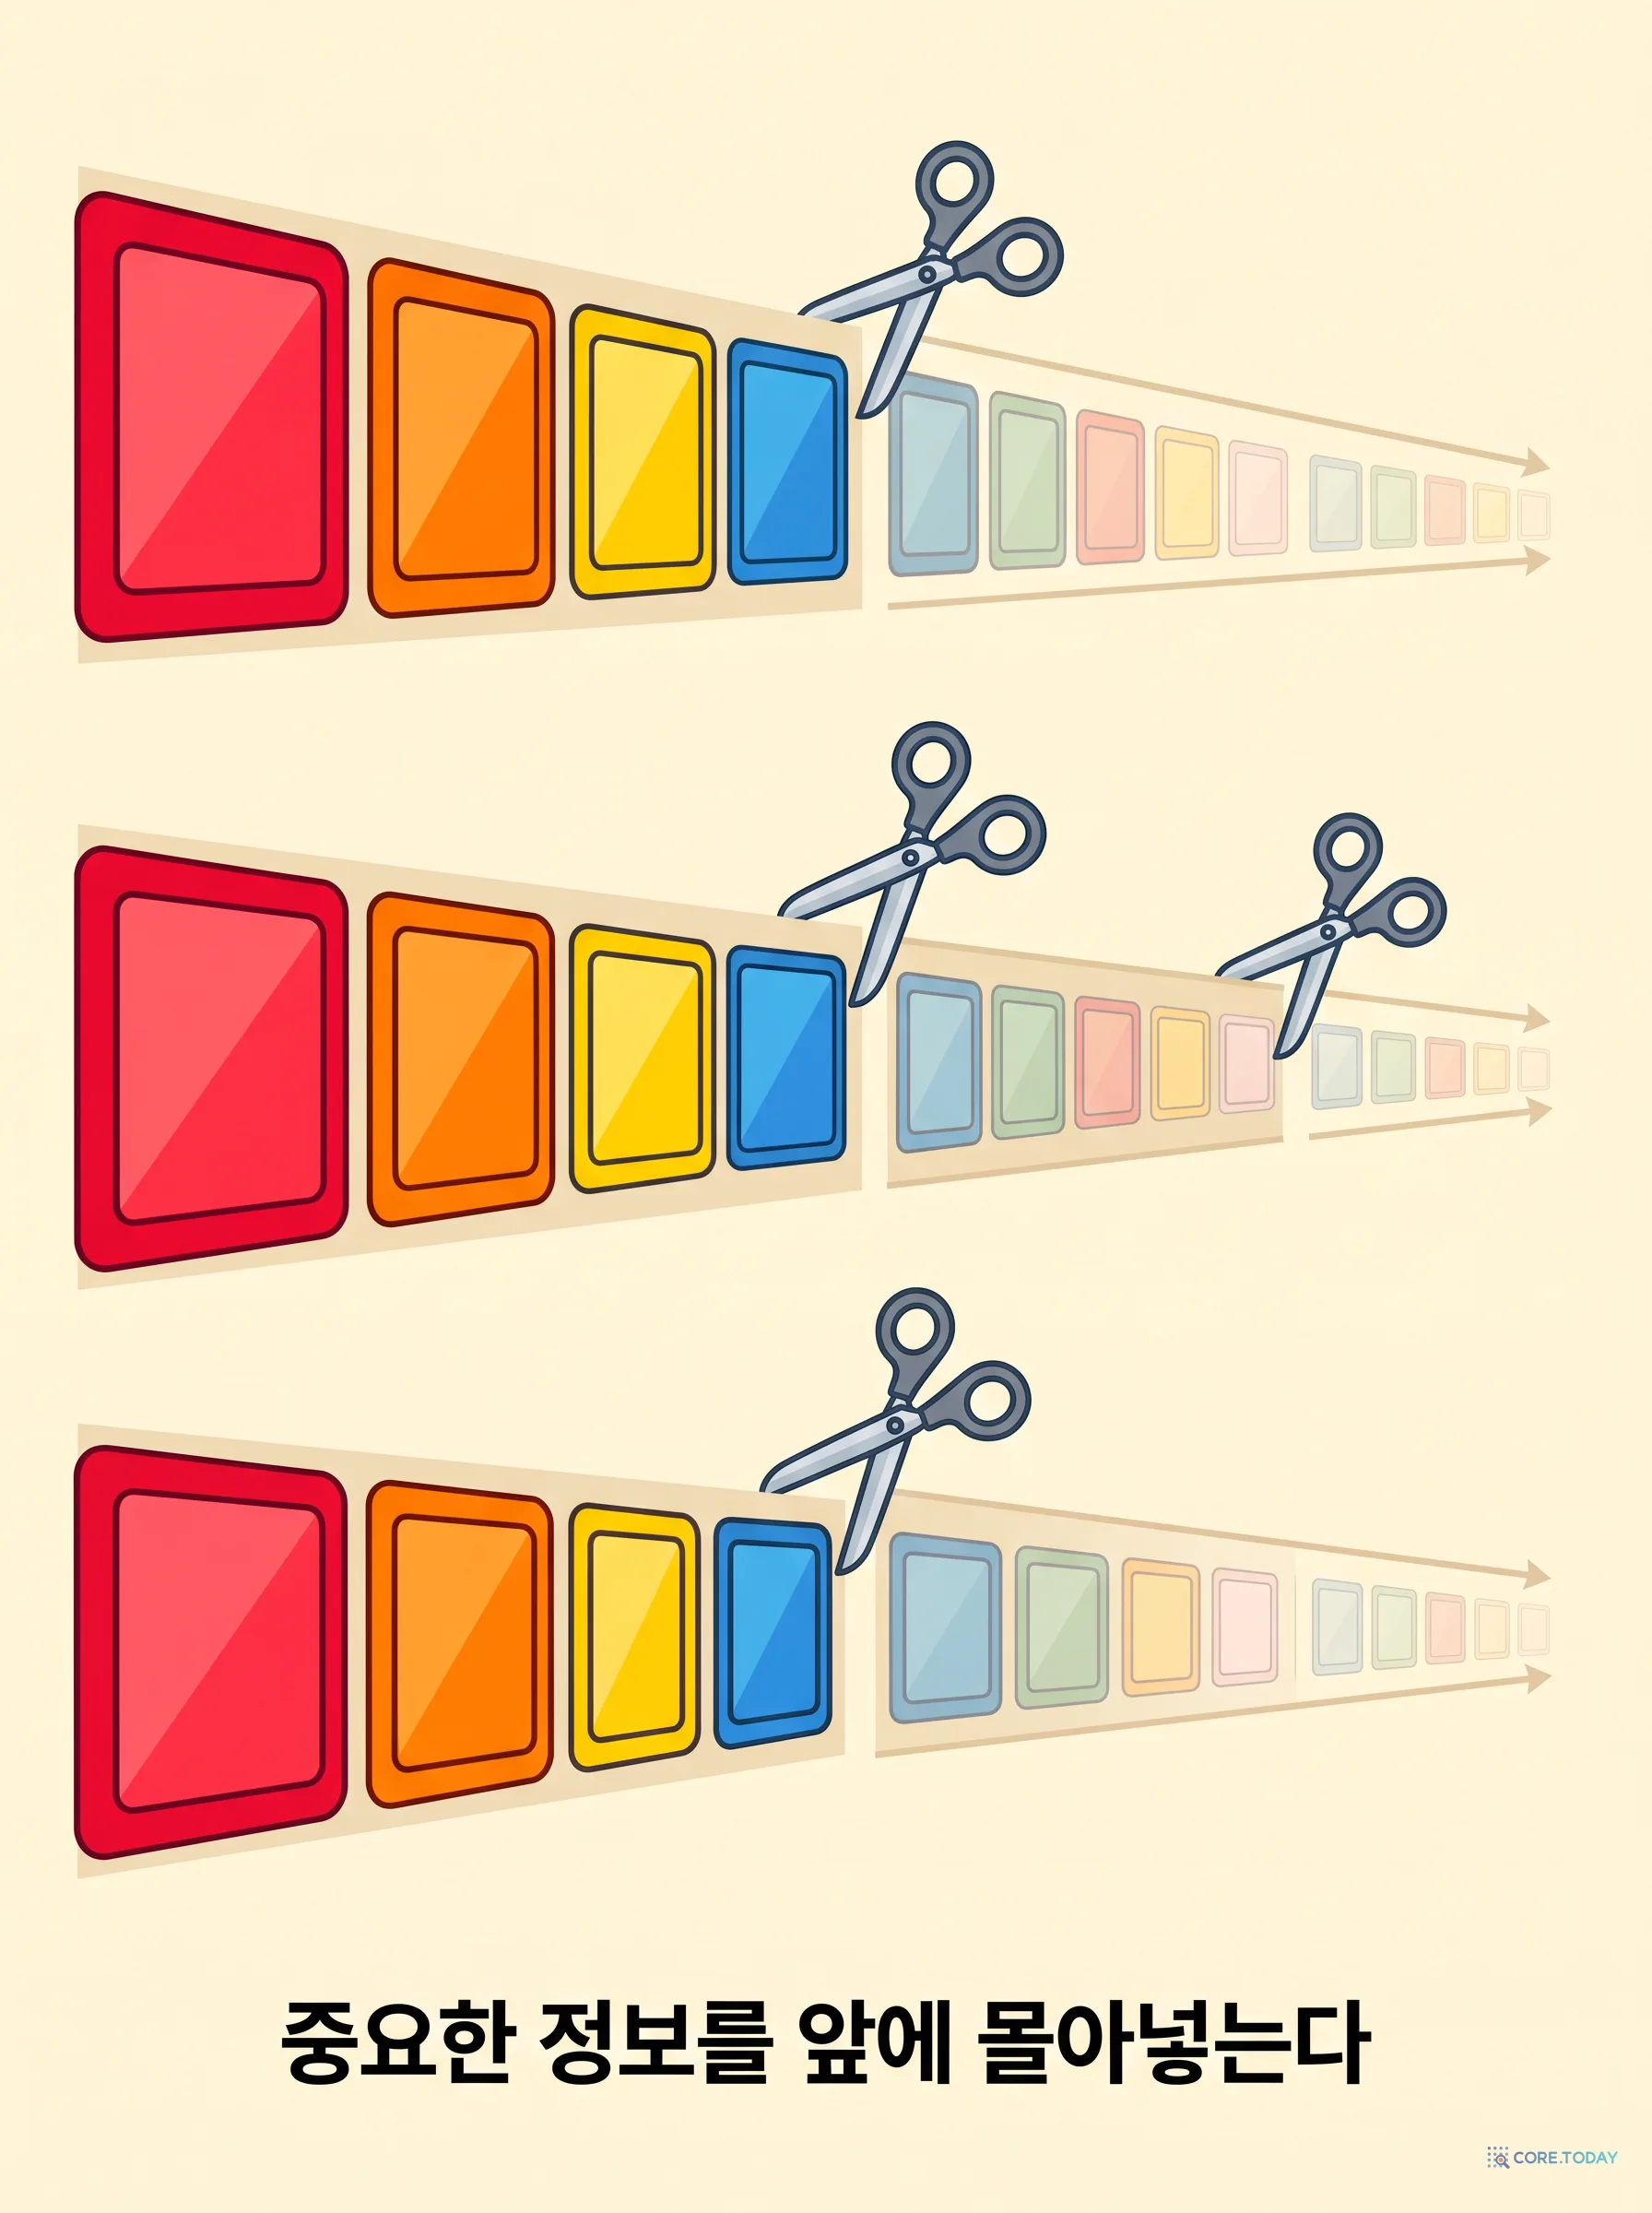
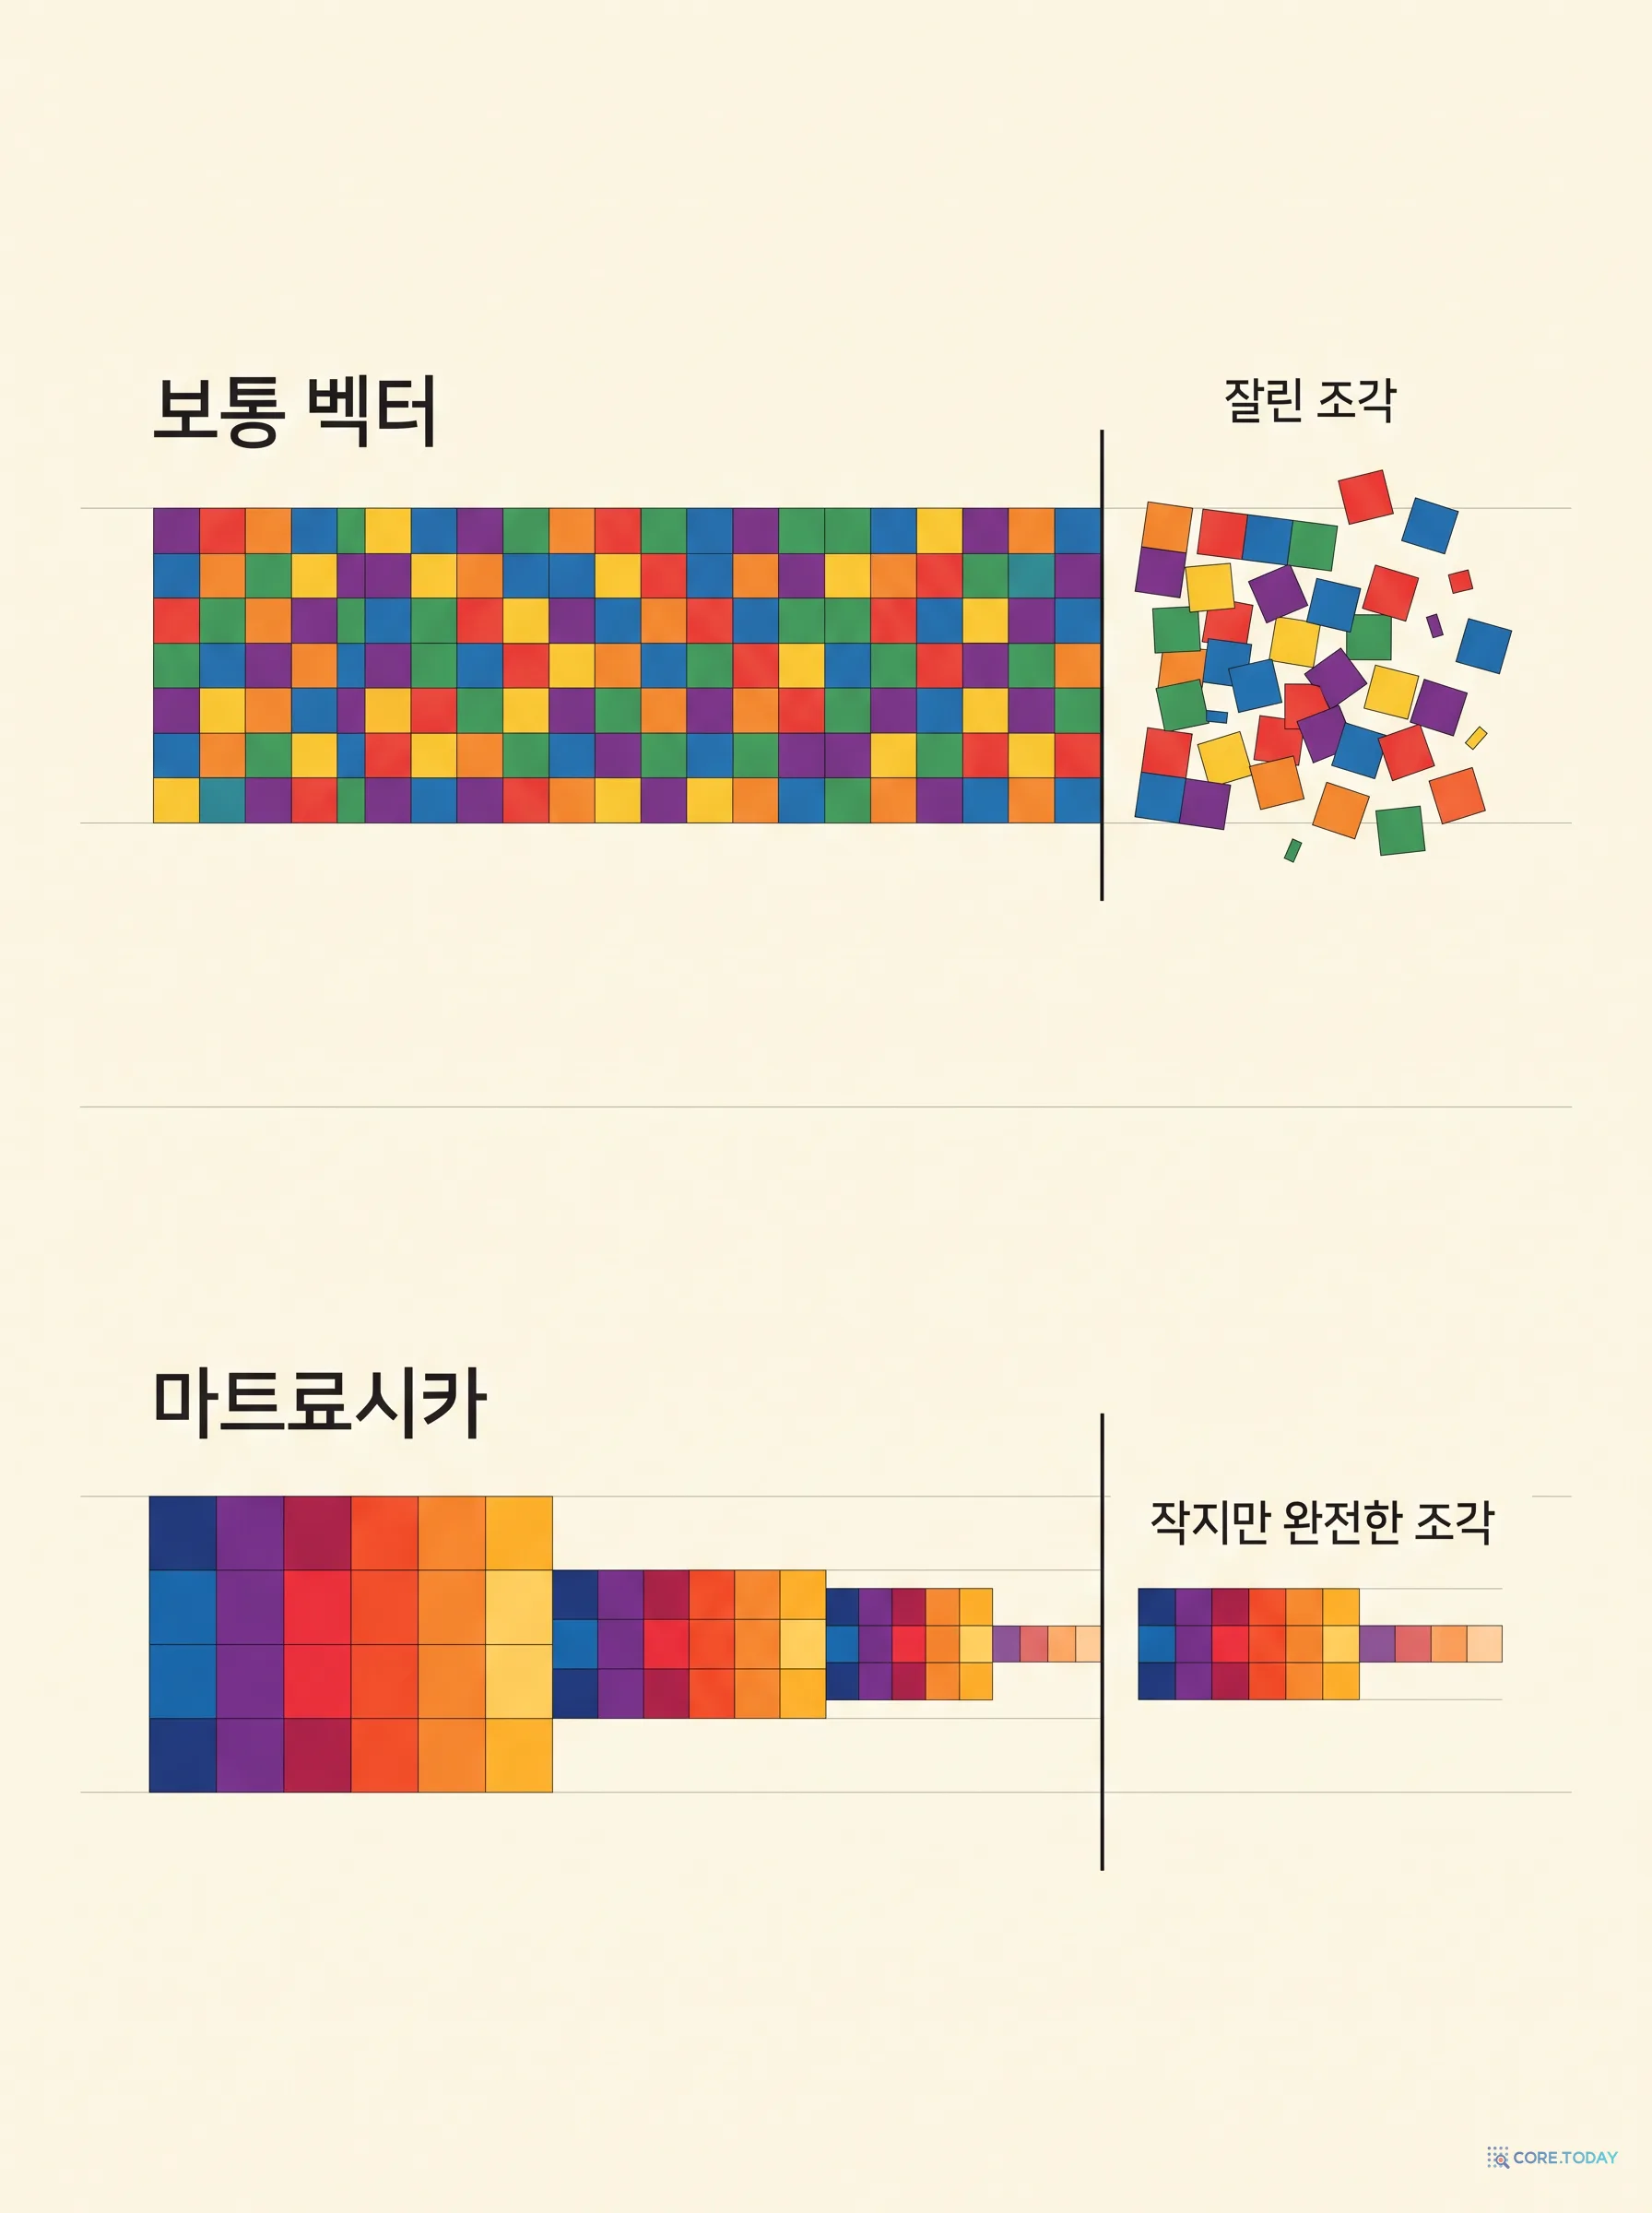
그런데 벡터를 그냥 잘라도 될까요? 4,096개 숫자 중 앞 256개만 남기면 뜻이 남을까요? 보통의 임베딩 모델에서는 안 됩니다. 정보가 4,096개 자리에 고르게 퍼져 있어서, 앞 256개는 전체의 6%짜리 파편일 뿐입니다. 마트료시카 임베딩은 이 전제를 바꿉니다. 중요한 정보를 앞쪽에 몰아넣도록 학습 해서, 앞 256개가 전체의 요약이 되게 만듭니다.
이 글의 순서입니다. 1부에서 원리를 장난감 모형으로 봅니다. 2부에서 2022년 원논문과 그 뒤의 채택 역사를, 3부에서 같은 한국어 코퍼스로 잰 실측 곡선을, 4부에서 저장 비용을, 5부에서 '짧게 걸러 길게 고르는' 적응형 검색을 봅니다. 6부는 한계입니다.
먼저 손으로 만져 봅시다. 아래는 32칸짜리 장난감 벡터입니다. 위의 쌍은 정보가 앞칸에 몰려 있고, 아래의 쌍은 고르게 퍼져 있습니다. 슬라이더로 앞에서 몇 칸만 남길지 정하면, 남은 칸만으로 잰 코사인이 전체로 잰 값에 얼마나 가까운지 보입니다.
마트료시카형은 앞 8칸만 남겨도 두 벡터의 관계(코사인)가 거의 그대로입니다. 보통형은 뒤쪽 칸을 버리는 만큼 관계가 흔들립니다. 벡터 검색은 결국 '어느 문서가 질문과 가까운가'의 순서이므로, 코사인의 절댓값이 아니라 순서가 유지되느냐 가 관건입니다. 마트료시카형은 그 순서를 앞칸만으로 지킵니다.
비결은 손실 함수에 있습니다. 보통 임베딩 모델은 전체 차원(예: 768)의 벡터 하나로 '비슷한 것은 가깝게, 다른 것은 멀게'를 학습합니다. 마트료시카는 같은 벡터를 여러 길이로 잘라 각각에 같은 손실을 걸고 합칩니다. 768차원으로도 잘 맞아야 하고, 앞 512로도, 앞 256으로도, 앞 128로도, 앞 64로도 잘 맞아야 합니다. 그러면 모델은 앞 64칸에 가장 중요한 정보를, 그다음 64칸에 그다음 정보를 넣는 식으로 스스로 배치합니다. 잘라도 살아남는 것이 채점 기준이 됐기 때문입니다.
Sentence Transformers 라이브러리는 이것을 MatryoshkaLoss라는 이름으로 제공합니다. 원래 쓰던 손실 함수를 감싸서 지정한 차원 목록(예: [768, 512, 256, 128, 64])마다 계산하고 더합니다. 추론할 때는 truncate_dim 하나로 원하는 길이를 고릅니다. 추가 계산은 없습니다. 벡터를 만든 뒤 뒤쪽을 버리고 다시 정규화할 뿐입니다.
여기서 '다시 정규화'가 중요합니다. 코사인 유사도는 벡터 길이를 무시하지만, 잘린 벡터의 길이는 원래와 다릅니다. 잘라낸 뒤 길이를 1로 맞추지 않으면 벡터 DB의 내적 검색이 틀어집니다. 이 글의 실험도 자른 뒤 매번 재정규화했습니다.
2부. 역사: 2022년 논문에서 2026년 표준으로
시점
누가
무엇을
숫자
2022. 5
Kusupati 외 (워싱턴대·구글), 「Matryoshka Representation Learning」 (NeurIPS 2022)
하나의 표현 안에 여러 크기의 표현을 포개는 학습법 제안. 비전(ViT·ResNet), 비전-언어(ALIGN), 언어(BERT)에 적용
ImageNet-1K 분류에서 정확도 손실 없이 임베딩 최대 14배 축소, 대규모 검색에서 최대 14배 속도 향상, 롱테일 퓨샷에서 최대 2% 정확도 향상
32~4096(8B), 32~2560(4B), 32~1024(0.6B) 범위의 사용자 지정 차원
MTEB 다국어 70.58(8B, 전체 차원)
2026
Ollama
/api/embed에 dimensions 파라미터. 마트료시카 모델을 로컬에서 바로 잘라 씀
이 글의 실험이 이 경로를 씀
원논문의 표현을 빌리면, 마트료시카는 "정보를 거친 것에서 세밀한 것 순으로(coarse-to-fine) 부호화"합니다. 앞칸은 '이 문서가 대략 무슨 이야기인가', 뒤칸은 '정확히 어떤 뉘앙스인가'. 그래서 앞칸만으로 후보를 넓게 추리고, 뒤칸까지 써서 정밀하게 고르는 것이 자연스럽습니다. 5부의 적응형 검색이 그것입니다.
3부. 실측: 4096에서 32까지 잘라 보기
1편과 같은 코퍼스(589건)와 같은 질문(어휘가 어긋난 67개)으로, Qwen3-Embedding 8B와 4B, Nomic v2 MoE의 벡터를 앞에서부터 잘라 가며 nDCG@10을 쟀습니다. 잘라낸 뒤 재정규화하고, 질의도 같은 길이로 잘랐습니다.
숫자를 표로 옮기면 이렇습니다(전체 차원 대비 비율).
남긴 차원
Qwen3-8B (4096)
Qwen3-4B (2560)
Nomic v2 (768)
전체
0.860 (100%)
0.815 (100%)
0.758 (100%)
1024
0.872 (101%)
0.817 (100%)
—
512
0.804 (94%)
0.815 (100%)
0.752 (99%)
256
0.798 (93%)
0.797 (98%)
0.667 (88%)
128
0.683 (79%)
0.700 (86%)
0.525 (69%)
64
0.585 (68%)
0.643 (79%)
0.395 (52%)
32
0.447 (52%)
0.550 (68%)
—
읽을 것이 셋 있습니다.
첫째, 1024차원은 공짜입니다. 8B를 4096에서 1024로 4분의 1로 줄였는데 점수가 오히려 0.012 올랐습니다(잡음 범위 안이지만 떨어지지 않은 것은 분명합니다). 4B도 2560→1024에서 변화가 없습니다. 이 코퍼스에서는 뒤쪽 3,000개 숫자가 검색 순서에 거의 기여하지 않았습니다.
둘째, 256까지는 견디고 128부터 무너집니다. 8B 256차원은 전체의 93%, 4B는 98%입니다. 16분의 1(8B) 또는 10분의 1(4B)로 줄이고 이 정도면 원논문의 '14배'와 같은 급입니다. 그런데 128로 내려가면 8B는 79%, 4B는 86%로 뚝 떨어집니다. 저장 비용을 더 줄이고 싶다면 128차원으로 가는 대신 256차원에 int8 양자화를 얹는 것이 낫습니다(4부).
셋째, Nomic은 공식 범위 밖에서 급락합니다. Nomic v2의 공식 마트료시카 범위는 768→256입니다. 256에서 88%로 Qwen3보다 손실이 크고, 128과 64로 내려가면 절반 근처까지 무너집니다. 학습 때 어떤 길이에 손실을 걸었느냐가 그대로 곡선 모양이 됩니다. 모델 카드가 명시한 차원 범위 밖으로 자르지 마세요.
흥미롭게도 4B가 8B보다 잘 견딥니다. 256차원에서 4B(0.797)와 8B(0.798)는 사실상 같고, 128 이하에서는 4B가 앞섭니다. 8B의 우위는 뒤쪽 차원에서 나오는 셈이어서, 저장 비용 때문에 256차원으로 갈 계획이라면 8B를 쓸 이유가 사라집니다.
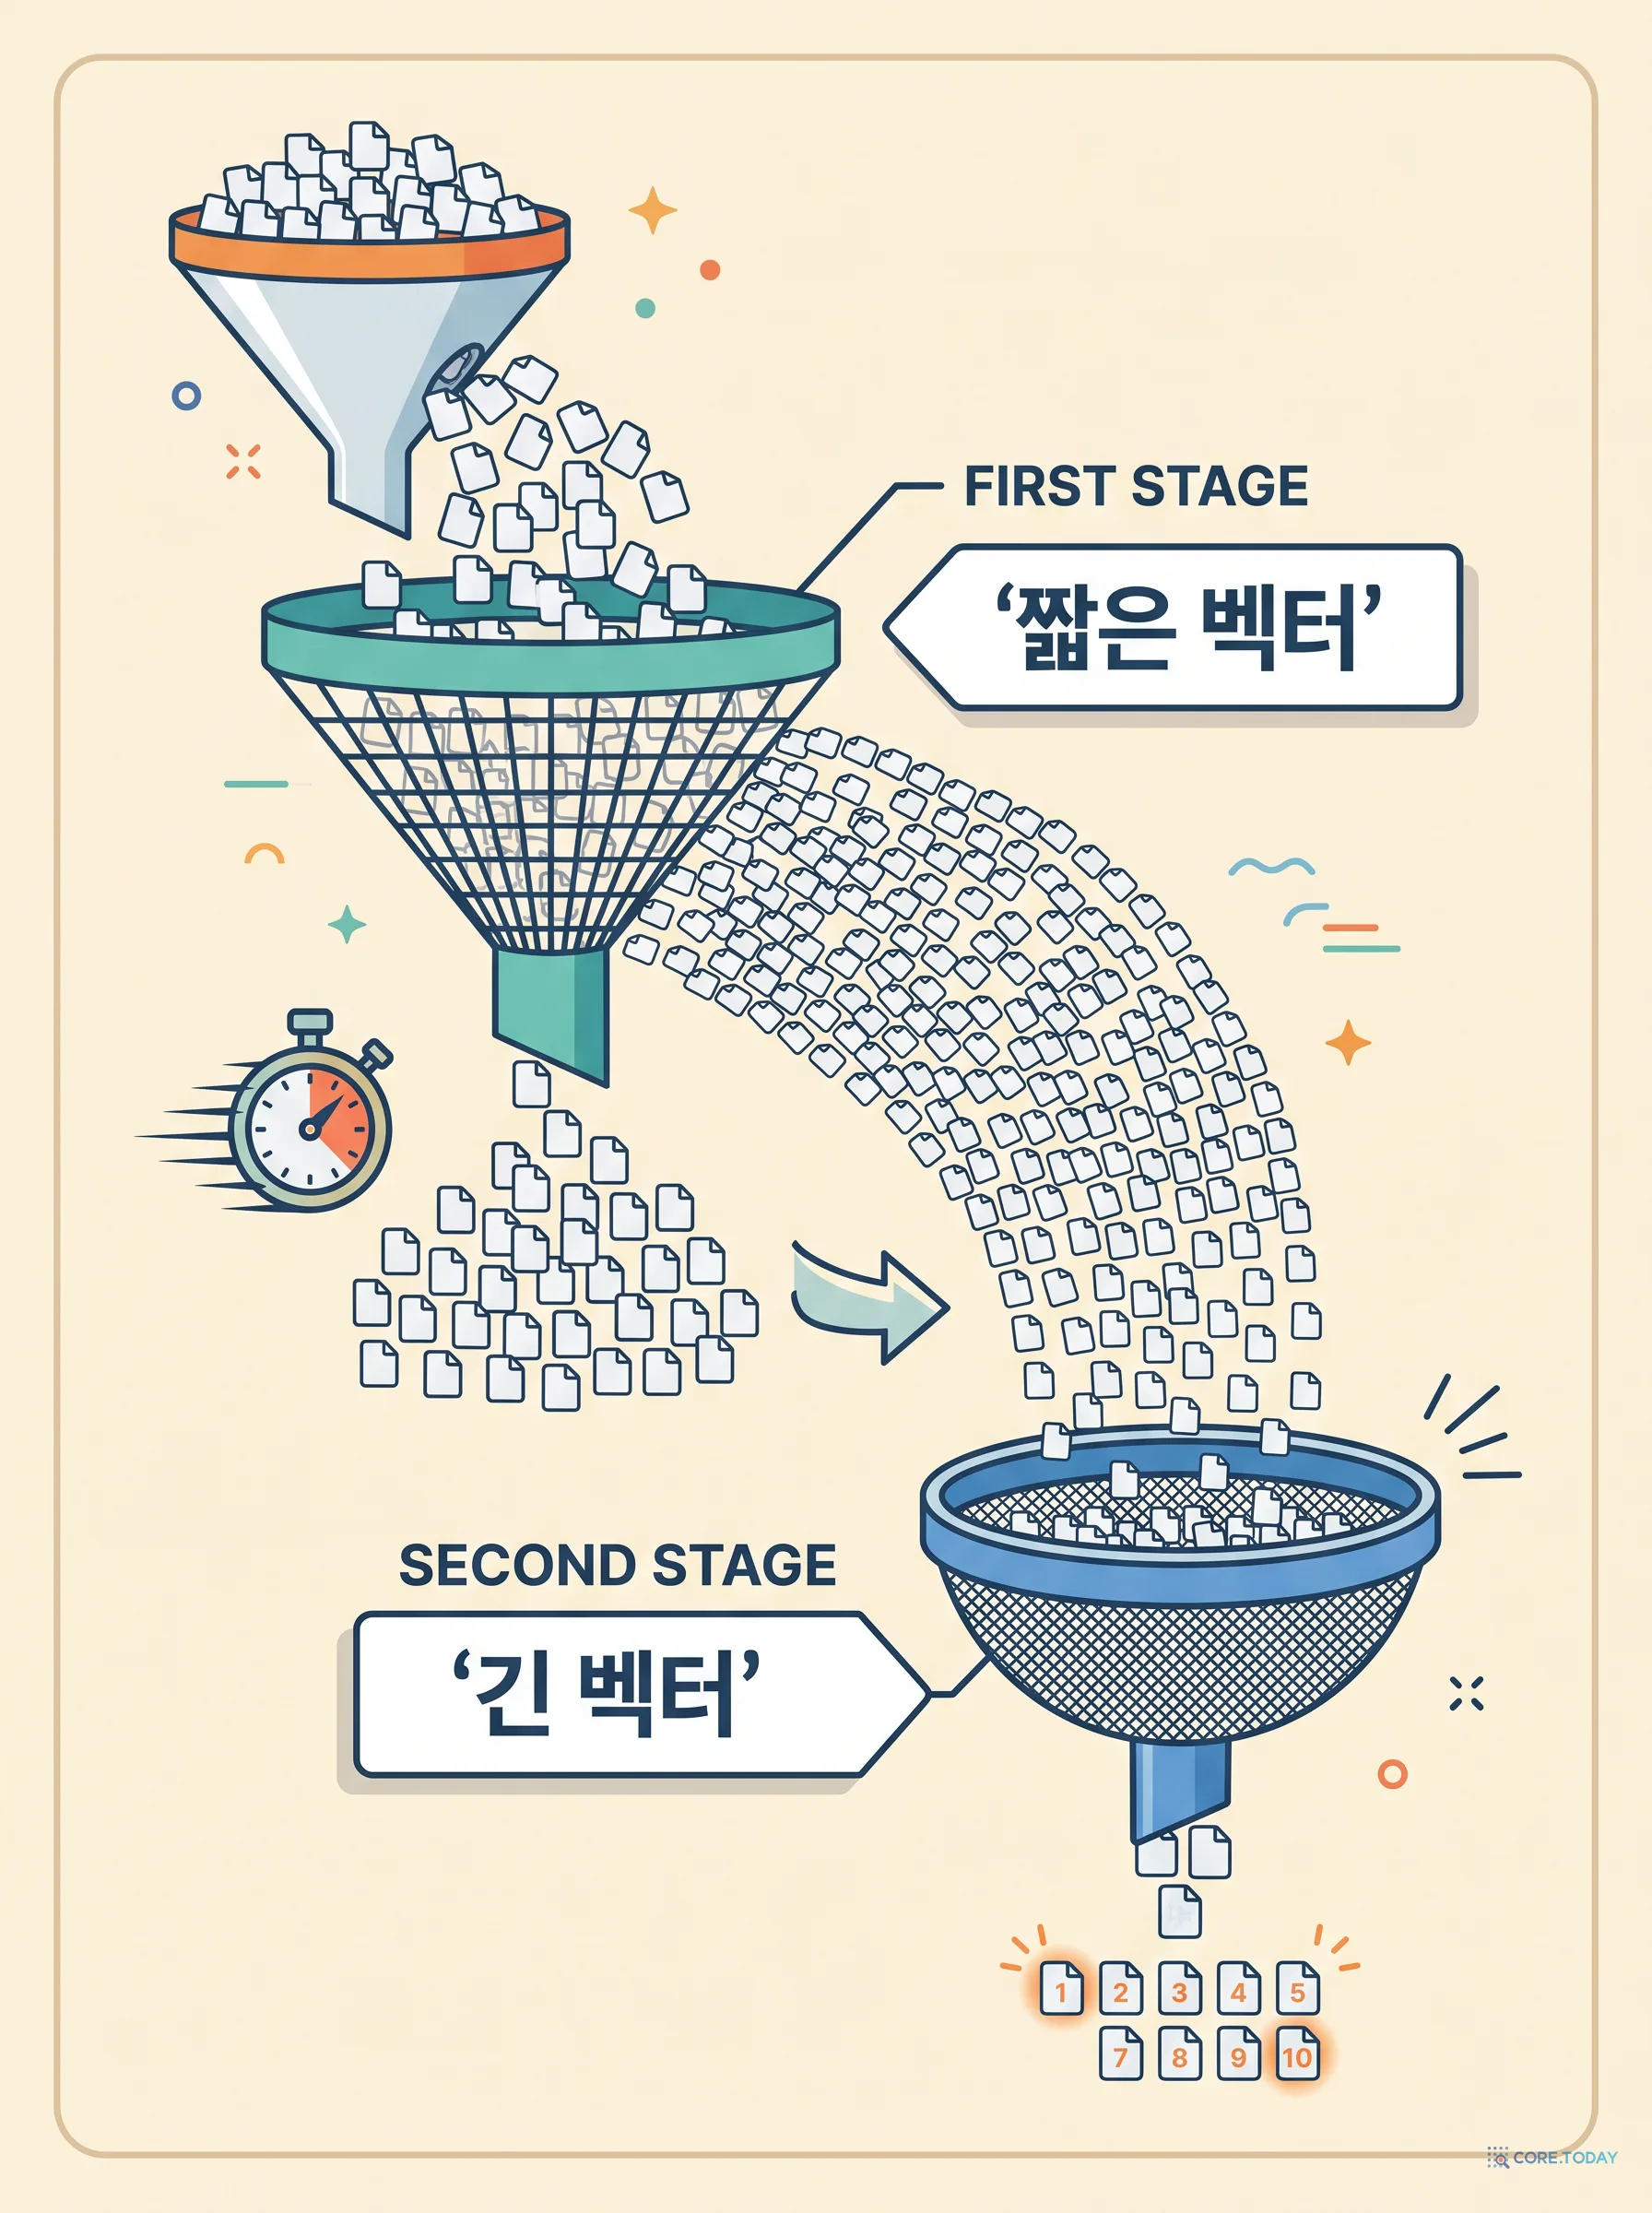
1차: 앞 d차원(예: 128)만으로 전체 코퍼스를 훑어 상위 L개(예: 100)를 고릅니다. 벡터가 32분의 1이니 메모리도 계산도 32분의 1입니다. 2차: 그 L개만 전체 차원으로 다시 정렬합니다. L이 100이면 전체 차원 내적을 100번만 합니다. Supabase가 OpenAI text-embedding-3-large 100만 벡터로 한 실험에서는 512차원 1차 + 3072차원 2차, 8배 과다 표집으로 정확 검색 대비 99% 정확도에 초당 580질의 를 냈습니다.
같은 구조를 우리 코퍼스로 재 봤습니다.
8B의 결과가 깨끗합니다. 128차원만으로 검색하면 0.683(79%)이지만, 128차원으로 상위 100개를 고르고 4096차원으로 다시 정렬하면 0.860, 전체 차원과 정확히 같은 값 이 나옵니다. 256차원으로 상위 20개만 추려 재정렬해도 0.860입니다. 1차의 역할은 '정답을 상위 L개 안에 넣는 것'뿐이고, 그것은 작은 차원으로도 충분히 됩니다. 4B도 같습니다. Nomic은 1차가 약해서(64차원은 공식 범위 밖) L을 100까지 늘려야 전체 값을 회복합니다.
계산량으로 보면, 589건 × 4096차원 = 241만 번의 곱셈이 589 × 128 + 100 × 4096 = 48만 번으로 5분의 1이 됩니다. 코퍼스가 5,000만 건이면 1차 검색의 메모리가 32분의 1이 되는 것이 진짜 차이입니다. 벡터 DB 관점에서는 128차원 인덱스 하나와 4096차원 원본 저장소 하나를 두는 구조가 됩니다. 원본은 디스크에 있어도 됩니다. 100개만 읽으면 되니까요.
6부. 한계와 주의
모델이 마트료시카로 학습돼 있어야 합니다. BGE-M3는 아닙니다. 1편에서 좋은 점수를 낸 BGE-M3의 1024차원 벡터를 256으로 자르면 보통형처럼 무너집니다. 이 글이 BGE-M3를 실험에서 뺀 이유입니다.
공식 범위 안에서만. Nomic의 64차원 결과가 보여 주듯, 학습 때 손실을 걸지 않은 길이는 보장이 없습니다. Qwen3는 32까지 지원한다고 적혀 있지만 우리 실측에서 32는 절반 수준이었습니다. '지원'과 '쓸 만함'은 다릅니다.
질의와 문서를 같은 길이로. 문서는 256으로 저장하고 질의는 4096으로 만들면 내적이 정의되지 않습니다. 적응형 검색은 1차와 2차에서 질의 벡터를 각각 잘라 씁니다.
재정규화를 잊지 마세요. Ollama의 dimensions 파라미터는 잘라 주지만, 정규화 여부는 모델과 버전에 따라 다릅니다. 저장 전에 직접 길이를 1로 맞추는 것이 안전합니다.
작은 코퍼스의 착시. 589건에서는 128차원으로도 정답이 상위 100개 안에 들어옵니다. 수천만 건에서는 1차의 Recall@L이 내려가므로 L을 키우거나 d를 올려야 합니다. Supabase의 8배 과다 표집이 그 조정입니다.
양자화와의 상호작용은 따로 재야 합니다. 이 글은 float32로 잘랐습니다. int8·binary로 바꾸면 곡선이 또 달라집니다.
맺으며: 시리즈를 닫으며
세 편의 실측을 한 문장씩으로 줄이면 이렇습니다. 1편: 한국어 검색에서 Qwen3-Embedding 8B가 가장 좋지만, 4B와의 차이는 '1등에 올리는 힘'이고 BGE-M3는 크기 대비 여전히 최고다. 2편: BM25와 벡터를 합치는 것은 두 쪽이 다 유능할 때만 이득이고, 약한 쪽은 가중치를 줄이거나 빼야 하며, 리랭커는 약한 1차 검색의 손실을 되찾지만 강한 1차 검색을 넘지는 못한다. 3편: 마트료시카 모델은 256차원까지 잘라도 93~98%가 남고, 짧게 걸러 길게 고르면 전체 품질을 되찾는다.
그래서 2026년 한국어 검색 스택의 기본형은 이렇게 됩니다. Qwen3-Embedding 4B(또는 8B를 1024차원으로), 256차원 1차 인덱스와 전체 차원 재정렬, 정확한 용어가 중요한 도메인이면 BM25를 낮은 가중치로 RRF, 마지막에 크로스 인코더 리랭커. 그리고 이 모든 선택을 여러분의 문서로 만든 질문 200~500개로 다시 재는 것. 세 편의 스크립트가 그 출발점입니다.