질문 하나로 연대기를 짓는 법 — TimelineAgent로 읽는 '질문 중심 문서 횡단 타임라인'
기사 서른 건을 주고 '스티브 잡스 연대기'를 만들라고 하면, 기계는 '월요일'이 며칠인지, '그'가 누구인지, '할 것이다'가 일어난 일인지부터 막힙니다. EMNLP 2026에 실린 TimelineAgent는 이 일을 여섯 단계로 쪼개고, 단계마다 필요한 원자 기술만 골라 쥐여 주는 규약을 더해 같은 모델의 한 번에 묻기보다 두 배 이상 높은 점수를 냈습니다. 편년체·기전체·기사본말체에서 SemEval-2015까지 연표 기술의 역사, 논문의 구조와 표·그림, 그리고 코어닷투데이가 공개 데이터와 공식 채점기로 로컬 9B 모델에서 직접 재현한 결과를 함께 정리합니다.
2011년 10월 6일자 위키뉴스 기사는 이렇게 시작합니다. "애플 공동 창업자이자 전 최고경영자 스티브 잡스가 어제 56세로 세상을 떠났다." 이 문장 하나에서 '세상을 떠났다'의 날짜를 정하려면 기사 작성일을 알아야 하고, '어제'를 하루 빼는 계산을 해야 합니다. 같은 기사의 몇 줄 아래에는 "1년 뒤 그는 회사에서 쫓겨났고 넥스트를 세웠다"가 나옵니다. '1년 뒤'의 기준은 앞 문장의 1984년이고, '그'는 잡스입니다.
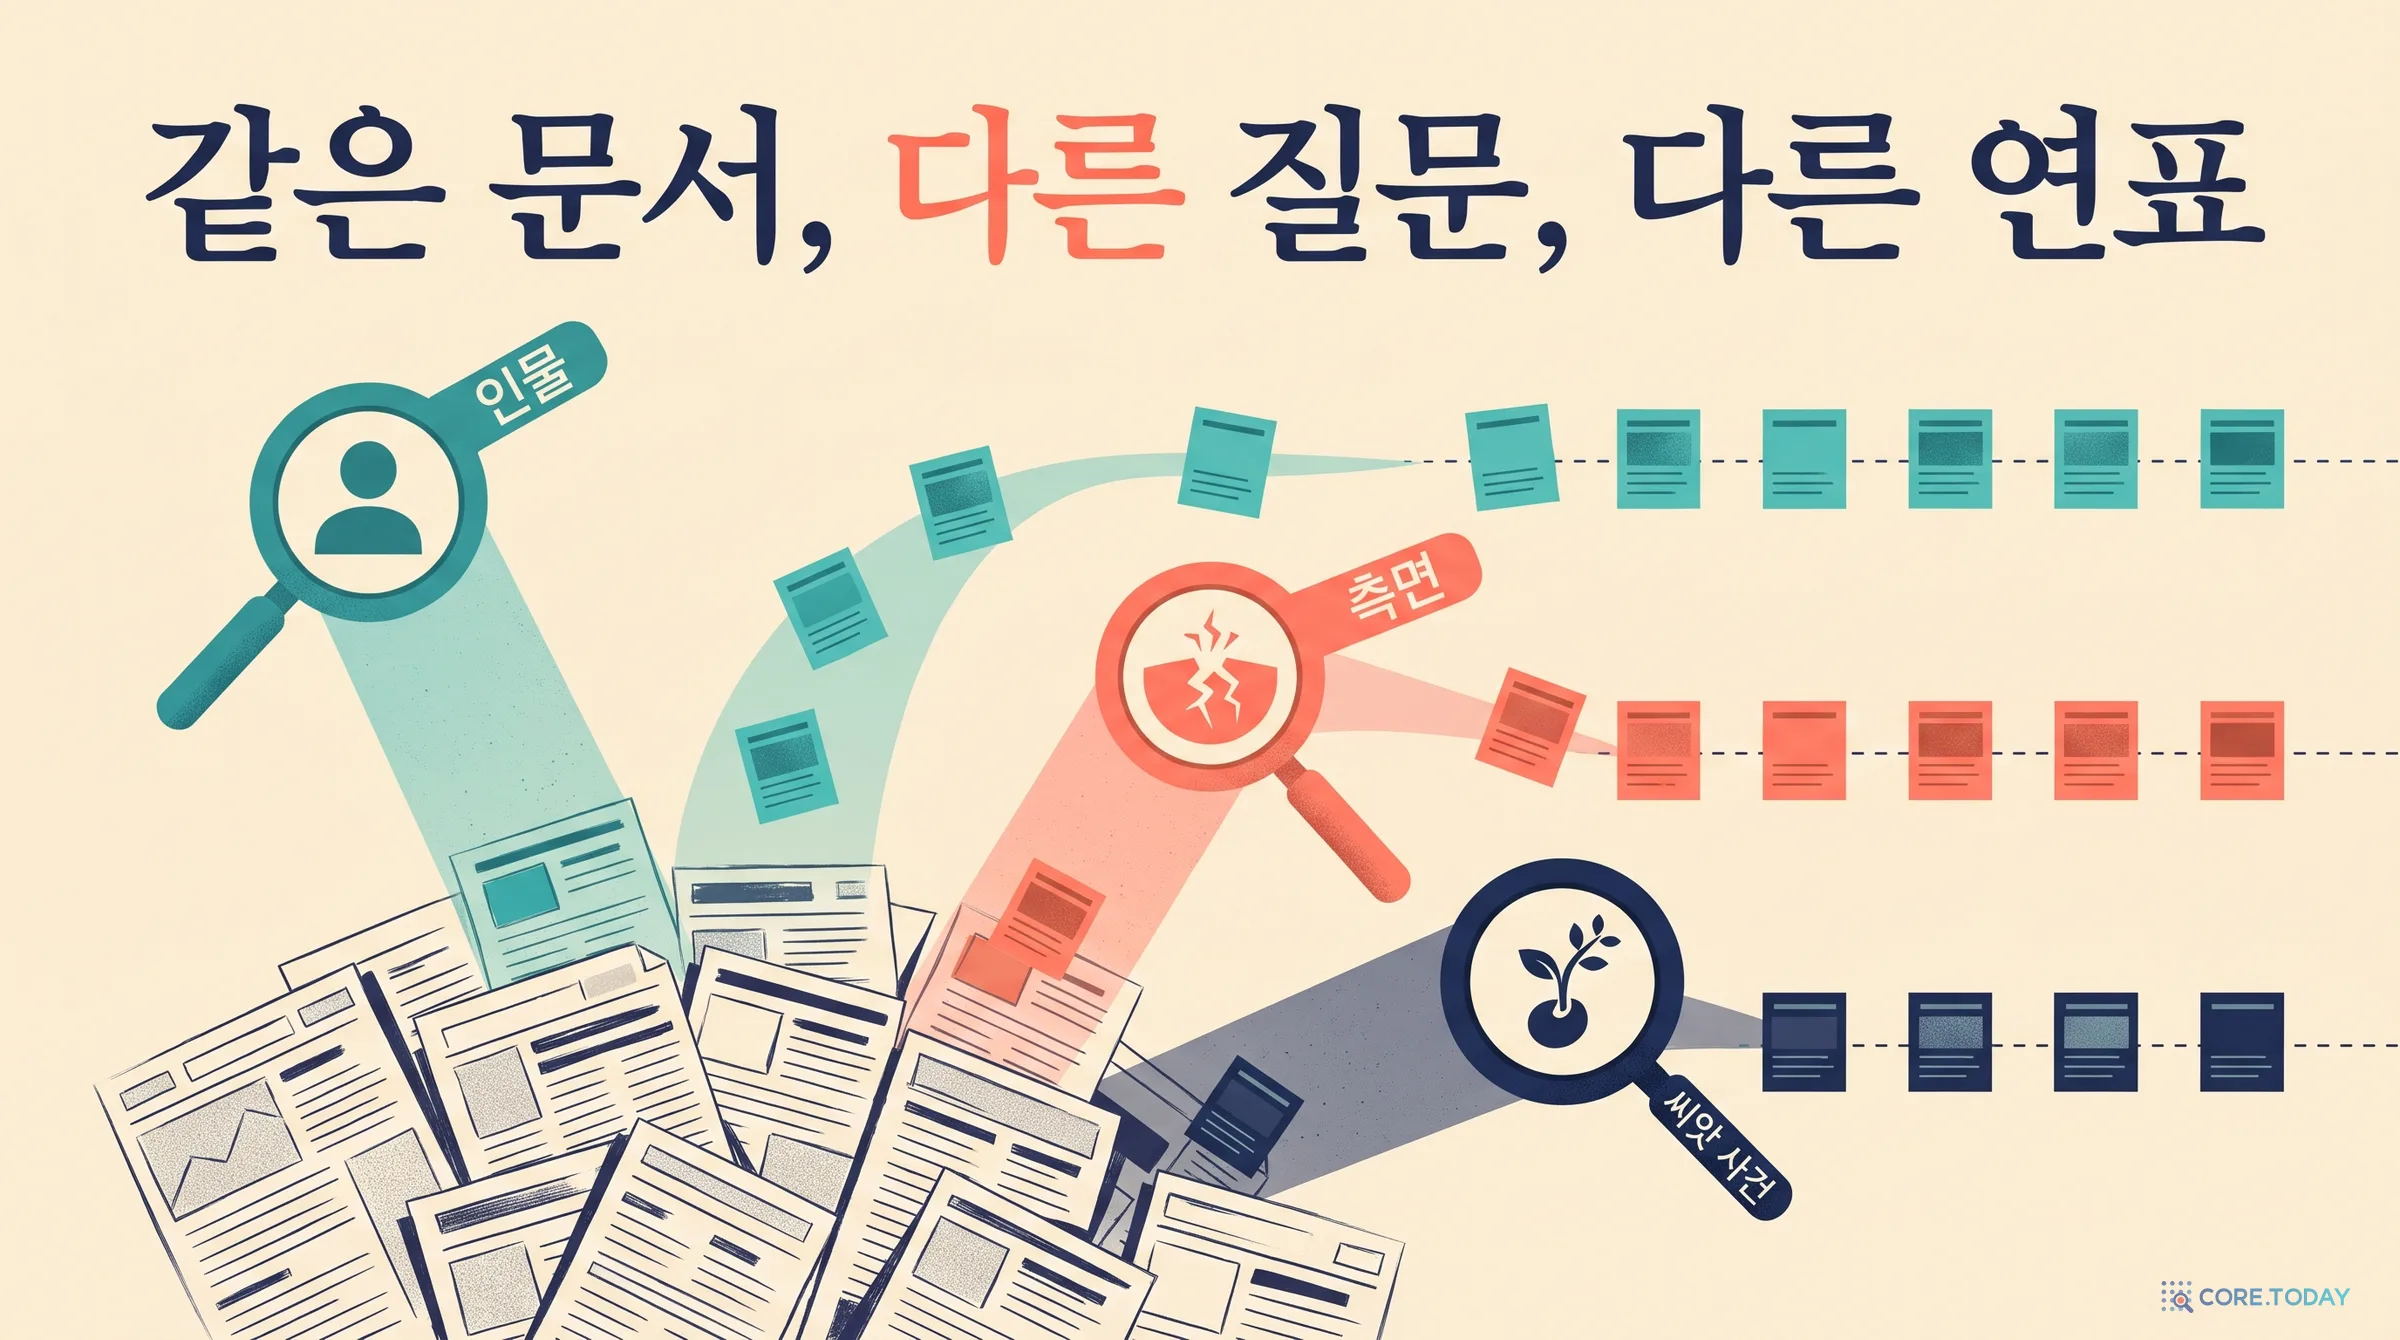
이런 문장이 서른 건의 기사에 흩어져 있다고 해 봅시다. 2005년 기조연설 기사, 2010년 아이폰 4 공개 기사, 2011년 병가와 사임 기사가 섞여 있습니다. 여기서 "스티브 잡스에게 일어난 일을 날짜순으로 정리해 달라"는 요청은 사람에게도 반나절 일거리입니다. 질문을 "아이폰 4"로 바꾸면 같은 기사 더미에서 전혀 다른 사건이 뽑혀야 합니다.
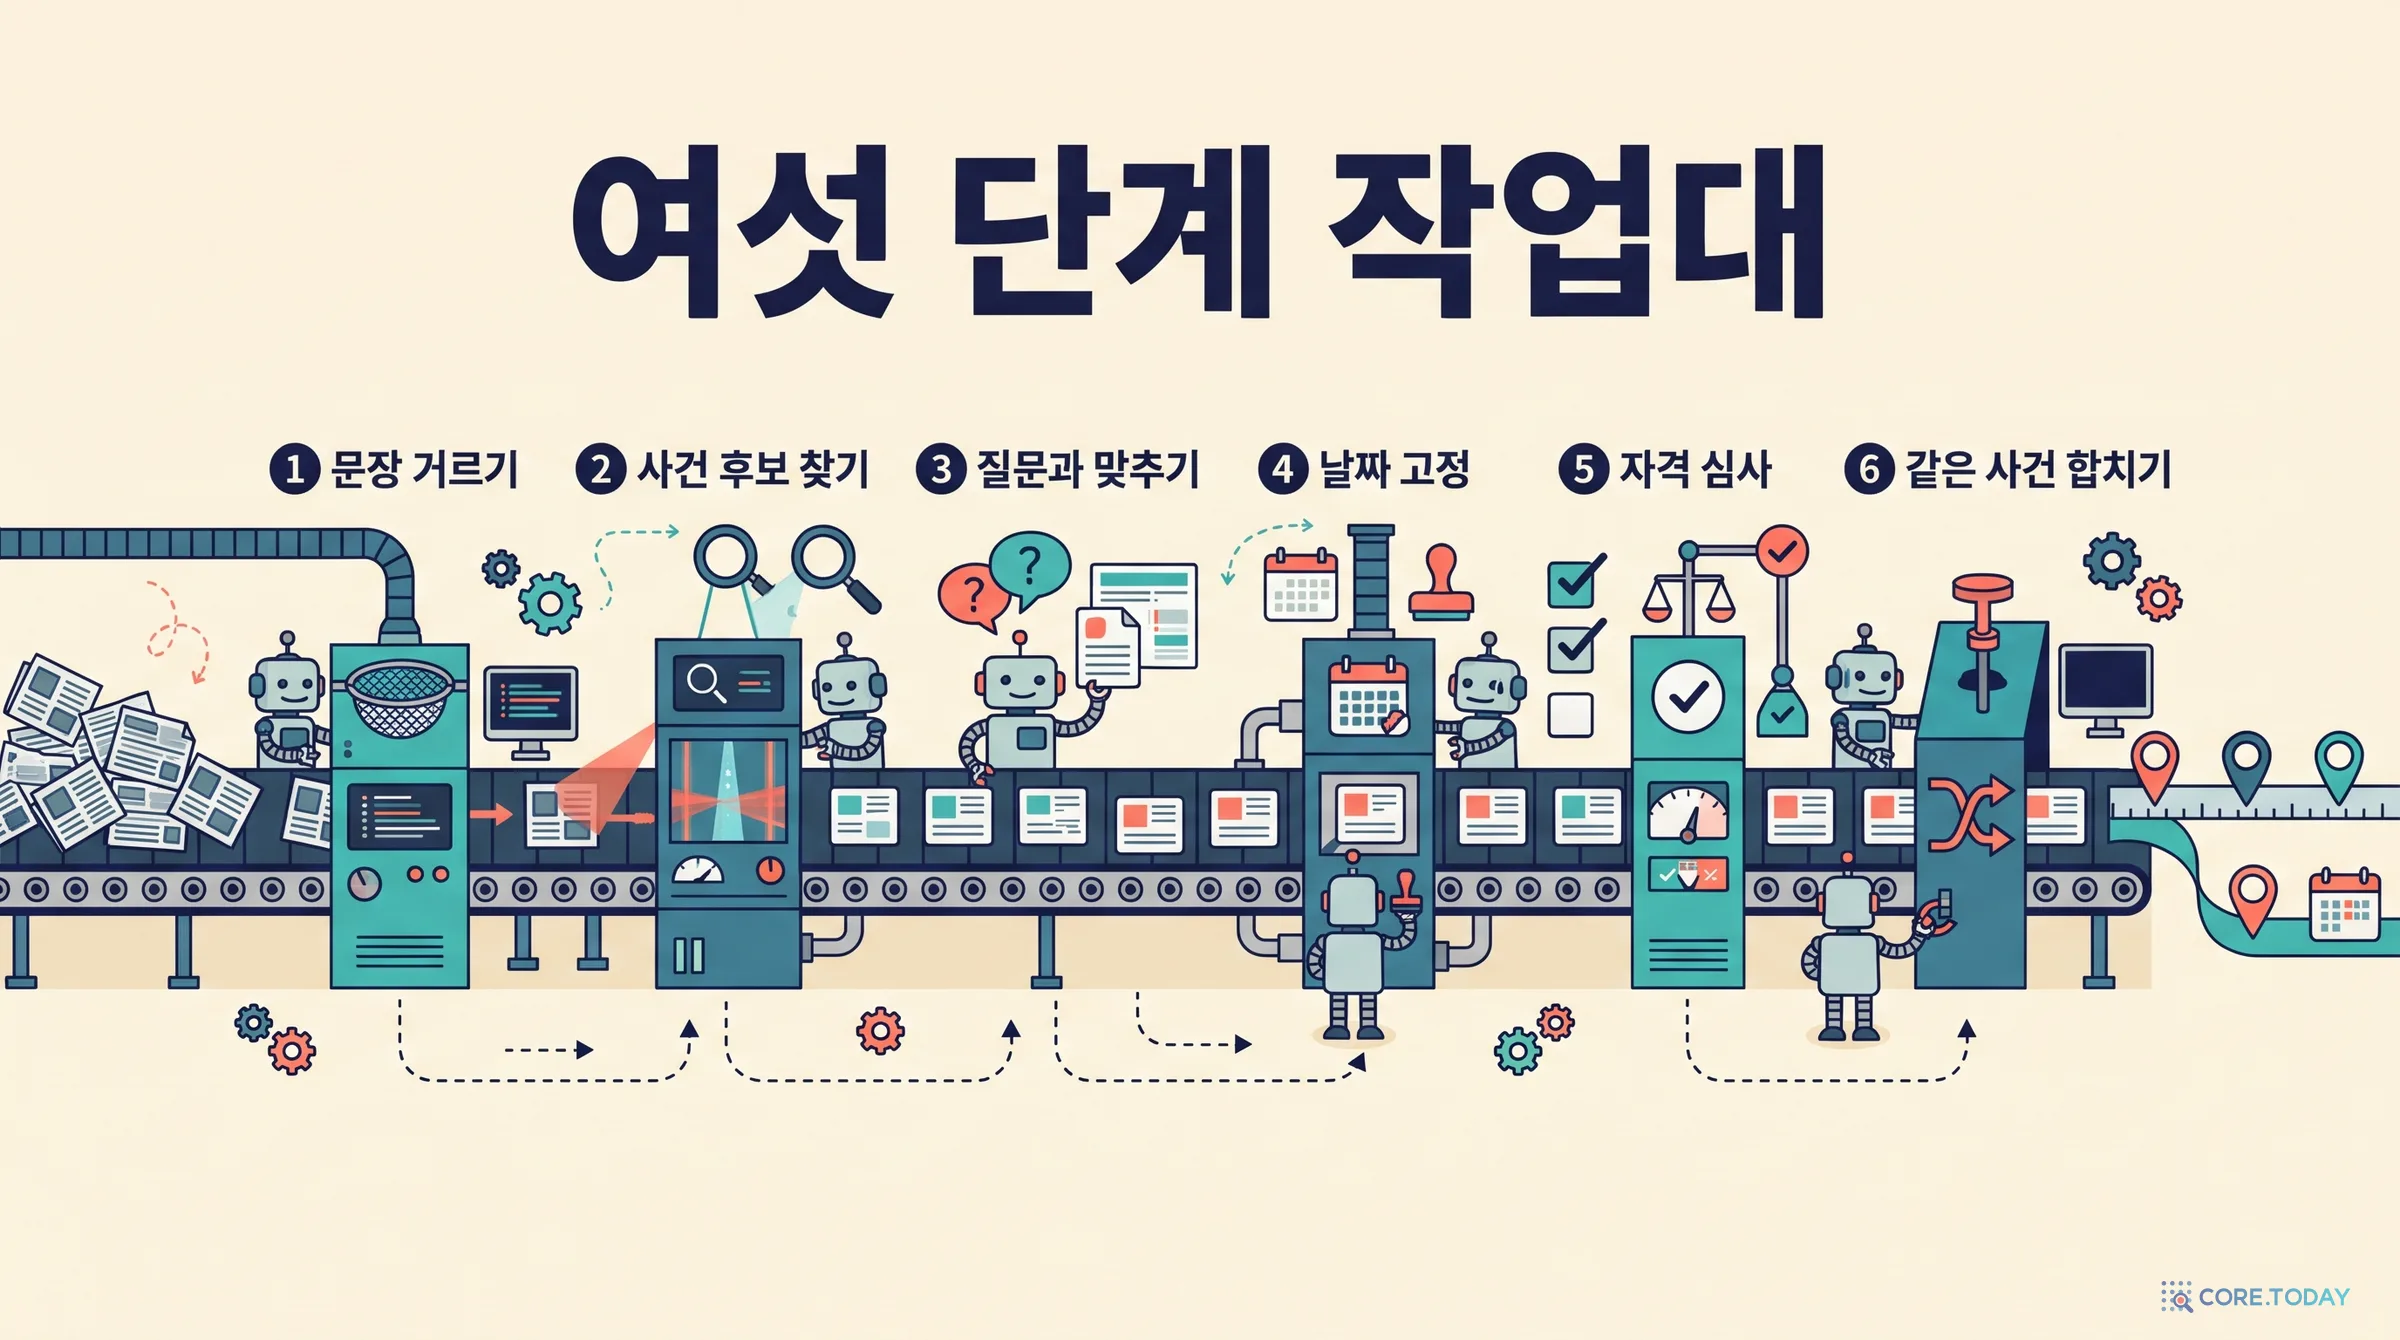
2026년 10월 arXiv에 올라오고 EMNLP 2026 본회의에 실린 「TimelineAgent: An LLM-based Framework for Query-Centric Event Timeline Extraction Across Multiple Documents」(웨스트레이크대·저장대·케임브리지대 등)는 바로 이 일을 다룹니다. 논문은 과제에 QUEST(Query-centric Cross-document Event Timeline Extraction)라는 이름을 붙이고, 질문을 세 가지로 나눕니다. 특정 인물·대상, 사건의 한 측면, 그리고 씨앗이 되는 한 사건입니다. 해법인 TimelineAgent는 일을 여섯 단계로 쪼갠 다음, 단계마다 필요한 '원자 기술'만 골라 쥐여 주는 규약을 둡니다.
?
문제
여러 문서에서 질문에 맞는 사건만 골라 날짜를 붙이고, 같은 사건을 합쳐 순서대로 세우는 일은 한 번의 프롬프트로는 잘 안 된다. 같은 모델이라도 한 번에 물으면 F1이 10~20점대에 머문다.
!
해법
문장 거르기 → 사건 후보 → 질문과 맞추기 → 날짜 고정 → 자격 심사 → 같은 사건 합치기의 여섯 단계. 단계와 질문 유형의 조합마다 21개 원자 기술 중 몇 개만 골라 켠다.
=
결과
DeepSeek-V3 기준 인물 37.9·측면 42.9·씨앗 사건 33.1. 한 번에 묻기(17.5·28.2·12.5)의 1.5~2.6배다. 그래도 최고점이 40점 안팎이라 과제 자체가 아직 어렵다.
이 글은 다섯 갈래로 갑니다. 먼저 왜 이 문제가 생겼는지, 사람이 연표를 만들어 온 역사와 기계가 시간을 읽게 된 역사를 짚습니다. 다음으로 QUEST가 무엇이고 왜 어려운지, TimelineAgent의 여섯 단계·기술 서재·조율 규약이 각각 무엇을 하는지 논문의 그림과 표를 따라 풀어 봅니다. 그다음 결과표를 읽고, 코어닷투데이가 공개 데이터와 공식 채점기로 로컬 9B 모델에서 직접 재현한 결과를 보입니다. 마지막으로 이 논문의 한계와, 2026년에 이런 '연표 기계'가 어디에 쓰일 수 있는지를 이야기합니다.
신입 기자가 이 과제를 받으면 무엇에 막힐까요. 논문이 인물 질문의 데이터로 쓴 SemEval-2015 공유 과제의 공개 시험 데이터, 위키뉴스 애플 기사 30건에 바로 그 '스티브 잡스' 연표가 들어 있습니다. 그 데이터를 직접 열어 보면 막히는 지점이 다섯 군데쯤 보입니다.
어제"스티브 잡스가 어제 56세로 세상을 떠났다" — 기사 작성일이 2011-10-06이므로 사망일은 2011-10-05. 기준 시점(작성일)을 모르면 날짜를 못 정한다.
1년 뒤"1984년 첫 매킨토시가 나왔다. 1년 뒤 그는 쫓겨났고 넥스트를 세웠다" — 앞 문장의 연도를 끌어와 1985를 계산하고, 같은 해 안에서도 '쫓겨남'이 '설립'보다 먼저다.
세 번의 투병"그는 2004년 췌장암과 싸웠다"(1월 기사), "2004년부터 췌장암과 싸워 왔다"(8월 기사), "2004년부터 싸워 왔다"(10월 기사) — 세 기사의 세 표현이 한 사건이다. 따로 세면 같은 일이 연표에 세 번 들어간다.
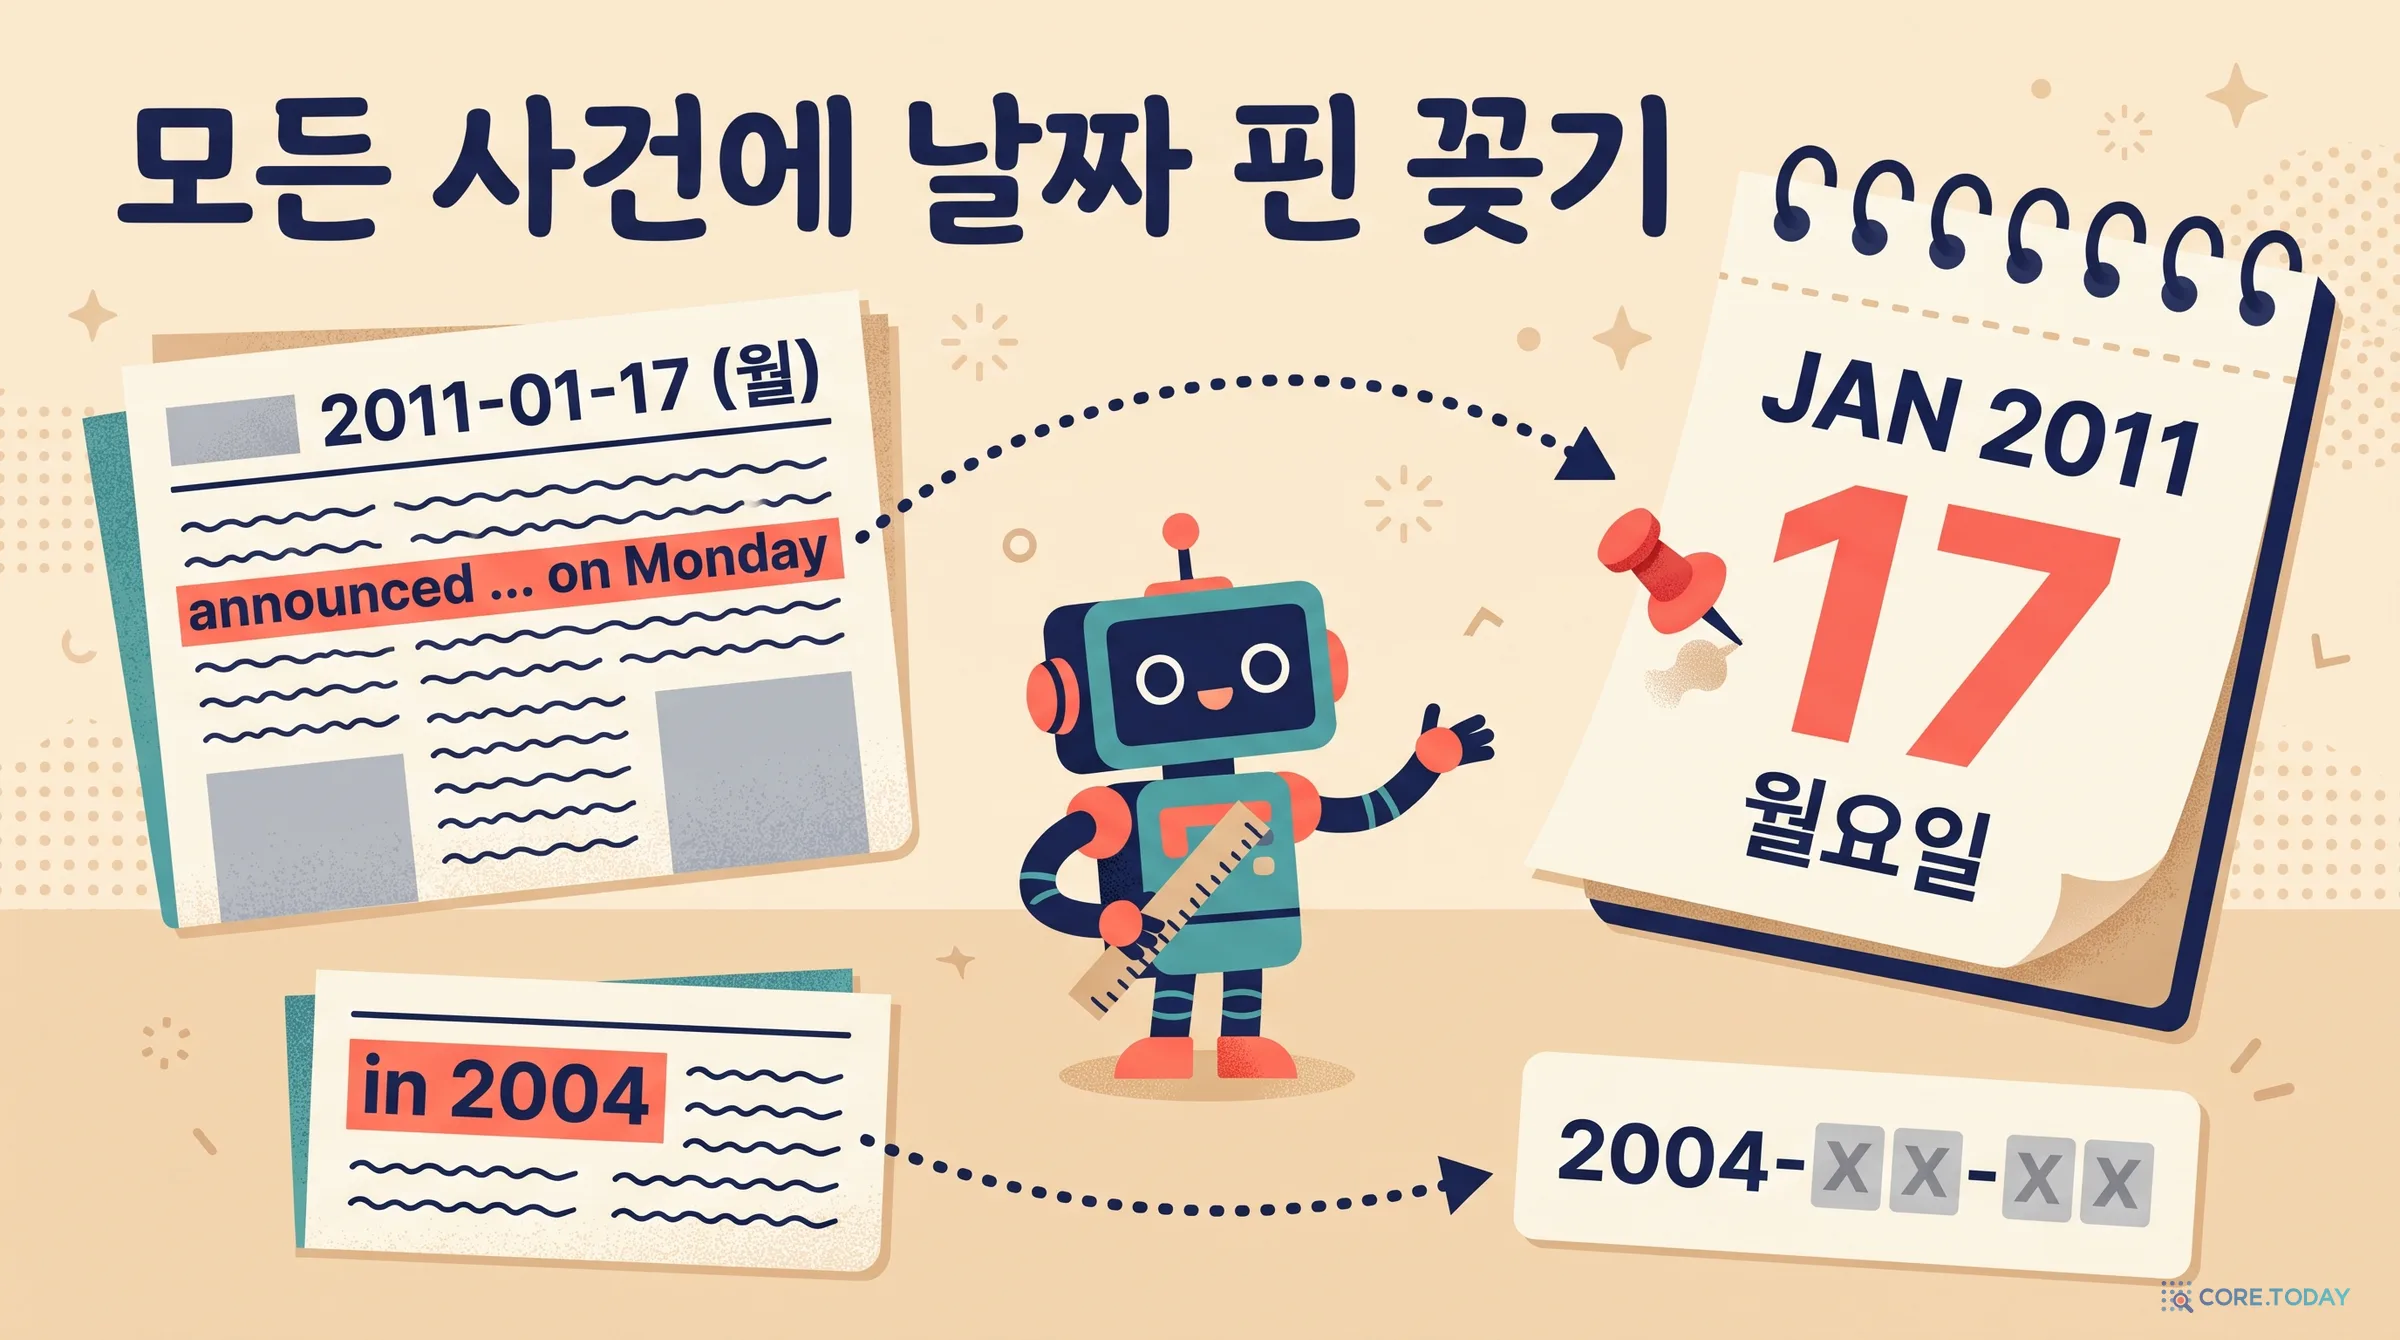
월요일"잡스는 월요일 사내 메모로 병가를 알렸다" — 작성일 2011-01-17이 마침 월요일이라 같은 날. 2010-06-16(수)자 기사의 "사전 주문이 화요일 시작됐다"는 하루 전인 06-15다.
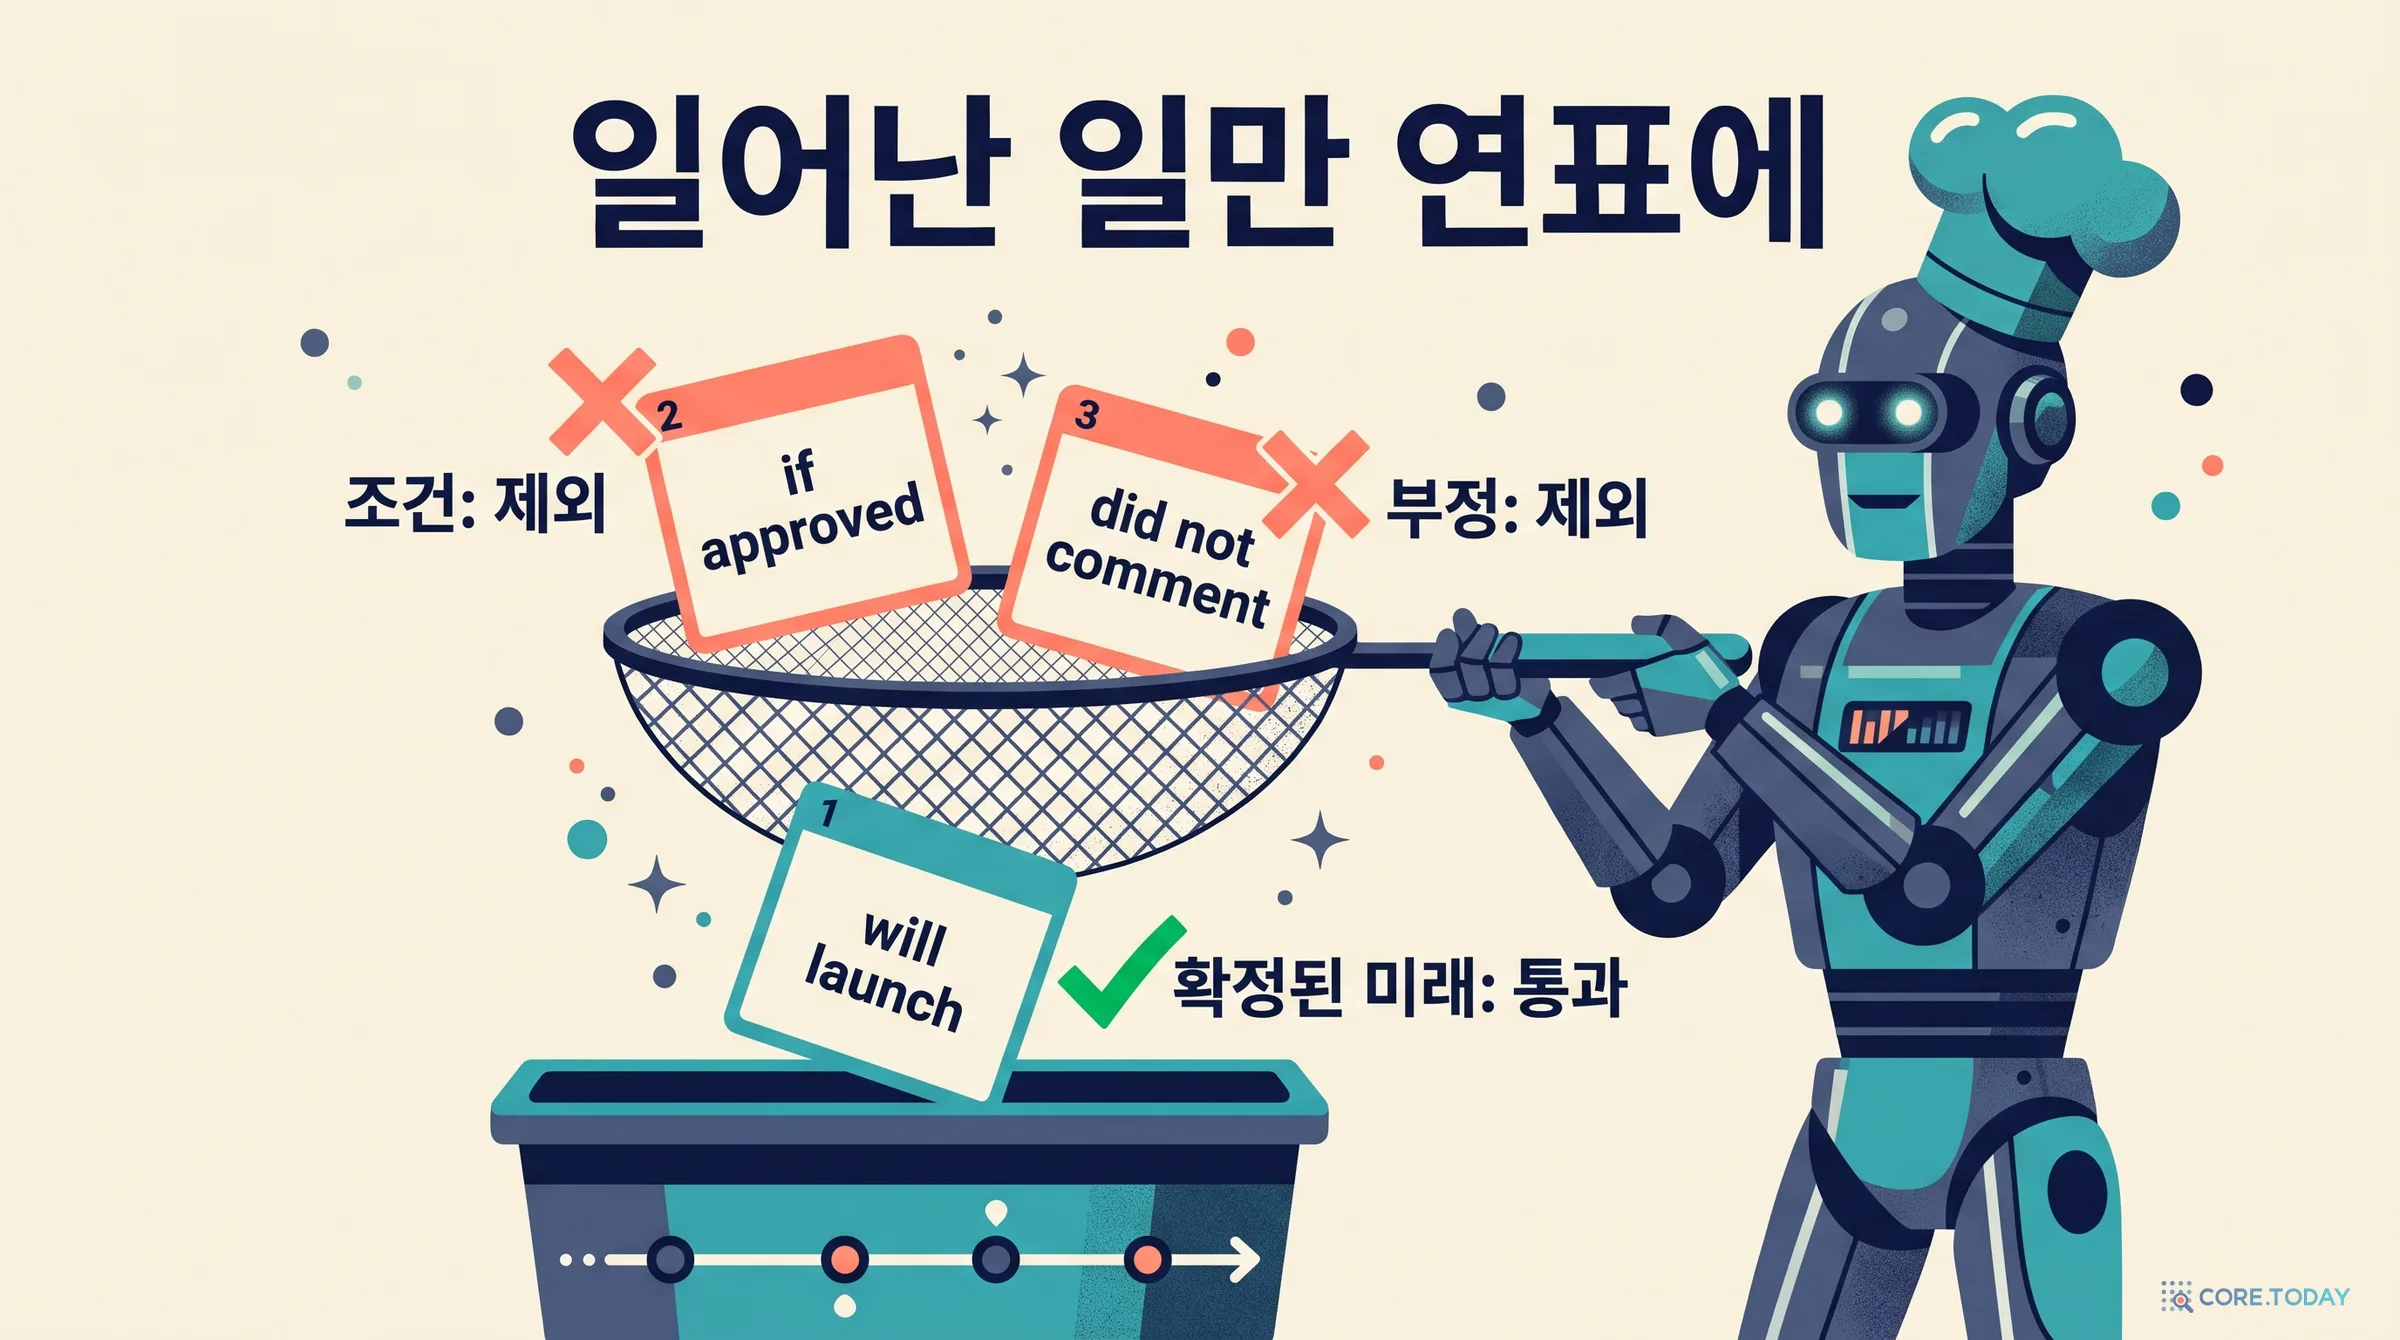
할 것이다"앞으로 매킨토시는 인텔 프로세서를 쓸 것이다"(2005) — 일어난 일인가? 논문의 규칙은 확정된 미래(will)는 넣고, 조건문 속 사건(만약 ~라면)과 부정된 사건(~하지 않았다)은 뺀다.
여기에 하나가 더 있습니다. 무엇이 '잡스의 사건'인가입니다. SemEval-2015 지침은 대상이 사건의 행위자(ARG0)나 대상(ARG1)으로 명시적으로 참여해야 한다고 정했습니다. "애플과 애플 코어가 합의했다"에서 '양측(the parties)'은 두 회사를 함께 가리킬 뿐 어느 한쪽과 같지 않습니다. 사람에게는 사소해 보이는 판단이 점수를 가릅니다.
이 과제는 2015년에 한 번 공유 과제로 열렸습니다. SemEval-2015 Task 4 'TimeLine: 문서 횡단 사건 정렬'입니다. 네 팀이 13개 결과를 냈고, 원문에서 출발하는 본 트랙의 최고 점수는 F1 7.85였습니다. 사건 위치를 정답으로 준 보조 트랙에서도 25.36이 최고였습니다. 그로부터 11년 뒤, TimelineAgent는 같은 계열의 인물 질문에서 37.9를 냅니다. 다섯 배쯤 올랐지만, 여전히 열에 여섯은 틀린다는 뜻이기도 합니다.
1부. 연표는 오래된 기술이다
편년체·기전체·기사본말체: 세 가지 질문은 이미 있었다
QUEST의 세 질문 유형은 새로 발명된 것처럼 보이지만, 동아시아 역사 서술은 천 년 넘게 같은 고민을 해 왔습니다. 역사를 쓰는 형식, 곧 사서의 체재가 세 가지로 갈렸기 때문입니다.
체재
무엇을 기준으로 묶나
대표 사서
QUEST로 옮기면
편년체(編年體)
해·달·날짜 순서 그대로
사마광 『자치통감』(1084), 『조선왕조실록』
질문 없는 전체 연표
기전체(紀傳體)
인물(본기·열전)
사마천 『사기』, 『고려사』(1451)
인물·대상 질문
기사본말체(紀事本末體)
사건 하나의 시작과 끝(원인·경과·결과)
원추 『통감기사본말』(남송), 이긍익 『연려실기술』
씨앗 사건·측면 질문
청나라 『사고전서총목제요』는 앞의 두 형식의 약점을 이렇게 요약했습니다. 기전체는 한 사건이 여러 인물의 전기에 겹쳐 나와 주객을 가리기 어렵고, 편년체는 한 사건이 여러 권에 흩어져 처음과 끝을 살피기 어렵다. 남송의 원추는 『자치통감』을 사건별로 다시 잘라 묶어 기사본말체를 열었습니다. 같은 자료를 질문에 맞게 다시 엮은 것입니다. TimelineAgent가 하려는 일도 정확히 이것입니다. 문서 더미(편년체에 가까운 원자료)를 질문에 따라 인물 중심으로, 혹은 사건의 원인과 결과 중심으로 다시 엮습니다.
연표를 '그린' 사람: 프리스틀리의 1765년
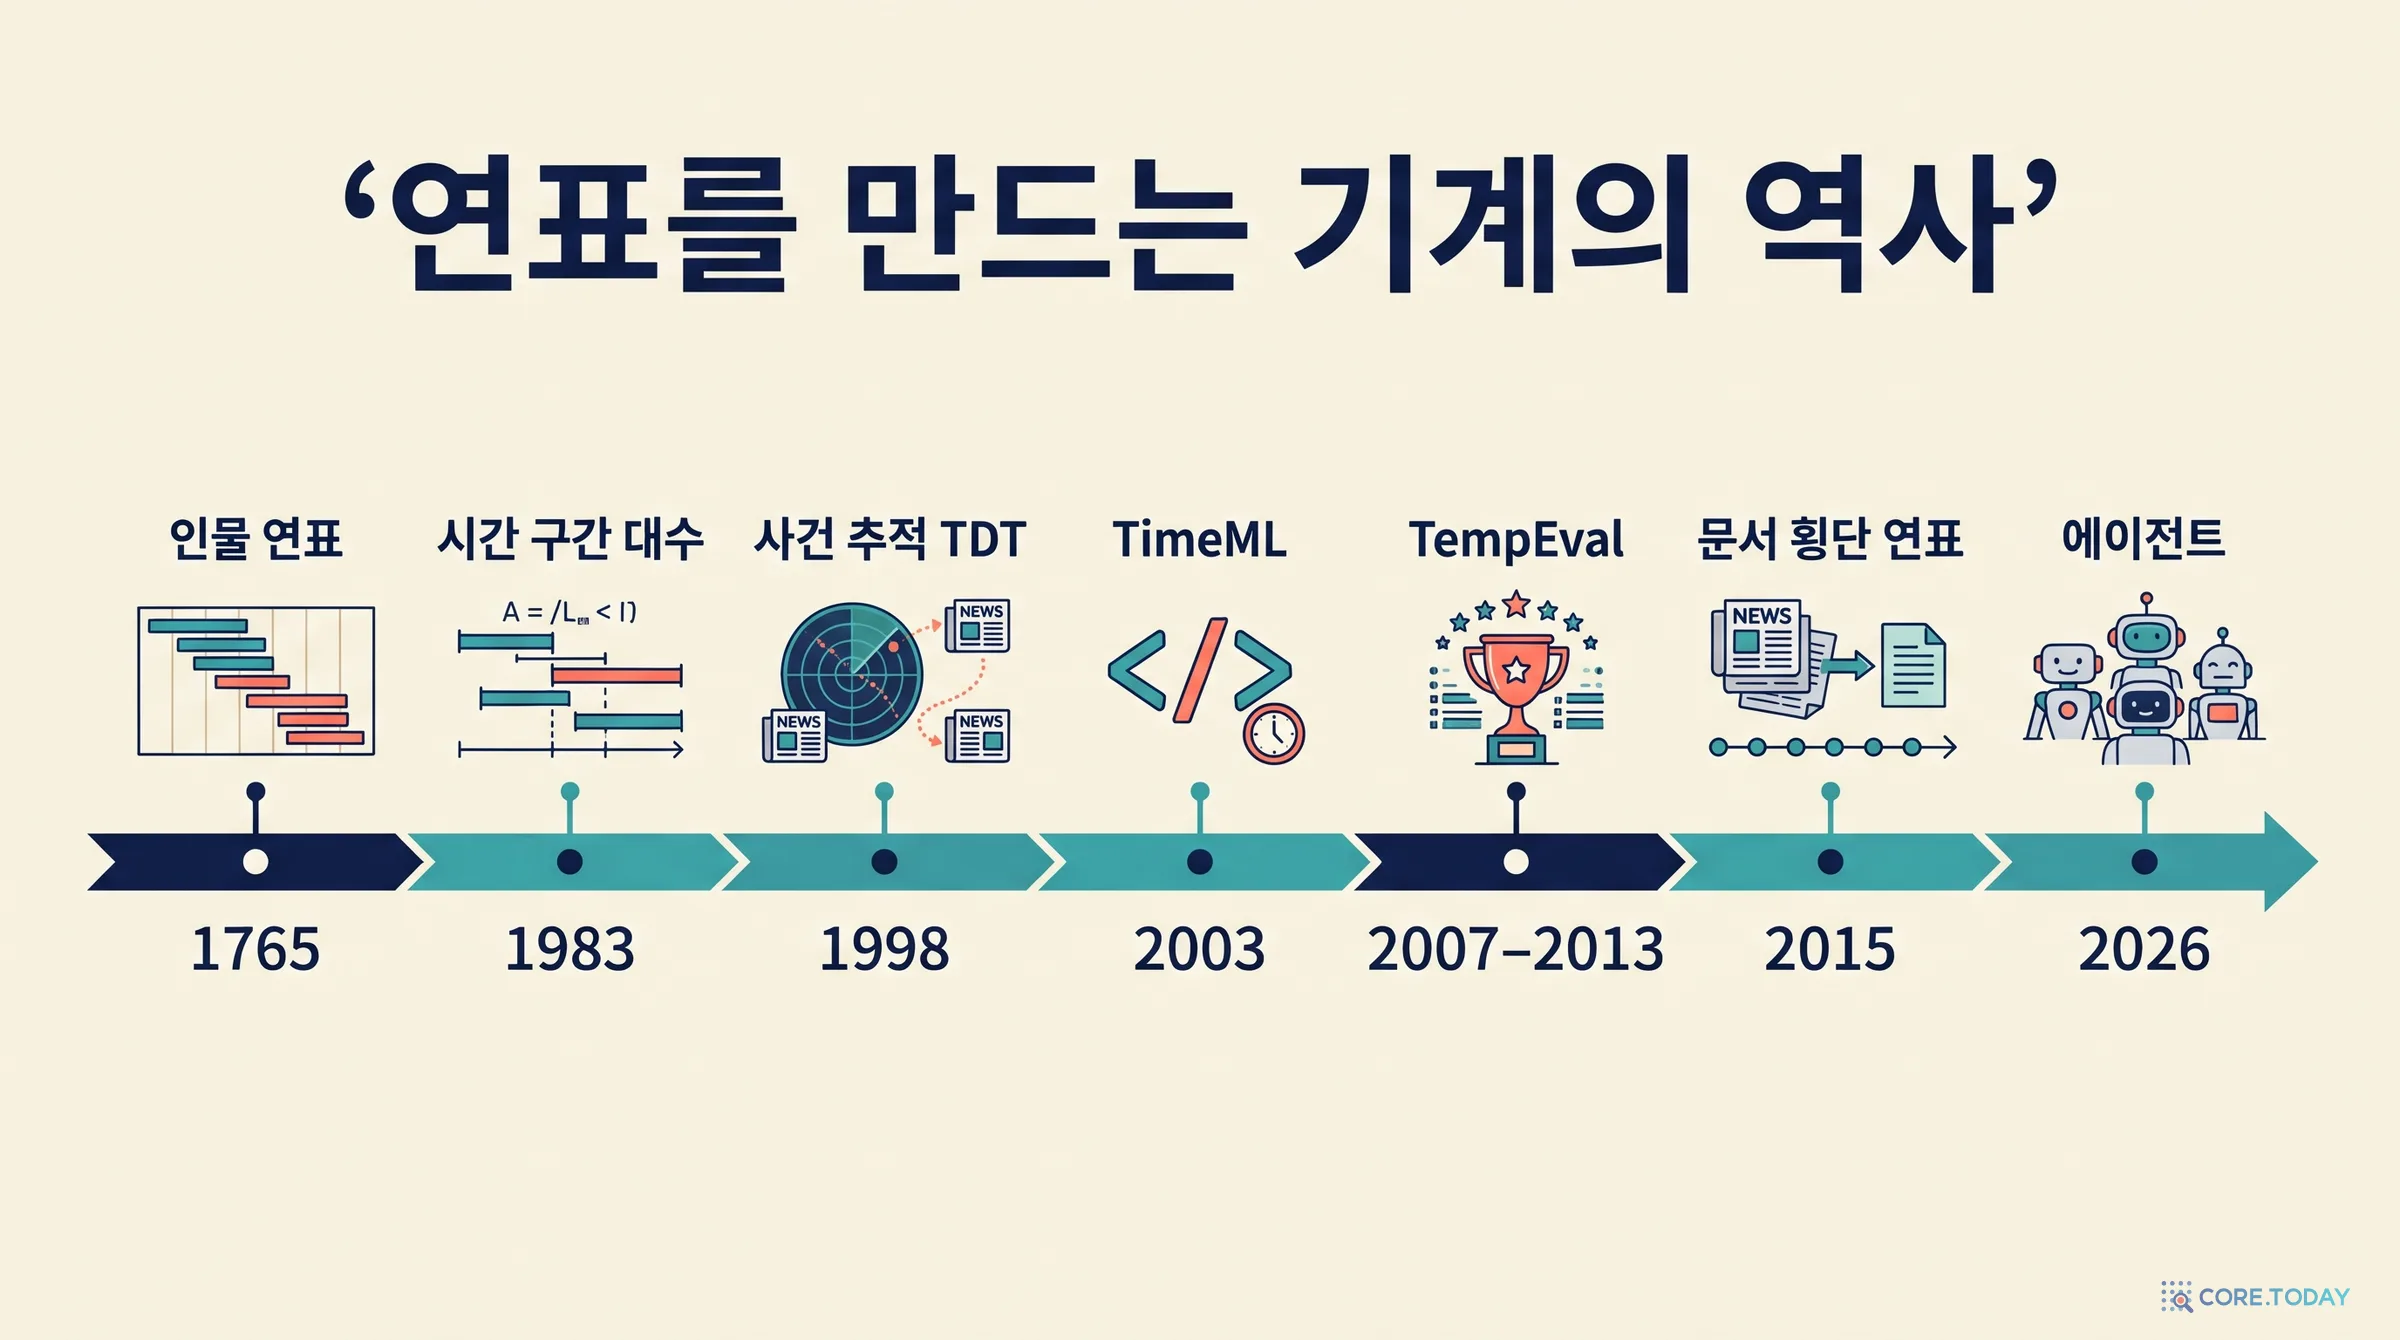
서양에서 오늘날 우리가 아는 가로축 연표는 18세기 영국에서 대중화됐습니다. 산소를 발견한 화학자로 더 유명한 조지프 프리스틀리는 1765년 「전기 연표(A Chart of Biography)」를 펴냈습니다. 기원전 1200년부터 기원후 1750년까지 유명인 약 2,000명의 생애를 가로 막대로 그렸습니다. 1769년의 「새 역사 연표(A New Chart of History)」는 제국의 흥망을 같은 방식으로 그렸습니다. 막대의 길이가 곧 시간이라는 생각은 지금 보면 당연하지만, 당시에는 새로운 발상이었습니다. 이 연표는 판을 거듭하며 수십 년 동안 팔렸습니다. 프리스틀리의 「전기 연표」는 기전체처럼 '인물' 질문에 대한 답이었고, 「새 역사 연표」는 '나라'라는 대상에 대한 답이었습니다.
1947라이헨바흐의 세 시점. 철학자 한스 라이헨바흐는 시제를 말하는 시점(S)·기준 시점(R)·사건 시점(E)의 관계로 설명했다. 뉴스에서 S는 기사 작성일(DCT)이다. TimelineAgent가 DCT를 '결정적 기준점'이라 부르는 이유가 여기서 시작된다.
1983앨런의 구간 대수. 제임스 앨런은 두 시간 구간 사이의 관계를 '앞·만남·겹침·시작·포함·끝·같음'과 그 역을 합친 13가지로 정리했다. 오늘의 시간 관계 분류(TLINK)의 뼈대다.
1998주제 탐지·추적(TDT). 미국 DARPA 사업으로 뉴스 흐름에서 새 사건을 찾고 그 후속 기사를 추적하는 과제가 열렸다. '이야기'를 따라가는 연구의 출발점이지만, 사건 하나하나의 날짜는 다루지 않았다.
2003TimeML과 TimeBank. 푸스테욥스키 등이 사건(EVENT)·시간 표현(TIMEX3)·시간 관계(TLINK)를 표시하는 표준을 만들었다. 'YYYY-MM-DD, 모르면 X'라는 QUEST의 날짜 형식이 여기서 왔다.
2007–2013TempEval 1·2·3. 시간 표현 정규화와 시간 관계 분류를 겨루는 공유 과제. 시간 표현 정규화는 F1 90점대까지 올랐지만, 관계 추출은 30점대에 머물렀다. QUEST의 채점 방식(시간 그래프 비교)도 TempEval-3에서 왔다.
2009–2015문서 횡단 사건 추적. 지 헝 등(2009)이 여러 문서의 사건을 '중심 개체' 기준으로 잇는 과제를 제안했고, 2015년 SemEval TimeLine 과제가 인물·회사 연표를 공식 과제로 만들었다. 최고점 7.85.
2017–2026이야기·위기·치료 연표, 그리고 LLM. 이벤트 스토리라인 말뭉치(2017), 지역 위기 연표 요약 CrisisLTLSum(2022), 항암 치료 연표 ChemoTimelines(2024), 공약 이행 추적 PledgeTracker(2025). LLM 시대에는 TimeBench·TRAM 같은 시간 추론 벤치마크가 나왔고, 2026년 TimelineAgent가 이를 질문 중심 에이전트 과제로 묶었다.
이 흐름에서 눈여겨볼 점은, 연표 만들기가 늘 여러 하위 기술의 조립이었다는 것입니다. 2015년 참가 팀들은 개체 인식·의미역 분석·시간 표현 정규화·상호참조를 각각 다른 도구로 돌려 이어 붙였습니다. 도구 하나가 틀리면 뒤가 다 무너지는, 그래서 F1 7점대에 머문 파이프라인이었습니다. LLM이 나오자 반대 방향의 유혹이 생겼습니다. 문서를 통째로 넣고 "연표를 만들어 줘"라고 한 번에 묻는 것입니다. TimelineAgent는 그 둘 사이에 섭니다. 단계는 다시 나누되, 각 단계의 일꾼을 LLM으로 바꾸고, 일꾼에게 주는 도구를 단계와 질문에 맞춰 고릅니다.
2부. QUEST: 같은 문서, 세 가지 질문
과제의 정의
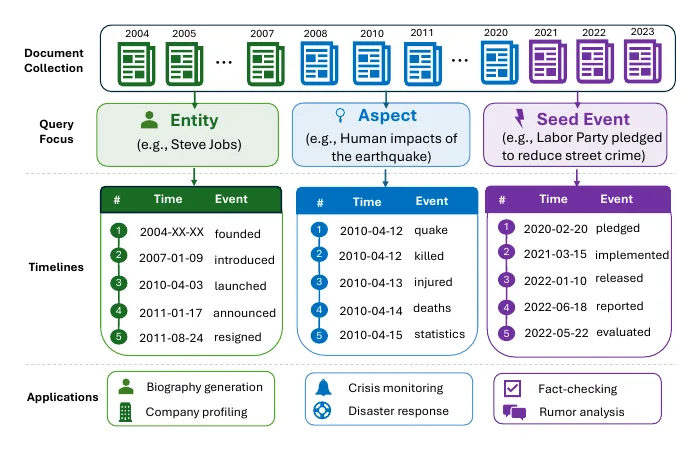
논문의 정의는 짧습니다. 문서 모음 D={D1,…,Dn}과 질문 q가 주어지면, 질문과 관련된 사건을 시간 순으로 늘어놓은 연표
Lq={(τi,Ei)}i=1mq
를 만듭니다. τi는 정규화된 날짜(YYYY-MM-DD, 모르는 자리는 X)이고, Ei는 여러 문서에서 같은 사건을 가리키는 표현을 합친 묶음입니다. 출력은 이런 모양입니다. 첫 칸은 순서, 둘째 칸은 날짜, 셋째 칸부터는 '문서번호-문장번호-사건어'입니다.
출처: Min et al., 2026, 그림 1. 같은 문서 모음(위)에서 질문(가운데)에 따라 다른 연표(아래)가 나온다.
인물·대상(Entity) 질문 — "스티브 잡스". 대상이 사건의 참여자인지를 본다. 논문은 이것을 "사건 논항(참여자)을 겨냥하는 질문"이라 부른다. 쓰임새는 전기 작성, 기업 프로필.
측면(Aspect) 질문 — "지진의 인명 피해". 사건의 의미 유형을 본다. 사망·부상 같은 유형의 사건에 더해, 그 피해를 낳은 앞선 사건(지진 발생)까지 인과로 끌어와 이야기가 되게 한다. 쓰임새는 위기 모니터링, 재난 대응.
씨앗 사건(Seed Event) 질문 — "노동당은 거리 범죄를 줄이겠다고 약속했다". 사건과 사건의 관계를 본다. 씨앗이 촉발한 후속 사건(법안 발의, 예산 집행, 평가 보고)을 따라간다. 쓰임새는 사실 확인, 소문 분석.
논문은 이 셋이 각각 사건의 참여자·유형·사건 간 관계를 겨냥하므로 "함께 사건 이해의 기초를 이룬다"고 설명합니다. 앞에서 본 편년체·기전체·기사본말체의 구분과 겹쳐 보면, 기전체는 인물 질문에, 기사본말체는 씨앗 사건과 측면 질문에 대응합니다.
작은 관찰 하나. 그림 1의 인물 연표 예시는 "2004-XX-XX founded"로 시작하고, 씨앗 사건 예시의 4번(2022-06-18)과 5번(2022-05-22)은 날짜가 거꾸로입니다. 설명용 그림이니 문제 삼을 일은 아니지만, '날짜순으로 세우는 일'이 사람에게도 실수하기 쉬운 일이라는 점을 보여 주는 장면이기도 합니다.
아래 위젯은 같은 구조를 한국어 가상 사례로 옮긴 것입니다. 가상의 도시 '가람시' 지진 기사 여섯 건에 세 질문을 던져 보세요.
세 질문에서 관련 사건이 얼마나 촘촘한지도 다릅니다. 논문 벤치마크에서 문서 한 건당 관련 사건은 씨앗 사건 질문이 평균 0.3개, 인물 질문이 9.2개, 측면 질문이 14.1개였습니다. 씨앗 사건 질문은 문서 1,475건 가운데 몇 문장만 관련이 있는, 건초 더미에서 바늘 찾기입니다. 결과에서 씨앗 사건 질문이 가장 어렵게 나오는 것도 이 희소성과 맞물립니다.
3부. 왜 어려운가: 여섯 개의 하위 문제
연표 하나를 만들려면 적어도 여섯 가지 판단을 차례로 해야 합니다. 논문 서론은 이것을 '사건 중심 정보 추출 파이프라인' 전체라고 부릅니다.
① 사건을 찾는다: 무엇이 사건인가
"두 회사 모두 기술 문제에 대해 공식 성명을 내지 않았다(Neither company made any official statement)." 여기서 사건어는 무엇일까요. '냈다(made)'는 뜻이 거의 없는 가벼운 동사(light verb)이고, 실제 사건은 명사 '성명(statement)'입니다. 그리고 이 성명은 부정되었으므로 결국 연표에서 빠져야 합니다. 논문 부록 C.3의 사례입니다. 사건 탐지는 품사와 구문 구조를 보고, 가벼운 동사와 계사(be)를 걸러 내고, 여러 단어로 된 사건(set out, accounts for)의 범위를 정하는 일입니다. TimelineAgent는 여기서 콜린스 영어 사전을 구 범위 판정의 기준으로 씁니다.
② 질문과 맞춘다: 관련 있음과 같음은 다르다
"16GB 모델은 199달러, 32GB 모델은 299달러다." 이 문장의 '가격이 매겨졌다(priced)'는 아이폰 4의 사건일까요? 논문의 오류 분석은 '아니다'라고 답합니다. '16GB 모델'은 아이폰 4의 변종일 뿐, 아이폰 4 자체를 가리키는 표현이 아니기 때문입니다. 이렇게 직접 같지는 않지만 부분–전체, 집합–원소, 기능 관계로 이어진 지시를 교량 조응(bridging anaphora)이라 부릅니다. 연표는 상호참조(같은 대상)와 교량 관계(관련 대상)를 구별해야 합니다.
씨앗 사건 질문에서는 더 미묘합니다. 노동당의 공약 "모든 초등학교에 무료 아침 클럽을 도입하겠다"와 "데번의 학교 25곳이 전국에서 가장 먼저 무료 아침 클럽을 열었다"는 낱말이 겹칩니다. 그러나 앞은 전국 정책 약속이고 뒤는 일부 학교의 지역 시행입니다. 반대로 "노동자에게 세금을 올리지 않겠다(국민보험료를 올리지 않겠다)"는 공약에 대해 "영국 가구의 소득 대비 직접세 비중은 2023~2024 회계연도 사이 22.7%로 비슷했다"는 문장은 공약 낱말이 하나도 없지만 이행 여부를 보여 주는 증거입니다. 낱말 겹침으로 거르면 앞의 것은 잘못 넣고 뒤의 것은 놓칩니다.
날짜 고정은 두 단계입니다. 먼저 시간 신호를 모읍니다. 시제(과거·현재·미래), 상(완료·진행), 시간 표현("월요일", "2004년", "지난주"), 순서 단서("이후", "1년 뒤")입니다. 다음으로 시간 추론을 합니다. 상대 표현을 기사 작성일 기준으로 계산하고, 날짜를 표준 형식으로 바꿉니다. 논문 부록 A.1의 예를 그대로 옮기면, 작성일이 2011-01-17인 기사의 "잡스는 월요일 제품을 발표했다"는 2011-01-17로, "잡스는 2004년 그 기기를 공개했다"는 2004-XX-XX로 정규화됩니다.
어려움은 두 가지입니다. 하나는 명시되지 않은 날짜입니다. "잡스는 아이폰 4의 안테나 디자인을 칭찬했다"에는 날짜가 없습니다. 이 칭찬이 6월 7일 기조연설 자리였다는 것은 다른 기사를 읽어야 압니다. 다른 하나는 형식입니다. 공식 채점기는 날짜를 문자열로 비교하므로, 정답이 "2008-02"(월까지만 앎)인데 "2008-02-XX"라고 쓰면 다른 시간으로 칩니다. 5부의 채점 위젯에서 이 효과를 직접 볼 수 있습니다.
질문과 관련이 있어도 연표에 들어갈 자격이 없는 사건이 있습니다. 실제로 일어나지 않은 사건, 그리고 시간 속성이 없는 사건입니다. 사실성(factuality) 연구의 고전인 사우리와 푸스테욥스키의 FactBank(2009)는 사건이 '확실히 일어났다 / 아마 / 가능 / 일어나지 않았다'를 체계적으로 표시했습니다. TimelineAgent는 이를 극성(부정 여부), 확실성, 사실 여부, 조건 구문의 네 가지 이진 분류 기술로 나눕니다. 인물 질문의 규칙은 이렇습니다. 'will'로 수식된 미래 사건은 사실로 보고 넣는다. 조건 구문 속 사건은 '조건부'로 표시하고 뺀다.
논문이 자격 심사를 관련성 판단과 따로 둔 이유가 흥미롭습니다. 자격은 질문의 내용이 아니라 질문의 유형과 연표 일반의 요건에 달려 있기 때문입니다. 그리고 이 단계는 날짜 고정 뒤에 둡니다. 씨앗 사건 질문처럼 "2024년 7월 이후"라는 기간 제한이 붙는 경우가 있어서입니다.
마지막으로 여러 문서에서 같은 실제 사건을 가리키는 표현을 하나로 합칩니다. 문서 횡단 사건 상호참조입니다. 논문의 예를 보면, "잡스가 발표했다"가 두 번 나와도 하나는 2010년 10월의 'Mac OS X 라이언 발표'이고 다른 하나는 2011년 1월의 '병가 발표'라면 다른 사건입니다. 의미 유형이 맞는지 먼저 보고, 다음에 참여자(논항)와 앞 단계에서 정한 날짜가 맞는지 봅니다. 측면 질문에서 이 단계가 특히 중요합니다. 지진 하나를 두고 여러 기사가 같은 '사망'을 반복해서 말하기 때문입니다.
⑥ 이 모든 것이 질문마다 다르다
여기까지가 공통 문제라면, QUEST를 정말 어렵게 만드는 것은 같은 단계라도 질문 유형마다 필요한 판단이 다르다는 점입니다. 인물 질문의 관련성은 의미역(PropBank)과 상호참조로 판단하고, 측면 질문의 관련성은 의미 유형 분류와 인과 지식(ConceptNet)으로, 씨앗 사건의 관련성은 의미 유사도와 FrameNet 논항과 인과로 판단합니다. 논문의 표현을 빌리면 QUEST는 "구문·의미·논항·시간·인과·사실성이라는 이질적인 사건 특징"을 모두 다뤄야 합니다. 한 번의 프롬프트에 이 모든 지시를 다 넣으면 어떻게 될까요. 4부의 답이 여기서 출발합니다.
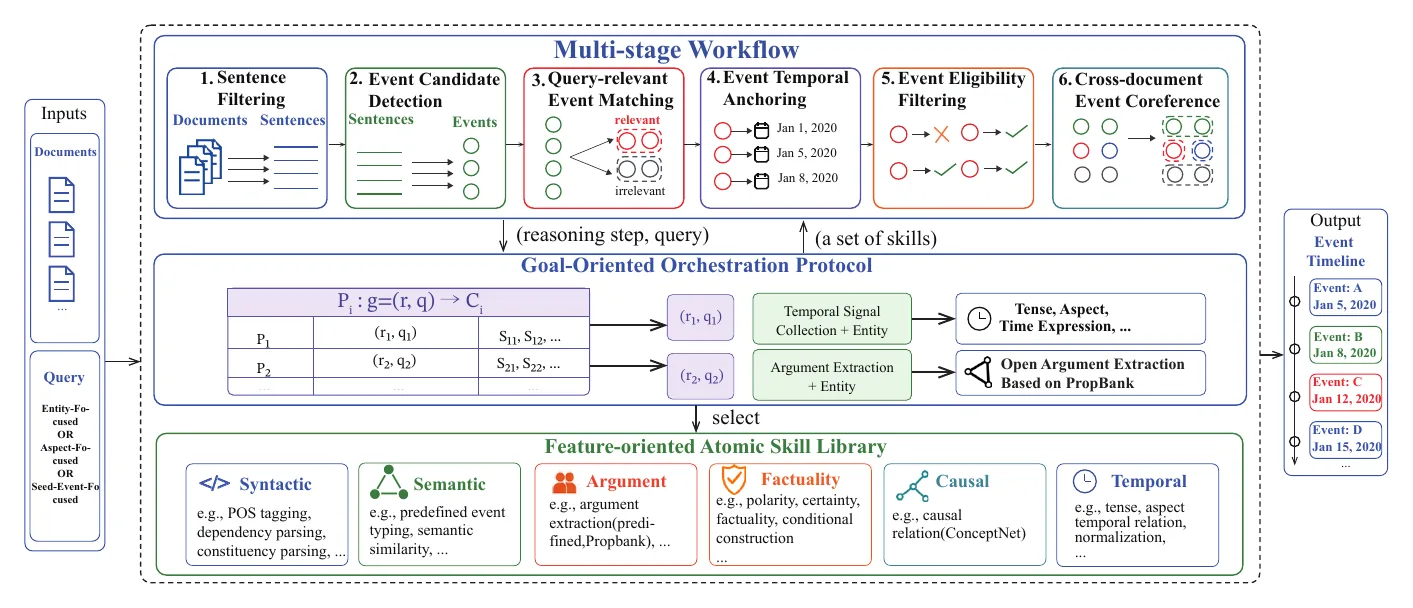
출처: Min et al., 2026, 그림 2. 위층(다단계 작업 흐름)이 무엇을 할지를, 가운데층(조율 규약)이 어떤 도구를 쓸지를, 아래층(기술 서재)이 도구 자체를 맡는다.
그림 2는 세 층으로 읽으면 쉽습니다. 위층의 작업 흐름은 순서를 정합니다. 아래층의 기술 서재는 능력을 담습니다. 가운데층의 조율 규약은 "지금 이 단계에서, 이 질문에 대해, 어떤 능력을 어떤 설정으로 꺼낼지"를 정합니다. 주방에 비유하면 작업 흐름은 코스 순서, 기술 서재는 칼과 냄비가 걸린 벽, 조율 규약은 코스마다 붙은 조리 카드입니다.
각 단계는 전담 에이전트가 맡고, 단계의 출력이 다음 단계의 입력이 됩니다. 논문은 이 설계를 "복잡한 추론 과정을 분리하고, 중간 사건 표현을 점진적으로 다듬는다"고 설명합니다.
문장 거르기. 질문과 닿을 법한 문장만 남깁니다. 사건 수준의 판단 없이 높은 재현율을 목표로 넓게 거릅니다. 인물 질문이면 대상 이름·별칭·대명사가 나온 문장입니다. 이 단계만으로 인물·측면·씨앗 사건 질문에서 각각 약 50%·30%·90%의 문장이 빠져 이후 계산량이 줄어듭니다.
사건 후보 찾기. 남은 문장에서 사건어를 찾습니다. 이 결과는 질문과 상관없는 '공유 사건 공간'입니다. 품사와 구성성분 구조로 후보를 뽑고, 범위 규칙과 사전으로 경계를 맞춘 뒤, 의존 구문으로 가벼운 동사와 계사를 걸러 냅니다.
질문과 맞추기. 여기서 질문 유형별로 길이 갈립니다. 인물 질문은 PropBank 의미역으로 논항을 뽑고 상호참조·교량 관계로 대상과 잇습니다. 측면 질문은 7개 위기 측면 유형으로 분류하고 ConceptNet 인과 지식으로 앞선 사건을 끌어옵니다. 씨앗 사건 질문은 의미 유형과 상식·인과 추론으로 관련 사건을 찾고, 사전 정의 스키마와 FrameNet으로 참여자·범위를 확인합니다.
날짜 고정. 시간 신호를 모은 다음 날짜를 계산·정규화합니다. 기사 작성일이 문서들을 하나의 시간축으로 잇는 기준점입니다.
자격 심사. 극성·확실성·사실 여부·조건 구문으로 일어나지 않은 사건을 걸러 냅니다. 질문이 정한 기간도 여기서 적용합니다.
같은 사건 합치기. 의미 유형이 맞는지 본 뒤, 논항과 날짜의 일관성을 확인해 묶습니다. 묶인 사건을 날짜순으로 세우면 연표가 됩니다.
효율을 위해 두 가지 장치도 있습니다. 하나는 1단계의 문장 거르기이고, 다른 하나는 같은 문장의 사건을 한 번에 처리하는 것입니다. 사건마다 따로 묻지 않고 문장 단위로 묶어 묻습니다. 논문은 그 결과 단계마다 한 번씩만 묻는 다단계 ICL보다 약 2.1배, 과제를 자동 분해하는 범용 에이전트 TDAG가 약 4배의 추론 호출을 쓴다고 보고합니다. 그래도 전체 추론 한 번에 약 10시간이 걸렸습니다.
4-2. 원자 기술 서재
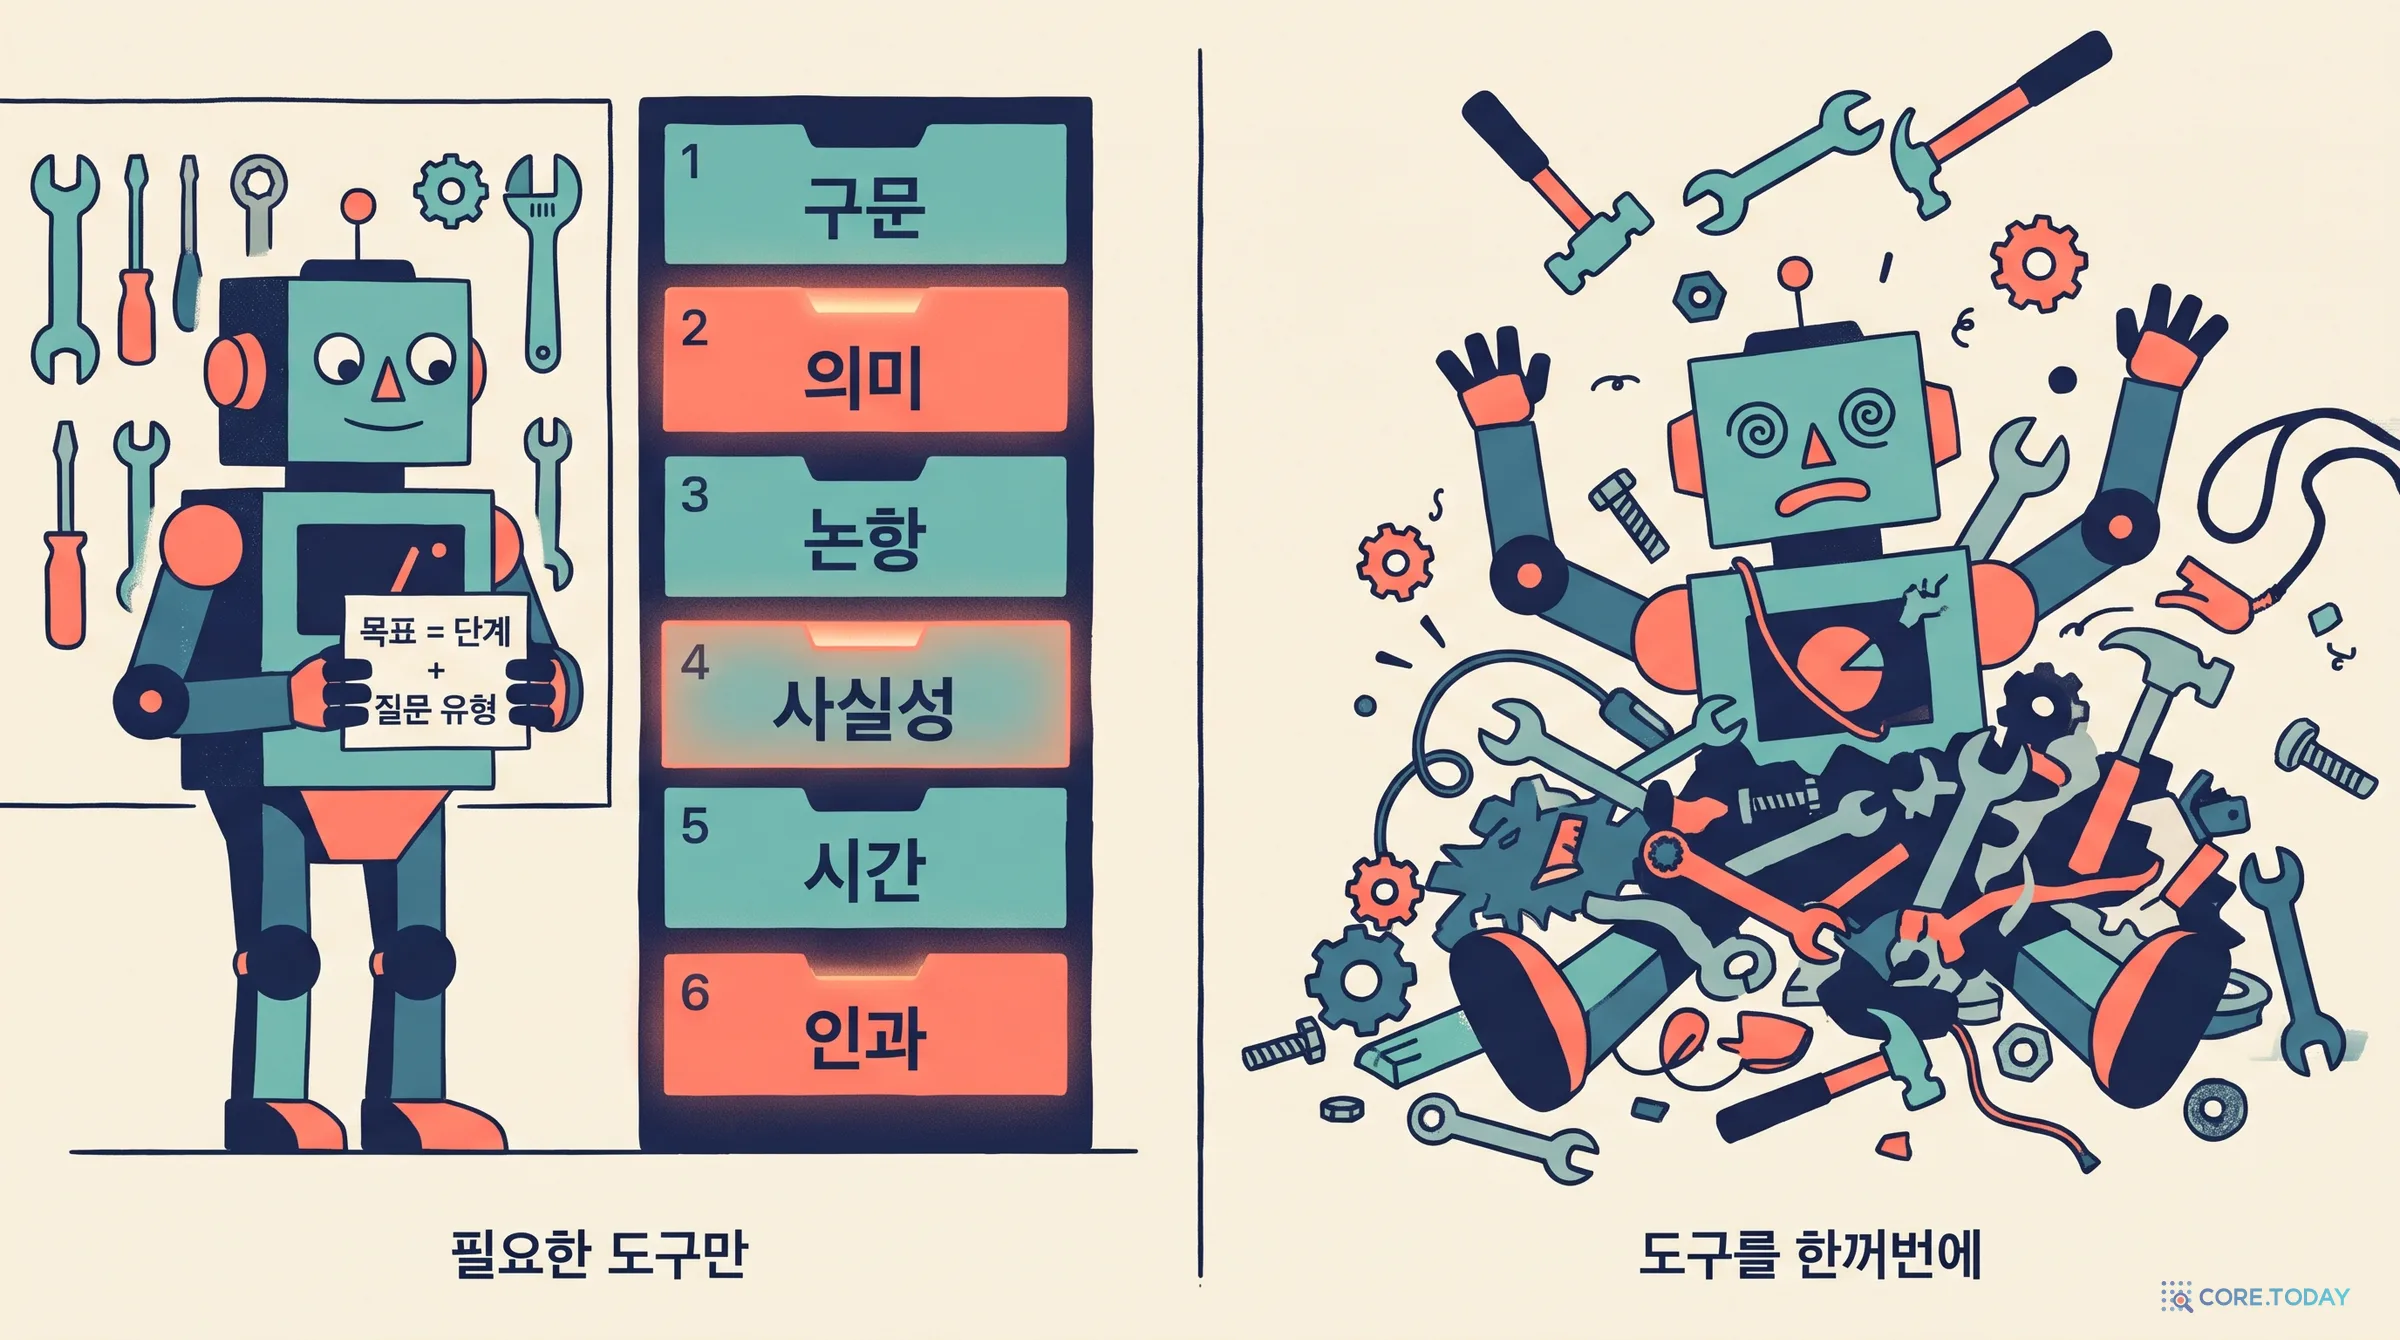
두 번째 층은 특징 지향 원자 기술 서재(Feature-oriented Atomic Skill Library)입니다. 사건의 이질적인 특징을 여섯 범주, 21개의 재사용 가능한 원자 기술로 쪼갰습니다(논문 표 6).
범주
원자 기술
설정(바꿀 수 있는 부분)
구문
품사 태깅, 구성성분 분석, 의존 분석, 구 범위 판정
콜린스 영어 사전(구 범위)
의미
사건 유형 분류, 의미 유사도
사전 정의 의미 범주
논항
논항 추출, 개체 상호참조, 교량 조응
PropBank / FrameNet / 사전 정의 스키마
사실성
극성, 확실성, 사실 여부, 조건 구문
확실성·사실성 레이블
시간
시간 표현 추출, 시제, 상, 순서 단서, 정규화, 날짜 계산, 시간 관계 분류
시간 관계 레이블 집합
인과
인과 관계 분류
ConceptNet 인과 지식
중요한 구현 사실 하나. 이 기술들은 실제 구문 분석기나 사전 API를 부르는 것이 아니라 모두 제약된 프롬프트 모듈입니다(부록 A.2.2). 각 기술은 "너는 원자적 사건 모델링 기술 전문가다. 정해진 레이블 공간을 따르고, 맡은 일만 하고, JSON으로 답하라"는 공통 틀 위에, 과제 목표와 설정(예: 논항 스키마는 PropBank)을 끼워 넣어 만듭니다. 출력은 {"event", "prediction", "confidence"} 같은 통일된 JSON입니다. 그래서 기술끼리 자유롭게 조합할 수 있습니다. 시간 기술 세 개(시제·상·시간 표현)를 묶어 '시간 신호 수집'을 만드는 식입니다.
왜 굳이 이렇게 잘게 쪼갤까요. 논문은 "서로 다른 추론 과정 사이의 간섭을 줄인다"고 말합니다. "시제를 판단하라"와 "이 사건이 조건문 속에 있는지 판단하라"를 한 프롬프트에 섞으면, 모델은 둘 중 하나를 대충 합니다. 맡은 일이 하나뿐이면 출력 형식도 단순해지고, 틀렸을 때 어디서 틀렸는지도 보입니다.
세 번째 층이 이 논문의 핵심 아이디어입니다. 기술 서재 전체를 에이전트에게 보여 주는 대신, 명시적인 규약이 기술을 골라 준다. 논문은 서재 전체를 노출하면 "기술 수준의 주의 분산과 맥락 오염"이 생긴다고 봅니다. 규약은 이렇게 형식화됩니다.
g=(r,q),Pi:g→Ci,Ci=(O,Φ)
추론 목표 g는 추론 하위 단계 r과 질문 유형 q의 쌍입니다. 규약 항목 Pi는 목표를 조율 설정 Ci에 대응시키고, 설정은 기술 조합 O(예: 시제+상+시간 표현)와 기술별 설정 Φ(예: 논항 스키마로 PropBank를 쓸지 FrameNet을 쓸지)로 이루어집니다. 예를 들어 g = (질문과 맞추기, 인물)이면 O = {논항 추출, 개체 상호참조, 교량 조응}, Φ = {스키마: PropBank}입니다. g = (질문과 맞추기, 씨앗 사건)이면 O = {의미 유사도, 논항 추출, 인과}, Φ = {스키마: 사전 정의 + FrameNet}으로 바뀝니다.
아래 위젯에서 단계와 질문 유형을 바꿔 가며 어떤 기술이 켜지는지 보세요. '규약 없이 전부 보여 주기'를 켜면 21개가 모두 켜진 상태, 곧 논문의 비교 조건(w/o Protocol)이 됩니다.
이 설계는 2026년 에이전트 업계의 흐름과도 맞닿아 있습니다. 2025년 가을 이후 에이전트 제품들은 '기술(skill)'을 파일 단위로 묶어 두고, 지금 필요한 기술의 설명만 맥락에 불러오는 방식을 앞다퉈 들였습니다. 도구 수십 개를 한꺼번에 프롬프트에 넣으면 모델이 엉뚱한 도구를 고르거나 지시를 섞는다는 경험이 쌓였기 때문입니다. TimelineAgent의 규약은 그 '필요할 때만 꺼내기'를, 에이전트 스스로의 판단이 아니라 사람이 미리 써 둔 표(단계 × 질문 유형)로 고정한 버전입니다. 유연성은 덜하지만 예측 가능하고, 무엇이 왜 켜졌는지 감사할 수 있습니다. 논문이 비교한 범용 에이전트 TDAG는 반대쪽 끝입니다. 과제를 스스로 하위 과제로 쪼개고 하위 에이전트를 만듭니다. 결과는 6부에서 봅니다.
5부. 벤치마크와 채점
세 데이터를 하나의 형식으로
질문 중심 연표 데이터는 거의 없습니다. 항암 치료 연표 데이터(ChemoTimelines 2024)는 데이터 사용 협약 때문에 공개할 수 없습니다. 그래서 저자들은 기존 데이터 셋을 가져와 고치고 새로 주석을 달았습니다.
질문 유형
원천
무엇을 새로 했나
문서 · 사건 · 연표
인물·대상
SemEval-2015 Task 4 (위키뉴스)
그대로 사용
120 · 1,102 · 42
측면
EventStoryLine + ECB+ 상호참조
7개 위기 측면으로 사건 분류(카파 0.85), 문서 내 시간·인과 관계를 연표로 변환
46 · 647 · 28
씨앗 사건
PledgeTracker (영국 공약 이행)
공약을 씨앗으로, 원문의 행위 수준 사건어를 새로 주석(일치도 F1 81%)
1,475 · 406 · 26
측면 질문의 7개 위기 유형은 소셜미디어 재난 정보 연구에서 왔습니다. ① 상황·위험 ② 사람 피해 ③ 기반시설·생명선 ④ 필요·도움 ⑤ 대응·복구 ⑥ 위험 소통 ⑦ 출처·신뢰도입니다. 예를 들어 2005년 11월 이란 케슘섬 지진 기사 11건에서 "여섯 번째 여진이 섬을 흔들었다(상황·위험)", "10명이 숨지고 최소 50명이 다쳤다(사람 피해)", "관리들과 국영 매체가 밝혔다(출처·신뢰도)"처럼 사건마다 측면을 붙이고, 인과 관계가 허락하는 앞선 사건(지진→여진)만 함께 연표에 넣었습니다.
씨앗 사건의 원천인 PledgeTracker는 케임브리지대와 영국 사실 확인 기관 풀팩트(Full Fact)가 함께 만든, 2024년 총선 노동당 공약의 이행을 추적하는 시스템입니다. 원래는 사건을 "축구 독립 규제 기관 설립 법안이 하원 2독회를 통과했다" 같은 요약 문장으로 표시했는데, 저자들은 이를 원문 문장의 사건어 수준(second_Reading, added)으로 다시 주석했습니다. 문서 1,475건에 관련 사건 406개, 씨앗 사건 질문이 왜 희소한지 숫자로 보입니다.
시간 그래프로 채점한다
채점은 SemEval-2015 TimeLine의 공식 방식을 그대로 따릅니다. 연표를 그대로 비교하지 않고 시간 그래프로 바꿔 비교합니다. 사건과 날짜가 노드가 되고, 사건마다 자기 날짜와 '동시(SIMULTANEOUS)' 관계로, 이웃한 사건끼리는 '앞(BEFORE)'이나 '동시' 관계로 이어집니다. 그다음 TempEval-3의 '시간 인지도(temporal awareness)' 지표로 비교합니다. 정밀도는 시스템 그래프의 관계 중 정답 그래프(의 추이적 폐포)에서 확인되는 비율이고, 재현율은 그 반대입니다.
이 방식의 장점은 사건 선택·날짜·문서 간 상호참조를 한 점수로 함께 잰다는 것입니다. 단점도 그만큼 분명합니다. 날짜를 문자열로 비교하고, 순서 0번(날짜도 순서도 정할 수 없는 사건)은 채점하지 않습니다. 아래 위젯은 실제 정답 연표 'iPhone 4'를 일부러 망가뜨려 공식 채점기로 잰 결과입니다.
몇 가지가 눈에 띕니다. 사건을 하나 빠뜨리는 것보다 같은 사건을 기사 날짜로 흩어 놓는 쪽(87.7)이 더 아픕니다. 사건 선택이 완벽해도 모든 사건에 기사 작성일을 붙이면 37.8점입니다. 그리고 날짜를 하나도 못 정하면, 사건을 다 맞혔더라도 0점입니다. 고르기·날짜·합치기가 서로 곱해지는 구조라서, 어느 하나가 무너지면 나머지가 좋아도 점수가 크게 깎입니다.
6부. 결과 읽기
비교 대상
논문은 네 종류와 겨룹니다. 2015년식 수작업 파이프라인 DLT(라파라 등, 문서 단위 시간 고정), 문서 모음을 통째로 넣고 연표를 만들라고 하는 ICL(in-context learning, 몇 개 예시를 곁들인 한 번에 묻기), 소량의 정답 연표로 LoRA 미세조정한 SFT, 그리고 과제를 스스로 쪼개고 하위 에이전트를 만드는 범용 멀티 에이전트 TDAG입니다. TDAG는 ReAct나 Plan-and-Solve 같은 에이전트 방식보다 복잡한 추론 과제에서 낫다고 보고된 강한 기준선입니다. 백본은 DeepSeek-V3(671B, API)와 Qwen3-32B(A100 80GB 네 장에 직접 배포)이고, 온도는 0입니다.
표 3: 같은 모델, 두 배 이상
방법
인물 F1
측면 F1
씨앗 사건 F1
DLT (2015)
14.3
—
—
Qwen3-32B · ICL
14.4
25.8
10.1
Qwen3-32B · TDAG
17.6
30.2
14.3
Qwen3-32B · SFT
25.8
35.5
20.9
Qwen3-32B · TimelineAgent
32.1
38.9
27.3
DeepSeek-V3 · ICL
17.5
28.2
12.5
DeepSeek-V3 · TDAG
29.6
36.4
23.7
DeepSeek-V3 · TimelineAgent
37.9
42.9
33.1
세 가지가 읽힙니다. 첫째, 같은 DeepSeek-V3로 한 번에 물으면 17.5인 인물 질문이 TimelineAgent로는 37.9가 됩니다. 씨앗 사건은 12.5에서 33.1, 2.6배입니다. 모델을 바꾸지 않고 일을 나누는 방식만으로 얻은 차이입니다. 둘째, Qwen3-32B로 만든 TimelineAgent(32.1)가 스무 배 큰 DeepSeek-V3로 돌린 범용 에이전트 TDAG(29.6)보다 높습니다. 논문은 이를 "과제 특화 추론 조직과 사건 모델링의 중요성"이라고 해석합니다. 셋째, 그래도 최고점은 30~40점대입니다. 씨앗 사건이 가장 어렵고, 인물, 측면 순입니다. 앞에서 본 관련 사건 밀도(문서당 0.3·9.2·14.1개)와 거의 반비례합니다.
DeepSeek-V3 TDAG의 인물 질문 결과도 흥미롭습니다. 재현율은 44.3으로 TimelineAgent(38.6)보다 높은데 정밀도가 22.2에 그칩니다. 스스로 과제를 쪼개는 에이전트는 사건을 많이 주워 오지만 거르지 못합니다. 자격 심사와 관련성 판단을 별도 단계로 강제한 설계가 정밀도(37.2)로 돌아온 셈입니다.
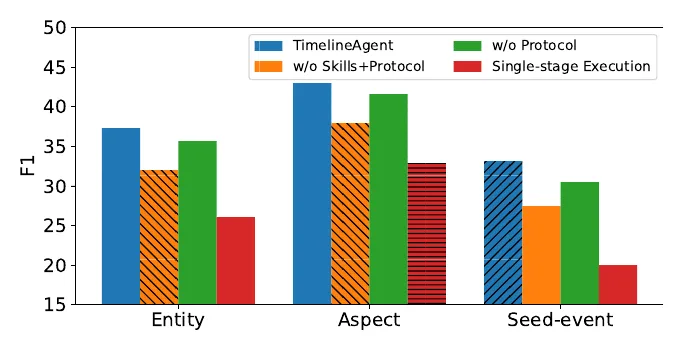
구성 요소를 하나씩 뺀 결과입니다(그림에서 읽은 근삿값). 기술과 규약을 둘 다 빼고 각 단계에 목표만 주면 인물 약 37→32, 측면 43→38, 씨앗 33→27.5로 떨어집니다. "높은 수준의 추론 목표만으로는 사건 중심 추론에 부족하다"는 뜻입니다. 규약만 빼고 기술을 평평하게 전부 보여 주면 1~3점 손해입니다. 기술은 여전히 쓸모 있지만, 다 보여 주면 덜 쓸모 있습니다.
그런데 가장 큰 하락은 따로 있습니다. 기술과 규약을 다 주되 여섯 단계를 한 단계로 몰아서 실행하면 인물 약 26, 씨앗 사건 약 20으로 무너집니다. 기술을 뺀 것보다 훨씬 나쁩니다. 좋은 도구와 좋은 조리 카드가 있어도, 코스를 한꺼번에 내라고 하면 요리가 망가지는 셈입니다. 이 논문에서 가장 일반화할 만한 교훈이 이것이라고 봅니다.
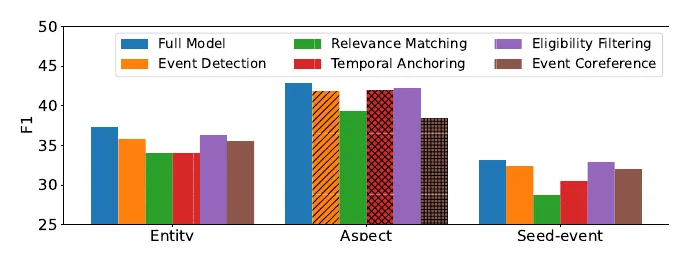
그림 4는 단계 하나씩을 '기술도 다단계 추론도 없는 한 번 묻기'로 바꾼 결과입니다. 모든 질문에서 가장 크게 떨어지는 것은 질문과 맞추기입니다(씨앗 사건 약 33→29). 날짜 고정은 시간 폭이 넓은 인물·씨앗 질문에서 중요하고(인물 약 37→34), 같은 사건 합치기는 측면 질문에서 중요합니다(약 43→38). 지진 하나를 두고 비슷한 사건이 좁은 시간 안에 반복되기 때문입니다.
표 4는 반대 방향의 실험입니다. 한 단계의 출력을 정답으로 바꿔 끼우고 나머지는 그대로 돌립니다. 어디가 병목인지 보는 방법입니다.
TimelineAgent (인물)
37.9
+ 정답 사건 고르기
67.6
+ 정답 날짜
55.6
+ 정답 합치기
42.1
사건 탐지·매칭·거르기를 정답으로 주면(데이터가 이 셋을 따로 주석하지 않아 한 덩어리로 묶었습니다) 인물 37.9→67.6, 측면 42.9→69.8, 씨앗 33.1→71.4로 30점 넘게 뜁니다. 날짜를 정답으로 주는 효과는 인물(55.6)에서 크고, 합치기를 정답으로 주는 효과는 측면(56.1)에서 큽니다.
부록 C.2의 해석이 정확합니다. 처음에 사건을 잘못 고르면, 뒤의 날짜 고정과 합치기가 그 자체로는 맞더라도 최종 연표는 틀립니다. 틀린 사건 집합 위에 지어졌기 때문입니다. 여섯 단계는 독립된 여섯 문제가 아니라 앞이 뒤를 결정하는 사슬이고, 그 사슬의 가장 약한 고리가 맨 앞에 있습니다.
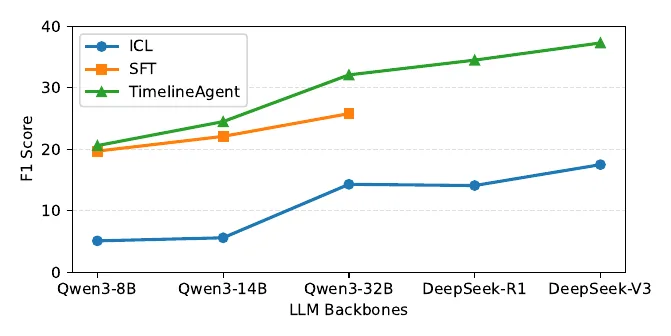
그림 5(인물 질문)에서 ICL은 Qwen3-8B·14B에서 5점대, 사실상 작동하지 않습니다. SFT와 TimelineAgent는 8B에서 약 20점으로 비슷하다가, 32B에서 25.8 대 32.1로 벌어집니다. 논문의 해석은 이렇습니다. 쪼갠 하위 문제를 잘 푸는 데는 강한 추론 능력이 필요하고, 그래서 모델이 클수록 이 틀의 이득이 커진다. 반면 32B에서 671B로 가는 이득(32.1→약 37)은 줄어듭니다. "모델 크기만으로는 더 이상 결정적이지 않다"는 것이 저자들의 말입니다.
SFT는 학습 연표 5~6개라는 극단적 저자원 조건이었습니다. 표 5는 이를 공정하게 따져 보려 학습 데이터를 다섯 배까지 늘린 실험입니다. 인물 질문 SFT는 6개→18개→30개에서 25.8→28.6→29.9로 오르지만 상승 폭이 줄고, 같은 32B TimelineAgent(32.1)에 못 미칩니다. 다만 측면 질문에서는 큰 SFT(39.5)가 TimelineAgent(38.9)를 0.6점 앞섭니다. 데이터가 충분하면 미세조정도 따라온다는 정직한 결과입니다. 그래도 TimelineAgent의 장점은 남습니다. 질문 유형마다 따로 모델을 학습시킬 필요가 없습니다.
7부. 코어닷투데이 실측: 로컬 9B로 다시 해 보기
논문의 코드는 아직 공개되지 않았지만, 인물 질문의 원천 데이터는 공개돼 있습니다. SemEval-2015 Task 4의 시험(trial) 데이터, 곧 위키뉴스 애플 기사 30건(2005~2011년, 약 1만 토큰)과 정답 연표 6개(스티브 잡스, iPhone 4, iPhone 3G, iPod, iTunes 스토어, 비틀스 애플 코어)입니다. 공식 채점기도 내려받을 수 있습니다. 코어닷투데이는 이것으로 논문의 핵심 주장, 즉 "같은 모델이라도 일을 나누면 훨씬 잘한다"를 작은 규모로 확인해 봤습니다.
실험 설계
항목
설정
모델
qwen3.5:9b 하나 (로컬 Ollama, 온도 0, 사고 모드 끔, JSON 스키마로 출력 고정)
데이터
SemEval-2015 Task 4 시험 데이터: 기사 30건, 연표 6개, 정답 사건 표현 192개(채점 대상 179개)
채점
공식 v3 채점기를 파이썬 3로 옮긴 것(원본 예시 점수 재현 확인), 마이크로 F1
비교
① 기사 30건 통째로 한 번에 묻기 ② 문서마다 한 번에 묻기 ③ 6단계 파이프라인 ④ ③에서 단계 하나씩 빼기 ⑤ 정답 사건을 주고 날짜·합치기만 하기
6단계 파이프라인은 논문의 부록 A.2를 따라 짠 축소판입니다. 1단계는 문서 전체를 보여 주고 대상이 나오는(대명사·별칭 포함) 문장 번호를 넓게 고르게 합니다. 2단계는 문장마다 동사와 사건 명사를 빠짐없이 나열하게 한 뒤, 조동사·계사·조동사 'have'·가벼운 동사를 코드 규칙으로 지웁니다. 3단계는 사건마다 행위자(ARG0)와 대상(ARG1)을 쓰게 하고, 대상 인물이 그 자리를 '그 자체로' 채우는지, 관련만 있는지(교량 관계)를 고르게 합니다. 4단계는 기사 작성일과 요일을 주고 시제·시간 표현·작성일과의 관계를 먼저 쓴 다음 날짜를 쓰게 합니다. 5단계는 극성·확실성·조건 여부를 따로 묻고, 6단계는 같은 연표 안의 사건 목록을 주고 같은 실제 사건끼리 묶게 한 뒤, 묶음 안에서 가장 구체적인 날짜를 전체에 퍼뜨립니다.
두 가지는 논문과 다릅니다. 첫째, 3단계는 문장마다가 아니라 '연표 × 문서'마다 한 번씩, 그 문서의 후보 사건을 모두 넣어 물었습니다. 공유 GPU에서 9B 처리량이 분당 15건 안팎이라 문장 단위로는 3단계만 1,091번을 불러야 했기 때문입니다. 판단은 여전히 사건 하나하나에 대해 받습니다. 둘째, 논문의 실제 프롬프트·레이블 공간은 공개되지 않아 부록의 틀을 바탕으로 직접 썼습니다. 그러니 이 실험은 논문의 재현이 아니라 논문의 구조를 따른 축소판이고, 모델도 논문의 Qwen3-8B가 아니라 qwen3.5:9b입니다. 파이프라인 한 벌에 9B 호출이 1,198번, 공유 GPU에서 약 1시간 15분이 걸렸습니다.
결과
숫자부터 정리하면 이렇습니다.
한 번에 묻기 (30건 통째)
5.6
문서마다 한 번에 묻기
10.6
6단계 · 9B가 묶은 대로 합치기
4.0
6단계 + 날짜 호환성 검사
11.5
6단계 − 자격 심사 − 합치기
11.7
정답 사건 + 9B 날짜만
52.0
① 한 번에 묻기는 9B에서 사실상 작동하지 않는다. 기사 30건을 통째로 넣은 한 번에 묻기는 F1 5.6(정밀도 8.0, 재현율 4.3)이었습니다. 논문 그림 5의 Qwen3-8B ICL이 약 5.1이었으니, 모델과 프롬프트가 달라도 거의 같은 자리에 떨어졌습니다. 출력을 보면 이유가 보입니다. 모델은 연표마다 사건 6~32개만 내놓았고, 주로 각 기사의 첫 문장(제목 다음 문장)에서 대표 동사 하나씩을 집었습니다. 1만 7천 토큰 안에서 질문과 관련된 문장을 다 찾아 읽는 일을 하지 않은 셈입니다. 덧붙여, 예시 프롬프트에 가상의 문서 번호를 'D1'처럼 썼더니 모델이 실제 문서 번호에도 'D'를 붙여(D4596-…) 처음에는 0점이 나왔습니다. 한 번에 묻기는 이런 작은 형식 차이에도 통째로 무너집니다.
② 일을 나누면 두 배가 된다 — 그런데 나누는 방식에 따라 이득이 다르다. 문서마다 한 번씩 묻기만 해도 10.6, 6단계로 나누면(합치기·자격 심사를 뺀 최고 설정) 11.7로 두 배가 됩니다. 흥미로운 것은 연표별 점수입니다(위젯의 '연표별 점수'). 문서마다 묻기는 스티브 잡스 연표에서 31.6으로 가장 높았지만, 제품 연표(iPhone 4·iPod·iTunes)에서는 1.8~4.4에 그쳤습니다. 모델이 "이 문서에 iPod의 사건이 없다"고 말하지 못하고, 거의 모든 문서에서 무언가를 찾아냈기 때문입니다(정밀도 6.8%). 6단계 파이프라인은 잡스 연표가 23.9로 낮아진 대신 iPhone 4가 13.5, iTunes 스토어가 8.5로 올랐습니다. 사건 후보를 먼저 뽑고 "이 대상이 행위자인가 대상인가"를 따로 묻는 구조가 제품 연표의 정밀도를 조금 살렸습니다.
③ 그래도 논문 수준과는 거리가 멀다. 논문의 8B TimelineAgent는 약 20.6, 우리 축소판의 최고는 11.7입니다. 논문의 프롬프트·레이블 공간·문장 단위 3단계를 그대로 쓰지 못한 탓도 있겠지만, 아래 두 가지 실패가 더 직접적입니다.
④ 9B는 '같은 사건'이 아니라 '같은 주제'로 묶는다. 가장 극적인 결과는 6단계입니다. 9B가 묶은 대로 합치고 묶음 전체에 날짜를 퍼뜨리면 점수가 11.6에서 4.0으로 무너집니다. 묶음을 열어 보니 잡스의 병가 발표·투병·간 이식·사임·후임 결정 표현 30개가 한 묶음, iTunes 스토어 연표는 108개 전부가 한 묶음이었습니다. 지시문에 "같은 실제 사건(같은 행위, 같은 참여자, 호환되는 시간)만 묶으라", "다른 것을 발표한 두 '발표'는 다른 사건"이라고 썼는데도 그랬습니다. 논문 6단계의 '시간 호환성' 판단을 코드 규칙으로 걸자(묶음 안에 날짜가 둘 이상이면 묶지 않음) 11.5로 회복했지만, 합치기를 아예 안 한 것(11.6)과 같아졌을 뿐입니다. 이 데이터에서 9B의 합치기는 날짜를 물려줘 얻는 이득보다 잘못 묶어 잃는 손해가 컸습니다. 코어닷투데이가 같은 사건 묶기 5편에서 "합침 금지 규칙이 로컬 모델을 구한다"고 정리한 것과 같은 현상입니다.
⑤ 9B의 자격 심사는 정답을 버린다. 자격 심사를 빼면 오히려 0.1~2점 오릅니다. 정답 사건을 준 실행에서 9B의 5단계가 걸러 낸 정답 사건은 23개였고, 그중에는 "잡스가 어제 세상을 떠났다(died)", "1년 뒤 그는 쫓겨났다(fired)", "잡스는 안테나 문제를 인정했다(admitted)"가 있었습니다. 부정도 조건도 아닌 확정 사건입니다. 문장 안의 다른 부정어("not yet mentioned")나 인용문의 조건절에 끌려간 것으로 보입니다.
⑥ 첫 단추: 정답 사건만 주면 52점. 1~3단계를 정답으로 바꿔 끼우고 9B는 날짜만 정하게 하자 52.0이 나왔습니다. 9B 파이프라인 최고(11.7)의 4.4배입니다. 논문 표 4에서 DeepSeek-V3가 37.9→67.6으로 뛴 것과 같은 방향이고, 비율은 더 큽니다. 같은 정답 사건에 날짜를 모두 기사 작성일로 붙인 기준선은 39.7이니, 9B의 날짜 추론은 기준선보다 12점을 더 얻었습니다. 정답 사건 표현 178개 중 9B가 날짜를 정답과 똑같이 쓴 것은 92개(51.7%)였습니다.
9B가 단계마다 남긴 것
위젯에서 스티브 잡스 사망 기사(18355)를 고르고 단계를 넘겨 보면, 9B 파이프라인의 정답 사건이 어디서 사라지는지 보입니다. 깔때기로 세면 정답 사건 표현 196개(0번 포함) 중 1단계 문장 거르기를 통과한 것이 190개(97%), 2단계 후보로 뽑힌 것이 152개(78%), 3단계에서 '잡스가 참여자'로 판정된 것이 112개(57%), 자격 심사를 통과한 것이 102개(52%), 날짜까지 맞은 것이 49개(25%)입니다. 반대편도 봐야 합니다. 3단계를 통과한 사건은 모두 661개로 정답의 세 배가 넘습니다.
과잉 포함의 대표 사례가 '비틀스 애플 코어' 연표입니다. 정답 사건은 13개인데 9B는 183개를 넣었습니다. 넣은 사건의 대부분은 비틀스의 회사 애플 코어가 아니라 애플(Apple Inc.)의 사건이었습니다. "유럽연합 집행위원회가 애플에 영국 iTunes 가격을 내리라고 강제했다"의 '애플'을 애플 코어로 본 것입니다. 3부에서 말한 '같은 이름, 다른 대상' 문제가 교과서처럼 나타난 장면입니다. SemEval-2015 데이터를 만든 사람들이 굳이 이 연표를 시험 데이터에 넣은 이유를 알 것 같습니다.
날짜는 얼마나 맞히나
12문항에서 9B는 5개를 맞혔습니다(오라클 실행 기준). 틀린 방식이 흥미롭습니다. "1년 뒤 쫓겨났다"는 앞 문장의 1984년이 아니라 기사 작성일(2011-10-06)에서 1년을 빼 2010-10-06이라고 답했습니다. "2004년에 싸웠다"는 '2004-01-01'처럼 모르는 월·일을 1월 1일로 채웠습니다. 형식 규칙(모르면 X)을 어긴 것이라 문자열 비교에서 틀립니다. "2주도 안 된 전에 공개했다"는 작성일에서 14일을 빼 6월 2일로 계산했습니다. 그럴듯하지만, 같은 사건을 말하는 다른 기사의 "어제 공개했다"를 보지 못하면 정답(6월 7일)에 닿을 수 없습니다. 반대로 사임(resigned)과 2007년 9월의 발표에는 기사 작성일을 그대로 붙였는데, 정답은 각각 'XXXX-XX-XX'와 '2007-09-XX'입니다. 날짜 고정이 '계산'만이 아니라 '주석 관행을 따르는 일'이기도 하다는 것을 보여 줍니다.
이 실측이 말해 주는 것과 말해 주지 않는 것
말해 주는 것은 세 가지입니다. 첫째, 작은 모델에서 한 번에 묻기는 거의 0점이고, 일을 나누면 두 배가 된다는 논문의 방향은 이 축소판에서도 그대로 나타났습니다. 둘째, 병목은 맨 앞입니다. 정답 사건을 주는 것만으로 4.4배가 됐고, 9B가 실제로 잃은 것은 '무엇이 이 대상의 사건인가'를 가리는 3단계의 정밀도였습니다. 셋째, 단계를 나눈다고 각 단계가 저절로 좋아지지는 않습니다. 합치기와 자격 심사는 9B에게 맡기자 오히려 해가 됐습니다. 단계 분할의 이득은 각 단계의 일꾼이 그 단계를 감당할 수 있을 때만 생깁니다. 논문이 그림 5에서 "모델이 클수록 이 틀의 이득이 커진다"고 쓴 것을 반대쪽에서 확인한 셈입니다. 그리고 감당하지 못하는 단계는, 날짜 호환성 검사처럼 코드 규칙으로 막거나 아예 빼는 편이 낫습니다.
말해 주지 않는 것도 분명합니다. 연표 6개·정답 사건 192개의 작은 데이터, 온도 0 단일 실행이라 1~2점 차이는 잡음일 수 있습니다. 프롬프트를 더 다듬거나 큰 모델을 쓰면 합치기·자격 심사의 결과는 달라질 수 있습니다. 측면·씨앗 사건 질문은 데이터가 공개되지 않아 재지 못했습니다. 논문 저장소에 코드가 올라오면 같은 데이터로 원래 프롬프트를 돌려 이 축소판과의 차이를 확인해 볼 생각입니다.
8부. 비판적으로 읽기
좋은 아이디어와 별개로, 이 논문을 그대로 믿기 전에 짚어 둘 점들이 있습니다.
① 공개됐다는 코드가 아직 없다. 논문 각주는 "코드와 데이터셋은 공개되어 있다"며 GitHub 주소(taolusi/QUEST)를 적었습니다. 2026년 11월 14일 현재 그 저장소에는 2026년 8월 30일의 초기 커밋과 두 줄짜리 README만 있습니다. 부록의 프롬프트는 {query}, {sentence} 같은 자리표시자가 있는 틀이라, 실제로 쓴 지시문·레이블 공간·규약 표를 그대로 재현할 수 없습니다. 새로 주석한 측면·씨앗 사건 데이터도 아직 받을 수 없습니다. 7부의 재현이 공개된 SemEval 시험 데이터에서 '논문을 따라 짠 축소판'에 머문 이유입니다.
② 벤치마크가 작고, 분산이 없다. 연표 수는 질문 유형별로 42·28·26개입니다. 구성 요소 제거 실험의 차이는 1~3점인 경우가 많은데(규약 제거, 자격 심사 단순화 등), 온도 0 단일 실행이라 신뢰구간이 없습니다. '한 단계로 몰아서 실행'(약 −11~13점)이나 정답 끼우기(+30점) 같은 큰 효과는 믿을 만하지만, 1~2점 차이를 구조의 우열로 읽기는 어렵습니다.
③ '기술'은 도구가 아니라 프롬프트다. 콜린스 사전, ConceptNet, PropBank·FrameNet은 실제로 조회되는 외부 자원이 아니라 프롬프트 안의 '설정'입니다(부록 A.2.2: 모든 원자 기술은 제약된 프롬프트 모듈). 모델이 콜린스 사전의 표제어 목록을 실제로 참조했는지, 아니면 "콜린스 사전 기준으로 판단하라"는 지시만 받았는지 논문만으로는 알 수 없습니다. 기술 서재의 효과는 '외부 지식'보다는 '좁은 지시와 고정된 출력 형식'의 효과로 읽는 편이 안전합니다.
④ 계산량을 맞춘 비교가 없다. TimelineAgent는 다단계 ICL보다 약 2.1배 많은 호출을 씁니다. 같은 호출 수를 한 번에 묻기에 몰아준 기준선, 예컨대 여러 번 묻고 다수결을 내는 자기 일관성 방식과의 비교는 없습니다. 단계 분할의 이득이 크다는 점(그림 3)은 분명하지만, 그 이득 중 얼마가 '구조'이고 얼마가 '더 많은 계산'인지는 열려 있습니다.
⑤ 채점 방식의 함정. 5부 위젯에서 봤듯 날짜는 문자열로 비교되고, 순서 0번 사건은 아예 채점되지 않습니다. 정답 자체에도 흠이 있습니다. SemEval 시험 데이터의 잡스 연표에서 2011년 8월의 사임(resigned)은 날짜가 'XXXX-XX-XX'로 주석되어 있습니다. 8월 25일자 기사의 문장에는 날짜가 없지만, 같은 사임을 말하는 10월 6일자 기사에는 "8월 24일 잡스는 CEO에서 물러났다(On August 24, Jobs resigned)"고 명시돼 있고, 정답 연표는 두 표현을 같은 사건으로 묶어 두었습니다. 그런데도 날짜는 비어 있습니다. 주석 오류로 보이지만 채점은 이 주석을 따르므로, 시스템이 '2011-08-24'를 정확히 찾아내면 오히려 점수가 깎입니다. 같은 데이터에서 사람 주석자 사이의 사건 표시 일치도도 다이스 계수 0.66이었습니다(SemEval-2015 과제 보고서). 사람끼리도 셋 중 하나는 다르게 표시하는 과제에서 F1 40점의 의미는 숫자보다 너그럽게 읽어야 합니다.
⑥ 사전학습 데이터 오염. 2005~2011년 위키뉴스의 스티브 잡스 기사는 거의 모든 LLM의 학습 데이터에 들어 있을 것입니다. 모델이 문장을 읽지 않고도 '1955년 2월 24일 출생'을 알 수 있다는 뜻입니다. 이것이 점수를 부풀리는지, ⑤처럼 오히려 깎는지는 논문이 다루지 않습니다. 측면 질문 데이터를 만들 때 저자들이 "세상 지식으로 날짜를 추론하지 않는다"고 명시한 것과 대조적입니다.
⑦ 고치지 못하는 사슬. 표 4가 보여 주듯 앞 단계의 실수는 뒤에서 복구되지 않습니다. 여섯 단계는 한 방향으로만 흐르고, 뒤 단계가 앞 단계에 "이 사건은 날짜가 없으니 다시 보라"고 되돌리는 경로가 없습니다. 저자들도 한계 절에서 사건 하나하나에 원자 기술을 따로 부르는 더 세밀한 조율, 그리고 큰 모델과 작은 모델을 섞는 혼합 구조를 앞으로의 과제로 꼽습니다.
⑧ 사소한 불일치들. 표 3의 DeepSeek-V3 인물 F1은 37.9인데 그림 3·4·5의 같은 막대는 약 37.3으로 그려져 있습니다. 그림 1의 씨앗 사건 연표는 4번과 5번 날짜가 거꾸로입니다. 결론을 흔들 정도는 아니지만, 공개 코드가 나오면 확인해 볼 지점입니다.
2026년의 LLM은 질문 하나에 문서 수천 건을 읽고 그럴듯한 요약을 씁니다. 그런데 요약은 '무슨 일이 있었나'에는 답해도 '언제, 어떤 순서로, 무엇이 무엇을 낳았나'에는 약합니다. 사람이 판단을 내리는 자리, 곧 책임이 따르는 자리일수록 필요한 것은 요약보다 근거가 달린 연표입니다. 논문 그림 1의 쓰임새를 한국의 2026년 상황에 옮겨 보면 이렇습니다.
공약 이행 추적(씨앗 사건 질문). 2026년 6월 3일 제9회 전국동시지방선거로 새 단체장과 지방의원이 일을 시작했습니다. "임기 안에 OO를 하겠다"는 약속 하나를 씨앗으로 삼아 조례 발의, 예산 편성, 착공, 감사 결과를 이어 붙이는 일은 PledgeTracker와 같은 구조입니다. 앞에서 본 두 함정, 곧 낱말은 겹치지만 다른 일(학교 한 곳의 아침 급식)과 낱말은 없지만 증거인 일(직접세 비중 22.7%)이 그대로 나타납니다.
재난 상황 연표(측면 질문). 대형 산불이나 폭우 때 상황실은 '인명 피해', '기반시설', '대피·지원' 같은 측면별로 상황을 따라갑니다. 기사와 기관 발표가 같은 사망을 몇 번씩 갱신해 보도하므로, 같은 사건 합치기와 값의 갱신을 구별하는 일이 핵심입니다. 코어닷투데이가 최신 기사와 최신 사실에서 본 것처럼, 같은 사실의 값이 기사마다 엇갈리고 늦게 바뀌는 일이 흔합니다.
기업·인물 연대기(인물 질문). 공시와 보도로 한 회사의 대표 교체, 증자, 소송, 합병을 날짜순으로 세우는 일입니다. 투자 심사, 실사, 기자의 취재 준비에서 매일 손으로 하는 작업입니다.
의료·법률 연표. 환자의 진료 기록에서 항암 치료의 시작·중단·재개를 세우는 ChemoTimelines, 판결문에서 사건 경위를 날짜순으로 세우는 일은 오류의 대가가 큰 분야입니다. 이런 곳일수록 '왜 이 사건을 넣었고 이 날짜로 정했는가'를 단계별로 보여 주는 TimelineAgent식 구조가 유리합니다.
에이전트의 기억 문제와도 닿아 있습니다. 대화가 길어진 비서 에이전트는 "사용자가 지난달에 이사했다"와 "새 주소는 어디다"를 시간 순서와 함께 기억해야 합니다. 2026년 에이전트 기억 연구가 시간 축이 있는 지식 그래프나 이중 시간(bitemporal) 기록으로 몰려간 것도, 결국 사실을 '연표'로 쥐고 있어야 바뀐 사실을 다룰 수 있기 때문입니다. 질문 중심 연표는 그 기억을 사람이 읽을 수 있는 형태로 꺼내는 인터페이스이기도 합니다.
코어닷투데이가 지난 한 달 동안 한국어 뉴스로 실측한 연작과도 정확히 겹칩니다. 같은 사건 묶기 연작은 TimelineAgent의 6단계(문서 횡단 사건 상호참조)를 기사 1만 건 규모에서 따로 파고들었고, 3편은 시간이 흐를 때 묶음이 어디서 끊어져야 하는지를, 4편은 사건을 사슬이 아니라 나무로 세우는 법을, 5편 설계도는 그 전체를 여섯 단계로 정리했습니다. 공교롭게도 그 설계도도 여섯 단계였고, 가장 큰 교훈도 "판정보다 추출(앞 단계)이 비싸고 중요하다"였습니다. TimelineAgent의 표 4와 같은 이야기입니다. 뉴스에는 대본이 없다는 씨앗 사건 다음에 무엇이 오는지를, 뉴스에서 육하원칙 뽑기는 사건 하나의 '언제'와 '누가'를 뽑는 단계를, 사실탐색기 v2 설계는 공적 기록에서 '지금 참인 것'을 유지하는 문제를 다뤘습니다. 이 글의 논문은 그 조각들을 '질문'이라는 하나의 입구로 묶는 틀을 제안한 셈입니다.
10부. 실무 체크리스트: 연표 시스템을 만든다면
질문질문 유형부터 정한다. 인물·측면·씨앗 사건은 '관련 있음'의 정의가 다르다. 한 시스템이 세 유형을 다 받는다면, 유형을 먼저 분류하고 단계별 지시를 갈아 끼우는 표(규약)를 만든다.
거르기첫 단계는 재현율이 전부다. 여기서 놓친 사건은 뒤에서 되살릴 수 없다(표 4). 문장 거르기는 넓게, 판단은 뒤 단계에 맡긴다.
날짜모든 문서에 작성일을 붙여 넣는다. 요일 이름이 나오면 작성일의 요일도 함께 준다. 모르는 날짜는 'XXXX-XX-XX'로 남기는 것을 정답으로 인정하고, 세상 지식으로 채우지 않게 한다.
자격부정·조건·가능성은 관련성과 별도 단계로 거른다. 같은 프롬프트에서 '관련 있나'와 '일어났나'를 동시에 묻지 않는다.
합치기같은 사건 합치기는 날짜를 전파하는 기회다. 날짜가 명시된 표현과 같은 사건으로 묶이면, 날짜 없는 표현도 그 날짜를 물려받는다.
검증단계별 중간 결과를 남긴다. 정답 일부를 끼워 넣는 실험(오라클)으로 어느 단계가 병목인지 먼저 재고, 거기에 계산을 몰아준다. 채점은 날짜 형식까지 맞춘 공식 채점기로 한다.
모델 선택에도 시사점이 있습니다. 그림 5와 7부 실측이 같은 방향을 가리킵니다. 작은 모델일수록 한 번에 묻기는 거의 작동하지 않고, 단계 분할의 이득이 큽니다. 다만 단계를 나누면 호출 수가 늘고, 각 단계의 일꾼이 감당해야 할 최소 능력이 있습니다. 저자들이 제안한 대로, 품사 판정·의미 유형 분류처럼 단순한 단계는 작은 모델에, 관련성·시간 추론처럼 어려운 단계는 큰 모델에 맡기는 혼합 구성이 2026년의 현실적인 답일 것입니다.
맺으며
사마광이 『자치통감』을 날짜순으로 쓴 지 90년쯤 뒤, 원추는 같은 책을 가위로 오리듯 사건별로 다시 엮었습니다. 자료는 그대로인데 질문이 바뀌자 책이 바뀌었습니다. TimelineAgent가 기계에게 가르치려는 것도 그 '다시 엮기'입니다. 다만 이 논문이 더 크게 보여 준 것은 엮는 기술보다 엮는 순서입니다. 좋은 도구와 좋은 지시를 다 줘도 한 번에 하라고 하면 무너지고, 단계를 나누면 같은 모델이 두 배를 해냅니다. 그리고 그 사슬의 가장 약한 고리는 맨 앞, '무엇을 사건으로 고를 것인가'에 있습니다.
11년 전 SemEval의 최고점은 7.85였고, 지금은 37.9입니다. 여전히 열에 여섯은 틀리는 과제입니다. 그래서 이 논문의 가치는 숫자보다, 연표 만들기를 '질문 유형 × 단계 × 기술'의 표로 분해해 어디를 고쳐야 하는지 보이게 만든 데 있다고 생각합니다. 공개 저장소에 코드가 올라오면, 코어닷투데이는 한국어 뉴스로 같은 표를 채워 보려 합니다.
참고 문헌
Min, Q., Bao, Y., Lu, Y., Feng, Z., Chen, Y., Vlachos, A., & Zhang, Y. (2026). TimelineAgent: An LLM-based Framework for Query-Centric Event Timeline Extraction Across Multiple Documents. EMNLP 2026. arXiv:2610.25733 · 저장소 taolusi/QUEST (2026-11-14 기준 README만 있음)
Minard, A.-L., Speranza, M., Agirre, E., Aldabe, I., van Erp, M., Magnini, B., Rigau, G., & Urizar, R. (2015). SemEval-2015 Task 4: TimeLine: Cross-Document Event Ordering. SemEval 2015. ACL Anthology S15-2132 · 과제 데이터·채점기
Laparra, E., Aldabe, I., & Rigau, G. (2015). Document Level Time-anchoring for TimeLine Extraction. ACL-IJCNLP 2015.
Caselli, T., & Vossen, P. (2017). The Event StoryLine Corpus: A New Benchmark for Causal and Temporal Relation Extraction. Events and Stories in the News Workshop.
Cybulska, A., & Vossen, P. (2014). Using a sledgehammer to crack a nut? Lexical diversity and event coreference resolution (ECB+). LREC 2014.
Chen, Y., Schlichtkrull, M., Deng, Z., Corney, D., Asl, N., Salisbury, J., Dudfield, A., & Vlachos, A. (2025). PledgeTracker: A System for Monitoring the Fulfilment of Pledges. EMNLP 2025 System Demonstrations.
Wang, Y., Wu, Z., Yao, J., & Su, J. (2025). TDAG: A Multi-Agent Framework based on Dynamic Task Decomposition and Agent Generation. Neural Networks 185.
Pustejovsky, J. et al. (2003). TimeML: Robust Specification of Event and Temporal Expressions in Text. New Directions in Question Answering.
UzZaman, N. et al. (2013). SemEval-2013 Task 1: TempEval-3: Evaluating Time Expressions, Events, and Temporal Relations. SemEval 2013.
Saurí, R., & Pustejovsky, J. (2009). FactBank: a corpus annotated with event factuality. Language Resources and Evaluation 43.
Allen, J. F. (1983). Maintaining knowledge about temporal intervals. Communications of the ACM 26(11).
Reichenbach, H. (1947). Elements of Symbolic Logic. Macmillan.
Ji, H., Grishman, R., Chen, Z., & Gupta, P. (2009). Cross-document Event Extraction and Tracking: Task, Evaluation, Techniques and Challenges. RANLP 2009.
Do, Q., Lu, W., & Roth, D. (2012). Joint Inference for Event Timeline Construction. EMNLP-CoNLL 2012.
Rajaby Faghihi, H. et al. (2022). CrisisLTLSum: A Benchmark for Local Crisis Event Timeline Extraction and Summarization. Findings of EMNLP 2022.
Yao, J. et al. (2024). Overview of the 2024 Shared Task on Chemotherapy Treatment Timeline Extraction. ClinicalNLP 2024.
Priestley, J. (1765). A Chart of Biography; (1769). A New Chart of History. — Rosenberg, D., & Grafton, A. (2010). Cartographies of Time. Princeton Architectural Press.
위키뉴스(Wikinews) 애플 관련 기사 30건 — SemEval-2015 Task 4 시험 데이터, CC BY 2.5.