
#정보 추출
9개의 포스트
한 줄만 틀려도 버린다 — 뉴스 4만 7천 묶음을 읽힐 LLM, 7종 12가지 설정을 같은 검증기로 재다
사실탐색기는 같은 사건을 다룬 기사 묶음 4만 7,300개에서 주장·시점·같은 사건 관계를 원문 인용과 함께 뽑아야 합니다. 어느 모델에 맡길지 정하려고 Claude 3종, DeepSeek Flash, Muse Spark, 무료 K-EXAONE, 사내 A100에 올린 Qwen3.8-27B까지 7종 12가지 설정을 같은 지시문과 같은 검증기로 쟀습니다. 검증기는 행 하나만 틀려도 이야기 전체를 거부합니다. 그래서 순위는 ‘통과하면 얼마나 잘하나’보다 ‘긴 이야기에서 끝까지 버티나’로 갈렸습니다. Claude Haiku 5.5는 7개를 모두 통과하며 기준 주장의 89%를 회수했습니다. DeepSeek·EXAONE·Qwen은 통과한 이야기에서는 72~88%를 회수하고도 긴 이야기를 거의 다 잃어, 판본에 남은 양이 14~29%였습니다. 지시문 한 줄은 Sonnet 5.5의 회수율을 34%에서 68%로 두 배 올렸지만 DeepSeek에는 독이 됐고, 생각 모드는 답 대신 생각만 남겼습니다. 무료와 할인의 조건, 사내 GPU로 돌리는 데 드는 시간, 주장 하나당 비용까지 정리했습니다. 위젯 3종, 코어닷투데이 실측, 삽화 6장.
라벨을 문장처럼 읽는 작은 추출기 — GLiNER2 해부: 개체명 인식 30년, 스팬 격자에서 경계 쌍까지, 그리고 한국어 실측
‘이 글에서 사람·회사·금액을 뽑아 표로 만들어 줘’는 2026년에도 가장 흔한 AI 일입니다. GLiNER2는 이 일을 2억 개 남짓한 파라미터의 인코더 하나로, CPU에서, 라벨을 글자로 적어 넣기만 하면 해냅니다. 1995년 MUC-6에서 ‘개체명’이라는 말이 생긴 때부터 고정 라벨의 시대, LLM 증류, 2023년 GLiNER의 ‘라벨도 입력이다’라는 발상을 거쳐 2025년 GLiNER2의 스키마 한 줄, 2026년 GLiNER2.5의 경계 쌍 구조까지 따라갑니다. 저장소 코드를 열어 입력 직렬화, 스팬 격자와 개수 헤드, 경계 인코더·후보 풀·재정렬·기권 헤드, 레코드 헤드를 하나씩 해부했습니다. 코어닷투데이는 공개 모델 두 개를 한국어 KLUE 개체명 300문장에 제로샷으로 돌렸습니다. 공백 기준 그대로는 조사가 붙어 엄격 F1이 34.9였고, 뽑은 뒤 끝의 조사만 잘라 내자 62.5로 올라 로컬 Qwen3.5 9B(61.0)와 비겼습니다. 속도는 CPU만으로 15배 빨랐습니다. 폭 8의 벽에 막힌 12단어 법률명은 경계 구조만 찾았고, 신형이 한국어에서 구형을 앞서지는 못했습니다.
[특집] 본문에 없는 사실은 받지 않는다 — 앵커로 묶은 지식 그래프 추출 AEVS, 그리고 출처를 글자 단위로 다는 시대
LLM에게 문서에서 사실(주어·관계·목적어)을 뽑게 하면 '세상에서는 참이지만 본문에는 없는' 트리플이 섞입니다. 2026년 3월 MDPI Computers에 실린 AEVS는 본문에서 개체·관계구·값과 그 글자 위치를 먼저 찾아 '앵커'로 삼고, 트리플을 앵커로만 조합한 뒤, 원소마다 원문으로 되돌려 검증합니다. 세 데이터셋에서 학습 모델과 EDC를 넘었고, 남은 오류의 95% 이상은 개체가 아니라 관계였습니다. 다만 'EDC 대비 최대 +0.152'는 서로 다른 모델끼리의 비교였고(같은 모델이면 +0.007~+0.074), 공개 코드는 논문과 달리 셋 중 둘만 맞아도 통과시켜 논문 자신의 환각 예시를 모두 받아들였습니다. 코어닷투데이가 로컬 모델로 한국어 30문장과 WebNLG 20문장을 다시 돌려 보니, 스키마를 준 '그냥 묻기'에서는 환각이 나오지 않았고 AEVS는 한국어에서 오히려 재현율을 잃었습니다(F1 0.80 대 0.72). 그냥 묻기에서 스키마를 빼면 F1이 0.18로 무너져, 향상의 상당 부분이 스키마 몫일 수 있음을 보여 줍니다. 검증 LLM은 본문에 충실한 반사실 트리플을 '현실과 다르다'며 거부하기도 했습니다. 역사, 논문의 주요 그림과 표, 2026년의 '글자 단위 출처' 도구들까지 함께 읽습니다.
사건을 뽑는 AI에게 채점표를 주다 — EAGER로 읽는 사건 추출 40년과 '검증 가능한 보상'
GPT-5.4에게 기사를 주고 사건을 뽑으라고 하면 평균 F1이 10점 안팎입니다. 독일 DFKI의 EAGER는 70억 매개변수 모델에 '여섯 명의 채점관'과 '문제지마다 다른 오답 보기'를 붙여 평균 30.79점까지 끌어올렸습니다. 사건 추출이 1987년 MUC의 템플릿 채우기에서 어떻게 지금의 코드 생성·강화학습까지 왔는지, 검증 가능한 보상(RLVR)이 수학 밖으로 나오면 무엇이 달라지는지, 그리고 그룹 점수가 모두 같아져 학습이 멈추는 '어드밴티지 붕괴'를 SCAE가 어떻게 푸는지 풀어 씁니다. 본문과 부록 표의 숫자가 엇갈리는 곳, 보상 식을 글자 그대로 구현하면 생기는 문제도 짚었습니다. 한국어 문장 40개로 로컬 4B 모델을 360번 돌려 같은 채점표를 직접 대 봤습니다.
AI 심판을 심판하다 — 육하원칙 추출을 채점하는 LLM 판사 벤치마크, 원자료로 다시 읽기
칠레 북부 가톨릭대 연구진이 2026년 2월 Electronics에 낸 논문은 GPT-4.1·Claude Sonnet 4.5·Gemini 2.5 Pro를 스페인어 뉴스의 육하원칙 추출을 채점하는 판사로 세우고, 기자 두 명에게 그 판결을 검수시켰습니다. 결론은 판사 셋 모두 98% 넘게 '수용'됐고 Claude가 99.79%로 1등이라는 것입니다. 이 글은 육하원칙이 2,000년 동안 어떻게 기사의 뼈대가 됐는지, 글자를 세던 BLEU·ROUGE가 왜 뜻을 못 보는지, LLM 판사가 어떤 구조로 채점하는지를 논문의 그림과 표로 차근차근 풀고, 이어서 논문 저장소의 검수 엑셀 5,736행을 직접 다시 셉니다. 기자는 판사가 1점을 줘도 5점을 줘도 거의 같은 비율(97~99%)로 동의했고, 같은 추출에 판사들 점수가 두 점 이상 갈린 358건 중 342건에서 세 판사 모두에게 동의했습니다. 카파 0.67은 4점과 5점 사이의 일치였고, ROUGE와의 상관 −0.53은 두 데이터셋을 섞어서 생긴 심슨의 역설이었습니다. 끝으로 한국어 기사 36건에 날짜·주체·숫자를 바꾸고 이유를 지어낸 함정 추출을 심어 판사가 실제로 오류를 잡는지 쟀습니다. Claude Sonnet은 함정 194쌍을 모두 깎았지만, 로컬 Qwen3.5 4B는 사실 함정 28건을 전부 5점으로 통과시키며 '출처와 완전히 일치한다'고 썼습니다. 자의 착시를 걷어 내면 이 논문이 남기는 교훈은 '판사는 쓸 만하다'가 아니라 '판사를 검증하는 방법을 바꿔야 한다'입니다. 위젯 6개와 삽화 10장.
4B를 Flash로 가르치기 — 육하원칙 추출, 선생님 답 1,623개로 로컬 모델을 키우다
이 시리즈의 첫 글에서 클라우드 Gemini 3.8 Flash는 육하원칙 추출 0.86, 로컬 9B는 0.69였습니다. 그 0.16을 지식 증류로 좁혀 보려고 Flash에게 기사 1,709건의 답을 쓰게 하고(5.6달러), 그 답으로 Qwen3 4B를 맥 한 대에서 LoRA로 가르쳤습니다. 결과는 실패였습니다. 아무것도 가르치지 않은 Qwen3 4B 2507이 이미 9B와 같은 0.686이었고, 1,623개를 다 본 학생은 0.656으로 오히려 내려갔습니다. 학생은 선생님의 판단보다 버릇을 먼저 배웠습니다. 예제 200개 지점에서는 이유가 없는 기사 44건 중 42건에 이유를 지어냈고, 끝까지 배운 뒤에도 학습 전(0건)보다 많은 12건을 지어냈습니다. Flash와 Flash-Lite가 함께 채운 이유만 남긴 '보수적 교재'는 버릇을 고치고 같은 예제 수에서 점수를 0.04 올렸지만, 학습 전 모델은 넘지 못했습니다. 교훈은 하나입니다. 증류보다 먼저, 같은 크기의 최신 모델을 정의서만으로 재 보세요. 학습 곡선·칸별 비교·버릇 상속·전후 비교·손익분기 위젯 5개.
채점이 순위를 바꾸는가 — 육하원칙 답 2,371개를 판사 여섯에게 다시 채점시키다
지난 글은 뉴스 72건에서 육하원칙을 꺼내는 24가지 방법을 글자 F1로 줄 세웠습니다. 그런데 그 자는 '50대 남성'과 'A(59)씨'를, '이날'과 '13일'을 다른 답으로 셉니다. 이번에는 같은 답 2,371개를 자 세 개(글자 F1·포함 일치·날짜 정규화)와 판사 여섯(Gemini 3.8 Flash·Claude Sonnet 5.5·GPT-5.4 mini·로컬 Qwen3.5 9B·Jev·로컬 Clef-Flash)에게 다시 채점시키고, 층화 표본 234개를 원문과 대조해 검수했습니다. 결과는 세 줄입니다. 강한 판사들로 바꿔도 방법의 순위는 거의 그대로였습니다(켄달 순위 상관 0.96~0.99). 대신 점수의 크기가 바뀌었고, 특히 '무엇을'에서 작은 모델이 0.15를 되찾았습니다. 그리고 판사에게는 버릇이 있었습니다. 같은 가족의 답을 후하게 주고, 검수자보다 엄격하며, 로컬 판사는 순위를 흔들었습니다. 판사 둘 이상이 정답을 의심한 칸은 다시 보니 모두 정답 쪽이 지나치게 엄격했습니다. 순위 기울기·검수 일치도·칸별 법정·자기 선호·칸별 회복 위젯 5개와 삽화 5장.
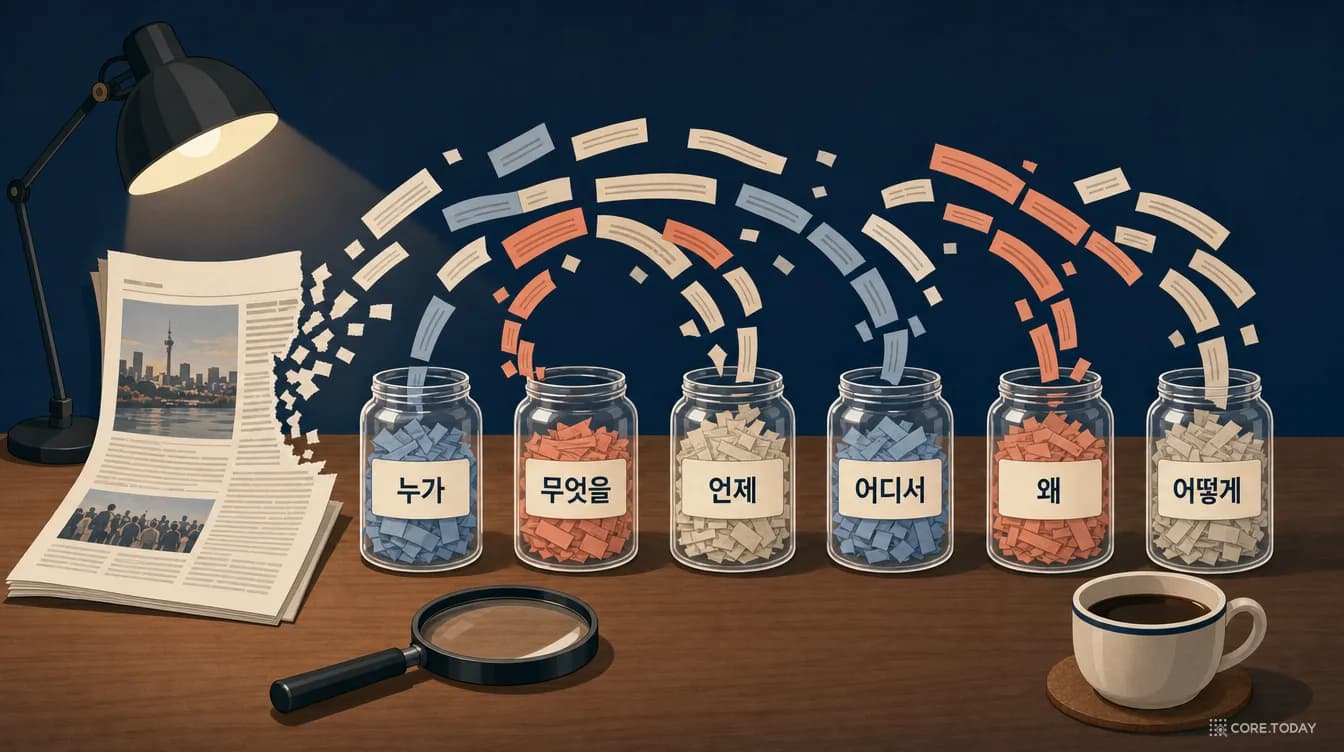
뉴스에서 육하원칙 뽑기 — 자르기·쓰기·고르기, 한국어 기사 72건으로 짠 추출 설계도
기자는 기사 첫 문장에서 여섯 질문에 답합니다. 누가, 무엇을, 언제, 어디서, 왜, 어떻게. 그걸 기계가 꺼내게 하는 손은 2026년에 네 종류입니다. 독해 모델은 자르고, 임베딩은 찾고, LLM은 쓰고, 판정 모델은 고릅니다. 연합뉴스 7개 섹션의 당일 기사 60건과 네이버 뉴스 12건, 합쳐 72건 432칸에 같은 정의서를 주고 스무 가지가 넘는 조합을 돌렸습니다. KorQuAD 독해 모델은 '이 사건의 주체는?' 같은 범용 질문에 '다소', '이미'를 잘라 와 평균 0.18에 그쳤고, 사고를 끈 Gemini 3.8 Flash가 0.86, 로컬 Qwen3.5 9B가 0.69였습니다. 판정 모델에게 후보 중 하나를 고르게 하면 정답이 후보 안에 있는데도(상한 0.9 이상) 단독 쓰기보다 낮았습니다. 반대로 '기사에 이유가 명시돼 있는가'를 따로 물으면 Nimble이 AUROC 0.85로 가려냈고, 이것을 Flash 뒤에 붙이자 '왜'가 0.73에서 0.79로, 쓰기 모델 셋의 다수결로는 0.85로 올랐습니다. 이 과제의 절반은 답을 찾는 일이고 나머지 절반은 '없다'고 말하는 일입니다. 방법별 점수표·기사별 탐색기·판정 앙상블·부재 탐지·파이프라인 설계기 위젯 5개와 삽화 6장.
Giveme5W1H — AI가 뉴스를 읽는 법: 육하원칙으로 해체하는 기사 분석의 모든 것
기자가 기사를 쓸 때 반드시 답하는 육하원칙(누가, 무엇을, 언제, 어디서, 왜, 어떻게) — 이걸 AI가 자동으로 추출할 수 있을까? 2019년 독일 콘스탄츠 대학 연구팀이 만든 Giveme5W1H 시스템의 원리부터 2026년 LLM 시대의 의미까지, 뉴스 이벤트 추출의 세계를 완전 해부한다.