WERCER단어 오류율글자 오류율음성 인식ASRWhisper편집 거리레벤슈타인sclite띄어쓰기어절형태소KsponSpeechZeroth-KoreanFLEURS정규화환각BLEUTER언어 모델 평가NLP 기초
‘23% 틀렸다’와 ‘4% 틀렸다’는 같은 받아쓰기다 — WER·CER, 한국어는 왜 글자로 재나 (특집)
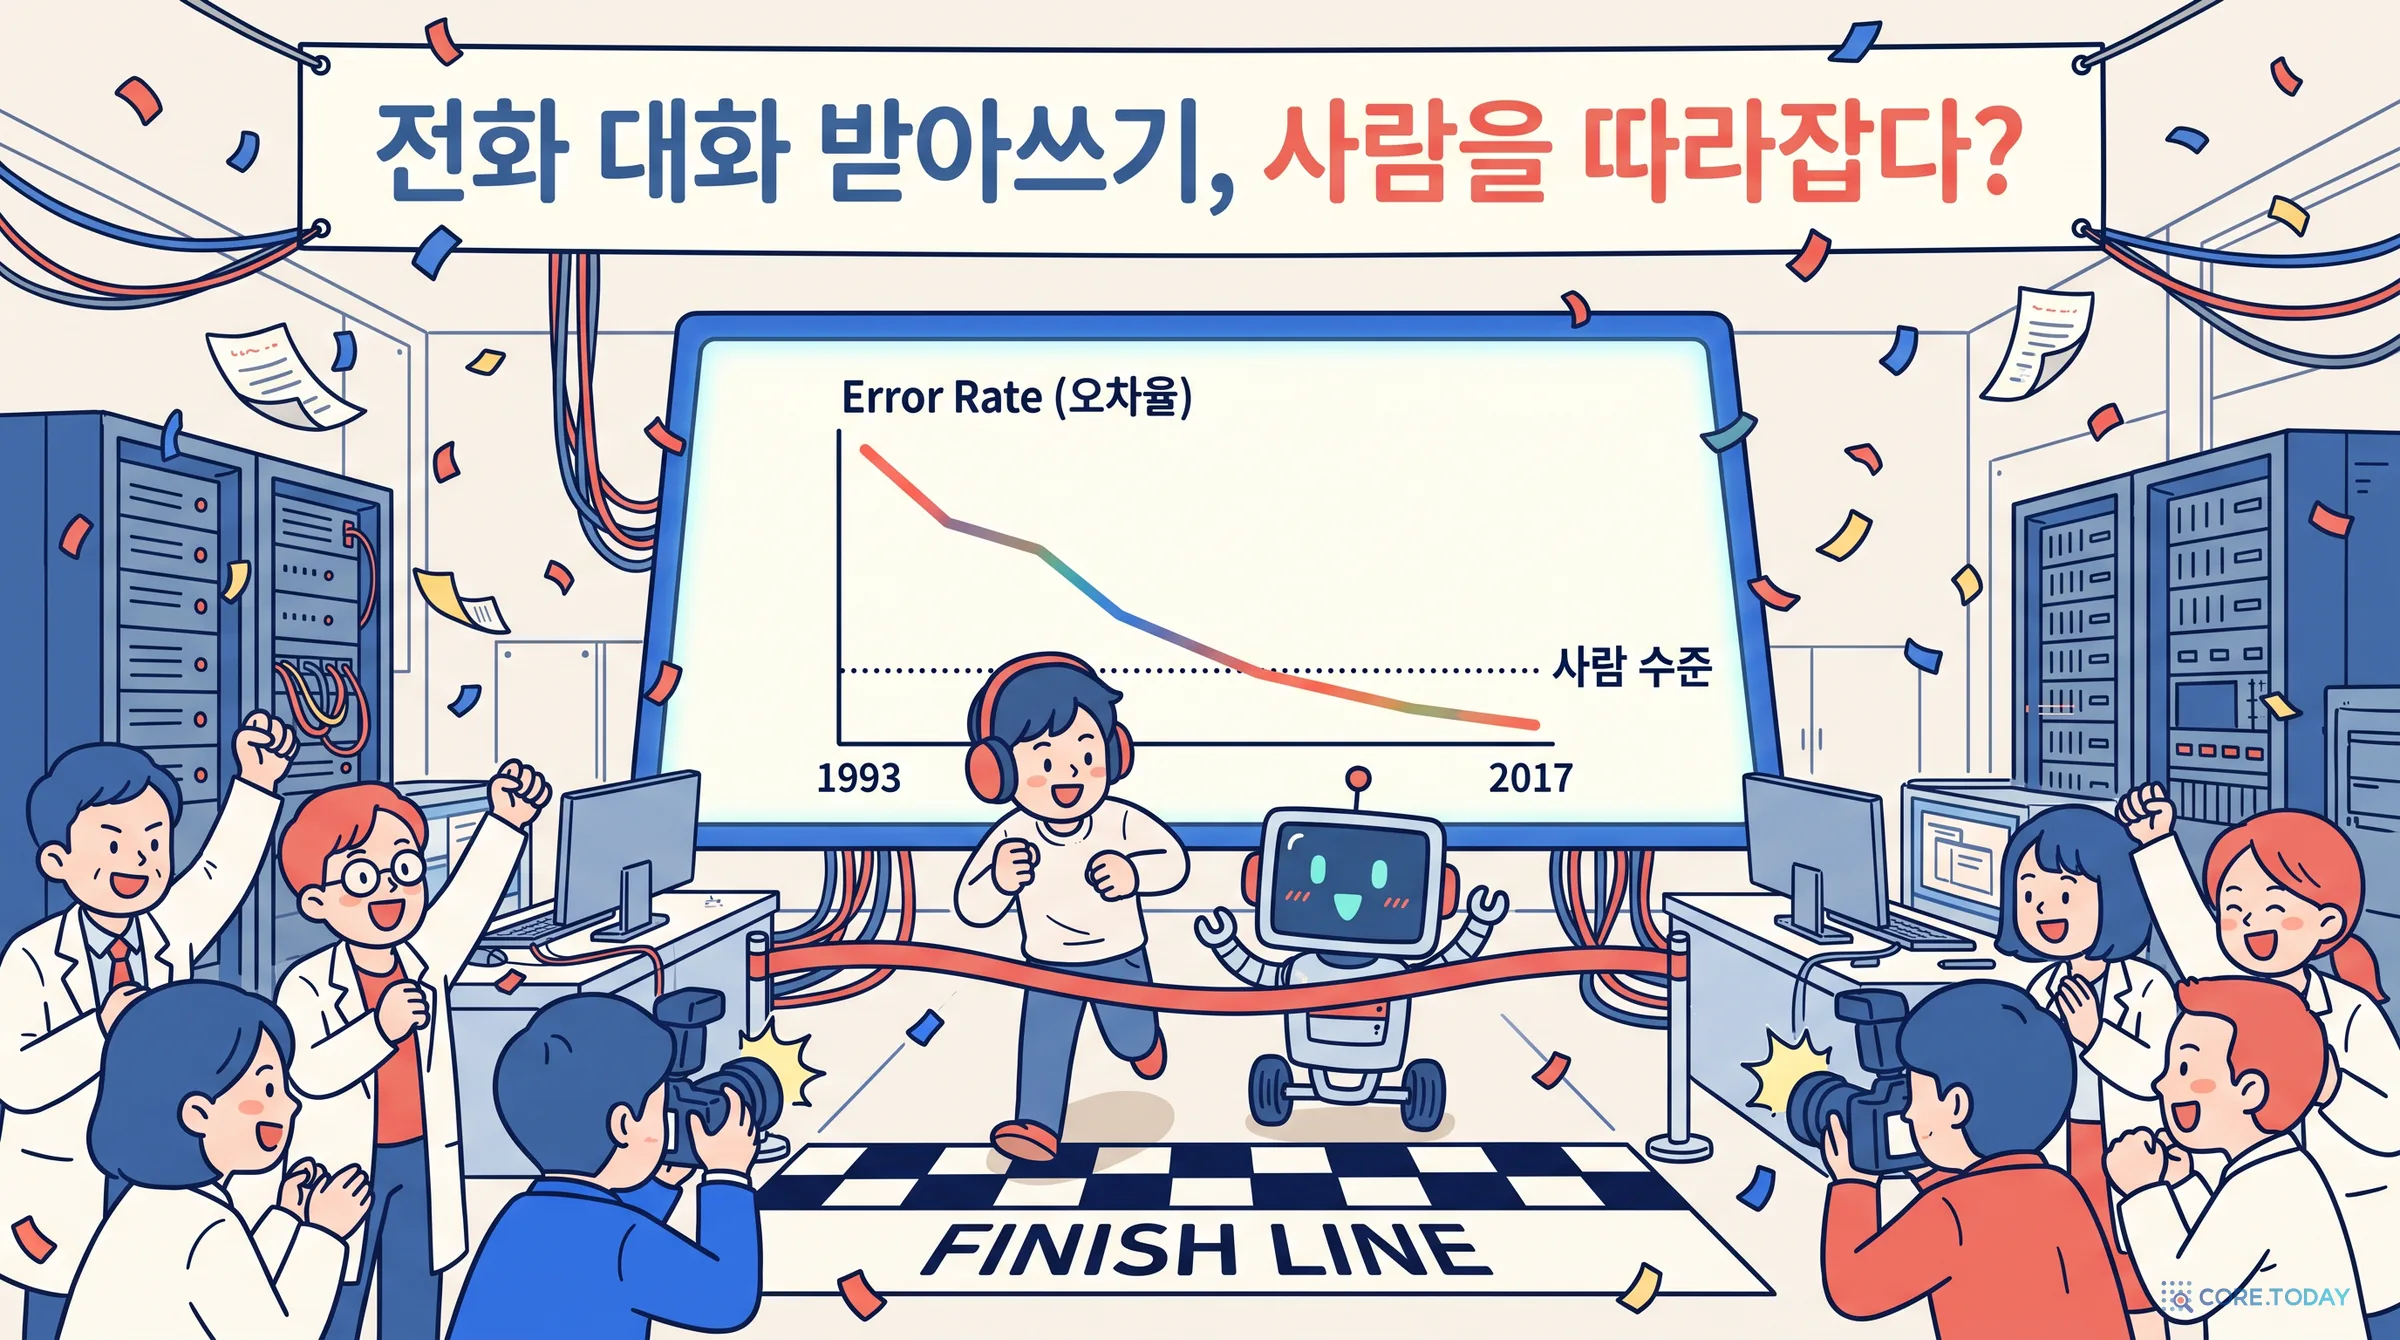
WER(단어 오류율)과 CER(글자 오류율)은 음성 인식기의 받아쓰기를 채점하는 표준 성적표다. 정답과 받아쓰기를 나란히 놓고 대체·삭제·삽입의 수를 세어 정답 길이로 나눈다. 1965년의 편집 거리에서 출발해 1988년 DARPA 벤치마크에서 지금의 모습을 갖췄고, 2016년 ‘사람 수준’ 논쟁을 거쳐 지금도 모든 음성 인식 모델의 성적이 이 숫자로 매겨진다. 이 글은 한국어가 왜 단어가 아니라 글자로 재는지를 띄어쓰기와 어절에서 풀고, 공개 모델 Whisper 6종을 한국어 시험 세트 두 개로 직접 재서 어절 WER 22.6%와 CER 4.3%가 같은 받아쓰기에서 나온다는 것, 어절 오류의 64%가 띄어쓰기 차이라는 것, 숫자 표기 규칙 하나로 CER이 26% 달라진다는 것을 보여 준다. 무음에 뉴스 앵커의 인사를 지어내는 환각, 같은 점수 속의 다른 피해까지 따라간다. 인터랙티브 위젯 6종, 코어닷투데이 실측, 삽화 12장.
공개 음성 인식 모델 Whisper large-v3에게 한국어 낭독 음성 457문장을 받아 적게 했다. 결과를 채점하니 두 개의 숫자가 나왔다.
22.6%
어절 단위로 잰 오류율 (WER)
4.3%
글자 단위로 잰 오류율 (CER)
64%
어절 오류 가운데 띄어쓰기를 맞추면 사라지는 몫
22/22
무음·잡음 클립에서 들리지 않은 말을 지어낸 수 (whisper-small)
Zeroth-Korean 시험 세트, 코어닷투데이 실측. 4부에서 직접 비교해 볼 수 있다.
같은 받아쓰기다. 어절로 보면 다섯 어절에 하나꼴로 틀리는 인식기이고, 글자로 보면 스물세 글자에 하나 틀리는 인식기다. 어느 쪽이 진실일까?
이런 예도 있다. 정답이 “6 대 6이 된 후 다시 타이 브레이크가 필요했다”인데 Whisper는 “6대6이 된 후 다시 타이브레이크가 필요했다”라고 적었다. 사람이 보기엔 완벽한 받아쓰기다. 그런데 어절로 채점하면 33%가 틀렸다.
이 글이 다루는 단어 오류율(WER)과 글자 오류율(CER)은 음성 인식기의 받아쓰기를 채점하는 표준 성적표다. 유튜브 자동 자막, 회의록 앱, 콜센터 녹취, 음성 비서의 성적이 모두 이 숫자로 매겨진다. 그리고 BLEU·ROUGE 특집에서 다룬 번역 점수 BLEU의 사촌이기도 하다. BLEU를 만든 사람들이 “음성 인식에서 성공한 WER을 참고했다”고 썼다.
한국어 음성 인식 논문을 보면 대부분 WER이 아니라 CER을 쓴다. 왜 그럴까? 이 질문을 따라가면 한국어라는 언어의 성질, 채점이라는 일의 성질이 함께 보인다.
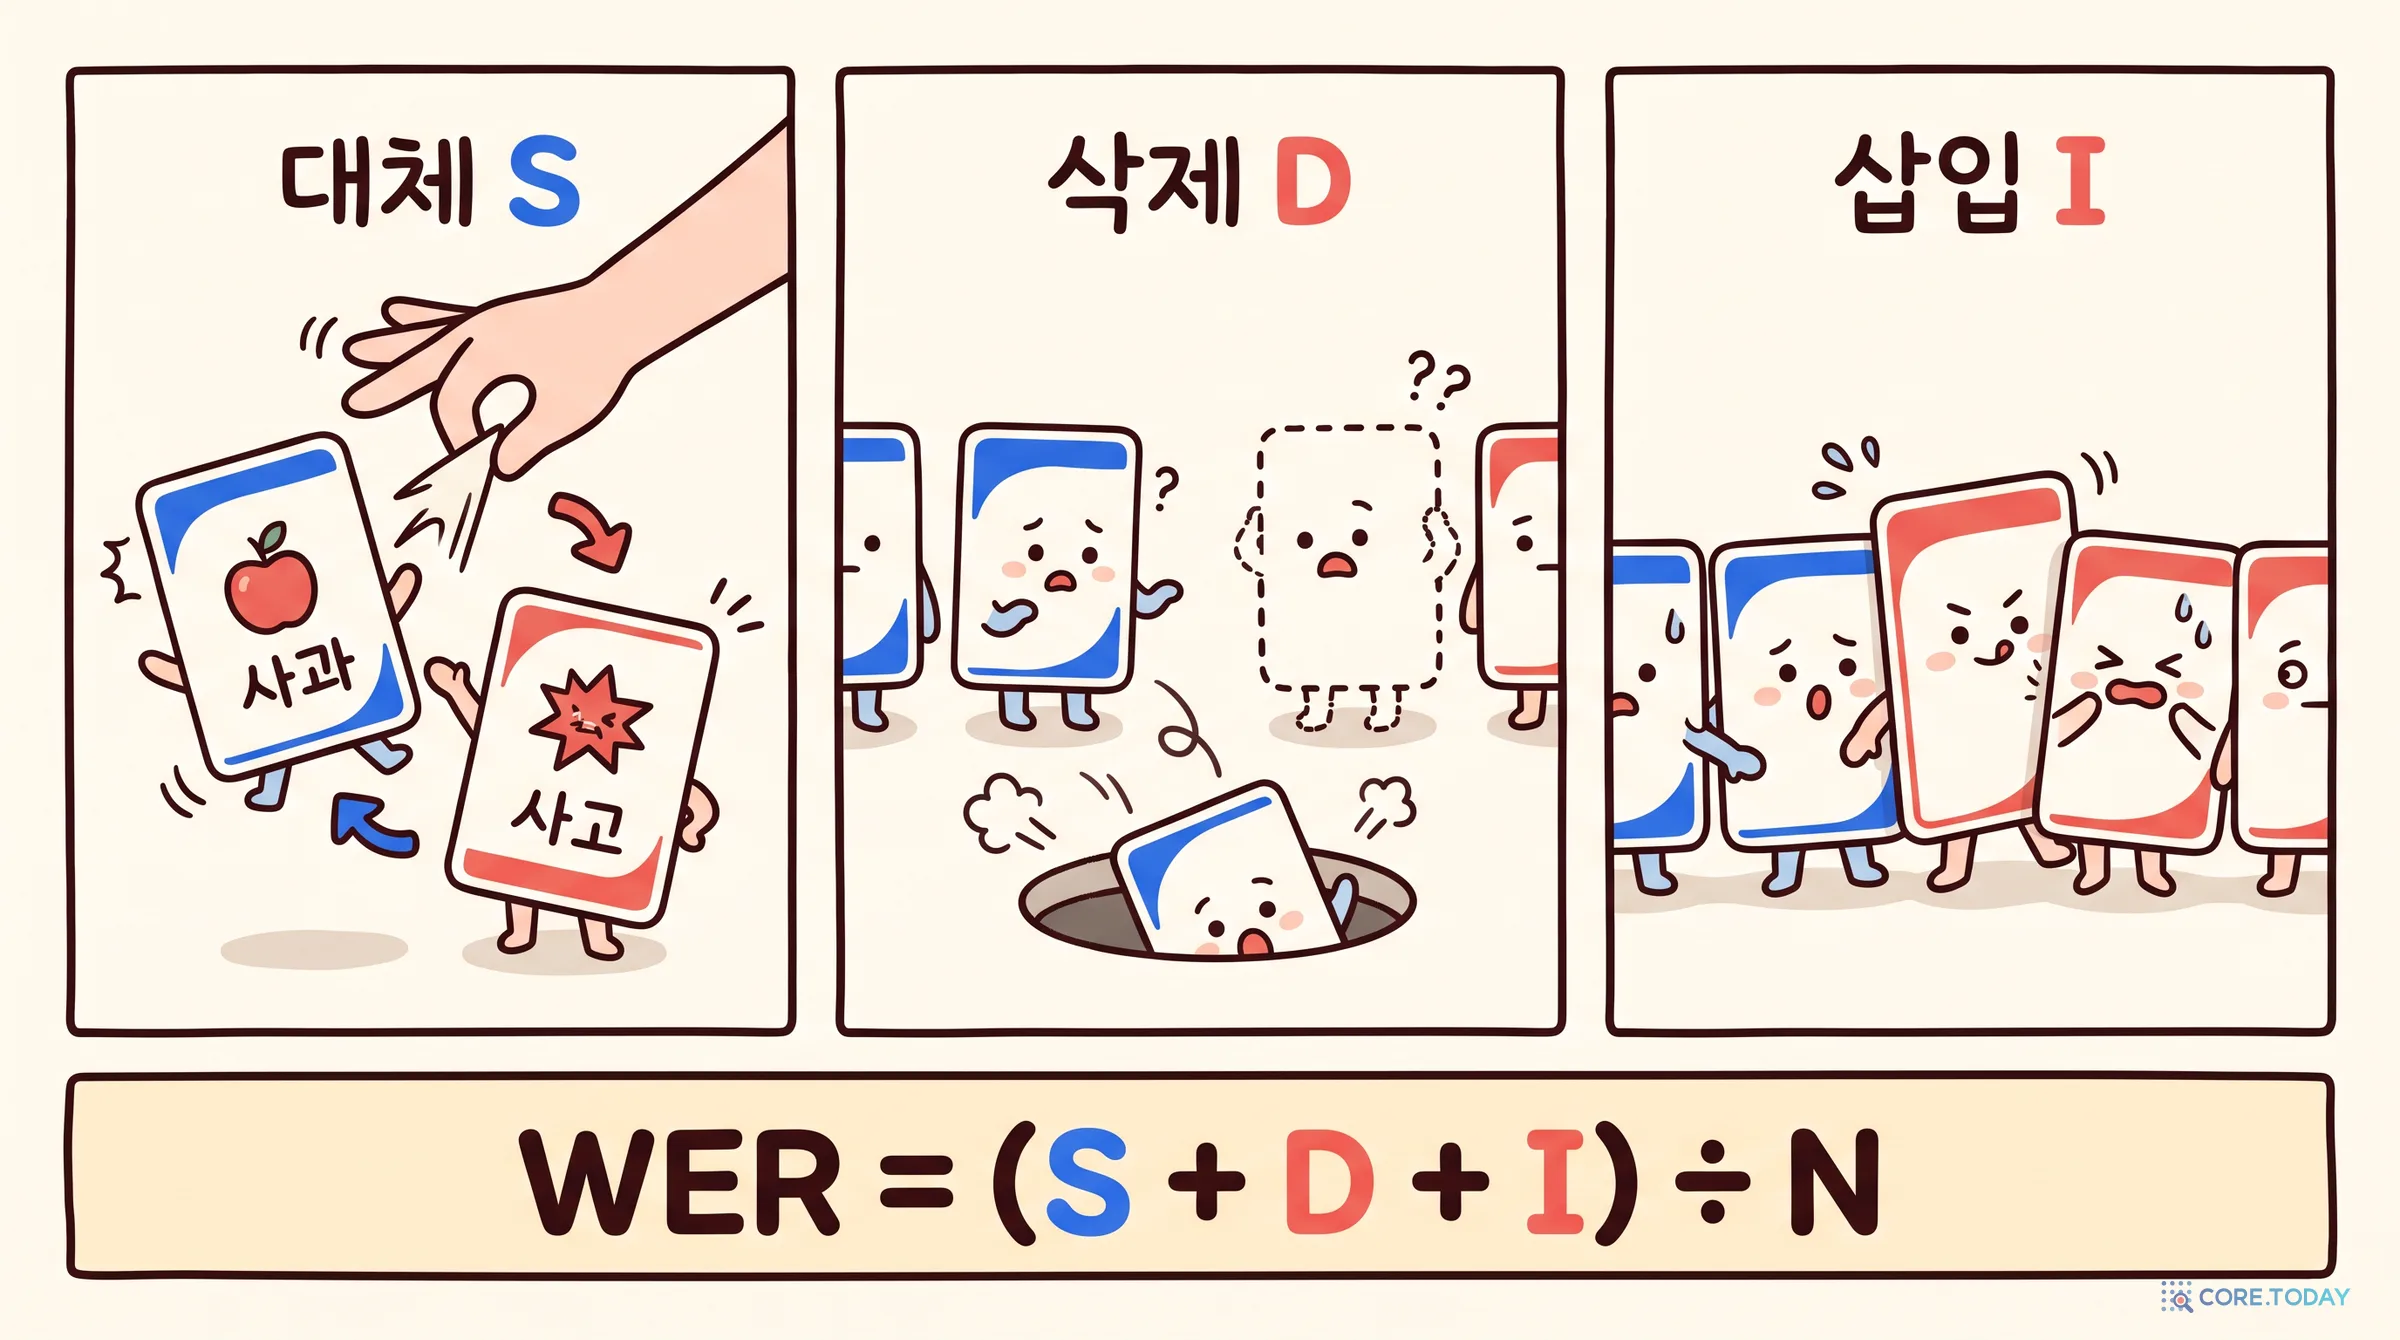
초등학교 받아쓰기를 떠올려 보자. 선생님이 “사과를 먹었다”라고 불렀는데 아이가 받아 적은 공책에는 세 종류의 실수만 나올 수 있다.
실수
대체 S (Substitution)
삭제 D (Deletion)
삽입 I (Insertion)
무슨 일
다른 말로 바꿔 적었다
들은 말을 빠뜨렸다
안 한 말을 덧붙였다
예
사과 → 사고
“를”이 사라짐
“맛있게”가 끼어듦
음성 인식기(ASR, Automatic Speech Recognition)도 기계일 뿐 받아쓰기를 하는 학생이다. 그래서 채점도 똑같다. 정답 문장과 인식 결과를 나란히 놓고, 정답을 인식 결과로 바꾸는 데 필요한 대체·삭제·삽입의 개수를 센다. 이를 정답의 길이로 나눈 것이 단어 오류율(WER, Word Error Rate)이다.
WER=NS+D+I
N은 정답에 든 단어 수다. 단위를 단어 대신 글자로 바꾸면 글자 오류율(CER, Character Error Rate)이 된다. 공식은 같고 자만 바뀐다.
교과서에 자주 나오는 영어 예를 보자.
정답 6단어 vs 인식 결과
정답 the cat sat on the mat
인식 the cat sit on mat today
대체 1(sat→sit) + 삭제 1(the) + 삽입 1(today) = 3 → WER = 3 ÷ 6 = 50%
1.2 어디가 틀렸는지 찾는 일 — 정렬
여기서 까다로운 점이 하나 있다. 사람은 두 문장을 보면 어디가 어긋났는지 바로 알지만, 기계는 정답의 몇 번째 단어가 인식 결과의 몇 번째 단어와 짝인지부터 정해야 한다. 이를 정렬(alignment)이라 한다. 위의 예도 “the→mat, mat→today로 두 번 바꿨다”고 볼 수 있다. 그러면 대체만 3개다. 오류 개수는 같지만 어떤 종류의 실수인지 해석이 달라진다.
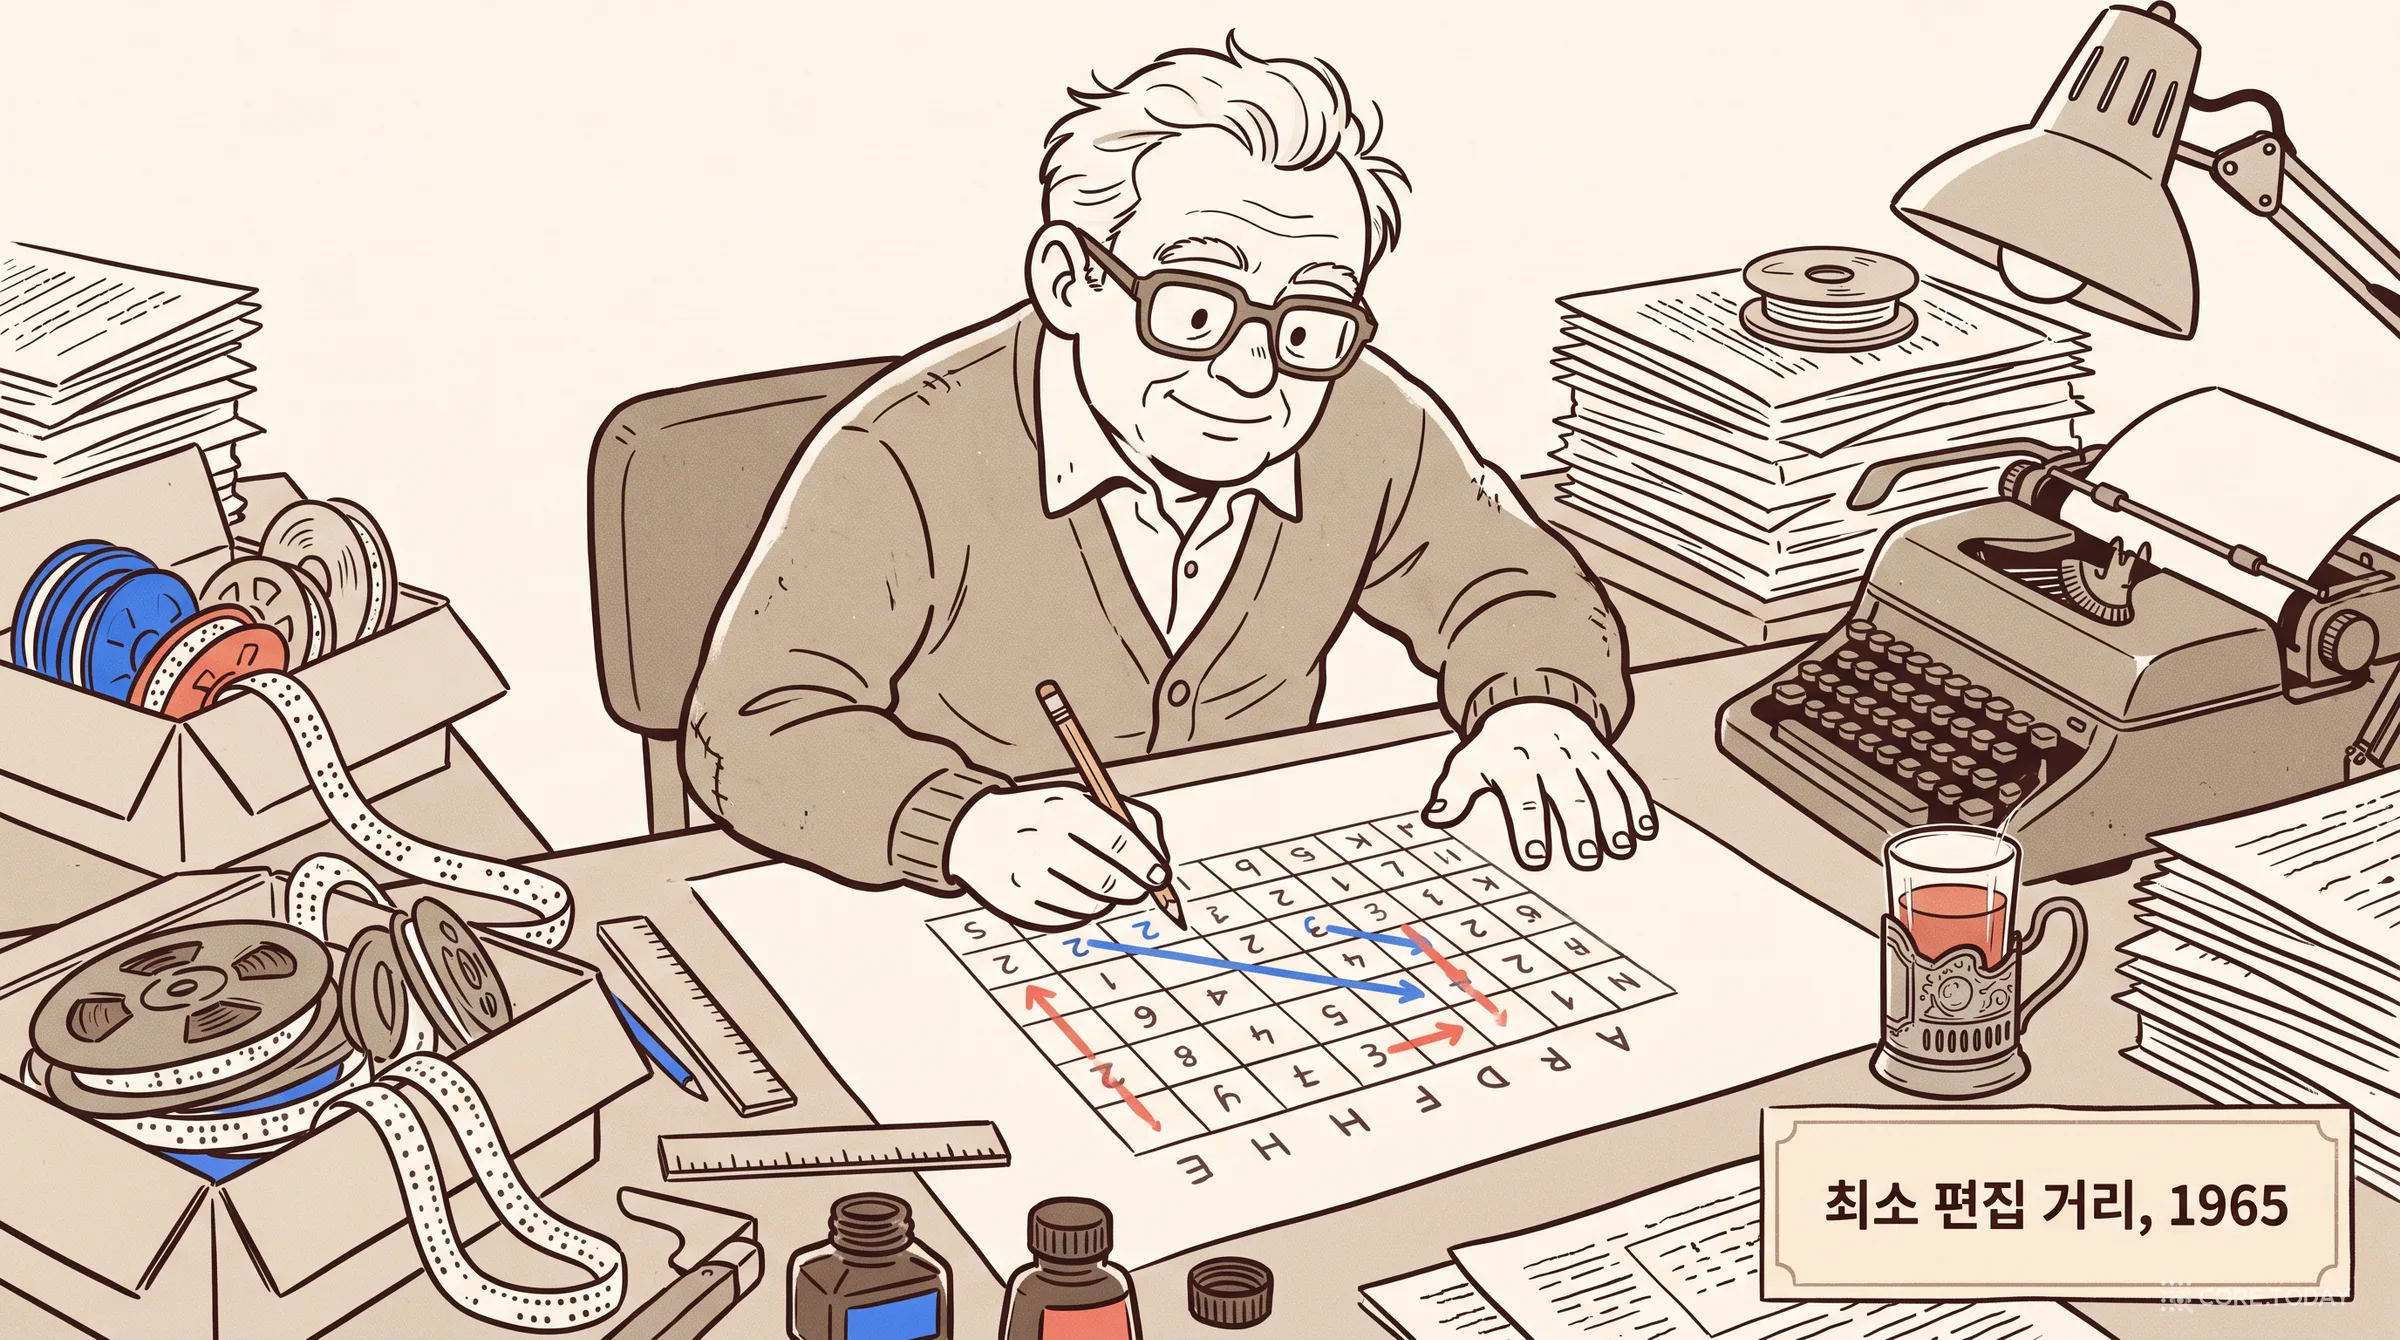
정렬은 편집 거리(edit distance)로 푼다. 한 문자열을 다른 문자열로 바꾸는 데 필요한 최소한의 편집 횟수다. 1965년 소련의 수학자 블라디미르 레벤슈타인이 오류 정정 부호를 연구하며 정의해 레벤슈타인 거리라고도 부른다. 계산은 표를 한 칸씩 채워 나가는 동적 계획법으로 한다. 2부에서 다시 만난다.
실무 표준 도구인 미국 표준기술연구소(NIST)의 sclite는 단순히 편집 횟수가 아니라 가중치를 둔다. 대체 4, 삭제 3, 삽입 3이다. 그래서 위 예처럼 동점이면 “대체 셋”보다 “대체·삭제·삽입 하나씩”을 고른다. 사람이 보기에 자연스러운 쪽이다. 아래 채점기도 같은 규칙을 쓴다.
1.3 WER은 100%를 넘을 수 있다
이름에 ‘율’이 붙었지만 WER은 0~100% 사이에 갇힌 숫자가 아니다. 분모는 정답의 길이인데, 삽입은 얼마든지 늘어날 수 있기 때문이다. 정답이 “네” 한 마디인데 인식기가 “네 다음 영상에서 만나요”라고 적었다면 정답 1어절에 삽입이 3개, WER은 300%다. 실제로 Whisper가 무음에 지어낸 말이다. 채점기의 ‘환각’ 예를 눌러 보면 된다. 이 숫자가 실제로 무엇을 뜻하는지는 6부에서 다룬다.
또 하나. WER은 낮을수록 좋다. BLEU처럼 높을수록 좋은 점수에 익숙하다면 헷갈리기 쉽다. 그래서 논문에서는 ‘정확도 = 1 − WER’로 바꿔 쓰기도 하는데, 삽입이 많으면 음수가 나온다.
WER의 뿌리는 음성 인식이 아니라 통신에 있다. 1965년 소련의 수학자 블라디미르 레벤슈타인은 전송 중에 기호가 빠지거나(삭제), 끼어들거나(삽입), 뒤바뀌는 오류를 바로잡는 부호를 연구했다. 그 과정에서 두 기호열이 얼마나 다른지를 ‘한쪽을 다른 쪽으로 바꾸는 최소 편집 횟수’로 정의했다. 이것이 레벤슈타인 거리다.
1974년 로버트 와그너와 마이클 피셔는 이 거리를 빠르게 구하는 방법을 발표했다. 정답의 앞 i글자를 인식 결과의 앞 j글자로 바꾸는 비용을 표의 (i,j) 칸에 적는다. 각 칸은 왼쪽(삽입), 위쪽(삭제), 왼쪽 위(일치·대체) 세 칸만 보면 채울 수 있다.
표의 오른쪽 아래 칸이 편집 거리이고, 거꾸로 따라 올라가면 정렬이 나온다. 50년이 지난 지금도 모든 WER 계산기는 이 표를 채운다.
2.2 1988년, 같은 시험지와 같은 채점표
1980년대 미국 국방고등연구계획국(DARPA)은 음성 인식 연구에 큰돈을 댔다. 문제는 연구소마다 다른 녹음, 다른 채점 방식으로 성적을 낸다는 점이었다. 그래서 DARPA는 같은 시험 세트를 나눠 주고 국립표준국(NBS, 지금의 NIST)이 채점을 맡는 공개 벤치마크를 열었다.
1988년 6월 벤치마크 문서를 보면 지금의 WER이 거의 그대로 있다. 동적 계획법으로 정렬하고, 대체·삭제·삽입을 세고, 이를 정답 단어 수로 나눈 ‘전체 오류율’을 낸다. 문서는 이렇게 경고하기도 한다.
단어 정확도(100 − 오류율)는 일반적으로 맞게 인식한 단어의 비율과 같지 않다.
삽입 때문이다. 정답 단어를 다 맞혀도 엉뚱한 단어를 끼워 넣으면 오류율은 올라간다. 이 채점 프로그램은 훗날 NIST의 sclite로 이어졌고, 지금도 많은 논문이 “sclite로 쟀다”고 적는다.
이후 15년간 NIST는 해마다 같은 방식으로 성적을 매겼다. 어휘 약 1,000개짜리 낭독(Resource Management)에서 시작해 신문 낭독(WSJ), 방송 뉴스, 그리고 가장 어려운 전화 대화(Switchboard)로 과제가 옮겨 갔다. 과제가 바뀔 때마다 WER은 다시 높게 시작해 조금씩 내려왔다. 같은 자로 쟀기 때문에 그 내려가는 모습을 그래프 하나에 그릴 수 있었다. WER의 가장 큰 공은 바로 이것이다. 분야 전체가 같은 숫자를 보고 달리게 만들었다.
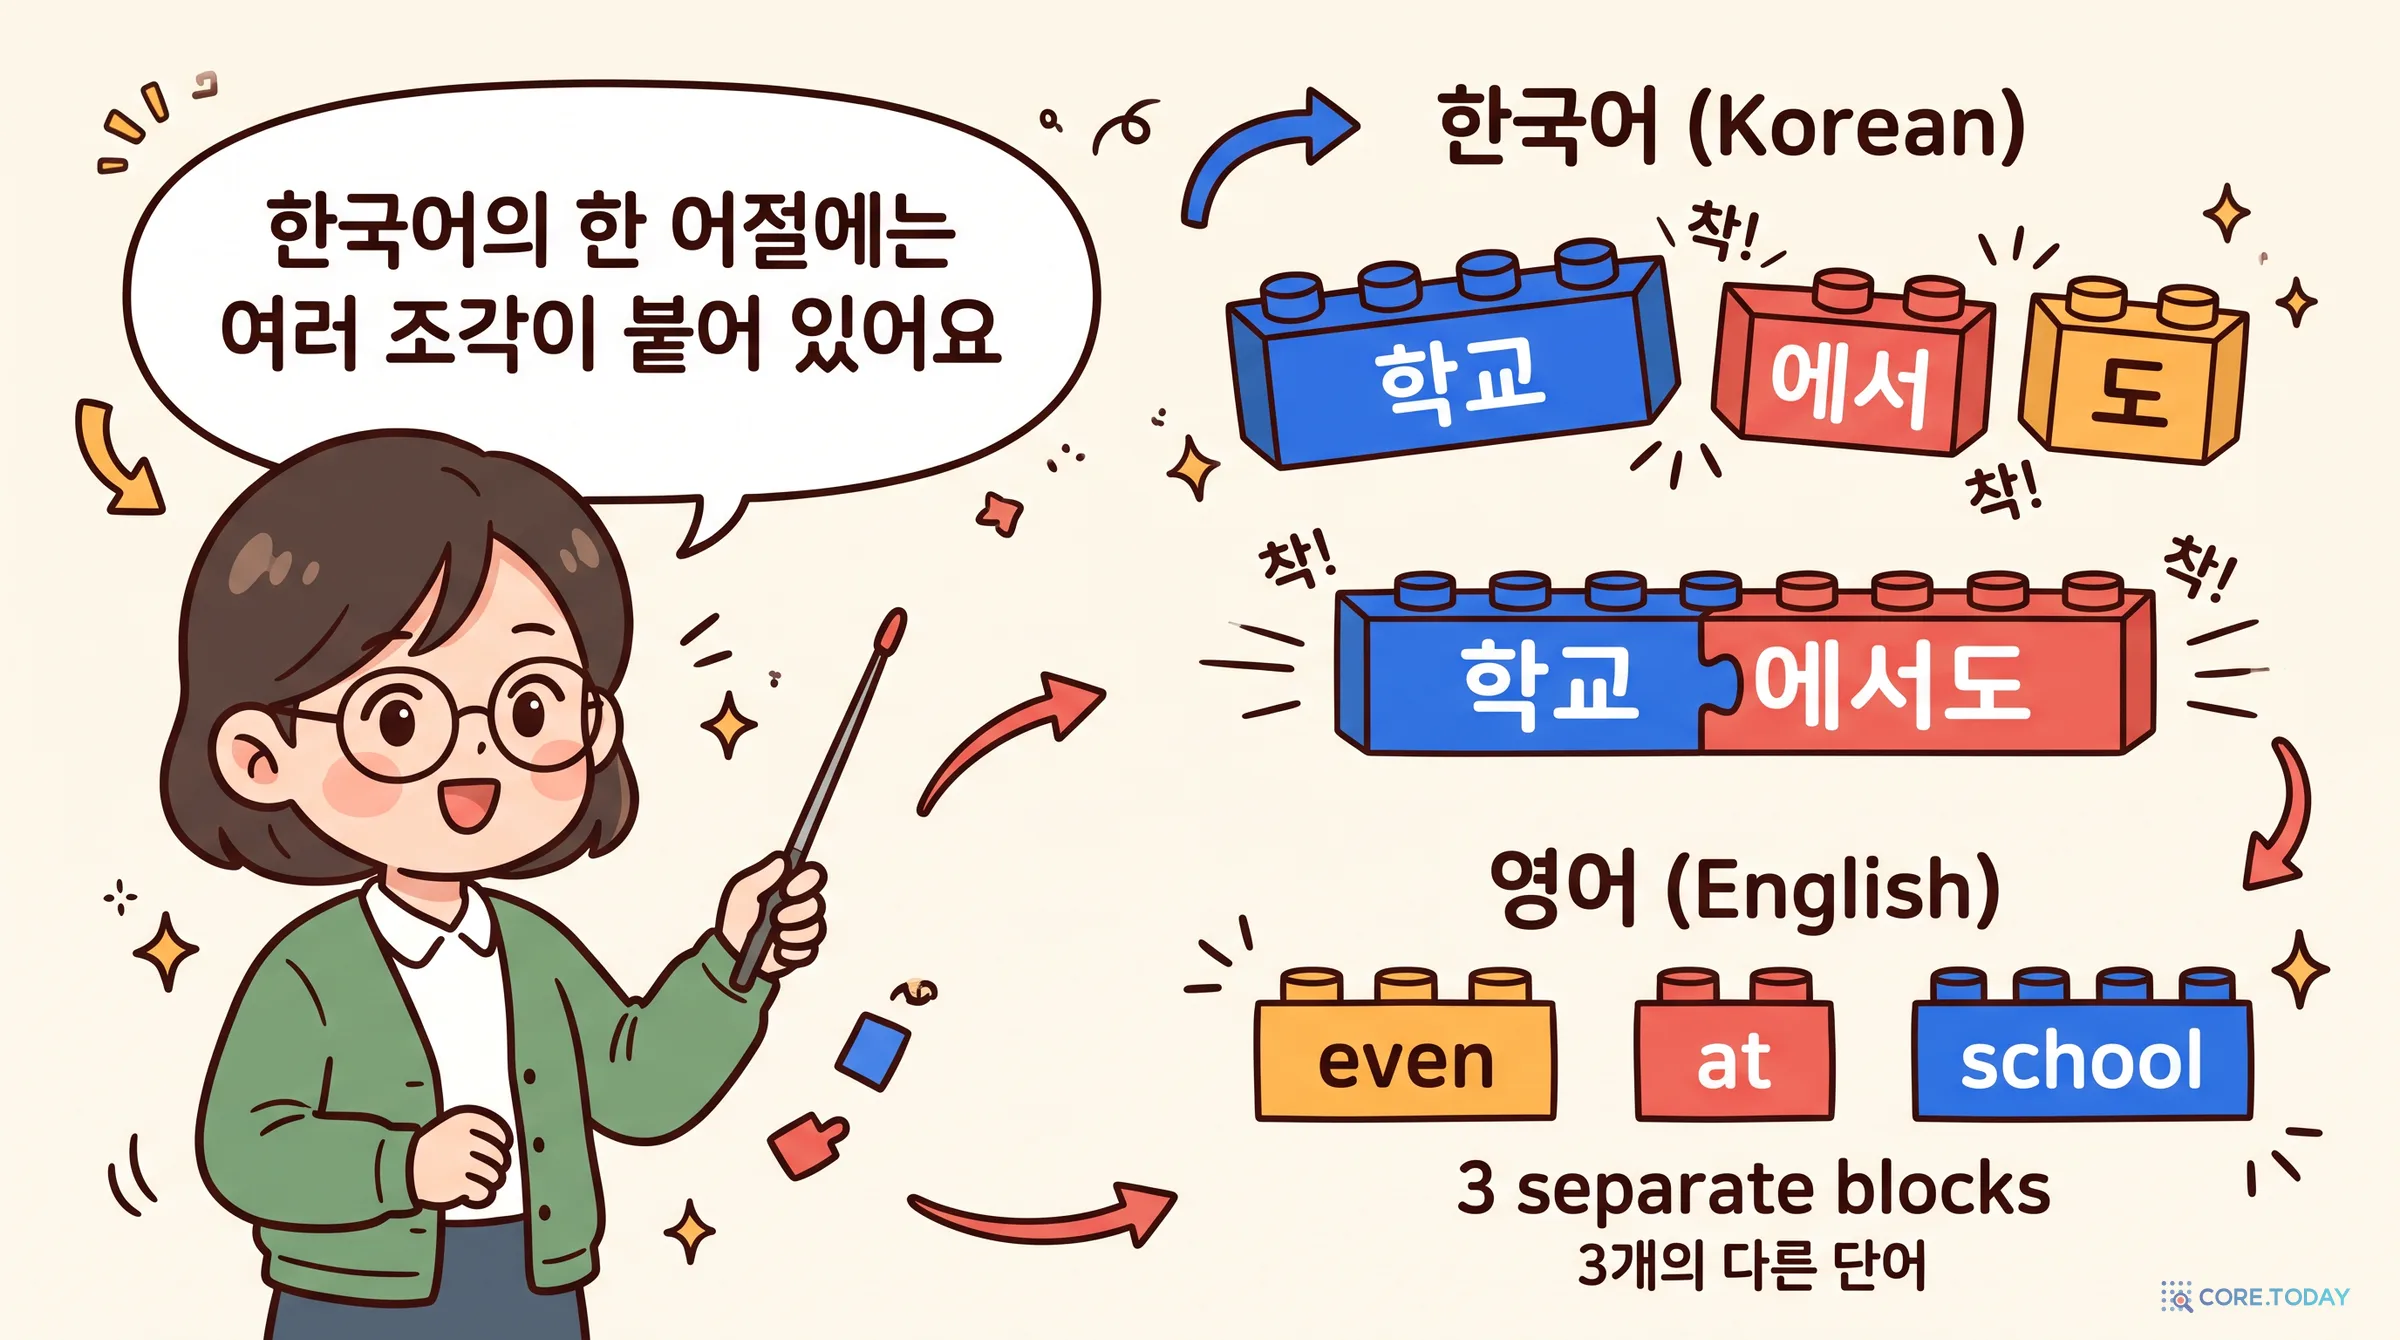
더 큰 문제는 띄어쓰기다. 한국어 띄어쓰기는 원어민도 자주 틀린다. 게다가 한글 맞춤법이 두 가지를 모두 허용하는 경우가 있다.
제47항 (보조 용언): “불이 꺼져 간다”와 “불이 꺼져간다” 모두 맞다.
제49항 (고유 명사): “대한 중학교”와 “대한중학교” 모두 맞다.
제50항 (전문 용어): “만성 골수성 백혈병”과 “만성골수성백혈병” 모두 맞다.
사람이 받아 적은 정답이 한쪽을 골랐고 인식기가 다른 쪽을 골랐다면, 둘 다 맞춤법에 맞는데도 어절 WER은 오류를 센다. “만성 골수성 백혈병”을 붙여 쓰면 세 어절 중 셋이 틀린 셈이라 WER 100%다. 글자는 하나도 틀리지 않았다.
아래 위젯에서 글자 사이를 눌러 칸을 넣고 빼 보자. 글자는 그대로인데 WER만 출렁인다.
음성에는 띄어쓰기가 없다. 말하는 사람은 “꺼져 간다”와 “꺼져간다”를 다르게 발음하지 않는다. 그러니 띄어쓰기는 인식기가 들은 것이 아니라 글로 옮기며 고른 것이다. 인식기가 들은 소리를 얼마나 정확히 옮겼는지 재고 싶다면 띄어쓰기의 영향은 줄이는 편이 공정하다. 이것이 한국어 음성 인식에서 글자 오류율(CER)이 표준이 된 가장 큰 이유다. 공백을 아예 빼고 세는 방식이 흔하지만, 2020년 한국어 대화 음성 969시간을 공개한 KsponSpeech처럼 공백도 한 글자로 세는 연구도 있다. 같은 ‘CER’이라도 정의를 확인해야 한다.
3.3 아예 띄어 쓰지 않는 언어들
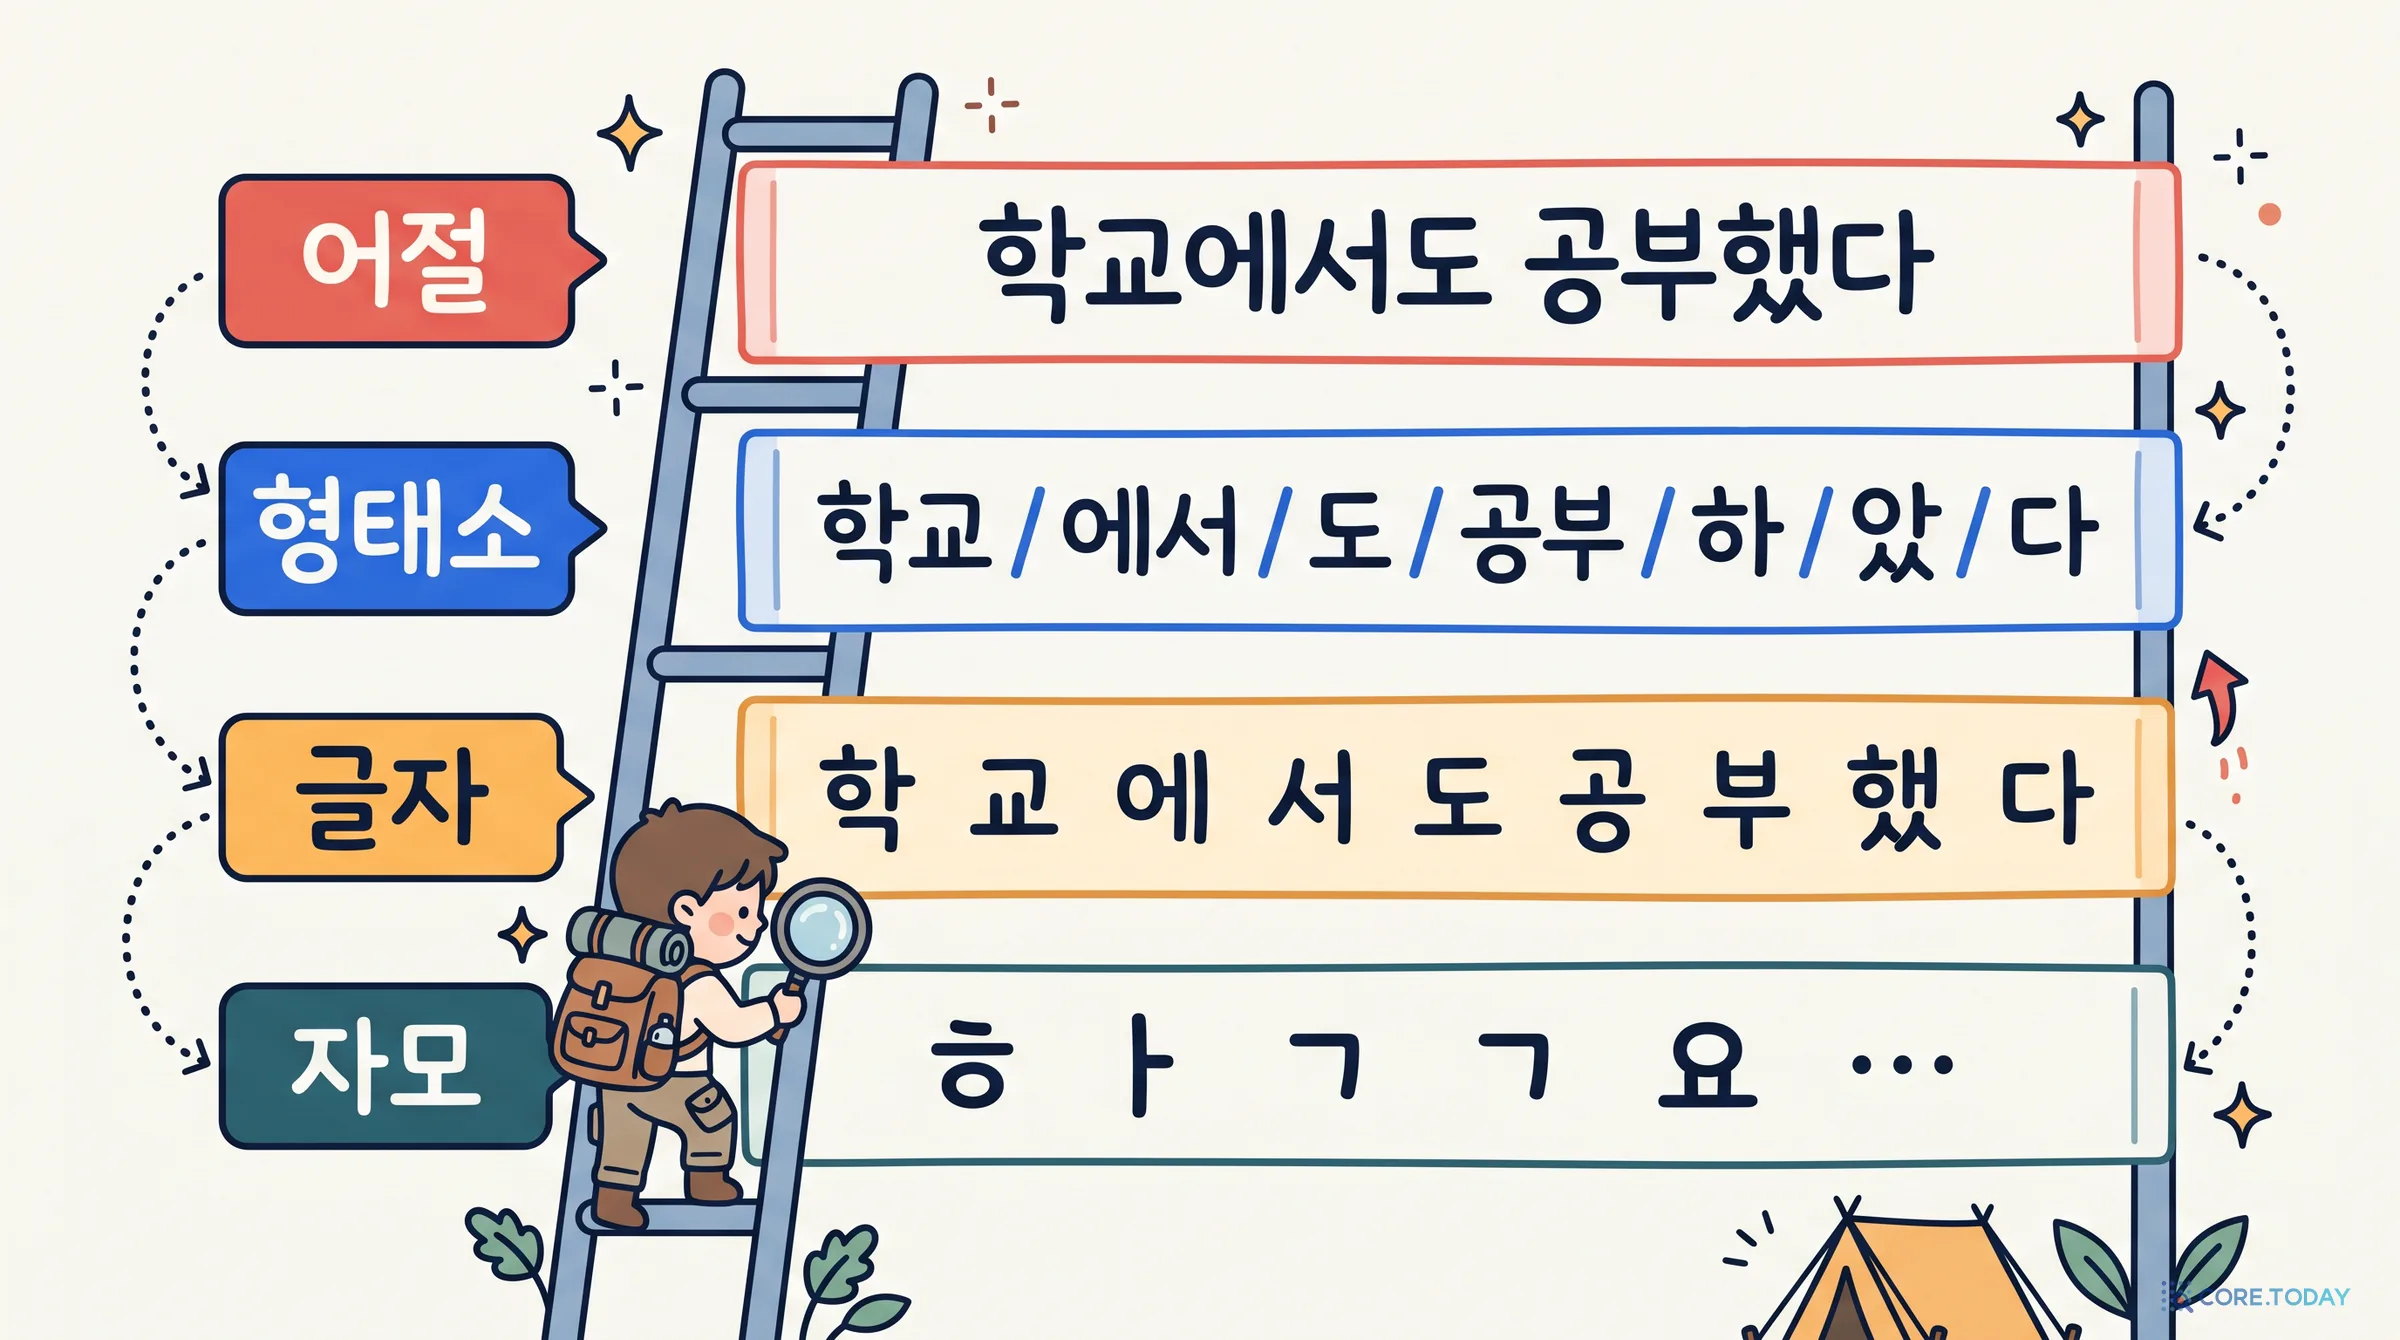
중국어와 일본어는 문장 안에서 아예 띄어 쓰지 않는다. 단어를 세려면 먼저 형태소 분석기로 문장을 잘라야 하는데, 분석기마다 자르는 방식이 다르니 같은 문장도 단어 수가 달라진다. 그래서 중국어·일본어 음성 인식은 일찍부터 CER로 쟀다. 태국어·라오어·미얀마어 등 띄어쓰기로 단어를 나누지 않는 언어도 마찬가지다.
한국어는 띄어 쓰기는 하지만 그 단위가 단어가 아니고, 그 위치마저 흔들린다. 그래서 같은 이유로 글자를 택했다.
그림에서는 ‘했’을 ‘하·았’으로 잘랐는데, 우리가 실측에 쓴 분석기 Kiwi는 ‘하·었’으로 자른다. 형태소 단위의 약점이 바로 이것이다. 무엇을 형태소로 볼지가 분석기마다 다르다.
글자 단위가 표준이 된 것은 가장 완벽해서가 아니다. 누가 재도 같은 값이 나오기 때문이다. 분석기도, 띄어쓰기 규칙에 대한 합의도 필요 없다. 지표의 첫째 미덕은 재현성이다.
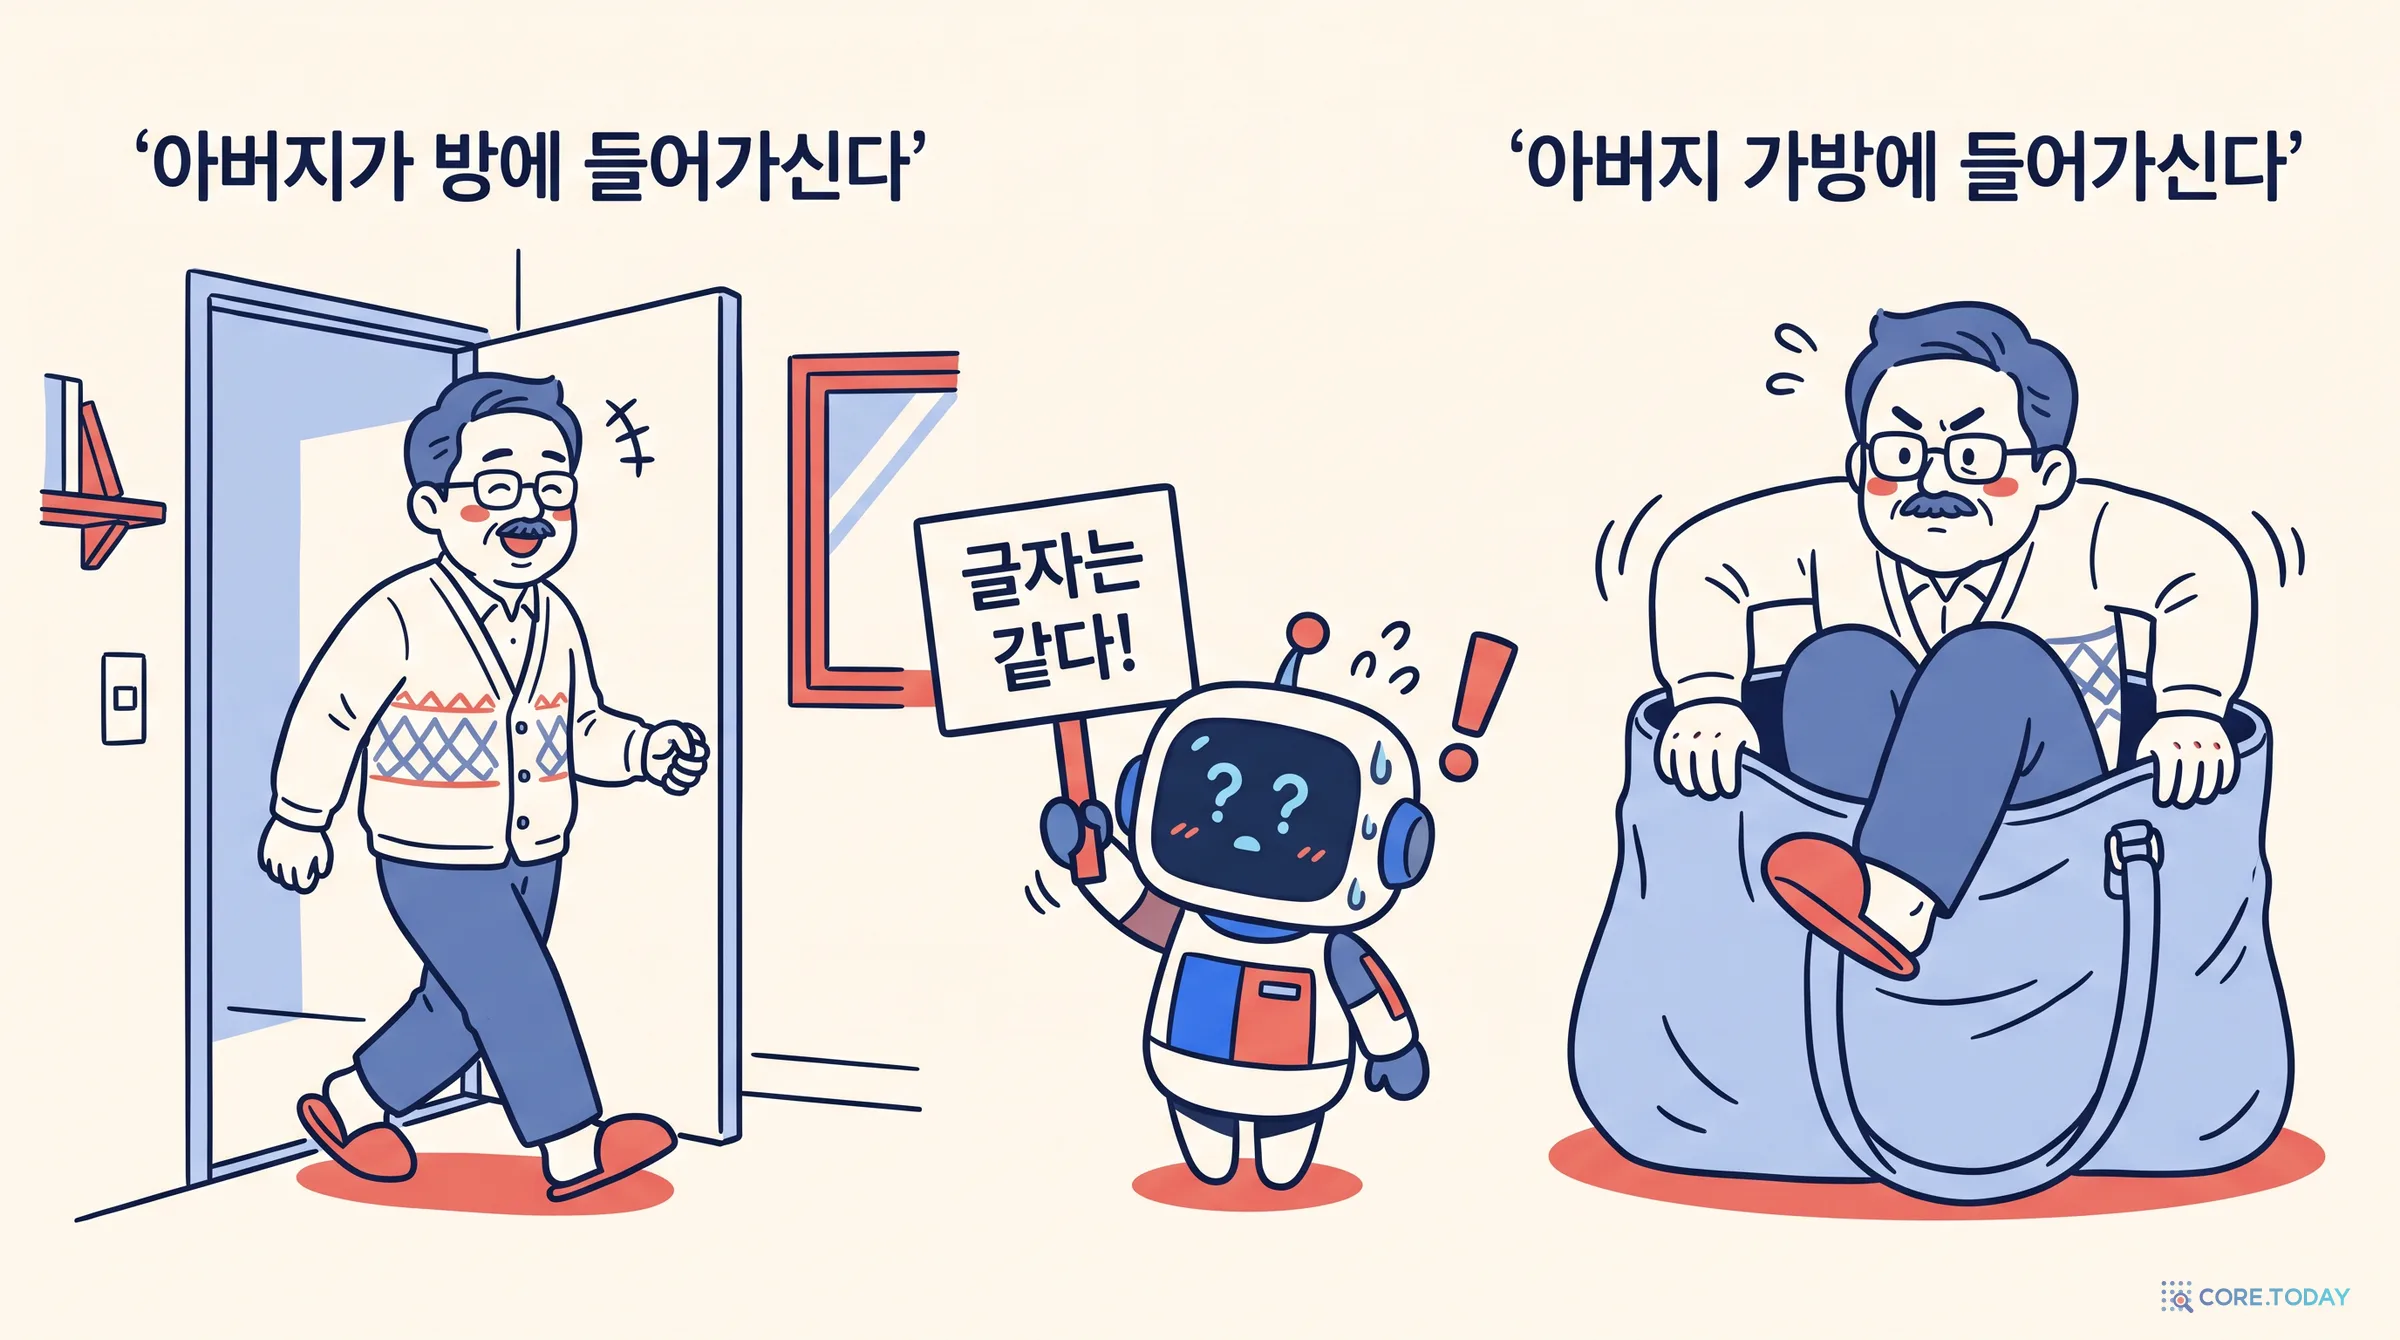
다만 CER에도 맹점이 있다. 그림 속 “아버지가 방에 들어가신다”와 “아버지 가방에 들어가신다”는 공백을 지우면 똑같은 글자열이다. CER 0%다. 띄어쓰기가 뜻을 바꾸는 드문 경우를 CER은 보지 못한다.
4부. 직접 재 봤다 — Whisper 6종, 다섯 개의 자
4.1 실험 설계
말로만 하면 감이 오지 않는다. 직접 쟀다.
모델: OpenAI의 공개 음성 인식 모델 Whisper 6종(tiny 3,900만 → base → small → medium → large-v3-turbo → large-v3 15억 파라미터). 언어를 한국어로 지정하고 가장 단순한 그리디 디코딩으로 받아 적게 했다.
시험 세트 ① Zeroth-Korean: 화자 10명이 문장을 읽은 녹음 457개(약 1.2시간, CC BY 4.0). 정답은 소리 나는 대로, 숫자까지 한글로 적었다.
시험 세트 ② FLEURS 한국어: 구글이 102개 언어로 만든 FLEURS의 한국어 시험 세트 382개 녹음(270개 문장). 글로 쓴 문장을 읽은 것이라 정답에 아라비아 숫자와 문장부호가 그대로 있다.
자: 같은 받아쓰기를 다섯 가지 단위로 쟀다. 어절 WER, 띄어쓰기 맞춘 WER(KsponSpeech의 sWER), 형태소 WER(형태소 분석기 Kiwi), 공백 뺀 CER, 자모 오류율. 모두 문장부호를 지우고 말뭉치 전체로 합산했다.
4.2 결과 — 같은 받아쓰기, 다섯 개의 숫자
whisper-large-v3의 결과만 표로 옮기면 이렇다.
시험 세트
어절 WER
띄어쓰기 맞춘 WER
형태소 WER
CER
자모
Zeroth-Korean
22.6%
8.1%
6.8%
4.3%
3.3%
FLEURS 한국어
15.1%
5.8%
5.0%
4.9%
2.8%
세 가지가 눈에 띈다.
첫째, 같은 받아쓰기의 점수가 다섯 배까지 벌어진다. Zeroth에서 어절 WER은 22.6%, CER은 4.3%다. 둘 중 무엇을 보고했느냐에 따라 같은 모델이 전혀 다른 모델처럼 보인다.
둘째, 어절 오류의 대부분은 띄어쓰기다. 인식 결과의 띄어쓰기만 정답에 맞춰 줘도 어절 WER이 22.6%에서 8.1%로 떨어진다. 어절 오류의 64%가 띄어쓰기 차이였다는 뜻이다. FLEURS에서도 62%였다. 문장 단위로 보면 large-v3가 하나라도 틀린 Zeroth 문장 353개 중 99개(28%)는 글자는 하나도 안 틀리고 띄어쓰기만 다른 문장이었다.
셋째, 모델이 좋아질수록 이 차이는 더 커진다. 이것이 가장 흥미로운 결과다.
tiny
2.2배
base
2.7배
small
3.2배
medium
3.5배
large-v3-turbo
5.2배
large-v3
5.3배
Zeroth-Korean에서 어절 WER ÷ CER. 막대는 최댓값(5.3배) 기준.
작은 모델은 글자를 많이 틀리니 어절 오류도 대부분 진짜 오류다. tiny의 어절 오류 가운데 띄어쓰기로 설명되는 몫은 29%뿐이다. 모델이 커지며 글자 오류가 줄면, 남은 어절 오류의 대부분은 띄어쓰기 차이가 된다. 다시 말해 좋은 모델일수록 어절 WER은 ‘얼마나 잘 들었나’가 아니라 ‘띄어쓰기 습관이 정답과 얼마나 같은가’를 잰다. 한국어에서 어절 WER을 표준으로 쓰면 안 되는 가장 분명한 증거다.
4.3 자를 바꾸면 순위도 흔들린다
대부분의 경우 다섯 개의 자는 같은 순위를 냈다. 큰 모델이 어느 자로 재도 더 좋았다. 하지만 가까운 모델끼리는 다르다. FLEURS에서 large-v3-turbo는 CER로 medium보다 낫지만(5.2% vs 5.5%) 자모 오류율로는 뒤진다(3.0% vs 2.9%). 차이는 작지만, 보고서가 어떤 자를 골랐느냐에 따라 “더 좋은 모델”이 바뀔 수 있다는 뜻이다.
공백을 글자로 셀지도 작은 차이를 만든다. KsponSpeech 논문은 CER을 “글자와 공백을 함께” 세어 계산했다. 우리 측정에서 large-v3의 Zeroth CER은 공백을 빼면 4.3%, 넣으면 6.0%였다. 똑같이 ‘CER’이라고 불러도 정의를 확인하지 않으면 비교할 수 없다.
4.4 논문 숫자와 비교하면
Whisper 논문은 FLEURS 한국어를 어절 WER로 쟀다. large-v2가 14.3%였다. 우리가 잰 large-v3는 15.1%로 비슷하다. 다만 정규화 방식이 다르고(우리는 문장부호만 지웠다) 모델 버전도 다르니 정확히 같은 조건은 아니다. 2026년 보고서들이 같은 FLEURS 한국어에서 2% 안팎을 보고하는 것은 단위가 CER이기 때문이기도 하다. 8부에서 다시 다룬다.
받아쓰기에서 숫자는 늘 골칫거리다. 누군가 “이천십일 년 팔월”이라고 말했다. 이걸 “2011년 8월”로 적어야 할까, “이천십일 년 팔월”로 적어야 할까? 둘 다 틀리지 않았다. 그런데 정답이 한쪽이고 인식 결과가 다른 쪽이면 오류율은 둘을 다른 글자로 본다.
우리가 쓴 두 시험 세트가 정확히 이 차이를 보여 준다.
Zeroth-Korean 정답 457문장에는 아라비아 숫자가 하나도 없다. “스물 센티미터”, “오 쩜 구 사 시간”처럼 모두 한글로 적었다. 소리 나는 대로 적는 것이 이 데이터의 규칙이다.
FLEURS 정답 382개 중 86개에는 “2011년”, “15미터”처럼 아라비아 숫자가 있다. 글로 쓴 문장을 사람이 소리 내어 읽은 데이터라 원문 표기를 그대로 정답으로 쓴다.
Whisper는 인터넷 자막으로 배워 숫자를 대개 아라비아 숫자로 적는다.
그래서 같은 Whisper가 두 시험 세트에서 다른 벌을 받는다. Zeroth에서 whisper-large-v3가 아라비아 숫자를 쓴 문장은 457개 중 71개였다. 이 문장들의 CER은 9.7%로 나머지 문장(3.1%)의 세 배였다. 대부분 잘못 들은 것이 아니라 다르게 적은 것이다. 작은 모델일수록 숫자를 더 자주 썼다. tiny와 base는 144개 문장에서 아라비아 숫자를 썼다.
KsponSpeech 논문도 이 문제를 짚었다. “2”와 “둘”은 같은 말이지만 채점에서는 여전히 틀린 것으로 본다고 밝혔다. 어떤 표기를 정답으로 칠지가 데이터셋마다 다르고, 그 규칙이 곧 점수를 정한다.
5.2 Whisper가 정규화기를 함께 내놓은 이유
2022년 OpenAI는 Whisper를 발표하며 모델만큼 공을 들인 것을 하나 더 공개했다. 텍스트 정규화기다. 논문은 이렇게 썼다.
WER은 사람이 보기에 무해한 표기 차이까지 모든 차이를 벌점으로 매긴다. 사람이 맞다고 판단할 받아쓰기도 사소한 표기 차이 때문에 WER이 클 수 있다.
Whisper는 특정 데이터셋의 표기 습관을 배운 적이 없다. 그래서 영어 정규화기는 “ten”과 “10”, “Mr.”와 “mister”, 영국식과 미국식 철자까지 하나로 맞춘다. 이걸로 여러 데이터셋에서 WER이 최대 50% 줄었다. 모델은 그대로인데 채점 규칙만 바꿔서 점수가 절반이 된 것이다.
영어가 아닌 언어에는 더 단순한 정규화기를 썼다. 괄호 안을 지우고, 문장부호와 기호를 공백으로 바꾸고, 소문자로 만들고, 공백을 정리한다. 숫자를 읽는 규칙은 없다. 한국어 숫자 표기 문제는 그대로 남는다.
5.3 직접 정규화해 보기
아래 위젯에서 정규화 단계를 하나씩 켜 보자. 예문은 우리 실측에서 나온 실제 Whisper 받아쓰기다.
숫자를 한글 읽기로 바꾸는 단계를 켜면 많은 오류가 사라진다. 하지만 완벽하지 않다. “세 시”, “다섯 경기”처럼 한국어에는 고유어 수사가 있다. 숫자 3을 ‘삼’으로 읽을지 ‘세’로 읽을지는 뒤에 오는 단위가 정한다. “3시 30분”은 ‘세 시 삼십 분’이다. 단순한 규칙으로는 다 맞출 수 없다. 반대로 정규화를 너무 세게 하면 진짜 오류까지 지워진다. “4만 명”을 “3만명”으로 적은 받아쓰기를 띄어쓰기만 보고 넘기면 안 된다.
그래서 정규화는 기술 문제이기 이전에 합의의 문제다. 무엇을 같은 것으로 칠지 정하고, 그 규칙을 적고, 모든 모델에 똑같이 적용해야 한다. 정규화 규칙이 다른 두 점수는 비교할 수 없다.
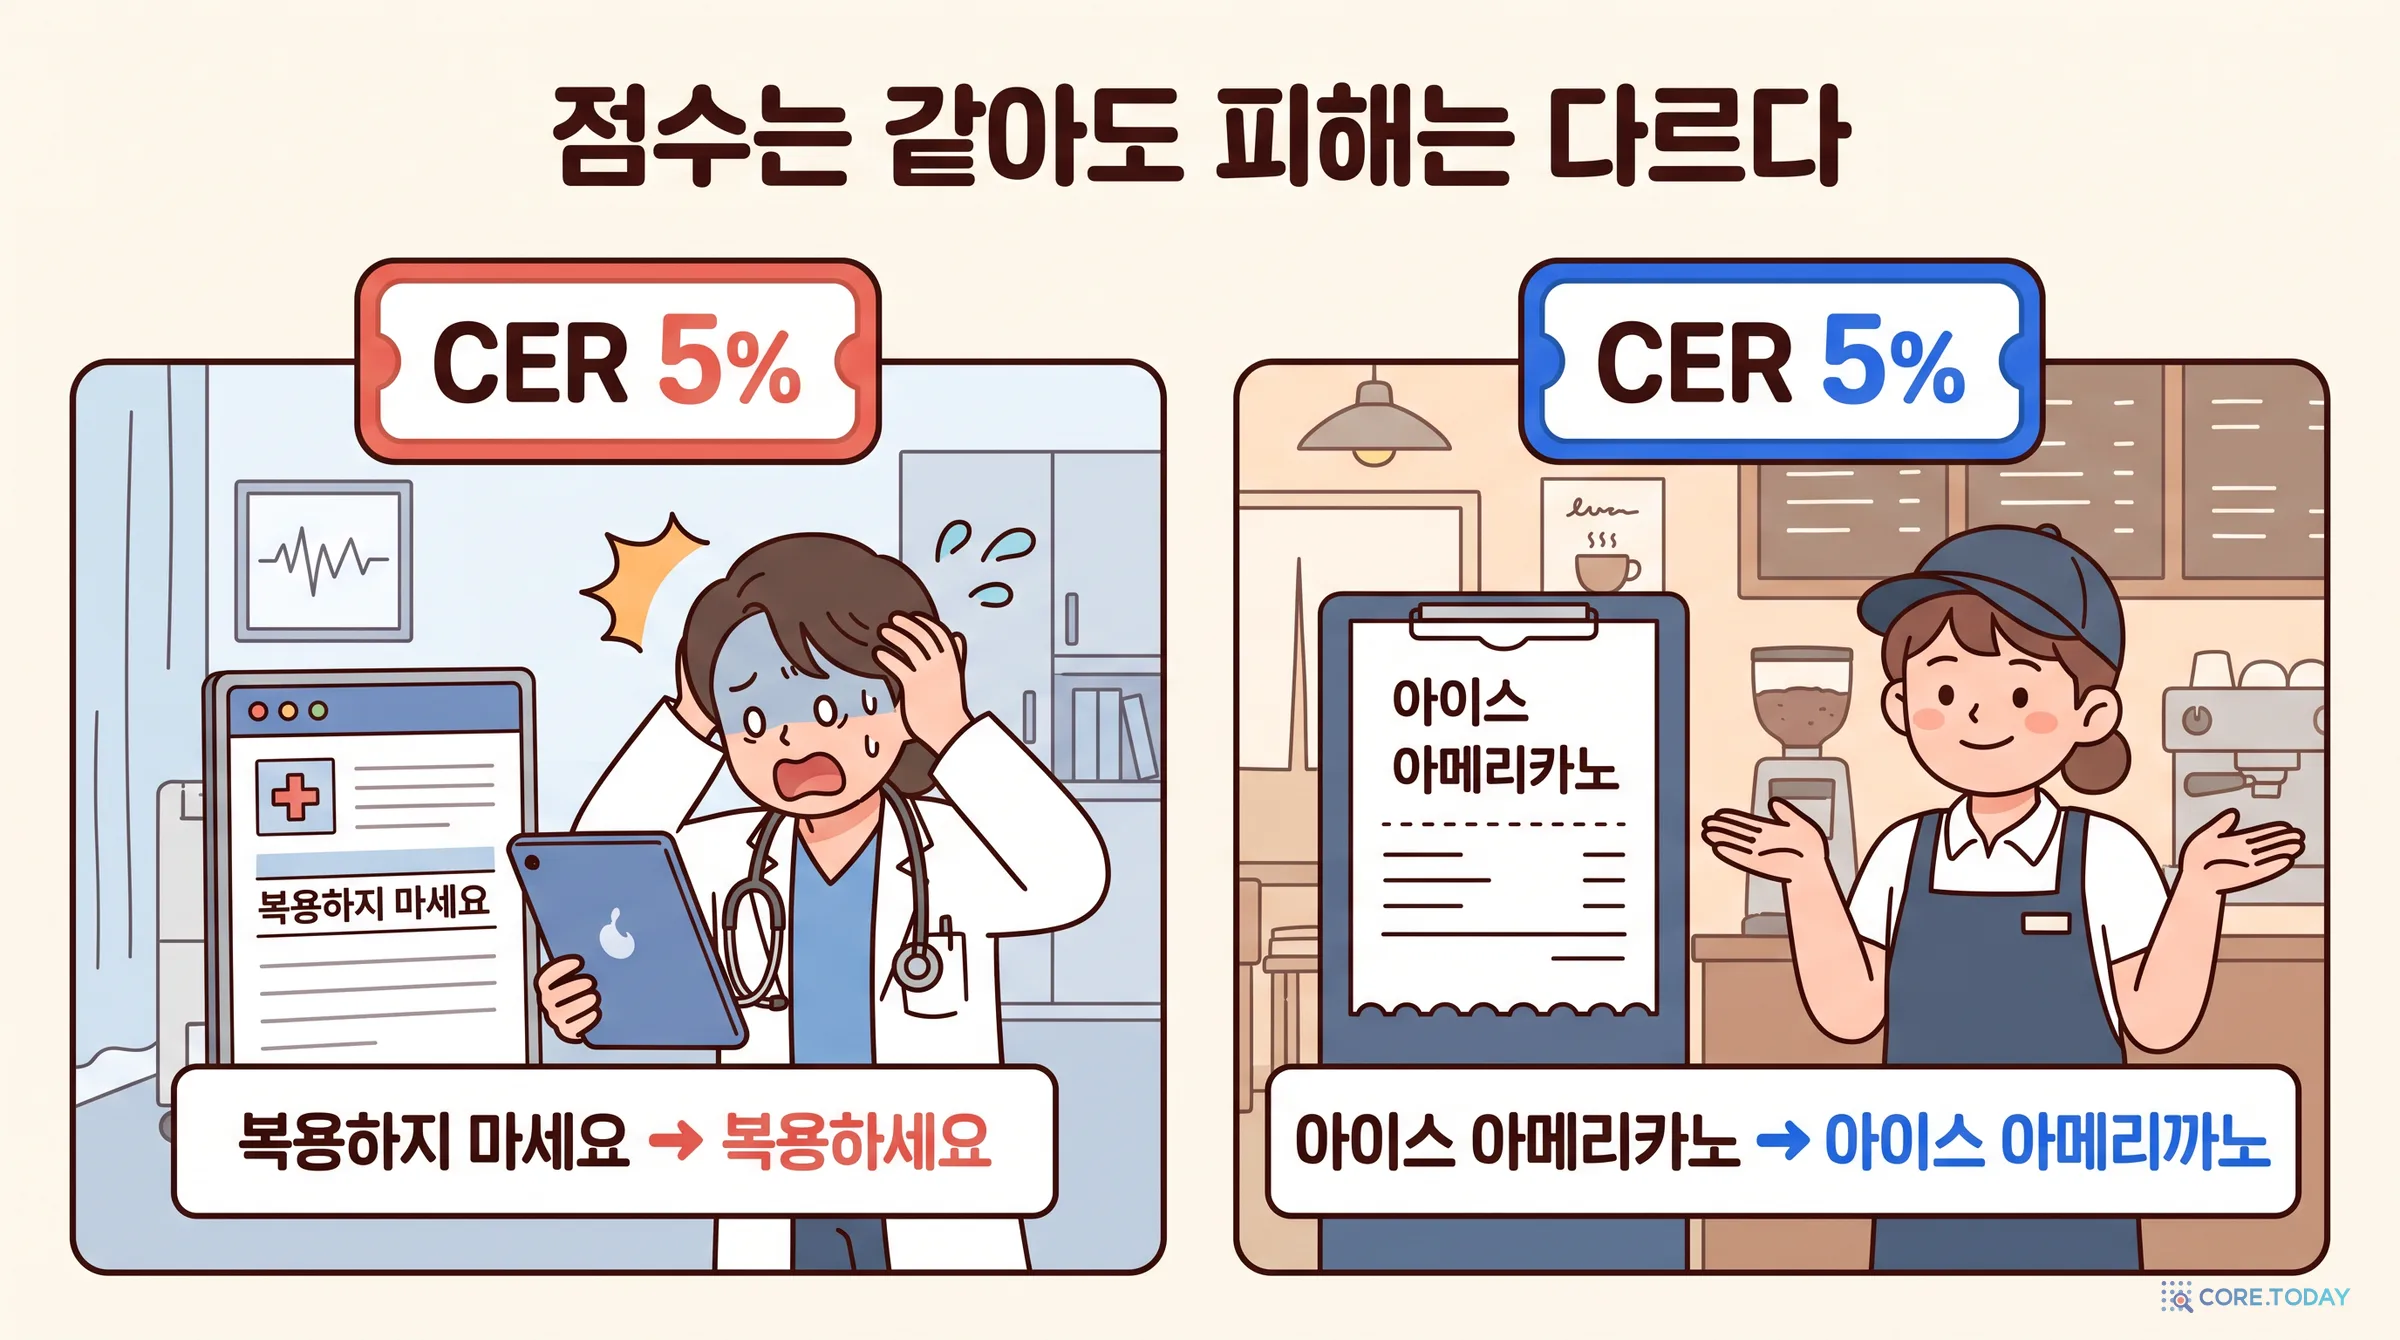
WER·CER에서 모든 오류의 무게는 1이다. 조사 ‘을’이 ‘를’이 된 것도 1, “하지 마세요”의 ‘지 마’가 사라진 것도 1씩이다. 오류율은 몇 개 틀렸는지를 셀 뿐, 어느 것이 틀렸는지는 묻지 않는다.
아래에서 먼저 위험한 받아쓰기를 골라 보고 점수를 공개해 보자.
복약 안내에서 지시를 정반대로 바꾼 받아쓰기의 CER은 11.8%로, 말투만 바꾼 무해한 받아쓰기(17.6%)보다 낮다. 계좌 이체에서 금액을 1만분의 1로 만든 받아쓰기는 CER 6.7%, 숫자를 아라비아 숫자로 적었을 뿐인 받아쓰기는 20%다. 점수만 보면 위험한 쪽이 더 잘한 받아쓰기다.
2003년 마이크로소프트 연구진은 이 문제를 실험으로 보였다. 음성으로 항공편을 묻는 시스템에서, 받아쓰기용으로 학습한 언어 모델과 의미 파악용으로 학습한 모델을 비교했다. 의미 파악용 모델은 WER이 46% 더 나빴는데도 내용 이해 오류는 최대 17% 줄였다. 받아쓰기를 더 잘하는 것과 말을 더 잘 알아듣는 것은 다른 일이다. 이듬해 모리스 등은 WER 대신 ‘정보를 얼마나 잃었나’를 재는 MER·WIL을 제안했지만, 표준은 바뀌지 않았다. 계산이 쉽고 누구나 같은 값을 얻는 WER의 장점이 그만큼 컸다.
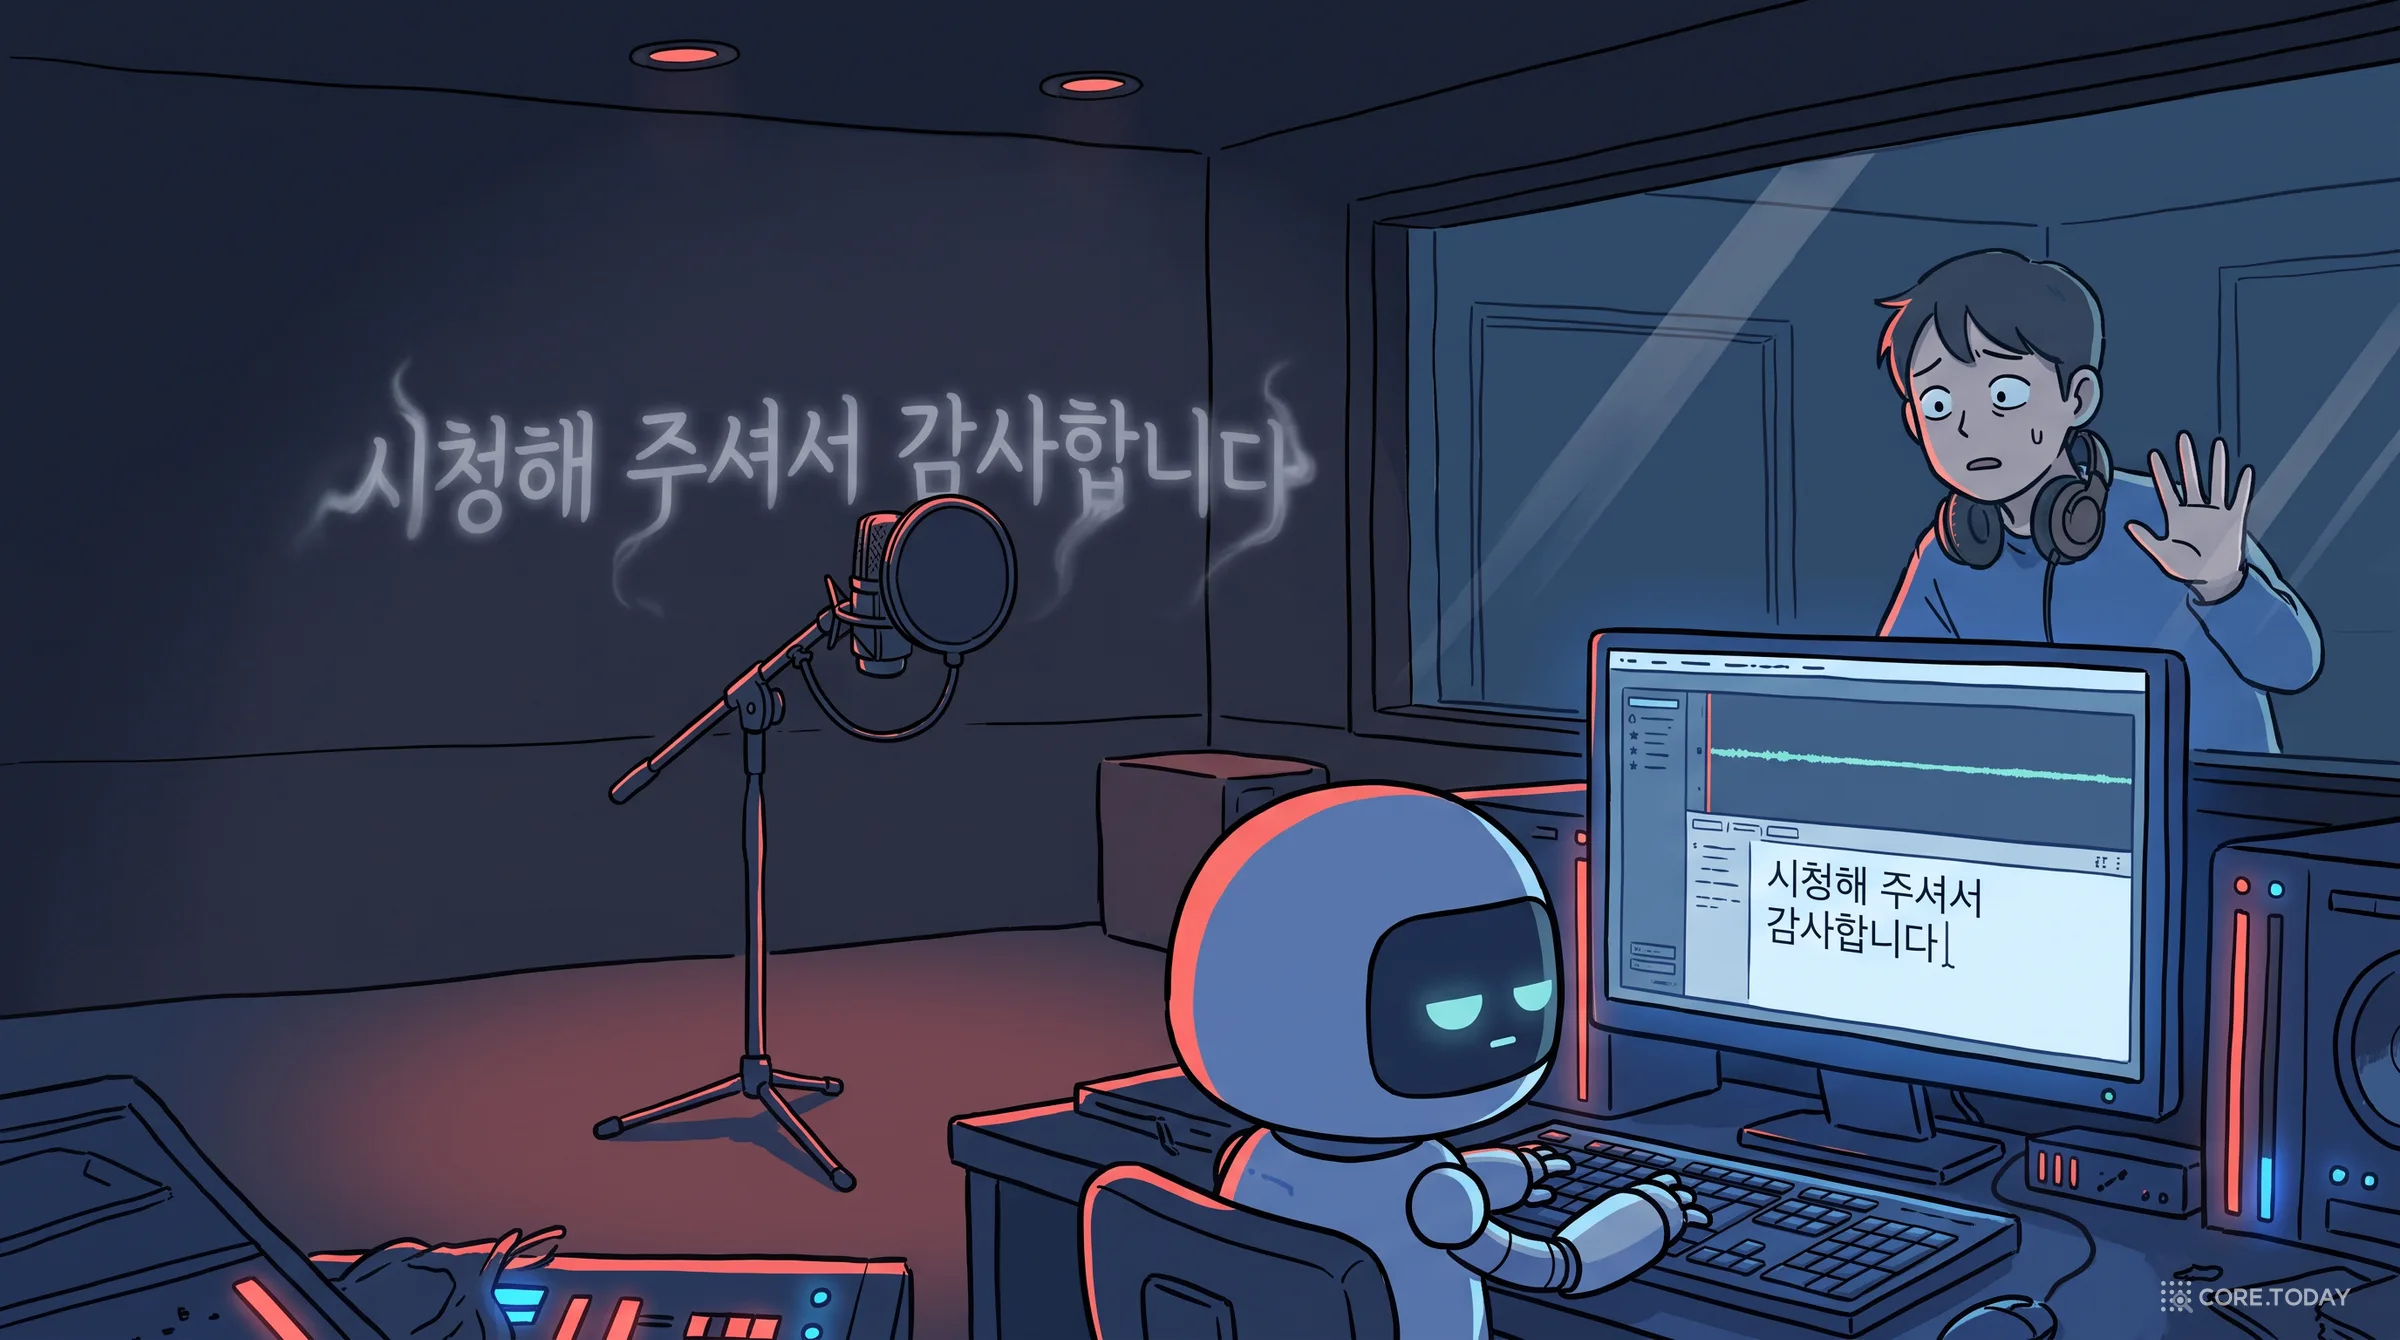
한국어로 Whisper를 써 본 사람들 사이에 유명한 현상이 있다. 영상 끝의 무음 구간이나 잡음에 “시청해 주셔서 감사합니다” 같은 인사가 찍혀 나온다. 아무도 그 말을 하지 않았다. Whisper는 인터넷의 음성과 그 자막 68만 시간으로 배웠다. 널리 퍼진 설명은 자막 달린 영상의 끝에 이런 인사가 아주 많았다는 것이다. 소리가 없으면 모델은 가장 그럴듯한 말을 지어낸다. 디코딩 특집에서 본 언어 모델의 버릇 그대로다.
우리도 확인했다. 무음(5~30초), 크기를 달리한 백색 잡음, 갈색 잡음, 60Hz 전원 험, 삐 소리, 키보드 소리처럼 말이 전혀 없는 소리 22개를 Whisper 세 모델에 한국어로 받아 적게 했다.
모델
말을 지어낸 클립
가장 많이 나온 말
그 밖의 말
whisper-small
22 / 22
“MBC 뉴스 ○○○입니다.” (무음 4개 모두)
“이 영상은 대화가 없어서요.”, “다음 주에 또 만나요!”, “고추장”, 키보드 소리에 “아”를 100번 넘게 반복
whisper-large-v3-turbo
21 / 22
“감사합니다.” (11개)
“아멘”(백색 잡음 9개), “다음 영상에서 만나요.”
whisper-large-v3
13 / 22
“감사합니다.” (9개)
“고속도로”(강한 백색 잡음 3개), “다음 영상에서 만나요.”
나머지 클립은 마침표 하나만 출력했다. ○○○은 small이 지어낸 사람 이름으로, 실존 인물일 수 있어 가렸다. 그리디 디코딩, 2026-11-07 측정.
완전한 무음에도 세 모델 모두 말을 지어냈다. 큰 모델은 덜 지어내지만 0이 되지는 않았다. small이 지어낸 “MBC 뉴스 ○○○입니다”는 뉴스 리포트의 끝맺음이다. 학습 데이터에 흔했던 형식이 무음을 만나 튀어나온 것이다. 실존할 수 있는 사람 이름까지 지어낸다는 점이 특히 위험하다. 회의록에 없는 사람의 발언이 기록될 수 있다는 뜻이다. 실무에서는 음성 구간 검출(VAD)로 말이 없는 구간을 먼저 잘라 내는 것이 기본 처방이다.
2024년 코에넥 등의 「Careless Whisper」 연구는 이 문제를 정면으로 다뤘다. 실어증 화자를 포함한 음성 1만 3천여 개를 Whisper로 받아 적었더니 약 1%에서 들리지 않은 문장이 통째로 들어갔다. 그 가운데 38%에는 폭력, 근거 없는 인물 정보, 허위 권위 같은 해로운 내용이 있었다. 말 사이의 쉼이 긴 실어증 화자에게서 환각이 더 잦았다.
환각은 WER로 잡을 수는 있다. 삽입이 폭증해 100%를 넘기 때문이다. 문제는 평균이다. 1,000문장 중 10문장에 환각이 들어도 전체 WER은 조금밖에 오르지 않는다. 그런데 그 10문장이 회의록에 남거나 진료 기록에 들어간다면 피해는 평균과 상관없다. 평균 오류율과 함께 ‘오류율이 100%를 넘은 문장의 수’를 따로 세야 하는 이유다.
6.3 평균이 가리는 사람들
2020년 스탠퍼드의 코에넥 등은 아마존·애플·구글·IBM·마이크로소프트의 음성 인식을 미국 흑인 화자와 백인 화자의 인터뷰로 시험했다. 다섯 시스템 모두 흑인 화자에게서 더 많이 틀렸고, 평균 WER은 흑인 0.35, 백인 0.19였다. 전체 평균 하나만 보면 이 격차는 보이지 않는다.
한국어에서도 같은 질문을 던질 수 있다. 사투리, 어르신의 말, 아이의 말, 외국인 화자의 한국어, 발음이 불편한 사람의 말. 공개 시험 세트는 대개 또렷한 낭독이다. 우리 실측의 Zeroth 시험 세트도 화자 10명이 원고를 읽은 녹음이다. 좋은 평균은 그 시험 세트의 화자들에게 좋다는 뜻일 뿐이다.
6.4 정답이 틀렸을 때
마지막으로, 정답도 사람이 만든다. 우리 실측에서 FLEURS 정답에는 “의미있는”, “그밖에”처럼 표준 띄어쓰기와 다른 표기가 있었고, Whisper는 이를 “의미 있는”, “그 밖에”로 맞게 적었다가 오류로 채점됐다. 정답의 오류는 모든 모델에게 똑같이 벌점을 주므로 순위를 크게 흔들지는 않는다. 그러나 오류율이 몇 % 아래로 내려가면, 남은 오류의 상당 부분이 기계의 실수가 아니라 정답의 흔들림일 수 있다. 2016년 ‘사람 수준’ 논쟁이 바로 이 지점에서 벌어졌다.
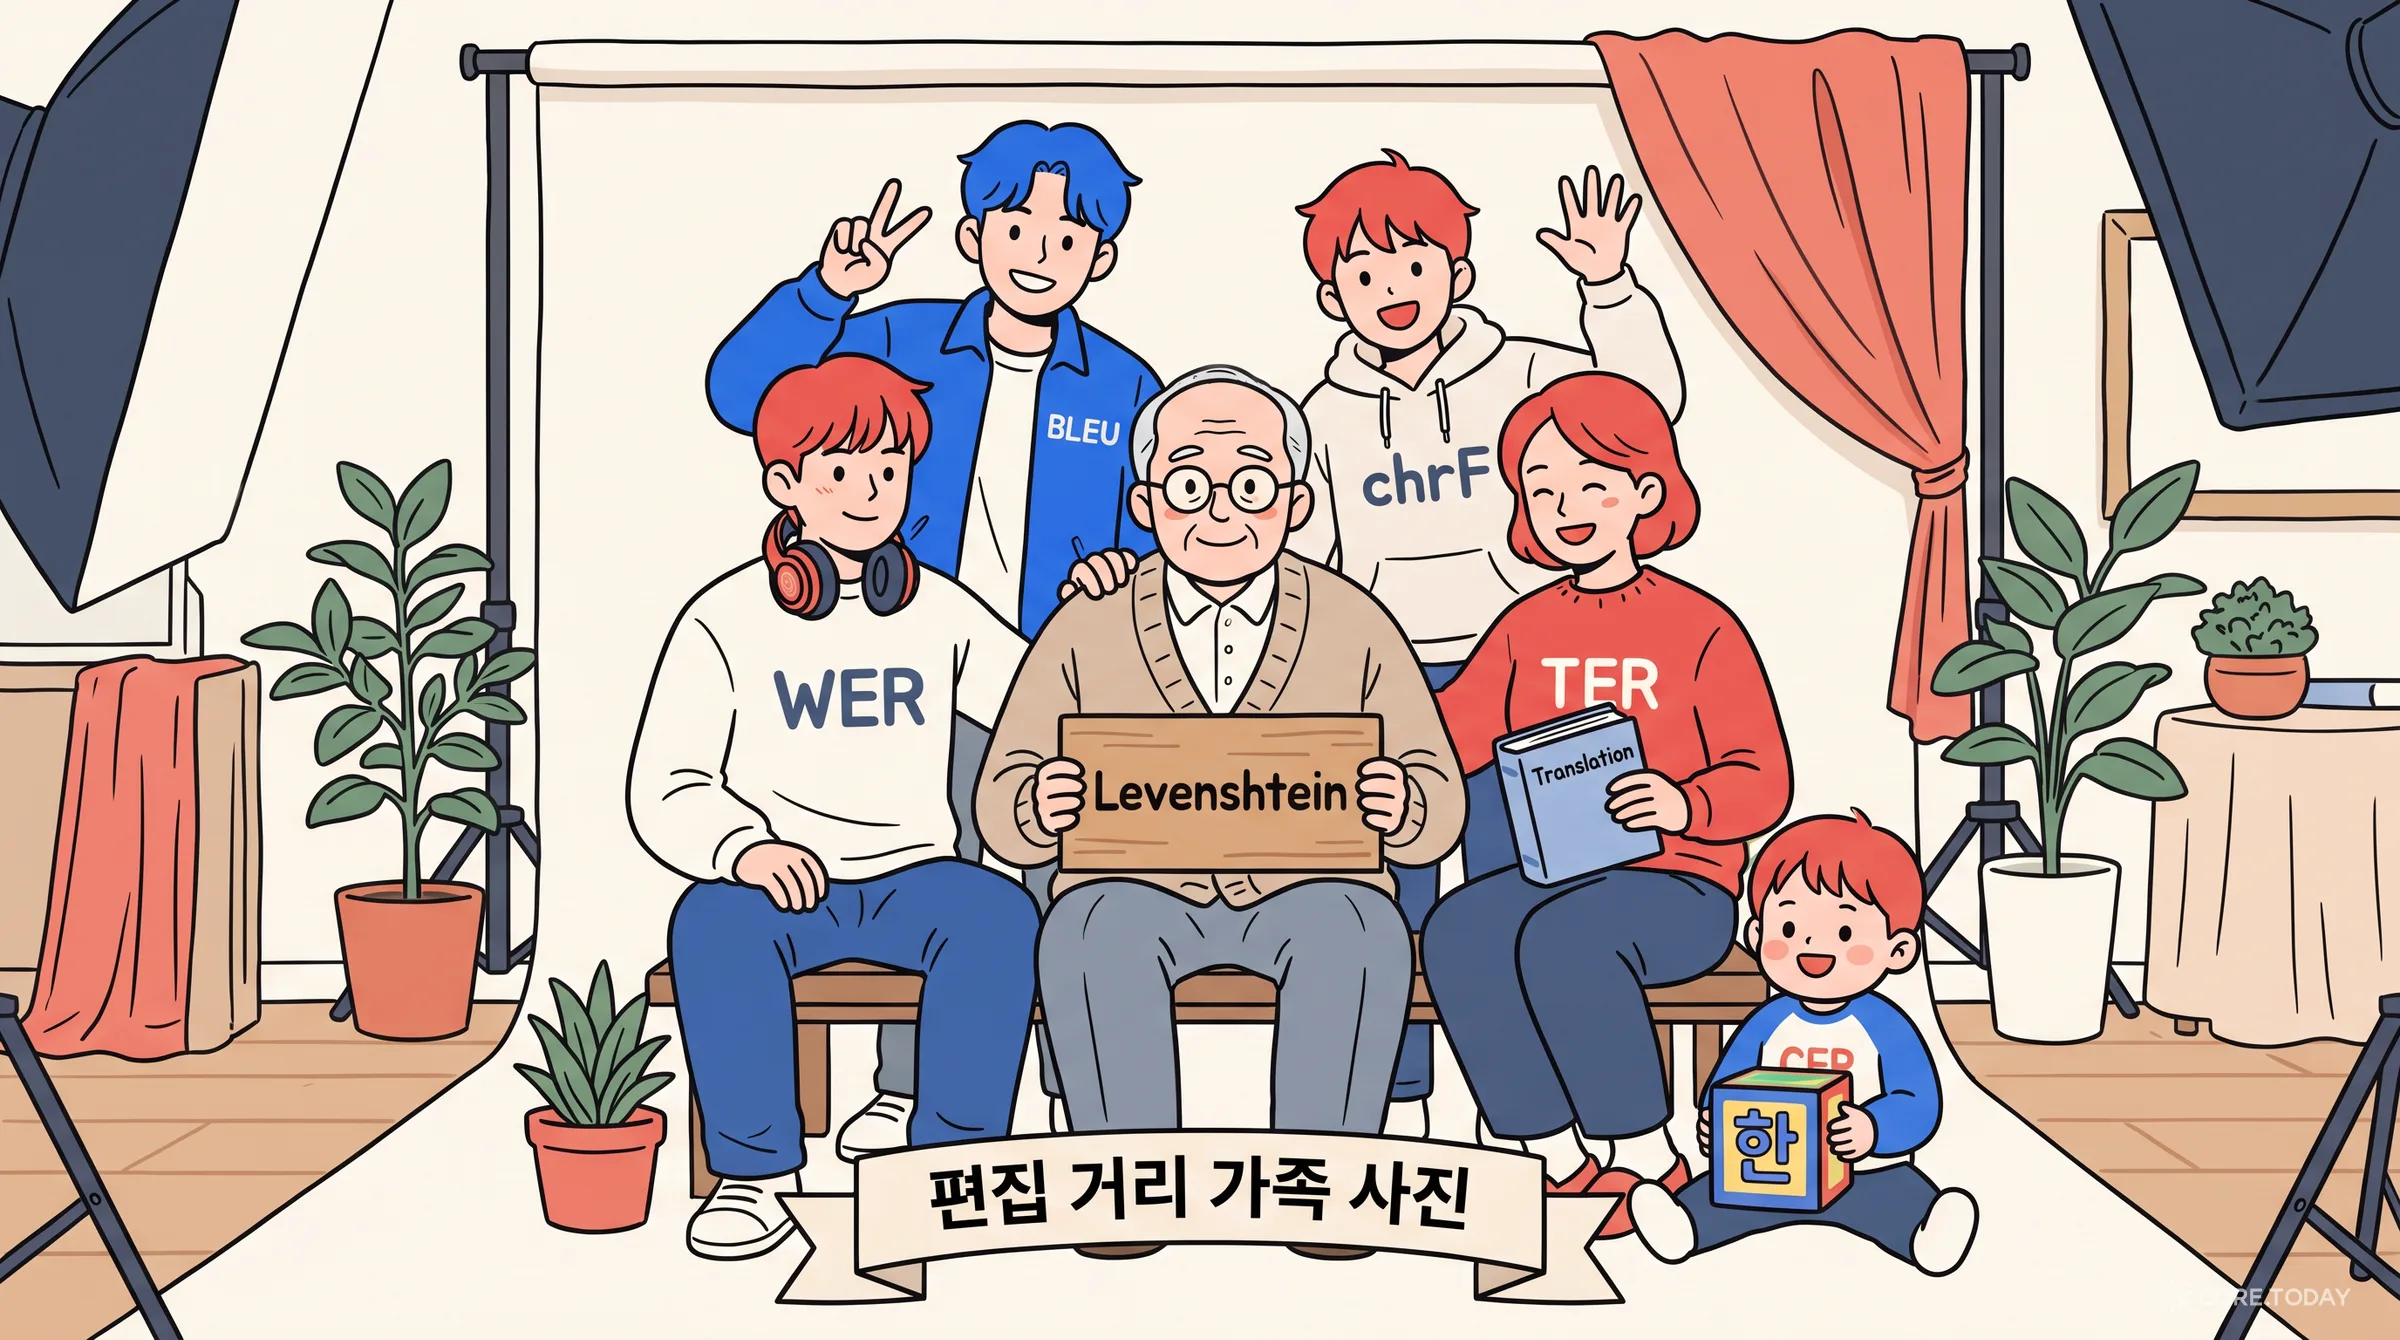
BLEU·ROUGE 특집에서 BLEU 논문의 저자들이 “음성 인식에서 성공한 WER을 참고했다”고 쓴 대목을 봤다. 두 지표는 같은 질문을 던진다. 기계가 낸 글이 사람이 낸 정답과 얼마나 가까운가. 다만 답하는 방식이 다르다.
WER·CER
BLEU
TER
chrF
쓰는 곳
음성 인식
기계 번역
기계 번역
기계 번역
무엇을 세나
편집 횟수
겹치는 n-gram
편집 횟수 + 덩어리 이동
겹치는 글자 n-gram
순서
엄격히 지킴
n-gram 안에서만
덩어리 이동 허용
n-gram 안에서만
정답 수
보통 1개
여러 개 가능
여러 개 가능
여러 개 가능
좋은 방향
낮을수록
높을수록
낮을수록
높을수록
왜 음성 인식은 편집 거리, 번역은 n-gram이 됐을까. 정답의 개수 때문이다. 받아쓰기의 정답은 사실상 하나다. 말한 그대로 적으면 된다. 그러니 한 줄로 맞대어 놓고 어긋난 곳을 세는 것이 자연스럽다. 번역은 같은 문장을 옮기는 방법이 수십 가지다. 어순이 바뀌어도 맞는 번역일 수 있다. 그래서 순서를 엄격히 따지는 편집 거리 대신 조각이 얼마나 겹치는지를 셌다.
번역 쪽에도 편집 거리 지표가 있다. 2006년 스노버 등이 제안한 TER(Translation Edit Rate)은 “사람이 몇 번 고쳐야 정답이 되나”를 센다. WER에 ‘덩어리 옮기기’를 한 번의 편집으로 쳐 주는 규칙을 더한 것이다. 번역은 어순이 바뀔 수 있으니까.
반대 방향의 사촌도 있다. chrF는 단어 대신 글자 n-gram을 센다. 어미와 조사가 붙는 언어에서 단어 단위가 너무 가혹하다는, CER과 똑같은 문제의식이다. BLEU 특집에서 한국어 BLEU가 토크나이저 하나로 출렁였던 것과, 이 글에서 한국어 WER이 띄어쓰기 하나로 출렁이는 것은 같은 병의 두 증상이다. 한국어에서 ‘단어’가 무엇인지 하나로 정해지지 않는다는 병이다. 두 분야는 같은 처방에 이르렀다. 단위를 글자로 내리는 것이다.
2026년의 음성 인식은 연구실 밖에 있다. 영상 자동 자막, 화상 회의 회의록, 콜센터 상담 기록, 진료실의 의무 기록 초안, 그리고 음성 비서와 음성 에이전트까지 모두 받아쓰기로 시작한다. 특히 음성으로 대화하는 AI 에이전트에서는 받아쓰기가 LLM의 입력이 된다. 받아쓰기가 틀리면 그 뒤의 똑똑한 모델도 틀린 질문에 답한다. 계좌 이체 예에서 ‘삼백만’이 ‘삼백’이 되면 에이전트는 성실하게 삼백 원을 보낸다.
8.2 숫자는 많이 내려왔다
한국어 성적은 크게 좋아졌다. 2022년 Whisper large-v2의 한국어 FLEURS 성적은 어절 WER 14.3%였다. 2026년 4월 알리바바의 Qwen3.5-Omni 기술 보고서는 같은 FLEURS 한국어를 CER로 쟀다. 자사 모델 1.7%, 제미나이 3.1 Pro 2.0%, GPT-4o-Transcribe 2.1%였다(모두 Qwen이 직접 측정한 값이다).
이 두 숫자를 나란히 놓고 “14.3%에서 2%로 일곱 배 좋아졌다”고 말하면 안 된다. 하나는 어절 WER이고 하나는 CER이다. 우리 실측에서 Whisper의 어절 WER과 CER은 2~3배 차이가 났다. 자가 다르니 거리를 바로 비교할 수 없다. 보고서를 읽을 때 가장 먼저 확인할 것은 숫자가 아니라 단위다.
같은 보고서 안에서도 단위가 섞인다. Qwen3.5-Omni 보고서의 표는 “WER, 단 기울임꼴 언어는 CER”이라고 적었고, 한국어·중국어·일본어·태국어가 기울임꼴이다. 2026년의 다국어 음성 인식 성적표는 대개 이렇게 언어마다 자를 바꿔 낀다.
8.3 리더보드에는 아직 한국어가 없다
2023년 9월 Hugging Face가 연 Open ASR 리더보드는 공개 음성 인식 모델의 사실상 표준 성적표가 됐다. 영어 여러 데이터셋의 평균 WER과 함께 RTFx(1초에 몇 초 분량의 음성을 처리하나)를 싣는다. 정확도만이 아니라 속도와 비용을 함께 보라는 뜻이다. 영어 정규화는 Whisper의 정규화기를 거의 그대로 따른다.
다만 2026년 11월 현재 이 리더보드의 다국어 부문에는 프랑스어·독일어·스페인어·이탈리아어·포르투갈어·힌디어·네덜란드어·아르메니아어만 있다. 한국어·중국어·일본어는 없다. 한국어 성능은 여전히 각 회사의 보고서나 각자의 측정에 기대야 한다. 앞에서 본 것처럼 그 보고서들은 서로 다른 자를 쓴다.
8.4 뜻을 채점하는 시도
6부에서 본 것처럼 WER·CER은 뜻을 보지 못한다. 그래서 뜻을 재려는 시도가 이어진다.
의미 거리(SemDist, 2021). 정답과 받아쓰기를 언어 모델로 임베딩해 그 거리를 잰다.
SeMaScore(2024). 편집 거리로 정렬한 뒤 구간마다 의미 유사도를 더한다.
LLM 채점(2025~2026). LLM에게 “이 받아쓰기 오류가 뜻을 바꾸는가, 위험한가”를 묻는다. 의료 받아쓰기 연구에서는 WER이 임상적 위험과 잘 맞지 않았고, LLM 심판이 의사의 판정과 90% 일치했다는 보고가 나왔다.
이 방법들은 WER·CER을 대체하기보다 보완한다. LLM 채점은 비용이 들고, 심판 모델이 바뀌면 값도 바뀐다. 재현성이 생명인 기준 지표로는 여전히 편집 거리가 쓰인다.
8.5 실무 체크리스트
한국어 음성 인식을 고르거나 개발한다면 이렇게 재자.
1
CER을 기준으로 삼고 정의를 적는다. 공백 포함인지 제외인지, 문장부호를 지웠는지 밝힌다. 공백 포함 여부만으로 값이 달라진다.
2
정규화 규칙을 정하고 고정한다. 숫자를 아라비아 숫자로 쓸지 한글로 쓸지, 단위와 영어 표기를 어떻게 할지 정한다. 정답과 받아쓰기에 같은 규칙을 적용한다.
3
평균 뒤를 본다. 화자·잡음·주제별로 나눠 재고, CER 100%를 넘는 문장(환각)을 따로 센다.
4
중요한 낱말은 따로 잰다. 숫자·고유명사·부정어처럼 틀리면 위험한 낱말의 정확도를 별도로 본다. 쓰임새에 따라 LLM 채점을 덧붙인다.
5
자기 데이터로 잰다. 공개 시험 세트는 낭독체가 많다. 회의·상담·현장 음성은 다른 세상이다. 실제 쓰일 음성 100문장만 받아 적어도 공개 성적표보다 많은 것을 알려 준다.
마치며
1965년 레벤슈타인은 전송 중에 빠지고 끼어든 기호를 세는 방법을 정의했다. 60년 뒤 같은 방법이 유튜브 자막과 진료 기록의 성적을 매긴다.
WER은 받아쓰기 채점표다. 정답과 받아쓰기를 정렬해 대체·삭제·삽입을 세고 정답 길이로 나눈다. 계산이 쉽고 누가 재도 같은 값이 나온다. 이 재현성 덕분에 음성 인식 분야 전체가 같은 숫자를 보고 달릴 수 있었다.
한국어는 글자로 잰다. 한국어의 띄어쓰기 단위는 단어가 아니라 조사와 어미가 붙은 어절이고, 띄어쓰기는 맞춤법조차 두 가지를 허용한다. 우리 실측에서 Whisper large-v3의 어절 오류 64%는 띄어쓰기 차이였다. 좋은 모델일수록 어절 WER은 듣기 실력이 아니라 띄어쓰기 습관을 잰다.
채점 규칙이 점수를 정한다. 숫자를 아라비아 숫자로 적을지 한글로 적을지, 공백을 글자로 셀지에 따라 같은 받아쓰기의 점수가 수십 % 달라진다. 숫자를 보기 전에 정의와 정규화 규칙을 확인해야 한다.
오류율은 뜻을 모른다. “복용하지 마십시오”를 “복용하십시오”로 바꾼 받아쓰기가 말투만 바꾼 받아쓰기보다 점수가 좋다. 들리지 않은 말을 지어내는 환각도 평균 속에 묻힌다. 위험한 오류는 따로 세야 한다.
그래서 23% 틀린 걸까, 4% 틀린 걸까? 같은 받아쓰기를 두 개의 자로 잰 것이다. 어느 자도 거짓말을 하지 않는다. 다만 어절 자는 띄어쓰기를 함께 재고, 글자 자는 띄어쓰기를 보지 않는다. 한국어 음성 인식이 글자 자를 고른 것은 그것이 완벽해서가 아니라, 우리가 정말 알고 싶은 것, ‘얼마나 잘 들었나’에 더 가깝기 때문이다. 그리고 그 너머의 질문, ‘뜻이 제대로 전해졌나’는 아직 어떤 자로도 완전히 재지 못한다.
코어닷투데이 실측 조건: openai/whisper-tiny·base·small·medium·large-v3-turbo·large-v3, HuggingFace transformers 4.57, Apple M5 Pro(MPS, fp16), language="ko", task="transcribe", 그리디 디코딩(빔 서치·온도 폴백 없음), 최대 220토큰. 시험 세트는 Zeroth-Korean test(457개, OpenSLR 40, CC BY 4.0)와 FLEURS ko_kr test(382개). 채점은 NFC 정규화·소문자화·문장부호 제거 후 sclite 기본 가중치(대체 4, 삭제·삽입 3)의 편집 거리 정렬로 말뭉치 단위 합산. 형태소는 Kiwi 0.24, 띄어쓰기 맞춘 WER은 글자 정렬을 따라 인식 결과의 공백을 정답 위치로 옮긴 뒤 계산했다. 환각 실험은 말이 없는 합성 소리 22개(무음 4, 백색 잡음 12, 갈색 잡음 3, 60Hz 험, 삐 소리, 키보드 소리)를 small·large-v3-turbo·large-v3에 넣었다. 2026-11-07 측정.
Levenshtein, V. I. (1965). Binary codes capable of correcting deletions, insertions, and reversals. Doklady Akademii Nauk SSSR, 163(4), 845–848. (영역: Soviet Physics Doklady, 10(8), 707–710, 1966.)
Wagner, R. A., & Fischer, M. J. (1974). The String-to-String Correction Problem. Journal of the ACM, 21(1), 168–173.
Pallett, D. S. (1988). Selected Test Material, Test and Scoring Procedures for the June 1988 DARPA Benchmark Tests. NBS/NIST.
Wang, Y.-Y., Acero, A., & Chelba, C. (2003). Is Word Error Rate a Good Indicator for Spoken Language Understanding Accuracy. IEEE ASRU 2003.
Morris, A. C., Maier, V., & Green, P. (2004). From WER and RIL to MER and WIL: improved evaluation measures for connected speech recognition. Interspeech 2004.
Snover, M., Dorr, B., Schwartz, R., Micciulla, L., & Makhoul, J. (2006). A Study of Translation Edit Rate with Targeted Human Annotation. AMTA 2006.
Papineni, K., Roukos, S., Ward, T., & Zhu, W.-J. (2002). BLEU: a Method for Automatic Evaluation of Machine Translation. ACL 2002.
Panayotov, V., Chen, G., Povey, D., & Khudanpur, S. (2015). LibriSpeech: an ASR corpus based on public domain audio books. ICASSP 2015.
Xiong, W. et al. (2016). Achieving Human Parity in Conversational Speech Recognition. arXiv:1610.05256
Saon, G. et al. (2017). English Conversational Telephone Speech Recognition by Humans and Machines. Interspeech 2017. arXiv:1703.02136
Xiong, W. et al. (2018). The Microsoft 2017 Conversational Speech Recognition System. ICASSP 2018. arXiv:1708.06073
Koenecke, A. et al. (2020). Racial disparities in automated speech recognition. PNAS, 117(14), 7684–7689.
Bang, J.-U. et al. (2020). KsponSpeech: Korean Spontaneous Speech Corpus for Automatic Speech Recognition. Applied Sciences, 10(19), 6936.
Kim, S. et al. (2021). Semantic Distance: A New Metric for ASR Performance Analysis Towards Spoken Language Understanding. Interspeech 2021. arXiv:2104.02138
Conneau, A. et al. (2022). FLEURS: Few-shot Learning Evaluation of Universal Representations of Speech. IEEE SLT 2022. arXiv:2205.12446
Radford, A., Kim, J. W., Xu, T., Brockman, G., McLeavey, C., & Sutskever, I. (2022). Robust Speech Recognition via Large-Scale Weak Supervision. arXiv:2212.04356
Koenecke, A., Choi, A. S. G., Mei, K. X., Schellmann, H., & Sloane, M. (2024). Careless Whisper: Speech-to-Text Hallucination Harms. ACM FAccT 2024. arXiv:2402.08021
Sasindran, Z., Yelchuri, H., & Prabhakar, T. V. (2024). SeMaScore. Interspeech 2024. arXiv:2401.07506
Srivastav, V. et al. (2025). Open ASR Leaderboard. arXiv:2510.06961
Ellis et al. (2025). WER is Unaware. arXiv:2511.16544
Qwen Team (2026). Qwen3.5-Omni Technical Report. arXiv:2604.15804