지식 증류knowledge distillation어두운 지식dark knowledge힌턴소프트 라벨온도소프트맥스KL 발산모델 압축DistilBERTAlpacaDeepSeek-R1온폴리시 증류MiniLLMGemmaLlama증류 공격온디바이스 AI소형 언어 모델
정답보다 오답이 더 많이 가르친다 — 지식 증류와 ‘어두운 지식’ (특집)
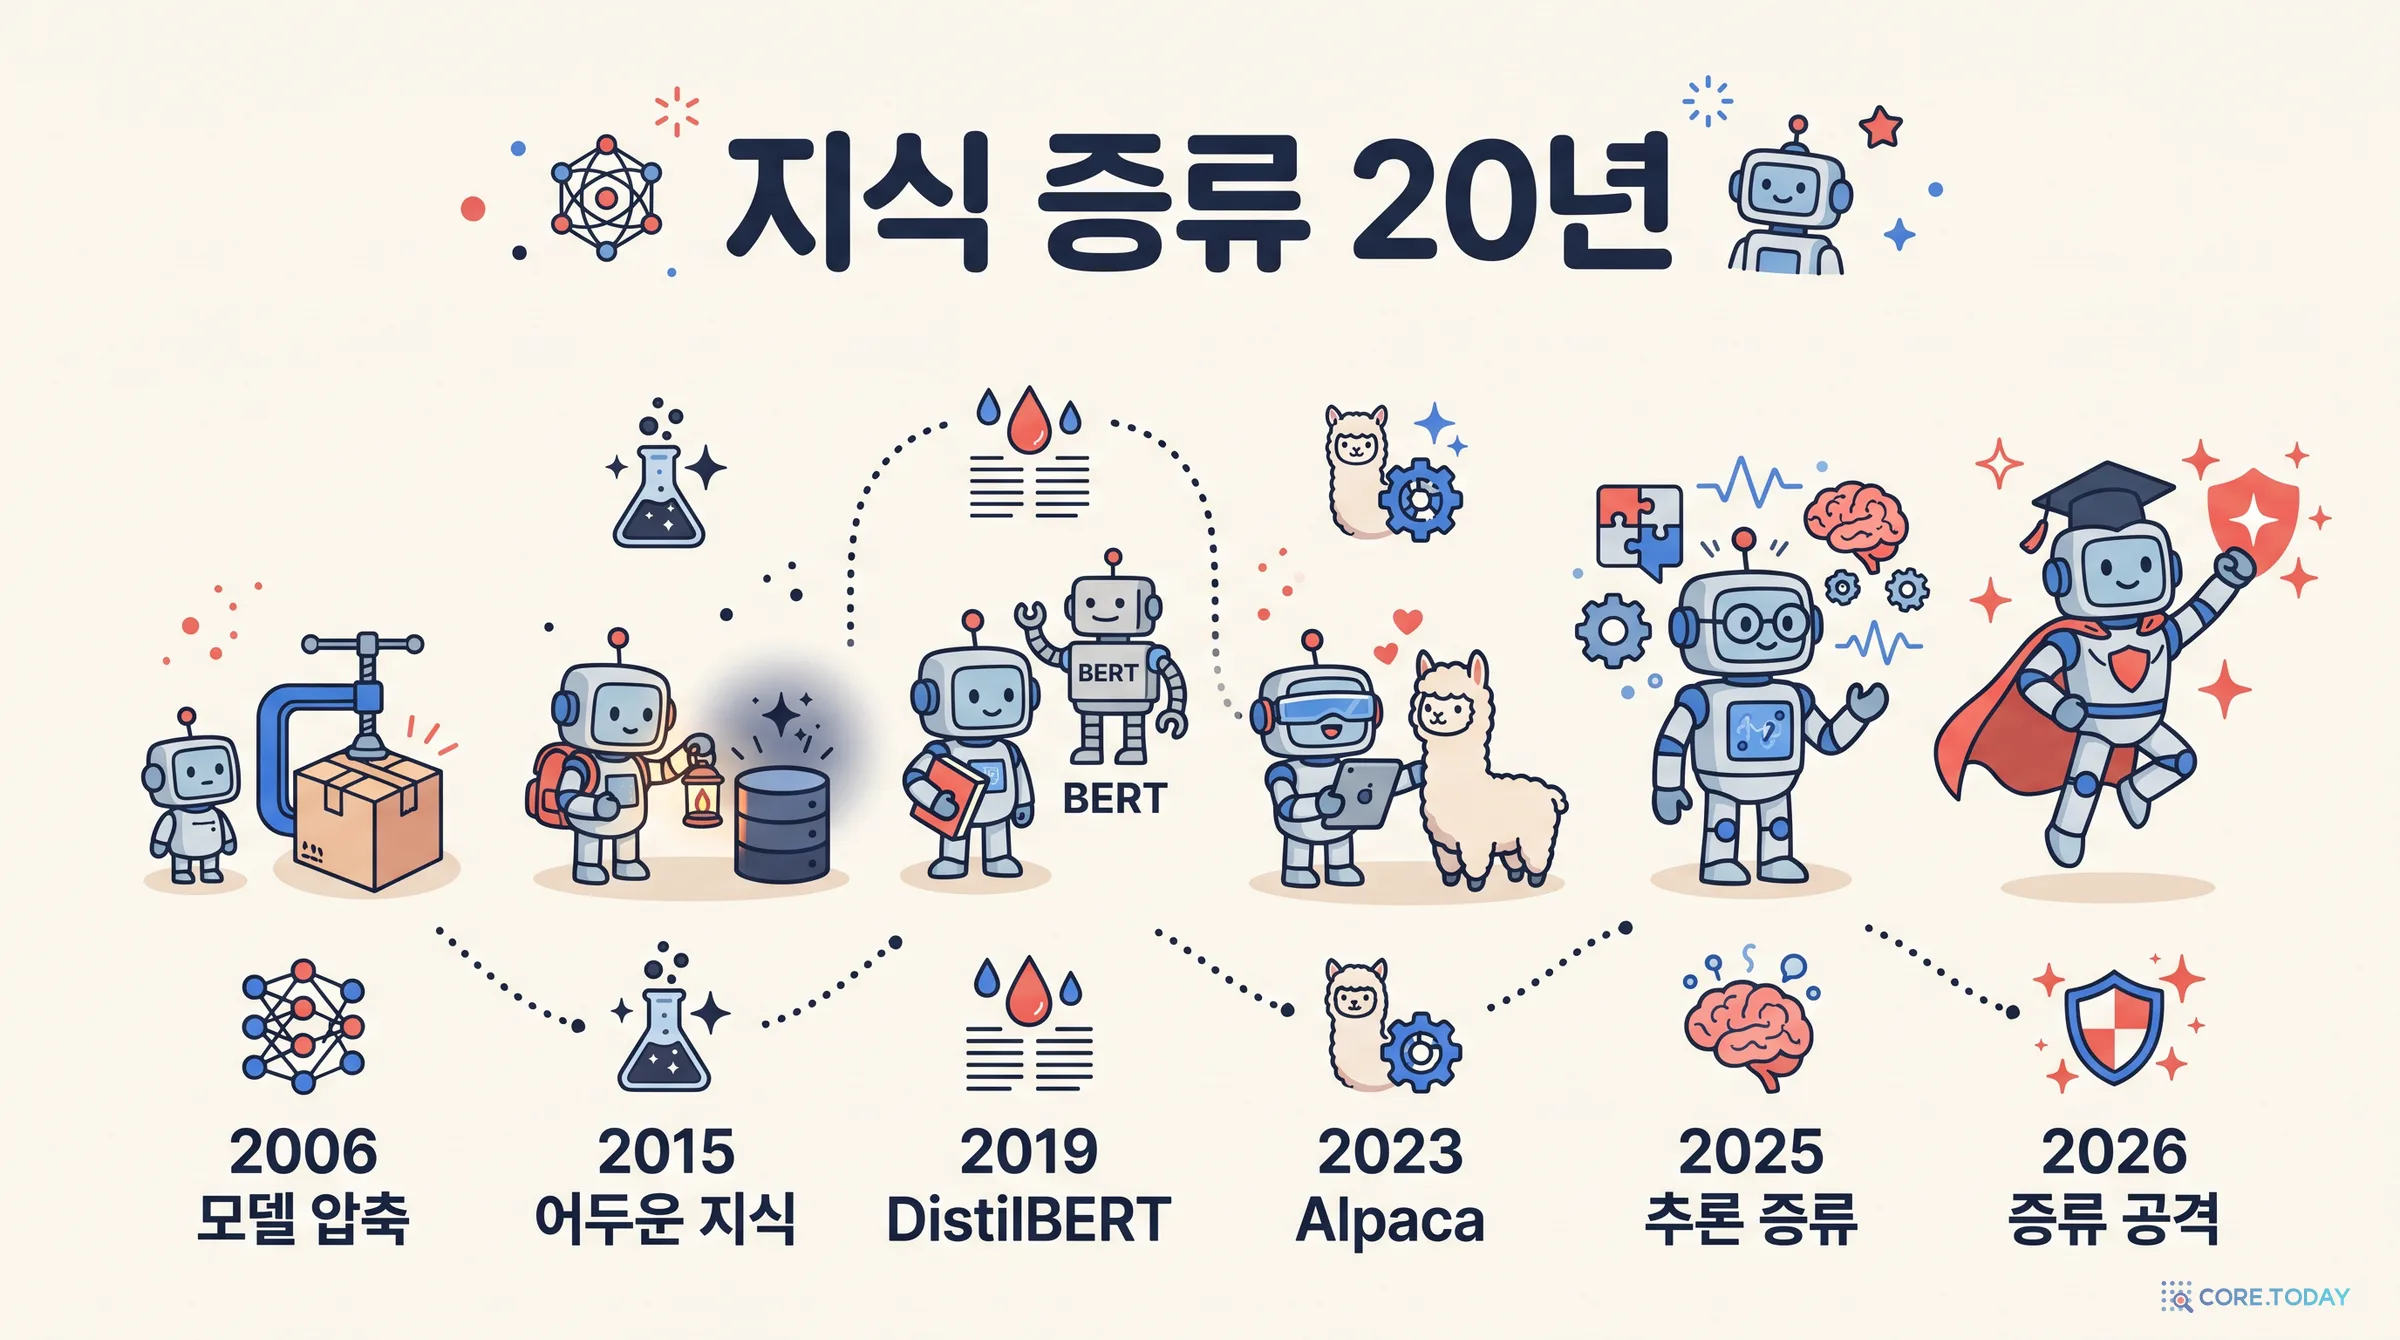
지식 증류는 큰 모델(교사)이 내놓은 확률 분포를 작은 모델(학생)이 따라 배우게 하는 기술이다. 2006년 앙상블 압축에서 출발해 2015년 힌턴·비냘스·딘이 ‘온도’와 ‘어두운 지식’이라는 이름을 붙였고 — 이 논문은 NeurIPS에서 떨어졌다 — 지금은 Gemma·Llama·Qwen 같은 작은 모델의 기본 공정이자 DeepSeek-R1 이후 추론 능력을 옮기는 방법, 그리고 2026년 ‘증류 공격’ 분쟁의 이름이 됐다. 이 글은 BMW와 쓰레기차와 당근의 비유로 어두운 지식을 설명하고, 힌턴의 MNIST 실험을 직접 재현해 숫자 3을 한 장도 보지 못한 학생이 3을 98.2% 맞히는 모습, 작은 학생에게 높은 온도가 독이 되는 이유, 라벨 1,000장과 교사 한 명이 라벨 1만 장보다 나은 결과를 보여 준다. Qwen3 형제 모델로 언어 모델의 소프트 라벨과 증류의 효과도 쟀다. 라벨 스무딩의 역설, 용량 격차, 모방의 거짓 약속, KL의 방향, 온폴리시 증류까지 짚고 실무 체크리스트로 마무리한다. 인터랙티브 위젯 6종, 코어닷투데이 실측 2건, 삽화 16장.
2025년 1월 말, 중국 스타트업 DeepSeek가 내놓은 추론 모델 R1이 세계 주식 시장을 흔들었다. 며칠 뒤 뉴스에는 낯선 단어가 쏟아졌다. 증류(distillation). OpenAI가 “DeepSeek가 우리 모델을 증류한 증거가 있다”고 말했다는 보도였다. 그 소동 한복판인 2월 6일, 구글 딥마인드의 오리올 비냘스가 이런 글을 올렸다.
증류가 (DeepSeek 덕분에!) 뉴스에 나오고 있다. 그 논문은 사실 NeurIPS 2014에서 떨어졌다. 새롭지 않다는 이유(어느 정도 맞다)와, 영향력이 없을 거라는 이유로. 2번 심사위원님(말 그대로) 고맙습니다. 그리고 arXiv 고마워요!
‘그 논문’은 제프리 힌턴, 오리올 비냘스, 제프 딘이 쓴 「신경망의 지식 증류(Distilling the Knowledge in a Neural Network)」다. 학회에서 떨어져 워크숍에 실린 이 논문은 10년 뒤 휴대폰 속 AI, 무료 챗봇의 작은 모델, 그리고 국가 간 기술 분쟁의 한가운데에 서 있다.
논문의 핵심은 한 문장으로 요약된다. 큰 모델이 ‘틀린 답’에 매긴 작은 확률에 귀중한 지식이 숨어 있다. 힌턴은 이렇게 썼다.
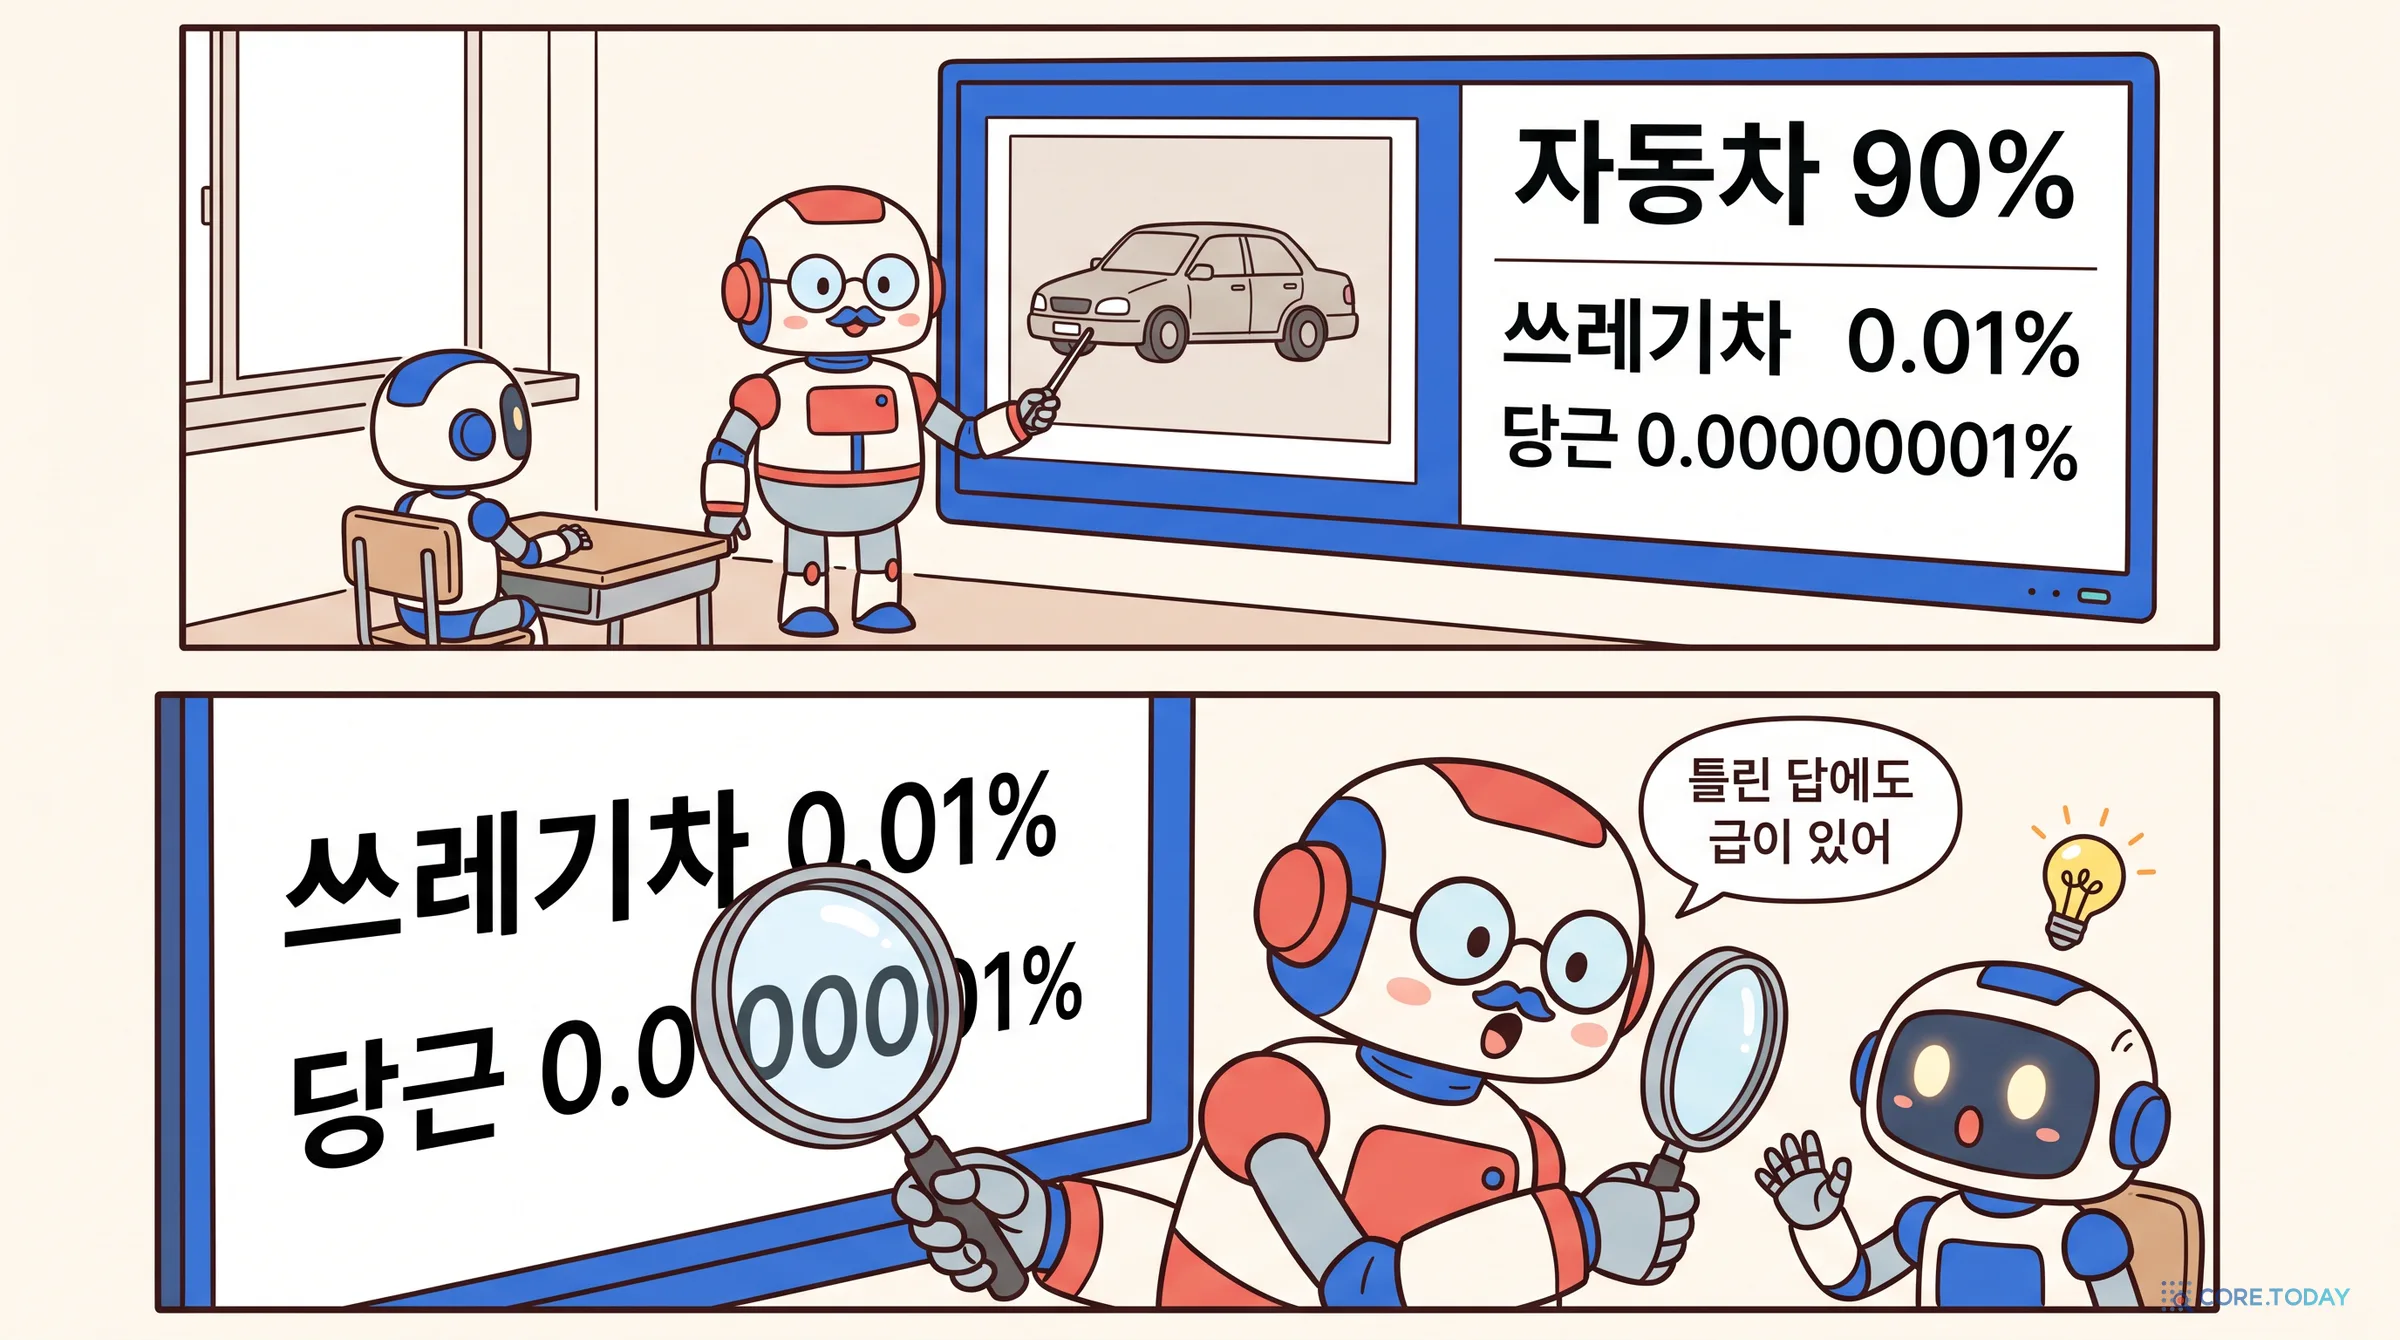
BMW 사진이 쓰레기차로 잘못 분류될 확률은 아주 작다. 하지만 그 실수는 당근으로 착각할 확률보다는 몇 배나 크다.
정답 라벨은 “이건 BMW다”라고만 말한다. 쓰레기차도 당근도 똑같이 0점이다. 그런데 잘 학습된 모델은 이를테면 쓰레기차에 0.01%, 당근에 0.00000001%를 준다. 둘 다 아주 작은 숫자지만 그 차이에 ‘자동차는 쓰레기차와 닮았고 당근과는 닮지 않았다’는 세상의 구조가 담겨 있다. 힌턴은 이것을 어두운 지식(dark knowledge)이라 불렀다.
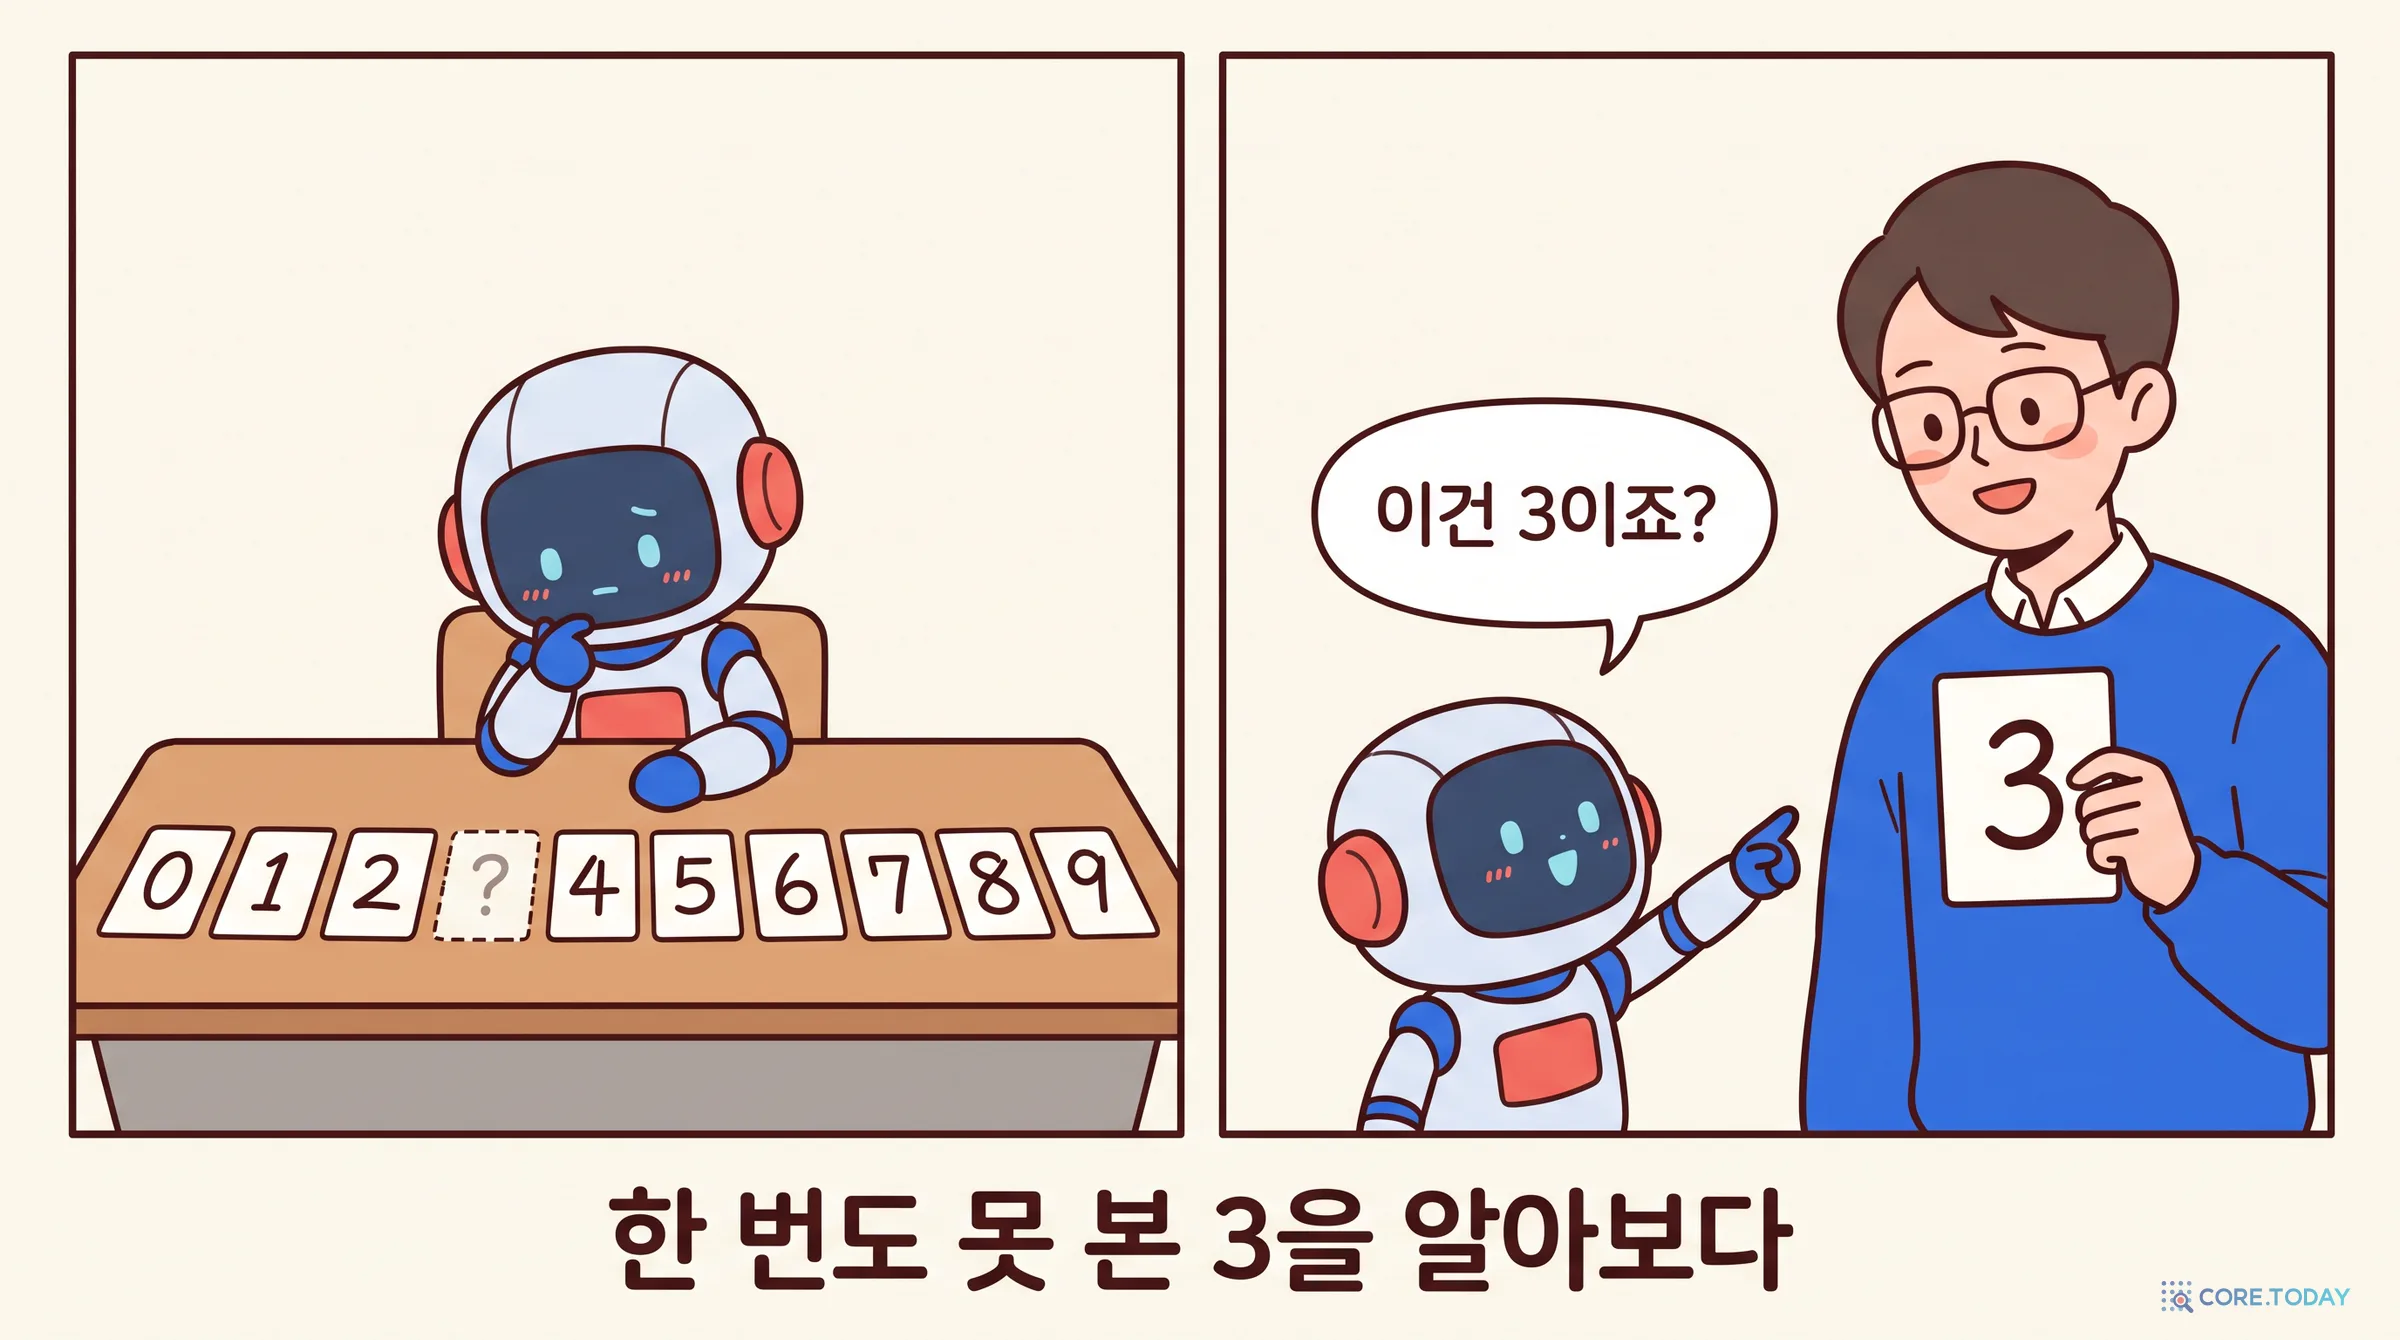
우리도 직접 확인해 봤다. 힌턴의 실험을 그대로 다시 해서, 손글씨 숫자 학생 모델에게 숫자 3을 한 장도 보여 주지 않고 가르쳤다. 선생님 모델의 ‘오답 확률’만 보고 배운 학생은 시험에서 처음 본 3을 맞혔다.
0장
학생이 학습에서 본 숫자 3
98.2%
그 학생이 시험에서 3을 맞힌 비율 (편향 보정 후)
50%
이미지 3천 장으로 배울 때 정답 라벨 대비 줄어든 오류
145.7 → 110
같은 학생, 같은 데이터, 선생님만 바꿨을 때의 시험 오류
코어닷투데이가 힌턴(2015)의 MNIST 실험을 재현한 결과. 시드 3개 평균. 4부에서 자세히 다룬다.
이 글은 이 기술을 처음부터 따라간다.
왜 증류가 필요했나 — 애벌레와 나비.
어두운 지식 — 틀린 답에도 급이 있다.
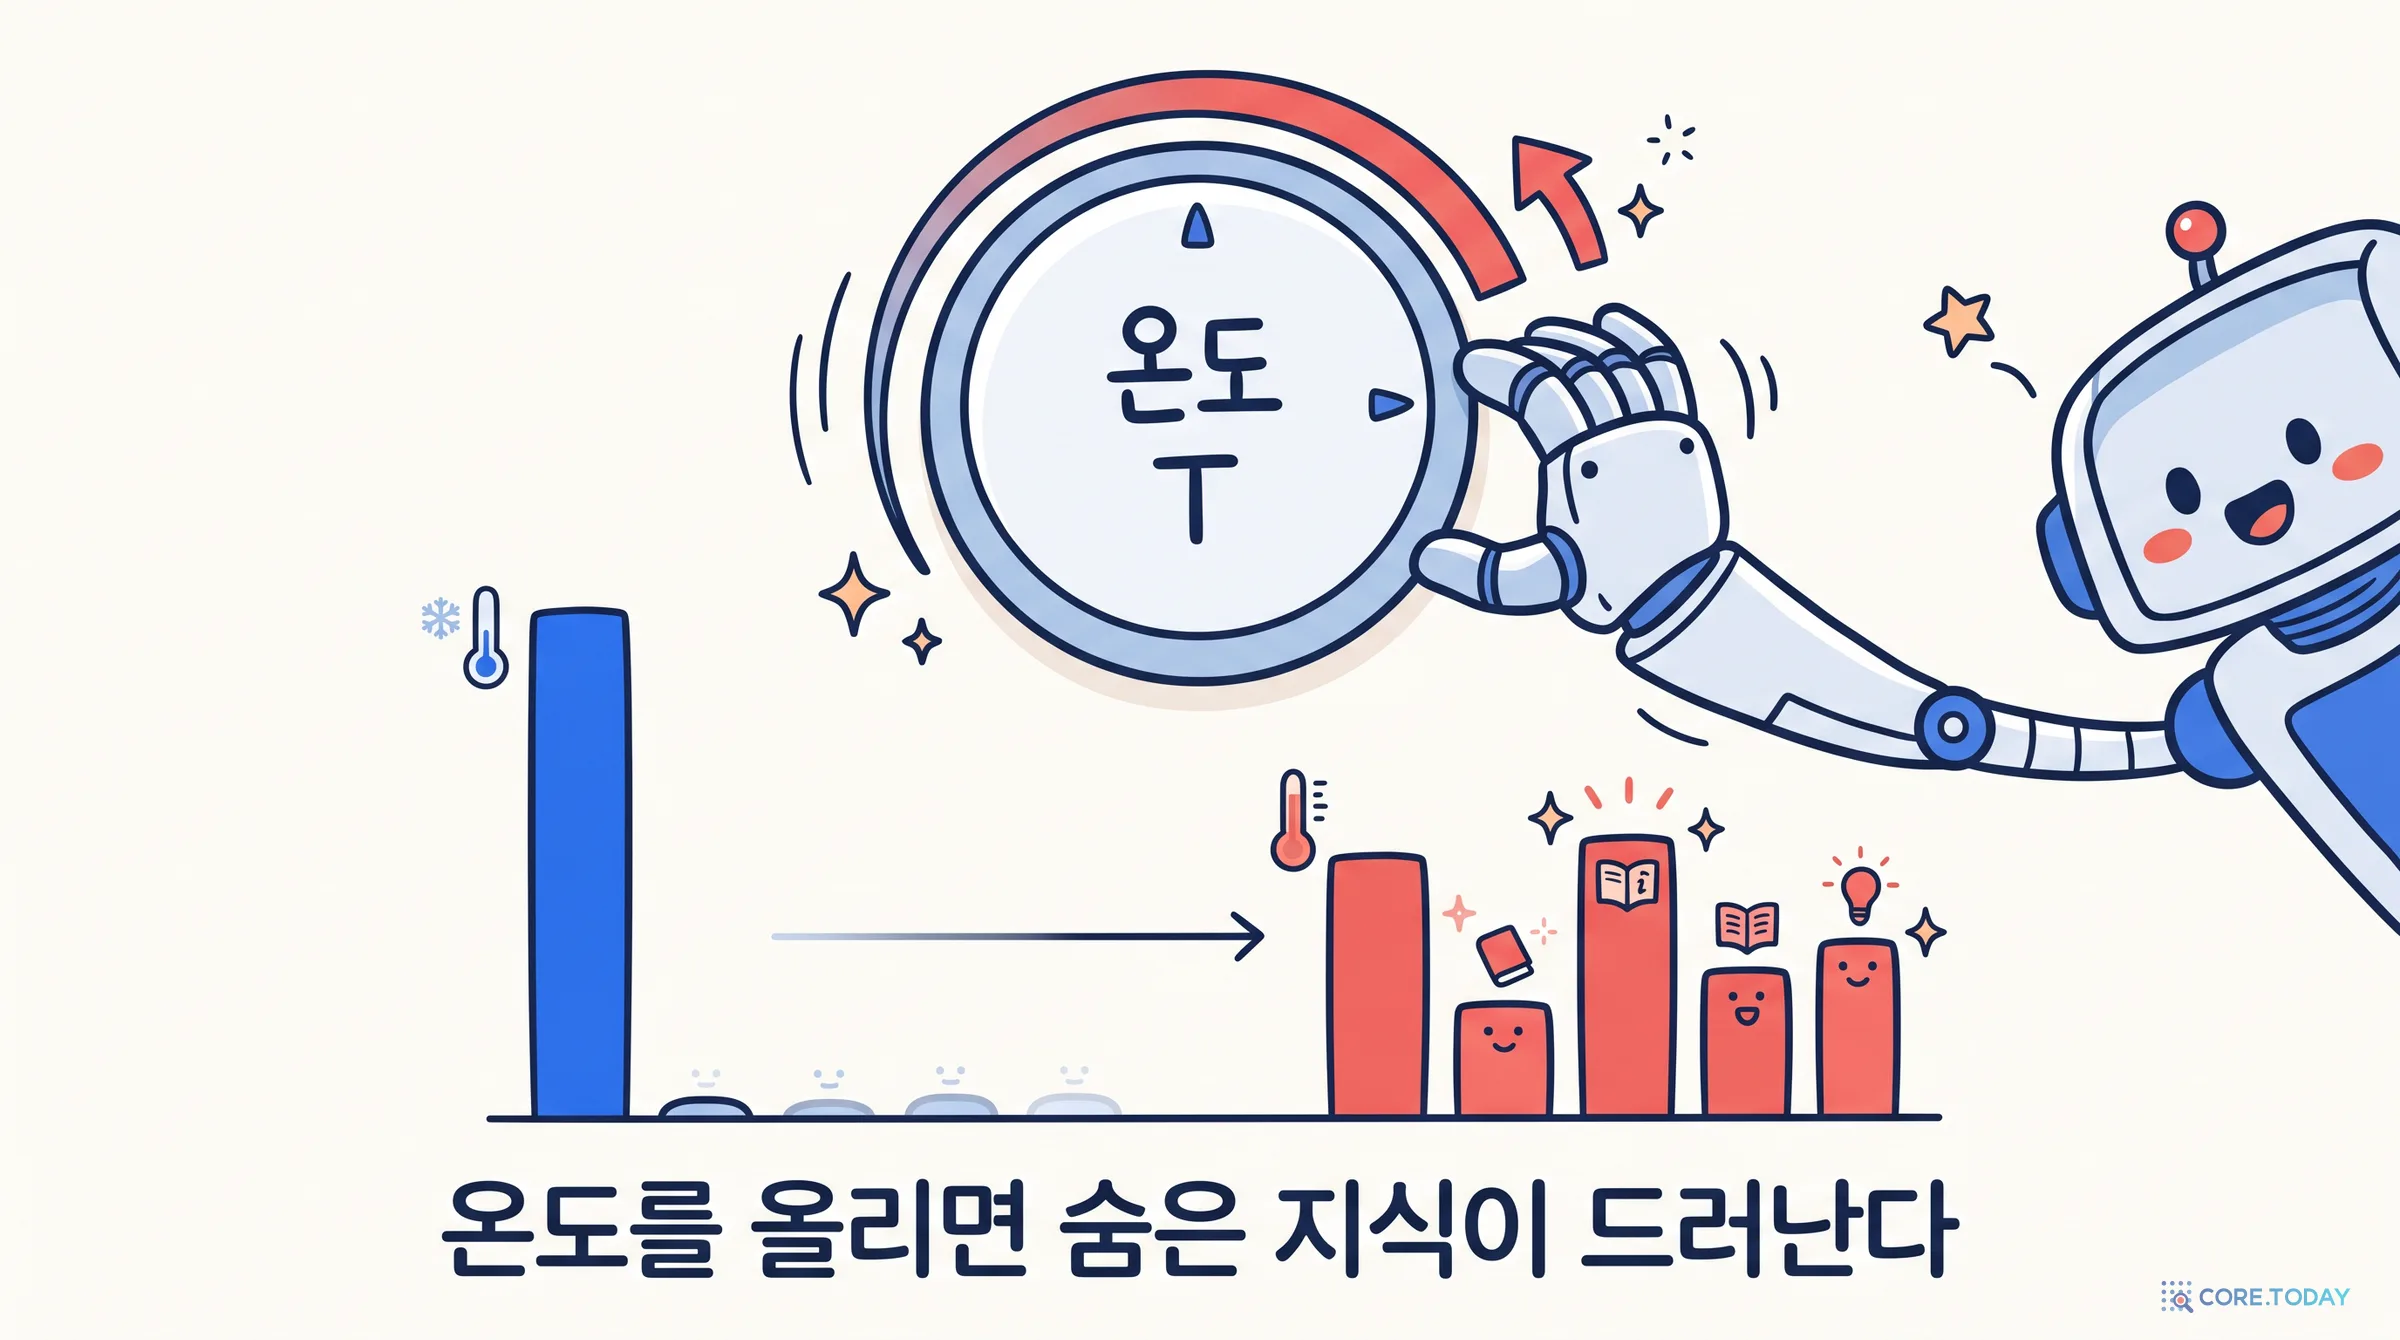
온도 — 숨은 지식을 드러내는 다이얼.
코어닷투데이 실측 ① — 힌턴의 MNIST 실험을 다시 해 보다.
무엇을, 어떻게 옮길까 — 증류의 가계도.
증류는 왜 되고, 언제 안 되나.
대형 언어 모델 시대의 증류 — Alpaca에서 DeepSeek-R1, 온폴리시 증류까지. 코어닷투데이 실측 ②.
2026년, 증류의 자리 — 증류 공격, 온디바이스, 그리고 체크리스트.
1부. 왜 증류가 필요했나 — 애벌레와 나비
1.1 배울 때와 일할 때 필요한 몸은 다르다
힌턴의 논문은 곤충 이야기로 시작한다.
많은 곤충은 애벌레 모습으로 환경에서 에너지와 영양분을 빨아들이는 데 최적화돼 있고, 어른벌레 모습으로는 이동과 번식이라는 전혀 다른 요구에 최적화돼 있다. 대규모 기계 학습에서 우리는 보통 학습 단계와 배포 단계에 아주 다른 요구가 있는데도 거의 같은 모델을 쓴다.
학습할 때는 시간과 계산을 아끼지 않아도 된다. 거대한 모델을 쓰고, 여러 모델을 묶은 앙상블을 쓰고, 며칠이고 데이터를 먹인다. 목표는 데이터에서 구조를 최대한 뽑아내는 것이다. 그러나 서비스할 때는 사정이 다르다. 사용자 수백만 명에게 0.1초 안에 답해야 하고, 휴대폰 배터리와 서버 비용을 걱정해야 한다.
애벌레가 번데기를 거쳐 나비가 되듯, 학습용으로 키운 큰 모델의 지식을 서비스용의 작고 빠른 모델로 옮길 수는 없을까? 이것이 증류의 출발점이다.
아이디어 자체는 힌턴보다 먼저 나왔다. 2006년 코넬대의 크리스티안 부칠루아, 리치 카루아나, 알렉산드루 니쿨레스쿠-미질은 「모델 압축(Model Compression)」이라는 논문을 발표했다.
당시 머신러닝 대회의 승자는 대개 앙상블이었다. 의사결정나무, 서포트 벡터 머신, 신경망 등 수백~수천 개 모델의 투표를 합치면 어느 한 모델보다 정확했다. 문제는 크기였다. 예측 한 번에 수천 개 모델을 다 돌려야 하니 느리고 무거웠다.
연구진의 해법은 단순했다. 이름표가 없는 데이터를 잔뜩 모아 앙상블에게 답을 달게 한다. 그리고 그 답을 정답 삼아 작은 신경망 하나를 학습시킨다. 이름표 없는 데이터가 모자라면 실제 데이터와 비슷한 가짜 데이터를 만드는 MUNGE라는 방법을 썼다. 결과는 놀라웠다.
성능은 거의 같으면서, 앙상블보다 천 배 작고 천 배 빠른 신경망을 얻었다.
핵심 통찰은 이것이다. 작은 모델이 데이터에서 직접 배우는 것보다, 이미 잘 배운 큰 모델을 흉내 내는 편이 쉽다. 진짜 데이터는 시끄럽고 애매하지만, 큰 모델의 답은 그 혼란을 이미 한 번 정리한 결과이기 때문이다.
1.3 2014년, 얕은 신경망도 깊은 신경망만큼
2014년 지미 바와 카루아나는 한 발 더 나갔다. 「깊은 신경망은 정말 깊어야 할까?(Do Deep Nets Really Need to be Deep?)」에서 이들은 층이 하나뿐인 얕은 신경망에게 깊은 신경망의 로짓, 즉 소프트맥스를 거치기 전의 점수를 그대로 따라 하게 했다.
TIMIT 음성 인식 데이터에서 얕은 신경망을 정답 라벨로 직접 학습하면 음소 오류율이 23% 언저리였다. 같은 얕은 신경망이 앙상블 교사의 로짓을 따라 하자 20.0%까지 내려가 깊은 신경망(21.9%)보다 나아졌다. 얕은 신경망이 못 배운 것은 용량이 모자라서가 아니라 배우는 방법 때문이었다.
힌턴, 비냘스, 딘은 이 흐름을 하나의 일반적인 틀로 정리하고 이름을 붙였다. 술을 증류하면 물과 잡내를 날리고 알코올의 정수만 남는다. 큰 모델이라는 ‘원액’을 끓여 작은 모델에 핵심만 담는다는 뜻이다. 이때부터 큰 모델을 교사(teacher), 작은 모델을 학생(student)이라 부르는 관례가 생겼다.
이들이 더한 것은 두 가지다. 하나는 정답 아래 숨은 작은 확률들이 왜 중요한지에 대한 설명, 즉 어두운 지식이다. 다른 하나는 그 지식을 꺼내는 도구, 즉 온도다.
이미지 분류 모델은 사진을 보고 클래스마다 확률을 낸다. BMW 사진이라면 이런 식이다(설명을 위해 지어낸 숫자다).
자동차
90%
쓰레기차
0.01%
당근
0.00000001%
정답 라벨로 학습할 때 우리가 모델에게 주는 목표는 원-핫(one-hot) 벡터다. ‘자동차’ 칸에 1, 나머지 칸은 모두 0. 쓰레기차도 당근도 똑같이 0이다.
하지만 잘 학습된 모델의 출력은 다르다. 쓰레기차와 당근은 둘 다 아주 작지만 백만 배 차이가 난다. 모델은 아무도 가르쳐 주지 않았는데 ‘자동차와 쓰레기차는 바퀴가 있고 네모나다’, ‘당근은 전혀 다르다’는 사실을 스스로 알아냈다. 이 정보는 정답 라벨 어디에도 없었다. 데이터 전체를 보며 모델이 추출해 낸 세상의 닮은꼴 지도다.
힌턴은 소프트 라벨의 장점을 이렇게 요약했다. 소프트 라벨은 엔트로피가 높아서 학습 예제 하나에 담긴 정보가 훨씬 많고, 예제마다 기울기의 흔들림이 훨씬 작다. 그래서 학생은 원래 데이터보다 훨씬 적은 데이터로, 더 큰 학습률로 배울 수 있다.
이 차이는 데이터가 적을수록 커진다. 힌턴 팀은 구글 음성 인식 모델로 이를 보였다. 학습 데이터의 3%만 정답 라벨로 학습하면 프레임 정확도가 44.5%에 그쳤다(전체 데이터는 58.9%). 같은 3%를 교사의 소프트 라벨로 학습하자 57.0%가 나왔다. 데이터 3%로 전체 데이터에 거의 다가간 셈이다. 게다가 소프트 라벨로 배운 모델은 과적합하지 않아 조기 종료도 필요 없었다.
2.3 일상의 비유
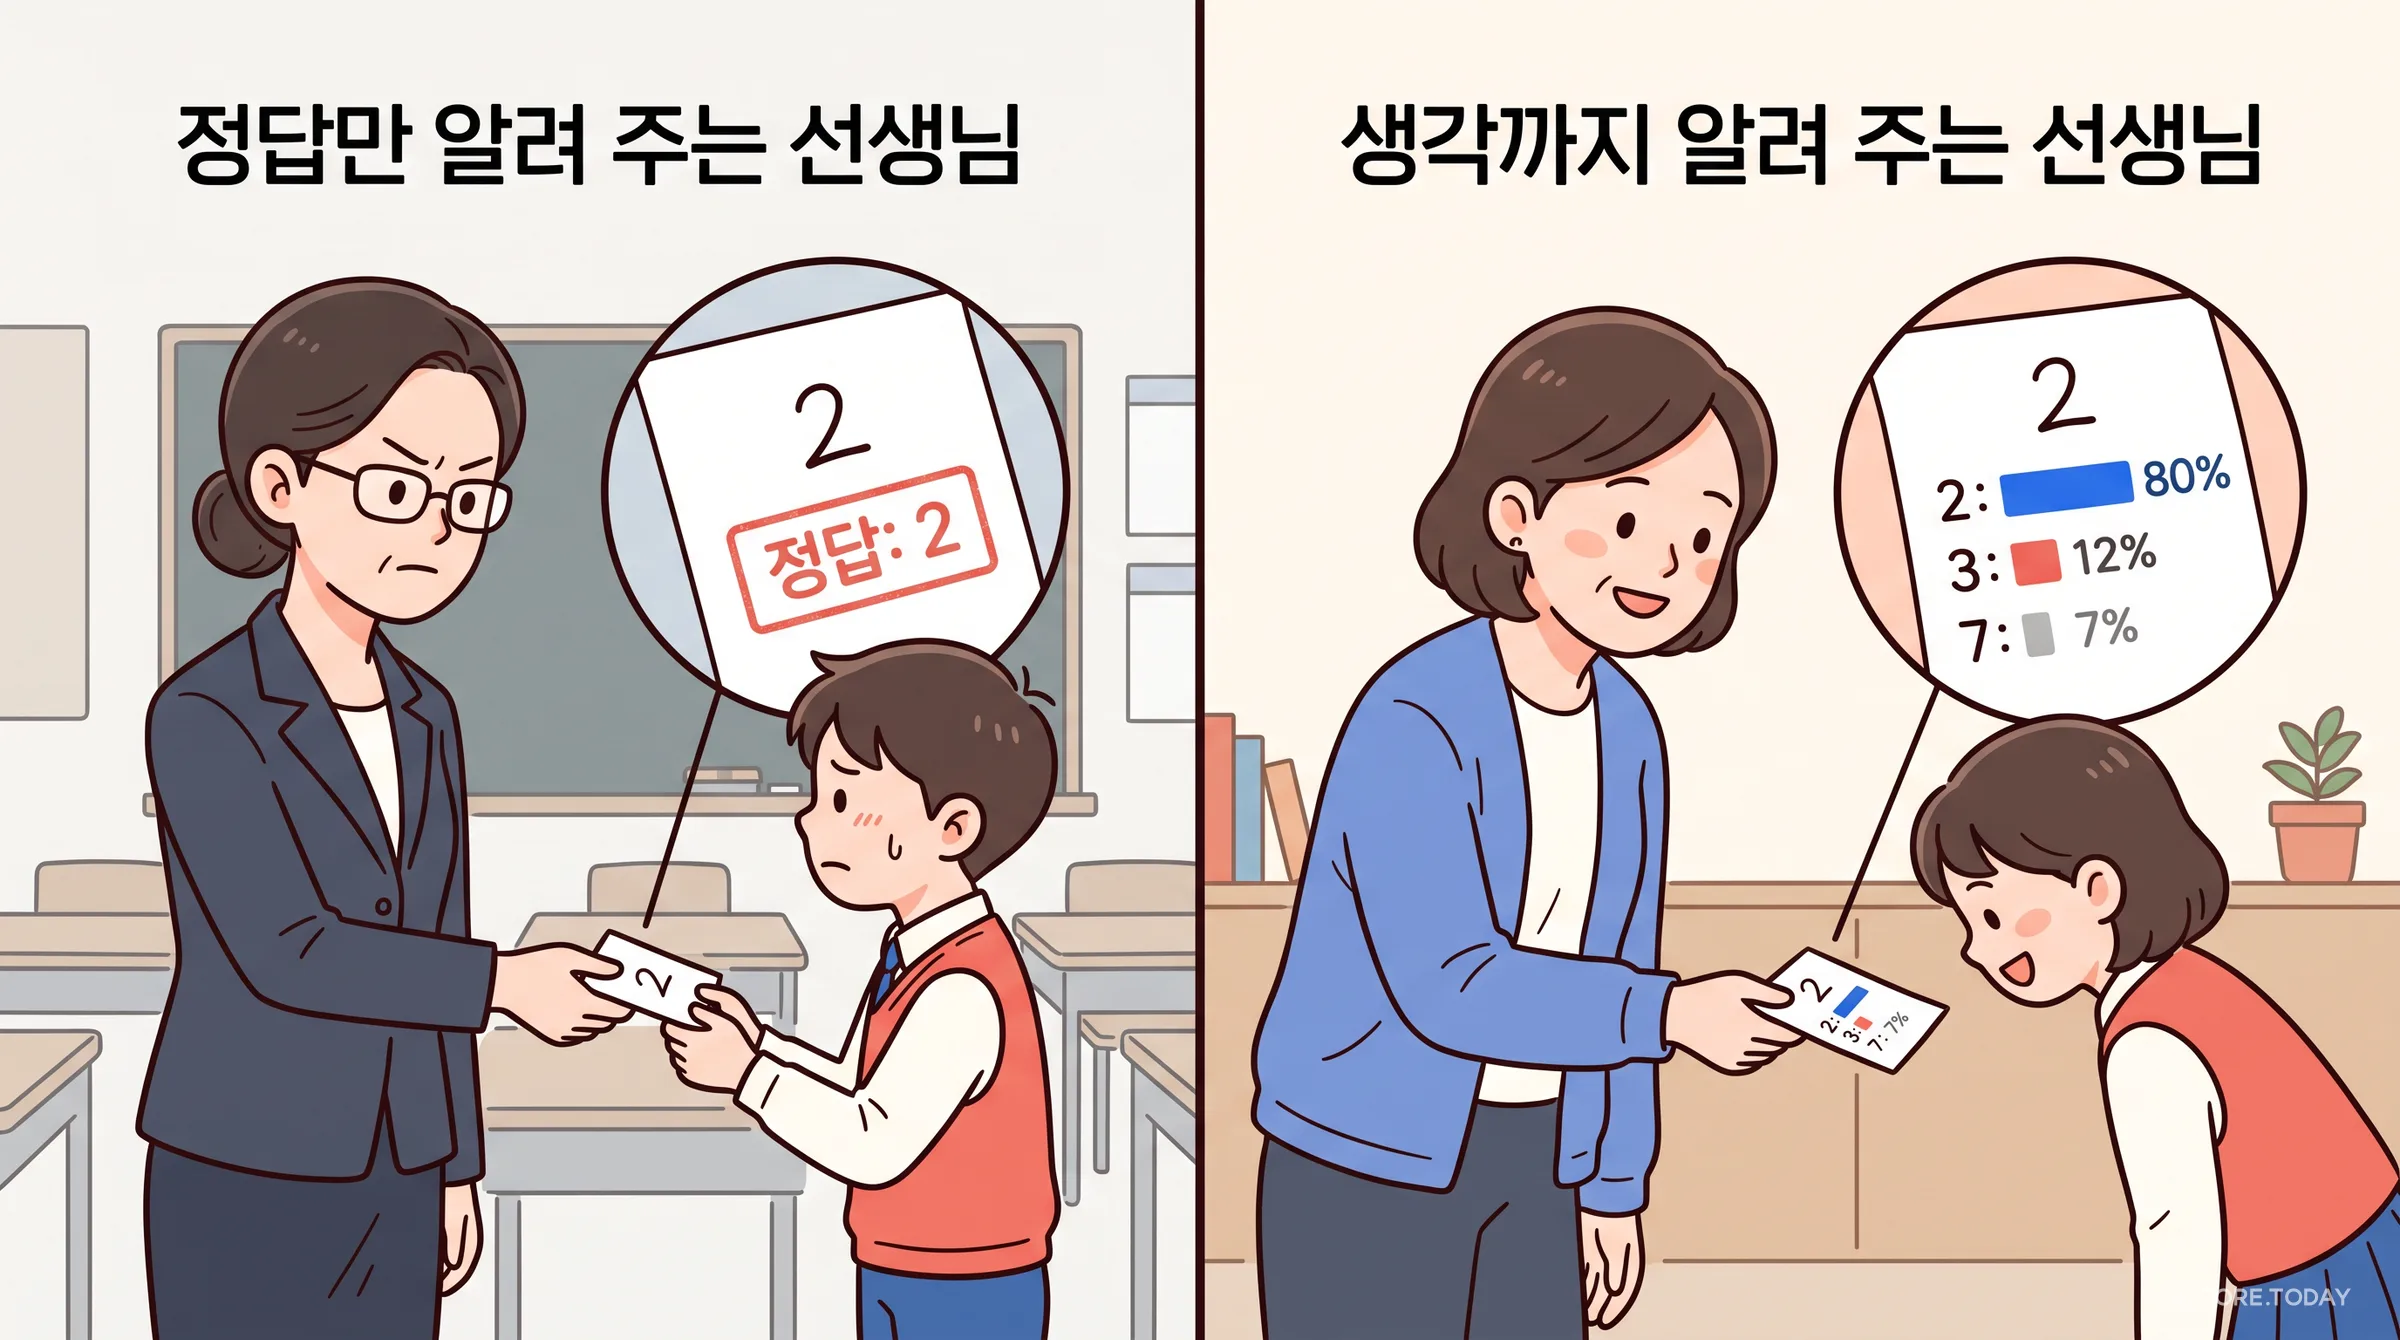
어두운 지식은 우리에게도 익숙하다. 바둑 기사가 복기를 할 때 “여기서 둔 수는 틀렸다”만 말하는 사람과 “이 수가 최선이고, 저 수는 나쁘지 않으며, 그 수는 최악”이라고 말하는 사람 중 누구에게서 더 많이 배울까? 객관식 시험의 해설지도 그렇다. 좋은 해설은 정답만 알려 주지 않는다. “③은 매력적인 오답이다. 왜냐하면…”이라고 오답들의 급을 나눠 준다.
정답은 결론이다. 소프트 라벨은 선생님의 머릿속이다.
3부. 온도 — 숨은 지식을 드러내는 다이얼
3.1 문제: 어두운 지식은 너무 어둡다
그런데 잘 학습된 모델일수록 정답에 거의 모든 확률을 몰아준다. 쓰레기차의 0.01%와 당근의 0.00000001%는 둘 다 0에 너무 가까워서, 학생이 그 차이를 따라 하려 해도 손실 함수에 거의 영향을 주지 않는다. 지식은 있지만 너무 희미하다.
바와 카루아나는 이 문제를 로짓(소프트맥스 이전 점수)을 직접 따라 하는 방식으로 피했다. 힌턴은 더 일반적인 도구를 내놓았다. 소프트맥스에 온도(temperature)T를 넣는 것이다.
qi=∑jexp(zj/T)exp(zi/T)
zi는 클래스 i의 로짓이다. T=1이면 평소의 소프트맥스다. T를 올리면 로짓 사이의 차이가 T배로 줄어들어 분포가 평평해진다. 순위는 그대로인 채 작은 확률들이 위로 떠오른다. 0.01%와 0.00000001%가 예컨대 3%와 0.5%가 되어 학생 눈에 보이게 된다.
‘온도’라는 이름은 통계 물리학에서 왔다. 볼츠만 분포에서 온도가 높으면 입자들이 에너지가 높은 상태에도 골고루 퍼지고, 온도가 낮으면 가장 낮은 상태에 몰린다. 디코딩 특집에서 본 생성 온도와 같은 식이다. 생성할 때는 온도로 다양성을 조절하고, 증류할 때는 온도로 숨은 지식의 밝기를 조절한다.
3.2 증류 손실
학생은 같은 온도 T에서 교사의 분포 pT를 따라 하도록 학습한다. 보통 정답 라벨 손실을 조금 섞는다.
L=(1−α)정답라벨CE(y,q1)+αT2교사따라하기KL(pTqT)
KL(p∥q)는 쿨백-라이블러 발산으로, 교사 분포 p와 학생 분포 q가 얼마나 다른지 잰다. 교사가 확률을 둔 곳에 학생이 확률을 적게 두면 크게 벌을 받는다.
학습이 끝나 서비스할 때 학생은 다시 T=1로 돌아간다.
왜 T2을 곱할까? 온도를 올리면 소프트 라벨 손실의 기울기가 대략 1/T2배로 작아진다. T2을 곱해야 온도를 바꿔도 두 손실의 비중이 유지된다.
힌턴은 온도를 아주 높이면 이 손실이 로짓의 차이를 제곱해 줄이는 것과 같아진다는 것도 보였다. 바와 카루아나의 로짓 따라 하기가 증류의 특수한 경우였던 것이다. 반대로 온도가 낮으면 학생은 아주 작은 로짓(대개 소음에 가까운 값)은 무시하고 큰 것 위주로 따라 한다. 어느 쪽이 나은지는 학생의 크기에 달려 있다. 아래 실측에서 직접 확인한다.
3.3 직접 만져 보기
아래는 우리가 직접 학습한 손글씨 숫자 교사 모델의 실제 출력이다. 또렷한 숫자(빨간 점이 없는 것)를 골라 온도를 올려 보자. T=1에서는 정답이 100%에 가까워 아무것도 보이지 않다가, 온도를 올리면 2·3순위가 떠오른다. 빨간 점이 붙은 헷갈리는 숫자는 T=1에서도 이미 교사의 고민이 드러난다. 아래 지도는 ‘교사가 어떤 숫자끼리 닮았다고 보는가’를 1만 장의 평균으로 보여 준다. 4와 9, 3과 5, 7과 9처럼 사람이 봐도 헷갈리는 쌍이 진하게 나타난다. 아무도 교사에게 이 관계를 가르치지 않았다.
4부. 코어닷투데이 실측 ① — 힌턴의 MNIST 실험을 다시 해 보다
힌턴의 논문에서 가장 유명한 실험은 손글씨 숫자 데이터 MNIST로 한 것이다. 10년 전 실험이 지금도 재현될까? 우리는 논문의 설정을 최대한 그대로 따라 맥북 한 대에서 다시 해 봤다.
교사 은닉층 1,200×1,200 드롭아웃 + 이미지 이동 증강 시험 오류 88개 / 1만 장
→
소프트 라벨 학습 이미지 5만 5천 장에 교사가 매긴 확률
→
학생 800×800 또는 30×30 정규화·증강 없음
모든 학생은 시드 3개로 학습해 평균을 냈다. 비교 기준은 똑같은 학생을 정답 라벨로만 학습한 것이다.
4.1 같은 데이터, 다른 선생님
먼저 원 논문과 같은 크기의 학생(800×800)이다. 정답만 보고 배운 학생은 시험 1만 장에서 145.7개를 틀렸다. 힌턴 논문의 146개와 거의 같다. 같은 학생이 교사의 소프트 라벨을 보고 배우자 110개(T=3)로 줄었다. 오류가 4분의 1 줄었다. 교사(88개)와의 격차 58개 중 36개를 메운 셈이다. 원 논문은 146개 → 74개였다. 우리 교사가 원 논문의 교사(67개)보다 조금 약한 만큼 학생의 개선 폭도 작았다.
정답만 (800×800)
145.7개
증류 T=1
127.3개
증류 T=3
110.0개
증류 T=20
111.0개
교사 (1200×1200)
88개
시험 1만 장 중 오류 개수, 시드 3개 평균. 막대 길이는 ‘정답만’ 학생의 오류를 100%로 놓은 비율.
T=1에서도 효과가 있지만 온도를 2 이상으로 올리면 훨씬 좋아졌다. 정답 아래 숨은 작은 확률들을 보이게 해 준 덕이다. 2에서 20까지는 큰 차이가 없었다.
4.2 학생이 작으면 온도도 낮춰야 한다
학생을 30×30으로 확 줄이면 이야기가 달라진다. 파라미터가 128만 개에서 2만 5천 개로, 50분의 1이 된다.
온도
큰 학생 800×800
작은 학생 30×30
정답만
145.7
371.0
T=1
127.3
353.7
T=2
112.7
368.3
T=3
110.0
371.3
T=4
113.7
403.7
T=8
115.0
451.7
T=20
111.0
496.3
큰 학생에게는 거의 상관없던 온도가 작은 학생에게는 결정적이었다. T=20으로 배운 작은 학생은 오히려 정답만 보고 배운 학생보다 125개 더 틀렸다. 온도가 높으면 교사의 아주 작은 로짓, 즉 ‘1이 8을 0.00001% 닮았다’ 같은 소음에 가까운 신호까지 똑같이 중요해진다. 용량이 작은 학생은 그것까지 따라 하느라 정작 중요한 구분을 놓친다.
힌턴도 같은 현상을 보고했다. 학생이 은닉 유닛 300개 이상이면 온도 8 이상에서 결과가 비슷하지만, 30개로 줄이면 2.5~4의 온도가 그보다 높거나 낮은 온도보다 훨씬 낫다고 했다. 우리 실험에서는 그보다 더 낮은 T=1이 가장 좋았다. 최적값은 다르지만 방향은 같다. 작은 학생에게는 낮은 온도를.
4.3 데이터가 적을 때
다음으로 학생이 볼 수 있는 이미지 수를 줄였다. 교사는 전체 데이터로 학습했고, 학생은 일부만 본다. 온도는 4로 고정했다.
학생이 본 이미지
정답만
소프트 라벨
오류 감소
100장
25.3%
26.6%
−5% (악화)
300장
15.3%
13.2%
14%
1,000장
9.6%
7.0%
27%
3,000장
6.4%
3.2%
50%
1만 장
3.6%
2.0%
44%
이미지 3천 장에서 오류가 절반이 됐다. 소프트 라벨로 3천 장을 본 학생(3.2%)은 정답 라벨로 1만 장을 본 학생(3.6%)보다 나았다. 한 장마다 정답 하나가 아니라 열 숫자의 관계가 함께 오기 때문이다.
예외도 있었다. 100장에서는 소프트 라벨이 오히려 조금 나빴다. 학생이 100장만 반복해서 보는 상황에서는 교사의 미묘한 확률까지 외우는 것이 도움이 되지 않았다. 증류가 데이터를 무한히 대신해 주지는 않는다.
그렇다면 100장으로는 증류가 아무 소용이 없을까? 2006년 「모델 압축」 논문을 떠올려 보자. 카루아나 팀은 데이터가 모자라면 그럴듯한 가짜 데이터를 만들어 앙상블에게 답을 달게 했다. 교사의 진짜 가치는 정답 100개를 부드럽게 바꿔 주는 데 있지 않다. 어떤 새 입력에도 답해 줄 수 있다는 데 있다.
그래서 실험을 하나 더 했다. 학생에게 라벨 붙은 이미지는 똑같이 100장·300장·1,000장만 준다. 대신 학습할 때마다 이미지를 상하좌우로 조금씩 옮기고, 옮긴 이미지를 교사에게 그때그때 물어 소프트 라벨을 받았다. 이미지를 옮기는 증강만의 효과를 가려내려고, 같은 증강을 정답 라벨에 적용한 학생도 함께 비교했다.
라벨 붙은 이미지
정답만
정답 + 이동 증강
소프트 라벨
이동 증강 + 교사에게 즉석 질문
100장
25.3%
18.7%
24.8%
12.3%
300장
15.2%
8.1%
12.8%
4.5%
1,000장
9.7%
5.0%
6.6%
2.7%
시험 오류율, 시드 3개 평균. 이 표는 별도 실행이라 위 표와 같은 조건의 값이 조금 다르다.
결과는 분명했다. 100장에서도 교사에게 새 입력을 계속 물어보게 하자 오류가 25.3%에서 12.3%로 절반이 됐다. 증강만 한 학생(18.7%)보다도 3분의 1이 적다. 라벨 1,000장으로 배운 학생은 2.7%로, 정답 라벨 1만 장으로 배운 학생(3.6%)보다 나았다. 교사는 정답지가 아니라, 학생이 무엇을 물어도 대답해 주는 과외 선생님이다. 오늘날 대형 언어 모델 증류에서 학생에게 교사의 답을 끝없이 생성해 먹이는 것도 같은 원리다.
이제 이 글의 첫머리에서 말한 실험이다. 학생의 학습 데이터에서 숫자 3을 한 장도 남기지 않고 모두 뺐다. 학생은 3이 정답인 예제를 한 번도 보지 못한다. 대신 다른 숫자 이미지에 교사가 매긴 소프트 라벨에는 3에 대한 정보가 조금씩 섞여 있다. ‘이 8은 3을 6% 닮았다’, ‘이 5는 3을 4% 닮았다’ 같은 것이다.
0장
학생이 학습에서 본 숫자 3
91.3%
시험에서 처음 본 3을 맞힌 비율
98.2%
편향 값 하나를 고친 뒤
학생은 처음 보는 3 1,010장 중 91.3%를 맞혔다. 오답에 숨은 정보만으로 3이 어떻게 생겼는지 배운 것이다. 다만 학습 중에 3이 정답인 적이 없으니 3을 고르기를 조금 주저한다. 출력층에서 3의 편향(bias) 값 하나만 올려 주면 98.2%가 된다. 이 보정값은 시험 데이터가 아니라 학습 데이터에서 떼어 둔 검증용 5천 장으로 골랐다. 힌턴의 원 결과는 보정 후 98.6%였다.
더 극단적으로, 학습 데이터에 7과 8만 남겨 봤다. 열 숫자 중 여덟을 한 번도 정답으로 보지 못한 학생이다. 그래도 시험 오류율은 21.6%였고, 빠진 여덟 숫자의 편향을 올리자 9.2%까지 내려갔다. 7과 8의 그림에 교사가 남긴 ‘오답 확률’에 나머지 여덟 숫자의 모양이 담겨 있었다는 뜻이다. 힌턴의 원 결과는 47.3% → 13.2%였다.
4.5 같은 크기의 학생
마지막으로 교사와 학생을 똑같이 800×800으로 만들었다. 정답으로 학습한 800×800 교사(오류 154개)의 소프트 라벨로 같은 크기의 학생을 가르쳤다. 학생은 152.3개를 틀렸다. 교사보다 조금 나았지만 시드 사이의 흔들림(151~154개) 안의 차이다. 이 작은 MNIST 실험에서는 5.2절에서 볼 Born-Again Networks만큼의 극적인 효과는 나오지 않았다. 좋은 교사가 먼저 있어야 한다. 정규화와 증강으로 학습한 1200×1200 교사에게서 배운 같은 학생은 110개까지 내려갔다.
5부. 무엇을, 어떻게 옮길까 — 증류의 가계도
힌턴의 증류는 교사의 출력을 따라 한다. 그 뒤 10년 동안 연구자들은 “무엇을 옮길 것인가”와 “누가 누구를 가르칠 것인가”를 다양하게 바꿔 봤다.
5.1 출력, 중간 생각, 관계
방식
무엇을 따라 하나
대표 연구
비유
응답 기반
교사의 최종 출력 분포(로짓·확률)
Hinton 2015, DistilBERT
시험 답안과 확신도를 보고 배우기
특징 기반
교사의 중간 층 표현
FitNets 2015, TinyBERT
선생님의 풀이 중간 과정을 보고 배우기
관계 기반
예제들 사이의 거리·각도 관계
RKD 2019 등
“이 문제와 저 문제는 비슷하다”를 배우기
시퀀스 기반
교사가 생성한 문장 자체
Kim & Rush 2016, Alpaca
모범 답안을 통째로 베껴 쓰기
FitNets(2015). 로메로 등은 학생을 교사보다 얇지만 더 깊게 만들고, 출력뿐 아니라 교사의 중간 층 표현을 ‘힌트’로 줬다. 학생의 중간 층이 교사의 중간 층과 비슷해지도록 먼저 학습시킨 뒤 증류를 하자, CIFAR-10에서 파라미터가 약 10분의 1인 학생이 교사를 이겼다.
시퀀스 수준 증류(2016). 번역처럼 출력이 문장인 경우, 단어마다 확률을 따라 하는 대신 교사가 빔 서치로 쓴 번역문 자체를 정답으로 삼아 학생을 학습시킬 수 있다. 김윤과 알렉산더 러시는 이 방식으로 학생이 빔 서치 없이 그리디 디코딩만으로도 좋은 번역을 하게 만들었다. 가장 좋은 학생은 교사보다 10배 빨랐다. 이 방식은 7년 뒤 대형 언어 모델 시대에 가장 흔한 증류가 된다. 교사가 쓴 답으로 학생을 지도 학습하는 것, 바로 그것이다.
5.2 같은 크기의 학생이 선생님을 이긴다 — Born-Again Networks
2018년 푸를라넬로 등은 이상한 실험을 했다. 학생을 교사와 똑같은 구조, 똑같은 크기로 만들고 증류한 것이다. 압축이 목적이 아니니 아무 의미가 없어 보인다. 그런데 학생이 교사를 크게 앞섰다. 이 학생을 다시 교사로 삼아 다음 세대를 증류하면 조금 더 좋아졌다. 이름하여 ‘다시 태어난 신경망(Born-Again Networks)’이다.
이 결과는 증류가 단순한 압축이 아니라는 것을 보여 준다. 소프트 라벨은 그 자체로 더 좋은 학습 신호다. 애매한 예제에 과도한 확신을 강요하지 않고, 클래스 사이의 관계를 알려 주니 같은 모델도 더 잘 배운다.
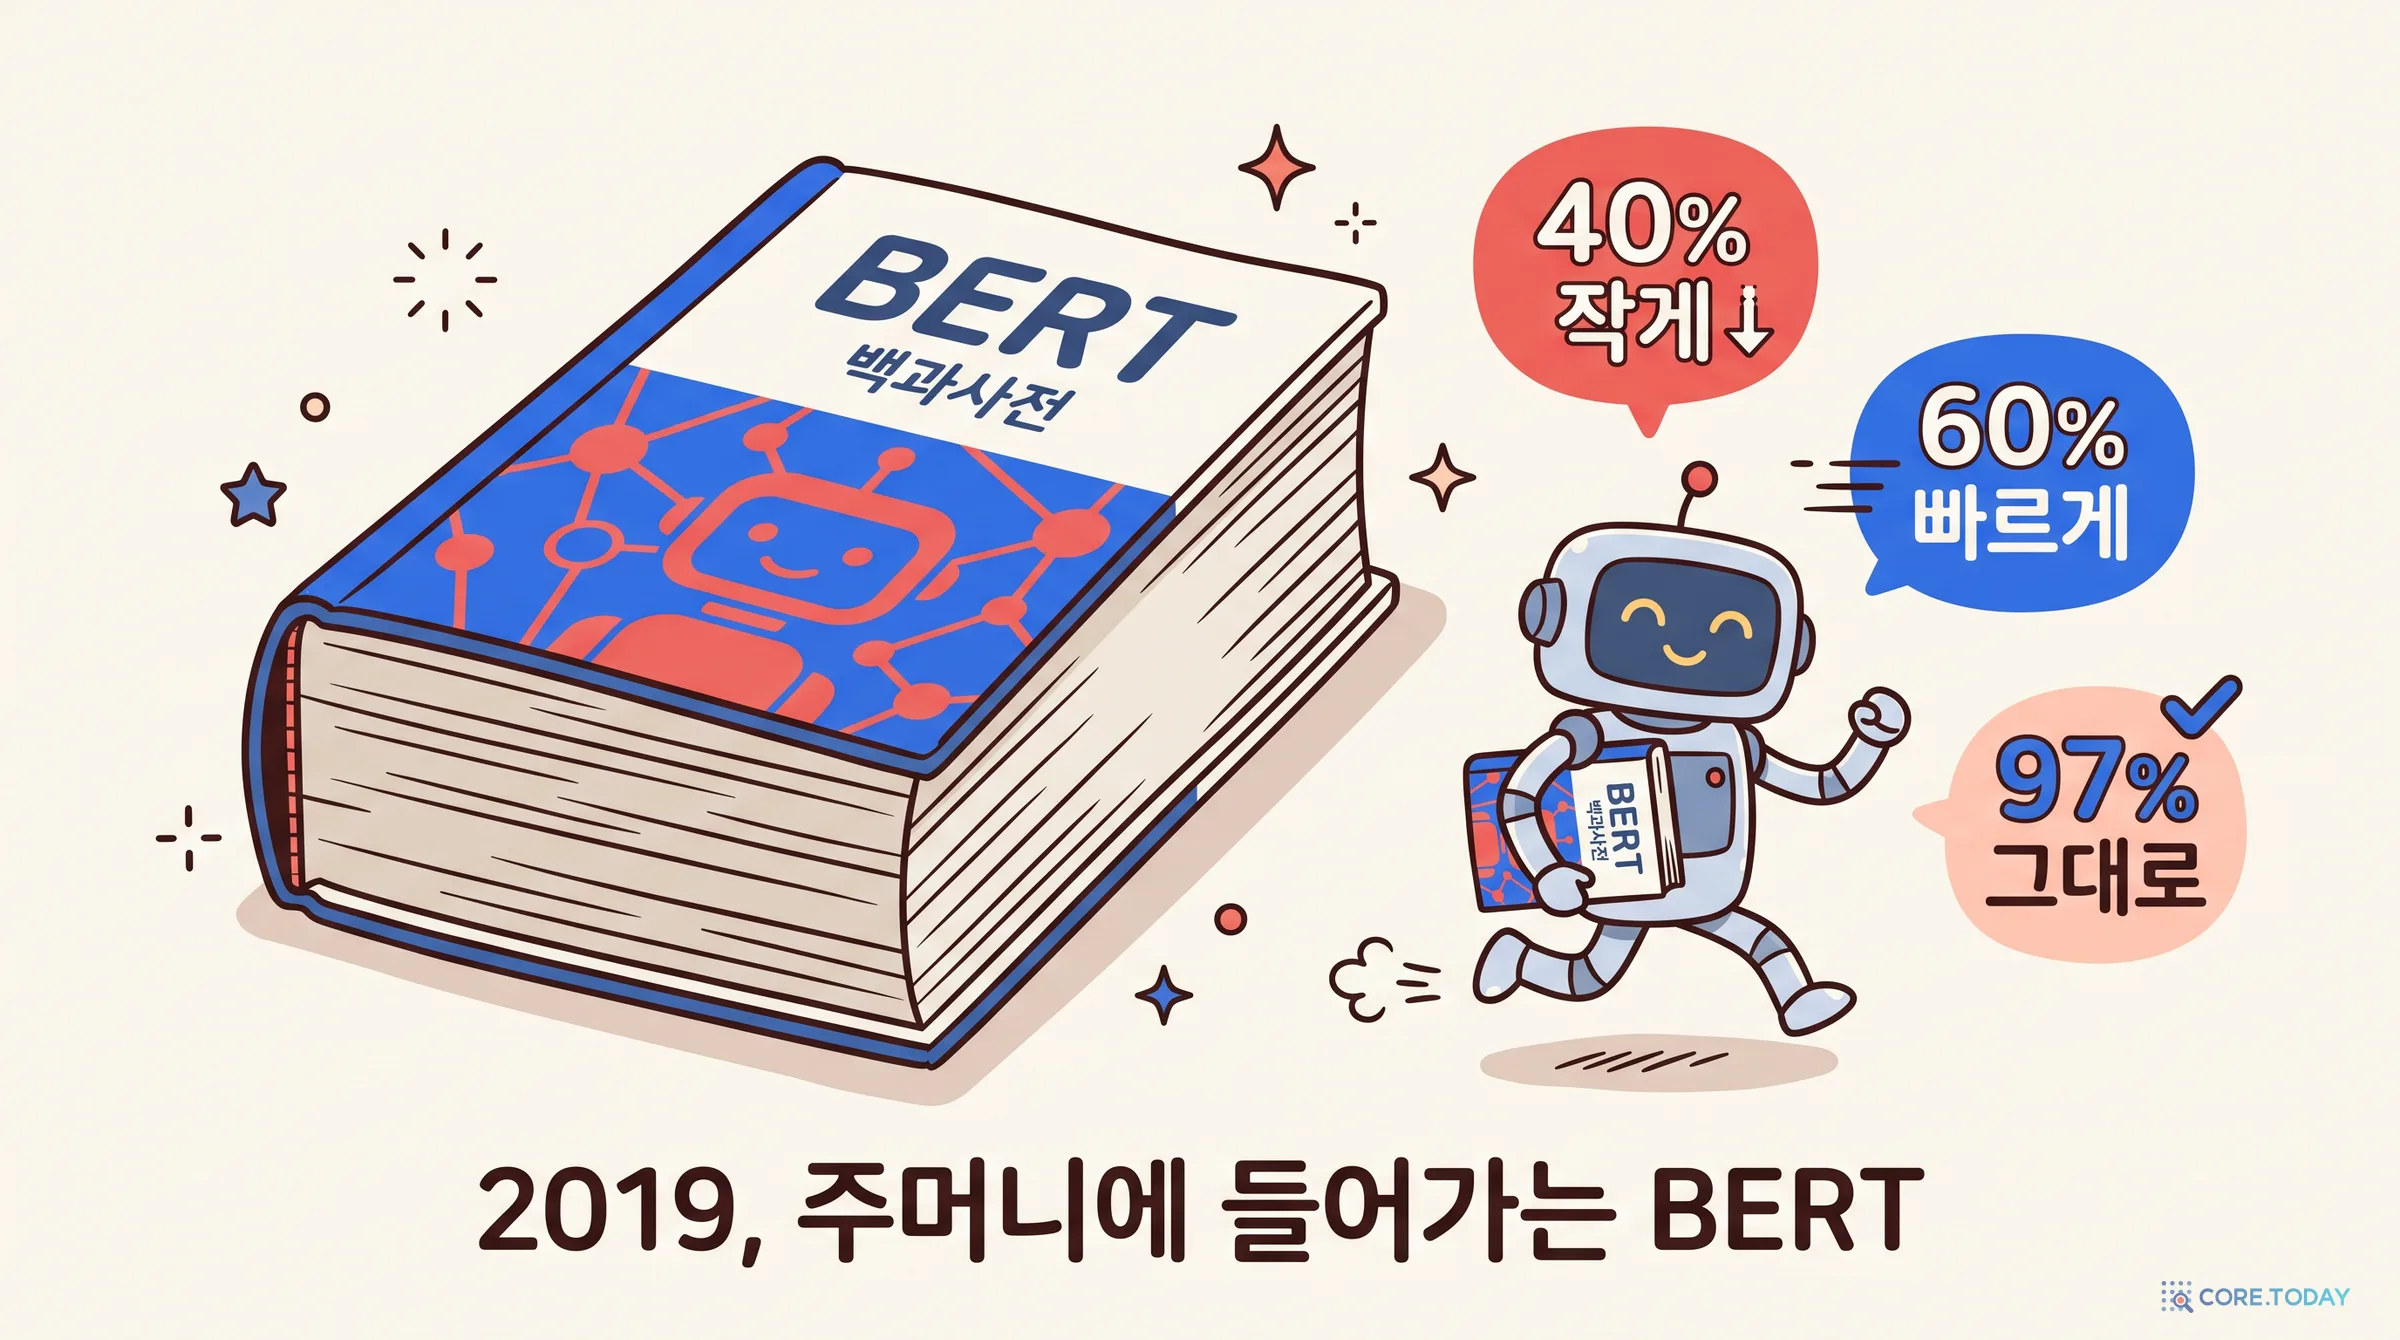
증류가 연구실 밖으로 나온 계기는 2019년 허깅페이스의 DistilBERT였다. BERT는 자연어 이해의 판도를 바꿨지만 휴대폰이나 실시간 서비스에 올리기엔 무거웠다. DistilBERT는 층을 12개에서 6개로 줄인 학생을 사전 학습 단계부터 증류했다. 손실은 세 가지를 섞었다. 빈칸 맞히기(언어 모델링), 교사 분포 따라 하기(증류), 그리고 교사와 학생의 은닉 벡터 방향 맞추기(코사인 거리).
40%
더 작게 (1억 1천만 → 6,600만 파라미터)
60%
더 빠르게
97%
언어 이해 성능 유지
같은 해 화웨이의 TinyBERT는 중간 층과 어텐션까지 증류해 4층 모델로 BERT-base의 GLUE 점수 96.8% 이상을 유지하면서 7.5배 작고 9.4배 빠른 모델을 만들었다. 이후 검색 엔진의 리랭커, 스팸 필터, 문장 임베딩 모델처럼 매일 수억 번 호출되는 모델은 거의 다 증류된 작은 모델이 됐다. 사용자는 모르지만 우리는 하루에도 여러 번 증류된 모델을 쓴다.
6부. 증류는 왜 되고, 언제 안 되나
증류는 간단해 보이지만 들여다볼수록 이상한 현상이 많다. 실무에서 꼭 알아야 할 네 가지를 정리한다.
6.1 정확한 선생님이 좋은 선생님은 아니다 — 라벨 스무딩의 역설
라벨 스무딩은 정답 라벨을 100% 대신 90%로, 나머지 10%를 오답에 고르게 나눠 주는 기법이다. 모델의 과신을 막아 정확도를 조금 올려 줘서 널리 쓰인다. 그런데 2019년 뮐러, 콘블리스, 그리고 힌턴은 라벨 스무딩으로 학습한 교사가 정확도는 더 높은데 증류는 더 못 한다는 것을 보였다.
이유는 어두운 지식에 있다. 라벨 스무딩은 모든 오답을 똑같이 대하라고 가르친다. 그 결과 모델 내부에서 같은 클래스의 예제들이 빽빽하게 뭉치고, ‘이 2는 3을 조금 닮았다’ 같은 예제별 미묘한 정보가 지워진다. 시험 점수는 좋지만 머릿속 지도를 잃어버린 선생님이 된 것이다.
더 좋은 교사를 쓰면 학생도 더 좋아질 것 같다. 그러나 2019년 조장환과 바라트 하리하란은 더 큰 모델이 꼭 더 좋은 교사는 아니다라고 보고했다. 학생과 교사의 용량 차이가 너무 크면 학생이 교사의 복잡한 분포를 따라가지 못한다. 대학원 교수님의 강의를 유치원생이 듣는 꼴이다. 오히려 학습을 일찍 멈춘 덜 완성된 교사가 더 좋은 선생님이 되기도 했다.
2020년 미르자데 등은 중간 크기의 조교(teacher assistant) 모델을 두자고 제안했다. 큰 교사가 조교를 가르치고, 조교가 학생을 가르친다. 구글 Gemma 3 보고서도 비슷한 현상을 확인했다. 학습이 짧을 때는 작은 교사가, 길 때는 큰 교사가 낫다.
6.3 학생은 생각보다 선생님을 닮지 않는다 — 충실도의 역설
2021년 스탠턴 등은 「지식 증류는 정말 작동하는가?」라는 도발적인 논문을 냈다. 결론은 ‘작동은 한다, 그러나 생각한 방식은 아니다’였다. 증류는 학생의 일반화 성능을 올린다. 하지만 학생이 교사와 얼마나 똑같이 예측하는가(충실도)는 생각보다 낮았다. 학생이 교사를 완벽히 흉내 낼 용량이 있어도 그랬다. 원인은 최적화의 어려움이었다. 더 이상한 것은, 교사를 더 똑같이 따라 하게 만든다고 학생의 성능이 꼭 좋아지지는 않았다는 점이다.
증류의 효과가 ‘교사 복제’에서만 나오는 것이 아니라, 소프트 라벨이 주는 좋은 학습 신호에서도 나온다는 뜻이다. Born-Again Networks와 같은 이야기다.
6.4 학생은 판단보다 버릇을 먼저 배운다 — 코어닷투데이의 실패담
지난달 우리는 실제 업무에서 증류를 시도했다. 클라우드 모델 Gemini Flash가 뉴스 기사에서 육하원칙을 뽑는 성능(0.86)을 맥북의 로컬 Qwen3 4B에게 옮기려 했다. Flash가 기사 1,709건에 쓴 답(비용 5.6달러)으로 4B 모델을 가르쳤다. 결과는 실패였다. 학습 전 0.686이던 학생이 1,623개를 다 배운 뒤 0.656으로 내려갔다. 더 흥미로운 것은 학생이 배운 내용이었다. 예제 200개를 본 시점에 학생은 ‘이유’가 없는 기사 44건 중 42건에 이유를 지어냈다. 선생님 답안의 형식, 즉 ‘이유 칸은 늘 채워져 있다’는 버릇을 판단보다 먼저 배운 것이다. 자세한 과정은 4B를 Flash로 가르치기에 있다.
답 텍스트만 보고 배우는 증류는 교사의 확률이 아니라 표면을 따라 한다. 7부에서 볼 ‘모방의 거짓 약속’과 같은 현상이다.
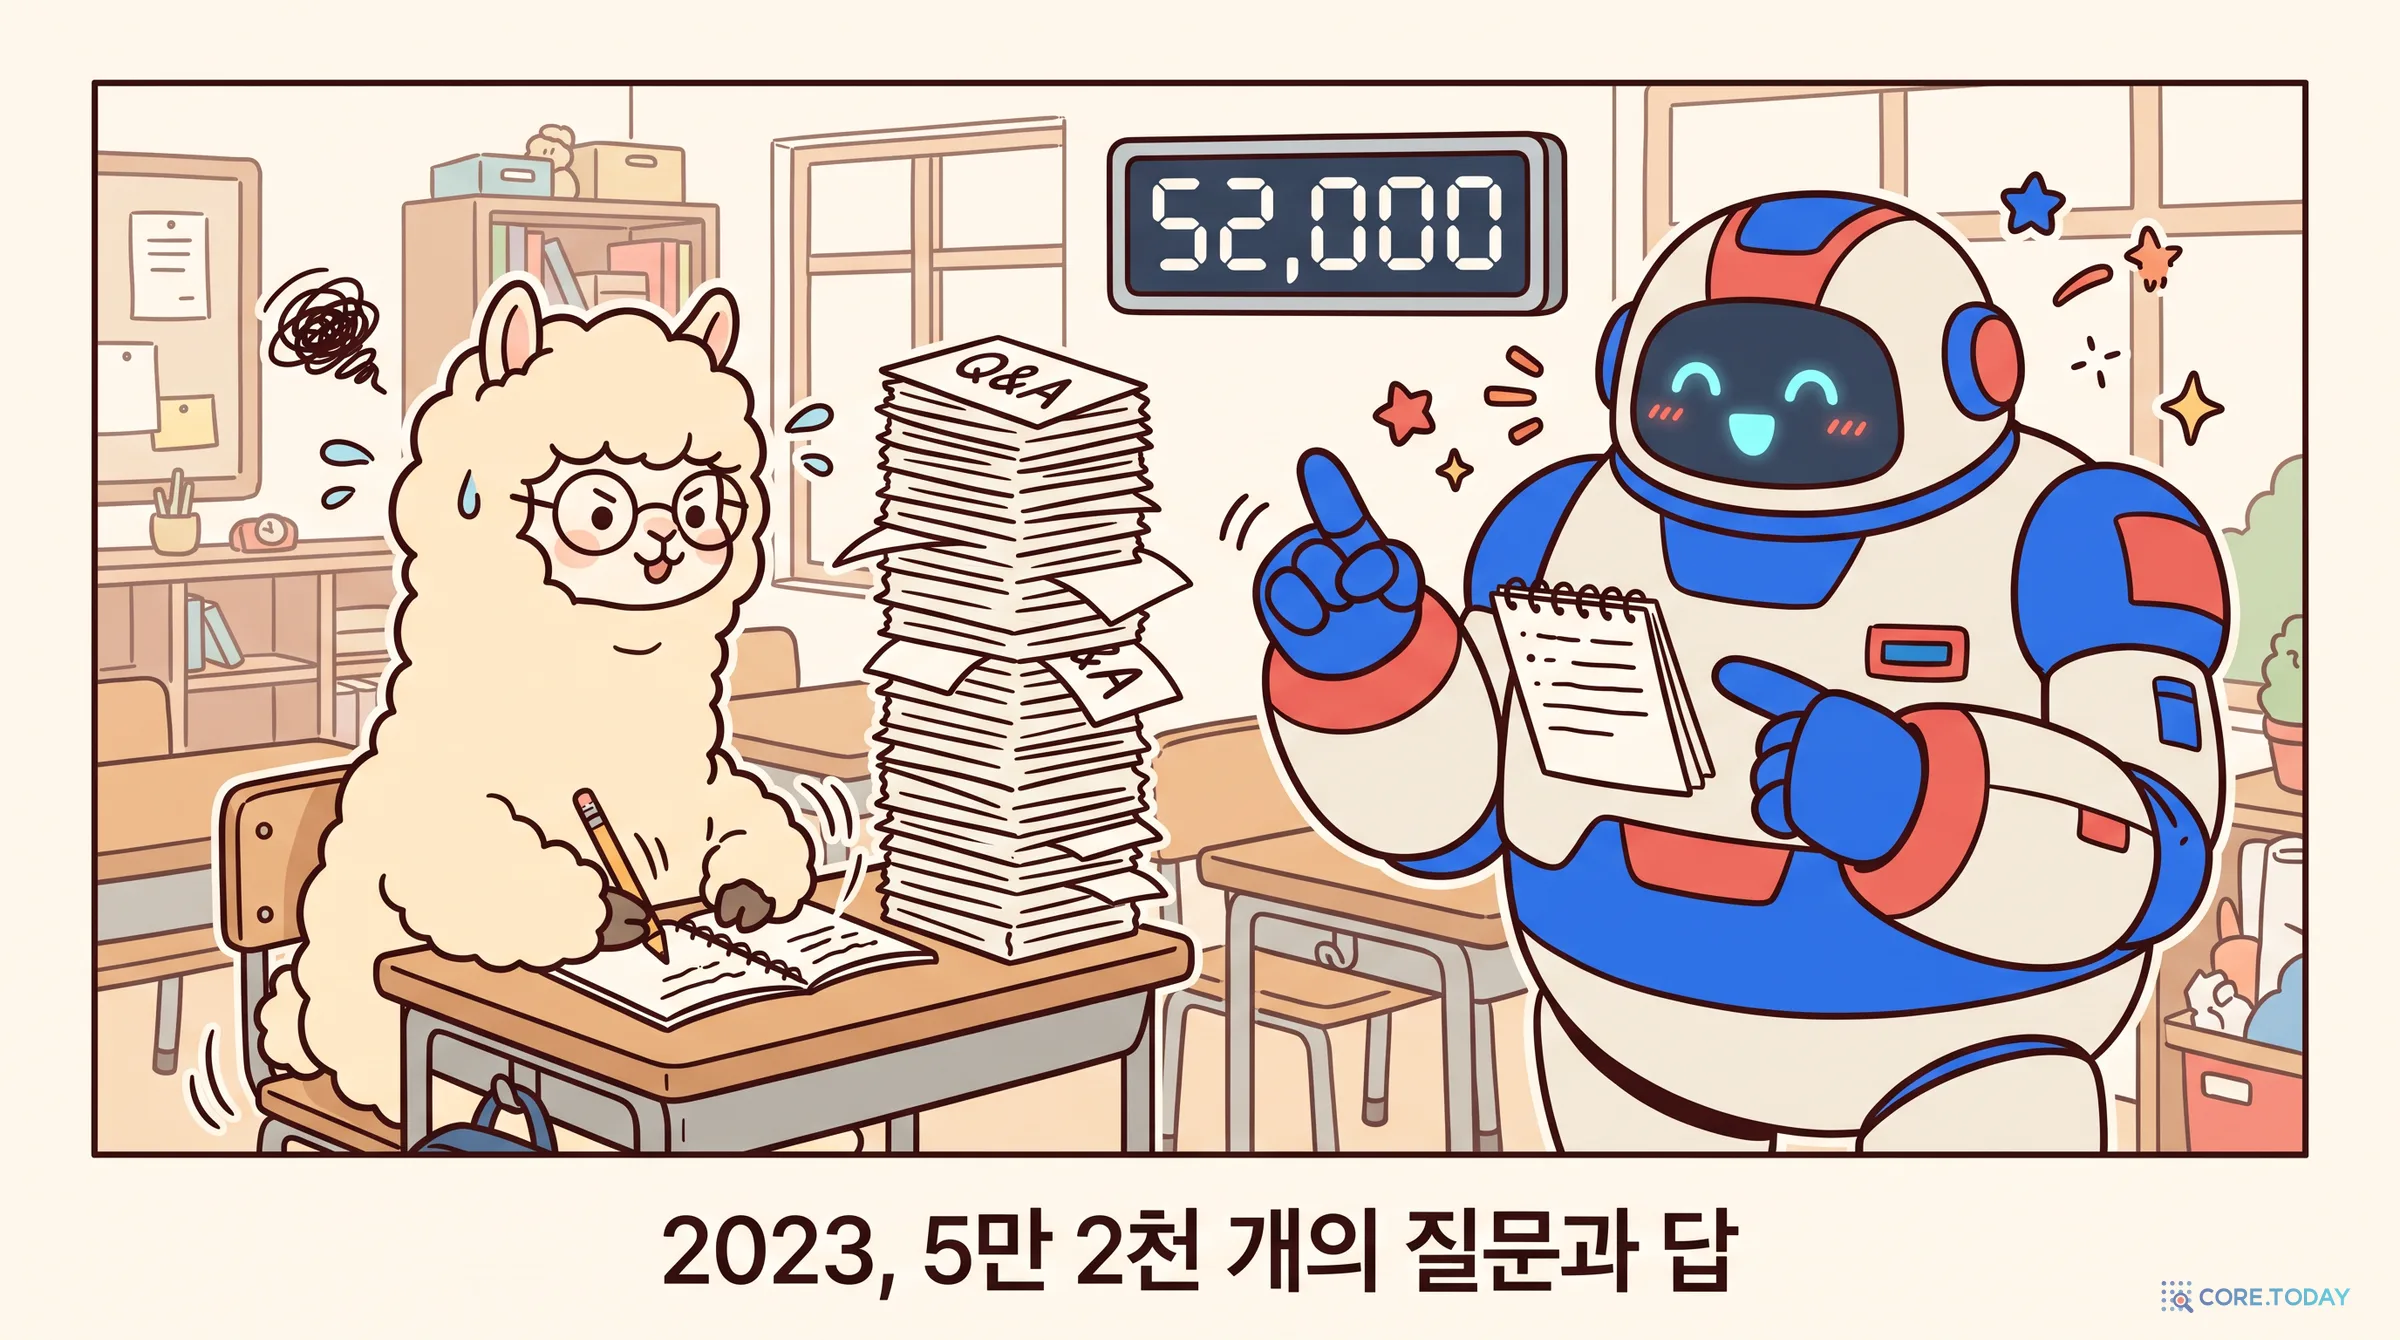
2023년 3월, ChatGPT가 나온 지 석 달 만에 스탠퍼드 연구진이 Alpaca를 공개했다. 만드는 법은 이랬다.
1
사람이 쓴 지시문 예시 175개를 OpenAI의 text-davinci-003에게 보여 주고 비슷한 지시문을 계속 만들게 한다.
2
그렇게 만든 지시문 5만 2천 개에 text-davinci-003이 답하게 한다. 데이터 비용 500달러 미만.
3
메타가 공개한 LLaMA 7B를 이 데이터로 미세 조정한다. A100 8장으로 3시간, 100달러 미만.
600달러짜리 모델이 사람들의 눈가림 비교에서 text-davinci-003과 90 대 89로 비겼다. 곧이어 사용자들이 공유한 ChatGPT 대화 7만 개로 학습한 Vicuna(“ChatGPT 품질의 90%”라고 GPT-4가 채점했다)가, 단계별 설명까지 따라 하게 한 마이크로소프트의 Orca가, GPT-3.5가 쓴 ‘교과서 같은’ 합성 데이터로 1.3B 모델을 학습해 코딩 벤치마크 HumanEval 50.6%를 낸 Phi-1이 나왔다. 교사의 확률은 못 보고 답 텍스트만 받아 배우는 이 방식이 앞서 본 김윤·러시의 시퀀스 수준 증류다.
그러나 같은 해 5월 버클리의 구디반데 등은 「독점 언어 모델 모방의 거짓 약속(The False Promise of Imitating Proprietary LLMs)」에서 찬물을 끼얹었다. 모방 모델은 사람 평가자에게 ChatGPT와 비슷하다는 평을 받았지만, 모방 데이터가 다루지 않은 과제에서는 격차를 거의 줄이지 못했다. 학생은 ChatGPT의 자신감 있는 말투를 배웠을 뿐 지식과 사실성은 배우지 못했다. 6.4절의 우리 실패담과 정확히 같은 현상이다.
7.2 사전 학습의 기본기가 된 증류 — Gemma, Llama, Apple
2024년부터 증류는 ‘작은 모델을 만드는 기본 공정’이 됐다. 이번에는 텍스트가 아니라 확률 분포를 옮긴다. 언어 모델은 매 위치에서 다음 토큰 수만~수십만 개에 확률을 매긴다. 일반 사전 학습은 실제로 나온 토큰 하나를 정답으로 삼지만, 로짓 증류는 교사의 분포 전체를 정답으로 삼는다. 토큰 하나하나가 수만 클래스짜리 소프트 라벨이 되는 셈이다.
구글 Gemma 2(2024). 2B와 9B 모델을 “다음 토큰 예측 대신 지식 증류로” 학습했다. 2B는 2조 토큰, 9B는 8조 토큰을 봤다. 보고서는 이것이 친칠라 법칙이 말하는 계산 최적량의 “50배 이상”이라고 썼다. 데이터를 그렇게 오래 먹여도 계속 좋아진 비결로 증류를 꼽았다.
구글 Gemma 3(2025). 모든 크기를 증류로 학습했다. 교사의 전체 분포 대신 토큰마다 로짓 256개를 교사 확률에 따라 뽑아 썼다. 저장 공간을 아끼는 실무적 방법이다.
메타 Llama 3.2(2024). 1B와 3B 모델은 Llama 3.1 8B를 가지치기(pruning)해 만든 뒤, 8B와 70B의 로짓을 “토큰 단위 목표”로 삼아 성능을 회복시켰다.
메타 Llama 4(2025). 활성 파라미터 2,880억 개의 거대 교사 Behemoth로 Maverick을 ‘공동 증류(codistillation)’했다. 소프트 라벨과 하드 라벨의 비중을 학습 중에 동적으로 바꾸는 새 손실을 썼다.
애플(2025). 기기 안에서 도는 약 30억 파라미터 모델을 만들 때, 먼저 큰 전문가 혼합(MoE) 교사를 만들고 학습의 마지막 10%(약 1.4조 토큰)를 그 교사로부터의 증류 손실로 다시 학습했다.
오늘날 우리가 내려받는 ‘작은 공개 모델’ 대부분은 이렇게 더 큰 형의 확률을 보며 자랐다.
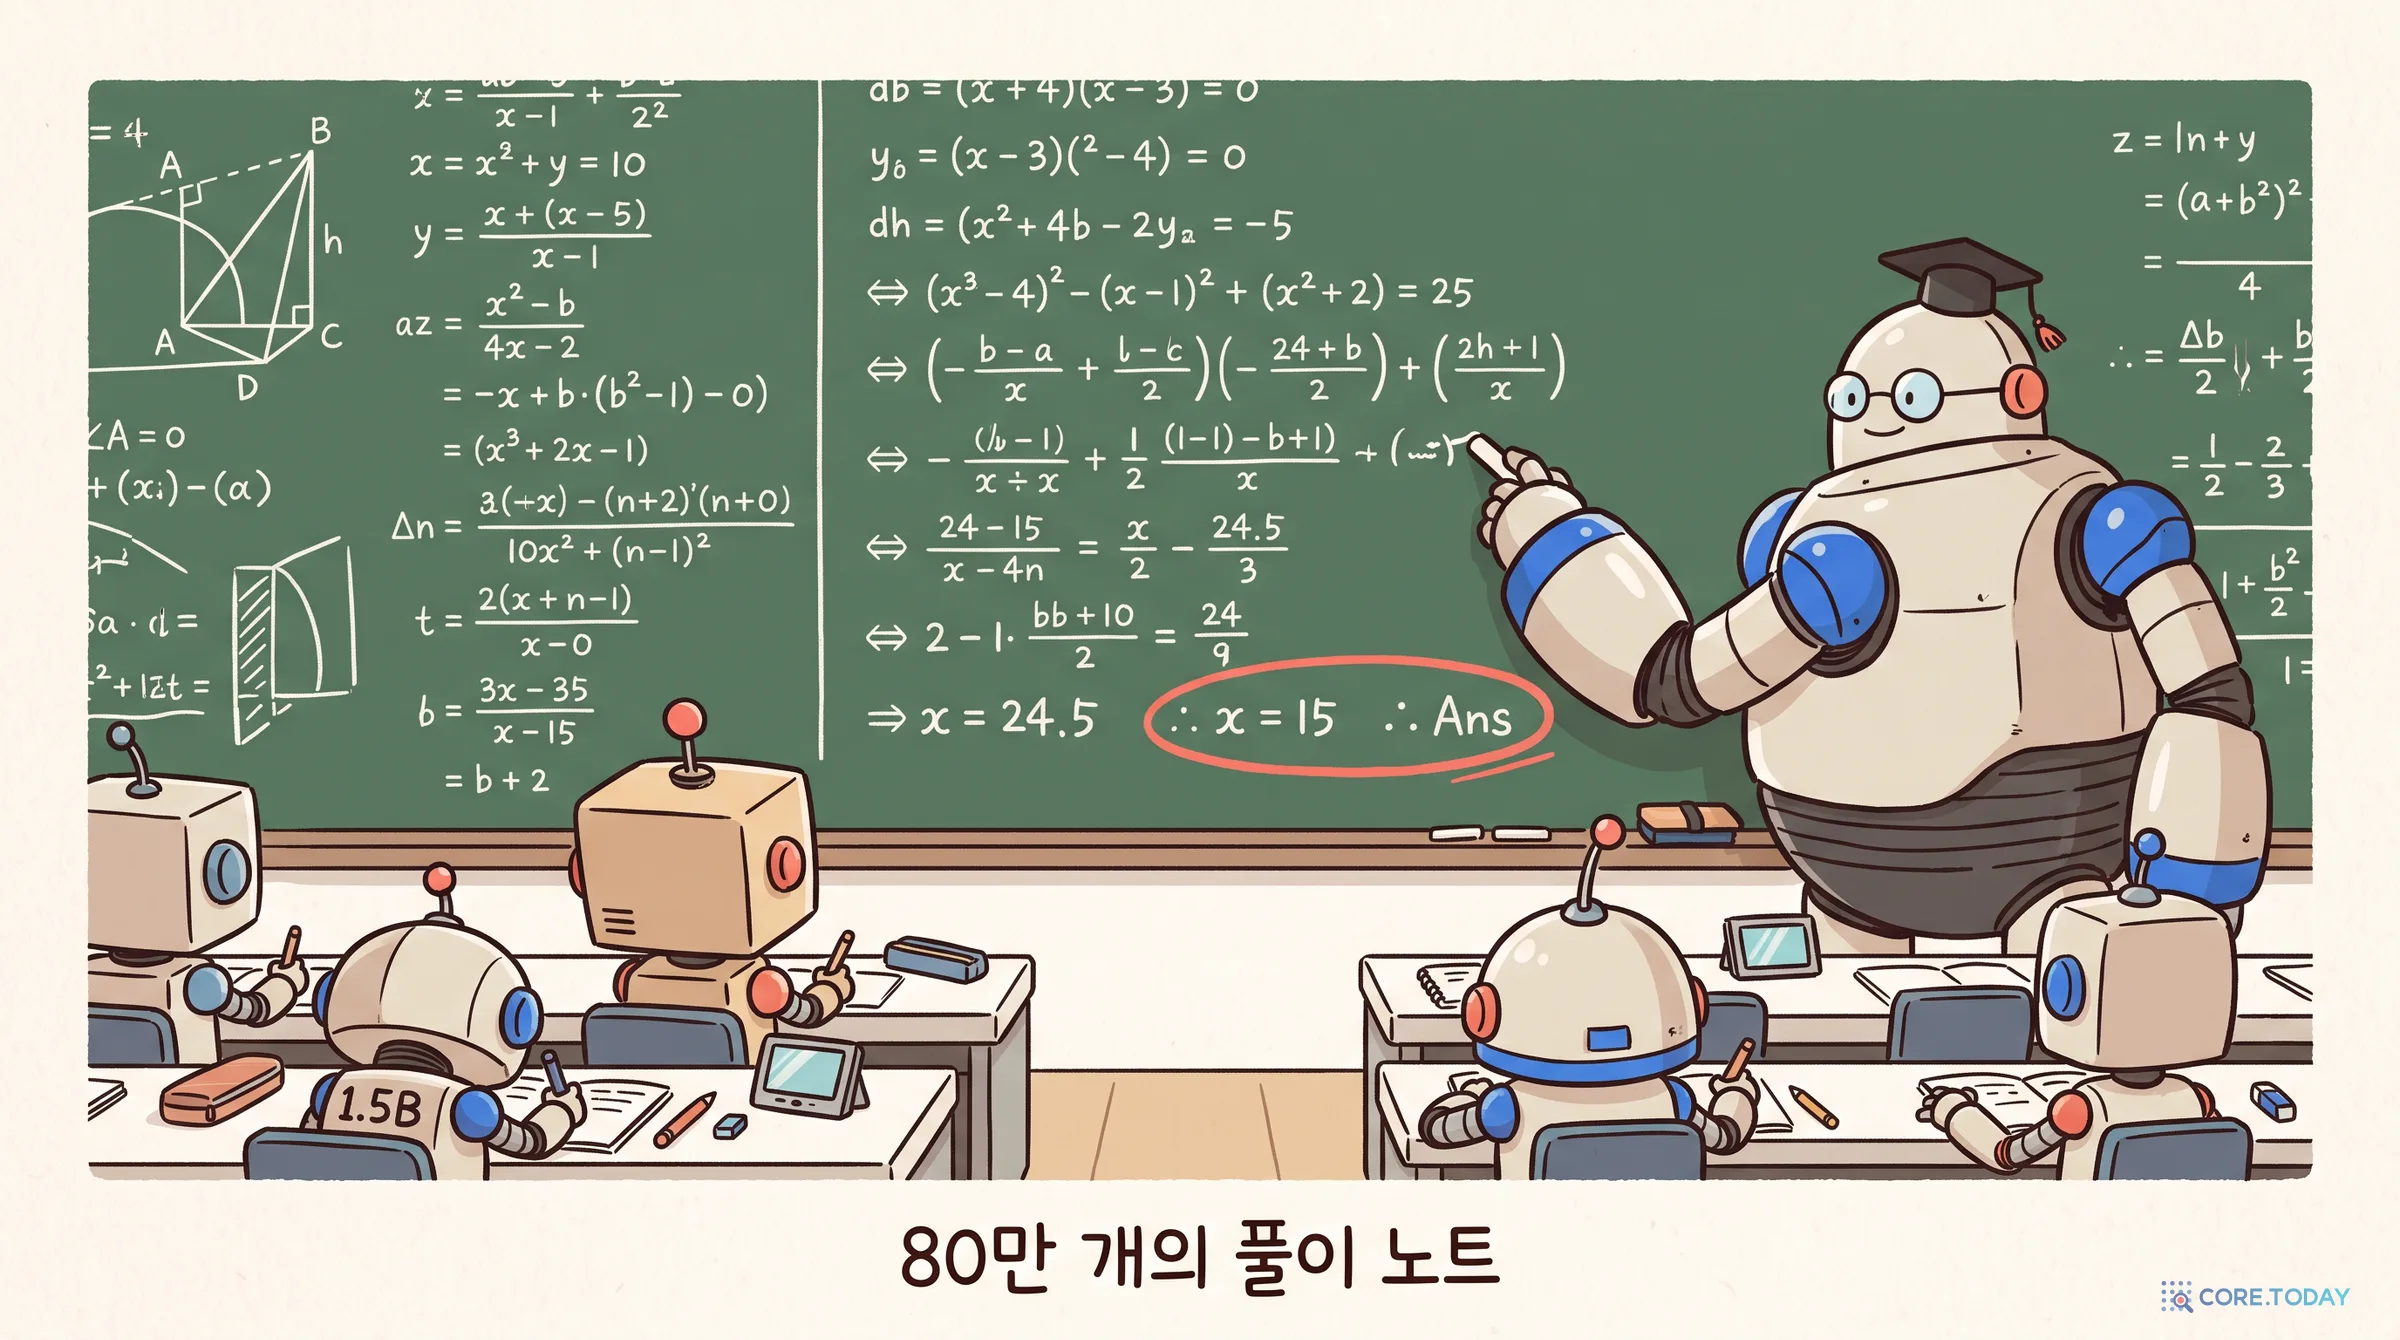
2025년 1월 DeepSeek-R1 논문은 증류 역사에서 또 하나의 이정표가 됐다. DeepSeek는 강화 학습으로 ‘길게 생각하는’ 추론 모델 R1을 만든 뒤(DeepSeek-R1 특집 참고), R1이 쓴 풀이 약 80만 개로 Qwen2.5와 Llama 기반의 1.5B~70B 모델을 지도 학습만으로 가르쳤다. 강화 학습 단계는 없었다.
두 가지가 충격이었다. 첫째, 15억 파라미터 모델이 수학 경시대회 문제에서 GPT-4o를 앞섰다. 둘째, 같은 32B 모델에 강화 학습을 1만 단계 넘게 시킨 것보다 R1의 풀이를 베끼게 한 것이 훨씬 나았다. DeepSeek는 이렇게 결론 내렸다. 작은 모델은 스스로 추론을 발견하기보다 더 큰 모델이 발견한 추론 패턴을 증류받는 편이 낫다.
며칠 뒤 스탠퍼드 등의 s1은 더 극단으로 갔다. Gemini 2.0 Flash Thinking이 쓴 풀이 단 1,000개로 Qwen2.5-32B를 H100 16장에서 26분 학습시켜, 수학 문제에서 OpenAI o1-preview를 최대 27% 앞섰다. 잘 고른 풀이 1,000개가 추론의 ‘형식’을 깨우기에 충분했다.
언어 모델 증류에는 고전 증류에 없던 문제가 있다. 분류는 답이 하나지만, 문장은 답이 여러 갈래다. “오늘 날씨는”의 다음 말은 “맑다”일 수도 “흐리다”일 수도 있다. 교사는 여러 갈래에 확률을 나눠 두는데, 작은 학생은 그 모든 갈래를 정확히 따라 할 용량이 없다.
이때 KL 발산의 방향이 중요해진다. 힌턴의 증류는 KL(교사∥학생), 즉 forward KL을 줄인다. 이 방향은 교사가 확률을 둔 곳을 학생이 놓치면 크게 벌한다. 그래서 학생은 모든 갈래를 덮으려고 넓게 퍼지고, 교사라면 절대 하지 않을 ‘갈래 사이의 어정쩡한 말’에도 확률을 둔다. 2024년 MiniLLM(구위셴 등)은 반대 방향인 KL(학생∥교사), reverse KL을 쓰자고 제안했다. 이 방향은 학생이 교사가 하지 않는 말을 하면 크게 벌한다. 학생은 갈래 하나를 골라 거기에 집중한다. 다양성은 줄지만 엉뚱한 말이 줄어든다.
아래에서 봉우리 사이 거리를 늘려 보자. 봉우리가 멀어질수록 두 방향의 차이가 극적으로 커진다.
교사가 쓴 답으로 배우는 방식에는 또 하나의 약점이 있다. 학생은 학습 내내 교사가 쓴 완벽한 문장만 본다. 그런데 실제로 글을 쓸 때 학생은 자기가 쓴 문장 위에서 다음 말을 이어 가야 한다. 한 번 실수하면 교사의 문장에서 본 적 없는 상황에 빠지고, 실수가 실수를 부른다. 운전을 영상으로만 배운 사람이 처음 차선을 벗어났을 때 어떻게 돌아와야 할지 모르는 것과 같다.
2024년 구글 딥마인드의 GKD(아가르왈 등)와 MiniLLM은 온폴리시(on-policy) 증류를 제안했다. 학생이 직접 답을 쓰게 하고, 교사가 학생이 쓴 토큰 하나하나에 “나라면 이 자리에서 이 말을 할 확률이 얼마인가”로 점수를 매긴다. 학생은 자기가 실제로 빠지는 상황에서, 토큰마다 촘촘한 피드백을 받는다. 강화 학습처럼 자기 경험에서 배우면서, 강화 학습과 달리 답 전체에 점수 하나가 아니라 토큰마다 점수를 받는다.
이 방식은 2025년 Qwen3에서 빛을 발했다. Qwen3의 0.6B~30B 소형 모델은 큰 형(32B·235B)의 풀이로 먼저 배우고(오프폴리시), 마지막에 온폴리시 증류로 마무리했다.
강화 학습보다 점수는 높고 계산은 10분의 1이었다. 2025년 10월 Thinking Machines는 이 결과를 재현하며, 400K개 풀이로 지도 학습해 AIME'24 60%에 이른 8B 학생을 온폴리시 증류 약 150단계 만에 70%로 끌어올렸다고 보고했다. 지도 학습만으로 같은 점수를 내려면 풀이가 약 200만 개 필요하다고 추산했다. 이후 Qwen3, 샤오미의 MiMo, 즈푸의 GLM-5 같은 공개 모델들이 사후 학습 파이프라인에 온폴리시 증류를 넣었다. 2026년 현재 온폴리시 증류는 추론 모델 사후 학습을 마무리하는 대표적인 방법으로 자리 잡았다.
7.6 코어닷투데이 실측 ② — 토큰 하나는 15만 클래스짜리 소프트 라벨
언어 모델의 소프트 라벨은 어떻게 생겼을까? 같은 토크나이저를 쓰는 형제 모델 Qwen3-1.7B-Base(교사)와 Qwen3-0.6B-Base(학생)로 확인했다. 어휘가 약 15만 개이니, 언어 모델에게는 다음 토큰 하나하나가 15만 클래스짜리 분류 문제다.
“대한민국의 수도는” 다음에 교사는 ‘␣서울’만 보지 않는다. ‘␣어디’(질문으로 이어지는 문장), ‘␣서울’, ‘␣어떻게’, ‘␣언제’에 확률을 나눠 둔다. 웹 문서에는 “대한민국의 수도는 어디인가요?” 같은 문장이 그만큼 많기 때문이다. 일반 사전 학습은 실제로 나온 토큰 하나만 정답으로 삼는다. 증류는 이 분포 전체, 즉 ‘이 자리에 올 수 있는 말들과 그 비율’을 정답으로 삼는다.
그다음 작은 실험을 했다. FLORES-200 한국어 문장 50·200·997개로 학생을 두 가지 방법으로 학습시켰다. 하나는 실제 다음 토큰을 맞히는 일반 학습(정답만), 다른 하나는 교사의 상위 64개 토큰 확률을 따라 하는 증류다. 평가는 학습에 쓰지 않은 300문장으로 했다.
997문장으로 학습
퍼플렉서티 ↓
교사와의 KL ↓
교사와 1순위 일치 ↑
학습 전 0.6B
31.86
0.819
58.0%
정답만 · 학습률 2e-5
36.46
1.834
43.6%
증류 · 학습률 2e-5
32.02
0.699
59.6%
정답만 · 학습률 5e-6
24.25
1.265
50.1%
증류 · 학습률 5e-6
31.64
0.649
61.6%
교사 1.7B
23.02
0
100%
결과는 생각보다 미묘했다. 세 가지가 보였다.
첫째, 증류는 학생을 교사 쪽으로 데려간다. 학습률과 관계없이 증류한 학생은 교사와의 KL이 줄고 다음 토큰 1순위가 교사와 같아지는 비율이 올랐다. 정답만으로 학습한 학생은 반대로 교사에게서 멀어졌다. 실제 문장 하나만 보고 배우면 그 문장의 단어 선택을 따라가게 되기 때문이다.
둘째, 증류는 과적합에 강하다. 처음 쓴 학습률 2e-5에서 정답만 학습한 학생은 문장 997개를 세 번 보는 동안 학습 문장을 외워 버렸다. 처음 보는 문장의 퍼플렉서티가 31.86에서 36.46으로 오히려 나빠졌고, 문장 수를 50·200·997로 늘릴수록 더 나빠졌다. 같은 학습률에서 증류한 학생은 거의 흔들리지 않았다(32.02). 힌턴이 음성 인식 실험에서 본 것과 같다. 소프트 라벨로 배운 모델은 과적합하지 않아 조기 종료가 필요 없었다.
셋째, 그러나 교사를 닮는 것이 곧 실력은 아니었다. 학습률을 5e-6으로 낮추자 정답만 학습한 학생이 퍼플렉서티 24.25로 교사(23.02)에 거의 다가갔다. FLORES의 문체를 직접 배운 것이다. 같은 조건의 증류 학생은 교사를 가장 많이 닮았지만(KL 0.649) 퍼플렉서티는 31.64로 거의 그대로였다. 문장 997개로 교사의 분포를 조금 닮는 것만으로는 교사의 예측력까지 옮겨지지 않았다. 6.3절에서 본 스탠턴 등의 ‘충실도의 역설’을 작게 다시 본 셈이다.
정리하면, 좁은 분야의 적은 데이터를 빨리 익히는 데는 학습률만 잘 맞춘 일반 학습이 나을 수 있다. 증류의 힘은 다른 곳에 있다. 학습률 같은 설정에 덜 민감하고, 학생을 교사의 판단 방식에 가깝게 유지한다. 그리고 그 효과는 규모가 커질수록 커진다. 997문장은 사전 학습에 비하면 아무것도 아니다. Gemma와 Llama는 이 일을 수조 토큰 규모로 한다.
2025년 1월 OpenAI는 DeepSeek가 자사 모델을 증류한 증거가 있다고 주장했다(파이낸셜 타임스 보도). 마이크로소프트는 DeepSeek와 연관된 집단이 OpenAI API로 데이터를 대량으로 빼낸 정황을 2024년 가을 포착해 계정을 막았다고 알려졌다(블룸버그 보도). 공개된 증거는 없었고, 주장으로 남았다.
2026년에는 공개 보고가 이어졌다.
2월 12일, OpenAI. 미국 하원 중국특위에 보낸 메모에서 DeepSeek가 우회 라우터와 VPN으로 미국 모델에 “무임승차”하려는 시도를 계속하고 있다고 썼다(블룸버그 보도).
2월 12일, 구글. 위협 인텔리전스 보고서에서 Gemini의 추론 과정을 빼내려 10만 개 넘는 프롬프트를 보낸 추출 시도를 실시간으로 탐지해 막았다고 밝혔다.
2월 23일, 앤트로픽. 「증류 공격의 탐지와 방지」에서 DeepSeek, Moonshot, MiniMax 세 연구소가 가짜 계정 약 2만 4천 개로 Claude와 1,600만 번 넘게 대화하며 능력을 빼내려 했다고 발표했다. MiniMax 1,300만여 건(에이전트 코딩·도구 사용), Moonshot 340만여 건(에이전트 추론·컴퓨터 사용·비전), DeepSeek 15만여 건(추론, 채점 기준 평가)이었다. 한 프록시 네트워크는 계정 2만 개 이상을 동시에 굴렸다. 세 회사는 공개적으로 답하지 않았다.
4월, 미국 정부. 백악관 과학기술정책실이 ‘적대적 증류’에 대응하는 메모를 냈고, 하원에는 모델 탈취를 억지하는 법안(H.R. 8283)이 발의됐다.
앤트로픽은 같은 글에서 이렇게 선을 그었다. “증류는 정당할 수 있다. AI 연구소들은 고객에게 더 작고 저렴한 모델을 제공하려고 증류를 쓴다.” 문제는 증류라는 기법이 아니라 허락받지 않은 추출이다. 대부분의 상용 AI 서비스 약관은 출력으로 경쟁 모델을 개발하는 것을 금지한다. 2015년 워크숍 논문의 기법이 10년 뒤 기업 간 분쟁과 국가 안보 정책의 주제가 된 것이다.
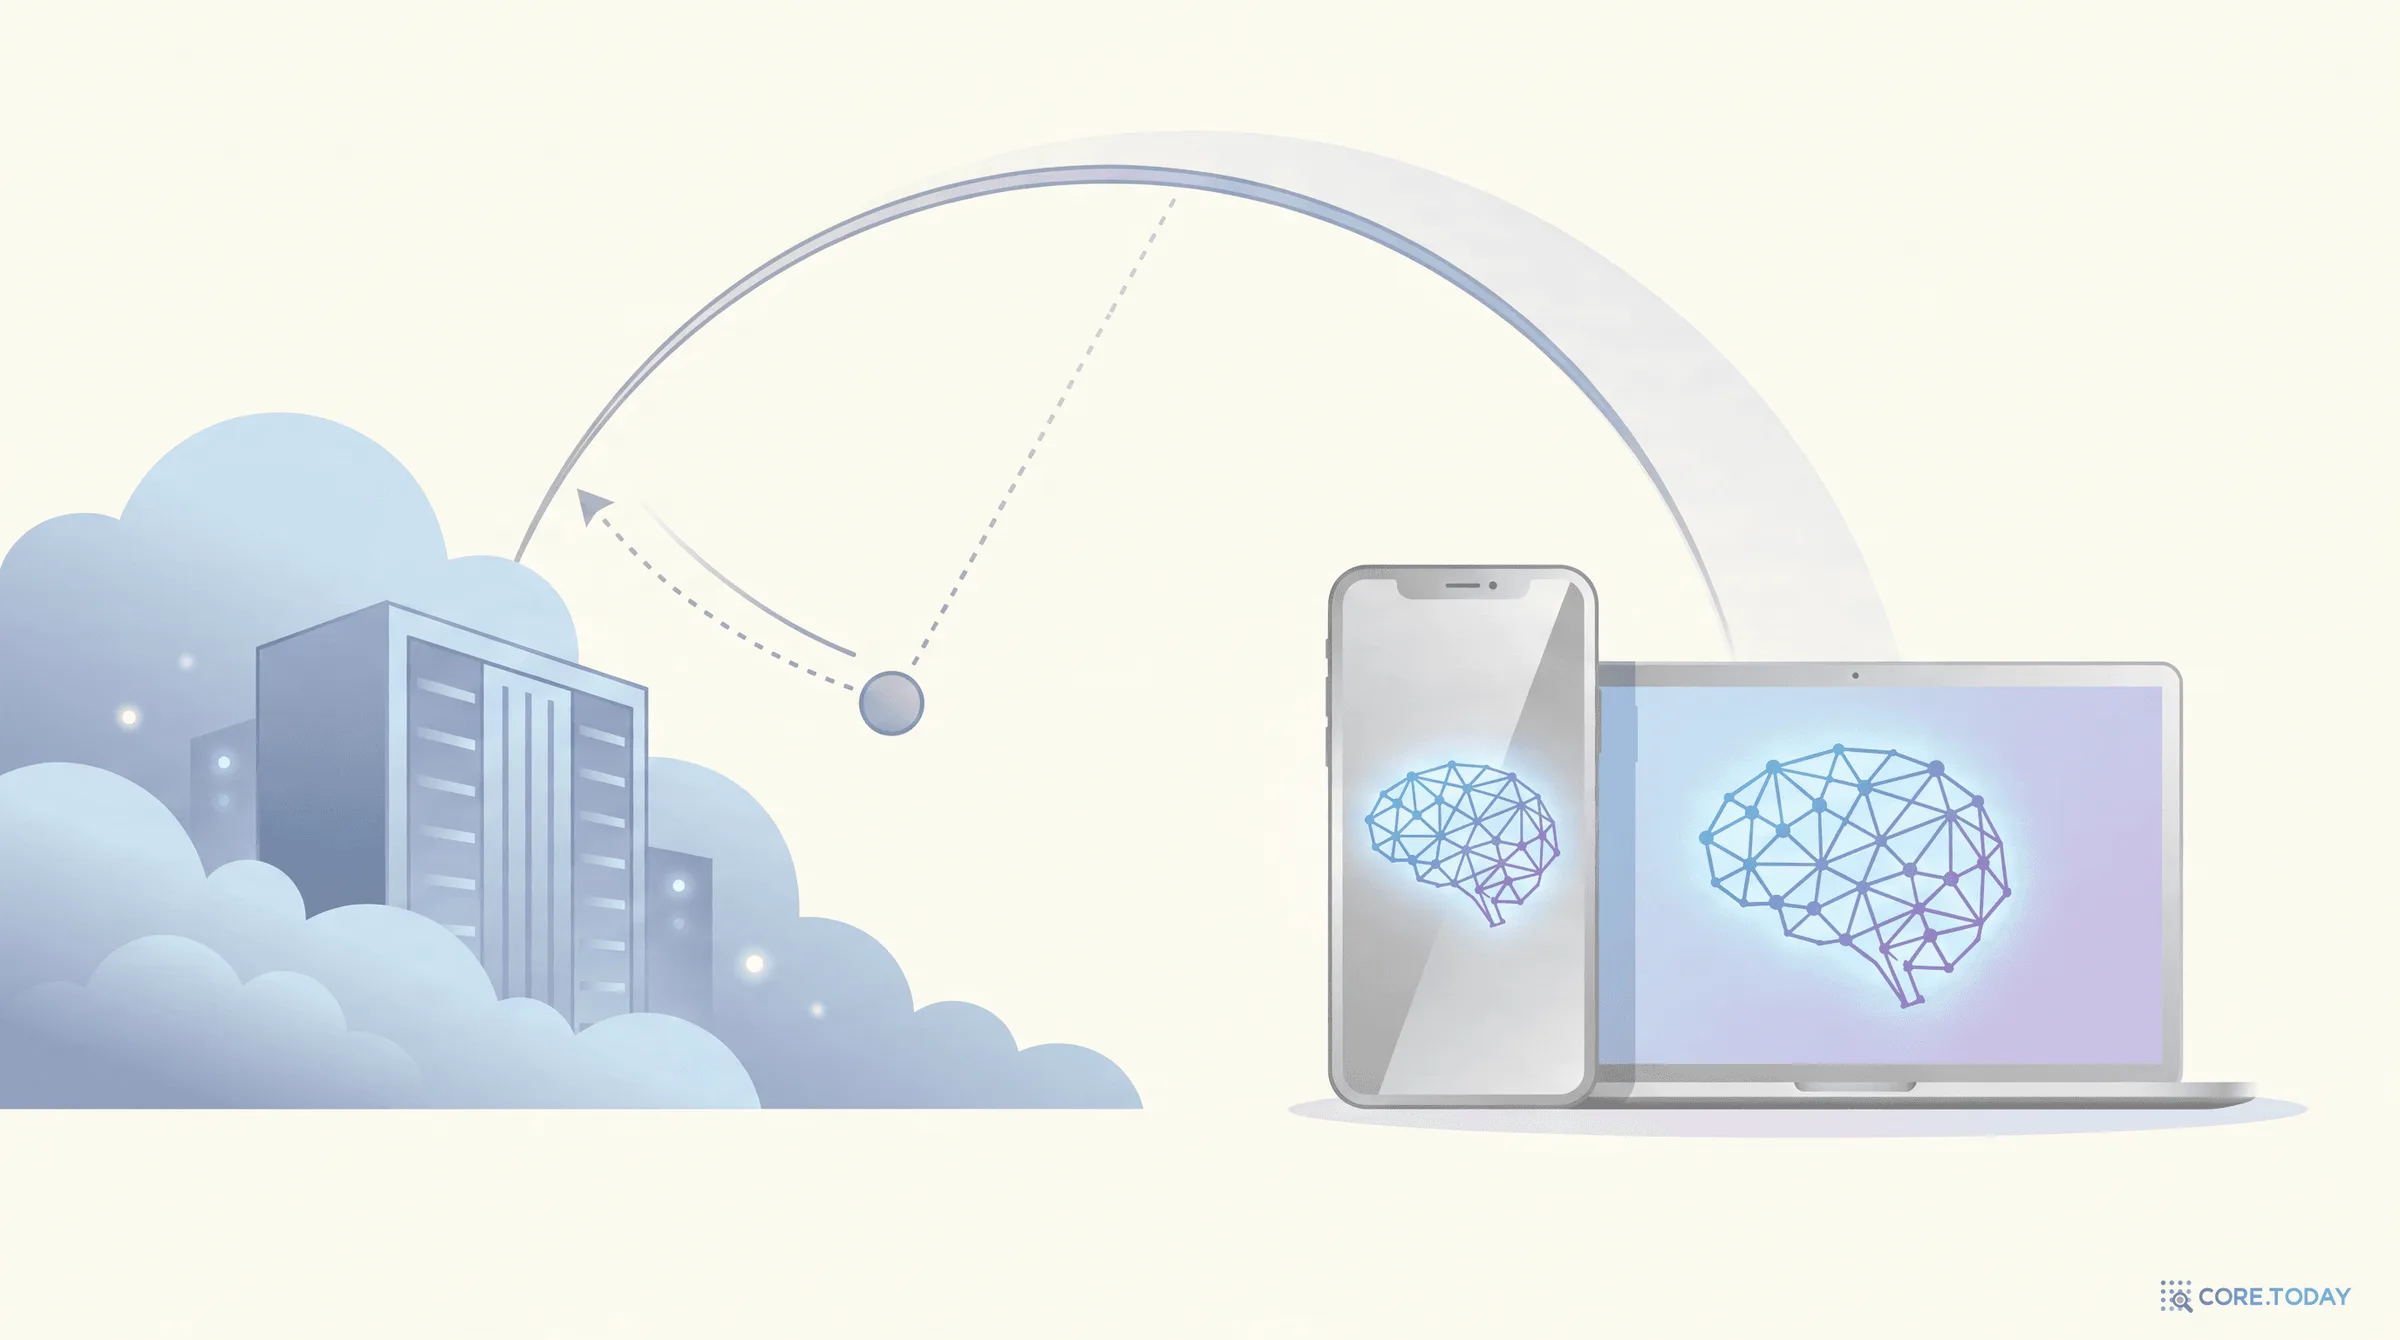
증류의 밝은 면은 우리 손 안에 있다. 2023년 구글은 Gemini Nano(1.8B·3.25B)를 “더 큰 Gemini 모델에서 증류해” 휴대폰에 넣었다. 애플의 기기 내 모델도 앞서 본 것처럼 큰 교사의 증류로 마무리한다. 인터넷 없이 도는 번역, 메시지 요약, 사진 검색 뒤에는 대개 데이터센터의 큰 모델이 키운 작은 학생이 있다.
2026년의 AI 업계를 거칠게 그리면 이렇다. 프런티어 연구소는 거대한 교사를 만든다. 그 교사는 직접 서비스되기보다 선생님 역할을 한다. 사용자가 매일 쓰는 빠르고 싼 모델(이름에 Flash, Mini, Haiku 같은 말이 붙은 모델들)은 그 선생님에게 배운다. 공개 모델 생태계도 마찬가지다. 큰 모델이 나오면 며칠 안에 그 풀이로 학습한 작은 증류판이 쏟아진다. 증류는 이제 ‘압축 기법’이 아니라 AI가 세대를 이어 지식을 물려주는 방식이다.
8.3 실무 체크리스트
1
증류하기 전에 최신 소형 모델부터 잰다. 같은 크기의 최신 공개 모델이 이미 증류의 결과물이다. 우리 실패담처럼 아무것도 가르치지 않은 최신 모델이 내 증류 학생보다 나을 수 있다.
2
확률을 볼 수 있으면 확률로 증류한다. 같은 토크나이저라면 로짓 증류가 텍스트 증류보다 훨씬 많은 정보를 준다. 저장이 부담되면 상위 k개 로짓만 저장한다.
3
답 텍스트로 배울 땐 버릇을 의심한다. 학생은 형식과 말투를 먼저 배운다. 교사 답을 검증해서 거르고, 교사가 다루지 않은 영역에서도 평가한다.
4
온도와 교사 크기는 학생에 맞춘다. 작은 학생일수록 낮은 온도(2~4)가, 큰 학생일수록 높은 온도가 낫다. 격차가 크면 중간 크기 조교를 둔다. 라벨 스무딩한 교사는 피한다.
5
생성 모델은 마지막에 온폴리시로 다듬는다. 교사 답으로 먼저 배우고, 학생이 직접 쓴 답에 교사가 토큰마다 점수를 주는 단계로 마무리한다. 강화 학습보다 싸고 안정적이다.
6
교사의 약관을 확인한다. 상용 API 출력으로 경쟁 모델을 학습하는 것은 대부분 금지돼 있다. 가중치 공개 모델도 라이선스에 따라 파생 모델의 이름·용도 제한이 있다.
2014년 NeurIPS의 2번 심사위원은 이 논문이 영향력이 없을 것이라 판단했다. 공정하게 말하면 그럴 만도 했다. 큰 모델을 흉내 내는 작은 모델이라는 아이디어는 이미 2006년에 나왔고, 논문의 실험은 손글씨 숫자와 음성 인식이었다. 그러나 이 논문이 붙인 이름과 던진 질문 — 정답 말고 무엇을 가르칠 수 있는가 — 은 10년 동안 점점 더 커졌다.
어두운 지식. 잘 배운 모델이 오답에 매긴 작은 확률에는 세상의 닮은꼴 지도가 담겨 있다. 정답 라벨은 결론만, 소프트 라벨은 선생님의 머릿속까지 전한다.
온도. 너무 희미한 지식은 온도를 올려 밝힌다. 학생이 작을수록 낮은 온도가, 클수록 높은 온도가 맞다.
증류는 압축 이상이다. 같은 크기의 학생도 소프트 라벨로 더 잘 배운다. 데이터가 적을수록, 본 적 없는 것일수록 차이가 크다. 우리 실측에서 3을 한 번도 못 본 학생이 3을 알아봤다.
무엇을 옮기느냐가 중요하다. 확률을 옮기면 지식이 옮겨지고, 텍스트만 옮기면 말투가 먼저 옮겨진다. 학생이 스스로 쓴 답에 교사가 토큰마다 점수를 주면 강화 학습보다 싸게 추론을 옮길 수 있다.
그리고 2026년, 증류는 AI가 세대를 이어 지식을 물려주는 기본 방식이자 누가 누구의 지식을 가져갈 수 있는지 다투는 분쟁의 이름이 됐다. 정답보다 오답이 더 많이 가르친다는, 거절당한 워크숍 논문의 통찰은 지금도 유효하다. 다만 이제는 그 오답을 누구에게 허락받고 배우느냐도 함께 물어야 한다.
코어닷투데이 실측 조건: ① MNIST — 학습 6만 장 중 5만 5천 장으로 학습하고 5천 장은 편향 보정용 검증에 썼다. 교사는 784-1200-1200-10 ReLU 다층 퍼셉트론(입력 드롭아웃 0.2, 은닉 드롭아웃 0.5, ±2픽셀 이동 증강, Adam 4만 단계). 학생은 784-800-800-10 또는 784-30-30-10, 정규화·증강 없음, Adam(학습률 1e-3, 코사인 감쇠) 9천 단계(데이터 양 실험은 3천 단계), 배치 128. 증류 손실은 0.1×정답 교차 엔트로피 + 0.9×T²×KL(3 빼기·7과 8만 실험은 소프트 라벨만, T=20). 시드 3개 평균. 편향 보정값은 검증 5천 장에서 0~15 사이를 0.25 간격으로 골랐다. ② LLM — Qwen/Qwen3-1.7B-Base(교사), Qwen/Qwen3-0.6B-Base(학생), FLORES-200 한국어 dev 997문장(학습)과 devtest 앞 300문장(평가). 교사 확률은 위치마다 상위 64개를 재정규화해 저장했다. 학생은 임베딩(출력층과 공유)을 고정하고 AdamW(학습률 2e-5, 997문장은 5e-6도 함께 측정, 선형 감쇠) 3에폭, 배치 8문장, 시드 1개. KL과 1순위 일치는 교사의 상위 64개 기준. HuggingFace transformers 4.57, PyTorch 2.x, Apple M5 Pro(MPS). 2026-11-07 측정.