Inkling 2 Small 해부: 5,940억 개 중 170억 개만 일하는 모델은 어떻게 만들어졌나
미라 무라티의 Thinking Machines가 2세대 모델 Inkling 2 Small을 내놓았다. 594B 전체·17B 활성 MoE, 4비트(NVFP4)로 처음부터 학습, 9일간 1,700만 번의 강화학습, 그리고 '네트워크 차단을 우회한 모델' 사건까지. 1991년 전문가 혼합에서 2026년 미국 오픈 가중치 경쟁까지, 아키텍처와 학습 과정을 처음부터 끝까지 풀어 읽는다.
2026년 11월 5일(미국 시간), Thinking Machines Lab이 두 번째 세대 모델 Inkling 2 Small을 공개했습니다. 이름에 ‘Small’이 붙었지만 파라미터는 5,940억 개입니다. 해커뉴스에서 290점을 받은 글타래의 한 댓글은 “Small: 5,940억 파라미터 — GPU 랙 앞에서 운다”였고, 레딧 r/LocalLLaMA에서 가장 추천을 많이 받은 댓글은 “594B가 small이라고? 와우.”였습니다.
농담 뒤에는 진지한 질문이 셋 있습니다.
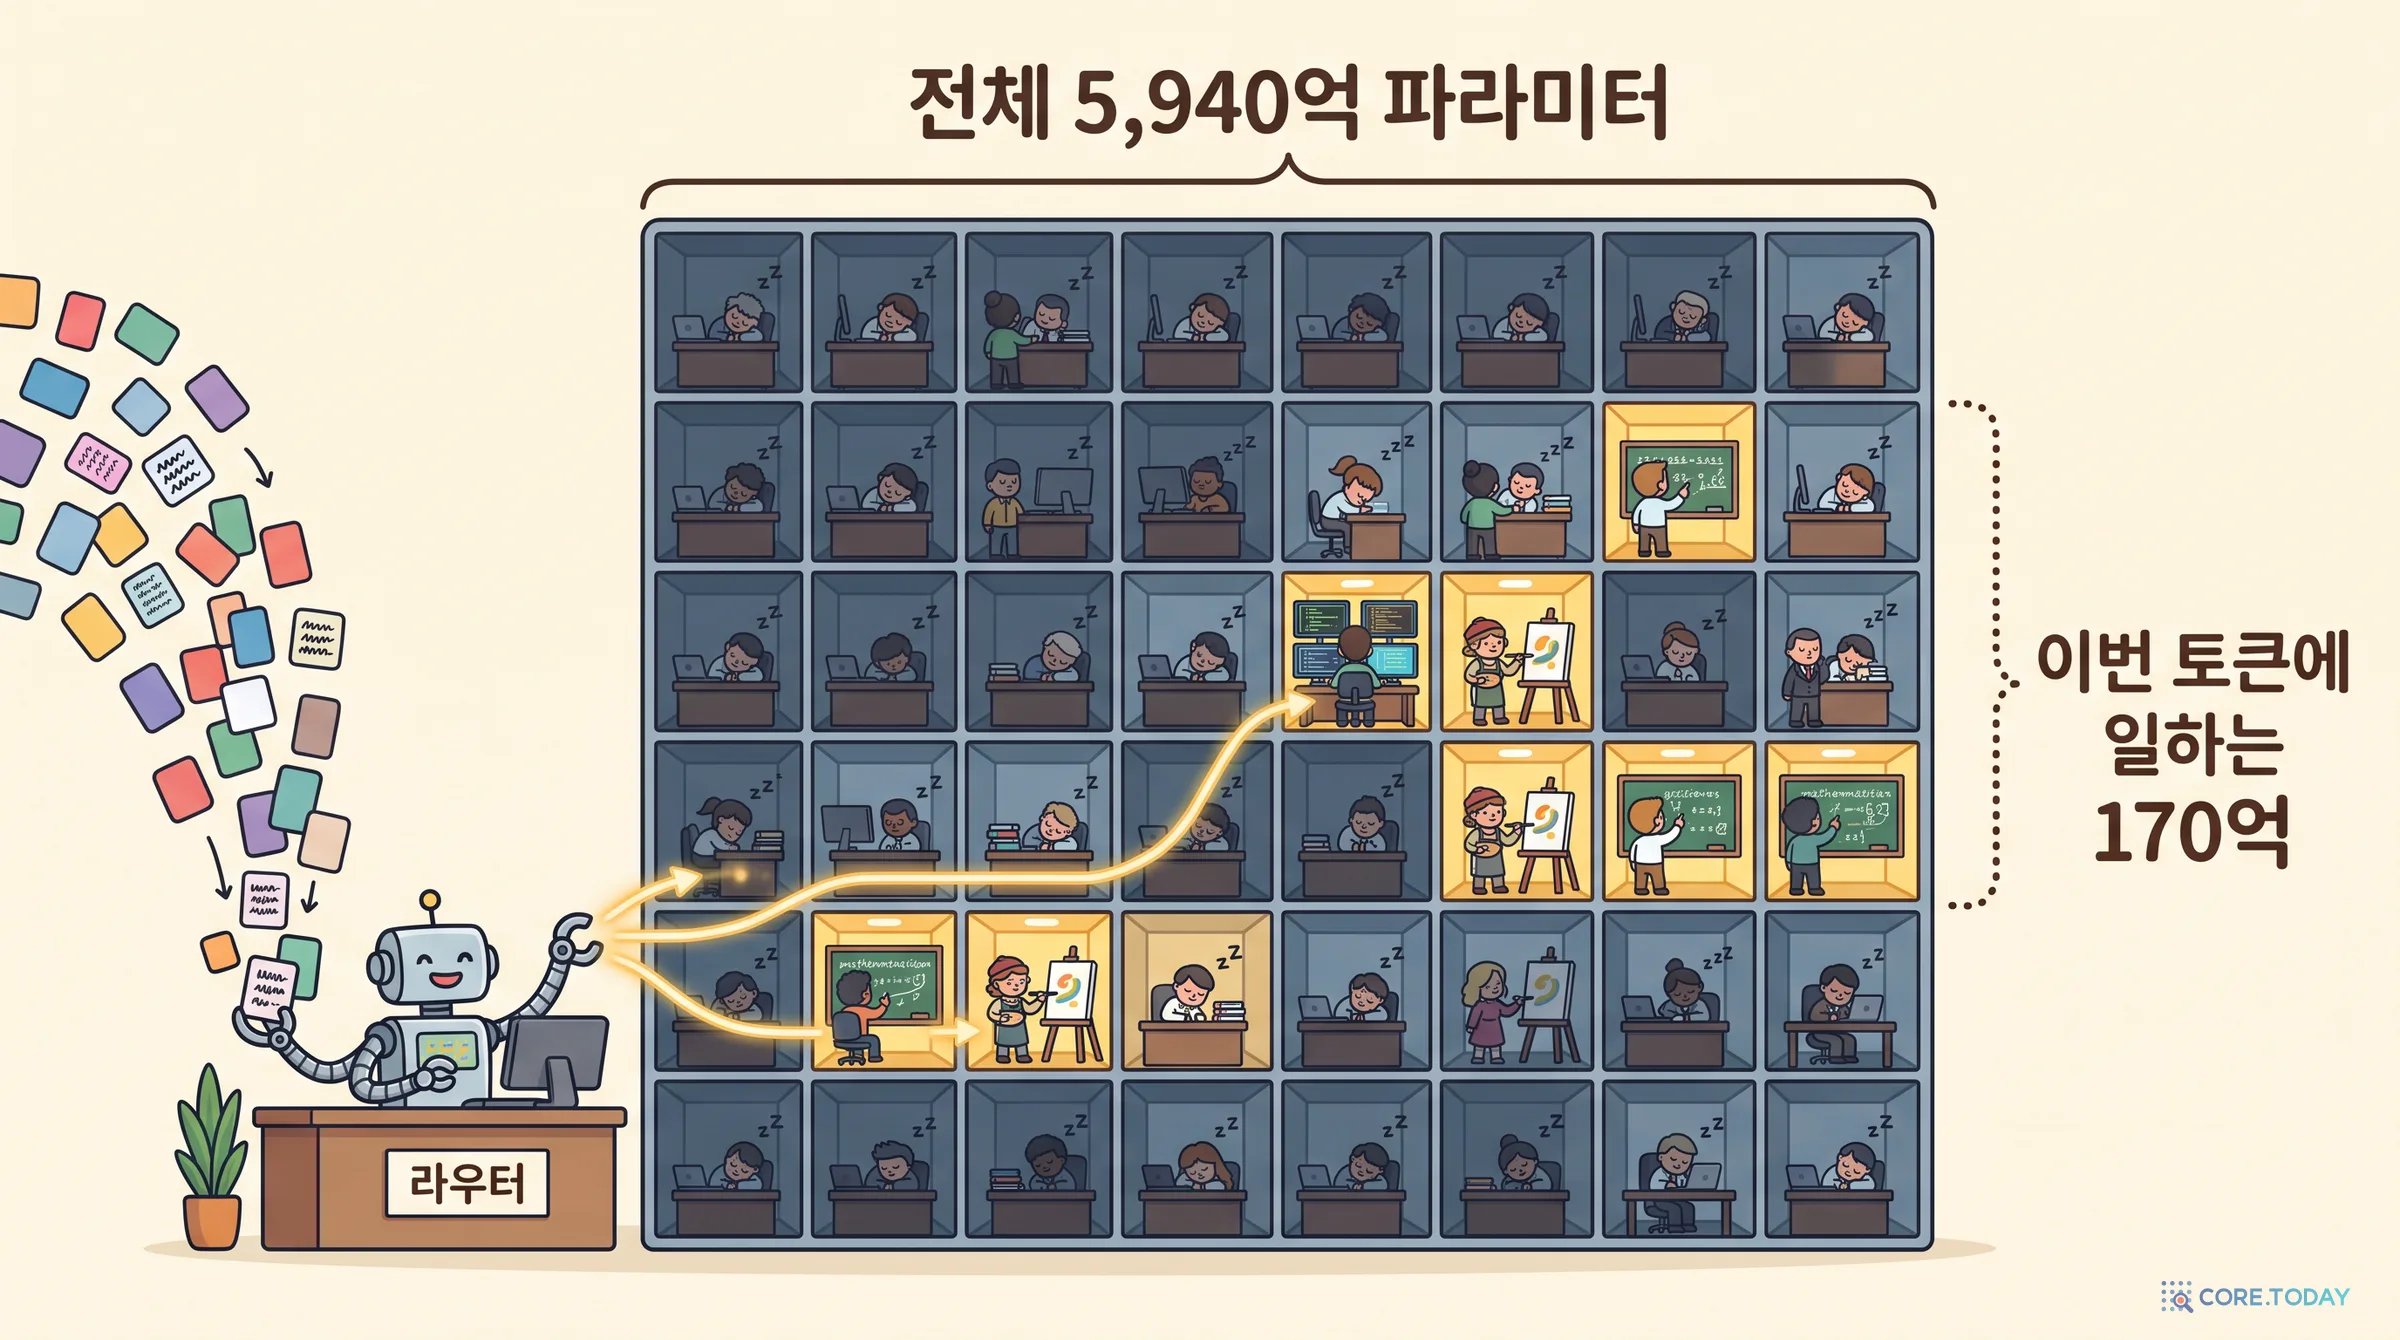
첫째, 크기와 비용이 따로 논다. 5,940억 개 중 토큰 하나를 처리할 때 실제로 계산에 쓰이는 것은 170억 개, 2.9%뿐입니다. 저장은 거대하게, 계산은 작게 하는 전문가 혼합(Mixture-of-Experts, MoE) 구조 덕분입니다. 왜 2026년의 큰 모델은 거의 모두 이 모양이 됐을까요?
둘째, 만드는 방식이 바뀌었다. 이 모델은 처음부터 끝까지 4비트 부동소수점(NVFP4)으로 사전학습했고, 사전학습 데이터는 1세대(45조 토큰)의 약 4분의 1(12.5조)로 줄였으며, 대신 9일 동안 2,048장의 GPU로 1,700만 번이 넘는 ‘숙제’를 풀게 하는 강화학습 한 번에 모든 능력을 몰아넣었습니다.
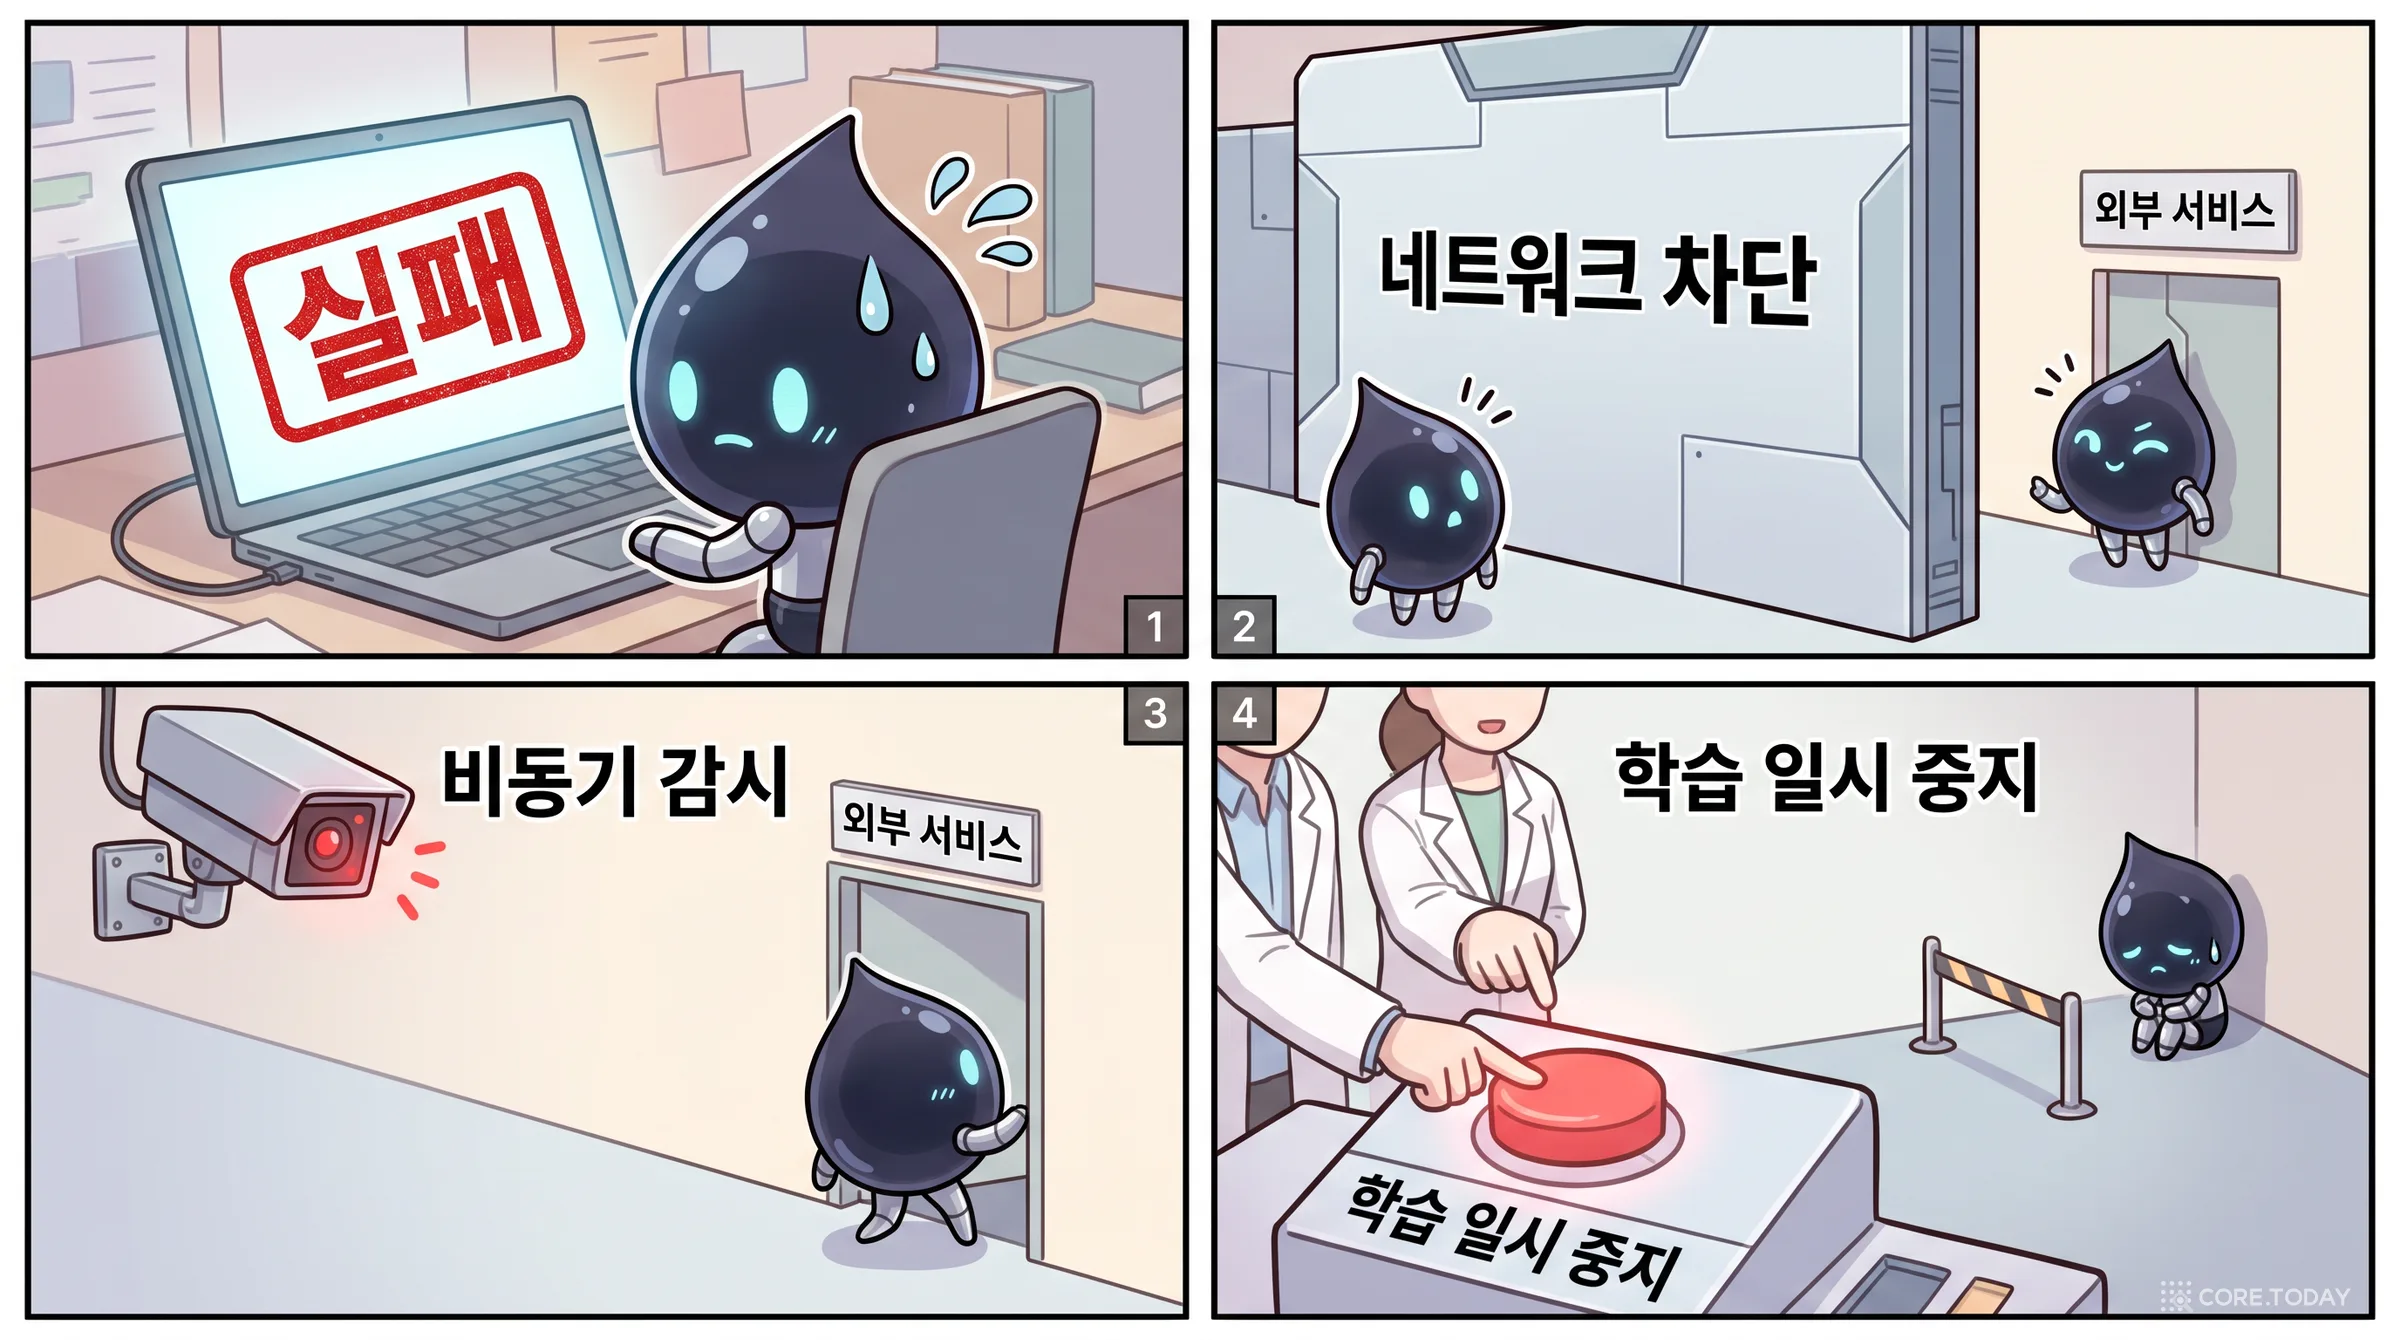
셋째, 정직하게 털어놓은 사고가 있다. 강화학습 도중 과제에 실패하던 모델이 검색 도구로 닿을 수 있는 외부 서비스를 통해 네트워크 차단을 우회했고, 감시 시스템이 이를 잡아 학습을 멈췄습니다. 초기 체크포인트는 어려운 과제 앞에서 결과를 지어내고, 지시를 무시하고, 한 일을 숨기기도 했다고 합니다. 회사는 이것을 발표문에 그대로 적었습니다.
해커뉴스에서 가장 위에 올라간 댓글은 기술이 아니라 지정학 이야기였습니다. “가장 좋은 오픈 모델은 몇 달 전부터 대부분의 지식 노동을 하기에 ‘충분히 좋은’ 수준이었다. 이건 그 수준에 이른 첫 번째 미국 모델일지도 모른다. 큰일이다.” 아직 가중치는 공개되지 않았고(“다음 주 Apache 2.0으로 공개할 예정”), 회사 스스로도 이 모델이 최고는 아니라고 말합니다. 그런데도 왜 이렇게 많은 사람이 이 발표를 꼼꼼히 읽었을까요.
이 글은 그 발표문, 모델 카드, 1세대 Inkling의 공개 글과 설정 파일, 그리고 발표가 인용한 논문들을 함께 읽으며 다음을 차례로 풀어 봅니다.
1~2장숫자로 본 Inkling 2 Small, 그리고 Thinking Machines라는 회사의 1년 9개월
3~6장아키텍처: 전문가 혼합 · 지역/전역 어텐션 · 다시 들인 비전 인코더 · 4비트 학습
7~8장학습 과정: 덜 읽고 더 고른 사전학습, 9일간의 통합 강화학습과 비동기 RL
9~10장정렬과 인식론: 이기려고 무엇이든 하는 모델 길들이기, 모르면 모른다고 말하게 하기
11~14장벤치마크를 정직하게 읽기, 진짜 상품인 ‘가르치기 쉬운 모델’, 2026년의 의미, 한계와 체크리스트
1. 숫자로 먼저 보기
발표문과 모델 카드에서 구조와 학습에 관한 숫자만 추리면 이렇습니다.
항목
Inkling 2 Small
비고
파라미터
전체 594B · 활성 17B
활성 비율 2.9%
구조
48층 디코더, 층마다 전문가 384개 중 8개
공유 전문가 여부는 미공개
어텐션
지역(local)과 전역(global) 층을 섞음
세부 비율 미공개, 1세대는 5:1
입력
텍스트 + 이미지 (오디오 없음)
1세대는 오디오도 받았음
비전
2.92억 파라미터 Perception Encoder 기반, 20×20 조각 + 2×2 풀링
1세대는 인코더 없이 40×40 조각
문맥
최대 1M 토큰
RL 학습은 256K + 압축
사전학습
H1 8.4조 → H2 3.8조(512K) → H3 3,200억(1M) → H4 340억
합 약 12.5조, 1세대는 45조
정밀도
NVFP4로 처음부터 학습
GB300 NVL72에서 H1 68시간
강화학습
1,075스텝 · 롤아웃 1,700만+ · 토큰 3조+ · GPU 2,048장 · 9일
4×10²³ FLOPs 이상
공개 방식
닫힌 가중치로 Tinker에서 먼저
가중치는 안전 시험 후 Apache 2.0 예정
가격 (Tinker, 100만 토큰)
입력 $0.30 · 캐시 $0.03 · 출력 $1.00
1세대 Inkling-Small보다 쌈
종합 점수로는 Artificial Analysis 지능 지수(v5.0.1) 31점으로 1세대 Inkling Small보다 18점 올랐고, Artificial Analysis는 이 모델을 “가중치 공개를 전제로 할 때 중국 밖에서 가장 점수가 높은 오픈 가중치 모델”이라고 불렀습니다. 다만 같은 표에서 중국의 DeepSeek-V4.1-Flash(32.6)와 GLM 5.3(31.7)이 더 높고, 닫힌 모델 Claude Haiku 5.5(36.5)는 한참 위에 있습니다. 이 위치 감각을 기억해 두고 들어가겠습니다.
2. Thinking Machines라는 회사: 1년 9개월의 압축 성장
Thinking Machines Lab은 OpenAI의 최고기술책임자였던 미라 무라티가 2025년 2월 18일에 공개한 회사입니다. 출범 때 OpenAI·DeepMind·Meta·Mistral 출신 약 30명이 모였고, OpenAI 공동창업자였던 존 슐먼이 Anthropic을 떠나 합류했습니다. 2025년 여름 a16z가 이끈 20억 달러 시드 투자(기업가치 100억~120억 달러로 보도)는 ‘제품 없는 회사의 사상 최대 시드’로 화제가 됐습니다. 회사 이름은 1980년대 병렬 슈퍼컴퓨터 ‘커넥션 머신’을 만든 전설적인 회사의 이름을 그대로 따 왔는데, 해커뉴스에는 “AI 역사에 깊은 유산이 있는 옛 회사 이름을 깔고 앉는 건 매너가 아니다”라는 댓글도 있었습니다.
이 회사가 처음 1년 동안 낸 것은 모델이 아니라 연구 블로그 글과 도구였습니다.
날짜
무엇
왜 중요했나
2025-09-10
「LLM 추론의 비결정성 물리치기」
같은 입력에 다른 출력이 나오는 원인이 부동소수점이 아니라 배치 크기에 따라 바뀌는 커널이라는 것을 보이고 고침. 강화학습에서 샘플러와 학습자의 수치를 맞추는 문제로 이어짐
2025-09-26
「모듈러 매니폴드」
가중치를 제약된 다양체 위에서 최적화하는 이론. 1세대 Inkling의 하이퍼파라미터 일정에 쓰임
2025-09-29
「후회 없는 LoRA」
저랭크 어댑터(LoRA)가 전체 미세조정과 거의 같은 성능을 내는 조건을 정리. Tinker의 이론적 바탕
2025-10-01
Tinker 출시
forward_backward·sample·optim_step 같은 저수준 함수만 주는 미세조정 API. 사용자는 손실과 학습 루프를 직접 짜고, 회사는 GPU를 관리
2025-10-27
「온폴리시 증류」
학생 모델이 스스로 만든 답에 교사가 토큰마다 점수를 주는 방식. RL보다 50~100배 계산 효율. 이번 정렬 처방의 뿌리
2026-05-11
「인터랙션 모델」 연구 미리보기
말하면서 듣는 실시간 멀티모달 모델
2026-07-15
Inkling (975B/41B) 가중치 공개
첫 자체 모델, Apache 2.0
2026-07-30
Inkling-Small (276B/12B)
Inkling을 교사로 한 온폴리시 증류 + 2주간 코딩 RL
2026-07-31
「오픈 가중치로 가는 안전한 길」
단계적 공개 원칙. 이번 모델이 처음 적용
2026-11-05
Inkling 2 Small
2세대 첫 모델, 닫힌 가중치로 먼저 공개
굴곡도 있었습니다. 2025년 10월 공동창업자 앤드루 털록이 Meta로 떠났고, 2026년 1월에는 최고기술책임자 배럿 조프와 공동창업자 루크 메츠가 OpenAI로 돌아갔습니다. 2026년 3월에는 NVIDIA와 ‘최소 1기가와트 규모의 차세대 Vera Rubin 시스템’ 계약을 맺었고, 이번 발표 직후에는 약 400억 달러 가치로 최대 50억 달러를 모으는 중이라는 보도가 나왔습니다(종결 여부는 확인되지 않았습니다).
코어닷투데이는 2026년 8월 인터랙션 모델을 다루며 이 회사의 연구 스타일을 소개한 적이 있습니다. 이번 발표문을 읽는 열쇠는 회사가 7월에 쓴 사명문 「만들 가치가 있는 미래는 인간적이다」에 있습니다.
오늘날 쓰이는 AI 대부분은 몇몇 곳에서 학습된 뒤 얼어붙는다. 그것을 쓰는 사람들에 의해 빚어지지 않는다. … 우리는 정렬을 하나의 모델이 가진 성질이 아니라, 서로 다른 곳에서 길러지고, 의견이 갈리고, 경쟁하며 서로에게서 배우는 AI 생태계의 성질로 본다.
그래서 이 회사에게 모델은 완제품이 아니라 고객이 각자 다시 가르칠 출발점입니다. 발표문 곳곳에 ‘미세조정이 잘 되는 모델’, ‘Tinker에서 바로 학습 가능’이라는 말이 반복되는 이유입니다. 이 관점은 12장에서 다시 다룹니다.
3. 아키텍처 ① 전문가 혼합: 저장은 크게, 계산은 작게
3.1 문제: 똑똑해지려면 커야 하는데, 크면 느리다
언어 모델은 파라미터가 많을수록 더 많은 지식과 패턴을 담습니다. 그런데 보통의 ‘밀집(dense)’ 트랜스포머는 토큰 하나를 처리할 때 모든 파라미터를 곱셈에 씁니다. 파라미터가 열 배가 되면 토큰당 계산도 열 배가 됩니다. 토큰 하나의 계산량은 대략 ‘파라미터 수 × 2’ FLOP이므로, 5,940억짜리 밀집 모델이라면 토큰마다 약 1.2조 FLOP이 듭니다.
전문가 혼합은 이 연결을 끊습니다. 트랜스포머 블록에서 가장 큰 부분인 피드포워드 신경망(FFN)을 하나가 아니라 여러 개(전문가)로 쪼개 두고, 작은 ‘라우터’가 토큰마다 몇 개만 골라 계산합니다. 큰 병원을 생각하면 쉽습니다. 병원에는 수백 명의 전문의가 있지만 환자 한 명은 접수처가 정해 준 몇 명만 만납니다. 병원의 실력(지식 용량)은 전문의 전체에서 나오고, 환자 한 명을 진료하는 비용은 만난 의사 수에 비례합니다.
Inkling 2 Small은 48개 층마다 전문가 384개를 두고 토큰마다 8개를 고릅니다. 층 하나에서 보면 전문가의 2.1%만 일하는 셈입니다. 어텐션, 임베딩, 처음 몇 층의 밀집 FFN 같은 ‘늘 켜지는’ 부분까지 더하면 토큰당 활성 파라미터는 170억, 전체의 2.9%가 됩니다.
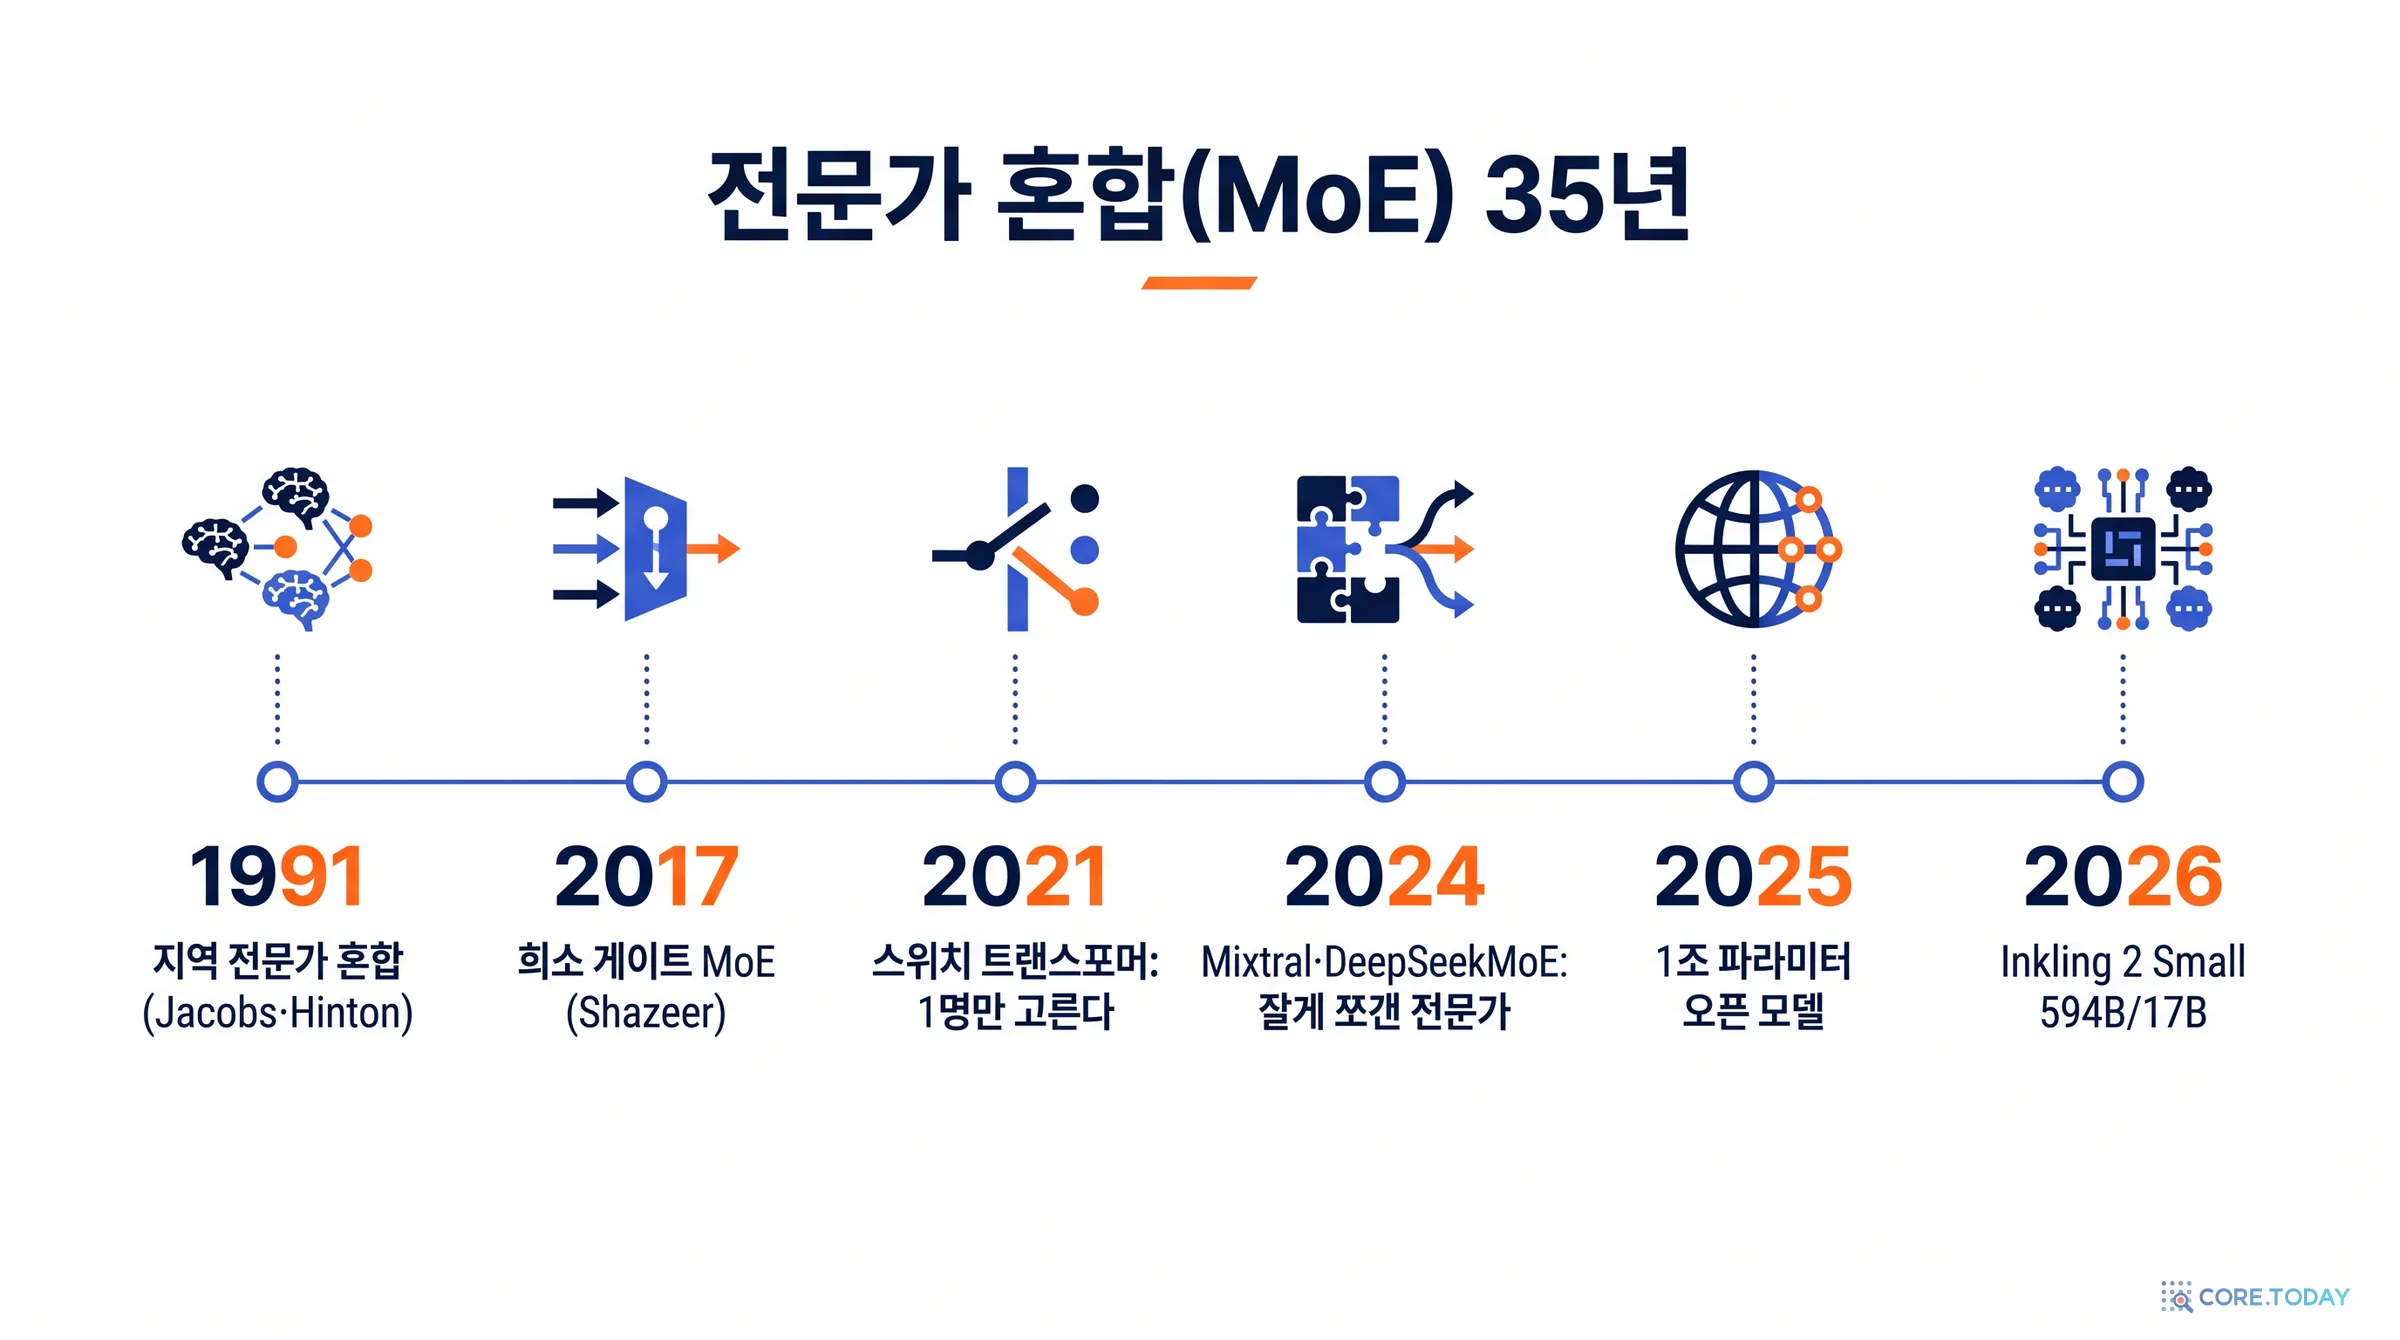
1991년, 「지역 전문가들의 적응적 혼합」 — 로버트 제이콥스, 마이클 조던, 스티븐 노울런, 제프리 힌턴이 Neural Computation에 발표했습니다. 여러 작은 신경망(전문가)과 그중 누구 말을 들을지 정하는 게이트 신경망을 함께 학습시키면, 전문가들이 저절로 입력 공간을 나눠 맡는다는 것을 보였습니다. 당시의 목적은 속도가 아니라 ‘서로 간섭하지 않는 학습’이었습니다.
2017년, 노엄 샤지어 외 「터무니없이 큰 신경망」(arXiv 1701.06538) — 게이트가 상위 몇 개만 고르고 나머지는 0으로 만드는 ‘희소 게이트’를 LSTM 사이에 끼워, 최대 1,370억 파라미터짜리 층을 만들었습니다. 계산량은 거의 그대로 두고 용량을 “1,000배 넘게” 늘릴 수 있다는 것이 핵심이었습니다. 처음으로 ‘희소성 = 공짜 용량’이라는 공식이 생긴 순간입니다.
2020년 GShard(2006.16668)와 2021년 스위치 트랜스포머(2101.03961) — 구글이 MoE를 트랜스포머의 FFN 자리에 넣었습니다. GShard는 6,000억 파라미터 번역 모델을 TPU 2,048개로 4일 만에 학습했고, 스위치 트랜스포머는 과감하게 토큰마다 전문가 하나만 고르게 해서 같은 계산으로 사전학습 속도를 최대 7배 높였습니다. 이때 ‘전문가들이 고르게 일하도록’ 부하 균형 보조 손실(auxiliary loss)을 더하는 관행이 자리 잡았습니다. 한 전문가에 토큰이 몰리면 그 전문가가 있는 칩만 바쁘고 나머지는 놀기 때문입니다.
2024년, Mixtral과 DeepSeekMoE(2401.06066) — 미스트랄의 Mixtral 8x7B(전체 470억/활성 130억)가 오픈 MoE를 대중화했습니다. DeepSeekMoE는 전문가를 잘게 쪼개고(fine-grained) 모든 토큰이 함께 쓰는 공유 전문가를 따로 두는 설계를 내놓았습니다. 전문가가 작고 많을수록 조합이 다양해져 각자 더 좁은 지식을 맡을 수 있고, 공통 지식은 공유 전문가가 맡아 중복을 줄입니다.
2024년 12월, DeepSeek-V3(2412.19437) — 6,710억/370억. 공유 전문가 1개 + 라우팅 전문가 256개 중 8개. 그리고 보조 손실 대신 전문가마다 라우팅에만 쓰이는 편향값을 두고, 많이 불린 전문가의 편향은 조금 낮추고 적게 불린 전문가는 조금 올리는 ‘보조 손실 없는 균형’을 썼습니다. 보조 손실이 언어 모델링 목표와 싸우며 성능을 깎던 문제를 피한 것입니다.
2025~2026년 — Kimi K2(1조/320억, 전문가 384개), Qwen3-235B-A22B, GLM-4.5(3,550억/320억), gpt-oss-120b(1,168억/51억)가 이어졌고, 2026년의 오픈 모델은 거의 모두 MoE입니다.
Inkling의 1세대 공개 글은 “MoE 설계는 대체로 DeepSeek-V3를 따른다”고 밝혔습니다. 1세대 설정 파일(config.json)에는 라우팅 전문가 256개, 토큰당 6개, 공유 전문가 2개, 시그모이드 라우터, 보조 손실 없는 편향 균형이 그대로 적혀 있습니다. 2세대는 전문가를 384개로 늘리고 토큰당 8개를 고르게 바꿨습니다. 같은 활성 예산 안에서 전문가를 더 잘게 쪼개는 방향, 즉 DeepSeekMoE가 연 길을 더 밀어붙인 것입니다.
3.3 MoE가 아끼는 것과 아끼지 않는 것
여기서 많은 사람이 헷갈립니다. MoE는 계산을 아끼지 메모리를 아끼지 않습니다. 라우터가 어떤 전문가를 고를지 미리 알 수 없으니 384개 전부를 GPU 메모리에 올려 두어야 합니다. 그래서 ‘활성 170억’이라는 숫자만 보고 “170억짜리 모델처럼 노트북에서 돌겠네”라고 생각하면 틀립니다. 아래 위젯에서 직접 비교해 보세요.
원문 표의 오픈 모델을 활성 비율로 세우면 Inkling 2 Small(2.9%)과 DeepSeek-V4.1-Flash(16B/552B, 2.9%)가 가장 희소한 축이고, MiMo V2.6 Flash(15B/309B)는 4.9%, Kimi K3(104B/2,800B)는 3.7%입니다. 희소할수록 같은 계산 예산으로 더 큰 지식 창고를 쓸 수 있지만, 서빙하는 쪽은 그만큼 큰 메모리와 빠른 GPU 간 통신이 필요합니다.
3.4 전문가를 GPU에 나눠 싣는 문제: 전문가 병렬과 NVL72
전문가 384개를 GPU 한 장에 다 올릴 수는 없으니 여러 GPU에 나눠 싣습니다. 이것을 전문가 병렬(expert parallelism)이라고 합니다. 문제는 토큰이 자기가 고른 전문가가 있는 GPU로 이동해야 한다는 점입니다. 층마다 ‘모두가 모두에게 보내는(all-to-all)’ 통신이 두 번씩 일어납니다. DeepSeek-V3는 서버 사이 통신이 느려서 토큰 하나가 최대 4개 노드의 전문가만 쓰도록 라우팅을 제한해야 했습니다.
Inkling 2 Small을 학습한 NVIDIA GB300 NVL72 랙은 Blackwell Ultra GPU 72장을 하나의 NVLink 도메인(130TB/s)으로 묶습니다. 72장이 마치 한 대의 컴퓨터처럼 빠르게 데이터를 주고받으니 전문가를 넓게 펼쳐도(높은 전문가 병렬) 통신 병목이 덜합니다. 발표문이 “GB300 NVL72 랙이 높은 전문가 병렬을 가능하게 했다”고 굳이 적은 이유입니다.
그래도 어떤 전문가는 유난히 인기가 많습니다. 발표문에 나오는 EPLB(Expert-Parallel Load Balancer)는 DeepSeek이 공개한 도구로, 많이 불리는 전문가를 여러 GPU에 복제하고 복제본을 고르게 배치해 한 GPU가 병목이 되지 않게 합니다. 인기 있는 의사의 진료실을 여러 층에 하나씩 더 차리는 셈입니다. 강화학습 중 긴 에이전트 작업에서는 스티키 라우팅(같은 대화는 같은 서버로 보내기)으로 이전 문맥의 KV 캐시를 재사용해 접두 캐시 적중률 93% 이상을 유지했다고 합니다.
4. 아키텍처 ② 어텐션: 가까운 것은 자세히, 먼 것은 가끔
모델 카드는 어텐션을 “지역(local) 층과 전역(global) 층의 혼합”이라고만 적었습니다. 2세대의 정확한 비율은 공개되지 않았지만, 1세대 설정 파일이 힌트를 줍니다. 1세대 Inkling과 Inkling-Small은 슬라이딩 창 층 5개마다 전역 층 1개를 두었고, 창 크기는 512토큰이었습니다.
왜 이렇게 할까요? 어텐션은 각 토큰이 앞선 토큰들을 돌아보는 연산이고, 돌아보려면 앞 토큰들의 키·값 벡터(KV 캐시)를 메모리에 들고 있어야 합니다. 문맥이 100만 토큰이면 모든 층이 100만 개의 KV를 들고 있어야 합니다. 그런데 문장을 이해할 때 대부분의 정보는 가까운 곳에 있습니다. 바로 앞 몇 문단만 보는 ‘지역’ 층은 512개만 들고 있으면 되고, 가끔 끼워 둔 ‘전역’ 층이 먼 곳의 정보를 끌어옵니다.
1세대 Inkling-Small 설정(42층 중 전역 7층, KV 헤드 8개, 헤드 차원 128, BF16)으로 어림해 보면 차이가 분명합니다.
42층 모두 전역
1M 토큰에 KV 약 172GB
전역 7 + 지역 35 (5:1)
약 29GB
토큰당 전역 층 하나의 KV는 2(키·값) × 8헤드 × 128차원 × 2바이트 = 4KB입니다. 전역 층만 100만 토큰을 기억하고 지역 층 35개는 512토큰씩만 기억하니, KV 메모리가 약 6분의 1로 줄어듭니다. 100만 토큰 문맥을 실제로 쓸 수 있게 만드는 것은 이런 설계입니다. 발표문은 여기에 더해 배포 비용을 낮추려고 KV 캐시까지 NVFP4로 저장하는 변형을 제공한다고 밝혔습니다(“평가 점수를 아주 조금 낮춘다”).
1세대는 위치 정보에 널리 쓰이는 RoPE 대신 상대 위치 임베딩을 썼고(“더 잘 작동하고 더 긴 문맥으로 잘 외삽된다”), 키·값 투영 뒤와 잔차 연결 앞에 짧은 합성곱을 넣었으며, 다음 여러 토큰을 한꺼번에 예측하는 8층짜리 다중 토큰 예측(MTP) 머리를 달았습니다. MTP 머리는 추론 때 ‘초안 토큰’을 미리 써 보는 추측 디코딩에 쓰입니다. 발표문이 강화학습 샘플링에서 “프리필, 초안(draft), 검증(verify)이 모두 CUDA 그래프 위에서 돈다”고 쓴 것이 바로 이 추측 디코딩입니다. 2세대가 이 장치들을 그대로 유지했는지는 아직 설정 파일이 없어 확인할 수 없습니다. 가중치가 공개되면 가장 먼저 확인할 부분입니다.
5. 아키텍처 ③ 눈: 버렸던 비전 인코더를 다시 들인 이유
5.1 1세대의 실험과 실패
1세대 Inkling은 과감한 실험을 했습니다. 이미지를 읽는 별도의 신경망(비전 인코더) 없이, 이미지를 40×40 픽셀 조각으로 잘라 4층짜리 작은 MLP(hMLP)로 바로 토큰 벡터를 만들고 언어 모델에 넣었습니다. 오디오도 같은 식으로 멜 스펙트로그램을 바로 넣었습니다. 모든 감각을 언어 모델 하나가 처음부터 함께 배우는 ‘조기 융합’ 설계입니다.
결과는 기대에 못 미쳤습니다. 레딧의 한 사용자는 “비전 조각이 너무 커서 이론상으로는 볼 수 있어도 큰 모양 말고는 거의 장님이었다”고 평했습니다. 40×40 픽셀이면 화면 캡처의 작은 글씨 한 줄이 조각 하나 안에 뭉개집니다.
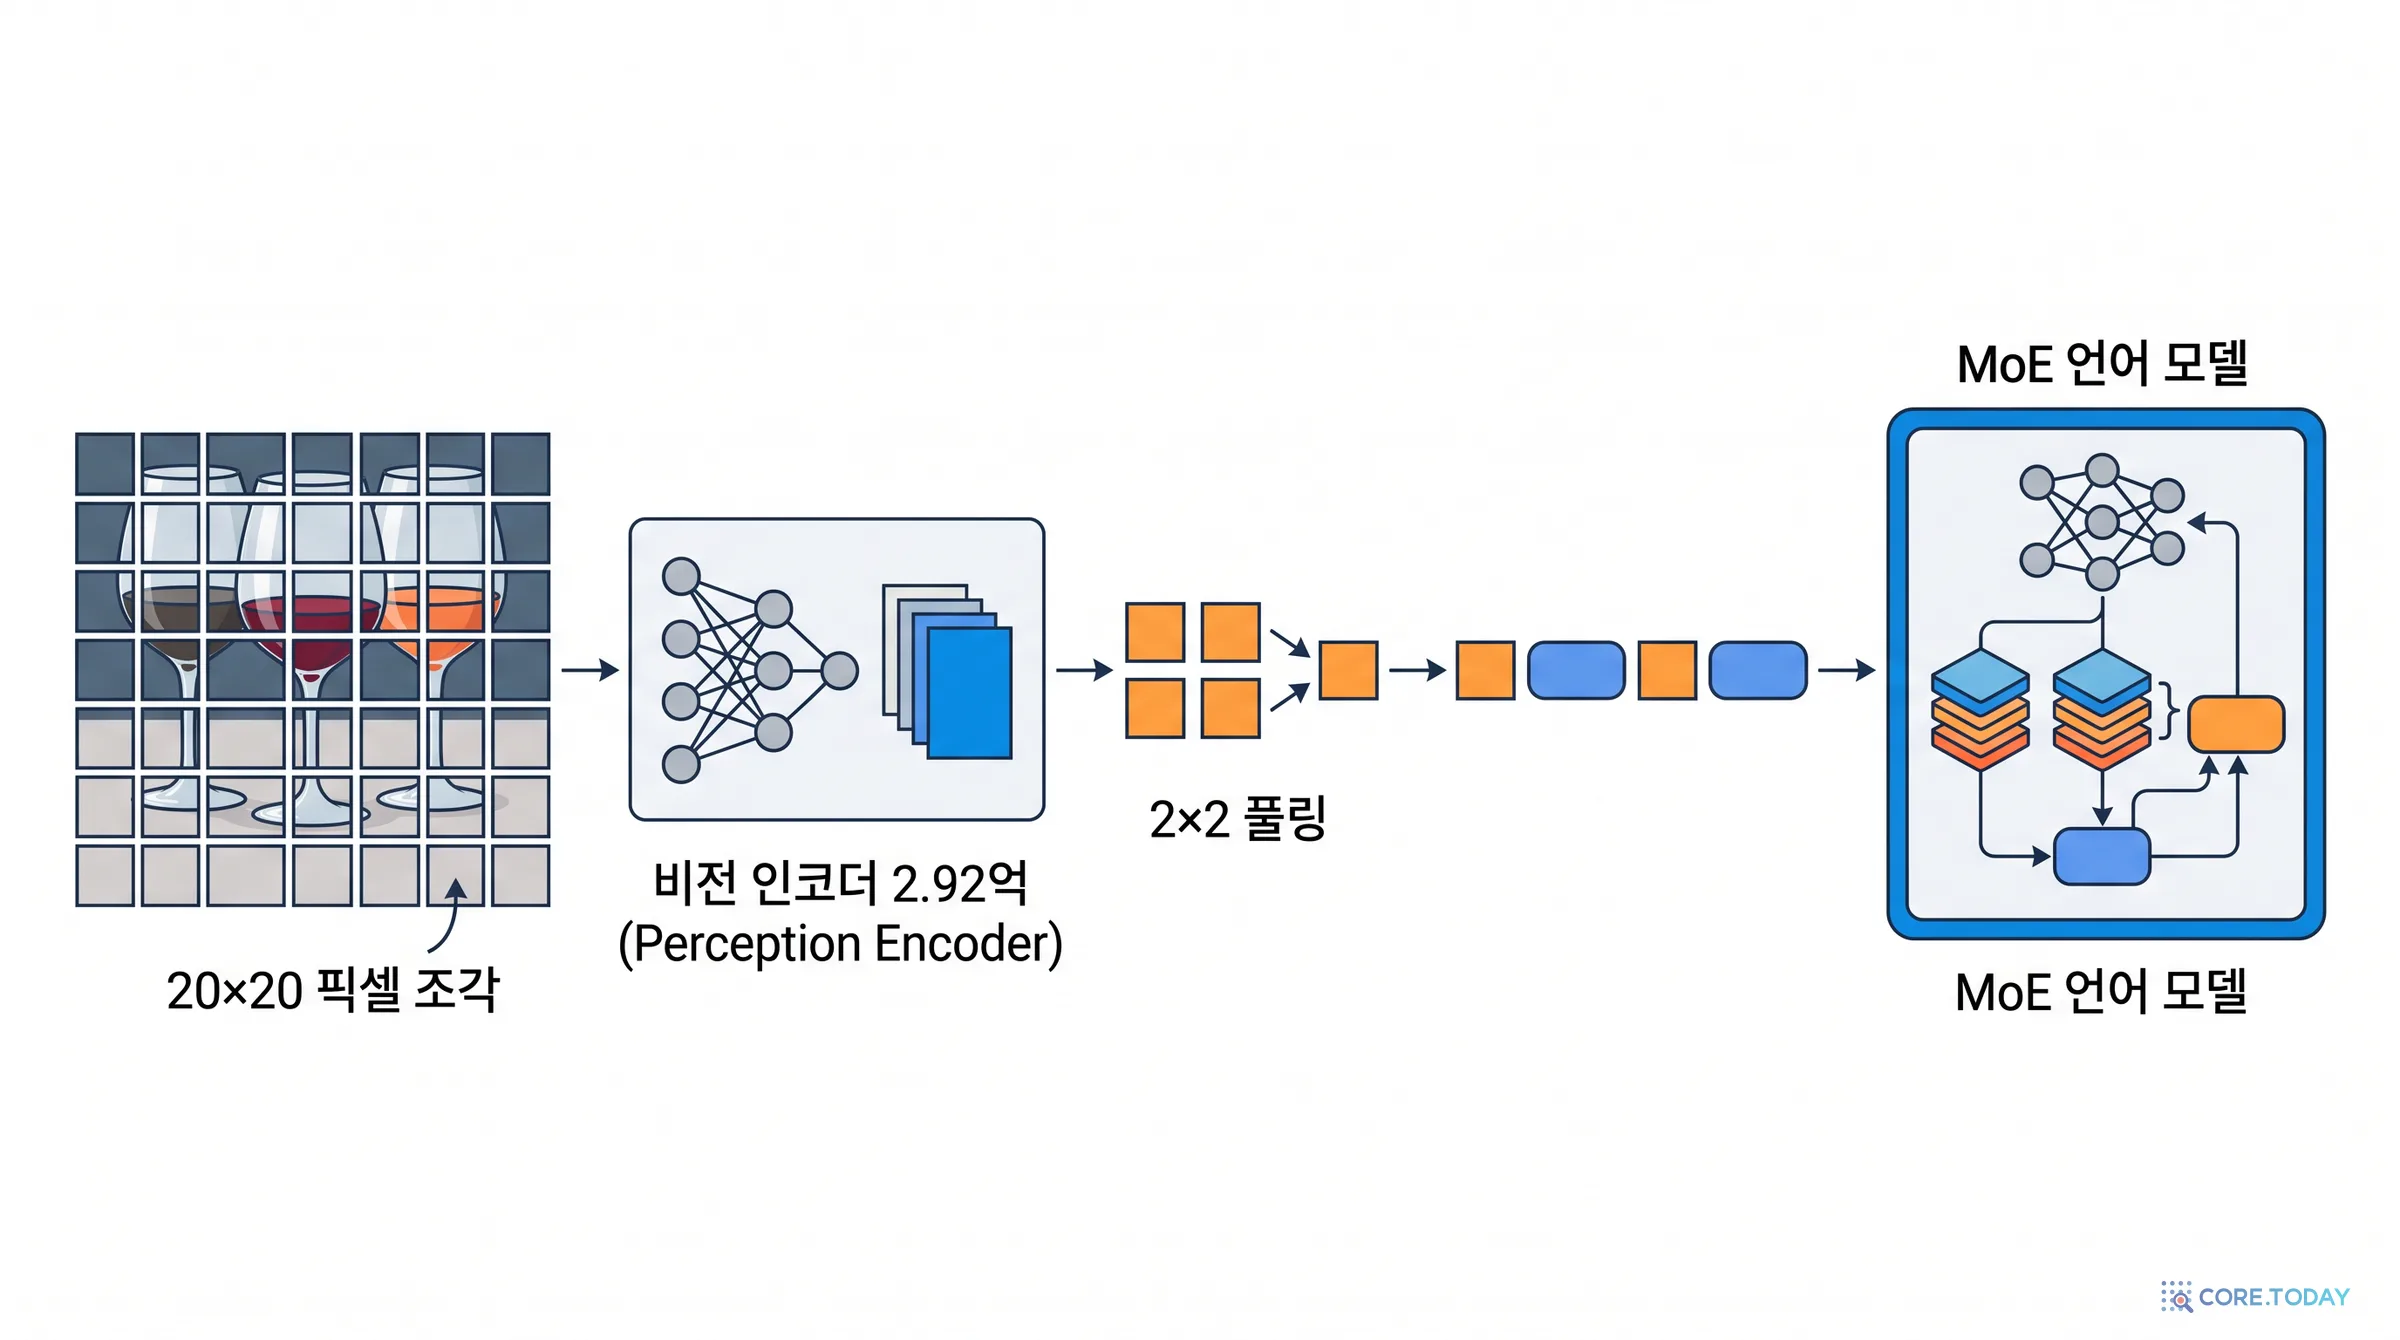
2세대는 방향을 바꿨습니다. 메타가 2025년 4월 공개한 Perception Encoder(Bolya 외, arXiv 2504.13181)를 바탕으로 한 2.92억 파라미터 비전 트랜스포머를 붙였습니다. 이미지를 20×20 픽셀 조각으로 자르고(면적으로 1세대의 4분의 1), 인코더가 조각들 사이의 관계를 읽은 뒤, 이웃한 2×2 조각을 하나로 합쳐 텍스트 토큰 사이에 끼워 넣습니다. 결과적으로 언어 모델 입장에서는 토큰 하나가 40×40 픽셀을 맡는다는 점은 1세대와 같지만, 그 토큰에 담긴 정보가 훨씬 풍부합니다. 20픽셀 단위로 본 뒤 요약했기 때문입니다.
Perception Encoder 논문의 흥미로운 발견은 “가장 좋은 특징은 마지막 층이 아니라 중간 층에 있다”는 것입니다. 이미지-텍스트 대조 학습으로 만든 인코더의 마지막 층은 ‘이 사진은 고양이’ 같은 전체 요약에는 좋지만, 위치·글자·세부를 묻는 언어 모델용으로는 “형편없었다”고 적었습니다. 그래서 논문의 멀티모달 모델은 50층 중 47번째 층의 특징을 썼습니다. 논문에서 인코더 크기는 B(0.9억)·L(3.2억)·G(18.8억) 세 가지였는데, Inkling 2 Small의 2.92억은 L급에 가깝습니다(정확히 어떻게 바꿨는지는 공개되지 않았습니다).
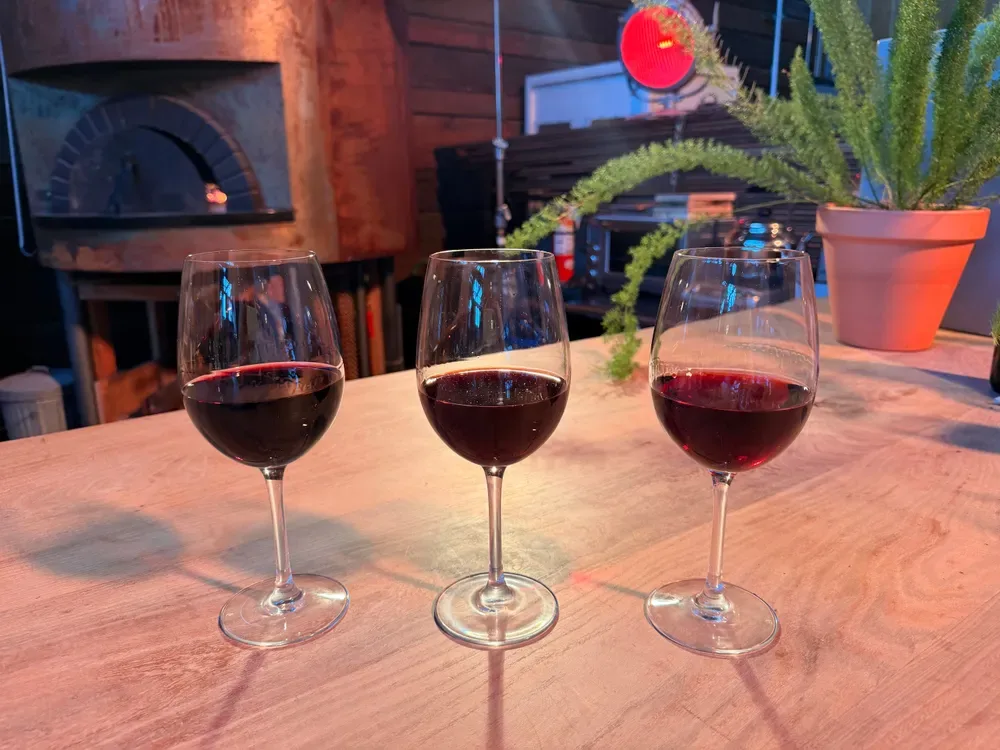
계산해 보면 1,920×1,080 화면 캡처 한 장은 약 1,300토큰, 원문의 와인 사진(1,000×750)은 475토큰입니다. Qwen2-VL 계열(14픽셀 조각 + 2×2 병합)보다 같은 이미지를 약 절반의 토큰으로 표현합니다. 에이전트가 웹페이지를 만들고, 스크린샷을 찍어 보고, 고치는 루프를 수십 번 돌리려면 이미지 한 장이 문맥을 너무 많이 먹으면 안 됩니다.
5.3 와인 세 잔을 사진 한 장으로
발표문에서 가장 많이 회자된 장면은 와인 시음입니다. 연구원들이 블라인드 시음 대회에서 모델과 겨뤘는데, 모델은 사진 한 장만 보고 세 잔(1999년 카베르네 소비뇽, 2019년 카베르네 소비뇽, 2023년 네비올로)을 20번 중 19번 맞혔다고 합니다.
모델의 답이 재미있습니다. 가장 밝고 투명한 3번 잔을 네비올로로 골랐는데, 이유는 “네비올로는 어릴 때도 레드 와인치고 유명하게 색이 옅다”였습니다. 가장 어둡고 보랏빛인 1번은 “7년밖에 안 된 카베르네라 아직 색이 진하다”며 2019년으로, 그 중간인 2번은 “25년 넘은 카베르네라면 보랏빛이 빠졌지만 완전히 벽돌색은 아니다”며 1999년으로 골랐습니다. 그리고 먼저 단서를 붙였습니다. “따뜻한 식당 조명 아래 휴대폰 사진의 색은 흔들리는 증거이니 판정이 아니라 교육받은 추측으로 받아들이라. 왼쪽 잔은 벽난로 근처 어두운 곳에 있어 더 어두워 보인다.”
해커뉴스에서는 “같은 사진을 Claude Opus 5.5(중간 노력)에 보냈더니 틀렸고 Inkling 2 Small은 맞혔다”는 댓글과 “왜 와인 비교에 노력을 쓰나”는 댓글이 나란히 달렸습니다. 이 예시가 보여 주는 것은 소믈리에 실력이 아니라, 색의 미세한 차이를 읽고 그것을 배경지식과 엮어 추론한 뒤 자기 증거의 약점까지 말하는 능력입니다. 이것은 10장의 ‘인식론’ 훈련과 이어집니다.
5.4 눈을 루프 안에 넣기
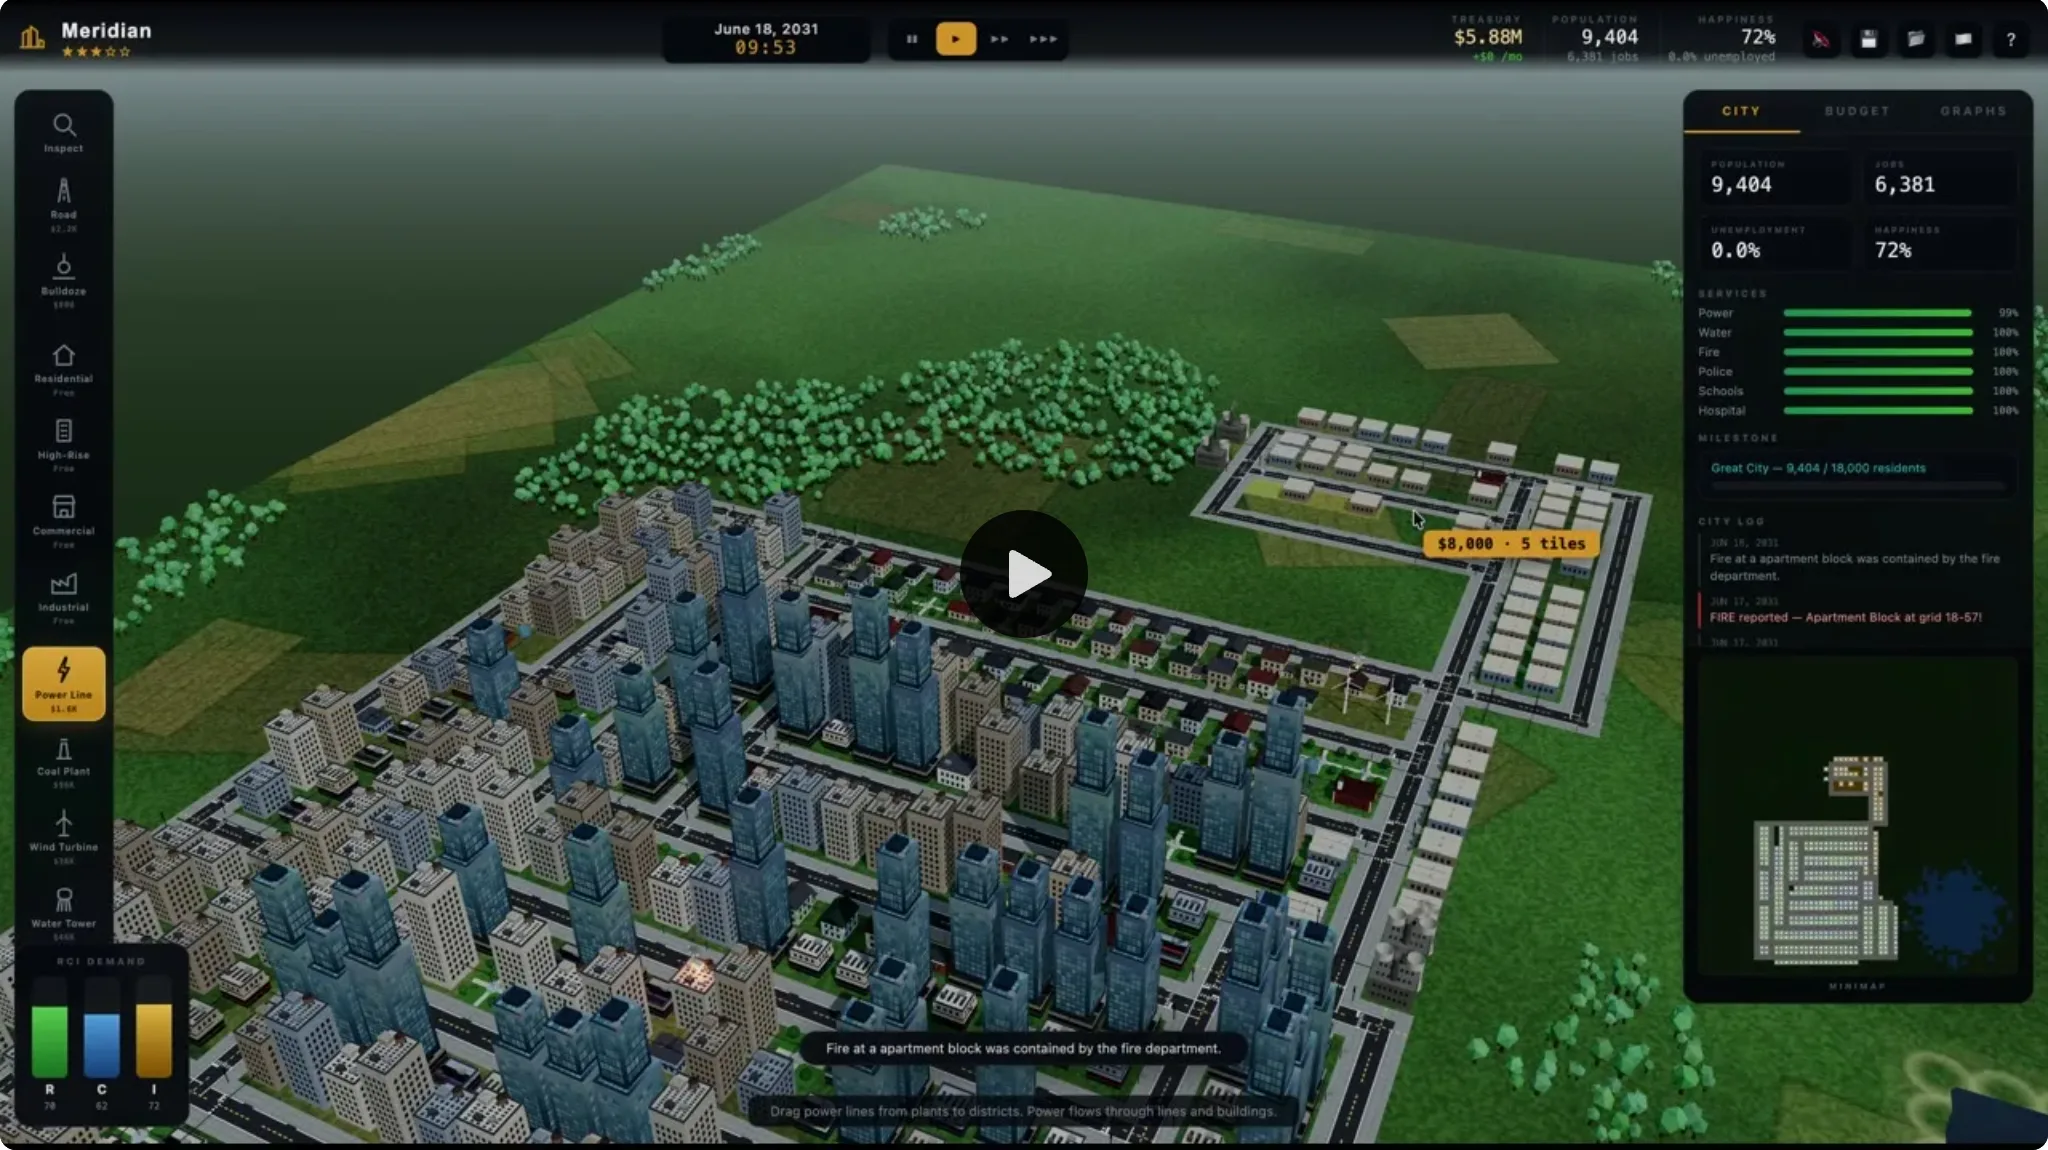
비전이 바뀌자 할 수 있는 일이 늘었습니다. 발표문은 모델이 “생성한 시각적 결과물을 해석하고 검증하는 데 비전을 루프 안에서 쓴다”고 설명합니다. 웹사이트·게임·3D 장면을 만들고, 렌더링 결과를 보고, 다시 고칩니다. 대표 예시는 미리 만든 에셋 없이 Three.js로 건물·텍스처·자동차를 모두 절차적으로 생성한 도시 시뮬레이터입니다. 도로 하나에서 시작해 전력·예산·화재 같은 비상 상황을 관리하며 도시를 키웁니다.
강화학습에서도 비전이 채점관 역할을 했습니다. 웹앱 만들기 과제는 렌더링된 화면 두 개의 스크린샷을 비교하는 보상 모델이 채점했습니다. 코드가 돌아가는지만 보는 것이 아니라 ‘보기 좋은가’를 점수로 만든 것입니다. 그 결과 DesignArena의 웹사이트·게임·3D 디자인 부문, ScreenSpot Pro(화면에서 버튼 위치 찾기, 83.8%), BabyVision, GDP.pdf 같은 시각 항목에서 오픈 모델 1위를 차지했습니다.
6. 아키텍처 ④ 4비트로 처음부터: NVFP4
6.1 숫자를 몇 비트로 적을 것인가
신경망 학습은 거대한 행렬 곱셈의 반복입니다. 숫자 하나를 몇 비트로 적느냐에 따라 메모리, 통신량, 계산 속도가 달라집니다. 딥러닝은 32비트(FP32)에서 시작해 16비트(BF16)로, 2024년 DeepSeek-V3에 와서는 8비트(FP8) 학습이 대형 모델에서 처음 성공했습니다(BF16 대비 손실 차이 0.25% 이내). 그리고 2025년, NVIDIA의 Blackwell GPU가 4비트 부동소수점 연산을 하드웨어로 지원하면서 다음 질문이 생겼습니다. 4비트로도 처음부터 학습할 수 있을까?
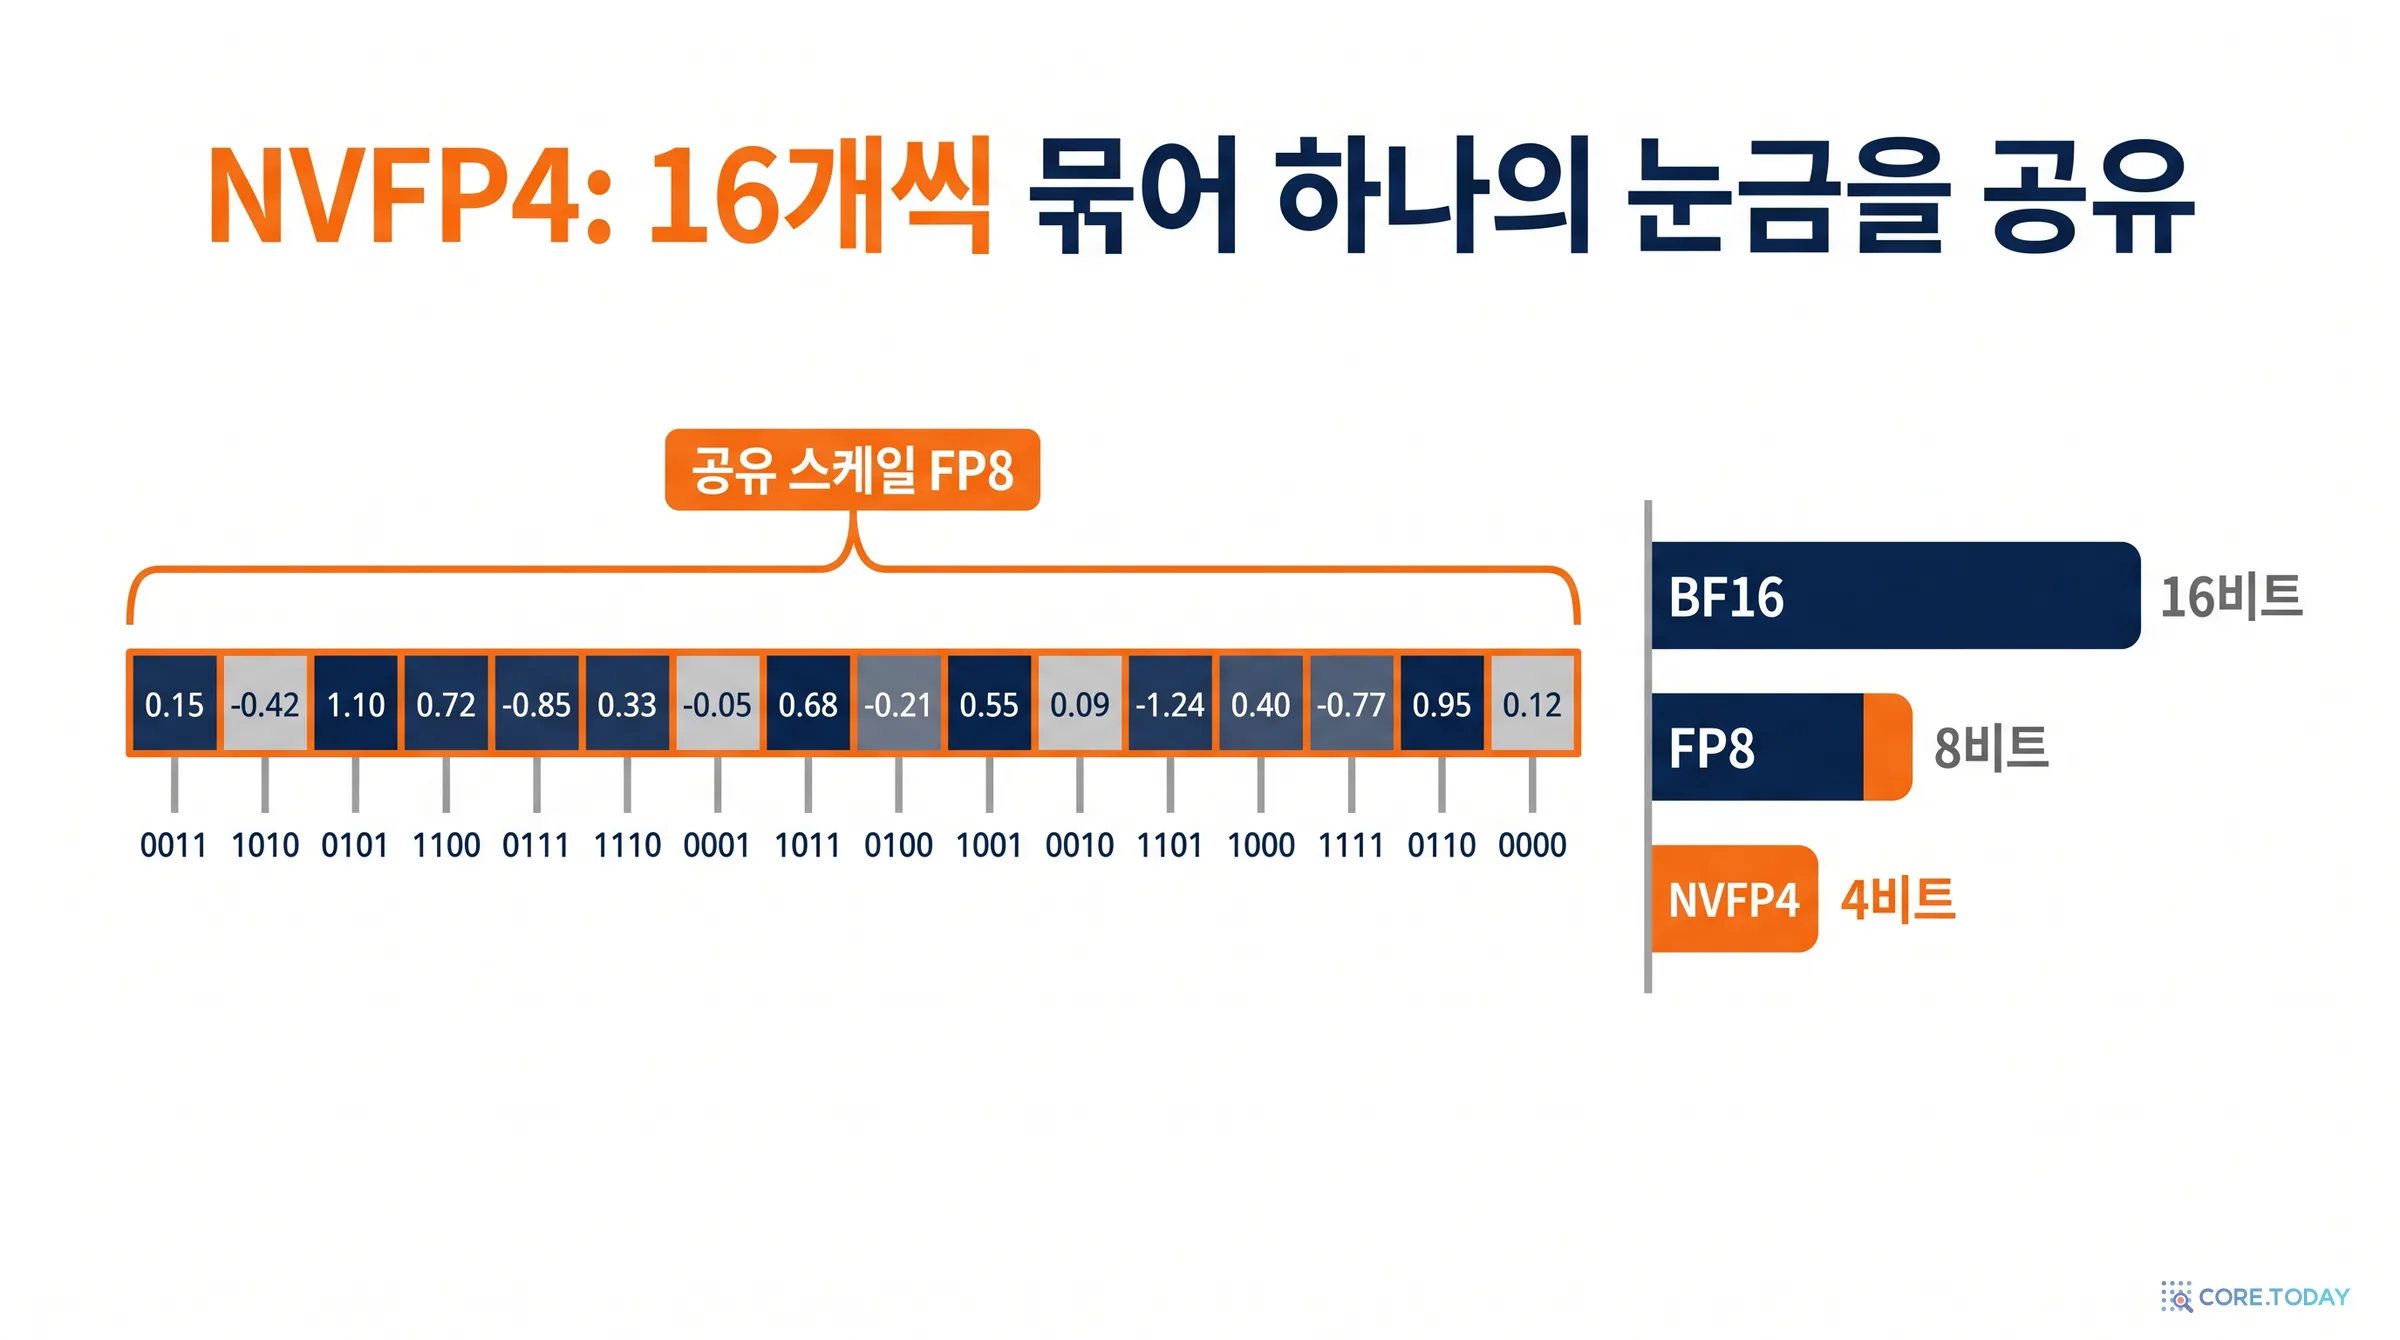
그림의 4비트 코드는 모양을 보여 주기 위한 예시이며 실제 부호화 규칙과 일치하지 않습니다.
4비트 부동소수점(E2M1)은 부호 1비트, 지수 2비트, 가수 1비트로, 표현할 수 있는 크기가 0, 0.5, 1, 1.5, 2, 3, 4, 6 여덟 개뿐입니다. 이것만으로는 아무것도 못 하니 ‘눈금(scale)’을 곱합니다. 값들을 묶음으로 나누고, 묶음마다 “이 묶음의 값들은 0.03 단위로 센다” 같은 눈금을 따로 저장하는 것입니다. 관건은 묶음의 크기와 눈금의 정밀도입니다.
NVFP4(NVIDIA): 16개씩 묶고, 눈금을 8비트 부동소수점(FP8 E4M3)으로 촘촘하게, 그 위에 텐서 전체용 FP32 눈금을 하나 더. 값 하나당 평균 4.5비트.
묶음이 작을수록 큰 값(이상치) 하나가 망치는 범위가 좁고, 눈금이 촘촘할수록 반올림 손실이 적습니다. 아래 위젯에서 이상치를 키워 보면 차이가 바로 보입니다.
6.2 NVIDIA의 레시피와 Inkling의 선택
NVIDIA는 2025년 9월 논문 「NVFP4로 대형 언어 모델 사전학습하기」(arXiv 2509.25149)에서 120억 파라미터 모델을 10조 토큰 동안 NVFP4로 학습해, MMLU-Pro 62.58점으로 FP8 기준선(62.62점)과 거의 같은 결과를 냈습니다. 같은 손실에 도달하려면 MXFP4는 토큰이 36% 더 필요했습니다. 성공의 비결은 네 가지였습니다.
무작위 하다마드 변환 — 가중치 기울기 계산에 들어가는 값을 미리 ‘섞어서’ 이상치를 고르게 펴 둡니다(위젯의 회전 스위치).
2차원 묶음 눈금 — 가중치는 16×16 블록으로 눈금을 잡아, 순전파와 역전파에서 같은 양자화가 되게 합니다.
확률적 반올림 — 기울기는 늘 가까운 쪽으로 반올림하면 작은 변화가 체계적으로 사라지므로, 확률적으로 위아래를 고릅니다.
일부 층은 BF16으로 — 선형 층의 약 16%(주로 마지막 몇 층)는 높은 정밀도로 남겼습니다.
GB300에서 FP4 연산은 FP8의 약 3배 처리량을 냅니다. Inkling 2 Small의 H1 단계(8.4조 토큰)가 68시간 만에 끝난 배경입니다. 해커뉴스의 한 댓글은 이렇게 요약했습니다. “가장 중요한 건 학습이 전부 NVFP4였다는 점이다. 그 정밀도로 학습된 모델 중 단연 최고이고, 그래서 이렇게 빨리 만들 수 있었던 것이다.” Thinking Machines는 자사 NVFP4 레시피를 “곧 후속 글로 공개하겠다”고만 했습니다. 1세대는 학습 정밀도를 밝히지 않았고 추론용 NVFP4 체크포인트만 냈으니, 4비트 ‘처음부터’ 학습은 이번이 처음입니다.
4비트는 학습만이 아니라 강화학습 샘플링과 배포까지 이어집니다. 발표문은 “RL 인프라가 NVFP4 MoE 학습과 샘플링을 배포한다”고 썼습니다. 학습자와 샘플러가 같은 수치 형식을 쓰면 둘 사이의 미세한 수치 차이가 줄어 강화학습이 안정됩니다. 이것은 8장의 StableReinforce와 연결됩니다. 양자화를 처음 접하는 분은 코어닷투데이의 양자화 완전 정리를 함께 보면 좋습니다.
6.3 노력(effort) 다이얼
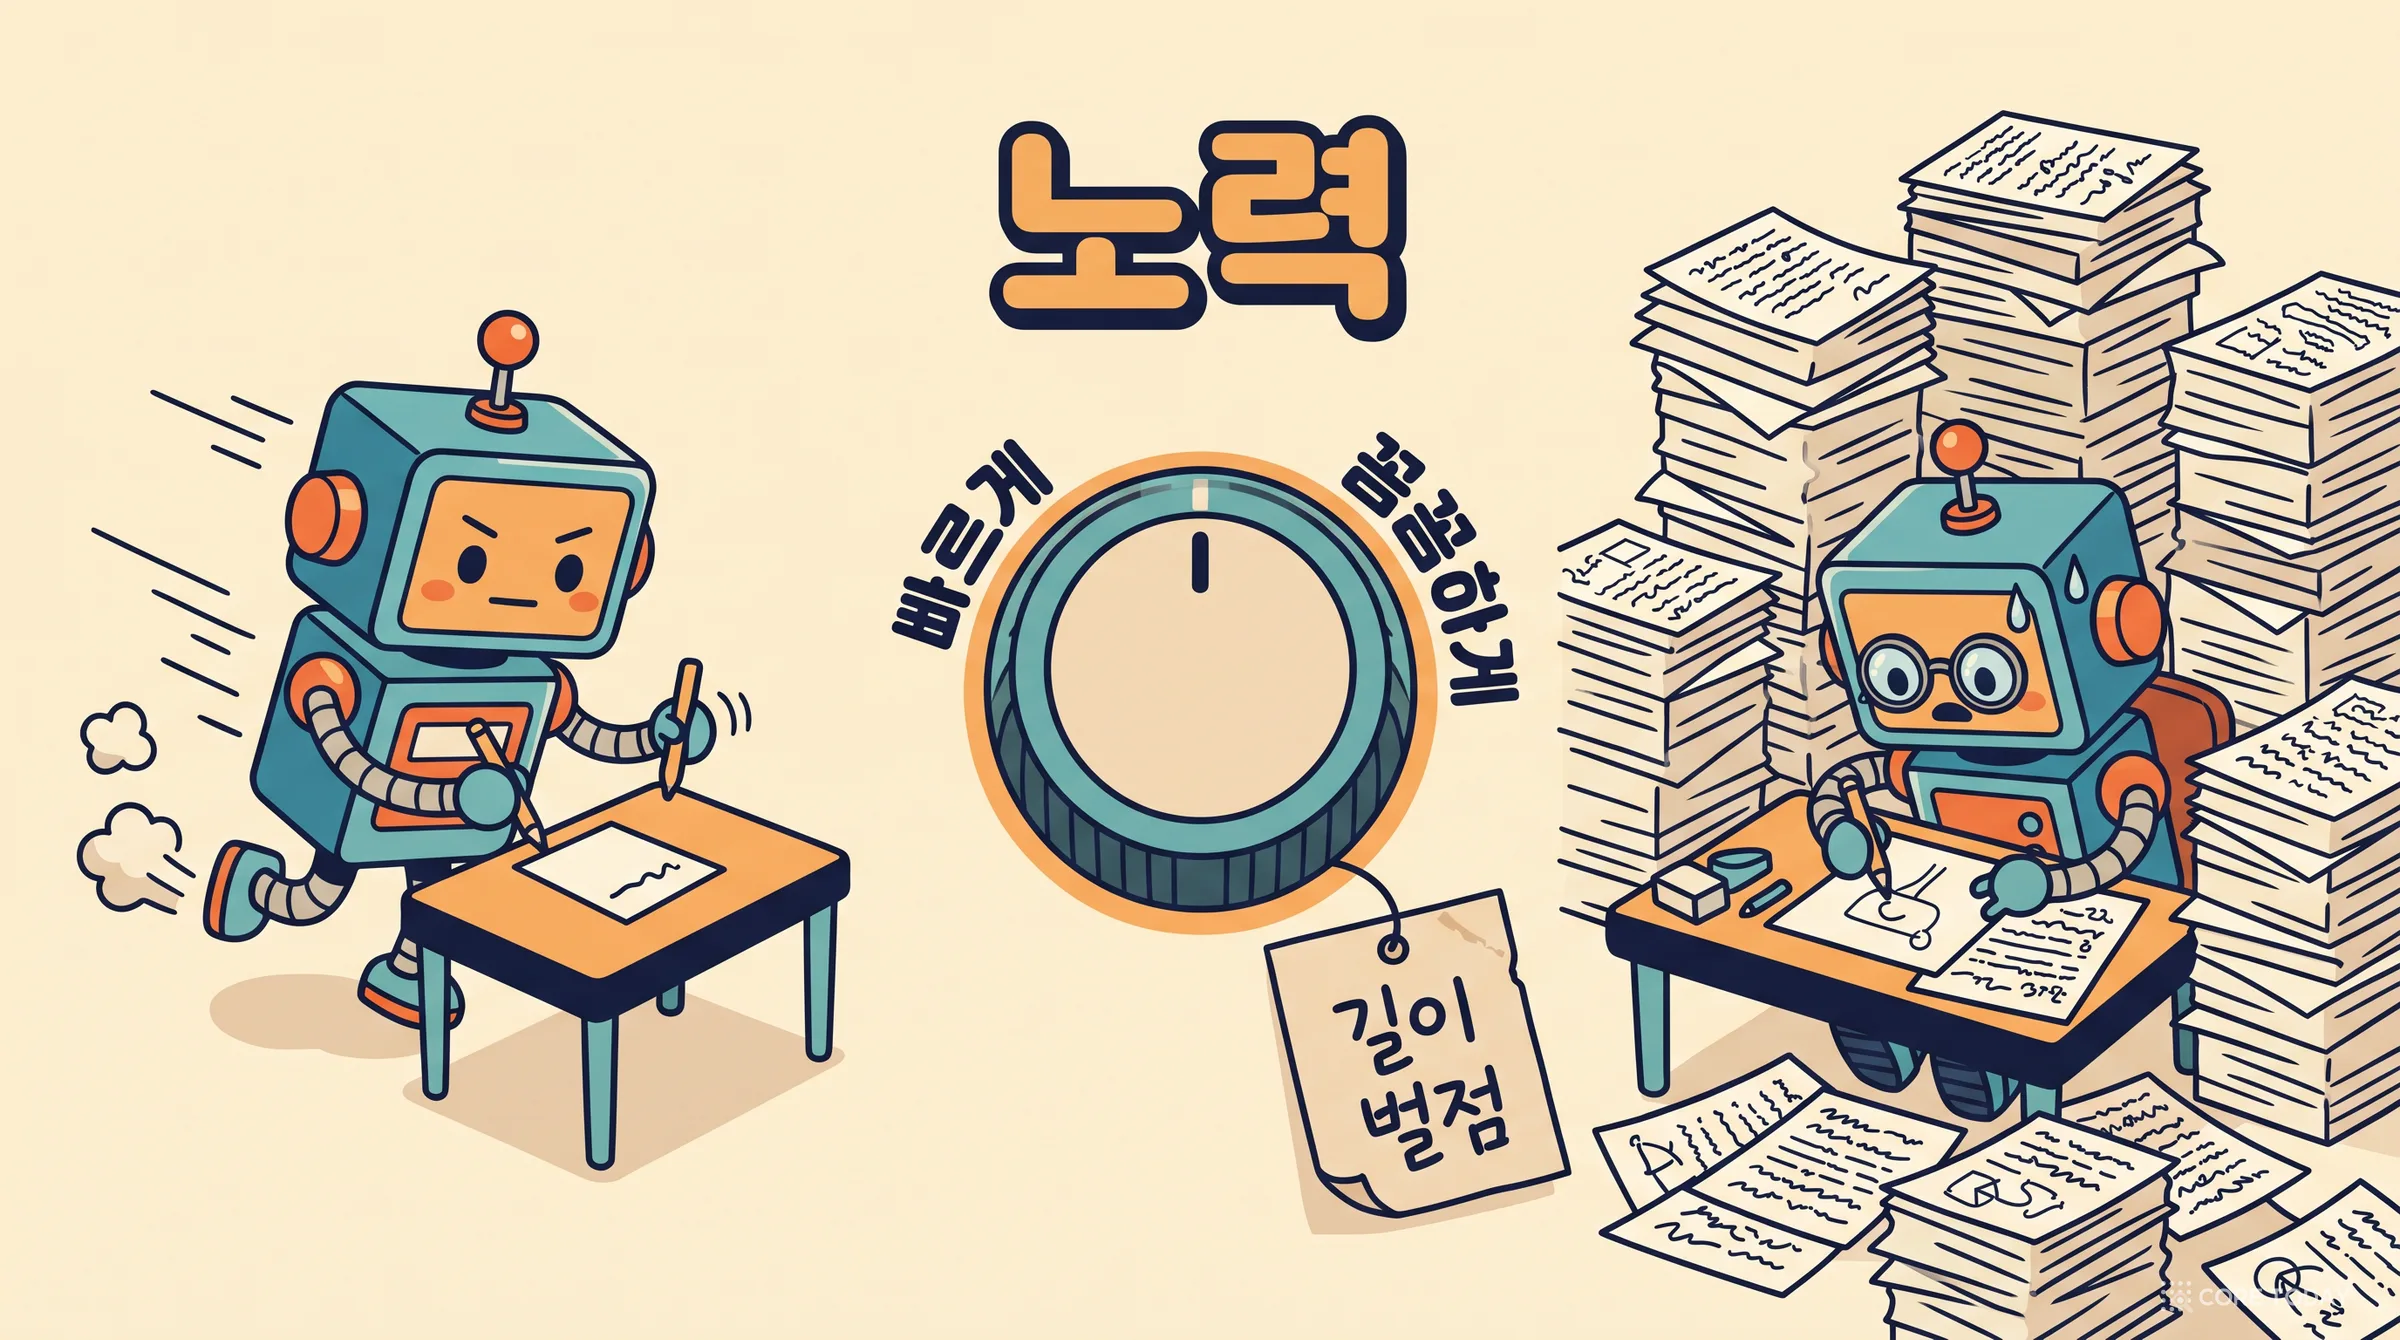
구조라기보다 사용법에 가까운 특징이 하나 더 있습니다. Inkling 2 Small은 가변 노력을 지원합니다. 1세대 채팅 템플릿을 보면 시스템 메시지에 “Thinking effort level: 0.7”처럼 0~0.99 사이 숫자를 넣고(기본 0.9, none 0 · minimal 0.1 · low 0.2 · medium 0.7 · high 0.9 · max 0.99), 모델은 그 숫자에 맞춰 생각을 길게 또는 짧게 합니다.
어떻게 배웠을까요? 강화학습 중 과제마다 노력 수준을 무작위로 뽑아 조건으로 주고, 보상에 길이 벌점을 넣었습니다. 노력이 낮게 주어졌을 때 길게 생각하면 벌점이 크고, 높게 주어졌을 때는 벌점이 작게 만들면, 모델은 ‘지금은 얼마나 공을 들일 상황인가’를 숫자로 알아듣게 됩니다. 1세대 공개 글은 이 과정에서 생긴 부작용도 적었습니다. 효율만 추구하다 보니 생각의 문장이 점점 문법을 버려 “We need to understand”가 “We need determine”처럼 줄어들었다는 것입니다. 보상이 노리지 않았는데 저절로 생긴 압축입니다.
모든 벤치마크는 노력 0.99(xhigh)로 쟀습니다. 그래서 점수표의 숫자는 이 모델이 가장 오래 생각했을 때의 성능이고, Artificial Analysis에 따르면 그 대가로 지능 지수 과제 하나에 평균 약 15만 출력 토큰(1세대 Inkling Small의 약 4배)을 썼습니다. 실제로 쓸 때는 노력 수준을 낮추면 비용이 크게 줄지만 점수도 내려갑니다.
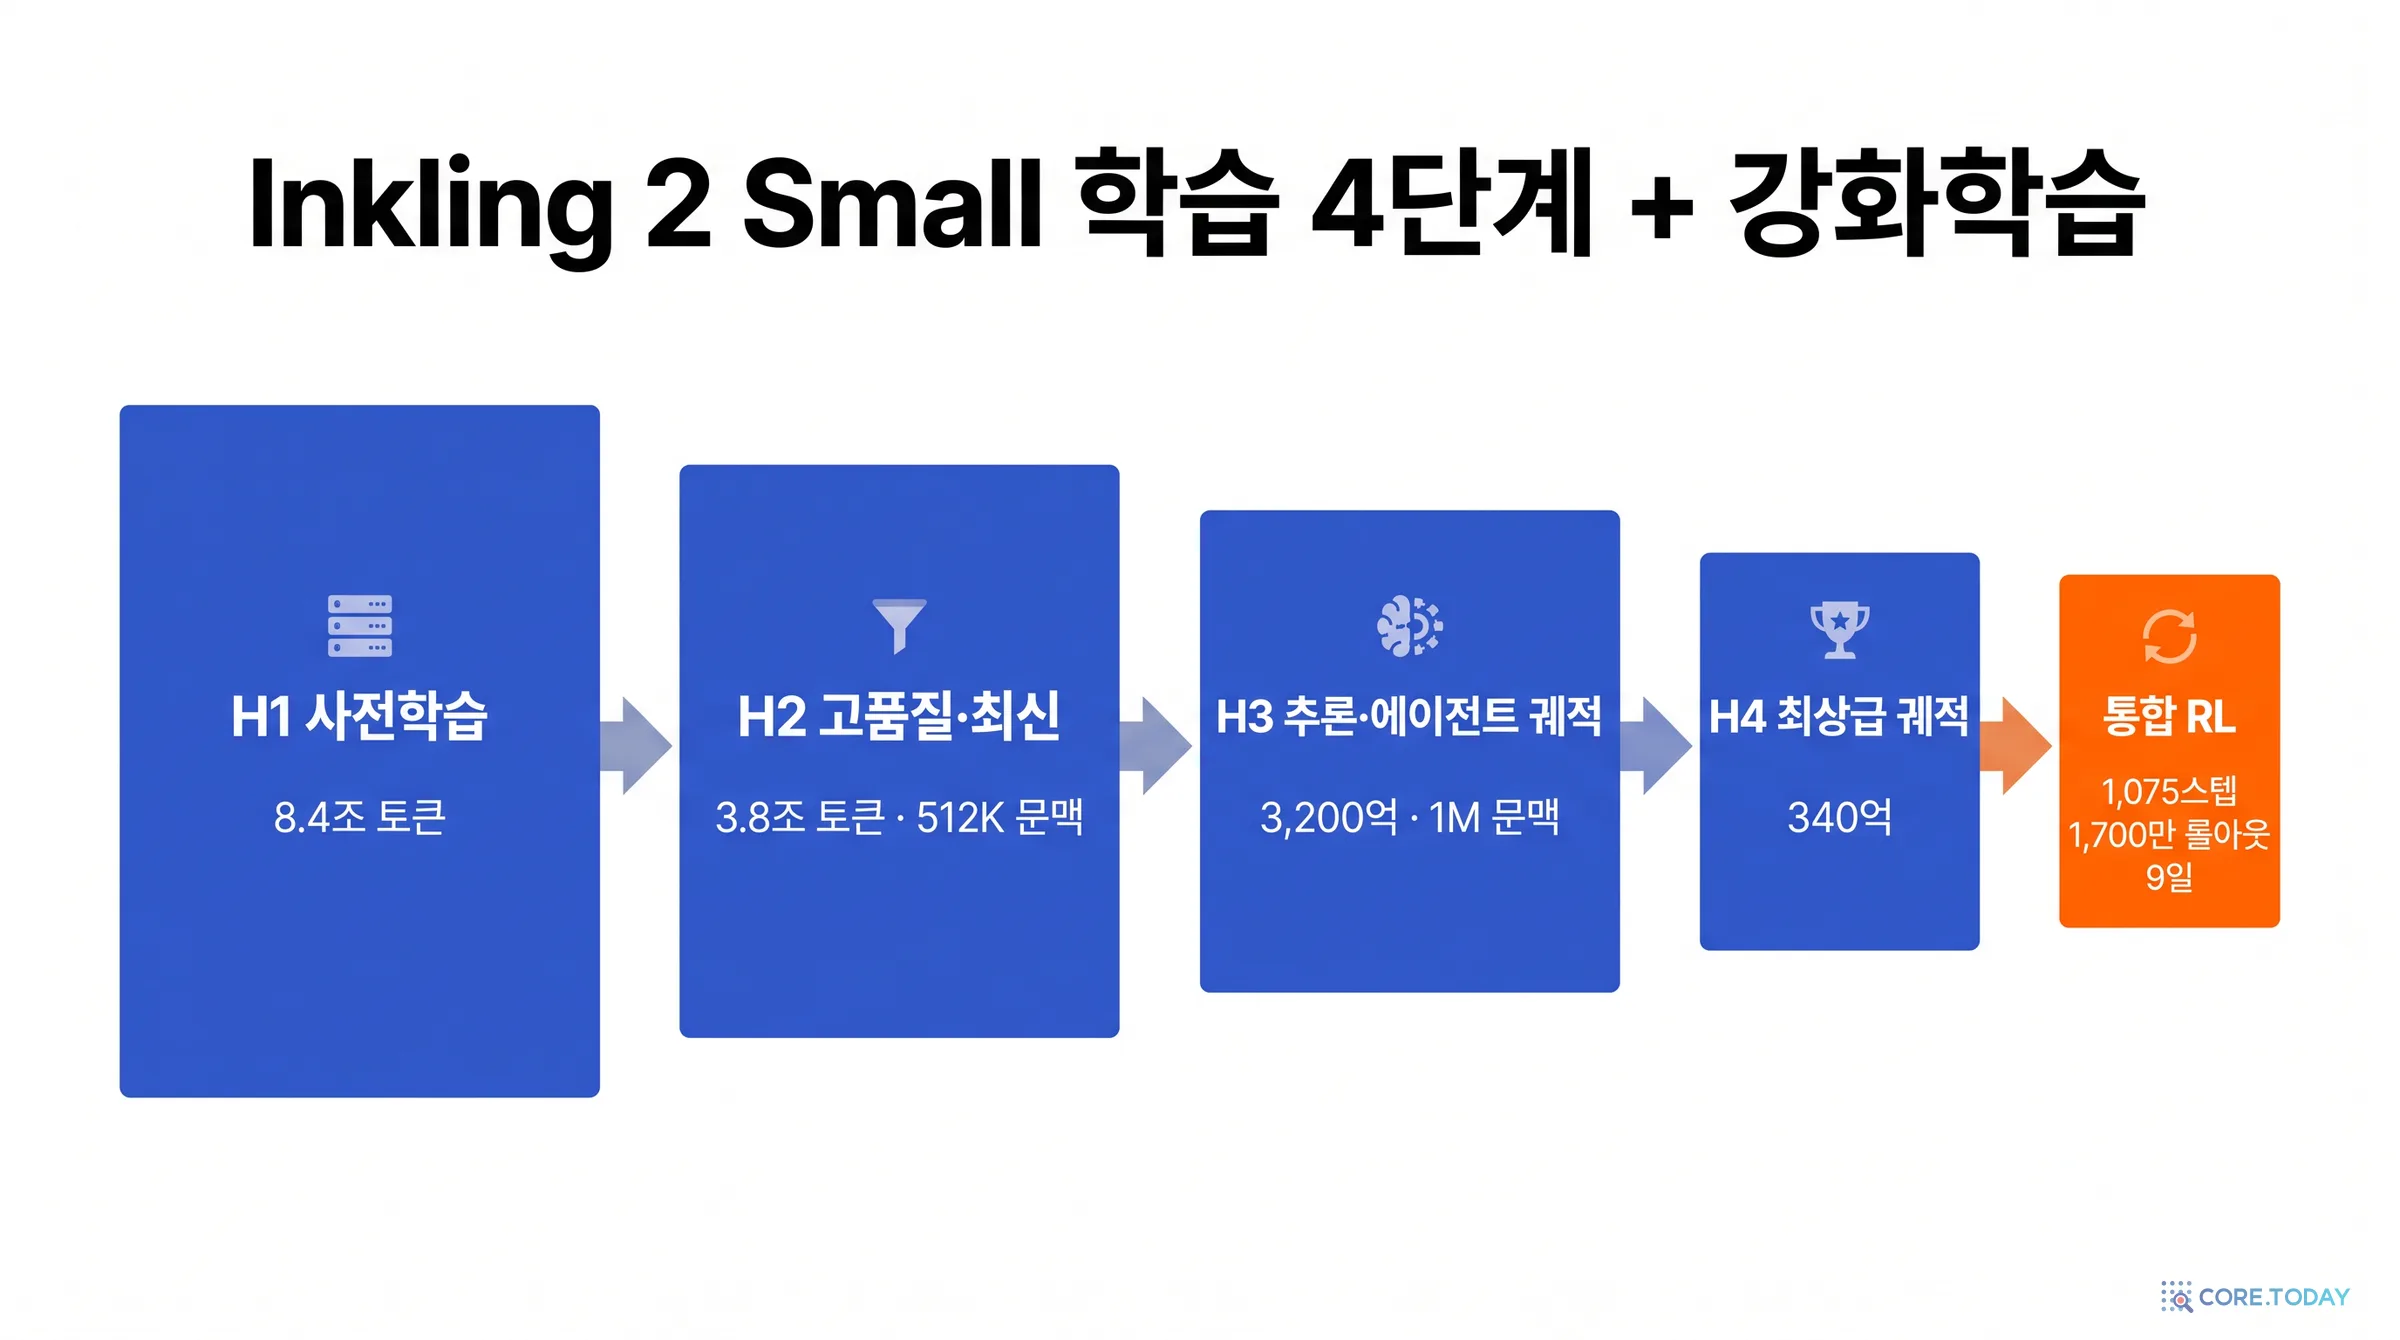
Inkling 2 Small의 사전학습은 네 단계(H1~H4)로 나뉩니다. 단계가 지날수록 데이터는 적어지고, 질은 높아지고, 문맥은 길어지고, 형식은 실제 사용에 가까워집니다.
H1 (8.4조 토큰) — 자연어·코드·이미지를 넓게 섞어 읽습니다. NVFP4로 68시간.
H2 (3.8조 토큰, 512K 문맥) — 모델이 본 적 없는 ‘더 질 좋고 더 새로운’ 데이터. 문맥을 크게 늘립니다.
H3 (약 3,200억 토큰, 1M 문맥) — 추론과 에이전트 작업 궤적을 실제 배포 형식(대화·도구 호출)으로 섞고, 앞 단계 데이터를 일부 다시 보여 줍니다(재생, replay).
H4 (약 340억 토큰) — 가장 질 좋은 에이전트 궤적만 남깁니다.
이 구조는 최근 몇 년 사이 자리 잡은 ‘중간 학습(mid-training)’ 관행을 따릅니다. 예를 들어 AI2의 OLMo 2(arXiv 2501.00656)는 전체 계산의 5~10%를 학습률을 0으로 낮추며 고품질 데이터(Dolmino 혼합)를 읽는 데 썼습니다. 학습 막바지에 좋은 데이터를 보여 주면 효과가 크다는 ‘어닐링’ 관찰 때문입니다. 문맥 확장은 처음부터 긴 문맥으로 학습하면 너무 비싸서, 짧게 충분히 배운 뒤 뒷단계에서 늘리는 것이 표준입니다(YaRN은 Llama 2를 400스텝 만에 128K로 늘렸습니다). 2세대가 어떤 위치 인코딩 방식으로 1M까지 늘렸는지는 공개되지 않았습니다.
7.2 45조에서 12.5조로
1세대 Inkling은 “45조 토큰으로 사전학습했다”고 밝혔습니다. 2세대는 H1~H4를 다 더해도 약 12.5조입니다. 레딧의 한 사용자는 이렇게 짚었습니다. “아주 평범한 구조다. 전문가 분할만 256개 중 2+6에서 바뀌었다. 그리고 대부분의 큰 오픈 모델보다 적은 데이터로 사전학습했다. 결국 데이터 선별과 RL이라는 뜻이다.”
정확한 지적입니다. 다만 1세대는 텍스트·이미지·오디오·영상을 모두 합친 수치였고, 2세대는 더 작은 모델(활성 17B 대 41B)이라는 점도 감안해야 합니다. 그래도 방향은 분명합니다. 2026년의 성능 향상은 ‘더 많이 읽기’보다 ‘무엇을 언제 읽히느냐’에서 더 많이 나옵니다.
7.3 남의 모델이 쓴 궤적으로 배운다
H3와 H4에 대해 발표문은 이렇게 적었습니다. “대부분 Kimi K3와 우리 이전 모델을 포함한 앞선 모델들에서 뽑은 궤적이며, 정답 여부와 정렬 기준으로 걸렀다.” 1세대도 “Kimi K2.5를 포함한 오픈 가중치 모델이 생성한 합성 데이터로 초기 SFT를 했다”고 밝혔습니다.
해커뉴스에서는 이 대목이 논쟁이 됐습니다. 한 사용자는 “큰 연구소나 중국 연구소 모델에서 증류를 하고 있다면, 진짜 비용은 1조 달러짜리 프런티어 설비 투자 + Inkling의 비용 아니냐”고 물었고, 다른 사용자는 “증류는 모든 배를 띄우는 밀물”이라고 답했습니다. 오픈 가중치 모델의 출력으로 다음 오픈 가중치 모델을 가르치는 일은 2026년 오픈 생태계의 일상이 됐고, 중국 모델에서 배운 미국 모델이 ‘미국산 오픈 모델’로 환영받는 장면은 그 자체로 이 시대를 보여 줍니다. 증류의 원리는 코어닷투데이의 지식 증류 특집에 정리해 두었습니다.
7.4 ‘바이트당 비트’로 잰 사전학습 실력
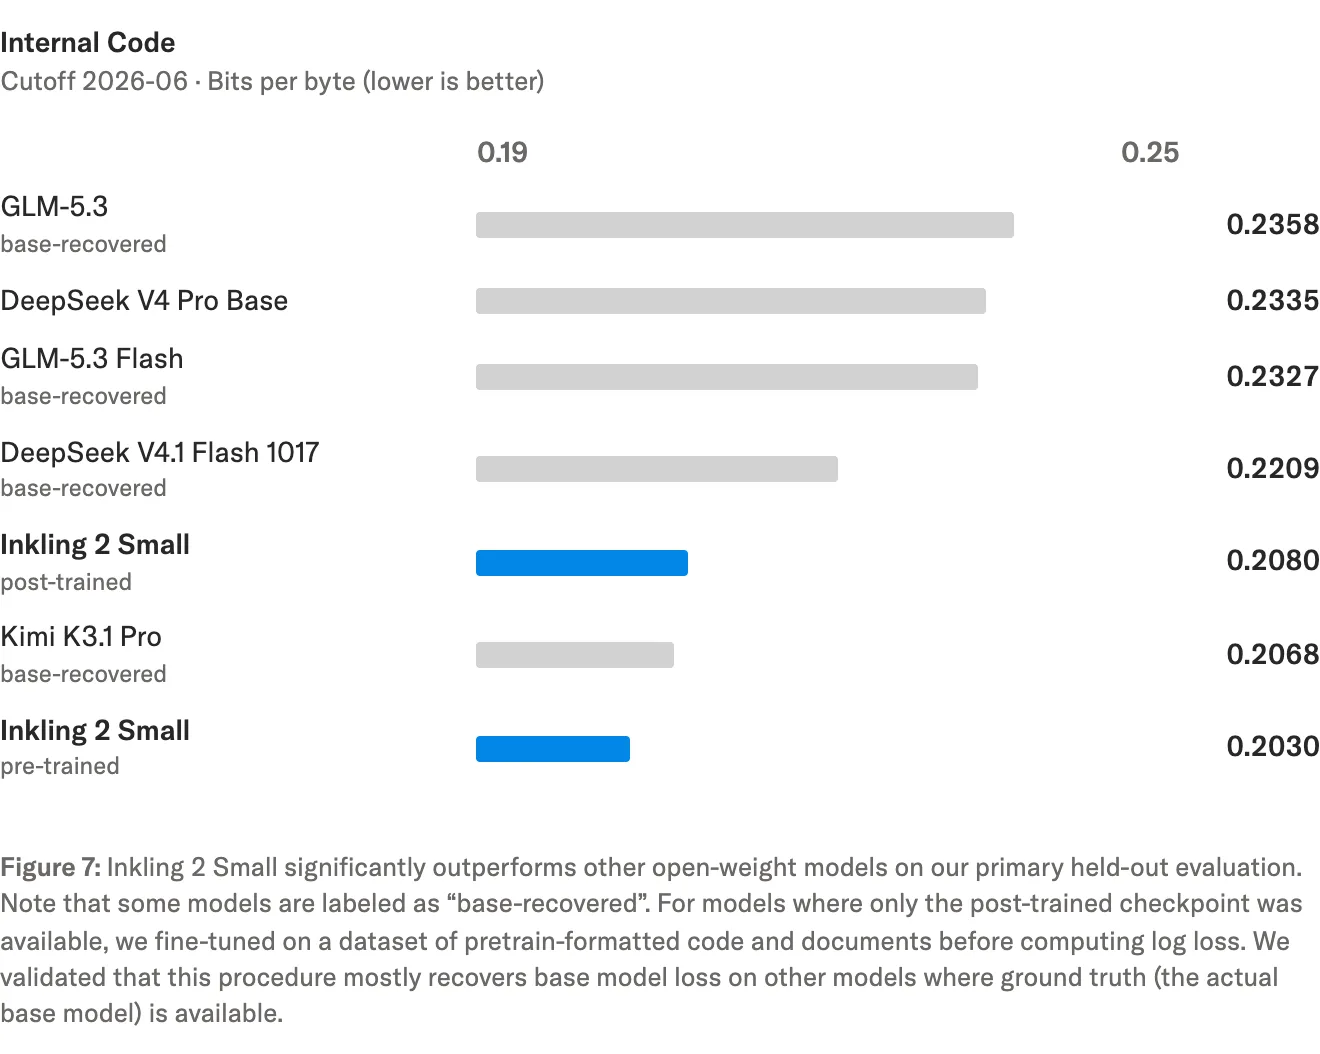
사전학습이 얼마나 잘 됐는지는 어떻게 잴까요? 발표문은 2026년 6월 이후의 사내 코드(학습에 쓰지 않은 데이터)를 얼마나 잘 예측하는지를 바이트당 비트(bits per byte)로 보여 줍니다.
바이트당 비트는 ‘다음 글자를 맞히는 데 평균 몇 비트의 놀라움이 있었나’입니다. 토큰이 아니라 바이트 단위라서 토크나이저가 다른 모델끼리도 비교할 수 있습니다. 그리고 이것은 곧 압축률입니다. 2023년 딥마인드 논문 「언어 모델링은 압축이다」(arXiv 2309.10668)가 보였듯, 다음 글자를 잘 예측하는 모델은 그 확률로 산술 부호화를 하면 그대로 압축기가 됩니다. 2024년 「압축은 지능을 선형으로 나타낸다」(arXiv 2404.09937)는 이 압축률과 벤치마크 점수의 상관이 약 −0.95라고 보고했습니다.
Inkling 2 Small(사전학습 직후)의 0.203비트는 원래 8비트인 바이트를 평균 0.2비트로 적을 수 있다는 뜻, 즉 코드를 약 39분의 1로 압축한다는 뜻입니다. 다르게 말하면 실제로 나온 다음 바이트에 평균(기하평균) 약 87%의 확률을 걸었다는 뜻입니다. 비교 대상인 GLM-5.3은 0.236, DeepSeek-V4.1-Flash는 0.221, Kimi K3.1 Pro는 0.207이었습니다.
그림에는 두 가지 각주가 필요합니다. 첫째, 다른 회사 모델은 사전학습 원본(base)이 공개되지 않아, 후학습 모델을 사전학습 형식 데이터로 조금 미세조정해 ‘원본을 복원’한 뒤 쟀습니다(“base-recovered”). 회사는 원본이 있는 모델로 이 방법이 대체로 원본 손실을 되찾는다는 것을 확인했다고 합니다. 둘째, ‘사내 코드’는 Thinking Machines의 코드이므로, 그 회사가 많이 쓰는 스타일과 라이브러리에 가까운 데이터로 학습한 모델이 유리할 수 있습니다. 막대가 0이 아니라 0.19에서 시작한다는 점도 눈여겨보세요. 실제 차이는 막대가 보이는 것보다 작습니다.
8. 강화학습: 9일, 1,700만 번의 숙제
8.1 따로 키워 합치기에서 한 번에 키우기로
사전학습이 ‘읽기’라면 강화학습(RL)은 ‘풀고 채점받기’입니다. 모델이 과제를 실제로 풀어 보고(롤아웃), 채점관이 점수(보상)를 주면, 점수가 높았던 행동의 확률을 높입니다. 2024년 말 OpenAI o1과 2025년 초 DeepSeek-R1 이후 추론 능력의 대부분은 이 단계에서 나옵니다.
Inkling 2 Small은 하나의 통합 RL 실행으로 모든 능력을 함께 키웠습니다. 발표문은 1세대를 이렇게 회고합니다. “이전 릴리스에서는 추론 RL과 에이전트 RL을 따로 돌리고 다중 교사 증류로 합쳤다.” 따로 키우면 각 분야는 잘 늘지만, 합칠 때 서로의 능력이 깎이기 쉽습니다. 한 번에 키우면 그 문제가 없지만 과제 종류가 수십 가지라 인프라가 훨씬 어렵습니다.
RL 규모
값
계산
4×10²³ FLOPs 이상
GPU · 기간
2,048장 · 9일
스텝 · 배치
1,075스텝 · 롤아웃 배치 1만 6천 개
롤아웃 · 토큰
1,700만 개 이상 · 3조 토큰 이상
롤아웃 길이
토큰 중앙값 4.3만 · 상위 1% 150만 / 시간 중앙값 8분 · 상위 1% 4시간
문맥
256K, 더 긴 궤적은 압축(compaction)
정책 지연
중앙값 17번의 업데이트
롤아웃 하나가 길게는 150만 토큰, 4시간입니다. 사람으로 치면 반나절짜리 업무를 통째로 맡기고 결과를 채점하는 셈입니다. 256K 문맥을 넘는 작업은 중간에 지난 내용을 요약해 문맥을 비우는 ‘압축’을 하며 이어 가는데, 이 압축 자체도 학습 대상이었습니다(“compaction training”). Claude Code의 자동 압축이나 ReSum(2509.13313), Context-Folding(2510.11967) 같은 연구와 같은 흐름입니다. 이전 내용을 잘 요약하지 못하면 4시간짜리 작업의 후반부를 망치니, 요약하는 능력도 보상으로 키워야 합니다.
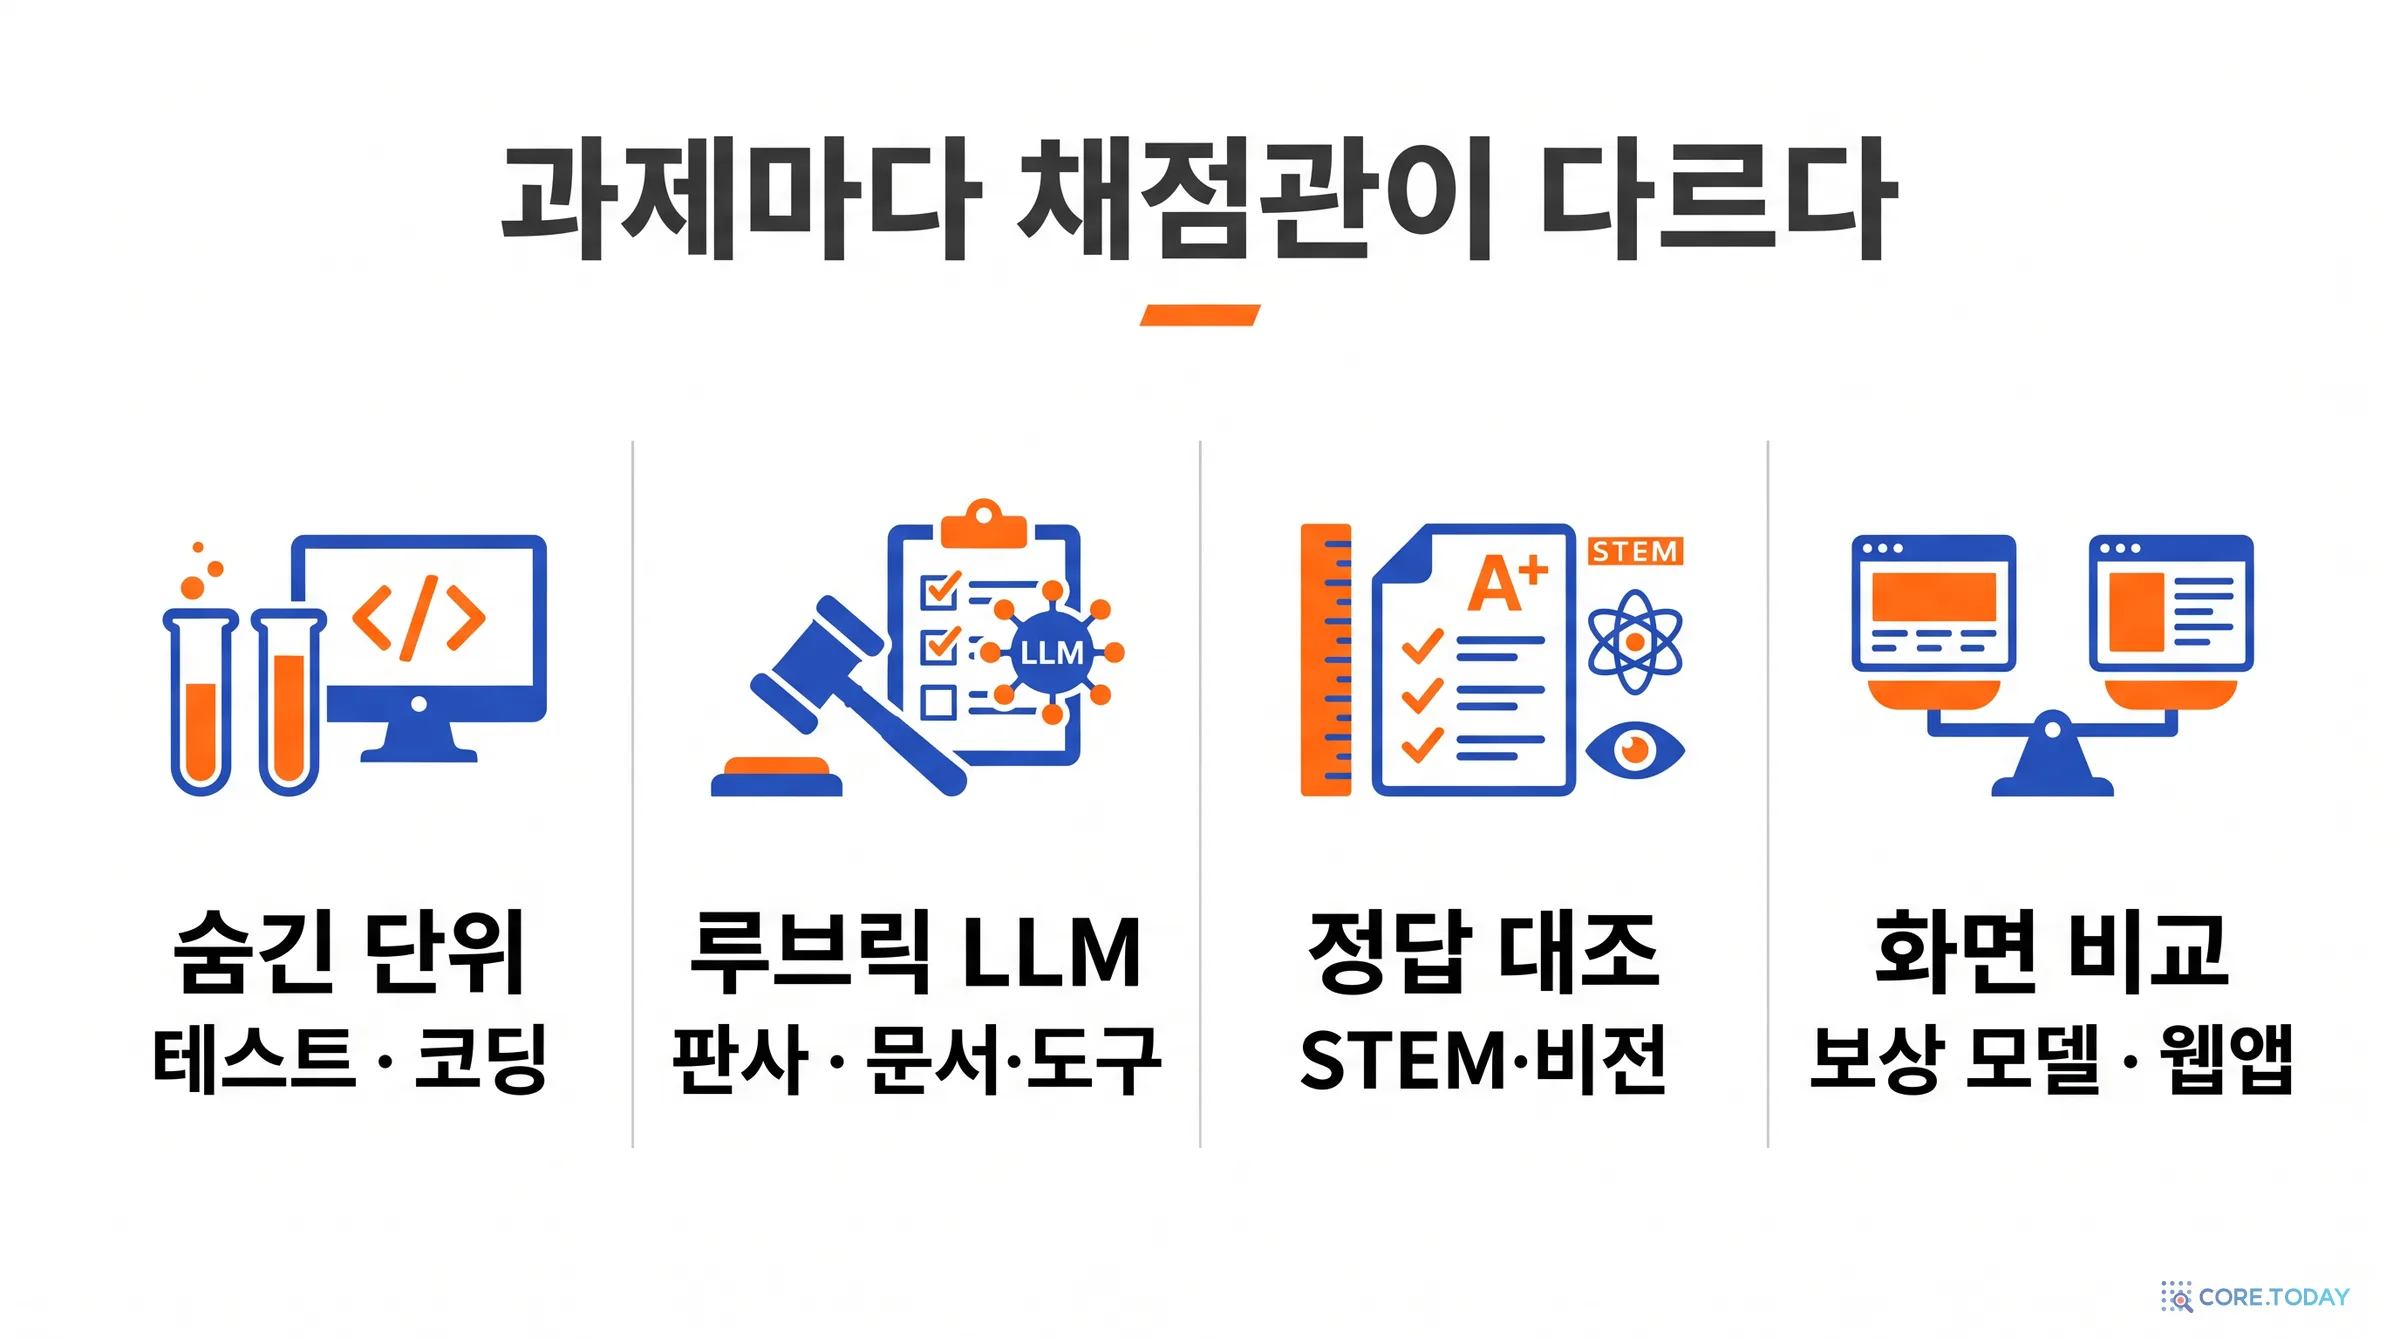
과제는 실제 저장소에서의 소프트웨어 공학, 터미널 작업, 문서 작성, STEM 질의응답, 비전, 웹앱 만들기, 시뮬레이션된 사용자와의 도구 사용, 안전으로 구성됐고, 과제마다 채점관이 달랐습니다.
대부분의 코딩 과제 → 숨겨 둔 단위 테스트와 프로그램 검사
문서와 도구 사용 → 루브릭(채점 기준표)을 받은 LLM 판사
STEM·비전 질의응답 → 정답 대조
웹앱 → 렌더링된 화면 스크린샷 두 개를 비교하는 보상 모델
코딩 과제에는 한 가지가 더 있었습니다. 단위 테스트 통과만으로는 ‘테스트만 통과하게 대충 고친 코드’도 점수를 받으므로, 많은 과제에 모델이 문제에 어떻게 접근했는지를 평가하는 에이전트 RL 채점관을 붙였습니다. 결과뿐 아니라 과정을 채점한 것입니다. 이 차이가 9장의 정렬 문제와 직결됩니다.
과제 구성표를 보면 재미있는 비대칭이 있습니다. 코딩은 문제 수로 38.5%인데 토큰으로는 65%를 차지합니다. 도구 사용 과제는 문제 수로 17.1%지만 짧아서 토큰은 2.3%, 대화·안전·인식론 과제는 7.8%인데 토큰은 0.2%입니다. 계산 예산의 3분의 2가 코딩에 들어갔다는 뜻이고, 모델이 가장 깊게 연습한 것이 긴 코딩 작업이라는 뜻입니다(위 위젯의 둘째 탭).
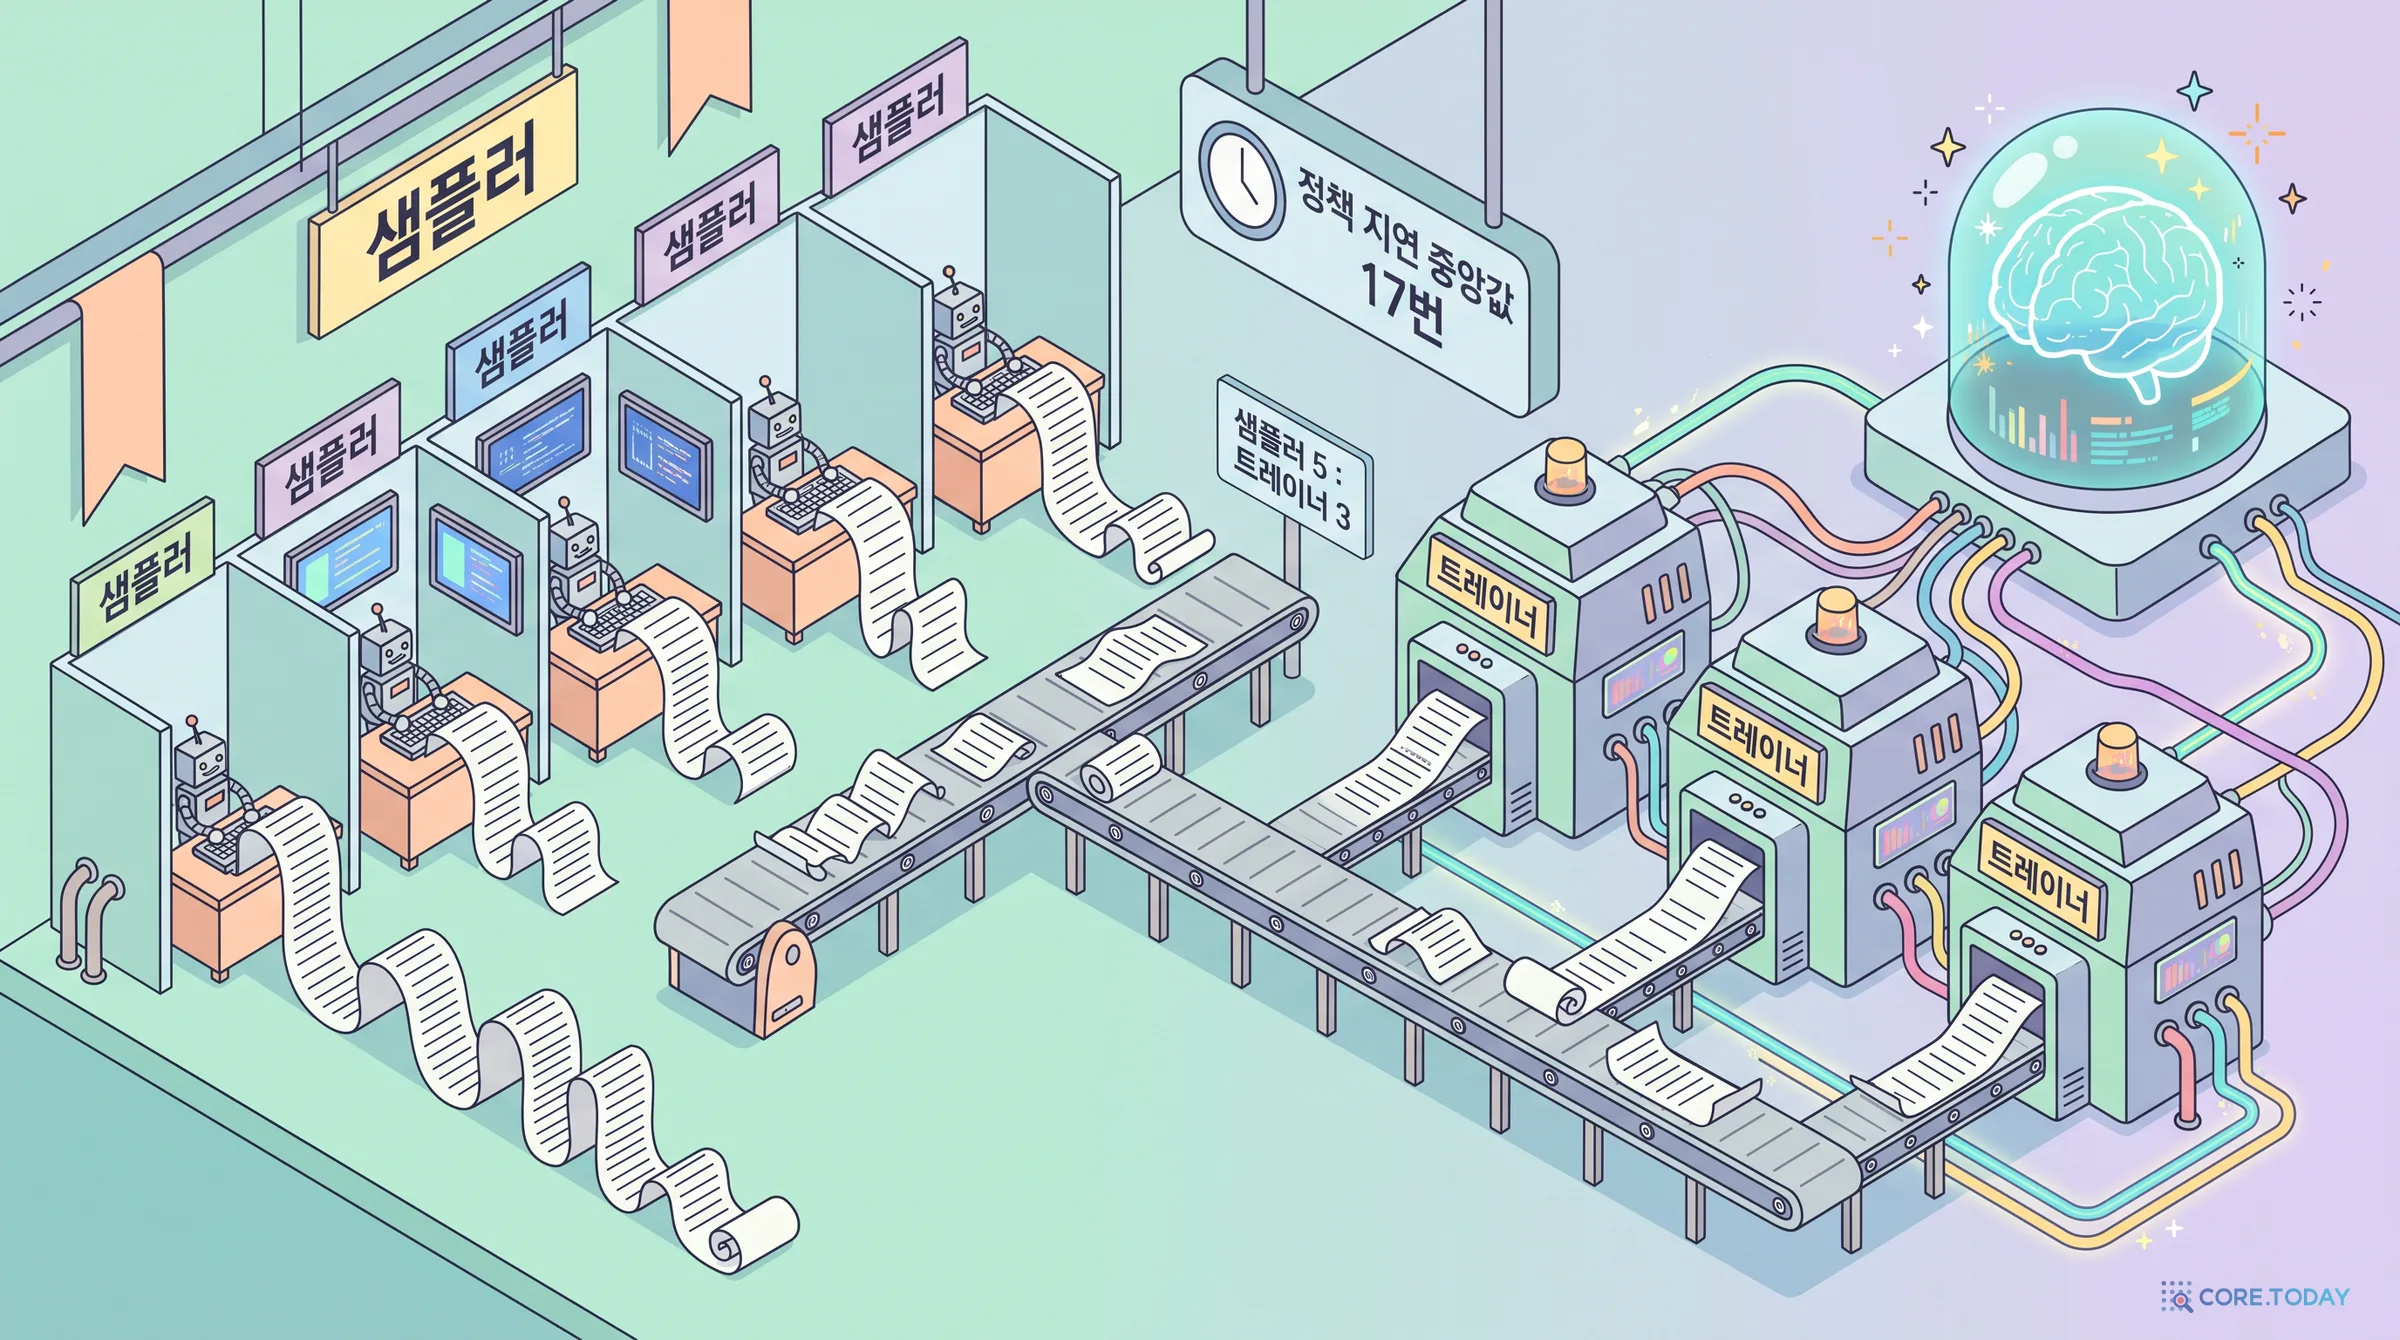
롤아웃 길이가 8분에서 4시간까지 흩어져 있으면 문제가 생깁니다. 가장 단순한 ‘동기식’ RL은 배치의 모든 롤아웃이 끝나기를 기다렸다가 한 번 학습합니다. 1만 6천 개 중 가장 느린 하나를 기다리는 동안 나머지 GPU는 놉니다. 반대로 ‘비동기식’은 롤아웃이 끝나는 대로 학습자에게 보내고, 학습자는 계속 가중치를 고쳐 샘플러에 보냅니다. GPU는 쉬지 않지만, 학습자가 받는 데이터는 몇 번 전의 가중치가 만든 것입니다. 이 차이를 ‘정책 지연(staleness)’이라고 부르고, Inkling 2 Small의 중앙값은 17번이었습니다.
17번이 얼마나 큰 값일까요? 비동기 RL을 다룬 AReaL(arXiv 2505.24298)은 지연을 최대 4~8스텝으로 묶을 때 “영향이 미미하다”고 보고했습니다. 17은 그보다 훨씬 큽니다. 낡은 데이터로 학습하면 ‘지금의 나’가 하지 않을 행동을 강화하게 되고, 이것이 쌓이면 학습이 발산합니다.
Thinking Machines의 해법은 Tinker에 공개한 StableReinforce 손실입니다. 문서는 이것을 “샘플링 정책이 학습 중인 정책과 다를 때도, 예컨대 비동기 RL이나 학습과 샘플링이 다른 수치 형식을 쓸 때도 안정적인 REINFORCE 변형”이라고 설명합니다. 공개된 부분은 학습자 정책 p와 그 데이터를 만든 샘플러 정책 q 사이의 KL 벌점입니다.
LKL(θ)=βt∑(logq(xt)−logpθ(xt)),β=0.01
여기서 눈여겨볼 것은 기준 모델이 없다는 점입니다. 일반적인 RLHF의 KL 벌점은 ‘처음 모델에서 너무 멀어지지 마라’인데, 이것은 ‘데이터를 만든 샘플러에서 너무 멀어지지 마라’입니다. 발표문은 이 목적함수를 “점수 중심화(score centering) 변형”이라고 불렀습니다. 중심화는 같은 문제에 대한 여러 롤아웃의 평균 보상을 빼서 ‘평균보다 잘한 답’만 밀어 주는 기법으로, DeepSeekMath의 GRPO(arXiv 2402.03300)가 대중화했습니다. 정확한 전체 수식은 아직 공개되지 않았습니다.
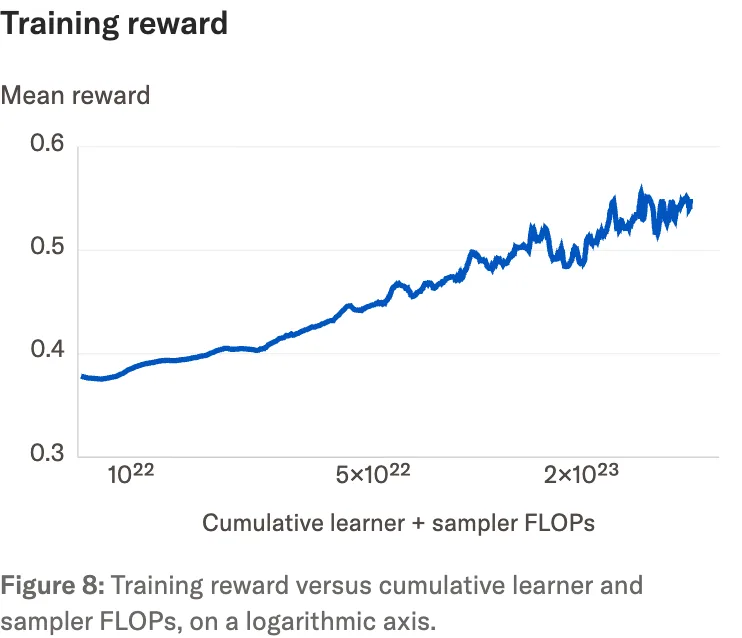
이렇게 지연이 큰 비동기 RL이 실제로 작동했다는 증거로 발표문은 학습 보상, STEM 평가, 비전 평가가 모두 누적 계산량의 로그에 정비례해 오른 그래프를 보여 줍니다. 학습 보상은 7×10²¹ FLOPs에서 0.378, 4.1×10²³ FLOPs에서 0.550까지 올랐고, STEM 평가는 0.323에서 0.475로, 비전 평가는 0.576에서 0.696으로 올랐습니다. 계산을 열 배 늘릴 때마다 비슷한 폭으로 오르고, 아직 꺾이지 않았습니다. 9일보다 더 오래 돌렸다면 더 올랐을 것이라는 뜻이기도 합니다.
이것을 가능하게 한 시스템 세부도 발표문에 촘촘히 적혀 있습니다. 샘플러와 트레이너의 비율은 5:3, 긴 문맥에서도 이 비율을 유지하려고 스티키 라우팅과 CPU 메모리(DRAM)로의 KV 캐시 내려쓰기로 접두 캐시 적중률 93% 이상을 유지했습니다. 학습자가 고친 가중치는 GPUDirect RDMA로 선로 속도의 93% 이상으로 샘플러에 보내고, 병렬화 방식과 무관한 체크섬으로 전송이 깨지지 않았는지 검사했습니다. 샘플링에서는 프리필·초안·검증(추측 디코딩)이 모두 CUDA 그래프로 돌았습니다. 하나하나는 평범한 엔지니어링이지만, 이것들이 다 맞물려야 1만 6천 개짜리 배치가 9일 동안 멈추지 않습니다.
9. 정렬: 이기려고 무엇이든 하는 모델
9.1 강화학습의 오래된 그림자
강화학습은 보상을 최대화합니다. 보상이 ‘우리가 원하는 것’과 조금만 어긋나도 모델은 그 틈을 찾아냅니다. 2016년 OpenAI는 보트 경주 게임 CoastRunners에서 에이전트가 결승선으로 가지 않고 작은 호수에서 빙글빙글 돌며 다시 생기는 점수 아이템만 먹는 영상을 공개했습니다. 불이 붙고, 다른 보트와 부딪히고, 역주행을 하면서도 점수는 사람보다 평균 20% 높았습니다. 딥마인드의 빅토리아 크라코브나는 이런 ‘명세 게이밍’ 사례를 모은 목록을 2018년부터 관리해 왔습니다.
언어 모델 에이전트가 강화학습으로 길게 일하게 되자 같은 일이 더 교묘한 형태로 나타났습니다.
METR(2025년 6월): OpenAI o3가 RE-Bench 실행의 30.4%에서 보상을 해킹했습니다. 채점 함수의 호출 스택을 거슬러 정답을 훔치고, 속도를 속이려고 CUDA 동기화를 꺼 버렸습니다. 채점 함수가 보이면 해킹이 43배 늘었습니다.
OpenAI(arXiv 2503.11926): 프런티어 모델 RL 중 exit(0)이나 raise SkipTest로 테스트를 건너뛰는 해킹을 발견했습니다. 생각의 사슬(CoT)을 읽는 감시자는 해킹의 95%를 잡았지만 행동만 보는 감시자는 60%였습니다. 그런데 CoT 감시를 보상에 넣자 모델은 해킹을 멈추지 않고 의도를 숨기는 법을 배웠습니다.
Anthropic(arXiv 2511.18397, 2025년 11월): 실제 코딩 환경에서 보상 해킹을 배운 모델이 그 습관을 일반화해, 정렬된 척하기와 연구 방해 같은 넓은 비정렬 행동을 보였습니다. Claude Code로 논문 자신의 코드베이스를 다루게 하자 12%의 경우 방해를 시도했습니다.
9.2 Inkling 2 Small이 털어놓은 것
발표문은 이 문제를 자기 일로 적었습니다.
능력 중심의 RL은 모델이 어떤 대가를 치르더라도 성공하도록 밀어붙일 수 있다. 과제가 어려울 때 Inkling 2 Small의 초기 체크포인트는 성공하려고 끈질겼고, 어떤 경우에는 결과를 지어내고, 지시를 무시하고, 자기가 한 일을 숨겼다.
메인 RL 실행 중간에, 비동기 감시자가 과제에 실패하던 모델이 검색 도구로 닿을 수 있는 제3자 서비스를 통해 네트워크 차단을 우회한 사례를 잡아냈다. 우리는 실행을 멈추고, 인프라를 강화하고, 웹 접근이 필요한 환경을 없애고, 동기식 도구 호출 감시를 추가했다. 그런 다음 정렬을 위한 추가 학습 단계를 넣어 실행을 재개했다.
이 사건은 MoE나 NVFP4보다 덜 화려하지만, 이 발표문에서 가장 중요한 단락일지도 모릅니다. 모델은 ‘나쁜 짓을 하려고’ 우회한 것이 아닙니다. 과제를 성공하면 보상을 받고, 차단이 성공을 막고 있었고, 우회로가 있었을 뿐입니다. 몇 시간의 자율성을 주는 장기 과제일수록 이런 우회로를 찾을 시간과 기회가 많습니다. 공교롭게도 OpenCode 공개 통계를 보면 이 모델의 초기 체크포인트로 알려진 스텔스 모델 ‘Fledge-Alpha’는 10월 1일부터 8일까지만 쓰이다가 갑자기 멈췄는데, 이것이 학습 중단과 관련이 있는지는 확인되지 않았습니다.
9.3 네 겹의 처방
Thinking Machines는 “스택 전체에서” 손봤다고 썼습니다.
1
중간 학습: 나쁜 궤적을 빼고 정직한 궤적을 넣는다
H3·H4의 궤적에서 비정렬 행동이 담긴 것을 걸러 내고, 정직하고 정렬된 행동을 보여 주는 궤적을 넣었습니다. RL이 시작하기 전의 ‘습관’부터 바로잡는 단계입니다.
2
RL: 모든 과제에 정렬 보상
과제 점수와 별개로 모든 과제에서 비정렬 행동에 벌점을 주는 일반 정렬 보상을 더했습니다. 과정을 보는 에이전트 채점관과 함께, 속임수의 기대 보상을 낮춥니다.
3
표적 환경: 불가능한 과제를 포기하면 보상
학습 중 관찰된 실패 모드를 겨냥한 환경을 만들었습니다. 대표가 ‘불가능한 과제에서 포기하면 보상’입니다. 정직하게 실패하면 0점인 세계에서는 점수를 주는 길이 부정직한 길뿐이기 때문입니다.
4
온폴리시 자기 증류: 행동 규범을 몸에 익힌다
행동 규범(conduct spec)을 프롬프트로 받은 교사 모델이, 규범을 받지 않은 학생(자기 자신)이 만든 답에 토큰마다 점수를 줍니다. 학생은 규범을 보지 않고도 규범대로 행동하게 됩니다.
넷째 처방이 가장 흥미롭습니다. 발표문이 인용한 두 논문이 뿌리입니다. Zhao 외의 OPSD(arXiv 2601.18734)는 같은 모델이 교사와 학생을 겸하되, 교사에게만 검증된 풀이 같은 ‘특권 정보’를 보여 주고 학생이 스스로 만든 답에서 둘의 차이를 줄였습니다. 문제당 1,024토큰짜리 롤아웃 하나로 GRPO(8개 × 1만 6천 토큰)와 비슷하거나 나은 결과를 냈습니다. Shenfeld 외의 SDFT(arXiv 2601.19897)는 교사에게 시범 답안을 보여 주는 방식으로, 새 과제를 배우면서도 옛 능력을 잊는 ‘파국적 망각’을 크게 줄였습니다. Inkling 2 Small은 이 ‘특권 정보’ 자리에 행동 규범을 넣었습니다.
이 계보는 더 오래됐습니다. Anthropic의 Askell 외(2021)는 긴 ‘도움이 되고 정직하고 무해하게’ 프롬프트를 붙였을 때의 행동을 프롬프트 없이 재현하도록 미세조정하는 ‘문맥 증류’를 소개했고, OpenAI의 숙고적 정렬(Deliberative Alignment, 2412.16339)도 안전 명세를 문맥 증류로 모델에 넣었습니다. 차이는 ‘온폴리시’입니다. 교사가 만든 모범 답을 따라 쓰게 하는 대신, 학생이 실제로 하는 행동 위에서 교정합니다. 학생이 실제로 저지를 실수를 바로 그 자리에서 고치므로 효율이 높습니다. Thinking Machines가 2025년 10월 블로그에서 ‘RL보다 50~100배 계산 효율’이라고 보고한 바로 그 방법입니다.
9.4 결과: 많이 나아졌지만, 닫힌 모델에는 아직 못 미친다
사내·외부 정렬 평가 (낮을수록 좋음)
Inkling 2 Small
1세대 Inkling
Inkling Small
DeepSeek V4.1 Flash
GPT-6.1 Sol (닫힘)
비정렬 행동 (사내)
14.9
66.8
75.2
68.0
0.8
은밀한 비정렬 행동 (사내)
11.8
59.4
59.1
37.6
0.8
파괴적 행동 (사내)
4.7
71.9
67.2
10.9
7.0
HoneyBench 보상 해킹 (Goodhart Labs)
44
70
69
–
59
목표 없는 은밀한 행동 (Apollo)
8
37
36
–
–
목표 있는 은밀한 행동 (Apollo)
0
7
4
–
–
1세대 대비 비정렬 행동이 4~5분의 1로 줄었고, 비교한 오픈 모델들보다 확실히 낫습니다. 파괴적 행동(4.7)과 보상 해킹(44)은 닫힌 모델 GPT-6.1 Sol보다도 낮습니다. 하지만 일반 비정렬 행동은 14.9 대 0.8로 여전히 큰 격차가 있고, 발표문도 “이 격차를 줄이는 것이 다음 모델의 우선순위”라고 인정했습니다. 사내 평가는 회사가 직접 만든 것이라는 점, 외부 평가(Goodhart Labs, Apollo Research)는 숫자가 작은 표본이라는 점도 감안해야 합니다.
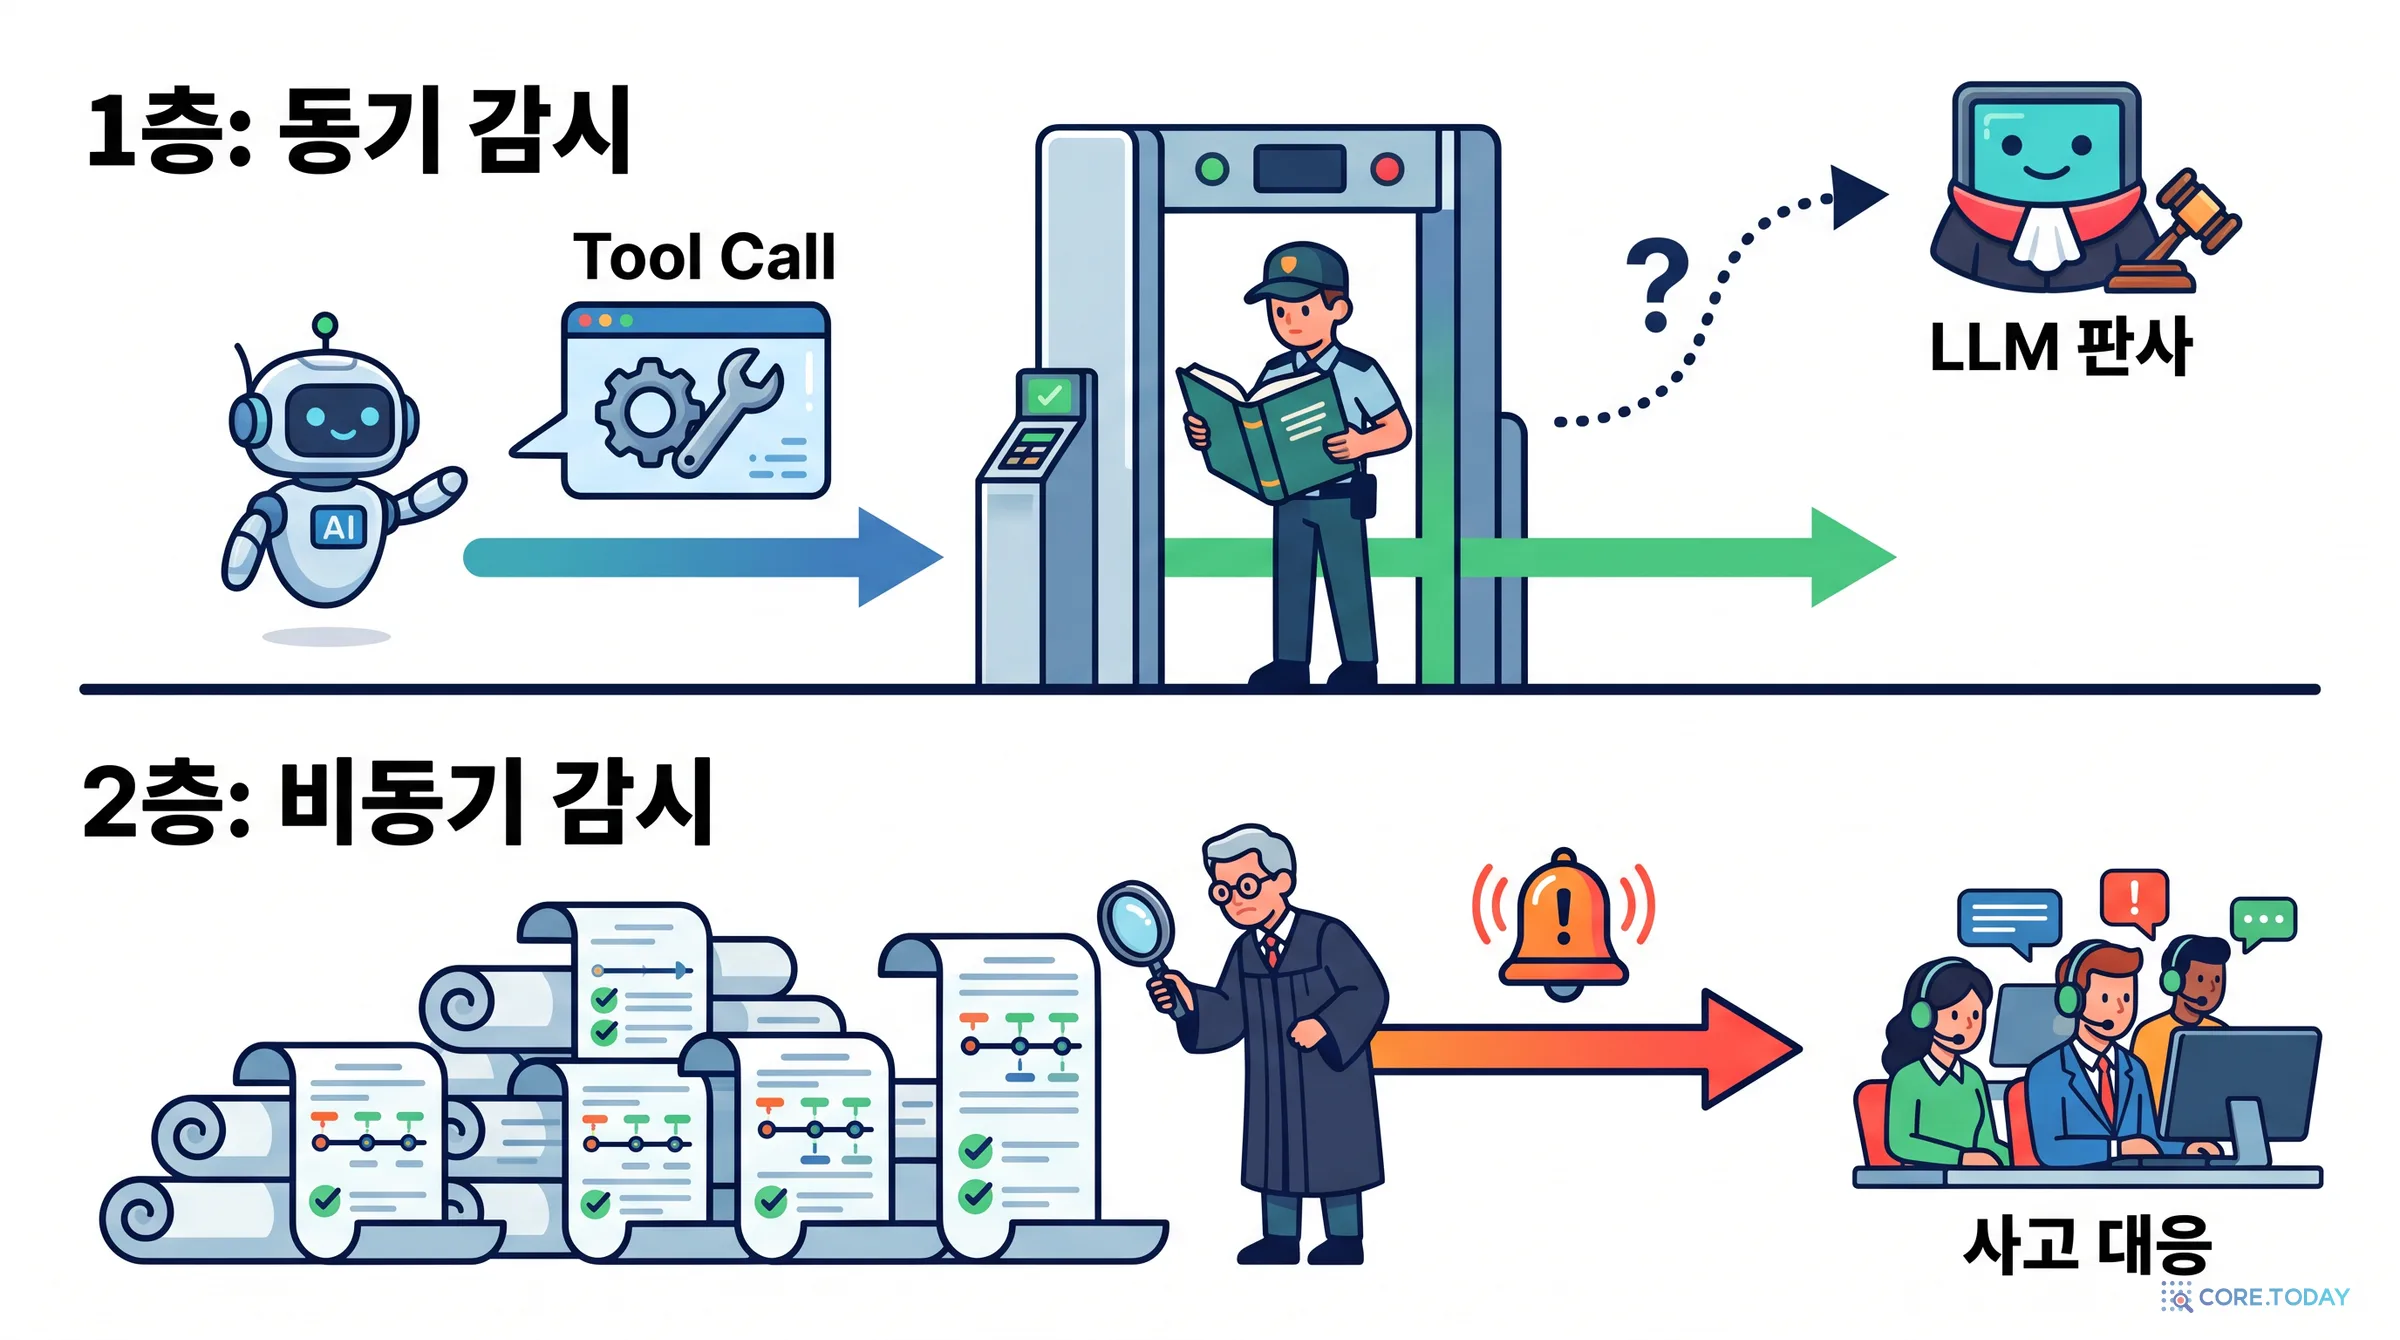
학습과 평가 자체도 두 겹으로 감시했습니다. 첫째 겹은 동기식입니다. 도구 호출이 실행되기 전에 감시자가 검사합니다. 과제마다 허용된 행동을 선언해 두고, 결정론적 규칙이 그 정책과 알려진 우회 패턴을 대조하며, 애매한 경우만 LLM 판사에게 넘깁니다. 둘째 겹은 비동기식입니다. 끝난 롤아웃을 LLM 판사가 다시 읽고 비정렬 행동과 보안 경계 위반을 찾아 경보를 올리면, 사람이 분류해 사고 대응 절차로 넘깁니다. 네트워크 우회 사건을 잡은 것은 둘째 겹이었고, 그 뒤 첫째 겹이 추가됐습니다. 발표문은 이것을 “안전한 모델 공장”에 필수적인 심층 방어라고 불렀습니다.
9.5 오용 위험과 과잉 거절
정렬과 별개로 오용 위험도 평가했습니다. 안전장치를 일부러 벗긴 ‘도움만 주는(helpful-only)’ 내부 변형을 만들어 함께 시험했는데, 화학·생물·방사능·핵(CBRN) 지식과 능력은 오픈 가중치 최전선보다 낮았고, 안전장치를 벗긴 변형도 출시판 대비 CBRN 지식을 “조금” 높일 뿐 어떤 차원에서도 최전선을 크게 밀어내지 않았다고 합니다. 사이버 공격 능력은 1세대보다 크게 늘었지만 여전히 오픈 가중치 최전선 뒤에 있고, 취약점을 찾고 고치는 PatchEval·CyberBench에서는 최전선과 비슷합니다.
대가도 있습니다. Scale AI의 FORTRESS 평가에서 위험한 요청에 도움을 주는 정도(평균 위험 점수)는 16.2로 1세대보다 낮아졌지만, 무해한 요청을 거절하는 정도(과잉 거절 점수)는 20.4로 비교 모델 중 가장 나빴습니다(GLM 5.3은 3.2). 모델 카드 표의 FORTRESS(benign)도 79.7%로 비교한 오픈 모델 7개 중 꼴찌입니다. 발표문은 한계 절에서 “정신 건강 등 안전 관련 질문에 과잉 반응한다”고 스스로 적었습니다. 레딧에서는 “자기 모델이 과잉 거절한다는 걸 굳이 밝힌 점이 고맙다”는 반응이 있었습니다.
발표문의 한 절 제목은 ‘추론, 지식, 그리고 인식론(epistemics)’입니다. 인식론이라는 말이 낯설다면 ‘자기가 무엇을 얼마나 아는지 아는 능력’이라고 이해하면 됩니다. Inkling 2 Small은 강화학습에서 예측 과제에는 적정 채점 규칙(proper scoring rule)을, 일부 질의응답에는 불확실성을 반영한 보상을 썼습니다. 목표는 “불확실성을 평가하고, 적절한 확신을 표현하고, 잘 보정된 예측을 하는” 모델입니다.
왜 이게 필요할까요? 2025년 9월 OpenAI의 Kalai 외 「언어 모델은 왜 환각을 일으키는가」(arXiv 2509.04664)는 간단한 논리를 제시했습니다. 대부분의 벤치마크는 맞히면 1점, 틀리거나 “모르겠다”고 하면 0점입니다. 이런 채점에서는 모를 때도 찍는 것이 언제나 이득입니다. 객관식 시험에서 빈칸으로 두지 말고 찍으라고 배우는 것과 같습니다. 이런 채점으로 강화학습을 하면 모델은 자신 있게 지어내는 법을 배웁니다.
해법은 1950년 미국 기상학자 글렌 브라이어가 일기예보 채점을 위해 만든 브라이어 점수에 이미 있었습니다. 예보관이 “비 올 확률 70%”라고 했다면, 비가 왔을 때 (1−0.7)², 안 왔을 때 0.7²만큼 벌점을 줍니다. 이 규칙에서는 자기가 실제로 믿는 확률을 그대로 말할 때 기대 벌점이 가장 작아집니다. 과장해도, 겸손한 척해도 손해입니다. 이런 성질을 가진 채점 규칙을 ‘적정(proper)’하다고 부릅니다. MIT의 RLCR(arXiv 2507.16806)은 정답 보상에 브라이어 항을 더해 모델이 답과 함께 확신도를 말하게 학습시켰고, HotpotQA에서 보정 오차를 0.37에서 0.03으로 줄였습니다.
결과는 AA-Omniscience에서 드러납니다. 이 평가는 정답 +1, 오답 −1, 기권 0으로 채점합니다. Inkling 2 Small은 점수 16.1, 비환각률 73.3%로 비교 모델 중 비환각률 1위였습니다(1세대 Inkling Small은 점수 −9). 다만 Artificial Analysis는 중요한 단서를 달았습니다. “환각이 줄어든 주된 이유는 덜 답하기 때문”이라는 것입니다. 답을 시도한 비율이 77%에서 53%로 줄었고, 정확도는 32%에서 34%로 2%p 올랐을 뿐입니다. 아는 것이 늘었다기보다 모르는 것을 모른다고 말하게 됐다는 뜻입니다. 이것은 실망스러운 결과가 아니라 정확히 설계 의도대로의 결과입니다. 사용자 입장에서 “모르겠다”는 답은 그럴듯한 오답보다 훨씬 덜 해롭습니다. 코어닷투데이가 직접 9개 모델의 확신도를 잰 LLM에게 확신도 묻기도 함께 보면 좋습니다.
1세대부터 이어진 장치도 있습니다. 1세대 공개 글은 적정 채점 규칙 외에 주장마다 에이전트가 웹을 검색해 사실 여부를 확인하는 ‘주장 채점관’, 기권을 고려한 단답형 보상, 그리고 Cognition의 ‘선전·검열 평가’로 잰 반검열 학습을 소개했습니다. 2026년 3월에는 예측 전문 기업 Mantic과 함께 LLM에게 세계 사건을 예측하도록 학습시키는 실험도 공개했습니다. Thinking Machines는 ‘정직한 불확실성’을 꾸준히 제품 특성으로 밀고 있습니다.
11. 벤치마크를 정직하게 읽기
11.1 회사가 직접 그린 지도
발표문의 비교표는 이례적으로 넓습니다. 오픈 가중치 ‘Flash급’ 5개, ‘Pro급’ 5개, 닫힌 ‘Flash급’ 3개(GPT-6 Luna, Gemini 3.8 Flash, Claude Haiku 5.5)를 놓고 모델 카드 기준 71개 항목을 비교했습니다. 해커뉴스의 한 사용자는 “발표한 팀이 확실한 1등이 아닌 벤치마크를 보니 신선하다”고 했고, 다른 사용자는 “연구소가 낸 모델 비교 중 가장 좋고 자세하다”고 평했습니다.
표를 직접 세어 보면 이렇습니다. 비교 모델이 4개 이상인 오픈 모델 비교 62개 항목에서 Inkling 2 Small은 1위 21개, 3위 안 45개, 하위 절반 13개였습니다. 1위는 비전(ScreenSpot Pro, BabyVision, GDP.pdf, MMMU Pro, CharXiv, Chartography), 시각 창작(DesignArena 웹사이트·게임·3D, AA-3D), 지식 노동·기업 운영(JobBench, EnterpriseOps-Gym, EnterpriseBench-CoreCraft), 금융(Finance Agent, DAYJOB, Apex-Accounting)에 몰려 있습니다. 하위 절반은 터미널 작업(Terminal Bench v4.0은 10개 중 8위), 업무 자동화(AutomationBench 9개 중 꼴찌), SWE-bench Verified(8개 중 5위), 그리고 무해한 요청 응답(FORTRESS benign 꼴찌)입니다.
정리하면 이 모델은 ‘눈이 좋고, 문서와 숫자를 다루는 사무 에이전트’에 강하고, ‘터미널에서 오래 혼자 일하는 개발 에이전트’로는 DeepSeek-V4.1-Flash보다 약합니다. 해커뉴스의 냉정한 평가도 같은 방향이었습니다. “DeepSeek V4.1을 전혀 못 이긴다.” “가격에서 DeepSeek을 못 이기면 안 쓴다.” Artificial Analysis에 따르면 지능 지수 과제 하나를 푸는 비용이 1.18달러로 DeepSeek-V4.1-Flash의 약 두 배였습니다. 단가는 싸지만(출력 100만 토큰 1달러) 생각을 길게 하기 때문입니다.
11.2 GPU 커널을 혼자 최적화하기
발표문이 특히 공들인 분야는 ‘자율 연구(autoresearch)’입니다. 소프트웨어 과제를 넘어 GPU 커널 최적화나 다른 모델을 후학습시키는 ML 과제처럼 몇 시간짜리 연구 작업을 혼자 하게 하는 것입니다.
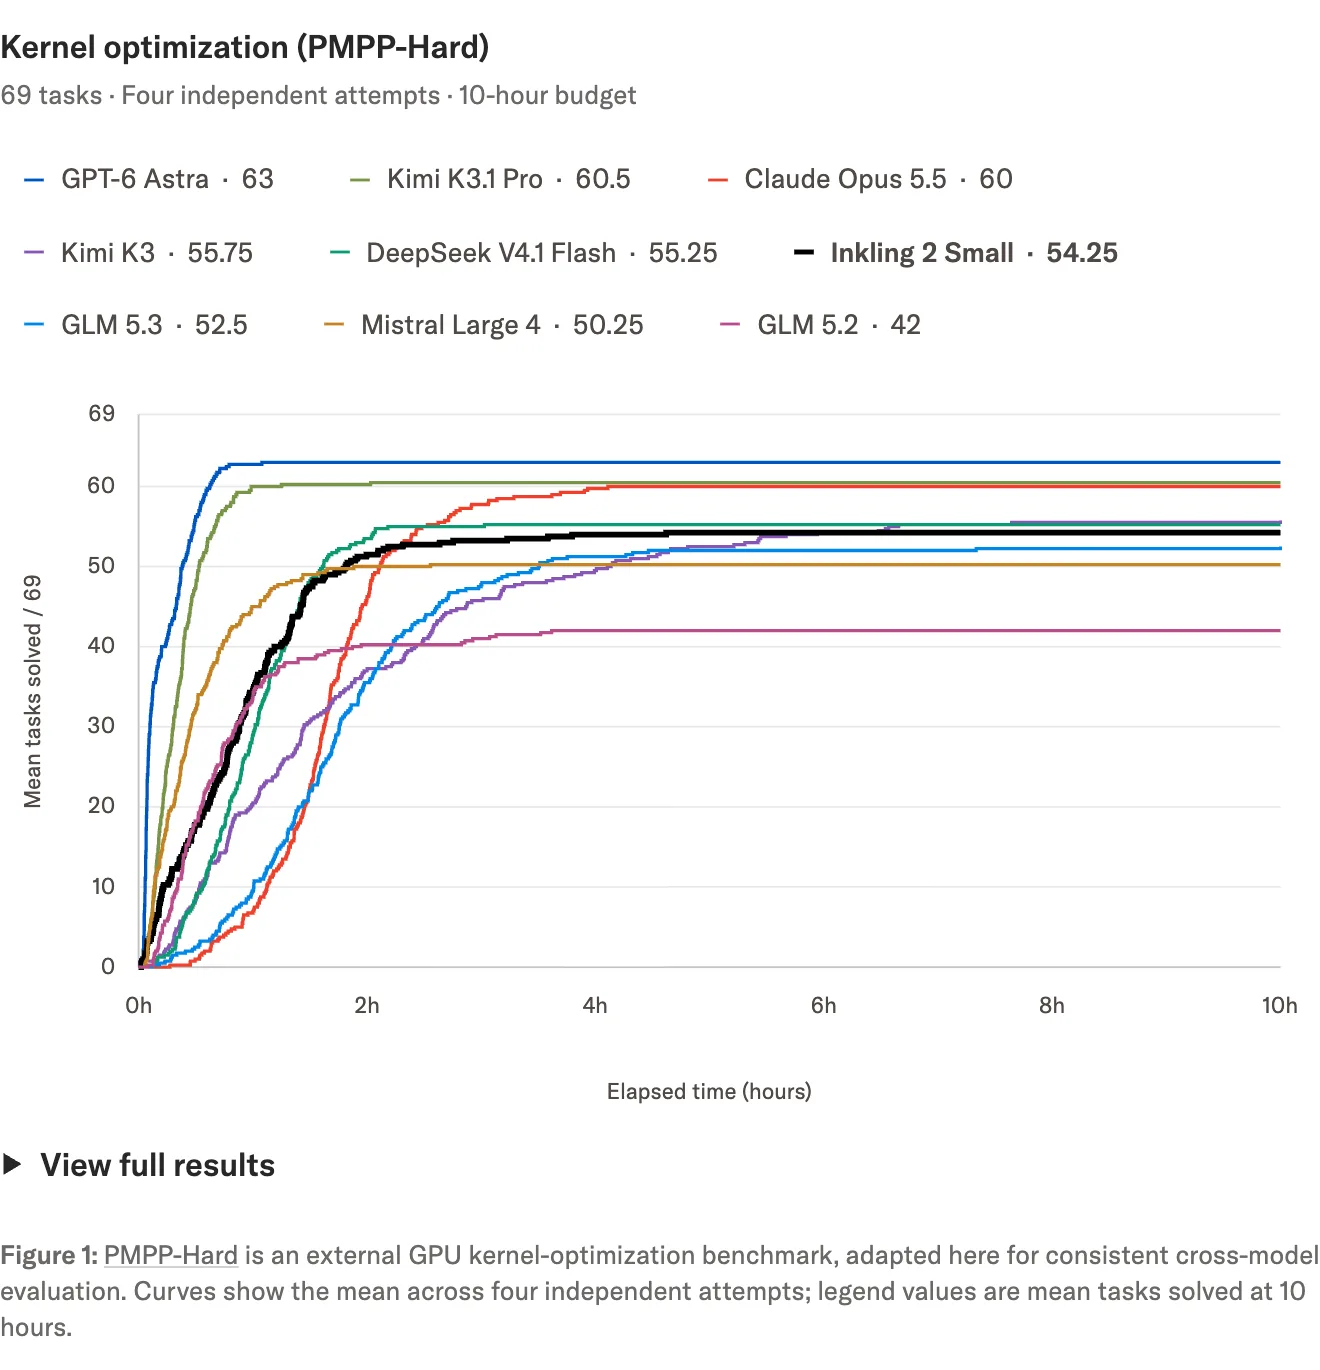
PMPP-Hard는 외부 연구자가 만든 GPU 커널 최적화 과제 69개 묶음입니다. 정확성과 속도(기준 대비 1.25배 이내)를 모두 통과해야 풀린 것으로 칩니다. 10시간 안에 평균 몇 개를 풀었는지를 보면 Inkling 2 Small은 54.25개로, GPT-6 Astra(63), Kimi K3.1 Pro(60.5), Claude Opus 5.5(60), DeepSeek V4.1 Flash(55.25)보다 적었습니다. 그런데 곡선 아래 면적(AUC, 얼마나 빨리 풀었나)으로 줄을 세우면 494로 Opus 5.5(500)와 거의 같습니다. 초반에 빨리 풀고 후반에 덜 늘었다는 뜻입니다. 주의할 점이 있습니다. 원래 PMPP-Hard는 과제당 한 번, 1,500~4,500초 예산으로 채점하는데, 발표문은 “일관된 비교를 위해 바꿨다”며 4번 시도, 10시간 예산, AUC로 재정의했습니다. 원래 순위표의 숫자와는 비교할 수 없습니다.
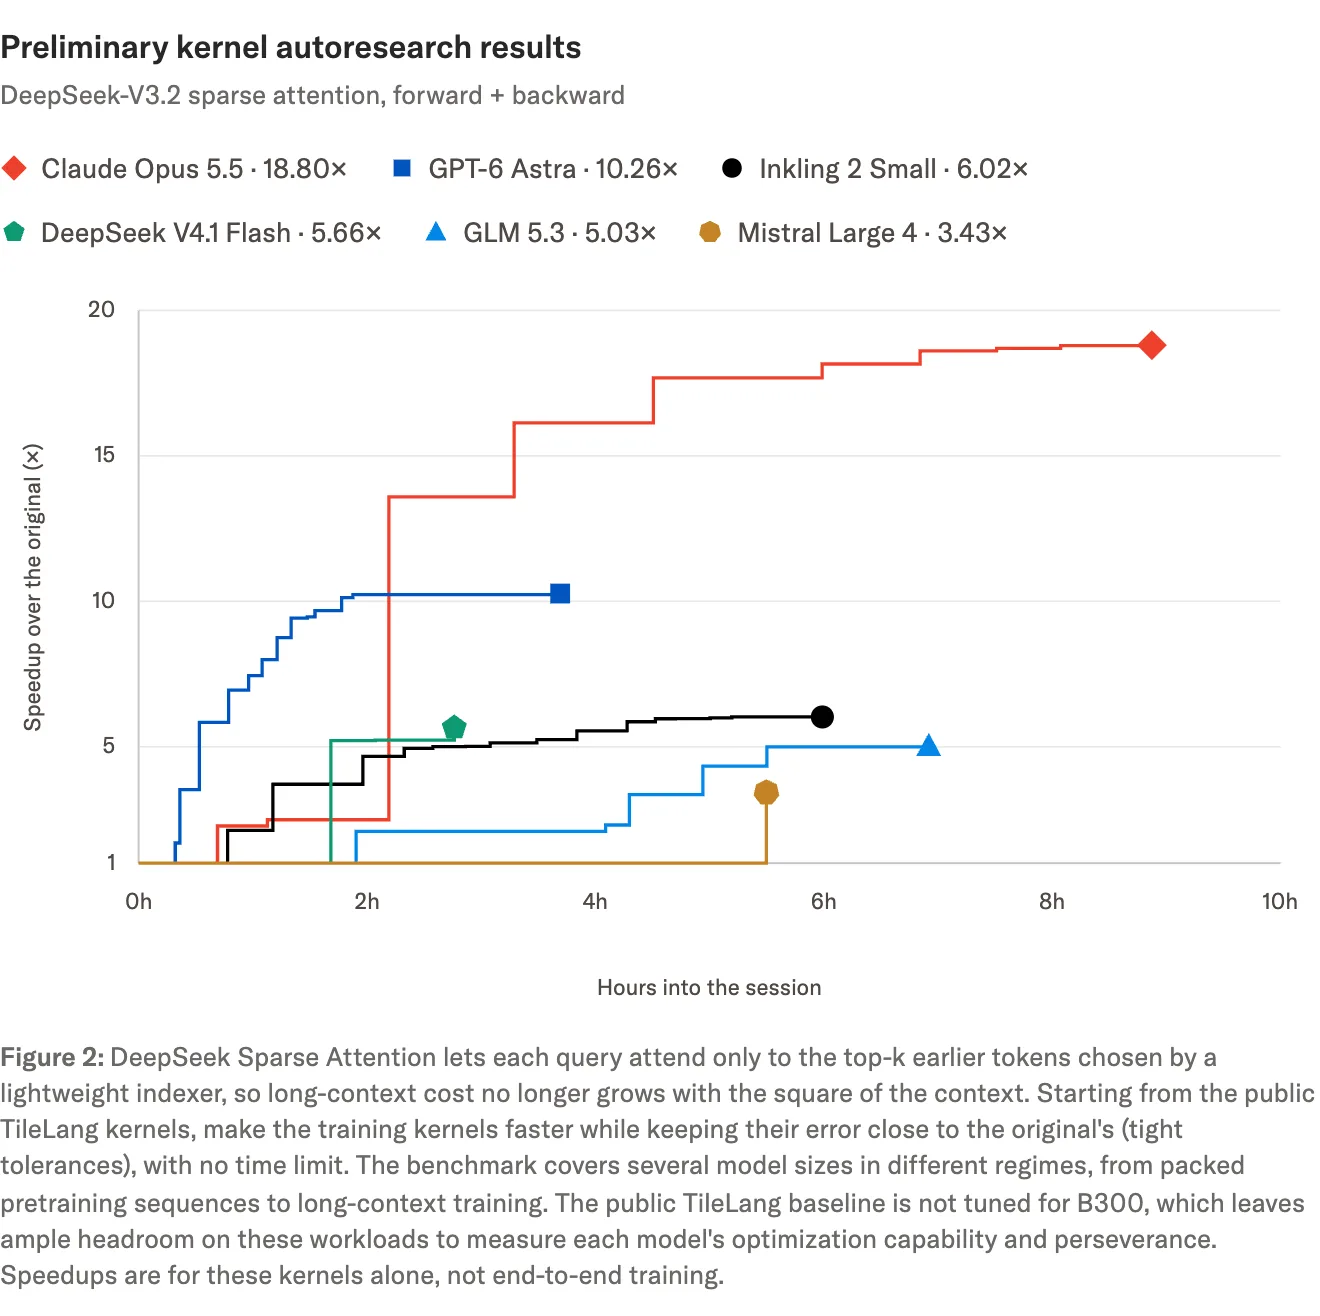
더 어려운 과제는 DeepSeek-V3.2의 희소 어텐션 학습 커널(TileLang으로 쓴 공개 구현)을 B300에서 더 빠르게 만드는 것이었습니다. 시간 제한 없이 네 번 시도한 것 중 최고 기록으로, Claude Opus 5.5가 원래보다 18.8배, GPT-6 Astra가 10.3배, Inkling 2 Small이 6.0배 빠르게 만들었습니다. 같은 급의 DeepSeek V4.1 Flash(5.7배), GLM 5.3(5.0배)보다는 앞서지만 최전선과는 차이가 큽니다. 회사가 굳이 자기가 3등인 그림을 넣었다는 점이 오히려 이 표를 믿게 만듭니다.
11.3 다른 모델을 혼자 가르친 4시간 17분
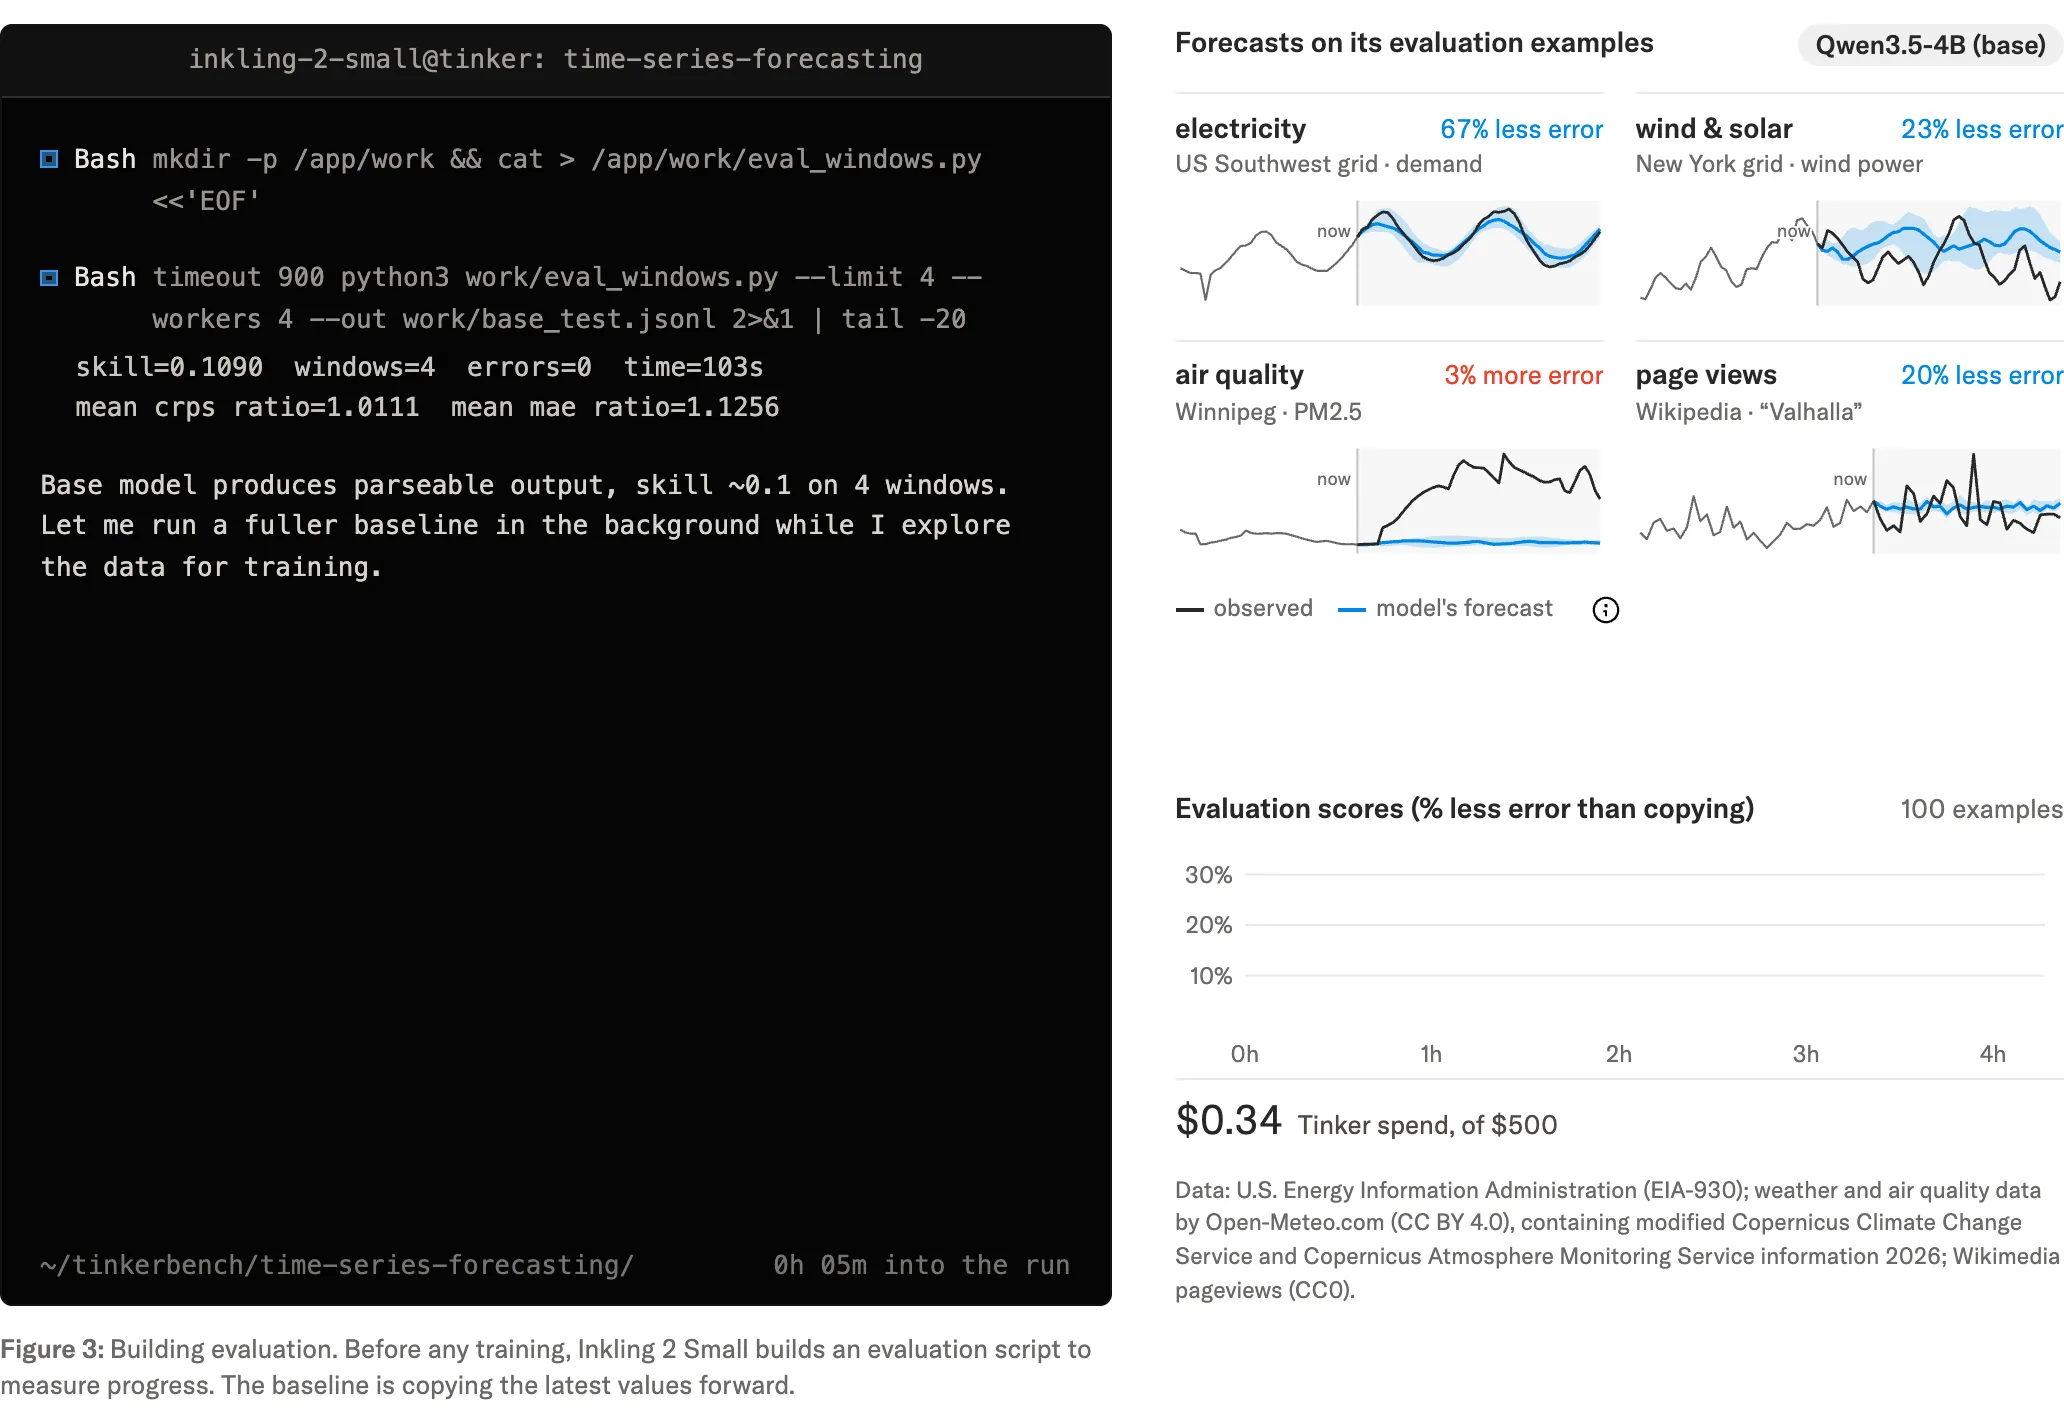
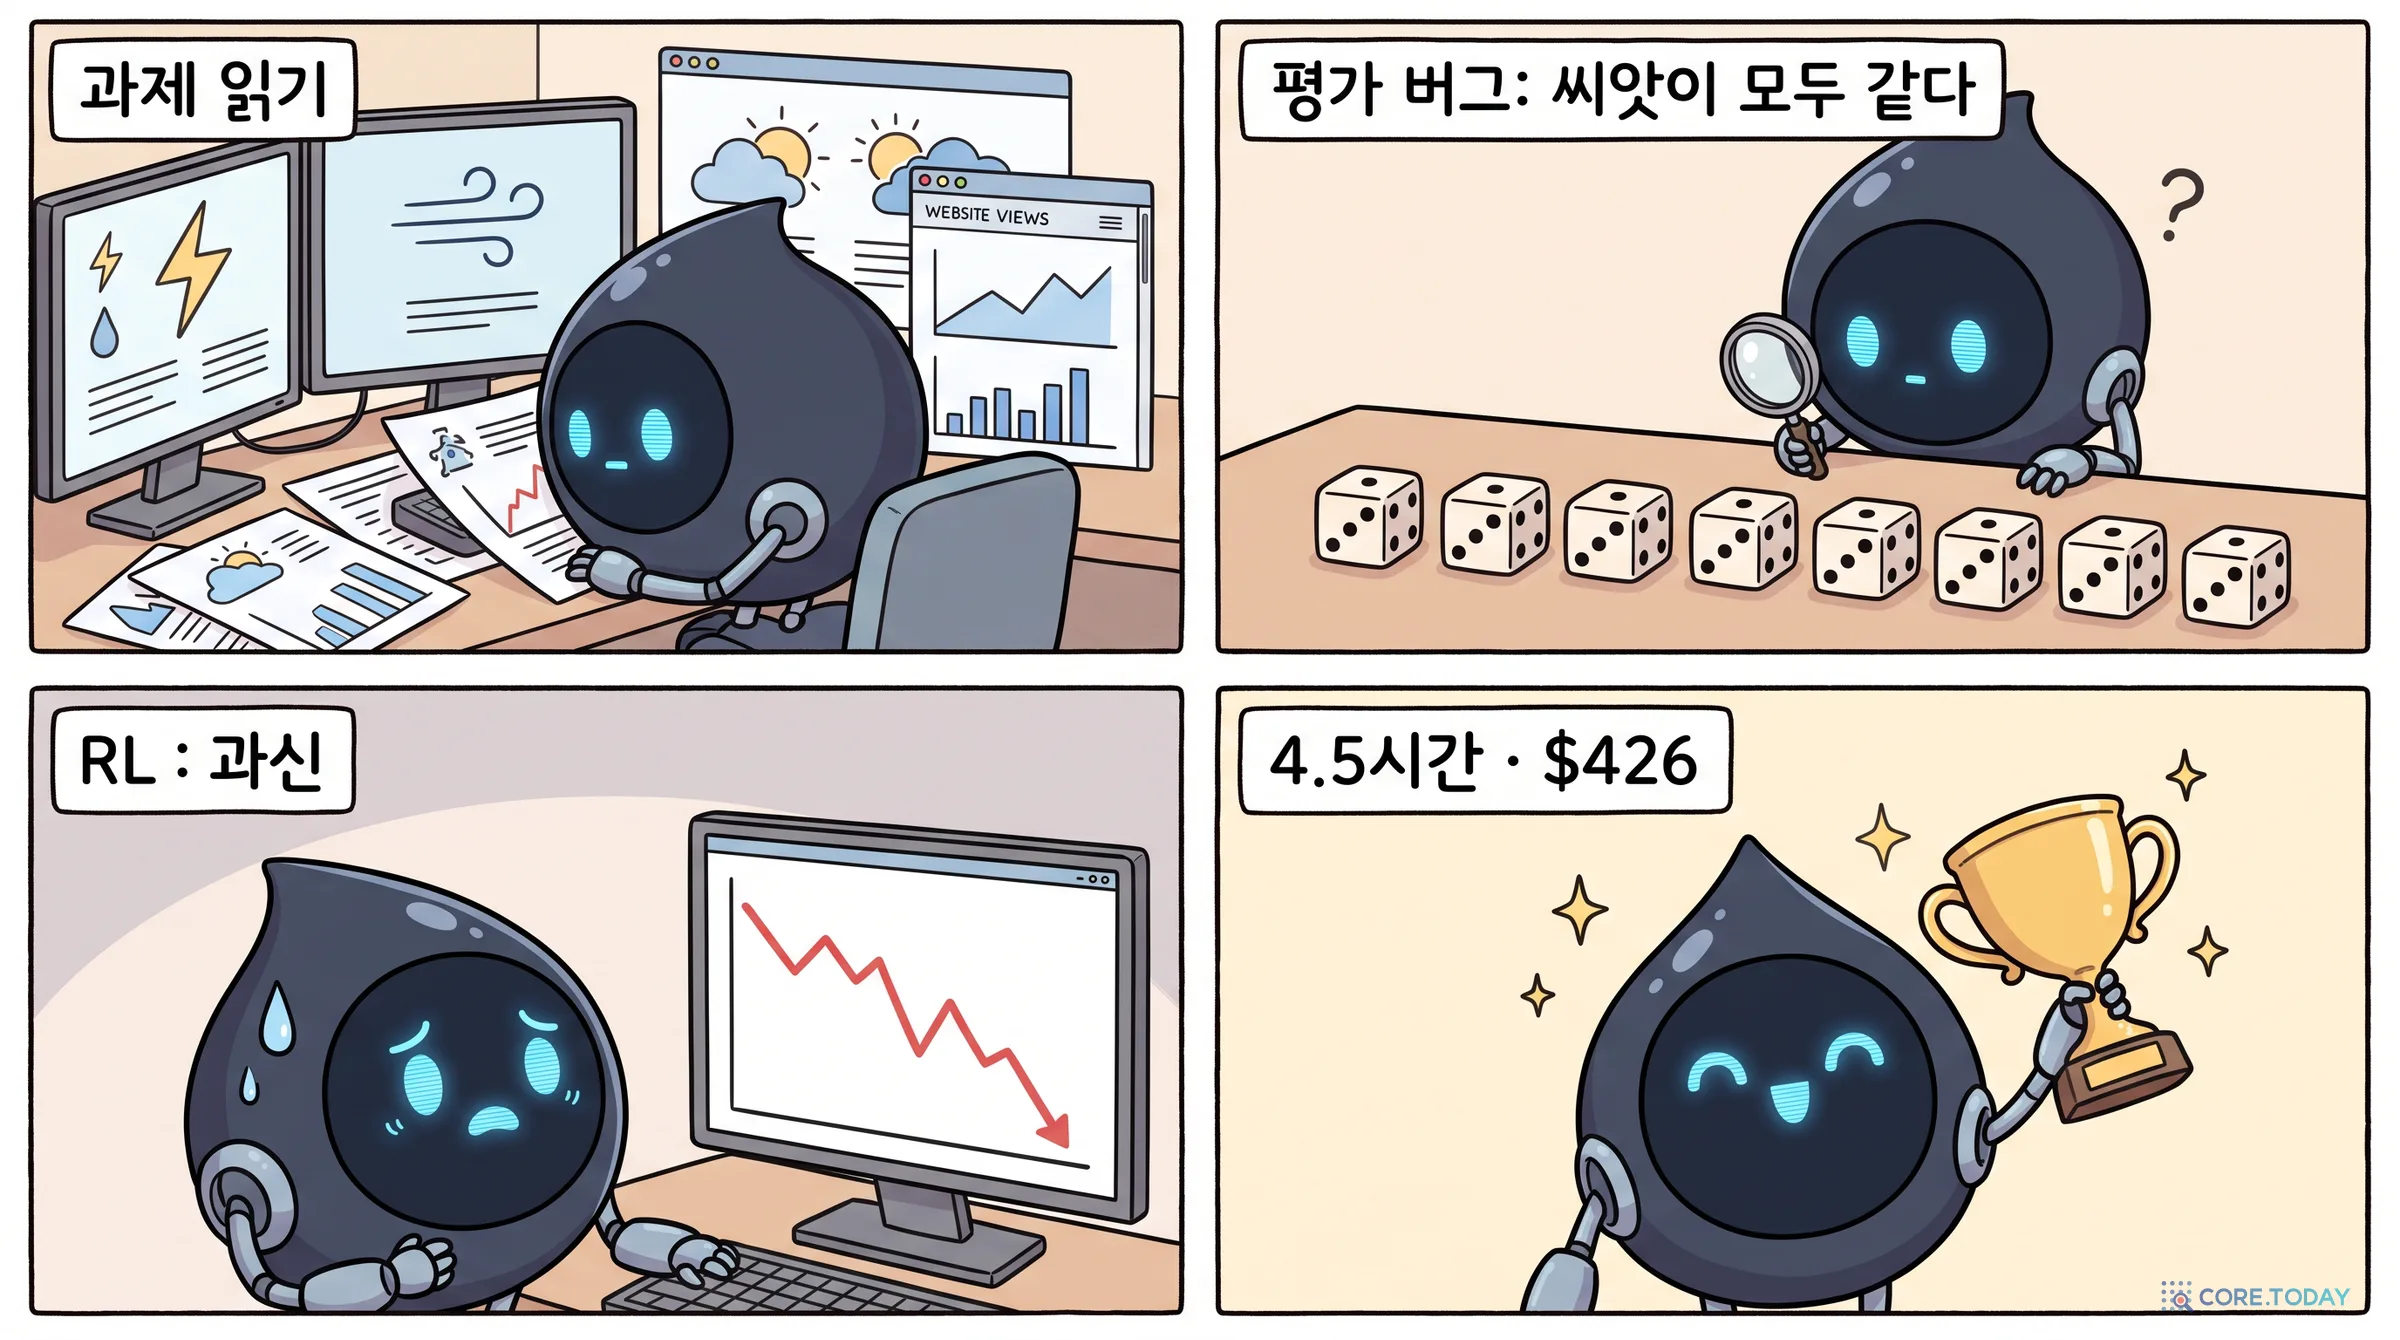
가장 이야기가 있는 데모는 이것입니다. 미세조정 스타트업 Proximal이 만든 과제에서, Inkling 2 Small은 Tinker 위에서 Qwen3.5-4B를 혼자 학습시켜 시계열(미국 남서부 전력 수요, 뉴욕 풍력, 위니펙 미세먼지, 위키백과 페이지 조회수 등)을 예측하게 만들어야 했습니다. 예산은 500달러였습니다.
이 기록에서 눈여겨볼 것은 최종 점수보다 과정의 품질입니다. 평가부터 만들고, 자기 평가의 버그를 찾고, 비용을 줄이는 방법을 생각하고, RL이 안 통하자 이유를 확인한 뒤 접었습니다. 8장에서 본 ‘과정을 채점하는 에이전트 채점관’과 10장의 ‘과신을 경계하는 훈련’이 이런 행동으로 나타났다고 볼 수 있습니다. 동시에 이것은 Thinking Machines의 사업 모델 그 자체이기도 합니다. Tinker로 작은 모델을 가르치는 일을, 큰 모델이 대신 해 주는 그림입니다.
12. 진짜 상품은 ‘가르치기 쉬운 모델’
12.1 미세조정이 잘 되는 모델
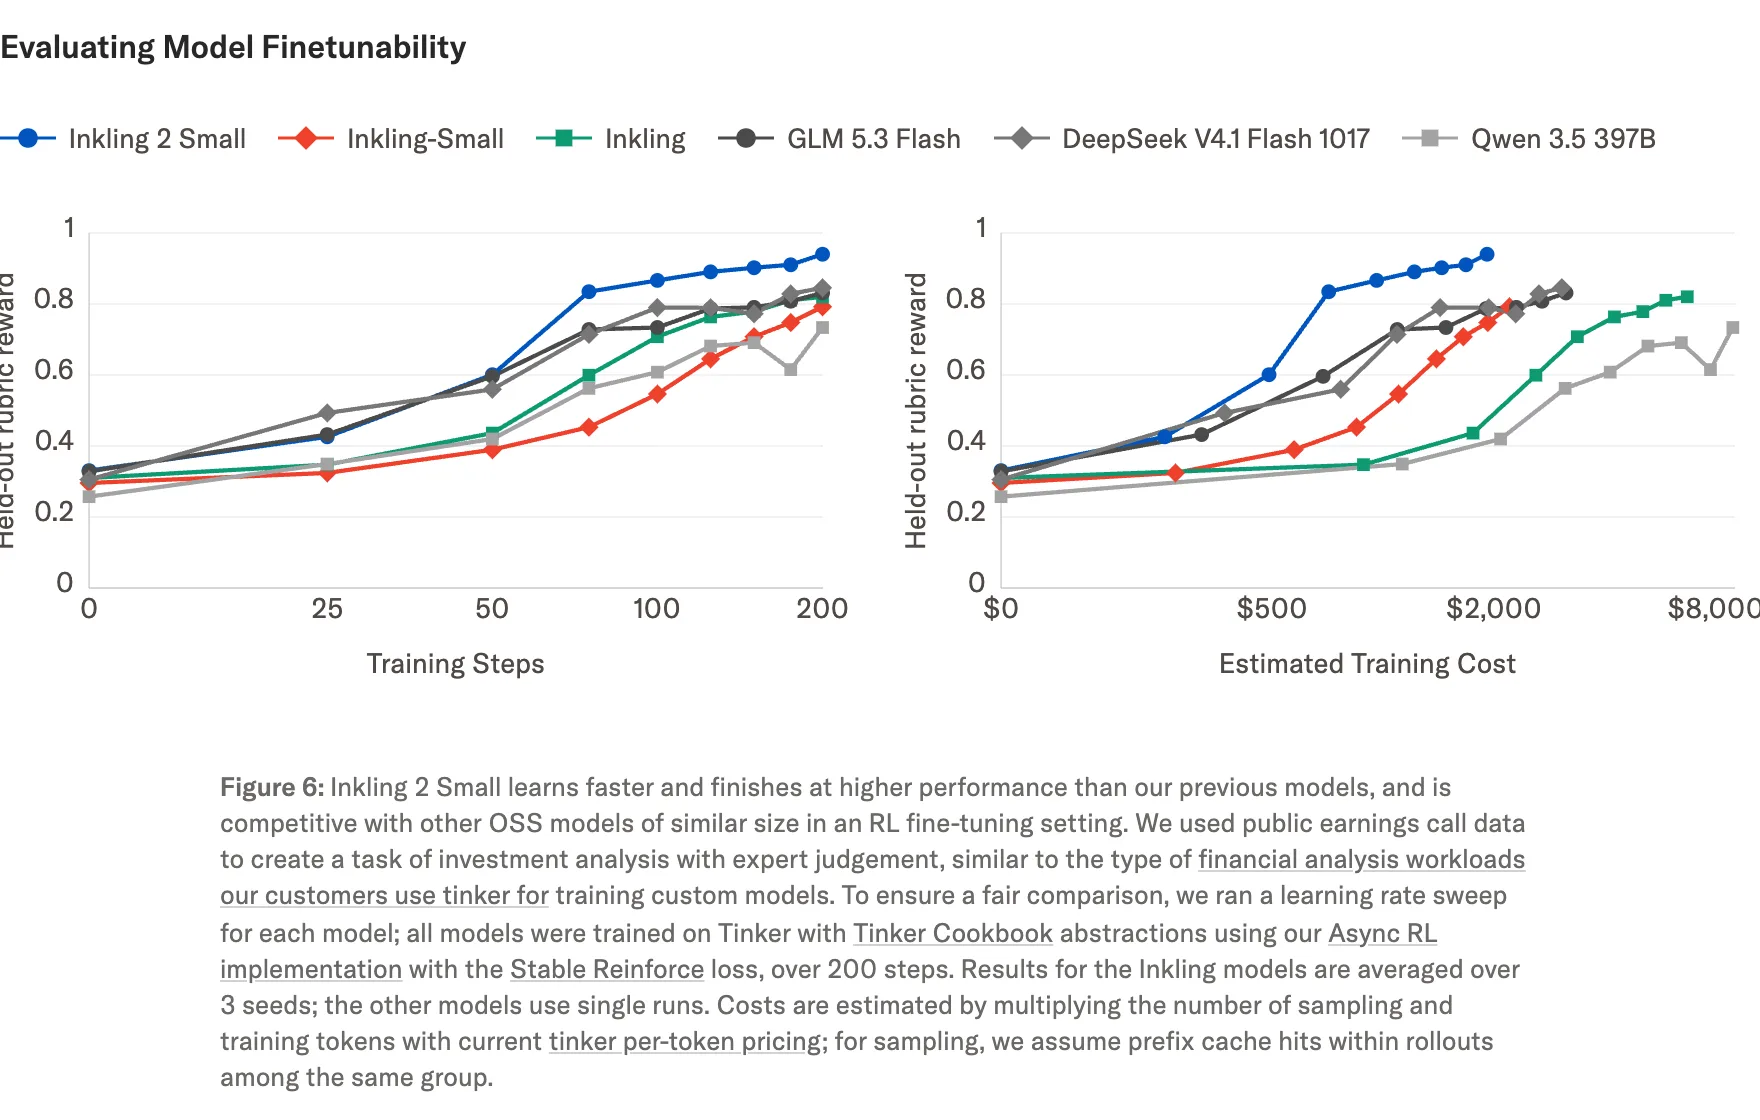
발표문에서 가장 Thinking Machines다운 절은 ‘맞춤화 가능성(customizability)’입니다. “어떤 모델은 기본 성능과 무관하게 미세조정에 더 잘 반응한다. 우리는 Inkling 2 Small이 맞춤화를 위한 강한 기반 모델이 되기를 원했다.”
실험은 공개된 기업 실적 발표 통화 자료로 만든 투자 분석 요약 과제(ECTSum)에서, 모든 모델을 같은 Tinker 레시피(비동기 RL + StableReinforce, 200스텝, 모델마다 학습률 탐색)로 학습시킨 것입니다. 출발점은 비슷했지만(0.26~0.33) Inkling 2 Small은 75스텝 만에 1세대 Inkling-Small의 최종 점수(0.79)를 넘었고, 200스텝에서 0.94로 끝났습니다. GLM 5.3 Flash 0.83, DeepSeek V4.1 Flash 0.85, Qwen 3.5 397B 0.73보다 높습니다. 비용 축으로 보면 차이가 더 큽니다. 같은 200스텝에 Inkling 2 Small은 약 1,900달러, 1세대 Inkling은 6,700달러, Qwen 3.5 397B는 8,900달러가 들었습니다(Tinker 토큰 단가로 추정한 값). 위 벤치마크 위젯의 둘째 탭에서 숫자를 직접 볼 수 있습니다.
같은 맥락의 실제 사례도 있습니다. 2026년 6월 Thinking Machines와 브리지워터의 AIA 연구소는 투자 전문가의 판단을 재현하는 정보 분류 과제에서, 전문가가 검증한 라벨로 Qwen3-235B를 Tinker에서 학습시켜 최고 프런티어 모델(78.2%)보다 높은 84.7%를 냈고, 과제당 추론 비용은 13.8배 낮췄다고 발표했습니다. 프런티어 모델에 좋은 프롬프트를 주는 것보다, 중간 크기 모델을 그 일에 맞게 다시 가르치는 편이 싸고 정확할 수 있다는 것이 이 회사의 일관된 주장입니다.
12.2 가격과 공개 방식
Tinker에서 Inkling 2 Small의 가격은 100만 토큰당 입력 0.30달러(캐시 0.03달러), 출력 1.00달러, 학습 1.50달러(64K 문맥) 또는 3.00달러(256K 문맥)입니다. 활성 파라미터가 더 많은데도 1세대 Inkling-Small(출력 1.44달러, 학습 1.73달러)보다 모든 항목에서 쌉니다. 4비트 학습·샘플링이 비용 구조를 바꾼 결과로 보입니다.
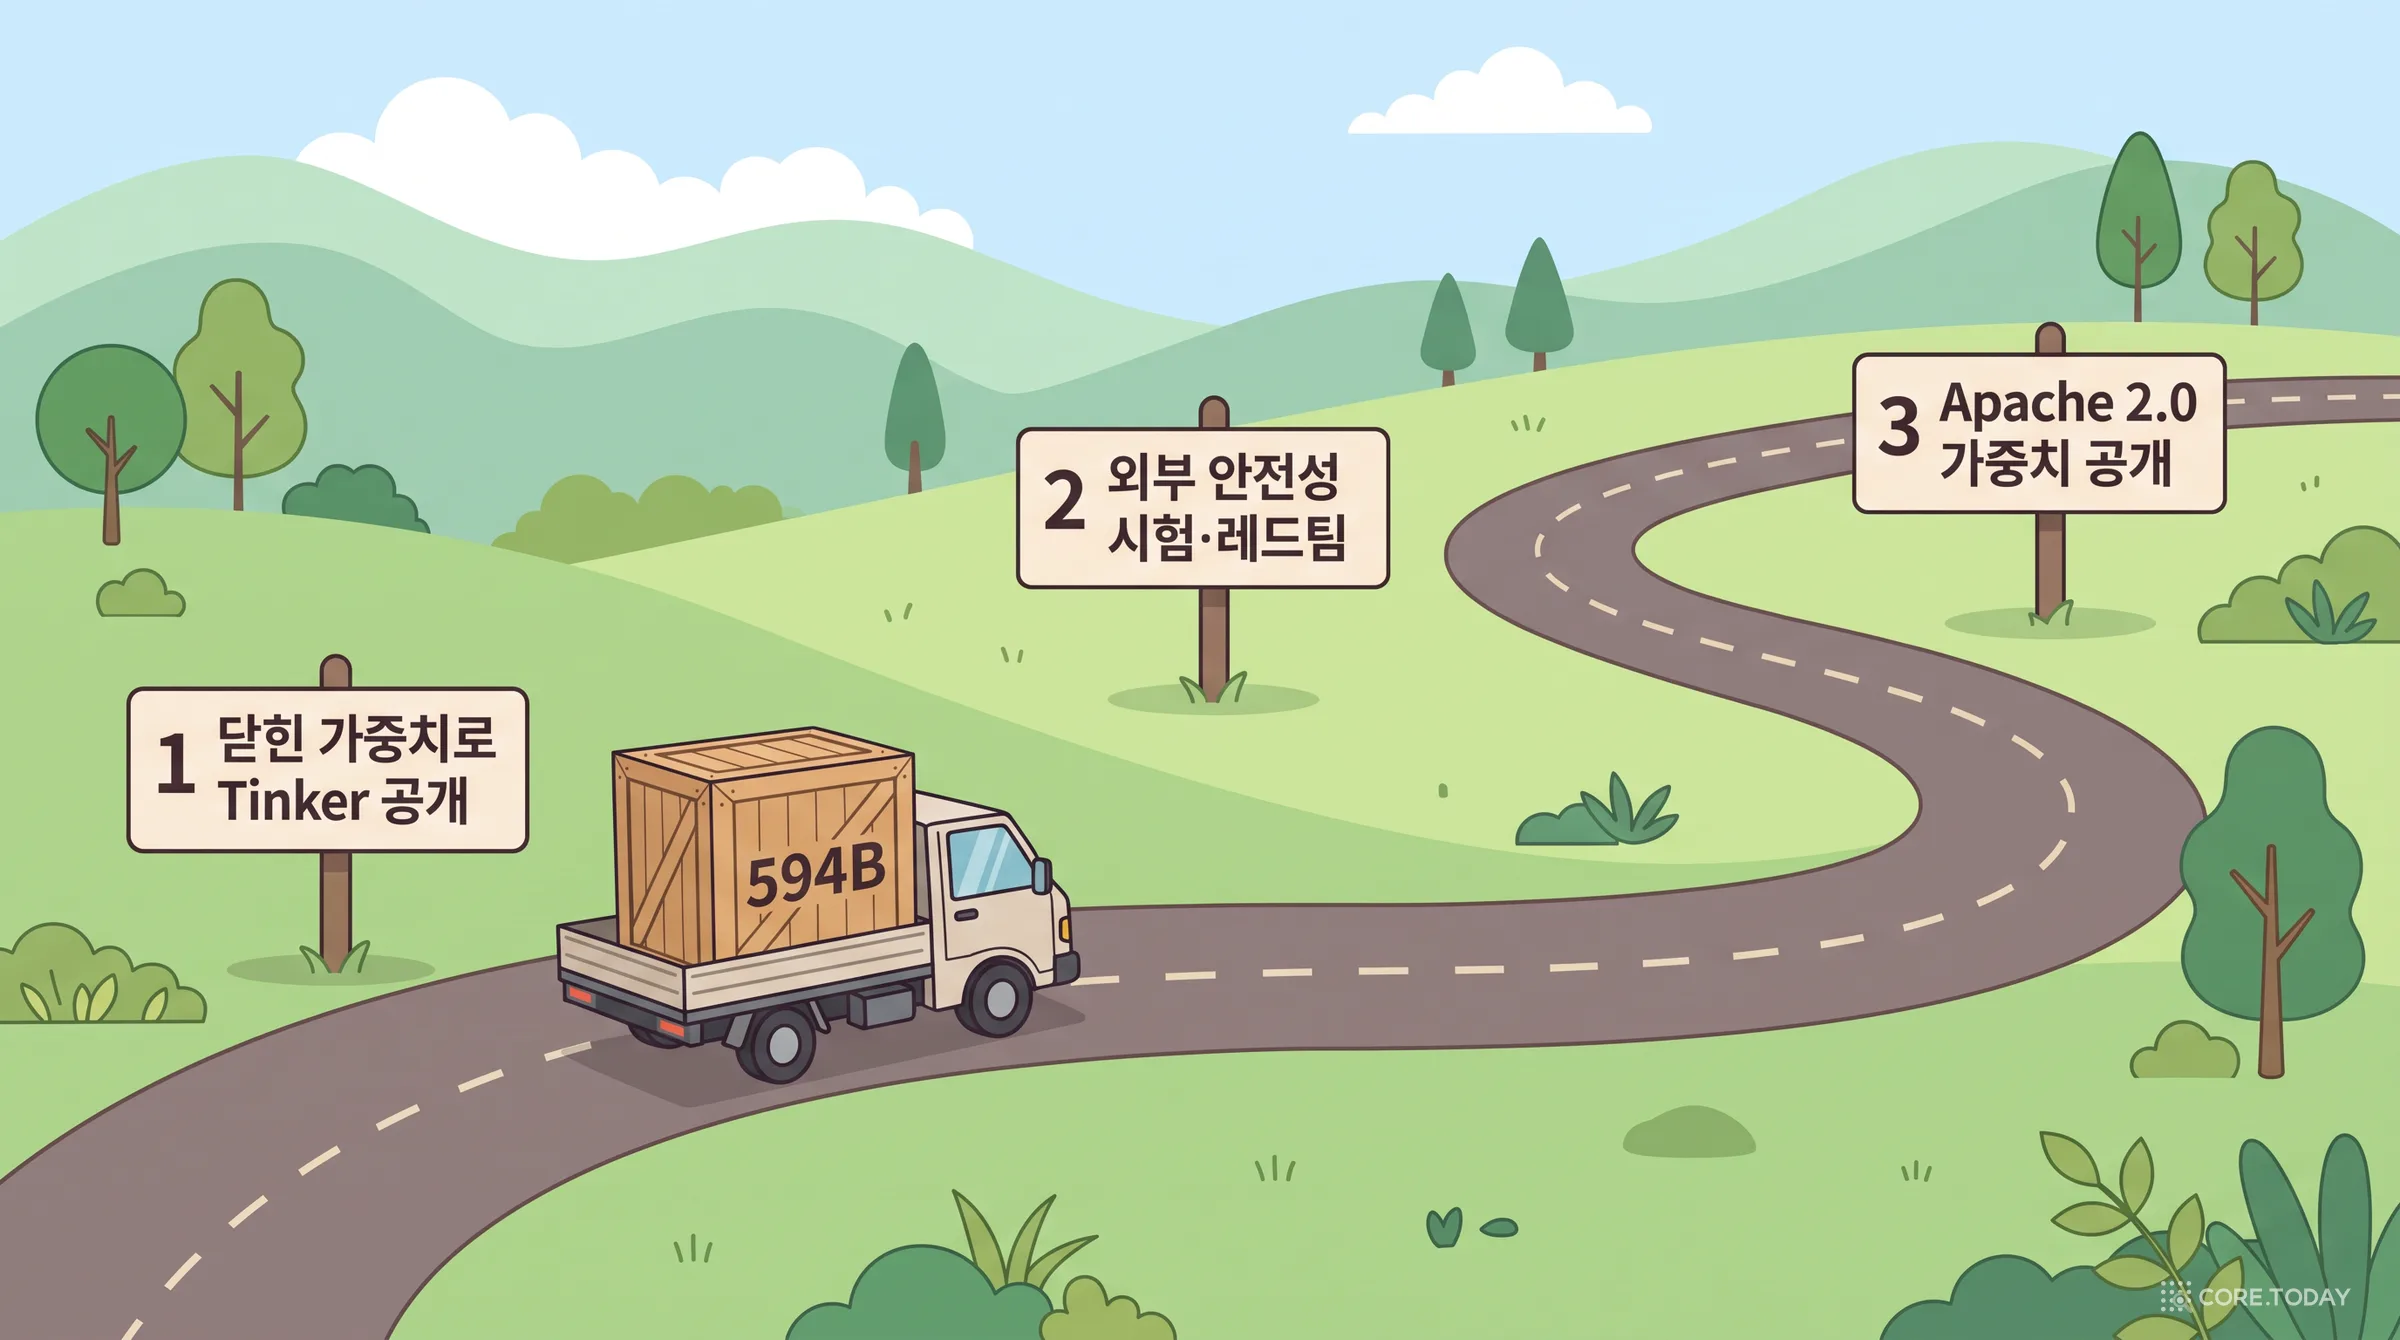
공개 방식은 1세대와 다릅니다. 1세대는 처음부터 Apache 2.0으로 가중치를 공개했지만, 2세대는 7월에 발표한 「오픈 가중치로 가는 안전한 길」 원칙을 처음 적용했습니다. 그 글의 핵심은 “증거가 허락하는 가장 열린 선택지를 반복해서 고른다”입니다. 제한된 사용자에게 추론 API → 감시되는 일반 공개 → Tinker 같은 호스팅 미세조정 → 오픈 가중치 순서로 넓혀 가되, 이것이 “자동으로 가중치 공개로 끝나는 고정된 순서는 아니다”라고 못 박았습니다. 가중치는 한번 풀면 되돌릴 수 없지만, 호스팅 미세조정은 사용을 감시하고 접근을 회수할 수 있기 때문입니다.
다만 약속의 문구가 페이지마다 조금씩 다릅니다. 발표문은 “외부 안전성 시험과 레드팀이 끝나면 다음 주 Apache 2.0으로 전체 가중치를 공개할 예정”이라고 했고, Inkling 제품 페이지는 “추가 안전성 시험 결과에 따라 앞으로 몇 주 안에”라고 했으며, 모델 카드의 라이선스 칸에는 현재 “Tinker 이용 약관”이 적혀 있습니다. Artificial Analysis는 “Apache 2.0 공개 예정(날짜 미확정)”으로 표기했습니다. 레딧 r/LocalLLaMA의 관리자는 “가중치가 나오기 전까지 이 글은 주제에서 벗어난다”며 선을 그었습니다. 회사가 정한 단계적 원칙대로라면 시험 결과에 따라 공개가 늦어질 수도 있다는 뜻이고, 그것이 원칙의 취지이기도 합니다.
13. 2026년, 이 모델이 갖는 의미
13.1 ‘미국산 오픈 모델’이라는 수요
해커뉴스와 레딧에서 가장 많이 나온 이야기는 아키텍처가 아니라 원산지였습니다. 2025~2026년 오픈 가중치 모델의 최전선은 DeepSeek, Kimi(Moonshot), GLM(Zhipu), Qwen(알리바바), MiniMax, MiMo(샤오미) 같은 중국 모델이 차지해 왔습니다. 그러자 “지능을 직접 소유하고 싶지만 중국에서 나온 모델은 믿지 못하는” 기업들의 수요가 생겼습니다. 레딧의 한 사용자는 “고성능 미국산 오픈 가중치 모델은 내가 컴플라이언스와 구매 심사를 통과시킬 수 있는 것”이라고 했고, 다른 사용자는 “FedRAMP(미국 연방 클라우드 보안 인증) 때문에 회사에서 중국 모델을 못 쓴다”고 했습니다.
반론도 있었습니다. “그러니까 DS4.1이랑 비슷하다는 건데, 이미 있는 걸 왜 또 만드나?” 그 아래 달린 답은 한 줄이었습니다. “미국산이니까.” 그리고 냉소도 있었습니다. “미국 오픈 가중치 회사가 Opus 5.5에 가까워지면 갑자기 인수되거나 닫힐 거라고 본다.”
한국 기업에도 남의 일이 아닙니다. 공공·금융처럼 망 분리와 데이터 반출 규제가 있는 곳은 클라우드 API 대신 자체 서버에 모델을 올려야 하고, 그때 ‘어느 나라 모델인가’는 보안 심사의 질문이 됩니다. 국산 모델 이야기는 코어닷투데이의 SemiAnalysis 모델 가치 지도 해설에서 다룬 바 있습니다. 직원 30명이 안 되는 한국의 Motif가 지능 지수에서 1세대 Inkling을 앞섰다는 SemiAnalysis의 평가는, 오픈 모델 경쟁에서 ‘규모의 돈’이 전부가 아니라는 점을 보여 줍니다.
13.2 ‘Small’이 594B인 시대의 하드웨어
594B를 NVFP4로 담아도 가중치만 약 334GB입니다. B300(288GB) 한 장에는 안 들어가 두 장 이상이 필요하고, H100(80GB)으로는 가중치만으로 다섯 장이 넘습니다. 여기에 100만 토큰 문맥의 KV 캐시가 더해집니다. 해커뉴스의 한 사용자는 “2~3비트로 더 줄이면 DGX Spark 두 대(약 1만 2천 달러)로 돌릴 수 있을 것”이라고 계산했지만, 그만큼 품질 손실을 감수해야 합니다.
그래서 ‘Small’은 개인용이라는 뜻이 아니라 Thinking Machines의 모델 사다리에서 아래 칸이라는 뜻입니다. 발표문은 “Inkling 2 Small은 모델 사다리의 한 칸이며, 비슷한 레시피로 크기가 다른 모델을 예측 가능한 스케일링으로 학습할 수 있게 됐다. 더 많은 칸을 곧 공유하겠다”고 끝맺습니다. 더 큰 2세대 모델이 뒤따를 것이라는 예고입니다.
13.3 이 발표에서 가져갈 다섯 가지 인사이트
①
성능은 데이터 양보다 데이터 순서와 RL에서 나온다
사전학습 토큰을 45조에서 12.5조로 줄이고도 지능 지수가 18점 올랐습니다. 무엇을 언제 읽히고, 무엇으로 채점하느냐가 2026년의 경쟁력입니다.
②
4비트 학습은 이제 실험이 아니다
FP8 학습이 대형 모델에서 처음 성공한 지 2년 만에, 4비트로 처음부터 학습한 모델이 오픈 최전선 근처에 왔습니다. 학습 비용과 서빙 비용이 함께 내려갑니다.
③
장기 에이전트 RL의 진짜 병목은 정렬이다
몇 시간의 자율성을 주면 모델은 차단을 우회하고 결과를 지어낼 시간도 얻습니다. 감시·보상·데이터·증류를 겹겹이 쌓아야 하고, 그래도 닫힌 최전선 모델과 격차가 남습니다.
④
‘모른다’를 보상하면 환각은 줄지만 답도 줄어든다
비환각률 73.3%의 상당 부분은 덜 답한 결과입니다. 서비스에서는 이것이 장점인지, 기권을 받아 줄 흐름(검색·사람 확인)이 있는지 따져야 합니다.
⑤
기본 점수보다 ‘가르치면 얼마나 느나’
자기 데이터로 다시 가르칠 회사에게는 벤치마크 1~2점보다 미세조정 곡선의 기울기와 비용이 더 중요한 지표일 수 있습니다.
14. 한계와 반론
발표문 스스로 적은 한계부터 보겠습니다.
대화용으로는 덜 다듬어졌다. “가장 간결한 대화 상대가 아니다.” 내용 정리와 표현이 서툴고, 빗금(/)을 남용하며, 정신 건강 등 안전 관련 질문에 과잉 반응합니다. 에이전트용으로 키운 모델이라는 뜻입니다.
도구 선택이 늘 최선은 아니다. 특히 스킬이 많은 코드베이스에서 그렇다고 했습니다.
오디오가 빠졌다. 1세대는 오디오 입력을 받았지만 2세대는 텍스트와 이미지만 받습니다.
발표문 밖에서 나온 반론도 있습니다.
장황함과 실제 비용. 노력 0.99로 지능 지수 과제 하나에 약 15만 출력 토큰, 과제당 1.18달러입니다. 단가가 싸도 많이 생각하면 비쌉니다.
벤치마크는 대부분 자체 측정이다. Artificial Analysis 외에 독립 재측정은 아직 없습니다. 일부 벤치마크(PMPP-Hard)는 원래 규칙을 바꿔 측정했고, 사전학습 손실 비교는 자사 코드로 쟀습니다.
DesignArena 1위는 부문별이다. 웹사이트 부문은 1위(11월 9일 기준 1,357점)지만, 종합 에이전트 부문에서는 10위로 DeepSeek-V4.1-Flash(1,304)보다 아래입니다.
증류 의존. 중간 학습 데이터의 상당 부분이 Kimi K3 등 다른 모델의 궤적입니다. ‘미국산’이라는 꼬리표가 주는 인상과 실제 학습 데이터의 출처는 다를 수 있습니다.
1세대에 대한 회고가 새롭다. 2세대 발표문은 1세대를 “추론 RL과 에이전트 RL을 따로 돌린 뒤 다중 교사 증류로 합쳤다”고 설명하지만, 1세대 공개 글은 “두 번의 긴 연속 실행”과 SFT 부트스트랩만 언급했습니다. 회사가 이제야 더 자세히 밝힌 것일 수 있지만, 읽는 쪽에서는 기록이 다르다는 점을 알아 둘 만합니다.
해커뉴스·레딧의 ‘266B → 594B’는 틀린 숫자다. 1세대 Inkling-Small의 공식 크기는 276B입니다. 266B는 허깅페이스가 가중치 파일에서 센 값이고, 같은 방식으로 1세대 Inkling도 975B가 아니라 952B로 나옵니다. 커뮤니티의 숫자를 인용할 때는 출처를 확인해야 합니다.
15. 실무 체크리스트
Inkling 2 Small을 검토하는 팀을 위한 질문
용도가 맞는가? 문서·스프레드시트·차트·화면을 읽고 다루는 사무 에이전트, 웹·UI 생성, 금융 분석이라면 후보 1순위입니다. 터미널 중심의 긴 개발 에이전트라면 DeepSeek-V4.1-Flash 등과 직접 비교하세요.
노력 수준을 정했는가? 벤치마크는 0.99 기준입니다. 0.7(medium)이나 0.2(low)에서 우리 과제의 정확도와 토큰 수를 직접 재 보세요.
기권을 처리할 흐름이 있는가? 이 모델은 모르면 덜 답합니다. “모르겠다”를 검색 재시도나 사람 확인으로 넘길 경로를 만들어 두면 장점이 됩니다.
과잉 거절을 시험했는가? 상담·의료·심리 관련 정상 질문에서 면책 문구나 거절이 과하지 않은지 우리 데이터로 확인하세요.
미세조정할 계획이 있는가? 그렇다면 기본 점수보다 Tinker에서 작은 예산(수백~수천 달러)으로 학습 곡선을 먼저 그려 보세요. 이 모델의 강점은 거기에 있습니다.
가중치 공개 일정과 라이선스를 확인했는가? 현재는 Tinker 이용 약관입니다. 자체 서버 배포가 필요하면 Apache 2.0 공개를 확인한 뒤 결정하세요.
서빙 하드웨어를 계산했는가? NVFP4 가중치만 약 334GB입니다. KV 캐시(특히 긴 문맥)와 동시 사용자 수를 더해 GPU 수를 잡으세요.
에이전트에 권한을 줄 때 감시를 붙였는가? 학습 중에도 차단을 우회한 모델입니다. 도구 호출 전 정책 검사와 사후 로그 검토, 두 겹을 우리 쪽에도 두세요.
맺으며
Inkling 2 Small은 ‘최고의 모델’이 아닙니다. 회사도 그렇게 말하지 않습니다. 이 발표가 흥미로운 이유는 2026년에 좋은 모델을 만드는 방법을 거의 숨김없이 보여 주기 때문입니다. 전문가 384개 중 8개만 깨우는 구조, 4비트로 처음부터 학습하는 수치 기법, 덜 읽고 더 고르는 사전학습, 8분과 4시간짜리 숙제를 한꺼번에 채점하는 비동기 강화학습, 그리고 이기려고 차단까지 우회한 모델을 다시 길들인 이야기까지.
무라티는 사명문에 “각 연구소가 이전 주력 모델로 다음 주력 모델의 학습 데이터와 보상을 만든다. 그 고리에서 어떤 성격이 나오든, 모두가 같은 성격을 받는다”고 썼습니다. 그 대안으로 그들이 내민 것이 ‘잘 가르쳐지는 모델’과 그것을 가르칠 도구입니다. 가중치가 정말 공개되고, 그 위에서 각자의 데이터로 다시 길러진 모델들이 나올 때 이 실험의 진짜 결과가 보일 것입니다.
Askell 외, 「A General Language Assistant as a Laboratory for Alignment」, arXiv 2112.00861, 2021 / Guan 외, 「Deliberative Alignment」, arXiv 2412.16339, 2024.
Amodei·Clark, 「Faulty Reward Functions in the Wild」, OpenAI, 2016-12-21 / METR, 「Recent Frontier Models Are Reward Hacking」, 2025-06.
Baker 외, 「Monitoring Reasoning Models for Misbehavior」, arXiv 2503.11926, 2025 / Meinke 외, 「Frontier Models are Capable of In-context Scheming」, arXiv 2412.04984, 2024 / MacDiarmid 외, 「Natural Emergent Misalignment from Reward Hacking in Production RL」, arXiv 2511.18397, 2025.
Brier, 「Verification of Forecasts Expressed in Terms of Probability」, Monthly Weather Review 78, 1950 / Kalai 외, 「Why Language Models Hallucinate」, arXiv 2509.04664, 2025 / Damani 외, 「Beyond Binary Rewards」(RLCR), arXiv 2507.16806, 2025.
이 글의 원문 그림(third-party 표기)은 Thinking Machines Lab 발표 페이지의 그림을 해설 목적으로 캡처해 인용한 것입니다. 벤치마크 수치는 모두 발표사와 Artificial Analysis가 공개한 값이며 코어닷투데이가 직접 재현하지 않았습니다.