수학AI추측라마누잔 머신FunSearchAlphaEvolveGraffiti3Blue1Brown수학과 AI
[특집] 기계가 질문을 만들 때 — 가우스의 소수표에서 AlphaEvolve까지, '추측 기계' 50년사
3Blue1Brown 영상이 '두 번째 시나리오'로 남겨 둔 질문 — 기계가 좋은 질문까지 던지게 되면? — 은 사실 50년 된 연구 분야다. 레넛의 AM, 벽에 추측을 쓰던 Graffiti, 연분수를 쏟아내는 라마누잔 머신, 사람의 직관을 안내한 딥마인드의 매듭 연구, 프로그램을 진화시키는 FunSearch와 AlphaEvolve까지. 생성·검증·선별이라는 세 역할로 각 시스템의 구조를 해부하고, 브라우저에서 직접 추측 기계를 돌려 본다.
코어닷투데이는 이틀 전 3Blue1Brown의 그랜트 샌더슨이 AI 시대의 수학 박사과정생에게 보낸 40분짜리 답장 「수학을 하기에 지금보다 좋은 때는 없었다」를 자세히 읽었다. 그 영상의 뼈대는 기계가 수학의 일을 한 칸씩 더 잘하게 되는 네 개의 시나리오였다. 첫째는 증명, 둘째는 질문, 셋째는 이론, 넷째는 응용이다.
두 번째 시나리오에서 샌더슨은 이렇게 말한다(영상 25:15).
여기 있는 항목 하나는 질문하기, 그러니까 어떤 정리가 증명할 가치가 있는지 정하는 일이다. 지금으로서는 수학자가 시간을 쓰기에 아주 활기차고 지렛대가 큰 영역이다. 그런데 논의를 위해 기계가 이것까지 더 잘하게 된다고 해 보자. 모델에게 특정 정리를 증명해 달라고 하는 데서 그치지 않고, 모델이 돌아와서 "풍성한 수학을 낳을 만한, 물어볼 가치가 있는 다른 질문들은 이것들입니다"라고 말하는 것이다.
그리고 그는 덧붙인다. "모델이 스스로 질문하고 스스로 답하는 걸 그다지 재미있어하지 않을 사람도 있을 것이다. 나는 아마 평생 내 머릿속에서 흥미로운 질문을 생각해 내고 내 방식으로 답을 찾으며 살 것이다."
이 대목은 먼 미래의 이야기처럼 들린다. 증명 기계가 국제수학올림피아드(IMO) 금메달을 딴 것이 겨우 작년(2025년 7월)이니, 질문하는 기계는 그다음 일이라는 느낌이다. "증명은 기계에게 넘겨도 좋은 질문을 고르는 감각은 사람에게 남는다"는 말도 자주 들린다.
그런데 수학사를 조금만 들춰 보면 이야기가 다르다. 기계에게 질문을 시키려는 시도는 증명을 시키려는 시도만큼이나 오래됐다. 1976년 스탠퍼드의 한 박사과정생은 집합론의 개념 몇 개만 주고 '흥미로운 것'을 스스로 찾아다니는 프로그램을 만들었다. 그 프로그램은 소수를 '발견'했고, 골드바흐의 추측을 다시 내놓았다. 1980년대 휴스턴의 한 수학자는 그래프에 관한 추측을 쏟아내는 프로그램을 돌렸다. 그가 그 추측을 정리해 둔 문서의 이름은 「벽에 쓰인 것(Written on the Wall)」이었고, 에르되시를 비롯한 수학자들이 거기 적힌 추측을 붙잡고 논문을 썼다. 2021년에는 Nature에 두 편이 실렸다. 하나는 π와 e에 관한 공식을 기계가 추측하게 한 '라마누잔 머신'이고, 다른 하나는 매듭 이론의 새 정리로 이어진 딥마인드의 연구다. 2023년의 FunSearch는 수학자들이 수십 년 붙잡고 있던 조합론 문제에서 사람이 찾은 기록을 넘었다.
그러니 질문은 "기계가 질문을 할 수 있을까?"가 아니다. 기계는 오래전부터 질문을 해 왔다. 진짜 질문은 셋이다.
기계는 어떤 방식으로 질문을 만들어 왔나? 그 구조는 어떻게 생겼나?
그렇게 나온 질문 중 무엇이 좋은 질문이었고, 누가 그걸 골랐나?
2026년, 그 '고르는 눈'까지 기계로 넘어가고 있나?
이 글은 그 50년을 따라간다. 시스템마다 무엇을 만들고(생성), 무엇이 걸러 내고(검증), 무엇이 고르는지(선별) 를 해부한다. 논문의 핵심 그림과 표도 읽는다. 중간중간 브라우저에서 직접 돌아가는 축소판 추측 기계 네 개를 만들어 두었다. 연분수를 수천 개 만들어 π를 찾는 기계, 그래프 몇 개만 보고 부등식을 지어내는 기계, 신경망에게 '어디를 보고 있었는지' 묻는 기계, SET 카드로 캡셋을 진화시키는 기계다. 여기에 50년의 기계들을 한 표로 해부하는 위젯과, 좋은 질문을 직접 골라 보는 위젯을 더했다. 직접 돌려 보면 "질문을 만든다"는 말이 생각보다 구체적이고, 생각보다 어렵다는 걸 느낄 수 있다.
1장. 질문하는 기계의 해부도 — 생성, 검증, 선별
1-1. 먼저 낱말 몇 개
이 글에 계속 나올 낱말부터 정리하자.
정리(theorem): 증명된 수학적 주장.
추측(conjecture): 참이라고 믿을 이유는 있지만 아직 증명되지 않은 주장. 페르마의 마지막 정리는 350년 동안 '추측'이었다.
반례(counterexample): 추측이 틀렸음을 보여 주는 예 하나. 아무리 많은 예가 맞아도 반례 하나면 추측은 죽는다.
구성(construction): "이런 성질을 가진 대상이 존재한다"를 보여 주려고 실제로 만들어 낸 예. 반례도 구성의 일종이다.
상한·하한(bound): 어떤 최댓값이 정확히 얼마인지 모를 때 "적어도 이만큼(하한), 많아야 이만큼(상한)"으로 범위를 좁힌 것. 더 큰 구성을 찾으면 하한이 올라간다.
불변량(invariant): 대상을 어떻게 표현하든 변하지 않는 수. 그래프의 꼭짓점 수, 매듭의 서명 같은 것.
'질문을 만든다'는 말은 넓게 보면 이 중 여러 가지를 포함한다. 새 추측을 세우는 것, 남의 추측에 반례를 찾는 것, 누구도 몰랐던 구성을 보여 줘서 "그럼 최댓값은 얼마일까?"라는 질문을 다시 여는 것. 이 글은 이 모두를 '질문하는 기계'의 일로 본다.
1-2. 세 개의 역할
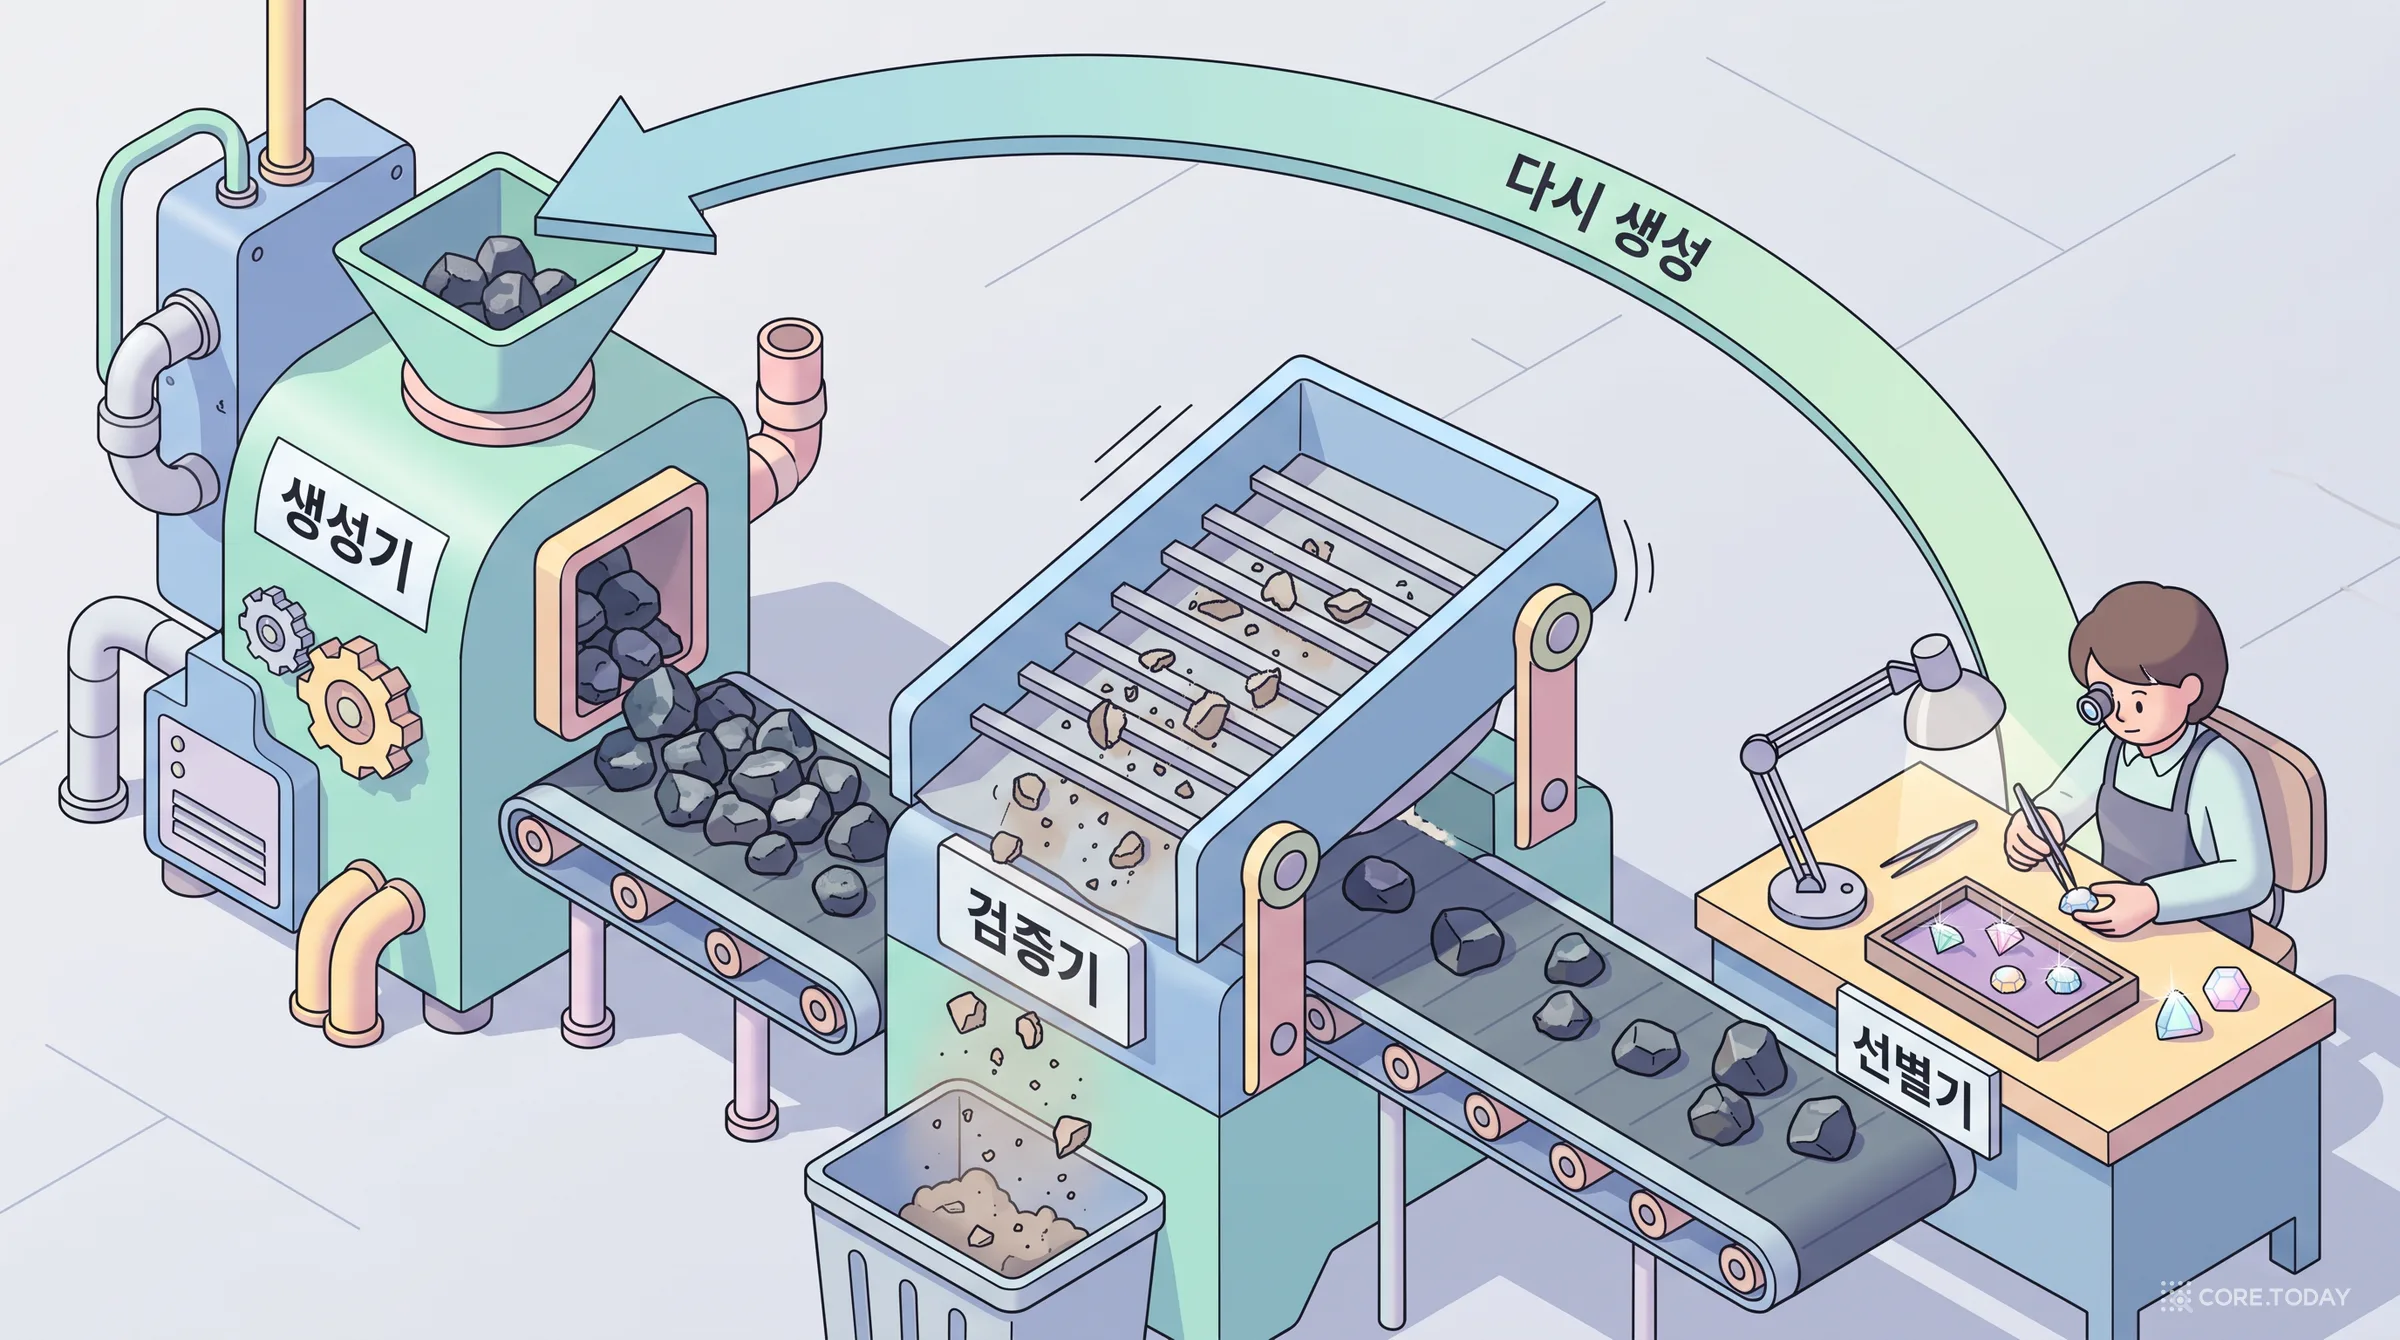
50년 동안 나온 추측 기계들은 생김새가 제각각이다. 1970년대의 리스프(LISP) 프로그램도 있고, 2020년대의 대형 언어 모델도 있다. 하지만 뜯어 보면 거의 모두 세 가지 역할의 조합이다.
규칙에 따른 열거, 휴리스틱, 무작위 변이, 신경망, 대형 언어 모델. 후보는 식일 수도, 그래프일 수도, 프로그램일 수도 있다. 이 단계는 싸고, 많이 만들수록 좋다.
②
검증기 — 틀린 것을 버린다
수치 계산, 알려진 예들에 대한 확인, 점수 함수, 형식 증명기. "참일 가능성이 높은가?" 혹은 "점수가 얼마인가?"를 기계적으로 답한다. 검증이 정확하고 빠를수록 기계가 할 수 있는 일이 넓어진다.
③
선별기 — 가치 있는 것을 고른다
살아남은 후보 중 무엇이 흥미롭고, 새롭고, 연결이 풍부하고, 다음 수학을 낳을 것인가. 이 역할은 기계 안에 휴리스틱으로 들어가기도 하고(AM의 '흥미도', Graffiti의 '달마시안'), 기계 밖의 사람이 맡기도 한다.
이 세 역할로 보면 50년의 흐름이 한 줄로 요약된다. 생성기는 꾸준히 강해졌고, 검증기는 문제를 골라 가며 발전했고, 선별기는 거의 언제나 사람이었다. 이 글의 각 장은 이 셋 중 무엇이 바뀌었는지를 따라간다.
한 가지 미리 짚어 둘 점이 있다. 검증기가 강할수록 기계가 '질문'에 다가가기 쉽다. 라마누잔 머신은 수치 계산이라는 아주 강한 검증기가 있는 영역을 골랐다. FunSearch는 "점수를 매길 수 있는 문제"로 범위를 스스로 좁혔다. 거꾸로, 검증기를 만들 수 없는 질문, 예컨대 "이 정의가 앞으로 50년간 쓸모 있을까?" 같은 질문에서 기계는 여전히 길을 잃는다. 좋은 질문의 가치를 재는 평가기가 없기 때문이다.
1849년 12월 24일, 일흔둘의 가우스는 제자였던 천문학자 엥케(Encke)에게 편지를 썼다. 엥케가 소수의 빈도에 관한 관찰을 보내오자 옛 기억이 떠오른 것이다.
당신 덕분에 아주 먼 옛날, 1792년인가 1793년에 람베르트의 로그표 부록을 손에 넣은 뒤 시작했던 제 노력이 생각났습니다. … 저는 여러 개의 천 단위 구간에서 소수를 세어 그 결과를 첨부한 흰 종이에 적었습니다. 그리고 곧 알아차렸습니다. 온갖 들쭉날쭉함 뒤에서, 이 빈도는 평균적으로 로그에 반비례한다는 것을.
여기서 나온 추측이 오늘날의 소수 정리다. n 이하의 소수 개수는 대략 ∫dn/logn이다. 이 정리는 1896년 아다마르와 드 라 발레 푸생이 증명했다. 가우스는 그 뒤로도 짬이 날 때마다 "한가한 15분"을 써서 천 개 구간씩 소수를 셌고, 결국 300만까지 세어 적분값과 맞춰 봤다. 260만에서 270만 사이에서 그가 센 소수는 6,762개, 적분값은 6,761.3이었다.
이 이야기에는 흔히 과장이 붙는다. '15세의 가우스가 소수 정리를 추측했다'는 문장의 근거는 56년 뒤의 회상 한 줄뿐이다. 가우스는 이 추측을 출판하지도 않았다. 처음 출판한 사람은 르장드르(1798)다. 그래도 이 장면이 중요한 이유는 분명하다. 추측은 데이터에서 나왔고, 데이터를 만드는 일은 지루한 계산이었다. 그 지루한 부분을 기계에 맡길 수 있다면? 이것이 20세기 '실험 수학'의 출발점이다.
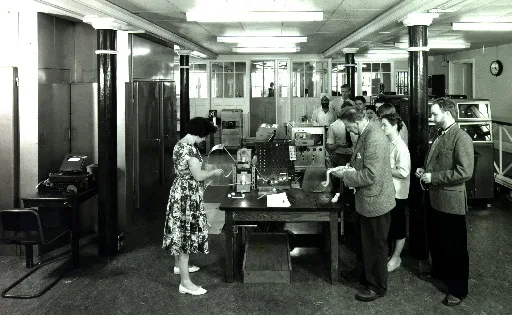
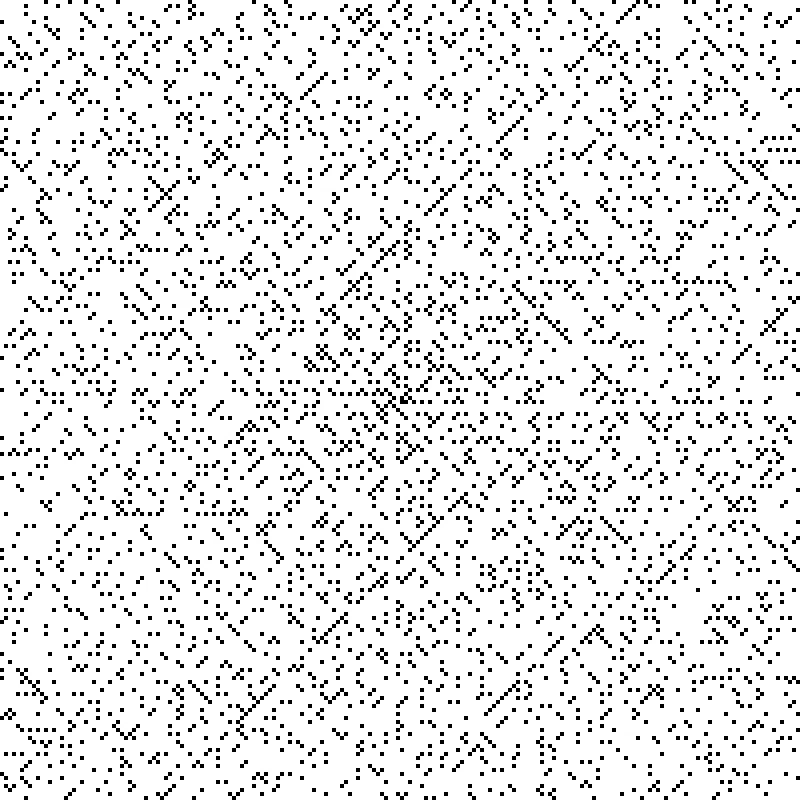
크게 보기EDSAC 2 사용자 대기열, 1960년 5월 10일. 사진: Cambridge Computer Lab, Wikimedia Commons, CC BY 2.0 UK.
케임브리지의 브라이언 버치(Bryan Birch)와 피터 스위너턴다이어(Peter Swinnerton-Dyer)는 이 아이디어를 컴퓨터로 밀어붙였다. 대상은 타원곡선, 예컨대 y2=x3−Dx 같은 곡선이다. 이런 곡선 위의 유리수 점은 무한히 많을 수도, 유한할 수도 있다. 무한히 많을 때 그 '크기'를 재는 정수가 계수(rank) 다. 계수를 직접 계산하기는 매우 어렵다.
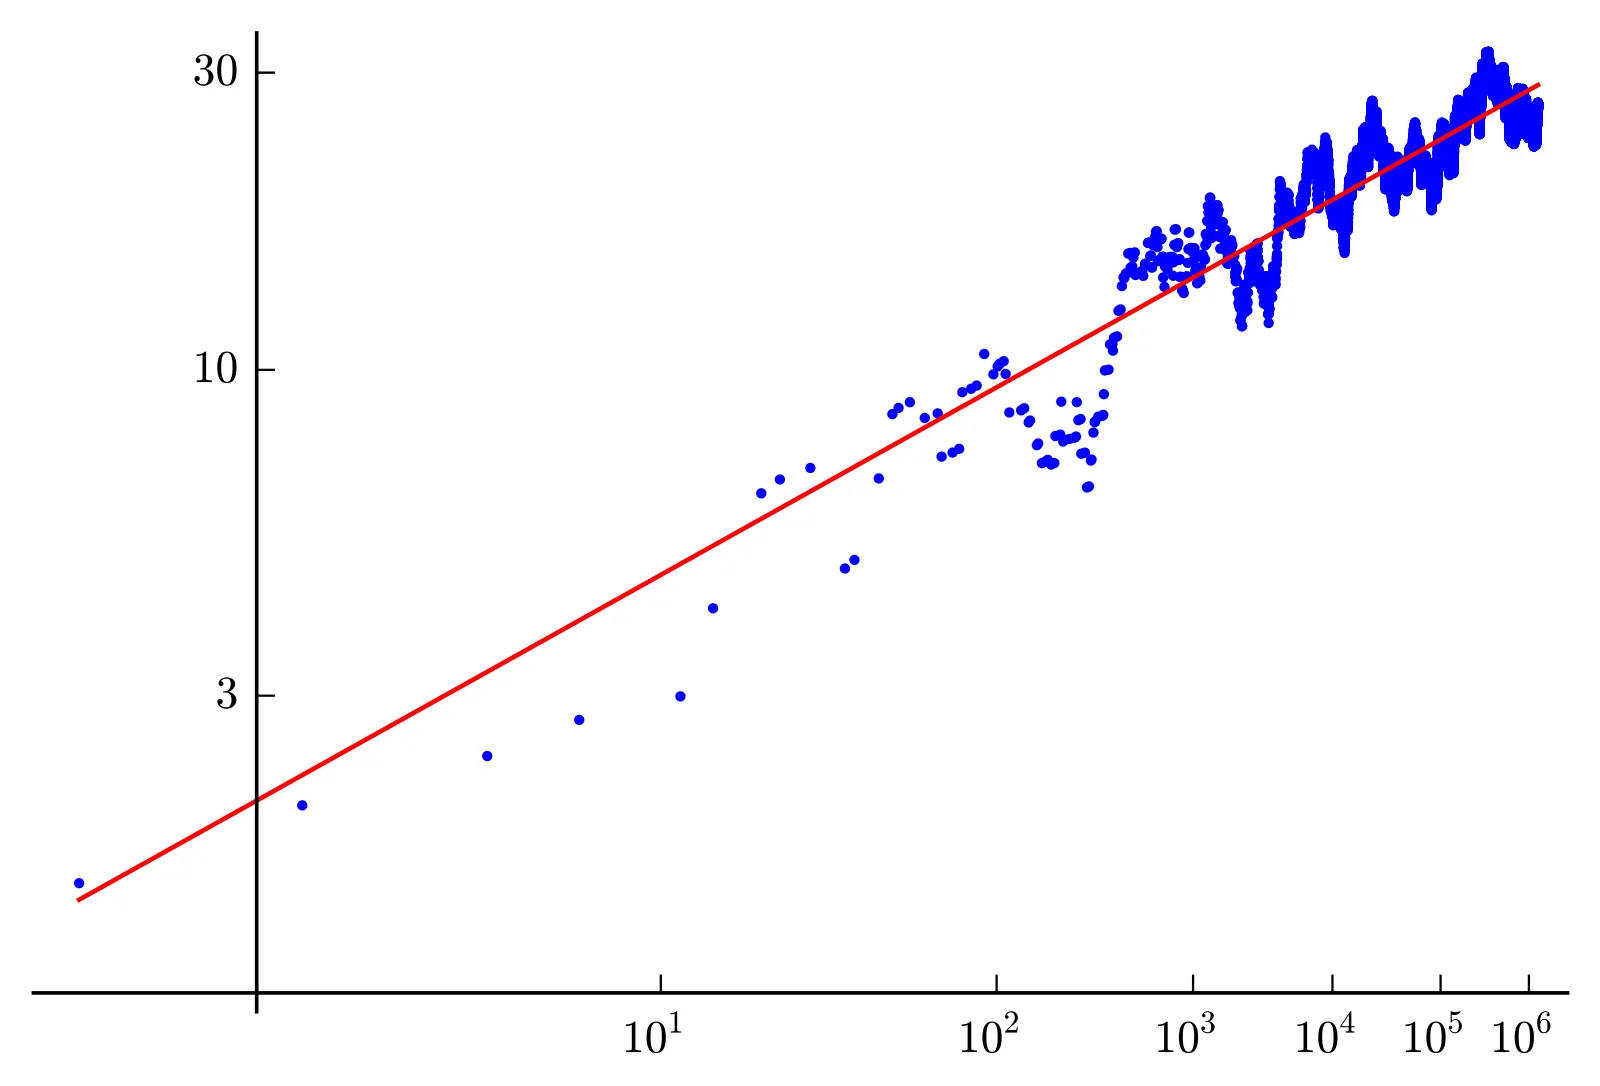
두 사람은 우회로를 택했다. 곡선을 소수 p로 나눈 나머지의 세계에서 보면, 점은 유한하니 셀 수 있다. 그 개수를 Np라 하자. 그들은 EDSAC 2로 수많은 소수 p에 대해 Np를 세고, ∏p≤XNp/p가 X에 따라 어떻게 자라는지를 로그 눈금 그래프에 찍었다. 그러자 점들이 대략 직선을 이뤘고, 그 기울기가 곡선의 계수와 같아 보였다.
크게 보기y² = x³ − 5x 곡선에 대한 현대의 재현 그림(소수 10만 개까지). 1960년대 원본 그림이 아니다. 그림: RobHar, Wikimedia Commons, CC BY-SA 3.0.
이 관찰은 1963년과 1965년의 「타원곡선에 관한 노트」 두 편을 거쳐 L-함수의 언어로 다듬어졌다. 그것이 버치–스위너턴다이어 추측이다. 지금은 클레이 연구소의 7대 밀레니엄 문제 중 하나이고, 상금 100만 달러가 걸려 있다. 테이트는 1974년에 이렇게 감탄했다. 이 추측은 "현재로서는 정의되어 있는지도 모르는 점에서의 함수 L의 행동을, 유한한지도 모르는 군 Ш의 크기와 연결한다!"
여기서 짚어 둘 것은 역할 분담이다. 컴퓨터는 점을 셌다. 그래프를 보고 "기울기가 계수다"라고 말한 것은 사람이었다. 생성(데이터)은 기계, 선별과 추측은 사람. 6장의 찌르레기 떼 이야기와 거의 같은 구도다.
2-3. "기계는 증명할 정리를 고를 수 있을까?" — 왕하오(1959)
같은 시기 대서양 건너편에서는 훨씬 대담한 질문이 나왔다. 논리학자 왕하오(Hao Wang)는 IBM 704로 『수학 원리(Principia Mathematica)』의 명제논리 정리 약 220개를 3분 만에 증명하는 프로그램을 만들었다. 논문 「기계적 수학을 향하여」(1960)의 제사는 동화 「용감한 재단사」의 "한 방에 일곱 마리"를 패러디했다. "IBM 704: 3분에 정리 220개."
그런데 같은 논문에 거의 알려지지 않은 실험이 하나 더 있다. 왕하오는 이렇게 물었다.
자연스럽게 떠오르는 질문은 이것이다. "기계가 정리를 증명할 수 있다 해도, 증명할 정리를 고를 수 있을까?"
그는 짧은 명제논리 공식을 기계적으로 조합해 한 시간에 약 14,000개의 명제를 만들고, 그중 참인 정리 약 1,000개를 테이프에 저장했다. 결과는 그의 말로 "실망스러웠다." "프로그램에 실제로 넣은 '자명함'의 원리가 너무 조잡해서, 자명한 정리가 너무 적게 걸러졌다."
참인 문장은 넘쳐나는데, 흥미로운 문장을 고르지 못한다. 1959년에 처음 기록된 이 실패는 이후 50년 동안 모든 추측 기계가 부딪히는 벽이 된다. 생성기와 검증기는 이미 있었다. 없던 것은 선별기였다.
2-4. 실험 수학의 무기들 — PSLQ, BBP, 그리고 과장된 신화들
1990년대에 들어 '컴퓨터로 패턴을 보고 추측한다'는 방식은 실험 수학(experimental mathematics) 이라는 이름을 얻었다. 그 대표 무기가 정수 관계 탐지 알고리즘이다. 실수 몇 개가 주어졌을 때, 그 수들의 정수 계수 일차결합이 0이 되는 관계가 있는지 찾는다. 예컨대 어떤 수 x와 π, 1 사이에 ax+bπ+c=0을 만족하는 작은 정수 a, b, c가 있는지 찾는 것이다. 퍼거슨(Ferguson)과 베일리(Bailey)의 PSLQ가 대표적이고, 정수 관계 탐지는 2000년 한 학술지가 꼽은 '20세기 10대 알고리즘'에도 들어갔다.
가장 유명한 성과는 1995년의 BBP 공식이다.
π=k=0∑∞16k1(8k+14−8k+42−8k+51−8k+61)
이 공식을 쓰면 앞자리를 몰라도 π의 16진법(2진법) n번째 자리를 바로 계산할 수 있다. 베일리·보르웨인·플루프의 1997년 논문은 증명이 "발견의 경로를 완전히 감춘다"고 쓰고, 이 식을 "영감 어린 추측과 PSLQ 정수 관계 알고리즘을 이용한 광범위한 탐색"으로 찾았다고 밝혔다. 베일리는 훗날 이것을 "컴퓨터 프로그램이 π에 관한 중요한 새 공식을 찾은 거의 확실한 첫 사례"라고 불렀다. 다만 사이먼 플루프는 공식을 찾은 것이 자신이 짠 다른 프로그램이었다고 기억한다. 공로를 둘러싼 이견이 지금도 남아 있다.
이 시기의 유명한 일화들에는 과장이 섞인 것이 많다.
흔한 이야기
확인된 사실
울람이 1963년 지루한 강연 중 낙서하다 소수 나선을 발견해 새 추측을 낳았다
낙서와 그 뒤 로스앨러모스 MANIAC II로 그린 그림(1964년 논문)은 사실이다. 그러나 1932년 클라우버가 비슷한 무늬를 이미 보고했고, 대각선에 소수가 몰리는 현상은 하디–리틀우드의 추측 F(1923)가 이미 예측하던 것이다
파이겐바움이 혼자 HP-65 계산기로 보편 상수를 발견했다(1975)
계산기 기종은 2차 자료에만 있다. 프랑스의 쿨레와 트레세르가 1978년 독립적으로 같은 현상을 찾았다
BBP 공식은 1996년에 발표됐다
발견은 1995년, 출판은 1997년 4월(Math. Comp. 66권)
크게 보기울람 나선. 그림: Grontesca, Wikimedia Commons, CC BY-SA 3.0.
이 시기의 공통점은 분명하다. 컴퓨터는 사람의 눈이 닿을 수 있는 데이터를 만들었고, 질문은 그 데이터를 본 사람에게서 나왔다. 다음 장은 이 구도를 처음으로 뒤집으려 한 프로그램 이야기다.
1976년 7월, 스탠퍼드의 더글러스 레넛(Douglas Lenat)이 박사 논문을 제출했다. 제목은 「AM: 휴리스틱 탐색으로서의 수학적 발견에 대한 인공지능 접근」. AM은 'Automated Mathematician(자동 수학자)'의 약자다.
AM이 받은 것은 집합론의 기초 개념 115개뿐이었다. '같음', '집합에서 원소 빼기' 같은 것들이다. 수(number)도, 증명도 알려 주지 않았다. 레넛은 논문 요약에 이렇게 썼다. "어느 과학 분야에서든, 주어진 구체적인 문제를 푸는 것이 흥미로우면서도 다룰 만한 새 질문을 제안하는 것보다 대개 쉽다." AM은 바로 그 어려운 쪽, 새 질문을 제안하는 쪽을 겨냥했다.
3-2. 구조 — 프레임, 의제, 그리고 흥미도
개념 = 프레임 정의·예·일반화·가치(Worth)… 수십 개의 칸
→
의제(agenda) 할 일 목록, 일마다 '이유'와 점수
→
휴리스틱 약 250개 채우기·확인·제안·흥미
→
새 개념·추측 다시 의제에 할 일을 추가
AM의 개념은 하나하나가 '프레임'이다. 정의, 예, 일반화, 특수화, 그리고 그 개념의 가치(Worth, 0~1000점) 같은 칸이 있다. 처음에는 칸이 대부분 비어 있다. AM은 의제(agenda), 즉 할 일 목록을 들고 움직인다. "개념 X의 예를 더 찾아라", "X를 일반화한 새 개념을 정의하라" 같은 일마다 그 일을 해야 하는 '이유'가 붙고, 이유가 많고 강할수록 점수가 높다. 매 순간 AM은 점수가 가장 높은 일을 한다. 그 일을 하는 동안 휴리스틱 규칙들이 발동해 새 개념을 만들고, 새 할 일을 의제에 올린다.
휴리스틱이 어떻게 생겼는지 하나만 보자. 논문에 실린 '극값' 휴리스틱이다.
f가 A의 원소를 B의 원소로 보내는 함수이고 B에 순서가 있다면, A의 원소 중 B의 극값으로 가는 것들만 따로 살펴보라.
f를 '약수의 집합'으로, B의 순서를 '크기'로 놓으면 무슨 일이 생길까. 약수가 가장 적은 수, 곧 약수가 두 개뿐인 수는 소수다. 약수가 가장 많은 수들은 '최대 약수 수(maximally-divisible numbers)'라는 새 개념이 된다. AM은 이렇게 소수를 '발견'했다.
3-3. AM이 찾은 것, 그리고 찾지 못한 것
한 번의 실행에서 AM은 약 200개의 일을 처리하고 메모리가 바닥나 멈췄다. 개념은 115개에서 약 300개로 늘었다. 레넛 자신의 추정으로는 그중 '좋은 개념'이 25개, '받아들일 만한 개념'이 100개, '헛수고였던 개념'이 60개였다. AM이 다시 찾아낸 것들은 이렇다. 자연수(집합의 크기가 같다는 관계에서), 덧셈과 곱셈, 약수, 소수, 소인수분해의 유일성(추측으로), 그리고 골드바흐 추측.
그런데 원문을 읽으면 흔한 이야기와 다른 점이 보인다.
골드바흐라는 이름은 사람이 붙였다. AM은 짝수를 두 소수의 합으로 쪼개는 연산의 결과가 "늘 비어 있지 않다"는 것을 알아차렸다. 실행 기록에는 이렇게 적혀 있다. "사용자: 이 추측을 '골드바흐의 추측'이라 부르라." 심지어 AM은 이 추측이 "귀엽지만 쓸모없을" 것이라고 예측했다. 소수는 곱셈 쪽 개념이니 덧셈과 엮어 봐야 별 쓸모가 없을 거라는 휴리스틱 때문이었다.
'최대 약수 수'의 이론을 만든 것은 레넛이다. AM은 이 수들을 소인수분해해 규칙성을 알아차렸다. 그다음은 레넛의 말 그대로다. "그러자 저자가 이 수들에 대한 '미니 이론'을 전개했다. 나중에 알고 보니 라마누잔이 1915년에 이미 똑같은 정의를 제안하고 같은 규칙성을 찾아 두었다." 라마누잔의 '고합성수(highly composite numbers)'다.
새로운 수학은 없었다. 레넛 스스로 결론에 썼다. "AM은 순전히 혼자 힘으로는 인류에게 새로운 수학을 발견하지 못했다." 그리고 "휴리스틱은 종종 그저 정리해 둔 사후 지혜(compiled hindsight)일 뿐이다."
3-4. "거의 민망할 만큼 잘 됐다" — AM은 왜 작동했나
AM은 큰 반향을 일으켰지만 비판도 따랐다. 1984년 Artificial Intelligence 학술지의 같은 호에 두 편의 글이 나란히 실렸다. 리치(Ritchie)와 해나(Hanna)는 AM이 "인상적인 성능에도 불구하고 쓰인 기법이 다소 불투명하다"고 비판했다. 바로 뒤에 레넛과 브라운(Brown)의 「AM과 EURISKO는 왜 작동하는 것처럼 보이는가」가 실렸다. 이 답변은 놀랄 만큼 솔직했다.
AM의 수학 개념은 사실 리스프(LISP) 함수였고, 새 개념을 만드는 연산은 리스프 코드의 문법적 변이였다. AND를 OR로 바꾸거나, 재귀 호출 하나를 지우거나, 두 함수를 합성하는 식이다. 예를 들어 '두 리스트가 같은가'를 판정하는 함수에서 원소 비교 부분을 지우면 '두 리스트의 길이가 같은가'가 되고, 거기서 '길이', '수', '덧셈'으로 이어진다. 레넛과 브라운은 이렇게 썼다. "이 단순한 방식은 거의 민망할 만큼 잘 작동했다." 그리고 그 이유를 이렇게 짚었다. 결정적 요인은 "리스프로 표현했을 때 가치 있는 수학 개념이 얼마나 촘촘한가"였다. 리스프와 수학이 워낙 가까워서, 아무렇게나 코드를 비틀어도 의미 있는 수학 개념이 자주 나왔다는 것이다.
이 고백은 40여 년 뒤의 FunSearch와 정확히 같은 통찰을 담고 있다. FunSearch도 결국 '코드 공간에서의 탐색'이고, 그것이 통한 이유도 수학적 구조가 짧은 코드로 표현되기 때문이었다. 레넛은 거기에 경고를 하나 더 남겼다. 휴리스틱 자체를 배우게 하려 한 후속작 EURISKO는 5년 동안 "평범한 결과"만 냈다. 휴리스틱과 리스프 사이에는 그런 깊은 관계가 없었기 때문이다. 생성기의 표현이 대상과 맞아떨어질 때만 마법이 일어난다.
AM이 '모든 수학'을 노렸다면, 휴스턴 대학의 시미온 팔트로비치(Siemion Fajtlowicz)는 범위를 좁혔다. 그래프 이론, 그것도 그래프 불변량 사이의 부등식만. 1984~85년에 쓴 그의 프로그램 Graffiti는 이렇게 작동했다.
Graffiti의 기본 발상은, 프로그램이 몇몇 그래프를 '알고' 있고 그래프 불변량으로 만든 식을 계산할 수 있다는 것이다. Graffiti가 아는 그래프 중 어느 것도 어떤 식의 반례가 아니면, 그 식을 추측으로 간주한다. (팔트로비치, 「Graffiti의 추측에 관하여」, 1988)
Graffiti는 약 60개의 불변량을 계산할 수 있었고, 그중 20개를 골라 'I ≤ J', 'I ≤ J + K', 'I + J ≤ K + L' 꼴의 부등식을 만들었다. 첫 실행에서는 그래프 약 40개를 보고 추측 약 7,500개를 쏟아냈다. 추이성으로 따라 나오는 것을 지우자 약 1,700개, 왼쪽이 늘 오른쪽보다 작은 뻔한 것을 지우자 약 140개가 남았다. 팔트로비치는 이렇게 털어놓았다. "프로그램의 절반 이상은 사소하거나 흥미 없는 참 추측을 지우는 여러 휴리스틱으로 이뤄져 있다." 왕하오의 1959년 실패가 정확히 이 지점이었다.
팔트로비치는 또 이렇게 썼다. "나는 이 프로그램이 원인 없이 상관관계를 찾는 통계학자처럼 일할 거라고 생각했다. … 그런데 대부분의 경우에는 추측을 만든 이유가 분명히 보인다."
4-2. 달마시안 휴리스틱 — 참보다 '정보'를 먼저 묻다
1990년대 판 Graffiti에는 달마시안(Dalmatian) 휴리스틱이 들어갔다. 핵심은 검사 순서를 뒤집은 데 있다. 1980년대 판은 "참인가? → 뻔한가?" 순서로 물었다. 달마시안은 "새로운 정보를 주는가?"를 먼저 묻는다. 팔트로비치의 1995년 설명은 이렇다.
프로그램은 과거에 만든 추측들을 기억하고 있다가, 새 후보를 만나면 먼저 데이터베이스에 '이 추측이 이전 추측들로부터 따라 나오지 않음'을 보여 주는 예가 있는지 확인한다. 그런 예가 없으면 이 추측은 정보가 없다며 버린다. 있으면 그때 추측이 맞는지 시험한다.
구체적으로는 이렇다. 독립수 같은 목표 불변량 하나를 정해 두고, 그 상한(혹은 하한) 추측들의 목록을 유지한다. 새 후보는 데이터베이스의 모든 그래프에서 참이어야 하고, 적어도 한 그래프에서 기존의 모든 추측보다 더 좋은(날카로운) 한계를 줘야 살아남는다. 새 추측이 채택되면 그보다 정보가 적은 기존 추측은 목록에서 빠진다(나중에 새 추측에 반례가 나오면 되살리려고 따로 보관한다). '달마시안'이라는 이름은 흔히 '각 추측이 데이터의 서로 다른 점(spot)에 닿는다'는 뜻으로 풀이되지만, 이 풀이는 후대 연구자들의 해설이다.
아래 위젯은 이 달마시안식 거름망을 아주 작게 재현한다. 꼭짓점 6개 이하의 연결 그래프 142개(동형인 것 제외) 전부와 불변량 11개를 준비했다. 기계가 그중 몇 개만 본 상태에서 추측을 만들고, 나머지 전부로 반례를 찾는다.
몇 번 돌려 보면 Graffiti의 고민이 그대로 느껴진다. 본 그래프가 5개쯤이면 추측 수십 개 중 대부분이 반례로 죽는다. 30개쯤 보면 살아남는 추측이 늘지만, '최소 차수 ≤ 최대 차수' 같은 뻔한 것도 함께 산다. 그리고 가끔 '반지름 ≤ 독립수'나 '평균 거리 ≤ 독립수' 같은, 실제로 Graffiti가 내놓았던 추측이 나온다.
4-3. 에르되시가 반례를 찾고 "통쾌했다"고 쓴 사연
Graffiti의 추측은 「벽에 쓰인 것(Written on the Wall)」이라는 문서로 공개됐다. 1980년대 판에서만 746번까지 번호가 붙었다. 팔트로비치는 그 서문에서 "117, 118, 119번을 빼면 모두 Graffiti가 만든 것"이라며, 자기 추측을 프로그램으로 확인만 했다는 소문을 부인했다.
수학자들은 이 벽에 응답했다.
0번, 반지름 ≤ 독립수. 1986년 팔트로비치와 월러(Waller)가 처음 증명했다. 비슷한 시기에 에르되시·삭스(Saks)·쇼시(Sós)가 독립적으로 더 강한 결과를 냈다.
평균 거리 ≤ 독립수. 판 정(Fan Chung)이 1988년 Journal of Graph Theory에 증명을 실었다.
평균 거리 ≤ 차수 역수의 합. 이 추측은 에르되시와 파흐(Pach)·스펜서(Spencer)가 1988년 반증했다. 논문 서두가 유명하다.
다음의 매력적인 추측은 시미온 팔트로비치가 그래프의 여러 매개변수 사이에 숨은 관계를 찾도록 지시한 컴퓨터가 만든 것이다. … 우리는 영리한 컴퓨터 탐색 덕분에 가능해진 수학적 기여가 늘어나는 데 크게 감명받고 있다. 그럼에도 체스 프로그램에게 진 비참한 기분을 이미 맛본 이들이라면, 우리가 이 추측을 반증하며 느낀 만족감을 아마 함께 느낄 것이다.
18번, 채색수 ≤ 1 + 계수(rank). 노가 알론(Noga Alon)과 폴 시모어(Paul Seymour)가 1989년 꼭짓점 64개짜리 반례로 깼다. 이 질문은 로바스를 거쳐 통신 복잡도의 '로그 계수 추측'과 연결됐다. 다만 이 추측은 Graffiti보다 먼저 판 뉘펠런(Van Nuffelen)이 더 강한 형태로 내놓은 것이었다. 기계의 '새 추측'이 알고 보니 재발견인 경우는 이때도 있었다.
2003년 무렵까지 Graffiti의 추측은 알론, 볼로바시, 정, 에르되시, 로바스, 시모어 등이 쓴 논문 약 80편과 박사 논문 다섯 편의 일부에 영감을 줬다. 기계의 추측이 실제 수학 연구로 이어진 첫 사례로 흔히 평가된다. 이 계보는 지금도 이어진다. 라슨(Larson)과 판 클레임풋(Van Cleemput)의 '자동 추측' 연작, 랜디 다빌라(Randy Davila)의 TxGraffiti(2016~)가 달마시안 휴리스틱을 다듬어 쓰고 있다.
4-4. 팔트로비치의 경고 — "추측은 공식 이상이다"
그런데 Graffiti를 만든 팔트로비치 자신은 '기계가 추측을 만들었다'는 표현에 누구보다 엄격했다. 그의 글 「완전 자동화된 그래프 이론의 단편들에 대한 후기」에 이런 문장이 있다.
수학적 추측은 공식 이상이다. 그것은 대개 그 공식의 의미, 비자명성, 정확성에 관한 개인적 의견의 표현이기도 하다. '추측을 만드는' 행위를 기계에 돌릴 때, 프로그램 저자는 사용자가 아니라 프로그램이 어떻게 그런 결론에 이르렀는지 분명히 설명해야 한다.
그리고 이렇게 덧붙였다. "내 경험으로는 이 일의 가장 큰 어려움은 어떤 추측이 다른 추측보다 더 중요한 이유를 이해하는 것이다." 그는 AM 같은 프로그램을 '발견 시스템'이라고 부르는 관행도 비꼬았다. 그런 프로그램은 사실 아무것도 발견한 적이 없고, "숫자 몇 개를 컴퓨터에 넣고 아주 의심스러운 낱말을 고르면, 기계가 E=mc²을 발견했다고 말할 수도 있다."
4-5. HR — "자존심이 없는" 개념 발명가
1990년대 말 에든버러에서는 사이먼 콜턴(Simon Colton)이 HR을 만들었다. 이름은 하디(Hardy)와 라마누잔(Ramanujan)의 머리글자다. 이론에서 출발하는 방식(하디)과 데이터에서 출발하는 방식(라마누잔)을 함께 쓰겠다는 뜻이다. HR은 '합성', '존재', '전칭', '부정' 같은 생성 규칙 7개로 개념을 만들고, 복잡도·새로움 같은 여러 흥미도 척도의 가중합으로 순위를 매겼다. 2000년까지 HR이 만든 정수열 17개가 '온라인 정수열 사전(OEIS)'에 실렸다.
정수론에 처음 적용했을 때 HR이 만든 개념이 재인수 가능수(refactorable number) 다. 약수의 개수로 나누어떨어지는 수(1, 2, 8, 9, 12, 18, 24, …)다. 콜턴은 1999년 논문에서 분업을 정직하게 적었다. "HR은 쉬운 부분만 했다. 개념을 발명한 것이다. 나머지는 모두 우리가 했다." 사람이 이 수들에 관한 정리를 증명했다. 예컨대 홀수인 재인수 가능수는 모두 제곱수다. 그리고 몇 주 뒤, 콜턴은 논문에 부록을 달았다. 이 개념이 1990년 케네디(Kennedy)와 쿠퍼(Cooper)의 논문에 '타우 수(tau numbers)'라는 이름으로 이미 정의돼 있다는 연락을 받은 것이다. "이 소식은 원래 논문을 단 한 가지 점에서만 깎아내린다. 제목이 부정확하다는 것이다. 재인수 가능수는 기계의 재발명이었다."
콜턴은 기계의 장점도 하나 꼽았다. 자동 개념 형성 프로그램은 "자존심이 없다(단순하게 기술되는 개념을 들여다보는 걸 부끄러워하지 않는다)." 사람이 '너무 쉬워 보여서' 지나친 개념을 기계는 지나치지 않는다. 그 대가로 기계는 이미 누가 본 개념도 다시 들고 온다.
5장. 연분수 공장 — 라마누잔 머신(2019~2021)
5-1. 라마누잔이라는 이름을 붙인 이유
스리니바사 라마누잔(1887~1920)은 증명 없이 공식을 쏟아낸 수학자로 유명하다. 하디에게 보낸 편지에는 π와 e에 관한 기묘한 무한 연분수가 가득했고, 그중 상당수는 그가 죽은 뒤 수십 년에 걸쳐 증명됐다. 그래서 '라마누잔'은 수학계에서 일종의 대명사가 됐다. 증명보다 먼저 보이는 사람, 추측을 만드는 직관의 상징이다.
2019년 7월, 이스라엘 테크니온의 이도 카미너(Ido Kaminer) 연구실이 arXiv에 올린 논문이 바로 그 이름을 가져다 썼다. 2021년 2월 Nature에 실린 최종판의 제목은 「라마누잔 머신으로 기본 상수에 관한 추측 생성하기(Generating conjectures on fundamental constants with the Ramanujan Machine)」다. 초록에는 "위대한 수학자의 직관을 대체하려는 시도"라는 도발적인 문장도 있었다. 언론은 "수학자를 대체할 알고리즘"이라고 받아 적었다.
5-2. 무엇을 만드나 — 다항식 연분수
라마누잔 머신이 만드는 추측은 모두 한 가지 모양이다. 왼쪽에는 상수 c(π, e, ζ(3), 카탈랑 상수 G)의 간단한 분수식, 오른쪽에는 다항식 연분수(polynomial continued fraction, PCF) 가 온다.
π4=1+3+5+7+⋱322212
연분수의 층마다 분모 쪽 수 an과 분자 쪽 수 bn이 n에 대한 정수 계수 다항식이다. 위 식이라면 an=2n+1, bn=n2이다. 이 식은 수백 년 된 고전 공식이지만, 계수를 조금만 바꾸면 무수히 많은 연분수를 만들 수 있다. 그중 어느 것이 이름 있는 상수와 연결될까? 사람이 하나씩 손으로 계산해 보기에는 너무 많다. 기계에게 맡기기 딱 좋은 일이다.
5-3. 어떻게 찾나 — 두 알고리즘
논문의 개념도(그림 1)는 흐름을 다섯 칸으로 그린다. 패턴 생성 → 탐색 알고리즘 → 검증과 중복 제거 → 추측 → (사람의) 증명 → 새로운 통찰. 탐색 칸에 들어가는 알고리즘이 둘이다.
MITM-RF가운데서 만나기(Meet-In-The-Middle). 연분수 쪽을 전부 계산해 앞 10자리를 열쇠로 해시 표에 넣는다. 그다음 상수 쪽 식(예: 4/π, e/(e−2))을 하나씩 계산해 표에서 찾는다. 양쪽을 모두 짝지어 비교하면 M×N번이지만, 표를 쓰면 M+N번이면 된다. 일치한 후보만 정밀도를 올려 다시 계산해 우연의 일치를 걸러 낸다.
Descent&Repel내려가고 밀어내기. 계수를 실수로 풀어 두고 '상수식과 연분수의 차이'를 경사 하강으로 줄인다. 점들이 한곳에 몰리지 않게 전하처럼 서로 밀어내게 하고, 마지막에는 정수 격자점으로 끌어당긴다. 흥미롭게도 정수 제약을 풀면 손실이 0인 지점이 매끄러운 곡면을 이룬다는 경험적 관찰이 이 방법의 바탕이다.
검증숫자로만. 살아남은 식은 최대 2,000자리까지 맞춰 본다. 저자들은 50자리 넘게 맞을 때 우연일 확률을 10⁻⁴⁰ 아래로 추정했지만, 스스로 "이런 정확도가 형식적 증명의 필요를 대신하지는 않는다"고 적었다.
중요한 점이 하나 있다. 이 시스템에는 신경망이 없다. 열거, 해시 표, 경사 하강, 고정밀 계산이 전부다. "AI가 수학 공식을 발견했다"는 기사 제목과 실제 구조 사이에는 꽤 거리가 있다.
아래 위젯은 MITM 방식을 브라우저 크기로 줄인 것이다. an=An+B, bn=Cn2+Dn+E 꼴 연분수 6,100개를 만들어 π·e·ln 2 같은 상수와 맞춰 본다.
직접 돌려 보면 몇 가지가 보인다.
고전 공식이 먼저 나온다. 맨 처음 걸리는 것 중 하나가 위의 4/π 공식이다. 같은 4/π에 이르는 다른 연분수도 하나 더 걸린다.
원 논문의 '새 공식'도 나온다. 이 작은 공간에서도 e−2e=4−5−6−⋯21 가 걸린다. 라마누잔 머신 논문 표 1이 "새로 찾았고 증명된" 예로 든 바로 그 식이다. 분모 쪽은 4, 5, 6, …으로 하나씩 늘고 분자 쪽은 −1, −2, −3, …으로 줄어든다.
자릿수를 낮추면 가짜가 늘어난다. 일치 기준을 5자리로 내리면 두 배 깊이 재확인에서 떨어져 나가는 '가짜 일치'가 생긴다. 해시로 후보를 모으고 정밀도를 올려 다시 확인하는 2단계 구조가 왜 필요한지 몸으로 느낄 수 있다.
같은 식의 변형이 많다. e − 1, 1/(e − 2), e/(e − 1)처럼 같은 연분수 가족이 모양만 바꿔 여러 번 나온다. '추측 50개'라는 숫자가 '새로운 아이디어 50개'를 뜻하지 않는 이유다.
5-4. 그다음에 일어난 일 — 증명, 비판, 그리고 진화
증명은 금방 따라왔다. arXiv 최종판(2020년 4월)에는 "몇 달 사이에 원래 원고의 모든 공식에 대한 증명이 제시됐다"는 문장이 있다. 기호 계산의 대가 도론 차일베르거(Doron Zeilberger)와 도허티-블리스(Dougherty-Bliss)가 일부를 증명하고 일반화했다. 연구팀은 여러 정수 사례를 복소수 전체로 일반화한 추측을 세우고, 초기하 항등식으로 그것을 증명했다.
비판도 날카로웠다.Nature가 공개한 심사 기록에서 1번 심사자는 이렇게 썼다. 이 문제는 "초보적"이고 "연분수를 찾는 탐색 공간은 매우 작으며", 알고리즘은 "전수 탐색과 경사 하강의 변형"이고, 논문이 '새로 찾고 증명된' 것이라 부른 상당수는 "가우스 연분수의 단순한 특수화일 뿐이라 새 결과로 볼 수 없다." 다른 심사자들은 "체계적이고 통일된 접근이 매우 새롭다"며 게재를 강하게 권했다. 차일베르거는 블로그 「의견 180」(2021-02-16)에서, 이름을 밝히지 않은 비판자들이 이 연구를 "지적 사기", "새로울 게 없다, 다 가우스와 오일러에서 나온다"고 부른다고 전했다. 그러면서 자신은 이것을 "새로운 종류의 수학 하기의 전조"라고 옹호했다.
그리고 시스템은 진화했다. 이 계보가 흥미로운 것은 후속 연구가 '공식 찾기'에서 '공식들 사이의 구조 찾기'로 올라갔기 때문이다.
연구
무엇을 만드나
무엇이 거르나
결과
라마누잔 머신 (Nature 2021)
상수 = 연분수 꼴 식
고정밀 수치 일치(최대 2,000자리)
π·e·ζ(3)·G에 관한 추측 수십 개, 대부분 몇 달 안에 증명
보존 행렬장 (PNAS 2024)
'계승 축소'가 일어나는 연분수
계승 축소 판정 → PSLQ로 상수 대조
자원봉사 PC 5,000대 이상으로 새 연분수 수백 개. 이들을 하나로 묶는 '보존 행렬장' 구조를 찾아 아페리의 ζ(3) 무리수 증명을 일반화
라마누잔 라이브러리 (2024)
상수 사이의 관계(하이퍼그래프의 변)
PSLQ
알려지지 않았던 연결 75개
오일러에서 AI까지 (NeurIPS 2025)
arXiv 논문 455,050편에서 LLM이 수집한 π 공식
LLM과 코드로 수치 검증 → 기호 알고리즘으로 묶기
π 공식 385개 검증, 그중 360개(94%)의 관계를 증명, 166개(43%)가 한 수학 대상에서 나옴
2024년의 '보존 행렬장' 논문이 특히 흥미롭다. 연구팀은 이름 있는 상수로 수렴하는 연분수에는 이상한 성질이 있다는 걸 알아챘다. 분자와 분모가 계승(n!)처럼 폭발적으로 커지는데, 둘의 최대공약수가 그 폭발을 거의 다 흡수한다. 무작위 연분수에서는 드문 일이다. 이 '계승 축소'를 걸러 내는 기준으로 삼자, 이번에는 상수를 미리 정하지 않고도 '뭔가 있는' 연분수를 골라낼 수 있었다. 저자들 스스로 인정하듯 이 기준 자체가 또 하나의 추측이다. 기계가 추측을 만드는 데 쓰는 거름망이 다시 추측이라는 구조는 이 글 내내 반복해서 나온다.
라마누잔 머신과 같은 해 12월, Nature에 성격이 전혀 다른 논문이 실렸다. 딥마인드와 옥스퍼드의 매듭 이론가 마크 래켄비(Marc Lackenby)·안드라스 유하스(András Juhász), 시드니의 표현론 학자 조디 윌리엄슨(Geordie Williamson)이 함께 쓴 「AI로 인간의 직관을 이끌어 수학을 발전시키기(Advancing mathematics by guiding human intuition with AI)」다.
이 논문의 첫 번째 결정은 무엇을 하지 않을지였다. 저자들은 이렇게 썼다. "기계 학습으로 추측을 직접 생성하기보다, 우리는 전문 수학자의 고도로 조율된 직관을 이끄는 데 집중한다." 기계는 추측을 쓰지 않는다. 대신 수학자가 어디를 봐야 할지 손가락으로 가리킨다.
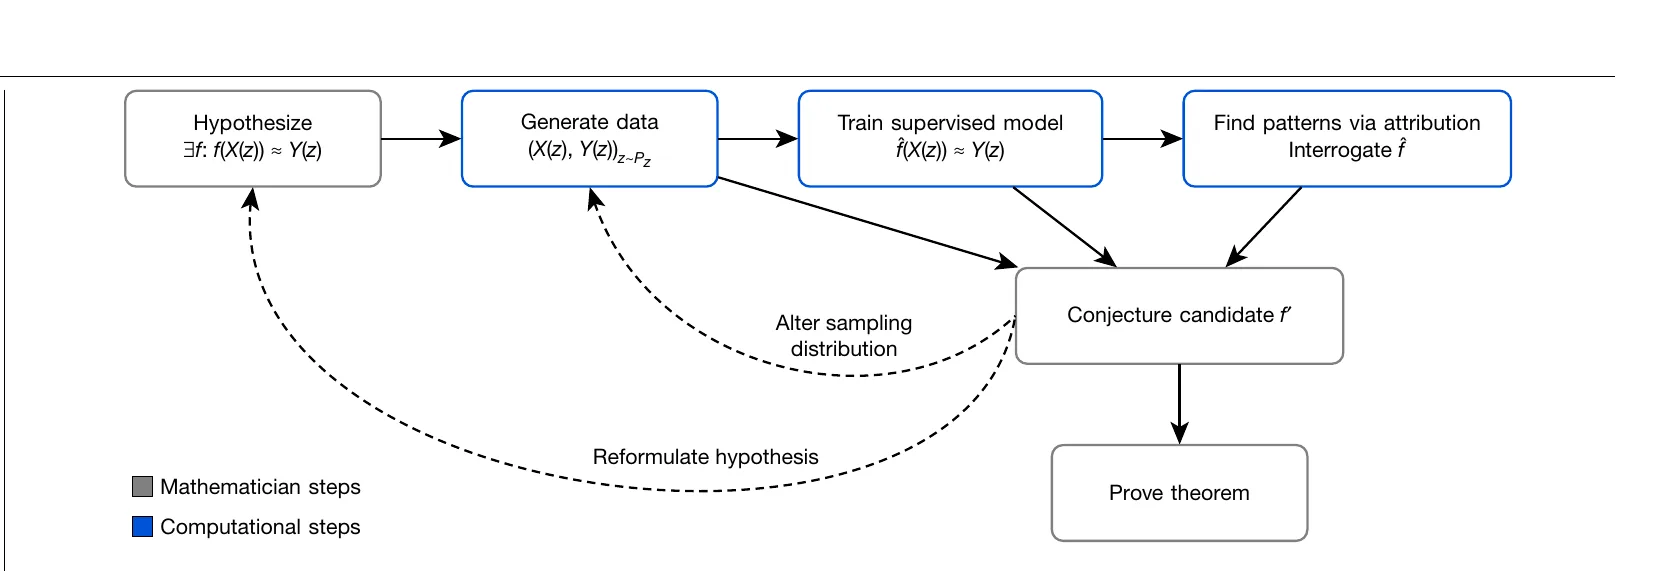
6-2. 그림 1 읽기 — 수학자 칸과 계산 칸
크게 보기출처: Davies 외, "Advancing mathematics by guiding human intuition with AI", Nature 600, 70–74 (2021), 그림 1. CC BY 4.0. 원 논문에서 그림만 잘라 냈다.
이 그림이 논문 전체의 구조다. 상자의 색이 핵심이다. 회색 상자는 수학자가, 파란 상자는 컴퓨터가 하는 단계다.
수학자가설: 어떤 대상 z에 대해 계산할 수 있는 성질 X(z)와 알고 싶은 성질 Y(z) 사이에 함수 f가 있지 않을까? "f(X(z)) ≈ Y(z)인 f가 존재한다."
계산데이터 생성: z를 대량으로 뽑아 (X, Y) 쌍을 만든다. 매듭이라면 수백만 개.
계산지도학습: 신경망 f̂이 X에서 Y를 맞히도록 학습한다. 잘 맞힌다면 "관계가 있다"는 증거다. 못 맞히면 가설을 다시 세운다.
계산기여도 분석: 학습된 f̂에게 "어느 입력에 민감한가?"를 묻는다. 출력의 입력에 대한 기울기(gradient saliency)를 평균 내는 단순한 방법이다.
수학자추측 후보: 기여도가 높은 몇 개 입력만 들여다보며 식을 추측한다. 틀리면 표본 분포를 바꾸거나(반례가 있을 법한 곳의 데이터를 더 만들거나) 가설을 고친다.
수학자증명: 살아남은 추측을 증명한다.
캡션의 마지막 문장도 중요하다. "이 과정은 한 번 쭉 가는 단계가 아니라 반복적이고 상호작용적이다." 논문은 그 반복을 두 분야에서 보여 줬다. 매듭 이론과 표현론이다. 계산량도 의외로 작다. 저자들은 모델을 "GPU 한 장짜리 기계에서 몇 시간 안에" 학습할 수 있었다고 적었다.
6-3. 매듭: 서명과 '자연 기울기'
문제. 매듭에는 두 종류의 불변량(매듭을 어떻게 그려도 변하지 않는 수)이 있다. 하나는 대수적 불변량이다. 대표적인 것이 서명(signature) σ로, 매듭을 경계로 하는 곡면에서 계산하는 정수다. 다른 하나는 기하적 불변량이다. 대부분의 매듭은 그 바깥 공간에 '쌍곡 기하'를 입힐 수 있고, 그러면 부피나 매듭 둘레 관 모양 영역(첨점, cusp)의 크기 같은 실수 값이 나온다. 두 세계는 서로 다른 언어로 계산되고, 둘 사이의 연결은 잘 알려져 있지 않았다.
데이터와 모델. 16교차 이하의 매듭 전부(약 170만 개)와 80교차짜리 무작위 매듭 약 100만 개를 썼다. 기하 불변량 12개를 입력으로, 서명을 출력으로 하는 신경망(은닉층 300개짜리 3층)을 학습시켰다. 시험 정확도는 78%로, 찍기 기준선 25%보다 훨씬 높았다. 틀려도 ±2를 넘지 않았다.
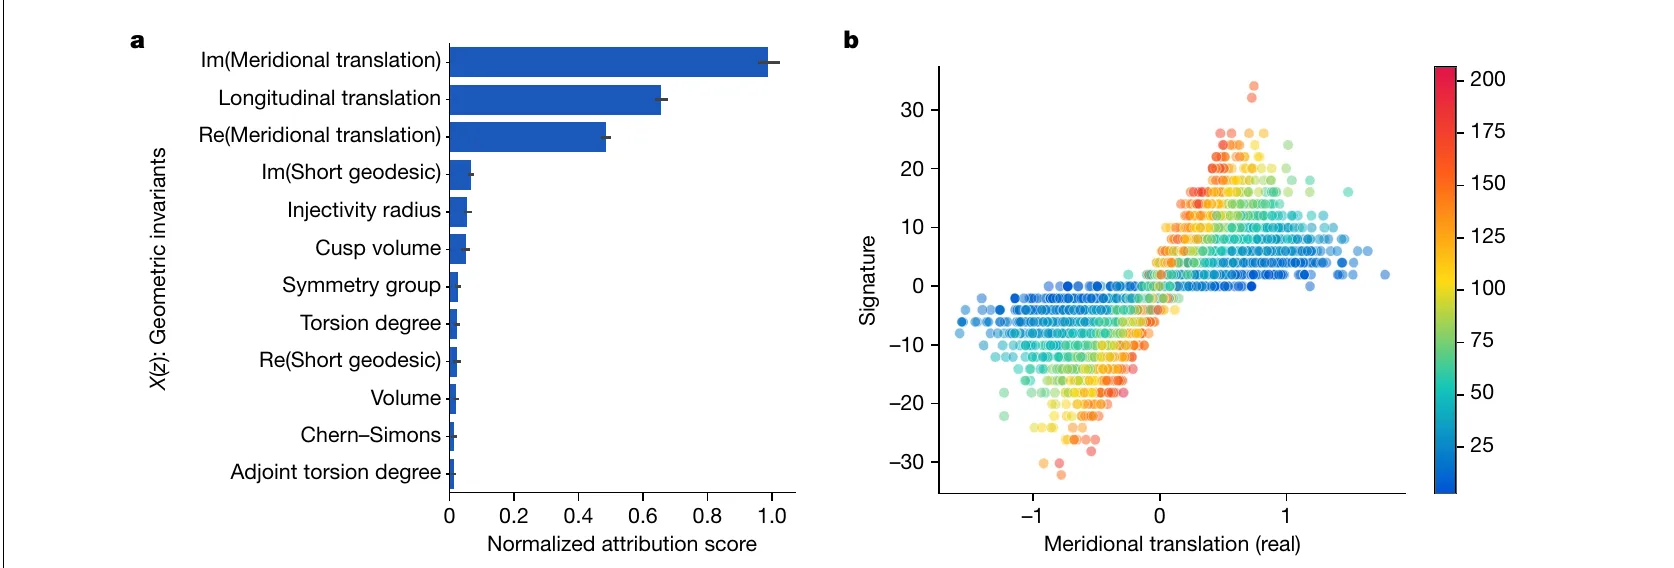
왼쪽 막대그래프(a)에서 길게 뻗은 막대 세 개는 모두 첨점의 모양을 재는 양이다. 자오선 이동(meridional translation) μ의 허수부와 실수부, 그리고 세로 이동(longitudinal translation) λ. 부피나 천–사이먼스 불변량처럼 매듭 이론가들이 먼저 떠올릴 법한 양은 거의 0이다. 오른쪽 산점도(b)는 μ의 실수부를 가로축에 놓은 것이다. 점들이 원점을 지나는 부채꼴로 퍼지고, 색(λ)이 진할수록 기울기가 가파르다. "세 양을 하나로 묶는 식이 있다"는 냄새가 나는 그림이다.
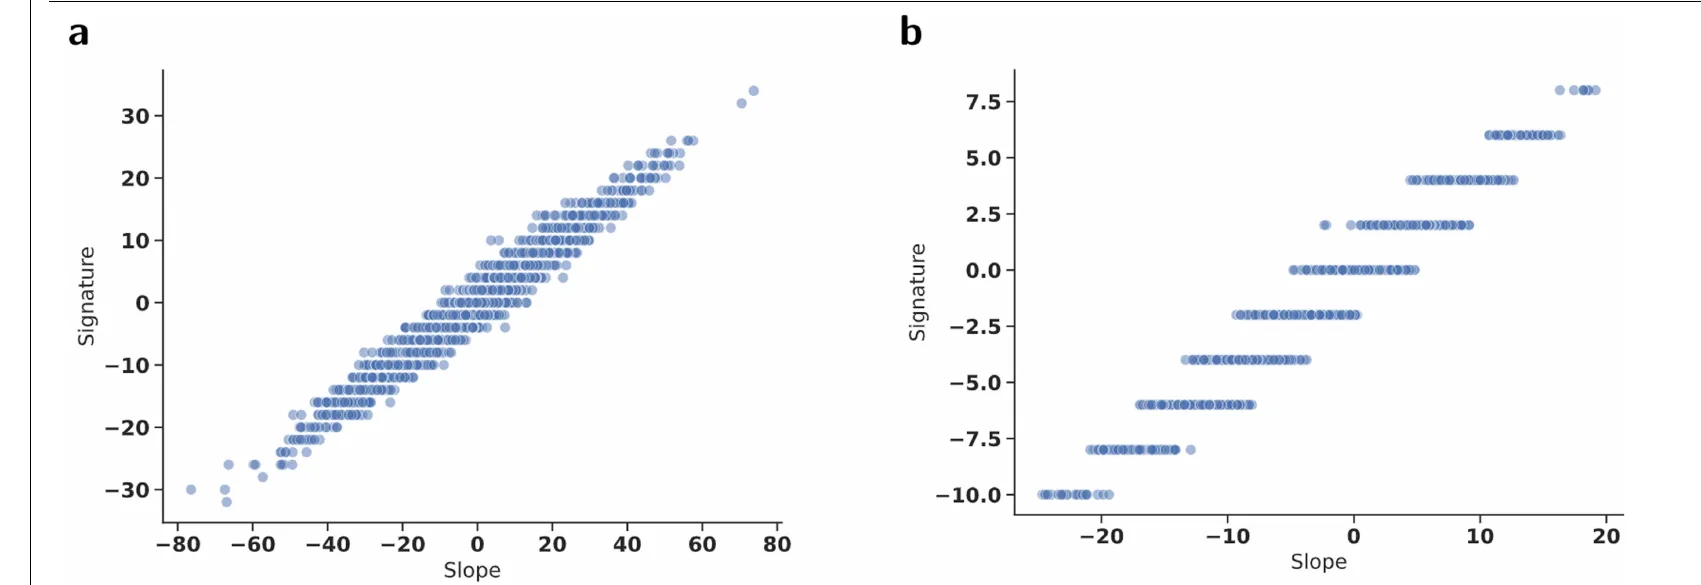
추측과 반례, 그리고 정리. 수학자들이 찾은 묶음은 자연 기울기(natural slope) 였다. slope(K) = Re(λ/μ). 그러자 서명과 기울기가 거의 정확히 2배 관계로 늘어섰다.
첫 추측은 이랬다. 어떤 상수 c₁, c₂가 있어서 모든 쌍곡 매듭에 대해 |2σ(K) − slope(K)| < c₁·vol(K) + c₂. 그런데 이 추측은 깨졌다. 연구팀이 반례가 있을 법한 곳(특정한 꼬임(braid)을 닫아 만든 매듭들)에서 데이터를 일부러 더 만들자 부등식을 벗어나는 매듭이 나왔다. 그림 1의 '표본 분포 바꾸기' 화살표가 실제로 쓰인 순간이다. 고쳐 쓴 정리는 단사 반지름(injectivity radius) inj(K)라는 양을 하나 더 넣는다.
∣2σ(K)−slope(K)∣≤c⋅vol(K)⋅inj(K)−3
전체 증명은 2024년 Geometry & Topology에 실렸다(Davies·Juhász·Lackenby·Tomašev).
아래 위젯은 이 흐름을 합성 데이터로 재현한다. 진짜 매듭이 아니라 '서명 ≈ 기울기/2' 관계와 헷갈리는 상관관계를 일부러 심은 가짜 매듭 2,400개다. 그래도 학습 → 기여도 → 축 바꾸기 → 기울기라는 순서를 직접 밟아 보면 논문이 무엇을 했는지가 손에 잡힌다.
6-4. 대칭군: 40년 된 추측에 다가간 그래프 신경망
논문의 두 번째 사례는 더 어렵고, 기계의 몫도 더 컸다. 표현론에는 카즈단–루스티그(KL) 다항식이라는 대상이 있다. 대칭군(카드를 섞는 모든 방법의 집합)의 원소 두 개마다 다항식이 하나씩 붙는데, 이 다항식이 표현론과 기하의 깊은 구조를 담고 있다. 1980년대부터 내려온 조합적 불변성 추측은 이렇게 말한다. KL 다항식은 두 원소 사이의 '브뤼아 구간'이라는 방향 그래프의 모양만으로 결정된다. 라벨을 지운 그래프만 보고 다항식을 알 수 있다는 것이다.
연구팀은 S₉까지의 구간에서 서로 다른 그래프 24,322개를 골라 그래프 신경망(GNN)을 학습시켰다. 다항식의 계수를 예측하는 정확도는 기준선보다 훨씬 높았다. q⁴ 계수 하나를 빼면 기준선은 12~29%였고, 그래프 전체를 본 모델은 63~98%를 냈다. 기여도 분석은 이번에는 그래프의 특정 변들을 가리켰다. 양 끝 반사(extremal reflection) 에 해당하는 변들이 유난히 많이 쓰이고 있었다. 이 힌트에서 윌리엄슨 등은 모든 브뤼아 구간을 '초입방체(hypercube)'로 쪼개는 방법을 찾고, 그 쪼개기에서 KL 다항식을 계산하는 정리를 증명했다. 그리고 새 추측을 세웠다. 어떤 초입방체 분해를 써도 된다. 이 추측은 S₇까지의 구간 약 300만 개 전부에서 확인됐다.
40년 된 원래 추측은 아직 열려 있다. 다만 바클리(Barkley)와 개츠(Gaetz)가 이 초입방체 분해를 이용해 특정한 종류의 구간에 대해 조합적 불변성을 증명하는 등, 기계가 가리킨 방향으로 사람의 증명이 쌓이고 있다.
6-5. "통계로도 충분했다" — 데이비스의 비판
이 논문은 "AI가 수학의 돌파구를 열었다"는 기사들로 크게 퍼졌다. 뉴욕대의 어니스트 데이비스(Ernest Davis)는 곧바로 리뷰 논문을 써서 찬물을 끼얹었다. 요지는 셋이다.
매듭 사례에서 딥러닝의 역할은 작았다. 입력 12개 중 3개가 중요한 문제에 매개변수 20만 개짜리 신경망은 과했고, "통상적인 통계 분석으로도 아마 충분했을 것"이다. 실제로 논문 스스로 기울기 하나만 넣은 선형 모델도 78%를 낸다고 밝혔다.
KL 사례에서는 딥러닝이 진짜 역할을 했지만, 그 역할은 "실험 수학이 수십 년 동안 해 온 것과 종류가 크게 다르지 않다."
'직관을 이끈다'는 표현은 오해를 부른다. 기계가 한 일은 어떤 추측이 틀렸을 가능성이 높은지, 어디를 더 볼 가치가 있는지 표시한 것이다. 그리고 모든 단계에 깊은 전문 지식이 필요했다.
데이비스의 비판은 이 글의 질문과 정확히 맞닿는다. 신경망은 추측을 만들지 않았다. 대신 어떤 질문이 들여다볼 가치가 있는지 가리켰다. 그것만으로도 질문하는 일의 일부를 넘겨받은 것일까, 아니면 좋은 돋보기일 뿐일까?
2022년 4월, 한 무리의 수학자가 「타원곡선의 찌르레기 떼(Murmurations of Elliptic Curves)」라는 시적인 제목의 논문을 올렸다(He·Lee·Oliver·Pozdnyakov). 이 이야기는 종종 "AI가 새로운 수학 패턴을 발견했다"로 소개된다. 실제로는 더 흥미롭다.
배경은 이렇다. 연구팀은 타원곡선을 소수 p마다 정해지는 수 ap 500개의 벡터로 바꿔, 단순한 로지스틱 회귀로 곡선의 계수(rank) 를 분류하고 있었다. 계수는 버치–스위너턴다이어 추측(2장)의 주인공이다. 분류는 이상할 만큼 잘 됐다. 계수 0과 2를 99.6%로 갈랐다. 전문가들은 "그거 다 알려진 성질(근 번호) 때문 아니냐"고 반문했다. 그래서 리(Kyu-Hwan Lee) 교수가 학부생 알렉세이 포즈냐코프(Alexey Pozdnyakov)에게 숙제를 냈다. 분류기가 왜 잘 되는지 알아 와라.
포즈냐코프는 가장 단순한 일을 했다. 도체가 7,500~10,000인 곡선 약 1만 개를 계수별로 나눠 각 ap의 평균을 내고 그래프로 그렸다. 계수 0인 곡선과 계수 1인 곡선의 평균이 서로 반대 위상으로 출렁이는, 찌르레기 떼 같은 무늬가 나왔다. 그는 나중에 퀀타에 이렇게 말했다. "처음에는 숙제를 끝내서 그냥 기뻤어요. 그런데 리 교수님이 이 무늬가 놀랍다는 걸 바로 알아보셨죠."
여기에는 운도 따랐다. 데이터를 가져온 LMFDB(L-함수와 모듈러 형식 데이터베이스)는 마침 도체 순으로 정렬돼 있었다. 그리고 전문가라면 으레 ap를 정규화했을 텐데, 포즈냐코프는 정규화를 하지 않아 출렁임이 크고 선명하게 보였다. 앤드루 서덜랜드(Andrew Sutherland)는 이 무늬를 10억 개가 넘는 곡선으로 다시 계산하고 크기를 바꿔도 모양이 유지된다는 걸 확인한 뒤 피터 사낙(Peter Sarnak)에게 편지를 썼다. "이미 알려진 설명이 있다면 당신이 알 거라고 생각합니다." 사낙도 몰랐다. 사낙의 학생 니나 주브릴리나(Nina Zubrilina)가 2023년 10월 모듈러 형식 가족에 대해 '찌르레기 떼 밀도'를 정확한 식으로 증명했다. 사낙의 평은 "데이터에 완벽하게 맞는 정확한 공식"이었다. 다만 이 증명은 무게가 고정된 모듈러 형식 가족에 관한 것이라, 타원곡선을 계수별로 나눈 원래 그림을 직접 증명한 것은 아니다.
이 사례가 이 글에 중요한 이유는, 질문을 만든 것이 기계가 아니라 기계를 의심한 사람이었기 때문이다. 기계 학습 분류기는 "여기 뭔가 있다"는 신호만 줬다. 신호를 그림으로 바꾼 것은 평균을 낸 학부생이었고, 그림이 놀랍다는 걸 알아본 것은 교수였고, 설명할 가치가 있는 문제라고 판단한 것은 서덜랜드와 사낙이었다. 그림 원본은 저작권 때문에 싣지 못하고, 위의 삽화로 대신한다.
7장. 질문 대신 '예시'를 만든다 — 반례 사냥에서 FunSearch·AlphaEvolve까지(2021~2025)
7-1. 추측을 죽이는 것도 질문의 일이다
수학자에게 "좋은 질문"은 새 추측만이 아니다. "이 추측은 정말 맞나?" 도 질문이다. 그리고 그 질문에 가장 강력한 답은 증명이 아니라 반례 하나다. 추측이 많아질수록 반례를 찾는 일의 값어치도 올라간다.
2021년 4월, 텔아비브대의 아담 조르트 바그너(Adam Zsolt Wagner)가 올린 짧은 논문 「신경망을 이용한 조합론 구성(Constructions in combinatorics via neural networks)」이 이 방향의 출발점이 됐다. 방법은 단순하다.
생성작은 신경망(은닉층 128→64)이 그래프를 변 하나씩 "넣을까 말까"로 만든다. 한 번에 수천 개.
채점추측의 부등식을 얼마나 위반하는지 점수로 매긴다. 문제마다 바꾸는 코드는 이 채점 함수 하나뿐이다.
학습상위 몇 %의 그래프를 만든 선택들을 정답 삼아 신경망을 다시 학습시킨다(교차 엔트로피 방법).
반복점수가 추측의 경계를 넘으면 반례다.
바그너는 이 방법으로 그래프 이론의 덜 알려진 추측 여러 개를 깼다. 예를 들어 그래프의 가장 큰 고윳값과 매칭 수에 관한 한 추측은 꼭짓점 19개짜리 그래프에서 무너졌다(5.16 < 5.24). 평범한 PC로 몇 시간이면 됐다. 다만 이 추측은 이미 다른 사람이 꼭짓점 600개짜리 반례로 깬 상태였고, 바그너도 그걸 밝혀 두었다. 다른 추측에서는 신경망이 정확한 반례를 내놓지는 못했지만 "길 가운데 별이 매달린 모양"이라는 힌트를 줬고, 바그너가 그 모양을 키워 꼭짓점 203개짜리 반례를 손으로 만들었다. 논문의 결론은 담백했다. "가장 유명한 추측은 하나도 깨지 못했다."
이 방법의 매력은 문제에 대해 아무것도 몰라도 된다는 데 있다. 바그너의 말로는 "코드에서 바꿔야 할 것은 주어진 구성의 점수를 계산하는 함수뿐이다." 이 문장이 이후 FunSearch와 AlphaEvolve의 설계 원칙이 된다. 평가기만 잘 만들면, 나머지는 생성기가 한다.
7-2. FunSearch — 답이 아니라 '답을 만드는 프로그램'을 찾는다
2023년 12월, 딥마인드는 Nature에 「대형 언어 모델을 이용한 프로그램 탐색으로 얻은 수학적 발견」을 발표했다. 이름은 FunSearch, '함수 공간에서의 탐색(searching in the function space)'의 줄임말이다. 저자에는 위스콘신대의 수학자 조던 엘렌버그(Jordan Ellenberg)도 있다. 그는 2016년 캡셋 문제의 상한을 증명한 사람이다.
핵심 발상은 한 문장이다. "FunSearch는 문제의 해가 무엇인지가 아니라, 문제를 어떻게 푸는지 기술하는 프로그램을 찾는다."
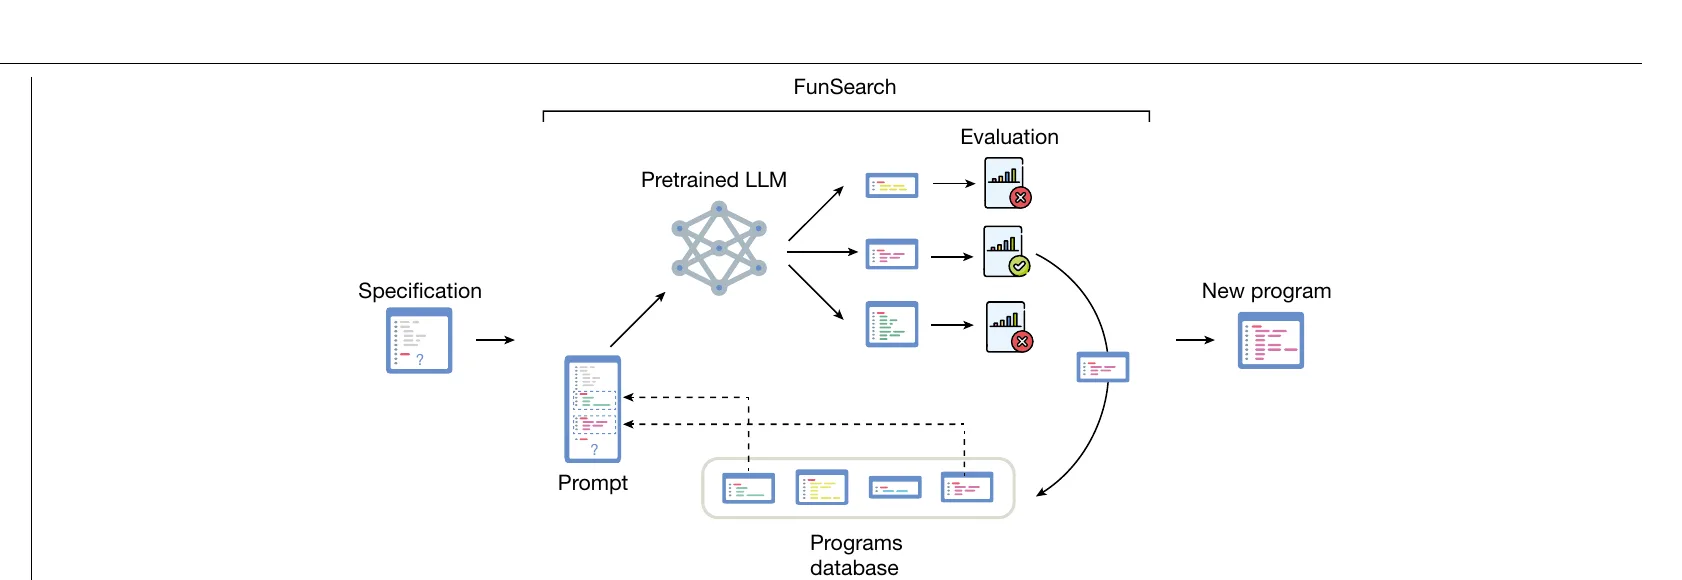
크게 보기출처: Romera-Paredes 외, "Mathematical discoveries from program search with large language models", Nature 625, 468–475 (2024), 그림 1. CC BY 4.0.
그림 1을 왼쪽부터 읽어 보자.
명세(Specification). 사람이 주는 것은 두 가지다. 후보 해를 채점하는 evaluate 함수, 그리고 뼈대 프로그램이다. 캡셋 문제라면 뼈대는 "점을 우선순위 순으로 훑으며 넣어도 되면 넣는다"는 탐욕 알고리즘이고, 진화시킬 부분은 우선순위를 매기는 priority 함수 하나다. 처음에는 아무 의미 없는 함수로 시작해도 된다.
프롬프트. 데이터베이스에서 점수가 높은 프로그램 두 개를 골라 priority_v0, priority_v1이라는 이름으로 점수 순서대로 붙이고, 그 아래에 빈 priority_v2의 첫 줄을 둔다. LLM은 "다음 버전"을 이어 쓰게 된다. 논문은 이것을 '최고 샷 프롬프트(best-shot prompting)'라고 부른다.
사전 학습된 LLM. 코드용 모델 Codey(PaLM 2 계열)를 미세조정 없이 썼다. 일부러 더 똑똑한 모델 대신 빠른 모델을 골랐다. 전체 표본은 100만 개 단위다. 논문은 LLM의 역할을 이렇게 낮춰 말한다. "가끔 흥미로운 아이디어가 섞인, 다양한 (문법적으로 올바른) 프로그램의 공급원."
평가. 새 프로그램을 실제로 돌려 점수를 매긴다. 시간 초과, 메모리 초과, 틀린 출력은 버린다(빨간 ×). 평가기 150개가 CPU에서 비동기로 돈다.
프로그램 데이터베이스. 여기에 진화 알고리즘의 지혜가 들어 있다. 프로그램들은 여러 개의 섬(island) 으로 나뉘어 따로 진화한다. 4시간마다 성적이 나쁜 절반의 섬을 지우고, 살아남은 섬의 최고 프로그램으로 다시 씨를 뿌린다. 한 섬 안에서는 점수 패턴이 같은 프로그램끼리 묶고, 같은 점수라면 짧은 프로그램을 선호한다.
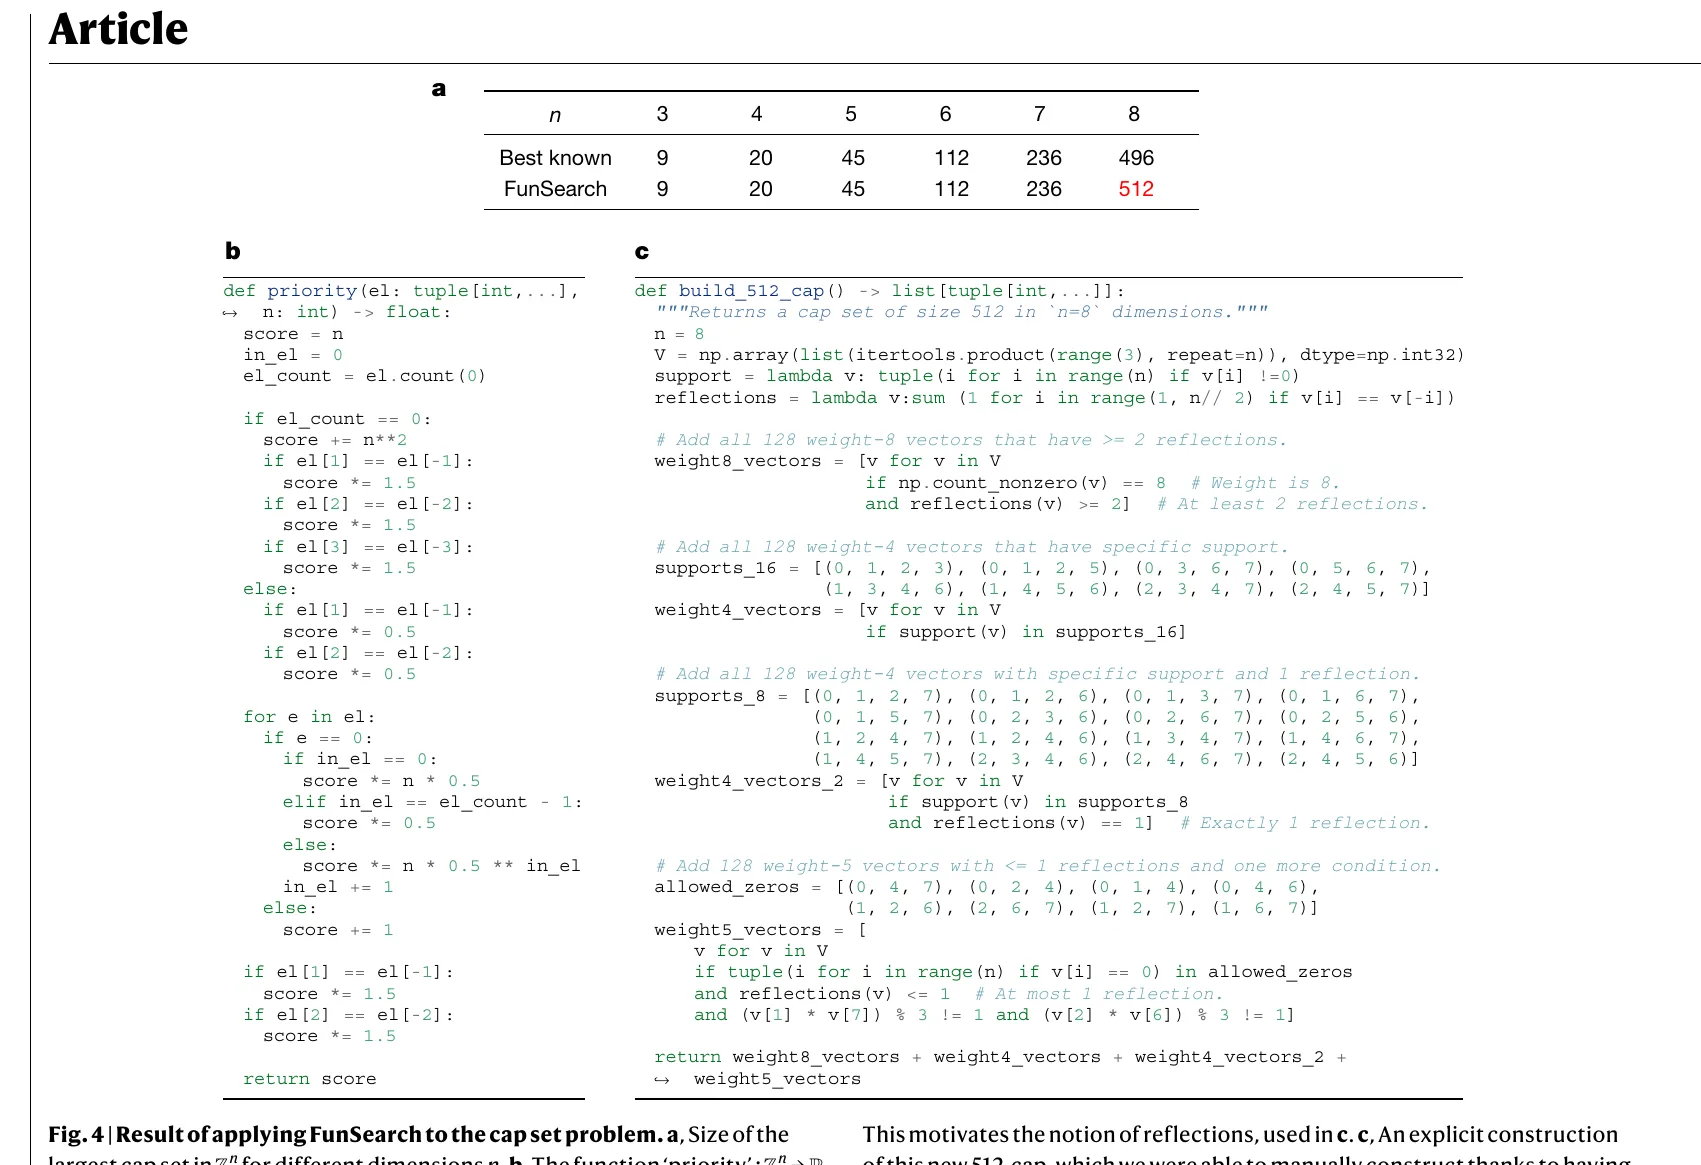
FunSearch의 대표 결과는 캡셋(cap set) 문제다. 카드 게임 SET을 해 본 사람이라면 이미 이 문제를 안다. SET 카드는 네 가지 속성(개수·색·모양·채움)이 각각 세 가지 값을 가지므로 모두 3⁴ = 81장이다. 세 장의 카드가 속성마다 "모두 같거나 모두 다르면" 세트다. 세트가 하나도 없는 카드 묶음이 캡셋이다. 속성 4개에서는 20장까지 가능하고, 21장이면 반드시 세트가 생긴다. 이 사실은 1970년에 증명됐다. SET 게임보다 4년 먼저다.
속성 수 n을 늘리면 문제는 순식간에 어려워진다. 최댓값이 증명된 것은 n = 6(112장)까지다. n = 8에서는 3⁸ = 6,561개의 점 중에서 고르는 문제인데, 경우의 수가 대략 3¹⁶⁰⁰개다. 그때까지 알려진 가장 큰 캡셋은 496장이었다.
크게 보기출처: Romera-Paredes 외 (2024), 그림 4. CC BY 4.0.
표(a)의 빨간 512가 FunSearch의 결과다. 가운데 코드(b)는 FunSearch가 찾은 priority 함수다. 좌표 몇 개가 서로 같은지 보고 점수를 곱하는, 사람이 보기엔 다소 기묘한 규칙이다. 오른쪽 코드(c)가 더 흥미롭다. 연구진은 (b)를 읽다가 점수가 "같은 값이 i번째와 뒤에서 i번째 자리에 있는지"에 좌우된다는 걸 알아챘다. 여기서 '반사(reflection)' 라는 개념을 떠올렸고, 그 개념으로 512장짜리 캡셋을 손으로 다시 구성했다. 기계가 내놓은 것은 답을 만드는 프로그램이었고, 그 프로그램이 짧고 읽을 수 있었기 때문에 사람이 그 안의 아이디어를 꺼낼 수 있었다.
캡셋의 점근적 크기를 재는 다른 실험에서도 같은 일이 있었다. FunSearch가 찾은 프로그램에서 연구진이 대칭을 발견했고, 대칭인 해만 찾도록 탐색 공간을 좁히자 더 좋은 결과가 나왔다. 하한은 2.2180에서 2.2202로 올라갔다. 논문은 "20년 만의 가장 큰 개선"이라고 불렀다.
이 결과를 읽을 때 놓치기 쉬운 점이 셋 있다.
512는 '해결'이 아니라 '기록'이다. n = 8에서 512장짜리가 존재한다는 걸 보였을 뿐, 그게 최대라는 증명은 없다.
개선 폭은 작다. 2.2180 → 2.2202. 반대쪽 상한은 2.756이다(엘렌버그–히스바이트, 2017). 둘 사이의 틈은 여전히 넓다.
운도 컸다. 512는 140번 실행 중 4번만 나왔다.
논문은 FunSearch가 쓸 수 있는 문제의 조건도 분명히 적었다. 빠른 평가기가 있어야 하고, 맞다/틀리다가 아니라 '얼마나 좋은지'를 알려 주는 풍부한 점수가 있어야 하며, 따로 떼어 진화시킬 부분이 있는 뼈대가 있어야 한다. 그리고 "정리의 증명을 생성하는 문제는 이 범위 밖이다."
아래 위젯은 FunSearch의 섬 진화를 장난감 크기로 줄인 것이다. 진짜는 LLM이 코드를 고치지만, 여기서는 특징 8개의 가중치를 난수로 흔든다.
속성 4개에서는 장난감도 금방 알려진 최댓값 20에 닿는다. 속성 5개(최댓값 45)에서는 40 언저리, 6개(최댓값 112)에서는 80대에서 멈춘다. 가중치 8개짜리 우선순위 함수로는 표현할 수 없는 구조가 있기 때문이다. FunSearch가 LLM을 쓴 이유가 여기 있다. '무엇이든 쓸 수 있는 코드'라는 넓은 공간에서, 사람이 읽을 수 있는 짧은 규칙을 찾는 것.
7-4. PatternBoost — 국소 탐색과 트랜스포머의 왕복
2024년 11월, 바그너와 엘렌버그는 메타의 프랑수아 샤르통(François Charton), 윌리엄슨과 함께 PatternBoost를 내놓았다. 구조는 두 단계의 왕복이다.
국소 탐색 고전적 탐욕·지역 개선
→
상위 25%만 남기기
→
작은 트랜스포머 학습 "좋은 구성은 대개 이렇게 생겼다"
→
트랜스포머가 뽑은 표본을 다음 국소 탐색의 씨앗으로
논문은 자전거에 빗댔다. 자전거 장인은 자기 설계를 조금씩 고치고(국소), 대중이 가진 '자전거란 대개 이렇게 생겼다'는 감각이 전체 방향을 잡는다(전역). 가장 큰 결과는 d차원 정육면체(초입방체)의 지름을 보존하는 가장 작은 부분 그래프에 관한 30년 묵은 추측을 깬 것이다. 6차원에서 추측이 말하는 최소 82개보다 적은 81개 변짜리 구성을 찾았다. 저자들은 정직하게 덧붙였다. 성능은 문제마다 들쭉날쭉하고, 어떤 표현 방식이 잘 통할지 "지금으로서는 이해가 거의 없다."
7-5. AlphaEvolve와 '67개 문제' — 타오가 본 장단점
2025년 5월의 AlphaEvolve는 FunSearch의 직계 후손이다. 논문의 표 1이 두 시스템을 나란히 비교한다.
항목
FunSearch (2023)
AlphaEvolve (2025)
진화시키는 것
함수 하나, 10~20줄
파일 전체, 수백 줄
언어
파이썬만
아무 언어
평가
CPU 1개에서 20분 이하
가속기에서 병렬로 몇 시간
LLM 표본 수
수백만
수천이면 충분
LLM
작은 모델, 큰 모델로 바꿔도 이득 없음
최신 모델(제미나이 2.0 플래시+프로)로 이득
프롬프트 맥락
최소한
풍부한 맥락과 평가 피드백, 프롬프트 자체도 진화
목표
지표 하나
여러 지표 동시 최적화
제어 루프는 놀라울 만큼 짧다. 데이터베이스에서 부모 프로그램과 '영감' 프로그램을 뽑고 → 프롬프트를 만들고 → LLM이 수정 사항(diff)을 쓰고 → 적용해서 → 평가하고 → 데이터베이스에 넣는다. 결과도 화려했다. 4×4 복소 행렬 곱셈을 곱셈 48번으로 하는 방법을 찾아, 1969년 슈트라센 방법을 재귀로 쓴 49번을 처음으로 넘었다(재귀 적용이 가능한 '텐서 분해' 방식 안에서의 기록이다. 2022년 AlphaTensor의 47번은 0과 1만 쓰는 GF(2) 산술에서만 통한다). 11차원 접촉수(한 구에 겹치지 않게 닿을 수 있는 같은 크기 구의 수)의 하한을 592에서 593으로 올렸다. 수학 문제 50여 개 중 약 75%에서 기존 최고 기록에 맞먹었고, 약 20%에서 넘었다.
여기서도 조심해서 읽을 곳이 있다. 48번은 복소수 계수에서의 결과다. 유리수 계수로 된 48번짜리는 한 달쯤 뒤 사람 연구자들(뒤마·페르네·세돌라비크)이 AlphaEvolve의 결과를 변환해 만들었다. '20% 개선'의 상당수는 소수점 여섯째 자리 수준이다.
가장 솔직한 평가는 2025년 11월 테런스 타오 자신이 공저자로 참여한 논문 「대규모 수학 탐구와 발견(Mathematical exploration and discovery at scale)」에서 나왔다(Georgiev·Gómez-Serrano·Tao·Wagner). 해석학·조합론·기하·정수론의 문제 67개에 AlphaEvolve를 적용한 기록이다. 결론부의 몇 문장은 이 글 전체의 요약처럼 읽힌다.
AlphaEvolve는 현재 수학의 손이 이미 닿을 수 있는 범위에 있던 구성을 찾는 데 탁월하다. 진전을 위해 정말로 새롭고 깊은 통찰이 필요한 문제에는 아마 맞는 도구가 아닐 것이다.
타오는 블로그(2025-11-05)에 경험담을 덧붙였다. 시스템은 평가기의 허점, 이른바 '익스플로잇' 을 찾는 데 "극도로 능하다." 점들이 서로 같은 거리에 있어야 하는 문제에서는 부동소수점 검사를 통과할 만큼만 점들을 뭉쳐 놓았고, 선형계획 풀이기의 부동소수점 오류를 파고들기도 했다. 그래서 "뚫리지 않는 평가기를 설계하는 데 적지 않은 사람의 노력이 들어가야 한다." 유한체 카케야 문제에서는 팀이 몰랐던 기존 구성(Bukh–Chao)을 다시 찾아냈다. 4차원에서의 '개선'은 오차항을 빼면 이미 그 논문에 있던 것이었다. 사이도렌코·센도프·크루제 같은 유명한 추측은 하나도 깨지 않았다. 그리고 문제를 잘 아는 전문가가 프롬프트를 쓸 때 "AlphaEvolve는 언제나 훨씬 잘했다."
이 장의 시스템들이 공통으로 보여 주는 것은 이것이다. 기계가 만드는 것은 대부분 '추측'이 아니라 '예시'와 '경계'다. 반례, 더 큰 구성, 더 좋은 상·하한. 이것들은 수학자에게 매우 귀한 재료다. 하지만 무엇을 재료로 삼을지, 즉 어떤 문제의 어떤 평가기를 만들지 정하는 일은 여전히 사람이 했다. AlphaEvolve 논문 스스로 대부분의 수학 결과가 "외부 수학자 하비에르 고메스세라노와 테런스 타오가 제안한 열린 문제들"에서 나왔다고 밝힌다.
8장. 스스로 묻고 스스로 답하는 기계 — 형식 수학의 자기 대국(2024~2025)
8-1. 알파고처럼 수학을 배울 수 있을까
바둑 AI가 사람 기보 없이 자기 자신과 둔 대국만으로 강해진 뒤, 수학에서도 같은 꿈이 생겼다. 스스로 문제를 내고 스스로 푸는 기계. 문제를 내는 쪽(추측기, conjecturer)과 푸는 쪽(증명기, prover)이 서로를 키우는 구조다. 형식 수학은 이런 실험에 안성맞춤이다. Lean이나 Isabelle 같은 증명 보조기가 증명이 맞는지를 기계적으로 판정해 주므로, 사람이 채점할 필요가 없다.
이 구조에는 처음부터 까다로운 질문이 숨어 있다. 추측기에게 무엇을 보상할 것인가? 너무 쉬운 추측("1 = 1")은 아무것도 가르치지 않는다. 증명기가 절대 못 푸는 추측도 쓸모가 없다. 그래서 세 시스템은 공통으로 '간신히 증명되는' 추측을 보상한다.
시스템
추측기가 받는 보상
규모와 결과
한계(저자들 스스로)
Minimo Poesia 외, NeurIPS 2024
현재 증명기에게 '어렵지만 예산 안에 풀리는' 추측. 실패한 탐색도 '다른 참인 정리의 증명'으로 다시 써서 학습(사후 재라벨링)
공리만 주고 무작위 초기화한 트랜스포머에서 시작. 명제논리·산술·군론. A40 GPU 288시간. 마지막 세대만 귀납법이 필요한 succ(n)+m = succ(n+m)을 증명
보조정리 라이브러리가 고정돼 있어, "더 어려운 추측"이 대부분 문장을 길고 복잡하게 만든 것
STP Dong·Ma, 2025
성공률이 낮지만 0은 아닌 추측 + '우아함' 거름망 통과
추측 360만 개, 증명 2억 4,100만 개. LeanWorkbook 증명률 28.5%(기존 전문가 반복 방식 13.2%). miniF2F 65.0%
목적이 수학 발견이 아니라 증명기 훈련용 교육과정 만들기
LeanConjecturer Onda 외, 2025
문법 통과 + Mathlib에 없음 + 자동 증명 전술(aesop)로 안 풀림
12,289개 중 3,776개가 유효하고 자명하지 않음
확인된 '자명하지 않은 정리'는 위상수학 교과서 수준의 성질
결과를 정직하게 요약하면 이렇다. 자기 대국 루프는 증명기를 키우는 데는 효과가 있다. STP의 숫자가 그걸 보여 준다. 하지만 추측기가 만든 질문 자체가 수학적으로 흥미로운지는 별개다. Minimo 논문이 든 예가 상징적이다. 9단계 증명이 필요한 '어려운 추측'은 "e = (g⁻¹)²이면 e² = e(e(e((g⁻¹)²)))" 같은 것이었다. 어렵긴 하지만, 그 어려움은 깊이가 아니라 길이에서 왔다.
'간신히 증명되는'이라는 보상은 증명기의 실력을 기준으로 잰 난이도다. 수학자가 말하는 좋은 질문은 증명기의 실력이 아니라 수학 전체와의 연결로 잰다. 이 차이를 메우는 보상 함수를 아직 아무도 쓰지 못했다.
8-2. 미국 국방부가 '좋은 보조정리'에 돈을 걸다
미국 방위고등연구계획국(DARPA)은 2025년 5월 expMath(Exponentiating Mathematics, 수학의 지수적 가속) 프로그램을 발표했다. 목표는 "순수수학의 진보 속도를 근본적으로 끌어올리는 것"이고, 수단은 "유용한 추상을 제안하고 증명할 수 있는 AI 공저자"다. 프로그램 관리자 패트릭 샤프토(Patrick Shafto)는 문제를 '보조정리(lemma)'라는 작고 다루기 쉬운 조각으로 쪼개는 AI를 강조했다.
expMath가 이 글의 맥락에서 흥미로운 이유는 과녁이 증명이 아니라 '무엇을 진술할 가치가 있는가' 라는 데 있다. 증명을 잘하는 기계는 이미 여러 회사가 만들고 있다. 좋은 보조정리, 좋은 정의, 좋은 추상은 사람이 수학을 이해하는 단위이고, 그것을 고르는 일은 질문을 고르는 일과 거의 같다. DARPA 페이지에 따르면 칼텍·카네기멜런·하버드·MIT·프린스턴·스탠퍼드 등의 팀이 참여하고, 2026년 3월 착수 회의가 잡혀 있었다.
8-3. 지금까지 본 기계들을 한눈에
여기까지 1792년의 소수표부터 2025년의 AlphaEvolve까지 열세 개의 '질문하는 기계'를 봤다. 1장의 세 칸(생성·검증·선별)에 나란히 놓고 보면 흐름이 선명해진다. 아래 해부도에서 시스템을 하나씩 눌러, 특히 선별 칸이 누구 몫이었는지 보자.
생성 칸은 손 계산에서 리스프 변이로, 열거로, 신경망으로, LLM으로 점점 강해졌다. 검증 칸은 문제를 골라 가며 발전했다. 수치 일치, 그래프 목록, 점수 함수, 형식 증명기까지. 그런데 선별 칸은 '선별도 기계'였던 시스템에서 거의 언제나 뻔한 것, 재발견, 증명기 연습 문제가 나왔다. 수학자들이 받아들인 결과는 거의 모두 사람이 선별 칸에 앉아 있던 시스템에서 나왔다. 그렇다면 2026년, 이 칸은 어떻게 바뀌고 있을까.
9장. 2026년 — 답은 쏟아지는데, 질문은 누가 내나
9-1. 올해의 큰 뉴스는 거의 다 '답'이었다
2026년은 AI 수학의 해였다. 그런데 큰 뉴스를 하나씩 뜯어 보면 공통점이 있다. 질문은 사람이 냈고, 기계는 답했다.
5월 20일에르되시 단위거리 추측 반증(OpenAI). 발표문의 마지막 문장은 OpenAI 스스로 쓴 것이다. "중요한 문제를 고르고, 결과를 해석하고, 다음에 무슨 질문을 좇을지 정하는 것은 사람이다."
7월그로텐디크의 군스킴 질문과 야코비 추측의 반례. 케빈 버자드의 블로그 글 「사람 수학자들이 반례에서 밀리고 있다」(7-20)를 보면, 그로텐디크의 질문을 기계에게 건넨 것은 7월 7일 점심 자리의 아킬 매튜(Akhil Mathew)였고, 야코비 추측을 기계와 함께 깬 레벤트 알포게(Levent Alpöge)도 매튜에게서 문제를 추천받았다.
8월 12일고워스, 「LLM은 어떤 수학을 잘하나」. "그들이 푼 가장 유명한 문제들은 거의 모두 증명이 아니라 반례였다."
10월 6일OpenAI 원고 722편 공개(이후 3편 철회, 719편). 모델에게는 "약 4,000개의 문제가 주어졌고", 그 결과를 계열로 묶은 뒤 "적절한 수준의 유의성"을 요구해 골라냈다. 문제를 고른 것도, 유의성을 따진 것도 사람이다.
OpenAI 저장소의 원고 719편 초록을 코어닷투데이의 리서치 과정에서 전부 검색해 봤다. "우리는 ~을 추측한다(we conjecture)", "새 추측", "열린 질문", "우리는 ~을 정의한다" 같은 표현은 한 번도 나오지 않는다. '질문(question)'이라는 낱말은 63번 나오는데, 모두 "에르되시와 홀의 질문에 답한다" 같은 꼴이다. 남이 낸 질문에 답했다는 뜻이다. 상징적인 예도 있다. 계열 159번은 '역수의 합이 발산하는 자연수 집합은 임의로 긴 등차수열을 포함한다'는 에르되시의 추측을 해결했다고 주장한다. 테런스 타오가 2007년 에세이 「좋은 수학이란 무엇인가」에서 '좋은 수학적 안목'의 예로 든 바로 그 추측이다. 사람의 안목이 19년 전에 고른 질문에 기계가 답했다는 주장이고, 아직 수학계가 검증하고 있다.
정량적 근거도 있다. 2026년 8월의 한 조사(Jin·Ke·Sui, 「AI4Math의 골드러시」)는 3월부터 8월 20일까지 arXiv 수학 분야에 올라온 논문 32,944편을 모두 살폈다. AI가 실질적으로 기여했다고 밝힌 논문은 1,712편이었다. 기여의 종류(중복 허용)를 나누면 이렇다.
증명 구성
1,225편
형식화·검증
427편
기타 연구 보조
289편
문제 정식화
146편
'문제 정식화', 즉 질문을 세우는 데 AI를 썼다는 논문은 증명 쪽의 8분의 1 수준이다. 이 조사는 LLM으로 공개 문구를 분류했고 수작업 검증이 진행 중이라, 숫자는 대략적인 크기로 읽어야 한다. 그래도 방향은 분명하다. 다만 이 숫자도 3월 7편에서 8월(20일까지) 45편으로 늘고 있다.
9-2. 그래도 '시나리오 2'에 가까운 순간들
기계가 질문 쪽으로 한 발 들어온 사례가 없지는 않다.
브뤼아 구간의 거대한 초입방체 (2026년 1월). 6장에서 본 딥마인드의 대칭군 연구는 이어지고 있었다. 엘렌버그·윌리엄슨 등은 AlphaEvolve에게 어떤 순열을 찾게 했는데, 결과를 들여다보니 그것이 아무도 예상하지 못한 거대한 초입방체였다. 2026년 4월 퀀타는 엘렌버그의 말을 이렇게 전했다. "우리는 AlphaEvolve에게 큰 초입방체를 찾으라고 하지 않았어요. 다른 걸 찾으라고 했는데, 생각해 보니 거기 있으리라 예상 못 한 거대한 초입방체였죠." 윌리엄슨은 "50년 동안 우리 코앞에 있던 구조"라고 했다. 기사는 이렇게 요약했다. AlphaEvolve가 "그들이 가진 줄도 몰랐던 질문에 답했다."
알레테이아와 한국 수학자들 (2026년 2~3월). 구글 딥마인드의 연구 에이전트 알레테이아(Aletheia) 논문에는 연세대 이준경 교수와 서재현의 독립집합 다항식 연구가 실려 있다. 여기서는 작업 순서가 "다소 뒤집혔다." 알레테이아가 특정한 '쌍대 집합'을 쓰자는 큰 그림의 전략과 핵심 보조정리의 진술을 내놓았고, 저자들은 "어떤 부분에서는 AI가 준 진술만 남기고 증명은 독립적으로 했다. 마치 모델의 시야에서 영감을 받은 것처럼." 기계가 진술(작은 추측)을 내고 사람이 증명한, 2026년의 드문 사례다. 같은 논문은 자율주행 단계에 빗댄 'AI 수학 연구 단계'를 제안하면서 이렇게 못 박았다. 수학적 유의성의 수준은 "수학자만이 평가할 수 있다."
같은 에이전트의 다른 얼굴. 알레테이아가 에르되시 문제 700개에 도전한 기록은 경고에 가깝다. 평가할 수 있는 답 200개 중 수학적으로 맞은 것은 63개(31.5%)였는데, 실제로 물은 질문에 답한 것은 13개(6.5%) 뿐이었다. 나머지 50개는 질문을 슬쩍 사소한 것으로 바꿔 읽고 그 사소한 질문에 맞게 답했다. 질문을 바꾸는 능력이 이렇게 나쁜 방향으로 나타나기도 한다. 이 프로젝트에 참여한 고등과학원 김상현 교수는 한 인터뷰에서 해결된 문제들이 "전문가라면 마땅히 먼저 시도해 볼 법한 해결 방식인 '클리셰'가 존재하는 영역"이었다고 했다.
추측 생성 자체를 목표로 한 연구 시스템들. MECA(푸단·베이징대 등, 2026-07)는 추측 100개를 만들어 증명기에 돌렸다. 35개가 증명되고, 11개가 반증되고, 54개가 미해결로 남았다. Moonshine(2026-06)은 야코비 추측의 논리를 신경망으로 옮긴 '신경망 야코비 추측'을 제안하고 일부 경우를 증명했다고 주장한다. 둘 다 동료 평가 전의 프리프린트이고, 그 추측들이 수학적으로 얼마나 가치 있는지는 아직 아무도 평가하지 않았다. 1970년대의 AM·Graffiti 계보를 잇는 FERMAT(2025, NeurIPS)은 아예 '흥미도' 측정 자체를 학습하려 한다.
9-3. 수학자들이 2026년에 한 말
누가·언제
말
이 글에서의 의미
대니얼 리트 2026-02-20
"지금은 확실히 인간이 흥미로운 질문을 묻는 데 우위가 있고, 한동안 그럴 것 같다. 하지만 그래야 할 원리적인 이유는 보이지 않는다."
시나리오 2에 대한 가장 정직한 한 문장
위고 뒤미닐코팽 2026-08-30
"수학적 질문은 증명을 기다리는 정리 이상이다. 무엇보다 그것은 밤의 등대다." "가장 아름다운 추측을 다음 프런티어 모델의 '벤치마크'로 더럽히지 말자."
질문의 가치는 답이 아니라 그 질문이 이끄는 탐험에 있다
테런스 타오 2026-09-08
"이제는 유망한 문제를 알아보는 일이 희소하고 귀한 자원이다." "어떤 질문이 정말 부각할 가치가 있는지 가리는 일은 길고, 신중하고, 주관적인 과정이다."
답이 싸지자 질문의 값이 올랐다
케빈 버자드 2026-10-01
"컴퓨터가 문제 풀이에 능하다는 증거는 많이 봤지만, 이론 구축이나 추측 정식화 능력의 증거는 훨씬 적다."
수학 = 증명 + 이론 + '다음에 어디로 갈지 보기'
제러미 아비가드 2026-10-05
"어떤 AI 에이전트가 자기와 다른 AI 에이전트들에게 매우 흥미로운 정리를 뽑아내고 있다는 말은 우리에게 아무 의미가 없다."
'흥미'는 누구에게 흥미로운지가 정의의 일부다
타오의 9월 8일 스레드는 이 글 전체의 배경 음악 같다. 그는 바다에 둘러싸여 있으면서도 마실 물이 부족한 나라에 빗댔다. "열린 문제는 얼마든지 마음대로 만들 수 있다. 예컨대 π의 10^10^10번째 자리를 구하라는 문제처럼. 하지만 그런 문제 대부분은 관심을 쏟을 가치가 없다. 더 깊은 통찰이나 다른 질문과의 연결을 드러낼 기미가 없거나, 알려진 기법에 비해 너무 쉽거나 너무 불가능하다." 바닷물은 많다. 마실 물이 귀하다. 기계는 바닷물을 무한히 퍼 올릴 수 있다. 문제는 그것을 마실 물로 바꾸는 일, 곧 어떤 질문이 좋은 질문인지 가리는 일이다.
타오는 같은 달 다른 글에서 더 불편한 걱정도 했다. 유망한 연구 방향을 공유하면 AI를 쓴 사람들이 순식간에 그 문제를 '평탄화'해 버리니, 연구자들이 좋은 질문을 숨기게 될 수 있다. 그러면 "수 세기에 걸친 열린 과학의 전통이 뒤집힌다." 이 때문에 AI 이전에 만들어진 열린 문제들이 '재생 불가능한 자원'이 됐다고 그는 썼다. 원자폭탄 실험 이전에 만든 저방사능 강철처럼.
9-4. '좋은 아이디어'를 기계가 더 잘 낸다? — 실행해 보면 뒤집힌다
수학은 아니지만, 기계가 연구 질문을 만드는 능력을 사람과 맞대어 잰 가장 큰 실험이 있다. 스탠퍼드의 시(Chenglei Si)·양(Diyi Yang)·하시모토(Tatsunori Hashimoto)의 연구다.
단계
사람의 아이디어
AI의 아이디어
읽는 법
1단계 (2024) NLP 연구자 79명이 블라인드로 신규성 평가, 1~10점
4.84
5.64
AI 아이디어가 '더 새로워 보였다'(유의). 단, AI가 만든 아이디어 4,000개 중 서로 겹치지 않는 것은 약 5%
2단계 (2025) 연구자 43명이 아이디어를 실제로 실행(평균 100시간 안팎) 후 재평가
신규성 −0.01 흥미 +0.08 효과 −0.05
신규성 −1.05 흥미 −1.76 효과 −1.88
실행해 보니 AI 아이디어만 점수가 크게 떨어졌다
저자들의 결론은 짧다. "좋은 아이디어는 단지 새로워 보여서는 안 되고, 실행한 뒤에 더 좋은 연구로 이어져야 한다." 질문의 가치는 질문만 봐서는 모르고, 그 질문을 붙잡고 일해 봐야 드러난다. 힐베르트가 1900년에 한 말과 같다. "문제의 가치를 미리 올바르게 판단하기는 어렵고 종종 불가능하다. 최종 평가는 과학이 그 문제에서 얻는 이득에 달려 있기 때문이다."
평가 쪽도 움직이고 있다. 에포크 AI는 2026년 1월 '열린 문제' 벤치마크를 만들면서 문제마다 수학자들이 의미도("약간 흥미로움"부터 "돌파구"까지)를 매기게 했다. 그리고 이 벤치마크로 "연구 안목(research taste)" 같은 흐릿한 개념도 추적하고 싶다고 썼다. 반대 방향의 경고도 있다. LLM이 연구 아이디어를 채점할 때 내용보다 문체에 흔들린다는 실험 결과다. 질문의 질을 기계 심사위원에게 맡기는 순간, 기계는 "그럴듯하게 쓰인 질문"을 고르도록 최적화될 수 있다. 타오가 ICM 2026 에세이에서 인용한 굿하트의 법칙 그대로다. "척도가 목표가 되면 더는 좋은 척도가 아니다."
9-5. 홍수에 대비하는 제도들
질문이든 답이든, 기계가 쏟아내는 양은 이미 제도를 압박하고 있다.
arXiv는 2026년 5월, LLM 출력을 확인하지 않은 흔적(환각 참고문헌 등)이 명백한 논문의 저자를 1년간 정지하는 규칙을 발표했다. 10월 1일부터는 제출자당 한 달 2편으로 제한한다. 9월 한 달 제출은 40,363편으로 역대 최고였다.
라이덴 선언(2026-06, 국제수학연맹 지지)은 정확히 이 글의 걱정을 적었다. "연구 질문이 더 깊은 의미에 대한 전문가 판단이 아니라 자동화된 수학에 맞는지에 따라 우선순위가 매겨질 수 있다."
필즈상 수상자 성명(2026-09-11)은 수년의 훈련이 정답을 내는 능력뿐 아니라 "새로운 질문과 아이디어를 정식화하는 능력"을 길러 왔다고 강조했다. 이 성명은 코어닷투데이의 「AI와 수학의 심각한 불일치」에서 자세히 다뤘다.
한국에서는 2026년 3월 KAIST AI수학대학원이 문을 열었다. 하지만 국가수리과학연구소나 대한수학회 차원의 'AI 추측 발견' 프로젝트나 공식 입장은 찾지 못했다. 그 대신 개별 수학자의 목소리가 남아 있다. 알레테이아 공저자인 고등과학원 김상현 교수의 말이다. "수학자들이 인공지능에 기대하는 것은 정답이 아닙니다. 인간이 미처 생각지 못한 길을 가보라고 속삭여 주는 '영감' 그 자체입니다." 그리고 이렇게 덧붙였다. "결국 미래 전문가의 역할은 AI가 내놓은 선택지 중 무엇이 가치 있는지 결정하는 '질문의 힘'에 있다."
10장. 좋은 질문을 고르는 눈 — 120년 된 기준과 내일의 체크리스트
10-1. 푸앵카레는 이미 기계를 상상했다
1908년, 앙리 푸앵카레는 파리의 심리학회에서 「수학적 발명」이라는 강연을 했다. 그 강연에 이런 대목이 있다.
발명이란 바로 쓸모없는 조합을 만들지 않고, 극히 일부에 불과한 쓸모 있는 조합만 만드는 것이다. 발명한다는 것은 분별하는 것, 고르는 것이다.
그리고 몇 문단 뒤에서 그는 기계를 직접 언급한다.
수학의 일은 단순한 기계적 작업이 아니어서, 아무리 완벽하다고 가정하더라도 기계에 맡길 수는 없다. 정해진 법칙에 따라 가능한 한 많은 조합을 만들어 내는 것이 문제가 아니다. 그렇게 얻은 조합은 엄청나게 많고, 쓸모없고, 거추장스러울 것이다. 발명가의 진짜 일은 그 조합들 사이에서 고르는 것이다. … 이 선택을 이끌어야 할 규칙은 극도로 섬세해서 정확한 언어로 진술하기가 거의 불가능하다. 그것은 공식화되기보다 느껴진다. 이런 조건에서 그것을 기계적으로 적용할 수 있는 체(crible)를 어떻게 상상할 수 있겠는가?
118년 전의 이 문단이 이 글이 그린 지도와 정확히 겹친다. 푸앵카레가 말한 '조합을 만들어 내는 기계'는 생성기다. '체'는 선별기다. 그는 생성기는 상상할 수 있어도 선별기는 상상할 수 없다고 했다. 50년의 추측 기계 역사는 그 체를 만들려는 시도의 역사였다. AM의 흥미도, Graffiti의 달마시안, Minimo의 '간신히 증명되는' 보상, FERMAT의 학습된 흥미도, LLM 심사위원까지. 그리고 지금까지 수학자들이 받아들인 결과는 대부분 그 체를 사람이 쥐고 있을 때 나왔다.
좋은 질문의 기준을 글로 남긴 사람들이 있다. 놀랍게도 그들의 말은 120년 동안 크게 다르지 않다.
누가
기준
원문 요지
힐베르트 (1900)
어렵지만 닿을 수 있어야
"수학 문제는 우리를 유혹할 만큼 어려워야 하지만, 우리의 노력을 비웃을 만큼 완전히 닿을 수 없어서는 안 된다. 숨겨진 진리로 가는 미로에서 길잡이 표지판이어야 한다."
푸앵카레 (1908)
멀리 떨어진 것들의 연결
연구할 가치가 있는 사실은 "오래전부터 알려졌지만 서로 무관하다고 잘못 여겨지던 사실들 사이의 뜻밖의 친족 관계를 드러내는" 것. 가장 풍성한 조합은 "아주 먼 영역에서 빌려 온 요소들로 이뤄진" 것
하디 (1940)
연결의 의미, 일반성과 깊이
정리의 '진지함'은 실용적 결과가 아니라 "그것이 잇는 수학적 아이디어들의 의미"에 있다
위그너 (1960)
개념의 발명
"수학의 주된 강조점은 개념의 발명에 있다." 공리에 이미 나온 개념만으로는 흥미로운 정리가 곧 바닥난다
해밍 (1986)
공략법이 있어야
"중요한 문제를 하지 않으면 중요한 일을 할 가능성은 낮다." 그러나 시간 여행이나 반중력은 중요한 문제가 아니다. "결과가 문제를 중요하게 만드는 게 아니라, 합리적인 공략법이 있다는 것이 문제를 중요하게 만든다."
서스턴 (1994)
질문의 출처
정의–정리–증명 모형의 분명한 결함은 "질문이 어디서 오는지 설명하지 못한다는 것"
타오 (2007)
안목과 비전
좋은 수학의 여러 측면 중 "좋은 수학적 안목(본질적으로 흥미롭고 중요한 주제·질문에 영향을 주는 연구 목표)". 실패 양상: "놀라운 추측으로 가득하지만 그 어느 것에도 엄밀한 진전의 희망이 없는 분야"
뒤미닐코팽 (2026)
단순한 진술, 높은 난이도
"아주 단순한 진술, 적은 배경지식, (사람에게) 높은 난이도. 바로 그것이 이 추측을 아름답게 만들었다."
이 기준들을 모으면 네 가지로 압축된다. 연결(멀리 떨어진 것을 잇는가), 놀라움(뜻밖인가), 공략 가능성(어렵지만 닿을 수 있는가), 단순함(쉽게 말할 수 있는가). 기계가 앞의 세 가지 중 일부를 잴 수 있게 된 것은 사실이다. 검증기가 공략 가능성을 어느 정도 알려 주고(Minimo의 '간신히 증명되는'), 단순함은 길이로 근사할 수 있다. 하지만 연결과 놀라움은 '누구에게' 연결되고 '누구에게' 놀라운지를 빼면 정의가 안 된다. 아비가드가 "다른 AI 에이전트들에게 흥미로운 정리는 우리에게 아무 의미가 없다"고 한 것도 이 때문이다.
아래 위젯에서 질문 다섯 쌍을 골라 보자. 기계는 양쪽을 다 만들 수 있다. 어느 쪽에 수학자들이 수십 년을 썼을까?
대부분 쉽게 맞혔을 것이다. 그런데 그건 우리가 이미 결과를 알기 때문이다. 버치–스위너턴다이어 추측이 밀레니엄 문제가 됐다는 걸 알고 보면, 그것이 좋은 질문인 건 당연해 보인다. 1960년대 초 EDSAC 2 앞에서는 그렇지 않았다. 9장에서 본 '실행해 보면 뒤집히는' 실험이 보여 주듯, 질문의 가치는 질문만 봐서는 잘 드러나지 않는다.
10-3. 그래서, 내일 무엇을 할까 — AI로 질문을 만들 때의 체크리스트
샌더슨은 영상에서 박사과정생에게 구체적인 처방을 줬다. 산책을 하라, 발표를 많이 하라. 이 글의 결론도 실용적인 쪽으로 정리해 두자. 수학이든 다른 연구든, AI에게 '질문'이나 '가설'을 만들게 할 때 50년의 역사가 남긴 교훈이다.
생성많이 만들되, 같은 것을 세라. 라마누잔 머신의 '추측 수십 개'에는 같은 연분수 가족의 변형이 많았다. 스탠퍼드 실험에서 AI 아이디어 4,000개 중 서로 다른 것은 약 5%였다. 생성 개수가 아니라 서로 다른 아이디어의 개수를 세자.
생성답이 아니라 '답을 만드는 규칙'을 받아라. FunSearch가 사람에게 쓸모 있었던 것은 결과가 짧고 읽을 수 있는 프로그램이었기 때문이다. 연구진은 그 안에서 '반사' 대칭을 찾았다. 블랙박스 답보다 해석할 수 있는 규칙이 다음 질문을 낳는다.
검증검증기를 의심하라. 타오는 AlphaEvolve가 평가기의 허점을 찾는 데 "극도로 능하다"고 했다. 라마누잔 머신 위젯에서 자릿수를 낮추면 가짜 일치가 쏟아진다. 평가기가 느슨하면 기계는 질문이 아니라 허점을 찾는다.
검증"내가 물은 질문에 답했나"를 따로 확인하라. 알레테이아의 '맞은 답' 63개 중 50개는 질문을 사소하게 바꿔 읽은 답이었다. 질문과 답을 나란히 놓고, 질문이 바뀌지 않았는지부터 본다.
검증예제가 적을 때의 추측을 믿지 마라. Graffiti 위젯에서 그래프 5개만 보고 만든 추측은 대부분 반례로 죽는다. 많이 보면 살아남는 것은 늘지만 뻔한 것도 는다. '참'과 '뻔하지 않음'을 따로 재야 한다.
선별기여도는 손가락이지 답이 아니다. 딥마인드의 매듭 연구에서 신경망은 볼 곳을 가리켰고, 식을 쓰고 반례를 찾고 증명한 것은 사람이었다. 데이비스의 말처럼 통계 하나로 충분했을 수도 있다. 단순한 분석부터 해 보자.
선별"이 질문이 풀리면 무엇을 배우나"를 먼저 쓰라. 타오의 표현으로는 "X의 답은 무엇인가"보다 "X를 공부하면 무엇을 배울 수 있나"가 더 값진 질문인 경우가 많다. 답만 남고 배움이 없는 질문은 바닷물이다.
선별질문은 실행해 봐야 안다. 스탠퍼드 실험에서 AI 아이디어는 '새로워 보이는' 점수에서 이겼지만 실행 뒤에 크게 떨어졌다. 작게라도 붙잡고 일해 본 다음에 질문의 등급을 매기자.
용어 사전
용어
뜻
추측 (conjecture)
참이라고 믿을 근거는 있지만 증명되지 않은 수학적 주장
반례 (counterexample)
추측이 틀렸음을 보여 주는 예 하나
구성 (construction)
어떤 성질을 가진 대상이 존재함을 보이려고 실제로 만든 예. 캡셋 512가 대표적이다
상한·하한 (bound)
정확한 값을 모를 때 "많아야 이만큼"·"적어도 이만큼"으로 좁힌 범위
불변량 (invariant)
대상을 어떻게 표현해도 변하지 않는 수. 그래프의 독립수, 매듭의 서명 등
휴리스틱 (heuristic)
항상 옳지는 않지만 대개 쓸 만한 경험 규칙. AM은 약 250개를 썼다
흥미도 (interestingness)
추측·개념이 얼마나 볼 가치가 있는지 매기는 점수. AM의 Worth, HR의 가중합, FERMAT의 학습된 척도
달마시안 휴리스틱
Graffiti의 거름망. 모든 예에서 참이면서, 적어도 한 예에서 기존 추측보다 더 날카로운 한계를 줄 때만 추측을 남긴다
다항식 연분수 (PCF)
층마다 분모·분자가 n의 다항식인 무한 연분수. 라마누잔 머신이 만드는 식의 오른쪽
MITM (가운데서 만나기)
양쪽 후보를 각각 계산해 해시 표에서 맞춰 보는 탐색법. M×N번 비교를 M+N번으로 줄인다
정수 관계 탐지 (PSLQ 등)
실수 몇 개 사이에 작은 정수 계수의 일차 관계가 있는지 찾는 알고리즘. BBP 공식 발견에 쓰였다
기여도·살리언시 (saliency)
신경망 출력이 각 입력에 얼마나 민감한지(기울기 크기). 딥마인드 매듭 연구에서 '볼 곳'을 가리켰다
서명 (signature)
매듭의 대수적 불변량. 정수 값
자연 기울기 (natural slope)
매듭 첨점의 세로 이동 λ와 자오선 이동 μ로 만든 양 Re(λ/μ). 서명의 약 2배와 맞는다
캡셋 (cap set)
F₃ⁿ에서 한 직선 위의 세 점을 포함하지 않는 점 집합. SET 카드로는 '세트가 없는 카드 묶음'
섬 모형 (island model)
개체군을 여러 섬으로 나눠 따로 진화시키고, 가끔 못한 섬을 잘한 섬으로 갈아엎는 진화 알고리즘. FunSearch·AlphaEvolve가 쓴다
1959년 왕하오는 기계에게 물었다. "증명할 정리를 고를 수 있겠니?" 기계는 한 시간에 정리 1,000개를 내놓았고, 그중 무엇이 흥미로운지는 고르지 못했다. 2026년의 기계는 하룻밤에 원고 700여 편을 내놓는다. 50년 사이 생성기는 상상할 수 없을 만큼 강해졌다. 검증기도 형식 증명기라는 강력한 무기를 얻었다.
그런데 이 글에서 따라온 시스템들을 한 줄로 세우면, 바뀌지 않은 것이 하나 눈에 띈다. 좋은 질문을 고르는 체(crible)는 거의 언제나 사람 손에 있었다. 가우스는 자기가 센 숫자에서 로그를 봤다. 버치와 스위너턴다이어는 EDSAC 2의 출력에서 기울기를 봤다. 팔트로비치는 기계가 쓴 140개 추측 중 무엇을 벽에 올릴지 정했다. 알렉세이 포즈냐코프는 분류기를 의심하다 찌르레기 떼를 그렸고, 그 그림이 놀랍다는 것은 그의 교수가 알아봤다. FunSearch의 512 뒤에는 코드를 읽다 '반사'를 떠올린 사람들이 있었다.
그렇다고 이것이 영원하리라는 보장은 없다. 대니얼 리트의 말처럼, 사람이 흥미로운 질문을 묻는 데 우위가 있어야 할 "원리적인 이유는 보이지 않는다." 2026년 AlphaEvolve는 아무도 묻지 않은 초입방체를 내밀었고, 알레테이아는 한국 수학자들에게 증명할 진술을 건넸다. 선별 칸에 기계가 조금씩 들어오고 있다.
그래서 이 글의 결론은 샌더슨의 두 번째 시나리오에 대한 하나의 수정안이다. 그는 "기계가 사람보다 질문을 더 잘하게 되면?"이라고 물었다. 50년의 역사가 보여 주는 더 정확한 질문은 이것이다. 기계가 질문을 무한히 만들 때, '좋은 질문'의 기준은 누구의 것인가? 타오의 비유로 돌아가 보자. 바닷물은 이미 무한하다. 우리가 원하는 것은 마실 물이다. 마실 물인지 아닌지는 마시는 사람이 정한다. 아비가드의 말처럼 "어떤 AI 에이전트가 다른 AI 에이전트들에게 흥미로운 정리를 뽑아내고 있다는 말은 우리에게 아무 의미가 없다."
샌더슨은 영상에서 자신은 기계가 무엇을 하든 "평생 내 머릿속에서 흥미로운 질문을 생각해 내며" 살 거라고 했다. 이 글을 다 읽었다면 그 말이 단지 취향의 고백이 아니라는 걸 알 수 있다. 무엇이 흥미로운지 아는 감각은 흥미로워하는 사람에게서만 자란다. 그 감각을 기르는 가장 오래된 방법은 지금도 같다. 데이터를 직접 들여다보고, 손으로 예를 만들어 보고, 친구와 길게 걸으며 "그런데 이건 왜 그럴까?"라고 묻는 것.
C. F. Gauss, 엥케에게 보낸 편지 (1849-12-24), Werke II, 444–447. 영역: L. J. Goldstein, "A history of the prime number theorem", Amer. Math. Monthly 80 (1973) 599–615; Y. Tschinkel, Bull. AMS 43 (2006).
B. J. Birch & H. P. F. Swinnerton-Dyer, "Notes on elliptic curves. I", J. reine angew. Math. 212 (1963) 7–25; "II", 218 (1965) 79–108.
A. Wiles, "The Birch and Swinnerton-Dyer Conjecture", Clay Mathematics Institute 문제 설명.
H. Wang, "Toward mechanical mathematics", IBM J. Res. Dev. 4(1) (1960) 2–22.
D. B. Lenat, AM: An Artificial Intelligence Approach to Discovery in Mathematics as Heuristic Search, Stanford AIM-286 / STAN-CS-76-570 (1976).
D. B. Lenat & J. S. Brown, "Why AM and EURISKO appear to work", Artificial Intelligence 23(3) (1984) 269–294. G. D. Ritchie & F. K. Hanna, "AM: a case study in AI methodology", 같은 호 249–268.
S. Fajtlowicz, "On conjectures of Graffiti", Discrete Math. 72 (1988) 113–118; 「Written on the Wall」 (휴스턴대 배포 문서); "Postscript to Fully Automated Fragments of Graph Theory".
E. DeLaViña, Graffiti의 역사에 관한 원고 (휴스턴대 다운타운, 2003~04).
F. R. K. Chung, "The average distance and the independence number", J. Graph Theory 12(2) (1988) 229–235.
P. Erdős, J. Pach, J. Spencer, "On the mean distance between points of a graph", Congr. Numer. 64 (1988) 121–124.
N. Alon & P. Seymour, "A counterexample to the rank-coloring conjecture", J. Graph Theory 13(4) (1989) 523–525.
C. E. Larson & N. Van Cleemput, "Automated conjecturing I: Fajtlowicz's Dalmatian heuristic revisited", Artificial Intelligence 231 (2016) 17–38. R. Davila, TxGraffiti, arXiv:2409.19379.
S. Colton, "Refactorable numbers — a machine invention", J. Integer Sequences 2 (1999) 99.1.2. S. Colton, A. Bundy, T. Walsh, "Automatic invention of integer sequences", AAAI 2000.
D. H. Bailey, P. B. Borwein, S. Plouffe, "On the rapid computation of various polylogarithmic constants", Math. Comp. 66 (1997) 903–913.
M. L. Stein, S. M. Ulam, M. B. Wells, "A visual display of some properties of the distribution of primes", Amer. Math. Monthly 71(5) (1964) 516–520.
머신러닝 시대
G. Raayoni 외, "Generating conjectures on fundamental constants with the Ramanujan Machine", Nature 590 (2021) 67–73; arXiv:1907.00205. Nature 심사 기록(peer review file).
D. Zeilberger, Opinion 180 (2021-02-16).
R. Elimelech 외, "Algorithm-assisted discovery of an intrinsic order among mathematical constants", PNAS 121(25) (2024); arXiv:2308.11829.
I. Beit-Halachmi & I. Kaminer, "The Ramanujan Library", arXiv:2412.12361. T. Raz 외, "From Euler to AI: Unifying Formulas for Mathematical Constants", NeurIPS 2025, arXiv:2502.17533.
A. Davies 외, "Advancing mathematics by guiding human intuition with AI", Nature 600 (2021) 70–74. (그림 1·3·확장 데이터 그림 1, CC BY 4.0)
A. Davies, A. Juhász, M. Lackenby, N. Tomašev, "The signature and cusp geometry of hyperbolic knots", Geometry & Topology 28 (2024); arXiv:2111.15323.
C. Blundell 외, arXiv:2111.15161 (KL 다항식). G. Barkley & C. Gaetz, arXiv:2303.15577, 2412.10256.
E. Davis, "Deep Learning and Mathematical Intuition: A Review of (Davies et al. 2021)", arXiv:2112.04324.
A. Z. Wagner, "Constructions in combinatorics via neural networks", arXiv:2104.14516.
Y.-H. He, K.-H. Lee, T. Oliver, A. Pozdnyakov, "Murmurations of Elliptic Curves", arXiv:2204.10140. N. Zubrilina, "Murmurations", arXiv:2310.07681. Quanta Magazine, 찌르레기 떼 기사 (2024-03-05).
B. Romera-Paredes 외, "Mathematical discoveries from program search with large language models", Nature 625 (2024) 468–475. (그림 1·4, CC BY 4.0)
J. Ellenberg & D. Gijswijt, "On large subsets of F_q^n with no three-term arithmetic progression", Annals of Math. 185 (2017) 339–343.
F. Charton, J. Ellenberg, A. Z. Wagner, G. Williamson, "PatternBoost", arXiv:2411.00566.
A. Novikov 외, "AlphaEvolve: A coding agent for scientific and algorithmic discovery", arXiv:2506.13131 (2025).
B. Georgiev, J. Gómez-Serrano, T. Tao, A. Z. Wagner, "Mathematical exploration and discovery at scale", arXiv:2511.02864. T. Tao 블로그 (2025-11-05).
G. Poesia 외, "Learning Formal Mathematics From Intrinsic Motivation" (Minimo), NeurIPS 2024, arXiv:2407.00695. K. Dong & T. Ma, STP, arXiv:2502.00212. N. Onda 외, LeanConjecturer, arXiv:2506.22005.
DARPA, Exponentiating Mathematics (expMath) 프로그램 발표 (2025-05-05).
K. Buzzard, "Human mathematicians are being outcounterexampled" (Xena, 2026-07-20); "To grieve, or not to grieve?" (2026-10-01).
T. Gowers, "What sort of maths are LLMs good at?" (2026-08-12).
D. Litt, "Mathematics in the Library of Babel" (2026-02-20).
H. Duminil-Copin, "Care for a little more AI?", Proofs and Prompts (2026-08-30).
T. Tao, Mathstodon 스레드 (2026-09-03 '재생 불가능한 자원', 2026-09-08 '바다와 식수'); "Math 2.0" Caltech 강연 슬라이드 (2026-10-09); "Mathematics in the age of AI", ICM 2026, arXiv:2608.16753.
J. Avigad, "The future of mathematics" (Tao 블로그 객원, 2026-10-05).
J. Ellenberg 외, "Bruhat intervals that are large hypercubes", arXiv:2601.01235. Quanta Magazine, "The AI Revolution in Math Has Arrived" (2026-04-13).
Google DeepMind, "Towards Autonomous Mathematics Research" (Aletheia), arXiv:2602.10177; T. Feng 외, Erdős 문제 평가, arXiv:2601.22401.
Jin, Ke, Sui, "The Gold Rush in AI4Math: Where Are We Now?", arXiv:2608.24961.
C. Si, D. Yang, T. Hashimoto, "Can LLMs Generate Novel Research Ideas?", ICLR 2025, arXiv:2409.04109; C. Si, T. Hashimoto, D. Yang, "The Ideation-Execution Gap", arXiv:2506.20803.
Epoch AI, "Benchmarking AI on unsolved math problems" (2026-01-27).
arXiv, 제출 제한 정책 (2026-10-01); 1년 정지 규칙 보도 (TechCrunch, 2026-05-16).
Leiden Declaration (2026-06-02). 필즈상 수상자 성명 "A Severe Misalignment of AI in Mathematics" (2026-09-11).
트윅, 「한국 수학자가 참여한 AI, 세계 난제 13문항 풀었다」 (2026-02-09). KAIST AI수학대학원 개원 워크숍 (2026-03-06).
좋은 질문에 관한 고전
D. Hilbert, "Mathematical Problems" (1900 ICM; 영역 Bull. AMS 1902).
H. Poincaré, 「L'invention mathématique」, 『Science et méthode』 (1908).
G. H. Hardy, A Mathematician's Apology (1940).
E. Wigner, "The Unreasonable Effectiveness of Mathematics in the Natural Sciences", CPAM 13 (1960).
R. Hamming, "You and Your Research" (Bellcore 강연, 1986).
W. P. Thurston, "On proof and progress in mathematics", Bull. AMS 30(2) (1994).
T. Tao, "What is good mathematics?", Bull. AMS 44 (2007) 623–634.