기계가 증명을 만들고 Lean이 검증까지 끝냈는데, 문제는 여전히 '열림(open)'이다. 아무도 그 증명을 소화하지 못했기 때문이다. 테렌스 타오가 이름 붙인 '증명 소화불량'의 뜻과 역사, 증명을 '이해했다'를 재는 교육학의 일곱 가지 잣대를 살펴본다. 그런 다음 OpenAI가 IMO 2025에 낸 날것의 답안 다섯 편을 AI에게 세 가지 문체로 해설시키고, 원 증명을 보지 못한 '눈먼 독자' 모델에게 읽혀 이해도와 오류 탐지를 직접 쟀다.
2026년 7월 26일, 테렌스 타오가 마스토돈에 짧은 글을 올렸다. 그가 관리에 참여하는 에르되시 문제 커뮤니티 데이터베이스(GitHub teorth/erdosproblems)에 처음 보는 상태 표시가 생겼다는 소식이었다.
Lean으로 형식화됐지만 사람 전문가가 받아들일 만큼 소화되지는 않은, AI가 생성한 증명이라는 최근의 (그리고 아마 오래갈) 현상에 대응해, 우리는 문제의 형식적 상태와 비형식적 상태를 분리했다. 이제 우리에게는 "open (Lean)" 이라는 직관에 반하는 상태를 가진 첫 사례, 1112번 문제가 있다. 검증 가능한 형식적 해답은 있지만 그 해답을 사람이 아직 소화하지 않았으므로, 비형식적 의미에서 이 문제는 여전히 열려 있다.
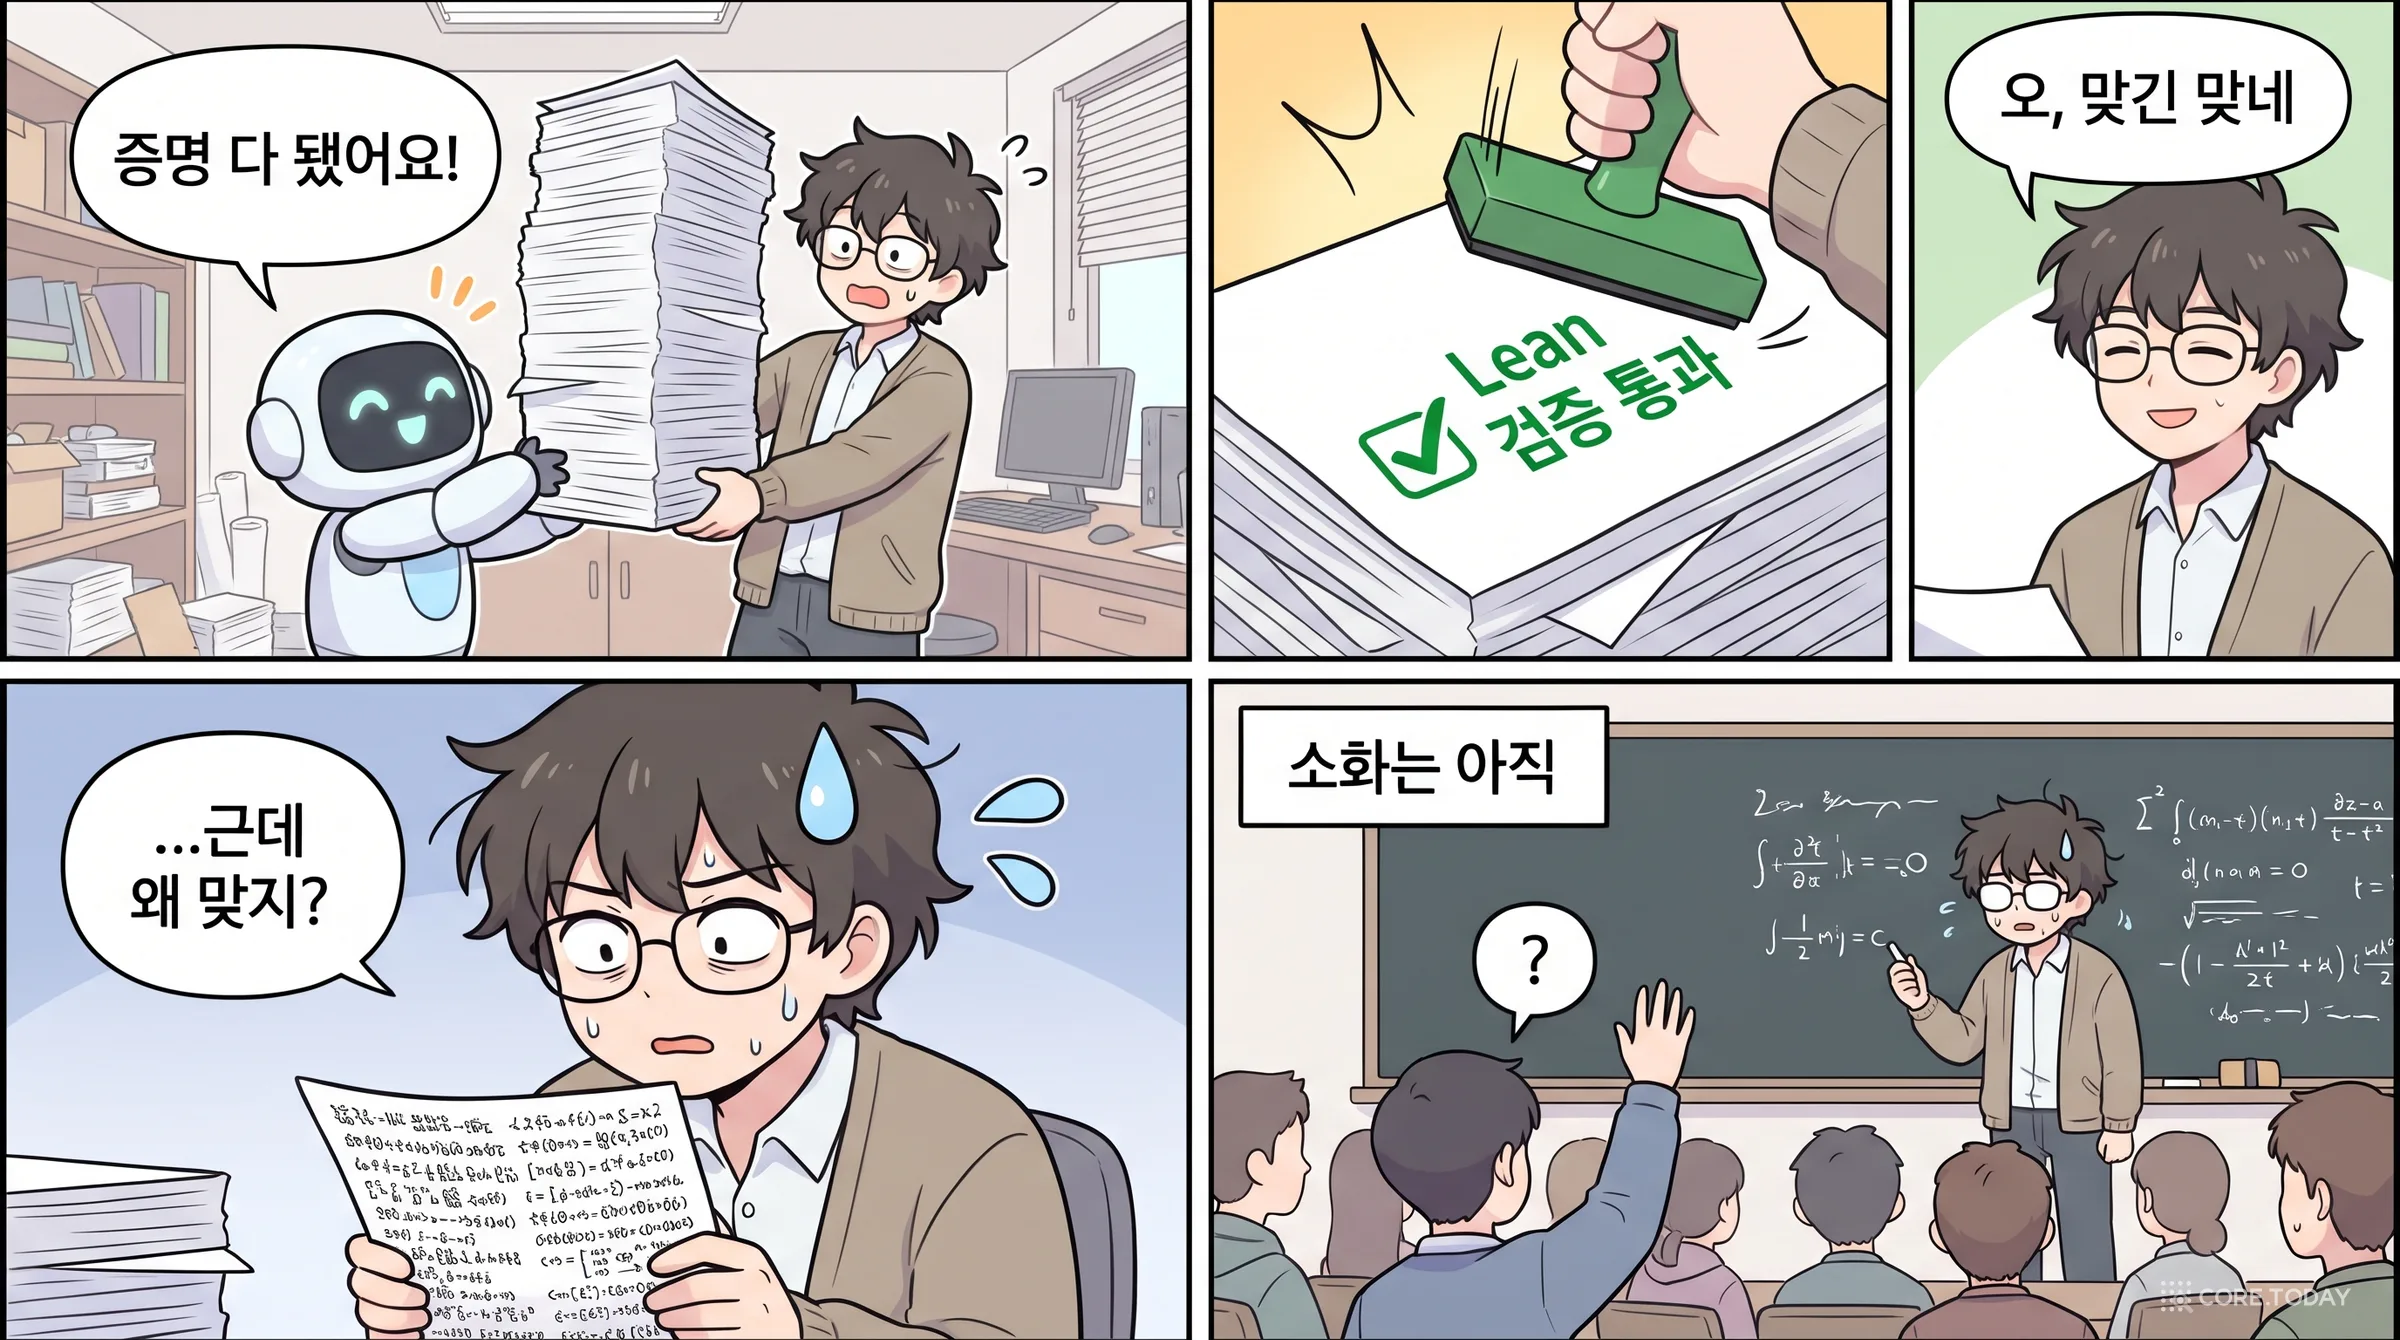
받아들이기 쉽지 않은 문장이다. 증명이 있다. 증명 보조기 Lean이 한 줄 한 줄 검사해서 맞다고 도장도 찍었다. 그런데 문제는 풀리지 않은 것으로 남는다. 2026년 10월 24일 현재 이 데이터베이스에서 'open (Lean)'인 문제는 #390, #522, #550, #973, #1112 다섯 개다.
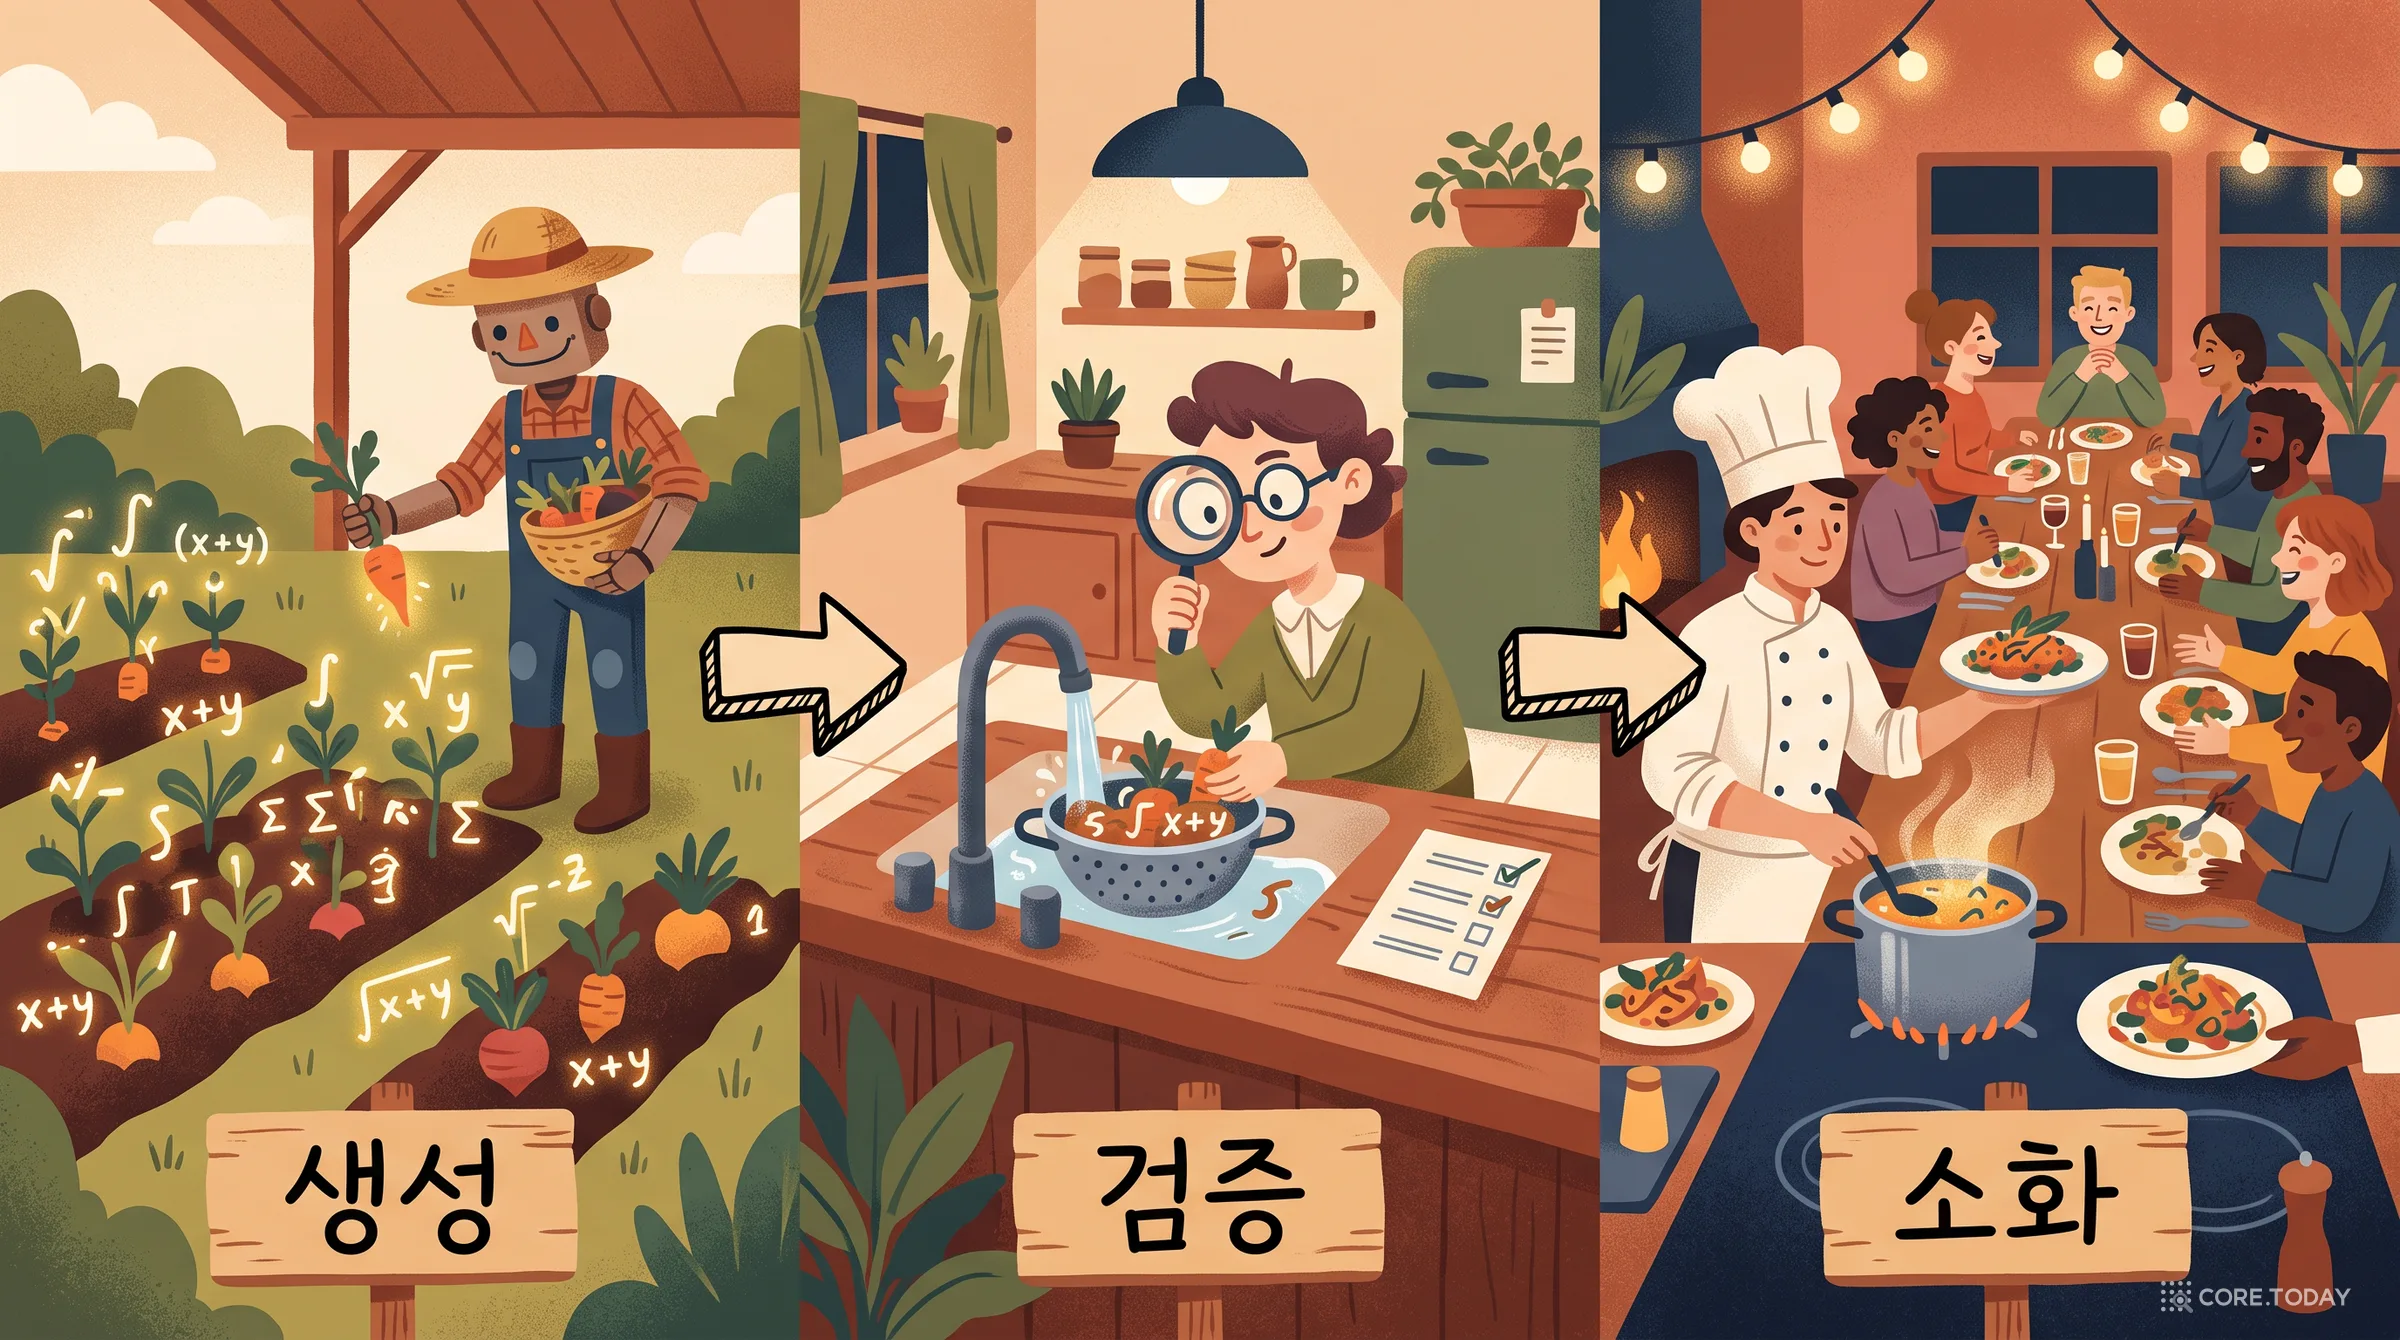
이 이상한 상태를 이해하려면 타오가 2026년 봄부터 쓰기 시작한 낱말 하나를 알아야 한다. 증명 소화(proof digestion). 그리고 그 반대말인 증명 소화불량(proof indigestion). 증명을 만드는 일(생성)과 맞는지 확인하는 일(검증)은 기계가 놀랄 만큼 빨리 해내게 됐다. 그 증명을 이해하고, 맥락에 놓고, 남에게 설명하는 일(소화)은 그 속도를 따라가지 못한다. 그 사이에 소화되지 않은 증명이 쌓인다.
코어닷투데이는 오늘 연작 「증명 다음의 수학」 첫 편으로 「기계가 질문을 만들 때」를 냈다. 그 글은 추측 기계 50년을 생성·검증·선별이라는 세 칸으로 해부했다. 이번 2편은 그 옆 칸, 증명이 나온 다음에 일어나는 일을 다룬다. 질문은 이렇다.
타오가 말하는 '소화'란 정확히 무엇이고, 왜 2026년에 갑자기 문제가 됐나?
소화가 늦은 증명은 처음이 아니다. 4색 정리, 페렐만, 모치즈키는 무엇을 남겼나?
사람이 증명을 '이해했다'는 것은 무엇으로 잴 수 있나? 교육학과 인지과학은 무엇을 알고 있나?
그렇다면 해설도 AI에게 시키면 되지 않을까? 시킨다면 어떤 문체로?
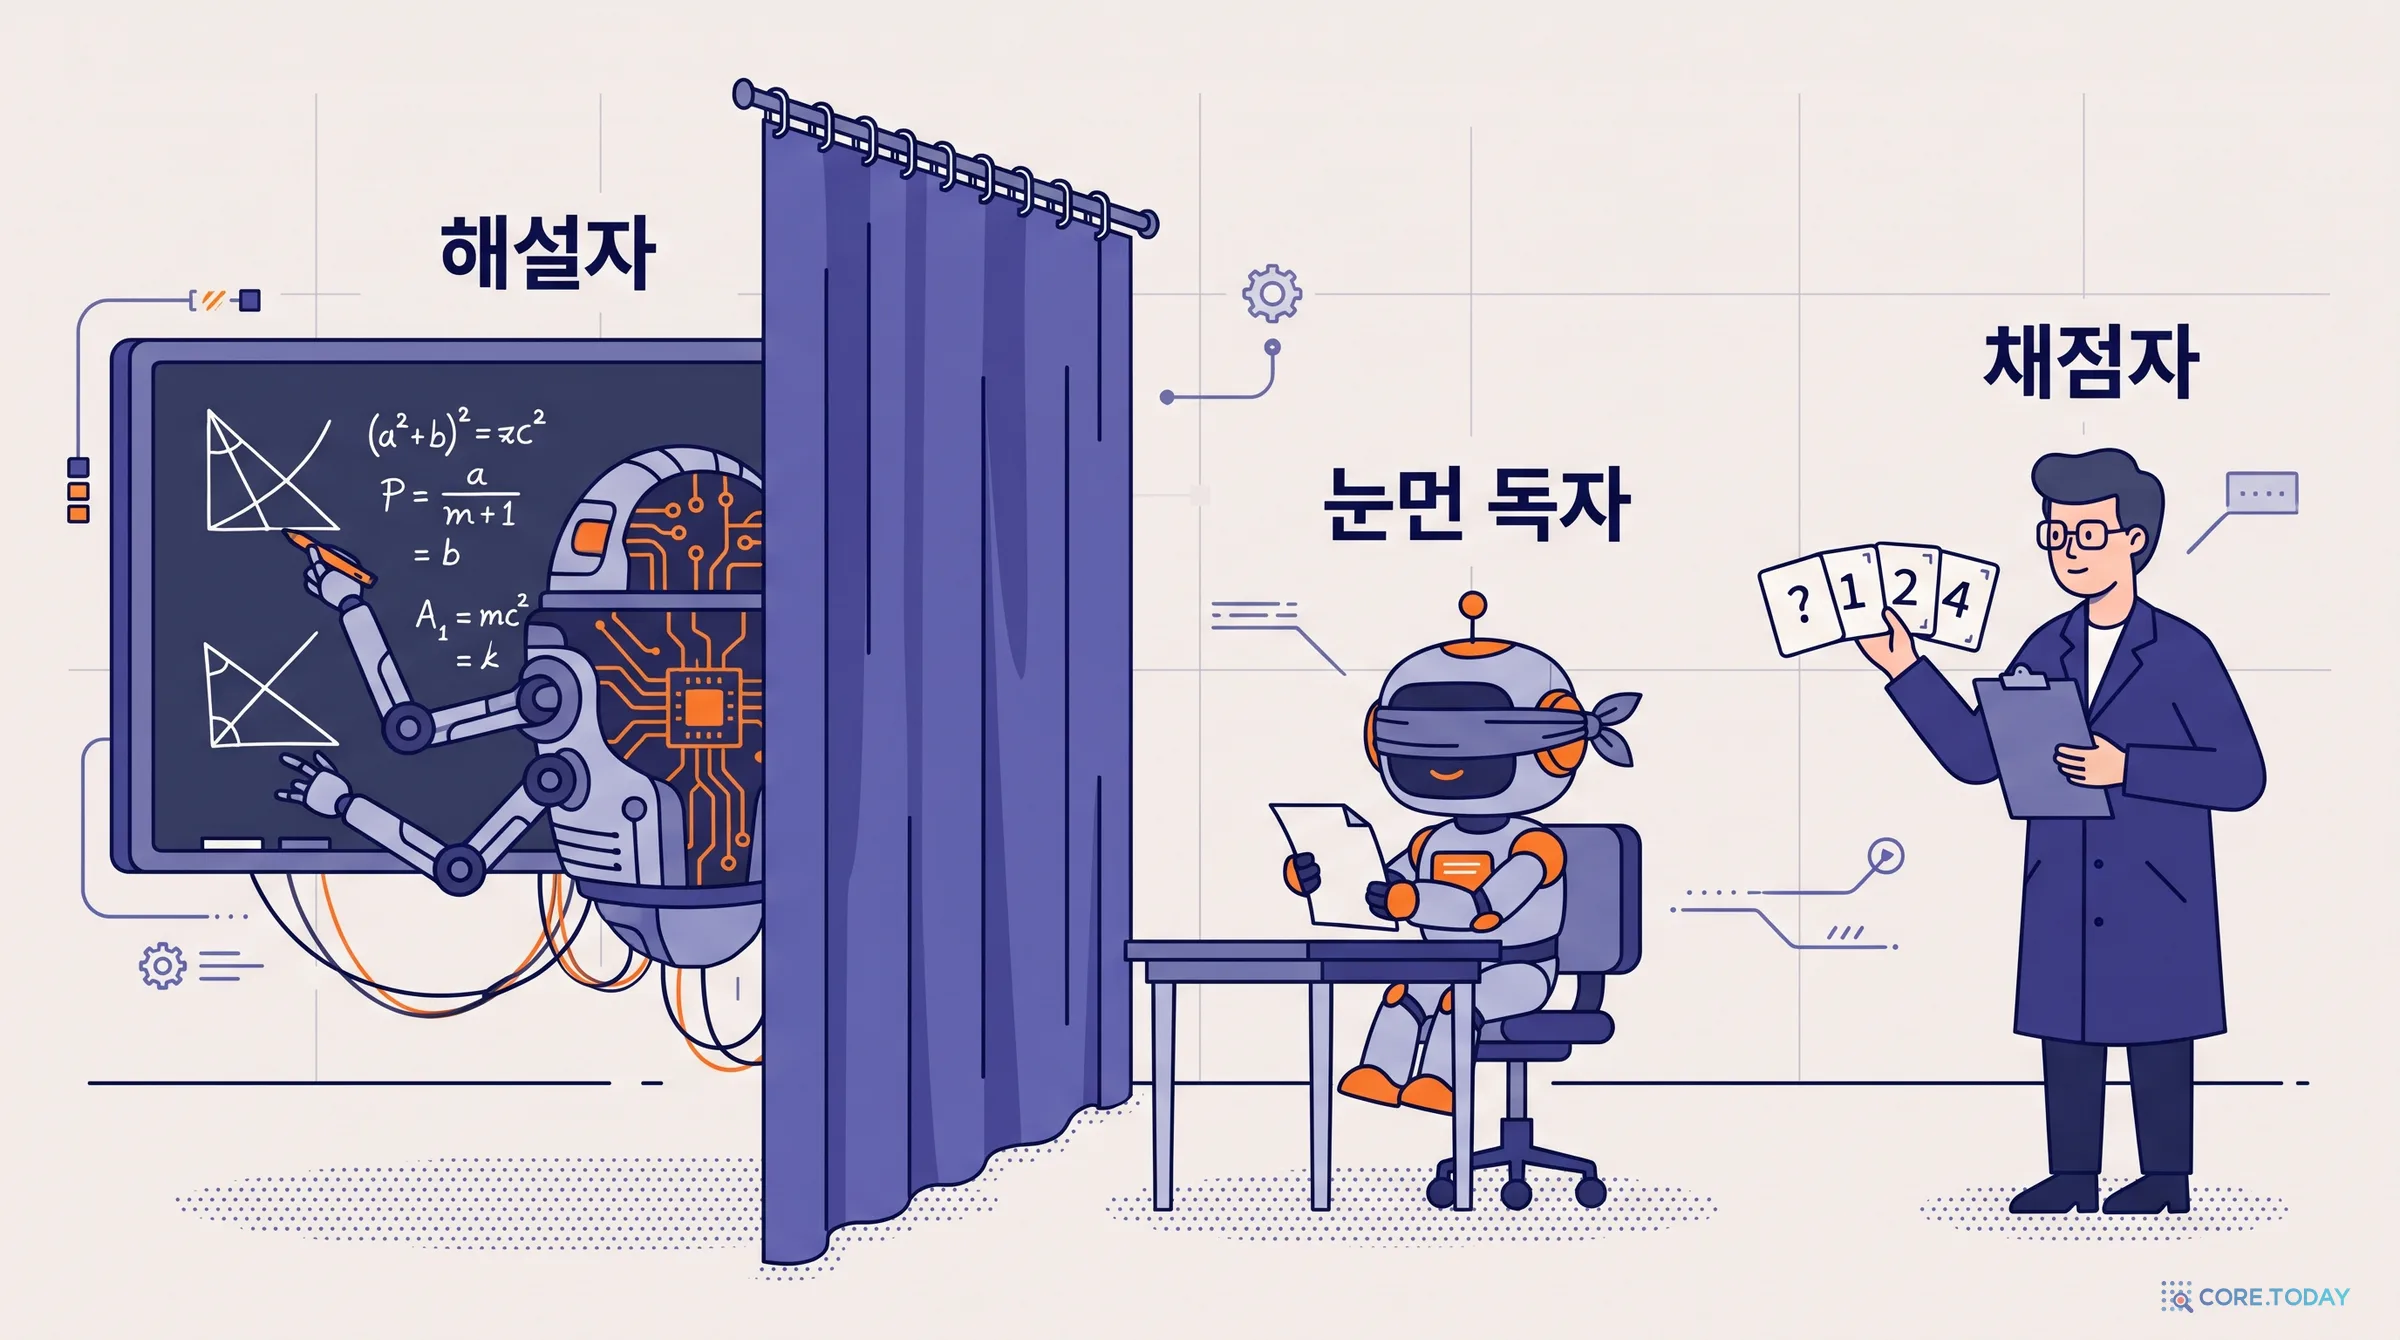
마지막 질문은 직접 재 보기로 했다. OpenAI의 실험 모델이 IMO 2025에서 쓴, 혼잣말 섞인 날것의 답안 다섯 편을 가져왔다. 이 답안을 두 AI(Claude Sonnet 5.5, Gemini 4 Argon)에게 세 가지 문체로 해설시켰다. 하나는 타오가 경고한 '블렌더'식으로 최대한 쉽고 매끄럽게, 하나는 핵심 아이디어와 뼈대부터 보여 주는 '지도'식, 하나는 전문가 앞 10분 '강연'식이다. 그런 다음 원 증명을 본 적 없는 눈먼 독자 모델들에게 해설만 읽히고, 수학교육 연구가 쓰는 증명 이해 시험을 치르게 했다. 해설 속에 일부러 심어 둔 논리 오류를 찾아내는지도 쟀다.
결과를 미리 조금만 말하면, "쉽게 써 주면 잘 이해한다"는 직관은 반만 맞았다. 자세한 숫자와 직접 만져 볼 수 있는 위젯 여섯 개는 본문에 있다.
1장. 생성·검증·소화 — 타오가 나눈 세 칸
1-1. "3분의 2짜리 해답"
시작은 2026년 4월 22일(한국 시간 23일 아침)의 3부작 게시물이다. 타오는 수학 연구 중 '문제 풀이' 부분을 거칠게 세 조각으로 나눴다. 그는 풀이가 연구의 유일한 측면은 아니라고 미리 못 박았다.
1. 증명 생성주어진 문제의 해답을 찾는 일 (proof generation)
2. 증명 검증제안된 해답이 실제로 통하는지 확인하는 일 (proof verification)
3. 증명 소화해답의 본질을 이해하고, 앞선 문헌과의 맥락에 놓고, 효과적으로 요약·설명하고, 관련된 다른 문제와 주제에 대한 통찰을 얻는 일 (proof digestion)
그가 지적한 것은 이 세 조각이 예전에는 한 묶음이었다는 점이다. 사람(또는 소수의 공동 연구자)이 몇 달을 들여 증명을 찾고 확인하고 나면, 그 과정에서 이미 증명의 구조를 깊이 알게 된다. 소화는 생성과 검증의 "유기적 부산물"로 저절로 따라왔다. 그래서 수학 공동체는 목표가 분명한 생성과 검증만 따지면 됐다. 소화는 주관적이고 끝이 열린 일이라 평가하기도 어려웠다.
AI와 형식 검증이 앞의 두 조각을 크게 앞당기면서 묶음이 풀렸다. 타오는 이것을 전기 공학 용어를 빌려 임피던스 불일치(impedance mismatch) 라고 불렀다. 해답이 빠르게, 거의 자동으로 생성·검증되는데, 정작 그 논증을 이해해 소화를 시작할 사람이 없는 문제들이 생긴다는 것이다. 그리고 더 나쁜 시나리오를 덧붙였다.
문제를 '처음 푼' 사람에게 보상하고 해답을 나중에 '소화하는' 사람에게는 보상하지 않는 현재의 문화적 유인 구조에서는, 의미 있는 소화 없이 공동체에 던져진 AI 생성(그리고 형식 검증된) 해답이 그 분야의 진보를 오히려 방해하는 왜곡된 상황이 생길 수 있다. 그 문제에 대한 추가 시도, 증명을 단순화하고 설명하려는 노력, 더 넓은 통찰을 끌어내려는 노력을 꺾어 버리기 때문이다.
그래서 그는 해답을 분수로 부르자고 제안했다. 제안됐지만 검증 안 된 증명은 기껏해야 3분의 1짜리 해답, 제안되고 검증됐지만 제대로 소화된 발표가 없는 증명은 3분의 2짜리 해답이다. 예로 든 것이 에르되시 문제 #1196이었다. 처음에는 #1169로 잘못 썼다가 고쳤다. 코어닷투데이가 5월에 「23살 아마추어가 ChatGPT로 60년 난제를 풀었다」로 소개한 바로 그 문제다.
먹을 것이 귀한 사회에서는 고기를 잡아 오는 사냥꾼이 가장 큰 칭송을 받는다. 누가 무엇을 가져오든 반갑고, 손질하고 요리할 사람은 쉽게 구한다. 먹을 것이 넘치는 사회의 포틀럭 파티는 다르다. 그는 이렇게 썼다. "낯선 사람이 정체 모를 고기의 사체를 내려놓고 다른 사람더러 손질해서 요리하라고 하면 환영받지 못할 것이다." 잘 검수된 기성품 도시락도 차려진 음식의 일부일 뿐이다. 믿을 만한 사람이 정성 들여 만든 요리가 대접받고, 그 요리를 둘러싼 대화가 모임의 중심이 된다. 다음 세대 요리사가 배우는 자리도 거기다.
수학으로 돌아오면 결론은 이렇다. 증명이 풍요해진 시대에는 '처음 증명을 생성한 사람'에게 가던 명예의 일부가 증명을 검증하고 소화하는 사람에게 옮겨 가야 한다. 그는 AI에게 증명을 받아 온 사람이 "그것을 검증하거나 남에게 요약할 시간이 없다"고 하는 '날것의' 기여가 에르되시 사이트에서 문제에 대한 관심을 오히려 꺼뜨리고 있다고 썼다. 문제가 이제 '풀렸으니까'. 그리고 이렇게 예측했다. "현대 사회가 날 식재료를 한 끼 식사로 여기지 않듯, 수학 연구 문화도 '날것의', '소화되지 않은' 증명을 문제의 해답으로 여기지 않게 될 것이다."
1-3. 블렌더의 경고 — 소화를 자동화하면 되지 않나?
당연한 반론이 있다. 소화가 병목이면 소화도 AI에게 시키면 된다. AI가 더 좋은 해설을 쓰도록 훈련하면 된다. 증명 소화불량(proof indigestion) 이라는 말이 처음 등장한 5월 10일 게시물이 바로 이 반론에 대한 답이다.
타오는 그런 자동화가 "어느 정도는 도움이 될 것"이라고 인정했다. 그러면서 해설 평가 루브릭 같은 '소화 용이성' 지표를 맹목적으로 최적화하면 전체로 봤을 때 결과물이 더 나빠질 수 있다고 경고했다. 비유는 여전히 음식이다.
우리는 삼키기 어려운 음식을 소화하기 쉽게 하려고 씹는다. 질긴 음식을 연하게 만들어 씹는 수고를 줄이는 조리법도 있다. 그런데 씹는 수고를 최소화하는 방향으로 소화를 자동화하고 최적화하기로 한다면, 논리적 귀결은 모든 식사를 블렌더에 갈아 급식관으로 넣는 것이다. 이것은 기술적으로 소화불량 문제를 해결하지만 인기 있는 선택지는 아니다.
핵심은 인공적인 어려움과 자연스러운 어려움의 구분이다. 질긴 고기를 연하게 하듯 원고 속 쓸데없는 난해함을 찾아 고치는 데는 AI가 쓸모 있다. 하지만 독자가 "곱씹어야" 이득인 자연스러운 어려움까지 매끄럽게 밀어 버리면, 그 결과의 이해를 공동체 전체에 넓힌다는 원래 목표에 거꾸로 간다. 사흘 뒤(5월 13일)에는 에르되시의 말을 빌려 한 문장을 더 붙였다. 지금의 AI는 마시멜로와 도토리를 함께 간 반죽을 대량으로 만드는 블렌더와 같아서, 먹을 만함·영양·소화 용이성 같은 벤치마크 지표에서는 점수를 잘 받지만 "뚜렷하게 입맛이 없다". 도토리 반죽으로는 참나무가 자라지 않는다.
7월 24일 필라델피아 세계수학자대회(ICM) 공개 강연 「AI 시대의 수학」 슬라이드는 이 논지를 더 구체적으로 적었다.
지금의 AI 도구는 증명 해설에서 성적이 아주 엇갈린다. 철자, 문법, 서식은 거의 흠잡을 데가 없다(너무 흠이 없다고 할 수도 있다). 그러나 글은 사소한 것에 오래 머무는 반면, 논증에서 가장 흥미롭고 새로운 부분은 아주 짧게 지나가거나 심지어 흐려 버린다. (…) 사람이 쓴 증명에서는 저자가 어렵다고 느낀 부분에 어느 정도 자연스러운 마찰이 남아 있어서 독자가 속도를 늦추고 주의를 기울이게 된다. 지나치게 AI로 다듬은 증명은 '인공적' 마찰과 '자연스러운' 마찰을 함께 없앨 수 있다. 역설적이게도 사람이 쓴 해설의 '실수'가 결국 독자에게 도움이 될 수 있다!
이 문단은 이 글의 실험 설계에 그대로 들어갔다. 매끄러운 해설은 정말 이해를 해칠까? 마찰이 사라지면 독자는 오류를 덜 찾게 될까? 5장부터 직접 잰다.
1-4. 바다가 탁해지는 산수 — 심슨의 역설
8월 27일 타오는 숫자로 된 장난감 모형을 하나 내놓았다. 숫자는 그 자신이 "지어낸 것"이라고 밝혔지만, 구조는 날카롭다.
AI 이전에는 문제 하나를 푸는 데 6개월, 제대로 정리해 쓰는 데 1개월이 걸렸다. 6개월을 들인 사람은 한 달을 더 들여 정리하는 쪽을 택한다. 그래서 한 분야가 1년에 100개를 풀면 90개는 출판할 만한 글로 남는다. 제대로 쓴 글이 날림보다 아홉 배 많으니, 학술지의 가벼운 거름만으로도 질 좋은 흐름이 유지된다.
AI가 풀이를 하루로 줄였는데 정리는 3주로 조금만 줄었다고 하자. 사람들은 하루짜리 날림 해답과 3주가 넘게 걸리는 제대로 된 글 사이에서 고르게 된다. 둘 다 예전보다 싸졌으니 양은 늘어난다. 제대로 쓴 글은 90편에서 500편이 될 수 있다. 하지만 정리 여부와 상관없는 해답의 총수는 100에서 5,000으로 늘어난다. 개인은 더 많이, 더 잘 쓰는데, 문헌 전체에서 잘 쓴 글의 비율은 90%에서 10%로 뒤집힌다. 통계학에서 부분마다 성립하는 경향이 합치면 뒤집히는 현상을 심슨의 역설이라고 부르는데, 타오는 이것을 그 변형으로 봤다.
"AI가 해설도 잘하게 되면 저절로 풀린다"는 반론에도 그는 미리 답했다. 그동안 AI는 생성도 지금보다 더 잘하게 될 것이므로 비율은 오히려 더 나빠질 가능성이 크다는 것이다. 아래 위젯에서 풀이 시간과 정리 시간을 직접 바꿔 보자.
이 숫자 놀이가 말하는 것은 단순하다. 소화가 생성보다 느린 한, 문헌의 바다는 커지면서 탁해진다. 9월 8일 타오는 이를 "바다에 둘러싸여 마실 물이 없는" 상황에 빗댔다.
1-5. 다섯 단계와 '강연 경험칙'
여름을 지나며 타오의 틀은 세 칸에서 다섯 칸으로 늘었다(8월 4일). 생성, 검증, 해설(exposition), 출판, 정전화(canonicalization). 정전화는 증명이 다듬어지고 단순해져 결국 교과서의 '표준 증명'이 되는 단계다. ICM 슬라이드는 이 단계를 두고 "가장 느리고, AI 최적화가 가장 덜 통하지만, 전 과정에서 가장 가치 있는 부분"이라고 썼다.
그렇다면 소화가 '일어났다'는 것은 무엇으로 아는가? 타오가 4월 25일 답글에서 처음 내놓고 ICM에서 다듬은 경험칙은 이것이다.
증명 소화가 정말 일어났는지에 대한 내 경험칙은, 사람이 그 증명을 연구 강연에서 발표하고 그 강연에 대한 후속 질문에 지적인 답을 할 수 있는가이다.
ICM 슬라이드판은 더 단호하다. "저자가 자기 결과에 대해 정확하고 출처가 올바른, 명료한 전문가 수준의 강연을 할 수 있음을 설득력 있게 보여 주지 못하면, 그 결과는 출판되지 말아야 한다." 8월 6일에는 한 걸음 더 나가 우선권 기준을 바꾸자고 제안했다. 앞으로 '누가 처음 풀었나'는 프리프린트를 올린 날이 아니라, 결과를 공개 강연이나 해설로 명료하게 설명해 낸 날로 따지자는 것이다. 이튿날 그는 정확한 공식까지 적었다. 공개일 = max(프리프린트 공개일, 해설 공개일). 해설에는 강연 녹화, 해설 블로그 글, 직접 찍은 영상도 들어간다.
이 경험칙이 이 글의 실험에서 독자에게 던지는 질문의 원형이다. 해설을 읽은 독자가 핵심 아이디어를 말할 수 있는가, 가장 어려운 고비가 어디인지 아는가, 가정이 어디에 쓰였는지 답할 수 있는가, 조건을 바꾸면 어디가 깨지는지 아는가. 강연장에서 청중이 손을 들고 묻는 바로 그 질문들이다.
2장. 소화불량은 처음이 아니다 — 늦게 소화된 증명들
2-1. 생성과 소화 사이의 시간
증명이 이해보다 먼저 도착한 일은 AI 이전에도 여러 번 있었다. 코어닷투데이는 9월 특집 「수학자가 훨씬 더 많이 필요해질 것이다」에서 서스턴, 4색 정리, 케플러 추측, 와일즈, 페렐만, 모치즈키, 리퀴드 텐서 실험의 이야기를 하나씩 풀었다. 여기서는 이야기를 되풀이하지 않고, 타오의 칸을 기준으로 각 단계가 얼마나 걸렸는지만 나란히 놓는다.
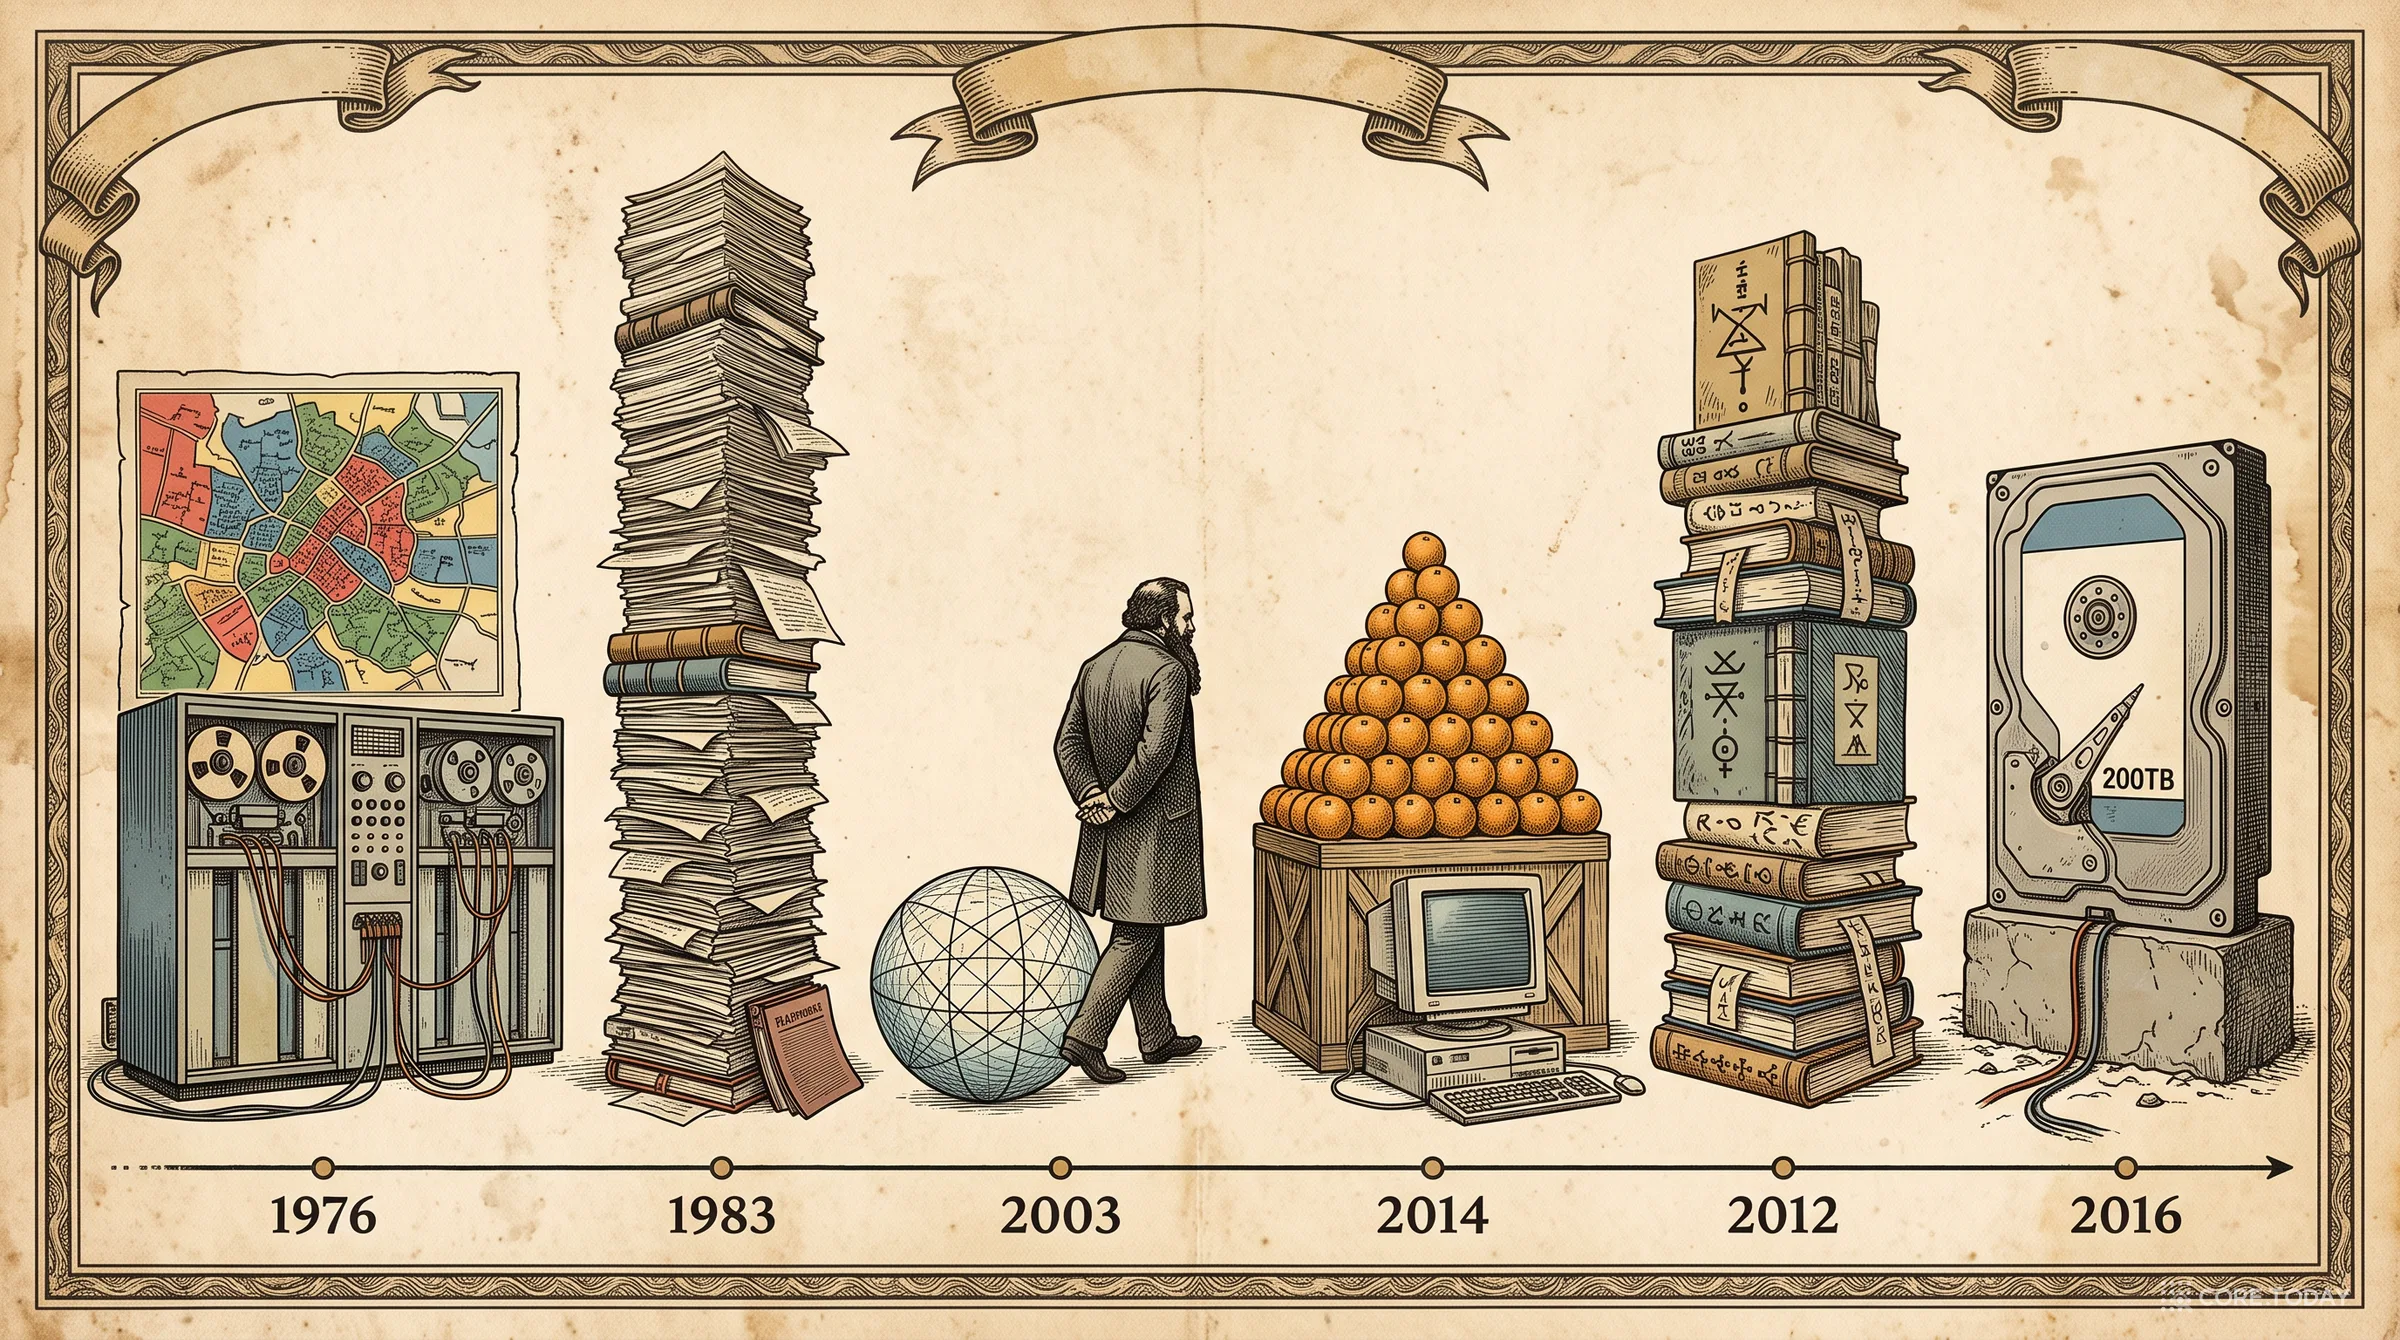
크게 보기그림 아래 연도는 1976(4색 정리), 1983(유한 단순군 분류 완료 선언), 2003(페렐만), 2014(케플러 추측의 형식 검증 완료), 2012(모치즈키), 2016(불 피타고라스 세 쌍)이다. 생성 이미지가 2012와 2014의 순서를 바꿔 그렸다.
증명
생성
검증
소화
무엇이 막혔나
4색 정리
1976 아펠·하켄, 피할 수 없는 배치 1,936개(뒤에 1,482개로 줄임)를 컴퓨터로 확인
1997 로버트슨 외 단순화한 재증명, 2005 공티에의 Coq 형식 검증
"왜 4인가"를 사람 손으로 보여 주는 증명은 아직 없다
사람이 훑어볼 수 없는(surveyable) 증명인가라는 철학 논쟁
케플러 추측
1998 헤일스·퍼거슨
심사위원들이 4년을 들이고도 완전한 인증 없이 출판(2005~06), 2014 Flyspeck 형식 검증 완료
헤일스가 형식 검증용 '청사진' 책(2012)으로 증명을 다시 썼다
사람 심사의 한계 → 형식 검증 프로젝트가 탄생
푸앵카레 추측
2002년 11월 ~ 2003년 7월 페렐만의 arXiv 세 편
2006년 클라이너–롯, 모건–톈, 차오–주 세 팀이 각각 수백 쪽으로 풀어 씀 (검증과 소화가 한 몸)
원고가 극도로 압축돼 있었고 저자는 해설에 나서지 않았다
ABC 추측(IUT)
2012 모치즈키, 500쪽 이상
2018 숄체–스틱스가 "고칠 수 없는 심각한 틈" 보고, 2021 교토의 학술지에 게재
공동체 대부분이 소화하지 못했다
"전문가 누구도 다른 전문가들에게 논증을 설명하는 데 성공하지 못했다"(에머턴)
리퀴드 텐서
2019 클라우센–숄체
2020년 12월 숄체가 Lean 형식화에 도전장, 2022년 7월 완료
2021년 6월 숄체: 보조정리가 형식화된 뒤에야 "완전히 소화된" 증명을 사람이 읽을 수 있는 블루프린트로 다시 썼다
저자 본인도 "왜 통하는지 이해하지 못했다"고 고백
에르되시 #1196
2026년 4월 13일 GPT-5.4 Pro
4월 16일 Math Inc의 Gauss가 Lean 형식화
5월 1일 타오 등 8인의 소화 논문(arXiv 2605.00301), 저자들 스스로 "진행 중"
생성·검증은 사흘, 소화는 몇 주 이상
에르되시 #1112
AI가 만든 Lean 증명, 2026년 7월 25일 등록
10월 24일 현재 'open (Lean)'
형식 증명은 있으나 사람이 소화하지 않음
표를 보면 패턴이 하나 보인다. 검증은 점점 빨라졌고, 기계에게 넘어갔다. 4색 정리 때 '컴퓨터가 확인한 증명을 믿어도 되나'는 철학의 문제였다. 2026년에는 Lean이 그 역할을 기본으로 맡는다. 반면 소화에 걸리는 시간은 거의 줄지 않았다. 리퀴드 텐서 실험이 흥미로운 예외인데, 이 경우에는 형식화 작업 자체가 소화의 도구가 됐다. 숄체는 2021년 6월 이렇게 썼다.
보조정리 하나가 완전히 형식화된 뒤에야, 이제 완전히 소화된 그 증명이 사람이 읽을 수 있는 형태로 블루프린트에 다시 쓰였다. (…) 증명 보조기가 증명을 이해하는 데 실제로 도움을 준 실험을 우리가 목격한 것 같다.
다만 그 소화를 한 것은 Lean이 아니라 Lean과 씨름한 사람들(요한 코멜린 등)이었다. 숄체 자신도 "이 경로로 산을 오를 수 있다는 확신은 얻었지만 지형에 대한 감각은 아직 없다"고 덧붙였다.
2-2. 믿을 만한 저자의 함정 — 보예보츠키
소화가 늦으면 검증도 위험해진다는 증언도 있다. 필즈상 수상자 블라디미르 보예보츠키는 2014년 고등연구소(IAS) 소식지에 자신이 형식 수학으로 돌아선 이유를 썼다. 1999~2000년 IAS 강의를 준비하며 피에르 들리뉴가 자기 1992~93년 논문을 한 줄씩 노트로 정리하는 과정에서, 핵심 보조정리의 증명에 오류가 있고 그 보조정리는 진술대로라면 살릴 수 없다는 것을 발견했다. 그는 이렇게 썼다.
1993년부터 여러 수학자 그룹이 세미나에서 내 논문을 공부했고 자기 연구에 썼지만, 아무도 그 오류를 알아채지 못했다. 그리고 그것은 분명히 우연이 아니었다. 믿을 만한 저자가 쓴 기술적 논증이, 확인하기 어렵고 맞다고 알려진 논증과 비슷해 보이면, 그것을 자세히 확인하는 일은 거의 없다.
이 문장은 2026년에 새로 읽힌다. '믿을 만한 저자'의 자리에 Lean 도장이나 유명한 AI 회사의 이름을 넣어 보자. 그리고 '맞다고 알려진 논증과 비슷해 보이는' 자리에는 문법이 흠잡을 데 없는 매끄러운 해설을 넣어 보자.
2-3. 단계별로 걸린 시간을 한눈에
아래 위젯은 위 사례들을 생성 시점을 0으로 놓고 검증과 소화가 언제 이뤄졌는지 로그 시간축에 찍은 것이다. 하루와 50년을 한 화면에 넣으려고 눈금을 로그로 잡았다. 사례를 누르면 각 단계의 근거가 나온다.
로그 눈금에서 보면 2026년 사례들의 모양이 독특하다. 생성과 검증 사이가 며칠로 붙어 버렸다. 그래서 그 뒤에 오는 소화의 공백이 상대적으로 길어 보인다. 예전에는 생성 자체가 몇 년씩 걸렸고, 그 긴 시간이 소화를 겸했다. 이제는 그 시간이 사라졌다. 타오가 말한 임피던스 불일치를 그림으로 그리면 이렇다.
3장. '이해했다'는 무엇으로 재나 — 증명 이해의 과학
3-1. 서스턴: 증명은 이해를 옮기는 수단
타오가 ICM에서 인용한 문장의 원출처는 윌리엄 서스턴의 1994년 글 「수학에서의 증명과 진보에 대하여(On proof and progress in mathematics)」다.
우리는 정의, 정리, 증명의 어떤 추상적인 생산 할당량을 채우려는 것이 아니다. 우리가 성공했는지는, 우리가 하는 일이 사람들로 하여금 수학을 더 명료하고 효과적으로 이해하고 생각하게 해 주는가로 잰다.
서스턴은 같은 글에서 이해가 사람에서 사람으로 옮겨 가는 과정이 "자동적이지 않다. 어렵고 까다롭다"고 썼다. 콜로키움 청중은 "처음 5분 만에 길을 잃고도 나머지 55분을 조용히 앉아 있다". 논문에서는 "저자가 생각을 기호와 논리로 번역하고, 독자는 그것을 다시 번역하려고 애쓴다". 그리고 사람은 증명의 형식적 정확성을 확인하는 데는 별로 능하지 않지만, 증명의 약점이나 결함이 있을 만한 곳을 감지하는 데는 꽤 능하다고 했다. 수학의 신뢰성은 형식 논증을 기계적으로 확인하는 데서보다, 수학자들이 아이디어를 신중하고 비판적으로 생각하는 데서 나온다는 것이다.
이 관찰은 이 글 실험의 '오류 찾기' 과제와 바로 이어진다. 해설이 독자의 아이디어 이해를 키우면, 독자는 줄 단위로 따지지 않아도 이상한 곳을 감지할 수 있어야 한다.
서스턴의 글에는 경고도 있다. 1970년대 초 그가 엽층(foliation) 이론의 주요 문제들을 연달아 풀자 몇 년 안에 사람들이 그 분야를 떠났다. 사람들은 그가 "분야를 죽이고 있다"고, 칭찬으로 말했다. 그가 꼽은 원인 하나는 결과를 "관습적이고 위압적인 수학자의 문체"로 써서 배경지식이 없는 사람에게 높은 진입 장벽을 만들었다는 것이다. 다른 하나는 이렇다. "사람들은 지식보다 개인적인 이해를 원한다. 그리고 우리의 공로 중심 체계에서는 정리라는 공로도 원하고 필요로 한다." 타오가 걱정하는 '소화되지 않은 해답이 분야를 죽이는' 시나리오와 똑같은 구조다. 다른 점은 이번에는 풀어 버린 쪽이 사람이 아니라는 것뿐이다.
3-2. 일곱 가지 잣대 — 증명 이해 평가 모델
'이해'는 막연한 말이지만, 수학교육 연구자들은 그것을 시험 문항으로 바꾸는 틀을 만들어 두었다. 메히아라모스(Juan Pablo Mejía-Ramos)와 웨버(Keith Weber) 등이 2012년 Educational Studies in Mathematics에 낸 「학부 수학의 증명 이해 평가 모델」이다. 그들은 수학자 9명을 면담하고 기존 기하 증명 독해 모델을 넓혀, 증명 이해를 국소적(local) 차원 셋과 전체적(holistic) 차원 넷, 모두 일곱으로 나눴다.
차원
무엇을 묻나
원 논문의 예(4k+3 꼴 소수가 무한히 많다는 증명)
이 글의 실험에서
국소적 — 증명 속 문장 하나 또는 몇 개에 대한 이해
1. 용어와 문장의 뜻
핵심 용어·문장을 이해하나
"triadic(4k+3 꼴)이라는 게 무슨 뜻인가?"
별도 문항 없음
2. 논리적 지위와 증명의 틀
각 문장이 가정인지 결론인지, 증명이 귀류법인지
"3행에서 정리가 거짓이라고 가정한 목적은?"
구조 문항에 일부
3. 주장의 정당화
각 주장이 앞의 무엇에서 나오나
"5행의 사실에서 왜 3이 M을 나누지 않나?"
Q1 정당화
전체적 — 증명 전체에 대한 이해
4. 큰 아이디어로 요약
주된 아이디어와 전체 접근법
좋은 요약과 세부만 나열한 요약 중 고르기
핵심 아이디어·단계 요약·고비
5. 모듈 구조 파악
큰 부품들과 그 사이의 논리 관계
"monadic 수의 곱이 monadic이라는 부분 증명은 왜 들어갔나?"
Q2 구조
6. 다른 맥락으로 옮기기
아이디어를 다른 증명 과제에 적용
"6k+5 꼴 소수가 무한함을 증명하라", "왜 같은 방법으로 4k+1 꼴은 안 되나?"
Q3 전이
7. 예로 보여 주기
구체적 예와의 관계
"3, 7, 11, 19만 triadic 소수라면 M은?"
Q4 예시
저자들은 두 가지를 강조했다. 첫째, 이 차원들은 위계가 아니다. 큰 그림은 잡았는데 기술적 세부를 모르는 사람도, 그 반대인 사람도 있다. 둘째, 이 모델은 새로운 증명 제시 방식의 효과를 재는 도구로 쓰라고 제안됐다. 이 글의 실험이 정확히 그 용도다. 논문 각주에는 수학자들이 언급했지만 교육 문헌에 없어서 뺀 항목도 두 개 있다. "증명이 어디서부터 판에 박히지 않고 어려워지는지 알아보기"와 "뻔한 접근이 왜 실패하는지 알아보기"다. 앞의 것은 실험의 '고비(crux)' 문항으로 넣었다.
3-3. 구조를 보여 주면 이해가 늘까? — 2014년의 선행 실험
이 실험과 가장 가까운 선행 연구는 같은 연구팀의 「구조화된 증명 이해하기」(Fuller 외, 2014)다. 레론(Leron)이 1983년에 제안한 구조화 증명, 곧 큰 단계부터 보여 주고 세부를 아래 층에 넣는 방식을 보통의 선형 증명과 비교했다. 미국 상위 50개 학과의 3·4학년 약 300명을 무작위로 나눠 같은 증명을 두 방식으로 읽혔다.
결과는 미묘했다. 구조화 증명은 좋은 요약을 고르는 데만 도움이 됐다. 정당화, 전이, 예시 적용에서는 이득이 없었고, 한 증명의 예시 적용 문항에서는 오히려 선형 증명이 유의하게 나았다. 더 흥미로운 것은 자기 평가다. "증명을 완전히 이해했다"고 답한 비율은 형식과 상관없이 비슷했다. 그런데 그렇게 답한 집단의 전이 문항 정답률은 33~45%였다. 느끼는 이해와 재는 이해가 따로 놀았다.
3-4. 읽는 사람을 바꾸면 — 자기 설명 훈련
텍스트를 바꾸는 대신 읽는 사람을 바꾼 연구도 있다. 영국 러프버러대학의 호즈·앨콕·잉글리스(2014)는 학생에게 15분짜리 '자기 설명(self-explanation)' 소책자를 먼저 읽혔다. 증명을 한 줄 읽을 때마다 그 줄을 앞의 아이디어로 설명해 보라는 훈련이다. "OK, 2(k+l+p)가 짝수인 건 알겠다"는 확인(monitoring)이고, "세 정수의 합은 정수이고 정수의 두 배는 짝수이므로"가 자기 설명이다. 결과는 컸다. 첫 실험에서 28점 만점 이해도 시험이 18.2점 대 14.2점(효과 크기 d = 0.95)으로 갈렸고, 강의 중 15분 개입만으로도 3주 뒤까지 효과(d = 0.35)가 남았다. 시선 추적에서는 훈련받은 학생들이 줄과 줄 사이를 더 자주 오갔다.
잉글리스와 앨콕의 2012년 시선 추적 연구도 같은 방향을 가리킨다. 학부생은 논증의 '표면적 특징'에 상대적으로 더 오래 머문 반면, 수학자는 연속된 줄 사이를 오가며 시선을 옮기는 경향이 강했다. 저자들은 이를 암묵적 근거(implicit warrant), 곧 "왜 이 줄에서 다음 줄이 나오는가"를 스스로 메우려는 노력으로 해석했다. 호즈의 학위논문은 이 연구를 정리하며 근거를 지나치게 많이 명시하면 독자의 인지적 참여가 줄어 증명을 완전히 이해하지 못할 수 있다고 덧붙였다. 타오의 '씹는 수고'와 같은 이야기다.
3-5. 쉬우면 배운 것 같다 — 유창성 착각
인지심리학은 이 현상들에 이름을 붙여 두었다.
설명 깊이의 착각(illusion of explanatory depth). 로젠블릿과 카일(2002)은 사람들에게 지퍼나 수세식 변기 같은 물건을 얼마나 잘 이해하는지 평가하게 한 뒤, 직접 설명을 써 보게 했다. 설명을 써 본 뒤 자기 평가는 크게 떨어졌다. 그런데 마지막에 전문가의 설명을 읽게 하자 이해가 "크게 늘었다"는 자기 평가가 다시 올라갔다. 아무것도 시험하지 않았는데도 그랬다. 좋은 설명을 읽는 경험 자체가 이해했다는 느낌을 만든다.
바람직한 어려움(desirable difficulties). 비요크(1994)는 "훈련 중의 수행을 높이는 조건이 장기 학습에도 좋다는 가정은 자주 의심스럽고 때로는 극적으로 틀렸다"고 썼다. 빠른 진도는 배우는 것이 별로 없어도 안심을 주고, 애쓰며 틀리는 경험은 많이 배우고 있어도 괴롭다.
능동 학습의 역설. 데로리어스 등(2019, PNAS)은 하버드 물리 수업에서 같은 학생에게 능동 수업과 매끄러운 강의를 번갈아 들려줬다. 능동 수업에서 시험 점수는 0.46 표준편차 높았지만, 학생들이 '배웠다고 느끼는 정도'는 0.56 표준편차 낮았다.
AI 튜터의 목발 효과. 바스타니 등(2025, PNAS)은 튀르키예 고교생 약 1,000명에게 GPT-4 튜터를 줬다. 연습 중 점수는 48%(기본 GPT)와 127%(교사용 안전장치를 단 튜터) 올랐다. 그런데 AI를 빼고 본 시험에서 기본 GPT 집단은 대조군보다 17% 낮았다. 학생들은 GPT를 '목발'로 썼다.
긴 설명은 확신만 키운다. 스테이버스 등(2025, Nature Machine Intelligence)은 사람들이 LLM 답의 정확도를 과대평가하며, 설명이 길수록 정확도와 무관하게 확신이 커진다고 보고했다. 코어닷투데이가 오늘 낸 「LLM에게 확신도를 묻는다는 것」의 결론과도 맞닿는다.
정리하면 교육·인지 연구는 하나의 가설을 가리킨다. 해설을 매끄럽게 할수록 독자는 이해했다고 더 강하게 느끼지만, 실제로 이해하는 양은 그만큼 늘지 않거나 오히려 줄 수 있다. 타오의 블렌더 비유를 실험으로 확인할 수 있는 가설로 바꾸면 이것이 된다.
그런데 2024~2026년 문헌을 두 번 뒤졌지만, LLM이 쓴 증명 해설을 읽힌 뒤 이 일곱 차원 같은 잣대로 이해도를 잰 무작위 실험은 찾지 못했다. 사람을 대상으로 한 실험은 코어닷투데이가 당장 할 수 없다. 그래서 사람 대신 '독자 역할을 하는 모델'을 세웠다. 이 선택의 한계는 5장에서 따로 짚는다.
4장. AI가 쓴 증명은 어떻게 생겼나
4-1. "Good." — 혼잣말하는 금메달 답안
2025년 7월 19일, OpenAI의 알렉산더 웨이는 실험용 추론 모델이 IMO 2025에서 42점 만점에 35점을 받아 금메달 기준을 넘었다고 발표했다. 전 IMO 메달리스트 세 명이 채점했다. 그는 답안을 GitHub(aw31/openai-imo-2025-proofs)에 공개하면서 한 줄을 덧붙였다. "이 모델의 독특한 문체에 대해 미리 사과한다. 아주 실험적인 모델이다 😅".
실제로 열어 보면 이렇게 생겼다. 1번 문제 답안의 앞부분이다.
text
Need families of n lines covering P_n.  "Sunny": direction not in {horizontal, vertical, slope -1}.
...
So "non-sunny" = line parallel to one of triangle sides. Good.
...
So main is: (a) for n>=4, any n-line cover must contain a side-line; inductively reduce to n=3. (b) Analyze n=3 exactly.
...
Need contradiction for n>=4.
관사가 빠진 전보체, "Good."이나 "Exactly lemma." 같은 맞장구, 형식을 갖추지 않은 기호. 뉴욕대의 어니스트 데이비스와 게리 마커스는 이 답안이 수학자의 비공식 구두 발표 같은 문체로 쓰였고, 제대로 가고 있다고 스스로를 안심시키는 말을 "중얼거린다"고 묘사했다. 같은 대회에서 금메달 점수(35점)를 받은 구글 딥마인드의 Gemini Deep Think 답안은 정반대였다. IMO 조정위원들이 학생 답안과 같은 기준으로 공식 채점했고, 그레고르 돌리나르 IMO 회장은 "명료하고 정확하며 대부분 따라가기 쉽다"고 평했다. 데이비스와 마커스는 딥마인드 답안이 "학술지 논문이나 교과서에 거의 손대지 않고 붙여 넣을 수 있다"고 했다. 그들이 꼽은 가장 큰 흠은 "가끔 장황하다"는 것이었다.
두 답안은 같은 문제를 다른 길로 풀었다. 1번 문제를 보면 OpenAI 답안은 경계의 격자점을 세어 n ≥ 4이면 덮개에 삼각형의 변이 반드시 들어 있음을 보이고, 한 단계씩 n=3까지 내려간다. Gemini 답안은 먼저 비양지(shady) 직선의 배치가 강제된다는 구조 보조정리로 문제를 'k개의 양지 직선만으로 P_k를 덮을 수 있는가'로 바꾼 뒤, 같은 경계점 세기를 그 핵심 문제에 쓴다. 정답(0, 1, 3)과 핵심 관찰은 같지만 길의 모양이 다르다. 이 글의 실험은 OpenAI 쪽 날것의 답안 다섯 편을 원재료로 쓴다. 문체가 가장 거칠어서 '소화'가 가장 필요한 원재료이기 때문이다.
4-2. 연구 수준에서는 — First Proof 심사위원들의 기록
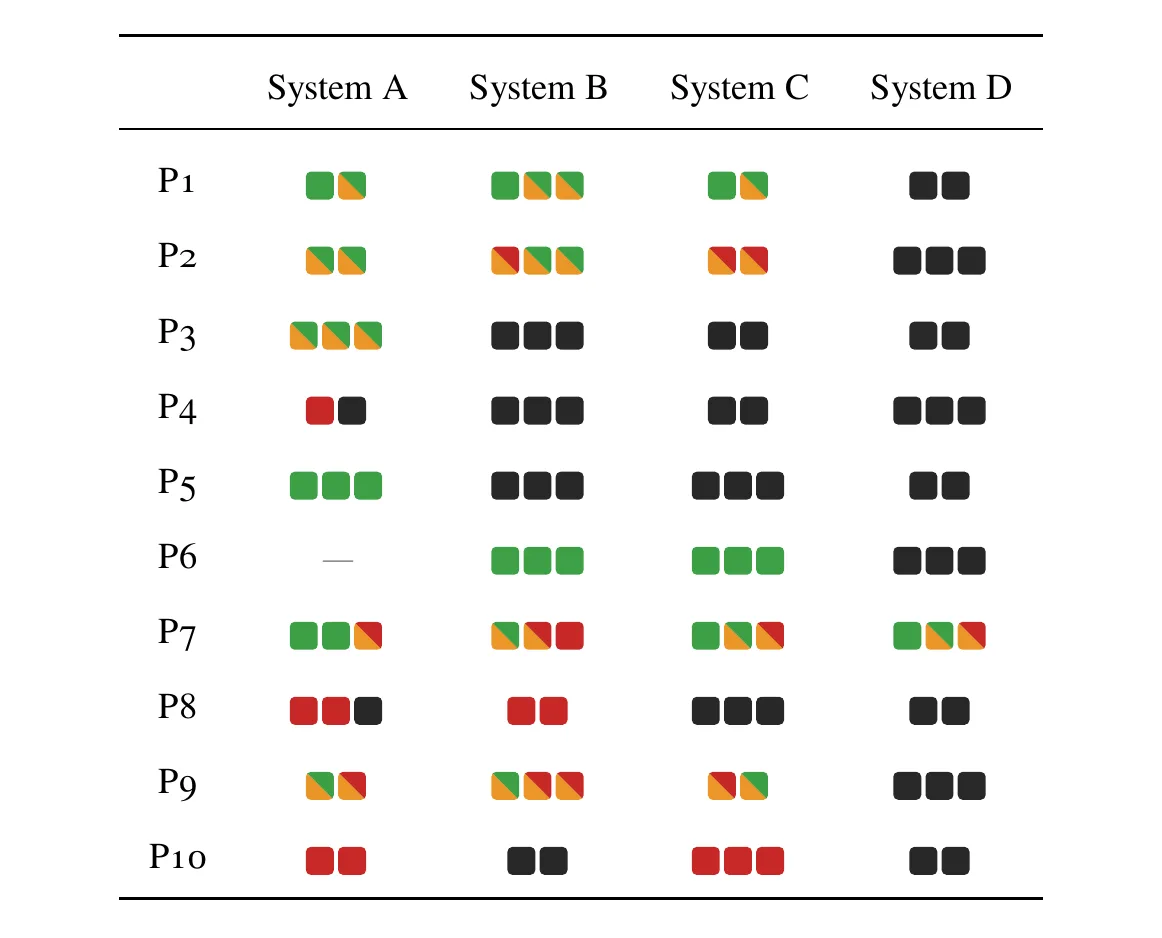
올림피아드는 정답이 정해진 시험이다. 연구 수준에서는 해설의 질이 더 큰 문제가 된다. 2026년의 가장 좋은 자료는 First Proof 2차 보고서(arXiv 2606.18119, CC BY 4.0)다. 아부자이드, 스리바스타바, 워드, 윌리엄스가 엮은 이 실험은 아직 출판되지 않은 연구 문제 10개를 네 AI 시스템에 풀게 했다. 시스템 A는 ETH 등의 ProofCouncil, B는 타오가 참여한 UCLA Moonshot Harness, C는 ChatGPT 5.5 Pro, D는 프린스턴의 Momus다. 그런 다음 하버드 CMSA에서 전문가 약 30명이 학술지 심사처럼 이중맹검으로 채점했다.
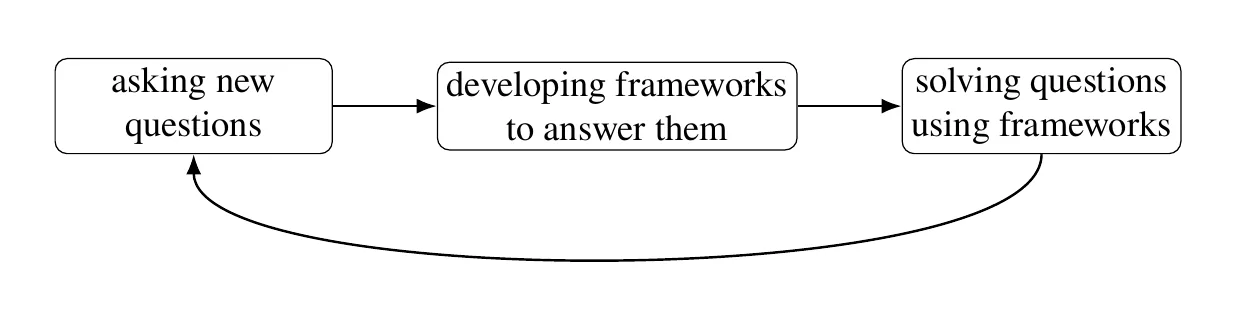
크게 보기그림 1. 수학 연구의 순환. 출처: Abouzaid 외, "First Proof Second Batch", arXiv 2606.18119, CC BY 4.0.
보고서가 맨 앞에 둔 이 그림은 소박하지만 요점이 있다. 연구는 질문 → 틀 → 풀이로 끝나는 직선이 아니라 풀이에서 다시 새 질문으로 돌아가는 고리다. AI 벤치마크는 거의 항상 세 번째 상자만 잰다. 1편에서 다룬 '질문하기'는 첫 상자이고, 이 글의 '소화'는 마지막 상자에서 첫 상자로 돌아가는 화살표에 해당한다. 해답을 이해해야 다음 질문이 나오기 때문이다.
크게 보기표 3. 해답별 심사위원 권고. 초록 = 거의 흠 없음, 주황 = 경미한 수정, 빨강 = 대폭 수정, 검정 = 거절. 대각선으로 나뉜 주황 네모는 수정 이유를 보여 준다. 초록 반쪽이면 수학은 맞지만 인용이 부족하거나 틀렸다는 뜻이고, 빨강 반쪽이면 고쳐야 할 수학적 오류나 틈이 지적됐다는 뜻이다. 출처: arXiv 2606.18119, CC BY 4.0.
표를 읽는 법은 이렇다. 한 칸에 네모가 2~3개인 것은 해답 하나를 심사위원 2~3명이 따로 봤기 때문이다. 같은 해답에도 심사위원마다 판정이 갈리는 칸이 많다(예: P7의 시스템 A는 초록·초록·주황). 10문제 중 7문제에서 적어도 한 시스템이 통과(거의 흠 없음 또는 경미한 수정) 판정을 받았다. 검정 줄이 길게 이어지는 열도 있다. 시스템 D는 P7 하나를 빼면 모두 거절이다. 그리고 주황 네모 다수가 초록 반쪽, 곧 수학은 맞는데 인용이 문제인 경우라는 점이 눈에 띈다.
이 글과 관련해 더 중요한 것은 표 아래 심사평이다. 보고서 1.3절은 반복된 주제를 이렇게 요약한다.
심사평에서 되풀이된 주제는, AI 해답이 논증의 판에 박힌 부분은 꼼꼼하게 자세히 다루면서 가장 어려운 단계는 얼버무리고 넘어가는 경향이 있다는 것이었다. 때로는 핵심 주장이 "표준적인 논증"으로 나온다고 근거 없이 주장하거나, 그 결과가 실제로 들어 있지 않은 논문을 인용했다.
개별 심사평은 더 생생하다. 시스템 B의 1번 해답(경미한 수정, 즉 정답)에는 "해설 면에서 해답이 때로 너무 현학적이어서 심사위원이 생각의 흐름을 따라가기 어려웠다. (…) 어떤 수학자도 굳이 하지 않을 명제들의 증명을 끼워 넣었다"는 평이 붙었다. 9번 해답에는 "(d − 1) − b = d − b − 1 이므로" 같은 불필요하고 사소한 세부가 지적됐다. 반대 방향의 실패도 있다. 시스템 C의 8번 해답(거절)에는 "문체는 대체로 명료하고 읽기 쉬웠다. 그러나 증명의 가장 결정적인 단계가 빠져 있었다"는 평이 붙었다. 읽기 쉬운 것과 맞는 것은 별개였다.
타오는 6월 10일 자기 팀(UCLA) 하네스의 약점으로 "적절한 문헌 인용 실패와 빈약한 해설"을 꼽았다. 특히 정답이었던 한 해답이 "사소한 단계에 지나치게 많은 시간을 쓰고 논증의 핵심 요소에는 충분한 시간을 쓰지 않는다"는 지적을 받았다고 했다. 보고서에서 이 묘사에 맞는 해답은 위의 1B와 9B다. 타오가 어느 쪽을 말했는지는 밝히지 않았다.
4-3. 2026년 10월의 원고 더미
이 모든 것이 한꺼번에 터진 것이 2026년 10월 6일이다. OpenAI가 수학 원고 수백 편을 하룻밤에 공개했다(코어닷투데이의 「722편의 원고」 참고). OpenAI는 공지에서 "앞으로 인용, 수학적 해설, 결과 제시의 질을 더 높이겠다"고 약속했다. 10월 15일에는 수학자들이 AI가 낸 결과를 "검토하고, 이해하고, 그 위에 쌓도록" 돕는 시몬스 재단 이니셔티브에 500만 달러를 내겠다고 덧붙였다. 블로그 Proofs and Prompts가 모은 수학자들의 반응에는 소화의 언어가 넘친다. 요하네스 슈미트는 원고들이 동료들 말로 "끔찍하게 쓰였다"며 함께 소화할 공개 토론장이 필요하다고 했다. 브라이나 크라는 "몇 달 전에 나온 연구와 달리, 증명에서 막혔을 때 물어볼 사람이 없다"고 썼다. 타오는 더 직접적이었다.
이 증명들에 관여한 사람 중 누구도 질문을 받거나, 강연을 하거나, 학회에 가거나, 학술지에 논문을 내거나, 학생을 가르치거나, 이 결과의 후속 발전에 참여할 수 없다는 점에 나는 깊이 좌절한다.
그 증명을 만든 '사람'이 없으니 강연 경험칙을 통과할 저자도 없다. 그렇다면 해설도 AI에게 맡길 수밖에 없는 상황이 온다. 그 해설은 쓸모가 있을까? 이제 직접 재 볼 차례다.
5장. 실측 설계 — AI 해설을 눈먼 독자에게 읽히다
5-1. 무엇을 재고 싶었나
질문은 셋이다.
해설 문체에 따라 독자의 이해가 달라지나? 특히 타오가 경고한 '블렌더' 해설과, 서스턴·레론·램포트 전통의 '지도' 해설, 타오의 경험칙을 옮긴 '강연' 해설은 어떻게 다른가?
매끄러운 해설은 오류를 숨기나? 같은 논리 오류를 문체만 다른 글에 심었을 때 독자가 찾아내는 비율이 달라지나?
독자가 느끼는 이해와 실제 이해는 얼마나 다른가? 3장의 '설명 깊이의 착각'이 모델 독자에게도 나타나나?
사람 독자를 모아 실험하는 것이 정석이다. 하지만 코어닷투데이가 지금 할 수 있는 실험이 아니고, 3장에서 봤듯 그런 실험은 아직 문헌에도 없다. 그래서 이번에는 독자 역할을 원 증명을 본 적 없는 작은 언어 모델에게 맡겼다. 이 대체에는 분명한 한계가 있고, 결과를 사람에게 그대로 옮길 수는 없다. 5-4절에 한계를 모아 두었다.
기준 카드 Claude Opus 5.5가 원문에서: 최종 답 · 핵심 아이디어 · 필수 단계 4~7개 · 고비 · 시험 문항 4개(모범 답·만점 요소 포함)
직역 Gemini 2.5 Pro가 혼잣말까지 살려 한국어로 직역
↓
해설 3문체 × 해설자 2 블렌더 · 지도 · 강연 Claude Sonnet 5.5 · Gemini 4 Argon
↓
이해 시험 눈먼 독자 3종이 글만 읽고 답: 최종 답 · 핵심 아이디어 · 단계 요약 · 고비 · Q1~Q4 · 자기 평가
오류 찾기 같은 논리 오류를 심은 판과 깨끗한 판을 따로 읽고 "오류가 있나, 어디인가"
충실도 감사 Opus가 해설을 원문과 대조: 틀린 주장 · 빠진 핵심 · 새 논증
↓
채점 Claude Opus 5.5가 기준 카드와 대조해 0/1/2점, 오류 지적은 적중·빗나감 판정
원재료. IMO 2025 1~5번이다. OpenAI 모델은 6번을 풀지 못했다. 1번은 격자점과 직선(조합 기하), 2번은 원과 수심(기하, 원 답안은 좌표로 밀어붙인 계산), 3번은 'bonza' 함수(정수론), 4번은 가장 큰 진약수 세 개의 합으로 이어지는 수열(정수론), 5번은 앨리스와 바자의 숫자 게임(부등식)이다. 원문은 한 편에 1,500~4,000단어(8.6~17KB), 다섯 편을 합쳐 약 11,100단어다.
글의 조건(문제마다 9가지, 모두 45편).
조건
만든 방법
겨냥한 질문
글 없음
문제만 주고 "아는 대로" 답하게 함
모델이 문제와 풀이를 미리 알고 있을 가능성(기억)의 기준선
원문(영어)
OpenAI 답안 그대로
날것의 증명을 직접 소화할 수 있나
원문 직역
문체를 살린 한국어 직역
언어만 바꿨을 때의 차이
블렌더
"수학을 좋아하는 고등학생도 막힘 없이 술술 읽을 수 있도록 최대한 쉽고 매끄럽게, 걸려 넘어질 곳이 하나도 없도록"
타오가 경고한 소화 용이성 최적화
지도
"① 핵심 아이디어 두세 문장 ② 뼈대: 단계와 의존 관계 ③ 가장 어려운 고비와 왜 거기서 풀리는지 ④ 각 가정이 쓰이는 곳 ⑤ 세부 증명" 순서 강제
구조화 증명·블루프린트 전통
강연
"전문 수학자 앞 10분 강연 원고, [칠판]과 [말] 구분, 계산은 생략해도 되지만 왜 통하는지는 전달"
타오의 강연 경험칙
세 해설 문체 모두 "원 증명과 같은 논증을 따라가고, 새 주장을 덧붙이지 말고, 수학적으로 정확할 것"을 조건으로 붙였다. 해설자는 Claude Sonnet 5.5와 Gemini 4 Argon 두 모델이다.
독자. 세 모델이 독자를 맡았다. 가장 작은 상용 모델인 Gemini 3.1 Flash-Lite, 중간급 Gemini 3.5 Flash, 그리고 코어닷투데이 맥북에서 돌린 Qwen3.5 9B(생각 모드 끔)다. 독자는 해설을 쓴 모델과 겹치지 않게 골랐다. 독자는 글과 시험 문항을 함께 받고(열린 책 시험), 답을 JSON으로 낸다. Gemini 독자는 같은 글을 두 번, Qwen은 한 번 읽었다.
시험 문항. 3장의 일곱 차원 중 다섯을 옮겼다.
핵심 아이디어(차원 4): 1~2문장으로
단계 요약(차원 4·5): 3~7단계 → 기준 카드의 필수 단계 중 몇 개를 담았나
고비: 가장 어려운 단계와 그 이유(논문 각주의 '증명이 어려워지는 곳')
Q1 정당화(차원 3), Q2 구조(차원 5), Q3 전이(차원 6), Q4 예시(차원 7): 문제마다 Opus가 원 증명에서 만든 문항
자기 평가: "이 풀이를 남에게 설명하고 질문에 답할 수 있을 만큼 이해했는지 0~10" — 타오의 강연 경험칙을 독자 스스로에게 묻는 문항
예를 들어 1번 문제의 Q3(전이)는 이렇다. "n=3에서는 왜 2절의 보조정리(변 직선이 반드시 포함됨)를 쓸 수 없습니까? 그리고 이것이 결과에 어떻게 드러납니까?" 만점을 받으려면 n=3에서 경계점 수 3n−3=6과 직선 세 개가 덮을 수 있는 상한 2n=6이 같아져 모순이 생기지 않는다는 점, 그리고 변 직선 없이 P₃을 덮는 양지 직선 세 개의 예를 들어야 한다.
채점. Claude Opus 5.5가 기준 카드의 모범 답·만점 요소와 대조해 핵심 아이디어·고비·Q1~Q4를 0/1/2점으로, 단계 요약은 기준 단계를 몇 개 담았는지로 채점했다. 이해 점수는 이 일곱 항목을 0~1로 맞춘 평균이다. 최종 답은 따로 셌다.
5-3. 심은 오류 — 같은 논리 오류를 다른 문체에
오류 찾기 과제의 핵심은 같은 오류를 문체만 다른 글에 심는 것이다. Opus가 문제마다 고비 단계에 심을 논리 오류 하나를 정하고, 그 오류를 8편의 글(원문, 직역, 해설 6편)에 각각 최소한으로 고쳐 넣었다. 고친 구간이 글 속에 정확히 한 번 나오는지 기계적으로 확인했고, 40편 모두 심기에 성공했다.
문제
심은 오류(논리 수준)
왜 치명적인가
1번 직선
삼각형 경계 격자점을 셀 때 꼭짓점 세 개의 중복을 빼지 않아 3n−3 대신 3n으로 세고, 그래서 "변 직선이 반드시 들어간다"를 n ≥ 3 전체로 넓힘
n=3에서는 변 직선 없이 덮는 예가 있으므로 증명 스스로 만든 예와 모순
2번 기하
마지막 대입 단계에서 서로 다른 양 S와 K를 같은 것처럼 약분
판별식이 0이 된다는 결론의 근거가 사라짐
3번 함수
"어떤 홀수 소수 p에서 f(p) > 1이면 f는 항등함수"를 p = 2를 포함한 모든 소수로 일반화
p = 2에서는 필요한 보조정리가 거짓
4번 수열
N/2가 홀수일 때 f(N)이 짝수가 되려면 나머지 합이 홀수여야 하는데 "짝수여야 한다"로 바꿈
d₃ = 2d₂라는 핵심 구조 대신 틀린 구조가 나옴
5번 게임
앨리스의 j번째 수의 상한을 구할 때 이미 쌓인 합의 하한을 버림
j에 따라 커지는 상한을 상수 √2로 잘못 일반화
독자는 깨끗한 판과 오류 판을 따로 받고 "결론을 무너뜨리는 수학적 오류가 있습니까? 있다면 그 문장을 인용하고 이유를 쓰세요"라는 질문에 답했다. 오류 판에서 '있다'고 한 답은 Opus가 인용 위치와 이유를 심은 오류와 대조해 적중인지 판정했다. 깨끗한 판에서 '있다'고 한 답은 경보로 셌다. 깨끗한 판의 경보가 모두 헛경보는 아니다. 해설 자체에 원래 틀린 곳이 있을 수 있기 때문이다. 그래서 각 해설을 원문과 대조하는 충실도 감사를 따로 했다. 오류 찾기에는 세 독자 외에 Claude Opus 5.5도 '전문 심사위원' 역할로 한 번씩 참여했다.
5-4. 미리 밝혀 두는 한계와 뜻밖의 사건
독자가 사람이 아니다. 모델 독자의 '이해'는 사람의 이해와 다르다. 특히 모델은 글이 길어도 지치지 않고, 사람처럼 "처음 5분 만에 길을 잃지" 않는다. 이 실험은 해설이 정보를 얼마나 잘 전달하는가를 재는 쪽에 가깝다.
채점자도 모델이다. Opus가 기준 카드를 만들고 채점까지 했다. 기준 카드가 원 증명의 표현에 가깝기 때문에 원문 조건이 유리할 수 있다. 다만 Opus는 해설자가 아니어서 특정 해설자의 문장을 편애할 이유는 적다.
표본이 작다. 문제 5개, 조건 9개, 독자 3종이다. 문제별 편차가 크므로 작은 차이는 해석하지 않는다.
기억 효과. IMO 2025 문제와 풀이는 2025년 7월부터 인터넷에 있었다. '글 없음' 조건이 그 효과를 잰다.
뜻밖의 거절. 처음에는 원문 직역을 Claude Opus 5.5에게 맡겼는데 응답이 비어서 돌아왔다. 확인해 보니 stop_reason: refusal, 분류는 reasoning_extraction이었다. Sonnet 5.5도 같은 이유로 거절했다. 다른 모델의 '추론 과정'을 그대로 옮겨 적는 요청으로 판단한 것이다. OpenAI 답안의 전보체 혼잣말이 안전 분류기 눈에는 날것의 사고 과정처럼 보인 셈이다. 그래서 직역은 Gemini 2.5 Pro가 맡았다. 해설(다시 쓰기)은 Claude도 거절하지 않았다. 같은 이유로 원문 직역 두 편의 충실도 감사도 Opus에서 거절돼 빠졌다.
5-5. 실제 글을 먼저 보자
결과로 가기 전에 독자들이 읽은 글이 어떻게 생겼는지부터 보자. 같은 1번 문제라도 원문은 "Need contradiction for n>=4." 같은 전보체로 시작한다. 블렌더 해설은 "약속과 정답"부터 친절하게 깔고, 지도 해설은 "① 핵심 아이디어"로 증명 전체를 서너 문장에 압축한 뒤 시작한다. 강연 원고는 [칠판]과 [말]이 번갈아 나온다.
길이에서 먼저 눈에 띄는 차이가 있다. Gemini 4 Argon의 해설은 Claude Sonnet 5.5의 해설보다 거의 두 배 길었다. 블렌더 해설 기준으로 Argon은 문제당 9,400~15,900자, Claude는 4,800~6,500자였다. 지도 해설도 Argon 8,000~15,100자, Claude 4,900~5,900자였다. 강연 원고만 두 모델 모두 4,200~6,300자로 비슷했다. 타오가 6월에 파스칼을 인용하며 한 말이 떠오른다. "짧게 쓸 시간이 없어서 길게 썼다." 이제는 긴 증명을 만드는 것이 짧은 증명을 만드는 것보다 쉽다. 이 길이 차이가 이해로 이어졌는지는 다음 장에서 본다.
6장. 결과 ① 이해 — 지도가 이겼고, 블렌더는 원문보다도 약했다
6-1. 종합 점수
채점된 답안은 모두 230건이다. 문체별 이해 점수(0~1, 일곱 항목 평균)는 이렇게 나왔다.
글 없음
0.29
원문(영어)
0.63
원문 직역
0.61
블렌더
0.58
지도
0.66
강연
0.64
독자 3종 평균. 막대 폭은 1점 만점 기준이다.
차이가 작아 보이지만 같은 문제·같은 독자끼리 짝지어 보면 구조가 드러난다. 독자 3종 × 문제 5개 = 15개 칸에서 지도 해설은 블렌더 해설보다 12칸에서 높고 2칸에서 같았다. 평균 차이는 +0.073, 칸 단위 부트스트랩 95% 구간은 [+0.044, +0.102]로 0을 넘지 않았다. 이번 실험에서 가장 확실한 결과다.
반대로 블렌더 해설은 원문보다도 평균이 낮았다(−0.038, 15칸 중 6칸에서만 원문보다 높음). 이 차이는 구간이 0을 걸쳐([−0.085, +0.010]) 확실하다고 말하기 어렵다. 그래도 "쉽게 풀어 쓰면 더 잘 이해한다"는 기대와는 방향이 반대다. 지도 해설은 원문보다 +0.036 높았지만 이것도 구간이 0을 걸친다. 정리하면 이렇다. 지도 ≥ 강연 ≈ 원문 ≥ 블렌더, 그리고 지도와 블렌더의 차이만 통계적으로 분명하다.
'글 없음' 기준선도 짚어 둘 것이 있다. Gemini 3.5 Flash는 해설 없이 문제만 보고도 0.55점을 받았다. 이 모델은 IMO 2025 풀이를 이미 알고 있었다는 뜻이다. Flash-Lite(0.17)와 Qwen(0.05)은 거의 몰랐다. 그래서 문체 간 비교는 언제나 같은 독자끼리 짝지어 했다.
6-2. 항목별로 쪼개면 — '고비'에서 벌어진다
종합 점수를 항목별로 쪼개면 차이가 어디서 오는지 보인다. 아래 위젯에서 항목을 바꿔 보자.
항목
원문(영어)
블렌더
지도
강연
핵심 아이디어
0.63
0.60
0.66
0.64
단계 요약
0.74
0.79
0.80
0.82
고비
0.52
0.45
0.76
0.60
Q1 정당화
0.54
0.52
0.60
0.56
Q2 구조
0.60
0.58
0.58
0.58
Q3 전이
0.63
0.51
0.57
0.60
Q4 예시
0.73
0.62
0.66
0.66
세 가지가 눈에 띈다.
첫째, 고비. "이 증명에서 가장 어려운 단계는 어디이고 왜 결정적인가"에 대한 답은 지도 해설을 읽은 독자가 0.76점, 블렌더는 0.45점이었다. 원문(0.52)보다도 낮다. 짝지은 차이는 +0.29(95% 구간 [+0.17, +0.43])로, 단일 항목에서 나온 가장 큰 차이다. 지도 해설은 프롬프트에서 고비를 명시하도록 요구했으니 당연하다고 볼 수도 있다. 하지만 그 '당연함'이 요점이다. 블렌더 해설은 모든 단계를 똑같이 쉽게 만들면서 어디가 어려운지에 대한 정보를 지웠다. 타오가 ICM 슬라이드에서 말한 "자연스러운 마찰"이 사라진 것을 숫자로 보면 이렇다. 독자는 단계를 잘 나열하지만(단계 요약 0.79), 그중 무엇이 증명의 무게를 지는지는 원문 독자보다도 못 짚었다.
둘째, 요약과 전이의 엇갈림. 해설 세 문체는 모두 단계 요약에서 원문보다 높았다(블렌더 +0.054, 구간 [+0.005, +0.107]). 그런데 전이(Q3)와 예시(Q4)에서는 블렌더가 원문보다 0.1점가량 낮았다. 전이는 "조건을 바꾸면 어디가 깨지나", 예시는 "작은 경우로 한 단계를 확인해 보라"는 문항이다. 이 패턴은 3장에서 본 2014년 풀러 등의 실험과 거의 같다. 그 실험에서 구조화 증명은 요약 고르기에만 도움이 됐고, 전이와 예시 적용에서는 이득이 없거나 오히려 손해였다. 열두 해 뒤, 사람 대신 모델 독자에게 AI가 쓴 해설을 읽혔는데도 같은 모양이 나왔다.
셋째, 해설자. Argon의 해설은 Claude 것보다 두 배 길었지만 점수는 거의 같았다. 지도 해설은 Claude 0.67, Argon 0.65였고, 블렌더는 Claude 0.59, Argon 0.57이었다. 강연만 Argon이 0.68로 Claude(0.60)보다 높았다. 길이는 이해를 사지 못했다. 블렌더 해설의 고비 점수는 Argon(0.38)이 Claude(0.52)보다 오히려 낮았다. 더 길고 더 친절하게 풀수록 고비가 더 묻힌 셈이다.
6-3. 문제별로는
문제 다섯 개 중 셋(1·3·4번)에서 지도 해설이 가장 높았고, 2번에서는 강연(0.61)과 지도(0.60)가 거의 같았다. 예외는 5번(앨리스와 바자의 게임)으로 원문(0.67)과 강연(0.64)이 지도(0.55)보다 높았다. 5번 원문은 두 전략을 차례로 보이는 짧고 선형적인 구조라 원문 자체가 이미 '지도'에 가까웠다. 2번(좌표 계산 기하)은 모든 조건에서 점수가 낮았다. 원 증명이 아이디어보다 계산으로 밀어붙인 증명이라 "핵심 아이디어"와 "고비"를 말하기 자체가 어렵기 때문이다. 기준 카드의 2번 고비는 "판별식이 0이 되도록 계수를 완전제곱 꼴로 정리하는 마지막 대입"이다. 이런 증명은 어떤 문체로 해설해도 소화가 어렵다. 타오가 말한 '정전화', 곧 더 개념적인 새 증명이 필요한 종류다.
1장에서 세운 가설은 "매끄러운 글일수록 오류가 숨는다"였다. 결과는 그렇게 나오지 않았다. 직접 한번 찾아보고 결과를 보자.
독자
원문(영어)
원문 직역
블렌더
지도
강연
Opus 5.5 (심사위원 역)
60%
80%
70%
60%
70%
Gemini 3.5 Flash
40%
50%
42%
26%
10%
Gemini 3.1 Flash-Lite
0%
0%
5%
5%
0%
심은 오류를 정확히 짚은 비율(적중률). Opus는 글마다 1회, Gemini는 2회 읽었다. Qwen3.5 9B는 50회 중 1회만 적중해 표에서 뺐다(위젯 표에 있다).
세 가지가 보인다.
첫째, 독자의 실력이 문체보다 훨씬 크게 작용했다. Opus는 어떤 문체에서든 절반 이상을 찾았고, Flash-Lite와 Qwen은 사실상 하나도 못 찾았다. 두 작은 모델은 오류 판에서 "오류 있음"이라고 답한 경우가 10~40% 있었지만 대부분 엉뚱한 곳을 짚었다. 3장의 서스턴 말을 떠올리면, 결함이 있을 만한 곳을 '감지'하는 능력은 글을 읽는 쪽에 있다.
둘째, 블렌더는 무죄였다. 중간급 독자(3.5 Flash)에게 블렌더 해설 속 오류는 원문 속 오류와 비슷하게 잘 보였다(42% 대 40%). 오히려 지도(26%)와 강연(10%)에서 오류가 덜 잡혔다. 짐작 가는 이유가 있다. 지도 해설은 맨 앞의 '핵심 아이디어'와 '뼈대'에서 올바른 줄거리를 먼저 보여 준다. 그러면 독자는 뒤쪽 세부에 심긴 오류를 줄거리에 맞춰 너그럽게 읽는다. 강연 원고는 계산을 생략하고 "왜 통하는지"를 말로 설명하므로 오류가 말 속에 섞이면 따져 볼 계산이 남지 않는다. 5번 강연 원고가 상징적이다. 우리가 오류를 심은 곳은 [말] 부분이었고, 바로 위 [칠판]에는 올바른 식이 그대로 남아 있었다. 그런데도 3.5 Flash는 이 모순을 한 번도 잡지 못했다.
이것은 보예보츠키의 경고와 같은 구조다. "맞다고 알려진 논증과 비슷해 보이면" 자세히 확인하지 않는다. 지도와 강연은 독자에게 '맞는 줄거리'를 먼저 확신시키는 문체다. 이해에는 도움이 되지만 검증에는 방해가 될 수 있다. 이해를 돕는 장치와 검증을 돕는 장치는 같지 않았다.
셋째, 큰 독자는 헛경보를 내지 않았다. 깨끗한 판에서 "오류 있음"이라고 한 비율은 Opus와 3.5 Flash 모두 0%였다. 작은 독자는 달랐다. Flash-Lite는 0~20%, Qwen은 0~50%의 헛경보를 냈고, 특히 강연 원고에서 많았다(Qwen 50%). 9장의 충실도 감사로 보면 해설들에는 틀린 주장이 없었으므로, 이 경보는 대부분 헛경보다. 작은 독자에게 "틀린 곳을 찾아라"고 시키면 오류가 있든 없든 무언가를 찾아낸다.
7-2. 문제별로는
2번(좌표 계산)에서 S와 K를 같은 것처럼 약분한 오류는 거의 아무도 찾지 못했다. 네 독자를 합쳐 강연 원고에서 12회 중 2회 잡힌 것이 전부다. 반대로 4번의 홀짝 오류와 5번의 상한 오류는 원문에서 60% 적중했다. 계산이 길게 이어지는 증명일수록 한 줄짜리 오류가 묻힌다. Lean 같은 형식 검증이 필요한 이유가 여기 있다. 그리고 그 형식 검증이 끝난 뒤에도 '소화'는 따로 해야 한다는 것이 이 글의 주제다.
8장. 결과 ③ 착각 — 모두가 "이해했다"고 답했다
독자는 답을 낸 뒤 "이 풀이를 남에게 설명하고 질문에 답할 수 있을 만큼 이해했는지"를 0~10으로 스스로 매겼다. 타오의 강연 경험칙을 독자 자신에게 물은 셈이다.
결과는 극단적이었다. 자기 평가가 남은 186건 중 96%가 9점 이상이었다. Gemini 3.5 Flash는 어떤 글을 읽든 평균 10점, 곧 매번 만점을 줬다. 해설을 읽고 이해 점수가 0.5 미만이었는데도 9점 이상을 준 경우가 161건 중 36건이었다. 가장 극적인 것은 '글 없음' 조건이다. Flash-Lite는 해설 없이 문제만 보고 0.17점을 받으면서 자기 평가는 평균 8.6점을 줬다. 3장의 로젠블릿과 카일이 사람에게서 본 '설명 깊이의 착각'보다 훨씬 심하다. 사람은 설명을 직접 써 보고 나서 자기 평가를 낮췄지만, 이 모델들은 답을 써 놓고도 낮추지 않았다.
자기 평가와 실제 점수의 상관이 0은 아니었다(전체 0.55). Flash-Lite와 Qwen은 글이 없을 때 자기 평가를 조금 낮췄기 때문이다. 하지만 문체 사이의 차이는 자기 평가에 전혀 나타나지 않았다. 블렌더 독자도 지도 독자도 자기 평가 평균은 9.7~9.8점이었다. 고비를 못 짚은 블렌더 독자는 자신이 고비를 못 짚었다는 것을 몰랐다.
이것이 AI 해설을 실무에 쓸 때 가장 중요한 결과일 수 있다. 해설을 읽은 쪽이 "이해했다"고 말하는 것은 소화의 증거가 아니다. 모델 독자도 그렇고, 3장의 연구들을 보면 사람 독자도 크게 다르지 않다. 타오가 소화의 기준을 '느낌'이 아니라 '강연과 질의응답'이라는 행동으로 정한 이유가 여기 있다.
9장. 결과 ④ 해설자는 정직했나 — 충실도 감사
마지막으로 해설 자체를 감사했다. Opus가 해설 30편을 원 증명과 한 줄씩 대조해 틀린 주장, 빠진 핵심 단계, 원문에 없던 새 논증을 찾았다.
문체
판정 '충실'
틀린 주장
빠진 핵심 단계
덧붙인 논증
그것만으로 완결된 증명
블렌더 (10편)
10
0
0
15
10
지도 (10편)
10
0
1
12
10
강연 (10편)
7 (나머지 3편 '경미한 문제')
0
11
9
8
해설자들은 정직했다. 30편 어디에도 수학적으로 틀린 주장은 없었다. 오히려 원 증명이 건너뛴 정당화를 메운 경우가 많았다(덧붙인 논증 36건). 예를 들어 1번 블렌더 해설(Claude)은 "변이 아닌 직선은 경계와 최대 두 점에서 만난다"를 경우를 나눠 정당화했고, 3번 블렌더 해설은 원문이 결론만 적은 f(n) | nⁿ의 근거를 보탰다. Opus는 이것들을 모두 옳다고 판정했다. 강연 원고는 계산을 "생략하겠습니다"로 넘긴 곳이 11군데였고, 2번의 두 강연 원고는 그 자체로는 완결된 증명이 아니라는 판정을 받았다. 강연이라는 형식에 맞는 생략이다.
옥에 티는 하나 있었다. 3번 강연 원고(Claude)는 원 증명에 없는 논평을 하나 덧붙였다. 상계 증명에서 경계가 n = 4에서 나온다는 말인데, 등호가 n = 4에서만 성립한다는 뜻으로 읽으면 근거가 없는 주장이다. 이런 '그럴듯한 덧붙임'이 해설이 원 증명보다 나아지는 지점이기도 하고, 사실과 다른 내용이 끼어드는 지점이기도 하다.
이 결과는 타오가 4월 25일에 지적한 것과 정확히 맞물린다. AI가 만든 요약은 "소화의 겉모양"을 갖췄지만, 그 한계는 요약 자체의 내용만 봐서는 드러나지 않고 전문가가 문헌과 대조해야 보인다. 이번 실험의 해설들은 원 증명에 충실했고 정확했다. 그런데도 블렌더 해설을 읽은 독자는 고비를 못 짚었다. 충실하고 정확한 해설이 곧 소화를 돕는 해설은 아니었다.
10장. 2026년의 소화 장치들 — 공동체는 무엇을 바꾸고 있나
실험 밖으로 나와 보자. 2026년 가을 수학 공동체는 소화불량에 대응하는 장치를 몇 가지 만들고 있다. 성격이 다른 일곱 가지를 모았다.
들어가며에서 본 장치다. 이슈 #346(2026년 7월 21일 개설)에서 논의가 시작됐고, 7월 25일 PR #350으로 teorth/erdosproblems의 상태가 비형식적 상태(informal_status) 와 형식적 상태(formal_status) 두 칸으로 나뉘었다. 기여 안내 문서는 'open (Lean)'을 이렇게 정의한다. "해답이 Lean으로 형식 검증됐지만 아직 사람 독자가 소화하지 않았으므로, 비형식적 의미에서 해결됐다고 주장하지 않는다." 10월 6일 기준 집계로는 1,221문제 중 318문제에 Lean 해답이 있다. 이 데이터베이스는 스스로를 "비공식 크라우드소싱 분류"라고 부른다는 점도 기억해 두자.
10-2. 사이트가 '상태'를 내리다 — erdosproblems.com의 10월 6일 결정
에르되시 문제 사이트를 만든 토머스 블룸은 10월 6일 더 과감한 결정을 공지했다. 사이트에서 문제의 상태(열림, 풀림 등)를 아예 표시하지 않고, 증명 주장 게시를 동결하고, 사람이든 AI든 공로를 주는 표현을 쓰지 않겠다는 것이다. 그가 든 이유는 이렇다. "이제 사람들이 사이트와 공개적으로 상호작용하는 주된 방식은 AI가 생성한 증명을 광고하는 것이고, 대개 설명하려는 시도도 없이 (점점 무의미해지는) 우선권 주장을 기록하는 수단으로 쓴다." 그리고 비유 하나를 남겼다. "도축장 안에 식당을 열지 않듯이." 대신 양질의 해설을 앞세우겠다고 했다. 사람이든 AI든, 옛것이든 새것이든 증명의 해설을 보내 달라고 하면서 이렇게 덧붙였다. "증명이 있다면 AI에게 PDF를 만들어 달라고 하지 말고 시간을 들여 직접 써야 한다. 증명을 이해하지 못한다면 다른 사람에게 도움을 청해 함께 쓸 수 있다."
10-3. 우선권을 해설에 묶기 — 타오의 제안
1장에서 본 제안이다. 우선권 날짜를 max(프리프린트 공개일, 해설 공개일)로 잡자는 것이다. 타오는 증명 하나에 네 가지 산출물을 두자고 정리했다. 생성 산출물(예: AI 대화 기록), 검증 산출물(예: Lean 코드), 해설 산출물(예: 녹화된 강연), 출판 산출물(전통적 논문)이다. "AI가 좋은 해설까지 자동으로 만들면 어쩌나?"라는 질문에는 "그렇게 된다면 오히려 기쁠 것"이라고 답하며 xkcd 810번(스팸 봇이 결국 유익한 댓글을 다는 만화)을 걸어 두었다. 비슷한 시기 '입양' 개념도 내놓았다. 증명을 일부 단계까지만 가져간 저자가 나머지 단계를 다른 저자들에게 명시적으로 "입양 보내는" 방식이다.
10-4. 영상 학술지와 해설 대회
7월에는 논문 대신 수학 영상을 심사해 출판하겠다는 학술지 Mathematical Discourse가 사전 공지됐다. 강연 경험칙을 출판 형식으로 만든 셈이다. 타오는 10월 9일 칼텍 공개 강연 「수학 2.0」에서 연구 문제 대신 열린 해설 문제(open exposition problems) 라는 말을 썼다. "현재 알려진 증명이 불투명한 결과에 대해, 동기가 분명한 설명을 찾는 것"이다. 11월 13~15일에는 칼텍 학생들이 공개 AI 도구로 기존 결과의 더 나은 증명을 찾는 '매스톤(Maththon)'이 열린다. 1편에서 다룬 '질문 고르기'와 이 글의 '소화'가 여기서 만난다. 좋은 해설 문제를 고르는 것 자체가 새로운 종류의 좋은 질문이다.
10-5. 형식화를 소화의 도구로 — 블루프린트
리퀴드 텐서 실험 이후 Lean 프로젝트들은 블루프린트(blueprint) 를 쓴다. 패트릭 마소가 2020년 구 뒤집기(sphere eversion) 형식화 프로젝트를 위해 만든 도구로, 사람이 읽는 증명 개요를 보조정리 단위로 쪼개고 각 보조정리의 의존 관계와 형식화 진척을 그래프로 보여 준다. 이 글 실험의 '지도' 문체가 바로 블루프린트의 자연어판이다. 흥미로운 역할 반전도 있다. Math Inc의 Gauss가 2025년 9월 강한 소수 정리를 3주 만에 2만 5천 줄의 Lean으로 형식화했을 때, 저장소 설명에 따르면 높은 수준의 블루프린트는 사람이 줬다. 사람이 소화하고 기계가 검증한 것이다. 2026년의 에르되시 #1196은 순서가 반대였다. 기계가 생성하고, 기계(Gauss)가 검증하고, 사람 8명이 소화했다.
10-6. 해설의 질을 재는 벤치마크
정답 여부 너머의 증명 품질을 재려는 시도도 나왔다. ETH 취리히 팀의 ProofRank(arXiv 2605.10379, 2026년 5월)는 증명이 "명료하고, 간결하고, 통찰을 주고, 옮겨 쓸 수 있어야" 한다며 간결성, 계산 부담, 인지적 단순성 같은 지표를 제안했다. 저자들은 품질 지표와 정답률 사이에 상당한 상충 관계가 있다고 보고했다. 다만 경시 문제 기반이라 연구 수준 증명의 소화와는 거리가 있다. 채점하는 쪽의 한계도 알려져 있다. 2025년 「Proof or Bluff」 연구에서는 LLM 채점자가 USAMO 풀이 점수를 사람 전문가보다 최대 20배 부풀렸다. 딥마인드의 IMO-Bench에서는 기준 답 없이 채점하는 과제의 정확도가 가장 좋은 모델도 54%였다. 이 글의 채점을 기준 카드(모범 답과 만점 요소)에 묶어 둔 이유다.
10-7. 규범 — 사람이 직관을 발명할 책임
규범 차원의 제안도 있다. 2026년 6월 2일 국제수학연맹(IMU)이 지지한 「AI와 수학에 관한 라이덴 선언」은 공개·검증·인간의 책임을 권고했다. 9월 11일에는 필즈상 수상자 25명이 「수학에서 AI의 심각한 불일치」 선언을 냈다(코어닷투데이 특집 「AI와 수학의 심각한 불일치」 참고). 선언은 해답이 "제대로 된 정리, 새로운 방법과 아이디어의 추출, 다른 사람의 선행 연구 인용을 할 시간도 없이" 서둘러 발표된다고 지적했다. 8월 말 arXiv에 올라온 볼트(Boldt)의 논문(CC0)은 한 문장으로 요약할 수 있다. "LLM이 얻은 결과는 이해하기 어려울 수 있으므로, 사람 저자에게는 직관적인 설명을 발명할 책임이 있다."
11장. 그래서 AI에게 해설을 시킨다면 — 코어닷투데이의 처방
이 실험은 작고 독자는 사람이 아니었다. 그래도 증명뿐 아니라 AI가 만든 긴 산출물, 이를테면 코드 변경, 분석 보고서, 법률 검토를 사람이 '소화'해야 하는 모든 자리에 옮겨 쓸 만한 교훈이 있다. 코어닷투데이가 내부에서 쓰기로 한 원칙 여섯 가지다.
1
"쉽게 써 줘"라고 하지 않는다
블렌더 해설은 단계를 잘 나열하게 해 줬지만 고비를 지웠고, 전이·예시 문항에서는 원문보다도 약했다. 요청은 '쉽게'가 아니라 '어디가 어려운지 표시해 줘'여야 한다.
2
지도를 먼저 요구한다
핵심 아이디어 → 뼈대와 의존 관계 → 고비와 그 이유 → 가정이 쓰이는 곳 → 세부. 이 순서 하나로 고비 점수가 블렌더보다 0.29 높아졌다. 서스턴, 레론, 램포트, 블루프린트가 수십 년 권해 온 순서다.
3
이해용 해설과 검증용 읽기를 분리한다
지도와 강연은 이해를 돕지만 그 속에 섞인 오류는 덜 보이게 했다. 맞는지 확인하는 일은 해설이 아니라 원문이나 형식 검증, 줄 단위 검토로 따로 한다.
4
"이해했나요?"라고 묻지 않는다
자기 평가의 96%가 9점 이상이었고 문체 차이를 전혀 반영하지 못했다. 대신 전이("이 조건을 빼면 어디가 깨지나")와 예시("가장 작은 경우로 이 단계를 확인해 보라") 질문을 던진다. 타오의 강연 경험칙을 시험으로 바꾼 것이다.
5
길이로 성의를 재지 않는다
두 배 긴 해설이 이해를 더 주지 않았다. 블렌더에서는 더 긴 쪽이 고비를 더 묻었다. 짧게 쓰는 데 시간이 더 든다(파스칼).
6
검토자는 해설보다 중요하다
오류 적중률은 문체보다 독자에 따라 훨씬 크게 갈렸다(최상위 모델 60~80%, 작은 모델 둘은 0~10%). 소화의 마지막 칸에는 결국 실력 있는 독자가 앉아야 한다.
참고로 이 실험에서 가장 좋은 점수를 낸 '지도' 해설 요청문은 이렇다. 증명이 아닌 다른 산출물에도 낱말만 바꿔 쓸 수 있다.
지도 해설 요청문 (실험에 쓴 그대로)
지시위 증명의 해설을 쓰세요. 다음 순서를 지키세요. ① 핵심 아이디어를 두세 문장으로. ② 증명의 뼈대: 보조정리·단계를 번호로 나열하고 각 단계가 어느 단계에 기대는지 밝히기. ③ 가장 어려운 고비가 어디이고 왜 거기서 풀리는지. ④ 문제의 각 가정이 어디서 쓰이는지. ⑤ 마지막으로 세부 증명.
조건원 증명과 같은 논증을 따라가세요(다른 풀이로 바꾸지 마세요). 원 증명에 없는 새 주장을 덧붙이지 말고, 수학적으로 정확해야 합니다.
확인 질문(읽은 뒤)이 조건을 빼면 어느 단계가 어떻게 깨지나요? 가장 작은 경우 하나로 고비 단계를 직접 확인해 보세요.
마지막 줄의 확인 질문이 중요하다. 해설은 소화를 대신하지 않는다. 해설이 할 수 있는 최선은 독자가 씹어야 할 곳을 정확히 가리키는 것이고, 씹는 일은 독자의 몫이다.
용어 사전
용어
뜻
증명 생성 / 검증 / 소화
타오의 세 칸(2026년 4월). 해답 찾기 / 해답이 맞는지 확인하기 / 해답의 본질을 이해하고 맥락에 놓고 설명하고 다른 문제로 넓히기
증명 소화불량(proof indigestion)
생성·검증은 빨라졌는데 소화가 따라가지 못해, 검증까지 됐지만 아무도 이해하지 못한 증명이 쌓이는 현상(타오, 2026년 5월)
임피던스 불일치
원래 전기 회로에서 신호가 잘 전달되지 않는 상태. 타오는 생성·검증 속도와 소화 속도가 맞지 않는 상황을 이렇게 불렀다
open (Lean)
에르되시 문제 커뮤니티 DB의 상태 표시. Lean 형식 해답은 있지만 사람이 아직 소화하지 않아 비형식적으로는 열린 문제(2026년 7월 도입)
Lean
수학 증명을 컴퓨터가 한 단계씩 검사하도록 쓰는 증명 보조기이자 프로그래밍 언어. 수학 라이브러리 Mathlib과 함께 쓰인다
형식화 / 비형식화
사람의 증명을 Lean 같은 형식 언어로 옮기기 / 형식 증명을 사람이 읽는 자연어 증명으로 옮기기
블루프린트
형식화 프로젝트에서 쓰는, 사람이 읽는 증명 개요. 보조정리 단위로 쪼개 의존 관계와 진척을 그래프로 보여 준다(마소, 2020)
정전화(canonicalization)
증명이 다듬어지고 단순해져 교과서의 표준 증명이 되는 단계. 타오의 다섯 단계 중 마지막
강연 경험칙
소화가 일어났는지는 그 증명을 연구 강연에서 발표하고 후속 질문에 지적으로 답할 수 있는지로 판단한다는 타오의 기준
증명 이해 평가 모델
메히아라모스 등(2012)의 일곱 차원: 용어의 뜻, 논리적 지위, 정당화, 요약, 모듈 구조, 전이, 예시
구조화 증명
큰 단계부터 보여 주고 세부를 아래 층에 넣는 증명 서술 방식(레론 1983, 램포트 1993)
자기 설명
증명을 읽으며 한 줄마다 그 줄을 앞의 아이디어로 설명해 보는 읽기 전략. 단순한 말 바꾸기나 "알겠다"는 확인과 구별된다
설명 깊이의 착각
사람들이 어떤 것의 작동 원리를 실제보다 훨씬 잘 안다고 느끼는 현상(로젠블릿·카일 2002)
바람직한 어려움
훈련 중에는 수행을 떨어뜨리지만 장기 학습은 높이는 어려움(비요크 1994)
눈먼 독자
이 글의 실험에서 원 증명을 보지 않고 해설만 읽고 시험을 치른 모델 독자
고비(crux)
증명에서 가장 어렵고 결정적인 단계. 이 실험에서 문체 차이가 가장 크게 드러난 항목
적중률 / 경보율
오류 판에서 심은 오류를 정확히 짚은 비율 / 깨끗한 판에서 '오류 있음'이라고 답한 비율
sunny(양지) 직선
IMO 2025 1번의 용어. x축, y축, x + y = 0 어느 것과도 평행하지 않은 직선
bonza 함수
IMO 2025 3번의 용어. 모든 양의 정수 a, b에 대해 f(a)가 bᵃ − f(b)^f(a)를 나누는 함수
타오의 요리 비유로 돌아가 보자. 기계는 이제 식재료를 엄청나게 잘 모은다(생성). 씻고 검수하는 일도 Lean이라는 정밀한 기계가 맡는다(검증). 남은 것은 조리, 곧 소화다. 이번 실험은 조리도 기계가 꽤 잘한다는 것을 보여 줬다. 해설자 두 모델은 원 증명에 충실했고, 틀린 말을 하지 않았고, 원문이 건너뛴 정당화를 메웠다.
그런데 어떻게 조리하라고 시키느냐에 따라 결과가 달랐다. "누구나 술술 먹을 수 있게" 갈아 달라고 하면, 독자는 많이 먹었다고 느끼면서도 무엇이 핵심 재료였는지 몰랐다. "무엇이 핵심 재료이고 어디가 질긴지" 먼저 보여 달라고 하면 독자는 그곳을 짚었다. 그리고 어떤 경우에도 독자는 자기가 다 소화했다고 믿었다.
타오가 소화의 기준을 '이해했다는 느낌'이 아니라 '강연과 질의응답'으로 잡은 것은 그래서 옳다. 에르되시 사이트가 상태 표시를 내리고 해설을 앞세운 것도, 우선권을 해설 공개일에 묶자는 제안도 같은 방향이다. 소화는 결과물이 아니라 사람에게 일어나는 사건이다. AI는 그 사건이 일어나기 좋은 곳으로 독자를 데려다줄 수 있다. 씹는 일까지 대신하게 하면, 우리는 급식관으로 영양을 공급받는 셈이 된다.
다음 편 「수학의 두 문화」에서는 이 이야기의 뿌리로 내려간다. 1993년 재프와 퀸이 '이론 수학'을 경고하고, 1994년 서스턴이 답하고, 2000년 고워스가 '수학의 두 문화'를 쓴 논쟁이다. 증명이 이해를 위한 것인지, 이해가 증명을 위한 것인지에 대한 30년 묵은 질문이 2026년에 왜 다시 급해졌는지 정독한다.
E. Davis & G. Marcus, "DeepMind and OpenAI achieve IMO Gold. What does it all mean?" (2025-07-22)
M. Abouzaid, N. Srivastava, R. Ward, L. Williams 편, "First Proof Second Batch", arXiv 2606.18119 (2026, CC BY 4.0)
Proofs and Prompts, "100+ reactions to 100+ solutions" (2026-10-08~19)
역사적 사례
T. Hales 외, "A formal proof of the Kepler conjecture", arXiv 1501.02155 / Forum of Mathematics, Pi (2017)
P. Scholze, "Liquid Tensor Experiment"(2020-12-05), "Half a year of the Liquid Tensor Experiment: Amazing developments"(2021-06-05), Xena 블로그
V. Voevodsky, "The Origins and Motivations of Univalent Foundations", The Institute Letter (IAS, 2014년 여름)
E. Klarreich, "Titans of Mathematics Clash Over Epic Proof of ABC Conjecture", Quanta Magazine (2018-09-20)
증명 이해와 인지과학
W. Thurston, "On proof and progress in mathematics", Bull. AMS 30(2) (1994)
J. P. Mejía-Ramos, E. Fuller, K. Weber, K. Rhoads, A. Samkoff, "An assessment model for proof comprehension in undergraduate mathematics", Educational Studies in Mathematics 79(1) 3–18 (2012)
E. Fuller 외, "Comprehending structured proofs", International Journal for Studies in Mathematics Education 7(1) (2014)
K. Weber & J. P. Mejía-Ramos, "Why and how mathematicians read proofs: an exploratory study", Educational Studies in Mathematics 76(3) (2011)
M. Inglis & L. Alcock, "Expert and novice approaches to reading mathematical proofs", JRME 43(4) (2012)
M. Hodds, L. Alcock, M. Inglis, "Self-explanation training improves proof comprehension", JRME 45(1) 62–101 (2014)
L. Lamport, "How to write a proof", Amer. Math. Monthly 102(7) (1995); "How to write a 21st century proof", J. Fixed Point Theory Appl. 11 (2012)
L. Rozenblit & F. Keil, "The misunderstood limits of folk science: an illusion of explanatory depth", Cognitive Science 26(5) (2002)
R. A. Bjork, "Memory and metamemory considerations in the training of human beings" (1994)
L. Deslauriers 외, "Measuring actual learning versus feeling of learning in response to being actively engaged in the classroom", PNAS 116(39) (2019)
H. Bastani 외, "Generative AI without guardrails can harm learning: Evidence from high school mathematics", PNAS 122(26) (2025)
M. Steyvers 외, "What large language models know and what people think they know", Nature Machine Intelligence 7 (2025)
해설·채점 벤치마크와 규범
I. Petrov 외, "Proof or Bluff? Evaluating LLMs on 2025 USA Math Olympiad", arXiv 2503.21934
T. Luong 외, "Towards Robust Mathematical Reasoning"(IMO-Bench), arXiv 2511.01846
I. Petrov 외, "Not All Proofs Are Equal"(ProofRank), arXiv 2605.10379 (2026)
Boldt, "Explanations, Prompts, and Formalizations: Arguments for New Norms in LLM-Enabled Mathematical Research", arXiv 2608.29401 (2026)
"A Severe Misalignment of AI in Mathematics", 필즈상 수상자 25인 성명(2026-09-11), https://mathandai.org
Leiden Declaration on AI and Mathematics (2026-06-02)
이 글의 실험: 기준 카드·채점·오류 심기·충실도 감사 Claude Opus 5.5, 해설 Claude Sonnet 5.5·Gemini 4 Argon, 직역 Gemini 2.5 Pro, 독자 Gemini 3.1 Flash-Lite·Gemini 3.5 Flash·Qwen3.5 9B(로컬), 오류 찾기 심사위원 역 Claude Opus 5.5. 2026년 10월 24일 실행. 모델 호출은 코어닷투데이 LLM 게이트웨이와 로컬 Ollama로 했다.