Manim3Blue1BrownTheoremExplainAgentCode2VideoAI 에이전트수학 교육설명 영상멀티미디어 학습수학과 AI
[특집] 기계가 해설자가 될 때 — Manim 해설 에이전트의 1년 반, 그리고 정리 10개를 직접 영상으로 만들어 보다
3Blue1Brown의 그랜트 샌더슨은 해설 영상을 만들려고 Manim을 직접 만들었다. 2025년 TheoremExplainAgent 이후 LLM이 Manim 코드를 써서 정리 해설 영상을 만드는 연구가 이어졌다. Manim의 구조와 역사, 애니메이션 학습 연구의 미지근한 숫자, TheoremExplainAgent와 Code2Video·OmniManim·ManimAgent까지 정리했다. 그리고 정리 10개를 Claude 세 모델과 로컬 Qwen에게 맡겨 영상 80편을 직접 만들고 렌더 성공률, 오류 원인, 배치와 수학 오류, 화면을 보고 고치기의 효과를 쟀다.
2026년 10월 16일, 3Blue1Brown의 그랜트 샌더슨은 「수학을 하기에 지금보다 좋은 때는 없었다」라는 40분짜리 영상을 올렸다. 코어닷투데이는 그 영상을 다룬 특집에서 영상의 결론을 이렇게 요약했다. AI가 증명을 쏟아낼수록 병목은 증명이 아니라 해설(exposition)로 옮겨 간다. 샌더슨이 한 달 전 테렌스 타오의 블로그에 객원으로 쓴 글의 표현을 빌리면, "모든 AI 생성 증명은 풀리지 않은 해설 문제로 태어난다."
마지막 5편은 샌더슨 자신의 일로 돌아간다. 그는 해설 영상을 만들려고 Manim이라는 파이썬 애니메이션 엔진을 직접 만들었다. 화면의 모든 원과 화살표와 수식이 코드 몇 줄에서 나온다. 그렇다면 코드를 잘 쓰는 기계는 해설 영상도 만들 수 있지 않을까? 2025년 2월 캐나다 워털루 대학의 TIGER 연구실은 정확히 그 질문을 던진 논문 TheoremExplainAgent를 냈다. 정리 이름 하나를 넣으면 기획 에이전트가 장면을 짜고, 코딩 에이전트가 Manim 코드를 쓰고, 렌더러가 5분짜리 영상을 뽑는다. 그 뒤 1년 반 동안 Code2Video, TeachMaster, OmniManim, ManimAgent 같은 후속 연구가 쏟아졌고, 바이두는 하루 100만 편을 만든다고 주장하는 시스템을 KDD에 발표했다.
해설 영상은 왜 코드로 만드나? Manim은 어떻게 생겼고, 움직이는 그림은 정말 배움을 돕나? 학습 과학의 답은 생각보다 미지근하다.
해설 에이전트는 어떻게 생겼고, 어디서 깨지나? TheoremExplainAgent를 표와 그림까지 정독하고, 2026년 10월까지의 후속 연구를 정리한다.
지금 직접 돌리면 어떻게 되나? 이것은 직접 쟀다. 털난 공 정리부터 칸토어의 대각선 논법까지 정리 10개를 Claude 세 모델과 로컬 Qwen에게 맡겨 스토리보드를 짜고 Manim 코드를 쓰게 했다. 렌더가 깨지면 오류를 돌려줘 고치게 하고, 렌더가 되면 자동 겹침 검사기와 비전 모델로 화면을 검토해 한 번 더 고치게 했다. 실제로 나온 영상도 붙였다.
위젯은 다섯 개다. Manim의 구조를 직접 조립해 보는 장면 조립대, TheoremExplainAgent를 단계별로 뜯어보는 해부도, 기계의 눈으로 화면 겹침을 재 보는 겹침 검출기, 실제 오류 코드를 보고 원인을 맞혀 보는 오류 퀴즈, 그리고 실측 결과와 영상을 한곳에서 뒤져 보는 실측 탐색기다.
1장. 해설을 코드로 그린다는 것
1-1. 부업으로 시작한 엔진
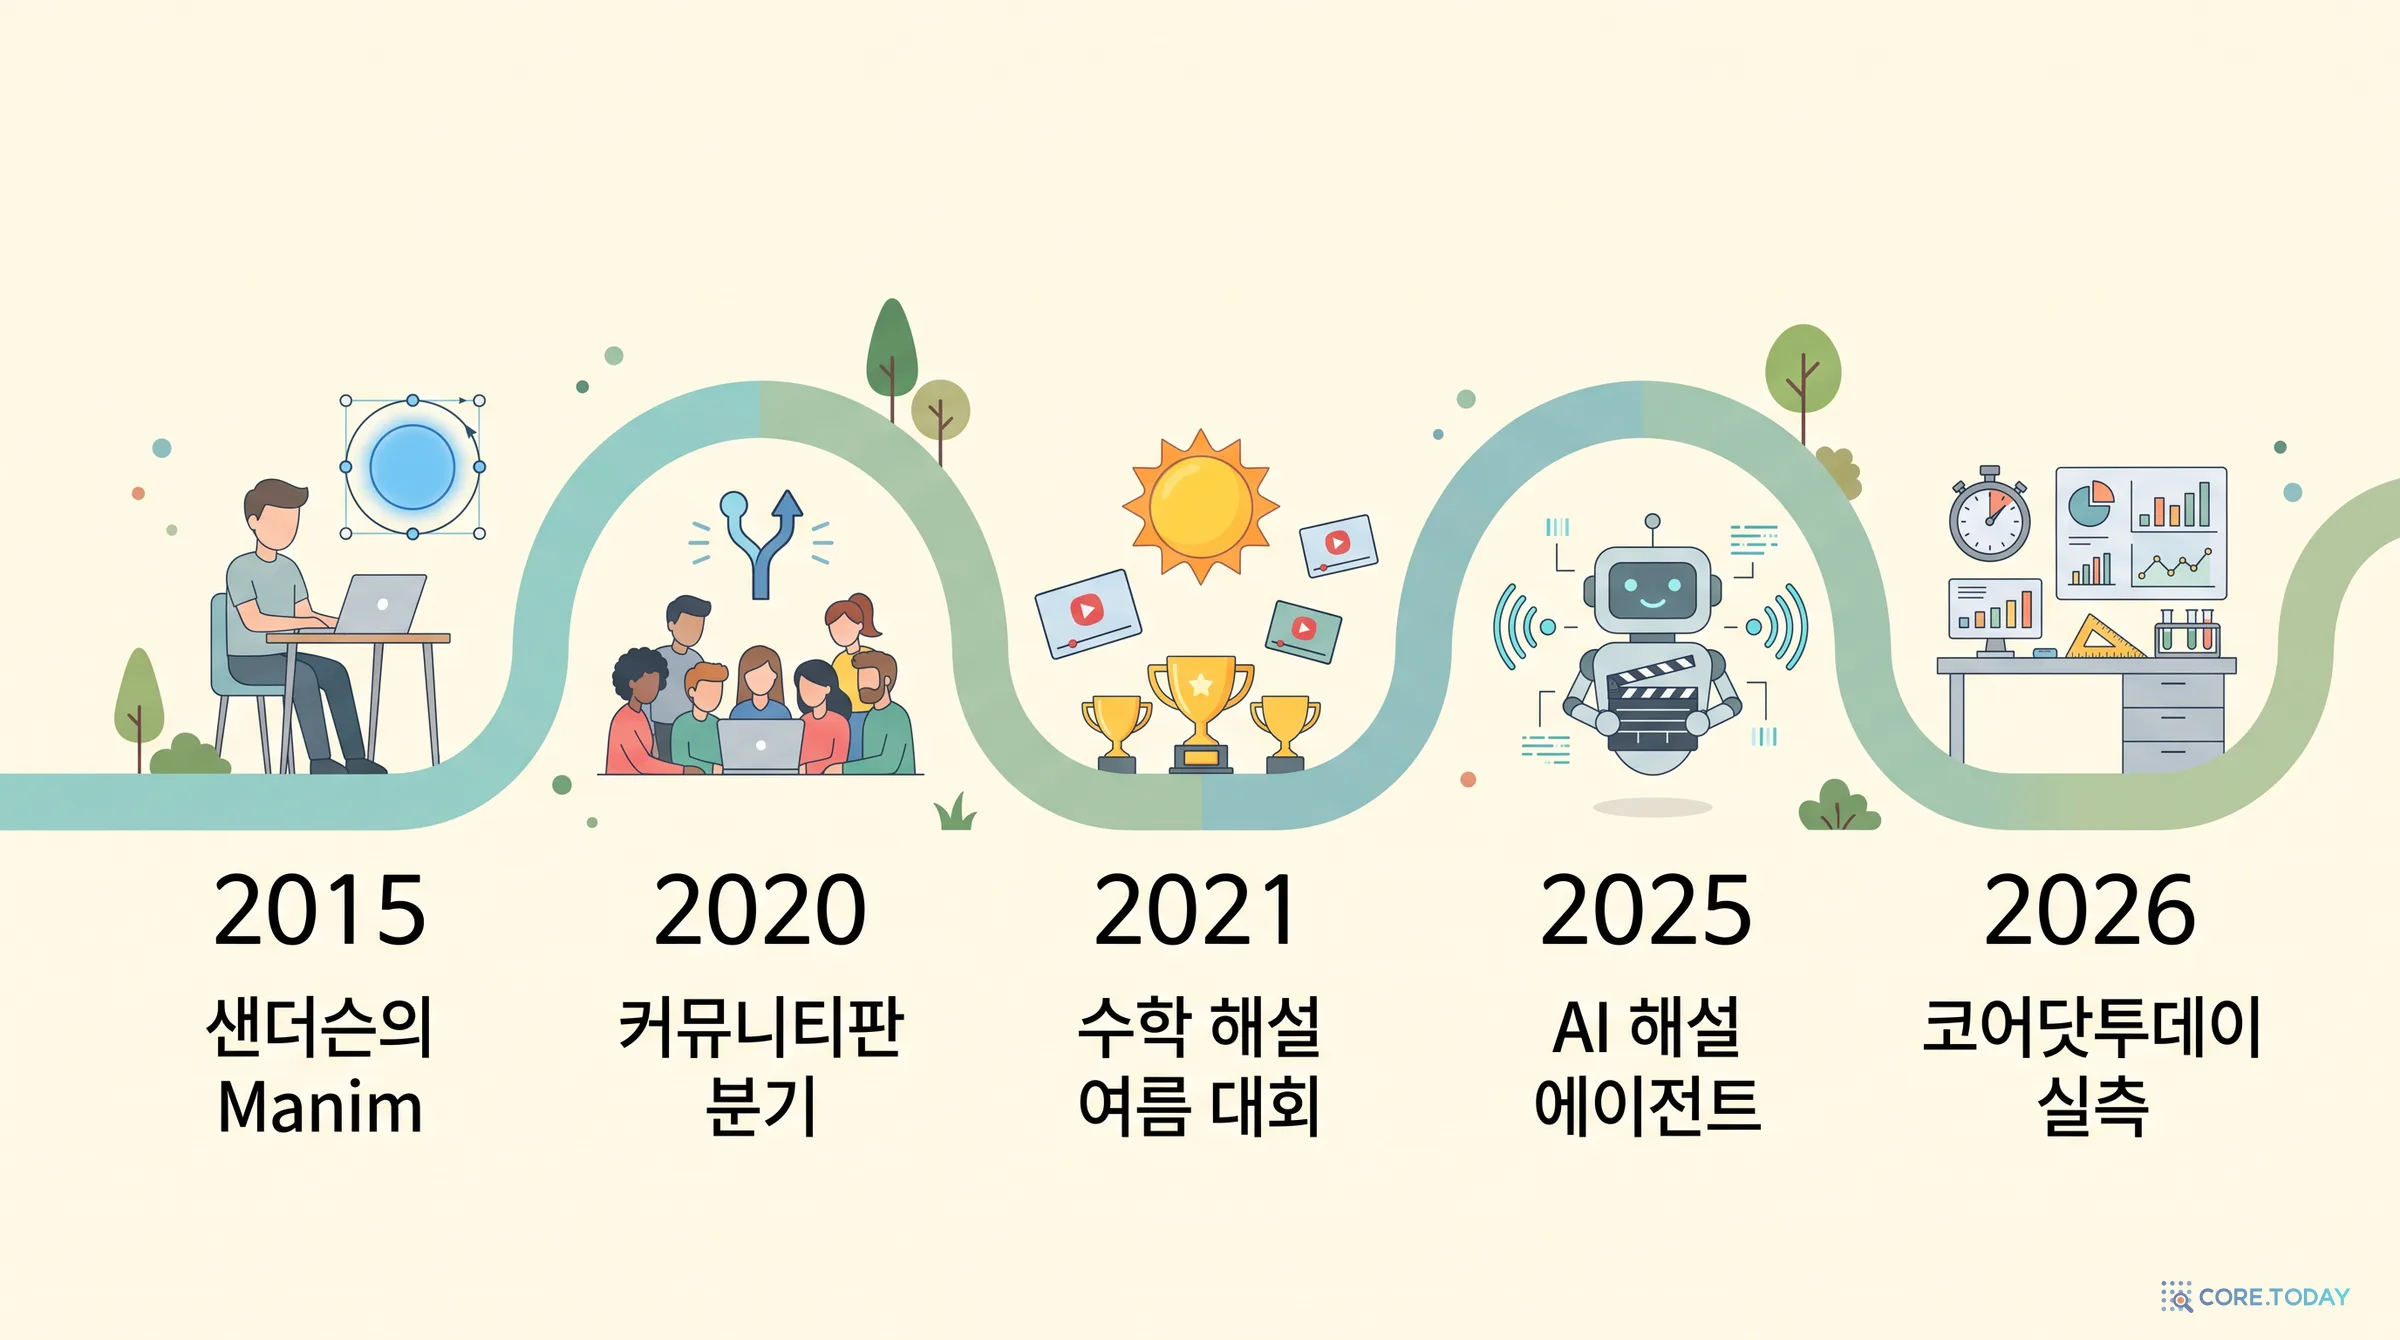
3b1b/manim 저장소가 깃허브에 만들어진 날은 2015년 3월 22일이다. 3Blue1Brown 홈페이지의 자주 묻는 질문(FAQ)에 따르면 영상도 Manim도 샌더슨이 스탠퍼드에서 수학과 컴퓨터 과학 공부를 마무리하던 무렵의 부업으로 시작했다. 그는 졸업 뒤 칸 아카데미에서 다변수 미적분 영상과 글을 만들다가 2016년 말부터 3Blue1Brown에만 전념했다. 그 사이 Manim은 계속 자랐다. FAQ에서 그는 처음의 Manim을 "엉성한 코드 놀이터"였다고 부르고, 공개 도구로 만들 생각이 없었다고 말한다.
왜 굳이 애니메이션을 코드로 그렸을까? 애프터 이펙트 같은 영상 편집 도구로도 원과 화살표는 움직일 수 있다. 코드에는 세 가지 장점이 있다.
코드로 그리면
구체적으로
수학 해설에서 중요한 이유
정확하다
점 (1, 2)는 정말 (1, 2)에 찍히고, 접선은 정말 접한다
그림이 곧 주장이다. 비스듬한 직각은 틀린 설명이 된다
매개변수로 바뀐다
숫자 하나를 바꾸면 그래프 전체가 다시 그려진다
'n이 커지면 어떻게 되나'를 보여 주는 것이 해설의 절반이다
수식이 변신한다
LaTeX 수식의 각 기호가 객체라서, 한 식이 다음 식으로 모양을 바꾸며 넘어간다
유도의 '어느 항이 어디로 갔는지'를 눈으로 따라갈 수 있다
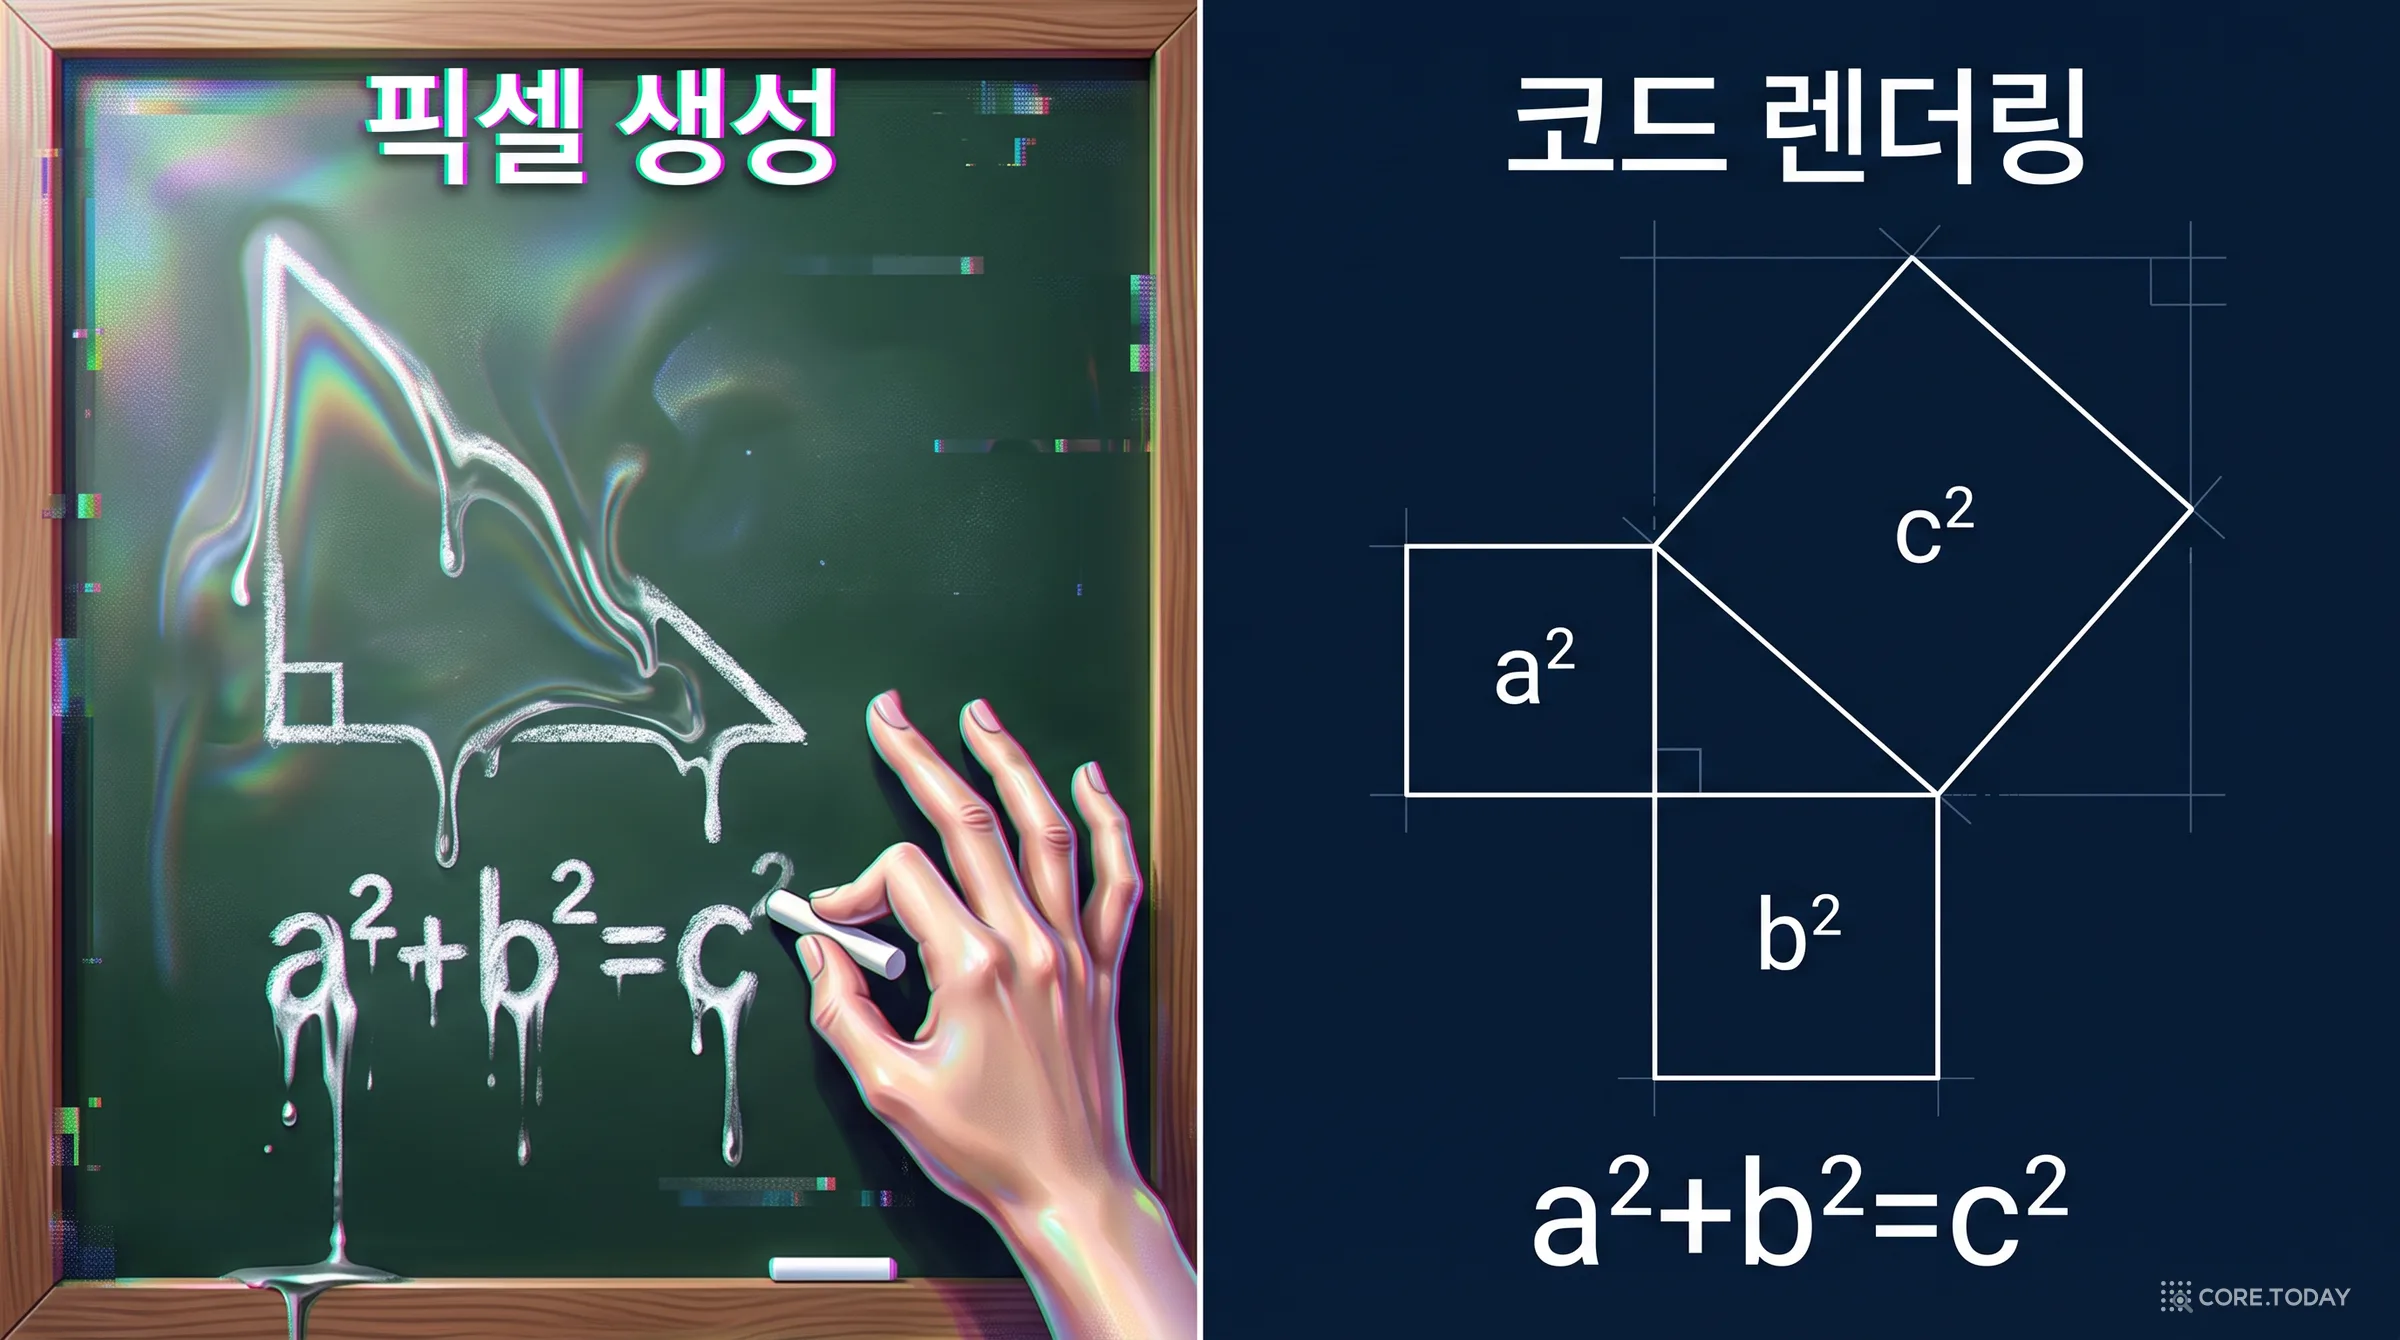
이 세 가지는 2026년의 동영상 생성 AI가 여전히 가장 못 하는 일이기도 하다. 소라나 비오 같은 픽셀 생성 모델은 그럴듯한 칠판을 그리지만, 그 위의 삼각형이 정말 직각인지, 수식의 지수가 제자리에 있는지는 보장하지 못한다. 반면 코드로 렌더한 화면은 틀리더라도 코드가 틀린 만큼만 틀린다. 그래서 2025~2026년의 해설 영상 연구는 거의 예외 없이 "모델이 영상을 직접 그리게 하지 말고 코드를 쓰게 하자"는 쪽을 택했다. 5장에서 숫자로 확인한다.
그런데 샌더슨은 영상을 만드는 시간의 대부분이 그림에 들어간다는 통념에 반대한다. 2026년 6월 드와르케시 파텔의 팟캐스트에서 그는 많은 사람이 영상 시간의 대부분이 시각 자료에 들어간다고 짐작하지만, 상당 부분은 애초에 무엇이 말할 가치가 있는지 정하는 데 든다고 말했다. 이 말은 이 글 끝까지 기억해 둘 만하다. 해설 에이전트가 자동화하는 것은 주로 '그리기'인데, 샌더슨이 말하는 본업은 '고르기'다.
또 하나 기억할 것이 있다. 샌더슨은 FAQ에서 Manim을 "나중에 이어 붙일 개별 클립을 만드는 도구일 뿐"이라고 소개하고, "내레이션을 Manim 안에서 어떻게 맞추나요?" 같은 질문이 걱정스럽다고 썼다. 편집은 전통적인 영상 편집 프로그램에서 하라는 것이다. 4장에서 볼 TheoremExplainAgent는 정확히 그 반대로 간다. 음성을 Manim 장면 안에서 동기화하고, 장면들을 자동으로 이어 붙인다. 사람이 하던 편집까지 기계에 맡기려면 그럴 수밖에 없다.
1-2. 둘로 갈라진 Manim
개인 도구였던 탓에 초기 Manim은 다른 사람이 설치하고 쓰기가 매우 어려웠다. 2019년 말 샌더슨이 OpenGL 렌더링을 위한 '셰이더 브랜치' 작업을 시작했고, 2020년 중반 개발자 무리가 저장소를 갈라 Manim Community Edition(ManimCE)을 만들었다. 목표는 "더 안정적이고, 더 잘 테스트되고, 기여에 더 빨리 반응하고, 입문이 쉬운" 판이었다. 싸워서 갈라선 것이 아니다. 샌더슨 자신이 입문자에게 커뮤니티판을 권한다. 2021년 초 샌더슨은 셰이더 브랜치를 본류에 합쳤고, 그것이 지금의 ManimGL이 됐다.
20153b1b/manim 저장소 생성(3월 22일). 스탠퍼드 졸업 무렵의 부업. 처음엔 공개용 도구가 아니었다.
2019PyPI에 manimlib 첫 업로드(5월), 셰이더 브랜치 시작(연말). 그 전 판은 지금 'ManimCairo'라고 불린다.
2020커뮤니티판 분기. ManimCommunity/manim 저장소 5월 19일 생성, v0.1.0은 10월 21일.
2021ManimGL 탄생, 수학 해설 여름 대회(SoME1). 커뮤니티판은 v0.5.0(4월)에서 ShowCreation을 Create로 바꾸고, v0.6.0(5월)에서 TexMobject를 지웠다. 7월 시작한 SoME1에는 1,300편 넘는 작품이 몰렸다.
2025TheoremExplainAgent(2월), Code2Video(10월). 기계가 Manim 코드를 써서 해설 영상을 만드는 연구가 본격화.
2026ManimCE v0.22.0(10월 8일). 깃허브 별은 3b1b/manim 약 9만 5,600개, 커뮤니티판 약 4만 1,800개(10월 25일 기준). ManimGL의 마지막 PyPI 릴리스는 2024년 12월의 v1.7.2에 멈춰 있다.
Manim이 3Blue1Brown 한 채널의 도구를 넘어선 계기는 2021년 7월 샌더슨과 제임스 슐로스가 연 수학 해설 여름 대회(Summer of Math Exposition, SoME)였다. 상금은 다섯 작품에 1,000달러씩, 응모는 1,300편을 넘었다. 2022년 SoME2는 참가자끼리 작품을 둘씩 비교해 1차 순위를 매기는 동료 평가를 썼고, 대회는 2025년 SoME4, 2026년 SoME5로 이어졌다.
이 대회가 2026년에 내건 AI 정책은 이 글의 질문에 대한 샌더슨 쪽의 가장 직접적인 답이다. 샌더슨이 AI가 만든 Manim 영상에 대해 공개적으로 평가한 발언은 찾지 못했다. 대신 그가 주관하는 대회의 규칙이 있다.
허용
금지
브레인스토밍과 자료 조사
대본·내레이션 생성
애니메이션 코딩 보조와 디버깅
핵심 논증·증명·설명 생성
문법 교정
창작의 상당 부분인 다이어그램·애니메이션 생성, AI 음성
주로 AI가 만들고 사람이 살짝 손본 작품
정책 문서는 이렇게 못 박는다. "SoME는 누가 AI에게 가장 잘 프롬프트하는지 겨루는 대회가 아니다." 선은 누가 설명을 설계했느냐에 그어져 있다. Manim 코드를 짜는 손은 빌려도 되지만, 무엇을 어떤 순서로 보여 줄지는 사람이 정해야 한다. 이 기준으로 보면 정리 이름만 넣고 대본·애니메이션·목소리를 모두 기계가 만드는 TheoremExplainAgent식 영상은 SoME에 낼 수 없다. 그렇다면 그런 영상은 쓸모가 없나? 그 질문은 6장의 실측 뒤에 다시 하자.
2장. Manim 해부 — Scene, Mobject, Animation
해설 에이전트가 어디서 깨지는지 이해하려면 Manim이 어떻게 생겼는지부터 알아야 한다. 구조는 단순하다. 등장인물은 셋이다.
Scene (장면)무대이자 감독construct() 안에 각본을 쓴다. self.play()와 self.wait()가 시간을 흘린다
Animation (애니메이션)연기Create, Write, FadeIn, Transform, Rotate. 시작 상태에서 끝 상태까지 1초 동안 보간한다
가장 작은 Manim 영상은 이렇게 생겼다.
python
from manim import *
classPythagoras(Scene):
defconstruct(self):
tri = Polygon(ORIGIN, RIGHT * 3, RIGHT * 3 + UP * 2) # 직각삼각형 (Mobject)
eq = MathTex("a^2", "+", "b^2", "=", "c^2").to_edge(DOWN) # 수식 (Mobject)self.play(Create(tri)) # 선을 따라 그리기 (Animation, 1초)self.play(Write(eq)) # 손글씨처럼 쓰기self.play(tri.animate.shift(LEFT * 2)) # 위치 이동도 애니메이션이 된다self.wait(1) # 1초 멈춤
터미널에서 manim -ql pythagoras.py Pythagoras라고 치면 480p 초당 15프레임 영상이 나온다(-qh면 1080p). 몇 가지 규칙을 알아 두면 뒤의 실패 사례가 읽힌다.
좌표계. 화면 한가운데가 원점(ORIGIN)이고, 화면 높이는 8단위, 너비는 16:9 비율에 맞춘 약 14.22단위다. 그러니 x가 7.1을 넘거나 y가 4를 넘으면 화면 밖이다. UP, RIGHT는 길이 1짜리 방향 벡터다.
시간.self.play() 한 번이 기본 1초, self.wait(n)이 n초다. 영상의 길이는 이 둘을 더한 값이다. 기본 움직임 곡선은 천천히 출발해 천천히 멈추는 smooth다.
글자 세 종류.MathTex는 LaTeX 수식, Tex는 LaTeX 문단, Text는 LaTeX를 거치지 않는 일반 글꼴이다. 한글은 LaTeX 기본 설정으로는 조판되지 않으므로 Text("털난 공 정리", font="Apple SD Gothic Neo")처럼 써야 한다.
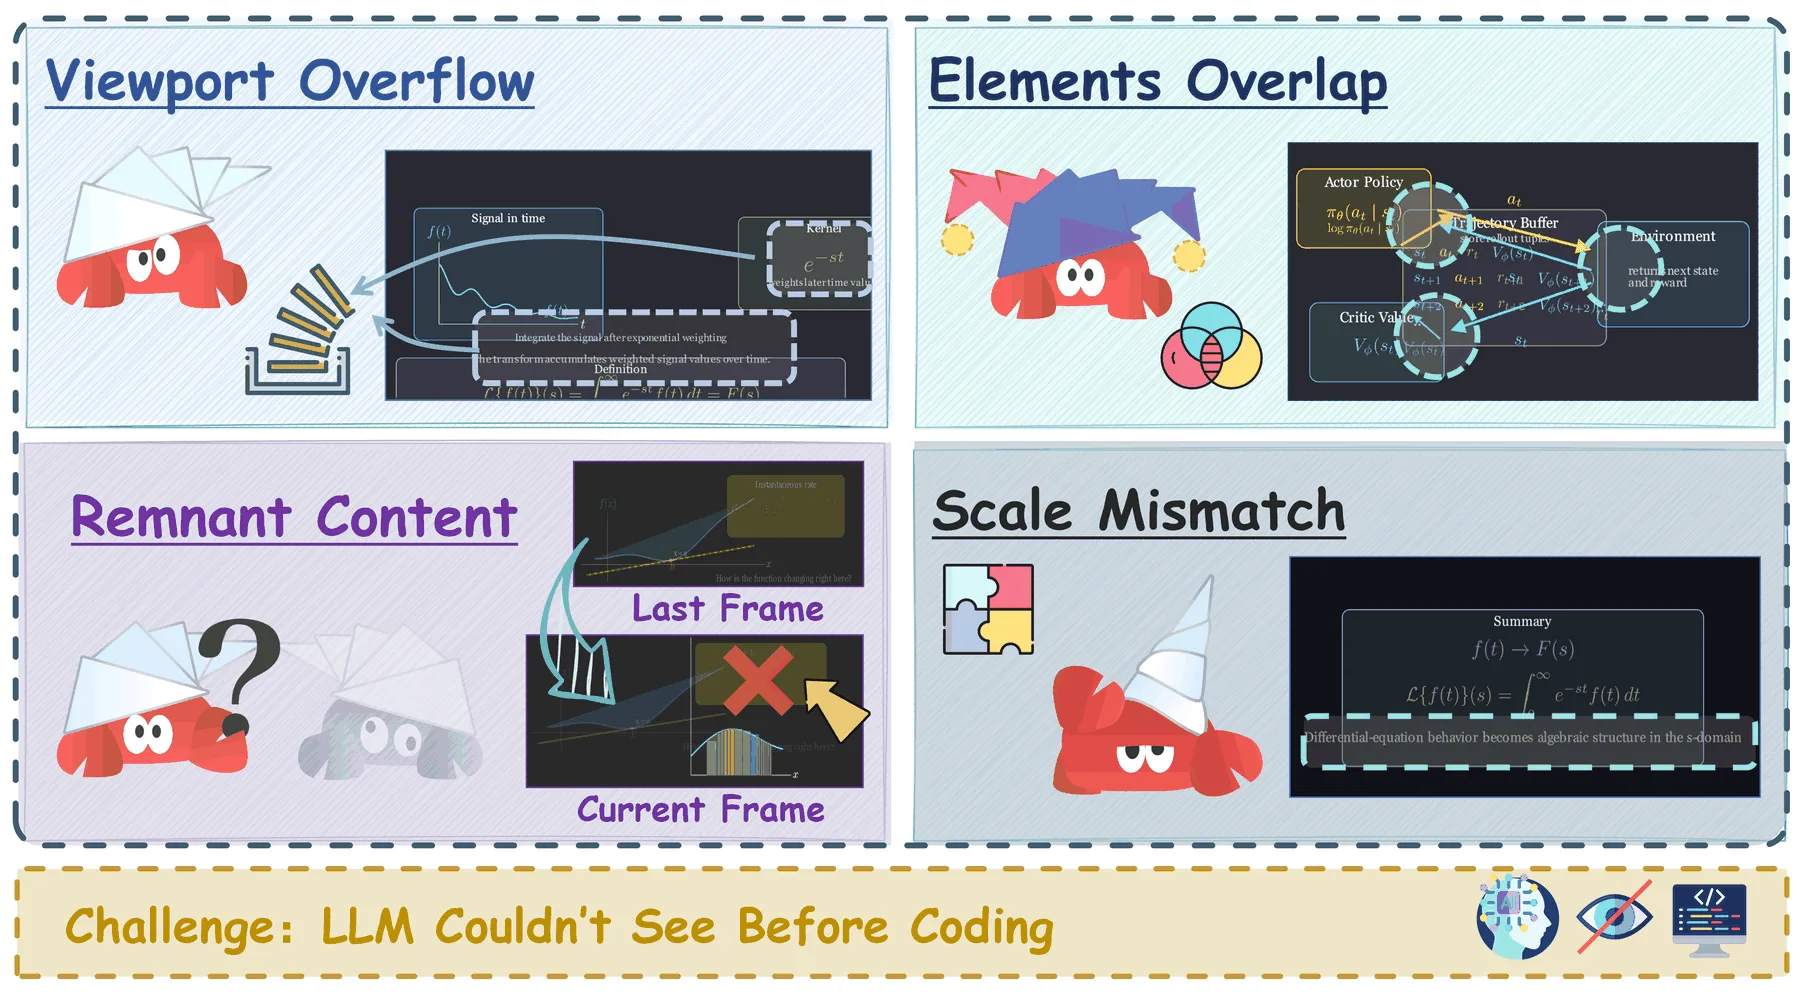
화면은 겹침을 알려 주지 않는다. 글자가 원 위에 겹쳐도, 수식이 화면 밖으로 나가도 Manim은 아무 오류 없이 렌더한다. 오류로 멈추는 것은 코드가 틀렸을 때뿐이다.
마지막 규칙이 이 글 후반의 주인공이다. 아래 장면 조립대에서 직접 단계를 쌓아 보자. "AI가 자주 하는 실수" 스위치를 켜면 세 가지 전형적인 실수가 어떻게 보이는지(혹은 보이지 않는지) 알 수 있다.
2-1. 같은 이름, 다른 뜻 — 기계가 헷갈리는 이유
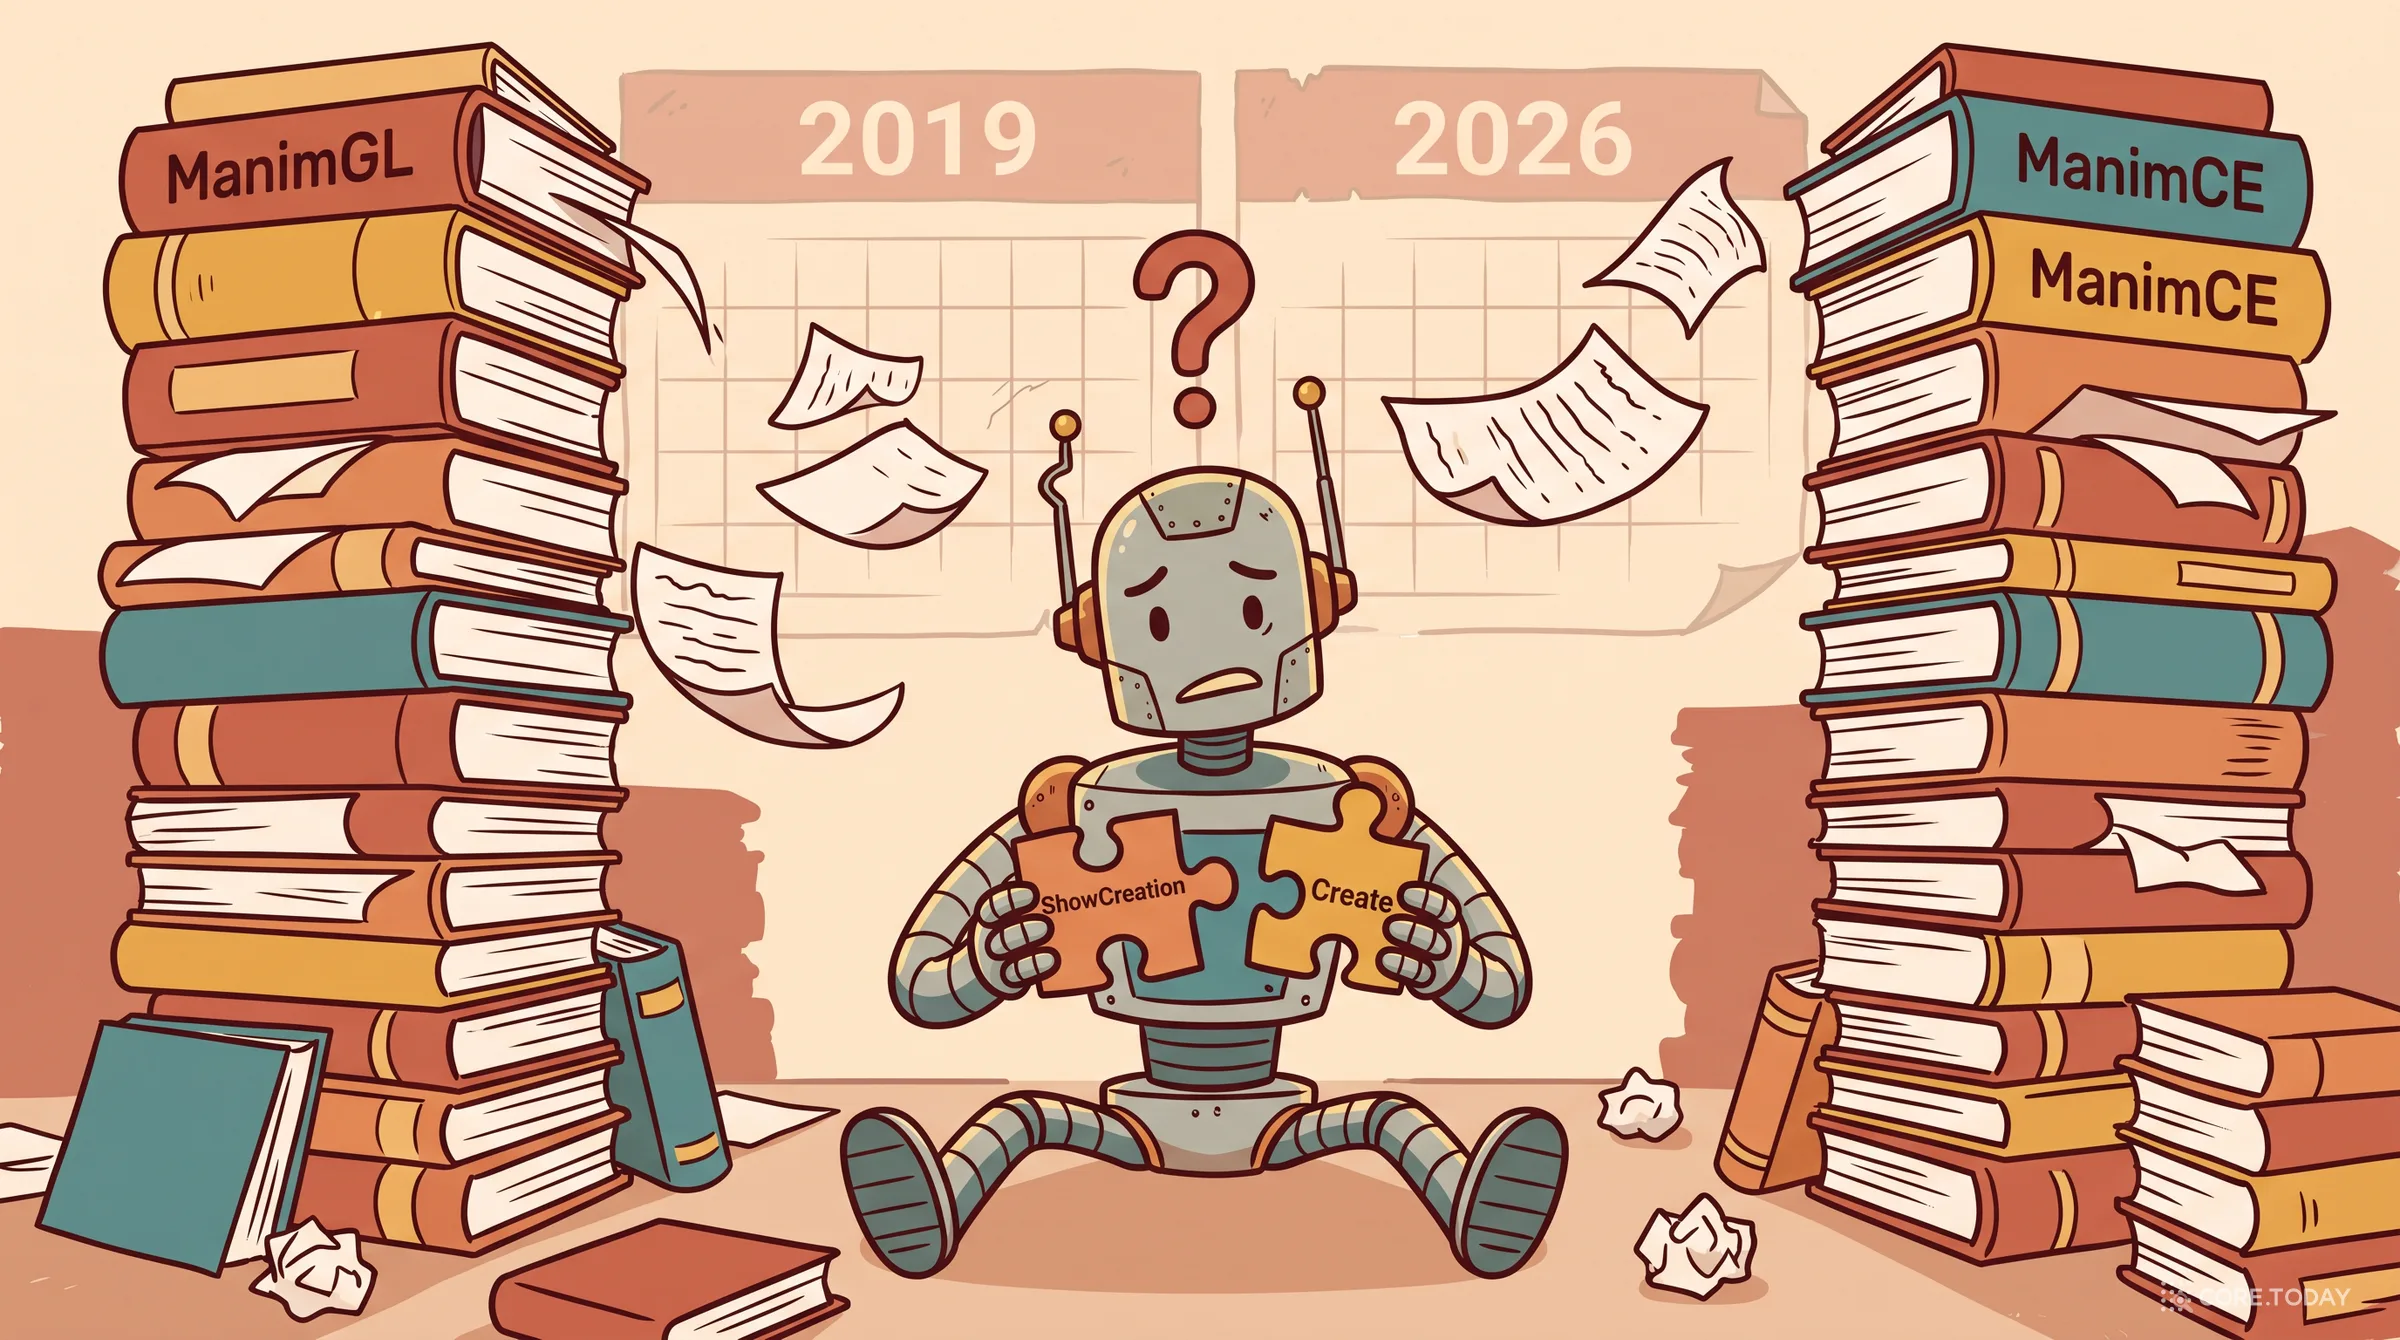
ManimGL과 ManimCE는 뿌리가 같아서 겉모습이 거의 같다. 둘 다 Scene, construct, self.play를 쓴다. 그런데 세부 이름이 조금씩 다르고, 몇몇은 같은 이름이 반대 뜻이다.
개념
ManimGL (샌더슨판)
ManimCE (커뮤니티판)
불러오기
from manimlib import *
from manim import *
선 따라 그리기
ShowCreation (지금도 현역)
Create (2021년 v0.5.0에서 개명)
LaTeX 수식
Tex
MathTex
LaTeX 문단
TexText
Tex
옛 이름
TexMobject·TextMobject (옛 Cairo판)
v0.6.0(2021년 5월)에서 완전 삭제
설정 방식
CONFIG 딕셔너리 관행
v0.2.0(2021년 1월)부터 생성자 인자
카메라 조작
self.frame.reorient()
없음 (MovingCameraScene 등 별도 클래스)
가장 고약한 것은 Tex다. ManimGL에서는 수식, ManimCE에서는 문단이다. ManimGL 코드를 보고 배운 모델이 ManimCE에서 Tex(r"\frac{a}{b}")라고 쓰면 수식이 문단 모드로 들어가 LaTeX 오류가 난다. 그리고 기계가 배운 인터넷에는 두 판의 코드가 섞여 있다. 3Blue1Brown 영상들의 실제 장면 코드를 모은 3b1b/videos 저장소(별 약 1만 1,400개)는 ManimGL이고, 블로그와 튜토리얼 대부분은 ManimCE다. 한 개발자가 3Blue1Brown 영상 12편을 문제로 삼아 만든 시험 세트 ManiBench(2026)는 두 판의 비호환 항목을 145개, 8가지 범주로 정리했다.
해설 에이전트 이야기로 가기 전에 불편한 질문 하나를 짚고 가자. 애니메이션 해설 영상은 정말 학습에 도움이 되나? 3Blue1Brown 영상을 보고 "아, 이제 알겠다"는 느낌을 받은 사람은 많다. 학습 과학은 그 느낌을 얼마나 믿어도 되는지에 대해 꽤 많은 자료를 쌓아 왔다. 결론부터 말하면 조건부로, 생각보다 작게 돕는다. 그리고 수학에서는 특히 미지근하다.
3-1. 눈과 귀, 그리고 좁은 작업 기억 — 메이어의 원리
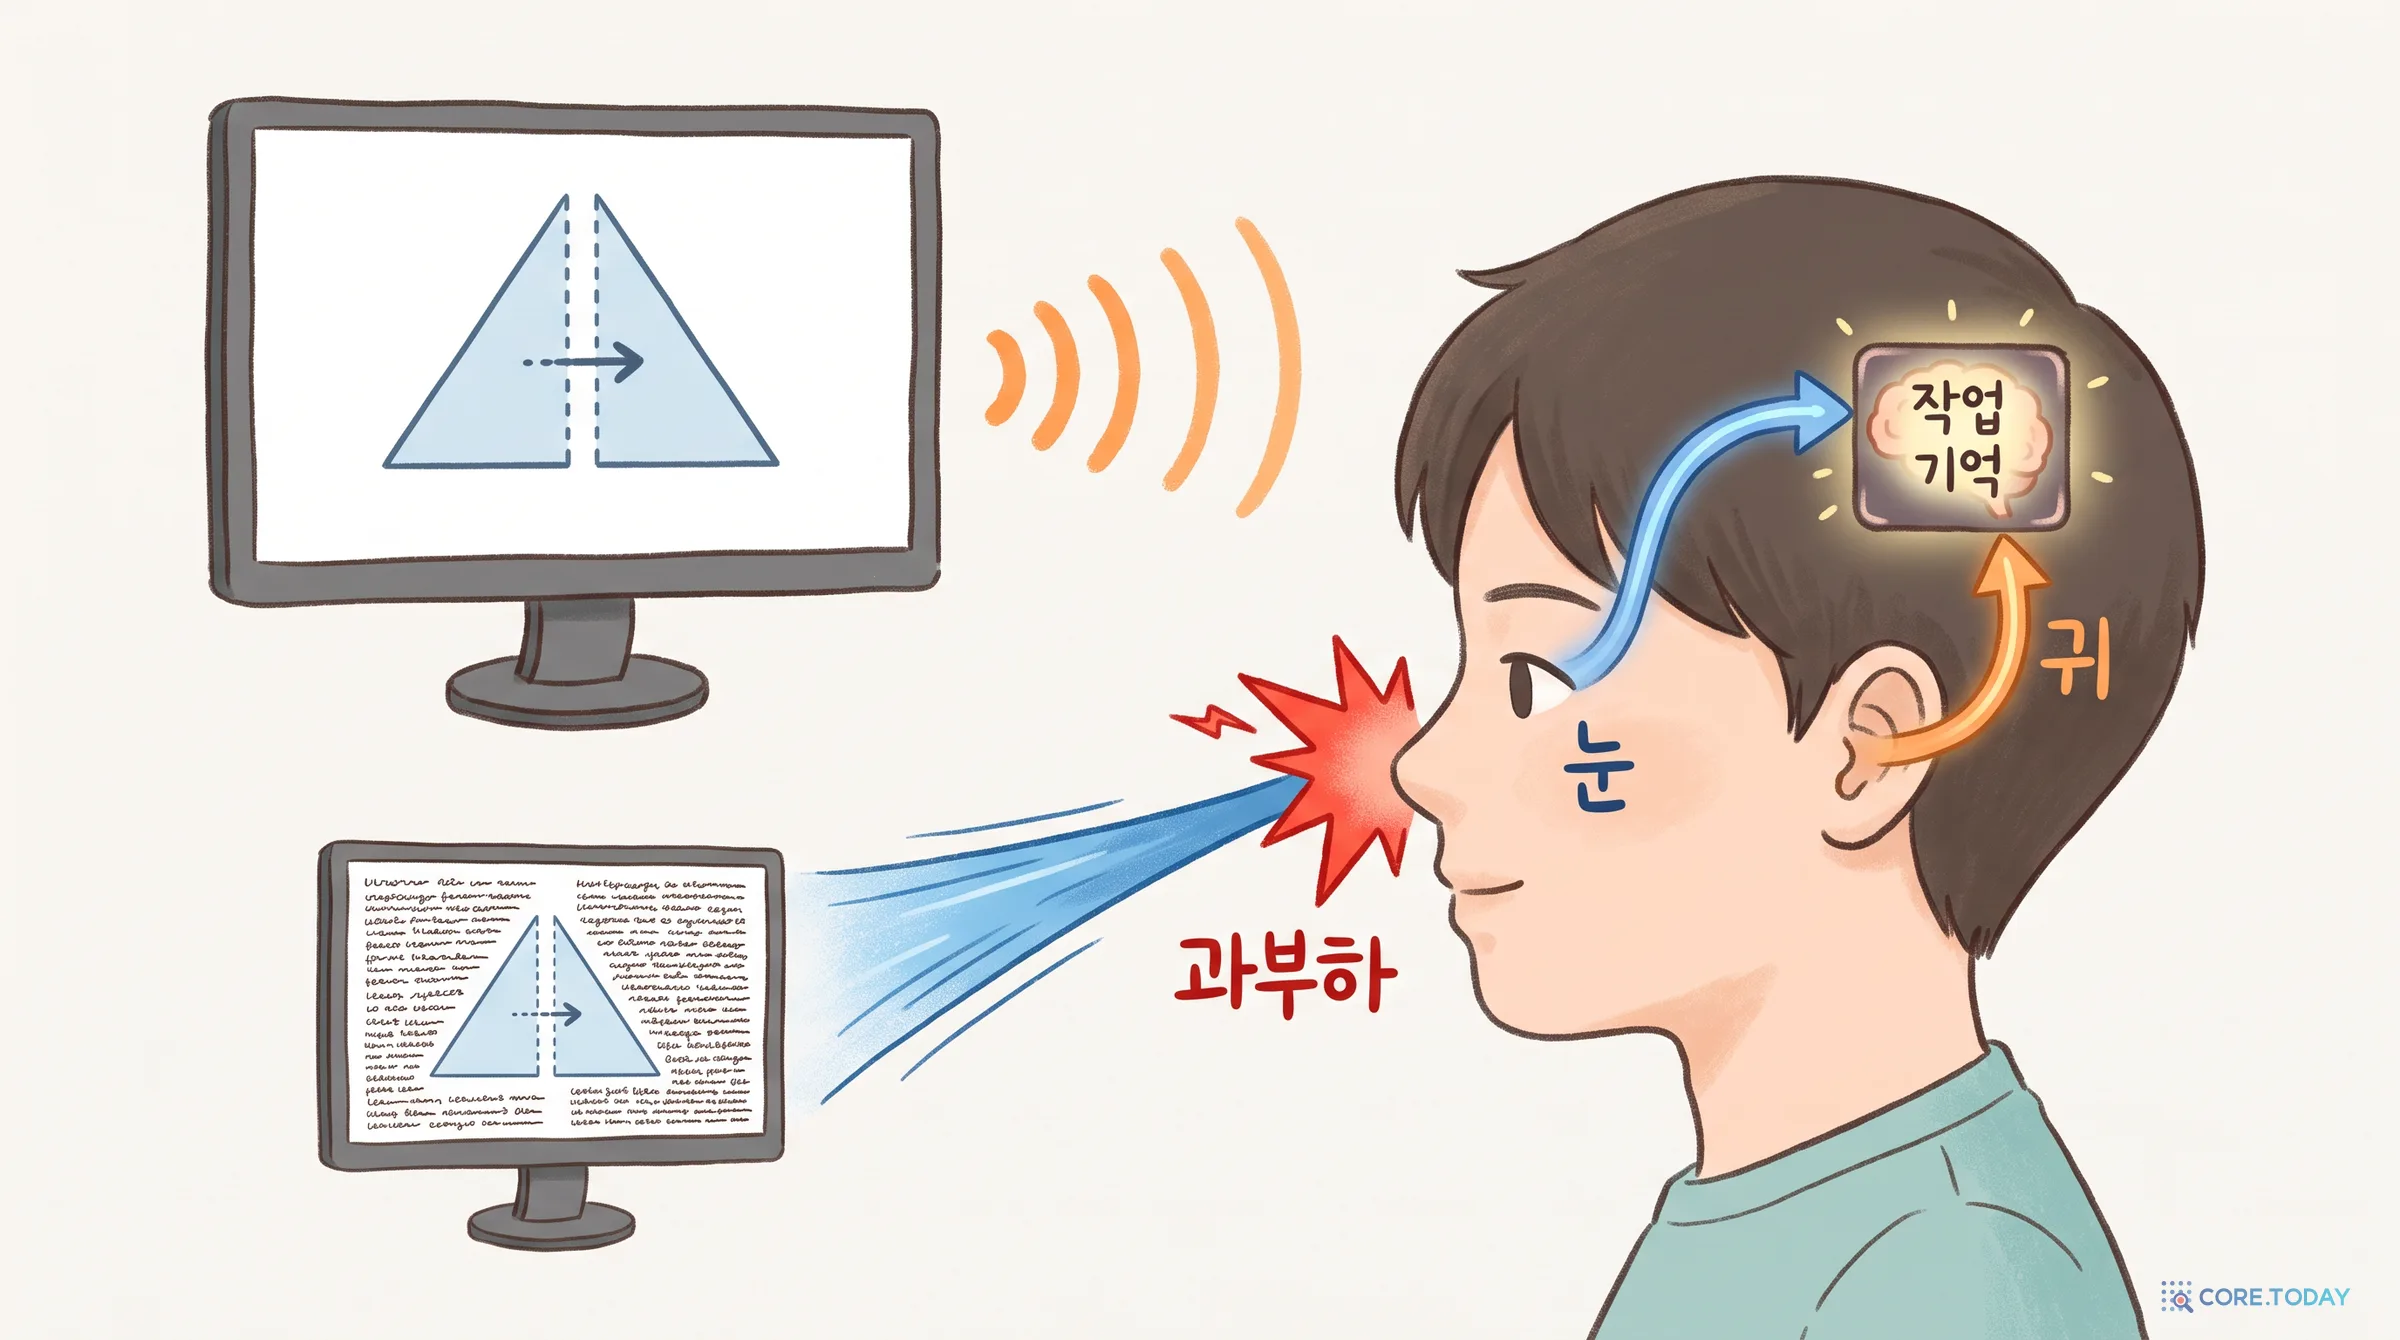
교육심리학자 리처드 메이어의 멀티미디어 학습 인지 이론은 이 분야의 표준 틀이다. 정본은 『Multimedia Learning』(캠브리지 대학 출판부, 3판 2020)이고, 200편 넘는 실험을 바탕으로 15개 원리를 정리했다. 이론의 뼈대는 세 가정이다.
이중 채널. 사람은 그림(눈)과 말(귀)을 서로 다른 통로로 처리한다.
용량 제한. 각 통로가 한 번에 처리할 수 있는 양은 적다. 이것이 작업 기억의 한계다.
능동 처리. 배움은 들어온 것 중 중요한 것을 고르고, 정리하고, 이미 아는 것과 엮는 일이다.
샌더슨의 조언 "쓸데없는 애니메이션을 피하라"와 같은 말. 기계는 화면을 채우려는 경향이 있다
신호
핵심 구조를 강조 표시하면 더 잘 배운다
색으로 대응 관계를 짚는 3Blue1Brown 특유의 문법
중복
그림+내레이션이 그림+내레이션+화면 자막보다 낫다
내레이션을 화면에 그대로 받아 적는 영상은 손해를 본다
공간 근접
글과 그에 해당하는 그림을 가까이 두면 낫다
라벨이 엉뚱한 곳에 있거나 겹치면 이 원리가 깨진다. 해설 에이전트의 최대 약점(4장)
시간 근접
내레이션과 해당 그림을 동시에 주면 낫다
음성과 화면 싱크. 에이전트가 자동으로 맞추기 가장 어려운 부분
분절
학습자 속도로 넘기는 조각으로 나누면 낫다
5분짜리 연속 영상은 이 원리와 어긋난다
목소리
기계 음성보다 친근한 사람 목소리가 낫다
TTS를 쓰는 에이전트 영상의 약점(다만 최신 TTS로 다시 재야 할 원리다)
3-2. 메타분석이 말하는 숫자
"애니메이션이 정적인 그림보다 나은가"는 수십 년 동안 반복 검증된 질문이다. 2002년 바버라 트버스키와 동료들은 「애니메이션: 도움이 될 수 있나?」라는 논문에서 낙관론에 찬물을 끼얹었다. 애니메이션이 나아 보인 연구를 뜯어보니 정적 그림보다 정보가 더 많거나 상호작용이 있었다는 것이다. 정보량을 맞추면 이점이 사라지는 경우가 많았다. 이들은 두 원리를 제시했다. 그림의 형식이 전하려는 개념의 형식과 맞아야 한다는 대응 원리(변화를 설명할 때는 움직임이 맞다), 그리고 그림이 정확히 지각돼야 한다는 파악 원리다. 애니메이션은 흔히 "너무 복잡하거나 너무 빨라서 정확히 지각되지 않는다." 그리고 사람은 연속된 움직임을 띄엄띄엄한 단계의 연쇄로 이해한다.
그 뒤 두 번의 큰 메타분석이 나왔다. 효과 크기d나 g는 두 집단 평균 차이를 표준편차로 나눈 값이다. 0.2면 작은 효과, 0.5면 중간, 0.8이면 큰 효과로 읽는 것이 관례다.
절차·운동 지식 (H&L 2007)
d = 1.06
사실적·비디오 기반 (H&L 2007)
d = 0.76
표상적 애니메이션 (H&L 2007)
d = 0.40
전체 (H&L 2007)
d = 0.37
내레이션 동반 (B&B 2016)
g = 0.32
전체 (B&B 2016)
g = 0.23
추상적 표상 (B&B 2016)
g = 0.006
수학 영역 (B&B 2016)
g = −0.07
막대 길이는 1.26(자연과학 영역, 표에는 없음)을 최댓값으로 놓고 그렸다. 숫자를 하나씩 보자.
회플러와 로이트너(2007)는 연구 26편, 비교 76쌍을 모아 애니메이션이 정적 그림보다 평균 d=0.37만큼 낫다고 했다. 저자들 표현으로 "중간 크기의 이점"이다. 그런데 가장 큰 효과(d=1.06)는 절차·운동 지식, 그러니까 매듭 묶기나 조립처럼 손으로 하는 일을 배울 때 나왔다. 추상적인 개념 이해에서가 아니다.
버니와 베트랑쿠르(2016)는 더 많은 자료(논문 50편, 연구 61개, 참가자 7,036명, 비교 140쌍)로 다시 쟀다. 전체 효과는 g=0.226, 저자들 스스로 "작다"고 부른 크기다. 효과가 뚜렷한 조합은 시스템이 속도를 정하고(g=0.309) 내레이션이 붙는(g=0.320) 경우였다. 이것은 정확히 Manim 해설 영상의 형식이다.
그런데 같은 논문에서 수학 영역은 g=−0.067, 0과 구별되지 않았다(비교 11쌍). 수식이나 도식 같은 추상적 표상도 g=0.006이었다. PDF에서 글자를 뽑으면 마이너스 부호가 사라져 +0.067로 읽히기 쉬운 숫자다.
물론 이 메타분석에 3Blue1Brown 같은 영상이 들어 있는 것은 아니다. 대부분 1970~2010년대의 실험실 자료이고, 수학 비교는 11쌍뿐이다. 그래도 "움직이면 더 잘 배운다"는 직관을 그대로 믿을 근거는 없다. 2005년 메이어와 동료들의 실험은 더 날카롭다. 번개, 변기 물탱크, 파도, 자동차 브레이크의 원리를 가르치는 네 실험에서, 종이 위의 그림+글 집단이 내레이션 애니메이션 집단보다 비교 8개 중 4개에서 유의하게 나았고 나머지는 차이가 없었다. 정적인 그림은 학습자가 스스로 머릿속에서 움직임을 만들어 내게 한다. 4편에서 본 '생성 효과'와 같은 이야기다.
3-3. 명료한 영상의 함정 — 이해했다는 착각
Veritasium 채널의 데릭 멀러는 유튜버가 되기 전 시드니 대학에서 물리 교육 멀티미디어로 박사 논문을 썼다(2008). 거의 1,000명을 대상으로 한 실험의 결론은 이렇다. 학생들은 명료하고 간결한 멀티미디어에서 배운 것이 거의 없었고, 특히 사전 지식이 적은 학생일수록 그랬다. 오히려 자기 오개념에 더 확신하게 됐고, 실제로 두 배를 배운 학생들과 같은 만큼 배웠다고 믿었다. 인터뷰에서 '간단하다', '명확하다'는 말은 오개념을 다루지 않은 영상의 시청자에게서만 나왔고, '헷갈린다'는 말은 오개념을 정면으로 다룬 영상의 시청자에게서만 나왔다. 그런데 더 많이 배운 쪽은 헷갈린다고 한 쪽이었다. 1학년 물리 학생 364명을 대상으로 한 그의 학술지 논문에서, 흔한 오개념을 먼저 꺼내고 반박하는 영상은 설명만 하는 영상보다 효과 크기 0.79~0.83만큼 나았다.
실험심리학에도 같은 현상이 있다. 카펜터와 동료들(2013)은 같은 대본을 유창한 강사와 더듬는 강사가 전달하게 했다. 유창한 강사를 본 학생들은 자기가 더 많이 기억할 것이라고 예측했지만(d=1.03) 실제 기억량은 차이가 없었다.
해설 에이전트에게 이것은 경고다. 기계가 만든 영상은 유창성 신호가 최대다. 매끄러운 합성 음성, 정돈된 화면, 막힘없는 전개. 그런데 4장에서 보듯 그 영상의 '정확성' 점수는 사람의 판단과 거의 상관이 없다. 유창한데 틀린 영상이 가장 위험하다. TheoremExplainAgent의 저자들도 논문의 위험 절에서 같은 걱정을 적었다. 오류가 감지되지 않으면 틀린 추론에 대한 잘못된 확신을 퍼뜨릴 수 있다는 것이다.
4장. TheoremExplainAgent 정독 — 정리 하나가 5분짜리 영상이 되기까지
4-1. 논문 한 장 요약
논문 카드
제목 TheoremExplainAgent: Towards Video-based Multimodal Explanations for LLM Theorem Understanding 저자 Max Ku, Thomas Chong(공동 1저자; ACL 판 표기는 Cheuk Hei Chong), Jonathan Leung, Krish Shah, Alvin Yu, Wenhu Chen — 워털루 대학, 벡터 연구소, Votee AI 발표 arXiv 2502.19400 (v1 2025-02-26, v2 2025-05-25), ACL 2025 본회의 구두 발표 한 줄 정리 이름과 짧은 설명을 넣으면 두 LLM 에이전트가 Manim으로 5분 넘는 해설 영상을 만든다. 정리 240개로 된 평가 세트 TheoremExplainBench와 5차원 평가 지표를 함께 냈다. 코드 github.com/TIGER-AI-Lab/TheoremExplainAgent (MIT, 별 약 1,500개, 마지막 커밋 2025-07-27)
출발점은 이렇다. LLM이 정리를 '이해했는지'를 글로 된 답으로만 재면, 그럴듯한 말 뒤에 숨은 오해를 놓친다. 논문의 그림 5가 좋은 예다. 8방향 체인 코드(도형 윤곽을 방향 숫자의 나열로 적는 방법)를 설명하게 했을 때, 글 설명에서는 "틀렸다"는 것만 보였지만 영상에서는 별 모양을 그리다 엉뚱한 방향으로 꺾이는 장면이 나와서 방향 코드를 잘못 이해했다는 것이 드러났다. 시각화는 모델의 추론을 밖으로 꺼내 보이게 한다. 이것이 논문 제목의 "LLM의 정리 이해를 위한" 부분이다. 해설 영상 생성은 그 자체로 목표이면서, 동시에 모델의 이해를 검사하는 창이다.
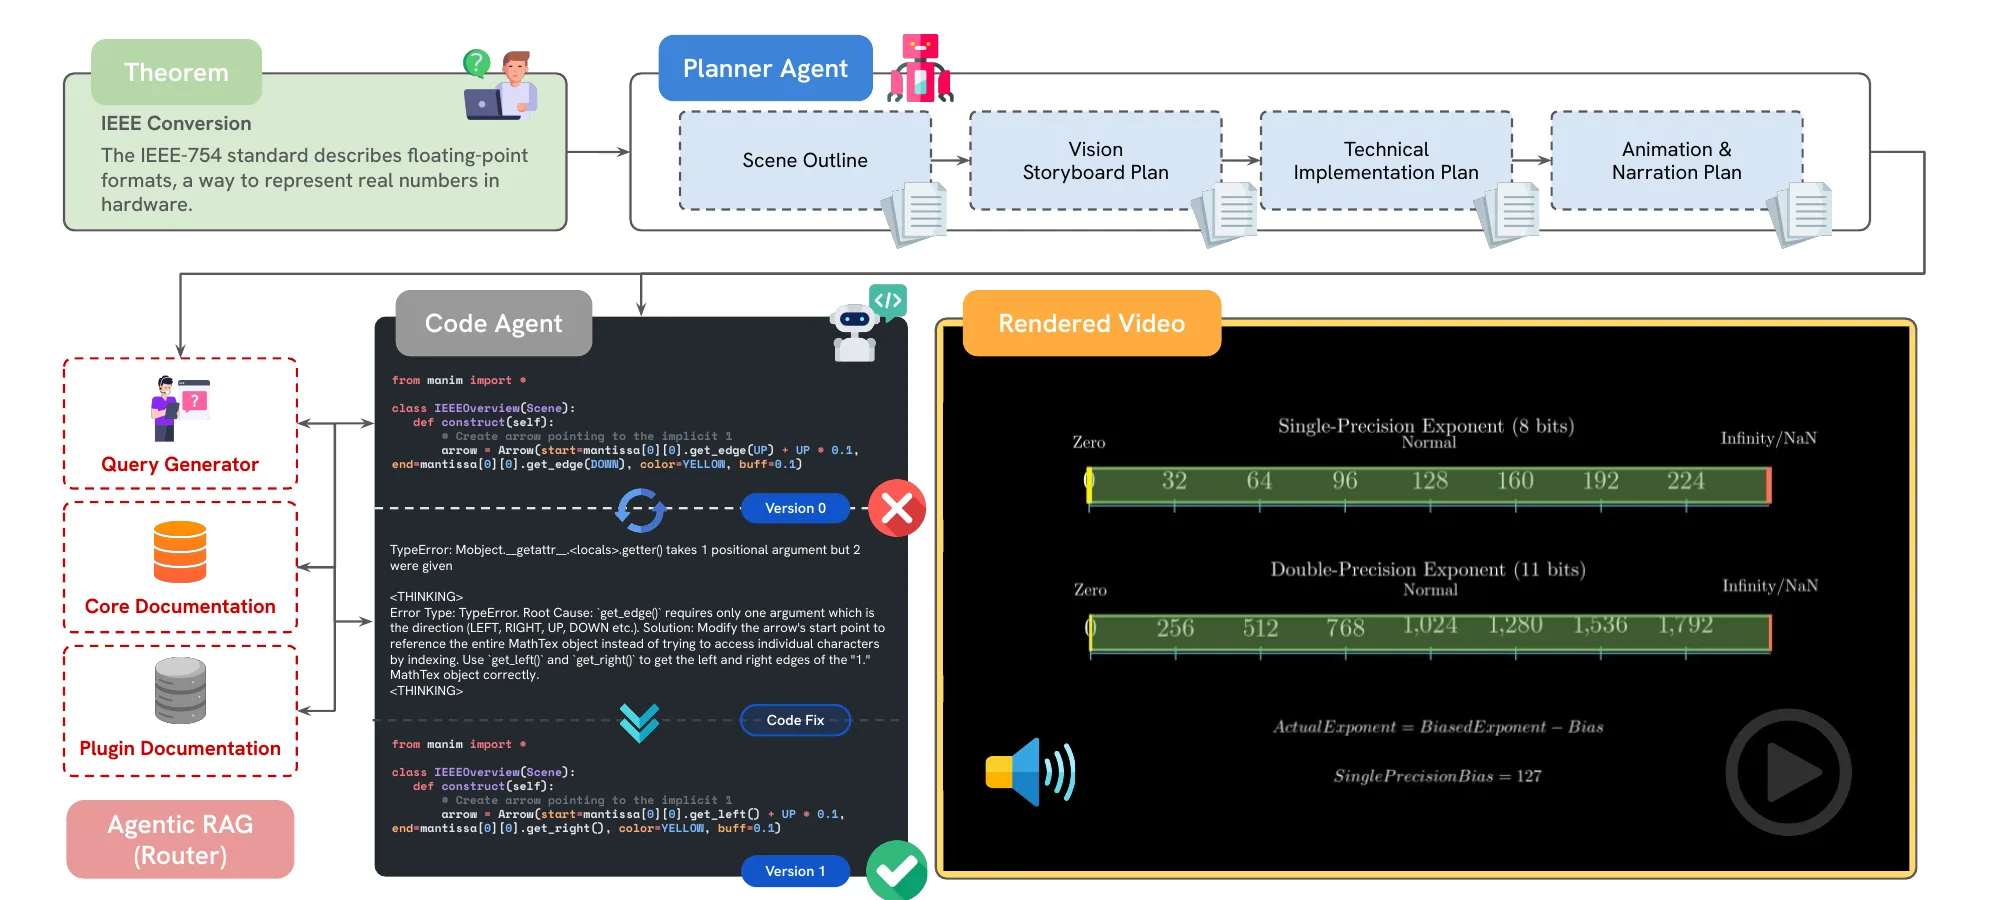
그림: Ku 외, 「TheoremExplainAgent」 그림 3 (arXiv 2502.19400, CC BY 4.0). 원본을 잘라 썼다.
그림을 왼쪽 위부터 따라가 보자.
입력. 정리 이름과 한두 문장의 설명. 그림의 예는 "IEEE-754 변환: 부동소수점 형식을 정의한 표준"이다.
기획 에이전트(Planner). 네 단계로 계획을 쌓는다.
장면 개요: 영상을 여러 장면으로 나누고, 장면마다 제목·목적·설명·배치(안전 여백과 최소 간격)를 적는다.
시각 스토리보드: 장면마다 화면에 무엇이 어디에 나오는지.
기술 구현 계획: 어떤 Manim 객체와 애니메이션을 쓸지.
애니메이션·내레이션 계획: 무엇을 언제 움직이고 무엇을 말할지.
코드 에이전트(Coder). 장면마다 Manim Community Edition(0.18.1) 코드를 쓴다. 프롬프트는 "Manim 전문 개발자"라는 역할을 주고, 안전 여백과 최소 간격을 엄격히 지키라고 요구한다.
오류 수정 루프. 렌더가 실패하면 오류 메시지를 코드 에이전트에게 돌려줘 고치게 한다. 최대 5번, 넘으면 그 영상은 실패다. 그림 속 예가 전형적이다. Version 0은 수식의 한 부분에 get_edge(UP)를 불렀다가 "인자를 하나만 받는데 두 개가 들어왔다"는 TypeError로 죽는다. 에이전트가 <THINKING> 블록에서 원인을 분석하고, Version 1은 get_left()·get_right()로 바꿔 통과한다.
에이전틱 RAG. 왼쪽 빨간 점선 상자. 먼저 이 정리에 화학·물리 같은 Manim 플러그인이 필요한지 분류한 뒤, 스토리보드·기술 구현·오류 수정의 세 시점에서 Manim 문서를 검색해 붙인다(ChromaDB, 질의당 문서 2개, 관련도 문턱 0.5).
음성과 이어 붙이기. 논문은 "TTS 서비스"라고만 쓰지만, 공개 코드를 보면 Kokoro 음성 합성을 manim-voiceover로 Manim 장면 안에서 동기화하고, 장면별 영상과 자막을 ffmpeg으로 이어 붙인다. 1장에서 본 샌더슨의 FAQ와 정반대의 선택이다.
모델은 GPT-4o, Gemini 2.0 Flash, Claude 3.5 Sonnet, o3-mini를 썼고, 각 실험에서 같은 모델이 기획과 코딩을 모두 맡았다. 저자들은 에이전트 없이 한 번에 만들게 하면 20초 넘는 영상을 만들지 못한다고 보고했다. 그래서 모든 결과는 에이전트 방식이다.
한 가지 짚어 둘 것. 공개 코드에는 렌더된 화면을 비전 모델이 보고 겹침·화면 이탈을 고치게 하는 시각 자기반성 옵션(--use_visual_fix_code)이 있다. 그런데 논문 본문과 실험에는 이 기능이 한 번도 나오지 않는다. 논문의 숫자는 화면을 보지 않고 코드 오류만 고친 결과다. 6장의 실측에서는 이 '화면 보고 고치기'를 직접 붙여 효과를 쟀다.
4-3. 시험 세트와 채점표
TheoremExplainBench는 수학·물리·화학·컴퓨터 과학 네 분야에서 정리 240개를 모았다. 난이도는 고교(Easy)·학부(Medium)·대학원(Hard) 세 단계, 분야×난이도마다 정확히 20개씩이다. 출처는 무료 교과서 OpenStax와 LibreTexts. 수학 Easy에는 피타고라스 정리와 오일러 공식이, Hard에는 테일러 정리와 그린·스토크스 정리가 있다. 다만 Hard에 심프슨 공식이나 이중 리만 합 같은 학부 미적분 내용도 섞여 있어서 '대학원'이라는 이름표는 느슨하다.
채점은 다섯 차원이다. 앞의 셋은 내용, 뒤의 둘은 화면을 본다.
차원
묻는 것
누가 채점하나
정확성과 깊이
내레이션이 정리를 정확하고 구조적으로, 직관과 엄밀함 모두로 설명하나
GPT-4o가 자막만 읽고
시각적 관련성
화면이 지금 설명하는 개념과 맞나
GPT-4o가 키프레임을 보고
논리적 흐름
아이디어가 차례로 쌓이나
GPT-4o가 자막만 읽고
요소 배치
위치와 크기가 적절하고, 의도하지 않은 겹침이 없나
GPT-4o가 키프레임을 보고
시각적 일관성
움직임이 매끄럽고 스타일이 일관되나
Gemini 2.0 Flash가 영상 조각을 보고
종합 점수는 다섯 점수의 기하평균(0~1)이다. 그리고 성공률은 '그 정리의 모든 장면이 렌더됐는가'다. 설명이 맞았는지가 아니라 영상이 끝까지 만들어졌는지를 센다. 이 정의를 기억하고 표를 보자.
4-4. 표 읽기 — 숫자 뒤의 함정 다섯
표 1(성공률). o3-mini가 93.8%로 압도적이다. GPT-4o 55.0%, Gemini 2.0 Flash 14.6%, 그리고 Claude 3.5 Sonnet은 2.1%, 240편 중 약 5편이다.
표 3(재시도 횟수별 누적 성공률, o3-mini). 이 표가 논문에서 가장 중요하다.
난이도
첫 시도
1회 수정
2회
3회
4회
5회
Easy
7%
51%
73%
86%
91%
93%
Medium
0%
33%
75%
83%
88%
91%
Hard
3%
46%
81%
90%
95%
96%
첫 시도에 모든 장면이 렌더된 경우는 0~7%다. 93.8%는 오류 메시지를 보고 다섯 번까지 고친 결과다. 해설 에이전트의 '에이전트'는 장식이 아니라 성공의 거의 전부다.
표 2(성공한 영상의 품질). 여기서 첫 번째 함정이 나온다. 종합 점수 1위는 Claude 3.5 Sonnet(0.79)이다. 그런데 이것은 렌더에 성공한 약 5편만 채점한 결과다. 끝까지 만든 영상만 보면 품질이 높아 보이는 생존자 편향이다. 두 번째로, 모든 모델에서 가장 낮은 점수는 요소 배치(0.57~0.65)였다. 사람이 만든 Manim 영상 10편은 0.73. 사람 영상의 종합 점수는 0.77로 o3-mini와 같았는데, 사람 영상이 가장 낮게 받은 차원은 논리적 흐름(0.70)이었다. 저자들은 사람 내레이션이 덜 정형적이라서라고 풀이한다.
나머지 함정 셋.
1
RAG가 오히려 깎았다
Manim 문서를 검색해 붙이자 o3-mini는 93.8% → 82.1%, GPT-4o는 55.0% → 45.8%로 떨어졌다. 검색된 문서가 너무 일반적이거나 무관해서 엉뚱한 함수를 부르게 만들었다는 것이 저자들의 분석이다. Claude와 Gemini는 올랐다. 모델마다 다르다.
2
자동 채점은 사람과 거의 무관했다
40편을 학생 12명이 채점해 비교했더니, 스피어먼 상관이 시각적 관련성 0.72, 요소 배치 0.42였고 정확성 0.14, 흐름 0.16, 일관성 0.17이었다. 내용을 보는 지표일수록 사람과 맞지 않았다(표 4).
3
사람은 다른 영상을 골랐다
모델 이름을 가리고 18명에게 순위를 매기게 했더니, 성공률과 자동 점수가 하위권이던 Gemini 2.0 Flash가 명확성 1위 70.6%, 시각 매력 1위 61.8%를 차지했다. o3-mini는 20.6%, GPT-4o는 8.8%(표 6).
→
그래서 무엇을 믿나
'렌더 성공'은 잘 재지만 '좋은 해설'은 아직 잘 재지 못한다. 이 논문의 진짜 기여는 영상 생성보다 이 측정의 어려움을 처음 드러낸 데 있다.
비용과 현장 반응도 보고됐다. 영상 한 편(장면 7개 가정)에 GPT-4o는 약 1.71달러와 19분, Gemini 2.0 Flash는 0.10달러가 들었다. 대학생 15명과 교사 8명에게 버블 정렬과 해밍 거리 영상을 보여 줬더니 명확성은 5점 만점에 4.1~4.4점이었다. 하지만 "그대로 수업에 쓰겠다"는 13%와 35%였고, 나머지 대부분은 "내용이 개선되면 쓰겠다"였다. 논문 본문의 일부 서술은 표와 어긋난다. 본문은 Gemini가 가장 고전했다고 쓰지만 표 1의 최저는 Claude다. 인용할 때는 표를 따르는 것이 안전하다.
아래 해부도에서 단계를 하나씩 눌러 보고, 재시도 슬라이더와 '성공한 영상만 채점' 스위치로 위의 함정을 직접 확인할 수 있다.
5장. 그 뒤 1년 반 — 렌더는 되는데 화면이 틀린다
TheoremExplainAgent 이후 2026년 10월까지 나온 관련 연구를 추리면 흐름이 선명하다. 처음에는 "LLM이 Manim 코드를 쓸 수 있나"가 질문이었다. 지금은 아무도 그걸 묻지 않는다. 질문은 렌더된 화면이 맞는가, 그리고 그걸 누가 어떻게 재는가로 옮겨 갔다.
때
이름 (만든 곳)
한 줄 요약
2025-02
TheoremExplainAgent (워털루)
기획+코딩 에이전트, 정리 240개 시험 세트. 4장
2025-07
Manimator
프롬프트·PDF·arXiv 논문 → 장면 설명 → Manim 코드의 2단 파이프라인
2025-10
Code2Video (싱가포르 국립대 Show Lab)
기획·코딩·비평 세 에이전트, 화면을 6×6 격자 닻으로 나눠 배치. 3Blue1Brown 영상으로 시험 세트 구성. ICML 2026
2025-12
TeachMaster (상하이 교통대)
강좌 단위로 Manim 영상을 찍어 내는 시스템, 교육자 1,000명 이상에게 배포했다고 보고. ACL 2026
2026-02
LASEV (바이두)
풀이·삽화(Manim)·내레이션 에이전트와 품질 관문. 하루 100만 편 이상이라고 주장. KDD 2026
2026-02
ManiBench
3Blue1Brown 영상 12편을 문제로 삼은 소규모 시험. ManimGL↔CE 비호환 145개 목록
2026-04
ManimTrainer (노팅엄 트렌트대)
30B 이하 공개 모델 17종을 미세 조정+강화학습+렌더 루프로 훈련. 렌더 성공 94%
2026-05
OmniManim (우한대)
코드를 쓰기 전에 화면 배치를 예측하는 배치 모델. "코딩하기 전에 보라"
2026-06
ManimAgent (앨버타대 등)
성공 이유와 실패 함정을 기억하는 에피소드 기억. EMNLP 2026
2026-07
SGA (KAUST)
렌더하지 않고 코드를 부분 실행해 경계 상자 겹침을 기하학적으로 계산
2026-08
Teaching Monster Challenge (국립대만대)
학습자 맞춤 교육 영상 생성 공개 대회, 77팀. 설문에 답한 상위 10팀 사이에서 가장 많이 쓴 엔진이 Manim
이름이 겹치는 것들이 있어 주의가 필요하다. 'Code2Video'는 싱가포르 국립대의 이 논문 말고도 푸단대의 HTML 영상 벤치마크(Code2Video-Compass)와 헤이젠의 모션 그래픽 벤치마크가 같은 이름을 쓴다. 'ManimAgent'도 노팅엄 트렌트대 논문 속 추론 파이프라인 이름과 EMNLP 논문 이름이 같다. 'ManimBench'(노팅엄 트렌트대, 문서 예제 417쌍)와 'ManiBench'(12문제)도 다르다.
5-1. Code2Video — 3Blue1Brown을 이겼다는 소문의 진상
2025년 10월 싱가포르 국립대 Show Lab의 Code2Video는 이 분야에서 가장 많이 인용되는 후속작이다. 구조는 TheoremExplainAgent를 세 갈래로 나눴다.
기획자: 개요(절·예시·대상 학습자)를 짜고, 강의 대사와 애니메이션을 짝지은 스토리보드를 만든다. 구글 이미지와 아이콘 사이트에서 참고 그림을 가져와 캐시해 둔다.
코더: 절마다 코드를 병렬로 생성한다. 오류는 'ScopeRefine'으로 고친다. 먼저 오류 줄 앞뒤 한 줄만, 안 되면 해당 대사 블록 전체를, 그래도 안 되면 그 절을 통째로 다시 쓴다.
비평가: 비전 모델(Gemini 2.5 Pro)이 렌더된 화면을 본다. 핵심 아이디어는 시각 닻 프롬프트다. 화면을 6×6 격자로 나누고 각 격자점을 Manim 좌표에 대응시킨 뒤, "이 요소를 B4 칸으로 옮겨라"처럼 이산적인 칸 단위로 지시한다. 비전 모델은 무엇이 잘못 놓였는지는 잘 말하지만 얼마나 옮겨야 하는지는 못 말하기 때문이다.
시험 세트 MMMC는 3Blue1Brown의 교육 영상 117편(13개 분야)을 저자 타임스탬프로 잘라 만든 456개 단위다. 평가는 비전 모델 채점(0~100) 다섯 축과, TeachQuiz라는 새 지표를 썼다. 영상을 보기 전과 본 뒤 퀴즈 점수의 차이다. 다만 '보기 전'은 진짜 초보자가 아니라, Gemini 2.5 Pro에게 "이 개념을 모르는 척하라"고 프롬프트로 시킨 상태다. 가중치를 지우는 진짜 '잊기'가 아니다.
초록의 "40% 향상"은 코드를 한 번에 생성하는 방식 대비 TeachQuiz 점수 차(약 46점)다. 사람 영상보다 낫다는 뜻이 아니다. 3Blue1Brown은 비전 모델 채점에서 여전히 위에 있다(97.1 대 86.0). '이겼다'는 말이 나온 곳은 40명(중학생 30명, 대학생 10명)의 사람 실험이다. 퀴즈 점수가 Code2Video+Claude 80.3, 3Blue1Brown 78.8로 근소하게 앞섰고, "끝까지 보겠다"는 응답은 64.0 대 36.2로 크게 앞섰다. 그런데 Code2Video 영상은 약 2분, 3Blue1Brown 원본은 평균 약 17분이었다. 이것은 품질 비교라기보다 형식 비교에 가깝다. 픽셀 생성 모델이 0점대인 것도 8초짜리 한 편으로 강의 하나를 대신하게 한 결과다.
흥미로운 관찰도 있다. 사람 평가자는 비전 모델보다 배치 점수를 더 낮게 줬다. 저자들은 사람이 "아주 잠깐의 가림에도 매우 민감하다"고 적었다. 기계 심판이 놓치는 겹침을 사람은 본다. 이 논문은 ICLR 2026에서 떨어진 뒤 ICML 2026에 붙었고, 그 과정에서 제목의 'Generation'이 'Creation'으로 바뀌었다.
5-2. 실패의 지도 — 코드를 쓰기 전에 보라
2026년 5월 우한대의 OmniManim 논문은 제목부터 문제를 정확히 짚는다. 「See Before You Code」. 아래 그림은 이 분야의 실패를 네 칸으로 요약한다.
그림: Li 외, 「See Before You Code」(OmniManim) 그림 1 (arXiv 2605.15585, CC BY 4.0).
네 가지 모두 코드는 정상 실행된다. 2장에서 말한 대로 Manim은 겹침과 화면 이탈을 오류로 알려 주지 않는다. 그래서 TheoremExplainAgent식 '오류 메시지 보고 고치기'로는 잡히지 않는다. 특히 잔여물(이전 장면에서 FadeOut하지 않은 객체가 남는 것)과 보간 중 충돌(시작과 끝 화면은 각각 멀쩡한데 Transform 도중에 겹치는 것)은 정지 화면 몇 장만 봐서는 놓치기 쉽다.
OmniManim의 해법은 배치를 먼저 정하는 것이다. 훈련된 배치 모델이 장면 설명을 받아 주요 프레임마다 요소의 경계 상자를 먼저 예측하고, 코드 에이전트는 그 상자에 맞춰 코드를 쓴다. 렌더 뒤에는 결정론적인 컴퓨터 비전으로 문제를 진단한다. 문제 500개짜리 시험에서 겹침 점수가 GPT-5.4 단독 0.628, Code2Video 0.598, OmniManim 0.763이었고, 배치 모델을 빼면 0.491로 떨어졌다. 대학생 20명의 사람 평가에서도 겹침 항목의 차이가 가장 컸다.
7월 KAUST의 SGA는 한 걸음 더 나간다. 렌더하지 않는다. 코드의 각 줄을 예외 처리로 감싸 부분 실행하고, 모든 객체의 경계 상자와 이름과 소스 줄 번호를 뽑아 장면 그래프를 만든다. 두 상자가 겹치면 '얼마나 어느 방향으로 밀어야 하는지' 최소 분리 벡터를 계산해 해당 줄 근처 다섯 줄만 고치라고 지시한다. 검사 한 번에 5초가 안 걸린다(전체 렌더는 30~90초). 그리고 이 논문에서 가장 중요한 숫자가 나온다. 비전 모델 채점 점수와 기하학적 겹침 점수의 상관이 거의 없었다(ρ = 0.24, 유의하지 않음). 비전 모델 점수는 85.9~96.4 사이에 몰려 있었다. 기계 심판은 다 좋다고 하는데, 자로 재면 겹쳐 있다.
이 차이를 직접 느껴 볼 수 있게 위젯을 만들었다. 화면 속 요소를 끌어다 놓으면 '상자 검사'가 겹침과 화면 이탈을 재고, '눈 검사' 모드로 바꾸면 비전 모델이 볼 법한 문제를 보여 준다. 두 검사가 엇갈리는 사례(거짓 경보와 놓친 문제)도 준비해 두었다.
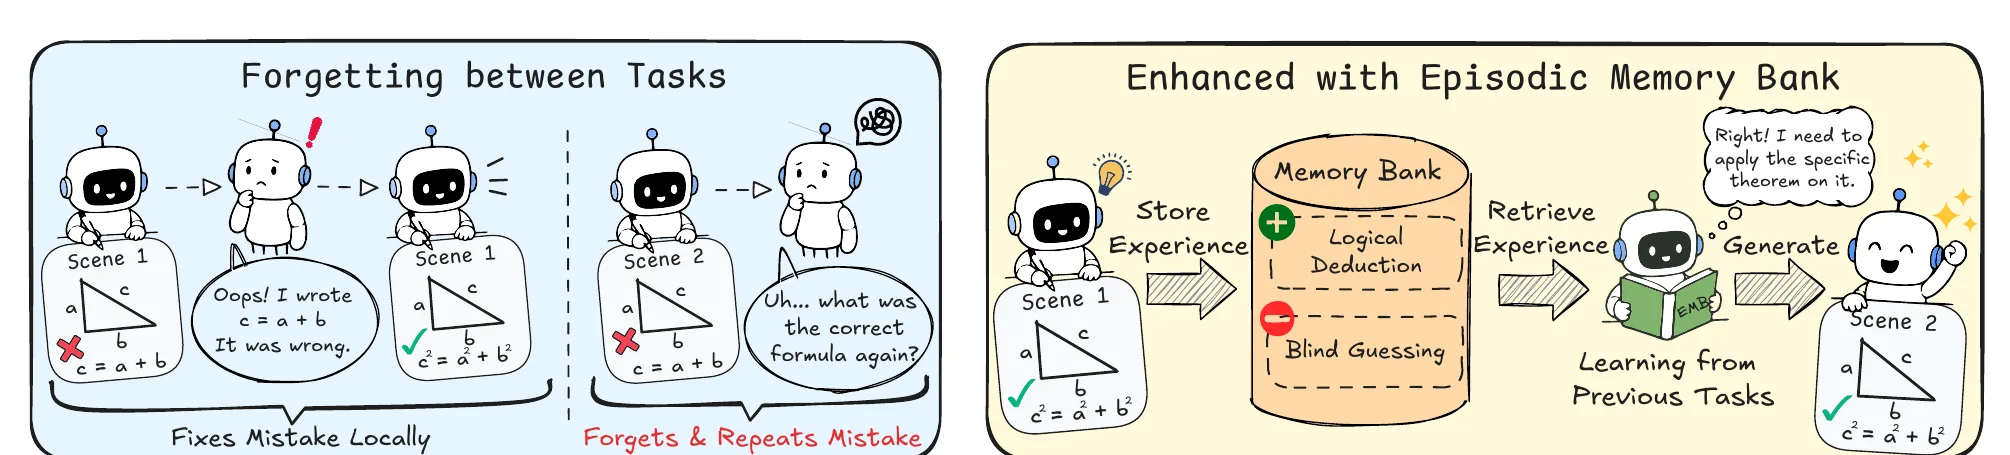
같은 실수를 반복하지 않게 하려는 시도도 있다. 2026년 6월 앨버타대 등의 ManimAgent는 영상 하나를 만들 때마다 경험을 두 갈래로 저장한다. 비전 모델 점수가 높았던 장면의 '성공 이유'와 코드는 참고 예시(M+)로, 렌더 실패에서 성공으로 넘어간 과정에서 뽑아낸 교훈은 '알려진 함정'(M−)으로. 다음 과제에서 비슷한 기억을 검색해 붙인다. 가중치는 바꾸지 않는다.
그림: Jiang 외, 「ManimAgent: Self-Evolving Multimodal Agents for Visual Education」 그림 1 (arXiv 2606.30296, CC0).
결과를 정직하게 읽으면 이렇다. 기억을 200개 쌓은 뒤 사람 평가 통과율(첫 시도)은 84.9%로, 기억이 없을 때(62.0%)보다 크게 올랐다. 그런데 단순히 Manim 문서와 코드를 검색해 붙이는 RAG도 이미 83.3%였다. 기억의 고유한 효과는 통과율보다 반성 횟수를 11.4번에서 6.5번으로 줄인 데 있었다. 그리고 54명 평가자의 '쓸 만한가' 판단은 서로 거의 일치하지 않았다(플라이스 카파 −0.01). 사람끼리도 좋은 해설 영상이 무엇인지 합의하지 못한다.
훈련 쪽에서는 노팅엄 트렌트대 연구진이 30B 이하 공개 모델 17종을 Manim 데이터로 미세 조정하고, 코드 유사도와 렌더된 영상의 시각 유사도를 합친 보상으로 강화학습(GRPO)을 시켰다. Qwen3-Coder-30B에 강화학습, 렌더 루프 3회, 문서 검색을 붙이자 렌더 성공 94%, 시각 유사도 85.7%로 GPT-4.1 기준선을 약 3~4%포인트 넘었다. 다만 시험 문제가 문서 예제 수준의 짧은 조각이라 긴 해설 영상과는 거리가 있다.
5-4. 심판이 흔들린다
2026년 연구들이 공통으로 부딪힌 벽은 평가다.
비전 모델은 잠깐의 겹침을 놓친다(Code2Video 사람 실험), 기하학을 보지 못한다(SGA, ρ = 0.24).
비전 모델 심판은 순서에 끌린다. 2026년 10월 Reels-RSI 논문에서 세 심판 모델은 두 영상 중 두 번째로 본 것을 62~81%의 확률로 골랐다. '11 대 1 압승'으로 보였던 비교가 사실은 투표 설계 탓이었고, 심판이 고른 영상은 꾸밈을 얻는 대신 사실 13개를 잃은 것이었다.
상위권에서는 점수가 포화된다. 77팀이 참가한 Teaching Monster 대회에서 상위 10개 시스템에 대한 LLM 심판의 순위와 청중 순위의 상관은 −0.17이었고, 최종 우승팀은 심판 순위 4위였다.
사람도 합의하지 못한다(ManimAgent, 카파 −0.01).
그래서 2026년의 흐름은 이렇게 정리된다. 배치처럼 잴 수 있는 것은 결정론적 검사(경계 상자 기하학, 컴퓨터 비전 진단, 테스트가 붙은 린트 규칙)로 잡고, 비전 모델은 순위 매기기나 의미 판단 같은 보조 역할로 돌린다. 학습 효과를 직접 잰 연구는 여전히 드물다. 교사가 검토하는 방식으로 학생 100명을 실험한 LLM2Manim(사후 시험 83% 대 파워포인트 78%), 40명의 Code2Video 정도다.
산업 쪽은 숫자가 크다. 바이두 LASEV는 하루 100만 편 이상, TeachMaster는 45시간 강좌를 83.70달러에 만든다고 보고했다. 둘 다 외부 감사가 없는 자기 보고다. 구글 NotebookLM의 영상 개요(2025년 7월)는 Manim이 아니라 내레이션 슬라이드다. 오픈소스 쪽에서는 2026년 10월 5일 공개된 manimgx가 3주 만에 별 2,100개를 모았다. ManimCE 문법과 호환되는 러스트 엔진으로 렌더 속도를 크게 높였다고 주장한다. 에이전트가 렌더를 수십 번 돌리기 때문에 렌더 속도가 새로운 설계 목표가 된 것이다.
정리하면, 해설 에이전트의 실패는 네 층으로 나뉜다.
① 실행이 안 된다 옛 API, 없는 함수, LaTeX 오류
→
② 실행은 되는데 화면이 틀린다 겹침, 화면 밖, 잔여물, 크기
→
③ 화면은 멀쩡한데 가르침이 틀린다 수학 오류, 순서, 빠진 단계
→
④ 심판이 틀린다 놓침, 순서 편향, 포화
①은 오류 수정 루프로 대부분 잡힌다. ②는 2026년 연구의 주전장이다. ③과 ④는 아직 열려 있다. 그렇다면 2026년 10월의 모델로 지금 직접 돌리면 어느 층에서 무엇이 얼마나 나올까? 6장은 그 실측이다.
6장. 직접 돌려 보기 — 정리 10개, 모델 4개, 파이프라인 80개
6-1. 설계
질문은 셋이었다. 2026년 10월의 모델은 Manim 코드를 얼마나 렌더까지 가져가나? 깨질 때는 왜 깨지나? 렌더된 뒤에는 무엇이 남고, 화면을 보여 주고 고치게 하면 나아지나?
① 스토리보드 3~5장면, 한국어, 60~90초
→
② 코드 Manim CE 0.22 파일 하나
→
③ 렌더 480p, 300초 제한
→
④ 오류 수리 오류 메시지 돌려주기, 최대 3번
⑤ 화면 검토 자동 겹침 검사기 + 비전 심사관
→
⑥ 시각 수리 1회 검토 결과를 같은 모델에 돌려주기
→
⑦ 다시 렌더·다시 검토
정리 10개: 털난 공 정리, 피타고라스 정리(재배열 증명), 홀수의 합 = n2, 등비급수 ½ + ¼ + … = 1, 오일러 다면체 공식 V−E+F=2, 중간값 정리, 칸토어의 대각선 논법, 소수는 무한하다(유클리드), 원의 넓이(부채꼴 재배열), 두 수의 산술-기하 평균 부등식(기하 증명). 모두 '그림이 증명이 되는' 정리를 골랐다.
코더 4종: Claude Haiku 4.5, Sonnet 5.5, Opus 5.5, 그리고 맥에서 돌리는 로컬 Qwen3.5 9B. 같은 모델이 스토리보드와 코드를 모두 쓴다(TheoremExplainAgent와 같다). 정리×모델마다 독립적으로 두 번씩 돌려 파이프라인은 80개다. OpenAI와 Gemini는 이날 게이트웨이에서 쓸 수 없어 넣지 못했다.
시스템 프롬프트는 모든 모델에 똑같이 줬다. 환경 사실만 알렸다. Manim CE 0.22, LaTeX 설치됨, 한글은 Text(font="Apple SD Gothic Neo")로만. 함정 목록은 주지 않았다. 자연스러운 실패를 보기 위해서다. 음성은 없고, 말할 내용은 화면 자막으로 쓰게 했다.
자동 배치 검사기는 모델이 쓴 장면을 그대로 실행하되 self.play를 가로채, 애니메이션이 끝날 때마다 화면에 보이는 글자 객체(Text, MathTex 등)의 경계 상자를 모은다. 그리고 두 가지를 센다. 화면 밖으로 0.1단위 넘게 나간 글자, 그리고 작은 쪽 넓이의 20% 이상 겹친 글자 쌍이다. 일부러 겹친 장면 등 손으로 만든 시험 장면 세 개로 먼저 검증했다.
비전 심사관은 Opus 5.5다. 정리 진술, 스토리보드, 코드, 키프레임 최대 10장을 보고 TheoremExplainAgent의 다섯 차원을 1~5점으로 매기고, 문제를 수학·배치·순서·글자 렌더링으로 나눠 적는다. 어느 모델이 만들었는지, 수리 전인지 후인지는 알려 주지 않았다.
한 가지 설정이 결과를 크게 좌우해서 먼저 밝혀 둔다. 첫 시범에서 Sonnet 5.5를 기본 설정(적응형 사고, 노력 수준 high)으로 두자, 코드 요청 12번이 모두 출력 한도 16,000토큰을 보이지 않는 사고에 다 쓰고 코드 없이 끝났다. 그래서 주 실험은 '사고 최소' 조건으로 돌렸다. Haiku는 기본값(사고 없음), Sonnet은 사고 끔, Opus는 사고를 끌 수 없어 노력 수준 low, 출력 한도는 32,000토큰이다. 기본 사고 설정의 결과는 6-6에서 따로 본다.
TheoremExplainAgent 때보다 첫 시도가 훨씬 낫다. 1년 반 전 o3-mini는 첫 시도에 장면 전부가 렌더되는 경우가 0~7%였다. 이번에 Opus 5.5는 70%였다. 영상이 1분 남짓으로 짧고 파일이 하나라는 차이는 있다. 그래도 오류 수리 3번 이내로 Claude 세 모델은 85~100%에 이르렀다. "코드를 끝까지 돌아가게 만드는 일"은 대형 모델에서는 거의 풀린 문제다.
Sonnet의 첫 시도가 Haiku보다 낮은 이유는 코드가 아니다. 20번 중 4번은 사고를 끈 설정에서도 숨은 사고 토큰이 32,000토큰 한도를 다 먹어 코드 없이 끝났다. 이 넷을 빼면 Sonnet의 첫 시도 성공은 7/16 = 44%다. 같은 이유로 Sonnet은 파이프라인당 비용(0.48달러)도 Opus(0.45달러)보다 비쌌다.
로컬 9B 모델은 한 편도 만들지 못했다. Qwen3.5 9B는 오류 수리 세 번을 거쳐도 20개 중 0개였다. 고칠 때마다 다른 없는 인자로 갈아 끼웠다(size= → scale= → opacity=). 파일은 545줄까지 길어졌고, 좌표를 주석으로 혼잣말하며 고민하다 출력 한도에서 잘리기도 했다. 5장의 노팅엄 트렌트대 연구가 30B 모델을 Manim 데이터로 따로 훈련해야 94%에 닿았던 것과 같은 그림이다.
Haiku는 렌더는 되지만 영상이 짧았다. 17편 모두 목표 60초에 못 미쳤고(22~58초) 중앙값은 43초였다.
가장 좋은 결과부터 보자. Opus 5.5가 첫 시도에 렌더한 '홀수의 합' 영상이다. 심사관은 5점 만점에 평균 4.8점을 줬다. ㄱ자 띠를 하나씩 덧붙여 정사각형을 키우는 그림이 수식과 정확히 맞는다. 화면 아래 자막은 음성 대신 넣은 것이다.
Opus 5.5가 만든 「처음 n개 홀수의 합」(58초, 720p로 다시 렌더). 코드는 사람이 한 줄도 고치지 않았다.
6-3. 왜 깨지나 — 옛 API는 사라지고, 한글과 지어낸 상수가 남았다
실패한 시도 148건의 오류를 분류했다(시각 수리 단계 포함).
오류 종류
전체
Haiku
Sonnet
Opus
Qwen 9B
없는 API·잘못된 인자
82 (55%)
26
2
2
52
파이썬 오류 (문법·이름·인덱스)
27 (18%)
0
1
1
25
LaTeX 컴파일 실패
24 (16%)
11
8
4
1
· 그중 수식 안의 한글
22
11
7
3
1
기하·수치 런타임 오류
6
3
1
0
2
출력 한도 소진 (코드 없음)
6
0
6
0
0
시간 초과 (300초)
3
0
2
1
0
ManimGL·옛 API 혼용
0
0
0
0
0
가장 놀라운 숫자는 마지막 줄의 0이다. 2장에서 ManimGL과 ManimCE를 섞는 실수가 LLM의 대표 실패라고 했고, 2024~2026년 논문들도 그렇게 썼다. 그런데 프롬프트에 "Manim CE 0.22"라고 적은 이번 실험에서는 실패한 오류 기록뿐 아니라 모든 코드 파일을 뒤져도 ShowCreation, TextMobject, TexMobject, GraphScene, CONFIG, manimlib가 한 번도 나오지 않았다. 두 세대가 섞인 흔적은 옛 방식 ApplyMethod 안에 새 방식 .animate를 넣은 단 1건이었다. 2026년의 모델에게 버전을 알려 주면, 적어도 이 문제는 사라진다.
대신 남은 것은 이렇다.
수식 안의 한글(22건). 시스템 프롬프트에 "한글은 Text로만"이라고 적었는데도 Claude 세 모델 모두 MathTex(r"n\text{번째 홀수} = 2n-1")처럼 LaTeX 안에 한글을 넣었다. Opus도 3번이다. 그중 한 번은 한글 MathTex를 만든 바로 다음 줄에서 Text 버전으로 덮어썼다. 하지만 첫 줄이 실행되는 순간 이미 LaTeX가 돌아 죽었다. 영어권 논문에는 나오지 않는, 한국어 해설 영상만의 실패다.
지어낸 상수와 인자(82건). 그럴듯하지만 없는 이름이다. 색 상수 CYAN, DARK_RED, DARKGREEN, LIGHT_BLUE, ORANGE_A와 위치 상수 CENTER, TOP이 24건이었다(Manim CE의 색은 TEAL, RED_E, GREEN_E 같은 이름이고 '가운데'는 ORIGIN이다). Text에 없는 size=, opacity=, height= 같은 인자가 27건, SurfaceMesh나 FancyArrowPatch(matplotlib의 클래스다) 같은 없는 클래스가 10건이었다. 대형 모델은 오류 메시지를 받으면 한 번에 고쳤고, 작은 모델은 다른 가짜 이름으로 바꿨다.
정리별로는 오일러 다면체 공식의 첫 시도 성공이 8번 중 1번으로 가장 낮았고, 등비급수가 6번으로 가장 높았다. 털난 공 정리는 3D 구를 그리다 렌더가 300초를 넘긴 시간 초과가 세 번 나왔다. 그래도 오류 수리 뒤에는 모든 정리가 8번 중 5~6번으로 비슷해졌다. Qwen의 2번을 빼면 거의 전부다.
아래 퀴즈는 실험에서 나온 실제 코드와 오류다. 어느 종류의 실패인지 맞혀 보자.
6-4. 렌더된 뒤 — 배치는 가장 낮고, 수학은 모델 차이가 가장 크다
렌더에 성공한 첫 영상 57편을 비전 심사관이 채점했다(1~5점).
코더
영상
정확성·깊이
시각 관련성
논리 흐름
배치
시각 일관성
평균
Haiku 4.5
17
1.71
2.06
2.29
1.82
2.65
2.11
Sonnet 5.5
20
3.55
3.75
3.75
2.95
3.65
3.53
Opus 5.5
20
4.05
4.15
4.15
3.45
3.90
3.94
전체
57
3.18
3.39
3.46
2.79
3.44
3.25
TheoremExplainAgent 표 2와 같은 모양이다. 다섯 차원 중 배치가 가장 낮다. 1년 반 동안 모델이 좋아졌지만 이 순서는 바뀌지 않았다.
수학 오류는 모델 차이가 가장 컸다. 심사관이 '중대한 수학 문제'를 하나 이상 지적한 영상의 비율이다.
Haiku 4.5의 피타고라스 재배열 영상(첫 렌더). 자막은 맞는 말을 하는데, 그림의 삼각형은 정사각형 밖으로 튀어나가 있다. 렌더 오류는 하나도 없었다.
그림이 증명을 배신한다. 피타고라스 재배열 증명에서 직각삼각형 네 개가 큰 정사각형 밖으로 튀어나갔다(Haiku). 재배열 증명은 '네 삼각형이 정사각형 안에 딱 맞는다'는 것이 전부인데, 그 그림이 틀렸다. 등비급수에서는 1/16, 1/32 조각이 정사각형 밖에 칠해졌다(Haiku).
손으로 적은 숫자가 틀린다. 칸토어 대각선 논법에서 목록의 수를 0.314159…, 0.271828…, 0.141421…, 0.707106…으로 잡아 놓고, 대각선 숫자를 3, 7, 1, 0으로 뽑았다. 네 번째 수의 네 번째 자리는 1인데 0이라고 적은 것이다(Haiku). 화면에서 지나치기 쉬운 이 오류를 심사관은 정확히 짚었다.
라벨과 그림이 어긋난다. 원의 넓이 영상에서 부채꼴 8조각 그림에 'N = 16' 라벨이 붙었고(Sonnet), 오일러 공식 영상에서 지운 모서리 수가 그림과 달랐다(Sonnet).
Opus의 5%는 따로 짚어야 한다. 심사관이 Opus 5.5이므로, 모델 이름을 가렸더라도 자기 문체에 너그러웠을 가능성이 있다. 그래서 심사관을 사람 눈으로 대조했다. 영상 10편의 키프레임을 먼저 직접 보고 판정을 적은 뒤 심사관 결과와 맞춰 봤다.
배치 문제 유무는 10편 모두 일치했다. 수식 잘림, 자막 겹침, '모순!'과 결론 식의 겹침, 너무 작은 표, 빈 화면이 이어지는 경우까지 같았다.
중대 수학 오류 유무는 6편에서 일치했다. 어긋난 4편은 모두 심사관이 더 엄격한 쪽이었다. 그중 둘은 480p 프레임으로는 보이지 않아 코드를 읽고 찾은 지적이었고, 나머지 둘은 '8조각에 N = 16'이나 '검은 배경 위의 검은 지름 선'처럼 그림과 라벨의 불일치를 수학 오류로 분류한 경우였다. 반대로 사람이 본 중대 수학 오류를 심사관이 놓친 경우는 없었다. 사람이 본 Opus 영상 4편에서도 중대 수학 오류는 없었다.
그러니 위의 수학 오류율은 '그림·라벨 불일치를 포함한' 숫자로 읽어야 한다. 그래도 Haiku와 Opus의 차이는 이 보정으로 사라질 크기가 아니다.
자동 검사기의 결과는 이렇다. 글자 겹침과 화면 밖 글자를 합쳐 영상당 Haiku 1.41개(영상의 59%), Sonnet 0.95개(55%), Opus 0.50개(35%)였다. Haiku와 Sonnet은 이전 자막을 지우지 않고 새 자막을 같은 자리에 써서 겹치는 경우가 많았다. Opus는 긴 수식이 화면 오른쪽 밖으로 잘리는 경우가 많았다.
검사기와 심사관은 113편(수리 전후 합계) 중 77편(68%)에서 '배치 문제 있음/없음'이 같았다. 검사기만 잡은 13편은 대부분 잠깐 겹쳤다 사라지는 경우였다. 심사관만 잡은 23편은 글자가 도형을 가리거나, 글자가 너무 작거나, 배경과 대비가 낮은 경우였다. 글자끼리의 상자만 보는 검사기가 잡을 수 없는 종류다. 5장의 SGA 논문이 말한 대로 둘은 서로 다른 것을 본다. 자는 겹침을 정확히 재고, 눈은 읽기 어려움을 본다.
6-5. 화면을 보여 주고 고치게 하면
렌더된 57편 모두에 지적이 하나 이상 있었으므로 전부 시각 수리를 한 번 시켰다. 검사기 결과와 심사관의 문제 목록을 같은 코더에게 돌려주고 고친 파일을 받았다. 고친 파일은 56편이 렌더됐다. Haiku 1편은 고치다 렌더가 깨졌다.
코더
검사기 문제 수 (전→후)
심사관 평균 (전→후)
중대 수학 오류 영상 (전→후)
영상당 중대 문제 (전→후)
Haiku 4.5
1.38 → 1.44
2.10 → 2.49
94% → 88%
5.3 → 4.1
Sonnet 5.5
0.95 → 0.50
3.53 → 3.74
50% → 35%
2.0 → 1.05
Opus 5.5
0.50 → 0.05
3.94 → 4.21
5% → 5%
0.30 → 0.45
1
시각 피드백은 잘하는 모델에게 더 잘 듣는다
Opus는 검사기 문제를 20편에서 10개 → 1개로 줄였다. Sonnet은 절반으로 줄였다. Haiku는 그대로였고, 고치면서 새 겹침을 만들기도 했다(한 편은 1개 → 4개).
2
수학 오류는 거의 고쳐지지 않는다
"이 그림이 틀렸다"는 지적을 받아도 좌표가 틀린 그림은 대개 틀린 채 남았다. Haiku 94% → 88%, Sonnet 50% → 35%. 화면 배치는 '옮기면' 되지만, 수학 오류는 '다시 생각해야' 한다.
3
심사관 점수 상승은 할인해서 읽는다
심사관 평균은 모든 모델에서 올랐다(전체 3.27 → 3.55). 하지만 같은 심사관이 지적한 문제를 고친 판을 같은 심사관이 다시 채점했다. 자기 일관성 편향이 섞이므로, 독립 지표인 검사기 숫자를 더 믿는다.
4
조용한 퇴행
Sonnet 한 편은 수리 응답이 출력 한도에서 잘렸다. 그런데 잘린 자리가 마침 주석 줄이라 파일은 문법상 멀쩡했고 '렌더 성공'으로 통과했다. 79초 영상이 40초가 됐고, 증명의 핵심인 4·5장면이 통째로 사라졌다. '렌더 성공'만 보는 루프는 이런 퇴행을 못 잡는다. 영상 길이와 장면 수를 같이 확인해야 한다.
6-6. 사고를 켜면
주 실험은 '사고 최소' 조건이었다. 그렇다면 모델이 충분히 생각하게 두면 더 나아질까? 주 실험이 끝난 뒤 남은 시간에 두 조건을 따로 돌렸다. 정리 10개를 한 번씩 돌릴 계획이었지만 시간 제한으로 중간에 멈췄으므로 방향만 본다.
조건
완료
첫 시도 렌더
수리 후 렌더
심사관 평균
파이프라인당 비용
Opus 5.5, 사고 많이 (effort high)
5 (+게이트웨이 시간 초과로 중단 2)
3/5
5/5
4.36 (같은 정리의 low 조건 4.12)
약 1.6달러 (low 약 0.70달러)
Sonnet 5.5, 기본 설정 (적응형 사고)
8
1/8
3/8
3.93 (렌더된 3편)
약 1.2달러
Sonnet 5.5의 기본 설정은 이 작업에서 대부분 실패했다. 8번 중 5번은 네 번의 시도 모두 코드를 한 줄도 내지 못했다. 매번 숨은 사고가 출력 한도 32,000토큰을 다 썼다. 한도를 64,000토큰 이상으로 늘리면 달라질 수 있지만 재지 않았다. 다만 이것은 실무에서 그대로 부딪힐 함정이다. 기본 설정 그대로 긴 코드를 요청하면 생각만 하다 끝날 수 있다.
Opus 5.5는 생각을 많이 하게 해도 크게 달라지지 않았다. 다섯 편 모두 렌더됐고 심사관 점수는 조금 높았다(+0.24, 다섯 편이라 판단 보류). 비용은 두 배를 넘었고 파이프라인 하나에 8~54분이 걸렸다. 응답이 길어 게이트웨이가 시간 초과로 끊은 경우가 두 번 있었다.
정리하면, 이 작업에서 '더 오래 생각하기'는 돈과 시간에 비해 얻는 것이 적었다. 오류 메시지를 보고 고치는 루프가 생각의 상당 부분을 대신한다.
6-7. 영상과 결과 직접 보기
아래 탐색기에서 파이프라인 80개를 모델·정리별로 걸러 보고, 하나씩 눌러 오류 기록과 검토 의견을 볼 수 있다. 대표 영상 몇 편은 실제로 재생된다. 털난 공 정리의 수리 전후 판을 나란히 보면 6-5의 숫자가 무엇을 뜻하는지 바로 보인다.
6-8. 이 실측의 한계
정리×모델 칸마다 표본이 둘이라, 정리별·칸별 결론은 일화 수준이다. 모델 사이의 차이만 신뢰구간이 갈린다.
심사관은 애니메이션이 끝난 화면(키프레임)만 본다. 움직이는 도중의 오류는 보지 못하고, 코드를 읽고 추론한 지적이 섞인다.
음성 없는 자막형 영상이다. TheoremExplainAgent처럼 음성과 화면을 맞추는 문제는 재지 않았다. 학습 효과도 재지 않았다.
480p 렌더이고 공유 머신에서 돌려, 300초 시간 초과(3건)가 머신 부하의 영향을 받았다.
프롬프트와 스토리보드가 한국어다. 수식 안의 한글 오류는 이 조건 때문이며, 영어 조건과는 비교하지 않았다.
비용은 주 실험 80개에 34.21달러(심사 13.67달러 포함), 사고 모드 곁가지 실험과 폐기한 시범을 합쳐 약 55달러였다. 파이프라인당 코더 비용은 Haiku 0.10달러, Sonnet 0.48달러, Opus 0.45달러다. 공유 머신에서 76분이 걸렸다.
7장. 처방 — AI에게 해설 영상을 맡기려는 사람에게
실측과 1년 반의 연구를 합치면, 2026년 10월 현재 해설 에이전트에 대해 이렇게 말할 수 있다.
이제 믿어도 되는 것
도구로 잡아야 하는 것
사람이 봐야 하는 것
대형 모델은 오류 수리 몇 번이면 거의 다 렌더한다 (Claude 85~100%)
글자 겹침·화면 밖 잘림 — 경계 상자 검사로 잴 수 있고, 좋은 모델은 그 결과를 받아 고친다
그림이 수학적으로 맞는가 — 수리 지시로도 잘 고쳐지지 않는다
버전을 명시하면 ManimGL·CE 혼용은 사라졌다 (0건)
수식 안의 한글 — 정규식 한 줄로 렌더 전에 잡힌다
무엇을 어떤 순서로 보여 줄지 — 그것이 해설의 본업이다
영상 길이·장면 수 — '조용한 퇴행'을 잡는 가장 싼 검사
심사 모델의 점수 — 스스로 고친 판을 스스로 채점하면 오른다
7-1. 만드는 사람을 위한 순서
1스토리보드는 사람이 쓴다. 장면마다 '이 장면이 끝나면 시청자가 알게 되는 것' 한 문장을 적는다. SoME의 AI 규칙이 선을 긋는 곳도, 샌더슨이 영상 시간의 대부분을 쓴다는 곳도 여기다.
2버전과 환경을 못 박는다. "Manim Community Edition 0.22, from manim import *". 한글을 쓸 거라면 "한글은 Text(font=…)로만, MathTex 안에는 절대 넣지 말 것"을 적고, 렌더 전에 MathTex(나 Tex( 안의 한글을 정규식으로 검사한다.
3장면 단위로 렌더하고 고친다. 오류 메시지를 그대로 돌려주면 대형 모델은 대개 한 번에 고친다. 같은 종류의 오류가 세 번 반복되면 모델을 바꾼다. 작은 로컬 모델은 이 일에 아직 맞지 않는다.
4배치는 자로 잰다. 매 애니메이션 뒤 글자 객체의 경계 상자를 모아 화면 밖과 겹침을 센다. 이번 실측의 검사기처럼 Scene.play를 감싸는 수십 줄이면 된다. 결과를 숫자로 돌려주면 좋은 모델은 그대로 고친다.
5퇴행을 막는다. 고친 판의 영상 길이와 장면 수가 줄지 않았는지, 출력이 잘리지 않았는지(stop_reason) 확인한다. '렌더 성공'은 '내용 보존'이 아니다.
6사람이 처음부터 끝까지 본다. 특히 그림의 수학을 본다. 삼각형이 정말 정사각형 안에 들어가는지, 대각선 숫자가 정말 대각선에 있는지, 라벨의 숫자가 그림과 같은지. 그리고 3장의 경고대로, 매끄러운 영상일수록 의심한다.
7-2. 그대로 쓰는 코더 프롬프트
이번 실측의 실패를 거꾸로 뒤집어 만든 프롬프트 뼈대다. 실측에 쓴 프롬프트가 아니라, 실측 결과를 반영한 권장안이다.
Manim 코더 시스템 프롬프트 (권장안)
환경Manim Community Edition 0.22 (from manim import *). ManimGL 문법(ShowCreation, TexMobject, CONFIG 등) 금지. 파일 하나, Scene 클래스 하나. 출력은 코드 블록 하나만.
글자한글은 Text("…", font="Apple SD Gothic Neo")로만 만든다. MathTex·Tex 안에는 한글을 한 글자도 넣지 않는다. 수식과 한글 설명은 별개 객체로 만들어 next_to로 붙인다.
이름색은 Manim CE에 있는 상수만 쓴다(BLUE, RED_E, TEAL, YELLOW 등). 확실하지 않으면 "#RRGGBB" 문자열을 쓴다. 가운데는 ORIGIN이다. Text의 크기는 font_size, 투명도는 set_opacity로 바꾼다.
배치화면은 가로 −7.1~7.1, 세로 −4~4. 모든 글자는 가장자리에서 0.5 안쪽에 둔다. 새 자막을 쓰기 전에 이전 자막을 FadeOut하거나 Transform으로 바꾼다. 긴 수식은 scale_to_fit_width(12) 이하로.
수학숫자·좌표는 손으로 적지 말고 코드에서 계산한다(예: 대각선 숫자는 문자열 인덱싱으로 뽑는다). 그림이 증명의 일부면, 그 그림이 정말 그 성질을 갖는지 주석으로 근거를 적는다.
7-3. 가르치는 사람에게
해설 에이전트는 교사의 '그리기 시간'을 크게 줄여 준다. 반대로 '고르기 시간'은 줄여 주지 않고, 검토 시간은 오히려 늘린다. 버니와 베트랑쿠르의 메타분석에서 애니메이션의 효과가 가장 뚜렷했던 조합은 내레이션이 붙고 시스템이 속도를 정하는 형식이었다. 하지만 수학 영역의 효과는 0에 가까웠다. 그러니 AI가 만든 영상을 수업에 쓴다면 영상 자체보다 영상 다음의 활동에 공을 들이는 편이 낫다. 4편에서 본 인출 연습과 생성 효과를 떠올리면 된다. 영상을 멈추고 다음 장면을 예측하게 하기, 틀린 그림을 찾게 하기, 학생이 직접 스토리보드를 쓰고 AI에게 그리게 하기. 마지막 방법은 SoME의 규칙과 정확히 같은 분업이다. 설명을 설계하는 일은 학생이, 그리는 손은 기계가 맡는다.
8장. 연작을 닫으며 — 증명 다음의 수학
다섯 편 동안 같은 질문을 각도를 바꿔 물었다. 기계가 수학의 어느 부분을 대신할 수 있고, 그때 사람에게 무엇이 남나.
1편질문. 기계는 50년 동안 추측을 만들어 왔다. 숫자 패턴은 잘 찾지만, 어떤 질문이 흥미로운지 고르는 감각은 여전히 사람에게 있다.
2편증명. 기계가 쓴 증명을 해설로 풀면 독자는 더 잘 이해한다. 다만 해설을 읽은 독자의 '이해했다'는 자기 평가는 문체와 무관하게 높았다. 착각은 늘 가까이 있다.
3편두 문화. AI가 쓴 수학 원고의 96.7%가 '문제 해결' 문화에 속했다. 이론을 짓고 개념을 엮는 일은 아직 사람 쪽에 몰려 있다.
4편체육관. 배움은 힘들어야 남는다. AI 튜터는 짧은 프롬프트로는 두 번째 조름에 무너졌고, 구체적 규칙과 참고 풀이를 주어야 버텼다.
5편해설. 기계는 이제 해설 영상을 끝까지 렌더한다. 그러나 무엇을 보여 줄지 고르고, 화면이 맞게 가르치는지 확인하는 일은 아직 사람의 눈을 필요로 한다.
다섯 편에 공통된 그림이 있다. 기계는 만드는 일에서 빠르게 사람을 따라잡는다. 추측을 만들고, 증명을 쓰고, 문제를 풀고, 튜터처럼 말하고, 영상을 렌더한다. 그런데 그 결과물이 좋은지를 가리는 일, 곧 흥미로운 질문인지, 소화된 증명인지, 이론으로 엮이는지, 배움이 일어났는지, 화면이 맞게 가르치는지를 판정하는 일은 매번 더 어려운 문제로 남았다. 그리고 그 판정을 다시 기계에 맡기면, 2편의 자기 평가 착각과 5편의 심판 편향처럼 같은 문제가 한 층 위에서 반복된다.
샌더슨은 영상의 마지막에 이렇게 말했다. "나는 그걸 설명하는 게 좋다. 시각화하는 게 좋다." 그가 말한 즐거움은 렌더 버튼을 누르는 즐거움이 아니라, 어떤 그림이 어떤 생각을 열어 주는지 고르는 즐거움일 것이다. 기계가 그리기를 대신해 줄수록 그 고르는 일은 더 많은 사람에게 열린다. Manim 코드를 짤 줄 몰라도 "털난 공에는 왜 가마가 생기나"를 어떤 순서로 보여 줄지 고민하는 사람은 이제 그 고민만으로 영상을 만들 수 있다. 수학을 하기에 지금보다 좋은 때가 없었다는 샌더슨의 말은, 적어도 해설에 대해서는 그런 뜻으로 읽힌다.
그랜트 샌더슨이 3Blue1Brown 영상용으로 만든 파이썬 수학 애니메이션 엔진. 지금은 샌더슨판(ManimGL)과 커뮤니티판(ManimCE)으로 나뉜다
ManimCE
2020년 커뮤니티가 갈라 만든 판. 문서와 테스트가 갖춰져 있어 입문자와 대부분의 연구가 쓴다. 이 글의 실측도 v0.22.0을 썼다
ManimGL
샌더슨이 지금 쓰는 판. 2021년 OpenGL 셰이더 브랜치를 합쳐 만들어졌다. 패키지 이름은 manimgl
Scene
Manim의 장면 클래스. construct() 메서드 안에 각본을 쓴다
Mobject
Mathematical object. 원·도형·수식·글자처럼 화면에 놓이는 모든 것
Animation
Mobject의 시작 상태에서 끝 상태까지를 보간하는 동작. Create, Write, Transform 등
MathTex / Tex / Text
ManimCE에서 각각 LaTeX 수식, LaTeX 문단, 일반 글꼴 글자. ManimGL에서는 Tex가 수식이라 이름이 엇갈린다
렌더
코드를 실제로 실행해 프레임을 그리고 영상 파일로 만드는 일
경계 상자
객체를 감싸는 가장 작은 직사각형. 겹침·화면 이탈 검사의 기본 단위
안전 여백
화면 가장자리에서 일정 거리 안쪽. 요소가 잘리지 않도록 이 안에 두라는 규칙
에이전트
LLM이 계획·도구 호출·결과 확인을 반복하며 과제를 수행하는 구조. 여기서는 렌더 결과를 보고 코드를 고치는 루프
RAG
검색 증강 생성. 관련 문서를 검색해 프롬프트에 붙여 주는 방법
비전 언어 모델(VLM)
이미지를 입력으로 받아 이해하고 글로 답하는 모델. 렌더된 프레임을 보고 문제를 지적하는 심판 역할을 맡는다
TheoremExplainBench
TheoremExplainAgent 논문이 낸 정리 240개 평가 세트(4분야 × 3난이도)
TeachQuiz
Code2Video의 지표. 영상을 본 뒤와 '모르는 척하는' 상태의 퀴즈 점수 차
생존자 편향
끝까지 살아남은 것만 보고 판단해 생기는 왜곡. 렌더에 성공한 영상만 채점하면 품질이 높아 보인다
효과 크기 (d, g)
두 집단 평균 차이를 표준편차로 나눈 값. 0.2 작음, 0.5 중간, 0.8 큼이 관례
메타분석
같은 질문을 다룬 여러 연구의 결과를 통계적으로 합치는 방법
멀티미디어 학습 원리
메이어가 실험으로 정리한 15개 설계 원리. 일관성·신호·중복·근접·분절·목소리 등
유창성 착각
매끄럽게 전달된 설명을 들으면 실제보다 더 많이 배웠다고 느끼는 현상
SoME
Summer of Math Exposition. 샌더슨이 2021년부터 연 수학 해설 공모전
털난 공 정리
공 표면의 모든 점에 접하는 연속 벡터장은 반드시 어딘가에서 0이 된다는 정리. 털을 빗으면 가마가 생긴다
마치며
TheoremExplainAgent가 나온 지 1년 반, 해설 에이전트는 "영상이 끝까지 만들어지나"라는 첫 관문을 사실상 넘었다. 코어닷투데이의 실측에서도 Claude 세 모델은 오류 수리 몇 번 만에 85~100%를 렌더했고, 옛 API 혼용은 한 번도 나오지 않았다. 남은 관문은 두 개다. 화면이 맞게 보이는가, 그리고 맞게 가르치는가. 앞의 것은 경계 상자와 자로 잴 수 있어서 2026년 연구들이 빠르게 좁혀 가고 있다. 뒤의 것은 아직 사람의 눈이 필요하다. 그리고 그 사람의 눈조차 서로 합의하지 못한다는 것이 2026년의 가장 정직한 발견이다.
그래서 지금 이 도구를 쓰는 가장 좋은 방법은 SoME의 규칙과 비슷하다. 무엇을 어떤 순서로 보여 줄지는 사람이 정하고, 그 그림을 코드로 옮기는 손은 기계에게 빌린다. 그리고 렌더된 영상은 반드시 처음부터 끝까지 사람이 본다. 기계가 '완성!'이라고 외칠 때가 검토를 시작할 때다.
Yanzhe Chen, Kevin Qinghong Lin, Mike Zheng Shou, "Code2Video: A Code-centric Paradigm for Educational Video Generation", arXiv:2510.01174 (ICML 2026 게재판 제목은 "…Creation"). https://github.com/showlab/Code2Video
Yuejia Li 외, "See Before You Code: Learning Visual Priors for Spatially Aware Educational Animation Generation"(OmniManim), arXiv:2605.15585 (CC BY 4.0).
Richard E. Mayer, Multimedia Learning, 3rd ed., Cambridge University Press, 2020.
Barbara Tversky, Julie Bauer Morrison, Mireille Bétrancourt, "Animation: can it facilitate?", International Journal of Human-Computer Studies 57(4), 247–262, 2002.
Tim N. Höffler, Detlev Leutner, "Instructional animation versus static pictures: A meta-analysis", Learning and Instruction 17(6), 722–738, 2007.
Richard E. Mayer, Mary Hegarty, Sarah Mayer, Julie Campbell, "When static media promote active learning", Journal of Experimental Psychology: Applied 11(4), 256–265, 2005.
Derek A. Muller, Designing Effective Multimedia for Physics Education, PhD thesis, University of Sydney, 2008. · Muller, Bewes, Sharma, Reimann, "Saying the wrong thing", Journal of Computer Assisted Learning 24(2), 144–155, 2008.
Shana K. Carpenter, Miko M. Wilford, Nate Kornell, Kellie M. Mullaney, "Appearances can be deceiving", Psychonomic Bulletin & Review 20(6), 1350–1356, 2013.