[특집] 722편의 원고 — OpenAI가 하룻밤에 공개한 372개의 '해결된' 수학 문제, 그 저장소를 열어 보다
2026년 10월 6일 밤, OpenAI는 일곱 문단짜리 글 「수학에서의 AI 진전을 공유합니다」와 함께 GitHub 저장소 하나를 열었다. 미공개 내부 모델이 쓴 수학 원고 722편, 결과 계열 372개. 준(準) 리만 가설, 4차원 카케야 추측, 행렬 곱셈 지수 2.25, 유일 게임 추측, 톰프슨 군 F의 비순종성 — 각각이 사람이 했다면 경력을 통째로 바칠 만한 문제들이 '거의 전부 프롬프트 하나, 에이전트 하나, 평균 세 시간'으로 나왔다고 적혀 있다. 이 글은 저장소를 직접 열어 README·카탈로그·Lean 라이브러리·추론 요약 10건을 읽고, 헤드라인 결과를 비전공자도 이해할 수 있게 풀고, '검증됨'과 '이해됨' 사이의 거리를 재고, 사흘간 쏟아진 수학자들의 반응('즉시 필즈상'에서 '힘의 시연'까지)을 지도에 놓는다. 그리고 하루 전 같은 블로그에 실린 아비가드의 편지와 겹쳐 읽는다.
GitHub 저장소 openai/math의 생성 시각은 2026년 10월 6일 21시 47분, 마지막 푸시는 22시 01분이다. 14분 사이에 722편의 수학 원고가 올라갔다. 이튿날 아침 한국 시간으로 수학자들이 눈을 떴을 때 저장소에는 별 9,400개가 붙어 있었고, 해커뉴스 1위 스레드에는 댓글 1,396개가 달려 있었다.
같은 시각 OpenAI 블로그에 올라온 글의 제목은 「수학에서의 AI 진전을 공유합니다(Sharing AI progress in mathematics)」. 본문은 일곱 문단, 숫자는 단 하나다.
평균적인 결과는 ChatGPT Pro로 약 세 시간 생각하는 것에 해당하는 계산을 썼다.
나머지 숫자는 저장소 README에 있다. 미공개·미명명 내부 모델에 약 4,000개의 문제를 냈고, "적절한 수준의 유의성"을 요구해 걸러낸 결과가 372개의 결과 계열(family), 722편의 원고였다. 그중 주 결과가 Lean으로 형식화된 원고는 162편. 10개 결과에 대해서는 모델의 추론 과정을 요약한 문서를 함께 냈다.
카탈로그를 열면 1번부터 372번까지 결과가 분야별로 적혀 있다. 3번은 "준 리만 가설". 4번은 "ℚ 위의 힐베르트 10번 문제". 17번은 "π의 무리수 지수는 2". 74번은 "3차원과 4차원의 카케야". 102번은 "유일 게임 추측". 107번은 "행렬 곱셈 지수 ≤ 9/4". 248번은 "톰프슨 군 F는 비순종". 287번은 "자유군 인자의 동형". 수학과 대학원생이라면 어느 한 줄에서 숨을 멈출 목록이다.
반응은 사흘 동안 두 극단으로 갈라졌다.
경이
경계
"준리만?!?!???! 농담인가요? 사람이 이걸 했다면 즉시 필즈상입니다." — 알렉스 콘토로비치(럿거스)
"파일 700개를 한꺼번에 공개하는 것은 학문의 시연이 아니라 힘의 시연이다." — AHM 커뮤니케이션 그룹 성명(10월 8일)
"모델을 공개하고 다른 사람들이 재현하기 전까지, 에이전트 하나가 한 번에 풀었다는 주장은 미검증으로 봐야 한다." — 앤드루 서덜랜드(MIT)
"내가 가장 좋아하는 질문 네댓 개 중 둘이 풀렸다!" — 콘스탄틴 코글러(고등연구소)
"밖에 나가 풀을 좀 만지고, 맛있는 걸 구워서 가족과 나누세요." — 토머스 블룸(맨체스터, Erdős 문제 사이트 운영자)
"재밌다! 수학자들이 할 신나는 일이 많아 보인다." — 대니얼 리트(토론토)
"이 공개는 인간 이해 과정의 시작이지 완성이 아니다." — AGMAI(가워스·헤어러·위튼 등 9인) 성명(10월 7일)
이 글은 그 저장소를 직접 열어서 읽은 기록이다. 1장에서 저장소의 구조를 해부하고, 2장에서 헤드라인 결과 열 개를 비전공자가 알아들을 수 있게 풀고, 3장에서 "프롬프트 하나, 에이전트 하나, 세 시간"이 기술적으로 무슨 뜻인지와 추론 요약 문서의 생김새를 보고, 4장에서 Lean 인증서가 보장하는 것과 보장하지 않는 것을 따진다. 5장은 2026년 OpenAI의 다섯 번의 수학 발표를 한 줄에 놓고, 6장은 사흘간의 반응을 지도에 놓는다. 7장은 바로 하루 전 타오의 블로그에 실린 아비가드의 「수학의 미래」와 겹쳐 읽는다. 8장은 한국의 독자에게.
한 가지를 먼저 말해 둔다. 이 글에 나오는 "증명했다", "반증했다"는 전부 OpenAI의 주장을 옮긴 것이다. 2026년 10월 8일 현재, 372개 중 외부 수학자가 끝까지 읽고 확인했다고 공개적으로 밝힌 결과는 없다. 그 사실 자체가 이 글의 주제다.
1장. 저장소 해부 — 722편은 어떻게 쌓여 있나
OpenAI는 arXiv가 아니라 GitHub을 골랐다. 블로그 글은 "자문 그룹의 지침에 맞는 공동체가 운영하는 대안을 계속 찾고 있다"고 쓴다. 공교롭게도 저장소가 열린 그날 타오의 블로그에는 LLM 결과를 위한 새 저장소 'Hexagon'의 출범 글이 올라왔고, arXiv는 닷새 전 1인당 월 2편 제한을 발표한 참이었다. 722편을 받을 곳이 없었던 것이다.
저장소의 뼈대는 다섯 부분이다.
README.md 어떻게 만들었는지(4,000문제·3시간·단일 절차), 예외 두 건, 버전·인용 규약. 4KB
overview.pdf · CONTENTS.md 372개 계열의 한 문단 설명(41쪽)과, 계열마다 원고·초록·Lean 링크를 단 지도(640KB)
lean/ 하나의 큰 Lean 라이브러리(OAI.lean 44KB + OAI/). formalization.yaml에 형식화된 원고 162편 목록. Comparator 재검사 설정
reasoning_traces/ (10건) 모델의 사고 과정을 요약한 PDF. π의 무리수 지수 42쪽, 등차수열 준다항 경계 등
결과 계열(family)이라는 단위
722편의 원고가 372개로 묶이는 이유는 '계열' 때문이다. README의 정의는 이렇다. "계열은 관련 논문을 묶은 것으로, 주 결과, 동반 논증, 귀결, 또는 대체 증명을 포함할 수 있다." 2번 계열 "셀머 코랭크 0·1에서의 BSD 공식 전체"를 열어 보면 원고 세 편이 들어 있다. 주 결과(「낮은 셀머 코랭크로부터의 정확한 BSD 공식」), 그 보조정리에 해당하는 「모든 소수에서의 타원곡선 셀머 역정리」, 그리고 2-부분만 따로 다룬 「셀머 코랭크 ≤ 1에서의 2-원시 BSD 공식」. 사람 수학자라면 한 편의 긴 논문으로 썼을 것을 모델은 세 편으로 냈고, OpenAI는 그것을 한 계열로 묶었다.
카탈로그는 17개 분야로 나뉜다. 정수론 31, 대수·복소기하 36, 실·복소해석 16, 볼록·거리기하 15, 이론 컴퓨터과학 40, 동역학 12, 조합론 37, 대수 18, 확률·통계역학 29, 수리논리 6, 군론 14, 수리물리 25, 작용소 대수 19, 위상 18, 함수해석 11, 미분기하 29, 편미분방정식 16. 이론 컴퓨터과학과 조합론이 가장 많다는 사실은 우연이 아니다. 두 분야는 문장이 짧고, 반례가 유한하고, 검증기가 돌리기 쉽다. 아래 탐색기에서 분야별로 OpenAI가 "풀었다"고 적은 대표 문제와 Lean 형식화 여부를 볼 수 있다.
README에는 눈여겨볼 문장이 셋 있다. 첫째, "대부분의 결과는 같은 절차로 얻었지만" 예외가 두 건 있다. 리만 제타 함수의 영점 없는 영역과 CM 아벨 다양체에 대한 호지 추측이다. 이 둘에는 "고정된 절차"보다 더 많은 자원이 들어갔다는 뜻이다. 둘째, Re(s) > 11/12 영점 없는 영역의 원고는 "가독성을 위해 사람이 편집했다." 722편 중 사람 손이 닿았다고 명시된 유일한 원고다. 셋째, "형식화되지 않은 결과 일부에는 문제가 있을 수 있다(could have issues). 그런 문제는 빠르게 고치겠다." 이것이 2장을 읽을 때 머리에 둬야 할 전제다.
2장. 헤드라인 결과 열 개 — 비전공자를 위한 번역
372개를 다 볼 수는 없다. 수학자들이 사흘 동안 가장 많이 입에 올린 열 개를 고르고, 각각 무엇을 묻는 문제인지, 왜 큰지, 모델이 무엇을 주장하는지, Lean이 있는지를 적는다. 다시 한번, 모두 주장이다.
① 준(準) 리만 가설 — "영점은 7/8 오른쪽에 없다"
리만 제타 함수는 소수의 분포를 담고 있는 함수다. 리만 가설(1859)은 그 함수의 '비자명 영점'이 전부 실수부 1/2인 직선 위에 있다는 주장이고, 150년 넘게 열려 있다. 수학자들이 실제로 증명한 것은 훨씬 약하다. 영점이 실수부 1인 직선 위에는 없다는 것(1896, 소수 정리와 동치), 그리고 1 근처의 아주 좁은 띠에 없다는 것(비노그라도프–코로보프)이 전부다.
OpenAI의 3번 계열은 모든 디리클레 L-함수(제타 포함)가 Re(s) > 7/8에서 영점이 없다고 주장한다. 1에서 1/2까지 가는 길의 4분의 1을 한 번에 간 셈이다. 수학자들이 "준 리만 가설"이라 부르는 이 종류의 결과는 소수 분포에 대한 수많은 따름정리를 즉시 개선한다. 앤트로픽의 레벤트 알페게는 "지겔 영점 없음"에도 박수를 보냈는데, 이것은 디리클레 L-함수에 예외적 영점이 없다는 뜻으로 그 자체가 70년 된 미해결 문제다. Lean 형식화 있음. 독립 재검사를 위한 Comparator 설정 파일 QuasiRiemannHypothesis.json까지 제공됐다. 다만 제타 함수 자체에 대해서는 별도 원고가 Re(s) > 11/12까지 더 밀었고, 그 원고는 사람이 편집했다.
② 카케야 — 3차원 극대 추측과 4차원
카케야 집합은 모든 방향의 단위 길이 선분을 담는 집합이다. 1917년 카케야가 "그런 집합은 얼마나 작을 수 있나"를 물었고, 20세기에 "넓이 0도 가능하지만 차원은 꽉 차야 한다"는 추측이 섰다. 3차원의 하우스도르프 차원 버전은 2025년 홍 왕과 조슈아 잘이 풀었고, 왕은 2026년 필즈상을 받았다. OpenAI의 74번 계열은 3차원 극대 추측(더 강한 함수 부등식 버전)과 4차원 하우스도르프 차원을 주장한다. 이바니슈빌리의 "3차원은 필즈상, 4차원은 AI"가 이것이다. Lean 형식화 없음.
③ BSD 공식 — 타원곡선의 랭크와 L-함수
버치–스위너턴다이어 추측은 밀레니엄 문제 중 하나로, 타원곡선 위 유리점의 '랭크'가 L-함수의 영점 차수와 같고, 그 선행 계수가 곡선의 산술 불변량들로 정확히 주어진다는 것이다. 2번 계열은 셀머 코랭크가 0 또는 1인 모든 타원곡선에 대해 BSD 공식 전체(테이트–샤파레비치 군의 유한성 포함)를 주장하고, 6번 계열(골드펠트 추측)과 합치면 "모든 타원곡선의 2차 비틀림 중 밀도 1"에 대해 BSD가 성립한다고 쓴다. 따름정리 하나가 눈에 띈다. 9로 나눈 나머지가 4, 7, 8인 모든 소수 ℓ은 두 유리수의 세제곱의 합이라는 것. Lean 형식화 없음.
④ 행렬 곱셈 지수 ω ≤ 9/4
n×n 행렬 두 개를 곱하는 데 몇 번의 곱셈이 필요한가. 교과서 방법은 n³, 슈트라센(1969)이 n^2.81로 내렸고, 그 뒤 반세기의 개선 끝에 2024년 기준 약 n^2.371이었다. 많은 사람이 ω = 2(거의 n²)를 믿지만, 2.37에서 2.3으로 내리는 데도 수년이 걸렸다. 107번 계열은 ω ≤ 9/4 = 2.25를 주장한다. 스트로가츠가 "특히 놀랍다"고 한 결과다. 현대 AI 자체가 행렬 곱셈으로 돌아간다는 점에서 가장 실용적인 결과이기도 하다. Lean 형식화 있음. 같은 이론 컴퓨터과학 섹션에는 하비–판 데르 후번의 2019년 n log n 기록을 깨는 정수 곱셈 알고리즘(109번, Lean 없음)과 L = RL = BPL(로그 공간 탈무작위화, Lean 없음)도 있다.
⑤ 유일 게임 추측(UGC)
2002년 코트가 제안한 추측으로, 많은 최적화 문제의 '최적 근사 비율'을 한 번에 결정하는 열쇠다. 참이면 수십 개 문제의 근사 한계가 정확히 정해진다. 102번 계열은 UGC와 그에 따른 최적 근사 임계값을 주장하며 원고 5편으로 이루어져 있다. 2018년 "2-to-2 게임" 정리로 절반까지 왔던 문제다. Lean 형식화 있음.
⑥ π의 무리수 지수는 정확히 2
어떤 무리수를 유리수 p/q로 근사할 때 얼마나 잘 되는가를 재는 수가 무리수 지수다. 2이면 '가장 근사하기 어려운' 수(거의 모든 수가 그렇다), 크면 유리수에 비정상적으로 가까운 수다. π의 지수가 2일 것이라고 모두 믿지만 증명된 상계는 약 7.10(젤렌코프 2020)이었다. 17번 계열은 정확히 2를 주장한다. 유명한 '플린트 힐스 급수'의 수렴 여부가 이 결과의 따름정리다. Lean 형식화 있음, 그리고 42쪽짜리 추론 요약이 공개된 10건 중 하나다(3장).
⑦ 톰프슨 군 F의 비순종성
1965년 리처드 톰프슨이 만든 군 F는 "순종(amenable)인가"라는 한 질문으로 반세기 동안 군론자들을 괴롭혔다. 양쪽 다 '증명'이 발표됐다가 철회된 역사가 있는 악명 높은 문제다. 248번 계열은 비순종이라고 주장한다. Lean 형식화 있음. 같은 군론 섹션에 캐넌 추측(246번, Lean 있음)도 있다.
⑧ 자유군 인자 동형 문제
폰 노이만 대수에서 1960년대 카디슨 이래의 문제. 서로 다른 개수의 생성원을 가진 자유군들이 만드는 '인자'가 같은가 다른가. 287번 계열은 모두 동형이라고 주장한다. 작용소 대수 분야에서는 가장 큰 미해결 문제 중 하나였다. Lean 형식화 있음, 추론 요약 공개.
⑨ 조합론의 반례들 — 하드위거, 평면 색칠, 보르숙, 시도렌코
조합론 섹션은 "증명"보다 "반례"가 많다. 하드위거 추측(1943, 그래프 마이너와 색칠을 잇는 추측)의 반례. 평면을 5색으로 칠할 수 없다(즉 하드위거–넬슨 문제의 답은 6 또는 7; 2018년 드 그레이가 5 이상임을 보인 뒤 처음). 보르숙 추측은 9차원에서 거짓(기존 최저 반례 차원 64). 시도렌코 추측의 반례. 반례는 '유한한 대상 하나'이므로 Lean으로 확인하기 가장 쉽다. 네 건 중 셋에 Lean 형식화 있음.
⑩ ℚ 위의 힐베르트 10번 문제
정수 계수 다항방정식에 유리수 해가 있는지 판정하는 알고리즘이 있는가. 정수 해의 경우는 1970년 마티야세비치가 "없다"고 증명했지만, 유리수 버전은 반세기 동안 열려 있었다. 4번 계열은 없다고 주장한다. Lean 형식화 없음. 이 결과가 맞다면 수리논리와 정수론의 경계에서 손꼽히는 문제가 닫힌 것이다.
계열
주장
종전 상태
Lean
003
모든 디리클레 L-함수, Re(s) > 7/8 영점 없음
1 근처 좁은 띠만(비노그라도프–코로보프)
있음 + Comparator
074
카케야 3차원 극대, 4차원 하우스도르프
3차원 하우스도르프(왕–잘 2025)
없음
002·006
셀머 코랭크 0·1에서 BSD 전체, 밀도 1 비틀림
특수한 경우들(그로스–자기에, 콜리바긴 등)
없음
107
행렬 곱셈 ω ≤ 2.25
약 2.371
있음
102
유일 게임 추측
2-to-2 정리(2018)까지
있음
017
π의 무리수 지수 = 2
≤ 7.10
있음 + 추론 요약
248
톰프슨 군 F 비순종
양쪽 '증명' 모두 철회된 역사
있음
287
자유군 인자 모두 동형
1960년대 이래 미해결
있음 + 추론 요약
156·158
보르숙 9차원 반례, 평면 색수 ≥ 6
반례 64차원, 색수 ≥ 5
있음
004
ℚ 위 힐베르트 10번: 알고리즘 없음
정수 버전만(1970)
없음
표를 읽는 법 하나. Lean이 있는 결과와 없는 결과의 무게가 다르다. 그러나 4장에서 보듯 Lean이 있다고 끝난 것도 아니다.
3장. 어떻게 만들었나 — "프롬프트 하나, 에이전트 하나, 세 시간"
한 달 전과 정반대의 숫자
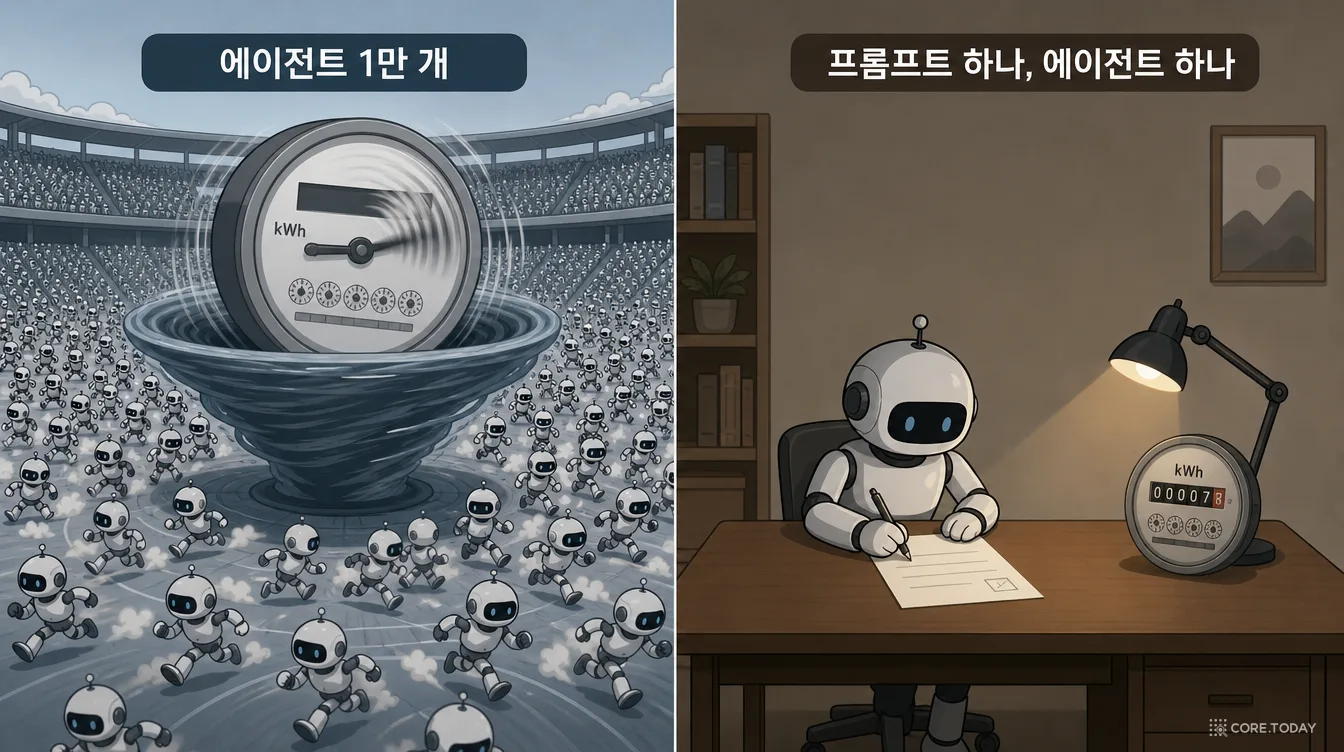
9월 8일의 나비에–스토크스 발표는 에이전트 약 1만 개가 88시간 동안 돈 결과였고, 외부 추정 비용은 수백만 달러였다. 10월 6일의 README는 정반대의 그림을 그린다. "결과의 대다수는 같은 절차로, 공개되지 않은 내부 OpenAI 모델을 써서 얻었다. 평균적으로 각 결과는 그 모델로 ChatGPT Pro 사고 계산 세 시간을 썼다." 그리고 보도자료에 따르면 "거의 모든 논문이 AI 에이전트 하나에 프롬프트 하나를 준 결과"였다.
이 변화가 무엇을 뜻하는지는 두 갈래로 읽힌다. 낙관적으로 읽으면, 떼와 오케스트레이션 없이 모델 자체가 미해결 문제를 풀 수준이 됐다는 뜻이다. 비판적으로 읽으면, 서덜랜드의 말대로 "모델을 공개하고 재현되기 전까지는 미검증"인 주장이다. 어느 쪽이든 숫자 하나는 분명하다. 4,000문제 중 372계열, 성공률 약 9%. 아비가드가 하루 전 글에서 "지금까지 AI가 푼 문제는 기존 기법을 이어 붙여 닿는 것들"이라고 했을 때, 그 '닿는 거리' 안에 있던 문제가 열에 하나였다는 실측치다. 나머지 아홉은, 적어도 이 모델과 세 시간으로는, 닿지 않았다.
모델은 무엇인가
이름은 없다. 블로그는 "내부 프런티어 모델"이라고만 쓰고 나비에–스토크스 글로 링크한다. 그 글에는 "GPT-6 Astra보다 훨씬 더 유능한 내부 모델"이라고 적혀 있다. 8월 1일의 '열 가지 결과'는 "Astra의 내부 버전", 7월 10일의 사이클 이중 덮개 추측 증명은 "GPT-5.6 Sol Ultra에 하위 에이전트 64개"였다. 다섯 달 사이에 모델 이름이 세 번 바뀌었고, 마지막 것은 이름조차 없다. AGMAI가 9월 29일 권고안에서 "모델 이름, 정확한 프롬프트, 계산 시간"을 공개하라고 했지만 OpenAI는 평균 계산 시간만 냈다. 사이언티픽 아메리칸은 OpenAI가 "권고에 구속되기를 거부했다"고 썼다.
기술적으로 이 모델이 어떻게 훈련됐는지는 공개된 바 없다. 그러나 2024~2026년의 공개 연구가 보여 주는 큰 그림은 분명하다. 어제 글의 4장에서 자세히 다룬 검증 가능한 보상을 이용한 강화학습(RLVR)이다. 모델이 풀이를 여러 개 쓰고, 검증기(수학이면 정답 대조나 Lean 커널)가 맞은 것에 1을 주고, 맞은 풀이의 단어들이 더 자주 나오도록 밀어 올리는 과정을 수만 번 반복한다. 결과만 보고 채점하기 때문에 모델은 아는 수를 더 길게, 더 끈질기게 이어 붙이는 데 초인적으로 능해진다. "세 시간 생각하기"는 그 길고 끈질긴 사슬의 길이다.
추론 요약 10건 — 모델은 세 시간 동안 무엇을 했나
이번 공개에서 가장 흥미로운 문서는 원고가 아니라 reasoning_traces/ 폴더의 PDF 10건이다. OpenAI가 "모델 추론의 요약본"이라 부르는 이 문서들은 모델의 사고 사슬을 사람이 읽을 수 있게 압축한 것이다. 「π의 무리수 지수는 2」의 요약은 42쪽이고, 구조는 이렇다.
reasoning_traces/irrationality-exponent-of-pi.pdf — 구조
머리말 "두 부분은 플린트 힐스 급수의 수렴에서 π의 정확한 무리수 지수로 가는 움직임을 추적한다. 1부는 62/25라는 근사 경계 주장과 그에 따른 수렴 논증을 기록한다. 2부는 앞선 보고의 보간-행렬식 기법을 출발점으로 삼아 지수 2를 주장한다."
1부 18개 절. 제목만 읽어도 실패의 기록이다 — "보조 형식과 되풀이되는 높이 장벽", "비소멸과 산술 비용에 의해 무효화된 차원 이득", "접촉 예산, 엔트로피 장벽, 역모멘트 구성", "잃어버린 행렬식 이득과 분모 의존 양의 형식", "사라지는 증폭", "섭동 손실과 소수진 절약으로의 선회"…
VERBATIM EXCERPT 라벨이 붙은 원문 발췌 69군데. 예: "그러면 로스가 모든 수에 지수 2를 줄 텐데." / "따라서 구성된 F는 대각선에서 항등적으로 소멸할 가능성이 높다. r에서만이 아니라. 탈출하려면 횡단 방향의 도함수가 필요하다. 정확히 엔트로피 함정이다."
참고문헌 21건. 그중 둘은 "[17] OpenAI. Catalan's constant is irrational. 2026.", "[18] OpenAI. The joint Dickman law for consecutive integers. 2026." — 모델이 같은 공개의 다른 결과를 인용한다.
「등차수열의 준다항 경계」 요약은 더 길다. 1부(에르되시 역수합 추측) 27개 절, 2부(준다항 강화) 이어서. 이 문서에는 원래 프롬프트가 실려 있다. 번역하면 이렇다.
문제. N₀ = {0,1,2,…}이고 A ⊂ N₀의 역수합이 발산한다고 하자. A가 모든 유한 길이의 등차수열을 포함하는지 증명하거나 반증하라. … 반증은 역수합이 발산하면서 어떤 고정된 길이 k ≥ 3의 등차수열이 없는 집합을 제시해야 한다.
이것이 "프롬프트 하나"의 실물이다. 문제 서술과 "증명하거나 반증하라", 그리고 반증의 요건. 힌트도 참고문헌도 없다. 그다음 절부터 요약은 모델이 블룸–시삭의 3항 결과를 출발점으로 삼고, 그린–타오의 r₄ 경계와 가워스의 일반 경계를 떠올리고, 렝–사–소니의 경계를 읽으며 "구조적 밀도 증가를 보통 등차수열로 바꿀 때 생기는 손실"에 주목하는 과정을 기술한다. 27개 절의 제목 중 "순환성 우려의 재발", "제안된 역수합 증명에 대한 마무리 검토", "양적 수리에 이은 기초 감사" 같은 것이 있다. 모델이 자기 증명을 스스로 감사하는 단계가 요약에 들어 있는 것이다.
이 요약들을 어떻게 받아들여야 할까. 두 가지는 분명하다. 첫째, 이것은 사고 사슬 원문이 아니라 요약이다. "요약된 사고 사슬(Summarized chain of thought)"이라고 문서 자체가 밝힌다. 모델이 실제로 생성한 토큰이 얼마나 되는지, 요약을 누가(어떤 모델이) 했는지는 적혀 있지 않다. 둘째, 그럼에도 이 문서들은 2026년 현재 공개된 자료 중 프런티어 모델이 연구 수준 수학 문제를 어떻게 공략하는지를 가장 길게 보여 주는 기록이다. 실패한 시도 18개 절 뒤에 성공 하나가 온다는 구조 자체가 아비가드가 말한 "실패와 성공의 이력으로부터 유망한 수를 배운다"의 추론 시점 버전이다.
4장. 검증됨 ≠ 이해됨 — Lean 인증서는 무엇을 보장하나
162편, 235계열, 그리고 560편
OpenAI는 "많은 증명의 Lean 형식화"를 함께 공개했다. 숫자를 정확히 하자. 저장소의 lean/formalization.yaml(v0.4, mathlib 이니셔티브의 공개 스키마를 따른다)에는 주 결과가 형식화된 원고 162편이 적혀 있다. 722편의 22%다. CONTENTS.md 기준으로 Lean 자료가 붙은 계열은 372개 중 235개지만, 계열 안의 모든 원고가 형식화된 것은 아니다. 뒤집어 말하면 원고 560편은 주 결과의 기계 검증이 없다. 카케야, BSD, 힐베르트 10번, 드 조르지, 야우 균일화, 힐베르트–스미스가 여기 속한다.
Lean 라이브러리는 "하나의 큰 라이브러리"로 묶여 있어 README가 "작은 부분만 나눠 컴파일하라"고 권한다. 전체를 빌드하면 리눅스의 vm.max_map_count가 부족해 실패할 수 있다는 기술 노트까지 붙어 있다. 그리고 Comparator가 있다. Lean 공식 조직(leanprover)이 만든 도구로, 증명을 샌드박스에서 내보내 독립적으로 다시 검사하는 '심판'이다. OpenAI는 준 리만 가설 등에 대해 Comparator 챌린지 파일을 제공했다. 설치 세 줄, 실행 한 줄이면 누구나 "이 Lean 파일이 이 문장을 증명하는가"를 자기 컴퓨터에서 확인할 수 있다.
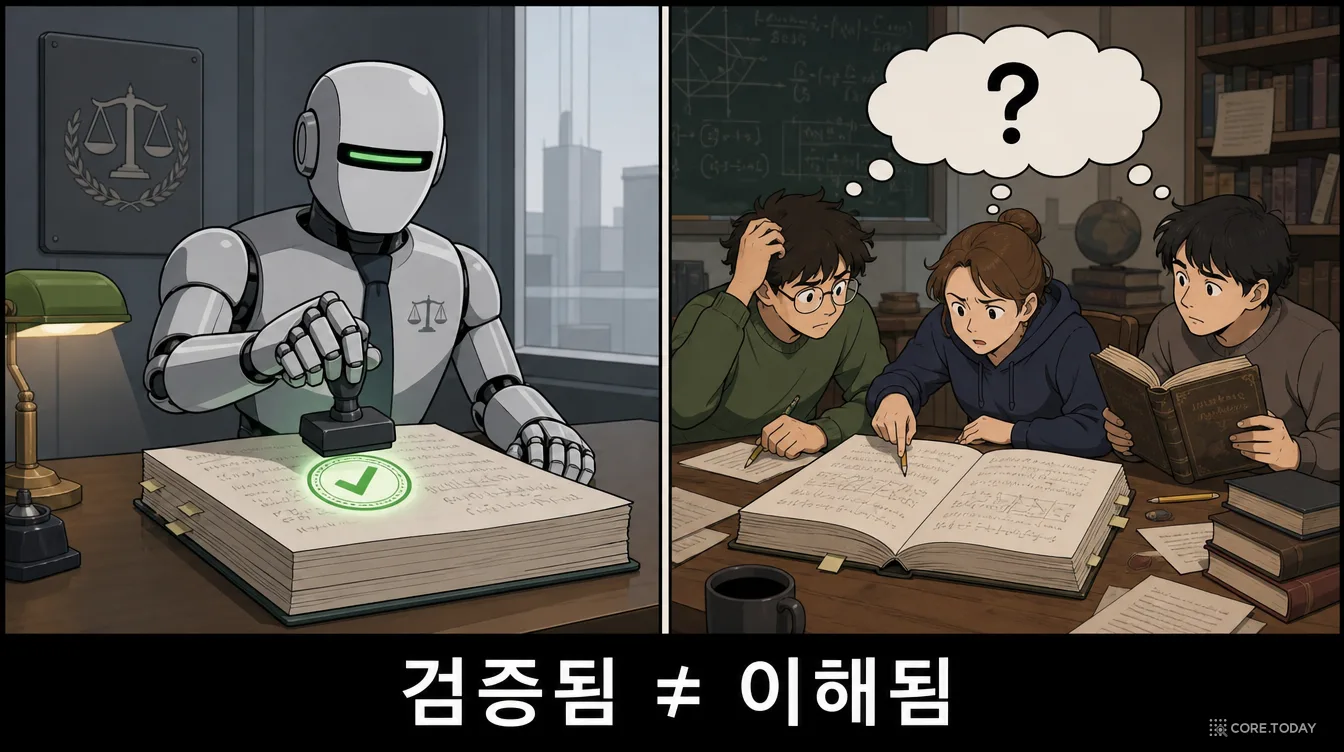
그런데 "이 Lean 파일이 이 문장을 증명하는가"는 세 개의 질문 중 하나일 뿐이다. 8월 공개 직후 나온 칼렐과 엘 루아디의 논문 「검증의 풍요, 판정의 희소」는 검증을 세 층으로 나눈다.
① 도출 타당성
형식 문장에서 결론까지 한 단계도 틀리지 않았는가. Lean 커널이 한다. 기계적이고, 이제 거의 공짜다. 8월의 열 가지 결과에서 기계가 검사한 증명은 합쳐서 20.6MB였다.
② 표현 충실성
Lean에 적힌 문장이 수학자가 묻던 그 질문인가. 정의가 표준(mathlib)인가, 아니면 저자가 새로 만든 것인가. 사람이 해야 한다. 8월 공개에서 감사가 필요한 '문장' 부분은 55.6KB에 불과했지만, 거기에는 비표준 정의 218개가 들어 있었다.
③ 인식론적 의의
이 결과가 왜 중요하고 무엇을 새로 알려 주는가. 공동체가 시간을 들여 한다. 페렐만 3년, 와일즈 2년. 기계가 도울 수는 있지만 대신할 수 없다.
①은 풍요롭고 ②·③은 희소하다는 것이 논문 제목의 뜻이다. 그리고 ②가 왜 중요한지를 보여 준 사건이 두 달 전에 있었다. 8월의 콘 강성 추측 '반증'은 Lean 코드 3만 7천 줄이 한 줄도 틀리지 않았지만, 구성된 군의 중심이 자명하지 않아 추측의 전제(ICC 성질)를 만족하지 않았다. 닐슨이 코드를 추적해 찾아냈다. 기계는 "이 군은 이런 성질을 가진다"를 완벽하게 확인했고, "그 군이 추측이 말하는 종류의 군인가"는 묻지 않았다. 아래 위젯에서 2026년의 다섯 사례가 세 층을 각각 어디까지 통과했는지 볼 수 있다.
8월의 열 가지는 지금 어떻게 됐나
이번 공개의 신뢰도를 가늠하는 가장 좋은 자료는 두 달 전 공개의 추적 기록이다. 시에니츠키 부자(父子)가 9월에 낸 「OpenAI의 AI 생성 수학 증명에 대한 사람 감사」는 8월의 열 가지 결과에 대한 전문가 리뷰 18건을 모아 평가했다. 결론은 이렇다.
검토된 평가들에서 주 결과에 확인된 실질적 수학 오류는 남아 있지 않다. 다만 검토 깊이는 제각각이고 일부 의존 관계는 부분적으로만 확인됐다. 8장(한 결과)에 가장 강한 유보가 있다. 전문가 리뷰가 압축된 해석적 논증의 대폭 수정을 요구한다. 6장에서 명백해 보였던 부호 오류는 PDF 추출 중 사라진 윗줄(overbar)이 조판 원본에서 복구되면서 철회됐다. 후속 연구는 3장의 증명 메커니즘을 독립적으로 재사용해 콘 강성 추측이 거짓임을 확인했다.
요약하면 두 달간의 집중 검토 끝에 "틀린 것은 없어 보이지만, 전부 확인됐다고도 못 한다"이다. 그 두 달은 결과 열 개에 대한 것이었다. 이번에는 372개다. 사이언티픽 아메리칸이 8월에 "열 가지 중 둘은 선행 연구의 아이디어를 제대로 인용하지 않았다"고 보도한 문제(결과가 틀린 것이 아니라 공로 표기가 틀린 것)도, 722편에서 어떻게 될지 아무도 모른다. OpenAI 블로그가 "향후 공개에서는 인용, 수학적 설명, 결과 제시의 질을 개선하겠다"고 쓴 것은 이 비판에 대한 답이다.
5장. 다섯 번의 발표 — 2026년 OpenAI의 수학 캠페인
10월 6일의 공개는 갑자기 나온 것이 아니다. 5월부터 다섯 달 동안 OpenAI는 거의 매달 수학 결과를 냈고, 그때마다 규모·비용·검증 방식·수학계의 반응이 달랐다. 한 줄에 놓고 보면 흐름이 보인다.
세 가지가 읽힌다.
첫째, 규모의 전환. 5월 결과 1개, 7월 1개, 8월 10개, 9월 1개(그러나 밀레니엄 문제), 10월 372개. 비용의 방향은 반대다. 8월은 "토큰 약 2,000달러", 9월은 "수백만 달러", 10월은 "결과당 세 시간". 9월이 떼(swarm)의 과시였다면 10월은 모델 단독 능력의 과시다. OpenAI가 "거의 전부 프롬프트 하나, 에이전트 하나"를 굳이 강조한 이유다.
둘째, 발표 방식의 학습. 8월에는 OpenAI 블로그와 자체 GitHub(ten-proofs)에 올리고 사람이 원고를 다듬었다. 사이언티픽 아메리칸이 "연구 부정행위"라는 표현까지 썼다. 9월에는 버크마스터와의 공로 다툼이 공개됐고, 9월 8일 시작된 771인의 서한("연구 수학자들이 보상도 공로도 없이 AI 기업의 결과를 검증·전파·수정하게 된다")이 10일 공개되자 OpenAI는 칼텍 매스어톤에 약속한 100만 달러의 컴퓨팅 크레딧을 거둬들였다. 9월 21일 AGMAI가 출범하고 29일 권고안이 나왔다. 10월의 공개는 그 권고안을 부분적으로 따른 첫 사례다. 버전 관리와 인용 규약, 추론 요약, 평균 계산량 공개는 따랐다. 모델 이름, 정확한 프롬프트, 개별 계산 시간은 따르지 않았다. 그리고 "내부 모델로 어려운 문제를 시험하는 일을 중단하라"는 권고는 명시적으로 거부했다. 블로그의 마지막 문단이 그것이다. "내부 프런티어 모델을 수학과 다른 과학에서 계속 평가하는 것이 중요하다."
셋째, 돈의 약속. 블로그는 "AI가 만든 주요 결과의 이해를 둘러싼 워크숍·학회·특별 프로그램 시리즈에 자금을 대겠다"고 썼다. 9월에 거둬들인 매스어톤 크레딧과 묘하게 겹친다. 사하이가 9월에 "이해하는 일을 할 수학자가 훨씬 더 많이 필요하다"고 썼을 때, 그 비용을 누가 대느냐는 질문이 따라붙었다. OpenAI의 답은 "우리가"다. AGMAI의 답은 조금 다르다. "강력한 연구 도구와 충분한 계산 자원에 대한 공평한 접근이 (수학자의 자유에) 필수적이다." 워크숍 비용이 아니라 모델 접근을 달라는 뜻이다.
6장. 사흘간의 반응 — '즉시 필즈상'에서 '힘의 시연'까지
반응을 한 축에 놓을 수는 없다. 같은 사람이 결과에는 경탄하고 과정에는 분노했기 때문이다. 아래 지도는 두 축(무엇을 보고 말했는가: 결과 ↔ 과정, 어떤 감정인가: 경이 ↔ 경계)에 사흘간의 발언을 놓은 것이다.
결과를 본 사람들
X에 가장 먼저 올라온 것은 수학자들의 날것 그대로의 탄성이었다. 콘토로비치의 "준리만?!?!???!"은 물음표와 느낌표가 여덟 개다. 프린스턴의 로드리고 포르토는 "이게 얼마나 큰지 설명할 수가 없다"고 썼다. 고등연구소의 콘스탄틴 코글러는 자기가 가장 좋아하는 질문 둘이 풀렸다고 했다. 인도 IISER 푸네의 카니니카 신하는 "우리 해석적 정수론 그룹은 오늘 아침 생각할 거리가 많다"고 썼고, 쿠란트의 스콧 암스트롱은 "내가 경쟁할 수 없을 가능성을 고려하기 시작했다"고 했다. 토론토의 대니얼 리트는 자기 추측의 특수한 경우가 풀린 것을 보고 "재밌다!"고 쓴 뒤, 사이언티픽 아메리칸에는 "답을 알고 싶다면 회사에 비밀로 해 달라고 할 이유가 없다"고 말했다. 공개 자체는 옳다는 입장이다.
과정을 본 사람들
MIT의 서덜랜드는 "모델을 공개하고 재현되기 전까지 미검증"이라고 선을 그었다. 코네티컷의 알바로 로사노-로블레도는 규모에 놀란 뒤 물었다. "그런데… 왜? OpenAI는 왜 수백 개의 수학 문제를 풀려고 하는가?" 이 "왜"는 9월 11일 선언문의 질문이기도 하다. 타오는 사이언티픽 아메리칸에 발표 속도가 "미쳤다(insane)"고 했다.
가장 날카로운 문서는 10월 8일 Proofs and Prompts에 올라온 AHM 커뮤니케이션 그룹의 성명이다. "OpenAI는 과학 연구의 규범에 대한 완전한 무시를 보여 줬다." "수학자들은 이 일을 해 달라고 요청한 적이 없다." "우리는 이 공개가 우리 학문을 발전시킨다는 OpenAI의 주장을 거부한다." 그리고 "수학자들에게 OpenAI와의 작업을 중단하고 인간의 이해를 중심에 두는 과학의 비전으로 돌아가라고 촉구한다." 9월 선언문이 AI 기업에 보낸 경고였다면, 이것은 동료 수학자들에게 보낸 보이콧 요청이다.
AGMAI의 10월 7일 성명은 그 사이에 있다. 공개를 "수학에 중요한 사건"이라 부르면서도, "우리의 자문 역할을 결과의 영향에 대한 판단이나 OpenAI가 결과를 얻은 과정에 대한 승인으로 해석해서는 안 된다"고 못 박았다. 그리고 "권고가 얼마나 성공적으로 따라졌는지 평가하는 것은 결국 수학 공동체의 몫"이라고 썼다. 서명자 아홉 명 중 셋(가워스·헤어러·위튼)이 필즈상 수상자다.
조용한 목소리들
폴란드 과학원의 타트와마시 암루탐은 같은 날 Proofs and Prompts에 「그랜드 피아노」를 올렸다. 자기 분야의 오랜 질문 둘이 기계에 풀린 날, 큰 프로젝트를 막 끝낸 소설가가 "거대한 무언가가 방에서 실려 나가 방이 아주 조용해졌다"고 느꼈다는 묘사를 빌려 왔다. "증명은 어디에나 넘쳐날 것이다. 줄어드는 것은 이해뿐이다." 그리고 "수학은 늘 시간의 게임이었다. 시간이 더는 필요 없어지면 수학은 어떻게 되는가." 그는 이것을 민주화라 부르는 데도 반대한다. "지금 수학을 움직이는 도구가 몇몇 기관에 집중돼 있다면, 일어난 일은 확장이 아니라 좁아짐이다."
해커뉴스 스레드의 가장 많이 추천된 댓글 중 하나도 같은 결이다. "이 중 어느 것도 보통 시민이 접근할 수 있는 기술로는 불가능하다. … 믿기 어려운 힘의 집중이다." 그리고 어떤 사용자는 이렇게 썼다. "그 문제에 수천 시간을 썼다. 정말 즐거웠다. 풀렸다는 소식이 어쩐지, 멀리서, 슬프다."
하루 전인 10월 5일, 타오의 블로그에는 아비가드의 「수학의 미래」가 실렸다. 세 개의 동사 — 더 어려운 문제를 풀어라, 더 큰 생각을 하라, 새로운 것을 시도하라 — 와 "우리는 당신들과 함께 선다"는 다음 세대를 향한 편지. 10월 6일의 저장소는 그 글의 모든 문장에 대한 실물 시험이다.
①
"더 어려운 문제를 풀어라" ↔ 4,000개 중 372개
아비가드는 "지금까지 AI가 푼 문제는 기존 기법을 이어 붙여 닿는 것들"이라 했고, 그런 문제가 다 떨어진 것은 아니라고 했다. 저장소는 그 진단의 양쪽을 다 보여 준다. 세 시간에 닿은 문제가 열에 하나, 닿지 않은 것이 아홉. 그러나 그 '하나'에 준 리만 가설과 UGC가 들어 있다면, "닿는 거리"의 정의를 다시 써야 한다. 아비가드가 "아직은"이라고 단서를 단 이유가 여기 있다.
②
"더 큰 생각을 하라 — 문제를 고르는 것은 우리다" ↔ 4,000개는 누가 골랐나
아비가드의 두 번째 답은 "우리가 문제를 고르고 채점한다"였다. 그런데 이 4,000개는 OpenAI가 골랐다. 어떤 기준으로, 누가 골랐는지는 공개되지 않았다. AGMAI 성명의 한 문장이 정확히 이 지점을 겨눈다. "수학자들은 자기 질문을 스스로 세우고, 자기 접근을 개발하고, AI 시스템의 능력을 보여 주는 사례로 선택되지 않은 방향을 탐구할 수 있어야 한다." 로사노-로블레도의 "왜?"도 같은 질문이다.
③
"새로운 것을 시도하라 — 도구를 만지는 사람도 수학자다" ↔ Comparator, formalization.yaml
저장소에서 가장 '수학적'인 부분은 어쩌면 원고가 아니라 인프라다. mathlib 이니셔티브가 만든 공개 스키마(formalization.yaml), Lean 공식 조직의 재검사 도구(Comparator), 버전·인용 규약. 이것들을 만든 사람들은 아비가드가 "기술자로 치부하지 말라"고 한 바로 그 사람들이고, 722편의 홍수에서 공동체가 붙잡을 수 있는 유일한 난간이다.
그리고 네 번째 메시지, "우리는 당신들과 함께 선다." 10월 6일 이후 이 문장은 더 무거워졌다. 암루탐이 쓴 대로 "시간이 더는 필요 없어진" 세계에서 박사과정 5년은 무엇을 위한 시간인가. 아비가드의 답은 "모른다, 그러나 함께 알아내자"였다. OpenAI의 답은 "워크숍에 자금을 대겠다"였다. AHM의 답은 "OpenAI와 일하지 말라"였다. 세 답 중 어느 것도 아직 대학원생 한 사람의 월요일 아침을 바꾸지 못한다. 그것이 2026년 10월 둘째 주의 정직한 상태다.
8장. 한국에서 읽기
한국 언론은 빨랐다. 재경일보는 10월 7일 「오픈AI 나비에-스토크스 이어 리만 가설까지… 수학 난제 논문 722편 기습 공개」로, 위키트리는 8일 「오픈AI, 수학 논문 722편 공개… 대부분 프롬프트 한 번에 에이전트 1개가 풀었다」로 전했다. 두 기사 모두 서덜랜드의 "미검증" 발언과 "참 명제를 대량 생산하면 새 아이디어가 자랄 토양을 해칠 수 있다"는 우려를 함께 실었고, 위키트리는 "수학자들이 양사(OpenAI·앤트로픽)의 기업공개를 앞둔 과시 경쟁에 수학이 이용되고 있다고 느낀다"는 해석을 덧붙였다. 디시인사이드와 루리웹에서는 "준리만가설 증명 성공"이 실시간 베스트에 올랐다. 다만 한국 수학자의 공개 발언이나 대한수학회 차원의 입장은 아직 확인되지 않는다.
한국 독자에게 이 사건이 던지는 질문은 셋이다.
첫째, 이 저장소를 어떻게 읽을 것인가. 722편을 다 읽을 사람은 없다. 그러나 자기 분야의 계열 서너 개는 읽을 수 있고, 읽어야 한다. 방법은 저장소가 알려 준다. ① overview.pdf에서 분야를 찾고 ② CONTENTS.md에서 계열의 원고와 초록을 보고 ③ lean/formalization.yaml에서 형식화 여부를 확인하고 ④ 있으면 Comparator로 자기 컴퓨터에서 재검사하고 ⑤ 없으면 "문제가 있을 수 있다"는 README의 경고를 전제로 읽는다. ⑥ 그리고 4장의 세 층을 기억한다. Lean이 확인한 것은 ①층뿐이다.
둘째, 한국의 AI·수학 역량은 어디 있는가. 7월 IMO 2026에서 한국 대표 이현준 학생이 42점 만점으로 전체 1위를 했고, 같은 대회에서 중국 기업 두 곳(화웨이, 샤오훙수)의 AI가 공식 채점으로 만점을 받았다. 10월의 722편은 미국 기업 한 곳의 미공개 모델이 냈다. 한국에는 Lean 형식화 공동체도, 연구 수준 수학 벤치마크도, 프런티어 모델도 아직 얇다. AGMAI가 말한 "공평한 접근"은 국가 간 문제이기도 하다. 암루탐의 "좁아짐"은 폴란드의 작은 연구소에서 쓴 말이지만, 한국의 대학에도 그대로 적용된다.
셋째, 산업 현장의 교훈. 이 사건의 기술적 핵심은 "결과당 세 시간, 성공률 9%, 검증 22%"라는 세 숫자다. 생성은 싸고, 선별은 자동화됐고, 검증과 이해는 사람 몫으로 남았다. 이것은 수학만의 구조가 아니다. 코드든 보고서든 설계든, 2026년의 AI 도입 현장은 전부 같은 모양이다. 만드는 쪽의 비용이 세 시간으로 떨어졌을 때 조직이 투자해야 할 곳은 만드는 쪽이 아니라 읽는 쪽이다. 3장의 깔때기 계산기가 보여 주듯, 그 비대칭을 계산해 보지 않은 조직은 722편 앞에 선 수학계와 같은 처지가 된다.
용어 사전
결과 계열(result family) — 주 결과와 그 동반 논증·귀결·대체 증명을 묶은 단위. 722편 원고 = 372개 계열, 계열당 평균 1.9편.
Lean / mathlib — 증명 보조기와 그 수학 라이브러리. 이번 공개에서 주 결과가 Lean으로 형식화된 원고는 162편(22%).
Comparator — Lean 공식 조직(leanprover)의 독립 재검사 도구. 증명을 샌드박스에서 내보내 다시 검사한다. OpenAI가 준 리만 가설 등의 챌린지 파일을 제공했다.
formalization.yaml — mathlib 이니셔티브가 만든 "형식화된 논문 목록" 공개 스키마(v0.4). 어떤 논문의 어떤 정리가 어느 Lean 파일에서 증명됐는지 기계가 읽을 수 있게 적는다.
추론 요약(reasoning summary) — 모델의 사고 사슬을 사람이 읽을 수 있게 압축한 문서. 10건 공개. 원문이 아니라 요약이다.
ChatGPT Pro 세 시간 — OpenAI가 결과당 평균 계산량을 표현한 단위. 원가가 아니라 소비자 서비스의 사용량으로 환산한 값.
준 리만 가설(quasi-Riemann hypothesis) — 제타(또는 L-)함수의 영점이 어떤 수직선 Re(s) = σ (1/2 < σ < 1) 오른쪽에 없다는 주장. 이번 공개는 σ = 7/8(모든 디리클레 L-함수), 11/12(제타).
카케야 추측 — 모든 방향의 단위 선분을 포함하는 집합은 차원이 꽉 차야 한다는 추측. 3차원 하우스도르프 버전은 2025년 사람(왕–잘)이 풀었다.
UGC(유일 게임 추측) — 많은 최적화 문제의 최적 근사 비율을 결정하는 계산복잡도 추측(코트 2002).
ω(행렬 곱셈 지수) — n×n 행렬 곱셈의 최적 복잡도 n^ω. 종전 약 2.371, 이번 주장 ≤ 2.25.
AGMAI — 수학과 인공지능 자문 그룹. 고등연구소에 기반을 둔 9인의 독립 기구. AHM — 10월 8일 Proofs and Prompts에 보이콧 성명을 낸 수학자 그룹(성명에는 '커뮤니케이션 그룹'으로만 표기).
세 층의 검증 — 도출 타당성(기계) / 표현 충실성(사람) / 인식론적 의의(공동체). 칼렐–엘 루아디(2026).
마치며 — 댐과 등불
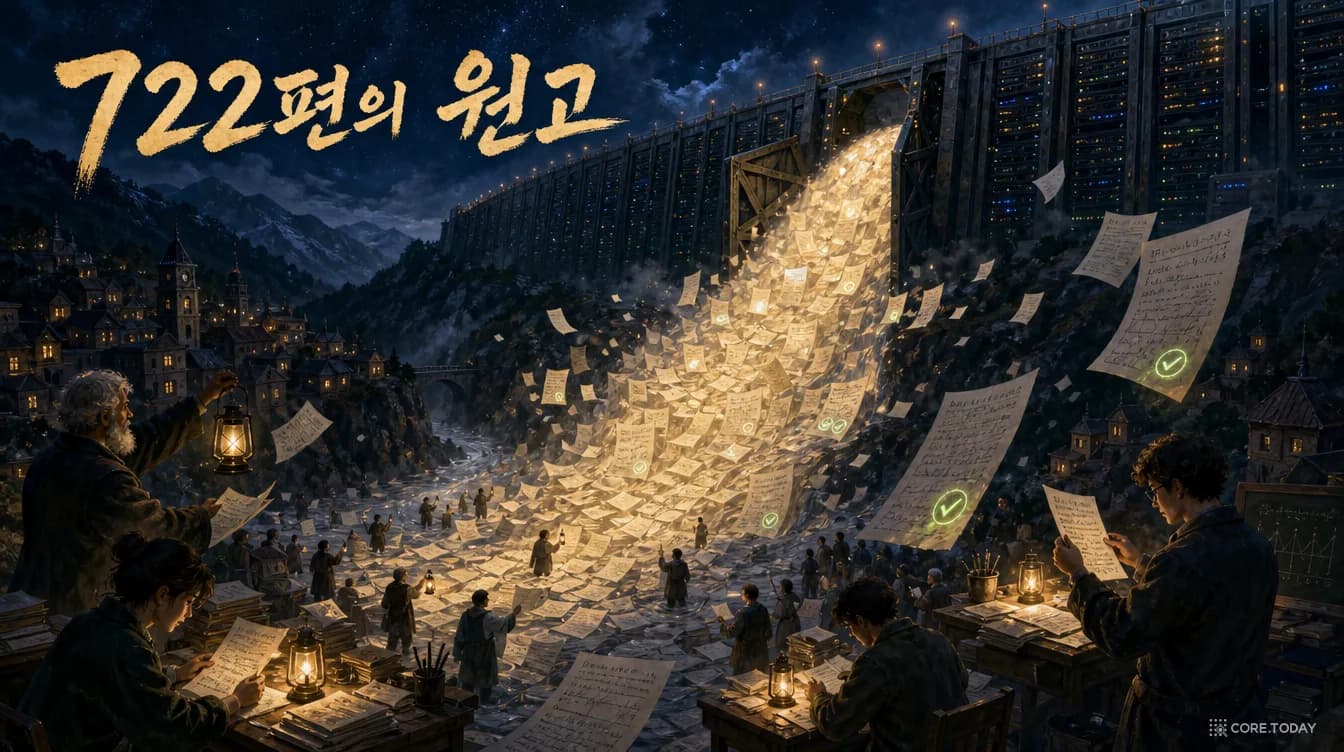
표지 그림은 밤의 댐이다. 서버 랙 모양의 댐이 열리고 722장의 종이가 쏟아져 내리고, 계곡의 마을에서는 사람들이 등불을 들고 종이를 주워 읽는다. 어떤 종이에는 초록 도장이 찍혀 있다. 도장은 종이가 스스로 모순되지 않는다는 뜻이지, 그 종이가 마을 사람들이 묻던 질문에 답한다는 뜻도, 읽을 가치가 있다는 뜻도 아니다. 그것을 아는 데는 등불과 사람과 시간이 든다.
OpenAI는 "이 진전이 인간 지식의 최전선을 밀어 올리기를 바란다"고 썼다. AGMAI는 "이것은 시작이지 완성이 아니다"라고 썼다. AHM은 "힘의 시연"이라고 썼다. 아비가드는 하루 전에 "수학은 우리가 들려줄 이야기이고, 어떻게 들려줄지는 우리가 정한다"고 썼다. 네 문장은 모순되지 않는다. 다만 넷 중 셋은 사람이 해야 할 일이 남았다는 뜻이고, 하나는 그 일을 할 시간을 주지 않았다.