[특집] 토큰의 값어치 — SemiAnalysis 스물한 편으로 그린 2026년 10월 AI 모델 가치 지도
반도체·AI 인프라 분석사 SemiAnalysis가 2025년 7월부터 2026년 10월까지 낸 글 스물한 편의 공개 구간을 모두 읽고, 지금 어떤 모델이 어떤 값을 하는지를 다섯 개의 자로 다시 쟀습니다. 표값 $5/$25짜리 모델의 실제 단가는 100만 토큰당 1달러 안팎이었고, 월 200달러 요금제 하나에 API로 사면 1만 달러가 넘는 토큰이 들어 있었으며, 같은 공개 모델의 원가는 소프트웨어만 바꿔도 14분의 1이 됐습니다. 가치는 칩·전력·메모리를 거쳐 2026년에 모델 회사로 흘러들었고, 최상위 모델은 가격을 오히려 올릴 힘을 얻었습니다. 오픈 모델은 프론티어의 값을 깎는 대신 '가격의 바닥'과 '하드웨어 경쟁의 무대'라는 다른 값을 갖게 됐습니다. 숫자마다 출처와 측정 조건을 달고, 위젯 다섯 개로 직접 계산해 볼 수 있게 했습니다.
코어닷투데이2026-10-2983분
?
질문
"요즘 어느 모델이 제일 좋은가"는 답이 없는 질문이 됐습니다. 같은 모델이 요금제·작업 모양·하드웨어에 따라 열 배 넘게 다른 값을 합니다.
→
방법
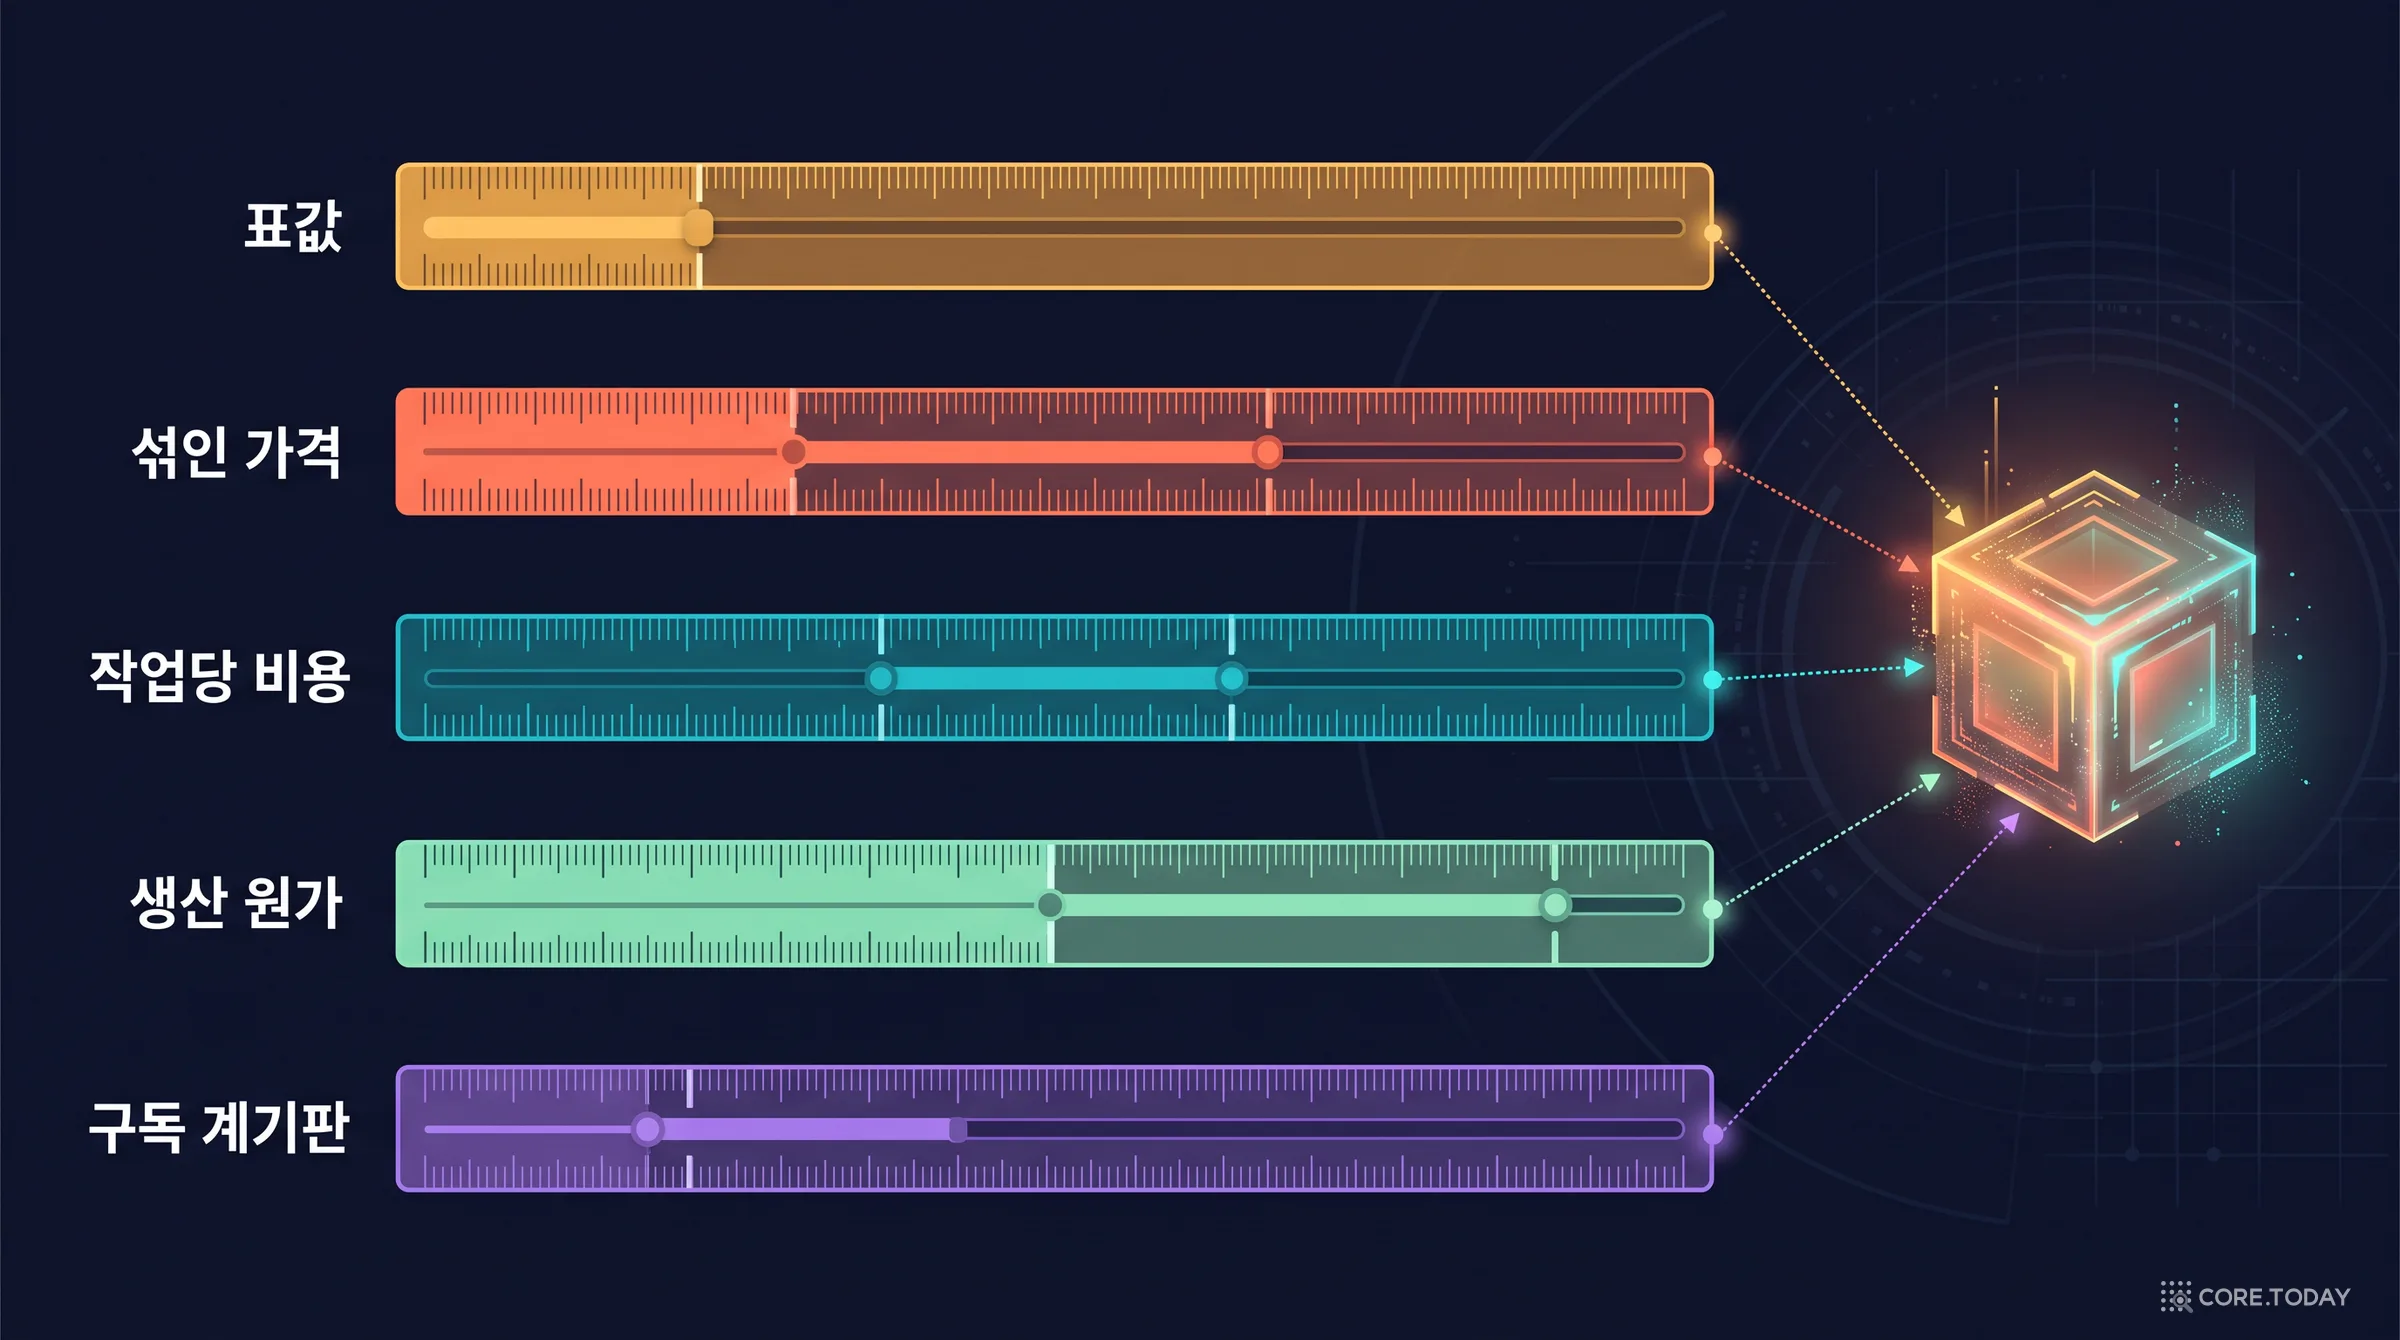
SemiAnalysis 글 스물한 편의 공개 구간에서 모델 가치에 관한 숫자를 모두 뽑아, 표값·섞인 가격·작업당 비용·생산 원가·구독 계기판이라는 다섯 개의 자로 다시 정리했습니다.
✓
결론
모델의 값은 '토큰당 가격'이 아니라 '끝낸 일 하나당 비용'으로 매겨지고 있고, 그 기준에서 최상위 모델은 가격을 올릴 힘을, 오픈 모델은 원가의 바닥을 쥐었습니다.
오늘은 작은 마감일입니다. OpenAI는 9월 말에 월 200달러 Pro 요금제에서 쓸 수 있는 토큰을 모든 모델에서 절반으로 줄였는데, 그 전에 가입한 사람에게는 10월 29일까지 옛 한도를 남겨 두었습니다. 반도체·AI 인프라 분석 회사 SemiAnalysis는 이 변화를 자기들이 만든 계측 장치로 잡아냈고, 10월 5일 글의 제목을 이렇게 달았습니다. 「Anthropic 구독은 OpenAI보다 5배 넘는 값을 준다(Anthropic Subscriptions Offer 5x+ More Value Than OpenAI)」.
이 제목 하나에 2026년 가을 AI 시장의 질문이 거의 다 들어 있습니다. '값(value)'이라는 말이 무엇을 뜻하는지, 누가 그 값을 보조하고 누가 가져가는지, 같은 모델이 왜 어디서는 싸고 어디서는 비싼지. 코어닷투데이는 이 질문에 답하려고 SemiAnalysis가 2025년 7월부터 2026년 10월까지 낸 글 가운데 모델의 값과 관련된 스물한 편을 골라 공개 구간을 모두 읽었습니다(대부분 유료 글이라 결론부는 잠겨 있습니다. 이 글의 숫자는 모두 무료로 공개된 앞부분과 공개 벤치마크, 공식 가격표에서 왔습니다).
SemiAnalysis를 출처로 고른 데는 이유가 있습니다. 이 회사는 칩의 트랜지스터부터 데이터센터 전력, GPU 임대료, 모델 회사의 매출까지 한 줄로 이어 계산하는 거의 유일한 곳입니다. 공개 추론 벤치마크 InferenceX(옛 이름 InferenceMAX)를 매일 밤 돌리고, 모델 회사의 토큰 생산량·단가·이익률을 추정하는 'Tokenomics Model'을 기관 고객에게 팝니다. 동시에 그들 자신이 지독한 토큰 소비자입니다. 2026년 5월 글에 따르면 SemiAnalysis의 Claude 토큰 지출은 한때 연 환산 1,095만 달러까지 올라갔고, 토큰 지출이 직원 보수 총액의 약 30%, 직원 한 명이 한 달에 쓰는 토큰이 50억 개 가까이 됩니다. 파는 사람과 사는 사람의 장부를 동시에 들여다보는 위치에서 쓴 글들이라는 뜻입니다. 이 위치는 그대로 약점이기도 해서, 뒤의 「반론과 한계」 장에서 따로 다룹니다.
이 글이 내놓는 결론을 먼저 적어 두면 이렇습니다.
모델의 값은 하나의 숫자가 아니라 네 개 항목의 조합(모델, 작업 모양, 요금제, 하드웨어)이다. SemiAnalysis는 "요금제가 X달러어치라고 따로 말하는 것은 의미가 없다"고 씁니다.
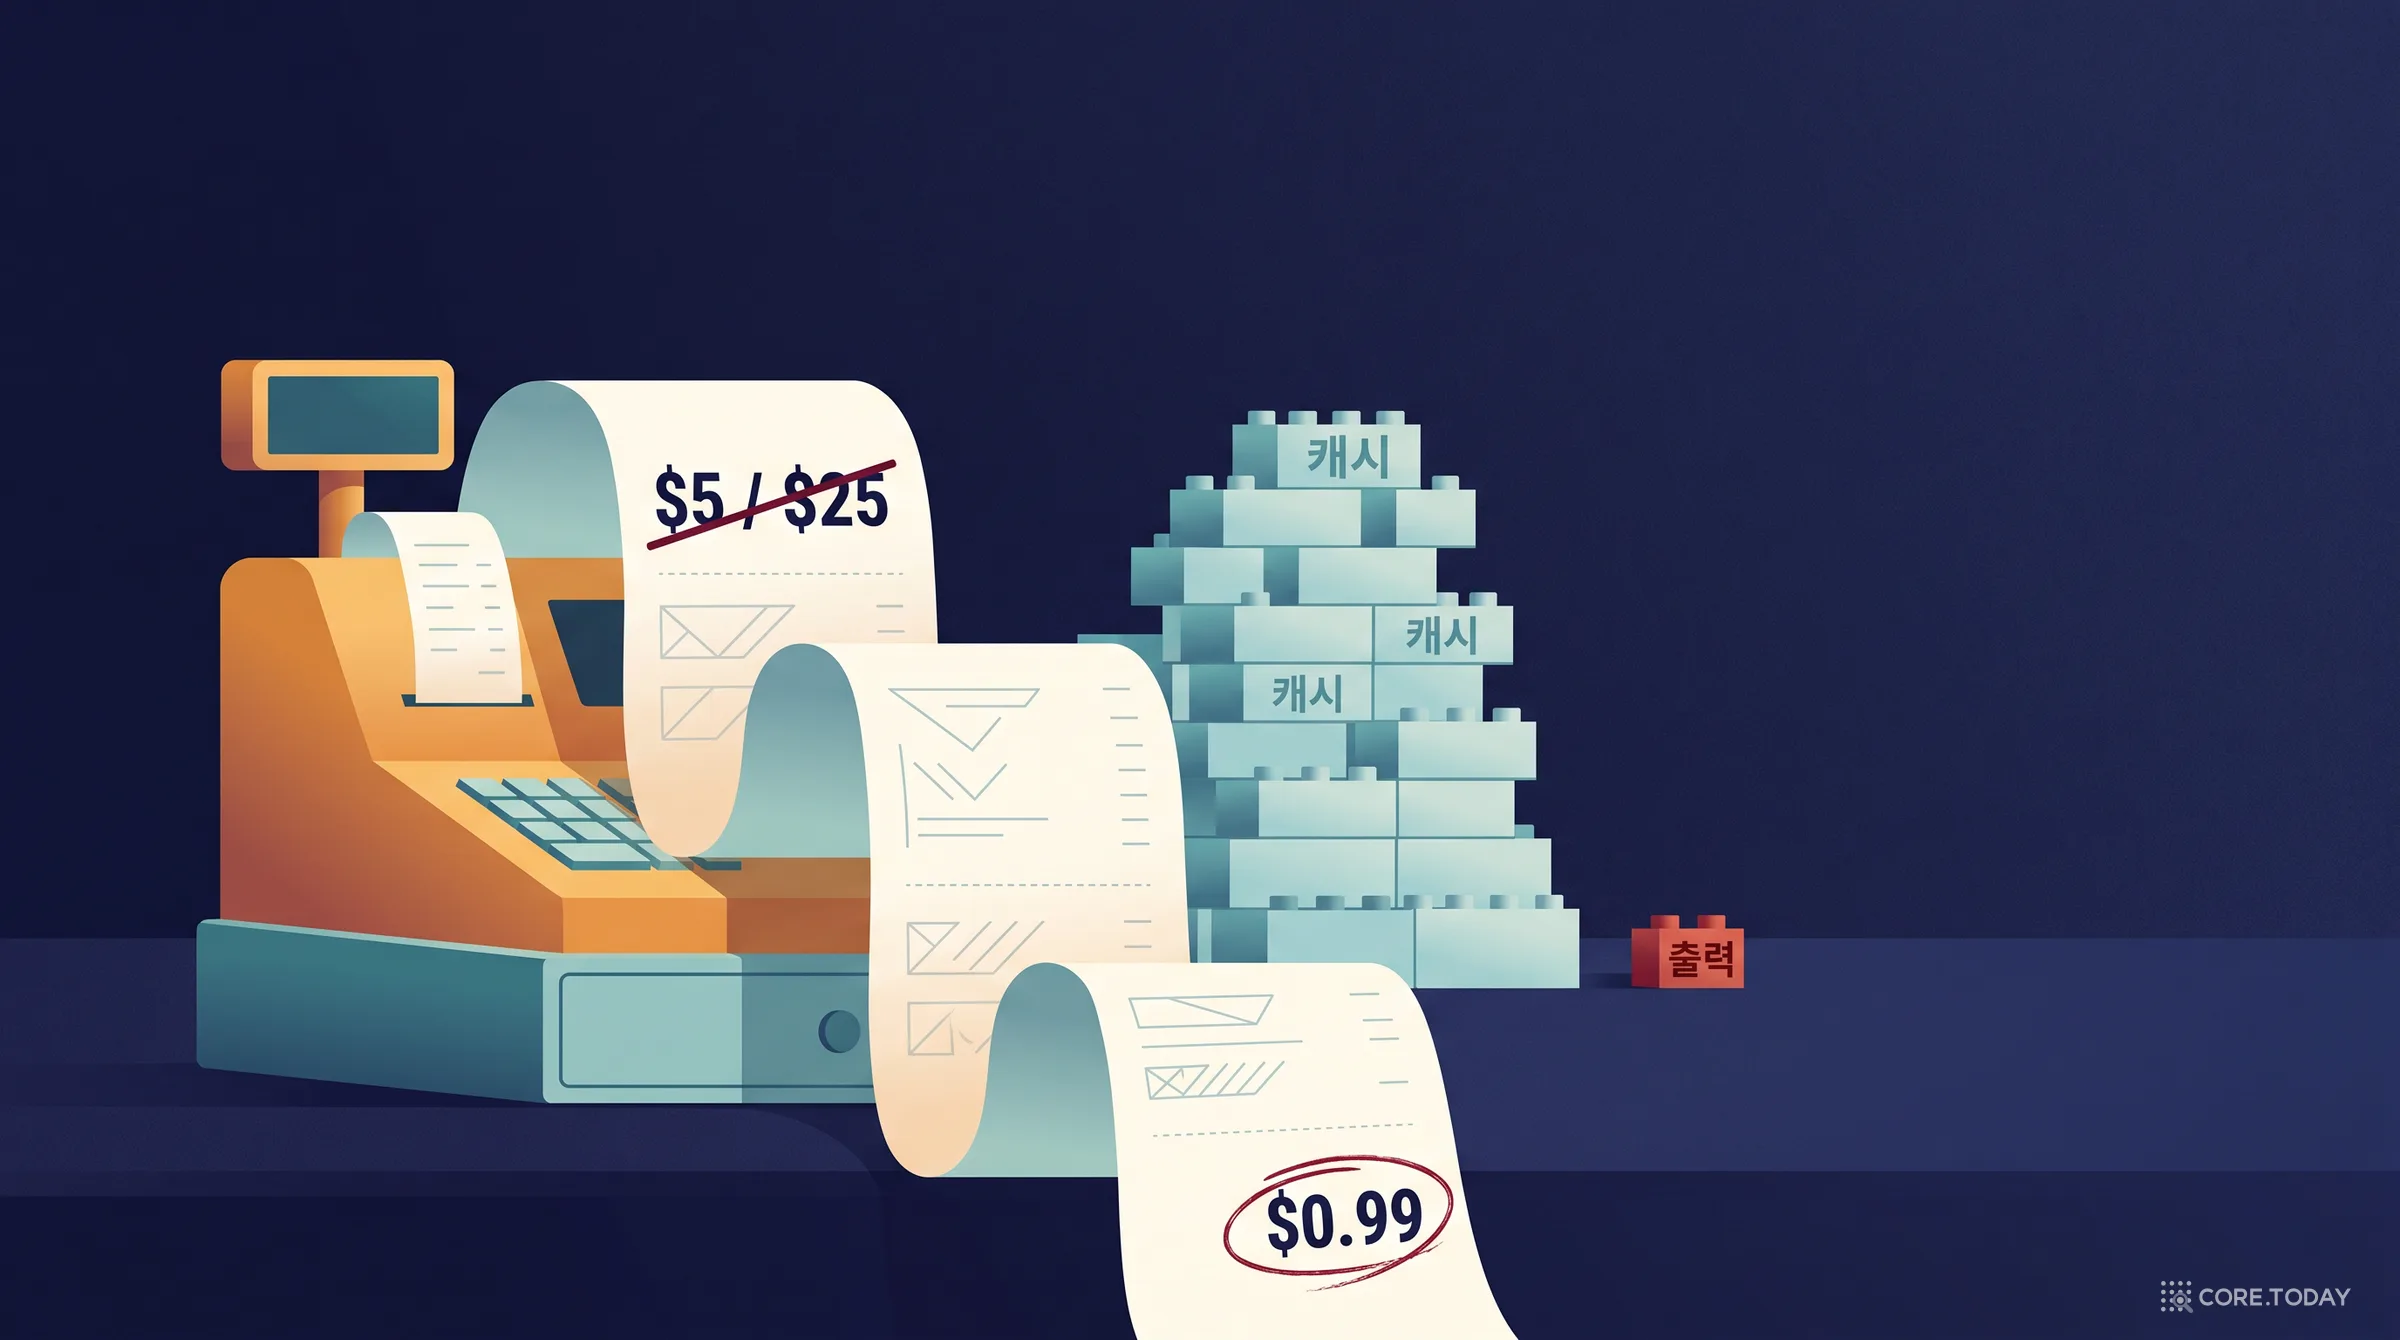
가격표는 출발점일 뿐이다. 표값 $5/$25짜리 모델이 에이전트 작업에서는 100만 토큰당 $0.99에 쓰입니다. 돈은 출력이 아니라 캐시를 놓친 입력에서 나갑니다.
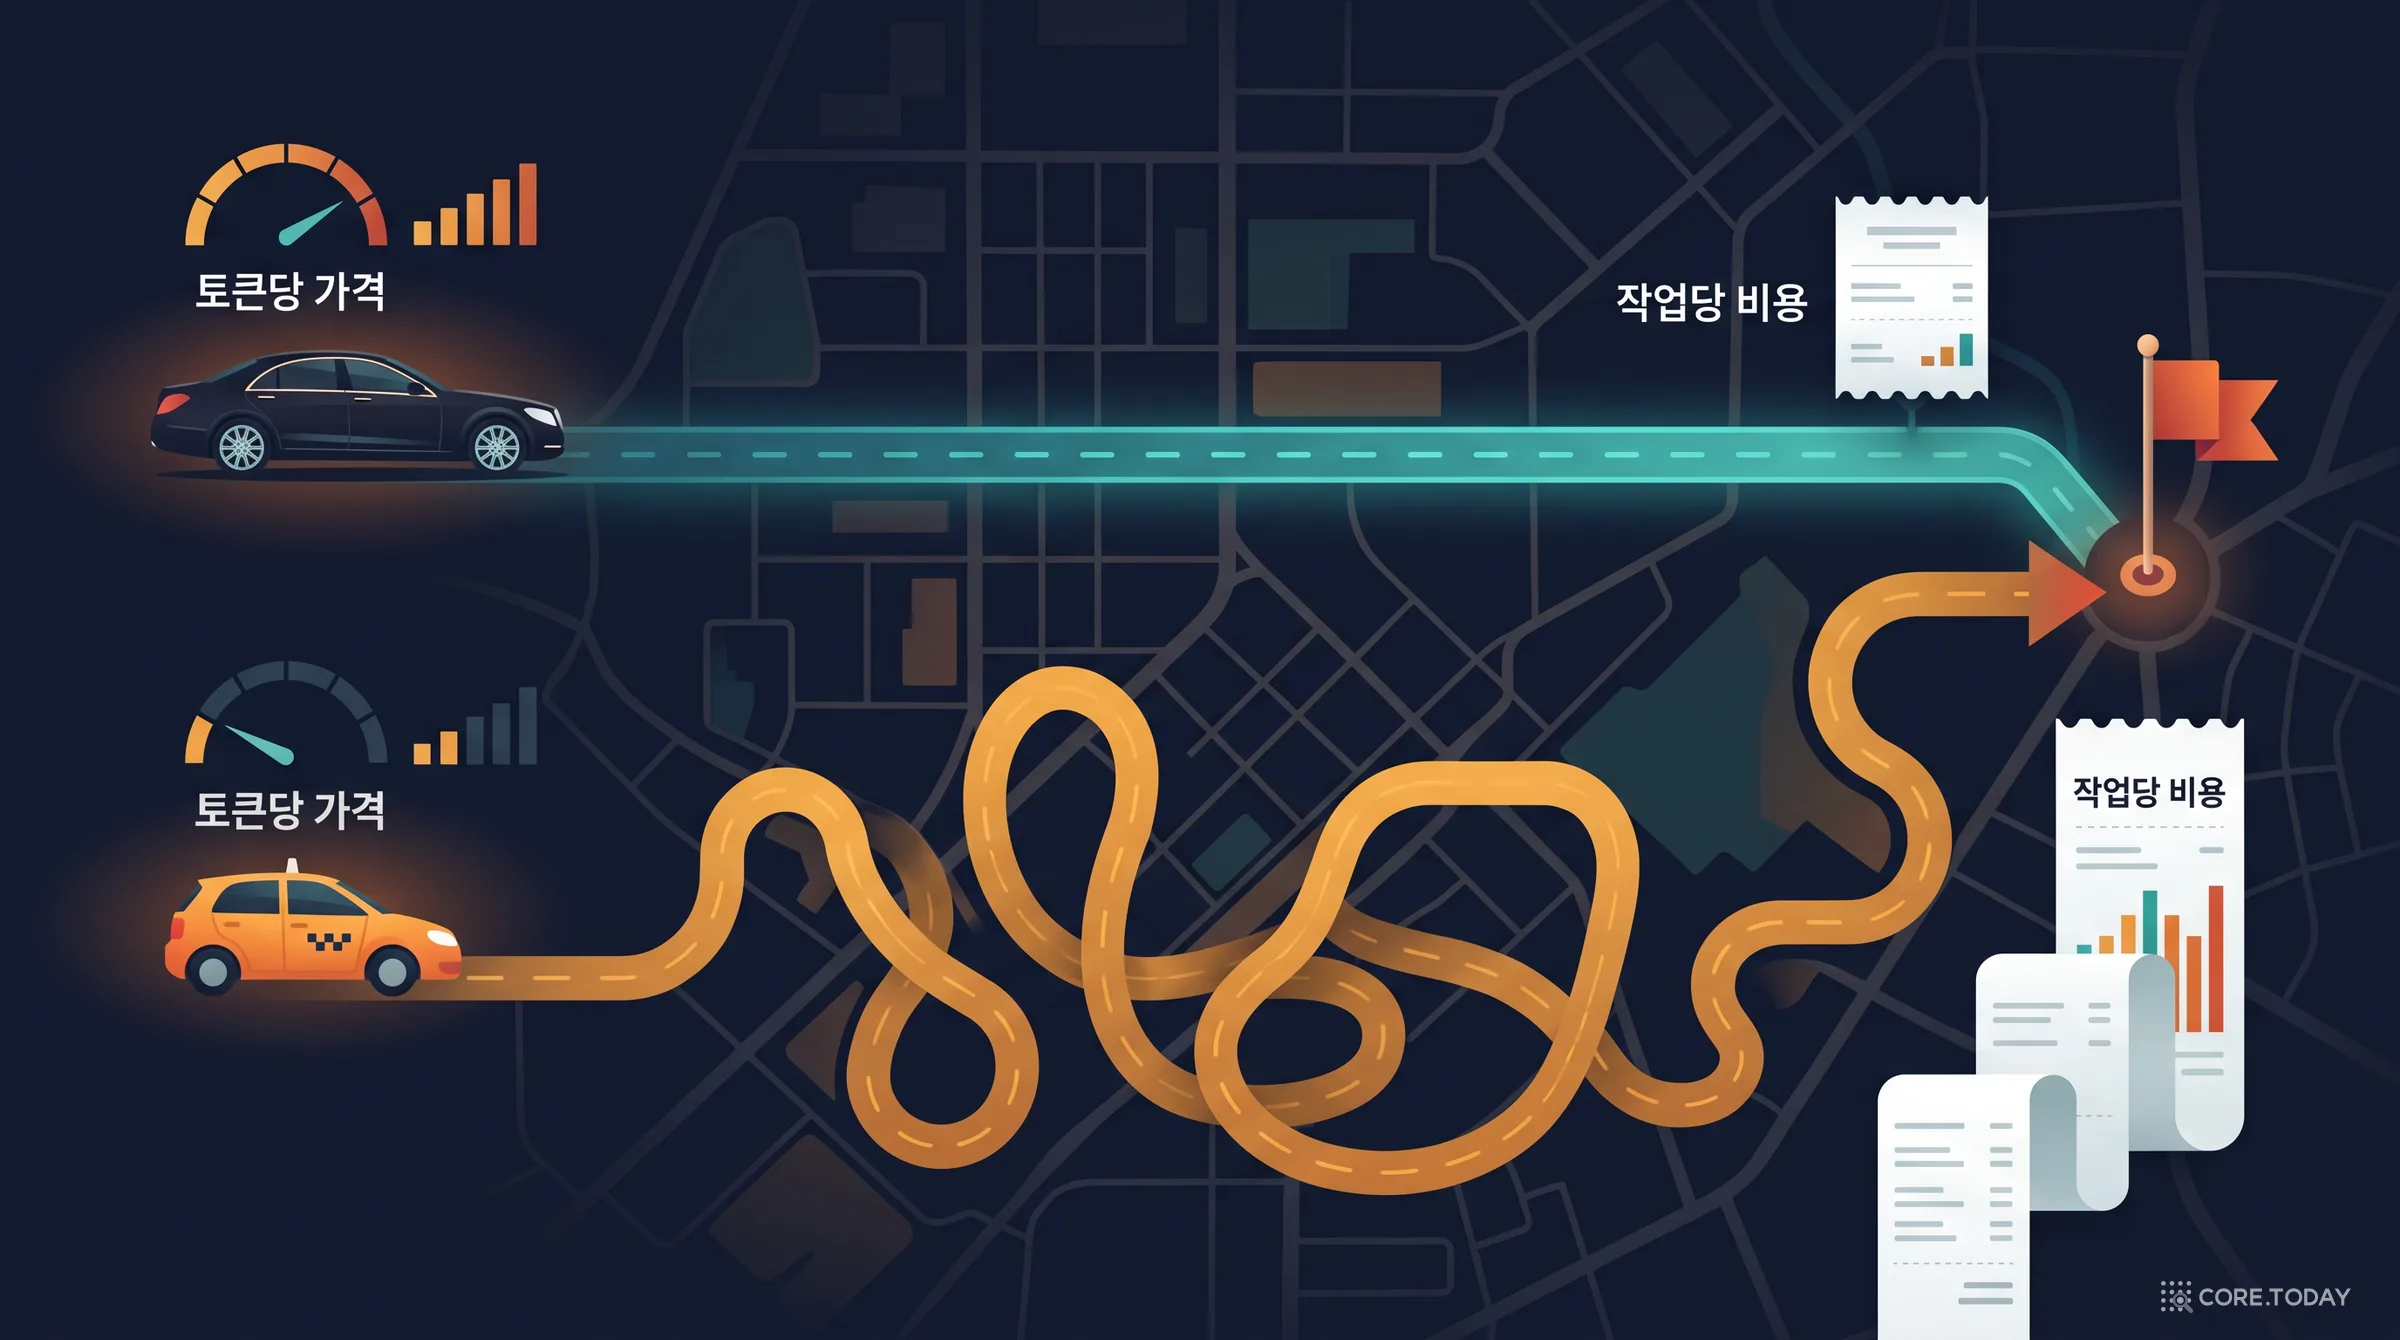
진짜 단위는 '토큰'이 아니라 '끝낸 일'이다. 토큰당 다섯 배 비싼 모델이 일 하나당으로는 더 쌀 수 있고, 빠른 모드의 값은 사람의 시급이 결정합니다.
2026년, 가치는 모델 회사로 흘렀다. 2023~2025년에 AI의 이익은 칩·전력·메모리가 가져갔지만, 에이전트가 실제로 일하기 시작한 2025년 12월 이후 Anthropic의 추론 이익률은 38%에서 70% 안팎으로 올랐습니다.
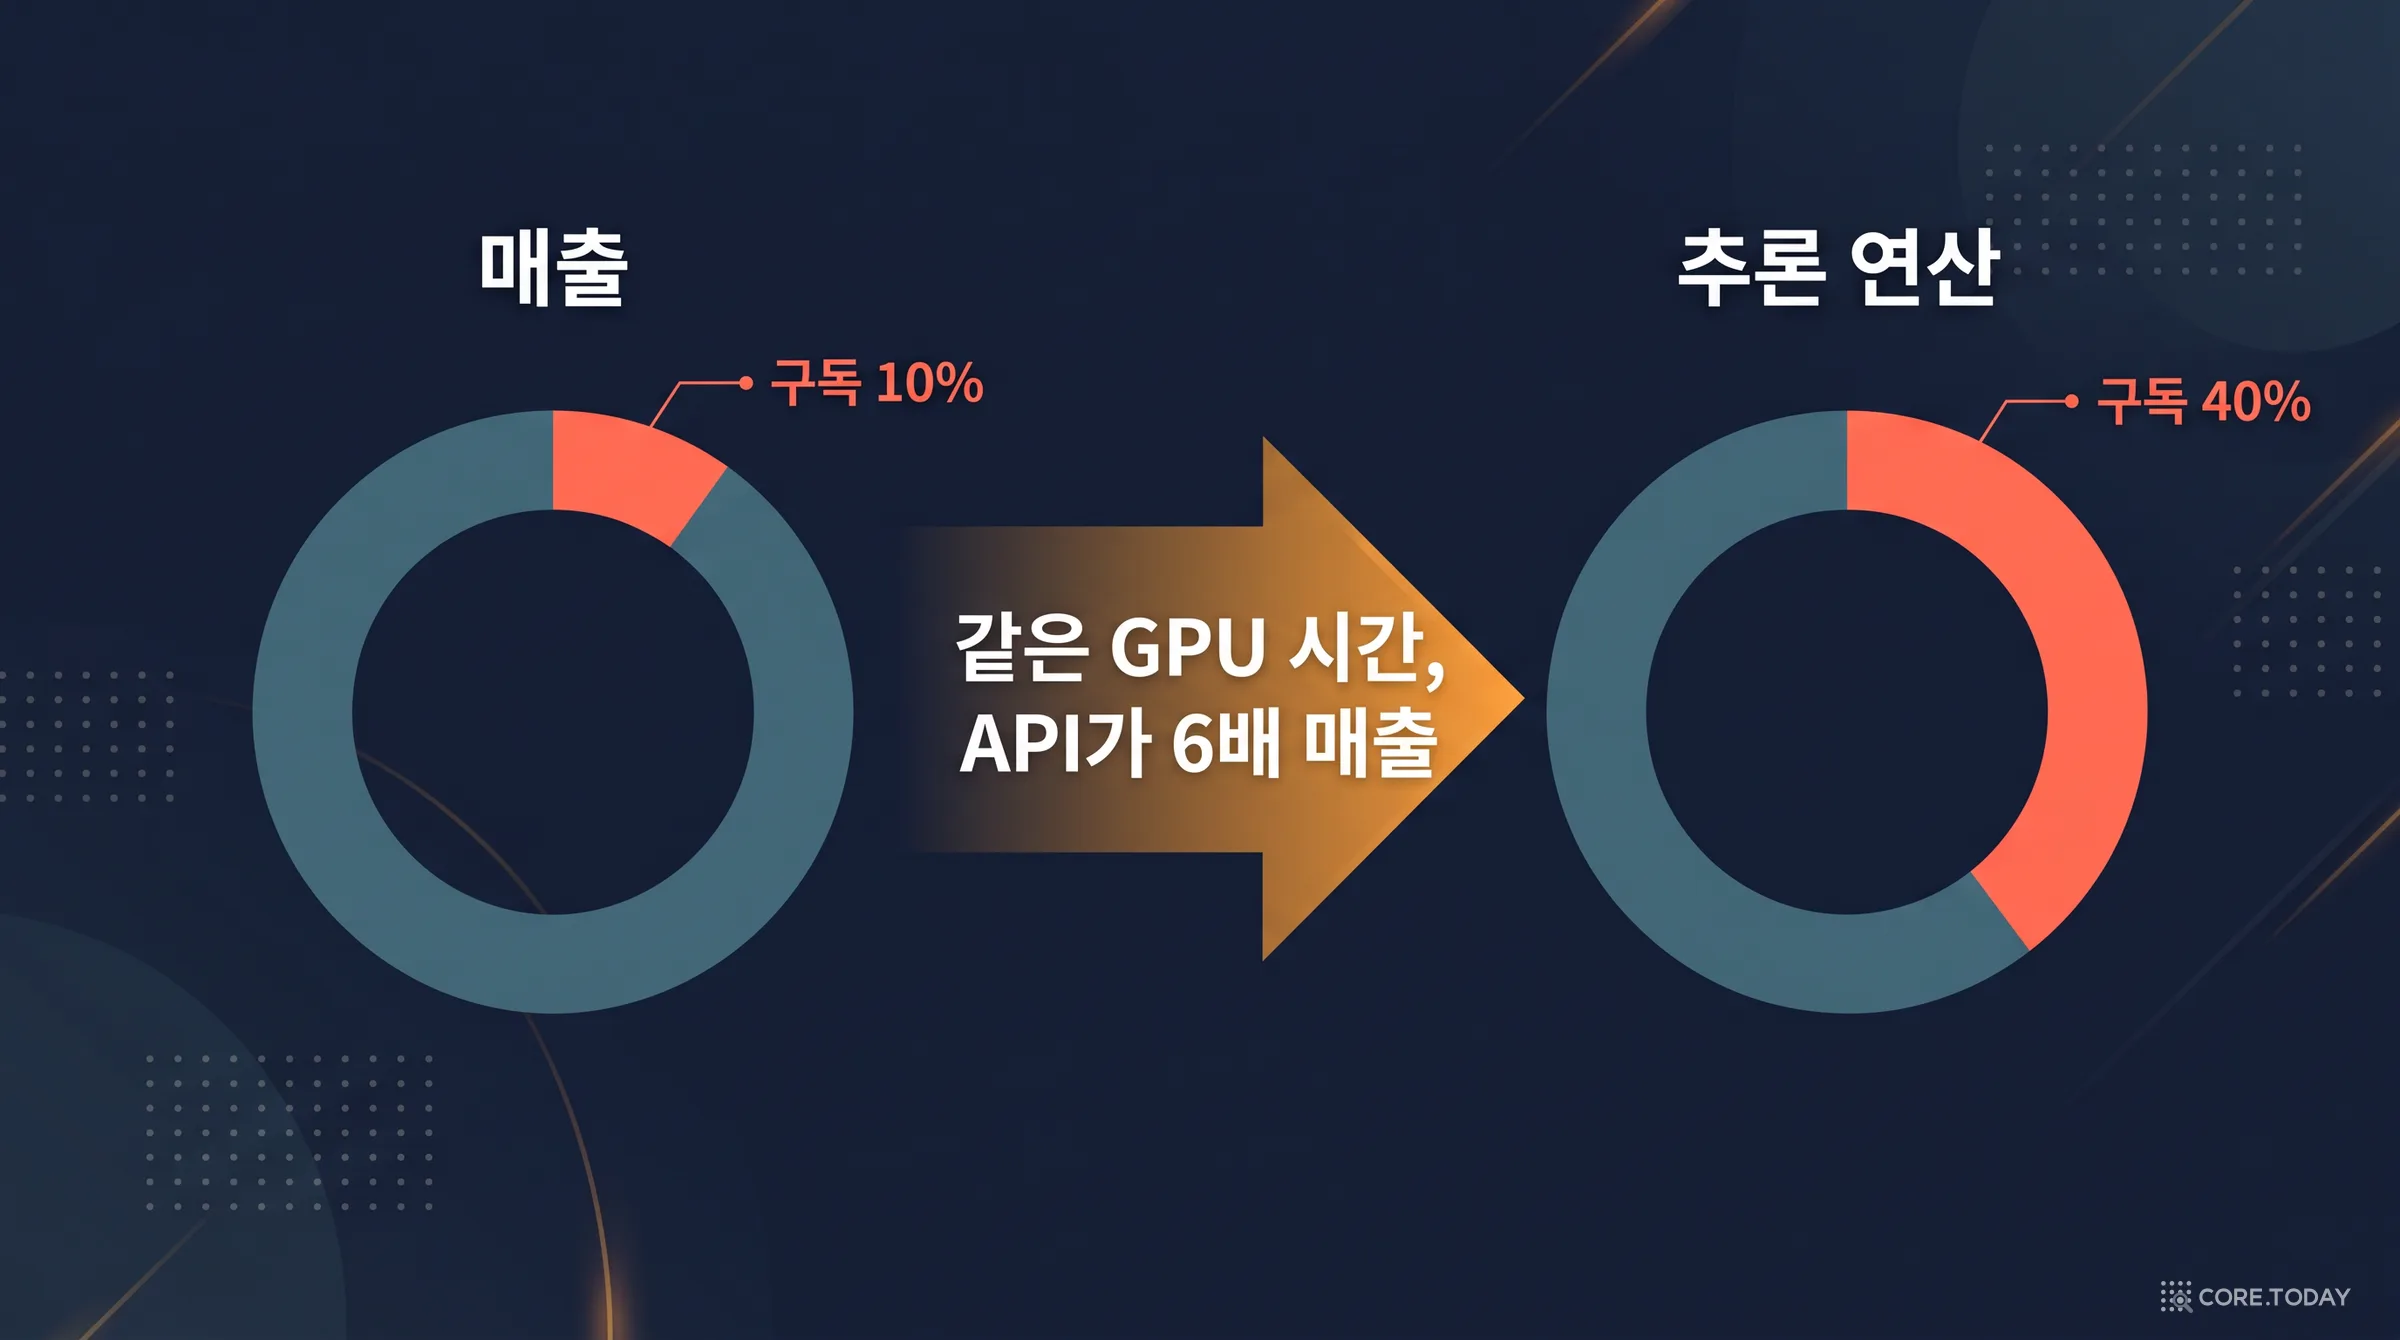
구독 요금제는 가장 크게 보조받는 가격표다. Anthropic 매출의 10%에 불과한 구독이 추론 연산의 40% 이상을 먹습니다. 같은 200달러 요금제 안에서도 모델에 따라 이익률이 −369%에서 +1%까지 갈립니다.
오픈 모델은 프론티어의 가격을 깎지 못했다. 대신 원가의 바닥과 하드웨어 전쟁의 무대가 됐다.
각 결론을 숫자와 함께 차례로 풀어 보겠습니다.
1장. 가치를 재는 다섯 개의 자
시작하기 전에 용어를 정리합니다. 이 글에서 '모델의 값'은 다섯 가지 서로 다른 숫자 중 하나를 가리킵니다. 대부분의 논쟁은 사람마다 다른 자를 들고 와서 생깁니다.
①에서 ⑤로 갈수록 숫자는 실제 경제에 가까워지고, 동시에 측정하기 어려워집니다. 표값은 웹 페이지에 적혀 있지만, 섞인 가격은 작업 기록(트레이스)이 있어야 나오고, 작업당 비용은 같은 일을 여러 모델로 시켜 봐야 나오며, 생산 원가는 GPU 클러스터가 있어야 잴 수 있습니다. 구독 계기판은 아예 공개된 적이 없어서, SemiAnalysis는 계정을 여러 개 사서 직접 계기판을 움직여 가며 거꾸로 알아냈습니다. 이 회사의 분석이 흥미로운 것은 다섯 개의 자를 모두 손에 쥐고 있다는 점입니다.
2026년 5월 1일 글 「AI 가치 포착 — 모델 연구소로의 이동(AI Value Capture - The Shift To Model Labs)」에서 SemiAnalysis는 이렇게 씁니다.
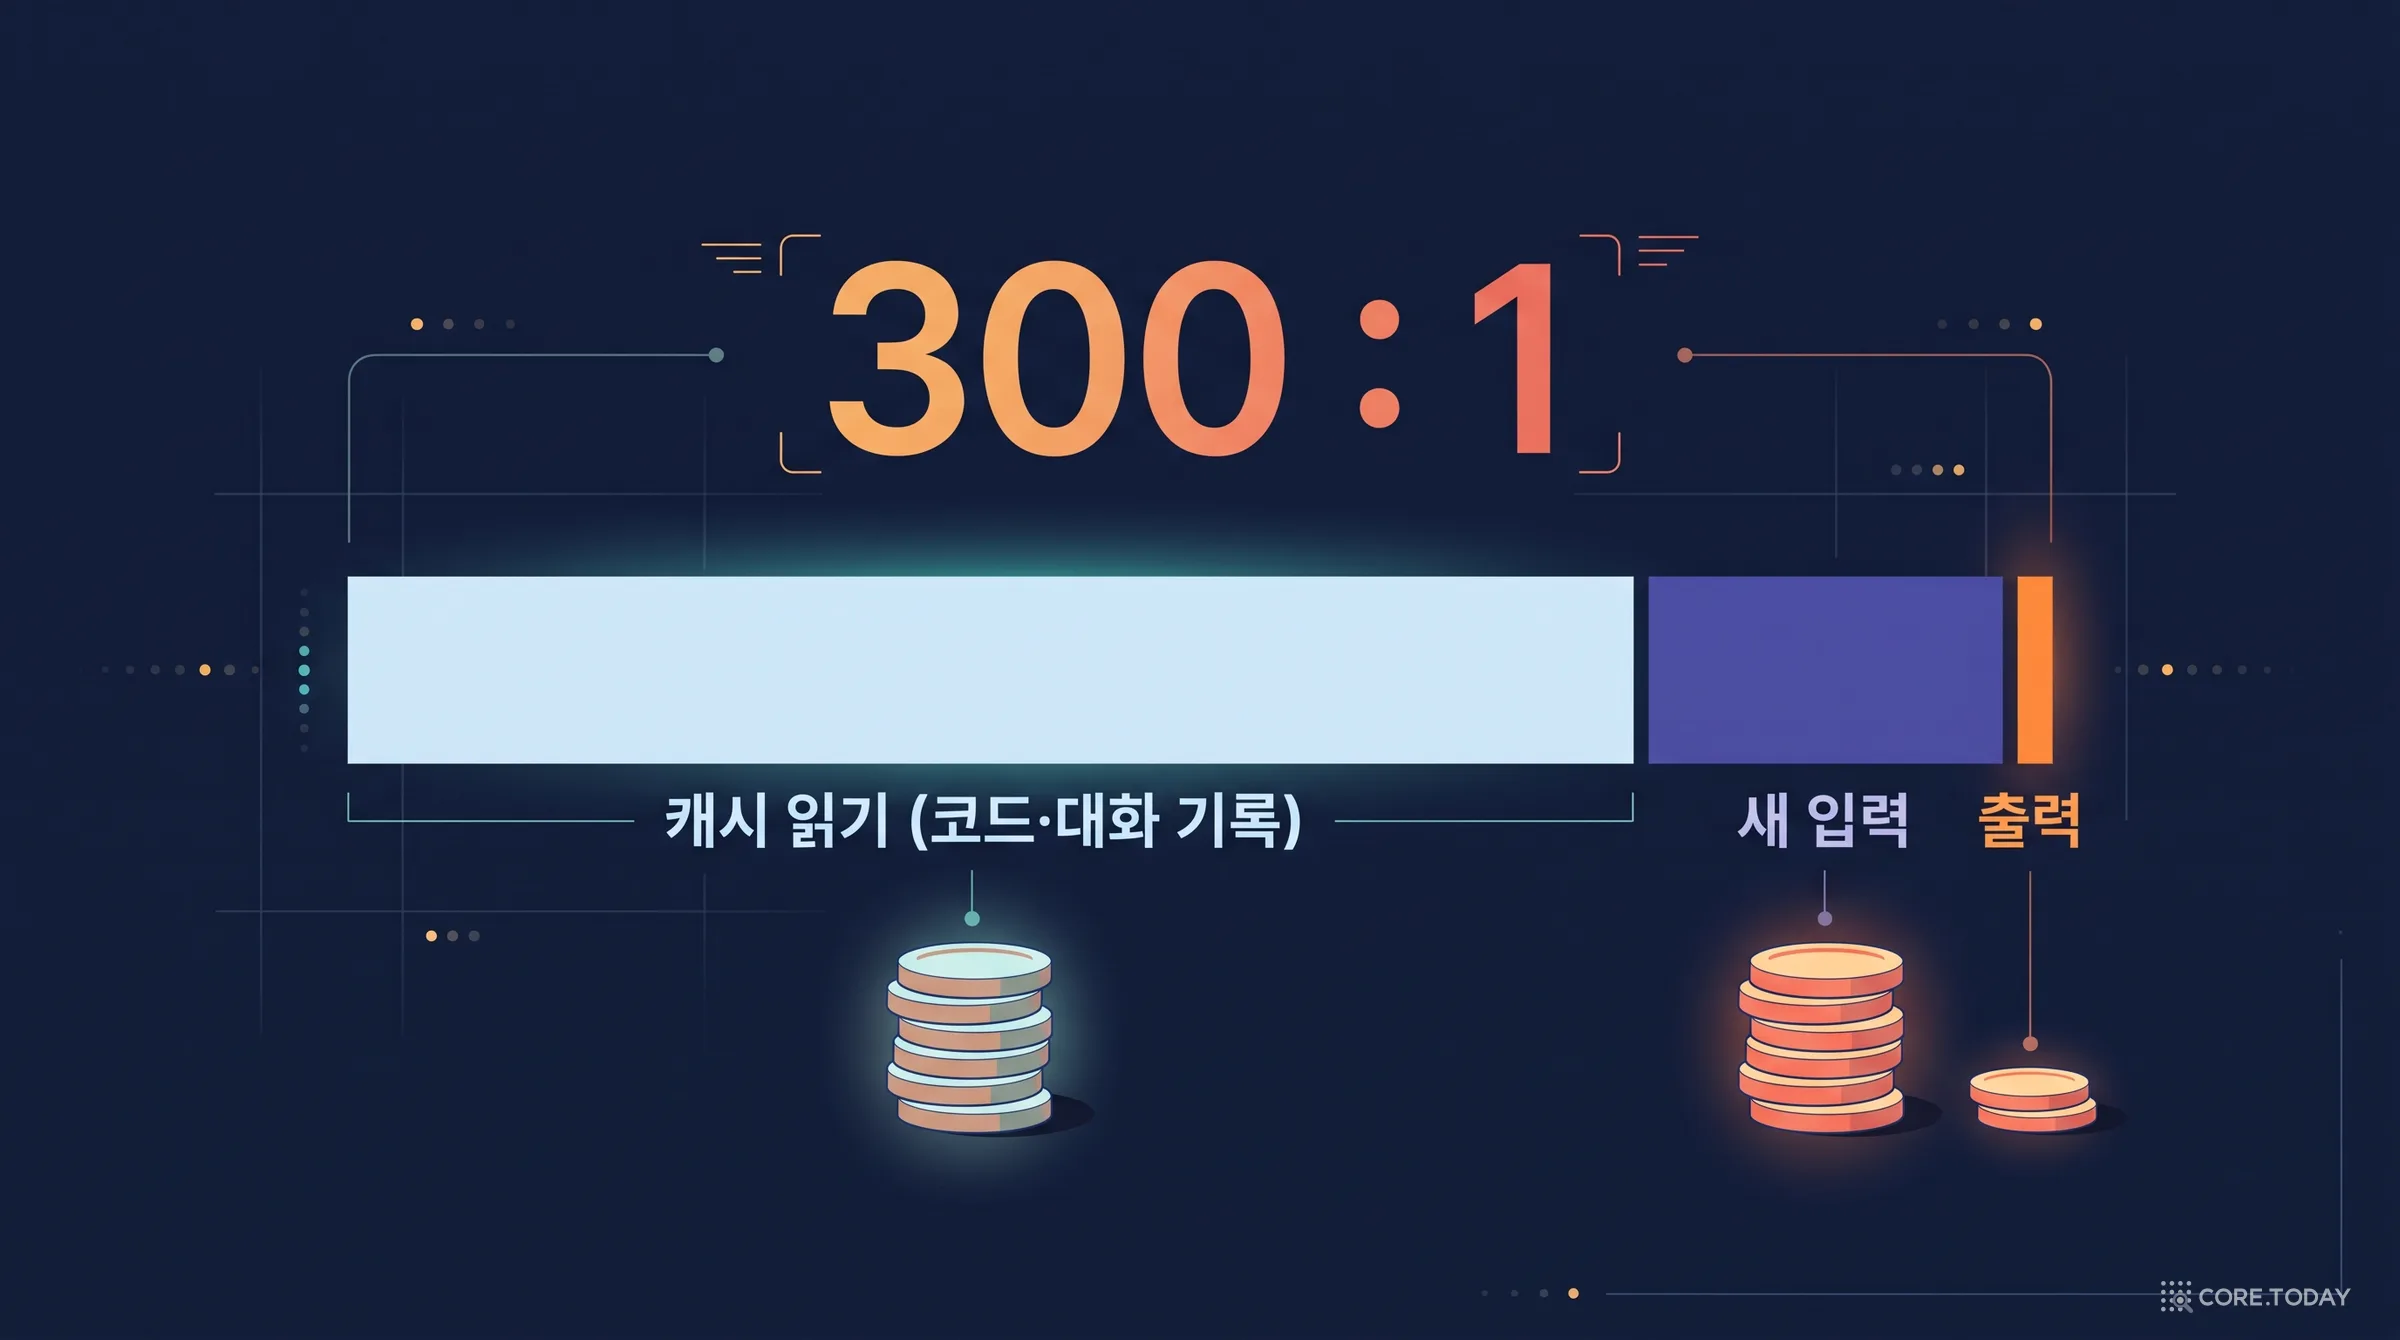
에이전트 작업에서 Opus 4.7을 돌리는 실제 섞인 가격은 100만 토큰당 0.99달러로 추정된다. 가격표는 $5/$25인데도. 에이전트 작업은 입력 대 출력 비율이 극단적으로 높고(우리 Claude Code 사용은 약 300:1) 캐시 적중률도 높다(90% 이상). 캐시된 입력은 100만 토큰당 0.5달러뿐이라, 토큰 대부분이 가장 싼 칸에 떨어진다.
계산을 따라가 보면 왜 그런지 바로 보입니다. 에이전트가 코드를 고칠 때마다 저장소의 같은 파일, 같은 시스템 프롬프트, 지금까지의 대화를 통째로 다시 모델에 넣습니다. 출력은 고친 코드 몇 줄과 도구 호출 몇 개뿐입니다. 그래서 출력 토큰 1개당 입력 토큰이 300개 들어가고, 그 입력의 90% 이상은 직전 요청과 똑같은 앞부분이라 캐시에서 읽힙니다.
위 막대는 300:1, 캐시 적중 91%, Opus 4.7 표값으로 토큰 301개의 청구액을 나눠 본 것입니다(캐시 쓰기 할증은 넣지 않았습니다). 이 조건에서 섞인 가격은 정확히 $0.99가 나옵니다. 흥미로운 점은 두 가지입니다. 첫째, 가장 비싼 출력은 토큰의 0.3%에 불과해 청구서의 8%밖에 차지하지 않습니다. 둘째, 토큰의 91%를 차지하는 캐시 읽기와 9%에 불과한 새 입력이 청구서를 반씩 나눠 가집니다. 에이전트의 청구서는 '캐시를 놓친 입력'이 지배합니다.
이 숫자가 실무에 주는 의미는 큽니다. 모델 회사들이 신모델을 낼 때 가장 많이 손대는 가격이 바로 캐시 읽기입니다. SemiAnalysis의 10월 글에 따르면 Fable 5.1은 Fable 5보다 캐시 읽기를 75% 내렸고, Opus 5.5는 Opus 5보다 입력·출력을 20%, 캐시 읽기를 60% 내렸습니다. GPT-6.1 Sol도 캐시 읽기를 절반으로 내렸습니다. Anthropic의 공식 가격표로 확인하면 Opus 5.5는 $4/$20, 캐시 읽기 $0.20이고 Fable 5.1은 $10/$50, 캐시 읽기 $0.25입니다. 출력 단가만 비교하면 Fable 5.1은 Opus 5.5의 2.5배지만, 캐시 읽기는 1.25배밖에 차이가 나지 않습니다. 에이전트 작업에서는 두 모델의 실제 단가 차이가 표값의 인상보다 훨씬 작다는 뜻입니다.
한 가지 짚어 둘 것이 있습니다. SemiAnalysis는 입력:출력 비율을 글마다 다르게 적었습니다. 5월 글은 자사 Claude Code 사용이 약 300:1이라고 했고, 4월 24일 글 「코딩 어시스턴트 해부(The Coding Assistant Breakdown)」는 수백만 달러어치 에이전트 트레이스를 모으는 중이라며 예비 분석으로 Codex 80:1, Claude Code 100:1을 제시했습니다. 측정 대상(사내 사용 전체 vs 수집 트레이스)과 시점이 다르기 때문으로 보입니다. 아래 위젯에서 두 값을 모두 넣어 볼 수 있습니다. 비율이 300:1에서 100:1로 바뀌면 섞인 가격이 얼마나 움직이는지 직접 확인해 보세요.
같은 원리 때문에 Codex와 Claude Code의 비교도 표값만으로는 판단할 수 없습니다. SemiAnalysis는 "입력:출력 비율이 높을수록 100만 토큰당 가격은 낮아지지만, Codex는 입력 토큰을 전체적으로 덜 쓰기 때문에 결국 더 싸다"고 썼습니다. 비율이 높다는 것은 단가에는 좋은 소식이지만, 같은 일에 더 많은 입력을 쓴다는 뜻이기도 합니다. 단가와 총량은 따로 봐야 한다는 이 지적이 다음 장으로 이어집니다.
SemiAnalysis가 2026년에 가장 자주 반복한 문장은 이것입니다. "토큰당 비용이 아니라 작업당 비용이 모델 가격을 결정하는 진짜 북극성 지표다." 4월 글은 이 문장을 Anthropic의 차세대 모델 Mythos로 설명했습니다. Mythos는 발표 당시 $25/$125로 Opus의 다섯 배 값이었지만, "같은 문제를 더 적은 토큰으로 풀기 때문에 가격 인상의 상당 부분이 상쇄된다. 끝에서 끝까지의 응답도 더 빠를 수 있다."
작업당 비용을 결정하는 변수는 세 가지입니다.
토큰 수같은 일을 끝내는 데 쓴 입력·출력 토큰의 총량. 모델이 얼마나 많이 읽고 얼마나 길게 생각하는지, 그리고 하네스(Claude Code·Codex 같은 실행 환경)가 맥락을 어떻게 넣는지가 정한다.
섞인 단가2장의 값. 표값 × 작업 모양 × 캐시 적중률.
성공률한 번에 끝나는 비율. 실패하면 다시 돌려야 하므로 비용을 성공률로 나눈다.
사람의 시간결과를 기다리고 검토하는 사람의 시간. 모델이 충분히 똑똑해진 뒤에는 이 항목이 가장 커진다.
SemiAnalysis의 글에는 이 네 변수가 모두 실제 사례로 등장합니다.
토큰 수를 늘린 사례 — Opus 4.7의 토크나이저. Anthropic은 Opus 4.7에서 새 토크나이저를 도입하면서, 같은 글을 최대 35% 더 많은 토큰으로 센다고 스스로 밝혔습니다. SemiAnalysis는 이것을 "사실상 최대 35% 가격 인상"이라고 불렀습니다. 표값은 Opus 4.6과 똑같은 $5/$25였는데도 말입니다. 같은 글에서 그들은 Opus 4.7이 기본적으로 도구 호출을 줄이고 추론을 늘리는 쪽으로 바뀌었고, 사내 엔지니어들이 맥락을 충분히 끌어오게 하려고 노력 수준(effort)을 high에서 xhigh나 max로 올리고 있다고 썼습니다. "발표문이 주장한 토큰 효율과는 거리가 있다."
토큰 수를 줄인 사례 — GPT-5.5와 Codex. OpenAI는 GPT-5.5가 5.4보다 점수는 높고 토큰은 덜 쓴다고 강조했습니다. SemiAnalysis의 엔지니어들도 Codex가 "변경 전에 훨씬 많은 맥락을 끌어오고", 버그 사냥과 PR 리뷰에서 더 낫다고 평가했습니다. 다만 대가가 있었습니다. "GPT-5.5는 실제로 코드를 바꾸는 데 너무 보수적이다. 토큰 효율은 좋아지지만 정확성을 대가로 치른다. 출력에서 '좁은 수정(narrow fix)'이라는 말이 보이면 다시 확인해야 한다는 신호다." 토큰을 아끼는 모델이 성공률을 깎으면 작업당 비용은 오히려 오릅니다.
사람의 시간을 산 사례 — 빠른 모드. 이 대목이 2026년 모델 가치론에서 가장 새로운 발견입니다. Opus 4.6 빠른 모드는 "2.5배 빠르게, 6배 값"이었습니다. 그런데 SemiAnalysis 엔지니어들은 이 비싼 모드에 몰렸습니다. 5월 13일 Cerebras 분석 글에 따르면 "4월에 우리 AI 지출(연 환산 최고 1,000만 달러)의 80%가 Opus 4.6 빠른 모드였다." 그리고 이렇게 일반화합니다.
어느 수준 이상의 지능을 넘어서면, 개발자는 더 똑똑한 토큰보다 더 빠른 토큰을 원한다.
엔지니어들이 내세운 이유는 '몰입 상태(flow state)'였습니다. 모델이 대부분의 일을 성공적으로 끝내는 단계가 되면, 품질을 조금 더 올리는 것보다 기다리는 시간을 줄이는 것이 사람의 생산성에 더 크게 작용합니다. SemiAnalysis는 같은 글에서 "Opus 4.6 빠른 모드가 Anthropic의 가장 이익률 높은 상품이며, 올해 ARR 폭발의 큰 이유"라고 추정했습니다.
흥미롭게도 빠른 모드의 값은 계속 움직였습니다. 2월 InferenceX v2 글은 빠른 모드를 "같은 품질, 약 2.5배 속도, 6~12배 가격"으로 묘사했지만, 5월 글은 "지금은 2배도 안 빠르다(초당 약 70토큰, 예전엔 100 이상)"며 "점점 나쁜 거래가 됐다"고 썼습니다. 그리고 지금 Anthropic 가격표에서 Opus 5.5의 빠른 모드는 $8/$40, 즉 표준의 2배입니다. 6배에서 2배로, 속도 프리미엄의 배수가 1년도 안 돼 3분의 1로 줄었습니다. SemiAnalysis의 2월 분석이 이 변화를 미리 설명해 줍니다. 빠른 모드는 하드웨어 이야기가 아니라 "같은 GPU에서 처리량을 지연과 맞바꾼 자연스러운 결과"이며, B200에서 DeepSeek R1을 사용자당 초당 50토큰에서 125토큰으로 올리면 출력 단가가 약 7배가 된다는 것입니다. 하드웨어가 빨라지면 같은 속도를 내는 데 포기해야 하는 처리량이 줄어들고, 프리미엄도 함께 내려갑니다.
아래 위젯에서 네 사례를 직접 계산해 볼 수 있습니다. 특히 두 '빠른 모드' 사례에서 사람 시급을 움직여 보세요. 토큰 비용만 보면 언제나 표준이 이기지만, 시급이 일정 수준을 넘는 순간 빠른 모드가 더 싸집니다. 위젯의 예시값(작업 하나에 1,000만 토큰, 섞인 단가 1달러, 표준 대기 12분, 성공률 85%)으로 계산하면, 6배 가격의 빠른 모드는 시급이 약 417달러를 넘어야 본전이지만 2배 가격이면 약 83달러에서 본전이 됩니다. 속도 프리미엄이 6배에서 2배로 내려온 일은 빠른 토큰을 '연봉 높은 실리콘밸리 엔지니어의 사치품'에서 '보통 개발팀의 합리적 선택'으로 옮겨 놓은 변화입니다.
하네스도 모델의 일부다. SemiAnalysis가 4월 글에서 강조한 또 하나의 논점은 비교의 단위입니다. 그들은 GPT-5.5·5.4·Opus 4.6을 같은 하네스로 돌려 벤치마크를 쟀는데, 점수가 연구소 발표보다 대체로 낮았습니다. 연구소들은 자체 비공개 하네스로 점수를 올리기 때문입니다. 그리고 결론을 이렇게 냅니다. "같은 하네스로 비교하는 편이 더 공정하다고 주장할 수도 있다. 그러나 하네스는 이미 제품의 일부다. 사람들이 실제로 궁금한 것은 GPT-5.5 대 Opus 4.7이 아니라 Codex 대 Claude Code다." 프롬프트 캐싱, 입력:출력 비율, 도구 사용 패턴이 모두 하네스가 정하므로, 작업당 비용도 하네스가 정합니다.
그 하네스가 사고를 치기도 했습니다. 4월 23일 Anthropic은 3월 초부터 4월 중순까지 Claude Code에 있었던 버그 세 개에 대한 사후 분석을 냈습니다. 몇 주씩 이어진 버그였고, 그동안 많은 사용자가 "모델이 몰래 나빠졌다"고 의심했습니다. SemiAnalysis의 촌평은 짧습니다. "하네스가 제품의 일부일 때, 욕은 모델이 먹는다."
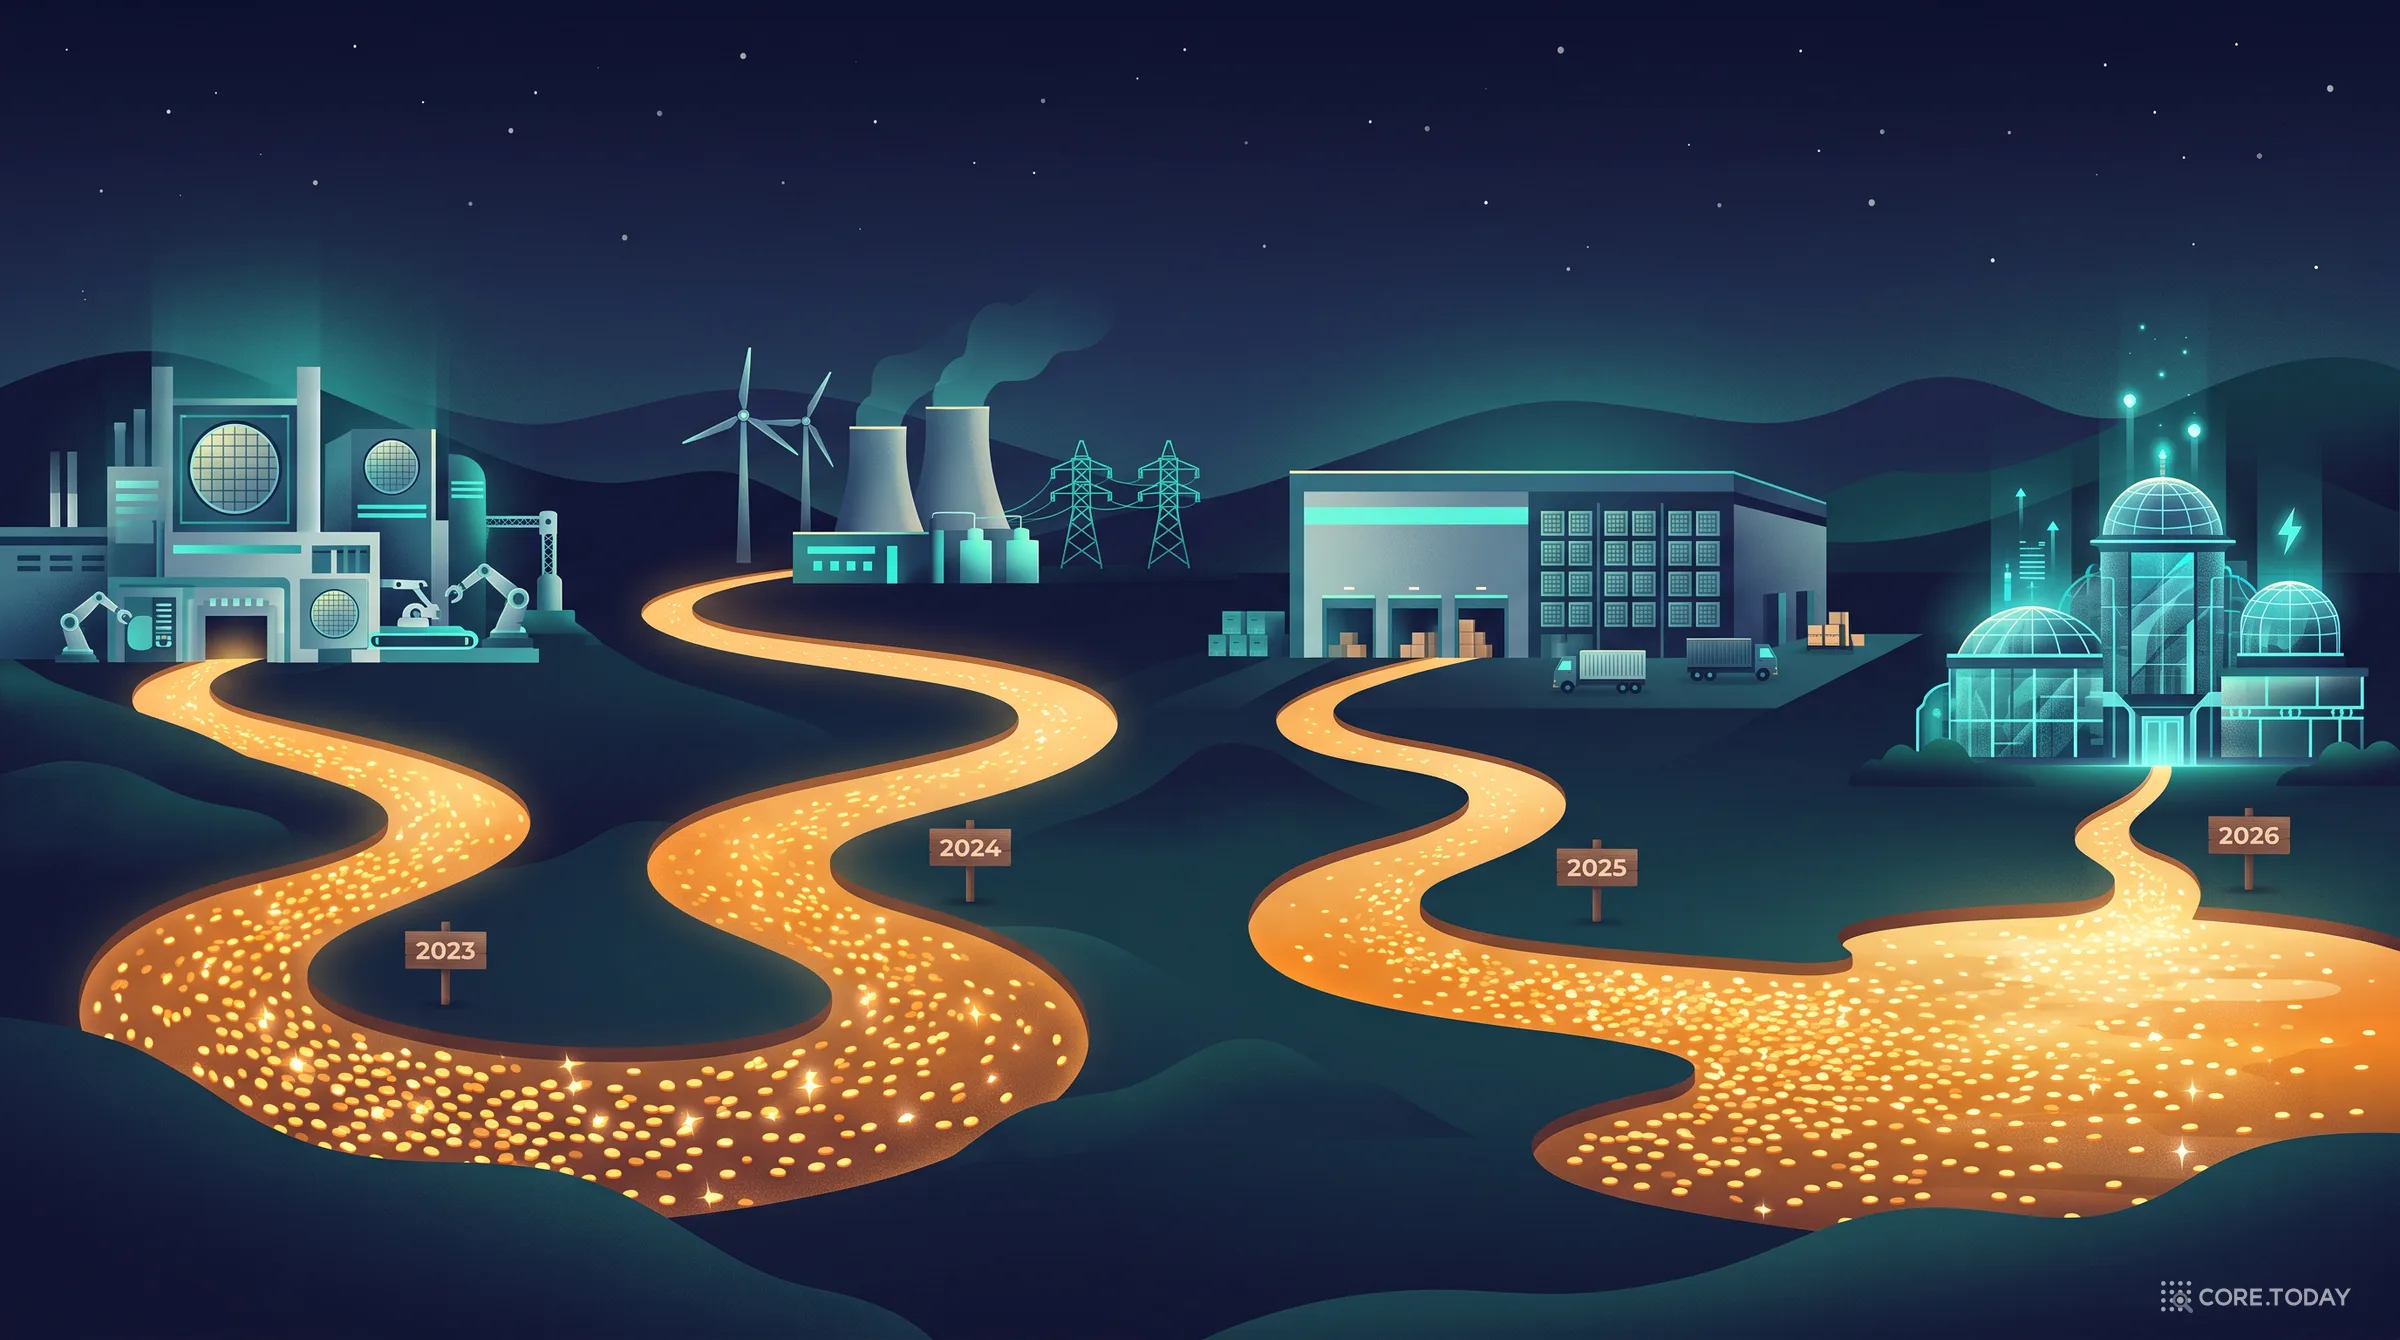
모델 하나의 값을 이야기하기 전에, AI 산업 전체에서 이익이 어디에 쌓였는지를 먼저 봐야 합니다. SemiAnalysis의 5월 1일 글은 이 흐름을 연도별로 요약합니다.
2023 · 칩5월 엔비디아의 첫 '블록버스터' 실적 발표 뒤 주가가 시간외에서 25% 뛰며 AI 투자가 공식적으로 시작됐다.
2024 · 전력전력이 병목이라는 사실이 알려지며 Vistra(+265%)와 GE Vernova(+146%)가 S&P 500 최상위 수익률을 냈다.
2025 · 메모리SanDisk·Western Digital·Seagate·Micron이 모두 한 해 200% 넘게 올랐다. 그동안 모델 회사와 추론 제공사의 이익률은 '악명 높게 나빴다'.
2026 · 모델 회사"AI 연구소들이 지난해 거의 0이던 가치를 이제 전부 가져가고 있다." 에이전트가 실제로 일하기 시작한 2025년 12월이 분기점이었다.
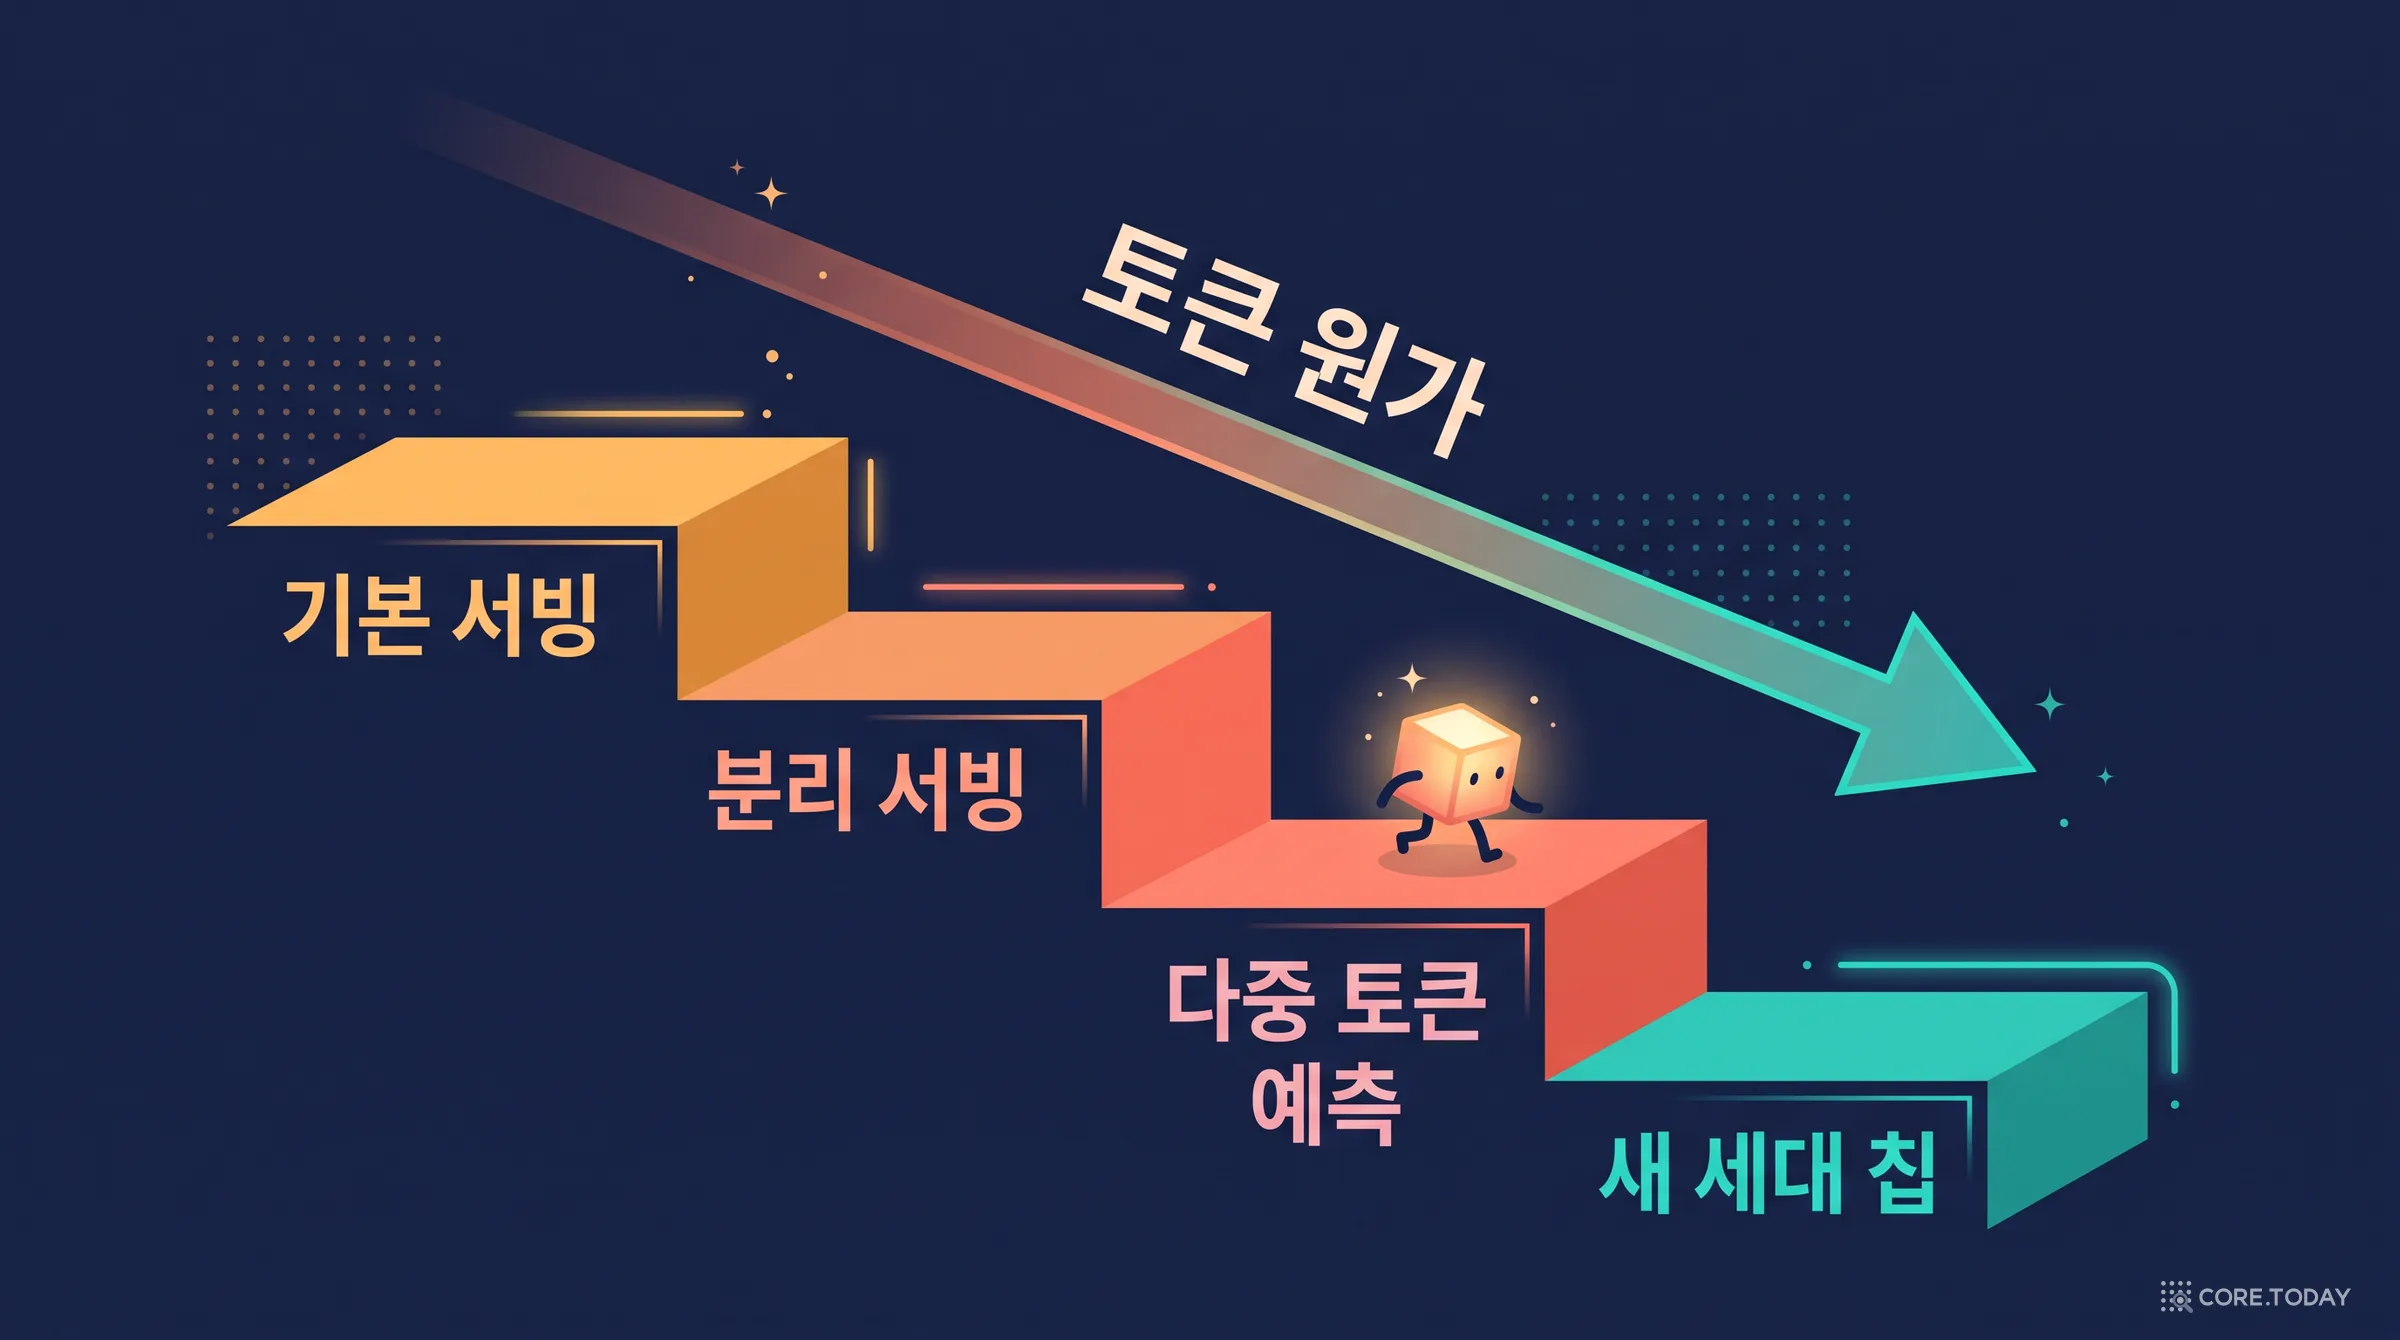
이 변화를 만든 것은 두 개의 곡선이 반대 방향으로 움직인 일입니다. 토큰 하나가 만드는 가치는 오르고, 토큰 하나를 만드는 원가는 떨어졌습니다.
토큰의 가치가 오른 증거
SemiAnalysis는 자기 회사를 첫 번째 증거로 듭니다. 연 환산 1,095만 달러를 Claude 토큰에 쓰지만 "그 가치 덕분에 모든 경쟁사를 이기고 점유율을 얻고 있다." 분석가들은 엑셀 모델을 대시보드로 바꾸고, 보고서의 차트를 만들고, 기업 실적을 분석하는 데 에이전트를 씁니다. 2월 5일 글 「Claude Code는 변곡점이다(Claude Code is the Inflection Point)」는 GitHub 공개 커밋의 4%를 이미 Claude Code가 쓰고 있다며, 2026년 말에는 20%를 넘을 것으로 내다봤습니다. 같은 글은 미국 지식 노동자 한 명의 하루 인건비를 350~500달러로, 그 업무 일부를 맡는 에이전트의 하루 비용을 6~7달러로 잡아 "지능의 개선을 빼고도 10~30배의 투자 수익"이라고 계산했습니다. 4월 2일 글은 한 걸음 더 나갑니다. "AI 사용의 진짜 수익률 논쟁은 이제 끝났다. AI 도구는 비용보다 한 자릿수 큰 가치를 낼 수 있다."
모델 회사의 숫자가 이 주장을 뒷받침합니다. SemiAnalysis의 서술을 시간순으로 이어 보면 Anthropic의 연간 반복 매출(ARR)은 2025년 말 90억 달러에서 1분기 말 300억 달러(분기 한 번에 210억 달러 순증)가 됐고, 4월 말 보도로는 440억 달러를 넘었습니다. 5월 27일 글은 "연말까지 1,000억 달러를 훌쩍 넘을 가능성"까지 언급합니다. Amazon Bedrock은 연 55억 달러 규모의 사업이 됐는데 고객의 80~90% 이상이 Anthropic 모델을 씁니다. SemiAnalysis는 이 숫자를 묶어 "프론티어 LLM이 AI API 산업 매출의 압도적 다수를 차지한다"고 정리합니다.
토큰의 원가가 떨어진 증거
동시에 원가는 무너졌습니다. 이 부분은 6장에서 자세히 다루지만, 5월 글의 요약은 이렇습니다. "블랙웰은 1년 전 호퍼보다 프론티어 작업에서 초당 30배 많은 토큰을 만든다." 그 결과 Anthropic의 추론 인프라 이익률은 같은 기간 38%에서 70% 이상으로 올랐다고 SemiAnalysis는 추정했습니다(5월 27일 글은 같은 수치를 "2024년 −94%, 2025년 38%, 지금 60% 중반"으로 적어, 두 글 사이에 몇 포인트 차이가 있습니다).
가격을 내렸는데 이익률이 오른 이유
이 대목에서 SemiAnalysis는 직관에 반하는 관찰을 하나 내놓습니다. Anthropic은 2025년 11월 Opus 4.5를 $5/$25에 내놓으며 Opus 4·4.1($15/$75)보다 값을 3분의 1로 내렸습니다. 그런데 Opus 토큰의 이익률은 오히려 올랐다는 것입니다. 이유는 두 가지입니다. 첫째, Trainium과 엔비디아 GPU 양쪽에서 소프트웨어가 개선되고 호퍼가 블랙웰로 바뀌면서 같은 토큰을 더 싸게 만들게 됐습니다. 둘째, 값이 내려가자 사용량이 Sonnet에서 Opus로 옮겨 가 토큰당 평균 판매가는 오히려 올랐습니다. 싼 모델을 쓰던 사람들이 비싼 모델로 올라탔기 때문입니다.
그리고 Anthropic에게는 아직 당길 지렛대가 남아 있습니다. 더 비싼 상품으로 사용량을 옮기는 것입니다. 표준의 6배였던 Opus 빠른 모드, 발표가가 Opus의 5배였던 Mythos가 그 예입니다. SemiAnalysis는 자기 고객으로서 이렇게 고백합니다. "Anthropic이 Mythos 빠른 모드를 $150/$750에 판다면 우리는 살 것이다." 그리고 결론을 이렇게 맺습니다.
프론티어 모델 제공사의 낮은 이익률 시대는 끝났다. 진짜 에이전트 AI가 토큰의 시장 청산 가격을 영구적으로 올렸고, 되돌아갈 길은 없다.
왜 경쟁이 이 이익을 깎아 먹지 못하나
가장 자연스러운 반론은 경쟁입니다. 오픈 모델이 싸게 나오면 프론티어의 이익은 사라져야 하지 않을까요? SemiAnalysis는 두 가지 이유로 아니라고 봅니다.
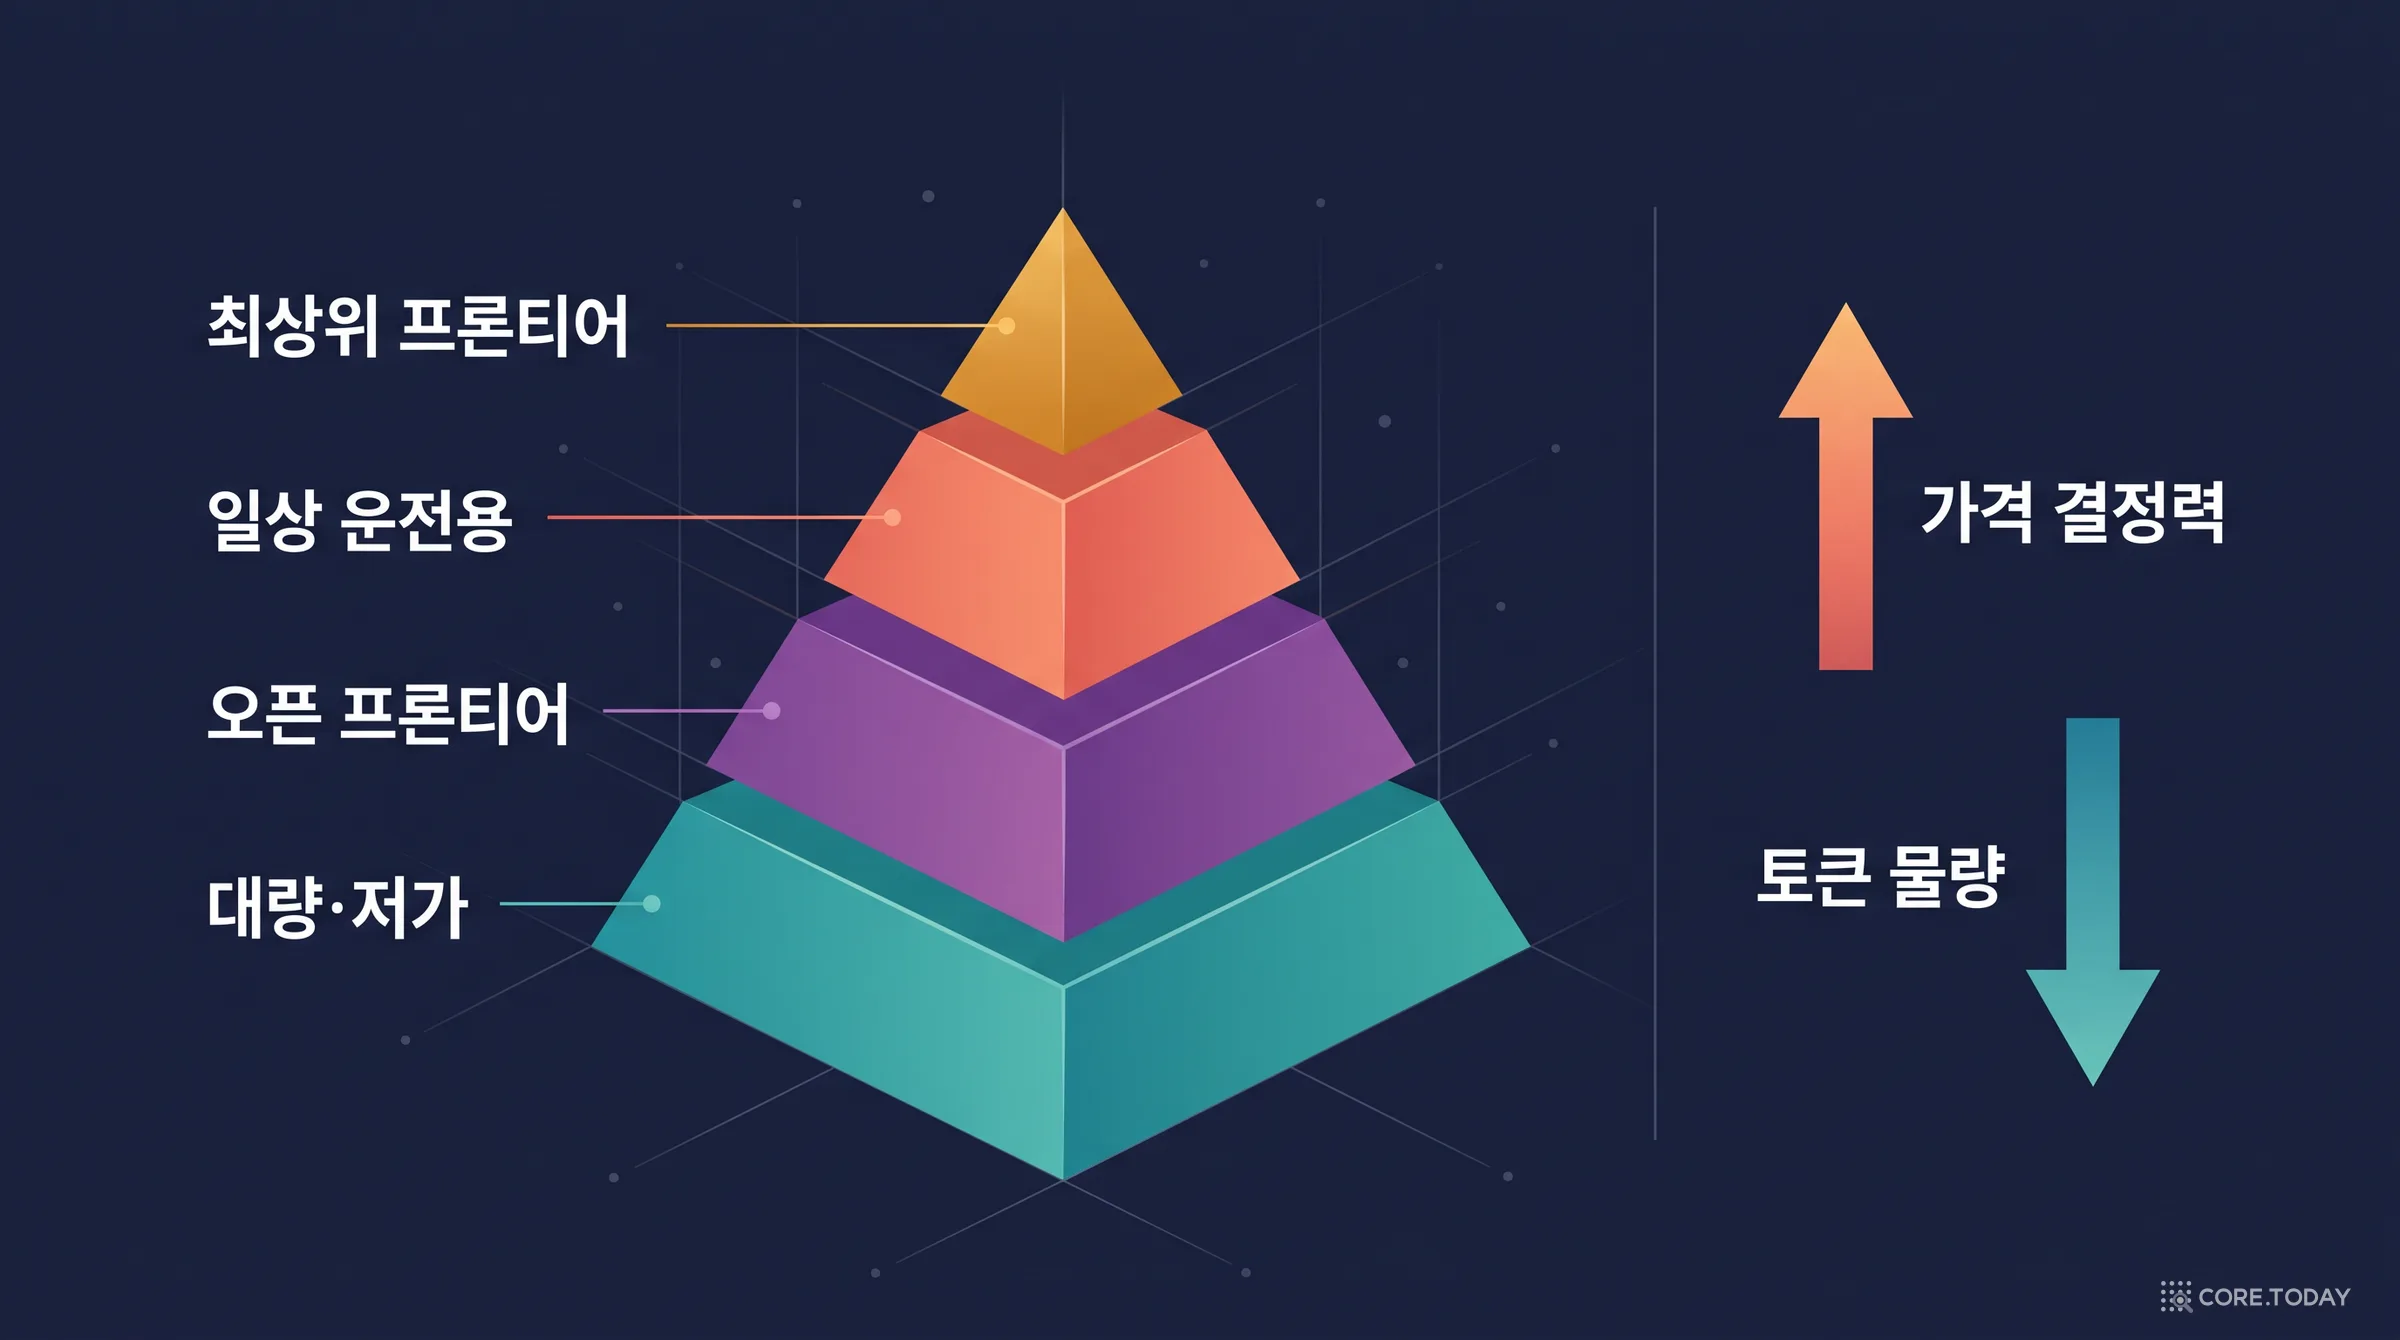
첫째, 프론티어가 가격 결정력을 유지한다. "벤치마크가 뭐라고 하든, 실제 지식 노동에서 오픈소스 모델은 여전히 눈에 띄게 못하고, 그 격차가 곧 좁혀질 이유도 없다. Kimi K2.6($0.95/$4)은 Opus 가격에 거의 아무런 하방 압력을 주지 못한다." 둘째, 연산이 부족하다. 어떤 프론티어 연구소도 시장 전체를 서빙할 수 없고, Anthropic은 이미 Claude Code를 월 100달러 이상 요금제에 묶고 외부 하네스를 막아 시장의 상당 부분을 밀어내고 있습니다. 수요가 공급을 크게 넘는 한 "진짜 프론티어 품질을 내는 연구소는 서로 이익을 깎아 먹는 대신 토큰이 만드는 경제적 가치에 맞춰 값을 매길 수 있다."
아직 가격을 올리지 않은 두 회사
이 흐름에서 SemiAnalysis가 가장 의아해하는 것은 TSMC와 엔비디아입니다. 둘 다 공급의 병목을 쥐고 있는데도 가격을 크게 올리지 않았습니다. SemiAnalysis는 이를 "엔비디아는 AI의 중앙은행"이라는 비유로 설명합니다. 반독점 감시를 피하고, 고객이 TPU·Trainium으로 옮겨 가는 속도를 늦추고, 생태계 전체의 수요를 키우는 쪽을 택했다는 것입니다. 그 결과 새 랙 Vera Rubin NVL72의 GPU 임대료는 원가 기준으로는 시간당 4.92달러면 네오클라우드의 수익률 문턱(5년 계약, 내부수익률 15.6%)을 넘는데, 성능당 가격 추세로 보면 9.63~12.25달러까지 받아도 고객이 GB300 대비 손해를 보지 않습니다. 그 사이 두 배의 간격이 지금은 모델 회사와 클라우드의 몫으로 남아 있다는 것이 5월 글의 핵심 주장입니다.
다만 부족은 이미 가격에 반영되기 시작했습니다. H100의 1년 계약 임대료는 2025년 10월 시간당 1.70달러에서 2026년 3월 2.35달러로 40% 가까이 올랐고, 8~9월까지 들어올 용량이 이미 다 예약됐습니다. AWS에서는 B200 스폿 인스턴스를 GPU당 시간당 14달러에 사려는 경쟁까지 벌어졌습니다. 9월 Rubin 분석은 반대 방향의 함의도 짚습니다. Rubin으로 서빙하면 GB300과 같은 GW당 매출을 내면서도 토큰 가격을 약 28% 낮출 수 있다는 것입니다. 하드웨어가 내려 준 원가를 모델 회사가 가격 인하로 나눌지, 이익으로 쥘지는 결국 경쟁의 강도에 달렸습니다.
이제 이 글의 출발점이었던 10월 5일 글로 돌아갑니다. 왜 구독 요금제가 중요할까요? SemiAnalysis는 Anthropic의 대략적인 숫자로 답합니다. 구독은 전체 매출의 10%에 불과하지만 추론 연산의 40% 이상을 차지하고, MW당 평균 매출을 약 3,600만 달러 끌어내린다.
이 두 비율만으로 간단한 계산을 할 수 있습니다. 연산 한 단위가 버는 매출을 비교하면 구독은 0.10 ÷ 0.40 = 0.25, API는 0.90 ÷ 0.60 = 1.5입니다. 같은 GPU 시간으로 API는 구독보다 약 6배의 매출을 냅니다. 연산이 부족한 상황에서 모델 회사가 왜 구독 한도를 계속 조이려 하는지, 그런데도 왜 구독을 없애지 못하는지가 동시에 설명됩니다. 구독은 고객 획득 비용이자 마케팅이기 때문입니다. SemiAnalysis는 OpenAI의 넉넉한 한도 초기화가 최근 Codex 채택 급증의 이유 중 하나였고, Anthropic이 계획했던 구독 축소를 여러 번 철회한 것도 여론 때문이었다고 씁니다.
문제는 구독의 한도가 공개되지 않는다는 점입니다. 요금제는 5시간·7일 창에 대한 0~100% 사용량 막대만 보여 주고, 상위 요금제는 "Plus의 5배" 같은 상대 배수로만 설명합니다. SemiAnalysis는 이를 실험으로 풀었습니다.
설계토큰 종류(입력·캐시 쓰기·캐시 읽기·출력) 하나만 최대로 쓰는 프롬프트를 만든다. 입력에는 『전쟁과 평화』 일부를 쓴다. 무작위 문자열을 넣으면 모델이 응답을 거부하기 때문이다. 출력은 기술 에세이로 길게 쓰게 한다.
반복같은 호출을 여러 번 하면서, 호출마다 실제 청구된 토큰 수와 계기판 값을 기록한다.
계단 측정계기판이 한 칸 오를 때까지 쓴 토큰을 '한 계단'으로 보고, 첫 계단과 마지막 계단(불완전한 계단)은 버린다. 범위가 ±5% 안에 들어올 때까지 계단을 더 모은다. 캐시 읽기 5억 토큰에도 계기판이 안 움직이면 무료로 본다.
환산100만 토큰이 한도의 몇 %를 쓰는지 → 주간 한도가 몇 토큰을 담는지 → 자사 9월 사용 비율로 섞어 API 가격으로 몇 달러어치인지 계산한다.
이 방법이 얼마나 예민한지 보여 주는 일화가 있습니다. 측정 도중 같은 요금제 계정 세 개 가운데 하나만 한도가 약 20% 낮게 나왔습니다. 계정이 오래될수록 한도를 줄이는 게 아닌가 의심했지만, 해당 회사에 문의한 결과 "아주 작은" 한도 A/B 실험에 그 계정이 걸렸던 것으로 확인됐습니다. SemiAnalysis는 두 가지를 짚습니다. 회사는 언제든 한도를 몰래 바꿀 수 있고, 자기들의 측정은 그것을 잡아낼 만큼 정밀하다는 것입니다.
측정 결과: 같은 200달러, 다른 값
결과는 이렇습니다(모두 에이전트 사용 기준).
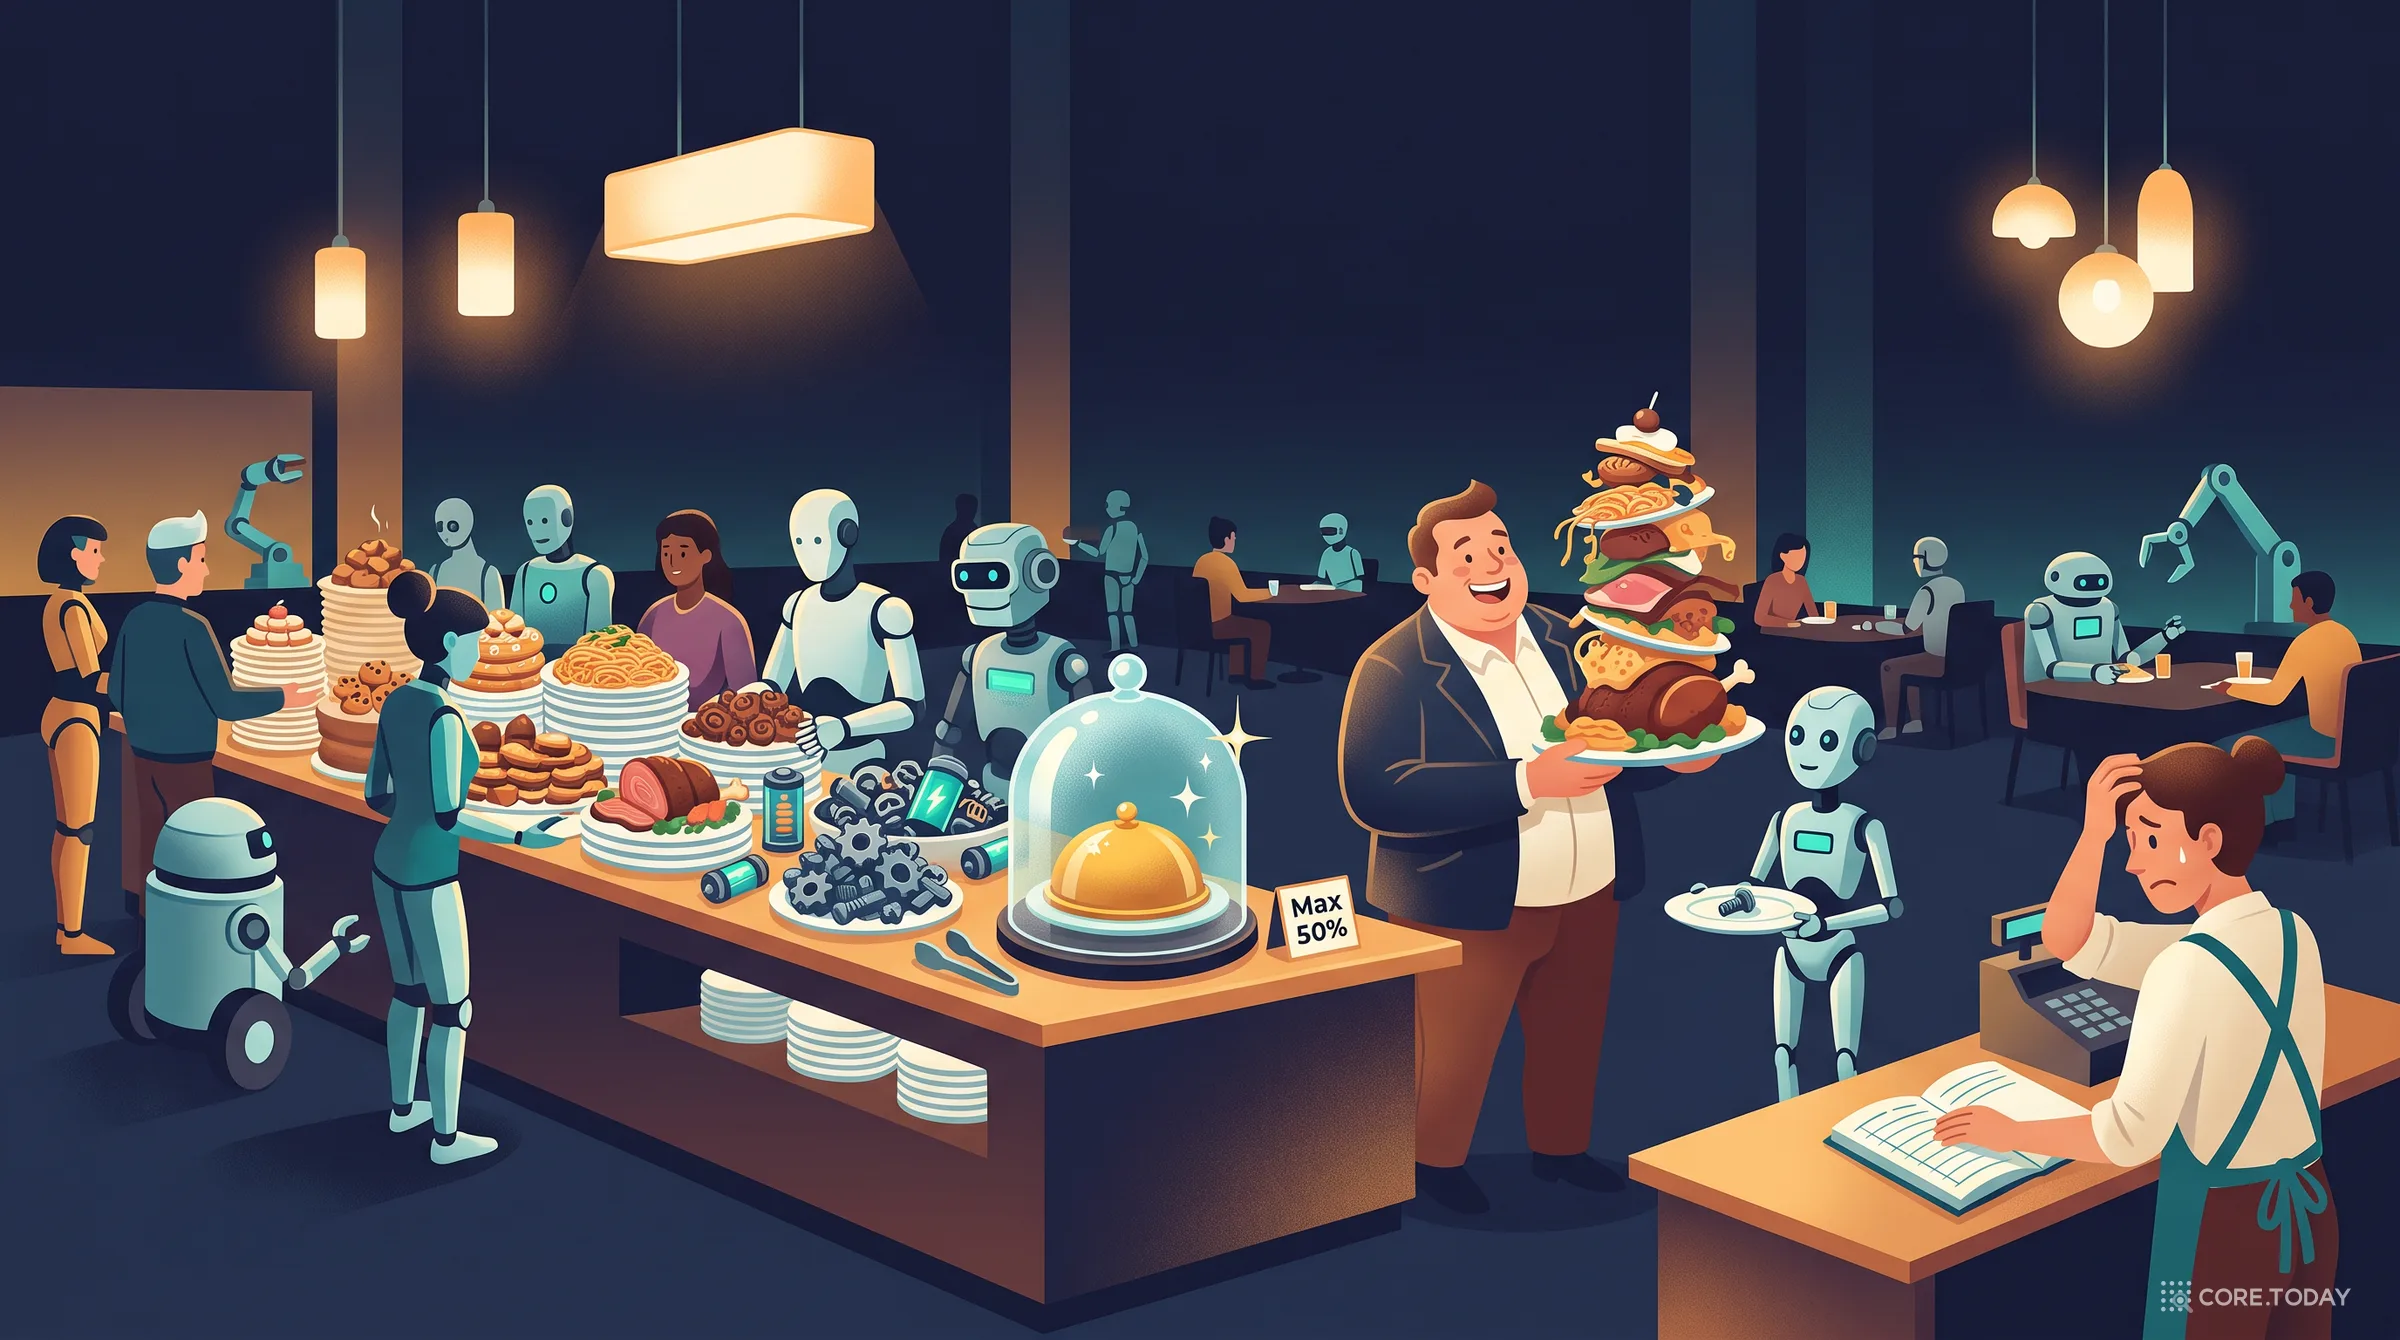
최상위 모델끼리는 비슷하다. GPT-6 Astra와 Fable 5.1의 한도는 거의 같습니다. 다만 Anthropic은 Fable을 한도의 50%까지만 쓰게 합니다. 200달러 Anthropic 요금제는 Fable 5.1을 2,485달러어치 쓴 뒤에도 한도가 절반 남지만, OpenAI 요금제는 Astra를 2,897달러어치 쓰면 끝납니다.
일상용 중간 모델에서는 Anthropic이 압도적이다. 두 회사가 "대부분 사용자의 일상 운전용"으로 미는 Opus 5.5와 GPT-6.1 Sol을 비교하면 Anthropic이 API 환산으로 약 5배를 줍니다. Sol이 토큰당 훨씬 싸다는 점을 감안해 토큰 수로 비교해도 격차는 여전히 큽니다.
OpenAI는 한도를 절반으로 잘랐다. 9월 말 OpenAI는 200달러 요금제의 모델별 토큰 한도를 정확히 절반으로 줄이고 500달러 요금제를 새로 냈습니다. Sol 계열은 캐시 입력 가격까지 함께 내리는 바람에 API 환산 가치가 50% 넘게 떨어졌습니다. 새 500달러 요금제는 옛 200달러 요금제보다 Astra를 21% 더 줄 뿐이고, 진짜 핵심은 '초당 300토큰 Ultrafast'입니다.
OpenAI의 요금제 계단이 평평해졌다. 예전에는 Pro 100이 Plus보다 달러당 약 2배, Pro 200이 다시 약 2배를 더 줬지만, 이번 조정 뒤 Pro 100·200·500은 모든 모델에서 달러당 같은 토큰을 줍니다. Anthropic은 원래부터 모든 요금제가 달러당 같은 값을 줬습니다.
중국 연구소 요금제는 여전히 후하다. 연산이 부족한데도 상위 요금제일수록 달러당 가치가 커지며, 평균은 OpenAI가 주는 약 12배보다 조금 낮습니다.
제3자 래퍼는 자사 요금제보다 나쁘다. Cursor·Cognition(Devin)으로 같은 모델을 쓰면 자사 요금제보다 값이 떨어집니다.
두 회사의 서로 다른 전략
가장 흥미로운 부분은 두 회사가 구독 보조금을 줄이는 방식이 정반대라는 관찰입니다. 아래 위젯은 SemiAnalysis가 공개한 이익률 숫자를 공식으로 재현합니다. 공개된 네 숫자(Opus 5.5를 끝까지 쓰면 −369%, 사용률 20%면 6%, Fable 5.1은 각각 1%와 80%)에서 역산하면, 200달러 요금제에 들어 있는 Opus 5.5의 API 환산 가치는 약 1만 1,700달러입니다. 월 200달러로 1만 달러어치가 넘는 토큰을 살 수 있다는 뜻입니다.
Anthropic은 비싼 모델일수록 요금제 안의 환산 가치를 낮춥니다. Sonnet 5.5에서 Opus 5.5로 갈 때는 낙폭이 작지만 Fable 5.1에서는 크게 떨어집니다. 그래서 Fable 5.1만 쓴다면 한도를 끝까지 써도 이익률이 본전(1%)이고, 현실적인 사용률 20%에서는 80%입니다. SemiAnalysis의 표현으로는 "모두가 Fable만 쓴다면 Anthropic은 이미 소프트웨어 같은 이익률을 내고 있을 것"입니다. 시간이 지나 Opus급 모델을 더 작게 만들어 서빙 원가가 떨어지면 보조금은 저절로 줄고, Fable 위의 새 등급은 한도가 더 낮게(포함된다면) 들어올 것입니다. 조용하지만 꾸준한 방식입니다.
OpenAI는 "핵 옵션"을 택했습니다. 모든 모델의 한도를 한 번에 Fable 수준으로 깎은 것입니다. 원래 이런 방식은 여론의 역풍을 맞기 마련인데, SemiAnalysis는 OpenAI가 이를 "어떻게든 거의 피해 갔다"고 씁니다. 바로 다음 날의 DevDay 홍보가 나쁜 소식을 덮었고, 기존 가입자에게 한 달의 유예를 준 덕분이라는 분석입니다. 그 유예가 끝나는 날이 바로 오늘입니다.
가격 인하와 한도의 관계도 눈여겨볼 만합니다. 모델 회사가 API 가격을 내리면 같은 요금제의 환산 가치는 자동으로 떨어집니다. 한도를 토큰 수로 고정해 두면 그렇습니다. OpenAI는 6.1 Sol을 내면서 Sol 한도를 바꾸지 않아 환산 가치가 약 30% 떨어졌습니다. Anthropic은 Fable 5.1 한도는 그대로 두고 Opus 5.5 한도는 올렸지만(Max 요금제 약 20%, Pro 요금제 약 50%), 가격 인하를 다 메우지는 못했습니다. 가격표가 싸지는 것과 요금제가 후해지는 것은 다른 일입니다.
구독 바깥의 세계
5월 28일 글 「재미로 컴파일러 오류 찾기(Finding Miscompiles for Fun, Not Profit)」는 구독의 한계를 반대쪽에서 보여 줍니다. 서브에이전트 떼를 풀어 컴파일러 버그를 찾는 실험에 몇 시간 만에 1만 달러가 들었고, 토큰당 과금 Opus 4.7로는 며칠 작업에 1,000달러 단위가 들었습니다. 비교 대상은 월 200달러 ChatGPT Pro 계정이었습니다. 이 글의 부제는 "1만 달러를 오후 한나절에 쓰는 데 Claude Mythos가 꼭 필요하지는 않다"였고, 본문에는 이런 문장이 있습니다. "다섯 달 전에는 불가능했던 일이 이제는 '그저' 아주 비쌀 뿐이다. 예산이 없으면 가능성 공간의 더 작은 부분에서 일하게 된다." 구독은 입문의 값이고, 가능성의 끝은 여전히 종량제에 있습니다.
지금까지는 모델을 사는 쪽의 숫자였습니다. 이제 만드는 쪽으로 넘어갑니다. 모델의 값이 '판매가 − 원가'라면, 원가를 아는 것은 가격을 아는 것만큼 중요합니다. 그리고 공개 모델의 원가를 공개적으로 재는 곳이 SemiAnalysis의 InferenceX입니다.
InferenceX가 하는 일은 단순합니다. 같은 공개 모델(DeepSeek, GLM, Kimi, MiniMax, Qwen, gpt-oss 등)을 여러 하드웨어(H100·H200·B200·B300·GB200/GB300 NVL72·MI355X·TPU·Trainium)와 서빙 소프트웨어(vLLM·SGLang·TensorRT-LLM·Dynamo·AMD ATOM)의 조합에서 매일 밤 돌리고, 처리량을 총소유비용(TCO)으로 나눠 100만 토큰당 원가를 냅니다. 2026년 8월의 v3(AgentX)부터는 300만 달러어치 실제 에이전트 트레이스(중앙값 입력 8만 8천 토큰, 상위 1%는 67만 토큰)로 다회차 대화와 서브에이전트를 재현합니다.
SemiAnalysis는 2025년 7월 DeepSeek 분석에서 이 원가에 관한 가장 중요한 문장을 남겼습니다.
어떤 모델이든 이 세 가지 지표(지연, 처리량, 맥락 길이)를 조작해 사실상 어떤 토큰당 가격도 만들어 낼 수 있다. 모델의 토큰당 가격은 이 지표들을 정한 결과물이다.
토큰 가격은 모델의 고유한 속성이 아니라 서빙 방식의 결과라는 뜻입니다. 같은 모델이라도 사용자 한 명에게 초당 몇 토큰을 보내 줄지(상호작용성), 응답 첫 토큰을 몇 초 안에 줄지, 얼마나 긴 맥락을 받을지를 정하는 순간 가격이 정해집니다. 아래 위젯에서 같은 모델을 두 방향으로 바꿔 보세요.
SemiAnalysis 글에 나온 InferenceX 수치를 모으면, 원가를 움직이는 지렛대가 얼마나 큰지 보입니다.
지렛대
모델 · 조건
원가 변화
출처
다중 토큰 예측(MTP)
DeepSeek R1, FP4, Dynamo TRT
$0.251 → $0.057 / 100만 토큰
2026-02 InferenceX v2
MTP (빠른 상호작용)
DeepSeek R1, GB300, 사용자당 초당 150토큰
약 $2.35 → 약 $0.11 (약 21배)
2026-02 InferenceX v2
세대 교체
호퍼 → 블랙웰 NVL72 FP4
달러당 토큰 9.7배(초당 40토큰) ~ 65배(초당 116토큰)
2026-02 InferenceX v2
칩 경쟁
GLM-5.3, 사용자당 초당 150토큰
GB200 $0.044 vs MI355X $0.049 (첫 토큰 2초 제한을 걸면 MI355X가 9% 쌈)
2026-09 GLM-5.3 분석
TPU 외부 판매
Qwen3.5 397B, 사용자당 초당 100토큰
Ironwood $0.181 vs B200 $0.222 vs B300 $0.276
2026-09 TPU 분석
메모리 계층
DeepSeek V4.1 Flash Engram 오프로드, B200
달러당 1억 2,100만 토큰(DRAM) vs 5,200만(SSD)
2026-09 Engram 분석
차세대 랙
DeepSeek V4 Pro, Vera Rubin NVL72 vs GB300
제목은 "67배", 실제 서비스 구간(초당 60~100토큰)은 1.4~3배
2026-09 Rubin 분석
표에서 두 가지를 읽을 수 있습니다.
첫째, 원가 숫자는 조건 없이 인용하면 거의 의미가 없습니다. GLM-5.3 원가만 해도 한 글 안에서 1위가 네 번 바뀝니다. 초당 100토큰에서는 AMD ATOM이 13% 싸고, 150토큰에서는 GB200이 12% 싸고, 첫 토큰을 2초 안에 줘야 한다는 조건을 걸면 다시 ATOM이 9% 싸고, 10초까지 허용하면 GB300 TRT-LLM이 26% 쌉니다. GB200의 싼 점들은 첫 토큰까지 90분위 14~19초가 걸리는 구간이었기 때문입니다. Rubin의 "67배"도 마찬가지입니다. SemiAnalysis 스스로 "높은 상호작용성 구간의 이득을 인용할 때는 엔진 이름이 필수"라고 적었습니다. 비교 대상인 GB300을 어떤 엔진으로 돌렸느냐에 따라 MW당 이득이 62.9배가 되기도 하고 5.56배가 되기도 합니다.
둘째, 같은 모델의 원가가 같은 시기에 열 배 넘게 차이 납니다. 이 차이가 곧 추론 제공사의 이익입니다. 2월 글은 Crusoe가 DeepSeek R1 0528을 입력 100만 토큰당 $1.35, 출력 $5.40에 파는 것을 InferenceX 원가와 비교해, 입력에서 최대 83%, 출력에서 45%의 매출총이익률을 낼 수 있다고 계산했습니다. 같은 모델을 파는 회사들 사이의 가격 차이는 모델의 차이가 아니라 공장의 차이입니다.
모델 설계가 원가를 정한다
2026년 하반기 SemiAnalysis 글들의 새로운 흐름은 모델 구조가 곧 원가 구조라는 관점입니다. 9월 이후 글에서 이 관점이 반복됩니다.
DeepSeek V4(4월): 맥락을 12만 8천에서 100만 토큰으로 늘리면서, 100만 토큰 맥락에서 V3.2 대비 토큰 하나당 연산은 27%, KV 캐시는 10%만 쓴다고 밝혔습니다. SemiAnalysis는 "구글의 TurboQuant 논문보다 훨씬 큰 영향"이라며 "낸드 플래시 투자자는 조심하라"고 썼습니다.
DeepSeek V4.1 Flash(9월): DeepSeek 모델 가운데 처음으로 Engram(약 189GiB의 조회용 기억 표)을 넣었습니다. 이 표는 HBM이 아니라 호스트 DRAM으로 내려도 되기 때문에, SemiAnalysis는 "같은 모델 품질이라면 HBM 용량보다 HBM 대역폭이 훨씬 중요해진다"고 결론지었습니다. 모델 구조 하나가 메모리 시장의 수요 모양을 바꾼다는 이야기입니다.
GLM-5.3(9월): 744B 전체·40B 활성의 전문가 혼합 모델로, 인덱서 하나를 희소 어텐션 층 네 개가 나눠 쓰는 IndexShare로 인덱서 캐시와 연산을 75% 줄이고 처리량을 1.5~1.8배 올렸습니다. 쿼리 헤드를 DeepSeek의 절반(64개)으로 줄인 것을 두고 SemiAnalysis는 중국 GPU(Moore Threads)의 연산 대 메모리 비율에 맞춘 설계라고 추정합니다.
이 흐름이 모델의 값에 주는 함의는 분명합니다. 오픈 모델의 경쟁력은 이제 벤치마크 점수만이 아니라 "얼마나 싸게 서빙되도록 설계됐는가"로도 매겨집니다. 이것이 다음 장의 주제입니다.
4장에서 SemiAnalysis는 "Kimi K2.6은 Opus 가격에 거의 아무런 하방 압력을 주지 못한다"고 단언했습니다. 그렇다면 오픈 모델은 값이 없는 것일까요? 숫자는 정반대의 그림을 보여 줍니다.
토큰은 오픈이, 돈은 프론티어가
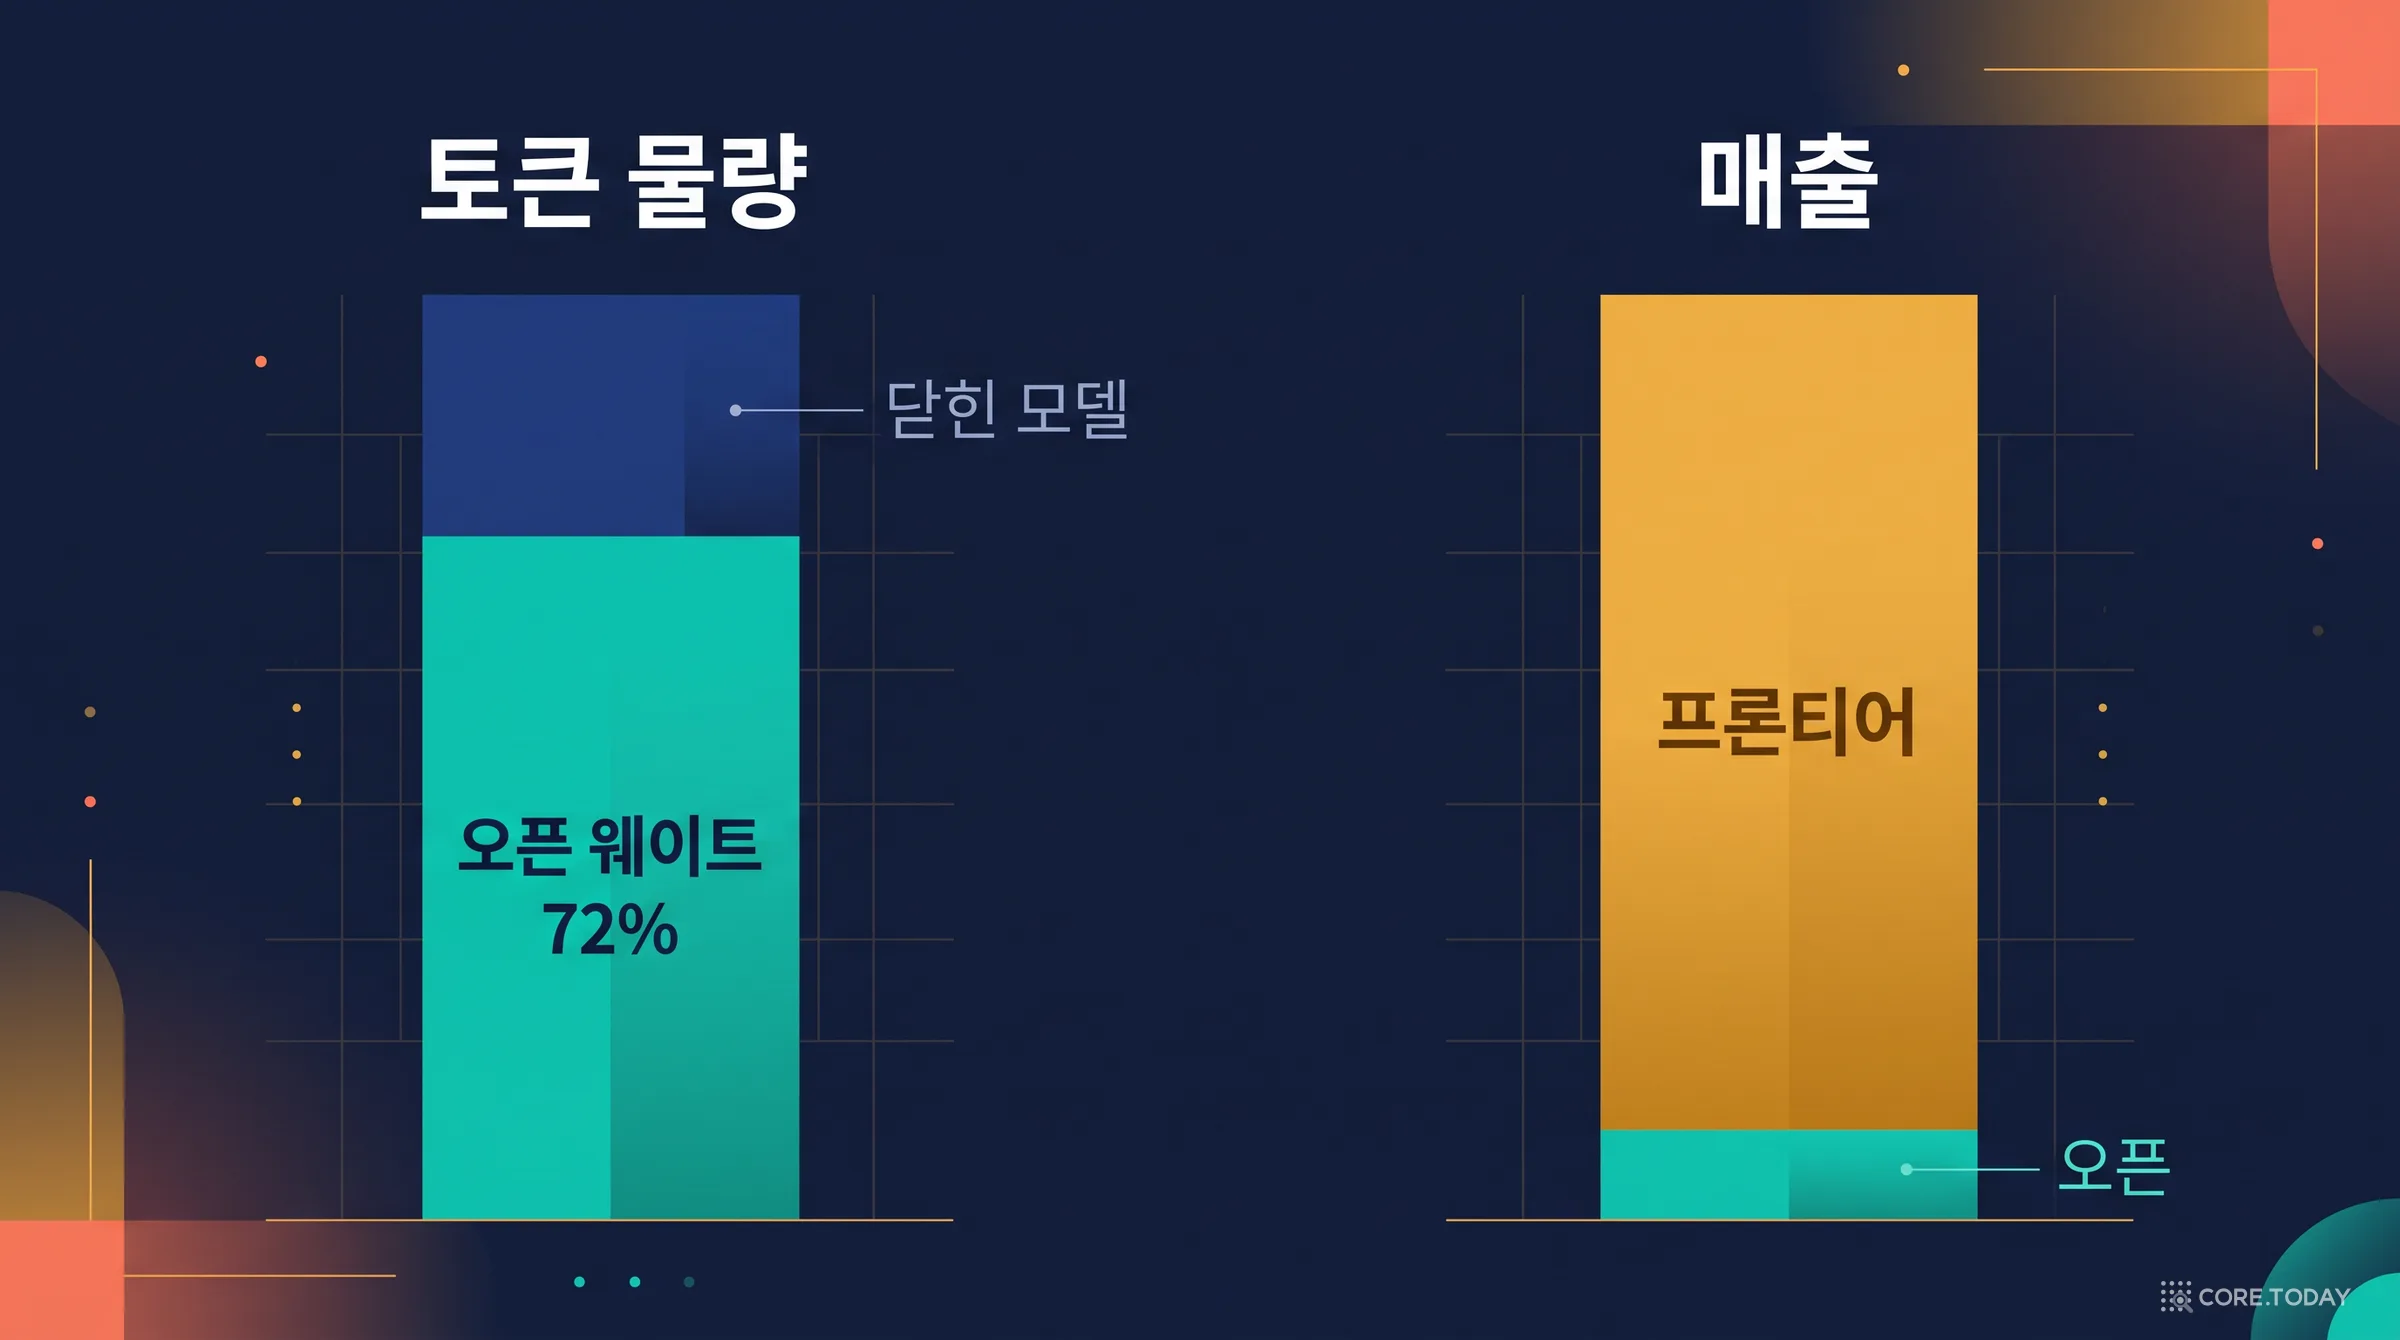
모델 중개 서비스 OpenRouter가 공개하는 사용량 순위(10월 28일까지 30일)를 보면, 오픈 웨이트 모델이 차지하는 토큰 비중은 8월 둘째 주 68.6%에서 10월 셋째 주 72.6%로 올랐습니다. 중국 연구소 모델의 비중은 2025년 11월 첫 주 20.2%에서 10월 셋째 주 61.6%로 세 배가 됐습니다. 30일 누적 1위는 DeepSeek V4.1 Flash(두 버전 합 25.5%)이고, 3위는 GLM-5.3-Flash(7.6%)입니다. 닫힌 모델 가운데 가장 많이 쓰인 것은 GPT-6 Luna(4.5%), 그다음이 Opus 5.5(3.6%)입니다. 전체 토큰의 97.5%가 입력이라는 점도 눈에 띕니다. 2장에서 본 에이전트형 작업 모양이 시장 전체의 모양이 됐다는 뜻입니다.
그런데 SemiAnalysis는 5월 글에서 "프론티어 LLM이 AI API 산업 매출의 압도적 다수를 차지한다"고 썼습니다. 두 주장은 모순이 아닙니다. 9장 위젯의 계산을 빌리면, 에이전트 작업 기준 실제 단가는 Opus 5.5가 100만 토큰당 약 $0.61, DeepSeek V4.1 Flash가 약 $0.036으로 약 17배 차이가 납니다. 토큰 점유 3.6%와 25.5%에 이 단가를 곱하면, Opus 5.5 하나가 V4.1 Flash 두 버전을 합친 것보다 두 배 넘는 매출을 냅니다. 물론 OpenRouter는 오픈 모델을 여러 제공사에 나눠 파는 중개소라 오픈 모델 비중이 시장 전체보다 높게 나오고, Anthropic 매출의 대부분은 자사 API·Bedrock·구독에서 나옵니다. 토큰의 다수는 오픈 모델이 처리하고, 돈의 다수는 프론티어가 번다는 구도는 그래서 더 강해집니다.
왼쪽 막대는 OpenRouter 10월 셋째 주 토큰 점유(오픈 웨이트 72.6%)이고, 오른쪽 막대는 "프론티어 LLM이 API 매출의 압도적 다수"라는 SemiAnalysis의 서술을 그린 개념도입니다. 매출 쪽은 정확한 비율이 공개되지 않았습니다.
오픈 모델이 가진 네 가지 값
그렇다면 오픈 모델의 값은 어디에 있을까요? SemiAnalysis의 글들을 이어 읽으면 네 가지가 보입니다.
첫째, 원가의 바닥. 프론티어의 가격은 깎지 못해도, 프론티어가 필요 없는 일의 가격은 정합니다. 문서 분류, 대량 요약, 서브에이전트의 탐색처럼 "충분히 좋으면 되는" 작업은 V4.1 Flash($0.30/$1.20)나 MiniMax M3.1 Flash($0.15/$0.60) 수준으로 내려갑니다. 4월 글은 DeepSeek V4를 "닫힌 모델의 가장 싼 대안이 될 것이지만 능력은 최첨단이 아니다. SemiAnalysis의 업무 흐름이 DeepSeek으로 잠식되지는 않을 것"이라고 평했습니다. 바닥이지 천장이 아니라는 평가입니다.
둘째, 연산 수요의 저변. 9월 1일 한국 소버린 AI 글에서 SemiAnalysis는 엔비디아의 고민을 이렇게 요약합니다. "API 가격으로 프론티어 토큰을 파는 것이 추가 연산의 가장 수익률 높은 용도다. 그래서 Anthropic과 OpenAI가 새로 지어지는 GW의 점점 더 큰 몫을 가져가게 된다." 그대로 두면 엔비디아에게는 "진짜 고객이 둘뿐"인 상황이 됩니다. 오픈 모델은 누구나 GPU를 사서 돈을 벌 수 있게 해 주는 장치이고, 그래서 엔비디아가 오픈 모델의 가장 큰 후원자가 된다는 해석입니다. 5월 글도 "GLM과 Kimi 같은 오픈 웨이트 모델이 연산의 수요 기반을 넓힌다"고 적었습니다.
셋째, 하드웨어 전쟁의 무대. InferenceX의 거의 모든 비교는 오픈 모델 위에서 벌어집니다. 닫힌 모델은 아무도 남의 칩에서 돌려 볼 수 없기 때문입니다. 그 결과 오픈 모델은 칩 회사들이 소프트웨어 실력을 겨루는 표준 시험지가 됐습니다.
모델
무대에서 벌어진 일
출처
GLM-5.3
공개 엔진 SGLang 기준으로는 엔비디아가 사용자당 초당 150토큰에서 "최대 5배" 비용 효율. "경쟁 칩을 공짜로 줘도 엔비디아가 쌀 것". 그러나 AMD 자체 엔진 ATOM으로는 곡선 일부에서 MI355X가 GB300을 이긴다
InferenceX 2026-08·09
Kimi K3
B200의 에이전트 작업 원가가 7월 29일 100만 토큰당 $1.35에서 10월 말 $0.077로, 소프트웨어만으로 94% 하락
InferenceX 대시보드
DeepSeek V4 Pro
MI355X 성능이 공개 26일 만에 "100배 넘게" 개선
InferenceX 2026-06
DeepSeek V4.1 Flash
MI355X가 공개 첫날 이미지 기준 B200·B300보다 달러당 성능 최대 42배 나빴고, 7일째에도 2~4배 나빴다
2026-09 Engram 분석
Qwen3.5 397B
구글 TPU Ironwood가 B200보다 19%, B300보다 34% 싸다. TPU 외부 판매의 증거
2026-09 TPU 분석
DeepSeek(전반)
화웨이 Ascend 지원 커널 공개. "하드웨어가 천장을 올리지만, 그 천장에 닿게 하는 것은 소프트웨어다"
2026-10 Huawei-DeepSeek
이 표가 모델의 값에 대해 말하는 바는 이렇습니다. 오픈 모델의 실제 원가는 공개된 순간이 아니라 공개 후 몇 주 동안 소프트웨어가 따라잡으며 정해집니다. 그래서 같은 모델을 공개 첫 주에 평가하는 것과 석 달 뒤에 평가하는 것은 전혀 다른 일입니다.
넷째, 서빙하는 쪽의 이익. InferenceX의 수익 추정기(시간당 임대료, 사용률 60% 가정)로 보면 오픈 모델의 이익은 모델을 만든 회사가 아니라 그 모델을 잘 굴리는 회사에 쌓입니다. DeepSeek V4.1 Flash는 DeepSeek 공식 가격으로 팔면 GB300 한 장이 시간당 45달러 넘게 남깁니다. 반면 DeepSeek V4 Pro는 같은 GB300에서 겨우 본전이고 Vera Rubin에서만 확실히 남습니다. Kimi K3는 공식 가격($3/$15)이면 GB300에서 시간당 12.67달러가 남지만, 7월 말 "모든 제공사가 $3/$15 밑으로는 팔지 않는다"던 OpenRouter의 가격 하한은 이미 무너졌고, GLM-5.3은 OpenRouter 최저가로 팔면 GB300에서도 손해입니다. 오픈 모델 시장은 이미 가격 전쟁 중이며, 이긴 쪽은 원가를 가장 낮춘 공장입니다.
오픈 모델의 값을 깎는 두 가지
동시에 SemiAnalysis는 오픈 모델의 값을 깎는 흐름 두 가지를 경고합니다.
하나는 라이선스입니다. 9월 글은 "이른바 오픈소스 라이선스들이 점점 더 제한적이 되고 있다"며 Kimi K3를 예로 듭니다. 연 매출 2,000만 달러가 넘는 '모델 서비스 사업'은 Kimi K3를 서빙하려면 Moonshot과 별도 계약을 맺어야 합니다. 같은 글은 반대편 끝의 가능성도 적었습니다. "OpenAI·Anthropic이 결국 가장 강력한 모델의 API 제공을 아예 멈출 가능성도 있다." 실제로 Anthropic의 Mythos 5.1은 지금 Project Glasswing이라는 제한된 프로그램으로만 제공됩니다. 최상위 모델이 '살 수 있는 상품'에서 빠지기 시작하면, 오픈 모델과의 격차를 재는 일 자체가 어려워집니다.
다른 하나는 안전성 공시입니다. 10월 8일 글 「베이징은 프론티어의 속도를 늦추지 않는다(Beijing Will Not Pace the Frontier)」는 중국 개발사 9곳이 2021년부터 2026년 9월 15일까지 낸 모델 857개를 세어, 안전성 결과를 한 번이라도 공개한 것이 31개(3.6%), 출시 시점 또는 그 전에 공개한 것은 9개(1.1%)뿐이라고 집계했습니다. 2026년의 중국 프론티어 공개 모델 가운데 출시 때 안전성 결과를 낸 것은 GLM-5.3 하나였습니다. 규제 산업에서 오픈 모델을 고르는 기업에게는 이 공시 여부가 가격 못지않은 선택 기준이 됩니다.
8장. 한국에서 읽는 법 — Motif 3와 '소버린'의 값
SemiAnalysis는 9월 1일 한국에 관한 긴 글을 냈습니다. 제목은 「한국의 1조 달러 소버린 AI 투자: 엔비디아는 이기고 하이닉스는 진다」, 부제는 "한국이 오징어 게임을 연다 — 국가 AI 토너먼트, 비중국 최고의 오픈소스 모델이 탈락하다"였습니다. 여기서 정리하는 내용은 모두 SemiAnalysis의 서술이며, 평가 기관과 정부의 설명은 이 글에 담겨 있지 않다는 점을 먼저 밝혀 둡니다. 2차 평가의 경과와 평가 방식 자체에 대한 논의는 코어닷투데이가 10월 3일 「소버린 AI 2차 평가의 역설 — 벤치마크 1위가 탈락했다」에서 따로 자세히 다뤘습니다.
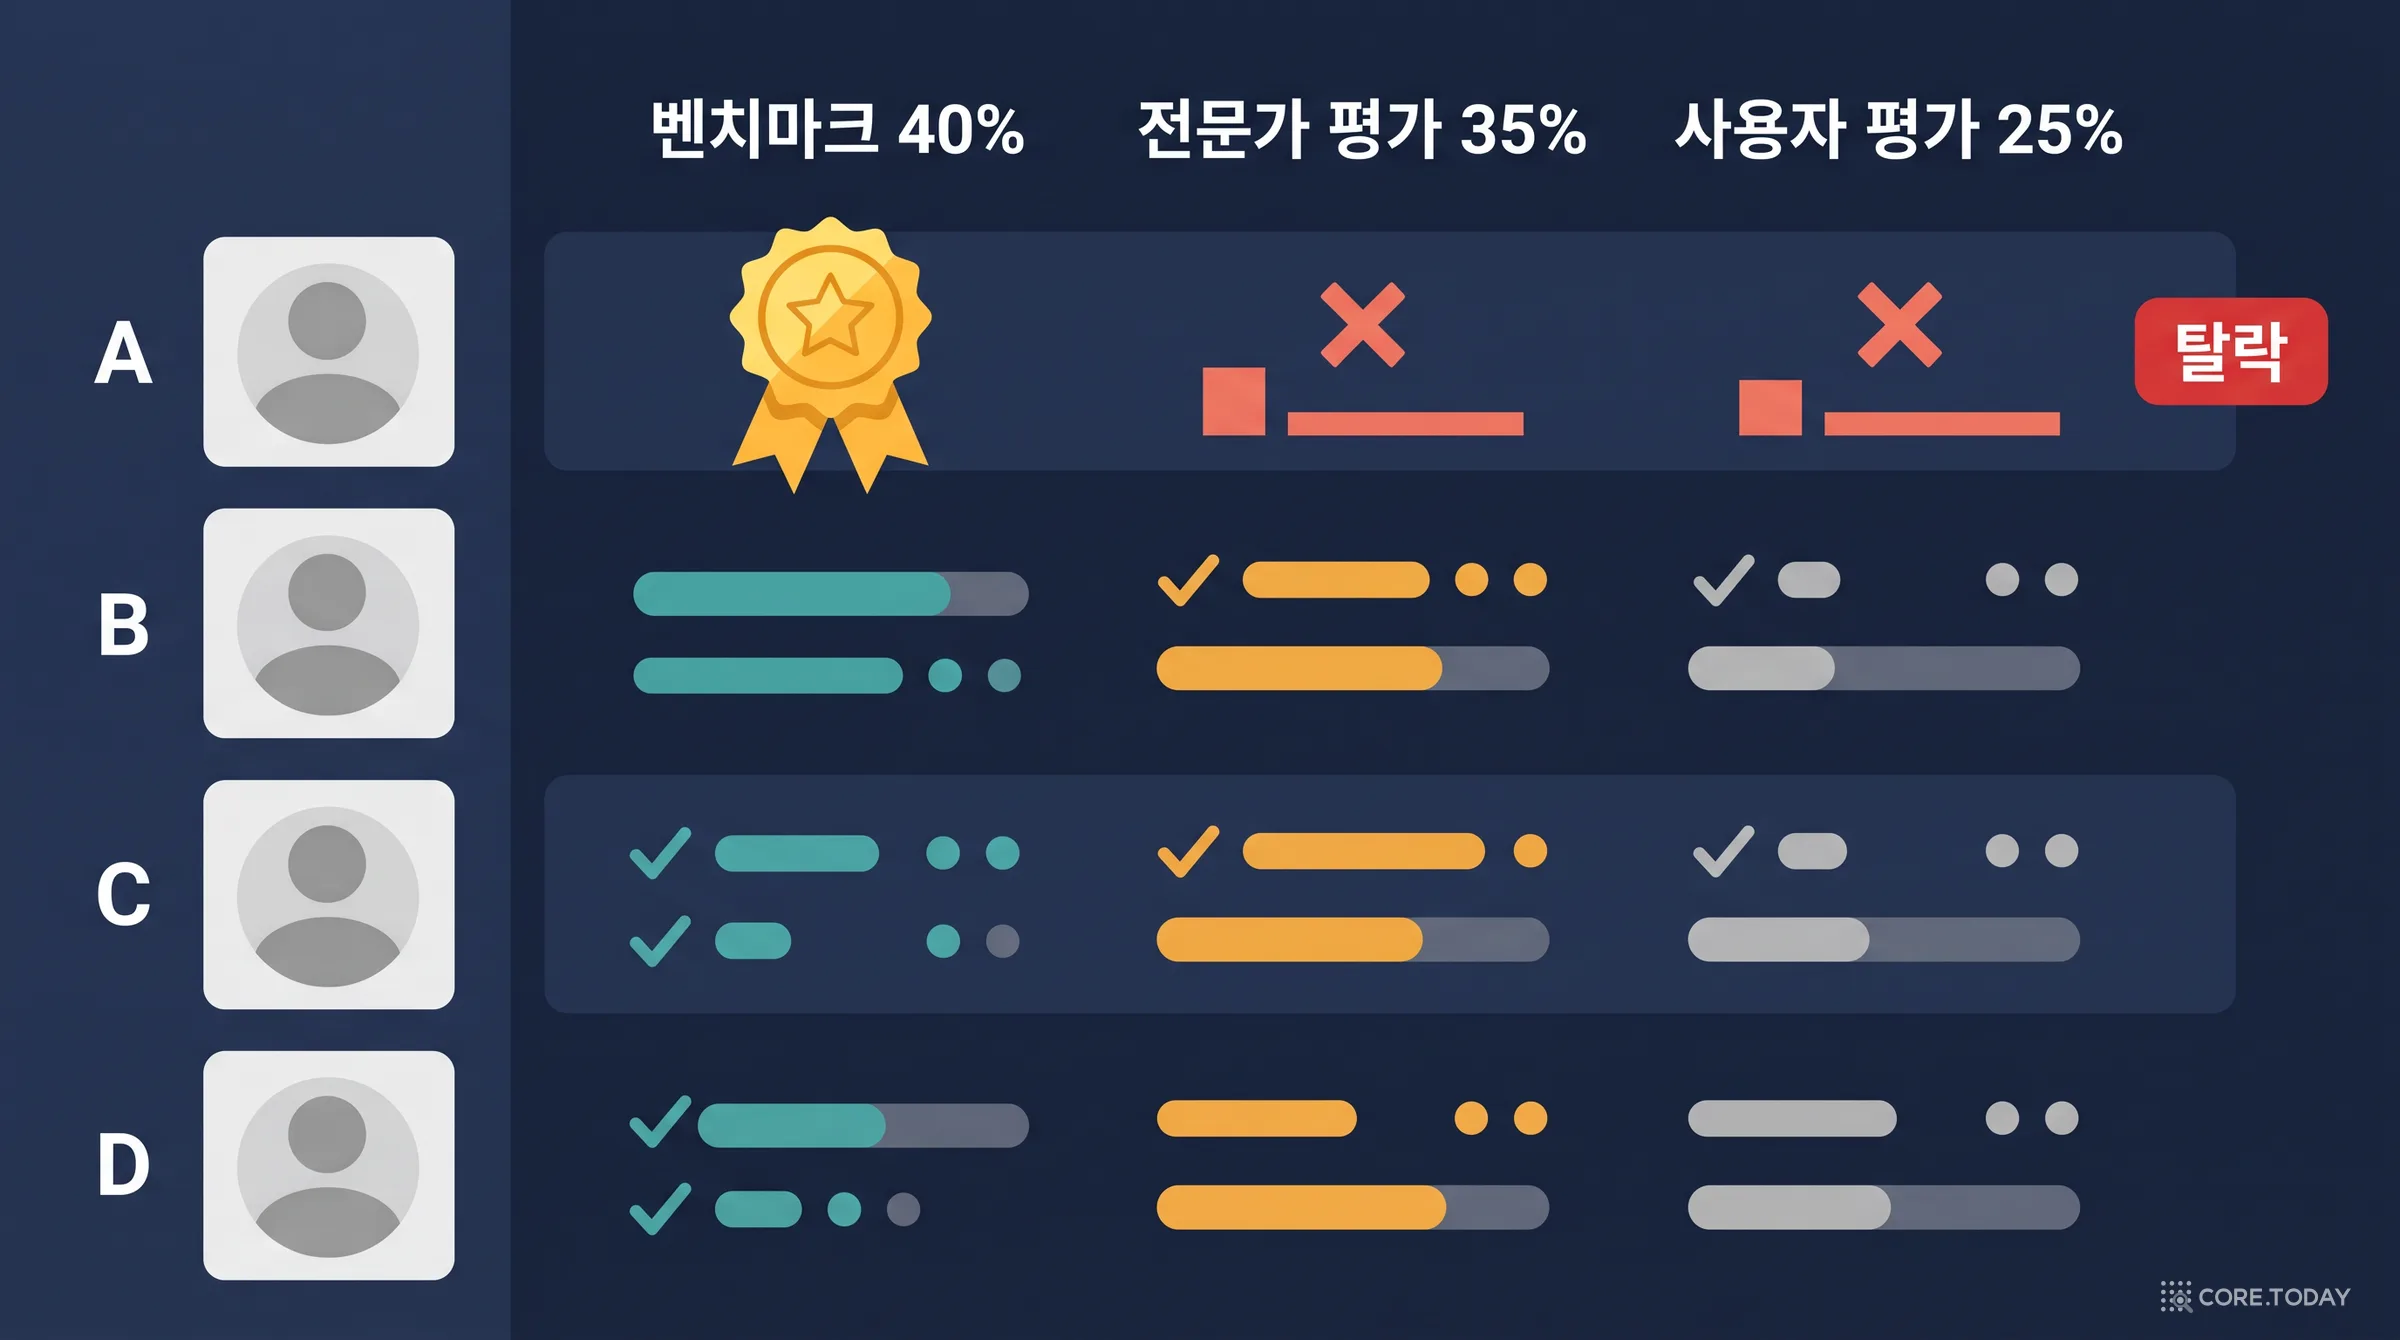
SemiAnalysis가 그린 구도는 이렇습니다. 정부는 한 명의 국가대표를 미리 고르지 않고 토너먼트를 열었습니다. 15개 컨소시엄 가운데 5곳(네이버클라우드, LG AI연구원, SK텔레콤, NC AI, 업스테이지)이 2025년 8월 선정됐고, 1차에는 H100 환산 약 3,000장의 연산, 데이터 구매에 약 4,500만 달러, 해외 인재 영입 지원 등이 주어졌습니다. 정부 예산 총액은 약 3억 5,000만 달러로, SemiAnalysis는 이를 "미국 연구소에 비하면 반올림 오차"라고 표현합니다. 평가는 벤치마크 40%, 전문가 평가 35%, 사용자 평가 25%였습니다. 1차에서 NC가 최하위였고, 네이버는 알리바바 Qwen 계열의 시각·음성 인코더를 썼다는 이유로 실격됐으며, 보충 선발로 모레에서 분사한 Motif Technologies가 들어왔습니다.
SemiAnalysis가 이 글에서 가장 강조한 것은 그다음입니다. Artificial Analysis Intelligence Index 기준으로 Motif 3는 업스테이지보다 10점 앞선 "단연 최고의 한국 모델"이고, 미국 최고의 오픈 모델 두 개(Inkling, Nemotron 3 Ultra)보다도 앞섭니다. Motif는 직원 30명이 안 되고, 투자금은 1,700만 달러, 쓸 수 있는 연산은 B200 768장(2MW 미만)이며, 실험까지 포함한 Motif 3의 총 학습 연산 비용은 지금 가격으로 약 1,500만 달러였다고 합니다. SemiAnalysis의 결론은 "거의 최고 수준의 오픈소스 모델을 처음부터 학습하는 데 드는 자원은 대부분의 생각보다 적다"는 것입니다.
그런데 8월 18일 발표된 2차 결과에서 탈락한 것은 Motif였습니다. 벤치마크는 1위였지만 전문가 평가와 사용자 평가에서 모두 꼴찌였기 때문입니다. SemiAnalysis는 사용자 평가가 블라인드가 아니었고, 전문가 평가 항목('개발 전략', '향후 계획', '생태계 영향')이 대기업에 유리했으며, 외국 투자자를 통한 기술 유출 우려가 거론됐다고 들었다고 전하면서 "진짜 아쉬운 일"이라고 썼습니다.
모델을 만드는 값은 생각보다 싸졌다. 1,500만 달러는 프론티어 연구소의 학습 비용과 비교할 수 없지만, 7장에서 본 대로 오픈 모델의 값은 벤치마크 순위보다 '얼마나 싸게 서빙되는가'와 '얼마나 빨리 생태계가 따라오는가'로 매겨집니다. 소버린 모델의 값도 같은 자로 재야 합니다.
연산의 값과 모델의 값은 다르다. 같은 글에 따르면 한국은 2029년까지 8.4GW, 2035년까지 18.4GW를 짓는 데 9,190억 달러를 투자할 계획이고, SK그룹은 이미 Rubin 2GW를 약속했습니다. 그런데 SemiAnalysis는 "그 상당 부분은 결국 Anthropic이나 OpenAI에 팔릴 것"이라고 봅니다. 4장의 논리 그대로, 연산을 가장 비싸게 사 주는 고객이 프론티어 연구소이기 때문입니다. 제목의 "하이닉스는 진다"도 이 맥락에서 나옵니다. 한국의 데이터센터 야심이 메모리를 파는 회사의 주주 이익과 꼭 같은 방향은 아니라는 주장입니다.
한국어라는 변수. 4월 글에서 SemiAnalysis는 DeepSeek이 직접 만든 중국어 글쓰기 평가에서도 어려운 과제는 Opus 4.7이 V4 Pro를 이겼다며 "Claude는 중국 모델을 그들의 언어로도 이긴다"고 썼습니다. 언어별 강점은 국적을 따르지 않는다는 뜻입니다. 코어닷투데이가 한국어 임베딩과 재정렬기를 직접 잰 실험에서도 1위는 과제마다 바뀌었습니다. 한국어 작업에서 어떤 모델이 값을 하는지는 결국 자기 작업으로 재야 합니다.
9장. 모델별 가치 카드 — 지금 무엇에 무엇을 쓰나
이제 지금까지의 다섯 개 자를 모델별로 모아 봅니다. 아래 위젯은 열세 개 모델의 공식 가격표로 작업 모양별 실제 단가를 계산하고, SemiAnalysis의 평가와 InferenceX 원가 상한을 붙인 것입니다. '에이전트'와 '챗봇 한 턴'을 오가며 순위가 어떻게 바뀌는지 보세요.
위젯을 움직여 보면 표값 비교표에서는 절대 보이지 않는 사실 몇 가지가 드러납니다.
표값이 같은 Fable 5.1과 GPT-6 Astra가 에이전트 작업에서는 1.5배 차이 난다. 둘 다 $10/$50이지만 캐시 읽기가 $0.25 대 $1입니다. 에이전트 기준 실제 단가는 Fable 5.1 약 $1.29, Astra 약 $1.97입니다.
Fable 5.1은 표값으로는 Opus 5.5의 2.5배지만, 에이전트 작업에서는 약 2.1배다. Fable의 캐시 읽기가 입력 가격의 2.5%로 유독 싸기 때문입니다. 3장의 논리대로 Fable이 같은 일을 더 적은 토큰으로 끝낸다면 작업당 차이는 더 줄어듭니다.
GLM-5.3은 챗봇에서는 Sonnet 5.5의 절반 값이지만, 에이전트 작업에서는 더 비싸다. 캐시 읽기($0.26)가 Opus 5.5($0.20)보다도 비싸기 때문입니다. "오픈 모델이니까 싸겠지"라는 직관이 에이전트 작업에서는 틀릴 수 있습니다.
Kimi K3의 에이전트 단가는 Opus 5.5와 거의 같다. 2.8조 파라미터 모델의 원가가 그대로 가격에 실렸습니다.
이 지도를 SemiAnalysis의 서술과 겹치면, 지금의 모델 시장은 대략 네 개의 층으로 나뉩니다.
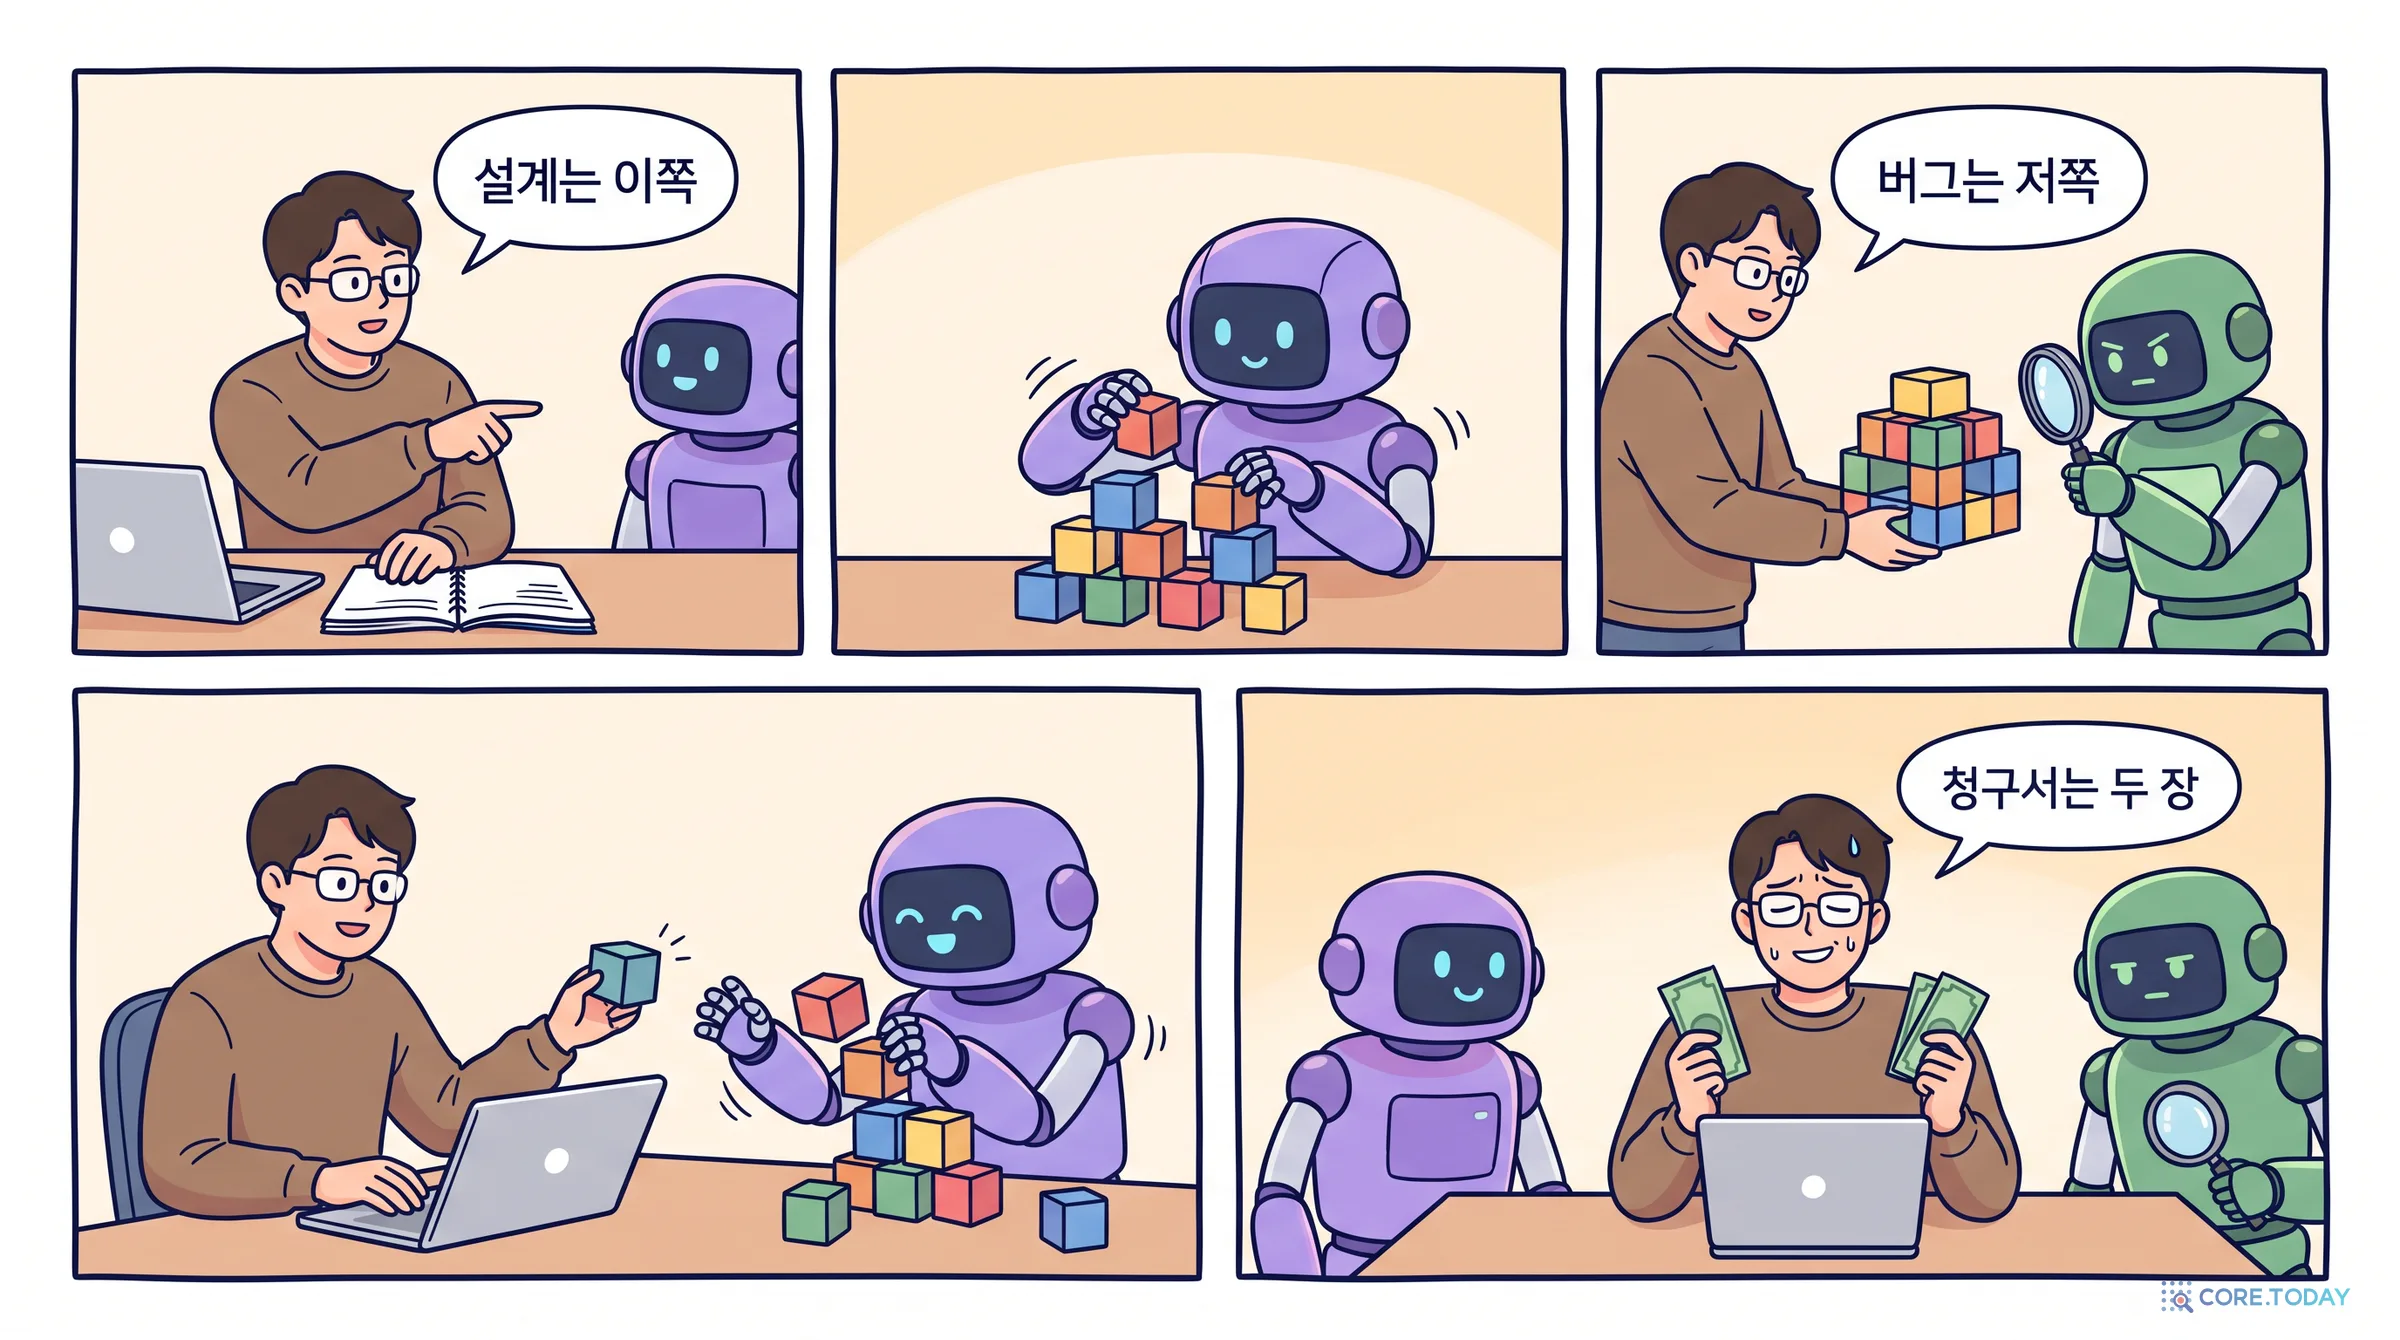
그리고 한 회사 안에서도 모델을 역할별로 섞어 쓰는 흐름이 굳어졌습니다. SemiAnalysis 엔지니어들은 4월 이후 "새 애플리케이션이나 기능의 계획·뼈대·첫 구현은 Claude로 시작하고, 실제 문제 해결과 버그 수정은 Codex로 넘기는" 방식에 정착했다고 썼습니다. Claude는 열린 문제와 의도 파악에, Codex는 좁고 어려운 추론에 강하다는 평가였습니다. 직전까지는 사실상 모든 직원이 두 단계 모두 Claude Code를 썼다는 점에서 큰 변화입니다.
모델을 섞어 쓰면 청구서도 두 장이 됩니다. 그리고 2장에서 본 대로 캐시는 모델별로 따로 쌓이므로, 모델을 바꿀 때마다 캐시 적중률이 떨어진다는 숨은 비용도 생깁니다. 역할 분담의 이득이 이 비용보다 큰지는, 다시 말하지만 작업당 비용으로 재야 합니다.
10장. 반론과 한계 — SemiAnalysis를 어디까지 믿을까
이 글은 SemiAnalysis의 분석에 크게 기대고 있으므로, 그 약점을 분명히 적어 둡니다.
1. 그들은 Claude의 큰 고객이다. SemiAnalysis는 스스로 "Claude를 띄우는 것으로 유명하다(악명 높다?)"고 썼습니다. 연 1,000만 달러 넘게 Claude에 쓰는 회사의 사용 경험은 분석·코딩·대시보드 작업에 치우쳐 있고, 그들의 "느낌(vibes)" 평가는 한 회사의 사례입니다. 4월 글이 GPT-5.5를 "프론티어에 도착했다"고 인정한 것처럼 평가가 바뀌기도 하지만, 출발점의 편향은 감안해야 합니다.
2. 결론은 유료 벽 뒤에 있다. 이 글이 읽은 것은 각 글의 공개 구간뿐입니다. 「코딩 에이전트 전쟁의 승자」 예측, 요금제별 세부 숫자, 모델별 이익률 추정은 모두 잠겨 있습니다. 이 글의 Opus 5.5 환산 가치(약 1만 1,700달러)처럼 공개된 숫자에서 역산한 값은 역산이라고 밝혔지만, SemiAnalysis의 실제 표와 다를 수 있습니다.
3. 숫자는 몇 주 단위로 낡는다. 빠른 모드의 배수는 1년 만에 6배에서 2배가 됐고, 요금제 한도는 예고 없이 A/B 실험 대상이 되며, Kimi K3의 원가는 석 달 만에 94% 떨어졌습니다. InferenceX의 모델별 측정일도 6월부터 10월까지 제각각이고, 일부 점은 측정 범위를 벗어난 외삽입니다.
4. 글 사이의 숫자가 어긋난다. 입력:출력 비율(300:1 vs 100:1), Anthropic 추론 이익률(70% 이상 vs 60% 중반), Rubin의 개선 폭(67배 vs 실제 구간 1.4~3배), MI355X 대 B200의 우열(2월에는 AMD 우세, 9월 V4.1 Flash에서는 2~4배 열세)이 글마다 다릅니다. 대부분 측정 대상·시점·엔진의 차이로 설명되지만, 숫자를 인용할 때는 조건을 함께 붙여야 합니다.
5. 이해관계와 영향력. SemiAnalysis는 Tokenomics Model과 각종 데이터를 기관 고객에게 팔고, InferenceX는 엔비디아·AMD·추론 엔진 개발자들과 함께 만듭니다. 그들의 글은 시장을 움직이기도 합니다. 10월 초 보도에 따르면 SemiAnalysis가 X에 GPT-6.1 Sol의 Ultrafast가 Cerebras가 아니라 엔비디아 GPU에서 돈다고 쓴 뒤 그 주 Cerebras 주가가 약 20% 떨어졌습니다(원 게시물과 정확한 날짜는 코어닷투데이가 확인하지 못했습니다). 분석의 영향력이 클수록 분석의 이해관계도 함께 봐야 합니다.
6. OpenRouter는 시장이 아니다. 7장의 토큰 점유율은 개발자 중심의 중개소에서 잰 값입니다. 기업 고객의 자사 API 사용, 클라우드 마켓플레이스, 구독은 포함되지 않습니다.
11장. 실무 체크리스트 — 모델의 값을 우리 장부로 옮기기
SemiAnalysis의 분석을 한국 기업의 모델 선택에 옮기면 이런 점검표가 됩니다.
1. 작업 모양부터 잰다API 응답의 사용량 필드(캐시 읽기·캐시 쓰기·새 입력·출력)를 한 주만 모아 입력:출력 비율과 캐시 적중률을 계산한다. 이 두 숫자 없이 가격표를 비교하는 것은 의미가 없다.
2. 출력 단가가 아니라 캐시 단가로 비교한다에이전트형 작업이라면 후보 모델의 캐시 읽기 가격을 먼저 본다. 표값이 같은 모델이 1.5배, 표값이 싼 모델이 더 비싸게 나올 수 있다(9장 위젯).
3. 작업당 비용으로 결정한다같은 과제 20~50개를 후보 모델로 돌려 토큰 수·성공률·소요 시간을 잰다. 사람이 결과를 기다리는 일이라면 시급을 넣어 빠른 모드까지 비교한다(3장 위젯).
4. 캐시를 지킨다시스템 프롬프트 앞부분에 날짜·요청 번호 같은 바뀌는 값을 넣지 않는다. 모델을 자주 갈아타면 캐시가 매번 새로 쌓인다는 점도 계산에 넣는다.
5. 구독은 입문용, 운영은 종량제개인·소규모 팀에게 지금 가장 후한 거래는 Claude 요금제의 Opus 5.5다. 그러나 한도는 예고 없이 바뀌고 회사는 보조금을 줄이려 한다. 서비스 운영을 구독 한도에 기대지 않는다.
6. 오픈 모델은 라이선스·공시·서빙 원가로 고른다벤치마크보다 매출 기준 라이선스 조항, 출시 때 안전성 결과 공개 여부, 쓰려는 하드웨어에서의 InferenceX 원가를 먼저 확인한다. 공개 첫 주의 원가로 판단하지 않는다.
7. 날짜를 달력에 적는다OpenAI 기존 $200 가입자의 옛 한도는 10월 29일까지, Gemini 4 Argon 판촉가는 11월 30일까지, DeepSeek 검색·가져오기 과금은 11월 1일부터다. 가격은 한 달마다 다시 잰다.
맺음말 — 토큰의 값어치는 일의 값어치다
SemiAnalysis의 스물한 편을 관통하는 문장을 하나 고르라면, 2026년 2월 「Claude Code는 변곡점이다」의 이 대목입니다. "선형 벤치마크로 어느 모델이 '최고'인지 집착하는 일은 다이얼업이 DSL보다 얼마나 빠른지 따지던 것처럼 낡아 보이게 될 것이다." 같은 글의 표현을 빌리면, 성능은 "패킷 하나의 품질이 아니라 웹사이트를 만들어 내는 패킷들의 순 산출"로 재야 합니다.
1년 전의 질문은 "토큰이 얼마나 싸지나"였습니다. 지금의 질문은 "토큰 하나가 얼마짜리 일을 하나"입니다. 그 질문으로 바꾸고 나면, 비싼 모델의 가격 인상과 오픈 모델의 물량 공세와 구독 요금제의 보조금 전쟁이 하나의 이야기로 이어집니다. 일을 끝내는 토큰은 값을 올릴 수 있고, 일을 거드는 토큰은 원가 경쟁을 하며, 일을 배우는 사람에게는 보조금이 붙습니다. 모델의 값어치를 재는 마지막 자는 결국 각자의 장부에 있습니다.
참고문헌
SemiAnalysis 뉴스레터 (newsletter.semianalysis.com, 각 글의 무료 공개 구간)