GLM-LegalZ.aiZhipuGLM-5.3-FlashHarvey LABLegal Agent BenchmarkLegalBenchPLawBenchVals AI법률 AI리걸테크에이전트하네스중간학습Mid-training강화학습루브릭 보상RL 환경법률 환각Mata v. AviancaAutoClaw수직 특화 모델
GLM-Legal 완전 해부 — 가벼운 모델이 법률 에이전트 시험에서 프런티어를 이긴 방법: 중간학습, 하네스 공진화, 그리고 19.2%의 의미
2026년 10월 12일, 중국 Z.ai가 법률 특화 모델 GLM-Legal을 공개했습니다. 활성 파라미터 18B짜리 가벼운 모델(GLM-5.3-Flash) 위에 법률 중간학습과 수만 개의 법률 과제 환경 강화학습을 얹었더니, 로펌 실무 과제를 끝까지 해내야 하는 Harvey LAB에서 전 항목 통과율 19.2%로 Claude Fable 5(11.3%)와 GPT-6 Astra(5.4%)를 앞섰습니다. 과제당 비용은 0.15달러로 Fable 5의 약 130분의 1입니다. 그런데 19.2%는 열 건 중 여덟 건을 '불합격'했다는 뜻이기도 합니다. 1970년대 규칙 기반 법률 AI부터 가짜 판례 사건, LegalBench에서 Harvey LAB으로 바뀐 시험지, 중간학습과 하네스 공진화라는 아키텍처, 시연 세 장면, 순위표에서 빠진 모델과 퇴보한 지표까지, 이 발표를 둘러싼 모든 것을 쉽게 풀어 씁니다. 인터랙티브 6개, 논문·벤치마크 그림 11장, 삽화 10장.
2026년 10월 12일 밤(한국 시각 13일 새벽), 중국 AI 회사 Z.ai(옛 Zhipu AI, 智谱)가 X에 짧은 글과 그래프 한 장을 올렸습니다. 제목은 「GLM-Legal: Advancing Agentic Legal Intelligence」. 법률 일을 하는 에이전트용 모델을 따로 만들었다는 발표였습니다.
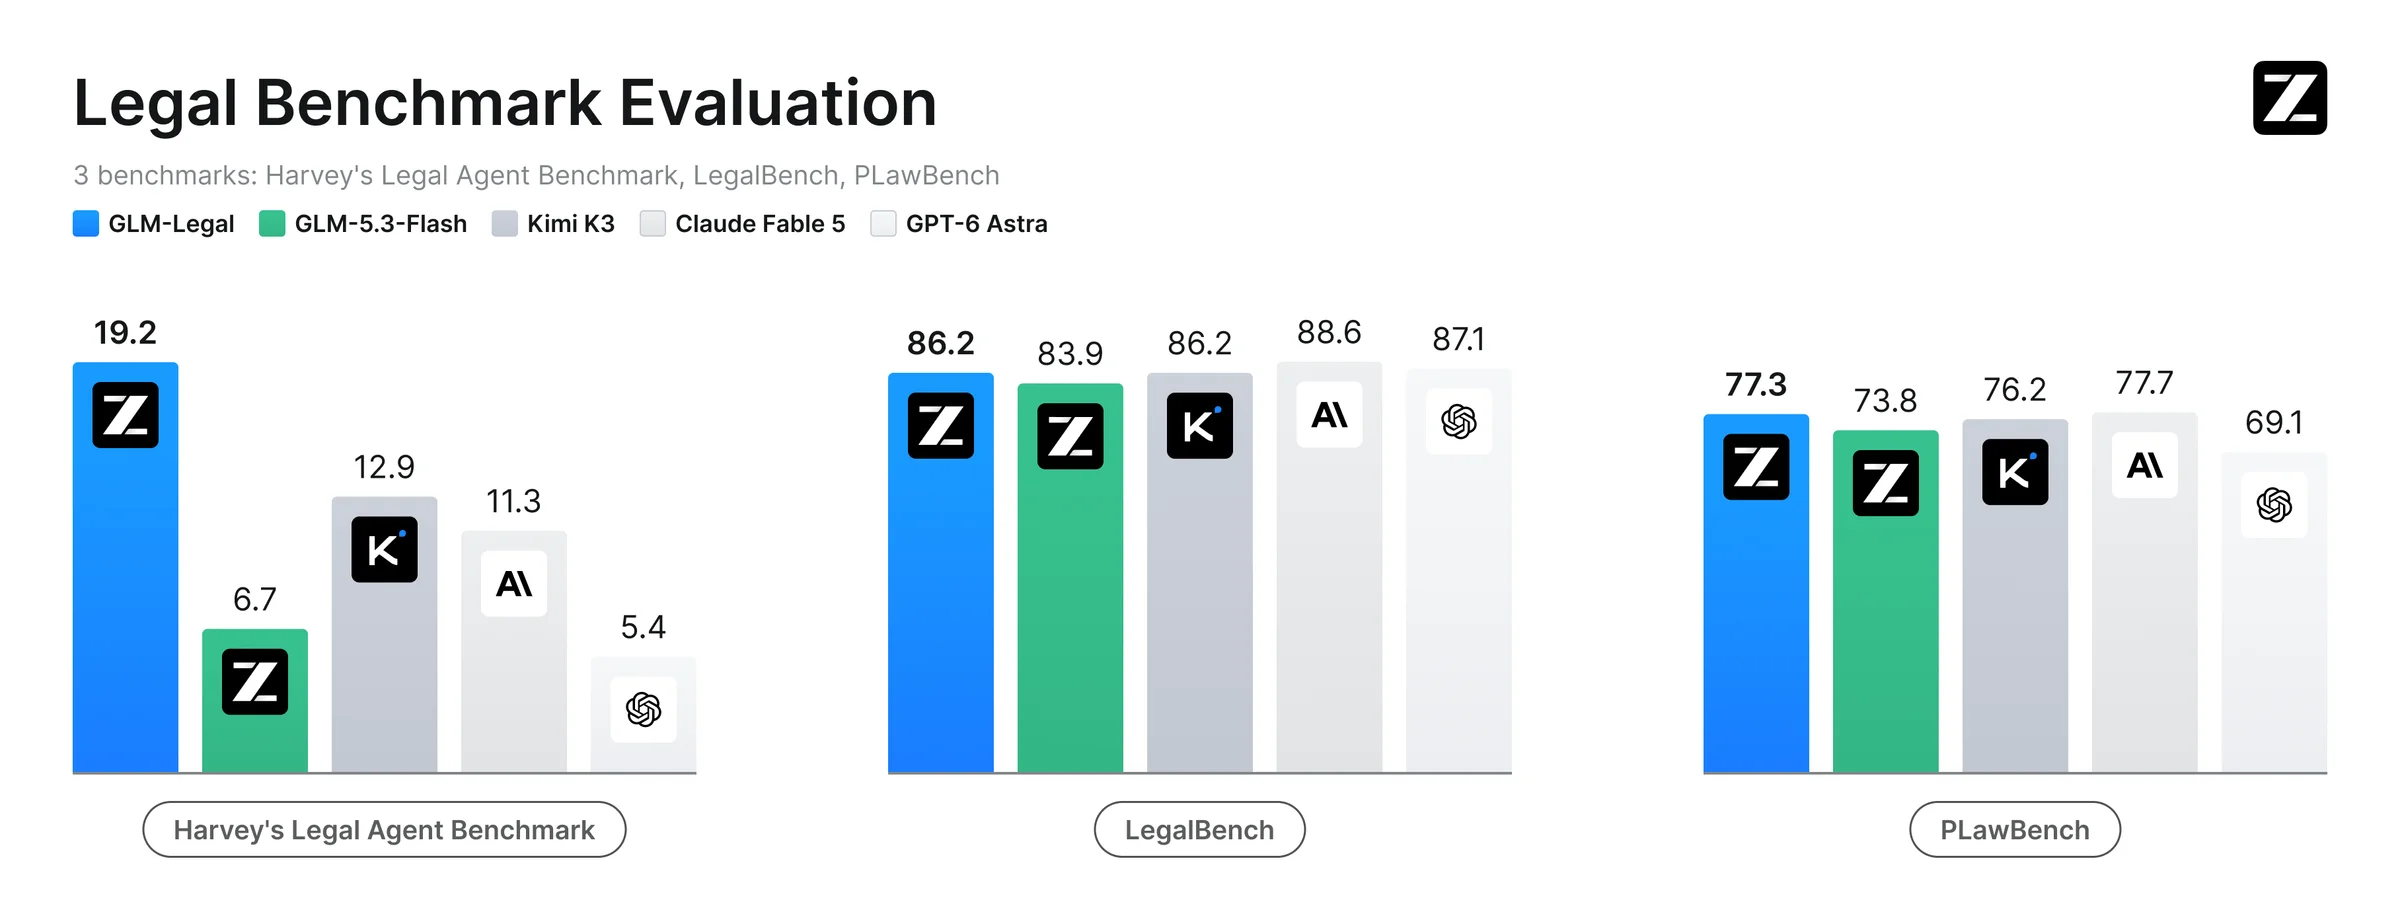
그래프의 첫 막대가 사람들의 눈을 붙잡았습니다. 로펌 실무를 흉내 낸 에이전트 시험인 Harvey LAB에서 GLM-Legal 19.2%, Kimi K3 12.9%, Claude Fable 5 11.3%, GPT-6 Astra 5.4%. GLM-Legal의 출발점인 GLM-5.3-Flash는 6.7%였습니다. 이름에 'Flash'가 붙은 가벼운 모델(전체 320B, 한 번에 일하는 활성 파라미터 18B)이 법률 특화 훈련을 거쳐 세 배 가까이 뛰었고, 그 결과 Anthropic과 OpenAI의 최상위 모델을 앞섰다는 그림입니다.
이 발표가 하루 만에 Hacker News 609점·댓글 338개까지 올라간 데는 몇 가지 이유가 겹쳤습니다.
점수를 회사가 아니라 제3자가 쟀습니다. Harvey LAB과 LegalBench 점수는 법률 AI 평가 회사 Vals AI가 독립적으로 돌린 값이고, Vals의 리더보드에서 그대로 확인됩니다(GLM-Legal 19.17%, 79개 모델 중 7위).
값이 터무니없이 쌉니다. Vals 집계로 Harvey LAB 과제 하나에 드는 비용이 GLM-Legal 0.15달러, Claude Fable 5 19.23달러, GPT-6 Astra 26.16달러입니다. 약 130~180분의 1입니다.
때가 묘했습니다. 8월에는 이 시험을 만든 리걸테크 회사 Harvey가 자사 모델 'Tenet'을 중국 오픈 모델 Kimi K3 위에 후속학습해 만들었다고 발표했습니다. 미국 리걸테크가 중국 오픈 모델로 옮겨 가던 참에, 이번엔 중국 모델 회사가 직접 법률 시장에 들어온 셈입니다.
19.2%라는 숫자 자체가 논쟁거리였습니다. HN에서 한 변호사는 "변호사로서 20% 통과율에는 별 감흥이 없다"고 썼고, 곧바로 "20%면 거의 최상위다. Opus 5.5는 4%다"라는 답글이 달렸습니다. 둘 다 맞는 말입니다. 이 글의 상당 부분은 이 모순을 푸는 데 씁니다.
그리고 박수만 나온 것도 아닙니다. Z.ai 그래프에는 GLM-Legal보다 높은 여섯 모델(Meta의 Muse 계열과 Gemini 4 Argon)이 빠져 있습니다. 같은 Vals의 법률 리서치 벤치마크에서는 GLM-Legal(41.83%)이 오히려 기반 모델(45.19%)보다 떨어졌습니다. 가중치를 공개할지도 불분명하고, 9월에 있었던 Z.ai 코딩 도구의 무단 업로드 사건 때문에 "고객 비밀을 중국 서버에 보내도 되나"라는 질문이 가장 큰 댓글 타래가 됐습니다.
이 글은 다음 순서로 갑니다.
왜 하필 법률인가 — Z.ai가 법률을 '전문직 협업 AI의 스트레스 테스트'라고 부른 이유
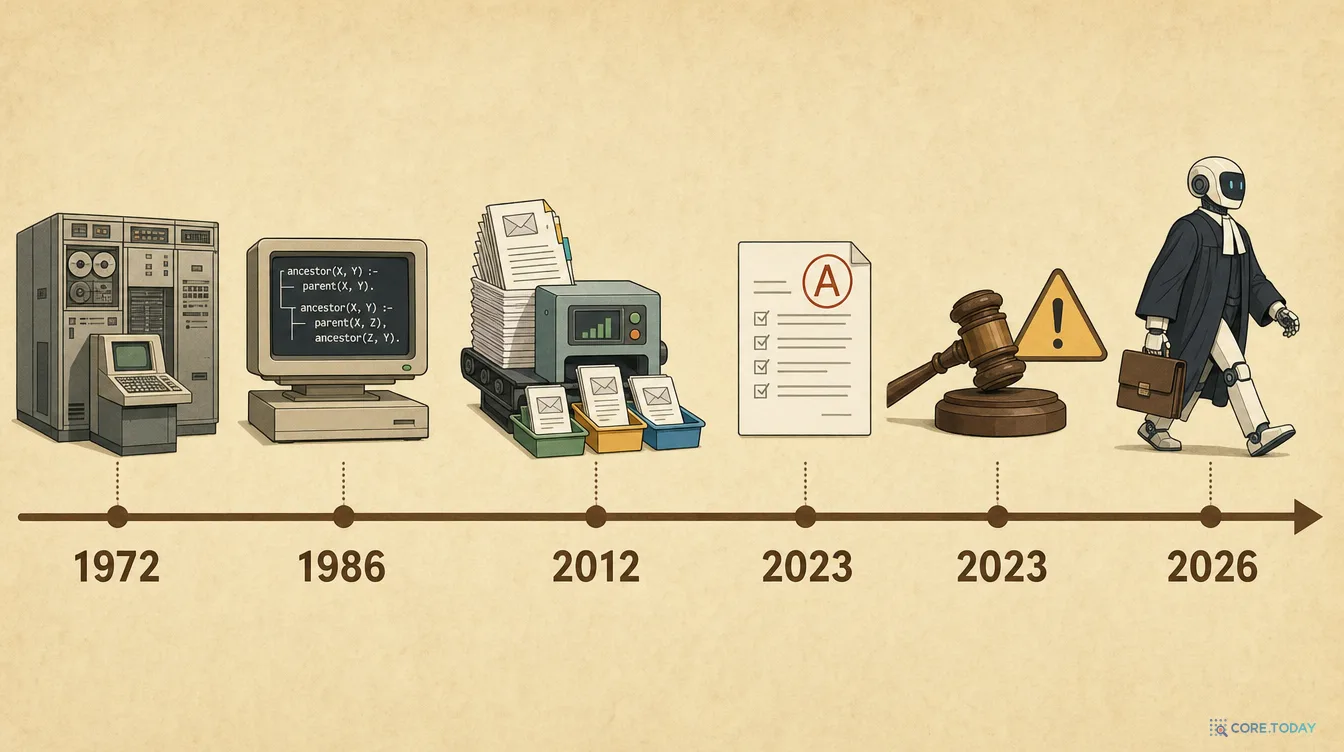
50년의 역사 — 1970년대 규칙 기반 법률 AI에서 2023년의 가짜 판례 사건, 2026년의 에이전트 시험까지
시험지가 어떻게 바뀌었나 — 객관식에 가까운 LegalBench에서, 자료 수십 건을 읽고 결과물을 내야 하는 Harvey LAB으로
아키텍처 — 기반 모델, 중간학습, 강화학습과 하네스의 공진화, 실무 피드백 루프
시연 세 장면 해부 — 계약 검토, 증거 분석, 규제 대응에서 일반 모델과 무엇이 달랐나
반론과 한계, 2026년의 의미, 한국에 주는 함의, 실무 체크리스트
결론부터 요약합니다.
GLM-Legal의 진짜 성과는 '법을 더 많이 안다'가 아니라 '일을 끝까지 해낸다'입니다. 지식 시험(LegalBench)에서 기반 모델 대비 상승은 2.3%포인트였지만, 실무 과제 시험(Harvey LAB)에서는 12.5%포인트였습니다.
그 차이를 만든 것은 모델 혼자가 아니라 모델과 '하네스'(모델을 감싸 도구·문서·피드백을 연결하는 실행 틀)를 함께 훈련한 방식입니다. Harvey와 Applied Compute가 6월에 공개한 GLM-5.1 후속학습 실험이 같은 패턴을 자세한 수치로 보여 줍니다.
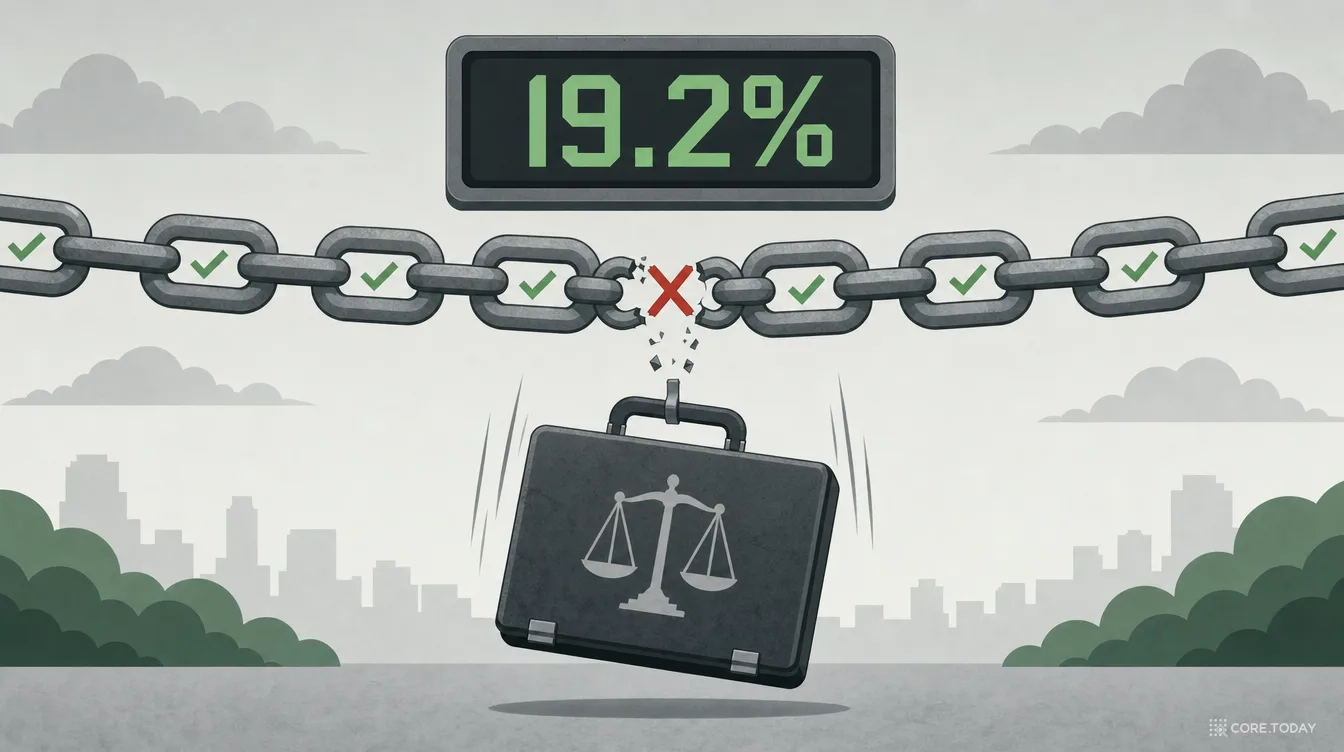
19.2%는 여전히 다섯 건 중 네 건이 '어딘가 하나'를 놓쳤다는 뜻입니다. 항목 단위로는 92.5%를 맞히지만, 60여 개 항목을 하나도 놓치지 않아야 하는 채점에서는 그렇습니다. 사람의 검토 없이 쓸 수 있는 단계는 아닙니다.
2026년 법률 AI 경쟁은 '누구의 모델이 더 똑똑한가'에서 '누가 더 현실적인 과제 환경·채점 기준·하네스를 가졌는가'로 옮겨 가고 있습니다. 한국 법률 AI가 준비해야 할 것도 바로 그것입니다.
1. 법률은 왜 AI의 '최종 시험장'인가
Z.ai 원문은 법률 이야기로 시작하지 않습니다. 첫 문장은 이렇습니다. "대규모 언어 모델은 한 번에 끝나는 코드 생성에서, 더 넓은 전문직 협업(Professional Cowork)으로 옮겨 가고 있다."
2024~2025년 AI 에이전트의 주 무대는 코딩이었습니다. 코딩은 에이전트를 훈련시키기에 운이 좋은 분야입니다. 코드는 돌려 보면 되고, 테스트가 통과하면 맞은 것입니다. 정답을 기계가 확인할 수 있으니 강화학습의 보상을 만들기 쉽습니다.
변호사, 회계사, 컨설턴트의 일은 다릅니다. 원문은 실제 지식 노동의 요구를 이렇게 정리합니다.
1
흩어진 자료를 소화한다
구체적인 목표와 빡빡한 마감 아래, 여기저기 흩어진 원본 파일(계약서, 이메일, 보고서, 송장)을 읽어 내야 한다.
2
전문 지식으로 구조를 세운다
읽은 것을 법리·조문·판례라는 틀에 맞춰 하나의 일관된 분석으로 엮어야 한다.
3
끝까지 엄밀함을 유지한다
첫 단계부터 최종 결과물 서명까지, 실행의 모든 단계에서 분야의 엄밀함이 무너지면 안 된다.
그리고 이렇게 말합니다. "법률 업무는 이 과제들을 한곳에 응축하고 있어서, 위험이 큰 전문직 환경에서 일할 모델을 훈련시키기에 이상적인 스트레스 테스트가 된다."
왜 법률이 그렇게 어려울까요? 원문은 한 문장으로 답합니다. "법률 실무는 사실, 법리, 분석적 추론, 고객에게 건넬 결과물 사이에 끊기지 않은 사슬을 요구한다."
사슬의 비유는 정확합니다. 계약서 검토 메모가 위험 열 개 중 아홉 개를 짚었다고 90점짜리 메모가 되지 않습니다. 놓친 하나가 인수 거래를 무너뜨리는 조항이라면 그 메모는 쓸모가 없거나, 더 나쁘게는 고객을 안심시켜 해를 끼칩니다. Harvey는 자기 벤치마크를 소개하며 이렇게 썼습니다. "위험 열 개 중 여덟 개를 찾아낸 거래팀 보고서는 80% 쓸모 있는 것이 아니다. 실질적으로 불완전한 것이다."
법률이 AI에게 유독 까다로운 이유를 조금 더 쪼개 보면 이렇습니다.
특성
무엇이 어려운가
구체적인 예
문서가 길고 많다
필요한 사실이 수십 건의 문서에 흩어져 있고, 관련 없는 문서가 섞여 있다
Harvey LAB 과제의 상위 10%는 원본 문서만 약 10만 토큰, 가장 큰 과제는 20만 토큰이 넘는다
근거를 대야 한다
결론마다 어느 문서, 어느 조항, 어느 판례에서 왔는지 밝혀야 하고, 그 인용이 실제로 존재해야 한다
2023년 Mata v. Avianca 사건, 존재하지 않는 판례 6건 인용으로 제재
형식이 정해져 있다
메모, 추적 변경이 달린 계약서, 증거 목록, 체크리스트 등 받는 사람이 기대하는 형식이 있다
"워드 문서에 추적 변경으로 달아 달라"는 요청에 요약 메모를 내면 실패
누락을 용납하지 않는다
평균 점수가 아니라 '빠진 것이 없는가'가 품질의 기준이다
위험 10개 중 8개 = 80점이 아니라 '불완전'
정답이 하나가 아니다
코드처럼 실행해서 맞았는지 확인할 수 없다. 숙련된 법률가의 판단이 기준이다
같은 계약을 고객 편에서 고칠지, 협상 가능성을 고려할지에 따라 좋은 답이 달라진다
마지막 줄이 특히 중요합니다. 법률은 '정답을 기계가 확인할 수 없는' 대표적인 분야입니다. 수학 문제는 답이 42인지 확인하면 되고 코드는 테스트를 돌리면 되지만, 계약 검토 메모가 좋은지는 경험 많은 변호사가 읽어 봐야 압니다. 이 성질이 뒤에서 볼 GLM-Legal의 훈련 방식(채점 기준표를 보상으로 쓰는 강화학습, 실무자 피드백 루프)을 결정합니다.
미국 로스쿨은 법률가의 사고를 IRAC이라는 네 단계로 가르칩니다. 쟁점(Issue)을 찾고, 적용할 규칙(Rule)을 떠올리고, 규칙을 사실에 적용(Application)하고, 결론(Conclusion)을 내립니다. 우리나라 변호사시험 사례형 답안의 '논점 → 법리 → 사안의 적용 → 결론' 구조와 같습니다. 법률 AI 연구의 시험지들은 대개 이 틀을 따라 만들어졌고, GLM-Legal이 강화하려 한 것도 원문 표현대로 "사실, 규칙, 결론 사이의 연역적 연결"입니다.
2. 50년의 역사: 규칙에서 통계로, 통계에서 에이전트로
법률은 AI 연구에서 가장 오래된 응용 분야 중 하나입니다. 지금의 법률 에이전트를 이해하려면 앞선 세대들이 무엇을 시도했고 어디서 막혔는지 아는 편이 빠릅니다.
TAXMAN (1970년대). 하버드의 L. 손 매카티(L. Thorne McCarty)는 1970년대 초 미국 세법의 기업 재편 조항(내국세입법 354~356조)을 컴퓨터가 판정하게 만들려 했습니다. 거래 사실을 논리식으로 넣으면 어떤 과세 규칙이 적용되는지 분류하는 시스템이었습니다. 1977년 「TAXMAN에 대한 성찰」이라는 논문에서 그는 중요한 벽을 보고했습니다. 세법의 핵심 논쟁인 '형식이냐 실질이냐'를 논리식으로 옮기는 데 실패한 것입니다. 법률 용어의 의미는 사건마다 다투어지며 변하는데, 규칙 시스템은 그 '열린 결'을 담지 못했습니다.
HYPO와 CATO (1980~1990년대). 매사추세츠 대학의 에드위나 리슬랜드(Edwina Rissland)와 케빈 애슐리(Kevin Ashley)는 방향을 틀었습니다. 규칙 대신 판례끼리의 비교를 가르친 것입니다. HYPO는 영업비밀 사건을 '차원(dimension)'들로 표현하고, 현재 사건과 가장 비슷한 승소 판례·패소 판례를 찾아 '주장 → 반박 → 재반박'의 3단 논증을 만들었습니다. 후속작 CATO는 이를 '요인(factor)'의 계층으로 바꿔 로스쿨 학생의 논증 연습에 썼습니다. 변호사의 일이 정답 찾기가 아니라 양쪽 논증 세우기라는 통찰을 처음 기계에 담은 시도였습니다.
영국 국적법을 Prolog로 (1986). 임페리얼 칼리지의 마렉 세르고트(Marek Sergot), 로버트 코왈스키(Robert Kowalski) 등은 1981년 영국 국적법을 논리 프로그래밍 언어 Prolog로 통째로 옮겼습니다. 「논리 프로그램으로서의 영국 국적법」(CACM, 1986)은 법조문을 'A이고 B이면 C' 꼴의 규칙으로 바꾸면 누가 국적을 얻는지 기계가 판정할 수 있음을 보여 줬습니다. 동시에 조문이 서로 참조하고 예외가 예외를 낳는 법의 구조가 얼마나 복잡한지도 드러냈습니다. 이 논문은 35년 뒤인 2021년 스탠퍼드 CodeX 상을 받았습니다.
이 시기에 학계도 자리를 잡았습니다. 1987년 보스턴에서 첫 국제 AI·법 학회(ICAIL)가 열렸고, 유럽의 JURIX가 1988년부터 매년 열립니다.
규칙의 시대가 남긴 교훈은 둘입니다. 법은 형식 논리로 다 옮겨지지 않는다는 것, 그리고 법률가의 핵심 능력은 사실과 규칙과 판례를 오가며 논증을 세우는 것이라는 것. 40년 뒤 GLM-Legal의 원문이 "사실, 규칙, 결론 사이의 연역적 연결"을 강조하는 것도 같은 문제의식입니다. 다만 이번에는 규칙을 사람이 손으로 짜 넣는 대신, 모델이 방대한 법률 문서에서 그 연결을 배웁니다.
통계와 검색의 시대 (2000~2010년대)
기술 지원 검토의 공인 (2012). 소송에서 상대방에게 관련 문서를 넘겨야 하는 '증거개시(discovery)' 단계는 수백만 건의 이메일을 사람이 읽는 노동이었습니다. 2012년 2월 뉴욕 남부연방지법의 앤드루 펙(Andrew Peck) 판사는 Da Silva Moore v. Publicis Groupe 사건에서, 약 300만 건의 문서를 기계 학습 분류기로 걸러 내는 '기술 지원 검토(TAR, 예측 코딩)'를 처음으로 공식 승인했습니다. 펙 판사는 그것이 "마법 같은 '쉬움 버튼'은 아니"라고 덧붙였습니다. 법원이 기계의 판단을 절차의 일부로 받아들인 첫 사례입니다.
판결 예측 (2017). 대니얼 카츠(Daniel Katz) 등은 1816~2015년 미국 연방대법원 사건 약 2만 8천 건을 랜덤 포레스트로 학습해, 사건 결과를 70.2%, 대법관 개별 표결을 71.9% 정확도로 예측했습니다(PLOS ONE). 법률 결과를 '데이터'로 다룰 수 있다는 상징적인 논문입니다.
ROSS Intelligence의 흥망 (2014~2026). '인공지능 변호사'로 유명했던 스타트업 ROSS는 법률 리서치 도구를 만들다가 2020년 Westlaw를 가진 톰슨 로이터에 저작권 소송을 당했고, 2021년 1월 문을 닫았습니다. 소송은 계속됐습니다. 2025년 2월 연방지법은 ROSS가 Westlaw 판례 요지(headnote) 2,243개를 학습에 쓴 것이 공정 이용이 아니라고 판단했고, 2026년 9월 29일 제3순회 항소법원이 이를 확정했습니다. AI 학습의 공정 이용을 다룬 첫 연방 항소심 판결입니다. 법률 AI를 훈련시킬 '데이터'가 누구의 것이냐는 문제는 지금도 현재진행형입니다. Z.ai가 중간학습에 쓴 법률 말뭉치의 출처를 공개하지 않은 것도 이 맥락에서 읽힙니다.
언어 모델의 시대: 법을 '읽는' 기계 (2019~2023)
도메인 사전학습의 효과는 조건부다 (2021). 2020년 무렵 법률 문서로 BERT를 다시 학습시킨 LEGAL-BERT, 법률 과제 모음 LexGLUE가 나왔습니다. 그중 2021년 스탠퍼드의 CaseHOLD 논문 「사전학습은 언제 도움이 되는가?」가 중요한 교훈을 남겼습니다. 판례 약 350만 건으로 사전학습한 모델은 판결 요지 고르기(5지선다, 5만 3천 문항)에서 일반 BERT보다 F1을 7.2점(12%) 올렸지만, 과제가 사전학습 말뭉치와 닮았을 때만 그랬습니다. 더 쉬운 기존 과제에서는 차이가 거의 없었습니다. "법률 데이터를 더 먹이면 법을 더 잘한다"는 직관이 생각만큼 단순하지 않다는 뜻이고, 이 논쟁은 뒤의 '중간학습' 절에서 다시 만납니다.
GPT-4, 변호사 시험에 붙다? (2023). 2023년 3월, 카츠와 마이클 봄마리토(Michael Bommarito) 등은 GPT-4가 미국 통합 변호사시험(UBE)에서 297점을 받아 애리조나 합격선(273점)을 넘었고 "상위 10%에 근접했다"고 발표했습니다. 이 문구는 GPT-4 발표 자료에 실려 전 세계에 퍼졌습니다.
1년 뒤 MIT의 에릭 마르티네스(Eric Martínez)가 이 숫자를 다시 계산했습니다(「GPT-4의 변호사 시험 성적 재평가」, AI and Law, 2024). '상위 10%'는 재수생 비율이 높은 2월 일리노이 응시자와 비교한 값이었습니다. 7월 응시자와 비교하면 전체 69백분위 미만, 서술형만 보면 약 48백분위였고, 합격자들과 비교하면 서술형은 약 15백분위였습니다. 객관식은 잘 풀지만, 사실관계를 읽고 논증을 써 내려가는 일은 아직 평범한 합격자에 못 미쳤던 것입니다.
LegalBench (2023). 같은 해 스탠퍼드의 닐 구하(Neel Guha) 등이 법률 전문가들과 함께 과제를 모아 만든 LegalBench가 나왔습니다. 162개 과제를 앞서 본 IRAC 틀에 맞춰 여섯 갈래의 법률 추론으로 분류한 것이 핵심입니다. 이 시험지는 3년 뒤 GLM-Legal 그래프의 가운데 막대가 됩니다. 4장에서 직접 풀어 봅니다.
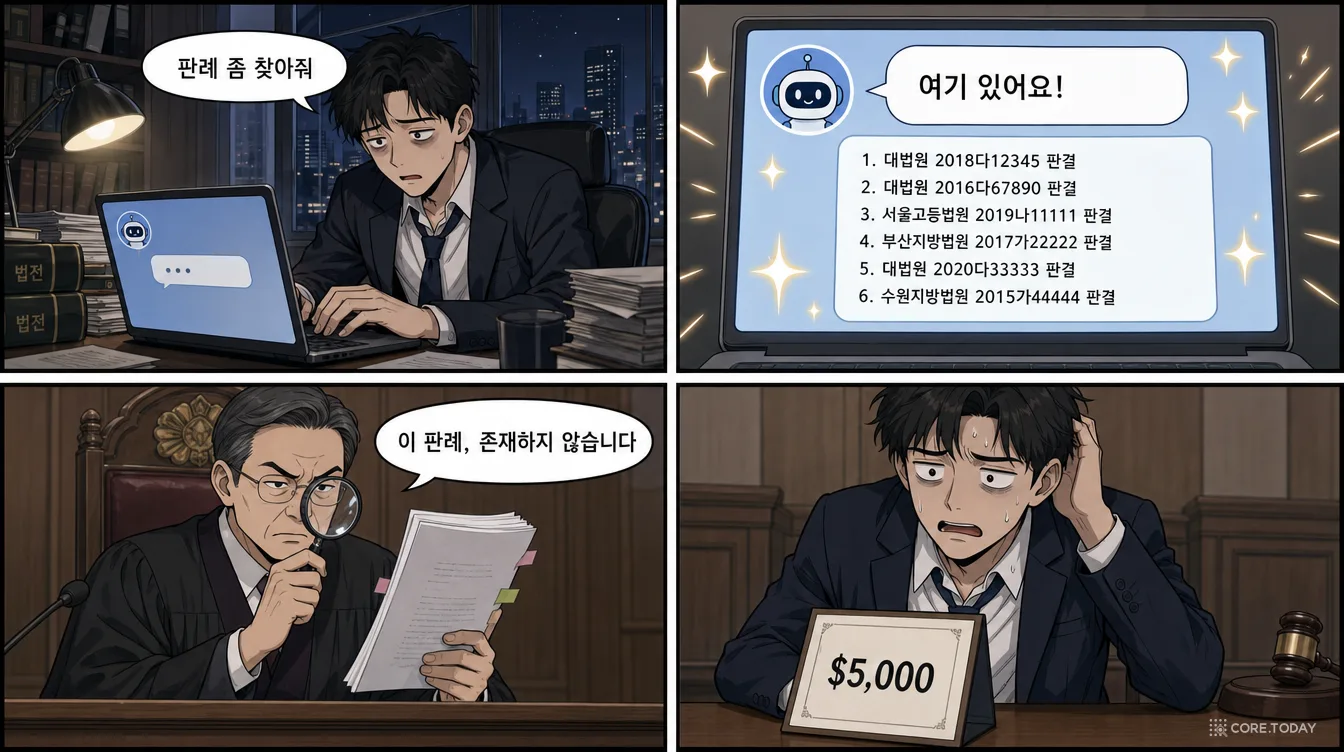
2023년 뉴욕 남부연방지법. 항공사 아비앙카를 상대로 한 개인 상해 소송에서 원고 측 변호사가 낸 서면에 존재하지 않는 판례가 적어도 6건 들어 있었습니다. 변호사는 ChatGPT로 판례를 찾았고, ChatGPT에게 "이 판례들이 진짜냐"고 물어 "그렇다"는 답을 받았다고 해명했습니다. P. 케빈 카스텔(P. Kevin Castel) 판사는 2023년 6월 변호사 두 명과 소속 로펌에 5,000달러의 제재금을 물렸고, 가짜 판례의 '저자'로 이름이 도용된 실제 판사들에게 사과 편지를 보내라고 명령했습니다.
이 사건은 법률 AI의 문제를 한 문장으로 요약했습니다. 법률 실무에서는 그럴듯한 문장이 아니라 실제로 존재하는 근거가 필요하다.
숫자로 본 환각
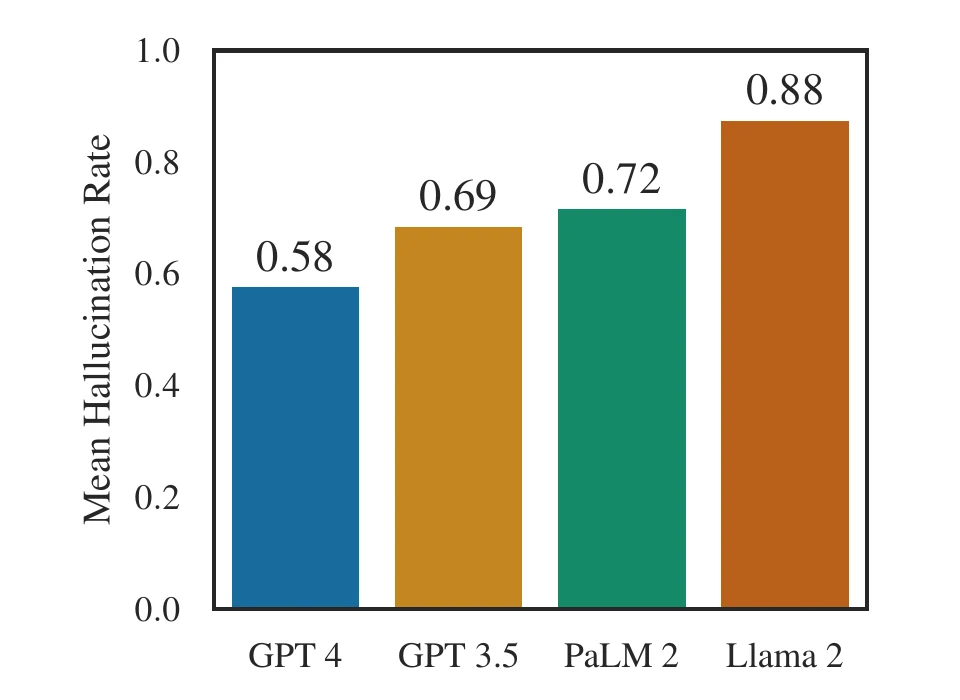
스탠퍼드 RegLab의 매슈 달(Matthew Dahl), 대니얼 호(Daniel Ho) 등은 2024년 「거대한 법률 허구(Large Legal Fictions)」 논문에서 이 문제를 체계적으로 쟀습니다. 무작위로 뽑은 미국 연방 판례에 대해 확인 가능한 질문(이 판결의 주심은 누구인가, 이 사건의 핵심 판시는 무엇인가 등)을 던지자, 당시 모델들은 절반이 넘는 경우 틀린 답을 지어냈습니다.
그림을 읽는 법은 간단합니다. 막대 높이는 '모델이 내놓은 답 중 사실과 다른 비율'입니다. 가장 좋은 GPT-4도 58%, Llama 2는 88%였습니다. 논문은 두 가지를 더 발견했습니다. 하급심 판례일수록 환각이 늘었고(대법원 → 항소법원 → 지방법원), 사용자가 잘못된 전제를 깔고 물으면("○○ 판결에서 법원이 반대 의견을 낸 이유는?") 모델이 전제를 바로잡지 않고 맞장구를 쳤습니다. 자기가 틀렸을 가능성도 제대로 가늠하지 못했습니다.
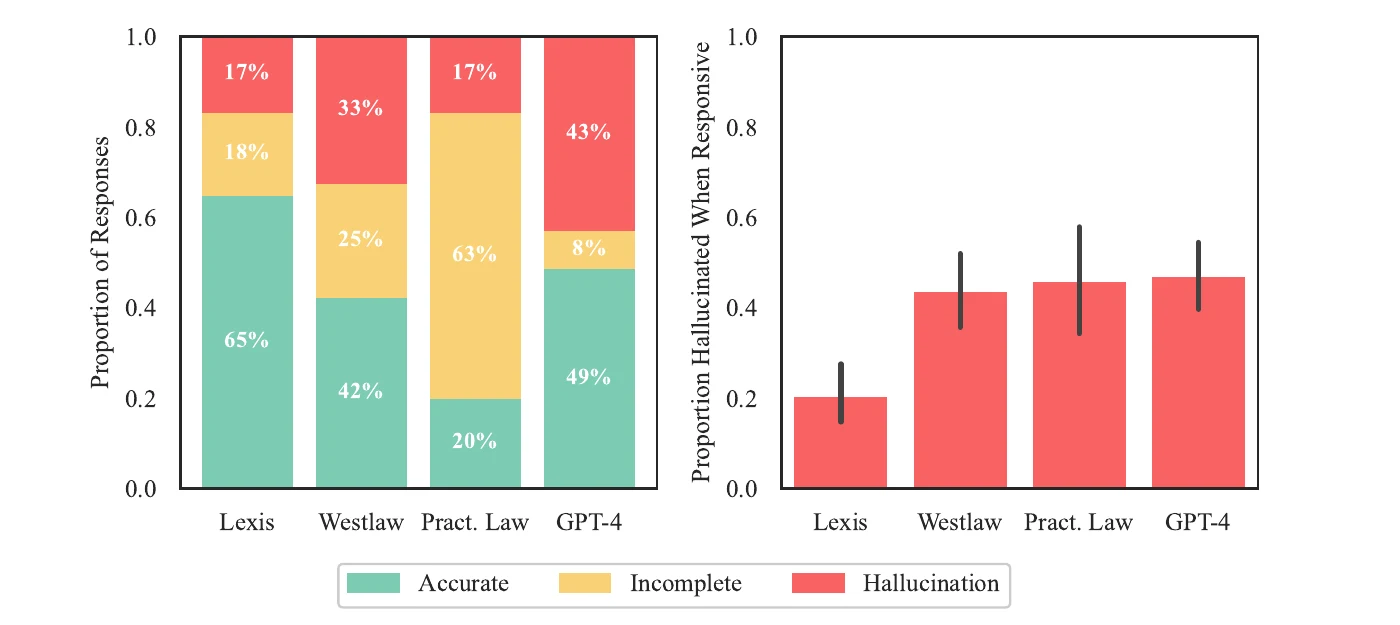
그러면 판례 데이터베이스를 붙인 상용 도구는 어떨까요? 같은 팀의 바룬 마게시(Varun Magesh) 등은 같은 해 「환각 없음?」 논문에서, '환각 없는 인용'을 내세운 리걸테크 제품들을 사전 등록한 방법으로 시험했습니다.
초록은 정확한 답, 노랑은 '불완전'(답을 거부했거나 핵심이 빠짐), 빨강은 환각입니다. 검색 증강(RAG)을 붙인 전문 도구들도 17~33%의 환각을 보였습니다. Westlaw의 환각률이 높은 데는 답이 가장 길었다는 이유도 있었습니다(평균 350단어, Lexis는 219단어). 문장이 길수록 틀릴 기회도 많습니다. 오른쪽 그림은 '답을 하긴 한 경우'만 보면 Westlaw·Practical Law·GPT-4가 비슷하다는 것을 보여 줍니다. Practical Law는 답을 많이 거부해서 환각이 적어 보였던 것입니다.
논문은 환각을 두 종류로 나눴습니다. 아예 틀린 내용(incorrect)과, 내용은 맞는데 엉뚱한 근거를 댄 것(misgrounded). 법률에서는 후자도 똑같이 위험합니다. 변호사는 근거를 확인하려고 그 판례를 열어 보고, 거기서 아무것도 찾지 못하기 때문입니다.
2,184건과 늘어나는 제재
프랑스 연구자 다미앵 샤를로탱(Damien Charlotin)은 전 세계 법원에서 AI가 만든 가짜 인용이 문제 된 사건을 모으는 데이터베이스를 운영합니다. 2026년 10월 13일 기준 2,184건입니다. 2025년 중반 약 120건, 2025년 12월 600건, 2026년 3월 1,000건, 6월 35개국 약 1,600건으로 불어났습니다. 미국만 보면 2023년 11건, 2024년 37건, 2025년 524건입니다.
영국 Ayinde v Haringey (2025년 6월). 존재하지 않는 판례 5건. 고등법원은 법정모욕의 기준을 충족한다고 보면서도 처벌 대신 규제 기관에 회부했고, 로펌의 대표들에게 소속 변호사의 AI 사용에 책임이 있다고 경고했습니다.
미국 Johnson v. Dunn (2025). 대형 로펌 Butler Snow의 변호사 세 명이 가짜 인용으로 그 사건에서 아예 배제됐습니다.
미국 Noland v. Land of the Free (2025, 캘리포니아 항소법원). 인용문 23개 중 21개가 지어낸 것이었고 1만 달러 제재금이 부과됐습니다.
한국. 법원행정처는 2025년 10월 AI 허위 제출물 대응 TF를 꾸렸고, 2026년 2월 20일부터 가짜 사건번호를 조회할 수 있는 기능을 열었습니다. 인용한 판결의 전문을 함께 내라고 명하는 재판부도 생겼습니다.
이 시기가 남긴 교훈이 GLM-Legal 설계의 출발점입니다. 모델이 법을 '아는 것'만으로는 부족합니다. 주어진 자료에 묶여서, 근거를 정확히 대며, 정해진 형식의 결과물을 끝까지 만드는 '작업 습관'이 필요합니다. 그것은 더 많은 법률 지식이 아니라 다른 종류의 훈련으로 길러집니다. AI 사용과 변호사의 비밀유지·책임 문제는 변호사가 AI 쓰면 특권은 깨지는가에서 따로 다뤘습니다.
4. 시험지가 바뀌었다: LegalBench에서 Harvey LAB까지
GLM-Legal 그래프의 세 막대는 서로 다른 시대의 시험지입니다. 각각 무엇을 재는지 알아야 숫자를 제대로 읽을 수 있습니다.
LegalBench: 법률가의 머릿속을 여섯 칸으로
LegalBench(2023)는 162개의 짧은 과제로 이뤄져 있습니다. 대부분은 지문을 읽고 정답이 정해진 질문에 답하는 형식입니다. 이 시험지의 공헌은 과제를 여섯 갈래의 법률 추론으로 나눴다는 데 있습니다.
추론 유형
무엇을 묻나
예시 과제
쟁점 찾기 (Issue-spotting)
사실관계에서 법적 쟁점을 집어낸다
일반인의 법률 상담 글이 '주거 문제'를 포함하는가
규칙 기억 (Rule-recall)
관련 법 규칙을 정확히 떠올린다
특정 관할 요건, 조문 내용
규칙 적용 (Rule-application)
규칙을 사실에 대입하고 이유를 설명한다
전문증거(hearsay) 해당 여부와 그 설명
규칙 결론 (Rule-conclusion)
규칙과 사실로부터 결론만 낸다
연방법원 관할이 있는가 (예/아니오)
해석 (Interpretation)
계약서·법령 문장의 의미와 효과를 읽는다
CUAD 계약 조항 분류, MAUD 합병계약 조항
수사 이해 (Rhetorical understanding)
문장이 논증·문서에서 하는 역할을 안다
이 문장은 용어 정의인가
2023년 논문에서 GPT-4가 받은 점수를 보면 어느 칸이 어려웠는지 보입니다(논문 표 2·3).
쟁점 찾기
82.9
규칙 기억
59.2
규칙 적용(정답)
82.2
규칙 적용(설명)
79.7
규칙 결론
89.9
해석
75.2
수사 이해
79.4
가장 낮은 칸은 규칙 기억(59.2)입니다. 법 규칙을 '떠올리는' 일이 가장 약했다는 것은, 앞 장의 환각 문제와 같은 뿌리입니다. 모델은 규칙을 대충 아는 상태에서 그럴듯하게 지어낼 때가 많았습니다.
아래 퀴즈에서 여섯 갈래를 한 문제씩 풀어 보세요.
그로부터 3년. Vals의 LegalBench 리더보드(2026년 10월 12일)에서 1위 Claude Fable 5가 88.56%, GLM-Legal은 86.24%로 150개 모델 중 14위입니다. Vals 스스로 이 시험이 "거의 포화됐다"고 씁니다. 상위권이 84~89%에 몰려 있어 모델을 가르는 힘이 약해졌다는 뜻입니다. GLM 계열의 Vals 점수 변화(GLM-4.5 75.6 → 4.6 79.6 → 4.7 83.4 → 5.3 84.8 → Legal 86.2)를 보면, 일반 모델의 세대 교체만으로 이 시험의 점수는 꾸준히 올라 왔습니다. 법률 특화 훈련이 더한 것은 기반 모델(83.9) 대비 2.3%포인트입니다.
BigLaw Bench: '쓸 만한 결과물'을 재려는 첫 시도
리걸테크 회사 Harvey는 2024년 8월 BigLaw Bench를 공개했습니다. 변호사들의 실제 업무 시간 기록(time entry)에서 과제를 뽑아, 답의 품질(answer score)과 근거 제시(source score)를 따로 채점했습니다. 당시 Harvey 자체 모델은 답 점수 74%, GPT-4o는 61%였고, 근거 점수에서는 Harvey 68%, GPT-4o 24%, Claude 3.5 8%로 차이가 컸습니다. 그런데 이 시험도 곧 포화됐습니다. 2026년 2월 무렵 최신 모델들이 90% 안팎에 이르렀습니다.
Harvey LAB: 로펌 한 건을 통째로 맡기다
그래서 Harvey는 2026년 5월 6일 Legal Agent Benchmark(LAB)를 MIT 라이선스로 공개했습니다. 이름처럼 '에이전트'를 재는 시험입니다. 질문에 답하는 것이 아니라 사건 하나를 맡아 결과물을 납품해야 합니다.
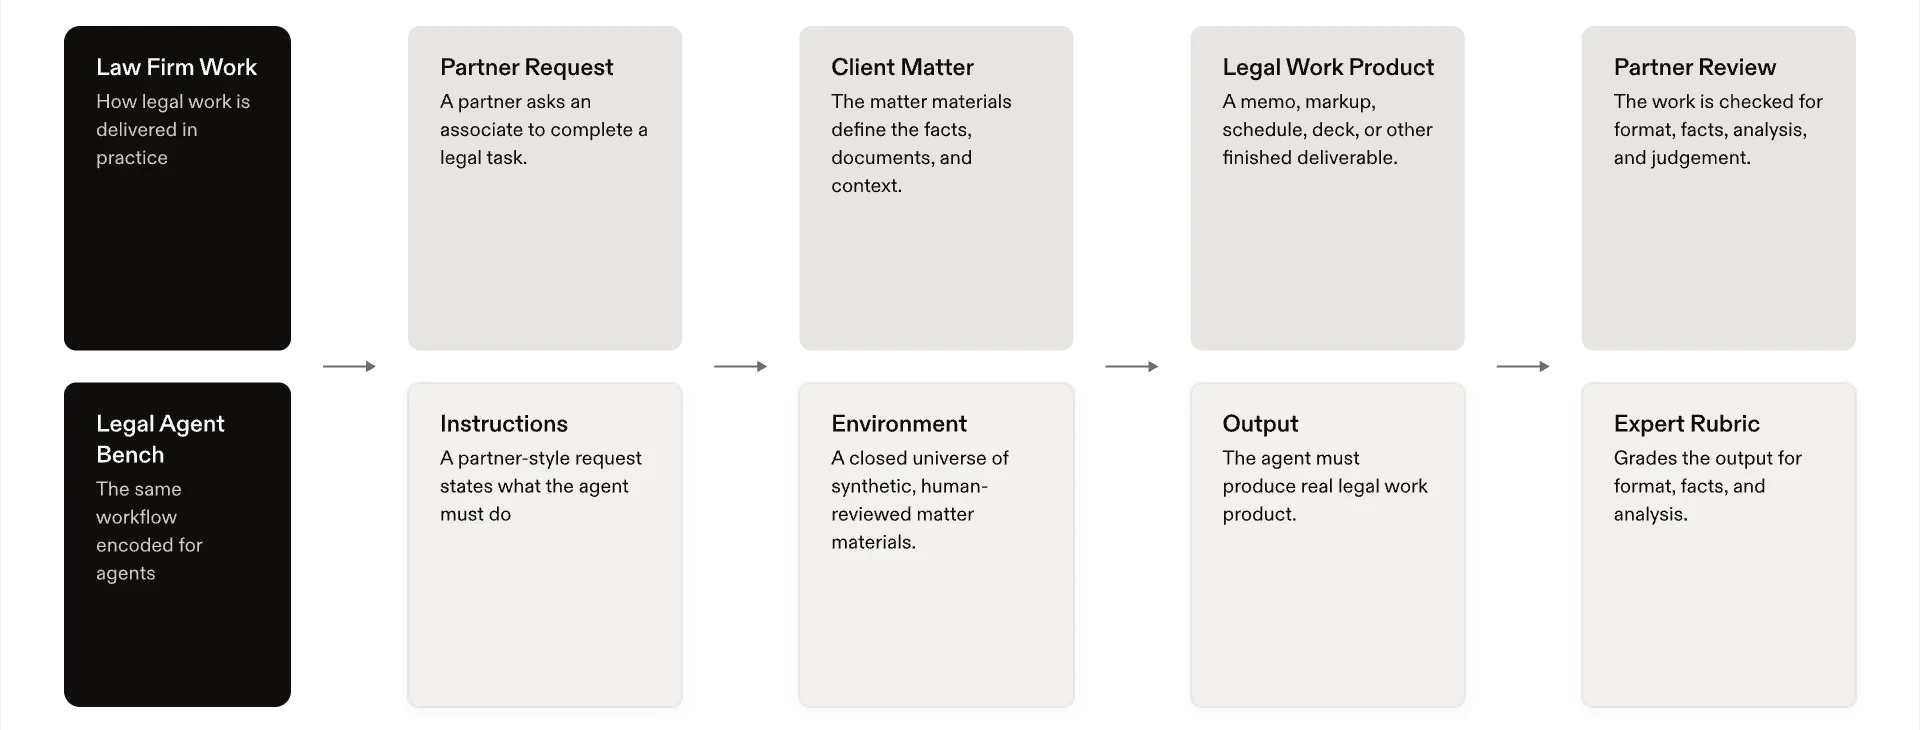
Harvey가 공개한 구조도는 LAB의 설계 철학을 그대로 보여 줍니다. 위 줄은 로펌에서 일이 실제로 흘러가는 방식입니다. 파트너가 어소시에이트에게 일을 맡기고(Partner Request), 어소시에이트는 사건 자료를 받아(Client Matter), 메모·수정본·일정표 같은 결과물을 만들고(Legal Work Product), 파트너가 형식·사실·분석·판단을 검토합니다(Partner Review). 아래 줄은 이것을 에이전트용으로 그대로 옮긴 것입니다. 지시문, 닫힌 문서 세계(인터넷 없이 주어진 자료만), 실제 파일 결과물(.docx, .xlsx, .pptx), 그리고 전문가가 쓴 채점 기준표(루브릭)입니다.
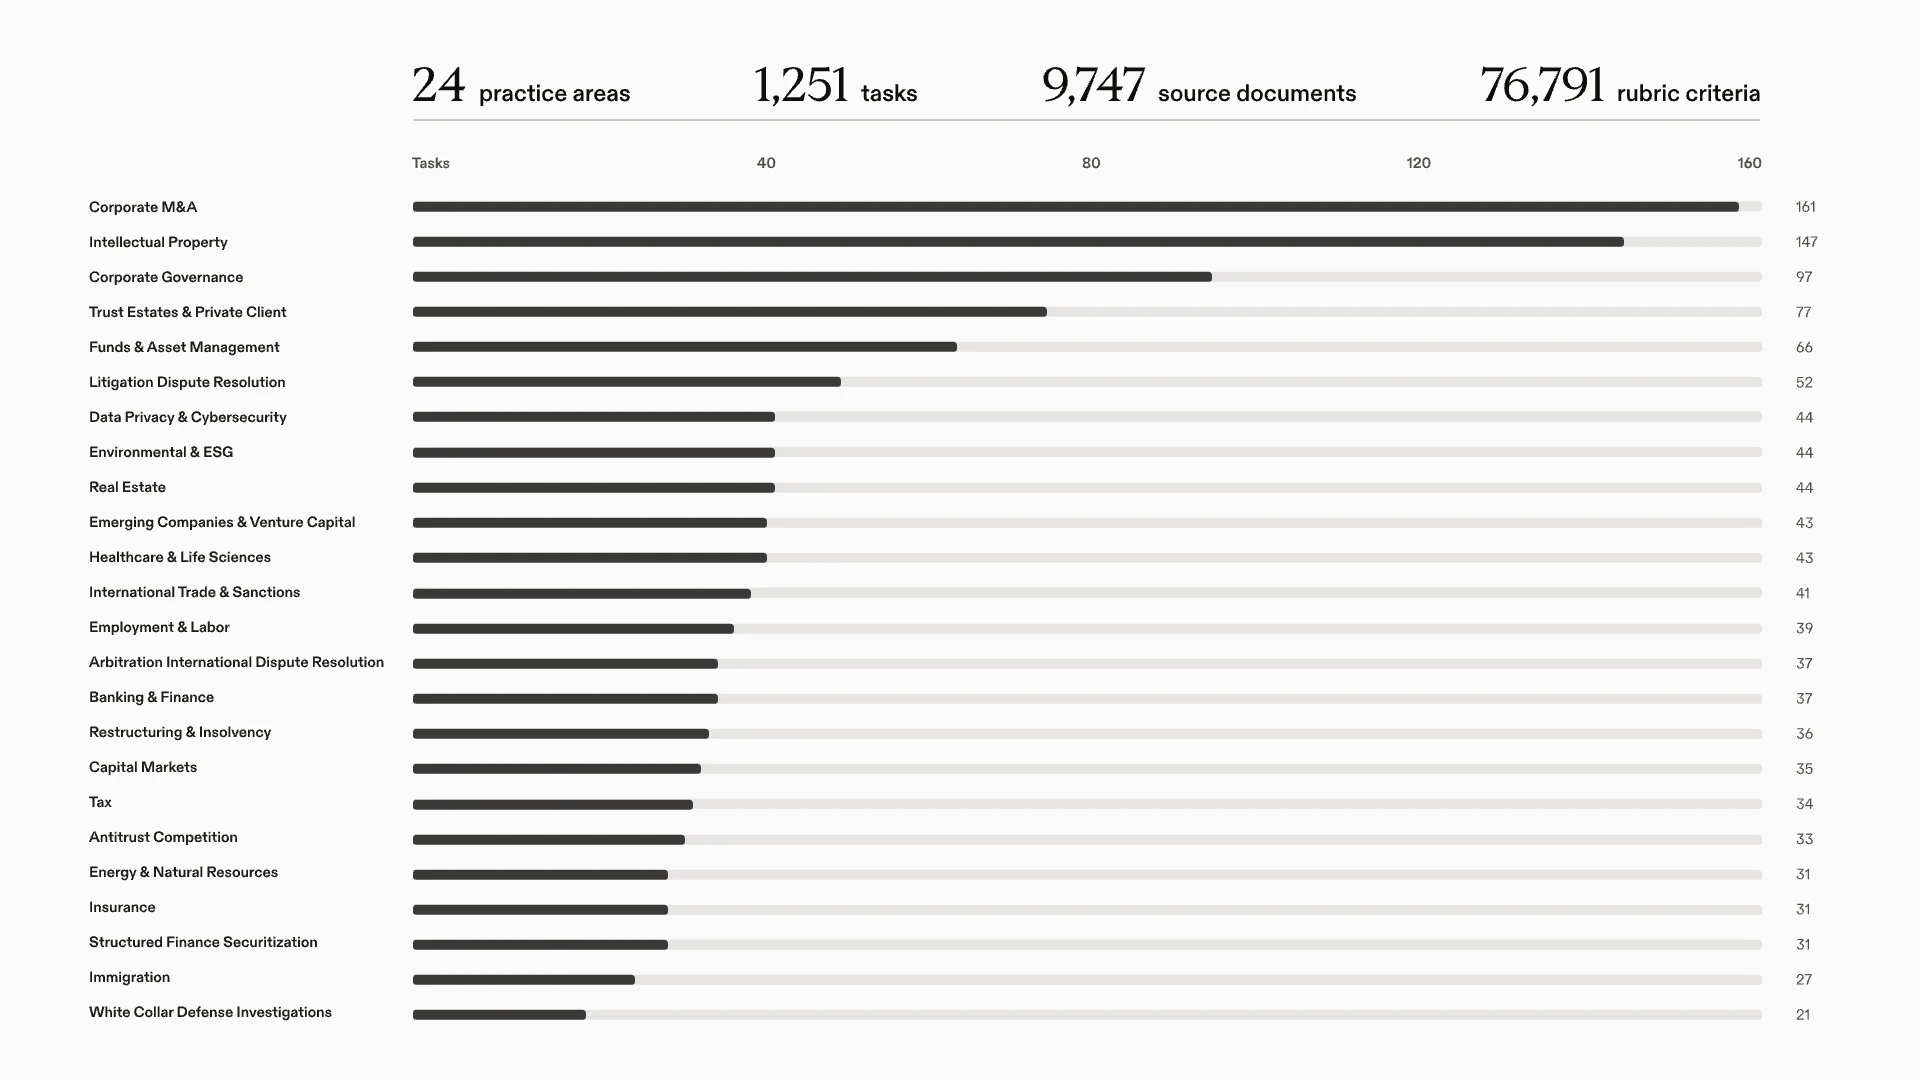
규모는 이렇습니다. 24개 실무 분야, 과제 1,251개, 원본 문서 9,747건, 채점 항목 76,791개. 과제 하나에 평균 약 61개의 채점 항목이 붙어 있는 셈입니다. 기업 인수합병(161개)과 지식재산(147개)이 가장 많고, 이민(27개)과 화이트칼라 범죄 수사(21개)가 가장 적습니다. 저장소의 최신 버전은 과제를 2,010개까지 늘렸습니다.
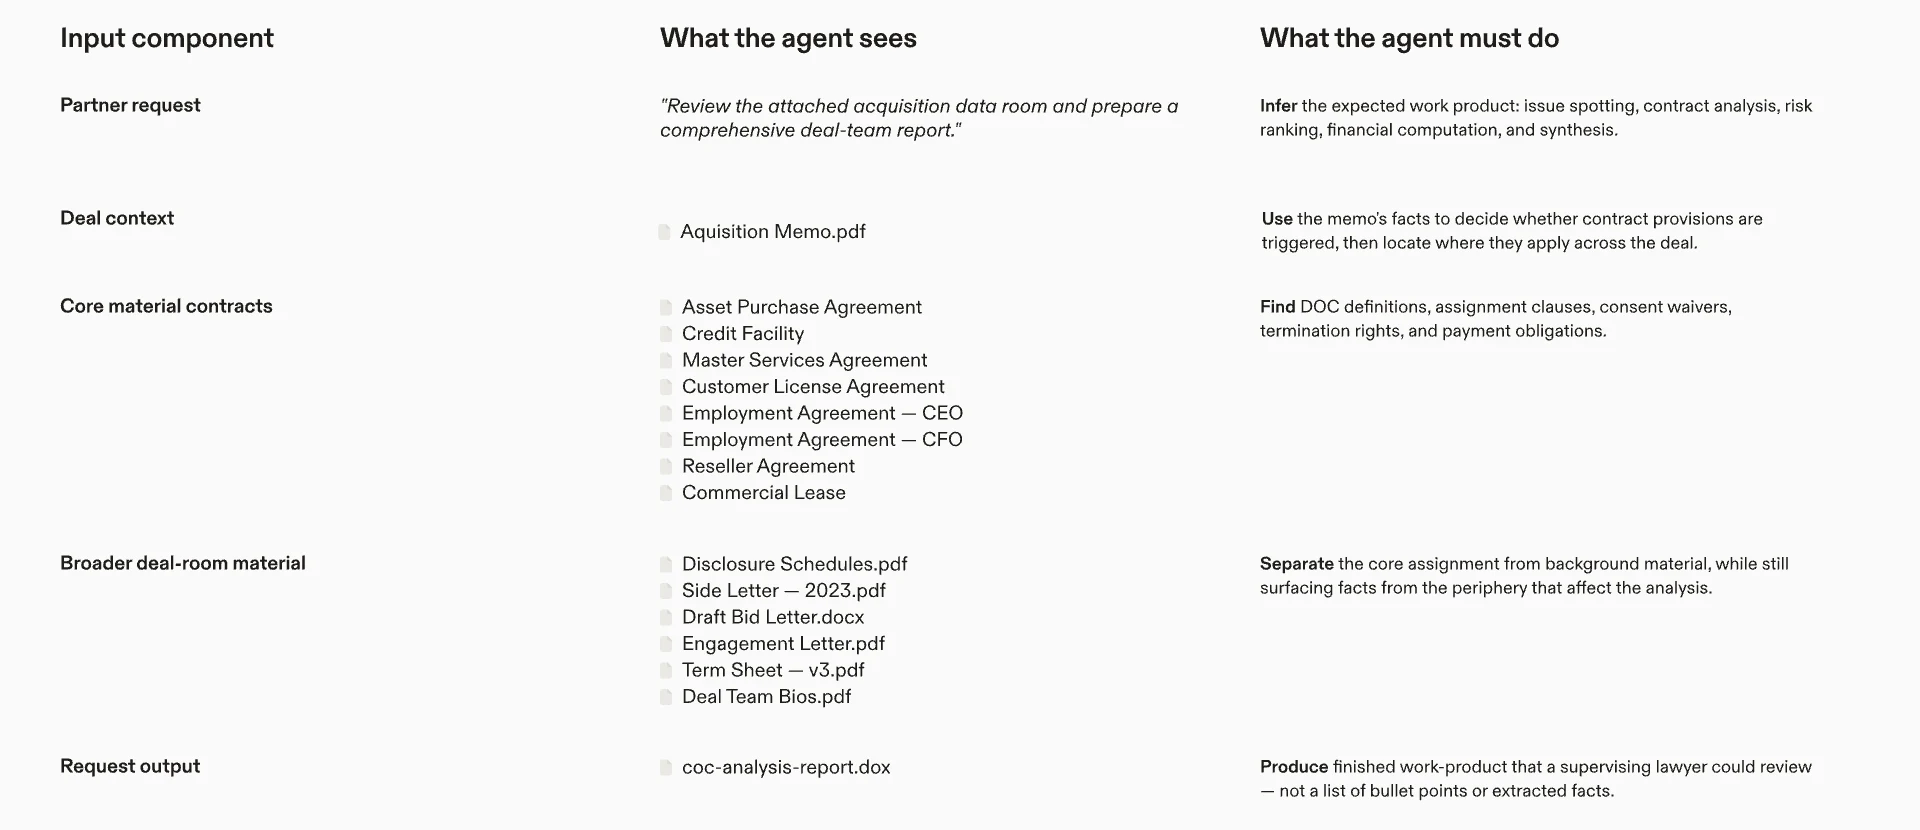
과제 하나가 어떻게 생겼는지 Harvey가 든 예를 보겠습니다. 가상의 소프트웨어 회사를 4억 5,800만 달러에 인수하는 거래에서, '지배권 변경(change of control)' 조항을 검토하라는 과제입니다. 회사의 주인이 바뀌면 거래처 계약들이 자동으로 해지되거나, 상대방 동의가 필요하거나, 빚을 당장 갚아야 하는 조항이 숨어 있을 수 있습니다. 인수 전에 이것을 다 찾아내는 것이 실사(due diligence)의 핵심 업무입니다.
파트너의 지시는 딱 한 줄입니다. "첨부한 인수 자료실을 검토해 종합적인 거래팀 보고서를 준비하라." 이 한 줄에서 에이전트는 기대되는 결과물이 무엇인지(쟁점 찾기, 계약 분석, 위험 순위, 금액 계산, 종합)를 스스로 추론해야 합니다. 자료실에는 핵심 계약 8건과 함께 입찰서 초안, 위임 계약서, 거래팀 약력 같은 '주변 자료'가 섞여 있습니다. 대부분은 무시해도 되지만, 2023년 부속 서신(side letter) 하나가 분석을 뒤집을 수도 있습니다. 실제 자료실이 그렇듯이 말입니다. 결과물은 요점 목록이 아니라 감독 변호사가 그대로 검토할 수 있는 워드 보고서여야 합니다.
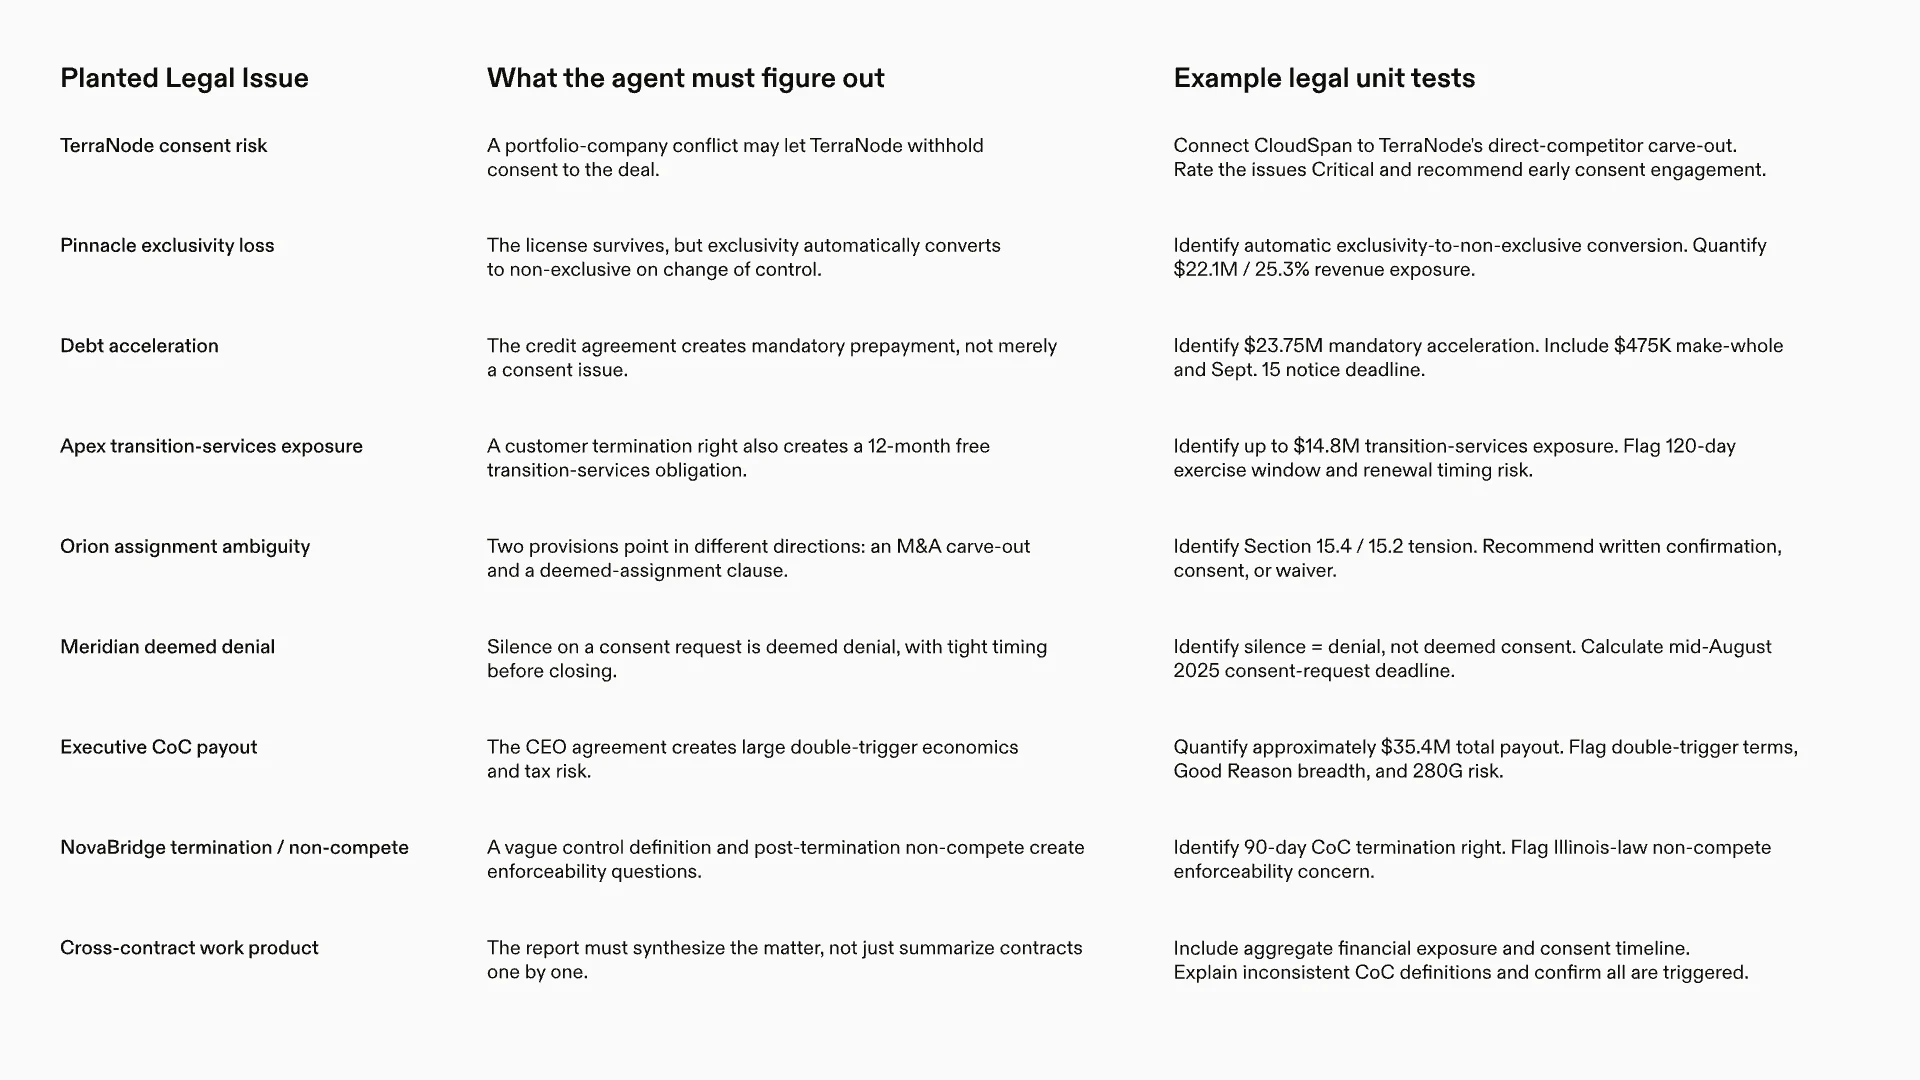
이 표가 Harvey LAB의 진짜 얼굴입니다. 출제자는 자료실에 법적 쟁점 9개를 숨겨 두고, 쟁점마다 4~9개의 채점 항목을 달았습니다(이 과제는 모두 57개). 몇 개만 풀어 보겠습니다.
Meridian 간주 거절. 한 계약에는 "동의 요청에 상대방이 일정 기간 답하지 않으면 거절한 것으로 본다"는 조항이 있습니다. 대부분의 계약은 침묵을 동의로 보기 때문에 대충 읽으면 반대로 해석합니다. 채점 항목은 "침묵 = 거절임을 짚었는가"와 "거래 종결 일정에서 역산해 8월 중순까지 동의를 요청해야 함을 계산했는가"입니다.
채무 조기 상환. 신용공여 계약은 단순히 동의를 받으면 되는 문제가 아니라 2,375만 달러를 의무적으로 조기 상환해야 하는 문제입니다. 채점 항목은 금액, 47만 5천 달러의 조기상환 수수료(make-whole), 9월 15일 통지 기한까지 정확히 짚었는지 봅니다.
계약 간 종합. 마지막 쟁점은 특정 조항이 아니라 보고서 전체에 관한 것입니다. 계약을 하나씩 요약하는 데 그치지 말고 총 재무 노출과 동의 일정표를 만들고, 계약마다 '지배권 변경'의 정의가 다르다는 점을 설명해야 합니다.
이런 항목을 법률가들은 "법률 단위 테스트(legal unit test)"라고 부릅니다. 소프트웨어의 단위 테스트처럼, 결과물이 갖춰야 할 작은 성질 하나하나를 '예/아니오'로 확인하는 것입니다.
'전 항목 통과'라는 잔인한 채점
LAB의 점수는 과제 하나의 채점 항목을 전부 통과해야 그 과제를 맞힌 것으로 칩니다(all-pass). 57개 중 56개를 맞혀도 0점입니다. 위험 열 개 중 여덟 개를 찾은 보고서는 80점이 아니라 '불완전'이라는 Harvey의 철학을 채점 규칙으로 만든 것입니다.
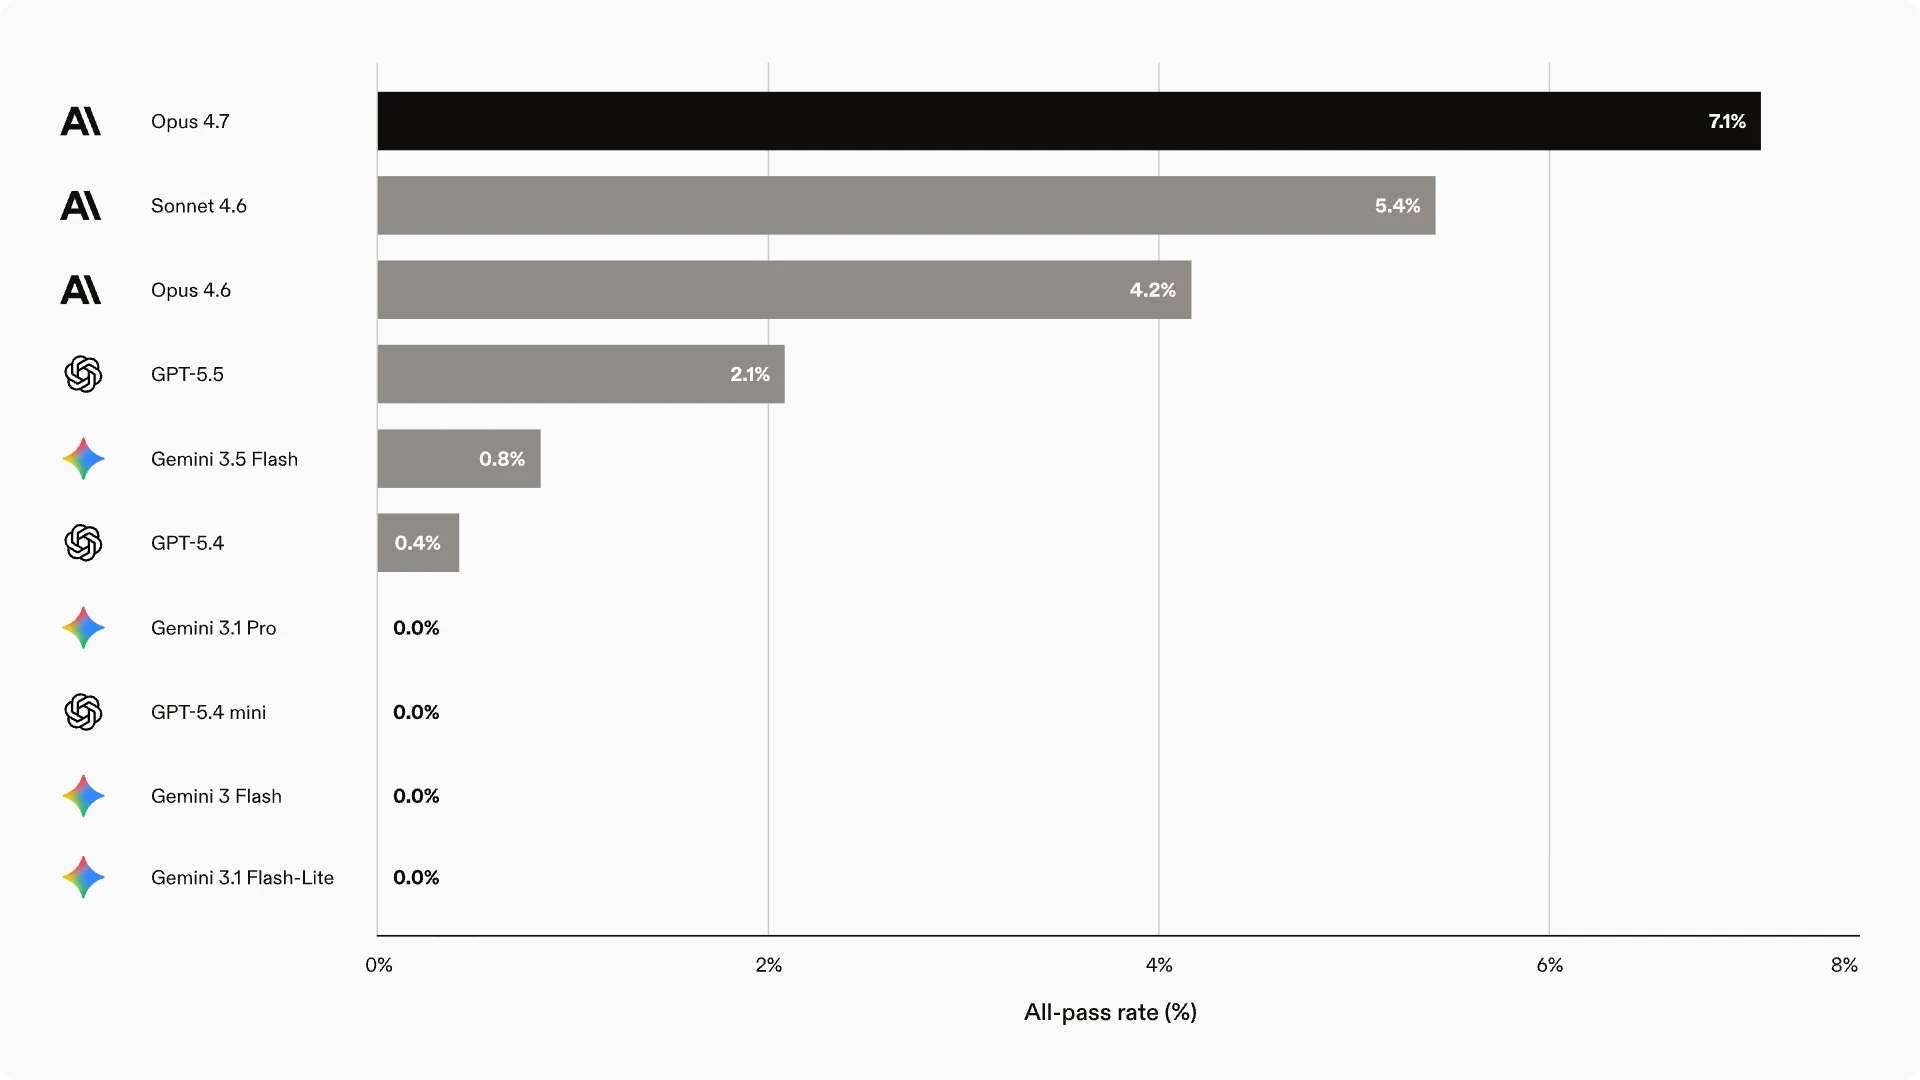
당시 최고였던 Claude Opus 4.7이 7.1%, 과제당 약 50.90달러를 쓰고 22분을 일했습니다. 네 모델은 0%였습니다. Harvey는 흥미로운 관찰도 덧붙였습니다. 초안을 쓴 뒤 스스로 점검하고 고친 실행은 1.5%포인트 올랐고, 검토 없이 바로 쓴 실행은 1.2%포인트 떨어졌습니다. 같은 모델이라도 일하는 방식이 점수를 바꾼다는 뜻입니다. 이 관찰이 뒤의 '하네스' 이야기로 이어집니다.
5개월 뒤인 지금, 독립 평가 회사 Vals가 운영하는 LAB 리더보드는 이렇게 돌아갑니다. 공개되지 않은 과제 120개를 쓰고, 인터넷은 끕니다. 에이전트에게는 파일 읽기·편집·쓰기, 파일 찾기(Glob), 셸(Bash), 텍스트 검색(Grep) 여섯 가지 도구와 워드·파워포인트·엑셀 작성 기능을 줍니다. 채점은 LLM 판정관 둘(GPT-5.5, Claude Sonnet 4.6)이 따로 하고, 두 판정관의 전 항목 통과율을 평균합니다.
여기서 두 숫자를 구분해야 합니다.
모델
항목 통과율 (평균 점수)
전 항목 통과율 (LAB 점수)
Muse Spark 1.3 Max
94.74%
23.75%
Muse Spark 1.2
94.52%
25.42% (1위)
Grok 4.6
92.52%
15.83%
GLM-Legal
92.46%
19.17% (7위)
항목 단위로는 모두 92~95%를 맞힙니다. GLM-Legal은 Grok 4.6보다 항목 통과율이 오히려 조금 낮은데, 전 항목 통과율은 3.3%포인트 높습니다. 같은 수의 항목을 놓치더라도 놓친 항목이 몇몇 과제에 몰려 있으면 나머지 과제는 완주할 수 있기 때문입니다. 위젯의 '실측과 대조' 상자가 보여 주듯, 항목이 서로 독립이라면 92.46%로는 0.8%밖에 나올 수 없습니다. 실제 실패는 "사실 하나를 놓치면 관련 항목이 줄줄이 틀리는" 식으로 뭉쳐 다닙니다.
PLawBench: 중국 법률 실무 시험
세 번째 막대인 PLawBench(arXiv 2601.16669, 2026년 1월)는 알리바바 Qwen 팀과 상하이교통대·칭화대·워털루대 등의 연구자들이 만든 중국 법률 실무 시험입니다. 850문항, 13개 시나리오, 약 1만 2,500개의 루브릭 항목으로 이뤄져 있고, 과제는 셋입니다.
대중 법률 상담(60문항): 일반인의 질문에 답하기
실무 사례 분석(750문항): 결론·사실·추론·법조문 네 측면으로 채점
법률 문서 작성(40문항): 원고·피고 양쪽 입장에서 소장·답변서 쓰기
중국 사법시험 합격자 39명이 문항당 약 3시간씩 들여 만들었고, 채점은 사람과 가장 일치도가 높았던 Gemini 3.0 Pro Preview가 맡습니다. 논문 발표 당시 1위는 GPT-5.2(69.67점)였습니다. 다만 GLM-Legal 그래프의 PLawBench 점수 다섯 개는 모두 Z.ai가 직접 잰 값이고, 독립 평가는 아직 없습니다.
세 시험지를 한 화면에
아래 위젯에서 시험지를 바꿔 가며 보세요. '그림 밖 순위까지'를 누르면 Z.ai 그래프에 없던 모델들이, '과제당 비용'을 누르면 Vals가 집계한 비용이 나옵니다.
정리하면 이렇습니다. LegalBench에서 GLM-Legal은 '잘하는 모델 중 하나'이고, Harvey LAB에서는 '확실히 잘하는 모델'이며, 비용까지 넣으면 '압도적으로 효율적인 모델'입니다. 그리고 기반 모델 대비 상승폭이 지식 시험보다 실무 시험에서 다섯 배 넘게 컸다는 점이, Z.ai의 훈련법이 무엇을 겨냥했는지 말해 줍니다.
5. 아키텍처: 가벼운 범용 모델에 세 겹을 덧입히다
Z.ai 원문의 「훈련 방법론」 절은 짧습니다. 그러나 문장마다 2025~2026년 AI 훈련의 큰 흐름이 압축돼 있습니다. 원문의 요지는 이 한 문장입니다. "기초 사전학습을 다운스트림 과제 실행에 직접 묶어, 모델이 원본 기록을 해석하고, 법리를 적용하고, 논증을 구조화하고, 최종 납품까지 결과물 품질을 유지하도록 훈련한다."
GLM-Legal은 맨바닥에서 만든 모델이 아닙니다. 2026년 8월 25일 공개된 GLM-5.3-Flash가 출발점입니다. Z.ai 문서에 따르면 이 모델은 다음과 같습니다.
전체 320B, 활성 18B 파라미터의 전문가 혼합(MoE) 모델. 전문가 혼합이란 모델 안에 '전문가'라 불리는 작은 신경망 여러 개를 두고, 단어(토큰) 하나를 처리할 때마다 그중 몇 개만 깨워 쓰는 구조입니다. 도서관에 사서가 수십 명 있어도 질문 하나에는 두세 명만 답하는 것과 같습니다. 그래서 전체 지식은 크게 담으면서 계산은 작은 모델만큼만 씁니다. 형님 모델 GLM-5.3은 355B/32B입니다.
희소 어텐션과 선형 어텐션을 섞어 100만 토큰 문맥을 다루고, 이미지도 함께 읽는 멀티모달 모델입니다. 사전학습 말뭉치는 30조 토큰입니다.
MIT 라이선스로 가중치가 공개돼 있습니다(Hugging Face zai-org/GLM-5.3-Flash).
이 '가벼움'이 GLM-Legal 이야기의 절반입니다. Vals가 집계한 과제당 0.15달러라는 비용은 활성 파라미터가 작은 모델이라서 가능합니다. 흥미롭게도 Vals 기록상 GLM-Legal은 기반 모델보다 과제 하나에 쓰는 시간은 더 길었지만(약 72분 대 52분) 비용은 4분의 1이었습니다. 같은 요금으로 계산했으니, 토큰을 훨씬 덜 쓰면서 더 오래, 더 신중하게 일했다는 뜻으로 읽힙니다. 아래에서 볼 Harvey의 GLM-5.1 훈련 실험에서도 똑같은 변화(도구 호출과 읽기 분량이 줄어듦)가 관찰됐습니다.
GLM의 계보를 짧게 정리하면, 칭화대에서 출발한 Zhipu AI는 2022년 GLM-130B를 공개했고, 2023년 ChatGLM으로 중국 챗봇 시장에 들어섰으며, 2025년 7월 에이전트·추론·코딩을 하나로 묶은 GLM-4.5("ARC")로 오픈 모델 최상위권에 올랐습니다. 2025년 1월 미국 상무부 수출 통제 명단(Entity List)에 올랐고, 2026년 1월 홍콩 증시에 상장했습니다. 그 뒤 GLM-5(2월), 5.1(4월), 5.2(6월), 5.3(8월)을 두 달 간격으로 내놓았습니다. 해외 브랜드가 Z.ai입니다.
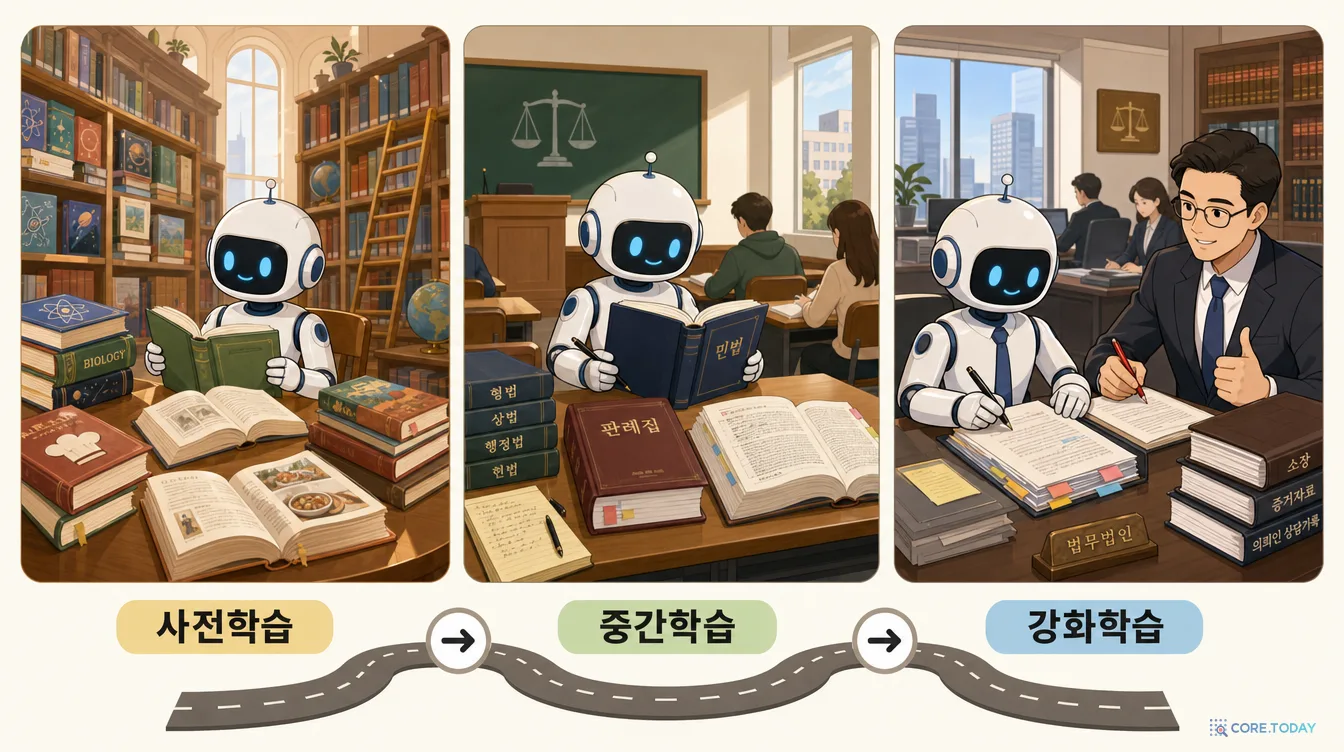
5-2. 중간학습(Mid-training): 로스쿨에 보내기
원문 첫 단계는 중간학습입니다. "고품질 법률 말뭉치의 양을 늘려, 모델이 촘촘한 도메인 문맥 안에서 법률 개념, 조문 규칙, 해석 틀을 배우게 했다. 이 단계는 사실·규칙·결론 사이의 연역적 연결을 강화해, 복잡한 과제 실행에 필요한 지식 기반을 제공한다."
중간학습이란 무엇인가. 언어 모델 훈련은 보통 두 단계로 설명됩니다. 인터넷 규모의 글을 읽으며 다음 단어 맞히기를 배우는 사전학습, 그리고 대화·지시 따르기·추론을 다듬는 후속학습(지도 미세조정과 강화학습). 2024~2025년 무렵부터 그 사이에 하나의 단계가 이름을 얻었습니다.
앨런 AI 연구소의 OLMo 2(2025) 보고서는 전체 훈련 계산량의 5~10%를 쓰는 두 번째 단계를 '중간학습'이라 부르며, 수학·학술 문서처럼 품질이 높은 데이터를 골라 학습률을 서서히 낮추며(annealing) 읽힌다고 설명합니다. Llama 3와 DBRX도 같은 일을 했다고 덧붙입니다.
마이크로소프트의 Phi-4는 중간학습 단계에서 문맥 길이를 4K에서 16K로 늘렸습니다.
2025년 가을에는 중간학습만 다룬 서베이 논문이 두 편 나왔고(arXiv 2510.06826, 2510.23081), 둘 다 중간학습을 "사전학습과 후속학습을 잇는 다리"로 정의합니다.
중간학습이 왜 중요해졌는지는 OctoThinker(2025) 논문이 잘 보여 줍니다. 같은 강화학습을 해도 어떤 기반 모델(Qwen)은 쑥쑥 크고 어떤 모델(Llama)은 잘 크지 않았는데, 그 차이를 만든 것이 중간학습 데이터였습니다. "중간학습의 규모를 키우면 그 뒤의 강화학습 성능이 꾸준히 좋아진다." 중간학습은 강화학습이 꽃피울 '토양'을 만드는 단계입니다. GLM-Legal이 강화학습 전에 법률 중간학습을 넣은 이유가 여기 있습니다. 강화학습은 모델이 이미 할 줄 아는 행동 중 좋은 것을 강화하는 방법이라, 법률 지식의 바탕이 없으면 강화할 거리도 없습니다.
"법률 데이터를 더 먹이면 된다"는 생각의 함정. 도메인 특화 사전학습에는 유명한 실패담이 있습니다. 2023년 블룸버그는 금융 문서 3,630억 토큰과 일반 문서 3,450억 토큰으로 500억 파라미터짜리 BloombergGPT를 처음부터 만들었습니다. 몇 달 뒤 다른 연구진이 비교해 보니, 범용 GPT-4가 아무 추가 학습 없이 금융 질의응답(ConvFinQA)에서 76.48 대 43.41, 금융 감성 분석에서 0.86 대 0.51로 이겼습니다. BloombergGPT가 앞선 것은 금융 개체명 인식처럼 좁은 표면 과제(60.82 대 56.71) 정도였습니다. 앞에서 본 CaseHOLD 논문의 "과제가 말뭉치와 닮았을 때만 효과가 있다"는 결론과 같은 이야기입니다.
그래서 2024년 이후 법률 특화 모델들은 처음부터 만들지 않고 강한 범용 모델 위에 법률 데이터를 이어 학습하는 쪽을 택했습니다.
모델
출발점
법률 학습
특징
SaulLM-7B (2024)
Mistral 7B
영어 법률 300억 토큰 이어 학습
첫 오픈 법률 LLM 계열, MIT 라이선스
SaulLM-54B·141B (2024)
Mixtral
법률 5,400억 토큰 + 지시 학습 + 선호 정렬
당시 LegalBench-Instruct 오픈 모델 1위
Harvey × OpenAI (2024)
GPT-4 계열
판례 약 100억 토큰 추가
변호사 선호도 97%(회사 발표)
LegalOne (2026.1)
범용 오픈 모델
중국 법률 중간학습 + 에이전트 추론 증류 + 커리큘럼 강화학습
'가소성 조정 샘플링'으로 망각 억제
GLM-Legal (2026.10)
GLM-5.3-Flash
법률 중간학습 + 수만 개 과제 환경 강화학습
모델과 하네스를 함께 훈련
망각이라는 대가. 특정 분야 글만 잔뜩 읽히면 모델이 원래 잘하던 것을 잊어버리는 파국적 망각(catastrophic forgetting)이 생깁니다. 법률 문서만 읽힌 모델은 법률 용어는 늘지만 코딩이나 일반 추론, 도구 사용이 무뎌질 수 있습니다. 그래서 보통은 원래의 범용 데이터를 일정 비율 섞어 다시 읽히고(replay), 학습률을 조심스럽게 다시 올렸다 내립니다. 2024년 연구는 이렇게 하면 처음부터 전부 다시 학습한 것과 비슷한 성능을 낼 수 있음을 보였고, LegalOne은 모델이 각 데이터에 얼마나 '말랑한지'(혼란도 기반)를 보고 샘플링 비율을 조절했습니다. GLM-Legal이 데이터 비율을 어떻게 맞췄는지는 공개되지 않았습니다. 다만 뒤에서 볼 법률 리서치 벤치마크의 퇴보(기반 모델보다 3.4%포인트 하락)는, 무언가를 얻는 과정에서 무언가를 잃었을 수 있다는 신호로 읽을 수 있습니다.
5-3. 후속학습: 수만 개의 '가상 사건'에서 강화학습
두 번째 단계가 이 모델의 핵심입니다. 원문은 이렇게 씁니다. "후속학습은 수만 개의 현실적인 법률 환경에서의 강화학습을 통해 도메인 지식을 과제 실행으로 바꾼다. 모델은 구체적 제약 아래서 분석을 계획하고, 워크플로를 밀고 나가고, 결과물을 만드는 법을 배운다."
강화학습 '환경'이란. 강화학습은 시행착오로 배우는 방법입니다. 모델이 어떤 행동을 하고, 결과에 점수(보상)를 받고, 점수가 높았던 행동을 더 자주 하도록 바뀝니다. 그러려면 모델이 행동할 무대가 필요합니다. 그것이 환경입니다. 법률 에이전트의 환경 하나는 대략 이렇게 생겼습니다.
GLM-Legal은 이런 환경을 수만 개 만들었다고 합니다. 비교하자면, Harvey가 8월에 발표한 자체 모델 Tenet은 약 1,750개 환경에서 훈련했습니다.
정답이 없는 분야의 보상: 루브릭. 2025년 초 DeepSeek-R1이 보여 준 '검증 가능한 보상을 쓰는 강화학습(RLVR)'은 수학·코딩처럼 정답을 기계가 확인할 수 있는 분야에서 위력을 발휘했습니다. 법률은 그렇지 않습니다. 그래서 2025년 7월 「보상으로서의 루브릭(Rubrics as Rewards)」 같은 연구가 나왔습니다. 문항마다 전문가가 쓴 채점 기준표를 만들고, LLM 판정관이 항목별로 충족 여부를 판단해 그 결과를 보상으로 쓰는 방법입니다. 의료 질의응답(HealthBench)에서 막연한 '1~10점 평가'보다 최대 31%(상대) 좋았습니다. 법률은 루브릭 보상의 교과서적인 분야입니다. Harvey LAB 자체가 7만 6천여 개의 루브릭 항목으로 된 거대한 보상 함수이기도 합니다. Harvey Tenet의 보상은 '통과한 항목 비율 + 쟁점 전체에 대한 종합 점수 + 만점 보너스'를 섞었습니다.
'환경'이 상품이 된 해. 2025년 9월 TechCrunch는 실리콘밸리가 에이전트 훈련용 강화학습 환경에 큰돈을 걸고 있다고 보도했습니다. Mechanize, Prime Intellect 같은 환경 전문 스타트업이 생겼고, Prime Intellect는 'RL 환경의 허깅페이스'를 표방하는 허브를 열었습니다. Anthropic 경영진이 1년간 10억 달러 넘게 환경에 쓰는 방안을 논의했다는 보도도 있었습니다(결정이 아니라 논의). 2026년에는 이것이 수직 분야로 내려왔습니다. 법률 환경, 회계 환경, 의료 환경. GLM-Legal의 "수만 개의 현실적인 법률 환경"은 그 흐름의 한가운데에 있습니다.
5-4. 하네스: 말에게 씌우는 마구
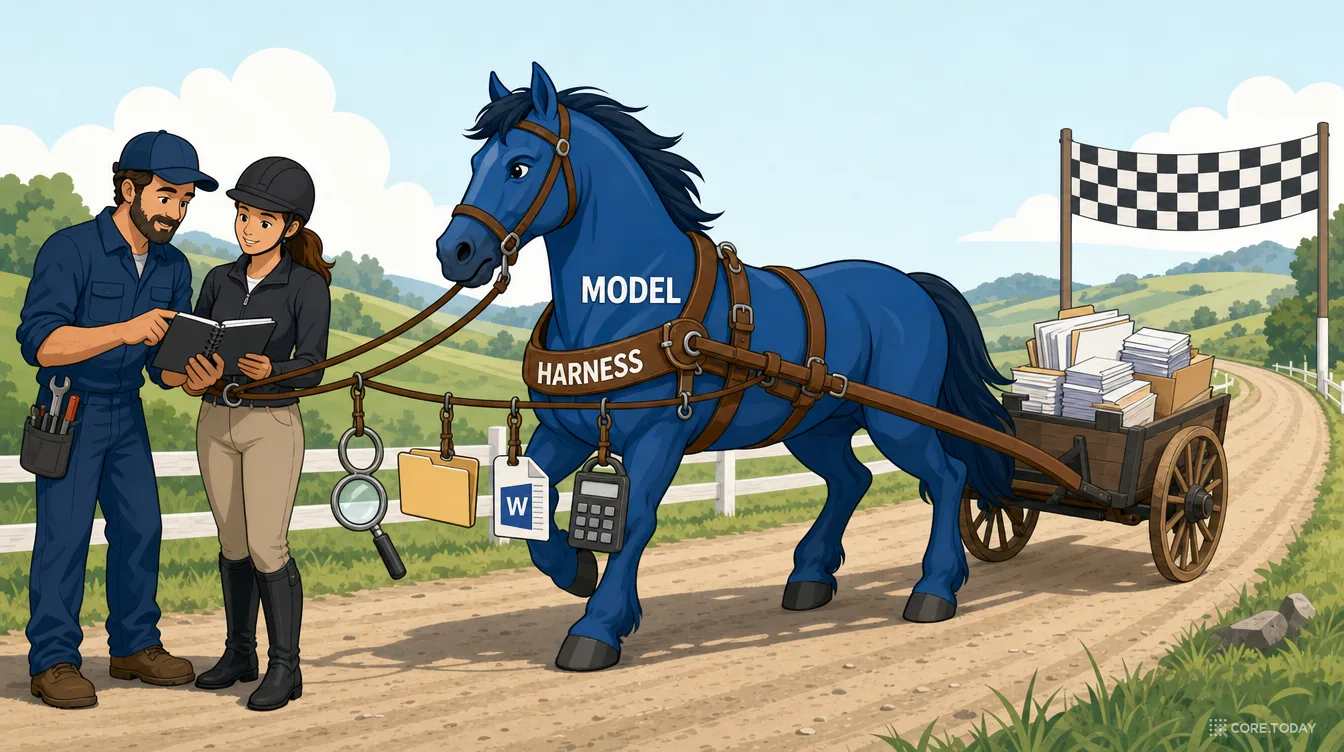
원문의 가장 독특한 대목은 하네스(harness)입니다. "이 구성에서 하네스는 실행 시점의 오케스트레이션 프레임워크 역할을 한다. 과제 맥락을 관리하고, 도구 모음을 연결하고, 실행 피드백을 전달한다."
영어 harness는 원래 말이나 소에 씌우는 마구입니다. 말이 아무리 힘이 세도 마구가 없으면 수레를 끌 수 없고, 마구가 몸에 맞지 않으면 힘이 엉뚱한 데로 새거나 말이 다칩니다. AI 에이전트에서 하네스는 모델을 감싸는 모든 실행 장치를 가리킵니다.
맥락 관리: 문서 40건 중 무엇을 언제 모델에게 보여 줄지, 문맥 창이 차면 무엇을 요약하고 버릴지
도구 연결: 파일 읽기, 검색, 워드 편집, 계산기 같은 도구를 모델이 부를 수 있게 하는 인터페이스와 설명문
실행 피드백: 도구 호출이 실패했을 때의 오류 메시지, 중간 점검, "결과물 파일을 아직 안 만들었다"는 알림
Claude Code나 OpenAI Codex 같은 코딩 에이전트의 성공 이후, 업계에서는 "하네스가 곧 제품"이라는 말이 돌았습니다. 같은 모델이라도 하네스에 따라 성능이 크게 달라지기 때문입니다. Prime Intellect의 용어 해설은 핵심을 짚습니다. 강화학습은 모델을 '특정 하네스 안에서' 잘 행동하도록 훈련한다. 다른 마구를 씌우면 다시 서툴러질 수 있다는 뜻입니다.
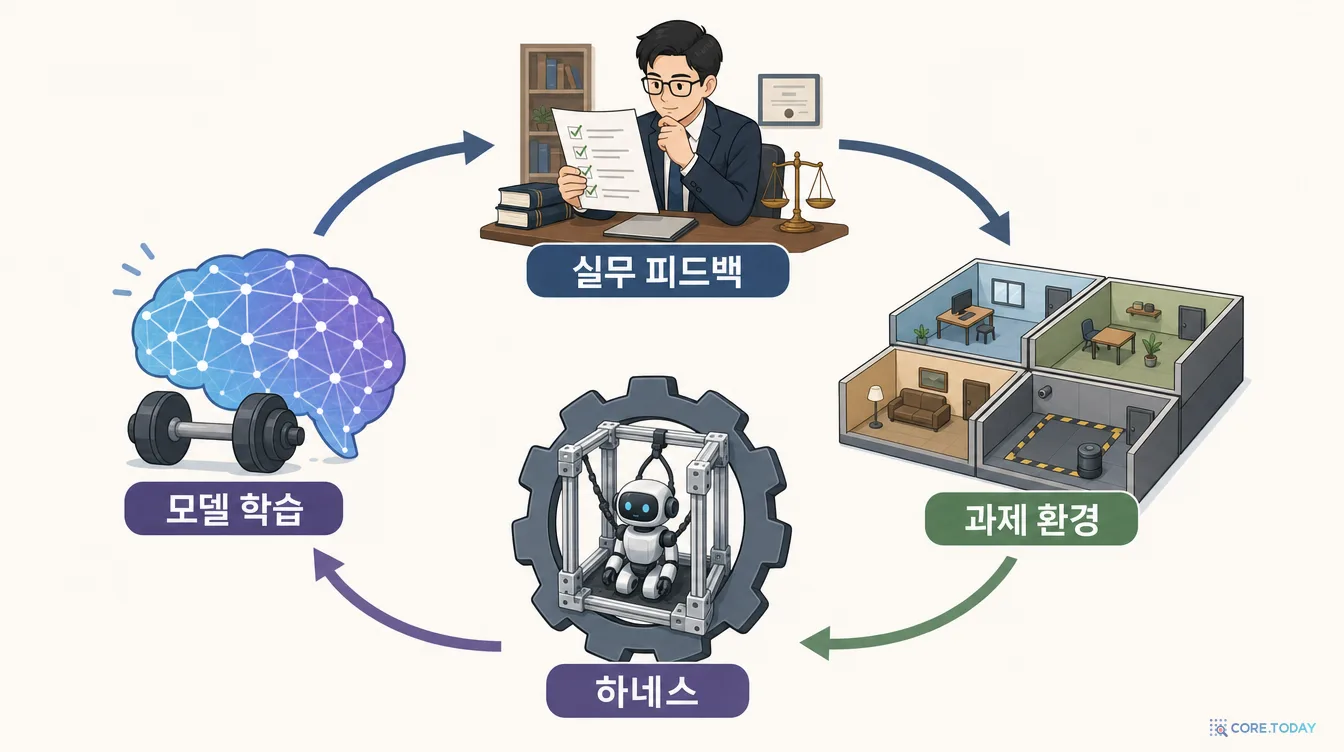
GLM-Legal 팀은 그래서 둘을 따로 만들지 않고 함께 진화시켰다고 말합니다.
공동 반복하네스 구조와 모델 훈련이 발맞춰 반복된다. 과제를 어떻게 구조화하고, 맥락을 어떻게 넣고, 실행 중 피드백을 어떻게 돌려주는지가 함께 에이전트의 탐색을 좌우한다.
모델 → 하네스훈련 중 드러난 모델의 이상한 실패(엣지 케이스)가 하네스의 구조적 병목을 정확히 짚어 준다. 예: 모델이 자꾸 중요한 문서를 놓친다 → 하네스가 문서를 잘라 넣고 있었다.
하네스 → 모델다듬어진 하네스는 모델을 더 현실적인 실행 제약에 노출시킨다. 모델은 필요한 맥락을 스스로 찾아오고, 중간 실행 신호에 적응하고, 요청 접수부터 최종 서명까지 실무 수준을 맞추도록 훈련된다.
말과 마구의 비유로 돌아가면, 조련사(모델 훈련)와 마구 장인(하네스 설계)이 같은 공책을 보며 일하는 셈입니다. 말이 오른쪽으로 자꾸 쏠리면 조련사는 말을 탓하기 전에 마구가 비뚤어졌는지 보고, 마구를 고친 뒤에는 새 마구로 다시 달리는 법을 가르칩니다.
구체적으로 무슨 일이 일어나나: Harvey × Applied Compute의 GLM-5.1 실험. Z.ai는 세부를 공개하지 않았지만, 거의 같은 일을 한 공개 사례가 있습니다. 2026년 6월 Harvey는 강화학습 회사 Applied Compute와 함께 GLM-5.1을 Harvey LAB 환경에서 후속학습한 과정을 자세히 공개했습니다. GLM-Legal의 '형님뻘' 실험이라 할 만합니다.
먼저 하네스를 고쳤습니다. 실패 사례를 보며 찾아낸 개선점은 의외로 소박합니다.
도구가 돌려주는 토큰 양을 제한하기 (문서를 통째로 쏟아 내 문맥을 채우지 않게)
형식이 틀린 도구 호출을 자동으로 고쳐 주기
도구 설명문을 더 명확하게 쓰기
도구 사용과 최종 결과물에 관한 알림 넣기 ("아직 보고서 파일을 만들지 않았다")
결과물 작성 지침 추가
압축(compaction): 대화가 일정 길이를 넘으면 같은 모델이 지금까지의 작업을 요약하고, 그 요약에서 새 대화를 이어 가게 하기. LAB 과제의 상위 10%는 원본 문서만 10만 토큰에 가까워서, 기반 모델 실행의 약 10%가 문맥 한도에 부딪혔습니다.
하네스만 바꿔도 대부분의 모델 점수가 올랐습니다. 그러나 가장 큰 상승은 새 하네스 안에서 강화학습을 했을 때 나왔습니다. Harvey의 표현이 이 절의 요약입니다. "하네스는 더 나은 전략을 가능하게 했고, 강화학습은 모델이 그 전략을 실행하도록 가르쳤다."
결과는 이랬습니다(Harvey 자체 시험 세트 180개 기준).
항목 통과율 · 훈련 전
85.3%
항목 통과율 · 훈련 후
91.3%
전 항목 통과율 · 훈련 전
5.9%
전 항목 통과율 · 훈련 후
12.6%
항목 통과율은 6%포인트 올랐는데 전 항목 통과율은 두 배가 넘게 뛰었습니다. GLM-Legal의 6.7% → 19.2%(약 세 배)와 같은 모양입니다. 더 흥미로운 것은 모델이 무엇을 배웠는가에 대한 분석입니다. 기반 모델이 놓친 약 1,500개 항목 중에서 훈련으로 실패에서 통과로 바뀐 항목을 세 가지 행동으로 분류했습니다.
185
결과물을 반드시 만든다
기반 모델은 분석만 하고 결과물 파일을 안 만들고 끝내는 일이 있었다. 훈련 후에는 항상 파일을 만들었다. 185개 항목이 통과로 바뀜.
243
숫자를 정확하게 쓴다
기반 모델은 계산하다 1.9를 2로 반올림하는 식으로 수치를 뭉갰고, 깐깐한 법률 채점은 이를 벌점 처리했다. 가장 큰 개선(243개 항목).
70
자료에 묶여 쓴다
기반 모델은 가끔 자료에 없는 항목을 지어냈다. 환각 벌점을 따로 주지 않았는데도, 문서의 특정 구절을 짚는 항목이 좋아지면서 환각이 줄었다. 70개 항목.
훈련 전후 같은 과제 하나를 비교하면 더 극적입니다. 루브릭 점수 0.061 → 0.803, 대화 턴 40 → 16, 도구 호출 104 → 42. 덜 읽고, 덜 헤매고, 더 정확하게 일하게 됐습니다. 모든 파일을 통째로 읽던 습관 대신 필요한 부분만 골라 읽는 법을 배운 것입니다. GLM-Legal이 기반 모델보다 비용(토큰)을 4분의 1만 쓴 것도 같은 학습의 결과로 보입니다.
Harvey Tenet: 같은 레시피, 다른 기반. Harvey는 8월에 자체 모델 Tenet을 발표했습니다. 중국 Moonshot의 오픈 모델 Kimi K3(2.8T/104B)를 약 1,750개의 법률 에이전트 환경에서 비동기 GSPO(강화학습 알고리즘의 일종)와 LoRA(일부 파라미터만 고치는 효율적 미세조정)로 후속학습했고, B300 GPU 약 150대로 두 달 걸렸습니다. 학습을 맡은 Fireworks에 따르면 LAB 전 항목 통과율이 기반 K3의 10.8%에서 19.7%로 올랐습니다. GLM-Legal(19.2%)과 거의 같은 지점입니다. 서로 다른 회사가 서로 다른 기반 모델로 같은 레시피(법률 과제 환경 + 루브릭 강화학습 + 하네스 최적화)를 써서 비슷한 높이에 도달했다는 점이, 이 방법이 한 회사의 요행이 아님을 보여 줍니다.
6. 실무 피드백 루프: 주관적 품질을 '손실 신호'로
원문 세 번째 단계는 훈련실 밖으로 나갑니다. "실제 업무 흐름과 실무자 피드백이 최적화 로드맵을 정한다." 실무에서 법률가들은 결과물을 이 네 질문으로 평가한다고 합니다.
완전성핵심 쟁점과 예외 상황을 빠짐없이 다뤘는가?
근거논증이 충분히 뒷받침되고, 인용이 법적으로 정확한가?
지시 준수결과물이 사건 지시서(matter brief)를 엄격히 따르는가?
즉시 사용다음 팀이 손으로 다시 고치지 않고 바로 쓸 수 있는가?
원문은 이 요구가 "주관적 품질을 구체적인 공학적 손실 신호로 바꾼다"고 말합니다. '좋은 메모'라는 막연한 감각을 '쟁점 누락 몇 건, 잘못된 인용 몇 건, 형식 이탈 몇 건'으로 셀 수 있게 만들면, 그것이 다음 훈련의 채점 기준(보상)이 됩니다.
여기서 원문이 강조하는 것은 진단의 분리입니다. "사실 누락, 얕은 분석, 형식 이탈 같은 문제를 진단할 때 우리는 실행 파이프라인 전체를 살펴, 모델의 원래 지능, 맥락 구성(context staging), 워크플로 로직의 기여를 분리한다." 그리고 발견한 것을 과제 환경, 채점 루브릭, 하네스 설계로 되먹입니다.
이것이 왜 중요한지는 직접 진단해 보면 압니다. 같은 '실패'라도 원인이 어디냐에 따라 처방이 완전히 다릅니다.
이 루프에는 숨은 함정이 하나 있습니다. 채점 기준 자체가 틀릴 수 있다는 것입니다. 강화학습은 보상을 정직하게 따라가므로, 루브릭이 '언급했는가'만 물으면 모델은 언급만 잘하는 쪽으로 자랍니다. Harvey가 GLM-5.1 실험 보고서에서 "모델은 환경이 허락하는 만큼만 배운다"며 판정관 신뢰도부터 검증한 이유입니다(GPT-5.5와 Opus 4.8의 판정이 95% 넘게 일치하는 항목을 기준으로 삼고, 값싼 판정관 GPT-5 Mini가 그 기준과 97% 넘게 맞는 것을 확인한 뒤에 썼습니다). 실제로 GLM-Legal 발표 나흘 전인 10월 9일에는 Harvey LAB 저장소에 일부 과제의 루브릭이 잘못됐다는 이슈(#191)가 올라왔습니다. 시험지도 사람이 만든 것이라 틀리고, 틀린 시험지로 훈련하면 틀린 쪽으로 배웁니다.
또 하나, 하네스 부품은 낡습니다. Anthropic은 장시간 에이전트용 하네스에 관한 글에서, 한 세대 전 모델을 위해 넣었던 문맥 초기화 장치가 다음 세대 모델에서는 "죽은 무게"가 됐다고 썼습니다. 모델이 바뀌면 마구도 다시 맞춰야 합니다. 원문이 '공진화'를 일회성 공정이 아니라 계속 도는 고리로 그린 이유입니다.
7. 시연 세 장면 해부: '검토하십시오'와 '60일에서 30일로'
원문 후반부는 GLM-Legal을 곧 Z.ai의 데스크톱 에이전트 플랫폼 AutoClaw에 넣겠다며 세 가지 시연을 보여 줍니다. 각 장면마다 같은 과제에 기반 모델(GLM-5.3-Flash)과 GLM-Legal이 낸 답을 나란히 놓았습니다. AutoClaw는 오픈소스 에이전트 OpenClaw를 데스크톱에서 한 번에 설치해 쓰도록 포장한 Z.ai의 제품입니다(OpenClaw 자체는 OpenClaw 다음 장에서 다뤘습니다).
과제: 공급자를 바꾸려는 고객을 위해 소프트웨어 서비스 계약의 해지·인수인계 조항을 검토하라.
기반 모델의 답은 틀린 데가 없습니다. 통지 기간을 줄이는 것을 "고려하라", 데이터와 대금을 치른 결과물을 돌려받으라, 교체 공급자와 협력할 의무를 넣으라, 미지급 대금을 "확인하라". 문제는 변호사가 이걸 받아도 할 일이 줄지 않는다는 것입니다. 며칠로 줄일지, 어떤 결과물을 돌려받을지, 협력 의무를 얼마나 길게 둘지는 여전히 사람이 정해야 합니다.
GLM-Legal의 답은 결정을 내립니다.
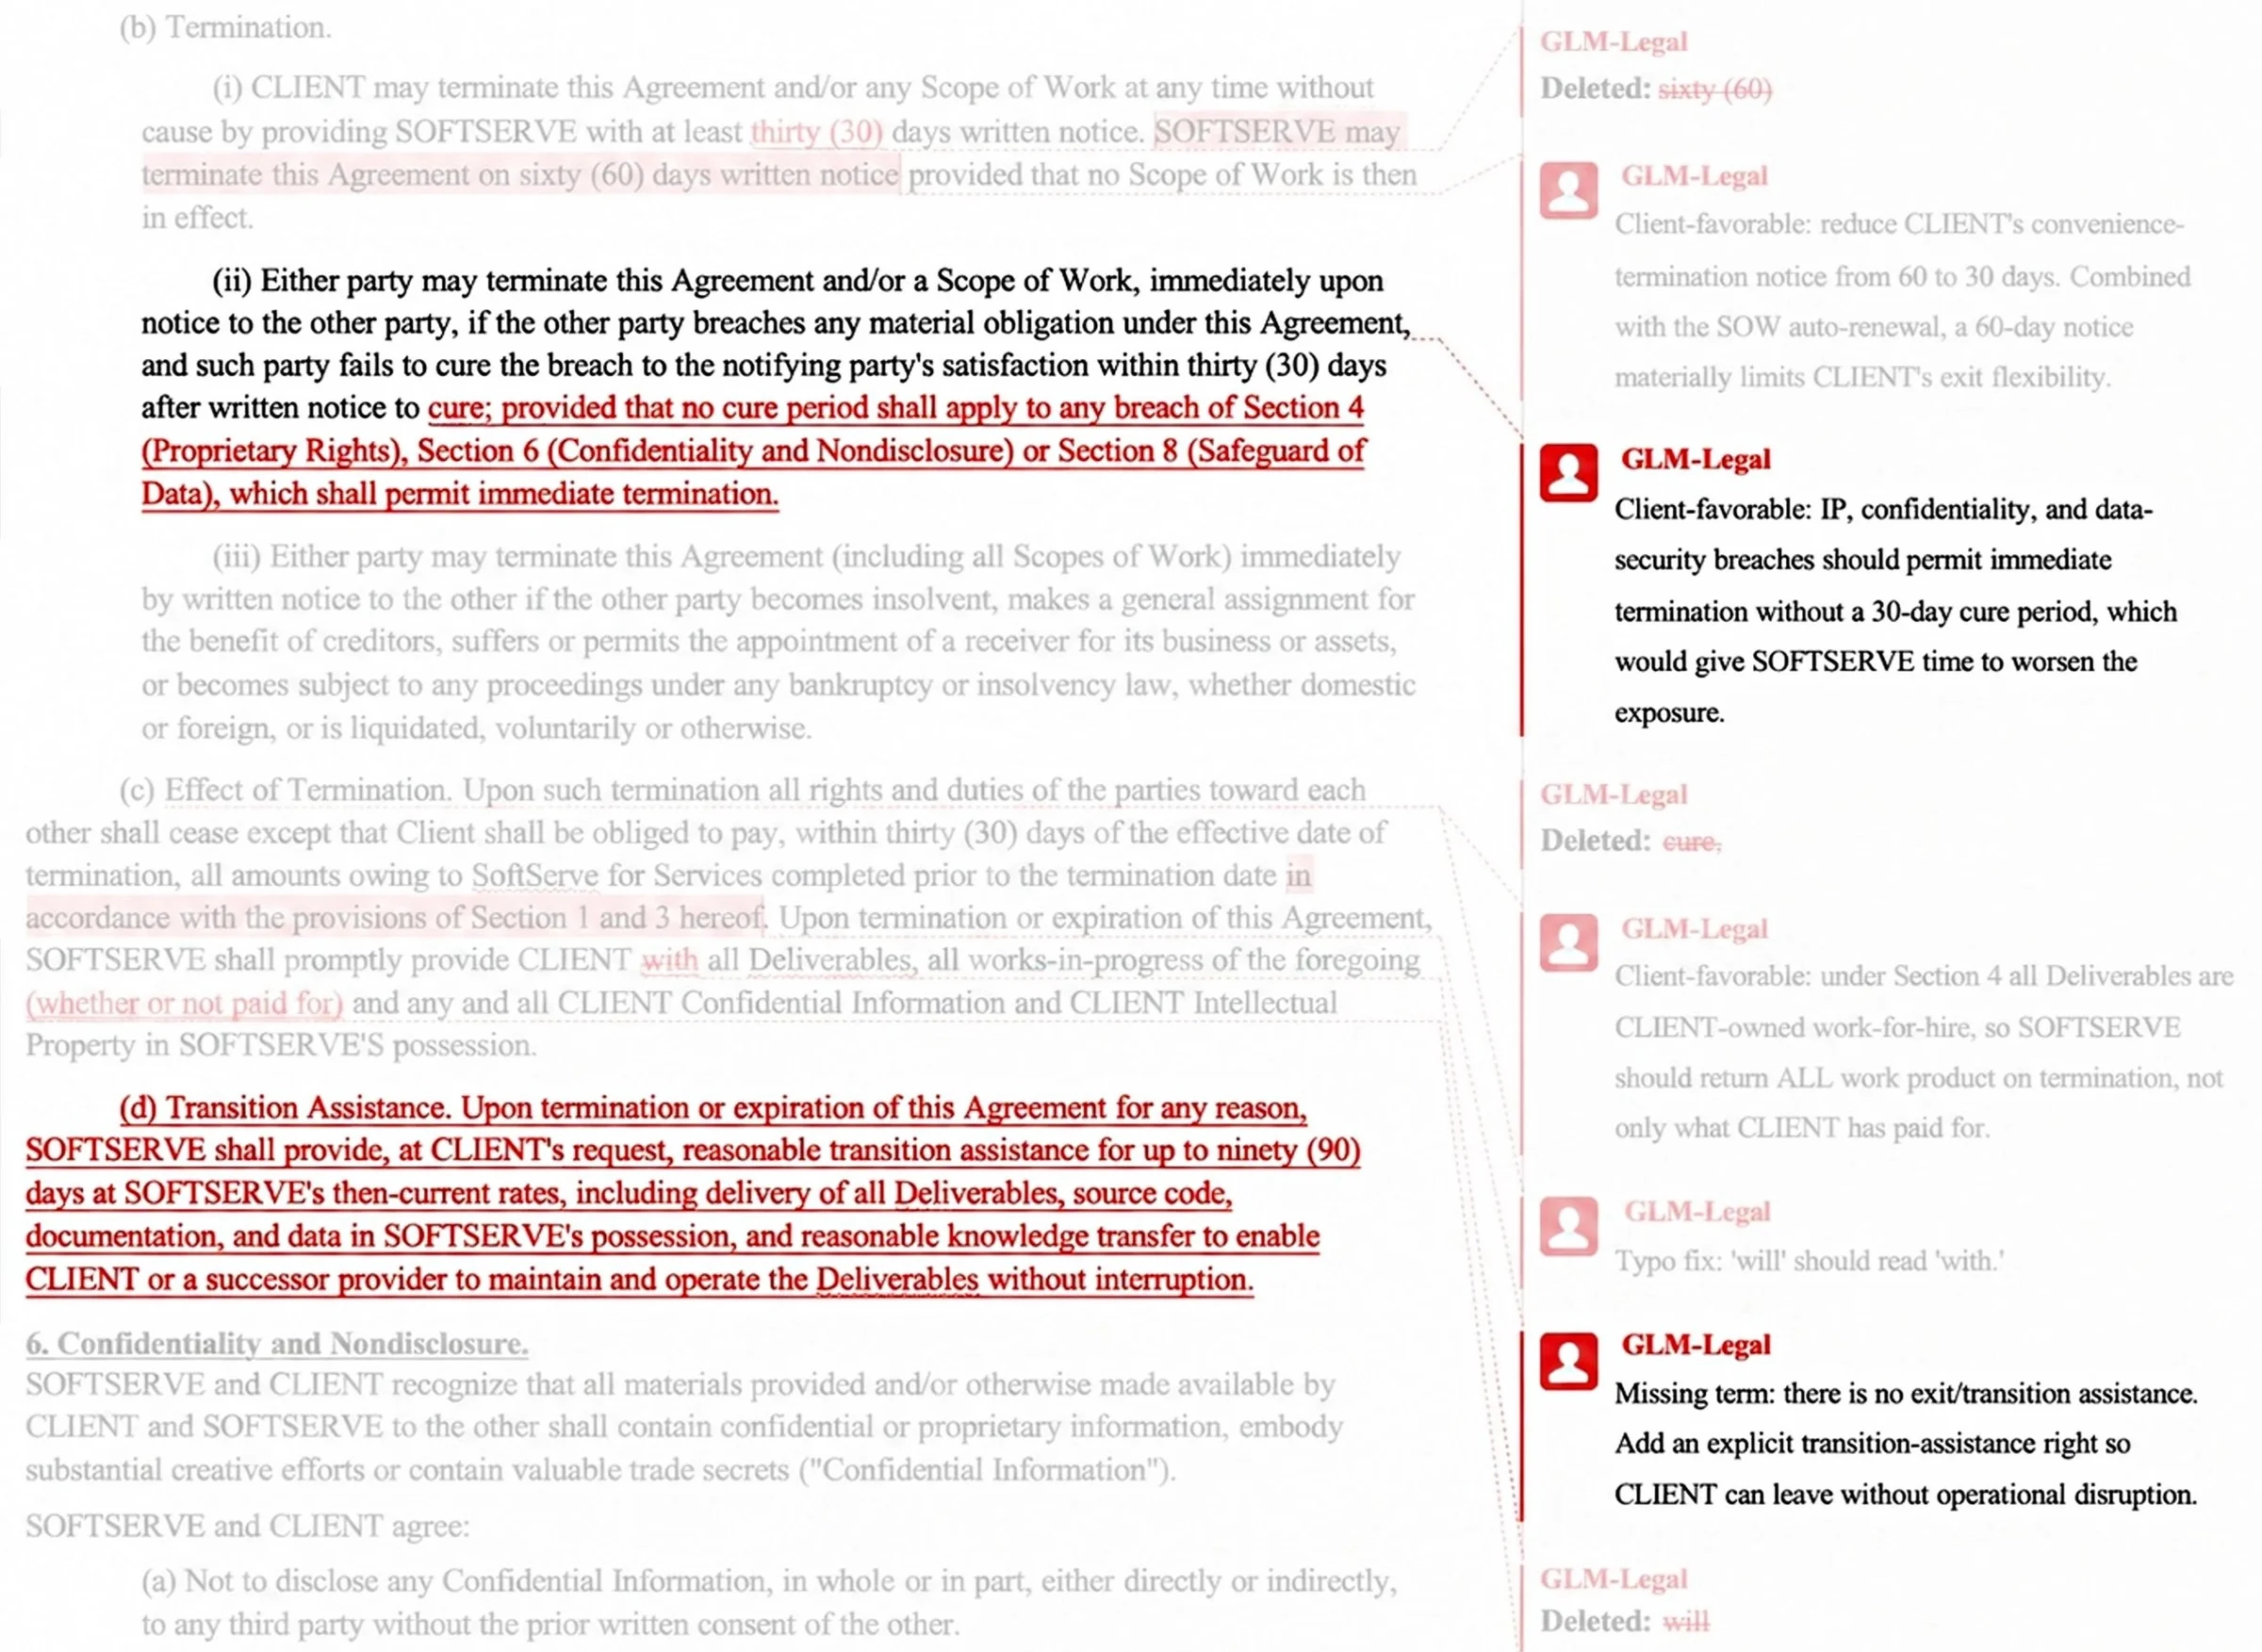
임의 해지 통지 기간을 60일에서 30일로.
지식재산·비밀유지·데이터 보안 의무 위반에는 30일 시정 기간을 없애 즉시 해지. (시정 기간이 있으면 상대가 그 사이 피해를 키울 수 있으니까)
계약 제4조가 이미 결과물을 고객 소유로 정하고 있으므로, 대금 지급 여부와 관계없이 모든 결과물과 진행 중 작업을 반환.
소스 코드·문서·데이터·지식 이전을 포함한 최대 90일의 전환 지원 조항 신설.
세 번째 줄이 특히 '법률가다운' 대목입니다. 계약서의 다른 조항(제4조)을 근거로 끌어와 요구의 정당성을 세웠습니다. 그리고 AutoClaw는 이 수정을 워드 문서에 추적 변경과 메모로 직접 답니다.
오른쪽 여백의 메모를 보면 수정마다 이유가 붙어 있습니다. "SOW 자동 갱신과 결합하면 60일 통지는 고객의 이탈 유연성을 실질적으로 제한한다", "누락된 조항: 전환 지원이 없다. 고객이 운영 중단 없이 떠날 수 있도록 명시적 권리를 추가하라". 'will'을 'with'로 고친 오타 수정까지 있습니다. 변호사가 실제로 상대방에게 보내는 수정본의 모습 그대로입니다. Harvey LAB이 왜 결과물을 .docx 파일로 요구하는지가 여기서 보입니다.
장면 2. 증거 분석: 문서 40건을 하나의 사건 이론으로
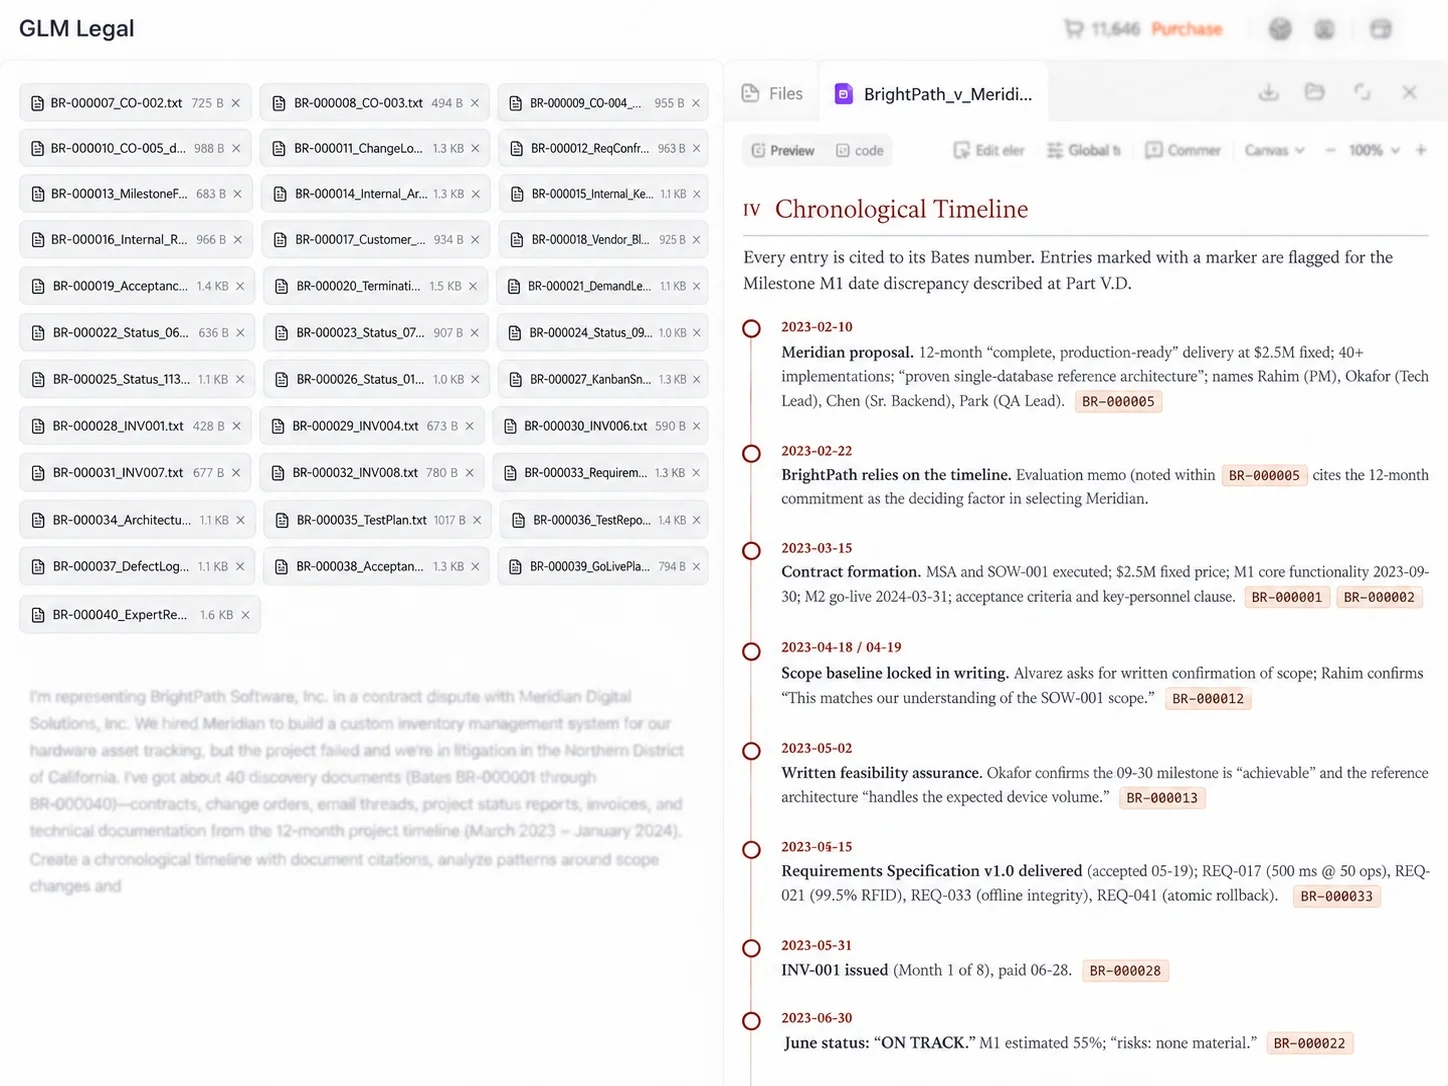
과제: 소프트웨어 프로젝트 분쟁의 문서 40건을 분석해 공급자 진척 보고서의 모순을 찾아라.
화면 왼쪽의 'BR-000024' 같은 번호는 베이츠 번호(Bates number)입니다. 소송에서 주고받는 문서 한 장 한 장에 매기는 고유 번호로, 법정에서 "어느 문서 몇 쪽"을 정확히 가리키는 주소 역할을 합니다. 오른쪽 타임라인은 항목마다 이 번호를 달았습니다. 앞에서 본 '근거에 묶여 쓰기'가 형식으로 구현된 모습입니다.
두 모델 모두 같은 모순을 찾았습니다. 9월 30일 고객에게 보낸 보고서는 "순조로움, 60% 완료"(BR-000024)인데, 내부 기록은 약 41%(BR-000027)였습니다. 차이는 그다음입니다.
기반 모델: 이 문서들이 고객 입장을 "뒷받침할 수도 있다". 보고 이력, 청구 기록, 계약 조건을 "검토해" 판단하라.
GLM-Legal: 이 보고서는 9월 8일 '마일스톤을 정직하게는 맞출 수 없다'는 내부 경고(BR-000014)와 함께 읽어야 한다. CEO의 '위험을 덮고 청구를 계속하라'는 지시(BR-000015)가 내부 인식을 공개 여부 결정과 이어 준다. 그리고 기본계약 제2·5조는 대금 지급이 권리 포기가 아니며 보증은 지급 뒤에도 존속한다고 정하므로(BR-000001), 고객이 대금을 계속 냈다는 사실만으로 분쟁이 끝나지 않는다. 이 연결들은 은폐 이론을 뒷받침한다. 결론 전에 완료율 측정 방식을 맞춰 보고 나머지 청구 요건을 검증하라.
GLM-Legal의 답에는 상대방이 할 반론("고객은 알면서도 대금을 냈으니 문제 삼을 수 없다")을 미리 막는 문장이 있습니다. 사실을 법적 의미로 잇고, 상대 논증까지 내다보는 것. 1980년대 HYPO가 기계에 가르치려던 '주장 → 반박 → 재반박'이 40년 뒤 이렇게 나타납니다. 마지막 문장에서 사실과 추론을 구분하고 남은 검증 과제를 적은 것도 실무에서 중요한 태도입니다.
장면 3. 규제 대응: 동남아 세 나라 동시 출시
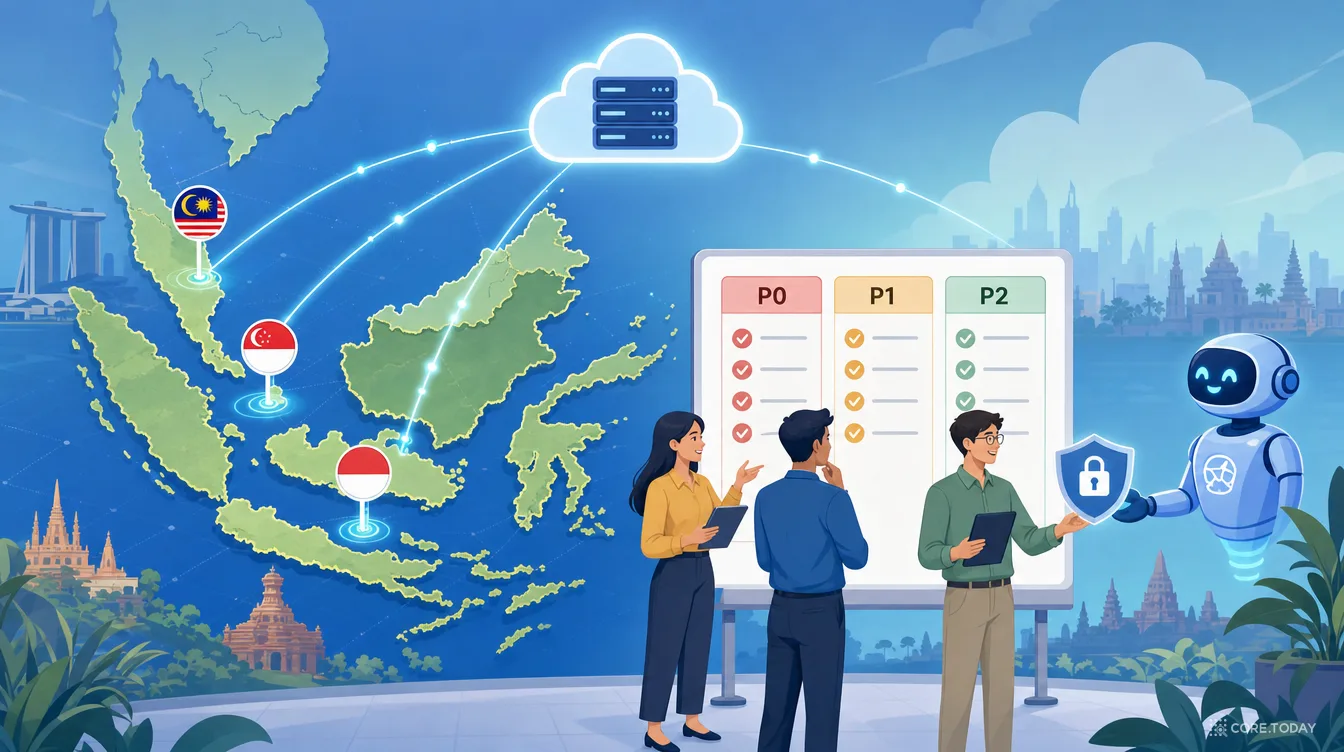
과제: 추적 도구·이메일 마케팅·해외 클라우드 저장을 쓰는 웹사이트를 싱가포르·말레이시아·인도네시아에 출시한다. 개인정보 준수 계획을 세워라.
기반 모델의 답은 체크리스트처럼 보이지만 동사가 모두 "검토하라", "확인하라", "점검하라"입니다. 무엇을 해야 할지가 아니라 무엇을 알아봐야 할지를 말합니다.
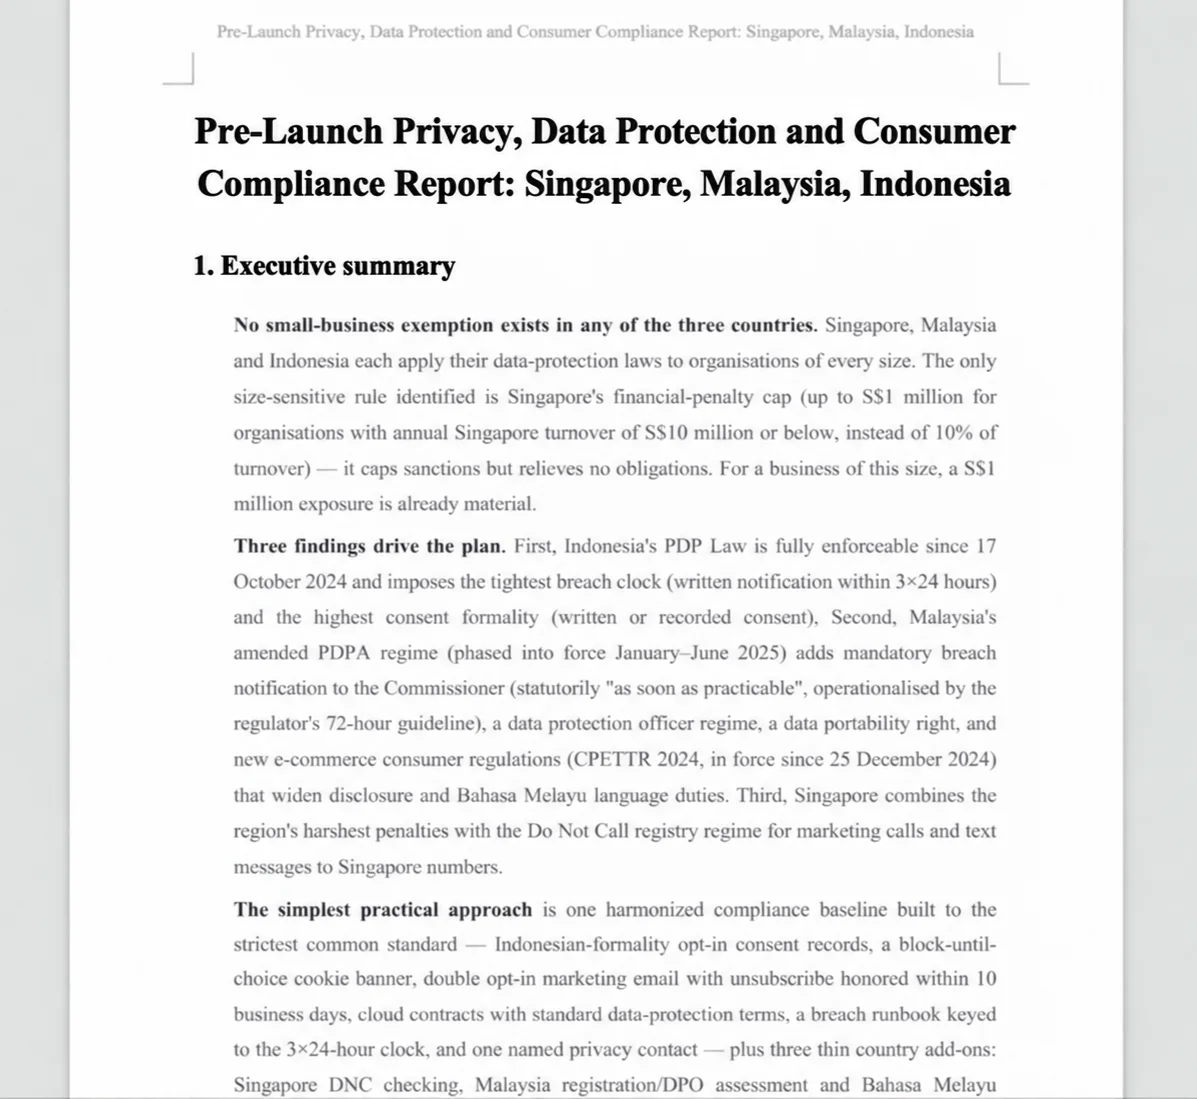
GLM-Legal은 우선순위(P0 = 출시 전 필수)를 붙이고 구체적인 통제를 나열합니다. 영어·인도네시아어 처리방침, 필수 아닌 분석·광고는 옵트인, 동의 기록 보관, 마케팅 동의를 회원가입과 분리, 수신 거부를 발송 제외 목록에 연결, 클라우드·결제·이메일·분석·CDN 업체를 데이터 목적지별로 표로 정리. 그리고 나라별 근거 조항을 댑니다. 싱가포르 개인정보보호법(PDPA) 26조는 국외 이전 제한, 말레이시아 PDPA 129조는 국외 이전, 인도네시아 개인정보보호법(PDP법) 55~56조는 국외 이전 규정입니다. 전략은 "가장 엄격한 공통 기준을 출시 기준선으로 삼고, 나라별 고유 요건은 따로 확인"입니다.
완성된 보고서 첫 쪽을 보면 '세 가지 발견이 계획을 이끈다'는 문장으로 결론부터 씁니다. 인도네시아의 3×24시간 유출 통지 시한, 말레이시아의 2025년 개정 시행, 싱가포르의 과징금 규모. 법률 메모의 정석인 '결론 먼저, 근거는 뒤에' 형식입니다.
아래 위젯에서 세 장면의 두 답을 한국어로 나란히 놓고, 숫자·근거·결정 지시·얼버무림 표현을 색으로 표시했습니다.
세 장면에 공통된 차이는 하나입니다. 기반 모델은 '해야 할 일의 목록'을, GLM-Legal은 '내린 결정과 그 근거'를 줍니다. 원문의 네 번째 질문 "다음 팀이 손으로 다시 고치지 않고 바로 쓸 수 있는가"를 가르는 것이 바로 이것입니다. Harvey의 GLM-5.1 실험에서 가장 많은 항목을 뒤집은 행동이 '수치를 정확하게 쓰기'였다는 사실과도 겹칩니다.
다만 이것은 회사가 고른 시연입니다. 세 예시 모두 영미식 계약·소송·동남아 규제이고, 실패 사례는 없습니다. 인용한 조항 번호가 정확한지, 보고서 전체에 오류가 없는지는 원문만으로는 확인할 수 없습니다.
8. 반론과 한계: 박수 뒤에 남는 질문들
그래프 밖의 모델들
Z.ai 그래프는 다섯 모델만 보여 줬습니다. Vals 리더보드 전체를 보면 GLM-Legal은 79개 중 7위입니다. 위에 Meta의 Muse Spark 1.2(25.42%), Muse Spark 1.3 Max(23.75%), Muse Spark 1.3(22.92%), Muse Wonder Full(21.67%), Muse Spark 1.1(20.00%), Google의 Gemini 4 Argon(19.58%)이 있습니다. HN에서는 "Meta Spark 모델을 통째로 뺐다", "Fable 5.1도, Opus 5.5도, GPT-6.1도 없다"는 지적이 나왔습니다.
한편 빠진 최신 모델 중 일부는 오히려 점수가 낮습니다. Claude Fable 5.1 6.67%, GPT-6.1 Sol 5.42%, Claude Opus 5.5 3.75%. 최신 범용 모델이 LAB에서 꼭 더 잘하지는 않는다는 뜻이고, 이는 LAB 점수가 '똑똑함'보다 이 하네스·이 채점 방식에서 끝까지 완주하는 습관에 크게 좌우된다는 방증이기도 합니다. 참고로 Fable 5의 11.25%에는 Vals가 4개 과제에서 Opus 4.8로 대체 실행한 결과가 들어 있어, 그것을 실패로 치면 10.42%입니다.
오히려 떨어진 지표
Z.ai가 언급하지 않은 Vals의 법률 리서치 벤치마크(Legal Research Bench)에서 GLM-Legal은 41.83%(78개 중 24위)로 기반 모델 GLM-5.3-Flash(45.19%)보다 낮습니다. MarkTechPost가 이 퇴보를 짚었습니다. 판례·법령을 찾아 질문에 답하는 리서치 능력은 오히려 줄었다는 뜻입니다. 앞에서 말한 중간학습의 망각일 수도 있고, 강화학습이 LAB형 과제(주어진 자료 안에서 일하기)에 맞춰지며 외부 검색형 과제에서 손해를 본 것일 수도 있습니다. Harvey의 GLM-5.1 실험에서도 "데이터가 적은 분야에서 작은 퇴보"가 관찰됐습니다. 특화는 공짜가 아닙니다.
자체 측정 숫자들
PLawBench 점수 다섯 개는 모두 Z.ai 자체 측정입니다.
GPT-6 Astra의 LegalBench 87.1은 Vals 목록에 없어 역시 자체 측정입니다.
훈련 데이터가 공개되지 않아, 공개된 LAB 과제(MIT 라이선스로 누구나 내려받을 수 있음)가 훈련에 섞였는지 확인할 수 없다는 지적도 나왔습니다. 다만 Vals는 공개되지 않은 120개 과제로 평가하므로 LAB 점수는 이 걱정에서 상대적으로 자유롭습니다.
19.2%라는 숫자의 무게
"변호사로서 20%에는 감흥이 없다"는 HN 댓글로 돌아가 봅시다. 맞는 말입니다. 19.2%는 다섯 건 중 네 건은 어딘가 하나를 놓쳤다는 뜻입니다. 동시에 "20%면 최상위권"이라는 반박도 맞습니다. 시험이 그만큼 잔인하게 설계됐기 때문입니다. 두 말을 합치면 결론은 이렇습니다. 지금의 법률 에이전트는 '초안을 매우 잘 쓰는 신입'이지, 서명할 수 있는 변호사가 아닙니다. 중국 SNS의 한 댓글이 이를 짧게 요약했습니다. "서명 책임은 여전히 사람에게 있다(签字责任还在人身上)."
가중치, 가격, 데이터
가중치 공개 여부가 엇갈립니다. Vals 모델 페이지는 "Weights: Open"이라고 적었지만, Artificial Lawyer는 "적어도 아직은" 오픈 가중치로 낼 계획이 없는 것으로 안다고 보도했고, 10월 13일 기준 Hugging Face에도 없습니다. 접근은 신청서를 받는 베타 방식입니다. HN에서는 "오픈 가중치가 아니면 법률 분야에서는 죽은 채로 도착한 것"이라는 반응이 나왔습니다. 로펌이 고객 정보를 외부에 보내지 않으려면 자체 서버에 올릴 수 있어야 하기 때문입니다.
가격이 미정입니다. Vals는 GLM-5.3-Flash 요금으로 계산했습니다.
데이터 주권 문제. HN에서 가장 큰 댓글 타래는 "고객 정보가 적대국에서 처리·저장된다"는 우려였습니다. 여기에는 배경이 있습니다. 2026년 9월 말 Z.ai의 코딩 도구 ZCode가 사용자 저장소의 암호화된 스냅숏을 몰래 업로드한 사실이 드러나, Z.ai가 사과하고 해당 기능을 제거한 뒤 코드를 공개하고 외부 감사를 받은 일이 있었습니다. 중국 빌리빌리에서도 "직접 쓰려고 만든 것 아니냐"는 냉소가 가장 많은 공감을 받았고, "오픈소스가 아니면 누가 감히 쓰겠느냐"는 반응이 이어졌습니다.
어느 나라 법인가. 시연은 미국식 계약·소송과 동남아 개인정보법이었고, PLawBench는 중국 법이었습니다. 한국 법에 대한 성능은 알 수 없습니다.
시험지의 한계
LAB 채점은 LLM 판정관이 합니다. 판정관 사이의 불일치, 앞서 본 잘못된 루브릭(이슈 #191)은 점수에 잡음을 더합니다. 독립 평가 회사 Artificial Analysis는 자체 버전 'LAB-AA'에 환각 검사 관문과 판정관 3명 체계를 넣었는데, 그 버전의 1위는 Muse Wonder Full의 13.1%였고 GLM-Legal은 아직 측정되지 않았습니다. 같은 이름의 시험이라도 운영 방식에 따라 숫자가 다릅니다.
9. 2026년, 법률 AI의 판이 바뀌는 방식
범용 모델 대 수직 모델, 2라운드
2023년의 교훈은 "범용 모델이 이긴다"였습니다. BloombergGPT는 GPT-4에 졌고, 법률 특화 모델들도 범용 프런티어 모델을 따라잡지 못했습니다. 그런데 2026년 가을의 풍경은 다릅니다. Harvey LAB 상위권에서 법률 특화 후속학습 모델(GLM-Legal 19.2%, Harvey Tenet 19.7%)이 범용 최상위 모델들(Fable 5 11.3%, GPT-6 Astra 5.4%)을 앞섭니다.
무엇이 달라졌을까요? 특화의 대상이 '지식'에서 '일하는 방식'으로 바뀌었습니다. 2023년의 특화는 법률 문서를 더 읽히는 것이었고, 그 정도의 지식은 범용 모델도 이미 갖고 있었습니다. 2026년의 특화는 법률 과제 환경에서 시행착오를 거쳐 '끝까지 해내는 습관'을 들이는 것이고, 이것은 범용 모델이 일반 훈련만으로는 얻기 어렵습니다. LegalBench 상승폭(2.3%포인트)과 LAB 상승폭(12.5%포인트)의 차이가 그 증거입니다.
다섯 가지 전략
2026년 법률 AI 시장의 주요 플레이어들은 서로 다른 답을 내놓고 있습니다.
누가
전략
무엇을 쥐었나
언제
Anthropic
범용 모델 + 법률 플러그인·커넥터 (Claude for Legal)
최상위 범용 모델과 업무 도구 생태계
2026.5
OpenAI
범용 모델 + 미국 법률 검색 색인 (Astra for Law)
2억 3천만 URL 규모의 법률 색인(리서치 벤치마크 54.0% 자체 발표)
2026.9
Harvey
오픈 모델 후속학습 (Tenet, Kimi K3 기반)
LAB 시험지, 로펌 고객, 법률 과제 환경
2026.8
Thomson Reuters
자체 법률 LLM 'Thomson' (오픈 기반 모델 위)
Westlaw 판례·요지 데이터
2026
Z.ai
모델 회사가 직접 만든 수직 모델 (GLM-Legal)
기반 모델, 강화학습 인프라, 하네스, 저가 추론
2026.10
Anthropic의 플러그인 전략은 Claude for Legal 완전 해부에서, 리걸테크 시장 전체는 리걸테크 AI 대전 2026에서 다뤘습니다. GLM-Legal의 등장이 의미심장한 것은 모델 회사가 리걸테크 회사의 영역(법률 과제 환경과 하네스)으로 직접 들어왔다는 점입니다. Artificial Lawyer는 이를 "애드인이 아니라 LLM 제조사가 직접 만든 법률 특화 모델"이라고 표현했습니다. 반대로 Harvey는 모델 회사의 영역(후속학습)으로 들어갔습니다. 보도에 따르면 Harvey는 미국 프런티어 모델 API 비용 때문에 매출총이익률이 크게 흔들렸다가 오픈 모델로 옮기며 회복했다고 합니다(블룸버그 보도의 2차 인용이라 수치는 확인하지 못했습니다).
돈의 규모도 커졌습니다. Harvey의 기업 가치는 2025년 12월 80억 달러에서 2026년 3월 110억 달러가 됐고, 가을에는 155억 달러 투자 유치 보도가 나왔습니다. Legora는 2026년 초 55억 5천만 달러 가치로 5억 5천만 달러를 유치했습니다. 사용도 늘었습니다. FTI·Relativity 조사에서 기업 법무 책임자의 87%가 팀 내 생성형 AI 사용을 보고했고(2025년 44%), 미국 변호사협회 조사(2024년 판)에서 AI 사용률은 1년 만에 11%에서 30%로 올랐습니다.
비용이 바꾸는 것
과제당 0.15달러와 19~26달러의 차이는 단순한 할인이 아닙니다. 비싼 모델은 '중요한 사건에 한 번' 쓰지만, 싼 모델은 같은 과제를 여러 번 돌려 결과를 비교하거나, 모든 계약서에 기본으로 돌리는 방식을 가능하게 합니다. LAB처럼 실패가 몰려 다니는 과제라면, 세 번 돌려 서로 다른 결과를 사람이 대조하는 것만으로도 놓친 쟁점을 찾을 확률이 올라갑니다. 저가의 특화 모델은 법률 AI를 '고급 컨설팅'에서 '기본 인프라'로 옮깁니다.
한국에 주는 함의
GLM-Legal은 한국 법을 겨냥하지 않았습니다. 그런데도 한국 법률 AI 업계가 이 발표를 주의 깊게 볼 이유가 있습니다.
첫째, 한국 법은 아직 따로 풀어야 할 문제입니다. 엘박스(LBox) 연구진이 2024년 만든 한국 법률 벤치마크 KBL에서 GPT-4는 2024년 한국 변호사시험 문항 평균 약 48.1점, Claude 3.5 Sonnet은 42.5점에 그쳤습니다. 논문은 "미국 변호사시험에 붙은 GPT-4가 한국 변호사시험은 붙지 못했다"고 정리했습니다. 반면 한국 데이터로 특화한 로앤컴퍼니의 슈퍼로이어는 2025년 1월 제14회 변호사시험 선택형에서 150문항 중 111개(74%)를 맞혔습니다(같은 시험에서 GPT-4.5는 49.3%, Claude 3.7 Sonnet은 45.3%였고, 이는 공식 합격선이 아니라 최근 5년 평균 합격 정답 수 103개와 비교한 결과입니다). 한국 법에서는 이미 '특화'가 통하고 있다는 뜻입니다.
둘째, 다음 경쟁은 '한국형 Harvey LAB'입니다. GLM-Legal과 Harvey Tenet의 레시피(강한 오픈 기반 모델 + 법률 중간학습 + 과제 환경 강화학습 + 하네스)는 재료만 있으면 누구나 따라 할 수 있습니다. GLM-5.3-Flash는 MIT 라이선스로 공개돼 있습니다. 부족한 것은 한국 법률 실무를 담은 과제 환경과 채점 루브릭입니다. 실사 보고서, 내용증명, 소장, 계약 검토 의견서를 한국 변호사가 채점하는 수천 개의 과제. 이것을 먼저 쌓는 쪽이 한국 법률 에이전트 경쟁에서 앞설 것입니다.
셋째, 규제와 신뢰. 한국 법률 AI는 변호사법과의 긴장 속에서 자랐습니다. 로톡 분쟁은 2023년 9월 법무부가 로톡 이용 변호사 123명에 대한 징계를 모두 취소하며 일단락됐지만, 2024년에는 변협이 AI 법률 서비스를 내놓은 엘박스와 법무법인 대륙아주에 대한 고발을 검토했고 대륙아주는 과태료 처분을 받았습니다. 2026년 1월 22일에는 AI 기본법이 시행됐습니다. 법원은 2026년 2월부터 가짜 사건번호 조회 기능을 열었습니다. 이런 환경에서 고객 정보를 해외(특히 중국) 서버로 보내는 모델은 쓰기 어렵고, 오픈 가중치를 자체 서버에 올려 후속학습하는 방식이 현실적인 길입니다. 한국 대형 로펌들이 폐쇄형 시스템을 택한 이유도 같습니다(한국 빅로 AI 백서 2026 참고). 태평양은 ChatGPT Enterprise와 Harvey를, 세종은 자체 '세종AI'와 Harvey를 쓰며 Legora를 시험 중이고, 율촌은 폐쇄형 '아이율'을 씁니다.
넷째, 일자리의 모양. 국내 10대 로펌의 2026년 신입 변호사 채용은 274명에서 244명으로 10.9% 줄었고, 업계는 AI를 이유 중 하나로 꼽습니다. 법률 에이전트가 가장 먼저 대체하는 것은 '자료실을 읽고 첫 초안을 쓰는' 신입의 일입니다. 동시에 그 초안의 80%가 어딘가 하나를 놓친다는 사실은, 검토하고 판단하고 서명하는 능력의 가치를 오히려 올립니다. 문제는 신입 시절의 초안 작성 경험 없이 그 능력을 어떻게 기를 것인가입니다.
10. 실무 체크리스트: 법률 에이전트를 고를 때
로펌, 기업 법무팀, 리걸테크 회사가 GLM-Legal 같은 법률 에이전트를 평가할 때 확인할 것들입니다.
1. 두 숫자항목 통과율과 전 항목 통과율을 함께 보라. 92%와 19%는 같은 모델의 두 얼굴이다. 우리 업무에 필요한 것이 '대체로 맞는 초안'인지 '빠짐없는 결과물'인지 먼저 정한다.
2. 우리 시험지공개 벤치마크 대신 우리 사건 20~50건으로 자체 시험지를 만든다. 쟁점을 숨겨 두고, 시니어 변호사가 '이것만은 반드시'라고 꼽은 항목으로 루브릭을 쓴다.
3. 우리 하네스모델은 특정 하네스에서 훈련된다. 우리 문서관리 시스템, 우리 워드 템플릿, 우리 검색 도구에 붙였을 때의 성능을 따로 잰다.
4. 인용 검증모든 인용(판례·조문·베이츠 번호)이 실제로 존재하고 그 내용을 담고 있는지 자동 대조하는 단계를 하네스에 넣는다. 환각은 줄었을 뿐 사라지지 않았다.
5. 퇴보 확인특화 모델이 잃은 능력은 없는지 본다. GLM-Legal은 리서치 벤치마크에서 기반 모델보다 낮았다. 우리 업무의 다른 축(리서치, 번역, 계산)도 함께 잰다.
6. 데이터 위치고객 정보가 어느 나라 어느 서버에서 처리·저장되는가. 오픈 가중치를 자체 서버에 올릴 수 있는가. 변호사법상 비밀유지 의무와 충돌하지 않는가.
7. 과제당 비용토큰 단가가 아니라 '과제 하나를 끝내는 데 드는 돈과 시간'으로 비교한다. 싼 모델을 여러 번 돌려 교차 확인하는 운영도 계산에 넣는다.
8. 서명은 사람결과물을 누가 검토하고 누가 책임지는지 업무 흐름에 명시한다. 에이전트의 결과물은 '신입의 초안'으로 취급한다.
맺으며: 법을 아는 기계에서 일을 끝내는 기계로
1970년대의 TAXMAN은 세법을 논리식으로 옮기려다 '형식이냐 실질이냐'에서 멈췄습니다. 2023년의 GPT-4는 변호사 시험 객관식을 잘 풀었지만 법정에 가짜 판례를 들고 갔습니다. 2026년 10월의 GLM-Legal은 자료 수십 건을 읽고, 계약서에 추적 변경을 달고, 상대방 반론까지 내다보는 메모를 씁니다. 그리고 다섯 건 중 네 건에서 여전히 무언가를 놓칩니다.
이 50년의 흐름에서 GLM-Legal이 보여 준 것은 '더 큰 모델'이 아니라 '더 좋은 훈련장'입니다. 가벼운 모델이라도 현실적인 과제 환경 수만 개, 실무자의 기준을 옮긴 채점표, 모델과 함께 다듬은 하네스, 실무 피드백이 돌아오는 고리를 갖추면 범용 최상위 모델을 앞설 수 있습니다. 그 레시피는 이제 공개된 상식이 됐습니다. Harvey도, Applied Compute도, Z.ai도 같은 방향을 가리킵니다.
그러니 다음 질문은 "어느 모델이 법을 가장 잘 아는가"가 아니라 "누가 가장 현실적인 법률 과제와 가장 정직한 채점표를 가졌는가"입니다. 한국 법률 AI에 남은 숙제도 거기에 있습니다. 그리고 그 채점표를 쓸 수 있는 사람은, 아직은 경험 많은 변호사들뿐입니다.