[특집] 에이전트가 CPU를 먹는다 — GPU 한 장에 CPU 몇 개? 코딩 에이전트로 재 본 대기 시간
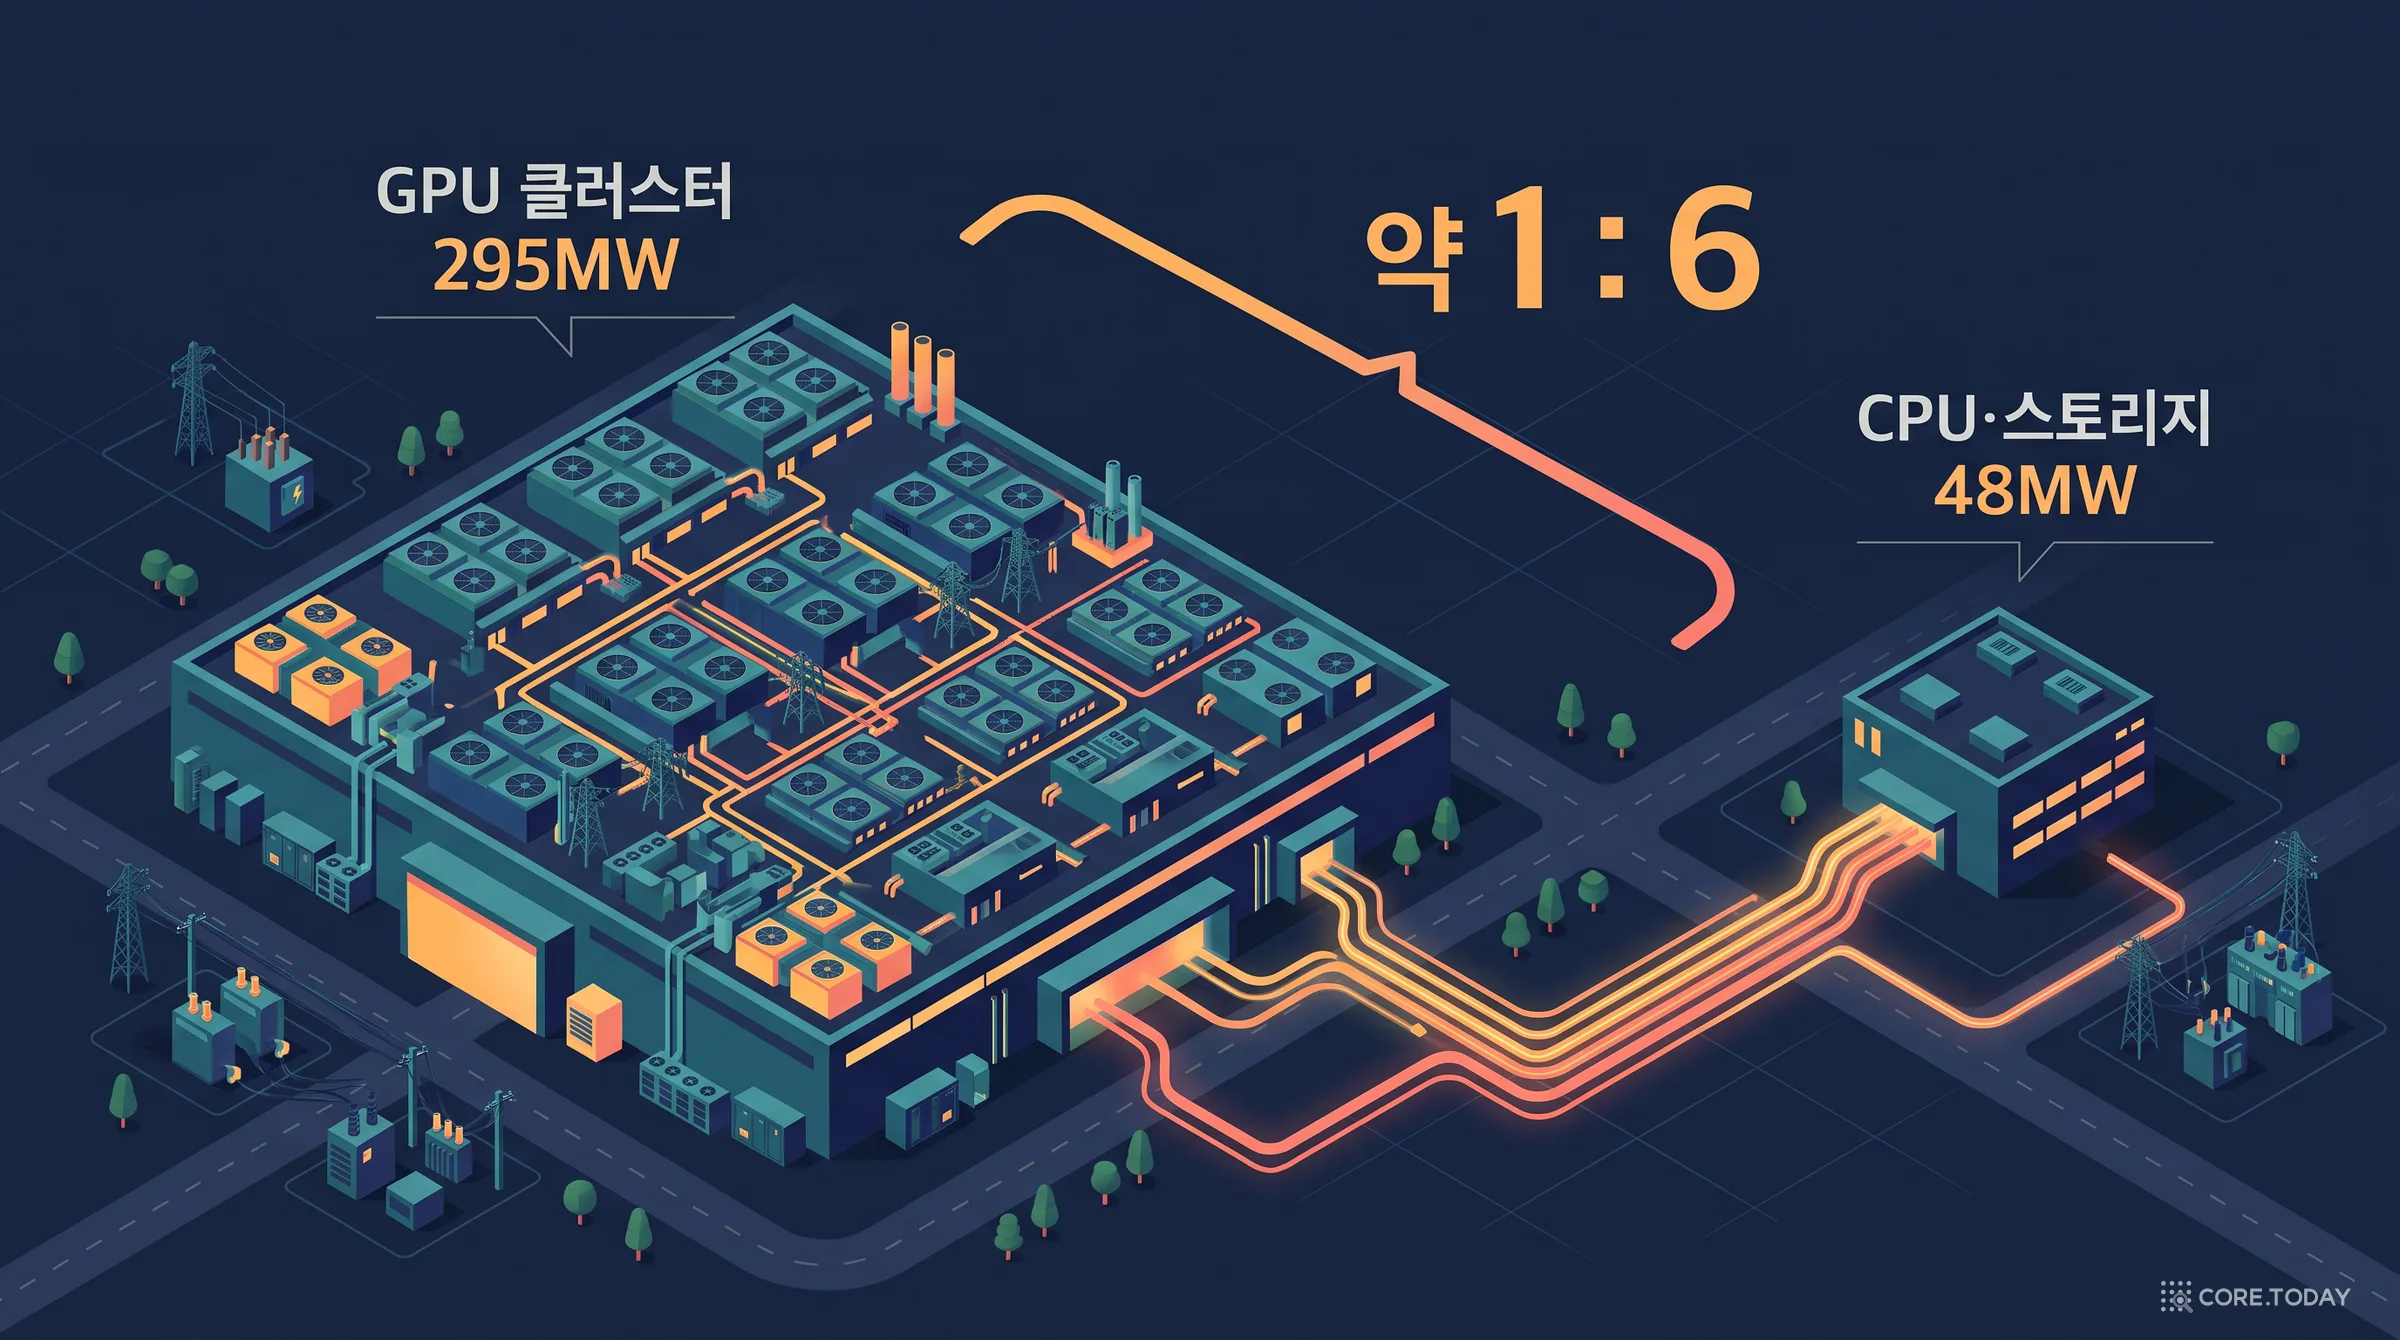
2026년 프런티어 연구소들은 강화학습에 쓸 CPU가 바닥나 클라우드 회사와 범용 서버를 놓고 다투고 있고, Microsoft의 OpenAI용 Fairwater 데이터센터는 295MW GPU 클러스터 옆에 48MW CPU·스토리지 건물을 붙였습니다(전력 약 1:6). 코어닷투데이가 Claude Code 로그 26일치(모델 응답 6만 2,600번, 도구 호출 7만 7,197번)를 세어 보니 메인 세션 활성 시간의 42%가 도구를 기다리는 시간이었고, 10초 넘는 도구 호출 8.6%가 도구 시간의 83%를 만들었습니다. 맥 한 대에서 로컬 모델로 코딩 에이전트를 돌려 테스트 수를 50개에서 6,410개로 늘리자 모델 시간은 그대로인데 모델 1초당 CPU초가 0.09에서 8.37로 커졌고, 병렬 실행은 기다림을 줄였을 뿐 CPU초를 줄이지 못했습니다. 이 비율로 계산하면 GPU 한 장 옆에 필요한 CPU 코어는 일감에 따라 10개 안팎에서 수백 개까지 벌어지며, 그 식과 계산기, 2026년 CPU 열 종의 정리를 함께 실었습니다.
코어닷투데이2026-10-3066분
?
질문
AI 예산은 GPU로 세는 것이 상식이었습니다. 그런데 2026년 들어 프런티어 연구소들이 "CPU가 바닥났다"며 클라우드 회사와 범용 서버를 놓고 다투고 있습니다. 에이전트는 왜 CPU를 먹고, GPU 한 장 옆에는 CPU가 얼마나 있어야 할까요?
→
방법
SemiAnalysis 글 여섯 편의 공개 구간에서 CPU에 관한 숫자를 모으고, 직접 두 가지를 쟀습니다. 맥 한 대에서 로컬 모델로 코딩 에이전트를 돌려 테스트 규모를 바꿔 가며 모델 시간과 도구 CPU초를 나눴고, 코어닷투데이의 Claude Code 로그 26일치에서 도구를 기다린 시간과 모델을 기다린 시간을 셌습니다.
✓
결론
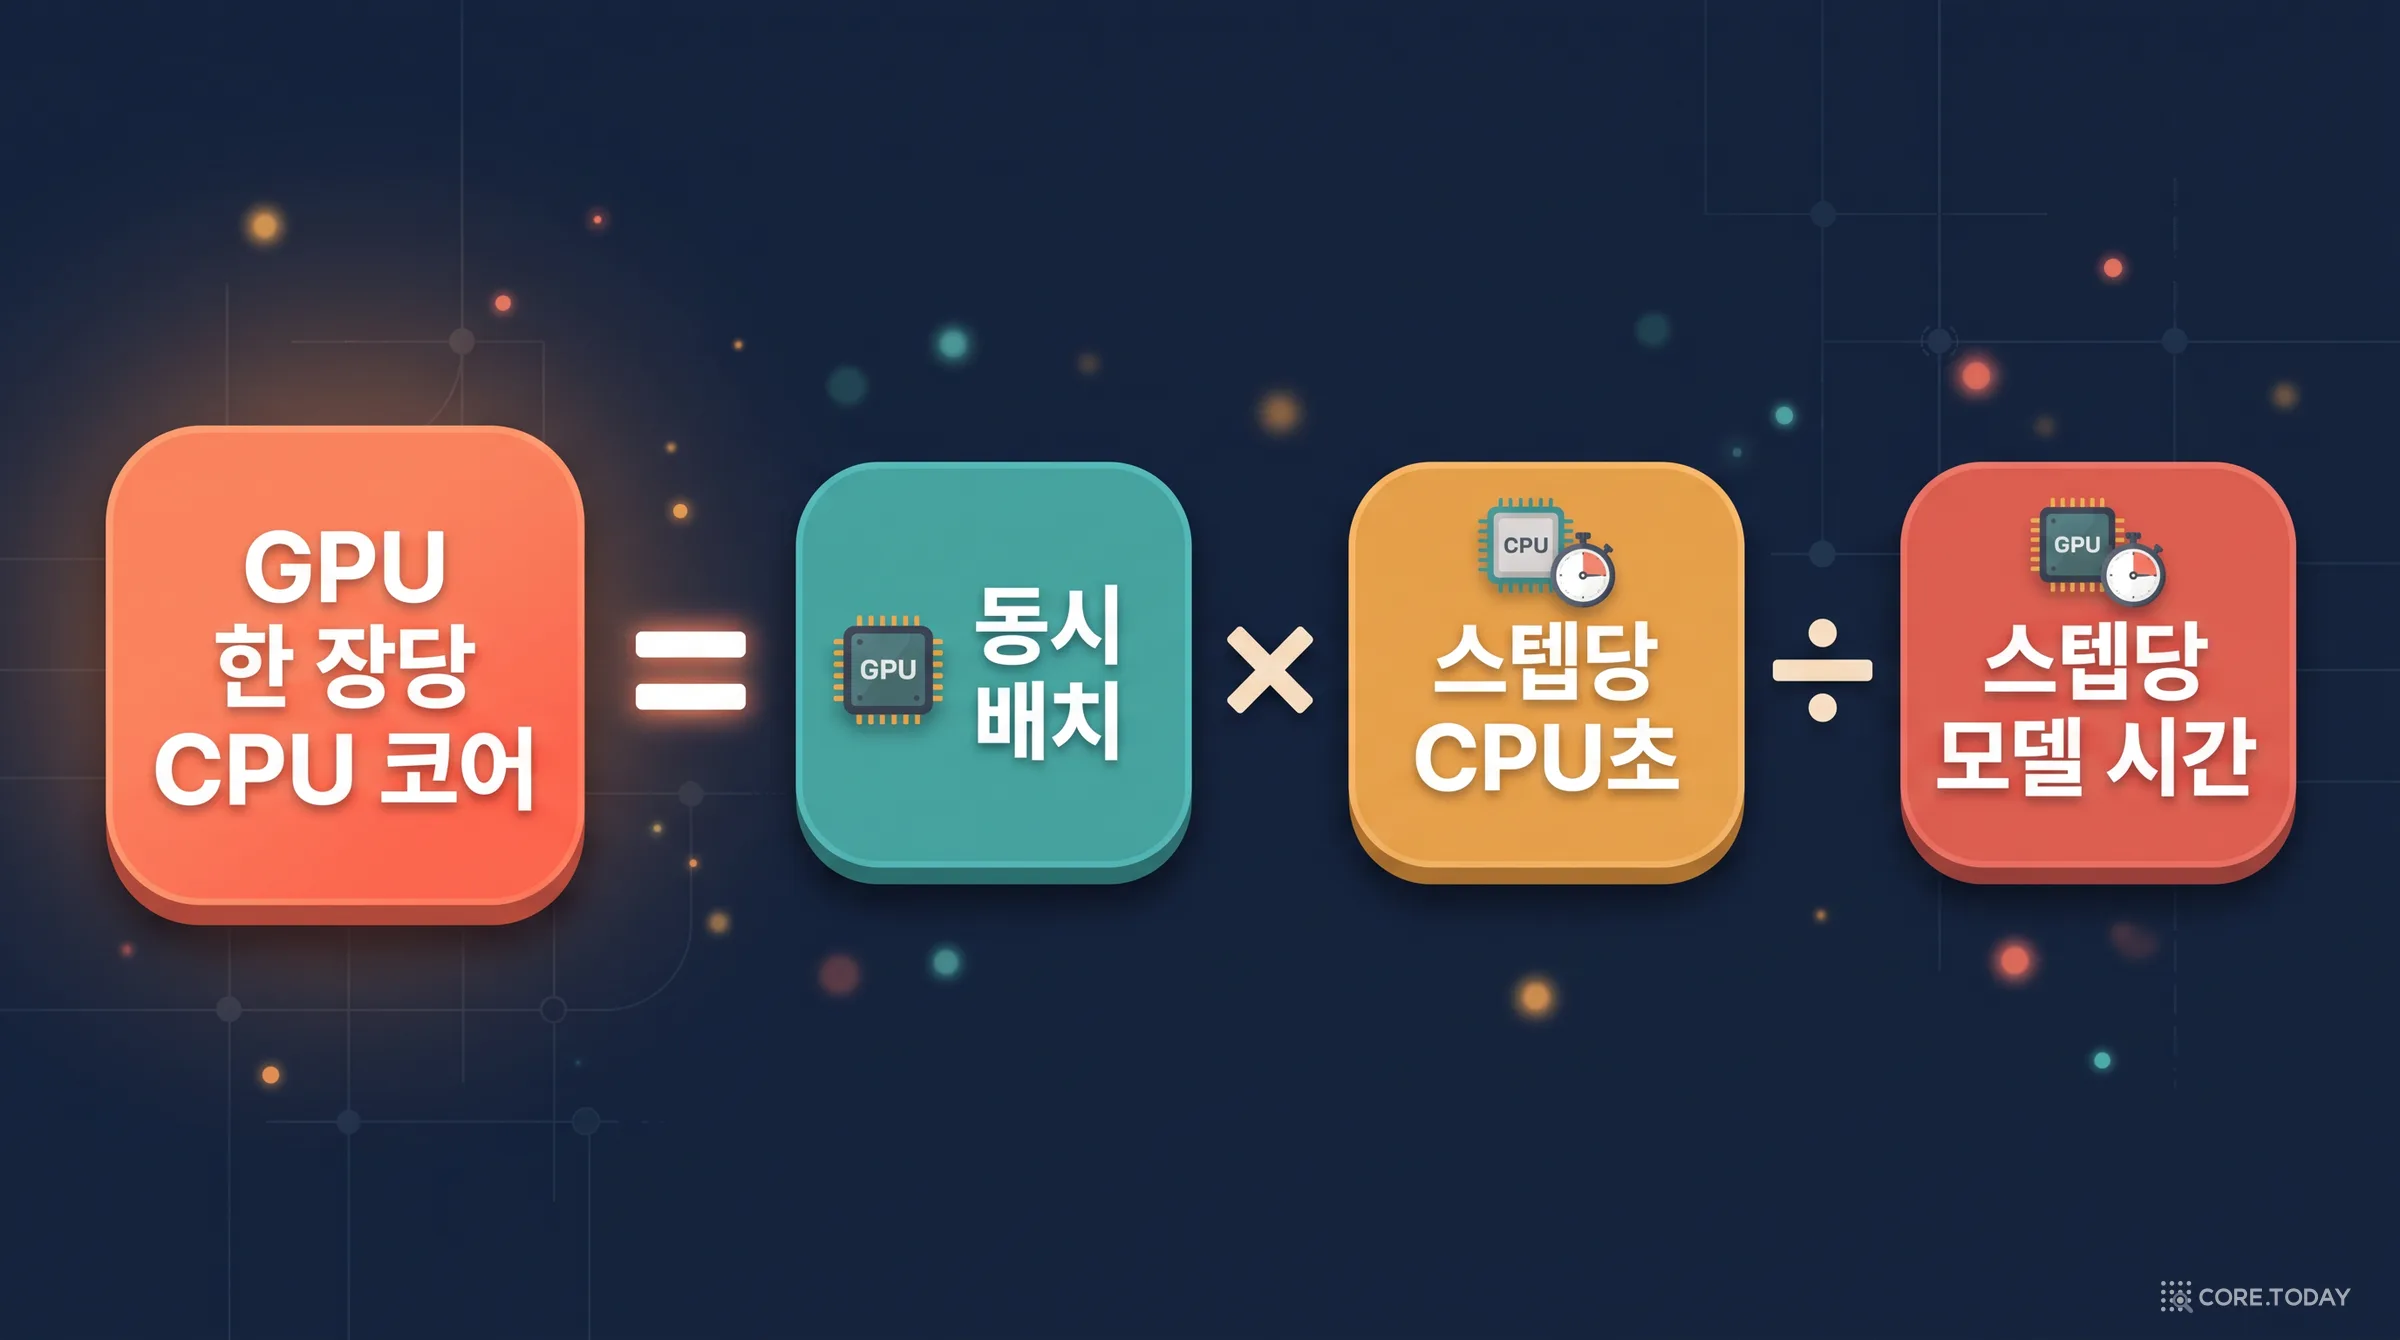
에이전트 활성 시간의 40% 안팎은 GPU가 아니라 도구를 기다리는 시간이었고, 그 대부분은 소수의 긴 테스트·빌드·스크립트가 만들었습니다. 필요한 CPU 코어는 '동시 배치 × 스텝당 CPU초 ÷ 스텝당 모델 시간'으로 정해지며, 테스트가 무거운 일감에서는 GPU 한 장당 수십~수백 코어가 됩니다.
2026년 2월 9일, 반도체·AI 인프라 분석사 SemiAnalysis가 낸 긴 글의 제목은 조금 뜻밖이었습니다. 「CPU가 돌아왔다(CPUs are Back)」. 2023년 이후 데이터센터의 이야기는 단순했습니다. GPU와 네트워크가 왕이고, CPU는 조연입니다. 행렬 곱셈만 놓고 보면 CPU는 GPU보다 성능과 효율이 100~1,000배 떨어지기 때문입니다. 서버 CPU의 최대 공급자인 Intel은 데이터센터 투자 붐을 타지 못했고, 서버 CPU 매출은 제자리걸음이었습니다.
그런데 이 글은 "지난 6개월 동안 이것이 크게 바뀌었다"고 씁니다. Intel은 2025년 4분기 실적에서 예상하지 못한 데이터센터 CPU 수요 증가를 보고했고, 2026년 설비 투자 계획을 올리면서 PC용 웨이퍼를 서버용으로 돌리기로 했습니다. 그리고 결정적인 문장이 나옵니다.
프런티어 AI 연구소들은 강화학습(RL)에 쓸 CPU가 바닥나, 범용 x86 CPU 서버를 놓고 클라우드 회사와 직접 경쟁하며 CPU 할당을 확보하려 애쓰고 있다. 재고가 예기치 않게 소진된 Intel은 Xeon 제품군 전반의 가격 인상을 검토하고 있다.
AMD는 2026년 서버 CPU 시장이 "큰 두 자릿수(strong double digits)"로 성장할 것이라 보고 공급을 늘리고 있습니다. GPU의 해에 CPU가 동난 것입니다.
원인으로 SemiAnalysis가 꼽은 것은 두 가지입니다. 강화학습, 그리고 바이브 코딩(코딩 에이전트). 같은 회사는 2026년 2월 5일 글에서 "지금 GitHub 공개 커밋의 4%를 Claude Code가 쓰고 있다"고 썼고, 8월 24일 글에서는 "2025년 11월 Claude Code 변곡점 이후 긴 문맥·여러 턴의 에이전트 작업이 빠르게 늘어 이제 실제 추론 트래픽의 대부분을 차지한다"고 썼습니다. 에이전트는 말만 하지 않습니다. 코드를 고치고, 테스트를 돌리고, 파일을 뒤지고, 웹을 읽습니다. 그 '손발'이 도는 곳이 CPU입니다.
코어닷투데이는 앞선 글 「에이전트의 추론은 '미드필'이다」에서 에이전트가 GPU의 메모리(HBM)를 어떻게 쓰는지를 다뤘습니다. 이번 글은 그 반대편, GPU가 쉬는 동안 일하는 CPU의 장부입니다. 질문은 하나입니다.
GPU 한 장 옆에 CPU가 얼마나 있어야 하는가?
이 질문에 공개된 답은 거의 없습니다. 그래서 SemiAnalysis의 공개 숫자로 뼈대를 세운 뒤, 직접 두 번 쟀습니다. 결론부터 적어 두면 이렇습니다.
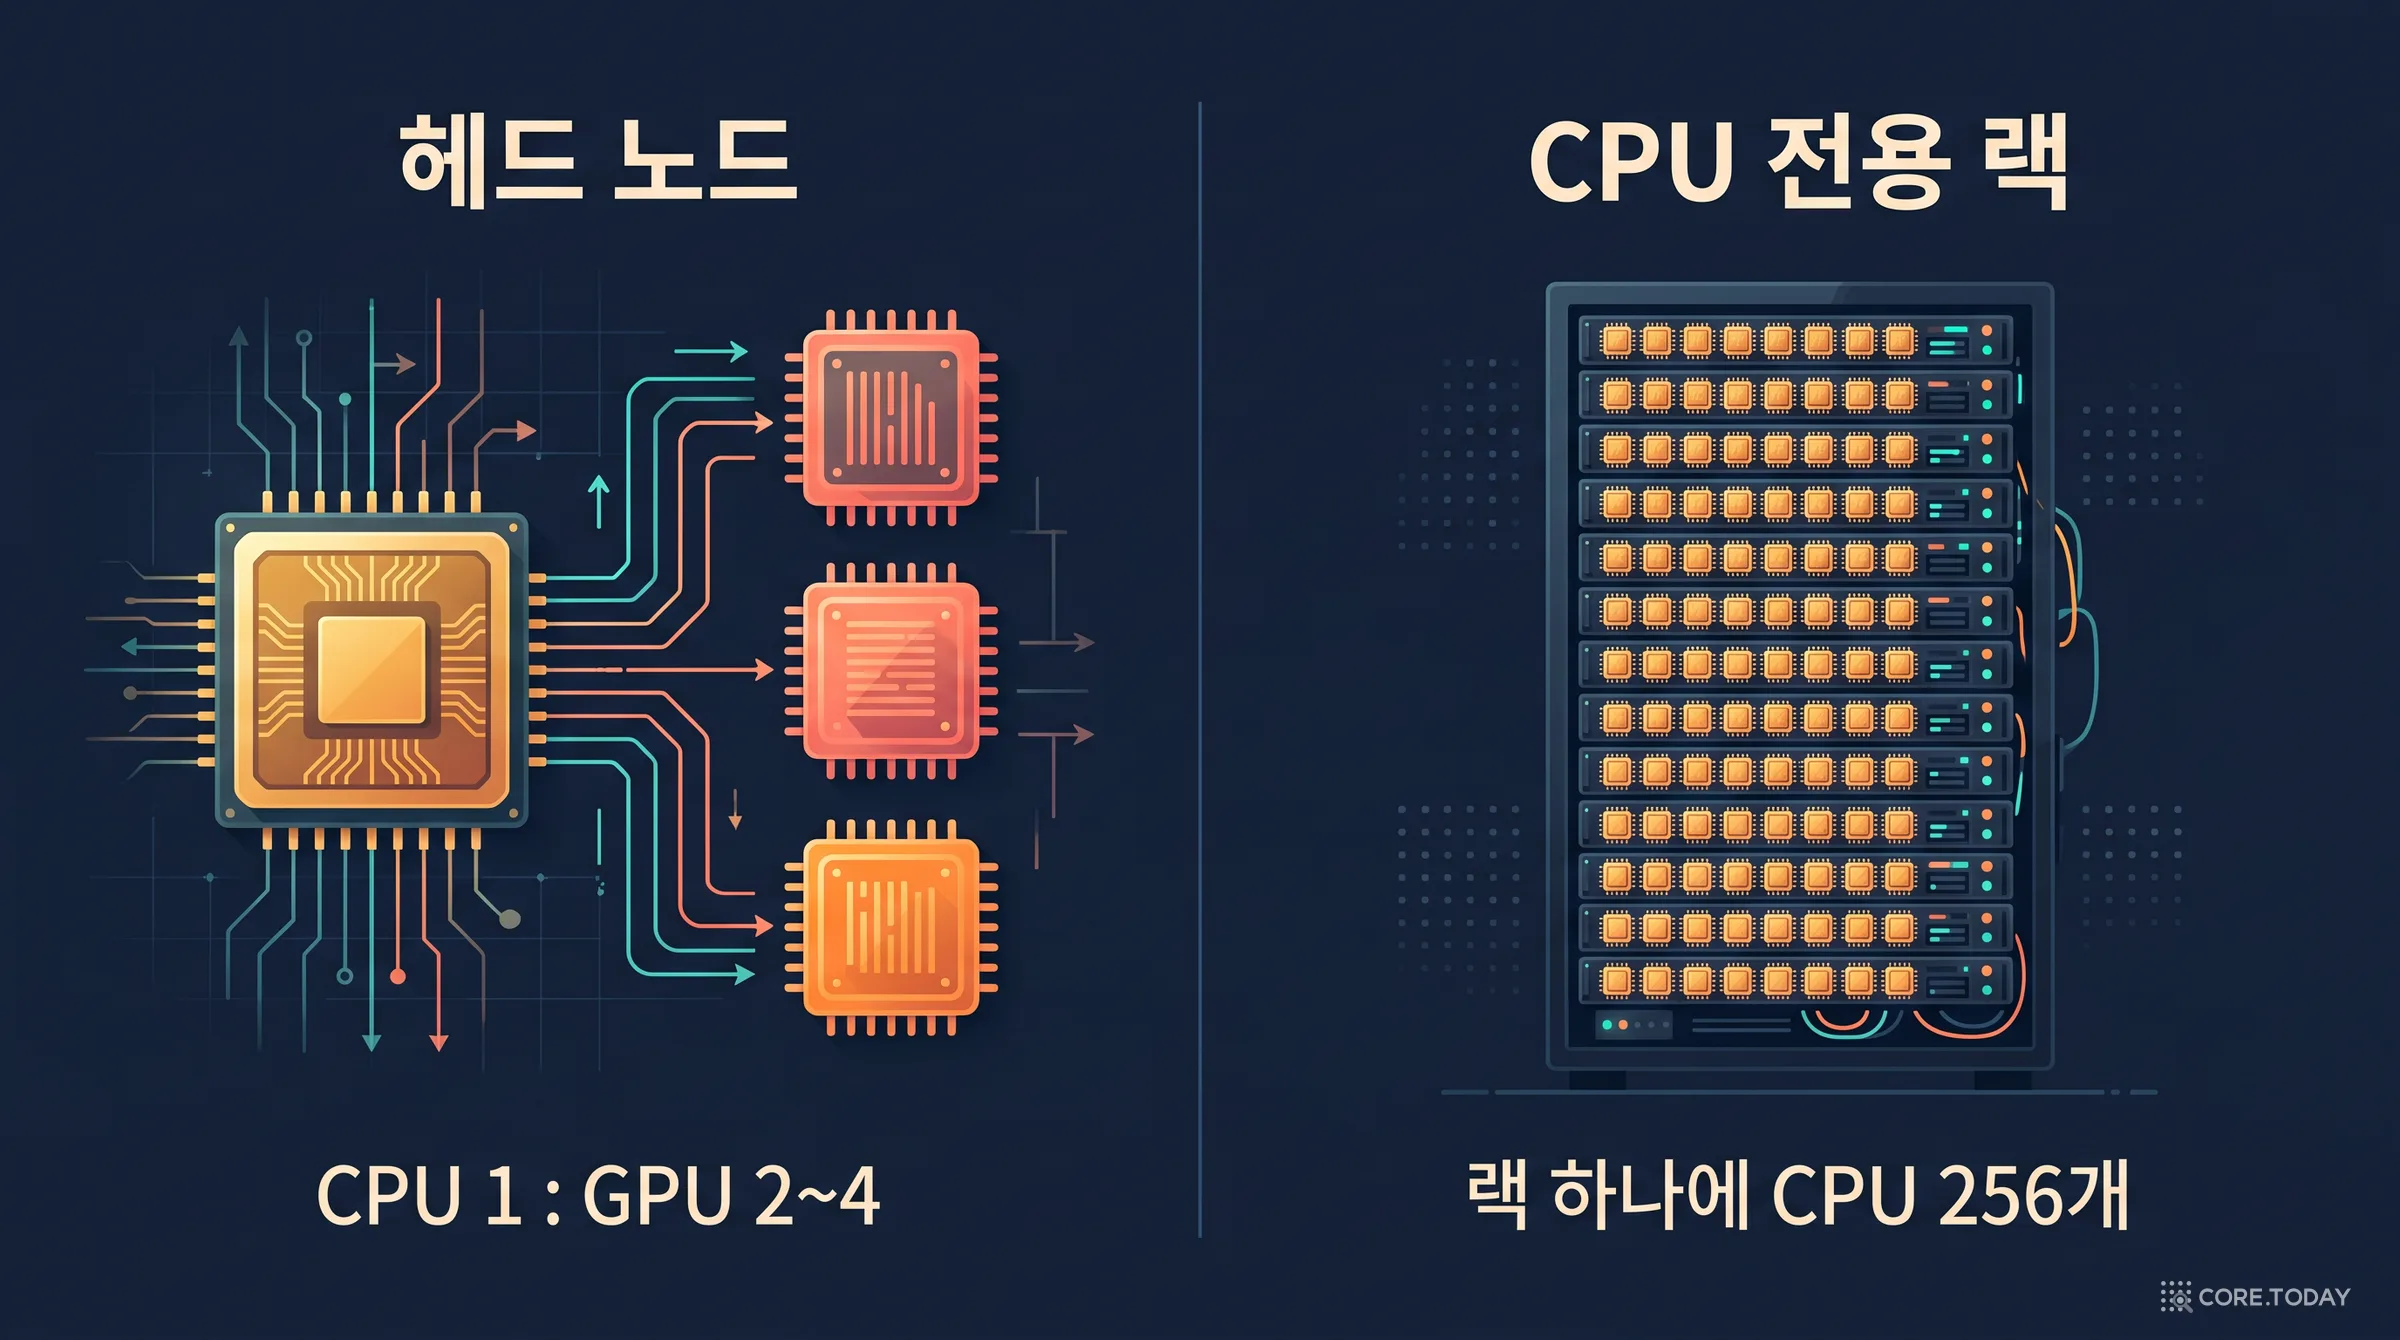
CPU의 일은 둘로 갈렸다. GPU를 먹이는 헤드 노드(CPU 1개에 GPU 2~4개)와, 에이전트·강화학습의 도구를 돌리는 범용 CPU 풀입니다. 늘어나는 것은 뒤쪽입니다. OpenAI용 Microsoft Fairwater 데이터센터는 295MW GPU 클러스터 옆에 48MW CPU·스토리지 건물을 붙였습니다(전력 약 1:6).
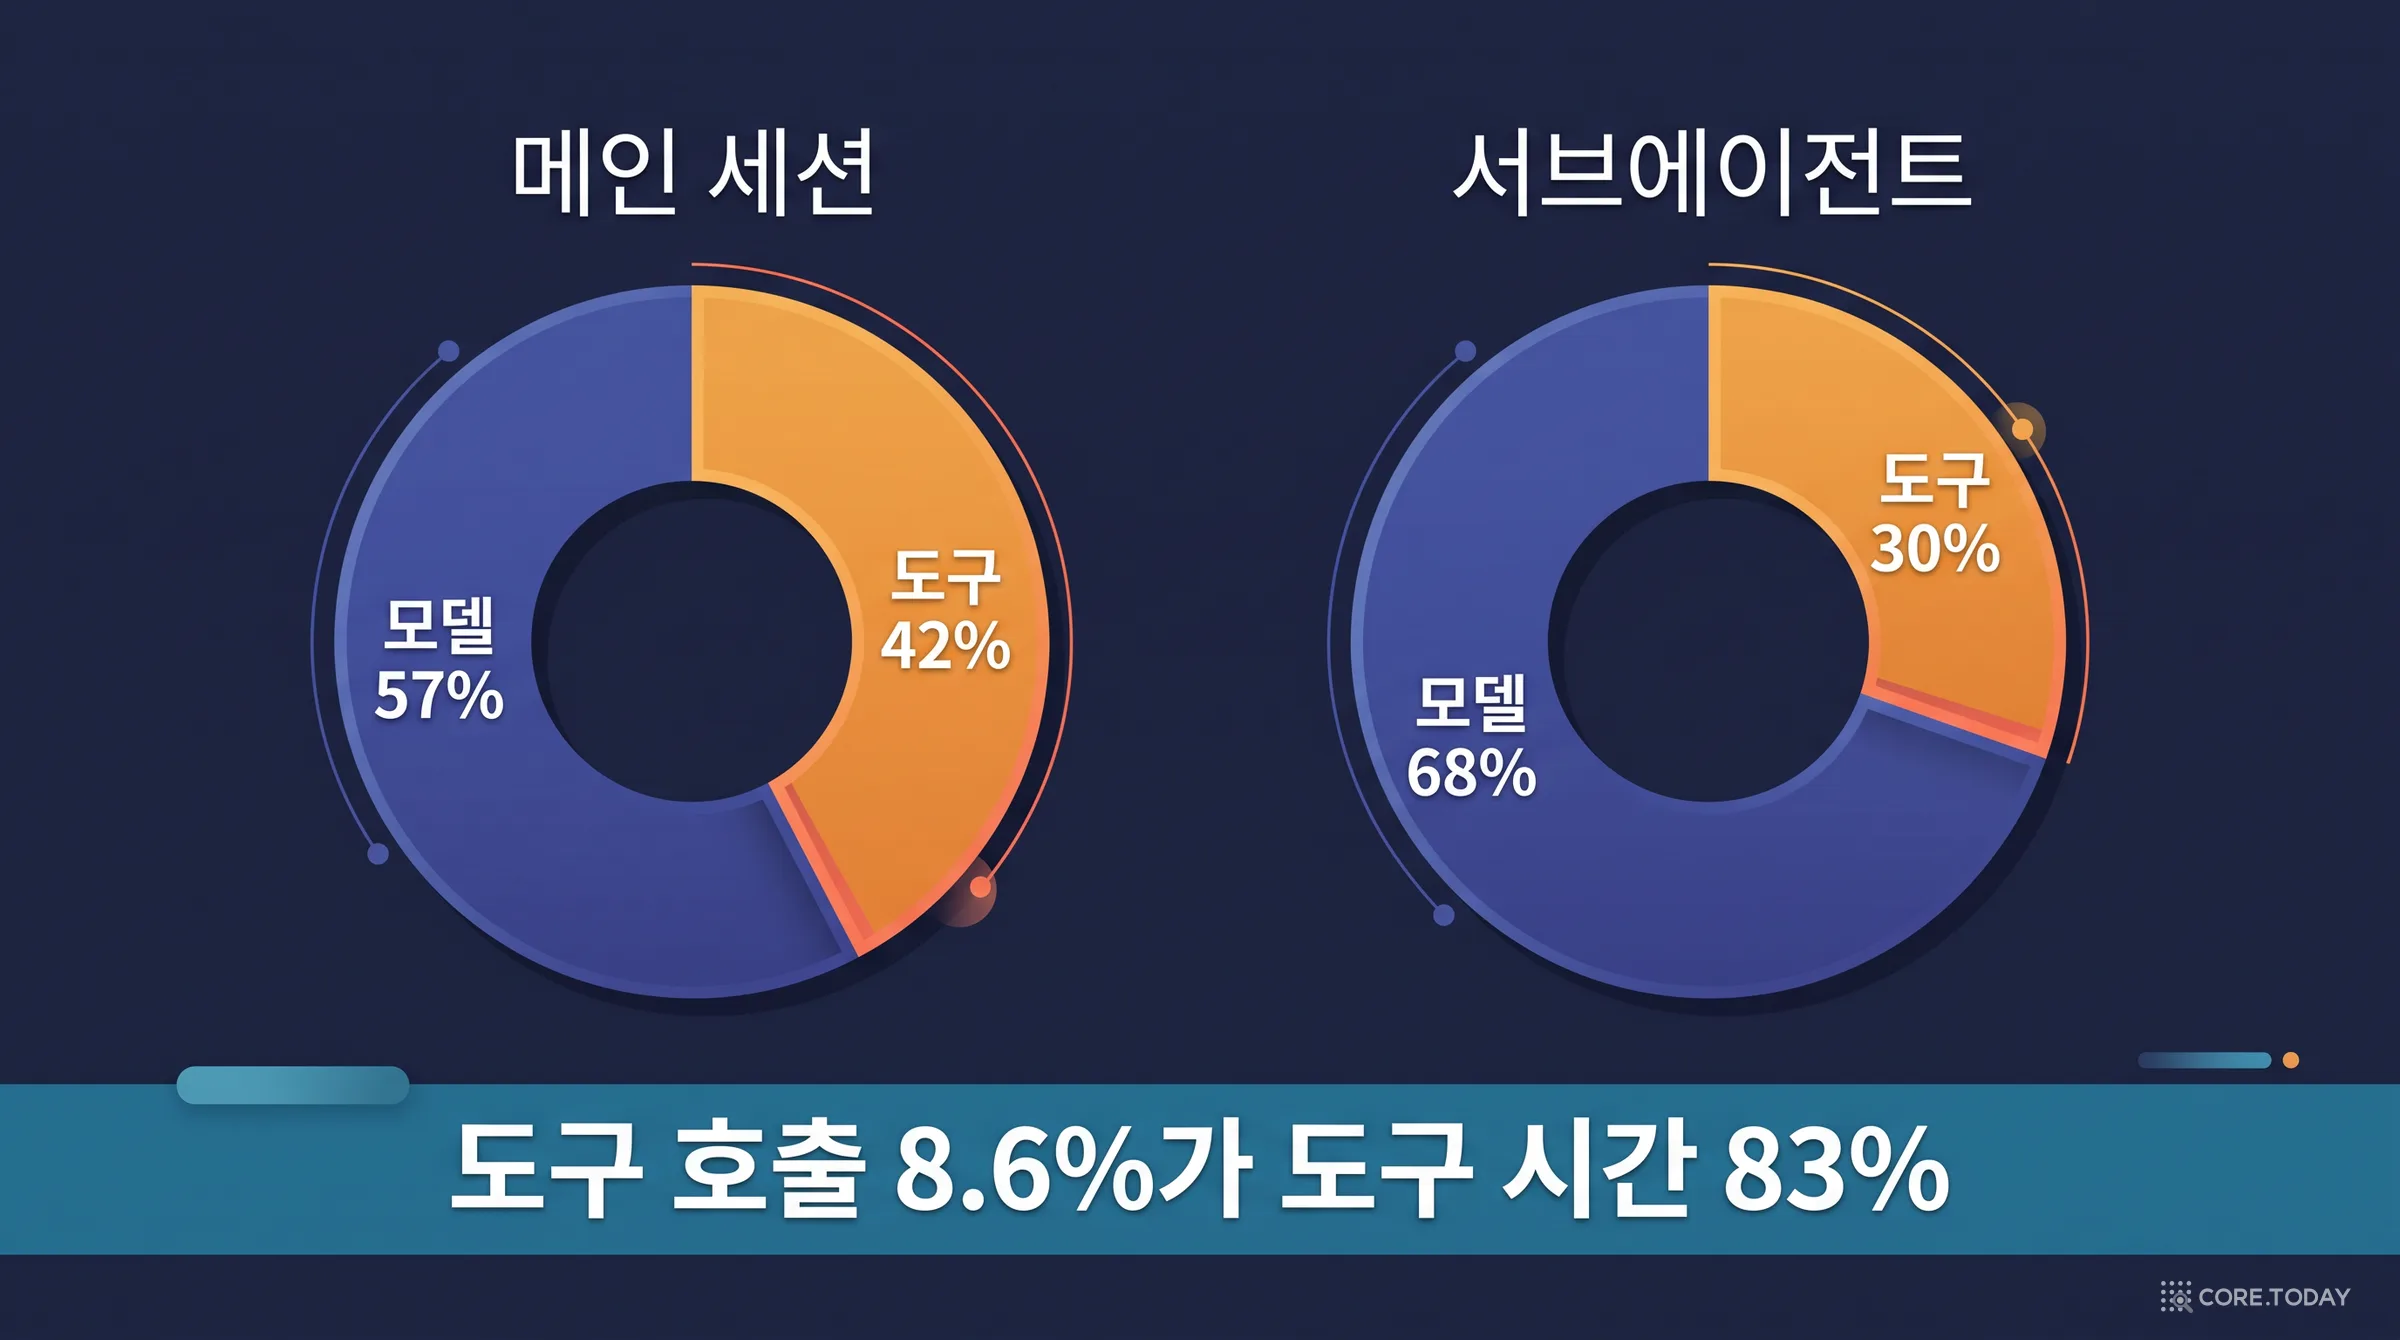
도구 시간은 '중앙값'이 아니라 '꼬리'로 쌓인다. 코어닷투데이 Claude Code 로그에서 셸 명령 하나의 중앙값은 0.21초였지만, 메인 세션 활성 시간의 42%가 도구 쪽이었습니다. 10초 넘는 호출 8.6%가 도구 시간의 83%를 만들었습니다.
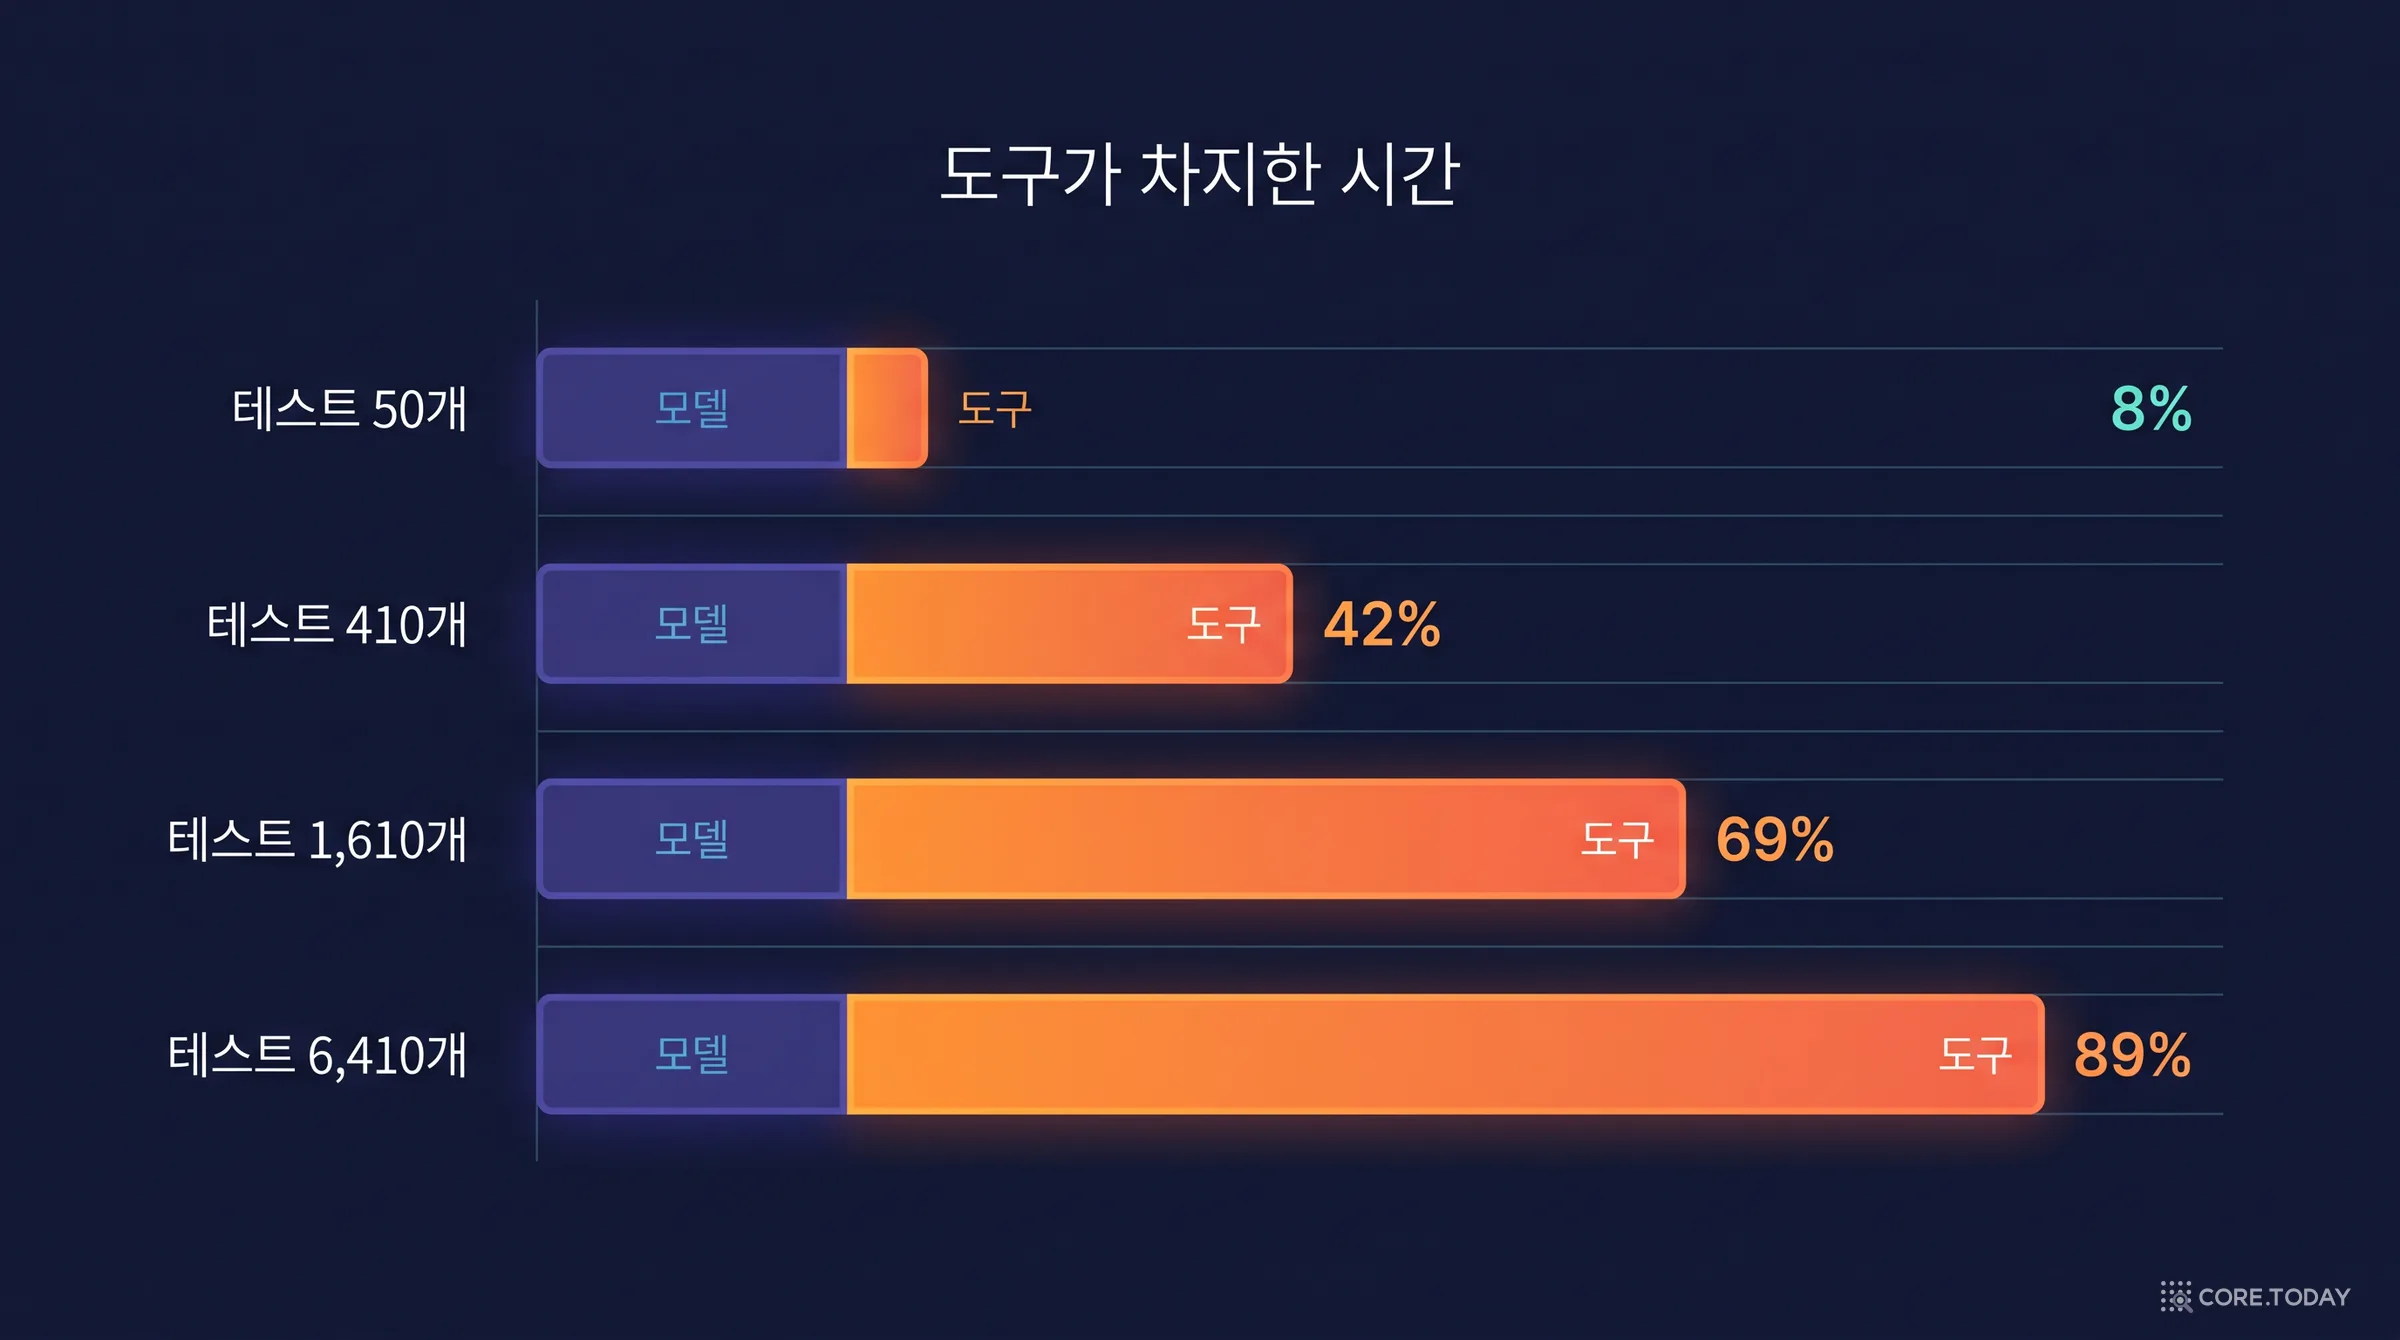
테스트가 무거워질수록 CPU 몫은 가파르게 커진다. 로컬 코딩 에이전트 실험에서 테스트 50개짜리 저장소는 모델 1초당 CPU 0.09초를 썼지만, 6,410개짜리는 8.4초를 썼습니다. 병렬 실행은 기다리는 시간을 줄일 뿐 CPU초는 줄이지 못했습니다.
필요한 코어 수는 간단한 식으로 나온다. GPU 한 장당 코어 = 동시 배치 × 스텝당 CPU초 ÷ 스텝당 모델 시간 ÷ 목표 사용률. 테스트가 무거운 코딩 환경에서는 GPU 한 장당 수십~수백 코어입니다.
CPU만이 아니라 서버 D램도 같이 먹는다. SemiAnalysis는 HBM이 D램 공급을 잠식하면서 서버 소켓당 D램이 크게 깎이고 있고, 이것이 "에이전트가 GPU 디코드보다 CPU 실행을 기다리는 데 많은 시간을 쓰는 것"과 맞물려 있다고 씁니다.
각각을 숫자와 함께 풀어 보겠습니다.
1장. 데이터센터 CPU의 네 시대 — 조연이 되기까지
지금의 변화를 보려면 CPU가 어떻게 조연이 됐는지부터 보는 편이 좋습니다. SemiAnalysis는 데이터센터 CPU의 역사를 네 시대로 나눕니다.
1990년대 · PC 시대PC 칩이 워크스테이션과 메인프레임의 일을 싸게 가져갑니다. Intel은 캐시를 키운 PC 칩 변형(1995년 Pentium Pro, 1998년 첫 Xeon)으로 '메인프레임 대체' 시장을 엽니다.
2000년대 · 닷컴 시대클럭 경쟁이 끝나고 멀티코어로 넘어갑니다. 메모리 컨트롤러와 PCIe가 CPU 안으로 들어오고, 코어 하나를 두 스레드로 나누는 SMT(동시 멀티스레딩)가 등장합니다.
2010년대 · 가상화와 클라우드기업들이 서버를 사는 대신 빌려 쓰면서 클라우드가 CPU 판매를 끌고 갑니다. 2018년 Spectre·Meltdown 이후 보안을 위해 SMT를 끄면 성능이 최대 30% 떨어지는 문제가 Intel의 설계 결정을 오래 괴롭힙니다.
2022년~ · AI GPU와 CPU 통합ChatGPT 이전 5년 동안 Intel은 Xeon Scalable을 1억 개 넘게 팔았습니다. 그 뒤로 전력은 GPU에 우선 배정되고, CPU는 'GPU를 먹이는 헤드 노드'와 '적은 전력으로 나머지 인터넷을 돌리는 클라우드 네이티브 CPU'로 갈라집니다.
마지막 시대의 '통합'이라는 말이 중요합니다. GPU가 데이터센터 전력을 차지하자, 클라우드 회사들은 낡은 서버를 새 서버로 바꾸면서 소켓 수를 줄였습니다. SemiAnalysis에 따르면 10:1 이상의 소켓 통합이 가능하고, 코로나 시기에 대량으로 산 Intel Cascade Lake 서버 수백만 대가 같은 성능을 5분의 1도 안 되는 전력으로 내는 최신 CPU로 교체되고 있습니다. 아낀 전력은 GPU로 갔습니다. CPU는 '더 적게, 더 효율적으로'가 목표였던 셈입니다.
그런데 SemiAnalysis는 다섯 번째 시대를 덧붙입니다. 강화학습과 에이전트의 시대입니다. 여기서 CPU는 다시 '더 많이'가 됩니다.
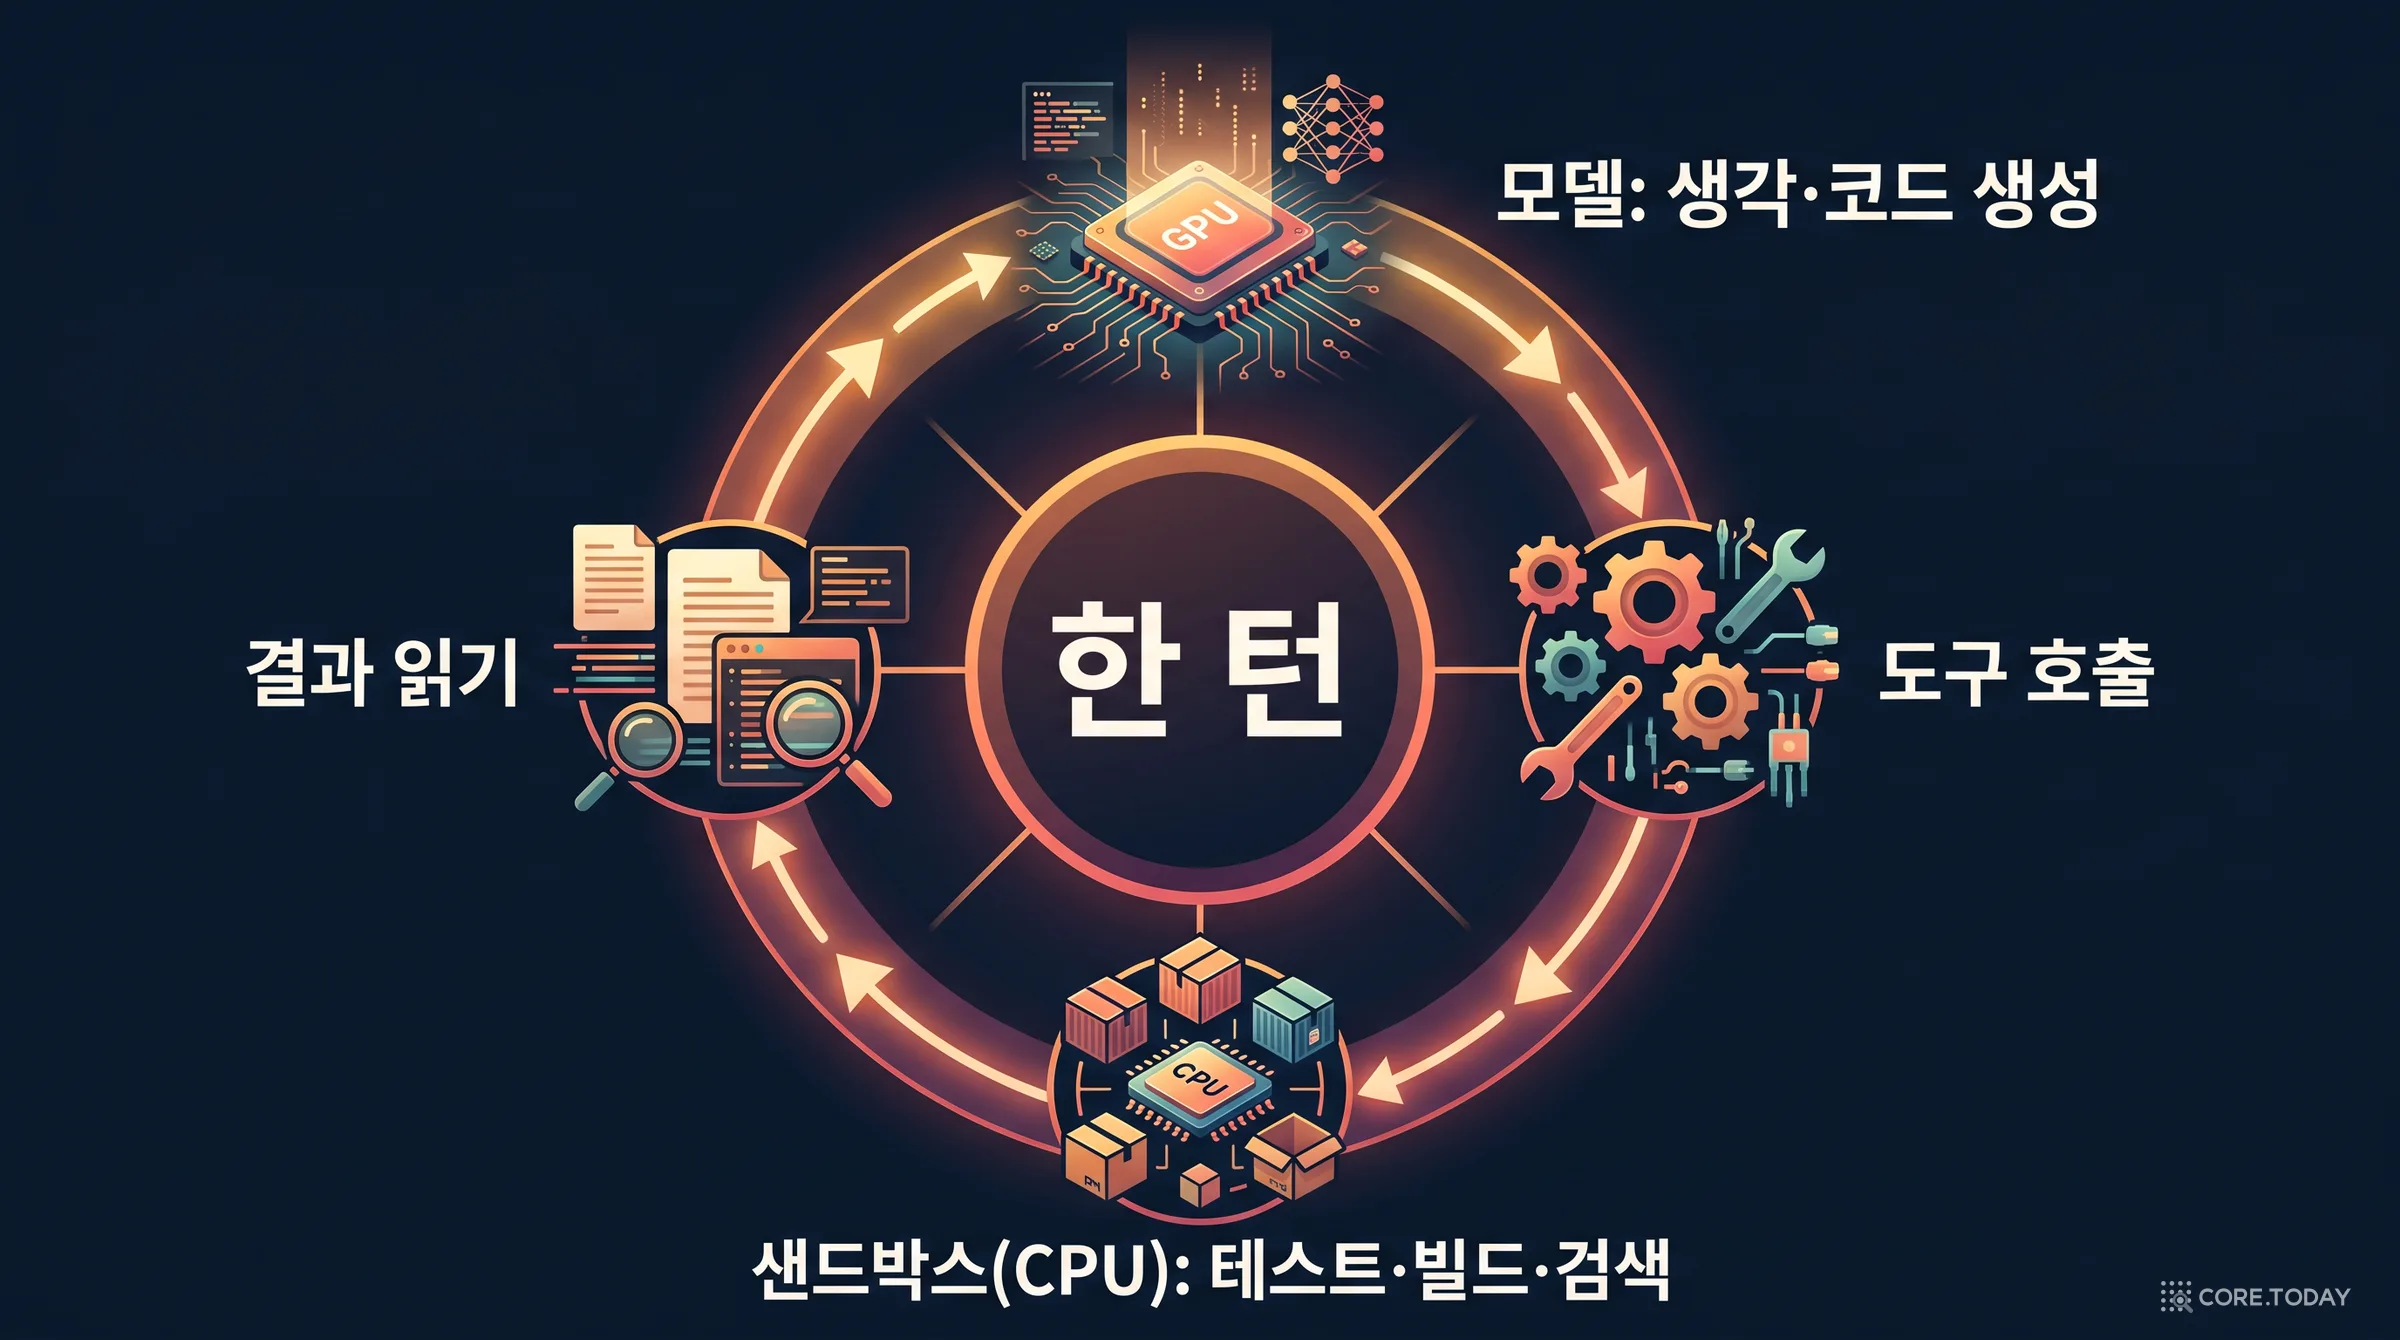
모델(GPU)이 지금까지의 대화와 코드를 읽고 다음 행동을 정합니다. 출력은 대개 짧은 도구 호출입니다. "이 테스트를 돌려라", "이 파일에서 이 문자열을 찾아라", "이 줄을 이렇게 고쳐라". 그다음 그 도구가 실행됩니다. 테스트가 돌고, 컴파일러가 돌고, 검색이 돕니다. 이 단계는 GPU가 아니라 CPU에서 일어납니다. 결과가 돌아오면 모델이 그것을 읽고 다음 행동을 정합니다.
SemiAnalysis가 8월에 공개한 에이전트 추론 벤치마크 AgentX는 이 리듬을 실제 기록으로 보여 줍니다. SemiAnalysis 직원들의 Claude Code 기록 393개를 익명화해 재생한 데이터인데, 요청 하나의 입력 길이 중앙값은 14만 2천 토큰, 출력 길이 중앙값은 444토큰이었습니다. 그리고 한 턴이 끝나고 다음 요청이 나가기까지의 간격, SemiAnalysis가 "에이전트 작업에서는 주로 도구 사용에 걸리는 시간"이라고 부르는 턴 간 지연의 중앙값은 3.84초였습니다. 1분 넘는 간격은 약 10%였고, SemiAnalysis는 이것이 대부분 사람의 응답을 기다린 시간일 것이라고 봅니다. 세션의 약 44%는 서브에이전트를 하나 이상 띄웠고, 서브에이전트 하나가 처음 요청부터 마지막 응답까지 걸린 시간의 중앙값은 2.27분이었습니다.
추론 서버 입장에서 이 3.84초는 '아무 일도 없는 시간'입니다. 그동안 대화의 KV 캐시는 HBM이나 D램에서 기다리고, GPU는 다른 사용자의 요청을 처리합니다. 그런데 그 3.84초 동안 누군가는 일을 합니다. 사용자의 노트북, 회사의 CI 서버, 클라우드의 샌드박스 컨테이너입니다. 사람이 쓰는 코딩 에이전트에서는 이 비용이 대부분 사용자의 기계로 흩어집니다. 문제는 연구소가 스스로 수만 개의 에이전트를 동시에 돌릴 때입니다. 바로 강화학습입니다.
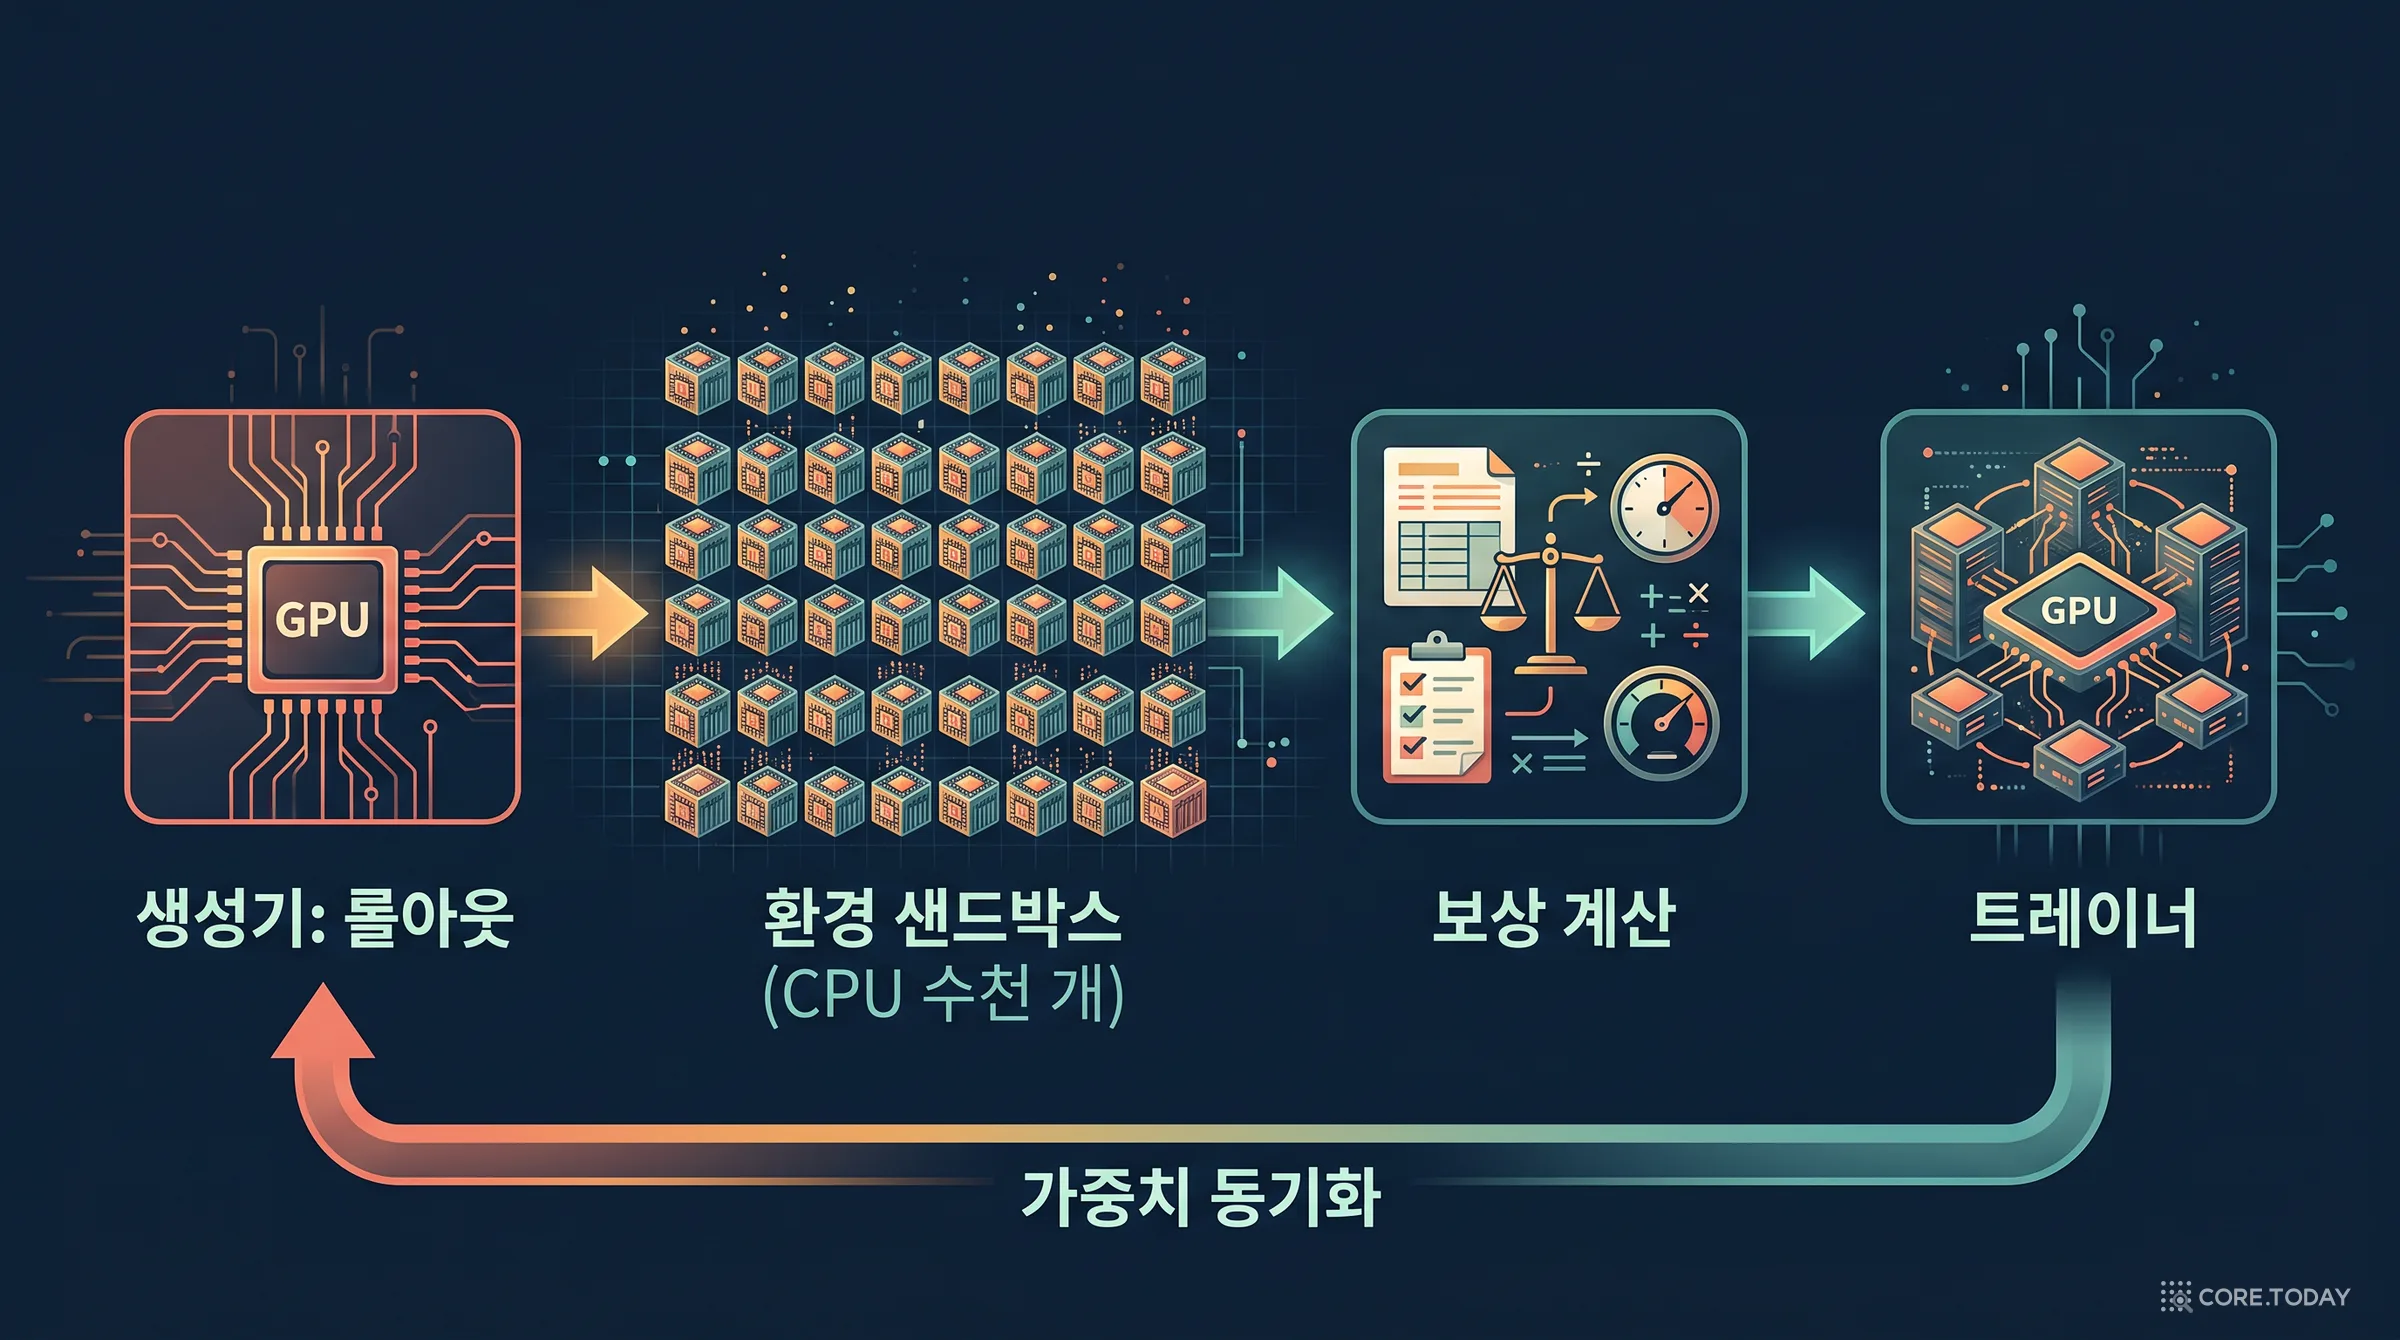
생성기(추론 엔진)가 문제를 풀려는 시도, 곧 롤아웃을 만듭니다. 롤아웃 안의 모든 도구 호출은 환경에서 실행됩니다. 환경은 보통 컨테이너 하나이고, 그 안에 저장소와 테스트, 웹사이트 복제본 같은 것이 들어 있습니다. 환경이 행동의 결과를 돌려주고 마지막에 보상(테스트 통과 여부 같은 것)을 계산하면, 트레이너가 그 결과로 모델을 고치고 새 가중치를 생성기로 보냅니다.
SemiAnalysis는 2026년 2월 글에서 이렇게 씁니다. "코딩·수학 같은 영역에서 RL 환경이 모델이 만든 행동을 실행하고 보상을 계산하려면 많은 CPU가 병렬로 필요하다. 코드 컴파일, 검증, 인터프리트, 도구 사용." 물리 시뮬레이션과 합성 데이터 검증도 CPU 몫입니다. 그리고 "GPU가 놀지 않도록, 고성능 CPU 클러스터가 주 GPU 클러스터 가까이에 있어야 한다"고 덧붙입니다.
규모를 짐작할 수 있는 숫자들이 1월 6일 글 「RL 환경과 과학을 위한 RL」에 나옵니다.
항목
숫자
뜻
SWE-rebench 파이프라인
저장소 3만 개·PR 45만 개 → 과제 2만 1,336개
PR마다 컨테이너를 띄워 '패치 전 실패, 패치 후 통과'를 실제로 실행해 거른다
DeepSeek V3.2 학습
GitHub에서 뽑은 코딩 과제 2만 4,667개
과제 하나당 수십 번의 롤아웃이 돈다
동시 인스턴스
1만 개 이상
Kimi 등 연구소의 인프라가 동시에 띄우는 환경 수
UI 짐(웹사이트 복제)
사이트 하나에 약 2만 달러
OpenAI는 ChatGPT Agent용으로 수백 개를 샀다. 한 번 사서 다음 모델에도 재사용
코딩 과제 한 번의 시도
"64번 시도하고 사소한 비용으로 채점"
생물 실험 하나가 수백~수천 달러인 것과 대비
환경을 만드는 회사들은 소프트웨어 하나를 컨테이너로 감싸고, 그 위에 에이전트가 부를 수 있는 도구(MCP 서버)를 얹어 수많은 인스턴스로 병렬 실행합니다. 에이전트가 클릭하거나 글자를 치면 그 행동이 컨테이너 안의 실제 소프트웨어에서 실행되고, 결과 화면이 돌아옵니다. 이 모든 것이 CPU와 메모리 위에서 돕니다. SemiAnalysis가 "코딩 과제는 64번 시도해도 채점 비용이 사소하다"고 쓴 것은 생물 실험에 비해서라는 뜻이지, 0이라는 뜻은 아닙니다. 과제 2만 개 × 시도 64번 × 시도당 테스트 몇 번을 곱하면, 그 '사소한' 비용이 데이터센터 한 동이 됩니다.
GPU 클라우드 평가 보고서 「ClusterMAX 3.0」(9월 23일)은 아예 이것을 새 시험 항목으로 넣었습니다. 쿠버네티스 시험에서 CPU 전용 샌드박스 파드를 묶음으로 늘려 가며 몇 개가 준비 상태에 도달하는지, 얼마나 걸리는지, 나머지는 왜 대기하는지를 잽니다. 곧 나올 SandboX라는 벤치마크는 "에이전트 작업에 맞춰 CPU 성능을 한계까지 밀어붙이는" 시험으로, 링 셔플 생산자·소비자 대기열, Kafka 호환 브로커 처리량, 동적 부하 시험 같은 코드 실행형 작업과 함께, GPU 클러스터의 남는 CPU·메모리에 RL 샌드박스를 같이 올렸을 때의 콜드 스타트 지연·스케줄링 처리량·노드당 밀도를 잴 계획입니다. SemiAnalysis는 "RL 스택은 트레이너, 추론 엔진, 환경 샌드박스 실행, 롤아웃 전송, 가중치 동기화 중 어느 하나만 병목이어도 전체가 멈춘다"고 씁니다.
3장. Fairwater의 1:6 — 전력 장부에 나타난 CPU
SemiAnalysis가 공개 구간에 남긴 가장 구체적인 숫자는 Microsoft가 OpenAI를 위해 짓는 'Fairwater' 데이터센터입니다.
48MW 규모의 CPU·스토리지 건물이 295MW 규모의 주 GPU 클러스터를 받친다. 이는 GPU가 만들어 내는 페타바이트 단위의 데이터를 처리하고 관리하는 데 수만 개의 CPU가 필요하다는 뜻이며, AI가 없었다면 필요하지 않았을 쓰임새다.
295 ÷ 48 ≈ 6.1이니 전력으로 약 1:6입니다(건물 크기는 개념도). 이 비율을 읽을 때 조심할 점이 세 가지 있습니다.
첫째, 48MW에는 CPU만이 아니라 스토리지도 들어 있습니다. 공개 구간에는 둘의 몫이 나뉘어 있지 않습니다. 학습 데이터 저장, 체크포인트, 로그와 롤아웃 기록이 모두 스토리지 몫입니다.
둘째, 295MW GPU 클러스터 안에도 CPU가 있습니다. GPU 서버마다 붙은 헤드 노드 CPU입니다. 1:6은 '헤드 노드 말고 따로 더 필요한' CPU·스토리지의 비율입니다.
셋째, 이 비율은 고정된 상수가 아니라 움직이는 값입니다. SemiAnalysis는 이렇게 씁니다. "AI 가속기는 와트당 성능이 CPU보다 훨씬 빠르게 좋아지고 있어서, Rubin 같은 다음 세대 GPU는 Fairwater의 1:6보다 더 높은 CPU 대 GPU 전력 비율을 요구할 수 있다." 논리는 간단합니다. GPU가 같은 전력으로 토큰을 두 배 더 만들면 롤아웃도 두 배 더 나오고, 그 롤아웃의 테스트를 돌릴 CPU 일도 두 배가 됩니다. CPU가 같은 기간에 와트당 성능을 1.7배밖에 못 올렸다면, CPU에 줘야 할 전력의 몫이 커집니다.
공개된 것은 두 건물의 전력뿐이라 'GPU 한 장당 CPU 코어 몇 개'는 가정을 넣어야 나옵니다. 아래 계산기에서 스토리지 몫, 소켓 하나와 GPU 한 장이 쓰는 시설 전력을 바꿔 보세요. 기본값(스토리지 40%, 소켓당 800W, GPU당 2kW, 256코어 소켓)에서는 GPU 약 14만 8천 장, CPU 소켓 약 3만 6천 개, GPU 한 장당 별도 CPU 코어 약 62개가 나옵니다. SemiAnalysis가 쓴 "수만 개의 CPU"와 자릿수가 맞습니다. 다만 이것은 Fairwater의 실제 구성이 아니라, 공개된 두 숫자에 코어닷투데이가 넣은 가정의 결과입니다.
헤드 노드는 GPU 서버 안에서 GPU를 관리하고 데이터를 먹이는 CPU입니다. 코어 하나의 성능, 큰 캐시, 높은 메모리·입출력 대역폭이 중요합니다. 꼬리 지연을 줄여야 하기 때문입니다. 2026년 시스템들의 비율은 대개 CPU 1개에 GPU 2~4개입니다.
시스템
헤드 노드 비율
NVIDIA Vera Rubin 슈퍼칩
Vera CPU 1 : Rubin GPU 2
AMD MI455X 컴퓨트 트레이
Venice CPU 1 : GPU 4
AWS Trainium3 컴퓨트 트레이
Graviton5 1 : Trainium3 4
Google TPUv7 노드
x86 CPU 2 : TPU 8
범용 CPU 풀은 GPU와 떨어져 있는, 에이전트의 도구와 RL 환경과 데이터 처리를 맡는 CPU입니다. 여기서는 코어 수와 와트당 처리량이 중요합니다. 1:6이 가리키는 것이 바로 이쪽입니다.
엔비디아는 이 두 번째 자리까지 직접 팔기로 했습니다. 3월 GTC에서 발표한 Vera ETL256은 GPU 없이 CPU만 담은 랙입니다. SemiAnalysis의 설명을 옮기면 이렇습니다. "CPU 수요는 AI 작업이 GPU 연산을 넘어 데이터 처리·전처리·오케스트레이션을 더 많이 요구하면서 늘고 있다. 강화학습은 CPU가 시뮬레이션을 돌리고 코드를 실행하고 출력을 검증하는 일을 병렬로 하게 만들어 수요를 더 키운다. GPU가 CPU보다 빨리 커지면서 GPU를 계속 바쁘게 하려면 더 큰 CPU 클러스터가 필요하고, CPU는 점점 커지는 병목이 된다." 랙 하나에 컴퓨트 트레이 32개(위 16개, 아래 16개)가 가운데 스위치 트레이 4개를 감싸고, 트레이마다 Vera CPU 8개가 들어가 랙당 CPU 256개입니다. 이 밀도 때문에 수랭이 필요하지만, 모든 연결이 구리 케이블 길이 안에 들어와 광 트랜시버를 없앤 비용이 냉각 비용보다 크다는 것이 엔비디아의 셈법입니다. Vera가 소켓당 88코어이니 랙 하나에 코어 2만 2,528개입니다.
헤드 노드 쪽에도 사연이 있습니다. SemiAnalysis는 Grace의 약점을 길게 설명합니다. Grace에 쓰인 Arm Neoverse V2 코어는 분기 예측기의 목표 버퍼가 명령 주소 공간을 2MB 영역 32개로 나눠 기억하는데, 뜨거운 코드가 24개 영역을 넘으면 성능이 급격히 떨어지고, 32개를 넘으면 버퍼 전체(64MB 분량)가 비워집니다. 분기 예측기가 모든 것을 잊으면 연산 장치는 할 일을 기다리며 놉니다. NVIDIA 튜닝 가이드는 큰 프로그램의 코드 배치를 바꾸면 최대 50% 빨라진다 고 적고 있고, SemiAnalysis는 "지금 GB200과 GB300의 AI 작업이 Grace 때문에 느려지고 있다"고 씁니다. 엔비디아가 Vera에서 8년 만에 자체 CPU 코어(Olympus)를 다시 만들고 SMT를 되살린 배경입니다.
x86 쪽 소식은 엇갈립니다. AMD Venice는 2나노 CCD 8개로 256코어를 만들고, 최상위 Turin보다 와트당 성능이 1.7배 이상이라고 AMD가 밝혔습니다. Intel Diamond Rapids는 SMT를 빼면서, SemiAnalysis 추정으로 128코어·256스레드 Granite Rapids보다 약 40% 빠른 데 그칠 전망입니다. 288코어 E코어 칩 Clearwater Forest는 출시가 반년 밀렸고, Intel 스스로 같은 코어 수의 전 세대보다 17% 빠르다고 밝혔습니다. 무엇보다 Intel은 주력 8채널 Diamond Rapids-SP 플랫폼을 취소해 가장 많이 팔리는 시장에 최소 2028년까지 새 세대가 없습니다. SemiAnalysis의 평가는 날카롭습니다. "AI 도구 사용과 컨텍스트 저장을 위한 범용 연산은 소켓당 거대한 성능보다 연결성이 좋은 주류 CPU를 쓴다. 우리는 이것이 잘못된 선택이라고 본다."
Arm 진영은 클라우드 회사들의 자체 칩(AWS Graviton5 192코어, Microsoft Cobalt 200 132코어, Google Axion)에, Arm이 처음으로 칩 전체를 설계해 파는 Phoenix(첫 고객 Meta)까지 더해졌습니다. AWS는 Graviton 수천 개를 사내 CI/CD와 칩 설계 검증에 쓰고 있다고 밝혔는데, 'CPU가 CPU를 설계한다'는 이 구조는 에이전트가 테스트를 돌리는 구조와 다르지 않습니다.
아래 위젯에 SemiAnalysis 공개 구간에 나온 2026년 CPU 열 종을 정리했습니다. 성능 배수는 회사 주장과 SemiAnalysis 추정을 구분했습니다.
5장. 코어닷투데이 실측 ① — 맥 한 대에서 돌린 코딩 에이전트
공개 자료만으로는 'GPU 한 장당 CPU 몇 개'의 핵심 재료인 스텝당 CPU초를 알 수 없습니다. 그래서 가장 작은 강화학습 환경을 직접 만들어 돌렸습니다. 크레딧이 드는 API는 쓰지 않았고, 모든 것이 데스크톱 맥 한 대(CPU 20코어) 안에서 돌았습니다.
샌드박스 저장소 가계부 패키지 · 버그 3개
→
에이전트 루프 Ollama qwen3.5:9b
→
도구 5종 목록·읽기·검색·교체·테스트
→
스텝마다 기록 모델 시간 · 도구 벽시계 · CPU초
환경. 작은 파이썬 패키지(가계부 CSV를 읽어 월별·분류별로 합치는 코드)에 버그 세 개를 심었습니다. 날짜의 월과 일을 뒤바꾸는 버그, 짝수 개 중앙값의 인덱스 버그, 백분율 계산 버그입니다. 이 버그들은 핵심 테스트 열 개 중 다섯 개를 깨뜨립니다. 여기에 버그가 없는 경로를 무거운 입력(4,000줄 CSV)으로 도는 부하 테스트를 붙여, 전체 테스트 수를 50개, 410개, 1,610개, 6,410개로 바꿨습니다. 코드와 버그는 같고, 테스트 묶음의 무게만 다릅니다. 실제 저장소에서 테스트가 많을수록 '고친 뒤 확인'이 비싸지는 상황을 흉내 낸 것입니다.
에이전트. 로컬 모델 qwen3.5:9b(생각 모드 끔, 온도 0)가 다섯 가지 도구를 씁니다. 파일 목록, 파일 읽기, 정규식 검색(ripgrep), 문자열 교체, 전체 테스트 실행(pytest). "테스트를 고치지 말고 패키지 코드를 고쳐 전부 통과시키라"는 지시만 받습니다. 각 설정을 시드 세 개(7·11·23)로 돌렸고, 테스트 실행은 직렬(작업자 1개)과 병렬(pytest-xdist 작업자 8개) 두 가지로 했습니다.
기록. 스텝마다 모델 호출의 벽시계 시간과 Ollama가 돌려준 입력 처리·생성 시간, 도구 실행의 벽시계 시간과 CPU초(실행 전후 자식 프로세스의 사용자+시스템 시간 차이)를 남겼습니다.
에이전트는 거의 모든 실행에서 11~13스텝 만에 버그 세 개를 모두 고쳤습니다(24번 중 23번 성공). 결과를 실행 한 번 평균으로 정리하면 이렇습니다.
첫째, 모델 시간은 테스트 수와 거의 무관했습니다. 실행당 14~16초. 에이전트가 하는 생각의 양은 버그의 수와 코드의 크기로 정해지지, 테스트가 몇 개인지와는 상관이 없습니다. 테스트 출력의 마지막 부분만 모델에게 돌려줬기 때문에 입력 길이도 크게 달라지지 않았습니다.
둘째, 도구의 CPU초는 테스트 수에 비례해 커졌습니다. 테스트 한 번 실행에 50개는 CPU 0.5초, 6,410개는 58초가 들었습니다. 그 결과 모델 1초당 CPU초가 0.09에서 8.37로 약 90배가 됐습니다. 직렬로 돌리면 실행 시간의 89%를 테스트를 기다리며 보냈습니다.
셋째, 병렬화는 기다림을 줄였지만 CPU초를 줄이지 못했습니다. 작업자 8개로 돌리면 6,410개 테스트 한 번이 59초에서 9초로 줄었고, 도구 몫도 89%에서 51%로 내려갔습니다. 그런데 CPU초는 58초에서 69초로 오히려 18% 늘었습니다. 작업자 프로세스를 띄우고 각자 패키지를 불러오고 결과를 모으는 비용입니다. 병렬화는 '사람(또는 GPU)이 기다리는 시간'을 '코어 여러 개가 동시에 일하는 시간'으로 바꿀 뿐이고, 그 코어는 어딘가에 있어야 합니다. 메모리도 마찬가지입니다. 6,410개 테스트를 돌리는 동안 프로세스들의 메모리 합계는 직렬일 때 최대 85MB, 작업자 8개일 때 최대 677MB로 여덟 배가 됐습니다.
하나 더 있습니다. 모델이 도는 동안 Ollama 프로세스 자체도 CPU를 썼습니다. 모델 1초당 약 0.6 CPU초. 맥의 GPU에 일을 넣고 결과를 받아 토큰을 처리하는 호스트 쪽 일입니다. 데이터센터에서 이것은 헤드 노드 CPU의 몫이고, 도구 실행과는 별도입니다.
생각 모드를 켜면 어떨까요. 테스트 1,610개, 직렬 설정에서 같은 시드(7)로 생각 모드를 켜자 모델 시간이 15초에서 29초로 두 배가 됐지만, 모델은 그만큼 테스트도 더 자주(2번에서 4번) 돌렸습니다. 모델 1초당 CPU초는 1.89에서 1.97로 거의 그대로였습니다. 더 오래 생각하는 모델이 도구를 덜 쓰리라는 기대는 적어도 이 실험에서는 맞지 않았습니다.
이 실험은 장난감입니다. 9B 모델은 데이터센터의 대형 모델보다 훨씬 빠르게 답하고(스텝당 약 1.2~1.5초), 롤아웃 하나만 돌렸으니 배치가 없습니다. 실제 RL에서는 스텝당 모델 시간이 더 길어져 모델 1초당 CPU초가 그만큼 작아집니다. 반대로 실제 저장소의 테스트는 우리 부하 테스트보다 무겁고, 의존성 설치와 빌드와 컨테이너 기동이 붙습니다. 그러니 절대값보다 모양을 가져가야 합니다. 모델 시간은 일감의 '생각 양'에, CPU초는 '확인 비용'에 비례하고, 둘은 서로 독립적으로 움직입니다. 그 비율이 GPU 옆에 둘 코어 수를 정합니다.
6장. 코어닷투데이 실측 ② — Claude Code 로그 26일, 무엇을 기다렸나
로컬 실험은 조건을 통제할 수 있지만 작고 인공적입니다. 그래서 실제 작업 기록도 셌습니다. Claude Code는 세션마다 대화 기록을 로컬 JSONL 파일로 남기고, 줄마다 기록 시각을 붙입니다. 모델이 도구를 부르는 블록(tool_use)과 그 결과(tool_result), API 요청을 보낸 시각도 따로 남습니다. 코어닷투데이는 2026년 10월 4일부터 29일까지 26일 동안 한 사람의 맥 한 대에 쌓인 메인 세션 290개와 서브에이전트 기록 793개를 읽기 전용으로 집계했습니다. 내용과 경로, 프로젝트 이름은 보지 않고 시각과 도구 이름, 셸 명령의 종류(첫 낱말 기준 분류)만 셌습니다.
측정 정의
도구 시간
tool_use 블록이 기록된 시각 → 같은 id의 tool_result가 기록된 시각. 도구 실행, 결과 전달, 클라이언트 처리가 들어간다.
모델 시간
API 요청이 나간 시각 → 그 응답의 마지막 블록이 기록된 시각. 서버 대기열, 네트워크, 입력 처리, 생각과 출력 생성이 모두 들어간다.
활성 시간의 몫
세션마다 두 종류의 구간을 시간축에 겹쳐 놓고 '모델만', '도구만', '둘 다'인 시간을 더한다. 어느 쪽도 아닌 시간(사람이 다음 지시를 생각하는 시간)은 뺀다.
모델 응답 6만 2,600번, 도구 호출 7만 7,197번이 잡혔습니다. 결과는 이렇습니다.
메인 세션의 활성 시간 약 235시간 가운데 모델을 기다린 시간이 57.2%(134.6시간), 도구를 기다린 시간이 42.2%(99.3시간)였고, 둘이 겹친 시간은 0.6%였습니다. 서브에이전트는 모델 67.8%, 도구 30.2%로 모델 쪽이 더 컸습니다. 서브에이전트는 주로 조사·읽기를 맡아 무거운 테스트를 덜 돌리기 때문으로 보입니다.
이 숫자를 Claude Code 자신의 계기판과 맞춰 봤습니다. Claude Code는 세션마다 누적 API 시간과 누적 도구 시간을 따로 기록합니다(cost-state). 그 값이 남은 세션 273개를 더하면 API 195.2시간, 도구 113.1시간, 도구 몫 36.7%였습니다. 서브에이전트까지 합친 코어닷투데이의 시간축 계산(약 38%)과 2%포인트 안쪽으로 맞습니다. 정의가 조금 다른 두 계산이 같은 자리에 떨어졌다는 점에서, '에이전트 활성 시간의 40% 안팎은 도구'라는 결론은 측정 방법의 산물이 아니라고 봅니다.
중앙값은 0.2초, 합계는 42%
그런데 호출 하나하나를 보면 도구는 순식간입니다.
무엇
호출 수
중앙값
상위 10% 경계
합계
모델 응답 (메인)
35,455
7.0초
30.0초
136.2시간
모델 응답 (서브에이전트)
27,145
5.3초
20.4초
84.4시간
Bash (셸 명령 전체)
55,049
0.21초
10.1초
135.3시간
Read · Write · Edit
10,754
0.02초
0.1~0.3초
1.4시간
WebSearch · WebFetch
9,955
5.5~6.6초
9~12초
20.2시간
Bash · 테스트
2,992
5.4초
51.6초
22.0시간
Bash · 빌드·타입체크·린트
1,904
5.9초
29.0초
8.9시간
Bash · 스크립트 실행
14,076
0.39초
18.9초
55.4시간
Bash · 파일 조회·셸 기본
26,124
0.08초
1.1초
17.3시간
셸 명령의 중앙값은 0.21초, 모델 응답의 중앙값은 7.0초입니다. 중앙값만 보면 '에이전트는 거의 언제나 모델을 기다린다'가 맞습니다. 합계가 42%로 뒤집히는 이유는 꼬리입니다. 도구 호출 가운데 10초를 넘긴 것은 8.6%뿐인데, 이것이 도구 시간의 82.6%를 차지했습니다. 1분을 넘긴 2.3%가 64%, 5분을 넘긴 0.5%가 33%였습니다. 파일을 읽고 고치는 가벼운 호출은 수만 번이어도 합쳐서 한두 시간이지만, 테스트·빌드·스크립트 몇천 번이 수십 시간을 만듭니다.
도구 시간을 성격별로 나누면 이렇습니다(서브에이전트 포함 157.3시간).
스크립트·일괄 처리
44.0%
웹·네트워크·대기
21.7%
테스트·빌드·설치
20.8%
파일·git·가벼운 도구
13.5%
테스트·빌드·패키지 설치처럼 CPU를 확실히 태우는 일은 호출 수로는 6.6%(5,132번)지만 도구 시간의 20.8%였습니다. 가장 큰 덩어리인 '스크립트·일괄 처리'(44%)는 데이터 변환, 실험 스크립트, 로컬 모델 호출 같은 것이 섞여 있어 CPU 일과 GPU 일, 기다림이 함께 들어 있습니다. 웹 검색·페이지 읽기·원격 명령·폴링(21.7%)은 CPU를 거의 쓰지 않고 기다리기만 합니다. 이 구분이 중요한 이유는 다음 장에서 나옵니다. 벽시계로 잰 도구 시간이 곧 CPU 수요는 아닙니다. 기다림은 코어가 아니라 동시성(열어 둘 수 있는 연결과 메모리)으로 해결하고, 테스트·빌드는 코어로만 해결됩니다.
AgentX의 3.84초와 우리의 0.27초
AgentX가 잰 턴 간 지연의 중앙값은 3.84초였습니다. 같은 방식으로, 한 응답이 끝난 시각부터 다음 요청이 나간 시각까지를 재 보니 코어닷투데이 메인 세션의 중앙값은 0.27초, 서브에이전트는 0.17초였습니다. 열 배 넘게 차이가 납니다. 이유는 몇 가지로 짐작됩니다. AgentX는 HTTP 프록시에서 요청과 응답을 잡았으므로 응답 스트림이 완전히 닫히는 시점과 클라이언트 처리 시간이 포함됩니다. Claude Code는 도구 호출 블록이 완성되는 즉시 도구를 실행하므로, 우리 기록에서는 응답의 '마지막 블록' 시각과 도구 실행 시작이 거의 겹칩니다. 작업의 성격도 다릅니다. 반도체 분석 회사의 작업과 블로그·실험 작업은 도구 구성이 다를 것입니다. 중요한 공통점은 분포의 모양입니다. 두 데이터 모두 로그 정규 분포에 가깝고, 짧은 간격이 대부분이며, 긴 꼬리가 시간을 지배합니다.
세션별로도 편차가 큽니다. 활성 시간이 10분 넘는 메인 세션 203개의 도구 몫은 중앙값 36%였지만, 하위 10%는 15% 이하, 상위 10%는 67% 이상이었습니다. 문서를 읽고 글을 쓰는 세션은 모델 쪽으로, 실험과 테스트를 돌리는 세션은 도구 쪽으로 기웁니다. 'GPU 한 장당 CPU 몇 개'에 하나의 정답이 없는 이유입니다. 일감의 모양이 답을 정합니다.
7장. GPU 한 장에 CPU 몇 개 — 롤아웃 함대를 계산하는 식
이제 두 실측을 'GPU 한 장당 CPU 코어'로 바꿔 보겠습니다. 강화학습의 롤아웃 하나는 모델 스텝(GPU에서 m초)과 도구 스텝(벽시계 w초, CPU c초)을 번갈아 밟습니다. GPU는 한 번에 여러 롤아웃을 묶어 디코드하는데, 이 동시 배치를 B라고 합시다.
GPU가 늘 B개를 디코드하고 있으려면, 도구를 기다리는 롤아웃까지 합쳐 B × (m + w) ÷ m 개의 롤아웃이 떠 있어야 합니다. 롤아웃 하나는 (m + w)초마다 CPU를 c초 쓰므로, 이 롤아웃들이 쓰는 코어는 B × (m + w) ÷ m × c ÷ (m + w), 정리하면 B × c ÷ m입니다. 실제로는 CPU를 100% 쓸 수 없으니 목표 사용률 u로 나눕니다.
롤아웃 함대의 두 식
GPU 한 장당 CPU 코어
동시 배치 B × 스텝당 CPU초 c ÷ 스텝당 모델 시간 m ÷ 목표 사용률 u
GPU 한 장당 떠 있는 롤아웃(샌드박스)
B × (m + 도구 벽시계 w) ÷ m — 여기에 샌드박스당 메모리를 곱하면 필요한 D램
이 식에서 흥미로운 점은 도구의 벽시계 시간 w가 코어 수에서 빠진다는 것입니다. w는 '몇 개를 띄워 둬야 하는가', 곧 메모리와 컨테이너 수를 정하고, 코어 수는 c와 m의 비율, 곧 앞 장에서 잰 모델 1초당 CPU초가 정합니다. 테스트를 병렬로 돌리면 w가 줄어 띄워 둘 샌드박스가 줄지만, c는 줄지 않으니 코어는 그대로 필요합니다. 그리고 5장에서 봤듯 병렬로 도는 샌드박스 하나는 메모리를 몇 배 더 씁니다. 계산기의 샌드박스당 메모리 기본값 2GB는 가정입니다. 우리 장난감 저장소는 테스트 실행 중 최대 85MB(직렬)~677MB(병렬 8)였지만, 실제 저장소와 의존성, 컨테이너 런타임은 이보다 훨씬 큽니다.
동시 배치를 64, CPU 목표 사용률을 70%로 두고 실측 값을 넣으면 이렇습니다.
일감 (실측 프리셋)
모델 1초당 CPU초
GPU 한 장당 코어
GPU당 떠 있는 롤아웃
로컬 · 테스트 50개
0.09
약 8
약 70
로컬 · 테스트 410개
0.72
약 66
약 111
로컬 · 테스트 1,610개
2.18
약 199
약 204
로컬 · 테스트 6,410개
8.37
약 765
약 603
Claude Code 로그 · 테스트·빌드·설치만 CPU
0.15
약 14
약 110
Claude Code 로그 · 스크립트 절반도 CPU
0.31
약 28
약 110
맨 아래 두 줄은 Claude Code 로그의 평균에서 만든 프리셋입니다. 모델 응답 한 번에 평균 12.7초, 그 뒤 도구에 평균 9.0초가 걸렸고, 그중 테스트·빌드·설치는 응답 한 번당 1.9초였습니다. 이 시간을 CPU 한 코어가 꽉 찬 시간으로 가정하면 모델 1초당 CPU초는 0.15, 스크립트 시간의 절반도 CPU 일이라고 보면 0.31입니다. Claude Code의 모델 시간은 대형 모델을 원격 API로 부른 시간이라 로컬 9B보다 열 배 가까이 깁니다. 그만큼 같은 도구 부담에서도 GPU 한 장당 코어는 적게 나옵니다.
표의 범위는 넓습니다. GPU 한 장당 코어 8개에서 700개 넘게까지. 이것이 이 글의 가장 정직한 결론입니다. 답은 일감에 달려 있고, 일감의 무게는 잴 수 있습니다. 예를 들어 테스트 1,610개짜리 과제로 GPU 256장 규모의 RL을 돌린다면, 모델 시간이 로컬 실측 그대로일 때 약 5만 1천 코어(Vera ETL256 랙 두 개 남짓)가 필요하고, 대형 모델이라 스텝당 모델 시간이 다섯 배라면 약 1만 200코어로 줄어듭니다. 어느 쪽이든 GPU 서버에 딸린 헤드 노드 CPU(GPU 2~4장당 하나)로는 감당할 수 없는 규모입니다.
Fairwater로 돌아가 보면, 3장의 계산기 기본값은 GPU 한 장당 별도 CPU 코어 약 62개였습니다. 위 표에서 테스트 410개짜리 로컬 일감(약 66)과 비슷한 자리입니다. 가정이 많은 비교라 맞춰 보는 정도로만 읽어야 하지만, 적어도 SemiAnalysis의 1:6이 터무니없는 숫자가 아니라 '중간 무게의 에이전트·RL 일감'과 같은 자릿수라는 것은 확인할 수 있습니다. 그리고 GPU가 빨라져 m이 줄어들수록, 같은 일감에 필요한 코어는 늘어납니다. "Rubin 세대는 1:6보다 높은 비율이 필요할 수 있다"는 SemiAnalysis의 말을 이 식으로 다시 쓰면 그렇게 됩니다.
8장. CPU만이 아니다 — 서버 D램도 같이 먹는다
샌드박스는 코어만 쓰지 않습니다. 컨테이너마다 저장소, 의존성, 테스트 프로세스가 메모리에 올라갑니다. 1만 개를 동시에 띄우면 메모리도 1만 배입니다. 그런데 바로 그 서버 D램이 지금 가장 귀한 부품 중 하나입니다.
SemiAnalysis는 9월 13일 글 「4단 HBM이 이기는 이유」에서 HBM을 덜 쌓으면(4단) 같은 D램 웨이퍼에서 HBM 묶음을 두 배 넘게 얻을 수 있고, 그러면 HBM에 잠식당한 일반 D램 공급에도 숨통이 트인다고 설명하면서 이렇게 씁니다.
가장 먼저 떠오르는 것은 서버 D램이다. 한정된 서버 D램 공급을 최대한 활용하려고 소켓당 D램이 크게 깎이고 있다. 이것은 에이전트 작업을 받치는 일과도 깊이 관련되어 있다. 에이전트 작업에서는 GPU가 토큰을 디코드하는 것보다 CPU 관련 실행을 기다리는 데 많은 시간이 실제로 쓰인다.
같은 흐름이 GPU 서버 안에서도 보입니다. 9월 14일 Vera Rubin 측정 글에서 SemiAnalysis는 실험한 랙이 "컴퓨트 트레이당 CPU 메모리 1.5TB"인 생산 사양이며, 엔비디아가 Vera의 메모리를 절반으로 줄여야 했던 이유는 유료 모델에서 다룬다고 적었습니다. Vera 한 소켓은 설계상 1.5TB까지 붙일 수 있습니다.
헤드 노드의 D램은 에이전트 추론에서 또 다른 일도 맡습니다. KV 캐시를 내려 두는 창고입니다. AgentX 측정에서 B300 서버에 D램 3TB를 붙여 KV를 내려 두게 했더니, 동시 에이전트 384개에서 HBM 캐시 적중 91%에 D램 적중이 1.36% 더해졌습니다. HBM이 작은 B200에서 동시 196개로 돌리면 HBM 적중은 73%로 떨어지고 D램 적중이 20% 가까이 됐습니다. 3만 2천 토큰의 앞부분을 CPU 메모리에서 다시 읽는 데 약 0.32초, 처음부터 다시 계산하는 데 약 2.5초가 걸려 여덟 배 차이가 납니다. SemiAnalysis는 D램이 HBM KV 용량의 1.5~3배는 되어야 이런 내려 두기가 효과적이라고 봅니다. 코어닷투데이가 미드필 글에서 다룬, 에이전트가 쉬는 동안 KV를 어디에 두느냐의 문제가 여기서 CPU 쪽 메모리 문제로 이어집니다.
정리하면 에이전트는 서버 D램을 세 군데서 찾습니다. ① GPU 서버의 헤드 노드(KV 내려 두기), ② 범용 CPU 풀의 샌드박스(환경 실행), ③ 스토리지 노드(롤아웃 기록·체크포인트). 셋 다 HBM과 같은 D램 웨이퍼를 두고 경쟁합니다.
한국 독자에게는 이 대목이 자연스럽게 삼성전자와 SK하이닉스로 이어집니다. 다만 SemiAnalysis의 「CPU가 돌아왔다」에서 D램 부족이 CPU 세그먼트별로 미치는 영향은 유료 구간이라, 코어닷투데이는 수요 증가율이나 업체별 득실을 추정하지 않습니다. 공개 구간에서 말할 수 있는 것은 방향뿐입니다. 에이전트와 RL이 늘수록 HBM만이 아니라 서버 D램(DDR5·LPDDR5X·SOCAMM)의 수요도 함께 커지고, 그 D램은 HBM과 같은 공장에서 나옵니다.
9장. 반론과 한계 — 어디까지 믿을까
SemiAnalysis 쪽의 한계. 「CPU가 돌아왔다」는 2월 글이고, 2028년까지의 로드맵과 D램 부족의 영향은 유료 구간이라 이 글에 넣지 않았습니다. Fairwater의 1:6은 데이터센터 하나의 숫자이며, 48MW 안의 CPU와 스토리지 몫이 공개되지 않았습니다. 다른 데이터센터, 다른 일감(사전학습 중심, 추론 중심)에서는 비율이 다를 것입니다. Venice 1.7배, Vera 2배 같은 성능 배수는 회사 발표이고, Diamond Rapids 40%는 SemiAnalysis의 추정입니다. SemiAnalysis는 CPU 수요 모델과 컨설팅을 파는 회사라 'CPU 수요가 급증한다'는 이야기에 이해관계가 있다는 점도 기억해 둘 만합니다.
로컬 실험의 한계. 9B 모델 하나, 생각 모드 대부분 끔, 맥 한 대, 롤아웃 하나씩 순서대로 돌렸습니다. 실제 RL에서는 수백 개의 롤아웃이 한 GPU의 배치를 나눠 쓰므로 롤아웃 하나의 스텝당 모델 시간이 우리 측정보다 길고, 모델이 클수록 더 깁니다. 그러면 모델 1초당 CPU초는 줄어듭니다. 반대로 저장소는 우리 장난감보다 훨씬 크고, 의존성 설치·빌드·컨테이너 기동이 붙으며, 에이전트가 테스트를 훨씬 자주 돌립니다(우리 에이전트는 실행당 2~5번만 돌렸습니다). 그러면 CPU초는 늘어납니다. 두 방향의 오차가 있으므로 이 글의 숫자는 '자릿수와 모양'으로 읽어야 합니다.
Claude Code 로그의 한계. 한 사람, 한 기계, 한 도구, 26일입니다. 도구 시간은 벽시계 시간이고 CPU 시간이 아닙니다. 웹 검색은 원격 서버를 기다린 시간이며, '스크립트 실행'에는 로컬 GPU를 쓰는 일도 섞여 있습니다. 모델 시간에는 서버 대기열과 네트워크가 들어 있어 순수 GPU 시간보다 깁니다. 기록 시각은 밀리초 단위지만 블록이 '완성된' 시각이라, 토큰이 흐르기 시작한 시각은 알 수 없습니다. 여러 도구를 동시에 부른 경우는 합집합으로 처리했고, 서브에이전트가 메인 세션과 동시에 돈 시간은 메인 세션 몫에서 따로 세지 않았습니다. 셸 명령의 분류는 첫 낱말 기준이라 틀린 칸에 들어간 명령도 있을 것입니다.
구조적 반론. 도구 시간이 길다고 GPU가 노는 것은 아닙니다. 추론 서버는 한 대화가 도구를 기다리는 동안 다른 대화를 처리하고, RL 프레임워크는 비동기 롤아웃과 학습 도중 가중치 교체로 기다림을 숨깁니다. SemiAnalysis도 이런 방식이 같은 시간의 반복 횟수를 2배까지 늘릴 수 있다고 썼습니다. 그러니 '도구 시간 42%'를 'GPU 사용률 58%'로 읽으면 안 됩니다. 대신 이렇게 읽어야 합니다. GPU를 바쁘게 유지하려면 도구를 기다리는 대화가 그만큼 더 많이 떠 있어야 하고, 그 대화들의 도구를 돌릴 CPU와 메모리가 있어야 한다. 7장의 식이 정확히 이 관계입니다.
한국에서 에이전트와 RL을 준비하는 팀들의 대화는 대개 GPU 수에서 시작합니다. 몇 장을, 얼마에, 몇 달 빌리느냐. ClusterMAX 3.0에 따르면 국가 대표 파운데이션 모델 사업 1차에서 정부가 SK텔레콤과 네이버로부터 H100 환산 약 3,000장을 빌렸고, SK텔레콤은 이 사업에 B200을 1,000장 넘게 돌리고 있습니다. 사전학습 단계에서는 GPU 수가 곧 계획이었습니다. 그런데 사후학습(RL)과 에이전트 서비스로 넘어가면 장부에 줄이 하나 더 필요합니다.
첫째, 샌드박스 CPU·메모리를 따로 견적한다. GPU 서버의 헤드 노드 CPU는 GPU를 먹이는 몫입니다. 수천 개의 환경 컨테이너를 그 위에 얹으면 GPU를 먹이는 CPU와 다툽니다. 7장의 계산기로 'GPU 한 장당 코어'를 먼저 정하고, 그만큼을 별도 CPU 노드나 클라우드 CPU 인스턴스로 잡습니다.
둘째, 환경의 무게를 먼저 잰다. 같은 코딩 RL이라도 테스트 50개짜리 과제와 6,000개짜리 과제는 CPU 수요가 수십 배 다릅니다. 과제 묶음을 만들 때 과제당 테스트 시간과 CPU초를 함께 기록해 두면 코어 수를 계산할 수 있고, 지나치게 무거운 과제를 덜어 내는 판단도 할 수 있습니다.
셋째, 병렬화와 코어는 짝이다. 테스트 병렬 실행은 기다리는 시간을 줄여 GPU 쪽 배치를 덜 필요하게 만들지만, CPU초는 그대로이거나 조금 늘어납니다. 코어가 없으면 병렬화는 대기열만 만듭니다.
넷째, 서버 D램 값이 오르는 국면임을 예산에 반영한다. 샌드박스 밀도(노드당 컨테이너 수)는 대개 코어보다 메모리에서 먼저 막힙니다. 메모리 가격이 오르는 동안에는 컨테이너당 메모리를 줄이는 설계(공유 의존성 이미지, 가벼운 테스트 러너)가 곧 비용 절감입니다.
다섯째, 에이전트 서비스라면 '사용자 쪽 CPU'를 잊지 않는다. 사람이 쓰는 코딩 에이전트에서는 도구가 사용자 노트북에서 돌기 때문에 서비스 회사의 장부에 CPU가 보이지 않습니다. 같은 기능을 클라우드 샌드박스로 옮기는 순간(원격 에이전트, 백그라운드 작업) 그 CPU가 회사 장부로 넘어옵니다. 코어닷투데이 로그 기준으로는 활성 시간의 40% 안팎이 그 몫이었습니다.
맺음말 — 손발을 세는 장부
2023년부터 3년 동안 AI 인프라의 질문은 "GPU를 몇 장 구했나"였습니다. 에이전트는 이 질문을 바꿉니다. 모델은 머리이고, 도구는 손발입니다. 머리가 아무리 빨라도 손발이 테스트를 돌리고 파일을 뒤지고 결과를 가져오기 전에는 다음 생각을 할 수 없습니다.
코어닷투데이가 잰 숫자들은 같은 그림을 가리켰습니다. 에이전트 활성 시간의 40% 안팎은 도구를 기다리는 시간이었고, 그 대부분은 드물게 오래 걸리는 테스트·빌드·스크립트였습니다. 테스트가 무거워질수록 모델 1초당 CPU초는 가파르게 늘었고, 병렬화는 그 시간을 감출 수는 있어도 없애지는 못했습니다. Microsoft는 GPU 295MW 옆에 CPU·스토리지 48MW를 지었고, 엔비디아는 GPU 없는 CPU 랙을 팔기 시작했으며, Intel은 CPU 값을 올리려 합니다.
GPU 한 장 옆에 CPU가 몇 개 필요한지에 대한 보편적인 답은 없습니다. 다만 그 답을 구하는 식은 있습니다. 동시 배치 × 스텝당 CPU초 ÷ 스텝당 모델 시간. 세 숫자 중 둘은 우리 팀의 로그에서 바로 잴 수 있습니다. 다음 GPU 견적서를 쓰기 전에, 에이전트가 무엇을 기다리는지부터 재 보기를 권합니다.
참고문헌
SemiAnalysis 뉴스레터 (newsletter.semianalysis.com, 각 글의 무료 공개 구간)