법률 AI리걸테크HarveyLegoraClaude for LegalAstra for LawHarvey LABAI 환각허위 판례시간당 청구AI 네이티브 로펌재판지원 AI변호사법AI기본법특집
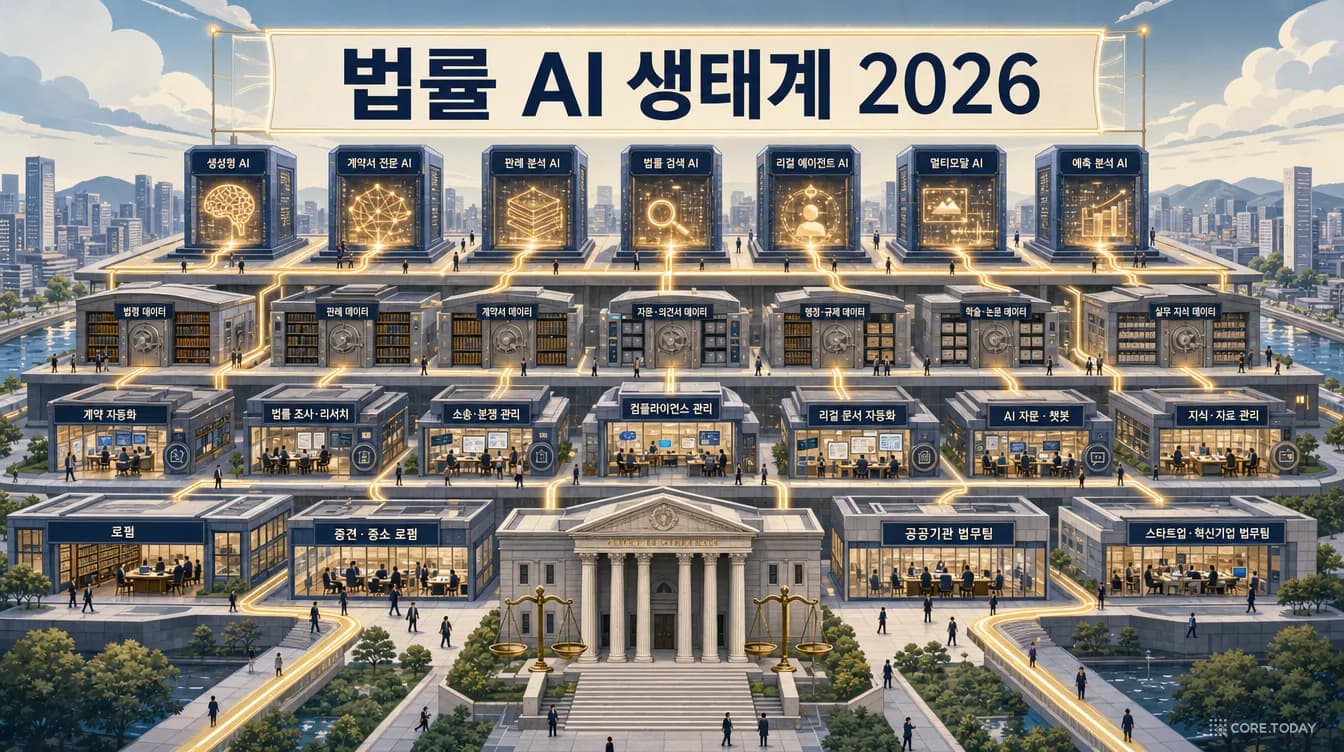
법률 AI 생태계 지도 2026 — 모델 회사는 법률로 내려오고, 법원은 검증을 요구하고, 돈은 '책임질 수 있는 결과물'로 모인다
2026년 2월 3일, Anthropic이 법률 업무 플러그인 하나를 내놓자 Thomson Reuters 주가가 하루에 16% 빠졌습니다. 그런데 반년 뒤 그 회사의 법률 매출은 10% 늘었고, 같은 해 법률 AI 스타트업 Harvey의 몸값은 80억 달러에서 155억 달러로 뛰었습니다. 한쪽에선 전 세계 법원이 AI가 지어낸 판례를 지적한 결정이 2,184건까지 쌓였고, 한국 법원 판결문에는 'AI Hallucination'이라는 영어가 그대로 적혔습니다. 모순처럼 보이는 이 장면들은 하나의 지도 위에 놓으면 이해됩니다. 모델·데이터·업무 도구·로펌·법원의 다섯 층이 2024년에서 2026년 사이 각각 어떻게 움직였는지, 법률 AI 시험지가 '변호사시험'에서 '실무 과제 전 항목 통과'로 바뀐 이유, 시간당 청구가 흔들리는 경제학, 신입 변호사의 사다리, 나홀로 소송의 역설, 그리고 한국 법원·로펌·리걸테크의 2026년까지. 논문과 판결과 실적 발표를 근거로 일곱 가지 인사이트를 뽑았습니다. 인터랙티브 6개, 논문·보고서 그림 8장, 삽화 9장.
장면 하나. 2026년 2월 3일, 뉴욕과 토론토와 런던. Anthropic이 자사 에이전트 앱 Cowork에 법률 업무용 플러그인을 붙였습니다. 계약서 검토, 비밀유지계약(NDA) 분류, 컴플라이언스 점검 같은 기능이었고, 설명서에는 "결과물은 변호사 검토가 필요하다"고 적혀 있었습니다. 대단한 발표는 아니었습니다. 그런데 그날 하루 동안 Westlaw를 가진 Thomson Reuters의 주가는 16%, LexisNexis의 모회사 RELX는 14%, Wolters Kluwer는 13% 떨어졌습니다. RELX에게는 1988년 이후 가장 큰 하루 낙폭이었다는 보도도 있었습니다. JP모건의 한 애널리스트는 이것을 "재판도 받기 전에 선고받았다"고 표현했습니다.
장면 둘. 2026년 9월 9일, 샌프란시스코. 법률 AI 스타트업 Harvey가 155억 달러 기업가치로 5억 5천만 달러를 투자받았다고 발표했습니다. 9개월 전에는 80억 달러였습니다. 회사는 미국 상위 100대 로펌(Am Law 100)의 80%가 자사 제품을 쓴다고 밝혔습니다. 모델 회사들이 법률 시장에 직접 뛰어든 바로 그해에, 그 시장의 대표 스타트업 몸값이 두 배가 된 것입니다.
장면 셋. 2026년 8월 11일, 대전지방법원. 차량 수리비를 둘러싼 평범한 민사 항소심에서 재판부가 판결문에 이렇게 적었습니다. 원고가 준비서면에 인용한 대법원 판결들은 "모두 존재하지 아니하거나 실제 판시와 전혀 다른 내용으로, 인공지능 환각(AI Hallucination)으로 보인다." 한국 판결문에 이 영어 단어가 박힌 것은 상징적이었습니다. 같은 해 6월 특허법원에서는 경력 27년 차 변호사가 AI가 만든 가짜 판례 8건을 검증 없이 냈다가 판결문에 그 사실이 남았습니다.
장면 넷. 2026년 7월 1일, 서울. 법무법인 태평양이 국내 로펌 처음으로 Harvey를 전 구성원에게 도입했습니다. 두 달 뒤에는 Harvey의 경쟁자 Legora가 한국에 상륙했고, 김앤장·광장·태평양·세종·율촌 다섯 곳이 모두 시험 운영이나 도입 검토에 들어갔다는 보도가 나왔습니다. 그런데 같은 해 한국 10대 로펌의 신입 변호사 채용은 274명에서 244명으로 10.9% 줄었습니다. 그 로펌들의 매출이 두 자릿수로 늘어난 해였는데도요.
공포와 열광, 사고와 도입, 성장과 감원이 한 해에 한꺼번에 일어났습니다. 따로 보면 모순처럼 보이는 장면들입니다. 하지만 법률 AI를 하나의 '생태계'로 놓고 층별로 나눠 보면 이 장면들은 같은 이야기의 다른 단면이 됩니다. 이 글은 그 지도를 그려 보려는 시도입니다.
?
이 글이 답하려는 질문
모델 회사들이 법률 시장에 직접 들어온 2026년, 법률 AI의 가치는 어디에서 생기고 어디로 흘러가는가? 그리고 그 흐름 속에서 로펌·법무팀·법원·시민·한국 시장은 각각 무엇을 해야 하는가?
→
읽는 방법
생태계를 모델 · 데이터 · 업무 도구 · 로펌과 법무팀 · 법원과 규제의 다섯 층으로 나누고, 각 층에서 2024년과 2026년 사이 무엇이 바뀌었는지 사례와 숫자로 따라갑니다. 중간에 '시험지가 바뀐 이야기'와 '접근성의 역설', 그리고 한국을 따로 다룹니다.
!
미리 말하는 결론
AI가 법률 문서를 '만드는' 비용은 거의 0에 가까워졌습니다. 그래서 희소해진 것은 그 문서가 맞다고 '확인하고 책임지는' 능력입니다. 2026년 법률 AI 생태계의 모든 층은 이 희소성을 누가 쥐느냐를 두고 재배치되고 있습니다.
1. 3년 만에 바뀐 질문: "AI가 법을 아는가"에서 "AI의 결과물을 누가 책임지는가"로
생태계가 왜 지금 이렇게 움직이는지 이해하려면, 지난 3년 동안 사람들이 법률 AI에게 던진 질문이 어떻게 바뀌었는지부터 보는 것이 좋습니다. 질문이 바뀌면 시험지가 바뀌고, 시험지가 바뀌면 돈과 규칙이 따라 움직이기 때문입니다.
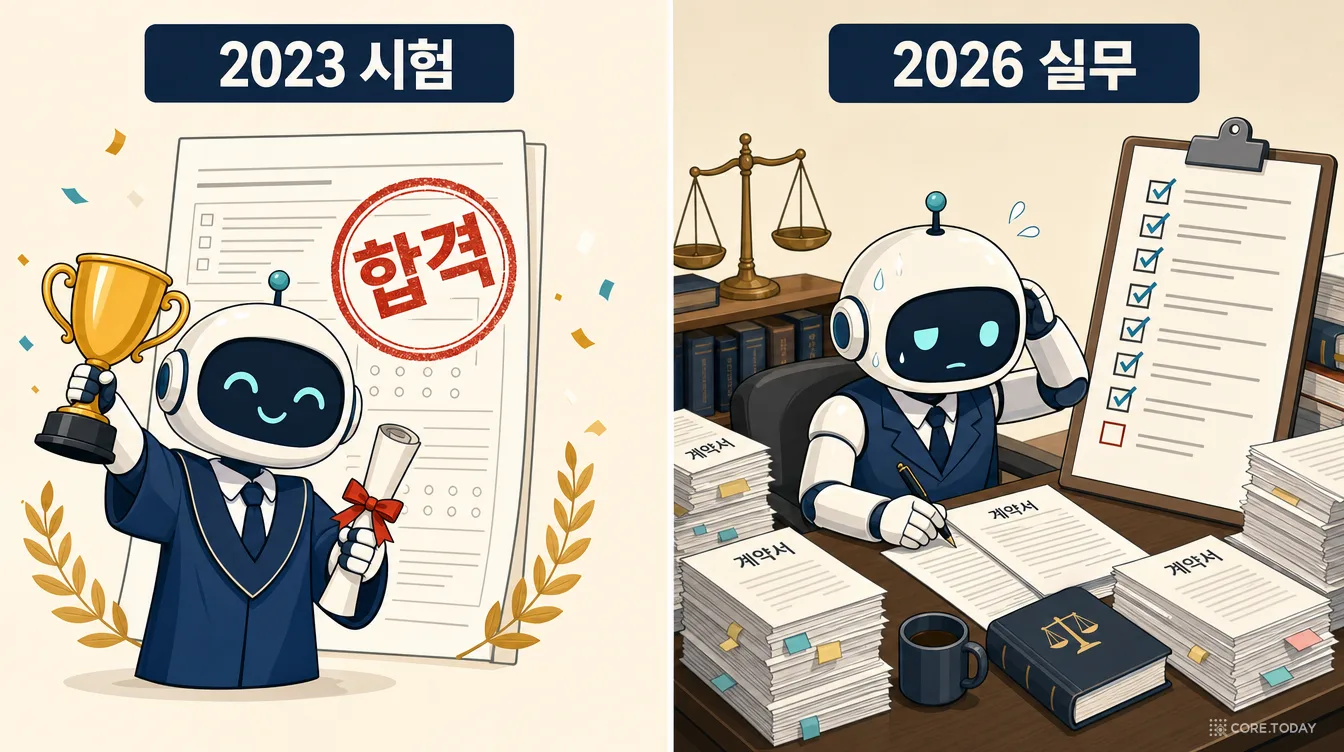
2023"AI가 법을 아는가?" — 3월, GPT-4가 미국 변호사시험(UBE) 모의 평가에서 상위권 점수를 받았다는 발표가 나왔습니다. 6월, 뉴욕의 Mata v. Avianca 사건에서 변호사가 ChatGPT가 지어낸 판례 6건을 법원에 냈다가 5천 달러 제재를 받았습니다. 시험은 붙었는데 법정에서는 망신을 당한 첫해였습니다. Thomson Reuters는 법률 AI 스타트업 Casetext를 6억 5천만 달러에 샀습니다.
2024"근거를 붙이면 믿을 수 있는가?" — 판례 DB에서 근거를 찾아 붙이는 검색 증강 생성(RAG)이 해법으로 떠올랐습니다. 하지만 스탠퍼드 연구진은 Lexis+ AI와 Westlaw의 AI 리서치 도구가 각각 17%, 33%의 질문에서 환각을 낸다고 발표했습니다. '환각 없음'을 내세우던 업체 광고에 정면으로 반박한 연구였습니다.
2025"AI가 일을 끝까지 할 수 있는가?" — 추론 모델과 에이전트가 등장했습니다. 동시에 허위 인용 제재가 폭발했습니다. 6월 영국 고등법원은 "공개된 생성형 AI 도구로는 믿을 만한 법률 조사를 할 수 없다"고 못 박았고, 미국에서는 대형 로펌 K&L Gates와 Butler Snow가 사건에 이름을 올렸습니다. 연말에는 판사가 낸 결정문에서도 AI 오류가 발견됐습니다.
2026"누가 그 결과물을 책임지는가?" — 모델 회사들이 법률 제품을 직접 내놓았고, 법률 회사들은 자기 모델을 훈련하기 시작했습니다. 평가 기준은 '전 항목 통과'로 엄격해졌고, 법원과 의회는 인용을 직접 확인했다는 서명과 AI 사용 고지를 요구하기 시작했습니다. 기술의 질문이 책임의 질문으로 넘어간 해입니다.
이 흐름을 한 문장으로 줄이면 이렇습니다. AI의 능력이 올라갈수록, 질문은 '능력'에서 '책임'으로 옮겨 갔습니다. 2023년에는 AI가 법을 아는지가 뉴스였습니다. 2026년에는 AI가 법을 꽤 안다는 것이 전제이고, 그 대신 "이 문서가 틀리면 누가 물어 주나", "이 인용을 누가 확인했나", "이 효율의 이익은 누구 몫인가"가 뉴스입니다.
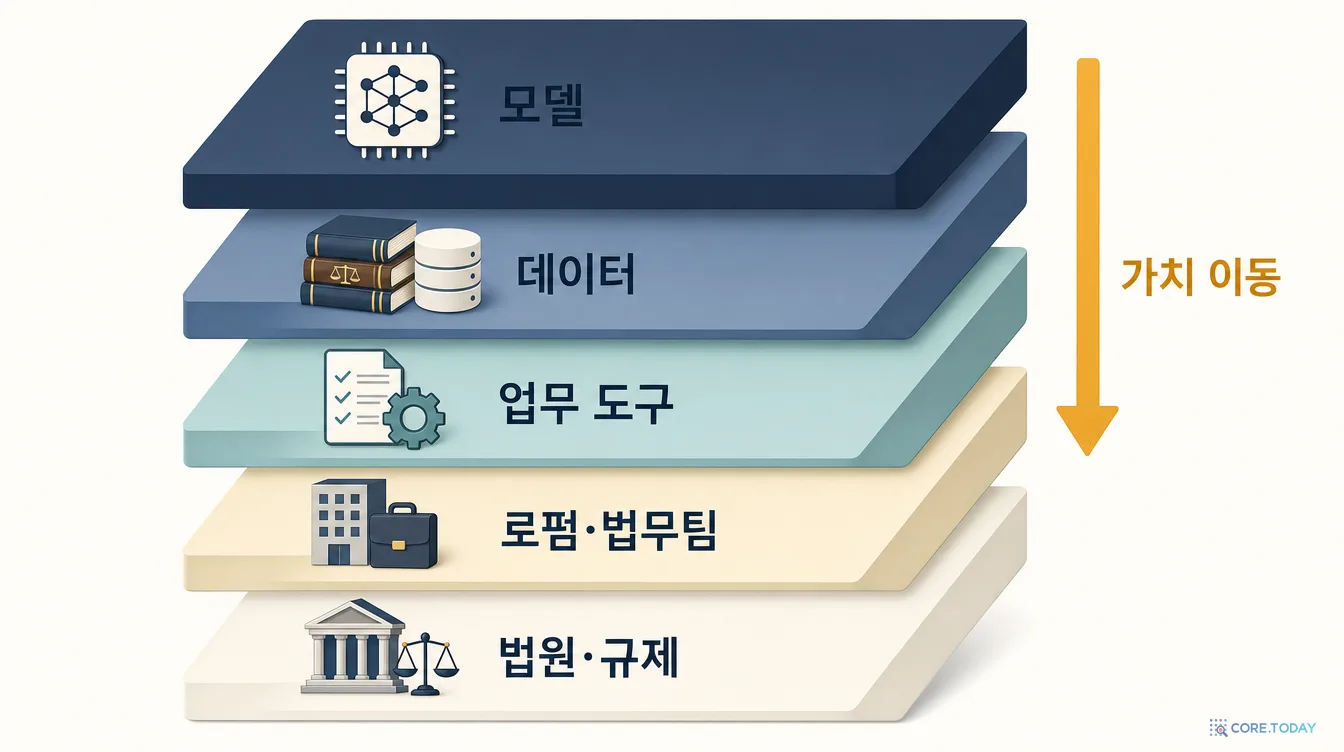
이 변화가 왜 '생태계'의 변화인지 짚어 둘 필요가 있습니다. 법률 서비스는 원래 여러 주체가 맞물려 돌아갑니다. 법을 담은 데이터(판례·법령·해설서)를 만드는 사람, 그것을 찾아 쓰는 도구를 만드는 사람, 그 도구로 일하는 변호사, 그 결과물을 받아 판단하는 법원, 그리고 이 모든 것의 규칙을 정하는 규제 기관이 있습니다. 생성형 AI는 이 사슬의 맨 위에 '모델'이라는 새 층을 얹었고, 그 층이 너무 빨리 강해지자 아래층들이 모두 자리를 다시 잡아야 했습니다.
3층 · 업무 도구Harvey · Legora · CoCounsel · Clio · 엘박스 · 슈퍼로이어모델과 데이터를 엮어 변호사의 업무 흐름에 끼워 넣는 소프트웨어
4층 · 로펌·법무팀대형·중소 로펌, 사내 법무팀, AI 네이티브 로펌결과물에 서명하고 고객에게 값을 받는 주체
5층 · 법원·규제법원 · 변호사 단체 · 의회 · EU · 한국 AI기본법무엇이 허용되고 누가 책임지는지를 정하는 층. 동시에 AI의 사용자
2024년까지 이 지도는 비교적 단순했습니다. 모델 회사는 모델을 빌려주고, 리걸테크 회사는 그 위에 화면을 얹고, 데이터 회사는 DB를 팔고, 로펌은 도구를 사고, 법원은 사고가 나면 제재했습니다. 각자 자기 층에 머물렀습니다.
2026년의 특징은 모두가 자기 층을 벗어나기 시작했다는 것입니다. 모델 회사는 아래로 내려와 법률 제품을 팔고, 도구 회사는 위로 올라가 자기 모델을 훈련하고, 데이터 회사는 도구와 모델을 동시에 만들고, 로펌은 GPU 서버를 사고, 법원은 자기 AI를 개통합니다. 아래 지도에서 층을 하나씩 눌러 2024년과 2026년을 비교해 보세요.
이제 층을 하나씩 내려가 봅니다.
3. 1층, 모델: 모델 회사는 내려오고, 법률 회사는 올라간다
3-1. 모델 회사들의 '법률 진출' 아홉 달
2026년은 범용 AI 모델을 만드는 회사들이 '법률'이라는 이름을 단 제품을 직접 내놓은 첫해입니다. 순서대로 보면 이렇습니다.
날짜
회사
무엇을 냈나
눈여겨볼 점
2월 3일
Anthropic
Cowork용 법률 플러그인 (계약 검토·NDA 분류·컴플라이언스)
법률 데이터 3사 주가 하루 13~16% 폭락
4월 23일
Anthropic × Freshfields
영국 대형 로펌 33개 사무소 5,700명에 Claude 배포
6주 만에 사용량 약 500% 증가
5월 12일
Anthropic
Claude for Legal: 분야별 플러그인 12개, 커넥터 20개 이상
Harvey·Thomson Reuters·LexisNexis가 '커넥터'로 들어옴
8월 말
Google
Gemini Enterprise for Legal
Weil·Cleary·Freshfields·Williams & Connolly 협업
9월 17일
OpenAI
Astra for Law: GPT-6 Astra + 법률 검색 색인 + 플러그인 26개
"Harvey와 Legora도 이 위에서 만들 수 있다"
10월 12일
Z.ai
GLM-Legal: 경량 모델에 법률 중간학습·강화학습
Harvey LAB 79개 중 7위, 과제당 0.15달러
OpenAI의 Astra for Law는 특히 상징적입니다. 이 제품은 GPT-6 Astra 모델에 2억 3천만 개 이상의 URL을 담은 법률 검색 색인을 붙였는데, 미국 선례 판결의 99.9% 이상을 비영리 단체 Free Law Project의 공개 판례 저장소 CourtListener에서 가져온다고 밝혔습니다. OpenAI가 공개한 수치로는, Vals의 법률 리서치 벤치마크 검증용 문항 200개에서 Astra for Law의 완전 정답률이 54.0%로, 같은 모델에 일반 웹 검색만 붙였을 때(38.7%)보다 15%p 이상 높았습니다. 모델이 같아도 어떤 법률 데이터에 연결되느냐가 점수를 크게 바꾼다는 뜻입니다. 이 숫자는 뒤에 나올 데이터 층 이야기의 복선이기도 합니다.
Anthropic 쪽에서는 흥미로운 내부 지표가 나왔습니다. Claude for Legal 제품 책임자 마크 파이크(Mark Pike)는 법무가 Cowork에서 다른 어떤 직무보다 세 배 이상 많이 쓰는 '파워 유저' 직무가 됐다고 말했습니다. 법률가들이 AI에 가장 적극적인 직업군 중 하나라는 것은 몇 년 전 통념과 정반대입니다. 그가 소개한 사례도 인상적입니다. 노인 학대 사건에서 미국 200대 로펌과 맞선 4인짜리 프로보노(무료 변론) 팀의 패럴리걸이 Claude API로 도구를 만들었는데, 이 도구가 재판 중 "변호인석에 앉아" 실시간으로 반대신문 질문을 뽑아 줬고, 팀은 큰 배심 평결을 받아냈다고 합니다.
3-2. 반대 방향: 법률 회사들이 모델을 소유하려 한다
모델 회사가 내려오는 동안, 법률 회사들은 위로 올라갔습니다. 세 장면이 있습니다.
① Harvey의 Tenet (8월 20일). OpenAI의 투자를 받은 미국 법률 AI 유니콘이 중국 Moonshot AI의 오픈 가중치 모델 Kimi K3를 가져와 다시 훈련했습니다. 엔비디아 B300 GPU 약 150개로 두 달 동안, 약 1,750개의 가상 법률 업무 환경에서 강화학습을 시켰고, 고객 데이터는 쓰지 않았다고 밝혔습니다. 결과는 Harvey LAB 비공개 과제에서 원래 Kimi K3보다 "거의 두 배 많은 과제를 완수"했다는 것입니다. 앞서 6월에는 Applied Compute와 함께 Z.ai의 GLM-5.1을 강화학습해 전 항목 통과율을 5.9%에서 12.6%로 올린 실험도 공개됐습니다.
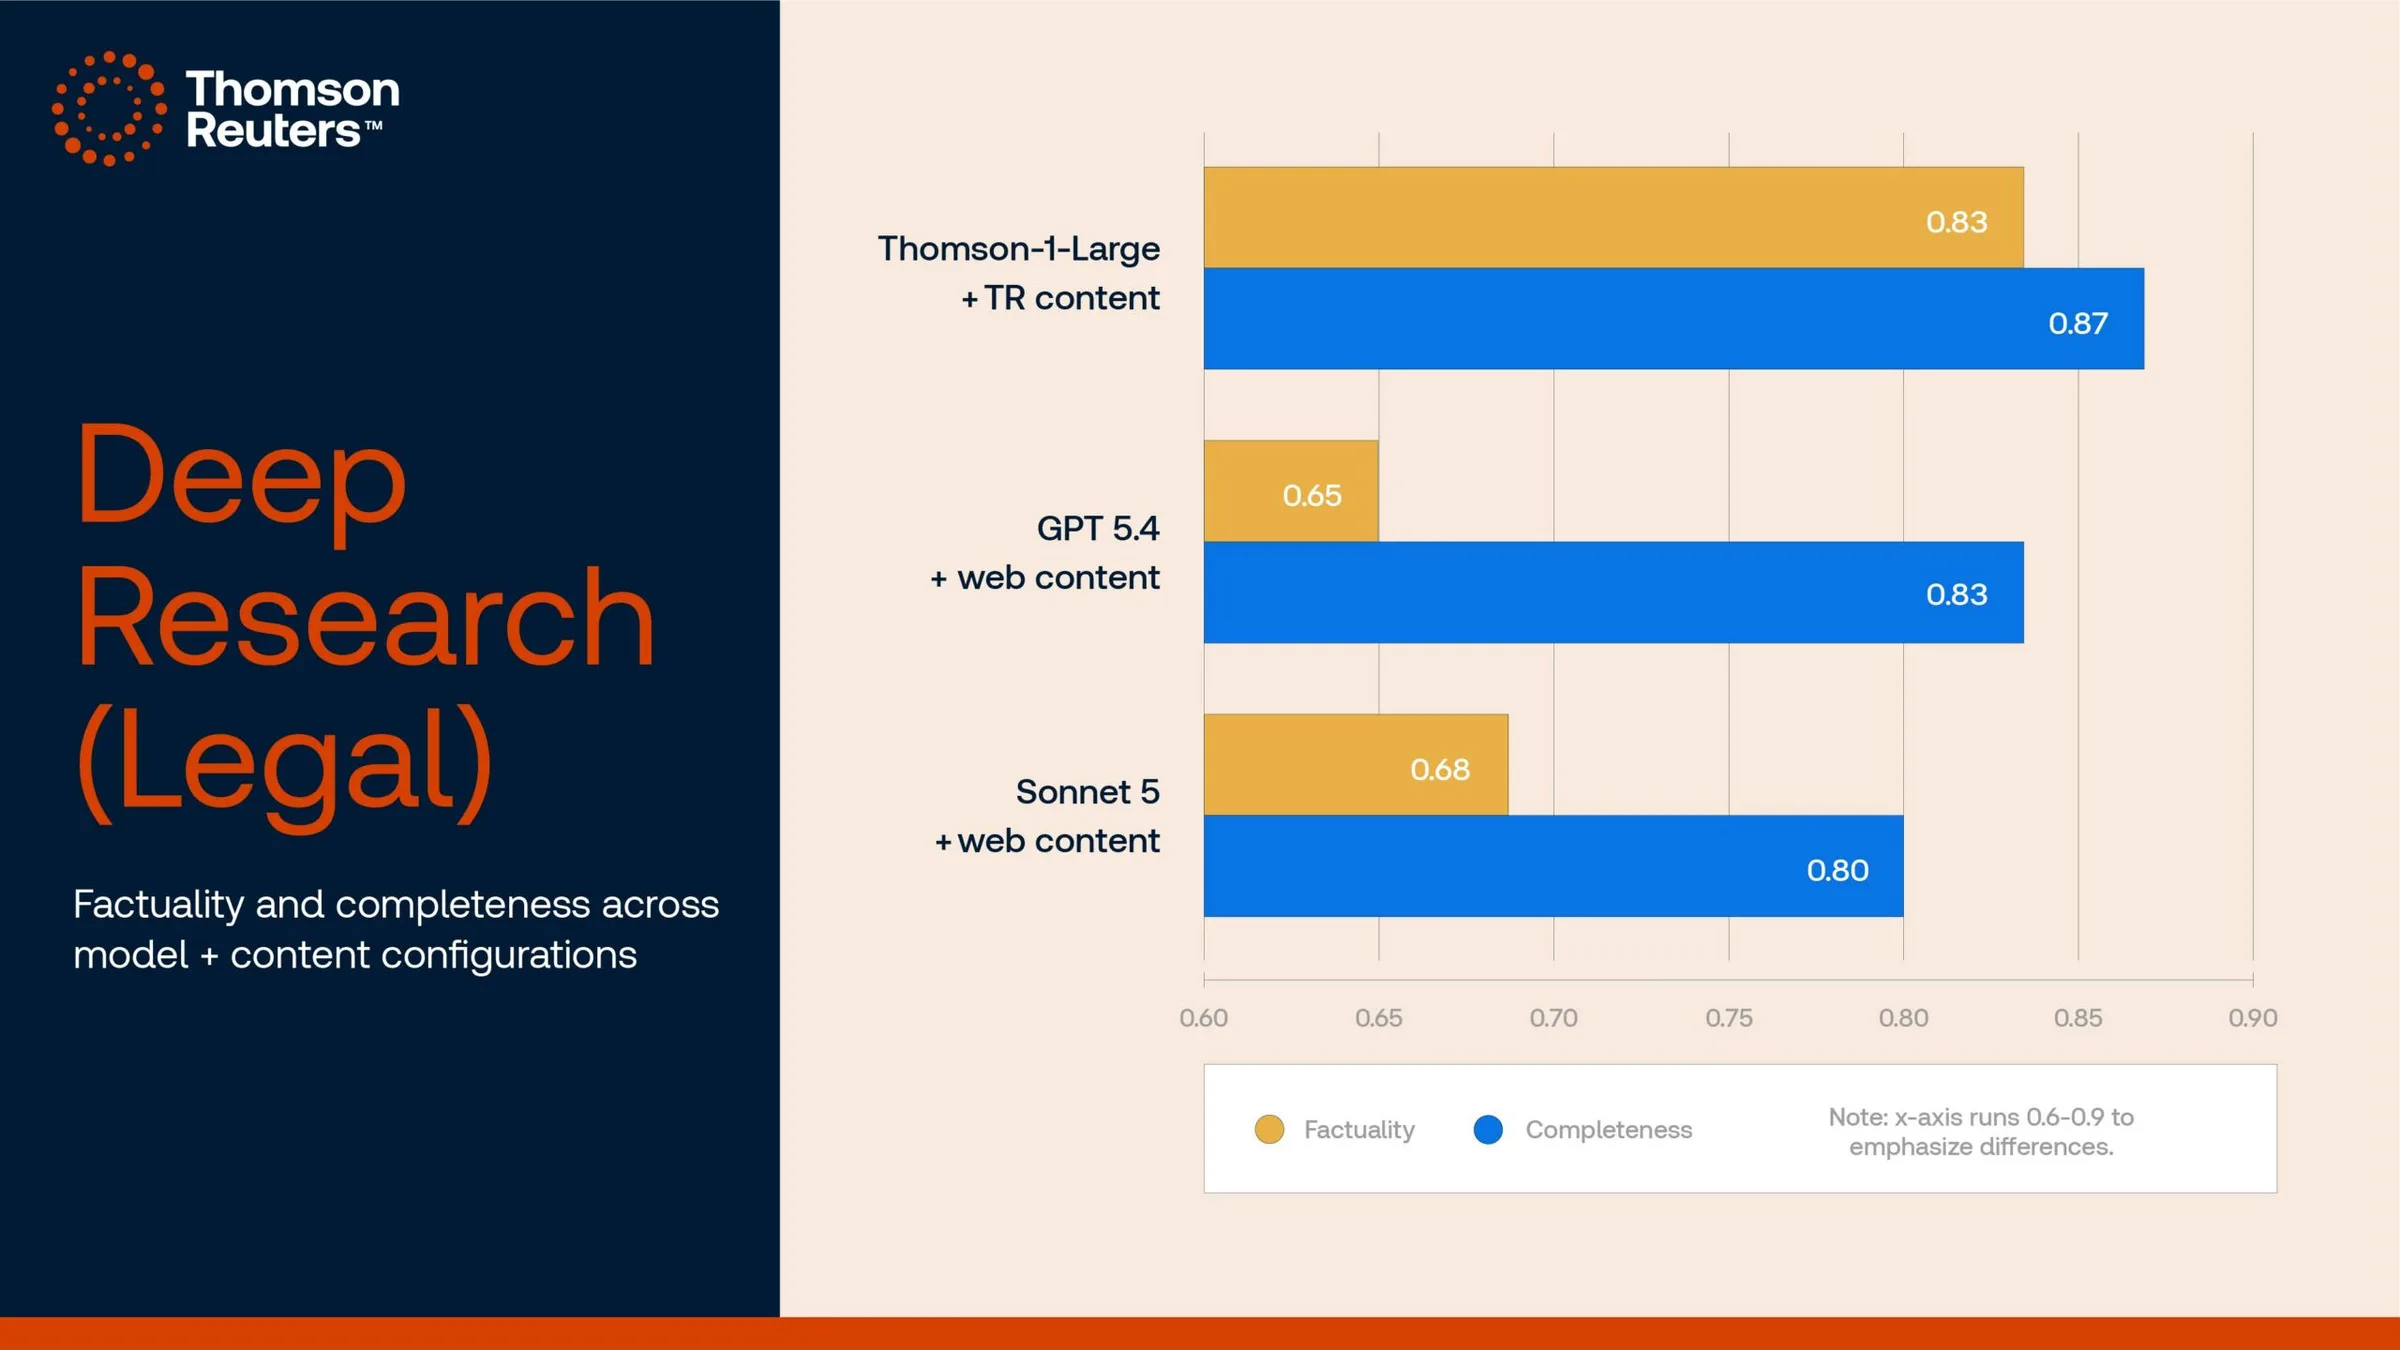
② Thomson Reuters의 Thomson (7월). 공개 모델을 바탕으로 Westlaw·Practical Law·Checkpoint·로이터 콘텐츠로 중간학습과 후속학습을 시킨 자체 모델입니다. 아래 그림은 TR이 공개한 법률 딥리서치 비교인데, 자사 콘텐츠에 연결한 Thomson 모델이 사실성(Factuality) 0.83, 완결성(Completeness) 0.87로, 웹 콘텐츠에 연결한 GPT-5.4(0.65/0.83)와 Sonnet 5(0.68/0.80)보다 높게 나왔습니다. 가로축이 0.6에서 시작한다는 점(차이를 강조하려고 잘랐다고 그림에 적혀 있습니다)과, 회사 자체 평가라는 점은 감안해야 합니다. 그래도 메시지는 분명합니다. 사실성의 차이가 완결성의 차이보다 훨씬 크고, 그 차이를 만든 것은 모델보다 '콘텐츠'라는 주장입니다. TR은 "학습에 쓴 콘텐츠가 아직 전체의 10% 미만"이라고 덧붙였습니다.
출처: Thomson Reuters, "Thomson Reuters built its own AI model that now ranks among the world's best" (2026년 7월). 회사 자체 평가이며 가로축은 0.6~0.9 구간만 표시.
흥미로운 것은 같은 TR이 8월에 내놓은 차세대 CoCounsel Legal이 "Anthropic의 Claude Agent SDK 위에 만들어졌다"고 밝혔다는 점입니다. 에이전트의 뼈대는 Anthropic 것을 쓰고, 문서 1만 건 × 질문 100개를 표로 정리하는 대량 작업에는 자기 모델을 기본값으로 씁니다. 2월에 자기 주가를 무너뜨린 회사의 도구로 자기 제품을 다시 짠 셈입니다.
③ 로펌 Latham & Watkins의 GPU 서버 (9월). 세계 최대 매출 로펌 중 하나가 엔비디아 H200 서버를 직접 사서 사설 데이터센터에서 오픈 모델을 미세조정하기 시작했다고 FT와 Bloomberg Law가 보도했습니다. 이유는 단순합니다. OpenAI나 Anthropic이 가격이나 약관을 바꿔도 흔들리지 않으려는 것입니다. Kirkland & Ellis도 사내 GPU 클러스터 관련 채용 공고를 냈습니다.
3-3. 어느 모델이 최고인가? "분야마다 다르다"
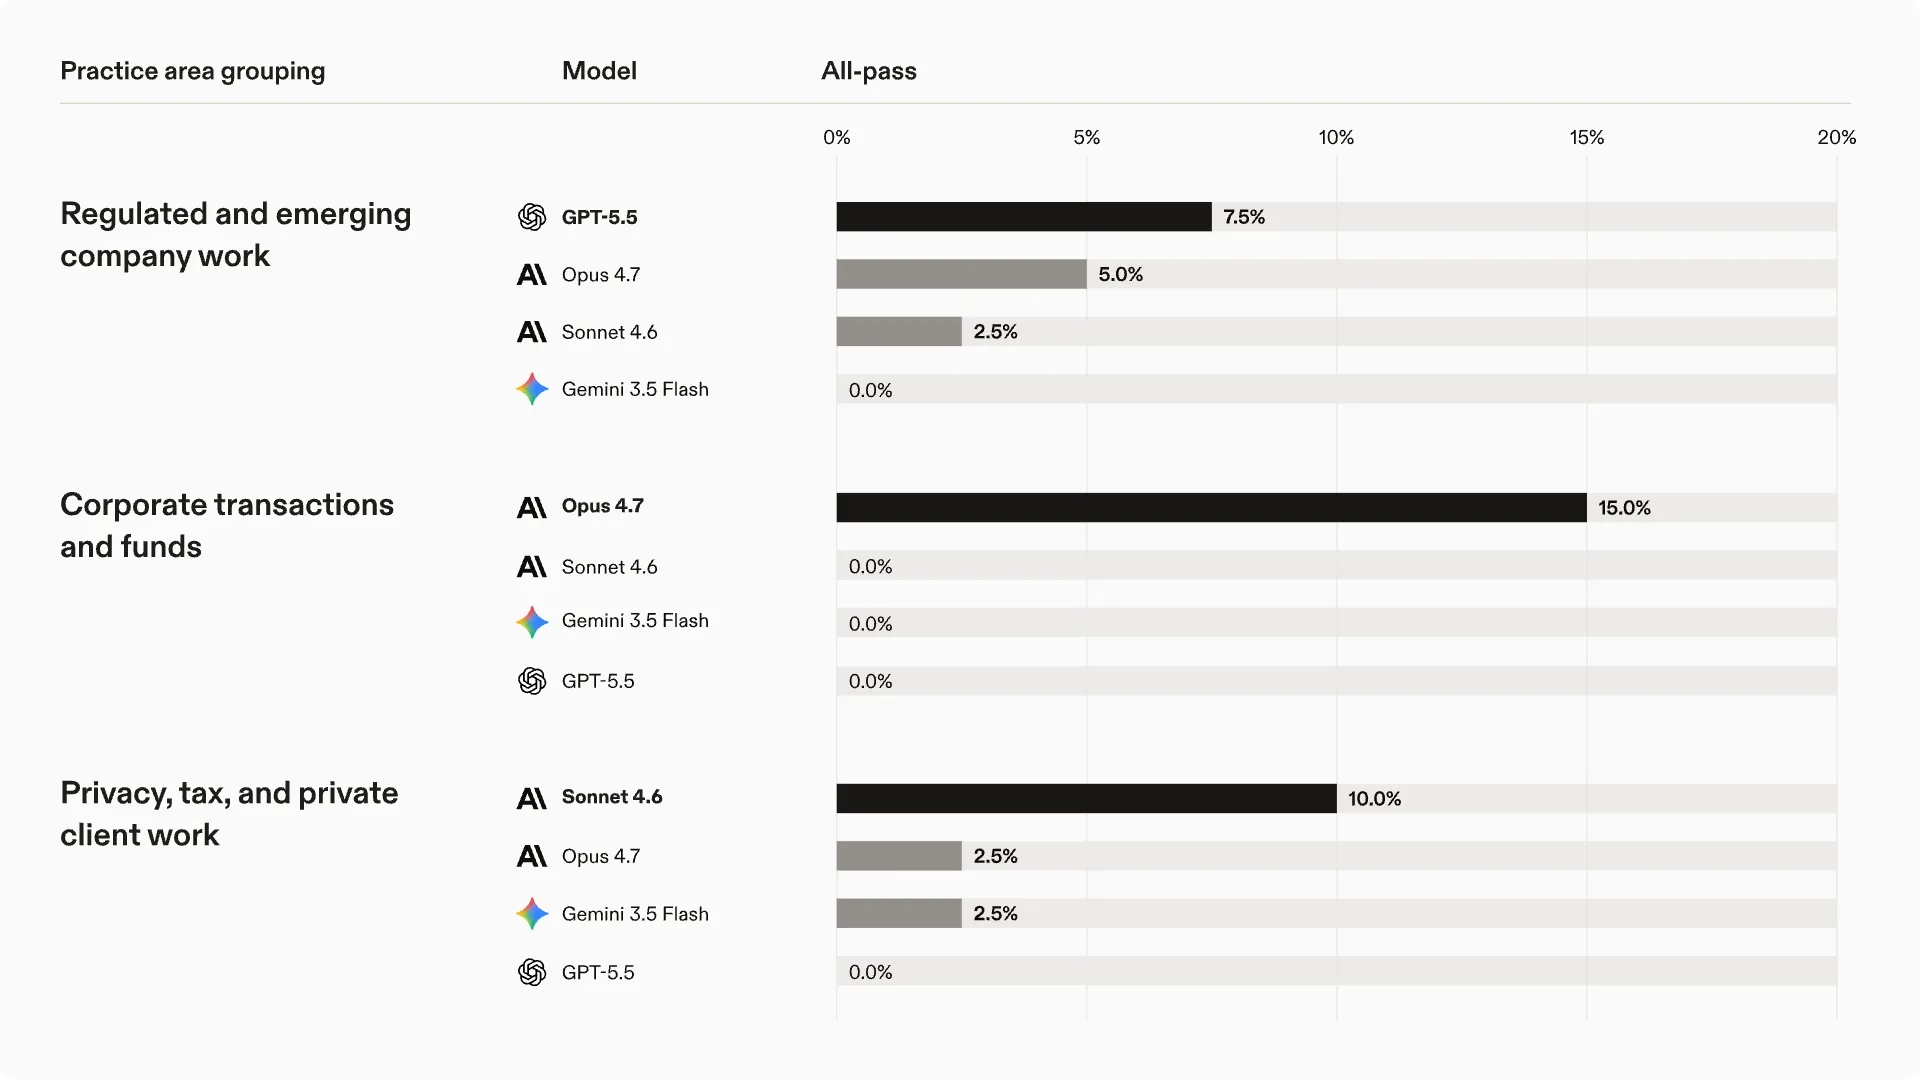
모델 층의 또 다른 변화는 '최고의 법률 모델'이라는 개념 자체가 흐려졌다는 것입니다. Harvey가 5월에 낸 첫 LAB 결과를 실무 분야별로 쪼개 보면, 규제·신생기업 업무에서는 GPT-5.5가 7.5%로 1위, 기업 거래·펀드에서는 Opus 4.7이 15.0%로 1위, 개인정보·세무·개인 고객 업무에서는 Sonnet 4.6이 10.0%로 1위였습니다. 더 눈에 띄는 것은 같은 GPT-5.5가 기업 거래·펀드에서는 0.0%, Opus 4.7이 개인정보·세무에서는 2.5%였다는 점입니다.
Harvey의 결론은 이랬습니다. "가장 강한 실전 에이전트 배치는 처음부터 여러 모델을 쓰는 구조가 될 것이다." 10월 Vals 리더보드에서는 이 흐름이 더 극적으로 드러났습니다. 1위부터 5위까지가 모두 Meta의 Muse 계열이었고(1위 Muse Spark 1.2, 25.42%), 그다음이 Google의 Gemini 4 Argon(19.58%), 7위가 Z.ai의 GLM-Legal(19.17%)이었습니다. Anthropic의 Claude Fable 5는 11.25%, OpenAI의 GPT-6 Astra는 5.42%였습니다. 법률 제품을 가장 열심히 판 두 회사의 최신 모델이 법률 에이전트 시험에서는 상위권이 아니었던 것입니다.
1
인사이트 ① 정문은 쪼개지고, 연결은 표준이 된다
변호사가 일을 시작하는 '정문'은 Claude, ChatGPT, Gemini, Word, Harvey, Legora로 흩어지고 있습니다. 동시에 모든 정문이 같은 커넥터(MCP·플러그인)로 같은 데이터와 같은 도구를 불러옵니다. 그래서 '어떤 모델을 쓰느냐'보다 '모델을 언제든 갈아 끼울 수 있느냐'가 경쟁력이 됩니다. 분야마다 1위 모델이 다르고, 석 달마다 순위가 뒤집히기 때문입니다. Harvey가 중국 모델을 다시 훈련하고 Latham이 GPU를 산 것도 같은 이유, 즉 특정 모델 회사에 묶이지 않기 위해서입니다.
4. 2층, 데이터: 주가는 무너졌는데 매출은 늘었다
2월 3일의 폭락으로 돌아가 봅시다. 시장의 논리는 단순했습니다. "모델이 법을 다 안다면, 비싼 판례 DB 구독료를 누가 내겠는가." 하지만 반년 뒤 숫자는 정반대였습니다.
Thomson Reuters의 2분기 실적에서 법률 전문가 부문은 유기적으로 10% 성장했고, 회사는 성장의 동력으로 Westlaw와 CoCounsel을 꼽았습니다. RELX의 법률 부문도 상반기에 10% 성장했고 영업이익은 13% 늘었습니다. LexisNexis는 "토큰 비용이 전체 비용의 1%도 안 된다"며 구독 모델을 바꿀 계획이 없다고 밝혔습니다. Morningstar는 폭락 당일에 이미 이렇게 지적했습니다. 그 플러그인은 "법률 리서치와 아무 관계가 없다." 판례 DB의 해자는 계약서 검토 기능 하나로 무너지는 종류가 아니었다는 뜻입니다.
왜 데이터 층은 버텼을까요? 두 가지 이유가 있습니다.
첫째, 법률에서 '그럴듯함'은 가치가 없고 '정확함'만 가치가 있습니다. 앞서 본 OpenAI의 54.0% 대 38.7%, TR의 사실성 0.83 대 0.65가 같은 이야기를 합니다. 모델이 아무리 똑똑해도, 실제로 존재하는 판결의 실제 문장에 연결되지 않으면 법정에서 쓸 수 없습니다. 2024년 스탠퍼드 연구(Dahl 외, "Large Legal Fictions")는 범용 모델에 실제 연방 판례에 대한 검증 가능한 질문을 던졌을 때 GPT-4가 58%, Llama 2가 88%의 비율로 환각을 낸다고 측정했습니다. 판례가 덜 유명할수록, 하급심일수록 환각이 늘었습니다. 법률가에게 정말 필요한 것은 바로 그 '덜 유명한 판례'인데 말입니다.
둘째, 데이터 회사들은 경쟁자가 아니라 모든 정문의 '부품'이 되는 길을 택했습니다. CoCounsel·Westlaw·Practical Law는 Claude for Legal의 커넥터로 들어갔고, ChatGPT로 들어가는 커넥터도 예고됐습니다. LexisNexis는 2025년부터 Harvey와 제휴해 Harvey 안에서 Lexis 판례를 쓰게 했고, 2026년 2월에는 Anthropic의 법률 플러그인을 자기 제품 Protégé 안으로 흡수했습니다. 10월에는 Harvey와 함께 '소 각하 신청(Motion to Dismiss)' 공동 워크플로를 내놨습니다. 누가 정문을 차지하든, 그 뒤에서 판례를 공급하는 쪽은 돈을 법니다.
물론 위협이 없는 것은 아닙니다. OpenAI가 CourtListener로 미국 선례의 99.9%를 덮었다는 사실은 공개 판례가 충분히 쌓인 나라에서는 유료 DB의 해자가 얇아질 수 있다는 신호입니다. 미국은 연방 판결이 공공 기록이고, 비영리 단체가 수십 년간 이를 모아 왔습니다. 그래서 진짜 해자는 판결문 원문보다 그 위에 쌓인 것, 즉 판례가 아직 유효한지 알려 주는 인용 추적(KeyCite·Shepard's), 실무 해설과 서식, 편집자의 요약으로 옮겨 가고 있습니다.
한국은 이 층의 사정이 미국과 크게 다릅니다. 판결서 공개 범위가 좁아서입니다. 민사·행정·특허의 미확정 판결서는 2023년 1월 1일 선고분부터 열람할 수 있게 됐지만, 형사 판결서 공개 확대는 아직 진행 중입니다. 그래서 한국 법률 AI의 경쟁력은 상당 부분 '판례를 얼마나 모았나'에서 갈립니다. 엘박스가 2024년 케이스노트를 인수하고, 로앤컴퍼니의 슈퍼로이어가 10월에 빅케이스를 연동해 '판례 534만 건 검색'을 내세운 것도 그래서입니다. 그리고 가장 많은 판결문을 가진 주체인 법원은 2026년 2월, 13년 치 판결문 전체를 넣은 자체 재판지원 AI를 판사들을 위해 개통했습니다(10장에서 자세히 봅니다).
2
인사이트 ② 데이터 해자는 줄지 않았다, 모양이 바뀌었을 뿐이다
생성 비용이 0에 가까워질수록 '정답의 원천'은 더 비싸집니다. 다만 해자는 판결문 원문(공개되면 누구나 가진다)에서 그 위의 가공층(유효성 추적, 실무 해설, 서식, 검증 도구)으로 옮겨 갑니다. 그리고 데이터 회사는 정문을 두고 싸우는 대신 모든 정문의 부품이 되는 쪽을 택했습니다. 판결문 공개가 좁은 한국에서는 이 층이 생태계 전체의 가장 두꺼운 병목입니다.
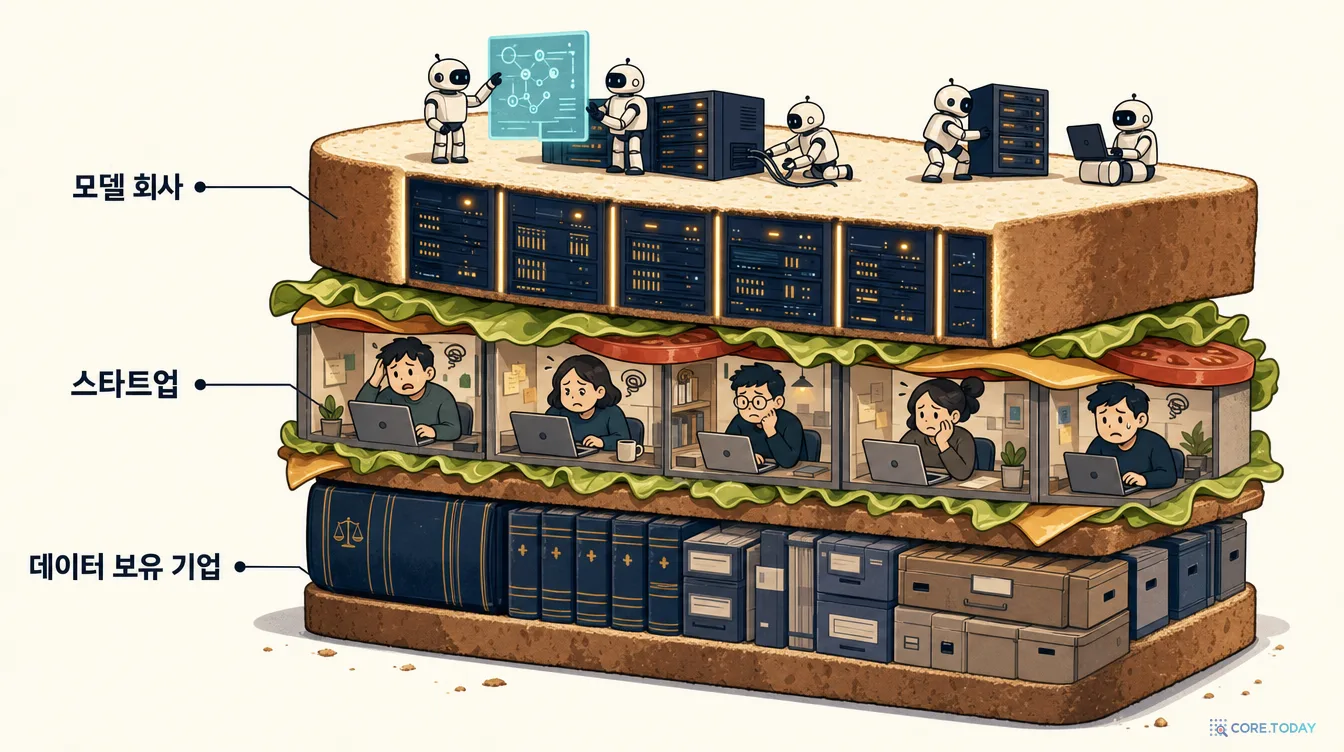
2023~2025년 리걸테크 스타트업을 따라다닌 질문은 "결국 GPT 위에 화면 얹은 것 아니냐"였습니다. 이른바 '래퍼(wrapper)' 논쟁입니다. 위에서는 모델 회사가, 아래에서는 데이터 회사가 누르면 가운데 낀 스타트업은 설 자리가 없다는 논리였습니다. 2026년 모델 회사들이 법률 제품을 직접 내놓자 이 공포는 현실이 되는 듯했습니다.
그런데 숫자는 반대로 움직였습니다.
회사
기업가치
연 반복 매출(ARR)
2026년의 움직임
Harvey (미국)
80억 → 110억(3월) → 155억 달러(9월)
1.9억(1월) → 약 3억(5월) → 4억 달러 이상(9월)
고객 3,000곳 이상, Am Law 100의 80%. Tenet 모델, LAB 벤치마크 공개
Legora (스웨덴)
18억(2025년 10월) → 56억 달러(4월)
약 0.23억(2025년 9월) → 1억 달러 이상(4월)
엔비디아의 첫 리걸테크 투자, 인수 5건 이상, 한국 5대 로펌 시험
Clio (캐나다)
50억 달러(2025년 11월)
5억 달러 이상, 흑자(5월)
vLex(10억 달러) 인수로 Vincent AI 확보
Norm Ai (미국)
12억 달러(7월)
비공개
컴플라이언스 에이전트 + 성과 기반 가격의 자회사 로펌 Norm Law
Crosby (미국)
약 4억 달러(4월, 보도)
비공개
문서당 고정가 계약 검토 로펌. 협상한 계약 규모 3천만 → 10억 달러
모든 곳이 잘된 것은 아닙니다. 영국의 계약 검토 스타트업 Robin AI는 2025년 말 5천만 달러 투자 유치에 실패하고 인력을 줄였고, 2026년 1월에는 마이크로소프트가 그 기술 인력 약 18명을 채용해 갔습니다. 전체 투자 규모도 생각만큼 폭발적이지 않았습니다. PitchBook 집계로 2026년 상반기 리걸테크 투자는 23억 달러로, 2025년 4분기 한 분기(25억 달러)보다 적었습니다. 돈이 줄었다기보다 몇몇 회사로 몰렸습니다.
왜 투자자들은 '샌드위치 속 재료'에 오히려 더 큰돈을 걸었을까요? 세 가지 답이 보입니다.
① 모델 회사들이 이들을 밀어내지 않고 끌어들였습니다. OpenAI는 Astra for Law를 발표하면서 "API 고객인 Harvey와 Legora도 이 위에서 만들 수 있다"고 명시했고, Anthropic은 Harvey를 Claude for Legal의 커넥터로 넣었습니다. Harvey 공동창업자 윈스턴 와인버그는 Claude 커넥터를 내면서 "기업들은 대체로 Anthropic을 도입할 테니, 이건 Harvey로 들어오는 또 하나의 입구"라고 말했습니다. 모델 회사 입장에서도 로펌 수천 곳에 직접 영업하고 교육하는 것보다 이미 그 현장에 깔린 회사를 통하는 편이 빠릅니다.
② 해자가 기술에서 '현장 배치'로 옮겨 갔습니다. Legora는 개발자만큼 많은 '리걸 엔지니어'(변호사 출신으로 고객 로펌에 들어가 업무 흐름을 바꿔 주는 사람)를 고용합니다. Harvey 고객들은 플랫폼 위에서 2만 5천 개가 넘는 맞춤형 에이전트를 돌린다고 합니다. 각 로펌의 서식, 승인 절차, 위험 분류 기준이 이 에이전트들에 들어가 있습니다. 모델이 아무리 좋아져도 이것을 하룻밤에 옮기기는 어렵습니다. Legora의 공동창업자는 이렇게 표현했습니다. "LLM은 필요하지만 충분하지 않다."
③ 가격 단위가 '좌석'에서 '사용량'으로 바뀌며 매출 천장이 사라졌습니다. Harvey의 토큰 사용량은 반년 만에 14배가 됐습니다. 공동창업자 가브리엘 페레이라는 간단한 초안 하나에 토큰 비용이 약 20달러, 계약서 10만 건을 검토하는 에이전트 작업은 약 2만 달러가 든다며 이렇게 경고했습니다. "고객들이 곧 1천만 달러짜리 사용료 청구서를 받고 '내 에이전트가 뭘 했길래 1천만 달러가 나왔지?'라고 묻게 될 것이다." Legora는 6월에 에이전트 상품을 사용량 과금으로 바꾸면서 이것을 "청구 시간과 라이선스 좌석에서, 전달된 결과로"의 전환이라고 불렀습니다.
마지막 대목이 중요합니다. 시간당 청구로 '무엇을 했는지'를 증명하던 로펌의 고민이, 이제 AI 회사의 청구서 안에서 그대로 되살아나고 있습니다. 이 이야기는 7장에서 다시 만납니다.
한쪽에서는 마케팅 전쟁도 벌어졌습니다. Harvey는 2월 법정 드라마 「슈츠」에서 하비 스펙터를 연기한 배우 가브리엘 마흐트와 손잡았고, Legora는 배우 주드 로를 내세운 광고로 맞섰습니다. Legora의 최고매출책임자는 그 광고가 한 달 만에 5천만 달러 이상의 영업 기회를 만들었다고 말했습니다. 법률 소프트웨어가 텔레비전 광고를 하는 시대가 된 것입니다.
한국의 업무 도구 층은 규모는 작지만 같은 방향으로 움직입니다. 엘박스는 2025년 11월 검색과 검증을 반복하는 에이전트형 구조로 서비스를 바꿨고, 대검찰청과 계약해 검사·수사관에게 AI를 제공하며, 법원 재판지원 AI 사업에서 워크플로 설계와 성능 평가 체계를 맡았다고 밝혔습니다. 로앤컴퍼니는 2025년 매출 약 154억 원(65% 성장)을 냈고, 그중 소프트웨어 구독 매출 비중이 8%에서 35%로 뛰었습니다. 다만 두 회사 모두 아직 영업손실(엘박스 약 100억 원, 로앤컴퍼니 약 57억 원)을 내고 있습니다. 그리고 태평양은 Harvey(국제 계약·해외 법령), 엘박스·슈퍼로이어(국내 판례·법령), ChatGPT Enterprise(범용)를 용도별로 나눠 쓰는 구조를 택했습니다. 이것이 인사이트 ①에서 말한 '여러 정문, 여러 모델'의 한국판입니다.
3
인사이트 ③ 샌드위치의 재료가 비싸지는 조건
업무 도구 회사는 세 가지를 가졌을 때 살아남았습니다. 고객 현장에 들어가 업무를 바꿔 주는 사람(리걸 엔지니어), 그 과정에서 쌓인 고객별 서식·절차·평가 기준, 그리고 어느 모델이든 갈아 끼우는 구조. 반대로 '좋은 프롬프트 + 깔끔한 화면'만 가진 회사는 모델 회사의 다음 업데이트 하나로 흡수될 위험이 커졌습니다.
6. 시험지가 바뀌었다: 평가가 곧 시장이 된 해
생태계의 층 이야기를 잠시 멈추고, 그 모든 층을 가로지르는 변화 하나를 보겠습니다. 바로 '무엇으로 법률 AI를 평가하느냐'입니다. 법률처럼 결과물의 품질을 일반인이 판단하기 어려운 분야에서는 평가 기준이 곧 시장의 언어가 됩니다. 2026년에 이 언어가 바뀌었습니다.
6-1. 1세대 시험: 시험 문제와 판례 퀴즈
2023년의 법률 AI 평가는 대부분 '시험'이었습니다. GPT-4의 변호사시험 점수, 법률가들이 직접 만든 162개 과제를 6가지 추론 유형(쟁점 찾기·규칙 찾기·규칙 적용·결론·해석·수사)으로 나눈 LegalBench(2023년 8월)가 대표적입니다. 이 시험들은 AI가 '법을 아는지'를 쟀습니다. 그리고 AI는 빠르게 높은 점수를 받았습니다. 2026년 10월 Vals의 LegalBench 리더보드 1위는 88%대입니다.
한국에서도 같은 일이 벌어졌습니다. 로앤컴퍼니는 6월, 자사 슈퍼로이어가 제15회 변호사시험 선택형 150문항을 모두 맞혀 375점 만점을 받았다고 발표했습니다(그해 수석 점수는 360점). 7월에는 쥬리서포트가 같은 시험에서 9번 연속 만점을 받았다고 발표했는데, 이 발표에는 흥미로운 대조 실험이 붙어 있었습니다. 같은 모델에서 법령·판례 검색 도구를 떼어 내자 한 번도 만점이 나오지 않았다(민사 70문항 중 65개, 공법 40문항 중 평균 33개)는 것입니다. 둘 다 회사 자체 측정이고 객관식에 한정된 결과지만, 모델의 지식보다 '연결된 도구와 데이터'가 점수를 가른다는 점에서 4장의 이야기와 정확히 겹칩니다.
학술 벤치마크는 조금 더 냉정합니다. LBox와 서울시립대 연구진이 만든 한국 법률 벤치마크 KBL(EMNLP 2024)은 "GPT-4는 미국 변호사시험은 통과했지만 한국 변호사시험은 통과하지 못했다"고 보고했습니다. 2025년 말의 KCL 벤치마크에서는 근거 판례를 주면 프런티어 추론 모델이 객관식에서 80%를 넘지만, 서술형 최고점은 74.9%였습니다. LG AI연구원의 KMMLU-Pro는 최신 모델들이 의료 면허 시험은 대부분 합격선을 넘으면서도 법 관련 면허 시험은 거의 떨어진다고 보고했습니다. 데이터가 적은 관할일수록 AI는 법을 덜 압니다.
6-2. 2세대 시험: 변호사와 같은 과제로 겨루기
2025년 2월, 평가 회사 Vals AI는 미국 대형 로펌들이 낸 실무 과제로 AI 도구와 변호사 대조군을 같은 기준으로 채점한 보고서(VLAIR)를 냈습니다. 결과가 흥미롭습니다. 아래 퀴즈로 직접 예상해 보세요.
패턴은 분명합니다. 읽고, 찾고, 뽑고, 줄이는 일에서는 AI 도구가 이미 변호사를 넘었습니다. 문서 질의응답에서 Harvey는 94.8점, 변호사는 70.1점이었습니다. 반면 무엇을 어떻게 고칠지 판단하는 일(계약서 수정, 변호사 79.7 대 AI 65.0)과 여러 단계를 오가며 조사하는 일(공시 리서치, 변호사 70.1 대 AI 55.2)은 아직 변호사가 앞섰습니다. 그리고 주목할 점이 하나 더 있습니다. 업계 최대 업체인 LexisNexis는 리서치를 뺀 모든 과제에서 참가를 철회했고, 2025년 10월 리서치 편에는 Thomson Reuters와 LexisNexis, Harvey가 모두 참가하지 않았습니다. 제품끼리 공개적으로 비교당하는 것을 피하는 흐름이 생긴 것입니다. 실제로 Vals는 2026년에 업체 제품 비교 보고서를 새로 내지 않았고, 대신 모델 단위 리더보드(LegalBench 150개, 법률 리서치 벤치 78개, Harvey LAB 79개 모델)를 운영하고 있습니다.
6-3. 3세대 시험: 끝까지 해내야 통과 — Harvey LAB
2026년 5월 6일, Harvey는 Harvey LAB(Legal Agent Benchmark)을 오픈소스로 공개했습니다. 24개 실무 분야, 1,250개 안팎의 과제, 7만 5천 개가 넘는 전문가 채점 항목으로 이뤄진 이 시험의 핵심은 채점 방식입니다. 과제의 모든 항목을 통과해야만 그 과제를 통과로 칩니다(all-pass). Harvey의 설명은 이렇습니다. "열 개의 위험 중 여덟 개를 찾아낸 실사 보고서는 80% 쓸모 있는 것이 아니라, 불완전한 것이다." (이 시험의 구조와 예시 과제는 GLM-Legal 글의 4장에 그림과 함께 자세히 풀어 두었습니다.)
이 기준을 적용하자 숫자가 확 낮아졌습니다. 5월 첫 결과에서 최고 모델(Claude Opus 4.7)의 통과율은 7.1%였습니다. 10월 Vals 리더보드 1위도 25.42%입니다. 그런데 같은 모델들의 '항목 단위' 통과율은 92~95%입니다. 거의 모든 항목을 맞히는데도 과제 전체로는 네 건 중 세 건을 실패하는 것, 이것이 2026년 법률 AI의 현주소입니다.
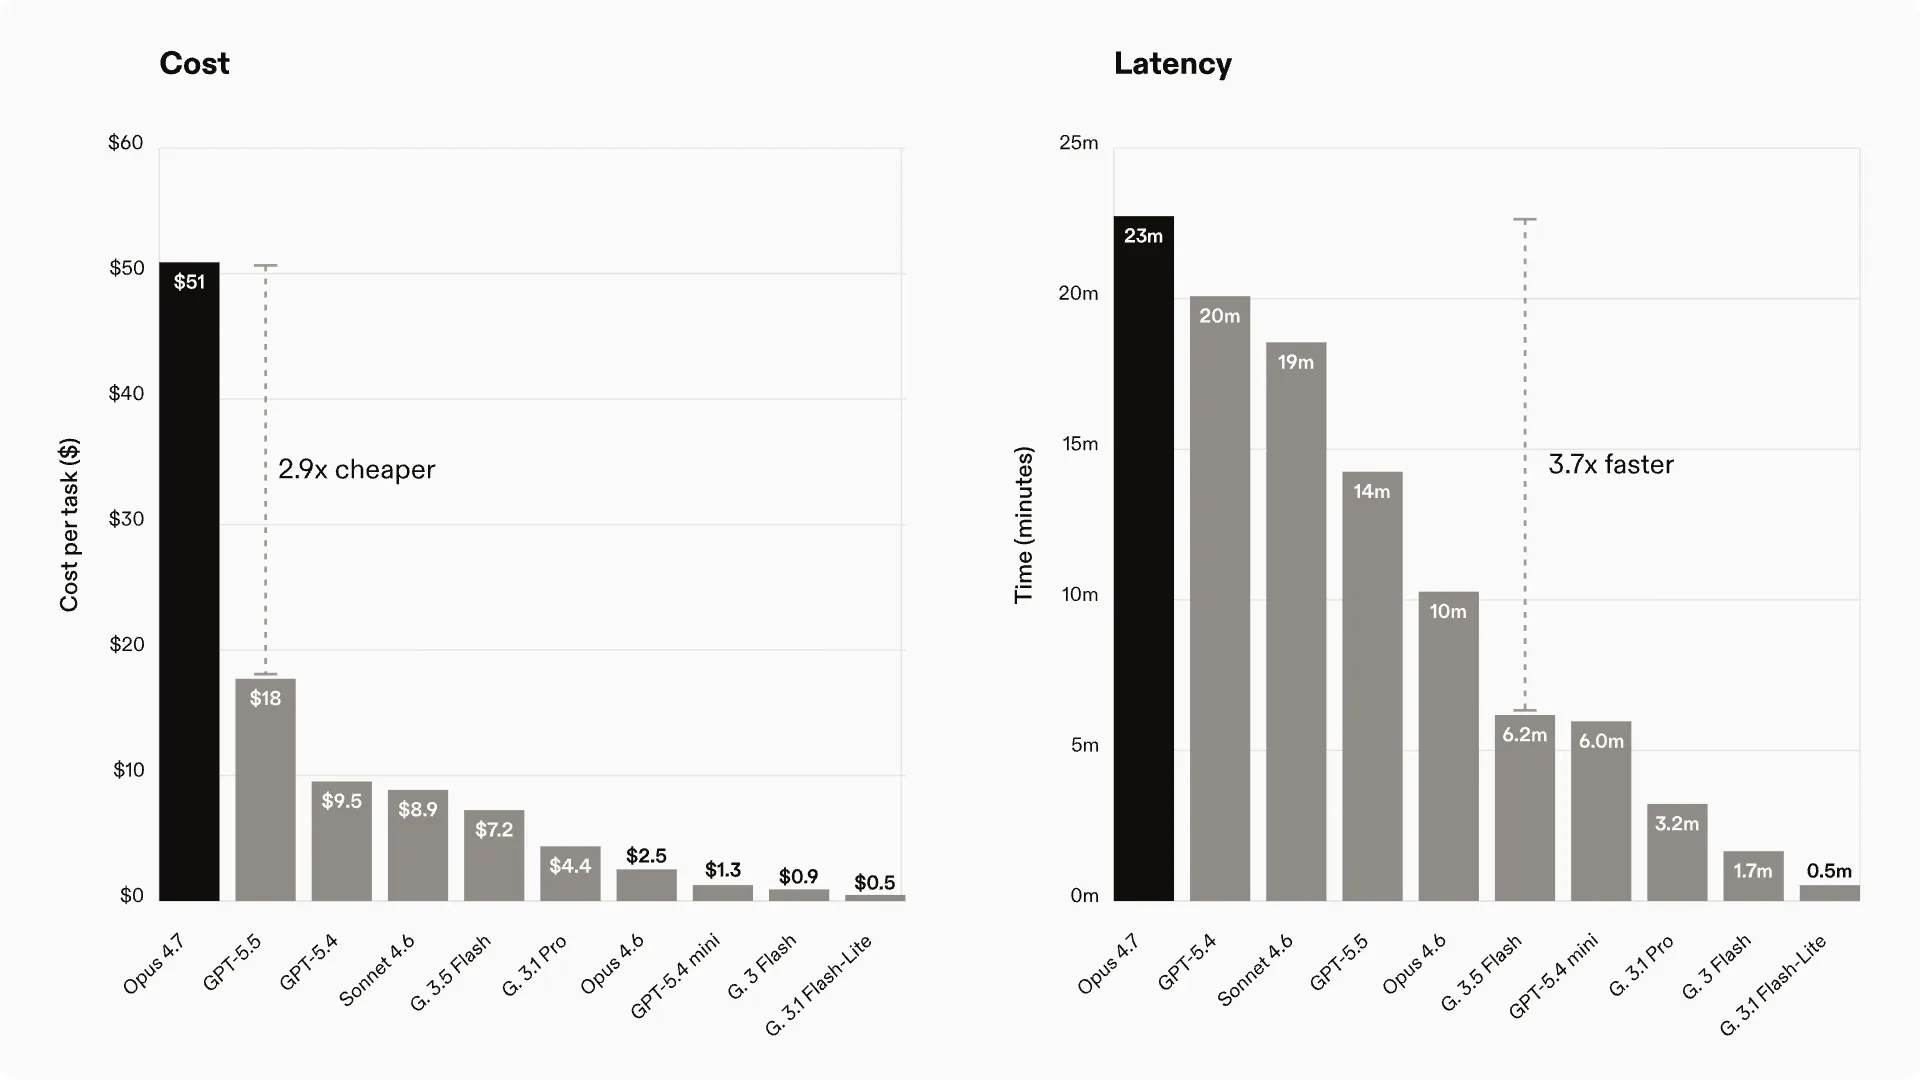
이 시험에서 나온 두 개의 그림이 생태계를 이해하는 데 특히 중요합니다. 첫째는 비용과 시간입니다.
최고 성능의 Opus 4.7은 과제 하나에 약 51달러, 23분이 들었습니다. 두 번째인 GPT-5.5는 2.9배 싼 18달러였습니다. 다섯 달 뒤 Vals 리더보드에서 Z.ai의 GLM-Legal은 19.17%를 과제당 0.15달러에 냈습니다(채점 환경과 과제 묶음이 달라 직접 비교는 조심해야 하지만, 자릿수가 두 개 다릅니다). 성능 곡선보다 비용 곡선이 훨씬 빠르게 움직이고 있다는 뜻이고, 이것이 3장에서 본 '모델 갈아 끼우기'의 경제적 이유입니다.
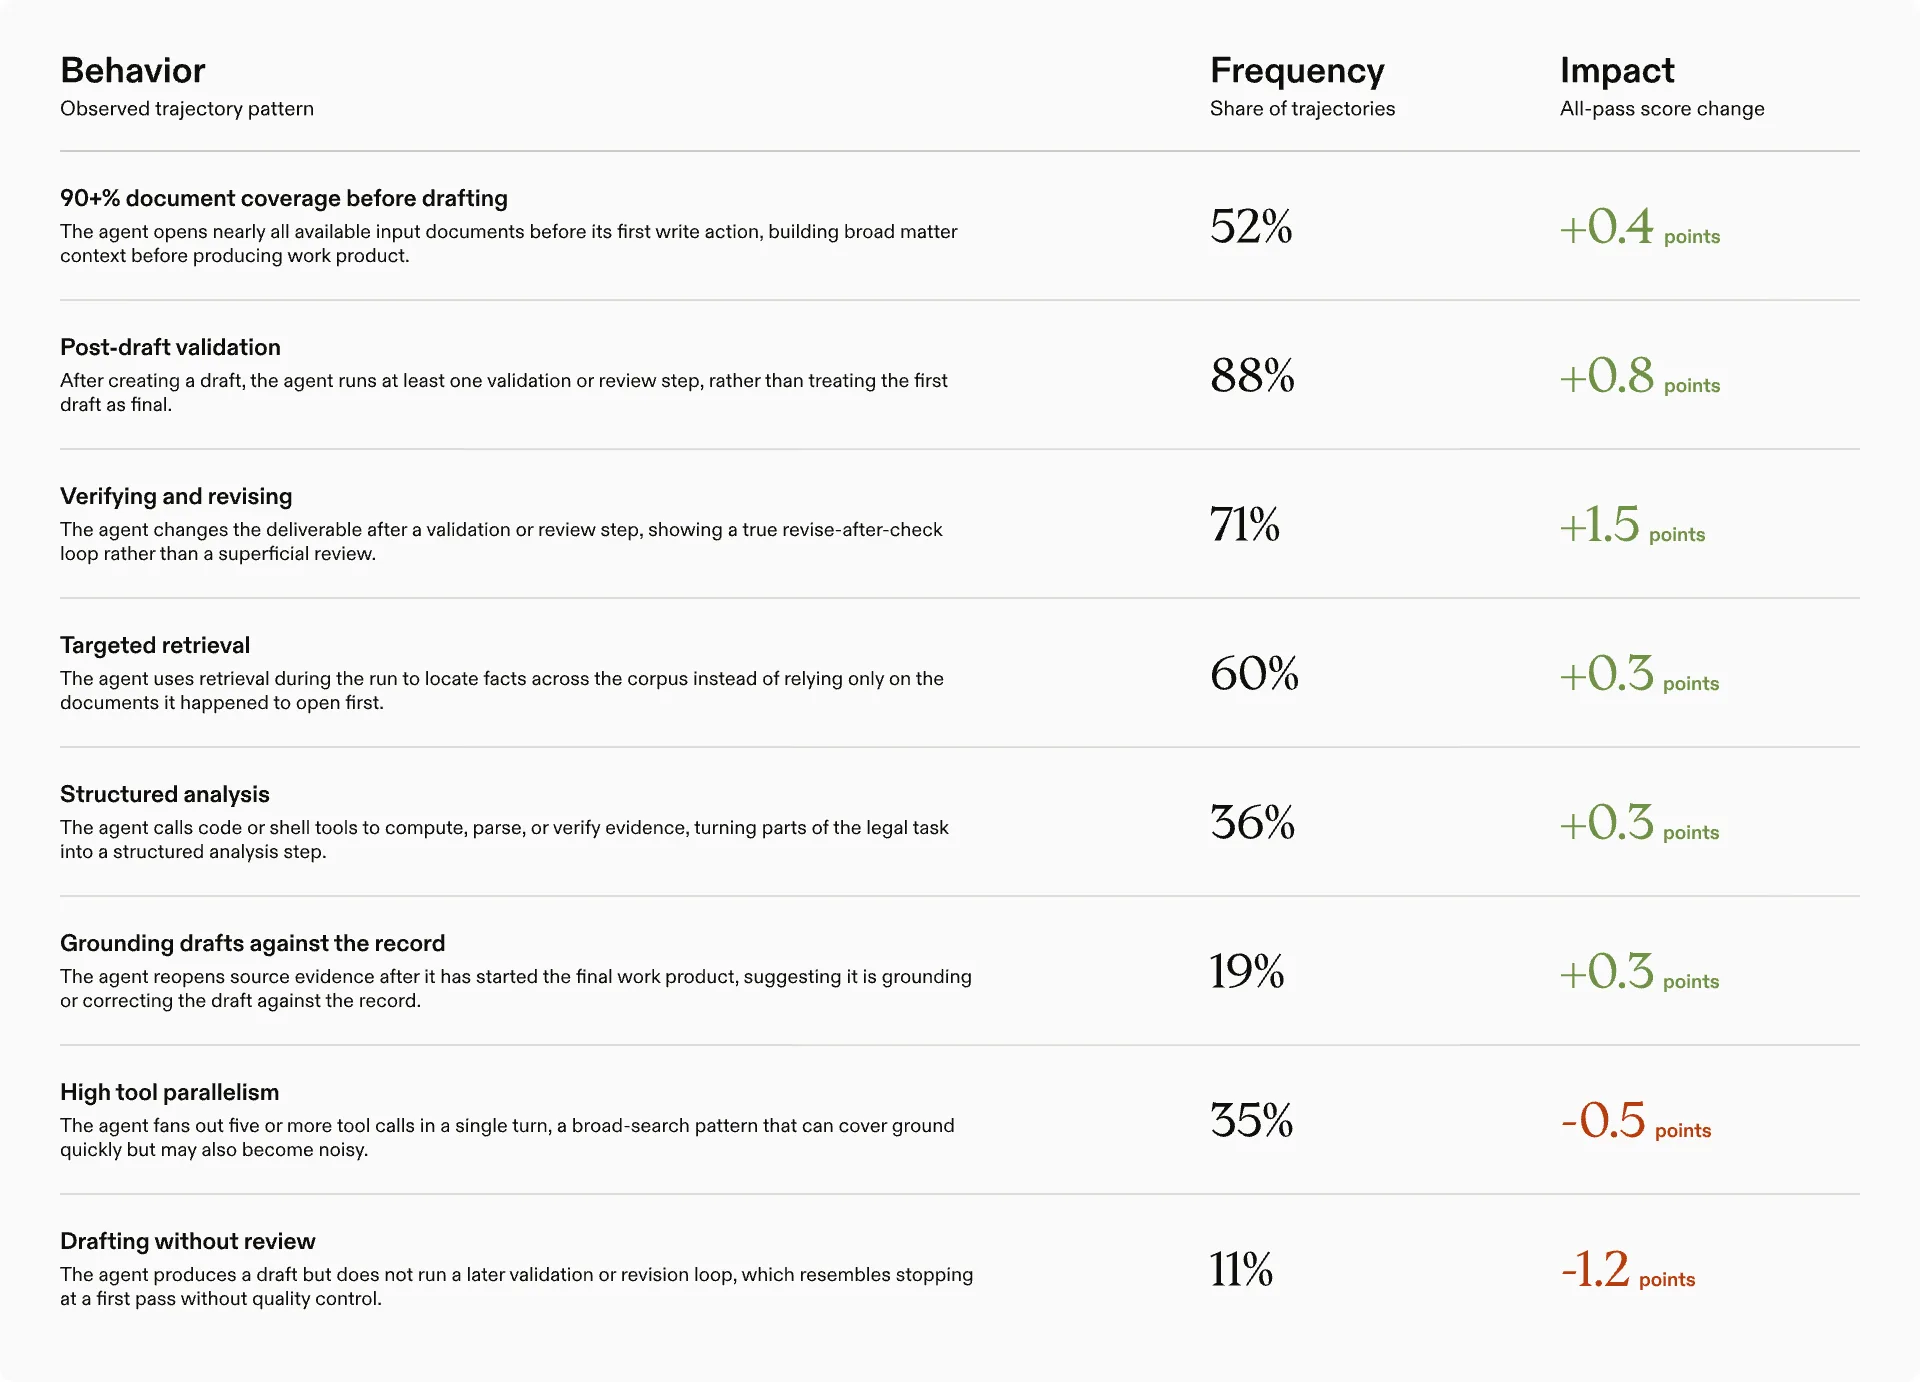
둘째는 행동 분석입니다. Harvey는 에이전트의 작업 기록을 분석해 어떤 행동이 통과율을 올리고 내리는지 쟀습니다.
가장 큰 플러스는 "검증하고 실제로 고치기"(+1.5점)였고, 가장 큰 마이너스는 "검토 없이 초안만 쓰기"(−1.2점)였습니다. 문서를 90% 이상 먼저 읽기(+0.4), 초안 뒤 검증 단계 거치기(+0.8)도 플러스였습니다. 반대로 한 번에 도구를 다섯 개 이상 동시에 부르는 '넓게 훑기'는 오히려 −0.5점이었습니다. 정리하면, AI도 사람처럼 '쓰고 나서 확인하고 고치는 습관'이 결과를 가릅니다. 이 문장은 이 글 전체의 결론과 같은 말입니다.
4
인사이트 ④ 평가가 영업 자산이 됐고, 평가를 만드는 쪽이 판을 짠다
OpenAI는 Astra for Law를 발표하며 Vals 벤치마크 점수를 내세웠고, Z.ai와 Harvey는 Harvey LAB 점수로 신모델을 홍보했습니다. 시장 참가자인 Harvey가 만든 시험이 업계의 공용 잣대가 된 것입니다(그래서 '오픈소스 연극'이라는 비판도 있습니다). 반대로 업체들은 제품 비교 평가에서는 빠지고 있습니다. 구매자 입장에서는 '어떤 제품이 좋은가'보다 '우리 업무로 직접 시험해 본 결과'가 점점 더 중요해집니다. 시험지가 실무에 가까워질수록, 최고의 시험지는 결국 우리 회사의 지난 사건 기록입니다.
AI가 법률 업무를 빠르게 만든다면, 시간 단위로 돈을 받는 로펌은 손해를 봐야 합니다. 그런데 2026년의 숫자는 이 상식과 어긋납니다. Bloomberg Law가 9월 정리한 바에 따르면, 미국 대형 로펌의 업무 수요(청구 시간)는 2026년 상반기에 4.2% 늘었습니다. 평소 증가율이 1.5% 안팎이니 이례적으로 높은 수치입니다. 같은 시기 모건스탠리·씨티·골드만삭스와 사모펀드 고객들은 로펌에 AI 절감분을 반영하라고 압박하고 있었습니다.
씨티가 57개 로펌을 조사한 결과는 이 역설의 내부를 보여 줍니다. 3분의 2가 '어소시에이트가 매일 AI를 쓴다'고 답했고, 4분의 3은 2028년까지 AI가 시간당 청구에 영향을 줄 것으로 봤으며, 절반은 이미 영향을 받고 있다고 답했습니다. 그런데 청구 시간은 늘었습니다. 2025년은 오히려 기록적인 해였습니다. Thomson Reuters와 조지타운대의 보고서에 따르면 미국 상위 100대 로펌의 변호사 1인당 이익은 2019년보다 53.7% 높았습니다.
어떻게 이럴 수 있을까요? 몇 가지 해석이 가능합니다. AI로 아낀 시간이 아직 청구서에 반영되지 않았을 수 있습니다. AI가 만든 초안을 검증하는 시간이 새로 생겼을 수 있습니다. 규제·소송·거래 수요 자체가 늘었을 수도 있습니다. 어느 쪽이든 분명한 것은, 효율의 이익이 누구에게 갈지는 기술이 아니라 '가격을 매기는 방식'이 정한다는 점입니다. 아래 계산기로 직접 확인해 보세요.
계산기에서 '검증에 다시 쓰는 비율'을 올려 보면 흥미로운 일이 생깁니다. 검증 비율이 높아질수록 시간제 매출 감소폭은 줄어듭니다. 즉, AI 초안을 꼼꼼히 검증하는 시간이 시간제 로펌의 매출을 지켜 주는 셈입니다. 고객 입장에서는 불편한 진실입니다. 그래서 고객들은 점점 '시간'이 아니라 '결과물'에 값을 매기려 합니다. Wolters Kluwer의 2026년 조사에서 법률가의 62%(사내 법무팀 67%, 로펌 57%)가 AI로 청구 시간이 줄 것이라고 답했습니다.
7-2. AI 네이티브 로펌: 처음부터 '건당 가격'으로 태어난 회사들
기존 로펌이 가격 구조를 바꾸는 데 시간이 걸리는 동안, 처음부터 다른 구조로 태어난 로펌들이 등장했습니다.
회사
어디서
무엇을
가격 구조
Garfield.Law
영국 (2025년 5월 SRA 인가)
1만 파운드 이하 소액 채권 회수
문서당 고정가
Crosby
미국 뉴욕
계약 검토·협상
문서당 고정가, 과실책임보험 포함
Norm Law
미국
컴플라이언스
성과 기반
Carta Law
영국 (2026년 5월)
대량 NDA·고객확인·컴플라이언스
지분관리 소프트웨어 회사가 로펌(Avantia)을 인수
LawFairy
영국 (2026년 2월 인가)
이민법
생성형 AI 없이 규칙 기반 '기술 전용' 로펌
KPMG Law US
미국 애리조나 (2025년 2월)
기술 기반 법률 서비스
회계법인 계열 첫 미국 로펌(비변호사 소유 허용 제도)
이 중 Garfield가 영국 방송 Channel 4의 다큐멘터리에서 치른 실험은 이 변화를 한 장면으로 보여 줍니다. 4,500파운드짜리 건축업자 채권 청구서를 쓰는 데 Garfield는 약 10분, 100파운드(부가세 별도)가 들었고, 수습 변호사는 3~4시간, 1,080파운드가 들었습니다. 감독 변호사는 수습 변호사의 결과물이 더 낫다고 평가하면서도 Garfield의 것도 "법정에서 받아들여질 만하다"고 판정했습니다. 의뢰인은 "당연히" Garfield를 고르겠다고 했습니다. 2026년 5월에는 Garfield가 처음으로 다툼이 있는 사건에서 이겼습니다. 다만 3시간짜리 재판에서 변론한 사람은 인간 법정변호사였습니다.
사내 법무팀도 움직입니다. 미국 통신사 AT&T는 2026년 1월 사내에 'AI 우선' 법률 조직 LegalEdge를 만들었고, 첫 6개월에 약 100건을 처리했다고 밝혔습니다. 법무 책임자 데이비드 매커티는 "법적 판단은 여전히 인간의 것"이라고 말했습니다. 법무 운영 조직 모임 CLOC의 2026년 조사에서 외부 로펌 비용이 늘 것이라고 예상한 법무팀은 58%에서 37%로 줄었습니다.
5
인사이트 ⑤ 가격의 단위가 시간 → 결과물 → 토큰으로 흔들린다
로펌은 '시간'을 팔았습니다. AI 네이티브 로펌은 '결과물'을 팝니다. 그런데 그 결과물을 만드는 AI 회사는 '토큰(사용량)'으로 값을 받기 시작했습니다. 세 단위가 한 거래 사슬 안에서 충돌하고 있습니다. 고객은 결과물로 사고 싶고, 로펌은 시간으로 팔고 싶고, AI 회사는 사용량으로 받고 싶어 합니다. 이 불일치가 정리되는 방식이 앞으로 몇 년간 법률 시장의 수익 구조를 정할 것입니다. 그리고 어느 단위로 정리되든, 맨 끝에서 '이 결과물이 맞다'고 서명하는 사람의 몫은 남습니다.
생산성 연구는 AI가 법률 업무를 빠르게 만든다는 것을 일관되게 보여 줍니다. 미네소타대 로스쿨생 60명을 대상으로 한 최초의 무작위 대조 실험(Choi·Monahan·Schwarcz, 2024)에서 GPT-4를 쓴 학생들은 과제에 따라 12~32% 빨랐고, 품질 향상은 "약간이고 일관되지 않았지만" 실력이 가장 낮은 학생들이 가장 큰 도움을 받았습니다. 2025년 후속 연구(Schwarcz 외)에서는 추론 모델 o1-preview를 쓴 학생들의 생산성이 과제에 따라 34~140%, 판례 검색을 붙인 vLex의 Vincent AI를 쓴 학생들은 38~115% 올랐습니다. 그런데 환각은 o1 쪽에서 11건, 검색을 붙인 Vincent 쪽에서 3건이었습니다. 다시 한번, 근거에 연결된 AI가 덜 지어냅니다.
문제는 그 '빨라진 일'이 바로 신입 변호사가 배우던 일이라는 점입니다. 문서 검토, 판례 조사, 초안 작성은 로펌의 도제 교육 그 자체였습니다. 휴스턴대 로스쿨의 닉 구겐버거 교수는 이렇게 말했습니다. "주니어 어소시에이트를 훈련시키던 일이 점점 자동화된다면, 그들이 훈련할 재료 자체가 사라진다."
숫자도 움직이기 시작했습니다. 미국 NALP 집계로 500인 이상 로펌이 채용한 2025년 졸업생은 6,588명으로 전년보다 7.5% 줄었습니다. 씨티 조사에서 대형 로펌의 3분의 2는 2028년 신입 규모가 2025년보다 작을 것이라고 답했습니다. 한국은 더 극적입니다. 법률신문 집계로 2026년 10대 로펌 신입 변호사 채용은 244명으로 전년(274명)보다 10.9% 줄었고, 10곳 중 6곳이 채용을 줄였습니다. 태평양은 35명에서 26명이 됐습니다. 이 로펌들의 2025년 매출은 10% 넘게 늘었습니다. 로펌들은 "AI가 기본 업무를 대체하면서 산업 경험이 있는 사람과 경력직을 선호한다"고 설명합니다.
같은 시기 미국 대형 로펌 신입 연봉은 23만 5천 달러로 올랐습니다. 사다리의 위 칸은 더 높아지고, 아래 칸은 줄어드는 모습입니다. 그리고 한국에서는 AI가 변호사시험 객관식에서 만점을 받았다는 발표가 나온 바로 그해였습니다.
6
인사이트 ⑥ 도제의 사다리를 다시 설계해야 한다
로펌은 '신입이 싸게 일하면서 배우는' 구조로 굴러왔습니다. AI가 그 일을 가져가면 당장은 이익이지만, 10년 뒤 파트너가 될 사람을 키울 재료가 사라집니다. 아이러니하게도 AI 결과물을 검증하려면 그 일을 직접 해 본 경험이 필요합니다. 앞으로 신입 교육은 'AI가 만든 초안의 오류를 찾고 고치는 훈련'으로 바뀔 가능성이 큽니다. 미국 로스쿨들 사이에서 "로펌이 하던 교육 기능을 로스쿨이 가져와야 한다"는 목소리가 나오는 이유입니다. 한국 로스쿨에서는 아직 23곳이 1학년 법률정보조사 수업에 리걸테크 특강을 한두 번 넣는 수준입니다.
8. 5층, 법원과 규제: 피해자이자 사용자이자 규칙 제정자
8-1. 2,184건의 기록
생태계의 맨 아래층인 법원은 2026년 법률 AI의 가장 큰 '외부 비용'을 떠안았습니다. 프랑스의 법률 연구자 다미앙 샤를로탱(Damien Charlotin)은 법원이 AI가 지어낸 판례나 인용문을 지적한 결정을 전 세계에서 모으고 있습니다. 2025년 5월 말 약 120건이던 이 데이터베이스는 2026년 10월 10일 2,184건이 됐습니다. 이 글을 위해 데이터베이스의 공개 CSV를 내려받아 결정 월별로 다시 세어 봤습니다.
몇 가지가 눈에 띕니다.
첫째, 증가 곡선은 2025년 여름에 가팔라졌다가 2026년 봄부터 평평해졌습니다. 월별 결정 수는 2025년 1월 16건에서 2026년 3월 182건까지 늘었다가, 이후 월 100~150건대에 머물고 있습니다. 사례가 나중에 소급해 추가되는 데이터베이스라 최근 몇 달은 더 늘어나겠지만, 하루 7~8건이던 추가 속도가 9월 이후 약 5건으로 줄었다는 분석도 있습니다. 경고와 제재가 쌓이면서 적어도 변호사들 사이에서는 학습 효과가 생기고 있다는 해석이 가능합니다.
둘째, 절반 넘게(약 58%)는 변호사 없이 혼자 소송하는 사람들입니다. 이 이야기는 9장에서 따로 다룹니다.
셋째, 변호사 쪽 사고는 작은 사무소에 몰려 있지만, 2026년에는 최상위 로펌도 이름을 올렸습니다. 스탠퍼드 인터넷과 사회 센터가 2025년 10월까지의 미국 변호사 사례 114건을 분석했더니 1인 사무소가 50.4%, 2~25인 로펌이 39.5%였습니다. 검증할 인력이 없는 곳에서 사고가 납니다. 그런데 2026년 4월, 월스트리트 최고 로펌 중 하나인 Sullivan & Cromwell이 뉴욕 파산법원에 낸 긴급 신청서에서 상대방 Boies Schiller가 40건이 넘는 오류를 찾아 세 쪽짜리 목록으로 제출했습니다. Sullivan & Cromwell의 구조조정 그룹 공동 책임자는 판사에게 보낸 서한에서 오류가 AI '환각'에서 비롯됐고, 회사의 AI 정책이 "지켜지지 않았으며", 2차 검토도 이를 놓쳤다고 인정했습니다.
넷째, 판사 32건. 법원이 낸 결정문 자체에 가짜 판례가 들어간 사례입니다. 2025년 미국 뉴저지와 미시시피의 연방 판사가 직원이 AI를 쓰다 생긴 오류로 결정을 철회했고, 2026년에는 더 무거운 사례가 나왔습니다.
오클라호마의 휠러(Wheeler) 판사(2026년). 친자 확인 사건에서 상대 변호사를 "경솔한 소송 전술"이라고 꾸짖는 결정을 내리면서 존재하지 않는 판례 두 건을 인용했습니다. 그는 수사기관에 ChatGPT를 "리서치용으로만" 썼고 그중 최소 두 건의 인용이 존재하지 않는다고 인정했습니다. 9월 주 법무장관은 형사 기소를 하지 않기로 했고, 징계 여부는 사법심사위원회에 남았습니다.
조지아주 대법원의 Payne 사건(2026년 5월 5일). 살인죄로 종신형을 받은 피고인의 재심 청구를 기각한 1심 결정문이 사실은 검사가 써 준 초안이었고, 그 초안에 검찰의 AI 활용 서면에서 옮겨 온 가짜·잘못된 판례가 들어 있었습니다. 주 대법원은 결정을 파기하고, 1심 판사들에게 당사자가 써 온 결정문 초안을 AI 사용 여부까지 따져 보라고 지시했으며, 해당 검사의 주 대법원 변론 자격을 6개월 정지했습니다.
인도 대법원(2026년 2월). 하급심이 AI가 지어낸 선례 네 건에 기대 판결한 사건을 직권으로 다루면서 "가짜 AI 판결에 기댄 결정은 비행(misconduct)"이라고 말하고 법무장관과 변호사협회에 통지했습니다.
한국도 예외가 아닙니다. 샤를로탱 데이터베이스에는 한국 사례가 8건 올라 있지만, 국내 보도로 확인되는 것만 10건이 넘습니다. 대구고법에서는 변호사가 존재하지 않는 대법원 판결 번호를 인용했다가 재판부가 확인을 요구하자 또 다른 가짜 번호를 내면서 "판례 번호가 부정확할 수 있다"고 버텼습니다. 9월 사법연수원 법관 연수에서는 서면에 인용된 판례 40개 중 39개가 허위였던 사례가 교재로 쓰였습니다. 울산지법에서는 변호인이 엉뚱한 대법원 판결을 인용했다가 재판장의 추궁에 "구글 제미나이로 검색한 뒤 확인하지 않았다"고 인정했습니다.
8-2. 규칙의 두 철학: "밝혀라" 대 "확인했다고 서명하라"
사고가 쌓이면서 규칙이 만들어지고 있습니다. 흥미로운 것은 같은 문제에 대해 두 가지 다른 철학이 경쟁하고 있다는 점입니다.
관할
무엇을 요구하나
상태 (2026년 10월)
철학
캘리포니아 SB 574
법원 제출 서류의 생성형 AI 사용 고지, 인용의 개인적 검증, 기밀 입력 보호. 로펌도 공동 책임
미국 주 단위 규칙을 추적하는 한 집계(10월 9일 기준)에 따르면, 변호사를 구속하는 주 전체 규칙 중 '검증'을 요구하는 것은 있어도 '고지'를 요구하는 것은 하나도 없었습니다. 고지 의무는 대부분 판사 개인의 명령(111건)에 머물러 있습니다. 흐름은 "AI를 썼는지 밝혀라"에서 "인용을 직접 확인했다고 서명하라"로 옮겨 가는 중이고, 캘리포니아는 두 가지를 모두 법률로 만든 예외적 사례입니다. 5순회 항소법원은 2024년에 AI 고지 규칙을 검토했다가 "기존 규칙으로 충분하다"며 접었지만, 2026년 2월 제재 결정에서 "문제가 줄어들 기미가 없다"고 적었습니다.
왜 '고지'보다 '검증'일까요? 거의 모든 변호사가 어떤 형태로든 AI를 쓰게 되면(맞춤법 검사기도, 검색 엔진도 AI입니다) 고지는 의미를 잃습니다. 중요한 것은 AI를 썼느냐가 아니라 틀린 것을 냈느냐이고, 그 책임은 서명한 사람에게 있다는 원칙입니다. 영국 사법부 지침의 표현이 이 철학을 잘 요약합니다. 판사는 "자기 이름으로 나가는 모든 자료에 개인적 책임"을 집니다.
8-3. 특권의 문제: Claude는 당신의 변호사가 아니다
2026년 2월, 미국 연방법원에서 일주일 사이에 엇갈린 판단이 나왔습니다. 뉴욕 남부지법의 제드 라코프 판사는 United States v. Heppner 사건에서 형사 피고인이 자기 방어를 위해 일반 소비자용 Claude로 만든 문서 31건이 변호사-의뢰인 특권으로도, 소송 준비 자료로도 보호되지 않는다고 판단했습니다. Claude는 변호사가 아니고, 개인정보처리방침상 제3자(정부 포함)에게 공개될 수 있으며, 변호사의 지시로 만든 것도 아니라는 이유였습니다. 반면 같은 시기 미시간의 한 치안판사는 Warner v. Gilbarco 사건에서 나홀로 소송 원고의 ChatGPT 자료를 소송 준비 자료로 보호하며 "ChatGPT는 사람이 아니라 도구"라고 했습니다. 3월 콜로라도 법원은 Warner 쪽에 섰지만, 상대방의 기밀 자료를 학습·공개 금지 계약이 없는 AI 플랫폼에 넣지 말라는 AI 전용 보호명령을 내렸습니다. (이 쟁점은 변호사가 AI 쓰면 특권은 깨지는가에서 자세히 다뤘습니다.)
이 판결들이 생태계에 주는 메시지는 분명합니다. 같은 모델이라도 어떤 계약 조건(데이터 보존·학습 금지)으로, 누구의 지시로 쓰느냐에 따라 법적 성격이 달라집니다. 기업용 계약, 데이터 무보존(ZDR), 망 분리 배치가 단순한 보안 옵션이 아니라 법적 방어선이 되는 이유입니다. 한국 대형 로펌들이 광장의 eLK처럼 외부망을 차단한 자체 GPU 서버를 고집하는 것도 같은 맥락입니다.
8-4. 법원도 AI를 쓴다: 그리고 법원도 과신한다
법원은 AI의 피해자이면서 동시에 사용자입니다. 영국은 2025년 4월부터 모든 판사에게 마이크로소프트 Copilot Chat을 제공하고 있습니다. 미국중재협회(AAA-ICDR)는 2025년 11월 건설 분쟁 서면 심리용 'AI 중재인'을 열었습니다. 당사자가 AI의 요약을 확인하고, 인간 중재인이 검토·수정해 서명하는 구조입니다. 그리고 한국 법원은 2026년 2월 판사와 법원 직원을 위한 재판지원 AI를 개통했습니다.
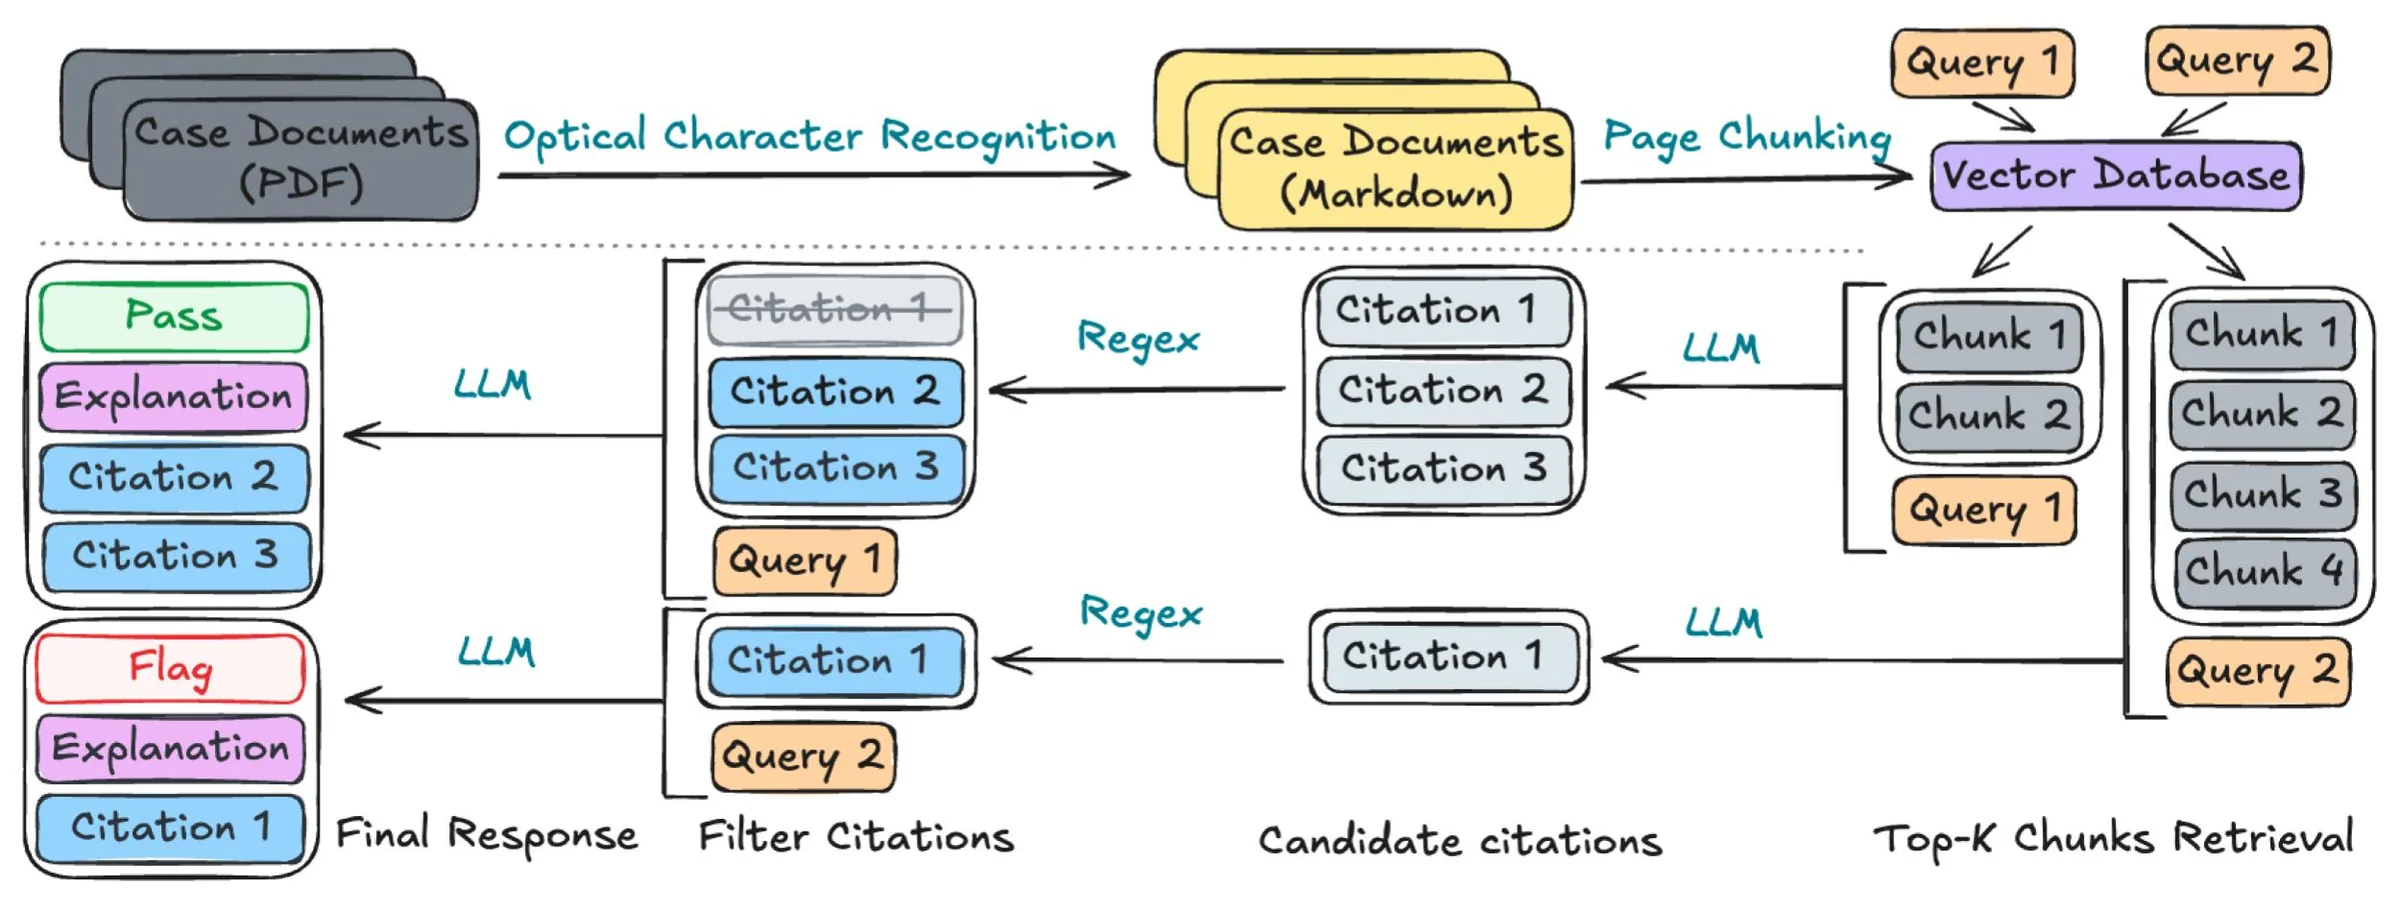
법원이 AI를 쓰면 무엇이 달라질까요? 스탠퍼드 연구진이 2026년 6월 발표한 연구가 좋은 실마리를 줍니다. 연구진은 로스앤젤레스 고등법원의 채무 추심 궐석판결 188건을 감사해 4%는 판결이 나가서는 안 될 중대한 결함, 10%는 금액을 줄여야 하는 불일치, 32%는 고쳐야 할 오류가 있었다는 것을 먼저 확인했습니다. 그리고 법원 실무자들과 함께 근거를 인용하며 요건을 점검해 주는 'Default Assistant'를 설계했습니다.
출처: Worledge 외, "AI Assistance for Human Review of Default Judgments" (arXiv 2607.01256, 2026), Figure 1.
이 구조에서 눈여겨볼 곳은 가운데의 '정규식(Regex)으로 인용 거르기' 단계입니다. LLM이 뽑은 인용 후보 중 실제 사건 문서에 그 문장이 그대로 있는 것만 남깁니다(그림에서 Citation 1에 줄이 그어진 것이 걸러진 예입니다). AI가 근거를 지어낼 여지를 구조적으로 막는 장치입니다. 로스쿨생 66명을 대상으로 한 실험에서 이 도구를 쓴 사람들은 요건당 정확도가 6.0% 올랐고 검토 시간은 25.9% 줄었습니다.
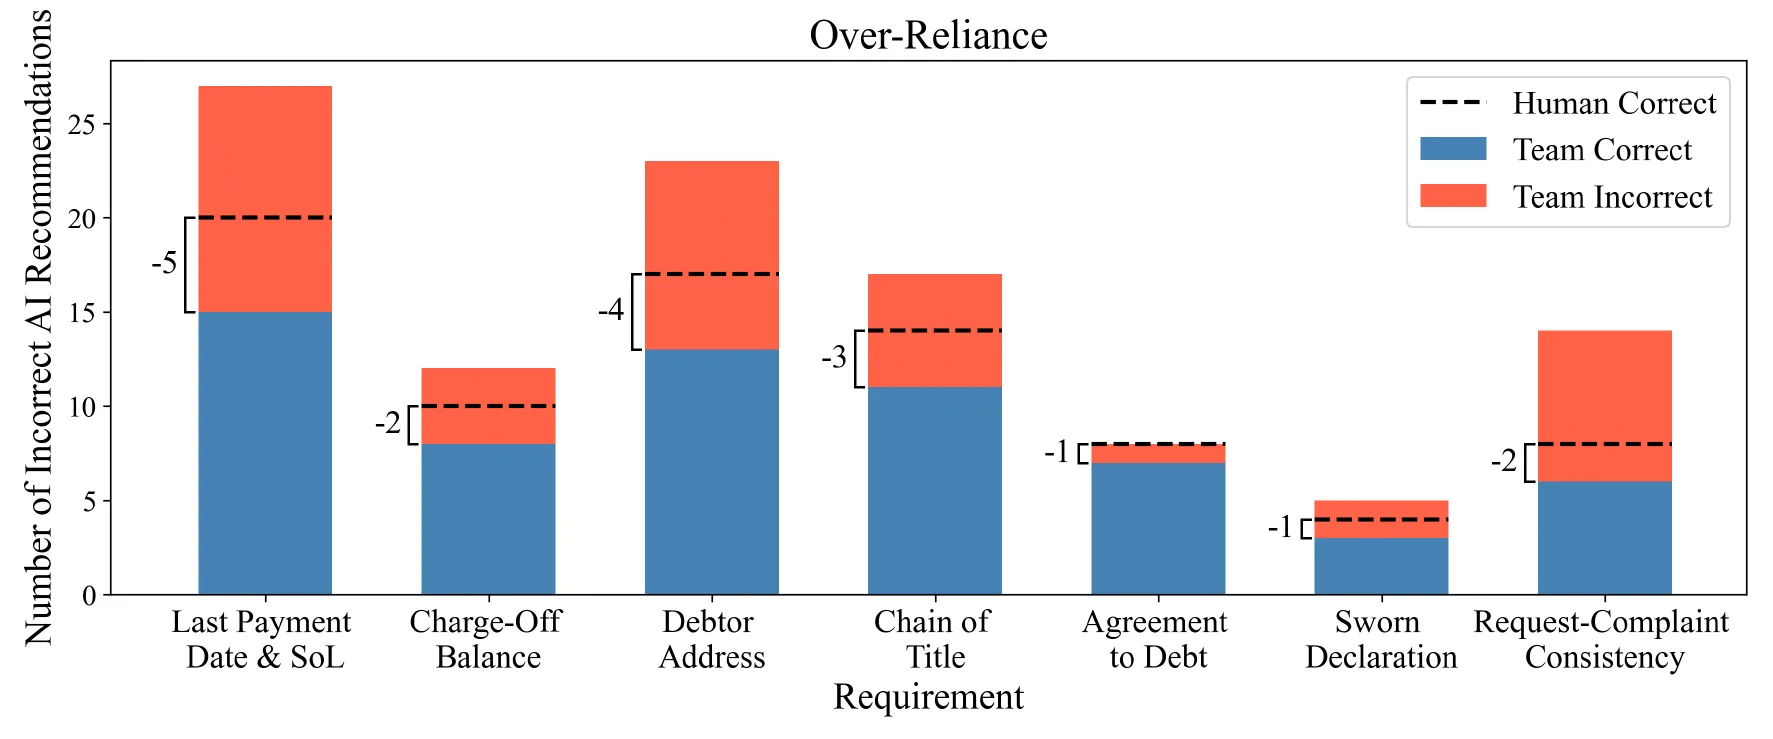
출처: Worledge 외 (2026), Figure 3. 점선은 AI 없이 검토한 사람이 맞힌 수, 파랑은 AI의 틀린 추천을 받고도 바로잡은 수, 빨강은 AI를 따라 틀린 수.
AI가 틀린 추천을 했을 때, AI의 도움을 받은 사람들은 혼자 검토한 사람들보다 그 오류를 덜 잡아냈습니다. 일곱 개 요건 모두에서 1~5건씩 적었습니다. 연구진의 표현대로 "차이는 작지만, 틀린 AI 추천에 과도하게 의존하는 경향"이 보인 것입니다. 전체 정확도는 올랐지만, 그 대가로 AI의 실수를 사람이 함께 따라가는 일이 생겼습니다.
이것이 법원이 AI를 쓸 때 가장 조심해야 할 지점입니다. 한국 재판지원 AI에 대해 대법원은 환각 방지에 관한 계약상 성능 기준이 없고("기술적 한계 때문에 기준을 명시하지 않았다"), AI 결과를 판결문 작성에 얼마나 썼는지도 따로 관리하지 않는다고 답했다는 보도가 있습니다. 같은 법원이 변호사들에게는 허위 인용에 소송비용을 물리고 있습니다. 법원 스스로에게도 같은 검증 기준이 필요합니다.
AI가 서면을 만드는 비용은 거의 0이 됐지만, 그 서면이 맞는지 확인하는 비용은 줄지 않았습니다. 오히려 사람은 AI가 틀렸을 때 그것을 덜 잡아냅니다. 그래서 2026년 생태계의 거의 모든 움직임이 이 깔때기의 좁은 끝을 향합니다. Thomson Reuters의 'Deep Research Verify'(6월), 한국 법원의 '허위 사건번호 확인' 서비스(2월), Harvey LAB의 전 항목 통과 채점, 캘리포니아와 플로리다의 '직접 확인' 의무, Default Assistant의 인용 거르기 단계가 모두 같은 지점을 겨눕니다. 다음 큰 법률 AI 시장은 '쓰는 AI'가 아니라 '확인하는 AI'와 '확인했다고 책임지는 사람'일 가능성이 큽니다.
9. 접근성의 역설: 더 많은 사람이 법원에 가지만, 더 이기지는 못한다
법률 AI의 가장 큰 약속은 '정의에 대한 접근(access to justice)'입니다. 변호사를 살 수 없던 사람도 AI의 도움으로 자기 권리를 주장할 수 있게 된다는 것입니다. 2026년, 이 약속이 실제로 어떤 모습인지 처음으로 큰 규모의 데이터가 나왔습니다.
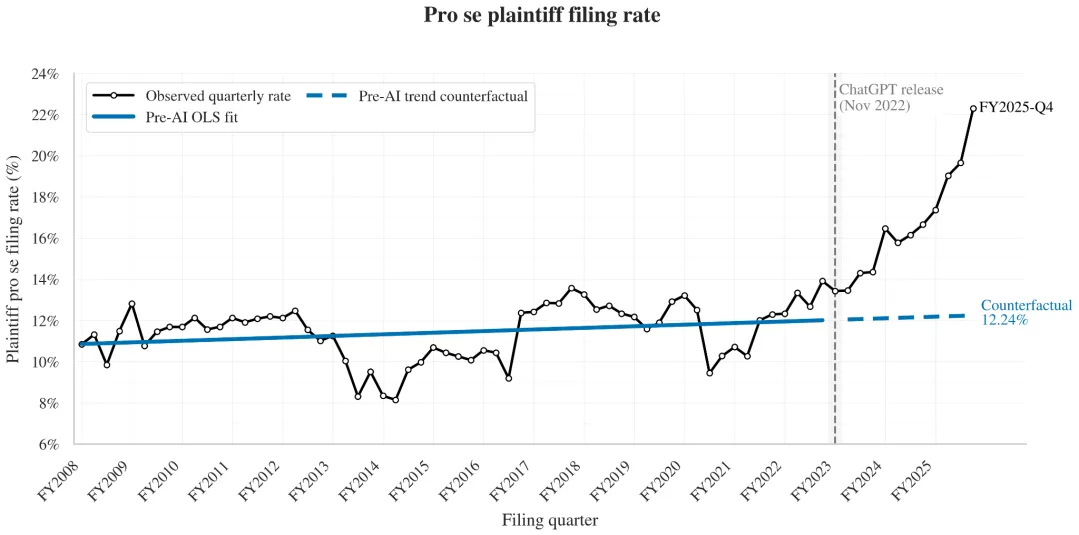
법학자 오르 코헨-사손(Or Cohen-Sasson)은 2008~2025 회계연도 미국 연방 민사소송 약 280만 건을 분석했습니다(arXiv 2605.29493, 2026년 5월). 결과는 아래 그림 한 장에 담겨 있습니다.
출처: Cohen-Sasson, "The New Pro Se: Generative AI and the Surge in Federal Civil Self-Representation" (arXiv 2605.29493, 2026), Figure 1.
그림을 읽는 법은 이렇습니다. 검은 선이 실제 분기별 나홀로 소송 비율이고, 파란 실선은 ChatGPT 이전 15년의 추세, 파란 점선은 그 추세가 이어졌다면 나왔을 값(반사실)입니다. 2022년 11월 ChatGPT 출시를 기준으로 비율은 11.33%에서 16.94%로 5.61%p 뛰었고, 2025 회계연도 마지막 분기에는 22.30%까지 올라갔습니다. 추세대로라면 12.24%였을 값입니다. 같은 기간 변호사를 선임한 소송 건수는 3.2% 줄었는데, 나홀로 소송 건수는 분기 평균 4,152건에서 6,423건으로 54.7% 늘었습니다. 연구진은 문체 지표로 'AI가 쓴 것으로 보이는' 소장을 표시했는데, 정형 서식이 아닌 소장 중 AI 표시 비율이 GenAI 이후 13.9%p 늘었습니다. MIT와 USC 연구진의 별도 분석도 비슷하게, AI 표시 소장 비율이 2023년 1.0%에서 2026년 초 18.0%로 올랐다고 보고했습니다.
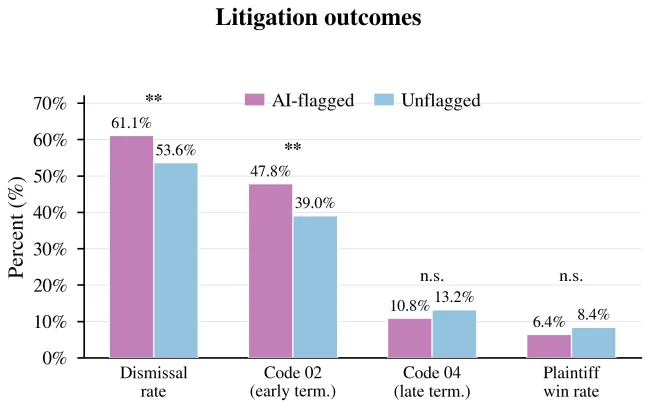
출처: Cohen-Sasson (2026), Figure 7. 분홍: AI 표시 소장, 하늘색: 표시되지 않은 소장.
AI 표시 소장은 더 자주 각하됐고(61.1% 대 53.6%), 더 일찍 끝났으며(47.8% 대 39.0%), 승소율은 나아지지 않았습니다(6.4% 대 8.4%, 통계적으로 유의한 차이 없음). 더 흥미로운 것은 이 소장들이 겉보기에는 더 그럴듯했다는 점입니다. 1천 단어당 판례·법령 인용 수가 AI 이전 소장보다 51% 많았습니다. 저자는 이것을 '소송 효능의 역설'이라고 불렀습니다. 더 법률 문서처럼 보이는 소장이 법정에서는 더 나쁜 성적을 냈습니다.
이 역설에는 두 얼굴이 있습니다. 한쪽에는 캘리포니아 롱비치의 린 화이트 같은 사람이 있습니다. 퇴거 소송 1심에서 진 그는 월 20달러짜리 ChatGPT와 Perplexity로 항소해 이겼고, 약 5만 5천 달러의 위약금과 1만 8천 달러 이상의 밀린 임대료를 면했습니다. "AI 없이는 절대, 절대 이 항소를 이길 수 없었을 것"이라고 그는 NBC에 말했습니다. 다른 쪽에는 미네소타의 69세 남성이 있습니다. 전처와 그 변호사, 판사를 상대로 낸 손글씨 소송이 한 달 만에 기각되자 그는 ChatGPT와 Claude로 쓴 소장과 50건이 넘는 서류를 들고 돌아왔고, 연방지법원장은 이후 제출물을 "추가 통지 없이 파쇄하겠다"고 경고했습니다.
저자는 결론을 성급하게 내리지 않습니다. 각하된 소송이라도 아예 법원에 오지 못한 것과는 다르고, 승소율이 그대로여도 소송 건수가 늘면 이기는 사람의 절대 수는 늘 수 있다는 점을 짚습니다. 그러니 정확한 표현은 이것입니다. AI는 '법원에 접근하는 능력'은 넓혔지만, '법원에서 이기는 능력'까지 넓히지는 못했습니다. 그 간극을 메우는 것은 다시 검증, 즉 그 소장이 맞는지 봐 줄 사람이나 장치입니다.
한국에서도 같은 조짐이 보입니다. 2025년 기준 변호사 선임 비율은 민사 합의 사건 약 87%, 단독 사건 약 56%인데, 소액 사건은 약 22%에 불과합니다. 판사들은 AI 덕분에 소액 사건 접수가 쉬워졌다고 말하고, 한 보도는 소액 사건이 전년 같은 기간보다 약 12.7% 늘었다고 전했습니다(비교 기간은 보도에서 명확하지 않습니다). 수원지법과 서울동부지법의 '가짜 판례' 지적 판결도 모두 나홀로 소송이었습니다. 서울동부지법은 판결문 각주에 원고가 "의도적으로 허위 판례를 인용하여 적극적으로 법원을 기망하려 한 것으로 보인다"고 적었습니다.
한국의 2026년을 다섯 층 지도에 올려 보면, 각 층의 속도가 크게 다르다는 것이 보입니다.
10-1. 가장 빨리 움직인 곳: 법원
의외로 한국에서 가장 빠르게 움직인 주체는 법원이었습니다. 2026년 한 해에만 이런 일이 있었습니다.
2월재판지원 AI 시범 개통. 대법원 판례, 13년 치 판결문 전체, 법령, 실무제요, 주석서를 넣은 사법부 자체 생성형 AI 리서치 도구입니다. 외부 공개형 AI에 기대지 않는 내부 플랫폼이고, 4단계 총 161억 원 사업 중 1단계(약 7개월)에 46억 원이 들었습니다. 2단계는 사건 기록의 요지와 쟁점을 정리하는 기능입니다. 같은 달 『법관을 위한 AI 가이드북』과 사법정보공개포털의 '허위 사건번호 확인' 서비스도 나왔습니다.
3월법원행정처 'AI 활용 허위 주장·증거 제출 대응 TF' 결과 발표. 현행법 안에서 ① 허위 인용으로 생긴 소송비용을 부담시키고 ② 해당 서면의 진술을 제한하며 ③ 판결서에 허위임을 적고 ④ 검증하지 않은 변호사는 대한변협에 징계를 의뢰하는 방안을 내놓았습니다. 입법 과제로는 AI 활용 고지와 과태료를 제시했습니다.
4~8월판결문에 '허위 판례'가 기록되기 시작. 서울고법(4월, "모두 존재하지 않는 사건번호로 보인다"), 수원지법(5월), 특허법원(6월, 27년 차 변호사의 가짜 판례 8건), 서울동부지법(6월, "법원을 기망하려 한 것"), 대전지법(8월, "인공지능 환각(AI Hallucination)으로 보인다"). 한 법원은 인용한 대법원 판결 원문을 모두 내라는 명령과 함께 누가 어떻게 인용했는지 적은 경위서를 요구했습니다.
7~9월국회와 연수. 이성윤 의원(7월)과 정진욱 의원(8월)이 존재하지 않는 법령·판례 인용에 500만 원 이하 과태료를 매기는 민사·형사소송법 개정안을 냈습니다(정진욱 안은 AI 이용 사실 기재 의무 포함). 대법원은 'AI 활용 사실 표기' 규칙 개정을 검토 중이라고 밝혔습니다. 9월 사법연수원은 '허위 인용 대응'을 주제로 법관 연수를 열었습니다.
10-2. 갈라진 시장: 대형 로펌의 '여러 정문'과 리걸테크의 '울타리'
대형 로펌들은 글로벌 흐름을 빠르게 따라가고 있습니다. 태평양은 7월 국내 첫 Harvey 전사 도입에 이어 8월 ChatGPT Enterprise를 깔았고, 자체 AI 플랫폼을 11월 정식 운영할 계획입니다. 9월 Legora가 한국에 들어오자 5대 로펌이 모두 시험하거나 검토 중이라는 보도가 나왔습니다. 광장은 Harvey 테스트를 끝내고 Legora 테스트를 마무리하며 OpenAI와도 논의 중이고, 율촌은 폐쇄형 '아이율'과 통합 플랫폼 위에 외부 도구를 시험하고 있습니다. 공통 원칙은 "판단은 인간, 기술은 조력"과 "보안 최우선"입니다. 대형 로펌들은 AI팀(김앤장 약 70명, 광장 약 100명, 율촌 약 90명, 세종 약 50명, 태평양 약 40명)을 두고 AI기본법 자문 수요에도 대응하고 있습니다.
반면 리걸테크 기업들은 여전히 변호사법이라는 울타리 안에서 움직입니다. 2026년 2월 12일 대법원은 로폼 사건(2025두35483)에서 리걸테크와 변호사 단체의 분쟁에서 처음으로 기업 쪽 손을 들어줬습니다. 이용자가 빈칸을 채우면 그대로 문서가 되는 자동 작성 서비스는 '법률사무 취급'이 아니다라는 1심 판단이 확정됐습니다. 하지만 같은 판결은 생성형 AI가 이용자 입력을 바탕으로 문서를 써 주는 경우는 법률사무 취급에 해당할 수 있다고 선을 그었습니다. 일부 언론의 "법률 AI가 쓴 소장은 합법"이라는 제목은 과장입니다. 한국에서 '변호사 없이 AI가 소장을 써 주는 서비스'는 여전히 회색 지대입니다.
국회 공청회에서 김병필 KAIST 교수가 지적한 '역차별'이 바로 이 지점입니다. 국내 리걸테크가 ChatGPT 같은 서비스를 제공하면 변호사법에 걸릴 수 있지만, 해외 AI에는 그 법이 사실상 적용되지 않습니다. 한국 시민은 이미 매일 ChatGPT와 Claude에 법률 질문을 던지고 있습니다. 리걸테크진흥법안은 두 건(2024년 7월, 2025년 7월)이 국회에 계류 중입니다.
10-3. 가장 조용한 곳: 변호사 단체와 AI기본법
대한변호사협회의 공식 AI 가이드라인은 2026년 10월 현재 없습니다. 내부 TF가 있지만 내용은 공개되지 않았습니다. 한 변호사는 언론에 "법관에게는 AI 가이드라인이 고지됐지만 변호사 대상 공식 가이드라인은 없다"고 말했습니다. 법원은 가이드북을 냈고 변호사를 징계 의뢰하겠다고 하는데, 정작 변호사들이 따를 기준은 없는 상황입니다. 미국은 2024년 ABA 공식 의견 512호와 여러 주 변호사회 의견이 있고, 영국은 규제기관 SRA가 경고 공지를 냈습니다.
2026년 1월 22일 시행된 인공지능기본법도 법률 AI에는 직접 답을 주지 않습니다. 법이 정한 '고영향 AI' 10개 영역에는 에너지, 보건의료, 채용·대출 심사 등이 있지만 '사법·재판'이나 '법률 서비스'는 명시되지 않았습니다. EU AI Act가 사법 판단 보조 AI를 고위험으로 명시한 것과 대조적입니다. 법률 AI가 고영향인지는 "권리·의무 관계에 중대한 영향을 미치는 판단"이라는 포괄 조항의 해석에 달려 있고, 이를 다룬 공식 해석은 아직 없습니다. 게다가 과기정통부는 사실조사와 과태료에 최소 1년의 계도기간을 두기로 했습니다.
10-4. 한국형 세 개의 병목
이렇게 놓고 보면 한국 법률 AI 생태계에는 세 개의 병목이 겹쳐 있습니다.
데이터 병목 판결문 공개가 좁다 → 학습·검증 재료 부족 → 한국어 법률 벤치마크에서 최신 모델도 서술형 70%대
+
규제 병목 변호사법상 생성형 AI 문서 작성은 회색 지대 → 국내 서비스만 묶이는 역차별
+
책임 병목 변협 가이드라인 부재 + AI기본법의 사법 공백 → 누가 무엇을 검증해야 하는지 기준이 없다
↓
결과: 대형 로펌은 해외 도구로, 시민은 해외 범용 AI로, 국내 리걸테크는 그 사이 좁은 길로
흥미롭게도 세 병목은 모두 '검증'과 연결됩니다. 판결문이 공개돼야 AI가 지어낸 판례를 대조할 수 있고, 변호사법의 경계가 분명해야 '누가 검증했는가'를 기준으로 서비스를 허용할 수 있으며, 가이드라인이 있어야 무엇을 어디까지 확인하면 책임을 다한 것인지 알 수 있습니다. 법원이 허위 사건번호 확인 서비스로 먼저 움직인 것은 그래서 의미가 있습니다. 한국 법률 AI의 다음 단계는 더 똑똑한 모델이 아니라 검증 인프라(판결문 공개, 인용 대조 도구, 검증 책임 기준)에서 열릴 가능성이 큽니다.
11. 일곱 가지 인사이트, 한 장으로
지금까지의 이야기를 한 장에 모으면 이렇습니다.
#
인사이트
근거가 된 장면
그래서 무엇을 봐야 하나
①
정문은 쪼개지고, 연결은 표준이 된다
모델 3사의 법률 제품, 분야별로 다른 1위 모델, Harvey Tenet·Latham GPU
모델 교체 비용이 낮은 구조인가
②
데이터 해자는 모양만 바뀌었다
주가 −16%, 매출 +10%. 54.0% 대 38.7%. CourtListener
원문이 아닌 '가공층'을 누가 가졌나
③
샌드위치의 재료가 비싸지는 조건
Harvey 155억 달러, 리걸 엔지니어, 맞춤 에이전트 2만 5천 개
현장 배치 능력과 고객별 기준 축적
④
평가가 영업 자산이 됐다
LAB 전 항목 통과 25%, 업체들의 비교 평가 이탈
우리 업무로 직접 시험하기
⑤
가격 단위가 흔들린다
청구 시간 +4.2%의 역설, 100파운드 대 1,080파운드, 1천만 달러 청구서
시간·결과물·토큰 중 어느 단위로 계약하나
⑥
도제의 사다리를 다시 설계해야 한다
신입 채용 미국 −7.5%, 한국 −10.9%
신입이 '검증자'로 성장할 경로
⑦
검증이 새 병목이자 새 상품이다
2,184건, 과신 실험, '검증 후 수정' +1.5점, 각하율 61.1%
확인하는 AI와 책임지는 사람
일곱 개를 다시 하나로 줄이면 이 글의 처음 결론으로 돌아옵니다. 법률 문서를 만드는 일은 싸졌고, 그것이 맞다고 책임지는 일은 비싸졌습니다. 모델 회사는 만드는 일을 가져갔고, 데이터 회사는 '맞음'의 원천을 쥐었고, 도구 회사는 현장의 기준을 쌓았고, 로펌은 서명을 쥐었고, 법원은 서명한 사람에게 책임을 묻기 시작했습니다. 2026년 법률 AI 생태계의 모든 재배치는 이 한 문장의 결과입니다.
12. 내 자리에서: 역할별 나침반과 체크리스트
같은 변화도 서 있는 자리에 따라 다르게 읽힙니다. 아래에서 내 자리를 골라 보세요.
그리고 어느 자리든 공통으로 적용되는 최소한의 체크리스트입니다.
원문 대조AI가 준 판례·법령 번호는 법원 포털·공식 DB에서 원문을 열어 문장까지 확인한다. 한국은 사법정보공개포털의 허위 사건번호 확인 서비스를 쓴다.
근거 연결범용 챗봇의 '기억'이 아니라 실제 법률 데이터에 연결된 도구를 쓴다. 근거 없이 결론만 주는 답은 초안으로도 쓰지 않는다.
계약 조건의뢰인 정보를 넣는 AI는 기업용 계약(학습 금지·데이터 무보존)인지 확인한다. 같은 모델도 계약 조건에 따라 비밀유지특권의 운명이 갈린다.
검증 후 수정AI 초안을 받으면 '읽기'로 끝내지 말고 '고치기'까지 한다. 에이전트에게도 같은 단계를 넣는다(LAB에서 +1.5점).
과신 경계AI가 맞을 때보다 틀릴 때가 위험하다. 중요한 판단은 AI 답을 보기 전에 스스로 먼저 결론을 적어 두고 비교한다.
서명의 의미내 이름으로 나가는 문서의 모든 인용에 대해 "내가 확인했다"고 말할 수 있는가. 답이 '아니오'면 내지 않는다.
맺으며: 법을 아는 기계 다음에 오는 것
2023년에 우리는 AI가 변호사시험을 통과했다는 소식에 놀랐습니다. 2026년에 AI는 한국 변호사시험 객관식에서 만점을 받았다는 발표가 나왔고, 아무도 크게 놀라지 않았습니다. 대신 사람들이 놀란 것은 다른 장면들이었습니다. 월스트리트 최고 로펌의 서면에서 나온 40개의 오류, 판사의 결정문에 들어간 가짜 판례, 살인 사건 재심 결정의 파기, 그리고 한국 판결문에 적힌 'AI Hallucination'.
법을 '아는' 기계는 이미 왔습니다. 2026년이 보여 준 것은, 그다음에 필요한 것이 더 많이 아는 기계가 아니라 자기가 아는 것이 맞는지 확인하고, 그 확인에 책임을 지는 구조라는 사실입니다. 모델 회사, 데이터 회사, 도구 회사, 로펌, 법원이 각자 자리를 옮긴 것도 결국 그 구조의 어느 부분을 누가 맡을지를 두고 벌어진 일입니다.
Harvey LAB의 행동 분석이 남긴 숫자를 다시 떠올려 봅니다. 쓰고 나서 확인하고 고친 에이전트는 +1.5점, 검토 없이 초안만 낸 에이전트는 −1.2점. 기계에게 적용되는 이 규칙은 사람에게도 똑같이 적용됩니다. 법률 AI 생태계의 미래는 아마 이 두 숫자 사이 어딘가에서 정해질 것입니다.
참고 자료
시장·기업 발표
Morningstar, "Thomson Reuters, RELX, Wolters Kluwer stocks crushed after Anthropic debuts Claude legal plug-in" (2026-02-03)
Thomson Reuters, 2026년 2분기 실적 발표 (2026-08-05); "Thomson Reuters built its own AI model…" (2026-07); 차세대 CoCounsel Legal 출시 (2026-08-20)
RELX, 2026년 상반기 실적 (2026-07-23, SEC 제출)
Harvey, 155억 달러 가치 5억 5천만 달러 투자 발표 (2026-09-09); CNBC, Harvey 110억 달러 라운드 (2026-03-25)