PARSER롱 컨텍스트긴 문서 추론멀티홉 QAMemAgentReMemR1Context RotLost in the Middle멀티 에이전트오케스트레이터-워커강화학습GRPORLVRQwen3.5DeepSeek-V4Scatter-Gather논문 리뷰홍콩중문대
읽기는 병렬로, 추론은 깊게 — 896K 토큰 문서를 4B 모델이 읽어 내는 법, PARSER 논문 특집
100만 토큰짜리 창을 가진 모델도 긴 문서 앞에서는 정확도가 수십 점씩 떨어집니다. 홍콩중문대 연구진이 2026년 9월에 내놓은 PARSER는 '문서를 읽는 순서는 문서가 정하지만, 질문을 푸는 순서는 질문이 정해야 한다'는 한 문장에서 출발합니다. 문서를 보지 않는 리드 에이전트가 질문을 쪼개 수천 개의 청크 담당 서브에이전트에게 동시에 흩뿌리고, 돌아온 증거로 다음 질문을 다듬습니다. 4B 모델이 896K 토큰에서 순차 메모리 에이전트를 12점 앞서고, 9B 모델이 DeepSeek-V4-Pro를 6.3점 앞섰으며, 지연은 11배 줄었습니다. 이 글은 Transformer의 어텐션 창에서 시작해 'Lost in the Middle'과 Context Rot, MemAgent의 순차 메모리까지 이 논문이 서 있는 자리를 되짚고, 흩뿌리기-모으기 구조와 리드 에이전트만 강화학습하는 설계, 세 가지 통제 실험, 실패 사례와 한계, 그리고 2026년 멀티 에이전트 지형에서의 의미를 사례와 함께 풀어 씁니다. 시뮬레이터·결과 탐색기·접근법 가이드 위젯 3개.
사건이 하나 있습니다. 질문은 간단합니다. "영화 Everything's Ducky와 Karthika 중 감독이 먼저 세상을 떠난 쪽은?" 단서는 6,400개 문단으로 된 서류 뭉치 어딘가에 흩어져 있습니다. 두 감독의 사망 연도는 서류 앞쪽(483번째, 3,911번째 문단)에, 어느 영화를 누가 감독했는지는 서류 끝(5,527번째, 5,631번째 문단)에 적혀 있습니다.
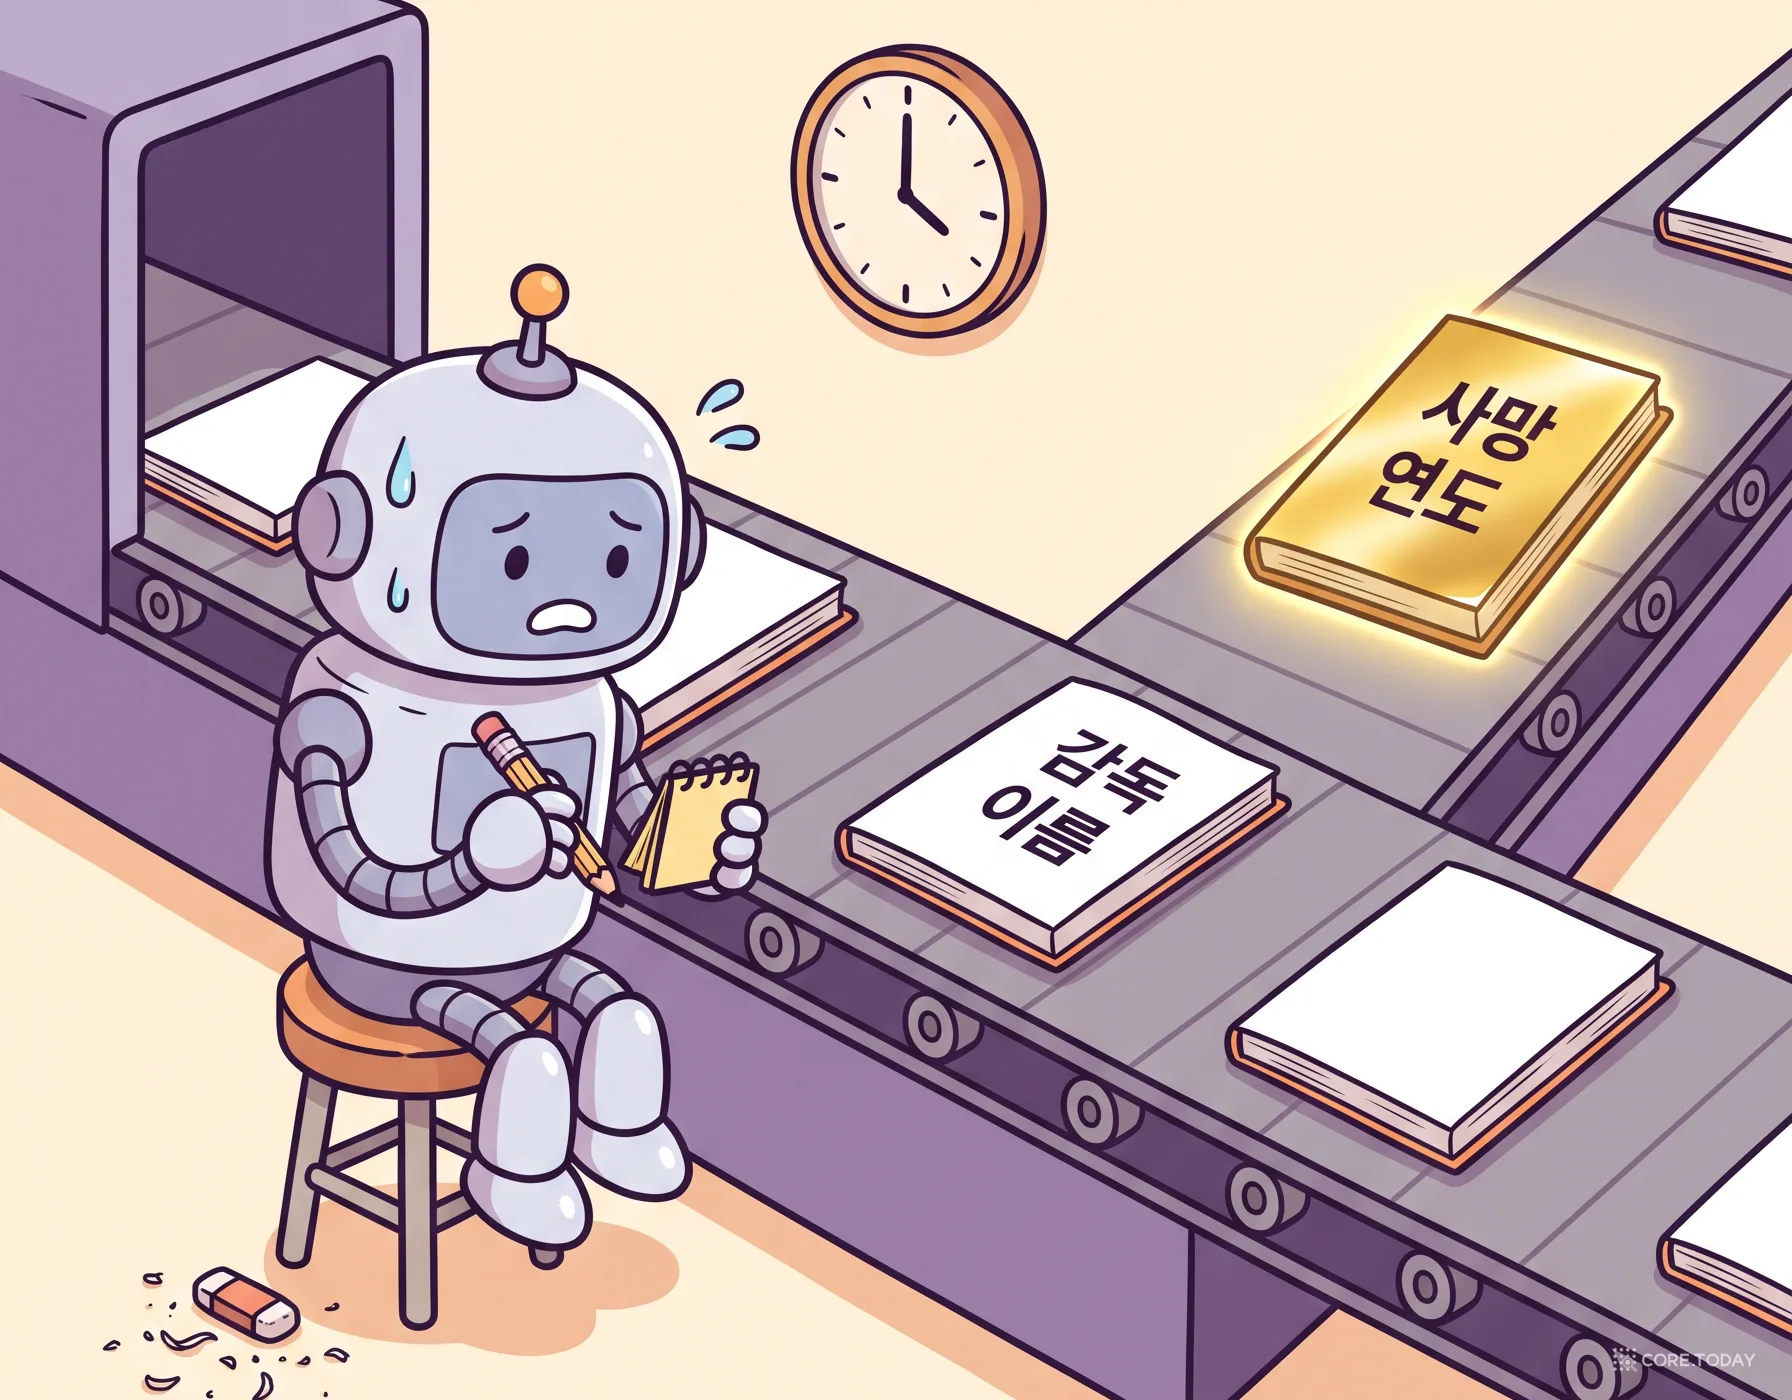
수사관 한 명이 이 서류를 첫 장부터 읽습니다. 메모지는 한 장뿐이라 중요해 보이는 것만 적고 나머지는 지웁니다. 483번째 문단에서 "M. Krishnan Nair, 2001년 사망"을 봅니다. 그런데 이 사람이 질문의 영화와 무슨 상관인지 아직 모릅니다. 메모지엔 다른 감독들 이름이 빼곡합니다. 넘깁니다. 5,527번째 문단에 와서야 "Karthika의 감독은 M. Krishnan Nair"를 발견합니다. 이제 사망 연도가 필요한데, 그 문단은 5,000쪽 전에 지나갔고 메모지에는 없습니다. 끝까지 읽은 수사관의 최종 보고서에는 감독 이름 둘만 있고 사망 연도는 없습니다. 비교는 불가능합니다.
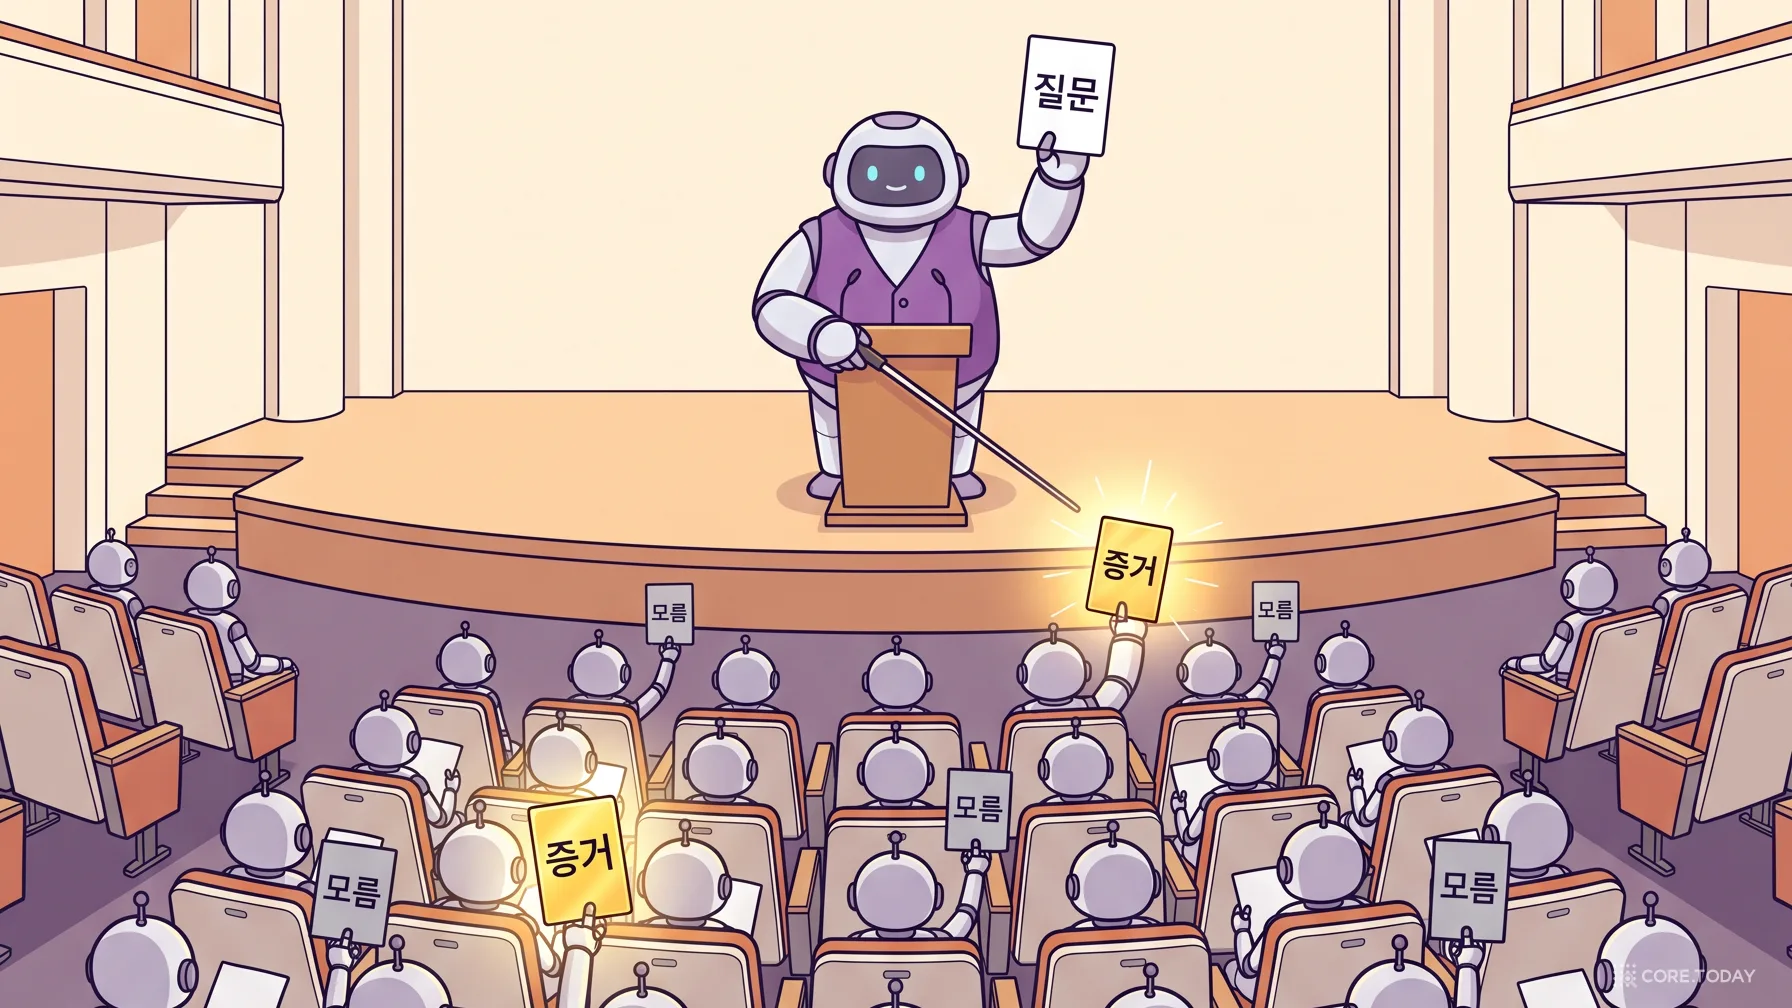
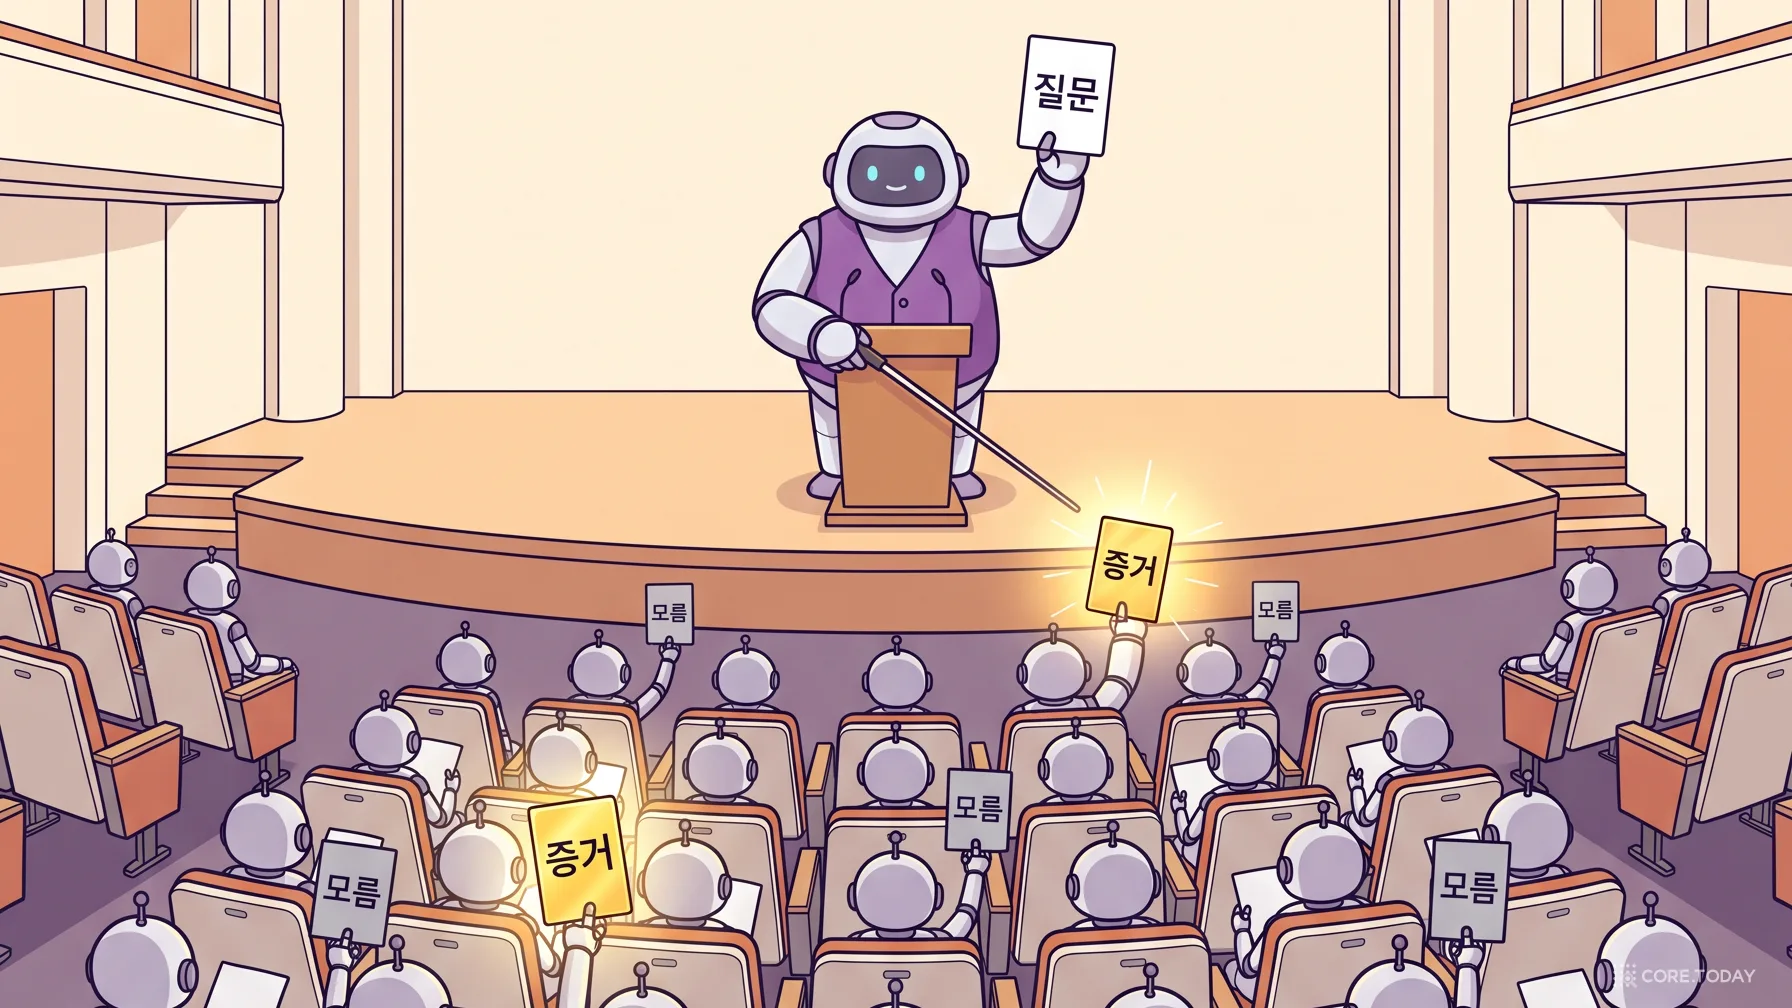
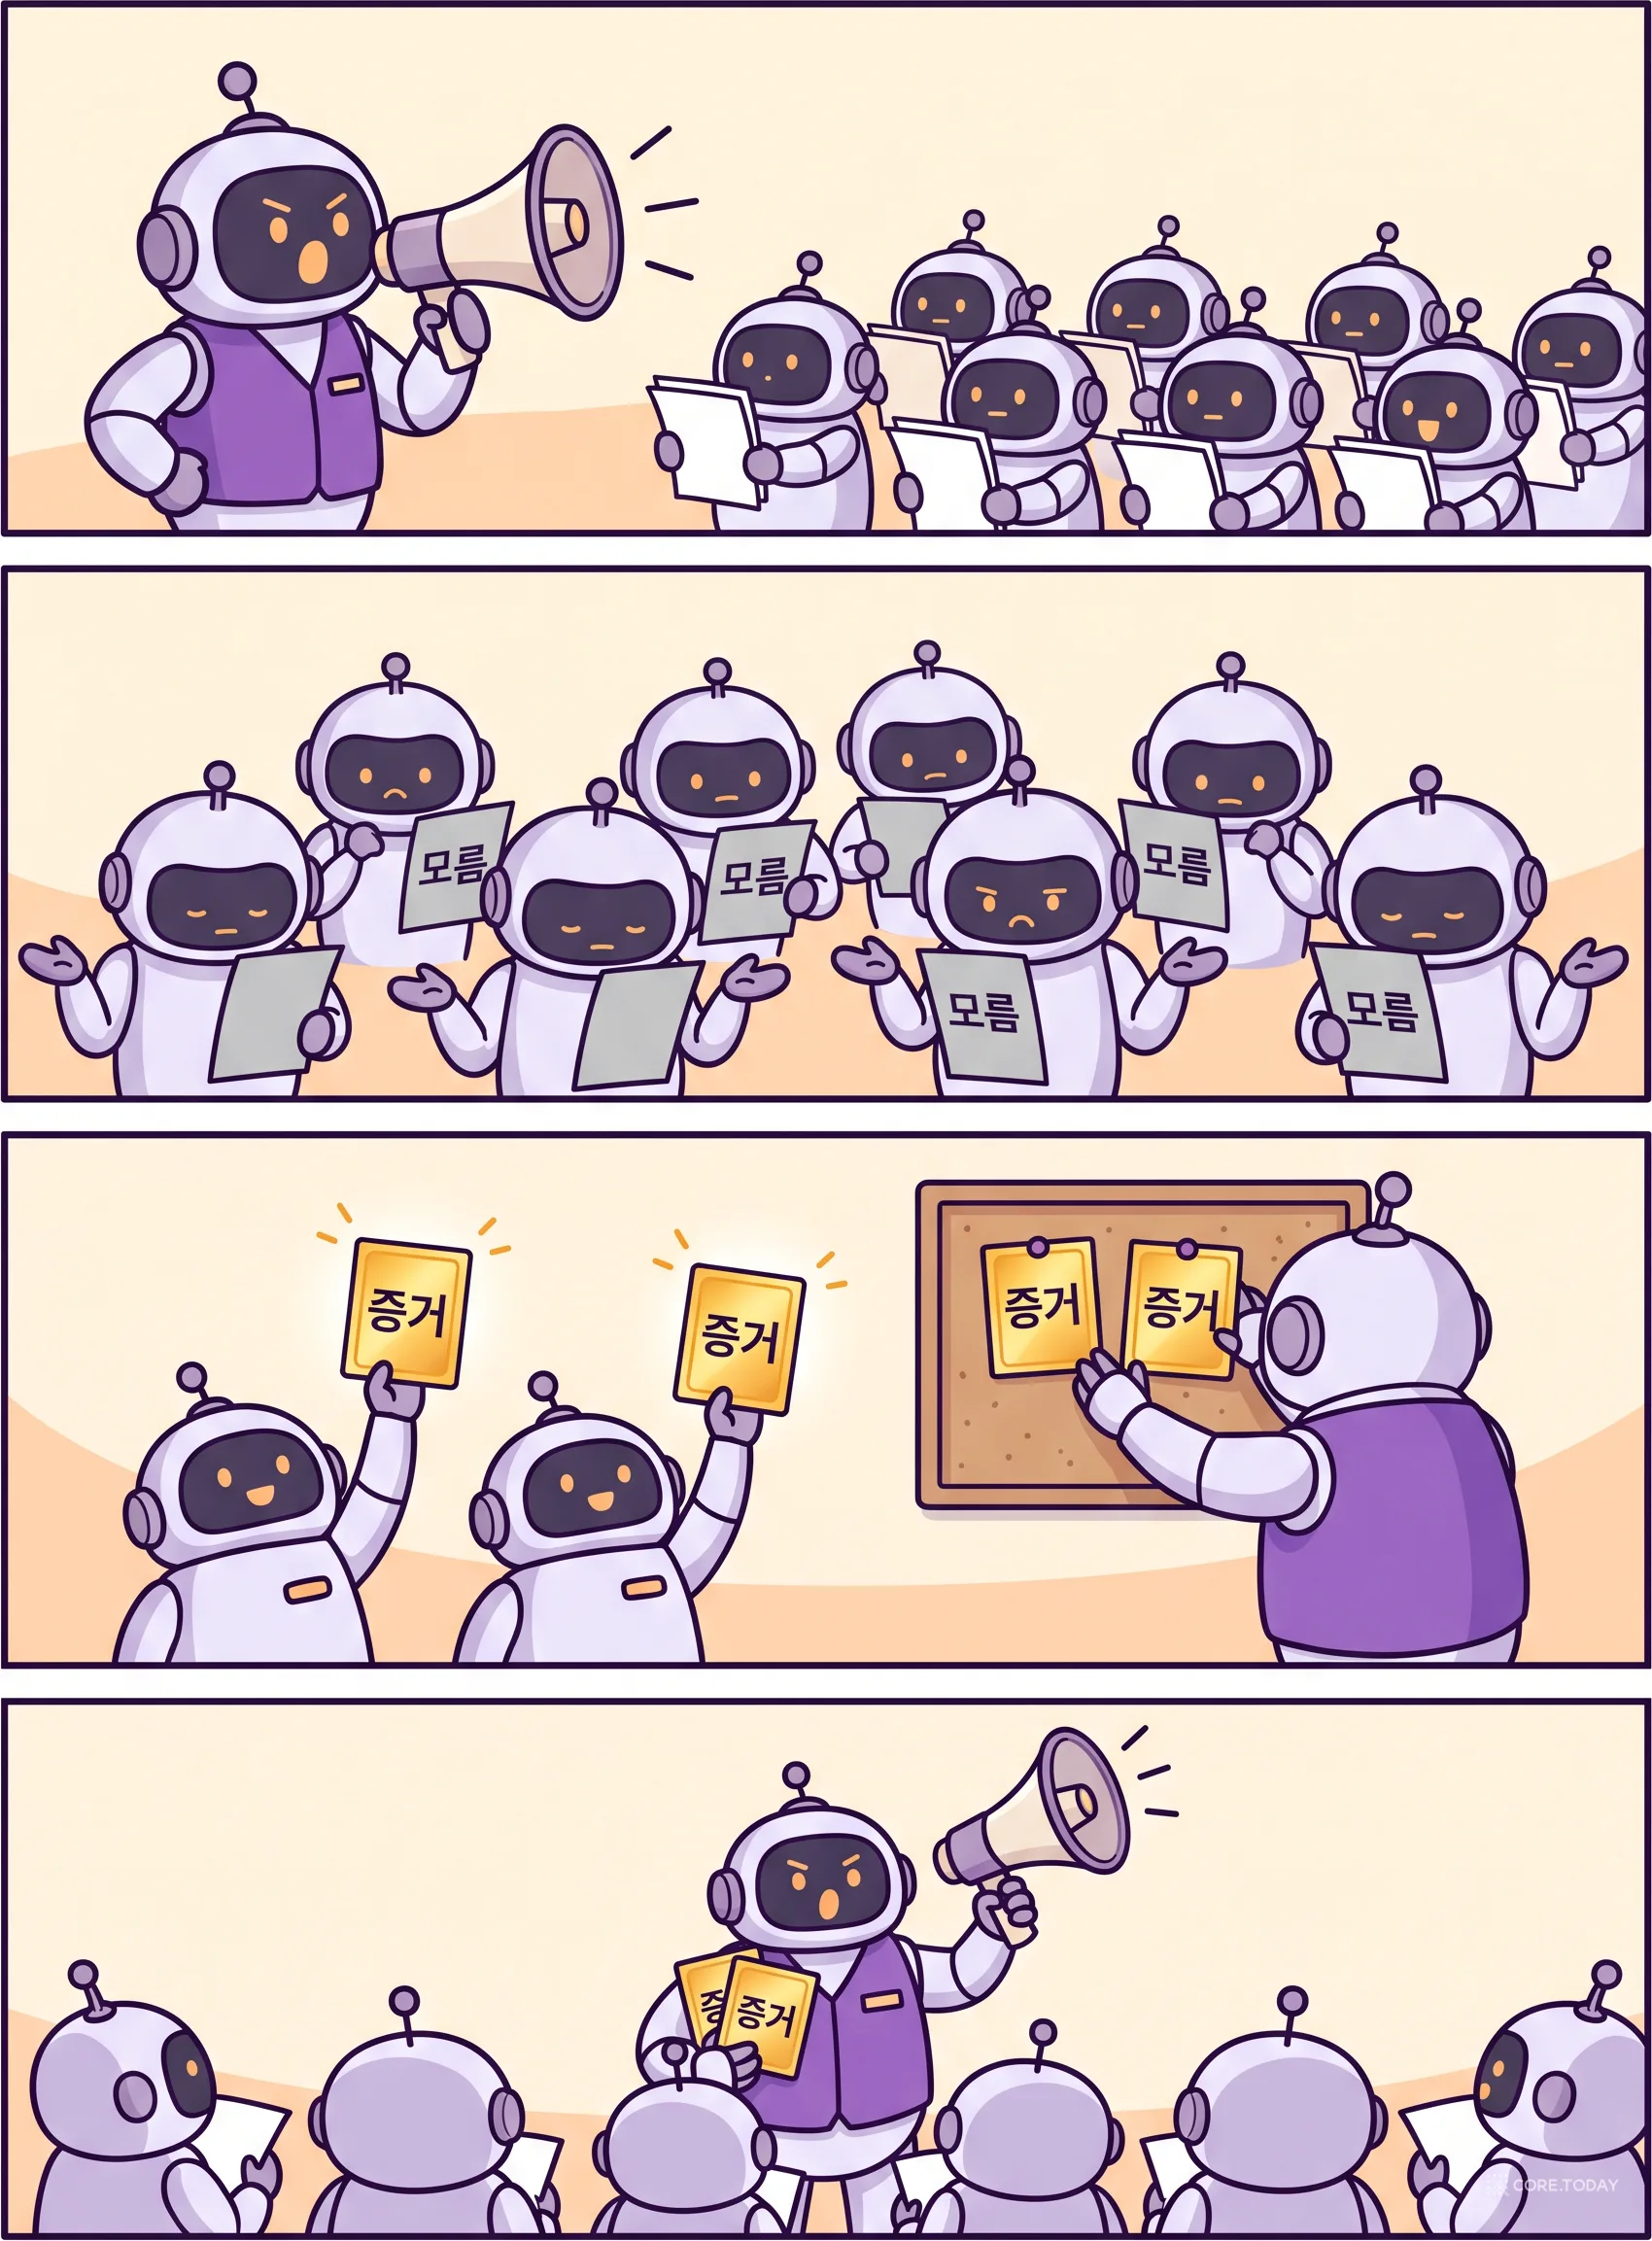
같은 사건을 PARSER는 세 단계 만에 끝냅니다. 수사반장(리드 에이전트)은 서류를 직접 보지 않습니다. 대신 6,400쪽을 한 장씩 나눠 든 수사관들(서브에이전트)에게 무전을 칩니다. "Everything's Ducky 감독은?" "Karthika 감독은?" 두 질문을 동시에 보냅니다. 6,400명이 각자 자기 장을 확인하고, 두 명이 손을 듭니다. 반장은 받아 적고 다시 무전을 칩니다. "Don Taylor 사망일은?" "M. Krishnan Nair 사망일은?" 또 두 명이 손을 듭니다. 1998년과 2001년. 답은 Everything's Ducky입니다.
✅
바쁜 분을 위한 요약.
① 창이 100만 토큰이어도 긴 문서의 정확도는 떨어집니다. 병목은 용량이 아니라 무엇을 어떤 순서로 읽을지입니다.
② 기존 답인 순차 메모리 에이전트(MemAgent·ReMemR1)는 문서를 한 번, 순서대로 읽으며 메모리를 덮어씁니다. 그래서 증거의 위치·순서·간격에 따라 성적이 크게 흔들리고, 지연이 문서 길이에 비례합니다.
③ PARSER는 읽기와 추론을 분리합니다. 문서를 못 보는 리드 에이전트가 질문을 쪼개고, 청크 하나씩 맡은 서브에이전트들이 동시에 읽어 증거만 돌려줍니다. 라운드를 거듭하며 질문이 정교해집니다.
④ 학습은 리드 에이전트만 합니다. 정답 일치 여부만 보상으로 주는 강화학습(GRPO)이고, 서브에이전트는 그대로 둔 기성 모델입니다.
⑤ 결과: 4B 모델이 896K 토큰에서 순차 메모리 최강 대비 +12.0점, 9B 모델이 100만 토큰 모델 DeepSeek-V4-Pro 대비 평균 +6.3점. 단일 요청 지연 11배 단축.
⑥ 증거의 위치·순서·거리를 바꿔도 PARSER는 거의 평평합니다. 순차 메모리는 증거 순서를 뒤집자 66.5%에서 23.3%로 떨어졌습니다.
⑦ 공짜는 아닙니다. 매 라운드 모든 청크를 다시 읽으므로 입력 처리량이 늘고, 동시 요청이 많으면 이점이 1.7배로 줄며, 서브에이전트가 '동명이인'에 속으면 리드가 그대로 믿는 실패가 있습니다.
⑧ 2026년의 맥락에서 이 논문은 '오케스트레이터만 학습하고 워커는 고정한다'는 흐름을 긴 문서 읽기에 옮긴 것입니다. 짧은 문서면 그냥 다 넣고, 같은 문서에 질의가 반복되면 RAG가, 글자 그대로의 단서가 있으면 grep이 더 쌉니다.
2017년 Transformer가 나왔을 때 어텐션은 입력의 모든 토큰 쌍을 서로 비교하는 구조였습니다. 비용은 길이의 제곱으로 늘어났고, 그래서 초기 모델의 창은 512토큰, GPT-3도 2,048토큰이었습니다. 긴 문서를 다루는 방법은 하나뿐이었습니다. 잘라서 넣거나, 검색으로 관련 부분만 고르거나.
그 뒤 몇 년은 창을 넓히는 경쟁이었습니다. 2023년 5월 Claude가 10만 토큰을, 같은 해 11월 GPT-4 Turbo가 12만 8천 토큰을 열었습니다. 2024년 2월 Gemini 1.5 Pro가 100만 토큰을 선언했고, 위치 보간(Position Interpolation)·YaRN·LongRoPE 같은 기법으로 짧게 학습한 모델을 긴 입력으로 늘려 쓰는 길도 열렸습니다. 2026년에는 DeepSeek-V4가 100만 토큰을 기본 지원하고, DeepSeek의 희소 어텐션(NSA)·MiniMax의 희소 어텐션·Kimi K3의 선형 어텐션이 제곱 비용 자체를 깎는 중입니다.
그런데 창이 넓어지는 속도만큼 창을 잘 쓰는 능력은 따라오지 않았습니다. 두 개의 연구가 이를 못 박았습니다.
Lost in the Middle (Liu et al., 2023→TACL 2024). 스탠퍼드 연구진이 여러 문서 중 정답이 든 문서의 위치만 바꿔 가며 QA 정확도를 쟀더니, 정답이 입력의 맨 앞이나 맨 뒤에 있을 때는 잘 맞히고 가운데 있을 때 크게 떨어지는 U자 곡선이 나왔습니다. 사람이 긴 목록의 처음과 끝을 잘 기억하는 초두·최신 효과를 모델도 보인 셈입니다.
Context Rot (Hong, Troynikov, Huber, Chroma, 2025년 7월). 벡터 DB 회사 Chroma의 기술 보고서는 18개 최신 모델에게 같은 과제를 입력 길이만 바꿔 주었을 때, 창이 아직 한참 남았는데도 길이가 늘수록 성능이 꾸준히 떨어진다는 것을 보였습니다. 바늘(정답)과 질문의 표현이 조금만 달라도, 비슷하지만 다른 문장(교란물)이 섞여 있어도, 심지어 아무 상관없는 글이 늘어나기만 해도 그랬습니다. 저희도 작년에 이 보고서를 긴 맥락이 독이 된다에서 다뤘습니다.
PARSER 논문은 이 두 현상을 자기 실험에서 다시 확인하는 것으로 시작합니다. HotpotQA 멀티홉 질문에 문서 전체를 넣고 답하게 했을 때, Qwen3.5-4B(사고 모드)의 정확도는 7K 토큰에서 80.5%였다가 896K 토큰에서 31.3%로 떨어졌습니다. 100만 토큰을 기본 지원하는 DeepSeek-V4-Pro도 최대 추론 모드에서 82.0%→78.9%로, 낙폭은 작지만 역시 떨어졌습니다.
논문의 진단은 이렇습니다.
정확도가 창이 가득 차기 훨씬 전부터 떨어진다면, 병목은 더 이상 용량이 아니다. 열린 질문은 무엇을 읽을지, 그리고 어떤 순서로 추론할지를 어떻게 고르느냐다.
이 문장이 논문 전체의 출발점입니다. 창을 더 넓히는 대신, 읽는 방식을 바꾸자는 것입니다.
💡
멀티홉(multi-hop) 질문이란. 한 곳만 찾으면 되는 질문("에펠탑 높이는?")이 아니라, 한 단서가 다음 단서를 가리키는 질문입니다. "영화 X의 감독은 언제 태어났나?"는 먼저 감독 이름을 찾고(1홉), 그 이름으로 생일을 찾아야(2홉) 풀립니다. 두 번째 단서는 첫 번째를 알기 전까지는 '질문과 상관없는 문장'으로 보입니다. 이 성질이 뒤에서 순차 메모리를 무너뜨리는 핵심 원인이 됩니다.
창을 넓히지 않고 긴 문서를 읽는 가장 자연스러운 방법은 사람이 책을 읽는 방식을 흉내 내는 것입니다. 한 번에 한 장씩 읽고, 중요한 것만 노트에 적고, 다음 장으로 넘어간다. 노트는 작아도 되고, 책은 얼마든지 길어도 됩니다.
이 아이디어의 계보는 생각보다 깁니다.
MemWalker(2023년 10월) 는 문서를 요약 트리로 만들어 두고 질문이 오면 트리를 내려가며 찾습니다.
ReadAgent(2024년 2월, Google DeepMind) 는 사람이 책의 '요지(gist)'만 기억하듯 각 부분의 요지를 저장해 두고 필요하면 원문을 다시 펼쳐 봅니다.
Chain-of-Agents(2024년 6월, Google) 는 청크마다 워커를 두되, 메시지 하나를 사슬처럼 순서대로 다음 워커에게 넘깁니다.
MemAgent(2025년 7월 → ICLR 2026, 바이트댄스·칭화) 는 여기서 한 걸음 나아가 "읽고 → 메모리 갱신"을 반복하는 워크플로 전체를 강화학습으로 끝까지 학습시켰습니다. 8K 창을 가진 모델이 350만 토큰 문서를 읽어 냈고, 성능이 길이에 따라 거의 선형으로만 떨어진다는 것을 보였습니다.
ReMemR1(ICLR 2026) 은 MemAgent에 '되돌아보기(callback)' 모듈을 붙여 과거 메모리 상태를 다시 꺼내 볼 수 있게 했고, GRU-Mem(2026년 2월) 은 게이트를 두어 증거 없는 청크는 건너뛰고 일찍 멈추게 했습니다.
PARSER 논문은 이 흐름을 "순차 메모리 패러다임"이라 부르고, 그 공로를 분명히 인정합니다. 작은 창, 임의 길이, 끝까지 학습 가능이라는 세 조건을 한꺼번에 만족시킨 진짜 어려운 문제의 답이라고요. 그런데 이 계보 전체가 구조적으로 같은 약속을 공유합니다.
문서는 정확히 한 번, 순서대로 통과한다.
이 약속에서 두 가지 비용이 나옵니다.
첫째, 증거를 정보 부족 상태에서 판단해야 합니다. 483번째 문단을 읽을 때 에이전트는 나머지 5,917개 문단을 아직 못 봤습니다. "M. Krishnan Nair, 2001년 사망"이 질문과 관계있는지 판단할 근거가 없습니다. 메모리는 용량이 정해져 있으니 뭔가는 버려야 하고, 지금 관계없어 보이는 것부터 버립니다. 멀티홉 질문에서는 바로 그것이 나중에 필요한 증거입니다. 논문은 이것이 증거의 절대 위치, 증거 사이의 논리적 순서, 증거 사이의 거리 세 가지에 성적이 흔들리는 원인이라고 봅니다(4절에서 실험으로 확인합니다).
둘째, 지연이 문서 길이에 비례합니다. t번째 청크의 메모리 갱신은 t−1번째 갱신이 끝나야 시작할 수 있습니다. 청크가 T개면 T개의 순차 단계가 생기고, GPU가 아무리 많아도 이 사슬은 줄어들지 않습니다. 896K 토큰 문서를 MemAgent가 요청 하나로 처리하는 데 걸린 시간은 876초였습니다.
후속 연구들은 이 두 증상에 패치를 붙였지만 하나를 고치면 다른 하나가 나빠졌습니다. ReMemR1의 되돌아보기는 위치 편향을 줄이는 대신 순차 경로에 검색을 하나 더 얹었고, GRU-Mem의 건너뛰기는 계산을 아끼지만 마지막 증거가 나올 때까지는 여전히 순서대로 훑어야 합니다.
⚠️
왜 '덮어쓰기'가 치명적인가. 순차 메모리의 갱신은 "질문 + 이전 메모리 + 현재 청크 → 새 메모리"입니다. 메모리에 들어가지 못한 정보는 다음 단계에서 존재하지 않는 것이 됩니다. RNN이 긴 문장의 앞부분을 잊는 것과 같은 구조입니다. 2017년 Transformer가 RNN을 밀어낸 이유가 바로 '모든 위치를 동시에 본다'였는데, 순차 메모리 에이전트는 문서 수준에서 RNN을 다시 만든 셈입니다. PARSER는 문서 수준에서도 '동시에 보기'로 돌아가자는 제안으로 읽을 수 있습니다.
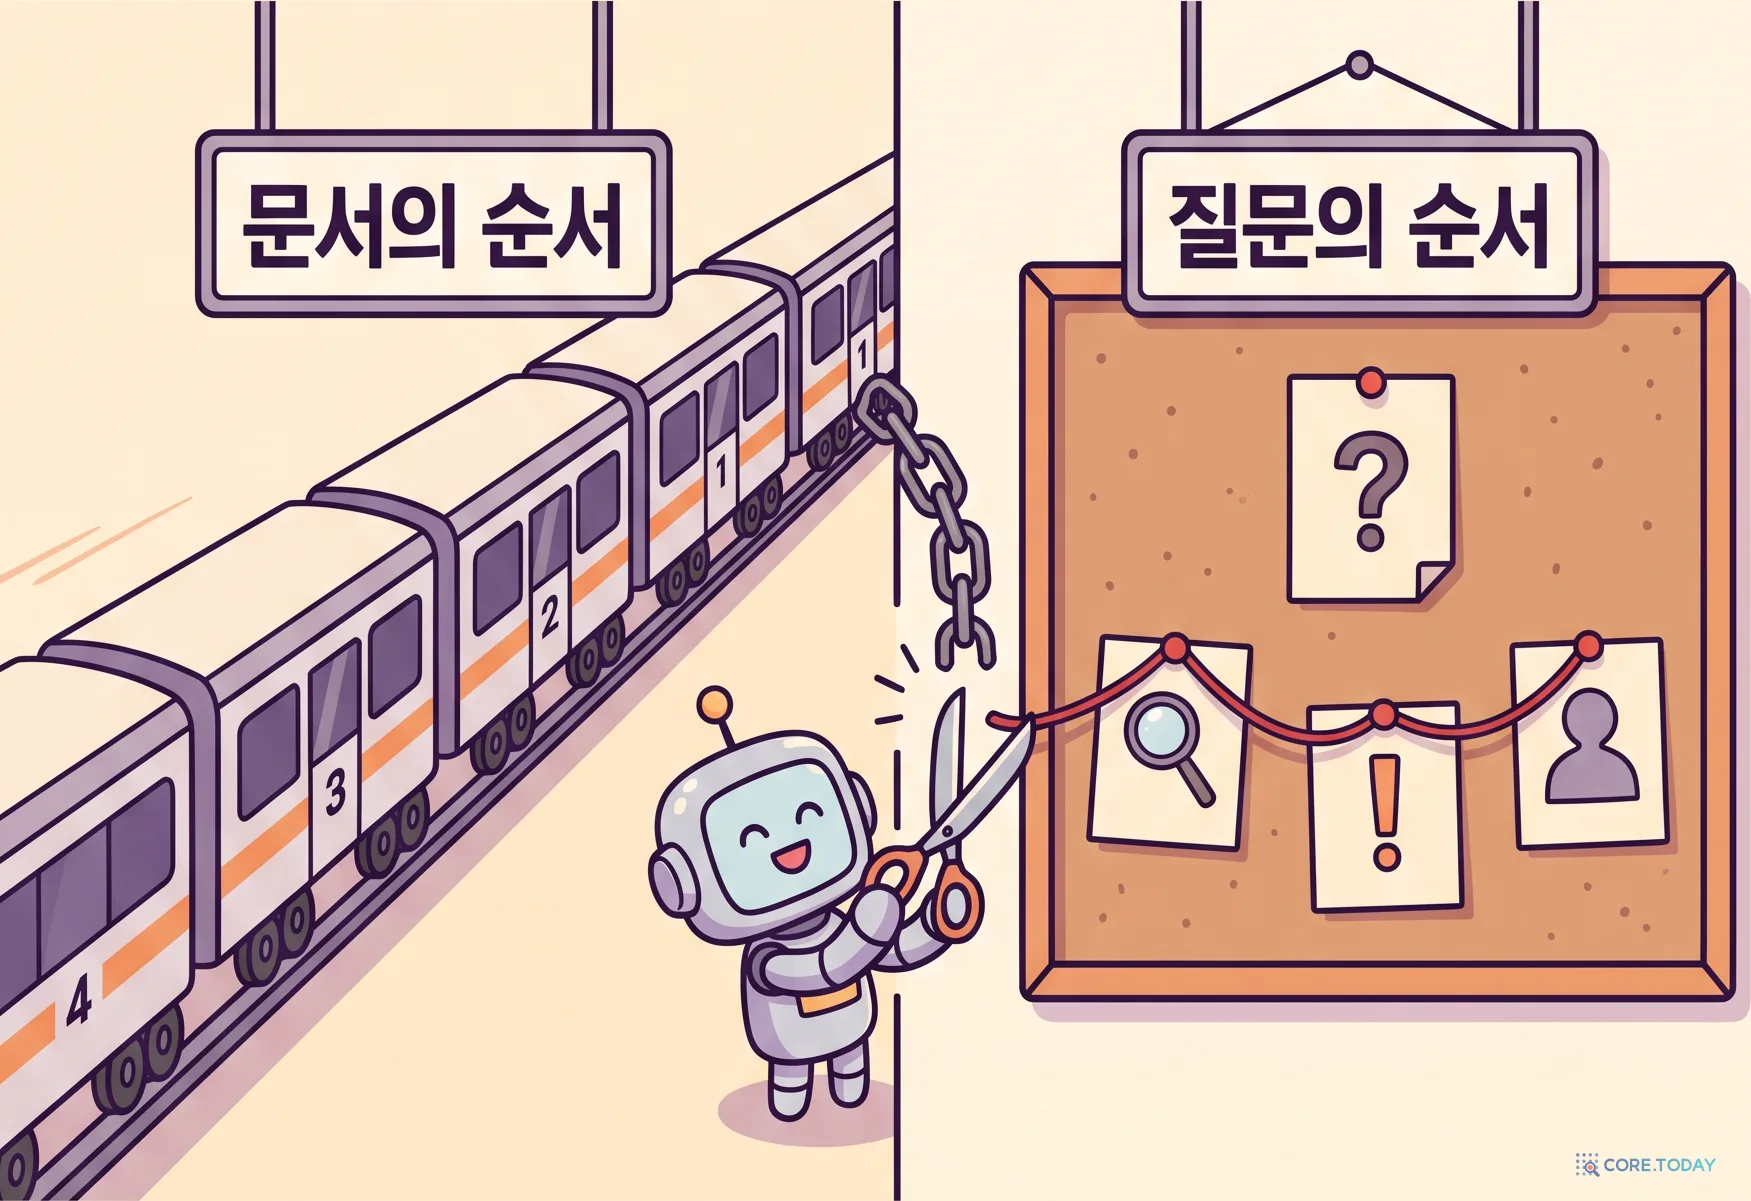
긴 문서를 읽는 순서는 문서가 정한다. 질문을 추론하는 순서는 질문이 정한다. 순차 메모리 에이전트는 앞의 것이 뒤의 것을 끌고 가게 놔둔다.
Everything's Ducky 사건으로 돌아가 봅시다. 질문이 요구하는 추론 순서는 명확합니다. ① 두 영화의 감독을 찾는다 → ② 두 감독의 사망 연도를 찾는다 → ③ 비교한다. 그런데 문서는 ②의 단서를 먼저, ①의 단서를 나중에 보여 줍니다. 순차 메모리는 문서의 순서를 따라 읽으니 ②를 만났을 때 ①을 모르고, 그래서 ②를 버립니다.
PARSER의 제안은 두 순서를 끊어 놓자는 것입니다. 읽기는 문서의 순서를 따를 필요가 없습니다. 모든 청크를 동시에 읽으면 순서라는 것 자체가 사라집니다. 추론만 질문의 순서를 따라 한 단계씩 갑니다. 그래서 이름이 Parallel Reading, Sequential Reasoning, PARSER입니다.
이를 위해 역할을 둘로 나눕니다.
PARSER의 두 역할
리드 에이전트 (Lead Agent)유일하게 학습되는 부분문서를 전혀 보지 않는다. 질문만 받는다.생각 → 질의 흩뿌리기 또는 답 제출을 반복하는 ReAct 루프이전 라운드에서 모은 증거를 보고 다음 질의를 만든다
↓ 같은 질의를 모든 청크에 동시에 (scatter) · 답한 것만 모아서 (gather) ↑
서브에이전트 1청크 1만 읽음
서브에이전트 2청크 2만 읽음
⋯청크 수만큼
서브에이전트 T청크 T만 읽음
기성 모델 그대로 · 사고 모드 끔 · 학습하지 않음자기 청크에서 질의의 증거를 찾으면 원문 인용(evidence)과 짧은 답(answer)을 JSON으로 돌려준다증거가 없으면 Unknown 한 마디만 내고, 이 응답은 리드에게 전달되지 않는다
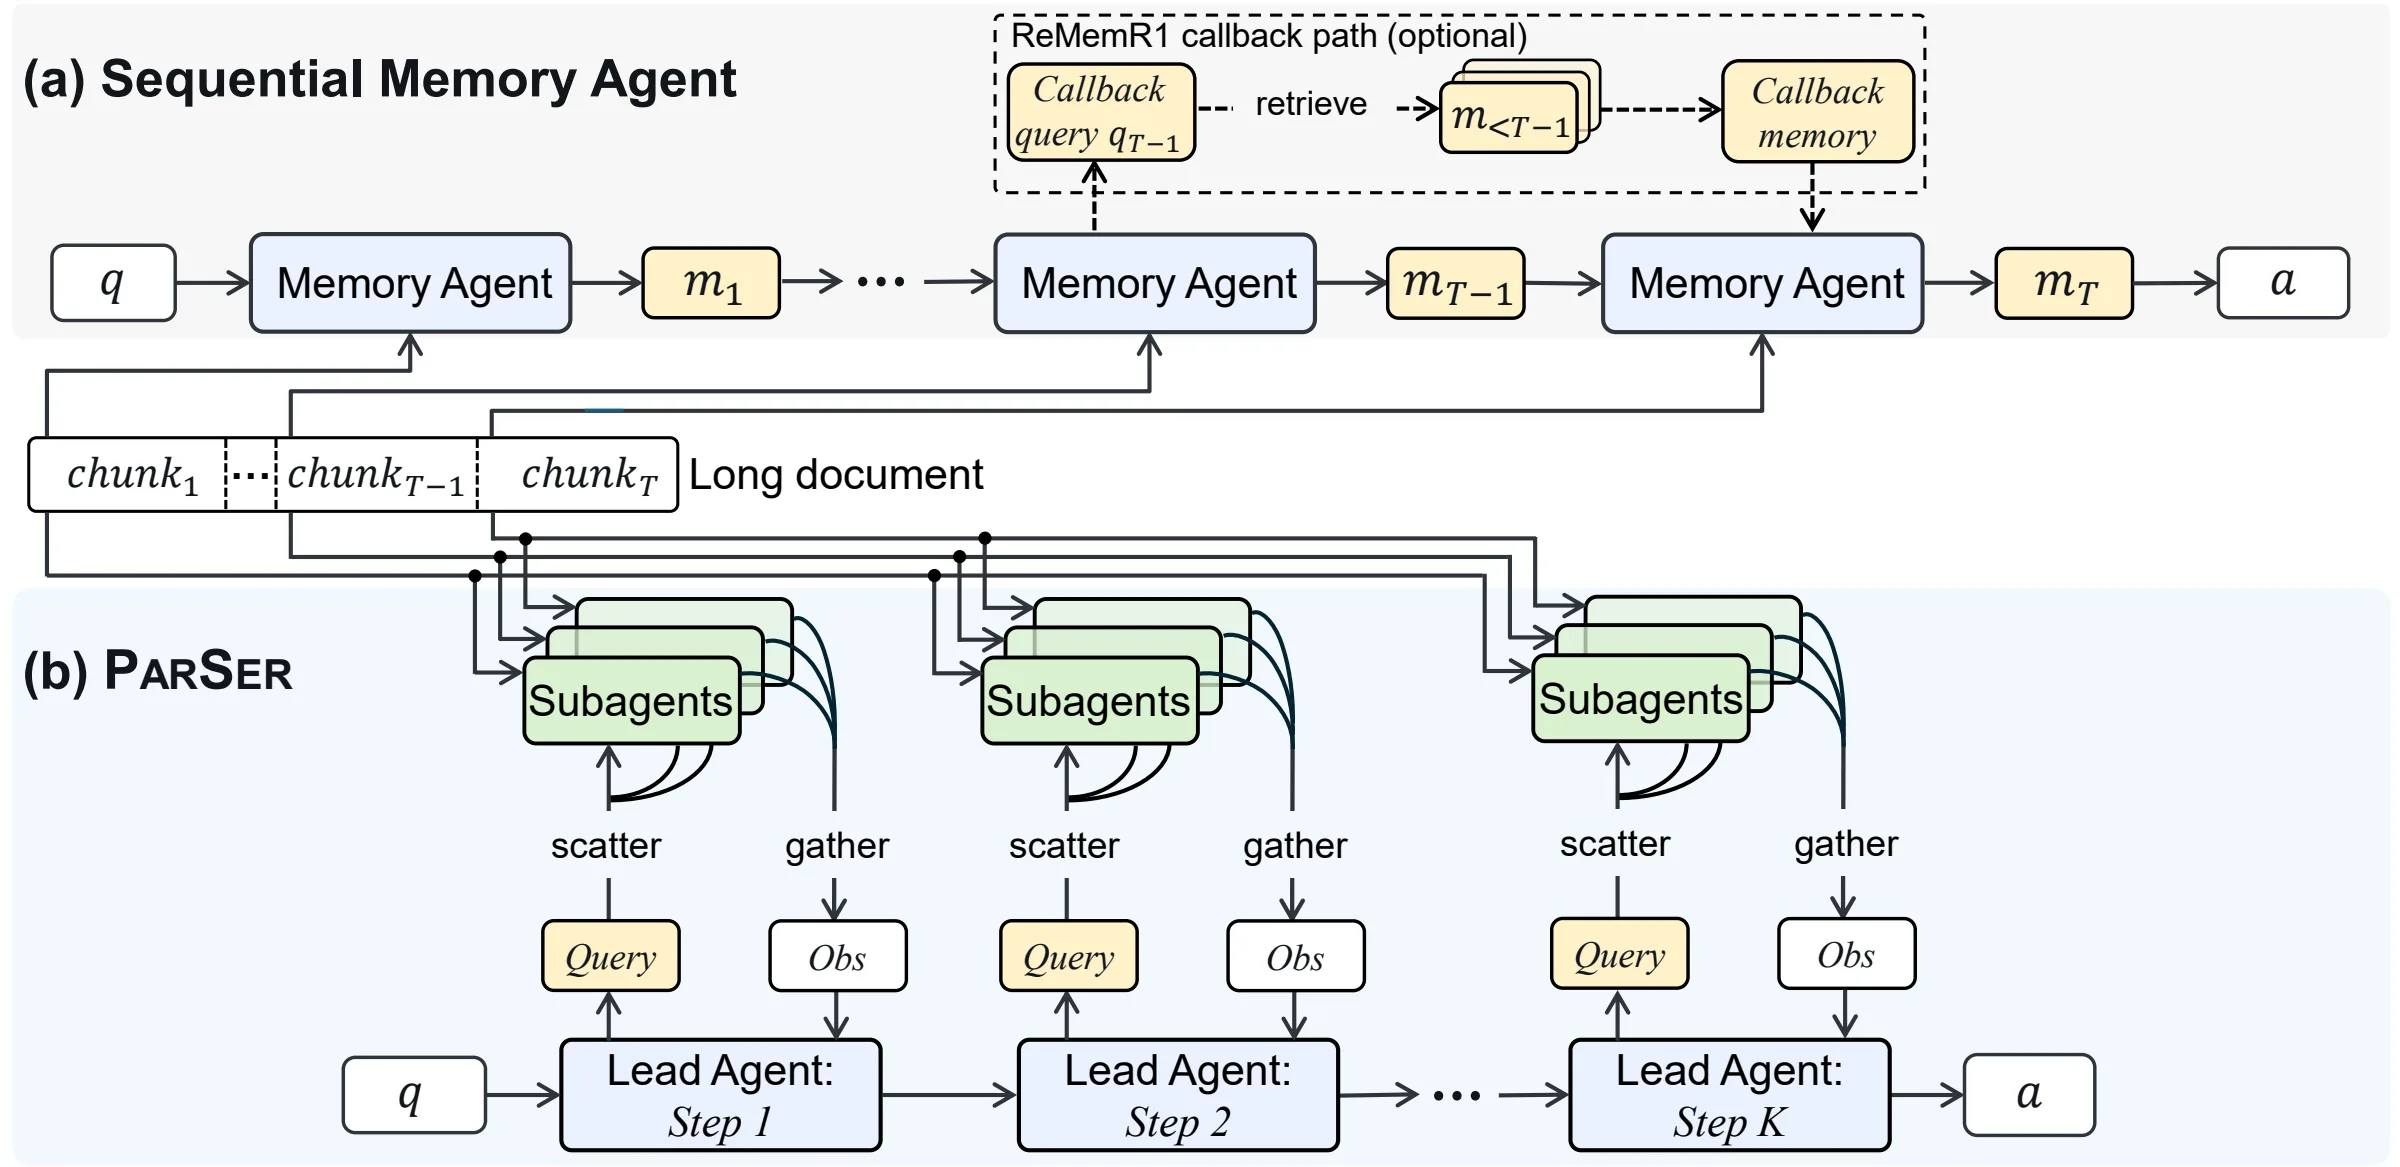
논문 Figure 1. 순차 메모리(위)는 T개의 청크를 T개의 의존 단계로 통과하고, PARSER(아래)는 청크 수를 '병렬 너비'로 바꾸어 K개의 추론 라운드만 순차로 둔다. (출처: cuhk-parser.github.io)
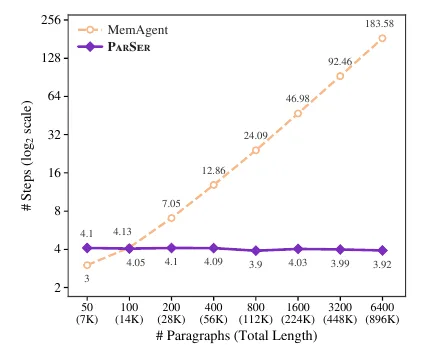
이 구조가 바꾸는 것은 의존 관계의 모양입니다. 순차 메모리는 T개의 갱신이 한 줄로 이어진 사슬이고, PARSER는 K개의 라운드 안에서 T개의 읽기가 병렬로 펼쳐진 사다리입니다. 문서가 길어지면 T는 커지지만, K는 질문이 몇 홉인지에만 달려 있습니다. 논문의 측정에서 K는 문서 길이와 무관하게 약 4였습니다.
💡
흩뿌리기–모으기(Scatter–Gather)의 뿌리. 이 용어는 병렬 컴퓨팅의 MPI 통신 패턴에서 왔습니다. 하나의 노드가 데이터를 여러 노드에 나눠 주고(scatter), 각자 계산한 결과를 다시 거둬들입니다(gather). 2004년 구글의 MapReduce가 이 패턴을 대규모 데이터 처리의 표준으로 만들었습니다. LLM 세계에서도 LLM×MapReduce(2024)·ToM(2025) 같은 선행 연구가 청크별로 답을 뽑아 합치는 맵리듀스를 시도했는데, 대부분 질의가 한 번 고정되면 끝이었습니다. 멀티홉 질문은 첫 질의로 두 번째 단서를 알 수 없으니 이 방식으로는 풀리지 않습니다. PARSER의 차이는 '모으기' 뒤에 리드 에이전트가 다시 흩뿌릴 질의를 새로 만든다는 점입니다. 맵리듀스를 여러 번, 그것도 매번 다른 질문으로 돌리는 셈입니다.
논문 부록 F의 실제 궤적(Figure 8, PARSER-4B, 6,400문단 문서)을 그대로 옮깁니다. 리드 에이전트의 생각은 <think> 안에, 행동은 도구 호출로 나옵니다.
질문. Which film has the director who died earlier, Everything's Ducky or Karthika (Film)?
1라운드. 리드 에이전트의 생각: "두 영화 각각의 감독을 알아낸 뒤 사망일을 비교해야 한다. 먼저 감독부터." 그리고 두 질의를 한 턴에 보냅니다.
json
{"name":"query_agents","arguments":{"query":"Everything's Ducky film director"}}{"name":"query_agents","arguments":{"query":"Karthika film director"}}
6,400개 문단을 4,096토큰 단위로 묶은 청크 하나마다 서브에이전트 하나가 두 질의를 받습니다. 거의 전부가 Unknown을 돌려주고, 그 응답은 모으는 단계에서 버려집니다. 남은 것은 둘뿐입니다.
json
{"agent_15":{"evidence":"Everything's Ducky is a 1961 comedy film directed by Don Taylor","answer":"Don Taylor"}}{"agent_121":{"evidence":"Karthika is a 1968 Indian Malayalam film, directed by M. Krishnan Nair","answer":"M. Krishnan Nair"}}
2라운드. 생각: "감독은 Don Taylor와 M. Krishnan Nair. 이제 둘의 사망일." 다시 두 질의를 동시에.
json
{"name":"query_agents","arguments":{"query":"Don Taylor director death date"}}{"name":"query_agents","arguments":{"query":"M. Krishnan Nair death date"}}
json
{"agent_172":{"evidence":"Donald Richie Taylor (December 13, 1920 – December 29, 1998) was an American actor and film director.","answer":"December 29, 1998"}}{"agent_175":{"evidence":"M. Krishnan Nair (2 November 1926 – 10 May 2001 in Thiruvananthapuram) was an Indian film director of Malayalam films.","answer":"10 May 2001"}}
3라운드. 생각: "1998년 12월 29일이 2001년 5월 10일보다 앞선다." 답 제출: <answer>Everything's Ducky</answer>.
순차 단계는 3개. 같은 질문에 MemAgent는 161단계가 필요했고, 그래도 틀렸습니다. 아래 시뮬레이터에서 두 방식을 직접 돌려 볼 수 있습니다. 청크 수를 늘려 가며 순차 단계 수가 어떻게 달라지는지 보세요.
설계의 세부: 왜 이렇게 만들었나
궤적을 보면 단순해 보이지만, 몇 가지 결정이 성능을 좌우합니다.
리드 에이전트는 문서를 못 봅니다. 질문과 서브에이전트들이 돌려준 증거만 봅니다. 그래서 리드 에이전트의 맥락은 문서가 아무리 길어도 작게 유지되고, 학습할 때도 "문서를 외우는" 대신 "질문을 쪼개고 증거를 조합하는" 능력만 익히게 됩니다. 논문은 이것이 학습하지 않은 벤치마크(2WikiMultiHopQA)에서 PARSER가 무너지지 않은 이유라고 봅니다. 순차 메모리 에이전트는 학습 문서의 패턴에 과적합되기 쉬운 반면, 문서를 안 보는 리드는 과적합할 대상이 없습니다.
서브에이전트는 청크 하나에 고정되고, 매 라운드 다시 읽습니다. 한 번 읽고 버리는 것이 아니라 라운드마다 새 질의로 다시 봅니다. 그래서 1라운드에서는 "상관없는 문장"이었던 사망 연도가 2라운드에서는 정답이 됩니다. 어떤 청크도 영구히 버려지지 않는다는 것이 멀티홉에서 결정적입니다.
서브에이전트는 기권할 수 있습니다. 질의와 무관한 청크는 Unknown 한 단어만 냅니다. 6,400문단 문서라면 매 라운드 수백 개의 서브에이전트가 돌아가지만 실제로 토큰을 길게 생성하는 것은 서너 개뿐입니다. 이 희소성이 PARSER의 출력 토큰을 MemAgent의 1% 아래로 눌러 줍니다(6절).
서브에이전트 프롬프트는 '인용 강제'입니다. 부록 E.2의 프롬프트는 증거를 "청크에서 복사해 붙인 정확한 원문"으로 내도록 요구하고, 설명이나 추가 텍스트를 금지합니다. 리드 에이전트가 받는 것은 짧은 답과 그 근거 문장이지, 서브에이전트의 추측이 아닙니다.
청크 안에서 다시 읽는 것도 Context Rot를 피하는 장치입니다. 청크가 4,096토큰이면 서브에이전트의 유효 맥락은 늘 짧습니다. 논문의 청크 크기 실험(Table 4)에서 청크를 4K→16K→64K→128K→문서 전체로 키울수록 성적이 84.6→83.6→81.8→80.3→73.8로 떨어졌습니다. 같은 모델이 같은 질의를 받아도 짧은 입력에서 더 잘 찾는다는, Context Rot 보고서의 결론과 정확히 같은 모양입니다.
리드 에이전트의 도구는 하나뿐입니다.query_agents(query). 부록 E.1의 시스템 프롬프트는 Qwen3.5의 기본 도구 호출 형식을 그대로 쓰고, 핵심 지시는 이것입니다.
text
CRITICAL: DO NOT GIVE UP EASILY. If a query returns no results, or only partial
results, you MUST NOT immediately conclude "Information not available."
Instead, you MUST simplify, rephrase, or break down your query into smaller
parts and call query_agents again.
"쉽게 포기하지 말고, 질의를 쪼개고 바꿔서 다시 물어라." 리드 에이전트가 배워야 하는 행동의 요약입니다.
5. 학습: 반장만 가르친다
읽기와 추론을 분리하면 무엇을 학습할지도 자연스럽게 정해집니다. 서브에이전트의 일(짧은 청크에서 한 질의의 증거를 찾기)은 기성 모델도 잘합니다. 배워야 하는 것은 리드 에이전트의 정책, 곧 지금까지의 추론 이력을 보고 다음에 무엇을 물을지, 언제 답을 낼지입니다. 그래서 리드 에이전트만 학습하고 서브에이전트는 얼립니다.
학습 방법은 2025년 DeepSeek-R1 이후 표준이 된 검증 가능한 보상의 강화학습(RLVR) 입니다. 보상은 단 하나, 최종 답이 정답과 일치하는가(0 또는 1). 형식 보상은 쓰지 않습니다. 모델의 기본 도구 호출 형식을 그대로 쓰기 때문에 형식은 처음부터 거의 틀리지 않았습니다(첫 10단계의 형식 오류율 0.22%). 최적화는 GRPO(Group Relative Policy Optimization)로, 같은 질문에 대해 5개의 궤적을 뽑아 그 안에서 상대적으로 잘한 것을 강화합니다. 중요한 세부가 하나 있습니다. 서브에이전트가 돌려준 관찰(observation) 토큰은 손실에서 마스킹됩니다. 정책 기울기는 리드 에이전트가 직접 생성한 토큰에만 적용됩니다. 리드가 쓰지 않은 말로 리드를 훈련하지 않겠다는 것입니다.
항목
PARSER 설정
의미
학습 데이터
HotpotQA에서 합성한 32,768문항. 문서당 200문단(약 28K 토큰)
정답을 모델이 이미 외우고 있는 문항은 미리 걸러 냄(문서 없이 3번 시도해 다 맞히면 제외)
백본
Qwen3.5-4B, Qwen3.5-9B (리드). 서브에이전트는 두 경우 모두 Qwen3.5-4B
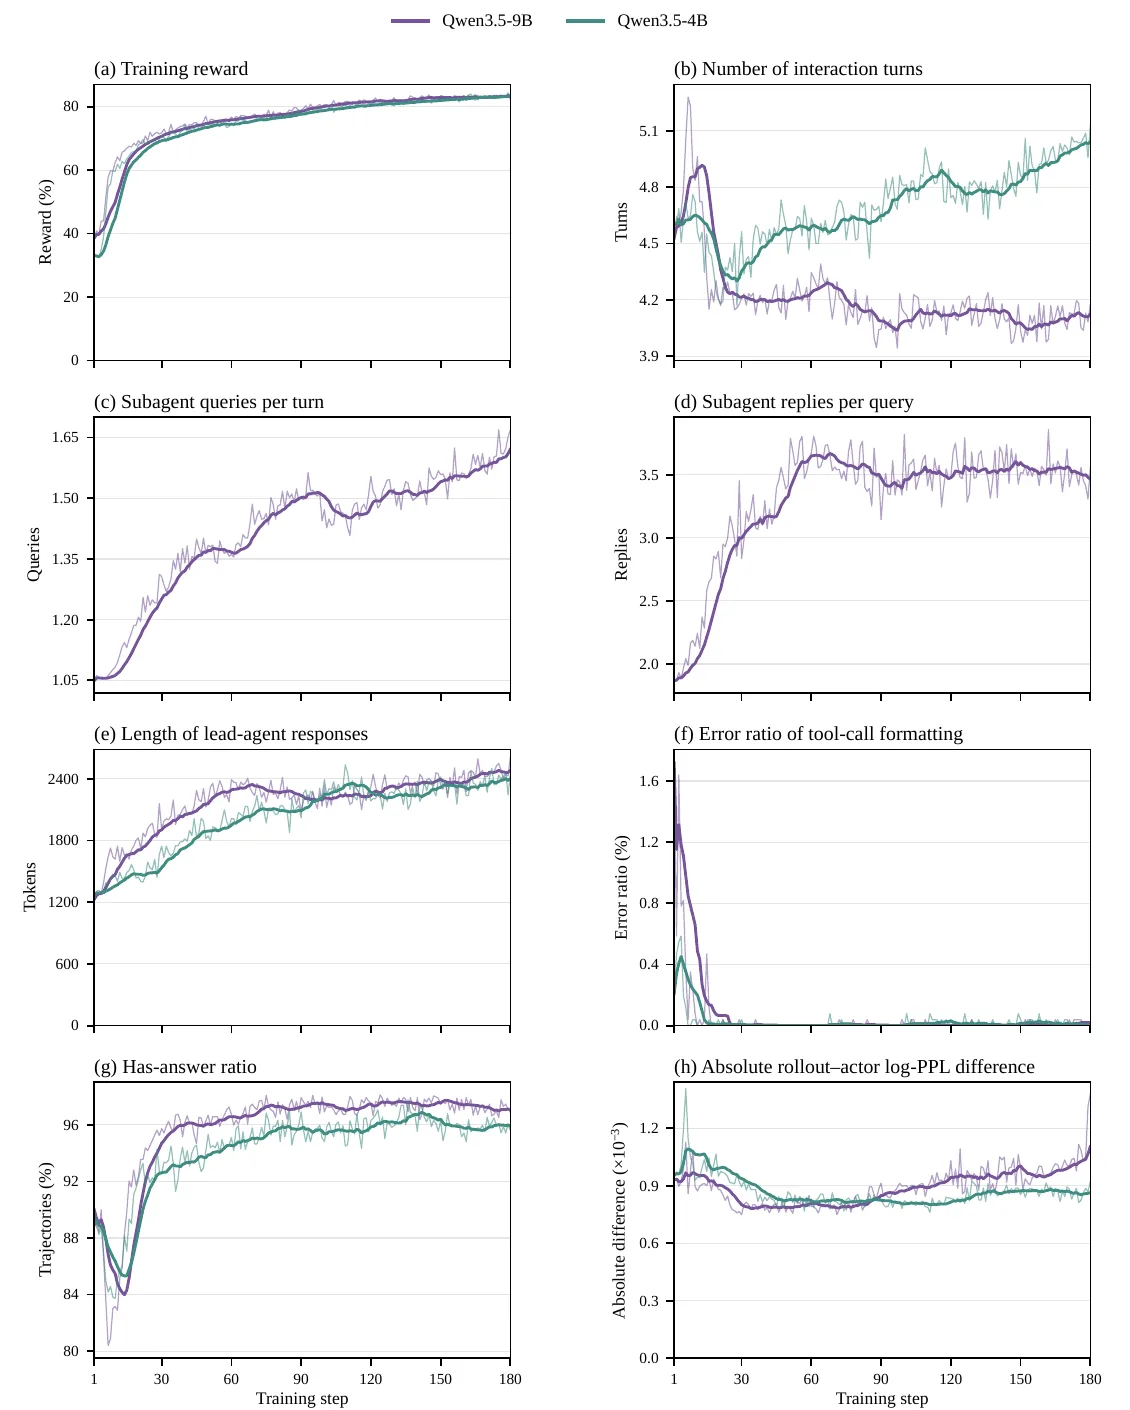
논문 Figure 5. 180단계 강화학습 동안의 학습 곡선. 보라색이 9B, 청록색이 4B. 가장 흥미로운 것은 (c) 패널이다.
보상은 4B가 44.9%→83.2%, 9B가 49.8%→83.3%로 올라갔습니다. 그런데 논문이 강조하는 것은 보상 곡선이 아니라 (c) 패널입니다. 턴당 서브에이전트 질의 수가 1.06에서 1.62로 꾸준히 늘었습니다. 보상은 턴 수를 벌하지도, 질의를 여러 개 보내는 것을 장려하지도 않습니다. 그런데도 리드 에이전트는 서로 의존하지 않는 질의를 알아서 묶어 한 턴에 보내는 법을 배웠습니다. "Everything's Ducky 감독은?"과 "Karthika 감독은?"은 서로 독립이니 동시에 물어도 되고, "Don Taylor 사망일은?"은 첫 답을 알아야 하니 다음 턴에 물어야 합니다. 이 구분을 아무도 가르치지 않았는데 창발했습니다. 라운드 수를 줄이는 것이 정답률에 간접적으로 도움이 됐기 때문일 것입니다.
두 모델이 같은 보상에 다른 길로 도달한 것도 눈에 띕니다. 4B는 턴 수를 4.65→5.04로 늘려 더 끈질기게 묻는 쪽으로, 9B는 4.85→4.12로 줄여 한 턴에 더 많이 묻는 쪽으로 갔습니다.
💡
RL 없이도 이미 이긴다. 부록 Table 7은 RL을 하기 전의 PARSER(기성 Qwen3.5-4B를 그대로 리드로 쓴 것)도 HotpotQA 평균 74.4%로, RL을 마친 MemAgent(78.6%)에는 못 미치지만 RL 전 MemAgent(45.1%)보다는 훨씬 높고 길이에 따라 거의 평평하다는 것을 보여 줍니다. 논문의 해석은 '형식의 친숙함'입니다. PARSER의 리드는 모델이 이미 훈련받은 멀티턴 도구 호출 형식을 쓰지만, 순차 메모리 에이전트는 모델이 본 적 없는 '메모리 갱신' 인터페이스를 새로 배워야 합니다. RL은 여기에 10점을 더 얹었습니다(74.4→84.6).
6. 결과: 128배 길어져도 평평한 선
이제 숫자입니다. 평가는 HotpotQA(학습에 쓴 분포)와 2WikiMultiHopQA(학습에 안 쓴 분포)에서, 같은 128개 질문에 문서 길이만 50문단(7K 토큰)부터 6,400문단(896K 토큰)까지 8단계로 바꿔 가며 쟀습니다. 비교 대상은 문서 전체를 넣는 Qwen3.5와 DeepSeek-V4-Pro, 임베딩 검색 기반 Agentic RAG, 그리고 같은 데이터·같은 백본으로 다시 학습한 MemAgent·ReMemR1입니다.
세 줄로 요약하면 이렇습니다.
첫째, 길이에 거의 무감합니다. HotpotQA에서 PARSER-4B는 7K에서 85.7%, 896K에서 85.4%입니다. 같은 구간에서 Qwen3.5-4B 전체 입력은 80.5%→31.3%, MemAgent는 81.3%→72.9%로 떨어졌습니다. 896K에서 순차 메모리 최강(ReMemR1 73.4%)과의 격차가 12.0점입니다.
둘째, 작은 모델이 큰 모델을 이깁니다. PARSER-9B의 HotpotQA 평균 86.8%는 100만 토큰 창을 가진 DeepSeek-V4-Pro(최대 추론 모드) 80.5%보다 6.3점 높습니다. 9B 리드와 4B 서브에이전트 조합이, 문서를 통째로 읽는 거대 모델을 넘어선 것입니다.
셋째, 학습하지 않은 벤치마크에서 더 벌어집니다. 2WikiMultiHopQA에서 MemAgent-4B는 평균 60.6%로 무너졌고(896K에서 45.1%), PARSER-4B는 87.0%를 지켰습니다. 리드가 문서를 안 보기 때문에 학습 문서에 과적합되지 않았다는 논문의 주장과 맞아떨어지는 결과입니다.
정직하게 덧붙일 것도 있습니다. 짧은 문서(7K~14K)에서는 2WikiMultiHopQA 기준 전체 입력 모델이 PARSER보다 높습니다. 문서가 창에 넉넉히 들어가고 Context Rot가 아직 안 생긴 구간이라면 그냥 다 넣는 것이 가장 좋은 전략입니다. PARSER의 이점은 길이가 수십만 토큰을 넘어가면서 커집니다.
왜 이기나: 세 가지 통제 실험
평균 점수보다 설득력 있는 것은 4.1절의 통제 실험입니다. 논문은 "어느 방법이 더 높은가"가 아니라 "증거의 배치를 바꿨을 때 각 방법이 얼마나 흔들리는가"를 쟀습니다.
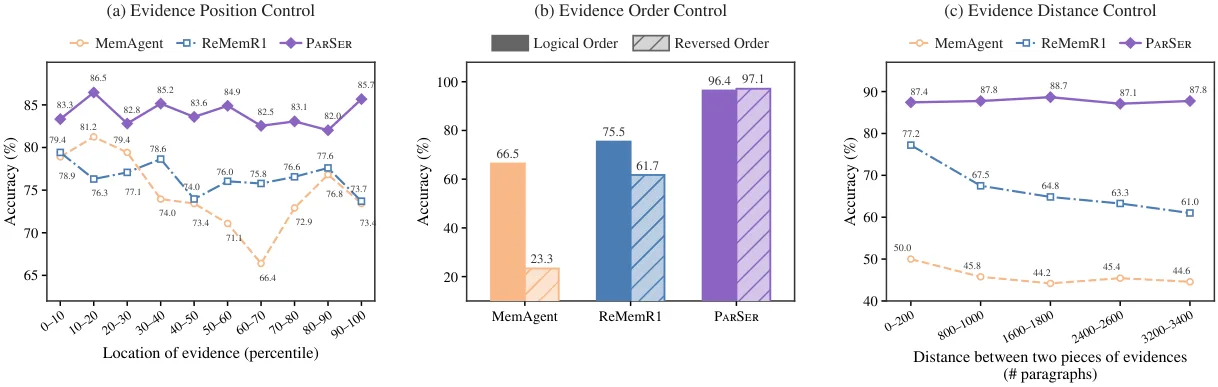
논문 Figure 2. 증거의 위치(a), 순서(b), 거리(c)를 바꿨을 때의 정확도. 보라색 PARSER만 세 조건 모두에서 평평하다. (출처: cuhk-parser.github.io)
위치. 894K 토큰 문서에서 증거 문단을 0~10 백분위부터 90~100 백분위까지 옮겨 가며 재자, MemAgent는 문서 가운데(60~70 백분위)에서 66.4%까지 떨어지는 U자를 그렸습니다. 'Lost in the Middle'이 문서 수준에서 재현된 것입니다. 메커니즘은 다릅니다. 앞에 있는 증거는 일찍 모여 답이 되고, 뒤에 있는 증거는 덮어쓰기를 몇 번 안 당하지만, 가운데 증거는 이미 포화된 메모리에 들어가 뒤에서 덮어쓰기까지 당합니다. PARSER는 82~86.5% 사이에서 평평했습니다. 모든 청크가 모든 라운드에 같은 질의를 받으니 위치가 의미가 없습니다.
순서. 2WikiMultiHopQA의 2홉 비교 질문 512개로, 같은 문단 집합의 증거 순서만 논리 순서와 역순으로 바꾼 두 문서를 만들었습니다. MemAgent는 66.5%→23.3%, ReMemR1은 75.5%→61.7%로 급락했고, PARSER는 96.4%→97.1%였습니다. 이 글 서두의 Everything's Ducky 사건이 바로 이 조건의 한 사례입니다.
거리. 두 증거 문단 사이에 끼워 넣는 교란 문단 수를 0~200에서 3,200~3,400으로 늘리자, MemAgent는 50.0→44.6%, ReMemR1은 77.2→61.0%로 떨어졌고 PARSER는 87.4→87.8%로 변함없었습니다. 순차 메모리에서는 첫 증거가 두 번째 증거를 만날 때까지 더 많은 갱신을 살아남아야 하므로 거리가 멀수록 쫓겨날 확률이 올라갑니다.
논문의 결론은 간결합니다. 세 현상은 하나의 병목, 곧 용량이 정해진, 문서 순서를 따르는, 반복 압축 메모리의 세 가지 얼굴이라는 것입니다.
논문 Figure 3. 순차 추론 단계 수. MemAgent는 청크 수에 비례해 늘고, PARSER는 질문의 홉 수(약 4)에서 멈춘다.
단일 요청 기준으로 896K 토큰 문서 한 건에 MemAgent는 876초, PARSER는 78초가 걸렸습니다. 11.2배입니다. 이유는 Figure 3이 그대로 보여 줍니다. MemAgent의 순차 단계는 183.6개, PARSER는 3.9개. 청크 읽기가 임계 경로에서 빠졌기 때문입니다.
그런데 동시 요청을 16개, 32개로 늘리면 격차가 1.7배로 줄어듭니다. MemAgent는 여러 요청을 배치로 묶어 GPU를 채울 수 있게 되고, PARSER는 반대로 손해를 봅니다. 서브에이전트는 매 라운드 자기 청크를 다시 읽는데, 원래는 "지시문 + 청크"가 매번 같은 접두사이므로 SGLang의 Radix 캐시가 KV를 재사용해 질의 부분만 새로 계산합니다. 하지만 동시 요청이 많아 GPU 메모리가 모자라면 캐시가 밀려나고, 청크 전체를 라운드마다 다시 프리필해야 합니다. 부록 A의 계산으로는 이때 프리필 비용이 MemAgent의 K배, 즉 약 4배가 됩니다. PARSER의 속도 이점은 "GPU 메모리가 청크 KV 캐시를 다 들고 있을 수 있다"는 전제 위에 서 있습니다.
⚠️
장비 조건을 같이 읽어야 합니다. 지연 측정에서 전체 입력과 MemAgent는 H100 한 장, PARSER는 서브에이전트용 H100 한 장 + 리드용 RTX 3090 한 장을 썼습니다. 논문은 리드와 서브에이전트가 번갈아 돌기 때문에 공정한 비교라고 설명하지만, 어쨌든 GPU 두 장입니다. 학습에는 H100 16장이 들어갔습니다. 작은 모델로 큰 모델을 이긴다는 말은 맞지만, 싸게 이긴다는 뜻은 아닙니다.
서브에이전트는 얼마나 커야 하나
리드를 4B로 고정하고 서브에이전트를 2B·4B·9B로 바꿔 보니(Table 3) 2B에서 4B로 가면 78.3→84.6%로 크게 오르지만 9B로 가면 84.8%로 거의 그대로였습니다. 질문이 쪼개지고 청크가 짧아진 뒤의 "이 4,096토큰 안에 이 질의의 답이 있는가"라는 일은 4B면 충분하다는 뜻입니다. 비용의 대부분을 차지하는 서브에이전트를 작게 둘 수 있다는 점에서 실무적으로 중요한 결과입니다.
반대로 리드를 재학습하지 않고 서브에이전트만 바꿔 끼우는 실험(Table 5)도 있습니다. 사고 모드를 켠 서브에이전트를 붙이면 85.6%, 셸 도구(rg, grep)로 원문을 직접 뒤지는 DCI 서브에이전트를 붙이면 84.7%였습니다. 각각의 단독 버전(전체 입력 사고 모드 65.8%, 단독 DCI 에이전트 75.6%)보다 높습니다. 리드 에이전트가 배운 것이 "특정 서브에이전트 다루기"가 아니라 "질문 쪼개고 증거 모으기"라는 일반적인 조정 능력이라는 방증입니다.
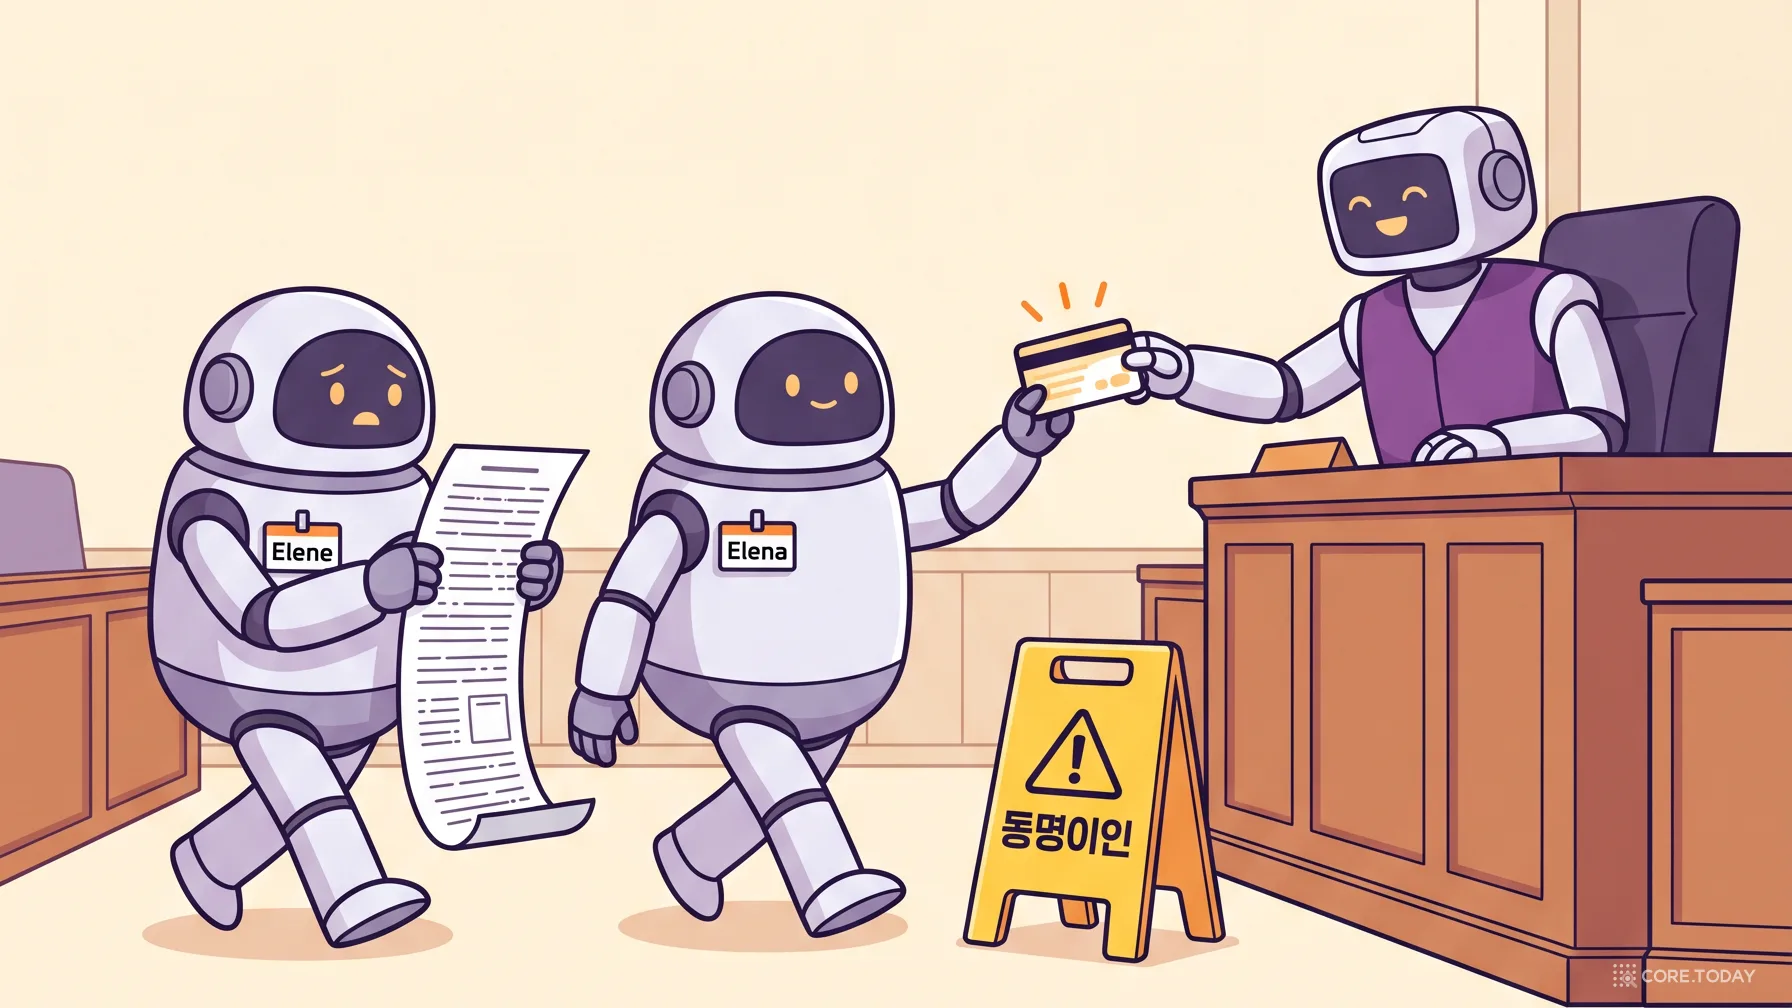
1라운드에서 한 서브에이전트가 정확한 단서를 줍니다. "엘레네(1753~1786)는 헤라클리우스 2세의 딸이자 이메레티의 솔로몬 2세의 어머니." 남편은 안 나옵니다. 2라운드에서 리드는 "husband of Princess Elene of Georgia"라고 묻고, 두 답이 돌아옵니다. 하나는 "솔로몬 2세는 이메레티의 아르칠 공과 그의 아내 헬레네(헤라클리우스 2세의 딸) 사이에서 태어났다"로, 1라운드 단서와 맞춰 보면 정답(아르칠 공)을 가리킵니다. 다른 하나는 러시아 대공녀 옐레나 블라디미로브나에 관한 청크를 맡은 서브에이전트가 돌려준 "그녀의 남편은 그리스와 덴마크의 니콜라스 왕자"입니다. 비슷한 이름에 속은 것입니다.
리드 에이전트는 짧고 직접적인 두 번째 답을 그대로 받아들여 틀립니다.
논문은 이 실패를 맥락 격리의 대가라고 진단합니다. 서브에이전트는 리드의 질의와 자기 청크만 볼 뿐 리드가 지금까지 무엇을 알아냈는지(엘레네가 헤라클리우스 2세의 딸이라는 것) 모릅니다. 질의가 모호하면 자기 청크 안에서 그럴듯한 답을 만들어 냅니다. 반대로 리드는 서브에이전트가 어떤 문단을 봤는지 모르므로 그 답이 질문 속 인물에 관한 것인지 검증할 수 없습니다. 읽기와 추론을 떼어 놓아 얻은 모든 장점의 뒷면에 바로 이 비용이 있습니다. 다른 사례에서는 리드가 더 구체적인 추가 질의로 교차 검증을 했지만, 이 경우엔 그 과정이 발동하지 않았습니다.
이 밖에 논문을 읽으며 함께 적어 둬야 할 한계들입니다.
벤치마크가 합성 문서입니다. 위키피디아 문단들을 섞어 붙인 '포장된' 문서이고, 질문은 128개를 길이별로 재사용합니다. 실제 계약서·판례·코드베이스처럼 문단 사이에 구조와 참조가 있는 문서에서 어떻게 작동할지는 별도의 검증이 필요합니다. 부록 B.2의 RULER 10개 과제(바늘 찾기·변수 추적·빈출 단어)에서 대부분 95~100%를 보인 것은 긍정적 신호이지만, 역시 합성 과제입니다.
평가 지표가 너그럽습니다. Sub_EM은 예측과 정답 중 한쪽이 다른 쪽의 부분 문자열이면 정답으로 칩니다. 선행 연구의 공개 코드를 따른 것이고 모든 방법에 같은 기준이 적용됐으니 비교는 공정하지만, 절대 수치를 다른 논문과 직접 견주기는 어렵습니다.
총 계산량은 늘 수 있습니다. 출력 토큰은 1% 이하로 줄지만, 매 라운드 모든 청크를 다시 읽는 프리필은 캐시가 없으면 K배입니다. 논문도 Table 6 각주에서 "충분한 GPU 메모리를 가정"한다고 명시합니다.
Qwen3.5 한 계열에서만 검증됐습니다. 리드의 도구 호출 형식도 Qwen3.5의 것을 그대로 씁니다. 다른 모델 계열, 특히 상용 API 모델을 리드로 쓸 때의 거동은 알 수 없습니다.
라운드 상한이 12입니다. 12홉이 넘는 질문이나 "문서 전체에서 X가 몇 번 나오나" 같은 집계 질문은 이 구조와 잘 맞지 않을 수 있습니다. RULER의 빈출 단어 과제에서 4B가 85%로 시작한 것이 그 신호일 수 있습니다(길이가 늘자 오히려 올랐는데, 논문은 정보가 더 많은 청크로 흩어져 서브에이전트들이 더 많이 건져 올렸기 때문이라고 해석합니다).
PARSER를 '긴 문서 QA의 새 기록'으로만 읽으면 절반만 읽은 것입니다. 이 논문은 2025~2026년에 에이전트 시스템 전반에서 굳어진 한 패턴을 긴 문서 읽기에 정식으로 옮겨 심은 사례입니다.
오케스트레이터–워커는 이미 표준 패턴입니다. 2025년 6월 Anthropic은 자사 리서치 기능이 리드 에이전트 하나가 서브에이전트 여러 개를 띄워 각자 독립된 맥락 창에서 조사하게 하는 구조라고 공개했습니다(논문도 이 글을 인용합니다). 워커의 중간 토큰이 리드의 맥락을 차지하지 않는다는 것이 핵심 이점이었고, Claude Code의 서브에이전트, 각종 에이전트 프레임워크의 플래너–워커 구조가 같은 모양입니다. Moonshot AI의 Kimi K2.5는 스케줄러만 최적화하는 '에이전트 스웜'을 상용화했고, OWL이나 '진화하는 오케스트레이션'(NeurIPS 2025) 같은 연구는 오케스트레이터만 학습하고 워커는 고정하는 방식을 탐구했습니다. PARSER는 이 설계에서 워커들에게 문서의 서로 겹치지 않는 조각을 하나씩 배정했을 뿐입니다. 그 덕에 "문서 전체를 빠짐없이 읽었다"가 구조적으로 보장되고, 리드의 일은 질의 만들기와 종합으로 줄어듭니다. 워커를 얼려도 되는 이유, 학습 비용이 문서 길이와 무관한 이유가 모두 여기서 나옵니다.
검색은 에이전트가 되었습니다. 저희가 RAG 특집 1편에서 다뤘듯, 2026년의 검색은 "임베딩으로 한 번 찾고 끝"이 아니라 에이전트가 질의를 바꿔 가며 반복하는 과정이 됐습니다. PARSER의 리드 에이전트가 하는 일이 정확히 그것입니다. 다만 검색 도구가 임베딩 인덱스가 아니라 문서를 다 읽는 LLM 무리라는 점이 다릅니다. 논문이 비교군으로 넣은 Agentic RAG(Qwen3-Embedding으로 상위 3청크 검색)는 표에 결과가 비어 있습니다(논문은 이유를 밝히지 않았습니다). 임베딩 검색이 멀티홉에서 겪는 어려움, 곧 "두 번째 홉의 질의가 첫 번째 홉의 답에 의존하는데 그 답을 담은 청크가 질문과 의미적으로 멀다"는 문제는 여전히 유효합니다.
grep으로 돌아간 사람들도 있습니다. 2026년 5월 전후로 DCI(Direct Corpus Interaction), GrepSeek, "Is grep all you need?" 같은 연구가 잇따라 나왔습니다. LLM에게 임베딩 대신 rg·grep을 쥐여 주고 원문을 글자 그대로 뒤지게 하는 접근입니다. 고유명사·코드 식별자·에러 메시지처럼 정확한 문자열 단서가 있을 때 효율적입니다. PARSER 논문은 이 접근을 배척하지 않고 서브에이전트로 흡수합니다(4.4절). 리드 아래에 grep 워커를 두니 단독 grep 에이전트보다 9점 높았습니다.
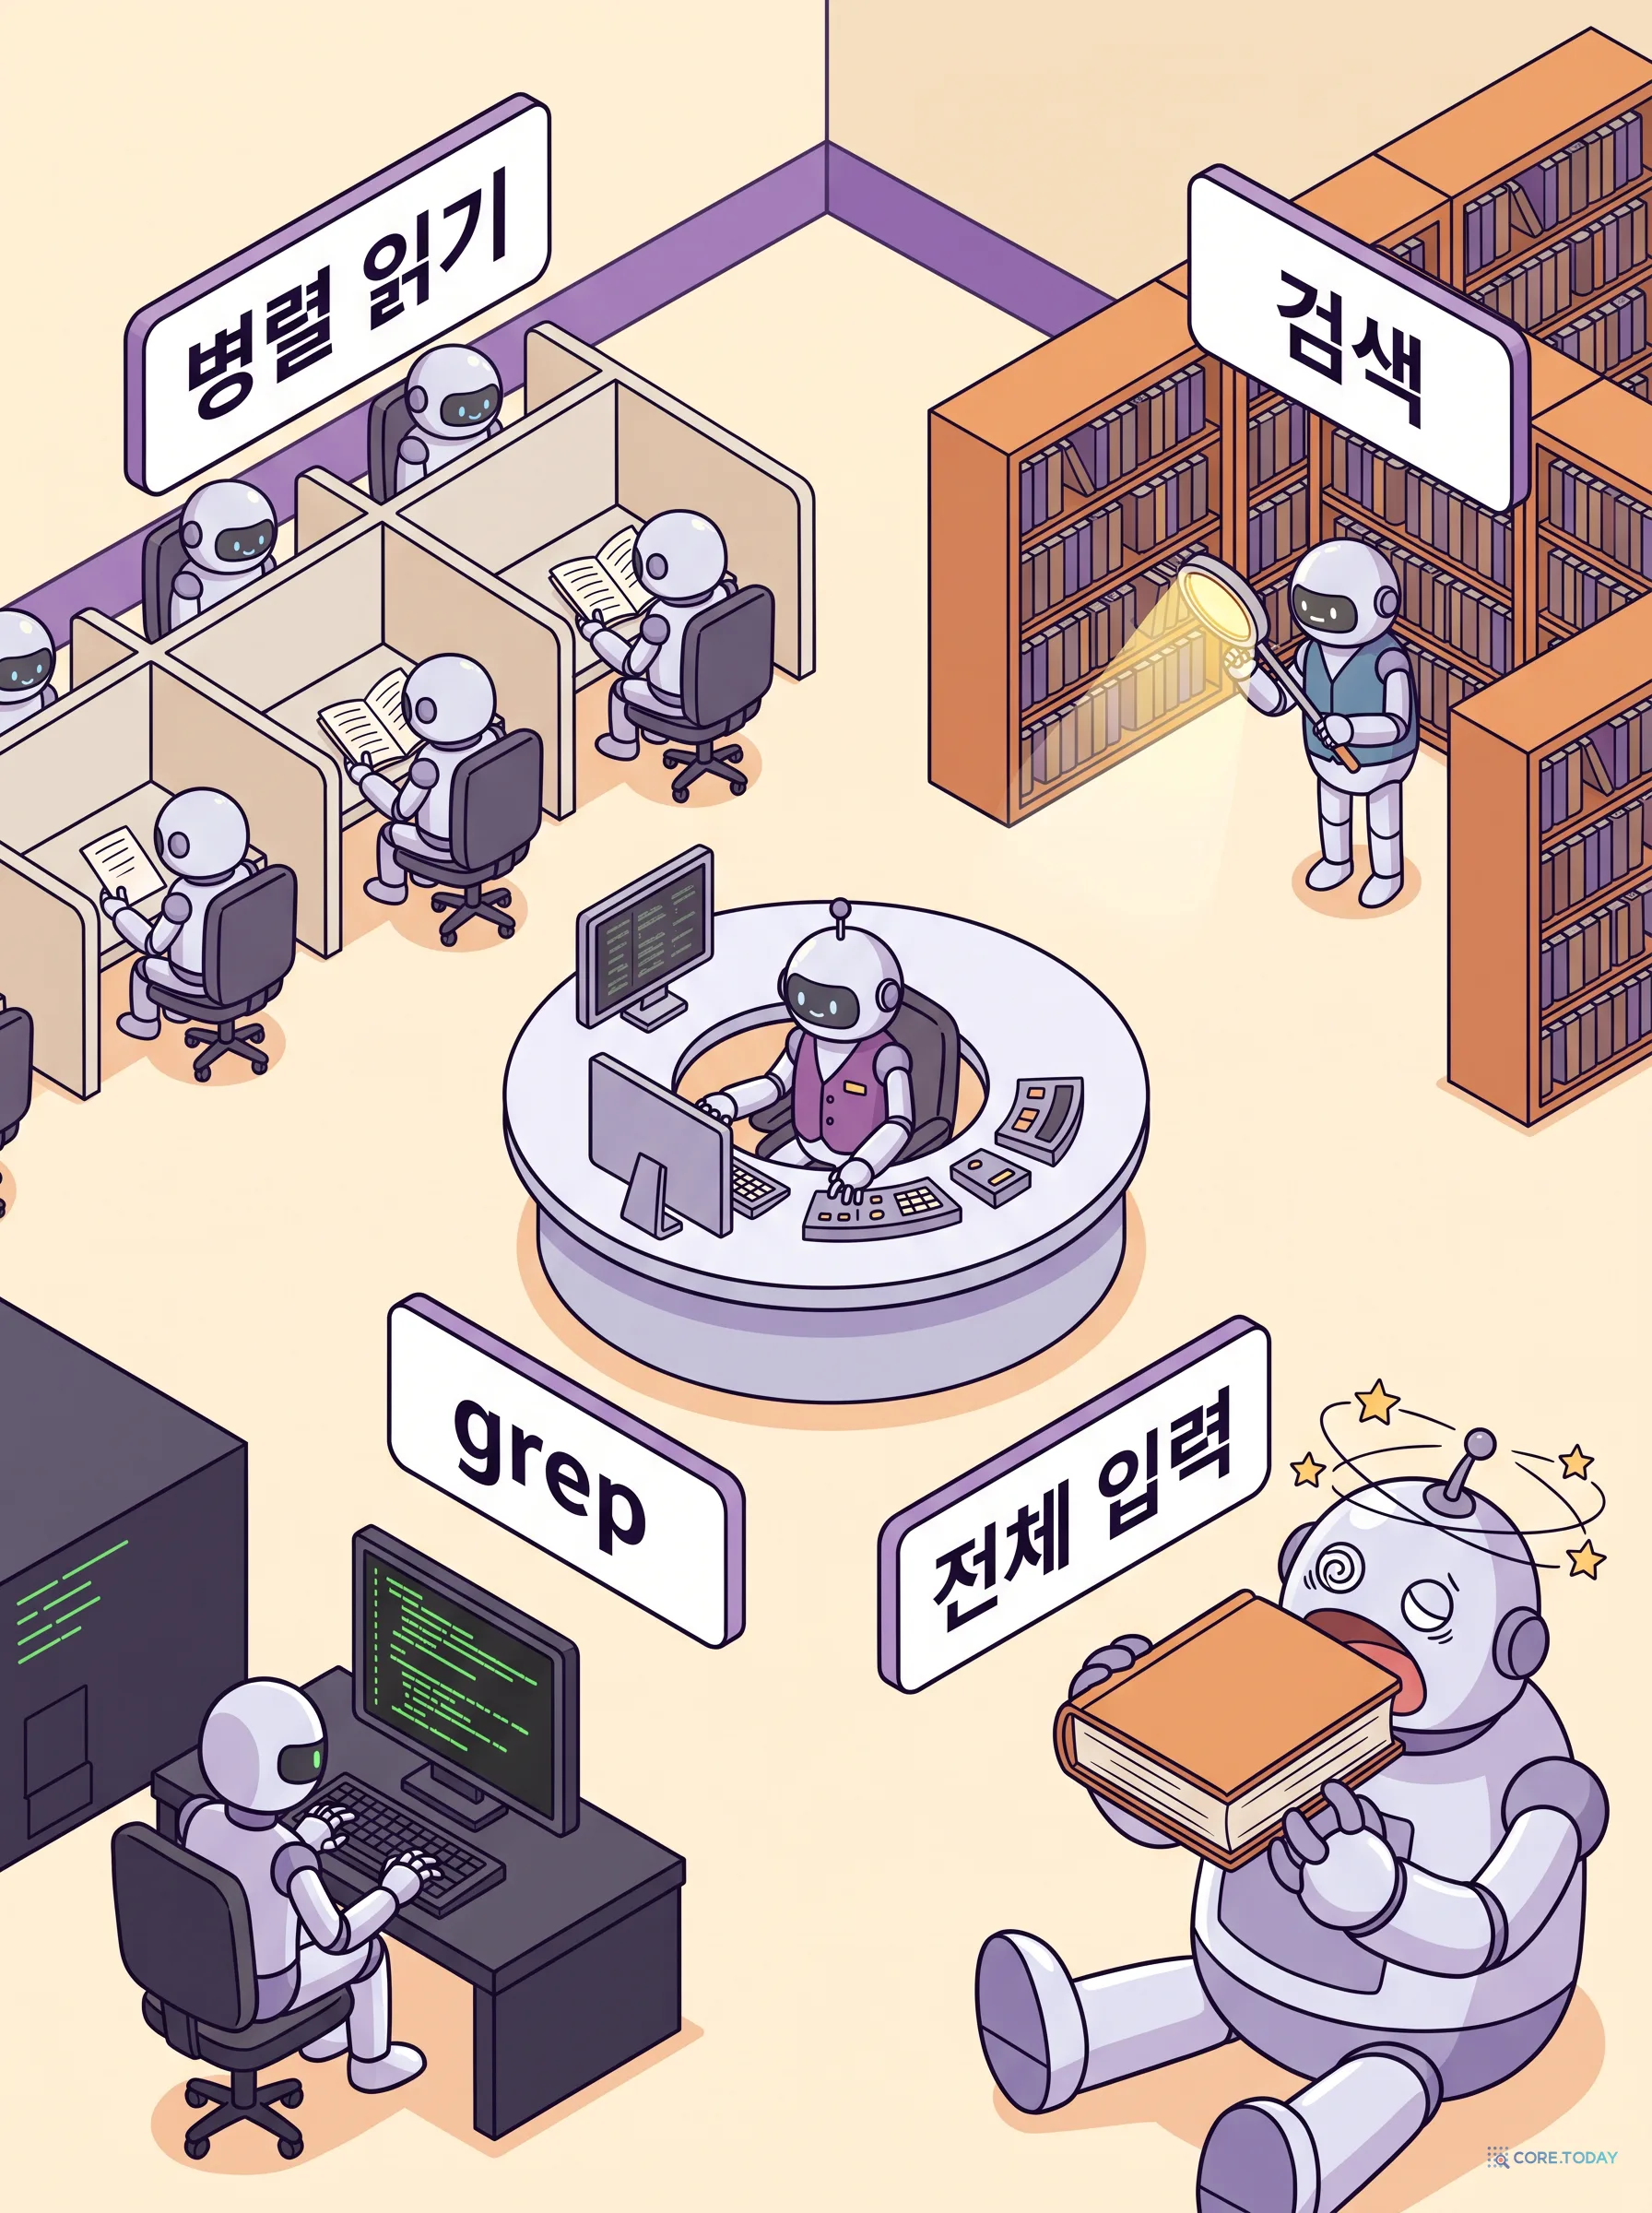
이 네 접근을 한 표에 놓으면 이렇습니다.
접근
읽기 방식
강한 조건
약한 조건
전체 입력
문서를 통째로 한 번에
수만 토큰 이하, 종합·집계 질문
수십만 토큰 이상에서 Context Rot, 제곱 비용
검색 후 읽기(RAG)
임베딩으로 상위 k청크만
같은 문서에 질의가 반복, 바늘 찾기
멀티홉(다음 단서를 미리 모름), 의미적으로 먼 증거
순차 메모리
청크를 차례로, 메모리 덮어쓰기
GPU 한 장, 임의 길이, 작은 창
증거 위치·순서·거리에 민감, 지연이 길이에 비례
병렬 읽기 + 순차 추론(PARSER)
모든 청크를 매 라운드 동시에, 리드가 질의 갱신
수십만 토큰 이상의 멀티홉, 요청마다 다른 문서, 지연 중요
GPU 여러 장, 캐시 부족 시 프리필 K배, 동명이인에 취약
직접 탐색(DCI, grep)
LLM이 셸 도구로 원문 검색
글자 그대로의 단서(이름·식별자·코드)
의미로 찾아야 하는 질문, 표현이 다른 증거
그래서 어디에 쓸 수 있나
논문은 "다중 문서 QA나 법률 분석처럼 한 질문의 증거가 수십만 토큰에 흩어진 과제"를 동기로 듭니다. 2026년 현재 실무에서 이 조건에 해당하는 일을 몇 가지 떠올려 봅니다.
법률 실사(due diligence). 인수 대상 회사의 계약서 수백 건에서 "변경 통제 조항이 있고 그 통지 기한이 30일 미만인 계약"을 찾는 일은 전형적인 멀티홉입니다. 조항의 존재(1홉)와 기한(2홉)이 다른 페이지에 있고, 계약마다 표현이 다릅니다.
감사와 규제 대응. "이 거래의 승인자가 당시 겸직하던 직책은?" 같은 질문은 결재 기록과 인사 기록을 잇습니다. 두 기록은 문서 뭉치의 멀리 떨어진 곳에 있습니다.
대형 코드베이스 질문. "이 설정값을 바꾸면 영향받는 API 엔드포인트는?"은 설정 → 읽는 모듈 → 호출하는 핸들러 → 라우트로 이어지는 3~4홉입니다. 코드는 식별자가 정확하니 grep 서브에이전트가 특히 잘 맞는 영역이고, 논문의 DCI 결합 실험이 그 가능성을 보여 줍니다.
의료 기록 요약. 수년치 진료 기록에서 "현재 복용 중인 약과 상충하는 과거 알레르기 기록"을 찾는 일은 거리 통제 실험(두 증거 사이의 간격)의 실제판입니다.
뉴스·공시 아카이브 분석. "A사가 B사 지분을 처음 공시한 분기의 CEO는?"처럼 사건과 인물을 시간을 건너 잇는 질문.
공통점은 세 가지입니다. 문서가 길고, 증거가 흩어져 있으며, 첫 질의로는 두 번째 단서가 무엇일지 모른다는 것. 이 셋이 다 해당하면 PARSER식이 맞고, 하나라도 빠지면 더 싼 방법이 있습니다. 아래 가이드에서 자기 문제를 대입해 볼 수 있습니다.
실무자가 당장 가져갈 수 있는 것
논문을 재현할 GPU 16장이 없어도 가져갈 수 있는 교훈이 있습니다.
첫째, 리드에게 문서를 보여 주지 마세요. 멀티 에이전트로 긴 문서를 다룰 때 흔한 실수는 오케스트레이터에게도 문서 일부를 주는 것입니다. PARSER의 리드는 질문과 증거만 봅니다. 그래서 맥락이 작고, 과적합이 없고, 어떤 서브에이전트와도 조합됩니다.
둘째, 워커에게 기권을 허락하세요. 서브에이전트가 "모르면 Unknown"을 낼 수 있게 하고, 그 응답은 리드에게 전달하지 않는 것만으로 토큰이 두 자릿수 배로 줄어듭니다. 워커에게 억지로 답을 짜내게 하면 Elena 같은 오답이 늘어납니다.
셋째, 증거는 인용으로 받으세요. 서브에이전트의 출력을 "요약"이 아니라 "원문 인용 + 짧은 답"으로 강제하면 리드가 근거를 확인할 수 있고, 환각이 끼어들 자리가 줄어듭니다.
넷째, 청크는 작게. 같은 모델이라도 4K 청크에서 128K 청크보다 4점 이상 잘 찾습니다. 큰 창이 있다고 큰 청크를 쓸 이유는 없습니다.
다섯째, 캐시를 설계에 넣으세요. "지시문 + 청크 + 질의" 순서로 프롬프트를 짜고, 같은 청크를 같은 서버로 보내는 캐시 인식 라우팅을 쓰면 라운드마다 질의 부분만 새로 계산됩니다. 상용 API의 프롬프트 캐싱도 같은 원리로 쓸 수 있습니다.
여섯째, 동명이인 방어를 넣으세요. 논문의 실패 사례가 가르치는 것입니다. 리드가 답을 내기 전에 "이 답이 질문 속 그 인물/그 문서에 관한 것인지" 한 번 더 묻는 검증 라운드를 두거나, 서브에이전트에게 지금까지 확인된 핵심 사실(예: "엘레네는 헤라클리우스 2세의 딸")을 질의에 함께 실어 주면 맥락 격리의 비용을 줄일 수 있습니다. 논문 자신도 이것을 "교차 검증이 발동하지 않은 경우"라고 부르며 후속 과제로 남겼습니다.
9. 마무리: 창을 넓히는 대신 읽는 법을 바꾸다
2017년 Transformer는 "모든 위치를 동시에 본다"로 RNN의 순차 병목을 깼습니다. 그 뒤 10년 가까이 긴 문서 문제는 창을 넓히는 쪽으로 풀려 왔고, 창이 100만 토큰에 이르자 이번엔 창 안에서 길을 잃는 문제가 남았습니다. 순차 메모리 에이전트는 창 밖에서 답을 찾았지만, 문서 수준에서 RNN을 다시 만들었고 RNN의 병을 함께 물려받았습니다.
PARSER가 한 일은 그 병목을 한 번 더 깨는 것입니다. 문서 수준에서도 모든 청크를 동시에 보고, 순차 계산은 질문이 요구하는 만큼만 남기자. 4B 모델이 896K 토큰에서 85%를 유지하고, 9B가 100만 토큰 모델을 이기고, 지연이 문서 길이에서 떨어져 나왔습니다. 그러면서도 저자들은 실패 사례와 전제 조건(GPU 메모리, 합성 벤치마크, 단일 모델 계열)을 숨기지 않았습니다.
프로젝트 페이지의 첫 문장이 논문 전체를 가장 잘 요약합니다.
문서의 순서가 추론의 순서를 지배해서는 안 된다.
긴 문서를 다루는 시스템을 설계하고 있다면, 그 시스템이 지금 어느 순서를 따르고 있는지 한 번 물어볼 때입니다.