기억은 미리 만들지 말고, 물어볼 때 지어라 — Just-In-Time 에이전트 메모리(JAM) 완전 해부
석 달 전 회의 요약에는 '가격 협의함'이라고만 적혀 있다. 그런데 오늘 필요한 건 '1,240만 원, VAT 별도'라는 한 줄이다. 대부분의 에이전트 메모리는 질문이 오기 전에 기록을 요약·추출해 두는 AOT(Ahead-of-Time) 방식이고, 그래서 '그때는 사소했던' 디테일을 먼저 버린다. BAAI·베이징대·홍콩이공대 연구진의 JAM은 발상을 뒤집는다. 원본은 폴더에 그대로 두고 README 색인만 미리 만든 뒤, 질문이 오면 작은 Researcher 에이전트가 open·search·browse로 찾아 들어가 그 질문만을 위한 맥락을 짓는다. 4B 모델로 14B 메모리 에이전트를 이기고, 4배 빨랐다. 토요타 공장과 JIT 컴파일러에서 시작해 Memory-Gym 데이터 합성, 힌트를 주는 강화학습, 결과표와 한계, 2026년의 다른 기억 설계와의 비교까지 인터랙티브 위젯 6종과 함께 해부한다.
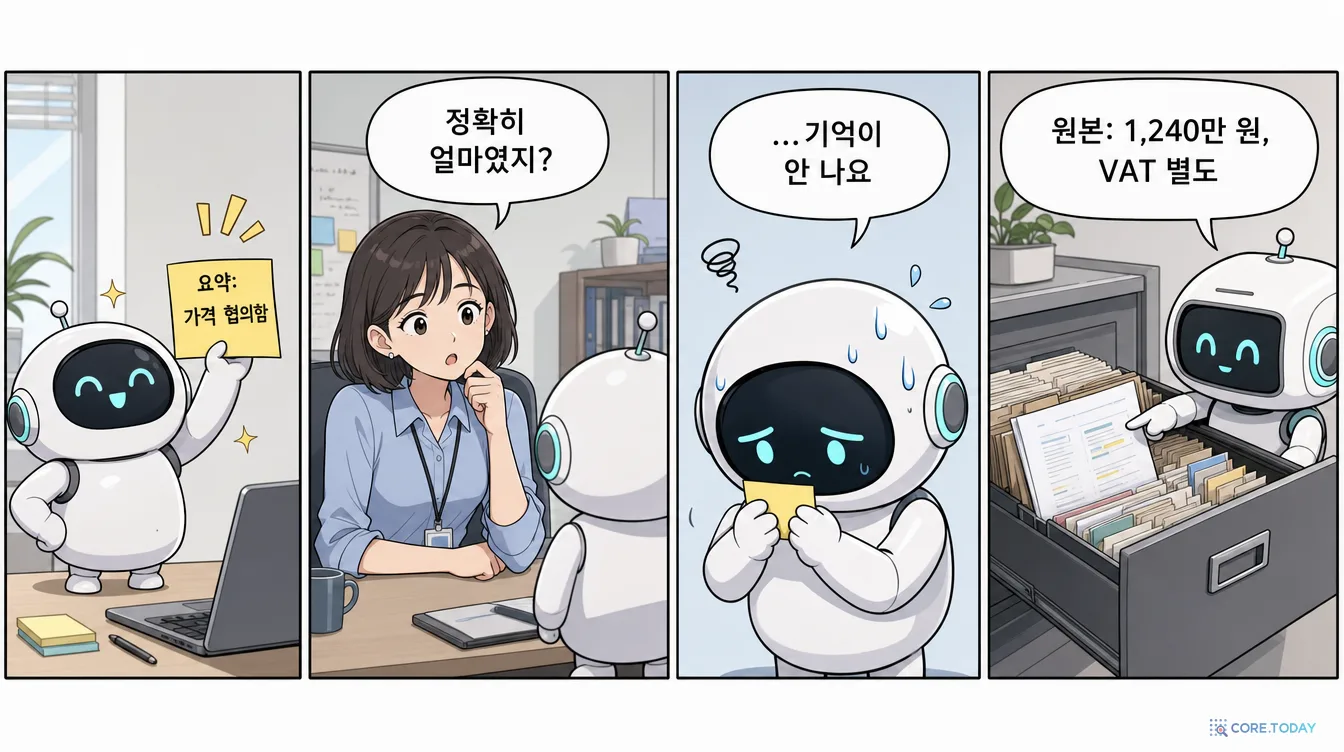
석 달째 집 인테리어 공사를 진행 중인 사람이 있다고 하자. AI 비서는 견적 미팅, 자재 선정, 일정 회의, 관리사무소 통화까지 모든 대화에 함께했다. 공사가 끝나 갈 무렵 잔금을 치르기 전에 묻는다. "욕실 공사, 정확히 얼마로 했었지?"
비서가 떠올린 기억은 이렇다. "7/02 견적 미팅 — 욕실 공사 가격 협의함." 틀린 말은 아니다. 다만 질문에 대한 답은 아니다. "욕실 두 곳 1,240만 원, 부가세는 별도로 보시면 됩니다"라는 문장은 그날 대화에서 지나가듯 나왔고, 비서는 그 세션을 요약할 때 숫자를 버리고 '협의함'만 남겼다. 그때는 그 문장이 중요할 거라고 판단할 근거가 없었다. 질문은 석 달 뒤에야 왔다.
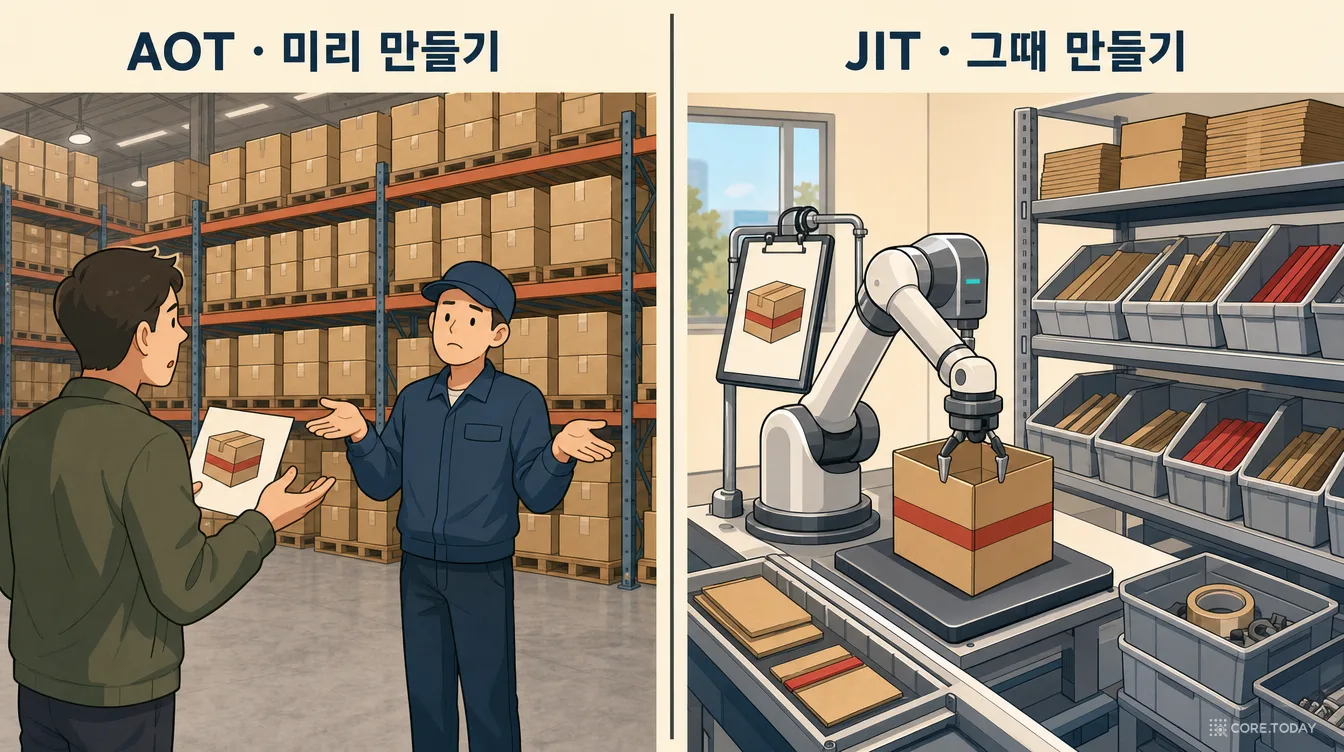
이것이 오늘날 대부분의 AI 에이전트 메모리가 일하는 방식이다. 대화나 작업이 끝나면 기록을 미리 요약하거나 사실 단위로 뽑아 저장해 두고, 나중에 질문이 오면 그 가공물에서 찾는다. 2026년 9월 28일 arXiv에 올라온 논문 "Just-In-Time Agent Memory with Runtime Agentic Research"(arXiv:2609.34385)는 이 방식에 이름을 붙인다. AOT(Ahead-of-Time), 즉 '미리 만들어 두는' 기억이다. 그리고 반대편에 JIT(Just-In-Time), '물어볼 때 짓는' 기억을 세운다.
저자는 BGE 임베딩으로 잘 알려진 베이징인공지능연구원(BAAI)의 Zheng Liu 팀(Bingyu Yan, Chaofan Li, Hongjin Qian, Shuqi Lu, Chaozhuo Li, Zheng Liu)과 베이징대·홍콩이공대 연구진이다. 이들이 제안한 시스템 JAM(Just-In-Time Agent Memory)의 핵심은 세 문장으로 요약된다.
?
문제
질문이 오기 전에 기록을 요약·정리하는 AOT 메모리는 '무엇이 나중에 중요할지' 모르는 채로 정보를 버린다. 근거가 여러 세션에 흩어진 질문에서 특히 치명적이다.
!
접근
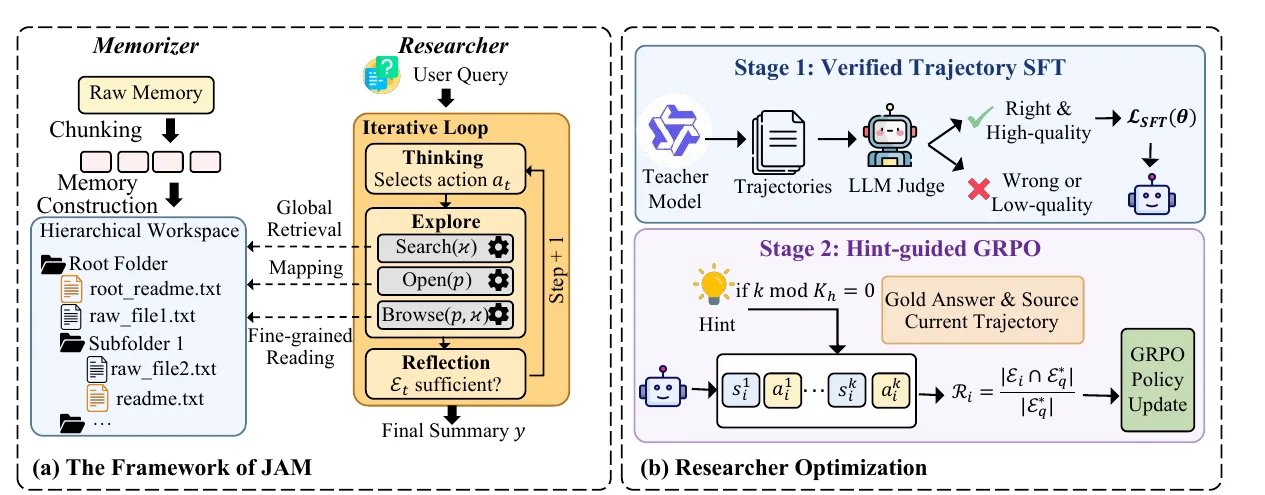
원본은 하나도 버리지 않고 폴더 트리에 보관하고, 폴더마다 README 색인만 미리 쓴다(Memorizer). 질문이 오면 작은 에이전트가 open·search·browse 도구로 찾아 들어가 그 질문만을 위한 맥락을 짓는다(Researcher). 이 탐색 습관은 합성 데이터 Memory-Gym과 SFT → 힌트 주입 강화학습으로 가르친다.
→
결과
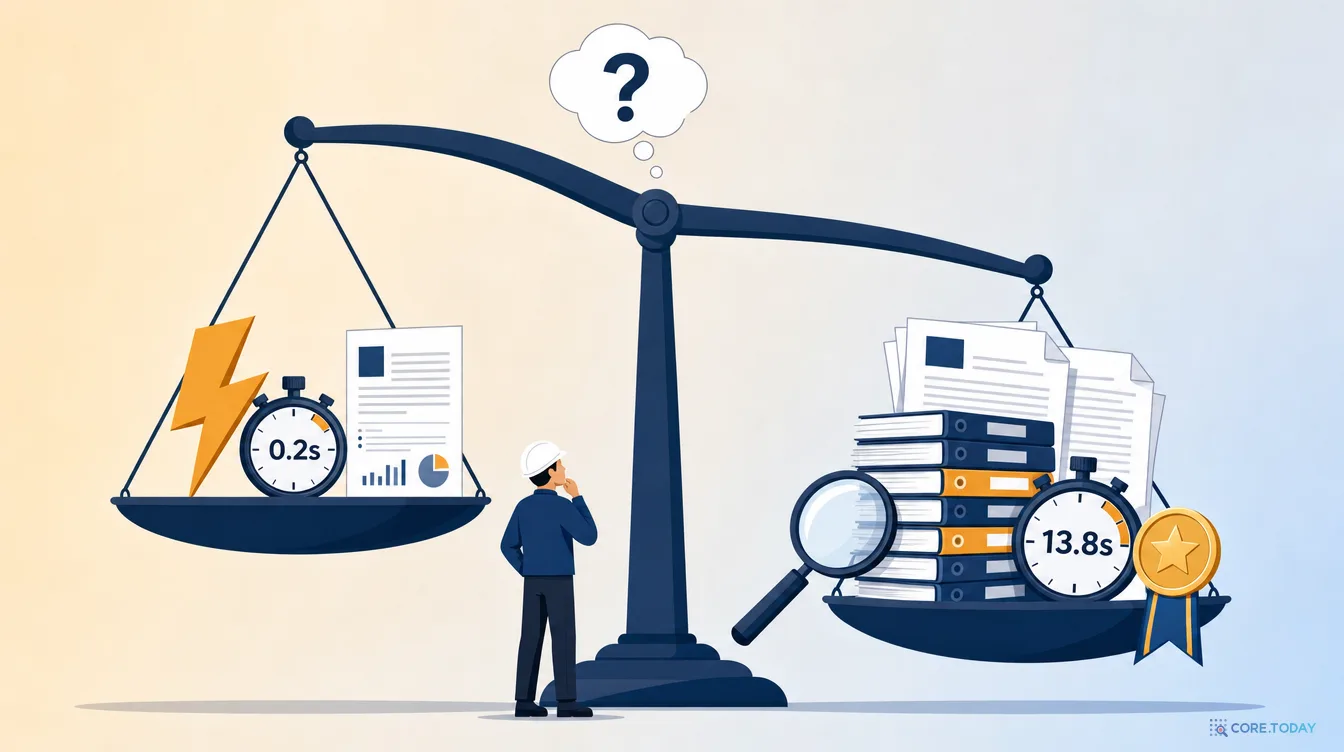
Qwen3.5-4B 하나로 LoCoMo F1 52.09. 같은 모델을 쓴 Mem0(32.10)·A-MEM(41.17)은 물론 14B짜리 학습형 메모리 에이전트 MemAgent(46.13)도 넘었고, 질문당 응답은 58.08초 → 13.81초로 4배 빨랐다. 대신 0.2초면 답하는 AOT 시스템보다는 수십 배 느리다.
흥미로운 건 타이밍이다. JAM이 나오기 닷새 전인 9월 23일, 전혀 다른 팀(Yefan Zhou, Semih Yavuz, Shafiq Joty 등)이 "Just-in-Time Memory: Learning to Curate Task-Adaptive Memory for LLM Agents"(JitMem, arXiv:2609.27334)를 올렸다. 초록 첫머리가 거의 같은 진단이다. "기존 설계 대부분은 기억을 쓰는 시점에 가공한다. 그래서 미래의 질문을 모르는 채 무엇을 기억할지 결정해야 하고, 정보를 되돌릴 수 없게 버린다." 9월 말 두 주 사이에 '기억 가공을 읽는 시점으로 미루자'는 논문이 연달아 나왔고, 해외 뉴스레터들은 이를 한 흐름으로 묶어 소개했다. 우연이라기보다는 업계가 같은 벽에 동시에 부딪혔다는 신호로 읽힌다.
이 특집은 JAM 논문 24쪽을 처음부터 끝까지 읽고, 다음 순서로 풀어 간다.
왜 기억이 문제가 되었나 — 에이전트가 토해내는 기록, 긴 컨텍스트의 함정, 그리고 AOT 메모리의 등장
AOT와 JIT — 토요타 공장, JIT 컴파일러, 안드로이드가 먼저 겪은 같은 딜레마
계보 — MemGPT에서 GAM을 거쳐 JAM까지
Memorizer — 원본을 지키는 사서
Researcher — 질문이 오면 찾아 나서는 탐정 (논문 사례를 직접 탐색해 보는 위젯 포함)
Memory-Gym — 기억 쓰는 법을 가르칠 교재 만들기
학습 — 모범 답안 따라 하기, 그리고 힌트를 받으며 스스로 찾기
결과 읽기 — 표 1부터 부록 표 12까지
비판적으로 읽기 — 지연, 재현성, 원본 보관의 그림자
2026년 지도 — 다른 기억 설계와의 차이, 어디에 맞나
실무 체크리스트
1. 왜 기억이 문제가 되었나
1.1 에이전트는 기록을 토해낸다
2024년의 챗봇은 질문 하나에 답 하나를 내놓았다. 2026년의 에이전트는 일을 한다. 딥 리서치 에이전트는 웹 페이지 수백 개를 열어 보고, 코딩 에이전트는 파일을 읽고 테스트를 돌리고 실패 로그를 분석하며 몇 시간씩 작업한다. 일하는 동안 관찰, 추론 흔적, 도구 호출 결과가 쉬지 않고 쌓인다.
에이전트 스타트업 Manus의 Yichao 'Peak' Ji는 2025년 7월 글 「Context Engineering for AI Agents」에서 자사 에이전트의 입력 대 출력 토큰 비율이 평균 100 대 1이라고 밝혔다. 모델이 한 단어를 쓸 때마다 백 단어를 읽는다는 뜻이다. 그리고 그 백 단어의 대부분은 에이전트 자신이 과거에 남긴 기록이다.
JAM 논문은 이 상황을 수식 하나로 정리한다. 에이전트의 기록은 시간 순서대로 쌓인 세션의 나열이다.
H={s1,s2,…,sT}
각 세션 si에는 관찰, 추론, 상호작용이 들어 있다. 문제는 T가 계속 커진다는 것이다. 논문의 표현을 빌리면 "H가 커질수록 기록 전체를 에이전트에게 그대로 먹이는 것은 비효율적이고 오류를 부른다."
1.2 "다 넣으면 되잖아?" — 긴 컨텍스트의 함정
2026년 주요 모델의 컨텍스트 창은 100만 토큰 안팎이다. 소설 몇 권이 들어간다. 그러니 기록을 통째로 넣으면 되지 않을까? 세 가지 이유로 그렇지 않다.
첫째, 길어지면 못 읽는다. 2023년 스탠퍼드·버클리 연구 「Lost in the Middle」(Liu et al., arXiv:2307.03172)은 모델이 긴 입력의 처음과 끝은 잘 쓰지만 가운데에 놓인 정보는 놓친다는 U자형 곡선을 보고했다. 2025년 7월 Chroma의 「Context Rot」 보고서는 18개 모델을 시험했는데, LongMemEval 과제에서 질문과 관련된 약 300토큰만 준 '집중 프롬프트'가 약 11만 3천 토큰 전체를 준 프롬프트보다 모든 모델에서 더 잘 맞혔다. 우리 블로그의 컨텍스트 부패 글에서 자세히 다뤘다.
JAM 논문의 표 1에도 같은 현상이 그대로 찍혀 있다. HotpotQA 질문 하나에 방해 문서를 섞어 문맥을 늘렸을 때, 기록을 통째로 넣은 Vanilla(Qwen3.5-4B)의 F1은 이렇게 떨어진다.
56k 토큰
63.56
112k 토큰
53.04
224k 토큰
36.97
(막대 폭은 JAM의 56k 점수 64.56을 100%로 잡았다.) 같은 조건에서 JAM은 64.56 → 59.28 → 58.69로 버틴다.
둘째, 비싸다. 기록 전체를 넣으면 질문마다 그 토큰값을 다시 낸다. 프롬프트 캐시가 있어도 기록이 매일 자라면 캐시는 계속 깨진다.
셋째, 기록은 창보다 빨리 자란다. 석 달짜리 비서 대화, 1년치 고객 상담 이력, 수천 번의 코딩 세션은 100만 토큰도 결국 넘는다.
1.3 그래서 등장한 '기억 시스템' — 그리고 AOT의 그림자
그래서 2023년부터 에이전트에 별도의 기억 장치를 달아 주는 연구가 쏟아졌다. 2023년 10월 UC 버클리의 MemGPT(arXiv:2310.08560, 지금의 Letta)는 운영체제의 가상 메모리처럼 '메인 컨텍스트'와 '외부 저장소' 사이로 정보를 옮기자고 제안했다. 이후 등장한 시스템들은 대부분 같은 전략을 택했다. 기록이 들어올 때 미리 가공해 둔다.
Mem0(arXiv:2504.19413, 2025년 4월) — 대화에서 '사실'을 뽑아 저장하고, 새 사실이 기존 것과 충돌하면 LLM이 ADD/UPDATE/DELETE를 결정한다.
A-MEM(arXiv:2502.12110, NeurIPS 2025) — 독일 사회학자 루만의 카드 상자(제텔카스텐)처럼 기억을 노트로 만들고 서로 링크를 건다.
MemoryOS(EMNLP 2025) — 단기·중기·장기 기억 계층을 두고 OS처럼 오래된 것을 내려보낸다.
LightMem(arXiv:2510.18866, ICLR 2026) — 감각→단기→장기 단계를 두고, 장기 기억 정리는 '잠자는 시간'에 오프라인으로 한다.
이 접근의 장점은 분명하다. 질문이 왔을 때 할 일이 거의 없으니 빠르고 싸다. Mem0 논문은 기록 전체를 넣는 방식 대비 p95 지연이 17.12초에서 1.44초로, 토큰이 90% 넘게 줄었다고 보고했다.
그런데 같은 Mem0 논문의 표를 자세히 보면 불편한 숫자가 하나 있다. LoCoMo에서 LLM 판정 점수(J)가 Mem0는 66.88%, 그래프 변종은 68.44%인데, 기록 전체를 그냥 넣은 쪽이 72.90%로 더 높다. 빠르고 싸지만, 정확도는 '다 넣기'보다 낮다. 정보를 미리 가공하는 순간 무언가를 잃기 때문이다.
우리 블로그가 사흘 전에 다룬 12개 메모리 시스템 비교 연구도 같은 결론이었다. "요약은 정보를 지우며, 정밀한 사실 추출은 추론을 무너뜨린다." JAM 논문은 이 현상의 원인을 하나로 지목한다. 가공 시점에 질문을 모른다는 것이다. 서론의 문장을 그대로 옮기면 이렇다.
기존 에이전트 메모리 시스템은 대개 AOT 설계 철학을 따른다. 구체적인 요청이 오기 전에 원본 기록을 압축하거나 정리해 요약이나 메모 노트 같은 사전 구축 기억을 만든다. 이런 요청 무관(request-agnostic) 전처리는 온라인 서빙 비용을 줄이지만, 나중에 결정적이 될 수 있는 세밀한 디테일과 세션 간 의존성을 버릴 수 있다.
상용 제품에서도 이 대비가 보인다. 2024년 2월 시험을 시작한 ChatGPT의 메모리는 사용자에 관한 사실을 추려 두었다가 대화 시작 때 미리 주입하는 쪽이었다(2025년 4월에는 '과거 대화 참조'가 추가됐다). 반면 Claude가 2025년 8월 내놓은 '과거 대화 검색'은 필요할 때 원본 대화 기록을 도구로 검색하는 쪽이었다. 개발자 Simon Willison 등이 당시 두 방식을 비교하며 짚은 차이가 바로 AOT 대 JIT다.
'Just-In-Time'이라는 말은 AI 연구자가 만든 말이 아니다. 두 번 빌려 온 말이다.
2.1 토요타 공장: "필요한 것을, 필요한 때에, 필요한 만큼"
첫 번째 출처는 자동차 공장이다. 토요타의 공식 75년사는 1938년 고로모 공장이 문을 열 때 도요다 기이치로가 내건 원칙을 이렇게 전한다. "필요한 것을 제때 만들되, 너무 많이 만들지 마라(Just make what is needed in time, but don't make too much)." 이 생각은 1950년대 오노 다이이치의 '슈퍼마켓 방식'과 간판(칸반) 시스템으로 완성됐다. 앞 공정이 미리 잔뜩 만들어 쌓아 두는 대신, 뒤 공정이 필요한 만큼만 가져가면 앞 공정은 가져간 만큼만 다시 만든다.
미리 잔뜩 만들어 두는 방식의 문제는 재고만이 아니다. 고객이 원하는 사양이 바뀌면 쌓아 둔 물건이 통째로 쓸모없어진다. 미리 만든 물건은 미래의 주문을 추측해서 만든 물건이기 때문이다.
2.2 컴파일러: 실행하는 순간 번역하기
두 번째 출처는 프로그래밍 언어다. 프로그램을 기계어로 바꾸는 방법은 크게 둘이다. C처럼 실행 전에 전부 번역해 두는 AOT 컴파일, 그리고 실행하면서 실제로 자주 도는 부분을 그때그때 번역하는 JIT 컴파일이다. 이 아이디어는 1960년 존 매카시의 LISP, 1968년 켄 톰슨의 정규식 엔진, 1980년대 스몰토크(Deutsch & Schiffman, POPL 1984)를 거쳐 다듬어졌다. 대중화의 계기는 1999년 4월 27일 공개된 썬의 HotSpot JVM과 2008년 9월 2일 크롬과 함께 나온 V8 자바스크립트 엔진이다. 'JIT 컴파일'이라는 이름 자체가 제조업 용어에서 왔다.
JIT 컴파일러가 AOT보다 나은 점은, 실행 중에야 알 수 있는 정보를 쓸 수 있다는 것이다. 어떤 함수가 실제로 몇 번 불리는지, 어떤 타입이 실제로 들어오는지 보고 거기에 맞춰 최적화한다. AOT 컴파일러는 이를 추측할 수밖에 없다.
2.3 안드로이드가 보여 준 결말: 순수 AOT는 졌고, 하이브리드가 이겼다
이 대비를 가장 극적으로 보여 준 사례가 안드로이드다.
2010 · 안드로이드 2.2
Dalvik 가상머신에 JIT 도입. 앱을 실행하면서 자주 도는 코드를 번역한다.
2014 · 안드로이드 5.0
ART 런타임으로 교체하며 순수 AOT로 전환. 설치할 때 앱 전체를 미리 기계어로 바꾼다. 실행은 빨라졌지만 설치가 수 분씩 걸리고, 저장 공간을 더 먹고, OS 업데이트 뒤에는 모든 앱을 다시 컴파일하느라 '앱 최적화 중' 화면에 갇혔다.
2016 · 안드로이드 7.0
하이브리드로 회귀. 처음엔 JIT로 돌리면서 자주 쓰이는 메서드의 프로파일을 모으고, 기기가 충전 중이고 쉬고 있을 때 그 부분만 AOT로 미리 컴파일한다. 설치 시간이 "수 분"에서 "수 초"로 줄었다.
안드로이드 7.0 개발자 문서는 이렇게 쓴다. "ART는 각 앱의 '뜨거운' 메서드 프로파일을 유지하며 그 메서드를 미리 컴파일해 캐시한다. 앱의 나머지 부분은 실제로 쓰일 때까지 컴파일하지 않는다." 모든 것을 미리 하는 것도, 모든 것을 그때 하는 것도 아니라 무엇을 미리 하고 무엇을 미룰지 나누는 것이 답이었다.
이 이야기를 기억해 두자. 뒤에서 보겠지만 JAM도 순수 JIT가 아니다. 안드로이드 7.0처럼 가벼운 것은 미리, 무거운 것은 그때 하는 하이브리드다.
2.4 기억에 옮기면
구분
AOT 컴파일
JIT 컴파일
AOT 메모리
JIT 메모리 (JAM)
언제 가공하나
실행 전, 한 번
실행 중, 필요할 때
질문 전, 기록이 들어올 때
질문이 온 뒤
무엇을 근거로
코드만 보고 추측
실제 실행 프로파일
기록만 보고 '중요해 보이는 것'
지금 들어온 질문
원본
소스는 따로 남음
바이트코드 유지
요약·추출 후 버리거나 안 씀
전부 보존
응답 비용
최저
워밍업 필요
0.2~0.5초
질문당 수 초~수십 초
약점
실행 정보 못 씀
시작이 느림
예측 못 한 질문에 약함
느리고 비쌈
2.5 목표를 수식으로 — "최고 성능을 내는 맥락 중 가장 짧은 것"
논문 2.1절은 기억 시스템의 목표를 깔끔하게 정의한다. 질문 q와 기록 H가 주어지면, 기억 시스템은 실제로 일하는 에이전트(논문은 '클라이언트 에이전트' A라고 부른다)에게 넘길 맥락 c∗를 만든다.
말로 풀면 두 단계다. ① 기록에서 만들 수 있는 모든 맥락 가운데, 에이전트 A가 이 질문을 가장 잘 풀게 해 주는 맥락들의 집합 C∗를 찾는다. ② 그중 가장 짧은 것을 고른다. 쓸모 있으면서 짧아야 한다.
이 식에서 c∗는 질문 q의 함수다. 질문마다 최적의 맥락이 다르다. 논문은 이렇게 정리한다. "AOT 메모리는 요청 무관 사전 압축으로 c∗를 근사하는 반면, JIT 메모리는 특정 요청 q에 조건을 걸어 실행 시점에 c∗를 구성한다." AOT는 '모든 미래 질문에 그럭저럭 쓸 만한 맥락 하나'를 만들어 두는 전략이고, JIT는 '이 질문 하나에 딱 맞는 맥락'을 그때 만드는 전략이다.
직접 확인해 보자. 아래 위젯은 프롤로그의 인테리어 공사 비서를 축소한 것이다. 8개 세션, 6개 질문. 요약 강도와 1회 검색 개수를 바꾸며 AOT가 어떤 질문에서 무너지는지 보자.
위젯에서 눈여겨볼 장면이 둘 있다. 하나는 '착공일' 질문에서 top-k를 1로 줄이면 AOT가 "8월 5일"이라고 자신 있게 틀리는 장면이다. 7/16 회의에서 정한 날짜는 요약에 남았지만, 7/30에 바뀌었다는 세션은 검색 상위에 들지 못했다. 모른다고 하는 것보다 나쁜 실패다. 다른 하나는 '추가 비용 합계' 질문이다. 요약을 하나도 안 해도(=원본 RAG) 1회 검색으로는 두 세션을 다 못 가져온다. JIT의 장점은 '원본 보존'만이 아니라 '여러 번 찾을 수 있다'는 데도 있다.
3. 계보 — JAM은 어디서 왔나
JAM은 갑자기 나온 논문이 아니다. 세 갈래의 흐름이 2026년 가을에 한 점으로 모였다.
3.1 세 갈래의 흐름
갈래 ① 기억 시스템 연구. MemGPT(2023)에서 시작해 Mem0·A-MEM·MemoryOS·LightMem(2025)으로 이어진 AOT 메모리 계열이다. 동시에 "기억을 어떻게 쓸지를 학습시키자"는 흐름도 생겼다. 긴 문서를 조각조각 읽으며 고정 길이 메모를 강화학습으로 덮어쓰는 MemAgent(arXiv:2507.02259, ICLR 2026 구두 발표), 기억 관리자와 답변 에이전트를 강화학습으로 훈련한 Memory-R1(arXiv:2508.19828), 일정한 크기의 내부 상태만 유지하는 MEM1(ICLR 2026) 같은 연구다. JAM이 실험에서 비교하는 '학습된 메모리 에이전트'가 이들이다.
갈래 ② 컨텍스트 엔지니어링 실무. 연구실 밖에서는 에이전트를 실제로 만드는 회사들이 같은 결론에 먼저 닿았다. Manus는 2025년 7월 글에서 이렇게 썼다.
열 단계 뒤에 어떤 관찰이 결정적이 될지 미리 알 수는 없다. 논리적으로 보면, 되돌릴 수 없는 압축은 모두 위험하다. (…) 그래서 우리는 파일 시스템을 궁극의 컨텍스트로 다룬다. 크기 제한이 없고, 본질적으로 영속적이며, 에이전트가 직접 다룰 수 있다.
웹 페이지 본문은 컨텍스트에서 지워도 URL만 남아 있으면 다시 열 수 있다는 '복원 가능한 압축'이 핵심이었다. 두 달 뒤인 2025년 9월 29일, Anthropic은 「Effective context engineering for AI agents」에서 아예 just in time이라는 표현을 썼다.
모든 관련 데이터를 미리 전처리하는 대신, "just in time" 접근으로 만든 에이전트는 가벼운 식별자(파일 경로, 저장된 쿼리, 웹 링크 등)를 유지하고, 이 참조를 이용해 실행 시점에 도구로 데이터를 컨텍스트에 동적으로 불러온다. (…) 어떤 환경에서는 가장 효과적인 에이전트가 하이브리드 전략을 쓸 수 있다. 속도를 위해 일부 데이터는 미리 가져오고, 나머지는 자율적으로 탐색한다. Claude Code가 이 하이브리드 모델을 쓰는 에이전트다. CLAUDE.md 파일은 처음부터 컨텍스트에 그냥 넣고, glob과 grep 같은 기본 도구로 환경을 돌아다니며 파일을 just-in-time으로 불러온다.
같은 글은 대가도 분명히 적었다. "물론 트레이드오프가 있다. 실행 시점 탐색은 미리 계산된 데이터를 꺼내는 것보다 느리다." 그리고 압축의 위험도 경고했다. "지나치게 공격적인 압축은 미묘하지만 결정적인 맥락, 즉 나중에야 중요성이 드러나는 맥락을 잃게 만든다." JAM 논문의 문제의식과 거의 같은 문장이다. Claude Code를 만든 Boris Cherny는 그보다 앞선 2025년 2월 해커뉴스 댓글에서 "에이전트식 검색이 RAG보다 성능이 좋았다"고 밝힌 바 있다. 메모리 서비스 Letta도 2025년 8월, grep·검색·열기·닫기 도구만 가진 단순한 파일 시스템 에이전트가 GPT-4o mini로 LoCoMo 74.0%를 냈다고 발표했다(Mem0가 보고한 그래프 변종 68.5%보다 높다. 다만 평가 설정이 서로 달라 논란이 있었다).
갈래 ③ 검색이 에이전트가 되는 흐름. 한 번 검색해 상위 k개를 붙이는 RAG에서, 에이전트가 검색·열기·읽기를 반복하며 근거를 모으는 '에이전틱 검색'으로의 이동이다. 이 흐름은 에이전틱 검색 특집에서 자세히 다뤘다. JAM의 Researcher는 이 흐름을 '기억'에 적용한 것이다.
3.2 직계 조상: GAM (2025년 11월)
JAM에게는 직계 조상이 있다. 같은 팀이 2025년 11월 23일 올린 「General Agentic Memory Via Deep Research」(GAM, arXiv:2511.18423)다. 허깅페이스 데일리 페이퍼에서 그날 1위(추천 173)를 했고, 코드 저장소 VectorSpaceLab/general-agentic-memory는 지금 별 860여 개를 받았다. JAM 논문이 링크하는 코드도 이 저장소다.
GAM 초록은 이미 같은 비유를 쓰고 있었다. "GAM은 'just-in-time(JIT) 컴파일' 원칙을 따른다. 오프라인 단계에서는 단순하지만 유용한 기억만 유지하고, 실행 시점에 클라이언트를 위한 최적화된 맥락을 만드는 데 집중한다."
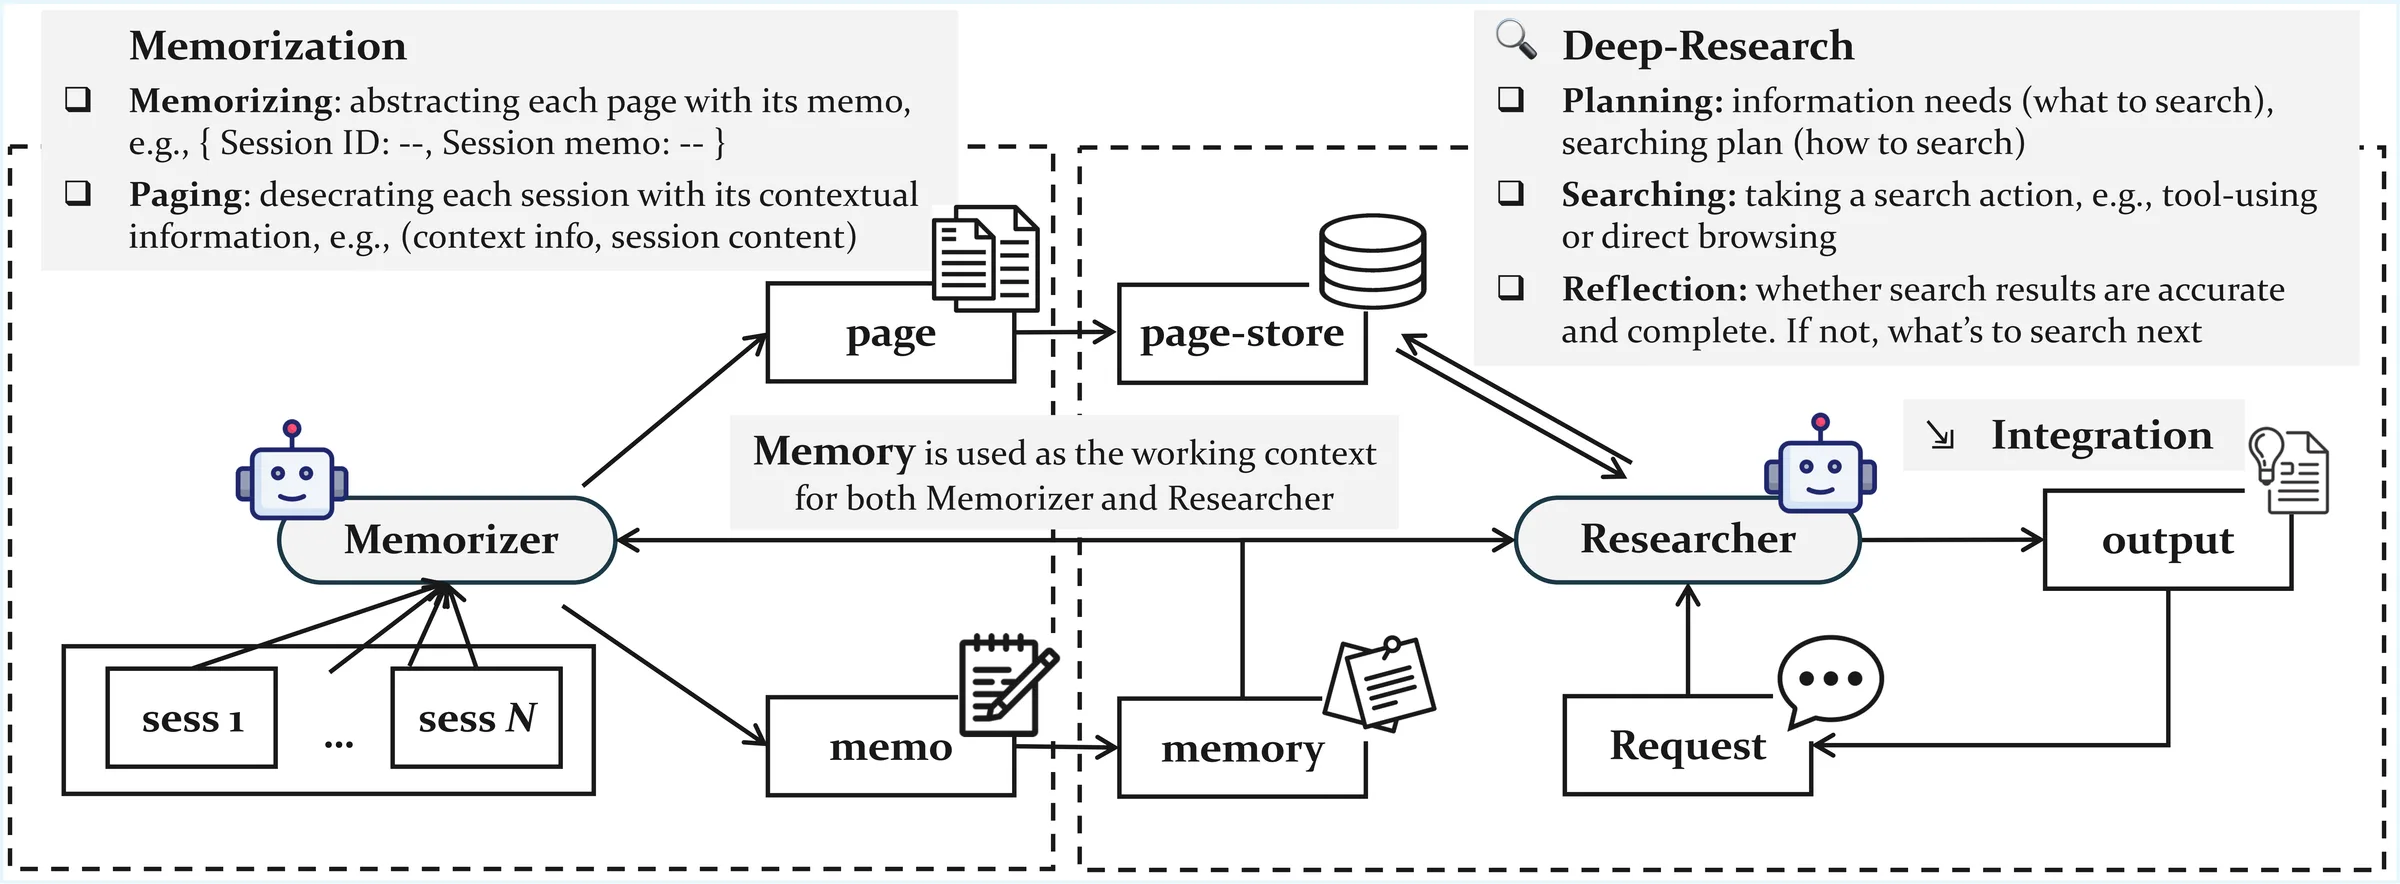
GAM 그림 1의 구조는 JAM과 거의 같다. 왼쪽의 Memorizer는 세션마다 짧은 메모(memo)를 쓰고, 세션 원문은 '페이지'로 만들어 페이지 저장소(page-store)에 그대로 넣는다. 오른쪽의 Researcher는 요청이 오면 계획하고, 검색하고, 결과가 정확하고 충분한지 성찰한 뒤 부족하면 다시 찾는다. 운영체제의 페이징에서 이름을 따왔다.
그렇다면 JAM은 무엇이 새로운가? 표로 정리하면 이렇다.
항목
GAM (2025.11)
JAM (2026.09)
저장 구조
세션별 페이지를 평평하게 나열한 page-store
의미가 비슷한 세션을 폴더로 묶은 계층형 작업공간 + 폴더마다 README
Researcher 도구
임베딩 검색, BM25, 페이지 ID 조회
open(폴더 README 읽기) · search(BM25+임베딩) · browse(파일 읽고 필요한 부분 추출)
탐색 길이
최대 3라운드
최대 20라운드 (실제 중앙값 3)
학습
하지 않음 — 강화학습 목적식만 제시, 프롬프트로 GPT-4o-mini·Qwen2.5-14B 구동
Memory-Gym 합성 데이터 + 검증된 궤적 SFT + 힌트 주입 GRPO
Researcher 모델
GPT-4o-mini 등 범용 모델
학습된 Qwen3.5-4B
GAM 저장소의 이슈 게시판에는 2025년 11월 말 한 사용자가 "강화학습으로 학습한 버전은 언제 나오느냐"고 묻자, 메인테이너가 "GAM은 아직 강화학습으로 학습하지 않았고, 학습 버전을 공개할 계획"이라고 답한 기록이 남아 있다. JAM은 그 약속의 결과물이라고 볼 수 있다. 2026년 2월에는 저장소가 'GAM in An Agent File System'으로 개편되면서 폴더 계층과 폴더별 README, ls·cat·grep·BM25 도구가 들어갔다. JAM의 런타임 구조가 이때 먼저 공개된 셈이다.
3.3 한눈에 보는 연표
2023.10
MemGPT — LLM을 운영체제처럼. 메인 컨텍스트와 외부 저장소 사이 페이징.
2024.02
LoCoMo 벤치마크(arXiv:2402.17753) — 최대 35세션, 평균 300턴에 이르는 장기 대화 기억 평가. 같은 달 ChatGPT 메모리 시험 시작.
2024.10
LongMemEval(ICLR 2025) — 500문항, 정보 추출·여러 세션 추론·시간 추론·지식 갱신·답변 거부의 다섯 능력. 기본 설정이 질문당 약 11만 5천 토큰.
2025.02~04
A-MEM, Mem0 — 사실 추출·연결 노트형 AOT 메모리의 대표주자.
2025.07~08
MemAgent, Memory-R1 — 기억 사용을 강화학습으로. Manus "파일 시스템이 궁극의 컨텍스트". Letta 파일 시스템 에이전트 LoCoMo 74.0%.
2025.09
Anthropic 컨텍스트 엔지니어링 글 — "just in time" 전략과 하이브리드. 같은 날 메모리 도구·컨텍스트 편집 발표.
Memorizer는 오프라인에서, 즉 질문이 오기 전에 일한다. 하는 일은 딱 두 가지다.
① 메모 쓰기(memorizing). 새 세션 si가 들어오면, 지금까지 만들어진 작업공간 W<i를 참고해 그 세션의 핵심을 담은 짧은 메모 μi를 쓴다.
Memorizer.memorize(si,W<i)→μi
② 작업공간에 쓰기(workspace writing). 세션 원문 si를 그대로 파일로 저장하고, 메모 μi를 보고 그 파일을 어느 폴더에 둘지 정한다.
Memorizer.write(si,μi,W<i)→W≤i
이 과정에서 의미가 비슷한 세션은 같은 폴더로 모이고, 각 폴더의 README는 그 안에 든 파일과 하위 폴더의 메모를 모아 만든다. 결과물은 우리가 컴퓨터에서 매일 보는 폴더 트리와 똑같다. 새 세션이 들어오면 같은 절차로 조금씩 덧붙이면 된다.
논문의 핵심 문장은 이것이다. "이 설계는 원본 파일을 완전하고 경로로 추적 가능한 증거로 유지하고, 메모와 README는 Researcher를 세밀하게 살펴볼 만한 세션으로 안내한다."
4.1 Memorizer도 AOT다 — 다만 '지도'만 미리 그린다
여기서 중요한 관찰이 하나 있다. Memorizer는 질문이 오기 전에 일한다. 즉 Memorizer 자체는 AOT다. 그런데 AOT 메모리 시스템과 결정적으로 다른 점이 있다. AOT 시스템이 미리 만드는 것은 답의 재료(요약, 추출된 사실)이고, 원본은 버리거나 다시 보지 않는다. Memorizer가 미리 만드는 것은 지도(README, 폴더 구조)이고, 원본은 한 글자도 버리지 않는다.
도서관에 비유하면, AOT 메모리는 책을 읽고 독서 카드를 써 둔 뒤 책을 반납해 버리는 사람이다. Memorizer는 책은 서가에 그대로 꽂아 두고 서가마다 '이 칸에는 이런 책들이 있음'이라는 안내판만 붙이는 사서다. 안내판이 틀려도 책은 남아 있다.
안드로이드 7.0과 같은 구조다. 자주 쓰일 '지도'는 미리 만들고(AOT), 실제 내용 읽기는 질문이 올 때 한다(JIT). Anthropic이 말한 Claude Code의 하이브리드, 즉 CLAUDE.md는 처음부터 넣고 나머지는 grep으로 찾는 방식과도 같은 모양이다. 사실 이 블로그를 운영하는 저장소에도 CLAUDE.md가 있고, 거기에는 "블로그 이미지는 CDN에서 서빙된다", "새 위젯은 이 폴더에 만든다" 같은 지도가 적혀 있다. 코드 자체는 적혀 있지 않다.
4.2 지도는 얼마나 값어치가 있나 — 부록 표 8
그렇다면 README와 폴더 구조는 정말 필요할까? 원본만 평평하게 쌓아 두고 Researcher가 검색하면 되지 않을까? 논문은 이를 통제 실험으로 확인했다. 같은 원본, 같은 학습된 Researcher, 같은 검색기, 같은 행동 예산에서 메모·폴더·README만 뺀 '평평한 원본 저장소'와 비교한 것이다(LoCoMo).
설정
오프라인 토큰 (작업공간당)
오프라인 시간
질문당 토큰
질문당 시간
평균 탐색 라운드
F1
평평한 원본 저장소
0
0초
8,174
17.11초
3.57
49.06
JAM 작업공간
36,925
79.53초
6,721
13.81초
3.16
52.09
지도를 그리는 데 작업공간 하나당 약 3만 7천 토큰과 80초가 한 번 든다. 그 대가로 질문마다 토큰은 18%, 시간은 19% 줄고, 정확도는 3점 오른다. 질문이 몇 개만 와도 본전을 뽑는다. 논문의 해석은 이렇다. "계층적 정리는 답의 품질만 올리는 게 아니다. 같은 기록 위에 간결한 길잡이 구조를 제공해 Researcher가 온라인에서 해야 할 탐색의 양을 줄인다."
4.3 지도는 작은 모델로도 그린다 — 부록 표 12
또 하나 흥미로운 실험이 있다. Memorizer를 더 큰 모델로 바꾸면 좋아질까?
Memorizer 모델
구축 시간 (초/작업공간)
질문당 시간
평균 라운드
LoCoMo F1
Qwen3.5-4B (기본)
79.53
13.81
3.16
52.09
Qwen3.5-122B-A10B
132.43
14.36
3.25
51.30
GPT-5.5
117.65
13.19
3.03
52.62
30배 큰 모델(122B)은 오히려 0.8점 낮았고, GPT-5.5는 0.5점 높았지만 구축이 1.5배 오래 걸렸다. 일관된 개선이 없다. 지도 그리기는 어려운 일이 아니라는 뜻이다. 참고로 선행 연구 GAM의 실험에서도 비슷한 경향이 있었다. 모델을 0.5B로 줄였을 때 Memorizer 쪽은 평균 48.83점으로 버텼지만 Researcher 쪽은 9.08점으로 무너졌다. 어려운 일은 지도를 그리는 쪽이 아니라 지도를 들고 찾아가는 쪽에 있다. 그래서 JAM은 Memorizer를 고정해 두고 Researcher만 학습시킨다.
browse가 영리한 장치다. 파일 전체를 Researcher의 컨텍스트에 붓지 않고, 별도의 모델이 파일을 읽어 질문과 관련된 부분만 돌려준다. Researcher의 컨텍스트는 탐색이 길어져도 깨끗하게 유지된다. 키워드 검색(BM25)과 의미 검색(임베딩)을 둘 다 쓰는 것도 의도된 선택이다. 뒤의 어블레이션에서 보겠지만 둘 중 하나만 빼도 성능이 떨어진다. '박도윤'처럼 고유명사는 BM25가, '경찰 따돌리기가 더 어렵다' 같은 의미는 임베딩이 잘 찾는다.
5.2 생각 → 탐색 → 성찰의 반복
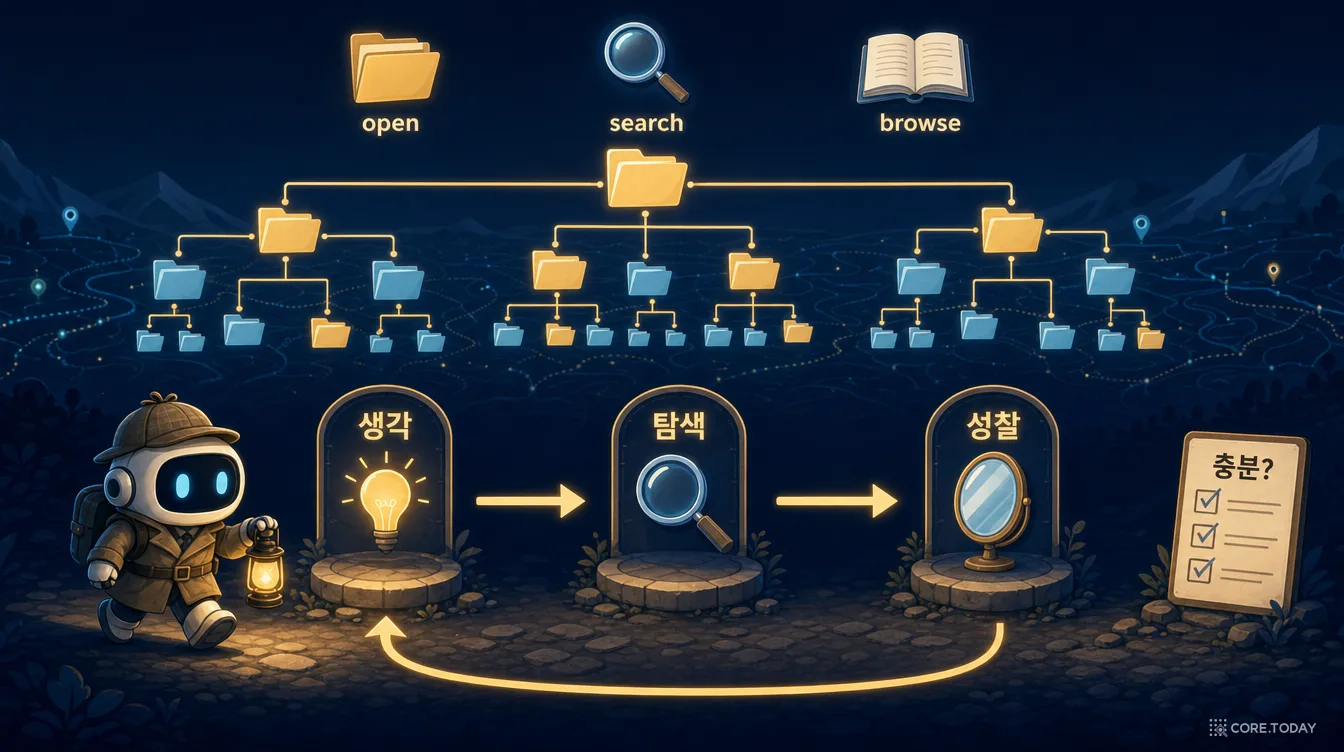
Researcher의 한 스텝 i는 세 박자다.
Researcher의 한 스텝최대 20라운드
생각질문 q와 지금까지의 궤적 hi-1을 보고 무엇이 부족한지 판단한 뒤, 이번에 부를 도구 호출 묶음 Ai = {ai1, …, aiK}를 정한다. 한 라운드에 최대 5개를 동시에 부른다.
탐색Ai의 도구들을 작업공간에서 실행해 관찰 Oi를 받고, 궤적에 덧붙인다: hi = hi-1 ⊕ (Ai, Oi)
성찰지금까지 모은 근거로 충분한가? yi = Reflect(q, hi). 충분하거나 예산(기본 20라운드)을 다 쓰면 멈추고, 아니면 다시 생각으로.
멈추고 나면 Finalize 단계에서 모은 궤적을 정리해 최종 맥락 c∗를 만든다. 이때 질문과 관련된 정보와 함께 출처 경로를 남긴다. 예산을 다 써서 멈춘 경우에도 같은 Finalize로 '지금까지 찾은 것'을 정리해 최선의 답을 낸다.
여기서 놓치기 쉬운 점이 있다. Researcher가 만드는 것은 '정답'이 아니라 '맥락'이다. JAM은 기억 시스템이고, 그 결과물은 실제 일을 하는 다른 에이전트(클라이언트)에게 넘어간다. 논문 실험에서는 답변 생성 모델(역시 학습하지 않은 Qwen3.5-4B)이 이 맥락을 받아 최종 답을 쓴다. 기억 담당과 실무 담당을 나눈 셈이다.
5.3 프롬프트는 어떻게 생겼나
논문 부록 표 13에 Researcher 프롬프트 전문이 실려 있다. 구조를 옮기면 다음과 같다.
Researcher 프롬프트 (부록 표 13 요약 번역)
역할
너는 계층형 지식 베이스를 탐색해 질문에 답하는 리서치 에이전트다.
지식 베이스 구조
맨 끝에 지식 베이스 개요(내용 요약 + 전체 디렉터리 구조)가 있다. 폴더마다 README가 있으니 그걸로 어떤 파일을 볼지 정하라.
도구
search(query) — 관련 파일 이름·경로·요약 반환 / browse(path, query) — 파일을 열어 질의 관련 내용만 요약 / open(path) — 폴더의 README와 목록
절차
생각 → 도구 사용(라운드당 최대 5개) → 관찰 → 다시 생각 … 충분해지면 <answer> 태그로 출력. 답에는 반드시 근거 파일 경로(sources)를 넣어라.
특별한 트릭은 없다. 중요한 건 이 프롬프트를 얼마나 잘 따르도록 학습시켰느냐이고, 그게 6~7장의 이야기다.
5.4 사례로 보기 — 영화 대본 속 '조언자'를 찾아라
논문 부록 C는 NarrativeQA의 한 문제로 Researcher가 실제로 어떻게 움직이는지 보여 준다. 영화 「쓰리 데이즈(The Next Three Days)」(2010)는 아내가 살인 누명을 쓰고 종신형을 받자 대학 강사 존 브레넌이 직접 아내를 탈옥시키기로 하는 이야기다. 질문은 이것이다.
탈옥 자체보다 경찰을 따돌리는 게 더 어렵다고 존에게 조언한 사람은 누구인가?
Memorizer는 대본과 장면 요약 자료를 film_script/와 source_materials/ 두 갈래로 정리해 두었다. 정답이 든 파일은 source_materials/narrativeqa_reference/the_next_three_days_screenplay.md 하나뿐이고, 같은 폴더에는 이름이 비슷한 함정 파일(the_last_three_months_film_script_part_2.md)과 '탈옥 준비'라는 그럴듯한 이름의 엉뚱한 파일이 섞여 있다.
학습된 Researcher의 궤적은 이렇다.
라운드 1 — 생각: "지식 베이스에 두 갈래가 있다. 검색하고, 참고 자료 폴더를 열어 파일 설명을 보고, 탈옥 준비 파일도 열어 보자." 그리고 도구 넷을 동시에 부른다. search 두 번(영어 질의 두 가지), open(source_materials/narrativeqa_reference/), 그리고 browse(john_brennan_escape_preparation_and_manhunt.md).
관찰: 탈옥 준비 파일에는 조언자가 없다. 그런데 폴더 README에 대본 파일이 "전직 탈옥수 데이먼 페닝턴과 만나 상세한 계획 정보를 얻는 장면"을 담고 있다는 단서가 있다.
라운드 2 — 대본 파일과 대본 2부를 browse하고, 확인용 검색을 한 번 더 한다. 대본에서 브루클린의 바, 일곱 번 탈옥한 『Over The Walls』의 저자 데이먼 페닝턴이 "탈옥은 쉬워. 어려운 건 자유로 남아 있는 거야"라고 말하고, 9·11 이후 보안 계획 때문에 15분이면 도시가 봉쇄되고 35분이면 보조 도로까지 검문이 깔린다고 경고하는 대목을 찾는다.
2라운드, 도구 호출 7번이다. 단서를 잡아 준 것은 검색 결과가 아니라 README였다. Memorizer가 미리 그려 둔 지도가 여기서 값을 했다. 넓게 훑은 뒤(coarse) 좁혀 들어가는(fine) 패턴, 그리고 한 라운드에 여러 도구를 병렬로 부르는 습관이 학습된 Researcher의 특징이다.
직접 해 보자. 아래 위젯에서 여러분이 Researcher다. 폴더 구조와 파일 이름은 논문 그림 6 그대로다.
해 보면 알겠지만, 사람도 처음에는 '탈옥 준비' 같은 그럴듯한 이름의 파일부터 열게 된다. 학습되지 않은 모델도 마찬가지다. 다음 장의 주제가 바로 이 탐색 습관을 어떻게 가르치느냐다.
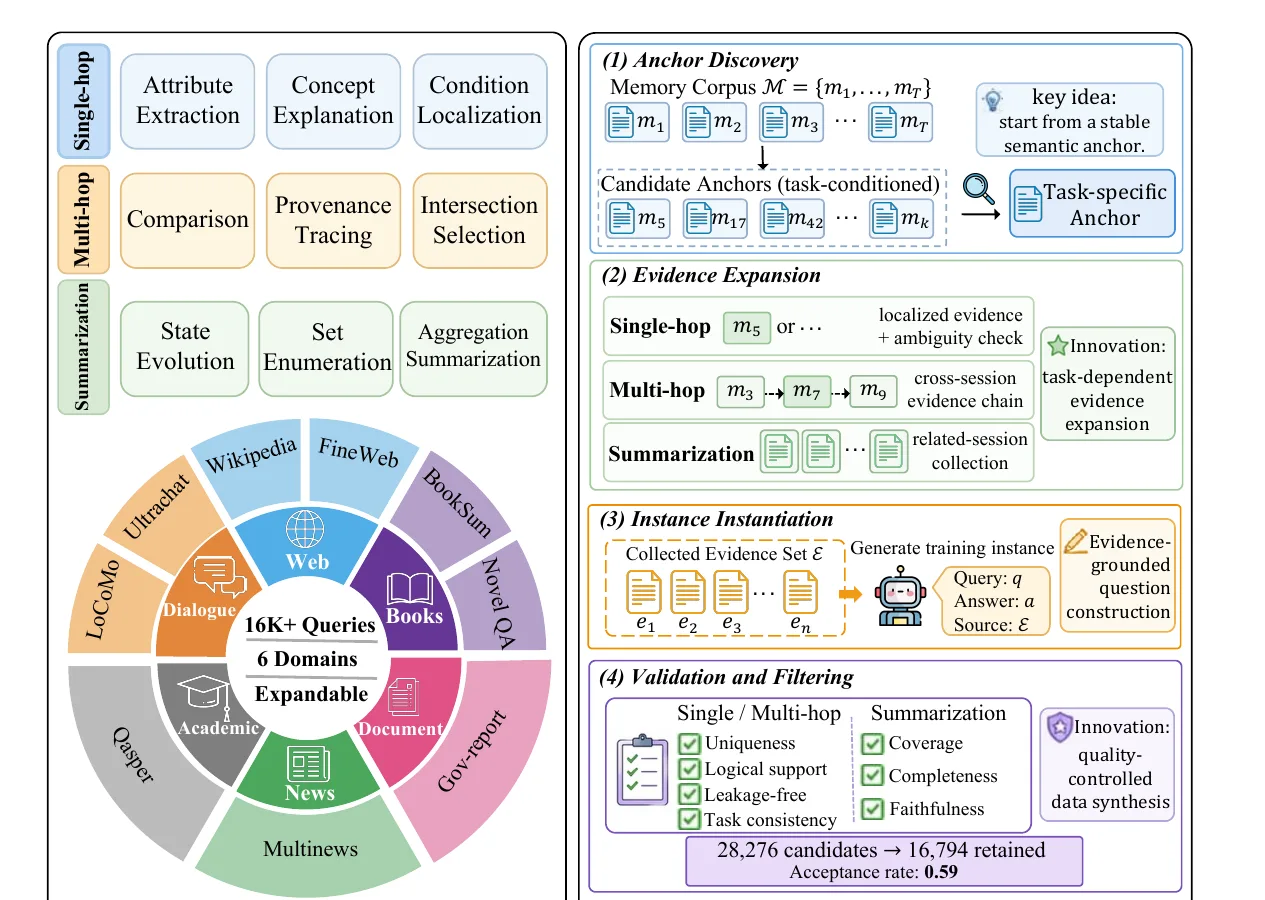
Researcher를 학습시키려면 '기억을 뒤져야만 풀리는 문제'가 대량으로 필요하다. 그런데 기존 학습형 메모리 에이전트들이 쓴 데이터는 범위가 좁았다. MemAgent는 HotpotQA 같은 멀티 홉 QA 데이터로 학습했고, Memory-R1은 LoCoMo의 일부를 쪼개 152개 질문-답 쌍으로 학습했다. 논문의 지적은 이렇다. "이들의 학습 데이터는 대개 전통적인 멀티 홉 QA나 벤치마크 전용 분할에서 왔고, 현실의 긴 기록 기억 시나리오를 충분히 다루지 못한다."
실제 기억 사용은 훨씬 다양하다. 석 달 전 대화에서 고양이 이름 하나를 찾는 일, 두 회의록을 이어 '왜 일정이 밀렸는지' 설명하는 일, 열 번의 상담 기록을 모아 '고객의 불만이 어떻게 변해 왔는지' 정리하는 일은 서로 다른 기술이다. 그래서 저자들은 Memory-Gym이라는 데이터 합성 파이프라인을 만들었다. 기억 에이전트를 위한 체육관이다.
그림 2 (a)의 왼쪽 위가 과제 분류다. 세 계열이 각각 세 종목씩, 모두 아홉 가지다.
단일 홉(위치 찾기) — 답은 세션 하나에 있다. 어려운 건 비슷한 세션 수십 개 중에서 그 하나를 찾는 것이다. 속성 추출, 개념 설명, 조건 찾기.
멀티 홉(근거 잇기) — 어느 세션 하나로도 답이 안 나온다. 인물·조건·사건·시간 관계를 세션 사이로 이어야 한다. 비교, 출처 추적, 교집합 선택.
멀티 세션 요약(모아서 정리) — 여러 세션에 흩어진 관찰을 모아 하나의 구조화된 답으로 묶는다. 상태 변화, 집합 나열, 종합 요약.
종목마다 문제를 만드는 규칙이 꽤 정교하다. 예를 들어 출처 추적은 두 세션 이상에 등장하는 인물을 고른 뒤, 한 세션에서는 이름 없이 묘사만 하는 대목("붉은 외투의 늙은 선장")을, 다른 세션에서는 그 인물과 관련된 사건을 가져와 질문을 만든다. 질문에서 이름은 철저히 지운다. 에이전트는 먼저 '이 묘사가 누구인지' 알아내고, 그다음 '그 사람이 무엇을 했는지' 찾아야 한다. 교집합 선택은 더 짓궂다. 조건 하나하나는 여러 대상에 들어맞도록 모호하게 만들고, 조건 셋을 겹쳤을 때만 대상이 하나로 좁혀지는지 판정 모델이 따로 확인한다.
6.3 여섯 도메인
과제를 여섯 종류의 기록 위에서 만든다. 부록 A.1의 구성은 이렇다.
도메인
원천
기억 말뭉치 만드는 법
웹
Wikipedia, FineWeb
위키 문서 5~8개를 이어 붙인 세션 30~50개 (방해 문서가 많은 사실 찾기용). FineWeb은 3만~15만 토큰 문서를 Memorizer로 세션화
책
BookSum, NovelQA
2만~50만 토큰 소설 전문을 Memorizer가 세션으로 나눔 (줄거리 순서 유지)
대화
UltraChat, LoCoMo식 생성
5턴 이상 대화 25~50개 묶음, 또는 LoCoMo 공식 스크립트로 새로 생성한 15턴 이상 세션 30개 이상
뉴스
MultiNews
1천 토큰 이상 기사를 BGE-M3로 군집화, 같은 군집 기사 30~35개 (같은 사건의 다른 보도 = 현실적인 방해물)
학술
Qasper
논문의 절 하나가 세션 하나 (10개 절 이상인 논문만)
문서
Gov-report
정부 보고서 목차 트리를 재귀적으로 펼쳐 노드 하나가 세션 하나 (28개 이상)
LoCoMo가 원천에 들어 있으니 '시험 문제 유출' 아닌가 싶을 수 있다. 저자들은 공개된 LoCoMo 평가 대화·질문·답·근거는 하나도 쓰지 않고, 공식 생성 스크립트로 새 대화를 만들어 썼다고 밝힌다. 사용자·대화·세션·질문 어느 층위에서도 평가셋과 겹치지 않는다는 것이다.
6.4 문제 공장 4단계와 품질 관리
그림 2 (b)가 문제를 찍어 내는 공정이다.
① 앵커 찾기
세션에서 인물·사건·개념·조건·변하는 상태 같은 '의미의 닻'을 여러 개 뽑고, 모호하거나 근거가 약한 닻을 버린다.
② 근거 확장
과제 계열에 따라 넓힌다. 단일 홉은 그 세션 하나 + 말뭉치 전체에서 비슷한 답이 또 있는지 모호성 검사, 멀티 홉은 공유 개체·사건·시간으로 세션 사슬 만들기, 요약은 같은 주제의 세션 묶음 모으기.
③ 문제 만들기
모은 근거 집합 ℰ만으로 질문 q와 답 a를 만들고, 근거 세션 경로를 함께 기록한다. 하나의 훈련 문항은 (q, a, ℰ, 과제 유형) 네 쌍이다.
④ 검증·거르기
단일·멀티 홉은 정답 유일성·근거 뒷받침·답 누설 없음·과제 일치, 요약은 여기에 커버리지·완전성·원문 충실성을 더 본다.
문제 생성과 판정에는 모두 MiniMax-2.5를 쓰되 프롬프트를 따로 둬서, 같은 생성 과정이 자기가 만든 불량품을 통과시킬 위험을 줄였다. 결과는 28,276개 후보 중 16,794개 통과(59.4%)다.
자동 판정을 얼마나 믿을 수 있을까? 저자들은 사람을 세 번 투입했다(부록 A.4).
거르기 전 후보 200개를 사람 둘이 따로 판정하고 셋째가 조정했다(사람끼리 일치율 96.0%, κ=0.916). 사람 기준 합격률은 62.0%. 같은 200개를 MiniMax-2.5가 판정하니 사람과 91.5% 일치(κ=0.823)했고, GPT-5.5(92.0%)와 Qwen3.5-122B(90.5%)도 비슷했다. 세 모델 모두 사람보다 조금 덜 합격시키는, 약간 보수적인 판정관이었다.
통과한 문항 200개를 사람이 다시 보니 190개가 모든 기준을 통과했다. 95.0%(95% 신뢰구간 91.0~97.3%). 기준별로는 답 누설 없음 99.5%, 근거 뒷받침 98.0%, 완전성 95.5%였다.
탈락한 후보 100개를 다시 보니 96개는 버려질 만했고(근거 불충분 33, 모호함 22, 답 누설·구성 오류 16, 과제 불일치 14, 커버리지 미달 11), 4개는 멀쩡한데 버려졌다.
합성 데이터 논문에서 사람 감사를 이 정도로 세분해 보고하는 경우는 드물다. 데이터가 이 논문의 진짜 기여 중 하나라는 뜻이다.
아래 위젯에서 아홉 종목의 생김새와 문제 공장, 그리고 "무엇으로 가르쳤나"에 따른 성능 차이(표 2)를 직접 볼 수 있다.
6.5 교재가 정말 중요했나 — 표 2
표 2는 Memory-Gym의 가치를 정면으로 확인하는 실험이다. 같은 JAM 틀, 같은 Qwen3.5-4B에 학습 데이터만 바꿔 SFT를 했다.
학습 데이터
LoCoMo
LongMemEval
NarrativeQA
HotpotQA
학습 없음
48.59
48.80
34.98
45.44
MemAgent 데이터
48.60
55.20
31.98
54.53
Memory-R1 데이터
48.90
57.20
32.42
49.81
단일 홉만
50.59
58.80
34.40
50.45
멀티 홉만
48.97
57.60
37.42
51.96
요약만
49.43
59.80
40.94
50.86
Memory-Gym 전체
50.70
60.20
41.59
52.08
세 가지가 보인다. 첫째, 다른 연구의 학습 데이터는 NarrativeQA에서 오히려 독이었다. MemAgent·Memory-R1 데이터로 가르치면 학습하지 않은 것(34.98)보다 낮아진다(31.98·32.42). 멀티 홉 QA만 배운 에이전트가 소설 전체를 모아 읽어야 하는 문제에서 길을 잃은 셈이다. 둘째, 한 계열만 가르치면 그 계열과 닮은 벤치마크에서만 강하다. LoCoMo는 단일 홉, HotpotQA는 멀티 홉, LongMemEval·NarrativeQA는 요약이 가장 좋았다. 셋째, 셋을 섞은 Memory-Gym 전체는 네 벤치마크 모두에서 어느 단일 계열보다 높았다. HotpotQA만은 MemAgent 데이터(54.53)가 더 높았는데, MemAgent 데이터가 바로 HotpotQA식 멀티 홉 문제이기 때문이다.
6.6 한 번도 본 적 없는 분야에서도 통할까 — 코드로의 전이
더 강한 시험이 있다. Memory-Gym에는 코드가 하나도 없다. 그런데 학습된 Researcher를 코드 저장소 이해 벤치마크 LongCodeQA(LongCodeBench 계열, 64K~256K 토큰)에 그대로 투입했다. 코드 예제로 학습하거나 적응시킨 적은 없다.
학습 없음
54.08%
SFT만
65.67%
SFT + 강화학습
75.54%
(233문항 전체 정확도, 막대 폭은 100% 만점 기준.) 21점 넘게 올랐고, 64K·128K·256K 세 길이 모두에서 고르게 올랐다. 256K에서는 학습 전 49.23%가 73.85%가 됐다. 소설·뉴스·대화로 배운 '찾는 습관'이 코드에도 옮겨 간다는 뜻이다. 코딩 에이전트의 장기 작업 기록을 다루는 사람들에게 특히 반가운 결과다.
7. 학습 — 모범 답안 따라 하기, 그리고 힌트를 받으며 스스로 찾기
Researcher 학습은 두 단계다(그림 1 (b)). Memorizer는 학습하지 않고 고정한다. Memorizer가 만드는 작업공간은 질문과 무관하게 재사용되므로, 고정해 두는 편이 Researcher에게 안정된 연습장이 된다는 이유다.
7.1 1단계: 검증된 궤적 SFT — 모범 답안 베끼기
먼저 큰 교사 모델(Qwen3.5-122B-A10B)에게 Memory-Gym 문제를 JAM 방식으로 풀게 해 탐색 궤적 τ를 모은다. 그리고 두 가지를 모두 만족하는 궤적만 남긴다.
최종 답이 맞았다.
탐색 과정이 좋았다. 판정 모델(Gemini 3 Flash)이 "얕게 검색 한 번 하고 찍기" 같은 지름길 행동을 걸러 낸다.
두 번째 조건이 중요하다. 답은 맞았지만 운으로 맞힌 궤적까지 베끼면 학생은 '운 좋게 찍는 법'을 배운다. 남은 궤적들로 Researcher가 각 스텝의 도구 호출 묶음을 따라 하도록 학습시킨다.
LSFT(θ)=−τ∈DSFT∑i=1∑∣τ∣logπθ(Ai∣q,hi−1)
식은 평범한 다음 토큰 예측 손실이다. "이런 질문과 이런 지금까지의 탐색 기록이 있을 때, 모범생은 이런 도구들을 불렀다"를 흉내 내게 한다. H100 8장에서 약 5시간 걸렸다.
7.2 2단계: 힌트를 주는 GRPO — 스스로 찾는 법
SFT만으로는 한계가 있다. 흉내는 교사가 간 길만 가르치고, 교사가 틀린 길에서 돌아오는 법은 가르치지 못한다. 그래서 강화학습을 붙인다. 알고리즘은 GRPO(Group Relative Policy Optimization)다. 2024년 DeepSeekMath 논문에서 제안되고 2025년 DeepSeek-R1으로 유명해진 방법이다.
GRPO의 아이디어는 단순하다. 같은 질문으로 궤적을 여러 개(JAM은 G=8) 굴린 뒤 각각 점수를 매긴다. 그리고 그룹 평균보다 잘한 궤적은 강화하고 못한 궤적은 약화한다. 가치 함수를 따로 학습하는 '비평가' 모델이 필요 없어 가볍다. 목적식은 이렇다.
Aj는 궤적 j의 보상을 그룹 안에서 정규화한 '이점', ρj는 새 정책과 옛 정책의 확률 비, clip은 한 번에 너무 크게 바뀌지 않게 막는 안전장치, 마지막 KL 항은 원래 모델에서 너무 멀어지지 않게 하는 끈이다. 설정은 학습률 1e-6, β=0.001, ϵ=0.2, 200스텝, H100 8장에서 약 6시간이다.
JAM에서 눈여겨볼 것은 두 가지 설계 선택이다.
① 보상은 '정답'이 아니라 '출처 재현율'이다. 궤적 τ가 모은(또는 인용한) 근거 세션 집합을 Eτ, Memory-Gym이 기록해 둔 정답 근거 세션 집합을 Eq∗라 하면 보상은 이렇다.
R(τ)=∣Eq∗∣∣Eτ∩Eq∗∣
정답 근거 세 개 중 두 개를 찾았으면 0.67점이다. 왜 답이 맞았는지가 아니라 근거를 찾았는지로 채점할까? 이 단계의 목적이 "교사 궤적을 흉내 내는 것을 넘어, 과제에 필요한 정보를 찾아내는 능력을 키우는 것"이기 때문이다. Researcher의 일은 맥락을 짓는 것이고, 좋은 맥락은 좋은 근거에서 나온다. Memory-Gym이 문항마다 근거 세션 경로를 기록해 둔 것이 여기서 쓰인다. 답만 있는 데이터로는 이런 보상을 줄 수 없다.
② 힌트를 준다. 문제는 보상이 드물다는 것이다. 어려운 문제에서 학습 초기 Researcher가 궤적 8개를 굴려 전부 근거를 하나도 못 찾으면, 8개의 보상이 모두 0이고 그룹 안에서 정규화한 이점도 모두 0이다. 비교할 거리가 없으니 아무것도 배우지 못한다. 그래서 JAM은 학습 중에만 Kh 스텝마다 '힌트 생성기'를 불러 궤적에 힌트 ηk를 끼워 넣는다.
s~k=sk⊕ηk,if kmodKh=0
힌트 생성기는 정답과 근거 출처, 그리고 지금까지의 궤적을 보고 "아직 안 찾은 정보", "아직 안 가 본 검색 방향", "써 볼 만한 도구" 수준의 큰 방향만 알려 준다. 정답이나 전체 탐색 경로는 알려 주지 않는다. 그리고 시험(추론) 때는 힌트를 완전히 뺀다.
운전 연수에 비유하면 이렇다. 처음 도로에 나간 사람에게 목적지만 알려 주고 "알아서 가 보세요"라고 하면 대부분 길을 잃고, 길을 잃은 경험끼리 비교해서는 배울 게 없다. 옆자리 강사가 가끔 "다음 사거리에서 오른쪽 차선을 보세요" 정도만 말해 주면, 어떤 시도는 목적지에 닿고 어떤 시도는 못 닿는다. 그 차이에서 배운다. 그리고 면허 시험 날에는 강사가 없다.
아래 장난감 시뮬레이터로 이 직관을 확인해 보자. 근거를 찾을 확률이 1%인 어려운 문제에서, 힌트 없는 학습은 80스텝 내내 바닥에 붙어 있다.
7.3 각 단계는 얼마나 기여했나
어블레이션 표 4에서 학습 단계만 떼어 보면 이렇다.
Researcher 학습
LoCoMo
LongMemEval
NarrativeQA
HotpotQA 평균
학습 없음
48.59
48.80
34.98
45.44
SFT만
50.70
60.20
41.59
52.08
SFT + GRPO (힌트 없음)
51.42
62.40
43.62
55.64
SFT + 힌트 GRPO (전체)
52.09
65.20
45.72
60.84
LongMemEval에서는 SFT만으로 12점 가까이 오른다. 기본기는 흉내로 익힌다는 뜻이다. 힌트의 효과는 HotpotQA에서 가장 크다(55.64 → 60.84). 근거가 여러 문서에 흩어져 있어 보상이 가장 드문 벤치마크다. 장난감 위젯에서 본 그림과 같은 방향이다.
비교 대상 10개: 학습 없는 기본형(Vanilla: 기록을 통째로 넣기, RAG), AOT 메모리 시스템(A-MEM, Mem0, MemoryOS, LightMem), 학습된 메모리 에이전트(MEM1-7B, MemAgent-14B, Memory-R1).
공정성 장치: JAM과 AOT 시스템은 모두 같은 Qwen3.5-4B를 쓴다. 학습형 비교 대상은 공개된 체크포인트를 쓰고, 공개되지 않은 Memory-R1은 원논문 수치를 옮겼다.
LoCoMo의 '단일 홉', '멀티 홉' 등은 LoCoMo 자체의 질문 유형 이름이다. Memory-Gym의 과제 계열과 이름은 같지만 별개다.
8.2 표 1의 세 가지 메시지
논문이 직접 강조하는 메시지는 셋이다.
① 이질적인 환경에서 고르게 강하다. AOT 메모리 시스템은 대화 중심인 LoCoMo에서는 그럭저럭 버티지만 장문·멀티 홉에서는 무너진다. A-MEM은 LoCoMo 41.17인데 HotpotQA 56k에서는 27.08이다. JAM은 네 벤치마크 모두에서 1위다(LoCoMo의 오픈 도메인 칸만 Memory-R1 원논문 수치가 더 높다).
② 훨씬 큰 학습형 에이전트보다 강하다. 4B로 7B(MEM1), 8B(Memory-R1), 14B(MemAgent)를 대부분의 칸에서 앞선다. LoCoMo 전체 52.09 대 MemAgent 46.13, NarrativeQA 45.72 대 28.24.
③ 길어져도 버틴다. HotpotQA를 56k → 224k로 늘렸을 때 Vanilla는 26.6점, MemAgent는 9.4점 떨어졌지만 JAM은 5.9점 떨어졌다.
그리고 논문이 크게 말하지 않는, 그러나 표에서 가장 놀라운 사실이 하나 있다. AOT 메모리 시스템 넷 모두가 LoCoMo 전체 점수에서 '아무것도 안 한' Vanilla(42.45)보다 낮다. Mem0 32.10, MemoryOS 31.67, LightMem 32.97, A-MEM 41.17. LoCoMo 대화는 평균 9천 토큰 남짓이라 4B 모델 컨텍스트에 통째로 들어가므로 Vanilla가 강할 수밖에 없는 조건이긴 하다. 그래도 '기억을 정리해 주는 시스템을 붙였더니 안 붙인 것보다 나빠졌다'는 결과는, 미리 가공하는 순간 잃는 것이 생각보다 크다는 경고로 읽힌다. 다만 이 시스템들은 원래 GPT-4o-mini 같은 더 큰 모델을 전제로 설계됐다는 점도 함께 기억해야 한다. 작은 모델이 추출을 하면 추출 품질 자체가 떨어진다.
8.3 F1이 52점이면 낮은 것 아닌가 — LLM 판정 (표 11)
F1은 정답과 예측의 단어가 얼마나 겹치는지를 잰다. "Damon Pennington"을 "데이먼 페닝턴이라는 전직 탈옥수"라고 답하면 맞는 답이어도 F1은 낮다. 그래서 저자들은 GPT-4o-mini(temperature 0)에게 정답과 예측을 주고 맞다/틀리다만 판정하게 하는 평가를 추가했다.
방법
LoCoMo
NarrativeQA
HotpotQA
RAG
58.25
48.00
53.13
A-MEM
54.74
45.00
35.68
Mem0
46.23
43.00
38.02
MemAgent
66.62
38.00
58.59
JAM
79.16
68.00
69.79
판정 방식으로 바꾸자 JAM은 LoCoMo에서 79%를 맞혔고, 2위와의 격차는 오히려 커졌다(LoCoMo +12.54, NarrativeQA +20.00, HotpotQA +11.20%p). F1 52는 '절반만 맞힌다'는 뜻이 아니라 '표현이 정답과 다른 경우가 많다'는 뜻에 가깝다. 같은 체크포인트로 난수 시드만 바꿔 세 번 돌렸을 때 표준편차는 0.31~1.34점으로 안정적이었다(부록 표 10).
8.4 직접 만져 보기
표 1·4·9·11과 그림 3·4·5의 숫자를 아래 위젯에 모두 넣었다. 탭을 바꿔 가며 보자.
8.5 무엇을 빼면 무너지나 — 어블레이션
어블레이션 표 4의 나머지 행은 구성 요소의 중요도를 보여 준다. Researcher를 빼면(반복 탐색 없이 한 번에 꺼내 답하기) HotpotQA 평균이 60.84에서 39.10으로 21.7점 떨어진다. 가장 큰 낙폭이다. JIT의 핵심은 '원본 보존'보다 '질문에 맞춰 여러 번 찾기'에 있다는 뜻이다. Memorizer를 빼면(원본만 평평하게) LoCoMo가 52.09 → 49.06, NarrativeQA가 45.72 → 38.87로 떨어지지만, 이상하게도 LongMemEval은 64.00으로 거의 그대로다. 4.2절에서 봤듯 지도는 정확도보다 찾는 속도에 더 기여한다. BM25를 빼면 LoCoMo가 45.90으로 6점 넘게 떨어지고, 임베딩을 빼면 NarrativeQA가 39.45로 떨어진다. 키워드와 의미 검색은 서로 대신할 수 없다.
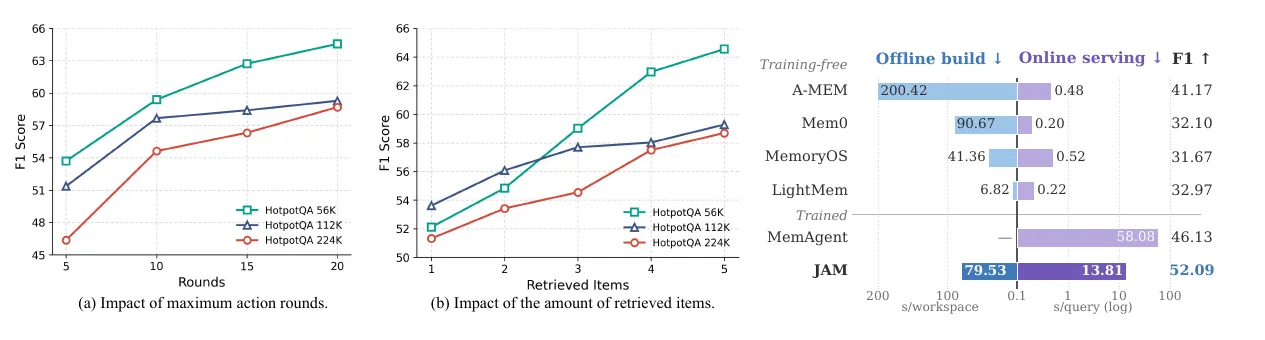
그림 4(오른쪽)가 이 논문의 가장 정직한 그림이다. AOT 시스템은 질문당 0.2~0.5초면 답한다. JAM은 13.81초다. 수십 배 느리다. 대신 F1이 31~41에서 52로 오른다. 같은 '찾아다니는' 계열인 MemAgent(58.08초, 46.13)와 비교하면 76% 빠르면서 더 정확하다. 오프라인 구축은 JAM이 79.53초로 A-MEM(200.42초)·Mem0(90.67초)보다 빠르고 LightMem(6.82초)보다 느리다.
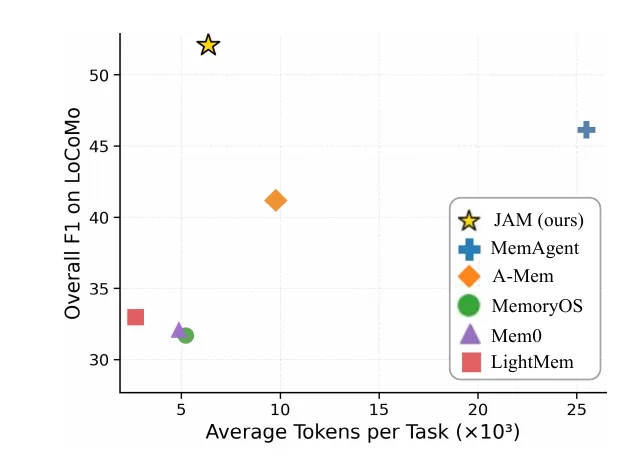
토큰으로 재도 그림은 같다. 오프라인 구축 비용을 질문 수로 나눠 더한 '과제당 평균 토큰'(부록 그림 5)에서 JAM은 약 6천 토큰대로, MemAgent(약 2만 5천)의 4분의 1 수준이면서 F1은 가장 높다. 가벼운 AOT 시스템들은 토큰이 더 적지만 F1이 30점대다.
그림 3(왼쪽)은 최대 라운드를 5에서 20으로, 검색 항목 수를 1에서 5로 늘릴수록 성능이 오른다는 '테스트 시점 확장(test-time scaling)'을 보여 준다. 그러면 질문마다 20라운드씩 쓰는 걸까? 부록 표 9가 답한다.
벤치마크
5라운드 안에 멈춤
평균
중앙값
상위 10%
예산 소진
LoCoMo
95.58%
3.16
3
4
0.00%
LongMemEval
82.80%
3.82
3
6
0.40%
NarrativeQA
84.00%
3.92
3
8
0.00%
HotpotQA
43.83%
7.11
6
14
4.70%
대부분의 질문은 3라운드에 끝난다. 근거가 흩어진 HotpotQA만 평균 7라운드를 쓰고, 상위 10%는 14라운드까지 간다. 20라운드를 다 쓰는 질문은 5% 미만이다. 쉬운 질문엔 짧게, 어려운 질문엔 길게 쓴다. 고정 비용이 아니라 상한이고, 이것이 사람이 일하는 방식과 닮은 JIT의 장점이다.
9. 비판적으로 읽기 — 아직 남은 질문들
좋은 논문이지만 그대로 믿고 가져다 쓰기 전에 짚어 둘 것이 여럿 있다.
9.1 13.81초는 누구에게나 괜찮은 시간이 아니다
JAM의 질문당 응답 시간(13.81초)은 AOT 시스템(0.20~0.52초)의 약 27~69배다. 백오피스 분석이나 리서치 보조에서는 문제가 안 되지만, 음성 비서나 실시간 상담 보조처럼 1초 안에 답해야 하는 서비스에서는 쓸 수 없다. 선행 연구 GAM의 저장소에서도 같은 불만이 나왔다. 한 사용자는 이슈 게시판에 온라인 응답이 질문당 12~18초로 기본 시스템(0.2~0.5초)보다 훨씬 느리다고 적었고, LoCoMo를 재현하는 데 한 번에 약 13시간이 걸렸다는 보고도 있다. JAM은 작은 학습 모델로 이를 많이 줄였지만, '질문마다 여러 번 모델을 부른다'는 구조적 비용은 사라지지 않는다. Researcher 외에도 browse 추출 모델과 답변 생성 모델이 따로 돈다는 점도 계산에 넣어야 한다.
9.2 공개된 것과 공개되지 않은 것
초록은 "익명화된 소스 코드"를 공개한다며 GAM 저장소를 가리킨다. 이 글을 쓰는 2026년 10월 10일 기준으로 저장소의 마지막 푸시는 3월 14일이다. 폴더 계층·README·탐색 도구 같은 런타임 구조는 들어 있지만, Memory-Gym 합성 파이프라인, SFT·힌트 GRPO 학습 코드, 학습된 Researcher 체크포인트는 보이지 않는다. 허깅페이스에도 모델·데이터셋이 없다. 논문의 핵심 기여인 '학습'과 '데이터'를 아직은 재현할 수 없다는 뜻이다. 또 GAM 저장소에는 "성찰을 더 깊게 해도 F1이 오르지 않았다"는, 원논문의 주장과 어긋나는 재현 보고가 열린 이슈로 남아 있다. JAM의 수치도 독립 재현을 기다려야 한다.
9.3 비교의 공정성
AOT 시스템들은 같은 Qwen3.5-4B로 돌렸다. 공정해 보이지만, Mem0·A-MEM 등은 원래 GPT-4o-mini 같은 더 큰 모델이 사실을 뽑고 정리한다는 전제로 설계됐다. 작은 모델이 추출을 맡으면 추출 품질이 떨어지고, 그 손해가 고스란히 AOT 쪽 점수로 간다. 반대로 학습형 비교 대상(MEM1-7B, MemAgent-14B)은 자기 체크포인트를 그대로 썼다. Memory-R1은 다시 돌리지 않고 원논문 수치를 옮겼다(저자들도 표에 † 표시로 밝혔다). 결론의 방향은 믿을 만하지만 격차의 크기는 설정에 민감할 수 있다.
9.4 재현율 보상의 사각지대
보상 R=∣Eτ∩Eq∗∣/∣Eq∗∣는 정답 근거를 '몇 개 찾았나'만 본다. 관계없는 세션을 잔뜩 모아도 감점이 없다. 극단적으로는 '보이는 대로 다 줍기'가 보상을 높이는 전략이 될 수 있다. 실제로는 라운드 예산과 Finalize 단계가 이를 억제하고, 실측 라운드 수(중앙값 3)를 보면 남용하지는 않는 것 같다. 그래도 정밀도나 비용을 보상에 넣는 변형은 자연스러운 다음 실험이다. 논문 스스로도 "긍정적인 충분성 판단은 내부의 멈춤 결정일 뿐 근거를 완전히 찾았다는 보장이 아니다"라고 쓴다.
9.5 Memorizer가 지도를 잘못 그리면
Memorizer는 학습하지 않고 고정한다. Memorizer가 어떤 세션을 엉뚱한 폴더에 넣거나 README에서 중요한 내용을 빼면, Researcher는 그 길로 덜 가게 된다. 검색 도구가 있어 완전히 길을 잃지는 않지만, 지도의 품질이 탐색 효율을 좌우한다는 것은 표 8이 보여 줬다. Memorizer와 Researcher를 함께 학습시키는 실험은 논문도 하지 않았다고 밝힌다.
9.6 바뀐 사실과 오래된 사실이 함께 남는다
원본을 다 남긴다는 것은 틀린 옛 정보도 다 남는다는 뜻이다. 인테리어 예제의 "착공 8/5"와 "착공 8/12"는 둘 다 원본에 있다. AOT 메모리는 UPDATE로 옛 사실을 지울 수 있지만, JIT 메모리는 질문할 때마다 Researcher가 '어느 쪽이 최신인가'를 판단해야 한다. LongMemEval의 '지식 갱신' 능력이 이를 재는데, 논문은 LongMemEval 전체 정확도(65.20)만 보고하고 능력별 점수는 내놓지 않았다.
가장 큰 숙제는 기술 밖에 있다. AOT 메모리는 "무엇을 기억할지"를 결정하는 시스템이었다. JIT 메모리는 "얼마나 오래, 무엇을 원본으로 보관할지"를 결정해야 하는 시스템이다. 고객 상담 기록, 업무 대화, 도구 호출 결과에는 개인정보와 문서, 때로는 인증 정보까지 섞여 있다.
삭제 요청이 오면 원본 파일만 지우면 끝이 아니다. 그 세션에서 만든 메모, 그 메모로 만든 폴더 README, 그 README를 참조해 만든 과거 맥락까지 따라가야 한다. 한국 개인정보보호법의 파기 의무, 유럽 GDPR의 저장 제한·최소화 원칙은 '전부 남긴다'는 설계와 정면으로 부딪친다. 보존 기간과 입고 필터를 설계 단계에서 정해야 한다.
보안 측면에서는 원본에 섞여 들어온 악성 지시문(프롬프트 인젝션)도 그대로 보존된다는 뜻이다. 요약 과정에서 우연히 걸러질 수 있었던 공격 문구가, JIT 구조에서는 Researcher가 browse할 때마다 다시 모델의 눈앞에 나타난다. 외부 콘텐츠·개인 데이터·외부 통신이 한 에이전트에 모이는 위험은 치명적 삼박자 글에서 다뤘다.
JAM 논문과 JitMem 논문 모두 이 문제를 다루지 않는다. 연구는 '원본을 지키면 더 정확하다'를 보였고, 이제 제품은 '원본을 지키면서 어떻게 책임질 것인가'를 풀어야 한다.
9.8 QA 밖의 기억
네 벤치마크는 모두 '질문에 답하기'다. 그러나 에이전트의 기억에는 사실만 있는 게 아니라 경험("지난번엔 이 API가 타임아웃 났지")과 절차("배포 전엔 이 순서로 확인한다")도 있다. 같은 시기 나온 연구들이 이 빈칸을 보여 준다. JitMem은 과거 작업 궤적을 원본 그대로 두고 새 과제가 올 때 맞춤 요약을 만드는 방식으로 ALFWorld·WebShop·τ²-bench에서 가장 강한 비교 대상보다 성공률을 각각 16.2·16.3·3.9%p 올렸다. 반면 Adobe·브라운대의 Designer-RSI(arXiv:2609.22086)는 반대 방향, 즉 미리 다듬어 검증한 절차 문서(SKILL.md)로 디자인 에이전트의 성공률을 크게 올렸다. 반복되는 절차는 AOT가, 질문마다 쓸모가 달라지는 사실·경험은 JIT가 유리하다는 그림이 그려진다.
10. 2026년 지도 — 무엇과 어떻게 다른가
10.1 일곱 가지 기억 설계 한눈에
설계
언제 가공하나
원본
질문에 맞추나
강점
약점
통째로 넣기 (롱컨텍스트)
안 함
전부 프롬프트에
모델이 알아서
가장 단순, 짧을 땐 손실 없음
길어지면 무너짐, 매번 전체 비용
AOT 추출·요약 (Mem0, LightMem, 제품 '기억' 기능)
기록 들어올 때
안 씀
아니오
0.2~0.5초, 수정·삭제 쉬움
버린 디테일 복구 불가
그래프·시간 메모리 (Zep/Graphiti, A-MEM)
기록 들어올 때
일부 연결
아니오
관계·시점 추론
구축 비용, 추출 손실
슬립타임 컴퓨트 (Letta)
쉬는 시간에 미리
남김
예상 질문에 맞춤
질문 시점 계산 약 5배 절감
질문 예측이 빗나가면 효과 감소
파일 시스템 에이전트 (Claude Code, Manus)
지도만 미리 (CLAUDE.md 등)
전부
예
범용 도구로 바로 구현
탐색 습관이 학습되지 않음
JitMem
읽을 때 (궤적 3개를 맞춤 요약)
성공 궤적 전부
예
경험 재사용, 과제 성공으로 바로 학습
1회 BM25 검색 의존
JAM
지도만 미리 + 읽을 때 탐색
전부
예 (여러 라운드)
긴 기록·흩어진 근거·출처 제시
질문당 수 초~수십 초, 보관 책임
슬립타임 컴퓨트는 특히 흥미로운 대조군이다. Letta 연구진의 2025년 4월 논문(arXiv:2504.13171)은 사용자가 질문하기 전, 에이전트가 쉬는 시간에 맥락을 미리 곱씹어 두면 질문 시점 계산을 약 5배 줄이면서 같은 정확도를 낸다고 보고했다. 전형적인 AOT 전략이다. 그런데 그 논문 스스로 찾아낸 조건이 있다. 이득은 사용자 질문이 얼마나 예측 가능한지에 비례한다. 예측할 수 있으면 미리 하고, 예측할 수 없으면 그때 한다. AOT와 JIT의 경계가 정확히 여기다.
JAM 같은 JIT 메모리가 빛나는 곳은 네 조건이 겹치는 곳이다. 기록이 길고 계속 자란다, 무엇을 물을지 예측할 수 없다, 정확한 수치와 출처가 필요하다, 몇 초쯤은 기다릴 수 있다.
계약·법무 이력 — 300건의 협상 메일과 회의록에서 "배상 한도 조항이 언제, 누구 요청으로, 어떻게 바뀌었나"를 묻는다. 상태 변화 추적이고 출처가 생명이다. JIT에 딱 맞는다.
코딩 에이전트의 장기 작업 기록 — "지난달 이 테스트가 불안정하다고 결론 낸 근거가 뭐였지?" 코드 전이 실험(LongCodeQA 54.08% → 75.54%)이 직접 근거다.
연구실 실험 노트 — 2년치 실험 기록에서 "온도 조건을 바꾼 뒤 수율이 떨어졌던 실험을 전부" 찾는 집합 나열 질문.
프로젝트 관리 비서 — 프롤로그의 인테리어 사례처럼 회의록·통화 기록이 쌓이는 모든 프로젝트.
고객 상담 이력 분석(사후) — "이 고객이 지난 1년간 환불을 왜, 몇 번 요청했나"를 상담 후 분석할 때.
반대로 맞지 않는 곳도 분명하다.
실시간 음성 비서·상담 보조 — 1초 안에 답해야 한다. 고객 프로필과 최근 이력 요약은 AOT로 미리 만들어 두고, 상담이 끝난 뒤 깊은 분석만 JIT로 돌리는 하이브리드가 현실적이다.
단순 선호 기억 — "저는 채식주의자예요"는 미리 사실로 뽑아 두는 게 맞다. 매번 원본을 뒤질 이유가 없다.
삭제 요구가 강한 민감 데이터인데 보관 정책이 없는 경우 — 기술보다 거버넌스를 먼저 설계해야 한다.
국내에서도 메신저·검색·업무 도구 안에서 사용자 맥락을 기억하는 AI 서비스가 늘고 있다. 그럴수록 질문은 "얼마나 많이 기억하나"에서 "무엇을 언제 가공하고, 원본은 얼마나 보관하나"로 옮겨 갈 것이다.
아래 선택기에 내 서비스의 조건을 넣어 보자. 대부분의 현실 조건에서 1순위는 순수 JIT가 아니라 하이브리드나 다른 설계로 나온다는 점도 눈여겨보자.
11. 실무 체크리스트 — 내일 적용한다면
JAM의 학습 코드는 아직 공개되지 않았지만, 설계 원칙은 지금 바로 가져다 쓸 수 있다.
저장
원본은 지우지 말고 경로로 남긴다. 요약은 원본을 대체하는 게 아니라 원본으로 가는 안내판이다(Manus의 '복원 가능한 압축').
폴더 + README 색인을 작은 모델로 만든다. 표 12처럼 큰 모델이 꼭 필요하지 않다. 새 기록은 증분으로 붙인다.
보존 기간과 삭제 전파 경로를 먼저 정한다. 원본 → 메모 → README → 캐시된 맥락까지.
검색
BM25와 임베딩을 함께 쓴다. 둘 중 하나를 빼면 성능이 떨어진다(표 4).
"폴더 열기(README 보기)" 도구를 따로 준다. 사례 연구에서 단서를 잡은 건 검색이 아니라 README였다.
파일 전체를 붓지 말고 '질의 관련 부분만 추출하는' 읽기 도구를 둔다. 탐색이 길어져도 컨텍스트가 깨끗하다.
탐색
한 라운드에 여러 도구를 병렬로 부르게 한다(최대 5개).
라운드 상한은 넉넉히, 멈춤은 충분성 판단으로. 중앙값은 3이고 상한은 여유다.
답에 출처 경로를 강제한다. 검증 가능성과 디버깅의 출발점이다.
운영
빠른 계층부터. 자주 묻는 프로필·선호는 AOT로 즉답하고, 모르거나 확신이 낮을 때만 JIT로 내려간다.
평가는 F1 하나로 하지 않는다. LLM 판정, 출처 재현율, 지연, 토큰을 함께 본다.
원본에서 읽어 온 텍스트는 지시가 아니라 데이터로 다룬다. 저장된 인젝션 방어.
뼈대만 보면 이렇게 단순하다.
python
defjit_memory(question, workspace, max_rounds=20):
"""JAM식 런타임 기억 구성의 뼈대 (설명용 의사 코드)"""
trajectory = [("overview", workspace.root_readme())]
for _ inrange(max_rounds):
# 생각: 무엇이 부족한가, 어떤 도구를 부를까 (최대 5개 병렬)
calls = researcher.plan(question, trajectory)
# 탐색: open(path) / search(query) / browse(path, query)
observations = [workspace.execute(c) for c in calls]
trajectory.append((calls, observations))
# 성찰: 근거가 충분한가?if researcher.is_sufficient(question, trajectory):
break# 최종 맥락: 질문 관련 정보 + 출처 경로 (예산을 다 써도 최선의 정리)return researcher.finalize(question, trajectory)
맺으며 — 기억은 명사가 아니라 동사
프롤로그의 비서로 돌아가 보자. 첫 번째 비서는 석 달 전에 "가격 협의함"이라고 적어 두었다. 그때로서는 합리적인 요약이었다. 실패의 원인은 요약 실력이 아니라 요약한 시점이었다. 석 달 뒤의 질문을 모르는 채로 무엇이 중요한지 정해야 했기 때문이다. 두 번째 비서는 아무것도 요약하지 않았다. 서랍에 원본을 넣고 서랍마다 이름표를 붙여 두었을 뿐이다. 그리고 질문이 왔을 때 서랍을 열었다.
JAM이 말하는 것은 결국 이것이다. 기억은 창고에 쌓아 둔 완성품(명사)이 아니라, 질문이 올 때마다 원본에서 새로 짓는 일(동사)이다. 토요타가 80여 년 전에 공장에서, JIT 컴파일러가 25년 전에 프로그램 실행에서 배운 것을 이제 AI의 기억이 배우고 있다.
필요한 것을 제때 만들되, 너무 많이 만들지 마라. — 도요다 기이치로, 1938
다만 안드로이드의 교훈도 함께 기억하자. 이긴 것은 순수 JIT가 아니라, 무엇을 미리 하고 무엇을 미룰지 나눈 하이브리드였다. JAM의 Memorizer가 미리 그리는 README 한 장이 바로 그 '나눔'이다. 2026년 기억 설계의 질문은 "AOT냐 JIT냐"가 아니라 "어디까지 미리 하고, 어디부터 그때 할 것인가"다.