[특집] 기억에도 종류가 있다 — MemoType이 바꾼 질문: 'AI는 무엇을 기억하나'에서 '어떤 기억을, 어떻게 찾나'로
"지난달 조지랑 태산 다녀왔어"라고 말해 둔 AI에게 4주 뒤 "조지는 어디 갔었지?"라고 물으면 왜 엉뚱한 답이 돌아올까. 2026년 10월 8일 arXiv에 올라온 NeurIPS 2026 채택 논문 「Memory Type Varies」는 원인을 '모든 기억을 같은 방식으로 찾기 때문'이라고 진단한다. 1972년 심리학자 엔델 털빙이 나눈 일화 기억과 의미 기억을 대화 AI에 맞게 세 갈래(에피소드·개인 의미·일반 의미)로 다시 나누고, 6,000개 대화에 라벨을 단 TriMEM 데이터셋으로 1.7B 라우터를 학습시켜, 기억의 종류마다 다른 검색법을 쓰는 MemoType을 만들었다. 단일 검색 전략에는 넘을 수 없는 천장이 있다는 정리, 기억 구축 비용을 최대 248분의 1로 줄인 비용표까지 — 논문의 그림과 표를 하나씩 읽고, 털빙에서 ChatGPT·Claude·Gemini의 2026년 메모리까지 이어지는 계보와 함께 인터랙티브 다섯 개로 풀어 본다.
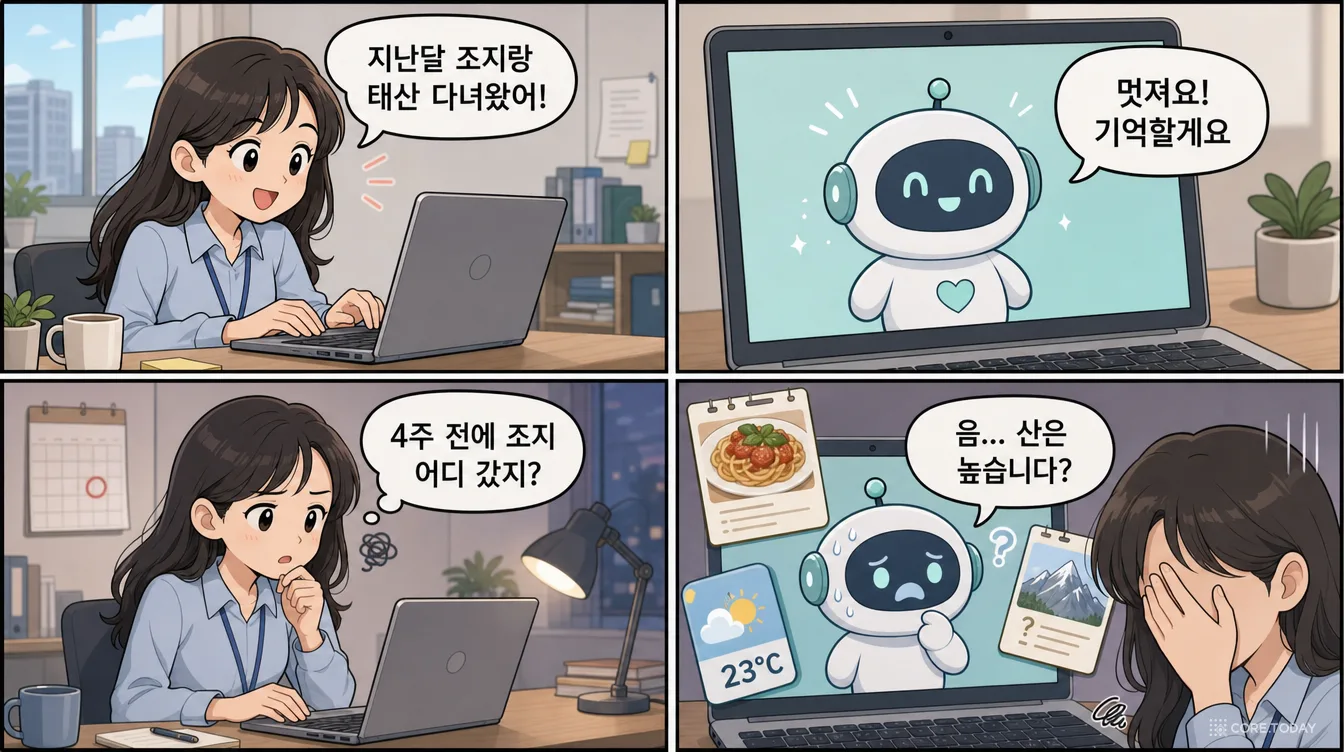
9월 초, 민지는 AI 비서에게 무심코 이렇게 말한다. "지난달에 조지랑 태산 올라갔다 왔어." 비서는 친절하게 답한다. "멋져요! 기억해 둘게요." 그리고 4주가 지난 어느 날, 민지가 묻는다. "4주 전에 조지는 어디 갔었지?"
비서는 기억 저장소를 뒤진다. 수천 개의 대화 조각 중에서 '조지'와 '가다'가 들어간 문장을 찾는다. 그러다 가장 그럴듯해 보이는 것을 집어 든다. "조지는 이번 주말에 제주도로 출장 간대요" — 일주일 전에 들은 말이다. 혹은 그날 태산에 대해 나눈 상식 대화를 집어 들고 "태산은 해발 1,545m입니다"라고 답한다. 질문과 단어는 잘 겹치지만, 민지가 원한 답은 아니다.
이 장면은 과장이 아니다. 장기 기억 벤치마크 LongMemEval(Wu 외, ICLR 2025)을 만든 연구진은 상용 대화 어시스턴트들이 긴 대화 이력을 거치면 정답률이 약 30% 떨어진다고 보고했다. 특히 무너지는 곳이 시간이 얽힌 질문("지난달에", "4주 전에")과 여러 세션에 흩어진 정보를 이어야 하는 질문이었다.
2026년 10월 8일 arXiv에 올라온 논문 한 편이 이 문제를 새로운 각도에서 본다. 홍콩시립대학교와 화웨이 노아의 방주 연구소(Huawei Noah's Ark Lab)가 함께 쓴 「Memory Type Varies: Empowering LLM Agents for Long-Term Memory with Diverse Strategies」(arXiv:2610.11573, NeurIPS 2026 채택)다. 제목 그대로 "기억은 종류가 다르다"는 것이 주장이다.
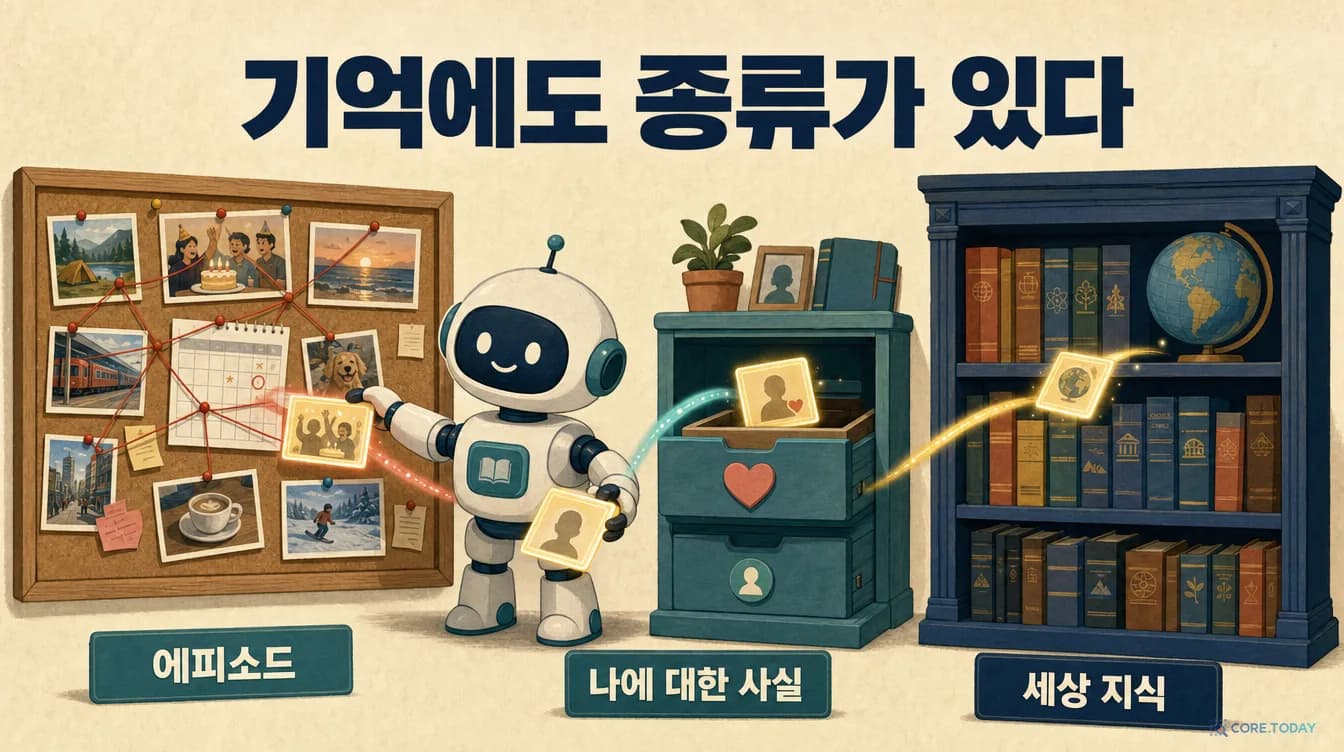
논문의 진단은 한 문장으로 요약된다. 지금까지의 AI 메모리는 모든 기억을 같은 방식으로 찾았다. 사건에 대한 기억("조지랑 태산에 갔다"), 나에 대한 사실("나는 수학을 전공했다"), 세상 지식("물은 100도에서 끓는다")은 생김새가 전혀 다른데도, 하나의 임베딩 모델로 똑같이 벡터를 만들고 똑같이 코사인 유사도로 순위를 매겼다. 저자들은 이것을 "같은 그물로 모든 물고기를 잡으려는 것"이라고 보고, 기억을 먼저 종류별로 분류한 다음 종류마다 다른 검색법을 쓰는 프레임워크 MemoType을 내놓았다.
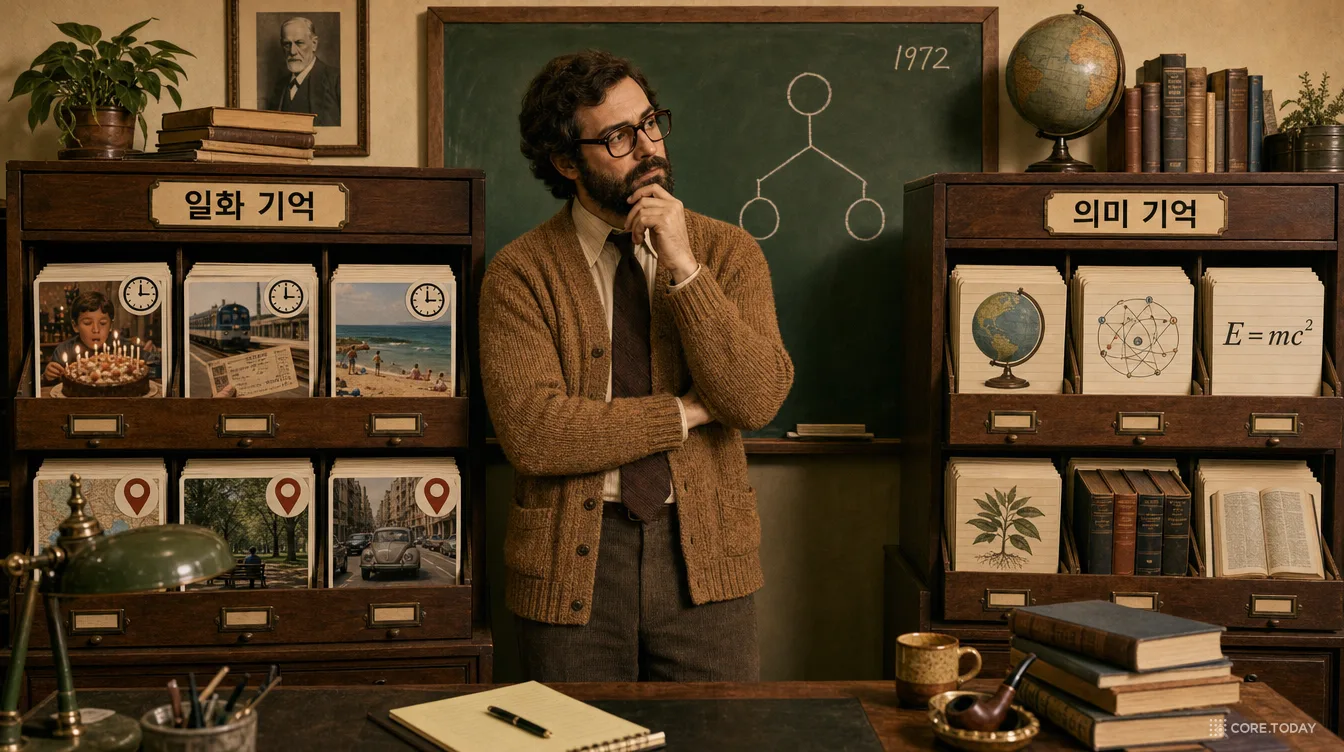
이 생각은 새롭지 않다. 오히려 아주 오래됐다. 1972년 캐나다의 심리학자 엔델 털빙(Endel Tulving)이 인간의 기억을 "일화 기억(episodic)"과 "의미 기억(semantic)"으로 나눈 이래, 심리학은 50년 넘게 기억에 종류가 있다고 말해 왔다. 새로운 것은 그 구분을 검색 전략의 차이로 번역하고, 그 번역이 실제로 성능과 비용에서 이득이 된다는 것을 숫자로 보인 점이다.
그리고 타이밍이 절묘하다. 2026년 6월 OpenAI는 ChatGPT의 기억을 배경에서 정리하는 'Dreaming V3'를 내놓으며 "7월에 싱가포르에 갈 예정"이라는 기억이 시간이 지나면 "2026년 7월 싱가포르에 다녀왔다"로 바뀌는 예를 들었다. 8월 Anthropic은 Claude의 기억을 편집 가능한 '토픽' 단위로 바꿨다. 그리고 바로 어제(10월 9일), 구글은 'Gemini at Work 2026' 행사에서 기업용 Gemini 에이전트가 세션·의미·절차·일화 기억의 네 종류를 따로 관리한다고 발표했다. 2026년 가을, 기억의 '종류'는 연구실의 개념이 아니라 제품의 설계 언어가 됐다.
이 글은 MemoType 논문(본문 9쪽 + 부록 39쪽)을 처음부터 끝까지 읽고 풀어 쓴 특집이다. 왜 이런 생각이 나왔는지 털빙의 1972년부터 거슬러 올라가고, 논문의 그림·표·정리를 하나씩 해설하고, 2026년 지금 비슷한 설계들과 무엇이 다른지, 어디에 쓰면 좋고 어디엔 맞지 않는지까지 다룬다.
1
문제 — 하나의 검색법으로 모든 기억을 찾는다
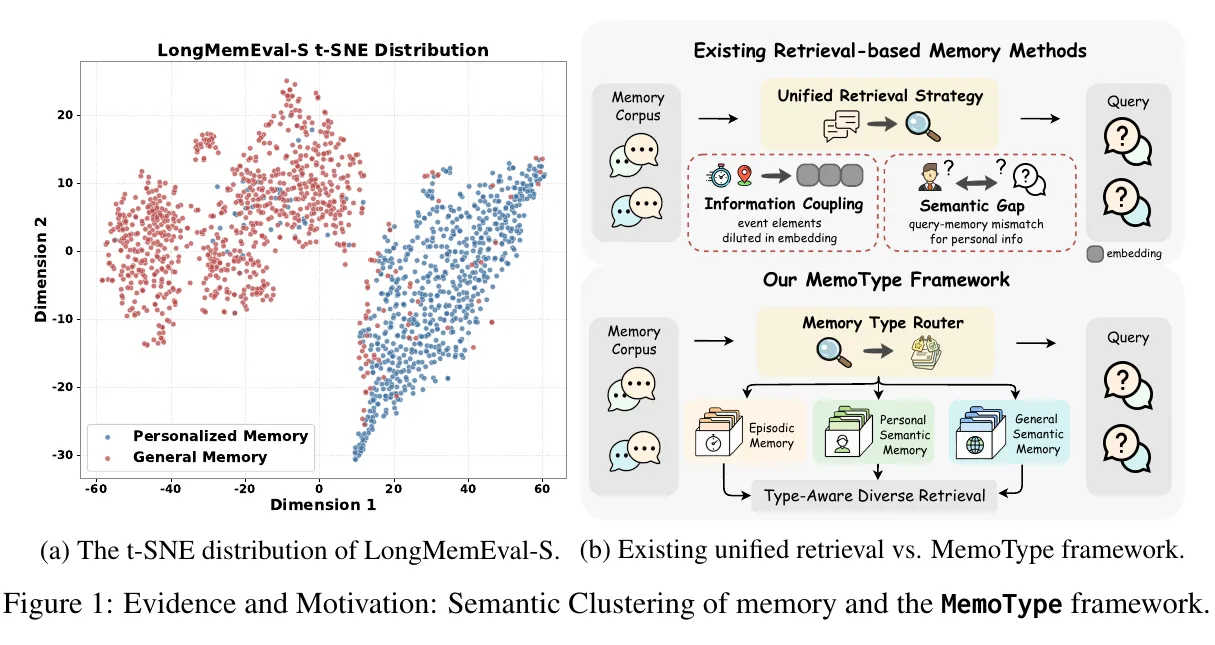
사건 기억은 시간·인물·장소가 한 벡터에 뭉개져 세부 단서를 잃고(정보 결합), 개인 정보 질문은 "내 전공이 뭐지?"처럼 너무 짧아 긴 기억과 어긋난다(의미 격차).
2
해법 — 분류하고, 종류마다 다르게 찾는다
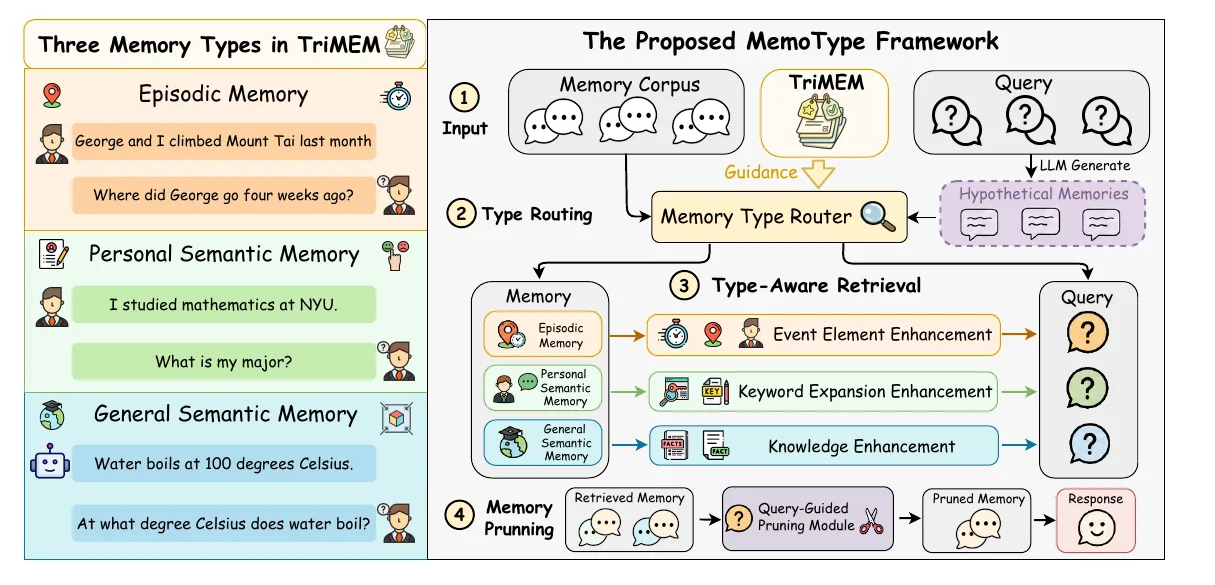
6,000개 대화에 라벨을 단 TriMEM으로 1.7B 라우터를 학습시켜 기억을 에피소드(EM)·개인 의미(PM)·일반 의미(GM)로 나눈다. EM은 시간·인물·장소·사건으로 쪼개 맞추고, PM은 기억 쪽에서 가상 질문을 만들어 두고, GM은 가상 기억(HyDE)으로 찾는다. 마지막에 질문과 무관한 기억을 쳐낸다.
3
결과 — 더 정확하고, 훨씬 싸다
네 개 벤치마크 모두에서 9개 비교 방법을 이겼다. 150만 토큰짜리 LongMemEval-M에서 Recall@1 48.09로 2위보다 16.18포인트 높다. 기억 구축 비용은 같은 데이터에서 HippoRAG2의 1/146, A-Mem의 1/248이다.
1장. 왜 '기억'이 문제가 되었나
컨텍스트 창은 기억이 아니다
대형 언어 모델(LLM)은 본래 기억이 없다. 모델이 '아는 것'은 두 종류뿐이다. 학습할 때 가중치에 새겨진 지식, 그리고 지금 이 대화에서 입력으로 받은 텍스트(컨텍스트). 어제 나눈 대화를 오늘 기억하게 하려면 어제의 대화를 오늘의 입력에 다시 넣어 주는 수밖에 없다.
컨텍스트 창은 빠르게 커졌다. 2022년 말 ChatGPT가 처음 나왔을 때 4천 토큰 남짓이던 창은 2024년 100만 토큰을 넘었고, 2026년에는 수백만 토큰을 받는 모델도 흔하다. 그렇다면 모든 대화를 그냥 다 넣으면 되지 않을까?
현실에서는 세 가지 이유로 그렇게 하지 않는다. 첫째, 비용이다. 매 질문마다 1년치 대화를 다시 읽히면 토큰 요금이 감당할 수 없게 불어난다. 둘째, 성능이다. 긴 입력의 중간에 있는 정보를 모델이 잘 활용하지 못하는 현상('lost in the middle', Liu 외 2023)은 창이 커져도 사라지지 않았다. LongMemEval-M처럼 질문 하나에 약 500세션, 150만 토큰이 따라붙으면 '다 넣기'는 사실상 불가능하다. 셋째, 누적이다. 대화는 계속 쌓인다. 창이 아무리 커도 언젠가는 넘친다.
그래서 등장한 것이 검색 증강 생성(RAG) 기반 메모리다. 지난 대화를 외부 저장소에 쌓아 두고, 질문이 오면 관련 있는 조각만 골라 컨텍스트에 넣는다. 사람으로 치면 모든 일기를 외우는 대신 일기장에서 필요한 쪽만 펼쳐 보는 방식이다. MemoType 논문도 이 틀 위에 있다. 논문의 정식화는 단순하다.
① 기억 구축
대화 이력 𝓜(세션들의 모음)에서 검색용 저장소 𝓑를 만든다. 대화 턴을 그대로 저장할 수도, 요약·노트·그래프로 바꿔 저장할 수도 있다.
② 기억 검색
질문 q가 오면 검색 함수 fR(q, 𝓑, n)이 관련 기억 턴 n개를 고른다. MemoType이 바꾸는 곳은 주로 여기다.
③ 답변 생성
고른 기억과 질문을 함께 LLM에 넣어 답 r = fG(q, {ti})를 만든다.
RAG 메모리의 두 갈래 — 비구조와 구조
2023년부터 2025년까지 RAG 메모리는 크게 두 방향으로 발전했다. MemoType 논문의 분류를 따르면 이렇다.
비구조 메모리는 대화 조각이나 요약을 그대로 쌓아 두고 유사도로 찾는다. 2023년의 MemoryBank(Zhong 외, AAAI 2024)는 사용자별 기억을 저장하고 에빙하우스의 망각 곡선을 흉내 내 오래된 기억의 가중치를 줄였다. 2025년의 SeCom(Pan 외, ICLR 2025)은 대화를 주제 단위로 잘라(segmentation) 압축·정제한 뒤 저장해 검색 품질을 높였다. 2025년 10월 기준 다운로드 1,400만 회를 넘긴 Mem0도 대화에서 사실을 뽑아 저장하는 실용적 설계로 크게 보면 이 계열이다.
구조 메모리는 기억 사이의 관계를 만든다. HippoRAG(Gutiérrez 외, NeurIPS 2024)는 인간 해마의 색인 이론에서 영감을 받아 기억에서 개체와 관계를 뽑아 지식 그래프를 만들고, 개인화 페이지랭크로 연관된 기억을 끌어올린다(HippoRAG 2는 별도 특집에서 다뤘다). A-Mem(Xu 외, NeurIPS 2025)은 제텔카스텐(메모 상자) 방식으로 기억마다 노트를 만들고 노트끼리 링크를 건다. Zep은 시간 축을 가진 지식 그래프(Graphiti)를 만든다. 구조를 만들면 연상과 추론이 좋아지지만, 저장할 때마다 LLM을 불러 개체·관계·노트를 뽑아야 하므로 비용과 지연이 커진다.
두 갈래는 무엇을 저장하느냐(원문이냐 그래프냐)에서는 갈라지지만, 한 가지는 같다. 모든 기억을 하나의 방식으로 처리한다. 비구조 메모리는 모든 기억을 같은 임베딩으로 찾고, 구조 메모리는 모든 기억을 같은 그래프로 만든다. "물은 100도에서 끓는다"도, "지난달 조지랑 태산에 갔다"도 똑같이 개체·관계 추출을 거친다. MemoType 논문은 바로 이 지점을 문제 삼는다.
사건 관련 기억에는 인물·시간·장소 같은 조각난 정보가 들어 있어 일반적인 임베딩 유사도로는 정밀하게 찾기 어렵다. 반대로 기억이 기본 개념에만 관련될 때는 시간이나 인물 같은 세부를 끌어들이면 오히려 검색에 잡음이 된다. — 논문 1장
그래서 논문은 질문 하나를 던진다. "기억을 종류별로 나누고, 종류마다 맞는 전략을 고를 수 있을까?" 이 질문에 답하려면 먼저 "기억의 종류"가 무엇인지 정해야 한다. 그리고 그 답은 컴퓨터 과학이 아니라 심리학에 있었다.
2장. 50년 전 심리학자가 먼저 나눈 서랍
털빙의 1972년 — 일화 기억과 의미 기억
1971년 3월 미국 피츠버그의 한 학회에서, 토론토 대학의 심리학자 엔델 털빙은 기억에 대한 짧은 발표를 했다. 이듬해 그 내용은 털빙과 도널드슨이 엮은 책 『기억의 조직(Organization of Memory)』(1972)에 「일화 기억과 의미 기억(Episodic and semantic memory)」이라는 장으로 실렸다. 인지심리학에서 가장 많이 인용되는 글 가운데 하나가 된 이 장에서 털빙은 기억을 두 개의 체계로 나눴다.
일화 기억(episodic memory)은 특정한 시간과 장소에서 겪은 사건의 기억이다. "지난 화요일 저녁 강남역 근처 식당에서 친구와 파스타를 먹었다." 이 기억에는 언제, 어디서, 누구와가 꼬리표처럼 붙어 있다. 의미 기억(semantic memory)은 그런 꼬리표가 떨어져 나간 지식이다. "파스타는 이탈리아 음식이다." 이 사실을 언제 어디서 배웠는지는 기억나지 않지만, 우리는 그냥 안다.
털빙은 1985년 논문 「기억과 의식」에서 이 구분을 의식의 차원으로 확장했다. 일화 기억을 떠올릴 때 우리는 그 장면으로 시간 여행을 하듯 '다시 겪는다'(그는 이것을 자기 인식적, autonoetic 의식이라 불렀다). 의미 기억을 떠올릴 때는 그냥 '안다'(noetic). "기억난다(remember)"와 "안다(know)"의 차이다.
이후 신경과학자 래리 스콰이어(Larry Squire)는 1980년대에 기억을 더 큰 지도에 배치했다. 말로 꺼내 설명할 수 있는 서술 기억(declarative)과 그렇지 않은 비서술 기억(nondeclarative). 일화 기억과 의미 기억은 서술 기억의 두 갈래이고, 자전거 타는 법 같은 절차 기억이나 점화(priming)는 비서술 기억에 속한다.
MemoType 논문은 이 지도를 그대로 가져온다. 대화로 오가는 기억은 모두 말로 표현된 것이므로 서술 기억이고, 서술 기억은 일화와 의미로 나뉜다. 그러니 이 둘이면 대화 기억 전체를 빠짐없이 덮는다는 것이 논문의 '완전성' 논증이다(부록 B.1). 절차 기억처럼 말로 표현되지 않는 것은 애초에 대화 기억의 범위 밖이다.
그런데 왜 셋인가 — '개인 의미 기억'의 발견
여기서 논문은 흥미로운 관찰을 내놓는다. 털빙의 이분법을 실제 대화 데이터에 대 보니, 사건 기억이 너무 적었다. LongMemEval-S에서 일화 기억에 해당하는 것은 12.35%뿐이고 나머지 87.64%가 의미 기억이었다. 한쪽이 90%에 가까우면 분류가 별 의미가 없다. 의미 기억이라는 큰 서랍 안을 다시 들여다봐야 했다.
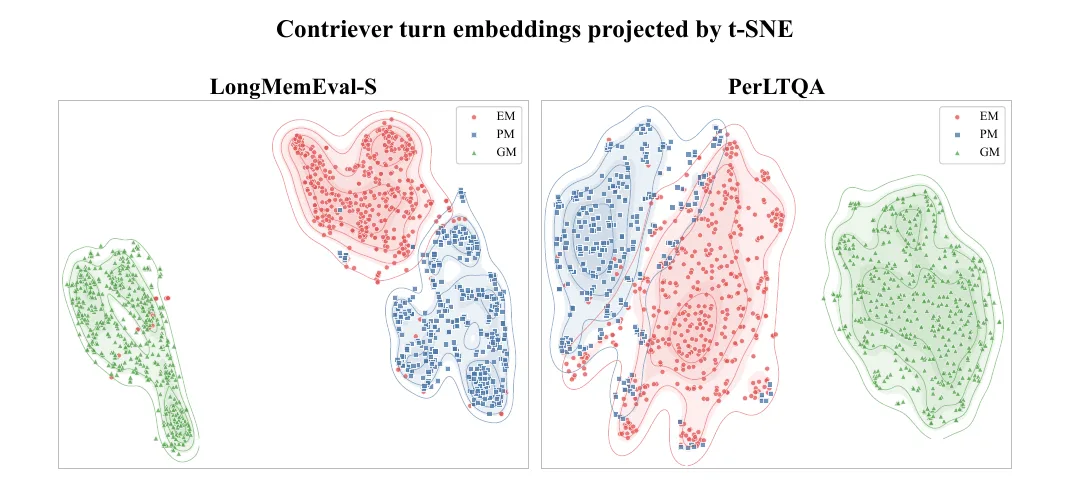
저자들이 LongMemEval의 기억들을 임베딩한 뒤 t-SNE로 2차원에 펼쳐 보자, 의미 기억 안에서 뚜렷하게 갈라진 두 덩어리가 보였다. 하나는 사용자 개인에 대한 내용, 다른 하나는 일반 지식이었다.
그림 1(a)의 파란 점은 "나는 이탈리아 음식을 좋아해", "나 요즘 이사 준비 중이야" 같은 사용자 관련 문장, 빨간 점은 "파스타 면은 듀럼밀로 만든다" 같은 어시스턴트의 지식 설명이다. 두 덩어리 사이에는 거의 겹침이 없다. 부록의 단어 구름(그림 5·6)도 같은 이야기를 한다. 개인 기억에는 "planning", "user" 같은 단어가, 일반 기억에는 "assistant", "offer" 같은 단어가 많다.
그래서 논문은 의미 기억을 둘로 나눠 세 가지 기억 유형을 정의한다.
유형
정의
하위 내용 (TriMEM 표 4)
예시
에피소드 기억 (EM)
특정 시간·장소·참여자에 묶인 사건. 과거뿐 아니라 계획된 미래 사건도 포함
일어난 사건 / 일어날 예정인 사건
"세라와 존은 시내 초밥집에서 저녁을 먹었다" · "다음 달 동료들과 노을을 보러 간다"
개인 의미 기억 (PM)
개인의 정체성·취향·습관·의도에 관한 오래 가는 지식
사용자 정보 / 취향과 습관 / 의도
"잭의 학위는 수학이다" · "파스타와 피자를 좋아한다" · "러닝화를 사려고 한다"
일반 의미 기억 (GM)
특정 개인·사건과 무관한, 누구에게나 통하는 지식
일반 지식 / 보편적 조언 / 개체의 객관적 묘사
"물은 해수면에서 100°C에 끓는다" · "일찍 일어나는 것은 건강에 좋다" · "학교 책상은 나무로 만들었다"
정보 없음
기억할 내용이 없는 발화
정보 없는 질문 / 정보 없는 문장
"신발장 정리 팁 있어?" · "좋은 아침, 피터"
재미있는 것은 이 세 번째 범주, 즉 '개인 의미 기억'이 심리학에서도 실제로 쓰이는 개념이라는 점이다. 2012년 토론토 대학의 루이 르누(Louis Renoult)와 동료들은 『인지과학 동향(Trends in Cognitive Sciences)』에 「개인 의미: 의미 기억과 일화 기억의 교차로에서」라는 논문을 냈다. "나는 서울에서 태어났다", "나는 매운 음식을 못 먹는다"처럼 나에 대한 사실은 일화 기억처럼 개인적이지만, 특정 장면을 '다시 겪는' 느낌 없이 그냥 '아는' 지식이라는 점에서 의미 기억에 가깝다. 르누 등은 이것을 두 극 사이에 놓인 별도의 기억 형태로 보자고 제안했고, 2023년 『eLife』에는 개인 의미·일반 의미·일화 기억이 뇌에서 서로 공유하는 영역과 고유한 영역을 함께 갖는다는 fMRI 연구가 실리기도 했다.
MemoType 논문이 르누를 인용하지는 않는다. 저자들은 t-SNE 그림이라는 데이터 쪽 증거에서 출발해 같은 결론에 도착했다. 심리학이 뇌를 보고 찾은 경계와 AI 연구자가 임베딩 공간에서 찾은 경계가 같은 자리에 있었다는 사실은, 이 분류가 임의적인 것이 아니라는 꽤 좋은 방증이다.
기계에게 '기억의 종류'를 주려는 50년
AI 쪽에서도 기억을 종류별로 나누려는 시도는 오래됐다. 다만 대부분은 무엇을 어디에 저장하느냐의 문제로 다뤄졌다.
시기
사건
기억을 어떻게 나눴나
1972
털빙, 「일화 기억과 의미 기억」
사건 기억 대 지식 기억 — 이후 모든 분류의 출발점
1980년대
스콰이어의 서술/비서술 기억 체계. 로저 섕크의 『역동적 기억(Dynamic Memory)』(1982)
섕크는 사람이 겪은 사건을 '스크립트'와 '사례'로 저장한다고 보고 사례 기반 추론(CBR)의 길을 열었다
2000년대
인지 아키텍처 Soar·ACT-R
Soar는 2000년대 후반 일화 기억 모듈과 의미 기억 모듈을 별도로 붙였다. 기호 AI에서 털빙의 구분이 처음 '부품'이 된 사례
2022
장기 대화 연구: 메타의 「금붕어 기억을 넘어서」(MSC), 네이버의 「Keep me updated!」(Bae 외)
여러 세션에 걸친 대화에서 사용자 정보(페르소나)를 기억·갱신. 네이버 연구는 MemoType 논문의 참고문헌에도 있다
2023
생성 에이전트(Park 외), MemoryBank, MemGPT, CoALA(Sumers 외)
CoALA는 언어 에이전트의 기억을 작업·일화·의미·절차 기억으로 나누는 설계 틀을 제시 — 이후 거의 모든 에이전트 메모리 논문이 이 어휘를 쓴다
2024
LoCoMo, LongMemEval, PerLTQA(Du 외), HippoRAG, ChatGPT 메모리 출시
PerLTQA는 의미·일화 기억을 나누고 '기억 분류' 단계를 둔 최초의 벤치마크 — MemoType의 가장 가까운 선행 연구
2025
LangMem, MIRIX(6종 기억), Mem0, A-Mem, Zep, Hindsight, Claude 메모리
MIRIX는 핵심·일화·의미·절차·자원·지식 금고의 6종을 각각 다른 에이전트가 관리. 저장·관리 단위로서의 '종류'가 표준이 된다
2026
ChatGPT Dreaming V3(6월), Claude 메모리 토픽(8월), MemoType(10월 8일), Gemini 엔터프라이즈 4종 기억(10월 9일)
MemoType은 종류를 검색 전략의 단위로 쓴다
표의 마지막 열을 보면 흐름이 보인다. 2023~2025년의 '종류'는 대체로 저장 칸이었다. MIRIX는 기억을 여섯 칸에 나눠 담고, 칸마다 담당 에이전트를 두어 갱신·관리한다. LangMem은 의미·일화·절차 기억을 다른 형식(사실 목록, 성공한 대화 예시, 시스템 프롬프트 갱신)으로 저장한다. 하지만 꺼내 올 때는 결국 비슷한 임베딩 검색을 쓰는 경우가 많았다.
MemoType이 보탠 것은 이 질문이다. "종류가 다르면, 찾는 방법도 달라야 하지 않을까?" 사건 기억을 찾을 때는 날짜와 인물을 맞춰 봐야 하고, 개인 정보를 찾을 때는 짧은 질문과 긴 기억 사이의 간극을 메워야 하고, 일반 지식은 원래 하던 대로 찾아도 대체로 잘 된다. 다음 장에서 그 이유를 하나씩 보자.
그림 1(b)의 위쪽 절반은 기존 방법이 겪는 두 가지 실패를 그린다. 이름은 어렵지만 내용은 일상적이다.
실패 ① 정보 결합 — 사건 요소가 임베딩 속에 녹아 버린다
임베딩 모델은 문장 하나를 숫자 수백 개짜리 벡터 하나로 바꾼다. "지난달에 조지랑 태산 올라갔다 왔어"라는 문장이 벡터가 되면, 그 안의 '지난달'(시간), '조지'(인물), '태산'(장소), '등산'(사건)이 하나로 섞인다. 벡터는 문장의 전체적인 분위기, 이 경우 "누군가와 산에 다녀온 이야기"를 가장 강하게 담는다.
문제는 질문이 그 분위기가 아니라 세부 하나를 묻는다는 데 있다. "4주 전에 조지는 어디 갔었지?"에서 결정적인 단서는 '4주 전'이다. 그런데 이 단서는 벡터 안에서 '어디 갔었지'라는 큰 의미에 묻힌다. 그 결과 '조지'와 '가다'가 겹치는 다른 문장("조지는 이번 주말 제주도로 출장 간대")이 더 높은 점수를 받는다. 게다가 '4주 전'과 '지난달'은 단어가 전혀 다르다. 질문 날짜와 대화 날짜를 놓고 계산해야만 둘이 같은 시기를 가리킨다는 것을 알 수 있는데, 코사인 유사도는 계산을 하지 않는다.
논문은 이것을 정보 결합(information coupling)이라 부른다. 여러 종류의 단서가 하나의 벡터에 결합되면서, 세부 단서가 지배적인 사건 의미에 가려진다.
실패 ② 의미 격차 — 질문은 짧고, 기억은 길다
두 번째 실패는 반대 방향이다. "내 전공이 뭐였지?"라는 질문은 다섯 단어다. 그 답이 들어 있는 기억은 "응, 나 대학 때 수학 전공했는데 뉴욕대 다녔어. 원래는 물리 하고 싶었는데 2학년 때 바꿨지" 같은 긴 발화다. 질문에는 '수학'도 '뉴욕대'도 없다. 질문과 기억이 공유하는 것은 '전공'이라는 단어 하나뿐이다.
이럴 때 임베딩 검색은 엉뚱하게도 "수학과 졸업생은 데이터 분석 직무로 많이 진출합니다" 같은 일반 지식 문장을 더 가깝다고 판단할 수 있다. '전공', '대학'과 관련된 단어가 더 많기 때문이다. 논문은 이것을 의미 격차(semantic gap) 또는 질문과 기억의 비대칭성이라 부른다. 개인 정보를 묻는 질문은 대개 짧고 정보가 부족한 반면, 그 답을 담은 기억은 맥락이 풍부하다.
그렇다면 일반 지식은?
세 번째 종류인 일반 의미 기억은 상대적으로 쉽다. "물은 100도에서 끓는다"는 사실은 누가 말해도 비슷한 문장으로 표현된다. 질문 "물은 몇 도에서 끓지?"와 기억 "물은 해수면 기압에서 섭씨 100도에 끓습니다"는 단어도 의미도 많이 겹친다. 기존의 임베딩 검색이 이미 꽤 잘 한다. 오히려 여기에 시간이나 인물 같은 구조를 덧씌우면 잡음이 된다. "물이 끓는다"에 '언제·누가'를 붙여 봐야 쓸모가 없다.
결국 세 종류의 기억은 서로 다른 처방을 원한다. 사건 기억에는 분해가, 개인 기억에는 간극 메우기가, 일반 기억에는 가벼운 보강이 필요하다. 하나의 전략을 고르면 어느 한쪽에서는 반드시 손해를 본다. 논문은 이 직관을 6장에서 볼 정리로 수학적으로 못 박는다.
하지만 그 전에 풀어야 할 문제가 있다. 기억을 세 종류로 나누려면, 컴퓨터가 문장 하나를 보고 어떤 종류인지 정확히 맞혀야 한다. 그리고 이게 생각보다 어렵다.
4장. TriMEM — 기억 분류 시험지를 만들다
왜 분류가 어려운가
"지난달에 조지랑 태산 올라갔다 왔어"는 누가 봐도 사건이다. 하지만 실제 대화는 그렇게 친절하지 않다. 논문은 대화 기억이 주제가 풍부하고(topic-rich), 상황이 복잡하고(scenario-complex), 경계가 흐리다(boundary-blurred)고 말한다. 몇 가지 예를 보자.
"다음 달에 동료들이랑 노을 보러 가기로 했어." 아직 일어나지 않았는데 사건인가? (TriMEM의 답: 그렇다. 계획된 사건도 EM이다.)
"러닝화 한 켤레 사려고 해." 계획이니 사건인가? (답: 아니다. 날짜가 박히지 않은 의도는 PM이다.)
"어제 엄마 생신이라 강릉에서 회 먹었는데, 엄마가 원래 회를 제일 좋아하셔." (답: 사건이면서 동시에 개인 취향이다. 둘 다.)
앞선 시도들은 이 문제를 가볍게 다뤘다. 기억 유형을 사람이 미리 정한 범주에 넣거나, LLM에게 프롬프트로 "이 문장은 어떤 기억이냐"고 묻는 식이었다. 가장 가까운 선행 연구인 PerLTQA(2024)는 처음으로 기억 분류 단계를 둔 벤치마크였지만, 논문은 세 가지 한계를 지적한다. ① 기억 하나에 라벨을 하나만 붙여 실제 대화의 다중 주제를 무시했고, ② 의미 기억에 사용자 관련 내용만 넣어 일반 지식을 빠뜨렸고, ③ 모든 대화를 일화 기억으로 취급해 대화라는 형식과 내용의 종류를 혼동했다.
어떻게 만들었나
그래서 저자들은 분류 전용 데이터셋 TriMEM을 새로 만들었다. 제작 과정은 꼼꼼하다.
① 표집
실제 대화에서 뽑는다. LongMemEval-S에서 1,000쌍(전체의 10%만 뽑아 쏠림 방지), LoCoMo 750쌍, 다양한 사용자 프로필을 가진 PersonaMem 750쌍, 그리고 기존 데이터가 다루지 못한 경계 사례를 위해 사람이 직접 쓴 500쌍. 사용자↔어시스턴트 대화와 사람↔사람 대화를 모두 담는다.
② 재작성
LongMemEval과 LoCoMo는 나중에 평가에도 쓰이므로, 라우터가 평가 문장을 외워 버리지 않게 이름·주제 표현·세부 사항을 바꿔 다시 쓴다(부록 그림 14·15의 '전환 프롬프트'). 원문과의 단어 겹침률 평균은 약 0.3, 의미 유사도(Contriever 코사인)는 평균 0.70으로, 같은 '종류'는 유지하되 같은 '문장'은 아니도록 맞췄다.
③ 자동 라벨
GPT-5.2로 초벌 라벨을 단다. 세 종류를 한 프롬프트로 묻는 것보다 종류마다 따로 묻는 프롬프트 세 개를 쓰는 편이 정확했다(부록 그림 16~18).
④ 사람 검수
자연어처리·대화 시스템 전공 박사급 검수자 3명이 전체의 20%(1,200개)를 층화 표집해 독립 검토한다. 검수자 간 일치도 플라이스 카파 0.87(거의 완벽한 일치), 전체 라벨 정확도 94.6%. 틀리거나 애매한 64개는 고치고, 23개의 경계 사례는 지침을 만들어 데이터 전체에 다시 적용했다.
완성된 TriMEM은 6,000개 샘플이다(본문은 출처별 숫자를 '대화 쌍'으로 적어 합이 3,000이 되는데, 공개된 CSV는 6,000행이다). 공개 저장소의 TriMEM.csv를 직접 세어 보면 각 행에 EM·PM·GM 세 개의 0/1 라벨이 붙어 있다. 논문이 밝힌 분포는 이렇다.
TriMEM 라벨 비율 (겹침 허용, 막대는 최댓값 49.35% 기준)
개인 의미 (PM)
49.35%
일반 의미 (GM)
33.95%
에피소드 (EM)
29.08%
정보 없음
16.25%
비율을 다 더하면 100%가 넘는다. 한 문장에 라벨이 여러 개 붙을 수 있기 때문이다. CSV를 세어 보면 6,000행 중 1,657행(27.6%)이 두 개 이상의 라벨을 갖는다. 가장 흔한 조합은 EM+PM(1,356행)이다. 에피소드 기억 1,745행 가운데 순수하게 EM만 붙은 것은 292행뿐이다. 사람이 자기 경험을 말할 때는 거의 언제나 자기 자신에 대한 정보가 함께 묻어 나온다는 뜻이다. "어제 동생 결혼식에서 축가를 불렀어"는 사건이면서 "나에게는 동생이 있다", "나는 노래를 한다"라는 개인 정보이기도 하다.
대화 유형에 따른 차이도 뚜렷하다. 일반 의미 기억의 90.48%는 사용자↔어시스턴트 대화에서 나왔다. 어시스턴트가 지식을 설명하는 역할을 하기 때문이다. 반면 에피소드(59.71%)와 개인 의미(57.72%)는 사람↔사람 대화 쪽에 조금 더 몰려 있다. 친구끼리는 사건과 근황을 나누니까.
직접 분류해 보면 이 일이 얼마나 미묘한지 감이 온다.
분류기는 얼마나 잘 맞히나
그렇다면 TriMEM으로 학습시킨 분류기는 프롬프트만 쓴 대형 모델보다 나을까? 부록 표 5가 답한다.
분류기
TriMEM 전체 정확도
전체 F1
EM 정확도
PM 정확도
GM 정확도
PerLTQA 사건(분포 밖)
Qwen3-8B (프롬프트)
71.90
55.26
81.65
71.37
62.68
46.23
Gemini-2.5-Flash (프롬프트)
77.84
72.75
82.47
76.72
74.33
91.83
Qwen3-32B (프롬프트)
77.75
72.03
87.82
80.88
64.55
87.55
GPT-4o-mini (프롬프트)
83.55
76.94
85.05
87.18
78.42
92.00
MemoType 라우터 (Qwen3-1.7B + LoRA 학습)
92.10
91.75
98.80
82.65
94.85
96.94
1.7B짜리 작은 모델이 GPT-4o-mini보다 전체 정확도에서 8.55포인트, F1에서 14.81포인트 높다. 특히 사건 기억 판별은 98.80%로 거의 완벽하다. 한 가지 눈에 띄는 예외는 개인 의미 기억 정확도(82.65%)가 GPT-4o-mini(87.18%)보다 낮다는 점이다(F1은 85.64 대 85.59로 비슷). 앞서 본 것처럼 PM은 EM과 거의 항상 붙어 다니고, 의도·취향·사실의 경계가 가장 흐린 범주다. 라우터의 약점이 어디 있는지 정직하게 보여 주는 숫자다.
오른쪽 끝 열은 TriMEM 제작에 전혀 쓰지 않은 PerLTQA에서의 성능이다. 학습 데이터에 없던 분포에서도 96~100%를 유지한다. 저자들은 이것을 라우터가 데이터셋 특유의 표현을 외운 게 아니라 '기억 종류'라는 일반적 특징을 배웠다는 증거로 든다.
더 놀라운 결과는 부록 표 10에 있다. 라우터를 Qwen3-1.7B 대신 BERT(1억 1천만 파라미터)로 바꿔도 최종 검색 성능이 크게 떨어지지 않았다. LongMemEval-S Recall@1이 59.15에서 55.74로, RoBERTa를 쓰면 58.09로 1.06포인트 차이에 그쳤고, LongMemEval-M에서는 RoBERTa(49.15)가 오히려 Qwen3-1.7B(48.09)를 앞섰다. 저자들의 결론은 이렇다. "분류를 잘하게 만든 것은 모델의 크기가 아니라 데이터의 품질이다." 실무적으로는 반가운 소식이다. 수백 MB짜리 인코더 하나로 라우팅을 할 수 있다는 뜻이니까.
5장. MemoType 해부 — 그림 2를 한 칸씩
이제 본체를 보자. 논문의 그림 2는 왼쪽에 세 종류의 기억과 그에 대응하는 질문을, 오른쪽에 전체 파이프라인을 그린다.
기억 라우터는 간단하다. 저장되는 대화 턴마다 학습된 라우터(Qwen3-1.7B + LoRA)가 EM·PM·GM 라벨을 붙인다. 다중 라벨 분류이므로 한 턴이 여러 서랍에 동시에 들어갈 수 있다.
질문 라우터가 까다롭다. 질문을 바로 분류하면 잘 안 된다. "내 전공이 뭐지?"는 기억이 아니라 질문이어서, 기억 문장으로 학습한 라우터가 보기에 생김새가 다르다. 게다가 짧다. 그래서 논문은 질문을 기억의 공간으로 옮긴다. LLM에게 "이 질문이 찾고 있을 법한 기억"을 K개 지어내게 하는 것이다.
{m~i}i=1K=GLLM(q;P),m~i∈M
"내 전공이 뭐지?"에 대해 LLM은 "나는 대학에서 경영학을 전공했다", "내 전공은 컴퓨터공학이다" 같은 가상의 기억을 만든다. 내용은 틀려도 상관없다. 중요한 건 이 가상 기억들이 개인 의미 기억처럼 생겼다는 것이다. 이제 기억 라우터가 이것들을 분류할 수 있다. K=5개의 가상 기억을 분류해 다수결로 질문의 대표 타입을 정하고, 한 표라도 받은 타입은 모두 후보 집합Cq에 넣는다.
이 아이디어의 뿌리는 2022년 12월의 HyDE(Hypothetical Document Embeddings, Gao 외, ACL 2023)다. HyDE는 "질문으로 검색하지 말고, 질문에 대한 가상의 답 문서를 만들어 그걸로 검색하라"고 제안했다. 질문과 문서의 생김새가 다르다는 문제를 '생김새를 맞춰 주는' 방식으로 우회한 것이다. MemoType은 이 기법을 검색이 아니라 분류에 썼다는 점이 새롭다.
타입 기반 필터 — 서랍을 닫는다
질문의 후보 타입이 정해지면, 그 타입에 속한 기억만 검색한다.
R(q)=Retrieve(q,c∈Cq⋃Mc)
"내 전공이 뭐지?"의 후보가 {PM, EM}이라면 일반 지식 서랍(GM)은 아예 열지 않는다. "수학과 졸업생은 데이터 분석 직무로 진출한다" 같은 함정 문장이 처음부터 경쟁에서 빠진다. 논문에 따르면 이 필터만으로 데이터셋 전반에서 무관한 기억의 약 50%가 제거된다.
효과는 부록 표 8에서 확인된다. 검색 보강 기법을 하나도 쓰지 않고 분류 필터만 켰다 껐다 했을 때다.
데이터셋
필터 없음 Recall@1
필터 있음 Recall@1
향상
LongMemEval-S
43.40
50.21
+6.81
LoCoMo
20.75
25.13
+4.38
LongMemEval-M
32.77
37.45
+4.68
PerLTQA
55.32
61.98
+6.66
검색 대상을 줄이기만 했는데 1등 적중률이 4~7포인트 오른다. 서랍을 제대로 고르는 것만으로 이미 절반은 이긴 셈이다. 한편 LongMemEval-S의 Recall@10은 필터를 켜면 94.26에서 92.34로 오히려 조금 떨어진다. 라우터가 정답이 든 서랍을 닫아 버리는 경우가 가끔 있다는 뜻이다. 후보 타입을 다수결 하나가 아니라 한 표라도 받은 타입 전부로 잡는 이유가 이 위험을 줄이기 위해서다.
사건 기억의 문제는 여러 단서가 한 벡터에 뭉개진다는 것이었다. 해법은 직관적이다. 뭉개기 전에 쪼갠다. 논문은 이것을 '분해 후 정렬(decompose-then-align)'이라 부른다. 질문과 기억을 모두 네 가지 요소로 분해한다. 시간(T), 인물(P), 장소(L), 사건 맥락(E). 그리고 통째 유사도에 요소별 유사도를 더한다.
여기서 핵심은 시간 정규화다. 부록의 사건 추출 프롬프트(그림 25·26)는 LLM에게 엄격한 규칙을 준다. "어제", "지난주", "다음 달" 같은 상대적 시간 표현은 반드시 대화 날짜를 기준으로 절대 날짜로 바꿔라. 상대 표현을 그대로 남기지 마라. 인물 칸에서는 'User'를 '나'로 바꾸고, 'Assistant'나 'AI' 같은 대화 역할은 빼고, 이름은 그대로 옮기되 지어내지 말라고 한다.
이 규칙 덕분에 9월 5일에 말한 "지난달"은 2026-08이 되고, 9월 28일에 물은 "4주 전"은 2026-08-31이 된다. 단어로는 전혀 다른 두 표현이 이제 같은 달을 가리킨다는 것을 숫자 비교로 알 수 있다. 코사인 유사도가 못 하던 계산을 저장 단계에서 미리 해 두는 셈이다.
이 전략은 비싸다. 기억마다 LLM을 불러 요소를 뽑아야 하니까. 그런데 라우터가 있기 때문에 에피소드로 분류된 기억에만 이 작업을 한다. 모든 기억을 그래프로 만드는 HippoRAG나 모든 기억을 노트로 만드는 A-Mem과의 결정적 차이다. 8장의 비용표에서 이 차이가 숫자로 드러난다.
개인 기억의 문제는 질문이 너무 짧다는 것이었다. 일반적인 해법은 질문을 부풀리는 것이다(HyDE처럼 가상 답을 만들거나, 키워드를 덧붙이거나). 그런데 논문은 여기서 이것이 잘 안 된다고 본다. "내 전공이 뭐지?"에서 출발해 가상 기억을 만들면 "나는 경영학을 전공했다"처럼 틀린 내용이 나온다. 개인 정보는 LLM이 알 수 없는 것이기 때문이다. 경영학이라는 가상 기억은 수학 전공이라는 실제 기억과 멀어질 수도 있다.
그래서 MemoType은 확장의 방향을 뒤집는다. 질문을 부풀리는 대신, 저장할 때 각 개인 기억마다 "이 기억이 답할 수 있는 질문"을 K개 미리 만들어 둔다. "나 대학에서 수학 전공했어. 뉴욕대 나왔고"라는 기억에서는 "전공이 뭐야?", "어느 학교 나왔어?", "학위가 뭐야?" 같은 질문이 나온다. 기억 쪽에 맥락이 풍부하므로, 여기서 만든 질문은 사실에 충실하고 다양하다.
sPM(q,mi)=j∈{1,…,K}maxsim(q,q~j)
검색할 때는 사용자의 질문을 이 가상 질문들과 비교해, 가장 닮은 것의 점수를 그 기억의 점수로 쓴다. 질문과 질문을 비교하니 생김새가 맞는다. 최종 순위는 이 점수 순위와 원래의 질문-기억 유사도 순위를 상호 순위 융합(RRF)으로 합친다. RRF는 여러 순위 목록에서 문서 d의 점수를 ∑1/(k+rank(d))로 더하는 단순한 방법이다(보통 k=60). 여러 검색기의 순위를 합칠 때 점수 척도를 맞출 필요가 없어 널리 쓰인다.
이 '문서 쪽에서 질문을 만들어 두는' 발상에도 족보가 있다. 2019년 노게이라(Nogueira) 등의 doc2query는 문서마다 그 문서가 답할 법한 질문을 생성해 문서에 붙여 색인했다. 공개 저장소의 README도 PM 전략을 'doc2query'라고 부른다. 한 가지 덧붙이면, 논문 그림 2는 PM 전략을 '키워드 확장 강화(Keyword Expansion Enhancement)'라고 적었고 부록에는 키워드 확장 프롬프트(그림 27)도 실려 있어 본문 설명(가상 질문)과 이름이 어긋난다. 본문 2.4절의 식 (4)와 README가 일치하므로 이 글은 가상 질문 방식으로 설명했다.
일반 의미 기억: 원래 하던 대로, 조금 더
일반 지식은 표현이 표준화돼 있어 LLM이 만든 가상 기억이 실제 기억과 아주 비슷하다. "물은 몇 도에서 끓지?"로 만든 가상 기억 "물은 1기압에서 100도에서 끓는다"는 저장된 기억과 거의 같은 문장이다. 그래서 여기서는 HyDE를 그대로 쓴다. 원래 질문의 검색 순위와 가상 기억의 검색 순위를 RRF로 합친다. 구조 분해도, 방향 반전도 필요 없다.
이렇게 세 가지 전략을 나란히 놓으면 설계 원칙이 보인다. 기억의 생김새에 따라 '어느 쪽을 확장할지'를 다르게 정한다. 사건은 양쪽을 쪼개고, 개인 정보는 기억 쪽을 부풀리고, 일반 지식은 질문 쪽을 부풀린다.
마지막 단계는 검색 이후다. 대화 기억의 검색 단위는 보통 여러 턴짜리 대화 조각이다. 정답이 들어 있는 조각을 제대로 찾아도, 그 안에는 날씨 이야기, 점심 메뉴 이야기 같은 무관한 내용이 섞여 있다. 논문은 이것이 일반 문서 검색보다 대화 기억에서 더 심하다고 지적한다. 위키백과 문단은 대개 한 주제를 다루지만, 대화는 주제가 수시로 바뀐다.
그래서 MemoType은 검색된 기억을 생성기에 넘기기 전에 LLM에게 한 번 더 묻는다.
Mqp={mi∈Mq∣JLLM(mi,q)=1}
실제 프롬프트(부록 그림 28)는 단순한 예/아니오 판정보다 영리하다. LLM에게 번호와 날짜가 붙은 기억 목록을 주고 "이 기억만으로 질문에 답하고, 실제로 사용한 기억의 번호를 인용하라"고 시킨다. 출력 형식은 딱 두 줄, Answer:와 References: [1, 4]다. 기억이 답을 뒷받침하지 않으면 지어내지 말고 "모르겠다"고 하라는 규칙도 있다. 인용된 기억만 남기는 것이 가지치기다.
부록 표 9에 따르면 가지치기는 네 데이터셋 모두에서 거의 모든 생성 지표를 올렸다. LoCoMo에서 답변 F1이 20.30에서 22.23으로, PerLTQA에서 BLEU가 19.27에서 20.65로 올랐다. 흥미롭게도 의미 유사도 지표(BERTScore)보다 단어 겹침 지표(BLEU·ROUGE)가 더 많이 올랐다. 저자들의 해석은 가지치기가 모델이 엉뚱한 주제의 단어를 섞어 쓰는 것을 주로 막는다는 것이다.
직접 따라가 보기
지금까지의 다섯 단계를 하나의 예로 따라가 보자. 민지의 기억 저장소에 12개의 발화가 있고, 세 종류의 질문을 던진다. 단계를 넘기면서 라우터가 어떤 서랍을 열고, 서랍마다 어떤 점수 계산을 하는지 보라.
6장. 정리 3.3 — 단일 전략에는 천장이 있다
MemoType 논문에는 실험만 있는 게 아니다. 3장에는 짧은 정리 하나가 있다. "어떤 검색 인코더도, 여러 범주가 섞인 말뭉치에서는 질문-문서 정렬의 기댓값에 넘을 수 없는 상한이 있다." 수식은 겁낼 것 없이, 그림으로 이해할 수 있다.
설정 — 범주마다 '방향'이 있다
임베딩 공간을 생각하자. 모든 문장은 길이 1로 정규화된 벡터, 즉 단위 구 위의 한 점이다. 두 벡터의 내적(코사인 유사도)이 클수록 가깝다.
말뭉치의 문서들이 C개의 범주(예: EM, PM, GM이면 C=3)에서 나온다고 하자. 범주 Si에 속한 문서 벡터들의 평균을 μi, 그 방향을 vi∗=μi/∥μi∥라 하자. 그림 1(a)와 아래 그림 13에서 본 것처럼 범주마다 점들이 뭉쳐 있으니, 각 범주는 대략 하나의 방향을 가리킨다.
두 범주가 얼마나 떨어져 있는지는 각도 분리δij=1−⟨vi<em>,vj</em>⟩로 잰다. 두 방향이 같으면 0, 직각이면 1이다. 가정 3.1은 "모든 범주 쌍이 적어도 δ>0만큼은 떨어져 있다"는 것뿐이다. 범주들이 완전히 같은 방향만 아니면 된다. 그림 13을 보면 실제 데이터에서 이 가정이 성립한다.
정리 — 평균 정렬의 상한
문서가 C개 범주에 고르게 퍼져 있으면, 어떤 인코더ϕ를 쓰더라도
Eq∼Q,d∼D[⟨equery,edoc⟩]≤1−2C(C−1)δ
이다. 예를 들어 범주가 세 개(C=3)이고 서로 꽤 떨어져 있다면(δ=0.5, 대략 60° 각도) 상한은 1−(2×0.5)/6≈0.833이다. 범주가 많을수록, 서로 멀수록 천장이 낮아진다.
증명의 뼈대 — 화살표 하나로 세 방향을 가리킬 수 없다
증명은 부록 A에 반 쪽 분량으로 실려 있고, 고등학교 벡터 수준으로 따라갈 수 있다.
① 평균으로 바꾼다
질문과 문서를 독립적으로 뽑으므로, 내적의 기댓값은 기댓값끼리의 내적이 된다. 질문 벡터의 평균을 u, 문서 벡터의 평균을 v̄라 하면 기대 정렬 = ⟨u, v̄⟩. 문서가 범주별로 고르게 있으니 v̄는 범주 평균 μi들의 평균이다.
② 코시-슈바르츠
⟨u, v̄⟩ ≤ ‖u‖·‖v̄‖ ≤ ‖v̄‖. 질문이 아무리 영리해도, 평균 정렬은 문서 평균 벡터의 길이를 넘을 수 없다.
③ 길이를 잰다
서로 다른 방향을 가리키는 화살표들을 평균하면 길이가 줄어든다. 각 쌍의 내적이 1 − δ 이하이므로 ‖v̄‖² ≤ 1 − (C−1)δ/C. 여기에 √(1−x) ≤ 1 − x/2를 쓰면 정리의 식이 나온다.
결국 핵심은 ③의 그림이다. 서로 다른 방향을 가리키는 화살표들을 평균하면, 평균 화살표는 짧아진다. 동쪽과 북쪽을 가리키는 화살표를 평균하면 북동쪽을 가리키지만 길이는 약 0.71로 줄어든다. 검색기가 어느 한 범주에 맞추면 다른 범주와의 정렬이 떨어지고, 가운데로 타협하면 모두와 어중간하게만 맞는다. 논문의 표현으로는 "한 범주의 정렬을 높이면 반드시 다른 범주의 정렬을 희생해야 한다." 그리고 희생된 범주의 정답 문서는 순위가 밀린다.
MemoType의 해법은 이 기하를 우회하는 것이다. 범주마다 전용 검색 방향(전용 전략)을 쓰면, 각 범주 안에서는 평균 화살표가 길어진다. 아래에서 직접 화살표를 돌려 보라.
이 정리를 얼마나 믿어야 할까
솔직히 말하면, 이 정리는 강력한 결과라기보다 직관을 수식으로 옮긴 것에 가깝다. 정리가 다루는 것은 무작위로 뽑은 질문과 무작위로 뽑은 문서 쌍의 평균 유사도다. 실제 검색에서 중요한 것은 "어떤 질문에 대해 그 질문의 정답 문서가 다른 문서보다 높은 순위에 오느냐"인데, 정리는 이것을 직접 다루지 않는다. 질문마다 임베딩이 다른 방향을 가리킬 수 있으므로, 평균 질문 방향 u 하나의 한계가 곧 개별 질문의 한계는 아니다. 논문도 정리 자체보다는 "그래서 타입별 설계가 필요하다"는 동기 부여로 쓴다.
같은 질문, 즉 "하나의 임베딩으로 모든 것을 찾을 수 있는가"를 더 날카롭게 다룬 연구가 있다. 구글 딥마인드의 웰러(Weller) 등이 2025년 8월 발표하고 ICLR 2026에 채택된 「임베딩 기반 검색의 이론적 한계(On the Theoretical Limitations of Embedding-Based Retrieval)」다. 이 논문은 임베딩 차원이 정해지면, 그 임베딩으로 돌려줄 수 있는 '상위 k개 문서 조합'의 수에 상한이 있다는 것을 보였다. 벡터를 테스트셋에 직접 최적화해도 마찬가지다. 이를 확인하려고 만든 LIMIT 데이터셋(문서 5만 개, 질문 1,000개, 질문당 정답 문서 2개)은 문장 자체가 아주 단순한데도 당시 최고 수준의 임베딩 모델들이 Recall@100에서 20%에도 못 미쳤다.
두 논문은 같은 방향을 가리킨다. 단일 벡터, 단일 전략에는 구조적 천장이 있다. 웰러 등의 처방이 다중 벡터·희소 검색·재순위화 같은 '더 풍부한 표현'이라면, MemoType의 처방은 '나눠서 다르게 처리하기'다. 2026년 검색 시스템이 점점 하이브리드(임베딩 + 키워드 + 재순위화 + 라우팅)로 가는 이유가 여기 있다.
7장. 실험 결과 읽기
시험 환경
논문은 네 개의 장기 기억 벤치마크에서 아홉 개의 비교 방법과 겨룬다.
벤치마크
대화 형태
규모
무엇을 시험하나
LongMemEval-S (Wu 외, ICLR 2025)
사용자↔어시스턴트
질문 500개, 질문당 약 50세션(단어 약 7.9만 개)
정보 추출·다중 세션 추론·시간 추론·지식 갱신·답변 보류
LongMemEval-M
사용자↔어시스턴트
질문당 약 500세션(약 150만 토큰), 전체 세션 25만 개
같은 능력을 10배 큰 기억 더미에서
LoCoMo (Maharana 외, ACL 2024)
사람↔사람
대화 10개, 평균 약 300턴, 최대 35세션, 질문 1,986개
몇 달에 걸친 두 사람의 대화에서 사건·시간 추론
PerLTQA (Du 외, 2024)
가상 인물 중심
인물 32명, 질문 2,838개
프로필·인간관계·사건·대화가 섞인 개인 기억
비교 방법은 세 부류다. 질문을 확장하는 HyDE·Mill·Query2Doc, 대화를 분할·압축하는 SeCom, 구조를 만드는 HippoRAG2·A-Mem·RAPTOR, 계층형 기억 시스템 MemoryOS·LightMem. 공정한 비교를 위해 모든 방법이 같은 임베딩 모델(Contriever)과 같은 생성 모델(gpt-4o-mini, 온도 0)을 쓴다. 답변 품질은 GPT-5.2를 심판으로 쓰는 GPT4Judge와 F1·BLEU·ROUGE·BERTScore로 잰다. A-Mem·HippoRAG2·RAPTOR는 LongMemEval-M에서 기억 구축에만 1주일 넘게 걸려 결과를 내지 못했다. 이 사실 자체가 8장의 비용 이야기를 예고한다.
검색과 답변 — 표 1·2
결과는 한 줄로 요약된다. MemoType이 네 데이터셋, 모든 검색 지표에서 1위다. 다만 격차의 크기가 데이터셋마다 다르고, 그 차이가 이야기를 담고 있다. 아래에서 데이터셋과 지표를 바꿔 가며 직접 보라.
몇 가지 읽을거리를 짚어 보자.
기억 더미가 클수록 격차가 커진다. LongMemEval-S에서 Recall@1 격차는 2위 LightMem 대비 2.16포인트에 불과하다. 그런데 기억이 10배 많은 LongMemEval-M에서는 2위 SeCom(31.91)보다 16.18포인트 높은 48.09다. 초록의 "최대 16.18% 향상"이 바로 이 숫자다(백분율이 아니라 포인트 차이이고, 상대 비율로는 약 51%). 건초 더미가 커질수록 서랍부터 고르는 일의 가치가 커진다는 해석이 자연스럽다. 표 8에서 분류 필터의 이득이 LongMemEval-M에서도 4.68포인트로 유지된 것과 맞물린다.
사람↔사람 대화(LoCoMo)는 모두에게 어렵다. 최고 점수도 Recall@1 31.07이다. 몇 달에 걸친 두 친구의 잡담에서 "멜라니가 도자기 수업을 처음 들은 게 언제였지?" 같은 질문에 답하는 일은 여전히 난제다. MemoType은 A-Mem(28.80)을 2.27포인트 앞선다.
답변 품질의 격차는 검색 격차보다 크다. LongMemEval-S에서 검색 Recall@1 차이는 2점 남짓이었지만, GPT4Judge는 MemoType 56.80 대 2위 A-Mem 47.00으로 약 10점, 답변 F1은 20.13 대 2위 LightMem 14.45로 크게 벌어진다. LoCoMo에서도 GPT4Judge 48.79 대 2위 HyDE 40.18이다. 검색 순위가 비슷해도 가지치기로 잡음을 걸러 낸 깨끗한 근거를 넘기는 것이 답변에서 차이를 만든 것으로 보인다.
구조가 늘 이기지는 않는다. HippoRAG2는 LongMemEval-S에서 강하지만(Recall@1 50.64) LoCoMo에서는 질문 확장 방식인 HyDE(25.33)보다도 낮다(24.97). RAPTOR는 답변 GPT4Judge가 대부분의 데이터셋에서 최하위권이다. 요약 트리가 개인적인 세부를 지워 버리기 때문으로 보인다. 논문의 관련 연구 절이 말하듯 "단순한 문제에서는 구조 보강이 잡음이 되어 성능을 떨어뜨릴 수 있다."
무엇이 효과를 냈나 — 절제 실험
타입별 전략 대 단일 전략 (표 3). 세 가지 보강 기법 중 하나를 모든 기억에 똑같이 적용한 경우와, 타입마다 맞는 기법을 고른 경우를 비교했다.
전략 (모든 기억에 동일 적용)
LongMemEval-S R@1
LoCoMo R@1
PerLTQA R@1
키워드 확장
51.77
25.93
66.10
가상 질문
53.91
24.42
62.65
가상 기억 (HyDE)
52.03
25.23
66.24
타입별 전략
59.15
31.07
71.92
최고 단일 전략 대비
+5.24
+5.14
+5.68
흥미로운 점은 데이터셋마다 최고의 단일 전략이 다르다는 것이다. LongMemEval-S에서는 가상 질문이, LoCoMo에서는 키워드 확장이, PerLTQA에서는 가상 기억이 가장 낫다. 데이터셋마다 기억 종류의 구성이 다르기 때문이다. 어느 하나를 고정하면 어딘가에서는 반드시 손해를 본다. 6장 정리의 실험판이다.
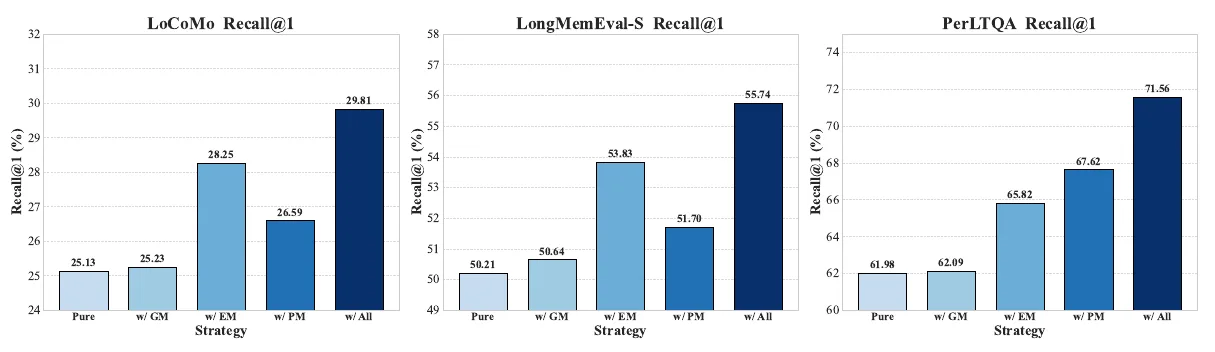
전략 하나씩 켜 보기 (부록 그림 11). 분류 필터만 켠 상태('Pure')에서 세 전략을 하나씩 켰을 때의 Recall@1이다.
에피소드 전략의 이득이 가장 크다. LoCoMo에서 25.13 → 28.25(+3.12), LongMemEval-S에서 50.21 → 53.83. 시간 추론이 얽힌 사건 기억이 가장 어려운 범주이고, 그래서 분해 후 정렬이 가장 큰 차이를 만든다.
개인 전략은 PerLTQA에서 빛난다. 61.98 → 67.62(+5.64). 인물 중심 데이터셋이라 "그의 직업이 뭐지?" 같은 개인 질문이 많기 때문이다.
일반 전략의 이득은 작다. 0.1~0.4포인트. 3장에서 말한 대로, 일반 지식은 원래 임베딩 검색이 잘 찾는다.
셋을 다 켜면 각각보다 낫다. 전략들이 서로 겹치지 않고 보완한다는 뜻이다.
(그림 11의 'w/ All' 값, 예컨대 LongMemEval-S 55.74는 본문 표 1의 59.15와 다르다. 55.74는 부록 표 10의 BERT 라우터 결과와 같은 숫자여서, 이 절제 실험은 다른 라우터 설정으로 돌린 것으로 보인다. 논문에 설명은 없다.)
검색기를 바꿔도 (부록 표 7). Contriever 대신 MPNet·MiniLM·QAMiniLM을 써도 MemoType은 모든 조합에서 1위였다. MPNet 기준 LongMemEval-S Recall@1 47.87로 2위 SeCom(37.66)보다 10포인트 이상 높았다. 이득이 특정 임베딩 모델과의 궁합에서 나온 것이 아니라는 증거다.
정확도만큼 실무자의 눈을 끄는 것은 부록 D.6의 비용표다. 기억을 저장하는 단계에서 유료 LLM을 몇 번 부르는지를 셌다.
A-Mem: 턴마다 LLM을 2번 부른다(노트 생성, 링크 생성).
HippoRAG2: 턴마다 2번 부른다(개체 추출, 관계 삼중항 추출). 말뭉치에 비례해 비용이 선형으로 는다.
MemoType: 모든 턴을 로컬 라우터(Qwen3-1.7B, 과금 없음)로 먼저 분류하고, 에피소드로 판정된 턴에만 유료 LLM을 불러 사건 요소를 뽑는다.
에피소드 턴의 비율은 데이터셋마다 다르다. LoCoMo 29.9%, LongMemEval-S 8.1%, LongMemEval-M 2.2%, PerLTQA 80.9%. 사용자↔어시스턴트 대화의 대부분은 정보 요청과 지식 설명(GM)이어서 사건이 드물다. 그 결과가 아래다.
LongMemEval-M에서 A-Mem은 기억을 쌓는 데만 487만 번 LLM을 부르고 936.90달러를 쓴다. HippoRAG2는 (5개 샘플에서 외삽한 추정치로) 548.98달러. MemoType은 5만 2천 번, 3.77달러다. HippoRAG2 대비 146분의 1, A-Mem 대비 248분의 1이다. 에피소드 비율이 80.9%로 가장 높은 PerLTQA에서도 MemoType은 HippoRAG2의 절반, A-Mem의 3분의 1 이하다.
이 차이의 원천은 기법이 아니라 선택이다. 비싼 구조화는 그것이 필요한 기억(사건)에만 하고, 나머지는 원문 그대로 둔다. "모든 것을 그래프로"가 2024~2025년 에이전트 메모리의 유행이었다면, MemoType은 "필요한 것만 구조화"라는 반대 방향의 설계가 정확도와 비용 둘 다에서 이길 수 있음을 보였다.
다만 이 표는 저장 비용만 센다는 점을 꼭 기억해야 한다. 이 점은 다음 장에서 다룬다.
9장. 비판적으로 읽기 — 이 논문이 말하지 않는 것
좋은 논문이지만 그대로 받아들이기 전에 짚어 둘 것들이 있다.
① 질문 시점의 비용과 지연이 빠져 있다. MemoType은 질문 하나마다 LLM을 여러 번 부른다. 가상 기억 5개 생성(라우팅), 질문의 사건 요소 추출(EM일 때), 가지치기 판단, 그리고 최종 답변. 단순 RAG가 1번 부를 때 최소 3~4번이다. 개인 기억마다 가상 질문 5개를 만드는 비용도 비용표에서 따로 드러나지 않는다. 표 11의 극적인 숫자는 쓰기 쪽의 이야기이고, 읽기 쪽의 지연 시간은 보고되지 않았다. 대화형 서비스에서 응답이 1~2초 늦어지는 것은 작은 문제가 아니다. 기억을 많이 쌓고 가끔 묻는 서비스라면 MemoType이 유리하고, 질문이 잦고 지연에 민감한 서비스라면 계산이 달라진다.
② 2026년 기준으로는 오래된 부품이다. 모든 실험은 2021년의 Contriever와 2024년의 gpt-4o-mini로 돌렸다. 비교의 공정성을 위해 통일한 것은 이해되지만, 지금 실무에서 쓰는 최신 임베딩 모델(긴 문맥, 지시문 기반, 다국어)이었다면 단일 검색의 기본 성능이 훨씬 높았을 것이고, 타입별 전략의 이득이 얼마나 남는지는 알 수 없다. 부록 표 7이 다른 검색기에서도 이득이 유지됨을 보이지만, 그것들도 모두 2020~2021년 무렵의 소형 모델이다.
③ 정리는 동기 부여 이상은 아니다. 6장에서 본 것처럼 정리는 무작위 질문-문서 쌍의 평균 유사도에 대한 것이지 정답 문서의 순위에 대한 것이 아니다. "단일 전략은 이론적으로 한계가 있다"는 문장은 조심해서 읽어야 한다.
④ 표마다 숫자가 조금씩 어긋난다. 그림 11의 'w/ All'(55.74)과 표 1(59.15), 표 9의 가지치기 적용 GPT4Judge(56.60)와 표 2(56.80), TriMEM 샘플 수(본문 출처별 합 3,000쌍 대 6,000샘플), 그림 2와 본문의 PM 전략 이름이 그렇다. 큰 결론을 흔들 정도는 아니지만 재현할 때 혼란을 줄 수 있다. 비교 대상인 LightMem은 일부 데이터셋에서 NDCG@3이 NDCG@1보다 낮게 보고되는 등 해석하기 어려운 수치도 있다.
⑤ 재현하려면 라우터를 직접 학습해야 한다. 공개 저장소(github.com/wenyiwy99/MemoType)에는 코드·프롬프트·TriMEM CSV가 있지만 학습된 라우터 가중치는 없다. README는 MIT 라이선스라고 적었지만 저장소에 LICENSE 파일이 없다. 10월 10일 현재 별은 0개이고, 해커뉴스나 허깅페이스 논문 페이지에서도 아직 반응이 없다. 공개된 지 이틀 된 논문이다.
⑥ 범위는 '대화 기억'으로 한정된다. 논문 각주가 밝히듯, 여기서 다루는 기억은 사람과 사람, 사람과 어시스턴트의 대화다. 에이전트가 작업하며 쌓는 경험 기억이나 절차 기억(어떤 도구를 어떻게 썼더니 성공했나)은 범위 밖이다. 코딩 에이전트나 업무 자동화 에이전트의 기억 문제에는 바로 적용되지 않는다.
⑦ 기억의 '수명'은 다루지 않는다. "나 요즘 서울 살아"가 6개월 뒤 "부산으로 이사했어"로 바뀌면 어느 쪽이 맞는가. LongMemEval이 시험하는 다섯 능력 가운데 '지식 갱신'이 이것이고, 2026년에는 오래된 기억을 시험하는 STALE(5월), 기억의 생애 주기 연산을 시험하는 MemOps(7월) 같은 벤치마크가 잇따라 나왔다. MemoType은 무엇을 어떻게 찾을지에 집중할 뿐, 무엇을 고치고 버릴지는 말하지 않는다. 개인 의미 기억은 특히 시간에 따라 바뀌기 쉬운 범주여서, 이 부분이 실제 제품에서는 큰 숙제로 남는다.
⑧ 라우터가 틀리면 정답 서랍이 닫힌다. 필터는 양날의 검이다. 표 8에서 LongMemEval-S의 Recall@10이 필터 후 오히려 조금 떨어진 것이 그 흔적이다. 후보 타입을 합집합으로 잡아 위험을 줄였지만, 실제 서비스라면 "필터 결과가 빈약하면 전체 검색으로 되돌아가기" 같은 안전장치를 함께 두는 편이 좋다.
10장. 2026년의 지형도 — 비슷한 설계와 무엇이 다른가
2026년 가을, '기억의 종류'를 말하는 시스템은 많다. 하지만 같은 단어를 써도 종류를 어디에 쓰느냐가 다르다.
시스템
기억을 어떻게 나누나
종류를 무엇에 쓰나
분류 주체
구축 비용
CoALA (2023, 설계 틀)
작업·일화·의미·절차
에이전트 구조를 설명하는 어휘
설계자
—
LangMem (LangChain)
의미·일화·절차
저장 형식을 다르게(사실 목록 / 성공한 대화 예시 / 프롬프트 갱신)
개발자가 지정
중간
MIRIX (2025)
핵심·일화·의미·절차·자원·지식 금고 6종
칸마다 담당 에이전트가 쓰기·갱신
LLM 에이전트
높음
Hindsight (2025)
세계·경험·의견·관찰 4개 네트워크
사실과 에이전트의 판단을 인식론적으로 분리
LLM 추출
높음
Mem0 / Zep
사실·관계(그래프), 시간 축
추출한 사실을 갱신·병합
LLM 추출
중간~높음
HippoRAG2 / A-Mem
종류 구분 없음 — 모두 그래프·노트로
연상·다단계 추론
LLM 추출
매우 높음
ChatGPT Dreaming V3 (2026.6)
저장 기억 + 배경에서 정리한 기억 요약(시간 인식)
제품 메모리, 사용자가 편집
모델(비공개)
비공개
Claude 메모리 (2026.8)
편집 가능한 '토픽' 단위
채팅·Cowork 간 공유, 민감 주제 기본 제외
모델(비공개)
비공개
Gemini 엔터프라이즈 에이전트 (2026.10)
세션·의미·절차·일화 4종
기업 에이전트의 기억 관리
비공개
비공개
MemoType (2026.10)
에피소드·개인 의미·일반 의미(다중 라벨)
검색 전략을 종류마다 다르게
학습된 소형 라우터
낮음 (EM만 구조화)
이 표에서 MemoType의 위치는 분명하다.
첫째, 종류를 '저장 칸'이 아니라 '찾는 법'으로 쓴다. MIRIX나 Hindsight가 "어떤 기억을 어디에 어떤 형식으로 둘까"를 고민한다면, MemoType은 "어떤 기억을 어떻게 찾을까"를 고민한다. 둘은 경쟁 관계가 아니라 층위가 다르다. Hindsight처럼 저장을 정교하게 나눈 시스템 위에도 MemoType식 타입별 검색을 얹을 수 있다.
둘째, 분류를 프롬프트가 아니라 학습된 작은 모델에 맡긴다. 대부분의 시스템은 GPT급 모델에게 "이건 어떤 기억이냐"를 프롬프트로 묻는다. MemoType은 6,000개 라벨 데이터로 1.7B(심지어 BERT급) 분류기를 학습시켰고, 그게 더 정확했다(표 5). 분류가 정확해야 필터와 전략 선택이 의미가 있다.
셋째, 비용 구조가 다르다. 모든 기억을 구조화하는 시스템은 기억이 쌓일수록 비용이 선형으로 는다. MemoType은 구조화가 필요한 소수(에피소드)에만 돈을 쓴다. 사용자↔어시스턴트 대화처럼 사건이 드문 환경일수록 유리하다.
한국의 맥락
국내에서도 대화 AI의 기억은 이미 제품 기능이다. SK텔레콤은 2023년 1월 에이닷에 '장기기억'을 발표했고, 2025년 8월 에이닷 4.0에서 대화 중 가치 있다고 판단한 정보를 저장하고 사용자가 '메모리 관리'에서 보고 지울 수 있는 기능을 내놓았다. 카카오는 2025년 10월 카나나 앱 베타에서 AI 메이트와의 일대일 대화 기억을 개인화에 쓰기 시작했다. 학술 쪽으로는 네이버 클로바 연구진의 2022년 「Keep me updated!」(Bae 외)가 장기 대화에서 사용자 정보를 계속 갱신하는 문제를 일찍 다뤘고, 이번 MemoType 논문의 참고문헌에도 올라 있다.
한국어 서비스에는 MemoType의 아이디어가 특히 잘 맞는 지점이 있다. 한국어 대화는 "어제", "지난주", "그저께", "다다음 주"처럼 상대적 시간 표현이 풍부하고 주어를 자주 생략한다. "엄마랑 갔었잖아"에서 누가 갔는지는 문맥으로만 알 수 있다. 통째 임베딩이 이런 문장을 다루기 어렵다는 점에서, 저장 시점에 시간을 절대 날짜로 바꾸고 인물을 복원해 두는 에피소드 전략의 가치가 크다. 다만 TriMEM은 영어 데이터이므로, 한국어 서비스에 쓰려면 한국어 대화로 라우터를 다시 학습시켜야 한다. 다행히 표 10이 보여 주듯 라우터는 BERT급으로도 충분하고, 필요한 것은 모델 크기가 아니라 잘 라벨링된 수천 개의 예시다.
11장. 어디에 쓰면 좋은가
잘 맞는 곳
개인 비서와 컴패니언 앱. 일정·여행·만남 같은 사건(EM), 취향·건강 상태·가족 관계 같은 개인 정보(PM), 대화 중 오간 지식(GM)이 고루 섞이는 전형적인 환경이다. "지난번에 추천해 준 그 식당 어디였지?"(EM)와 "나 갑각류 알레르기 있는 거 알지?"(PM)는 다른 방식으로 찾아야 한다.
고객 상담. 고객 프로필과 선호(PM), 과거 문의·장애·환불 이력(EM), 제품 정책과 사용법(GM)이 한 상담 이력 안에 섞인다. "지난달 환불 요청 건 어떻게 됐어요?"는 날짜와 건을 정확히 맞춰야 하는 에피소드 질문이고, "제 요금제가 뭐였죠?"는 개인 의미 질문이다. 상담 로그는 대부분 GM·PM이고 EM은 소수이므로 비용 구조에서도 이득이 크다.
의료·돌봄 문진. "두통이 언제부터 시작됐는지"(EM, 시간이 핵심), "평소 복용하는 약"(PM), "약의 일반적 부작용"(GM)은 정확히 다른 범주다. 증상의 시작 시점을 틀리게 찾는 것은 단순한 불편이 아니라 위험이 된다. (물론 의료 환경에서는 기억 시스템의 오류를 사람이 확인하는 절차가 별도로 필요하다.)
교육 튜터. 학습자의 수준과 취향(PM), 지난 수업에서 틀린 문제와 날짜(EM), 개념 설명(GM). "저번 주에 틀렸던 그 유형 다시 내 줘"는 에피소드 검색이다.
영업·CRM 비서. 고객사 담당자의 성향(PM), 미팅 일정과 약속(EM, 미래 계획 포함), 업계 정보(GM).
맞지 않는 곳
대화가 짧은 서비스. 전체 이력이 컨텍스트 창에 다 들어간다면 굳이 검색할 필요가 없다.
문서 검색(사내 위키, 논문 검색). MemoType은 대화 기억용으로 설계됐다. 논문도 "말뭉치 수준의 다른 기억 유형"은 향후 과제로 남겼다.
코딩·업무 자동화 에이전트의 경험 기억. 절차와 도구 사용 경험은 세 범주 밖이다.
지연에 극도로 민감한 실시간 응답. 질문마다 LLM을 여러 번 부르는 구조는 응답을 늦춘다.
직접 만든다면 — 실무 체크리스트
1. 분포부터 잰다
우리 서비스 대화 로그 200~500턴을 EM·PM·GM·없음으로 라벨링해 본다. EM이 5% 미만이면 사건 구조화 비용은 거의 들지 않고, PM이 많으면 가상 질문 전략의 효과가 클 것이다. 이 숫자 하나가 설계의 절반을 정한다.
2. 시간을 저장 시점에 정규화한다
MemoType 전체를 도입하지 않더라도, 저장할 때 "어제·지난달"을 대화 날짜 기준 절대 날짜로 바꿔 메타데이터로 붙이는 것만으로 시간 질문의 정확도가 크게 오른다. 가장 싸고 효과 큰 한 가지다.
3. 개인 기억에는 '답할 질문'을 붙여 둔다
사용자 정보가 담긴 턴을 저장할 때 그 턴이 답할 수 있는 질문 3~5개를 생성해 함께 색인한다(doc2query). 짧은 개인 질문에 강해진다.
4. 라우터는 작게 시작한다
처음엔 LLM 프롬프트로 라벨을 만들고 사람이 일부를 검수해 수천 개를 모은 뒤, BERT/RoBERTa급 다중 라벨 분류기를 학습시킨다. 표 10에 따르면 이것으로 충분하다. 한국어라면 한국어 대화로 학습해야 한다.
5. 필터에 안전장치를 둔다
후보 타입은 다수결이 아니라 합집합으로 잡고, 필터 후 상위 점수가 너무 낮으면 전체 검색으로 되돌아간다.
6. 답변 전에 근거를 인용시킨다
"이 기억들로 답하고 사용한 번호를 대라"는 가지치기 프롬프트는 잡음 제거와 함께 답변의 출처 표시, 환각 억제("모르면 모른다고")까지 한 번에 해 준다. 사용자에게 "9월 5일 대화에서"라고 근거를 보여 줄 수도 있다.
7. 쓰기와 읽기 비용을 따로 잰다
저장 비용(턴당 LLM 호출)과 질문 비용(질문당 LLM 호출, 지연 시간)을 분리해서 측정한다. 논문의 비용표는 앞쪽만 보여 준다. 그리고 LongMemEval·LoCoMo 같은 공개 벤치마크와 함께, 우리 서비스의 실제 질문으로 만든 작은 평가셋을 꼭 둔다.
에필로그 — 기억한다는 것은, 다시 찾을 수 있다는 것
털빙은 기억을 연구하며 평생 한 가지를 강조했다. 정보가 머릿속에 저장돼 있는 것(available)과 그것을 꺼낼 수 있는 것(accessible)은 다르다는 것이다. 우리가 무언가를 '잊었다'고 느낄 때, 많은 경우 정보는 사라진 게 아니라 그것을 불러낼 단서가 맞지 않았을 뿐이다. 그는 이것을 '부호화 특수성 원리'라고 불렀다. 기억할 때 함께 저장된 단서가 떠올릴 때도 주어져야 기억이 살아난다.
MemoType은 이 오래된 통찰을 AI 메모리에 옮겨 놓은 연구로 읽을 수 있다. 민지의 AI 비서는 "조지랑 태산에 갔다"는 사실을 분명히 저장하고 있었다. 실패한 것은 저장이 아니라 인출이었다. '4주 전'이라는 단서가 '지난달'이라는 저장 단서와 맞지 않았고, 하나의 그물로 모든 기억을 건지려 했기 때문이다.
2026년의 AI는 이미 많은 것을 저장한다. ChatGPT는 밤사이 기억을 정리하고, Claude는 기억을 토픽으로 묶고, Gemini 에이전트는 네 종류의 기억을 관리한다. 다음 경쟁은 아마 얼마나 많이 기억하느냐가 아니라, 필요한 순간에 맞는 기억을 맞는 방법으로 찾아내느냐에서 벌어질 것이다. 기억에는 종류가 있고, 종류마다 찾는 길이 다르다. 50년 전 심리학자가 서랍장 두 개로 그렸던 그림이, 이제 AI 사서의 서랍장 세 개로 다시 그려지고 있다.
참고문헌
이 글의 원문
Wen, Y., Xu, D., Jia, P., Wang, Y., Zhang, Y., Wang, M., Li, J., Zhang, W., Li, X., Liu, Y., & Zhao, X. (2026). Memory Type Varies: Empowering LLM Agents for Long-Term Memory with Diverse Strategies. arXiv:2610.11573. NeurIPS 2026. https://arxiv.org/abs/2610.11573
Tulving, E. (1972). Episodic and semantic memory. In E. Tulving & W. Donaldson (Eds.), Organization of Memory. Academic Press.
Tulving, E. (1983). Elements of Episodic Memory. Oxford University Press.
Tulving, E. (1985). Memory and consciousness. Canadian Psychology, 26(1), 1–12.
Tulving, E., & Thomson, D. M. (1973). Encoding specificity and retrieval processes in episodic memory. Psychological Review, 80(5), 352–373.
Squire, L. R. (2004). Memory systems of the brain: A brief history and current perspective. Neurobiology of Learning and Memory, 82(3), 171–177.
Renoult, L., Davidson, P. S. R., Palombo, D. J., Moscovitch, M., & Levine, B. (2012). Personal semantics: At the crossroads of semantic and episodic memory. Trends in Cognitive Sciences, 16(11), 550–558.
Schank, R. C. (1982). Dynamic Memory: A Theory of Reminding and Learning in Computers and People. Cambridge University Press.
Nogueira, R., Yang, W., Lin, J., & Cho, K. (2019). Document Expansion by Query Prediction (doc2query). arXiv:1904.08375.
Izacard, G. 외 (2021). Unsupervised Dense Information Retrieval with Contrastive Learning (Contriever). arXiv:2112.09118.
Weller, O., Boratko, M., Naim, I., & Lee, J. (2025). On the Theoretical Limitations of Embedding-Based Retrieval. arXiv:2508.21038. ICLR 2026.
Sumers, T. R., Yao, S., Narasimhan, K., & Griffiths, T. L. (2023). Cognitive Architectures for Language Agents (CoALA). arXiv:2309.02427.
Park, J. S. 외 (2023). Generative Agents: Interactive Simulacra of Human Behavior. arXiv:2304.03442.
Zhong, W. 외 (2023). MemoryBank: Enhancing Large Language Models with Long-Term Memory. arXiv:2305.10250. AAAI 2024.
Packer, C. 외 (2023). MemGPT: Towards LLMs as Operating Systems. arXiv:2310.08560.
Bae, S. 외 (2022). Keep Me Updated! Memory Management in Long-term Conversations. arXiv:2210.08750.
Gutiérrez, B. J. 외 (2024). HippoRAG: Neurobiologically Inspired Long-Term Memory for Large Language Models. arXiv:2405.14831. / (2025). From RAG to Memory (HippoRAG 2). arXiv:2502.14802.
Xu, W. 외 (2025). A-MEM: Agentic Memory for LLM Agents. arXiv:2502.12110.
Chhikara, P. 외 (2025). Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory. arXiv:2504.19413.
Rasmussen, P. 외 (2025). Zep: A Temporal Knowledge Graph Architecture for Agent Memory. arXiv:2501.13956.
Wang, Y., & Chen, X. (2025). MIRIX: Multi-Agent Memory System for LLM-Based Agents. arXiv:2507.07957.
Latimer, C. 외 (2025). Hindsight. arXiv:2512.12818.
벤치마크
Wu, D. 외 (2024). LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory. arXiv:2410.10813. ICLR 2025.
Maharana, A. 외 (2024). Evaluating Very Long-Term Conversational Memory of LLM Agents (LoCoMo). arXiv:2402.17753. ACL 2024.
Du, Y. 외 (2024). PerLTQA: A Personal Long-Term Memory Dataset for Memory Classification, Retrieval, and Fusion in Question Answering. arXiv:2402.16288.