[특집] 당신의 게임이 하네스다 — 'LLM은 게임에 약하다'는 착각, 그리고 게임 자체를 AI 에이전트의 하네스로 만드는 일곱 가지 방법
2026년 9월 캐나다 캘거리의 인디 게임 행사에서 15년 차 게임 프로그래머 카일 쿠크슈텔이 45분 발표를 했다. 제목은 「당신의 게임이 하네스다」. 게임 업계에 퍼진 'LLM은 게임에 약하다'는 말을 그는 뒤집는다. 문제는 모델의 능력이 아니라 게임이 AI에게 읽히지 않는다는 것, 곧 맥락(context)의 문제라는 것이다. 처방은 AI가 아니라 게임 쪽에 있다 — 시드 하나, 한 모양의 오브젝트(나무도 개다), 텍스트로 재생되는 명령, 코드 밖의 데이터, 엔진과 분리된 시뮬레이션, 스크린샷 대신 픽셀 diff, 사람용 GUI 대신 텍스트 프로파일. 이 글은 그 처방을 하나씩 풀면서, 각각이 둠의 데모 파일(1993)과 에이지 오브 엠파이어의 '28.8 모뎀 위의 1,500명의 궁수', 스타크래프트 리플레이, 팩토리오의 디싱크 리포트에서 어떻게 이미 쓰였는지를 따라간다. 하네스라는 말이 테스트 하네스에서 2026년 '하네스 엔지니어링'까지 어떻게 왔는지, 같은 제미나이가 RAM을 텍스트로 받으면 포켓몬을 완주하고 픽셀만 받으면 0.48%에 머무는 이유, 게임 업계 52%가 AI를 해롭다고 보는 2026년의 반감과 한국 게임사 70%의 도입률까지 — 여섯 개의 인터랙티브 도구와 함께 정리했다.
2026년 9월 12일, 캐나다 캘거리. 인디 게임 개발자들이 모이는 작은 행사 인디 로데오(Indie Rodeo)의 둘째 날 무대에 카일 쿠크슈텔(Kyle Kukshtel)이 올랐다. 발표 제목은 「당신의 게임이 하네스다(Your Game Is A Harness)」. 45분짜리였다.
쿠크슈텔은 15년 가까이 게임을 프로그래밍해 온 사람이다. 전략 게임 「칸타타(Cantata)」를 만들었고, 게임 데이터를 다루는 팟캐스트를 진행하고, 게임 데이터 편집기 「디포(Depot)」를 만든다. 그리고 AI로 코드를 짜는 일을 즐긴다고 숨기지 않는 사람이다. 그는 발표 내용을 한 달 뒤인 10월 10일 자기 블로그에 글로 옮기면서 맨 앞에 이런 말을 붙였다.
"내가 블로그에서 AI 이야기를 많이 하니까 사람들은 내가 AI로 글을 쓴다고 짐작한다. 아니다! 아래 내용은 100% 사람이 썼다. … AI로 코드와 도구를 만드는 것만큼, '옛날 방식'으로 글을 쓰는 데서도 비슷한 즐거움을 느낀다."
AI로 게임을 만드는 법을 말하면서, 그 말을 담은 글은 손으로 썼다는 것. 이 작은 고백이 글 전체의 태도를 잘 보여 준다. 그는 AI를 찬양하지도, 거부하지도 않는다. AI가 무엇을 볼 수 있고 무엇을 볼 수 없는지를 따진다.
발표의 출발점은 게임 업계에 널리 퍼진 한 문장이다.
"LLM은 게임에 약하다(LLMs are bad at games)."
웹사이트나 백엔드는 AI가 곧잘 만든다. 그런데 게임 쪽 사람들이 클로드나 GPT에 진짜 게임 일을 맡겨 보면 금세 넘어진다는 것이다. 쿠크슈텔도 그랬다. 그런데 그는 이 문장을 뒤집는다. 문제는 LLM이 게임을 '못 하는' 것이 아니라 게임이 LLM에게 '읽히지 않는' 것이고, 이것은 모델의 한계가 아니라 맥락(context)의 문제라고. 그렇다면 해법도 모델 쪽이 아니라 게임 쪽에 있다. 게임을 AI가 읽을 수 있게 만들면, 게임 자체가 AI 에이전트를 붙잡아 주는 하네스(harness)가 된다.
이 글은 그 45분을 천천히, 한 장씩 풀어 읽는다. 왜 '하네스'라는 말이 2025~2026년 AI 업계의 핵심어가 됐는지, 그가 내놓은 일곱 가지 처방 — 고정 시드, 스크린샷과 이미지 diff, 결정적 상태, 명령 패턴, 외부 데이터, 블랙박스 시뮬레이션, 텍스트 프로파일링 — 이 각각 게임 개발의 어떤 30년 역사에서 왔는지, 그리고 이 이야기가 왜 게임 개발자만의 것이 아닌지를 따라간다. 중간중간 직접 만져 볼 수 있는 여섯 개의 실험 도구를 넣었다.
💡 코어닷투데이는 '하네스'를 여러 번 다뤘다. AI가 스스로 일하는 방식을 설계한다는 개념의 입문은 하니스(Harness) — AI가 스스로 일하는 방식을 설계하다에서, 같은 모델이 하네스 설계만으로 SWE-Bench 6.4%에서 58.4%까지 오르내린 실험은 같은 모델인데 성적이 10배 차이에서 정리했다. 이번 글은 그 하네스를 AI 쪽이 아니라 작업물 쪽에서 만든다는, 조금 다른 방향의 이야기다. 이 글에서는 업계에서 더 흔히 쓰는 '하네스'로 적는다.
0부. 한눈에 보기 — 발표의 뼈대
쿠크슈텔의 발표는 크게 세 덩어리다.
진단LLM은 게임을 '읽지' 못한다. 웹은 거의 전부 코드지만, 게임은 코드 + 에셋·씬·엔진 상태 같은 '코드가 아닌 것'이다. AI에게 그것들은 불투명한 블랙박스다.
원리그것은 맥락의 문제다. LLM은 매 턴 지난 대화 전체를 다시 읽는다. 좋은 정보를 적게, 오염 없이 넣어야 한다. 게임이 그 정보를 내놓게 만들면 된다.
처방게임을 하네스로 만든다. 고정 시드 → 결정적 상태 → 주소 지정 가능한 상태 → 검증 가능한 상태 → 영향 평가, 그리고 스크린샷 diff. 이 고리를 '턴당 몇 초'로 돌린다.
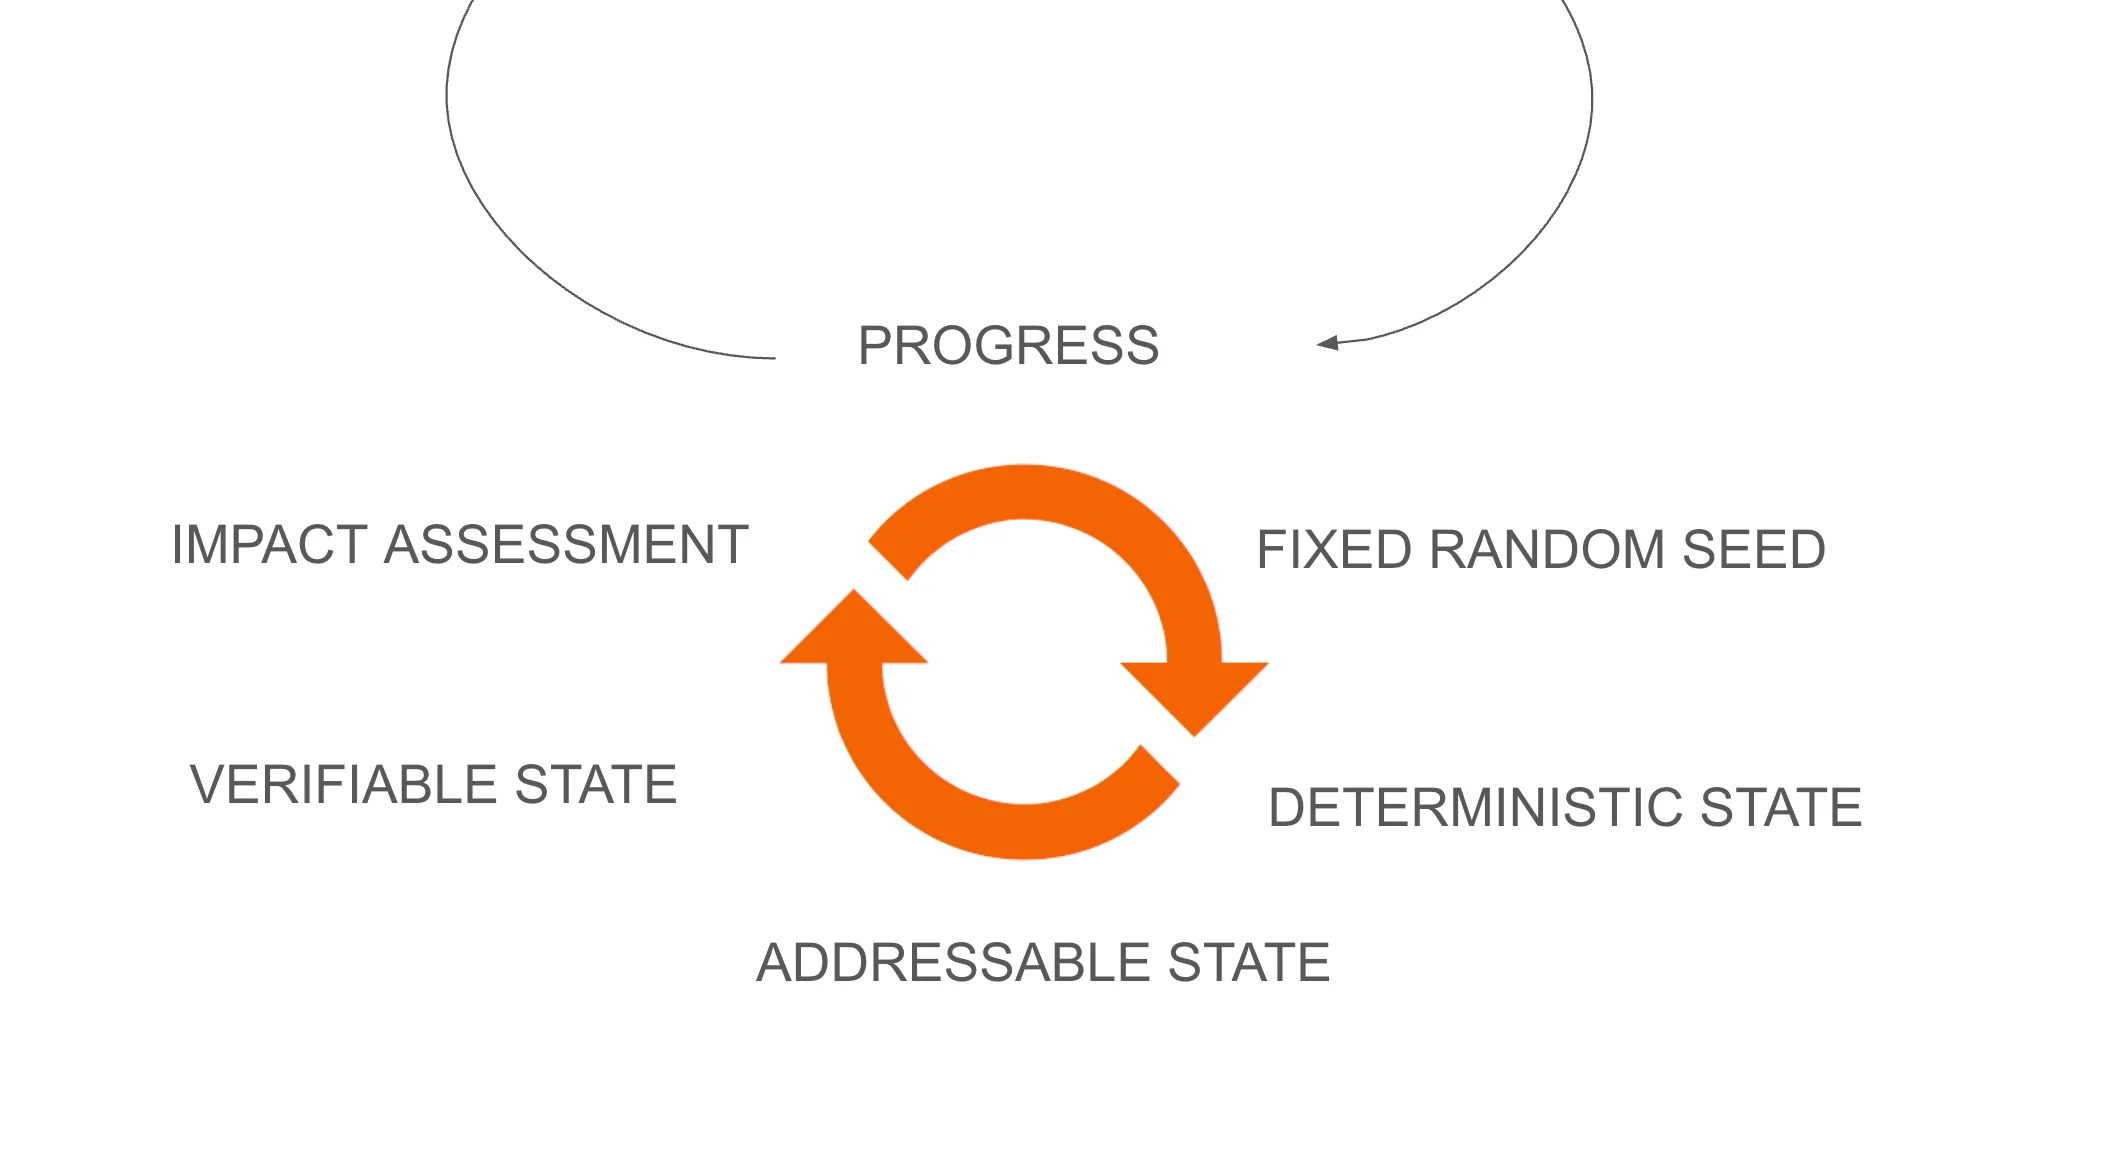
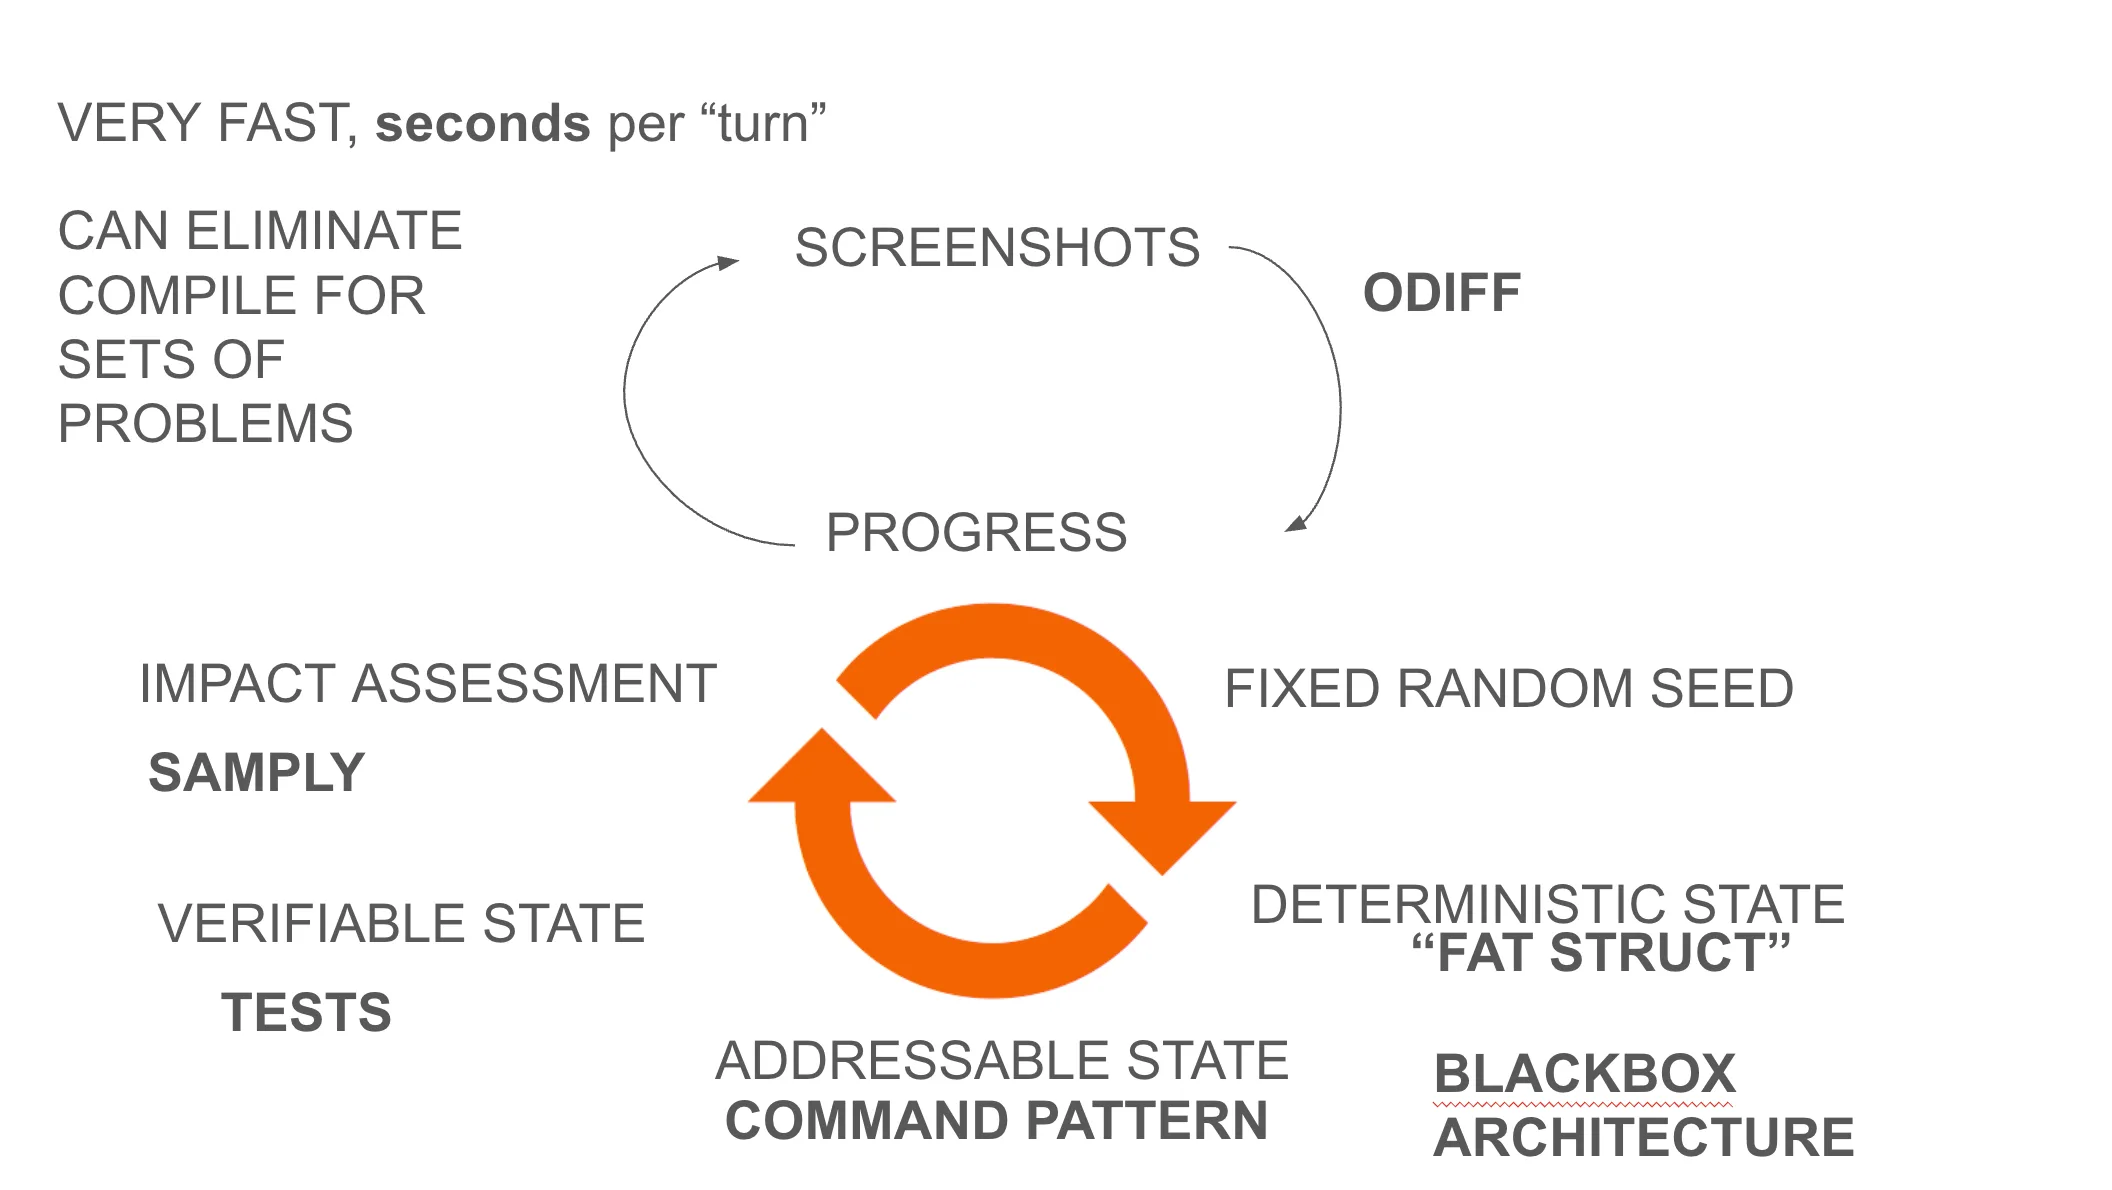
그리고 처방의 중심에는 이 그림이 있다. 발표 중반부터 거의 모든 슬라이드에 다시 등장하는 주황색 화살표 고리다.
크게 보기출처: Kyle Kukshtel, 「Your Game Is A Harness」(2026) 발표 슬라이드. 에이전트가 한 번 수정할 때마다 이 고리를 한 바퀴 돈다.
고리의 칸
질문
쿠크슈텔의 도구
게임 개발사의 선례
고정 시드
같은 판을 다시 만들 수 있나
시드 있는 난수원 하나
둠 데모 파일, 로그라이크 시드 공유
결정적 상태
지금 상태를 정확히 저장·복원할 수 있나
'팻 스트럭트' Thing 하나
ECS, 미디어 몰레큘 「드림즈」
주소 지정 상태
상태를 텍스트로 조종할 수 있나
명령 패턴 + 리플레이
「에이지 오브 엠파이어」 락스텝, 「스타크래프트」 리플레이
검증 가능한 상태
엔진 없이 로직을 시험할 수 있나
블랙박스 시뮬레이션(순수 C#)
「몬스터 트레인」, 「솔리움 인페르눔」
영향 평가
그 변경이 게임 전체에 어떤 영향을 줬나
samply 텍스트 프로파일
유니티·언리얼 프로파일러(사람용)
진척(PROGRESS)
목표에 가까워졌나
스크린샷 + odiff
웹의 시각 회귀 테스트
표의 오른쪽 열이 이 글의 숨은 주제다. 쿠크슈텔이 내놓은 처방 가운데 AI 때문에 새로 발명된 것은 거의 없다. 대부분은 게임 개발자들이 네트워크 동기화, 리플레이, 버그 재현, 디자이너와의 협업 때문에 지난 30년 동안 이미 고안해 둔 기법이다. 그가 직접 말한다. "이 팁 대부분은 게임 개발 일반에도 좋다. AI와 함께하면 효과가 몇 배가 될 뿐이다." 달라진 것은 그 기법을 누가 쓰느냐다. 예전에는 사람 동료와 네트워크 상대편이었다. 이제는 AI 에이전트가 그 자리에 하나 더 앉는다.
1부. 왜 "LLM은 게임에 약하다"는 말이 나왔나
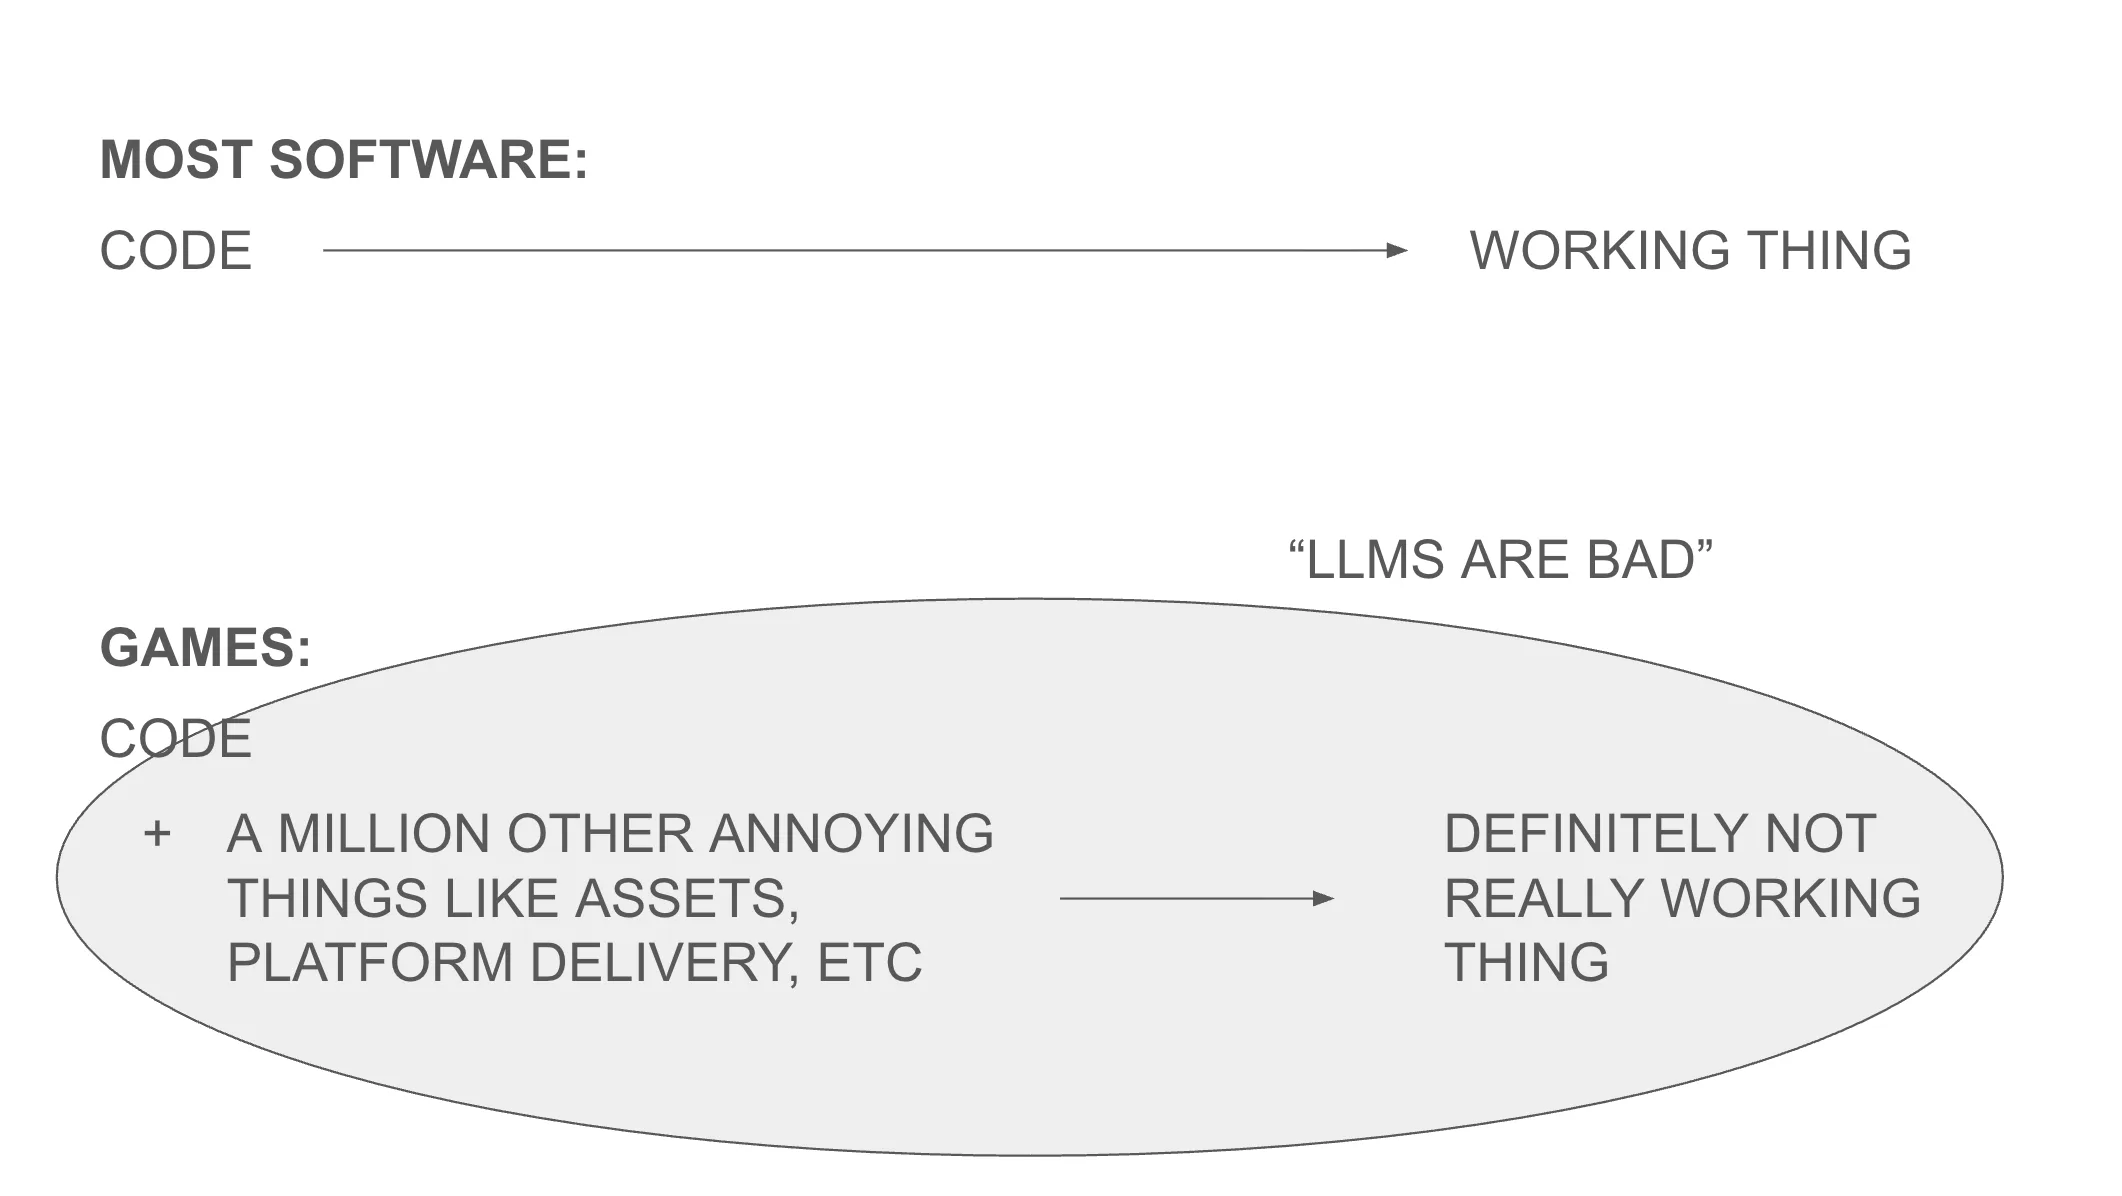
웹은 코드고, 게임은 코드 + 백만 가지 다른 것이다
쿠크슈텔의 LLM 입문기는 아직 '에이전트'라는 말도 없던 시절의 평범한 이야기로 시작한다. 무드보드 사이트 mood.site를 만들 때 그는 챗GPT 웹 화면에 코드를 붙여 넣고 결과를 다시 복사해 오는 일을 끝없이 반복했다. "과정은 형편없었지만 결과는 놀라웠다." 평일 밤 2~3주, 합쳐서 스무 시간쯤에 사이트가 완성됐다. LLM이 없었다면 "아마 지금도 첫 버전을 만들고 있을 것"이라고 그는 쓴다. 그 뒤 클로드 코드와 새 클로드 모델들이 나오면서, 웹 기술로 만드는 것이라면 "LLM이 못 할 일은 거의 없다"고 느끼게 됐다.
그런데 게임 일을 맡기면 늘 넘어졌다.
크게 보기출처: Kyle Kukshtel, 「Your Game Is A Harness」(2026). '대부분의 소프트웨어'와 '게임'의 차이.
그는 이유를 세 가지로 든다.
첫째, 학습 데이터의 양. 소스가 공개된 고품질 웹 프로젝트는 엄청나게 많다. 깃허브에 올라온 리액트·스벨트 앱은 셀 수 없지만, 출시된 상용 게임의 소스는 거의 공개되지 않는다. 그는 "게임은 학습할 데이터가 몇 자릿수는 적을 것"이라고 짐작한다. 여기에 솔직한 단서도 붙인다. 15년 차 게임 프로그래머인 그는 나쁜 게임 코드를 "1마일 밖에서도 냄새로 안다." 반면 스벨트 웹앱은 잘 모르니 LLM이 내놓는 코드가 좋다고 믿기 쉽다. "어쩌면 그것도 쓰레기일지 모른다." 전문 분야일수록 AI의 실수가 더 잘 보인다는, 많은 사람이 겪는 착시를 그는 감추지 않는다.
둘째, 코드가 아닌 것들. 게임은 화면에 정적인 이미지와 글자를 배치하는 일로 끝나지 않는다. 3D 모델, 애니메이션, 사운드, 셰이더, 씬 파일, 프리팹, 물리 설정, 플랫폼별 빌드와 배포. 웹이 하는 '글자 배치' 일은 게임이 다뤄야 할 100가지 시스템 가운데 하나일 뿐이다. 그리고 이 대부분은 텍스트가 아니다. 유니티 씬 파일은 YAML이긴 하지만 사람이 읽으라고 만든 것이 아니고, 언리얼의 블루프린트는 바이너리 에셋이다. AI에게 이것들은 열어 볼 수 없는 상자다.
셋째, 엔진 상태. 게임에서 버그는 대개 '실행 중인 어떤 순간'에 있다. 점프하다 바닥을 뚫는 버그는 코드에서가 아니라 특정 위치, 특정 속도, 특정 프레임에서 생긴다. 그 순간을 AI는 볼 수 없다. 코드는 읽을 수 있지만 게임이 실행되는 모습은 읽을 수 없다.
여기서 쿠크슈텔은 재미있는 반례를 짚는다. 2025년부터 X(트위터)에는 "프롬프트 한 줄로 만든 3D 게임" 영상이 넘쳐 났다. 거의 다 웹 3D 라이브러리 Three.js로 만든 것들이다. 비행 시뮬레이터, 레이싱 게임, 마인크래프트 흉내. 그가 보기에 이건 진짜 게임 개발이 아니다. 슬라이드 한 장이 그 생각을 요약한다.
"게임을 만드는 건 Three.js 데모를 원샷하는 일이 아니다. 하지만 어쩌면 그들 말에도 일리가 있다."
일리가 있는 부분은 이것이다. Three.js 데모에서는 모든 것이 코드다. 캐릭터는 상자 몇 개를 쌓은 도형이고, 지형은 수식으로 만든 메시이고, 색은 코드 안의 16진수다. 에셋을 만들고 엔진 형식에 맞추는 단계를 통째로 건너뛰니, AI가 처음부터 끝까지 읽고 고칠 수 있다. 대가도 있다. 그는 그런 게임 대부분을 '슬롭(slop)'이라 부르는데, "LLM의 중앙값 말고는 어떤 작가적 목소리도 없기 때문"이다.
여기서 발표의 핵심 통찰이 나온다. Three.js 데모가 잘 되는 이유와 진짜 게임이 안 되는 이유는 같은 동전의 양면이다. 코드로 표현된 것은 AI가 다룰 수 있다. 코드로 표현되지 않은 것은 AI에게 불투명하다. 그리고 게임이 그 불투명한 것을 "꼭두각시처럼 조종하고 변형하는 데" 의존할수록 AI는 넘어진다.
"구조적으로, LLM은 게임을 읽는 데 서툴다. 적어도 기본 상태에서는."
그는 게임 개발 커뮤니티의 'LLM은 별로'라는 정서가 이 한계에 정면으로 부딪힌 경험에서 나왔다고 본다. 여기에 큰 단서도 단다. 자신은 오직 능력에 대해서만 말하고 있고, 사회를 무너뜨릴 수 있는 함의에 대한 우려는 별개의 이야기라고. 이 단서는 뒤에서 다시 돌아볼 것이다. 게임 업계의 AI 반감은 능력 문제만이 아니기 때문이다.
이 진단을 받쳐 주는 연구들
"LLM은 게임에 약하다"는 말은 느낌만이 아니다. 게임을 플레이하는 쪽에서는 꽤 체계적인 측정이 쌓였다. 코어닷투데이가 2026년 4월에 다룬 GameWorld 벤치마크가 그런 예다. 멀티모달 모델에게 화면을 보여 주고 게임을 하게 하면, 사람에게는 쉬운 일 — 캐릭터가 지금 어디에 있는지, 방금 무엇이 바뀌었는지 — 에서 자주 무너진다.
쿠크슈텔의 문제는 조금 다르다. 그는 AI에게 게임을 하라고 하는 게 아니라 게임을 만들라고 한다. 그런데 두 문제의 뿌리는 같다. 화면은 AI에게 정보가 너무 많고 너무 흐릿한 입력이다. 그리고 게임의 진짜 상태 — 누가 어디 있고, 체력이 몇이고, 다음 난수가 무엇인지 — 는 화면 뒤에 숨어 있다. 보는 능력을 키우는 대신, 볼 필요가 없게 만들 수는 없을까. 이것이 발표 후반부 전체를 끌고 가는 질문이다.
2부. LLM 기초 — 왜 이것이 '맥락의 문제'인가
프롬프트의 세 칸
쿠크슈텔은 게임 개발자 청중을 위해 LLM의 기초부터 짚는다. 어떤 LLM 서비스를 부르든 요청은 세 종류의 칸으로 나뉜다.
시스템(System)서비스의 모든 사용자에게 공통으로 들어가는 글. "당신은 앤트로픽이 만든 대형 언어 모델…" 같은 정체성, 규칙, 쓸 수 있는 도구 목록이 여기 들어간다. 중요하지만, 쓰는 사람이 직접 건드릴 일은 적다.
어시스턴트(Assistant)모델이 앞서 내놓은 응답들. 쿠크슈텔은 이 칸을 '모델이 입력에 반응하는 방향을 잡아 주는 보조 칸'쯤으로 설명했는데, 정확히는 지난 턴에 모델 자신이 한 말이 대화 기록으로 다시 들어가는 자리다.
사용자(User)"진짜 중요한 칸." 내가 입력한 채팅, 붙여 넣은 코드, 도구가 돌려준 결과가 전부 이쪽으로 쌓인다. 사람들이 '컨텍스트'라고 부르는 것은 대체로 사용자·어시스턴트 칸에 쌓인 토큰의 양이다.
여기서 많은 사람이 놓치는 사실이 하나 있다. 대화창에서 새 메시지를 보낼 때, 모델은 그 한 줄만 받는 게 아니다. 지난 메시지 전부가 매번 다시 제출된다. 클로드 코드 세션이든 웹 채팅이든 마찬가지다. 모델 자체는 기억이 없고, 기억처럼 보이는 것은 대화 기록을 통째로 다시 읽히는 것이다.
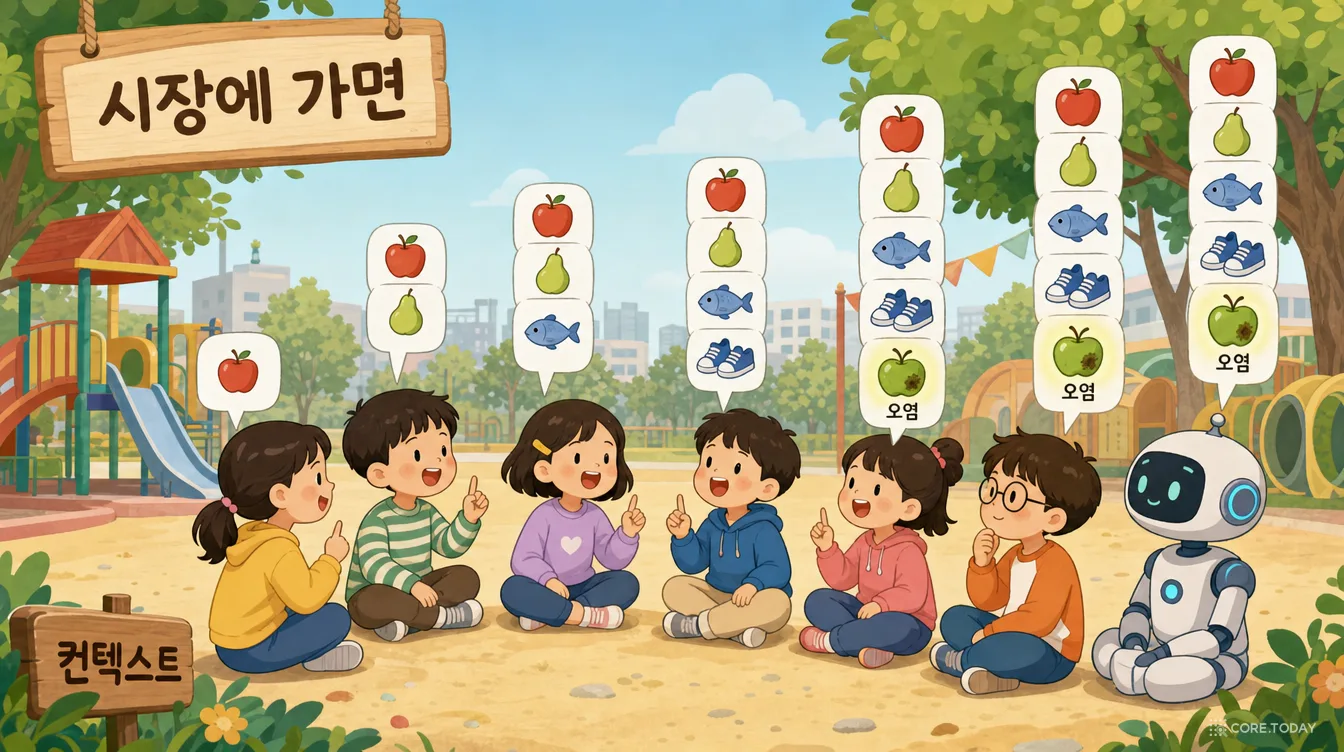
'시장에 가면'
쿠크슈텔은 이것을 놀이터 게임에 빗댄다. 자기 차례가 되면 앞사람들이 말한 것을 처음부터 다 따라 한 뒤 하나를 덧붙이는 놀이. 한국 사람에게는 익숙한 그 놀이다.
"시장에 가면 사과도 있고" → "시장에 가면 사과도 있고, 배도 있고" → "시장에 가면 사과도 있고, 배도 있고, 생선도 있고" …
하나, 뒤로 갈수록 말이 길어진다. 열 번째 아이는 아홉 개를 외워야 한다. LLM도 같다. 대화가 길어질수록 한 번의 요청이 커지고, 모델이 처리하는 총량은 턴 수의 제곱에 가깝게 늘어난다.
둘, 앞에서 누가 틀리게 말하면 그 실수가 끝까지 간다. 세 번째 아이가 "썩은 사과도 있고"라고 잘못 말하면, 그 뒤 모든 아이가 썩은 사과를 따라 말한다. 나중 차례의 아이가 할 수 있는 일은 '맨 끝에 하나를 덧붙이는 것'뿐이다. 앞에 이미 나온 말을 지울 방법은 없다.
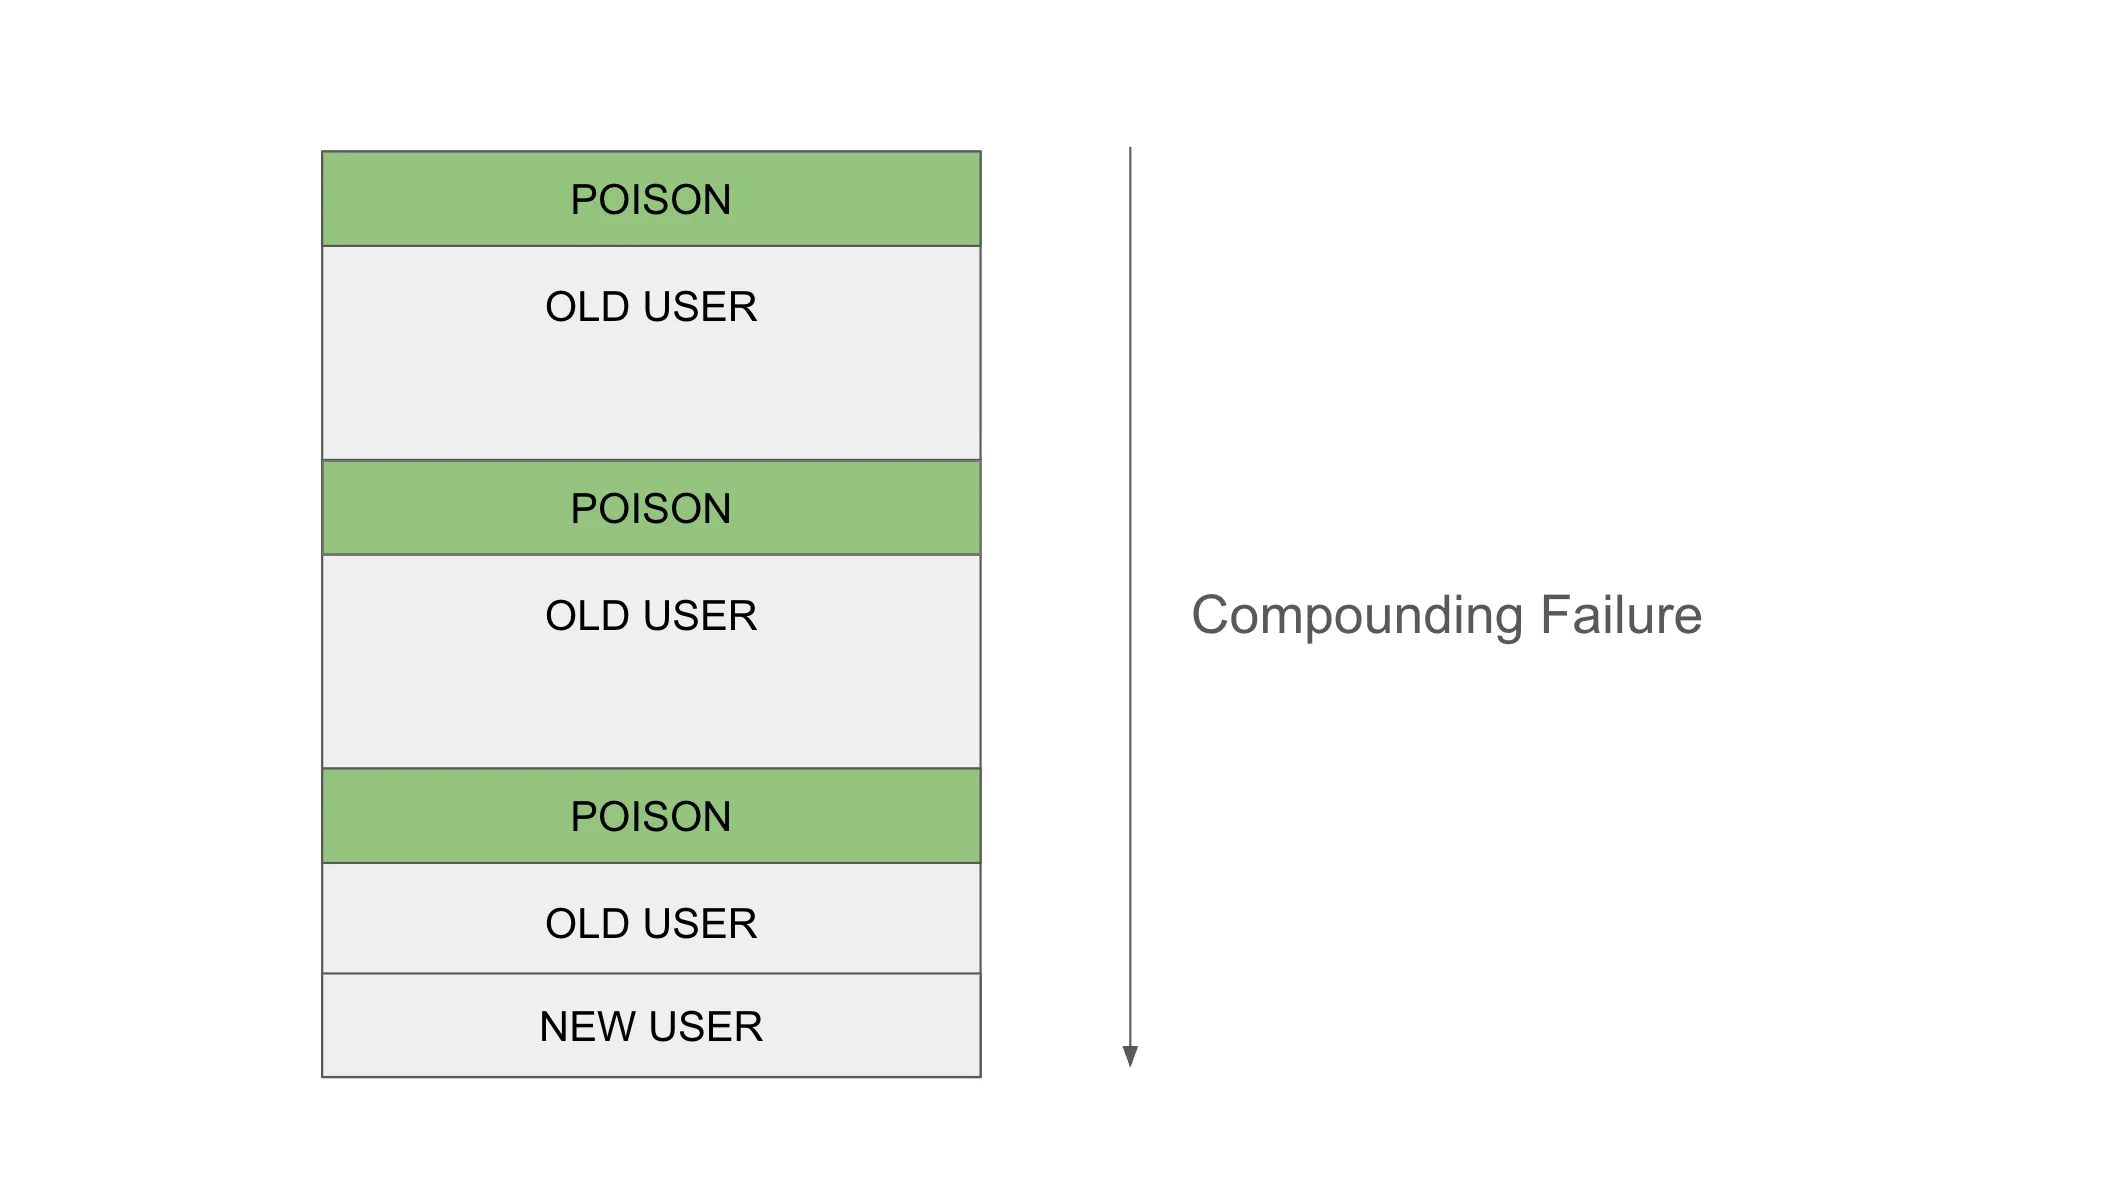
쿠크슈텔이 강조하는 것이 이 둘째다. 사용자는 언제나 가장 최근 메시지만 건드릴 수 있다. 앞에서 들어간 나쁜 정보는 매 턴 다시 제출되며 새 작업에 계속 영향을 준다. 그는 이것을 '맥락 오염(context pollution)'이라 부르고, 슬라이드에는 아예 '독(POISON)'이라고 적었다.
크게 보기출처: Kyle Kukshtel, 「Your Game Is A Harness」(2026). 오염은 지워지지 않고 쌓이며, 실패는 복리로 커진다.
아래 도구로 직접 쌓아 보자. 특히 '매 턴 붙이는 결과 확인 자료'를 바꿔 보면, 뒤에서 나올 '스크린샷 대신 diff' 이야기가 왜 중요한지 미리 보인다.
이것이 실제로 모델을 망가뜨리는 방식
'오염'이 비유만은 아니다. 2025년 6월 22일, 드루 브루니그(Drew Breunig)는 블로그 글 「긴 컨텍스트는 어떻게 실패하는가(How Long Contexts Fail)」에서 실패의 종류를 넷으로 나눴다. 쿠크슈텔이 슬라이드에 그대로 옮겨 실은 목록이다.
☠️
맥락 중독 (Context Poisoning)환각이나 오류가 컨텍스트에 들어가 거듭 참조되는 것. — 썩은 사과가 끝까지 따라오는 경우.
🌀
맥락 산만 (Context Distraction)컨텍스트가 너무 길어져 모델이 학습으로 배운 것은 소홀히 하고 컨텍스트에만 매달리는 것.
🧩
맥락 혼동 (Context Confusion)필요 없는 내용이 컨텍스트에 있어서 모델이 그것을 끌어다 질 낮은 답을 만드는 것.
⚔️
맥락 충돌 (Context Clash)새로 쌓인 정보·도구가 컨텍스트의 다른 정보와 서로 어긋나는 것.
'중독'이라는 이름은 사실 브루니그가 지은 것이 아니다. 구글 딥마인드는 2025년 7월 공개한 제미나이 2.5 기술 보고서에서, 독립 개발자 조엘 장(Joel Zhang)이 제미나이에게 「포켓몬스터 블루」를 처음부터 끝까지 플레이시킨 실험을 길게 분석했다. 거기에 이런 문장이 있다.
"목표, 요약 같은 컨텍스트의 여러 부분이 게임 상태에 대한 잘못된 정보로 '중독'되는 경우가 있었고, 이를 되돌리는 데는 흔히 아주 오랜 시간이 걸렸다. 그 결과 모델은 불가능하거나 무관한 목표에 집착하곤 했다."
같은 보고서는 컨텍스트가 10만 토큰을 크게 넘어서자 에이전트가 "새 계획을 짜기보다 방대한 기록 속 행동을 되풀이하는 쪽으로 기울었다"고도 적었다. 모델이 앞 차례의 말만 따라 하게 된 것이다.
길이 자체도 문제다. 2025년 7월 벡터 DB 회사 크로마(Chroma)는 「컨텍스트 부패(Context Rot)」 보고서에서 18개 모델을 시험했다. 같은 질문에 필요한 부분만 추린 약 300토큰을 주었을 때와, 관련 없는 대화까지 다 포함한 약 11만 3천 토큰을 주었을 때를 비교하면, 모든 모델이 앞쪽에서 눈에 띄게 잘했다. 보고서의 결론은 이렇다. "모델은 컨텍스트를 고르게 쓰지 않는다. 입력이 길어질수록 성능은 점점 믿을 수 없게 된다." 2023년 스탠퍼드 연구진의 「중간에서 길을 잃다(Lost in the Middle)」도 같은 이야기를 먼저 했다. 정답 문서가 입력의 한가운데 있으면 GPT-3.5-터보의 정확도가 20%p 넘게 떨어졌고, 최악의 경우에는 문서를 아예 주지 않았을 때(56.1%)보다도 낮았다.
그래서 '컨텍스트 엔지니어링'이 생겼다
이 제약에 맞서 생긴 새 기술 분야가 컨텍스트 엔지니어링(context engineering)이다. 2025년 6월 25일 안드레이 카파시가 "'프롬프트 엔지니어링'보다 '컨텍스트 엔지니어링'에 +1"이라며 "다음 단계에 딱 맞는 정보로 컨텍스트 창을 채우는 섬세한 기술이자 과학"이라고 쓰면서 이름이 퍼졌다. 그해 9월 29일 앤트로픽은 공학 블로그에서 이를 "목표 결과를 낼 가능성을 최대로 만드는, 가능한 한 작은 고신호(high-signal) 토큰 집합"을 찾는 일로 정의했다. 쿠크슈텔의 말로는 이렇다.
"어떻게 하면 최선의 정보를, 최소한의 오염으로, 컨텍스트에 넣을 수 있는가."
그리고 그는 결론으로 건너뛴다.
"다시 말해, LLM이 게임과 잘 일하게 만드는 것은 컨텍스트의 문제다. 게임이나 LLM이 본래 어떻다거나(혹은 어떻지 않다거나) 하는 것과 본질적으로 엮인 문제가 아니다."
이 한 문장이 발표 전체의 회전축이다. 'LLM은 게임에 약하다'를 모델의 능력 문제로 보면 할 수 있는 일은 다음 모델을 기다리는 것뿐이다. 컨텍스트의 문제로 보면, 게임 쪽에서 할 수 있는 일이 생긴다. 게임이 AI에게 내놓는 정보를 바꾸면 된다.
다만 게임은 그러기에 유독 까다롭다. 쿠크슈텔의 표현이 걸작이다.
"모든 게임은 특별하고 역겨운 한 송이 꽃이다(Every game is a special disgusting flower)."
게임 엔진은 있지만, 게임을 만드는 표준 도구는 사실상 없다. 웹에는 브라우저라는 공통 실행 환경과 DOM이라는 공통 구조가 있어서, AI가 웹앱을 들여다보는 도구 하나를 만들면 거의 모든 웹앱에 쓸 수 있다. 게임은 저마다 자기 필요를 자기 방식으로 드러낸다. 그래서 그 꽃 한 송이 한 송이마다 따로, AI가 붙잡을 손잡이를 달아 줘야 한다. 그 손잡이를 업계는 '하네스'라고 부른다.
3부. '하네스'라는 말은 어디서 왔나
말에서, 전선으로, 테스트로
영어 harness의 첫 뜻은 마구(馬具)다. 말의 힘을 수레에 전달하면서도 말이 제멋대로 가지 않게 하는 가죽끈 묶음. 힘을 쓰게 하면서 방향을 잡는 장치라는 이 이중성이 이 말의 모든 후손에게 그대로 내려온다. 등반가의 하네스는 몸을 자유롭게 움직이게 하면서 추락은 막고, 자동차의 와이어 하네스는 수백 가닥의 전선을 정해진 경로로 묶어 부품끼리 신호가 오가게 한다.
소프트웨어로 넘어온 것은 테스트 하네스(test harness)다. 시험하려는 코드를 둘러싼 드라이버(호출하는 쪽)와 스텁(대신 응답하는 쪽)의 묶음으로, 국제 소프트웨어 테스트 자격 위원회(ISTQB) 용어집의 정의로는 "테스트 묶음을 실행하는 데 필요한 드라이버와 테스트 더블의 모음"이다. 코드를 실제 환경에서 떼어 내 같은 입력을 몇 번이고 넣어 보고 결과를 기계적으로 확인하게 해 주는 장치다. 구글 엔그램(Ngram)으로 보면 이 말은 1985년부터 2000년 사이에 열 배 가까이 늘었다.
2020년 8월, AI 연구 커뮤니티 엘루서AI(EleutherAI)가 lm-evaluation-harness라는 저장소를 연다. 언어 모델에게 수백 가지 시험을 똑같은 형식으로 치르게 하는 도구다. 여기서 하네스는 '모델을 묶어 놓고 시험하는 틀'이 된다. 그리고 2024~2025년, 모델이 시험을 치르는 대상에서 일을 하는 주체로 바뀌면서 말의 뜻도 한 번 더 바뀐다.
에이전트 하네스: 모델이 아닌 모든 것
2024.5SWE-agent — '에이전트-컴퓨터 인터페이스'. 프린스턴 연구진은 같은 GPT-4 터보에게 리눅스 셸을 그대로 주는 대신 AI에 맞게 설계한 명령(파일을 100줄씩 보여 주는 뷰어, 검색 결과 요약, 편집할 때마다 문법 검사)을 주자 SWE-bench Lite 해결률이 11.0%에서 18.0%로 올랐다고 보고했다. 파일을 통째로 보여 주면 12.7%, 30줄씩 보여 주면 14.3%로 떨어졌다. "사람을 위해 설계된 인터페이스보다 LM에 맞춘 인터페이스가 낫다."
2025.2~5클로드 코드. 2월 24일 연구 미리보기, 5월 22일 정식 출시. 모델에 파일 읽기·편집·셸·검색 도구와 권한·컨텍스트 관리를 묶은 터미널 하네스.
2025.3~5제미나이, 포켓몬을 깨다. 813시간 만의 완주. 두 번째 판은 하네스를 다듬어 406.5시간 — 같은 모델, 절반의 시간.
2025.11앤트로픽 「장기 실행 에이전트를 위한 효과적인 하네스」. 클로드에게 claude.ai를 복제하게 하면서 200개 넘는 기능을 '전부 실패' 상태의 JSON 목록으로 주고, 브라우저 자동화 도구로 직접 눌러 보게 했다. "이런 테스트 도구를 주자 성능이 극적으로 좋아졌다."
2026.2'하네스 엔지니어링'이 이름을 얻다. 2월 5일 미첼 하시모토가 AI 적응기 여섯 단계 중 하나로 '하네스를 엔지니어링하라'를 꼽고, 11일 오픈AI가 「하네스 엔지니어링」 글을, 17일 랭체인이 모델은 그대로 두고 하네스만 고쳐 터미널-벤치 2.0 점수를 52.8%에서 66.5%로 올린 실험을 냈다.
2026.3~4정의가 굳다. 랭체인: "에이전트 = 모델 + 하네스. 하네스는 모델 자체가 아닌 모든 코드·설정·실행 로직이다." 마틴 파울러 사이트의 비르기타 뵈켈러: 하네스는 미리 방향을 주는 '가이드'와 결과를 감지하는 '센서'로 이뤄진다.
2026.9쿠크슈텔 「당신의 게임이 하네스다」. 하네스를 에이전트 쪽이 아니라 작업물 쪽에 짓자는 제안.
이 흐름에서 눈여겨볼 단어가 하나 있다. 오픈AI의 「하네스 엔지니어링」 글은 다섯 달 동안 사람이 손으로 쓴 코드 0줄, 약 100만 줄 규모의 제품을 만든 경험을 정리하면서, 저장소를 "무엇보다 먼저 코덱스가 읽을 수 있게(legibility) 최적화했다"고 썼다. 크롬 개발자 도구를 연결해 에이전트가 화면 스냅숏을 직접 찍게 하고, 작업 공간마다 로그·지표 수집기를 따로 띄웠다. 쿠크슈텔의 글 부제도 정확히 같은 단어를 쓴다. "게임을 AI 에이전트에게 더 읽히게(legible) 만드는 실용적인 방법." 2026년의 하네스 이야기는 결국 이 단어로 모인다. AI가 읽을 수 있는가.
같은 모델, 다른 하네스
하네스가 얼마나 중요한지는 숫자로 보면 분명하다.
사례
모델
하네스 A
하네스 B
SWE-agent (2024)
GPT-4 터보
리눅스 셸 그대로 11.0%
AI용 인터페이스 18.0%
포켓몬 블루 완주 (2025)
제미나이 2.5 프로
첫 하네스 813시간
다듬은 하네스 406.5시간
터미널-벤치 2.0 (2026.2)
GPT-5.2-코덱스
기본 52.8%
검증 단계 추가 66.5%
SWE-bench Verified (2026.9)
네모트론-3 550B
맥락 관리 없음 6.4%
맥락 관리 58.4%
터미널-벤치 2.1 (2025.11)
제미나이 3 프로
제미나이 CLI 65.8%
Terminus 2 73.9%
마지막 줄이 흥미롭다. 구글의 모델을 구글이 만든 하네스에 넣었을 때보다, 벤치마크 쪽이 만든 범용 하네스에 넣었을 때 8%p 높았다. 하네스는 모델 회사가 만들었다고 저절로 좋은 게 아니다. (리더보드의 하네스 간 차이는 통제 실험이 아니라 관찰값이라는 점은 감안해야 한다.)
포켓몬 사례는 쿠크슈텔의 주장과 거의 겹친다. 보고서에 따르면 제미나이 2.5 프로는 "게임보이 화면의 원시 픽셀을 직접 쓰는 데 애를 먹었고", 그래서 하네스가 게임의 메모리(RAM)에서 필요한 정보를 읽어 텍스트로 번역해 넣어 줘야 했다. 시각 정보를 통째로 빼 버리는 실험에서도 모델은 "시각 정보가 있을 때와 대략 비슷하게" 작동했다. 반대 실험도 있다. 2025년 5월 프린스턴의 비디오게임벤치(VideoGameBench)는 1990년대 게임 10개를 화면 픽셀만으로 하게 했는데, 가장 잘한 모델(제미나이 2.5 프로, 클로드 3.7 소네트)도 진행률이 0.48%였다. 게임 시작 부분을 넘지 못한 것이다.
같은 모델이 한쪽에서는 게임을 깨고, 다른 쪽에서는 첫 방을 못 나간다. 차이는 게임이 텍스트로 열려 있었느냐다.
하네스는 167개인데, 내 게임과 말하는 것은 없다
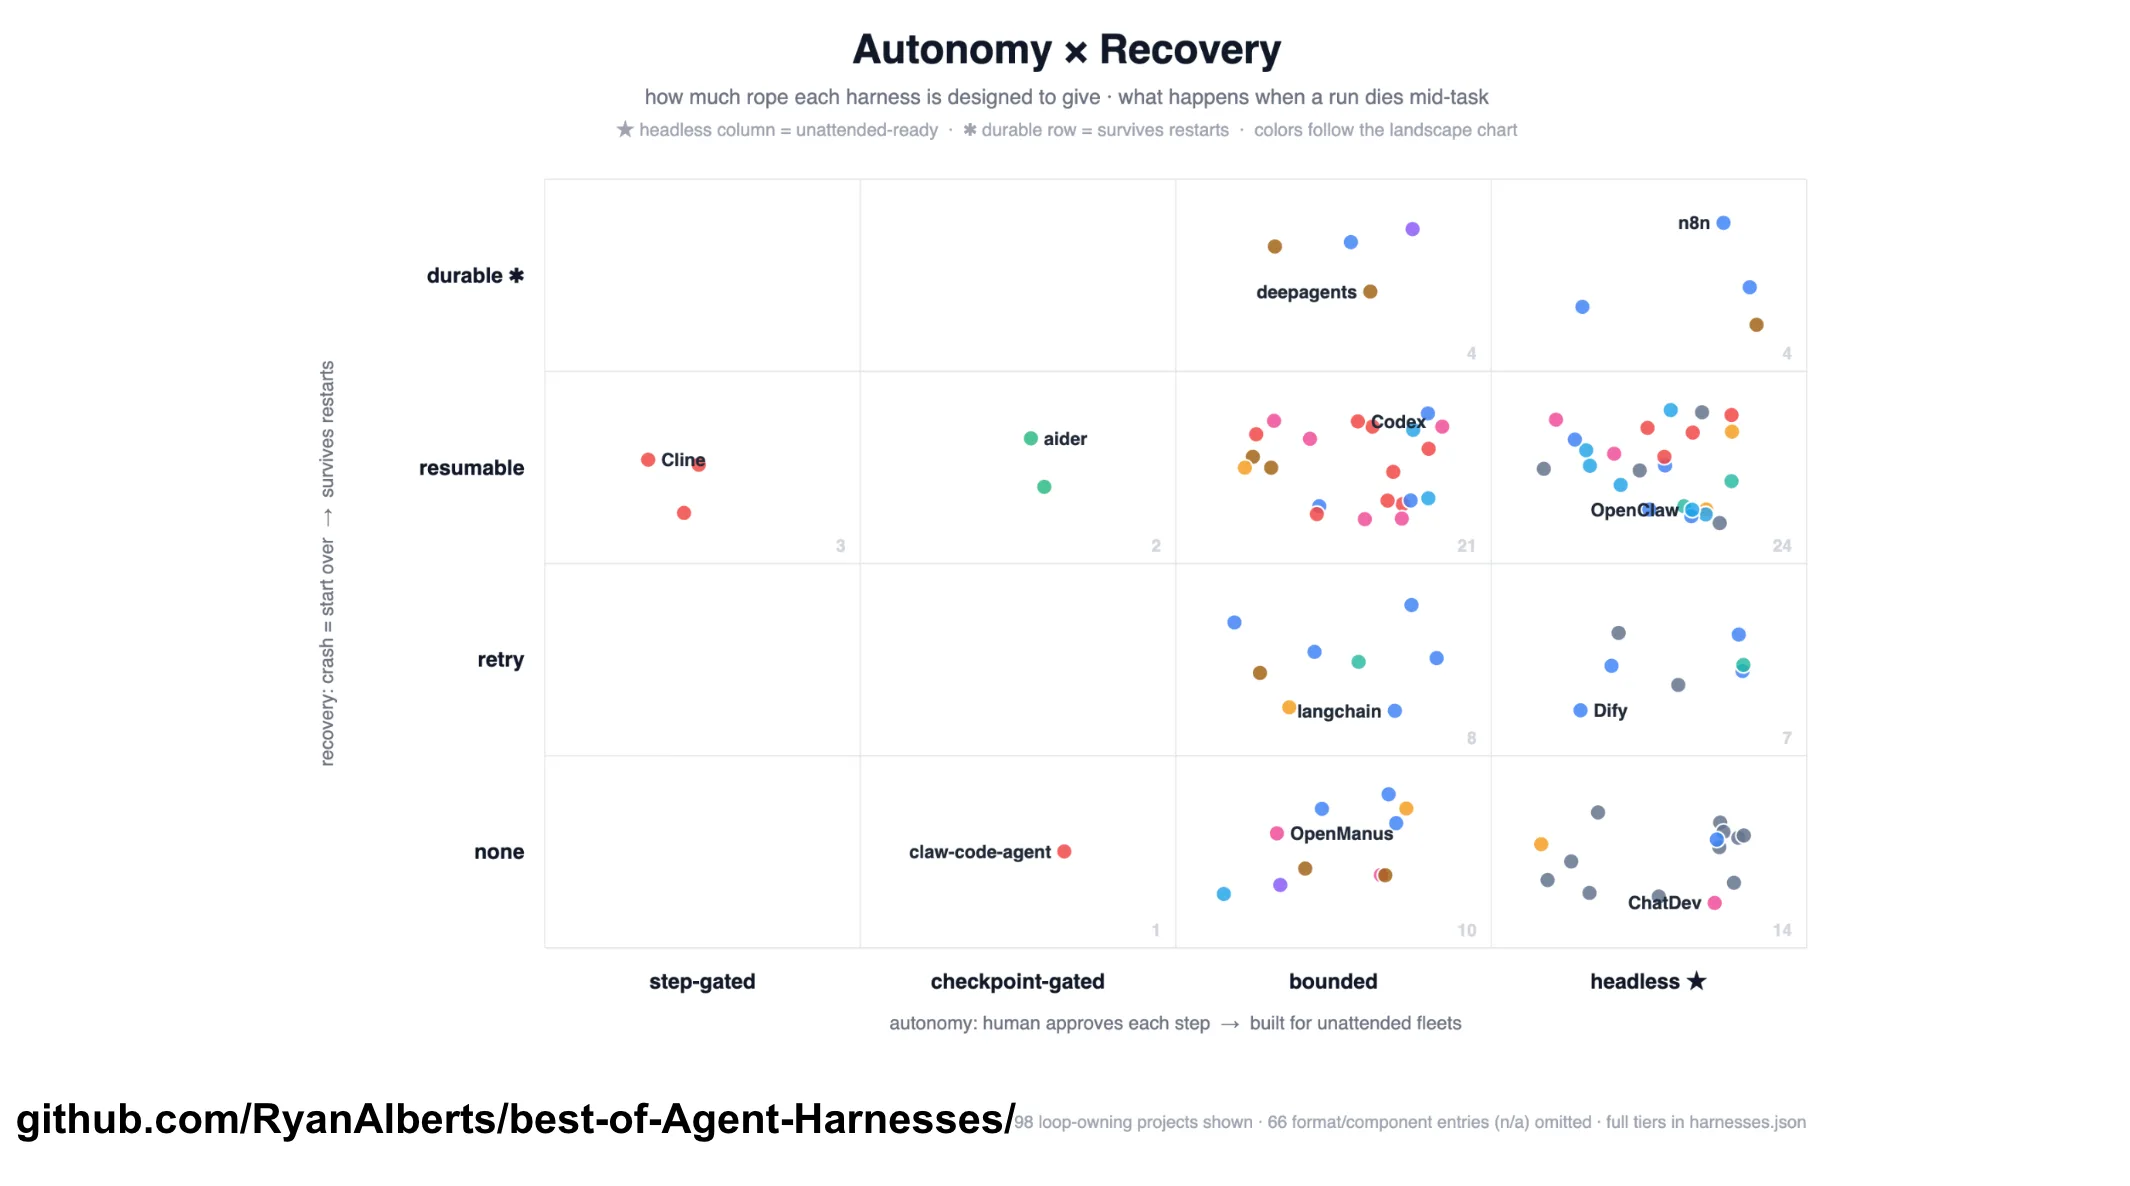
2026년 3월에 만들어진 깃허브 목록 「best-of-Agent-Harnesses」는 10월 현재 167개의 에이전트 하네스를 매주 다시 채점한다. 쿠크슈텔은 이 목록의 그림을 슬라이드에 실었다. 가로축은 자율성(사람이 한 단계씩 승인 → 체크포인트 승인 → 범위 제한 → 완전 무인), 세로축은 복구력(없음 → 재시도 → 재개 가능 → 영속).
크게 보기출처: github.com/RyanAlberts/best-of-Agent-Harnesses, 쿠크슈텔 발표 슬라이드에서 재인용. 오른쪽 위로 갈수록 사람 없이 오래 버티는 하네스다.
그는 이 하네스들이 가리키는 방향을 이렇게 요약한다. "내가 만드는 것을 어떻게 더 잘 이해하고, 만들어지는 과정을 어떻게 이끌 것인가." 브라우저를 띄워 반복하고, 텔레메트리와 프로파일링을 묶고, 티켓과 문서까지 만드는 하네스도 있다. 그런데 이 중 어느 것도 당신의 게임과 말을 잘 하지는 못한다. 게임은 여전히 블랙박스이고, AI에게 보이는 것은 '쓰여 있는 코드'뿐이다. 그리고 AI가 코드에 강하다는 건 이미 안다. 하네스를 아무리 좋게 만들어도 처음의 문제 — 게임은 코드만이 아니다 — 는 그대로 남는다.
그래서 해야 할 일은 하나다. 게임 속의 '코드가 아닌 것'을 AI가 다룰 수 있는 무언가로 바꾸는 것. 블랙박스를 열어 더 많은 부분을 LLM이 직접 가리킬 수 있게(addressable) 만드는 것. 쿠크슈텔은 발표에서 이걸 화살표 하나로 그렸다. '코드 + 백만 가지 다른 것'에서 '코드(지만 이제 코드가 더 많아진)'로 가는 화살표. 그리고 그 화살표를 가리키며 이렇게 말했다고 한다. "이 화살표가 이 발표의 실제 내용입니다." 블로그로 옮기니 농담이 영 안 산다고 그는 투덜거렸지만, 이 농담에는 정확한 뜻이 있다. AI를 게임에 맞추는 게 아니라, 게임을 조금씩 코드 쪽으로 옮기는 것.
뵈켈러의 구분을 빌리면 더 선명해진다. 그는 하네스를 에이전트에게 미리 방향을 주는 가이드(AGENTS.md 같은 지침, 규칙)와, 에이전트가 한 일을 감지해 되돌려 주는 센서(테스트, 린터, 타입 검사, 리뷰)로 나누고, 센서는 "LLM이 소비하기 좋게 최적화된 신호를 낼 때 특히 강력하다"고 썼다. 클로드 코드 같은 범용 하네스는 가이드와 손발을 준다. 하지만 게임의 센서 — 지금 무엇이 바뀌었는지, 더 나아졌는지, 성능이 나빠졌는지를 알려 주는 장치 — 는 범용 하네스가 대신 만들어 줄 수 없다. 그 센서를 게임 안에 심는 것, 이것이 '당신의 게임이 하네스다'의 정확한 뜻이다.
4부. 게임을 AI에게 읽히게 만드는 일곱 가지 방법
여기서부터가 발표의 본론이다. 쿠크슈텔은 처방 전체를 꿰는 한 단어를 먼저 내놓는다. 결정성(determinism). 게임의 아주 특정한 상태를 얼마나 정확하게 다시 만들 수 있는가. 목표는 "아주 쉽고, 아주 정확하게"다.
그리고 경고를 붙인다. 이것을 개발 막바지에 하려고 하면 "매우 어렵고", 마지막 순간에 게임의 근본을 뜯어고쳐야 할 것이다. 반대로 첫 줄의 코드를 쓰기 전에 이 제약을 받아들이고 끝까지 지키면, 엔트로피와 스파게티 코드와 싸우는 대신 훨씬 생산적인 막판을 맞게 된다.
① 고정 시드 — 같은 판을 다시 만들 수 있는가
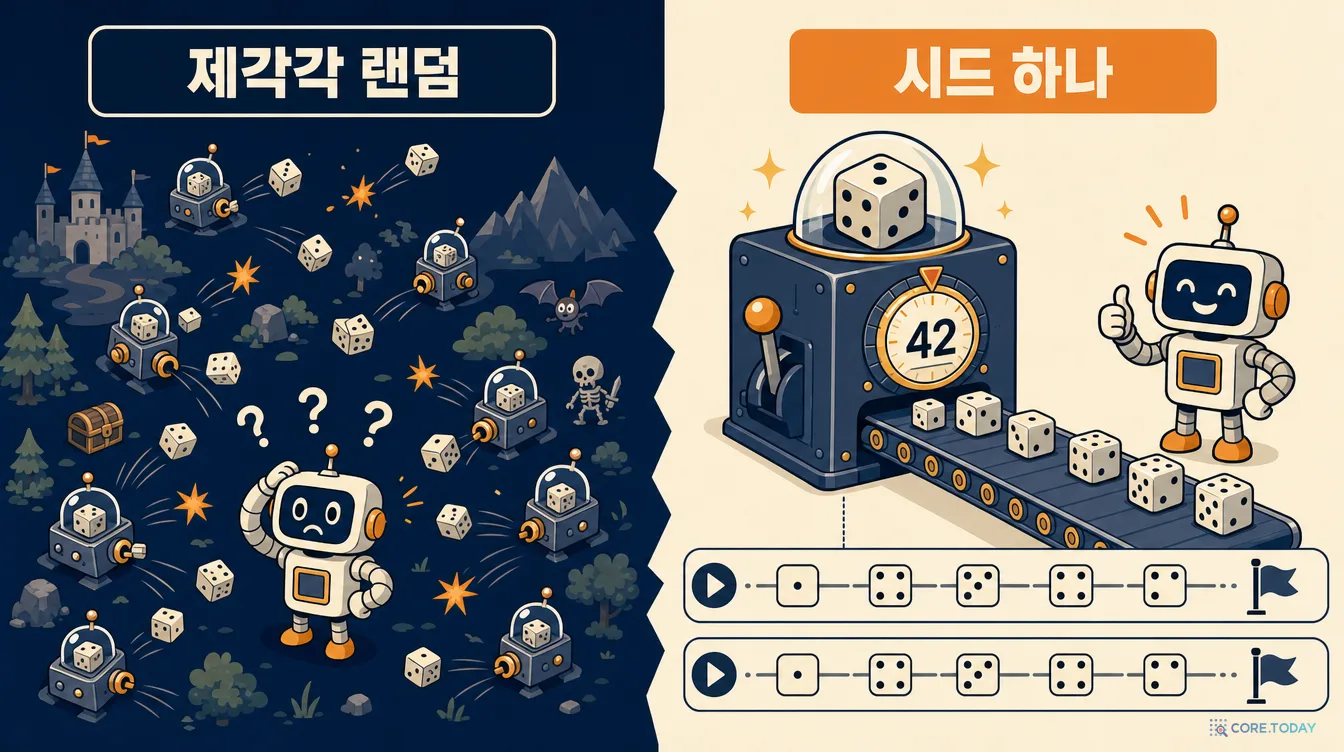
시작은 가장 쉬운 일이다.
"게임이 시작할 때 시드가 있는 난수원 하나를 만들어라. 비결정적인 것을 부르는 모든 호출이 이 난수원을 쓰게 하라. … 코드가 게임플레이를 정하려고 Random.Float 같은 것을 30군데에서 부른다면, 30번째 호출은 매번 같다. 쉽다."
컴퓨터의 '난수'는 대부분 진짜 무작위가 아니다. 시작값(시드) 하나에서 정해진 계산으로 숫자를 줄줄이 뽑아내는 의사난수다. 시드가 같으면 수열도 같다. 그러니 게임의 모든 '운'이 한 수열에서 나오면, 시드 하나만 알면 그 판의 모든 운을 그대로 되살릴 수 있다.
이건 게임 업계가 아주 오래전에 배운 교훈이다. 1993년 12월에 나온 「둠(DOOM)」은 플레이를 녹화한 데모 파일(.lmp)을 남길 수 있었다. 이 파일에는 화면이 아니라 1/35초마다 플레이어의 입력 — 앞으로 얼마나, 옆으로 얼마나, 몇 도 돌았는지, 어떤 버튼을 눌렀는지 — 만 4바이트쯤씩 들어 있다. 1초에 140바이트. 그걸로 한 판 전체가 재생된다. 그게 가능하려면 게임이 같은 입력에 언제나 같은 결과를 내야 한다. 1997년 공개된 둠 소스의 m_random.c에는 256칸짜리 난수표 하나를 두 개의 커서가 따로 읽는 코드가 있다. P_Random()은 "플레이 시뮬레이션에서만 쓰고", M_Random()은 나머지 전부(화면 효과, 메뉴)에 쓴다. 주석에는 "어느 쪽이 결정적인가?"라는 질문과 "데모를 위해 난수를 고정한다"는 말이 적혀 있다.
이 분리가 중요한 이유를 아래 실험에서 직접 볼 수 있다. 세 번째 버튼이 바로 둠 개발자들이 피하려 했던 함정이다.
시드는 버그 재현 도구이기 전에 게임 디자인 도구이기도 했다. 2013년 7월 PC판 「스펠렁키(Spelunky)」의 '데일리 챌린지'는 그날 모든 플레이어에게 똑같은 시드의 던전을 한 번씩만 주고 순위를 매겼다. 「슬레이 더 스파이어(Slay the Spire)」는 사용자 지정 모드에서 시드를 직접 입력하게 해 '이 시드 좋더라'를 커뮤니티가 주고받는다. 흥미롭게도 슬레이 더 스파이어의 (커뮤니티가 디컴파일한) 코드는 몬스터·카드·유물·상점·포션용 난수열을 따로 두고, 그 전부를 한 판의 시드에서 파생시킨다. '시드 하나'는 '수열 하나'가 아니라 '근원 하나'라는 뜻이다. 한 시스템이 난수를 하나 더 뽑아도 다른 시스템의 운이 밀리지 않게.
반대로 많이 쓰이는 엔진의 기본값은 이 원칙과 거리가 있다. 유니티의 UnityEngine.Random은 프로세스 전체가 공유하는 전역 생성기 하나다. 공식 문서도 독립적인 생성기가 필요하면 System.Random 인스턴스를 따로 만들라고 권한다. 전리품 드롭과 총알 퍼짐이 한 생성기를 나눠 써서 서로를 흔드는 일은 유니티 포럼의 단골 질문이다.
왜 이게 AI에게 중요한가. 쿠크슈텔의 설명은 단순하다. 에이전트는 무언가를 고치려고 같은 시도를 수십 번 반복한다. 그때마다 "처음부터 같은 상태에 다시 도달할 수 있어야 하고, 상태 재현에 실패하느라 헛바퀴를 돌면 안 된다." 사람도 마찬가지다. 「팩토리오(Factorio)」 개발자 랍 세딩(Rseding)은 2024년 6월 개발 블로그에 이렇게 썼다.
"보고된 버그를 고치는 데 드는 시간의 90~95%는 아마 그 버그를 내 컴퓨터에서 재현할 수 있게 만드는 데 들 것이다."
그 글에서 그가 다룬 버그는 2017년 7월부터 7년 가까이 숨어 있던 멀티스레드 비결정성이었고, CPU 코어 수가 다른 컴퓨터끼리 할 때만 나타났다. 재현이 전부라는 말이다. 그리고 재현을 기계가 할 수 있게 되면, 고치는 일도 기계가 할 수 있게 된다.
② 스크린샷과 이미지 diff — 무엇이 바뀌었나
상태를 재현할 수 있게 됐다면, 다음 질문은 "그래서 바뀌었는지 어떻게 아나"다. 첫 번째 답은 스크린샷이다. 대부분의 엔진에는 이미 기능이 있다. 유니티의 ScreenCapture.CaptureScreenshot, 고도(Godot)의 뷰포트 텍스처, 언리얼의 콘솔 명령 Shot(기본 단축키 F9). 쿠크슈텔은 여기에 하나를 더 권한다. UI 레이어, 게임플레이 레이어 등을 쉽게 켜고 끌 수 있게 하라. UI의 글꼴 문제를 고치려는데 화면 뒤에서 전투가 벌어지고 있으면 LLM의 주의가 흩어진다. 슬라이드에는 "찍기 전에 버퍼를 걸러서, 원하는 것만 남겨라"라고 적었다.
변경 전과 후를 찍어 에이전트에게 보여 주면, 에이전트가 무엇이 바뀌었는지 이해할 수 있다. …과연 그럴까?
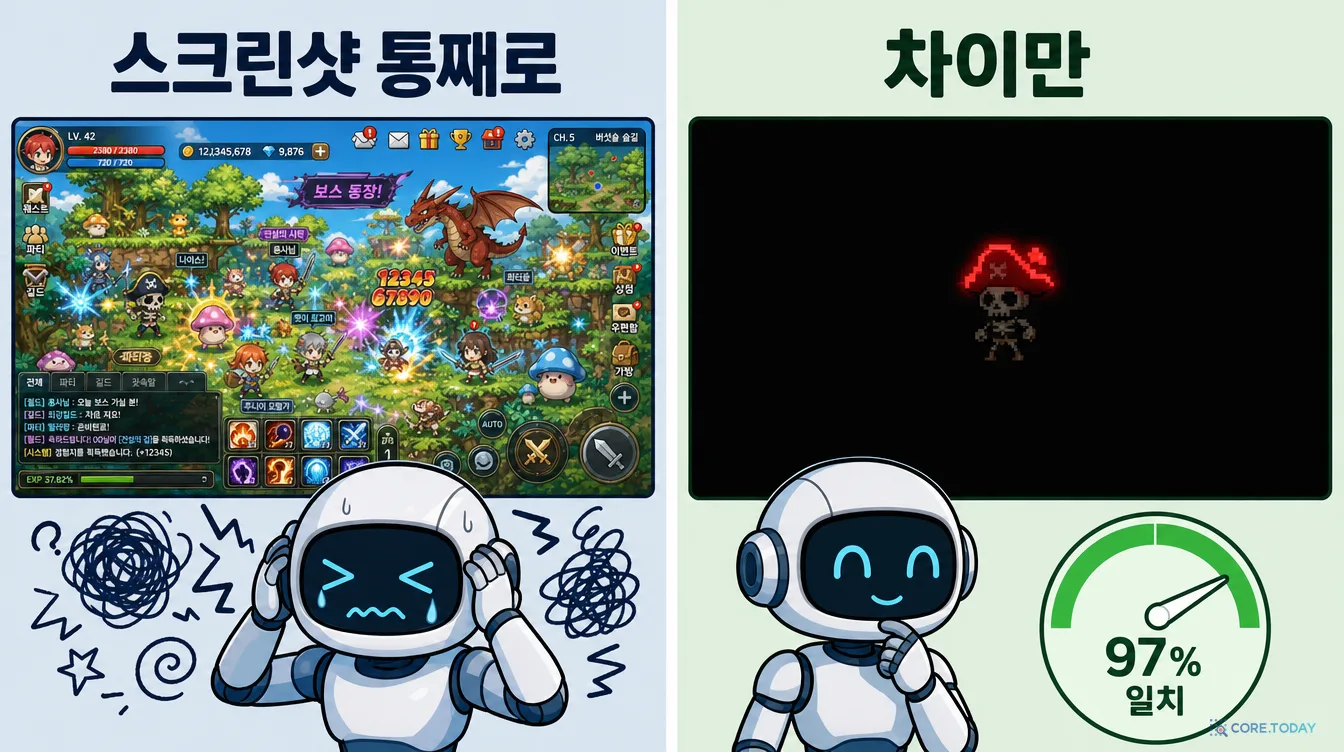
쿠크슈텔의 답은 '아니다'에 가깝다. 시각 능력이 있는 멀티모달 모델이라도 두 장의 스크린샷을 받으면 "무엇이 바뀌었는지 이해하는 것도, 그 변화가 목표에 가까워진 것인지 판단하는 것도 아주 어려워한다." 그는 이것을 이미지판 컨텍스트 부패라고 부른다. "스크린샷을 순진하게 모델에 던지면 모델 자신의 진척 감각이 흐려져서, 모델도 당신도 헷갈리게 된다."
그는 인디 로데오 홈페이지로 예를 들었다. 행사장 일러스트 속 해골 하나를 가리키며 "이 해골을 해적으로 바꿔 줘"라고 요청한다고 하자. 구글이 2025년 5월 공개한 UI 디자인 도구 스티치(Stitch)처럼 이미지 위에 주석을 달 수 있다 해도, 모델에게 넘어가는 것은 이미지 전체다. 바꾸고 싶은 해골 하나와 함께, 건드릴 생각이 없는 나머지 전부가 따라간다. 슬라이드에서 그는 그 나머지를 초록색으로 칠했다. 그 초록 전부가 '맥락 오염'이다. 모델은 해골만이 아니라 그림 전체를 생각하게 된다.
비용도 있다. 앤트로픽의 비전 문서에 따르면 이미지는 대략 (가로 픽셀 × 세로 픽셀) ÷ 750 토큰을 쓴다. 1092×1092 화면 한 장이 약 1,590토큰이다. 앞의 '시장에 가면' 도구에서 '전체 스크린샷 1장'을 골랐을 때 막대의 주황색이 무섭게 자란 이유다. 매 턴 찍어 붙인 화면은 매 턴 다시 읽힌다.
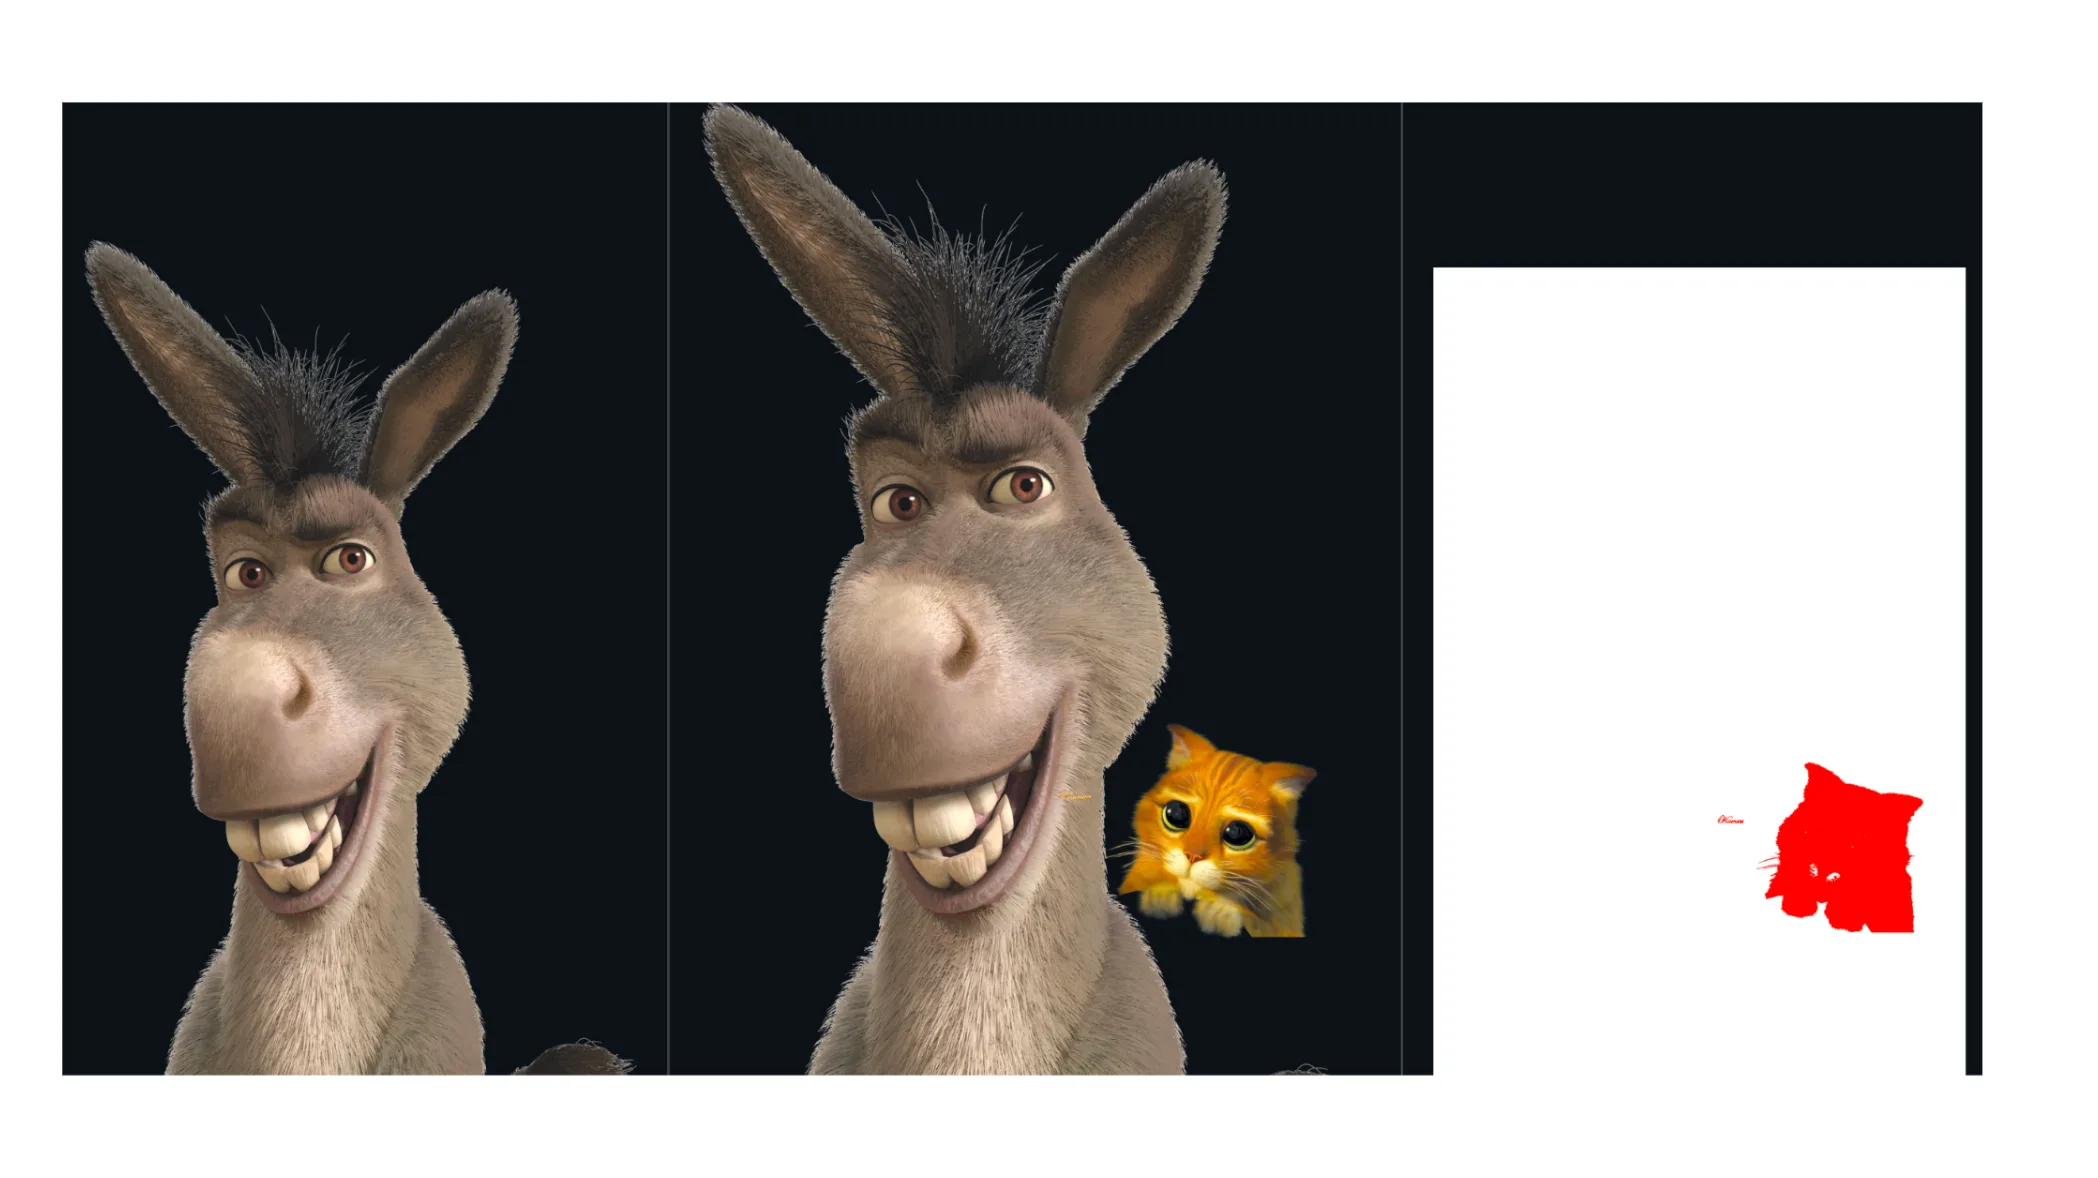
그래서 필요한 것이 이미지 diff다. 코드 변경을 diff로 보듯, 두 이미지를 픽셀 단위로 비교해 다른 곳만 남긴다. 잘 자르기까지 하면, LLM은 "변경 후의 결과가 내가 준 목표 이미지에 얼마나 가까운지"를 정량적으로 알 수 있다. 쿠크슈텔의 슬라이드는 이렇게 정리한다.
입력 → 목표
→
'이미지 통째' 비교
→
컨텍스트 부패
입력 → 목표
→
DIFF
→
바뀐 것만 비교 = '순수한 신호'
그가 추천하는 도구는 odiff다. 드미트리 코발렌코가 2020년 11월 시작한 무료 명령줄 도구로, 원래 OCaml로 짰다가 지금은 SIMD 명령을 쓰는 Zig로 다시 썼다. 저장소 첫 줄의 자랑은 "세계에서 가장 빠른(단일 스레드) 픽셀 단위 이미지 비교 도구"다. 저장소에 실린 벤치마크로는 웹 페이지 한 장을 비교하는 데 odiff 1.17초, 같은 일을 하는 자바스크립트 라이브러리 pixelmatch가 7.71초, 이미지매직이 8.88초였다. 사람 눈에 비슷하게 보이는 색 차이를 재려고 YIQ 색 공간을 쓰고, 안티에일리어싱(경계를 부드럽게 하려고 섞인 픽셀)은 차이에서 빼는 옵션이 있다. 결과는 diff 이미지와 함께 다른 픽셀 수와 비율로 나온다.
크게 보기출처: Kyle Kukshtel, 「Your Game Is A Harness」(2026) 슬라이드. 두 그림의 차이(고양이)만 빨갛게 남았다. 에이전트에게 필요한 정보는 이 오른쪽 그림, 그리고 '몇 % 다른가'라는 숫자다.
쿠크슈텔이 특히 강조하는 것은 그 숫자다. odiff는 "85% 비슷하다" 같은 값을 줄 수 있는데, LLM은 이런 값을 아주 잘 읽는다. 그러면 그 숫자가 에이전트의 매 턴에 걸쳐 안정된 평가 기준선이 된다. 에이전트는 차이를 줄이는(유사도를 높이는) 쪽으로 계속 움직이면 된다. 스크린샷 → 진척 diff 확인이라는 짧은 고리가 "지속적인 에이전트 평가의 토대"가 되는 것이다.
이건 웹 개발자들에게는 익숙한 이야기다. 2014년의 BackstopJS, 2015년 맵박스가 "테스트에서 스크린샷을 비교하려고" 만든 pixelmatch, 2020년 브라우저스택이 사들인 퍼시(Percy), 그리고 플레이라이트의 toHaveScreenshot()까지, 시각 회귀 테스트는 웹 프런트엔드의 오래된 표준이다. 쿠크슈텔이 한 일은 그것을 게임으로, 그리고 사람 대신 에이전트를 위한 신호로 옮긴 것이다. 클로드 코드 공식 문서의 모범 사례도 같은 지점을 짚는다.
"클로드에게 실행할 수 있는 검사를 줘라: 테스트, 빌드, 비교할 스크린샷. 그것이 지켜봐야 하는 세션과, 자리를 떠도 되는 세션의 차이다." … "클로드는 일이 끝나 보이면 멈춘다. 실행할 검사가 없으면 '끝나 보인다'가 유일한 신호이고, 당신이 검증 루프가 된다."
클로드 코드를 만든 보리스 체르니는 2026년 초 자기 작업 방식을 공개하면서 "클로드에게 자기 일을 검증할 방법을 주는 것"이 가장 중요하며, 그런 피드백 고리가 있으면 결과물의 질이 2~3배 좋아진다고 했다(벤처비트 보도, 그의 체감 추정치다).
아래 실험실에서 이 차이를 직접 보자. 두 에이전트는 똑같이 서툴다. 한쪽만 숫자를 받는다.
물론 이게 전부는 아니다. 게임은 시각 요소 이상이다. 쿠크슈텔은 "진척(PROGRESS)"이라는 칸이 다시 작은 안쪽 고리로 쪼개진다고 말한다. 앞의 플라이휠 그림이 그것이다. 고정 시드, 결정적 상태, 주소 지정 상태, 검증 가능한 상태, 영향 평가. 에이전트는 대부분의 시간을 이 안쪽 고리에서 보낸다. 시각적 변화가 있을 때만 바깥의 스크린샷 비교로 나온다. 목표는 모든 변경을 원하는 결과에 필요한 최소한의 변경으로 만들고, 그 변경을 빠르게 검증하는 것. 그 위에 무엇을 쌓아도 넓게 번지는 기술 부채(즉 스파게티)가 생기지 않도록, "믿을 수 있을 만큼 안정되고 '지루한' 기반"을 만드는 것이다.
③ 결정적 상태 — 나무도 개다
결정적 상태에 얼마나 가까운지 알아보는 질문은 하나다.
"게임의 정확한 상태를 얼마나 쉽게 저장하고 불러올 수 있는가?"
저장/불러오기는 아마추어 개발자들이 게임 마지막에 미루는 기능이다. 쿠크슈텔은 이것을 "중대한 실수"라고 부른다. 저장과 불러오기를 '언젠가 추가할 기능'으로 보지 말고, 개발 첫날부터 그것과 함께 프로그래밍하면 "셀 수 없이 많은 이점이 있는 개발 초능력"이 된다는 것이다.
그 방법으로 그는 객체 지향 프로그래밍(OOP) 이론에 대한 작은 도발을 내놓는다.
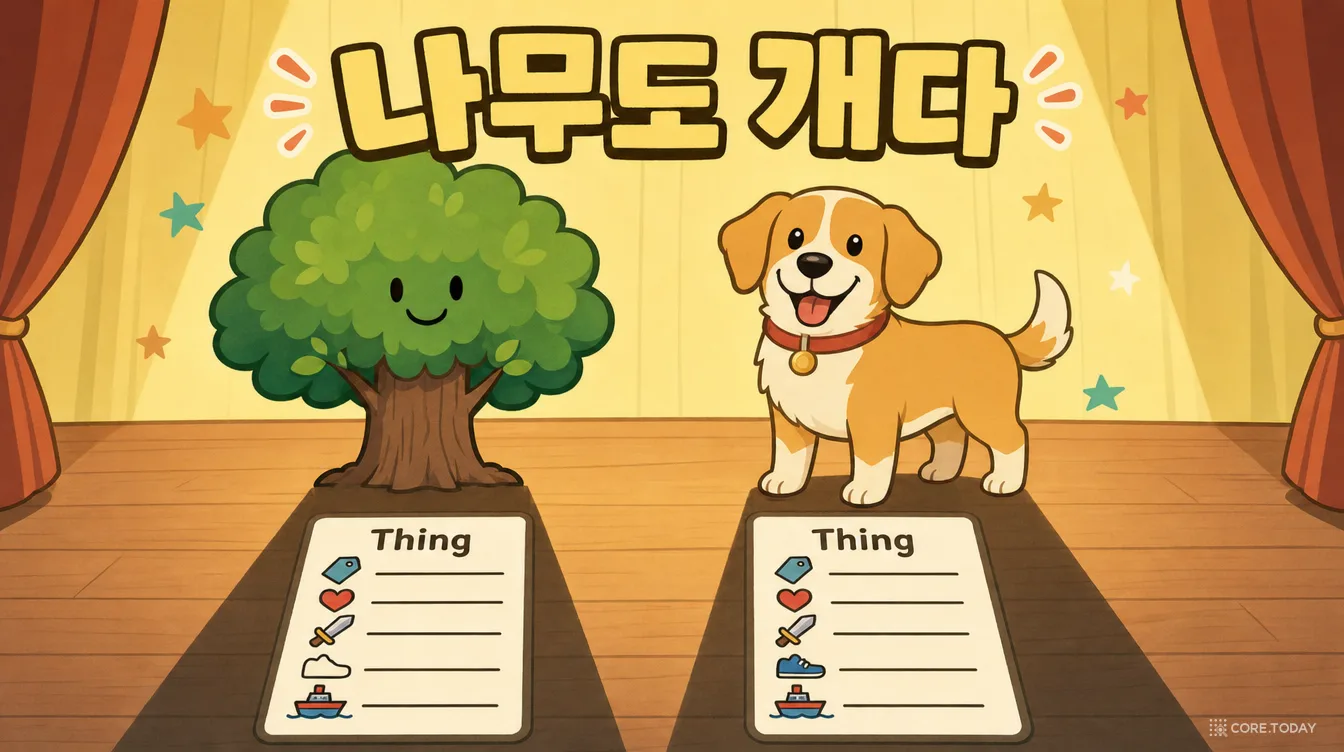
"나무는 개다(A Tree is a Dog)."
게임을 OOP로 오래 만들어 본 사람은 프로젝트 끝 무렵에 이 이상한 문장이 참이라는 걸 깨닫는다는 것이다. 처음에는 Tree 클래스와 Dog 클래스가 서로 다른 상속 계층에 있다. 그런데 게임에서 실제로 하는 일을 보면, 나무는 메시와 충돌체를 가진 물체이고, 개는 메시와 충돌체를 가지고 움직일 수 있는 물체다. '움직임'은 개만의 성질이 아니다. 게임의 다른 것들도 움직인다. 결국 나무와 개는 '게임 속 표현을 가진 부품들의 조합'일 뿐이고, 코드 입장에서는 사실상 같은 종류다.
그래서 그의 제안은 처음부터 모든 것이 같은 것이라고 가정하는 것이다. 타입 이름도 아예 Thing으로 해도 좋다고 한다. 그가 슬라이드에 그린 Thing은 이렇게 생겼다.
csharp
struct Thing
{
ThingType Type; // enum: Player, Dog, Tree, Boat, GameManager ...bool isAlive; // 모든 것이 공유하는 '살아 있음'int attackDamage;
int walkSpeed;
int boatSpeed;
// ... 게임에 존재할 수 있는 모든 오브젝트의 모든 필드
}
'모든 가능한 오브젝트를 담는다'는 뜻에서 이런 구조체를 팻 스트럭트(fat struct, 뚱뚱한 구조체)라고 부른다. 나무의 walkSpeed는 0이고, 개의 boatSpeed도 0이다. 쓰지 않는 칸은 그냥 비워 둔다. 무엇을 할지는 Type 값을 보고 코드가 정한다.
그리고 쿠크슈텔은 슬라이드에 커다랗게 썼다. "AI는 이걸 좋아한다! (나도 좋아한다)"
이유는 컨텍스트로 돌아간다. 오브젝트 종류마다 클래스가 100개 있다면, AI는 무언가 하나를 바꾸려고 그 100개와 그 사이의 관계를 이해해야 한다. 컨텍스트가 찬다. 그리고 판단이 애매해진다. "기존 클래스를 상속할까? 클래스의 성격을 바꿔 새 것을 담을까? 새 클래스를 만들까? 말하기 어렵다!" 단일 타입이면 애매함이 없다. AI는 매번 정확히 어디를 고쳐야 하는지 안다.
저장과 불러오기도 극적으로 쉬워진다.
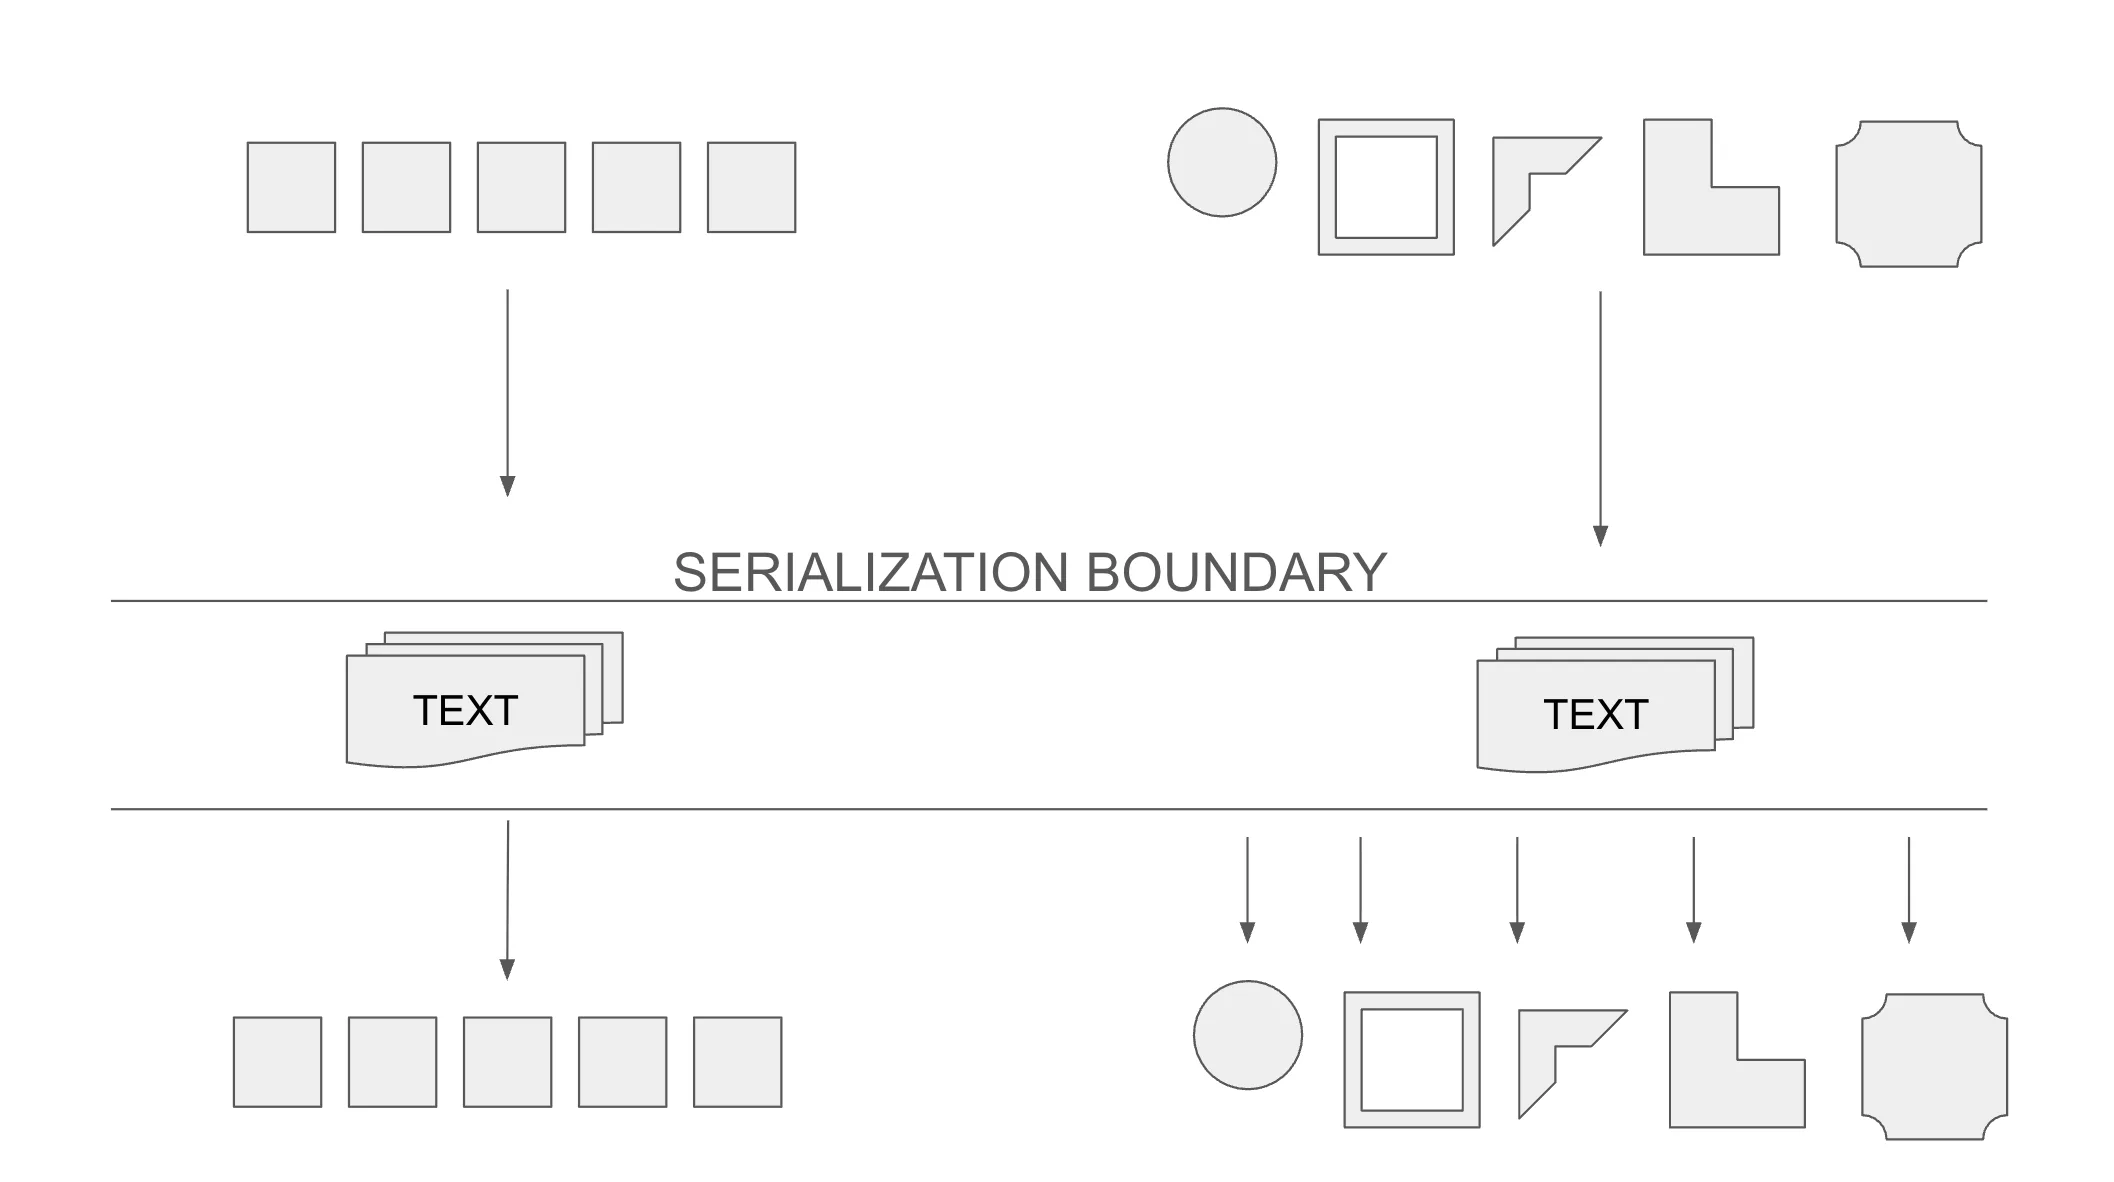
크게 보기출처: Kyle Kukshtel, 「Your Game Is A Harness」(2026). 타입이 하나면 직렬화의 입구도 출구도 하나다(왼쪽). 타입이 여럿이고 상속 트리까지 있으면 복원 경로가 갈라진다(오른쪽).
타입이 하나면 직렬화·역직렬화는 하찮은 일이 된다. "들어가는 길 하나, 나오는 길 하나." 타입이 여럿이고 상속 트리까지 있으면, 객체와 자식 트리를 이상한 순서로 다시 이어 붙여야 하는 경쟁 상태 같은 역직렬화 경로에 빠지고, '다형성 역직렬화' 같은 개념과 씨름하게 된다. 그는 이렇게 덧붙인다. "그런 것을 알고 필요할 때 쓰는 건 좋다. 하지만 게임에서는 거기에 용이 산다(There Be Dragons)." 게임은 결국 Thing의 거대한 목록이고, 저장은 그 목록을 한 경로로 쓰는 것, 불러오기는 그 반대다. 상태 자체도 같은 체계로 담긴다. 모든 구조체에 '턴 번호' 필드를 두고, 타입이 GameManager인 Thing을 만들어 말 그대로 모든 일을 시켜도 된다. 그리고 "아니, 생각만큼 메모리를 많이 먹지 않는다."
이 생각에는 족보가 있다. 쿠크슈텔 자신도 "이걸 말하는 첫 사람과는 거리가 멀다"고 말한다.
1998「시프: 다크 프로젝트」. 1999년 포스트모템에서 톰 레너드는 이렇게 썼다. "「시프」에는 코드로 된 게임 오브젝트 계층이 어떤 종류도 없었다." 오브젝트 시스템은 "시뮬레이션 속 개별 오브젝트를 관리하는 범용 데이터베이스"였고, 디자이너가 프로그래머와 무관하게 속성과 관계를 조합했다.
2002「던전 시즈」, 스콧 빌라스의 GDC 발표 「데이터 주도 게임 오브젝트 시스템」. 고유한 오브젝트 종류 7,300개 이상, 배치된 오브젝트 10만 개 이상을 상속 대신 컴포넌트 조합으로 다뤘다.
2007애덤 마틴, 「엔티티 시스템이 MMOG 개발의 미래다」. "엔티티는 사실 이름 하나일 뿐이다." 오늘날 ECS(엔티티-컴포넌트-시스템)라 불리는 설계가 이름을 얻었다.
2017「오버워치」 GDC 발표. 팀 포드가 ECS 기반 게임플레이 구조와 넷코드를 공개했다.
2025캐시 무라토리와 「드림즈」. 무라토리는 팻 스트럭트를 꾸준히 옹호해 왔고, 쿠크슈텔은 PS4 창작 게임 「드림즈」를 만든 미디어 몰레큘의 알렉스 에반스·안톤 미하일로프가 '게임 아키텍처'를 이야기한 와쿠시(Wookash) 팟캐스트 에피소드(2025년 11월)를 추천한다.
엄밀히 말하면 팻 스트럭트와 ECS는 같지 않다. ECS는 엔티티를 이름표로 두고 데이터를 컴포넌트별 배열에 흩어 놓는 반면, 팻 스트럭트는 모든 필드를 한 구조체에 몰아넣는다. 하지만 둘은 같은 적과 싸운다. 깊은 상속 계층. 그리고 같은 것을 얻는다. 데이터가 한 모양이라는 것, 그래서 기계가 — 이제는 AI가 — 다루기 쉽다는 것.
대조가 되는 사례도 하나 있다. 시간을 되감는 퍼즐 게임 「브레이드(Braid)」의 조너선 블로는 2010년 GDC에서 되감기를 입력 기록이 아니라 상태 스냅숏으로 구현했다고 설명했다. 콘솔에서 40MB로 30~60분 분량을 담았다. 결정성을 얻는 길이 하나만은 아니라는 뜻이다. 다만 어느 길이든, 상태를 한 모양으로 다룰 수 있어야 한다는 점은 같다.
④ 주소 지정 가능한 상태 — 명령 패턴
오브젝트 타입이 하나가 되면 상태의 변화를 붙잡기도 쉬워진다. 모든 변화가 결국 같은 타입을 겨냥하기 때문이다. 여기서 쿠크슈텔은 오래된 디자인 패턴 하나를 꺼낸다. 명령 패턴(Command Pattern)이다.
슬라이드의 설명은 간단하다. myObject.hp += 1처럼 값을 직접 바꾸는 대신, 변화 자체를 (되도록 직렬화 가능한) 객체로 만든다.
이 명령들은 처리기로 넘어가고, 오브젝트를 실제로 바꾸는 것은 내가 아니라 처리기다. 1994년 '4인방(Gang of Four)'의 『디자인 패턴』이 "요청을 객체로 캡슐화하라"고 정리한 바로 그 패턴이고, 로버트 나이스트롬의 『게임 프로그래밍 패턴』은 이것을 "실체화된(reified) 메서드 호출"이라 부르며 "많은 게임이 각 엔티티가 매 프레임 수행한 명령 집합을 기록한다"고 적었다.
이 우회가 무엇을 주는지 쿠크슈텔은 버그 이야기로 설명한다. 어떤 시작 상태가 있고, 플레이어가 한 행동들이 명령으로 기록되고, 어떤 끝 상태에서 버그가 난다. 재현하는 방법은 두 가지다. 플레이어에게 무엇을 했는지 묻고 내 게임에서 똑같이 해 보거나. 아니면 시작 상태를 가져와 직렬화된 명령을 '재생'하거나. 명령은 플레이어가 한 일을 정확히 담고 있다. 그리고 재생은 내가 할 필요도 없다. AI 에이전트도 할 수 있다. 자기 수정이 상태에 어떤 영향을 줬는지 계속 확인하면서.
한 걸음 더 가면, 명령이 꼭 게임 안에서 만들어질 필요도 없다는 걸 알게 된다. 텍스트 편집기로 명령을 줄줄이 써도 되고 AI가 써도 된다. 그걸 실행 중인 게임에 그대로 재생하면 된다. 컴파일은 필요 없다.
"명령은 AI(와 당신)에게 게임과 상호작용하는 타입이 있는 인터페이스를 준다. 게임을 사실상 '꼭두각시처럼 조종할 수 있게' 만들고, 게임과 일하려는 모든 시도마다 별도의 처리 로직이나 리플렉션(그리고 그걸 다시 컴파일하는 일)이 필요하지 않게 한다. AI는 이걸 좋아한다!"
컴파일 없는 변경에 대해 그는 조금 더 머문다. 게임을 컴파일 없이 바꿀 수 있게 만들수록 좋다. 무슨 훈장이어서가 아니라, 특히 에이전트의 반복 루프에서 그렇다. 컴파일 시간을 기다리지 않고 시험할 수 있는 것이 많을수록, 에이전트는 더 빨리 움직이고 더 촘촘한 고리 안에서 변경과 검증을 반복한다.
아래 도구가 이 모든 것을 한 화면에 담았다. 세계는 Thing의 배열이고, 상태를 바꾸는 길은 명령 한 줄뿐이다. 플레이어가 보낸 명령 로그를 재생하면 버그가 난 순간이 정확히 다시 나온다.
1,500명의 궁수와 28.8k 모뎀
명령을 기록해 재생한다는 생각이 게임 업계에서 가장 극적으로 쓰인 곳은 사실 AI도 버그 재현도 아닌 네트워크였다.
1990년대 후반, 앙상블 스튜디오는 「에이지 오브 엠파이어」를 만들면서 불가능해 보이는 목표를 세웠다. 메모리 16MB짜리 펜티엄 90 컴퓨터, 28.8kbps 전화 모뎀, 8명의 플레이어, 초당 15프레임. 화면에는 수백 명의 유닛이 동시에 움직인다. 유닛 상태를 통째로 주고받으면 움직이는 유닛이 250개쯤에서 한계에 걸린다는 계산이 나왔다. 해법은 2001년 폴 베트너와 마크 테라노의 유명한 글 「28.8 모뎀 위의 1,500명의 궁수」에 정리돼 있다. 유닛 상태를 보내지 않는다. 플레이어의 명령만 보낸다. 모든 컴퓨터가 같은 명령을 같은 순서로 받아 똑같은 시뮬레이션을 각자 돌린다. 한 턴은 보통 200밀리초였고, N번째 턴에 내린 명령은 N+2번째 턴에 실행됐다. 플레이어들은 평균 1.5~2초에 명령 하나를 내렸다(몰아칠 때는 초당 3~4개).
이 방식을 결정적 락스텝(deterministic lockstep)이라고 부른다. 네트워크 프로그래머 글렌 피들러의 정리로는 "대역폭이 오브젝트 수가 아니라 입력 크기에 비례한다." 대가는 엄격함이다. 컴퓨터 한 대에서 난수 하나만 달리 뽑아도 세계가 어긋나고, 그 순간 게임은 멈춘다. 앙상블은 '동기화 실패'를 추적하려고 50MB짜리 기록을 남겼고, 후속작 「에이지 오브 미솔로지」에서는 모든 컴퓨터가 같은 횟수만큼 난수를 뽑는지 검사하는 매크로를 코드 곳곳에 심었다. ①에서 본 '시드 하나'의 원칙이 이미 여기 다 들어 있다. 「에이지 오브 킹즈」의 녹화 기능도 같은 원리에서 공짜로 나왔다. 개발자들은 이렇게 썼다. "우리 시뮬레이션은 결정적이니까."
2001년 5월 18일, 「스타크래프트」 1.08 패치가 리플레이 저장 기능을 넣었다. .rep 파일에 담긴 것은 영상이 아니라 명령의 목록이고, 게임 엔진이 그 명령을 "말 그대로 다시 실행한다." 한국의 스타크래프트 붐 시절, 프로게이머의 리플레이 파일을 내려받아 돌려 보는 것은 일상이었다. 그 파일이 몇십 킬로바이트에 불과했던 이유가 이것이다. 「팩토리오」는 2014년부터 디버그 모드에서 매 틱(tick)마다 맵 전체의 체크섬을 계산해, 리플레이가 어긋나는 첫 틱의 세이브 두 개를 비교하는 방식을 썼다. 개발자들의 말로는 "차이는 대개 아주 작다. 변수 하나인 경우가 많다." 서버와 클라이언트의 상태를 담은 '디싱크 리포트'를 플레이어에게서 받아 diff하는 것이 그들의 일상이 됐다.
결정성이 공짜는 아니라는 경고도 같은 역사에 남아 있다. 피들러가 2010년에 모은 증언에 따르면, 부동소수점 계산은 같은 컴파일러·같은 CPU 구조·같은 설정일 때만 결정적이다. 레이싱 게임 「모토GP」의 입력 리플레이는 디버그 빌드와 릴리스 빌드 사이에서조차 어긋났다. 이 부분은 뒤의 '반론' 절에서 다시 다룬다.
30년의 역사가 쿠크슈텔에게 건네주는 교훈은 이것이다. 게임 업계는 네트워크 건너편의 다른 컴퓨터에게 게임을 정확히 전달하려고 명령 패턴과 결정성을 발명했다. 그런데 그 '다른 컴퓨터' 자리에 AI 에이전트를 앉혀도 구조는 똑같이 작동한다. 에이전트는 상태 대신 명령을 받고, 같은 시뮬레이션을 돌리고, 어긋나면 첫 틱을 찾아 diff한다.
⑤ 데이터 관리 — 값은 코드 밖에
이 지점에서 쿠크슈텔은 "내 개인적인 불만"이라며 데이터 관리를 꺼낸다. 그가 말하는 데이터는 게임이 '세상은 이렇다'를 묘사하는 데 쓰는 정적인 운영 데이터다. 앞의 Thing에서는 Type, attackDamage, walkSpeed, boatSpeed가 데이터다. 플레이 중에 바뀌지 않는 성질, 플레이어는 그 숫자를 직접 보지 않을 수도 있지만, Thing이 게임 속에 존재하는 기본 모양을 정하는 값.
흔한 방식은 이 값을 코드에 직접 쓰는 것이다. 개의 기본 걷기 속도를 바꾸고 싶으면 코드를 고치고 다시 컴파일하거나, 값을 바꾸는 함수를 따로 만들어 콘솔 명령으로 부르게 한다. 둘 다 AI 에이전트에게 헛바퀴다. 특히 컴파일이 끼면, 값 하나를 시험하는 일이 빌드 뒤에 갇힌다.
더 나은 방법은 모든 데이터를 게임 밖에 두는 것이다. 데이터를 역직렬화해 알맞은 오브젝트에 적용하면 끝이다. 그러면 나(또는 에이전트, 또는 다른 팀원)는 빌드만 있으면 게임을 바꿔 가며 반복할 수 있다. 에디터 접근 권한조차 필요 없다.
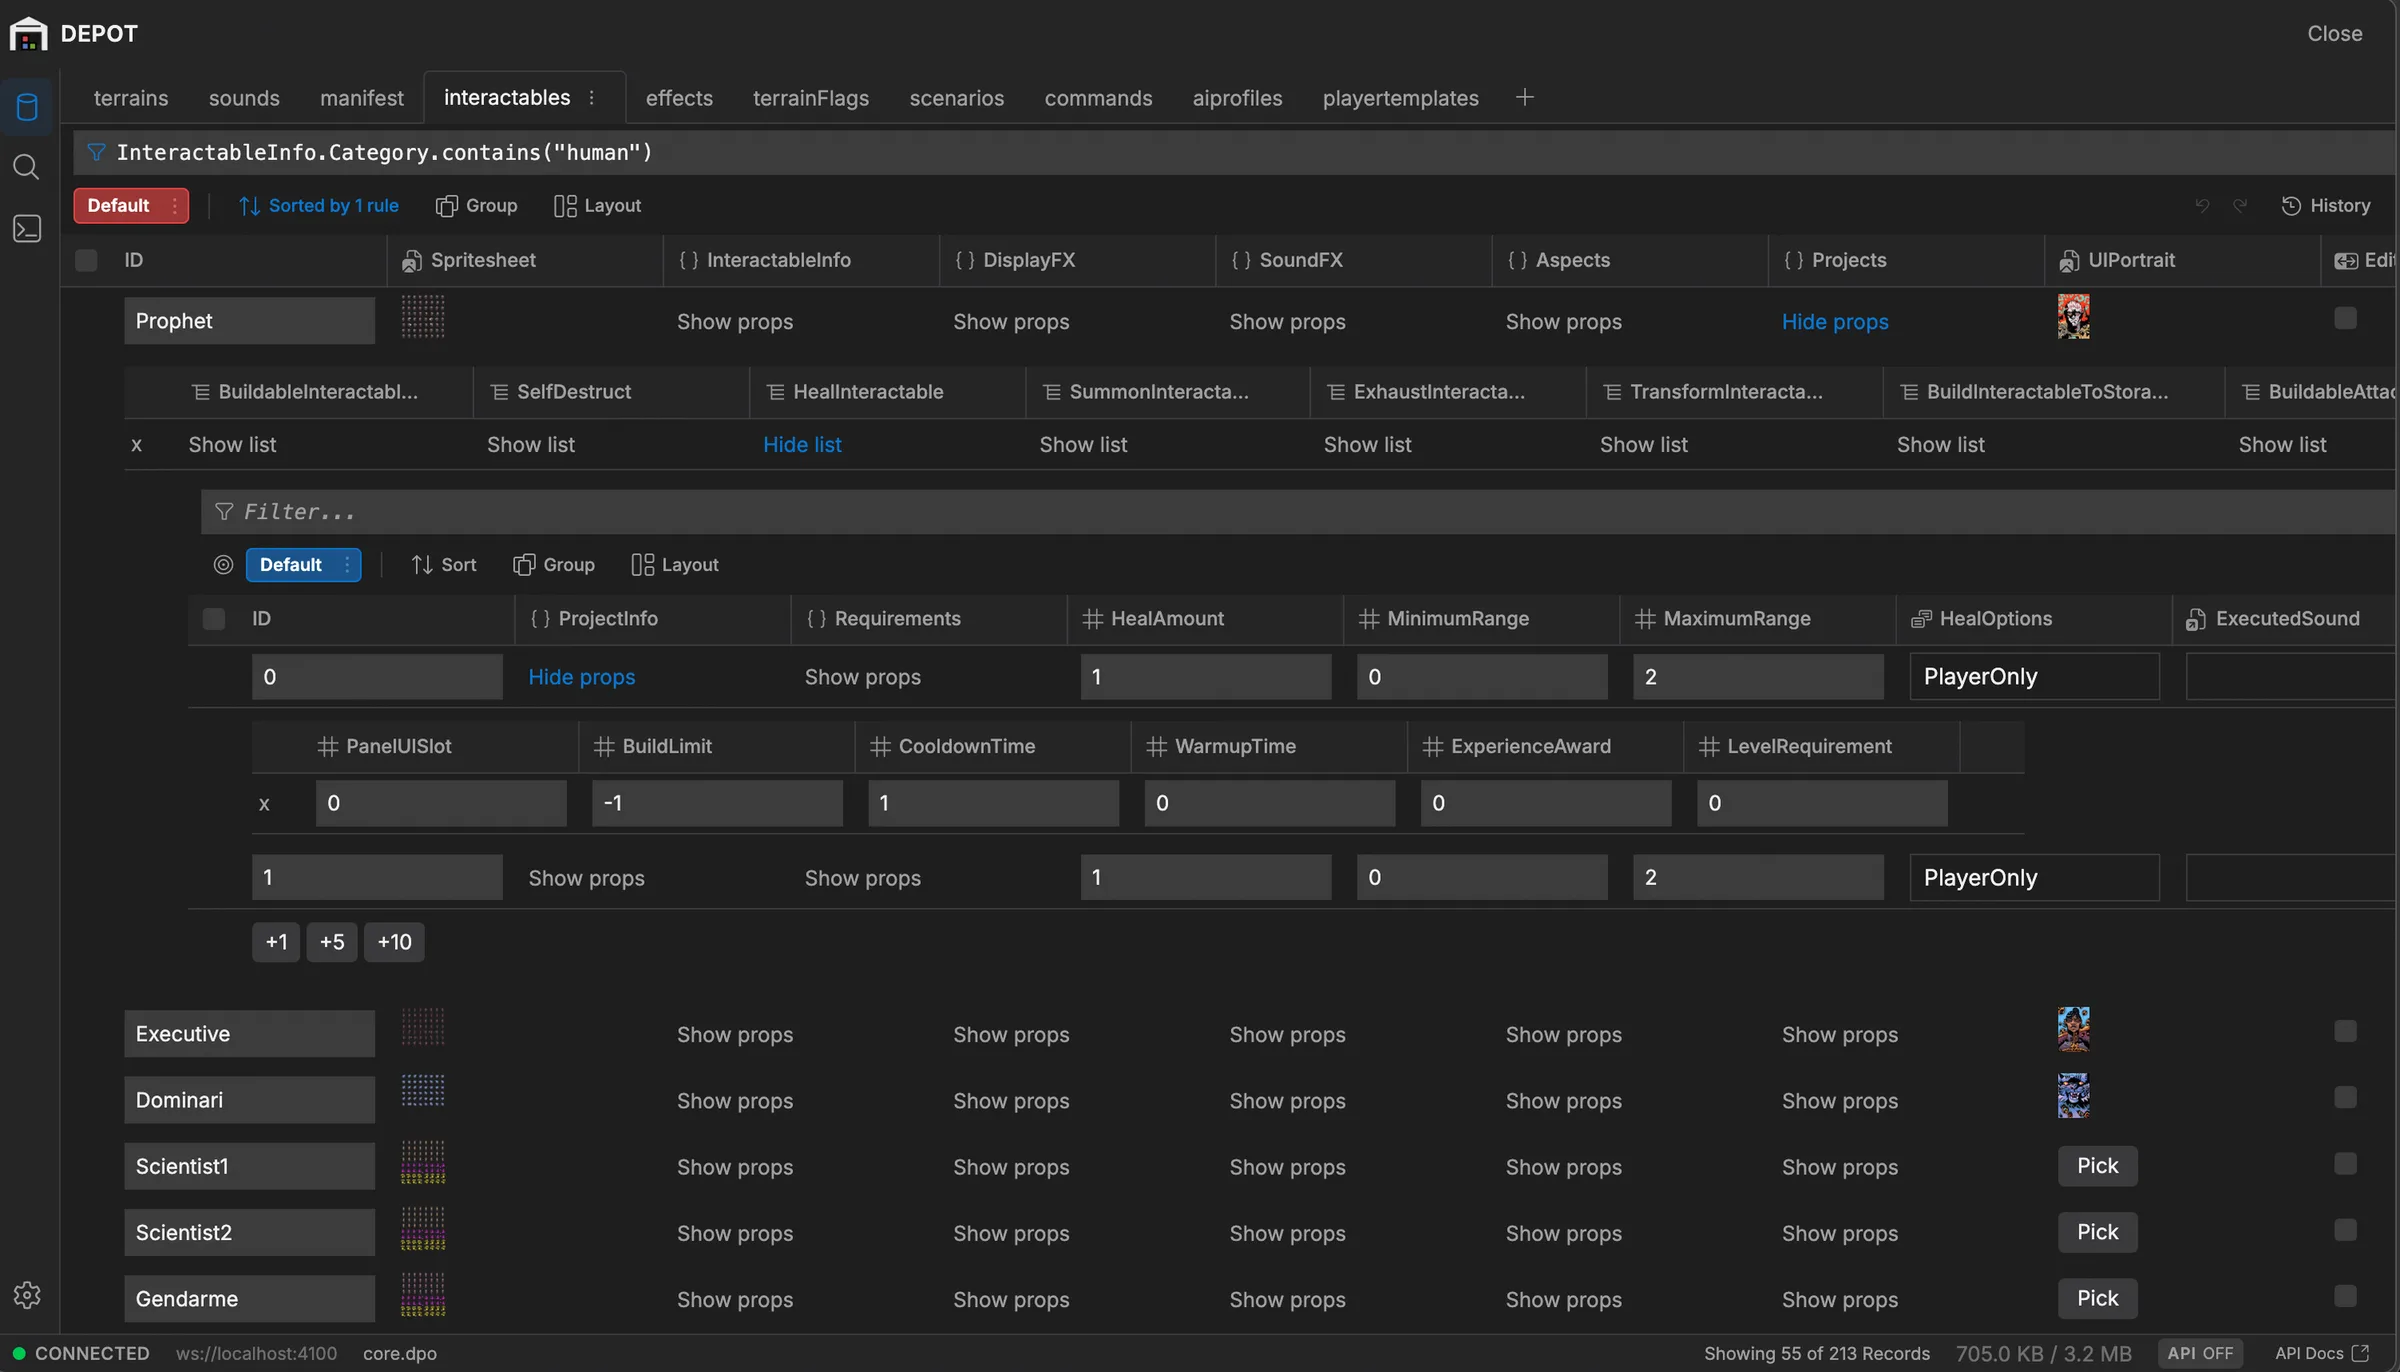
쿠크슈텔의 게임 「칸타타」가 정확히 이렇게 만들어졌다. 2022년 5월 얼리 액세스, 2023년 8월 정식 출시한 이 전술 게임 팀에서 프로그래머가 아닌 약 7명은 게임 빌드와 그가 만든 데이터 편집기 디포(Depot)를 받았다. 팀원들은 디포에서 값을 바꾸고, 게임 빌드는 바뀐 데이터를 역직렬화해 그대로 반영했다. 그가 새 빌드를 뽑아 줄 필요가 없었다. 이 작업 방식이 너무 효과적이어서 그는 지금 디포를 정식 제품으로 만들고 있다.
크게 보기출처: Kyle Kukshtel, 「Your Game Is A Harness」(2026) 슬라이드. 디포의 초기 오픈소스 판은 2020년 VS Code 확장으로 시작했다.
이 문제는 큰 회사도 똑같이 겪었다. 라이엇 게임즈의 빌 클라크는 2016년 2월 기술 블로그 글 「콘텐츠 효율: 게임 데이터 서버」에서 「리그 오브 레전드」 초기의 데이터가 DATA 폴더의 흩어진 .ini 파일이었고 메모장류 편집기로 고쳤다고 털어놓았다. 필드 정의도, 타입 검사도 없었다. 977개의 스킬 파일이 MissileEffect=AnnieBasicAttack_mis.troy라는 같은 줄을 복사해 들고 있었다. 라이엇이 내건 목표는 "패치마다 게임플레이 팀이 만드는 콘텐츠를 두 배로"였고, 그 답이 모든 개발자 컴퓨터에서 돌아가는 로컬 데이터 서버와 스키마였다. 다른 팀들은 구글 스프레드시트를 쓰기도 한다.
쿠크슈텔의 요점은 그다음이다. AI 에이전트도 당신의 도구 쓰는 법을 배울 수 있다. 그러면 다른 팀원처럼, 게임을 매번 다시 빌드하지 않고도 데이터 변경을 스스로 시험한다. "에이전트 루프를 촘촘하게 만들수록 좋다. 전부 반복 주기의 병목을 없애는 일이다." 슬라이드 한 장에는 이 문장만 크게 적혀 있었다.
엔진 안에서든 직접 만든 도구로든 게임을 만들다 보면, 게임의 논리가 화면 전환, UI 호출 같은 것과 뒤엉키기 쉽다. 누구의 잘못도 아니다. 어떤 일이 일어나면 UI를 갱신하고 화면을 조금 바꾸는 것은 자연스러운 기본 모델이다. 하지만 그렇게 다 엮어 놓으면, 무언가를 시험하거나 누군가의 버그를 재현하려 할 때 게임 전체를 띄워야 한다. 모델을 불러오고, 사운드를 준비하고, 씬을 로드하고. 무언가 깨지면 무엇이 왜 깨졌는지 가르기 어렵다. 시뮬레이션인가? 모델인가? 씬 설계인가?
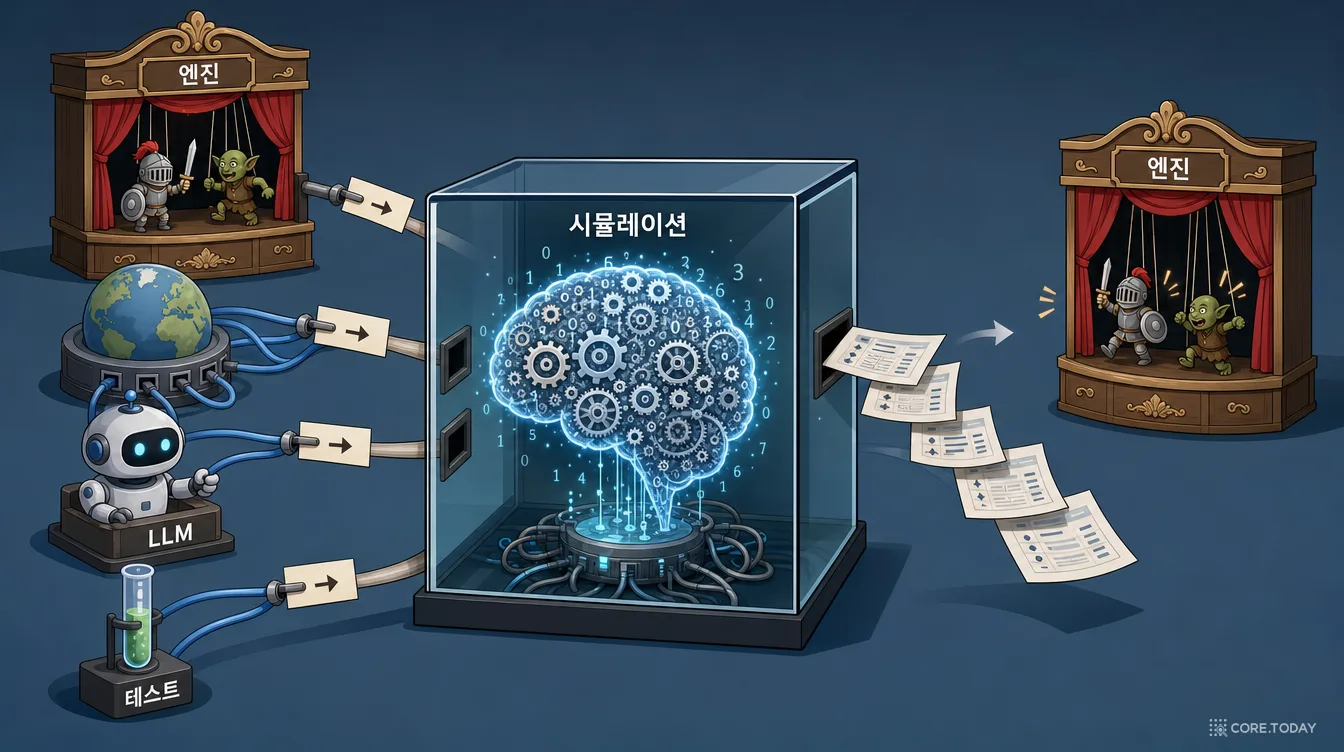
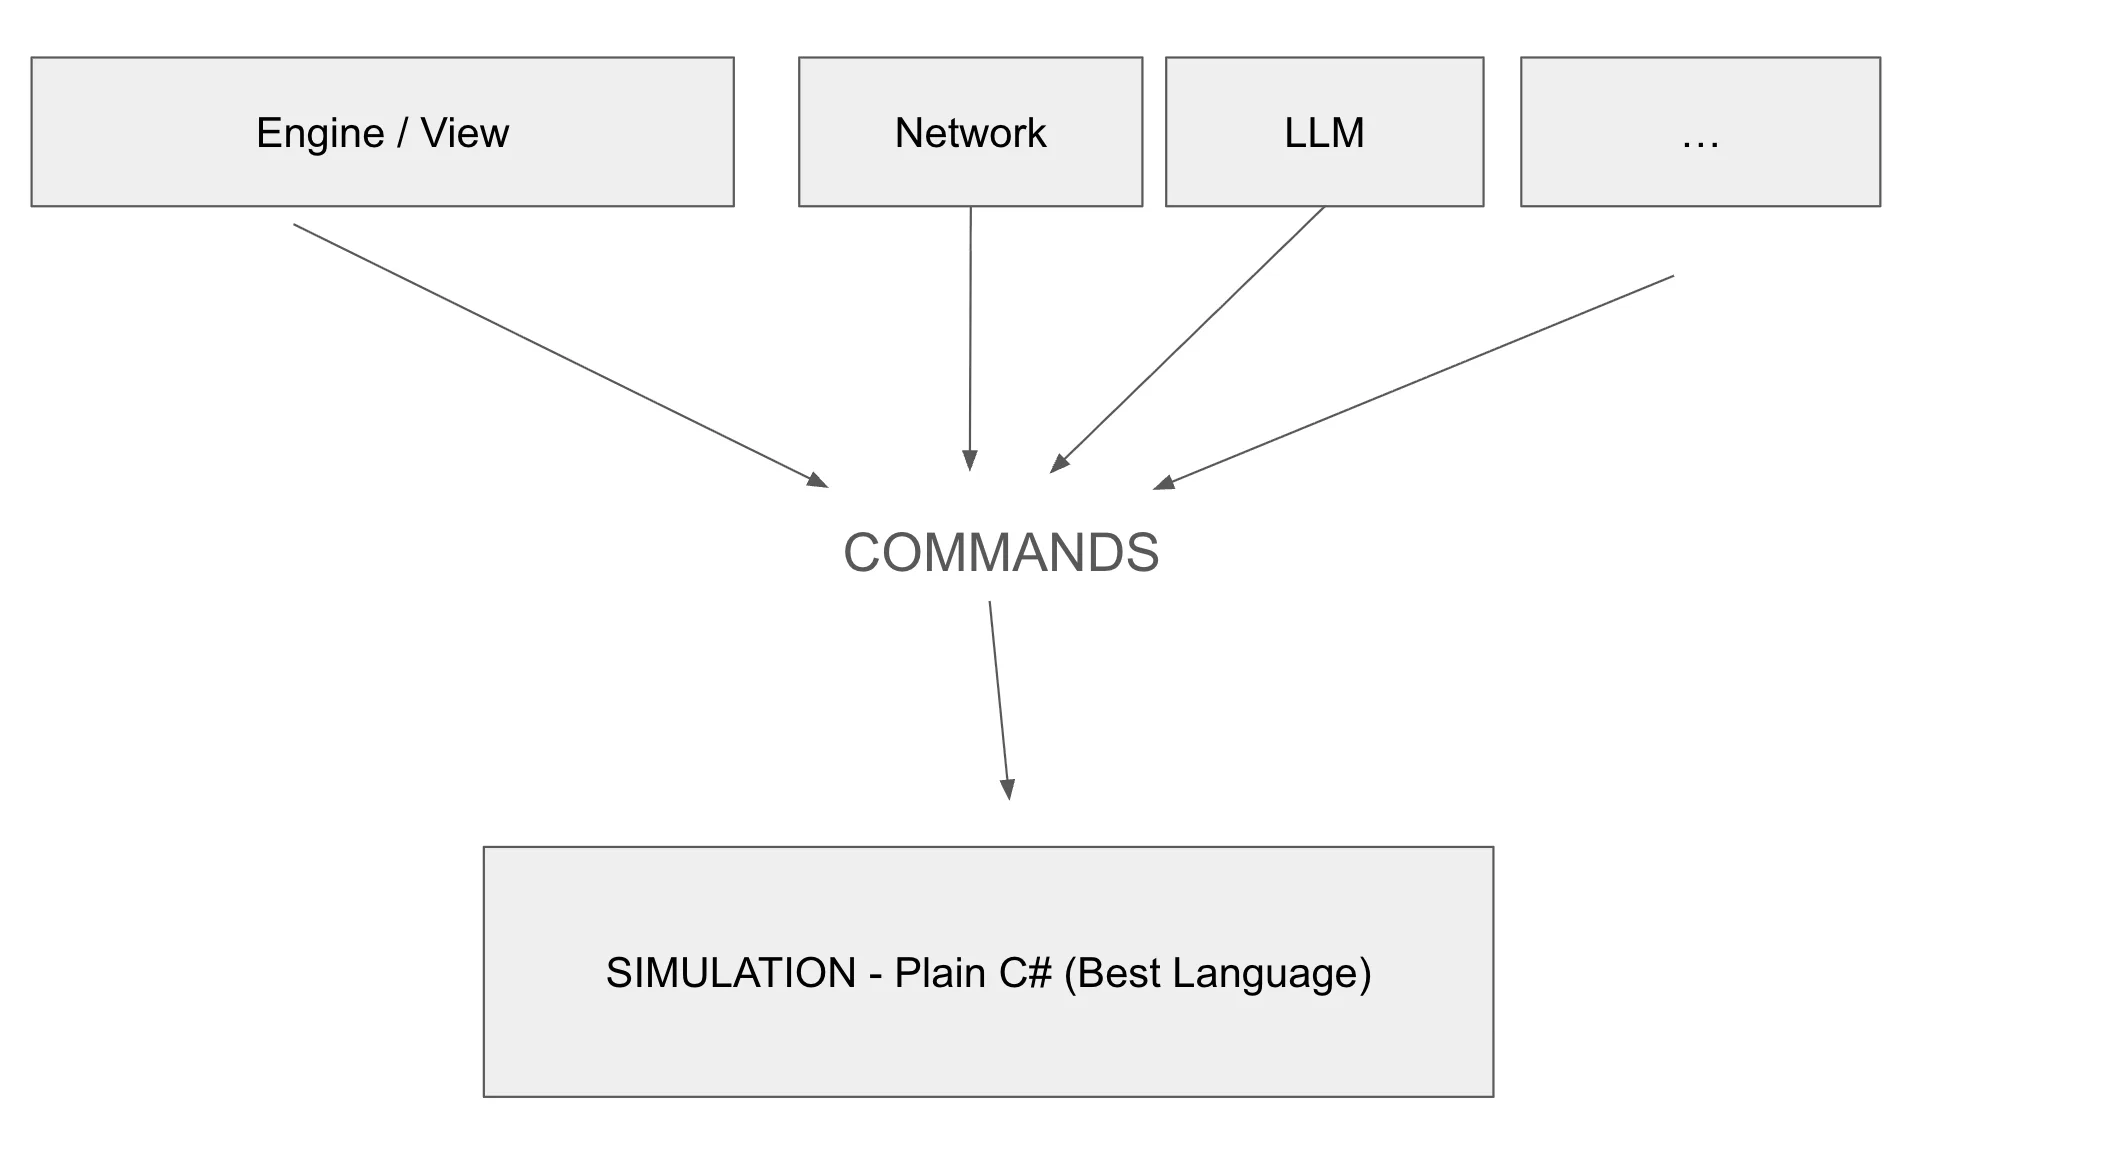
그의 제안은 게임의 시뮬레이션을 엔진의 동작 논리 바깥에 두는 것이다. 그리고 '바깥'은 비유가 아니다. 말 그대로 별도의 DLL, 별도의 라이브러리다. 게임은 시뮬레이션과 그 결과를 소비하지만, 시뮬레이션을 '소유'하지는 않는다. 엔진과 시뮬레이션은 명령으로 대화한다. 웹 프로그래밍의 클라이언트와 서버처럼.
예를 들어 게임 속 무언가가 움직인다고 하자. 그 움직임에는 애니메이션, 모델, 효과음, 이동 시작·지속·정지 논리, 이동하며 바뀌는 시야 같은 것이 얽혀 있다. 하지만 움직임의 본질은 "플레이어 입력에 따라 무언가가 A에서 B로 가는 것"이다. 엔진은 어떤 Thing의 이동 요청 명령을 보낸다. 시뮬레이션은 그 목표가 유효한지 스스로 판단하고(엔진이 미리 걸러도 된다), 이동을 처리한 뒤 '움직였다'는 갱신된 상태를 돌려준다. 엔진은 이전 상태와 비교해 움직임을 알아채고 화면의 오브젝트를 옮긴다. 핵심은 엔진이 '멍청하다'는 것이다. 받은 것을 따르기만 하고 묻지 않는다. 시뮬레이션이 진실의 원천이다. 시뮬레이션이 움직였다고 하면, 엔진은 군말 없이 움직인다.
이 정도 우회는 과한 추상화처럼 보일 수 있다. 그런데 시뮬레이션 코어가 엔진과 분리되면, 무엇이든 코어에 명령을 보낼 수 있다.
크게 보기출처: Kyle Kukshtel, 「Your Game Is A Harness」(2026). 엔진, 네트워크, LLM, 그 밖의 무엇이든 같은 명령 입구를 쓴다. 상자 이름의 '(최고의 언어)'는 그의 농담이다.
가장 먼저 얻는 것은 네트워크 프로그래밍이 훨씬 쉬워진다는 점이다. 게임이 상태나 상태 차이(diff)를 받아 소비하도록 짜여 있으니, 그게 어디서 오는지는 상관없다. 네트워크에서 오든, LLM에서 오든. ④에서 본 「에이지 오브 엠파이어」가 한 일이 바로 이것이다.
더 단순한 쓸모도 있다. 게임 개발에서 테스트는 악명 높게 어렵다. 쿠크슈텔은 그 이유의 상당 부분이 상태·논리·데이터가 너무 단단히 엮여 있어서, 테스트 하나에 너무 많은 발판이 필요하기 때문이라고 본다. 시뮬레이션이 분리돼 있으면 엔진 없이 게임의 시뮬레이션을 테스트할 수 있다. 순수한 C# 프로젝트로, 표준 C# 도구로, 엔진을 하나도 띄우지 않고 테스트를 쭉쭉 돌린다. 슬라이드의 말로는 "아주 빠르다!!!!". 그리고 다시, "AI는 이걸 좋아한다!"
이 생각을 그는 '블랙박스 게임 아키텍처'라고 부른다. 그가 추천하는 사례는 둘이다. 하나는 2020년 5월 출시돼 150만 명 넘는 플레이어를 모은 덱빌딩 로그라이크 「몬스터 트레인」이다. 개발사 샤이니 슈의 브라이언 크로닌은 2021년 로그라이크 셀러브레이션에서 「궤도 이탈: 몬스터 트레인 개발에서 배운 것」이라는 발표로 이 게임의 구조와 "다시 시작한다면 무엇을 달리 할지"를 이야기했다. 다른 하나는 2024년 2월 출시된 전략 게임 「솔리움 인페르눔」이다. 쿠크슈텔은 자기 팟캐스트 「게임 데이터 팟캐스트」 4화에서 개발사 리그 오브 기크스의 윌리엄 다이스·피터 매킨토시와 이 게임의 AI와 시뮬레이션 엔진을 어떻게 만들었는지 이야기했다.
이 구조를 쓰면 게임을 플레이 경험과 분리된 기술적 대상으로 다룰 수 있게 된다. 시뮬레이션 위에서 직접 실험하고, 가설을 세우고, 테스트를 돌린다. 이런 구조가 없는 시도들을 늘 괴롭히는 상태 문제를 비켜 간다. 쿠크슈텔의 말로는 "게임 개발의 초능력"이다.
⑦ 영향 평가 — 사람용 프로파일러, 기계용 텍스트
여기까지 오면 플라이휠의 거의 끝이다. 결정적인 입력값을 정하고, 컴파일 없이 구조화된 방식으로 상태를 바꾸고, 진공 속에서 그 변경을 검증할 수 있다. 남은 질문은 하나다. 그 변경이 실제 게임 전체에 우리가 원하는 대로 영향을 주는가? 그는 이것을 '영향 평가(impact assessment)'라고 부른다.
테스트, 정해진 게임플레이 시나리오를 돌려 밸런스 영향을 보는 것 같은 도구는 게임마다 달라서 그는 깊이 다루지 않는다. 대신 모든 게임이 공유하는 걱정 하나에 집중한다. 성능.
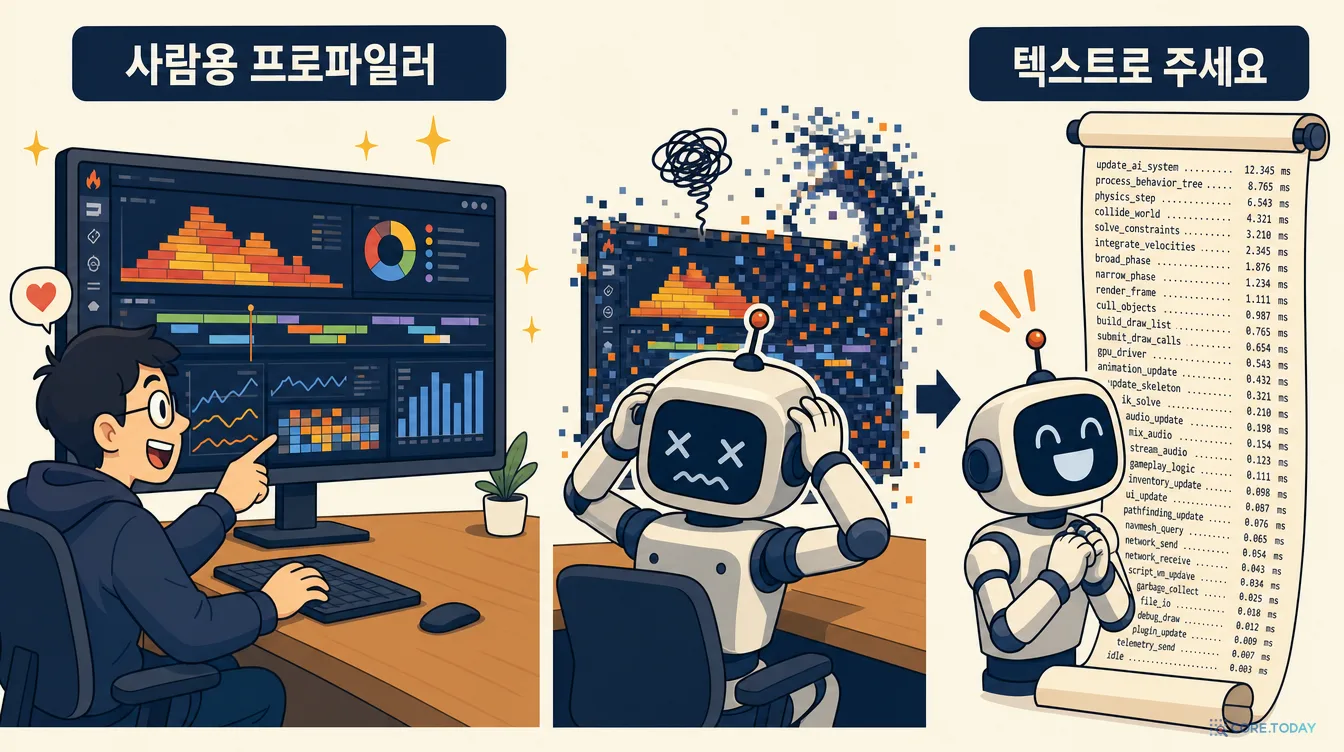
성능 프로파일링은 전통적으로 손이 많이 가는 일이었다. 유니티·언리얼에 내장된 프로파일러나 IDE의 메모리 분석 도구(dotMemory 같은)를 열고, 개발자가 호출 스택과 그래프를 파고들어 병목을 찾는다. 이 도구들은 사람이 소비하라고 설계됐다. 그러니 놀랍지 않게도 "AI는 이런 도구를 쓰기 싫어한다. 에이전트에게 읽히지 않는다." (그는 괄호를 달아, 유니티가 프로파일러를 에이전트가 읽을 수 있게 만드는 작업을 많이 하고 있다고 덧붙인다. 인디 로데오 소개란에 따르면 그는 현재 유니티의 엔지니어링 매니저다.)
AI가 정말 좋아하는 것은 텍스트, 그것도 많은 텍스트다. 그래서 측정 결과를 원시 텍스트로 쏟아 낼 수 있는 프로파일러가 AI의 반복을 크게 앞당긴다. 그가 가장 좋아하게 된 도구는 무료 프로파일러 samply다. 모질라에서 파이어폭스 프로파일러를 만든 마르쿠스 슈탕게가 2020년 시작한 명령줄 CPU 프로파일러로, macOS·리눅스·윈도우에서 돌고 결과는 파이어폭스 프로파일러 화면으로 본다. 쿠크슈텔의 설명으로는 samply를 내 프로젝트에 붙여 캡처 결과를 콘솔로 쏟아 내게 할 수 있고, 에이전트는 samply의 소스와 문서를 읽어 자기 변경을 평가하는 법을 알아낸다. 그래서 "캡처하고 반복하는 고리를 사실상 자율적으로 돌릴 수 있다." (samply 자체에 '텍스트 보고서' 기능이 있는 것은 아니다. --save-only와 -o 옵션으로 화면을 띄우지 않고 프로파일을 JSON 파일로 저장할 수 있고, 에이전트는 그 파일을 읽는다. 쿠크슈텔이 말한 '콘솔 출력'은 이렇게 자기 프로젝트에 맞춰 엮은 결과로 읽는 편이 정확하다.)
5부. 다 합치면 — 턴당 몇 초
이제 조각을 모을 차례다. 쿠크슈텔이 발표 끝에 띄운 그림은 처음의 플라이휠에 각 칸의 도구 이름을 써넣은 것이다.
크게 보기출처: Kyle Kukshtel, 「Your Game Is A Harness」(2026). 고리의 칸마다 도구가 하나씩 붙었다.
고정 시드시드 있는 난수원 하나같은 판을 다시 만든다
결정적 상태팻 스트럭트 Thing한 경로로 저장·복원
주소 지정 상태명령 패턴텍스트로 조종·재생
검증 가능한 상태블랙박스 시뮬레이션 + 테스트엔진 없이 확인
영향 평가samply성능을 텍스트로
진척스크린샷 + odiff목표까지 몇 %
그의 정리는 이렇다. 데이터 중심이고, 바이너리로 격리돼 있고, 컴파일이 필요 없는 이런 방식의 개발에서는 에이전트의 한 턴이 이 고리 전체를 몇 초 안에 돈다. 단순한 기본 방식보다 반복이 훨씬 빨라지고, 고리의 매 단계가 AI에게 게임과 당신의 의도를 더 잘 이해시킨다. 그리고 결정적인 한 문장.
"고리 전체가 효율적이고 빠르기 때문에, 모든 변경에 돌릴 수 있다. '중요할 때'를 위해 아껴 둘 필요가 없다."
이게 왜 중요한지는 반대 경우를 떠올리면 안다. 검사가 비싸면 사람은 검사를 아낀다. 큰 변경 뒤에만, 출시 직전에만 돌린다. 그 사이에 쌓인 작은 변경 수십 개 중 어디서 문제가 생겼는지는 아무도 모른다. 검사가 몇 초면 그런 계산이 필요 없다. 에이전트는 변경 하나마다 고리를 한 바퀴 돌고, 사람을 부르지 않고 다음 턴으로 간다.
아래 계산기로 그 차이를 직접 따져 보자. 기법을 하나씩 켜면서 어떤 막대가 사라지는지 보면, 쿠크슈텔이 왜 고정 시드와 세이브/로드를 '모든 것의 토대'라고 했는지 보인다.
그리고 그는 마지막 슬라이드를 넘긴다. 플라이휠 그림 옆에 화살표 하나를 긋고 적었다. "이것이 당신의 게임이다." 고리 전체가, 칸마다 붙은 도구 전부가 결국 게임 안에 있다. 클로드 코드는 그 고리를 돌리는 손이고, 고리 자체는 게임이 제공한다. 그래서 어떤 게임이든 이 모든 걸 할 수 있고, 어떤 게임이든 스스로 자기 하네스가 될 수 있다.
"당신의 게임이 하네스다."
6부. 후기의 고백, 그리고 반론들
"정작 지금 내 프로젝트에는 하나도 안 썼다"
쿠크슈텔의 글에서 가장 인상적인 부분은 본문이 아니라 후기다.
"발표를 하고 나서 이 글을 쓰는 건 흥미로운 경험이었다. 내가 한 말 대부분을 지지한다. 하지만 지금 출시를 앞둔 프로젝트에서는 이 중 어느 것도 쓰지 않았다. 여기서 내가 겨냥한 규모는 더 큰 프로젝트라고 생각한다. 지금 내놓는 건 아주 작아서, 하네스 같은 것을 거의 할 필요가 없었다."
그리고 지금 준비 중인 더 큰 게임에서는 이 내용이 분명히 쓸모 있을 거라고 덧붙인다. 발표자 스스로 처방의 적용 범위를 줄여 놓은 셈이다. 이 정직함이 오히려 처방을 더 믿을 만하게 만든다. 하네스는 공짜가 아니다. 결정성, 직렬화, 명령 계층, 시뮬레이션 분리는 모두 선불 비용이다. 주말 게임잼에서 그걸 다 하는 건 과잉이다. 반대로 3년짜리 프로젝트에서 그걸 마지막에 하려면 그가 경고한 대로 "근본을 뜯어고쳐야" 한다. 언제 내야 하는 비용인지가 문제다.
여기에 코어닷투데이가 보기에 짚어 둘 반론이 몇 가지 더 있다.
반론 1: 결정성은 생각보다 비싸다
결정적 락스텝의 역사는 성공담인 만큼 고생담이다. 글렌 피들러가 2010년에 모은 증언들은 하나같이 "조건부로만 가능하다"였다. 부동소수점은 같은 컴파일러, 같은 CPU 구조, 같은 부동소수점 설정에서만 같은 답을 낸다. 「모토GP」의 입력 리플레이는 디버그 빌드와 릴리스 빌드 사이에서 어긋났고, 「배틀존 2」는 인텔과 AMD에서 삼각함수 결과가 달랐다. 「팩토리오」의 멀티스레드 비결정성은 7년 가까이 숨어 있었다. 상용 엔진의 물리 엔진은 대개 플랫폼 간 결정성을 기본으로 보장하지 않는다.
쿠크슈텔의 처방은 이 비용을 줄이는 쪽으로 짜여 있기는 하다. 시뮬레이션을 엔진 밖 순수 코드로 빼면 엔진의 물리·렌더링에서 생기는 비결정성은 시뮬레이션 바깥에 남는다. 다만 '첫날부터'라는 조건이 그래서 붙는다. 이미 엔진의 물리에 게임 논리를 맡겨 놓은 프로젝트에게 이 처방은 리팩터링이 아니라 재작성에 가깝다.
반론 2: 팻 스트럭트는 타입 안전을 내준다
나무의 boatSpeed에 값을 넣지 말라고 막아 주는 것은 이제 컴파일러가 아니라 규칙과 테스트다. 필드는 게임이 커질수록 늘어나고, 어떤 Type이 어떤 필드를 쓰는지는 문서와 관례로 지켜야 한다. 메모리도 걱정거리다. 캐시 무라토리의 Q&A 80회(2025년 10월)에 올라온 질문 자체가 "안 쓰는 필드 때문에 메모리가 낭비되지 않느냐"였다. 쿠크슈텔은 "생각만큼 비싸지 않다"고 답하며 그 회차를 링크했고, 실제로 오브젝트 수가 수만 개 수준인 대부분의 인디 게임에서는 맞는 말이다. 수백만 개의 파티클을 다루는 곳에서는 ECS처럼 데이터를 컴포넌트별 배열로 흩는 쪽이 낫다. 다만 쿠크슈텔의 진짜 요점은 메모리가 아니라 '모양이 하나'라는 데서 오는 단순함이고, 그 점에서는 ECS도 같은 편이다.
반론 3: 픽셀 diff는 '재미'를 재지 못한다
odiff는 목표 이미지가 있을 때 강하다. "해골을 해적으로"처럼 목표가 그림으로 주어지는 일. 그런데 게임 개발의 많은 결정에는 목표 이미지가 없다. 점프가 '쫀득한가', 타격감이 있는가, 이 보스가 너무 어려운가. 이런 것은 픽셀 일치율로도, 프로파일러로도 잴 수 없다. 화면 diff 자체도 까다롭다. 파티클, 안티에일리어싱, 시간에 따라 바뀌는 셰이더는 '바뀌지 않았어야 할 픽셀'을 바꾼다. 그래서 쿠크슈텔이 고정 시드와 레이어 끄기를 diff보다 앞에 둔 것이다. 화면을 결정적으로 만들어야 diff가 의미를 가진다.
이 한계는 그가 Three.js 데모를 '슬롭'이라 부른 대목과 이어진다. 하네스는 AI가 틀린 것을 빨리 고치게 해 준다. 무엇이 좋은 것인지 정하는 일, 작가적 목소리는 여전히 사람 몫이다. 하네스가 빨라질수록 오히려 그 판단이 병목이 된다.
반론 4: 업계가 원하는 건 능력이 아닐 수도 있다
쿠크슈텔은 자신이 오직 능력만 말한다고 단서를 달았다. 하지만 게임 업계의 반감은 상당 부분 능력 밖에 있다. 2026년 1월 공개된 GDC 「게임 산업 현황」 조사에서 응답자 2,300여 명 가운데 생성형 AI를 업무에 쓴다는 사람은 36%였는데, 생성형 AI가 업계에 해롭다고 답한 사람은 52%였다. 2년 전 18%, 1년 전 30%에서 가파르게 오른 숫자다. 긍정적이라는 답은 7%였다. 가장 부정적인 직군은 비주얼·테크니컬 아트(64%), 디자인·내러티브(63%), 그리고 프로그래밍(59%)이었다. 지난 2년 사이 해고를 겪었다는 응답도 28%였다(조사 설계가 바뀌어 연도 간 비교에는 주의가 필요하다).
그러니 이 글의 처방을 읽는 방식도 둘로 갈린다. 하나는 '드디어 AI가 게임을 만들 수 있게 됐다'. 다른 하나는 '사람이 만드는 게임을 AI가 덜 망치게 됐다'. 쿠크슈텔의 처방 대부분이 사람 동료에게도 똑같이 좋은 것 — 디자이너가 빌드만으로 수치를 바꾸고, QA가 플레이어 로그로 버그를 재현하는 것 — 이라는 점은 뒤쪽 해석에 힘을 싣는다. 그리고 그는 이 글을 AI 없이 손으로 썼다.
반론 5: 명령 입구는 공격 입구이기도 하다
실행 중인 빌드에 텍스트 명령을 주입할 수 있다는 것은, 다른 누군가도 그럴 수 있다는 뜻이다. 디버그 콘솔이나 명령 소켓이 출시 빌드에 그대로 남으면 치트와 보안 사고의 문이 된다. 에이전트용 명령 입구는 개발 빌드에서만 열리게 하고, 출시 빌드에서는 빌드 설정으로 아예 빼는 것이 기본이어야 한다. 네트워크 명령을 받는 구조라면, 그 명령이 정말 서버나 상대 플레이어에게서 온 것인지 검증하는 일도 그대로 남는다.
7부. 2026년, 이 이야기가 게임 밖에서도 중요한 이유
에이전트는 이미 일상이 됐다
2026년 8월 젯브레인스가 개발자 1만 5천여 명을 조사한 결과, 90%가 매주 한 번 이상 업무에 코딩 에이전트를 썼고 68%는 매일 썼다. 클로드 코드를 쓴다는 응답은 1월 18%에서 39%로 늘었다(미국은 47%). 10월 6일 발표된 스택 오버플로 2026 개발자 설문(응답 3만여 명)에서도 AI 사용자의 66%가 코딩 에이전트를 쓴다고 답했다. 이 정도면 '에이전트를 쓸까 말까'는 더 이상 질문이 아니다. 질문은 '내 작업물이 에이전트에게 얼마나 읽히는가'로 옮겨 갔다.
엔진들이 문을 열고 있다
게임 엔진 쪽에서도 변화가 빠르다. 유니티는 2026년 5월 공식 MCP(모델 컨텍스트 프로토콜) 서버를 AI 어시스턴트 패키지에 넣었다. 클로드 코드나 커서 같은 에이전트가 씬 계층을 읽고, 게임 오브젝트를 만들고 고치고, 콘솔 로그와 컴포넌트 값을 보고, 스튜디오가 직접 짠 C# 도구를 부를 수 있다. 그보다 앞서 커뮤니티가 만든 유니티 MCP(깃허브 별 1만 5천 개), 고도 MCP(6천 개), 언리얼 MCP(2천 개)가 2025년 봄에 이미 등장했다.
이건 쿠크슈텔이 말한 '하네스' 중 엔진 쪽 절반이다. 에이전트가 에디터를 만질 수 있게 된다. 하지만 MCP가 열어 주는 것은 에디터이지, 게임의 결정성이 아니다. 씬 계층을 읽을 수 있어도 버그가 난 그 순간의 상태를 다시 만들 수 없다면, 에이전트는 여전히 '시장에 가면'의 끝자리에서 썩은 사과를 따라 부를 것이다. 엔진이 문을 열수록, 문 안쪽의 게임이 읽히게 생겼는지가 더 중요해진다.
픽셀을 보는 AI와, 픽셀이 필요 없게 만드는 길
같은 시기 AI 연구의 큰 흐름은 반대 방향처럼 보인다. 구글 딥마인드의 SIMA 2(2025년 11월)는 사람처럼 키보드와 마우스로 화면을 보며 3D 게임을 하고, 스스로 플레이하며 배운다. 같은 회사의 지니 3(2025년 8월)는 텍스트로 720p 24fps의 플레이 가능한 세계를 즉석에서 생성한다. 마이크로소프트의 뮤즈(WHAM, 2025년 2월 『네이처』)는 「블리딩 엣지」의 플레이 7년 분량, 10억 장이 넘는 화면과 컨트롤러 입력으로 학습한 '게임 세계 모델'이다. 모두 AI가 픽셀을 더 잘 보게 만드는 연구다.
쿠크슈텔의 길은 그 반대편에 있다. 볼 필요가 없게 만든다. 둘은 경쟁 관계가 아니라 분업에 가깝다. 픽셀을 보는 AI는 '이 게임이 사람에게 어떻게 보이고 느껴지는가'를 언젠가 재 줄지 모른다. 게임을 텍스트로 여는 하네스는 '이 변경이 맞았는가'를 오늘 당장 싸고 확실하게 알려 준다. 제미나이의 포켓몬 완주와 비디오게임벤치의 0.48%가 보여 주듯, 2026년 현재 실제로 일을 끝내는 쪽은 뒤쪽이다.
결국 '읽히는 소프트웨어'의 이야기다
이 발표가 게임 개발자 밖에서도 읽힐 가치가 있는 이유는 여기 있다. 고리의 칸들을 게임 용어에서 떼어 내면, 모든 소프트웨어에 적용되는 질문이 남는다.
쿠크슈텔의 칸
게임
웹앱·백엔드
데이터·ML 파이프라인
고정 시드
난수원 하나
시간·UUID·난수 주입
샘플링·셔플 시드 고정
결정적 상태
세이브/로드
DB 스냅숏·픽스처
중간 산출물 체크포인트
주소 지정 상태
명령 패턴
이벤트 소싱·액션 로그
선언적 단계 정의
데이터 분리
외부 데이터·디포
설정·기능 플래그
파라미터 파일
검증 가능한 상태
블랙박스 시뮬레이션
프레임워크 없는 도메인 테스트
작은 입력의 변환 테스트
영향 평가
samply 텍스트
성능·번들 크기 리포트
단계별 시간·비용 기록
진척
스크린샷 + odiff
시각 회귀 테스트
출력 diff
오픈AI가 「하네스 엔지니어링」에서 저장소를 "코덱스가 읽을 수 있게" 고치고 크롬 개발자 도구를 연결한 것, 앤트로픽이 장기 실행 에이전트에게 브라우저 자동화 도구를 쥐여 준 것, 미첼 하시모토가 "에이전트가 실수할 때마다 다시는 그 실수를 못 하게 하는 장치를 만든다"고 한 것. 모두 같은 일이다. 클로드 코드 문서의 표현이 가장 날카롭다. 검사가 없으면 "당신이 검증 루프가 된다." 쿠크슈텔의 처방은 그 루프를 사람에게서 떼어 내 작업물 안으로 옮기는 방법이고, 게임은 그 일이 가장 어려운 분야였을 뿐이다. 가장 어려운 곳에서 통하는 방법이라면, 나머지 대부분에서도 통한다.
한국 게임 업계의 2026년
한국 게임 업계는 다른 콘텐츠 분야보다 훨씬 빨리 AI를 받아들이고 있다. 한국콘텐츠진흥원이 2026년 4월 낸 콘텐츠산업 동향 보고서에 따르면 게임업체의 70%가 생성형 AI를 활용하고 있어, 콘텐츠 산업 전체(32.1%)의 두 배를 넘었다. 도입한 회사의 절반(49.6%)은 전사 차원으로 도입했고, 쓰는 도구는 텍스트 LLM이 96.6%로 압도적이었다. 크래프톤은 2025년 10월 'AI 퍼스트'를 선언하며 약 1,000억 원 규모의 GPU 클러스터 구축과, 2026년부터 매년 약 300억 원의 임직원 AI 도구 지원을 내걸었다. 한편 같은 해 4월 국회 토론회에서 소개된 조사에서는 게임 업계 종사자의 77.3%가 고용 불안을 느낀다고 답했다. 기대와 불안이 동시에 가장 높은 곳이 게임이다.
이 숫자를 쿠크슈텔의 글 옆에 놓으면 한 가지가 보인다. 도입률 70%의 대부분은 아마 기획 문서, 번역, 코드 보조 같은 '텍스트로 된 일'일 것이다. 게임 자체 — 엔진 안의 상태, 실행 중인 순간 — 가 AI에게 읽히게 만드는 일은 아직 거의 시작되지 않았다. 그 일이 시작될 때, 그것은 AI 도구를 하나 더 사는 일이 아니라 게임 구조를 바꾸는 일일 것이다. 그리고 그 구조는 사람 개발자에게도, QA에게도, 디자이너에게도 이미 좋은 구조다.
아래 점검표로 내 프로젝트가 지금 어디쯤인지 재 보자. 프로젝트 종류를 바꾸면 같은 원리가 웹과 데이터 일에서 어떤 질문이 되는지 보인다.
8부. 실전 체크리스트 — 언제 무엇을
쿠크슈텔의 처방을 프로젝트의 시점별로 다시 나누면 이렇다. 그가 강조한 대로, 앞쪽일수록 싸고 뒤로 갈수록 비싸다.
첫날시드 있는 난수원을 만들고 모든 게임플레이 난수를 거기서 뽑는다(연출용은 따로). 오브젝트를 한 모양(Thing 하나, 또는 ECS)으로 정한다. 저장/불러오기를 개발 도구로 먼저 만든다.
프로토타입상태 변경을 명령 객체로만 하게 한다. 명령을 파일·콘솔·소켓으로 받는 입구를 하나 연다. 수치를 외부 데이터로 뺀다. 화면 캡처 명령과 UI·게임플레이 레이어 끄기를 만든다.
제작시뮬레이션을 엔진 밖 라이브러리로 뺀다(이미 늦었다면 새 시스템부터). 엔진 없이 도는 단위 테스트와 불변식 검사를 붙인다. 플레이어·QA의 명령 로그를 버그 리포트에 자동으로 첨부한다.
에이전트 연결스크린샷 → odiff → '몇 % 일치'를 한 명령으로 묶는다. samply 같은 텍스트 프로파일을 저장하는 스크립트를 둔다. 이 명령들의 이름과 쓰는 법을 CLAUDE.md·AGENTS.md에 적는다 — 에이전트가 찾지 못하는 하네스는 없는 것과 같다.
출시명령 입구·디버그 콘솔을 출시 빌드에서 빼거나 잠근다. 리플레이 기록은 남겨 두되 개인 정보와 치트 위험을 점검한다.
그리고 하나만 기억한다면 이것이다. 에이전트에게 무언가를 시키기 전에 물어라. "이 일이 끝났는지, 에이전트가 사람에게 묻지 않고 알 수 있는가?" 답이 '아니요'라면, 모델을 바꾸기 전에 하네스를 먼저 만들어야 한다.
맺음말: 화살표가 발표의 내용이다
쿠크슈텔이 블로그로 옮기며 "농담이 영 안 산다"고 투덜댄 슬라이드가 있었다. '코드 + 백만 가지 다른 것'에서 '코드(지만 이제 코드가 더 많아진)'로 가는 화살표 하나. 그는 그 화살표가 발표의 진짜 내용이라고 했다.
그 화살표를 다시 보면 방향이 흥미롭다. AI를 게임 쪽으로 끌어오는 화살표가 아니다. 게임을 AI가 읽을 수 있는 쪽으로 옮기는 화살표다. 그리고 그 길에 놓인 기법들은 하나도 새것이 아니다. 둠의 데모 파일(1993), 시프의 오브젝트 데이터베이스(1998), 에이지 오브 엠파이어의 1,500명의 궁수(1997~2001), 스타크래프트의 리플레이(2001), 라이엇의 데이터 서버(2016), 팩토리오의 디싱크 리포트. 게임 개발자들은 30년 동안 네트워크 건너편의 컴퓨터에게, 디자이너에게, QA에게 게임을 '읽히게' 만들어 왔다. 2026년에 달라진 것은 그 읽는 사람 목록에 이름이 하나 더 붙었다는 것뿐이다.
'LLM은 게임에 약하다'는 말은 아마 한동안 계속 들릴 것이다. 그 말이 틀렸다기보다, 질문이 잘못 놓였다. 물어야 할 것은 "LLM이 게임을 할 수 있는가"가 아니라 "내 게임은 읽힐 수 있게 생겼는가"다. 그리고 그 질문의 답은 다음 모델이 아니라 오늘 내 코드 안에 있다.
참고 자료
원문
Kyle Kukshtel, "Your Game Is A Harness", kylekukshtel.com, 2026-10-10 (Indie Rodeo 2026, 캘거리, 2026-09-12 발표). 본문의 슬라이드 그림(third-party-gih-*)은 이 글에서 인용했다.
Indie Rodeo 2026 (2026-09-11~12, Calgary Game Developers Association) — indierodeo.com
하네스·컨텍스트 엔지니어링
John Yang et al., "SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering", arXiv:2405.15793 (NeurIPS 2024)
Drew Breunig, "How Long Contexts Fail", 2025-06-22 — dbreunig.com
Kelly Hong, Anton Troynikov, Jeff Huber, "Context Rot: How Increasing Input Tokens Impacts LLM Performance", Chroma, 2025-07-14
Nelson F. Liu et al., "Lost in the Middle: How Language Models Use Long Contexts", arXiv:2307.03172 (TACL 2024)
Gemini Team, "Gemini 2.5" 기술 보고서, arXiv:2507.06261 (Gemini Plays Pokémon 절)
Anthropic, "Effective context engineering for AI agents", 2025-09-29 / "Effective harnesses for long-running agents", 2025-11-26
Claude Code 문서, "Best practices" — "Give Claude a way to verify its work"
Mitchell Hashimoto, "My AI Adoption Journey", 2026-02-05
Ryan Lopopolo (OpenAI), "Harness engineering: leveraging Codex in an agent-first world", 2026-02-11
Vivek Trivedy (LangChain), "Improving Deep Agents with harness engineering", 2026-02-17 / "The Anatomy of an Agent Harness", 2026-03-10
Birgitta Böckeler, "Harness engineering for coding agent users", martinfowler.com, 2026-04-02