
#RAG
59개의 포스트
사건은 문서가 아니라 궤적이다 — Microsoft RAFT와 '어느 단계에 와 있는가'로 검색하기
Apache Jira에서 사람이 직접 '이건 저것의 중복'이라고 링크한 30쌍을 펼쳐 보면, 그중 14쌍은 제목에 공통 단어가 하나도 없다. 「NPE가 납니다」와 「2.2와 3.0의 페이징 상태가 프로토콜 v4에서 호환되지 않는다」가 같은 문제다. 사건의 유사성은 첫 화면이 아니라 조사가 도달한 지점에 담긴다. EMNLP 2026 Industry Track에 채택된 Microsoft의 RAFT는 종결된 사례를 문서 한 장이 아니라 상태의 사슬로 색인하고, 그 사슬의 중간 지점을 검색 대상으로 삼는다. 이 특집은 실제 Jira 티켓 한 건을 상태로 쪼개 보고, 여섯 단계 파이프라인과 Algorithm 1을 직접 돌려 보고, 무관한 대화 한 턴이 기존 RAG를 49%p 무너뜨리는 실험을 따라가고, 이 발상을 장애 대응·영업·법무·에이전트 메모리로 옮기는 법까지 간다. 인터랙티브 위젯 6종과 공개 데이터 분석을 함께 싣는다.
RAG는 생각보다 단순합니다 — 벡터 DB 없이 시작하는 6단계 레시피
RAG를 어렵게 느끼는 이유는 개념이 아니라 '처음부터 임베딩·벡터 DB·청킹을 다 갖춰야 한다'는 오해 때문입니다. 오픈북 시험 비유로 RAG의 뼈대를 3분 안에 잡고, 라이트하우스 뉴스레터가 정리한 6가지 RAG 레시피를 전문 검색부터 전체 임베딩까지 계단처럼 올라가며 살펴봅니다. 실제 시스템의 60%는 검색기 하나와 프롬프트 한 장으로 충분합니다. 우리 팀에 맞는 출발점을 고르는 진단 도구와, 같은 질문을 세 방식으로 검색해 보는 놀이터를 함께 담았습니다.
하루 15,000개의 질문에 답하는 사내 AI — Cerebras는 지식 베이스를 어떻게 만들었나
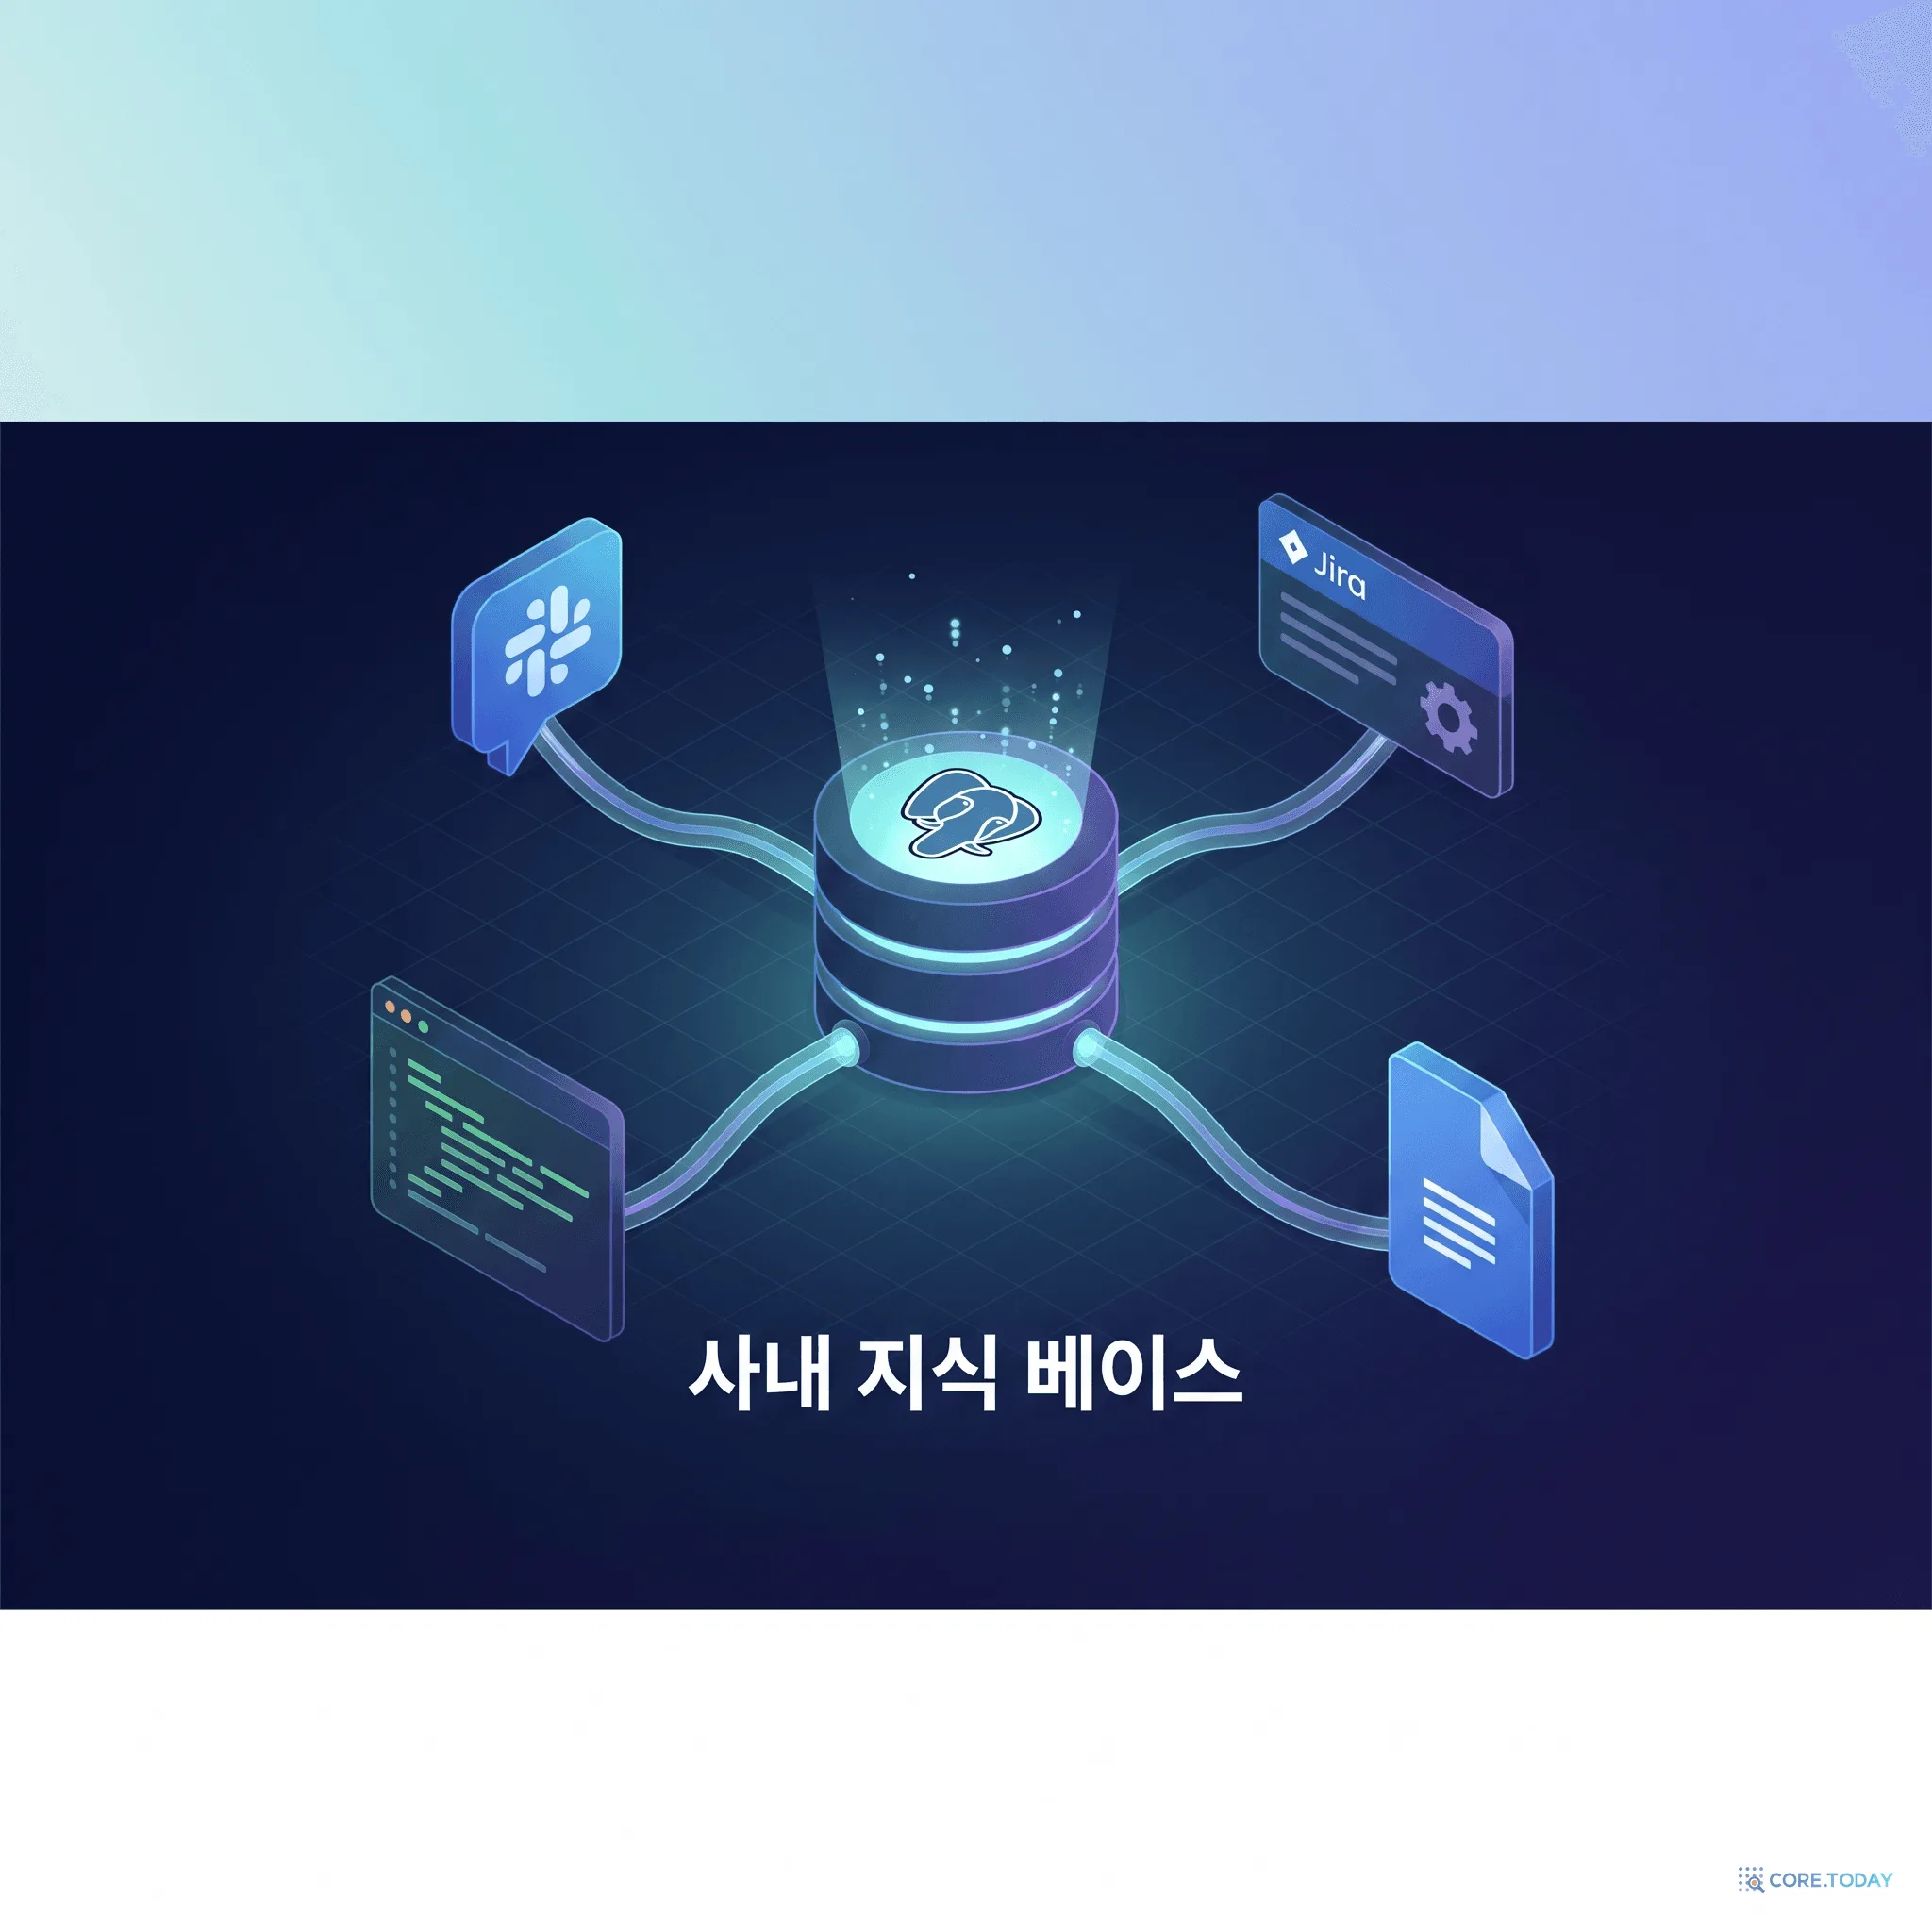
"그거 어디 있죠?" "이거 누가 담당이죠?" — 회사가 커질수록 정보는 흩어지고, 같은 질문이 반복된다. Cerebras는 Slack·코드·문서를 하나의 임베딩 테이블로 모아 하루 15,000개 질문에 답하는 사내 지식 베이스를 만들었다. 그 안에는 반세기 검색의 역사가 응축돼 있다. 키워드 검색에서 BM25, 임베딩, HNSW, 하이브리드, 그리고 에이전트 검색까지 — 왜 이런 개념들이 하나씩 필요해졌는지, 인터랙티브하게 만져보며 이해한다.
ChatGPT는 어떻게 출처를 고르는가 — 네트워크 트래픽을 뜯어본 특집
한 연구자가 ChatGPT의 화면이 아니라 '네트워크 트래픽'을 열어봤다. 거기서 result_source, turn_use_case, fan-out 같은 내부 필드들이 튀어나왔다. AI가 무엇을 읽고, 무엇을 인용하고, 무엇을 아예 무시하는지 — 열 개의 파란 링크가 하나의 답변으로 접히는 시대에, '출처로 뽑히는 법'의 실제 작동 원리를 역사·논문·아키텍처까지 파고들어 쉽게 풀었다.
AI 사서 7명이 협업한다 — Google의 Agentic RAG가 '믿을 수 있는 답'을 만드는 법
한 번 검색하고 답하는 RAG는 여러 데이터베이스에 흩어진 질문 앞에서 무너진다. Google이 Gemini Enterprise에 넣은 Agentic RAG는 7명의 전문 에이전트가 '계획 → 검색 → 충분성 검증 → 재검색 → 합성'을 반복해 답을 만든다. 왜 이 구조가 나왔는지 ReAct부터의 역사와 논문, 병원·기업 사례, FRAMES 벤치마크(정확도 34%↑)로 쉽고 자세하게 풀었다.
만능 선수가 전문가를 이겼다: 범용 LLM이 전문 의료 AI를 압도한 날 — Nature Medicine 2026 완전 해부
‘의료 전용으로 만든 AI가 당연히 더 낫다’ — 60년간 의심받지 않던 이 가정이 처음으로 무너졌다. NYU Langone·UT오스틴 연구진이 *Nature Medicine*(2026.6)에 발표한 독립 검증에서, 범용 프런티어 LLM(GPT-5.2·Gemini 3.1 Pro·Claude Opus 4.6)이 전문 의료 AI(OpenEvidence·UpToDate Expert AI)를 *세 가지 평가 전부*에서 앞섰다. 실제 의사 질문 100개를 *12명이 맹검*으로 채점한 실전 벤치마크(RCQ)에서도 결과는 같았다. 왜 ‘전문가’가 ‘만능 선수’에게 졌을까? RAG가 오히려 독이 되는 이유, USMLE·MedQA·HealthBench의 정체, 그리고 2026년 병원 구매·규제·한국 의료 AI에 던지는 질문까지 — 의학사 60년을 거슬러 쉽고 자세하게 해부한다.
AI는 입구, 구조화된 데이터가 출구 — DX를 위한 AI/ML 이해의 기술
DX 전문가 로드맵 4편 — 1959년 Arthur Samuel의 체커 프로그램부터 2026년 AI 에이전트까지. 88%의 기업이 AI를 활용하지만 실제 성과를 내는 기업은 6%에 불과한 이유. AI를 '도구'로 이해하는 DX 전문가의 시각을 총정리한다.
From RAG to Memory: AI에게 '기억'을 가르치다 — HippoRAG 2 논문 완전 해부
RAG는 AI에게 참고서를 주는 것이고, 기억은 AI가 직접 경험하여 아는 것이다. ICML 2025에 발표된 HippoRAG 2는 인간의 해마(hippocampus)에서 영감받아, RAG를 진정한 장기기억 시스템으로 진화시킨다. 사실 기억, 의미 추론, 연상 기억 세 가지를 동시에 달성한 이 논문을 사례와 그림으로 완전 해부한다.
Zep 논문 해부: AI 에이전트에게 '시간을 아는 기억'을 선물하다
AI 에이전트가 어제 대화를 기억하지 못한다면? Zep은 시간 인식 지식 그래프(Temporal Knowledge Graph)로 이 문제를 해결한다. 3계층 그래프 구조, 이중 시간축 모델, 동적 엣지 무효화 — MemGPT를 넘어 LongMemEval에서 최대 18.5%(상대) 정확도 향상과 90% 레이턴시 감소를 달성한 Zep의 핵심을 완전 해부한다.
GraphRAG는 정말 효과적인가? — ICLR 2026 논문이 밝힌 9가지 진실
그래프가 RAG를 377배 비싸게 만든다면, 언제 쓸 가치가 있을까? ICLR 2026에서 발표된 GraphRAG-Bench 논문이 9개 시스템을 체계적으로 벤치마킹하여 밝혀낸 9가지 핵심 발견을 깊이 있게 분석합니다.
컨텍스트 엔지니어링 완전 정복: 프롬프트의 시대는 끝났다
프롬프트 한 줄로 AI를 다루던 시대가 저물고 있다. 2026년, AI 에이전트 시대의 핵심 역량은 '컨텍스트 엔지니어링'이다. 역사적 배경부터 핵심 개념, 실전 사례까지 — Anthropic의 가이드를 바탕으로 완전 해부한다.
RAFT 특집: 시험 공부하듯 AI를 훈련시키는 법 — RAG와 파인튜닝의 황금 교차점
RAG만으로는 부족하고, 파인튜닝만으로는 한계가 있다. UC Berkeley가 제안한 RAFT는 '오픈북 시험 준비'라는 직관적 비유로 두 기법을 결합한다. 7B 모델이 GPT-3.5를 이기는 비결, 방해 문서 훈련과 인용 기반 추론의 원리를 파헤친다.