
#Qwen3
7개의 포스트
[특집] 하네스도 분업을 배운다 — Adaptive-GEPA, 요청을 나누는 법과 푸는 법을 한 번의 탐색으로 함께 진화시키기
하나의 AI 창구에는 성격이 다른 요청이 섞여 들어온다. 사실을 찾아야 하는 질문, 오래 생각해야 하는 수학 문제, 개인정보를 가려야 하는 부탁, 조건을 지켜 글을 고치는 일. 2026년 9월 30일 공개된 Adaptive-GEPA(arXiv 2609.38762)는 이 창구를 최적화하는 세 번째 길을 제안한다. 프로그램 하나를 통째로 다듬지도, 과제별로 미리 나눠 따로 다듬지도 않고, 요청을 나누는 라우터와 전문가 프로그램 묶음을 한 번의 탐색에서 함께 진화시킨다. 라우터의 지시문, 전문가마다 붙는 한 줄 설명, 프로그램 코드가 모두 사람이 읽는 글이고 실패 기록을 읽은 반성 모델이 그중 하나를 골라 고친다. 서로 다른 갈래를 합칠 때는 슬롯 번호가 아니라 ‘실제로 처리한 요청’의 겹침으로 전문가를 짝짓는다. Qwen3-8B 실험에서 네 과제 평균은 52.6에서 70.6으로 올랐고(프로그램 하나 진화 62.5, GRPO 54.0), 과제 이름을 한 번도 받지 않은 라우터가 시험 요청 651건을 과제 구분과 똑같이 나눴다. 이 글은 논문을 부록까지 읽고, 1991년 전문가 혼합에서 2025년 GEPA까지의 계보, 후보 하나의 구조, 다섯 가지 편집, 발자국 정렬 병합, 결과 표와 탐색 기록을 차례로 푼다. 시드 하나, 같은 프로그램을 다시 채점해도 2점씩 흔들리는 검증 점수, 세지 않은 계산량 같은 한계도 숫자로 짚었다. 한국어 요청 64건으로 논문의 ‘설명·라우터 편집’ 현상을 로컬 모델에서 다시 확인한 실측을 덧붙였다. 인터랙티브 6개, 일러스트 14장, 논문 그림 9장.
파라미터는 크지만 계산은 일부만 — 전문가 혼합(MoE) 35년 (특집)
<!--SUMMARY-->
예시 네 개, 순서만 바꿨을 뿐인데 — GPT-3의 퓨샷부터 유도 헤드, 예시 수천 개까지, 문맥 내 학습의 모든 것 (특집)
언어 모델에게 예시 몇 개를 보여 주면, 다시 학습시키지 않아도 새 일을 한다. 2020년 GPT-3가 ‘문맥 내 학습’이라 이름 붙인 이 능력은 지금 모든 프롬프트의 기본기다. 이 글은 GPT-2의 ‘TL;DR:’, GPT-3의 퓨샷, 순서만 바꿔도 54%와 93%를 오간 2021년 실험, 정답 라벨을 무작위로 바꿔도 거의 그대로였다는 2022년 연구, 큰 모델만 뒤집힌 라벨을 따른다는 2023년 연구, 모델 안의 ‘유도 헤드’, 예시 수천 개를 넣는 many-shot과 그 그림자인 탈옥 공격, 그리고 예시가 오히려 해롭다는 추론 모델까지 따라간다. 그리고 직접 쟀다. Qwen3 0.6B부터 14B, 카카오 Kanana를 한국어·영어 과제 셋에 돌렸고, 피티아 학습 체크포인트를 거슬러 올라가며 유도 헤드가 생기는 순간을 다시 찾았다. 같은 예시 네 개의 순서만 바꿔도 작은 모델의 한국어 감정 분류는 21%포인트 흔들렸고, 큰 모델에서는 그 폭이 줄었다. 라벨을 전부 뒤집으면 8B까지의 Qwen3 베이스 모델은 대부분 한쪽 라벨로 몰아 답했지만, 14B는 영어에서 뒤집힌 규칙을 따라 정확도가 28.5%로 떨어졌다. 인터랙티브 위젯 7종, 코어닷투데이 실측, 삽화 13장.
말할수록 무거워지는 기억 — KV 캐시로 본 긴 대화의 비용, 2017년의 첫 캐시부터 GQA·페이지드 어텐션·MLA·어텐션 싱크까지 (특집)
챗봇과의 대화가 길어질수록 답이 느려지고 요금이 오르는 이유는 KV 캐시에 있다. 언어 모델은 한 토큰씩 글을 쓰는데, 앞서 읽은 모든 토큰의 ‘키(K)’와 ‘값(V)’을 메모리에 쌓아 두고 다시 꺼내 쓴다. 계산을 메모리와 맞바꾼 이 장치 덕분에 생성은 빨라졌지만, 대신 대화가 길어질수록 GPU 메모리를 정직하게 잡아먹는다. 이 글은 2017년 원조 트랜스포머 논문에는 없던 캐시가 석 달 뒤 구글 코드에 들어간 이야기에서 시작해, 헤드를 나눠 쓰는 MQA·GQA, 캐시를 압축해 담는 딥시크의 MLA, 운영체제의 가상 메모리를 빌려 온 페이지드 어텐션, 같은 앞부분을 재사용하는 프롬프트 캐싱, 캐시를 2비트로 줄이는 양자화, 그리고 모델이 첫 토큰을 ‘주의 하수구’로 쓴다는 어텐션 싱크까지 따라간다. 그리고 직접 쟀다. 사내 V100에서 Qwen3 0.6B~8B의 캐시 크기와 속도, 동시 사용자 한계, 앞부분 재사용 효과, 캐시 양자화, 창 크기 제한을 실험했고, 피티아의 학습 체크포인트를 거슬러 올라가 어텐션 싱크가 생기는 순간을 찾았다. 1.6만 토큰짜리 앞부분의 캐시를 재사용하자 Qwen3-8B의 첫 토큰이 54배 빨리 나왔다. 캐시를 4비트로 줄일 때 Qwen3는 키를 토큰별로 자르자 무너졌지만, 채널별로 자르면 멀쩡했다. 최근 토큰만 남기자 흔들리던 모델은 첫 토큰 하나를 붙잡아 두자 되살아났다. 인터랙티브 위젯 7종, 코어닷투데이 실측, 삽화 13장.
4B를 Flash로 가르치기 — 육하원칙 추출, 선생님 답 1,623개로 로컬 모델을 키우다
이 시리즈의 첫 글에서 클라우드 Gemini 3.8 Flash는 육하원칙 추출 0.86, 로컬 9B는 0.69였습니다. 그 0.16을 지식 증류로 좁혀 보려고 Flash에게 기사 1,709건의 답을 쓰게 하고(5.6달러), 그 답으로 Qwen3 4B를 맥 한 대에서 LoRA로 가르쳤습니다. 결과는 실패였습니다. 아무것도 가르치지 않은 Qwen3 4B 2507이 이미 9B와 같은 0.686이었고, 1,623개를 다 본 학생은 0.656으로 오히려 내려갔습니다. 학생은 선생님의 판단보다 버릇을 먼저 배웠습니다. 예제 200개 지점에서는 이유가 없는 기사 44건 중 42건에 이유를 지어냈고, 끝까지 배운 뒤에도 학습 전(0건)보다 많은 12건을 지어냈습니다. Flash와 Flash-Lite가 함께 채운 이유만 남긴 '보수적 교재'는 버릇을 고치고 같은 예제 수에서 점수를 0.04 올렸지만, 학습 전 모델은 넘지 못했습니다. 교훈은 하나입니다. 증류보다 먼저, 같은 크기의 최신 모델을 정의서만으로 재 보세요. 학습 곡선·칸별 비교·버릇 상속·전후 비교·손익분기 위젯 5개.
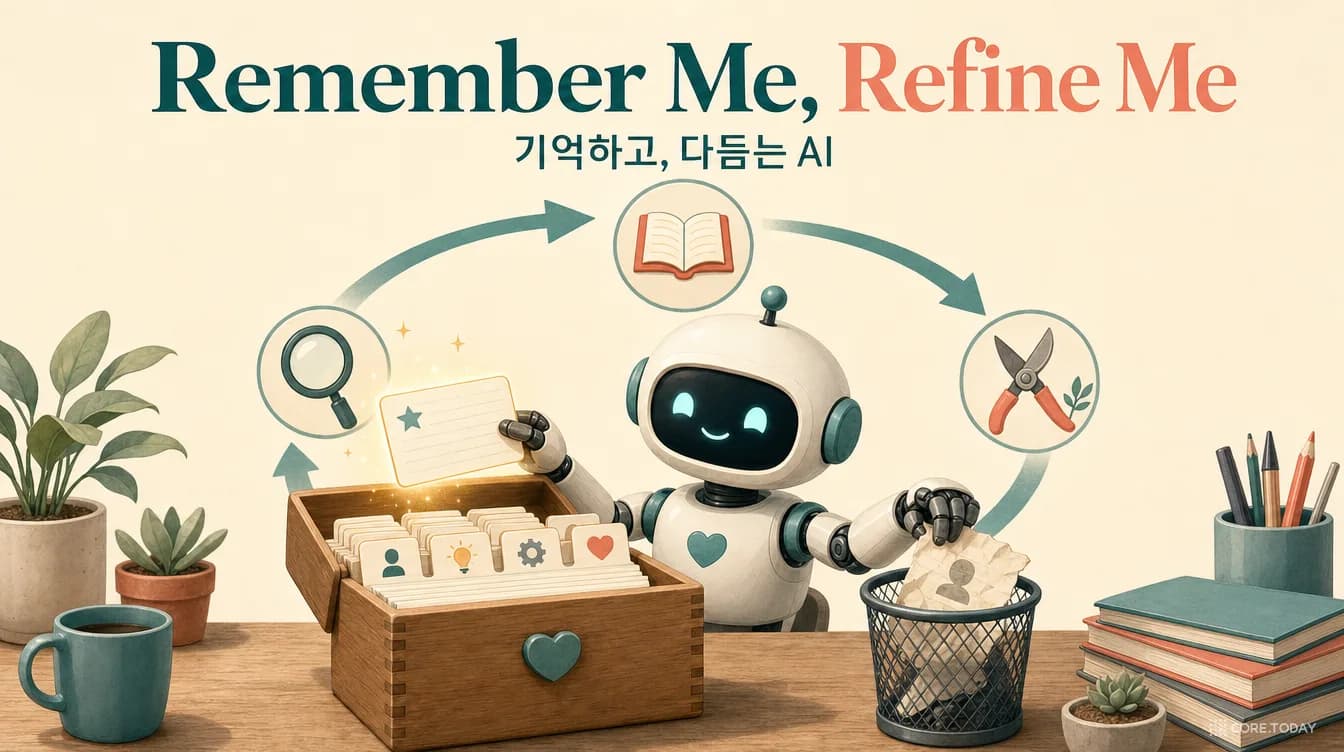
어제의 실수를 오늘 반복하지 않는 AI — ReMe, '기억하고 다듬는' 절차 기억의 모든 것
AI 에이전트는 똑똑하지만 매일 아침 기억이 지워지는 신입사원과 같다. 어제 주가를 지어내 주문을 망쳤어도 오늘 또 지어낸다. 경험을 쌓아 두면 해결될까? 알리바바 통이 연구소와 상하이교통대의 ReMe(Remember Me, Refine Me)는 '쌓기만 하는 기억은 결국 독이 된다'고 답한다. 성공·실패·비교의 세 렌즈로 경험을 한 줄짜리 요령으로 증류하고, '언제 쓰나'로 색인해 꺼내 고쳐 쓰고, 불려 나온 횟수 대비 쓸모가 없는 경험은 지운다. 그 결과 Qwen3-8B가 기억 없는 14B를 넘어섰다. 1962년 거울 속 별을 그리던 환자 H.M.부터 2026년 '기억을 파일로' 진화한 ReMe 0.4까지, 논문의 그림·표·코드와 인터랙티브 위젯 6개로 절차 기억을 완전히 풀어 본다.
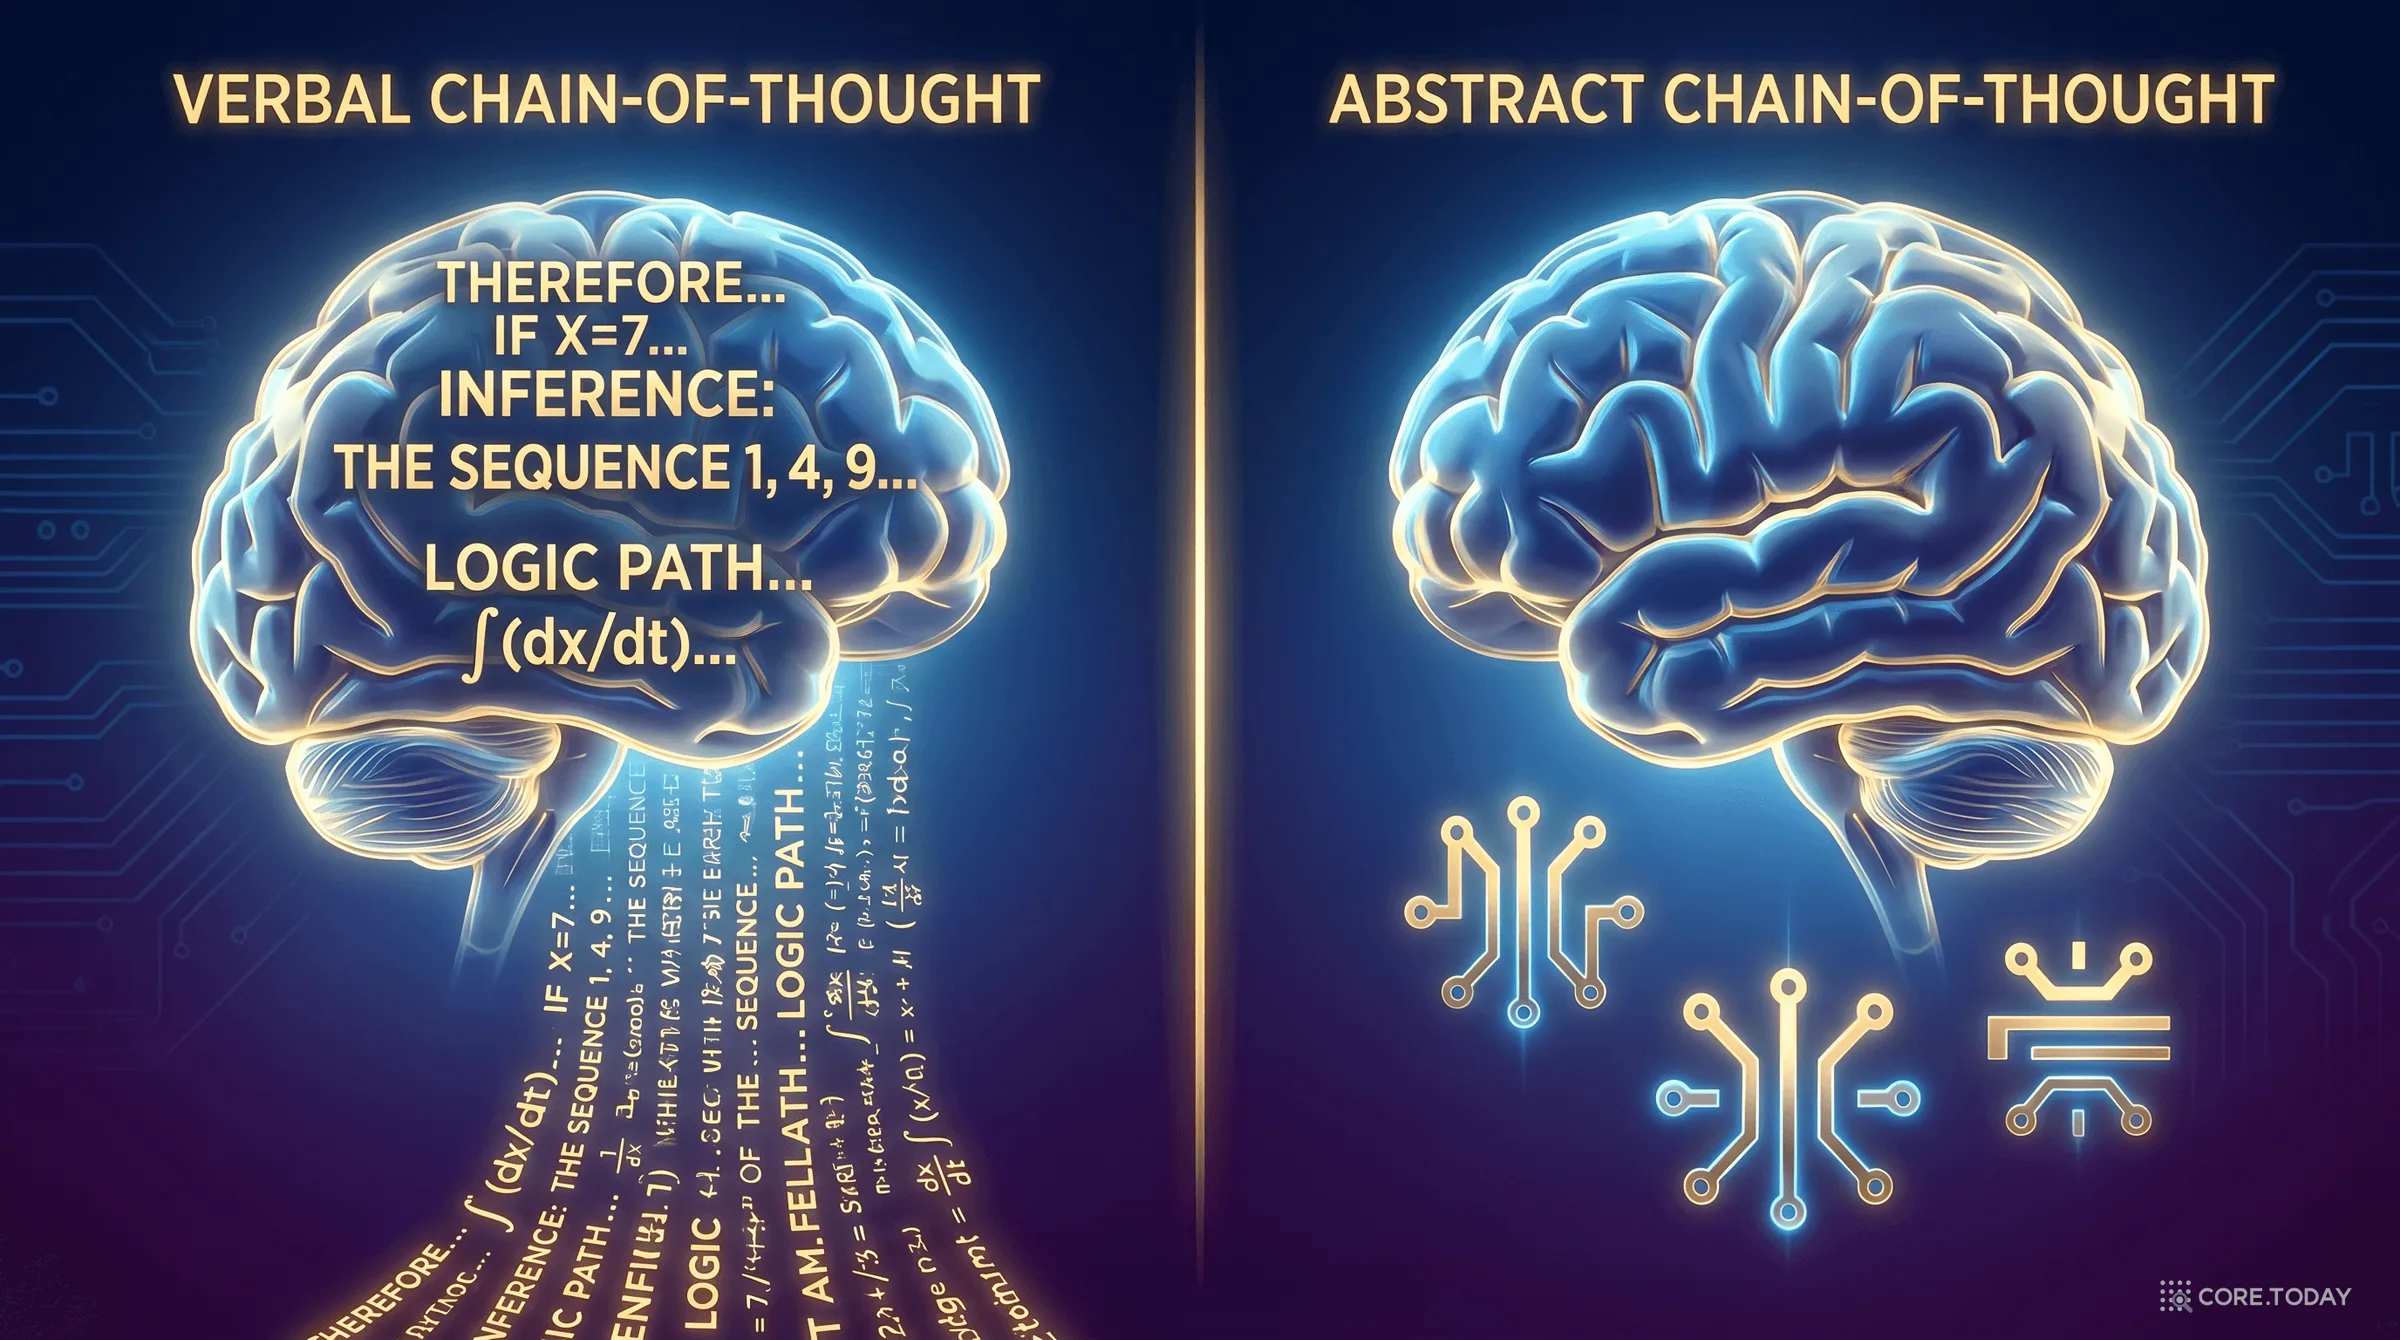
Thinking Without Words: AI가 단어 없이 생각하는 법 — Abstract Chain-of-Thought 완전 분석
IBM Research가 2026년 4월 발표한 'Thinking Without Words'를 깊이 파헤칩니다. 64개의 정체불명 토큰만으로 추론 토큰을 최대 11.6배 줄이고도 동등한 성능을 내는 비밀, 그리고 그 안에서 자연 언어와 똑같이 떠오른 Zipf의 법칙까지 — 'AI가 말 없이 생각한다'는 명제가 현실이 된 순간을 해부합니다.