OpenRouter오픈 웨이트추론 공급자GLM-5.3DeepSeek V4.1 FlashKimi K3MiniMax섞인 가격프롬프트 캐시양자화InferenceX추론 원가GPU 임대업스테이지 Solar오픈 시장 데이터
[특집] 같은 가중치, 10배 가격 — 오픈 모델을 사는 법
OpenRouter에 올라온 오픈 웨이트 모델 28개의 엔드포인트 518개를 내려받아 같은 모델의 가격을 나란히 놓았습니다. 출력 단가의 폭은 중앙값으로 2.8배, 입력 단가는 5배였고, GLM-5.3은 49개 엔드포인트 사이에서 채팅형 섞인 가격이 10.7배 벌어졌습니다. 가장 싼 공급자는 캐시 적중률과 입력:출력 비율에 따라 바뀌었고(DeepSeek V4.1 Flash는 채팅·RAG·에이전트에서 1등이 모두 달랐습니다), 가장 싼 가격 상당수에는 할인 표시와 미공개 양자화가 붙어 있었습니다. InferenceX 원가로 보면 모든 공급자 가격이 최신 칩에서는 남지만 H100·H200급에서는 DeepSeek V4.1 Flash를 파는 42곳 모두가 손해였고, 연구소 자체 가격은 최적 칩 원가의 1.4~9.2배였습니다. 같은 가중치는 같은 상품이 아니며, 오픈 모델은 출력 단가가 아니라 '내 작업 모양의 섞인 가격'과 라벨로 사야 합니다.
코어닷투데이2026-10-3087분
?
질문
GLM-5.3을 쓰기로 했습니다. 그런데 OpenRouter에는 이 모델을 파는 엔드포인트가 49개 있습니다. 가중치가 같다면 가장 싼 곳을 고르면 끝일까요?
→
방법
오픈 웨이트 모델 28개의 공개 엔드포인트 518개(가격·캐시 읽기 가격·할인·양자화·등급·가동률)를 내려받고, InferenceX의 수익 추정기에 각 공급자의 실제 가격을 넣어 칩별 매출과 원가를 다시 계산했습니다. 모든 수치는 코어닷투데이가 공개 자료로 직접 계산했습니다.
✓
결론
같은 가중치의 가격은 10배까지 벌어지고, 가장 싼 곳은 작업 모양에 따라 바뀝니다. 가장 싼 가격 상당수는 할인가이거나 양자화를 밝히지 않았습니다. 출력 단가 대신 '내 작업 모양의 섞인 가격'으로 비교하고, 라벨을 읽고, 두 번째 공급자를 정해 두는 것이 오픈 모델을 사는 법입니다.
코어닷투데이는 이틀 전 「입력 토큰 경제」에서 OpenRouter의 1년치 기록을 다시 계산했습니다. 그 글의 결론 가운데 하나는 오픈 웨이트 모델이 이미 시장의 토큰 대부분을 처리한다는 것이었습니다. 10월 셋째 주 OpenRouter 전체 토큰의 72.6%가 가중치를 공개한 모델로 갔고, 연구소 하나(DeepSeek)가 32.1%를 가져갔습니다. 지난주(10월 28일까지) 리더보드 1위 DeepSeek V4.1 Flash 1017 혼자 전체 토큰의 21.5%였습니다.
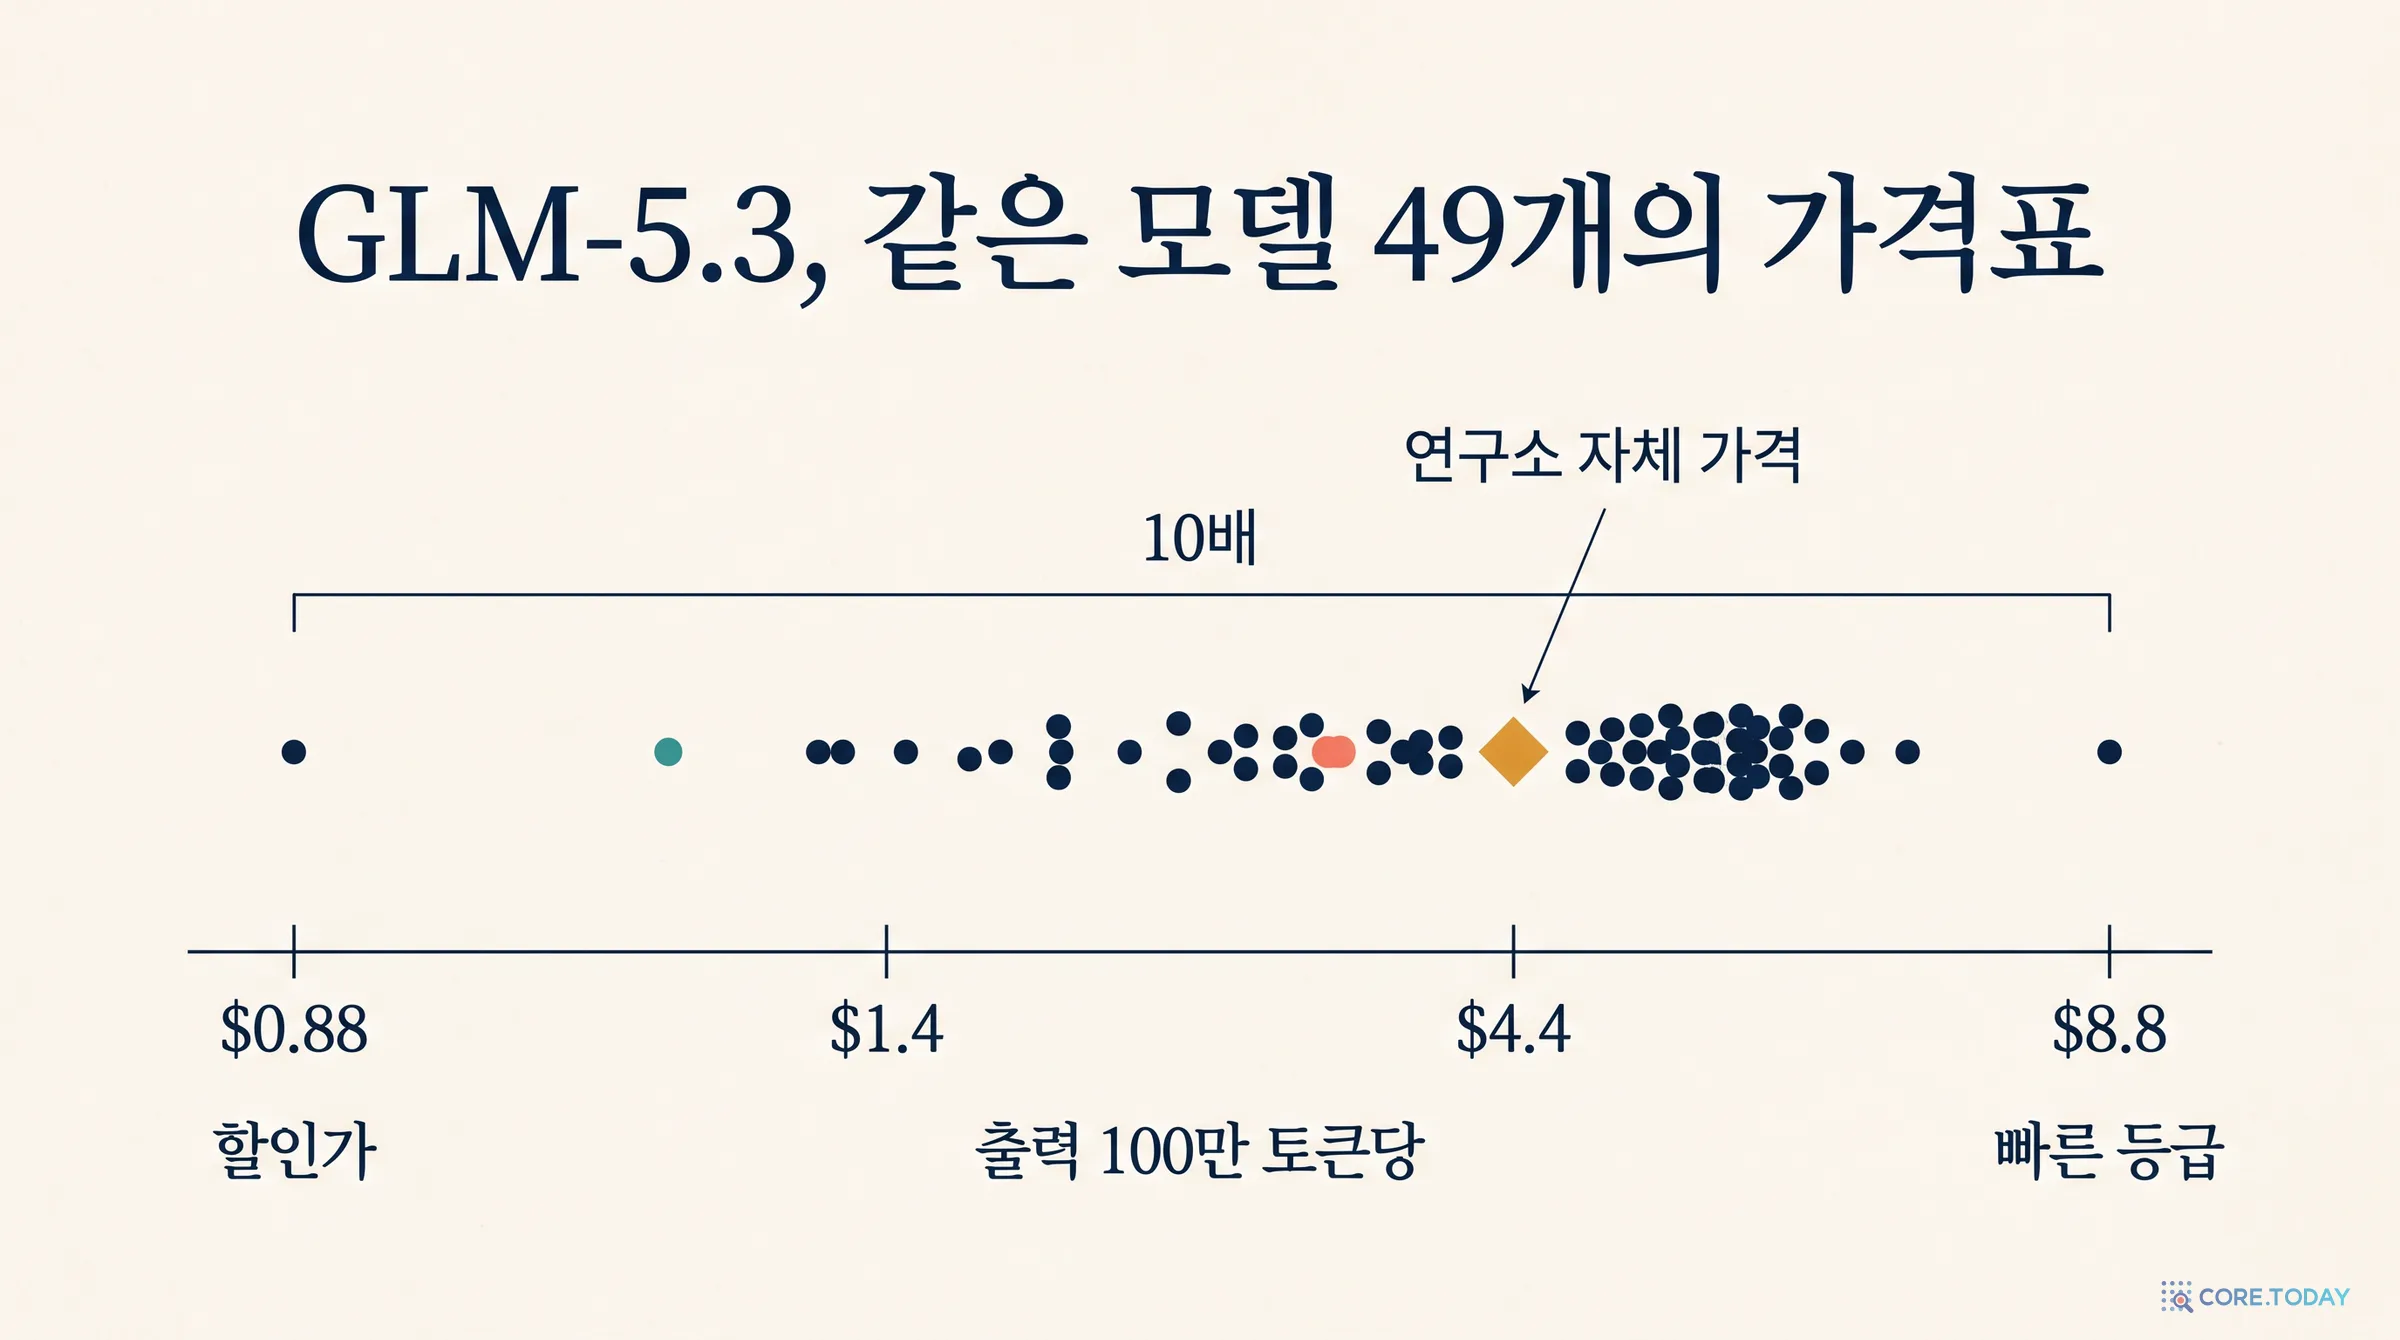
오픈 웨이트 모델에는 닫힌 모델에 없는 특징이 하나 있습니다. 누구나 팔 수 있습니다. Claude나 GPT를 사려면 Anthropic이나 OpenAI(또는 그들과 계약한 클라우드)에 가야 하지만, GLM-5.3의 가중치는 공개돼 있으니 GPU를 가진 회사라면 누구든 서버에 올려 API로 팔 수 있습니다. 그 결과 OpenRouter의 GLM-5.3 페이지에는 공급자 38곳이 낸 엔드포인트 49개가 줄지어 있습니다. 출력 100만 토큰당 가격은 $0.88부터 $8.80까지, 정확히 10배 벌어져 있습니다.
같은 가중치를 10배 다른 값에 판다는 것은 이상한 일입니다. 같은 책을 서점마다 10배 다른 값에 파는 시장은 오래가지 않습니다. 그런데 이 시장은 오래가고 있습니다. 왜일까요? 답은 세 갈래입니다.
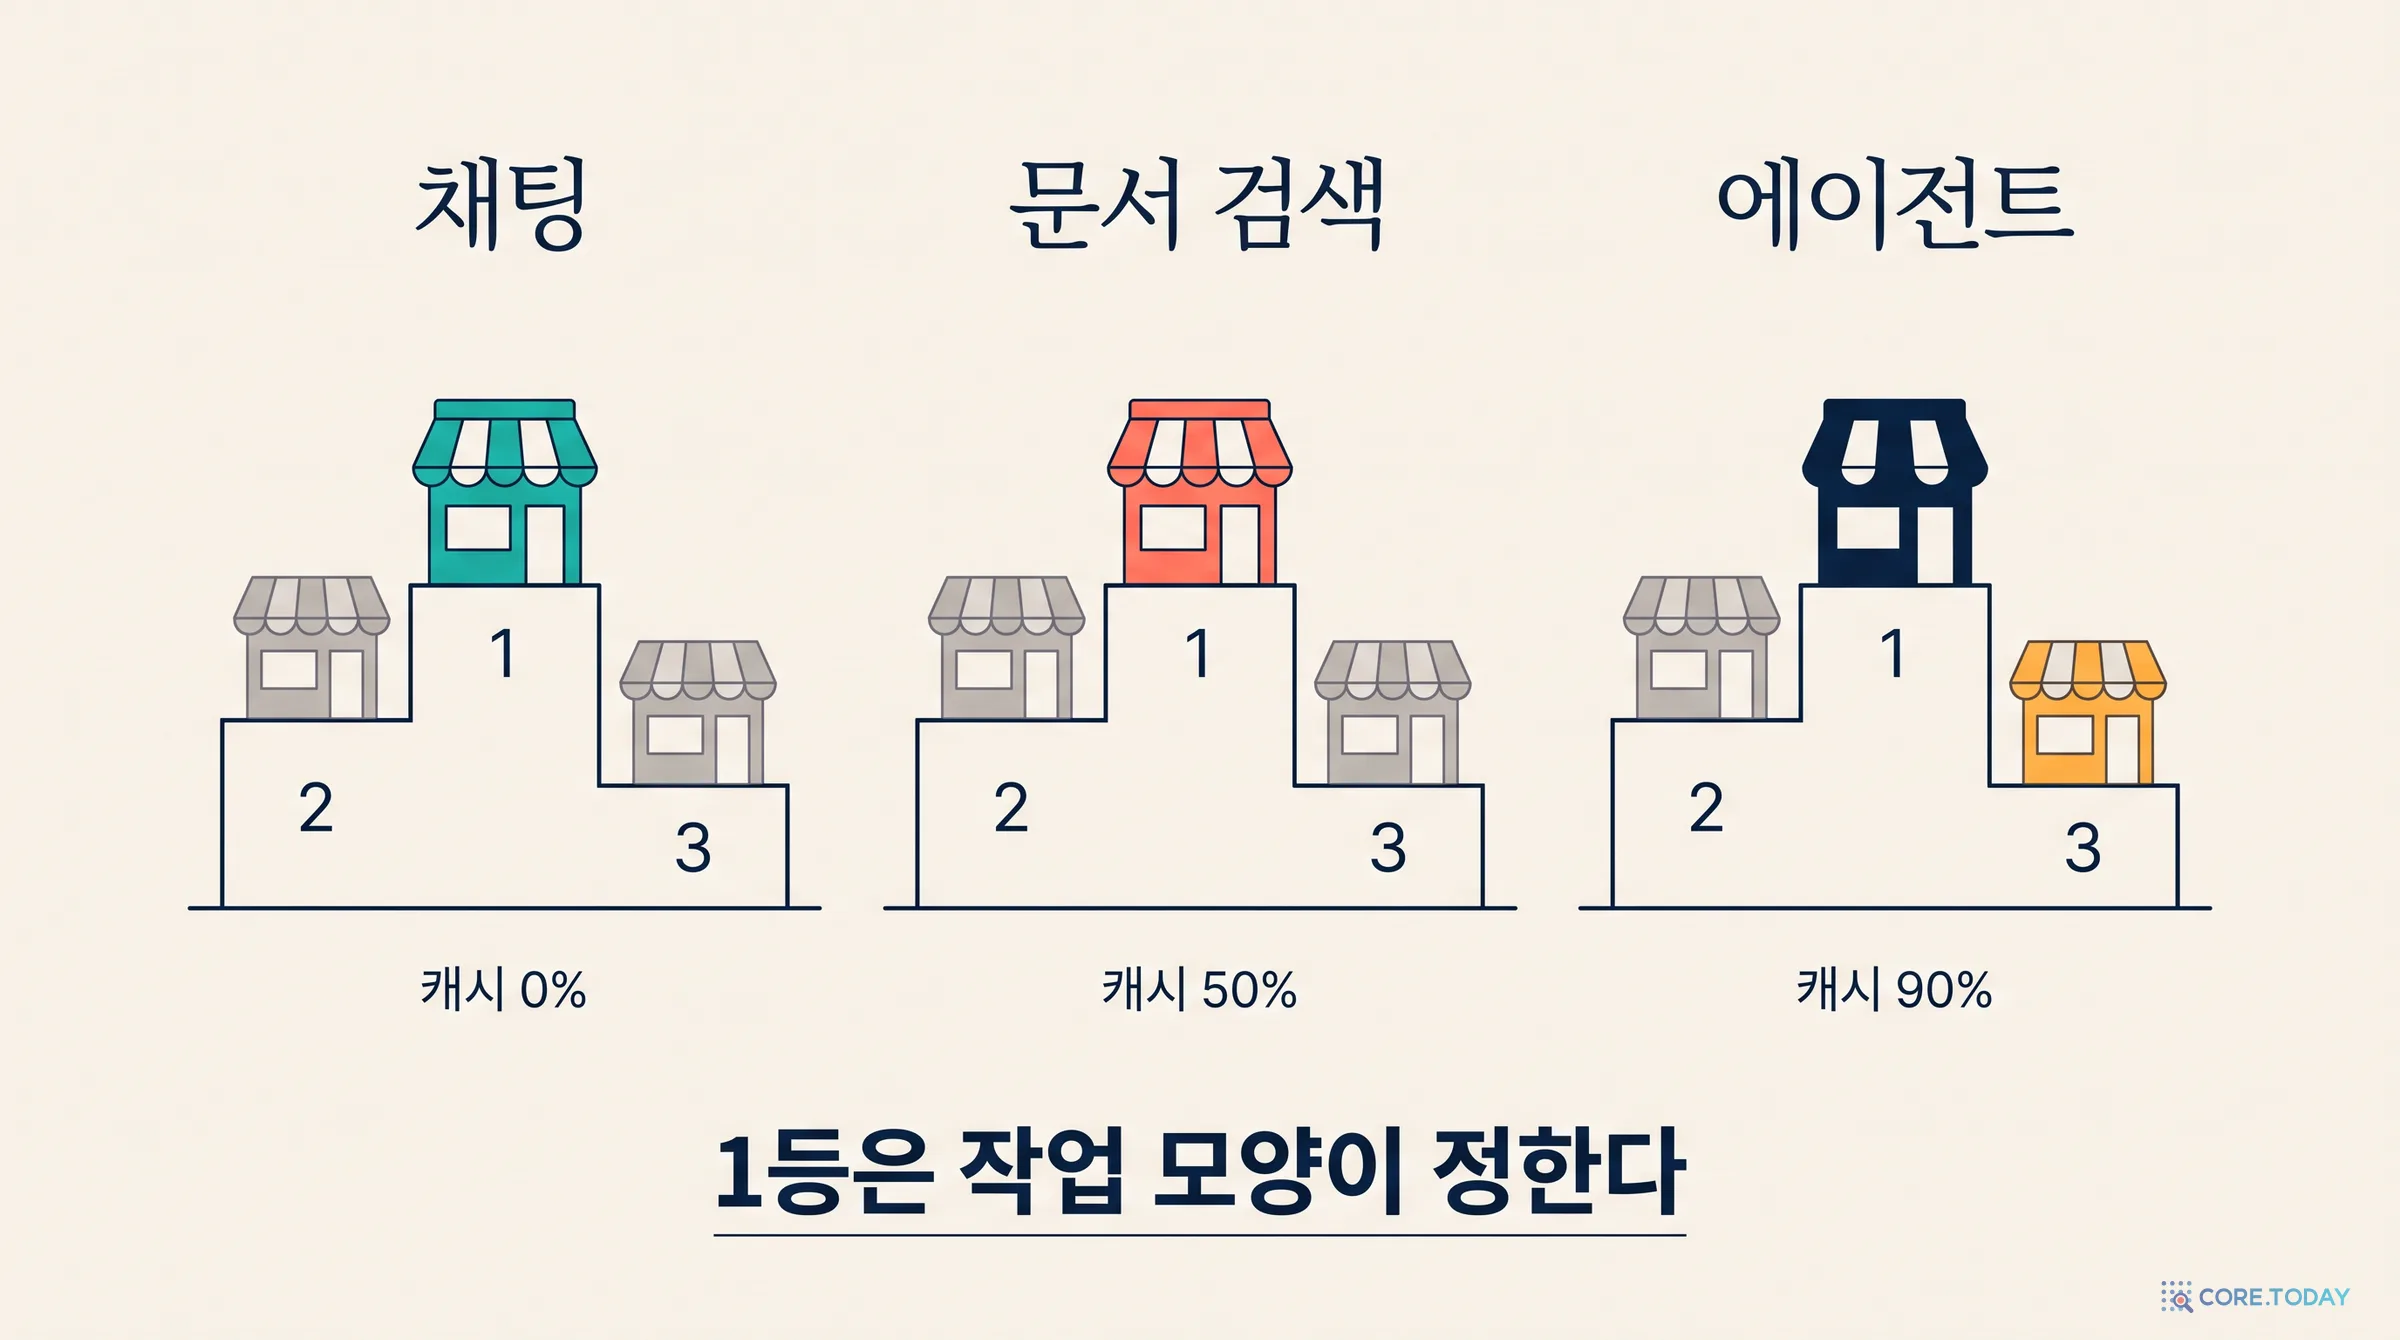
가격표가 하나가 아닙니다. 공급자는 입력·캐시 읽기·출력이라는 세 칸을 따로 매기고, 어떤 칸을 싸게 할지가 저마다 다릅니다. 그래서 '가장 싼 곳'은 사는 쪽의 작업 모양에 따라 바뀝니다.
같은 가중치가 같은 상품이 아닙니다. 4비트로 줄인 곳, 8비트로 돌리는 곳, 밝히지 않는 곳이 있고, 빠른 등급과 느린 등급이 있고, 기간 한정 할인이 있고, 하루 가동률이 90%인 곳이 있습니다.
파는 쪽의 원가가 다릅니다. 최신 GPU로 돌리는 곳과 2년 전 GPU로 돌리는 곳은 같은 가격에서 전혀 다른 이익을 냅니다. 어떤 가격은 어떤 칩에서는 팔수록 손해입니다.
이 글은 이 세 갈래를 숫자로 따라갑니다. 2~5장은 사는 쪽(가격 폭, 천장과 바닥, 작업 모양, 라벨), 6~8장은 파는 쪽(공급자와 연구소의 원가 대비 배수, 직접 서빙할 때의 칩), 9~11장은 한국 팀의 자리와 체크리스트입니다.
이 글은 코어닷투데이의 「오픈 시장 데이터 3부작」 2편입니다. 1편 「입력 토큰 경제」가 수요 쪽(누가 얼마나 쓰나)을 봤다면, 이번 편은 공급 쪽 가운데 '같은 모델을 파는 사람들'을 봅니다. 다음 편에서는 공개 추론 벤치마크로 본 생산 원가 자체를 깊게 다룰 예정입니다. 모델의 가치를 다섯 개의 자로 잰 직전 특집 「토큰의 값어치」와 함께 읽으면 좋습니다.
1장. 오픈 모델은 누가, 어떻게 파나
세 종류의 판매자
오픈 웨이트 모델 하나를 API로 살 수 있는 길은 크게 세 가지입니다.
연구소 자체 APIZ.AI · DeepSeek · Moonshot · MiniMax모델을 만든 회사가 직접 판다. 가격표의 기준점
추론 전문 사업자DeepInfra · Together · Fireworks · Novita 등GPU를 빌리거나 사서 여러 오픈 모델을 서빙한다
클라우드·대형 플랫폼Amazon Bedrock · Alibaba · Baidu · Cloudflare 등자기 플랫폼 고객에게 오픈 모델을 끼워 판다
중개소OpenRouter위의 모두를 한 API 뒤에 모으고, 요청마다 공급자를 고른다
OpenRouter는 이 가운데 맨 아래, 중개소입니다. 모델 하나에 여러 공급자의 엔드포인트를 붙여 두고, 사용자가 따로 지정하지 않으면 요청마다 공급자를 골라 보냅니다. OpenRouter 문서에 적힌 기본 규칙은 이렇습니다. 최근 30초 동안 큰 장애가 없었던 공급자 가운데 가장 싼 후보들을 가격의 역제곱에 비례한 확률로 고르고, 나머지는 실패했을 때의 대체 경로로 씁니다. 사용자는 provider.sort로 가격·처리량·지연 순서를 강제하거나, quantizations로 양자화 수준을 거르거나, data_collection: "deny"나 zdr: true로 데이터를 보관하지 않는 곳만 쓰게 할 수 있습니다. 이 글 11장의 체크리스트는 이 설정들로 이어집니다.
여기서 중요한 단어가 엔드포인트입니다. 공급자 한 곳이 같은 모델을 여러 엔드포인트로 낼 수 있습니다. 양자화가 다르거나(baseten/fp4), 지역이 다르거나(mistral/nvfp4/eu), 등급이 다르면(baseten/fast) 각각 다른 엔드포인트입니다. GLM-5.3의 49개 엔드포인트는 공급자 38곳에서 나옵니다. 이 글은 엔드포인트를 기본 단위로 세고, 필요할 때 공급자 수를 함께 적습니다.
코어닷투데이가 받은 자료
자료
내용
쓴 곳
OpenRouter 엔드포인트 목록
상위 80여 개 모델(2026-10-29). 세 칸 가격, 할인율, 양자화, 등급, 상태, 하루 가동률, 맥락 길이
1~5장, 9장, 11장
OpenRouter 주간 리더보드
지난주(10월 28일까지) 모델 643개의 토큰·지출 점유. 1편에서 쓴 자료
프롤로그, 7장, 9장
InferenceX 수익 추정기
모델 6개 × 목표 7개 × 임대·소유 × 단위 가격 3개 = 252회 호출(2026-10-30)
6~7장
InferenceX 원가 계산기
모델 14개 × 작업 2개 × 목표 5개 × 소유·임대의 칩별 100만 토큰당 원가(1편 준비 때 받은 280회 호출)
8장
연구소 공식 가격표
DeepSeek·Z.AI·Moonshot·MiniMax API 문서(10월 19~29일 게시본)
3장, 7장
분석 대상은 OpenRouter가 Hugging Face 저장소를 연결해 둔 오픈 웨이트 모델 가운데 유료 엔드포인트가 3개 이상인 28개, 엔드포인트로는 518개입니다. 무료 변형(:free)과 배치 변형(:batch)은 모델 id가 따로라 뺐습니다.
가격은 모두 100만 토큰당 달러이고, 할인이 반영된 값입니다. OpenRouter 엔드포인트 정보에는 discount라는 칸이 있는데, 이것이 이미 반영된 가격인지 확인이 필요했습니다. Baidu의 GLM-5.3 엔드포인트는 discount 0.8에 입력 $0.28·출력 $0.88인데, 이것은 Z.AI 정가 $1.40·$4.40의 정확히 20%입니다. Novita(0.55)·SiliconFlow(0.5)·GMICloud(0.5)·Phala(0.4)·Friendli(0.1)도 같은 식으로 역산하면 모두 Z.AI 정가가 나옵니다. 따라서 표시 가격은 할인 후 가격이고, 할인 전 정가는 가격 ÷ (1 − discount)로 되돌릴 수 있습니다.
섞인 가격: 세 칸을 하나로
가격표가 세 칸이면 비교가 어렵습니다. 이 글은 직전 특집에서 쓴 섞인 가격(blended price)을 기준으로 씁니다. 토큰 100만 개를 썼을 때 실제로 내는 돈입니다.
섞인 가격 (100만 토큰당)
입력:출력 = r : 1, 캐시 적중 h
섞인 가격 = { r × ( h × 캐시 읽기가 + (1 − h) × 입력가 ) + 출력가 } ÷ ( r + 1 )
지난주 1위 모델 DeepSeek V4.1 Flash 1017의 실제 입력:출력 비율 (OpenRouter 리더보드). 시장 전체는 39:1
캐시 읽기 가격을 아예 적지 않은 엔드포인트는 입력가로 계산했습니다. 캐시를 지원하더라도 가격표에 나와 있지 않으면 사는 쪽이 기대할 수 없기 때문입니다. 1편에서 본 것처럼 지금 시장의 토큰은 대부분 입력이고, 그 입력의 대부분은 같은 앞부분을 다시 읽는 캐시 읽기입니다. 그래서 캐시 읽기 가격 한 칸이 출력 가격보다 청구서를 더 크게 움직이는 일이 흔합니다. 이 점이 4장의 핵심입니다.
2장. 가격 폭 — 2.8배, 5배, 그리고 10배
28개 모델의 중앙값
먼저 전체 그림입니다. 28개 모델 각각에서 가장 비싼 엔드포인트 가격을 가장 싼 가격으로 나눈 뒤, 그 28개 비율의 중앙값을 구했습니다.
28개 모델의 중앙값
입력 단가 폭
출력 단가 폭
엔드포인트 전부 (518개)
×5.0
×2.8
표준 등급·정상 상태만
×5.0
×2.7
'표준 등급만'은 빠른(priority)·유연(flex) 등급과 상태 코드가 정상이 아닌 엔드포인트를 뺀 값. 코어닷투데이 계산.
같은 모델 안에서 출력 단가는 보통 2.8배, 입력 단가는 5배 벌어집니다. 빠른 등급처럼 '다른 상품'이 분명한 엔드포인트를 빼도 중앙값은 거의 그대로입니다. 폭은 소수의 고급 등급이 만드는 것이 아니라 표준 상품 사이에서 이미 벌어져 있다는 뜻입니다.
입력 쪽 폭이 더 큰 것은 공급자마다 '입력을 싸게 걸고 출력에서 돌려받는' 정도가 달라서입니다. 출력은 GPU 연산 시간을 직접 잡아먹어 원가 아래로 내리기 어렵지만, 입력은 그렇지 않습니다.
폭이 큰 모델들
모델
엔드포인트 (공급자)
입력 폭
출력 폭
표준 등급만 (입력 / 출력)
DeepSeek V3.2
9 (9)
×14.4
×14.5
×14.4 / ×14.5
DeepSeek V4.1 Flash 0910
41 (32)
×35.3
×13.4
×26.5 / ×10.1
DeepSeek V4 Flash 0423
17 (17)
×12.7
×13.2
×12.7 / ×9.4
DeepSeek V4.1 Flash 1017
42 (35)
×14.6
×12.0
×14.6 / ×12.0
GLM-5.3 Flash
40 (35)
×4.9
×12.0
×4.9 / ×12.0
DeepSeek V4 Pro 0813
26 (23)
×15.9
×10.0
×15.9 / ×10.0
GLM-5.3
49 (38)
×40.1
×10.0
×30.0 / ×7.5
DeepSeek V4 Flash 0731
25 (22)
×8.6
×9.3
×8.6 / ×9.3
출력 단가 폭이 큰 순서. 코어닷투데이 계산, OpenRouter 엔드포인트 목록(2026-10-29).
상위 여덟 개 가운데 여섯이 DeepSeek, 둘이 GLM입니다. 엔드포인트가 많은 모델들이지만 수만으로 설명되지는 않습니다. 엔드포인트가 9개뿐인 DeepSeek V3.2(2025년 12월판, DeepSeek가 더 이상 직접 팔지 않음)도 14배가 벌어집니다. 연구소가 손을 뗀 옛 버전일수록 가격이 정리되지 않은 채 흩어져 있습니다.
GLM-5.3 한 모델만 자세히 보겠습니다. 출력 단가 기준으로 가장 싼 곳은 Baidu의 $0.88이고 가장 비싼 곳은 Alibaba의 빠른 등급 alibaba/prime $8.80입니다. 정확히 10배입니다. 그런데 이 두 끝은 모두 '보통 상품'이 아닙니다. Baidu 가격은 80% 할인가이고, Alibaba 가격은 빠른 등급입니다. 할인 없는 엔드포인트만 보면 출력 폭은 $1.40(Wafer)에서 $8.80까지 6.3배, 표준 등급만 보면 $0.88에서 $6.60까지 7.5배입니다.
입력 쪽은 더 극적입니다. Wafer의 미국 엔드포인트는 입력 $0.0699, Alibaba prime은 $2.80으로 40배 차이입니다. Wafer는 출력에서 $1.40을 받고 입력은 거의 원가로 내놓은 셈입니다. 이런 가격표는 입력이 많은 작업에서 매우 유리하지만, 캐시 읽기 가격($0.0689)이 입력가와 거의 같다는 점이 함정입니다. 이 이야기는 4장에서 이어집니다.
채팅 작업(3:1, 캐시 없음)의 섞인 가격으로 바꾸면, 가장 싼 곳(Wafer $0.40)과 가장 비싼 곳(Alibaba prime $4.30)의 차이는 10.7배, 중앙값은 $1.51입니다. 에이전트 작업(69:1, 캐시 90%)에서도 가장 싼 곳(Baidu $0.086)과 가장 비싼 곳($0.90)의 차이는 10.4배입니다. 제목의 "10배"는 이 숫자입니다. 빠른 등급을 빼면 채팅 8.0배, 에이전트 7.6배로 줄지만, 여전히 같은 가중치에 여덟 배를 더 내는 길이 열려 있습니다.
아래 위젯에서 28개 모델의 점들을 직접 보세요. 출력과 입력을 바꾸면 폭의 모양이 달라집니다.
3장. 천장과 바닥 — 연구소 가격이 하는 일
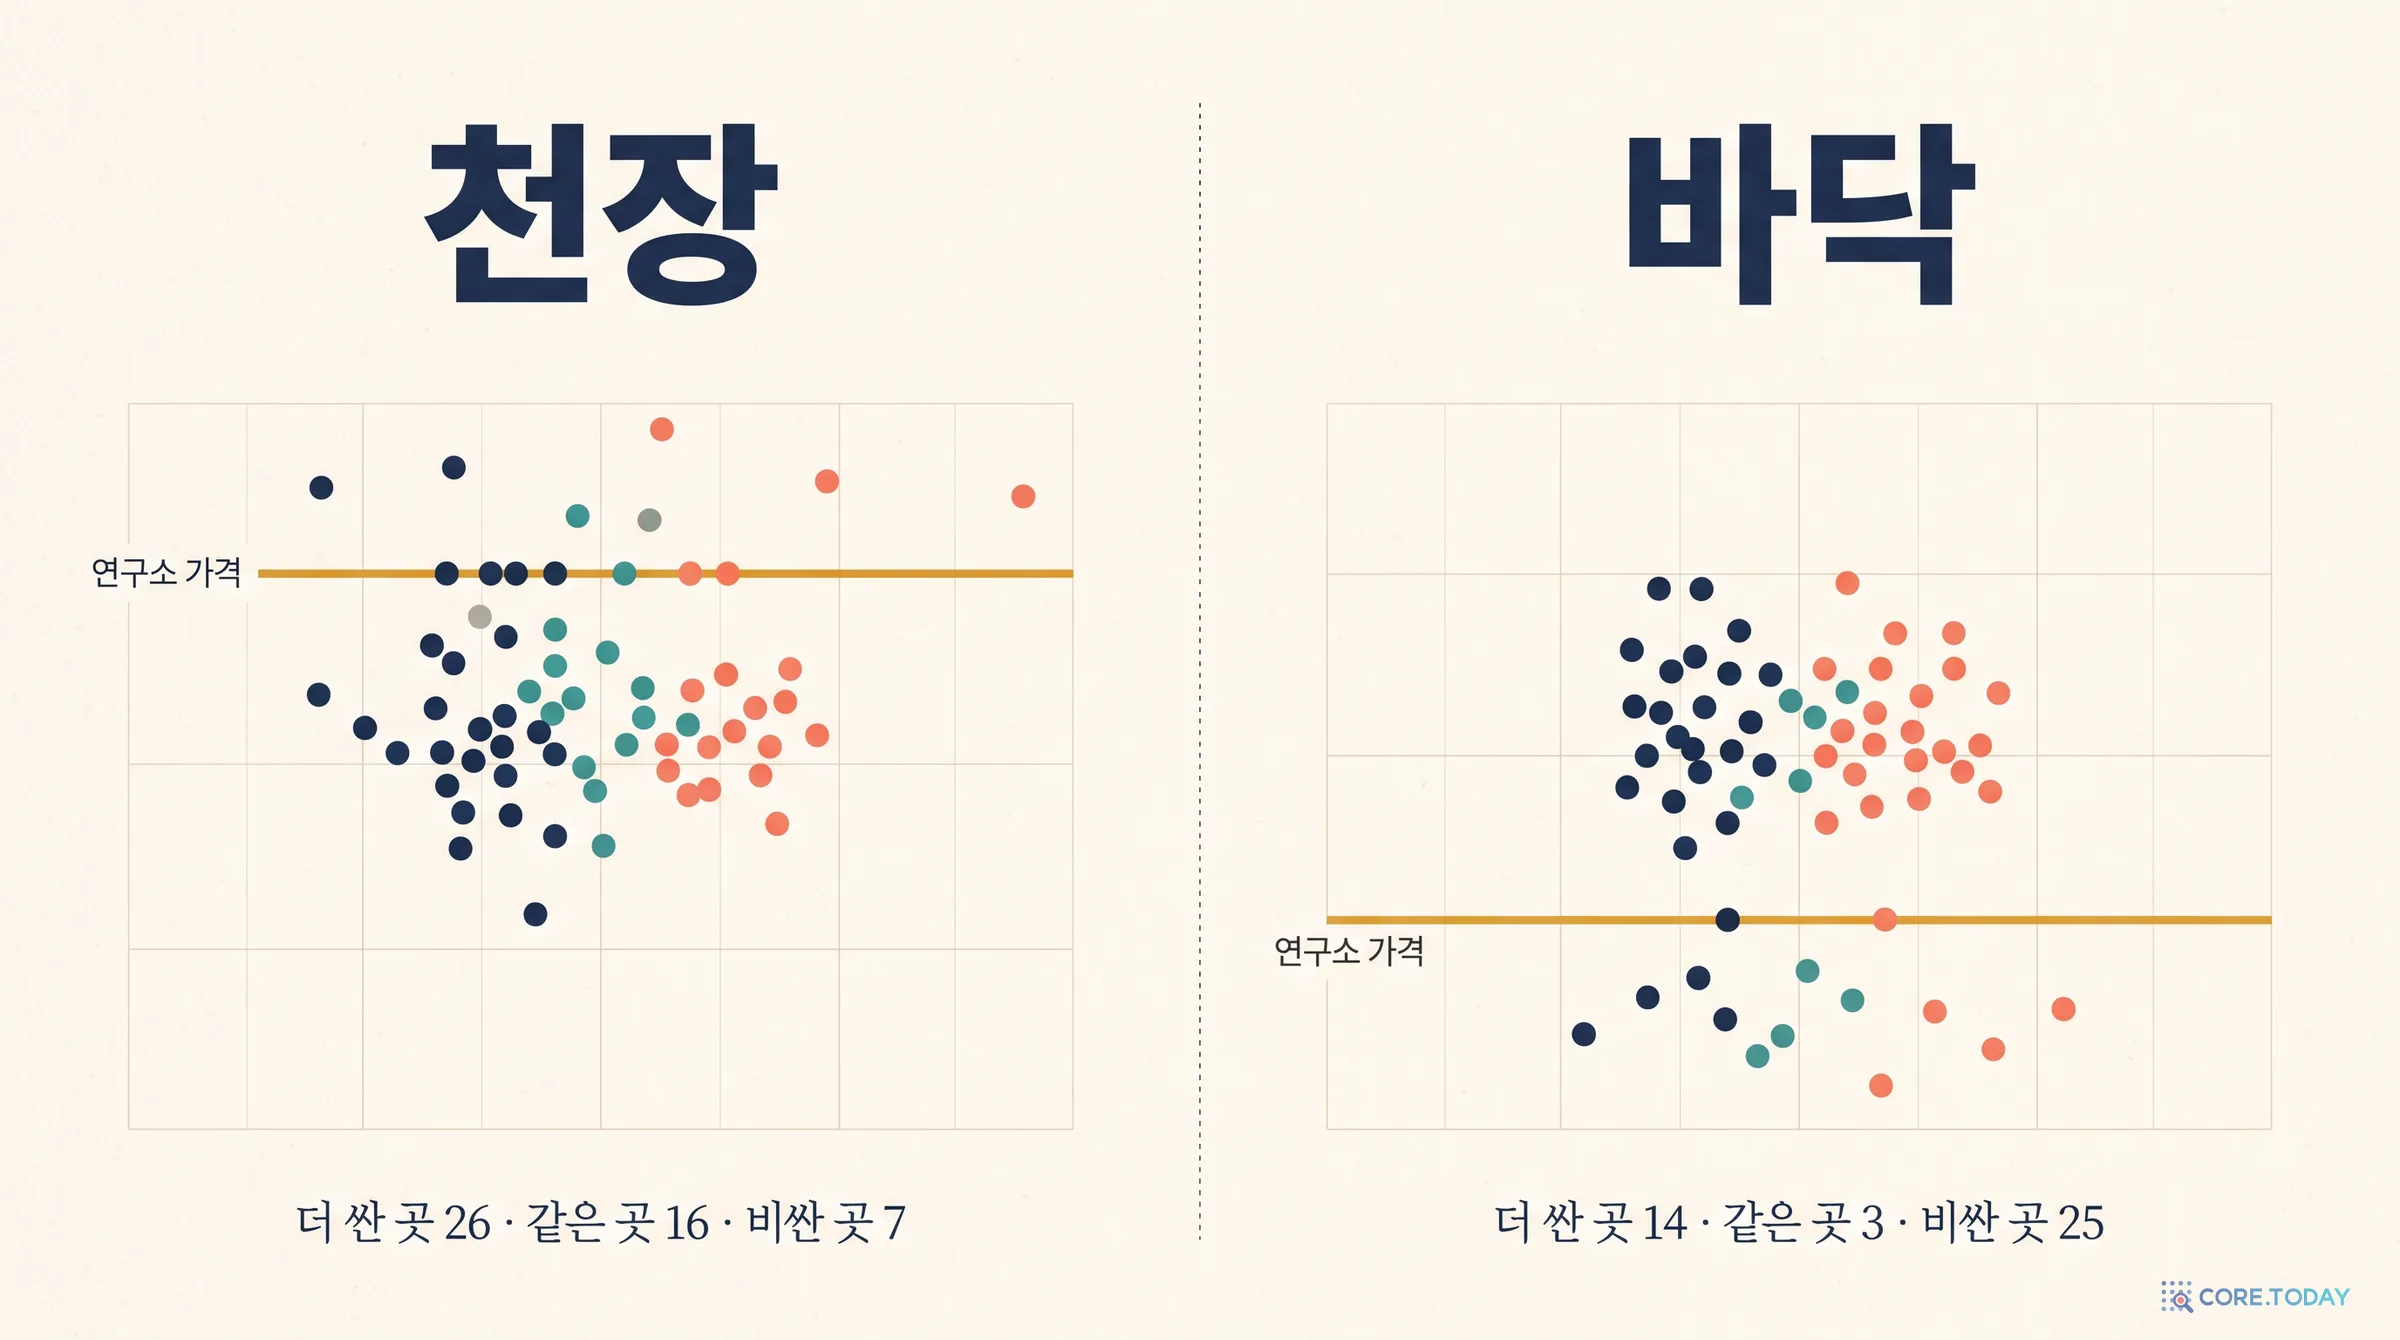
가격 폭을 그림으로 보면 점들이 고르게 흩어져 있지 않습니다. 어떤 값에 몰려 있습니다. 그 값이 대개 모델을 만든 연구소의 자체 가격입니다. 연구소 가격은 모델마다 전혀 다른 역할을 합니다. GLM-5.3에서는 천장, DeepSeek에서는 바닥입니다.
Z.AI는 GLM-5.3을 입력 $1.40, 캐시 읽기 $0.26, 출력 $4.40에 팝니다(Z.AI 공식 가격표, 10월 28일 게시본). OpenRouter의 다른 엔드포인트 48개를 이 가격과 비교하면 이렇습니다.
같은 가격입력·출력이 Z.AI와 정확히 같은 엔드포인트 13개 (Together, Fireworks, Cloudflare, Nebius, BaseTen 2개, Mistral 2개 등)
같은 정가에서 할인할인 전 가격을 역산하면 Z.AI 정가와 같은 엔드포인트 6개 더 (Baidu 80%, Novita 55%, SiliconFlow 50%, GMICloud 50%, Phala 40%, Friendli 10%)
더 싼 곳출력 단가가 $4.40보다 싼 엔드포인트 26개, 같은 곳 16개(Z.AI 포함)
더 비싼 곳7개뿐. 그중 4개는 빠른 등급(Fireworks fast, BaseTen fast 2개, Alibaba prime), 나머지는 EU 지역(Mistral), 대형 클라우드(Amazon Bedrock), ModelRun
Z.AI보다 비싸게 파는 곳은 '더 빠르다'거나 '유럽에 있다'거나 '이미 쓰는 클라우드 안에 있다'처럼 별도의 이유가 있는 곳뿐입니다. 표준 상품을 Z.AI보다 비싸게 팔 이유는 없으니, 연구소 가격이 사실상 시장의 천장입니다. 그리고 천장에 붙은 곳이 열아홉 곳(그대로 13 + 할인 6)입니다. 연구소 가격을 정가로 받아들이고 그 아래로 경쟁하는 구조입니다.
섞인 가격으로 보면 천장의 위치가 더 분명합니다. 채팅 작업에서 Z.AI의 섞인 가격 $2.15보다 더 싼 엔드포인트는 49개 가운데 28개, 같은 곳은 Z.AI 포함 14개, 비싼 곳은 7개입니다. 에이전트 작업에서는 더 싼 곳이 33개로 늘어납니다. Z.AI의 캐시 읽기 가격($0.26)이 시장에서 비싼 편이라, 캐시를 많이 쓰는 작업일수록 다른 곳이 상대적으로 더 싸지기 때문입니다.
DeepSeek: 연구소 가격이 바닥이 된다
DeepSeek은 정반대입니다. DeepSeek은 V4.1 Flash 1017을 입력 $0.15, 캐시 읽기 $0.003, 출력 $0.60에 팝니다. 이것은 비피크 시간 가격이고, 피크 시간에는 정확히 두 배($0.30·$0.006·$1.20)를 받습니다(DeepSeek 공식 가격표, 10월 19일 게시본). OpenRouter에는 DeepSeek의 엔드포인트가 비피크 가격으로 올라 있습니다.
엔드포인트 42개의 출력 단가를 DeepSeek 가격과 비교하면 더 싼 곳은 14개, 같은 곳은 DeepSeek 자신을 포함해 3개, 비싼 곳이 25개입니다. GLM과 반대로 연구소 가격이 아래쪽에 있습니다. 그리고 그 위에 또 하나의 기준점이 있습니다. DeepSeek의 피크 가격입니다.
모델
다른 엔드포인트
정가가 피크 가격과 같은 곳
그중 할인 중
V4.1 Flash 0910 ($0.30 / $1.20)
41
17
5
V4.1 Flash 1017 ($0.30 / $1.20)
41
12
3
V4 Pro 0813 ($1.32 / $3.96)
25
12
4
할인 전 가격을 가격 ÷ (1 − discount)로 역산해 DeepSeek 공식 피크 가격과 비교. 코어닷투데이 계산.
V4.1 Flash 0910에서는 41개 중 12개가 할인 없이 $0.30/$1.20을 그대로 받고, 5개는 그 가격에서 할인합니다. 1017에서도 12개가 같은 정가를 씁니다. 반면 DeepSeek의 비피크 가격($0.15/$0.60)을 정가로 쓰는 다른 엔드포인트는 1017에서 단 하나입니다. 제3자 공급자들은 DeepSeek의 피크 가격을 업계 정가로 삼고 있습니다. 하루 중 일부 시간에만 적용되는 가격이 시장 전체의 기준이 된 셈입니다.
여기서 한국 독자에게 중요한 사실이 하나 있습니다. DeepSeek의 피크 시간은 평일(중국 공휴일 제외) UTC 01~04시와 06~10시입니다. 한국 시간으로 옮기면 평일 오전 10시~오후 1시, 오후 3시~7시입니다. 한국 회사의 업무 시간이 DeepSeek 피크와 거의 겹칩니다. DeepSeek 자체 API의 '반값'은 한국 업무 시간에는 대부분 적용되지 않으며, 업무 시간에 쓰는 한국 팀에게 DeepSeek의 실질 정가는 피크 가격입니다. 그렇게 보면 제3자 공급자들이 피크 가격을 정가로 삼는 것도 이상하지 않습니다. 이들은 시간대에 따라 값을 바꾸지 않기 때문에, 한국 업무 시간 기준으로는 DeepSeek 자체 API와 같은 값을 받는 셈입니다.
MiniMax M3.1 Flash: 폭이 거의 없는 모델
반대 끝에는 MiniMax M3.1 Flash가 있습니다. 엔드포인트 13개 가운데 MiniMax 자신을 포함한 11개가 MiniMax 정가($0.15/$0.015/$0.60)와 정확히 같고, 나머지 둘은 그 가격에서 10%(StreamLake)와 5%(GMICloud)를 할인했을 뿐입니다. 가격 폭은 1.1배입니다.
왜 이 모델만 이렇게 가격이 모여 있을까요? 7장의 계산이 답을 줍니다. MiniMax가 이 모델을 파는 가격은 최적 칩 임대 원가의 1.4배에 불과합니다. 연구소 가격 자체가 원가에 바짝 붙어 있으니 제3자가 그 아래로 내려갈 여지가 없습니다. 연구소의 마크업이 크면 제3자가 그 아래로 들어올 자리가 넓고, 마크업이 작으면 모두가 연구소 가격에 줄을 섭니다. GLM-5.3(마크업 9.2배, 폭 10배)과 M3.1 Flash(1.4배, 1.1배)가 양 끝입니다. 다만 이 관계가 깔끔한 비례는 아닙니다. DeepSeek V4 Pro는 비피크 가격의 마크업이 2.5배뿐인데도 출력 폭이 10배입니다. 제3자 공급자들이 그 두 배인 피크 가격을 정가로 삼기 때문입니다.
Kimi K3와 MiniMax M3는 그 중간입니다. Kimi K3는 엔드포인트 30개 가운데 Moonshot 자신을 포함한 8개가 Moonshot 가격($3/$0.30/$15)과 정확히 같고, MiniMax M3는 13개 가운데 MiniMax 자신을 포함한 7개가 MiniMax 가격($0.30/$0.06/$1.20)과 같습니다. 한 가지 덧붙이면, MiniMax 공식 가격표에서 M3의 이 가격은 "영구 50% 할인"이 적용된 값($0.60/$2.40에서 할인)이고, 입력이 512k 토큰을 넘는 요청은 두 배를 받습니다. 그런데 OpenRouter 목록에는 가격이 한 줄뿐입니다. Mara라는 공급자는 할인 전 정가 $0.60/$2.40을 그대로 받습니다. 긴 맥락 요청이 어떤 값으로 청구되는지는 공개 목록만으로는 확인할 수 없었습니다.
4장. 가장 싼 공급자는 작업 모양이 정한다
세 칸 가격표의 함정
가격표가 한 칸이라면 '가장 싼 곳'은 하나입니다. 세 칸이면 그렇지 않습니다. 공급자 A는 입력을 싸게, 캐시 읽기는 입력과 거의 같게, 출력은 비싸게 받습니다. 공급자 B는 입력은 보통이지만 캐시 읽기를 입력의 2%로 받습니다. 캐시가 거의 없는 채팅에서는 A가 이기고, 같은 앞부분을 수십 번 다시 읽는 에이전트에서는 B가 이깁니다.
실제 데이터에서 이런 A형 가격표는 드물지 않습니다. 518개 엔드포인트 가운데 캐시 읽기 가격이 입력가의 90% 이상이거나 아예 적혀 있지 않은 곳이 75개(그중 표기 없음 37개)입니다. 반대쪽 끝에는 캐시 읽기를 입력가의 1%도 안 되는 값에 받는 곳도 있습니다(Xiaomi MiMo v2.6 Pro를 파는 엔드포인트들). 같은 '캐시 읽기'라는 이름 아래 100배 가까운 차이가 있습니다.
DeepSeek V4.1 Flash 1017: 세 작업, 세 명의 1등
지난주 OpenRouter 토큰의 21.5%를 처리한 모델로 실제 순위를 매겨 보겠습니다.
작업 모양
1등 (섞인 가격)
그 공급자의 가격표 (입력 / 캐시 / 출력)
DeepSeek 자체 (순위)
채팅 3:1, 캐시 0%
Sail Research $0.113
$0.101 / $0.0067 / $0.15 — 출력이 가장 쌈
$0.263 (더 싼 곳 15개)
RAG 20:1, 캐시 50%
Morph $0.041
$0.044 / $0.004 / $0.383 — 입력이 아주 쌈
$0.101 (더 싼 곳 15개)
에이전트 69:1, 캐시 90%
DeepInfra 유연 등급 $0.0132
$0.078 / $0.0024 / $0.235 — 캐시 읽기가 쌈 (51% 할인 중)
$0.026 (더 싼 곳 14개)
에이전트 69:1, 캐시 97%
DeepInfra 유연 등급 $0.0079
같은 엔드포인트
$0.016 (더 싼 곳 10개)
OpenRouter 엔드포인트 목록(2026-10-29)으로 코어닷투데이 계산. 가격은 100만 토큰당.
세 작업 모양에서 1등이 모두 다릅니다. 더 흥미로운 것은 꼴찌 쪽입니다. OpenInference의 fp4 엔드포인트는 입력가가 $0.0309로 42개 가운데 가장 쌉니다. 그런데 캐시 읽기가 $0.0306으로 입력가와 거의 같고 출력이 $1.80으로 비쌉니다. 이 엔드포인트의 순위는 채팅 31위, RAG 19위, 에이전트 40위, 캐시 97% 에이전트에서는 42위, 꼴찌입니다. 입력이 가장 싼 곳이 입력을 가장 많이 쓰는 작업에서 가장 비싼 곳이 됩니다. 입력 대부분이 캐시 적중인 작업에서는 '입력가'가 아니라 '캐시 읽기가'가 실제 입력 단가이기 때문입니다.
에이전트 1등에도 단서가 붙습니다. DeepInfra의 유연(flex) 등급은 51% 할인가이고, 최근 하루 가동률이 91.2%입니다. 할인 없이 표준 등급으로 파는 2등 Morph($0.0134)와의 차이는 1.5%에 불과합니다. 이 차이라면 대부분의 팀은 Morph를 고르는 편이 낫습니다. 5장에서 이 '라벨' 이야기를 자세히 합니다.
GLM-5.3과 다른 모델들
GLM-5.3에서는 채팅과 RAG의 1등이 Wafer 미국 엔드포인트($0.0699 / $0.0689 / $1.40)이고, 에이전트에서는 Baidu($0.086)가 Wafer($0.088)를 근소하게 앞섭니다. 그런데 Baidu 가격은 80% 할인가입니다. 할인이 끝나면 Baidu의 에이전트 섞인 가격은 다섯 배로 돌아가고, 1등은 다시 Wafer가 됩니다. 같은 Wafer라도 wafer/fp4 엔드포인트는 입력가가 $0.179로 달라서 에이전트 순위가 13위입니다. 같은 공급자의 엔드포인트끼리도 순위가 크게 다릅니다.
28개 모델 전체로 넓히면 다음과 같습니다.
28개 모델 가운데 9개에서 채팅과 에이전트의 1등이 다르고, 12개(43%)에서 에이전트 1등이 할인가입니다(채팅 1등은 7개). 할인을 빼고 다시 계산하면 그 12개 모두에서 1등이 바뀝니다. '가장 싼 공급자'라는 말에는 작업 모양과 할인 기간이라는 두 개의 숨은 조건이 붙어 있는 셈입니다.
출력 단가만 보고 고르면 얼마나 손해일까요? 모델마다 출력 단가가 가장 싼 엔드포인트를 골라 에이전트 작업(69:1, 캐시 90%)의 섞인 가격을 계산하고, 진짜 1등과 비교했습니다. 28개 중 절반 이상은 출력이 가장 싼 곳이 에이전트에서도 1등이라 손해가 없습니다(중앙값 1.00배). 하지만 꼬리가 깁니다. Gemma 4 31B는 출력이 가장 싼 DeepInfra 유연 등급($0.16 / 캐시 표기 없음 / $0.32)을 고르면 에이전트 작업에서 1등(Chutes, $0.12 / $0.012 / $0.37)보다 5.85배를 냅니다. DeepSeek V4 Flash 0731은 3.5배, DeepSeek V4 Pro(4월판)는 1.85배, GLM-5.3 Flash는 1.69배, Kimi K3는 1.51배입니다. 원인은 모두 같습니다. 출력이 싼 곳이 캐시 읽기를 싸게 주지 않았습니다.
직접 줄 세워 보기
아래 위젯은 이 장의 계산을 그대로 옮긴 것입니다. 모델을 고르고, 작업 모양 버튼을 누르거나 슬라이더로 우리 팀의 입력:출력 비율과 캐시 적중률을 넣어 보세요. 노란 줄이 연구소 자체 엔드포인트이고, 줄마다 양자화·등급·할인·캐시 가격·가동률 표시가 붙습니다.
위젯으로 몇 가지를 확인할 수 있습니다. Kimi K3는 채팅·RAG에서는 Relace가, 에이전트에서는 Sail Research가 1등입니다. MiniMax M3은 어떤 작업 모양에서도 DeepInfra가 1등이라 순위가 흔들리지 않습니다. MiniMax M3.1 Flash는 모두가 같은 가격이라 위젯의 막대가 거의 같은 길이입니다. 우리 팀의 캐시 적중률을 모르면 가장 싼 공급자도 알 수 없습니다.
5장. 같은 가중치 ≠ 같은 상품
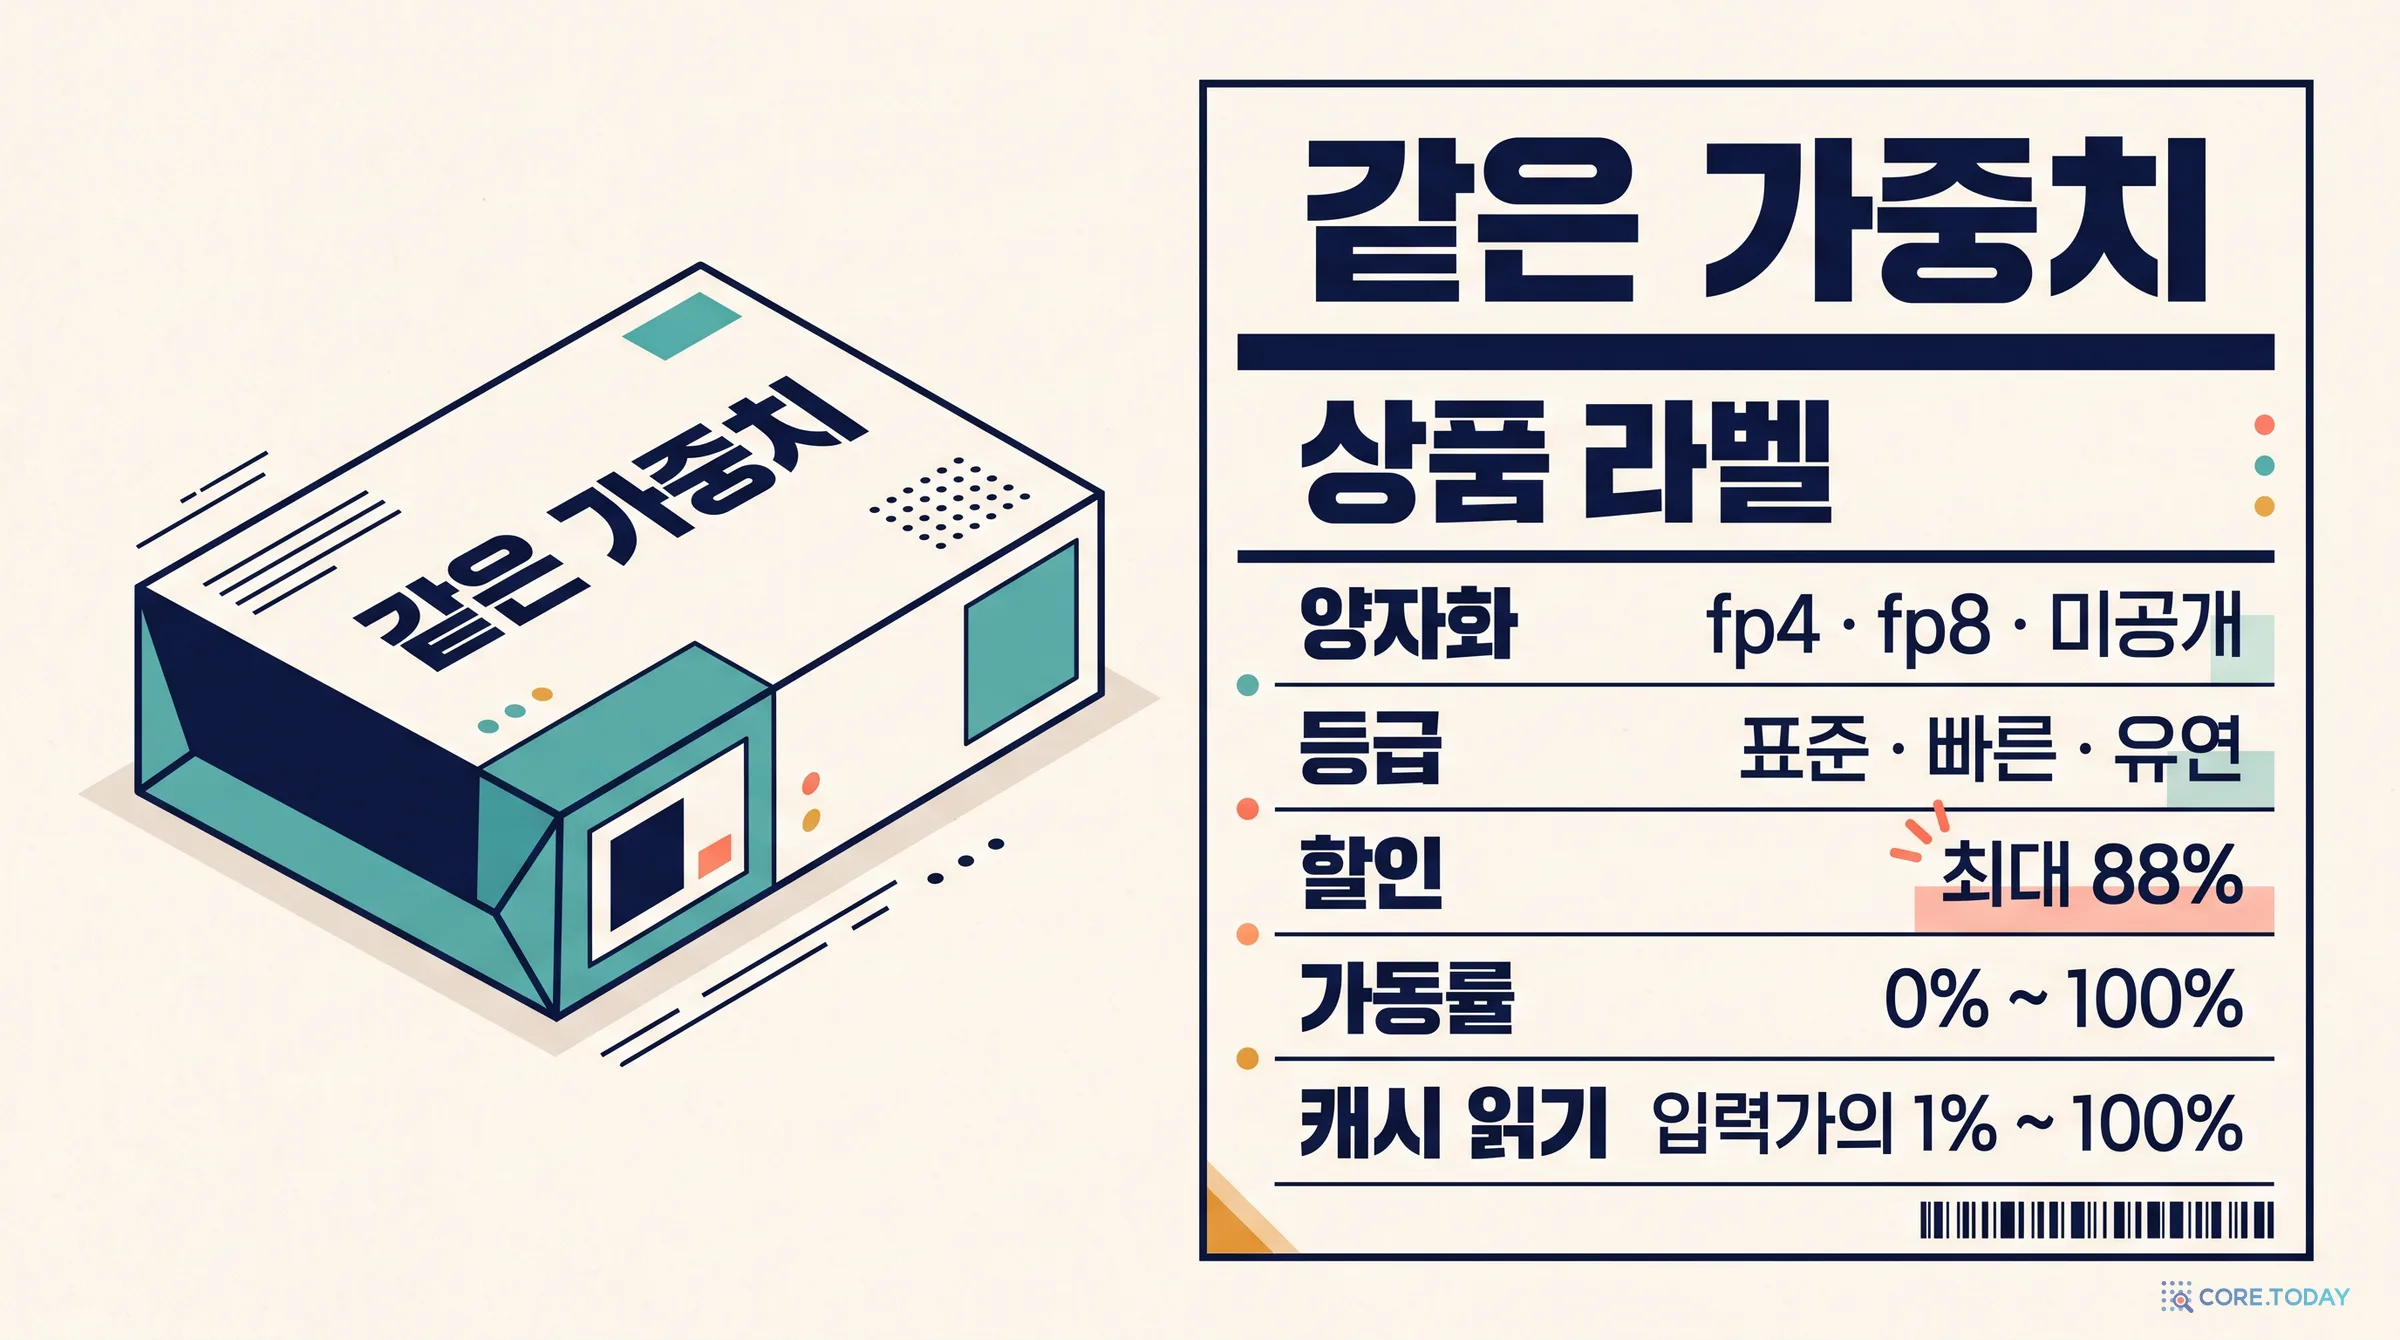
가격을 비교할 때 전제는 '같은 물건'입니다. 오픈 모델에서는 이 전제가 약합니다. 가중치 파일은 같아도, 그것을 어떻게 줄이고 어떤 하드웨어에서 어떤 약속으로 파는지는 공급자마다 다릅니다. OpenRouter 엔드포인트 정보에는 그 차이가 '라벨'로 붙어 있습니다.
518개 엔드포인트의 양자화 표기. 막대 길이는 전체 대비 비율. OpenRouter 엔드포인트 목록(2026-10-29).
양자화는 모델의 숫자를 더 적은 비트로 줄여 메모리와 연산을 아끼는 기법입니다(16비트 → 8비트면 메모리 절반, 4비트면 4분의 1). 최근 모델은 처음부터 fp8·fp4 서빙을 염두에 두고 설계되기도 해서 비트가 낮다고 곧 품질이 나쁜 것은 아닙니다. InferenceX도 DeepSeek V4.1 Flash·GLM·Kimi·MiniMax의 원가를 fp4로 잽니다. 문제는 같은 모델을 공급자마다 다른 비트로 돌린다는 점과, 31%가 무엇으로 돌리는지 밝히지 않는다는 점입니다.
GLM-5.3의 49개 엔드포인트는 미공개 17개, fp8 16개, fp4 13개, nvfp4 3개로 나뉩니다. DeepSeek V4.1 Flash 1017의 42개는 fp8 18개, 미공개 17개, fp4 5개, mxfp4 2개입니다. 같은 이름의 모델이 실제로는 서너 가지 정밀도로 돌아갑니다. 코어닷투데이는 이번에 공급자별 품질을 직접 재지 않았습니다(10장 참고). 확실한 것은 하나입니다. 가격이 싼 엔드포인트가 왜 싼지는 라벨에 반쯤만 적혀 있습니다. OpenRouter는 provider.quantizations로 원하는 비트만 고를 수 있게 해 주고, 그 목록에 unknown도 있습니다. 품질이 중요한 작업이라면 미공개를 거르는 것이 기본값이어야 합니다.
등급: 빠른 줄과 느린 줄
같은 공급자가 같은 모델을 등급별로 나눠 팝니다. 518개 가운데 빠른(priority) 등급이 18개, 유연(flex) 등급이 6개입니다. OpenRouter 문서에 따르면 빠른 등급은 :nitro 변형으로, 유연 등급은 :floor 변형으로 요청할 때 후보에 들어갑니다. GLM-5.3에서 빠른 등급(Fireworks fast, BaseTen fast)은 표준 가격의 1.5배($2.10/$6.60), Alibaba prime은 2배($2.80/$8.80)를 받습니다. 반대로 DeepInfra의 유연 등급은 같은 회사 표준 엔드포인트보다 20% 싸고(DeepSeek V4.1 Flash 1017 기준), 대신 기다릴 수 있다는 조건이 붙습니다. 2장에서 '빠른 등급을 빼면 폭이 줄어든다'고 한 것이 이 차이입니다. 빠른 등급의 값은 속도의 값이지 가중치의 값이 아닙니다.
할인: 가장 싼 가격의 상당수는 기간 한정이다
28개 모델의 518개 엔드포인트 가운데 74개에 할인 표시가 있습니다. 닫힌 모델까지 포함한 전체 수집분에서는 101개입니다. 전체 101개를 공급자별로 세면 GMICloud(14개, 최대 50%), DeepInfra(12개, 최대 51%), StreamLake(11개, 최대 70%), Google(11개, 50%), Baidu(10개, 최대 88%), Novita(8개, 최대 65%) 순입니다. 할인 기간이나 조건은 엔드포인트 정보에 나와 있지 않습니다.
4장에서 본 대로 할인은 순위를 바꿉니다. 28개 모델 가운데 12개에서 에이전트 작업의 1등이 할인가였고, 할인을 빼면 12개 모두 1등이 바뀌었습니다. 할인가를 기준으로 공급자를 정하고 비용 계획을 세웠다면, 할인이 끝나는 날 청구서가 두 배에서 다섯 배로 뛸 수 있습니다. 할인 전 정가는 가격 ÷ (1 − 할인율)로 계산할 수 있으니, 비용 계획은 정가로 세우고 할인은 덤으로 보는 편이 안전합니다.
가동률·맥락 길이·버전
나머지 라벨도 차이가 큽니다.
가동률: 518개 가운데 최근 하루 가동률이 99% 미만인 곳이 98개, 95% 미만이 35개입니다. GLM-5.3의 Amazon Bedrock 미국 동부 엔드포인트는 수집 시점 가동률이 42%였고 상태 코드도 정상이 아니었습니다. 가장 싼 곳 하나만 지정해 두면, 그곳이 멈췄을 때 전체 서비스가 멈춥니다.
맥락 길이: GLM-5.3은 공식적으로 100만 토큰 맥락을 지원하지만 Io Net 엔드포인트는 26만 2천 토큰까지만 받습니다. 긴 문서를 통째로 넣는 작업이라면 싼 엔드포인트가 요청 자체를 거절할 수 있습니다.
버전: DeepSeek 공식 API의 모델 표에는 V4.1 Flash 1017과 V4 Pro 0813만 있고, 옛 이름으로 들어온 요청은 1017로 넘긴다고 적혀 있습니다. 9월판(0910)이나 7월판(0731)으로 고정하려면 제3자 공급자에게 가는 수밖에 없습니다. 지난주 OpenRouter 토큰의 13.3%가 이런 옛 버전으로 갔습니다(0910만 9.0%). 결과가 바뀌면 안 되는 파이프라인에서는 버전 고정이 가격보다 중요할 수 있습니다.
데이터 보관: 엔드포인트 태그에 지역(us, eu, us-east-1)이나 무보관(zdr)이 붙은 곳이 있습니다. 518개 가운데 미국 계열 지역 태그가 43개, EU 계열이 5개, zdr이 2개이고, 한국이나 아시아 지역 태그는 하나도 없었습니다. 어느 나라 서버로 가는지는 태그만으로 다 알 수 없고, 공급자 정책을 따로 읽어야 합니다.
같은 가중치를 산다는 것은 이 다섯 줄짜리 라벨 중 하나를 고르는 일입니다. 가격은 그 라벨의 여섯 번째 줄일 뿐입니다.
6장. 공급자는 돈을 버나 — 같은 가격, 다른 칩
지금까지는 사는 쪽의 이야기였습니다. 이제 파는 쪽으로 건너갑니다. 가격 폭이 10배라면, 가장 싸게 파는 곳은 손해를 보고 있는 걸까요? 아니면 가장 비싸게 파는 곳이 폭리를 취하는 걸까요? 이 질문에 답하려면 원가가 필요합니다.
방법: 공급자 가격을 InferenceX에 넣는다
SemiAnalysis의 InferenceX는 공개 모델을 여러 GPU와 서빙 소프트웨어 조합에서 매일 돌려 처리량을 재고, 그 처리량을 칩 1시간 원가로 나눠 토큰 원가를 냅니다. 직전 특집에서 소개한 대로, 2026년 8월의 v3부터는 실제 에이전트 대화 기록(트레이스)을 재현합니다. InferenceX에는 수익 추정기(profit estimator)라는 화면이 있어서, 토큰 가격을 넣으면 칩 1시간이 벌어 오는 매출과 그 칩의 1시간 원가를 칩·엔진 조합마다 돌려줍니다. 기본 설정은 사용률 60%, 연구소 몫(라이선스 수수료) 0, 벤치마크에서 잰 실제 캐시 적중률, 그리고 모델마다 정해진 목표 상호작용성(사용자 한 명에게 초당 보내는 토큰 수)입니다.
코어닷투데이는 이 추정기를 공개 API로 불러, 모델 6개마다 입력·캐시 읽기·출력 가격에 각각 $1씩만 넣은 응답 세 개를 받았습니다. 추정기의 매출은 세 가격에 대해 선형이라, 이 세 응답만 있으면 어떤 공급자 가격이든 칩별 매출을 바로 계산할 수 있습니다. 실제로 OpenInference의 DeepSeek 가격($0.0309 / $0.0306 / $1.80)을 직접 넣은 응답과 세 단위 응답을 합친 값은 18개 칩·엔진 조합 모두에서 소수점 셋째 자리까지 일치했습니다. 이렇게 목표 상호작용성 7개(기본값, 30, 50, 75, 100, 150, 200) × 임대·소유 두 기준을 모두 받았습니다(252회 호출, 10월 30일).
InferenceX의 에이전트 트레이스가 어떤 작업 모양인지도 이 응답에서 보입니다. DeepSeek V4.1 Flash를 GB300(Dynamo+vLLM)에서 돌린 경우, 칩 1시간 동안 처리하는 입력의 97%가 캐시 적중이고 입력:출력은 약 134:1입니다. 4장의 '에이전트(캐시 97%)'보다도 입력 쪽으로 더 치우친 작업입니다.
결과 1: 최신 칩에서는 모두가 남긴다
기본 목표에서, 각 공급자 가격을 '가장 좋은 칩'에 넣었을 때의 매출 ÷ 임대 원가입니다.
모델 (기본 목표)
공급자 가격
최적 칩에서 손해인 가격
가장 낮은 배수
중앙값
DeepSeek V4.1 Flash 1017 (150)
42
0
3.14 (DeepInfra, 51% 할인)
7.71 (GB300)
DeepSeek V4.1 Flash 0910 (150)
41
0
1.77 (Baidu, 85% 할인)
9.27
GLM-5.3 (135)
49
0
1.84 (Baidu, 80% 할인)
6.39 (VR200)
Kimi K3 (60)
30
0
2.04 (Sail Research)
4.63 (GB300)
MiniMax M3 (115)
13
0
2.96 (DeepInfra)
3.98 (VR200)
DeepSeek V4 Pro 0813 (170)
26
0
2.49 (Baidu)
5.09 (VR200)
MiniMax M3.1 Flash (45)
13
0
1.25 (StreamLake)
1.39 (MI355X)
임대 기준, 사용률 60%. 괄호 안 숫자는 InferenceX의 모델별 기본 목표(사용자당 초당 토큰). 코어닷투데이 계산.
가장 좋은 칩이라면 214개 공급자 가격(엔드포인트 기준) 가운데 원가 아래인 것은 하나도 없습니다. MiniMax M3.1 Flash를 빼면 가장 싸게 파는 곳도 원가의 1.77배 이상을 남기고, 가장 낮은 값들은 대개 큰 할인을 붙인 Baidu입니다. 유일하게 원가에 바짝 붙은 모델이 10월 23일에 나온 MiniMax M3.1 Flash입니다. 13개 가격이 모두 1.25~1.39배에 몰려 있고, 그나마 이 목표(45)에서 측정된 칩은 MI355X와 H200 둘뿐입니다. 3장에서 본 '폭이 없는 모델'의 이유가 여기 있습니다. 원가 위에 남은 마진이 얇으니 할인할 여지가 없습니다.
결과 2: H200은 DeepSeek 토큰을 팔 때마다 손해를 본다
그런데 '가장 좋은 칩'은 대개 GB300이나 VR200 같은 최신 랙입니다. 모든 공급자가 이 칩을 가진 것은 아닙니다. 같은 가격을 칩별로 나눠 보면 그림이 뒤집힙니다.
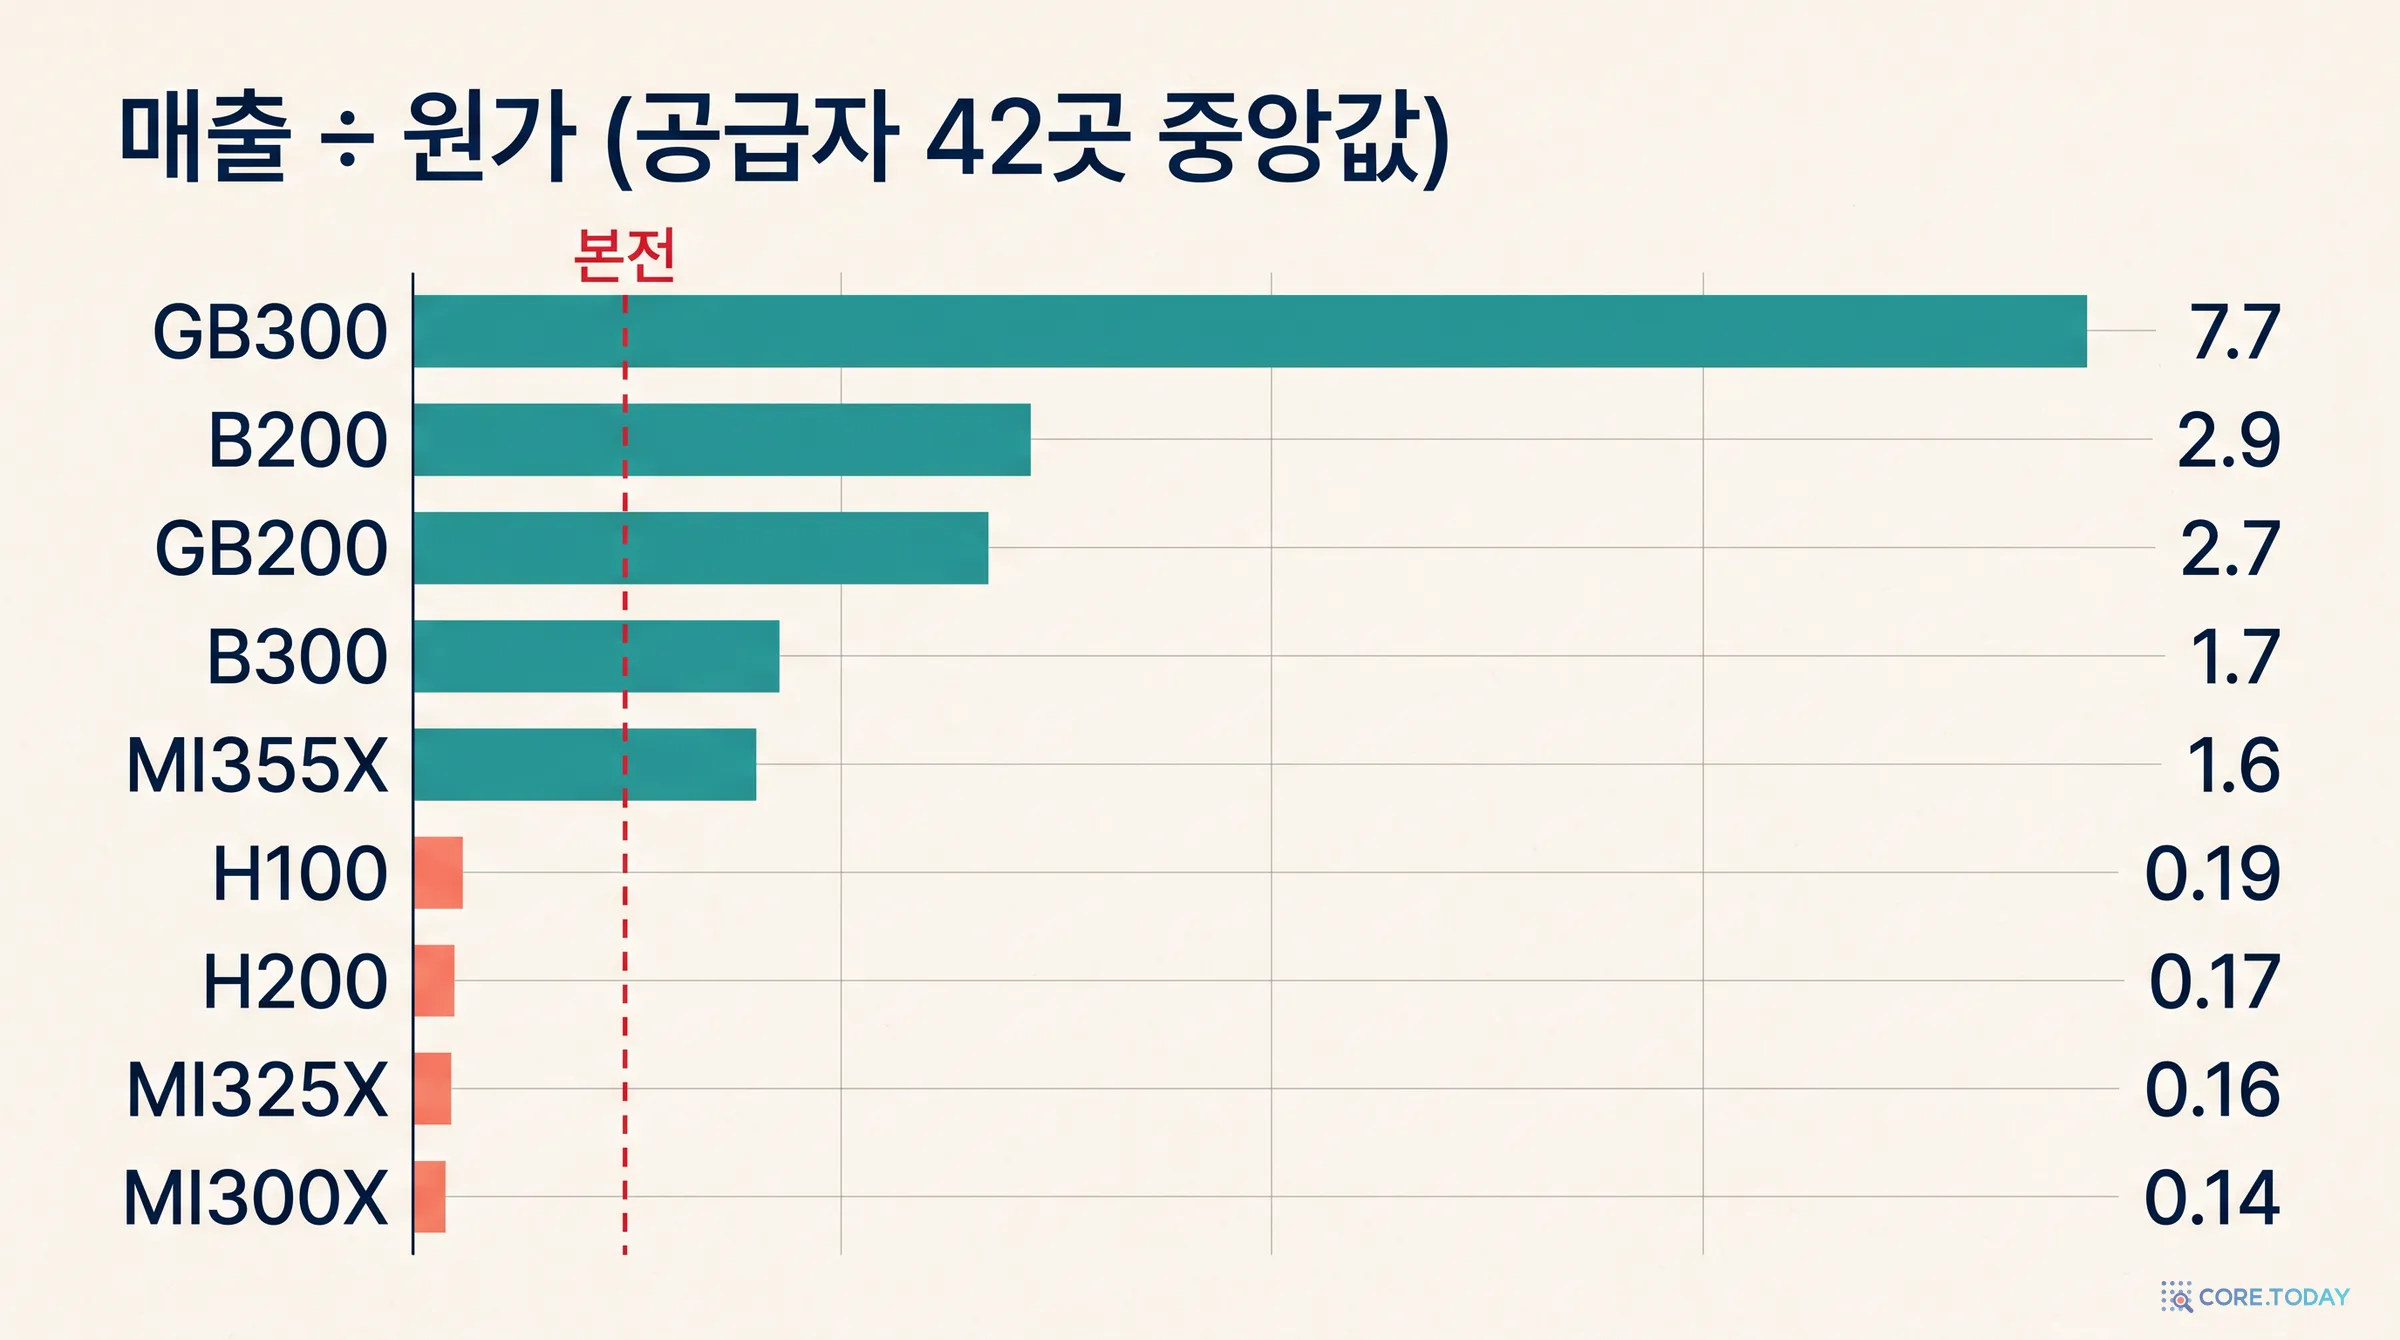
DeepSeek V4.1 Flash 1017을 기본 목표(사용자당 초당 150토큰)로 볼 때, 42개 공급자 가격의 칩별 결과입니다.
GB300
7.71 · 손해 0/42
B200
2.86 · 0/42
GB200
2.74 · 0/42
B300
1.66 · 6/42
MI355X
1.56 · 7/42
H100
0.19 · 42/42
H200
0.17 · 42/42
MI325X
0.16 · 42/42
MI300X
0.14 · 42/42
매출 ÷ 임대 원가의 중앙값(42개 공급자 가격)과 원가 아래인 가격 수. 막대 길이는 GB300 중앙값(7.71)을 100으로 둔 비율. InferenceX(2026-10-30)·OpenRouter(2026-10-29)로 코어닷투데이 계산.
H100·H200·MI300X·MI325X에서는 42개 가격 모두가 원가 아래이고, 중앙값은 0.14~0.19입니다. 가격 1달러어치를 팔 때 원가가 5~7달러 든다는 뜻입니다. 같은 가격이 GB300에서는 원가의 7.7배를 남깁니다. 오픈 모델 가격 전쟁의 바닥을 정하는 것은 공급자의 의지가 아니라 칩 세대입니다. 구형 칩을 가진 공급자는 최신 칩을 가진 공급자가 정한 가격을 따라갈 수 없고, 따라가면 팔수록 손해입니다.
단서: 목표 상호작용성이 결과를 크게 바꾼다
이 결과에는 큰 단서가 붙습니다. 사용자당 초당 150토큰은 꽤 빠른 응답입니다. 그보다 느려도 된다면 칩 하나에 더 많은 사용자를 묶을 수 있어 구형 칩의 처리량도 올라갑니다. 같은 계산을 목표 7개에서 반복했습니다.
목표 (토큰/초)
H200
MI300X
H100
측정된 칩 중 최고
30
측정 범위 밖
0.76 · 28/42
0.08 · 42/42
MI300X 0.76 (최신 칩은 측정 범위 밖)
50
0.65 · 38/42
0.53 · 39/42
0.04 · 42/42
GB300 3.03
75
0.30 · 42/42
0.33 · 42/42
0.03 · 42/42
B300 3.53
100
0.31 · 42/42
0.24 · 42/42
0.37 · 42/42
GB300 7.08
150 (기본)
0.17 · 42/42
0.14 · 42/42
0.19 · 42/42
GB300 7.71
200
0.12 · 42/42
0.06 · 42/42
0.11 · 42/42
GB300 6.79 (B300은 24/42 손해)
DeepSeek V4.1 Flash 1017, 42개 공급자 가격. 칸마다 매출 ÷ 임대 원가 중앙값 · 원가 아래인 가격 수. '측정 범위 밖'은 InferenceX가 그 목표에서 측정값이 없어 추정하지 않은 경우. 코어닷투데이 계산.
목표를 낮추면 구형 칩의 사정이 분명히 나아집니다. H200의 중앙값은 150토큰에서 0.17이지만 50토큰에서는 0.65로 네 배 가까이 오릅니다. MI300X는 30토큰에서 0.76까지 오르고, 42개 가격 가운데 14개는 원가를 넘습니다. 하지만 어느 목표에서도 이 네 칩의 중앙값은 1을 넘지 못했습니다. 그리고 목표가 낮은 쪽에서는 측정 범위 밖이라 최신 칩이 아예 표에 없다는 점도 기억해야 합니다. 30토큰에서 '가장 좋은 칩'이 MI300X인 것은 MI300X가 좋아서가 아니라, GB300이 그 느린 구간에서 측정되지 않았기 때문입니다. 반대 방향도 있습니다. 목표를 200토큰으로 올리면 최신 칩 B300에서도 42개 중 24개 가격이 원가 아래가 됩니다.
정리하면 "H200은 DeepSeek 토큰을 팔 때마다 손해를 본다"는 문장은 InferenceX의 최적화 구성과 사용률 60%를 전제로, 사용자당 초당 50토큰 이상을 보장하는 서비스라면 참입니다. 더 느린 배치 작업에서 구형 칩이 살아날 여지는 있지만, 공개 측정으로 원가를 넘는 구간은 확인하지 못했습니다.
다른 모델들
Kimi K3: 기본 목표(60)에서는 B200에서 30개 중 8개, B300에서 7개가 손해입니다. 목표를 150으로 올리면 B200 29개, GB200·B300 각 27개가 손해로 바뀌고, VR200만 모두를 살립니다.
DeepSeek V4 Pro 0813: 기본 목표(170)에서 B300 21/26, B200 20/26, GB200 17/26, H200 26/26이 손해이고 VR200에서만 모두 남습니다. 목표를 100으로 낮추면 H200을 뺀 모든 칩에서 26개 가격이 모두 남습니다.
MiniMax M3.1 Flash: 목표 200에서는 13개 공급자 가격이 모든 칩에서 원가 아래입니다(가장 나은 GB200의 중앙값 0.99).
아래 위젯에서 모델·목표·원가 기준(임대/소유)을 바꿔 가며 직접 확인해 보세요. 소유 기준으로 바꾸면 칩 1시간 원가가 절반 가까이로 떨어져 많은 점이 1 오른쪽으로 넘어갑니다. 자기 데이터센터에 칩을 가진 공급자와 시간 단위로 빌려 쓰는 공급자의 체력이 다른 이유입니다.
7장. 연구소의 마크업 — 만든 회사는 원가의 몇 배에 파나
공급자 가격과 같은 방법으로 연구소 자체 가격도 원가와 비교할 수 있습니다. 모델을 만든 회사는 연구개발비를 회수해야 하니 제3자보다 비싸게 받을 이유가 있습니다. 그 '프리미엄'이 얼마인지 보겠습니다.
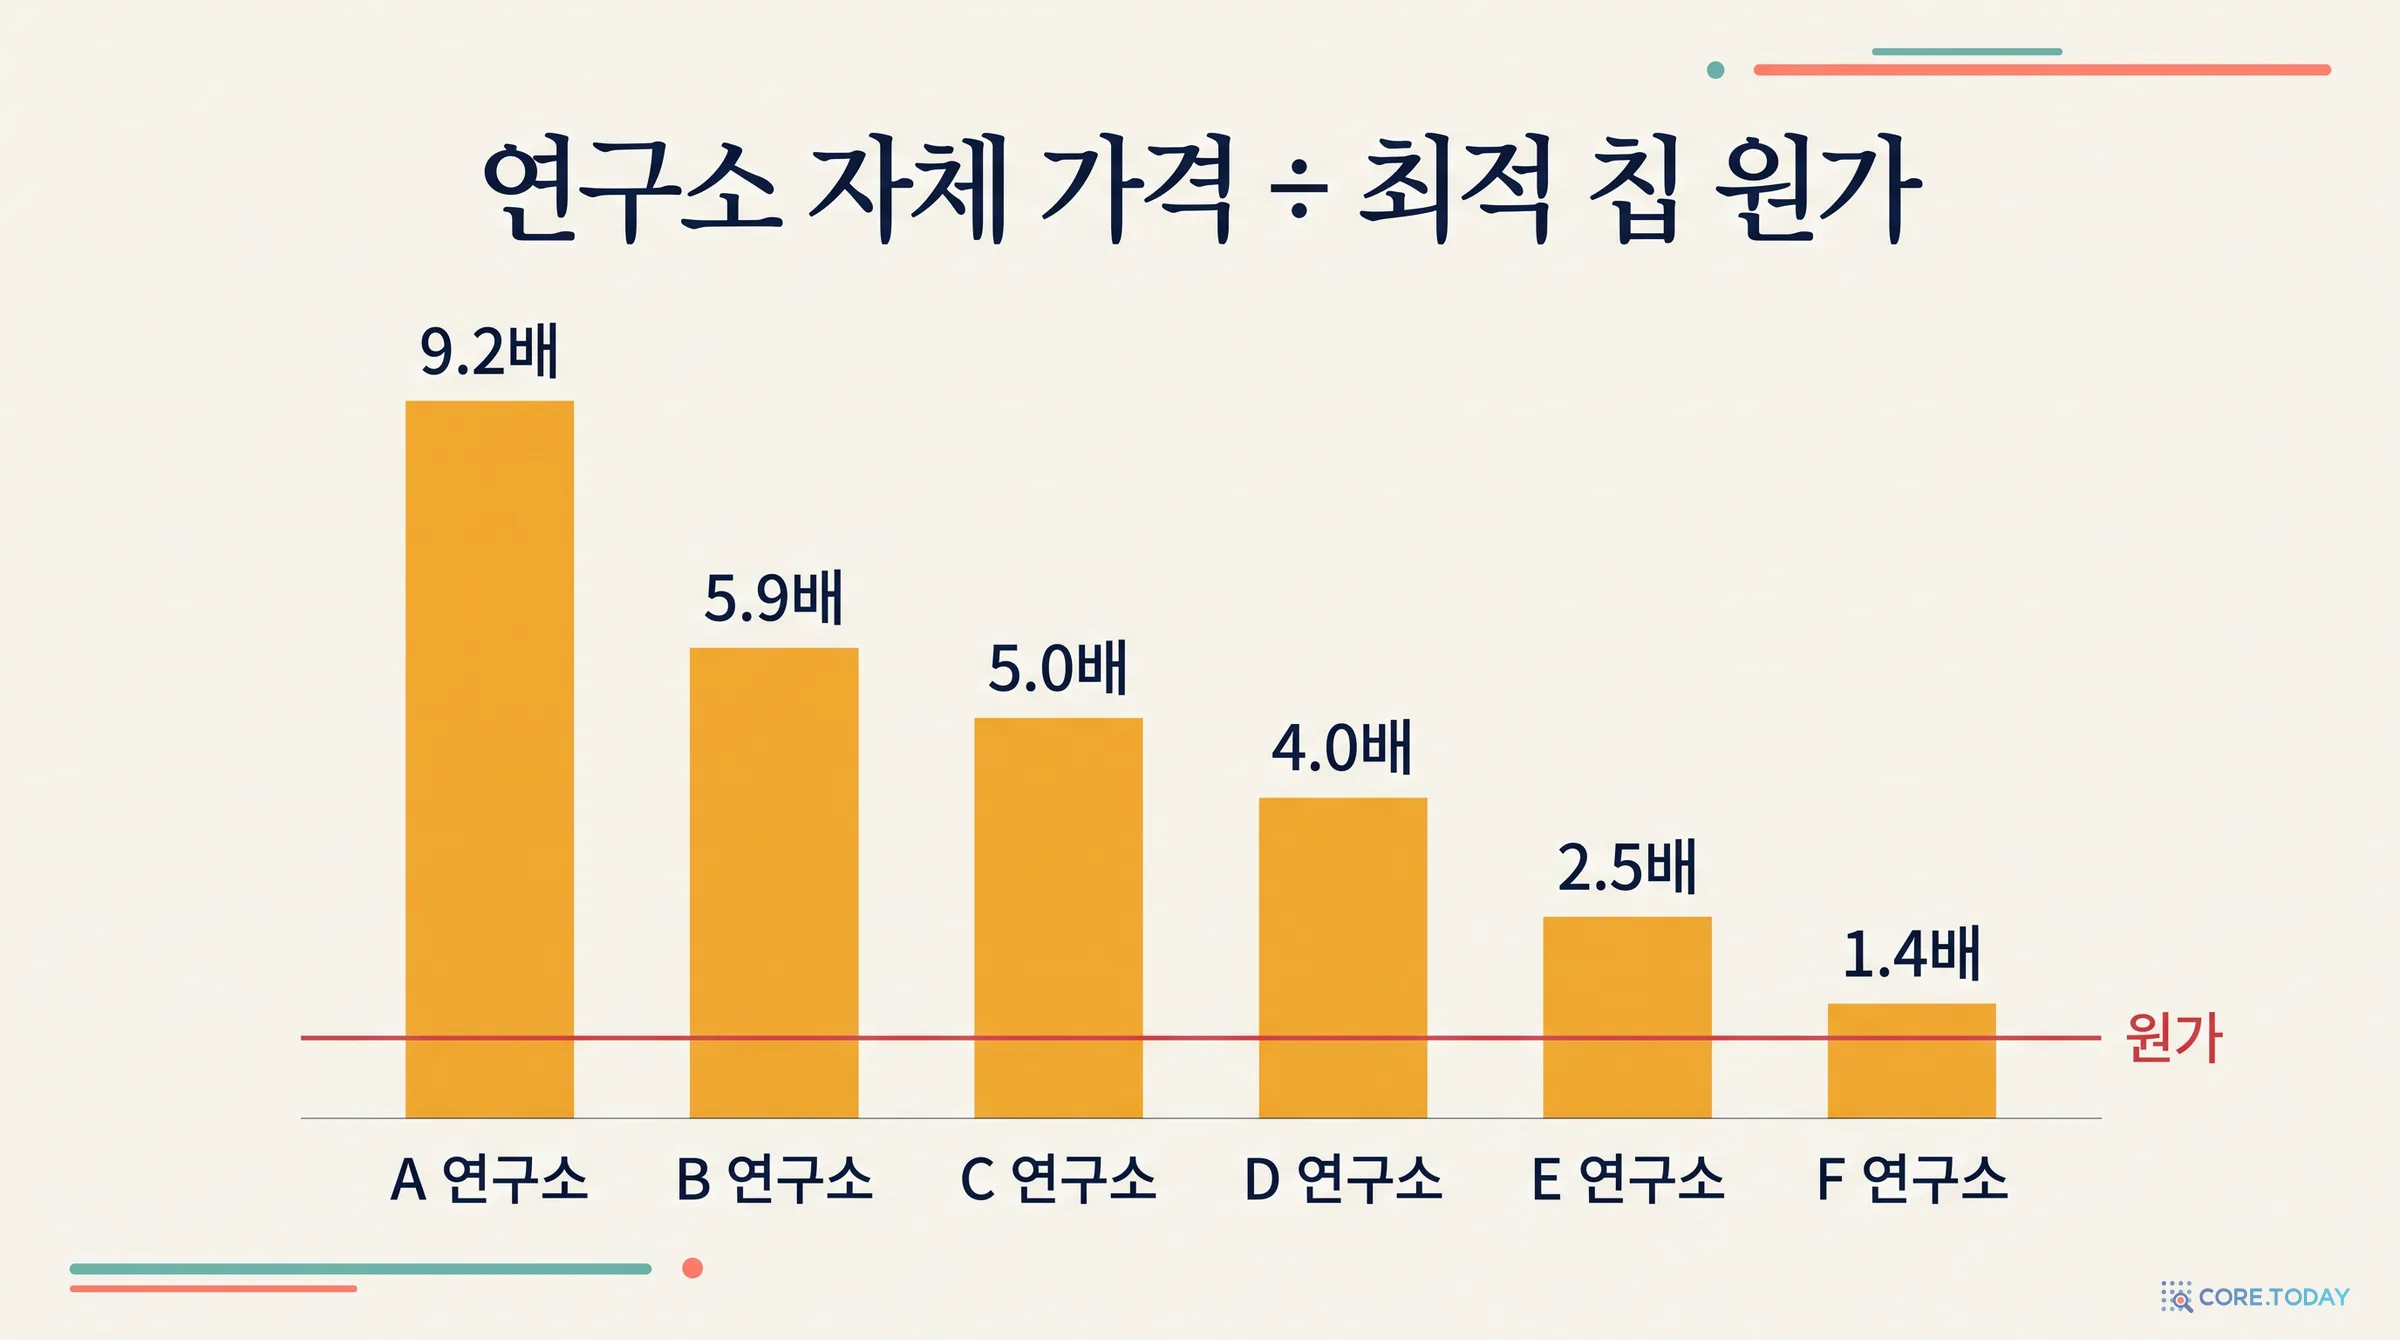
매출 ÷ 칩 1시간 원가, InferenceX 기본 설정(사용률 60%, 연구소 몫 0, 실측 캐시 적중, 모델별 기본 목표). 연구소 가격은 각사 공식 가격표와 OpenRouter 엔드포인트 목록이 일치하는 값. 코어닷투데이 계산.
Z.AI는 GLM-5.3을 최적 칩 임대 원가의 9.2배에 팝니다. 비피크 기준 DeepSeek V4.1 Flash는 5.9배, Kimi K3는 5.0배, MiniMax M3는 4.0배, DeepSeek V4 Pro는 2.5배, MiniMax M3.1 Flash는 1.4배입니다. DeepSeek은 피크 시간에 두 배를 받으니, 3장에서 본 대로 한국 업무 시간 기준으로는 V4.1 Flash 11.9배, V4 Pro 5.1배가 실제 배수에 가깝습니다.
이 배수를 읽을 때 기억할 점이 셋 있습니다.
첫째, 이것은 칩 시간만 넣은 총이익 배수입니다. 연구개발비, 유휴 칩, 네트워크·인력 비용은 빠져 있으니 9.2배가 곧 폭리라는 뜻은 아닙니다. 다만 같은 칩을 빌려 같은 모델을 돌리는 제3자에게 그만큼의 '들어올 자리'가 있다는 뜻입니다. GLM-5.3의 가격 폭이 10배이고 26개 엔드포인트가 Z.AI보다 싸게 파는 것은 이 자리가 실제로 채워지고 있다는 증거입니다.
둘째, 목표 상호작용성에 따라 배수가 바뀝니다. Z.AI의 배수는 목표 50에서 6.4배(MI355X), 100에서 9.0배, 200에서 7.1배입니다. Kimi K3는 목표 100에서 2.9배로 떨어집니다. MiniMax M3.1 Flash는 목표 200에서 0.99배로, 연구소 자체 가격이 모든 칩의 임대 원가 아래로 내려갑니다. 빠른 응답을 약속하는 서비스일수록 연구소의 마진도 얇아집니다. 아래 위젯에서 목표를 바꿔 보세요.
셋째, 연구소가 직접 팔지 않는 모델도 많습니다. 2장의 28개 모델 가운데 연구소 자체 엔드포인트가 있는 것은 16개뿐입니다. gpt-oss-120b·Gemma 4 31B·NVIDIA Nemotron처럼 처음부터 '공개용'으로 낸 모델들, 그리고 DeepSeek의 옛 버전들이 나머지입니다. 5장에서 본 대로 DeepSeek가 직접 팔지 않는 옛 버전들은 지난주 OpenRouter 전체 토큰의 13.3%, 지출의 4.9%를 차지했습니다. V4.1 Flash 0910 하나만 토큰의 9.0%이고, 41개 엔드포인트가 이 버전을 팝니다. 연구소가 새 버전으로 옮겨 가도 옛 가중치의 시장은 제3자들이 이어 받습니다. 오픈 웨이트가 아니라면 불가능한 일입니다.
8장. 사서 쓸까, 빌려 쓸까 — 직접 서빙한다면
API를 사는 대신 GPU를 빌리거나 사서 직접 서빙하는 팀도 있습니다. 데이터를 밖으로 내보낼 수 없거나, 쓰는 양이 아주 많거나, 특정 버전을 오래 고정해야 할 때입니다. 이 경우 질문은 '어느 공급자가 싼가'에서 '어느 칩이 싼가'로 바뀝니다. 이 주제는 다음 편에서 깊게 다루고, 여기서는 구매자가 알아야 할 한 가지만 짚습니다. 칩을 사느냐 빌리느냐에 따라 가장 싼 칩이 달라진다는 점입니다.
InferenceX 원가 계산기를 모델 14개 × 작업 2개(8k/1k 고정 길이, 에이전트 트레이스) × 목표 5개(30·50·100·150·200)로 불러, 소유 원가와 임대 원가가 모두 칩 2개 이상을 가진 82칸을 비교했습니다.
82칸 중 12칸(15%)에서 두 기준의 1등이 다릅니다. 소유 기준에서는 82칸 모두 엔비디아가 이기지만, 임대 기준에서는 AMD MI355X가 7칸을 가져갑니다. 예를 들어 MiniMax M3 에이전트 작업, 사용자당 초당 50토큰에서 소유 기준 1등은 VR200(100만 토큰당 $0.0057)이지만, 임대 기준에서는 MI355X($0.012)가 VR200을 앞섭니다.
이유는 칩마다 '임대료 ÷ 소유 원가'가 다르기 때문입니다. InferenceX가 쓰는 시간당 원가로 계산하면 H200은 2.38배, VR200은 2.35배, GB300은 2.16배인데 MI355X는 1.93배, B300은 1.88배, TPU7x는 1.65배, MI300X는 1.37배입니다. 최신 엔비디아 랙은 빌려 쓰는 값이 사는 값의 두 배를 훌쩍 넘고, AMD는 상대적으로 덜 붙습니다. 그래서 같은 성능 차이라도 임대 기준에서는 AMD 쪽으로 기웁니다. MI355X가 이기는 7칸 가운데 6칸은 사용자당 초당 30~50토큰의 느린 구간입니다. 구글 TPU7x는 82칸 어디서도 1등을 하지 못했고, 가장 높은 자리는 소유 기준 Qwen 3.5 397B 에이전트 작업의 2등이었습니다.
자기 칩을 가진 공급자와 빌려 쓰는 공급자는 같은 가격에서 다른 마진을 냅니다(6장 위젯을 소유 기준으로 바꿔 보세요). 구매자 입장에서 이것은 "왜 이 공급자는 이 가격에 팔 수 있나"를 묻는 단서가 됩니다. 터무니없이 싼 가격은 최신 칩을 직접 가졌거나, 큰 할인으로 손님을 모으고 있거나, 덜 정밀하게(양자화) 돌리고 있거나, 셋 중 하나일 가능성이 큽니다.
9장. 한국에서 — OpenRouter의 한국 모델은 Upstage 하나
이 시장에서 한국 모델의 자리는 좁습니다. 코어닷투데이가 10월 29일 OpenRouter 모델 목록 457개의 id·이름·설명을 검색한 결과, LG의 EXAONE, 네이버 HyperCLOVA X, SK텔레콤 A.X, 카카오 Kanana, Motif는 하나도 없었습니다. 한국 회사 모델은 Upstage의 Solar 계열뿐입니다.
OpenRouter 주간 리더보드(10월 28일까지)와 엔드포인트 목록(10월 29일). 정가는 가격 ÷ (1 − discount)로 역산. 코어닷투데이 계산.
Solar Mini4는 지난주 643개 모델 가운데 토큰 기준 26위였습니다. 입력:출력이 97:1이라는 것은 이 모델이 주로 긴 입력을 읽는 에이전트·추출 작업에 쓰인다는 뜻입니다. Upstage 모델 전체(Mini4·Pro4와 다른 모델 셋)를 합치면 토큰의 1.01%, 지출의 0.080%입니다. 토큰 몫에 비해 지출 몫이 작은 것은 가격이 싸기 때문이고, 그 가격에는 엔드포인트 정보상 50% 할인이 붙어 있습니다. 할인 전 정가로 돌아가면 Mini4는 $0.10/$0.40입니다.
이 글의 다른 모델들과 다른 점이 둘 있습니다. 하나는 가중치가 공개되지 않았다는 점입니다. OpenRouter는 Solar Mini4·Pro4에 Hugging Face 저장소를 연결해 두지 않았고, 엔드포인트도 Upstage 자신의 것 두 개(표준과 무보관 zdr)뿐입니다. 그래서 2~6장의 '같은 가중치, 다른 가격' 논리가 적용되지 않습니다. 다른 하나는 양자화가 '미공개'로 표시돼 있다는 점입니다. 단일 공급자라 비교 대상이 없으니 큰 문제는 아니지만, 5장의 라벨 기준으로는 확인할 칸이 하나 비어 있습니다.
한국 팀에게 이 사실은 두 가지를 뜻합니다. 첫째, 글로벌 오픈 모델 시장의 가격 경쟁은 한국 모델에 아직 오지 않았습니다. 한국어에 강한 모델을 쓰고 싶다면 연구소 한 곳의 가격표를 그대로 받아들여야 합니다. 둘째, 반대로 GLM·DeepSeek·Kimi 같은 중국 오픈 모델을 쓰기로 한다면, 5장에서 본 대로 한국 지역 태그를 단 엔드포인트가 하나도 없다는 점을 알고 시작해야 합니다. 한국에서 처리해야 하는 데이터라면 직접 서빙(8장)이 사실상 유일한 길입니다.
10장. 반론과 한계
"목록 가격은 실제 청구 가격이 아니다"
맞습니다. 이 글의 가격은 OpenRouter 엔드포인트의 표시 가격입니다. 직접 계약 가격, OpenRouter 수수료, 캐시 쓰기 할증, 최소 과금, 긴 맥락 가격 계단은 넣지 않았습니다. 다만 '같은 중개소 안의 상대 비교'에는 표시 가격이 가장 공정한 기준입니다.
"섞인 가격은 캐시가 실제로 맞는다고 가정한다"
이것이 가장 큰 한계입니다. 같은 요청을 보내도 공급자마다 실제 캐시 적중률이 다를 수 있습니다. 캐시를 자동으로 잡는 곳(supports_implicit_caching)과 명시적으로 요청해야 하는 곳이 있고, OpenRouter가 같은 대화를 매번 같은 공급자로 보내지 않으면 캐시가 깨집니다. 캐시 읽기가 싼 공급자도 실제 적중이 낮으면 4장의 순위는 달라집니다. 1편에서 확인했듯 OpenRouter의 공개 리더보드에는 캐시 토큰 칸이 모두 0이라, 공급자별 실제 적중률은 공개 자료로 확인할 수 없었습니다. 위젯의 슬라이더로 적중률을 바꿔 보는 것이 지금 할 수 있는 최선입니다.
"양자화가 품질을 바꾸는지는 재지 않았다"
맞습니다. 공급자 수십 곳에 같은 평가셋을 돌리려면 유료 API 호출이 필요했고, 코어닷투데이는 이번에 유료 API를 쓰지 않았습니다. 그래서 '미공개 양자화가 31%'라고는 말할 수 있어도 '그래서 품질이 몇 점 떨어진다'고는 말할 수 없습니다. 품질이 중요한 팀은 후보 두세 곳에 직접 같은 평가셋을 돌려야 합니다.
"InferenceX 원가는 최상의 경우다"
InferenceX는 칩·엔진마다 튜닝된 최적 구성을 잽니다. 실제 공급자는 그보다 덜 최적화된 구성으로 돌릴 수 있고, 사용률도 60%보다 낮거나 높을 수 있습니다. 그래서 6~7장의 배수는 '이 가격이 이 칩에서 최선으로 돌렸을 때 남기는 몫'이지, 그 공급자의 실제 이익률이 아닙니다. 또 이 추정기는 모델마다 측정한 날짜가 다르고, 측정 범위 밖의 목표는 추정하지 않습니다. GLM-5.3은 InferenceX의 'GLM-5.2' 항목(5.2와 5.3 측정을 함께 씀)으로 계산했습니다. InferenceX 하드웨어 목록에서 RTX PRO 6000의 임대가($0.52/시간)가 소유 원가($0.68/시간)보다 싸게 적혀 있는 것처럼, 원가 가정 자체에도 확인이 필요한 부분이 있습니다.
"가격은 매일 바뀐다"
이 글의 숫자는 10월 29~30일의 단면입니다. OpenRouter는 가격 이력을 공개하지 않아 할인 기간이나 가격 폭의 추세는 확인할 수 없었고, 오픈 모델의 원가는 공개 후 몇 주 동안 급격히 떨어지므로 6장의 칩별 결과도 곧 달라질 수 있습니다.
4. 정가로 계획할인가는 `가격 ÷ (1 − 할인율)`로 정가를 계산해 예산을 세운다. DeepSeek는 한국 업무 시간이 피크라 피크 가격이 실질 정가다(3장)
5. 품질 재기상위 두세 곳에 같은 평가셋을 돌린다. 같은 가중치라도 양자화와 엔진이 다르면 결과가 다를 수 있다
6. 두 번째 길한 곳만 지정하지 말고 대체 공급자를 정한다. OpenRouter라면 `provider.order`와 대체 경로, `max_price`로 가격 상한을 건다
7. 데이터와 버전`data_collection: "deny"`·`zdr`로 보관 정책을 거르고, 한국 지역 엔드포인트가 없다는 점을 전제로 데이터 등급을 나눈다. 결과가 바뀌면 안 되는 파이프라인은 버전을 고정한다(옛 버전은 제3자만 판다)
OpenRouter를 쓴다면 몇 가지 설정이 이 체크리스트를 대신해 줍니다. 다만 주의할 점이 하나 있습니다. OpenRouter 문서는 기본 라우팅이 '가격'을 우선한다고만 적고 있고, max_price는 입력(prompt)과 출력(completion) 가격으로만 상한을 겁니다. 캐시 읽기 가격까지 반영해 고르는지는 공개 문서로 확인되지 않았습니다. 캐시 적중이 높은 에이전트 작업이라면, 라우터에 맡기기보다 4장의 방식으로 직접 계산한 순서를 provider.order로 넣는 편이 확실합니다.
마지막 위젯은 이 체크리스트를 우리 팀의 숫자에 대 보는 도구입니다. 한 달 토큰 양과 작업 모양을 넣으면 같은 모델을 어디서 사느냐에 따라 달라지는 월 청구서를 원화로 보여 주고, 가장 싼 곳의 라벨에서 확인할 점을 자동으로 표시합니다.
맺음말 — 가중치는 같고, 상품은 다르다
오픈 웨이트는 모델을 '누구나 팔 수 있는 물건'으로 만들었습니다. 그 결과 같은 GLM-5.3이 49개의 가격표를 달고 팔리고, 같은 DeepSeek V4.1 Flash가 42곳에서 팔리며, 그 사이에는 10배의 폭이 있습니다. 이 폭은 비효율이라기보다 정보입니다. 연구소가 원가의 몇 배를 받는지(1.4~9.2배), 어떤 칩이 이 가격 전쟁에서 살아남는지(최신 랙은 7배 넘게 남기고 H200은 팔수록 손해), 어떤 공급자가 할인으로 손님을 모으는지(에이전트 1등의 43%)가 모두 이 폭 안에 들어 있습니다.
사는 쪽에게 남는 교훈은 단순합니다. 가장 싼 공급자는 모델의 속성이 아니라 우리 작업의 속성입니다. 캐시 적중률과 입력:출력 비율을 모르면 순위가 틀리고, 라벨을 읽지 않으면 같은 가격에 다른 물건을 사고, 정가로 계획하지 않으면 할인이 끝나는 날 청구서가 뛰어오릅니다. 1편에서 본 '입력 토큰 경제'가 이 시장에서 뜻하는 바가 이것입니다. 출력 단가로 상품을 고르던 시대는 지났고, 이제는 입력을 얼마나 싸게, 얼마나 자주 다시 읽게 해 주는지가 가격입니다.
다음 편에서는 이 글에서 잠깐 빌려 쓴 InferenceX의 원가 자체를 들여다봅니다. 같은 모델의 원가가 몇 주 만에 어떻게 10분의 1이 되는지, 그리고 그것이 이 글의 가격 폭을 앞으로 어떻게 바꿀지가 다음 질문입니다.
참고문헌
OpenRouter, 모델별 엔드포인트 API https://openrouter.ai/api/v1/models/{작성자}/{모델}/endpoints — 상위 80여 개 모델, 2026-10-29 수집