[특집] 학교는 손실 함수다 — 340만 명이 읽은 'AI 시대의 커리어 조언', 채점할 수 없는 일을 찾아서
2026년 7월 3일 새벽, 전 OpenAI·딥마인드 연구자 필 첸이 X에 올린 에세이 한 편이 주말 사이 300만 명을 넘게 읽혔다. 첫 문장은 이랬다 — 'AI는 손실 함수를 쓸 수 있는 모든 것에서 좋아진다. 그리고 학교는 대부분 손실 함수다.' 이 글은 그 한 문장을 끝까지 파고든다. 손실 함수와 '검증 가능한 보상'이 모델을 어떻게 가르치는지(DeepSeek-R1의 AIME 15.6%→71.0% 곡선, GRPO의 구조), 제이슨 웨이의 '검증자의 법칙'이 왜 커리어 예언이 되는지, 그리고 '문제 찾기·가장 야심찬 형태·마지막 10%·xG와 효율·연구 진입'이라는 여섯 조언이 1938년 아인슈타인부터 2025년 '탄광 속 카나리아'까지 어떤 생각의 계보 위에 서 있는지를 사례와 데이터로 풀었다. 리트코드를 옹호한 반론과 '문제 선정도 결국 채점 가능해지지 않느냐'는 날카로운 질문, 메타의 AI 동반 면접과 우버의 토큰 예산 소진, 네이버·카카오의 신입 공채 실종까지 — 2026년 가을, 한국의 독자가 이 글에서 무엇을 가져가야 하는지 다섯 개의 인터랙티브 도구와 함께 정리했다.
2026년 7월 3일 새벽 6시 25분(한국 시간), 필 첸(Phil Chen)이라는 이름의 엔지니어가 X에 긴 글 하나를 올렸다. 제목은 평범했다. 「AI 시대의 커리어 조언(Career advice in the age of AI)」. 평범하지 않았던 것은 첫 문장이었다.
"AI 모델은 손실 함수를 쓸 수 있는 모든 것에서 점점 좋아진다. 그리고 학교는 대부분 손실 함수다 — 알려진 정답에 대고 채점하는, 잘 정의된 문제들. 그러므로 다음 10년의 가치 있는 일은 모델 학습 기간 안에 채점할 수 없는 모든 것이다."
주말이 지나기 전에 조회수는 300만을 넘었고, 10월 현재 341만 회를 기록하고 있다. 비즈니스 인사이더가 받아썼고, 디지털투데이가 「문제를 찾아라」라는 제목으로 국내에 소개했으며, 구글의 애디 오스마니(Addy Osmani)는 사흘 뒤 "필 첸의 글에서 자라난" 후속 에세이 「에이전트 시대의 커리어」를 썼다. 폴란드의 채용 플랫폼 CEO는 자기 회사의 면접 질문을 바꾸겠다고 썼고, 타이완과 중국에서는 전문이 번역됐다.
필 첸이 누구인지 먼저 짚자. 그는 스탠퍼드를 4.0 만점으로 졸업한 뒤 자기 스타트업을 하다가, 자율주행 스타트업 헬름 AI(Helm AI, 15→50명), 데이터 라벨링 기업 스케일 AI(Scale AI, 500→1,500명), 구글 딥마인드(제미나이 학습·추론), OpenAI(1,500→3,000명)를 거쳤다. 2026년 4월에는 램프(Ramp)의 초기 멤버였던 TK 콩(TK Kong)과 함께 새 회사를 세웠다. 아직 이름도 공개하지 않은 그 회사는 "국제수학올림피아드와 물리올림피아드 금메달리스트들로 이루어진 팀"이고, 본인 표현으로는 "완전히 에이전트 네이티브(fully agent-native)"다. 아무도 코드를 손으로 쓰지 않는다는 뜻이다.
그러니까 이 글은 '앞으로 AI가 어떻게 될 것 같다'는 예측이 아니다. 지금 이 순간 사람을 뽑고 있는 창업자가, "무엇을 보고 뽑는가"를 적은 채용 메모에 가깝다. 그래서 더 많이 읽혔다.
왜 하필 이 글이, 하필 2026년 여름에 터졌을까. 배경이 있다. 한 달 전 우버는 2026년 AI 코딩 예산을 넉 달 만에 다 써버려 엔지니어 1인당 월 1,500달러의 토큰 상한을 걸었다. 2주 뒤 메타의 애덤 모세리는 "뛰어난 엔지니어의 토큰 소모량이 연봉과 비슷해질 것"이라며 토큰 예산 상한을 예고했다. 그리고 8월, 스탠퍼드 디지털경제연구소는 「탄광 속 카나리아」 보고서를 갱신했다 — AI 노출이 큰 직종에서 22~25세 고용이 또래 대비 19% 뒤처진다고. 1년 전엔 13%였다.
학교에서 10년 넘게 '정답 맞히기'를 훈련받은 세대가, 정답 맞히기를 기계가 가장 잘하게 된 세상으로 걸어 나오고 있다. 필 첸의 글은 그 세대에게 던진 지도였다. 이 글은 그 지도를 처음부터 끝까지, 논문과 데이터와 사례로 읽어 보려 한다.
💡 이 글은 코어닷 특집 시리즈의 연장선에 있다. 켄트 벡이 신입에게 "태스크 완료는 아무도 신경 쓰지 않는다"고 한 이야기는 우리는 네가 '태스크를 끝내라고' 뽑은 게 아니야에서, AI가 청년에게서 빼앗는 것이 '사다리 아랫칸'이라는 분석은 「경험의 단절」에서, 서튼의 '쓴 교훈'을 한 단계 더 밀어붙인 논의는 가장 쓴 교훈에서 이어진다.
1부. 첫 문장 해부 — "손실 함수를 쓸 수 있는 모든 것"
손실 함수란 무엇인가: 채점표와 내리막길
머신러닝을 배운 적 없는 독자를 위해 가장 쉬운 비유부터 시작하자. 손실 함수(loss function)는 채점표다. 모델이 답을 내면, 그 답이 정답에서 얼마나 멀리 떨어져 있는지를 숫자 하나로 돌려준다. 정답에 가까우면 0에 가깝고, 엉뚱하면 큰 수가 나온다.
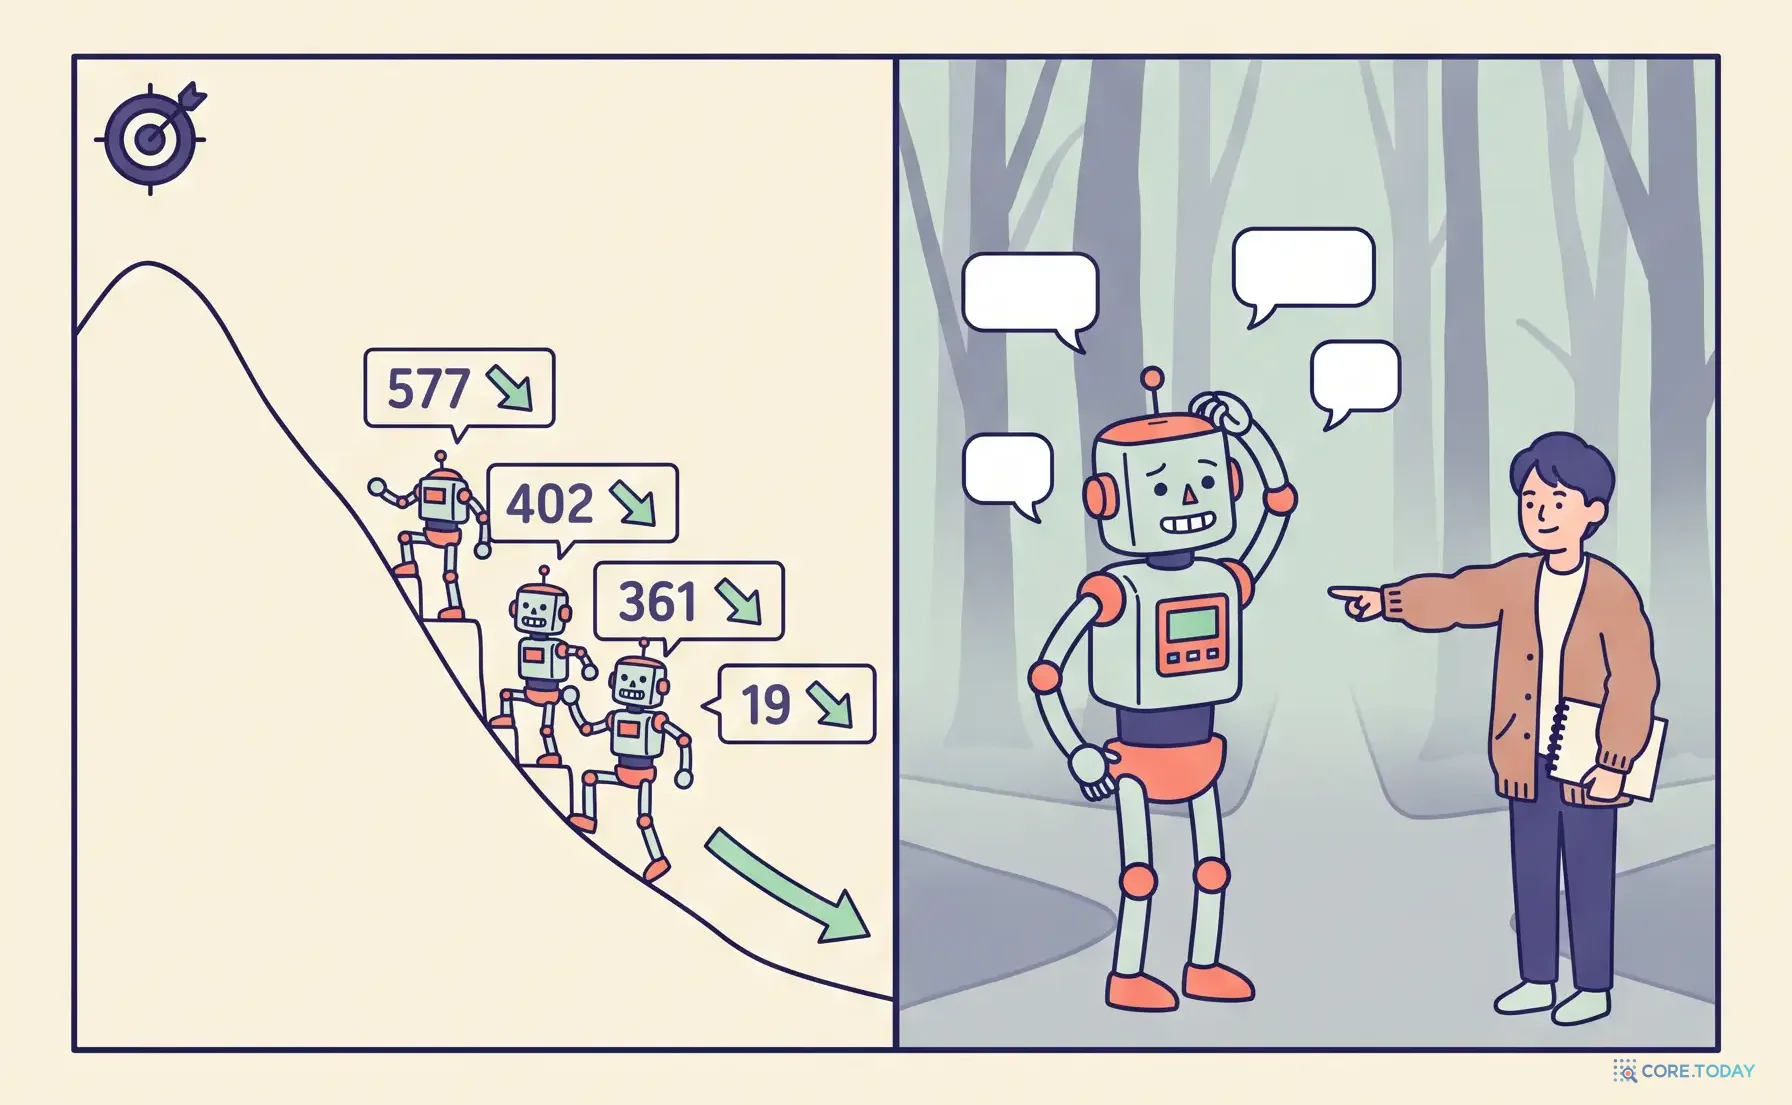
이 숫자가 중요한 이유는 하나다. 숫자가 있으면 방향이 생기기 때문이다. 안개 낀 산에서 내려오는 사람을 상상해 보라. 앞이 안 보여도 발밑 경사만 느낄 수 있으면 — 어느 쪽이 내리막인지만 알면 — 한 걸음씩 내려갈 수 있다. 손실 함수는 그 경사다. 모델 안의 수십억 개 숫자(가중치)를 "손실이 줄어드는 방향"으로 아주 조금씩 밀어 주는 일을 수백만 번 반복하는 것, 그것이 경사 하강법(gradient descent)이고, 딥러닝 학습의 전부다.
① 문제
모델에게 문제를 준다. "이 사진은 고양이인가?", "이 방정식의 해는?", "이 함수의 테스트를 통과시켜라."
② 답
모델이 답을 낸다. 처음에는 거의 무작위다.
③ 채점
손실 함수가 정답과의 거리를 숫자로 돌려준다. 이 단계가 자동·즉시·대량으로 가능해야 한다.
④ 수정
손실이 줄어드는 방향으로 가중치를 아주 조금 밀고, ①로 돌아간다. 수백만 번 반복.
여기서 필 첸의 첫 문장이 왜 날카로운지 보인다. 이 네 단계 중 사람이 설계해야 하는 유일한 부분은 ③ 채점이다. 채점표만 만들 수 있으면 나머지는 계산량이 알아서 한다. 그런데 학교는 무엇을 하는 곳인가? 알려진 정답이 있는 문제를 내고, 그 정답에 대고 채점하는 곳이다. 수능, 올림피아드, 리트코드, 자격증 시험 — 전부 손실 함수다. 우리는 12년 넘게 가장 자동화하기 쉬운 형태의 능력을 훈련받아 온 셈이다.
아키텍처: '정답 여부'만으로 추론을 가르치는 법 — RLVR과 DeepSeek-R1
여기까지는 2010년대 딥러닝에도 해당하는 이야기다. 그런데 왜 2025~2026년에 와서 이 문장이 '커리어 예언'이 되었을까. 채점표를 쓸 수 있는 범위가 갑자기 넓어졌기 때문이다. 그 전환점이 되는 논문이 2025년 1월 22일 공개된 DeepSeek-R1(arXiv:2501.12948)이다.
이전까지 언어 모델에게 "추론"을 가르치는 표준 방식은 사람이 쓴 모범 풀이를 보여 주고 따라 쓰게 하는 것(지도 미세조정)이거나, 사람의 선호를 학습한 보상 모델에게 점수를 받는 것(RLHF)이었다. 둘 다 사람의 손이 많이 갔고, 보상 모델은 모델이 '점수만 높게 받는 꼼수'를 배우는 보상 해킹(reward hacking)에 취약했다.
DeepSeek 팀은 다른 길을 갔다. R1-Zero라는 실험에서, 사람이 쓴 풀이를 한 줄도 보여 주지 않고, 보상 모델도 쓰지 않았다. 보상은 딱 두 가지 규칙뿐이었다.
정확도 보상
Accuracy reward
수학: 상자 안의 최종 답이 정답과 같은가? 코딩: 컴파일하고 테스트 케이스를 통과하는가? → 맞으면 보상, 틀리면 0
형식 보상
Format reward
생각 과정을 <think> 태그 안에, 답을 <answer> 태그 안에 썼는가?
이 방식을 같은 시기 앨런 AI 연구소(Ai2)의 Tülu 3 논문(2024년 11월)은 RLVR — 검증 가능한 보상을 이용한 강화학습(Reinforcement Learning with Verifiable Rewards)이라 이름 붙였다. 정의는 간단하다. "RLHF의 목적함수는 그대로 두되, 보상 모델을 검증 함수로 교체한다. 정책은 생성한 답이 검증 가능하게 옳을 때만 보상을 받는다."
그렇다면 그 '검증 함수'로 어떻게 모델을 움직이는가. DeepSeek이 쓴 알고리즘이 GRPO(Group Relative Policy Optimization)다. 이름은 어렵지만 구조는 직관적이다.
① 한 문제, 여러 답
같은 문제에 대해 모델이 답을 G개(예: 16개) 생성한다. 어떤 답은 맞고 어떤 답은 틀린다.
② 그룹 안에서 상대 평가
16개 답의 보상 평균과 표준편차를 구하고, 각 답이 평균보다 얼마나 좋은지(어드밴티지)를 계산한다. 별도의 '가치 평가 네트워크(critic)'가 필요 없다 — 같은 반 친구들의 점수가 곧 기준선이다.
③ 좋은 답의 확률을 올리고, 너무 멀리 가지 않게 묶는다
평균보다 좋았던 답을 낼 확률을 키우고 나빴던 답은 줄인다. 단, 원래 모델에서 너무 벗어나지 않도록 KL 페널티로 고삐를 쥔다.
쉽게 말해 "같은 문제를 열여섯 번 풀게 하고, 그중 맞은 풀이를 더 자주 하도록 등 떠미는 것"이다. 사람이 "이렇게 생각해라"라고 가르친 부분은 없다. 그런데 결과가 놀라웠다.
논문의 그림 2(Figure 2)는 R1-Zero의 학습 과정에서 미국 수학경시대회 AIME 2024 정답률을 그린 곡선이다. 시작점은 15.6%였다. 학습이 진행되며 곡선은 꾸준히 오르더니 71.0%에 도달했고, 열여섯 개 답 중 다수결을 취하면 86.7%까지 올라 당시 OpenAI o1과 같은 수준이 됐다. 더 흥미로운 것은 그림 3(Figure 3)이다. 학습 중 모델이 내놓는 답의 평균 길이를 그린 것인데, 아무도 "더 길게 생각하라"고 시키지 않았는데 응답 길이가 수천 토큰으로 꾸준히 늘어났다. 논문의 표현을 빌리면 "R1-Zero는 더 많은 생각 시간을 써서 추론 문제를 푸는 법을 스스로 배웠다."
그리고 논문에서 가장 많이 인용된 표 3(Table 3), 이른바 '아하 모먼트'. 학습 중간 단계의 모델이 수학 문제를 풀다가 갑자기 이렇게 썼다.
DeepSeek-R1-Zero 중간 체크포인트의 출력 (논문 Table 3, 요지)
문제
a > 1일 때, √(a − √(a + x)) = x 의 실수 해의 합을 구하라.
모델의 풀이 중간
…양변을 제곱하면 a − √(a + x) = x² … 다시 정리하면 … 잠깐, 잠깐. 잠깐. 여기서 짚고 넘어갈 '아하' 순간이 있다. 처음부터 단계별로 다시 평가해 보자. 우리는 …
모델이 스스로 자기 풀이를 의심하고 되돌아가는 행동이, 아무도 가르치지 않았는데 "정답이면 보상"이라는 규칙 하나에서 창발한 것이다. 리치 서튼과 데이비드 실버는 넉 달 뒤 쓴 에세이 「경험의 시대」에서 이 장면을 두고 이렇게 평했다. "강화학습의 힘과 아름다움을 보여 준다. 문제 푸는 법을 명시적으로 가르치는 대신, 올바른 유인(incentive)만 제공한 것이다."
이것이 필 첸 문장의 기술적 뼈대다. 채점표(검증 함수)를 쓸 수 있는 영역이라면, 사람이 풀이를 가르칠 필요조차 없다. 계산량이 알아서 풀이를 찾아낸다. 그래서 그는 '학습 데이터가 있는 일'이 아니라 '손실 함수를 쓸 수 있는 일'이라고 썼다. 더 넓고, 더 무서운 범위다.
필 첸의 첫 문장에는 사실상 원전이 있다. 2025년 7월 15일, OpenAI 연구자 제이슨 웨이(Jason Wei)가 블로그에 올린 짧은 글 「검증의 비대칭성과 검증자의 법칙(Asymmetry of verification and verifier's law)」이다.
출발점은 간단한 관찰이다. 어떤 과제는 푸는 것보다 검증하는 것이 훨씬 쉽다. 스도쿠는 풀기 어렵지만 채워진 판이 맞는지 확인하는 건 10초면 된다. 웹사이트 버튼이 제대로 동작하는지 확인하는 것은, 그 사이트를 만드는 것보다 쉽다. 반대로 에세이가 좋은 글인지 판단하는 일은 에세이를 쓰는 것만큼 어렵고, 과학 가설의 옳고 그름을 확인하는 데는 몇 년이 걸린다.
웨이는 여기서 한 문장을 끌어냈다.
"AI가 어떤 과제를 풀도록 훈련하는 것의 쉬움은 그 과제가 얼마나 검증 가능한지에 비례한다. 풀 수 있으면서 검증하기 쉬운 모든 과제는 AI가 풀게 될 것이다."
그리고 '검증하기 쉬운 과제'의 다섯 가지 속성을 제시했다. 객관적 진리(모두가 좋은 답에 동의), 빠른 검증(몇 초), 대량 검증(동시에 많이), 낮은 잡음(채점이 품질과 긴밀히 상관), 연속적 보상(여러 답의 순위를 매길 수 있음). 이 다섯 속성을 갖춘 과제에서는 "추측하고 확인하기(guess-and-check)"를 무자비하게 반복할 수 있고, 그것이 곧 학습이다.
이 다섯 기준을 학교·면접·일터의 과제에 직접 대 보면 어떻게 될까. 아래 도구에서 과제를 골라 보라.
결과는 불편할 만큼 선명하다. 학교와 면접이 측정하는 것은 대부분 '완전한 손실 함수' 영역에 있고, 일터에서 보상이 큰 일은 대부분 '채점 불가' 영역에 있다. 그 사이에 우리가 서 있다.
벤치마크가 무너지는 순서 = 학교가 채점하는 순서
이론만이 아니다. 지난 2년 동안 '채점 가능한 과제'의 봉우리들이 차례로 함락되는 것을 우리는 실시간으로 봤다.
시점
무엇이
어디까지
채점 방식
2024.9
OpenAI o1-preview
AIME 83%
정답 일치
2025.1
DeepSeek-R1-Zero
AIME 15.6% → 71.0% (순수 RL)
정답 일치 + 형식
2025.7
OpenAI·구글 딥마인드 실험 모델
국제수학올림피아드(IMO) 금메달 기준(35/42)
사람 채점관(딥마인드는 공식 채점)
2025.9
OpenAI 시스템
ICPC 세계 결선 12문제 전부 해결, 인간 139팀 전원 추월
테스트 케이스 통과
2025.11
Claude Opus 4.5
SWE-bench Verified 80% 첫 돌파
저장소 테스트 통과
2026.7
프론티어 모델들
SWE-bench Verified 90%대 중반, IMO 2026 만점(42/42) 공식 채점 시스템 등장
테스트 통과 · 사람 채점관
—
"무엇을 만들지 고르기"
벤치마크 없음
몇 년 뒤에야 알 수 있음
표의 윗줄들이 함락되는 속도를 보라. 그리고 마지막 줄을 보라. 벤치마크가 없다는 것은 아직 안 풀렸다는 뜻이 아니라, 채점표를 만들 수 없다는 뜻이다. 필 첸이 "모델 학습 기간 안에 채점할 수 없는 일"이라고 쓴 것은 정확히 이 줄을 가리킨다.
'학습 기간 안에'라는 수식어가 핵심이다. 어떤 결정이 옳았는지 알려면 몇 달, 몇 년이 걸리는 일이 있다. 어떤 제품을 만들지, 어떤 사람과 일할지, 어떤 시장에 들어갈지. 그 피드백은 느리고, 잡음이 많고, 한 번뿐이고, 반사실(그때 다른 선택을 했다면?)을 알 수 없다. 웨이의 다섯 기준을 하나도 만족하지 못한다. 모델이 이것을 배우려면 수백만 번 시도하고 채점해야 하는데, 한 번 시도에 3년이 걸리는 일은 수백만 번 반복할 수 없다. 그래서 그 영역이 남는다 — 적어도 당분간은.
2부. 계보 — 이 생각은 어디서 왔나
필 첸의 문장이 신선하게 들리는 것은 표현 때문이지, 생각 자체가 새로운 것은 아니다. 적어도 네 갈래의 오래된 생각이 2026년에 그의 문장으로 합류했다. 타임라인에서 항목을 눌러 가며 따라가 보자.
갈래 1: 노동경제학 — '규칙으로 적을 수 있는 일'
2003년 데이비드 오터, 프랭크 레비, 리처드 머네인은 「최근 기술 변화의 숙련 내용」이라는 논문에서 컴퓨터가 일자리에 미치는 영향을 한 문장으로 정리했다. 컴퓨터는 "명시적 규칙을 따라 수행할 수 있는 인지·육체 과업에서 노동자를 대체하고, 비정형 문제 해결과 복잡한 의사소통 과업에서는 노동자를 보완한다." 이른바 루틴/비루틴 가설이다. 이후 20년간 자동화 논쟁은 전부 이 틀 안에서 벌어졌다.
필 첸의 '손실 함수'는 이 가설의 2026년판 갱신이다. 2003년의 경계선은 "규칙으로 적을 수 있는가"였다. 그 경계는 2010년대 딥러닝이 넘어섰다 — 고양이 사진을 알아보는 규칙은 아무도 적을 수 없지만 데이터로 학습할 수는 있었으니까. 그래서 경계선이 "학습 데이터가 있는가"로 밀렸다. 그리고 RLVR이 그 경계도 넘었다. 풀이 데이터 없이 정답 여부만 있어도 배우니까. 지금의 경계선은 "채점표를 쓸 수 있는가"다. 선은 세 번 밀렸지만, 선의 구조는 같다.
갈래 2: AI 연구 — 서튼의 쓴 교훈과 경험의 시대
2019년 3월, 강화학습의 아버지 리치 서튼(Rich Sutton)은 한 페이지짜리 글 「쓴 교훈(The Bitter Lesson)」을 올렸다. 요지는 이렇다. "70년 AI 역사에서 읽어 낼 수 있는 가장 큰 교훈은, 계산량을 활용하는 일반적 방법이 결국 가장 효과적이며 그 차이가 크다는 것이다." 체스에서 인간 지식을 정교하게 집어넣은 프로그램은 무식한 대규모 탐색에 졌다. 바둑에서는 20년 늦게 같은 일이 반복됐다. 음성 인식에서 음소와 성도(聲道)에 대한 지식은 통계 모델에 밀렸다. 컴퓨터 비전의 손수 설계한 특징들은 "오늘날 전부 폐기됐다."
왜 '쓴' 교훈인가. 연구자 입장에서 자기 지식을 모델에 넣는 것은 단기적으로 늘 효과가 있고, 자존심도 세워 준다. 그런데 장기적으로는 플래토를 만들고 발전을 가로막는다. 서튼은 이 교훈이 "제대로 소화되지 않았다"고 썼다. 2025년 3월 그는 앤드루 바토와 함께 튜링상을 받았고, 한 달 뒤 데이비드 실버와 쓴 「경험의 시대에 온 것을 환영합니다」에서 한 걸음 더 나갔다. "수학·코딩·과학 같은 핵심 영역에서 인간 데이터에서 뽑아낼 수 있는 지식은 한계에 빠르게 접근하고 있다. … 보상은 인간의 사전 판단이 아니라 환경에 대한 경험에 뿌리내릴 것이다."
필 첸은 이 교훈을 커리어와 회사 선택에 그대로 적용한다. 그의 세 번째 조언 "가장 야심찬 형태의 문제를 풀어라"는 쓴 교훈의 직역이다. 과제 특화 최적화(쉬운 버전의 문제)는 단기적으로는 되지만, 결국 일반적 방법의 스케일에 밀린다. 회사도, 커리어도 그렇다.
1950년대 영국의 전직 공군 회계사 찰스 리프(Charles Reep)는 축구 경기를 보며 모든 패스와 슛을 손으로 적기 시작했다. 그의 결론 중 일부는 틀렸지만(그의 통계는 '롱볼 축구'를 정당화하는 데 쓰였다), 경기의 '결과'가 아니라 '과정'을 숫자로 재겠다는 집착은 60년 뒤 xG(기대 득점)로 꽃을 피웠다. 2012년 4월 데이터 회사 옵타(Opta)의 샘 그린이 프리미어리그 득점자들의 '슛의 질'을 30만 개 넘는 슛 데이터로 모델링하면서다. 이 이야기는 3부에서 다시 만난다.
갈래 4: 교육심리학 — 문제를 '찾는' 사람이 이긴다
1964년 시카고 미술대학에서 심리학자 제이콥 게첼스와 미하이 칙센트미하이는 학생 31명에게 같은 27개 물건(포도, 자동차 변속기, 고서, 유리 프리즘…)을 주고 정물화를 그리게 했다. 어떤 학생은 물건 몇 개를 집어 바로 그리기 시작했고, 어떤 학생은 물건을 이리저리 만지고 배치를 바꾸며 무엇을 그릴지 오래 탐색했다. 후자를 연구진은 '문제 발견자(problem finders)'라 불렀다.
7년 뒤, 그리고 18년 뒤 추적 조사에서 결과가 갈렸다. 그림 솜씨가 아니라 문제 발견 성향이 화가로서의 성공을 예측했고, 빨리 그리기 시작했던 '문제 해결자' 중 다수는 미술을 아예 그만뒀다. 1976년 출간된 『창조적 비전(The Creative Vision)』은 이렇게 "문제 찾기"를 "문제 풀기"와 다른 능력으로 분리한 첫 연구가 됐다.
이 생각에는 더 오래된 조상도 있다. 1938년 아인슈타인과 인펠트는 『물리학의 진화』에서 "문제를 정식화하는 것이 그 해법보다 더 본질적인 경우가 많다. 해법은 단지 수학적·실험적 기술의 문제일 수 있다"고 썼다. 1986년 벨 연구소의 리처드 해밍은 「당신과 당신의 연구」 강연에서 "중요한 문제를 붙들고 있지 않으면 중요한 일을 할 가능성이 낮다"며, 동료들에게 점심시간마다 "당신 분야의 중요한 문제가 뭡니까? 그런데 왜 그걸 안 하고 있습니까?"라고 물어 미움을 샀다고 고백했다.
필 첸의 두 번째 조언 "문제를 푸는 것에 더해 찾는 법을 배워라"는 이 60년 묵은 발견을, "풀기"의 값이 0으로 수렴한 시대에 다시 꺼낸 것이다.
3부. 여섯 가지 조언, 하나씩 정독
이제 본문으로 들어가자. 필 첸은 "유명한 격언들은 여전히 참이지만(로켓선에 자리가 나면 어느 좌석인지 묻지 마라, 어쩌고), 에이전틱 코딩의 등장으로 많은 것이 바뀌었다"며 "무엇이 그대로이고 무엇이 새로운가"를 여섯 항목으로 적었다. 참고로 그 격언은 2001년 에릭 슈미트가 구글 입사를 망설이던 셰릴 샌드버그에게 한 말이다.
조언 1. 진짜 희소한 자원에 집중하라
필 첸은 스케일 AI에 들어가기 전, 보장 현금이 훨씬 많은 퀀트 회사 오퍼를 들고 있었다. 그런데 스케일을 골랐다. 이유는 "커뮤니티와, 스케일의 온갖 제품과 응용에 노출되는 것"이 설렜기 때문이었다. 결과적으로 스케일에서 LLM 추론 회사들과 일하며 딥마인드와 OpenAI로 가는 문이 열렸고, 거기서 만난 동료들은 지금 창업자 네트워크가 됐다. 그의 결론은 이렇다.
"자본에 대한 접근은 그 어느 때보다 쉬워졌다. 사람과의 실제 시간, 강한 관계에 대한 접근은 여전히 드물다. … 시간, 관계, 평판 — 이것들이 주의를 집중해야 할 진짜 희소 자원이다."
여기에 1971년 허버트 사이먼의 문장을 겹쳐 보자. "정보가 소비하는 것은 명백하다. 수신자의 주의다. 따라서 정보의 풍요는 주의의 빈곤을 만든다." AI 시대의 버전은 이렇다 — 코드의 풍요는 판단의 빈곤을 만들고, 자본의 풍요는 시간과 신뢰의 빈곤을 만든다. 흔해진 것의 값은 떨어지고, 흔해지지 않는 것의 값은 오른다.
그가 덧붙인 실천 지침은 소박하다. "좋은 일을 하고, 그것이 좋은 일을 하는 평판 있는 사람들에게 알려지도록 하라." 그리고 경고도 있다. "바이브 코딩으로 빠르게 돈 버는 기회를 찾기는 쉽지만, 진짜 가치를 찾을 때 상금은 보통 훨씬 크다."
이 항목이 글의 심장이다. 그리고 가장 많은 반론을 불렀다. 필 첸은 자기 회사의 채용 과정을 이렇게 설명한다.
"아무도 코드를 한 줄도 손으로 쓰지 않는다는 점을 감안하면, 전통적인 리트코드식 질문과 심지어 시스템 설계 질문도 실제 업무 성과와 상관없게 느껴진다. 결국 우리는 이런 면접에 도달했다 — 어떤 사람이 자기가 놓인 환경을 얼마나 빨리 이해하는지, 풀 가치가 있는 문제를 식별하는지, 그리고 기존 환경의 제약 안에서 그 문제를 실행해 내는지를 측정하는 면접."
링크드인에는 더 구체적으로 썼다. "모든 면접은 이제 AI 동반이다. 지원자에게 우리 저장소의 열린 이슈 하나를 건네고, 모델이 이미 말해 줬을 것 너머에 그 사람이 무엇을 보태는지 본다. 도구 숙련도는 기본이다. 모델의 제안 중 어떤 것이 실제로 틀렸는지 가려내는 날카로운 판단도 기본이다."
낯선 환경에 투입
→
환경을 빨리 이해
→
풀 가치가 있는 문제 식별
→
제약 안에서 실행
주목할 것은 그가 관찰한 분산이다. "학생들이 '에이전트가 내 과제를 다 풀어 버린다'며 낙담하는 걸 본다. 하지만 면접에서 보면, 지원자들이 해법에 도달하기까지 쓰는 시간과 토큰의 양은 여전히 크게 다르다. 뛰어난 지원자는 높은 수준의 직관과 바깥 맥락을 에이전트와의 협업에 들고 온다." 모두가 같은 모델을 쓰는데 결과가 다르다면, 차이는 모델이 아니라 모델에게 무엇을 시키는가에 있다.
그래서 그는 가장 중요한 기술을 이렇게 못 박는다. "문제 선정과 자원 배분(problem selection and resource allocation)." 점점 강력해지는 에이전트가 복잡하지만 잘 정의된 문제를 떠맡으니, 가장 영향력 있는 사람은 "중요한 문제를 식별하고, 거기에 토큰과 시간을 배분하는" 사람이 된다.
'토큰을 배분한다'는 표현이 2026년에 얼마나 문자 그대로인지 보여 주는 뉴스들이 있다. 우버는 2026년 AI 코딩 예산을 넉 달 만에 소진했다 — 엔지니어들이 월 500~2,000달러씩 쓰고 있었고, 도입률은 넉 달 사이 32%에서 84%로 뛰었다. 회사는 도구당 월 1,500달러 상한을 걸었다. 메타의 애덤 모세리는 내부의 '토큰 소비 리더보드'를 없앴다며 "1~2년 안에 상한이 생길 것이고, GPU·CPU 할당처럼 관리하게 될 것"이라 말했다. 반대편에는 클라우드제로의 엔지니어링 책임자 빌 버클리가 있다. 그는 엔지니어 1인당 월 5,000달러의 토큰을 준다며 이렇게 썼다. "토큰은 병목이 아니다. 엔지니어가 병목이다." 같은 직군 안에서 토큰 예산이 25배 차이 나는 회사들이 공존하는 시대다. 그 예산을 어디에 쓰는지가 곧 일의 내용이 됐다.
이 배분 문제를 직접 겪어 보자. 토큰 100과 사람 시간 100을 여섯 문제에 나눠 보라.
몇 번 만져 보면 두 가지가 보인다. 첫째, 잘 정의된 문제는 토큰만으로 거의 끝나지만 보상이 작다. 둘째, 보상이 큰 문제는 사람의 시간이 먼저 '정의'를 만들어 줘야 토큰이 먹힌다. 모호한 문제에 토큰부터 쏟으면 에이전트는 열심히 엉뚱한 것을 만든다. 필 첸이 말한 "자원 배분"은 예산 관리가 아니라, 어떤 문제를 토큰이 풀 수 있는 형태로 번역해 줄 것인가에 대한 판단이다.
그가 높이 평가한 지원자의 공통점은 하나였다. "문제 해결 환경에 스스로를 담가 본 사람" — 자기 열정으로 밀어붙인 사이드 프로젝트든, "의미 있는 문제가 사람 수보다 많은" 고성장 회사든. 문제를 찾는 눈은 교과서에서 생기지 않는다. 문제가 널려 있는 곳에 서 있어 봐야 생긴다.
조언 3. 가장 야심찬 형태의 문제를 풀어라
세 번째 조언은 2부에서 본 서튼의 쓴 교훈을 커리어에 옮긴 것이다. "회사와 커리어는 늘 멱법칙(power-law) 결과를 가졌지만, AI가 그 결과에 도달하는 속도를 가속했다. 소프트웨어 만들기가 훨씬 쉬워졌으니 단순한 시스템은 누구나 만든다. 진짜 지속되는 가치는 진정 야심찬 문제에 극단적으로 집중할 때만 만들어진다."
그의 체크리스트는 두 줄이다. 회사를 고를 때는 "그 회사가 자기 문제의 가장 야심찬 형태를 풀고 있는가, 그리고 실제로 풀 가능성이 있는가." 역할을 고를 때는 "그 역할이 회사가 푸는 문제의 최전선에서 직접 일하게 해 주는가."
여기엔 폴 그레이엄의 2023년 에세이 「위대한 일을 하는 법」이 겹친다. "첫 단계는 무엇을 할지 정하는 것이다. … 인기 없는 문제는 저평가돼 있다." 그리고 샘 올트먼의 2019년 글 「성공하는 법」의 한 줄 — "2년 한 사람이 20년 한 사람만큼 효과적일 수 있는 커리어에 있고 싶지는 않을 것이다." AI가 '쉬운 버전의 문제'를 공짜로 만들수록, 이 조언들은 더 날카로워진다.
조언 4. 마지막 1마일을 전력 질주하라
"AI는 결과를 양극화했다. 중간값(median)은 에이전트가 엉성한 프롬프트로 뽑아내는 것이기 때문이다. 따라서 가치는 어떤 문제 조각에 대한 고유한 관점, 혹은 디테일에 대한 집착에서 나온다."
그가 인용한 글은 세쿼이아 캐피털 알프레드 린(Alfred Lin)의 2026년 6월 에세이 「마지막 10%」다. 린의 요지는 파레토 법칙(80/20)에 대한 반박이다. 80/20은 이미 있는 시스템을 최적화할 때는 옳지만, 없던 것을 만들 때는 적극적으로 오도한다. 벤처 수익은 멱법칙을 따르고, 펀드 상위 10%의 투자가 그 펀드가 '좋은지, 위대한지, 전설인지'를 결정한다. 그러니 90%까지 가는 것은 "어렵지만 그래도 쉬운 부분"이고, "마지막 10%는 일의 90%이자 보상의 90%"다.
소프트웨어 업계는 이 사실을 40년 전부터 알았다. 1985년 벨 연구소의 톰 카길이 말하고 존 벤틀리의 칼럼으로 유명해진 90-90 법칙 — "코드의 첫 90%는 개발 시간의 첫 90%를 차지한다. 나머지 10%의 코드는 나머지 90%의 개발 시간을 차지한다." 그리고 2024년 12월 애디 오스마니의 「70% 문제」: 비전공자가 AI로 70%까지는 순식간에 가지만, "마지막 30%는 수확 체감의 연습이 된다. 작은 버그를 고치면 다른 게 깨지고, 그걸 고치면 문제가 둘 더 생긴다."
데이터도 이 그림을 뒷받침한다. 깃클리어(GitClear)가 2억 1,100만 줄의 코드 변경을 분석한 2025년 보고서에서, 복사·붙여넣기 줄은 2020년 8.3%에서 2024년 12.3%로 늘었고, 리팩토링(옮긴 코드)은 24.1%에서 9.5%로 줄었으며, 2주 안에 다시 고쳐지는 코드는 3.1%에서 5.7%로 늘었다. 구글 DORA의 2025년 보고서는 AI 도입이 처리량과는 이제 양의 관계지만 "배포 안정성과는 계속 음의 관계"라고 적었다. "AI는 가속한다. 그 가속이 하류의 약점을 노출한다."
그러니 70%는 공짜가 됐고, 그 위는 더 비싸졌다. 아래 곡선을 움직여 보라.
필 첸의 실천 조언에는 2026년다운 대목이 하나 있다. "코딩 에이전트의 발전이 너무 빨라서, 이전 반복에서 배운 것을 들고 다음 세대 지능으로 처음부터 다시 시작하는 편이 나을 때가 많다." 이것이 과장이 아님을 보여 주는 사례가 있다. 앤트로픽의 성능 최적화 팀장 트리스탄 흄은 2026년 1월, 팀의 채용 과제(AI 사용 허용)를 모델이 나올 때마다 다시 설계해야 했다고 썼다. Opus 4가 지원자 대부분을 앞질렀고, Opus 4.5가 최상위 지원자까지 따라잡자 "최상위 지원자의 결과물을 구별할 방법이 없어졌다." 2026년 프론티어 모델은 대략 6~8주마다 한 번씩 나왔다. 어제 다듬은 마지막 10%의 상당 부분이 다음 모델에서는 70%에 포함된다. 그래서 다듬는 기술 자체가 — 무엇이 거친지 보는 눈이 — 다듬은 결과물보다 오래 간다.
다섯 번째 조언은 축구 통계에서 빌려 왔다. xG(expected goals, 기대 득점)는 한 팀이 만든 기회들의 질을 바탕으로 "이 정도 기회면 평균적으로 몇 골이 들어가야 하는가"를 계산한 값이다. 슛의 거리, 각도, 몸의 어느 부위로 찼는지, 어시스트 종류, 수비수와 골키퍼 위치 같은 20여 개 변수를 약 100만 개 슛 데이터로 학습한 모델이 매 슛마다 0에서 1 사이의 확률을 매긴다. 페널티킥 한 번은 약 0.79골, 먼 거리의 어려운 슛은 0.02골 식이다. 효율(efficiency)은 그 기회를 실제 골로 바꾼 비율이다.
xG가 축구를 바꾼 이유는 운과 실력을 분리해 주기 때문이다. 2015~16시즌 레스터 시티는 시즌 중반 승점 2위였지만 xG로는 4위였고, 시뮬레이션은 우승 확률을 16.7%로 봤다(아스널 49.0%). 레스터는 우승했다 — 통계학자들이 "상위 꼬리의 낮은 확률이 실현된 것"이라 부르는 사건이었다. 반대로 꾸준히 xG보다 많이 넣는 선수는 메시처럼 극히 드물고, 홀란드조차 36골을 넣은 2022~23시즌(xG 28.5)의 초과 성과가 이듬해 평균으로 돌아갔다. 브렌트포드의 구단주 매슈 벤엄은 이렇게 말했다. "스트라이커에게는 골을 넣는 것보다 좋은 위치에 들어가는 것이 훨씬 많은 정보를 준다."
필 첸은 이 틀로 자기 커리어를 복기한다. 2023년 그는 앤트로픽(그의 기억으로 당시 50명 안팎)과 커서(비창업자 직원 2명)의 오퍼를 거절하고 딥마인드로 갔다. 2024년에도 둘을 다시 거절하고 OpenAI로 갔다. 두 회사는 이후 각각 수천억 달러, 수백억 달러 가치가 됐다. 그의 평가는 담담하다. "둘 다 커리어 관점에서 xG가 높은 기회였지만, 나는 내 관심사·문화 적합성·목표에 더 맞는 회사를 골랐다." 그리고 반성 하나. "결정에 앞서 데이터를 더 모으는 데 시간을 더 썼으면 좋았겠다."
여기서 그가 끌어내는 교훈은 둘이다. 첫째, 기회가 보이는 자리에 서는 것이 골의 첫걸음이고, 그 자리는 평판과 전문성이 만든다. 커서 오퍼는 창업자들과의 공통 지인 사이에서 그의 평판이 좋았기 때문에 왔고, 앤트로픽 오퍼는 그가 그 팀이 관심 있는 문제에 업무 시간과 개인 시간을 투자해 왔기 때문에 왔다. 둘째, 어느 순간부터는 골을 넣어야 한다. 효율도 중요하다. 그 효율의 핵심은 "초기 회사를 고를 때는 팀과 시장을 보라. 지원자들은 지금 제품에 닻을 내리지만, 팀이 좋으면 제품은 거의 항상 완전히 다른 것으로 진화한다. 앤트로픽의 첫 데모는 나한테는 ChatGPT보다 못한 슬랙봇이었다."
그리고 이 항목에는 글 전체에서 가장 큰 주장이 숨어 있다. "나는 ASI(초지능)가 지식 노동의 모든 인간을 대체하리라고 믿지 않는다. 인간은 ASI가 풀 의미 있는 문제를 고르는 것, 그리고 그 문제를 풀 자본을 배분하는 것에서 차별적 능력을 갖기 때문이다." 이 문장이 4부에서 가장 날카로운 반론을 부른다.
조언 6. 지금은 연구에 진입할 수 있다
마지막 조언은 "연구를 어떻게 시작하냐"는 질문에 대한 답이다. 그는 전 동료 블라드 파인버그(Vlad Feinberg) — 현재 구글 딥마인드에서 제미나이 플래시 계열의 사전학습을 이끄는 사람 — 의 글 「프론티어 랩에 취업하는 법」(2026년 5월)을 추천한다. 파인버그의 요지는 세 가지다. 의도(가치 있는 문제 공간을 의식적으로 고른 흔적), 수학적 성숙도(모호한 영역에서의 일반화된 문제 해결력), 근성("영혼을 갈아 넣는" 증명 기반 수업을 버텨 낸 경험). 그리고 프론티어 컴퓨팅 없이도 들어갈 수 있는 두 입구 — LLM 아래의 커널·저수준 시스템, LLM 위의 에이전트 시스템. "이미 할 줄 아는 일에만 AI를 써라. 단, 공격적으로."
필 첸 자신의 조언은 더 실용적이다. "현대 연구는 컴퓨팅이 많으면 쉽지만, 좋은 출발점은 모델을 직접 쓰면서 자기 직관을 평가(evaluation)로 증류하는 것이다." 그리고 공개 최적화 리더보드를 권한다. 전 동료 켈러 조던(Keller Jordan)의 modded-nanogpt 스피드런이 대표적이다.
규칙은 단순하다. 1억 2,400만 파라미터짜리 GPT-2 소형 모델을 H100 8장으로 FineWeb 데이터에서 검증 손실 3.28까지 가장 빨리 학습시켜라. 카르파티의 기준선은 45분이었다.
2024.5 기준선 (llm.c)
45.0분
2024.10 로터리·QK-norm·ReLU²
15.2분
2024.11 bf16 등
7.8분
2025.1
2.99분
2026.2
1.52분
2026.8 기록 #92
0.67분 (약 40초)
2년 남짓한 사이 68배가 빨라졌다. 중요한 것은 이 기록들이 거대 연구소가 아니라 공개 저장소의 92개 PR에서 나왔다는 점이다. 이 과정에서 Muon 옵티마이저가 탄생했고, 켈러 조던 본인은 이 공개 작업의 평판으로 2025년 1월 OpenAI에 합류했다. "기록 보유 코드를 짧게 유지한다"는 그의 원칙은 다른 사람이 새 아이디어를 시험하기 쉽게 하기 위해서다. 카르파티는 2025년 10월 nanochat — "100달러로 살 수 있는 최고의 ChatGPT" — 를 공개했다. 토크나이저부터 사전학습·미세조정·강화학습·평가·웹 UI까지 8,000줄로, H100 8장 네 시간이면 2019년에 4만 3,000달러가 들었던 GPT-2급 모델이 나온다.
컴퓨팅은 생각보다 가깝다. 모달(Modal)은 학술 연구자에게 프로젝트당 수천~수만 달러의 크레딧을 주고, 구글 TPU 리서치 클라우드는 결과를 공개하는 연구자에게 TPU를 무료로 연다. 필 첸의 말은 이렇다. "대부분의 아이디어는 결국 스케일에서 실패한다. 그 실패를 이해하는 것이, 무엇이 실제로 작동하는지 이해하는 첫걸음이다."
그리고 글에서 가장 많이 인용된 문장. "연구자가 된다는 것은 직업이 아니라 마음가짐이다. 프론티어 랩 연구자의 일은 대부분 — 새 아이디어를 탐색할 만큼 호기심 많고, 그것을 구현하기 위해 인프라와 싸우고, 문제를 효율적으로 디버깅하기 위해 전체 시스템을 극단적으로 자세히 이해하고, 더 많은 컴퓨팅을 따내기 위해 결과의 가치를 설득하는 것이다. 이 전부를 프론티어 랩 밖에서도 할 수 있다."
가장 날카로운 질문은 애나 장(Anna Zhang)이라는 독자에게서 나왔다. 요지는 이렇다. "일반적 방법이 과제 특화된 인간의 구조를 계속 집어삼킨다면, 문제 선정이라고 왜 결국 채점 가능 영역 안으로 들어가지 않겠는가? 그것은 인간의 영구적 우위인가, 아니면 '아직 채점되지 않은' 현재의 경계선일 뿐인가?"
이 질문은 글의 가장 큰 주장(인간은 ASI가 풀 문제를 고르는 데 차별적 능력을 가진다)을 글 자신의 논리(쓴 교훈)로 찌른다. 필 첸의 답은 솔직했다. "'아직 채점 불가능한 것'과 '인간이 계속 한 걸음 앞서 있을 것이라는, 어쩌면 순진한 믿음'이 섞여 있다."
코어닷의 생각은 이렇다. 서튼의 쓴 교훈에는 전제가 있다. 환경이 있고, 거기서 보상이 돌아와야 한다. 바둑은 한 판에 몇 분이고 수백만 판을 둘 수 있다. '어떤 회사를 세울 것인가'는 한 판에 몇 년이고, 한 사람이 평생 몇 번 못 둔다. 쓴 교훈은 채점표가 있는 곳에서 인간 지식이 진다는 교훈이지, 채점표가 저절로 생긴다는 교훈이 아니다. 다만 두 가지는 인정해야 한다. 첫째, 시뮬레이션과 시장 데이터가 쌓이면 '느린 피드백'의 일부는 빨라진다 — METR의 측정으로 모델이 50% 성공률로 해내는 과제 길이는 2024년 이후 약 3~4개월마다 두 배가 되고 있고, 2026년 봄에는 이미 "사람 이틀치"를 넘겼다. 둘째, 필 첸 자신이 "순진할 수 있다"고 인정한 그 믿음은, 믿음이지 증명이 아니다. 이 글의 조언은 '영원히 안전한 땅'을 가리키는 게 아니라, '경계선이 가장 늦게 도착할 땅'을 가리킨다. 그걸로 충분하다. 커리어는 영원이 아니라 10년 단위로 산다.
반론 2. "자료구조·알고리즘 없이 뽑으면 잘못 뽑는다"
두 번째 반론은 라이언 챈들러라는 엔지니어의 것이다. "데이터와 이산 구조, 논리, 알고리즘이 면접 패널이 확인해야 할 잘못된 축이라는 건 믿기 어렵다. 리트코드는 망가졌을지 몰라도, 컴퓨터과학의 언어에 대한 유창함은 여전히 최상위 중요도다. 어떤 형태로든 DSA 없이 뽑으면 잘못 뽑는다."
필 첸의 답은 짧았다. "우리도 여전히 논리와 문제 해결의 유창함을 평가한다. 다만 에이전트의 도움으로 더 어려운 문제를 푸는 방식으로."
여기엔 데이터가 있다. 2013년 구글 인사 책임자 라즐로 복은 수만 건의 면접 점수와 입사 후 성과를 대조한 결과 "아무 관계가 없었다"고 했고, 브레인티저는 "면접관이 똑똑하다고 느끼게 해 줄 뿐"이라고 했다. 산업심리학의 고전인 슈미트·헌터의 1998년 메타분석에서 업무 샘플 테스트(실제 일을 시켜 보기)는 직무 성과와 0.54의 타당도를 보여 비구조화 면접(0.38)보다 훨씬 높았고, 2022년 재분석에서는 구조화 면접이 최상위 예측 변수가 됐다. 면접 플랫폼 interviewing.io의 데이터에서 리트코드 문제 풀이 수는 면접 성과와는 0.27, 실제 취업과는 0.17의 상관을 보였다 — 리트코드는 리트코드 면접을 예측하지, 일을 예측하지 않는다.
그렇다고 챈들러가 틀린 것은 아니다. 필 첸의 면접 — "저장소의 열린 이슈를 주고 모델 너머에 무엇을 보태는지 본다" — 은 사실상 AI 시대의 업무 샘플 테스트다. 그리고 그 샘플에서 "모델의 제안 중 어떤 게 틀렸는지 가려내려면" 자료구조와 복잡도에 대한 감각이 필요하다. 다른 점은 그것을 화이트보드에서 고립시켜 재는가, 실제 문제 안에서 드러나게 하는가다. 쇼피파이의 엔지니어링 책임자 파르한 타와르는 같은 생각을 더 직설적으로 말했다. "지원자가 AI를 100% 쓰길 바라지 않는다. 90~95% 쓰길 바란다. 들어가서 코드를 보고 '아, 이 줄이 틀렸네'라고 말할 수 있길 바란다."
반론 3. "그래서 신입은 어디로 가라는 건가"
세 번째 반론은 질문의 형태를 띤다. 이 글은 "문제가 사람 수보다 많은 고성장 회사에 들어가라"고 하는데, 그 회사들이 신입을 안 뽑는다면?
숫자를 보자. 스탠퍼드의 「탄광 속 카나리아」 2026년 8월 갱신판: AI 노출이 큰 직종에서 22~25세 고용은 덜 노출된 또래 대비 19% 뒤처진다(2025년 7월 13~15%에서 확대). 경로는 해고가 아니라 채용 감소이고, AI가 사람의 과업을 대체하는 직종에서만 나타나며, 보완하는 직종에서는 고용이 평평하거나 늘고 있다. 시그널파이어의 2026년 보고서는 빅테크 신입 채용이 2019년 대비 65%, 초기 스타트업은 76% 줄었다고 했다. 인디드 하이어링 랩은 AI 노출 상위 직종에서 신입 공고 비중이 2021년 29%에서 2026년 10%로 떨어지고 시니어 비중이 22%에서 47%로 올랐다고 했다.
한국도 다르지 않다. 2026년 9월 헤럴드경제 단독 보도에 따르면 네이버와 카카오는 올해 신입 공채 계획이 없다. 네이버 관계자는 "AI 확산으로 인재상을 새롭게 정립하면서 채용 계획도 전면 재검토 중"이라 했다. 지속가능경영보고서 기준 30세 미만 신규 채용은 네이버가 2021년 528명에서 2025년 163명, 카카오가 716명에서 187명으로 줄었다. 소프트웨어 개발자 공고 중 신입 비중은 2022년 53.5%에서 2024년 37.4%로 떨어졌다. 원티드랩 설문에서 기업이 집중 채용하겠다는 연차는 4~7년차가 49.7%, 신입은 12.4%였다.
반대 증거도 있어야 공정하다. 예일 예산연구소는 2025년 10월 "ChatGPT 출시 후 33개월 동안 노동시장 전반에 식별 가능한 교란은 없다"고 했고, 뉴욕 연준은 2026년 5월 노출 직종의 주니어·시니어 공고가 "대체로 평행하게" 움직이며 감소는 ChatGPT 이전에 시작됐다고 했다. 금리, 팬데믹 과잉 채용(메타는 3년 만에 4만 5,000명에서 8만 6,000명이 됐다), 그리고 "AI 때문"이라고 말하는 게 이해관계자에게 더 잘 먹힌다는 기업의 계산이 섞여 있다는 지적이다.
그러나 두 진영이 동의하는 지점이 있다. AI가 '대체'하는 과업 — 즉 채점 가능한 과업 — 으로 채워진 자리가 먼저 사라진다. 그리고 그 자리가 전통적으로 신입의 자리였다. 필 첸의 글이 신입에게 가혹하게 읽히는 이유이자, 동시에 신입에게 가장 필요한 이유다. '사다리 아랫칸'이 사라지고 있다면, 아랫칸 없이 올라가는 법을 — 즉 처음부터 문제가 널린 곳에 자기를 담그는 법을 — 배워야 한다. 그의 글은 그 방법을 적은 것이다.
5부. 2026년, 면접장과 사무실에서 실제로 벌어지는 일
필 첸의 회사가 특이한 사례일까. 아니다. 2026년의 채용 현장은 이미 그가 묘사한 방향으로 움직이고 있다 — 다만 속도와 방식이 제각각이다.
회사
무엇을 바꿨나
무엇을 보려 하나
메타
2025년 10월부터 AI 어시스턴트가 내장된 60분 코딩 면접 시범. 온사이트 코딩 라운드 둘 중 하나를 대체
"미래 직원들이 일할 개발 환경을 더 잘 대표하며, LLM 기반 부정행위를 덜 효과적으로 만든다"(내부 메모)
앤트로픽
2025년 2월 "AI 쓰지 마라" → 7월 철회. 지원서 초안은 직접, 다듬기는 Claude로. 성능 팀 과제는 AI 허용, 모델마다 재설계
Opus 4.5가 최상위 지원자와 같아지자 "구별할 방법이 없어졌다" — 과제 자체를 다시 발명 중
쇼피파이
2025년 4월 "AI 반사적 사용"을 기본값으로. 인원 요청 전에 AI로 안 되는 이유를 입증
면접에서 AI 90~95% 사용 후 "틀린 줄"을 짚어 내는 능력
커서
초기 스크리닝은 AI 금지(자동완성 제외), 이후 자사 코드베이스에서 AI 허용 며칠짜리 온사이트 프로젝트
실제 환경 안에서의 업무 샘플
필 첸의 회사
모든 면접이 AI 동반. 저장소의 열린 이슈를 건넴
환경 이해 → 문제 식별 → 제약 안 실행. 모델 너머에 무엇을 보태는가
구글·시스코·맥킨지
AI 부정행위 대응으로 대면 면접 일부 복원
"혼자 힘으로 하는" 순간의 확인
면접 플랫폼 카라트(Karat)가 2026년 1월 엔지니어링 리더 400명을 조사한 결과는 과도기의 혼란을 보여 준다. 62%의 조직이 기술 면접에서 AI를 금지하고, 71%는 AI 때문에 기술 역량 평가가 더 어려워졌다고 답했으며, 리더들은 지시와 무관하게 지원자의 절반 이상이 AI를 쓴다고 추정했다. 미국 기업은 38%만 라이브 면접에서 AI를 허용하지만 중국은 68%다. 한편에선 컬럼비아대 학생이 만든 리트코드 커닝 도구 '인터뷰 코더'가 정학 사태를 거쳐 "모든 것을 커닝하라"는 슬로건의 회사 클루리(Cluely)로 변신해 a16z의 투자를 받았다. 채점표가 있는 면접은 커닝할 수 있다. 채점표가 없는 면접만이 커닝할 수 없다. 업계가 AI 동반 면접으로 옮겨 가는 이유는 이상주의가 아니라 이 단순한 사실이다.
사무실 쪽도 보자. 앤트로픽의 Claude Code 개발자 보리스 체르니는 2026년 6월 "8개월째 코드를 한 줄도 손으로 쓰지 않았다"고 했고, 앤트로픽에서 병합되는 코드의 80% 이상이 Claude가 쓴 것이라고 했다. 순다르 피차이는 2026년 4월 구글 신규 코드의 75%가 AI 생성이라고 밝혔다. Y 콤비네이터 2025년 겨울 배치의 4분의 1은 코드의 95% 이상이 AI가 쓴 것이었다. 필 첸이 "아무도 코드를 손으로 쓰지 않는다"고 쓴 것은 자기 회사 얘기지만, 1~2년의 시차를 두고 업계 전체의 얘기가 되고 있다.
애디 오스마니는 후속 글에서 이 전환을 세 문장으로 압축했다. "정답지가 있는 모든 것은 자동화된다. 당신의 커리어는 정답지가 없는 모든 것이다.""초안이 공짜가 되면, 마무리가 제품이다.""평판이 당신을 골문 앞에 데려다 놓고, 좋은 판단이 그것을 골로 바꾼다."
6부. 그래서 한국의 독자는 무엇을 할 것인가
필 첸의 글은 미국 스타트업 창업자가 미국의 야심 있는 20대에게 쓴 글이다. 그것을 2026년 한국에 옮겨 올 때 세 가지를 조정해야 한다.
첫째, "문제가 사람보다 많은 고성장 회사"의 문이 좁다. 네이버·카카오가 공채를 멈추고 4~7년차만 찾는 시장에서, '그런 회사에 들어가서 배우라'는 조언은 그대로 쓸 수 없다. 대신 문제가 사람보다 많은 곳을 넓게 봐야 한다. 디지털 전환이 덜 된 중견 제조·유통·공공, 사람 두 명이 열 사람 몫을 해야 하는 초기 팀, 그리고 오픈소스. 문제의 밀도가 높은 곳이 반드시 연봉이 높은 곳은 아니다. 필 첸이 퀀트 대신 스케일을 골랐듯, 처음 몇 년은 문제 밀도를 사야 한다.
둘째, "손실 함수 훈련"의 비중이 한국 교육에서 특히 크다. 수능과 코딩 테스트는 세계에서 가장 정교한 채점표다. 그만큼 그 바깥 — 모호한 문제를 정의하고, 누구에게 무엇을 물을지 정하고, 결과를 설득하는 일 — 의 훈련은 더 부족하다. 바꿔 말하면 이 영역의 상대적 희소성이 한국에서 더 크다.
셋째, 토큰은 한국에서도 이미 배분 문제다. 월 수십만 원짜리 에이전트 구독을 회사가 줄 것인가, 개인이 낼 것인가, 그 예산을 어떤 문제에 쓸 것인가. 이 질문에 답을 가진 신입은 아직 거의 없다. 바로 그래서 차별점이 된다.
이를 바탕으로 코어닷이 정리한 실천 목록이다.
①
내 포트폴리오를 '채점 가능성'으로 분류하라
이력서의 각 항목을 1부의 진단기에 넣어 보라. 70% 이상 '채점 가능'한 성과(코딩 테스트 등수, 자격증, 잘 정의된 기능 구현)만 있다면, 그것은 2년 뒤 모델의 기본 능력이 된다. 채점 불가 영역 — 무엇을 만들지 내가 정했고, 왜 그것이었는지 설명할 수 있는 일 — 을 최소 하나 만들어라.
②
문제가 널린 환경에 스스로를 담가라
필 첸이 높이 산 지원자의 유일한 공통점이다. 실제 사용자가 있는 사이드 프로젝트, 이슈가 수백 개 쌓인 오픈소스, 사람이 모자란 초기 팀. '배울 수 있는 곳'이 아니라 '풀어야 할 문제가 사람보다 많은 곳'이 기준이다.
③
에이전트에게 시킨 일의 '토큰 영수증'을 기록하라
같은 문제를 푸는 데 쓴 토큰과 시간을 적어 보라. 줄어드는 추세가 곧 당신의 '문제 번역 능력'이다. 면접관이 보는 것도 정확히 그 분산이다. 모델이 이미 말해 줬을 것 너머에 당신이 보탠 한 줄이 무엇이었는지 설명할 수 있어야 한다.
④
마지막 10%를 한 번은 끝까지 가 보라
70%짜리 데모를 열 개 만드는 것보다, 하나를 실제 사용자가 돈을 내거나 매일 쓰는 수준까지 밀어 보는 경험이 낫다. 그 과정에서 '무엇이 거친지 보는 눈'이 생기고, 그 눈은 다음 세대 모델에서도 유효하다.
⑤
xG를 올리는 일을 매주 하나씩
좋은 일을 하는 사람들에게 내 좋은 일이 알려지게 하는 행동 — 공개 글, 재현 가능한 실험 기록, 리더보드 PR, 커뮤니티 발표. 기회는 평판을 타고 온다. 그리고 기회가 왔을 때 팀과 시장에 대한 데이터를 모을 시간을 미리 확보해 두라. 그것이 효율이다.
결론: 채점표가 없는 땅으로
필 첸의 글을 한 문장으로 줄이면 이렇다. 채점할 수 있는 모든 일은 기계가 가져간다. 그러니 채점할 수 없는 일을 찾아라. 그리고 그 일은 결국 세 가지로 모인다 — 어떤 문제를 풀지 고르는 것, 거기에 시간과 토큰과 사람을 배분하는 것, 그리고 마지막 10%를 끝까지 밀어붙이는 것.
이 조언이 불편한 이유는, 우리 대부분이 정확히 그 반대로 훈련받았기 때문이다. 12년의 학교와 몇 달의 코딩 테스트 준비는 '주어진 문제를 빨리 정확하게 푸는 능력'을 가장 완벽한 손실 함수로 다듬어 왔다. 그 능력이 나쁜 게 아니다. DeepSeek-R1의 AIME 곡선이 보여 주듯, 그것은 기계가 가장 먼저, 가장 잘 배우는 능력일 뿐이다.
애나 장의 질문은 옳았다. 이 경계선은 영원하지 않을 수 있다. 하지만 커리어는 영원을 사는 게 아니라 다음 10년을 산다. 그리고 다음 10년 동안 경계선이 가장 늦게 도착할 땅이 어디인지, 지금 사람을 뽑고 있는 사람이 적어 둔 것이 이 글이다.
필 첸은 글을 이렇게 맺었다. "세상은 여전히 기회로 가득하다. 그것을 여는 열쇠는 흥미로운 문제를 찾고 비범한 결과를 내놓는 데 집중하는 것이다."
채점표는 기계에게 주자. 우리는 채점표가 없는 땅으로 걸어가면 된다. 그 땅의 지도는 아직 아무도 그리지 않았고 — 바로 그래서 거기에 일이 있다.
David Silver & Richard Sutton, "Welcome to the Era of Experience" (2025)
Autor, Levy & Murnane, "The Skill Content of Recent Technological Change" (QJE, 2003)
Acemoglu & Restrepo, "Automation and New Tasks" (JEP, 2019)
Dell'Acqua et al., "Navigating the Jagged Technological Frontier" (HBS Working Paper 24-013, 2023)
Getzels & Csikszentmihalyi, The Creative Vision (1976); Einstein & Infeld, The Evolution of Physics (1938); Hamming, "You and Your Research" (1986); Simon, "Designing Organizations for an Information-Rich World" (1971)
마지막 10%·xG·연구
Alfred Lin, "The Last 10%" (X Article, 2026-06-09)
Addy Osmani, "The 70% problem" (2024-12); GitClear, "AI Copilot Code Quality 2025"; Google DORA, "State of AI-assisted Software Development 2025"
Sam Green (Opta), "Assessing the performance of Premier League goalscorers" (2012); The Analyst, "What is expected goals (xG)?"
Karat, "Engineering Interview Trends 2026" (2026-01); interviewing.io, "How well do LeetCode ratings predict interview performance"
Schmidt & Hunter (1998), Psychological Bulletin; Sackett et al. (2022), Journal of Applied Psychology
TechCrunch, "Uber caps employee AI spending after blowing through budget in four months" (2026-06-02); "Meta's Adam Mosseri says AI token budgets could soon be capped per engineer" (2026-07-14); "Anthropic has to keep revising its technical interview test" (2026-01-22)