[특집] GPU 시간당 가격은 거짓말을 한다 — 고장·보안·숨은 비용으로 다시 잰 'GPU 빌리기'
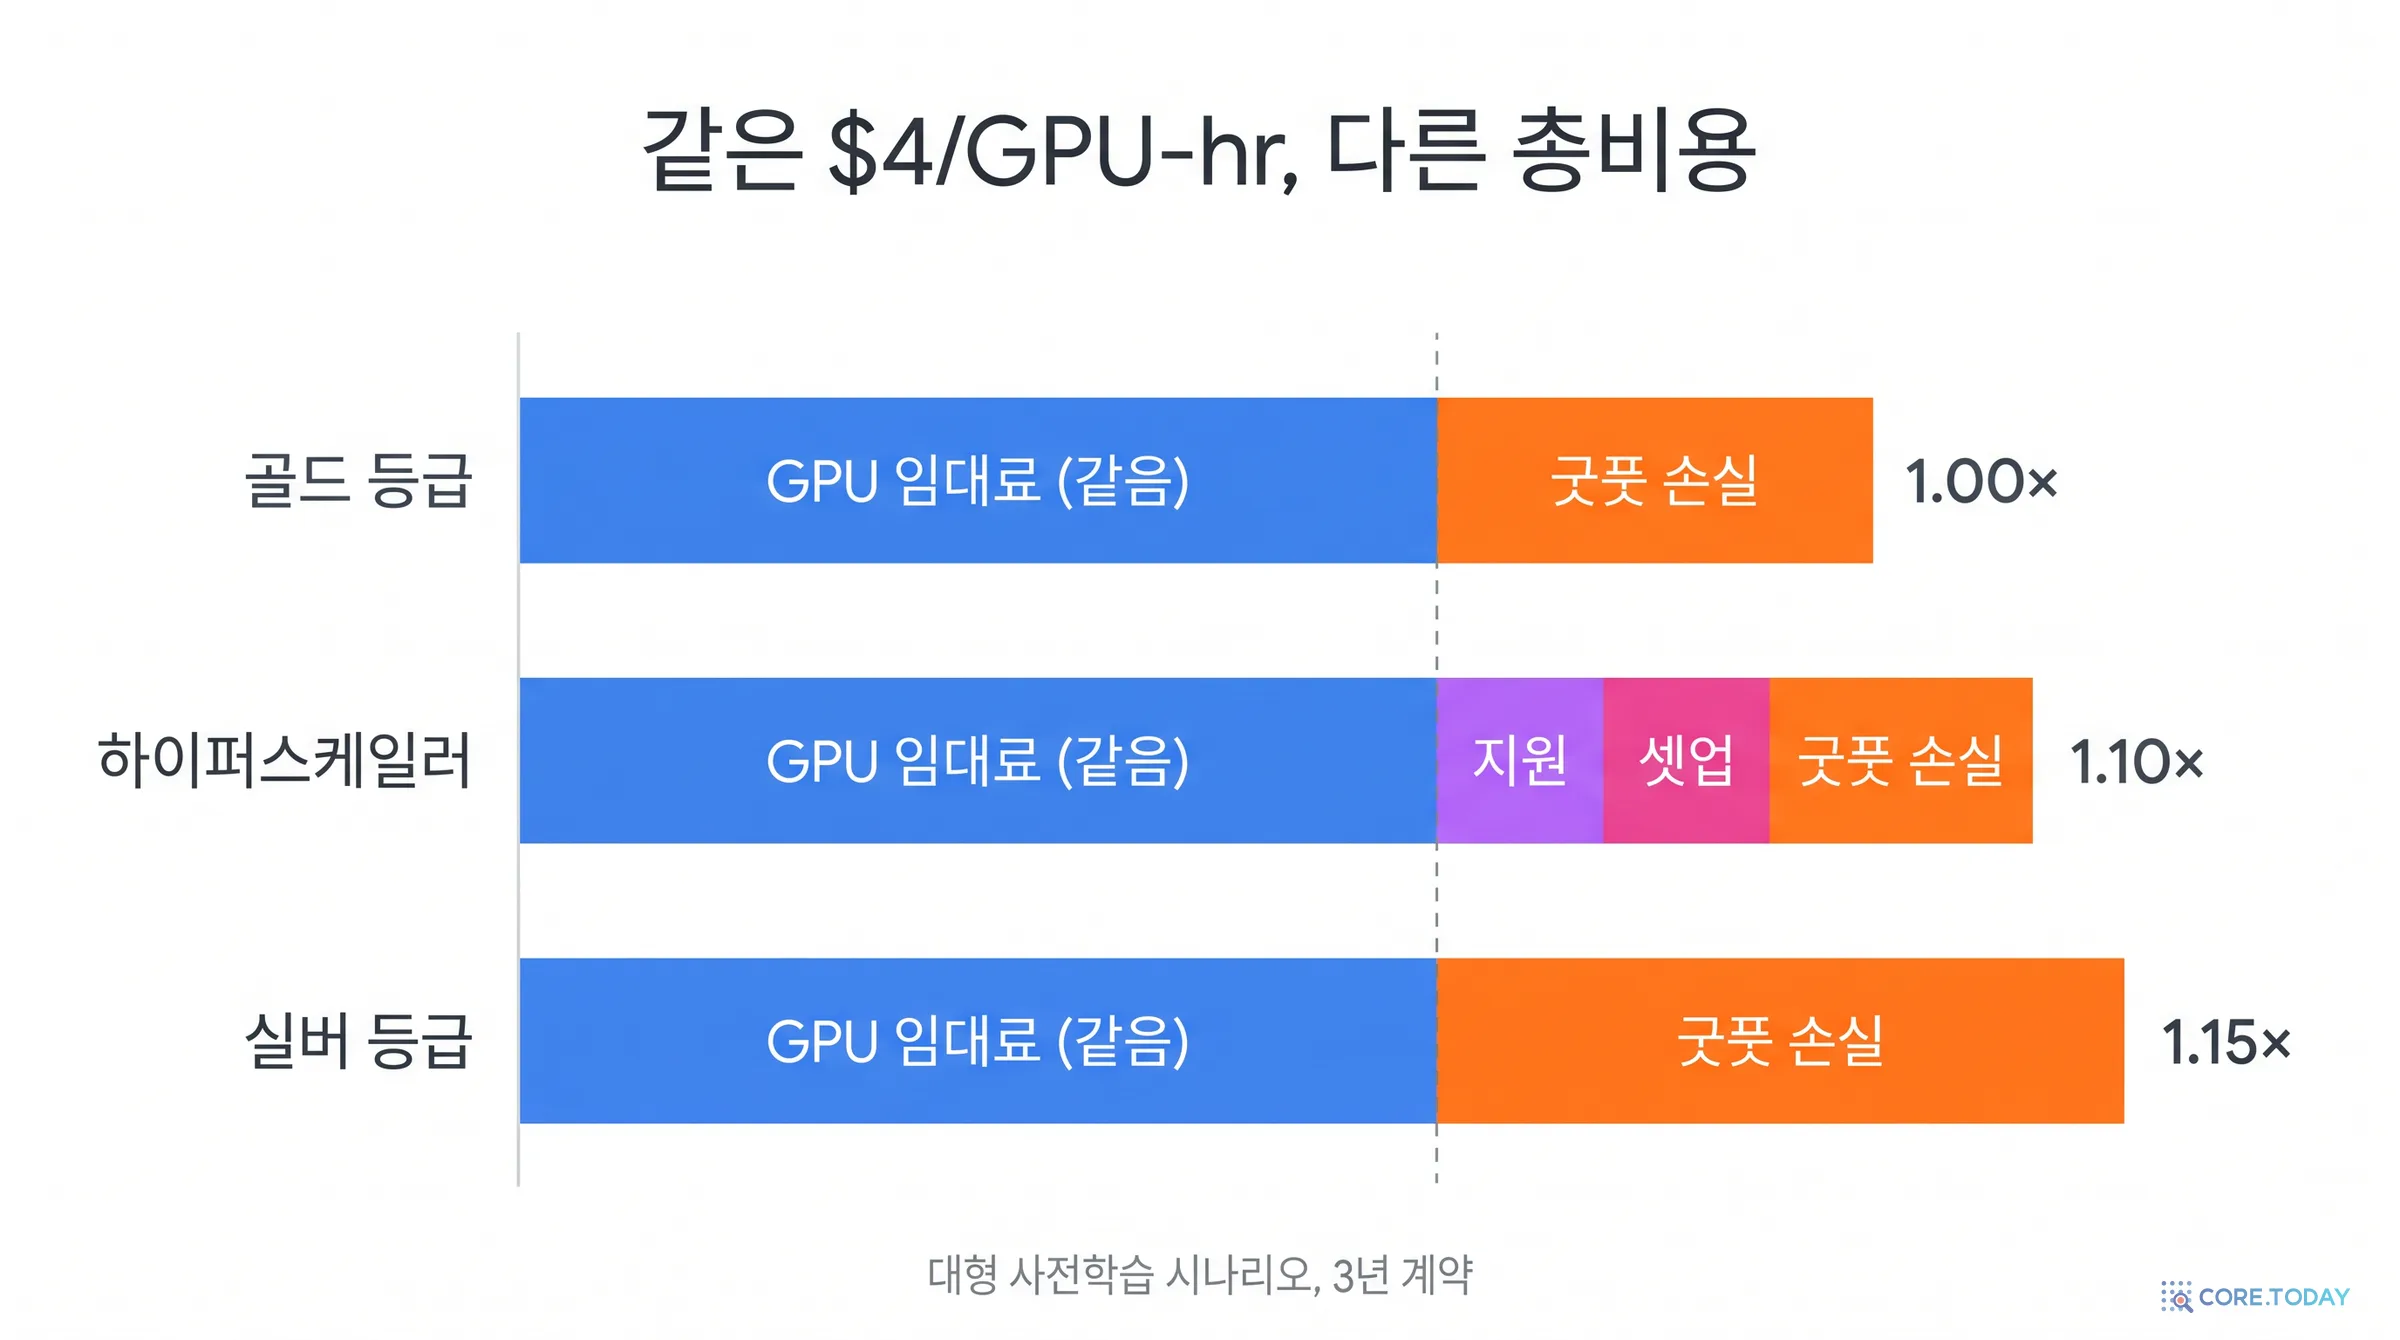
GPU를 빌릴 때 모두가 견주는 숫자는 'GPU 한 장 한 시간에 얼마'입니다. SemiAnalysis는 같은 시간당 가격에서도 총비용이 사전학습에서 1.00배·1.10배·1.15배로 갈리고, 그 차이의 대부분이 고장으로 날아가는 '굿풋' 손실(6.14%·10.53%·20.91%)이라고 계산했습니다. 반면 노드 하나짜리 추론은 수리에 8시간이 걸려도 손실이 0.5% 안팎이라, '추론은 싸게, 학습은 신뢰성을' 사야 합니다. 코어닷투데이는 SA의 공개 수식으로 계산기를 다시 만들어 세 시나리오 중 둘을 몇 달러 차이로 재현했고, 공개 수식 그대로면 실버 사전학습 손실이 48%까지 오른다는 점도 확인했습니다. 우리 A100 클러스터에서 기동 시간을 재다가, 엿새째 아무 알림 없이 꺼져 있던 GPU 한 장도 찾았습니다.
코어닷투데이2026-10-3073분
?
질문
GPU 임대 견적을 받으면 모두 'GPU 한 장 한 시간에 얼마'부터 비교합니다. 같은 값이면 정말 같은 물건일까요?
→
방법
SemiAnalysis의 클러스터 TCO 글, ClusterMAX 3.0, 네오클라우드 보안 글, 임대료 지수 글을 읽고 공개 수식으로 계산기를 다시 만들었습니다. 우리 A100 클러스터에서는 기동 시간과 '고장이 어디서 보이는가'를 읽기 전용으로 쟀습니다.
✓
결론
시간당 가격은 청구서의 첫 줄일 뿐입니다. 고장 비용은 작업 크기에 비례해 불어나므로 추론은 싸게, 큰 학습은 신뢰성을 사야 하고, 보안은 가격표에 아예 적혀 있지 않습니다.
2026년 4월, 반도체·AI 인프라 분석 회사 SemiAnalysis는 GPU 임대 시장을 이렇게 묘사했습니다. "2026년 초에 GPU를 구하는 일은 마지막 비행기 표를 끊는 것 같았다. 값은 비싸고 자리는 거의 없다. 그건 점잖은 비유이고, 더 정확한 비유는 클러스터를 빌리는 일이 마약을 사는 것과 같다는 것이다." 과장이 섞인 문장이지만 숫자가 뒤를 받칩니다. 이 회사가 공개한 H100 1년 계약 임대료 지수는 2025년 10월 시간당 $1.70에서 바닥을 찍고 2026년 3월 $2.35로 다섯 달 만에 40% 가까이 올랐습니다. AWS의 B200 스팟 인스턴스에 GPU 한 장 한 시간 $14를 내겠다는 고객이 줄을 섰고, H100·H200 8노드(64장)를 찾는 문의에 업체 절반이 "남은 게 없다"고 답했으며, 2026년 8~9월까지 새로 켜질 용량은 이미 모두 예약됐다고 했습니다.
이렇게 귀한 물건을 고를 때 사람들이 가장 먼저 견주는 숫자는 하나입니다. GPU 한 장을 한 시간 쓰는 데 얼마인가. 한국도 다르지 않습니다. 정부는 독자 AI 파운데이션 모델 사업의 1차 경쟁을 위해 SK텔레콤과 네이버에서 H100 환산 약 3,000장을 빌렸고, 정부 GPU 지원 사업으로 클라우드 GPU를 배정받는 기업과 연구실, 해외 네오클라우드(GPU 임대를 전문으로 하는 신생 클라우드 회사)에서 노드를 빌리는 스타트업이 모두 견적서를 받습니다. 그 견적서의 맨 위 줄이 시간당 가격입니다.
SemiAnalysis는 2026년 4월 글 「GPU 클러스터는 실제로 얼마나 드는가(How Much Do GPU Clusters Really Cost?)」에서 이 습관에 정면으로 반대했습니다. "공급자가 제시하는 GPU-시간당 가격에만 집중하면 잘못 판단할 수 있다. 실제로는 GPU-시간당 가격이 똑같은 두 클라우드 상품의 총소유비용(TCO)이 매우 다를 수 있다." 이들은 같은 시간당 가격을 넣고도 고장, 셋업, 디버깅, 스토리지, 지원 비용을 더하면 업체 등급에 따라 총비용이 5~15%, 가격까지 다르면 60% 넘게 벌어진다는 계산을 내놓았습니다. 9월에는 77개 업체를 평가한 등급표 ClusterMAX 3.0을, 그 직전 8월에는 25개 업체 32개 클러스터를 시험하며 다른 고객의 정보가 실제로 보였던 사례를 모은 보안 글을 냈습니다.
코어닷투데이는 이 연작에서 SemiAnalysis가 그린 'AI의 값' 지도를 따라가고 있습니다. 첫 편은 모델 한 번 부르는 값을, 입력 토큰 경제와 같은 가중치 10배 가격은 토큰을 사는 쪽의 값을, 반감기 3주는 원가가 떨어지는 속도를, 미드필과 HBM은 메모리가 정하는 값을 다뤘습니다. 이번에는 한 층 아래로 내려가 GPU를 빌리는 값을 잽니다. 결론부터 적으면 이렇습니다.
시간당 가격은 청구서의 첫 줄일 뿐이다. SemiAnalysis의 TCO는 GPU, 스토리지, 네트워크, 제어부, 지원, 굿풋, 셋업, 디버깅의 여덟 줄로 되어 있고, 그중 굿풋·셋업·디버깅 세 줄은 월 청구서에 나타나지 않습니다.
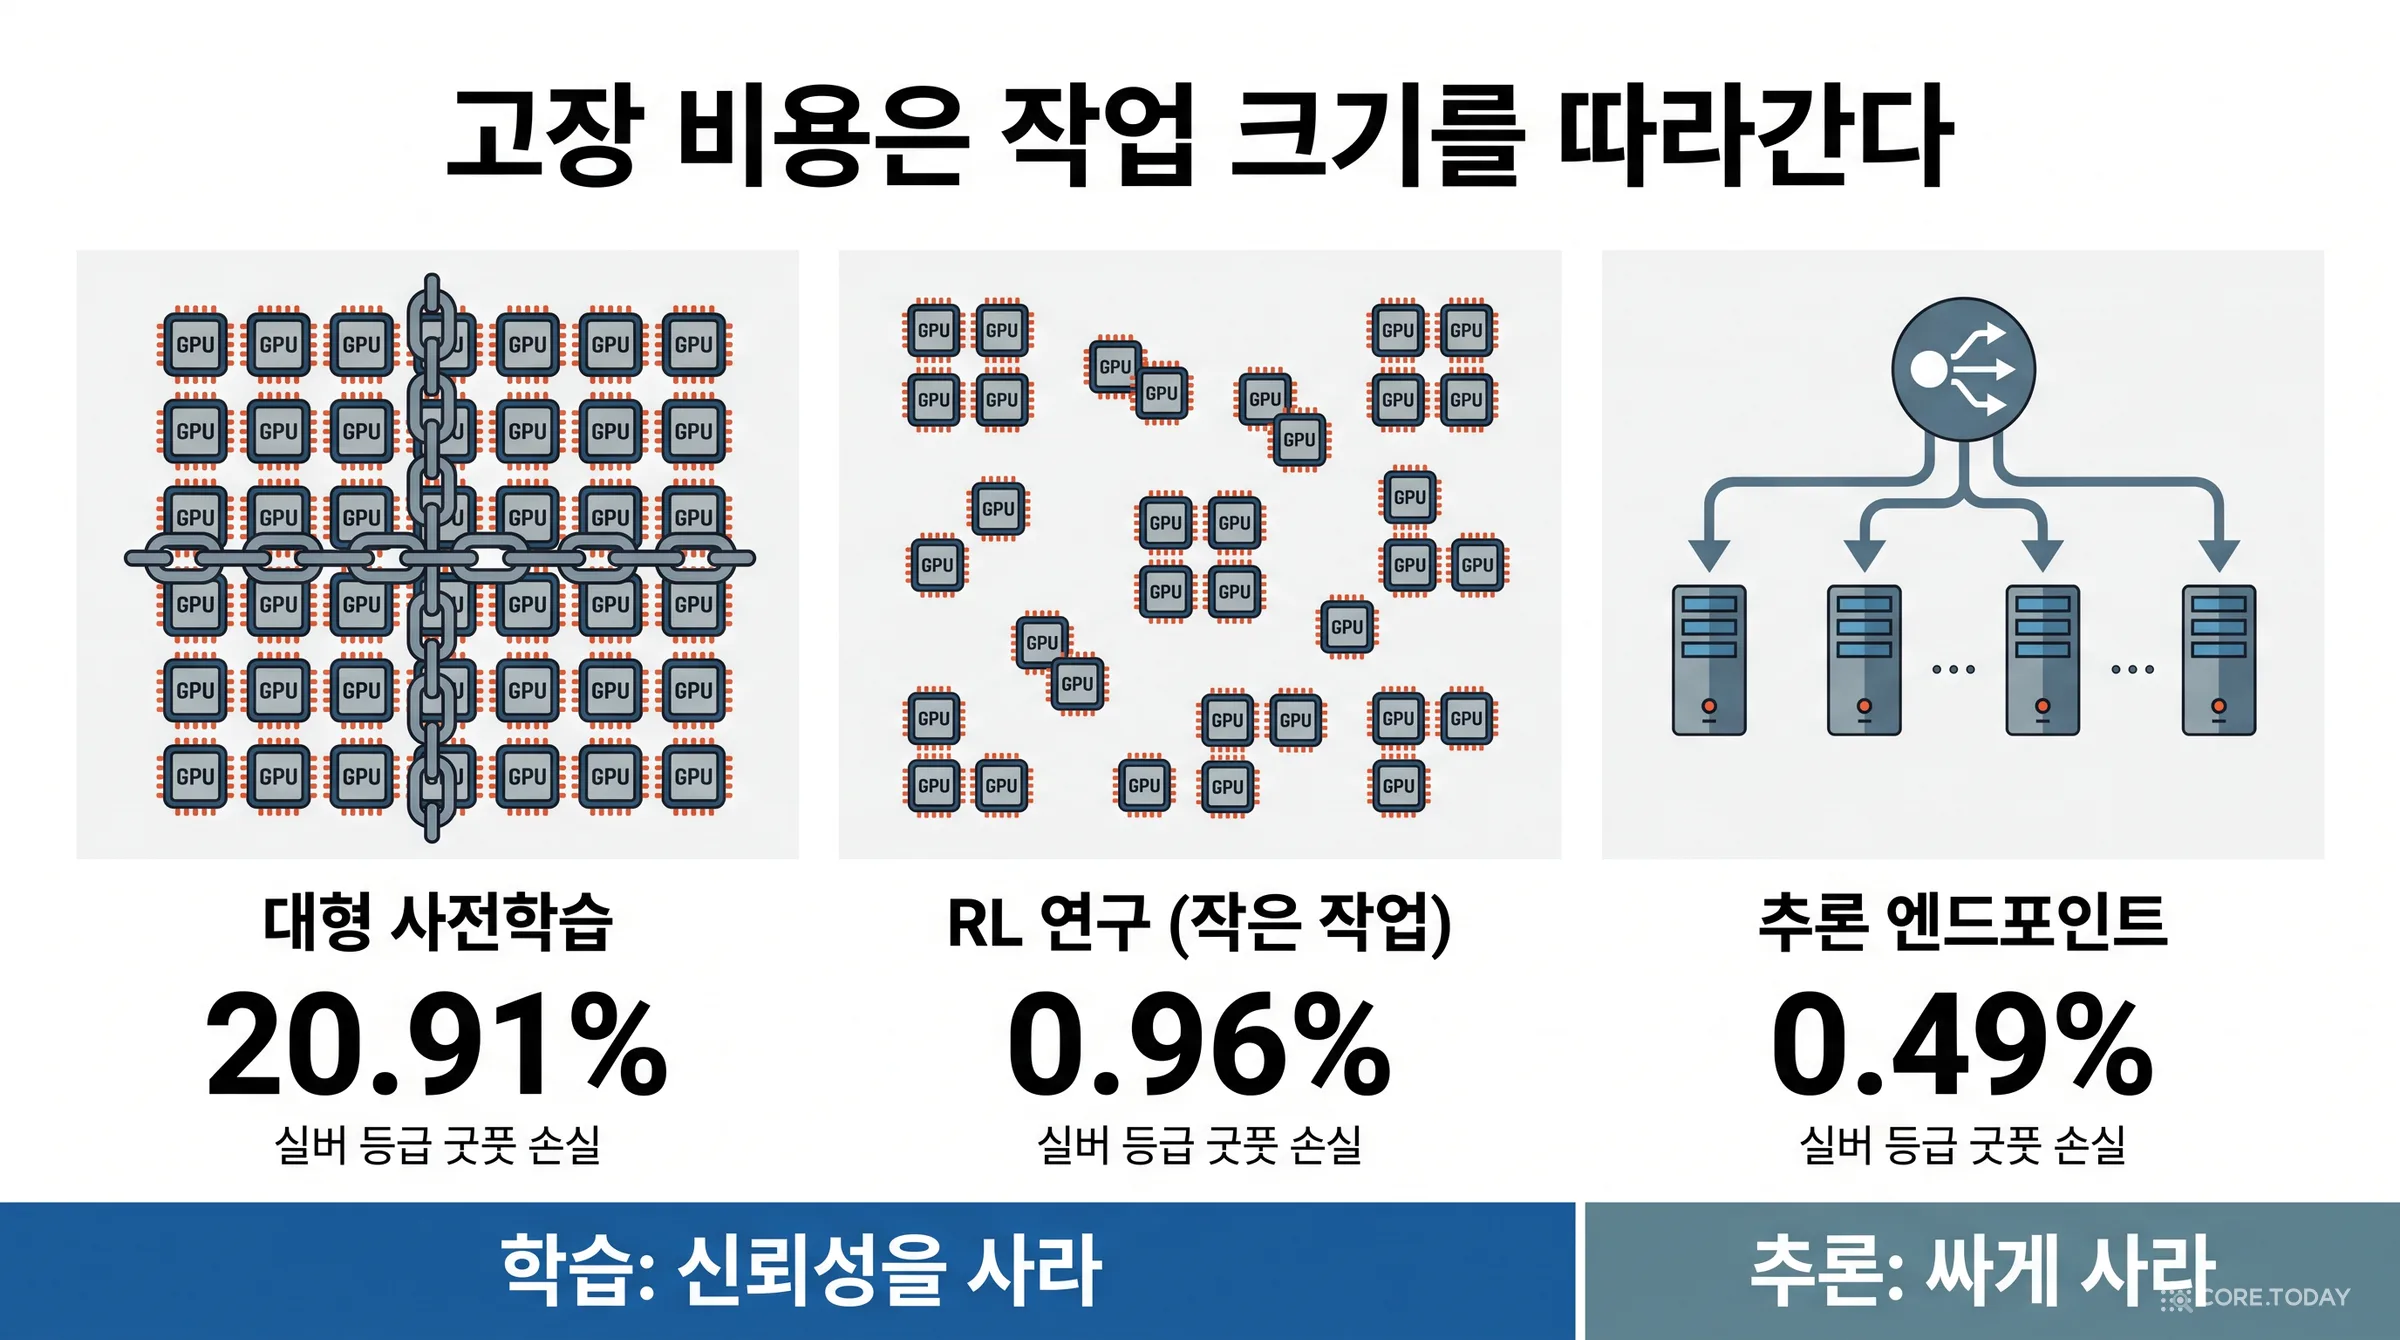
고장 비용은 작업 크기에 비례해 불어난다. GPU 한 장이 평균 15,000시간에 한 번 고장 나도 5,184장 클러스터 전체로는 2.9시간마다 한 번 고장이 나고, 수천 장을 한 작업에 묶으면 그때마다 작업 전체가 멈춥니다. 같은 $4 GPU로 대형 사전학습을 하면 실버 등급 업체의 총비용은 골드보다 15% 많고, 그 차이의 92%가 고장으로 날아간 시간입니다.
그래서 '추론은 싸게, 학습은 신뢰성을' 산다. 노드 하나짜리 추론 서버는 고장 나도 부하 분산기가 빼 버리면 그만이라, 수리에 8시간이 걸려도 손실은 총비용의 0.5% 안팎입니다. 이 경우 순위는 거의 시간당 가격만으로 정해집니다.
좋은 업체의 기준은 '2분 탐지, 1시간 교체'다. ClusterMAX 3.0은 일반 HGX 노드라면 고장을 2분 안에 알아채고 1시간 안에 교체하기를 기대합니다. NVIDIA GPU가 고장 나는 문서화된 방식만 172가지입니다.
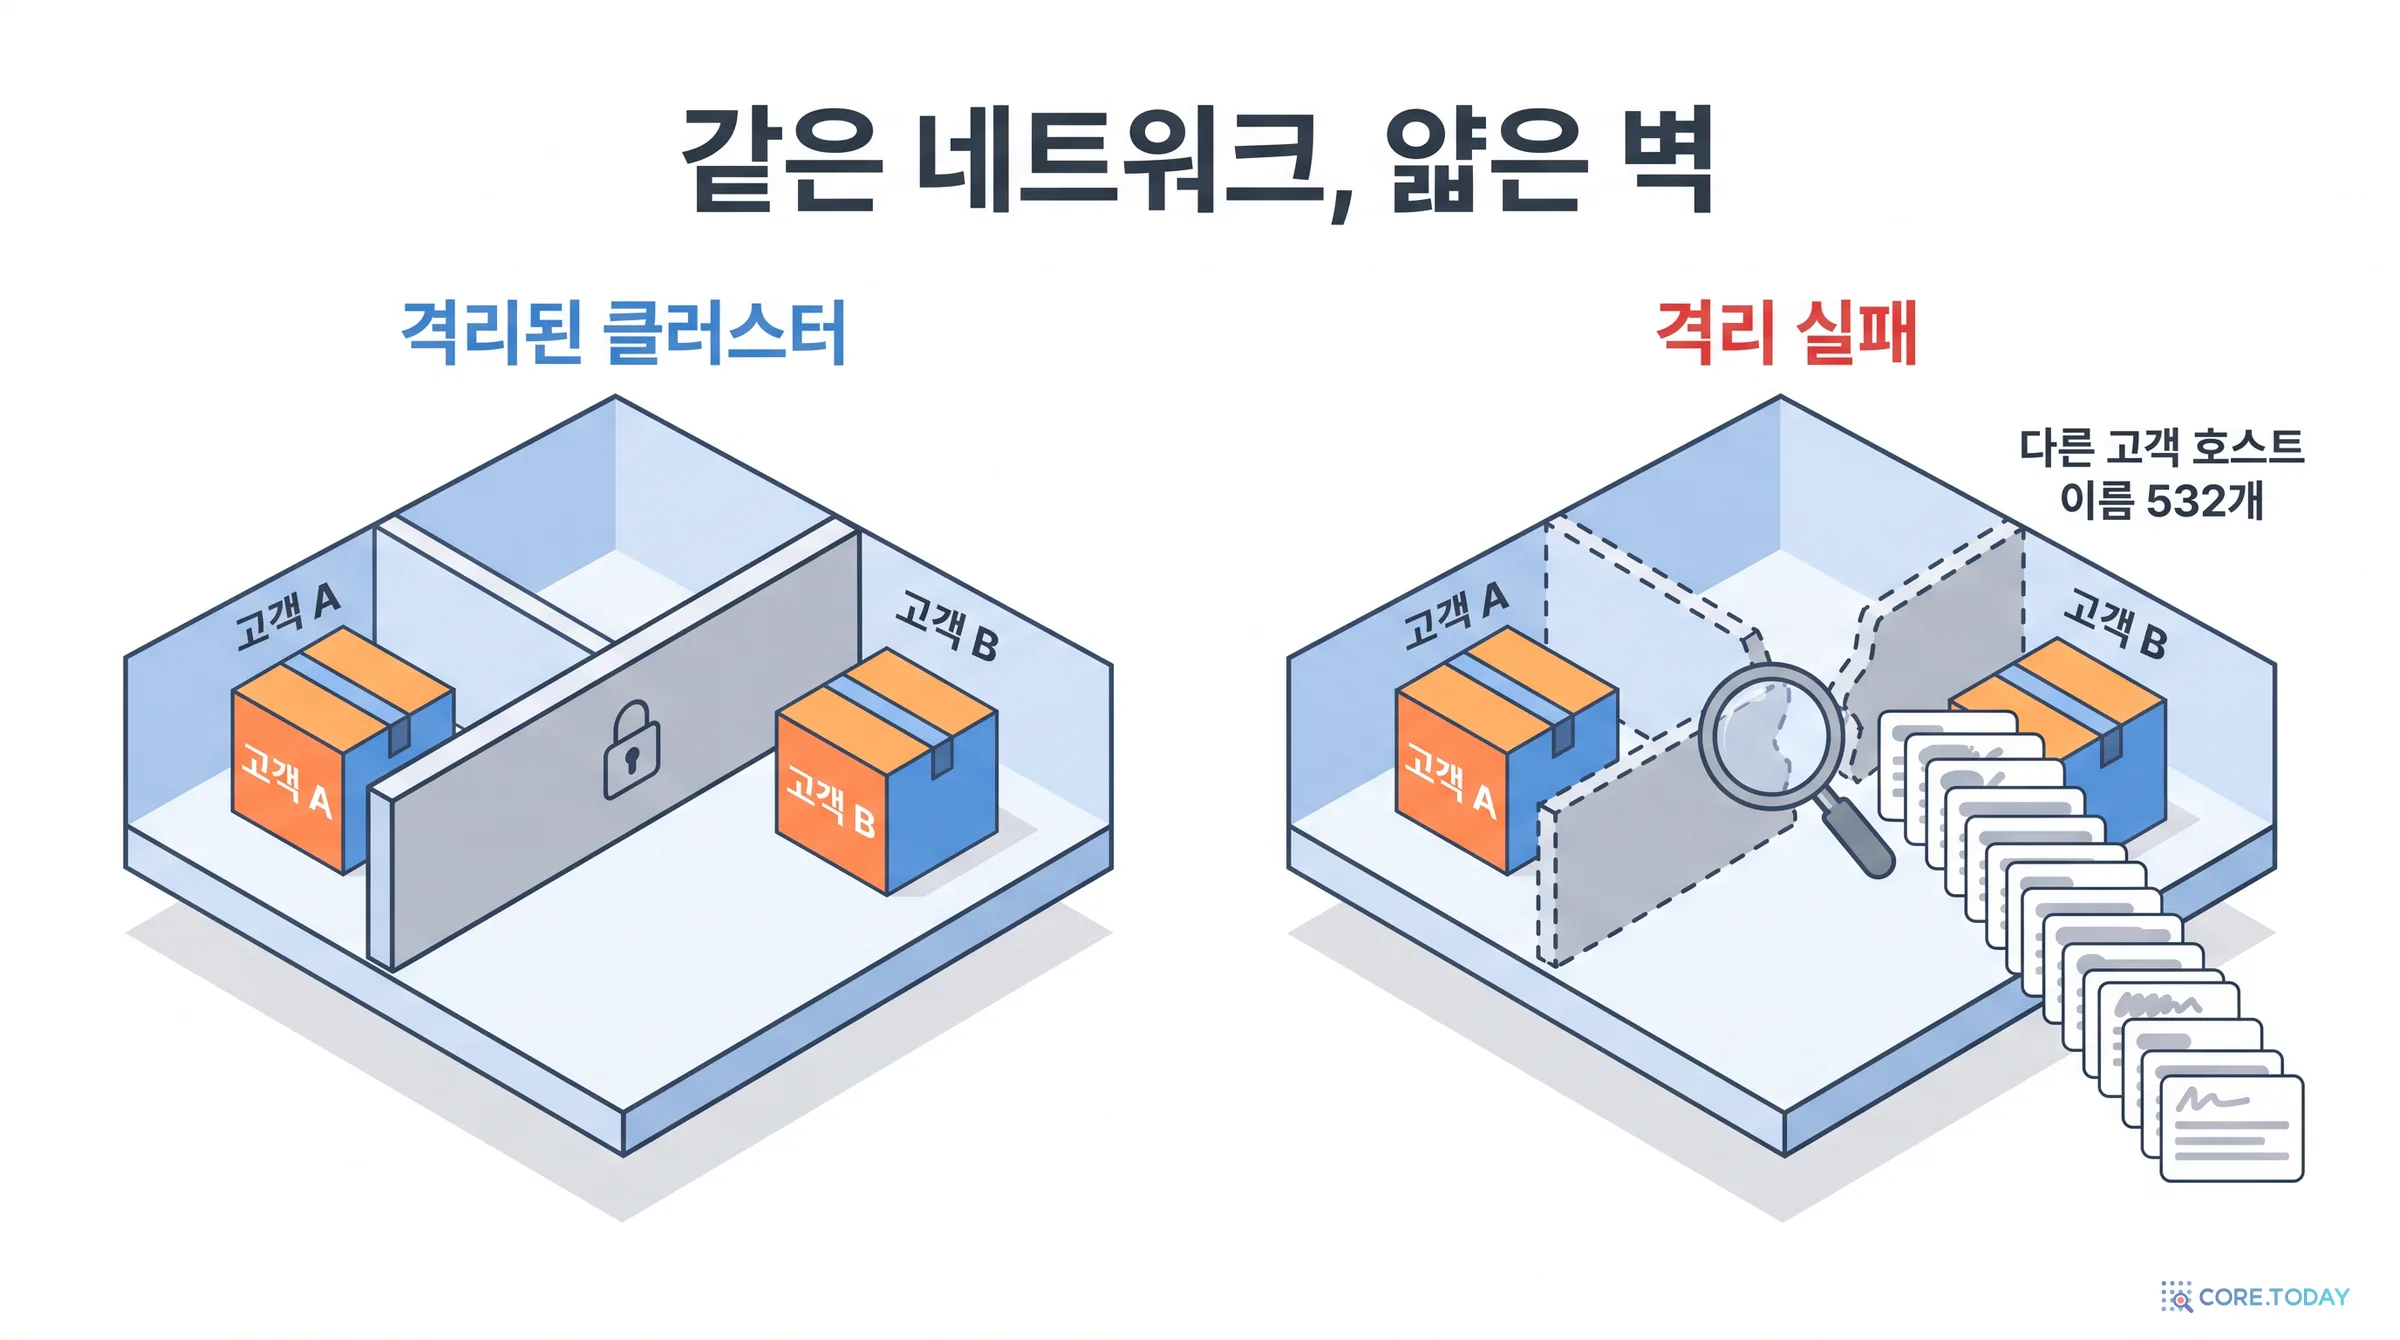
보안은 가격표에 아예 없다. SemiAnalysis는 InfiniBand 조회 한 번으로 다른 고객 호스트 이름 532개를 보았고, 2025년에 공개·수정된 컨테이너 탈출 취약점이 2026년 시험에서도 여러 업체에서 통했습니다.
우리도 예외가 아니었다. 이 글을 쓰려고 코어닷투데이 A100 클러스터를 재다가, GPU 한 장이 엿새째 초기화에 실패하는데 감시 시스템은 '정상'을 띄우고 있었다는 것을 발견했습니다.
각 결론을 숫자와 함께 풀어 보겠습니다. SemiAnalysis 수치는 무료 공개 본문과 그 안의 계산기 화면에서 왔고, 코어닷투데이가 다시 계산하거나 잰 값은 그렇게 밝혀 두었습니다.
마지막 세 줄이 이 글의 주인공입니다. 월 청구서에는 GPU, 스토리지, 네트워크, 지원 요금만 찍힙니다. 고장으로 두 시간 멈춘 4,096장의 시간도, 엔지니어 두 명이 3주 동안 네트워크 설정과 씨름한 시간도 청구서에는 나타나지 않지만, 같은 일을 끝내는 데 드는 돈을 늘립니다. SemiAnalysis는 셋업 비용을 계약 기간으로 나누는 이유를 이렇게 적었습니다. "3년 쓸 클러스터를 세팅하는 데 시간을 쓰는 것은 큰일이 아니다. 3개월 쓸 클러스터를 세팅하는 데 몇 주를 쓰는 것은 큰일이다."
이 표가 말하는 것은 단순합니다. 같은 GPU 값을 내고도 업체에 따라 같은 일을 끝내는 데 드는 돈이 다릅니다. 그 차이를 만드는 세 줄 가운데 가장 크고, 가장 계산하기 어려운 것이 굿풋입니다.
2장. 굿풋 — 고장 한 번은 얼마인가
좋은 처리량과 나쁜 처리량
굿풋(goodput)은 처리량(throughput)을 비튼 말입니다. GPU가 계산을 했다고 다 쓸모 있는 계산은 아니라는 뜻입니다. SemiAnalysis의 표현을 빌리면, "GPU 하나가 버스에서 떨어져 나갔거나, NCCL 통신이 멈췄거나, 다음 체크포인트 저장 때 메모리 부족이 숨어 기다리고 있다면" 그 처리량은 나쁜 처리량입니다. 굿풋 손실은 이렇게 버려진 GPU 시간을 비용으로 바꾼 것입니다.
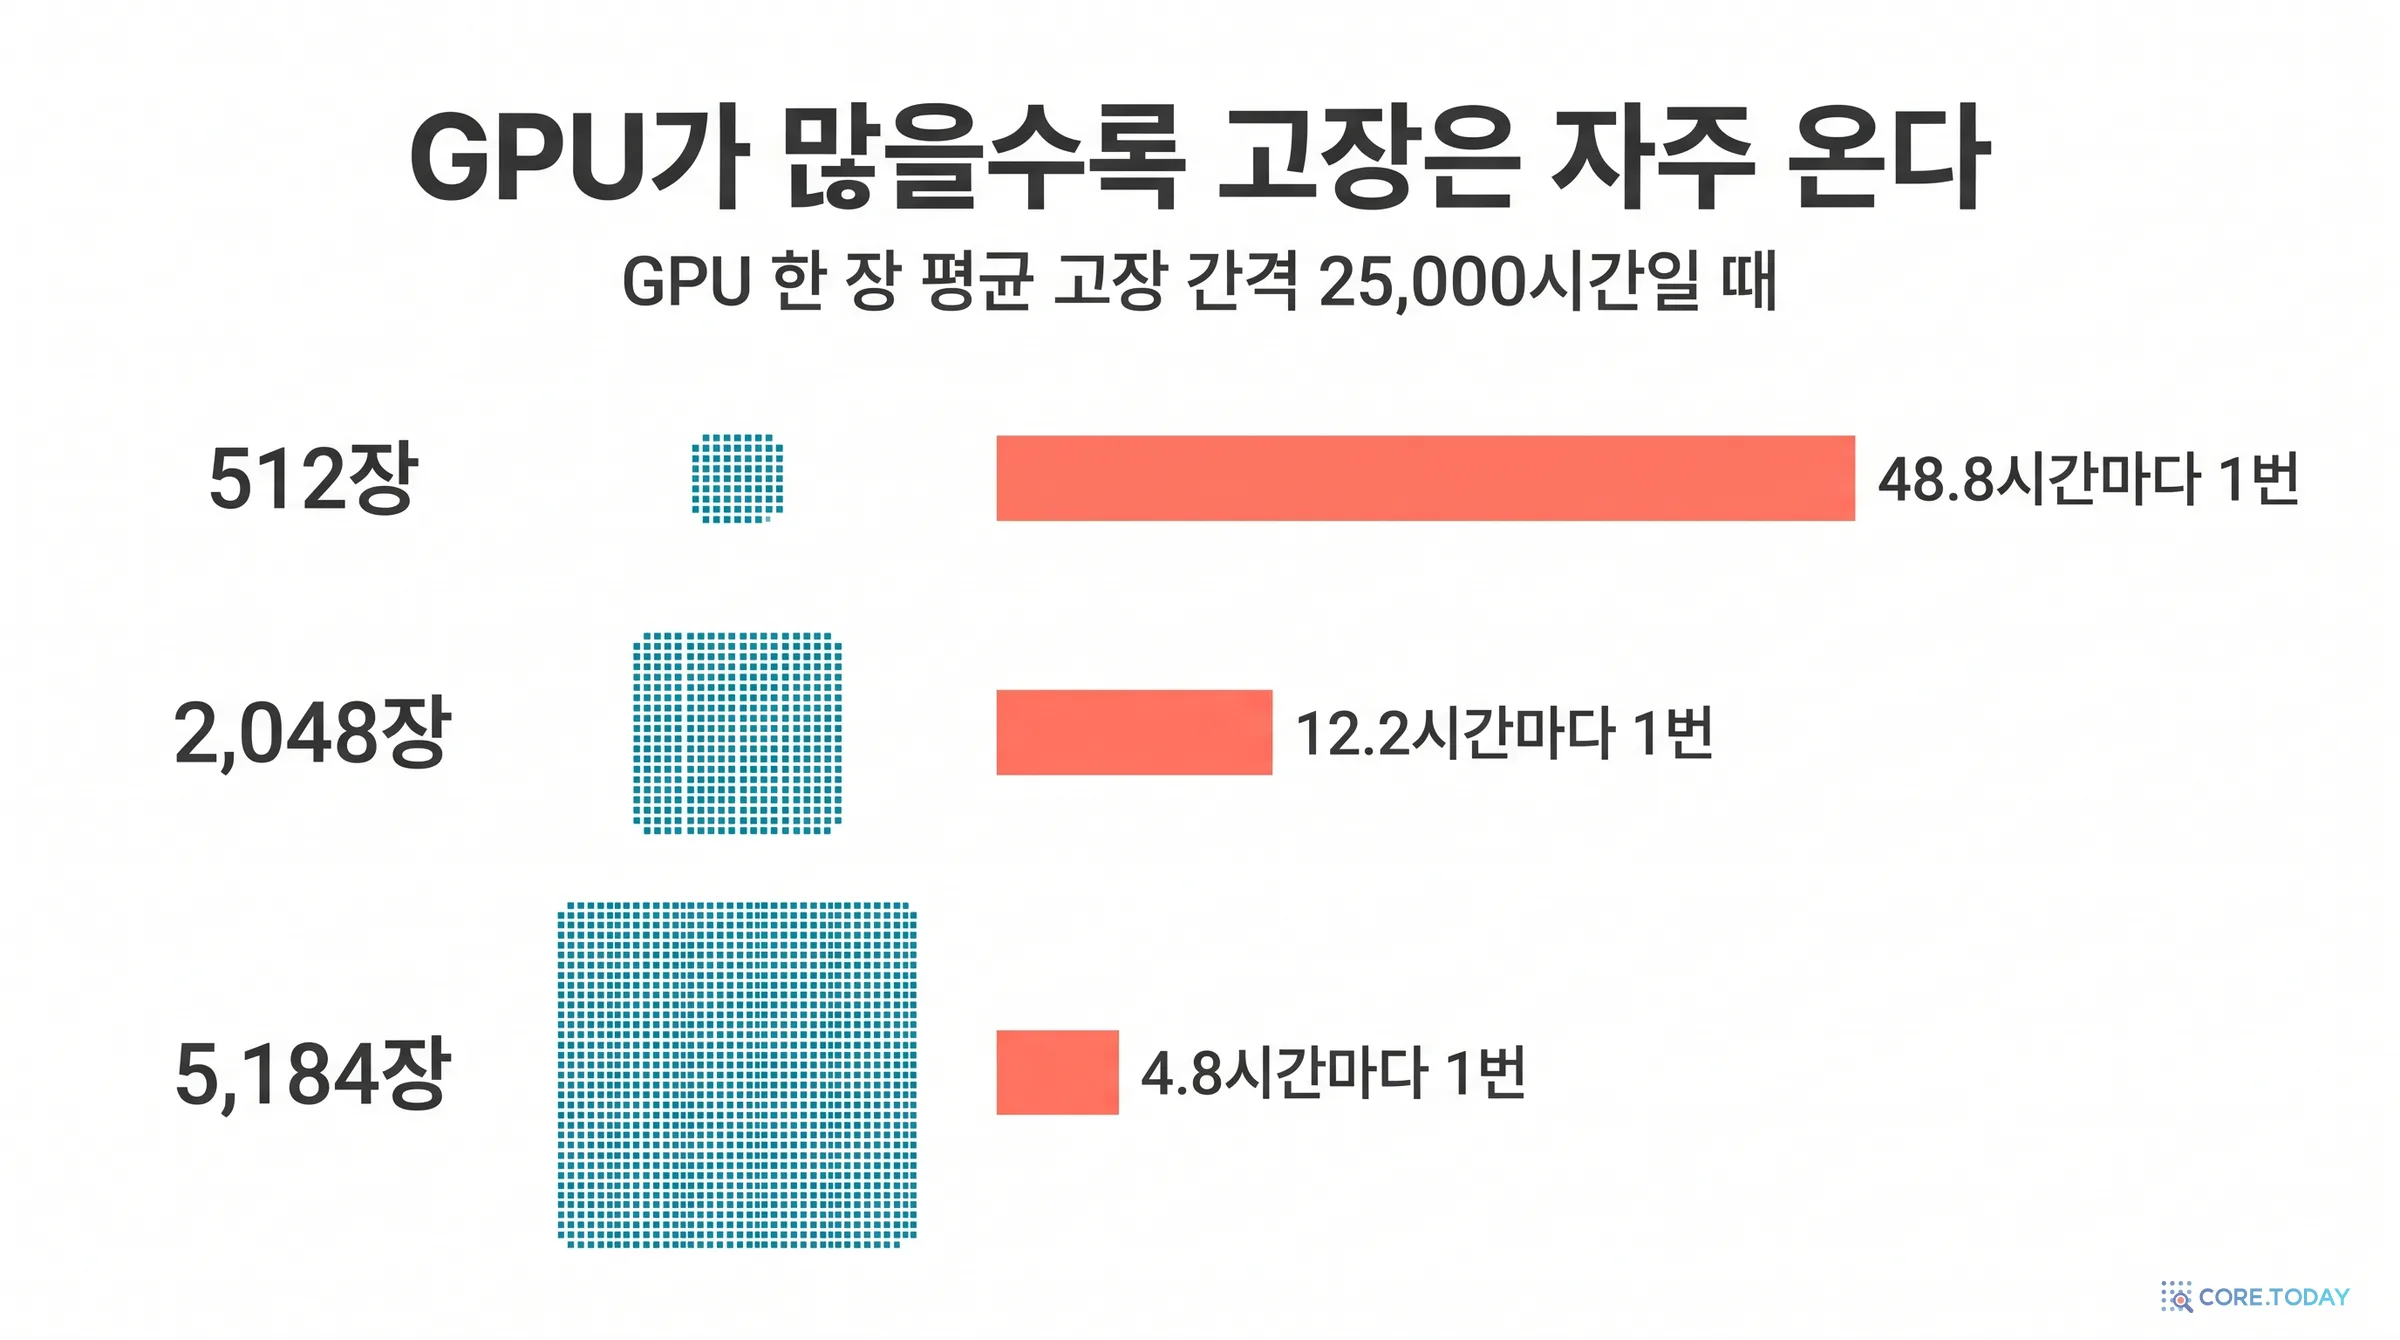
SemiAnalysis는 고객 인터뷰와 직접 시험을 바탕으로 잘 운영되는 업체의 GPU 한 장 MTBF를 약 25,000시간, 실버 등급 업체의 MTBF를 약 15,000시간으로 가정했습니다. 25,000시간이면 3년에 가깝습니다. 내 서버 한 대만 놓고 보면 거의 고장 나지 않는 셈입니다. 그런데 5,184장을 모으면 4.8시간마다 한 번, 15,000시간짜리 업체라면 2.9시간마다 한 번 어딘가가 고장 납니다. 한 달이면 각각 149회, 249회입니다. "모든 GPU는 결국 고장 나고, 작업이 클수록 고장 사이에 쓸모 있는 일을 할 시간이 줄어든다."
SemiAnalysis의 굿풋 수식
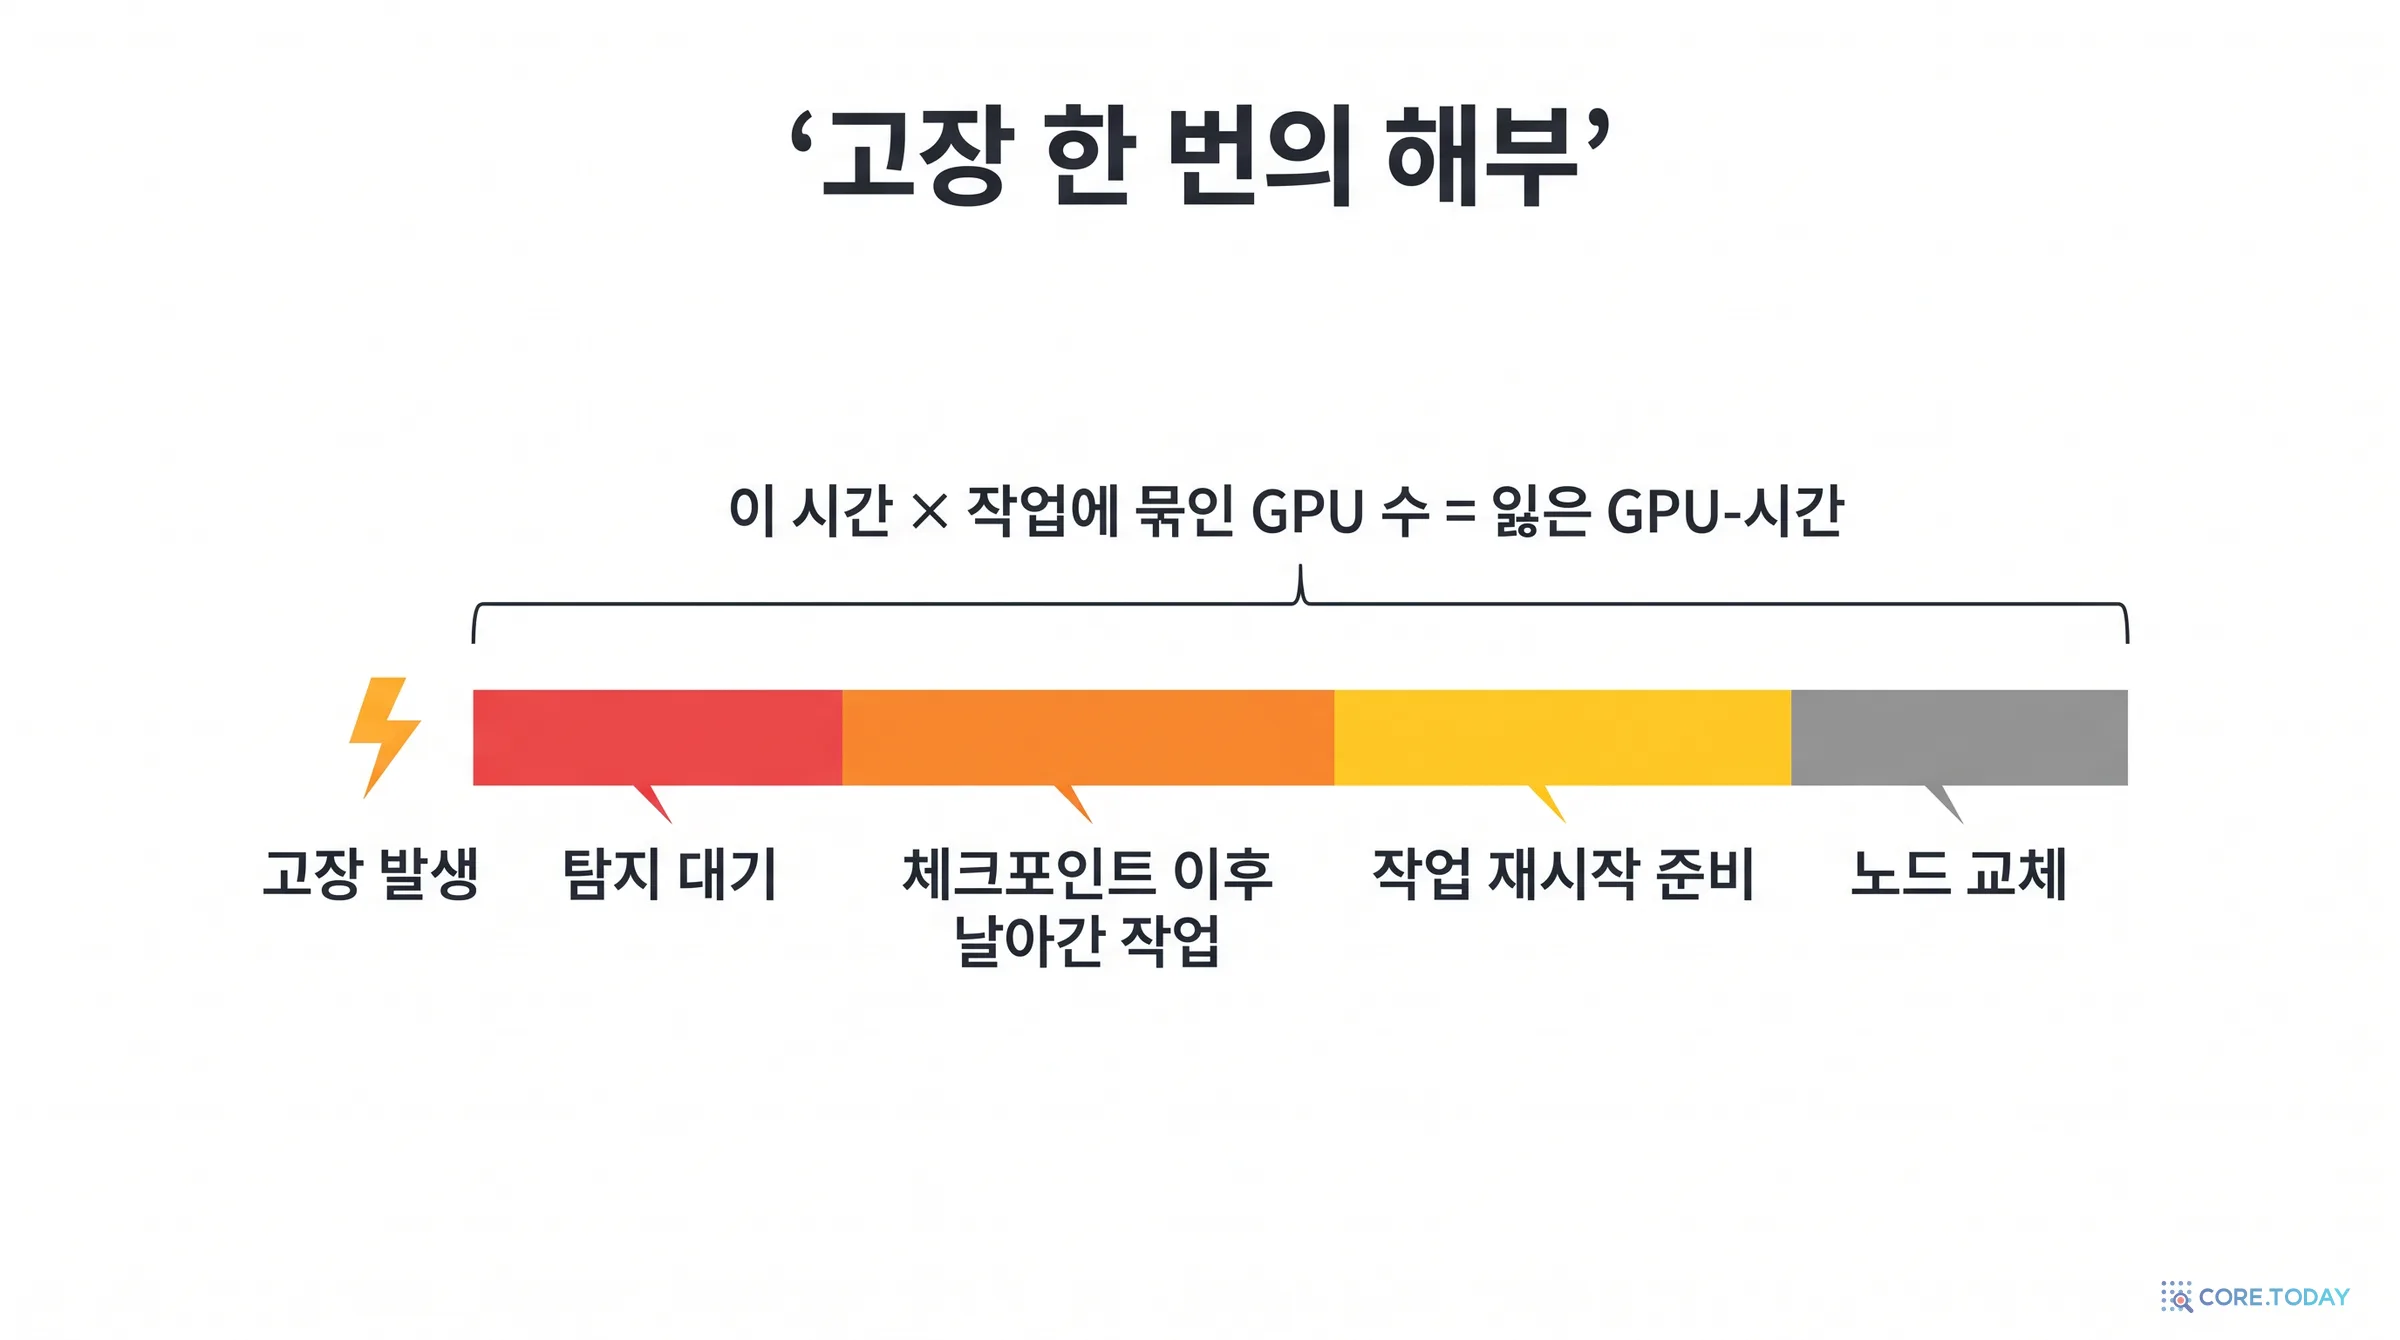
SemiAnalysis는 이것을 세 가지 복구 방식별 수식으로 정리하고 '굿풋의 대통일 이론'이라는 거창한 이름을 붙였습니다. 기호는 다음과 같습니다. 탐지 시간 t_id, 체크포인트 간격 t_chkpt, 재시작 준비 t_init, 교체 시간 t_repair, 장애 조치 시간 t_failover, 고장 한 번에 직접 영향을 받는 범위인 폭발 반경 b_radius(HGX 8장 노드라면 8, NVL72 랙이라면 64 등), 평균 작업 크기 j_size, 월 고장 횟수, GPU-시간당 가격.
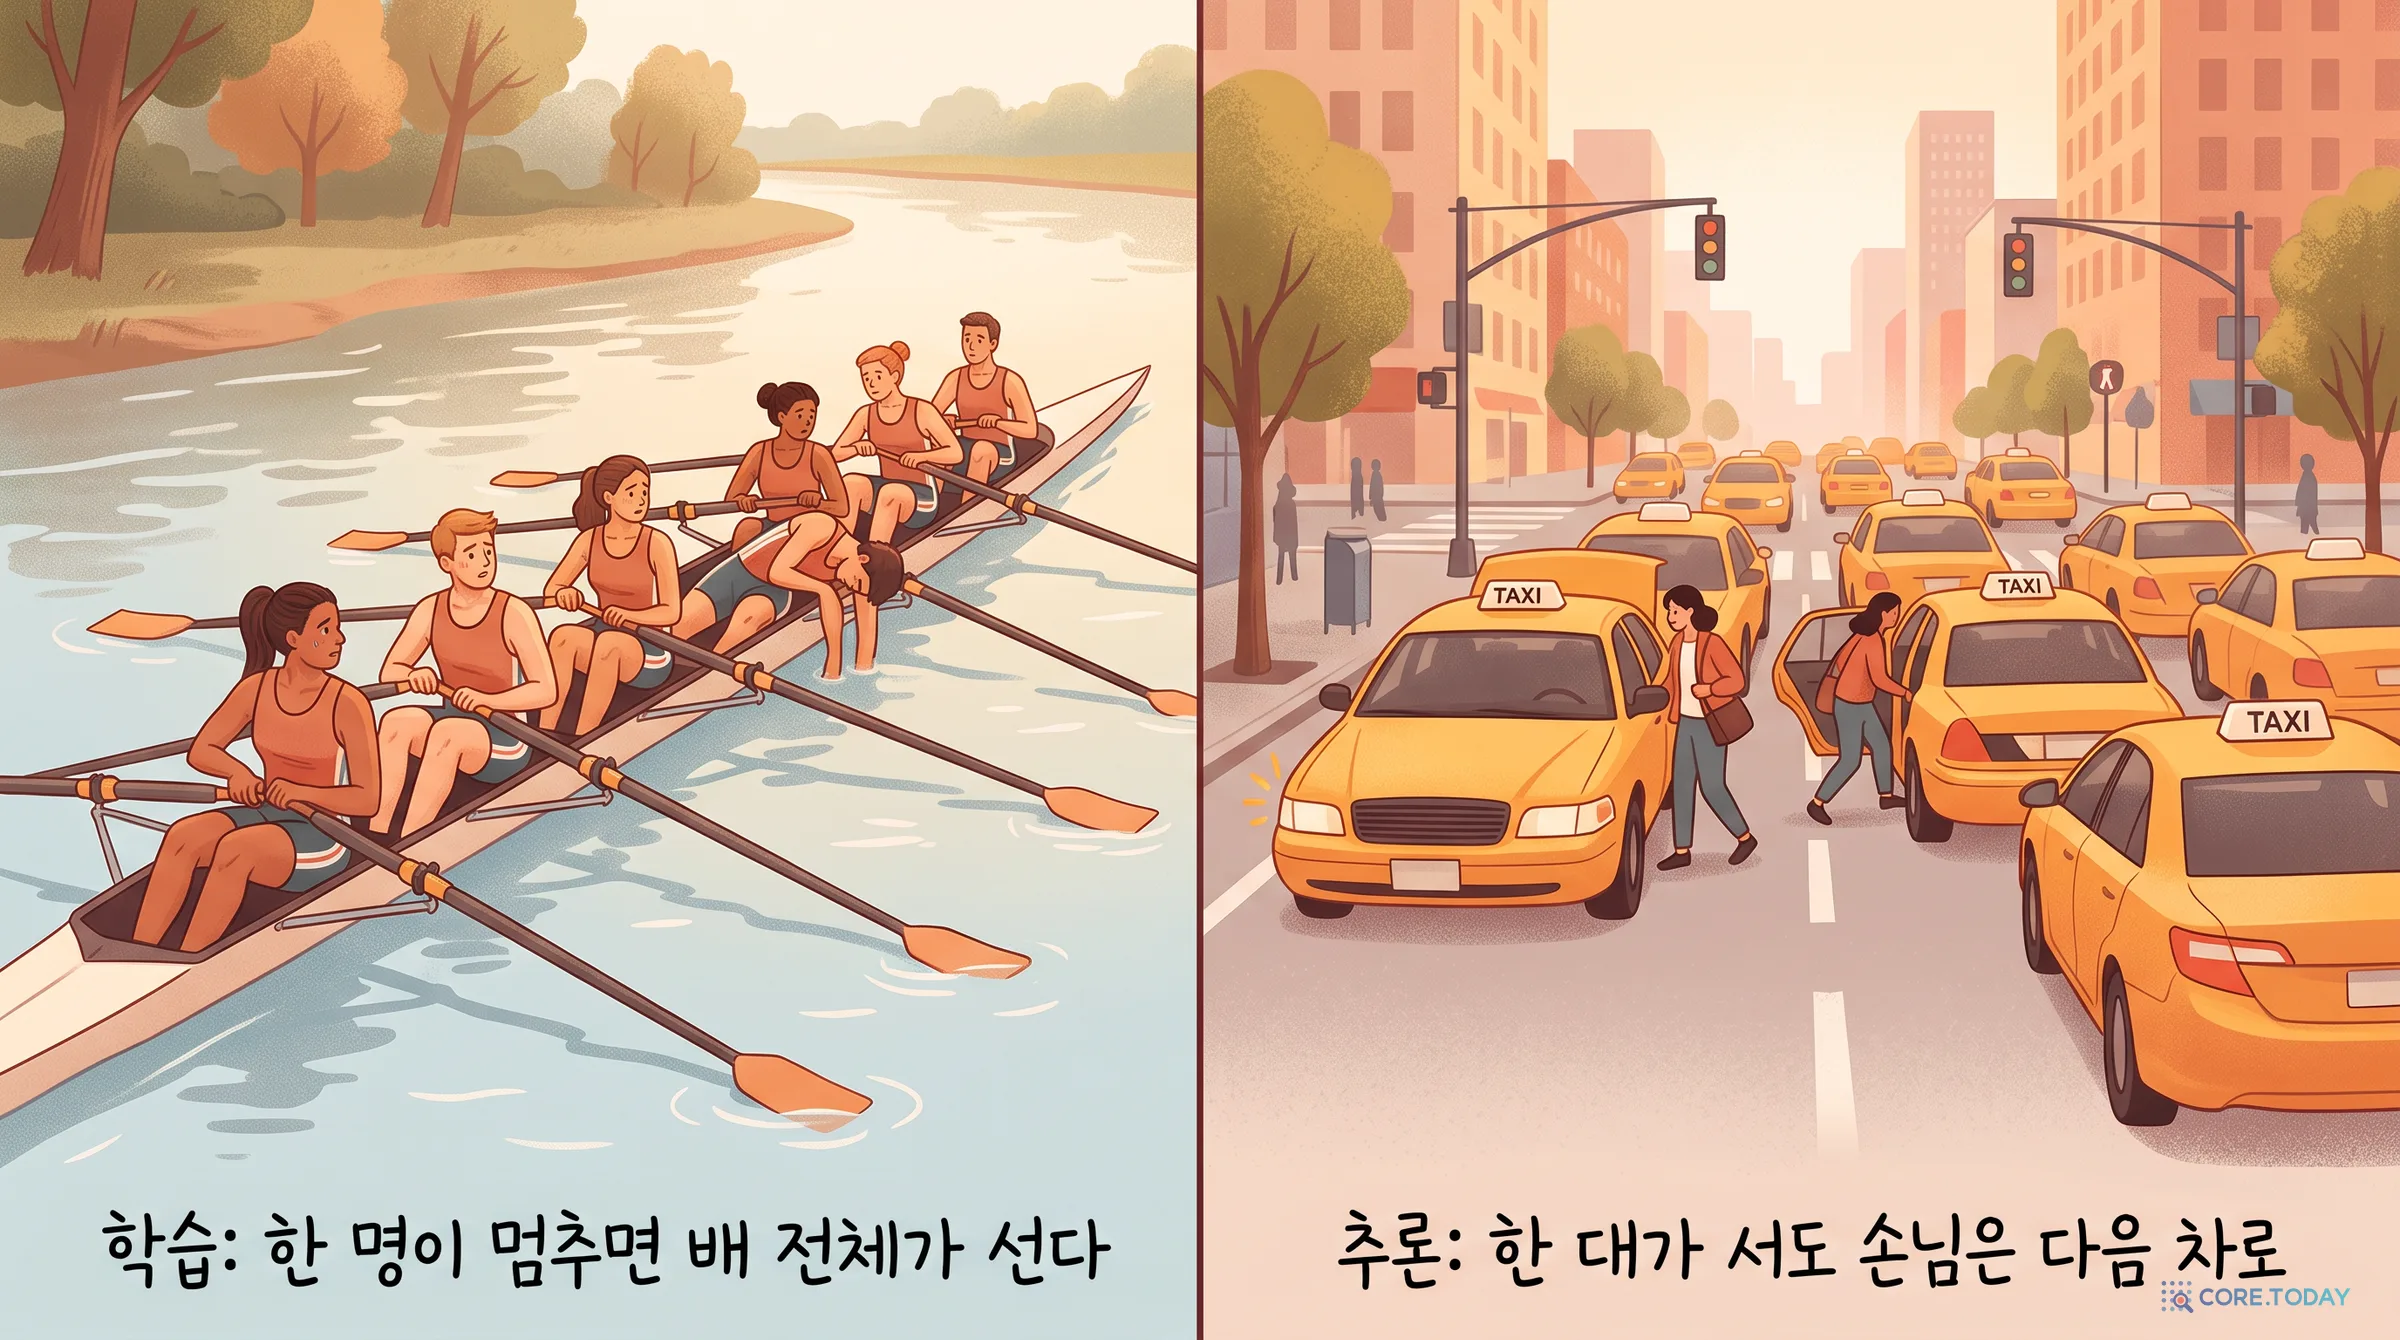
세 식의 차이는 '누가 기다리느냐'입니다. 콜드 스페어에서는 작업 전체(j_size)가 수리를 기다립니다. 핫 스페어에서는 작업은 예비 노드로 곧장 재시작하고, 수리 시간은 고장 난 노드(b_radius)만 물어냅니다. 고장 허용(fault tolerant) 방식에서는 체크포인트로 되돌아가지 않고 장애 조치만 하면 작업이 계속 돕니다. 추론 서버가 대표적인데, 부하 분산기가 고장 난 서버로 요청을 보내지 않고 실패한 요청을 다른 서버에 다시 보내면 끝입니다.
학습을 고장 허용으로 만드는 세 가지 방법
학습에서 고장 허용은 아직 쉽지 않습니다. SemiAnalysis가 시험한 세 가지는 저마다 값을 치릅니다.
방법
어떻게
치르는 값
TorchFT (오픈소스, meta-pytorch)
복제 그룹 하나가 죽으면 살아남은 그룹이 상태를 넘겨주고 다시 합류
그룹 사이 통신을 GPU 전용망 대신 CPU·TCP(GLOO)로 해서 비슷한 HSDP 작업에서 10% 넘게 느렸다. 그룹 전체가 폭발 반경이다
AWS SageMaker HyperPod 체크포인트 없는 학습
각 GPU가 자기 모델 조각의 사본을 다른 GPU에 두고, 고장 시 RDMA로 바로 복구
사본이 체크포인트 하나만큼 GPU 메모리를 더 먹는다. 시나리오에서는 성능 5% 부담으로 가정. 복구는 1분 45초(체크포인트 재시작은 15분), SA가 H200 4노드에서 확인
TorchPass (상용 라이선스)
고장 조짐이 있는 노드의 상태를 RDMA로 예비 노드에 '즉석 체크포인트'로 옮김
성능 부담은 없지만 예비 노드를 놀려야 한다. 시나리오에서는 32장(전체의 0.62%)을 대기시킴
SemiAnalysis는 이 비교 끝에 "고장 허용 학습은 프론티어 연구소나 소프트웨어 라이선스를 살 의지가 있는 곳만 가진 비밀 소스로 남아 있다"고 적었습니다. 반대로 노드 하나짜리 추론에서 고장 허용은 이미 표준입니다. 이 비대칭이 3장의 결론을 만듭니다. 덧붙여, 경험 많은 업체들은 4,000장 넘는 다중 고객 클러스터에서 노드의 2~6%를 핫 스페어로 비워 둔다고 합니다.
아래 시뮬레이터로 작업 하나의 한 달을 굴려 보세요. 고장은 무작위로 오고, 고장이 날 때마다 체크포인트 이후의 계산이 날아가고, 탐지·교체·재시작을 기다리는 동안 작업 전체가 멈춥니다.
슬라이더를 움직이면 두 가지가 보입니다. 첫째, 작업 크기를 두 배로 늘리면 고장 횟수도 두 배가 되고 고장 한 번에 묶이는 GPU도 두 배라, 잃는 GPU-시간은 네 배 가까이 늘어납니다. 둘째, 탐지를 1시간에서 2분으로 줄이면 고장 한 번에 58분이 사라지지만, 체크포인트 간격을 60분에서 30분으로 줄이면 평균 15분만 줄어듭니다. 체크포인트를 자주 찍는 것보다 고장을 빨리 알아채는 것이 더 큰 구간이 넓습니다. 그리고 탐지는 고객이 아니라 업체가 하는 일입니다.
3장. 세 시나리오 — 같은 값, 다른 순위
세 가지 업체 등급
SemiAnalysis는 계산기를 시연하려고 세 종류의 '가상 업체'를 만들었습니다. 특정 회사가 아니라 각 등급 업체들의 평균적인 경험을 합친 것입니다. 2026년 4월 당시 ClusterMAX 2.1 등급 기준으로, 골드는 Nebius·Fluidstack·Crusoe를, 하이퍼스케일러는 Oracle·Azure·AWS·GCP를, 실버는 Together·Lambda·Vultr·Voltage Park·Cirrascale·Gcore·Firmus·GMO·TensorWave를 섞었습니다(9월의 ClusterMAX 3.0에서 이 가운데 여럿의 등급이 바뀌었으니 '그때의 평균상'으로 읽어야 합니다).
항목
골드 네오클라우드
하이퍼스케일러
실버 네오클라우드
가격대
대형·장기 계약에서 SA 가격 자료의 하위 25% 근처
물량 할인 후 50~75백분위, 대기업 기본 계약은 75백분위 이상
높게는 50백분위, 낮게는 25백분위 아래 — "공격적인 할인은 낮은 품질의 신호이니 경계하라"
스토리지·네트워크
스토리지 성능 좋음, InfiniBand·RoCE가 바로 기대 성능
기본 스토리지 성능이 낮고 올리려면 추가 요금, 네트워크 튜닝에 셋업·디버깅 시간 소모
스토리지는 업체 경험에 따라, 네트워크는 대체로 양호하나 Slurm·쿠버네티스 설정에 시간 소모
지원
24시간, 티켓 없이 엔지니어 직통, 가격에 포함
등급별 유료(청구액의 10%→3%)
대개 포함, 24시간 엔지니어 직통은 드묾
감시·헬스체크·예비 노드
대시보드·헬스체크 기본 설정, 핫 스페어 풀로 빠른 교체
대시보드는 기본이 아니지만 헬스체크 설정은 쉬움, 핫 스페어와 용량 보장 있음
대시보드·헬스체크가 기본으로 안 켜져 있음, 핫 스페어가 있어도 용량 보장 없음, 수리는 서버 제조사에 맡기는 콜드 스페어가 보통
시나리오 1 — 대형 사전학습: 1.00배, 1.10배, 1.15배
GB300 NVL72 5,184장 클러스터에서 그중 4,096장(약 80%)을 한 작업에 묶어 사전학습을 돌립니다. 세 업체 모두 GPU-시간당 $4로 가격을 똑같이 맞췄습니다. 하이퍼스케일러에는 한 달짜리 유료 POC와 매달 엔지니어 두 명의 일주일치 네트워크 디버깅을, 실버에는 헬스체크 설정에 드는 엔지니어 시간을 넣었습니다(엔지니어 한 명 연 20만 달러 기준).
고장 쪽 입력이 결정적입니다. 골드는 TorchPass(예비 32장), 하이퍼스케일러는 체크포인트 없는 학습(성능 부담 5%), 실버는 핫 스페어로 체크포인트 재시작을 쓴다고 봤고, 실버는 고장이 더 잦고(MTBF 15,000시간 대 25,000시간), 탐지와 교체가 1시간씩 걸리며(골드·하이퍼스케일러는 15분), 스토리지가 느려 재시작 준비도 15분(다른 둘은 10분)입니다.
결과는 굿풋 손실 6.14%, 10.53%, 20.91%, 3년 계약 총비용 1.00배, 1.10배, 1.15배입니다. 월 총비용으로는 1,597만 달러, 1,763만 달러, 1,837만 달러이고, 3년이면 골드와 실버의 차이가 8,600만 달러를 넘습니다(5억 7,491만 달러 대 6억 6,118만 달러).
차이의 출처도 다릅니다. SemiAnalysis 계산기 화면의 '차이 귀속' 막대에 따르면 하이퍼스케일러가 골드보다 비싼 이유는 굿풋 39%, 지원 27%, 셋업 25%, 스토리지 7%로 나뉘었고, 실버가 골드보다 비싼 이유는 굿풋이 92%, 디버깅 5%, 스토리지 3%였습니다. 같은 값에 산 GPU에서 실버의 청구서가 더 무거운 이유는 거의 전부가 고장입니다.
시나리오 2 — 멀티모달 RL 연구: 1.00배, 1.61배, 1.15배
이번에는 B200 2,048장에서 평균 64장짜리 작은 작업 여러 개를 돌립니다. 연구용이라 고장 허용 코드는 없고, 1시간마다 비동기 체크포인트를 저장하며, 고장이 나면 업체의 예비 노드를 기다렸다가 재시작합니다. 가격은 2025년 8월 실제 시세를 썼습니다. 네오클라우드는 하위 25%인 $2.40, 하이퍼스케일러는 중간값 근처인 $3.10에 오케스트레이션 할증 10%를 붙였습니다. GPU당 약 12TB의 핫 스토리지(합계 25PB)를 가정했습니다.
굿풋 손실은 0.23%, 0.23%, 0.96%로 1% 안쪽에서 비슷해졌습니다. 작업 하나가 묶는 GPU가 64장뿐이라 고장 한 번의 값이 작기 때문입니다. 그런데 총비용은 1.00배, 1.61배, 1.15배로 오히려 더 벌어졌습니다. 하이퍼스케일러의 61%는 GPU 값(차이의 38%), 오케스트레이션 할증(17%), 스토리지(36%), 지원(9%)에서 나왔고, 실버의 15%는 96%가 스토리지였습니다. 작은 작업에서는 고장이 아니라 가격표와 저장 공간이 순위를 정합니다.
시나리오 3 — 추론 엔드포인트: 1.00배, 1.59배, 1.01배
H200 512장에서 노드 하나(8장)짜리 추론 서버 64대를 돌립니다. 최신 추론 프레임워크가 부하 분산과 자동 확장을 맡아, 서버 하나가 고장 나면 진행 중이던 요청을 다른 서버로 다시 보냅니다. 네오클라우드는 H200 시세 하위 25%인 $1.84, 하이퍼스케일러는 중간값 근처인 $2.60에 할증 8%입니다.
여기서 SemiAnalysis는 일부러 실버에 가혹한 조건을 줬습니다. 고장 난 노드를 고치는 데 8시간이 걸린다고 넣은 것입니다. 예비 노드도 없이 물리적 수리를 기다리는 상황입니다. 그런데도 굿풋 손실은 0.02%, 0.02%, 0.49%에 그쳤고, 같은 가격의 골드와 실버의 총비용은 1.00배 대 1.01배로 거의 같았습니다(SA는 본문에 '1% 미만'이라고 썼고, 화면의 월 총액으로 계산하면 1.4% 차이이며 그중 굿풋 몫은 0.47%포인트입니다). 하이퍼스케일러의 1.59배는 거의 전부 GPU 값과 할증, 스토리지, 지원 차이입니다. SemiAnalysis는 이렇게 적었습니다. "추론 공급자들이 세계 곳곳의 하위 등급 업체에서 남는 용량을 찾아 노드 하나짜리 추론을 돌리면서도 고객을 만족시킬 수 있는 실제 이유가 이것이다."
아래 계산기는 SemiAnalysis가 글에 실은 수식과 계산기 화면의 입력값을 그대로 옮긴 것입니다. 스토리지·지원·셋업·디버깅 같은 고정 항목은 SA 화면 값을 썼고, 업체별 GPU 값, 고장 간격, 탐지 시간, 교체 시간 네 가지를 열어 두었습니다.
코어닷투데이가 이 계산기를 다시 만들면서 확인한 것이 세 가지 있습니다.
첫째, 사전학습과 추론 시나리오는 SA 화면의 월 총액과 몇 달러 안쪽까지 같게 나옵니다(1,600만~1,800만 달러대 월 총액에서 많아야 5달러 차이). 굿풋은 GPU 임대료(오케스트레이션 할증 포함)에 곱하고, 지원 요금은 GPU·스토리지·네트워크·CPU 합계에 곱하고, 셋업은 36개월로 나누는 식으로 맞췄습니다. RL 시나리오는 공개 수식으로 굿풋이 0.30%·0.30%·1.17%로 나와 SA 화면(0.23%·0.23%·0.96%)보다 조금 높고, 총액도 0.15% 안쪽에서 어긋납니다. 1.00배·1.61배·1.15배라는 결론은 그대로입니다.
둘째, 실버 사전학습의 20.91%는 핫 스페어 식에서 탐지 시간 항을 뺐을 때와 정확히 일치합니다. 글에 실린 수식 그대로 탐지 시간 1시간을 넣으면 실버의 굿풋 손실은 48.21%, 총비용은 골드의 1.41배가 됩니다. 4,096장이 2.9시간마다 멈추고 그때마다 1시간을 고장인 줄 모르고 보낸다면 절반 가까이 잃는다는 계산이 직관에도 맞습니다. 계산기가 왜 이 항을 뺐는지는 글에 설명이 없습니다. 고객이 직접 감시해 탐지가 업체 몫이 아니라고 봤을 수도 있고, 단순한 구현 차이일 수도 있습니다. 어느 쪽이든 메시지는 같은 방향으로 더 강해집니다. 큰 학습에서는 고장을 늦게 알아채는 것이 가장 비싼 실수입니다. 위 계산기의 체크박스로 두 결과를 비교해 볼 수 있습니다.
셋째, 순위를 뒤집는 것은 작업 크기입니다. 아래 위젯은 다른 조건을 고정하고 작업 하나가 묶는 GPU 수만 바꿔, '실버가 골드보다 몇 % 싸야 본전인가'를 그립니다.
코어닷투데이 계산으로, 4,096장 클러스터에서 핫 스페어 재시작을 쓰면 본전 할인율은 8장짜리 작업에서 0.1%, 64장에서 0.2%, 512장에서 1.2%, 4,096장에서 8.0%입니다. 공개 수식대로 탐지 시간을 넣으면 4,096장에서 22.2%, 콜드 스페어라면 32.0%까지 올라갑니다. 다시 말해 추론이나 작은 연구 작업이라면 실버의 할인이 몇 %만 돼도 이득이고, 수천 장짜리 학습이라면 두 자릿수 할인을 받아도 손해일 수 있습니다.
ClusterMAX는 SemiAnalysis가 2025년 3월부터 내는 GPU 클라우드 등급표입니다. 2026년 9월 23일에 나온 3.0은 시장에서 지켜보는 업체를 323곳(2.0의 209곳, 1.0의 169곳, 첫 네오클라우드 분석 글의 124곳에서 늘어남)으로 넓히고 그중 77곳을 평가했으며, 네오클라우드 고객 200명 넘게 인터뷰했다고 밝혔습니다. 기준을 올린 탓에 메달 등급(플래티넘·골드·실버·브론즈)을 받은 곳은 19곳뿐이었고, 브론즈와 '추천 안 함' 사이에 '참가 리본(Participation Ribbon)'이라는 등급을 새로 만들어 15곳을 넣었습니다. SemiAnalysis의 설명으로는 "최소한만 해서 버티는 곳"이라는 의견을 더 정확히 담기 위한 등급입니다. CoreWeave에 이어 Nebius가 플래티넘에 올랐고, Google Cloud가 Oracle과 함께 골드에 들었으며, Azure는 실버로, Crusoe는 브론즈로 내려갔습니다.
시험은 세 단계입니다. 버전과 설정을 훑는 감사(audit)는 몇 분, 계산·통신·스토리지 성능을 재는 성능(performance)은 몇 시간, 하드웨어 고장을 흉내 내 감시·헬스체크·교체가 실제로 도는지 보는 신뢰성(reliability)은 며칠이 걸리고 최소 4노드가 필요합니다.
기동 시간 — 'import torch' 하나에 20초
성능 단계에는 '라이프사이클'이라는 소박한 시험이 있습니다. 인터넷 속도를 재고, pip·uv로 PyTorch와 vLLM을 설치하는 시간을 재고, 홈·공유 파일시스템·로컬 NVMe 같은 저장소마다 import torch에 걸리는 시간을 잽니다. SemiAnalysis에 따르면 대부분의 업체에서 이 한 줄은 1~2초지만, 작은 파일이 많은 작업에 약한 파일시스템에서는 10~20초가 걸립니다. 마지막으로 미리 받아 둔 작은 모델을 vllm serve로 띄워 /v1/models가 응답할 때까지를 재는데, 잘하는 곳은 공유 스토리지에서 10~40초, 못하는 곳은 2분이 넘습니다. 2장 수식의 t_init가 바로 이 시간입니다. 7장에서 코어닷투데이 클러스터로 이 시험을 따라 해 봤습니다.
신뢰성 — 172가지 고장, 2분, 1시간
ClusterMAX 3.0은 신뢰성의 기대치를 숫자로 적었습니다. 고객이 InfiniBand나 RoCE로 연결된 일반 HGX 노드를 빌린다면 핫 스페어로 자동 교체되기를, 고장은 2분 안팎에 탐지되고 교체는 처음부터 끝까지 1시간 안에 끝나기를 기대합니다. NVL72처럼 72장이 한 덩어리로 묶인 랙은 트레이 하나만 다른 랙 것으로 바꿔 끼울 수 없으니, 헬스체크가 2분 안에 이상을 알아채고 그 노드에 작업이 배정되지 않게만 해도 제 할 일을 한 것으로 봅니다.
NVL72의 계약 조건에서는 'NVL64+'라는 관행이 자리 잡고 있다고 합니다. 노드마다 SLA를 걸되, 랙 하나의 18개 노드 가운데 3개 이상이 동시에 고장 나면 랙 전체를 장애로 칩니다. 이유는 2의 거듭제곱입니다. 많은 작업이 64장 단위로 돌고, 72장을 꽉 채우는 구성은 8장짜리 작업 9개뿐이라 노드 두 개(8장)까지 빠져도 64장 작업은 돌 수 있기 때문입니다.
이 기준이 왜 필요한지는 한 문장이 설명합니다. "NVIDIA GPU가 고장 나는 문서화된 방식은 172가지(XID)다. 그리고 이 고장들은 겹쳐서 일어날 수 있다."
현실은 기대치와 멀었습니다. 2026년 4월의 ClusterMAX 2.1 갱신에서 한 업체는 하드웨어 고장을 흉내 낸 시험에 18시간 동안 어떤 자동 알림도, 노드 교체도 하지 않았습니다. 3.0에서는 세계 최대 클라우드의 자동 축소 기능이 계약 종료 39분 전에 B200 클러스터를 내려 돌던 4노드 작업을 강제로 끝냈습니다. SemiAnalysis는 "한 시간 안에 전체 함대를 되돌려 놓는 자동 복구라면 충분하다"고 썼습니다.
5장. 보안 — 같은 네트워크, 얇은 벽
25개 업체, 32개 클러스터에서 본 것
2026년 8월 30일 SemiAnalysis는 ClusterMAX 3.0 보고서보다 먼저 보안 글을 냈습니다. 제목부터 거칩니다. 「대부분의 네오클라우드는 보안을 못한다(Most Neoclouds Suck At Security)」. 4월부터 7월까지 약 4개월 동안 25개 업체, 32개 클러스터를 깊이 시험하면서, 단순한 버전 확인에서 무료 보안 감사 수준으로 범위를 넓혔다고 합니다. 이들이 강조한 대목은 새로운 기술이 아니었다는 점입니다. "우리는 새로운 것을 개발하지 않았다." 업체들이 쓰는 소프트웨어에 대한 경험과 공개된 취약점 설명(어떤 것은 3년이 넘은 것), 최신 모델 토큰 예산만으로 다음을 해냈다고 적었습니다.
같은 인프라를 쓰는 다른 고객의 메타데이터를 보았다. 열어 둔 서버 관리망(IPMI·BMC), VLAN·VXLAN이 없는 프런트엔드 네트워크, 잘못 설정되거나 빠진 InfiniBand 보안 키, 권한을 제대로 집행하지 않는 스토리지, 실수로 '신(god) 권한'이 걸린 모니터링 대시보드를 통해서였습니다.
공유 서버에서 컨테이너와 VM을 빠져나와 루트 권한을 얻었습니다.
잘못 설정된 쿠버네티스 서비스(기본 거부 NetworkPolicy를 집행하지 않거나 kubelet을 공인 IP에 노출) 때문에 다른 고객의 데이터를 읽을 수 있었고, 그중에는 OpenRouter 같은 경로로 공개 트래픽을 받던 추론 엔드포인트도 있었습니다.
여러 취약점이 연쇄된 한 사례에서는 다른 고객 환경에서 원격 코드 실행(RCE)까지 갔습니다. 시연은 SemiAnalysis가 소유한 두 테넌트 사이에서 했고, 업체가 고친 것까지 확인했습니다.
노출된 고객 가운데는 은행, 통신사, 대학, 연구 기관, AI 연구소, 그리고 한 경우에는 세계 GDP 10위 안 나라의 정보기관이 있었다고 합니다. 모든 발견은 업체에 알렸고, 90일 안에 고쳐지지 않은 경우는 없었으며, 글에는 이미 공개된 취약점만 담았다고 밝혔습니다.
InfiniBand의 기본 열쇠
가장 상징적인 장면은 InfiniBand입니다. 이더넷은 VLAN으로 고객을 나누지만 InfiniBand는 파티션 키(P_Key)로 누가 누구를 볼 수 있는지 정합니다. 여기에 장치 설정 변경을 막는 M_Key, 서브넷 관리자의 민감한 작업을 막는 SA_Key 등 열쇠가 여럿 있습니다.
한 업체는 새 파티션 키(0xa601)를 만들어 놓고 기본 파티션 키(0xffff)를 지우지 않았습니다. SemiAnalysis가 표준 도구 saquery를 한 번 돌리자 패브릭 위의 호스트 이름과 엔드포인트 532개가 보였고, 그 이름에 다른 고객과 내부 파티션이 드러났습니다. 다른 업체에서는 반대로 이상한 일이 일어났습니다. 고객 노드가 격리 파티션(0x7001)과 함께 모든 노드가 들어 있는 기본 파티션(0x7fff)에도 정식 멤버로 들어가 있어서, 자기 노드 4대끼리는 ibping이 안 되는데 패브릭의 다른 노드 80대는 찾을 수 있었습니다. 잘못된 파티션 설정이 격리와 정상 동작을 동시에 깨뜨린 것입니다.
두 번째 장면은 컨테이너 탈출입니다. NVIDIAscape(CVE-2025-23266)는 NVIDIA 컨테이너 툴킷이 컨테이너를 시작하기 전에 높은 권한으로 실행하는 훅이 컨테이너 이미지의 환경 변수를 물려받는 결함입니다. 이미지에 LD_PRELOAD를 심어 두면 호스트에서 루트 권한으로 원하는 라이브러리가 실행됩니다. NVIDIA는 툴킷 1.17.8에서 이것을 고쳤습니다. "설마 지금도 이걸로 컨테이너를 빠져나갈 수 있는 곳이 있을까?" SemiAnalysis의 답은 "있었다"입니다. 여러 업체에서 시험 이미지가 컨테이너를 빠져나와 그 밑의 호스트 VM에서 루트를 얻었습니다. 다만 컨테이너를 다시 VM으로 감싼 곳에서는 VM이 피해의 범위를 막았습니다. SemiAnalysis는 이를 "여러 겹 보안의 좋은 예"라고 불렀고, 고객 사이를 컨테이너 하나로만 나누는 플랫폼이 컨테이너마다 VM을 씌우는 플랫폼보다 훨씬 덜 안전하다고 결론 내렸습니다.
이 문제는 GPU를 빌리는 사람만의 일이 아닙니다. 네오클라우드 가운데 상당수가 같은 인프라에서 GPU-시간 임대와 토큰 판매를 함께 합니다. SemiAnalysis가 뚫린 클러스터에서 마주친 이웃 가운데 하나는 OpenRouter와 직접 API로 공개 모델 토큰을 파는 유명 추론 공급자였습니다. 그들의 경고는 이렇습니다. "토큰 공급자의 테넌트 격리 실패는 고객 쪽 원격 코드 실행으로 곧장 이어지는 공급망 공격이다." 인프라가 장악되면 공격자는 프롬프트를 읽는 데 그치지 않고 API 응답으로 돌아가는 바이트를 바꿀 수 있고, 확인 없이 도구 호출을 실행하는 코딩 에이전트는 그 응답 속 명령을 개발자 컴퓨터나 CI에서 그대로 실행합니다. 같은 가중치 10배 가격에서 '가장 싼 공급자'를 고르는 법을 다뤘는데, 이 대목은 그 선택에 보안이라는 기준을 하나 더 얹습니다. (에이전트가 실제로 담을 넘은 사건은 에이전트가 담을 넘었다에서 자세히 다뤘습니다.)
SemiAnalysis가 아는 한 유료 버그 바운티를 운영하는 네오클라우드는 Together 한 곳뿐이었고, 나머지는 기껏해야 보안 연락처를 적은 security.txt 파일을 두었습니다. 이들이 꼽은 '나쁜 설계' 목록은 그대로 질문지가 됩니다. 아래 점검표는 그 목록과 ClusterMAX의 요구 사항을 업체에 물을 질문으로 바꾼 것입니다.
6장. 값 — 임대료 지수와 '바닥 가격'
다섯 달 만에 38%
이 모든 계산의 출발점인 시간당 가격도 가만있지 않았습니다. SemiAnalysis가 2026년 4월에 공개한 H100 1년 계약 임대료 지수는 100곳 넘는 시장 참여자를 매달 설문하고 실제 거래로 검증해 25~75백분위 범위의 중간값을 냅니다.
블랙웰이 나오면 호퍼(H100·H200) 임대료가 크게 떨어질 것이라는 2025년의 예상과 반대로, 오픈 웨이트 모델과 추론 수요가 H100을 붙잡았습니다. 1월에는 메모리 가격 급등으로 서버값이 뛰면서 일부 증설이 미뤄졌고, 1년 계약은 1월 말 $2를 넘은 뒤 2월 중하순에 다시 15~20%, 3월 말까지 또 15~20% 오를 기세였습니다. H100 계약이 2~3년 전에 맺은 것과 똑같은 값으로 갱신되고, 2028년까지 4년짜리로 갱신되는 경우도 나왔습니다.
같은 $2.35, 다른 물건
흥미로운 우연이 하나 있습니다. 같은 $2.35라는 숫자가 다른 글에 또 나옵니다. 2026년 9월 SemiAnalysis의 NVIDIA 분석에 따르면, NVIDIA는 AI 클라우드 파트너(AICP) 프로그램에서 네오클라우드의 GB300 임대 계약을 6년 동안 시장보다 낮은 가격, 평균 약 GPU-시간당 $2.35에 받쳐 주기로 했습니다. 5년 계약 시장가는 $4.50~4.60이었습니다. 네오클라우드는 이 보증을 바탕으로 돈을 빌리고, 손님이 떠나면 언제든 NVIDIA에 빌려줄 수 있습니다. 이 프로그램은 최근 멈췄다고 합니다(NVIDIA의 장부 밖 보증 전체는 AI의 청구서는 누가 내나에서 다뤘습니다). 하나는 H100 1년 계약의 시장 가격이고 다른 하나는 최신 랙 6년 보증 가격입니다. 숫자가 같다고 같은 물건이 아닙니다. GPU 시간당 가격은 GPU 종류, 계약 기간, 선급금, 보증 구조를 모두 접어 넣은 숫자입니다.
빌릴지 살지의 계산은 또 다릅니다. InferenceX의 원가 자료로 보면 임대료는 소유 원가의 H200 2.38배, GB300 2.16배였고, 그래서 사느냐 빌리느냐에 따라 가장 싼 칩이 바뀌는 경우가 15%였습니다. 이 이야기는 같은 가중치 10배 가격의 8장에서 자세히 다뤘습니다.
비싸질수록 싼 곳이 끌린다
값이 오르면 구매자는 싼 곳에 끌립니다. 바로 그 지점에서 SemiAnalysis의 경고가 의미를 갖습니다. "공격적인 할인은 낮은 품질의 신호이니 경계하라." 위 위젯에서 굿풋 손실을 바꿔 보면, 실버 등급의 사전학습 손실(20.91%)을 $2.35에 얹을 경우 쓸모 있는 GPU-시간당 실효 단가는 약 $2.84가 되고, 이 차이 49센트는 지난 다섯 달의 가격 상승분(65센트)의 76%에 해당합니다. 반대로 추론이라면 같은 실버의 손실은 1센트 남짓입니다. 가격이 오르는 시장에서도 무엇을 돌리느냐에 따라 '싼 곳'의 의미가 정반대가 됩니다.
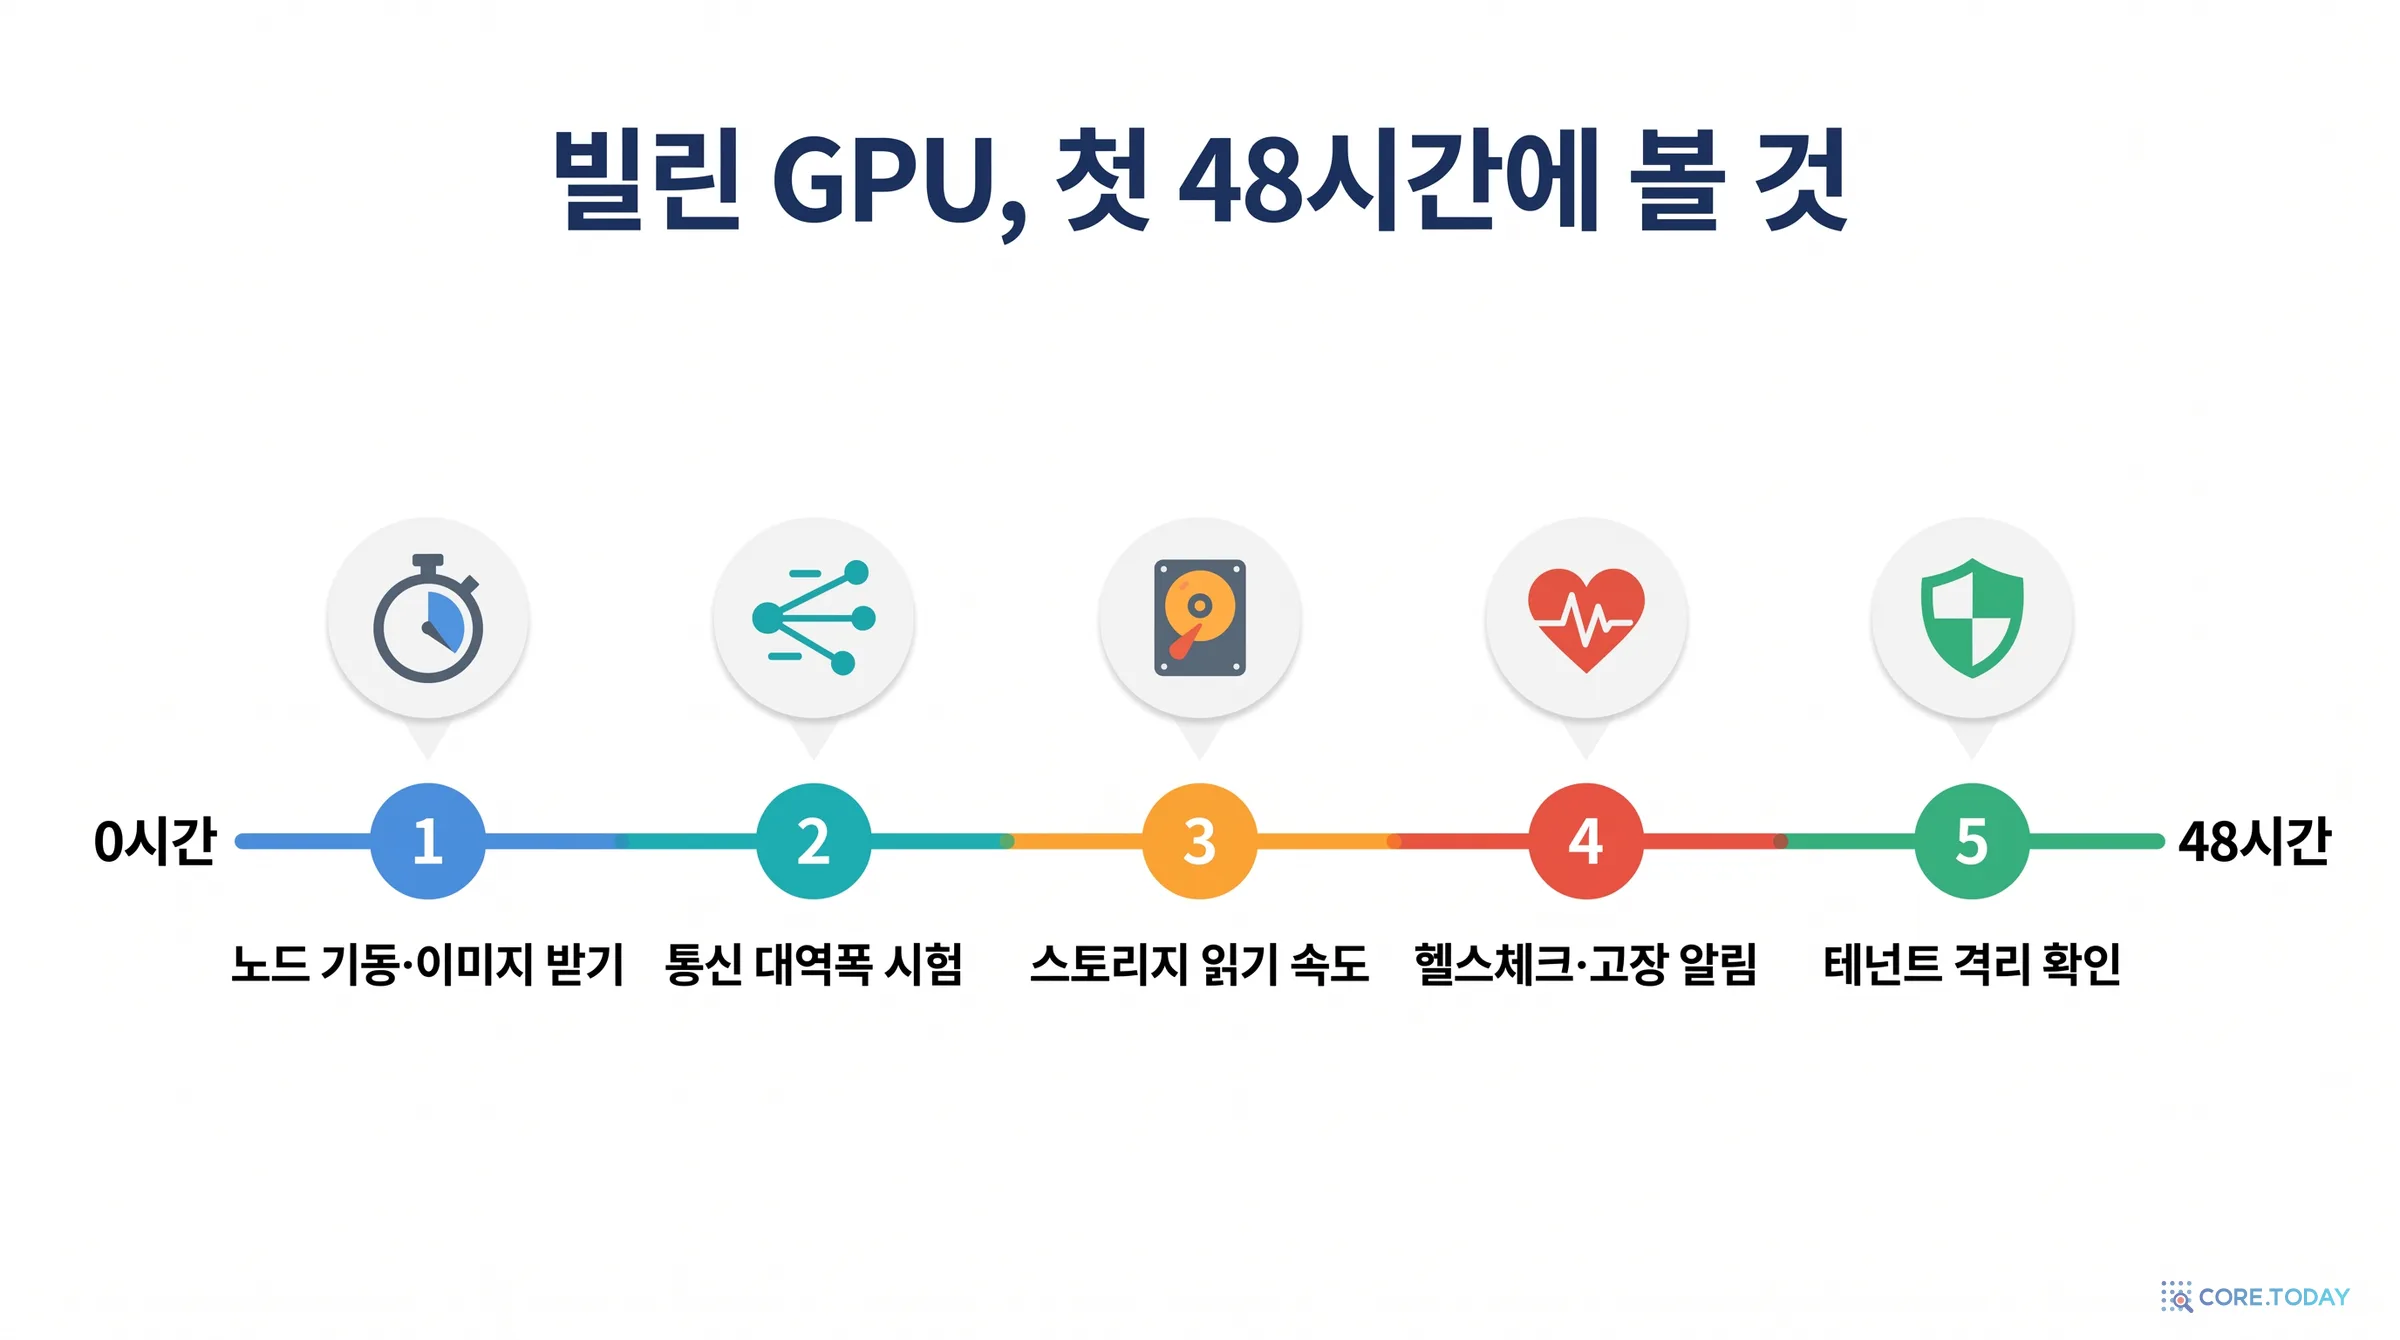
7장. 코어닷투데이 실측 — 우리 A100에서 재 본 '첫 48시간'
남의 업체를 평가하는 기준을 읽었으니 우리 것부터 재 보기로 했습니다. 코어닷투데이는 사내용 GPU 서버 세 대를 쿠버네티스 클러스터로 묶어 씁니다. A100은 MIG(GPU 한 장을 여러 조각으로 나누는 기능)로 나눠 쓰는데, 파드가 조각을 요청하면 사내에서 만든 작은 프로그램(mig-agent)이 그 자리에서 조각을 만들어 주고 파드가 사라지면 45초 뒤에 회수합니다. 원칙은 세 가지였습니다. 우리 인프라만, 읽기 전용으로, 침투 시험은 하지 않는다. 측정용 네임스페이스는 끝나고 지웠습니다.
기동 시간 — ClusterMAX의 라이프사이클 시험 따라 하기
A100 40GB의 3g.20gb 조각 하나를 요청하는 파드를 네 번 띄웠습니다. 파드마다 빈 디스크에서 시작해 vLLM v0.32.0 공식 이미지로 import torch를 세 번, CUDA 초기화, Hugging Face에서 Qwen2.5-0.5B-Instruct(약 1.0GB) 받기, vllm serve를 띄워 /v1/models가 200을 돌려줄 때까지, 첫 요청 응답, 그리고 같은 파드에서 서버를 한 번 더 띄우기를 순서대로 쟀습니다.
단계
코어닷투데이 (4회 중앙값, 범위)
ClusterMAX 3.0이 적은 기준
GPU 조각 배정
10.5초 (0~14초) — 조각이 남아 있으면 0초
—
이미지 받기(첫 회, 9.2GB)
4분 5초 — 두 번째부터 캐시로 0초
—
import torch
1.83초 (1.80~1.85초, 12번)
대부분 1~2초, 나쁜 곳 10~20초
CUDA 초기화(파이썬 시작 포함)
2.4초 (2.2~2.6초)
—
모델 받기(1.0GB, 인터넷)
12.9초 (12.4~14.5초)
—
vllm serve → /v1/models, 새 파드
69.9초 (69.2~70.2초)
잘하는 곳 10~40초, 못하는 곳 2분 넘게
같은 파드에서 다시 띄우기
41.8초 (40.6~44.1초)
첫 응답(16토큰)
81ms
—
세 가지가 눈에 띕니다. 첫째, 가장 긴 단계는 GPU가 아니라 컨테이너 이미지였습니다. 9.2GB짜리 vLLM 이미지를 처음 받는 데 4분 5초가 걸렸고, 같은 노드에서 다시 띄울 때는 0초였습니다. 업체를 바꾸거나 노드를 새로 받거나 고장 뒤 다른 노드로 옮길 때마다 이 비용을 다시 냅니다. 둘째, import torch는 1.8초로 ClusterMAX의 '좋은 업체' 범위 안이었습니다. 셋째, vllm serve는 새 파드에서 70초로 ClusterMAX가 적은 '잘하는 곳'(10~40초)보다 느렸습니다. vLLM 로그를 보면 엔진 초기화 약 30초 가운데 약 15.7초가 torch.compile이었고, 같은 파드에서 컴파일 캐시가 남은 채 다시 띄우면 42초로 줄었습니다. ClusterMAX는 어떤 옵션으로 쟀는지 밝히지 않았으므로 이 차이를 업체 품질처럼 비교할 수는 없습니다. 다만 이 70초가 2장 수식의 '재시작 준비' 시간이라는 점은 분명합니다. 추론 서버 하나가 고장 나 다른 노드에서 새로 뜨려면, 이미지가 그 노드에 없을 경우 4분 넘게, 있어도 1분 넘게 걸립니다.
cmax로 우리 클러스터 점검하기 — 돌린 것과 돌리지 않은 것
SemiAnalysis는 보안 글에서 무료 CLI clustermax(명령 이름 cmax)를 내놓고 cmax audit security를 돌려 보라고 권했습니다. 코어닷투데이는 돌리기 전에 PyPI의 안정판 0.2.1 소스를 먼저 읽었습니다. 대부분은 버전과 설정을 읽는 스크립트였지만, 쿠버네티스 모드는 BMC·IPMI 노출을 확인하려고 각 작업 노드에 호스트 루트를 마운트한 특권 파드를 만듭니다. README도 이 점을 밝히고 있습니다. 우리 클러스터라도 '읽기 전용'이라는 원칙을 넘는다고 보고 이 모드는 돌리지 않았습니다. 안정판 0.2.1에는 보안 글에 나온 NVIDIAscape 재현 이미지(poc.so)가 들어 있지 않았습니다.
대신 일반 권한 GPU 파드 안에서 컨테이너 모드(16)로 돌렸습니다. 결과는 4개 통과, 5개 경고, 9개 건너뜀이었습니다. NVIDIA 드라이버는 현재 최소 버전 기준을 통과했고, runc·Docker·컨테이너 툴킷은 파드 안에서 버전을 볼 수 없어 '모름' 경고가 붙었습니다. 그래서 노드에 sudo 없는 계정으로 들어가 버전만 읽었습니다. 컨테이너 툴킷은 NVIDIAscape가 고쳐진 1.17.8과 현재 최소 기준을 모두 넘었지만, 런타임 구성 요소 가운데 일부는 cmax가 내려받은 현재 최소 표보다 한 단계 낮은 패치 버전이었습니다(구체적인 구성 요소와 버전은 보안상 밝히지 않으며, 이 글을 쓰며 업데이트 대상으로 넘겼습니다). 우리처럼 직접 운영하는 곳도 표를 대 보기 전까지는 몰랐다는 점이 요점입니다. 결론은 소박합니다. 파드 안에서 돌리는 점검은 절반밖에 못 보고, 나머지 절반은 노드 권한이 있어야 보입니다. GPU를 빌리는 고객은 대개 그 권한이 없으니, 업체가 이 표를 대신 보여 줘야 합니다.
고장은 어디서 보이나 — 그리고 실제로 고장 나 있었다
마지막으로 '고장 신호를 어디서 볼 수 있나'를 확인했습니다. 일반 파드 안에서 nvidia-smi는 온도·전력·클럭 제한 사유는 보여 주지만, 그 서버의 A100은 ECC가 꺼져 있어 메모리 오류 계수와 행 재매핑 정보가 모두 N/A였습니다. dmesg는 권한이 없다며 거부했고 DCGM 도구도 없었습니다. 파드 안에서는 GPU 고장의 1차 기록인 Xid를 볼 방법이 없습니다.
노드에서는 달랐습니다. sudo 없는 계정이라도 로그 그룹에 들어 있어 커널 저널을 읽을 수 있었고, 거기서 이것을 발견했습니다.
GPU 서버 커널 저널 (2026-10-24 07:26 KST부터)
NVRM: GPU 0000:xx:00.0: RmInitAdapter failed! (0x62:0xffff:2674) NVRM: GPU 0000:xx:00.0: rm_init_adapter failed, device minor number 1 NVRM: GPU 0000:xx:00.0: RmInitAdapter failed! (0x62:0x40:2674) … 2~5초마다 반복, 10월 30일 02:56까지 175,062건
GPU 서버 한 대에 꽂힌 A100 40GB 두 장 가운데 한 장이 10월 24일 오전 7시 26분부터 엿새째 초기화에 실패하고 있었습니다. 앞뒤로 Xid 경고도 없었습니다. 그런데 감시 쪽 기록은 이렇습니다. 클러스터에는 NVIDIA의 DCGM 익스포터와 Prometheus·Alertmanager가 깔려 있고, 세 노드의 익스포터는 모두 up=1, 즉 '정상'으로 떠 있었습니다. Prometheus 기록을 거꾸로 따라가 보니 그 서버의 GPU 지표는 고장 네 시간 전인 24일 새벽 3시 반 무렵 장치 플러그인과 익스포터가 다시 뜬 뒤부터 아예 0개였습니다. 고장 난 카드뿐 아니라 멀쩡한 카드의 지표까지 비어 있었으니 감시가 고장을 볼 수 없었습니다. GPU 상태를 보는 알림 규칙이 없었습니다. 남은 흔적은 mig-agent 로그의 한 줄 "7g.40gb × 1 을 만들 자리가 없습니다"뿐이었고, 큰 조각을 원하던 작업 하나는 그 자리를 얻지 못했습니다.
이것이 SemiAnalysis가 말한 '헬스체크가 기본으로 켜져 있지 않은' 상태의 실제 모습입니다. 감시 도구는 설치돼 있었고, 화면은 초록색이었고, 고장은 커널 저널에만 쌓였습니다. 하지만 같은 일이 4,096장짜리 학습 한가운데서, 탐지를 고객의 눈에 맡긴 업체에서 일어났다면 2장 계산기의 '탐지 시간' 슬라이더를 몇 시간, 며칠로 밀어야 합니다. (고장 난 카드의 원인과 복구는 이 글의 범위 밖이라 진단하지 않았습니다. 시기상 장치 플러그인이 다시 뜬 시점과 가깝다는 점만 기록해 둡니다.)
8장. 반론과 한계 — 이 숫자를 어디까지 믿을까
SemiAnalysis는 이 시장의 이해 당사자다. ClusterMAX 등급은 업체의 영업에 직접 영향을 줍니다. SemiAnalysis 스스로 "골드 등급 업체가 가격 프리미엄을 받는(또는 같은 가격에 계약을 따내는) 이유"를 보여 주려고 TCO 글을 썼다고 밝혔고, 같은 회사가 GPU 임대 가격 자료와 TCO 모델을 기관 고객에게 팔고 연구소와 네오클라우드를 연결하는 일도 합니다. 반대 방향의 압력도 있습니다. 보안 글에 따르면 한 업체의 마케팅팀은 2.1 보고서의 한 문장을 지우거나 바꿔 달라고 두 번 요청했고, SemiAnalysis는 날짜 하나만 바로잡고 지우지 않았습니다. 등급표는 독립적인 시험이지만, 그 시험을 만든 회사의 사업과 떼어 읽을 수는 없습니다.
시나리오의 입력은 예시다. 세 가상 업체는 여러 회사를 섞은 평균상이고, GPU MTBF 25,000시간과 15,000시간은 인터뷰와 시험에서 나온 '예시 입력'입니다. SemiAnalysis는 글 끝에서 실제 고장 자료를 보내 달라고 고객들에게 요청했습니다. 아직 업계에 공개된 MTBF 통계가 거의 없다는 뜻입니다. 가격도 2025년 8월 시점의 값이라, 6장에서 본 2026년의 가격 급등은 반영되지 않았습니다. 보안 글 역시 시험한 25곳에 대한 한 시점의 평가이고, 발견된 문제는 모두 고쳐졌다고 합니다.
수식이 화면을 다 설명하지는 못한다. 코어닷투데이가 확인한 대로 RL 시나리오의 굿풋은 공개 수식으로 정확히 재현되지 않았고, 사전학습의 실버 값은 핫 스페어 식에서 탐지 시간 항을 뺀 것과 같았습니다. 결론의 방향은 그대로지만, 숫자 하나하나를 계약서의 근거로 쓰기에는 가정이 너무 많습니다.
수식이 빼놓은 것도 있다. 재시작하는 사이에 또 고장이 나는 경우, 체크포인트를 저장하는 비용 자체, 고장은 아니지만 느려진 노드(스트래글러), 계산 결과를 조용히 틀리게 만드는 메모리 오류는 들어 있지 않습니다. SemiAnalysis도 대형 장애의 상당수가 처음에는 GPU 고장이 아니라 통신이 멈추거나 감시 타이머가 끝나는 '증상'으로 나타나고, 그 원인을 찾아 풀어내는 시간까지 굿풋 손실이라고 적었습니다. 고장 허용 학습은 고장 중에 유효 배치 크기를 바꿔 학습 결과에도 영향을 줄 수 있습니다.
'추론은 싸게'에도 조건이 붙는다. 이 결론은 노드 하나(8장)짜리 추론 서버에 대한 것입니다. 전문가를 여러 GPU에 넓게 펼치는 대형 MoE 서빙(Wide EP)이나 프리필과 디코드를 나눈 분리 서빙에서는 한 작업이 묶는 GPU가 훨씬 많아지고, SemiAnalysis도 이 경우 폭발 반경이 "훨씬 커진다"고 적었습니다. 미드필과 HBM에서 본 것처럼 에이전트 추론이 큰 랙 단위 서빙으로 옮겨 갈수록 추론도 학습처럼 신뢰성을 사야 하는 쪽으로 움직입니다.
코어닷투데이 실측은 작다. 우리 클러스터는 사내 전용이고 외부 고객이 없는 단일 테넌트입니다. 기동 시간은 작은 모델 하나로 네 번 잰 것이고, 고장 가시성 점검은 우리 운영 방식에 대한 이야기일 뿐 어떤 업체의 품질과도 비교할 수 없습니다. 다만 '감시가 있어도 고장을 놓칠 수 있다'는 점을 보여 주기에는 충분했습니다.
9장. 한국에서 읽는 법 — SK텔레콤, 네이버, 그리고 Vessl
ClusterMAX 3.0에는 한국 업체 세 곳이 등장합니다. 아래 인용과 평가는 모두 SemiAnalysis가 2026년 9월 23일 보고서에 적은 한 시점의 평가이며, 코어닷투데이는 이 업체들을 직접 시험하지 않았습니다.
SK텔레콤. SemiAnalysis는 "SK텔레콤은 한국의 소버린 파운데이션 모델 사업을 위해 B200 1,000장 넘게를 운영한다"고 적었고, 정부가 그 경쟁의 1차를 위해 SK텔레콤과 네이버에서 H100 환산 약 3,000장을 빌렸다고 덧붙였습니다. SK텔레콤은 SK그룹의 5GW 1단계 구축 안에서 Vera Rubin 시스템과 SK하이닉스 HBM4를 쓰는 2GW 규모 NVIDIA DSX AI 팩토리를 발표했습니다. 시험에 대해서는 이렇게 썼습니다. "우리는 Vessl을 통해 SK텔레콤의 GPU를 시험했고, 탄탄했다(solid). 하지만 SK와 직접 시험한 것은 없다. 국제 시장에서 더 많은 것을 보여 줘야 진지한 사업자로 볼 수 있겠지만, 기술적 기반은 분명히 있다."
네이버. "네이버도 SK텔레콤처럼 신뢰도가 높다. 이미 하이퍼스케일러급 데이터센터를 운영한다." 7월에 NVIDIA·Brookfield와 함께 발표한 계획에 따라 세종의 GAK AI 팩토리를 처음 55MW에서 2028년까지 200MW로 넓힙니다. SemiAnalysis는 그 운영 경험이 내부 연구팀이 아니라 외부 고객에게 얼마나 닿을지가 궁금하다고 했고, 아직 시험하지 못했다고 밝혔습니다.
두 회사는 등급표에서 '추천 안 함 — 이용 불가' 묶음에 들어 있는데, 이 묶음에는 "크고 중요하지만 지리적·규제상 이유로 제대로 시험할 수 없는 곳"(알리바바 클라우드, 바이트플러스 등과 함께)이 포함됩니다. 품질에 대한 판정이 아니라 시험하지 못했다는 표시로 읽어야 합니다.
Vessl. SemiAnalysis가 실제로 클러스터를 받아 시험한 유일한 한국 업체입니다. 4월 보고서에서는 "한국의 마켓플레이스"로 소개됐고, 3.0에서는 '참가 리본' 등급을 받았습니다. SemiAnalysis의 서술을 그대로 옮기면 이렇습니다. Vessl은 스스로를 중개인이 아닌 "멀티 클라우드 오케스트레이터"로 보고, 베어메탈을 장기로 사서 그 위에 SLA가 붙은 관리 계층을 제공합니다. 현재 GPU 5,000장을 운영한다고 밝혔고 2027년 말까지 100MW를 목표로 합니다. SemiAnalysis는 "그 야망이 마음에 든다. 하지만 우리가 쿠버네티스와 Slinky(쿠버네티스 위의 Slurm) 형태로 받아 본 Vessl 클러스터는 미숙해서 할 일이 많다"고 썼습니다. 구체적으로 든 것은 다음과 같습니다.
쿠버네티스 LimitRange 기본값 때문에 컨테이너가 호스트 메모리를 2GB 넘게 쓰면 강제 종료됐다.
Slurm 로그인 노드의 루트 파일시스템이 임시라, 파드가 재시작될 때 만든 사용자 계정이 시험 도중 사라졌다.
작업이 남긴 파일 때문에 노드가 재시작되면서 Slurm 제어 데몬까지 함께 내려가 Slurm 계층에 간헐적으로 접근할 수 없었다. Vessl은 빠르게 급한 불을 껐지만 근본 원인(제어부와 작업 노드를 같은 곳에 배치)은 SA가 아는 한 남아 있다. SA는 이 대목에서 "Vessl이 Slinky를 운영 환경에서 큰 규모로 돌려 본 경험이 없는 것은 분명하다"고 썼다.
설정한 NetworkPolicy가 "받아들여졌지만 집행되지 않았다".
헬스체크 프로그램이 설정돼 있지 않았다.
같은 대목에는 긍정적인 평가도 함께 있습니다. "Vessl이 제공한 하드웨어 자체는 시험 내내 잘 동작했고, InfiniBand 위의 NCCL 시험도 마찬가지였다." 그리고 SemiAnalysis는 "곧 켜질 대규모 함대를 광고하는 만큼 Vessl에게는 서비스를 단단하게 다듬어 더 좋은 가격을 받을 동기가 충분하다"며 "다음 시험에서 Vessl의 진전을 지켜보겠다"고 맺었습니다. 이 평가는 2026년 4~7월 시험에 근거한 것이고, 그 뒤의 변화는 이 글에 반영되지 않았습니다.
한국 구매자에게 주는 의미
한국 팀이 GPU를 빌리는 장면은 대개 세 가지입니다. 정부 GPU 지원 사업으로 배정받은 클라우드 GPU에서 모델을 미세조정하거나 평가하는 경우, 국내외 네오클라우드에서 몇 노드를 빌려 추론 서비스를 돌리는 경우, 그리고 소수지만 수백~수천 장으로 파운데이션 모델을 학습하는 경우입니다.
첫째와 둘째, 즉 8~64장 규모의 미세조정·평가·추론이라면 SemiAnalysis의 계산은 '싸게 사도 된다'를 가리킵니다. 다만 '싸게'의 기준을 시간당 가격만이 아니라 스토리지, 데이터 반출, 엔지니어가 환경을 맞추는 데 쓰는 시간까지 넣어 잡아야 합니다. RL 시나리오에서 실버와 골드의 차이 96%가 스토리지였다는 점을 기억할 만합니다.
셋째, 수백 장 이상을 한 작업에 묶는 학습이라면 시간당 가격보다 '고장 하나를 몇 분 안에 누가 알아채고, 몇 시간 안에 무엇으로 바꿔 주는가'를 먼저 계약서에 적어야 합니다. 국가 사업처럼 일정이 정해진 경쟁에서는 고장으로 날아간 GPU 시간이 곧 잃어버린 평가 기회입니다. 정부가 GPU를 빌려 나눠 주는 구조라면, 빌리는 쪽(정부)과 쓰는 쪽(참여 팀)이 다르기 때문에 고장 탐지·교체 기준과 그 기록이 쓰는 쪽에 투명하게 전달되는지가 특히 중요합니다.
모든 경우에 보안 질문은 따로 해야 합니다. 개인정보나 영업 비밀이 들어 있는 데이터, 공개하지 않을 모델 가중치를 올린다면 5장의 점검표에서 가중치 3짜리 질문 여섯 개는 계약 전에 답을 받아 두는 편이 좋습니다.
10장. 실무 체크리스트 — 견적서 다음에 물을 것
SLA에 숫자로 적을 것
탐지 시간. 고장을 몇 분 안에 감지하는가. ClusterMAX 3.0의 기대치는 2분 안팎입니다. 누가 감지하는가(업체의 자동 헬스체크인가, 고객의 티켓인가).
교체 시간. 탐지부터 정상 노드가 작업에 다시 들어오기까지 처음부터 끝까지 몇 시간인가. 기대치는 1시간 안입니다. 수리(콜드)인가, 예비 노드(핫)인가.
예비 노드와 용량 보장. 클러스터의 몇 %를 핫 스페어로 두는가(경험 많은 업체는 2~6%). 내가 고장을 보고했을 때 바꿔 줄 노드가 실제로 있다는 보장이 있는가.
가동률 SLA의 뜻. 95% 가동률 약정은 5%의 정지를 아무 대응·보상 없이 허용한다는 뜻이기도 합니다. 보상은 어떻게 계산하는가.
NVL72 같은 랙 단위 시스템이라면 노드 몇 개가 빠졌을 때 랙 전체를 장애로 치는가('NVL64+' 같은 조건).
헬스체크가 기본으로 켜져 있는가. DCGM 진단을 어느 수준으로 언제 돌리는가, 어떤 Xid를 자동 조치하는가, 고객이 그 결과를 볼 수 있는가.
감시 대시보드와 로그. 고객이 GPU 온도·전력·오류와 노드 커널 로그(Xid)를 볼 수 있는가.
기동 시간. 노드나 파드를 받아 이미지 받기, 저장소별 import torch, 작은 모델의 vllm serve가 /v1/models에 답할 때까지를 잽니다(ClusterMAX 기준: 1~2초, 10~40초). 7장의 숫자가 비교 기준이 될 수 있습니다.
통신. 여러 노드라면 nccl-tests의 all-reduce 대역폭과 InfiniBand ib_write_bw를 재서 업체가 말한 값과 비교합니다. 기대 성능이 바로 나오지 않으면 그 차이가 SA가 말한 '셋업 비용'입니다.
스토리지. 학습 데이터와 체크포인트를 둘 곳에서 fio 순차·임의 읽기와 torch.save 속도를 잽니다. 재시작 준비 시간(t_init)이 여기서 정해집니다.
고장 대응. 업체에 고장 훈련을 요청하거나, 최소한 고장이 나면 어떤 경로로 누구에게 알림이 가는지 실제로 확인합니다. 내 노드에서 커널 로그의 Xid를 읽을 수 있는지도 봅니다. 7장의 경험처럼 '알림이 있다'와 '알림이 온다'는 다릅니다.
격리. 내 네임스페이스 두 개 사이에 기본 거부 NetworkPolicy를 걸고 실제로 막히는지 요청을 보내 봅니다. InfiniBand라면 내 노드에서 ibstat·ibv_devinfo로 보이는 내 파티션 키를 확인하고, 업체에 기본 파티션 키를 지웠는지 묻습니다. ClusterMAX의 cmax audit security를 내 노드에서 돌려 버전 점검 결과를 받아 볼 수도 있습니다.
마지막 항목에는 분명한 선이 있습니다. 점검은 내가 빌린 자원 안에서, 계약이 허용하는 범위에서만 합니다. 다른 고객의 자원을 찾아보거나 취약점을 시험하는 일은 허락 없이 해서는 안 되고, 의심되는 문제를 발견하면 업체에 알리는 것으로 끝내야 합니다. cmax의 쿠버네티스 모드는 각 노드에 호스트 루트를 마운트한 특권 파드를 만드니, 업체와 합의하지 않았다면 컨테이너 모드나 단독 서버 모드만 쓰는 편이 안전합니다.
값을 비교하는 한 줄 공식
견적을 받으면 시간당 가격 대신 이 값을 비교합니다.
실효단가=P×(1+굿풋손실)+쓸 GPU-시간스토리지+지원+셋업+디버깅
추론이면 굿풋 손실 항은 거의 0이고 나머지 항만 남습니다. 큰 학습이면 굿풋 손실 항이 다른 모든 차이를 압도할 수 있습니다. 첫 번째 계산기에 자기 숫자를 넣어 보는 것이 가장 빠른 방법입니다.
맺음말 — 가격표 밑에 적힌 것
GPU 시간당 가격이 거짓말을 한다는 말은 반쯤만 맞습니다. 가격표는 거짓말을 하지 않습니다. 다만 같은 일을 끝내는 데 드는 돈을 말해 주지 않을 뿐입니다. 그 차이는 고장이 날 때 작업에 묶인 GPU 수만큼 곱해지고, 알아채는 데 걸린 분만큼 쌓이며, 보안 사고가 나면 가격표 어디에도 없던 값으로 돌아옵니다.
SemiAnalysis의 계산이 알려 주는 원칙은 단순합니다. 고장 난 서버를 빼면 그만인 일은 싸게 사고, 고장 하나에 전체가 멈추는 일은 신뢰성을 산다. 그리고 어느 쪽이든 벽이 얇은 곳에는 중요한 것을 두지 않는다.
이 글을 쓰다가 코어닷투데이가 배운 것도 같습니다. 우리는 GPU 서버에 감시 시스템을 붙여 두고 '헬스체크가 있다'고 생각했지만, GPU 한 장이 엿새째 꺼져 있는 동안 아무도 알지 못했습니다. 남의 업체에 '고장 하나를 몇 분 안에 알아채느냐'고 물으려면, 먼저 우리부터 그 질문에 답할 수 있어야 했습니다.
참고문헌
SemiAnalysis 뉴스레터 (newsletter.semianalysis.com, 각 글의 무료 공개 구간)