로봇피지컬 AIVLA온디바이스엣지 추론Jetson ThorB300총소유비용지터와이파이꼬리 지연SemiAnalysisBoston Dynamics로봇 파운데이션 모델
[특집] 로봇의 뇌는 어디에 두나 — 7대의 교차점, 그리고 와이파이 지터
SemiAnalysis는 로봇 96대를 놓고 '로봇마다 Jetson Thor를 다는 길'과 'B300 한 장을 여러 대가 나눠 쓰는 길'을 비교해, GPU 한 장에 5~7대가 넘으면 비용·실리콘·DRAM 모두 공유 쪽이 이긴다고 계산했습니다. 그러나 가동률 반영 전 시간당 비용은 오히려 온보드가 쌌고($14.97 대 $18.63), 판을 뒤집은 것은 '서버 90%·로봇 칩 40%'라는 가동률 가정이었습니다. 코어닷투데이가 같은 표를 '일한 로봇 한 시간'으로 다시 재면 46%가 아니라 55%였습니다. 사무실에서 20ms 간격으로 잰 왕복 시간은 유선이 p99 1ms 안팎으로 늘 같았지만, 와이파이는 첫 2분에 p99.9 1.25초를 찍었다가 30분 뒤에는 93ms, 이어진 10분 동안은 27ms로 조용했습니다. 로봇의 뇌를 어디에 둘지는 평균 지연이 아니라 언제 올지 모르는 이 꼬리가 정합니다.
코어닷투데이2026-10-3082분
?
질문
로봇이 쓸 큰 모델은 로봇 몸 안에 넣어야 하나, 데이터센터 GPU에 두고 무선으로 불러 써야 하나.
→
방법
SemiAnalysis 「A Brain Too Big to Carry」(2026-09-14)의 공개 구간 본문과 표를 숫자 하나하나 다시 계산하고, 사무실 유선·와이파이의 왕복 시간 분포와 사내 A100 한 장의 배치 크기별 지연을 직접 쟀습니다.
✓
결론
돈으로 따지면 GPU 한 장에 5~7대가 넘는 순간 공유가 이깁니다. 그러나 그 셈은 서버가 늘 바쁘다는 가정 위에 서 있고, 실제 배치를 가르는 것은 평균이 아니라 꼬리 지연입니다. 와이파이의 p99.9는 첫 측정에서 중앙값의 수백 배였고, 회차마다 크게 달랐습니다.
미국의 가정용 로봇 회사 Sunday Robotics는 빨래를 개는 로봇을 만듭니다. 몸통이 오르내리는 바퀴 달린 로봇 Memo가 처음 보는 집에서 아홉 종류의 옷을 개는 성공률이 99.1%라고 합니다. 이 회사는 처음에 추론을 클라우드에서 하기로 했습니다. 연구실에서는 당연한 선택이었습니다. 연산이 넉넉하고, 디버깅이 쉽고, 연구자들이 쓰던 환경 그대로였으니까요.
반도체·AI 인프라 분석 회사 SemiAnalysis가 2026년 9월 14일에 낸 글에 따르면, Sunday는 새 모델 ACT-2를 실제 가정에서 시험한 지 이틀 만에 방향을 뒤집었습니다. 가정용 와이파이는 음영 지역과 이웃집 간섭, 잘못 설정된 메시 공유기, 위아래가 비대칭인 회선이 뒤엉킨 곳이었습니다. 글은 이 경험을 두 문장으로 요약합니다.
"Latency was mostly fine. Jitter was the problem."
(지연은 대체로 괜찮았다. 지터가 문제였다.)
몇 시간 동안 99%를 지켜야 하는 로봇은 영상 통화처럼 가끔의 끊김을 넘기지 못합니다. 위성 인터넷은 위성이 몇 분마다 하늘을 가로지를 때 나무나 지붕에 걸려 끊겼고, 5G 공유기도 똑같이 끊겼습니다. Sunday는 추론을 로봇 안의 GPU로 옮겼습니다.
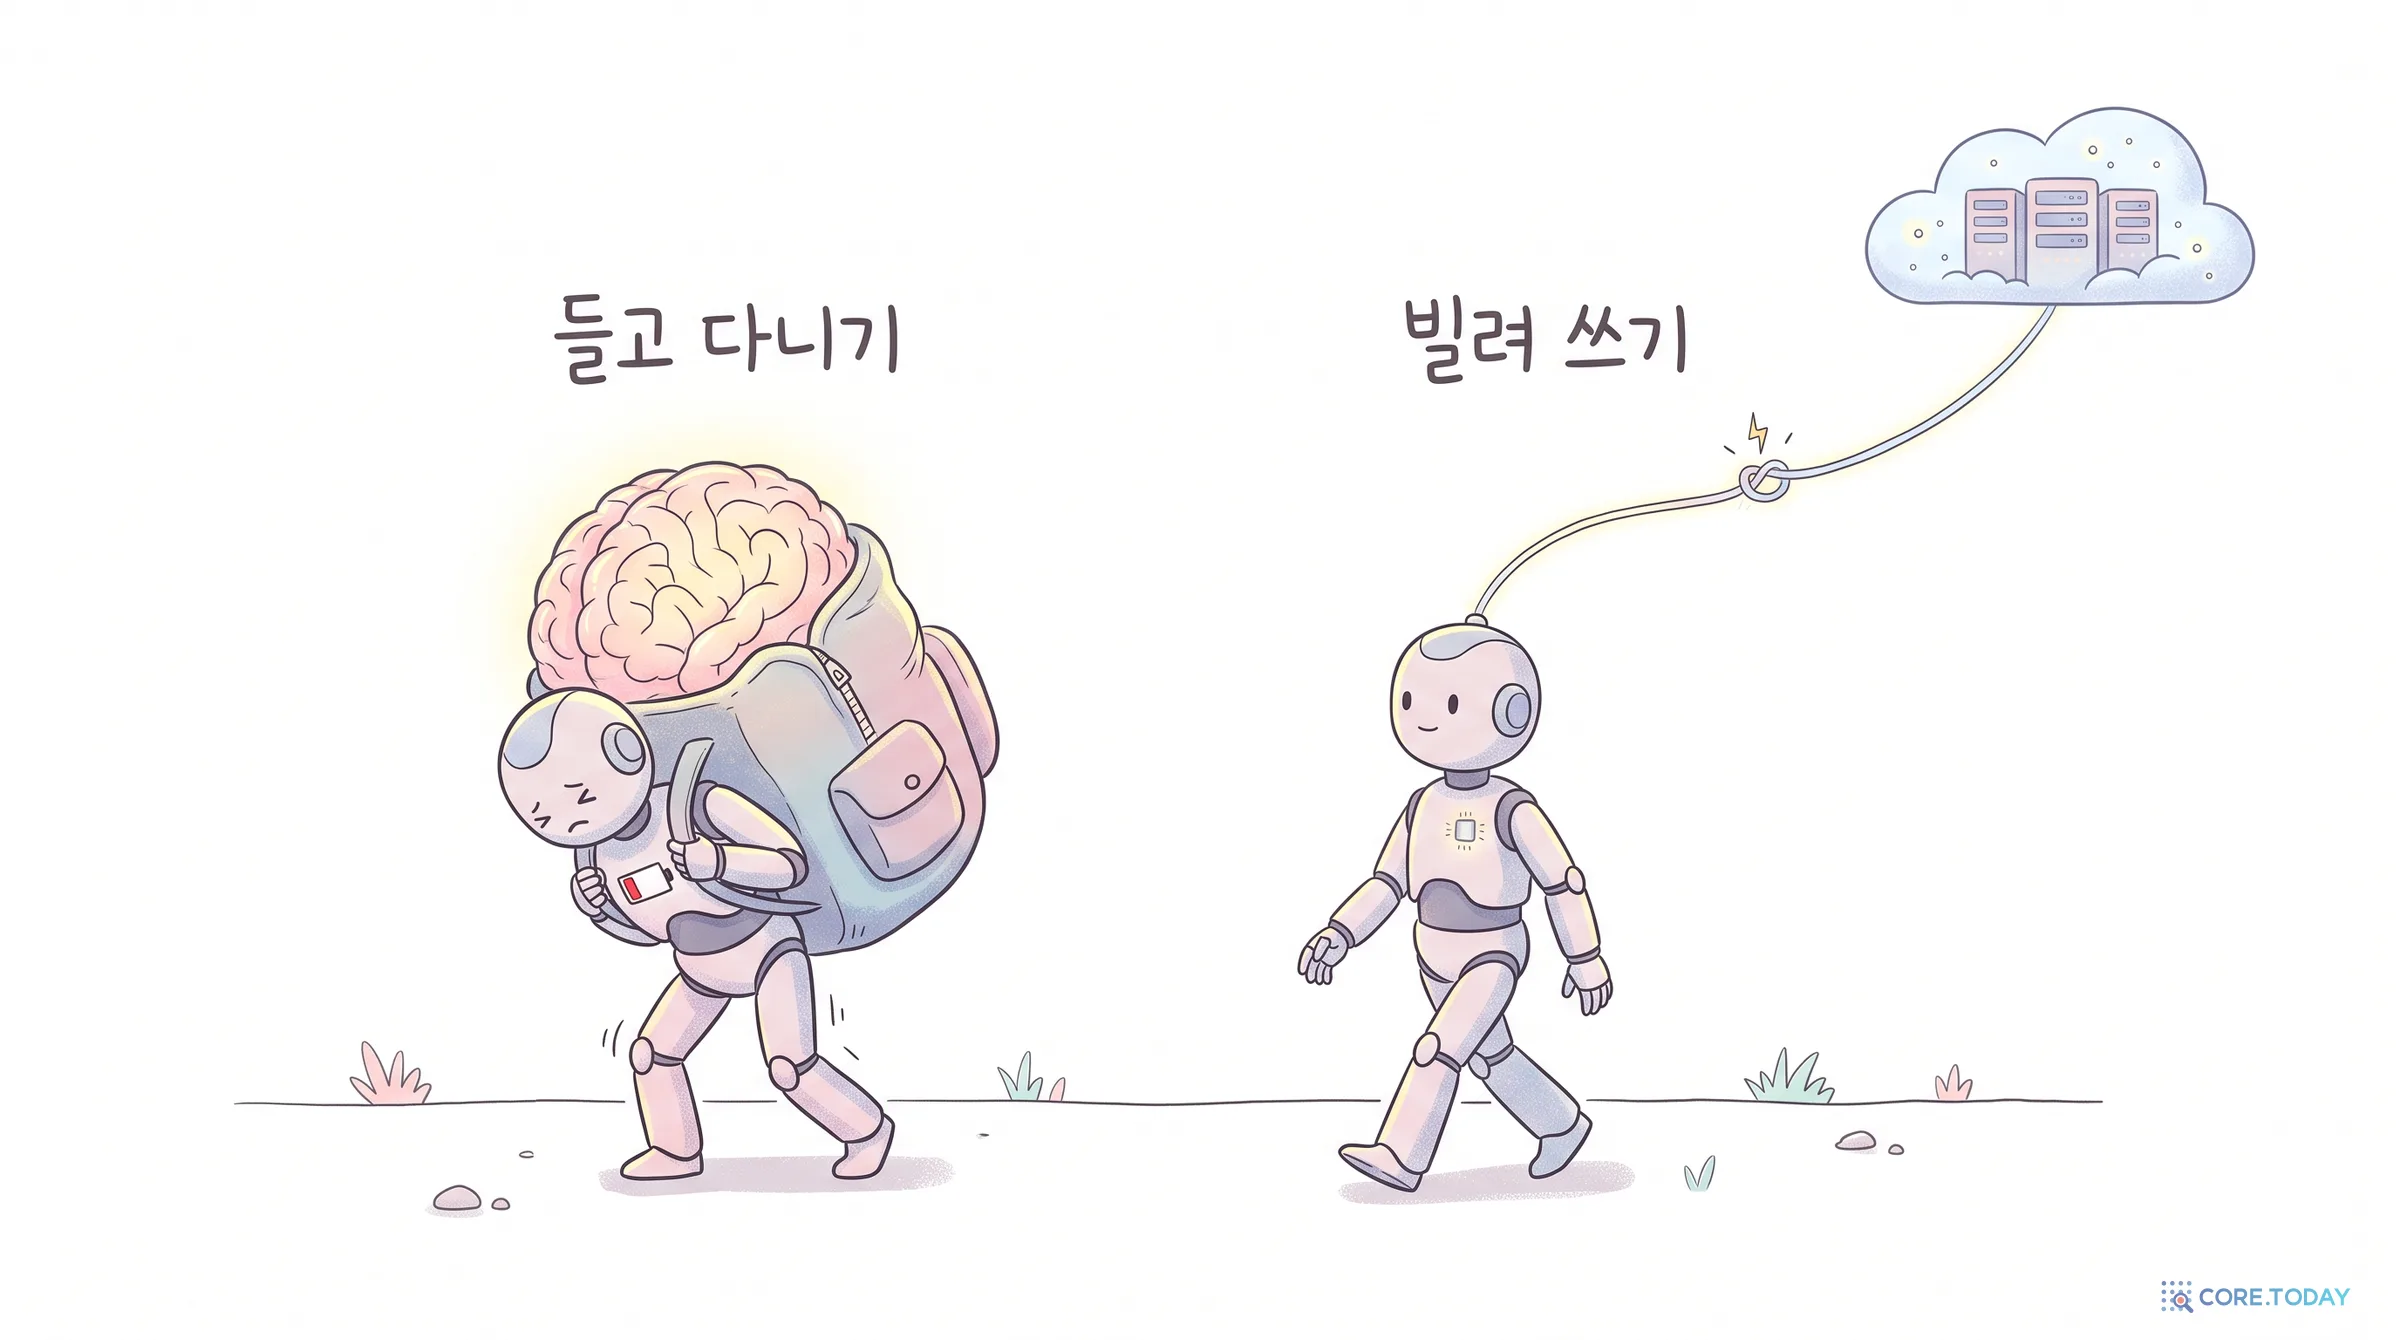
이 일화가 이번 글의 출발점입니다. 로봇의 '뇌', 즉 카메라 영상을 보고 다음 동작을 정하는 큰 신경망을 로봇 몸 안에 들고 다닐 것인가, 데이터센터에 두고 무선으로 빌려 쓸 것인가. SemiAnalysis의 글 「A Brain Too Big to Carry(들고 다니기엔 너무 큰 뇌)」는 이 질문에 반도체 공급망, 메모리, 총소유비용(TCO), 실제 배치 사례, 네트워크라는 다섯 개의 자를 댑니다. 결론은 둘로 갈립니다. 장부 위에서는 데이터센터가 이기고, 현장에서는 아직 로봇 안이 이깁니다. 그 사이를 가르는 것이 바로 지터, 평균이 아니라 '가끔'의 문제입니다.
이 글에서는 SemiAnalysis의 본문과 표를 숫자 하나하나 다시 계산했고(본문과 표가 어긋난 곳 두 군데와, '공유 GPU가 46%'라는 결론이 기대는 가정을 4장에서 풉니다), 사무실 유선·와이파이의 왕복 시간을 20ms 간격으로 6,000번씩 재어 데드라인이 얼마나 자주 깨지는지 계산했으며(6장), 사내 A100 한 장에서 30억 파라미터급 공개 시각-언어 모델을 배치 크기 1~32로 돌려 배치와 지연의 맞바꿈을 쟀습니다(7장).
코어닷투데이는 2026년 3월에 「Edge AI vs Cloud AI」 1부와 2부에서 엣지와 클라우드의 일반론을, 6월에 애플의 온디바이스 AI를 다뤘습니다. 그 글들이 "어디서 추론하나"를 휴대폰과 자동차까지 넓게 훑었다면, 이 글은 로봇 하나, 그리고 그 로봇과 GPU 사이의 무선 구간 하나에 초점을 좁힙니다.
1장. 로봇은 왜 LLM과 거꾸로 가나 — 시간과 돈
대형 언어 모델(LLM)의 세계에서는 하드웨어가 모델에 맞춥니다. 학습에 데이터와 연산을 최대한 붓고, 나온 모델을 어떻게 서빙할지는 그다음에 고민합니다. SemiAnalysis는 로봇에서는 이 순서가 뒤집힌다고 씁니다. 이유는 두 가지 제약입니다.
첫째는 시간입니다. 로봇은 실시간 제어 루프를 돌리고, 마감(데드라인)을 놓칠 수 없습니다. 챗봇은 답이 조금 늦어도 답의 내용이 바뀌지 않지만, 로봇이 늦으면 그사이 세상이 바뀌어 동작이 낡아 버립니다. 컵을 잡으려고 계산한 손의 궤적은, 컵이 이미 밀려난 뒤에는 쓸모가 없습니다.
둘째는 돈입니다. LLM은 사용자가 가져온 화면 뒤에 삽니다. 로봇은 제조사가 연산 장치와 몸체를 모두 만들어 대당 선불로 값을 치러야 합니다. 대수가 늘면 그 선불이 수십억 달러, 언젠가 로봇이 10억 대가 된다면 수조 달러가 됩니다.
그래서 로봇에서는 로봇에 달린 하드웨어가 먼저 정해지고, 모델은 그 하드웨어에 들어가도록 설계됩니다. SemiAnalysis의 표현으로는 "지능이 지연 시간과 대당 경제성에 맞춰 배급되는" 구조입니다.
로봇 모델은 아직 작다
이 때문에 최전선 로봇 모델은 수조 파라미터로 간 최전선 LLM보다 훨씬 작습니다. SemiAnalysis가 정리한 크기는 이렇습니다.
모델
만든 곳
크기
어디서 도나 (SA 서술)
π0 계열
Physical Intelligence
약 30억
—
π0.7
Physical Intelligence
50억
로봇 밖 H100
GR-3
ByteDance
40억
—
Generalist 모델
Generalist
약 100억
—
DreamZero
NVIDIA
140억
로봇 밖 GB200 두 장(실시간)
RoboTTT
NVIDIA
30억 정책
로봇 안에 들어갈 만큼 작다
Boston Dynamics System 2
(Gemini Robotics ER을 '그림'으로 제시)
비공개, SA 추정 수천억~1조
로봇 밖 TPU
SemiAnalysis는 이 숫자를 해석할 때 조심하라고 덧붙입니다. LLM 연구소는 학습 예산과 추론 비용을 놓고 품질을 최적화해 크기를 정하지만, 로봇 연구소는 "데이터가 감당할 수 있는 크기, 그리고 Jetson이나 H100에 지연 예산 안에 들어가는 크기" 로 정합니다. 그러니 지금의 크기는 크기가 수렴할 곳이 아니라 제약이 어디 걸려 있는지를 알려 줄 뿐입니다.
추세는 두 방향으로 동시에 당겨집니다. 140억 파라미터의 DreamZero는 영상 확산 모델을 뼈대로 '미래 영상'을 만들어 가며 행동을 고르는 '세계 행동 모델'인데, 실시간으로 돌리려면 로봇 밖에 GB200 두 장이 필요합니다. 몇 달 뒤 NVIDIA가 낸 RoboTTT는 반대쪽에 걸었습니다. 30억 파라미터 정책이 미래 영상을 만드는 대신 추론 중에 자기 가중치를 조금씩 고쳐 쓰는(테스트 시점 학습, test-time training) 방식으로 몇 분짜리 맥락을 기억하고, 로봇 안에 들어갈 만큼 작습니다.
SemiAnalysis의 입장은 "결국 계단식(cascade) 구성이 될 것"입니다. 어떤 로봇은 인지를 통째로 로봇 안에서, 어떤 로봇은 일부를 데이터센터 GPU로 넘깁니다. 그리고 진짜 지능이 필요한 범용 로봇이라면 로봇 밖 연산이 유리한 점이 많다고 봅니다. 로봇의 연산·전력 예산에서 벗어나고, 여러 로봇의 추론을 한데 모을 수 있기 때문입니다.
아래 위젯에서 모델과 칩을 바꿔 보세요. '메모리에 들어간다'와 '제때 계산한다'가 얼마나 다른 이야기인지 보입니다.
위젯의 핵심 계산은 단순합니다. 모델이 한 번 순전파(입력을 넣어 출력을 얻는 계산 한 번)를 하려면 적어도 가중치 전체를 메모리에서 한 번 읽어야 하므로, 가중치 바이트 ÷ 메모리 대역폭이 한 번 계산의 하한입니다. DreamZero를 BF16(파라미터당 2바이트)으로 두면 가중치가 28GB입니다. Jetson Thor의 메모리는 128GB라 넉넉히 들어가지만, 대역폭이 273GB/s라 한 번 읽는 데만 약 103ms가 걸립니다(코어닷투데이 계산). 같은 가중치를 B300(8TB/s)에서 읽으면 3.5ms입니다. 영상 확산형 모델은 한 번의 결정에 순전파를 여러 번 하므로, 로봇 칩에서는 '들어가는데 못 쓰는' 상황이 생깁니다.
2장. 로봇 두뇌의 세 층 — 무엇을 밖으로 뺄 수 있나
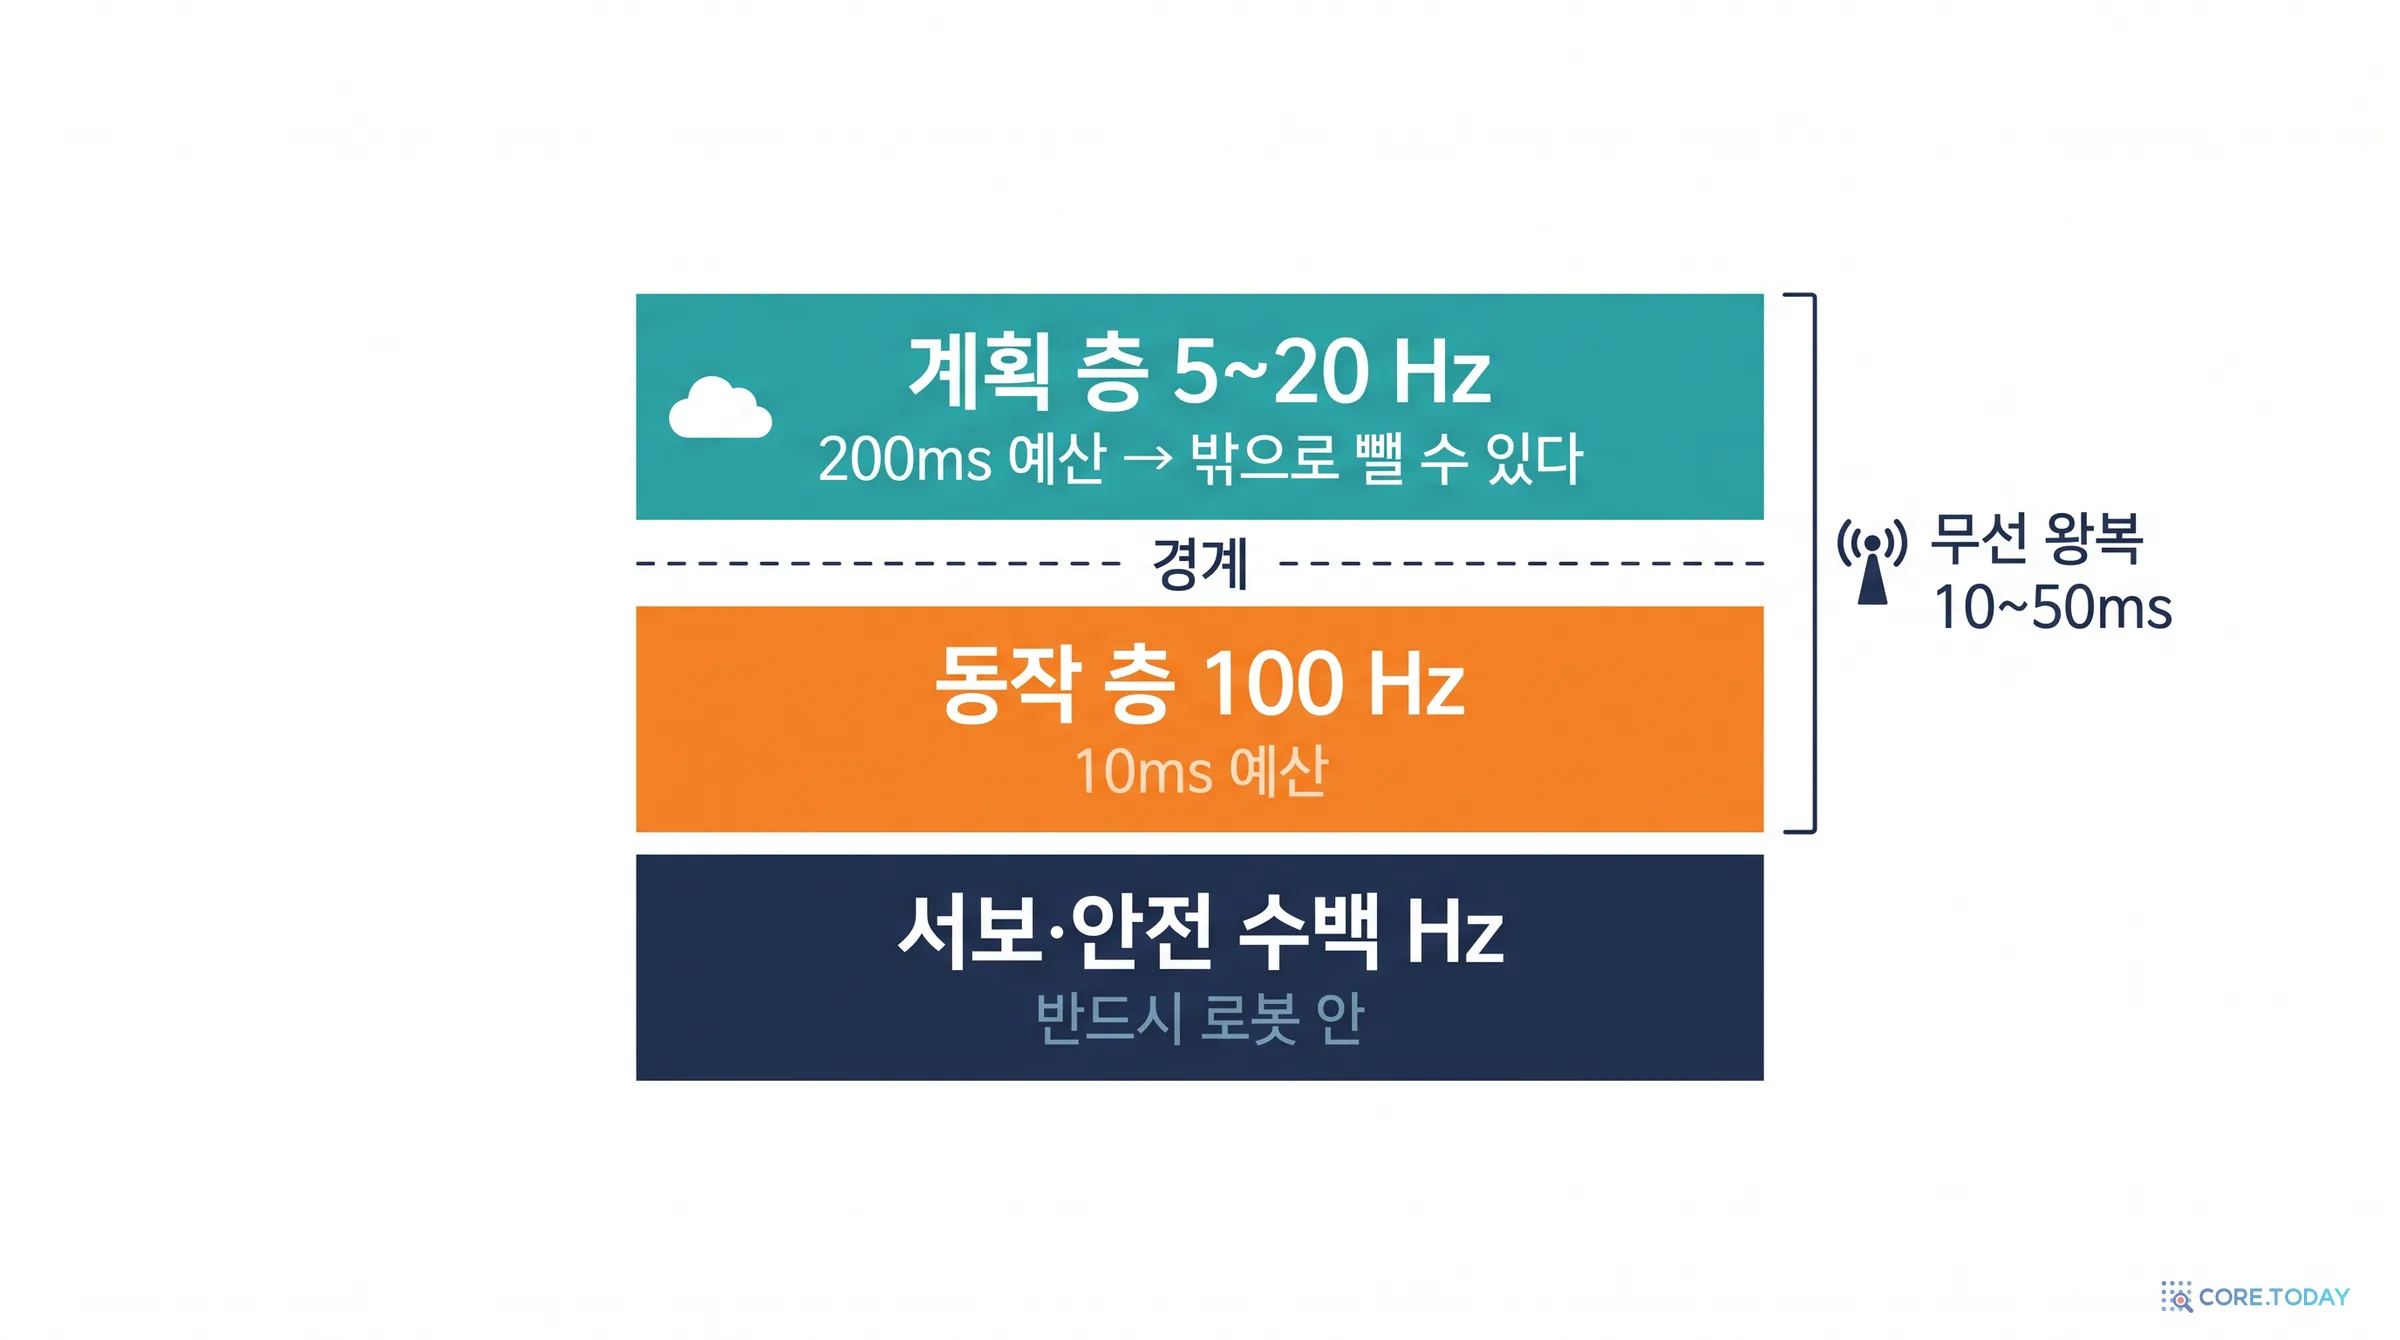
SemiAnalysis는 범용 로봇의 모델을 세 층으로 나눕니다.
계획 층지시와 장면을 해석해 다음에 무엇을 할지 정한다. 하위 작업, 목적지, 잡을 자세, 발 디딤 계획을 내놓는다. 가장 무겁고, 일반성이 커질수록 더 무거워진다.
동작 층계획 층의 출력을 짧은 동작 묶음(액션 청크), 자세, 속도로 바꾼다. 비전-언어-행동 모델(VLA)이 주로 여기 있다.
서보·안전 층로봇의 상태를 추정하고, 접촉과 미끄러짐에 반응하고, 균형을 잡고, 마지막으로 모터에 명령을 보낸다.
동작 층과 서보 층은 수백 Hz로 돕니다. 100Hz 루프는 10ms마다 다음 출력을 내야 합니다. SemiAnalysis에 따르면 일반적인 무선 왕복은 그것만으로 10~50ms, 잘 설계된 링크가 10ms 아래입니다. 그러니 이 층에서 네트워크는 지연을 '더하는' 정도가 아니라, 모델이 아무것도 계산하기 전에 예산을 거의 다 먹어 버립니다. 글은 "대략 100Hz가 넘는 것은 결코 로봇을 떠날 수 없다"고 못박습니다.
계획 층은 다릅니다. 대략 20Hz 아래, 예컨대 5Hz로 도는 계획기는 결정 하나에 200ms를 씁니다. 10~50ms 왕복이 들어가고도 남습니다. 잘 다듬은 네트워크 스택이라면 이 경계를 20Hz 위로 밀어 올릴 수도 있다고 SemiAnalysis는 봅니다.
지연이 아니라 지터
여기서 SemiAnalysis는 이 글 전체의 열쇠가 되는 구분을 꺼냅니다.
"고정된 지연은 계획으로 흡수할 수 있다. 시스템은 그 시간 동안 로봇과 주변이 얼마나 움직일지 대략 알고 조금 앞서 계획하면 된다. 지터는 더 어렵다. 명령이 불규칙한 간격으로 도착해서 로봇이 다음 업데이트가 정확히 언제 올지 모르기 때문이다."
해결책이 없지는 않습니다. 최악의 경우만큼 버퍼를 두면 들쭉날쭉한 지연을 예측 가능한 지연으로 바꿀 수 있습니다. 대신 모든 동작이 매번 최악의 대가를 치릅니다. p99.9가 1초인 링크라면, 1초짜리 버퍼를 두고 모든 동작을 1초 늦게 하는 셈입니다. 그래서 SemiAnalysis는 "지터를 잡는 것이 계획 층을 밖으로 빼는 일의 실제 열쇠"라고 씁니다.
지연(latency)과 지터(jitter)
지연: 요청을 보내고 답이 돌아오기까지 걸린 시간. 평균이나 중앙값(p50)으로 흔히 말한다. 지터: 그 시간이 얼마나 들쭉날쭉한가. 이 글에서는 연속한 두 측정값 차이의 절댓값, 그리고 분포의 꼬리(p99·p99.9·최댓값)로 본다. p99: 100번 중 99번은 이보다 빠르다. p99.9: 1,000번 중 999번은 이보다 빠르다. 50Hz 루프는 1초에 50번 돈다. 한 시간이면 18만 번이므로, p99.9를 넘는 사건이 한 시간에 180번 일어난다.
마지막 줄이 로봇 네트워크를 웹 서비스와 다르게 만드는 지점입니다. 웹 페이지는 1,000번에 한 번 1초 늦어도 사용자가 새로고침을 누르고 맙니다. 50Hz로 도는 로봇에게 1,000번에 한 번은 20초에 한 번입니다.
Boston Dynamics는 어떻게 나눴나
이 층 구분을 실제로 쓰는 회사가 2021년 6월부터 현대자동차그룹이 지분 80%를 가진(현대자동차그룹 보도자료, 2021-06-21) Boston Dynamics입니다. SemiAnalysis는 Boston Dynamics를 "높은 수준의 추론을 일부러 무선 링크 너머에 두는 몇 안 되는 회사"로 소개합니다.
이 회사의 구분은 System 1과 System 2입니다. System 1은 로봇을 실제로 움직이는 VLA로, Atlas에서는 로봇 안의 NVIDIA Jetson Thor에서 돕니다. System 2는 계획기로, 제조 실행 시스템(MES)에서 "작업 345번을 실행하고 결과를 5번 재고함에 넣어라" 같은 작업 지시를 받아 System 1이 알아들을 만큼 작은 단계로 쪼갭니다. System 2는 회사의 운영 소프트웨어 Orbit을 거쳐 로봇 밖에서, 지금은 DeepMind와의 협력으로 Google TPU 위에서 돕니다.
글이 소개하는 장면 하나가 인상적입니다. '5번 재고함'은 VLA에게 아무 뜻이 없습니다. 그래서 System 2는 로봇의 카메라 화면 속 올바른 통에 초록 점을 찍어 줍니다. 그러면 System 1은 "캔을 집어 초록 점이 있는 통에 넣어라"라는 짧은 지시와 화면만 보고 움직입니다. 지저분한 현실을 System 1이 이해하는 말로 번역하는 것이 System 2의 핵심 일입니다. System 2는 감독도 합니다. 작업이 진행되는 것을 지켜보다 System 1이 엇나가면 잡아냅니다. 그래서 System 2는 생각보다 자주 불립니다. 몇 초에서 10초에 한 번, 어떤 경우엔 1초에 한두 번입니다.
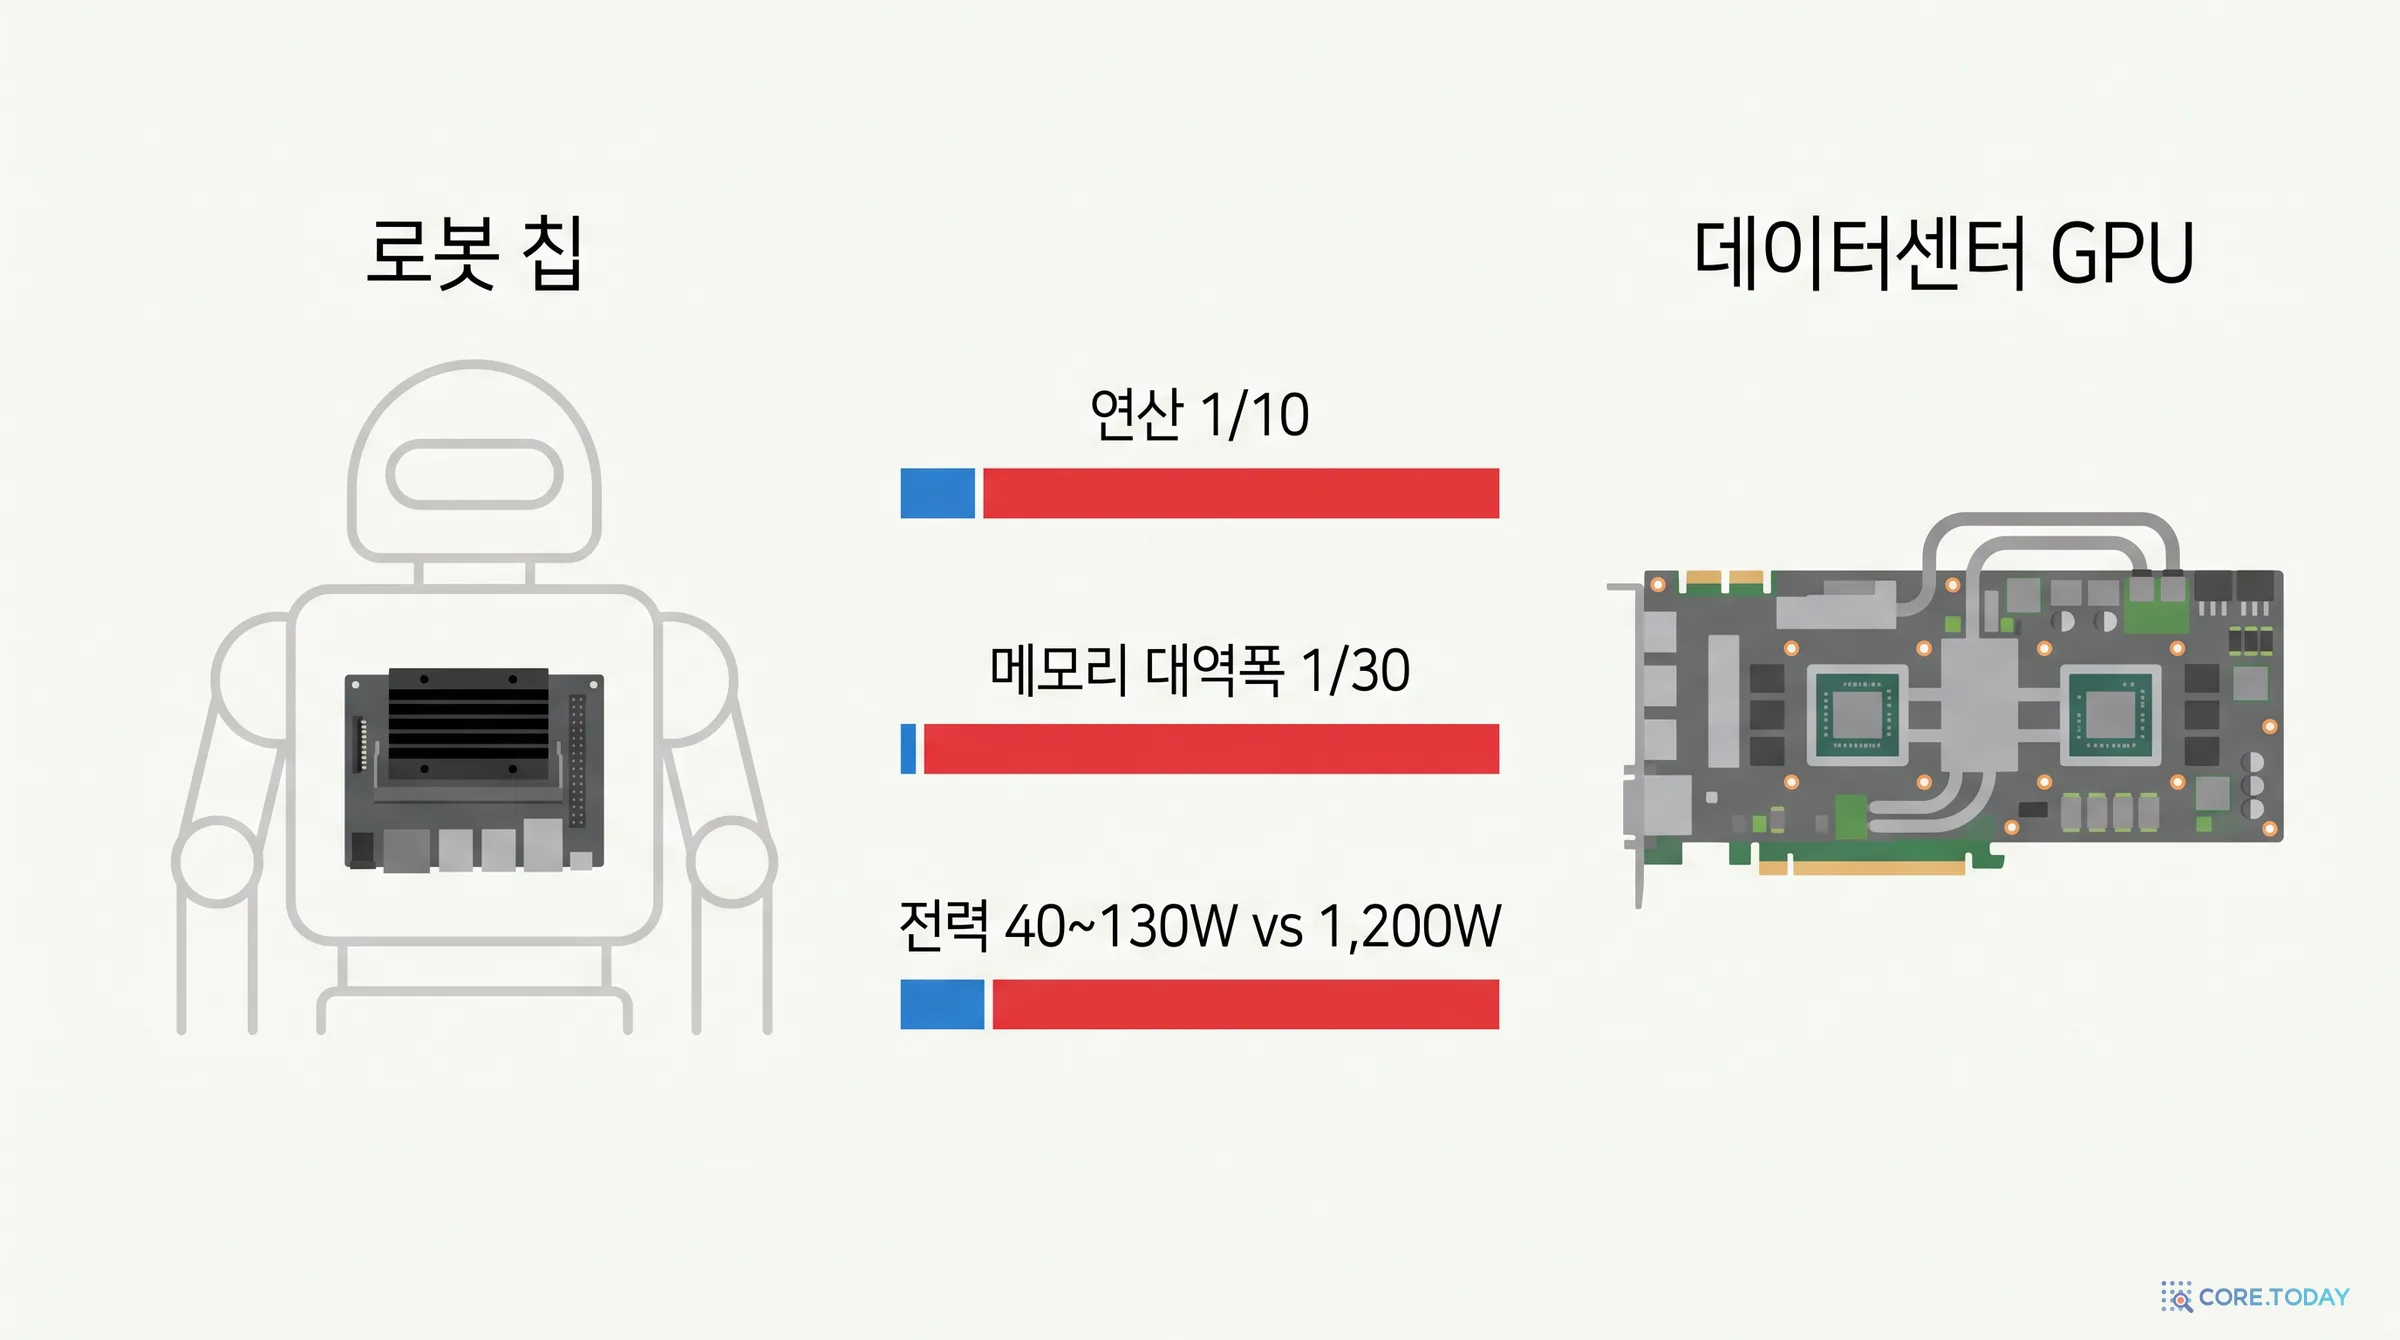
System 2가 로봇 안에 들어갈 수 없는 이유는 크기만이 아닙니다. 그 크기의 모델은 칩 하나에 1.2~1.4kW를 먹는 수랭식 블랙웰급 GPU를 원합니다. 휴머노이드의 배터리는 약 2kWh이고, 평소 움직일 때 수백 와트, 최대로 쓸 때 1~2kW를 씁니다. 그래서 로봇 안의 GPU가 40~130W짜리 Jetson Thor인 것입니다. 데이터센터 GPU를 로봇에 달면 칩 하나가 로봇 전체보다 전기를 많이 먹고, 로봇이 싣고 다닐 수 없는 냉각이 필요하고, 배터리가 몇 분 만에 바닥납니다.
이 구성의 대가는 네트워크입니다. SemiAnalysis는 "평균 지연은 큰 문제가 아니다. 문제는 꼬리, 로봇을 작업 도중에 얼려 버리는 가끔의 1초짜리 스파이크"라고 쓰고, Boston Dynamics에는 네트워크만 다루는 팀이 여럿 있다고 전합니다. 로봇 쪽 무선 스택, 고객의 인프라, 주파수, 프로토콜 설계를 각각 맡는 팀입니다.
3장. 들고 다닐 수 있는 칩의 한계 — 그리고 파운드리 이야기
SemiAnalysis는 "지금 살 수 있는 최고의 로봇용 연산 장치"인 Jetson Thor조차 GB200 대비 연산은 약 10분의 1, 메모리 대역폭은 약 30분의 1이라고 씁니다. 글의 사양표로 확인하면 Jetson AGX Thor(T5000)는 FP4 밀집 연산 1.04 PFLOPS, LPDDR5X 128GB, 대역폭 273GB/s입니다. GB200 패키지는 FP4 밀집 10 PFLOPS, 대역폭 8TB/s입니다. 나눠 보면 연산은 9.6분의 1, 대역폭은 29분의 1로, 본문의 '10분의 1·30분의 1'과 맞습니다.
1장의 위젯이 보여 준 것처럼, 로봇 칩의 벽은 용량보다 대역폭입니다. Jetson의 메모리 용량은 세대마다 늘어 왔습니다. Xavier 32GB, AGX Orin 64GB, Thor 128GB입니다. 하지만 메모리 대역폭은 같은 속도로 늘지 않았고, 확산형·자기회귀형 모델의 한 걸음은 대역폭에 묶입니다.
공급망은 로봇 편이 아니다
SemiAnalysis는 공급망도 데이터센터 실리콘 쪽으로 기울어 있다고 봅니다. NVIDIA의 가속기 생산량은 거의 전부 데이터센터용이고, 로봇용 Jetson은 2026년에도 그래프 바닥의 "거의 보이지 않는 얇은 띠"입니다. 이익률도 다릅니다. 블랙웰 데이터센터 GPU의 매출총이익률은 70% 중후반, Jetson 모듈은 60% 중반이라 NVIDIA로서는 귀한 최첨단 웨이퍼를 데이터센터에 돌릴 이유가 충분합니다.
한국 독자에게 눈에 띄는 대목이 여기 있습니다. SemiAnalysis에 따르면 이전 세대 Jetson Orin은 삼성의 SF8 공정에서 만들어졌습니다. 그 덕에 Jetson은 데이터센터 칩과 웨이퍼를 다투지 않았습니다. 그런데 현 세대 Thor는 TSMC N4로 옮겨 그 간격이 사라졌고, 다음 세대는 Rubin과 함께 N3, 그다음은 Feynman과 함께 N2로 갈 가능성이 높다고 봅니다. 저물량·저마진 Jetson이 첨단 웨이퍼 줄의 맨 뒤에서 데이터센터 칩과 경쟁하게 된다는 뜻입니다. 로봇 칩이 첨단 공정으로 갈수록, 성숙 공정을 쓰던 시절의 파운드리 다변화 여지는 줄어듭니다.
다만 SemiAnalysis는 웨이퍼 물량 자체가 병목은 아니라고 봅니다. 2030년에 Jetson급 칩 100만 개(개당 약 400mm²)를 만들어도 한 해 약 1만 장의 웨이퍼로, 데이터센터 GPU 증산에 비하면 반올림 오차입니다. 로봇이 한 해 수천만 개의 칩을 필요로 하는 2030년 이후에야 공급이 빠듯해진다고 봅니다. 그래서 진짜 질문은 "로봇이 웨이퍼를 구할 수 있나"가 아니라 "같은 로봇 군단을 돌리는 데 어느 쪽이 첨단 실리콘을 덜 쓰나" 입니다.
DRAM은 사정이 좀 더 급합니다. 전체 DRAM 웨이퍼 생산 능력은 늘고 있지만 늘어난 몫의 대부분을 AI 가속기용 HBM이 가져가고, 로봇 칩이 쓰는 범용 DRAM·LPDDR은 줄어드는 HBM 아닌 웨이퍼를 두고 경쟁합니다. 이 연작의 HBM 4단 편에서 다룬 메모리 공급의 긴장이 로봇에도 그대로 걸려 있는 셈입니다.
4장. 7대의 교차점 — 실리콘, DRAM, 그리고 돈
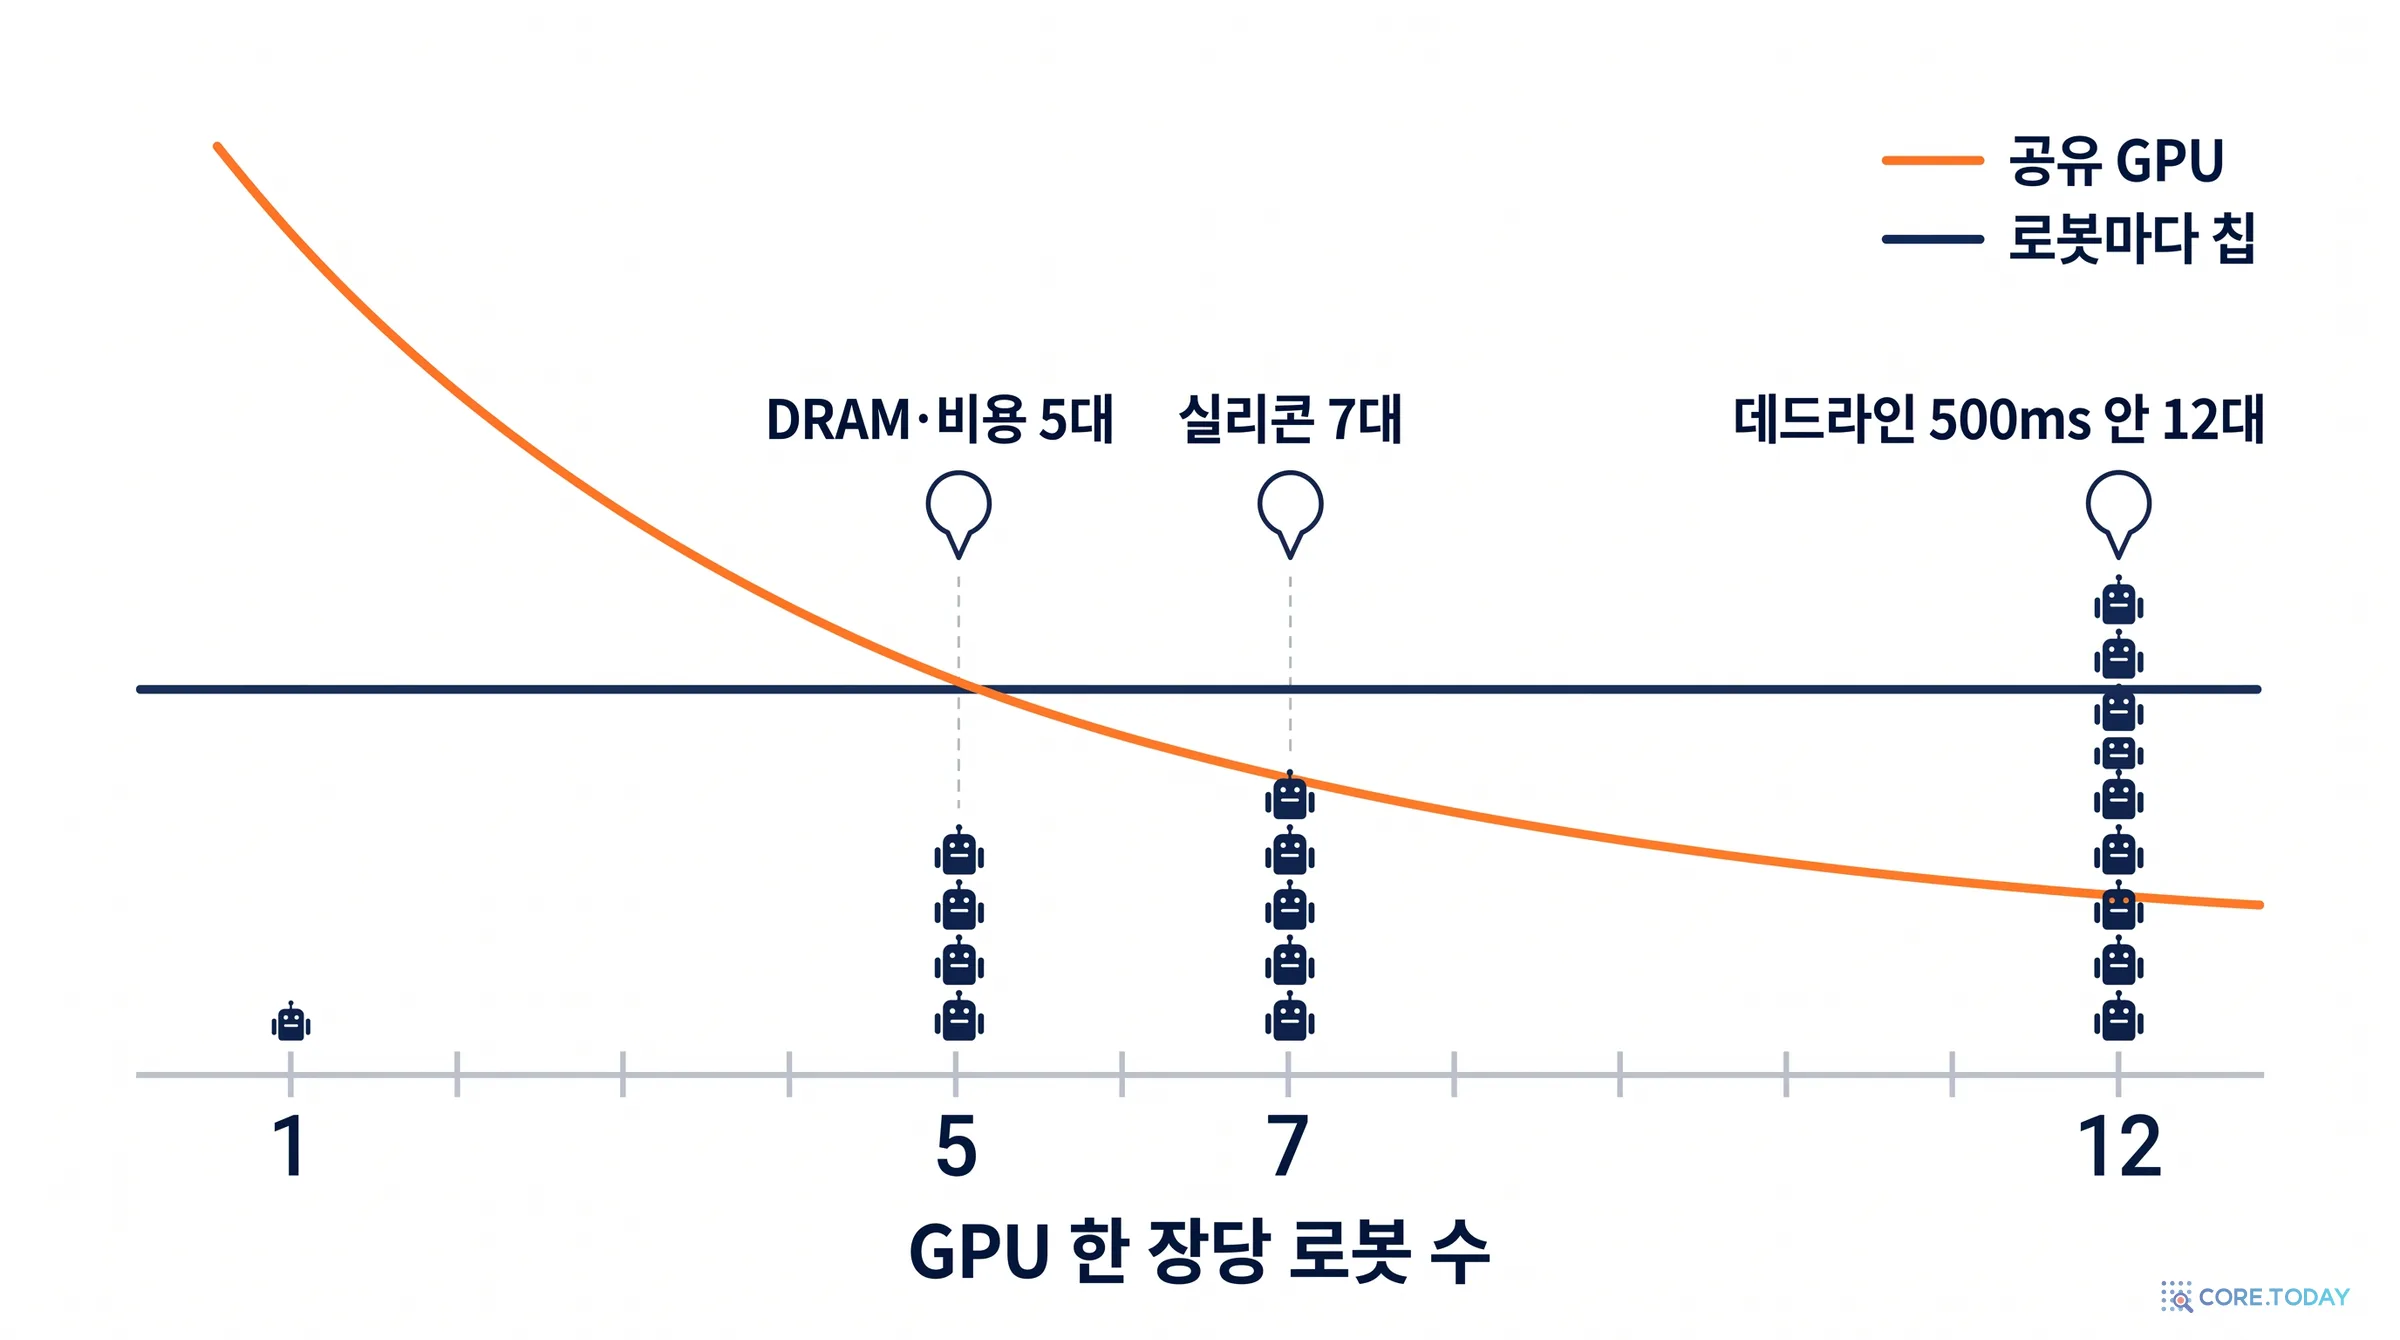
웨이퍼로 센 교차점: 7대
SemiAnalysis는 '실리콘 효율'을 로봇 한 대당 웨이퍼 수로 셉니다. 계산은 단순합니다.
로봇 안 칩은 "1 ÷ 웨이퍼 한 장의 양품 Thor 다이 수", 공유 GPU는 "1 ÷ 양품 B300 다이 수 ÷ GPU 한 장이 맡는 로봇 수"입니다. DRAM도 같은 방식으로 Thor의 LPDDR 128GB와 B300의 HBM3E 288GB를 셉니다.
그림을 읽으면 Thor는 로봇 한 대에 웨이퍼 약 0.012장, B300은 로봇 한 대만 맡을 때 약 0.089장입니다. B300 쪽은 맡는 로봇 수로 나뉘므로 7대에서 아직 조금 많고 8대에서 역전됩니다. SemiAnalysis는 이를 "약 7대" 라고 씁니다. DRAM은 Thor 약 0.045장, B300 한 대 기준 약 0.22장이라 약 5대에서 교차합니다. 공급이 부족한 자원을 덜 쓰는 쪽이 커질 수 있다는 것이 SemiAnalysis의 논리입니다.
교차점이 의미가 있으려면 GPU 한 장이 실제로 그만큼의 로봇을 데드라인 안에 처리해야 합니다. SemiAnalysis는 RoboTTT를 직접 돌려 보려 했지만 공개된 코드와 가중치가 없었습니다. 그래서 시간 특성만 흉내 낸 재구성 모델을 만들었습니다. 공개된 GR00T N1.7 체크포인트의 행동 헤드에 테스트 시점 학습 블록 16개를 끼우고(교차 주의 뒤에 8개, 자기 주의 뒤에 8개), 논문과 같은 57토큰 시퀀스(학습 가능한 레지스터 16 + 상태 1 + 행동 40)를 만들었습니다. 로봇 한 대마다 151MB의 '빠른 가중치' 상태가 있어, 배치로 돌릴 때마다 모았다가 다시 흩어 놓아야 합니다. 가중치를 공유하는 보통의 VLA는 내지 않는 비용입니다.
중요한 단서가 있습니다. 학습되지 않은 빠른 가중치는 발산해 엉터리 행동을 내므로, 이 재구성은 과제 성공률이 아니라 서빙 비용만 잽니다. "RoboTTT 모양의 추론을 서빙하는 데 얼마나 드나"라는 질문에만 답하는 숫자입니다.
결과는 이렇습니다(로봇 한 대당 초당 2회 요청, 180초 시험 5회, 500ms 액션 청크 데드라인).
GPU
데드라인 안 최대 로봇 수
그때 p99 지연
한 대 더 붙이면
B300
12대
449ms (5회 중 4회 통과, 합산 통과)
13대: p99 약 2.1초로 실패
RTX PRO 6000
4대
367ms (5회 모두 통과)
5대: p99 약 600ms로 실패
이 표에서 하나를 꼭 짚어야 합니다. B300 12대의 p99는 449ms입니다. 데드라인 500ms에서 빼면 남는 것은 51ms입니다. 벤치마크 그림에는 무선 구간이 포함됐다는 설명이 없습니다. 실제 배치라면 카메라 영상이 로봇에서 서버까지 올라가고 행동이 내려오는 왕복을, 그것도 p99로 이 51ms 안에 넣어야 합니다. 2장에서 본 "일반적인 무선 왕복 10~50ms"가 평균 이야기라면, 꼬리는 여기에 들어가지 않을 수 있습니다. 6장에서 이 51ms를 사무실 와이파이에 대 봅니다.
96대의 시간당 비용: 장부 위의 승부
그다음이 비용입니다. SemiAnalysis는 로봇 96대를 세 가지 방법으로 돌리는 총소유비용을 계산했습니다. 로봇 몸체·기구처럼 세 경우에 공통인 부품은 뺐고, 클라우드 임대가가 아니라 직접 사서 운영하는 경우입니다.
시나리오
구성
설비 투자
시간당 TCO
수명
B300 공유
8-GPU 서버 1대 + 무선 보드 96장
약 $554K
$18.63
6년
RTX PRO 6000 공유
8-GPU 서버 3대 + 무선 보드 96장
약 $436K
본문 $15.61 / 표 $18.65
6년
로봇마다 Thor
Thor 96개(개당 $3,500) + 기판·저장장치·냉각·추가 배터리·무선
약 $394K
$14.97
4년
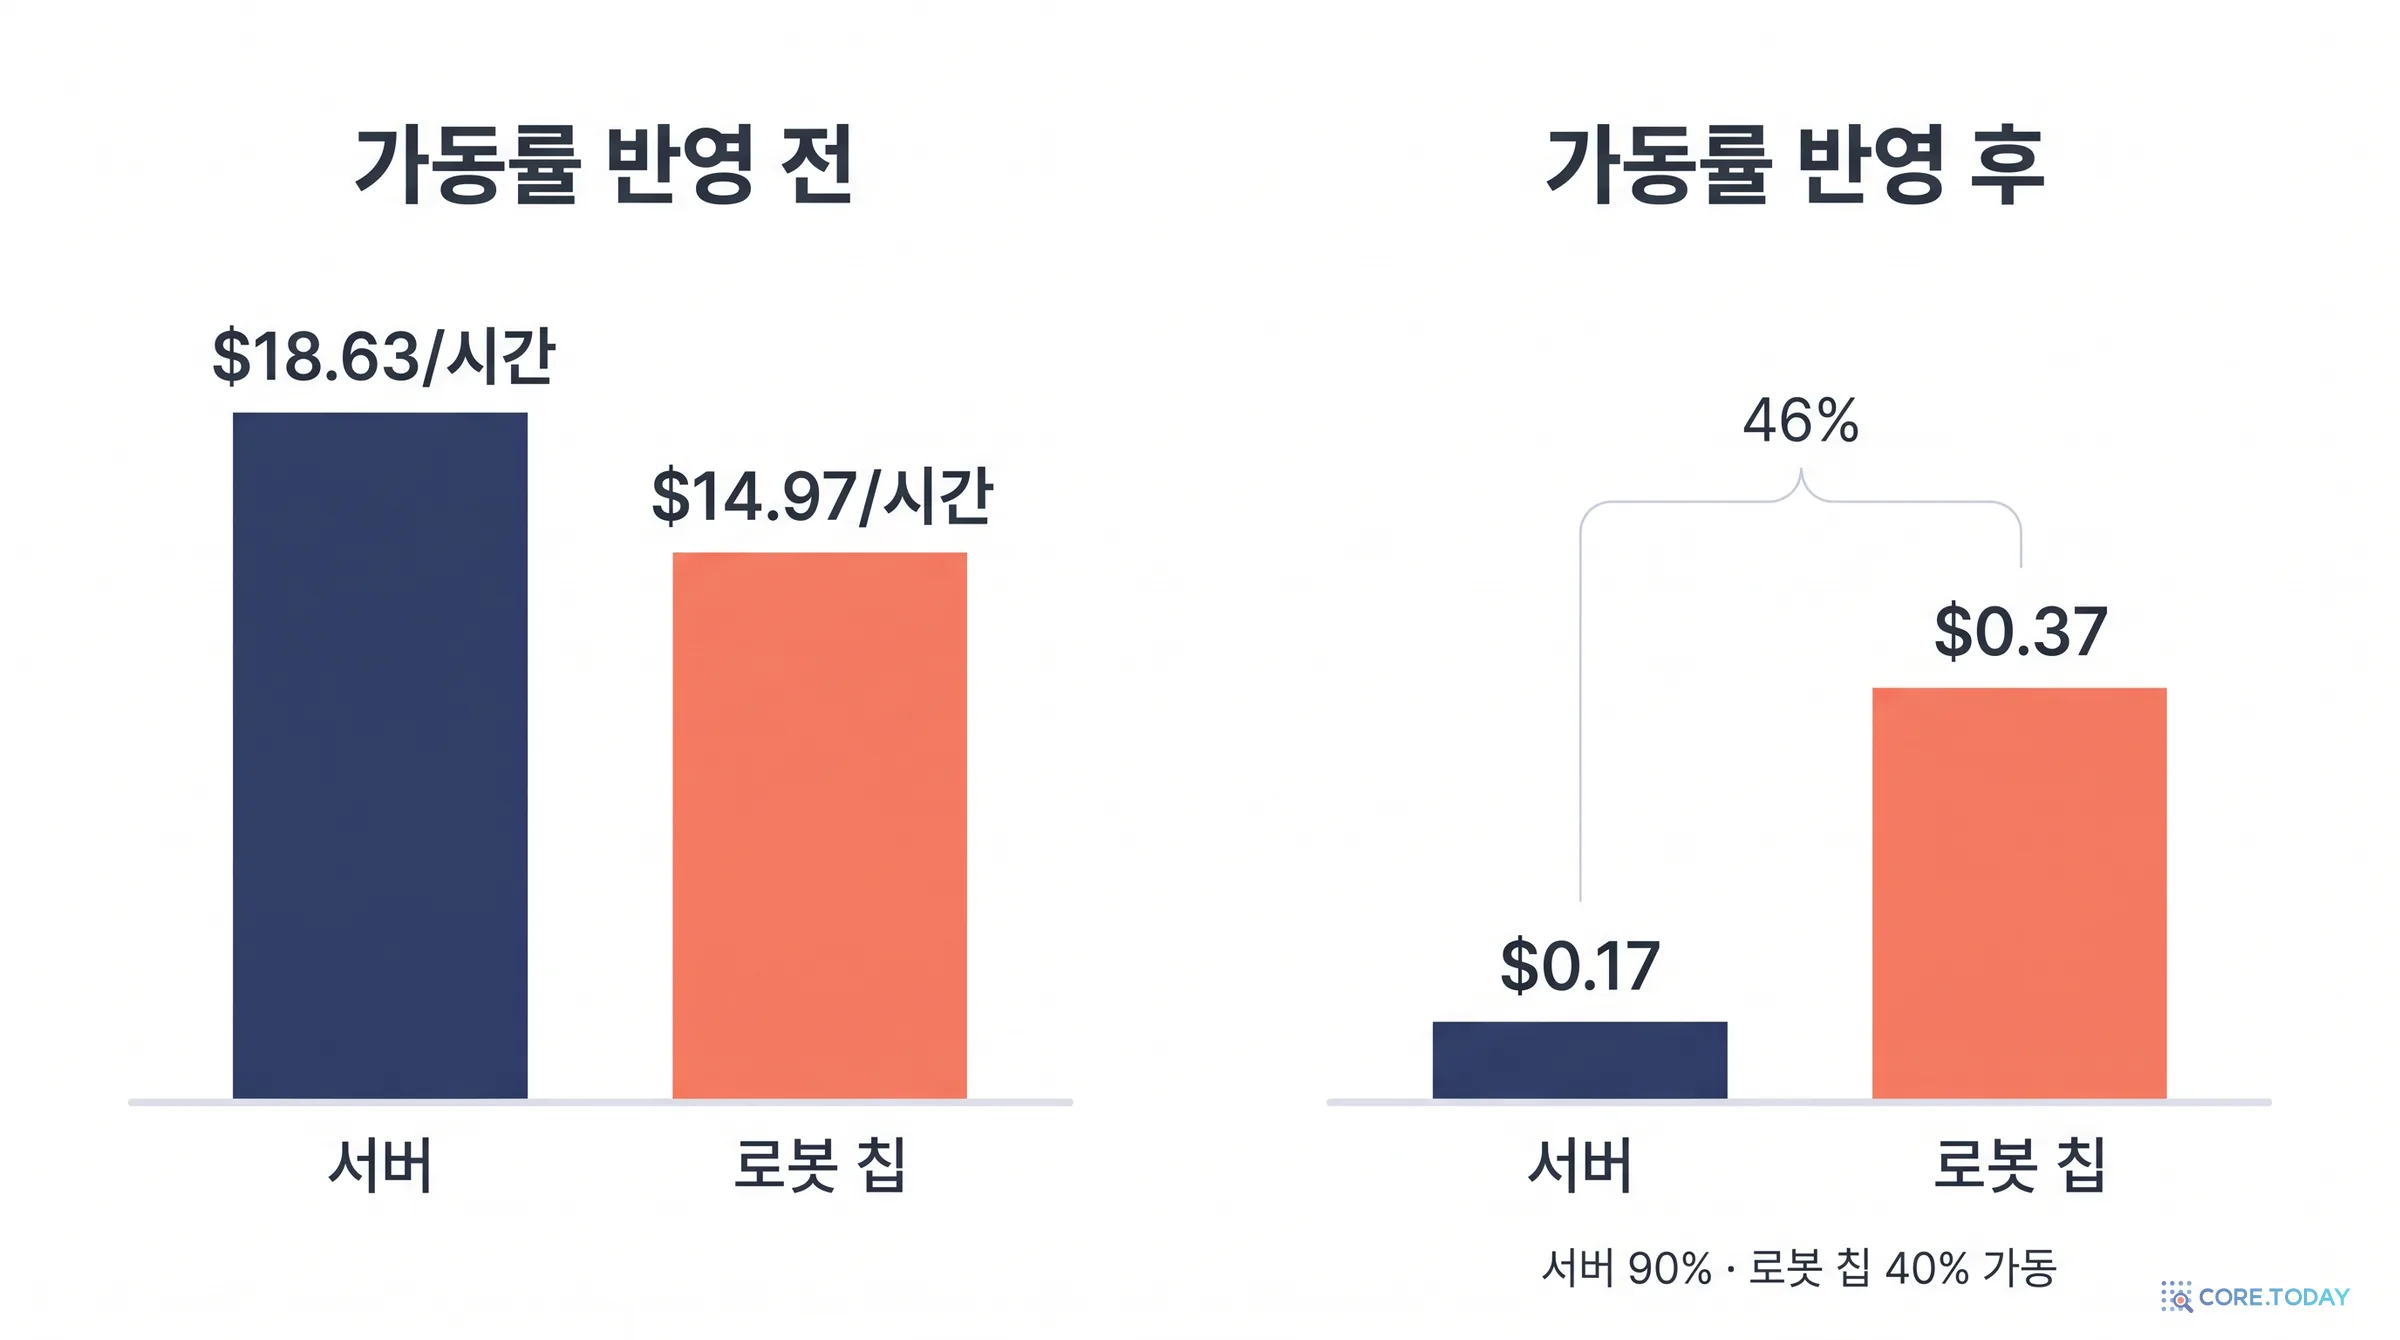
가동률을 반영하기 전에는 로봇마다 Thor를 다는 쪽이 가장 쌉니다. B300 서버보다 시간당 3.66달러, 약 20% 쌉니다. Thor의 수명을 4년으로 짧게 잡았는데도(진동·충격·물 튐을 견디는 환경이라 데이터센터 GPU보다 빨리 닳는다는 이유) 그렇습니다. 자본 비용(WACC)은 세 경우 모두 10.3%로 같게 뒀습니다. 신생 로봇 회사의 자본 비용이 더 높을 수 있지만, 이미 수명을 짧게 잡았으니 보수적으로 같게 뒀다는 설명입니다.
코어닷투데이가 표를 대조하다 찾은 것이 두 가지 있습니다.
RTX PRO 6000 시나리오의 시간당 TCO가 본문($15.61)과 표($18.65)에서 다릅니다. 설비 투자 $436,539는 둘이 같습니다. 표의 PFLOP당 비용 $0.39는 $18.65 ÷ 48 PFLOPS와 맞고, $15.61로는 $0.33이 나옵니다. 표 쪽이 내부적으로 일관됩니다.
가동률 반영 전 PFLOP당 비용이 본문에서 뒤바뀌어 있습니다. 본문은 "B300 $0.15, Thor $0.16"이라고 쓰지만 표는 B300 $0.16, Thor $0.15입니다. 계산해 보면 B300은 $18.63 ÷ 120 PFLOPS = $0.155, Thor는 $14.97 ÷ 100 PFLOPS = $0.150으로 표가 맞습니다.
어느 쪽도 결론을 바꾸지는 않지만, "가동률을 반영하기 전에는 PFLOP당으로도 Thor가 가장 싸다"는 점은 본문만 읽으면 놓치게 됩니다.
SemiAnalysis는 "가동률이 TCO의 승부를 가르는 변수"라고 씁니다. 로봇과 그 뒤의 GPU는 거의 전부 고정 자본이라, 돌든 놀든 청구서는 같습니다. 그러니 생산적인 한 시간당 비용은 얼마나 일하느냐에 반비례합니다.
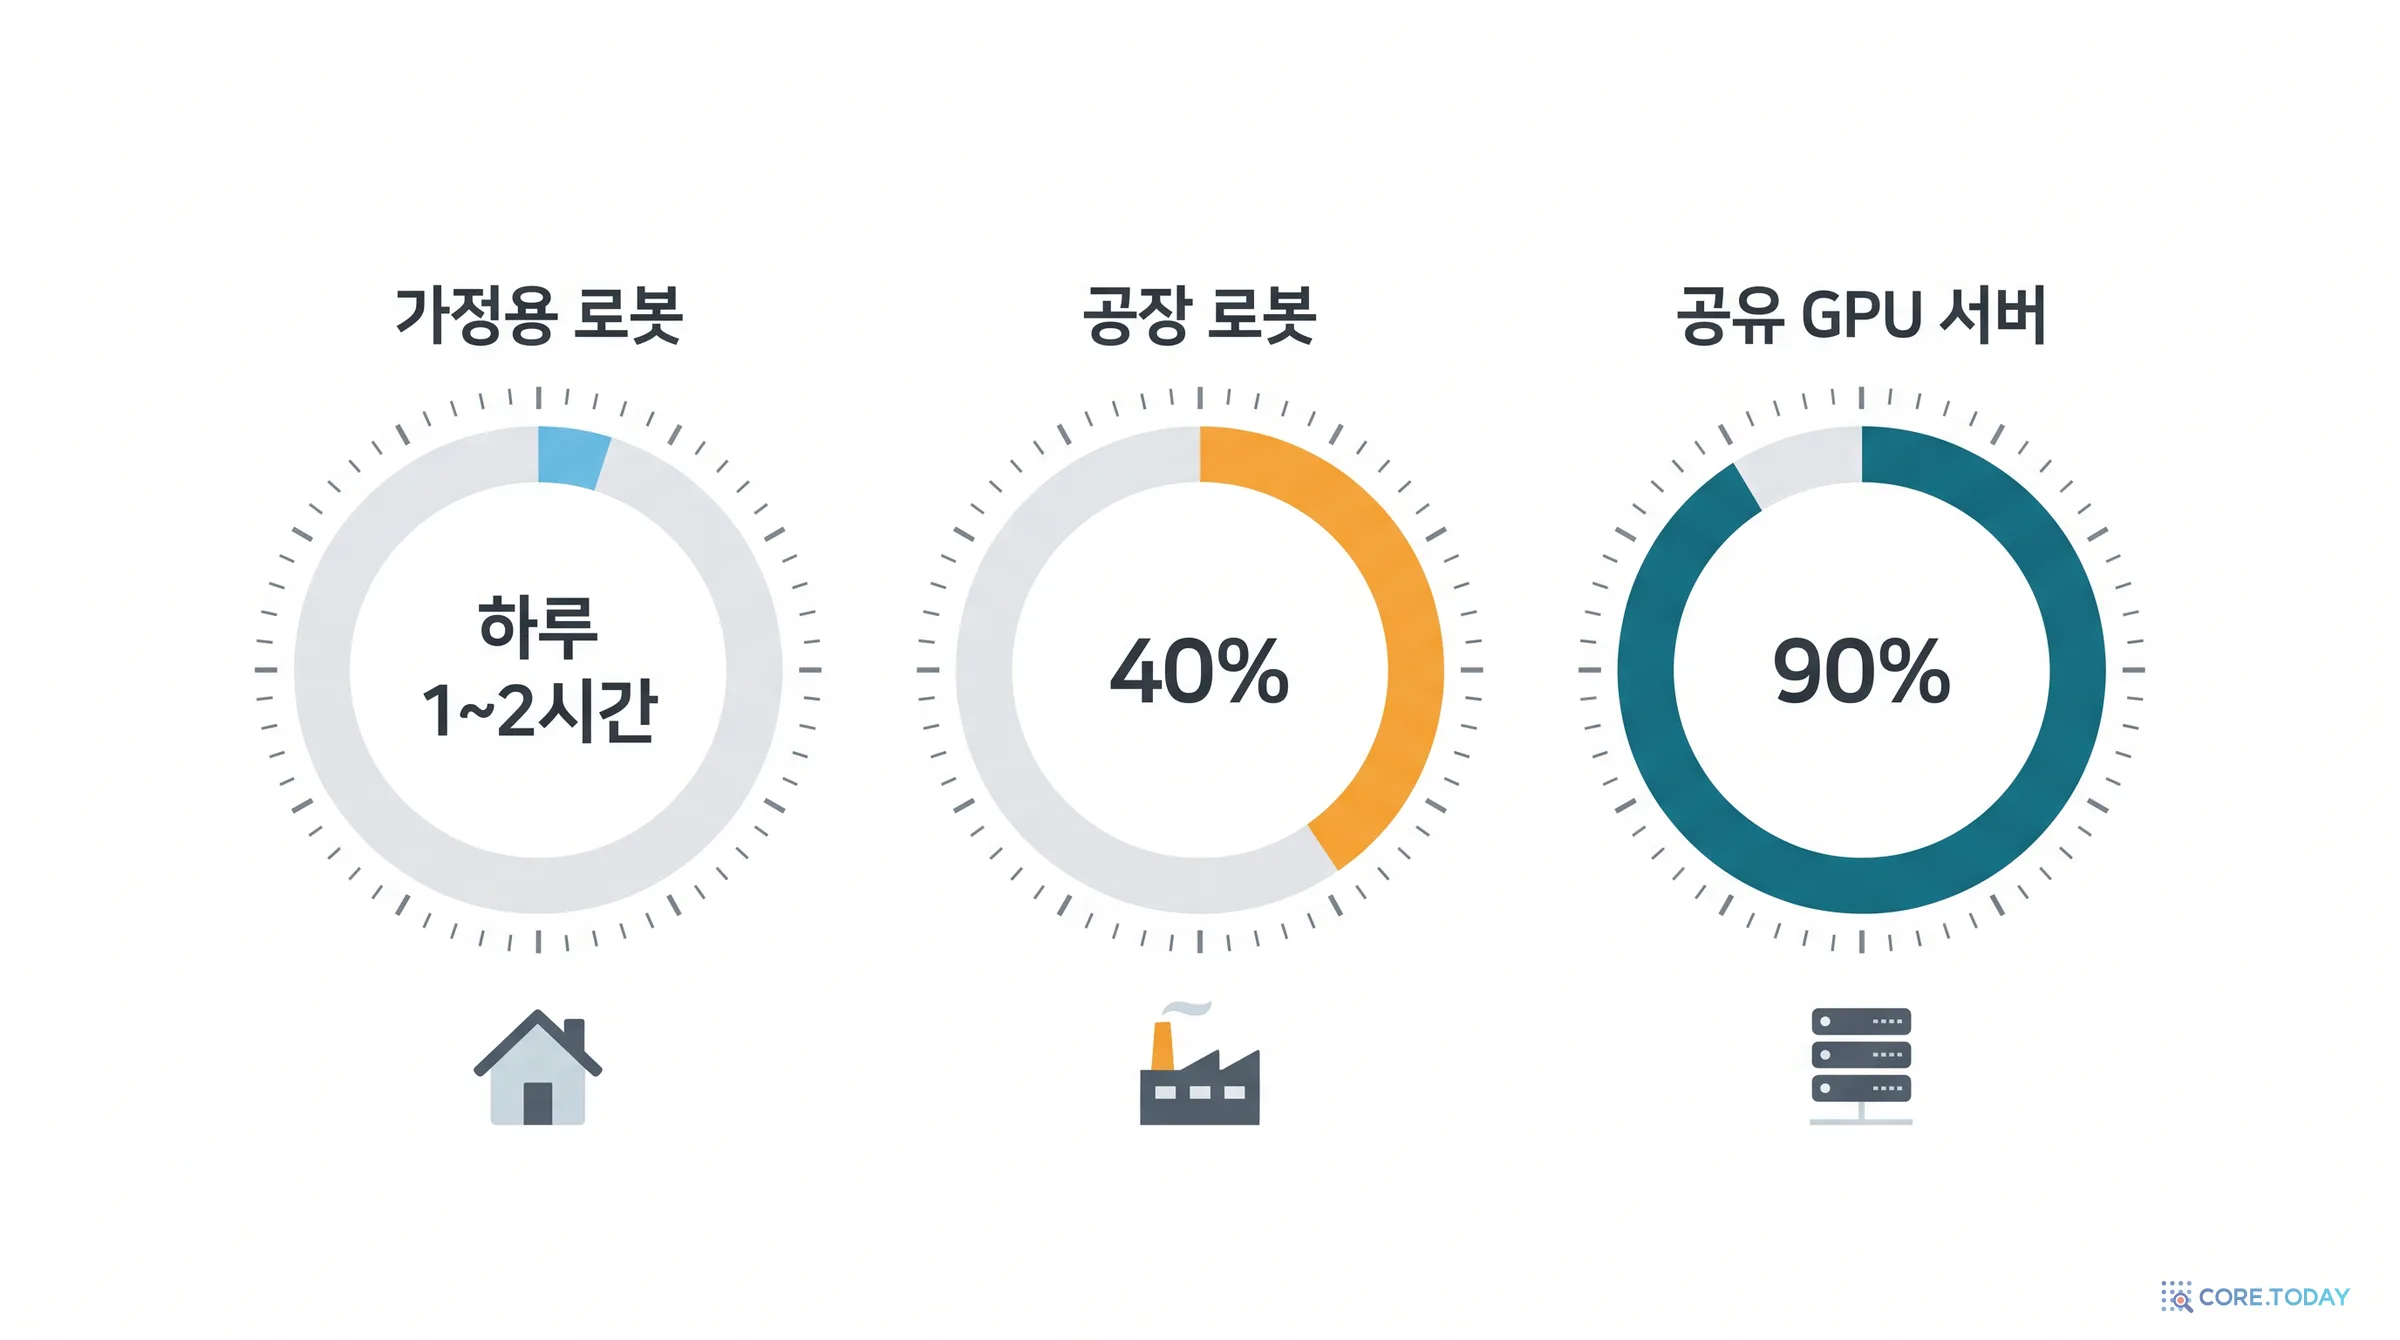
공유 서버: 여러 로봇의 요청을 모아 받으므로 하루 종일 바쁘다고 보고, GPU 가동률을 90% 로 둡니다. 표 각주의 정의는 "GPU가 서빙하는 로봇 수 ÷ 최대 배치 크기, 상한 90%"입니다. B300 한 장에 12대를 붙이면 상한 90%에 닿습니다.
로봇 안 칩: 기본값 40%. 근거로 Figure의 BMW 공장 배치를 듭니다. 약 11개월의 평일 교대 동안 약 1,250시간을 일했고, 하루 약 10시간, 가동률 40%라는 설명입니다.
가정용 로봇: 대량 배치한 한 회사가 SemiAnalysis에 하루 1~2시간(시계의 4~8%)만 일한다고 말했습니다. 집안일이 몰아서 생기고, 지금 모델이 감독 없이 할 수 있는 일이 제한되기 때문입니다. 4~5시간(17~21%)으로 늘어나는 추세지만, 결국 집안일은 동이 납니다.
이 가동률을 넣으면 FP4 PFLOP-시간당 비용은 B300 $0.17, Thor $0.37이 되어, 공유 쪽이 약 46% 가 됩니다. 민감도 표에서 로봇 칩 가동률 10%(하루 약 2.4시간) 칸은 0.12배입니다. SemiAnalysis가 "가정용은 약 12%"라고 한 숫자가 이 칸입니다. 코어닷투데이가 표를 다시 풀어 보면 이 비율은 정확히 다음 식 하나입니다.
SA 민감도 표를 재현하는 식 (코어닷투데이 역산)
공유 ÷ 온보드 = (0.1553 ÷ 서버 가동률) ÷ (0.1497 ÷ 로봇 칩 가동률) = 1.037 × 로봇 칩 가동률 ÷ 서버 가동률
서버 90%·로봇 40% → 0.46배 · 서버 90%·로봇 10% → 0.12배 · 서버 100%·로봇 100% → 1.04배 (표의 모든 칸과 일치)
그리고 GPU 한 장에 붙이는 로봇 수를 바꾸면, 로봇 칩 가동률 40%에서 B300 한 장당 5대부터 공유 쪽이 싸집니다. 0.1553 × 12 ÷ k가 0.374보다 작아지는 k가 4.98이기 때문입니다. 이렇게 해서 실리콘 7대, DRAM 5대, 비용 5대라는 세 개의 교차점이 나옵니다.
'일한 로봇 한 시간'으로 다시 재면
여기서 코어닷투데이는 한 가지를 더 계산했습니다. SemiAnalysis의 비교 단위는 'FP4 PFLOP-시간'입니다. 그런데 B300 한 장(15 PFLOPS)이 로봇 12대를 맡으면 로봇 한 대에 1.25 PFLOPS가 돌아가고, Thor는 한 대에 1.04 PFLOPS입니다. 둘 다 같은 데드라인을 지킨다면, 로봇 입장에서 남는 연산은 쓸 데가 없습니다. 그러니 PFLOP당 비교는 공유 쪽에 약 20%의 덤을 얹어 주는 셈입니다.
같은 표로 "실제로 일한 로봇 한 시간" 의 비용을 재면 이렇습니다.
일한 로봇-시간당 비용 (코어닷투데이 재계산, SA 표 값 사용)
공유: $18.63 ÷ (GPU 8장 × 12대) = 로봇 한 자리-시간 $0.194 → ÷ 서버 가동률 90% = $0.216
온보드: $14.97 ÷ 96대 = $0.156 → ÷ 로봇 칩 가동률 40% = $0.390
비율 = 0.55배 (SA 방식 0.46배) · 가정용(로봇 10%) = 0.14배 (SA 방식 0.12배)
공유가 싸지는 조건: 로봇 칩 가동률 < 서버 가동률 × 0.80 (SA 방식 × 0.96)
결론은 그대로입니다. 공장에서도 공유가 싸고, 가정에서는 훨씬 쌉니다. 다만 '절반 이하'가 '절반을 조금 넘는'으로 바뀌고, 공유가 이기는 범위가 조금 좁아집니다.
더 큰 질문은 따로 있습니다. 서버 가동률 90%는 어디서 오나. 표 각주의 정의대로라면 90%는 "GPU 한 장에 12대가 늘 붙어 있다"는 뜻입니다. 그런데 로봇은 40%만 일합니다. 둘이 동시에 성립하려면 서버 하나가 로봇 수십 대의 서로 다른 근무 시간을 이어 받아야 합니다. 3교대 공장이나 시간대가 다른 여러 현장을 묶는 클라우드라면 가능합니다. 한 교대만 도는 공장 한 곳에 서버를 두면 밤에는 놉니다. 가정용 로봇은 퇴근 뒤 저녁에 몰려 일하고, 서버는 그 피크에 맞춰 사야 합니다. SemiAnalysis도 "아주 작은 배치에서 현장 서버가 대부분 놀 때"는 예외라며, 그럴 땐 서버를 사기보다 필요할 때 빌리는 쪽을 생각해 볼 수 있다고 씁니다.
아래 계산기에서 장면을 바꿔 보세요. '현장 서버가 놀 때'(서버 50%, 로봇 15시간)를 누르면 판이 뒤집힙니다.
5장. 평균이 아니라 꼬리 — 네트워크의 벽
장부가 공유 쪽을 가리키는데 왜 대부분의 회사는 추론을 로봇 안에 둘까요. SemiAnalysis가 만난 회사들은 거의 한목소리로 같은 이유를 댔습니다. 네트워크입니다. 그리고 로봇 밖에 추론을 둔 회사들은 "그 일만 하는 팀을 여럿 꾸려서" 거기에 닿았습니다.
몸금속으로 된, 움직이는 기계에서 좋은 통신을 기대하는 일이다. 모터와 전자 장치가 같은 주파수에 잡음을 뿌리고, 차체가 제 신호를 가리고 튕기며, 자세가 바뀔 때마다 안테나 위치가 바뀐다.
망와이파이와 5G는 로봇을 염두에 두고 만들어지지 않았다. 소파에서 영상을 내려받는 데 맞춰져 있다. 로봇은 영상 한 편 분량을 올려 보내면서 움직인다. 이것이 업링크 문제다.
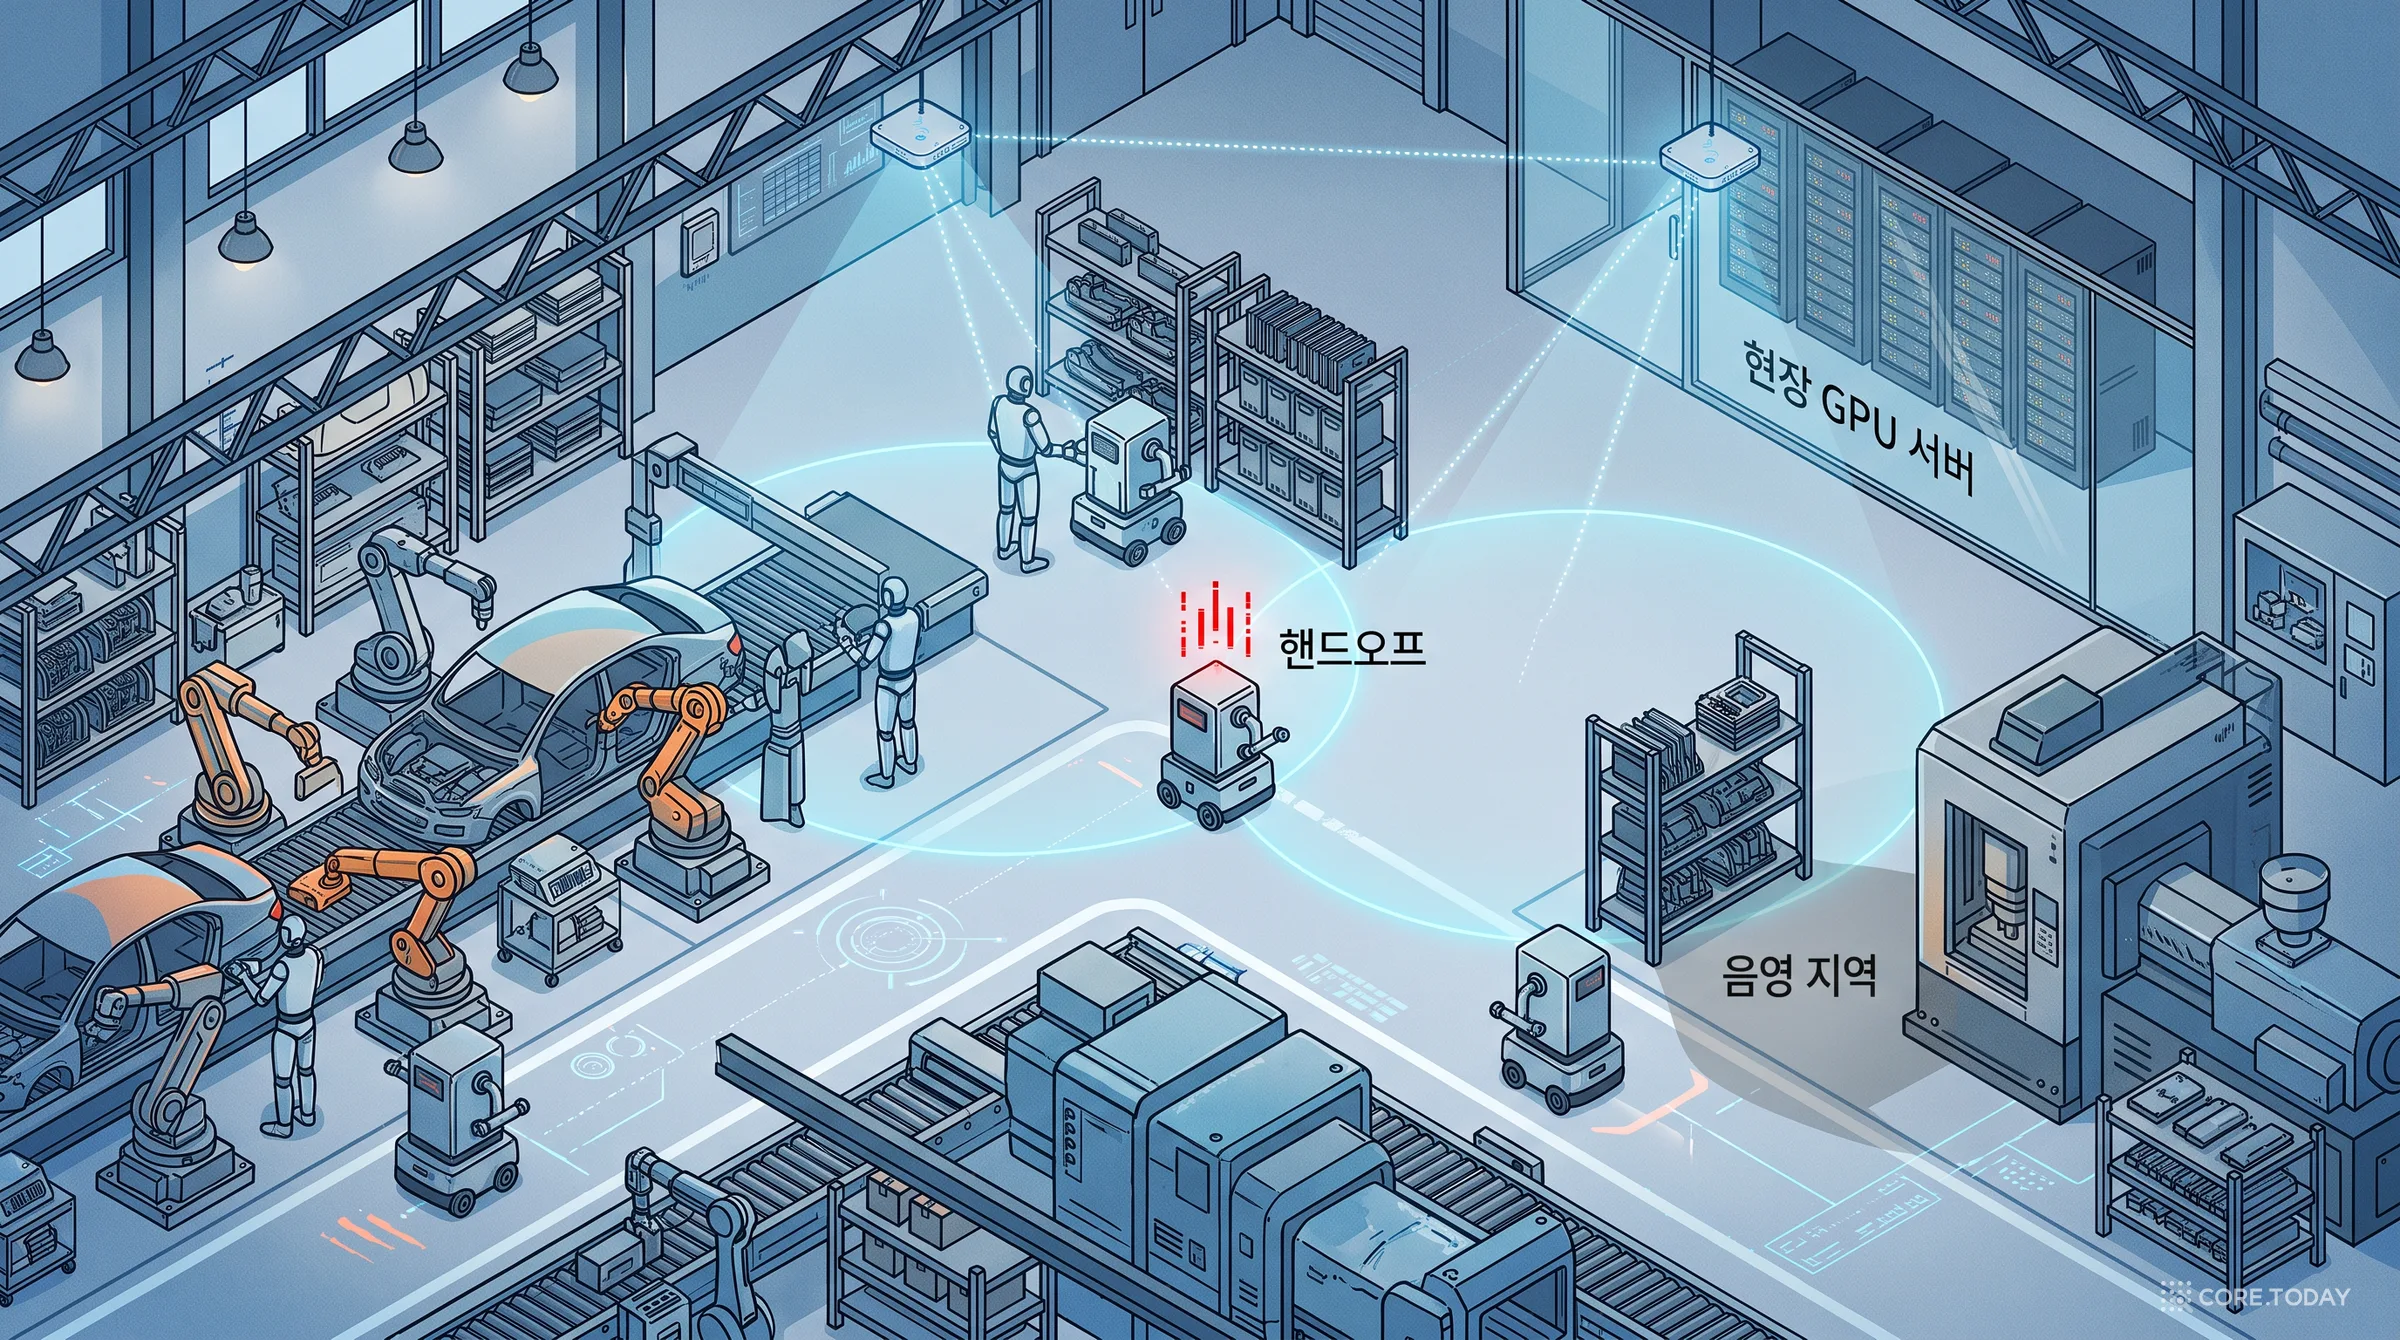
환경벽·금속·다른 전자 기기가 전파 환경을 바꾼다. 식기세척기를 켜면 바뀌고, 공장에서 큰 기계를 돌리면 그 옆에 음영 지역이 생긴다. 재고와 설비가 매일 움직이면 음영도 따라 움직인다.
망 이야기의 핵심은 방향이 거꾸로라는 것입니다. 지금의 공유기, 칩셋, 알고리즘은 내려받기에 맞춰져 있어서 SemiAnalysis의 표현으로 "우선순위가 뒤집혀 있고, 업링크 다중 안테나(MIMO)는 거의 지원되지 않으며, UDP 스트림을 믿을 만하게 만드는 중복이 없고, 공유기 사이를 낮은 지연으로 넘겨주는 기능이 없고, 업링크 스케줄링은 뒷전이고, 결정적(deterministic)이어야 할 모든 것이 통계적"입니다. 공유 광회선까지 더하면 "이웃이 영상을 켜는 순간 일하던 휴머노이드가 말 그대로 사람을 다치게 할 수 있다"고까지 씁니다.
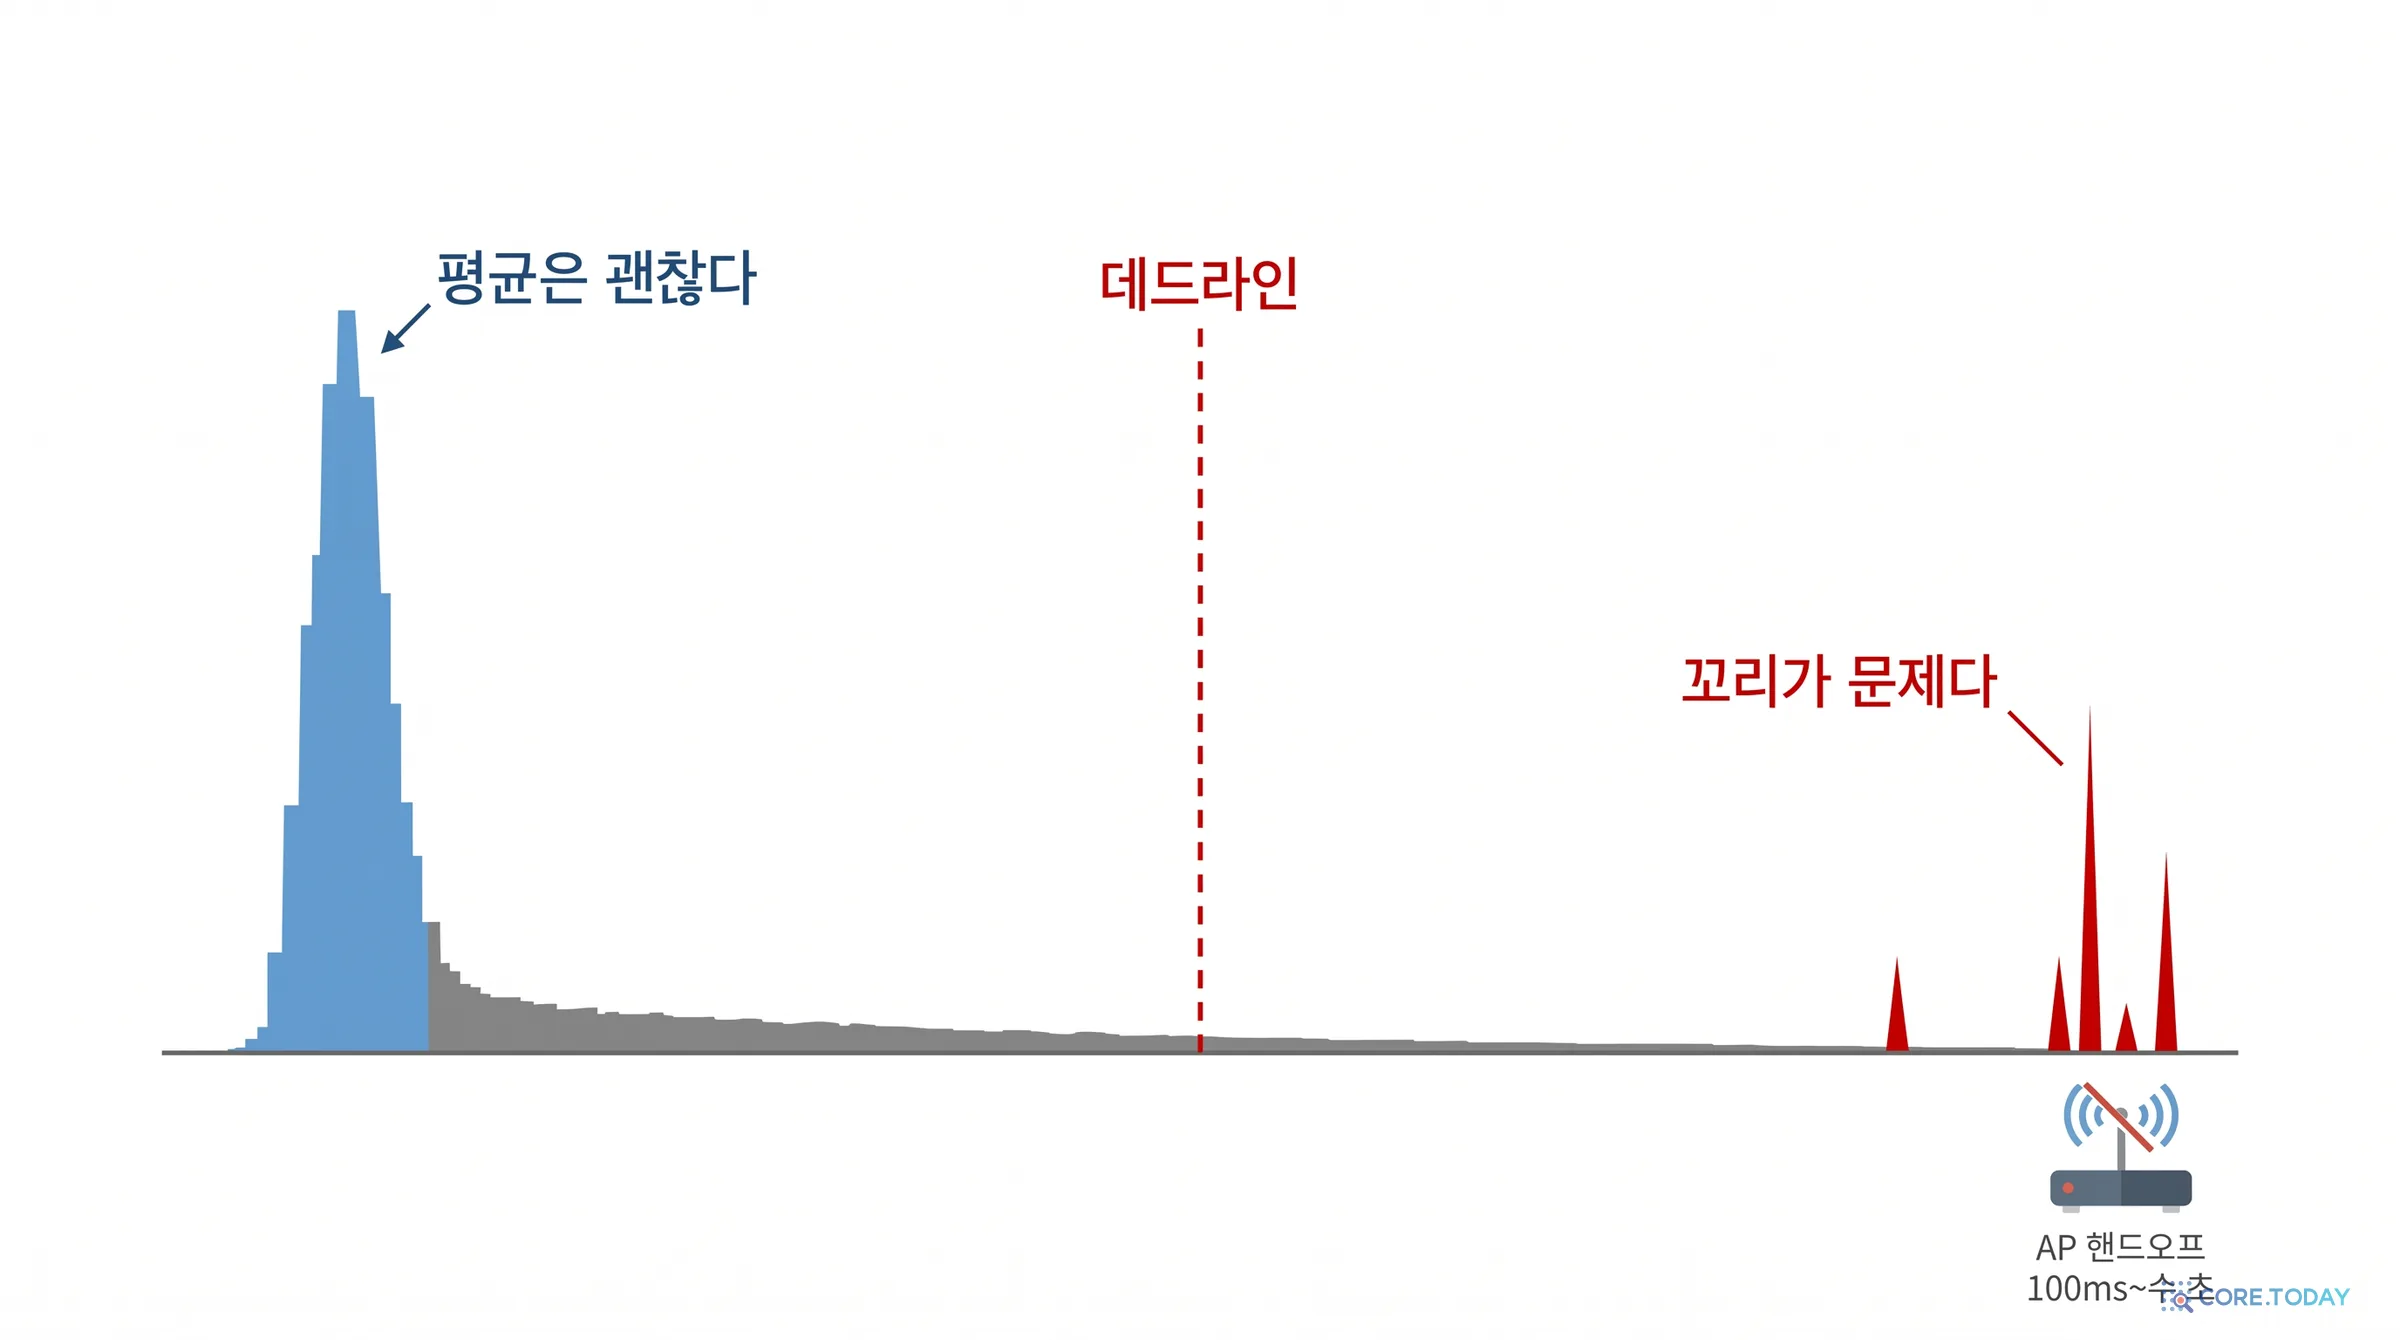
그리고 이 글의 숫자 하나가 여기서 나옵니다. 공유기(AP) 사이를 옮겨 갈 때(핸드오프), 보통의 공유기는 100ms에서 수 초 동안 조용해집니다. 그 일이 물건을 집는 도중에 일어나면 정책이 죽거나 원격 조종자가 뒤처지고, 복구에 다시 몇 초가 걸리며, 그 사이 휴머노이드는 바닥에 누워 있을 수 있습니다. 다른 곳에서는 "200ms 핸드오프는 프레임 여러 장을 잃는 것"이라고 씁니다.
자율주행이 이 벽의 극단입니다. 커버리지가 넓고, 운영자가 전파 환경을 거의 통제할 수 없고, 차가 빨라 지연 예산이 0에 가깝고 핸드오프가 잦습니다. 운전은 휴머노이드 노동보다 쉬운 학습 문제라 모델이 차 안에 들어가기도 합니다. 그래서 연산은 차 안에 두고 밖에는 느린 차량 관리만 남습니다. SemiAnalysis는 로봇 밖 연산의 환경 전제 조건을 "전파를 통제할 수 있을 만큼 구조화된 작거나 중간 크기의 공간"으로 정리하고, 가정과 공장은 그 조건을 갖췄다고 봅니다. 쉽다는 뜻은 아닙니다.
벽을 넘는 네 갈래
SemiAnalysis는 운송 계층(재전송 없는 UDP, 여러 안테나로 같은 패킷을 반복해 보내는 신뢰성, 패킷 중요도를 아는 응용 계층, 무엇보다 신선도)은 이미 팀들이 만들고 있는 흔한 기술이라고 봅니다. 진짜 벽은 기존 하드웨어에 있고, 이를 넘을 네 가지를 꼽습니다.
1. 로봇이 아니라 환경을 고친다 로봇 업링크를 먼저 스케줄하는 AP, 로봇 위치를 알고 미리 빔을 돌리는 AP, 현장 단일 시계, 여러 대역·와이파이+5G 동시 사용, 6GHz, 관찰 주기 안에 끝나는 핸드오프, 측정에 기반한 AP 배치
2. 짐을 줄인다 업링크의 거의 전부는 카메라다. 네트워크 문제이기 전에 지각(perception) 문제다
3. 업링크를 키운다 소비자 모듈의 1~2개 스트림 대신 4×4 업링크 MIMO, AP의 시간표에 맞춰 자기 슬롯만 채우는 무선부
4. 모든 것을 한 시계에 1ms 이하 동기화로 현장의 모든 로봇이 같은 박자에 찍고, 압축하고, 보낸다. GPU는 그 박자에 맞춰 배치를 기다렸다가 프레임이 다 모이면 바로 돈다. 늦은 관찰은 대기열이 아니라 다음 배치로 간다
네 번째가 4장의 비용 계산과 이 장을 잇는 고리입니다. 공유 GPU가 싸지려면 배치가 커야 하고, 배치가 지연을 부풀리지 않으려면 여러 로봇의 관찰이 같은 시각에 도착해야 합니다. 지터는 단지 로봇 하나의 제어를 흔드는 게 아니라, 배치 자체를 깨뜨립니다. 다른 로봇의 늦은 프레임을 기다리느라 모두가 늦어지거나, 늦은 로봇은 다음 배치로 밀려 한 박자를 잃습니다. SemiAnalysis의 다른 글 「Computation and Data Movement for Inference」(2026-09-21)에는 같은 생각이 데이터센터 안쪽 이야기로 나옵니다. "밀리초 단위의 변동을 만드는 스케줄러는 작업자 안의 정교한 마이크로초 단위 엔지니어링을 압도할 수 있다."
SemiAnalysis는 와이파이가 가정과 공장 대부분을 맡고, 실외 경로·큰 현장·와이파이 혼잡을 통제할 수 없는 곳은 사설이든 공용이든 5G가 메우되, 둘이 하나의 스케줄러 아래에서 공존하며 로봇이 빠르게 넘나들어야 한다고 봅니다.
SemiAnalysis의 네트워크 장에는 숫자가 많지 않습니다. 핸드오프 100ms~수 초, 무선 왕복 10~50ms, 그리고 "가끔의 1초짜리 스파이크"가 거의 전부입니다. 그래서 코어닷투데이는 가장 흔한 환경, 평범한 사무실 와이파이의 꼬리가 어떤 모양인지 직접 쟀습니다.
어떻게 쟀나
장비는 맥 한 대입니다. 같은 기계가 유선(1Gbps 이더넷)과 와이파이(802.11ac, 5GHz, 80MHz 채널, 신호 −42dBm으로 강함)에 동시에 붙어 있어, 인터페이스만 바꿔 같은 목적지를 잴 수 있었습니다. 목적지는 ① 사무실 공유기(로봇과 서버가 같은 공간에 있는 경우)와 ② 서울의 공용 DNS 서버(현장 밖 서버까지 가는 경우, 1.1.1.1의 서울·인천 거점으로 응답)입니다. ICMP ping을 50Hz 루프와 같은 박자인 20ms 간격으로 조건마다 6,000번(약 2분) 보냈고, 유선·와이파이 × 두 목적지의 네 조건에 와이파이로 큰 파일을 계속 내려받는 동안의 두 조건을 더했습니다. 노트북은 움직이지 않았습니다. 지표는 p50~p99.9·최댓값, 연속한 두 표본 차이의 평균(지터), 손실, 그리고 문턱마다 '넘었거나 응답 없음'의 비율과 그것이 이어진 최장 길이입니다.
측정은 10월 30일 금요일 밤 9시 43분부터 약 14분간, 사무실이 거의 빈 시간에 했습니다. 다른 사람들이 회선을 쓰는 낮 시간이라면 꼬리는 더 길었을 가능성이 큽니다.
결과: 중앙값은 비슷하고, 꼬리가 전혀 다르다
조건
p50
p99
p99.9
최댓값
지터 평균
유선 → 사무실 공유기
0.58ms
0.97ms
1.34ms
8.9ms
0.09ms
와이파이 → 사무실 공유기
5.1ms
121ms
1,250ms
1,392ms
11.5ms
유선 → 서울 공용 DNS
9.2ms
9.7ms
10.9ms
38.9ms
0.20ms
와이파이 → 서울 공용 DNS
13.6ms
121ms
338ms
416ms
14.1ms
와이파이(내려받기 중) → 공유기
13.8ms
122ms
150ms
237ms
18.1ms
와이파이(내려받기 중) → 공용 DNS
39.2ms
153ms
353ms
438ms
25.6ms
세 가지가 눈에 띕니다.
첫째, 유선은 거의 흔들리지 않았습니다. 공유기까지 6,000번 중 가장 느린 것이 8.9ms였고, 99.9%가 1.34ms 안에 들어왔습니다. 서울 공용 DNS까지도 p99와 p50의 차이가 0.5ms입니다. 같은 사무실에서 서버를 유선으로 잡으면, 서버가 건물 안에 있든 서울 어딘가의 데이터센터에 있든 왕복 10ms를 거의 넘지 않습니다.
둘째, 와이파이는 중앙값만 보면 멀쩡합니다. 공유기까지 5.1ms로, SemiAnalysis가 말한 '잘 설계된 링크(10ms 미만)'에 들어갑니다. 그런데 p99는 121ms, p99.9는 1.25초, 최댓값은 1.39초였습니다. p99.9가 중앙값의 약 245배입니다. 중앙값이 비슷한 두 망이 꼬리에서는 세 자릿수 차이가 납니다.
셋째, 가장 나쁜 사건은 짐이 없을 때 일어났습니다. 공유기까지 잰 와이파이 6,000번 중 500ms를 넘은 것은 39번이었는데, 그중 38번이 측정 시작 81초 무렵의 한 구간에 몰려 있었습니다. 약 0.8초 동안 응답이 줄줄이 0.5~1.4초 늦게 돌아왔습니다. 50ms를 넘는 표본은 최장 58개가 연속, 즉 1.16초 동안 이어졌습니다. 50Hz로 도는 루프라면 명령 58개를 연달아 받지 못한 셈입니다. SemiAnalysis가 말한 "로봇을 작업 도중에 얼려 버리는 가끔의 1초짜리 스파이크"가, 신호가 강하고 아무것도 움직이지 않는 빈 사무실에서도 2분 만에 나왔습니다.
내려받기를 걸었을 때는 중앙값이 2.7~2.9배로 올랐지만(공유기 5.1→13.8ms, 공용 DNS 13.6→39.2ms) 이번 측정에서는 1초짜리 사건이 없었습니다. 그래서 최댓값은 오히려 낮게 나왔습니다. 꼬리는 '바쁠 때 길어지는 것'이기도 하지만, 그보다 '가끔 무엇인가가 일어나는 것' 에 가깝다는 뜻입니다. 2분짜리 측정 한 번이 그 '가끔'을 잡을지 못 잡을지는 운에 달려 있습니다. 이 점은 한계 절에서 다시 다룹니다.
30분 뒤, 그리고 10분 동안: 꼬리는 '가끔' 온다
첫 측정이 끝나고 30분 뒤(오후 10시 14분) 같은 자리에서 여섯 조건을 다시 쟀고, 이어서 와이파이 → 공유기만 10분 동안(30,000번) 쟀습니다.
와이파이 → 사무실 공유기
p50
p99
p99.9
최댓값
B300 12대 설정 놓침(예산 51ms)
1회차 21:43 (2분)
5.1ms
121ms
1,250ms
1,392ms
7.7%
2회차 22:14 (2분)
3.9ms
64ms
93ms
105ms
1.4%
3회차 22:29 (10분)
3.9ms
6.1ms
27ms
113ms
0.013%
같은 노트북, 같은 공유기, 같은 자리인데 B300 설정의 놓침 비율이 회차마다 7.7%, 1.4%, 0.013%로 약 600배 차이 났습니다. 유선은 두 회차 모두 공유기까지 최댓값 9ms 아래였습니다. 와이파이로 잰 26분 가운데 0.5초를 넘는 사건은 1회차의 그 한 번(약 0.8초)뿐이었고, 10분 동안 조용히 4ms 안팎을 지킨 구간도 있었습니다.
이것이 SemiAnalysis가 "지연이 아니라 지터"라고 한 말의 실제 모양입니다. 와이파이는 대부분의 시간에 훌륭합니다. 문제는 언제 나빠질지 모른다는 것입니다. 10분짜리 측정만 했다면 "사무실 와이파이로 로봇 계획 층을 빼도 된다"는 결론을 냈을 것이고, 2분짜리 1회차만 봤다면 "절대 안 된다"고 했을 것입니다. 몇 시간씩 일하는 로봇은 그 둘을 모두 겪습니다. 그래서 현장 측정은 짧은 평균이 아니라 긴 시간의 최악을 봐야 합니다. 아래 위젯들의 '측정 회차' 단추로 두 회차를 바꿔 볼 수 있습니다.
한 가지 조심할 점: 맥의 와이파이는 로봇의 무선부가 아니다
스파이크가 나타난 시각을 늘어놓아 보면, 50ms를 넘는 표본들이 0.26초(13표본)나 0.14~0.16초(7~8표본) 간격으로 규칙적으로 묶여 나타나는 구간이 있습니다. 맥은 AirDrop 같은 주변 기기 기능을 위해 무선 채널을 주기적으로 잠깐씩 옮겨 다니고, 배경에서 주변 공유기를 훑기도 합니다. 이런 동작이 규칙적인 스파이크를 만들 수 있습니다. 관리자 권한 없이 이 기능을 끌 수 없어서 끈 상태로는 재지 못했습니다.
그러니 이 숫자는 "로봇의 무선부가 겪을 꼬리"가 아니라 "평범한 노트북 한 대가 평범한 사무실에서 겪는 꼬리" 입니다. 다만 이것이 로봇에게 위안이 되는지는 분명하지 않습니다. 로봇도 공유기 사이를 옮겨 다니려면 주변을 훑어야 하고, SemiAnalysis가 지적한 대로 자기 모터가 같은 대역에 잡음을 뿌리고, 차체가 자기 신호를 가리며, 무엇보다 움직입니다. 우리 노트북은 그 셋 중 아무것도 하지 않았습니다.
데드라인으로 번역하면
이 분포(1회차)를 로봇의 루프에 대 봅니다. 계산하고 남은 시간이 네트워크 예산이고, 왕복이 그 예산을 넘거나 응답이 없으면 그 회차는 놓친 것입니다(계산 시간에는 꼬리가 없다고 둔, 낙관적인 계산입니다).
루프 (예산)
유선 → 공유기
와이파이 → 공유기
와이파이 → 공용 DNS
동작 50Hz (20ms − 계산 5ms = 15ms)
0%
30.4% · 시간당 5.5만 번
46.4%
계획 5Hz (200ms − 계산 100ms = 100ms)
0%
1.6% · 시간당 294번
3.8% · 시간당 675번
B300 12대 공유 (500 − 449 = 51ms, 초당 2회)
0%
7.7% · 시간당 556번
16.8% · 시간당 1,209번
RTX PRO 4대 공유 (500 − 367 = 133ms, 초당 2회)
0%
1.0% · 시간당 71번
0.7% · 시간당 53번
System 2 감독 (1초 − 계산 500ms = 500ms, 초당 1회)
0%
0.65% · 시간당 23번
0.05% · 시간당 2번
계산 시간 5ms·100ms·500ms는 코어닷투데이의 가정이고, 449ms·367ms는 SemiAnalysis 벤치마크의 서버 p99입니다. 와이파이 → 공유기의 'System 2 감독' 놓침 0.65%는 모두 앞서 말한 0.8초짜리 한 사건에서 나왔습니다.
이 표가 4장과 이어지는 지점이 있습니다. SemiAnalysis의 '12대'는 GPU를 데드라인 바로 아래(p99 449ms)까지 꽉 채운 숫자입니다. 그 상태에서 남은 51ms는 유선이면 넉넉하지만, 같은 사무실의 와이파이에서는 열세 번에 한 번 늦습니다. 4대만 붙인 RTX PRO 설정은 133ms가 남아 놓침이 7분의 1로 줄어듭니다. 배치를 키워 PFLOP당 비용을 낮추는 것과 네트워크 예산을 남기는 것은 같은 500ms를 나눠 먹는 일입니다.
SemiAnalysis 그림에서 읽은 B300의 대수별 p99(8대 약 245ms, 10대 약 320ms)를 우리 와이파이 분포에 대 보면 이렇게 됩니다(코어닷투데이 계산). 10대까지는 네트워크 예산이 180ms 이상 남아 공유기 경유 놓침이 0.9% 안팎인데, 12대가 되면 예산이 51ms로 줄며 7.7% 로 뜁니다. 반면 PFLOP당 비용은 10대일 때(GPU 가동률 83%) $0.186으로, 12대($0.172)보다 8% 비쌀 뿐입니다. 장부의 마지막 8%를 짜내려다 현장의 놓침이 여덟 배가 되는 셈입니다. 비용 곡선의 바닥과 지연 곡선의 절벽이 바로 옆에 붙어 있습니다.
아래 시뮬레이터에서 직접 바꿔 보세요. '동작 100Hz'를 고르면 유선으로 서울 공용 DNS까지 가는 것조차 왕복 9ms라 예산(7ms)을 넘어 100% 놓칩니다. 100Hz 루프가 로봇을 떠날 수 없다는 SemiAnalysis의 말이 그대로 확인됩니다.
7장. 코어닷투데이 실측 ② 사내 A100 한 장에 로봇 몇 대
비용 쪽 이야기의 핵심은 "GPU 한 장이 여러 로봇의 요청을 묶어서(배치로) 처리하면 로봇 한 대당 비용이 내려간다"입니다. 그런데 묶으면 한 번의 응답은 늦어집니다. 이 맞바꿈을 직접 보려고 사내 A100 한 장(80GB)에서 작은 실험을 했습니다.
SemiAnalysis처럼 RoboTTT를 재구성할 여력은 없었으므로, 크기가 비슷한 공개 시각-언어 모델 Qwen2.5-VL-3B-Instruct(30억 파라미터, BF16)를 골랐습니다. π0가 30억 파라미터급 시각-언어 모델을 뼈대로 쓰는 것과 비슷한 규모입니다. 로봇처럼 카메라 세 대의 224×224 영상과 "다음에 어떤 상자를 집을까"라는 짧은 지시를 넣고(입력 약 240토큰), 8토큰짜리 짧은 답(로봇의 짧은 결정에 해당)과 1토큰(입력 처리만)을 내게 했습니다. 동시에 요청하는 로봇 수를 1·2·4·8·12·16·24·32대로 바꿔 각각 40번씩 쟀고, 요청마다 영상을 새로 만들어 캐시 효과를 막았습니다.
결과는 이렇습니다(서버 안에서 잰 시간, 이미지 전처리 포함, 네트워크 제외).
동시 로봇 수
vLLM p50
vLLM p99(40회 최댓값)
로봇 한 대당 GPU 시간
transformers 기본 p50
1대
136ms
153ms
136ms
315ms
4대
209ms
220ms
52ms
474ms
8대
312ms
324ms
39ms
774ms
12대
390ms
406ms
32ms
1,141ms
16대
467ms
485ms
29ms
1,585ms
24대
624ms
1,036ms
26ms
2,680ms
32대
774ms
875ms
24ms
4,017ms
8토큰 생성 기준. 로봇 한 대당 GPU 시간 = vLLM p50 ÷ 동시 로봇 수. 모든 값은 코어닷투데이 실측(2026-10-30).
네 가지가 보입니다.
첫째, 배치는 정말로 싸집니다. 혼자 쓰면 한 번에 136ms이던 GPU 시간이, 12대가 함께 쓰면 로봇 한 대당 32ms로 4.2분의 1이 됩니다. 32대면 24ms로 5.6분의 1입니다. SemiAnalysis의 공유 GPU 경제학이 작은 GPU 한 장에서도 그대로 보입니다.
둘째, 대신 한 번의 응답은 늦어집니다. 1대일 때 136ms이던 응답이 12대에서 390ms, 32대에서 774ms가 됩니다. 로봇 한 대의 입장에서는 친구가 늘수록 자기 차례가 늦어집니다. 데드라인 500ms에 맞추면 서버만으로는 16대(p99 485ms)까지 붙일 수 있습니다.
셋째, 여기에 네트워크를 더하면 대수가 반으로 줍니다. 6장의 유선 p99(약 1ms)를 더하면 그대로 16대지만, 같은 사무실 와이파이의 p99(121ms)를 더하면 8대(324 + 121 = 445ms)에서 멈춥니다. 12대는 406 + 121 = 527ms로 데드라인을 넘습니다. 로봇 한 대당 GPU 시간은 8대일 때 39ms로, 16대(29ms)보다 약 34% 비쌉니다. 와이파이의 꼬리가 GPU 비용을 3분의 1 올린 셈입니다(코어닷투데이 계산). 2회차 와이파이(p99 64ms)를 쓰면 12대(406 + 64 = 470ms)까지 들어갑니다. 같은 GPU에 붙일 수 있는 로봇 수가 그날 그 시간의 와이파이에 따라 8대와 12대 사이를 오가는 셈입니다.
넷째, 서버에도 꼬리가 있습니다. 24대에서 40번 중 한 번은 1,036ms가 걸렸습니다(p50 624ms). 이 실험에서는 네트워크도, 다른 사용자도 없었습니다. 6장의 데드라인 시뮬레이터가 계산 시간을 고정값으로 둔 것이 낙관적이라는 뜻이고, SemiAnalysis의 B300 12대 설정이 "5회 중 4회 통과"였던 것도 같은 이야기입니다.
마지막 열은 덤으로 얻은 교훈입니다. 같은 모델, 같은 GPU를 범용 transformers 코드로 돌리면 배치를 키워도 지연이 거의 정비례로 늘어 12대에서 1.14초가 됩니다. 이미지 전처리와 위치 인덱스 계산이 요청마다 따로 돌기 때문입니다. 연속 배칭을 하는 서빙 엔진(vLLM)으로 바꾸자 같은 12대가 390ms가 됐습니다. 직전 특집 「토큰의 값어치」 6장에서 "같은 모델, 다른 공장"이라고 쓴 것과 같은 현상입니다. 공유 GPU의 경제성은 칩만이 아니라 서빙 소프트웨어가 만듭니다.
8장. 회사들은 어디에 뒀나 — 배치의 지도
SemiAnalysis는 "종이 위에서는 로봇 밖 연산이 TCO에서 이기지만, 아직 아무도 대량 생산에 들어가지 않았으므로 오늘은 TCO가 결정하지 않는다"고 씁니다. 실제로 로봇을 내보내는 회사들은 두 진영으로 갈렸고, 무엇이 그들을 갈랐는지는 세 가지였습니다. 로봇이 얼마나 일반적인 일을 해야 하나, 무선이 얼마나 나쁜가, 고객의 현장을 얼마나 바꿀 수 있나.
다섯 회사의 위치는 아래 점검표 위젯 끝에 정리했습니다. Boston Dynamics만 계획 층을 로봇 밖(TPU)에 두고, Agility·Verne·Sunday·Weave는 추론을 로봇 안에 둡니다.
몇 가지 대목은 따로 볼 만합니다.
Agility의 '10초'. Agility는 작업 배정·현장 지도·소프트웨어 업데이트는 클라우드(Agility Arc)에 둡니다. 로봇 앞에 30~60초 분량의 일이 이미 쌓여 있어서, 다음 작업 묶음을 10초 동안 못 받아도 괜찮기 때문입니다. 이것이 "어느 층을 밖으로 빼나"에 대한 가장 실용적인 답입니다. 지연 변동을 견디는 층은 밖으로, 견디지 못하는 층은 안으로. 6장의 표에서 System 2 감독 같은 1초짜리 루프가 와이파이에서도 놓침이 적었던 것과 같은 이야기입니다.
안전은 언제나 안에. Agility의 Digit은 현재 물리적 울타리가 있는 작업 구역 안에서만 일합니다. 동적으로 균형을 잡는 로봇 가운데 사람 가까이에서 일하도록 안전 인증을 받은 것이 아직 없기 때문입니다. SemiAnalysis는 안전 판단을 로봇 밖으로 빼면 "링크 자체가 고장 모드가 된다"고 씁니다. 연결이 끊긴 로봇은 무엇이 잘못됐는지조차 알 수 없으니, 할 수 있는 것은 눈을 감은 채 최악을 가정한 정지뿐입니다.
Sunday의 사전 학습. Sunday가 추론을 로봇 안으로 들여오면서도 큰 모델을 포기하지 않은 이유가 사전 학습 그래프에 있습니다. 사전 학습 없이 후속 학습만 한 모델은 연구실(후속 학습 데이터가 나온 곳)에서 96%, 처음 보는 집에서 14% 였습니다. 사전 학습 데이터 전체를 쓰면 둘 다 100% 입니다. 일반성은 사전 학습의 규모에서 오고, 그 규모를 흡수하려면 모델이 커야 합니다. Sunday는 "큰 모델이 더 잘 일반화하지만, 클라우드에 기대면 로봇이 네트워크에 묶인다"는 맞바꿈을, 모델을 로봇 안 GPU에 넣는 쪽으로 풀었습니다.
Boston Dynamics의 데이터 문제. 로봇 밖에 추론을 두면 로봇마다 고객 공장 바닥의 영상을 밖으로 내보내게 됩니다. 고객은 "우리 데이터로 학습하지 말 것, 다른 고객 것과 섞지 말 것, 요청하면 지울 것"을 요구하고, 원자력 발전소나 군 고객은 어떤 보증이 있어도 데이터를 내보내지 않습니다. Boston Dynamics는 로봇 단계의 공유 통제, SOC 2 Type 2 인증을 받은 운영 플랫폼 Orbit, Google 쪽의 기업용 에이전트 플랫폼이라는 세 겹으로 답합니다. 비용과 지연 다음의 세 번째 축이 데이터 주권인 셈입니다.
아래 점검표는 SemiAnalysis의 사례들에서 뽑은 일곱 개 질문으로, 어느 쪽에 가까운지를 보여 줍니다.
9장. 반론과 한계
SemiAnalysis의 계산에 대해
RoboTTT는 재구성입니다. 공개 코드도 가중치도 없어, SemiAnalysis는 GR00T N1.7에 TTT 블록을 끼운 '시간 특성만 같은' 모델로 쟀습니다. 과제 성공률은 재지 않았고, 학습되지 않은 빠른 가중치는 엉터리 행동을 냅니다. 12대·4대라는 숫자는 "RoboTTT 모양의 추론을 서빙하는 비용"이지, RoboTTT 자체의 숫자가 아닙니다. 로봇 한 대당 151MB의 상태를 모으고 흩는 비용이 있는 모델이라, 가중치를 공유하는 보통 VLA라면 한 장에 더 많이 붙을 수도 있습니다.
가동률 90%는 가정입니다. 4장에서 본 것처럼 결론의 대부분이 이 숫자에 달려 있습니다. 서버 90%와 로봇 40%가 동시에 성립하려면 서버가 여러 현장·여러 교대의 로봇을 이어 받아야 합니다. 서버가 50%만 바쁘고 로봇이 15시간 일하는 현장이라면 SA 방식으로도 1.30배, 일한 로봇-시간당으로는 1.56배로 로봇 칩이 쌉니다(코어닷투데이 계산).
PFLOP당 비교는 공유 쪽에 덤을 줍니다. B300은 로봇 한 대에 1.25 PFLOPS, Thor는 1.04 PFLOPS를 줍니다. 같은 데드라인을 지키는 한 남는 연산은 쓸모가 없으므로, '일한 로봇 한 시간'으로 재면 46%가 55%가 됩니다.
본문과 표가 어긋난 곳이 두 군데 있습니다. RTX PRO 6000의 시간당 TCO(본문 $15.61, 표 $18.65)와 가동률 반영 전 PFLOP당 비용(본문 B300 $0.15·Thor $0.16, 표는 반대)입니다. 표 쪽이 내부적으로 일관됩니다.
무선 구간의 비용과 꼬리가 빠져 있습니다. B300 시나리오의 설비 투자에는 무선 보드 96장이 들어 있지만, 현장 AP 재설계·RF 측량·전담 네트워크 팀의 인건비는 표에 없습니다. Boston Dynamics가 "네트워크만 다루는 팀을 여럿" 두고 있다는 것 자체가 그 비용의 크기를 말해 줍니다. 그리고 벤치마크의 p99 449ms에는 무선 왕복이 들어 있지 않습니다.
이해관계. SemiAnalysis는 데이터센터 칩·메모리 공급망을 분석해 파는 회사이고, 이 글의 결론(데이터센터가 이긴다)은 그들의 주 고객층에 반가운 이야기입니다. 다만 같은 글이 Sunday·Agility처럼 반대로 간 회사들의 이유를 공정하게 소개하고, "오늘은 TCO가 결정하지 않는다"고 스스로 선을 긋는다는 점은 적어 둡니다. 이 글은 유료 글이라 결론부("누가 벽을 넘을 것인가")는 읽지 못했습니다.
코어닷투데이 실측에 대해
노트북은 로봇이 아닙니다. 움직이지 않았고, 모터 잡음도 차체 가림도 없었으며, 신호는 강했습니다(−42dBm). 대신 맥 특유의 주변 기기 탐색 동작이 꼬리의 일부를 만들었을 수 있습니다. 로봇의 무선부는 더 나쁠 수도, 더 좋을 수도 있습니다.
ICMP ping은 영상이 아닙니다. 우리가 잰 것은 작은 패킷의 왕복입니다. 로봇은 카메라 영상을 올려 보내고, SemiAnalysis가 강조한 대로 업링크가 진짜 문제입니다. '내려받기 중' 조건은 짐이 실린 망의 근사일 뿐, 로봇의 업로드 패턴과는 다릅니다.
표본이 짧습니다. 조건마다 2분(6,000회)입니다. p99.9는 표본 6개, 최댓값은 표본 1개로 정해지는 숫자라 회차마다 크게 흔들립니다. 6장에서 본 것처럼 같은 조건의 놓침 비율이 회차마다 600배 달라졌고, 가장 나쁜 사건(0.8초)은 26분 중 한 번이었습니다. 한 회차의 숫자를 일반화하면 안 됩니다.
사무실이 비어 있었습니다. 금요일 밤이라 다른 사람의 트래픽이 거의 없었습니다. 업무 시간에는 더 나빴을 가능성이 높습니다.
A100 실험은 VLA가 아닙니다. 크기가 비슷한 시각-언어 모델로 배치와 지연의 맞바꿈을 본 것이고, 행동 헤드·확산 단계·TTT 상태가 없습니다. A100은 B300보다 연산이 크게 낮아 대수를 직접 비교할 수 없습니다.
측정 시각에 대한 덧붙임
1회차 측정(오후 9시 43분~57분) 무렵에는 이 글 7장의 GPU 실험을 준비하느라 사내 다른 장비가 인터넷에서 모델 파일(약 7GB)과 패키지를 내려받고 있었습니다. 우리가 잰 '와이파이 → 공유기'는 인터넷을 거치지 않는 구간이고 같은 시각의 유선 측정은 깨끗했으므로 주원인으로 보기는 어렵지만, 공유기의 부하에 영향을 줬을 가능성은 배제하지 못합니다. 2·3회차에는 그런 작업이 없었습니다. 공정하게 말하면 "조용한 사무실 와이파이에서도 1초짜리 사건이 날 수 있고, 그 빈도는 이번 측정으로는 정할 수 없다" 가 우리가 말할 수 있는 전부입니다.
10장. 한국에서 읽는 법 — 공장 밀도, 파운드리, 그리고 특화망
로봇 밀도 세계 1위의 공장
국제로봇연맹(IFR)에 따르면 한국은 제조업 노동자 1만 명당 산업용 로봇 1,220대(2024년)로 세계에서 로봇 밀도가 가장 높은 나라입니다(싱가포르 818, 중국 567, 독일 449, 일본 446). 지금까지의 산업용 로봇은 대부분 SemiAnalysis가 "이 글의 대상이 아니다"라고 한 고전적 제어, 즉 정해진 궤적을 작은 내장 칩으로 도는 기계입니다. 범용 로봇이 들어오면 이 공장들은 4장의 비용표가 가장 먼저 시험받는 곳이 됩니다. 3교대로 도는 라인이 많다면 서버 가동률 90%라는 SemiAnalysis의 가정에 가장 가까운 환경이기도 합니다.
SemiAnalysis가 Boston Dynamics의 범용 로봇이 필요한 이유로 든 장면도 자동차 공장입니다. 차 한 대에 부품이 수만 개, 한 라인에서 5~10개 모델이 십수 가지 색으로 동시에 흐르고, 해마다 구성이 바뀌는 곳. 그래서 단계마다 전용 자동화를 맞추는 대신 범용 로봇이 필요하다는 논리입니다. 글에 실린 Atlas 사진의 출처 표기는 "Boston Dynamics. Hyundai Plant"입니다.
삼성 파운드리와 Jetson
3장에서 본 대로 Jetson은 Orin(삼성 SF8)에서 Thor(TSMC N4)로 옮겨 가며 데이터센터 칩과 같은 첨단 공정 줄에 섰습니다. 반대로 4장의 계산대로 로봇 두뇌의 상당 부분이 데이터센터로 간다면, 로봇이 쓰는 반도체의 무게 중심은 로봇 안 SoC가 아니라 데이터센터의 GPU와 HBM으로 옮겨 갑니다. 어느 쪽이든 로봇 반도체는 성숙 공정의 틈새 시장이 아니라 첨단 공정·메모리 경쟁의 한가운데로 들어옵니다.
특화망과 공장 와이파이
한국에는 기업이 자기 건물·부지 안에서만 쓰는 5G 특화망(이음5G) 제도가 있습니다. SemiAnalysis의 처방(와이파이가 대부분을 맡고, 실외·대형 현장·혼잡을 통제할 수 없는 곳은 사설 5G가 메우며, 둘이 하나의 스케줄러 아래에서 공존)은 이런 망을 가진 공장에서 가장 먼저 시험해 볼 수 있습니다. 다만 그 글에서 Sunday의 사례는 "5G 공유기도 똑같이 끊겼다"였습니다. 망의 종류보다 업링크 스케줄링, 핸드오프 시간, 측정에 기반한 배치가 먼저라는 것이 SemiAnalysis의 요지입니다.
실무 체크리스트
로봇이나 현장 AI 장비를 기획하는 팀이 이 글에서 가져갈 것을 정리합니다.
1. 층을 나눈다모델을 계획·동작·서보·안전 층으로 나누고 각 층의 주파수와 데드라인을 적는다. 100Hz 이상과 안전 판단은 처음부터 로봇 안에 둔다.
2. 꼬리를 잰다현장에서 로봇이 다닐 경로를 따라 실제 업링크 크기의 패킷으로 p99·p99.9·최장 연속 지연을 잰다. 평균과 중앙값은 보고서에서 빼도 된다. 측정은 업무 시간에, 기계가 돌 때 한다.
3. 예산을 나눈다데드라인 = 계산 p99 + 네트워크 p99 + 여유. 배치를 키워 계산 p99가 데드라인에 바짝 붙으면 네트워크 예산이 사라진다. 비용 곡선의 바닥 바로 앞에서 멈춘다(6장: 12대→10대, 비용 +8%, 놓침 1/8).
4. 가동률을 정직하게 넣는다서버 가동률은 '몇 교대, 몇 현장을 이어 받나'로 계산한다. 한 교대 한 현장이면 50% 안팎이고, 그때는 로봇 칩이 싸다.
5. 끊겼을 때를 설계한다링크가 1초 끊겨도 System 1이 마지막 지시로 버티거나 안전하게 멈출 수 있게 한다. 늦은 명령은 버리고(신선도 우선) 다음 박자를 기다린다.
6. 데이터 경계를 먼저 묻는다영상이 현장 밖으로 나가도 되는지, 학습·보관·삭제 조건이 무엇인지를 계약 단계에서 확인한다. 안 된다면 현장 안 서버(유선 연결)가 선택지다.
맺음말 — 뇌는 무게가 아니라 박자로 정한다
SemiAnalysis의 글 제목은 「들고 다니기엔 너무 큰 뇌」입니다. 무게로 보면 답은 분명합니다. 수천억 파라미터짜리 계획 모델은 2kWh 배터리를 멘 로봇이 들 수 없습니다. 돈으로 봐도 답은 기울어 있습니다. GPU 한 장에 5~7대가 넘으면 실리콘도, DRAM도, 시간당 비용도 공유 쪽이 이깁니다.
그런데 이 글에서 따라가 본 숫자들은 그 사이에 다른 축 하나가 더 있다고 말합니다. 박자입니다. 로봇은 정해진 박자로 세상을 보고 움직이고, 그 박자를 놓치면 계산이 아무리 정확해도 쓸모가 없습니다. 사무실 와이파이는 중앙값 5ms로 박자를 잘 맞추다가, 2분짜리 측정 한 번에서 1초 넘게 박자를 통째로 잃었습니다. 공유기까지 가는 유선은 6,000번 동안 한 번도 9ms를 넘지 않았습니다. SemiAnalysis가 그린 네 가지 처방(환경을 고치고, 짐을 줄이고, 업링크를 키우고, 모든 것을 한 시계에 맞춘다)은 결국 무선을 유선처럼 '박자를 지키는' 망으로 만드는 일입니다.
그래서 "로봇의 뇌를 어디에 두나"라는 질문은 이렇게 바꿔 물을 수 있습니다. 우리 현장의 망은 몇 Hz의 박자를 p99.9까지 지켜 주나. 그 답보다 느린 층은 밖으로 빼서 싸게 쓰고, 그보다 빠른 층은 로봇 안에 둡니다. 계산이 싸지는 7대의 교차점은 장부에 있고, 그 장부가 현장에서 맞는지는 지터가 정합니다.
이 글로 SemiAnalysis 연작 일곱 편을 마칩니다. 모델의 값에서 시작해 GPU의 값, CPU와 메모리의 쓰임새를 거쳐 로봇과 무선까지 왔습니다. 일곱 편을 관통한 하나의 교훈이 있다면, 평균은 계약서를 쓰고 꼬리는 청구서를 쓴다는 것입니다. 토큰 가격의 평균, GPU 시간당 가격의 평균, 왕복 지연의 평균은 늘 좋아 보입니다. 일을 끝내게 하거나 멈추게 하는 것은 늘 그 뒤의 긴 꼬리였습니다.
참고문헌
SemiAnalysis 뉴스레터 (newsletter.semianalysis.com, 무료 공개 구간과 공개 그림)