[특집] 요약도 실력이다 — 컨텍스트 압축을 강화학습 안으로 들여온 CompactionRL 완전 해설
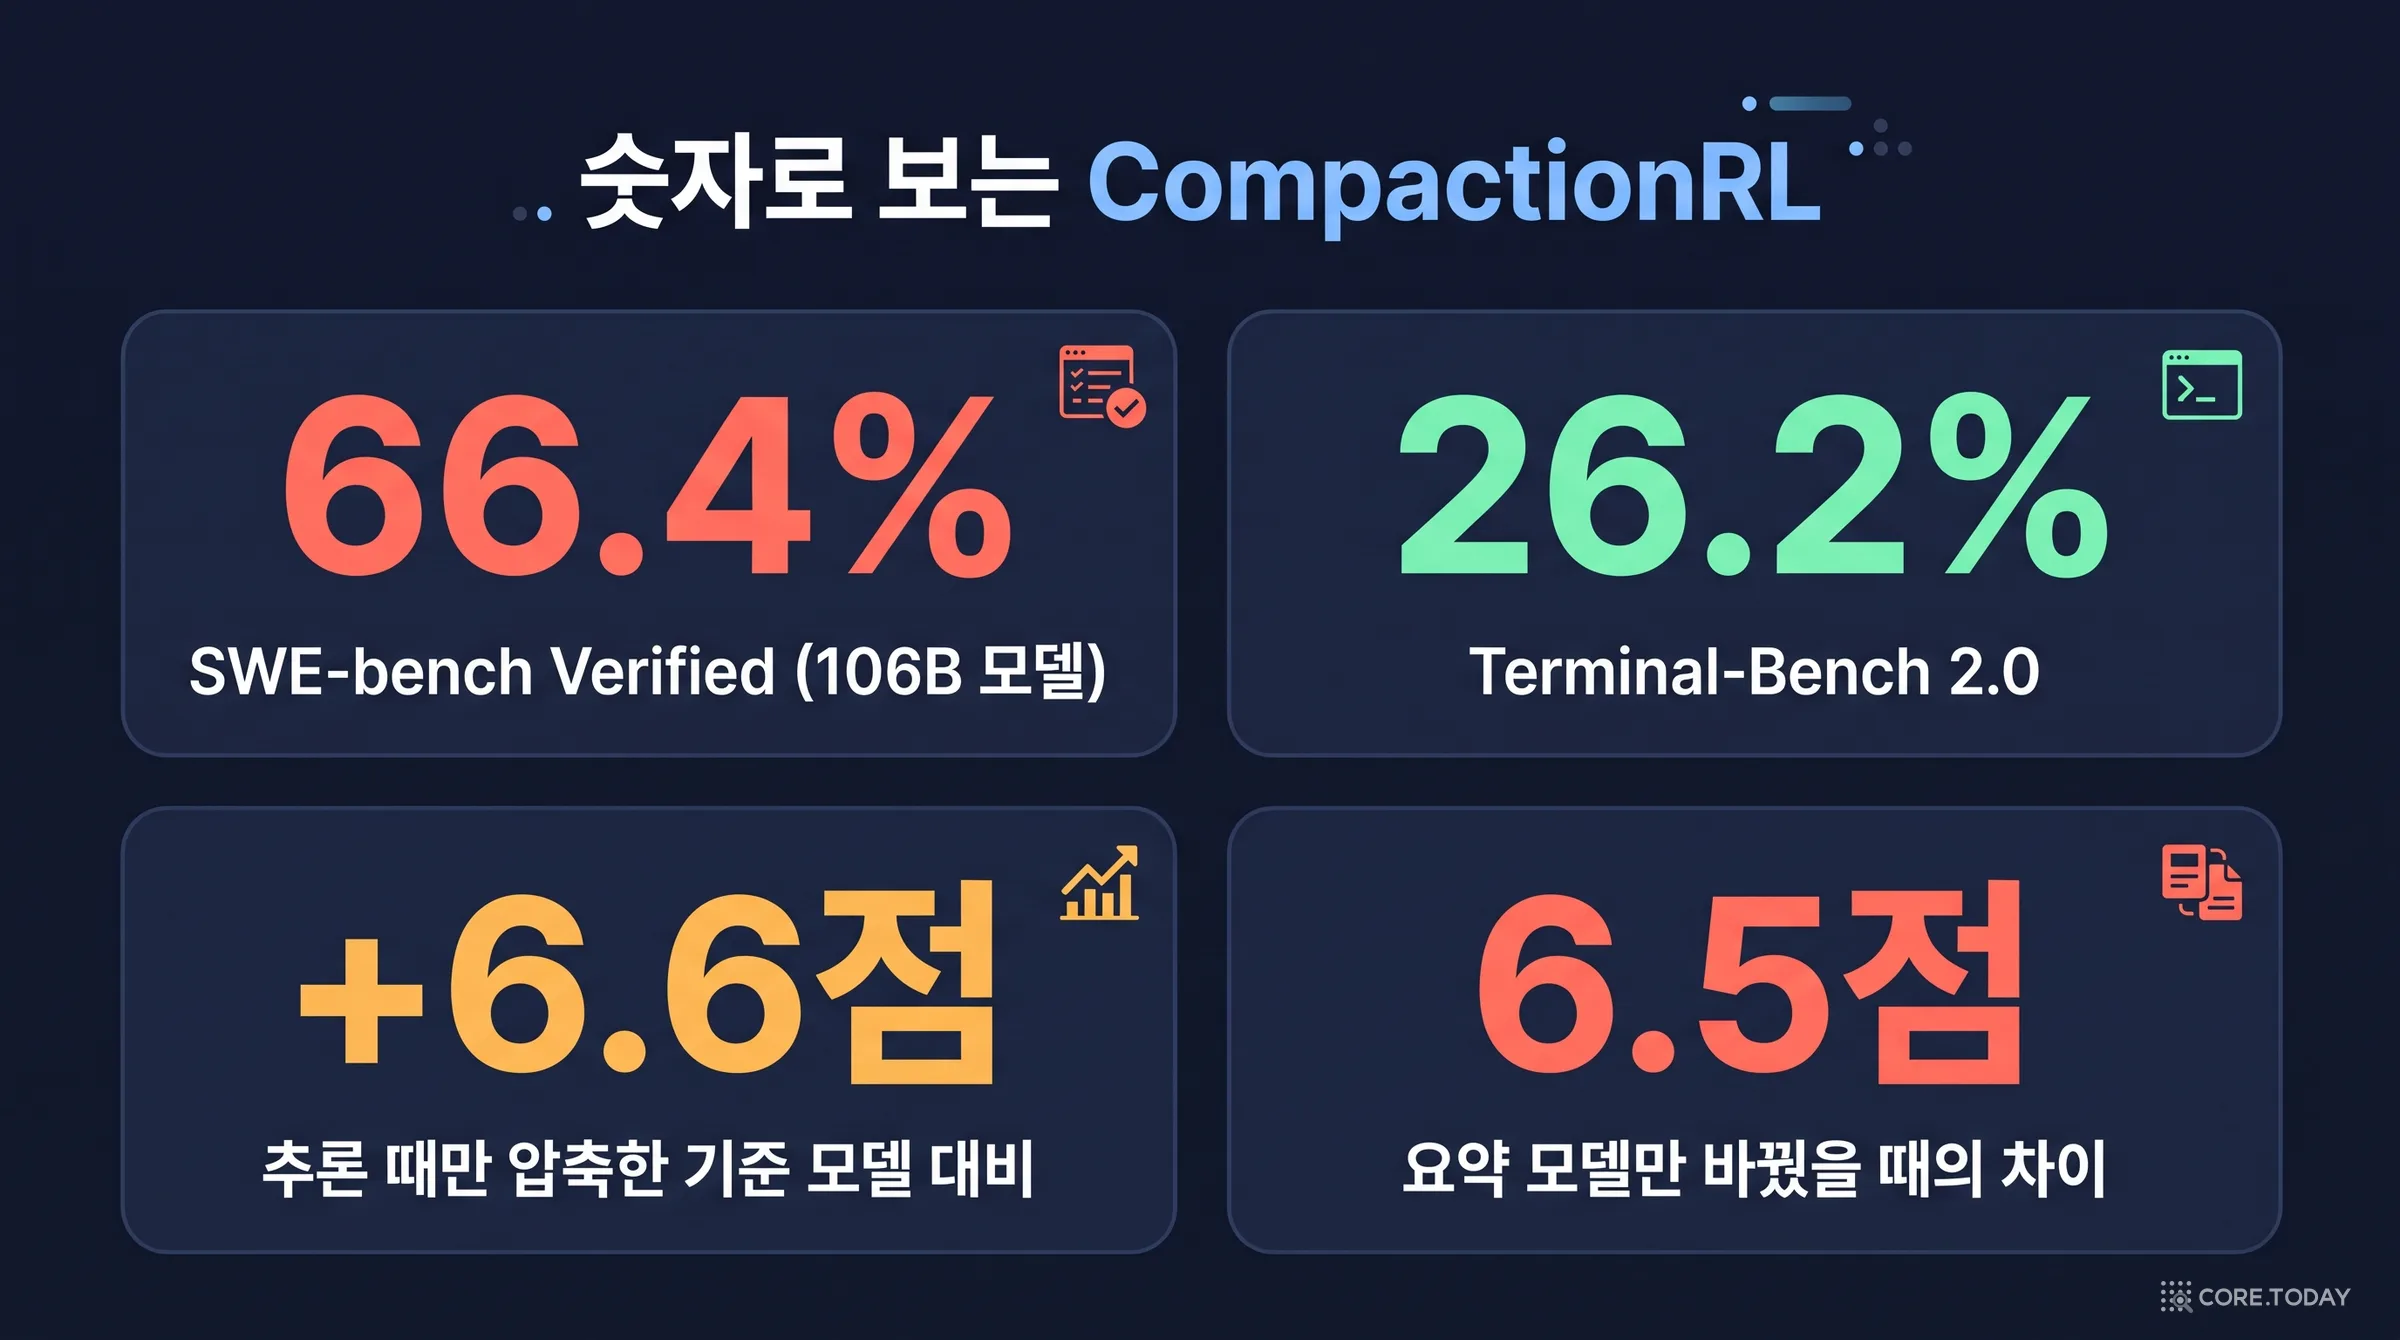
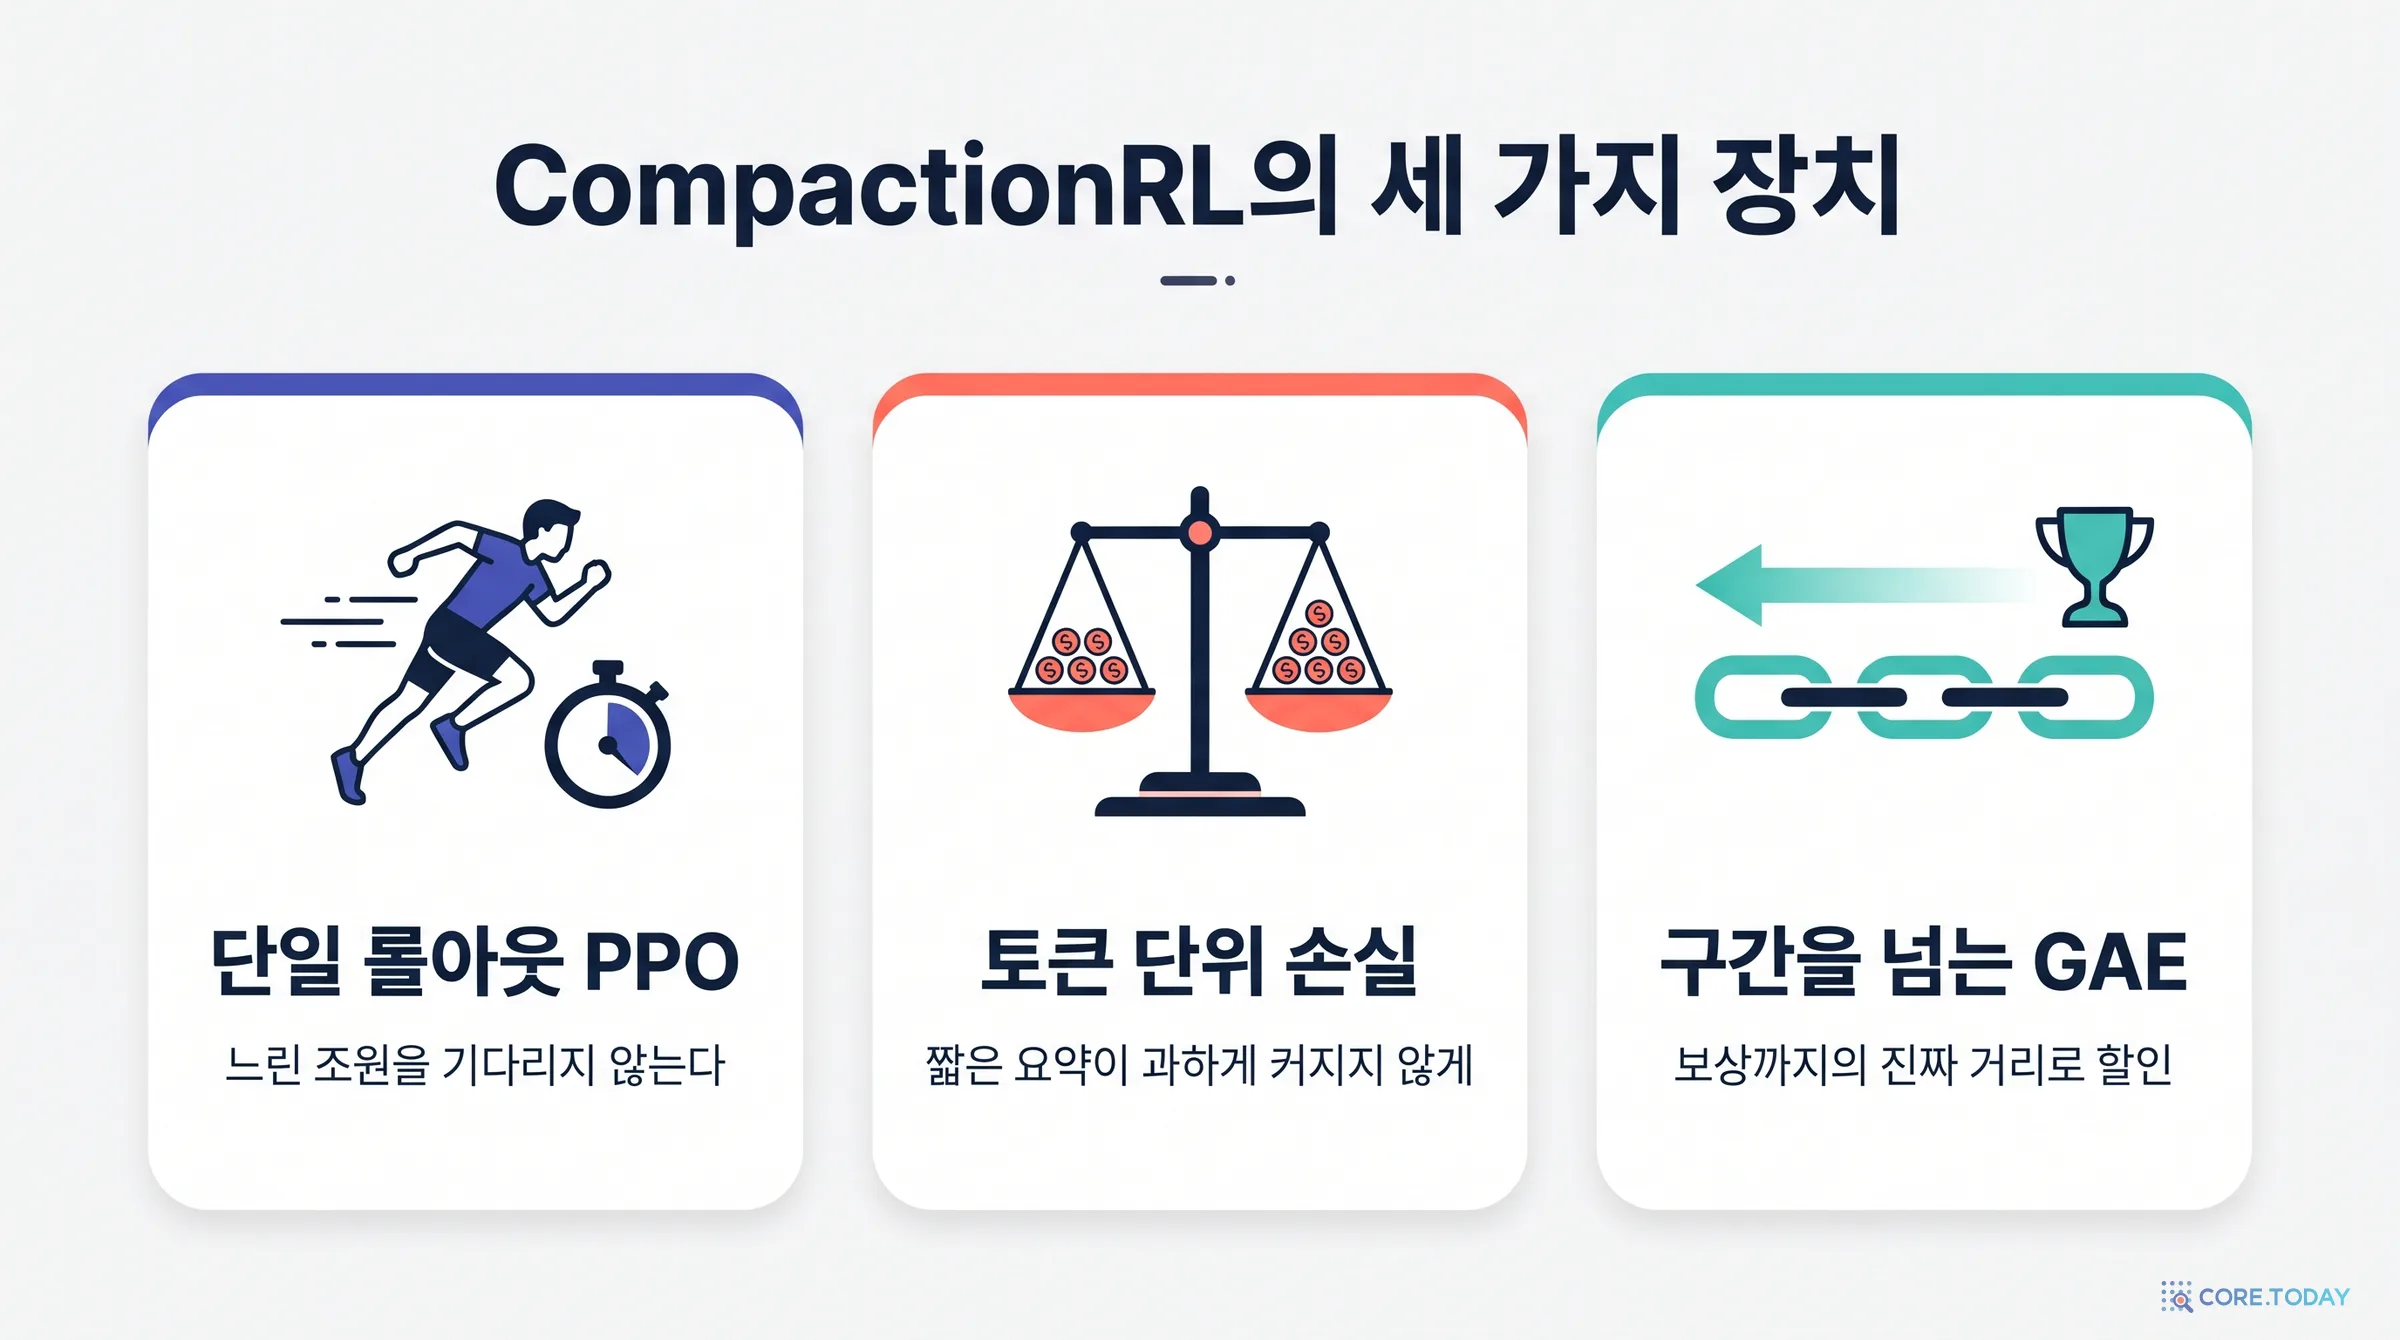
코딩 에이전트가 몇 시간째 일하다 보면 컨텍스트 창이 가득 찹니다. 그때 하네스는 지금까지의 대화를 요약으로 접고 새 창에서 일을 이어 가게 합니다. 이것이 컨텍스트 압축(compaction)입니다. 그런데 이 요약은 지금까지 훈련 밖에 있었습니다. 모델은 요약에서 이어 가는 연습을 한 적이 없고, 요약을 잘 쓴다고 보상을 받은 적도 없습니다. 칭화대와 Z.AI의 2026년 7월 논문 CompactionRL은 압축을 강화학습 롤아웃 안에 넣고, 요약 토큰과 실행 토큰을 같은 최종 보상으로 함께 훈련합니다. 이를 위해 세 가지 장치를 씁니다. 조원을 기다리지 않는 단일 롤아웃 PPO, 짧은 요약이 손실을 독차지하지 않게 하는 토큰 단위 손실, 그리고 잘린 구간 너머로 보상의 거리를 되살리는 구간 넘는 GAE입니다. 106B 모델에서 SWE-bench Verified 66.4%, Terminal-Bench 2.0 26.2%로, 추론 때만 압축한 기준 모델보다 6.6점·4.9점 높습니다. 요약 모델만 바꿔도 6.5점이 움직인다는 실험, 요약을 훈련하면 요약이 길어진다는 관찰, 그리고 이 이득이 압축을 켰을 때만 나온다는 한계까지 표와 그림을 하나씩 읽습니다. 직접 돌려 보는 위젯 일곱 개를 함께 실었습니다.
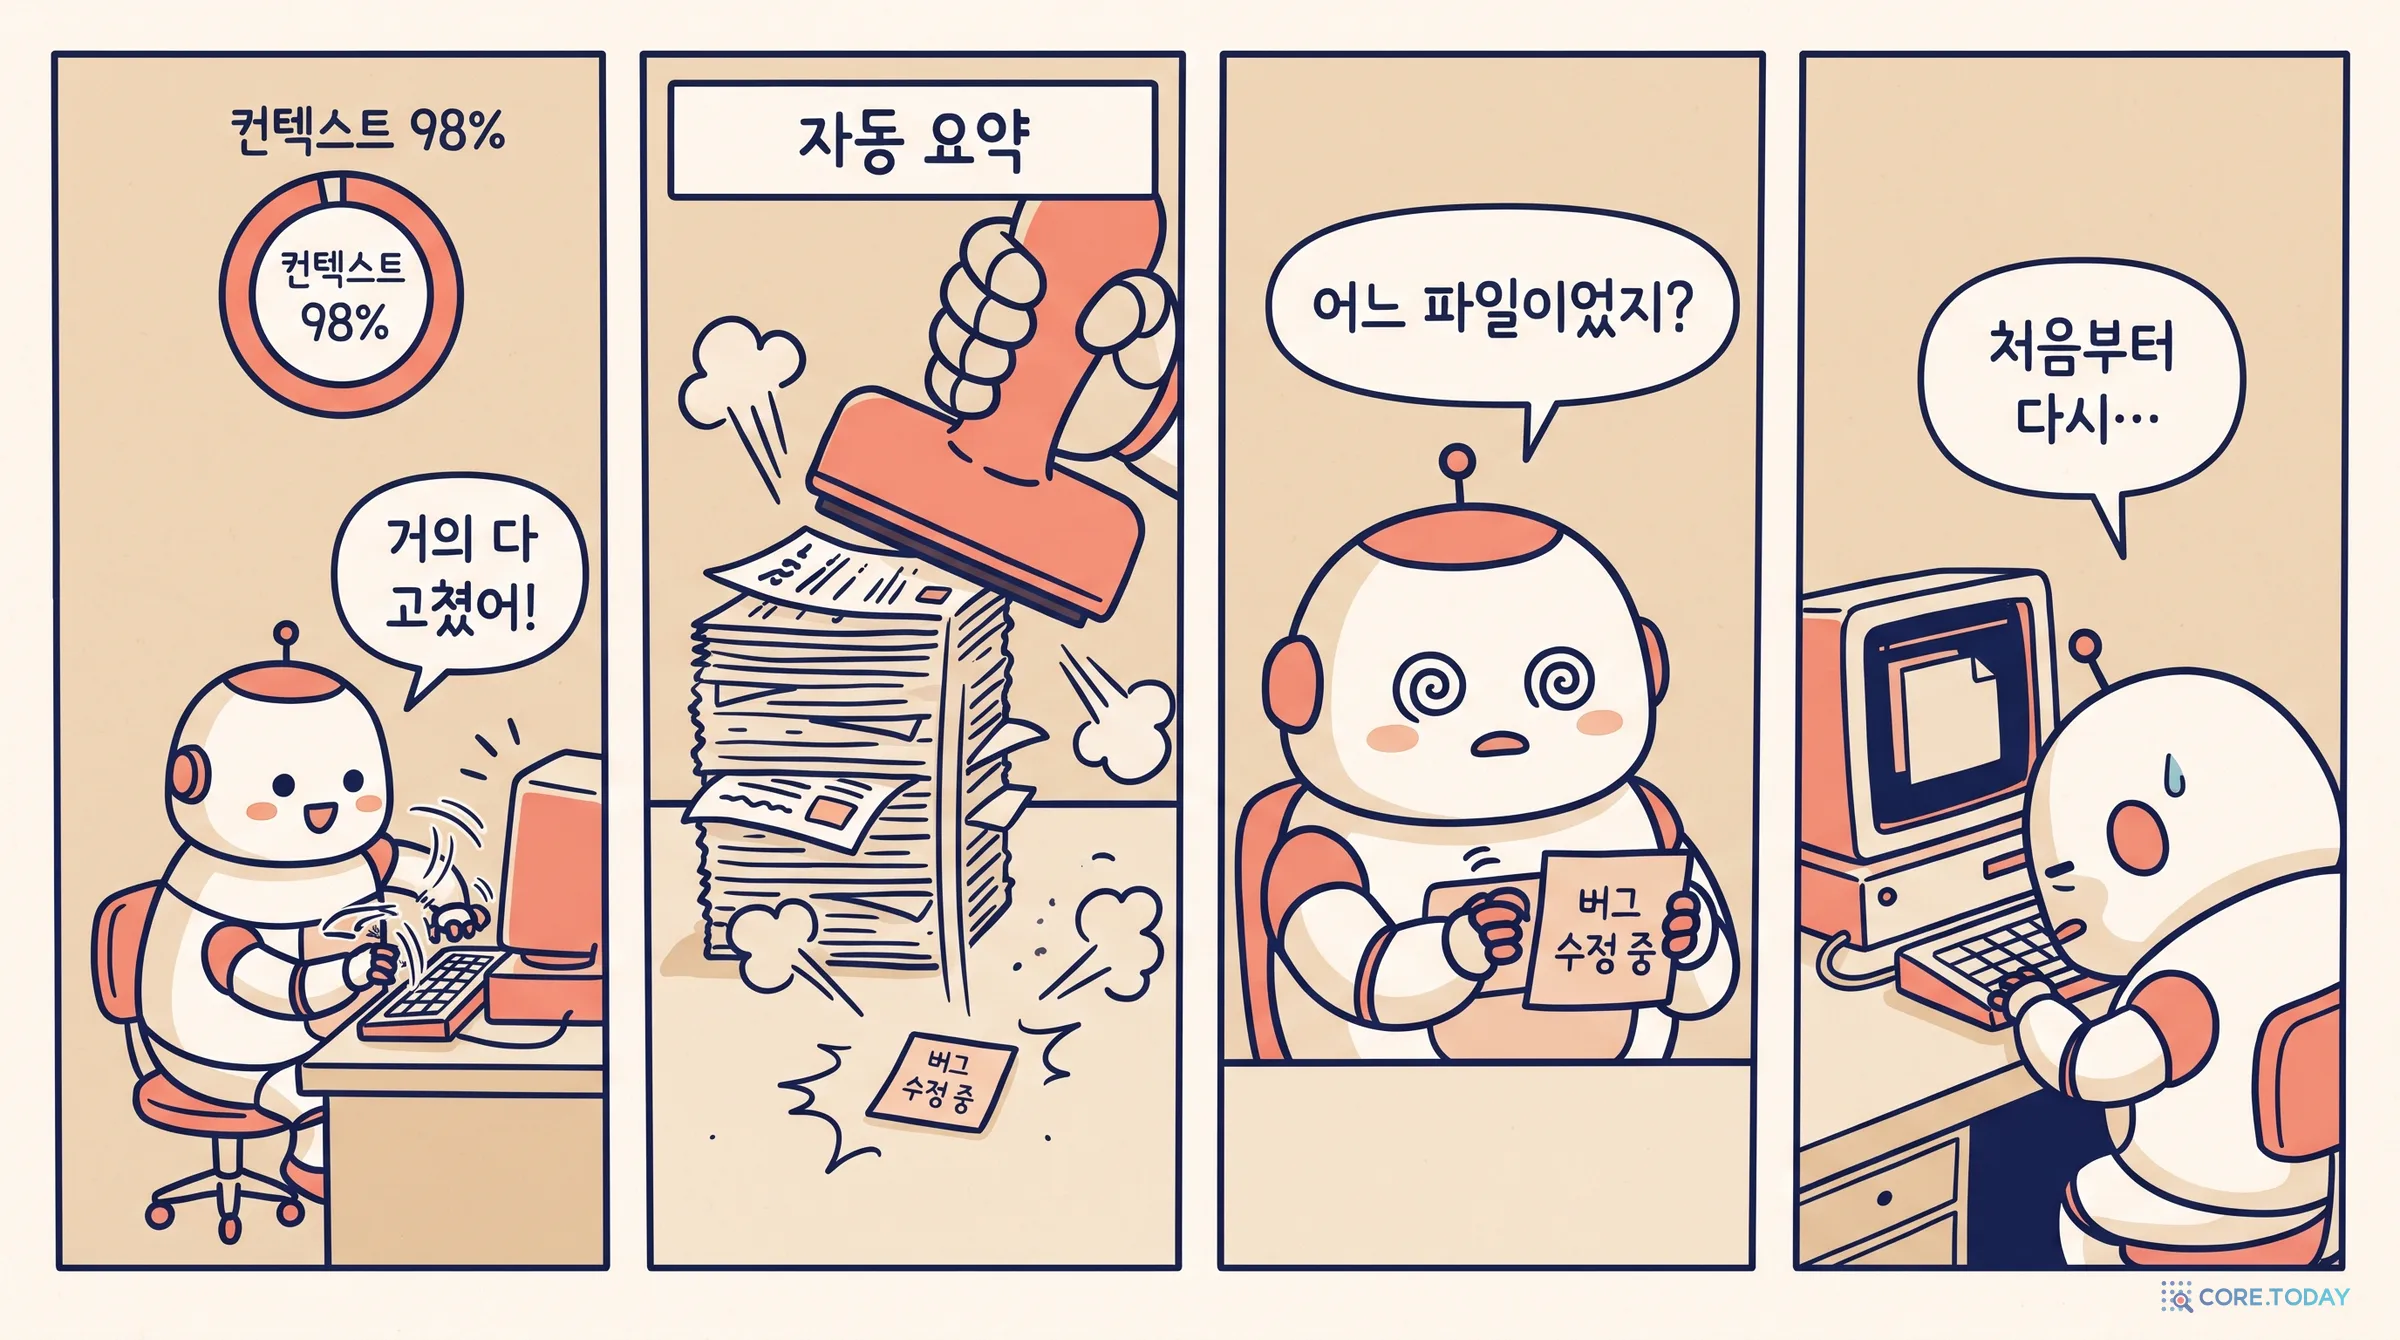
금요일 저녁, 민재 씨는 코딩 에이전트에게 버그 하나를 맡기고 회의에 들어갔습니다. CSV 내보내기에서 한글 파일명이 깨지는 문제였습니다. 에이전트는 성실했습니다. 저장소를 뒤지고, 원인 파일을 찾고, 한 가지 방법을 시도했다가 Safari 테스트에서 막혀 되돌리고, 다른 방법으로 패치를 저장하고, 테스트 열두 개 가운데 열한 개를 통과시켰습니다. 도구 호출 백여든 번째쯤, 화면에 한 줄이 떴습니다.
컨텍스트가 가득 찼습니다. 이전 대화를 요약한 뒤 계속합니다.
회의에서 돌아온 민재 씨가 본 것은 이상한 장면이었습니다. 에이전트가 이미 고쳐 놓은 파일을 다시 열어, 한 시간 전에 실패했던 그 방법을 다시 시도하고 있었습니다. 요약에는 "한글 파일명 버그 수정 중, 일부 진행"이라고만 적혀 있었습니다. 어느 파일인지, 무엇이 실패했는지, 테스트가 어디까지 통과했는지는 요약과 함께 사라졌습니다.
에이전트의 코딩 실력이 갑자기 떨어진 것은 아닙니다. 달라진 것은 에이전트가 볼 수 있는 것입니다. 요약이 원래의 대화를 대신하는 순간부터, 요약에 없는 것은 에이전트에게 일어난 적이 없는 일이 됩니다.
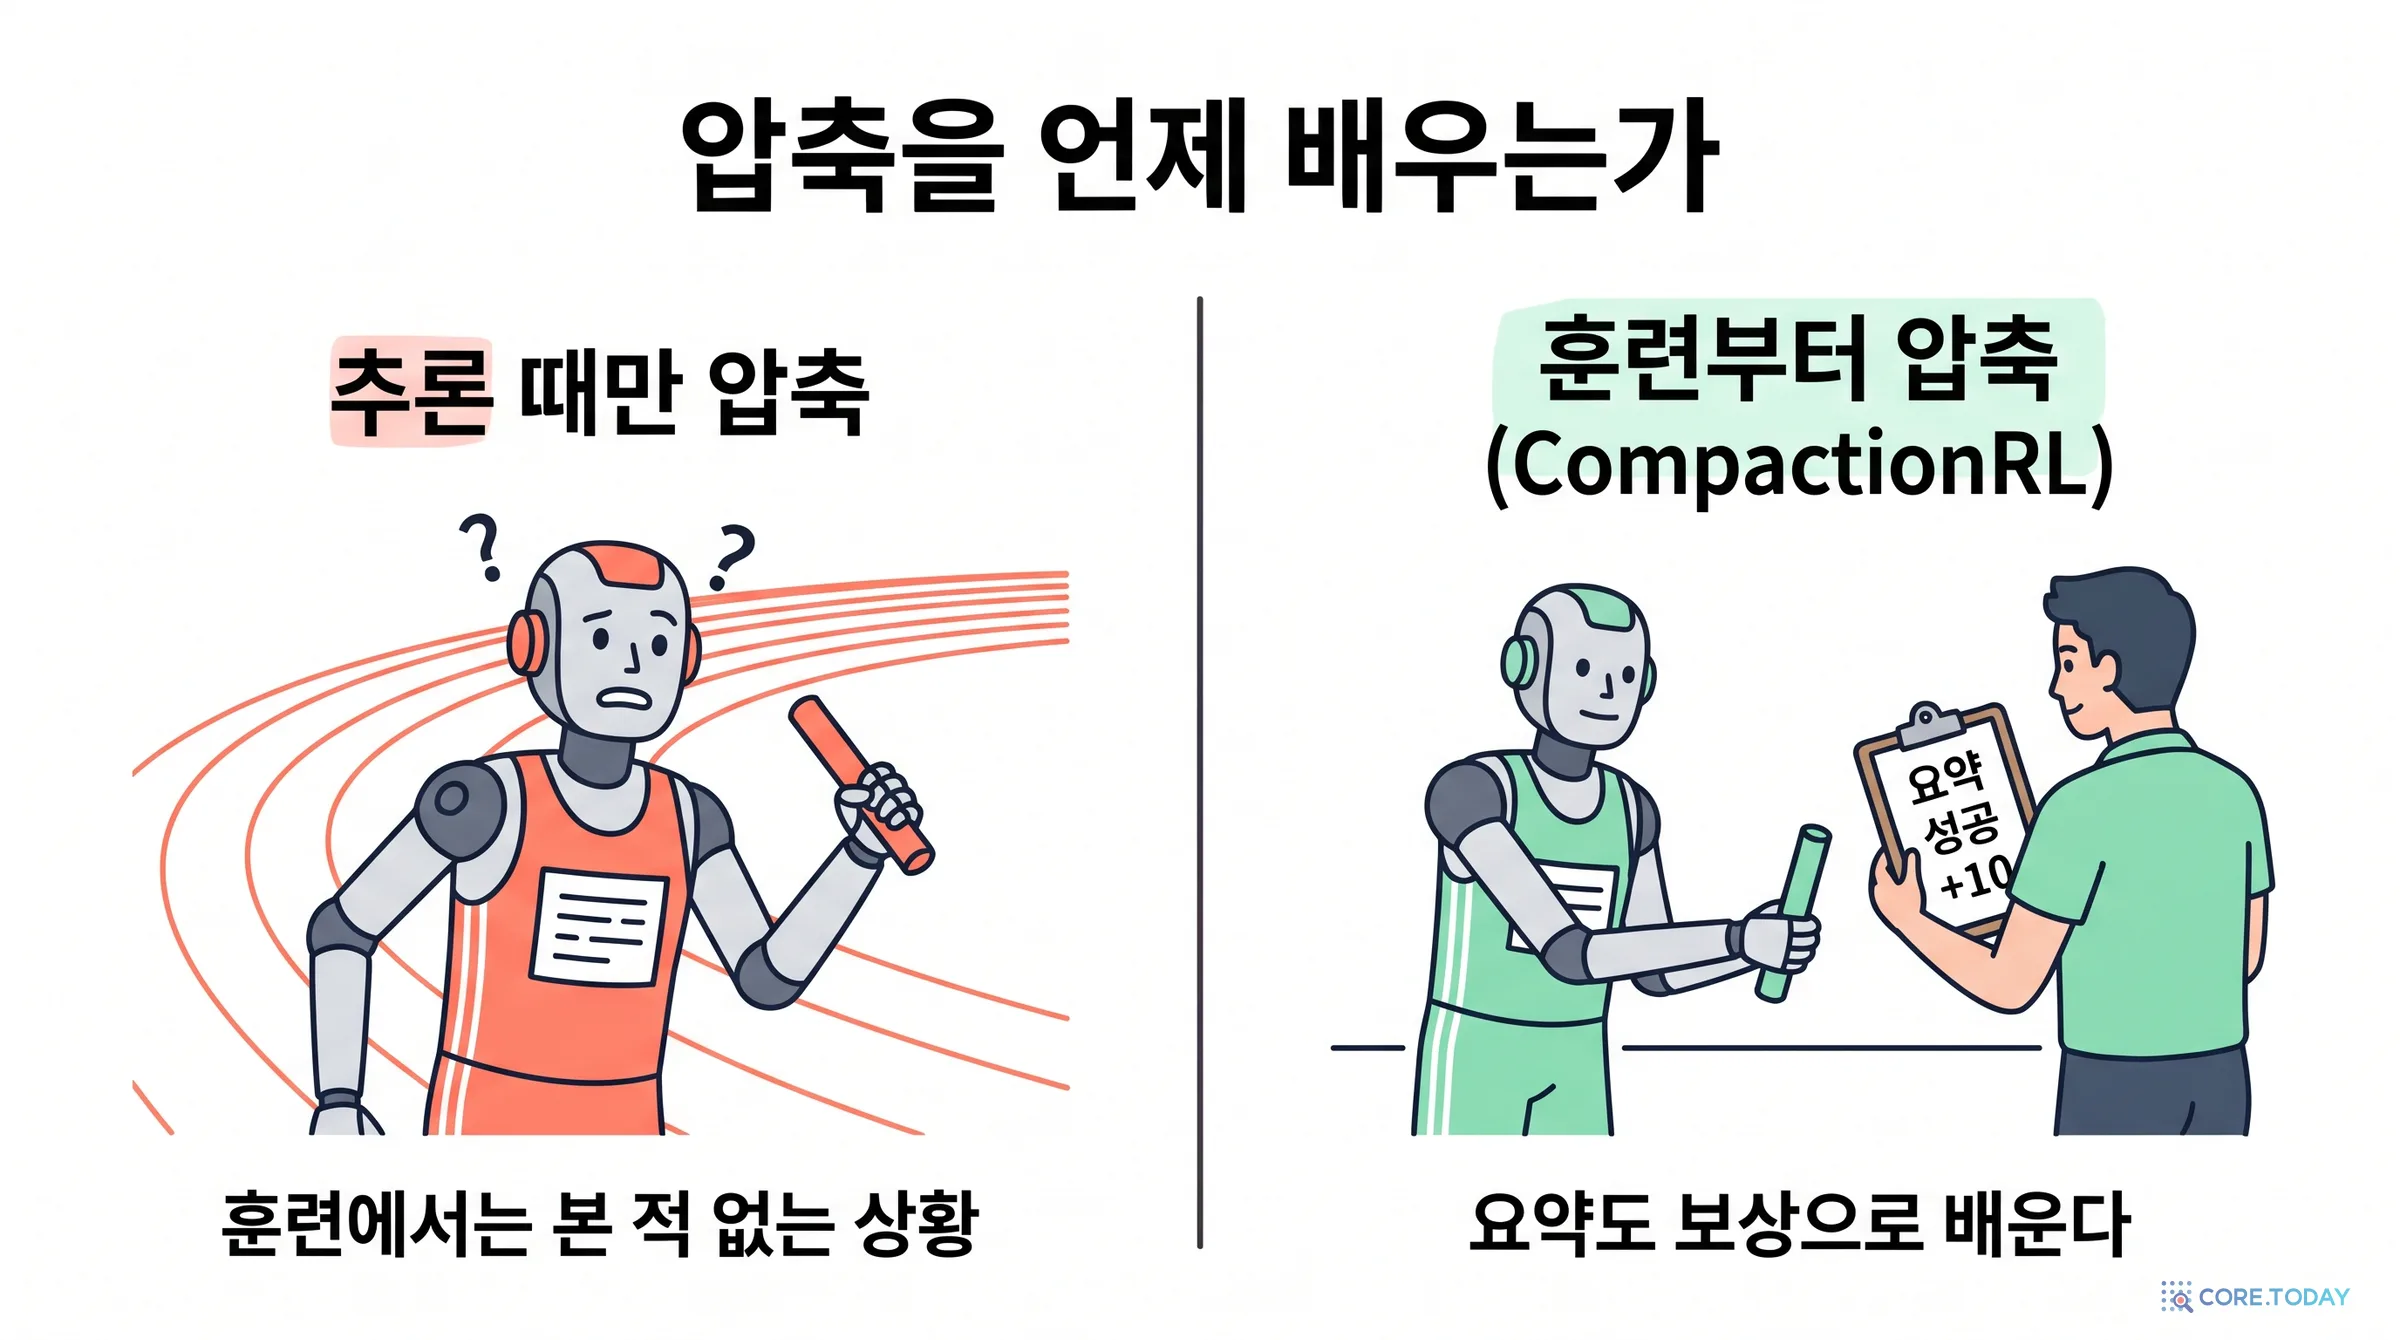
코딩 에이전트를 써 본 사람이라면 한 번쯤 겪은 장면입니다. 그리고 이 장면에는 잘 드러나지 않는 사정이 하나 있습니다. 이 요약을 쓴 것도, 요약에서 일을 이어 간 것도 같은 모델입니다. 그런데 그 모델은 요약을 쓰는 연습도, 요약에서 이어 가는 연습도 한 적이 없습니다. 요약은 하네스(모델을 감싸 도구와 문맥을 관리하는 프로그램)가 추론 때 덧붙인 절차일 뿐, 모델을 훈련할 때는 없던 일이기 때문입니다.
칭화대와 Z.AI(지푸)의 연구자들이 2026년 7월 6일 arXiv에 올린 논문 「CompactionRL: Reinforcement Learning with Context Compaction for Long-Horizon Agents」(arXiv 2607.05378, 10월 1일 v2)는 이 틈을 메우려는 시도입니다. 주장은 한 문장으로 줄일 수 있습니다.
압축은 추론 때의 요령이 아니라 정책의 일부다. 그러니 훈련 안에 넣고, 요약도 과제의 성패로 보상하자.
?
문제
오래 일하는 에이전트는 컨텍스트 창이 차면 대화를 요약으로 접고 이어 갑니다. 그런데 이 압축은 추론 때만 쓰는 요령이었습니다. 강화학습은 창 하나 안에서 끝나는 궤적으로만 이뤄졌고, 요약은 보상을 받은 적이 없습니다. 요약이 나쁘면 그 뒤의 모든 행동이 헛돕니다.
→
해결
압축을 롤아웃 수집 과정에 넣습니다. 창이 차면 정책이 직접 요약을 쓰고, 요약 + 최근 두 턴으로 새 문맥을 짜서 이어 갑니다. 실행 구간과 요약 구간이 모두 같은 최종 보상을 받습니다. 구간이 잘려서 생기는 세 가지 문제는 단일 롤아웃 PPO, 토큰 단위 손실, 구간을 넘는 GAE로 풉니다.
✓
결과
GLM-4.5-Air(106B)가 80k 창으로 SWE-bench Verified 66.4%, Terminal-Bench 2.0 26.2%. 추론 때만 압축한 기준 모델보다 6.6점·4.9점 높고, 160k 창으로 훈련한 모델도 앞섭니다. 다만 이 이득은 압축을 켰을 때만 나옵니다. 저자들은 이 방법을 GLM-5.2의 강화학습 파이프라인에 넣었다고 밝힙니다.
이 글은 논문을 순서대로 따라 읽지 않고, 이해에 필요한 순서로 다시 짰습니다. 먼저 컨텍스트 창이 왜 늘 모자라는지, 창을 키우는 것이 왜 답이 되지 못했는지를 봅니다(1장). 그다음 압축이라는 발상이 어디서 와서 어떻게 '훈련의 대상'이 되었는지 족보를 따라갑니다(2장). 3장에서는 논문의 출발점인 "요약이 곧 성적이다"를 표 하나와 위젯 두 개로 확인합니다. 4장은 강화학습을 처음 보는 분을 위한 복습이고, 5장이 논문의 본론인 세 가지 장치입니다. 6장에서 실험 표와 그림을 읽고, 7장에서 이 논문이 보여 준 것과 아직 보여 주지 못한 것을 가릅니다. 8장은 2026년 말의 시점에서 이 기술이 놓인 자리, 9장은 에이전트를 만드는 사람을 위한 점검표입니다.
1. 창은 왜 늘 모자라는가
에이전트는 모든 것을 붙여 가며 일한다
챗봇과 에이전트의 차이는 일하는 방식에 있습니다. 챗봇은 질문 하나에 답 하나를 씁니다. 에이전트는 생각하고, 도구를 부르고, 결과를 읽고, 다시 생각하기를 되풀이합니다. 2022년의 ReAct 논문이 정리한 이 순환이 지금 모든 코딩 에이전트의 기본 틀입니다.
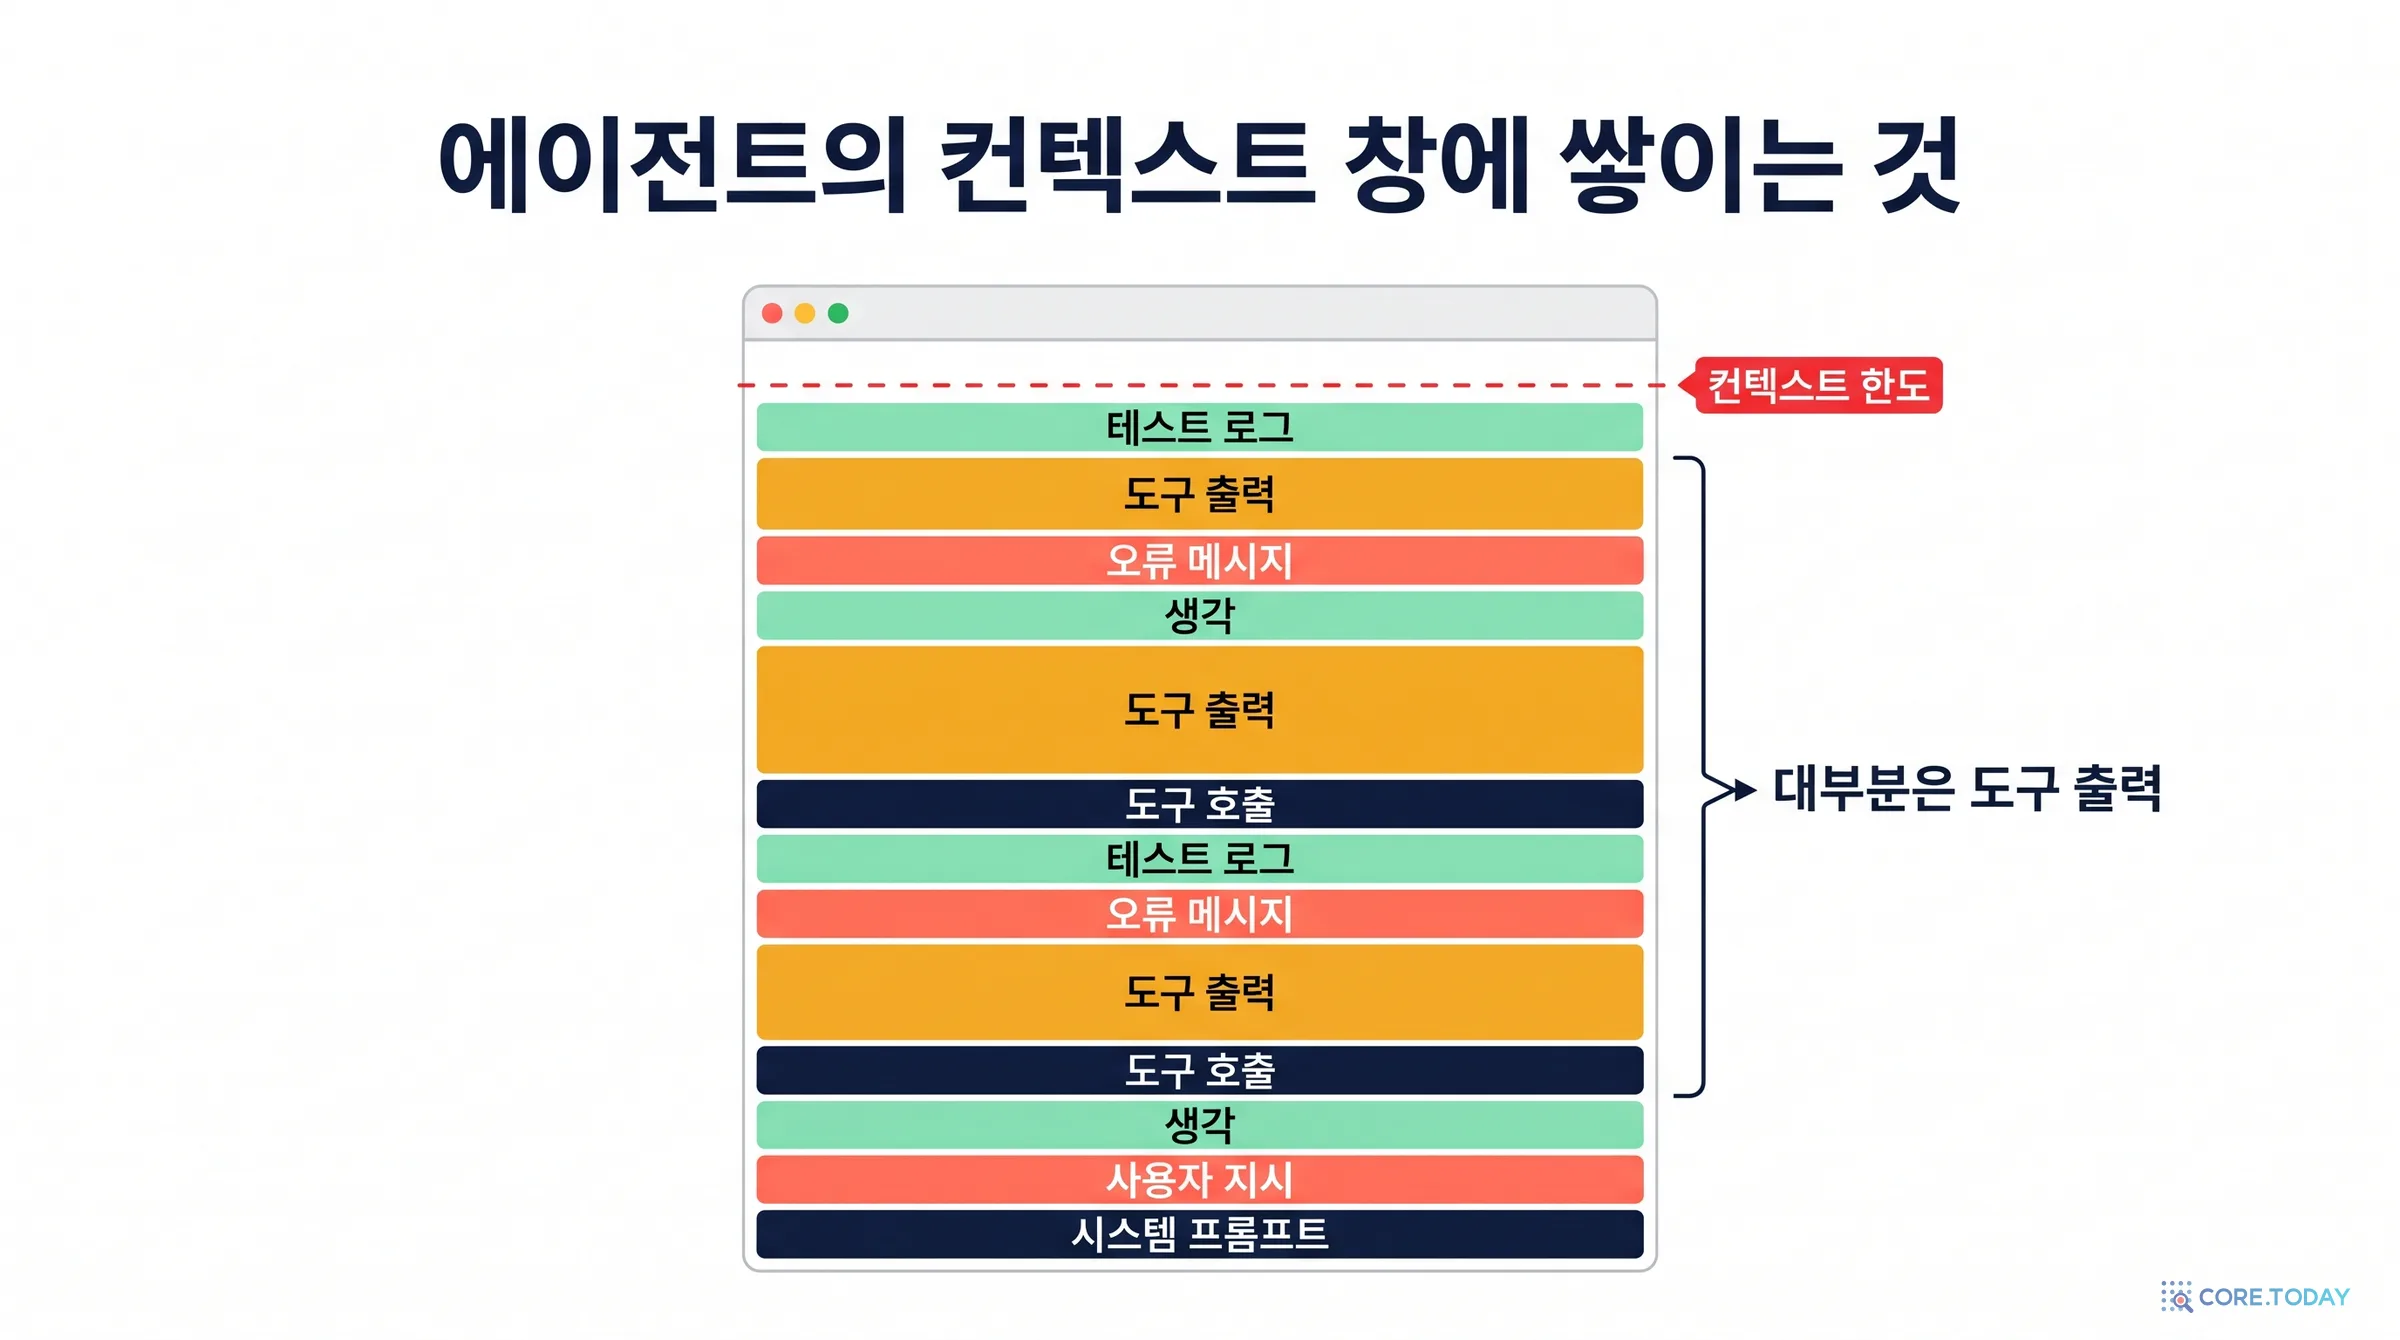
이 틀에는 조용한 전제가 하나 있습니다. 지나간 모든 것을 문맥에 계속 붙여 둔다는 것입니다. 모델은 기억이 없습니다. 다음 토큰을 정할 때 볼 수 있는 것은 컨텍스트 창 안에 든 글자뿐입니다. 그래서 하네스는 시스템 프롬프트, 사용자의 지시, 그리고 지금까지의 생각·도구 호출·도구 출력을 전부 이어 붙여 매번 다시 넣어 줍니다.
쌓이는 속도는 생각보다 빠릅니다. 파일 하나를 열면 수천 토큰, 테스트를 돌리면 로그가 또 수천 토큰입니다. 이 논문의 실험에서 기준 모델은 SWE-bench Verified 과제 하나에 평균 83번 도구를 불렀고(그림 3b), 평가는 최대 250턴까지 허용했습니다. 훈련 통계로 보면 롤아웃 하나에서 모델이 직접 쓴 토큰만 평균 4만 개입니다. 도구 출력은 여기에 더해집니다. 2026년의 최상위 모델들은 SWE-bench 과제 하나에 50만~160만 토큰을 씁니다(Vals.ai 집계).
논문이 쓴 창은 64k와 80k입니다. 과제 하나의 기록이 창 하나에 들어가지 않는 것은 예외가 아니라 일상입니다.
창을 키우면 되지 않나
가장 먼저 떠오르는 답입니다. 실제로 창은 무섭게 커졌습니다.
2020GPT-3, 약 2천 토큰. A4 서너 쪽
2023.3GPT-4, 8,192 토큰과 32,768 토큰
2023.5Claude, 9천에서 10만 토큰으로. 책 한 권이 들어가기 시작
2023.11GPT-4 Turbo 12.8만, Claude 2.1 20만
2024.2Gemini 1.5 Pro, 100만 토큰(비공개 미리보기). 6월에 200만
2025.8Claude Sonnet 4, 100만 토큰 베타
2026.11Claude·GPT·Gemini의 주력 모델과 공개 가중치 GLM-5.2까지 모두 약 100만 토큰
4년 만에 500배가 되었습니다. 그런데 이 연표의 마지막 두 줄을 보면 이상한 점이 있습니다. 2024년 이후로 창은 100만 근처에서 멈춰 있습니다. 그 사이 에이전트가 한 번에 맡는 일의 길이는 계속 늘었습니다. METR의 측정으로 모델이 절반의 확률로 해내는 과제의 길이는 약 넉 달마다 두 배가 되었고, 2026년 초 모델에서 열두 시간에 이르렀습니다(신뢰구간은 넓습니다). 창은 멈췄고 일은 길어졌습니다. 그 사이를 메우는 것이 압축입니다.
창을 키우는 길이 막힌 이유는 세 가지입니다.
첫째, 길게 넣는다고 다 읽는 것이 아닙니다. 2023년 스탠퍼드의 「Lost in the Middle」은 정답이 든 문서를 입력의 처음·가운데·끝에 놓아 보았습니다. 가운데에 놓으면 성능이 20% 넘게 떨어졌고, 최악의 경우 문서를 아예 주지 않았을 때(56.1%)보다도 낮았습니다. 2024년 NVIDIA의 RULER는 "32K 이상을 지원한다"는 모델 17개를 시험했는데, 32K 길이에서 만족스러운 성능을 유지한 것은 절반뿐이었습니다. 2025년 Chroma의 「Context Rot」 보고서는 18개 모델 모두에서 입력이 길어질수록 성능이 내려간다고 보고했습니다. 코어닷투데이는 Context Rot 해설에서 이 현상을 자세히 다뤘습니다.
둘째, 비쌉니다. 에이전트는 턴마다 문맥 전체를 다시 넣습니다. 문맥이 길수록 매 턴이 비싸지고 느려집니다. 캐시가 이 비용을 많이 덜어 주지만 없애지는 못합니다(코어닷투데이의 세션 경제학 글에서 다뤘습니다). 모델을 직접 띄워 쓰는 쪽에서는 창의 크기가 곧 GPU 메모리입니다.
셋째, 훈련도 그 창 안에서 해야 합니다. 이 논문이 서 있는 지점입니다. 강화학습으로 에이전트를 훈련하려면 롤아웃 전체가 창 안에 들어가야 합니다. 창을 두 배로 키우면 롤아웃 생성도, 정책과 비평가의 학습도 그만큼 무거워집니다. 논문의 문장으로는 이렇습니다.
문맥 길이를 키우는 것만으로는 비용이 크고, 긴 시퀀스에서 활용도가 떨어지는 문제를 완전히 풀지 못한다. 그러므로 LLM 에이전트의 장기 과제 강화학습에는 고정된 컨텍스트 예산 아래에서 훈련을 진행하게 해 주는 장치가 필요하다.
논문은 이 주장을 실험으로도 확인합니다. 160k 창으로 압축 없이 훈련한 모델보다 80k 창을 접어 쓰도록 훈련한 모델이 높았습니다(6장의 표 4).
2. 압축의 족보 — '요령'에서 '훈련 대상'까지
압축은 새 발상이 아닙니다. 새로운 것은 그것을 어디에 두느냐입니다. 지난 4년의 흐름을 세 시기로 나눌 수 있습니다.
1기 (2022~2024): 하네스의 요령
대화가 길어지면 앞부분을 요약으로 바꾸자는 생각은 ChatGPT가 나오기 닷새 전에 이미 라이브러리에 들어와 있었습니다. LangChain의 ConversationSummaryMemory가 2022년 11월 25일 배포판에 처음 등장하고, 한 달 뒤 ConversationSummaryBufferMemory가 나옵니다. 뒤쪽은 오래된 대화는 요약으로, 최근 대화는 원문 그대로 둡니다. CompactionRL의 "요약 + 최근 k턴"과 같은 틀입니다. 4년 전의 구조가 그대로 살아 있는 셈입니다.
2023년 10월 버클리의 MemGPT는 한 걸음 더 나갔습니다. 운영체제가 좁은 주기억장치와 넓은 디스크 사이에서 페이지를 넣고 빼듯, 모델이 스스로 문맥 창과 외부 저장소 사이로 정보를 옮기게 했습니다. 같은 해 Reflexion은 실패한 시도에서 교훈을 글로 적어 다음 시도에 넘겼고, Generative Agents는 관찰을 쌓아 두었다가 주기적으로 요약(반성)을 만들었습니다.
이 시기의 공통점은 압축이 모델 바깥의 일이었다는 것입니다. 모델은 그대로 두고, 프롬프트와 코드로 요약을 시켰습니다.
2기 (2025): 제품의 기본 기능
2025년에 코딩 에이전트가 제품이 되면서 압축도 일상어가 되었습니다. Claude Code는 2025년 2월 24일 첫 배포 뒤 한 달이 안 된 3월 18일(v0.2.47)에 "무한한 대화 길이를 위한 자동 대화 압축"을 넣었습니다. OpenAI의 Codex CLI에는 4월에 /compact가 들어왔습니다. 9월 29일 Anthropic은 「AI 에이전트를 위한 효과적인 컨텍스트 엔지니어링」이라는 글에서 긴 작업을 위한 기법을 압축, 구조화된 메모, 하위 에이전트의 셋으로 정리하고 압축을 이렇게 정의했습니다. "컨텍스트 창 한도에 가까워진 대화를 요약하고, 그 요약으로 새 컨텍스트 창을 다시 시작하는 일." 같은 글은 위험도 적었습니다. "지나치게 공격적인 압축은, 나중에야 중요성이 드러나는 미묘하지만 결정적인 문맥을 잃게 할 수 있다."
사용자들도 같은 것을 겪었습니다. Claude Code 저장소에는 "자동 압축 뒤의 기억 상실"(2025년 6월) 같은 이슈가 이어졌고, 2026년 2월의 한 이슈는 압축을 "한 방향의 손실 변환"이라고 불렀습니다. 공식 문서도 인정합니다. "요약은 요청과 핵심 코드 조각을 유지하지만, 대화 초반의 자세한 지시는 사라질 수 있다." 프롤로그의 장면은 지어낸 것이 아닙니다.
코어닷투데이가 9월에 다룬 코딩 하네스 해부 연구도 같은 방향을 가리킵니다. 모델을 한 글자도 바꾸지 않고 하네스의 문맥 관리만 켰더니 32k 창에서 SWE-bench Verified가 6.4%에서 58.4%로 뛰었습니다. 문맥 관리는 하네스의 가장 큰 부품입니다.
3기 (2025 가을~): 훈련 안으로
여기서 물음이 바뀝니다. 압축이 그렇게 중요하다면, 왜 모델은 그것을 연습하지 않는가.
산업 쪽에서 먼저 답이 나왔습니다. 2025년 11월 19일 OpenAI는 GPT-5.1-Codex-Max를 내놓으며 이렇게 썼습니다. "압축이라는 과정을 통해 여러 컨텍스트 창에 걸쳐 일하도록 기본적으로 훈련된 우리의 첫 모델." 내부 평가에서 24시간 넘게 과제를 이어 갔다고도 했습니다. 다만 어떻게 훈련했는지는 공개하지 않았습니다.
표에서 CompactionRL의 자리가 보입니다. "실행과 요약을 함께 훈련한다"는 것은 SUPO가 먼저 했습니다. "비평가를 쓴다"는 것은 MEM1이 먼저 했습니다. CompactionRL이 더한 것은 그 둘을 코딩 에이전트의 긴 궤적에 맞게 엮은 것, 그리고 잘린 구간에서 생기는 두 가지 어긋남(길이와 거리)을 따로 고친 것입니다. SUPO의 저자들은 논문에서 "비평가를 훈련해 토큰 단위 어드밴티지를 추정하는 것은 후속 연구로 남긴다"고 적었는데, 그 숙제를 9개월 뒤 다른 연구진이 푼 셈입니다.
이 논문이 왜 2026년 여름에 나왔는지도 연표에서 읽힙니다. 창은 100만에서 멈췄고(긴 문맥의 한계), 압축은 모든 하네스의 기본 기능이 되었고(제품), 비평가를 쓰는 PPO가 긴 추론에서도 통한다는 것이 다시 확인되었고(VC-PPO·VAPO·SAO), 압축된 궤적을 그대로 다룰 수 있는 비동기 훈련 프레임워크(slime)가 공개되어 있었습니다. 네 조각이 모이자 남은 일은 그것을 잇는 것이었습니다.
3. 요약이 곧 성적이다 — 논문의 출발점
압축은 정확히 어떻게 일어나나
논문의 정의부터 봅니다. 에이전트의 대화 기록은 다음과 같이 생겼습니다.
ht=(s,u,z1,…,zt),zi=(ai,oi)
s는 시스템 프롬프트, u는 사용자의 원래 지시, ai는 i번째 턴에서 모델이 쓴 응답(생각과 도구 호출), oi는 그 결과로 환경이 돌려준 관찰(도구 출력)입니다. 모델의 응답과 그 관찰을 한 쌍 zi로 묶어 쪼갤 수 없는 한 걸음으로 다룹니다. 도구를 불러 놓고 결과를 못 본 채 잘리는 일이 없게 하려는 것입니다.
창의 크기를 C, 지금 기록의 토큰 길이를 ∣ht∣라고 하면, 압축은 남은 공간이 문턱 아래로 내려갈 때 걸립니다.
C−∣ht∣<Tcomp
논문의 설정에서 Tcomp는 10,240 토큰입니다. 모델의 응답 한 번에 허용한 최대 길이가 10,240 토큰이므로, "다음 응답 하나를 온전히 쓸 자리가 없어지는 순간"이 곧 압축 시점입니다.
압축이 걸리면 기록 끝에 고정된 요약 지시문 qsum을 붙이고, 같은 정책(같은 모델) 이 요약 St를 씁니다. 그러고 나서 문맥을 다음과 같이 다시 짭니다.
hˉt=s⊕uresume(St)⊕(zt−k+1,…,zt)
시스템 프롬프트, 요약을 담은 재개 안내문, 그리고 가장 최근의 k턴 원문입니다. 요약은 그 k턴 이전의 기록만 다룹니다. 기본값은 k=2입니다. 오래된 일은 요약으로, 방금 일은 원문 그대로 가져가는 구성입니다. 방금 실행한 명령과 그 출력은 한 글자도 바뀌지 않은 채 남으므로, 지금 환경이 어떤 상태인지는 정확히 알 수 있습니다.
1에이전트가 턴을 쌓아 간다. 응답과 도구 출력이 한 쌍씩 문맥에 붙는다
2남은 공간이 10,240 토큰 아래로 내려가면 요약 지시문을 붙이고, 같은 모델이 요약을 쓴다
3새 문맥 = 시스템 프롬프트 + 요약 + 최근 2턴 원문. 여기서 일을 이어 간다
4롤아웃 하나에 압축은 최대 3번. 창 하나로 최대 네 구간, 곧 창의 4배까지 일한다
아래 위젯은 이 규칙을 그대로 옮긴 것입니다. 창 크기와 압축 상한을 바꿔 가며 같은 작업을 돌려 보세요. 압축 상한을 0으로 두면 어디서 멈추는지, 3으로 두면 창은 그대로인데 일한 양이 얼마나 늘어나는지가 보입니다.
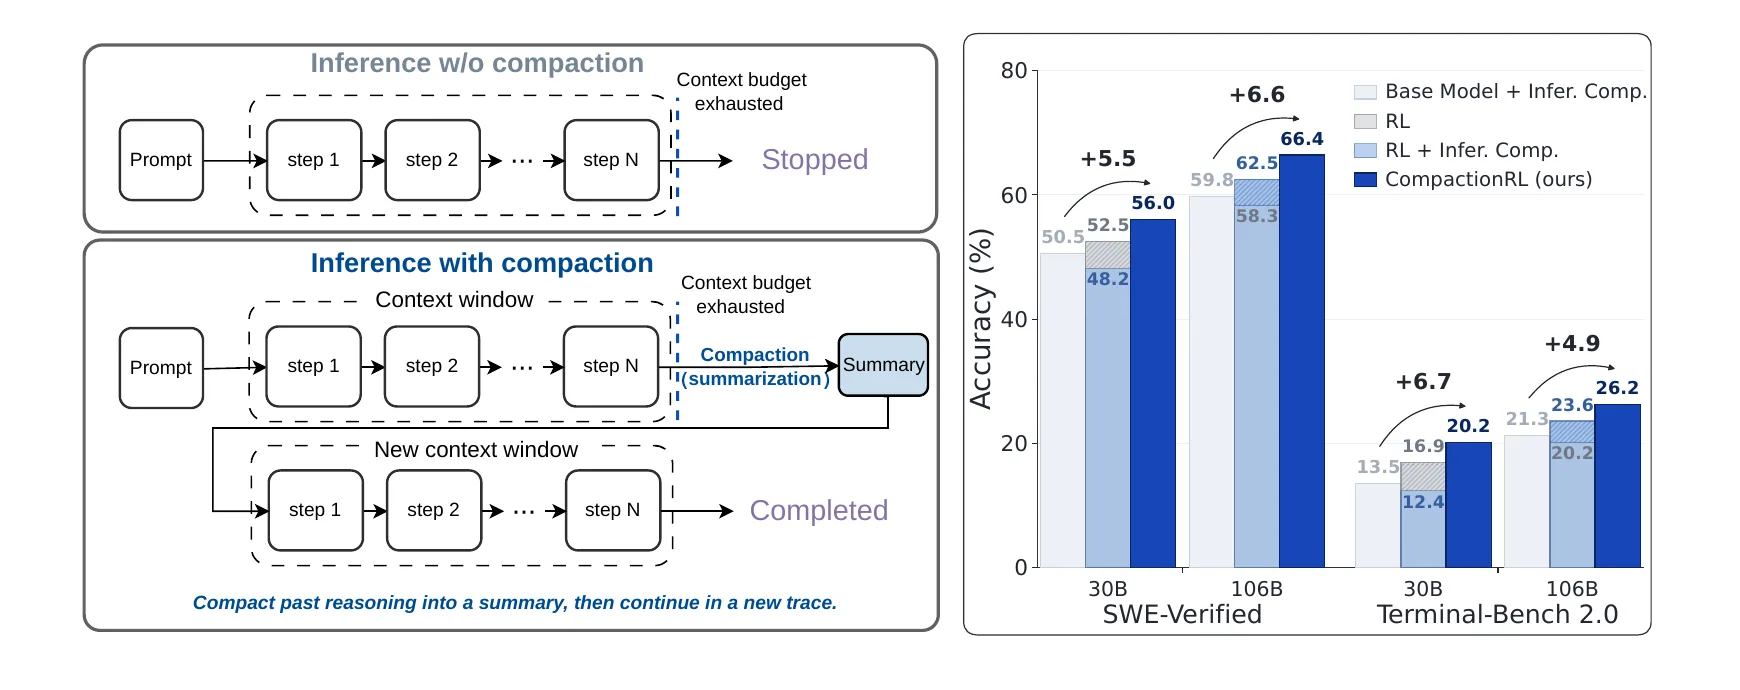
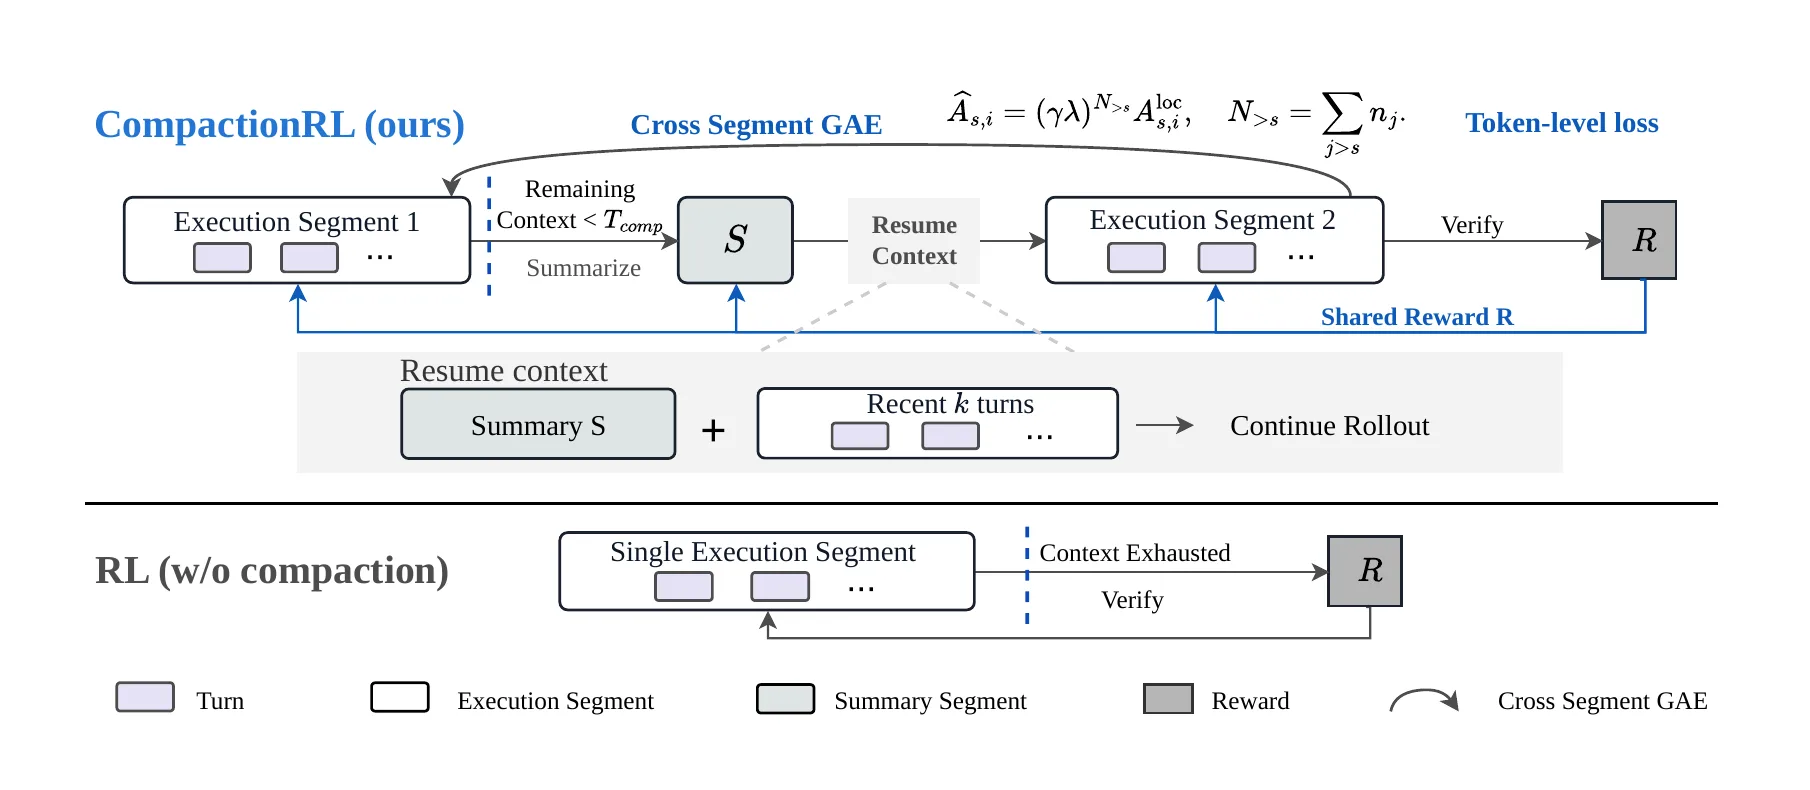
논문의 그림 1 왼쪽이 같은 내용을 한 장으로 그린 것입니다. 위쪽은 압축이 없는 경우로, 창이 차면 거기서 멈춥니다(Stopped). 아래쪽은 압축이 있는 경우로, 지금까지의 추론을 요약으로 접고 새 창에서 이어 가 끝까지 갑니다(Completed).
지금까지의 대화를 자세히 요약하라. 사용자의 명시적 요청과 이미 끝낸 작업에 특히 주의하라. 원래 과제: {원래 지시문}. 최근 메시지는 원문 그대로 남으니 자세히 되풀이하지 말라. 외부 파일을 읽거나 도구를 쓸 수 있다고 가정하지 말라.
아홉 항목
① 주된 요청과 의도 ② 핵심 기술 개념 ③ 살펴보거나 바꾼 파일과 코드 ④ 만난 오류와 대처 ⑤ 문제 해결 과정과 중요한 결정 ⑥ 사용자의 모든 메시지와 명시적 요구 ⑦ 남은 작업 ⑧ 지금 하던 일 ⑨ (선택) 다음 단계. 먼저 <analysis>에 무엇을 남길지 짧게 생각하고, <summary>에 요약을 쓴다. 작업을 이어 가는 데 필요하면 명령·출력·오류 문구를 정확히 보존하라.
재개
이 세션은 컨텍스트가 소진된 이전 대화에서 이어진다. 아래 요약이 앞부분을 다룬다. {요약}. 최근 메시지는 원문 그대로 아래에 있으며 최신 상태의 기준으로 삼는다. 추가 질문 없이 하던 일을 이어서 하라.
이 지시문은 훈련 내내 고정입니다. 논문이 훈련하는 것은 지시문이 아니라 이 지시문을 받고 요약을 쓰는 모델입니다. 같은 양식을 받아도 무엇을 얼마나 구체적으로 적느냐는 모델마다 다르고, 그 차이가 성적을 가릅니다. 다음 표가 그 증거입니다.
표 1: 실행 모델은 그대로 두고 요약 모델만 바꾸면
저자들은 방법을 설명하기 전에 실험 하나를 먼저 보여 줍니다. 일을 하는 모델(실행 에이전트)을 GLM-4.7-Flash로 고정하고, 압축 시점에 요약을 쓰는 모델만 세 가지로 바꿔 봅니다.
실행 에이전트
요약 에이전트
SWE-bench Verified 정확도
궤적당 요약 횟수
GLM-4.7-Flash
Qwen3.5-27B
55.5%
1.010
GLM-4.7-Flash
GLM-4.7-Flash (자기 자신)
50.5%
1.075
GLM-4.7-Flash
Qwen3-30B-A3B
49.0%
1.126
코드를 읽고 고치고 테스트를 돌리는 쪽은 세 줄 모두 같은 모델입니다. 달라진 것은 창이 찼을 때 메모를 쓰는 쪽뿐입니다. 그런데 정확도가 49.0%에서 55.5%까지 6.5점 움직입니다. 요약을 잘 쓰는 모델이 붙으면 요약 횟수도 조금 줄어듭니다(1.126 → 1.010). 요약이 좋으면 헛걸음이 줄어 창을 덜 쓰기 때문이라고 읽을 수 있습니다.
6.5점은 작은 숫자가 아닙니다. 뒤에서 보겠지만 이 논문의 방법 전체가 가져오는 이득이 5~7점입니다. 요약 하나가 강화학습 한 번만큼의 차이를 낸다는 뜻입니다. 저자들의 결론은 이렇습니다.
압축은 수동적인 전처리 단계가 아니라, 성능을 좌우하는 의사결정 과정이다.
그래서 요약을 따로 떼어 훈련하지 않고, 과제 실행과 함께 훈련합니다.
직접 써 보기: 무엇을 남길 것인가
요약이 왜 그렇게 중요한지는 직접 써 보면 바로 알 수 있습니다. 아래 위젯에서 당신은 프롤로그의 에이전트입니다. 앞 구간에서 알아낸 사실 여덟 가지 가운데 예산 안에 들어가는 것만 메모에 적을 수 있습니다. 틀린 문장 두 개도 섞여 있습니다. 예시 버튼으로 "한 줄 요약"과 "아홉 항목 양식"을 번갈아 눌러 보세요.
위젯의 시나리오는 설명용으로 만든 것이지만, 실패의 종류는 논문에서 가져왔습니다. 논문 부록 C는 품질이 낮은 요약에서 되풀이되는 실패를 세 가지로 정리합니다.
논문이 든 실제 사례는 두 번째 유형입니다. 압축 없이 훈련한 모델의 요약은 초반의 데이터베이스 오류를 '현재 테스트 상태'로 적었습니다. 그 뒤에 테스트가 성공적으로 돌았는데도 말입니다. 압축 뒤의 에이전트는 이미 사라진 문제를 계속 디버깅하다 실패했습니다. 반대로 CompactionRL로 훈련한 모델의 요약은 어떤 파일 쓰기 시도가 실패했는지, 그 실패가 소스 파일을 어떻게 망가뜨렸는지, 왜 과제가 아직 끝나지 않았는지를 적었습니다. 다음 구간의 에이전트는 그 메모를 보고 파일을 복구하고, 필요한 수정을 마치고, 검증까지 했습니다.
여기서 한 가지가 분명해집니다. 좋은 요약의 기준을 사람이 미리 정하기는 어렵습니다. 짧을수록 좋은 것도, 원문과 비슷할수록 좋은 것도 아닙니다. 기준은 하나뿐입니다. 그 요약을 받은 다음 구간이 과제를 끝냈는가. 논문이 요약 품질 점수 같은 별도의 보상을 만들지 않고 최종 과제 보상 하나만 쓰는 이유가 이것입니다. 저자들의 표현으로는 "손으로 설계한 요약 지표는 이어 가기에 어떤 세부 사항이 쓸모 있는지를 반영하지 못할 수 있다"입니다.
그러면 "과제의 성패로 요약을 훈련한다"는 것은 구체적으로 무엇을 하는 일일까요. 그것을 이해하려면 강화학습의 기본 부품 몇 개를 먼저 알아야 합니다.
4. 강화학습 10분 복습 — 보상, 어드밴티지, 비평가
이 장은 강화학습이 낯선 분을 위한 준비 운동입니다. PPO와 GRPO를 이미 아신다면 "왜 GRPO가 아니라 PPO인가"부터 읽으셔도 됩니다.
정답 예시가 없을 때 배우는 법
언어 모델의 보통 훈련(지도학습)은 정답 문장을 보여 주고 따라 쓰게 합니다. 그런데 "이 버그를 고쳐라" 같은 과제에는 따라 쓸 정답 궤적이 없습니다. 고치는 길은 수없이 많고, 우리가 아는 것은 끝난 뒤 테스트가 통과했는지뿐입니다.
강화학습은 이 상황을 위한 방법입니다. 모델에게 일을 직접 시켜 보고(이 한 번의 시도를 롤아웃이라고 합니다), 끝에 점수(보상)를 매깁니다. 그리고 점수가 좋았던 시도에서 모델이 쓴 토큰들은 다음에 더 자주 나오게, 나빴던 시도의 토큰들은 덜 나오게 모델을 조금 고칩니다. 코딩 과제에서 보상은 단순합니다. 숨겨 둔 테스트를 통과하면 1, 아니면 0입니다. 이렇게 프로그램으로 채점할 수 있는 보상을 쓰는 방식이 2025년 DeepSeek-R1 이후 추론 모델 훈련의 표준이 되었습니다.
여기에 문제가 두 가지 있습니다.
첫째, 기준점이 필요합니다. 쉬운 문제에서 받은 1점과 어려운 문제에서 받은 1점은 같은 1점이 아닙니다. 원래 90%는 푸는 문제를 풀었다면 칭찬할 일이 별로 없고, 10%밖에 못 풀던 문제를 풀었다면 그 시도에는 배울 것이 많습니다. 그래서 보상 그 자체가 아니라 "기대보다 얼마나 잘했나" 를 씁니다. 이 값을 어드밴티지(advantage)라고 부릅니다.
둘째, 공로를 나눠야 합니다. 보상은 맨 끝에 한 번 나옵니다. 그 사이에 모델은 수만 개의 토큰을 썼습니다. 어느 토큰이 성공에 기여했는지를 가리는 문제를 공로 배분(credit assignment)이라고 합니다.
두 문제를 푸는 방식에 따라 알고리즘이 갈립니다.
길 하나: 비평가를 두는 PPO
PPO(Proximal Policy Optimization, 2017)는 2022년 RLHF 시절까지 언어 모델 강화학습의 기본이었습니다. PPO는 일하는 모델(정책, actor) 옆에 비평가(critic) 모델을 하나 더 둡니다. 비평가는 지금까지의 문맥을 보고 "여기서부터 끝까지 가면 평균적으로 몇 점을 받을까"를 예측합니다. 이 예측값을 가치 V(xt)라고 합니다.
비평가가 있으면 토큰마다 "방금 한 걸음으로 전망이 얼마나 나아졌나"를 잴 수 있습니다.
δt=rt+γV(xt+1)−V(xt)
rt는 그 자리에서 받은 보상(대부분 0, 맨 끝에만 과제 보상), γ는 할인율입니다. δt가 양수면 그 토큰을 쓴 뒤 전망이 밝아졌다는 뜻입니다. 이 값을 TD 잔차라고 부릅니다.
토큰 하나의 어드밴티지는 그 뒤에 이어지는 잔차들을 멀수록 작게 쳐서 더한 값입니다. 2015년 슐먼(John Schulman)이 제안한 GAE(Generalized Advantage Estimation)입니다.
AtGAE=ℓ=0∑T−t(γλ)ℓδt+ℓ
λ는 0과 1 사이의 값으로, "얼마나 먼 미래까지 믿을 것인가"를 정하는 손잡이입니다. λ가 1에 가까우면 실제로 받은 최종 보상을 그대로 믿고(편향은 작지만 운에 흔들립니다), 0에 가까우면 비평가의 바로 다음 예측만 믿습니다(안정적이지만 비평가가 틀리면 같이 틀립니다). 이 식에서 기억할 것은 하나입니다. 맨 끝의 보상은 토큰 t에 (γλ)T−t만큼 할인되어 닿습니다. 끝에서 멀수록 적게 닿습니다. 5장의 세 번째 장치가 이 거리 계산을 다룹니다.
PPO의 나머지 절반은 "한 번에 너무 많이 바꾸지 않기"입니다. 데이터를 만든 옛 정책과 지금 정책이 같은 토큰에 주는 확률의 비율 ρ가 1−ϵ과 1+ϵ 사이를 벗어나면 그만큼은 잘라 냅니다. 논문의 식 (5)가 이 손실입니다.
M은 배치 안에서 학습 대상이 되는 모든 토큰 자리의 집합이고, (s,i)는 "구간 s의 i번째 토큰"입니다. 맨 앞의 1/∣M∣, 곧 무엇으로 나누어 평균을 내는가가 5장의 두 번째 장치입니다.
길 둘: 조원끼리 비교하는 GRPO
비평가는 정책만큼 큰 모델을 하나 더 돌려야 하고, 잘 가르치기도 까다롭습니다. 2024년 DeepSeekMath 논문은 비평가를 없앤 GRPO(Group Relative Policy Optimization)를 내놓았습니다. 같은 문제를 여러 번(예를 들어 8번) 풀게 하고, 그 그룹의 평균 점수를 기준점으로 씁니다.
A^i=std(R1,…,RG)Ri−mean(R1,…,RG)
같은 조 평균보다 잘한 시도의 모든 토큰이 같은 양의 칭찬을 받습니다. 단순하고, 비평가가 필요 없고, 수학 문제처럼 한 번에 답을 쓰는 과제에서 잘 통했습니다. DeepSeek-R1이 GRPO로 훈련되면서 2025년의 추론 모델 훈련은 대부분 GRPO와 그 변형(DAPO 등)으로 넘어갔습니다. 코어닷투데이는 DAPO 해설에서 이 흐름을 자세히 다뤘습니다.
GRPO 계열
PPO (비평가 사용)
기준점
같은 문제를 푼 조원들의 평균 점수
비평가가 예측한 가치 V(x)
어드밴티지의 단위
롤아웃 하나에 값 하나 (모든 토큰이 같은 값)
토큰마다 다른 값
문제당 롤아웃 수
여러 개 (보통 8~64)
하나여도 된다
추가 비용
없음
비평가 모델 훈련과 추론
약한 곳
조원이 다 끝나야 계산 가능, 도중 상태의 차이를 못 봄
비평가가 부정확하면 무너짐
왜 GRPO가 아니라 PPO인가
2025년 내내 GRPO가 대세였는데, CompactionRL은 PPO로 돌아갑니다. 이유는 두 가지이고, 둘 다 압축과 관계가 있습니다.
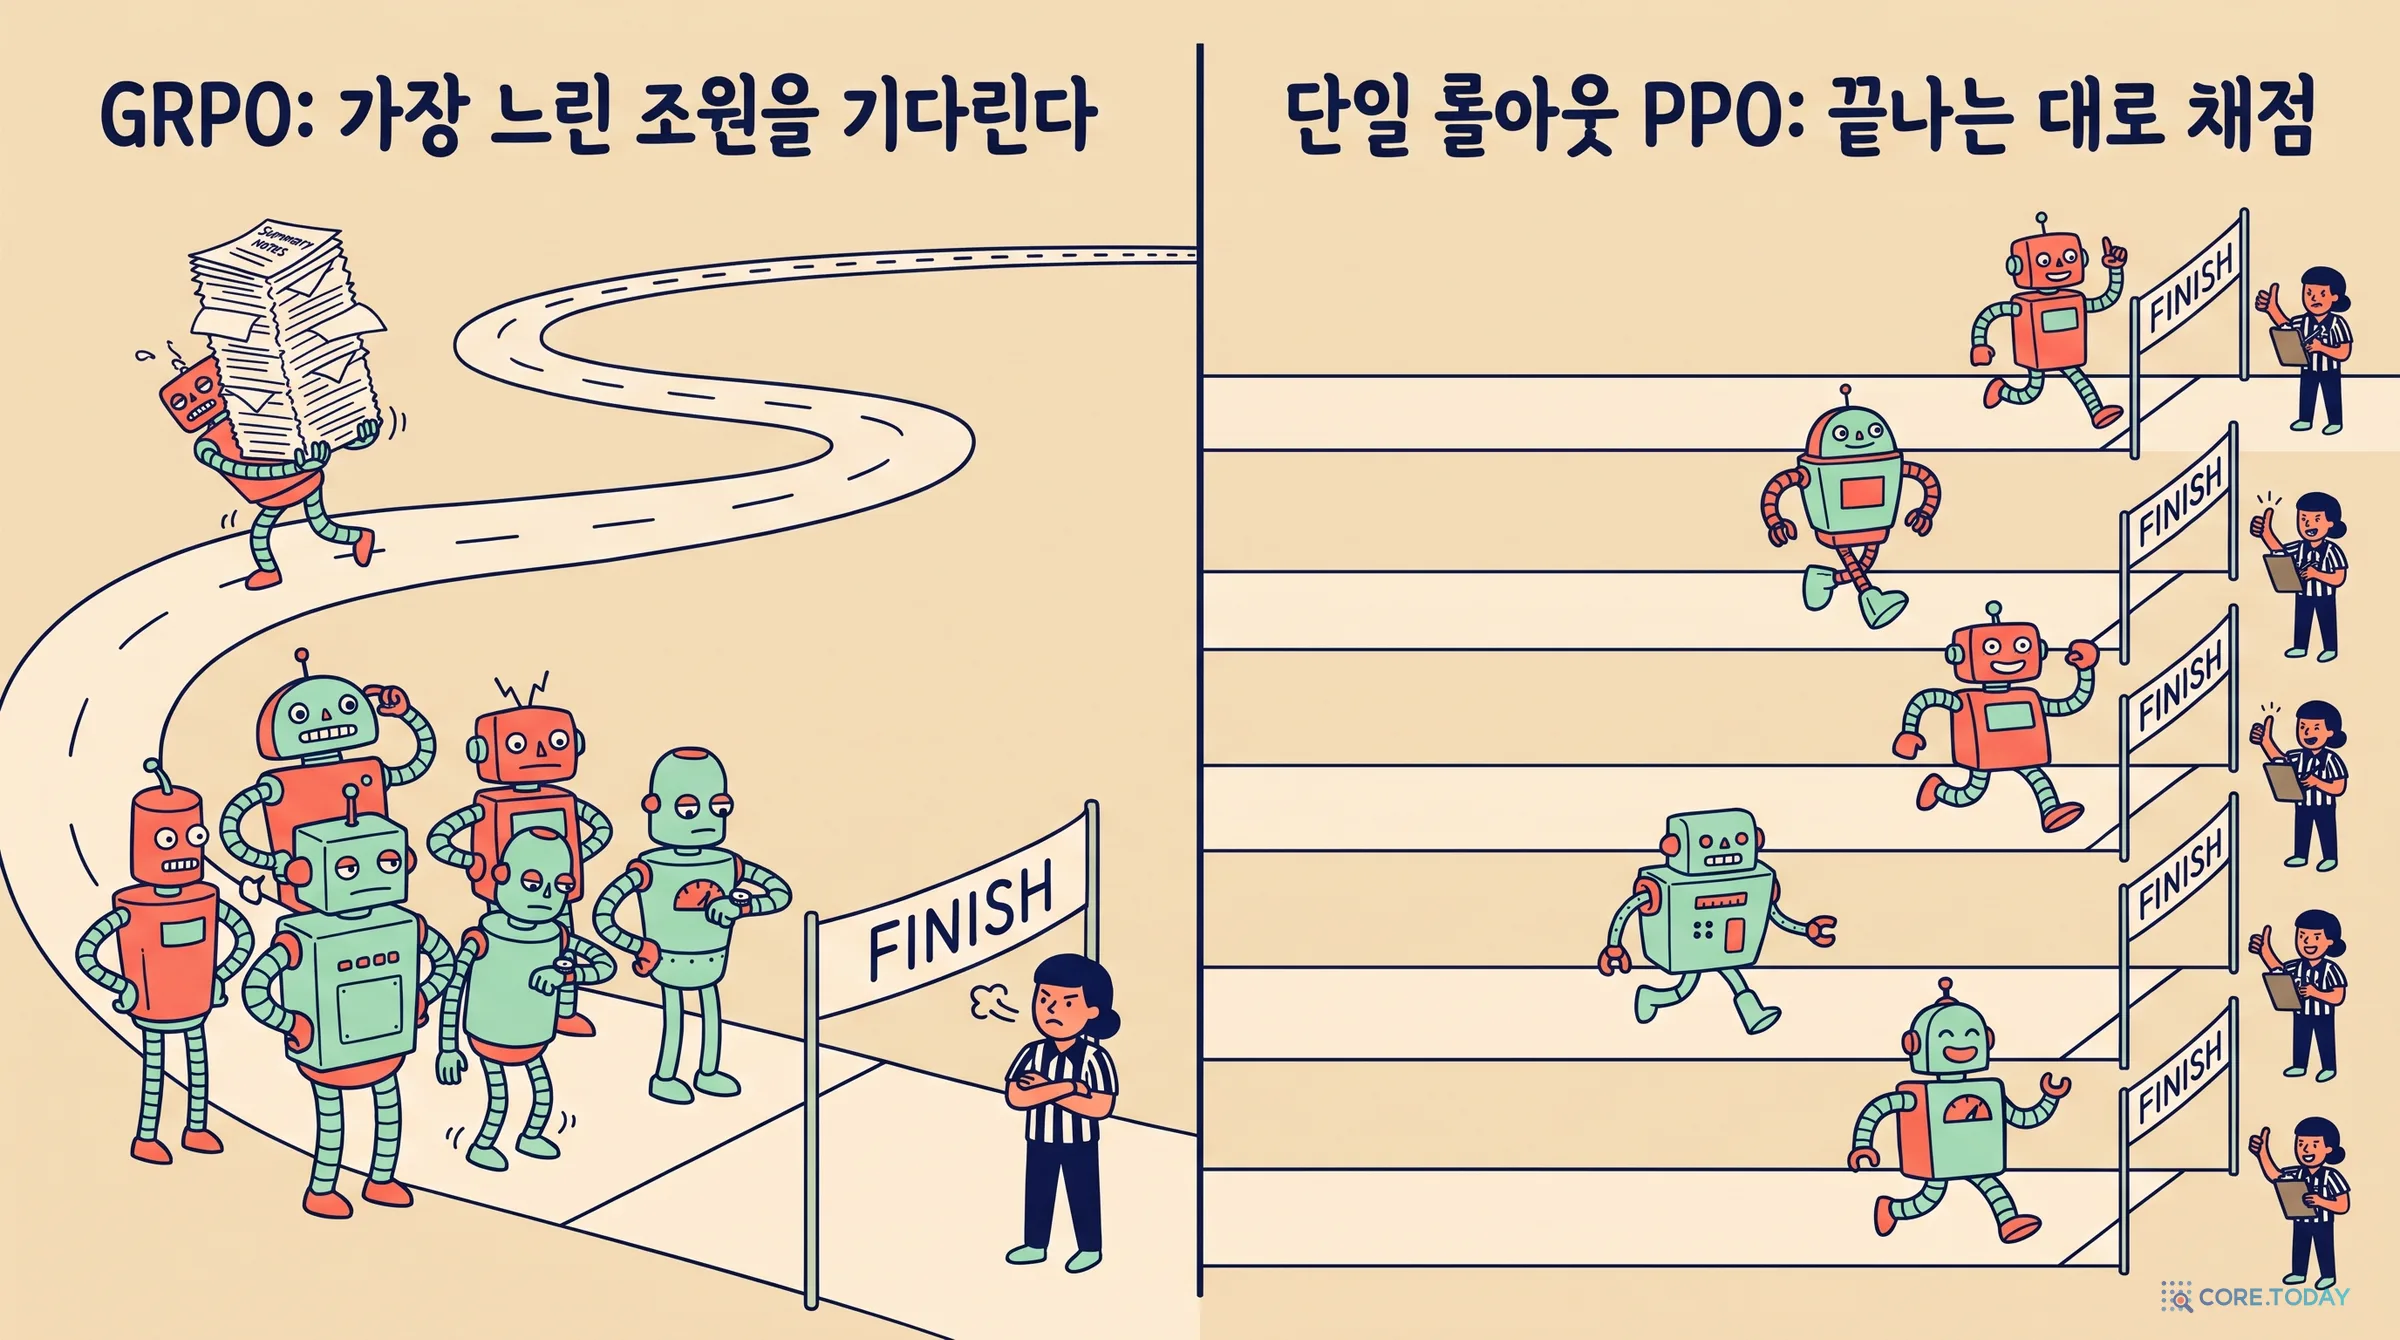
이유 하나: 조원을 기다리는 시간. GRPO는 조원 여덟 명의 점수가 모두 나와야 평균을 낼 수 있습니다. 수학 문제는 누구나 비슷한 시간에 끝나니 괜찮습니다. 에이전트 과제는 다릅니다. 어떤 롤아웃은 20턴 만에 끝나고 어떤 롤아웃은 250턴을 다 씁니다. 여기에 압축까지 들어오면 차이가 더 벌어집니다. 압축을 세 번 한 롤아웃은 한 번도 안 한 롤아웃보다 몇 배 오래 걸립니다. 먼저 끝난 일곱 개는 가장 느린 하나를 기다려야 합니다.
대규모 에이전트 훈련은 비동기로 돕니다. 롤아웃을 만드는 서버와 모델을 고치는 서버가 따로 돌고, 롤아웃이 만들어지는 동안에도 모델은 계속 갱신됩니다. 그러니 기다린 데이터는 이미 몇 번 갱신된 옛 정책이 만든 데이터가 됩니다. 이것을 정책 지연(policy lag)이라고 합니다. 같은 연구진이 이틀 뒤(2026년 7월 8일) 올린 자매 논문 SAO(Single-rollout Asynchronous Optimization)가 이 문제를 따로 다룹니다. SAO의 표현은 이렇습니다. "그룹은 가장 느린 표본이 끝나기를 기다려야 훈련에 들어갈 수 있다." CompactionRL은 SAO를 따라 문제 하나에 롤아웃 하나만 뽑습니다. 조가 없으니 기다릴 조원도 없습니다.
이유 둘: 도중의 상태가 서로 다릅니다. 조원이 없으면 기준점이 사라집니다. 그 자리를 비평가가 메웁니다. 그런데 비평가는 단순한 대체품이 아니라, 압축 훈련에서는 더 맞는 도구입니다. 압축 뒤의 구간은 요약에서 출발합니다. 요약이 좋으면 전망이 밝은 상태에서, 나쁘면 어두운 상태에서 출발합니다. GRPO는 롤아웃 전체에 점수 하나를 매겨 모든 구간, 모든 토큰에 똑같이 나눠 주므로 이 차이를 보지 못합니다. 비평가는 문맥을 직접 읽고 가치를 예측하므로, 같은 롤아웃 안에서도 구간마다 토큰마다 다른 어드밴티지를 줄 수 있습니다. 논문의 문장으로는 "롤아웃 수준의 그룹 정규화는 이런 중간 상태의 차이를 명시적으로 고려하지 않는다"입니다.
비평가를 쓰는 대가는 치러야 합니다. 논문은 비평가를 정책과 같은 체크포인트에서 초기화하고 값 하나를 내는 머리(value head)를 붙인 다음, 강화학습에 앞서 50스텝 동안 비평가만 먼저 훈련합니다. 훈련 중에는 정책을 한 번 고칠 때마다 비평가를 두 번 고쳐서, 비평가가 정책의 변화를 놓치지 않게 합니다. 2025년 바이트댄스의 VC-PPO와 VAPO가 "긴 추론에서 PPO가 무너지는 원인은 비평가 쪽에 있고, 미리 훈련해 두면 GRPO보다 낫다"는 것을 보인 뒤로 자리 잡은 요령입니다.
정리하면, CompactionRL의 뼈대는 이렇습니다. 문제마다 롤아웃 하나, 비평가가 토큰마다 어드밴티지를 매기는 PPO. 이제 그 위에 압축을 얹을 때 생기는 문제 두 가지를 볼 차례입니다.
아래쪽부터 봅니다. 압축 없는 강화학습에서는 롤아웃 하나가 실행 구간 하나입니다. 창이 다 차면(Context Exhausted) 거기서 끝나고, 그 상태로 검증을 받아 보상 R이 정해집니다. 창 안에 들어가는 길이의 일만 배울 수 있습니다.
위쪽이 CompactionRL입니다. 왼쪽부터 따라가면 이렇습니다.
실행 구간 1(Execution Segment 1). 보라색 작은 상자 하나가 한 턴입니다. 턴이 쌓이다가 남은 문맥이 Tcomp 아래로 내려갑니다(파란 점선).
요약 구간 S(Summarize). 정책이 요약을 씁니다. 회색 상자입니다. 요약도 토큰의 나열이고, 정책이 쓴 것이므로 하나의 학습 구간이 됩니다.
재개 문맥(Resume Context). 가운데 회색 띠가 그 구성입니다. 요약 S + 최근 k턴. 여기서 롤아웃이 이어집니다.
실행 구간 2. 새 문맥에서 일을 계속합니다. 필요하면 다시 요약하고 구간 3, 4로 갑니다.
검증과 보상 R. 끝나면 테스트를 돌려 보상을 매깁니다.
파란 선이 두 종류 있습니다. 아래쪽의 Shared Reward R은 보상 R 하나가 실행 구간 1, 요약 구간, 실행 구간 2 모두에게 돌아간다는 표시입니다. 위쪽의 둥근 화살표 Cross Segment GAE는 뒤 구간에서 앞 구간으로 거슬러 올라가는 할인입니다. 오른쪽 위의 Token-level loss까지, 그림 위쪽에 적힌 세 낱말이 이 장에서 다룰 내용입니다.
논문은 롤아웃을 구간의 나열로 적습니다.
τ=(σ1,…,σK)
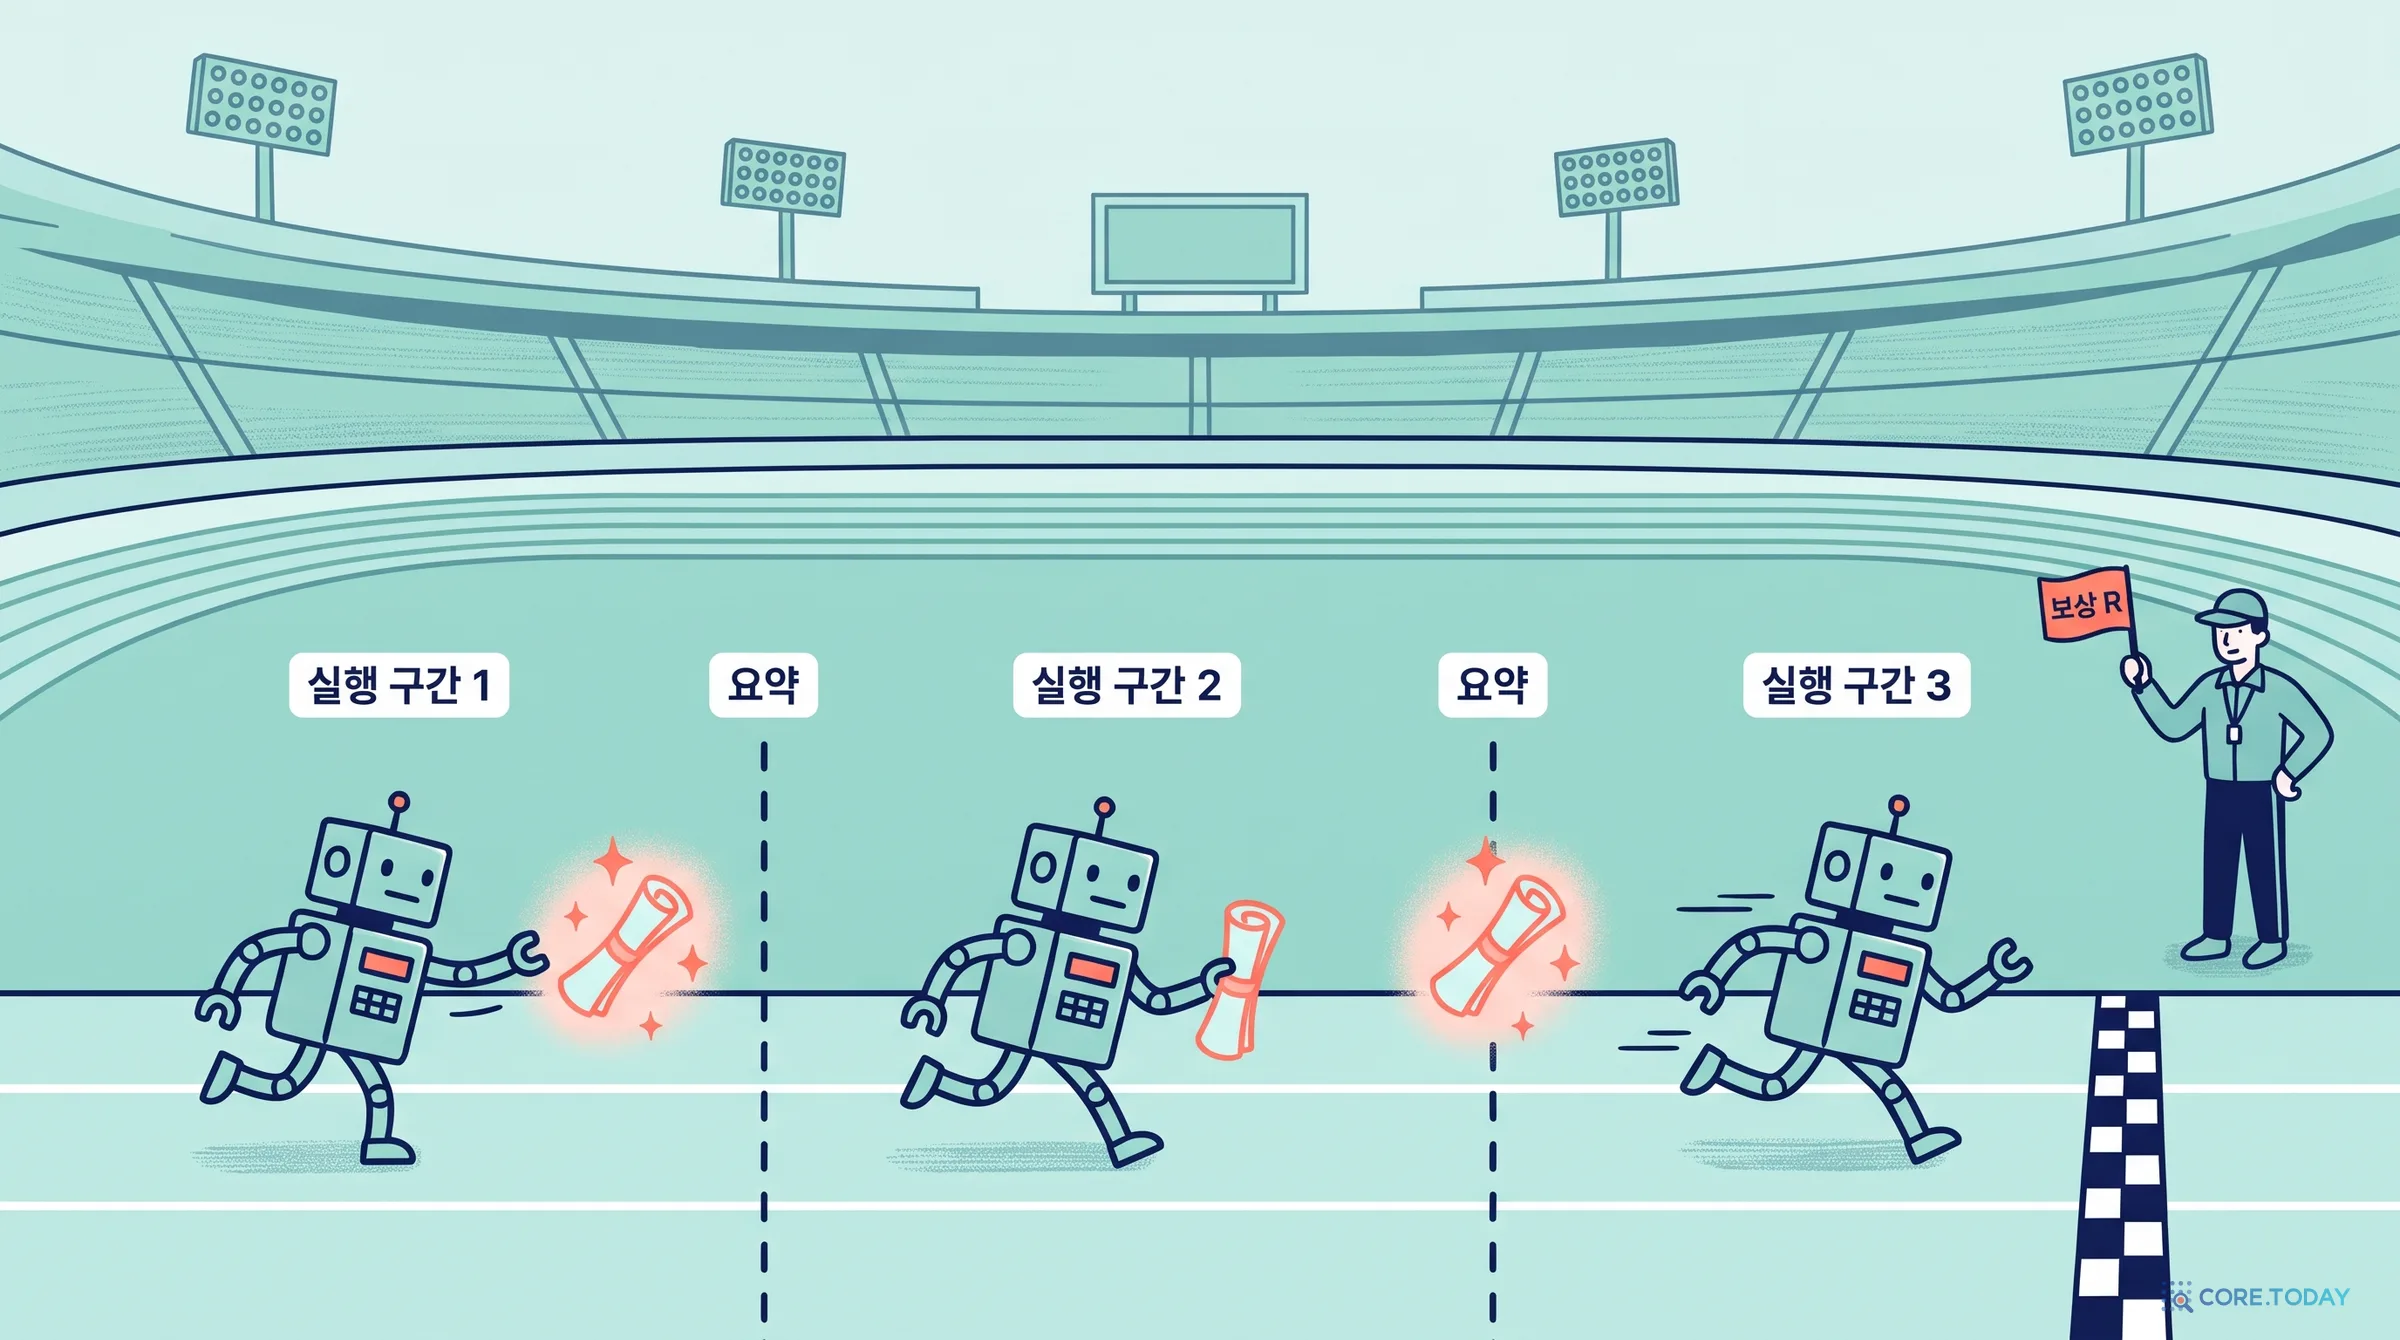
각 σ는 실행 구간이거나 요약 구간입니다. 이어달리기에 빗대면, 실행 구간이 주자이고 요약이 바통입니다. 결승선의 심판은 팀 전체에 점수 하나를 줍니다.
여기까지는 "압축을 훈련 데이터 수집에 넣었다"는 이야기입니다. 문제는 그다음입니다. 이렇게 잘린 구간들로 정책을 고치려 하면 세 가지가 어긋납니다. 첫째는 4장에서 본 조원 대기 문제이고, 단일 롤아웃 PPO로 풀었습니다. 남은 둘이 길이의 불균형과 거리의 왜곡입니다.
장치 2: 토큰 단위 손실 — 짧은 요약이 과하게 들리지 않게
실행 구간 하나는 수만 토큰입니다. 요약 구간 하나는 2천 토큰 남짓입니다. 길이가 열 배쯤 차이 나는 두 종류의 구간이 한 배치에 섞입니다.
구간을 보통의 훈련 표본처럼 다루면 이렇게 됩니다. 구간마다 토큰 손실의 평균을 내고, 그 평균들을 다시 평균합니다. 언뜻 공정해 보이지만 두 가지가 틀어집니다.
요약 토큰이 과대 대표됩니다. 2천 토큰짜리 구간과 2만 토큰짜리 구간이 같은 한 표를 가지면, 요약 토큰 하나는 실행 토큰 하나보다 열 배 큰 목소리를 냅니다.
압축을 많이 한 롤아웃이 과대 대표됩니다. 압축 없이 끝난 롤아웃은 구간이 1개, 세 번 압축한 롤아웃은 7개입니다. 둘의 보상이 같아도 뒤쪽이 일곱 표를 행사합니다.
CompactionRL의 처방은 단순합니다. 구간을 거치지 않고, 배치 안의 학습 토큰 전체를 한꺼번에 평균합니다. 4장에서 본 식 (5)의 맨 앞 1/∣M∣이 그것입니다. 모든 토큰이 같은 한 표를 갖습니다.
숫자로 확인해 봅니다. 아래 위젯의 기본값은 롤아웃 A(압축 없음, 2만 토큰)와 롤아웃 B(압축 3회, 실행 2만 토큰 × 4 + 요약 2.2천 토큰 × 3)입니다. 구간 단위로 평균하면 글자 수로는 6.2%뿐인 요약이 손실의 37.5%를 차지합니다.
당연해 보이는 이 장치가 실제로는 가장 중요했습니다. 6장의 절제 실험에서 이것 하나를 빼면 성적이 훈련 전으로 돌아갑니다. 압축이 없던 시절에는 롤아웃 하나가 구간 하나였으므로 어떻게 평균해도 큰 문제가 없었습니다. 압축이 길이가 제각각인 구간을 만들어 내면서 생긴 새 문제입니다.
장치 3: 구간을 넘는 GAE — 보상까지의 진짜 거리
마지막 장치는 4장에서 미뤄 둔 '거리' 이야기입니다.
GAE에서 맨 끝의 보상은 끝에서 먼 토큰일수록 더 할인되어 닿는다고 했습니다. 끝에서 d토큰 떨어진 자리에는 (γλ)d만큼만 닿습니다. 이 할인에는 뜻이 있습니다. 결과 바로 앞의 행동은 결과에 책임이 크고, 한참 앞의 행동은 그 사이에 많은 일이 끼어들었으니 책임을 덜 묻는다는 것입니다.
압축은 이 거리를 망가뜨립니다. 훈련에서는 구간마다 따로, 병렬로 어드밴티지를 계산합니다. 그리고 모든 구간이 같은 보상 R을 공유한다고 했으니, 계산상으로는 구간마다 자기 끝에 보상이 놓여 있는 것처럼 됩니다. 구간 σs의 토큰 수를 ns라고 하면 구간 안에서 계산한 어드밴티지는 이렇습니다(식 8).
As,iloc=ℓ=0∑ns−i(γλ)ℓδs,i+ℓ
첫 번째 실행 구간의 마지막 토큰을 생각해 봅니다. 구간 안에서만 보면 이 토큰은 보상 '바로 앞'에 있습니다. 실제로는 그 뒤에 요약이 있고, 두 번째 구간이 있고, 또 요약과 세 번째 구간이 있은 다음에야 결과가 나옵니다. 수만 토큰 뒤의 일입니다. 따로 계산하면 한참 앞의 행동과 요약이, 결과 직전의 행동과 똑같은 책임을 지게 됩니다. 논문의 표현으로는 최종 결과가 "실제보다 인위적으로 가까워 보여, 과제 완료 한참 전의 행동이나 요약에 공로를 과하게 준다"입니다.
고치는 방법은 한 줄입니다. 구간 σs뒤에 남은 학습 토큰의 수를 세어,
N>s=j>s∑nj
그만큼 한 번 더 할인합니다(식 9).
A^s,i=(γλ)N>sAs,iloc
이렇게 하면 구간 s의 i번째 토큰에 닿는 보상의 할인이 (γλ)N>s+ns−i가 됩니다(식 10). 구간들을 하나로 이어 붙였을 때 그 토큰에서 결과까지의 거리와 정확히 같습니다. 그림 2 위쪽의 둥근 화살표와 수식이 이 내용입니다.
위젯으로 확인해 봅니다. 주황 점선이 구간마다 따로 계산한 경우, 파란 실선이 보정한 경우입니다. 따로 계산하면 구간이 끝날 때마다 가중치가 1로 튀어 오르는 톱니 모양이 됩니다. 보정하면 결과에서 멀어질수록 매끈하게 줄어듭니다.
위젯 기본값(압축 2회, 실행 구간 12,000 토큰, 요약 2,200 토큰)으로 읽으면, 첫 번째 요약의 마지막 토큰은 따로 계산할 때 가중치 1.0으로 보상을 받습니다. 그 뒤에 26,200 토큰의 일이 남아 있다는 것을 반영하면 0.23입니다. 네 배 넘게 과대평가되고 있었던 셈입니다.
λ는 어떻게 정하나. 논문은 γ=1로 두고(먼 미래의 보상을 깎지 않음), λ를 길이에 맞춰 정합니다.
λ=1−αl1,α=1.5
l은 응답의 길이입니다. 2025년 바이트댄스의 VAPO가 제안한 '길이 적응 GAE'입니다. 고정값 λ=0.95를 쓰면 100토큰만 떨어져도 보상의 무게가 0.6%로 줄어, 수만 토큰짜리 응답의 앞부분에는 보상이 사실상 닿지 않습니다. 길이에 맞춰 λ를 정하면 길이가 얼마든 첫 토큰에 닿는 보상의 무게가 e−1/α 근처로 일정합니다. α가 1.5면 약 0.51입니다. 그러니 뒤에 구간 하나가 더 있을 때마다 앞 구간의 몫이 대략 절반씩 줄어든다고 생각하면 됩니다(위젯은 l을 실행 구간 길이로 두었습니다. 논문은 l을 '응답 길이'라고만 적어, 구간 길이인지 궤적 전체 길이인지는 본문만으로 확정되지 않습니다).
이것은 근사입니다. 논문이 스스로 밝히는 대목입니다. 궤적 전체의 GAE를 정확히 복원하려면 뒤 구간의 TD 잔차를 앞 구간으로 차례로 넘겨야 합니다. 그러면 뒤 구간의 계산이 끝나야 앞 구간을 계산할 수 있어, 배치 안에서 구간을 병렬로 처리할 수 없게 됩니다. 저자들은 정확성 대신 훈련 효율을 골랐습니다. 구간 안의 계산은 그대로 두고, 구간의 위치에 따른 계수 하나만 곱합니다. 보상 항의 거리는 정확히 맞고, 비평가의 예측이 구간 경계를 넘어 이어지는 부분은 맞추지 않습니다.
세 장치를 한 표로
압축이 만든 문제
그대로 두면
CompactionRL의 처방
빼면 (표 3, SWE)
롤아웃 시간이 크게 흩어진다
그룹이 가장 느린 롤아웃을 기다리고, 그동안 정책이 낡는다
문제당 롤아웃 하나 + 비평가 (SAO 방식 PPO)
GRPO 기반 SUPO: 61.8%
구간의 길이와 개수가 제각각이다
짧은 요약과 압축 많은 롤아웃이 손실을 과하게 차지한다
토큰 단위로 손실 평균
60.0%
보상까지의 거리가 구간마다 끊긴다
앞 구간의 행동·요약이 결과 직전처럼 과대평가된다
뒤에 남은 토큰 수만큼 추가 할인
63.0%
세 장치 모두 적용
66.4%
훈련 설정은 다음과 같습니다. 숫자가 많지만 한 번 적어 둘 가치가 있습니다. 재현하려는 사람에게는 이것이 논문의 절반이기 때문입니다.
항목
GLM-4.7-Flash (30B, 활성 3B)
GLM-4.5-Air-SFT (106B, 활성 12B)
창 크기 C
64k
80k
압축 문턱 · 응답 상한
남은 공간 10,240 토큰 미만 · 응답 1회 최대 10,240 토큰
압축 상한 · 남기는 턴
롤아웃당 3회 · 최근 2턴
배치 · 롤아웃
전역 배치 128, 문제당 롤아웃 1개
학습률
정책 2×10⁻⁶ · 비평가 3×10⁻⁶ (정책 1회당 비평가 2회 갱신)
어드밴티지
γ = 1, 길이 적응 GAE (α = 1.5), 비평가 사전 훈련 50스텝
훈련 데이터 · 프레임워크
SWE-Dev (공개) · slime (비동기 RL 프레임워크, 공개)
훈련 시간
180스텝, 15시간, 960 GPU-시간
100스텝, 23시간, 1,472 GPU-시간
장비
NVIDIA H800 64장 (정책·비평가 32장, 롤아웃 생성 32장)
106B 모델 기준으로 훈련에 쓰인 것은 프롬프트 1,405개, 롤아웃 11,092개, 생성 토큰 4억 4,200만 개입니다. 롤아웃 하나가 평균 4만 토큰쯤을 생성한 셈입니다. 하루가 채 안 되는 훈련입니다. 이 정도 규모로 6점이 움직인다는 점은 6장을 읽을 때 기억해 둘 만합니다.
6. 실험 읽기 — 표 네 장과 그림 두 장
무엇으로, 어떻게 쟀나
평가에 쓰인 벤치마크는 두 가지입니다.
SWE-bench Verified. 실제 오픈소스 저장소의 GitHub 이슈를 주고 고치게 한 뒤, 숨겨 둔 테스트로 채점합니다. OpenAI가 2024년 8월에 사람이 검수한 500문항으로 정리한 판입니다. 이 논문은 그 가운데 무작위로 뽑은 200문항만 씁니다(부록에 목록 전체가 실려 있습니다).
Terminal-Bench 2.0. 터미널 안에서 해결해야 하는 89개 과제입니다. 과제마다 고유한 환경과 사람이 쓴 정답 풀이, 테스트가 있습니다. 2026년 1월 논문 기준으로 최전선 모델도 65% 아래였던 어려운 벤치마크입니다. 이 논문은 89문항 전부를 씁니다.
지표는 Pass@1, 곧 한 번 시도해서 통과한 비율입니다. 평가를 세 번 돌려 평균과 표준편차를 적었습니다. 실행 환경은 Harbor(Terminal-Bench 제작진의 평가 프레임워크), 에이전트 틀은 Terminus-KIRA(크래프톤 AI가 공개한 하네스)입니다. 온도 1.0, 최대 250턴, 압축 최대 3회입니다.
비교 대상은 모델마다 여섯 줄입니다. 이름이 비슷해 헷갈리기 쉬우니 먼저 정리합니다.
이름
훈련할 때 압축
평가할 때 압축
뜻
기준 모델
–
없음
강화학습 전의 모델, 창 하나로 평가
기준 모델 + 추론 때 압축
–
있음
지금 대부분의 하네스가 하는 방식
RL (압축 없이)
없음
없음
보통의 PPO, 창 하나 안에서 훈련·평가
RL + 추론 때 압축
없음
있음
윗줄과 같은 체크포인트에 압축만 붙임
CompactionRL (요약 손실 제외)
있음
있음
압축된 궤적으로 훈련하되 요약 토큰은 손실에서 가림
CompactionRL
있음
있음
요약 토큰까지 훈련
다섯째 줄이 영리한 대조군입니다. "압축된 문맥에서 일하는 연습"의 효과와 "요약 쓰기 자체를 훈련한" 효과를 갈라 볼 수 있습니다.
표 2: 주 결과
아래 위젯의 첫 탭이 표 2입니다. 모델과 벤치마크를 바꿔 가며 여섯 줄을 비교해 보세요.
표에서 읽을 것은 네 가지입니다.
하나, CompactionRL이 네 칸 모두에서 가장 높습니다. 106B 모델은 SWE-bench Verified 66.4%, Terminal-Bench 2.0 26.2%. 30B 모델은 56.0%와 20.2%입니다. 지금의 관행인 '기준 모델 + 추론 때 압축'과 비교하면 106B에서 +6.6점·+4.9점, 30B에서 +5.5점·+6.7점입니다. 초록에 실린 숫자가 이것입니다.
둘, 압축 없이 훈련한 모델에 압축을 붙이면 득이 될 수도, 독이 될 수도 있습니다. 이 표에서 가장 눈여겨볼 줄입니다. 30B 모델을 보통의 PPO로 훈련하면 창 하나에서 47.3 → 52.5%로 오릅니다. 그런데 그 모델에 추론 때 압축을 켜면 48.2%로 떨어집니다. 훈련하지 않은 기준 모델에 압축을 붙인 50.5%보다도 낮습니다. Terminal-Bench에서도 16.9 → 12.4%로 내려갑니다. 강화학습이 모델을 '창 하나 안에서 끝내는 일'에 맞춰 다듬어 놓았는데, 평가 때 갑자기 본 적 없는 '요약에서 이어 가기'를 시킨 결과입니다. 106B에서는 같은 조작이 득이 됩니다(58.3 → 62.5%). 모델이 크면 낯선 상황을 견디는 여유가 더 있다고 볼 수 있지만, 그래도 CompactionRL에는 3.9점 못 미칩니다.
셋, 요약을 직접 훈련한 몫이 따로 있습니다. 요약 손실을 뺀 CompactionRL과 온전한 CompactionRL의 차이가 그것입니다. SWE-bench Verified에서는 1.5점(30B), 1.9점(106B)으로 크지 않습니다. Terminal-Bench에서는 큽니다. 30B에서 12.4% 대 20.2%, 106B에서 21.7% 대 26.2%입니다. 30B의 12.4%는 표준편차가 0.0입니다. 세 번 모두 89문항 가운데 11문항을 맞혔다는 뜻입니다. 요약을 훈련에서 빼면 압축된 궤적으로 훈련해도 Terminal-Bench에서는 아무 이득이 없었고, 요약을 넣자 18문항이 되었습니다.
넷, 그림 1 오른쪽이 이 표의 요약입니다. 3장에서 본 그림 1의 막대 그래프를 다시 보면, 회색이 '기준 모델 + 추론 때 압축', 빗금이 'RL', 하늘색이 'RL + 추론 때 압축', 진한 파랑이 CompactionRL입니다. 30B의 SWE-bench에서 하늘색(48.2)이 빗금(52.5) 아래에 있는 것이 '둘'의 내용입니다.
표 3: 장치를 하나씩 빼 보면
위젯의 둘째 탭입니다. 106B 모델, 80k 창에 압축 3회 조건입니다.
CompactionRL
66.4%
− 구간 넘는 GAE
63.0%
SUPO (GRPO)
61.8%
− 토큰 단위 손실
60.0%
훈련 전 + 압축
59.8%
(SWE-bench Verified, 막대 길이는 80% 기준입니다. 차이가 작아 보이므로 숫자를 함께 읽어 주세요.)
토큰 단위 손실을 빼면 60.0%로, 훈련 전(59.8%)과 사실상 같습니다. Terminal-Bench에서는 21.3%로 훈련 전과 소수점까지 같습니다. 하루 가까이 강화학습을 하고도 얻은 것이 없다는 뜻입니다. 구간을 넘는 GAE를 빼면 63.0%·22.5%로 이득의 절반쯤이 남습니다.
SUPO는 바이트댄스가 2025년 10월에 낸 방법으로, 같은 일(실행과 요약을 함께 훈련)을 GRPO로 합니다. 롤아웃 하나에 어드밴티지 하나를 매겨 모든 구간에 똑같이 나눠 줍니다. 저자들이 SUPO를 같은 조건에서 다시 구현해 돌린 결과는 61.8%·21.3%입니다. CompactionRL과의 차이는 4.6점·4.9점입니다. 비용도 적혀 있습니다(표 7). 같은 프롬프트 1,405개에 CompactionRL은 23시간·1,472 GPU-시간, SUPO는 25시간·1,600 GPU-시간이 들었습니다.
표 4: 그냥 창을 두 배로 키워 훈련하면 안 되나
가장 자연스러운 반문입니다. 압축 같은 복잡한 일을 하지 말고, 창을 160k로 키워 압축 없이 훈련하면 되지 않을까요. 위젯의 셋째 탭입니다.
모델 (106B)
훈련 예산
SWE · 80k + 압축 3회
SWE · 160k 창 하나
TB · 80k + 압축 3회
TB · 160k 창 하나
기준 모델
–
59.8
59.5
21.3
20.6
RL (압축 없이)
160k
62.8
64.0
23.2
22.1
CompactionRL
80k×4
66.4
61.8
26.2
24.2
(SWE는 SWE-bench Verified, TB는 Terminal-Bench 2.0입니다.) 80k 창을 접어 쓰는 CompactionRL(66.4%)이, 160k로 훈련하고 160k로 평가한 RL(64.0%)보다 높습니다. 창을 키우는 것보다 접는 법을 가르치는 쪽이 나았다는 결과입니다.
같은 표에 이 논문의 한계도 들어 있습니다. CompactionRL 모델을 압축 없이 160k 창 하나로 평가하면 61.8%입니다. 160k로 훈련한 RL(64.0%)보다 낮습니다. CompactionRL이 가르친 것은 '압축과 함께 일하는 법'이지 '일반적으로 더 잘하는 법'이 아닙니다. 저자들도 결론의 한계 절에서 이렇게 적습니다. "압축을 켠 평가에서 관찰된 이득은 단일 창 추론으로 일관되게 옮겨 가지 않는다."
표 8: 추론 때 설정을 바꾸면
위젯의 넷째 탭입니다. 훈련이 끝난 CompactionRL 모델(106B)의 추론 설정만 바꿔 봅니다.
창 크기. 32k로 줄여도 63.0%입니다(64k에서 65.5%, 80k에서 66.4%). 창을 60% 줄였는데 3.4점만 내려갑니다.
압축 상한. 0회면 59.1%, 1회면 65.3%, 3회면 66.4%입니다. 이득의 대부분은 첫 번째 압축에서 나옵니다.
남기는 최근 턴. 하나도 남기지 않아도(k=0) 66.0%입니다. k=2의 66.4%와 거의 같습니다.
마지막 줄이 흥미롭습니다. 최근 두 턴의 원문은 안전장치입니다. 방금 실행한 명령의 출력을 요약이 놓쳐도 원문이 남아 있게 하려는 것입니다. 그 안전장치를 떼어도 성적이 유지된다는 것은, 훈련된 요약이 이어 가기에 필요한 상태를 거의 다 담고 있다는 뜻입니다.
그림 3: 행동이 어떻게 달라졌나
점수 말고 행동을 본 그림입니다. 106B 모델, SWE-bench Verified입니다.
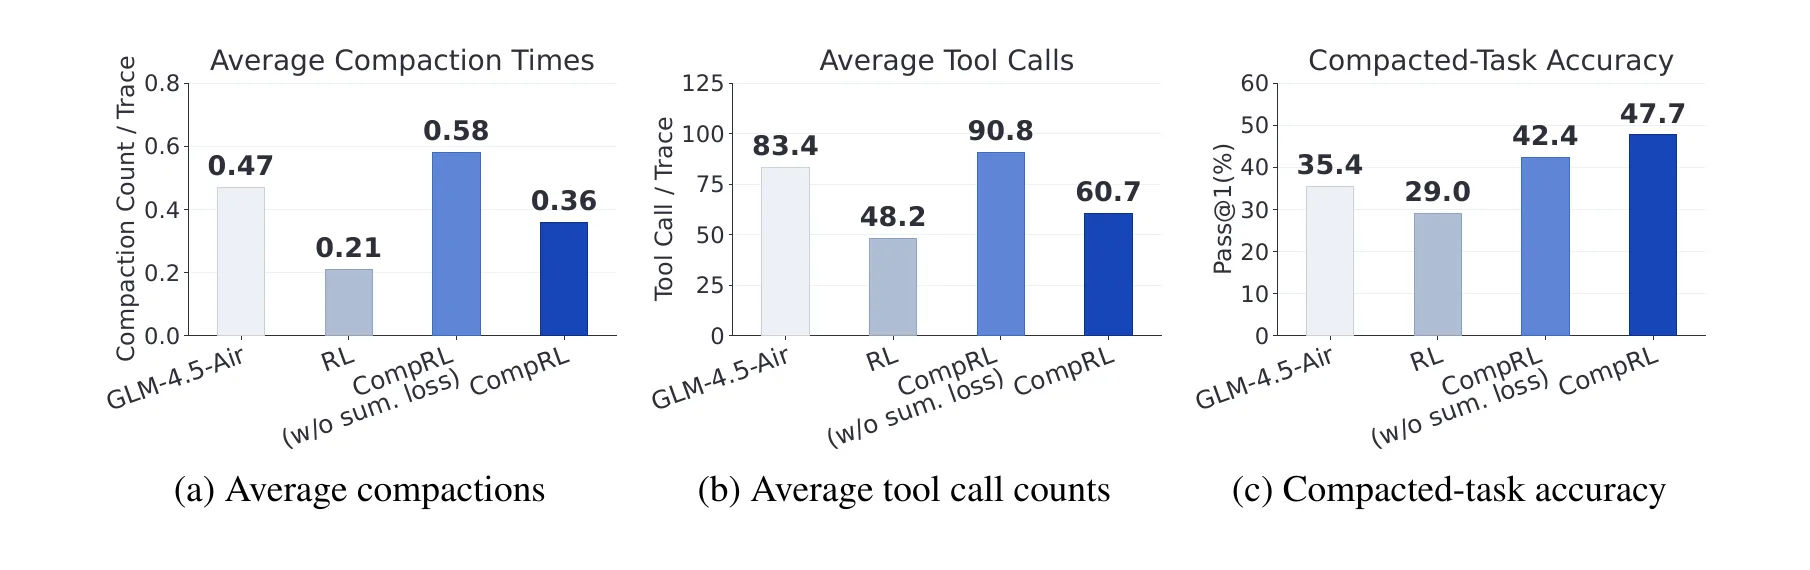
압축 없이 훈련한 RL은 '빨리 끝내는 모델'이 되었습니다. 도구 호출이 83.4회에서 48.2회로 거의 절반이 됩니다. 창 하나 안에서 끝내야 보상을 받는 훈련이었으니 당연한 적응입니다. 그 결과 압축이 걸릴 일 자체가 줄지만(0.21회), 막상 압축이 걸리는 긴 과제에서는 29.0%로 훈련 전(35.4%)보다 못합니다. 짧은 과제를 잘하게 된 대가로 긴 과제를 잃은 셈입니다.
요약을 훈련하지 않은 CompactionRL은 '많이 돌아다니는 모델'이 되었습니다. 도구 호출이 90.8회로 가장 많고 압축도 가장 잦습니다(0.58회). 압축 덕에 길게 일할 수 있다는 것은 배웠지만, 요약이 부실해 압축 뒤에 같은 곳을 다시 뒤지는 일이 많다고 읽을 수 있습니다.
온전한 CompactionRL은 그 사이에 있습니다. 도구 호출 60.7회, 압축 0.36회. 기준 모델보다 적게 움직이면서 압축이 걸린 과제의 정확도는 47.7%로 가장 높습니다. 저자들은 이것을 이렇게 해석합니다. 이득이 "단지 더 긴 상호작용에서 나온 것이 아니라", 훈련된 요약이 과제에 필요한 정보를 보존해 "압축 뒤의 중복 재탐색을 줄였기" 때문이라는 것입니다. 3장의 인수인계 위젯에서 본 '헛걸음'이 줄어든 것입니다.
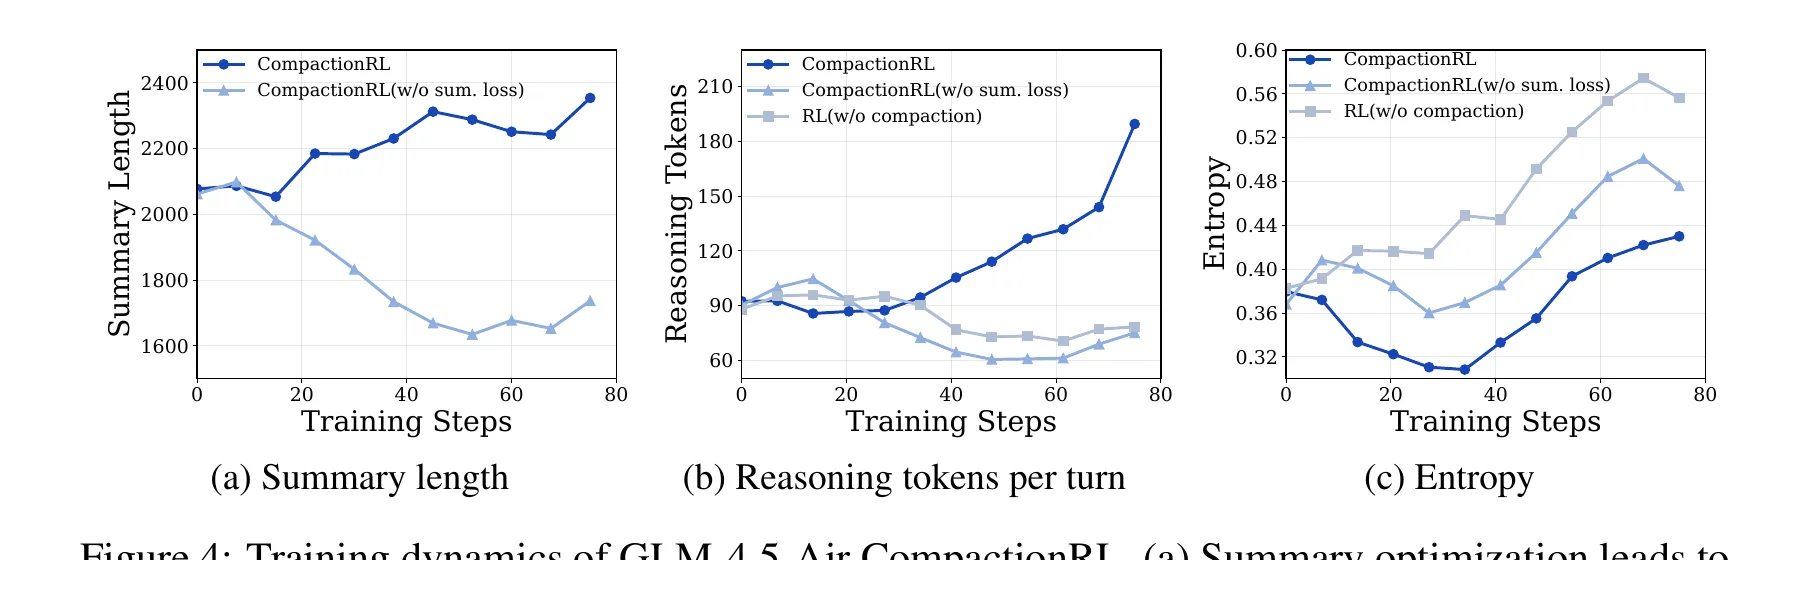
세 그래프 가운데 (a)가 이 논문에서 가장 직관적인 그림입니다. 가로축은 훈련 스텝, 세로축은 요약의 평균 길이입니다.
요약을 보상으로 훈련하면 요약이 길어집니다. 약 2,070 토큰에서 시작해 2,350 토큰 근처까지 올라갑니다.
요약을 훈련에서 빼면 요약이 짧아집니다. 같은 곳에서 시작해 1,650~1,740 토큰으로 내려갑니다.
아무도 "길게 써라"고 시키지 않았습니다. 지시문은 고정이고, 보상은 과제의 성패뿐입니다. 과제를 끝내는 데 도움이 되는 방향으로 요약이 스스로 움직였고, 그 방향이 '더 자세히'였습니다. 논문의 표현으로는 "높은 수준의 진행 상황만 기록하는 대신, 구현에 관련된 문맥과 이어 가기 상태를 더 잘 보존하는, 완결되고 실행 가능한 압축 상태"입니다. 프롤로그의 "버그 수정 중, 일부 진행"과 반대쪽입니다.
요약을 훈련하지 않으면 왜 요약이 짧아질까요. 논문은 설명하지 않습니다. 그림 (b)가 실마리가 될 수 있습니다. 요약 손실을 뺀 모델과 압축 없는 RL은 턴당 추론 토큰이 90에서 70~80으로 줄어듭니다. 실행 쪽에서 '간결하게, 빨리'를 배운 버릇이 훈련 대상이 아닌 요약 쓰기에도 번졌다고 볼 수 있습니다(코어닷투데이의 해석입니다). 반대로 CompactionRL은 턴당 추론 토큰이 90에서 190으로 두 배가 됩니다. 저자들의 해석은 이렇습니다. 압축을 믿을 수 있게 되자 창이 실질적으로 넓어졌고, 모델이 그 여유를 생각하는 데 쓰기 시작했다는 것입니다. 창이 모자랄까 봐 생각을 아끼던 모델이, 접을 수 있다는 것을 알고 나서 생각을 늘린 셈입니다.
표 9: 요약의 품질을 직접 재면
위젯의 다섯째 탭입니다. 요약이 정말 좋아졌는지를 다른 모델(claude-opus-5)에게 채점시켰습니다. 압축이 한 번이라도 걸린 79개 궤적이 대상이고, 다섯 항목을 0~5점으로 매깁니다.
항목
묻는 것
RL (압축 훈련 없음)
CompactionRL
요구 조건 보존
과제의 요구·제약·합격 기준을 정확히 남겼나
3.67
4.00
현재 상태 보존
저장소·패치·테스트·완료 상태를 정확히 적었나
3.28
3.53
실패 이력 보존
실패, 진단, 버린 접근을 남겼나
3.38
3.48
다음 단계의 타당성
남은 일과 다음 단계가 맞고 구체적이며 실행 가능한가
3.14
3.43
이어 가기 유용성
빠지거나 틀린 상태 탓의 재탐색을 줄였나
3.05
3.15
합계
3.30
3.52
다섯 항목 모두 올랐고, 가장 많이 오른 것은 요구 조건 보존(+0.33)과 다음 단계의 타당성(+0.29)입니다. 평균 차이는 +0.22입니다. 큰 숫자는 아닙니다. 더 눈에 띄는 것은 분포입니다. 0~2점대의 나쁜 요약 비율이 22.2%에서 11.9%로 줄었습니다. 평균을 끌어올렸다기보다 치명적인 요약을 걷어 낸 것에 가깝습니다. 과제의 성패는 평균적인 요약이 아니라 최악의 요약에서 갈리므로, 보상이 그쪽을 먼저 깎아 낸 것은 자연스럽습니다.
채점 기준표에는 실무자가 그대로 가져다 쓸 만한 문장이 들어 있습니다. "길이나 세부 사항의 개수가 아니라, 관련 있는 완결성과 정보 밀도를 평가하라." "요약의 품질을, 이어 가는 정책·실행·환경의 품질과 분리하라." 9장의 점검표에서 다시 씁니다.
SWE-bench Verified의 6.6점은 13문항으로, 세 번 반복한 표준편차를 넉넉히 넘습니다. Terminal-Bench의 차이는 문항 네댓 개이고 표준편차가 ±2 안팎이라, 방향은 일관되지만 크기를 단정하기는 이릅니다. '요약 손실을 넣은 효과'를 SWE-bench에서만 보면(+1.5, +1.9) 표준편차와 비슷한 크기입니다. 그 효과가 분명히 드러나는 곳은 Terminal-Bench입니다.
200문항의 구성도 한 번 볼 만합니다. 부록의 목록을 세어 보면 200문항 가운데 106문항이 Django입니다(53%). SymPy 29, Sphinx 17이 뒤를 잇고 나머지 일곱 저장소가 4~8문항씩입니다. 무작위 추출이라 원래 500문항의 분포(Django 비중이 가장 큼)를 따른 결과이지만, "코딩 과제 전반"이라기보다 "Django가 절반인 파이썬 저장소 과제"의 점수라는 점은 기억해 둘 만합니다.
② 압축은 생각보다 드물게 일어났다
그림 3(a)를 다시 보면 CompactionRL의 궤적당 평균 압축 횟수는 0.36회입니다. 80k 창에서 SWE-bench Verified 과제의 다수는 압축 없이 끝납니다. 부록 C가 이를 확인해 줍니다. 두 모델(CompactionRL, 압축 없이 훈련한 RL) 가운데 하나라도 압축이 걸린 과제는 200문항 중 79개였습니다.
그러면 6.6점은 어디서 왔을까요. 압축이 걸린 과제에서의 정확도가 35.4%에서 47.7%로 오른 것(그림 3c)이 한 축이고, 압축이 걸리지 않은 과제에서도 강화학습 자체의 이득이 있었을 것입니다. 논문은 이 둘을 갈라서 보여 주지 않습니다.
한 가지 더 있습니다. 그림 3(c)의 '압축이 걸린 과제'는 모델마다 다른 과제 집합입니다. 빨리 끝내는 모델은 어려운 과제에서만 압축이 걸리고, 많이 돌아다니는 모델은 쉬운 과제에서도 걸립니다. 그러니 29.0%와 47.7%를 그대로 맞대기는 어렵습니다. 같은 과제끼리 비교한 숫자는 부록 C에 있습니다. 두 모델 모두 압축한 과제에서 성공률이 38.10% 대 28.57%입니다. 이 소수점은 분모를 알려 줍니다. 8/21과 6/21입니다. 같은 21문항에서 두 문항 차이입니다. 방향은 맞지만 이 숫자 하나에 큰 무게를 싣기는 어렵습니다.
③ 요약 품질 차이의 신뢰구간
표 9의 평균 차이 +0.22에는 95% 부트스트랩 신뢰구간 [0.020, 0.420]이 붙어 있습니다. 하한이 0.02로, 0을 겨우 벗어납니다. 채점자는 claude-opus-5 한 모델이고, 사람의 검수나 다른 판정 모델과의 일치도는 보고되지 않았습니다. "요약이 좋아졌다"는 주장은 이 표보다 그림 4(a)의 길이 변화와 표 8의 k=0 결과(최근 턴을 지워도 성적 유지)가 더 튼튼하게 받쳐 줍니다.
④ 이득은 압축을 켰을 때만 나온다
6장에서 본 대로입니다. CompactionRL 모델을 압축 없이 돌리면 59.1%(80k 창, 표 8) 또는 61.8%(160k 창, 표 4)입니다. 압축 없이 훈련한 RL은 같은 조건에서 58.3%와 64.0%입니다. 창 하나로만 쓸 것이라면 CompactionRL을 고를 이유가 없습니다. 이 방법은 압축하는 하네스와 짝을 이룰 때만 뜻이 있습니다.
⑤ '기준 모델'의 정체와 판본에 따라 달라진 숫자
표 2의 "GLM-4.5-Air (106B-A12B)"는 공개된 GLM-4.5-Air 그대로가 아닙니다. 본문 4.1절에 따르면 GLM-4.7이 만든 궤적으로 한 번 미세조정한 GLM-4.5-Air-SFT입니다. 강화학습의 출발점이 이미 한 단계 손본 모델이라는 뜻입니다. 비교 자체는 같은 출발점끼리 이루어지므로 공정하지만, 공개 모델의 점수로 읽으면 안 됩니다.
판본도 확인해야 합니다. 7월 6일의 v1 초록은 106B 모델을 "106B-A30B"로 적고 66.8%·24.5%(+7.0·+3.1)를 보고했습니다. 10월 1일의 v2는 "106B-A12B", 66.4%·26.2%(+6.6·+4.9)입니다. 7월에 나온 해설 글 대부분은 v1의 숫자를 인용하고 있습니다. 이 글은 v2를 기준으로 합니다.
⑥ 절대 점수의 위치
66.4%라는 숫자를 최전선과 견주면 안 됩니다. 2026년 11월 현재 SWE-bench Verified는 사실상 다 풀린 벤치마크입니다. 평가 기관 Vals.ai는 성능이 포화했다며 이 벤치마크를 '보관(Archived)'으로 분류했고(2026년 9월 갱신 기준 최상위 모델 97%), OpenAI는 2월에 테스트 설계 결함과 학습 데이터 오염을 이유로 이 벤치마크의 점수 보고를 중단했습니다. Terminal-Bench 2.0의 최고 기록도 84.7%입니다.
이 논문의 주제는 최고 기록이 아닙니다. 활성 파라미터 3B·12B짜리 중형 공개 모델이, 64k·80k라는 좁은 창으로 어디까지 가는가입니다. 표 2 위쪽의 참고 줄을 보면 창이 256k인 Qwen3-Coder-480B가 66.5%입니다. 80k 창의 106B 모델이 그 옆에 섰다는 것이 이 논문의 자리입니다. 다만 저자들이 스스로 주의를 달았듯 그 참고 줄은 500문항 전체와 다른 하네스에서 나온 값이라 직접 비교는 아닙니다. 같은 참고 줄의 Qwen3.5-35B-A3B(64k 창, 압축 사용)는 58.0%·27.0%로, 같은 체급의 CompactionRL 30B(56.0%·20.2%)보다 높게 적혀 있다는 점도 함께 적어 둡니다.
⑦ 프롬프트의 출처, 그리고 하네스 의존성
부록 A.3의 요약 지시문은 낯익습니다. 아홉 항목의 이름과 순서(주된 요청과 의도, 핵심 기술 개념, 파일과 코드 … 다음 단계), <analysis>와 <summary> 태그 구조가 공개 저장소들에 정리된 Claude Code의 대화 요약 프롬프트와 같습니다. 문장은 줄이고 고쳤지만 뼈대가 같고, 재개 안내문의 첫 두 문장("This session is being continued from a previous conversation that ran out of context…")은 비공식적으로 복원된 Claude Code의 문구와 글자까지 일치합니다. 논문은 출처를 밝히지 않았습니다.
평가에 쓴 Terminus-KIRA 하네스도 원래 창이 넘치면 대화를 요약하고 다시 시도하는 기능을 갖고 있습니다. 압축은 이미 평가 도구의 기본 동작이었습니다.
문제 삼을 일이라기보다 읽는 데 필요한 정보입니다. 첫째, 이 지시문은 연구용으로 새로 고안한 것이 아니라 실제 제품에서 쓰이는 형식이므로, 실험이 현실의 하네스와 가깝습니다. 둘째, 모델은 이 한 가지 형식에 맞춰 훈련되었습니다. 지시문이 다른 하네스(항목이 다르거나, 요약을 구조화된 메모로 남기거나, 도구 출력만 지우는 방식)에서도 이득이 유지되는지는 실험되지 않았습니다. ④와 같은 종류의 물음입니다. 훈련한 조건을 벗어나면 얼마나 남는가.
⑧ 재현에 필요한 것
코드. CompactionRL 자체의 저장소는 공개되지 않았습니다(arXiv 페이지에 링크 없음). 훈련 프레임워크 slime은 공개되어 있고, 그 안에 코딩 에이전트용 압축 훅과 "압축 전후의 문맥을 별도 구간으로 표현할 수 있다"는 문서가 있습니다. 논문의 이름은 등장하지 않습니다.
시드. "같은 설정에서 두 개의 무작위 시드로 훈련을 반복했고 비슷한 성능을 관찰했다"는 한 문장이 있고, 숫자는 없습니다. 표의 ±는 평가를 세 번 반복한 표준편차이지 훈련을 반복한 것이 아닙니다.
근사. 구간을 넘는 GAE는 근사이고, λ 식의 l이 정확히 무엇인지는 본문에 한 줄뿐입니다.
훈련 중 압축 빈도. 보고되지 않았습니다. 표 7에서 100스텝 × 배치 128(구간 기준) = 12,800구간, 롤아웃 11,092개이므로 단순히 나누면 롤아웃당 약 1.15구간입니다. 이 계산이 맞다면 훈련 롤아웃의 대부분은 압축 없이 끝났고, 요약은 꽤 적은 표본에서 배운 것이 됩니다. 다만 배치 집계 방식을 논문이 자세히 적지 않아 추정일 뿐입니다.
그래서 무엇이 남는가
조심할 점을 길게 적었지만, 이 논문이 설득력 있게 보여 준 것은 분명합니다.
꽤 단단하게 보인 것
방향은 보였지만 더 필요한 것
아직 보이지 않은 것
요약의 질이 과제 성적을 6점 넘게 좌우한다 (표 1)
요약을 직접 훈련한 몫의 크기 (SWE에서는 표준편차 수준)
압축을 끄면 이득이 사라진다 → 단일 창으로의 전이
압축 없이 훈련한 모델에 추론 때 압축을 붙이면 손해일 수 있다 (30B)
요약 품질 향상의 크기 (신뢰구간 하한 0.02)
다른 하네스·다른 요약 형식에서의 효과
토큰 단위 손실 없이는 압축 훈련이 통하지 않는다 (표 3)
GRPO 대비 우위 (SUPO 재구현 하나와의 비교)
코딩 밖의 과제(웹 탐색, 리서치), 사흘짜리 작업
보상만으로 요약이 스스로 길고 구체적이 된다 (그림 4a)
창을 키우는 것보다 낫다 (160k 한 지점과의 비교)
GLM-5.2에서 이 방법이 기여한 몫
8. 2026년의 자리 — 하네스를 입고 훈련하는 모델
실제 모델에 들어간 방법
이 논문이 여느 방법 논문과 다른 점은 초록의 마지막 문장입니다. "CompactionRL은 공개 모델 GLM-5.2(750B-A40B)를 훈련하는 강화학습 파이프라인에 배치되었다."
순서를 보면 모델이 논문보다 먼저 나왔습니다. Z.AI는 2026년 6월 16일 GLM-5.2의 가중치를 공개했습니다(MIT 라이선스, 100만 토큰 창, Hugging Face 집계로 약 7,530억 파라미터). 논문 v1은 그 3주 뒤입니다. GLM-5.2 발표문에는 CompactionRL이나 SAO라는 이름이 나오지 않지만, 내용은 그대로 적혀 있습니다.
아주 긴 궤적이 압축으로 여러 하위 궤적으로 나뉘면 … 우리는 그룹 단위 최적화에서 벗어나, 개별 롤아웃에서 학습하는 비평가 기반 PPO 정식화로 옮겨 간다. … 압축된 하위 궤적을 모두 학습 가능한 궤적으로 넣어 압축을 훈련 안으로 들여오고, 길이 불균형을 다루기 위해 토큰 단위 손실을 적용한다.
4장과 5장에서 읽은 내용 그대로입니다. 논문은 제품에 들어간 훈련법을 뒤에 풀어 쓴 기술 문서에 가깝습니다. 다만 GLM-5.2의 성능에서 이 방법이 얼마를 기여했는지는 알 수 없습니다. 모델 카드는 SWE-bench Pro(62.1)와 Terminal-Bench 2.1(81.0)을 보고하고, 논문은 SWE-bench Verified와 Terminal-Bench 2.0을 훨씬 작은 모델로 쟀습니다. 둘을 이어 주는 실험은 없습니다.
100만 토큰 창을 가진 모델에 왜 압축 훈련이 필요할까요. 1장의 이야기로 돌아갑니다. 창이 넓어도 길게 채울수록 품질과 비용이 나빠지므로, 실제 제품들은 창이 다 차기 전에 접습니다. slime 저장소의 코딩 에이전트 예제는 "문맥의 70%에서, 궤적당 최대 두 번" 압축하도록 설정되어 있습니다. 창의 크기와 상관없이 긴 일은 접어 가며 하게 되고, 그렇다면 접는 연습을 한 모델이 유리합니다.
세 회사가 같은 곳에 도착했다
2026년 말의 지형을 정리하면 이렇습니다.
회사
압축을 제품에 넣은 때
압축을 훈련에 넣었다고 밝힌 때
방법 공개
OpenAI
Codex CLI /compact (2025.4), Responses API 압축 엔드포인트
GPT-5.1-Codex-Max (2025.11): "압축을 통해 여러 창에 걸쳐 일하도록 기본적으로 훈련"
없음. API의 압축 결과물은 암호화되어 "사람이 해석하도록 의도되지 않음"
Anthropic
Claude Code 자동 압축 (2025.3), API 서버 측 압축 베타 (2026.2)
명시적 발표는 찾지 못함. Sonnet 4.5부터 남은 토큰을 추적하는 '컨텍스트 인식'을 내세움
기법 글과 API 문서는 공개, 훈련법은 없음
Z.AI
GLM-5.2 (2026.6), slime의 압축 훅
GLM-5.2 발표문 (2026.6)
CompactionRL · SAO 논문, slime 프레임워크
세 회사가 서로 다른 시점에 같은 결론에 닿았습니다. 압축은 하네스가 모델에게 하는 일에서 모델이 할 줄 아는 일로 옮겨 가고 있습니다. 한 해설 글(블레이크 크로슬리, 2026년 7월)의 표현이 간명합니다. "압축은 모델에 가하는 처리에서, 모델을 만들 때 넣는 것으로 옮겨 갔다."
이 가운데 훈련법을 식과 설정값까지 공개한 것은 CompactionRL이 처음입니다. 공개 모델로 에이전트를 훈련하려는 연구실과 기업에게는 이 점이 논문의 점수보다 값집니다.
한 가지 대조도 눈에 띕니다. OpenAI의 API가 돌려주는 압축 결과물은 암호화된 불투명한 덩어리입니다. CompactionRL의 요약은 사람이 읽을 수 있는 자연어이고, 아홉 항목 양식을 따릅니다. 에이전트가 무엇을 기억한 채 다음 구간으로 넘어갔는지를 사람이 열어 볼 수 있습니다. 보상으로 훈련된 요약이 사람 눈에는 점점 읽기 어려운 형태로 흘러가지 않을지는 앞으로 지켜볼 문제이지만, 적어도 이 논문에서 요약은 더 길고 구체적인 쪽으로 움직였습니다.
더 큰 흐름에서 보면 CompactionRL은 한 방향을 가리키는 여러 사례 가운데 하나입니다. 모델을 실전에서 쓸 장비째로 훈련한다는 방향입니다.
2024년까지 모델 훈련과 하네스 설계는 따로 놀았습니다. 연구소가 모델을 만들면, 바깥의 개발자들이 그 위에 도구와 프롬프트와 문맥 관리를 얹었습니다. 2025년부터 이 경계가 흐려집니다. 도구 호출 형식이 훈련 데이터에 들어가고, 하위 에이전트에게 일을 넘기는 방식이 훈련에 들어가고, 이제 압축이 들어갑니다. GLM-5.2 발표문은 slime의 훈련 양식으로 "압축된 궤적"과 "하위 에이전트 워크플로"를 나란히 적고 있습니다.
이 방향에는 그림자도 있습니다. 6장의 실험이 보여 주었듯, 훈련한 조건과 쓰는 조건이 어긋나면 손해를 봅니다. 압축 없이 훈련한 30B 모델은 압축을 붙이자 4점을 잃었고, 압축과 함께 훈련한 모델은 압축을 떼자 이점을 잃었습니다. 모델이 특정 하네스의 습관에 맞춰질수록, 모델과 하네스를 따로 고르기가 어려워집니다. 어떤 모델이 어떤 요약 양식, 어떤 압축 시점, 어떤 재개 문구로 훈련되었는지가 모델 카드에 적혀야 하는 정보가 되어 갑니다.
중형 공개 모델에게 갖는 뜻
이 논문의 실험이 30B와 106B 모델, 64k와 80k 창에서 이루어졌다는 점은 한국의 실무자에게 따로 의미가 있습니다. 금융·공공·제조처럼 모델을 사내에 직접 띄워야 하는 곳에서 쓸 수 있는 것은 대개 이 체급의 공개 모델이고, 창을 넉넉히 줄 GPU 메모리도 한정되어 있습니다. 100만 토큰 창은 남의 이야기입니다.
그 조건에서 이 논문은 두 가지를 말해 줍니다. 좁은 창은 접는 법을 아는 모델에게는 생각보다 덜 치명적입니다(32k 창으로도 63.0%). 그리고 접는 법은 타고나는 것이 아니라 하루 안쪽의 강화학습으로 가르칠 수 있습니다(H800 64장으로 15~23시간). 물론 그 '하루'에는 코딩 과제 환경, 비동기 훈련 인프라, 비평가를 다루는 요령이 전제되어 있습니다. 그래도 방법이 공개된 지금, 사내 과제에 맞춘 에이전트를 직접 훈련하려는 팀에게 압축은 건너뛸 수 없는 설계 항목이 되었습니다.
9. 실무 점검표 — 모델을 훈련하지 않는 사람도 가져갈 것
대부분의 독자는 모델을 훈련하지 않습니다. 그래도 이 논문에서 내일 쓸 수 있는 것이 적지 않습니다.
요약을 누가 쓰는지부터 확인합니다. 표 1에서 요약 모델만 바꿔 6.5점이 움직였습니다. 비용을 줄이려고 요약을 작은 모델에 맡기고 있다면, 그 절약이 실행 모델을 한 단계 낮춘 것과 같은 손해를 내고 있을 수 있습니다. 요약 모델을 바꿔 가며 최종 과제 성공률을 재 보는 것이 가장 싼 실험입니다.
요약 양식에 '상태'를 넣습니다. 논문의 아홉 항목 가운데 프롤로그의 사고를 막는 것은 이런 항목입니다. 살펴보거나 바꾼 파일, 만난 오류와 대처, 남은 작업, 지금 하던 일. "진행 상황"만 적는 요약은 길이는 짧고 쓸모는 없습니다.
명령·출력·오류 문구는 원문 그대로 남기게 합니다. 지시문의 한 줄입니다. "작업을 이어 가는 데 필요하면 정확한 명령, 출력, 코드 동작, 오류 문구를 보존하라." 요약이 "테스트가 실패했다"고만 적으면 다음 구간은 테스트를 다시 돌려야 합니다.
최근 턴은 원문으로 남깁니다. 요약이 방금 일을 놓쳐도 원문이 받쳐 줍니다. 논문의 기본값은 2턴입니다. 훈련된 모델은 이것 없이도 버텼지만(66.0%), 훈련되지 않은 모델에게는 싼 보험입니다.
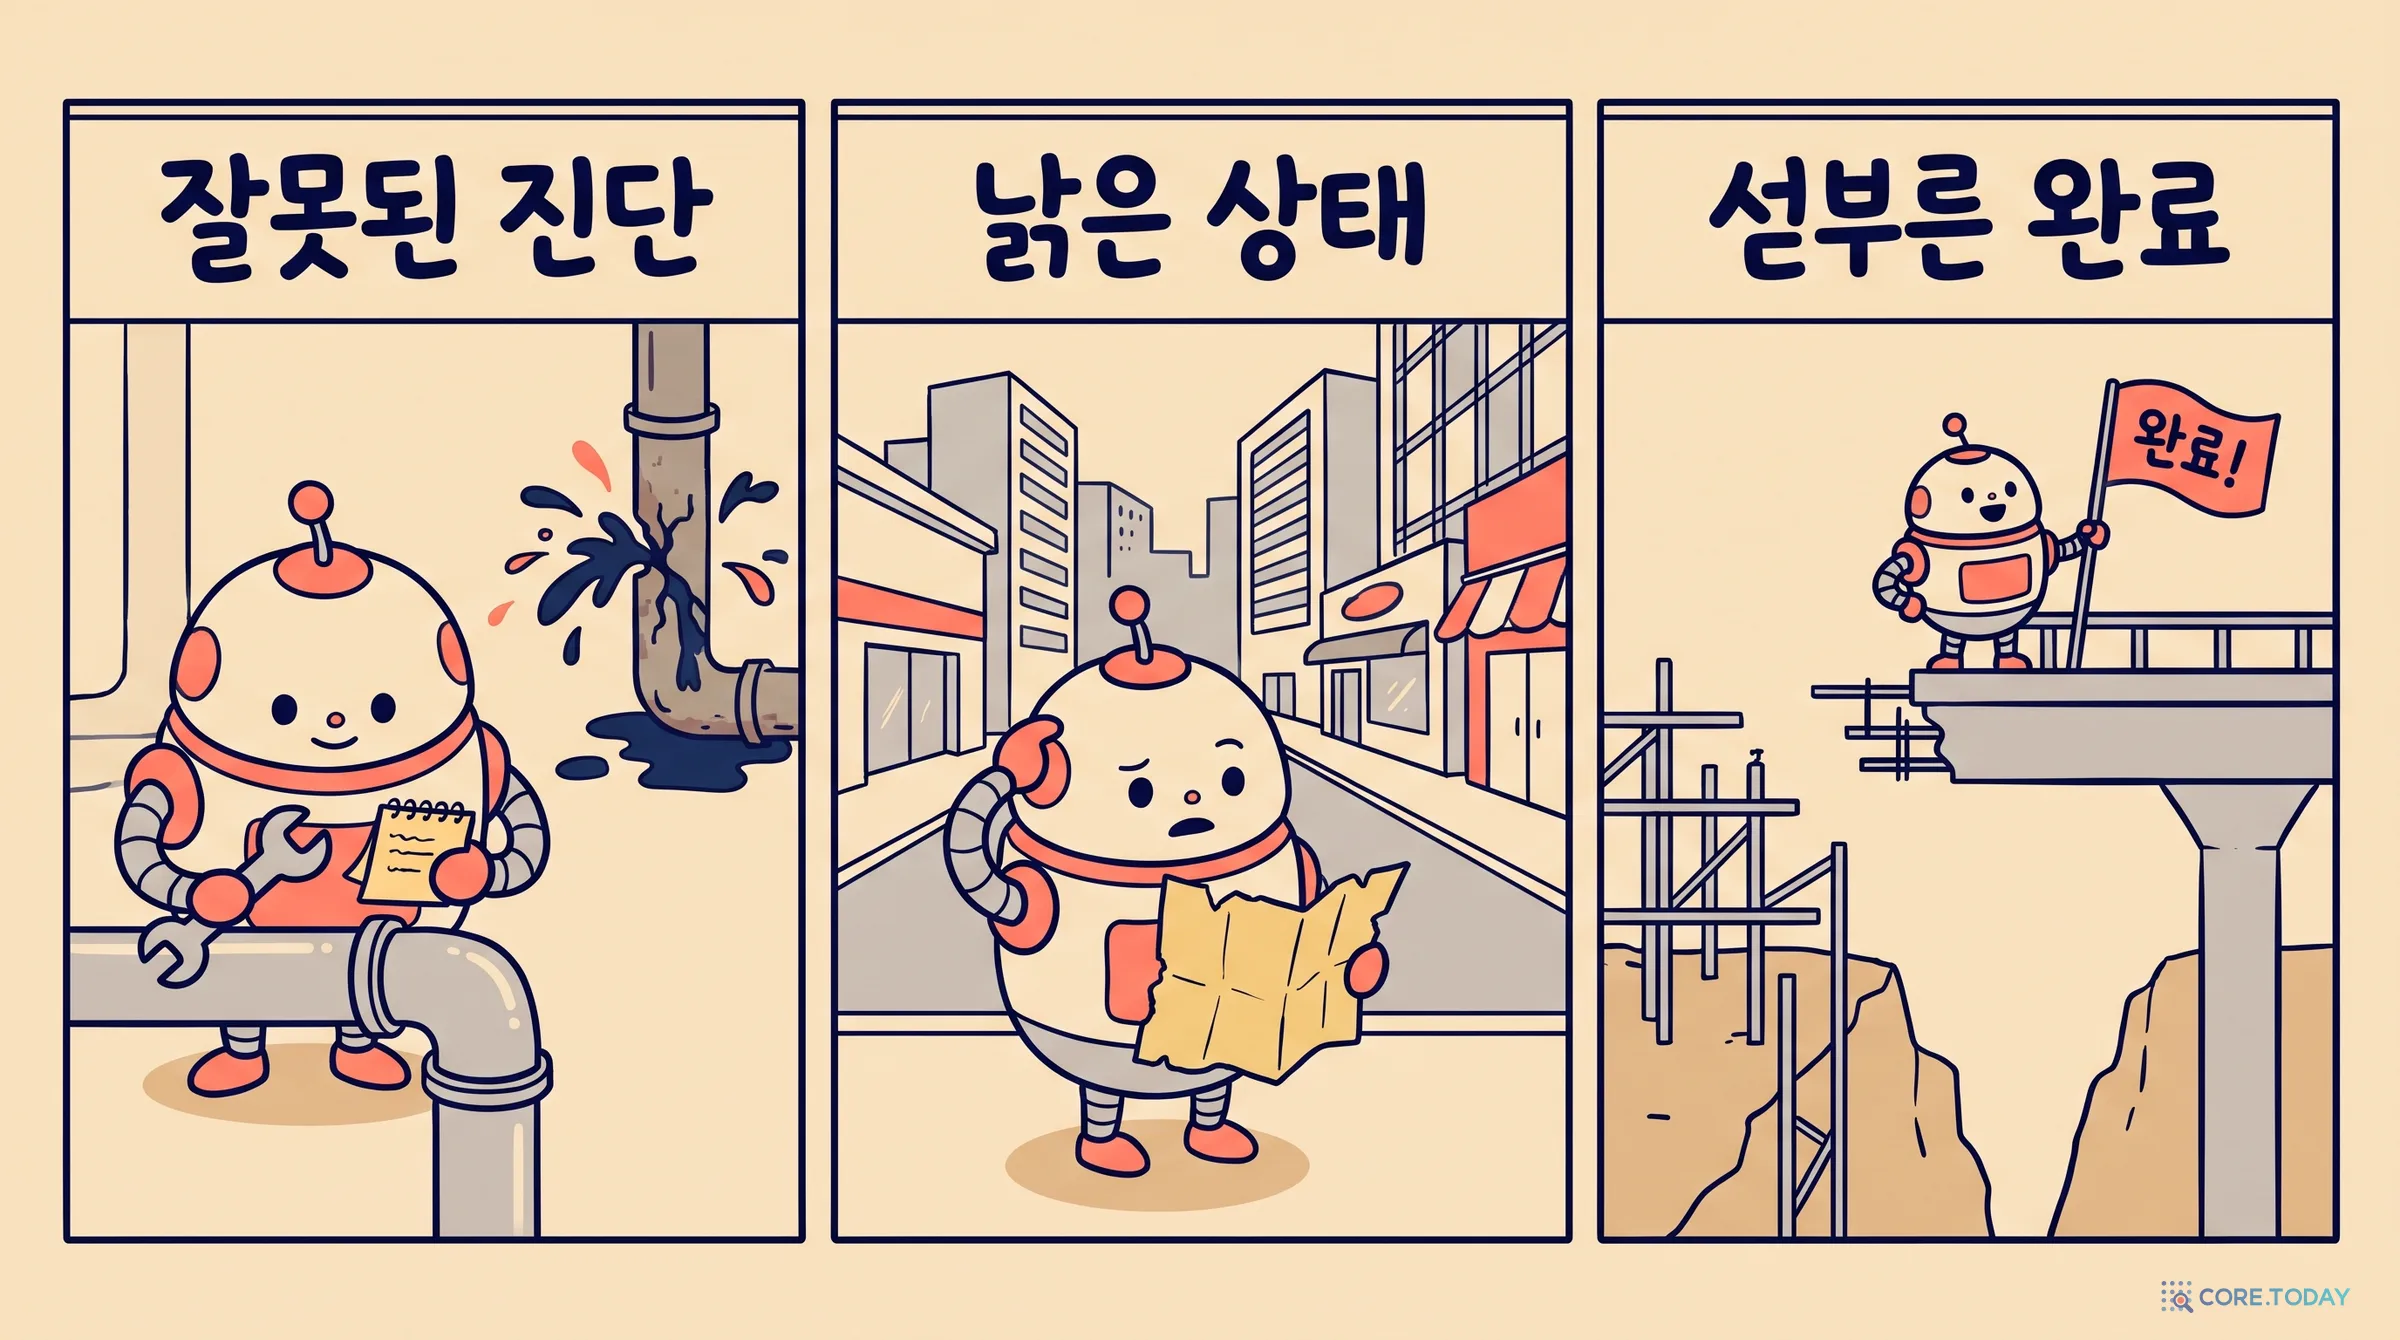
요약의 나쁜 꼬리를 봅니다. 표 9의 교훈은 평균이 아니라 바닥입니다. 요약 100개 가운데 치명적인 10개가 과제를 망칩니다. 요약 품질을 점검한다면 다섯 가지를 묻습니다. 요구 조건을 정확히 남겼는가, 현재 상태가 맞는가, 실패 이력이 남았는가, 다음 단계가 타당한가, 이어 가기에 실제로 도움이 되었는가. 그리고 세 가지 실패를 따로 찾습니다. 잘못된 진단, 낡은 상태, 섣부른 완료 선언.
평가는 실제로 쓸 조건에서 합니다. 압축을 켜고 쓸 것이면 압축을 켜고 평가합니다. 창 하나에서 좋은 모델이 압축을 붙이면 나빠질 수 있다는 것을 표 2가 보여 주었습니다. 새 모델을 들일 때 "긴 과제에서 압축 뒤의 성공률"을 따로 재는 항목을 두면 좋습니다.
압축 횟수에 상한을 둡니다. 논문은 3회입니다. 이득의 대부분은 첫 압축에서 나왔고(0회 59.1 → 1회 65.3 → 3회 66.4), 요약의 요약이 거듭될수록 정보는 닳습니다. 상한에 닿는 과제는 압축을 더 하기보다 과제를 쪼개는 쪽이 낫습니다.
모델과 하네스의 궁합을 기록합니다. 어떤 모델이 어떤 압축 방식으로 훈련되었는지를 알 수 있으면, 그 방식에 맞춰 줍니다. 압축 훈련을 받은 모델에게는 그 모델이 훈련받은 것과 가까운 요약 지시문과 재개 문구를 쓰는 편이 안전합니다.
점검 항목
논문의 근거
내일 할 일
요약 모델
표 1: 49.0 ~ 55.5%
요약 모델을 바꿔 최종 성공률을 재 본다
요약 양식
부록 A.3: 아홉 항목, 원문 보존 지시
파일·오류·남은 일·하던 일을 항목으로 둔다
최근 턴 원문
표 8: k = 0 66.0, k = 2 66.4
2턴 안팎을 원문으로 남긴다
요약 품질 점검
표 9, 부록 C: 나쁜 요약 22.2 → 11.9%
다섯 항목 + 세 가지 실패 유형으로 표본을 읽는다
평가 조건
표 2: 30B RL 52.5 → 압축 붙이면 48.2
압축을 켠 채 긴 과제를 따로 잰다
압축 상한
표 8: 0회 59.1, 1회 65.3, 3회 66.4
상한을 두고, 닿으면 과제를 쪼갠다
맺으며 — 메모를 잘 쓰는 것도 일의 일부
오래 일해 본 사람은 압니다. 일을 잘하는 동료와 인수인계를 잘하는 동료가 늘 같은 사람은 아니라는 것, 그리고 긴 프로젝트에서는 뒤쪽이 더 귀할 때가 많다는 것을. 금요일 저녁에 적어 둔 메모 한 장이 월요일 아침의 두 시간을 살립니다. 그 메모에는 "거의 다 됐음"이 아니라 어느 파일의 몇째 줄을 보고 있었는지, 무엇을 해 봤다가 접었는지, 다음에 무엇을 할 참이었는지가 적혀 있어야 합니다.
에이전트에게 이 능력은 지금까지 덤이었습니다. 창이 찼을 때 하네스가 시키는 일이었고, 잘해도 못해도 훈련에는 반영되지 않았습니다. CompactionRL이 한 일은 그 메모를 성적표에 넣은 것입니다. 메모를 받아 든 다음 구간이 과제를 끝내면 메모를 쓴 토큰도 칭찬받고, 실패하면 함께 책임을 집니다. 그러자 아무도 시키지 않았는데 메모가 길어지고 구체적이 되었습니다.
이 논문의 숫자는 겸손하게 읽어야 합니다. 문항 수는 많지 않고, 이득은 압축을 켰을 때만 나오며, 하나의 하네스와 하나의 요약 양식에서 얻은 결과입니다. 그래도 방향은 또렷합니다. 창은 100만에서 멈췄고 일은 계속 길어지고 있습니다. 그 사이를 메우는 것이 요약이라면, 요약은 더 이상 요령이 아니라 실력입니다. 그리고 실력은 훈련할 수 있습니다.
참고문헌
이 글이 다룬 논문
Yujiang Li, Zhenyu Hou, Yi Jing, Jie Tang, Yuxiao Dong. "CompactionRL: Reinforcement Learning with Context Compaction for Long-Horizon Agents." arXiv:2607.05378 (v1 2026-07-06, v2 2026-10-01). arxiv.org/abs/2607.05378
Zhenyu Hou, Yujiang Li, Jie Tang, Yuxiao Dong. "Single-Rollout Asynchronous Optimization for Agentic Reinforcement Learning (SAO)." arXiv:2607.07508 (2026). arxiv.org/abs/2607.07508