
AI 실험
9개의 포스트
한 줄만 틀려도 버린다 — 뉴스 4만 7천 묶음을 읽힐 LLM, 7종 12가지 설정을 같은 검증기로 재다
사실탐색기는 같은 사건을 다룬 기사 묶음 4만 7,300개에서 주장·시점·같은 사건 관계를 원문 인용과 함께 뽑아야 합니다. 어느 모델에 맡길지 정하려고 Claude 3종, DeepSeek Flash, Muse Spark, 무료 K-EXAONE, 사내 A100에 올린 Qwen3.8-27B까지 7종 12가지 설정을 같은 지시문과 같은 검증기로 쟀습니다. 검증기는 행 하나만 틀려도 이야기 전체를 거부합니다. 그래서 순위는 ‘통과하면 얼마나 잘하나’보다 ‘긴 이야기에서 끝까지 버티나’로 갈렸습니다. Claude Haiku 5.5는 7개를 모두 통과하며 기준 주장의 89%를 회수했습니다. DeepSeek·EXAONE·Qwen은 통과한 이야기에서는 72~88%를 회수하고도 긴 이야기를 거의 다 잃어, 판본에 남은 양이 14~29%였습니다. 지시문 한 줄은 Sonnet 5.5의 회수율을 34%에서 68%로 두 배 올렸지만 DeepSeek에는 독이 됐고, 생각 모드는 답 대신 생각만 남겼습니다. 무료와 할인의 조건, 사내 GPU로 돌리는 데 드는 시간, 주장 하나당 비용까지 정리했습니다. 위젯 3종, 코어닷투데이 실측, 삽화 6장.
‘롯데 홈구장 새로 짓는 거’를 찾아라 — 부산 공적 기록으로 잰 한국어 임베딩 모델 14종
사실탐색기가 질문 속 바꿔 말한 이름을 찾을 때 쓰는 임베딩 모델을 고르려고, 부산 공적 기록 362건에서 만든 네 과제로 임베딩 14종(설정 28가지)을 맥과 A100에서 쟀습니다. 한국어로 다시 학습한 1.1B 모델 KURE-v3가 8B 모델들보다 앞섰고, 300M짜리 EmbeddingGemma 1세대가 그 바로 뒤에 붙었습니다. 그러나 과제마다 1위가 바뀌었고, 권장 접두사를 빼면 1위 모델이 글자 검색보다도 못해졌으며, 열네 모델 가운데 여섯은 ‘7월 1일’과 ‘7월 8일’처럼 숫자 하나 다른 값의 절반 넘게를 같은 값 쪽으로 봤습니다. 무엇을 고를지와 함께, 임베딩에 맡기지 말아야 할 일을 정리했습니다.
‘299억’을 고른 재정렬기 — 재정렬기 15종·로컬 LLM·질의 고쳐 쓰기로 정한 사실탐색기 검색 설계
1편에서 고른 임베딩 KURE-v3 위에 무엇을 더 얹어야 할지 정하려고, 재정렬기 15종과 로컬 LLM 두 개, 질의 고쳐 쓰기, 문단에 제목 붙이기를 같은 부산 시험지로 쟀습니다. 재정렬기는 근거·술어 찾기를 올렸지만 주어 찾기는 대부분 깎았습니다. 작은 재정렬기는 '순천만 박람회 경제적 효과'에 대상 이름 대신 '299억'을 골랐습니다. 지시문 한 줄이 이 어긋남을 고쳤고, 값 가르기까지 거의 완벽하게 만들었습니다. 근거 찾기의 가장 큰 개선은 재정렬이 아니라 제목 붙이기였고, '기록에 없음'은 어떤 점수로도 잘 걸러지지 않았습니다. 프로덕트에 무엇을 넣을지 설치 환경별로 정리했습니다.
‘가결’과 ‘원안대로 가결’은 같은 값인가 — 글자 유사도를 걷어 내고 값의 ‘해상도’로 비교하기
코어닷투데이 사실탐색기는 부산시의회 회의록의 '원안 가결'과 '원안대로 가결'을 서로 다른 값으로 보고, 한 안건에 의결결과를 둘씩 열어 두고 있었습니다. 그런 안건이 134개였습니다. 같은 엔진은 '2024년 4월 1일부터'와 '…까지'를 같은 값으로 보았습니다. 원인은 둘 다 값을 글자 조각의 겹침으로 비교한 데 있었습니다. 날짜·나이 범위·의결결과를 칸이 있는 구조로 읽고, 칸이 빈 값은 '덜 자세한 같은 값'으로 다루는 계층을 넣었습니다. 그 결과 판정이 바뀐 값 쌍은 열 개였지만 명제가 136개 줄었고, 설명 안 되는 대체가 7건에서 5건으로 줄었습니다. Y2K와 엑셀의 1900년 윤년, 앨런의 구간 관계 13가지, 푸앵카레와 루스의 '같은데 다른' 역설을 따라가며, 값의 해상도가 왜 값의 일부인지, 2026년의 판정 모델은 어디에 서야 하는지 정리했습니다.
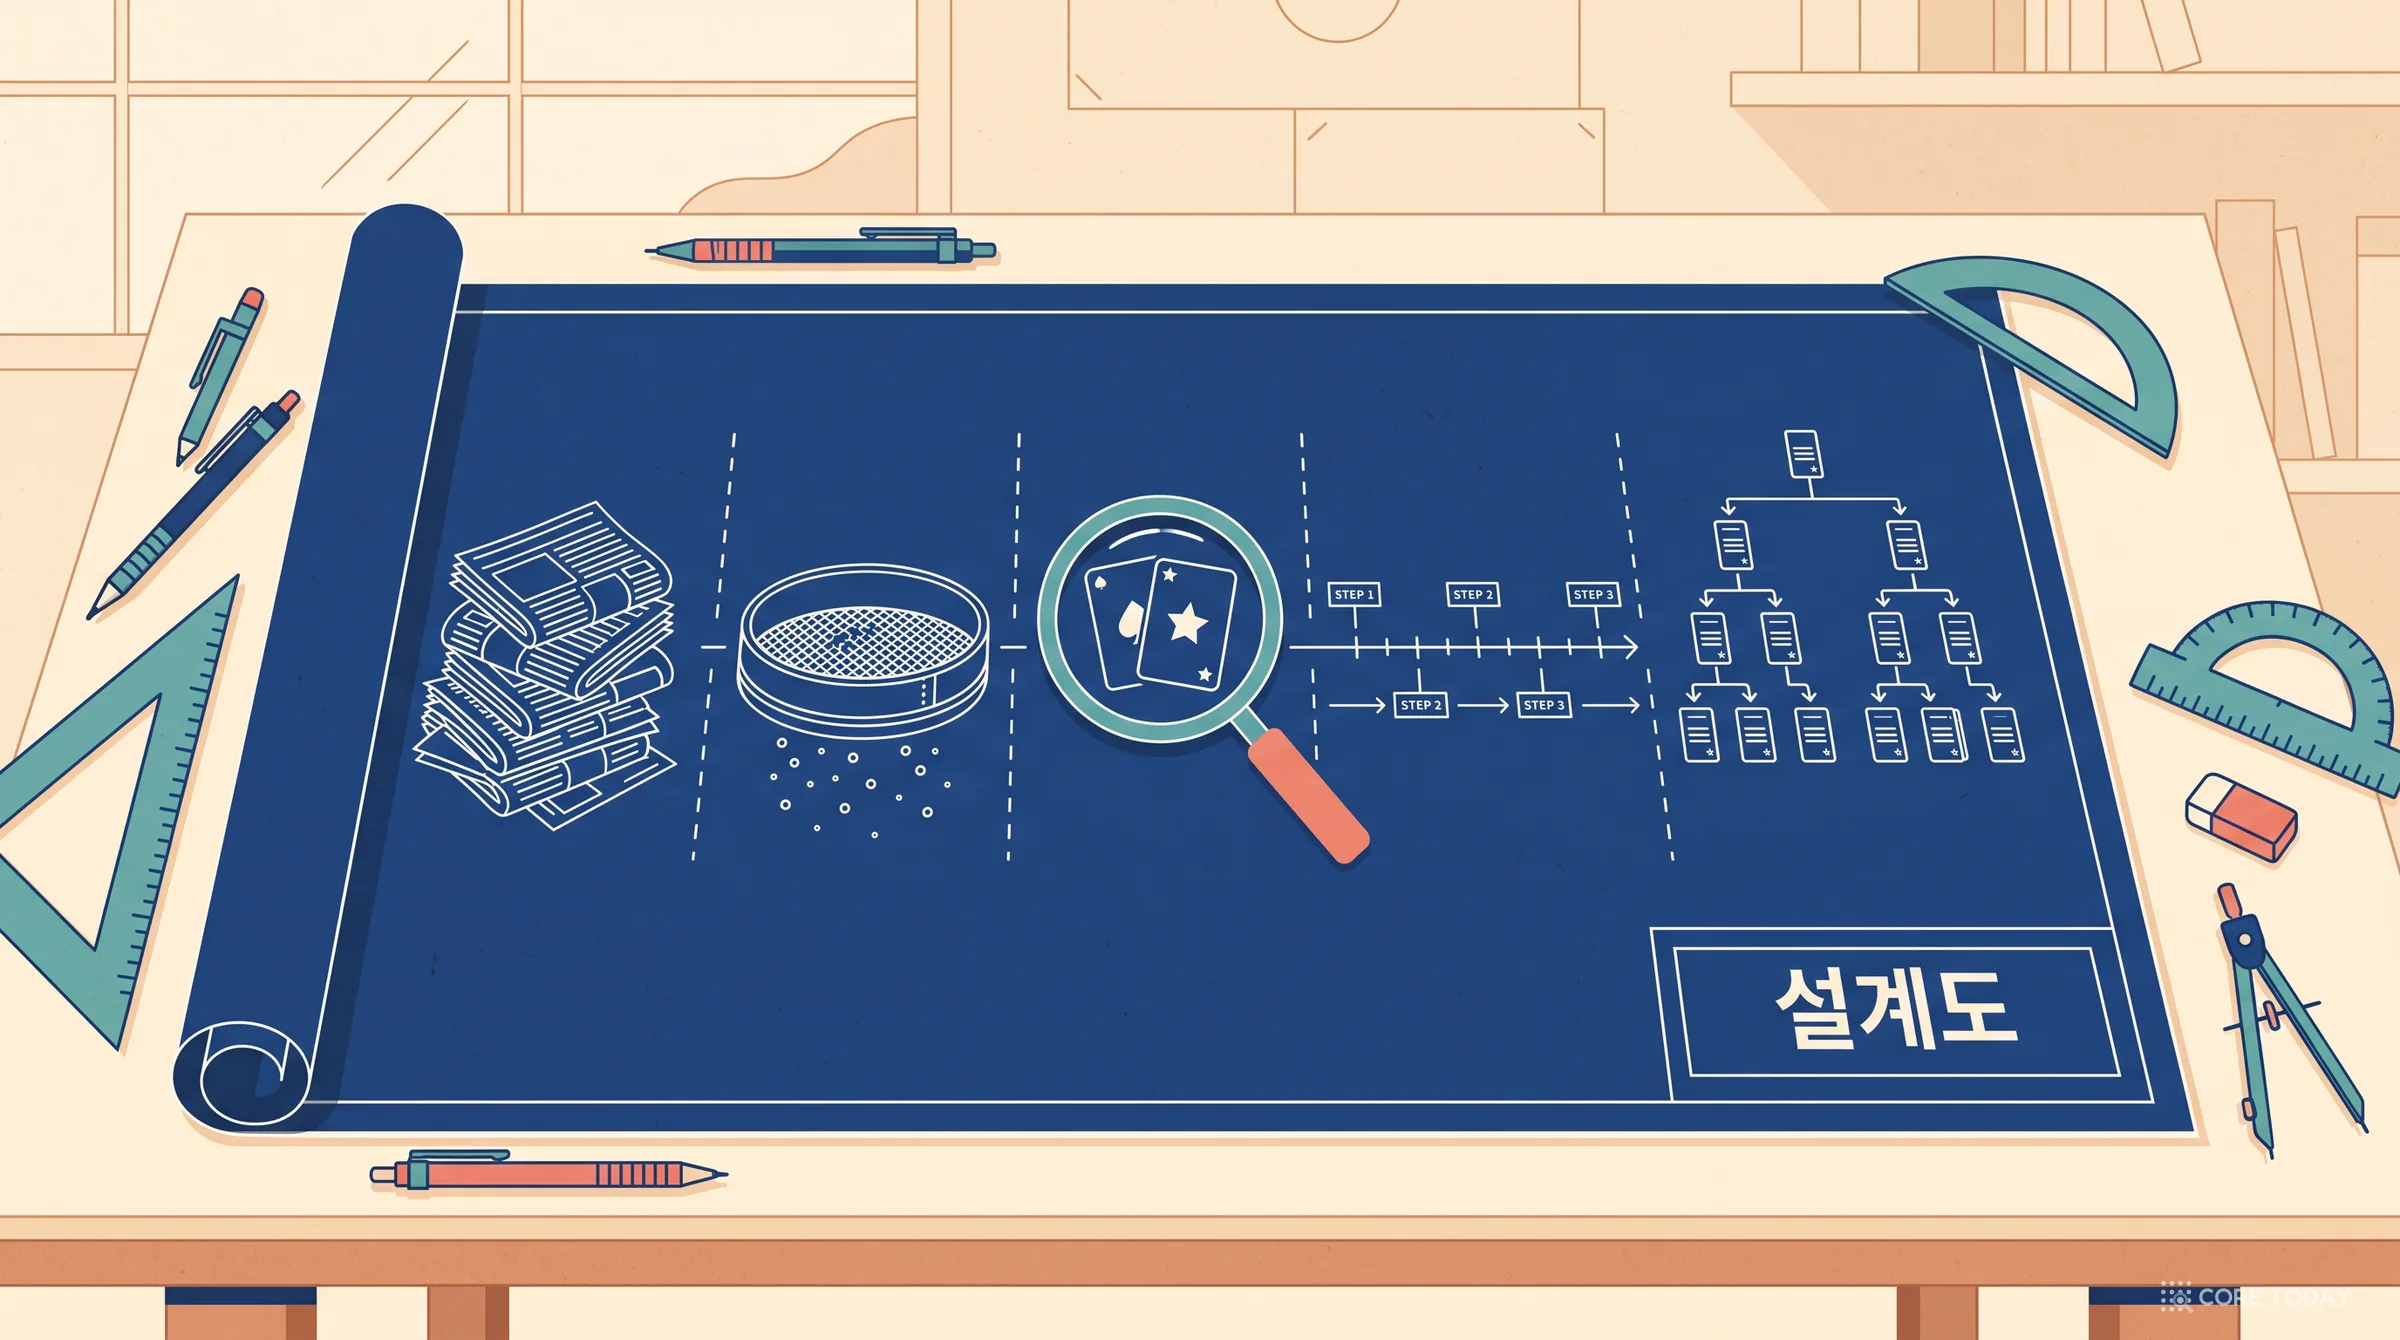
같은 사건 묶기 5편(총정리) — 뉴스 기사를 사건과 이야기로 묶는 여섯 단계 설계도
네 편에 걸쳐 하루치 603건에서 여드레치 1만 건까지 자료를 키우며 '같은 사건'과 '같은 이야기'를 묶는 법을 실측했습니다. 이 글은 그 결과를 따라 할 수 있는 한 장의 설계도로 정리합니다. 여섯 단계의 기본값과 각 값을 정한 근거, 캐시된 판정만으로 다시 돌린 기준 파이프라인의 품질, 기사 1,000건당 비용, 그리고 시도했지만 버린 열두 가지입니다. 가장 큰 교훈은 둘입니다. 판정은 싸고 레코드 추출이 비싸며, 쌍의 정확도보다 묶는 규칙이 결과를 더 크게 바꿉니다.
최신 기사는 대체로 맞다, 엇갈린 값은 끝내 남는다 — 기사 2천 건에서 사실 1,831개를 따라가 보니
뉴스를 읽는 기계는 흔히 '가장 최근 기사의 값'을 믿습니다. 13개 언론사 여드레치 기사 2천여 건에서 두 기사 이상이 함께 실은 사실 1,831개를 뽑아 값이 어떻게 갈리는지 따라갔습니다. 89%는 처음부터 끝까지 같은 값이었고, 실제로 바뀐 사실에서도 가장 최근 기사는 91%가 지금 값을 담고 있었습니다. 출처 등급을 앞세운 규칙(85%)보다 나았습니다. 문제는 다른 데 있었습니다. 새 값이 나온 뒤에도 여덟 건 중 한 건은 옛 값만 실었고, 출처마다 엇갈린 값 35개 중 31개는 마지막 날까지 정정되지 않고 나란히 남았습니다.
뉴스에는 대본이 없다 — 883개 후속 전개로 본 한국 뉴스 이야기의 문법
사건 보도에는 정해진 순서, 즉 대본이 있을까요? 13개 언론사 여드레치 기사에서 정답으로 확인한 후속 전개 883개에 단계 유형 22개를 붙여 다음 단계를 맞혀 봤습니다. 대본은 법이 순서를 정한 사법 절차에만 있었습니다. 그 밖에서는 유형으로 다음을 맞히는 통계가 '늘 비판이라고 답하기'와 같았습니다. 대신 규칙성은 다른 데 있었습니다. 발표 뒤에는 시행보다 비판이 세 배 많이 오고, 해명은 이야기를 잇고 재판·시행·행사는 닫습니다. 그리고 여러 단계로 이어진 이야기의 절반 가까이는 '말'입니다.
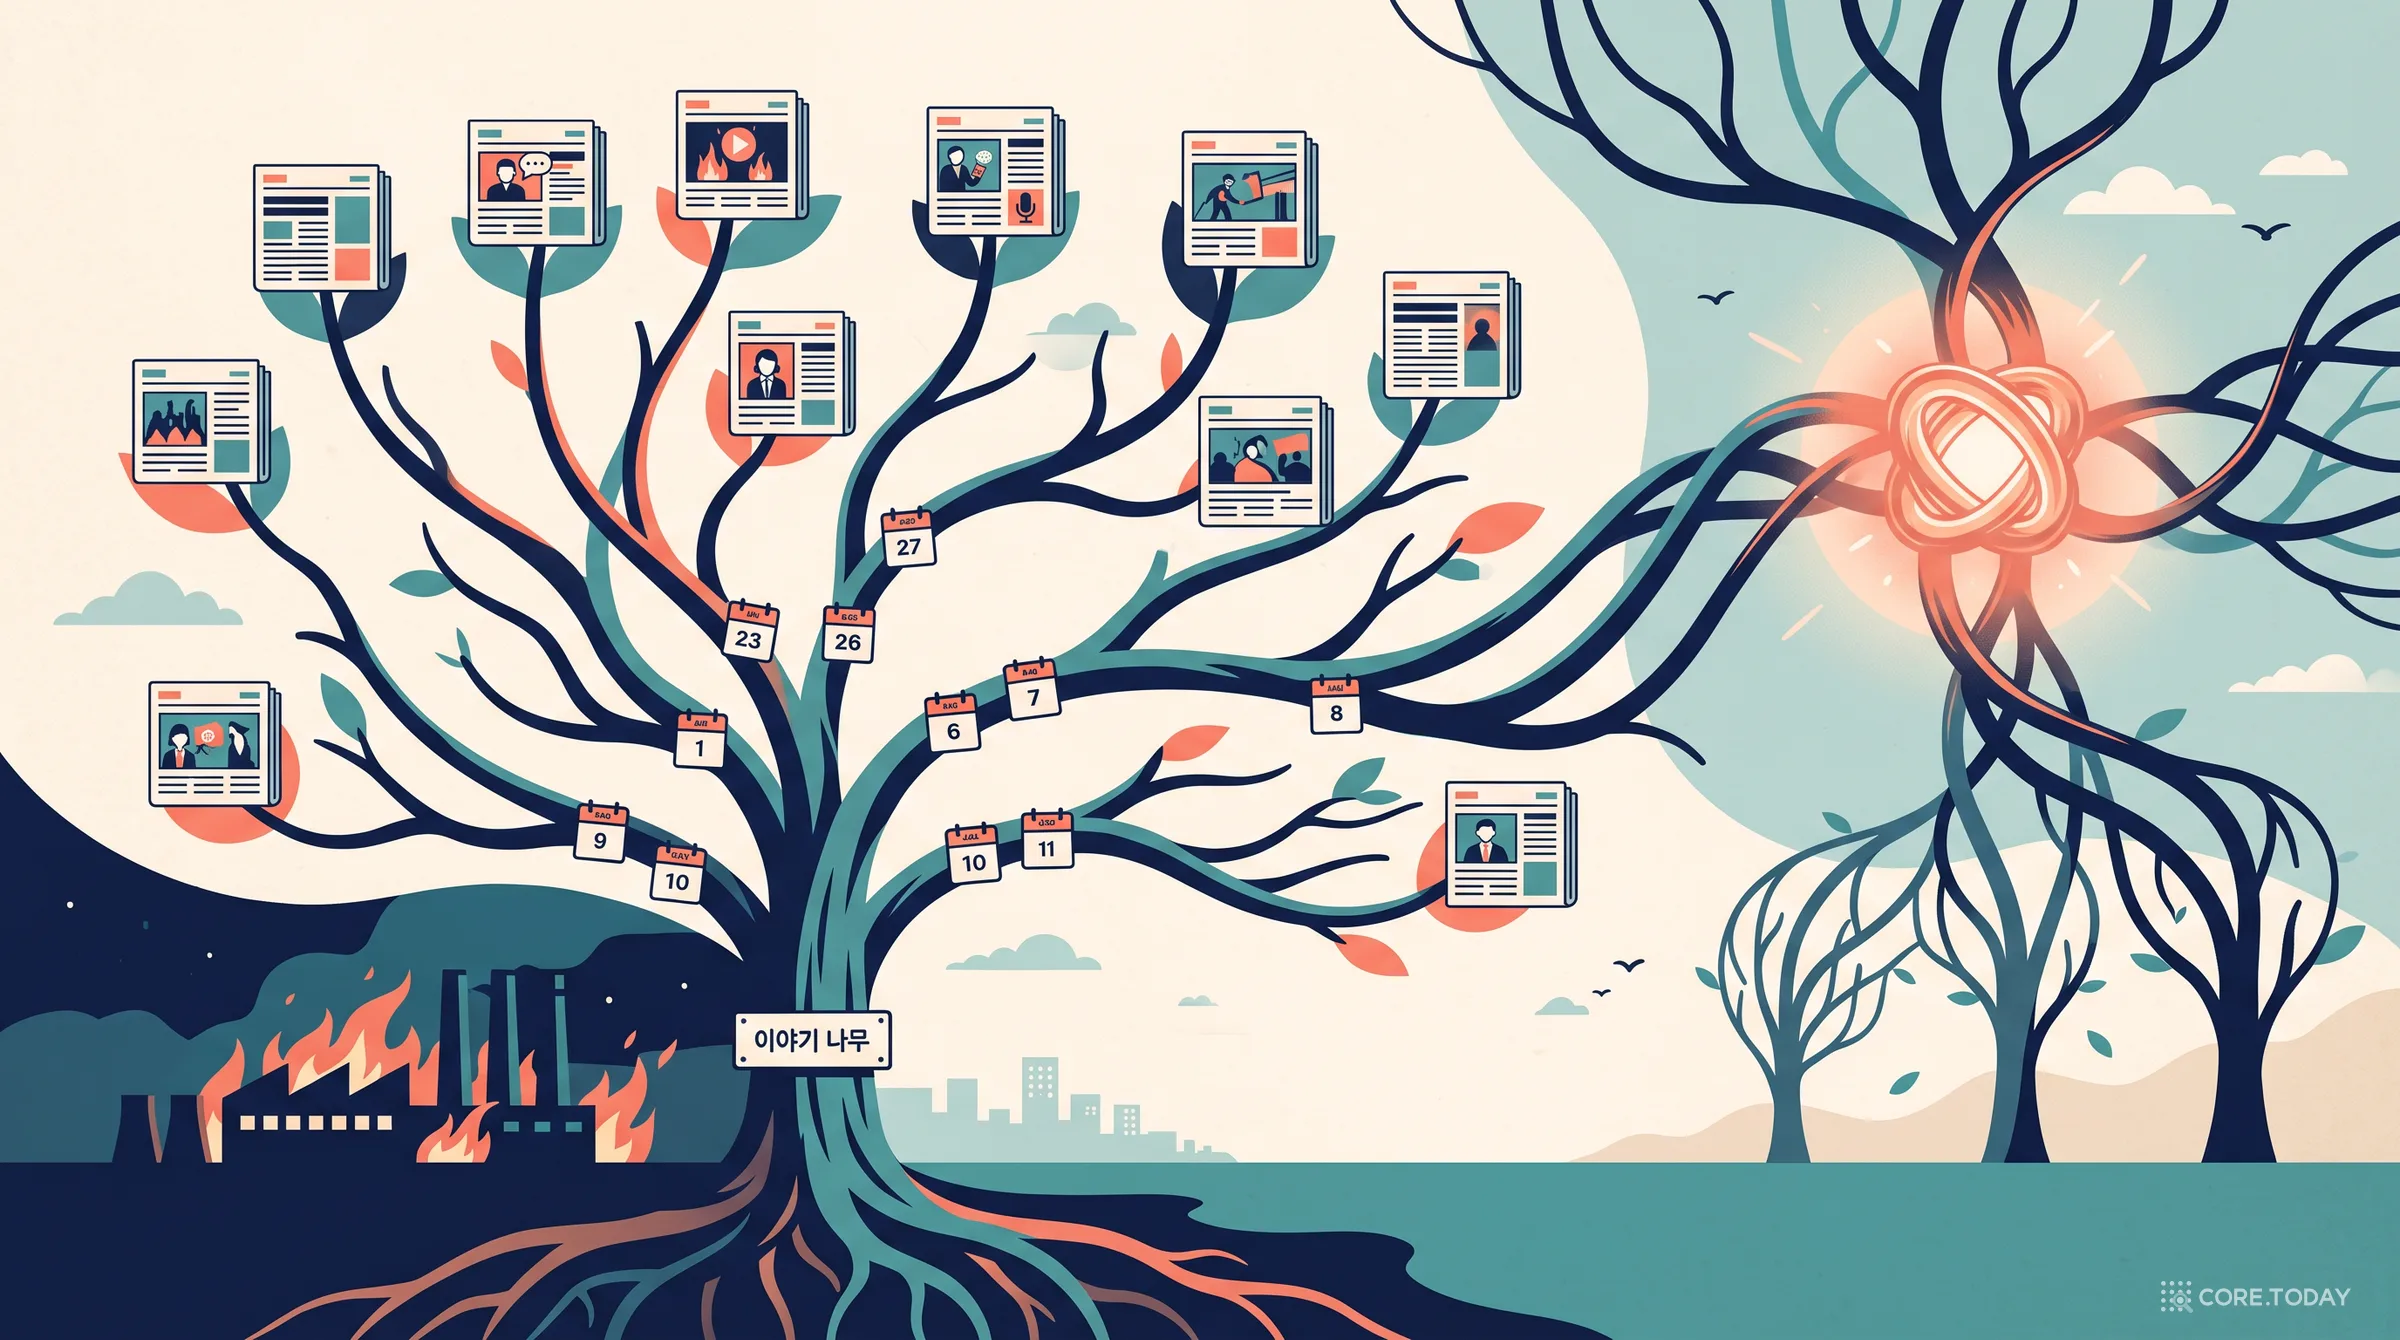
같은 사건 묶기 4편 — 여드레치 1만 건, 이야기를 사슬이 아니라 나무로 세울 수 있는가
3편은 '같은 이야기'가 쌍으로는 쉽고 성분으로는 불가능하다는 데서 끝났습니다. 4편은 13개 언론사의 여드레치 정치·사회 기사 10,000건으로 그 다음을 실측했습니다. 같은 사건 묶음을 '단계'로 다시 쪼개고, 단계 사이에 후속·형제·참조 간선 정답 16,734개를 세 판사로 만들고, 어떤 점수가 다음 단계의 부모를 찾는지 쟀습니다. 결론은 뜻밖이었습니다. 정답 나무도 나무가 아니라 그물이었고, 그래서 이야기의 단위는 성분이 아니라 '부모 하나'여야 했습니다.
같은 사건 묶기 3편 — 나흘치 5,404건, 시간이 흐를 때 묶음은 어떻게 자라고 어디서 끊어야 하는가
1편은 하루치 한 언론사, 2편은 하루치 25개 언론사였습니다. 3편은 13개 언론사의 나흘치 정치·사회 기사 5,404건으로, 게재일이 벌어질수록 '같은 사건'이 어떻게 희귀해지는지, 판정 모델에 날짜를 주면 후속 보도를 더 잘 가르는지, 기사가 도착하는 순서대로 묶는 온라인 방식이 배치보다 사슬 합침을 막는지, 사건 묶음 위에 이야기 묶음을 어떻게 세우는지를 실측했습니다.