
특집
172개의 포스트
페이지가 아니라 토큰을 고른다 — 멀티모달 문서 RAG의 다음 단계, Doc-REFRAG와 HAM-RAG (RAG 특집 6편)
실제 문서 RAG에서 질문 하나에 검색되는 페이지 이미지는 평균 37.4장이다. 한 장이 2,304 시각 토큰인 모델이라면 8만 6천 토큰 — 32K 컨텍스트에는 14장도 안 들어간다. 그래서 다들 상위 5장만 넣고, 정확도는 46.6%에서 멈춘다. EMNLP 2026에 채택된 Doc-REFRAG는 질문을 뒤집는다. ‘어떤 페이지가 관련 있나’가 아니라 ‘검색된 수십 장 중 어떤 영역의 어떤 토큰만 VLM에 넘길 것인가’. 페이지를 108개 청크로 접고 질문이 가리키는 20%만 다시 펴서, 페이지당 150 토큰으로 20장을 다 넣고도 57.5%를 6.1초에 낸다. 같은 달 나온 HAM-RAG는 반대편 문제를 짚는다 — 그림과 텍스트를 낱개로 흩어 놓으면 ‘같은 페이지’라는 이유로 엉뚱한 문장이 붙는다. 문서 계층을 보존하자 이미지 배치 정확도가 24.2% 올랐다. 이 글은 두 연구와 Qwen3-VL 검색 모델을 따라가며, 텍스트 인덱스와 시각 인덱스를 어떻게 한 쌍으로 묶어야 하는지까지 위젯 5종으로 만져 본다.
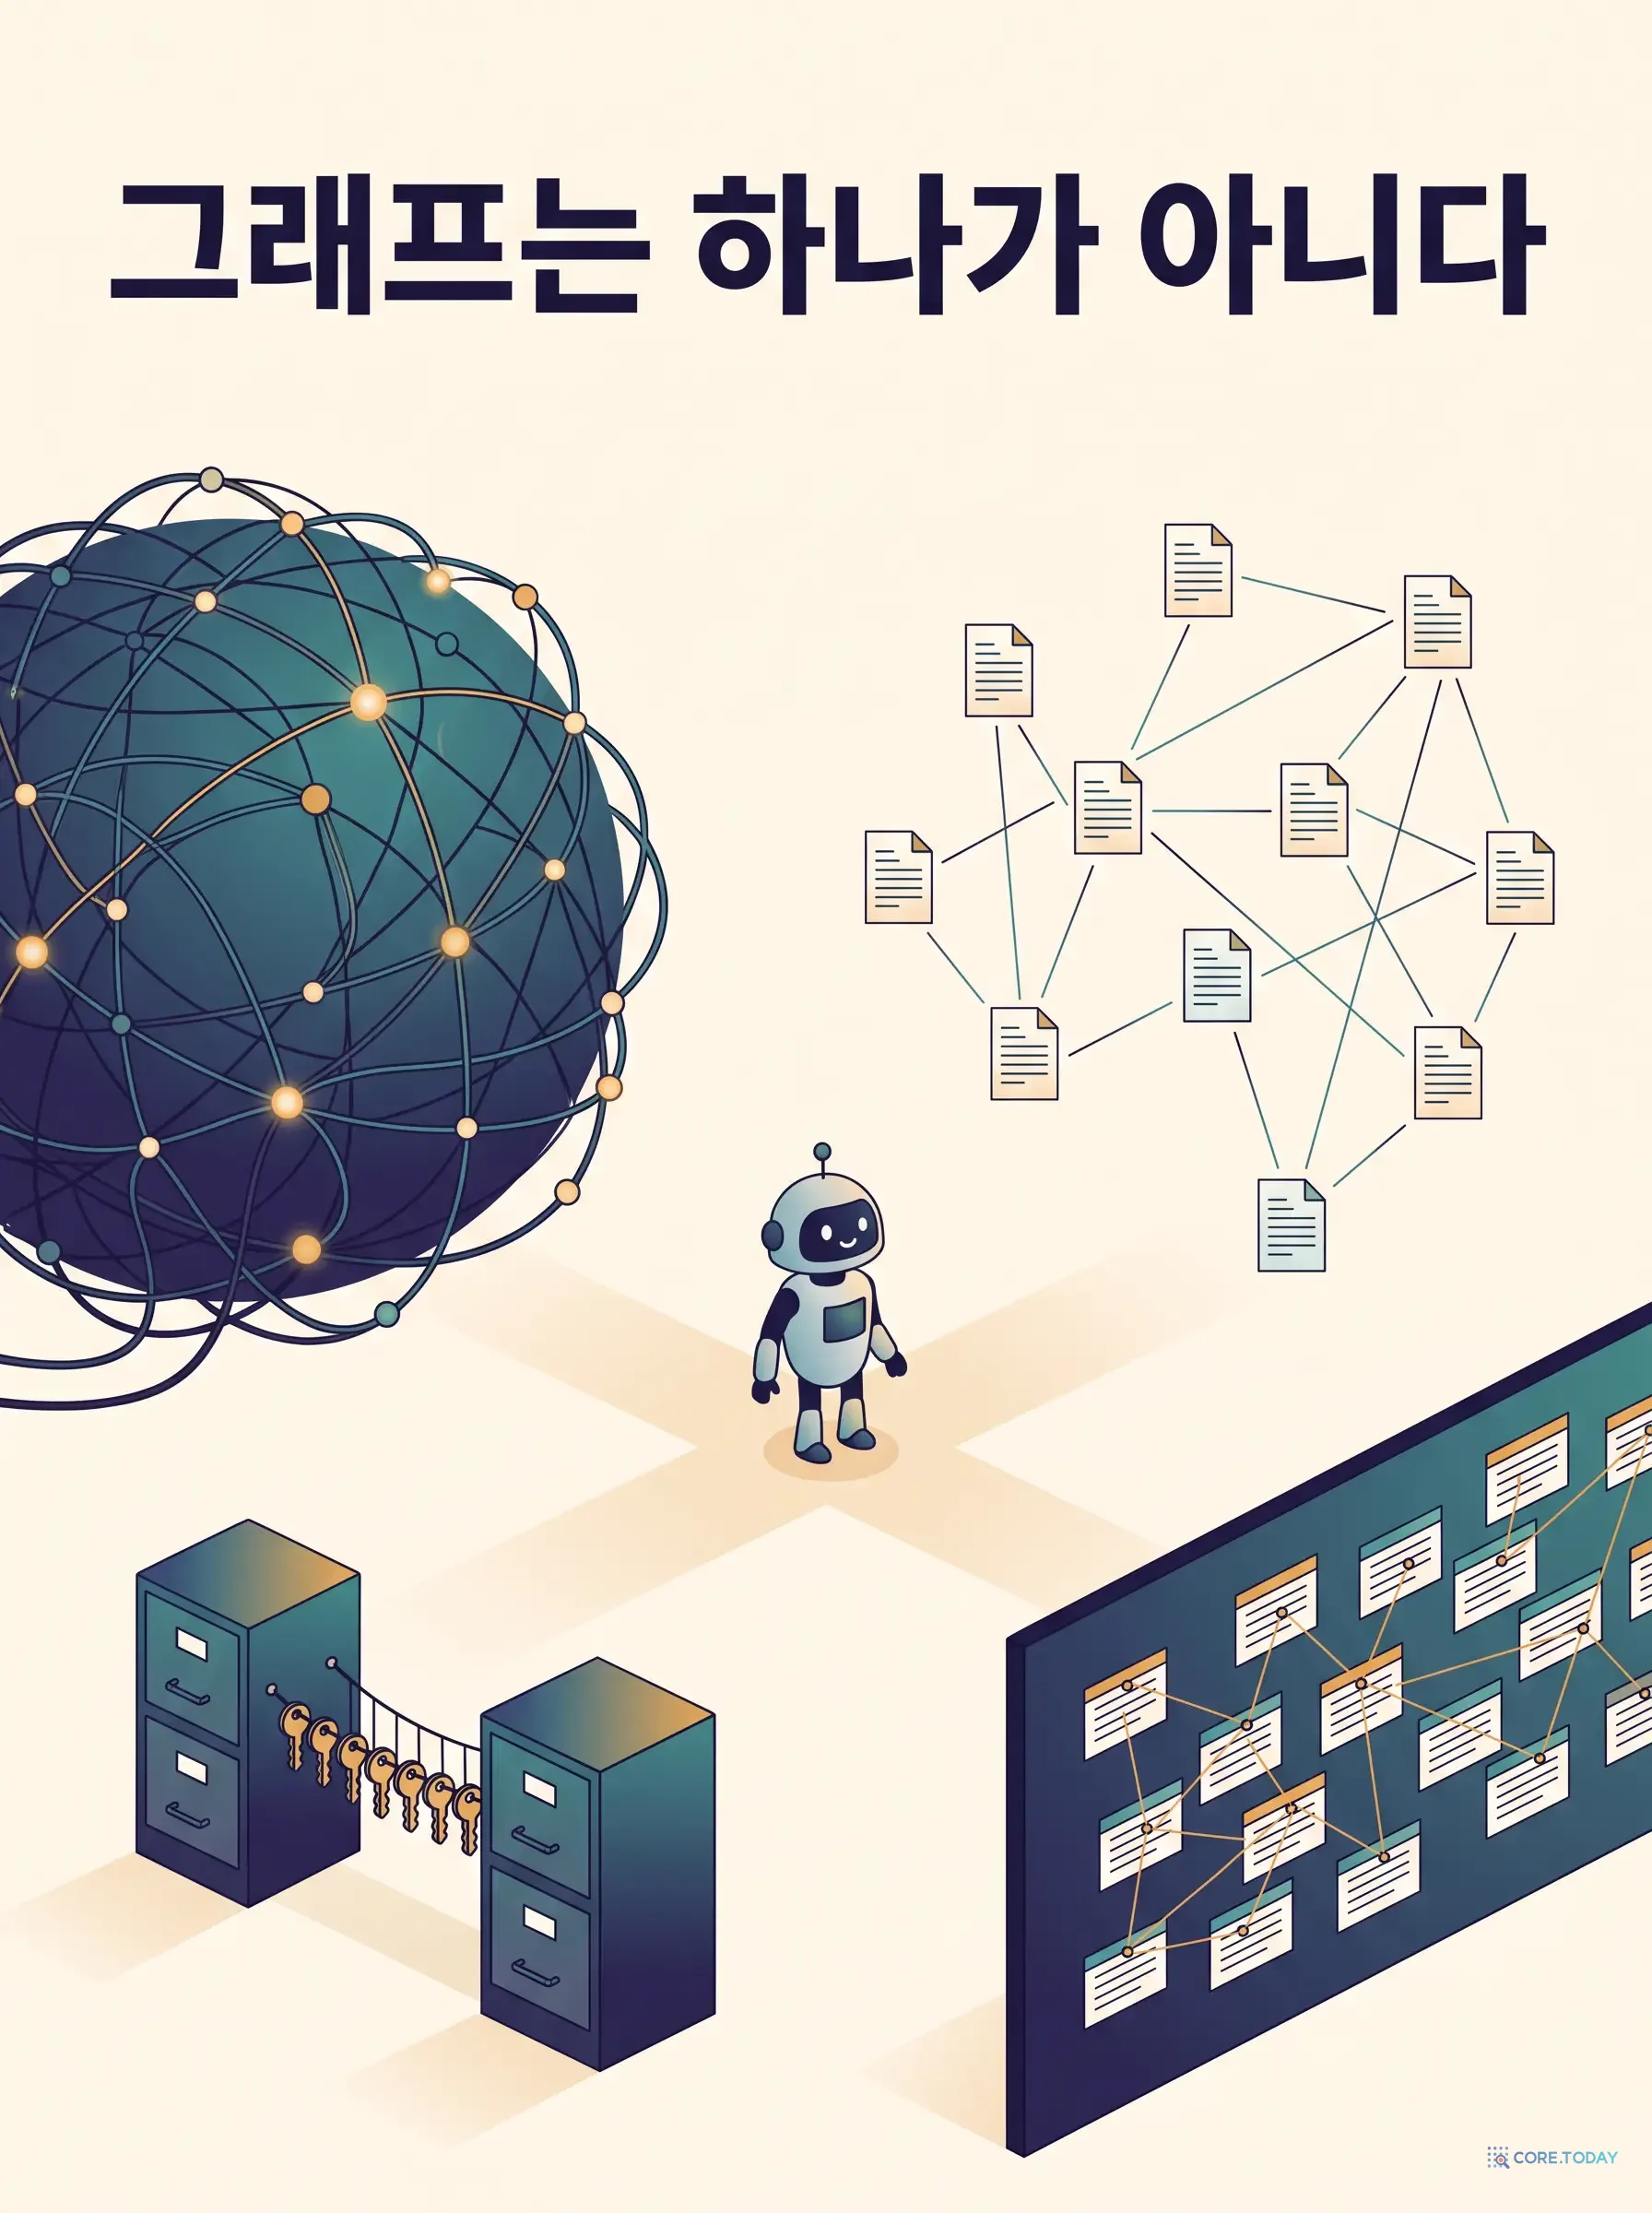
그래프는 하나가 아니다 — GraphRAG의 다변화, 거대 지식 그래프 하나에 종속되지 않기 (RAG 특집 5편)
Microsoft GraphRAG 저장소는 이제 스스로를 ‘대부분 유지보수 모드’라고 적는다. 새 기능도 PR도 받지 않는다. 그렇다고 그래프가 끝난 것은 아니다. 끝난 것은 ‘모든 문서를 LLM으로 엔티티·관계로 쪼개 거대한 전역 그래프를 만들고 모든 질의를 그 위에서 처리한다’는 공식이 무조건적 기본 선택이던 시대다. 2026년의 그래프는 네 갈래로 갈라졌다. 활발히 확장되는 LightRAG, 임베딩 각도만으로 토큰 0에 그래프를 짓는 G³RAG, 전역 그래프 없이 질의 시점에 SQL 조인으로 잇는 SAG, 그리고 위키 링크 구조. 이 특집은 왜 정적 지식 그래프가 비싸고 깨지기 쉬운지를 시뮬레이터로 보이고, cosθ·sinθ 한 식으로 엣지를 만드는 법과 공유 엔티티를 JOIN 키로 쓰는 법을 직접 만져 보고, 내 데이터에 맞는 구조를 고르는 진단 도구까지 간다. 위젯 6종. RAG 특집 시리즈 5편.
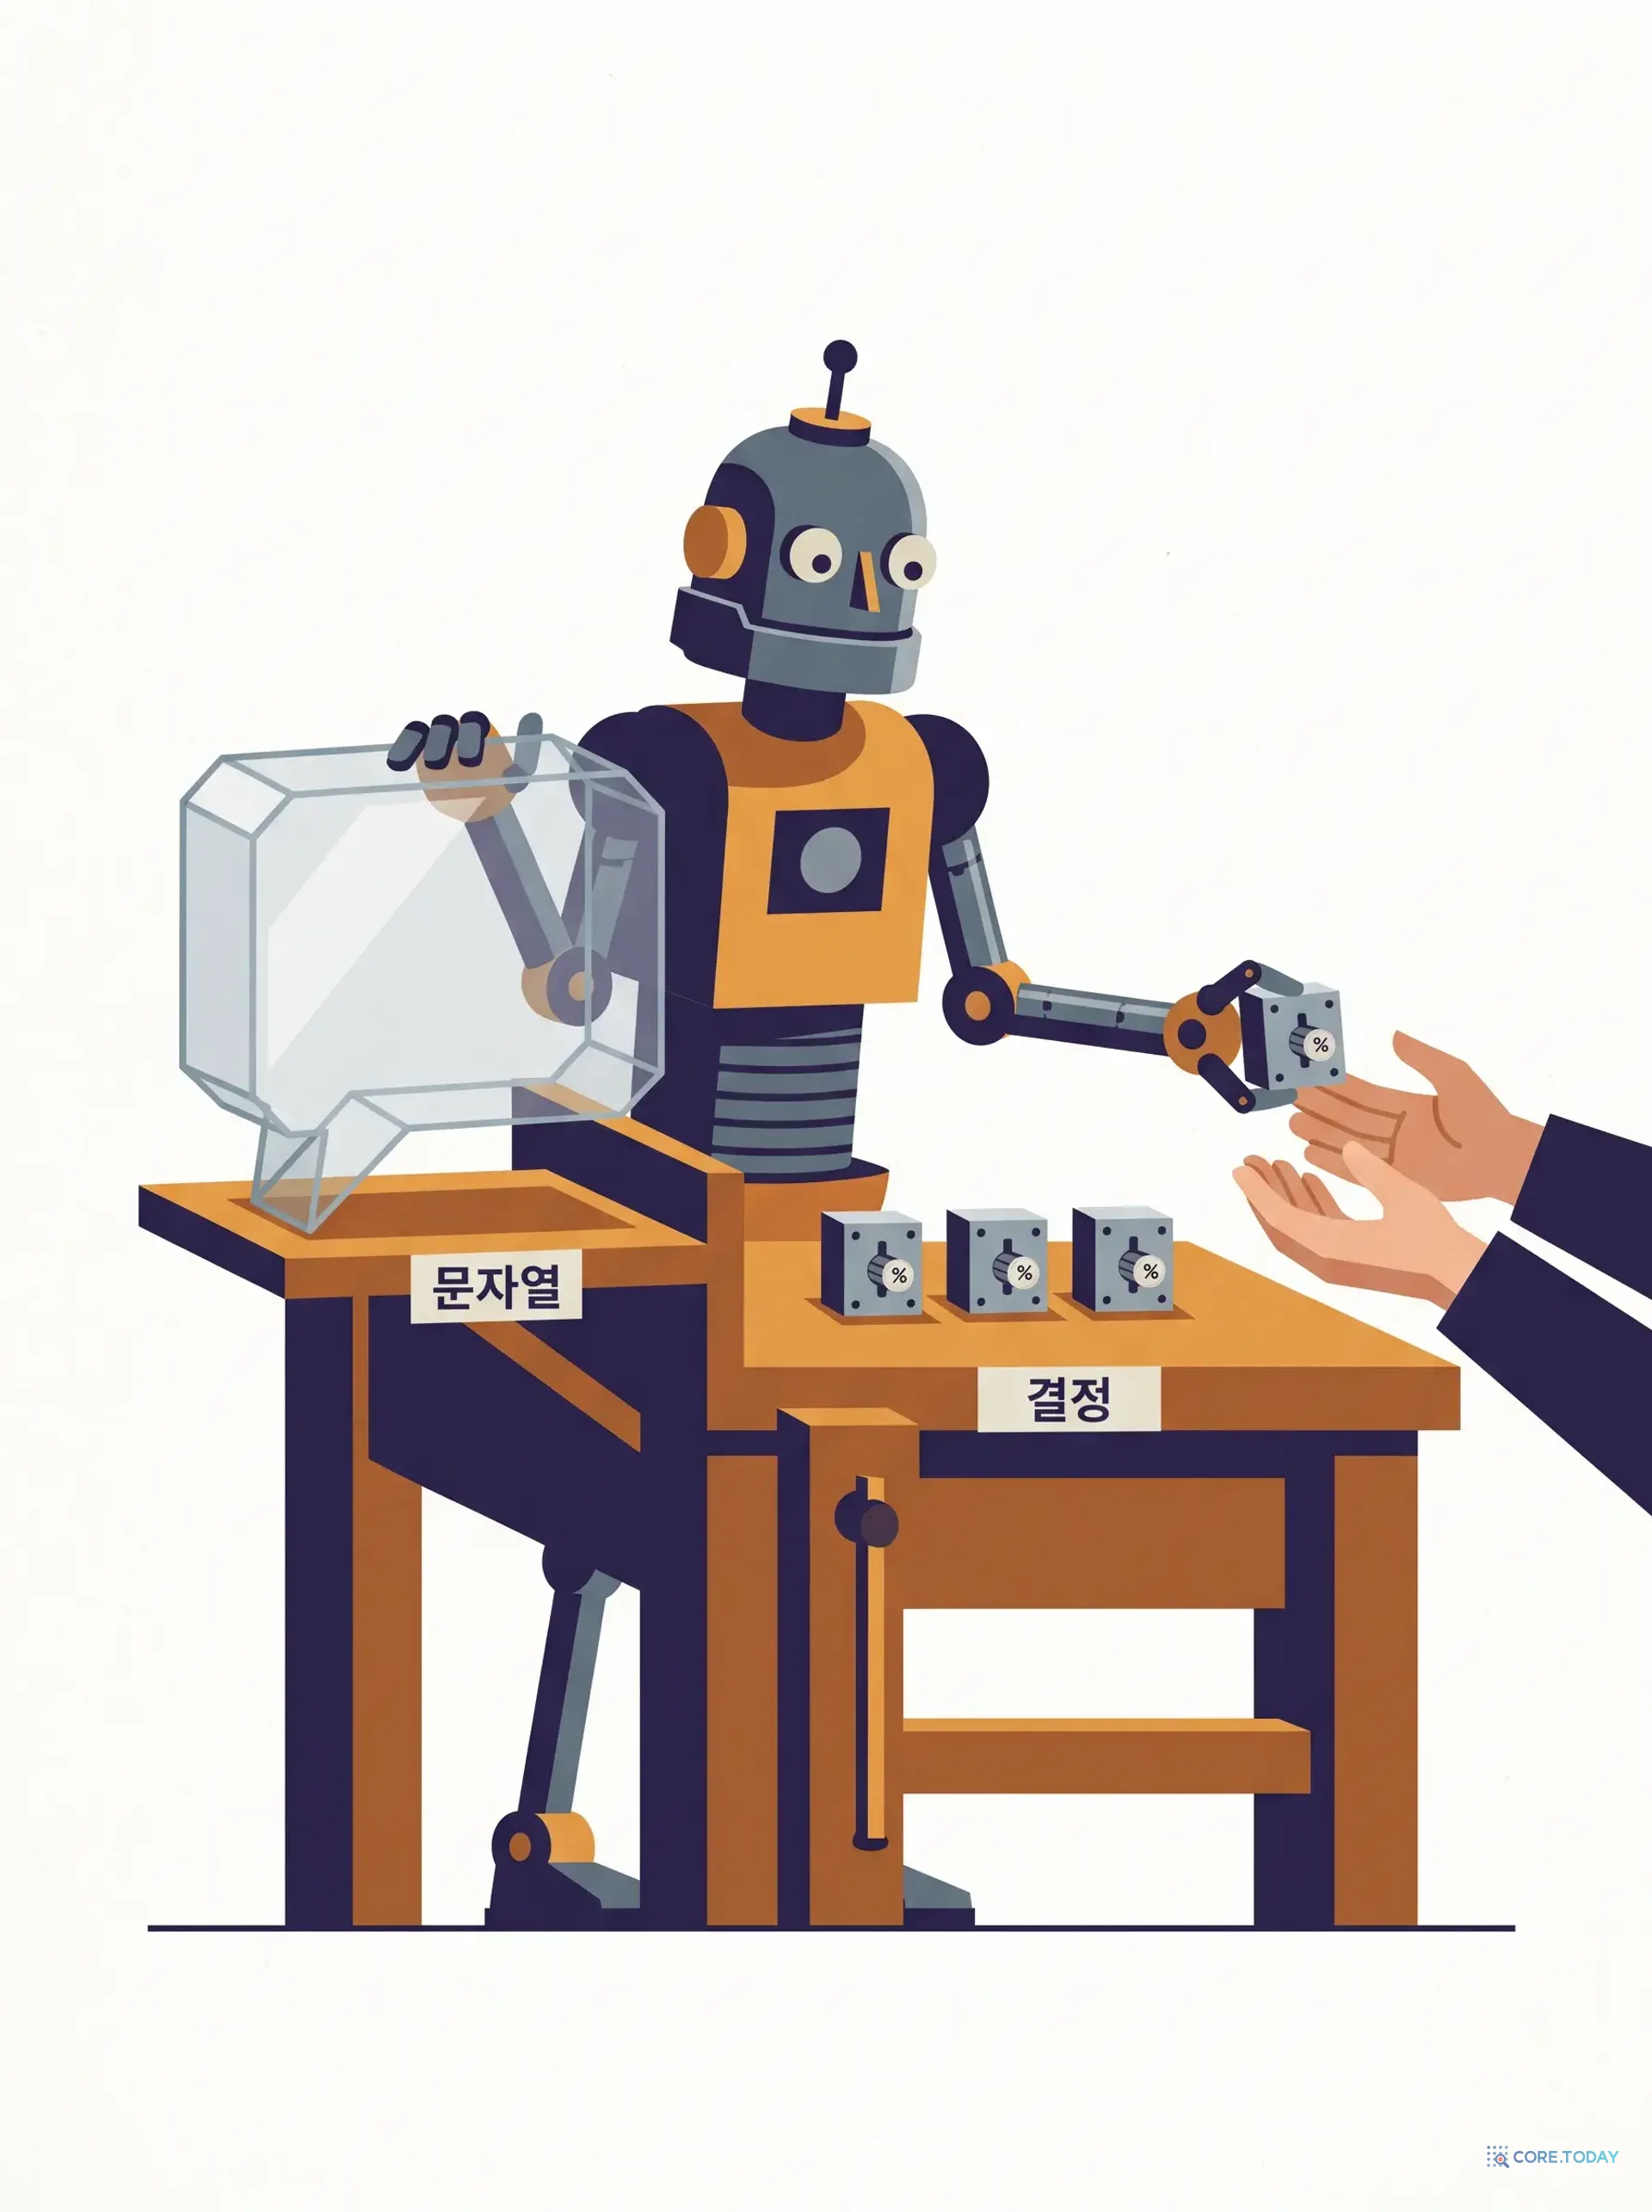
글자를 포기한 모델 — TypeSafe의 Jev와 '시스템 원' 완전 해부
2026년 9월 15일, ChatGPT를 만든 사람이 2년 스텔스 끝에 내놓은 모델은 글을 쓰지 않는다. 상태와 타입이 정해진 질문을 받아 확률이 붙은 결정만 돌려준다. 해커뉴스 1,924점, API가 수요를 감당 못 해 잠시 멈췄다. 이 글은 그 모델의 구조(Choice·Score·Noul), 실제 API 모양, 회사가 공개한 워크플로 평가 데이터 전량, 그리고 커뮤니티가 제기한 반론까지 한자리에 놓는다. 흥미로운 사실 하나 — 평가 데이터를 뜯어 보면 Jev는 정확도 1등이 아니고, 정작 가장 유용한 발견은 Jev와 무관하다. 인터랙티브 위젯 7종과 삽화 12장. 한국어 사용자를 위한 경고도 포함.
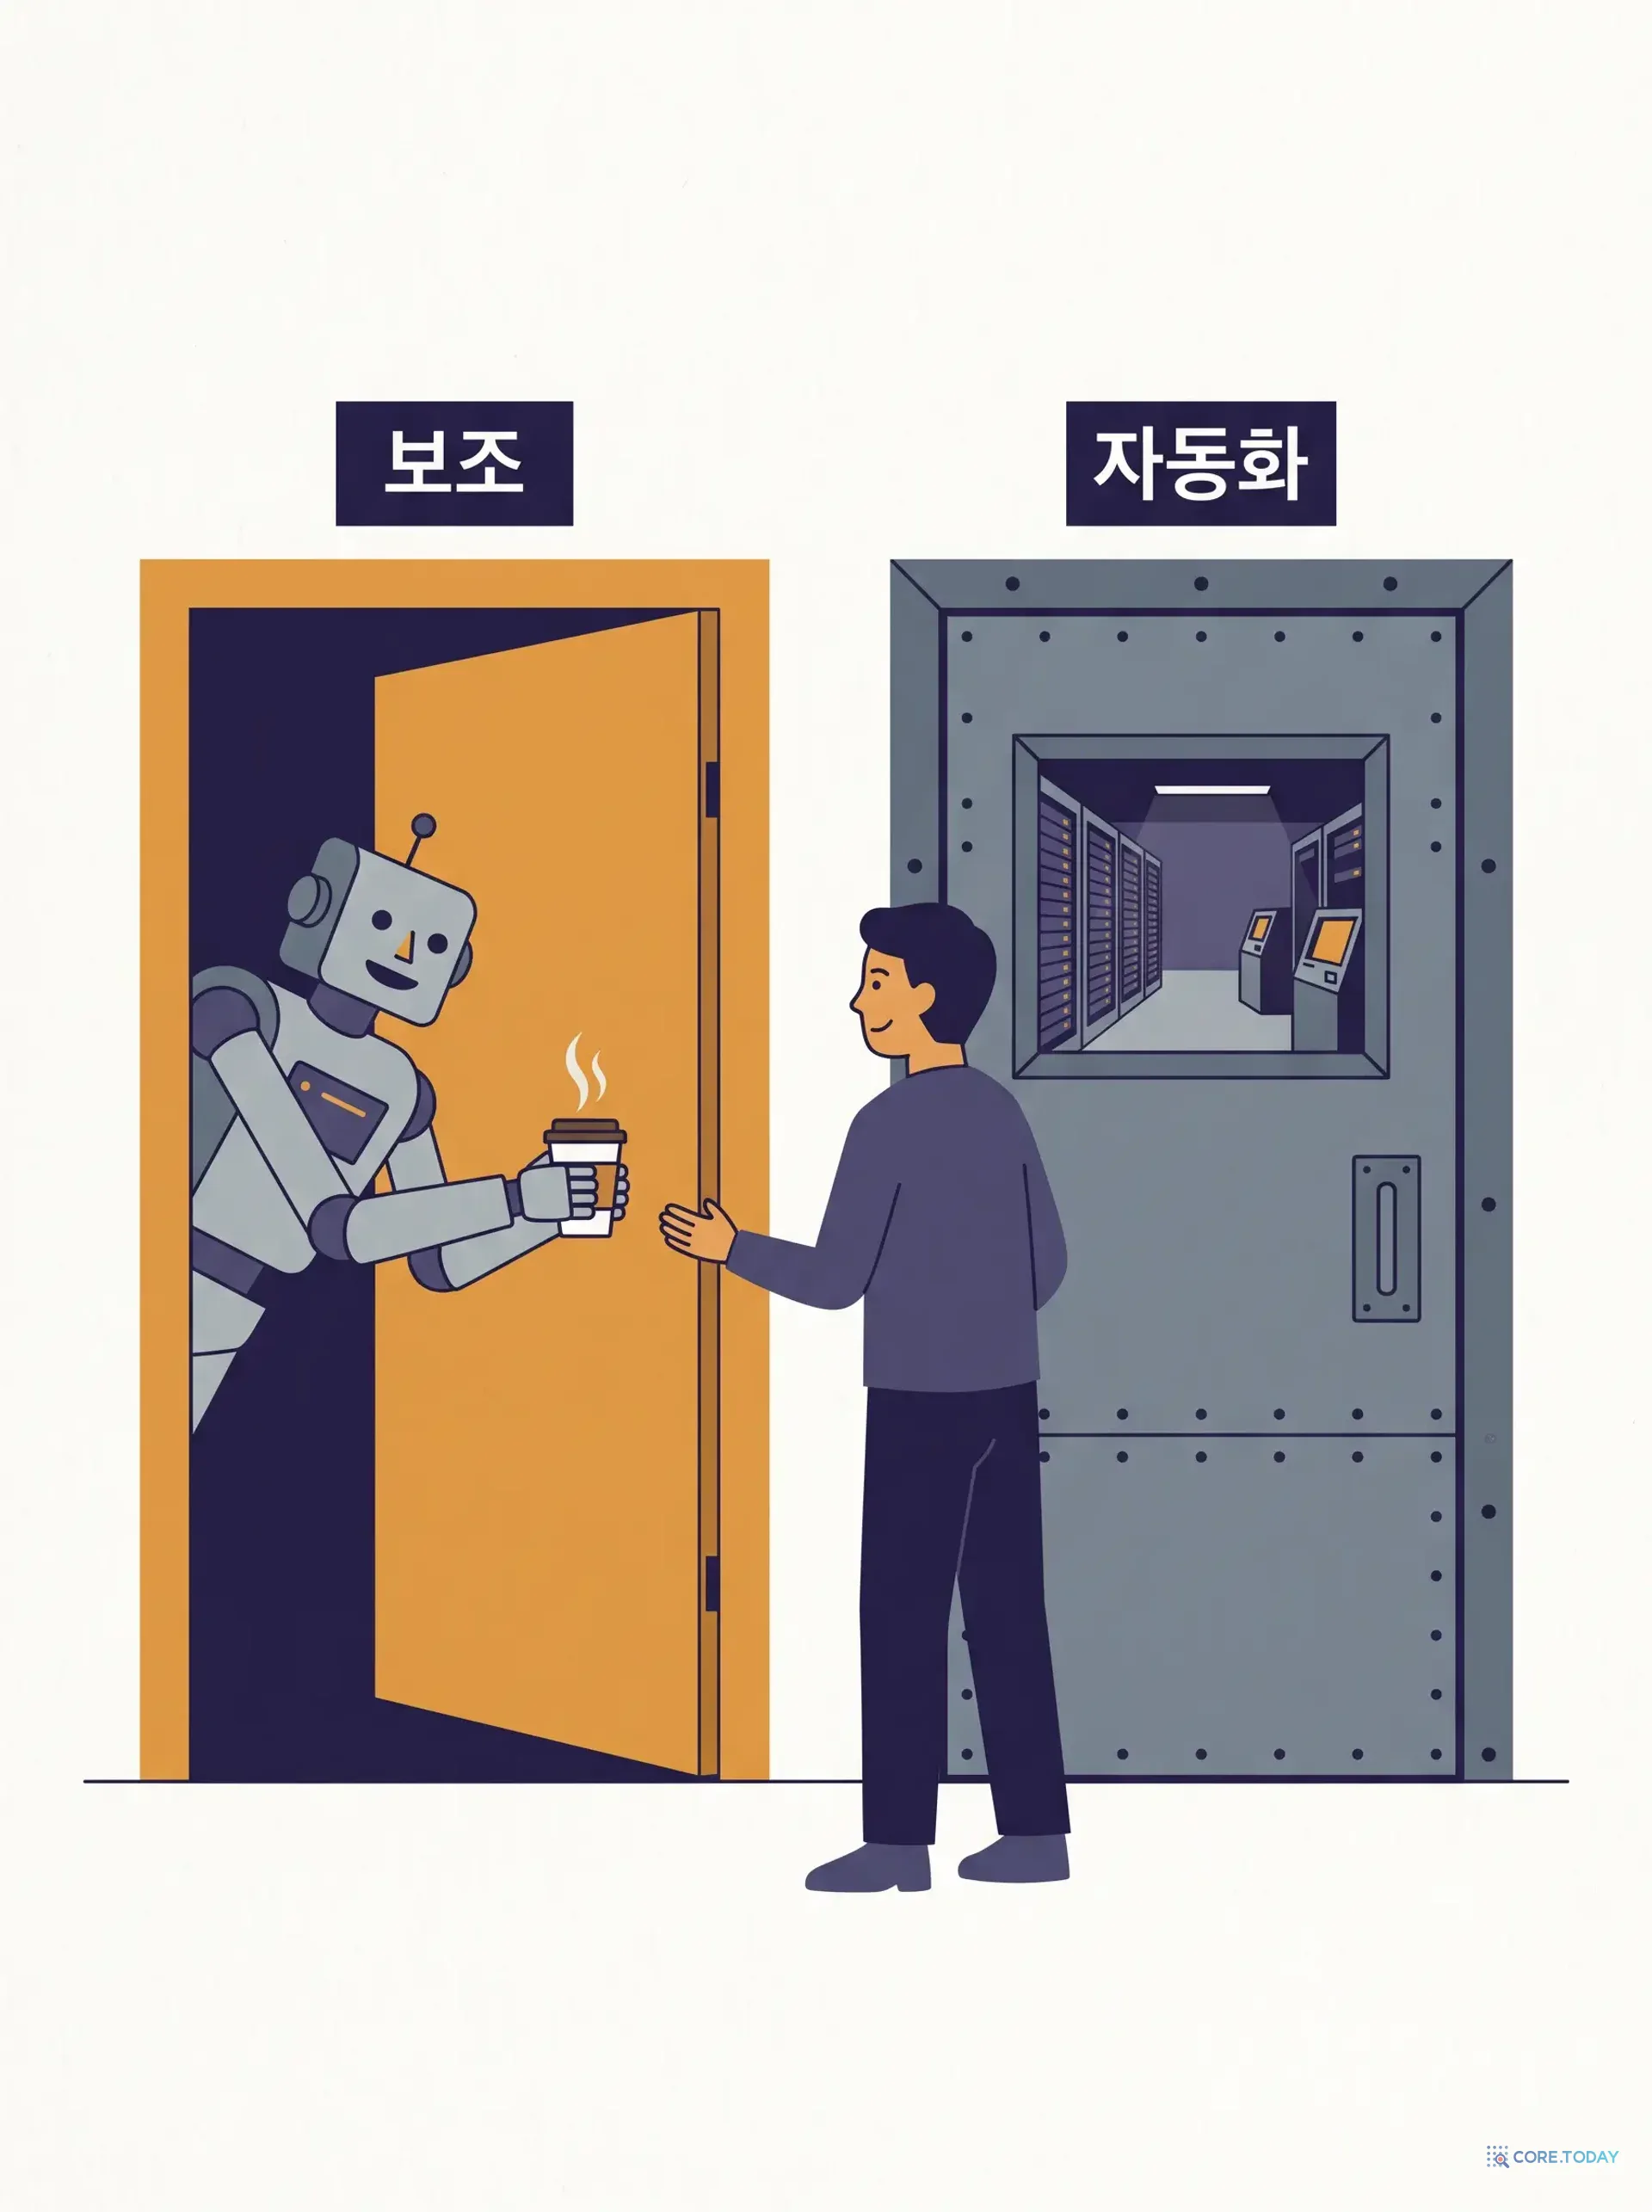
AI는 왜 미해결 수학은 풀면서 환불 처리는 못 맡기나 — RLHF 다음은 무엇인가
InstructGPT를 만든 사람이 18분 동안 무대에서 한 이야기는 이것이다. 'AI가 벤치마크를 다 부수는데 왜 고객센터는 아직 사람이 결정하나?' 그의 답은 난이도가 아니라 목표에 있다 — 오늘의 AI는 전부 사람의 선호를 최적화하도록 만들어졌고, 그래서 사람 옆에서는 경이롭지만 사람 없이는 못 미덥다. 이 글은 그 논리를 처음부터 끝까지 따라가고, GPT-4 기술 보고서가 남긴 결정적 증거(후학습이 보정을 10배 망가뜨렸다)를 실측 수치로 다시 그린다. 인터랙티브 위젯 7종과 삽화 12장. 그리고 과장하면 안 되는 지점도 함께 짚는다.
검색 인덱스도 스스로 고쳐진다 — 파싱에서 SELF-INDEX까지, 인덱스를 살아 있는 것으로 운영하기 (RAG 특집 4편)
“못 찾았다”는 하나의 증상이지만 원인은 다섯 층 어디에나 있다. 표가 텍스트로 안 나왔거나, 청크가 문장 중간에서 잘렸거나, 절 제목이 청크에 없거나, 사용자 어휘와 문서 어휘가 다르거나, 구버전이 걸렸거나. 지금까지는 사람이 로그를 뒤져 원인을 찾고 전체를 다시 색인했다. 2026년 9월 17일 공개된 SELF-INDEX는 정답 라벨 없이 ‘함께 검색된 키들의 프로필’로 부족을 진단하고, 책임 있는 문서의 키만 고쳐 쓰고, 세 기준으로 검증한 뒤 반영한다. 같은 검색기로 BRIGHT nDCG@10이 +39~57% 올랐고, 검증을 빼면 기준선 아래로 떨어졌다. 이 글은 그 발상이 서려면 무엇이 먼저 있어야 하는지 — 파서, 보존해야 할 문서 객체 필드, 실패 원인 분류, 회귀 게이트 — 를 위젯 6종으로 만져 본다. RAG 특집 시리즈 4편.
가장 쓴 교훈 — 계산량보다 데이터, 데이터보다 '올바른 과제'
2026년 9월 10일, ChatGPT를 만든 사람 중 하나가 900단어짜리 글을 올렸다. 리치 서튼의 '쓴 교훈'(계산 > 알고리즘)은 빙산의 일각이며, 진짜 위계는 '올바른 과제 > 데이터 > 계산 > 알고리즘'이라는 주장이다. 그리고 그 증거로 자기가 만든 InstructGPT의 논문 그림 한 장을 내놓았다 — 100배 작은 모델이 100배 큰 모델 위에 통째로 올라앉은 그림. 이 글은 왜 이 개념이 나왔는지를 1997년 딥블루부터 2026년의 에이전트 시대까지 따라가며, 과제를 잘못 고른 여덟 건의 값비싼 실패와 잘 고른 다섯 건의 성공을 함께 본다. 인터랙티브 위젯 8종과 삽화 14장.
질문마다 다른 검색기, 다른 모델, 다른 예산 — 동적 라우팅과 DRAG (RAG 특집 3편)
HotpotQA 질의의 22%는 BM25만으로 검색해도 정답이 나온다. 가장 비싼 구성이 꼭 필요한 질의는 15.6%다. 그런데 대부분의 RAG는 모든 질의에 같은 검색기와 같은 모델을 쓴다. 2026년 9월 15일 공개된 DRAG는 검색기 4단계 × 생성기 추론 강도를 전부 조합해 잰 뒤 두 가지를 보여 줬다 — 더 강한 검색이 더 많은 추론보다 크게 이기지만 단조롭게 좋아지지는 않는다는 것, 그리고 정답을 아는 오라클 라우터는 최고 정적 구성보다 정확하면서 지연은 절반이라는 것. 이 특집은 1편의 5경로 라우팅을 8경로로 확장하고, 라우터가 경로와 함께 정해야 하는 8가지 결정, 오라클 대비 손실(router regret)을 재는 법, 그리고 같은 날 나온 추론형 임베딩(CoFree)·추론형 재랭커(MERIT-Rank)가 라우터의 선택지를 어떻게 늘렸는지를 위젯 5종으로 따라간다. 결론은 하나다 — 추론형 부품은 맨 위 한 단이고, 대부분의 질의는 아래에서 끝나야 한다.
관련성은 문단에, 충분성은 집합에 — ‘부족한 증거’를 찾는 RAG와 평가의 재정의 (RAG 특집 2편)
‘우리 회사가 이 사업에 신청할 수 있나요?’에 답하려면 신청 자격·예외 조건·마감일 변경 공지 세 가지가 모두 필요하다. 관련성 순으로 뽑은 top-5는 전부 신청 자격의 변형이고, 그런데도 Recall@k는 만점이다. 지표가 실패를 보지 못한다. 2026년 9월 17일 공개된 「The Missing Complement」는 검색을 ‘이슈와 닮은 것의 순위’가 아니라 ‘지금 이 결정에 아직 부족한 것의 회수’로 다시 정의하고, 45개 저장소 500개 에이전트 상태에서 집합 단위 충분성을 재는 SERBench를 만들었다. 같은 주 CIKM 2026에 실린 TRACE는 OCR이 깨진 1887년 프랑스 의회·신문 아카이브에서 ‘답을 만드는 대신 출처를 찾고 모든 판정에 근거를 남기는’ 검색을 질문당 0.02달러로 구현했다. 두 논문을 따라가며, 왜 개별 관련성 대신 집합 충분성을 재야 하는지, 검색 결과에 어떤 네 필드를 더해야 하는지, 출처를 찾는 RAG와 답하는 RAG를 왜 분리해야 하는지를 인터랙티브 위젯 6종으로 만져 본다. RAG 특집 시리즈 2편.
“달 착륙을 6살에게 설명해 줘” — 되묻기만 하던 AI는 어떻게 말귀를 알아듣게 됐나 (RLHF 특집)
2022년 1월, OpenAI는 “사용자의 의도를 GPT-3보다 훨씬 잘 따르는” 모델을 발표했다. 13억 파라미터 모델이 1750억 모델을 이겼고, 그 비용은 사전학습의 1.6%였다. 열 달 뒤 같은 레시피로 만든 ChatGPT가 세상을 바꿨다. 이 글은 그 기술 — 인간 피드백 강화학습(RLHF) — 이 왜 필요했는지를 2017년 뒤공중돌기 로봇부터 따라간다. 보상을 글로 적을 수 없다는 문제, 순위 하나가 여섯 개의 비교가 되는 방식, 보상 모델을 너무 믿으면 벌어지는 일, 그리고 RLHF가 고친 것이 아니라 ‘만든’ 네 가지 버릇까지. 인터랙티브 위젯 8종과 삽화로 풀었다.
검색은 파이프라인이 아니라 에이전트가 되었다 — Agentic Search 완전 해부 (RAG 특집 1편)
‘1953년 월별 국방비 지출 합계는?’ 스캔된 재무부 회보 8만 9천 쪽에서 이 질문에 답하는 one-shot RAG의 정답률은 6.3%였다. 같은 모델에 search·open·navigate·read·grep 다섯 도구를 쥐여 주자 51.9%가 됐다. 2026년의 RAG는 더 좋은 임베딩 하나를 고르는 일이 아니라, 질문과 현재 상태를 보고 증거를 찾고 문서 안을 이동하고 충분한지 판단하고 예산 안에서 멈추는 에이전트를 설계하는 일로 바뀌고 있다. 이 특집은 A-RAG·LLM-Wiki·DCI 세 연구와 Mistral의 제품화를 따라가며, 왜 도구가 늘었는데 토큰은 줄었는지, 어느 질의를 어느 경로로 보내야 하는지, 몇 스텝에서 끊어야 하는지를 인터랙티브 위젯 6종으로 직접 만져 본다. RAG 특집 시리즈의 첫 글이다.
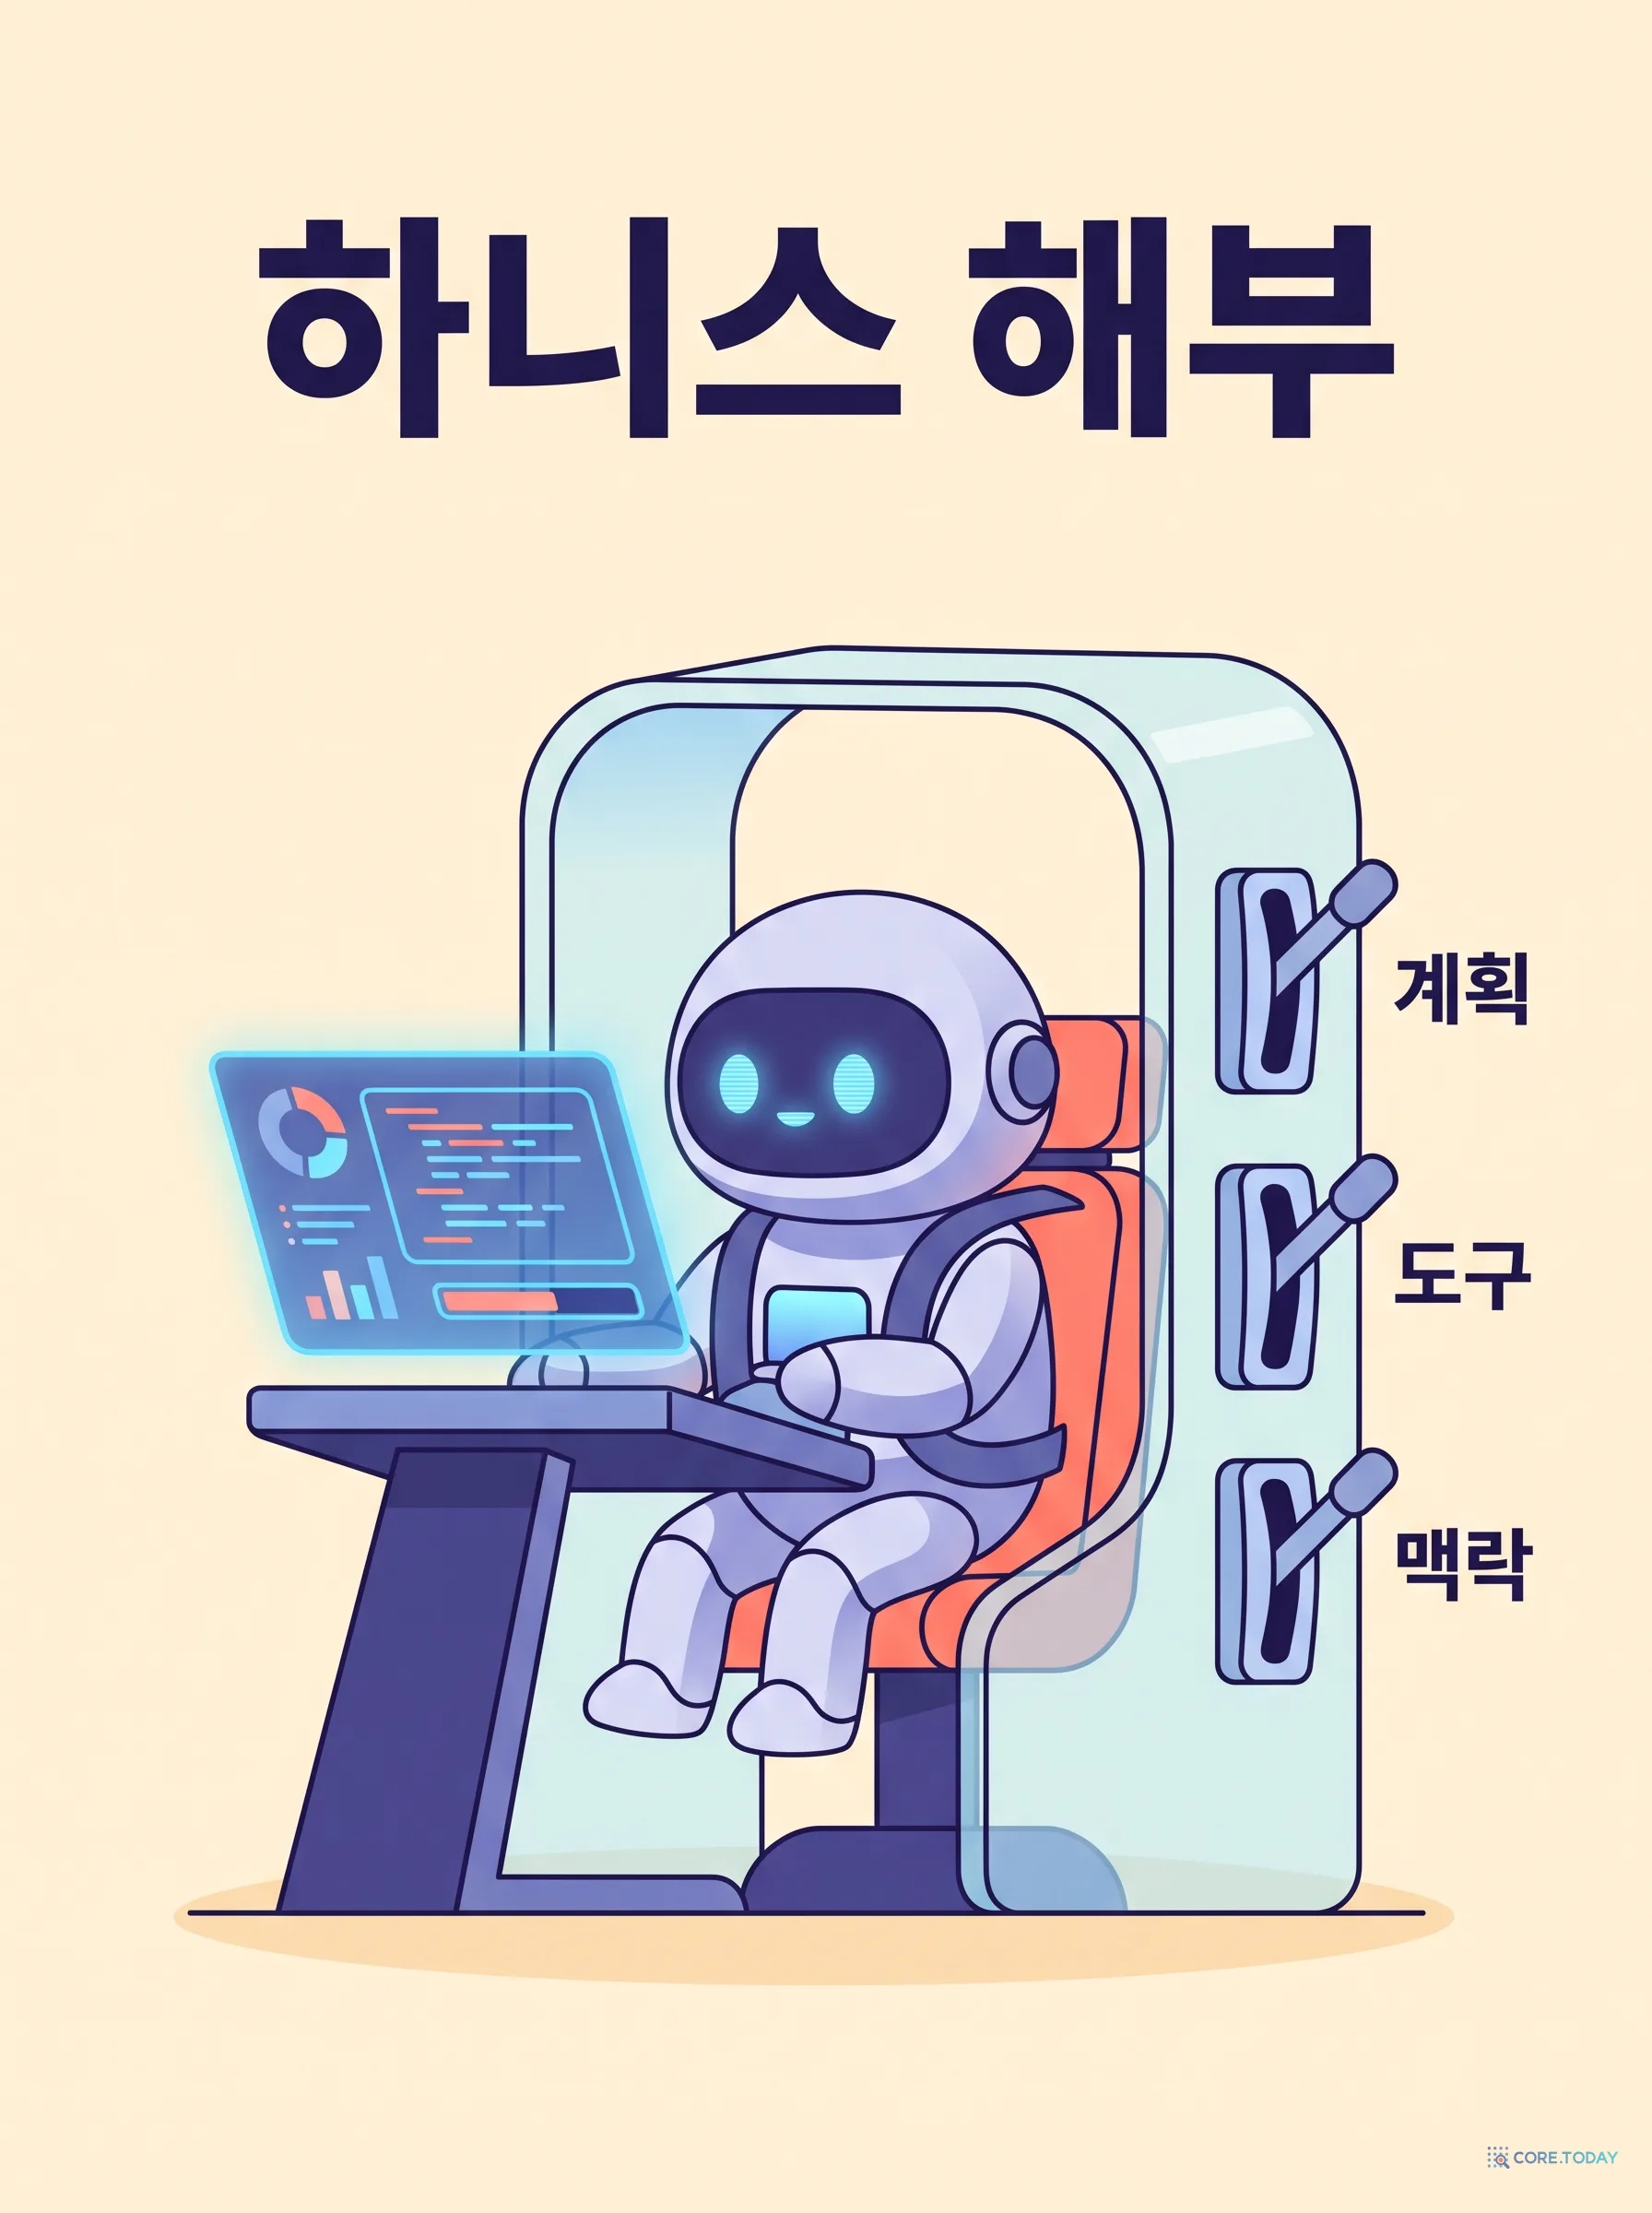
같은 모델인데 성적이 10배 차이 — 코딩 에이전트 하니스 해부 (Zoom·UMass 176개 실험 완전 정리)
Nemotron-3 550B가 32k 창에서 SWE-Bench Verified 6.4%를 받았다. 모델을 한 글자도 바꾸지 않고 하니스의 맥락 관리만 켜자 58.4%가 됐다. 같은 bash 단독 인터페이스가 550B에게는 +3.6pp에 비용 절반, Mistral에게는 −24pp였다. 2026년 9월 17일 공개된 Zoom·UMass·Emory 연구진의 논문은 코딩 하니스를 계획·행동 공간·맥락 관리 세 부품으로 분해해 4개 모델 × 2개 벤치마크 × 176개 설정에서 부품 하나씩의 효과를 쟀다. 결론은 ‘좋은 하니스’가 아니라 ‘모델·예산·과제에 따라 갈리는 하니스’다. ReAct에서 하니스 엔지니어링까지의 역사, 논문의 네 가지 발견, 그것이 Claude Code·Codex의 오늘과 어떻게 맞물리는지를 인터랙티브 위젯 6종과 삽화로 풀었다.
8,722개의 트윗에서 41개의 사건을, 라벨 없이 — RAG와 구조 엔트로피로 사건의 생몰을 추적하다 (WWW 2026)
2012년 10월 29일 하루치 트윗 8,722건 안에 41개의 사건이 섞여 있다. 정답 라벨도, 사건 개수도 모르는 채로 이것을 갈라내고, 나아가 각 사건이 어느 날 태어나 어떻게 변하고 언제 끝났는지까지 추적할 수 있을까. 2026년 1월 arXiv에 올라와 The Web Conference 2026에 채택된 RagSEDE는 지난 5년간의 표준이던 '표현 후 군집'을 버리고, 사건 지식베이스를 만들어 LLM에게 직접 묻는 방식으로 이 문제를 다시 푼다. 그리고 1996년 DARPA의 TDT부터 2016년 구조 정보이론까지 30년치 아이디어가 여기서 만난다. 논문 전체를 뜯고, 공개된 코드를 열어 논문과 다른 여섯 군데를 찾고, 인터랙티브 위젯 8종으로 직접 만져 본다.