
특집
152개의 포스트
[특집] 당신의 게임이 하네스다 — 'LLM은 게임에 약하다'는 착각, 그리고 게임 자체를 AI 에이전트의 하네스로 만드는 일곱 가지 방법
2026년 9월 캐나다 캘거리의 인디 게임 행사에서 15년 차 게임 프로그래머 카일 쿠크슈텔이 45분 발표를 했다. 제목은 「당신의 게임이 하네스다」. 게임 업계에 퍼진 'LLM은 게임에 약하다'는 말을 그는 뒤집는다. 문제는 모델의 능력이 아니라 게임이 AI에게 읽히지 않는다는 것, 곧 맥락(context)의 문제라는 것이다. 처방은 AI가 아니라 게임 쪽에 있다 — 시드 하나, 한 모양의 오브젝트(나무도 개다), 텍스트로 재생되는 명령, 코드 밖의 데이터, 엔진과 분리된 시뮬레이션, 스크린샷 대신 픽셀 diff, 사람용 GUI 대신 텍스트 프로파일. 이 글은 그 처방을 하나씩 풀면서, 각각이 둠의 데모 파일(1993)과 에이지 오브 엠파이어의 '28.8 모뎀 위의 1,500명의 궁수', 스타크래프트 리플레이, 팩토리오의 디싱크 리포트에서 어떻게 이미 쓰였는지를 따라간다. 하네스라는 말이 테스트 하네스에서 2026년 '하네스 엔지니어링'까지 어떻게 왔는지, 같은 제미나이가 RAM을 텍스트로 받으면 포켓몬을 완주하고 픽셀만 받으면 0.48%에 머무는 이유, 게임 업계 52%가 AI를 해롭다고 보는 2026년의 반감과 한국 게임사 70%의 도입률까지 — 여섯 개의 인터랙티브 도구와 함께 정리했다.
[특집] 카파시의 「수업을 잘 듣는 법」 — 15년 된 시험 공부 경험칙 23개를 100년 학습 과학으로 채점하고, AI 시대에 다시 읽다
2026년 10월 12일, 한 트윗이 오래된 웹페이지 하나를 다시 끌어올렸다. 안드레이 카파시가 대학원생 시절 써 둔 「수업을 잘 듣는 법(Doing well in your courses)」이다. 밤샘은 하지 마라, 읽고 이해한 것과 덮고 다시 쓸 수 있는 것은 다르다, 시험장에서 절대 일찍 나가지 마라, 그리고 가장 똑똑한 학생은 모든 과목에서 85%를 받는다. 이 글은 그 23개의 경험칙을 하나씩 꺼내 에빙하우스(1885)부터 로디거·카피키(2006), MIT 핏빗 수면 연구, 7천만 건의 채점 기록까지 지난 100년의 학습 과학과 맞대어 채점한다. 대부분은 놀랍게 맞았고, 두 개는 틀렸다. 페이지가 실제로 쓰인 시기(2009~2011)와 사람들이 지금 읽는 2016년 개정판의 차이, 토론토 대학의 '85점 = A = 4.0' 환산표, 그리고 AI가 숙제를 대신 풀어 주는 2026년에 이 조언이 왜 오히려 더 중요해졌는지 — 튀르키예 고등학생 1천 명 실험의 '연습 +48%, 시험 −17%', 연세대 집단 부정행위, 하버드의 A학점 상한 표결, 한국 고교생 주중 수면 5.6시간까지 — 여섯 개의 인터랙티브 도구와 함께 풀었다.
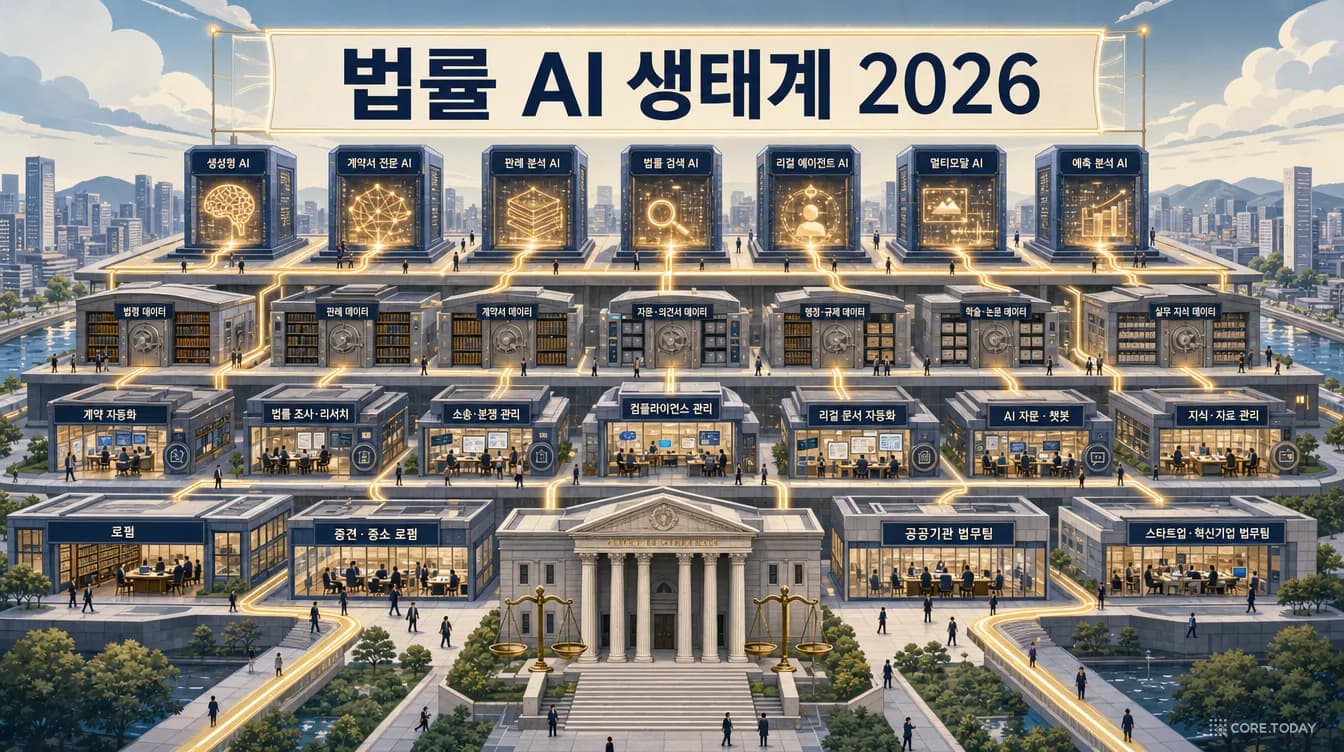
법률 AI 생태계 지도 2026 — 모델 회사는 법률로 내려오고, 법원은 검증을 요구하고, 돈은 '책임질 수 있는 결과물'로 모인다
2026년 2월 3일, Anthropic이 법률 업무 플러그인 하나를 내놓자 Thomson Reuters 주가가 하루에 16% 빠졌습니다. 그런데 반년 뒤 그 회사의 법률 매출은 10% 늘었고, 같은 해 법률 AI 스타트업 Harvey의 몸값은 80억 달러에서 155억 달러로 뛰었습니다. 한쪽에선 전 세계 법원이 AI가 지어낸 판례를 지적한 결정이 2,184건까지 쌓였고, 한국 법원 판결문에는 'AI Hallucination'이라는 영어가 그대로 적혔습니다. 모순처럼 보이는 이 장면들은 하나의 지도 위에 놓으면 이해됩니다. 모델·데이터·업무 도구·로펌·법원의 다섯 층이 2024년에서 2026년 사이 각각 어떻게 움직였는지, 법률 AI 시험지가 '변호사시험'에서 '실무 과제 전 항목 통과'로 바뀐 이유, 시간당 청구가 흔들리는 경제학, 신입 변호사의 사다리, 나홀로 소송의 역설, 그리고 한국 법원·로펌·리걸테크의 2026년까지. 논문과 판결과 실적 발표를 근거로 일곱 가지 인사이트를 뽑았습니다. 인터랙티브 6개, 논문·보고서 그림 8장, 삽화 9장.
[특집] 월급은 엔진이지 목적지가 아니다 — 해커뉴스를 달군 '커리어로 부를 쌓는 법', 인적 자본을 소유로 바꾸는 70년의 경제학
2026년 10월 11일, 반년 전에 올라온 블로그 글 한 편이 해커뉴스 첫 화면에 올라 이틀 동안 166개의 댓글을 모았다. 나이지리아 급여 핀테크 창업자 아셔 아데니이가 쓴 「커리어로 부를 쌓는 법」 — 부는 창업가만의 몫이 아니며, 좋은 직장은 '엔진'이고 그 출력을 소유로 바꾸는 규율이 부를 만든다는 글이다. '저축하라는 말을 길게 늘였을 뿐'이라는 냉소와 '아이들에게 읽히겠다'는 찬사가 정면으로 부딪쳤다. 이 글은 그 논쟁을 출발점으로, 원문이 기대고 있는 70년 치 경제학을 처음부터 풀어 본다. 슐츠·베커·민서의 인적 자본 이론과 학교 1년의 수익률 9%, 스펜스의 신호 이론, 모딜리아니의 생애주기 가설과 '인적 자본이 금융 자본으로 옮겨 가는 곡선', 베블런에서 킬링스워스·카너먼까지 이어지는 쾌락의 쳇바퀴, 그리고 의지가 아니라 기본값이 저축률을 바꾼다는 매드리언·시어와 탈러·베나치의 실험까지. 2026년 노동소득 분배율이 1947년 이후 최저로 내려가고 AI가 커리어 사다리의 아래 칸을 바꾸는 지금, 한국 직장인이 이 글에서 무엇을 가져가야 하는지 여섯 개의 인터랙티브 도구와 함께 정리했다.
[특집] 「Fable이 내 일자리를 가져갔다」 — AI는 더 잘해서가 아니라 '더 싸서' 사람을 밀어낸다: 마지막 엔지니어의 고백으로 읽는 2026년 AI 감원의 구조
2026년 10월 11일, 보안·암호학 글로 알려진 블로거 Cendyne이 8분짜리 글 「Fable이 내 일자리를 가져갔다(Fable took my jorb)」를 올렸다. 회사의 '마지막 엔지니어'였던 그는 이렇게 쓴다. Fable이 내 일을 더 잘해서가 아니라, 내 연봉보다 쌌다. 그리고 'AI가 내 일을 가져갔다'는 말은 'AI가 내 자리를 없애는 데 한몫했다'보다 말하기 재미있을 뿐이라고. 해커뉴스에서 댓글 355개가 붙은 이 글을, 러다이트와 케인스부터 아제모을루의 '그저 그런 자동화', 브리뇰프슨의 '탄광 속 카나리아' 2026년 갱신판, 챌린저의 AI 감원 통계, 그리고 쇼피파이 Helix와 테오의 ts-rust가 보여 준 '하네스'의 구조, METR의 시간 지평, 'hmm-hmm-hmm' 반복의 정체까지 따라가며 읽는다. 인터랙티브 여섯 개와 함께.
GLM-Legal 완전 해부 — 가벼운 모델이 법률 에이전트 시험에서 프런티어를 이긴 방법: 중간학습, 하네스 공진화, 그리고 19.2%의 의미
2026년 10월 12일, 중국 Z.ai가 법률 특화 모델 GLM-Legal을 공개했습니다. 활성 파라미터 18B짜리 가벼운 모델(GLM-5.3-Flash) 위에 법률 중간학습과 수만 개의 법률 과제 환경 강화학습을 얹었더니, 로펌 실무 과제를 끝까지 해내야 하는 Harvey LAB에서 전 항목 통과율 19.2%로 Claude Fable 5(11.3%)와 GPT-6 Astra(5.4%)를 앞섰습니다. 과제당 비용은 0.15달러로 Fable 5의 약 130분의 1입니다. 그런데 19.2%는 열 건 중 여덟 건을 '불합격'했다는 뜻이기도 합니다. 1970년대 규칙 기반 법률 AI부터 가짜 판례 사건, LegalBench에서 Harvey LAB으로 바뀐 시험지, 중간학습과 하네스 공진화라는 아키텍처, 시연 세 장면, 순위표에서 빠진 모델과 퇴보한 지표까지, 이 발표를 둘러싼 모든 것을 쉽게 풀어 씁니다. 인터랙티브 6개, 논문·벤치마크 그림 11장, 삽화 10장.
Postgres는 느리지 않다, 느린 건 저장장치다 — 37ms 영수증으로 읽는 데이터베이스와 디스크의 50년
2026년 8월 ClickHouse가 공개한 발표 요약 「Postgres는 느리지 않다, 느린 건 저장장치다」가 10월 해커뉴스에서 174점·댓글 185개를 받으며 다시 불붙었습니다. 같은 기계, 같은 Postgres, 같은 쿼리에서 저장장치만 네트워크 디스크(EBS gp3)에서 서버에 꽂힌 NVMe로 바꿨더니 처리량이 9.24배가 됐다는 실험입니다. 이 글은 그 37ms짜리 지연 영수증을 항목별로 뜯어보고, CPU가 왜 놀고 있었는지, 3,000 IOPS가 어떻게 정확히 1,734 TPS가 되는지 리틀의 법칙으로 계산합니다. UPDATE 한 줄이 Postgres 안에서 지나가는 아홉 정거장(B-트리, MVCC, WAL, fsync, 체크포인트, 논리 복제)을 따라가고, 하드디스크와 5분 규칙에서 EBS, Aurora, 다시 로컬 NVMe로 돌아오기까지 50년의 역사를 논문으로 짚습니다. 'gp3 기본값은 허수아비'라는 반론과 판매 맥락까지 공정하게 다루고, 디스크가 사라지는 세계에서 데이터를 지키는 운영 구조를 장애 훈련으로 확인한 뒤, 2026년 내 데이터베이스를 진단하는 체크리스트로 끝냅니다. 인터랙티브 6개와 삽화 9장.
[특집] 생각이 취미가 되는 날 — 스피넬리스의 「생각은 취미가 될 것이다」, 사냥·서예·목공·승마의 길을 생각도 걷게 될까
2026년 10월 8일, 『코드 리딩』의 저자이자 소프트웨어 공학의 대가 디오미디스 스피넬리스가 600단어짜리 블로그 글을 올렸다. 첫 문장은 '내 무덤을 파는 기분'이었고, 결론은 '생각은 취미가 될 것이다'였다. 가축화 뒤의 사냥, 인쇄술 뒤의 서예, 산업화 뒤의 목공, 자동차 뒤의 승마처럼. 해커뉴스에서 421개의 댓글이 달린 이 글을 한 문단씩 읽고, 성능·비용·가용성이라는 세 전제를 OECD 성인역량조사·PISA 2025·OpenAI 수학 원고 722편으로 확인했다. 네 비유의 역사(왕실 사냥림, 필경사 예찬, 윌리엄 모리스, 말 2,520만 마리), AI에 진 뒤 66년 만에 강해진 프로 바둑(580만 수 분석, 신민규 외 PNAS), 1961년 골딩의 「취미로서의 생각」, 아리스토텔레스의 스콜레에서 케인스의 15시간·아렌트의 '노동 없는 노동자 사회'까지의 계보를 따라갔다. 과업 기반 모델로 본 경제학의 설계도, 인지 오프로딩 연구, 스피넬리스 자신의 3~7월 글과의 충돌, 그리고 청년 일자리 28.5만 개가 사라진 한국의 데이터까지 — 여섯 개의 인터랙티브 도구와 함께 정리했다.
[특집] 모든 것의 사이클 — a16z 「State of Markets II」 90장 정독: 빅테크의 현금은 반도체로, GPU는 늙어도 비싸지고, SaaS는 '증명해 봐'를 듣는다
2026년 9월 30일, 실리콘밸리 벤처캐피털 a16z가 90장짜리 차트 묶음 「State of Markets II」를 내놓았다. 핵심 문장은 다섯 개다. 테크는 더 이상 한 업종이 아니라 경기 그 자체인 '모든 것의 사이클'이 됐고, 올해 S&P 500 이익 증가분의 76%를 테크가 만들었다. 빅테크가 데이터센터에 쏟는 7,770억 달러는 그들의 잉여현금흐름을 반도체 회사의 잉여현금흐름으로 바꿔 놓았다. '3년이면 고철'이라던 GPU는 오히려 임대료가 올랐다. 그런데도 AI 도입은 넓지만 얕다 — 기업 열에 일곱이 AI를 쓴다지만 성과를 지표로 추적하는 곳은 2%뿐이다. 그리고 연초의 'SaaS 종말론'은 종말이 아니라 '증명해 봐'였다. 1865년 제번스의 석탄 문제부터 1840년대 철도 광풍과 2000년 광섬유 거품, 카를로타 페레스의 기술 혁명 이론, 회계의 감가상각과 할인현금흐름까지 — 이 보고서를 읽는 데 필요한 개념을 처음부터 풀고, 차트 서른 장을 하나씩 읽으며, 반론과 한국 시장의 시선까지 함께 정리했다. 인터랙티브 여섯 개로 직접 계산해 볼 수 있다.
기억은 미리 만들지 말고, 물어볼 때 지어라 — Just-In-Time 에이전트 메모리(JAM) 완전 해부
석 달 전 회의 요약에는 '가격 협의함'이라고만 적혀 있다. 그런데 오늘 필요한 건 '1,240만 원, VAT 별도'라는 한 줄이다. 대부분의 에이전트 메모리는 질문이 오기 전에 기록을 요약·추출해 두는 AOT(Ahead-of-Time) 방식이고, 그래서 '그때는 사소했던' 디테일을 먼저 버린다. BAAI·베이징대·홍콩이공대 연구진의 JAM은 발상을 뒤집는다. 원본은 폴더에 그대로 두고 README 색인만 미리 만든 뒤, 질문이 오면 작은 Researcher 에이전트가 open·search·browse로 찾아 들어가 그 질문만을 위한 맥락을 짓는다. 4B 모델로 14B 메모리 에이전트를 이기고, 4배 빨랐다. 토요타 공장과 JIT 컴파일러에서 시작해 Memory-Gym 데이터 합성, 힌트를 주는 강화학습, 결과표와 한계, 2026년의 다른 기억 설계와의 비교까지 인터랙티브 위젯 6종과 함께 해부한다.
[특집] 기억의 교통정리 — MemAgent: '만능 메모리는 없다'는 발견과, 13개의 기억 중 하나를 고르는 4B 라우터
에이전트에게 기억을 달아 주는 방법은 이미 수십 가지다. 궤적 요약, 실패에서 뽑은 경고, 변수 자리를 비운 워크플로, 실행 가능한 파이썬 함수, 통찰의 그래프. 각자 자기 시험에서는 1등이라고 보고했다. 칭화대와 텐센트 연구진은 13개 방식을 같은 에이전트에 하나씩 붙여 세 개의 시험을 치르게 했고, 세 시험 모두에서 상위권에 드는 방식은 하나도 없다는 걸 확인했다. 그런데 '문제마다 맞는 기억을 골랐다면'의 점수는 89.6% — 최고의 단일 기억(71.0%)보다 18%p 이상 높았다. 그래서 그들은 더 나은 기억을 만드는 대신 기억을 고르는 4B 모델, MemAgent를 학습시켰다. 시작 전엔 13개 서랍을 살짝 열어 보고, 진행 중엔 메모를 보여 줄지 정하고, 끝나면 어느 서랍에 넣을지 고른다. 인지과학의 다중 기억 체계부터 SAT 솔버 포트폴리오의 '오라클', 2026년 ChatGPT·Claude·Mem0·Letta의 메모리 설계까지, 논문과 코드, 그림과 표를 바탕으로 인터랙티브 일곱 개와 함께 풀어본다.
[특집] 기억에도 종류가 있다 — MemoType이 바꾼 질문: 'AI는 무엇을 기억하나'에서 '어떤 기억을, 어떻게 찾나'로
"지난달 조지랑 태산 다녀왔어"라고 말해 둔 AI에게 4주 뒤 "조지는 어디 갔었지?"라고 물으면 왜 엉뚱한 답이 돌아올까. 2026년 10월 8일 arXiv에 올라온 NeurIPS 2026 채택 논문 「Memory Type Varies」는 원인을 '모든 기억을 같은 방식으로 찾기 때문'이라고 진단한다. 1972년 심리학자 엔델 털빙이 나눈 일화 기억과 의미 기억을 대화 AI에 맞게 세 갈래(에피소드·개인 의미·일반 의미)로 다시 나누고, 6,000개 대화에 라벨을 단 TriMEM 데이터셋으로 1.7B 라우터를 학습시켜, 기억의 종류마다 다른 검색법을 쓰는 MemoType을 만들었다. 단일 검색 전략에는 넘을 수 없는 천장이 있다는 정리, 기억 구축 비용을 최대 248분의 1로 줄인 비용표까지 — 논문의 그림과 표를 하나씩 읽고, 털빙에서 ChatGPT·Claude·Gemini의 2026년 메모리까지 이어지는 계보와 함께 인터랙티브 다섯 개로 풀어 본다.