소셜 이벤트 탐지Social Event Detection사건 진화RAG구조 엔트로피Structural Entropy지식베이스LLM무감독 학습클러스터링RAGFlowWWW 2026트위터재난 대응논문 해부
8,722개의 트윗에서 41개의 사건을, 라벨 없이 — RAG와 구조 엔트로피로 사건의 생몰을 추적하다 (WWW 2026)
2012년 10월 29일 하루치 트윗 8,722건 안에 41개의 사건이 섞여 있다. 정답 라벨도, 사건 개수도 모르는 채로 이것을 갈라내고, 나아가 각 사건이 어느 날 태어나 어떻게 변하고 언제 끝났는지까지 추적할 수 있을까. 2026년 1월 arXiv에 올라와 The Web Conference 2026에 채택된 RagSEDE는 지난 5년간의 표준이던 '표현 후 군집'을 버리고, 사건 지식베이스를 만들어 LLM에게 직접 묻는 방식으로 이 문제를 다시 푼다. 그리고 1996년 DARPA의 TDT부터 2016년 구조 정보이론까지 30년치 아이디어가 여기서 만난다. 논문 전체를 뜯고, 공개된 코드를 열어 논문과 다른 여섯 군데를 찾고, 인터랙티브 위젯 8종으로 직접 만져 본다.
2012년 10월 하순부터 11월 초까지 3주 동안, 트위터에는 이런 것들이 겹쳐 흐르고 있었다. 오바마와 롬니의 대선 토론이 세 차례 이어졌고, 발리우드의 거장 야시 초프라가 세상을 떠났고, FBI가 뉴욕 연방준비은행 폭파를 시도하던 남성을 체포했다. 허리케인 샌디가 뉴저지 해안에 상륙했고, 인도 남동부에서는 사이클론 닐람이 타밀나두 해안을 덮쳤다. 샌프란시스코 자이언츠가 월드시리즈에서 우승했고, 디즈니가 루카스필름을 40억 달러에 인수한다고 발표했으며, 뉴욕시 마라톤이 취소됐다.
연구자들은 이 3주를 하루 단위로 쪼개 놓고 쓴다. 그중 가장 붐비는 하루에는 필터링을 거친 뒤에도 메시지가 8,722건 남아 있고, 그 안에 서로 다른 사건이 41개 섞여 있다.
이제 문제. 정답 라벨도 없고, 사건이 몇 개인지도 모른 채, 이 8,722건을 41개의 묶음으로 갈라낼 수 있는가. 그리고 더 어려운 두 번째 문제. 내일 또 8,000건이 들어올 때, 그중 어느 것이 오늘 그 사건의 계속이고 어느 것이 새로 태어난 사건인지 알 수 있는가. 나아가 어제까지 활발하던 어떤 사건이 오늘 끝났다는 것을 기계가 스스로 알아챌 수 있는가.
메시지를 벡터로 바꿔 묶지 말고, 사건의 ‘카드’를 만들어 LLM에게 직접 물어라. 지난 5년간 이 분야의 표준은 메시지를 임베딩한 뒤 K-Means로 나누는 ‘표현 후 군집(representation-then-cluster)’이었다. RagSEDE는 그 대신 사건의 이름과 키워드를 담은 지식베이스를 실시간으로 만들어 가며, 새 메시지가 오면 RAG로 후보 사건을 검색해 LLM에게 “이건 어느 사건이냐”고 묻는다. 그리고 날마다 만들어진 지식베이스들을 구조 엔트로피로 이어 붙여, 사건의 탄생·변화·소멸까지 추적한다.
이 글은 그 논문을 처음부터 끝까지 따라간다. 먼저 이 문제가 30년 동안 어떻게 다뤄져 왔는지(1996년 DARPA의 TDT부터), 지금 방식이 어디서 막혔는지, RagSEDE의 세 부품이 각각 무엇을 하는지, 성적표의 숫자가 실제로 무엇을 말하는지, 그리고 공개된 코드가 논문과 어디서 갈라지는지를 본다. 논문의 표와 그림은 위젯으로 직접 만져 볼 수 있게 옮겼고, 어려운 개념 — 특히 구조 엔트로피 — 은 직접 계산해 보는 놀이터를 만들었다.
RAG를 다룬 지난 9편 시리즈가 “검색해서 잘 답하기”를 다뤘다면, 이 논문은 RAG의 방향을 뒤집는다. 검색해서 답하는 게 아니라, 답하면서 검색할 것을 만든다. 지식베이스가 입력이 아니라 출력이다.
먼저 감을 잡자. 소셜 이벤트 탐지(Social Event Detection, SED)의 표준 데이터셋인 Event2012는 2012년 10월 말~11월 초의 트위터를 수집해 사람이 직접 사건 라벨을 붙인 것이다. 연구자들은 이것을 하루 단위 블록으로 쪼갠다. 어제 데이터로 오늘을 푸는 것은 되지만 내일 데이터를 미리 보는 것은 안 되는, 실제 운영 환경을 흉내 낸 설정이다.
데이터셋
Event2012
Event2018
언어
영어
프랑스어
메시지 수
68,841건
64,516건
사건 수
503개
257개
기간
21일 (블록 M1~M21)
16일 (블록 M1~M16)
가장 큰 블록
M1 — 8,722건 / 41개 사건
M1 — 5,356건 / 22개 사건
가장 작은 블록
M20 — 893건 / 34개 사건
M16 — 1,107건 / 14개 사건
사건이 가장 많은 날
M7 — 5,278건에 57개 사건
M10 — 2,385건에 32개 사건
출처
McMinn 외, CIKM 2013
Mazoyer 외, LREC 2020
숫자를 하나씩 뜯어보면 문제의 성격이 드러난다.
첫째, 분포가 극단적으로 치우쳐 있다. M1의 8,722건이 41개 사건에 고르게 나뉘지 않는다. 대선 토론처럼 인기 있는 사건 하나가 수천 건을 차지하고, 어떤 사건은 열 건 남짓이다. 인기 사건 안의 수천 건은 대부분 서로 거의 같은 말이다. "오바마 이겼다", "오바마가 이김", "Obama won"… 이 수천 건을 전부 처리하는 것은 낭비다.
둘째, 한 건 한 건은 조각이다. 트윗 한 줄에는 사건의 전모가 없다. "여기 완전 암흑"이라는 트윗은 그 자체로는 무슨 사건인지 알 수 없다. 앞뒤 맥락 — 첸나이에 사이클론이 상륙했고 정전이 났다는 배경 — 을 알아야 의미가 생긴다. 그런데 기존 방법은 메시지 임베딩만으로 군집을 만든다. 전역 맥락이 없다.
셋째, 사건의 개수를 모른다. K-Means를 쓰려면 K를 알아야 한다. 논문 표에서 별표(*)가 붙은 다섯 개 기준선 — KPGNN, QSGNN, SBERT, CP-Tuning, PromptSED — 은 모두 정답 사건 수를 알려 주고 돌린 결과다. 실전에서는 그걸 모른다. 별표 없이 돌아가는 무감독 방법은 HISEvent와 RagSEDE 둘뿐이다. 이 사실은 표를 읽을 때 반드시 기억해야 한다.
넷째, 그리고 가장 큰 문제 — 시간이다. 위 네 가지는 전부 "하루치를 어떻게 나눌 것인가"다. 그런데 정작 사람이 알고 싶은 것은 "이 사건이 어제부터 계속되는 것인가, 어떻게 달라졌는가, 끝났는가"다. 기존 연구의 절대다수는 여기에 답하지 않는다.
RagSEDE를 이해하려면 이 문제가 어디서 왔는지 알아야 한다. 아래 타임라인의 연도를 눌러 가며 각 시기가 무엇을 풀었고 무엇을 남겼는지 보자.
몇 대목은 따로 짚을 만하다.
2010년 — 사람을 지진계로 쓴 논문
이 분야에서 가장 자주 인용되는 실증 사례는 2010년 WWW 학회에 발표된 사카키 다케시(Takeshi Sakaki) 연구팀의 Earthquake shakes Twitter users다. 발상은 단순하다. 지진이 나면 사람들이 트윗한다. 그러니 트위터 사용자를 센서로 보자는 것.
시스템은 "지진", "흔들린다"가 들어간 트윗을 3초마다 수집해 분류기에 넣고, 파티클 필터로 진앙의 위치를 추정했다. 두 달간의 실측 결과는 이랬다.
Toretter 시스템의 지진 탐지율 (2009년 8월부터 두 달)
일본 기상청(JMA) 진도 등급별. 괄호 안은 해당 등급의 지진 건수
진도 4 이상 (3건)
100%
진도 3 이상 (25건)
96%
진도 2 이상 (78건)
89.7%
숫자보다 인상적인 것은 속도였다. 시스템은 알림 메일을 대개 1분 안에, 때로는 20초 안에 보냈다. 기상청의 공식 발표는 평균 6분 뒤였다. 논문의 표에 실린 실제 사례 하나: 2009년 8월 18일 6시 58분 55초 도치기현 규모 4.5 지진 → 시스템 메일 발송 7시 00분 30초 → 기상청 발표 7시 08분. 7분 30초 빨랐다.
지진파가 지각을 초속 3~7km로 전달되므로, 진원에서 100km 떨어진 곳에는 흔들림이 도착하기까지 약 20초가 걸린다. 논문은 조심스럽게 "메일이 지진이 실제로 도달하기 직전에 사용자에게 닿기를 희망한다"고 썼다. 소셜 미디어 신호가 기관의 공식 채널보다 빠를 수 있다는 것을 처음 실증한 사례다.
이 논문에서 가장 중요한 문장은 사건의 정의다. 그들은 사건을 "시간에 따른 급상승 엔티티 군집들의 목록(a list of clusters of trending entities over time)"으로 정의했다. 사건은 하나의 덩어리가 아니라 시간 축을 따라 이어지는 사슬이라는 것. RagSEDE가 6년 뒤 상속(inheritance) 메커니즘으로 풀려는 문제와 정확히 같은 문제의식이다.
2021~2024년 — GNN에서 구조 엔트로피로
2021년 KPGNN 이후 이 분야의 표준은 그래프 신경망이었다. 트윗을 노드로 놓고, 같은 사용자가 썼거나 같은 해시태그·개체명을 공유하면 엣지로 연결한 이종 그래프를 만들어 GNN으로 표현을 학습한다. 그리고 그 표현을 K-Means로 나눈다.
문제는 두 가지였다. 지도학습이라 라벨이 필요했고(그래서 표의 별표), 속성이 빠진 메시지는 엣지가 끊기거나 엉뚱하게 이어졌다. 트윗의 태반은 해시태그도 없고 개체명도 인식되지 않는다.
2024년 AAAI의 HISEvent는 여기에 다른 길을 냈다. 라벨도 군집 수도 없이, 구조 엔트로피 최소화만으로 그래프를 나누는 것이다. 이 논문에서 가장 강한 비교 대상이고, 뒤에서 보겠지만 프랑스어 데이터셋에서는 여전히 RagSEDE를 앞선다.
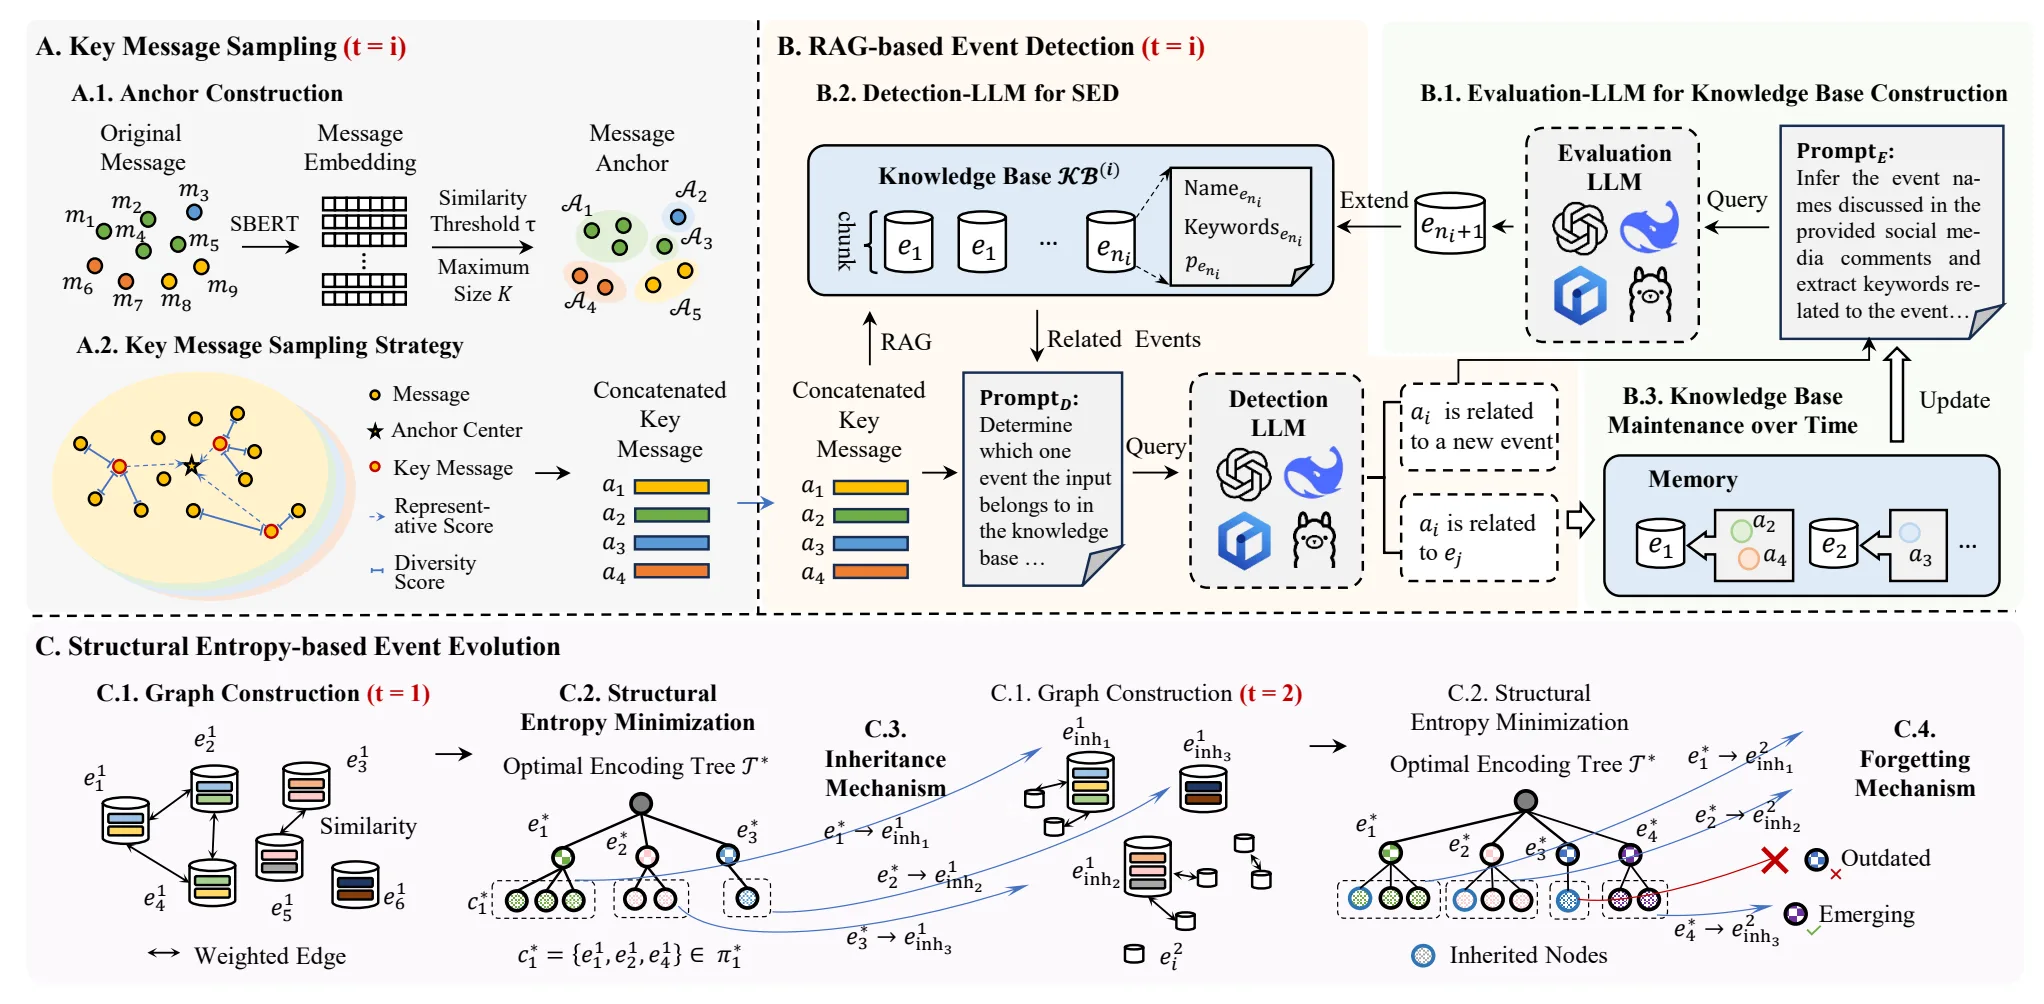
▲ Liu et al. (2026), arXiv:2601.12035, Figure 2. 논문 전체가 이 한 장에 들어 있다. (A) 키 메시지 샘플링 — 비슷한 메시지를 앵커로 묶고 각 앵커에서 셋만 뽑는다. (B) RAG 기반 탐지 — 지식베이스에서 후보 사건을 검색해 탐지 LLM에게 묻고, 새 사건이면 평가 LLM이 항목을 써서 넣는다. (C) 구조 엔트로피 기반 진화 — 날마다의 지식베이스를 그래프로 만들고 엔트로피 최소화로 정렬한 뒤, 상속 노드로 잇고 지지받지 못한 노드는 잊는다. (CC BY 4.0)
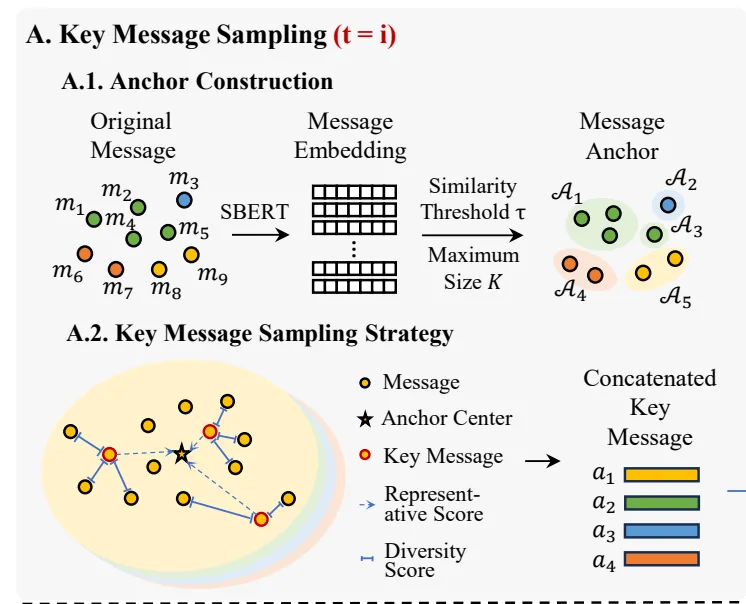
▲ 같은 논문 Figure 2(A). 왼쪽 위: 원본 메시지를 SBERT로 임베딩해 유사도 임계값 τ 이상이면 같은 앵커로 묶는다(최대 크기 K로 제한). 왼쪽 아래: 각 앵커에서 별표(앵커 중심)와의 거리 — 대표성 — 와 다른 메시지와의 겹침 — 을 저울질해 상위 셋을 고른다. 오른쪽: 뽑힌 셋을 이어 붙인 것이 LLM에 보낼 한 덩어리다. (CC BY 4.0)
LLM에게 8,722번 물으면 어떻게 될까. 논문의 실측이 있다. deepseek-r1:32b를 로컬에 띄워 놓고 샘플링 없이 M1 블록을 처리했더니 30시간이 넘어도 끝나지 않았다. 하루치 데이터를 처리하는 데 하루 이상이 걸린다면 실시간 시스템이 될 수 없다.
그래서 먼저 줄인다. 방법은 두 단계다.
4.1 앵커 — 거의 같은 말은 하나로
모든 메시지를 SBERT로 임베딩한 뒤, 코사인 유사도가 임계값 τ 이상인 것끼리 하나의 앵커(anchor)로 묶는다. 인기 사건에서 앵커가 수천 개짜리 괴물이 되는 것을 막기 위해 최대 크기 K를 둔다.
4.2 대표성과 다양성 — 앵커마다 셋만
앵커 안에서 어떤 셋을 뽑을 것인가. 논문은 두 기준을 정의한다.
대표성(Representativeness): 앵커 중심 벡터와의 코사인. 높을수록 그 앵커의 주된 이야기를 잘 담고 있다.
다양성(Diversity): 같은 앵커의 나머지 메시지들과의 평균 코사인. 논문은 이것을 "새로운 정보를 얼마나 주는가"라고 설명한다.
그리고 최종 점수를 λ·대표성 + (1−λ)·다양성으로 정의한다(λ=0.7).
여기서 처음으로 논문과 코드가 갈라진다. 논문의 식 6은 "다양성"을 나머지와의 평균 유사도로 정의하는데, 그 값이 높다는 것은 오히려 다른 메시지와 비슷하다는 뜻이다. 즉 이름은 다양성인데 재는 것은 중복도다. 그리고 식 7은 그것을 대표성에 더한다. 그대로 계산하면 대표성을 두 번 세는 셈이 된다.
변수 이름이 redundancy(중복도)이고, 빼고 있다. 코드가 맞고 논문의 식 7에 부호 오류가 있는 것으로 보인다. 아래 위젯은 코드 쪽을 따랐다.
λ를 0으로 내려 보면 무슨 일이 일어나는지 분명해진다. 대표성을 완전히 버리면 앵커의 주변부에 있는 이상한 메시지들이 뽑힌다. λ를 1로 올리면 중심에 가장 가까운 셋 — 거의 같은 말 셋 — 이 뽑혀 다양성을 잃는다. 논문의 0.7은 대표성 쪽에 무게를 둔 값이다.
4.3 τ — 손잡이 하나가 전부를 바꾼다
τ는 이 시스템에서 가장 위험한 손잡이다. 너무 낮으면 서로 다른 사건의 메시지가 한 앵커에 갇히는데, 이 오류는 되돌릴 수 없다. 앵커에 속한 원본 메시지 전부가 그 앵커의 라벨을 그대로 받기 때문이다. 탐지 LLM이 아무리 똑똑해도 이미 섞인 것을 풀 수 없다.
논문의 민감도 실험이 이것을 보여 준다. τ=0.1에서 Event2012 M10의 ARI는 0.29까지 떨어진다(τ=0.4에서는 0.97). Event2018 M15는 NMI가 0.23이다. 반면 0.3~0.5 구간에서는 상당히 안정적이다. 논문은 영어에 0.4, 프랑스어에 0.3을 썼다.
흥미로운 점 하나. Event2018 M15에서 실제 최고점은 τ=0.4(NMI .84, ARI .82)인데 논문은 0.3을 썼다. 데이터셋 전체에 하나의 τ를 고정했기 때문에 블록별 최적값을 포기한 것이다. 실전에서는 블록마다, 혹은 사건 종류마다 다른 τ가 필요할 수 있다는 힌트다.
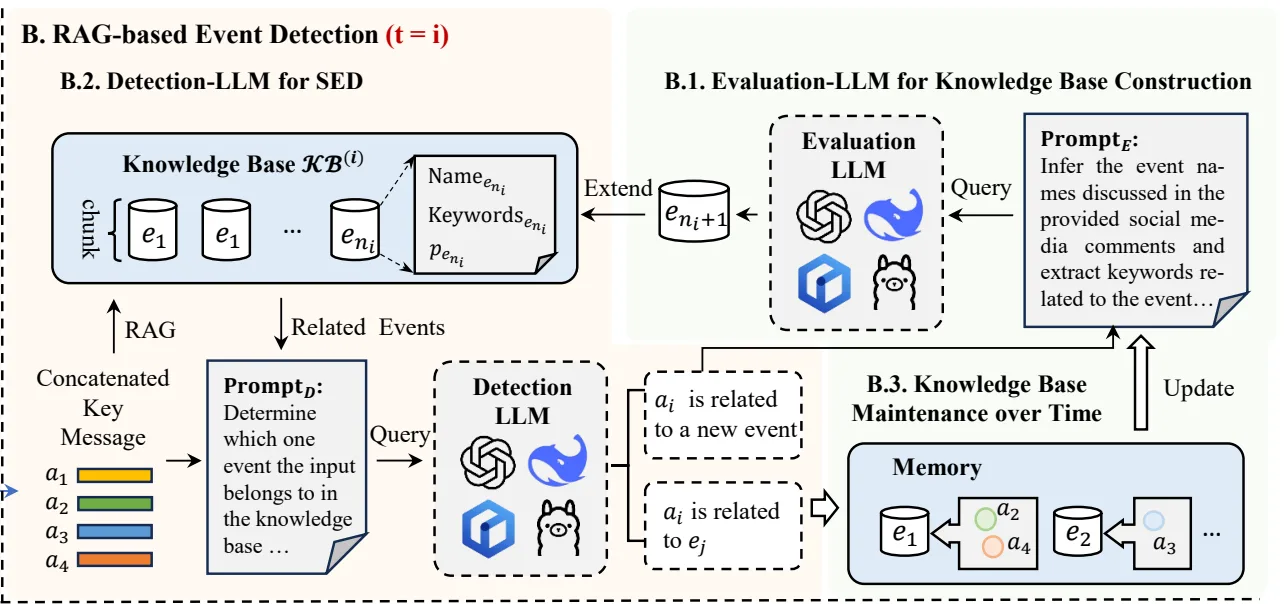
▲ 같은 논문 Figure 2(B). 오른쪽의 평가 LLM이 새 사건의 이름과 키워드를 써서 지식베이스에 넣고(B.1), 왼쪽의 탐지 LLM이 들어온 메시지에 대해 검색된 후보 중 하나를 고르거나 "Others"라고 답한다(B.2). 아래의 메모리 구조는 사건별 버퍼로, 일정량이 차면 키워드를 다시 뽑아 갱신한다(B.3). (CC BY 4.0)
여기가 이 논문의 심장이다.
5.1 지식베이스라는 발상
기존 방식은 이렇다. 메시지 → 임베딩 → 군집. 각 군집이 하나의 사건. 이 과정 어디에도 "사건이 무엇인가"에 대한 명시적 표현이 없다. 군집은 벡터들의 덩어리일 뿐이고, 그것이 무슨 사건인지는 사람이 나중에 들여다봐야 안다.
RagSEDE는 사건을 명시적인 항목으로 만든다. 지식베이스의 한 항목은 이렇게 생겼다.
지식베이스의 한 항목(chunk)
EVENT: Cyclone Nilam Approaches Tamil Nadu Coast.
KEYWORDs: nilam, cyclone, tamil, nadu, andhra, pradesh, coastal, impact, evacuation, alert.
이름과 키워드 열 개 이하, 그리고 그 둘을 이어 붙여 인코딩한 임베딩. 그게 전부다. 사건 하나가 텍스트 한 조각으로 존재한다. 사람이 읽을 수 있다는 점이 중요하다. 군집 번호 17번이 아니라 "타밀나두 해안에 접근하는 사이클론 닐람"이다.
5.2 두 개의 LLM — 사서와 분류원
RagSEDE는 LLM을 두 역할로 나눈다. 논문 부록에 프롬프트 전문이 실려 있는데, 짧아서 그대로 볼 만하다.
평가 LLM(Evaluation-LLM) — 사건 항목을 쓰는 사서다.
Prompt E · 사건 항목 생성
당신은 사건 분석 보조원이다. 제공된 소셜 미디어 댓글에서 논의되는 사건 이름을 추론하고 사건과 관련된 키워드를 뽑는 것이 당신의 임무다.
첫째, 모든 COMMENTS를 주의 깊게 읽고 그들이 논의하는 핵심 내용을 이해하라.
둘째, COMMENTS에 기반해 간결하고 정확한 EVENT NAME을 요약하라.
셋째, 사건과 관련된 KEYWORDS를 10개 이하로 뽑되, 핵심 주제·인물·장소·시간 또는 사건에 관한 다른 중요한 정보를 포괄해야 한다. 각 키워드는 COMMENTS에 실제로 등장하는 한 단어여야 한다.
EVENT-NAME(문자열)과 KEYWORDS(리스트) 속성을 포함하는 JSON 형식으로 답하라. 그 밖에 다른 정보를 포함해서는 안 된다.
탐지 LLM(Detection-LLM) — 들어온 메시지를 분류하는 분류원이다.
Prompt D · 사건 배정
지식베이스는 EVENT들과 그에 대응하는 KEYWORD들을 담고 있다.
당신은 INPUT이 지식베이스의 어느 한 EVENT에 속하는지 판정하는 소셜 미디어 댓글 분류기다.
INPUT과 EVENT 속성을 포함하는 JSON 형식으로 답하라. 그 밖에 다른 정보를 포함해서는 안 된다. 지식베이스의 모든 내용이 INPUT과 무관하면, 당신의 EVENT 답은 반드시 ‘Others’여야 한다.
지식베이스가 비어 있으면, 당신의 EVENT 답은 반드시 ‘Others’여야 한다.
답변은 대화 기록을 고려할 필요가 없다.
여기 지식베이스가 있다: {knowledge}
이 설계에서 가장 영리한 부분은 "Others"라는 탈출구다. 군집화 알고리즘은 새 사건을 만들 방법이 없다 — K를 정해 놓았으니 모든 점이 어딘가에 배정된다. 반면 탐지 LLM은 "모르겠다"고 말할 수 있고, 그 말이 곧 새 사건 생성 신호가 된다. 열린 세계(open-world) 설정을 자연스럽게 다루는 것이다.
{knowledge} 자리에는 RAG가 검색한 후보 사건들이 들어간다. 검색은 코사인 유사도 기준 상위 8개(q=8), 임계값 γ=0 — 사실상 상위 8개를 조건 없이 넣는다. 지식베이스가 커져도 프롬프트는 여덟 항목으로 고정된다.
5.3 한 걸음씩 따라가기
위 위젯에서 5번째 메시지 — "첸나이 전역 정전 / 전기 끊긴 지 12시간 / 통신도 두절" — 를 보자. 이 문장에 '닐람'이라는 단어가 한 번도 안 나온다. 표현-군집 방식이라면 '정전'이라는 별개의 사건으로 떨어질 가능성이 높다. 지식베이스에 "닐람 … chennai, coastal, alert" 항목이 있고, LLM이 그 항목과 이 문장을 함께 보면 "아 이건 닐람 때문에 난 정전"이라고 판단할 수 있다. 논문이 "전역 의미 지침(global semantic guidance)"이라고 부르는 것이 이것이다.
지식베이스 스위치를 끄고 다시 돌려 보면 모든 메시지가 새 사건이 된다. 논문의 절제 실험에서 지식베이스를 빼면 Event2018 M15의 ARI가 .70에서 .28로 떨어진다.
5.4 지식베이스가 낡지 않게 — 버퍼와 갱신
하루는 길다. 아침에 만든 "사이클론 닐람 접근" 항목은 저녁이 되면 낡는다. 그 사이 상륙했고, 정전이 났고, 사상자가 나왔기 때문이다. 그런데 항목의 키워드는 아침 것 그대로다.
그래서 사건마다 버퍼를 둔다. 그 사건으로 배정된 메시지를 쌓아 두다가 개수가 임계값 θ(=10)에 도달하면, 버퍼 내용을 평가 LLM에 넘겨 키워드를 새로 뽑고 항목을 갱신한 뒤 버퍼를 비운다.
절제 실험을 보면 이 모듈의 효과는 블록 크기에 비례한다. 작은 블록에서는 차이가 거의 없지만, Event2018 M15(2,411건)에서는 NMI .77 → .79, ARI .68 → .70으로 올라간다. 긴 스트림일수록 중요해지는 장치다.
탐지가 끝나면 날마다 지식베이스 하나씩이 남는다. 21일치면 21개. 이것만으로는 사건의 진화를 알 수 없는데, 두 가지 고장 때문이다.
🔬
고장 1 — 입자도가 안 맞는다
LLM은 인기 사건을 잘게 쪼갠다. 대선 토론 하나를 두고 “롬니의 토론 참여”, “오바마 재선 토론”, “롬니-오바마 토론 충돌” 세 항목을 만들어 버린다. 반대로 관심이 적은 사건은 뭉뚱그린다. 날마다 쪼개지는 방식도 다르다.
📅
고장 2 — 날마다 지식베이스를 새로 만든다
열린 세계 설정을 지키기 위해 탐지는 날마다 빈 지식베이스에서 시작한다. 그래서 어제의 “사건 17번”과 오늘의 “사건 4번”이 같은 실제 사건인지 알 방법이 없다.
🧩
필요한 것 — 입자도를 맞추고 시간을 잇는 장치
구조 엔트로피 최소화가 첫째를, 상속·망각 메커니즘이 둘째를 푼다.
6.2 구조 엔트로피란 무엇인가
섀넌 엔트로피는 확률분포의 불확실성을 잰다. 2016년 앙성 리(Angsheng Li)와 이청 판(Yicheng Pan)이 IEEE Transactions on Information Theory에 발표한 구조 정보이론은 같은 아이디어를 그래프로 확장한다.
직관은 이렇다. 그래프 위에서 랜덤 워커가 한 걸음 걷는다. 지금 어디에 있는지 모르는 관찰자에게 워커가 도착한 노드가 어디인지 알려 주려면 몇 비트가 필요한가. 그 최소 비트 수가 구조 엔트로피다.
여기서 핵심은 어떻게 주소를 매기느냐다. 노드 1,000개에 그냥 번호를 붙이면 매번 10비트가 필요하다. 그런데 그래프가 군집 구조를 갖고 있다면 — 즉 워커가 대개 같은 군집 안에서 움직인다면 — "몇 번 군집의 몇 번째"라는 두 단계 주소가 훨씬 싸다. 군집 안에서 움직였다면 군집 번호는 안 보내도 되니까.
논문의 식은 이렇다.
HT(G)=−α∈T,α=λ∑vol(G)gαlog2vol(α−)vol(α)
기호를 풀면 이렇다. T는 그래프에 씌운 인코딩 트리(주소 체계)이고, 2차원이면 루트 아래 군집 층, 그 아래 노드 층의 두 단계다. α는 그 트리의 한 노드, α−는 그 부모다. vol(α)는 α에 속한 그래프 노드들의 차수 합(가중치 포함)이고, gα는 α의 경계를 가로지르는 엣지 가중치의 합 — 즉 이 군집을 만들기 위해 잘라야 하는 엣지의 양이다.
식을 말로 옮기면 "군집을 만들 때 자른 엣지가 많을수록 벌점, 군집이 클수록 할인"이다. 그리고 이 값을 최소로 만드는 인코딩 트리가 그래프의 본질적 구조라는 것이 이 이론의 주장이다.
6.3 직접 해 보자
말로는 감이 안 온다. 하루치 지식베이스의 사건 일곱 개를 그래프로 놓고 직접 나눠 보자. 아래 위젯은 위 식을 그대로 계산하고, 877가지 모든 분할을 완전 탐색해 최솟값도 찾아 둔다.
여기서 꼭 확인해야 할 것이 하나 있다. "전부 따로"와 "전부 한 덩어리"를 눌러 보라. 두 값이 정확히 같다.
이것이 우연이 아니다. 모두 따로 두면 모든 엣지가 잘리므로 절단 벌점이 최대이고, 모두 한 덩어리로 두면 잘리는 엣지가 없지만 군집 안에서 노드를 특정하는 비용이 최대다. 두 극단은 서로 다른 이유로 똑같이 비싸며, 둘 다 1차원 엔트로피(구조를 전혀 쓰지 않은 값)와 같다. 구조를 실제로 맞췄을 때만 값이 내려간다. 구조 엔트로피가 "구조 정보량"을 재는 자라고 불리는 이유다.
그리고 "최솟값으로" 버튼을 누르면 닐람 셋, 샌디 둘, 스포츠 둘로 갈린다. 군집 개수 3을 아무도 알려 주지 않았다. 엔트로피가 스스로 골랐다. 이것이 논문이 말하는 "입자도 정렬"이다. 인기 사건의 잘게 쪼개진 세부 항목들은 자연스럽게 하나로 뭉치고, 엣지가 적은 비인기 사건은 그대로 남는다.
최소화 알고리즘 자체는 단순하다. 2016년 논문의 MERGE 연산자 — 인코딩 트리의 두 노드를 합치는 — 를 엔트로피가 가장 많이 줄어드는 쌍에 반복 적용하다가 더 줄지 않으면 멈춘다.
6.4 그래프는 어떻게 만드는가
노드는 그날 지식베이스의 사건 항목들(그리고 어제에서 상속된 노드들). 엣지는 키워드를 하나라도 공유하면 연결하고, 가중치는 두 사건 임베딩의 유사도다.
"키워드 하나만 공유해도 연결"은 거칠어 보이지만 효과가 있다. 같은 실제 사건에서 갈라진 세부 항목들은 필연적으로 이름·장소·인물 키워드를 공유하기 때문이다. 그리고 가중치가 유사도이므로, 우연히 흔한 단어 하나를 공유한 무관한 쌍은 약한 엣지로만 이어져 최소화 과정에서 쉽게 잘린다.
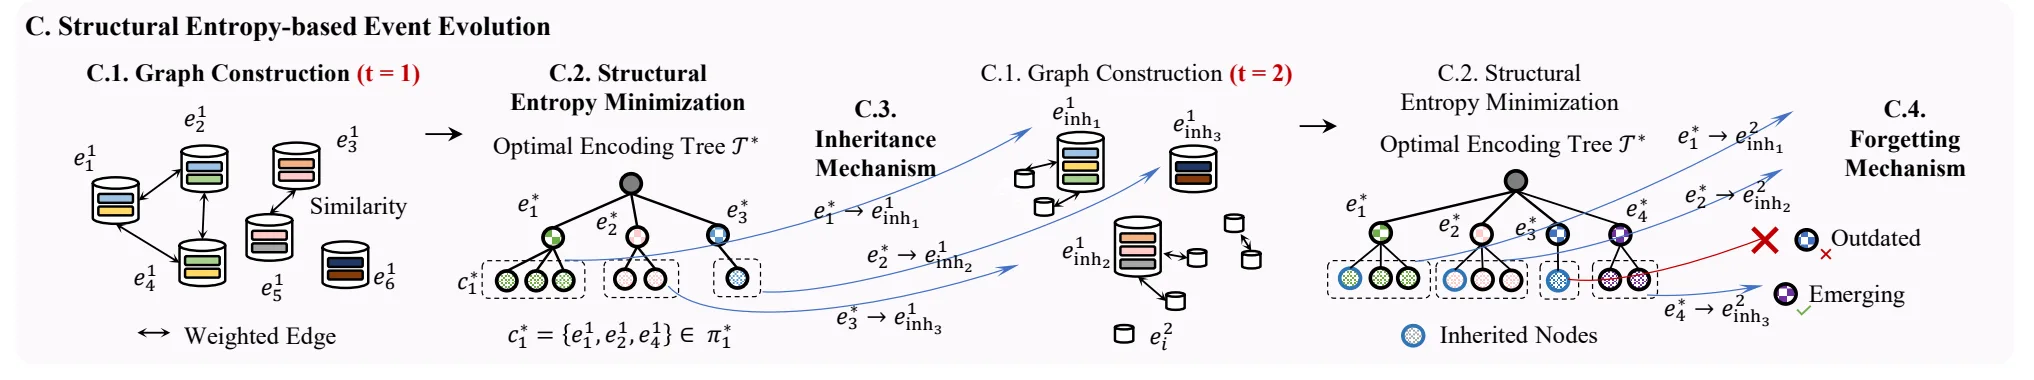
▲ 같은 논문 Figure 2(C). 왼쪽(t=1): 사건 여섯 개로 그래프를 짜고 엔트로피를 최소화해 세 개의 정렬된 사건을 얻는다. 가운데: 그 셋이 상속 노드가 되어 다음 날 그래프에 심어진다. 오른쪽(t=2): 상속 노드끼리는 절대 합쳐지지 않게 제약을 걸고(no-merge) 다시 최소화한다. 어떤 상속 노드도 붙잡아 주지 않으면(빨간 X) 그 사건은 낡은 것으로 보고 다음 날부터 제외한다. (CC BY 4.0)
7.1 상속 — 어제를 오늘 그래프에 심는다
간단하고 우아한 트릭이다. 어제 정렬된 사건 각각에 대해, 그 키워드를 가진 상속 노드(inherited node)를 하나 만들어 오늘 그래프에 함께 넣는다. 오늘 새로 생긴 항목들이 그 상속 노드와 키워드를 공유하면 엣지가 생기고, 엔트로피 최소화 과정에서 같은 군집으로 묶인다. 묶였다는 것은 곧 "이것은 어제 그 사건의 계속"이라는 뜻이다.
여기에 한 가지 제약이 붙는다. 상속 노드끼리는 절대 같은 군집에 들어갈 수 없다. 이 제약이 없으면 어제의 서로 다른 두 사건이 오늘 하나로 합쳐져 버려서, 각 사건의 정체성이 사라진다. 논문은 이것을 no-merge 제약이라 부른다.
7.2 망각 — 끝을 아는 법
상속만 있으면 지식베이스가 무한히 부푼다. 3주 전에 끝난 사건이 매일 상속 노드로 되살아나 그래프를 오염시킨다.
그래서 망각(forgetting)이 필요하다. 규칙은 한 줄이다. 오늘의 엔트로피 최소화에서, 어떤 상속 노드의 군집에 일반 노드가 하나도 들어오지 않았다면 — 즉 오늘 아무도 그 사건 이야기를 하지 않았다면 — 그 사건은 낡은 것으로 보고 내일부터 상속에서 제외한다.
이것이 단순히 청소 기능이 아니라는 점이 중요하다. 이 순간이 곧 사건의 종료 시점 기록이다. SED 문헌에서 사건의 시작은 늘 다뤄졌지만 끝은 거의 다뤄지지 않았다. 망각 메커니즘은 끝을 명시적으로 만든다.
두 스위치를 하나씩 꺼 보면 각각이 무엇을 막고 있었는지 보인다. 상속을 끄면 날마다 사건이 새로 태어날 뿐 이어지지 않아 진화 추적 자체가 성립하지 않는다. 망각을 끄면 끝난 사건이 계속 남아 다음 날의 그래프를 오염시킨다.
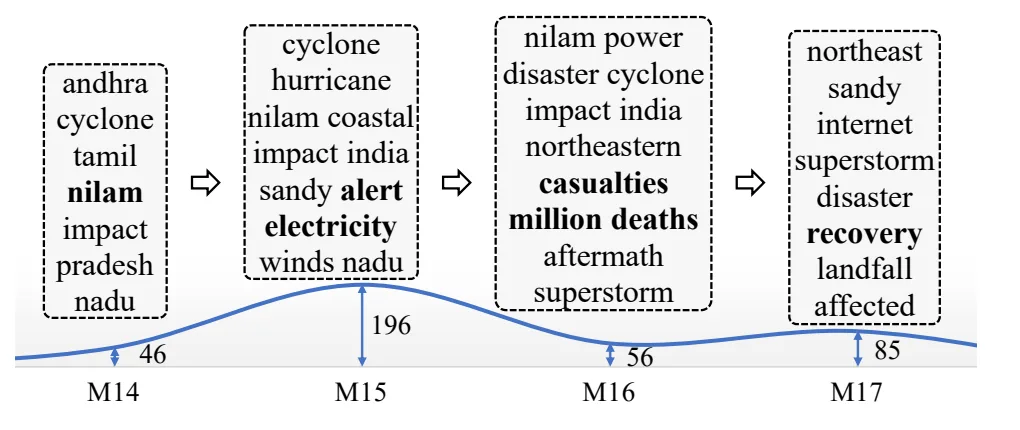
접근 → 상륙과 정전 → 사상자 → 복구. 재난 보도의 전형적인 생애 주기가 키워드만으로 재구성됐다. 아무도 이 단계들을 미리 정의해 주지 않았고, 키워드는 전부 실제 트윗에 등장한 단어다.
다만 여기서 논문이 언급하지 않는 것이 하나 있다. M15부터 sandy와 superstorm이 끼어들고, M17에서는 nilam이 아예 사라지고 northeast, sandy, internet이 자리를 차지한다. 이것은 닐람 사건이 아니라 허리케인 샌디 사건이다. 두 재난이 같은 시기에 일어났고 landfall, disaster, impact, superstorm 같은 어휘를 공유하므로, 키워드 공유 엣지가 두 사슬을 이어 버린 것으로 보인다. 그러니까 이 사슬의 마지막 칸은 "닐람의 복구 국면"이라기보다 "닐람에서 출발한 사슬이 샌디로 옮겨 탄 것"에 가깝다.
키워드 공유로 엣지를 만드는 방식의 구조적 취약점이다. 어휘가 겹치는 동시대 사건들 — 같은 날 여러 지역의 지진, 같은 시즌의 여러 경기, 같은 선거의 여러 후보 — 에서 이 현상이 반복될 가능성이 높다.
8. 성적표 — 숫자가 실제로 말하는 것
8.1 탐지 — 영어에서는 압도, 프랑스어에서는 접전
Event2012(영어)의 결과는 대단히 깔끔하다.
21/21
NMI·AMI에서 모든 블록 1위
.89
RagSEDE 평균 NMI (최고 기준선 .82, HISEvent .80)
+.63
M15 블록의 ARI 최대 개선폭 (.34 → .97)
17/21
ARI에서 1위한 블록 수 (2블록 패배, 2블록 동률)
특히 인상적인 것은 밀도 편차에 강하다는 점이다. 8,722건짜리 M1에서도, 893건짜리 M20에서도 1위다. 사건이 유난히 많은 M7(5,278건에 57개 사건)에서도 NMI .75로 기준선 .70을 앞선다. 기존 방법들이 밀도에 따라 성적이 출렁이는 것과 대조적이다.
그런데 Event2018(프랑스어)에서는 이야기가 다르다. 논문은 "거의 모든 블록에서 최고 또는 차선"이라고 쓰는데, 표를 전부 집계하면 이렇다.
Event2018 · RagSEDE vs 최고 기준선
승
패
무
평균 비교
NMI
6
8
2
.748 vs HISEvent .754
AMI
6
10
0
.733 vs HISEvent .747
ARI
7
7
2
.599 vs HISEvent .604
세 지표 모두에서 HISEvent가 평균적으로 약간 앞선다. "최고 또는 차선"이라는 표현은 사실이지만(차선이 많다), 영어 데이터셋의 압도적 승리와 같은 결론으로 읽으면 안 된다. M13에서는 ARI가 .86 대 .51로 크게 진다.
논문은 원인을 솔직하게 밝힌다. "비교적 작은 32B 모델을 썼기 때문이며, 프랑스어 이해 능력이 제한적이다. 실전에서는 언어별 LLM을 고르면 성능을 더 높일 수 있다." 백본 실험이 이를 뒷받침한다. GPT-4o-mini로 바꾸면 M15의 ARI가 .70에서 .77로 뛴다 — 영어 블록에서의 개선폭(.94 → .95)보다 훨씬 크다. 언어 능력이 병목이었다는 뜻이다.
여기서 이 설계의 성격이 드러난다. RagSEDE의 성능은 백본 LLM의 언어 능력에 직접 묶여 있다. 좋은 소식은 모델이 좋아지면 시스템도 좋아진다는 것이고, 나쁜 소식은 저자원 언어에서는 그 이득을 못 받는다는 것이다. 한국어를 생각하면 남 일이 아니다.
8.2 부품별 기여 — 무엇을 빼면 무엇이 무너지는가
설정
M3 (2012)
M10 (2012)
M8 (2018)
M15 (2018)
RagSEDE (deepseek-r1:32b)
.95 / .95 / .94
.96 / .96 / .97
.82 / .81 / .67
.79 / .78 / .70
− 키 메시지 샘플링
.84 / .81 / .61
.93 / .92 / .88
.72 / .67 / .41
.73 / .69 / .55
− 지식베이스
.86 / .85 / .57
.91 / .89 / .72
.73 / .68 / .34
.68 / .64 / .28
− 지식베이스 유지보수
.95 / .95 / .94
.96 / .96 / .97
.81 / .79 / .67
.77 / .76 / .68
+ deepseek-r1:70b
.96 / .95 / .95
.96 / .96 / .97
.81 / .79 / .64
.79 / .78 / .72
+ GPT-4o-mini
.96 / .95 / .95
.97 / .97 / .97
.82 / .81 / .68
.81 / .80 / .77
+ GPT-4o
.96 / .95 / .95
.97 / .96 / .97
.82 / .80 / .68
.79 / .78 / .68
값은 NMI / AMI / ARI 순이다. 읽을 만한 것이 세 가지 있다.
첫째, 키 메시지 샘플링은 속도 장치가 아니라 품질 장치다. 이름만 보면 "비용을 아끼는 대신 품질을 조금 희생하는" 모듈처럼 들리는데, 실제로는 빼면 성능이 떨어진다. M3에서 ARI가 .94 → .61이다. 이유는 논문이 설명한다 — 앵커 안의 상위 세 개를 이어 붙인 것이 트윗 한 줄보다 훨씬 좋은 질문이기 때문이다. 짧고 파편적인 한 줄보다 같은 이야기를 하는 세 줄이 LLM에게 더 많은 단서를 준다. 줄이는 것이 곧 다듬는 것이었다.
둘째, GPT-4o가 GPT-4o-mini보다 낫지 않다. M15에서 mini가 .77, 정식 4o가 .68이다. 70b도 32b를 일관되게 이기지 않는다. 이 과제에서는 모델 크기보다 JSON 형식을 얌전히 지키고 주어진 후보 중에서만 고르는 순응성이 더 중요한 것으로 보인다. 큰 모델이 자기 판단으로 후보 밖의 답을 내놓거나 형식을 벗어나면 코드의 재시도 로직에 걸린다.
셋째, 유지보수 모듈의 효과는 블록 크기에 비례한다. 작은 블록에서는 차이가 없고, 큰 블록에서만 조금씩 벌어진다. 21일보다 훨씬 긴 스트림을 운영한다면 이 모듈의 비중이 커질 것이다.
8.3 진화 — 한쪽만 잘하면 실패다
진화(SEE) 평가는 두 지표를 쓴다. Cv는 한 사건의 키워드들이 서로 얼마나 잘 어울리는지(일관성), TD는 서로 다른 사건의 키워드가 얼마나 안 겹치는지(다양성)를 잰다.
이 둘은 서로 잡아당긴다. 모든 사건에 같은 키워드를 주면 Cv는 높고 TD는 0이다. 사건마다 완전히 다른 키워드를 억지로 주면 TD는 1이고 Cv는 바닥이다. 산점도에서 이것이 그대로 보인다.
CFDTM — Event2012에서 Cv .65로 높지만 TD가 .14다. 사건들의 키워드가 거의 같다는 뜻, 즉 사실상 전부 한 사건으로 봤다는 뜻이다.
TSCTM — TD가 .93으로 최고지만 Cv가 .44다. 키워드 공유에 과도한 벌점을 줘서, 사건을 설명하지 못하는 키워드들이 나온다.
RagSEDE — .49 / .88, 평균 .69. 동적 방법 중 평균 1위다.
그런데 표에서 눈에 띄는 것은 자기 자신의 절제판이다. 상속을 뺀 RagSEDE가 평균 .72로 본판(.69)보다 높다. 논문은 이 사실을 표에 정직하게 싣고, 그 판이 '동적 아님(×)'이라고 표시한다. 무슨 뜻인가.
상속을 빼면 날마다 사건이 독립적으로 만들어지므로, 전날과 키워드를 맞출 이유가 없어져 다양성 점수가 잘 나온다. 하지만 그 결과는 사건의 진화가 아니다. 21일치 독립된 스냅숏일 뿐이다. 즉 Cv와 TD로는 "시간을 잇는 일을 얼마나 잘했는가"를 잴 수 없다. 두 지표는 원래 정적 토픽 모델을 평가하려고 만든 것이기 때문이다.
논문이 "SEE에는 확립된 기준선이 없어 토픽 모델링 방법과 비교했다"고 밝힌 것과 같은 한계다. 진화 추적의 품질을 재는 지표 자체가 아직 없다. 이 분야의 다음 과제 중 하나다.
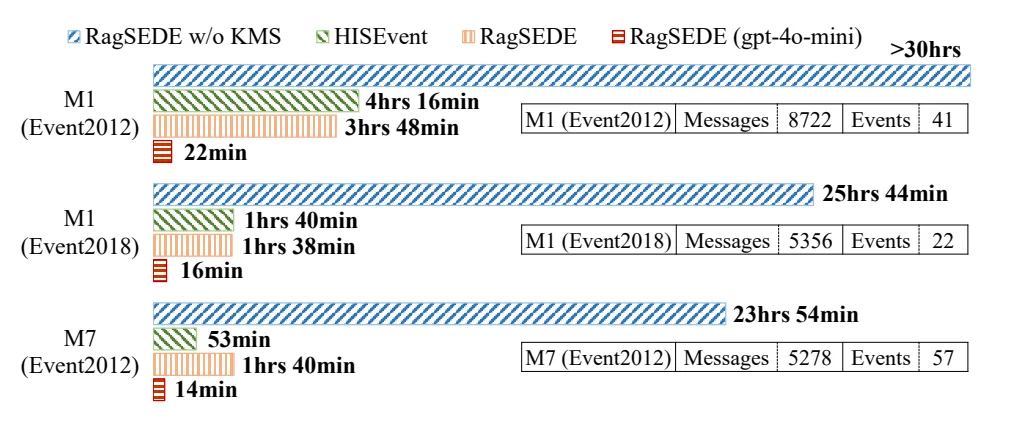
▲ 같은 논문 Figure 5. 가장 큰 세 블록의 실행 시간. 빗금 막대가 샘플링 없는 RagSEDE, 초록이 HISEvent, 주황이 RagSEDE(deepseek-r1:32b), 빨강이 RagSEDE(gpt-4o-mini). (CC BY 4.0)
블록
샘플링 없음
HISEvent
RagSEDE (32b)
RagSEDE (4o-mini)
M1 (2012) · 8,722건 · 41사건
> 30시간
4시간 16분
3시간 48분
22분
M1 (2018) · 5,356건 · 22사건
25시간 44분
1시간 40분
1시간 38분
16분
M7 (2012) · 5,278건 · 57사건
23시간 54분
53분
1시간 40분
14분
샘플링의 효과는 분명하다. 25시간 44분 → 1시간 38분, 약 15.8배. 이것이 논문이 말하는 "최대 15배"다.
HISEvent와의 비교는 조건부다. 논문은 "대규모 블록에서 HISEvent보다 우수한 효율"이라고 쓰는데, 세 블록 중 두 곳에서만, 그것도 근소하게 그렇다(3:48 vs 4:16, 1:38 vs 1:40). M7에서는 HISEvent가 두 배 가까이 빠르다(53분 vs 1시간 40분). M7은 사건이 57개로 가장 많은 블록 — 지식베이스 항목이 많아 RAG 검색과 LLM 호출이 늘어나는 조건이다. 사건 다양성이 높을수록 RagSEDE가 불리해진다는 신호로 읽힌다.
gpt-4o-mini로 바꾸면 이야기가 끝난다. 14~22분으로, 어느 블록에서도 압도적이다. 로컬 32B GPU 추론의 느림이 병목이었지 설계의 문제가 아니었다는 뜻이다. 논문은 이것을 "지역 계산 자원의 제약"이라고 담담히 적었다. 실전에서 API 모델을 쓴다면 이 파이프라인은 하루치를 20분 안에 처리한다.
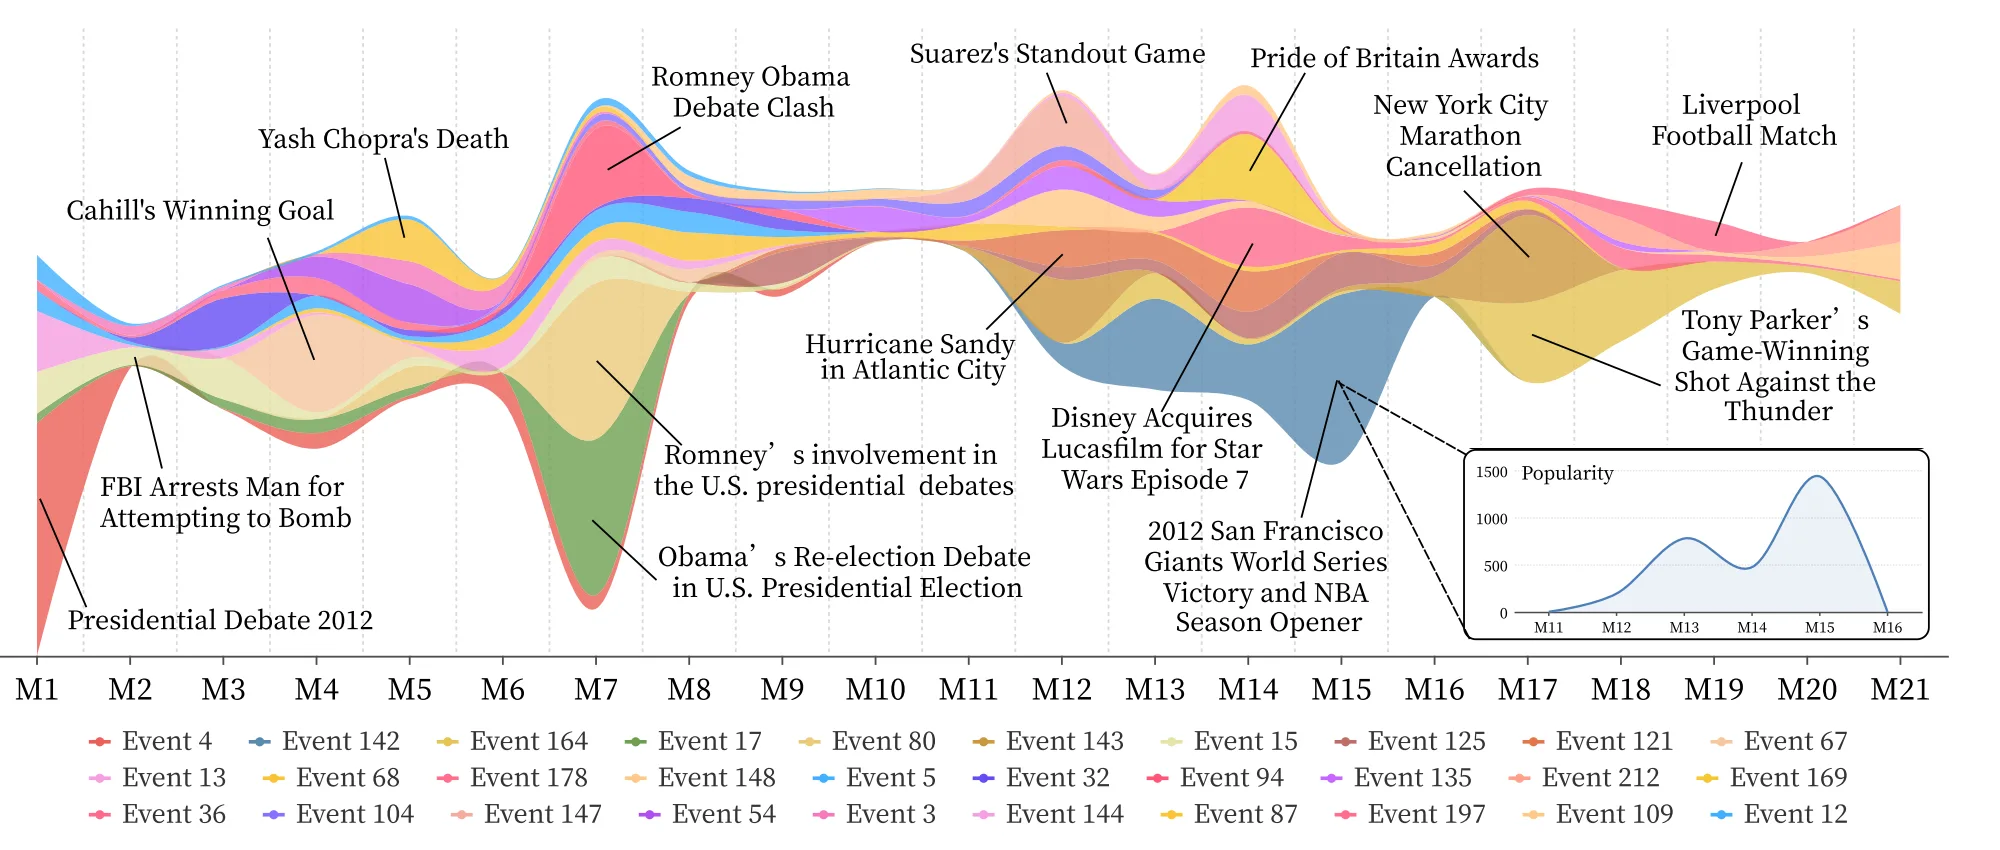
▲ 같은 논문 Figure 6. Event2012에서 RagSEDE가 탐지한 상위 30개 사건의 21일치 흐름. 색이 사건, 띠의 세로 두께가 논의 강도다. 2012년 미국 대선 토론, 허리케인 샌디, 디즈니의 루카스필름 인수, 뉴욕시 마라톤 취소, 야시 초프라의 죽음이 태어나고 부풀고 사그라드는 것이 보인다. 오른쪽 아래 작은 상자는 특정 사건(2012 샌프란시스코 자이언츠 월드시리즈 우승과 NBA 개막)의 M11~M16 논의량 곡선이다. (CC BY 4.0)
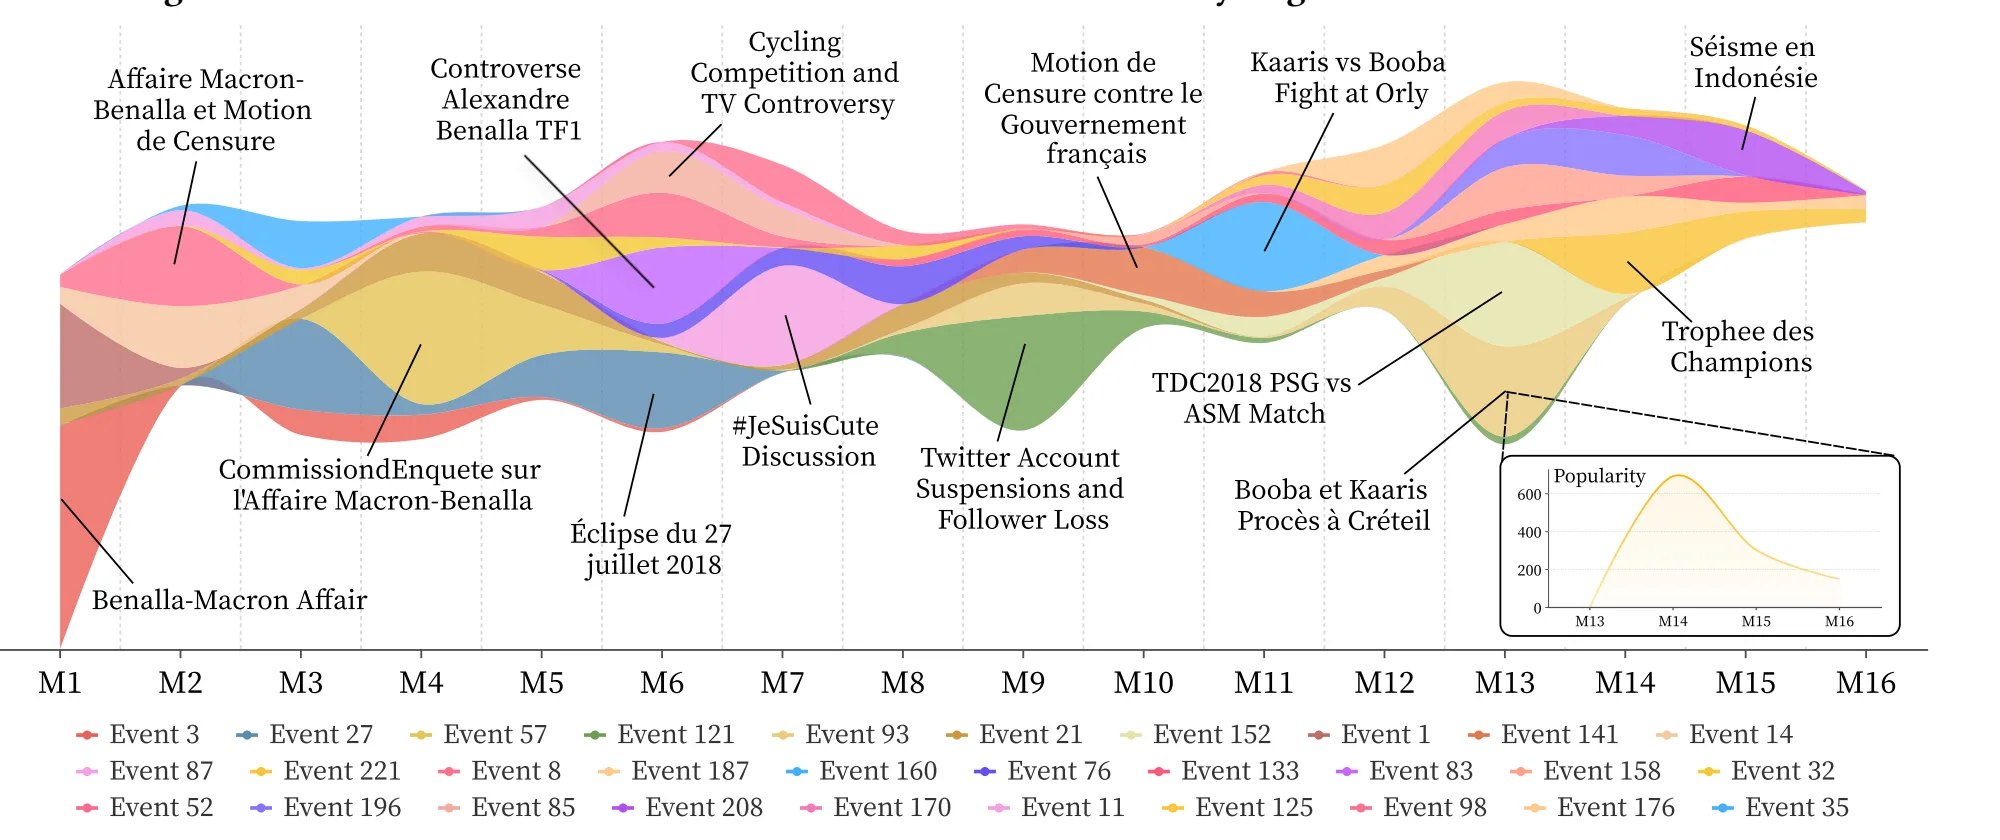
▲ 같은 논문 Figure 7. Event2018(프랑스어)의 16일치. 마크롱-베날라 사건(Affaire Macron-Benalla)이 조사위원회 구성과 정부 불신임안으로 이어지는 흐름, 2018년 7월 27일 월식, 부바와 카아리스의 오를리 공항 난투극과 크레테유 재판, 인도네시아 지진이 보인다. (CC BY 4.0)
이 두 장이 논문의 진짜 결과물이다. 기존 SED 방법이 내놓는 것은 "오늘의 군집 41개"인데, RagSEDE가 내놓는 것은 이것 — 이름이 붙은 사건들의 21일치 흐름이다. 사람이 그대로 읽을 수 있고, 어느 사건이 언제 시작해 언제 정점을 찍고 언제 끝났는지 손으로 짚을 수 있다.
마크롱-베날라 사건의 사슬을 보라. 사건 발발 → 조사위원회 → TF1 방송 인터뷰 논란 → 정부 불신임안. 프랑스 정치의 한 달이 한 줄의 띠로 남았다.
9. 코드를 열어 보다 — 논문에 없는 여섯 가지
논문과 공개 저장소를 나란히 놓고 읽으면 여섯 군데가 갈린다. 비난하려는 것이 아니라, 이 방법을 실제로 써 보려는 사람에게 필요한 정보다.
항목
논문
코드
다양성 점수의 부호
식 7: λ·Rep + (1−λ)·Div
λ*rep - (1-λ)*redundancy — 변수명도 redundancy(중복도)
앵커 묶는 규칙
식 4: 앵커 안 모든 쌍의 유사도 ≥ τ (완전 연결)
AgglomerativeClustering, linkage='average' — 평균 연결
앵커 최대 크기 K
값을 밝히지 않음
max_cluster_size=100 (함수 기본값은 5)
진화 그래프의 엣지 가중치
두 사건 임베딩의 코사인 유사도
np.corrcoef — 피어슨 상관계수, 양수만 사용
엔트로피 최소화 알고리즘
“Li & Pan(2016)의 알고리즘을 따랐다”
hier_2D_SE_mini(n=500) — HISEvent의 계층적 변형
LLM에 넣는 텍스트 길이
언급 없음
탐지는 앞 200자, 항목 생성은 뒤 400자만 사용
마지막 항목이 특히 중요하다. main.py를 보면 이렇다.
hljs language-python
for ans in session.ask('INPUT: ' + text[:200], stream=True):   # 탐지: 앞 200자
...
for ans in session.ask('COMMENTS: ' + text[-400:], stream=True):  # 항목 생성: 뒤 400자
앵커에서 뽑은 키 메시지 세 개를 이어 붙여 놓고, 실제로는 앞 200자만 탐지 LLM에게 보낸다. 트윗 세 개면 200자를 쉽게 넘긴다. 즉 세 번째 메시지는 탐지 단계에서 잘려 나가는 경우가 많다. 이 절단이 성능에 어떤 영향을 주는지는 논문에 없다. 다시 구현하는 사람은 여기를 먼저 확인해야 한다.
코드에서 눈에 띄는 것이 두 가지 더 있다.
하나. RAGFlow 데이터셋을 만들 때 임베딩 모델이 BAAI/bge-small-zh-v1.5로 고정돼 있다. 이름 끝의 zh는 중국어다. 영어(Event2012)와 프랑스어(Event2018) 데이터를 돌리면서 지식베이스 청크는 중국어 특화 모델로 인코딩하고 있는 셈이다. 다국어 성능이 아주 나쁘지는 않겠지만, 프랑스어에서의 열세에 이것이 얼마나 기여했는지는 따로 볼 만하다.
둘. 탐지 LLM이 열 번 재시도해도 유효한 JSON을 못 내놓으면, 코드는 그 메시지를 "Confusion"이라는 이름의 사건에 배정한다. 평가 지표상 이것은 하나의 군집으로 계산된다. 실전 시스템이라면 이 쓰레기통 군집을 따로 모니터링해야 한다.
또 하나. 코드는 blocks[1:]부터 돌린다. 즉 표의 M1은 데이터의 두 번째 블록이다. HISEvent의 관례를 따른 것으로, 첫 블록은 초기화용이다. 논문의 블록 통계표와 대조하면 일치한다.
2012년과 2018년 트위터 데이터로 평가한 논문이다. 그런데 2026년 현재 이 기술의 수요는 오히려 커졌다. 이유는 세 가지다.
10.1 정보 환경이 더 파편화됐다
2012년에는 트위터 하나를 보면 됐다. 지금은 X, 스레드, 블루스카이, 디스코드, 텔레그램, 레딧, 그리고 각국의 지역 플랫폼이 동시에 흐른다. 한 사건에 대한 이야기가 열 군데에 흩어진다. 사람이 읽고 통합하는 것은 불가능하다. 그리고 각 플랫폼의 메시지는 더 짧고 더 파편적이다 — 논문이 말하는 "파편화" 문제가 심해졌다.
10.2 LLM이 싸졌다
2024년까지 "모든 메시지를 LLM에게 물어본다"는 것은 비용상 농담이었다. 지금은 그렇지 않다. 논문의 실측에서 gpt-4o-mini는 하루치 8,722건을 22분에 처리했다. 여기에 키 메시지 샘플링으로 호출 수를 한 자릿수 퍼센트로 줄이면, 실시간 운영이 현실적인 가격대로 들어온다. 비싸서 못 하던 접근이 가능해진 순간에 나온 논문이다.
10.3 에이전트에게 '세계의 상태'가 필요해졌다
이게 가장 중요한 변화일 수 있다. 2026년의 AI 에이전트는 사용자 대화를 기억하는 것을 넘어 바깥세상이 지금 어떤 상태인지 알아야 한다. Zep의 시간 인식 지식 그래프나 에이전트 메모리가 "이 사용자와 무슨 이야기를 했는가"를 다룬다면, RagSEDE가 만드는 것은 "세상에 무슨 일이 벌어지고 있는가"의 구조화된 표현이다. 이름 붙은 사건, 키워드, 생몰 시점, 논의 강도 — 에이전트가 검색해 쓸 수 있는 형태다.
10.4 구체적인 쓰임새
분야
무엇이 필요한가
RagSEDE의 어느 부분이 답하는가
재난 대응
지금 어디서 무슨 일이 났는가, 피해 국면은 어디까지 왔는가
진화 키워드(접근→상륙→정전→사상자→복구)가 국면 자체를 알려 준다
브랜드·평판 모니터링
새 이슈가 터졌는가, 기존 이슈의 연장인가
“Others” 판정이 곧 새 이슈 경보. 지식베이스로 기존 이슈와 구분
금융·상품 시장
가격에 반영되기 전 신호
사건의 탄생 시점 기록. 키 메시지 샘플링으로 지연 최소화
공공 여론·정책
논의가 언제 시작돼 언제 식었는가
망각 메커니즘이 종료 시점을 명시적으로 남긴다
뉴스룸·팩트체크
이 주장이 어느 사건 맥락에서 나왔는가
사람이 읽을 수 있는 사건 이름과 키워드 카드
보건 감시
증상 언급의 비정상적 군집
라벨 없이, 사건 개수를 모르고 돌아간다는 점이 결정적
한국 맥락에서 생각해 보면 더 구체적이다. 재난문자 시스템은 기관이 인지한 사건만 알린다. 소셜 신호는 그보다 빠를 수 있다 — 2010년 일본의 사례가 정확히 그것이었다. 지자체의 민원·SNS 모니터링, 공공기관의 이슈 대응, 언론사의 실시간 이슈 추적 모두 같은 구조다. 다만 앞서 본 대로 백본 LLM의 한국어 능력이 성능을 좌우한다.KURE-v2 같은 한국어 검색 모델을 임베딩 단에 쓰고, 한국어를 잘하는 모델을 탐지 LLM으로 두는 조합이 출발점이 될 것이다.
11. 한계와 열린 질문
이 논문을 그대로 실전에 옮기려 할 때 부딪힐 것들을 정리한다.
📅
데이터가 오래됐다
2012년과 2018년 트위터다. 당시 트윗은 140자였고, 지금의 소셜 텍스트와는 길이·형식·이미지 비중이 모두 다르다. 논문 스스로 향후 과제로 멀티모달 확장을 꼽는다. 이 분야 전체가 같은 데이터셋을 10년 넘게 쓰고 있다는 것이 더 큰 문제다.
⏳
시간 단위가 하루로 고정돼 있다
지식베이스는 날마다 초기화되고 진화는 일 단위로 추적된다. 몇 분 안에 터지는 속보에는 너무 굵고, 몇 달 이어지는 사안에는 너무 잘다. 시간 창을 가변으로 만들면 상속·망각 규칙을 다시 설계해야 한다.
🔗
키워드 공유 엣지가 사슬을 잘못 잇는다
앞서 본 닐람 → 샌디 전이가 그 사례다. 어휘가 겹치는 동시대 사건에서 반복될 수 있다. 엣지 조건을 키워드 공유가 아니라 의미·시간·개체 일치의 복합 조건으로 바꾸는 것이 자연스러운 개선 방향이다.
📏
진화 품질을 재는 지표가 없다
Cv와 TD는 정적 토픽 모델용이다. 상속을 뺀 판이 본판보다 평균 점수가 높다는 사실이 이 지표들의 한계를 그대로 보여 준다. “사건을 언제 시작되고 끝난 것으로 봤는가”를 정답과 비교하는 지표가 필요하다.
🌏
언어 능력이 곧 시스템 성능이다
프랑스어에서의 열세, 그리고 모델을 바꿨을 때의 큰 개선폭이 이를 말한다. 저자원 언어에서는 이 접근 자체가 성립하지 않을 수 있다. 반대로 말하면 모델이 좋아지는 만큼 시스템도 공짜로 좋아진다.
🧾
LLM의 비결정성이 재현성을 흐린다
코드는 temperature를 0으로 두지만, 서비스형 모델은 완전한 결정성을 보장하지 않는다. 열 번 재시도 후 “Confusion” 군집으로 떨어지는 경로도 있다. 같은 데이터에 같은 설정으로 몇 번 돌렸을 때의 분산은 논문에 보고돼 있지 않다.
그리고 한 가지 더. 이 시스템은 감시 기술이기도 하다. 무엇이 사건으로 잡히고 무엇이 잡히지 않는가, 어떤 사건에 어떤 이름이 붙는가는 중립적인 판단이 아니다. 사건의 이름을 LLM이 짓는다는 것은 그 모델의 관점이 사건 정의에 들어간다는 뜻이다. 재난 대응에 쓰이는 것과 여론 감시에 쓰이는 것의 기술적 차이는 거의 없다. 논문은 이 문제를 다루지 않는다.
마치며 — RAG의 방향을 뒤집다
🔄
이 논문에서 가장 오래 남을 발상은 성능 수치가 아니라 RAG의 용법이다. 우리가 익숙한 RAG는 이미 있는 지식베이스에서 검색해 답을 만든다. RagSEDE의 RAG는 답을 만들면서 지식베이스를 짓는다. 검색과 생성이 서로를 먹여 살리는 순환이고, 지식베이스는 입력이 아니라 시스템의 출력이자 기억이다.
정리하면 이렇다.
구조. 소셜 스트림 → 앵커로 묶어 키 메시지만 뽑고 → RAG로 후보 사건을 검색해 LLM에게 묻고 → 새 사건이면 지식베이스에 항목을 추가하고 → 날마다의 지식베이스를 구조 엔트로피로 정렬한 뒤 상속 노드로 이어 붙인다.
성적. 영어 21개 블록에서 NMI·AMI 전승, 평균 .89(기존 최고 .82). 프랑스어에서는 HISEvent와 접전이며 평균으로는 근소하게 뒤진다. 샘플링이 처리 시간을 최대 15.8배 줄였고, API 모델을 쓰면 하루치를 14~22분에 끝낸다.
진짜 기여. 탐지가 아니라 진화다. 기존 방법 중 사건의 시작·변화·끝을 명시적으로 기록하는 것은 없었다. 망각 메커니즘이 "이 사건은 끝났다"고 말할 수 있게 만든 것은 작지만 새로운 일이다.
남은 일. 진화 품질을 재는 지표, 가변 시간 창, 키워드 공유보다 나은 엣지 조건, 멀티모달, 그리고 저자원 언어.
30년 전 DARPA가 뉴스 방송에서 "새 이야기의 첫 보도"를 찾으려 했을 때부터 문제는 같았다. 스트림에서 사건을 발견하고, 추적하고, 끝을 안다. 바뀐 것은 도구다. 규칙에서 통계로, 통계에서 그래프 신경망으로, 그리고 이제 사람이 읽을 수 있는 카드를 쓰는 언어 모델로. 8,722개의 트윗 속 41개의 사건을, 아무도 개수를 알려 주지 않은 채로.
📚
출처와 저작권. 이 글의 주 논문은 Qitong Liu, Hao Peng, Zuchen Li, Xihang Meng, Ziyu Yang, Jiting Li, Li Sun, Philip S. Yu, Effective and Unsupervised Social Event Detection and Evolution via RAG and Structural Entropy, The Web Conference (WWW) 2026, arXiv:2601.12035이며, CC BY 4.0으로 공개돼 있다. third-party- 접두사가 붙은 그림(Figure 2·4·5·6·7)은 이 논문의 것을 원형 그대로 인용했다. 코드 인용은 SELGroup/RagSEDE 저장소에서 가져왔다.
논문 본문의 인용은 한국어로 옮긴 것이며, 프롬프트 원문은 부록 A.1·A.2를 번역했다. 승패 집계(Event2018에서 NMI 6승 8패 2무 등)와 위젯에 실린 평균값은 논문 Table 1·2의 전체 수치를 코어닷투데이가 직접 계산한 것으로, 논문에 그 형태로 실려 있지는 않다. 구조 엔트로피 놀이터의 예시 그래프와 키 메시지 샘플링 실험실의 예시 메시지는 설명을 위해 만든 것이며 논문의 실제 데이터가 아니다. 논문 그림이 아닌 삽화는 코어닷투데이가 생성했다.