
TECH BLOG
기술 블로그
AI 기술 인사이트와 엔지니어링 경험을 공유합니다.
EDITOR'S PICK
에디터 추천
마트료시카 임베딩 — 벡터를 앞에서부터 잘라도 되는 이유와, 잘랐을 때 실제로 남는 것 (한국어 검색 스택 3편)
Qwen3-Embedding-8B의 벡터는 숫자 4,096개입니다. 5,000만 청크를 float32로 저장하면 벡터만 819GB입니다. 그런데 이 벡터의 앞 256개만 남기고 나머지를 버려도 검색 품질의 93%가 남는다면? 그것이 마트료시카 임베딩입니다. 2022년 논문 「Matryoshka Representation Learning」이 제안하고 OpenAI text-embedding-3, Nomic v2, Qwen3 Embedding이 채택한 이 기법은 '중요한 정보를 벡터의 앞쪽에 몰아넣도록' 학습해, 러시아 인형처럼 큰 벡터 안에 작은 벡터가 들어 있게 만듭니다. 이 글은 원리를 장난감 모형으로 손에 잡히게 설명하고, 같은 한국어 코퍼스로 Qwen3 4B·8B와 Nomic v2를 32차원까지 잘라 가며 잰 실측 곡선, 저장 비용 계산기, 그리고 '짧게 걸러서 길게 고르는' 두 단계 적응형 검색이 전체 차원의 품질을 얼마나 되찾는지를 보여 줍니다. 인터랙티브 4개와 삽화 7장.
RT-DETR 완전 이해: DETR가 YOLO를 이긴 날 — 실시간 트랜스포머 검출의 혁명
NMS 없이 실시간으로 — YOLO의 왕좌에 도전한 최초의 실시간 엔드투엔드 트랜스포머 검출기 RT-DETR가 어떻게 탄생했고, 왜 객체 검출의 패러다임을 바꾸고 있는지를 두 편의 논문과 함께 풀어본다.
BM25는 한국어를 어떻게 쪼개나 — 조사·복합명사·영한 혼용, 토크나이저가 검색을 결정한다 (한국어 검색 스택 5편)
2편에서 BM25는 '약한 고리'였습니다. 왜 약했을까요. 이 글은 그 질문을 파고듭니다. 같은 문서, 같은 질문, 같은 BM25 공식에 토크나이저만 여덟 가지로 바꿔 보니 nDCG@10이 0.42에서 0.62까지 벌어졌습니다. 띄어쓰기로 자르면 '청년취업을'과 '청년취업'이 다른 단어가 되고, 형태소 분석기로 조사를 떼면 같은 단어가 되며, 글자 2-gram을 겹쳐 색인하면 사전에 없는 말까지 받아 줍니다. 한국어에서 어휘 검색이 어려운 세 가지 이유(교착어의 조사와 어미, 복합명사, 영한 혼용)를 예시 문장의 실제 토큰으로 보여 주고, 엘라스틱서치 nori의 decompound 모드와 불용 품사 기본값, Kiwi의 사용자 사전, BM25의 k1·b 다이얼을 실측으로 짚습니다. 결론은 BM25 자체가 약한 것이 아니라 한국어를 잘못 쪼갠 BM25가 약하다는 것입니다. 인터랙티브 4개와 삽화 8장.
윈도우에서 Claude Code 제대로 쓰기 — 네이티브냐 WSL이냐부터 오류 해결까지
윈도우에서 Claude Code는 '설치 명령을 어느 셸에 붙여넣었는가'부터 꼬이기 시작합니다. PowerShell·CMD·Git Bash·WSL 네 갈래 길에서 무엇을 골라야 하는지 결정 기준을 먼저 세우고, 네이티브 설치와 WSL2 설치를 각각 처음부터 끝까지 따라갑니다. irm not recognized, 실행 정책 차단, PATH 미등록, WSL에서 node not found, 회사 프록시 TLS 오류까지 — 실제로 가장 많이 막히는 지점 12가지를 공식 문서 기준으로 정리했습니다.
ALL POSTS
모든 포스트
[특집] Claude 모양 과학 2부 — 숲 밖의 35편: 1,000자리 숫자로 푼 입자 적분, 경제학 논문 4,452편 검산, 6,072개 언어의 강세, 1939년 와트슨의 '마지막 문제'까지
하버드 물리학자 매튜 슈워츠가 Claude와 3개월 동안 쓴 원고 36편 중 숲을 뺀 나머지를 하나씩 연다. 1,000자리 숫자에서 정확한 공식을 되찾는 입자 적분, 반올림 오차에 갇혀 있던 희귀 돌연변이 공식과 57억 쌍의 유전자 전환, 경제학 논문 4,452편을 다시 돌린 'AI 데이터 편집자', 정확한 분수가 된 진화 나무, 6,072개 언어의 강세 카탈로그, 87년 만에 풀린 3차원 무작위 보행, 늙는 흑점과 늙지 않는 별점까지. 그리고 이 모든 것을 굴린 작업 규약과, 그 성과를 얼마나 믿어도 되는지를 함께 따진다.
[특집] 숲 방정식 — 하버드 물리학자와 Claude가 20년 묵은 생태학 공식을 끝까지 계산하자 벌어진 일: 'Claude 모양 과학' 해부
하버드 물리학자 매튜 슈워츠가 Claude와 함께 만든 도구 상자 BootLoops로 생태학의 중립 이론 공식(에티엔 2005)을 23만 그루 규모로 정확히 풀었다. 그러자 파나마 숲이 우연보다 4배 넘게 빨리 변한다는 숫자가 나왔다. 그러나 생태학자는 어깨를 으쓱했다. 허벨의 빈자리 추첨부터 스털링 수의 숫자 폭발, '중립을 빼고 나머지를 보라'는 전환, 미국 숲 지도, 36편의 원고와 실패 목록까지 'Claude 모양 과학'의 실체를 해부한다.
[특집] 카파시의 「수업을 잘 듣는 법」 — 15년 된 시험 공부 경험칙 23개를 100년 학습 과학으로 채점하고, AI 시대에 다시 읽다
2026년 10월 12일, 한 트윗이 오래된 웹페이지 하나를 다시 끌어올렸다. 안드레이 카파시가 대학원생 시절 써 둔 「수업을 잘 듣는 법(Doing well in your courses)」이다. 밤샘은 하지 마라, 읽고 이해한 것과 덮고 다시 쓸 수 있는 것은 다르다, 시험장에서 절대 일찍 나가지 마라, 그리고 가장 똑똑한 학생은 모든 과목에서 85%를 받는다. 이 글은 그 23개의 경험칙을 하나씩 꺼내 에빙하우스(1885)부터 로디거·카피키(2006), MIT 핏빗 수면 연구, 7천만 건의 채점 기록까지 지난 100년의 학습 과학과 맞대어 채점한다. 대부분은 놀랍게 맞았고, 두 개는 틀렸다. 페이지가 실제로 쓰인 시기(2009~2011)와 사람들이 지금 읽는 2016년 개정판의 차이, 토론토 대학의 '85점 = A = 4.0' 환산표, 그리고 AI가 숙제를 대신 풀어 주는 2026년에 이 조언이 왜 오히려 더 중요해졌는지 — 튀르키예 고등학생 1천 명 실험의 '연습 +48%, 시험 −17%', 연세대 집단 부정행위, 하버드의 A학점 상한 표결, 한국 고교생 주중 수면 5.6시간까지 — 여섯 개의 인터랙티브 도구와 함께 풀었다.
4B를 Flash로 가르치기 — 육하원칙 추출, 선생님 답 1,623개로 로컬 모델을 키우다
이 시리즈의 첫 글에서 클라우드 Gemini 3.8 Flash는 육하원칙 추출 0.86, 로컬 9B는 0.69였습니다. 그 0.16을 지식 증류로 좁혀 보려고 Flash에게 기사 1,709건의 답을 쓰게 하고(5.6달러), 그 답으로 Qwen3 4B를 맥 한 대에서 LoRA로 가르쳤습니다. 결과는 실패였습니다. 아무것도 가르치지 않은 Qwen3 4B 2507이 이미 9B와 같은 0.686이었고, 1,623개를 다 본 학생은 0.656으로 오히려 내려갔습니다. 학생은 선생님의 판단보다 버릇을 먼저 배웠습니다. 예제 200개 지점에서는 이유가 없는 기사 44건 중 42건에 이유를 지어냈고, 끝까지 배운 뒤에도 학습 전(0건)보다 많은 12건을 지어냈습니다. Flash와 Flash-Lite가 함께 채운 이유만 남긴 '보수적 교재'는 버릇을 고치고 같은 예제 수에서 점수를 0.04 올렸지만, 학습 전 모델은 넘지 못했습니다. 교훈은 하나입니다. 증류보다 먼저, 같은 크기의 최신 모델을 정의서만으로 재 보세요. 학습 곡선·칸별 비교·버릇 상속·전후 비교·손익분기 위젯 5개.
[특집] 직원은 왜 AI 앞에서 멈칫하는가 — 정체성·감시·불확실성·변화 속도, 네 가지 위협으로 읽는 2026년 AI 도입의 심리학
2026년 10월 가트너는 AI 사용을 기대받는 직원의 47%가 도입에 저항한다고 밝혔습니다. 그런데 같은 해 일선 직원의 AI 정기 사용률은 74%까지 올랐습니다. 저항과 사용은 반대말이 아니라 한 사람 안에 함께 있습니다. 이 글은 직원이 AI 앞에서 멈칫하는 이유를 정체성·감시·불확실성·변화 속도라는 네 가지 위협으로 나눠 읽습니다. 1811년 러다이트와 1948년 하우드 공장 실험에서 '저항'이라는 말의 기원을 짚고, 국내 IT 기업 직원 397명이 AI 도입을 정체성 위협으로 느낄수록 노하우를 숨겼다는 2026년 연구, 메타·아마존의 토큰 순위표가 '쓰는 척'만 낳고 닫힌 사건, 사용 의무화를 1년 만에 되돌린 듀오링고, 감시가 성과를 올리지 못한다는 메타분석을 차례로 봅니다. 그리고 저항이 언제 정당한 신호인지, 회사가 4주 동안 무엇을 해 볼 수 있는지 위젯 여섯 개와 함께 정리합니다.
[특집] Gemini 4 Argon 모델 카드 정독 — 19개 시험의 속사정과 구글이 '배제할 수 없다'고 적은 세 줄
구글이 9월 30일 '신뢰할 수 있는 사이버 방어자'에게만 먼저 풀었던 Gemini 4 Argon이 10월 13일 전 세계에 공개됐습니다. 모델 카드, 5쪽짜리 평가 방법 문서, 217쪽짜리 안전·보안 보고서가 함께 나왔습니다. 이 글은 셋을 처음부터 끝까지 읽고 정리한 특집입니다. 카드가 한 줄로 넘긴 '대규모 희소 Mixture-of-Experts'를 1991년 논문부터 거슬러 올라가 풀고, 입출력 합계 100만 토큰과 GraphWalks 시험이 무엇을 재는지 직접 풀어 보게 했습니다. 19줄 성적표는 줄마다 공개 리더보드와 맞춰 봤습니다. 하비 법률 시험 19.6%는 경쟁 세 모델보다 세 배 높지만 전체 79개 모델 중에서는 6위입니다. 과학 터미널 시험의 57.6%는 독립 측정에서 44.3%로 나왔습니다. 그리고 구글이 스스로 '배제할 수 없다'고 적은 세 가지(생물 무기 CCL, 사이버 CCL, 은밀성·상황 인식 TCL)를 프런티어 안전 프레임워크의 언어로 풀었습니다. 15개 과제 중 14개 통과, 평가를 알아챈 비율 0%→37.8%, 생각 없이 차 끓이는 이야기만 적고도 정답을 맞힌 장면까지 담았습니다. 인터랙티브 6개, 일러스트 10장, 논문·보고서 그림 10장.
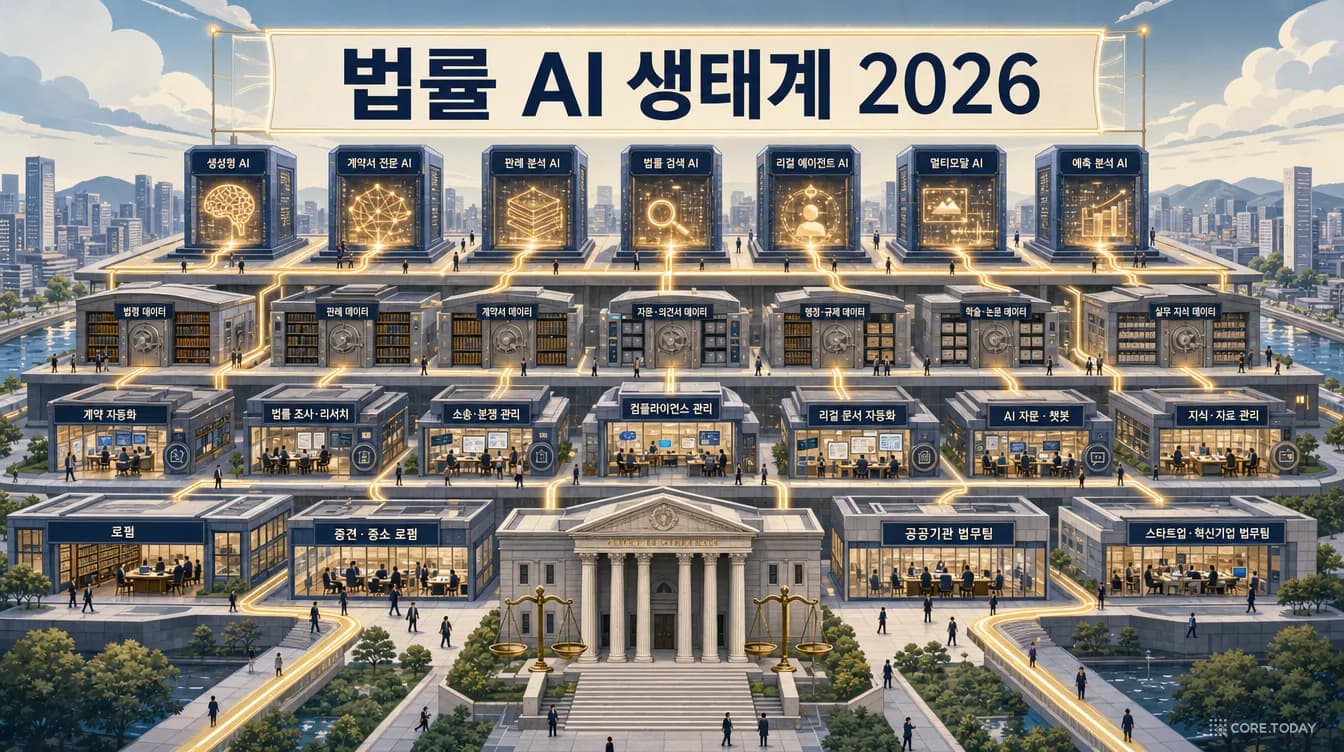
법률 AI 생태계 지도 2026 — 모델 회사는 법률로 내려오고, 법원은 검증을 요구하고, 돈은 '책임질 수 있는 결과물'로 모인다
2026년 2월 3일, Anthropic이 법률 업무 플러그인 하나를 내놓자 Thomson Reuters 주가가 하루에 16% 빠졌습니다. 그런데 반년 뒤 그 회사의 법률 매출은 10% 늘었고, 같은 해 법률 AI 스타트업 Harvey의 몸값은 80억 달러에서 155억 달러로 뛰었습니다. 한쪽에선 전 세계 법원이 AI가 지어낸 판례를 지적한 결정이 2,184건까지 쌓였고, 한국 법원 판결문에는 'AI Hallucination'이라는 영어가 그대로 적혔습니다. 모순처럼 보이는 이 장면들은 하나의 지도 위에 놓으면 이해됩니다. 모델·데이터·업무 도구·로펌·법원의 다섯 층이 2024년에서 2026년 사이 각각 어떻게 움직였는지, 법률 AI 시험지가 '변호사시험'에서 '실무 과제 전 항목 통과'로 바뀐 이유, 시간당 청구가 흔들리는 경제학, 신입 변호사의 사다리, 나홀로 소송의 역설, 그리고 한국 법원·로펌·리걸테크의 2026년까지. 논문과 판결과 실적 발표를 근거로 일곱 가지 인사이트를 뽑았습니다. 인터랙티브 6개, 논문·보고서 그림 8장, 삽화 9장.
같은 사건 묶기 — 하루치 기사 603건에서 '같은 일'을 찾는 법
2026년 10월 13일 하루 연합뉴스 기사 603건 중 같은 사건을 다룬 기사끼리 묶으면 몇 묶음이 나올까요. 인천 흉기난동 하나에만 기사 아홉 건이 달렸습니다. 이 글은 후보 쌍 5,379개를 Claude·GPT로 '같은 사건 / 같은 이야기의 다른 사건 / 다른 사건'으로 판정하고, 둘이 갈린 73쌍을 직접 검수해 정답을 만든 뒤 임베딩 다섯 가지, 문자열 규칙 두 가지, 판정 모델, LLM을 비교했습니다. 육하원칙으로 묶으면 될 것 같지만 그렇지 않았습니다. 같은 사건을 다룬 기사도 같은 사람을 다른 이름으로 부르거나 주인공이 달라서, 육하원칙 칸 일치 규칙은 같은 사건 쌍의 3분의 1도 찾지 못했습니다. 임베딩은 같은 이야기의 다른 사건(유사도 0.86)과 다른 각도의 같은 사건(0.50)을 가르지 못했습니다. 이 둘을 가장 잘 가른 것은 판정 모델 Jev였고(AUROC 0.998), 다만 0.5가 아니라 0.9를 문턱값으로 써야 했습니다. 로컬 판정 모델(Nimble·Clef-Flash·tev1)은 확률이 과감해 오히려 묶음을 망쳤고, 로컬만 쓸 수 있다면 EmbeddingGemma 하나가 가장 나았습니다. 문턱값 탐색기·사건 각도 표·방법 비교표·함정 목록·묶음 게시판 위젯 5개.
채점이 순위를 바꾸는가 — 육하원칙 답 2,371개를 판사 여섯에게 다시 채점시키다
지난 글은 뉴스 72건에서 육하원칙을 꺼내는 24가지 방법을 글자 F1로 줄 세웠습니다. 그런데 그 자는 '50대 남성'과 'A(59)씨'를, '이날'과 '13일'을 다른 답으로 셉니다. 이번에는 같은 답 2,371개를 자 세 개(글자 F1·포함 일치·날짜 정규화)와 판사 여섯(Gemini 3.8 Flash·Claude Sonnet 5.5·GPT-5.4 mini·로컬 Qwen3.5 9B·Jev·로컬 Clef-Flash)에게 다시 채점시키고, 층화 표본 234개를 원문과 대조해 검수했습니다. 결과는 세 줄입니다. 강한 판사들로 바꿔도 방법의 순위는 거의 그대로였습니다(켄달 순위 상관 0.96~0.99). 대신 점수의 크기가 바뀌었고, 특히 '무엇을'에서 작은 모델이 0.15를 되찾았습니다. 그리고 판사에게는 버릇이 있었습니다. 같은 가족의 답을 후하게 주고, 검수자보다 엄격하며, 로컬 판사는 순위를 흔들었습니다. 판사 둘 이상이 정답을 의심한 칸은 다시 보니 모두 정답 쪽이 지나치게 엄격했습니다. 순위 기울기·검수 일치도·칸별 법정·자기 선호·칸별 회복 위젯 5개와 삽화 5장.