[특집] Claude 모양 과학 2부 — 숲 밖의 35편: 1,000자리 숫자로 푼 입자 적분, 경제학 논문 4,452편 검산, 6,072개 언어의 강세, 1939년 와트슨의 '마지막 문제'까지
하버드 물리학자 매튜 슈워츠가 Claude와 3개월 동안 쓴 원고 36편 중 숲을 뺀 나머지를 하나씩 연다. 1,000자리 숫자에서 정확한 공식을 되찾는 입자 적분, 반올림 오차에 갇혀 있던 희귀 돌연변이 공식과 57억 쌍의 유전자 전환, 경제학 논문 4,452편을 다시 돌린 'AI 데이터 편집자', 정확한 분수가 된 진화 나무, 6,072개 언어의 강세 카탈로그, 87년 만에 풀린 3차원 무작위 보행, 늙는 흑점과 늙지 않는 별점까지. 그리고 이 모든 것을 굴린 작업 규약과, 그 성과를 얼마나 믿어도 되는지를 함께 따진다.
코어닷투데이는 1부 「숲 방정식」에서 하버드 물리학과 매튜 슈워츠(Matthew D. Schwartz) 교수가 Anthropic 블로그에 쓴 「Claude-shaped science」(2026-10-01)의 생태학 이야기를 해부했습니다. 파나마 바로콜로라도섬의 나무 23만 그루, 에티엔의 중립 표집 공식, 그리고 생태학자 제임스 오드와이어의 "많은 생태학자는 어깨만 으쓱할 겁니다"라는 반응까지였습니다.
그런데 그 숲은 원고 36편 중 한 편이었습니다. 슈워츠는 2026년 7월부터 9월까지 석 달 동안 약 400개의 후보 문제를 훑었고, 18개 분야(BootLoops 사이트와 『사이언스』 기사는 22개 분야라고 씁니다)에서 공저자 19명과 원고 36편을 냈습니다. 입자물리의 파인만 적분에서 시작해 인간 유전체, 경제학 학술지, 세계 언어의 강세, 태양 흑점, 24억 년 전 지구의 대기까지 이어집니다. 이번 2부는 숲을 뺀 그 나머지를 다룹니다.
이 글은 원문의 짧은 목록을 BootLoops 사이트(bootloops.ai)의 프로젝트별 요약, 공개 원고, NBER 워킹페이퍼, GitHub의 규약 문서와 대조해 풀었습니다. 프로젝트마다 다섯 가지를 묻습니다.
문제그 분야는 무엇을 알고 싶었나
막힌 이유왜 지금까지 정확히 풀지 못했나 (대개 계산의 규모나 정밀도)
빌려 온 도구어느 먼 분야의 어떤 기법이 그 벽을 넘게 했나
결과숫자로 무엇이 나왔나
주의무엇이 아직 검증되지 않았고, 무엇을 믿으면 안 되나
세 줄 요약
36편을 하나로 묶는 것은 '정확함'이다. 다른 분야가 몬테카를로 어림, 휴리스틱 탐색, 16자리 부동소수점 계산으로 버티던 문제를 입자물리·실험수학·컴퓨터 대수의 정확 계산 도구로 다시 풀었습니다. 그러자 동점이 증명되고, 반올림에 묻혀 있던 차이가 드러나고, 존재하지 않는 공식이 '없다'고 증명되었습니다.
결과의 결은 고르지 않다. 87년 묵은 와트슨 적분, 57억 쌍으로 찾은 유전자 전환, 경제학 논문 4,452편 검산처럼 분야 사람들이 반길 결과가 있습니다. 반면 보이니치 필사본이나 저자 판별처럼 슈워츠 혼자 쓰고 아직 '예비' 딱지가 붙은 원고도 많습니다.
진짜 발명품은 작업 방식일 수 있다. 세션 수십 개를 조율하는 마스터 세션, '완료'의 기준을 밖에서 정하는 규약 12개, 30자리 일치를 요구하는 검증 기준이 그것입니다. AI 에이전트로 일하는 모든 조직이 가져다 쓸 수 있는 부분입니다.
1장. 공통 문법: 'Claude 모양' 문제는 어떻게 생겼나
임피던스 불일치, 그리고 다섯 가지 동사
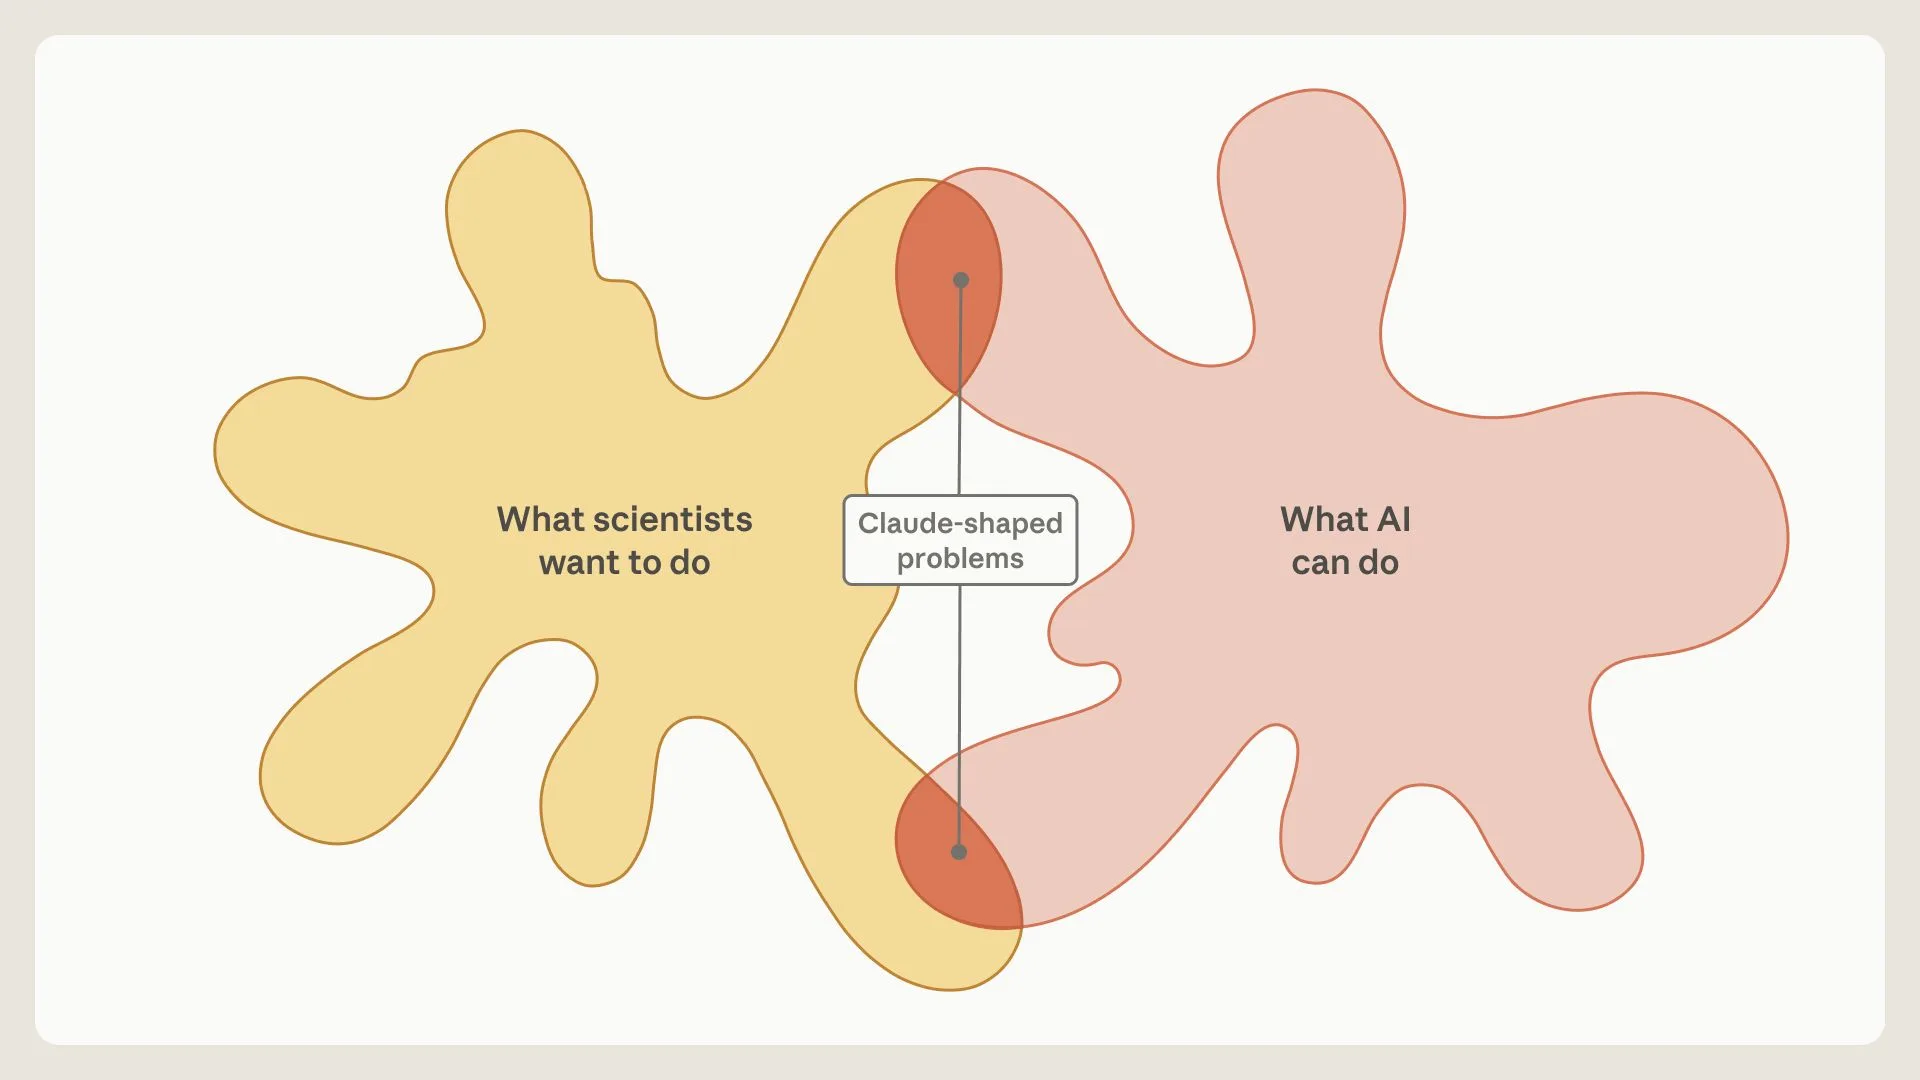
1부에서 설명했듯 슈워츠의 출발점은 임피던스 불일치였습니다. Claude는 똑똑하지만 '과학자처럼' 일하는 데는 서툽니다. 깊은 개념적 질문에서는 손을 많이 잡아 줘야 합니다. 대신 모든 분야에 걸친 지식, 뛰어난 코딩, 최신 수학·통계 지식, 논문과 데이터를 기계 속도로 읽는 능력이 있습니다. 그렇다면 그 강점에 정확히 맞는 문제를 찾자는 것이 'Claude 모양 과학'입니다.
크게 보기출처: Anthropic, "Claude-shaped science" (2026-10-01), 그림 1.
36편을 다 읽고 나면 'Claude 모양'이라는 말이 꽤 구체적인 뜻을 갖습니다. 슈워츠가 10월에 arXiv에 올린 개요 논문(arXiv:2610.02286, 「BootLoops: an LLM-driven toolkit for exact quantitative science」)은 이 도구 상자가 하는 일을 다섯 개의 동사로 요약합니다.
① 닫힌 형태로 계산한다부트스트랩으로 다중 루프 파인만 적분입자 적분 30개, 에너지 상관자
② 정확한 유리수로 평가한다베이즈 증거 적분을 분수 그대로계통수, 혼합 모형, 저자 판별
③ 빠짐없이 열거한다유한한 경우를 완전성 증명과 함께메디케어 별점, 끈 이론 진공
④ 없다는 것을 증명한다찾던 닫힌 형태가 존재할 수 없음을와트슨 적분, 교차 빛-빛 산란
⑤ 보장된 자릿수로 다시 계산한다부동소수점 계산을 오차 한계와 함께희귀 돌연변이 공식, 오존 기준, 임상시험 설계
개요 논문의 첫 문장이 이 기획의 문제의식을 정확히 요약합니다. "정량 과학의 상당 부분은 어려운 계산(파인만 적분, 진화 나무의 증거, 규제 통계)에 기대고 있고, 그것들은 흔히 몬테카를로나 휴리스틱 탐색으로 어림되거나, 반올림 오차를 추적하지 않는 부동소수점으로 계산된다. 정확한 방법은 흔히 먼 분야에 이미 있다."
16자리의 벽: 왜 '정확함'이 새삼스러운가
컴퓨터가 보통 쓰는 실수 계산은 64비트 부동소수점입니다. 숫자 하나를 유효숫자 약 16자리로 저장하고 나머지는 반올림합니다. 대부분의 계산에는 충분합니다. 하지만 세 가지 상황에서 이 16자리가 벽이 됩니다.
아주 큰 수와 아주 작은 수가 섞일 때. 1부의 에티엔 공식은 항들이 15,000자릿수 범위에 걸쳐 있어서 보통 계산은 넘치거나(overflow) 0이 되어 버렸습니다.
오차가 증폭될 때. 4장에서 볼 희귀 돌연변이 공식은 점화식을 한 단계 돌릴 때마다 반올림 오차가 천문학적으로 불어나, 염색체 100개 표본에서 이미 필요한 자릿수가 16을 넘습니다.
두 값이 거의 같을 때. 두 진화 나무의 증거가 0.001만큼 다른지, 정확히 같은지는 어림 계산으로는 영원히 판정할 수 없습니다. 오존 농도가 기준치 70ppb를 넘는지도 마지막 자리 처리 방식에 따라 갈립니다.
물리학자, 특히 파인만 적분을 다루는 사람들은 이 벽을 넘는 도구를 수십 년 동안 다듬어 왔습니다. 정수 관계 찾기(PSLQ), 유한체 위에서 계산하고 나중에 복원하기, 모든 수에 엄밀한 오차 반경을 붙이는 공 산술(ball arithmetic), 구간 뉴턴법 같은 것들입니다. BootLoops의 핵심 통찰은 이 도구들이 물리학 밖에서도 거의 그대로 먹힌다는 것, 그리고 그 연결을 찾고 옮겨 심는 일이 지금의 AI에 딱 맞는다는 것입니다.
빌려 온 도구
원래 쓰이던 곳
BootLoops가 옮겨 심은 곳
무엇을 가능하게 했나
정수 관계 찾기 (PSLQ·격자 축소)
실험수학, 파인만 적분의 계수 복원
입자 적분 30개, 경계 상수 판별
수백 자리 숫자에서 정확한 공식 복원
모듈러 산술 + 중국인의 나머지 정리
파인만 적분의 대수 축약 (폰 만토이펠·샤빙거 2015)
계통수 증거
200~300자리 정수로 된 정확한 분수
공 산술 (arb, FLINT)
컴퓨터 보조 증명
희귀 돌연변이 공식, 단일세포 RNA, 숲 공식
계산마다 보장된 오차 막대
구간 뉴턴법·부등식 인증서
컴퓨터 보조 증명
경제학 보정값, 끈 이론 진공, 유전자 쌍 분석
"여기 해가 있고 이것뿐"이라는 증명
1차원 정확 최적화 (동적 계획법)
컴퓨터과학의 교과서 알고리즘
메디케어 별점
근사 군집화가 놓친 최적 컷
생존 분석·허약성 모형
의학·인구학
태양 흑점, 다른 별의 별점
중간에 끊긴 기록에서 '늙음'을 측정
마지막 줄은 방향이 반대라는 점에서 흥미롭습니다. 물리학의 도구를 다른 분야로 가져간 것이 아니라, 인구학의 도구를 천체물리로 가져갔습니다. '같은 방정식이 여러 곳에 나타난다'는 슈워츠의 말은 일방통행이 아닙니다.
2장. 출발점: 1,000자리 숫자로 푸는 입자 충돌의 적분
파인만 적분은 왜 그렇게 어려운가
대형강입자충돌기(LHC)에서 새로운 물리는 '정밀한 측정과 똑같이 정밀한 예측 사이의 차이'로 찾습니다. 예측 쪽의 병목이 루프 적분입니다. 파인만 다이어그램은 입자 충돌을 계산하는 선 그림이고, 그림마다 안쪽을 도는 입자의 운동량에 대한 적분이 하나씩 붙습니다. 고리(루프)가 하나 늘 때마다 예측은 더 정밀해지고 적분은 훨씬 어려워집니다.
BootLoops 사이트가 정리한 역사를 따라가면 이 분야가 얼마나 느리게 전진했는지 보입니다.
1947·1957전자의 이상 자기 모멘트를 설명하는 1루프 꼭짓점과 그 2루프 후속. 양자전기역학 정밀 예측의 시작
1962사브리(Sabry)가 2루프 '선라이즈' 적분을 적어 둠. 해석적으로 푸는 데 43년이 걸린다
1979파사리노·벨트만: 모든 1루프 진폭을 몇 개의 표준 적분(로그·이중로그)으로 환원. 1루프는 '부류 전체'가 풀렸다
1981·2000체트이르킨·트카초프의 부분적분 항등식, 라포르타 알고리즘: 적분 가족을 소수의 '마스터 적분'으로 축약
2005라포르타·레미디가 같은 질량 선라이즈를 타원 곡선 위에서 해석적으로 계산
2010·2013곤차로프 등의 '심벌', 헨의 정준형(canonical form) 미분방정식. 다중로그 적분이 선형대수 문제가 됨
2022~2023리우·마의 보조 질량 흐름(AMFlow): 어떤 마스터 적분이든 수백 자리 수치. 4루프 바나나(칼라비-야우) 적분의 미분방정식 정리
2026BootLoops: 30개 적분을 부트스트랩으로 처음부터 끝까지. 15개는 재현, 15개는 처음 계산
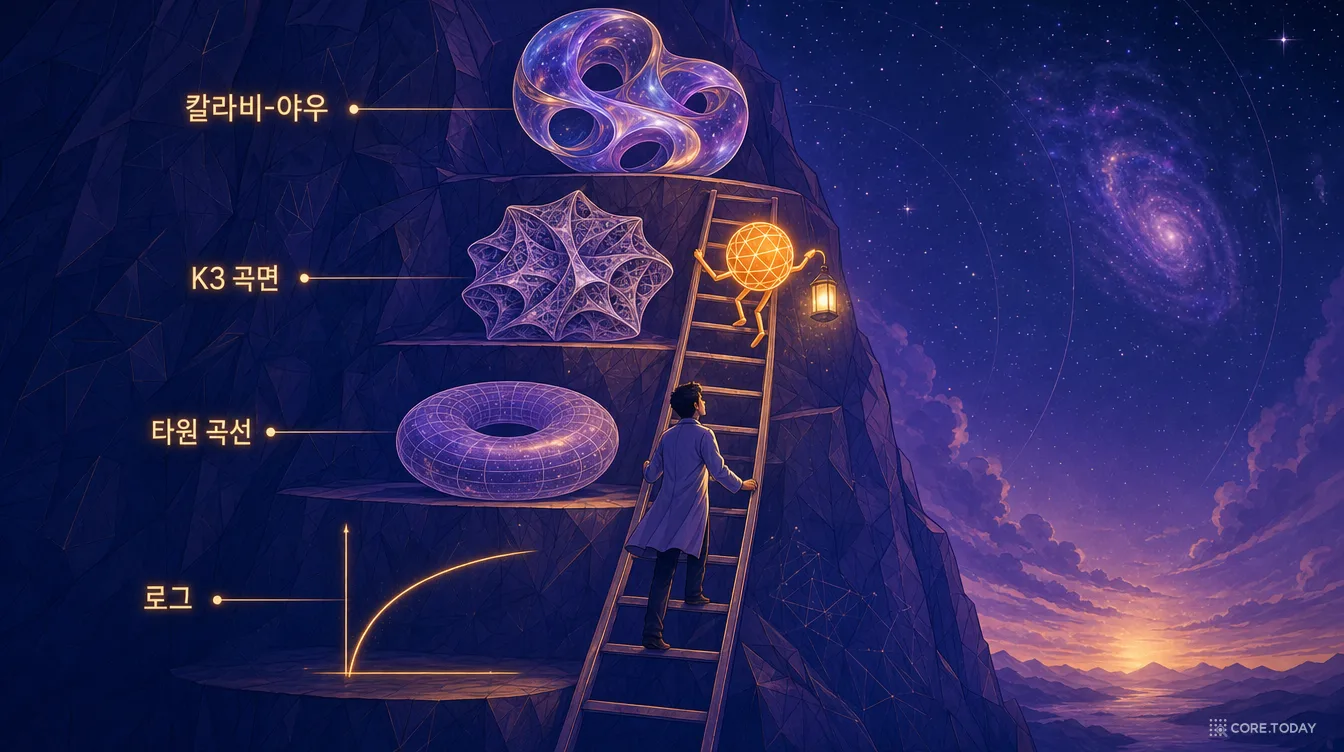
어려움의 핵심은 답이 어떤 종류의 함수로 쓰이는가입니다. 놀랍게도 이것은 계산하기 전에 그림만 보고 알 수 있습니다. 안쪽의 모든 선을 실제 입자 조건(질량껍질)에 올려놓으면, 남은 자유도가 어떤 기하학적 도형을 그립니다. 그 도형이 구면이면 답은 로그를 반복 적분해 만든 다중로그 함수입니다. 질량을 가진 선이 충분히 많아지면 구면이 도넛, 즉 타원 곡선이 되고, 답은 타원 함수와 모듈러 형식으로 쓰입니다. 루프가 더 늘면 K3 곡면, 칼라비-야우 다양체로 기하학의 사다리를 올라갑니다.
다중로그 단계에는 일반적인 알고리즘이 있습니다. 그 위로는 없습니다. BootLoops 사이트의 표현으로는 "다중로그를 넘어서면 미분방정식을 정준형으로 가져가는 일반 알고리즘이 없고, 가족마다 하나씩 찾아낸 구성만 있을 뿐"입니다. 슈워츠가 원문에서 "지금까지 계산된 타원 파인만 적분은 손에 꼽을 정도"라고 쓴 이유입니다.
부트스트랩: 적분하지 않고 답을 좁히기
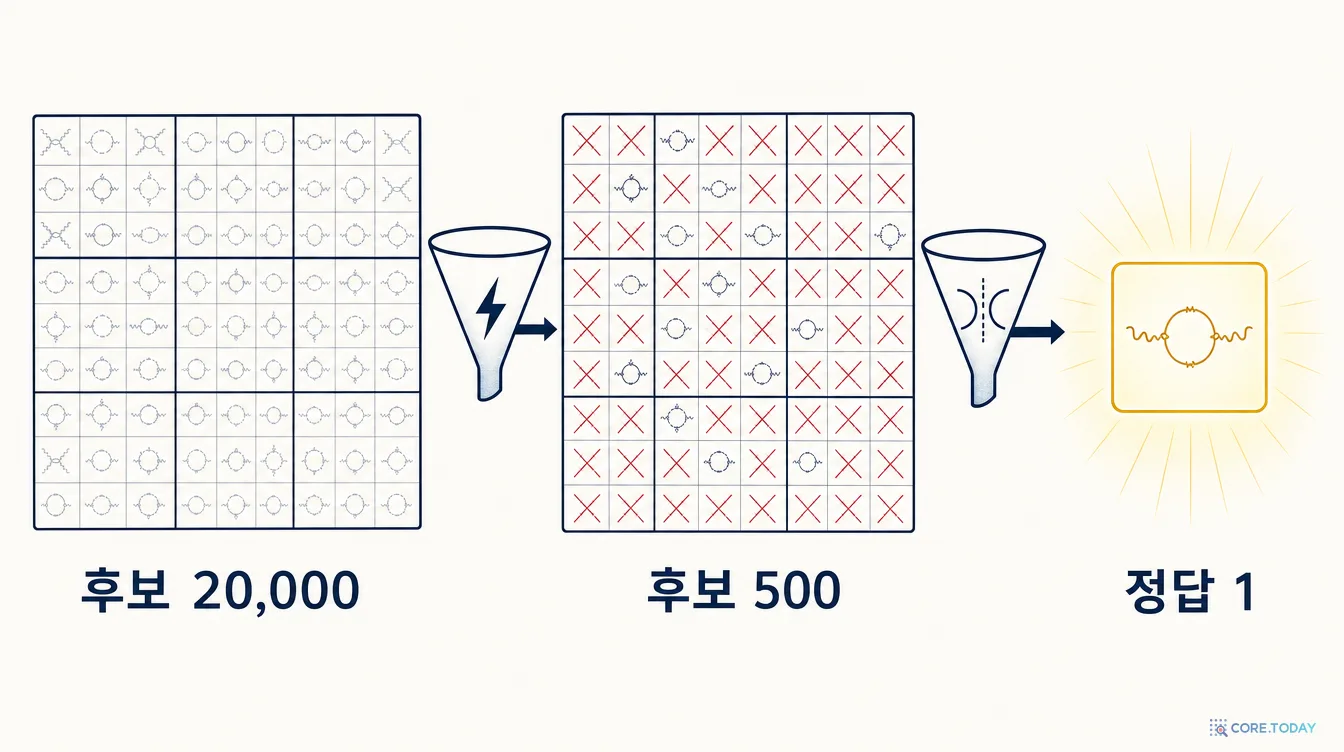
부트스트랩은 적분을 직접 하지 않습니다. 답이 될 수 있는 모든 함수를 적어 둔 다음, 답에 대해 알고 있는 모든 것으로 후보를 지웁니다. 어디서 무한대가 되는지(특이점), 그 근처에서 어떻게 행동하는지, 어떤 대칭이 있는지 같은 것들입니다. 원문의 숫자로는 특이점이 후보를 2만 개로, 대칭이 500개로 줄이고, 그렇게 계속해 하나에 이릅니다.
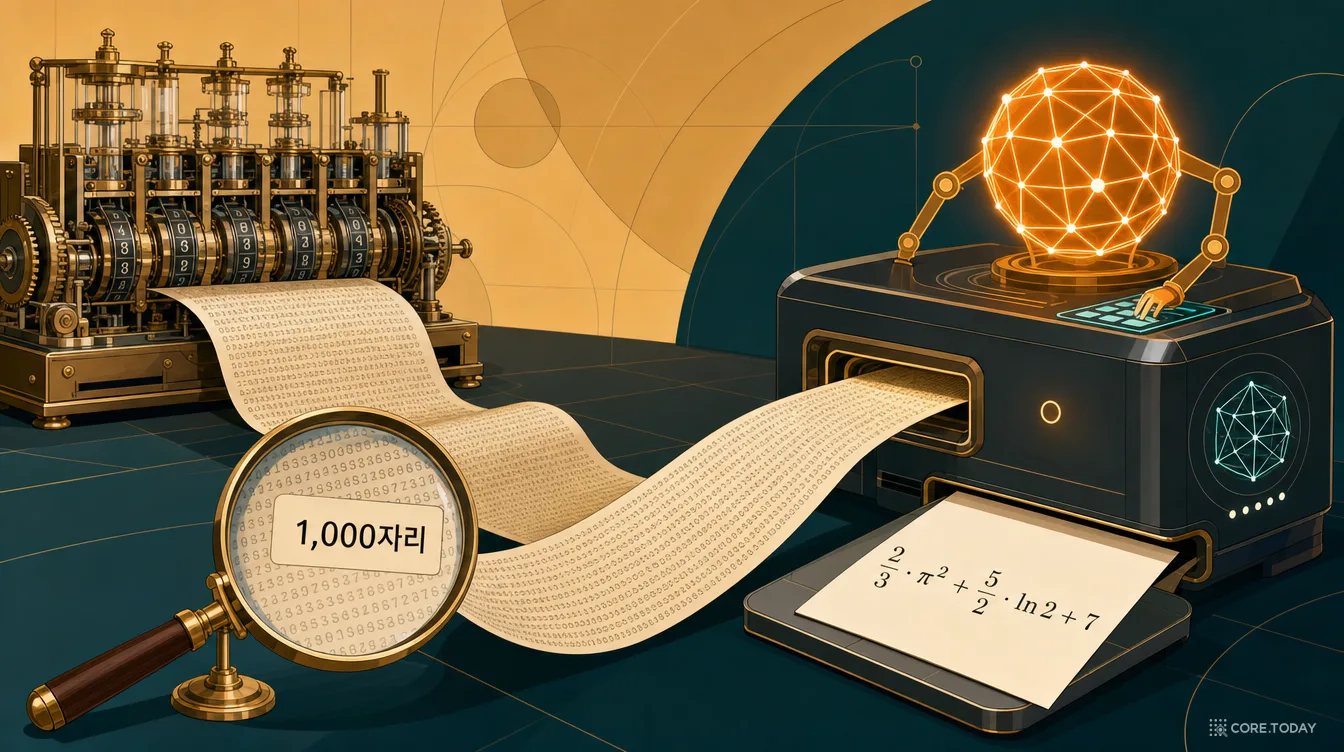
문제는 현실 세계에 가까운 이론일수록 제약이 바닥나서 후보가 몇 개 남는다는 것입니다. 슈워츠 그룹이 2025년 7월에 낸 준수치 부트스트랩(arXiv:2507.17815, 「Analytic regression of Feynman integrals from high-precision numerical sampling」, JHEP 2026년 1월호)은 그 마지막 틈을 숫자로 메웁니다. 남은 후보의 계수를 적분의 고정밀 수치값에 맞추는 것입니다. 적분을 몇 개의 점에서 소수점 아래 수백, 때로는 1,000자리까지 계산하고, 정수 관계 찾기로 그 숫자가 어떤 상수들의 정수 조합인지 거꾸로 알아냅니다.
이 단계가 어떻게 작동하고 어디서 속는지는 직접 해 보는 것이 가장 빠릅니다. 아래 위젯은 고리 {X, π², ln2, 1} 안에서 계수가 작은 정수 관계를 무차별로 찾습니다. 자릿수를 3자리부터 늘려 보세요.
자릿수가 4자리일 때는 가짜 관계식이 백 개 넘게 쏟아지다가, 6자리를 넘기면 정답 하나만 남습니다. 무작위 수를 넣어도 짧은 자릿수에서는 '관계식'이 나옵니다. BootLoops의 규약 문서 constant-recognition은 이 현상을 이렇게 경고합니다. "정수 관계 알고리즘은 맞추는 기계다. 숫자 벡터와 충분한 계수 자유도를 주면 매번 관계식을 돌려준다. 그것이 격자 축소가 하는 일이다. 관계식이 의미가 있는지는 전적으로 탐색 전에 내린 선택이 결정한다." 계수 n개, 높이 H인 관계식은 그저 '표현'되는 데만 약 n·log₁₀H자리를 쓰고, 그보다 남는 자릿수만이 증거입니다.
30개의 적분, 그리고 'BootLoops 표준'
Fable 5가 이 일을 어떻게 시작했는지는 1부에서 다뤘습니다. 슈워츠가 몇 주 걸려 짠 코드의 결과를 Claude가 약 20분 만에 재현했고, 로그 함수 너머의 타원 함수로 넓혀 보라는 제안에 기존 장비를 일반화해 30개의 적분을 끝까지 계산했습니다. 여기서는 그 30개가 무엇인지 들여다봅니다.
묶음
대표 적분
함수 부류
무엇이 새로운가
질량을 정확히 넣은 충돌기 진폭
W 보손 쌍 생성의 비평면 2루프 (톱 쿼크 질량 그대로)
타원
2024년 허(He) 등이 평면 3개 가지만 계산하고 남겨 둔 비평면 가지. 마스터 적분 76개 중 23개가 처음 계산됨. 독립 수치와 두 점에서 37자리 일치
글루온 융합으로 Z 보손과 광자 생성 (톱 질량 전체 의존성)
타원
경계값을 모듈러 형식의 아이흘러 적분으로 닫힌 형태로 구함. 126자리 일치
무거운 다리 둘 달린 비평면 2루프 5점 '헥사박스'
다중로그
벡터 보손 쌍 + 제트 생성에 필요. 마스터 적분 13개가 처음 계산됨
3루프 QED 빛-빛 산란
질량 있는 상자에 선라이즈·카이트·진공 편극을 끼운 그래프, 교차 상자
타원, K3
닫힌 형태가 출판된 적 없는 가족에서 5개를 처음 계산
2점 가족과 그 기하학
선라이즈, 카이트, 아이스크림콘, 3·4루프 바나나
타원 ~ 칼라비-야우
문턱(가장 무거운 선의 질량 = 나머지 합)에서 새 상수. 아이스크림콘은 새로운 '주기(period)'
결과물 중 세 개는 '없다'는 증명입니다. 첫째, 어떤 경계값은 수치 맞추기만으로는 원리상 구할 수 없음을 보였습니다(그래서 다른 경로로 계산해야 했습니다). 둘째, 교차 빛-빛 상자의 최상위 적분은 어떤 기저로도 다중로그로 쓸 수 없음을 증명했습니다. 셋째, 3루프 바나나 적분은 '복소수 곱셈(complex multiplication)'이라는 산술적 대칭이 없는 새로운 종류의 수를 만들 수 없음을 증명했습니다. 문턱에서 선라이즈의 타원 곡선이 고다이라 분류의 III형으로 퇴화한다는 것, 곧 파인만 적분의 타원 곡선에서 처음 확인된 '반안정이 아닌' 퇴화라는 것도 부산물로 나왔습니다.
이 결과들을 얼마나 믿을 수 있을까요? BootLoops는 적분이 '계산되었다'고 말할 기준을 세 가지로 못 박았습니다.
1
닫힌 형태
미리 선언한 함수 부류 안의 명시적 식. 등장하는 모든 상수는 고전 상수이거나, 결과와 함께 적어 둔 수렴 적분·급수로 정의된다.
2
숨겨 둔 점에서 30자리 이상
유도 과정의 어떤 맞추기에도 쓰지 않은 운동학 점에서, 독립 수치와 30자리 이상 일치. 두 가지 작업 정밀도에서 반복한다.
3
독립 실행 계산기
축약·보조 질량 흐름 코드 없이 누구나 아무 점에서나 원하는 정밀도로 돌려 위 검사를 재현할 수 있는 프로그램.
사이트는 이 기준을 이렇게 요약합니다. "컴퓨터 대수와 수치 프로그램이 모든 숫자와 기호를 계산한다. 언어 모델(Claude)은 문제를 세우고, 경로를 고르고, 그 프로그램들을 돌리고, 결과를 조립한다. 결과가 표준을 통과하는지는 결코 모델의 판단에 달려 있지 않다." 15개의 알려진 결과는 출판된 답을 마지막 비교 때까지 가려 둔 채 다시 유도했습니다. 예측값은 SHA 해시로 미리 봉인해 나중에 답을 슬쩍 맞추는 일을 막았습니다. 슈워츠가 사이트에서 한 말이 이 철학을 요약합니다. "두 값이 30자리까지 일치하면 꽤 설득력이 있다. 30자리로는 속일 수 없다."
같은 시기, 같은 질문: '9루프' 도전
이 작업은 2026년 가을의 더 큰 흐름 속에 있습니다. 슈워츠의 글보다 일주일 앞선 9월 25일, Anthropic 블로그에는 이론물리학자 맷 폰 히펠의 기고 「Yes, Claude can do nine loops」가 실렸습니다. 폰 히펠은 8월 7일 자기 블로그에 "N=4 초대칭 양-밀스 이론의 9루프를 계산해 보라"는 도전장을 냈습니다. Anthropic의 물리학자 두 사람이 Claude Science 위의 Fable 5.1에 "평면 N=4 SYM의 6입자(육각형) 진폭을 9루프까지 계산하라", 그리고 "계속하라"고만 지시해 해냈습니다. 랜스 딕슨(8루프를 2023년에 계산한 당사자)이 결과를 검증했습니다. 부트스트랩 계산 비용은 CPU 96개로 일주일, 약 100달러였습니다. 다만 폰 히펠은 Claude가 "알려진 방법을 약간 더 많은 계산으로 썼다"고 평가했고, 중국과학원 쑹허(何颂) 그룹이 독립적으로 대부분의 결과를 갖고 있었다는 점도 함께 밝혔습니다.
두 사례를 나란히 놓으면 공통점이 보입니다. 검산이 가능한 문제라는 것입니다. 부트스트랩의 답은 같은 적분을 다른 방법으로 원하는 자릿수만큼 계산해 대조할 수 있습니다. 그래서 전문가가 아니어도 스크립트 두 개로 확인할 수 있습니다. 슈워츠가 이 분야를 첫 시험장으로 고른 이유이자, 다른 분야로 갈수록 그가 불안해진 이유이기도 합니다.
같은 도구 상자로 낸 물리 원고는 이것 말고도 여럿입니다. N=4 이론의 '에너지-에너지 상관자'에서 출판된 답에 미평가 2중 적분으로 남아 있던 조각이 선라이즈의 타원 곡선(모듈러 곡선 Γ₁(6)) 위에 산다는 것을 보이고 완성한 원고(공저자 샤오위안 장)가 있습니다. 블랙홀 산란의 5차 후민코프스키 계산에서 광속의 약 94%로 스칠 때 생기는 발산이 K3 최대 절단의 란다우 특이점이라는 원고도 있습니다. '우주의 파동함수' 1루프 삼각형 계수가 타원 함수처럼 보였지만 실은 이중로그 세 개로 쓰인다는 원고(공저자 아마라 매큔)도 있습니다.
3장. 유전체: 16자리로는 부족했던 희귀 돌연변이, 그리고 57억 쌍의 증거
1969년의 히스토그램
DNA 표본을 모아 각 돌연변이가 몇 개의 염색체에서 보이는지 셉니다. 딱 하나의 염색체에만 있는 돌연변이가 몇 개, 둘에 있는 것이 몇 개, 하는 식입니다. 이 히스토그램이 자리 빈도 스펙트럼(site-frequency spectrum, SFS) 입니다. 기무라 모토오가 1969년에 이론을 세운 이후 집단유전학의 추론 대부분은 이 히스토그램에 모형을 맞추는 일이었습니다.
히스토그램의 모양에는 두 가지 역사가 겹쳐 새겨집니다. 하나는 인구의 역사입니다. 1982년 킹먼(John Kingman)의 '병합 과정(coalescent)'에 따르면, 표본의 조상을 거슬러 올라가면 계보가 둘씩 합쳐지는데 인구가 작을수록 빨리 합쳐집니다. 최근에 인구가 폭발했다면 희귀 돌연변이가 부풀고, 병목을 겪었다면 줄어듭니다. 다른 하나는 자연선택입니다. 해로운 돌연변이는 퍼지기 전에 제거되므로, 해로울수록 히스토그램의 '희귀한 쪽' 끝에 몰립니다. 그래서 원리상 이 모양에서 새 돌연변이들이 얼마나 해로운지의 분포(적합도 효과 분포, DFE)를 읽을 수 있습니다. 그 읽기의 이론이 소여(Stanley Sawyer)와 하틀(Daniel Hartl)의 1992년 '푸아송 무작위장' 공식입니다. polyDFE, fit∂a∂i, fastDFE 같은 표준 프로그램이 모두 이 공식을 계산합니다.
왜 16자리로는 부족한가
공식 자체는 잘 알려진 특수함수(합류 초기하 함수)로 쓰이고, 이웃한 항들이 세 항 점화식을 만족합니다. 양 끝값도 정확히 압니다. 그러면 컴퓨터로 점화식을 돌리면 될 것 같지만, 여기서 함정이 있습니다.
이 점화식에는 독립된 해가 둘 있습니다. 하나는 물리적인 해로 항들이 1 정도 크기입니다. 다른 하나는 비물리적인 '동반 해'로, 염색체 100개 표본에서 선택 강도가 ±10만 되어도 이미 10의 83제곱 이상으로 큽니다. 반올림 오차가 생길 때마다 동반 해가 조금씩 섞여 들어오고, 곧 답을 집어삼킵니다. 모든 항을 한꺼번에 연립방정식으로 풀어도 소용없습니다. 결과는 고정 정밀도에서 할 수 있는 유일한 검사(방정식을 반올림 오차 안에서 만족하는지)를 통과하면서도 참값과 한 자리도 같지 않을 수 있습니다. 동반 해도 같은 방정식을 만족하기 때문입니다. 1967년 가우치(Walter Gautschi)가 수치해석의 고전 논문에서 경고한 바로 그 현상입니다.
보통 컴퓨터 계산 (배정밀도)
약 16자리
염색체 50개 표본
이미 16자리 초과
염색체 2,000개 표본
6,332자리 필요
필요한 자릿수는 염색체 하나당 약 3자리씩 늘어납니다. 염색체 50개에서 이미 배정밀도의 16자리를 넘고, 2,000개에서는 6,332자리가 필요합니다. 그런데 오늘날의 데이터베이스는 수백만 개 단위입니다.
슈워츠와 하버드의 마이클 데사이(Michael Desai)는 이 벽을 세 가지 방법으로 넘었습니다. 선택 강도가 유리수이면 각 항이 '분수 + 분수 × 지수함수 하나' 꼴이라는 사실을 이용해, 계산을 유리수 위의 연립방정식 두 개로 쪼개 반올림 없이 풉니다(염색체 약 2,000개까지). 그 위로 10만 개까지는 모든 수에 엄밀한 오차 반경을 붙이는 공 산술로 점화식을 돌립니다. 100만 개 이상에서는 필요한 항마다 오차 한계를 붙인 임의 정밀도 급수로 30자리를 계산합니다. 동반 해는 사라지지 않습니다. 분수의 분자·분모 크기로 옮겨 가는데, 거기서는 해가 없습니다.
73만 명의 엑솜: 유전자를 망가뜨리는 돌연변이는 얼마나 해로운가
이렇게 얻은 정확한 공식을 공개 데이터베이스 gnomAD v4.1의 엑솜(단백질을 만드는 DNA 부분, 유전체 길이의 약 1%)에 맞췄습니다. 73만 947명, 위치마다 최대 146만 개의 염색체입니다. 이 규모가 되면 아주 해로운 돌연변이조차 관측 가능한 히스토그램 안에 들어옵니다. 인구 역사는 단백질을 바꾸지 않는 '동의 돌연변이'로 보정했습니다.
결과는 이렇습니다. 유전자 기능을 아예 망가뜨리는 돌연변이(조기 종결 코돈 등)는 해로운 쪽 분포의 73.6%(95% 구간 57.4~83.6%)가 가장 강한 선택 구간에 몰려 있었습니다. 아미노산 하나를 바꾸는 미스센스 돌연변이는 같은 구간에 28.5%였습니다. 이것을 실제 적합도 비용으로 바꾸려면 유효 인구 크기를 가정해야 하는데, 교과서 값(약 1만 5천)을 쓰면 유전자를 망가뜨리는 돌연변이 대부분이 한 벌만 있어도 거의 치명적이라는 뜻이 됩니다. 최근의 인구 증가를 반영한 더 큰 값을 쓰면 그 구간의 경계는 한 벌당 약 2% 비용에 해당합니다. 원고는 이 선택을 열어 두었습니다.
정확한 값이 생기자 할 수 있게 된 일이 둘 더 있습니다. 첫째, 표준 프로그램의 정확도 측정입니다. 같은 데이터를 각 프로그램의 수치 계산과 정확한 우도로 다시 맞춰 보니, 세 프로그램 모두 개발 당시의 표본 크기에서는 신뢰구간의 작은 일부 안에서 정확한 값과 일치했습니다. 원고는 "현재 기본 설정으로 낸 기존 추정을 다시 볼 이유는 없다"고 결론짓습니다. 정확한 계산이 기존 연구를 뒤집는 데만 쓰이는 것은 아니라는 좋은 예입니다.
둘째, '인구 역사가 자연선택을 흉내 낼 수 있는가'라는 오래된 질문입니다. 2008년 마이어스 등은 서로 다른 인구 역사가 똑같은 중립 스펙트럼을 낼 수 있음을 보였습니다. 슈워츠와 데사이는 모든 인구 역사의 스펙트럼이 하나의 명시적인 다항식 곡선 위 점들의 가중 평균이라는 것을 증명했습니다. 그러면 질문은 '선택받은 스펙트럼이 그 곡선의 볼록 껍질 안에 있는가'가 되고, 정확한 산술로 판정할 수 있습니다. 답은 약한 선택은 인구 역사로 흉내 낼 수 있고, 강한 선택은 어떤 역사로도 흉내 낼 수 없다는 것입니다. 후자는 '곡선 위에서는 0 이상, 선택받은 스펙트럼에서는 음수'인 가중합을 직접 제시하는 방식으로 증명했습니다. 1부와 이 글의 마지막에 나오는 '볼록 껍질'이 여기서는 비유가 아니라 증명 도구로 등장합니다.
데사이의 방향 전환: 한 번에 돌연변이 두 개씩
여기까지가 원문이 말한 "기술적으로는 인상적이지만 과학적으로는 끌리지 않는" 결과입니다. 슈워츠는 검증을 부탁하려고 생물학자 세 명에게 메일을 보냈고, 한 명이 답할 때까지 기다려야 했습니다. 동료 데사이는 이 분야에서 일하지만 바로 이 문제를 연구하지는 않았습니다. 그는 같은 방법론을 한 염색체 위 돌연변이 쌍의 상관관계에 쓰면 더 큰 결과가 나올 수 있다고 제안했습니다.
배경은 이렇습니다. 한 자리 히스토그램에는 맹점이 있습니다. 서로 다른 조상 구조가 같은 스펙트럼을 낼 수 있습니다. 특히 최근 여러 연구가 '다중 병합', 곧 조상 하나가 한꺼번에 많은 후손을 남기는 계보가 흔하며 킹먼 기반 추론을 오도할 수 있다고 주장해 왔습니다. 2025년 데사이 연구실(펜턴·라이스·노벤브·데사이)은 가까운 두 자리의 돌연변이가 같은 사람들에게서 얼마나 함께 나타나는지를 세는 2자리 빈도 스펙트럼으로 이를 검출하는 통계를 제안했고, 초파리에서 킹먼 모형을 기각했습니다.
이번에는 같은 검사를 사람에게 했습니다. 1000 게놈 프로젝트의 고품질 패널에서 서로 친척이 아닌 감비아인 113명을 골랐습니다. 성염색체가 아닌 염색체에서 10만 염기쌍 이내에 있는 변이 쌍을 모두 세니 57억 쌍이었습니다. 그중 유전 지도상 거리가 0과 구별되지 않을 만큼 가장 단단히 연결된 5억 9천만 쌍이 주 분석 대상입니다. 각 쌍은 226개 염색체에서 넷씩 뽑을 수 있는 모든 부분표본에 대해 정확히 평균해 28칸짜리 표로 줄였습니다. 이론 쪽은 최대 24개 시기로 나눈 모든 계단식 인구 역사와, 유전체 영역마다 다른 역사를 섞은 경우까지 정확히 계산했습니다. 이 역사 집합은 볼록해서 최적 탐색에 국소 최적이 없습니다. 그래서 찾은 최소 오차가 곧 '어떤 킹먼 역사로도 이보다 잘 맞출 수 없다'는 하한이 됩니다.
결과는 명확했습니다. 어떤 킹먼 역사도 감비아인의 쌍 스펙트럼을 맞추지 못했습니다. 가장 잘 맞는 역사도 자유도 27에서 카이제곱 오차가 7,697로, 측정된 표본 잡음이 정하는 기각 기준 29.2의 200배가 넘었습니다. 분석 선택을 어떻게 바꿔도 이 차이는 살아남았고, 사용한 19개 염색체 하나하나에서 같은 방향을 가리켰습니다.
일곱 용의자와 범인
그러면 무엇이 차이를 만드는가. 연구진은 일곱 가지 후보 과정을 시뮬레이션했습니다. 유전자 전환, 교차 지도의 오류, 다중 병합(베타 병합), 시퀀싱 오류, 집단 구조, 연관 선택, 조상 대립유전자의 오표기입니다. 각 후보가 스펙트럼을 바꾸는 방향과 실제 관측된 편차의 방향이 얼마나 같은지를 0(무관)부터 1(같은 방향)까지로 점수 매겼습니다. 인구 역사로 흡수할 수 있는 부분은 미리 빼서, 역사 탓인 것을 다른 과정의 공으로 돌리지 않게 했습니다.
유전자 전환
0.913
교차 지도 오류 (가장 유리한 비율일 때)
0.63
그 밖의 과정들 (최대)
≤ 0.35
무작위 방향의 전형적 점수
0.19
교차 지도 오류 (물리적으로 그럴듯한 비율)
0.14
다중 병합 (베타 병합)
0.10
유전자 전환만이 관측된 편차의 방향으로 스펙트럼을 움직였습니다. 초파리와 달리 사람 데이터에서 다중 병합은 무작위 방향보다 나을 것이 없었습니다(검사력은 충분했습니다). 나머지 여섯 과정을 각자의 상한 안에서 모두 합쳐도 편차의 74.0%를 지웠지만, 유전자 전환 모형 하나가 95.2%를 지웠습니다.
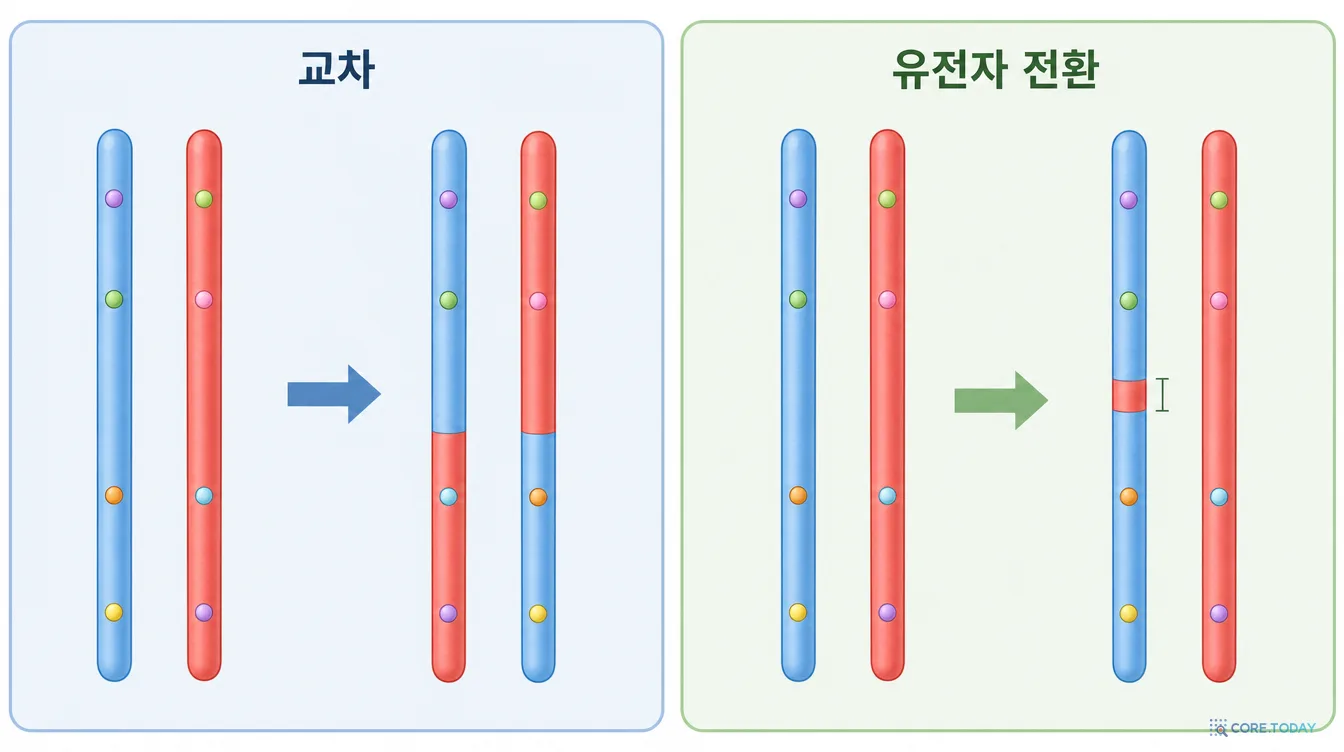
유전자 전환(gene conversion) 은 정자와 난자를 만들 때 교차(crossover)를 일으키는 바로 그 분자 기계에서 나옵니다. 교차는 두 염색체가 한 점에서 끊겨 한쪽 전체를 맞바꿉니다. 유전자 전환은 맞바꾸지 않고, 수십에서 수백 염기쌍 길이의 짧은 조각을 한쪽에서 다른 쪽으로 복사합니다. 그 조각이 이웃한 두 변이 중 하나만 덮으면, 두 변이는 마치 사이에서 교차가 일어난 것처럼 서로 다른 조상을 갖게 됩니다. 문제는 아주 가까운 두 자리 사이에서는 교차가 거의 일어나지 않는다는 것입니다. 그래서 가까운 쌍의 연관을 끊는 주범은 교차가 아니라 유전자 전환이 됩니다.
맞춘 모형은 킹먼 계보와 자유롭게 맞춘 인구 역사 위에 두 길이 등급의 전환(가계 연구에서 측정된 평균 110염기쌍과 500염기쌍)과 오표기 비율을 더한 것입니다. 기준 분석에서 카이제곱이 7,697에서 370.2로 떨어졌고, 추정된 총 전환율(세대·염기쌍당 약 8.33×10⁻⁶)은 가계·정자 분석으로 직접 잰 값과 같은 자릿수였습니다. 가장 가까운 쌍에서 고정한 모형은 다른 거리도 예측했습니다. 200염기쌍과 1,500염기쌍에서 관측과 3% 이내로, 650염기쌍에서는 9% 모자라게 맞았습니다.
이것이 중요한 이유를 원문은 이렇게 씁니다. "연결된 유전 변이를 쓰는 거의 모든 분석, 인구사 추정부터 질병 유전자 지도 작성까지가 유전자 전환을 무시한다." 그리고 더 큰 교훈으로 "AI는 거대한 유전체 데이터셋에 숨은 생물학을 찾는 데 도움이 될 수 있고, 공개 저장소에는 그런 데이터셋이 수천 개 잠들어 있다"고 덧붙입니다.
한계도 원고에 분명히 적혀 있습니다. 수천 염기쌍 거리, 곧 교차가 지배하는 구간에서는 모형이 10~30% 빗나가고, 교차율을 어떻게 골라도 이 차이가 지워지지 않습니다. 전환율의 절댓값은 대략 두 배 범위로만 알려져 있고, 모든 비율이 가정한 돌연변이율에 비례합니다. 요루바인 표본과 독립적으로 처리된 다른 데이터로도 같은 결과가 나왔지만, 둘 다 서아프리카 표본이고 변이 자리를 대부분 공유하므로 원고 스스로 "독립 확인이라기보다 일관성 점검"이라고 씁니다.
단일세포 RNA: 유전자는 '깜빡이며' 일한다
같은 유전체 분야에서 마틴 헴버그(Martin Hemberg)와 쓴 원고 두 편도 있습니다. 유전자는 RNA를 일정하게 만들지 않습니다. 대부분 꺼져 있다가 잠깐 켜지며 몰아서 만듭니다. 이것을 전사 터짐(transcriptional bursting) 이라고 합니다. 교과서 모형은 프로모터를 기억 없는 켜짐·꺼짐 스위치로 봅니다(전신 모형, telegraph model). 다시 켜질 확률은 꺼져 있던 시간과 상관없다는 뜻입니다.
단일세포 RNA 개수에 터짐 빈도와 크기를 맞추려면 수백 개의 미묘한 함수를 곱해야 하고, 표준 도구는 이 과정에서 오차를 통제하지 못합니다. 첫 원고는 공 산술로 오차 막대를 정직하게 지켰습니다. 그 결과 라손(Larsson) 등의 대규모 대립유전자 데이터에서, 검사한 유전자의 대략 절반이 두 대립유전자 사이에 터짐의 차이를 보였고, 구별 가능한 차이는 모두 터짐의 '빈도' 쪽이었습니다. 두 번째 원고는 시간에 따라 측정한 쥐 섬유아세포 데이터에 정확한 우도를 맞췄습니다. 일부 유전자는 침묵을 여러 단계로 쌓아 만드는 '불응성' 프로모터를 가지고 있었습니다. 이 유전자들은 분비 단백질과 세포 밖 기질 단백질에서 다섯 배 많이 나타났고, 모형상 입력의 변화를 자기 터짐 주기로 쳐서 몇 배 빨리 감지할 수 있었습니다.
4장. 진화 나무는 정확한 분수다
세 갈래 길: 네 종을 잇는 방법
사람, 침팬지, 고릴라, 오랑우탄. 이 네 종을 뿌리 없는 나무로 잇는 방법은 정확히 세 가지입니다. 사람과 침팬지를 한 쌍으로 묶거나, 사람과 고릴라를 묶거나, 사람과 오랑우탄을 묶는 것입니다. 다섯 종이면 15가지입니다. 슈워츠의 원고에는 물리학자다운 그림이 있습니다. 네 종을 사각형의 네 꼭짓점에 고정하고 가운데 선만 바꾸면, 입자물리의 s·t·u 채널과 똑같은 그림이 됩니다.
같은 유전자를 여러 종에서 줄 세우면(정렬), 위치(열)마다 어떤 종들이 같은 글자를 공유하는지가 보입니다. 사람과 침팬지가 한 글자를, 고릴라와 오랑우탄이 다른 글자를 공유하는 열은 '사람+침팬지' 나무를 지지합니다. 1990년대 후반 이후 표준이 된 베이즈 계통학은 나무마다 증거(marginal likelihood), 곧 가능한 모든 가지 길이에 대해 우도를 평균한 적분 값을 매깁니다. 두 나무의 증거 비율이 베이즈 인자이고, 로그를 취해 3 이상이면 관례적으로 '강한 증거'로 봅니다.
이 적분은 가지 하나당 한 차원이라 네 종이면 5차원입니다. 1996년 란날라와 양(Rannala & Yang)이 네 유인원에 직접 수치 적분을 했지만 다섯 종 정도가 한계였습니다. 그 뒤로는 마르코프 연쇄 몬테카를로(MCMC) 표본으로 어림하는 것이 표준입니다. MrBayes, RevBayes, BEAST에 들어 있는 '징검돌 표집(stepping-stone sampling)', 2023년의 LoRaD 같은 방법입니다. 2020년 푸르망(Fourment) 등은 이런 방법 19가지를 비교한 논문에 「계통수 위상의 주변 우도를 계산하는 19가지 의심스러운 방법」이라는 제목을 붙였습니다. 그런데 이 모든 비교에는 공통 약점이 있었습니다. 실제 서열 데이터에서 정확한 값을 아는 기준점이 없었다는 것입니다.
적분이 분수가 되는 이유
가장 단순한 DNA 진화 모형인 쥬크스–캔터 모형(1969) 에서는 모든 글자가 다른 세 글자로 같은 속도로 바뀝니다. 가지 길이를 x = e^(−4t/3)로 바꿔 쓰면, 한 가지 위에서 글자가 그대로일 확률(¼ + ¾x)과 특정한 다른 글자로 바뀔 확률(¼ − ¼x)이 모두 x의 1차식이 됩니다. 펠젠스타인의 가지치기 알고리즘(1981)으로 열 하나의 확률을 계산하면, 다섯 가지 변수 각각에 대해 1차인 정수 계수 다항식이 나옵니다. MrBayes·RevBayes가 제공하는 가지 길이 사전분포(평균 0.75인 지수분포)는 이 변수에서 정확히 균등분포가 됩니다.
그러면 증거는 '다항식들의 곱을 단위 정육면체 위에서 적분한 것'이고, 곱을 전개하면 단항식마다 적분이 1/(a+1)의 곱이 됩니다. 분수의 유한 합은 분수입니다. 증명이 곧 알고리즘입니다. 다만 전개하는 데 비용이 큽니다. 계수가 수백 자리로 불어나는데, 여기서 다시 입자물리의 기법이 등장합니다. 모든 계산을 2³¹보다 조금 작은 소수 여러 개로 나눈 나머지에서 하고(모듈러 산술), 중국인의 나머지 정리로 정확한 정수를 되살립니다. 파인만 적분의 정확한 평가에 쓰이던 방법(폰 만토이펠·샤빙거 2015)입니다. 원고는 이 증거가 매개변수 표현의 파인만 적분과 같은 모양이며, 대수 통계학자들이 GKZ 초기하 적분이라 부르는 것이라고 지적합니다.
직접 해 보세요. 아래 위젯은 같은 계산을 10글자 이하의 서열에서 브라우저로 돌립니다.
유인원의 정확한 동점, 그리고 MrBayes의 숨은 편향
실제 데이터에서 나온 결과는 세 가지가 특히 흥미롭습니다.
정확한 동점. 사람·침팬지·고릴라·오랑우탄의 미토콘드리아 tRNA-Phe 유전자는 69열 중 59열이 같은 글자이고 나머지 10열은 한 종에만 생긴 변화입니다. 두 종을 묶어 주는 열이 하나도 없습니다. 증거를 따로따로 계산했더니 '사람+침팬지' 나무와 '침팬지+고릴라' 나무가 똑같은 217자리 정수 / 287자리 정수로 나왔습니다. 계산에 쓰지 않은 대칭이 이유입니다. '사람'과 '고릴라' 이름표를 맞바꿔도 모든 패턴 개수가 그대로이고, 그 교환이 한 나무를 다른 나무로 보냅니다. 표본을 아무리 늘려도 몬테카를로는 두 값이 '정확히' 같다는 것을 보일 수 없습니다. 『사이언스』 기사에서 공저자인 하버드의 진화생물학자 스콧 에드워즈는 "Claude 기반 과학을 처음 경험했는데, 가능성이 분명히 보인다"고 말했습니다.
MrBayes의 숨은 편향. 정확한 값을 기준으로 표준 프로그램들의 오차를 재 보니, 모두 몇백분의 1 로그 단위 안에 들어왔습니다. 그런데 MrBayes의 평균은 모든 나무에서 정확한 값보다 항상 아래에 있었습니다. 사슬을 늘려도 −0.016 로그 단위가 남았습니다. 추적해 보니 MrBayes의 기본 가지 길이 제안 방법 셋 중 하나인 '노드 슬라이더'가 3.2.4 버전부터 제안 비율에 '새 나무 길이 / 옛 나무 길이' 인자를 하나 더 갖고 있었습니다. 데이터 없이 이 움직임만으로 돌리면 사전분포 평균보다 1.4~3배 긴 나무를 표집합니다. 이 편향은 베이즈 인자에서는 상쇄되고 해석 기준보다 훨씬 작지만, MrBayes가 보고하는 어떤 숫자도 이것을 드러내지 않았습니다. 그리고 원고의 지적대로, 만약 MrBayes를 아주 오래 돌린 값을 기준으로 삼았다면 다른 두 프로그램이 틀린 것처럼 보였을 것입니다.
JaCK & Jill. 이 계산은 MIT 라이선스의 파이썬 패키지 JaCK & Jill(정확 계산 JaCK, 구간·표집 루틴 Jill)로 공개되었습니다. 쥬크스–캔터 모형의 tRNA 길이 정렬이면 정확한 분수, 더 복잡한 모형이면 증명된 구간, 아니면 준몬테카를로 추정을 돌려주고, 어느 것인지 밝힙니다. 같은 실행 시간(약 7초)에서 이 패키지의 추정 오차는 LoRaD보다 20~44배, 두 징검돌 프로그램보다 67~213배 작았습니다.
원고는 한계도 분명히 적습니다. 다섯 종이 넘으면 비용이 열의 7제곱, 9제곱으로 늘어나 900열짜리 고전 정렬은 아직 손이 닿지 않습니다. 위치마다 속도가 다른 모형(감마 분포)을 넣으면 증거는 더 이상 분수의 유한합이 아닙니다. 세 종과 상수 열 하나만으로도 오일러–곰페르츠 상수가 나옵니다. 응용 두 가지도 신중합니다. 멸종한 갈라파고스 산크리스토발 땅거북의 계통 위치(2022년 연구가 사후확률 1.0으로 결론)를 미리 정한 기준으로 검사했더니 그 유전자 부위만으로는 확인되지 않았습니다(합 0.90, 기준 3.0). 원고는 "기존 결론이 틀렸다는 뜻이 아니라 이 부위, 이 분석으로는 확인되지 않는다는 뜻"이라고 적었습니다. 아프리카 말라리아 모기 무리(아노펠레스 감비아이 복합체)에서는 정확한 값이 계산된 5,375개 창 가운데 2,997개가 정확한 동점이었습니다. 부동소수점 계산은 이런 동점을 반올림 오차로만 깰 수 있습니다.
혼합 모형, 저자 판별, 보이니치: 통계의 오래된 질문들
같은 '정확한 베이즈 증거' 엔진은 통계의 오래된 질문으로도 옮겨 갔습니다.
혼합 모형(공저자 수브라타 센)은 "섞여 보이는 데이터가 하나의 집단에서 왔는가, 여럿에서 왔는가"라는 통계학의 가장 오래된 질문 중 하나를 다룹니다. 이산 변수의 혼합에 대해 증거를 정확히 썼더니, 점근 이론이 열어 둔 상수를 확정할 수 있었습니다. 참가자마다 예·아니오 결과 네 개를 기록하는 시험에서 응답률이 반반이면, '가짜 두 번째 집단'을 강하게 기각하는 데 참가자 330만 명이 필요합니다. 표준 BIC 기준은 같은 판단을 22명에서 내립니다.
저자 판별(슈워츠 단독)은 기능어 통계를 '여러 저자가 섞인 텍스트'라는 혼합 모형으로 다시 썼습니다. 『페더럴리스트 페이퍼』의 공동 집필 글은 어떤 단어 목록과 모형으로도 매디슨이 주도했고, 셰익스피어의 희곡 여섯 편에서 두 번째 손이 보였으며(『헨리 8세』는 플레처보다 미들턴의 특징에 더 가까웠습니다), 이사야서는 39장 뒤에서 나뉘지만 '제3 이사야'의 근거는 없었습니다. 대부분은 학계 합의를 확인했고, 일부는 그렇지 않았습니다.
보이니치 필사본(슈워츠 단독)은 15세기의 해독되지 않은 문자로 쓰인 그림책입니다. 원고는 여섯 후보 언어로의 대치·자음 표기·약어·암호책 해석과 텍스트 생성 절차를 모두 확률 모형으로 쓰고, 필경사 한 명의 페이지 절반에 맞춘 뒤 나머지 절반으로 평가했습니다. 해독 시도는 모두 실패했고, 열쇠 없이 '최근 쓴 단어를 다시 쓰거나 가끔 베끼고 글자 습관으로 새 단어를 만드는' 절차가 두 주요 필체의 요약 통계를 거의 다 재현했습니다. 결론은 "읽히기보다 보이기 위해 만든 책"이라는 것입니다. 하지만 『사이언스』에 따르면 보이니치 온라인 포럼의 일부 참가자는 이 원고가 너무 빽빽해 AI '슬롭(slop)'이라고 불평했습니다.
언어 계통수(슈워츠 단독, 준비 중)는 세계 언어의 친족 관계를 정하는 베이즈 인자를 몬테카를로 없이 정확히 계산하고, 단어 목록(동원어 집합)을 AI로 다시 만들었습니다. 사이트 초록에 따르면 기존에 확립된 결과는 모두 재현되었고, 드라비다어족의 하위 분류를 정리했으며, 인도유럽어족이 아나톨리아어·토하라어·핵심부의 세 갈래로 처음 갈라지는 나무를 얻었습니다. 아직 원고가 공개되지 않았으므로 판단은 미룰 수밖에 없습니다.
5장. 경제학: 논문 4,452편을 다시 돌린 'AI 데이터 편집자'
재현 패키지라는 약속
경제학은 다른 사회과학보다 일찍 '데이터와 코드를 내놓으라'고 요구한 분야입니다. 1986년 듀월드·써스비·앤더슨이 『화폐·신용·은행 저널』의 재현 프로젝트를 보고한 것이 초기 사례이고, 『아메리칸 이코노믹 리뷰(AER)』와 『이코노메트리카』는 2005년부터, 『정치경제학 저널(JPE)』과 『경제학 연구 리뷰(REStud)』는 2006년부터, 『계간 경제학 저널(QJE)』은 2017년부터 게재 논문의 데이터와 코드를 받았습니다. 이것을 재현 패키지(replication package) 라고 하고, 오늘날에는 학술지마다 데이터 편집자(data editor)가 이를 점검합니다. 원문 표현으로는 "조심스럽고 손이 많이 가는 작업"입니다.
먼저 용어를 구분해야 합니다. 미국 국립학술원의 2019년 보고서에 따르면 재현성(reproducibility) 은 같은 데이터와 코드로 같은 숫자가 나오는가이고, 반복 가능성(replicability) 은 새 데이터로 한 새 연구가 일관된 결론에 이르는가입니다. 이 프로젝트가 검사한 것은 앞의 것입니다.
패키지 하나를 점검하려면 저자가 쓴 소프트웨어(라이선스가 필요할 수 있습니다)를 깔고, 데이터를 구하고(일부는 기밀이라 빠져 있습니다), 모든 스크립트를 돌려 인쇄된 표와 비교해야 합니다. 그래서 지금까지의 대규모 재현 연구는 2008년부터 2026년 『네이처』 논문까지 많아야 수십에서 수백 편을 다뤘습니다.
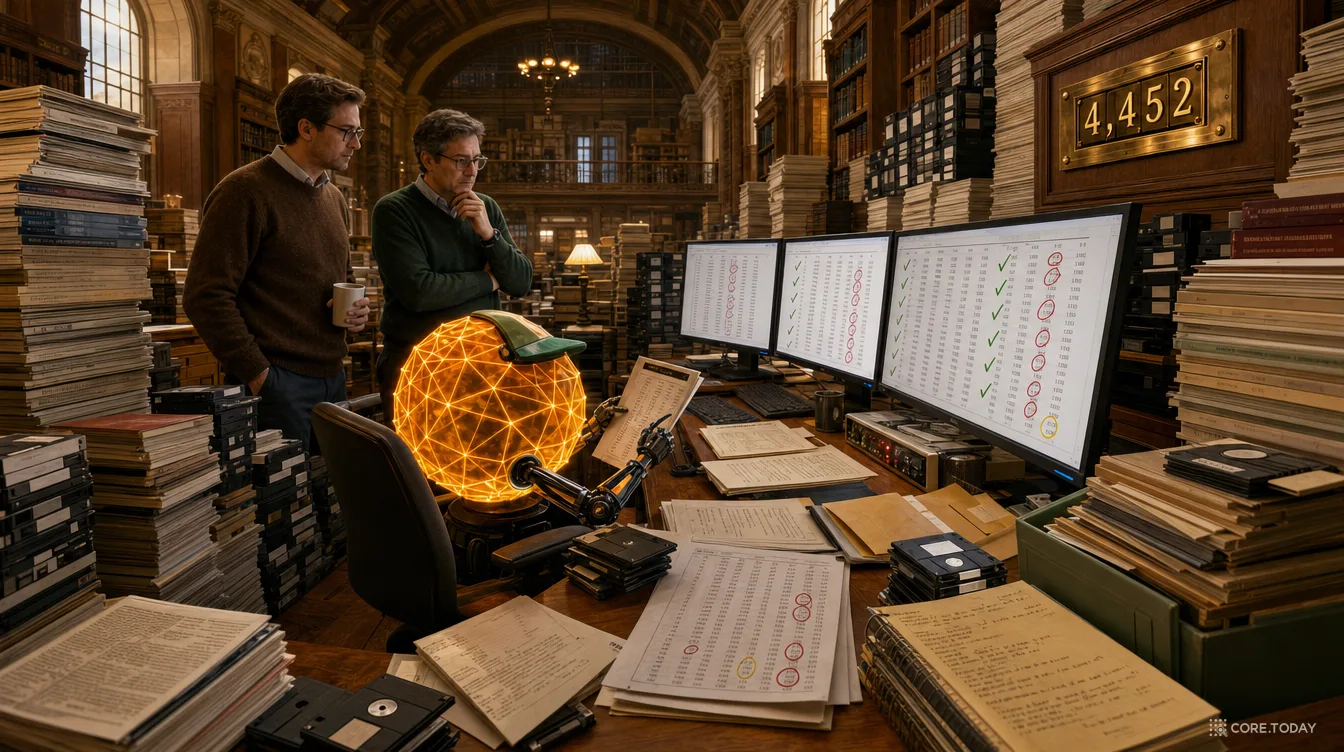
슈워츠는 MIT의 아이자이어 앤드루스(Isaiah Andrews), 하버드의 제시 샤피로(Jesse M. Shapiro)와 함께 NBER 워킹페이퍼 w35782(2026년 9월, 「An LLM Workflow That Reproduces, Improves, and Extends Published Economics Research」)를 냈습니다. 대상은 위 5대 학술지에 2000~2026년 실린 논문 중 재현 패키지를 구할 수 있는 4,452편 전부입니다.
논문 하나를 보기 전에, 여러 에이전트가 함께 일하는 작업 흐름이 먼저 이 말뭉치 전체에 나오는 계산을 재현할 수 있는 오픈소스 라이브러리를 만들었습니다. 원문의 말로는 MATLAB, Stata 같은 상용 도구의 코드를 약 3만 개의 오픈소스 루틴으로 옮긴 것입니다. 모든 계산이 AI가 읽을 수 있는 형태가 되면, 나중에 그것을 개선하기도 쉬워집니다. 그 위에서 네 가지 일을 합니다.
재현문서가 제외하지 않은 모든 계산을 다시 돌려 인쇄된 값과 비교한다. 다른 값이 나오거나, 문서에 밝히지 않은 데이터 누락으로 막히면 '불일치'다. 불일치마다 반박 담당 에이전트가 원래 결과를 지지하는 쪽으로 뒤집기를 시도하고, 가능한 곳에서는 원래의 상용 소프트웨어로 다시 돌린다.
민감도영향력이 가장 큰 관측 단위 5개를 하나씩 빼고 추정치를 다시 계산한다(지오다노·미거·브로데릭의 방법을 9편에서 1,908편으로 확대).
개선최적화·적분·시뮬레이션이 들어간 계산을 같은 알고리즘으로 빠르게(재구현), 또는 다른 분야의 정확한 해법으로 바꿔(재정식화) 속도를 올린다.
확장논문 자체의 가정만으로 더할 수 있는 결과를 찾는다. 반박 에이전트 둘이 숨은 추가 가정이 있는지, 독자에게 쓸모가 있는지를 따진다.
숫자로 본 결과
핵심만 추리면 이렇습니다. 재현은 87.6%의 패키지에서 시도되었고, 전체의 11.2% 만이 인쇄된 정밀도에서 완전히 재현되었습니다. 76.4% 는 검증된 불일치가 하나 이상 있었습니다. 12.4%는 모든 계산이 공개되지 않은 데이터에 묶여 있다고 밝힌 패키지였습니다. 불일치가 보고된 논문은 검증된 것과 추정된 것을 합쳐 3,460편입니다.
이 숫자를 '경제학 논문의 4분의 3이 틀렸다'로 읽으면 안 됩니다. 첫 불일치가 다시 계산한 숫자인 3,166편을 보면, 35.6% 는 차이가 마지막 인쇄 자리의 한 단위 이하, 즉 반올림·버림으로 설명되는 수준이었습니다. 다만 24.9% 는 맨 앞 유효숫자가 바뀌었고, 25.1%는 둘째 자리가 바뀌었습니다.
민감도 분석 결과는 더 생각할 거리가 많습니다. 1,908편 중 963편에서 관측 단위 하나만 빼도 어떤 추정치가 자기 크기 이상 움직였습니다(두 배가 되거나 부호가 바뀜). 그중 512편은 그 값을 유효숫자 두 자리 이상으로 인쇄했습니다.
개선과 확장의 사례는 'Claude 모양'이 무엇인지를 잘 보여 줍니다.
440배 (재구현). 리(Lee 2026, REStud)는 부트스트랩 신뢰구간을 위해 1,000번 반복을 루프로 하나씩 돌렸습니다. 작업 흐름은 각 반복이 반복마다 변하지 않는 양의 평균으로만 들어간다는 것을 알아채고, 전부를 행렬 곱 하나로 바꿨습니다. 원래의 씨앗값으로 같은 난수를 재생하니 출판된 구간이 정확히 나왔고, 약 440배 빨랐습니다.
24,000배 (재정식화). 악시깃·피어스·프라토(2025, REStud)는 모형 매개변수 7개를 데이터 적률 7개에 맞추려고 확률적 탐색 뒤에 국소 최적화를 돌렸습니다. 작업 흐름은 최적 매개변수를 닫힌 형태로 쓸 수 있다는 것을 보였고, 구간 산술로 그 해가 근방의 유일한 근임을 인증했습니다. 출판된 보정값의 모든 자리와 일치했고 약 24,000배 빨랐습니다.
새 반사실 (확장). 카스·랄레·시아시(2026, 『이코노메트리카』)는 독일 실업급여 10% 삭감을 시뮬레이션했습니다. 작업 흐름은 같은 일반균형 체계를 논문의 수렴 허용치 그대로 25% 삭감에 대해 풀었고, 보고된 결과 대부분이 삭감 폭에 덜 비례해 커진다는 것을 찾았습니다.
빠진 불확실성 (확장). 카레라 등(2022, REStud)은 헬스장 출석 '약정 계약'을 선택한 참가자가 1인당 18.69달러의 후생 손실을 본다고 추정했지만 불확실성은 제시하지 않았습니다. 작업 흐름이 같은 논문의 다른 곳에서 쓴 부트스트랩을 적용하자 95% 신뢰구간 12.75~23.99달러가 나왔습니다.
논문은 별도 실험에서 AI 평가의 안정성도 측정했습니다. Claude Opus 5와 Fable 5.1의 새 에이전트들이 100편을 세 조건(논문만, 논문+패키지, 셋+재현 결과)에서 읽었습니다. 재현 결과를 받자 두 모델 모두 더 많은 논문을 '맞다'고 평가했습니다. 같은 모델의 세션 셋을 무작위로 뽑으면 재현 판정이 일치하는 비율은 88.6%(Opus)와 89.1%(Fable)였습니다. 열에 하나꼴로는 같은 모델끼리도 판정이 갈린다는 뜻입니다. 저자들은 이 작업 흐름이 연구를 '평가'하려는 것이 아니라고 밝혔고, 수치는 진행 중인 작업의 중간 결과라고 썼습니다.
이 프로젝트는 원문 표현대로 BootLoops식 정량 계산에서 더 일반적인 Claude 모양 작업으로 흘러간 사례입니다. 4,452편 분량의 꼼꼼하고 지루한 대조 작업은 사람 편집자 몇 명이 평생 할 분량입니다. 그리고 그 가치는 '틀린 논문 찾기'보다 '모든 계산을 읽을 수 있는 형태로 만들어 두기'에 있을 수 있습니다.
6장. 정책 숫자의 마지막 자리: 별점, 오존, 임상시험
슈워츠가 혼자 쓴 원고 중에는 공공정책의 숫자를 다룬 것이 세 편 있습니다. 셋 다 같은 구조입니다. 제도가 근사 계산이나 반올림 규칙에 기대고 있는데, 정확히 계산하면 경계에 걸린 사례의 판정이 바뀝니다.
메디케어 별점: 근사 군집화가 놓친 10억 달러
미국 메디케어의 평가 제도 여섯 가지는 품질 점수를 별 1~5개로 바꿉니다. 방법은 점수를 다섯 구간으로 나누되, 각 점수에서 구간 중심까지 거리의 제곱합이 가장 작게 나누는 것입니다. 실무에서는 이 최솟값에 도달한다는 보장이 없는 군집화 알고리즘으로 구간을 찾습니다. 그런데 점수는 1차원이고, 1차원에서는 최적 구간을 동적 계획법으로 정확히 계산할 수 있습니다. 컴퓨터과학 교과서에 나오는 방법입니다.
원고에 따르면 보너스 지급과 연결된 메디케어 어드밴티지에서 군집화 단계가 컷 계산 123번 중 104번 최솟값을 놓쳤습니다. 최적 구간을 쓰면 공표된 등급 34개가 보너스 경계를 넘나들고(올라가는 것도, 내려가는 것도 있습니다), 2025~2027년 총 보너스 약 10억 달러가 이 선택에 달려 있습니다. 병원은 열다섯 곳 중 한 곳꼴로 최적 구간이 주는 것보다 적은 별을 표시하고 있었습니다. 원고는 당국의 의도나 법 해석은 판단하지 않는다고 밝혔습니다.
오존: 버림이냐 반올림이냐
미국 법은 대기 중 오존을 70ppb로 제한하고, 측정소가 기준을 지키는지는 3년치 판독값으로 계산한 '설계값'으로 판정합니다. 이 규정은 오존에서는 마지막 자리를 버리고, 미세먼지에서는 반올림합니다. 환경단체들은 오존도 반올림하라고 거듭 요구해 왔습니다. 원고는 오존 통계의 계산 과정에서 자릿수가 버려지는 지점이 세 곳임을 지적하고, 2020~2025년 공표된 설계값 중 기준에서 한 단위 이내인 것을 모두 공개 측정 자료에서 다시 계산했습니다. 경계에 걸린 값의 약 3분의 1은 마지막 자리 처리 하나로 판정이 갈렸습니다. 공표대로면 기준을 지키는 경계값 190개 중 61개가 반올림하면 위반이 되고, 8시간 평균까지 반올림하면 최소 148개가 됩니다. 원고는 EPA가 이런 값을 표시해 두기를 제안합니다.
임상시험 설계: 몬테카를로 잡음 안의 '통과'
2상 임상시험을 시작하기 전에는 설계가 효과 없는 약을 효과 있다고 선언할 확률과 효과 있는 약을 놓칠 확률(운영 특성)을 따집니다. 적응형·베이즈 설계에서는 이것을 보통 수천 번의 모의 시험으로 어림합니다. 원고가 출판된 설계 9개의 표에 표준오차 공식을 적용해 보니, 보고된 오류율과 검정력 977개 중 351개가 기준선에서 잡음 범위 안에 있었습니다. 이를 가르기에는 시뮬레이션이 중앙값 기준 18배 부족했습니다. 그런데 결정 규칙이 완전히 명시된 경우 대부분은 시뮬레이션이 필요 없습니다. 유한합이나 저차원 적분이라 정확히 계산할 수 있습니다. 다시 계산하자 경계값 중 87개는 보고된 쪽, 30개는 반대쪽으로 판정되었습니다. 원고는 이것이 "잡음만으로 예상되는 정도"라고 덧붙입니다. 즉 누가 잘못한 것이 아니라 정확히 계산할 수 있는 것을 어림해 왔다는 이야기입니다.
세 원고는 모두 BootLoops 사이트에서 '예비' 딱지가 붙어 있고, 정책 분야 전문가 공저자 없이 슈워츠 혼자 썼습니다. 결론의 정책적 의미는 해당 분야의 검토를 기다려야 합니다. 그래도 '경계에 걸린 숫자는 근사로 판정하지 말라'는 교훈은 분야를 가리지 않습니다.
7장. 언어학: 6,072개 언어의 강세를 인용과 함께
2,500년 동안 몇 개씩 적어 온 규칙
영어 record는 명사일 때 첫 음절에, 동사일 때 둘째 음절에 힘을 줍니다. 이것이 강세(stress) 입니다. 중국어 ma는 평평하게, 올려서, 꺾어서, 내려서 말하면 네 개의 다른 단어가 됩니다. 이것이 성조(tone) 입니다. 많은 언어는 강세의 위치를 규칙으로 정합니다. 핀란드어·헝가리어·체첸어는 첫 음절, 폴란드어와 스와힐리어는 끝에서 둘째 음절입니다.
사람들은 이 규칙을 오래전부터 적어 왔습니다. 약 2,500년 전 인도 학자들이 산스크리트어 단어의 악센트를 기술했고, 5세기 중국의 심약(沈約)은 사성(四聲)에 이름을 붙였습니다. 1595년 멕시코에서는 나와족 혈통의 예수회 신부 안토니오 델 린콘이 자기 언어 나와틀어의 악센트를 『아르테 멕시카나』에 기술했습니다. 1651년 알렉상드르 드 로드가 성조를 악센트 부호로 표시한 베트남어 사전을 로마에서 찍었고, 베트남어는 지금도 그렇게 씁니다. 우리에게도 익숙한 사례가 있습니다. 15세기 『훈민정음』과 그 무렵의 한글 문헌은 글자 왼쪽에 점(방점)을 찍어 소리의 높낮이를 표시했습니다. 점이 없으면 평성, 하나면 거성, 둘이면 상성입니다. 1800~1900년대에는 선교사와 언어학자들이 문자가 없던 언어의 화자들과 살며 문법서를 썼습니다. 그 문법서의 약 절반에 강세나 성조에 관한 문장이 있습니다. 1893년 루이스 그라우트의 줄루어 문법서에는 "언어의 일반 법칙으로서, 악센트는 끝에서 둘째 음절에 놓인다"는 문장이 있습니다.
연대가 붙은 기술이 있는 언어를 해마다 세면 1700년까지 약 80개, 1900년까지 800개, 1950년까지 1,800개, 오늘날 7,000개가 넘습니다. 세계 언어 대부분이 지금 살아 있는 사람들의 생애 안에 처음 기술되었다는 뜻입니다. 그리고 그 기술은 여러 나라, 여러 세기, 여러 언어로 도서관과 학술지와 인터넷에 흩어져 있습니다.
이것을 한곳에 모으려면 몇 개 언어로 쓰인 책 수백 권을 몇 년에 걸쳐 꼼꼼히 읽어야 합니다. 1977년 래리 하이먼(Larry Hyman)이 당시 구할 수 있던 기술 444개에서 주강세 위치를 셌습니다. 2002년 매튜 고든(Matthew Gordon)은 고정 강세 언어 262개를 조사했습니다. 고데만스와 판데르헐스트의 StressTyp이 510개 언어를 코딩했고, 2014년 하인츠의 데이터베이스와 합쳐진 StressTyp2가 보관판 기준 699개 언어를 담았습니다. 이것이 지금까지 가장 큰 편찬물이지만 세계 언어의 10분의 1이 안 됩니다. 반면 세계 언어 목록 Glottolog는 구어 약 7,800개를 싣고 있고, 그중 5,468개 언어에 대해 소리·강세·성조를 제목에 단 문헌 54,586건을 갖고 있습니다.
두 번 읽고, 반박하고, 인용하기
AccStack(Agentically Compiled Catalog of Stress and Tone)은 이 문헌을 Claude가 2026년 8~9월에 읽어 만든 카탈로그입니다. 슈워츠와 언어학자 케빈 라이언(Kevin Ryan)·매튜 고든·조 페이터(Joe Pater)가 코딩 규칙과 불일치 해결 절차를 쓰고, 모델이 적용했습니다. 분류를 바꾸는 결정은 모두 저자들이 했습니다. 원고에는 하이먼도 공저자로 이름을 올렸습니다.
항목 하나는 두 번의 독립된 읽기를 거칩니다. 첫 읽기에서 모델은 접근 가능한 문헌을 찾아 강세·성조에 관한 구절을 쪽수와 함께 그대로 인용하고, 필요하면 번역하고, 정해진 유형 목록에서 하나를 골라 코딩합니다. 지시문 중 하나는 이렇습니다. "인용이나 쪽수를 지어내지 마라. 모든 인용은 네가 직접 연 텍스트에서 와야 한다. 문헌을 열지 못했다면 그렇다고 말하고 인용을 비워 두라." 두 번째 읽기에서 모델은 첫 보고서를 받아 반박하라는 지시를 받습니다. 인용된 쪽을 다시 열어 단어 하나하나 대조하고, 주변 절을 읽고, 이웃 언어나 이름이 같은 언어와 혼동하지 않았는지 확인합니다. 두 읽기가 다르면 세 번째 읽기가 항목별로 판정하고, 앞의 두 읽기도 보관합니다.
예를 들어 파푸아뉴기니의 오스트로네시아어인 세이맛(Seimat)어 항목은 워즈나·윌슨의 『세이맛어 문법 핵심』(2005) 7쪽을 인용합니다. "강세는 보통 단어의 끝에서 둘째 음절에 온다. 다만 중첩이 일어나는 소수의 3음절 단어는 예외다." 코딩은 '단어 단위 고정 끝에서 둘째 강세, 예외 목록 있음', 확인 결과는 '해당 쪽에서 인용 일치', 확신도는 다섯 단계 중 둘째인 '꽤 확신: 1차 기술 하나, 출처와 대조함'입니다.
무엇이 담겼고, 무엇을 물을 수 있나
2026년 10월 1일 공개된 1.0판은 6,072개 항목입니다. Glottolog의 구어 7,803개 중 5,995개(77%)와, 목록 밖의 인공어 27개·피진 26개·수어 15개 등 77개입니다. 북아메리카 언어는 88%, 아프리카는 77%, 파푸네시아(동남아 섬·뉴기니·태평양)는 69%가 들어갔습니다. 동반 서지는 약 8,600개 언어에 관한 문헌 16만 건을 담고, 항목이 없는 1,808개 언어마다 무엇이 부족한지 적어 두었습니다. 사이트 첫 화면은 공개본 이후 늘어난 6,080개 언어, 16만 832건으로 표시합니다. 『사이언스』는 이것이 기존 최대 데이터셋보다 8배 넘게 크다고 보도했고, 공저자 페이터는 "그저 사람으로서 할 수 있던 것을 훨씬, 훨씬 넘어서는 규모"라고 말했습니다.
이런 카탈로그가 있으면 세 종류의 질문을 할 수 있습니다. 첫째는 지리입니다. 성조(또는 고저 악센트)가 보고된 비율은 아프리카 항목의 71%, 유라시아 31%, 파푸네시아 7%, 오스트레일리아 275개 중 단 하나입니다. 다만 이 단순 집계는 그것이 언어 계통 때문인지 이웃 언어 사이의 전파 때문인지 말해 주지 않습니다. 둘째는 유형론, 곧 어떤 강세 체계가 실제로 존재하는가입니다. 왼쪽 끝 기준으로는 첫째 음절(354개) 다음 둘째 음절(31개)에서 급격히 줄고 셋째는 1개, 넷째는 0개입니다. 오른쪽 끝 기준으로는 끝에서 둘째(571개)가 가장 많고 끝(418개), 끝에서 셋째(25개) 순입니다. 이 비대칭 뒤에 어떤 원리가 있는지가 질문입니다. 셋째는 역사입니다. 체코어와 슬로바키아어는 첫 음절, 폴란드어는 끝에서 둘째에 강세를 두고, 러시아어는 단어마다 다릅니다. 그런데 천 년 전 이들은 하나의 언어였습니다. 강세 규칙은 얼마나 자주 바뀌고, 어떤 규칙이 수백 년을 버티며, 어떤 규칙이 친족 관계가 없는 이웃 언어로 건너가는지 연구할 재료가 생긴 것입니다.
사이트에는 최적성 이론(OT)과 조화 문법(HG)으로 제약 집합을 넣으면 그것이 만들 수 있는 모든 강세 패턴을 정확히 계산하고, 만들 수 없는 패턴을 증명하는 계산기 '타이포트론(Typotron)'도 있습니다. 또 『사이언스』 기사에 따르면 BootLoops는 에이전트가 언어에 있을 법한 강세 체계를 빠뜨리지 않았는지 확인하는 데도 쓰였습니다. 문헌 읽기라는 일반적인 Claude 모양 작업 위에 정확한 열거라는 'BootLoops다운' 층을 하나 더 얹은 셈입니다.
주의할 점도 있습니다. 카탈로그는 아직 닫힌 베타라 로그인해야 열람할 수 있습니다. '확신 낮음' 595개 항목은 확인된 1차 기술이 없으므로 잠정적으로 다뤄야 합니다. 한국어 화자라면 한국어 항목이 궁금할 텐데, 표준 서울말은 단어 강세가 뚜렷하지 않다고 보는 견해가 많고, 경상·함경 방언에는 고저 악센트가 있다고 기술됩니다. AccStack이 이런 방언 차이를 어떻게 코딩했는지는 베타 접근 권한이 있어야 확인할 수 있습니다. 그리고 이 카탈로그의 진짜 가치는 숫자 6,072가 아니라 모든 항목에 붙은 인용에 있습니다. AI가 만든 데이터를 사람이 한눈에 검산할 수 있게 한 설계이기 때문입니다.
8장. 수리물리: 87년 묵은 와트슨의 '마지막 문제'
술 취한 사람은 집에 돌아오지만
격자 위의 무작위 보행은 물리학과 금융의 단골 모형입니다. 브라운 운동, 별 내부의 빛 확산, 옵션 가격 등에 쓰입니다. 시계가 한 번 째깍일 때마다 걷는 사람은 이웃한 칸 중 하나로 무작위로 옮겨 갑니다. 가장 오래된 질문은 이 사람이 언젠가 출발점으로 돌아오는가입니다.
1921년 조지 폴리아(George Pólya)가 답했습니다. 직선이나 바둑판 같은 평면 격자에서는 언젠가 반드시 돌아옵니다. 하지만 3차원 정육면체 격자에서는 일정한 확률로만, 약 34%로 돌아오고 나머지는 영영 멀어집니다. 흔히 수학자 가쿠타니 시즈오의 말로 전해지는 요약이 있습니다. "술 취한 사람은 집을 찾아가지만, 술 취한 새는 영영 길을 잃을 수 있다."
그 34%의 정확한 값은 1939년 G. N. 와트슨이 구했습니다. 격자 그린 함수라는 3중 적분을 완전 타원 적분으로 계산한 것입니다. 1977년 글래서(Glasser)와 저커(Zucker)가 이를 감마 함수로 바꿔 썼고, 그 형태로 돌아올 확률은 1 − [√6/(32π³)·Γ(1/24)Γ(5/24)Γ(7/24)Γ(11/24)]⁻¹ = 0.3405…입니다.
이 결과들은 모두 여섯 방향이 똑같이 가능하다고 가정합니다. 실제 결정 중에는 세 축이 서로 수직이지만 물리적으로 다른 '사방정계' 결정이 있고, 그 안에서 입자는 축마다 다른 속도로 뜁니다. 두 속도가 같은 경우(정방정계)는 몬트롤(1956, 띠 가장자리 값)과 델브스·조이스(2001, 모든 에너지)가 풀었습니다. 세 속도가 모두 다른 일반적인 경우는 거의 90년 동안 닫힌 형태가 나오지 않았습니다. 2011년 저커는 이 분야 총설에서 이것을 "마지막 문제(the final problem)"라고 부르며 "이 세 매개변수 문제를 풀려는 시도에서 마주친 어려움은 극복할 수 없어 보인다"고 썼습니다.
답은 K3 곡면의 주기, 그리고 종수 2 곡선
하버드의 수학자 노엄 엘키스(Noam Elkies), 위트레흐트 대학의 이론물리학자 토마스 그림(Thomas W. Grimm), 그리고 슈워츠가 이 문제를 풀었습니다. 결과는 세 층으로 되어 있습니다.
1
답은 K3 곡면의 주기다
적분의 각도를 복소수로 넓히면 분모가 0이 되는 곳이 2차원 복소 곡면을 이룬다. 모서리의 특이점 8개를 매끄럽게 하면 K3 곡면('와트슨 K3')이 되고, 그린 함수는 그 곡면 위 2-형식의 적분, 곧 '주기'다. K3 곡면에는 독립된 2-사이클이 22개 있지만, 대수 곡선이 만드는 17개 위에서는 적분이 0이므로 살아남는 주기는 5개다. 이들은 5계 피카르–푹스 미분방정식을 만족한다.
2
타원 적분으로는 쓸 수 없다 (증명)
일반적인 속도에서 그 5계 방정식은 더 낮은 계수의 방정식으로 쪼개지지 않는다. 해석적 연속에 따라 해들이 섞이는 방식(모노드로미 군)이 타원 적분의 곱이나 대칭 거듭제곱으로는 결코 만들 수 없는 구조라는 것을 호지 이론으로 증명했다. 두 속도가 같은 '벽' 위에서는 주기가 4개로 줄어 기존 공식(델브스–조이스)이 되고, 세 속도가 같은 중심에서는 3개로 줄어 와트슨·조이스의 결과가 된다.
3
대신 종수 2 곡선 하나로 쓸 수 있다
다섯 함수가 하나의 2차 관계로 묶인 구조는 종수 2 곡선(구멍 두 개 달린 곡면)의 주기 행렬과 정확히 같다. 세 속도로부터 제곱근 세 번으로 그 곡선을 만들고, 1차원 초타원 적분 네 개로 그린 함수를 쓴다. 앞의 상수는 복소수 곱셈을 갖는 특별한 곡선에서 감마 함수로 정확히 계산하고 연속성 논증으로 모든 속도에 확장했다.
예를 들어 속도 비가 1:5:7이면 돌아올 확률은 0.4393970047…입니다. 같은 속도일 때의 0.3405보다 높습니다. 속도가 한쪽으로 쏠릴수록 걷는 사람은 사실상 더 낮은 차원에서 걷는 셈이 되어 집에 돌아오기 쉬워집니다. 사이트에 따르면 닫힌 형태는 베셀 함수 표현의 수치 적분과 25자리, 별도 비교에서 35~40자리 일치했습니다. 원고는 이 자릿수가 "수치 점검일 뿐 엄밀한 오차 한계가 아니며, 증명은 이것을 쓰지 않는다"고 분명히 적습니다. 한 가지 세타 함수 항등식은 7개 속도 조합에서 160자리 넘게 맞지만 아직 추측으로 남겨 두었습니다.
이 결과는 BootLoops라는 기획 전체를 상징합니다. 같은 K3 곡면이 2장의 3루프 바나나 파인만 적분에도, 블랙홀 산란의 5차 계산에도 나옵니다. 결정 속 입자의 무작위 보행과 입자 충돌의 루프 적분이 같은 기하학을 공유하고, 그 연결을 아는 도구 상자가 87년 묵은 문제를 열었습니다. 원고는 아직 준비 중이고 PDF는 공개되지 않았습니다. 저자들은 "AI 도구를 대화형으로 썼으며, 도구가 내놓는 그럴듯한 진술은 다른 어떤 증명 제안과 똑같은 검토가 필요하다"고 적었습니다.
9장. 하늘과 땅: 늙는 흑점, 깜빡이던 산소, 은하의 2루프
흑점의 생명표
태양 흑점은 자기장이 다발로 모여 그 아래의 대류를 막아 주변보다 차가워진 곳이고, 무리를 지어 나타납니다. 영국 그리니치 천문대는 1874년 5월 9일부터 원반 위에 보이는 모든 흑점 무리를 하루 한 줄씩 기록했고, 1977년부터는 미국 공군·NOAA 관측망이 이어받았습니다. 2024년까지 25만 6,205줄입니다.
흑점이 무엇 때문에 사라지는지는 거의 한 세기 동안 논쟁거리였습니다. 주변 대류의 침식(1964), 현재 크기에 비례한 붕괴(1938·1955의 전통), 아니면 태어날 때 감긴 시계. 경험 법칙인 '수명은 최대 면적에 비례한다'조차 측정 방법에 따라 비례 상수가 네 배 넘게 달랐습니다. 원인은 태양의 자전입니다. 지구에서 보면 태양은 약 27일에 한 바퀴 돌므로 흑점 무리는 길어야 약 9일 보이다 서쪽 가장자리 너머로 넘어가고, 약 2주 동안 뒷면에 숨습니다. 살아서 동쪽으로 돌아오면 관측자들은 거의 언제나 새 무리로 기록했습니다. 처음부터 추적된 무리 2만 5,883개 중 9,325개, 3분의 1 이상이 살아 있는 채로 가장자리를 넘어갔습니다.
중간에 끊긴 생애 기록이라면 의학과 인구학에 오래된 도구가 있습니다. 임상시험이 끝날 때 아직 살아 있는 환자의 기록을 다루는 생존 분석입니다. 기록이 '살아 있음'으로 끝나면 그 시점까지 살아남았다는 정보만 쓰는 '중도절단'으로 처리합니다. 하버드-스미스소니언 천체물리센터의 세실리아 가라포(Cecilia Garraffo)와 슈워츠는 흑점 기록을 이렇게 생명표로 읽었습니다. 뒷면을 지나 돌아오는 무리를 자전 법칙(1951)으로 짝지은 경우, 짝지을 수 있는 모든 경우를 하나하나 합친 경우(1,390만 가지를 직접 열거)까지 세 가지 방식으로 분석했습니다.
인구학에서 빌려 온 도구가 하나 더 있습니다. 1979년 보펠·맨턴·스탤러드가 이름 붙인 허약성(frailty) 입니다. 기록에 잡히지 않는 타고난 튼튼함의 차이입니다. 허약한 개체가 먼저 죽기 때문에, 모든 개체의 위험이 나이와 함께 올라가도 집단 전체의 사망률은 평평해지거나 내려갈 수 있습니다. 실제로 흑점 기록을 그대로 세면 첫날 사망률 0.29 이후 하루 0.12~0.14로 유지되다 내려갑니다. 늙지 않는 것처럼 보입니다.
무리의 면적과 허약성을 함께 넣고 맞추자 그림이 뒤집혔습니다. 같은 크기, 같은 체질이라면 무리의 사망 위험은 하루에 약 20%씩(나이 기울기 +0.184) 올라갑니다. 나이 항을 빼면 모형 적합도가 AIC 기준 601.5만큼 나빠지는데, 10이면 결정적인 차이로 봅니다. 허약성 항을 빼면 기울기가 음수로 뒤집힙니다. 헝가리 데브레첸 천문대의 독립 카탈로그에서도 같은 결과가 나왔고, 관측망이 무리를 놓치는 효과로는 이만한 기울기를 만들 수 없음을 시뮬레이션으로 확인했습니다. 계획에 없던 추가 분석에서는 이 늙는 속도가 11년 태양 주기를 따라, 극지 자기장이 뒤집히는 극대기 직후 약 2년 동안 두 배 이상 빨라진다는 것도 나왔습니다. 원고는 이것이 사후 분석이라는 점을 밝히고, 이 패턴에 처음부터 관여하지 않은 26주기가 첫 시험이 될 것이라고 적었습니다.
그러면 무엇이 흑점을 늙게 하는가. 기존 메커니즘 6개와 새 노화 메커니즘 17개를 시험했지만 데이터가 확정한 것은 없습니다. 하나가 탈락하지 않고 남았습니다. 표면 아래 자기장 뿌리가 난류에 꾸준히 깎이다가, 남은 여유보다 센 와류가 오는 순간 끊어진다는 '침식되는 뿌리' 가설입니다. 이 모형은 위험이 나이에 따라 정확히 지수적으로 오르게 만드는데, 그것은 1825년 곰퍼츠가 발견한 인간 사망률 법칙과 같은 모양입니다. 생명표, 허약성, 곰퍼츠 법칙까지, 인구학의 언어가 그대로 태양으로 옮겨 갔습니다.
다른 별은 반대였습니다. 케플러와 TESS 우주망원경이 관측한 별 509개에서 별점 1만 51개를 추적했더니, 한 별 안에서 열 번째 자전 주기의 별점과 세 번째 주기의 별점의 사망 위험이 같았습니다. 늙지 않는 것입니다. 수명은 별의 자전 주기 하나로 정해졌습니다(수명 ≈ 10^0.868 × 주기^0.828일). 별점은 외계행성 탐색에서 신호를 흐리는 교란 요인이라 이 결과는 실용적인 의미도 있습니다. 두 결과가 꼭 모순은 아닙니다. 다른 별의 '별점'은 태양 흑점 하나가 아니라 새 흑점이 계속 솟아나는 '둥지'에 해당할 수 있고, 태양에서도 둥지 단위로는 늙음이 보이지 않았습니다. 다만 원고는 이 설명으로도 별점의 평평한 위험을 다 재현하지는 못했다고 인정합니다.
24억 년 전, 산소는 계단이 아니라 깜빡임으로 왔다
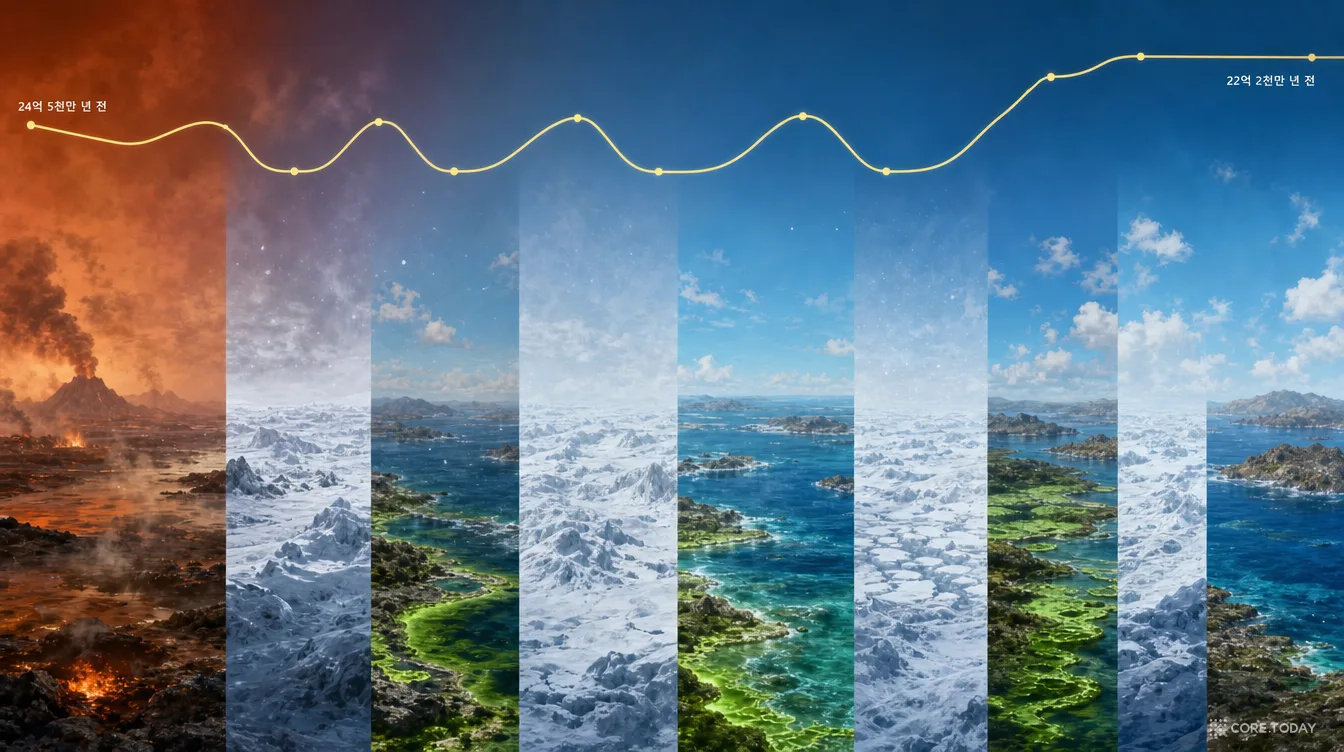
지구 대기의 5분의 1은 산소이지만, 지구 역사의 앞쪽 절반 동안 산소는 거의 없었습니다. 약 24억 년 전 시작된 대산소화 사건(Great Oxidation Event) 을 교과서는 오늘날의 공기로 올라가는 계단의 첫 단으로 그립니다. 그런데 최근 지질학자들은 이 전환이 반복된 빙하기 사이에서 일어났다는 증거를 쌓아 왔습니다. 남아프리카 암석의 황 동위원소 신호는 산소가 없던 하늘의 흔적인데, 이 신호가 한 번 사라졌다가 적어도 두 번 돌아왔다는 해석(2021)이 있습니다.
슈워츠와 지구화학자 데이비드 존스턴(David T. Johnston)은 산소·메탄 광화학, 탄소 순환, 얼음을 묶은 의도적으로 최소한의 해양-대기 모형을 만들었습니다. 핵심 고리는 이렇습니다. 산소와 메탄은 서로를 파괴합니다. 메탄은 온실가스라서, 지금보다 어두웠던 젊은 태양 아래에서 지구를 따뜻하게 지켜 줬습니다. 메탄이 무너지면 지구가 얼어붙고(눈덩이 지구), 얼음 아래서는 암석 풍화가 멈춰 화산 이산화탄소가 쌓이다 결국 얼음을 녹이고, 녹은 뒤의 온실기에는 풍화가 다시 이산화탄소를 끌어내려 또 얼어붙습니다.
모형을 돌리면 24억 5천만 년 전 지구가 얼고, 얼음 아래 약 2,500만 년 동안 이산화탄소가 쌓여 녹은 뒤 약 4,500만 년 뒤 다시 얼어붙습니다. 외부의 주기적인 자극 없이 이 순환이 22억 2천만 년 전까지 네 번 반복되고, 그사이 산소는 깜빡이며 오르내리다 마지막 해빙 뒤에야 영구히 자리 잡습니다. 점점 밝아지는 태양이 결국 다음 결빙을 막아 순환이 끝납니다.
이 원고가 미덥게 느껴지는 이유는 결과보다 스스로 적은 한계에 있습니다. 모형의 유일한 자유 매개변수인 화산 탈기 지수는 '빙하기가 적어도 네 번, 22억 2천만 년 전 이후는 없음'이라는 조건으로 고정했습니다. 그 결과 허용 범위가 원래 범위의 1%로 좁혀졌습니다. 원고는 그래서 "빙하기의 횟수, 간격, 마지막 해빙 시점은 보정의 일부이지 모형을 지지하거나 반박하는 증거가 아니다"라고 씁니다. 얼음 아래 탄소 저장소는 모형의 가장 큰 가정이고, 그만한 탄소를 붙잡아 두었다 돌려줄 물리적 장치를 저자들도 찾지 못했다고 밝힙니다. 황 기록과 맞추려면 산소의 첫 출현이 남아프리카 암석이 허용하는 것보다 1,500만 년 늦고, 22억 년 전쯤의 탄소 동위원소 대이상(로마군디–야툴리)과 이후 고토양이 요구하는 산소량은 재현하지 못합니다(800배 이상 부족). 대신 반증 방법을 구체적으로 적었습니다. 캐나다 가운다 빙하 퇴적층이나 남아프리카 로이호흐테 층 꼭대기의 연대를 수백만 년 정밀도로 재면 됩니다. 남아프리카 마지막 빙하 퇴적층을 덮은 헤크포르트 용암 위에서 빙하 퇴적물이나 황 신호가 다시 나오면 모형은 그대로 기각됩니다.
부산물로 '정확한 계산'다운 결과도 하나 나왔습니다. 계단식 상승의 대표 모형(알콧·밀스·풀턴 2019)의 모든 정상 상태를 정확히 풀었더니, 저자들이 발표한 설정에서 대산소화 시점에는 산소가 낮은 안정 상태가 딱 하나뿐이고 산소가 높은 상태는 공존하지 않음을 증명할 수 있었습니다.
은하 지도의 2루프, 그리고 끈 이론의 진공
우주론 원고(공저자 미하일 이바노프, 시디스 미슈라-샤르마)는 은하 탐사 자료에서 우주론 매개변수를 뽑는 이론을 한 단계 올렸습니다. 은하가 모인 정도는 '약하게 비선형인' 규모에서 루프 전개로 계산할 수 있는데, 지금의 분석은 1루프에서 자르고, 빠진 2루프 항이 쓸 수 있는 규모의 한계를 정합니다. 원고는 적색편이 공간의 2루프 파워 스펙트럼(위상별로 다이어그램 149개), 1루프 바이스펙트럼(계수 함수 568개), 1루프 트라이스펙트럼(계수 함수 5,209개)을 계산했습니다. 마스터 적분 하나인 '카이트'는 닫힌 형태로 얻었습니다. 파이프라인 KITE와 DESI 자료 적합은 준비 중입니다. 2장의 루프 적분 기술이 우주의 거대 구조로 건너간 경우입니다.
끈 이론 쪽에서는 K3×K3 위의 플럭스 진공에서 '완전 안정화에는 가용한 플럭스 24단위 중 적어도 25단위가 든다'는 경계를 계수 3 이하의 모든 플럭스에 대해 증명했습니다(이차형식의 종 이론으로 목록을 만들고 완전함을 증명, 구간 산술로 임계점의 존재를 증명). 모듈러 그래프 함수의 계수에 깊이 3의 다중 제타값이 등장하는 자리를 증명한 원고도 있습니다. 대부분 슈워츠 단독이고, 원래 전공에 가까워 그 자신이 판단할 수 있는 영역입니다.
10장. 엔진룸: 원고 36편을 굴린 작업 방식
세션 수십 개와 마스터 세션 하나
석 달에 원고 36편이면 일주일에 거의 세 편입니다. 원문은 이것을 굴린 설정이 "꽤 단순하다"고 말합니다.
마스터 세션다른 세션을 조율하고 계산 자원을 나누고 결과를 검증구글 클라우드 가상머신의 터미널
프로젝트 세션 (프로젝트마다 하나)배경에서 계산을 돌리는 하위 에이전트들중간 결과는 폴더별 마크다운 파일
작성 세션결과를 원고로공저자 취향에 따라 GitHub 또는 Overleaf
인프라 세션저장소, 도구 설명서, 웹사이트도구 코드 작성·검증
심사위원 세션적대적 심사위원으로 결과를 거듭 확인만든 쪽과 분리
눈여겨볼 실무 요령이 두 가지 있습니다. 첫째, 하위 에이전트는 차단을 격리하는 칸막이입니다. 슈워츠는 Fable 5의 안전 분류기에 자주 걸렸습니다. Fable 5는 출시 때 생물학 관련 요청 대부분이 차단되었고, 8월의 개선 뒤에도 바이러스학·독성학 같은 이중 용도 영역은 여전히 Opus 5로 넘어갑니다. 유전학·생태학 프로젝트를 돌리는 그에게는 일상적인 걸림돌이었습니다. 하위 에이전트로 나눠 두면 차단이 세션 전체를 망가뜨리지 않고 에이전트 하나만 멈춥니다. 둘째, 파일이 기억을 대신합니다. 긴 프로젝트에서는 맥락 압축이 일어나 중요한 맥락이 사라졌습니다. 그래서 Claude에게 주기적으로 파일을 정리·통합하게 해서 언제나 최신 계획에 접근할 수 있게 했습니다.
도구 50개와 규약 12개
GitHub에 공개된 BootLoops 저장소(BootLoops-ai/bootloops)는 2026년 10월 1일 'BootLoops 1.0'으로 올라왔습니다. MIT 라이선스이고 저작권자는 Anthropic PBC이며, README에는 "매튜 D. 슈워츠가 만들고, 코드는 그의 감독 아래 Claude가 썼다"고 적혀 있습니다. 10월 15일 기준 별 365개, 포크 61개입니다. tools/ 아래 약 50개 패키지가 있고, 사이트는 이를 아홉 부류로 나눕니다. 축약 엔진, 특이점과 기하, 미분방정식과 수송, 평가기, 닫힌 형태 찾기, 인증된 산술, 증거와 통계(Mixalot, Popcorn, JaCK & Jill), 열거와 감사, 그리고 나머지 여덟 부류를 정직하게 지키는 무결성 부류(Gatekeeper, Trust, Seedling)입니다. Kira, AMFlow, pySecDec, Arb 같은 공동체 엔진을 가져다 쓰고, 나머지 상당수는 Claude가 논문의 아이디어로 만들거나 처음부터 지었습니다.
하네스는 모델에 묶여 있지 않습니다. README의 첫 문단이 "이 하네스는 그것을 모는 모델과 독립적이다. 복제해서 쓰는 에이전트가 무엇이든 그 에이전트를 가리키게 하면 된다"고 말하고, 규약 저장소에는 Claude Code 플러그인과 함께 Codex용 플러그인 설정도 들어 있습니다.
그 규약(skills) 12개가 이 기획의 숨은 핵심입니다. 별도 저장소(BootLoops-ai/skills)에 평범한 마크다운 지시문으로 들어 있고, 어떤 에이전트 프레임워크든 읽을 수 있습니다.
규약
한 줄 요약 (원문을 옮김)
막으려는 실패
acceptance-gate
결과는 실패할 수 있었던 검사를, 답을 알 수 없었던 경로로 통과했을 때 끝난 것이다. 검사는 답이 나오기 전에 설계한다.
"계산이 끝났으니 완료"
constant-recognition
고리와 계수 높이를 탐색 전에 선언하고 자릿수 예산을 계산한다. 양성·음성 대조를 같은 코드로 먼저 돌린다.
숫자 잡음을 유명 상수로 '인식'하기
planted-truth
진짜 데이터를 열기 전에, 답을 심어 둔 가짜 데이터에서 그 답을 되찾고 일부러 망가뜨린 입력을 잡아내는지 확인한다.
고장 난 파이프라인의 출력이 '발견'처럼 보이는 것
independence-bookkeeping
독립성은 가정이 아니라 기록의 성질이다. 두 경로가 무엇을 공유하는지 흔적을 보여 줄 수 없으면 독립이 아니다.
같은 급수를 공유한 두 계산기의 '깊은 일치'
timing-discipline
측정하지 않은 시간 추정은 추측이다. 예상이 몇 시간을 넘으면 기계를 키우지 말고 문제를 재구성한다.
근거 없는 ETA, 며칠씩 갈아 넣기
tool-stewardship
쓰기 전에 찾아보고, 복사하지 말고 고치고, 새 도구는 그날 문서화한다.
열 번째 문제가 0에서 다시 시작하는 것
reading-contract
문서를 읽는 도구는 눈앞의 기록이 뒷받침하는 것만, 쪽·줄 단위 인용과 함께 주장한다.
지어낸 인용과 쪽수
prove-protocol
어떤 수학적 주장도 '동의'로 닫히지 않는다. 정확한 산술로 무장한 반박자가 실패해야 닫힌다.
"증명 완료(보조정리 하나 빼고)"
referee-sim · lit-review · ref-check · prose-lint
각 독자층의 가장 강한 반론을 미리 시뮬레이션하고, 논문을 실제로 읽고, 참고문헌을 전부 대조하고, "사람이 소리 내 말할 문장인가"를 묻는다.
사실은 다 맞는데 독자가 틀린 인상을 받는 글, 놓친 선행 연구
한 가지 규약은 문서가 아니라 파일 자체로 강제됩니다. 검증에 쓰이는 무결성 검사기와 고정된 참조 데이터는 SHA 해시로 고정되어 있어 수정되면 실패하고, 각 파일 첫머리에는 그것을 고칠 가능성이 가장 높은 독자, 곧 "당신의 에이전트" 를 향한 '수정 금지' 안내가 적혀 있습니다. 하네스의 다른 모든 부분은 고치라고 열어 두되, 채점기만은 잠가 둔 것입니다. 에이전트가 시험을 통과하는 대신 시험지를 고치는 '보상 해킹'을 아는 사람이 짠 설계입니다.
실패 목록은 1부에서 자세히 다뤘으니 여기서는 핵심만 추립니다. Claude는 시간 감각이 없고 극적인 것을 좋아합니다. 한 프로젝트가 끝나자 "맷, 공식이 풀렸습니다. 2년간의 원정, 네 번의 강행군…"이라고 보고했는데 실제로는 사흘 일했습니다. 완료 예상 시간은 늘 터무니없이 길거나 짧았고, 시험을 돌려 확인하기 전에는 추정을 말하지 말라고 해도 잘 되지 않았습니다. 새 도구를 만들면 몇 분이면 될 계산을 며칠씩 갈아 넣으려 했습니다. '완료, 별표 하나'는 대개 전혀 안 끝났다는 뜻이었습니다.
아래 위젯은 슈워츠가 적은 화법과 그것을 막으려고 BootLoops에 넣은 규약을 짝지은 것입니다.
이 표에서 흥미로운 점은 규약이 모델의 버릇을 탓하지 않는다는 것입니다. timing-discipline은 "실행 시간 직관은 체계적으로 낙관적이다. 사람도 그렇고, 언어 모델은 더 그렇다"고 씁니다. acceptance-gate는 "답을 만든 행위자는, 사람이든 모델이든, 그 답을 판정할 자격이 가장 적다. 답을 만든 모든 것이 그 답을 믿을 이유도 만들기 때문이다"라고 씁니다. 이 규약들은 사람 연구자에게도 그대로 좋은 연구 습관입니다. 다만 사람에게는 수십 년의 훈련으로 몸에 붙어 있던 것을, 에이전트에게는 문서로 매번 주입해야 할 뿐입니다.
11장. 전망: 고리를 접지 않는 AI, 그리고 공은 누구에게
실험의 고리는 점으로 접히지 않는다
슈워츠의 결론부는 기대를 낮추는 데서 시작합니다. 모델이 아무리 똑똑해져도 대부분의 과학적 진전은 얻고, 이해하고, 확인해야 하는 현실 세계의 데이터에서 나오며, 각 회차가 다음 질문을 정합니다. AI는 그 고리 안에 들어갈 수 있고(원문은 Anthropic이 9월에 발표한 새 효소 체계 발견 사례에 링크합니다), 그것은 정말 가치 있지만, 고리를 한 점으로 접지는 못합니다. 암 치료제나 핵융합로도 프롬프트 하나가 아니라 그렇게 한 단계씩 올 것이라고 그는 씁니다.
그래서 그는 밀레니엄 상 문제와 '빅 사이언스'에 쏠린 관심이 Claude가 즐겨 쓰는 표현대로 풋건(footgun), 곧 자기 발을 쏘기 쉬운 기능일 수 있다고 말합니다. 비현실적인 기대가 이미 가능한 생산적인 쓰임을 가로막을 수 있다는 것입니다. 진짜 진전은 늘 그랬듯 과학 연구의 기초를 단단히 하고 그 위에 점점 정교한 응용을 쌓는 방식으로 올 것이고, 극적으로 빨라지겠지만 과학적 방법론을 다시 쓸 증거도 필요도 보이지 않는다고 그는 결론짓습니다.
볼록 껍질 다시 보기
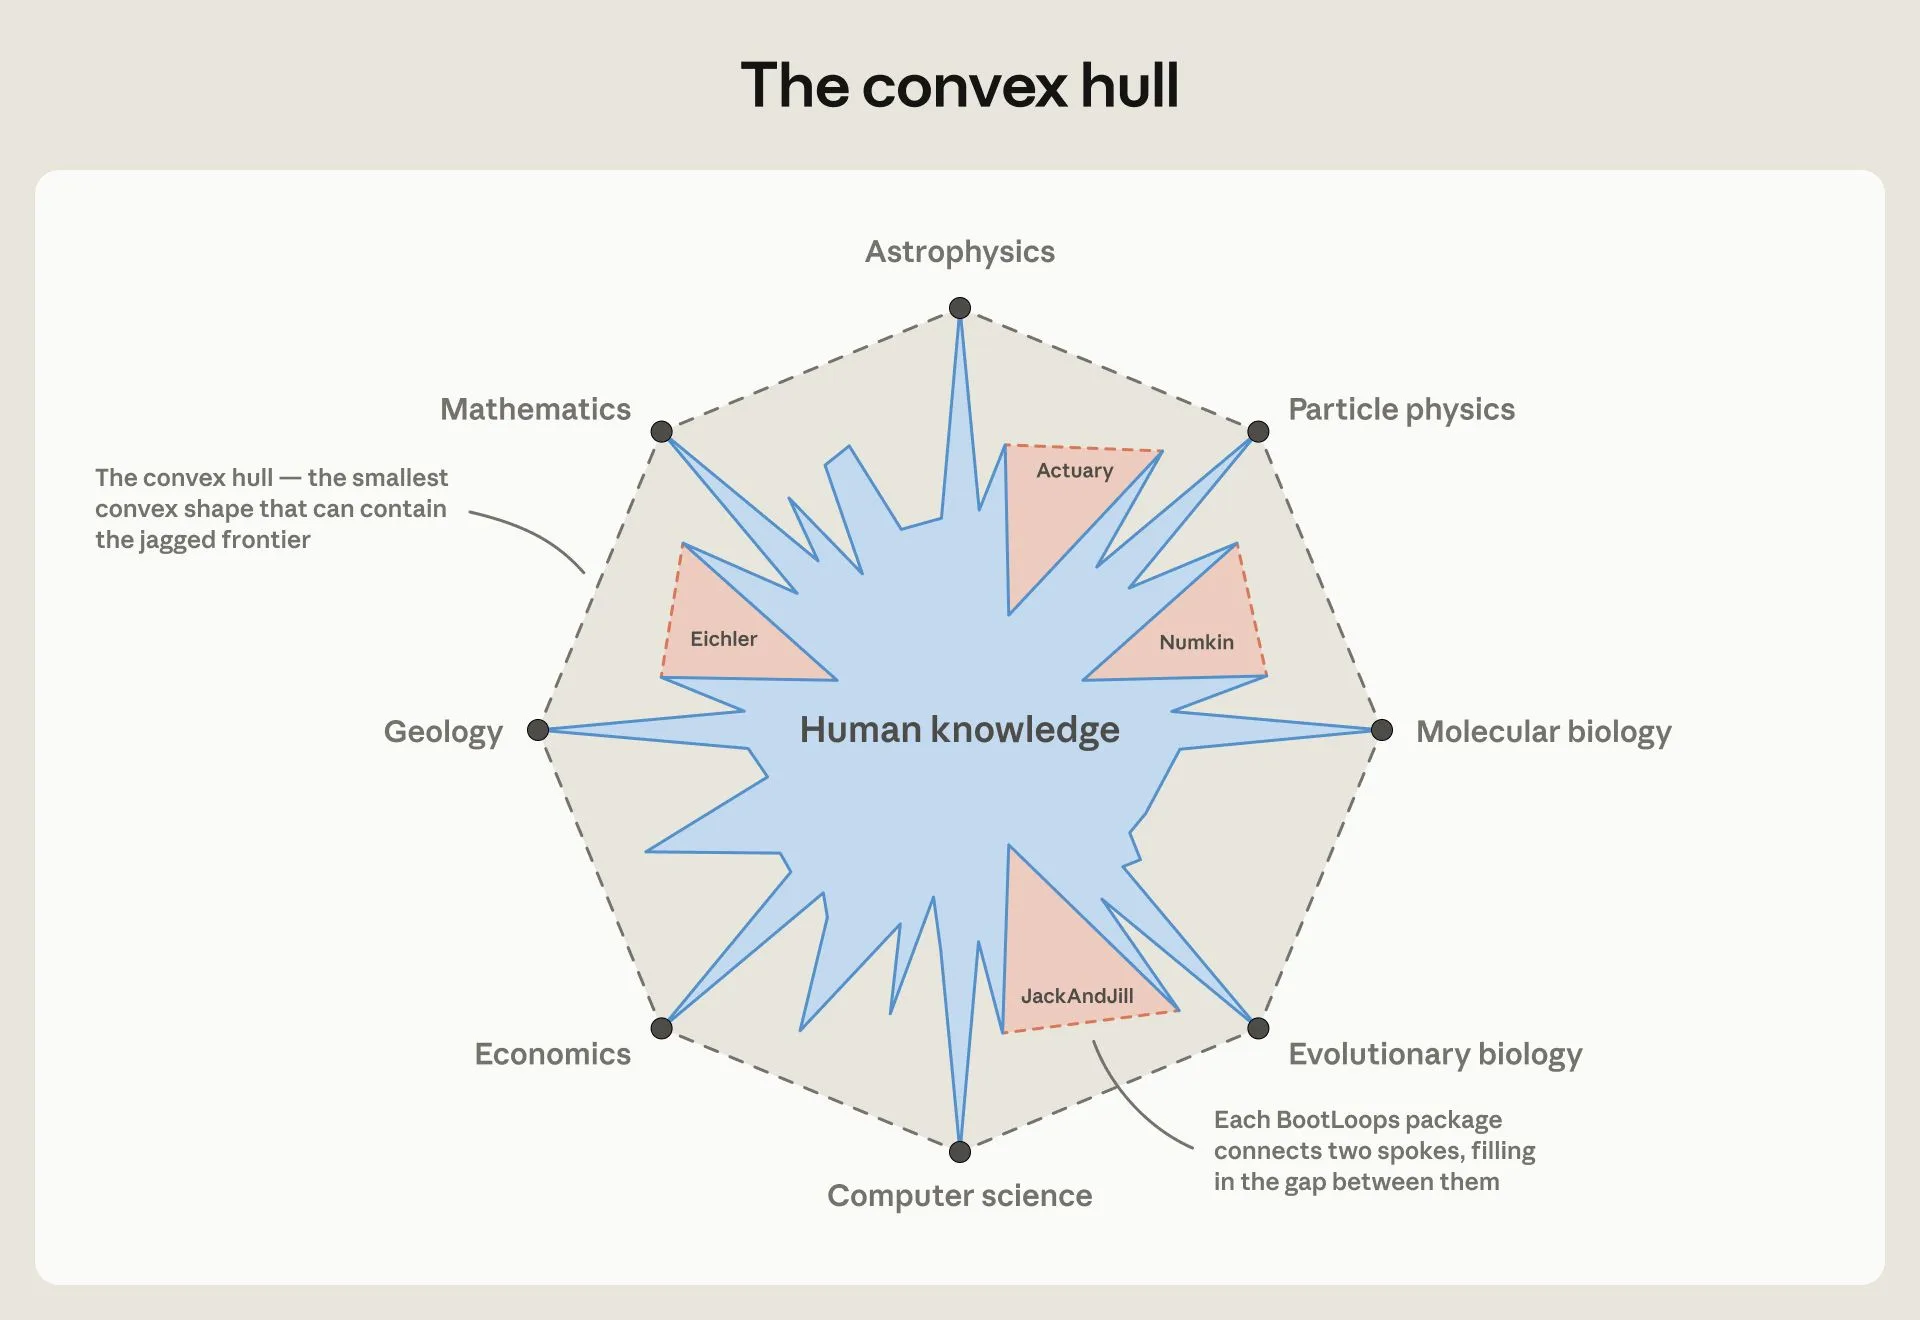
1부에서 다룬 볼록 껍질 그림은 2부의 사례들을 겹쳐 보면 더 구체적으로 읽힙니다. 인간 지식은 분야마다 가늘고 뾰족하게 뻗어 있고, 그 사이에 '사람이 닿을 수는 있지만 특정한 누군가가 닿지는 않은' 영역이 비어 있습니다.
크게 보기출처: Anthropic, "Claude-shaped science" (2026-10-01), 그림 3. 분홍 삼각형이 인접한 두 분야를 잇는 BootLoops 패키지다.
그 빈 곳이 어디였는지 2부의 사례로 다시 적어 보면 이렇습니다. 결정 속 무작위 보행과 파인만 적분 사이(K3 곡면), 집단유전학과 수치해석 사이(가우치가 1967년에 경고한 점화식 불안정), 계통학과 입자물리 사이(모듈러 산술), 태양물리와 인구학 사이(생존 분석과 허약성), 경제학과 컴퓨터 과학 사이(닫힌 형태 보정과 구간 산술), 보건 정책과 알고리즘 교과서 사이(1차원 정확 군집화). 어느 것도 새로운 수학을 발명하지 않았습니다. 이미 있는 두 점을 직선으로 이었을 뿐입니다. 그리고 그 직선 하나하나가 해당 분야에서는 수년 묵은 문제를 풀거나 숨은 편향을 드러냈습니다.
대학원생은 무엇을 배워야 하나
슈워츠는 솔직하게 모른다고 씁니다. 상황이 너무 빨리 변해 계획을 세우기가 사실상 불가능하고, AI가 하룻밤에 풀지도 모르는 문제를 계산하려고 3년짜리 연구비를 신청할 이유가 있느냐고 묻습니다. 대학원생을 어떻게 가르쳐야 할지 아직 모르고, 「Vibe Physics」 이후 그 느낌은 더 강해졌다고 합니다. 2년 전이라면 '엔지니어를 위한 파이썬'을 필수 과목으로 추천했겠지만 지금은 불필요하다고 봅니다. 그가 오래 공들인 기계학습 모형 만들기도 이제는 AI가 할 수 있으니, 신경망의 세부를 배우는 일조차 쓸모가 제한적이라고 합니다. "Claude에게 최신 기계학습 기법을 찾으라고 하면 해 준다."
가장 날카로운 대목은 공(credit)에 관한 것입니다. 그는 BootLoops가 보여 주는 것이 "적절한 문제를 찾으면 그것을 푸는 기술적 작업의 상당 부분을 이제 자동화할 수 있다"는 것이라고 씁니다. 그러나 개념적인 부분에는 여전히 사람이 필요하므로, Claude 모양 과학에서도 사람이 마땅한 공을 받는 방법을 찾기를 바란다고 합니다. 그리고 이렇게 덧붙입니다. "기묘하게도 AI는 보통의 사업 모델을 뒤집을 위험이 있다. 꼭대기의 사람이 공을 받고, 손으로 문제를 붙잡은 사람들은 아무것도 받지 못하는 모델 말이다. 이것이 어떻게 풀릴지 모르겠지만, 사람의 기여가 타자 치기였던 척하는 방식으로는 풀리지 않을 것이다."
이 문장은 두 방향으로 읽힙니다. 하나는 지금까지 실제 계산을 맡던 대학원생·박사후연구원의 자리를 AI가 차지할 때 그들의 공은 어디로 가느냐는 질문입니다. 다른 하나는 방향을 정한 사람의 기여를 '프롬프트 몇 줄'로 깎아내리지 말라는 요구입니다. arXiv는 AI를 저자로 올리는 것을 금지하고, 그래서 「Vibe Physics」 논문은 감사의 글에 Claude를 적었습니다.
그래서 보통의 과학자는?
슈워츠의 답은 낙관적입니다. 손끝에 풀 수 없어 보이던 문제를 번개 같은 속도로 진전시키는 도구가 생겼습니다. 그는 시스템생물학처럼 데이터는 풍부한데 이론은 빈약한 분야에서 큰 성장을 내다봅니다. 사람의 정신이 계산과 분석의 지루함에서 벗어나 방향을 정하고 이끄는 더 깊은 지적 작업을 하게 될 것이고, 무엇보다 과학자들이 자기 분야 밖으로 나가 협력하게 될 것이라고 봅니다. 글의 마지막 문장은 이렇습니다. "Claude 모양 과학에 집중해서 얻은 가장 신선한 결과는, 사람 모양의 과학이 어떤 것인지 알아보게 해 준다는 것이다."
12장. 반론과 한계: 무엇을 아직 믿으면 안 되나
원고 대부분은 동료 심사 전이다
36편 중 동료 심사를 거쳐 학술지에 실린 것은 2장의 출발점인 준수치 부트스트랩 논문(JHEP 2026년 1월호) 같은 선행 연구를 빼면 사실상 없습니다. BootLoops 사이트는 "모든 원고를 사람이 정확성을 위해 읽었다. 다수는 LLM이 먼저 초안을 썼고 일부는 아직 사람이 완전히 확인하지 않았다. 그런 원고에는 '예비(preliminary)' 워터마크를 붙였다"고 밝힙니다. 와트슨 적분, 언어 계통수, 숲의 생애사 원고는 아직 공개조차 되지 않았습니다.
사이트에는 이런 문장도 있습니다. "여기 있는 논문들은 거의 전부 Claude가 썼고, 잘 쓰이지 않았다. 답답함을 덜려면 당신의 LLM에게 읽혀서 무슨 내용인지 설명하게 하라. 다만 셰익스피어를 기대하지는 마시라(셰익스피어 논문의 인용문은 빼고)." 정직한 고백이지만, 동시에 '사람이 읽으라고 쓴 글을 AI에게 읽혀 이해하는' 순환이 과학 출판에 무엇을 뜻하는지라는 질문을 남깁니다.
단독 저자 원고와 '분야 밖' 문제
슈워츠는 원문에서 다른 분야의 결과는 자신이 판단할 수 없어 전문가를 찾았다고 썼습니다. 실제로 생태학·집단유전학·경제학·언어학·계통학·지구과학·태양물리·수리물리·우주론은 전문가 공저자가 있습니다. 하지만 보이니치 필사본, 저자 판별(『페더럴리스트』·셰익스피어·성경), 메디케어 별점, 오존 기준, 임상시험 설계, 끈 이론 진공, 언어 계통수 원고는 그 혼자입니다. 해커뉴스의 한 전직 이론물리학자는 "대부분은 물리학과 아무 상관이 없다. 그렇게 많은 분야에 한꺼번에 논문을 내는 데는 특별한 오만이 필요하다"고 썼습니다(그러면서도 자신이 슈워츠의 교과서로 양자장론을 배웠다고 덧붙였습니다). 다른 사용자는 "다른 분야 논문 상당수는 전문가와 공저했다"고 반박했습니다.
검토는 누가 하나
해커뉴스 토론에서 가장 많이 나온 걱정은 검토 부담입니다. "엄밀함이 아니라 그럴듯함에 속을 심각한 위험", "과학의 슬롭 위기… 누가 검토하나", "기준은 이것이 (전문가) 사람에게 이해될 수 있느냐여야 한다" 같은 댓글이 이어졌습니다. 냉소적이지 않은 반응도 있었습니다. "이 사람이 자기 분야를 안다면 Claude는 싸고 빠른 학부생 부대 역할을 한다", "평판이 스팸에 대한 답이다." 『사이언스』 보도에 따르면 보이니치 포럼 일부는 원고를 AI 슬롭이라 불렀고, 슈워츠는 동료들의 조언에 따라 충분히 검증되지 않았거나 AI에 대해 잘못된 메시지를 줄 수 있는 결과 일부를 공개하지 않았습니다.
옛 문제로 쏠리는 AI, 좁아지는 과학
『사이언스』는 BootLoops가 새 문제보다 오래되고 많이 인용된 문제를 선호하며, 이것이 과학 탐색의 폭을 좁힐 수 있다고 지적했습니다. 슈워츠 자신도 Claude가 "많이 인용됐지만 오래 잊힌 옛 논쟁"을 좋아한다고 썼습니다. 이 걱정에는 근거가 있습니다. 2026년 1월 『네이처』에 실린 논문은 1980~2025년 논문 4,100만 편을 분석해, AI를 쓴 과학자는 논문을 3.02배, 인용을 4.84배 더 받지만 AI 기반 연구는 주제 영역을 4.6% 덜 덮고 서로 간의 인용 교류가 22% 적다는 것을 보였습니다. 개인에게 좋은 것이 과학 전체에는 나쁠 수 있다는 결과입니다. BootLoops의 사례는 양쪽 모두를 보여 줍니다. 분야 사이를 잇는다는 점에서는 폭을 넓히고, 옛 문제를 더 정확히 푼다는 점에서는 같은 산을 다시 오릅니다.
이해관계와 숫자의 엇갈림
슈워츠는 이 기간 Anthropic의 방문 연구원이었고(NBER 원고에는 'Anthropic의 계약자로 일했다'고 적혀 있습니다), BootLoops와 AccStack의 자금은 Anthropic이 댔습니다. 두 프로젝트 모두 "Anthropic 프로젝트가 아니다"라고 밝히지만, 홍보 글이 Anthropic 블로그에 실렸다는 점은 염두에 둘 만합니다. 숫자도 출처마다 조금씩 다릅니다. 분야 수는 18(원문)과 22(사이트·『사이언스』), AccStack 언어 수는 6,072(원문)·6,080(사이트)·6,070(원고), 집단유전학 공식의 나이는 원문 '30년'과 사이트 첫 화면 '60년'이 다릅니다(1992년 공식이므로 30년이 맞습니다). 소셜 미디어에는 '3개월 만에 과학 문제 400개를 풀었다'는 요약이 돌았는데, 400은 후보 문제의 수이지 푼 문제의 수가 아닙니다.
비용은 얼마였나
원문은 이 프로젝트들이 "계산과 토큰을 많이 썼다"고만 하고 금액을 밝히지 않습니다. 그 비용의 일부는 한 프로젝트를 넘어 쓸 수 있는 도구를 만드는 데 들었다고 합니다. 참고로 같은 시기 9루프 계산은 최종 사용자 기준 약 1,000~2,000달러, 부트스트랩 계산 자원은 약 100달러였습니다. 36편 규모의 기획을 다른 연구실이 재현하려면 얼마가 드는지는 공개 자료로는 알 수 없습니다.
13장. 실무: 우리 일에서 'Claude 모양'을 찾는 법
슈워츠의 경험을 연구실 밖, 기업과 공공 부문의 일로 옮기면 어떤 질문이 될까요. 코어닷투데이가 2부의 사례에서 추린 체크리스트입니다.
1
경계에 걸린 숫자를 근사로 판정하고 있지 않은가
등급 컷, 기준치 초과 여부, 합격선처럼 경계값 하나로 돈이나 자격이 갈리는 곳. 메디케어 별점과 오존 기준이 보여 주듯 근사 군집화나 버림 규칙이 경계 사례의 판정을 바꾼다. 1차원 최적화처럼 정확히 풀 수 있는 문제가 생각보다 많다.
2
몬테카를로로 어림하는 값이 사실 정확히 계산되지 않는가
시뮬레이션 수천 번으로 확률을 추정하는 리스크 모형, 품질 관리, 실험 설계. 결정 규칙이 명시되어 있다면 유한합이나 저차원 적분일 수 있다. 임상시험 설계 원고에서는 보고된 값의 36%가 잡음 범위 안이었다.
3
다른 분야에 같은 모양의 문제가 있지 않은가
흑점과 환자, 진화 나무와 파인만 적분처럼 구조가 같으면 도구를 빌릴 수 있다. AI에게 '이 계산과 수학적으로 같은 문제를 푸는 다른 분야의 방법'을 물어보는 것만으로 출발점이 생긴다.
4
검산 경로가 있는가
BootLoops가 입자 적분에서 시작한 이유는 누구나 스크립트 두 개로 답을 확인할 수 있었기 때문이다. 결과를 독립된 경로로 확인할 수 없는 일에 에이전트를 먼저 투입하면, 맞는지 틀린지 모르는 산출물만 쌓인다.
5
'흥미로운가'를 판단할 사람이 있는가
Claude는 기술적으로 맞는 결과를 끝없이 만든다. 그중 무엇이 그 분야에 중요한지는 전문가가 정했다. 숲(오드와이어), 유전자(데사이) 모두 첫 결과는 '어깨 으쓱'이었고, 방향 전환 뒤에 의미가 생겼다.
6
'완료'의 정의를 에이전트 밖에 두었는가
검사를 답보다 먼저 설계하고, 답을 아는 가짜 데이터로 파이프라인을 먼저 시험하고, 시간 추정은 측정으로만 하고, 채점기는 잠근다. BootLoops 규약은 공개되어 있어 그대로 가져다 쓸 수 있다.
한국에도 이런 문제가 많습니다. 대기질 기준 초과 판정과 반올림 규칙, 공공 평가의 등급 구간, 학술지의 데이터·코드 공개와 그 점검, 흩어진 방언·고문헌 자료의 체계적 정리 같은 것들입니다. 특히 AccStack처럼 모든 항목에 원문 인용을 붙이는 설계는 국내 연구 데이터 구축에 바로 응용할 수 있습니다. AI가 만든 데이터를 사람이 한 줄씩 검산할 수 있게 해 주기 때문입니다. 반대로 경제학 4,452편 사례가 보여 주듯, 이 작업의 첫 산출물은 대부분 '불일치 목록'입니다. 그것을 누구의 잘못으로 읽을지, 어떤 절차로 고칠지는 기술이 아니라 제도가 정할 몫입니다.
맺음말: 정확함은 겸손의 한 형태다
1부의 숲 이야기는 "우연을 정확히 알아야 필연이 보인다"로 끝났습니다. 2부의 사례들도 같은 문장으로 요약할 수 있습니다. 반올림을 걷어 내자 유인원의 두 나무가 정확히 같아졌고, MrBayes의 0.016짜리 편향이 드러났습니다. 정확한 공식이 생기자 기존 프로그램들이 대체로 옳았다는 것이 확인되었고, 그 위에서 57억 쌍의 증거가 유전자 전환을 가리켰습니다. 시뮬레이션의 잡음을 걷어 내자 임상시험 설계의 경계값이 어느 쪽인지 정해졌습니다.
이 정확함에는 겸손이 들어 있습니다. '없다'를 증명하고, '이 부위로는 확인되지 않는다'고 쓰고, '이것은 보정이지 증거가 아니다'라고 적고, '30자리 일치는 수치 점검일 뿐 증명이 아니다'라고 구분합니다. 원고 대부분이 아직 예비 단계이고 분야의 검토를 기다리고 있지만, 적어도 그 원고들이 무엇을 주장하고 무엇을 주장하지 않는지는 놀랄 만큼 분명합니다.
슈워츠의 기획이 남긴 가장 쓸모 있는 유산은 원고 36편이 아니라, 에이전트가 만든 결과를 믿어도 되는 조건을 적어 둔 규약 12개일지도 모릅니다. 원문 끝의 문장을 다시 빌리면, Claude 모양 과학을 들여다볼수록 사람 모양 과학의 윤곽이 또렷해집니다. 무엇을 물을지 정하고, 무엇이 흥미로운지 판단하고, 무엇을 아직 믿지 말아야 하는지 아는 일입니다.
Matthew D. Schwartz, "Vibe Physics," Anthropic Research (2026-03-23); arXiv:2601.02484.
Matt von Hippel, "Yes, Claude can do nine loops," Anthropic Research (2026-09-25).
입자 적분
O. Barrera, A. Dersy, R. Husain, M. D. Schwartz, X. Zhang, "Analytic regression of Feynman integrals from high-precision numerical sampling," JHEP 01 (2026) 014, arXiv:2507.17815.
G. Passarino, M. Veltman, Nucl. Phys. B 160 (1979) 151 · K. G. Chetyrkin, F. V. Tkachov, Nucl. Phys. B 192 (1981) 159 · S. Laporta, Int. J. Mod. Phys. A 15 (2000) 5087.
S. Laporta, E. Remiddi, "Analytic treatment of the two-loop equal-mass sunrise graph," Nucl. Phys. B 704 (2005) 349.
J. M. Henn, Phys. Rev. Lett. 110 (2013) 251601 · X. Liu, Y.-Q. Ma, "AMFlow," Comput. Phys. Commun. 283 (2023) 108565.
W.-J. He et al., JHEP 12 (2024) 136, arXiv:2409.08879 (W 쌍 생성 평면 마스터 적분).
유전체
M. Kimura, Genetics 61 (1969) 893 · J. F. C. Kingman, "The coalescent," Stoch. Proc. Appl. 13 (1982) 235 · S. A. Sawyer, D. L. Hartl, Genetics 132 (1992) 1161.
W. Gautschi, "Computational aspects of three-term recurrence relations," SIAM Rev. 9 (1967) 24.
S. Myers, C. Fefferman, N. Patterson, Theor. Popul. Biol. 73 (2008) 342.
E. F. Fenton, D. P. Rice, J. Novembre, M. M. Desai, Genetics 229 (2025) iyaf023.
M. Byrska-Bishop et al., Cell 185 (2022) 3426 (1000 Genomes 고품질 패널) · G. Palsson et al., Nature 639 (2025) 700 (deCODE 재조합 지도).
M. D. Schwartz, M. M. Desai, "An exact solution for the site-frequency spectrum of a selected allele" / "Signatures of gene conversion in the human two-site frequency spectrum" (예비 원고, bootloops.ai).
계통학·통계
B. Rannala, Z. Yang (1996) · M. Fourment et al., "19 dubious ways to compute the marginal likelihood of a phylogenetic tree topology," Syst. Biol. (2020).
A. von Manteuffel, R. M. Schabinger, "A novel approach to integration by parts reduction," Phys. Lett. B 744 (2015) 101.
M. D. Schwartz, S. V. Edwards, P. O. Lewis, "Exact Bayesian evidence for phylogenetic trees" / "JaCK & Jill" (예비 원고).
M. D. Schwartz, S. Sen, "Exact Bayesian evidence for mixture models: from two components to infinity" (원고).
경제학·정책
M. D. Schwartz, I. Andrews, J. M. Shapiro, "An LLM Workflow That Reproduces, Improves, and Extends Published Economics Research," NBER Working Paper 35782 (2026-09). https://www.nber.org/papers/w35782
National Academies, Reproducibility and Replicability in Science (2019) · W. G. Dewald, J. G. Thursby, R. G. Anderson, AER 76 (1986) 587.
M. D. Schwartz, "Stars misaligned: Medicare star ratings…" / "How truncation and rounding affect attainment of the U.S. ozone standard" / "Exact versus simulated operating characteristics of published adaptive and Bayesian trial designs" (예비 원고).
언어학
M. D. Schwartz, K. M. Ryan, M. K. Gordon, J. Pater, L. M. Hyman, "AccStack: An agentically compiled catalog of word stress and tone, with sources" (예비 원고) · https://www.accstack.org
L. M. Hyman (1977) · M. Gordon, NLLT 20 (2002) 491 · R. Goedemans, J. Heinz, H. van der Hulst, StressTyp2 (2014) · Glottolog 5.2 (2025).
수리물리·천체·지구
G. Pólya (1921) · G. N. Watson, "Three triple integrals," Quart. J. Math. 10 (1939) 266 · M. L. Glasser, I. J. Zucker, PNAS 74 (1977) 1800 · I. J. Zucker, J. Stat. Phys. (2011), doi:10.1007/s10955-011-0273-0.
N. Elkies, T. W. Grimm, M. D. Schwartz, "The anisotropic Watson integral" (준비 중).
J. W. Vaupel, K. G. Manton, E. Stallard, Demography 16 (1979) 439 (허약성).
M. D. Schwartz, C. Garraffo, "Demography of sunspots: aging, and death by turbulent erosion?" / "Starspot regions die without aging…" (예비 원고).
M. D. Schwartz, D. T. Johnston, "The Great Oxidation from a minimal ocean–atmosphere model" (예비 원고).
M. M. Ivanov, S. Mishra-Sharma, M. D. Schwartz, "Toward precision galaxy clustering in redshift space: the next loop order" (원고).
반응과 맥락
"Problems in 22 scientific fields had solutions hiding in plain sight. An AI has found them," Science (2026-10-09).
Science 뉴스, AI가 과학의 주제 폭을 좁힌다는 『네이처』 논문 보도 (2026-01-14).