
#지식 그래프
28개의 포스트
[특집] 스키마 없이 9억 노드 — AutoSchemaKG 깊이 읽기: 사건 노드, 개념화, ATLAS, 그리고 초록의 숫자가 표에서 뜻하는 것
지식 그래프는 40년 동안 분류표(스키마)를 사람이 먼저 그리고 그 칸에 사실을 채우는 방식으로 만들어졌습니다. ACL 2026에 실린 AutoSchemaKG(홍콩과기대·화웨이)는 순서를 뒤집어, LLM으로 개체와 '사건'을 먼저 뽑고 뽑힌 것마다 개념 꼬리표를 붙여 스키마를 끌어냅니다. 문서 5천만 건에서 노드 13.6억·엣지 86억짜리 그래프 ATLAS가 나왔고 GPU 78,400시간이 들었습니다. 이 글은 Cyc·Freebase·OpenIE·허스트 패턴으로 이어지는 역사부터 논문의 세 아이디어를 풀고, 표를 한 줄씩 다시 읽습니다. 사건 노드는 문단 정보의 89%를 지켰지만(개체 트리플은 35%), '12~18% 향상'은 BM25 대비였고 같은 검색기의 원본 그래프와는 비기거나 졌으며, 개념 노드가 보탠 점수는 1점 안팎, '92% 정렬'은 정답률이 아니라 BERTScore였습니다. 코어닷투데이가 한국어 위키백과 25문단에 같은 프롬프트를 돌린 실측과, 저장소 이슈·IBM의 재현·저자들의 후속 논문까지 함께 정리했습니다.
검색에서 재구성으로 — '누가 그렇게 말했는지' 기억하는 AI, CogMem과 PEC²F 기억 그래프
"지나는 준호가 잘린 게 회사 실수래"라는 말을 들은 AI가 몇 주 뒤 "준호는 회사 실수로 잘렸어요"라고 답한다면, 기억은 있었지만 출처를 잃은 것입니다. 칭화대 선전 국제대학원의 CogMem(arXiv 2610.11314)은 대화 기억을 사람·사건·개념·주장·사실 다섯 종류의 노드로 나누고, 남의 의견은 '누가, 누구에 대해' 한 말인지가 붙은 주장 노드로 따로 보관합니다. 질문이 오면 규칙 기반 제어기가 닻 내리기·교집합·시공간 탐색·원문 확인 네 연산자를 골라 답을 다시 짓습니다. 바틀릿의 '재구성 기억'과 툴빙의 일화·의미 기억, 출처 감시 이론, 샐리-앤 실험, 상보적 학습 이론에서 이 설계가 어디서 왔는지 따라갔습니다. 논문 표를 원 논문들과 대조해 보니 기준선 숫자 상당수가 GAM·LightMem 논문의 표를 그대로 옮긴 것이었고, LongMemEval의 'Qwen2.5-14B' 열은 실제로는 Qwen3-30B 결과였습니다. 한국어로 직접 재 보니 논문식 문장 쌍은 유사도 0.824에도 오귀속이 0건이었지만, 실제 대화 저장 형식에서는 최대 48%가 남의 의견을 집어 왔습니다. 인터랙티브 7개.
[특집] 본문에 없는 사실은 받지 않는다 — 앵커로 묶은 지식 그래프 추출 AEVS, 그리고 출처를 글자 단위로 다는 시대
LLM에게 문서에서 사실(주어·관계·목적어)을 뽑게 하면 '세상에서는 참이지만 본문에는 없는' 트리플이 섞입니다. 2026년 3월 MDPI Computers에 실린 AEVS는 본문에서 개체·관계구·값과 그 글자 위치를 먼저 찾아 '앵커'로 삼고, 트리플을 앵커로만 조합한 뒤, 원소마다 원문으로 되돌려 검증합니다. 세 데이터셋에서 학습 모델과 EDC를 넘었고, 남은 오류의 95% 이상은 개체가 아니라 관계였습니다. 다만 'EDC 대비 최대 +0.152'는 서로 다른 모델끼리의 비교였고(같은 모델이면 +0.007~+0.074), 공개 코드는 논문과 달리 셋 중 둘만 맞아도 통과시켜 논문 자신의 환각 예시를 모두 받아들였습니다. 코어닷투데이가 로컬 모델로 한국어 30문장과 WebNLG 20문장을 다시 돌려 보니, 스키마를 준 '그냥 묻기'에서는 환각이 나오지 않았고 AEVS는 한국어에서 오히려 재현율을 잃었습니다(F1 0.80 대 0.72). 그냥 묻기에서 스키마를 빼면 F1이 0.18로 무너져, 향상의 상당 부분이 스키마 몫일 수 있음을 보여 줍니다. 검증 LLM은 본문에 충실한 반사실 트리플을 '현실과 다르다'며 거부하기도 했습니다. 역사, 논문의 주요 그림과 표, 2026년의 '글자 단위 출처' 도구들까지 함께 읽습니다.
메모리 위의 두 그래프 DB — FalkorDB의 진화와 Memgraph의 근황, 그리고 언제 무엇을 쓸 것인가
4월에 RedisGraph의 종말과 FalkorDB의 부상을 다룬 뒤 반년, 두 인메모리 그래프 DB에 큰 변화가 있었습니다. FalkorDB는 9월 29일 엔진을 Rust로 다시 쓴 6.0을 내놨고(4.x에서 올라가는 경로는 아직 없음), 7월에는 Bolt 프로토콜을 뺐습니다. Memgraph는 3.8의 'Atomic GraphRAG'부터 3.13까지 기능을 쌓는 동안 자동 장애 조치·멀티테넌시·동적 알고리즘을 엔터프라이즈 전용으로 묶었습니다. 주변도 바뀌었습니다. PostgreSQL 19는 그래프 질의(SQL/PGQ)를 넣었다 뺐고, Kuzu는 멈췄으며, 에이전트 메모리 회사들은 범용 그래프 DB를 떠나 자기 엔진을 만들기 시작했습니다. 이 글은 2026년 10월 3일 기준으로 두 제품의 설계 차이(행렬 대 포인터), 10년 연표, 라이선스가 허락하는 쓰임새, 메모리 비용, 벤치마크를 읽는 법을 정리하고, 다섯 가지 질문으로 어느 쪽을 고를지 답합니다. 위젯 5개.
Zep 생태계 지도 — Graphiti, Konig, Context Lake는 각각 무슨 일을 하나
반년 전 Zep 논문을 해부할 때는 'Zep의 엔진은 Graphiti'라는 한 줄로 충분했습니다. 지금은 Konig, Context Lake, Memory MCP 서버, Graphiti MCP 서버처럼 이름이 늘어 누가 무슨 일을 하는지 헷갈립니다. 이 글은 도서관에 빗대어 문·접수대·사서·서고·대출 데스크·관리 규정 여섯 층으로 생태계를 정리하고, 문장 하나가 기억이 되기까지 어느 구성요소를 거치는지 위젯으로 따라갑니다. 열린 것과 닫힌 것, 요금과 크레딧 계산법, 직접 운영과 서비스 이용 중 무엇을 고를지도 함께 다룹니다.
그래프는 하나가 아니다 — GraphRAG의 다변화, 거대 지식 그래프 하나에 종속되지 않기 (RAG 특집 5편)
Microsoft GraphRAG 저장소는 이제 스스로를 ‘대부분 유지보수 모드’라고 적는다. 새 기능도 PR도 받지 않는다. 그렇다고 그래프가 끝난 것은 아니다. 끝난 것은 ‘모든 문서를 LLM으로 엔티티·관계로 쪼개 거대한 전역 그래프를 만들고 모든 질의를 그 위에서 처리한다’는 공식이 무조건적 기본 선택이던 시대다. 2026년의 그래프는 네 갈래로 갈라졌다. 활발히 확장되는 LightRAG, 임베딩 각도만으로 토큰 0에 그래프를 짓는 G³RAG, 전역 그래프 없이 질의 시점에 SQL 조인으로 잇는 SAG, 그리고 위키 링크 구조. 이 특집은 왜 정적 지식 그래프가 비싸고 깨지기 쉬운지를 시뮬레이터로 보이고, cosθ·sinθ 한 식으로 엣지를 만드는 법과 공유 엔티티를 JOIN 키로 쓰는 법을 직접 만져 보고, 내 데이터에 맞는 구조를 고르는 진단 도구까지 간다. 위젯 6종. RAG 특집 시리즈 5편.
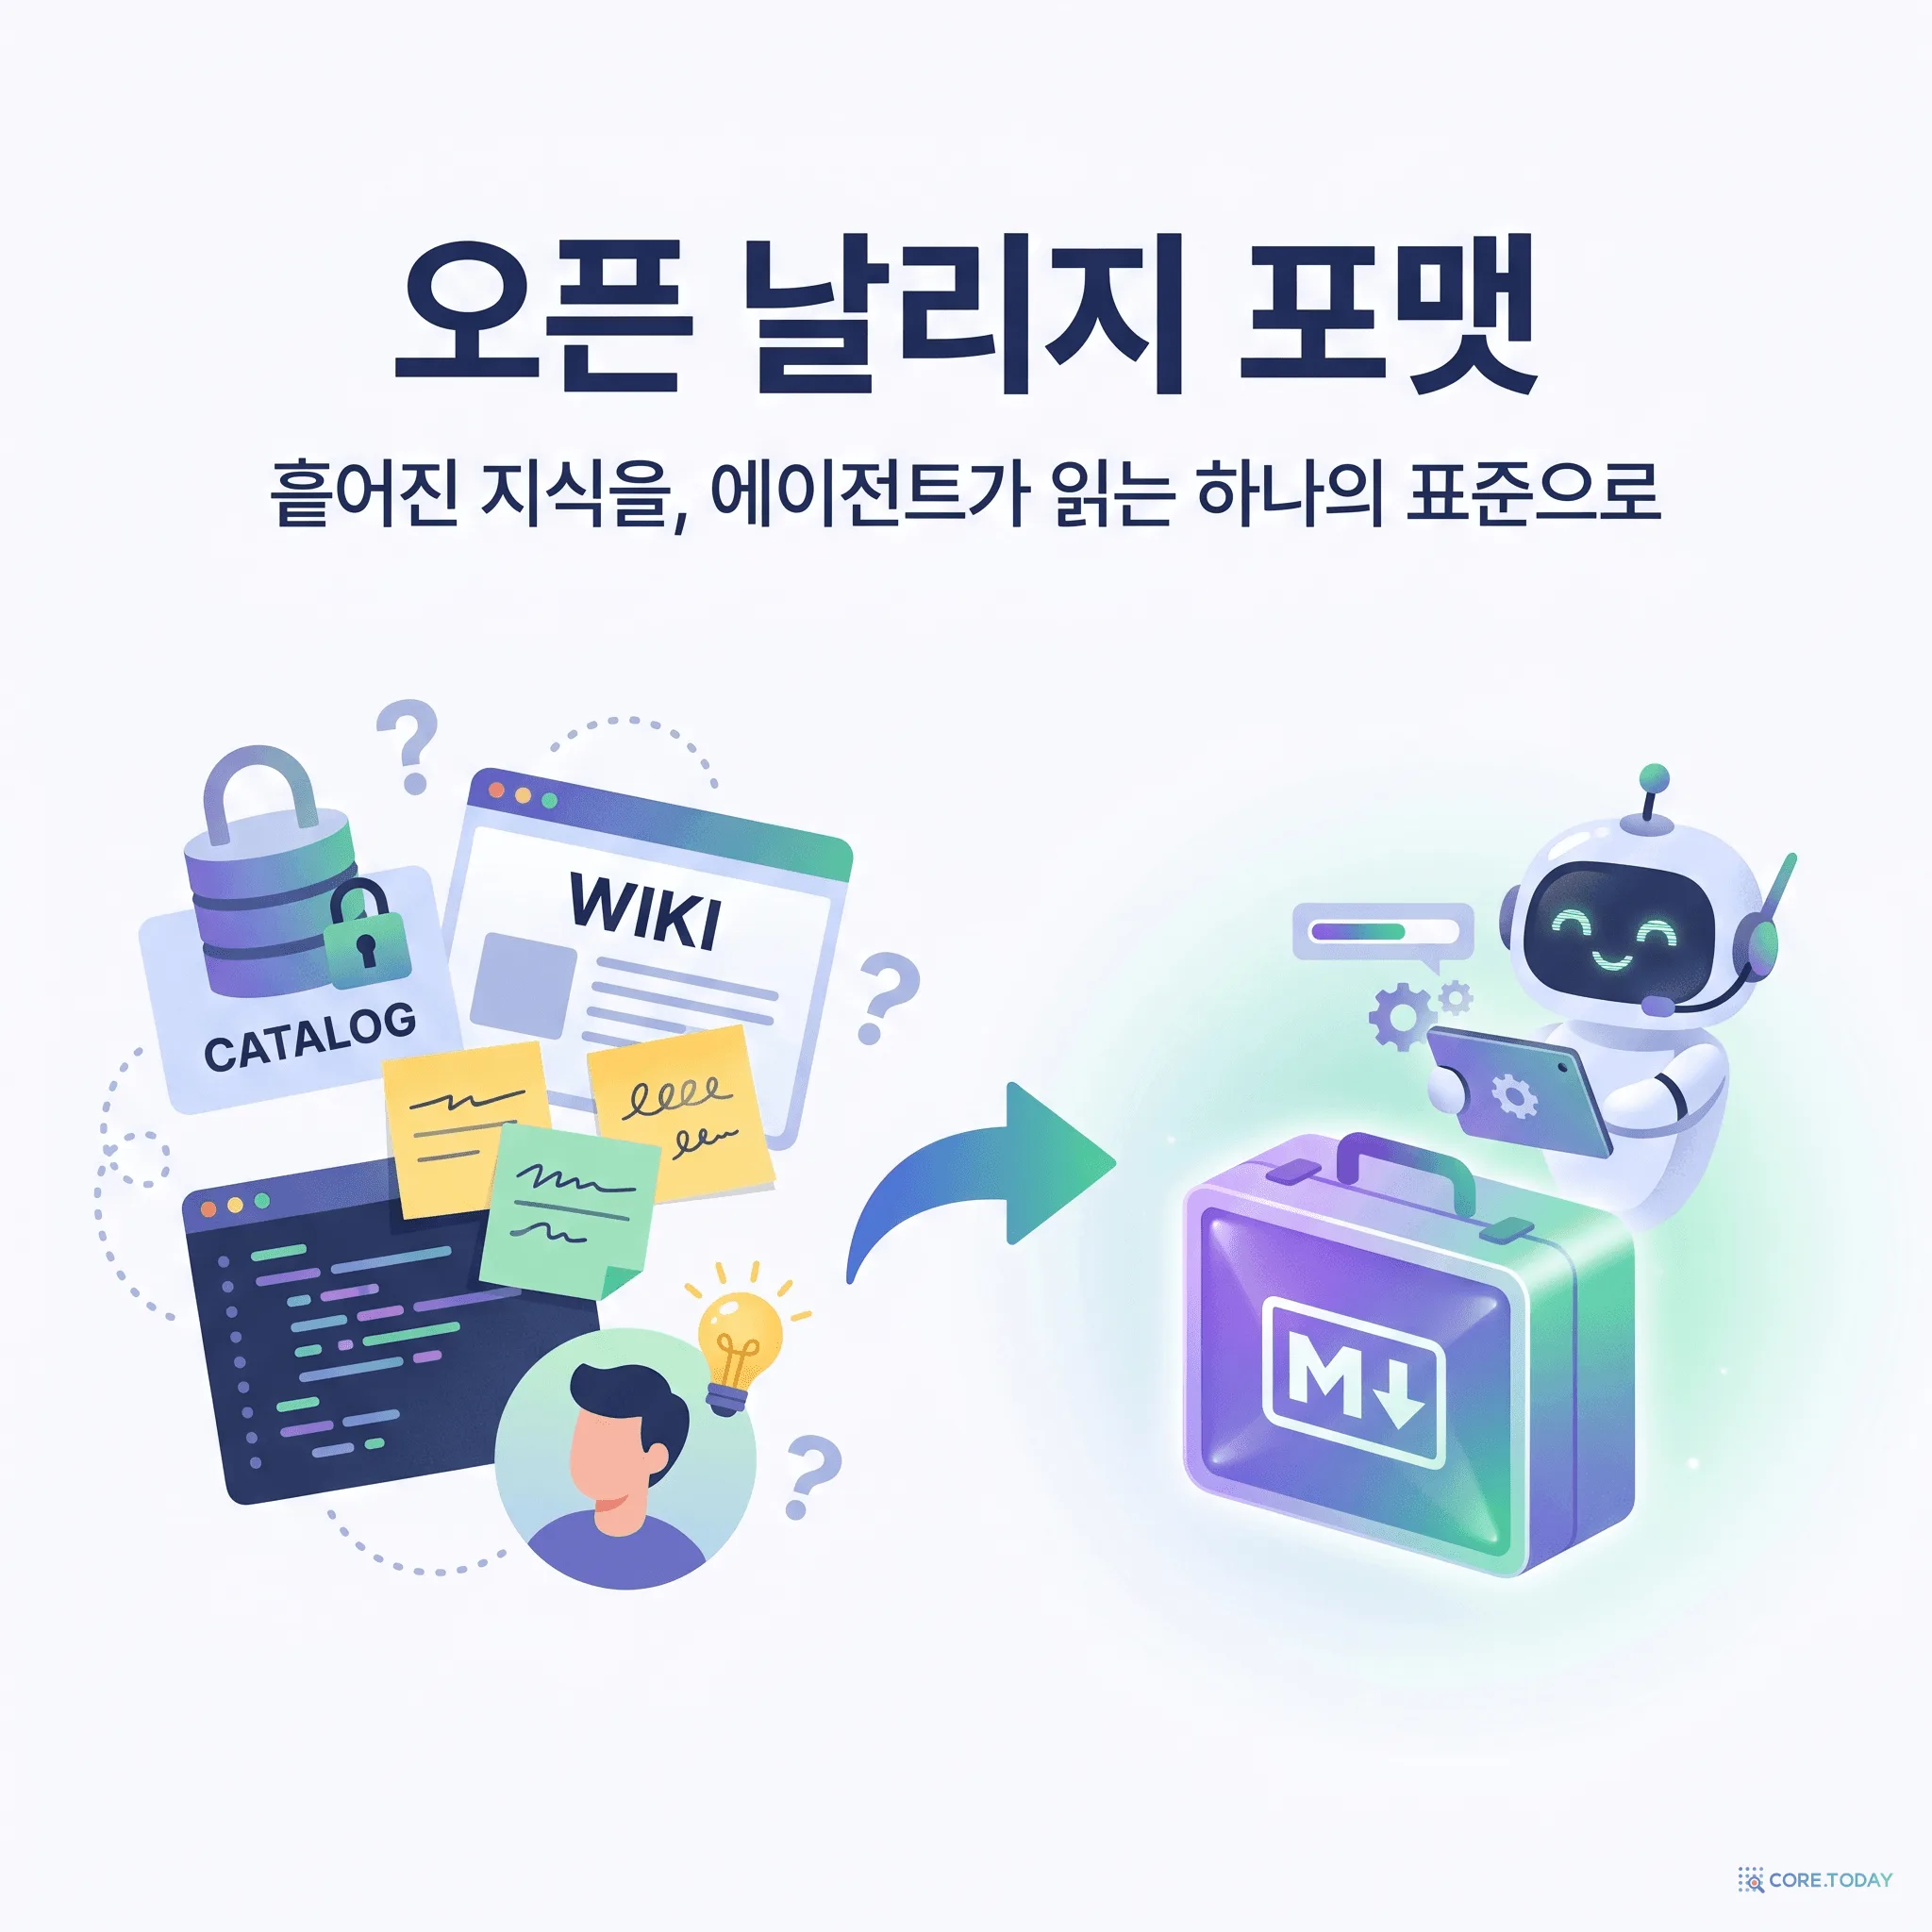
오픈 날리지 포맷(OKF) — 흩어진 지식을 에이전트가 읽는 하나의 표준으로
AI 에이전트에게 '주간 활성 사용자를 어떻게 계산하지?'라고 물으면, 답은 메타데이터 카탈로그·위키·코드 주석·시니어의 머릿속에 흩어져 있습니다. 2026년 6월 Google Cloud가 내놓은 답이 OKF입니다. 더블린 코어와 시맨틱 웹부터 Karpathy의 LLM 위키까지, 30년에 걸친 '데이터를 함께 쓰자'는 꿈의 역사와, 왜 이번엔 '그냥 마크다운'이 답이 되었는지를 사례와 함께 쉽게 풀어드립니다.
SciAtlas 완전 해부: 4,300만 논문의 지도가 자동화된 과학 연구를 여는 법
2026년 5월, 저장대 ZJUNLP가 공개한 SciAtlas는 4,300만 편의 논문, 1억 5,700만 개체, 30억 트리플을 하나의 지식 그래프로 묶었다. 단순 키워드 검색을 넘어 'tri-path 협력 회수 + 그래프 재정렬'이라는 뉴로-심볼릭 알고리즘으로, AI 에이전트가 논문 사이를 추론하면서 걸을 수 있게 한 첫 인프라. 정보 폭발의 역사, MAG에서 OpenAlex로 이어지는 학술 그래프 계보, SciAtlas의 스키마와 알고리즘, 그리고 2026년 자동화된 과학의 의미까지 특집으로 풀어본다.
데이터를 못 보면 DX 못 한다 — 데이터 구조 이해의 기술
DX 전문가 로드맵 3편 — Edgar Codd의 1970년 관계형 모델부터 2026년 AI-Ready 데이터까지. 비정형 데이터가 기업 데이터의 90%를 차지하는 지금, 데이터 구조를 이해하지 못하면 AI도, DX도, 아무 의미가 없다. 데이터 모델링 56년의 계보와 실전 인사이트를 총정리한다.
From RAG to Memory: AI에게 '기억'을 가르치다 — HippoRAG 2 논문 완전 해부
RAG는 AI에게 참고서를 주는 것이고, 기억은 AI가 직접 경험하여 아는 것이다. ICML 2025에 발표된 HippoRAG 2는 인간의 해마(hippocampus)에서 영감받아, RAG를 진정한 장기기억 시스템으로 진화시킨다. 사실 기억, 의미 추론, 연상 기억 세 가지를 동시에 달성한 이 논문을 사례와 그림으로 완전 해부한다.
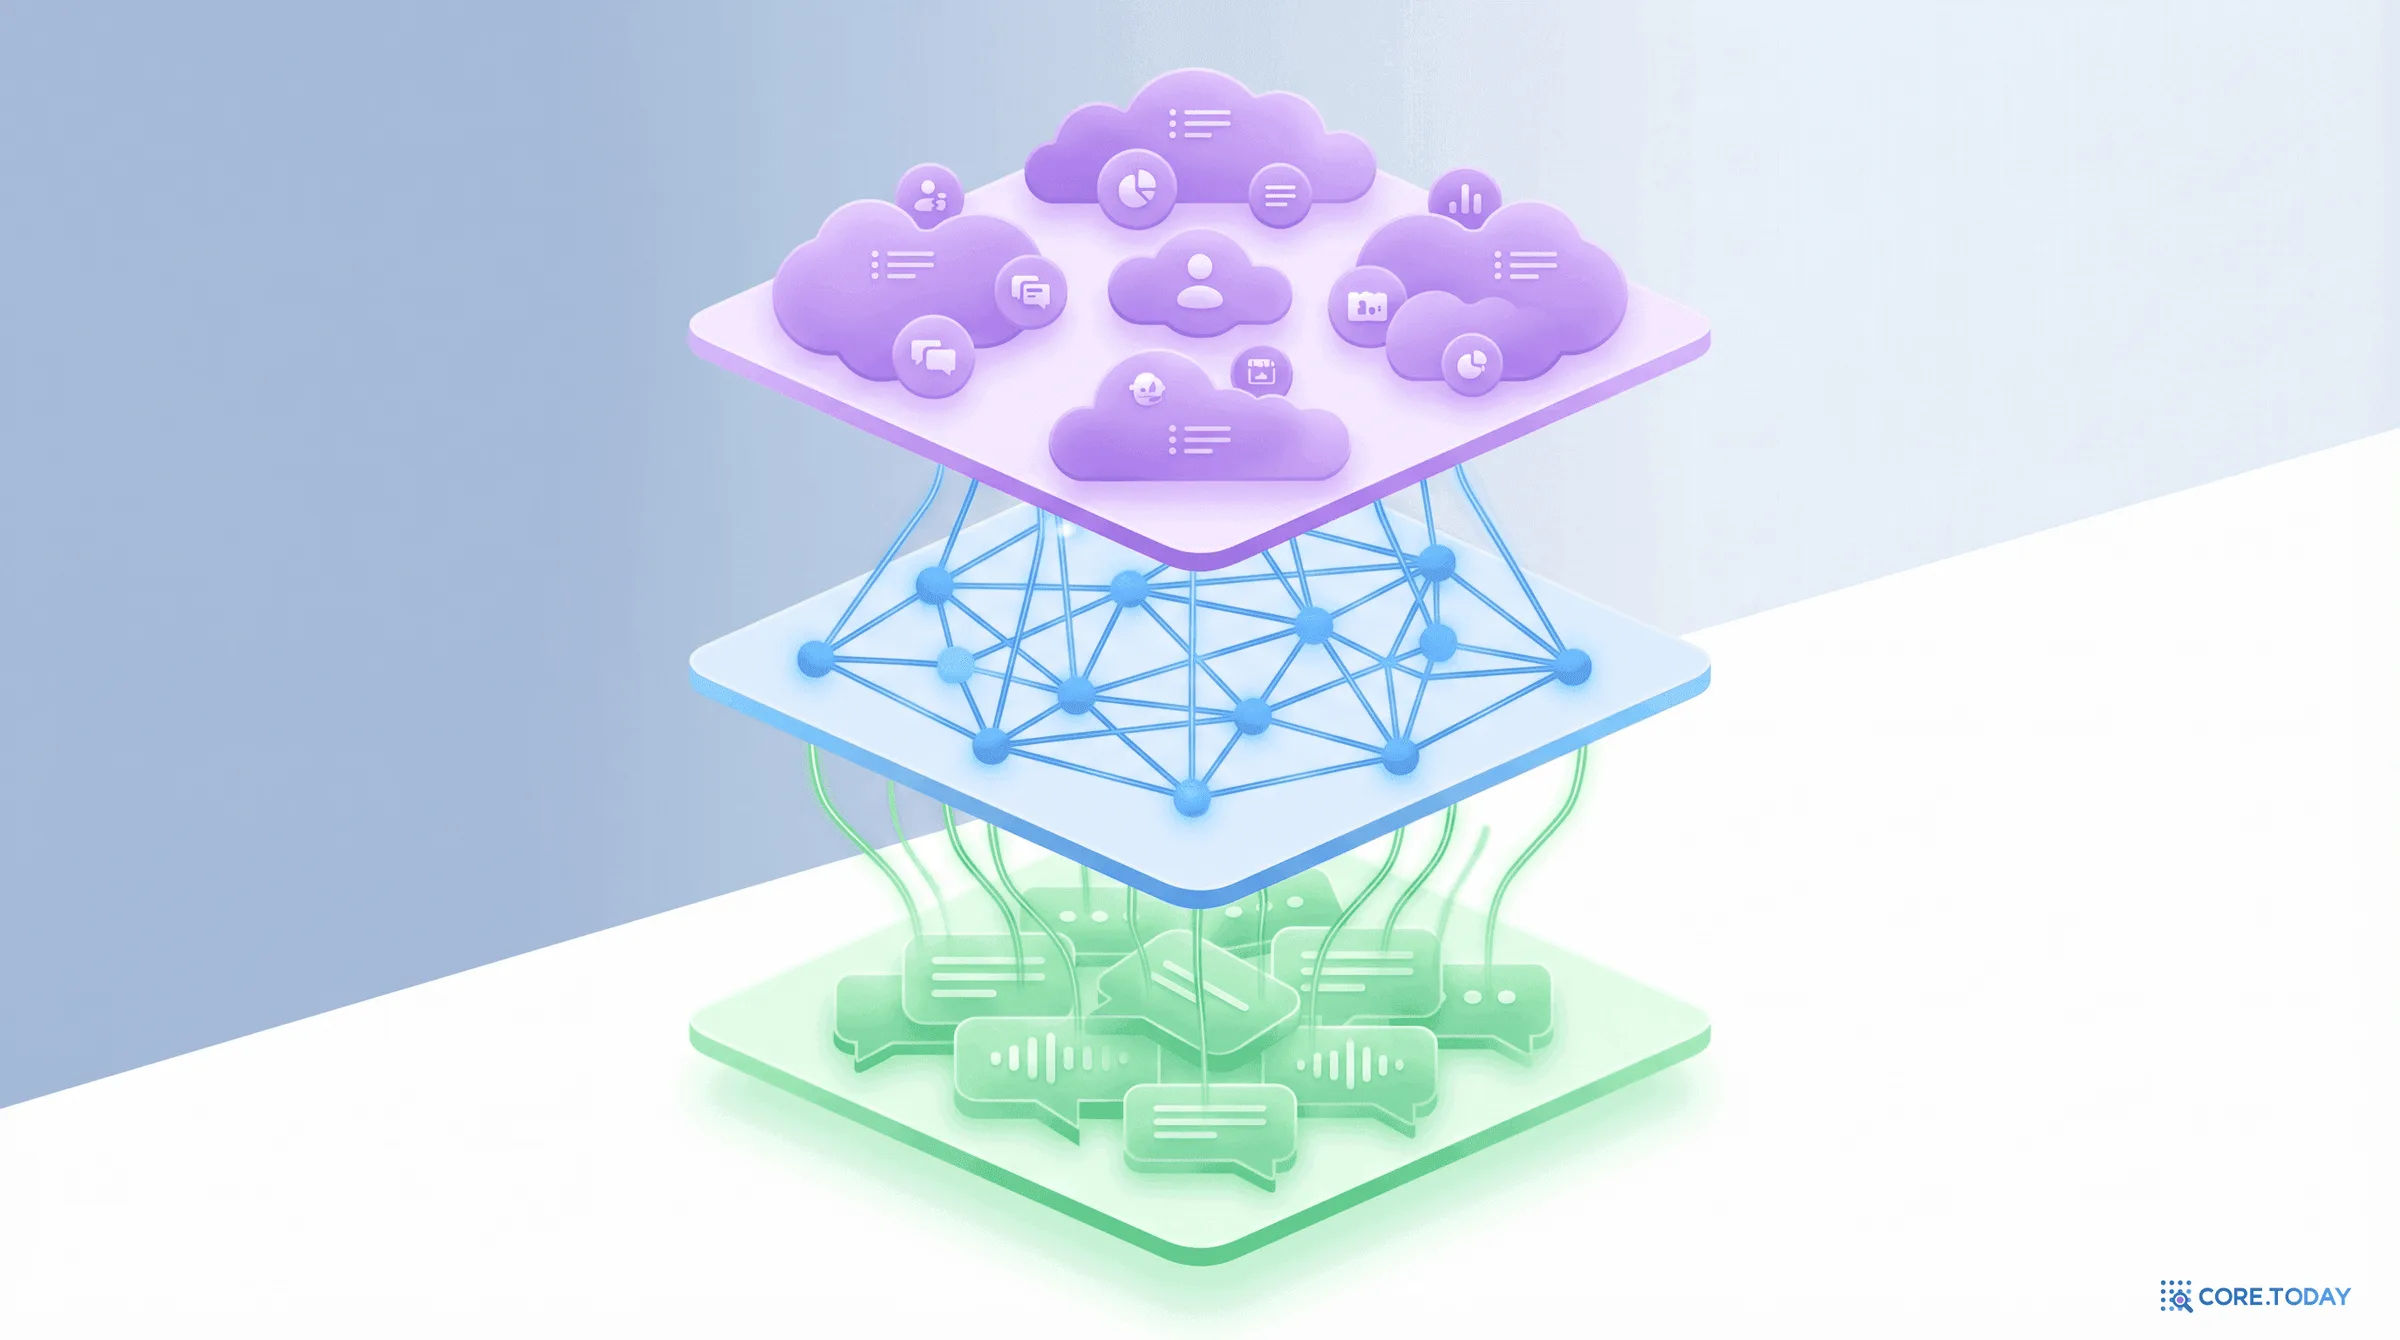
Zep 논문 해부: AI 에이전트에게 '시간을 아는 기억'을 선물하다
AI 에이전트가 어제 대화를 기억하지 못한다면? Zep은 시간 인식 지식 그래프(Temporal Knowledge Graph)로 이 문제를 해결한다. 3계층 그래프 구조, 이중 시간축 모델, 동적 엣지 무효화 — MemGPT를 넘어 LongMemEval에서 최대 18.5%(상대) 정확도 향상과 90% 레이턴시 감소를 달성한 Zep의 핵심을 완전 해부한다.
그래프 데이터베이스의 모든 것: RedisGraph의 종말에서 FalkorDB의 부상까지
관계형 DB의 한계를 넘어선 그래프 데이터베이스의 역사부터 핵심 개념, RedisGraph EOL과 FalkorDB 마이그레이션, 그리고 2026년 AI 시대의 GraphRAG까지. 풍부한 사례와 인터랙티브 시각화로 그래프 DB의 세계를 탐험합니다.