
#법률 AI
6개의 포스트
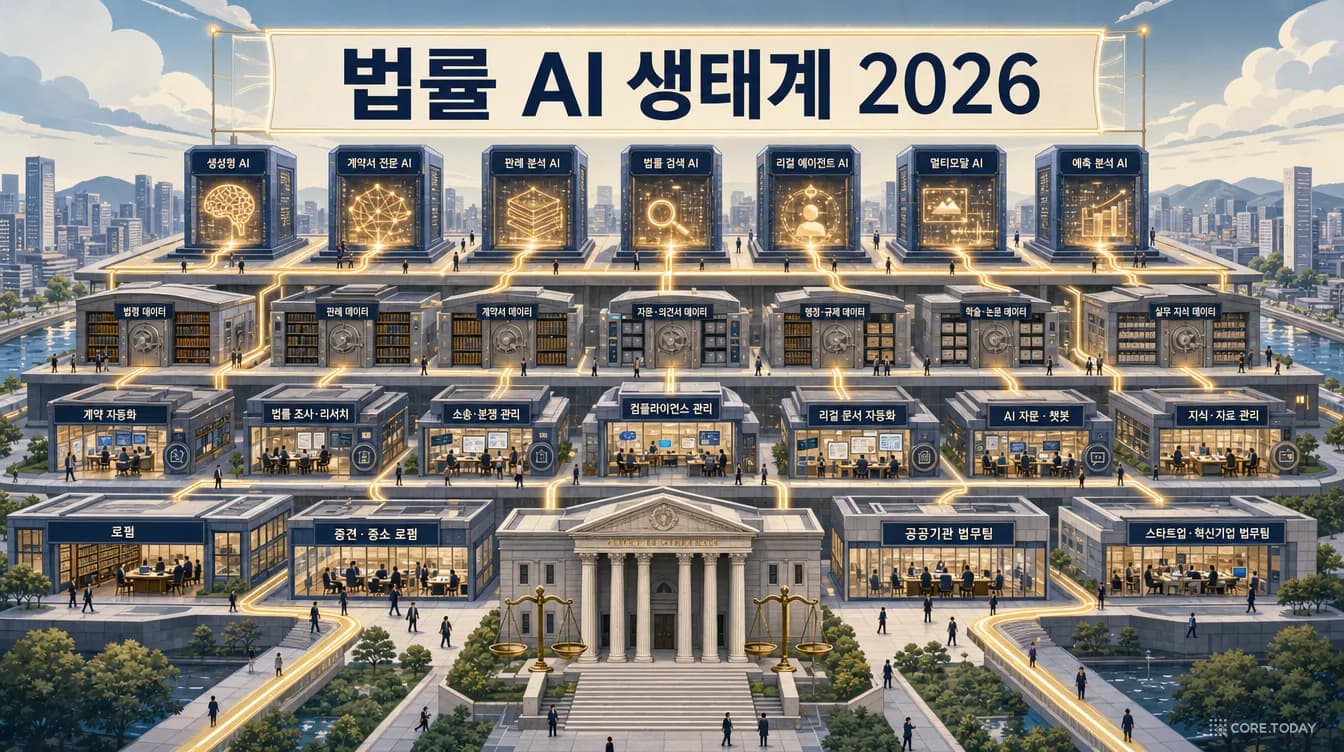
법률 AI 생태계 지도 2026 — 모델 회사는 법률로 내려오고, 법원은 검증을 요구하고, 돈은 '책임질 수 있는 결과물'로 모인다
2026년 2월 3일, Anthropic이 법률 업무 플러그인 하나를 내놓자 Thomson Reuters 주가가 하루에 16% 빠졌습니다. 그런데 반년 뒤 그 회사의 법률 매출은 10% 늘었고, 같은 해 법률 AI 스타트업 Harvey의 몸값은 80억 달러에서 155억 달러로 뛰었습니다. 한쪽에선 전 세계 법원이 AI가 지어낸 판례를 지적한 결정이 2,184건까지 쌓였고, 한국 법원 판결문에는 'AI Hallucination'이라는 영어가 그대로 적혔습니다. 모순처럼 보이는 이 장면들은 하나의 지도 위에 놓으면 이해됩니다. 모델·데이터·업무 도구·로펌·법원의 다섯 층이 2024년에서 2026년 사이 각각 어떻게 움직였는지, 법률 AI 시험지가 '변호사시험'에서 '실무 과제 전 항목 통과'로 바뀐 이유, 시간당 청구가 흔들리는 경제학, 신입 변호사의 사다리, 나홀로 소송의 역설, 그리고 한국 법원·로펌·리걸테크의 2026년까지. 논문과 판결과 실적 발표를 근거로 일곱 가지 인사이트를 뽑았습니다. 인터랙티브 6개, 논문·보고서 그림 8장, 삽화 9장.
GLM-Legal 완전 해부 — 가벼운 모델이 법률 에이전트 시험에서 프런티어를 이긴 방법: 중간학습, 하네스 공진화, 그리고 19.2%의 의미
2026년 10월 12일, 중국 Z.ai가 법률 특화 모델 GLM-Legal을 공개했습니다. 활성 파라미터 18B짜리 가벼운 모델(GLM-5.3-Flash) 위에 법률 중간학습과 수만 개의 법률 과제 환경 강화학습을 얹었더니, 로펌 실무 과제를 끝까지 해내야 하는 Harvey LAB에서 전 항목 통과율 19.2%로 Claude Fable 5(11.3%)와 GPT-6 Astra(5.4%)를 앞섰습니다. 과제당 비용은 0.15달러로 Fable 5의 약 130분의 1입니다. 그런데 19.2%는 열 건 중 여덟 건을 '불합격'했다는 뜻이기도 합니다. 1970년대 규칙 기반 법률 AI부터 가짜 판례 사건, LegalBench에서 Harvey LAB으로 바뀐 시험지, 중간학습과 하네스 공진화라는 아키텍처, 시연 세 장면, 순위표에서 빠진 모델과 퇴보한 지표까지, 이 발표를 둘러싼 모든 것을 쉽게 풀어 씁니다. 인터랙티브 6개, 논문·벤치마크 그림 11장, 삽화 10장.
Claude for Legal 완전 해부: AI가 법률 산업의 운영체제가 되는 날
2026년 5월 12일, Anthropic이 'Claude for Legal'을 출시하며 12개의 실무 플러그인과 20개 이상의 MCP 커넥터를 공개했다. 변호사가 가짜 판례를 인용해 벌금을 물던 시대에서, AI가 법률 워크플로우의 OS가 되는 시대로 — 그 사이에 무슨 일이 벌어졌는가. 역사부터 기술 아키텍처(MCP, Agent Skills, CLAUDE.md), 12개 플러그인, 파트너 사례, 그리고 한국 시장의 함의까지 완전 해부한다.
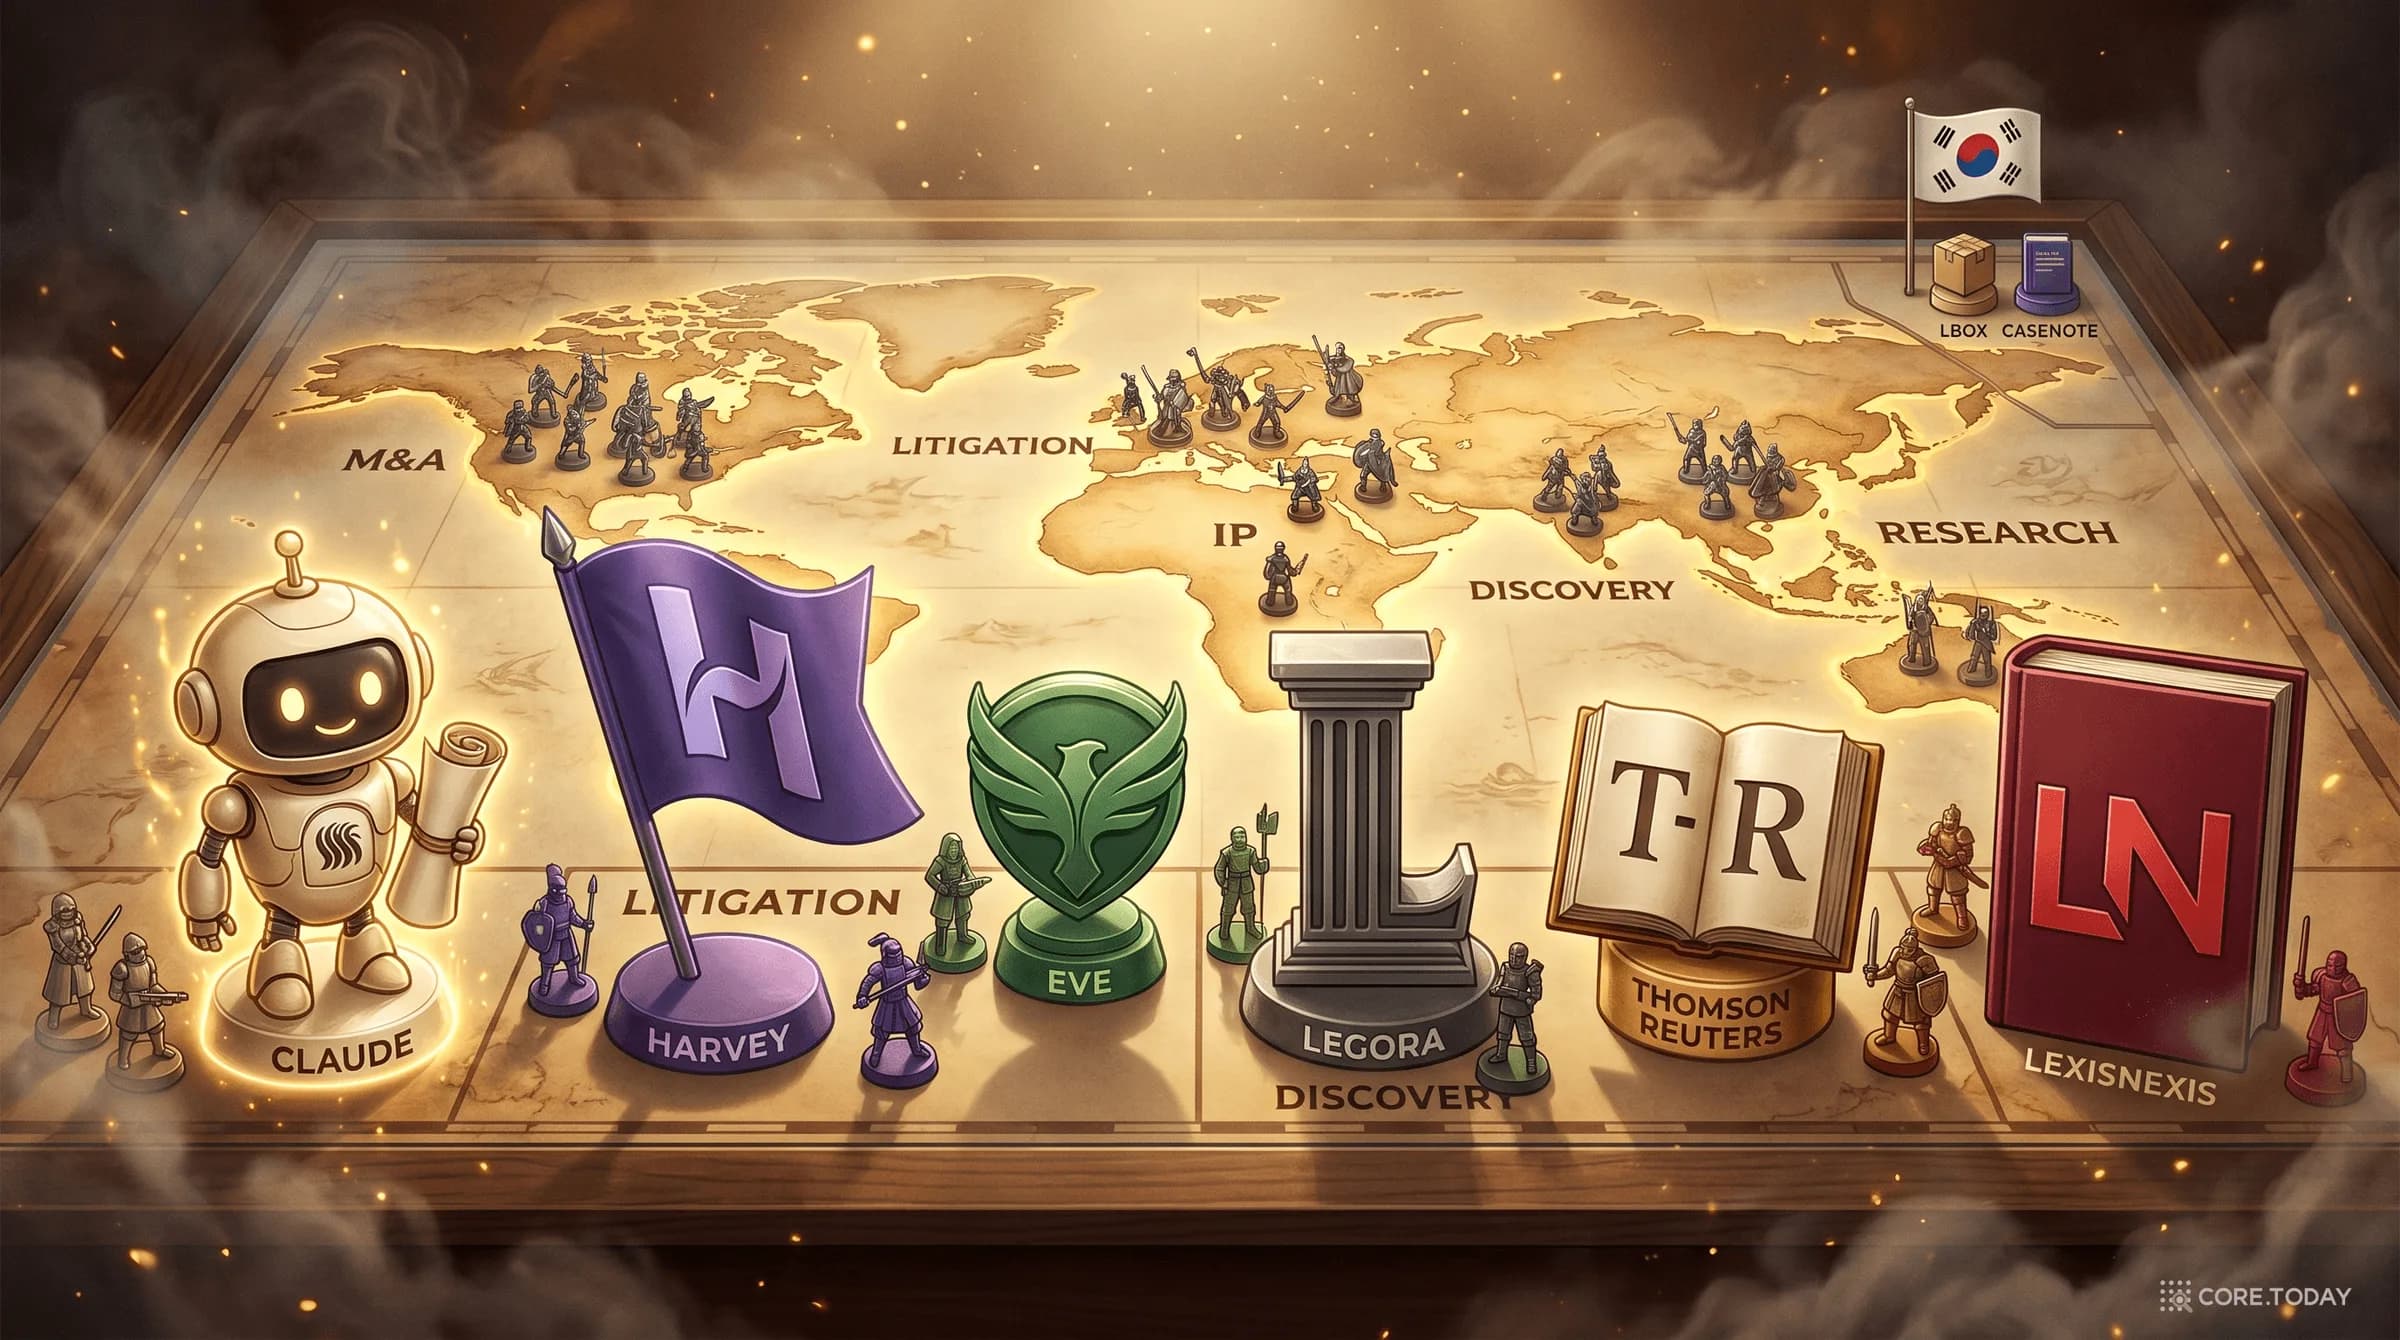
리걸테크 AI 대전 2026: 변호사의 일을 빼앗는 130조 원 시장의 모든 것
2026년 글로벌 리걸테크 시장이 965억 달러(약 130조 원)를 넘어섰다. Harvey($11B), Legora($5.55B), Hebbia($700M)가 수십억 달러 단위로 경쟁하고, 한국에서는 로폼·LBOX·Casenote·BHSN이 변협과의 25년 갈등 끝에 대법원 판결로 길이 열렸다. 시간당 $2,000짜리 변호사 노동을 1시간 단위가 아니라 1분 단위로 다시 가격 매기는 AI의 폭발 — 이 산업의 모든 플레이어, 모든 기술, 모든 윤리 논쟁을 한 편으로 정리한다.
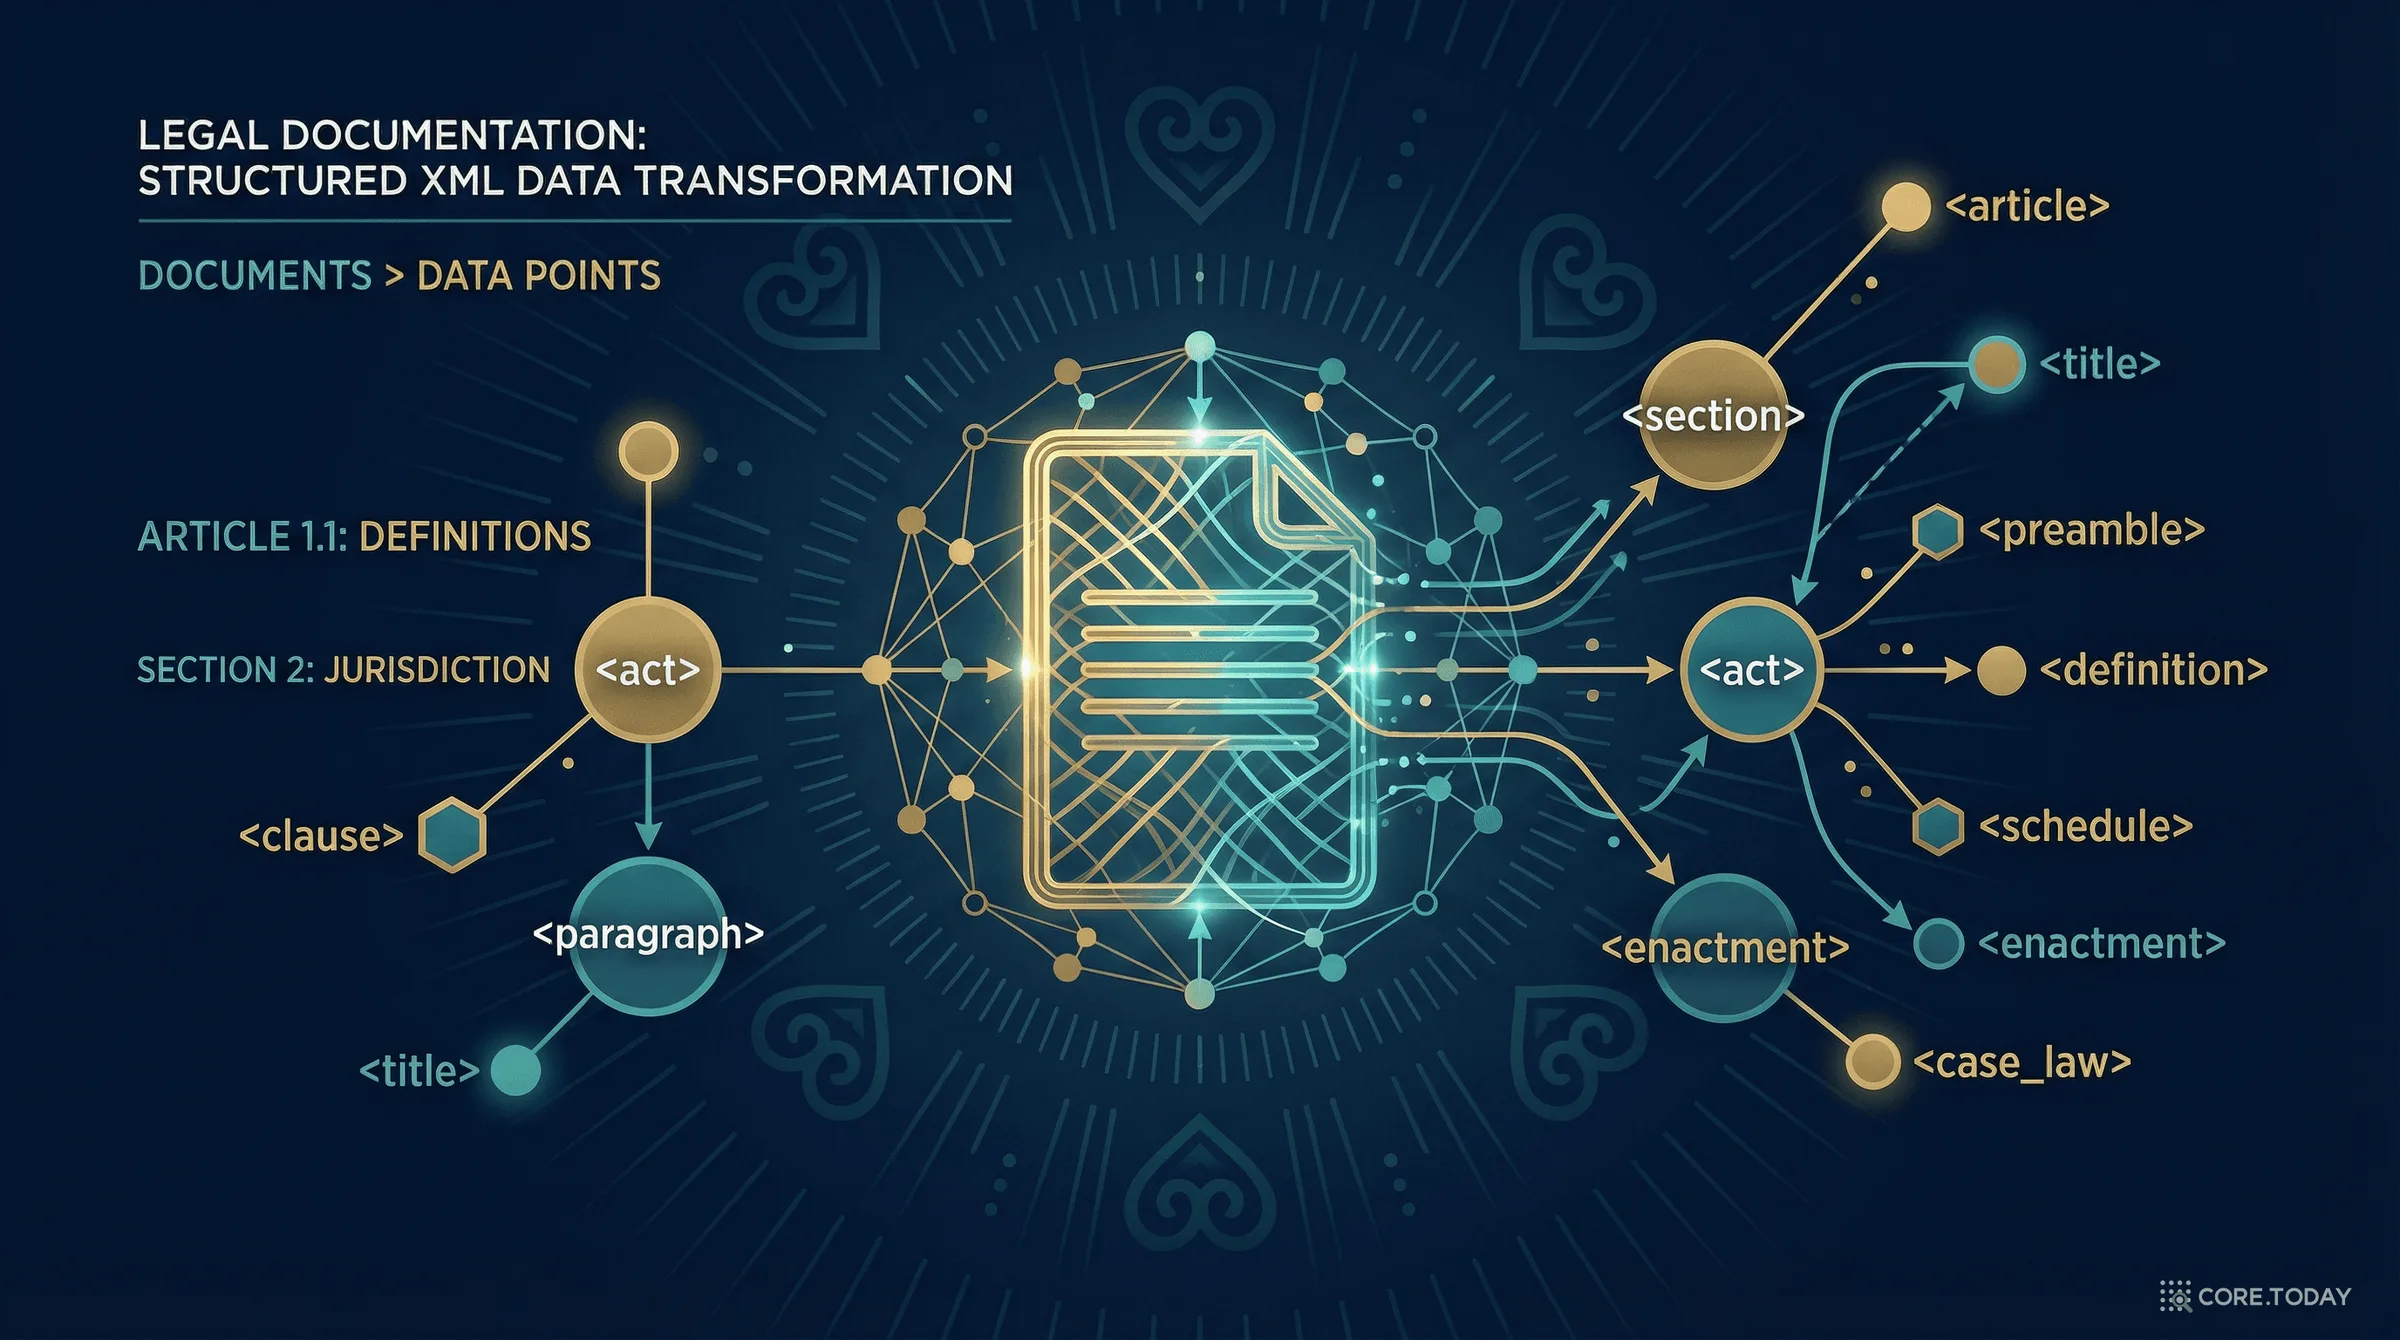
Akoma Ntoso 완전 해부: 세상의 모든 법률을 기계가 읽게 만드는 XML 혁명
아프리카 의회 투명성 프로젝트에서 출발해 전 세계 법률 문서의 표준이 된 Akoma Ntoso. '연결된 마음'이라는 이름 뒤에 숨겨진 기술 혁명과, 2026년 AI 시대에 이 표준이 왜 더욱 중요해졌는지 완전 해부합니다.
AI 법률 추론의 미래 — SOLAR: 검증 가능한 법률 추론을 위한 멀티 에이전트 프레임워크
GPT-4o가 세금 계산 문제에서 18.8%의 정확도를 보이는 동안, 추론 모델 o4-mini는 91.7%를 기록한다. 하지만 비용이 수십 배 비싸다. SOLAR 프레임워크는 저비용 모델의 정확도를 76.4%로 끌어올려, 이 격차를 68.2%에서 5.9%로 줄인다.