PostgreSQLNVMeEBSgp3io2저장장치IOPS지연리틀의 법칙WALfsyncMVCCVACUUM체크포인트논리 복제동기 복제WAL-G클라우드 데이터베이스ClickHousePlanetScaleAurora5분 규칙데이터베이스 성능
Postgres는 느리지 않다, 느린 건 저장장치다 — 37ms 영수증으로 읽는 데이터베이스와 디스크의 50년
2026년 8월 ClickHouse가 공개한 발표 요약 「Postgres는 느리지 않다, 느린 건 저장장치다」가 10월 해커뉴스에서 174점·댓글 185개를 받으며 다시 불붙었습니다. 같은 기계, 같은 Postgres, 같은 쿼리에서 저장장치만 네트워크 디스크(EBS gp3)에서 서버에 꽂힌 NVMe로 바꿨더니 처리량이 9.24배가 됐다는 실험입니다. 이 글은 그 37ms짜리 지연 영수증을 항목별로 뜯어보고, CPU가 왜 놀고 있었는지, 3,000 IOPS가 어떻게 정확히 1,734 TPS가 되는지 리틀의 법칙으로 계산합니다. UPDATE 한 줄이 Postgres 안에서 지나가는 아홉 정거장(B-트리, MVCC, WAL, fsync, 체크포인트, 논리 복제)을 따라가고, 하드디스크와 5분 규칙에서 EBS, Aurora, 다시 로컬 NVMe로 돌아오기까지 50년의 역사를 논문으로 짚습니다. 'gp3 기본값은 허수아비'라는 반론과 판매 맥락까지 공정하게 다루고, 디스크가 사라지는 세계에서 데이터를 지키는 운영 구조를 장애 훈련으로 확인한 뒤, 2026년 내 데이터베이스를 진단하는 체크리스트로 끝냅니다. 인터랙티브 6개와 삽화 9장.
데이터베이스가 느려지면 개발자는 대개 데이터베이스를 의심합니다. 쿼리를 다시 짜고, 인덱스를 추가하고, 설정값을 만지고, 그래도 안 되면 "역시 Postgres는 이 규모에선 한계야"라며 다른 데이터베이스를 알아봅니다.
2026년 6월 마이크로소프트가 주최하는 Postgres 온라인 콘퍼런스 POSETTE에서, ClickHouse의 Postgres 총괄 사이 스리람푸르(Sai Srirampur)가 이 습관에 정면으로 반대하는 발표를 했습니다. 제목부터 도발적입니다. "Postgres는 느리지 않다. 느린 건 여러분의 저장장치다(Postgres Isn't Slow. Your Storage Is)." 8월 20일 ClickHouse 블로그에 요약글이 올라왔고, 10월 12일 발표자 본인이 해커뉴스에 올린 글이 하루 만에 174점, 댓글 185개를 받으며 그 주의 가장 뜨거운 데이터베이스 토론이 됐습니다.
주장은 단순하고, 숫자는 강렬합니다. 같은 기계, 같은 Postgres, 같은 쿼리, 같은 데이터. 저장장치만 AWS의 네트워크 디스크(EBS gp3)에서 서버에 직접 꽂힌 NVMe SSD로 바꿨더니 처리량이 9.24배가 됐습니다. 트랜잭션 하나의 지연은 36.9ms에서 4.0ms로 줄었습니다. 그리고 EBS 쪽 37ms를 쪼개 보니, Postgres가 실제로 계산한 시간은 2ms였습니다. 나머지 35ms는 기다림이었습니다.
댓글창은 둘로 갈렸습니다. 한쪽은 "네트워크 디스크는 하드디스크 시절에나 말이 되던 구조다. 운영 편의 하나 때문에 IOPS와 지연 둘 다에서 10배 손해를 보는 건 말이 안 된다"고 했습니다. 다른 쪽은 "Postgres가 느린 게 아니라 스키마와 쿼리가 느린 것이다. 제대로 고쳐 줬다"고 받아쳤고, 또 다른 쪽은 "벤치마크가 가장 싼 EBS 설정과 비교했고, 글쓴이 회사가 바로 NVMe 기반 Postgres를 판다"는 점을 짚었습니다. 셋 다 일리가 있습니다.
이 글은 그 논쟁을 제대로 따라가기 위한 안내서입니다. 데이터베이스를 깊이 다뤄 본 적 없는 독자도 끝까지 따라올 수 있도록, 원문의 그림과 숫자를 하나씩 풀고 그 밑에 깔린 개념을 처음부터 설명합니다. 순서는 이렇습니다.
1~2절다섯 가지 증상과 기본 낱말 다섯 개 (페이지, 버퍼, 캐시 미스, IOPS, 지연)
3~6절실험 설계와 결과, 37ms 영수증, 놀고 있던 CPU
7~9절리틀의 법칙으로 푸는 19ms의 수수께끼, UPDATE 한 줄의 여정, 하나의 예산을 나눠 쓰는 다섯 증상
10절하드디스크에서 EBS, Aurora, 다시 로컬 NVMe까지 — 데이터베이스와 디스크의 50년
11~12절반론과 한계, 그리고 디스크가 사라지는 세계에서 데이터를 지키는 운영 구조
13~14절2026년에 이 이야기가 갖는 의미, 내 데이터베이스 진단 체크리스트
1. 다섯 가지 증상, 범인은 하나
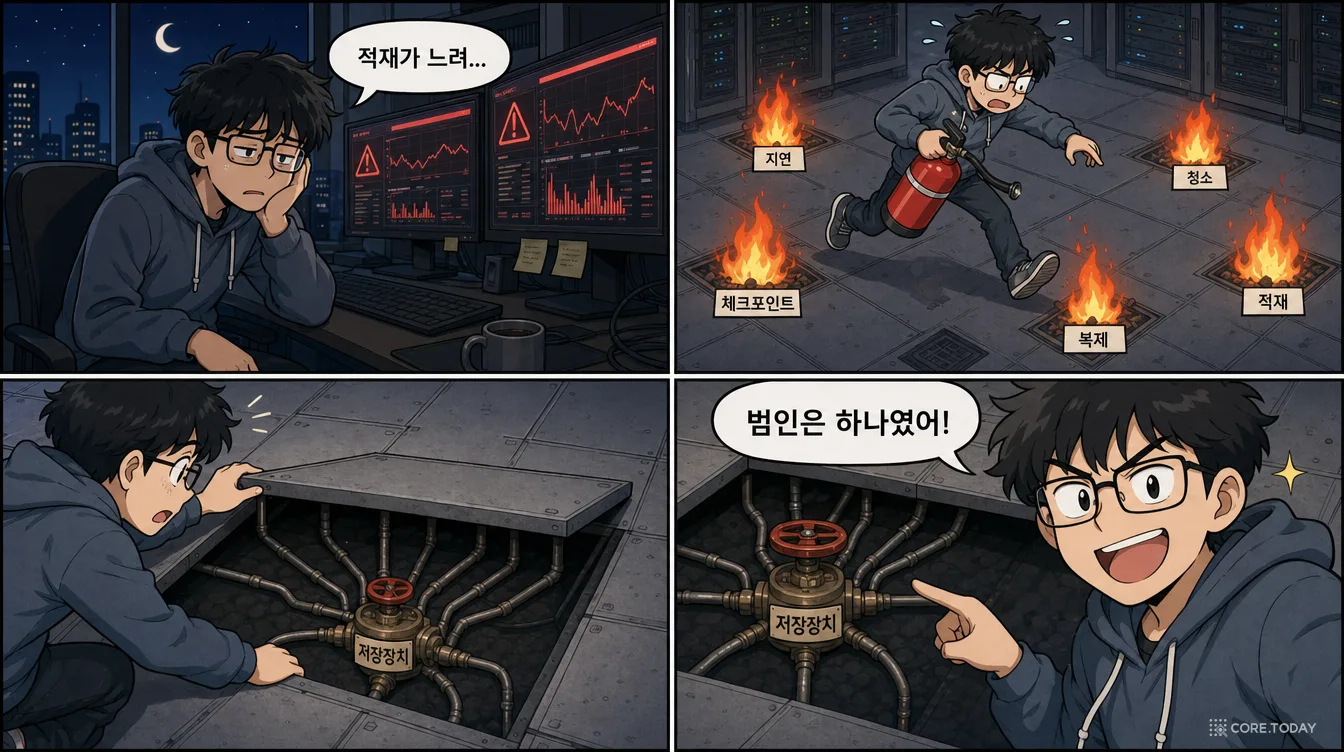
발표는 데이터베이스 운영자라면 한 번쯤 겪어 봤을 증상 다섯 개로 시작합니다. 데이터가 수백 GB에서 수 TB로 커지고, 동시 접속과 처리량이 실제 서비스 수준으로 올라가면 흔히 나타나는 것들입니다.
다섯 증상은 서로 관계없어 보이고, 실제로 원인이 각각 따로일 때도 많습니다. 운영자는 증상마다 다른 설정을 고치고 다른 도구를 의심합니다. 위 웹툰의 엔지니어처럼 소화기를 들고 이 불에서 저 불로 뛰어다니는 것이죠. 발표자의 주장은 이 다섯이 흔히 놓치는 공통 원인 하나를 가질 수 있다는 것입니다. 저장장치의 성능입니다.
논리는 두 단계입니다. 첫째, 자주 쓰는 데이터(작업 집합, working set)가 메모리보다 커지면 읽기 요청이 실제 디스크 입출력이 됩니다. 느린 저장장치에서는 그 읽기 하나하나가 비싸고, 줄을 서고, 평균과 꼬리 지연을 함께 끌어올립니다. 둘째, 클라이언트 쿼리와 배경 작업(테이블·인덱스 쓰기, WAL 동기화, 체크포인트, VACUUM, 논리 디코딩)이 같은 저장장치 예산을 나눠 씁니다. 대역폭, IOPS, 대기열 용량이 한계에 닿으면 이 작업들이 서로를 늦추기 시작합니다. 그래서 겉보기에 무관한 다섯 증상이 한꺼번에 나타납니다.
이 주장이 맞는지 확인하려면 몇 가지 낱말부터 알아야 합니다.
2. 먼저 낱말 다섯 개: 페이지, 버퍼, 캐시 미스, IOPS, 지연
원문은 데이터베이스를 매일 만지는 사람을 독자로 상정하고 썼습니다. 그래서 낱말 몇 개를 설명 없이 씁니다. 이 낱말들만 잡으면 나머지는 생각보다 쉽습니다.
페이지(page). Postgres는 데이터를 한 줄씩이 아니라 8KB짜리 상자 단위로 디스크에 쓰고 읽습니다. 이 상자가 페이지입니다. 행 하나만 필요해도 그 행이 든 8KB 페이지를 통째로 가져와야 합니다. 테이블도 페이지의 묶음이고, 인덱스도 페이지의 묶음입니다.
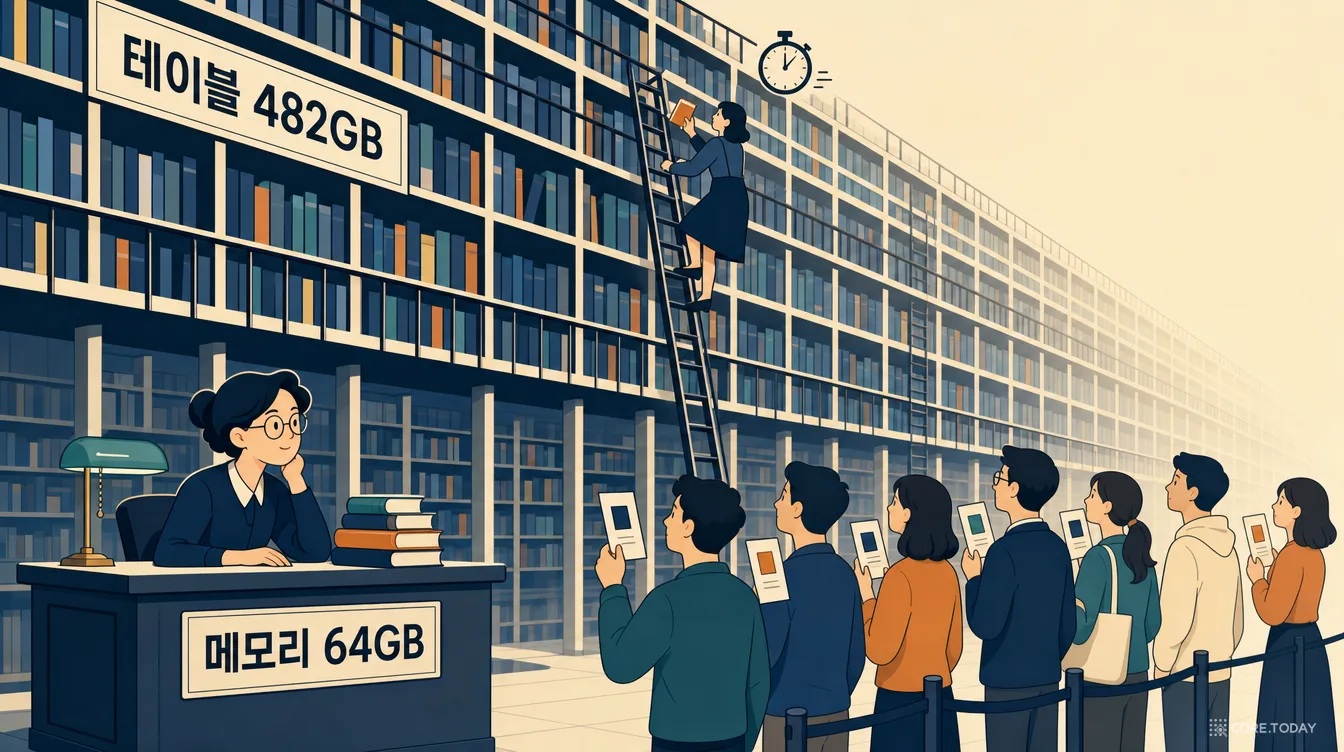
버퍼(buffer)와 캐시. 디스크에서 가져온 페이지는 메모리에 잠시 보관됩니다. Postgres가 직접 관리하는 공간이 shared_buffers(원문 실험에선 16GiB)이고, 그 바깥에서 운영체제도 최근 읽은 파일 조각을 따로 들고 있습니다(페이지 캐시). 원문 서버의 메모리는 64GiB였으니, 두 캐시를 합쳐도 대략 50~60GB가 한계입니다.
캐시 미스(cache miss). 찾는 페이지가 두 캐시 어디에도 없어서 디스크까지 가야 하는 상황입니다. 위 그림의 사서를 떠올리면 됩니다. 책상 위에 있는 책은 손만 뻗으면 되지만, 서고에 있는 책은 사다리를 타야 합니다. 원문 실험의 테이블은 482GiB였습니다. 책상이 64GB인데 서고가 482GB이고, 손님들이 33억 권 중 아무 책이나 무작위로 청한다면, 열에 아홉은 사다리를 타야 합니다.
IOPS. 초당 입출력 횟수(Input/Output Operations Per Second)입니다. 저장장치가 1초에 처리할 수 있는 읽기·쓰기 요청의 개수죠. 클라우드 저장장치는 이 숫자를 상품 사양으로 팝니다. AWS의 범용 SSD 볼륨 gp3는 기본으로 3,000 IOPS를 주고, 그 이상은 돈을 더 내고 삽니다. 3,000이라는 숫자는 "아무리 바빠도 1초에 3,000번까지만 디스크에 다녀올 수 있다"는 뜻입니다.
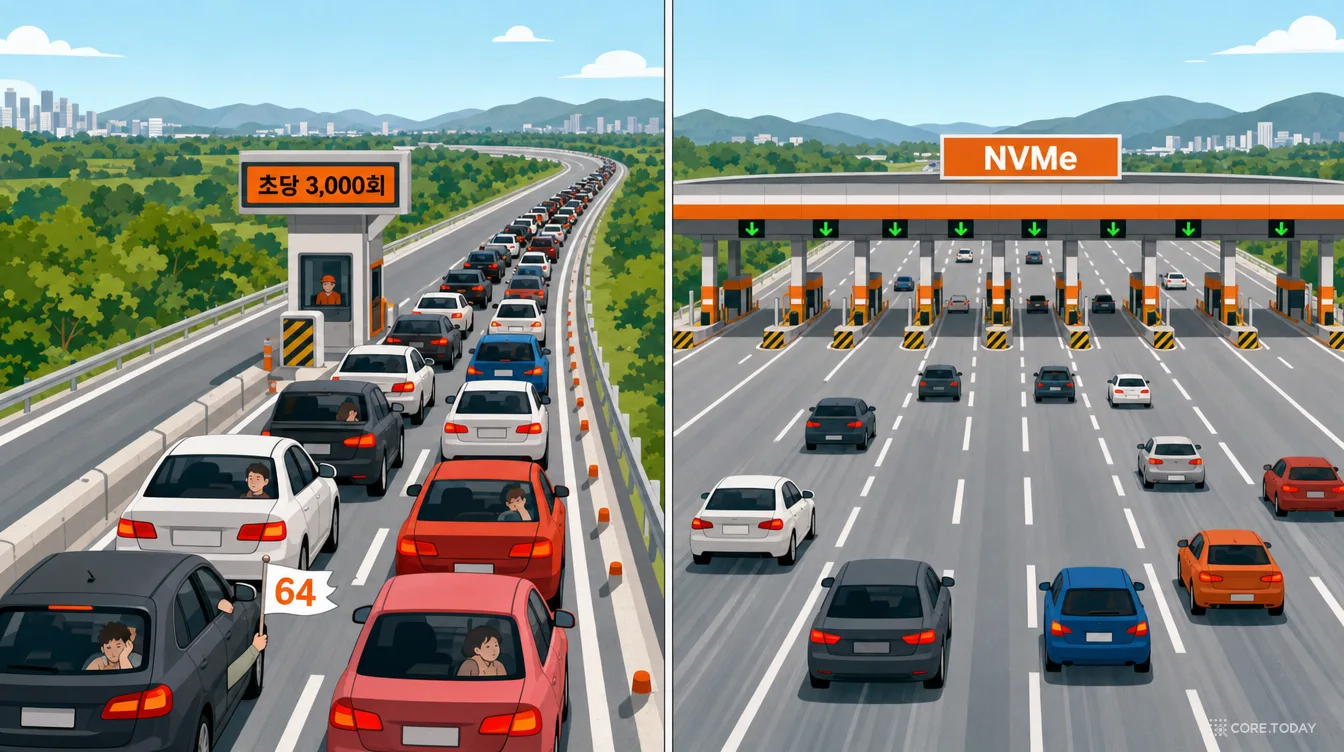
지연(latency). 요청 하나가 끝날 때까지 걸리는 시간입니다. 처리량(throughput, 초당 몇 건)과 헷갈리기 쉬운데, 둘은 다른 물건입니다. 고속도로로 치면 지연은 "서울에서 부산까지 몇 시간", 처리량은 "한 시간에 몇 대가 톨게이트를 통과하나"입니다. 차선을 늘리면 처리량은 늘지만 서울-부산 거리는 그대로입니다.
이 다섯 낱말 위에, 원문 전체를 관통하는 숫자 감각을 하나 얹어 두겠습니다. 아래 사다리는 "1나노초를 1초로 늘리면" 각 저장 계층이 사람 시간으로 얼마나 걸리는지 보여 줍니다.
메모리 접근이 1분 40초라면, 서버에 꽂힌 NVMe SSD는 하루 남짓, 네트워크 너머의 EBS 볼륨은 열흘 가까이 걸리는 거리입니다. 그리고 원문 실험에서 EBS 쪽 트랜잭션이 페이지 읽기에 쓴 19ms는 사람 시간으로 7개월이 넘습니다. 옛날 하드디스크보다도 깁니다. 이 숫자가 어떻게 나왔는지가 이 글의 절반입니다.
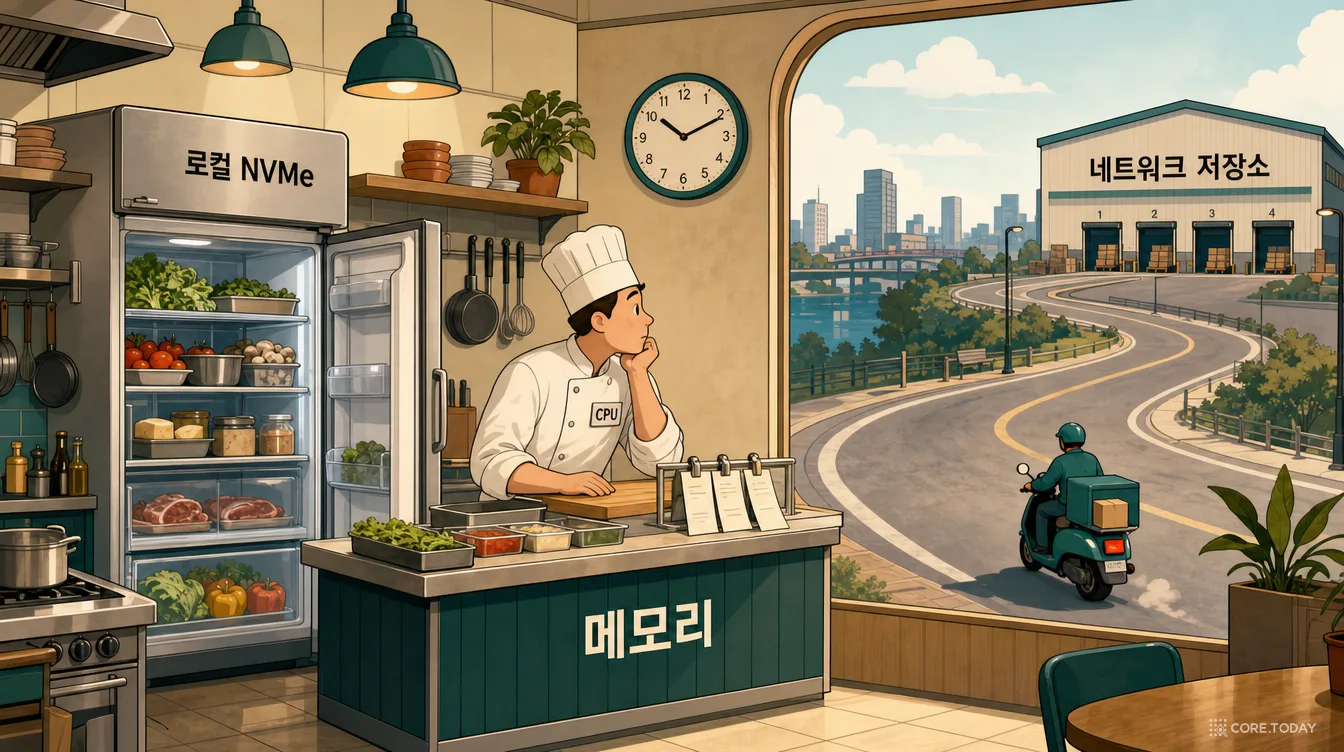
주방으로 바꿔 말하면 이렇습니다. 요리사(CPU)의 손놀림은 어느 주방에서나 같습니다. 다른 건 재료가 어디 있느냐입니다. 주방 안 냉장고(로컬 NVMe)에서 꺼내느냐, 도시 건너편 창고(네트워크 저장소)에서 스쿠터로 배달받느냐. 손님이 많아질수록 요리사는 요리보다 배달을 기다리는 데 시간을 더 씁니다. 원문의 제목 "Postgres는 느리지 않다, 느린 건 저장장치다"는 바로 이 장면을 말합니다.
3. 실험 설계: 저장장치 말고는 전부 같게
좋은 실험은 변수를 하나만 바꿉니다. 원문의 벤치마크는 이 원칙을 꽤 성실하게 지켰습니다.
항목
NVMe 그룹
EBS 그룹
클러스터 수
4개
4개
인스턴스
m6id.4xlarge (vCPU 16, RAM 64GiB)
m6id.4xlarge (같음)
shared_buffers
16GiB
16GiB
저장장치
인스턴스 스토어 NVMe (서버에 직접 꽂힌 SSD)
gp3 EBS, 기본 3,000 IOPS (네트워크로 붙는 볼륨)
데이터
pgbench_accounts 482GiB, 33억 행
같음
부하
클라이언트 64개, 워커 스레드 16개, 5분간 무작위 UPDATE
같음
몇 가지를 풀어 보겠습니다.
왜 클러스터를 네 개씩 썼나. 클라우드에서는 같은 사양의 기계라도 놓인 위치, 이웃 손님(같은 물리 서버를 나눠 쓰는 다른 고객), 그날의 네트워크 상태에 따라 성능이 흔들립니다. 그래서 종류마다 네 대를 띄우고 중앙값을 보고했습니다. 한 번 돌리고 끝낸 벤치마크보다 믿을 만합니다.
m6id라는 이름. AWS 인스턴스 이름에서 m은 CPU와 메모리 비율이 균형 잡힌 범용 계열, 6은 6세대, i는 인텔 프로세서, d는 로컬 NVMe 디스크가 달려 있다는 뜻입니다. 두 그룹 모두 d가 붙은 같은 기계를 썼다는 게 중요합니다. EBS 그룹도 NVMe가 꽂힌 기계에서 그 NVMe를 쓰지 않고 EBS에 데이터를 둔 것입니다. CPU, 메모리, 네트워크 대역이 완전히 같습니다.
pgbench와 그 쿼리. pgbench는 Postgres에 함께 들어 있는 부하 생성 도구입니다. 은행 계좌를 흉내 낸 pgbench_accounts 테이블을 만들고 거기에 쿼리를 쏩니다. 원문이 쓴 쿼리는 딱 두 줄입니다.
sql
\set aid random(1, 3300000000)
UPDATE pgbench_accounts SET abalance = abalance +1WHERE aid = :aid;
33억 개 계좌 중 아무거나 하나를 골라 잔액을 1 올립니다. 단순해 보이지만 저장장치 입장에서는 최악에 가까운 부하입니다. 세 가지 이유가 겹칩니다.
무작위다. 다음에 읽을 페이지를 예측할 수 없으니 미리 읽어 둘(prefetch) 수 없습니다.
데이터가 메모리보다 7배 넘게 크다. 482GiB 대 64GiB. 열에 아홉은 캐시 미스입니다.
쓰기다. 읽기만 하는 부하라면 커밋 때 디스크에 확정 기록(fsync)할 일이 없습니다. UPDATE는 커밋마다 기록을 디스크에 내려야 합니다.
발표 영상에는 요약글에 없는 세부도 몇 가지 있습니다. Postgres는 18.3을 소스에서 직접 빌드했고, pgbench 규모 계수(scale factor)는 33,000(계좌 10만 개 × 33,000 = 33억)이었습니다. 데이터 체크섬은 켜 두었고, 5분 동안 NVMe 쪽은 약 1,900만 건, EBS 쪽은 약 200만 건의 트랜잭션을 처리했습니다. 측정에는 eBPF 기반 연속 프로파일러 Parca, 블록 계층 지연을 재는 ebpf_exporter, 1초마다 찍은 pg_stat_activity를 썼습니다.
즉 이 실험은 "Postgres를 저장장치가 가장 괴로워하는 방식으로 몰아붙였을 때 저장장치의 차이가 얼마나 드러나는가"를 잰 것입니다. 이 점은 뒤에서 반론을 다룰 때 다시 중요해집니다.
4. 결과: 9.24배
NVMe 처리량
16,030 TPS
EBS 처리량
1,734 TPS
지표
로컬 NVMe
EBS gp3 3,000 IOPS
차이
처리량 (중앙값)
16,030 TPS
1,734 TPS
9.24배
트랜잭션 지연 (중앙값)
4.0 ms
36.9 ms
9.2배
VACUUM, 블로트 10GB 청소
366초
964초
2.6배
논리 복제, 밀린 10GB 따라잡기
139초
238초
1.7배
처리량과 지연의 배율이 거의 같다는 점(9.24배와 9.2배)을 눈여겨봐 두세요. 우연이 아닙니다. 클라이언트 64개가 쉬지 않고 쿼리를 던지는 실험에서는 처리량 = 동시 요청 수 ÷ 지연이 성립합니다. 64 ÷ 0.0369초 = 1,734, 64 ÷ 0.004초 = 16,000. 대기행렬 이론에서 리틀의 법칙(Little's Law)이라고 부르는 관계입니다. 지연이 9배 늘면 처리량이 9분의 1이 되는 것이죠. 그러니 질문은 하나로 좁혀집니다. 37ms는 어디에 쓰였나?
VACUUM과 복제 쪽 배율이 2.6배, 1.7배로 UPDATE보다 작은 것도 이유가 있습니다. 둘 다 무작위 접근보다는 순서대로 훑는 작업에 가깝습니다. 순서대로 읽는 작업은 미리 읽기와 큰 단위 묶어 읽기가 통하므로, 요청 하나하나의 지연보다 대역폭이 중요해집니다. 저장장치의 차이가 덜 드러나는 영역입니다.
원문은 결론을 내리기 전에 단서를 하나 답니다. "이 결과는 이 부하와 이 저장장치 구성에만 해당한다. EBS 쪽은 기본 gp3 3,000 IOPS였고, 다른 EBS 구성이라면 결과가 달랐을 가능성이 크다." 이 단서는 해커뉴스 토론과 외부 비평에서 가장 많이 거론된 지점이 됩니다. 11절에서 자세히 봅니다.
5. 37ms 영수증 읽기
원문에서 가장 중요한 그림은 이것입니다.
크게 보기출처: ClickHouse 블로그 「POSETTE Talk Recap — Postgres Isn’t Slow. Your Storage Is」(2026-08-20). 그림 제목 “Where the 37 ms EBS latency goes / CPU work is the same. Everything else is disk.”
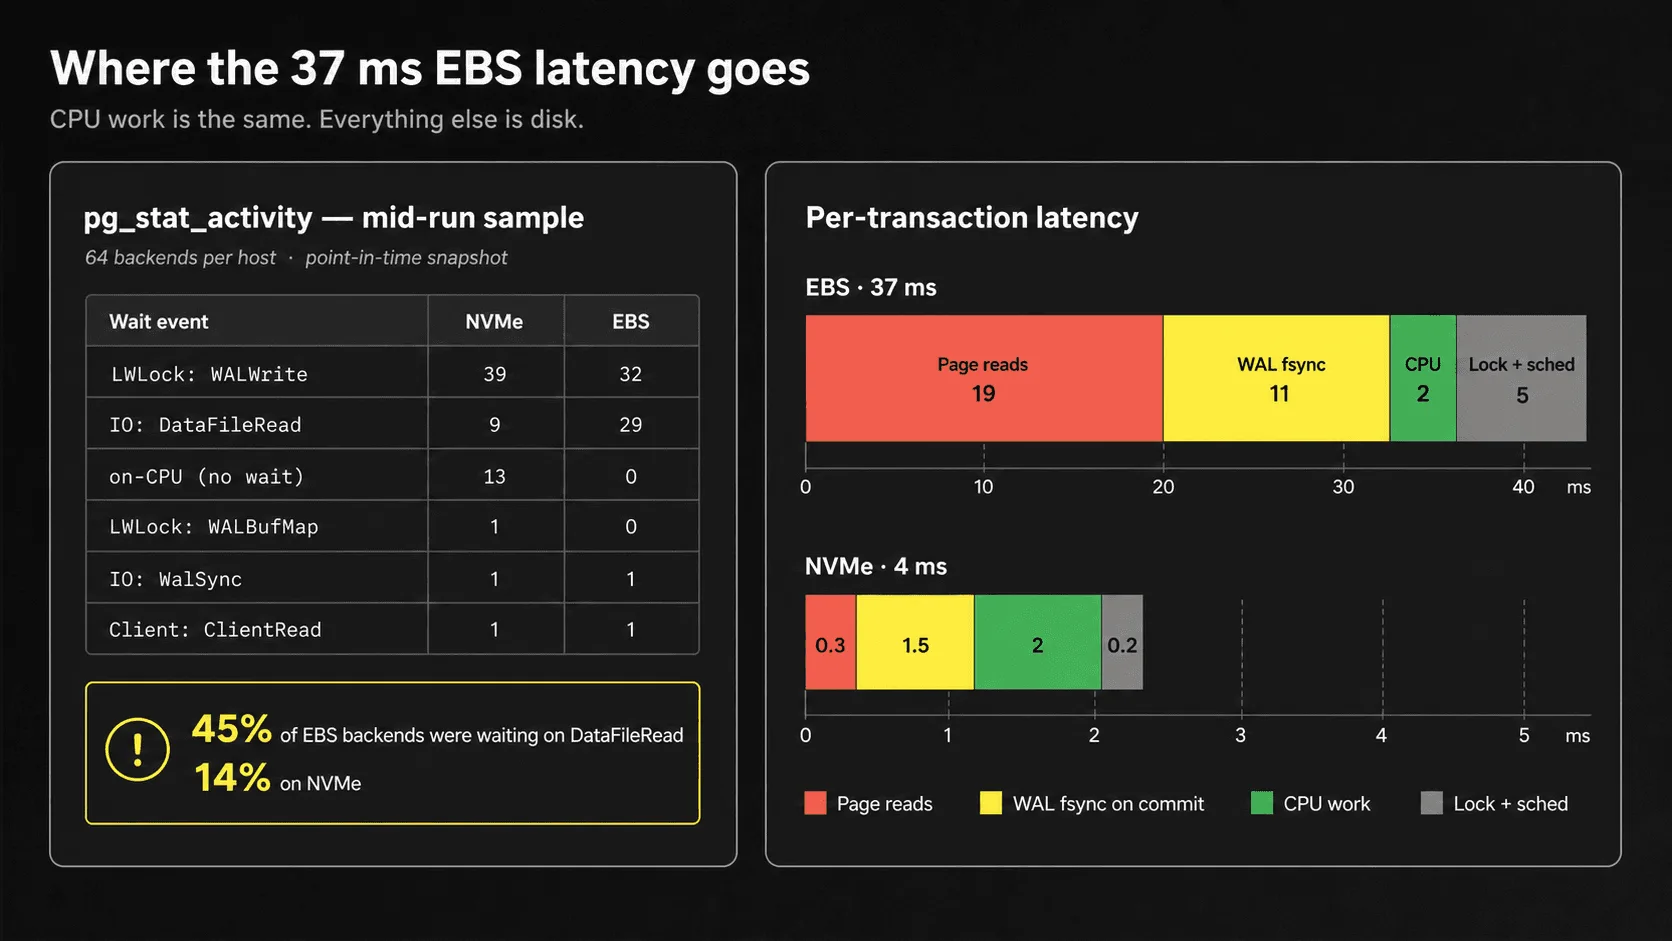
그림의 부제가 요약 그 자체입니다. "CPU 작업은 같다. 나머지는 전부 디스크다." 오른쪽 막대부터 봅시다. UPDATE 트랜잭션 하나가 쓴 시간을 네 항목으로 나눴습니다.
항목
EBS
NVMe
무엇을 기다렸나
페이지 읽기 (Page reads)
19 ms
0.3 ms
메모리에 없는 인덱스·테이블 페이지를 디스크에서 가져오기
WAL fsync (커밋 시)
11 ms
1.5 ms
변경 기록을 디스크에 확정하고 ‘완료’ 답을 받기
CPU 작업
2 ms
2 ms
진짜 계산. 양쪽이 같다
락 + 스케줄링
5 ms
0.2 ms
다른 세션이 쥔 락을 기다리기, CPU를 다시 배정받기
합계
37 ms
4 ms
EBS 쪽 37ms 가운데 Postgres가 실제로 "일한" 시간은 2ms입니다. 나머지 35ms는 기다림입니다. 그중 가장 큰 덩어리 19ms는 페이지 읽기 대기, 11ms는 커밋 fsync 대기입니다. 락 대기 5ms도 따지고 보면 디스크 탓입니다. 앞 세션이 느린 디스크를 기다리며 락을 쥐고 있으니 뒤 세션이 줄을 서는 것이죠.
여기서 흥미로운 질문이 하나 생깁니다. gp3 볼륨의 읽기 하나는 부하가 없을 때 1ms도 안 걸립니다(AWS 문서 표현으로는 "한 자릿수 밀리초", 실측은 대개 0.5~1ms). 트랜잭션 하나가 페이지를 두 장쯤 읽는데, 어떻게 19ms가 되었을까요? 답은 대기열입니다. 3,000 IOPS라는 상한에 부딪힌 순간부터, 요청은 디스크에 닿기 전에 줄을 섭니다. 19ms의 대부분은 디스크가 일한 시간이 아니라 줄 서 있던 시간입니다. 이 대목은 7절에서 계산기로 직접 확인합니다.
왼쪽 표는 같은 이야기를 다른 각도에서 보여 줍니다. pg_stat_activity는 Postgres가 "지금 각 접속이 무엇을 하고 있는지" 보여 주는 시스템 뷰이고, wait_event는 그 접속이 무엇을 기다리는지 알려 줍니다. 실행 도중 한순간을 찍어 보니 EBS 서버에서는 64개 중 29개(45%)가 IO: DataFileRead, 즉 데이터 파일 읽기를 기다리고 있었습니다. NVMe에서는 9개(14%)였습니다. 그리고 CPU에서 일하고 있던(on-CPU) 접속이 EBS 쪽은 0개, NVMe 쪽은 13개였습니다.
표에서 원문이 크게 다루지 않은 줄이 하나 더 있습니다. NVMe 쪽에서 가장 많은 접속(39개)이 기다리던 것은 디스크가 아니라 LWLock: WALWrite였습니다. WAL을 디스크로 내보내는 일은 한 번에 한 세션만 할 수 있어서 생기는 락입니다. 디스크 대기가 사라지자 다음 병목이 드러난 것입니다. 병목은 없어지지 않고 자리를 옮깁니다. NVMe로 옮긴 뒤에도 성능 튜닝은 계속된다는 뜻이고, 그 다음 상대는 WAL 쓰기 직렬화(그룹 커밋 설정, wal_buffers, WAL을 별도 장치에 두기 같은 주제)입니다.
아래 영수증에서 항목을 하나씩 빼 보거나, EBS의 한 항목만 NVMe 값으로 바꿔 보세요.
6. CPU가 놀고 있었다
원문의 두 번째 그림은 더 직관에 반합니다.
크게 보기출처: 같은 ClickHouse 블로그. 240초 표본 동안 함수별로 CPU를 쓴 시간(초).
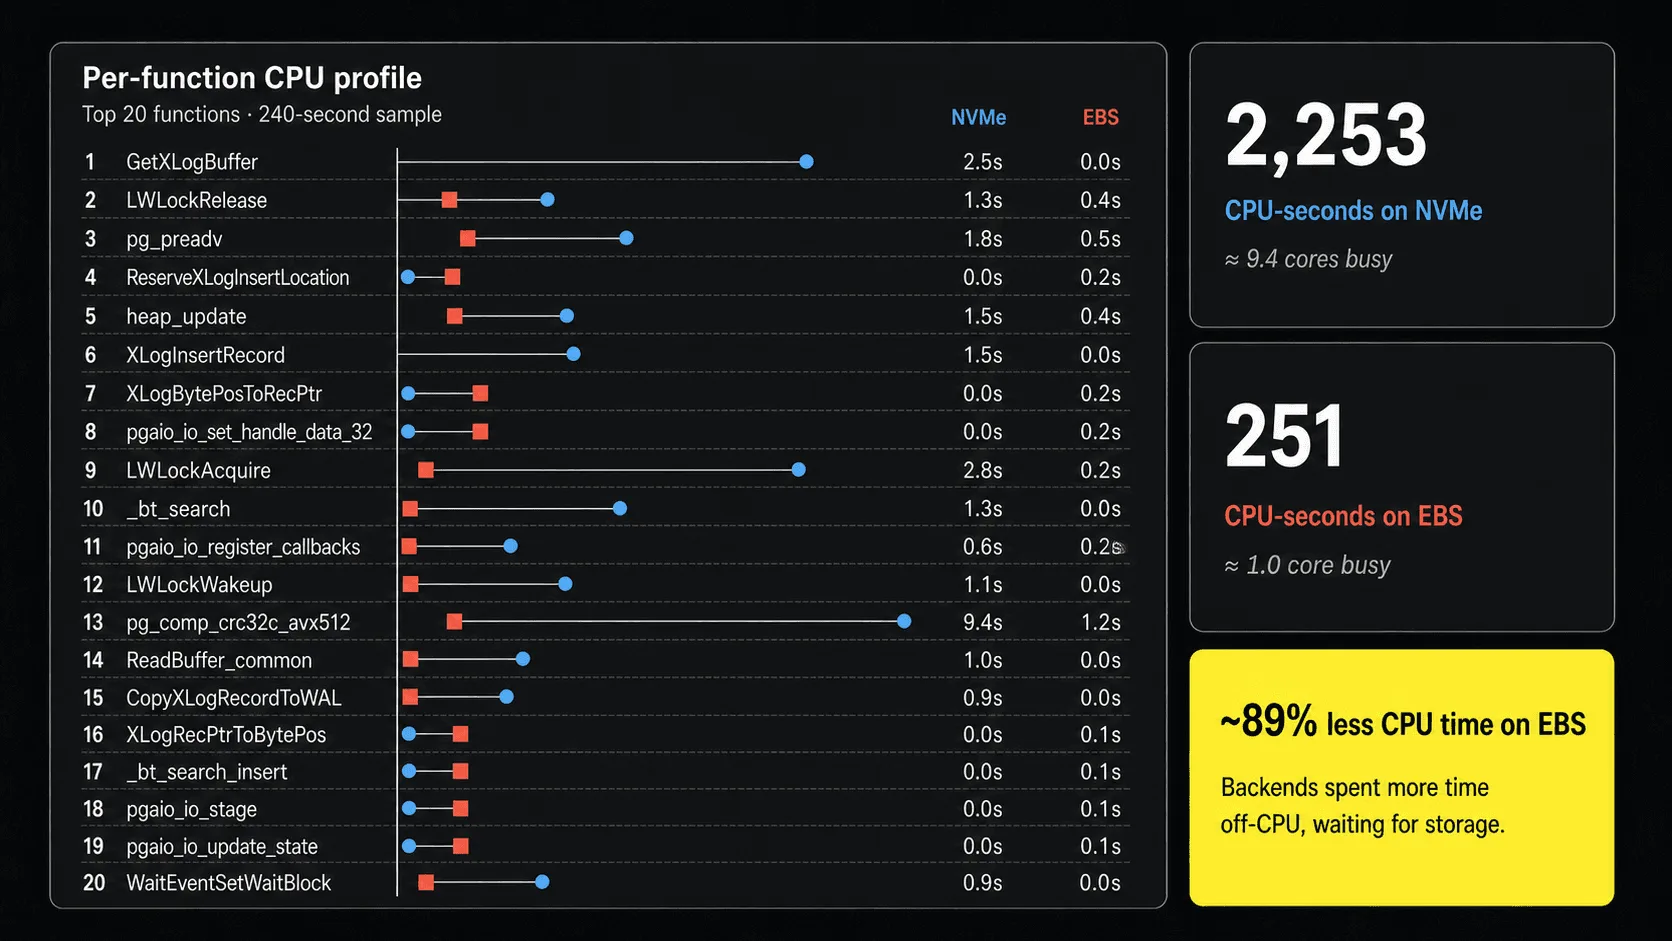
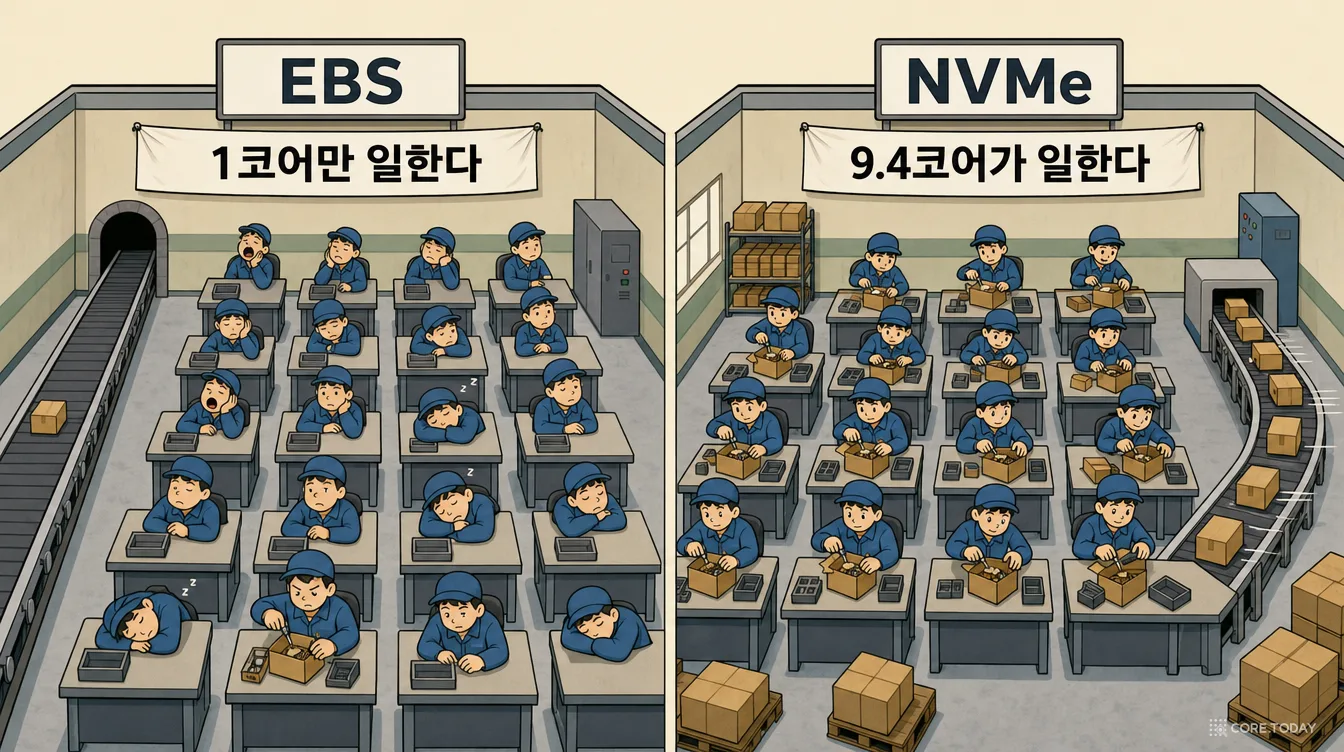
240초 동안 NVMe 서버는 CPU를 2,253초어치 썼습니다. 코어 16개 중 평균 9.4개가 일했다는 뜻입니다. EBS 서버는 251초, 코어 1개 분량이었습니다. 16코어짜리 비싼 기계를 빌려 놓고 15코어를 놀린 셈입니다.
그런데 이 숫자를 처리량으로 나눠 보면 재미있는 일이 생깁니다.
트랜잭션 하나당 CPU 시간 (원문 숫자로 역산)
NVMe
2,253 CPU초 ÷ 240초 ÷ 16,030 TPS ≈ 0.59 ms
EBS
251 CPU초 ÷ 240초 ÷ 1,734 TPS ≈ 0.60 ms
트랜잭션 하나에 드는 CPU는 양쪽이 똑같이 0.6ms입니다. Postgres는 어느 기계에서나 같은 양의 일을 했습니다. 다만 EBS 쪽은 그 일을 1초에 1,734번밖에 할 기회가 없었고, NVMe 쪽은 16,030번 할 기회가 있었을 뿐입니다. (영수증의 "CPU 2ms"가 0.6ms보다 큰 것은, 그 2ms가 순수 연산 시간이 아니라 CPU 위에 있던 벽시계 시간이기 때문으로 보입니다. 원문은 분해 방법을 자세히 밝히지 않았습니다.)
첫째, pgaio_ 함수가 보인다는 건 실험에 Postgres 18 이상이 쓰였다는 뜻입니다. 2025년 9월에 나온 Postgres 18은 비동기 I/O를 처음 들였습니다. 그런데도 EBS가 9배 느렸습니다. 비동기 I/O가 만능이 아니라는 이야기인데, 이유는 8절에서 봅니다.
둘째, EBS 쪽이 NVMe보다 큰 함수는 몇 개뿐이고, 그마저 0.1~0.2초로 작습니다. I/O 요청을 준비하고 등록하는 pgaio_io_* 함수들, WAL에 자리를 예약하는 ReserveXLogInsertLocation 같은 부대 작업입니다. 원문 표현대로 "몇몇 함수가 EBS에서 비율상 더 뜨거워 보이지만, 절대 CPU 시간을 보면 EBS 프로세스들은 CPU 밖에서 저장장치를 기다리며 훨씬 많은 시간을 보냈다." 비율만 보는 프로파일 도구(플레임 그래프 같은)로 EBS 서버를 보면 엉뚱한 함수를 범인으로 지목하기 쉽다는 뜻입니다.
셋째, NVMe 쪽 1위가 체크섬 계산이라는 것. 디스크 대기가 사라지자 이제 WAL을 만드는 순수 계산이 가장 큰 비용이 되었습니다. 앞 절에서 본 LWLock: WALWrite 대기와 같은 이야기입니다. NVMe 위의 Postgres는 이제 WAL을 얼마나 빨리 만들고 내보내느냐의 싸움을 합니다. 건강한 상태의 병목입니다.
프로파일링에는 함정이 하나 있습니다. CPU 프로파일은 CPU 위에서 일어난 일만 보여 줍니다. 기다리는 프로세스는 CPU를 쓰지 않으니 프로파일에 나타나지 않습니다. 그래서 EBS 서버의 프로파일만 보면 "Postgres가 크게 바쁜 데는 없는데 왜 느리지?"라는 수수께끼에 빠지기 쉽습니다. 느린 이유가 CPU 밖에 있을 때는 대기 이벤트(pg_stat_activity.wait_event)와 오프-CPU 분석을 함께 봐야 합니다. 원문이 두 그림을 나란히 놓은 이유입니다.
1단계: 트랜잭션 하나가 디스크를 몇 번 읽나. 무작위 계좌 하나를 고치려면 기본키 인덱스의 잎 페이지 한 장과 테이블 페이지 한 장이 필요합니다(인덱스 위쪽 층은 늘 메모리에 있습니다). 데이터가 메모리의 7~8배이니 각각 90% 가까운 확률로 캐시 미스입니다. 대략 트랜잭션당 1.7~1.8회 디스크를 읽습니다.
2단계: 상한에서 나눗셈. gp3 기본 볼륨은 1초에 3,000번까지만 디스크에 다녀올 수 있습니다. 3,000 ÷ 1.73 ≈ 1,734. 원문의 EBS 처리량과 정확히 같은 숫자가 나옵니다. (역으로 말하면, 실측 1,734 TPS는 트랜잭션당 1.73회 읽기로 IOPS 상한을 꽉 채운 상태와 맞아떨어집니다. 엄밀하게는 쓰기 I/O도 같은 IOPS 예산을 쓰기 때문에 실제 계산은 이보다 복잡합니다. 다만 자릿수는 이 단순한 나눗셈이 설명합니다.)
3단계: 남은 클라이언트는 줄을 선다. 디스크가 1초에 1,734건분만 처리할 수 있는데 클라이언트 64개가 쉬지 않고 요청을 던지면, 처리되지 못한 요청은 대기열에 섭니다. 리틀의 법칙으로 64 ÷ 1,734 = 36.9ms. 트랜잭션 하나의 지연이 이렇게 정해집니다. 디스크 자체는 1ms 안에 답할 수 있어도, 줄 맨 뒤에 선 요청은 앞의 수십 개가 끝나길 기다려야 합니다.
대기 이벤트 표로 검산도 됩니다. 같은 리틀의 법칙을 디스크 앞 대기열에 적용하면, 읽기를 기다리던 접속 29개 ÷ 초당 약 3,000회 처리 ≈ 읽기 하나당 약 10ms입니다. 트랜잭션당 두 번 읽으면 약 19~20ms. 영수증의 "페이지 읽기 19ms"와 맞아떨어집니다. AWS 문서는 "3,000 IOPS 볼륨이라면 평균 대기열 깊이가 3이어야 한다"고 안내하는데, 이 역시 리틀의 법칙으로 풀면 I/O 하나의 처리 시간이 약 1ms라는 뜻입니다. 결국 19ms 가운데 디스크가 실제로 일한 시간은 2ms 남짓이고, 나머지 17ms는 줄 서 있던 시간입니다.
4단계: 그래서 클라이언트를 늘려도 소용없다. 128개로 늘리면? 처리량은 그대로 1,734이고 지연만 74ms로 두 배가 됩니다. 이것이 "부하가 늘수록 P95가 예측 불가능해진다"는 원문 증상의 정체입니다. 처리량 천장에 닿은 시스템에 요청을 더 넣으면 늘어나는 것은 대기 시간뿐입니다.
NVMe 쪽은 같은 계산을 해도 천장이 보이지 않습니다. m6id.4xlarge에 달린 950GB NVMe는 AWS 사양상 무작위 읽기 26만 8천 IOPS, 쓰기 13만 4천 IOPS입니다. gp3 기본값의 약 89배입니다. 16,030 TPS × 1.73 ≈ 2만 8천 IOPS로, 읽기 상한의 10분의 1 남짓입니다. 그래서 NVMe 쪽 처리량은 디스크가 아니라 지연(4ms)과 동시 요청 수(64)로 정해집니다. 64 ÷ 0.004 = 16,000.
아래 계산기는 이 논리를 그대로 옮긴 것입니다. 처리량은 세 천장 중 가장 낮은 값입니다. ① 동시 요청 ÷ 지연, ② IOPS ÷ 트랜잭션당 읽기, ③ CPU 코어 ÷ 트랜잭션당 CPU. 기본값은 원문 조건이고, 모델은 EBS 1,675 TPS(실측 1,734), NVMe 16,000 TPS(실측 16,030)를 냅니다. 메모리를 늘려 보거나, gp3의 IOPS를 16,000으로 올려 보세요.
계산기를 만지다 보면 원문이 말하지 않은 사실 두 가지가 보입니다.
하나, 메모리를 늘리면 저장장치 차이가 줄어듭니다. 테이블 482GB에 메모리를 512GB 이상 주면 캐시 적중률이 100%에 가까워지고, 디스크 읽기가 거의 사라지면서 네 저장장치의 처리량이 비슷해집니다. 원문 실험은 일부러 데이터를 메모리의 7배 넘게 만들어 저장장치를 드러냈습니다. 여러분의 데이터베이스가 메모리 안에 다 들어간다면 이 글의 9배는 여러분의 이야기가 아닐 수 있습니다.
둘, gp3의 IOPS를 돈 내고 올리면 격차의 상당 부분이 메워집니다. 16,000 IOPS짜리 gp3로 바꾸면 모델상 약 8,900 TPS가 나옵니다. NVMe의 절반을 넘습니다. 다만 IOPS를 올려도 읽기 하나의 지연(네트워크 왕복)은 그대로라, 지연이 중요한 서비스에서는 여전히 차이가 남습니다. 그리고 인스턴스마다 붙일 수 있는 EBS 대역과 IOPS에도 별도 상한이 있습니다. 이 부분은 반론 절에서 숫자로 다시 봅니다.
8. UPDATE 한 건의 여정: Postgres 안에서 일어나는 일
이제 상자를 열어 봅니다. UPDATE 한 줄이 Postgres 안에서 지나가는 정거장을 따라가면, 왜 이 데이터베이스가 저장장치에 이토록 민감한지 보입니다. 아래 위젯에서 "자동 재생"을 누르고, EBS와 NVMe를 바꿔 가며 보세요.
정거장마다 몇 가지 개념이 숨어 있습니다. 차례로 풀어 보겠습니다.
B-트리: 33억 개 중 하나를 네 번 만에 찾기
기본키 인덱스는 B-트리라는 나무 모양 자료 구조입니다. 페이지 한 장(8KB)에 정수 키를 수백 개 담을 수 있어서, 뿌리 페이지 하나가 수백 개의 자식 페이지를 가리키고, 그 자식들이 또 수백 개씩 가리킵니다. 300 × 300 × 300 × 300이 81억이니, 33억 행짜리 인덱스도 4층 남짓이면 됩니다. 위쪽 세 층은 다 합쳐도 몇 만 장, 몇 백 MB라 늘 메모리에 있습니다. 문제는 맨 아래 잎 층입니다. 잎 페이지는 천만 장 가까이(수십 GB) 되기 때문에 무작위 키라면 대개 캐시에 없습니다.
1970년대에 B-트리가 등장한 이유 자체가 디스크였다는 점이 재미있습니다. 루돌프 바이어와 에드워드 맥크레이트가 1970년에 보잉 연구소에서 B-트리를 고안할 때 목표는 "디스크를 몇 번만 읽고 원하는 키를 찾는 것"이었습니다. 한 번 읽을 때 최대한 많은 키를 가져오도록 노드를 디스크 블록 크기에 맞춘 것이죠. 50년이 지나도 그 설계 목표는 그대로이고, 원문 실험은 그 "몇 번"이 얼마나 비싼지를 잰 셈입니다.
MVCC: 지우개 대신 새 줄
Postgres는 UPDATE를 할 때 기존 행을 고쳐 쓰지 않습니다. 옛 버전에 "여기까지 유효"라고 표시하고, 새 버전을 새로 씁니다. 이를 다중 버전 동시성 제어(MVCC, Multi-Version Concurrency Control)라고 합니다. 덕분에 읽는 쪽은 쓰는 쪽을 기다리지 않습니다. 누군가 계좌를 고치는 동안에도 다른 사람은 고치기 전 버전을 읽으면 되니까요.
대가는 죽은 행입니다. 옛 버전은 아무도 보지 않게 된 뒤에도 페이지 안에 남아 자리를 차지합니다. 이걸 치우는 청소부가 VACUUM(자동으로 도는 것은 autovacuum)이고, 치우지 못한 죽은 행이 쌓여 테이블이 부푸는 현상을 블로트(bloat)라고 합니다. 원문이 말한 "블로트가 기가바이트에서 테라바이트로"가 이것입니다. VACUUM은 테이블을 다시 읽어야 하므로, 디스크가 느리면 청소 속도가 UPDATE 속도를 못 따라갑니다. 원문에서 10GB 블로트 청소에 EBS는 964초, NVMe는 366초가 걸렸습니다.
새 버전이 같은 페이지에 들어갈 자리가 있으면 인덱스를 건드리지 않아도 됩니다. 이를 HOT 업데이트(Heap-Only Tuple)라고 합니다. 자리가 없으면 새 버전을 다른 페이지에 쓰고 인덱스에도 새 항목을 넣어야 해서 I/O가 늘어납니다. 그래서 UPDATE가 많은 테이블은 페이지를 일부러 덜 채워(fillfactor를 100 아래로) HOT 자리를 남겨 두기도 합니다.
WAL과 fsync: 등기 우편
데이터베이스가 "커밋했습니다"라고 답한 뒤에 전원이 나가도 그 변경은 살아남아야 합니다. 그렇다고 고친 테이블 페이지를 매번 디스크에 쓰면 너무 느립니다(무작위 쓰기니까요). 해결책은 1990년대 초 IBM의 C. 모한 등이 정리한 ARIES 계열 복구 기법의 핵심인 선행 기록 로그(WAL, Write-Ahead Log)입니다. 변경 내용을 한 줄로 이어지는 로그 파일 끝에 덧붙이고, 로그만 디스크에 확정하면 커밋을 인정합니다. 테이블 페이지는 메모리에 둔 채 나중에 천천히 씁니다. 장애가 나면 로그를 다시 재생해 복구합니다.
"확정한다"는 말이 바로 fsync입니다. 운영체제에게 "이 파일의 내용이 정말로 저장장치에 내려갔다고 확인될 때까지 돌아오지 마"라고 요청하는 시스템 콜이죠. 등기 우편과 같습니다. 보내기만 하는 게 아니라 수령 확인 도장을 받아야 끝납니다. 네트워크 저장장치는 이 도장을 받으러 네트워크 너머까지 다녀와야 하고, 원문에서 그 값이 EBS 11ms, NVMe 1.5ms였습니다.
여러 세션이 동시에 커밋하면 Postgres는 이들의 WAL을 한 번의 fsync로 묶어 내립니다(그룹 커밋). 앞 세션이 fsync를 하는 동안 뒤에 도착한 세션들은 LWLock: WALWrite에서 기다리다가 다음 fsync에 함께 탑니다. 5절의 대기 이벤트 표에서 이 락이 상위권이었던 이유입니다.
체크포인트: 영업 끝난 뒤의 장부 정리
WAL만 계속 쌓으면 장애 복구 때 재생할 로그가 끝없이 길어집니다. 그래서 Postgres는 주기적으로(기본 5분, 또는 WAL이 max_wal_size만큼 쌓이면) 메모리의 "더러운" 페이지를 모두 디스크에 쓰고 "여기까지는 안전하다"는 표시를 남깁니다. 이것이 체크포인트입니다.
체크포인트에는 숨은 비용이 하나 더 있습니다. 체크포인트 직후 어떤 페이지를 처음 고칠 때는 그 페이지 전체(8KB)를 WAL에 한 번 더 기록합니다(full_page_writes). 쓰는 도중 전원이 나가 페이지가 반쪽만 써지는 "찢어진 페이지(torn page)" 문제를 막기 위해서입니다. 무작위 UPDATE 부하에서는 체크포인트 직후 거의 모든 UPDATE가 새 페이지를 건드리므로, 체크포인트 직후 WAL 양이 크게 부풀고 쓰기 I/O가 몰립니다. 원문이 말한 "예전엔 보이지 않던 작업이 주기적인 지연 스파이크로 바뀐다"가 이 장면입니다.
논리 복제: WAL을 다시 읽어 남에게 전하기
요즘 Postgres는 혼자 일하지 않습니다. 변경 사항을 실시간으로 Kafka나 ClickHouse 같은 분석 시스템에 흘려보내는 경우가 많습니다(CDC, Change Data Capture). 이때 Postgres는 WAL을 다시 읽어 "어느 테이블의 어느 행이 이렇게 바뀌었다"는 형태로 풀어냅니다(논리 디코딩). 받는 쪽이 아직 가져가지 않은 WAL은 복제 슬롯이 지우지 못하게 붙잡아 둡니다. 큰 트랜잭션을 풀다가 메모리(logical_decoding_work_mem)를 넘치면 디스크에 임시로 흘려 씁니다. 디스크가 느리면 디코딩이 밀리고, 슬롯이 붙잡은 WAL이 쌓이고, 쌓인 WAL을 읽느라 디스크가 더 바빠집니다. 원문에서 10GB 밀린 복제를 따라잡는 데 EBS는 238초, NVMe는 139초가 걸렸습니다.
원문 발표자 사이 스리람푸르가 바로 이 분야 출신이라는 점은 기억해 둘 만합니다. 그가 공동 창업한 PeerDB는 Postgres에서 다른 시스템으로 데이터를 옮기는 CDC 도구였고, 2024년 ClickHouse에 인수됐습니다. "복제 지연"은 그가 고객사에서 가장 많이 본 증상이었을 겁니다.
Postgres 18의 비동기 I/O는 왜 이걸 못 구했나
2025년 9월에 나온 Postgres 18은 오랜 숙원이던 비동기 I/O(io_method = worker 또는 리눅스의 io_uring)를 들였습니다. 페이지를 하나 읽고 기다리고, 또 하나 읽고 기다리는 대신, 여러 개를 한꺼번에 요청해 놓고 도착하는 대로 처리하는 방식입니다. 네트워크 저장장치처럼 요청 하나는 느려도 동시에 많이 처리할 수 있는 장치에서 특히 효과가 큽니다.
하지만 이 기능이 빨라지게 하는 것은 다음에 읽을 페이지를 미리 아는 작업입니다. 순차 스캔, 비트맵 힙 스캔, VACUUM이 그렇습니다. 인덱스로 행 하나를 찾는 일은 다릅니다. 잎 페이지를 읽어야 테이블 페이지 주소를 알 수 있으니, 두 읽기는 겹칠 수 없습니다. 게다가 Postgres 18의 비동기 I/O는 읽기에만 적용되고 쓰기는 여전히 동기식이며, 일반 인덱스 스캔의 미리 읽기는 Postgres 20을 목표로 미뤄졌습니다(피터 가이건의 PGConf.EU 2026 발표 초록). 원문 실험 같은 무작위 UPDATE는 Postgres 18에서도 "읽고, 기다리고, 읽고, 기다리는" 길을 그대로 걷습니다. 앞 절 CPU 프로파일에 pgaio_ 함수가 보이는데도 EBS가 9배 느렸던 이유입니다.
9. 다섯 증상, 하나의 지갑
1절의 다섯 증상으로 돌아가 봅시다. 이제 각 증상이 어디서 오는지 보입니다.
1
적재가 느려진다
UPDATE·UPSERT마다 캐시 미스 읽기 + 커밋 fsync. 데이터가 메모리를 넘어서는 순간부터 건당 비용이 계단처럼 오른다.
2
P95가 튄다
캐시에 걸린 쿼리는 빠르고 못 걸린 쿼리는 대기열 뒤에 선다. 평균은 멀쩡한데 꼬리가 길어진다.
3
VACUUM이 밀린다
청소부도 같은 디스크를 쓴다. 클라이언트가 IOPS를 다 쓰면 청소가 늦어지고, 블로트가 쌓이고, 테이블이 커져 캐시 적중률이 더 떨어진다.
4
체크포인트가 스파이크가 된다
더러운 페이지 쓰기 + 전체 페이지 WAL이 몇 분마다 한꺼번에 몰린다.
5
복제가 뒤처진다
WAL을 다시 읽고 흘려 쓰는 일도 같은 예산에서 나간다.
=
공통 원인
클라이언트 쿼리와 배경 작업이 하나의 저장장치 예산(대역폭·IOPS·대기열)을 나눠 쓴다. 예산이 바닥나면 서로를 늦춘다.
증상 3에는 악순환이 들어 있다는 점을 짚어 두겠습니다. 청소가 밀리면 테이블이 부풀고, 부푼 테이블은 메모리에 덜 들어가고, 캐시 미스가 늘고, 디스크가 더 바빠지고, 청소는 더 밀립니다. 저장장치가 한계에 닿은 데이터베이스는 그냥 느린 게 아니라 점점 더 느려지는 경향이 있습니다.
아래 위젯에서 클라이언트 부하를 올리고 배경 작업을 하나씩 켜 보세요. 사용률이 70%를 넘으면 대기 시간이 눈에 띄게 불어나기 시작하고, 100%에 가까워지면 폭발합니다. 대기행렬 이론의 가장 단순한 모형(M/M/1)에서 평균 대기는 1/(1−사용률)에 비례하기 때문입니다. 사용률 50%면 2배, 90%면 10배, 99%면 100배입니다.
같은 부하를 로컬 NVMe로 옮기면 사용률이 몇 퍼센트로 떨어지고, 체크포인트나 VACUUM을 켜도 대기 시간이 거의 움직이지 않습니다. 원문의 표현으로는 이렇습니다. "로컬 NVMe의 장점은 I/O를 없애는 것이 아니라 I/O의 비용을 크게 낮추는 것이다. 캐시 미스, WAL 플러시, 유지 관리 I/O는 여전히 일어나지만, 시스템 전체에 주는 영향이 훨씬 작다."
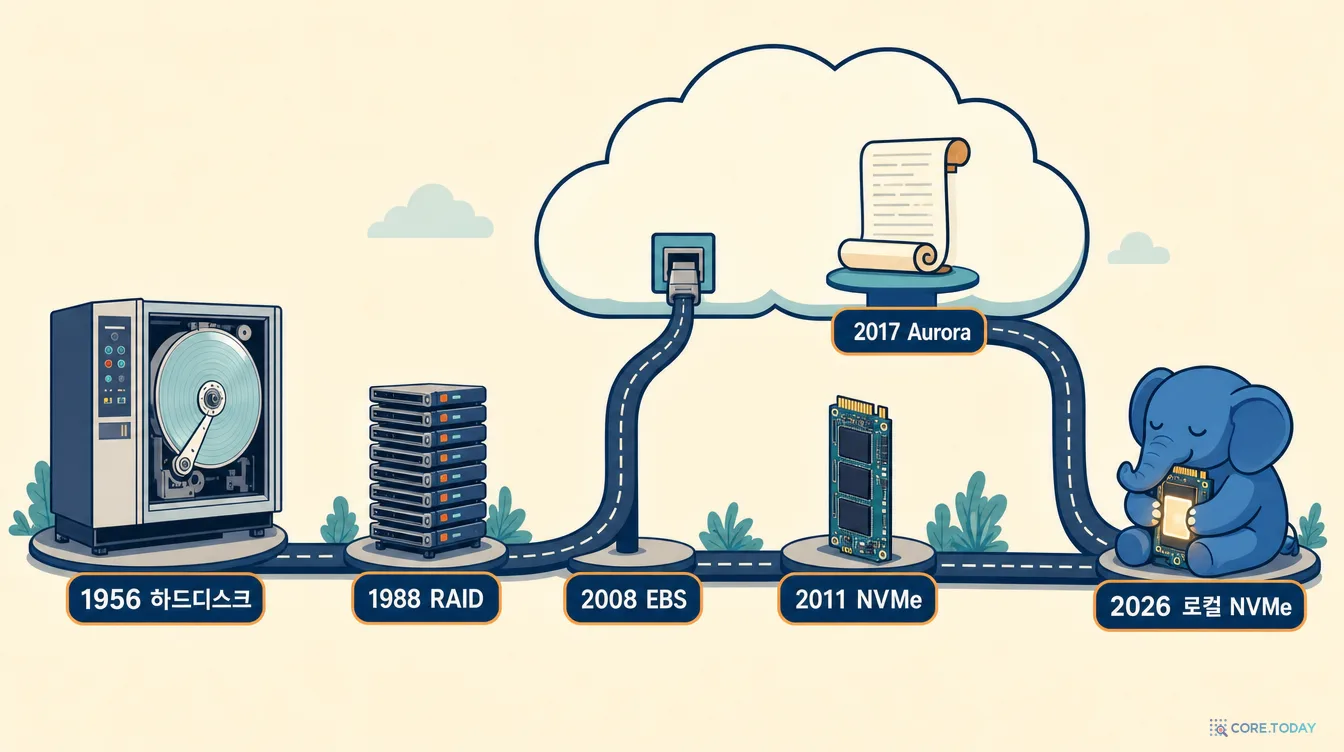
10. 데이터베이스와 디스크의 50년: 멀어졌다가 다시 가까워지기까지
"로컬 디스크가 네트워크 디스크보다 빠르다"는 말은 너무 당연해서, 왜 이게 2026년에 화제가 되는지 의아할 수 있습니다. 답은 역사에 있습니다. 데이터베이스는 지난 50년 동안 디스크에서 멀어졌다가, 다시 가까워지고 있습니다.
1956년 IBM이 첫 하드디스크(RAMAC 350)를 내놓은 뒤 반세기 동안, 데이터베이스 설계의 가장 큰 적은 디스크 탐색(seek)이었습니다. 무작위로 어떤 데이터를 읽으려면 디스크 팔이 해당 트랙으로 움직이고, 원판이 돌아 원하는 자리가 머리 밑에 올 때까지 기다려야 합니다. 7,200rpm 디스크는 한 바퀴에 8.33ms이니 평균 회전 대기만 4ms가 넘고, 팔 이동까지 더하면 무작위 읽기 하나에 8~10ms가 걸립니다. 제프 딘이 2009년 발표한 유명한 "모두가 알아야 할 숫자" 표에도 디스크 탐색은 10ms로 적혀 있습니다. 1초에 100~200번. 그게 디스크 한 개가 할 수 있는 무작위 읽기의 전부였습니다.
그래서 이 시대의 데이터베이스 기술은 거의 전부 "디스크를 덜 건드리는 법"입니다. B-트리는 노드를 디스크 블록 크기에 맞춰 탐색 횟수를 줄였고, 버퍼 풀은 자주 쓰는 페이지를 메모리에 붙잡아 두었고, WAL은 무작위 쓰기를 순차 쓰기로 바꿨습니다. 8절에서 본 Postgres의 구조가 바로 이 시대의 유산입니다.
5분 규칙: 메모리에 둘까, 디스크에 둘까
1987년 짐 그레이와 프랑코 푸톨주는 이 고민을 경제학으로 정리했습니다. "5분 규칙"입니다. 어떤 데이터 페이지를 메모리에 계속 둘지, 필요할 때마다 디스크에서 읽을지는 메모리 가격과 디스크 IOPS 가격의 비교로 정해진다는 것입니다. 그 페이지에 5분에 한 번 이상 접근한다면 메모리에 두는 게 싸고, 그보다 드물면 디스크에서 그때그때 읽는 게 쌉니다.
이 규칙은 10년마다 다시 계산됐습니다. 1997년 그레이와 괴츠 그래페는 8KB 페이지 기준으로 다시 266초, 여전히 약 5분이 나온다고 확인했습니다(재미있게도 같은 논문에 "체크포인트 간격은 보통 5분"이라는 문장이 있는데, Postgres의 checkpoint_timeout 기본값도 5분입니다). 2019년 아푸스와미·그래페 등의 "30년 뒤의 5분 규칙"은 흥미로운 결론을 냅니다.
연도
메모리 ↔ 하드디스크 손익분기 (4KB 페이지)
메모리 ↔ SSD 손익분기
1987
약 5분 (원조 규칙)
—
1997
9분
—
2007
1.5시간
15분
2018
4시간 ("하드디스크는 이제 테이프다")
5분 (원조 규칙이 SSD에서 되살아남)
출처: Appuswamy, Graefe, Borovica-Gajic, Ailamaki, 「The Five-Minute Rule 30 Years Later and Its Impact on the Storage Hierarchy」, CACM 62(11), 2019.
이 규칙으로 원문 실험을 보면 무엇이 보일까요. 482GiB 테이블은 8KB 페이지 약 6,300만 장입니다. EBS 쪽이 초당 1,734건을 처리할 때 특정 테이블 페이지는 평균 약 10시간에 한 번 접근됩니다. 5분 규칙의 기준으로는 메모리에 둘 이유가 전혀 없는 차가운 데이터입니다. 실험은 의도적으로 "거의 모든 접근이 차가운 읽기"인 세계를 만든 것이고, 그런 세계에서는 디스크 한 번 읽기의 가격과 속도가 곧 데이터베이스의 성능입니다. 2019년 논문 저자들은 클라우드 저장장치는 따로 계산하지 않았다며 그것을 후속 과제로 남겼는데, 원문 실험은 그 빈칸에 들어갈 사례로 읽어도 됩니다.
2막. RAID: 싼 디스크를 여러 개
1988년 버클리의 데이비드 패터슨, 가스 깁슨, 랜디 카츠는 「싼 디스크들의 중복 배열을 위한 변론(A Case for Redundant Arrays of Inexpensive Disks)」을 SIGMOD에 냅니다. 비싼 대형 디스크 하나 대신 개인용 컴퓨터에 쓰던 싼 디스크를 여러 개 묶으면 IOPS와 용량이 늘고, 일부가 고장 나도 패리티로 복구할 수 있다는 제안이었습니다. 여기서 중요한 건 발상입니다. "디스크 하나는 믿을 수 없다. 여럿을 묶어 시스템 수준에서 신뢰성을 만든다." 38년 뒤 원문이 제안하는 운영 구조도 같은 문장으로 요약됩니다. 다만 묶는 단위가 디스크에서 서버 전체로 바뀌었을 뿐입니다.
3막. 클라우드: 디스크가 네트워크 너머로 가다 (2008)
2008년 8월 20일, AWS는 EBS(Elastic Block Store)를 출시합니다. 그 전까지 EC2 가상 서버의 디스크는 서버가 꺼지면 함께 사라졌습니다. 데이터베이스를 클라우드에서 돌리기 어려웠던 가장 큰 이유입니다. EBS는 디스크를 네트워크 너머의 별도 저장 서버군으로 옮겼습니다. 가상 서버는 네트워크로 디스크를 "빌려" 씁니다. 서버가 죽어도 볼륨은 살아 있고, 다른 서버에 다시 붙이면 됩니다. 스냅숏을 찍어 복제하고, 크기를 늘리고, 성능 등급을 바꾸는 일이 클릭 몇 번이 됐습니다.
이것은 혁명이었습니다. 데이터베이스 운영의 가장 무서운 일, 즉 "디스크가 죽으면?"이라는 질문을 클라우드 회사가 대신 떠안았으니까요. 그리고 2008년의 비교 대상은 하드디스크였습니다. 하드디스크의 탐색 시간이 10ms인 세계에서, 네트워크 왕복 0.5ms를 더하는 것은 거의 공짜였습니다. 해커뉴스의 한 댓글이 정확히 이 점을 짚었습니다. "네트워크 저장장치는 하드디스크 시절에만 말이 되던 구조다."
AWS는 그 뒤로 EBS를 꾸준히 개선했습니다. 2017년 자체 설계한 Nitro 카드가 네트워크와 저장장치 처리를 전담하면서 EBS 볼륨이 가상 서버 안에서 NVMe 장치처럼 보이게 됐고(그래도 실체는 네트워크 왕복입니다), 2020년 12월에는 지금의 기본값인 gp3가 나왔습니다(기본 3,000 IOPS·125MiB/s, 2025년 9월부터 볼륨당 최대 8만 IOPS·2,000MiB/s). 고성능 io2 Block Express는 2021년 정식 출시돼 16KiB I/O 평균 지연 500µs 미만, 볼륨당 25만 6천 IOPS까지 제공합니다. 하지만 아무리 개선해도 지울 수 없는 것이 하나 있습니다. 빛이 케이블을 따라 저장 서버까지 다녀오는 시간, 그리고 그 사이의 소프트웨어 계층들입니다.
4막. "로그가 곧 데이터베이스다": 네트워크를 전제로 다시 설계하기 (2017)
네트워크 저장장치의 비용을 정면으로 다룬 첫 대형 시도는 아마존 자신의 Aurora입니다. 2017년 SIGMOD에 실린 버비츠키 등의 논문은 출발점에서 이렇게 말합니다. "높은 처리량을 내는 데이터베이스의 핵심 제약은 계산과 저장에서 네트워크로 옮겨 갔다."
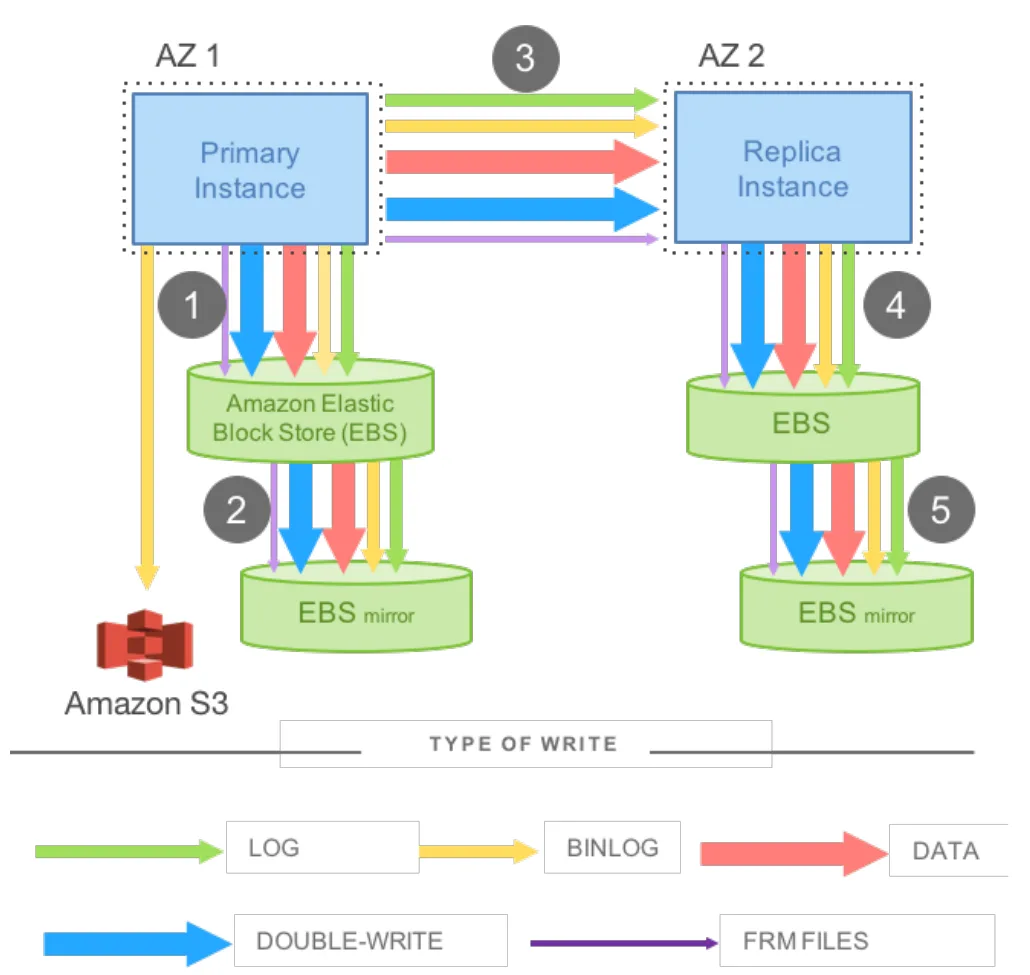
크게 보기출처: Verbitski et al., 「Amazon Aurora: Design Considerations for High Throughput Cloud-Native Relational Databases」, SIGMOD 2017, 그림 2 「Network IO in mirrored MySQL」.
이 그림은 "전통적인 데이터베이스를 EBS 위에 그대로 얹으면 무슨 일이 생기는가"를 보여 줍니다. 화살표 색은 쓰기의 종류입니다. 초록은 로그(MySQL의 redo 로그, Postgres로 치면 WAL), 노랑은 바이너리 로그(복제·시점 복구용 변경 기록), 빨강은 데이터 페이지, 파랑은 이중 쓰기(찢어진 페이지를 막으려고 페이지를 한 번 더 쓰는 것, Postgres의 full_page_writes에 해당), 보라는 테이블 정의 파일입니다. 번호는 순서입니다. ① 주 인스턴스가 다섯 종류를 EBS에 쓰고, ② EBS가 그것을 같은 AZ의 미러에 다시 쓰고, ③ 다른 AZ의 복제 인스턴스로 보내고, ④⑤ 복제 쪽에서 같은 일을 반복합니다. 1, 3, 5단계는 순서대로 기다려야 하는 동기 단계입니다. 쓰기 한 번이 네트워크를 여러 번 건너고, 가장 느린 단계가 전체 지연을 정합니다.
Aurora의 해법은 과감했습니다. 데이터베이스가 데이터 페이지를 아예 쓰지 않게 했습니다. 네트워크를 건너는 것은 redo 로그 레코드뿐이고, 페이지는 저장 계층이 로그를 받아 스스로 만들어 냅니다. 논문 3장의 제목이 "로그가 곧 데이터베이스다(The Log is the Database)"입니다. 로그는 세 AZ에 걸친 여섯 사본에 보내고 그중 넷이 답하면 커밋합니다(쓰기 쿼럼 4/6). 결과는 극적이었습니다. 논문 표 1에서 미러링 MySQL은 트랜잭션당 I/O 7.4회로 78만 건을 처리했고, Aurora는 0.95회로 2,737만 8천 건을 처리했습니다. 35배 많은 트랜잭션을 7.7배 적은 I/O로.
이 노선은 이후 클라우드 데이터베이스의 주류가 됩니다. 마이크로소프트는 2019년 SIGMOD에 SQL Server를 계산·로그·페이지 서버·저장소의 네 층으로 쪼갠 Socrates(Azure SQL Hyperscale)를 냈고, 오픈소스 쪽에서는 Neon이 Postgres를 같은 방식으로 쪼갰습니다. 상태 없는 Postgres 계산 노드, WAL을 팩서스 쿼럼으로 받아 두는 세이프키퍼, WAL을 페이지로 바꿔 로컬 SSD에 캐시하고 S3에 올리는 페이지서버. 2025년 데이터브릭스가 Neon을 약 10억 달러에 인수한 것도, 계산과 저장을 분리한 구조가 "필요할 때만 켜지는 데이터베이스"를 값싸게 만들기 때문입니다. 이런 분리 구조 덕분에 데이터베이스를 몇 초 만에 만들고, 복제하고, 0으로 줄이는 일이 가능해졌습니다. 우리 블로그의 Aurora 해부 글이 이 노선을 자세히 다룹니다.
눈여겨볼 점이 있습니다. 이 노선의 시스템들도 로컬 SSD를 버린 적은 없습니다. Socrates는 계산 노드에 로컬 SSD 캐시(RBPEX)를 두고, Neon의 페이지서버도 로컬 SSD에 캐시합니다. 분리 아키텍처의 핵심은 "로컬 디스크를 없앤다"가 아니라 "로컬 디스크를 캐시로 강등하고, 내구성은 네트워크 너머 로그 서비스에 맡긴다"입니다.
5막. NVMe: 하드디스크용 문법을 버리다 (2011~)
그사이 저장장치 자체가 바뀌었습니다. 플래시 SSD는 움직이는 부품이 없어 탐색 시간이 사라졌고, 2011년 3월 나온 NVMe 규격은 SSD를 하드디스크용 연결 방식(SATA/AHCI)에서 해방시켰습니다. AHCI는 명령 대기열이 1개에 깊이 32였습니다. 디스크 팔이 하나뿐인 하드디스크에는 충분했죠. NVMe는 대기열 최대 6만 5천여 개에 각각 6만 5천여 개의 명령을 담습니다. CPU 코어마다 자기 대기열을 갖고 수천 개의 요청을 동시에 던질 수 있습니다. 인텔은 2017년 플래시보다 10배 빠른 지연(10µs 미만)을 내는 Optane SSD로 한 걸음 더 나갔지만, 상업적으로 실패해 2022년 사업을 접었습니다.
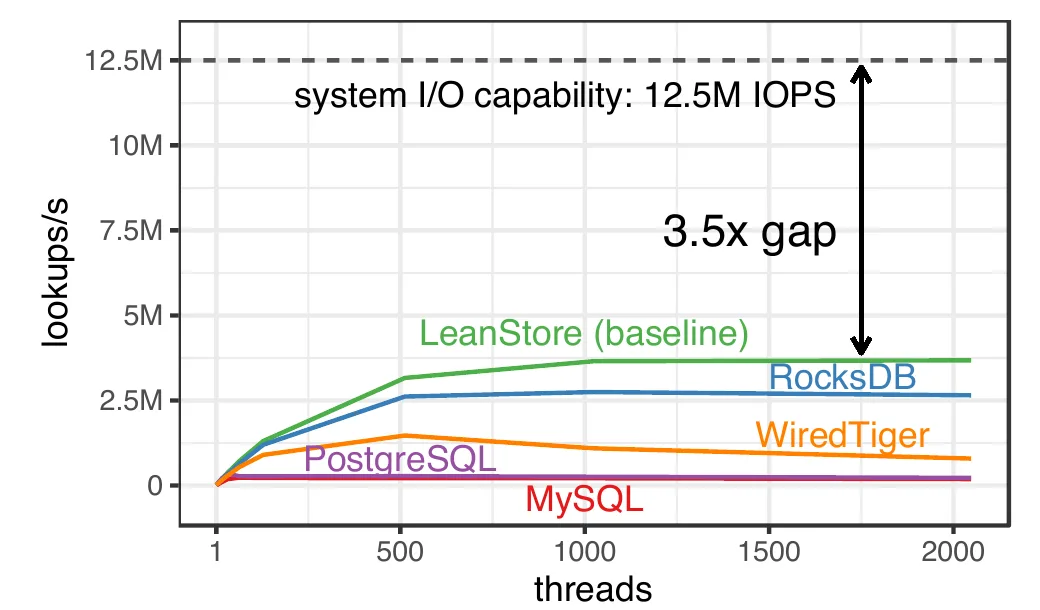
뮌헨공대의 가브리엘 하스와 빅토르 라이스는 2023년 VLDB 논문 「현대 NVMe 저장장치는 무엇을 할 수 있고, 어떻게 활용하는가」에서 이 변화가 데이터베이스에 무엇을 뜻하는지 측정했습니다.
크게 보기출처: Haas & Leis, 「What Modern NVMe Storage Can Do, And How To Exploit It: High-Performance I/O for High-Performance Storage Engines」, PVLDB 16(9), 2023, 그림 1.
그림을 읽어 봅시다. 64코어 AMD 서버에 삼성 PM1733 SSD 8개를 꽂았더니 하드웨어는 초당 1,250만 번의 무작위 읽기를 해냈습니다(점선). 그 위에서 데이터베이스 다섯 종에 무작위 조회를 시켰습니다. 가장 잘한 LeanStore(저자들의 연구용 엔진)도 약 360만 회로 하드웨어 능력의 3.5분의 1에 그쳤고, PostgreSQL과 MySQL은 그래프 바닥에 붙어 있습니다. 하드웨어는 이미 충분히 빠른데, 소프트웨어가 하드디스크 시절의 문법으로 짜여 있어 그 속도를 못 쓴다는 것이 논문의 문제 제기입니다.
논문의 또 다른 문장이 원문 실험을 이해하는 열쇠입니다. "플래시의 무작위 읽기 지연은 100µs 자릿수로 디스크보다 100배 빠르지만 DRAM보다는 여전히 1,000배 느리다. 요청을 하나씩 기다리는(동기) 방식이라면 겨우 1만 IOPS밖에 못 낸다." 이 하드웨어를 포화시키려면 동시에 3,000개 안팎의 요청이 떠 있어야 합니다. 원문 실험의 Postgres 백엔드 64개는 각자 한 번에 하나씩 읽으므로, 떠 있는 요청은 많아야 64개입니다. 그래서 NVMe 쪽은 디스크가 한참 남는 상태로 CPU(9.4코어)와 WAL 락이 먼저 한계가 된 것입니다. 원문의 9.24배는 Postgres가 NVMe의 능력을 다 쓰고도 남긴 숫자가 아니라, 일부만 쓰고도 낸 숫자입니다.
6막. 그런데 클라우드의 NVMe는 멈춰 있었다 (2016~2025)
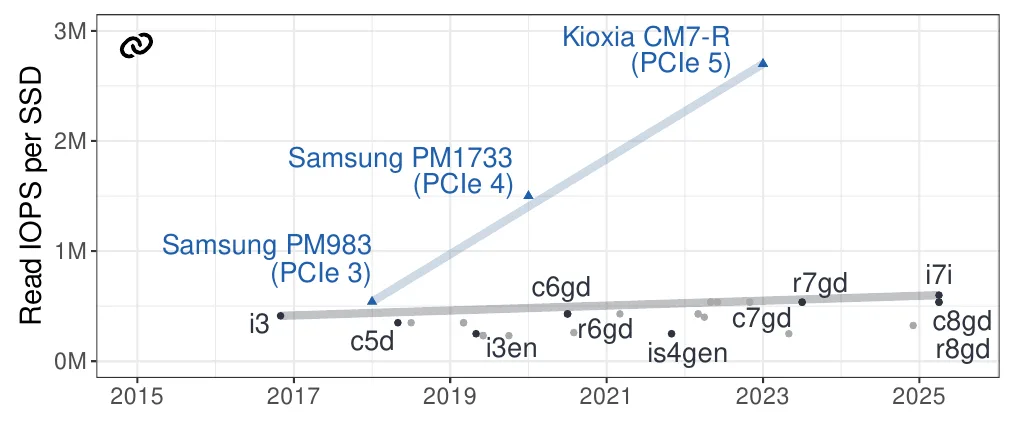
여기에 2026년 1월 CIDR에 실린 「Cloudspecs」 논문(스타이너트·쿠셰프스키·라이스)이 반전을 하나 더합니다. 2015~2025년 AWS 인스턴스 사양과 가격을 전수 조사한 이 논문의 초록은 이렇게 말합니다. "네트워크 대역폭은 달러당 10배 좋아졌지만, CPU와 DRAM의 개선은 훨씬 작고, NVMe 저장장치 성능은 2016년 이후 정체돼 있다."
크게 보기출처: Steinert, Kuschewski, Leis, 「Cloudspecs: Cloud Hardware Evolution Through the Looking Glass」, CIDR 2026, 그림 7 「AWS vs. on-premise NVMe SSD performance」.
가로축은 출시 연도, 세로축은 SSD 한 개당 읽기 IOPS입니다. 파란 삼각형(데이터센터용 SSD 신제품)은 PCIe 세대가 바뀔 때마다 두 배씩 뛰어 2023년 270만 IOPS에 닿았습니다. 회색 점(AWS 인스턴스에 달린 NVMe)은 2016년 i3부터 2025년 i7i까지 40만~60만 사이에서 거의 수평입니다. 논문에 따르면 I/O 대비 가격으로는 2016년에 나온 i3가 아직도 거의 2배 차이로 1위입니다. 같은 기간 온프레미스 SSD는 달러당 용량이 약 3배, I/O 처리량이 5배 넘게 좋아졌습니다.
이 그림은 두 가지를 말합니다. 첫째, 클라우드가 하드웨어 발전을 고객에게 그대로 전달하지 않았다는 것. 둘째, 그럼에도 정체된 클라우드 NVMe조차 네트워크 디스크보다는 자릿수가 다르다는 것입니다. 40만 IOPS와 3,000 IOPS의 차이는 하드웨어 세대 차이가 아니라 아키텍처 차이입니다.
7막. 다시 로컬로 (2025~2026)
그리고 지금, 바람이 바뀌고 있습니다. 2025년 3월 PlanetScale은 로컬 NVMe 위에 MySQL을 올린 Metal을 정식 출시하며 "Aurora 대비 p99 지연 최대 65% 감소, 비용 53% 절감"을 내세웠고, 7월에는 같은 구조로 Postgres 지원을 발표했습니다. 같은 회사의 벤 디킨은 "I/O 장치와 지연" 글에서 RAM 약 100ns, 로컬 NVMe 약 50µs, EBS 왕복 약 250µs를 비교하는 인터랙티브 해설로 크게 회자됐습니다. 오픈소스 클라우드 Ubicloud도 로컬 NVMe Postgres의 벤치마크를 공개했고, ClickHouse는 2026년 1월 Ubicloud와 함께 만든 NVMe 기반 관리형 Postgres를 비공개 미리보기로 내놓은 뒤 6월 공개 베타로 전환했습니다. 원문 발표는 이 흐름 한가운데에서 나왔고, 발표 마지막은 실제로 자사 서비스 소개로 끝납니다.
반대 방향의 베팅도 여전히 큽니다. 데이터브릭스는 2025년 Neon을, 스노우플레이크는 같은 해 Crunchy Data를 인수했습니다. 분리 아키텍처의 장점(순간 복제, 0으로 줄이기, 브랜치)은 AI 에이전트가 데이터베이스를 수천 개씩 만들었다 지우는 2026년에 오히려 더 커졌습니다. 그래서 지금의 지형은 "로컬이 이겼다"가 아니라 "무엇을 위해 무엇을 포기할 것인가"의 선택지가 다시 넓어진 상태라고 보는 게 정확합니다. pgrun.dev의 한 문장이 이 선택을 잘 요약합니다. "네트워크 저장장치는 내구성을 쉽게, 지연을 어렵게 만든다. 로컬 NVMe는 지연을 쉽게, 내구성을 여러분의 일로 만든다."
11. 반론과 한계: 9배를 얼마나 믿어야 하나
여기까지 읽으면 "당장 NVMe로 옮기자"는 생각이 들 수 있습니다. 잠깐 멈추고 반대편 이야기를 들어 봅시다. 해커뉴스 토론과 외부 비평, 그리고 원문의 숫자 자체에서 나오는 반론을 정리했습니다.
가장 많이 나온 지적입니다. 원문의 EBS 쪽은 gp3 볼륨을 만들면 추가 비용 없이 따라오는 기본값 3,000 IOPS였습니다. 7절에서 계산했듯 이 실험의 EBS 처리량은 거의 정확히 이 상한으로 설명됩니다. 그렇다면 이 실험이 잰 것은 "네트워크 저장장치의 본질적 한계"라기보다 "3,000 IOPS 상한에 막힌 볼륨"이라고 볼 여지가 큽니다. 실제로 원문 요약글도 "다른 EBS 구성이라면 결과가 달랐을 가능성이 크다"고 인정합니다.
숫자로 따져 보면 이렇습니다.
선택지
얻는 것
대가 (AWS 공개 가격 기준 대략값)
gp3 IOPS를 3,000 → 16,000으로
IOPS 상한 5.3배. 계산기 모델상 약 8,900 TPS
초과분 IOPS당 월 0.005달러 → 월 약 65달러
gp3 IOPS를 20,000까지
m6id.4xlarge 인스턴스의 EBS 기본 상한(2만 IOPS·625MB/s)까지
월 약 85달러. 그 위로는 인스턴스가 막음(버스트 4만)
io2 Block Express
16KiB 평균 지연 500µs 미만, 800µs 넘는 I/O가 범용 볼륨의 10분의 1, 내구성 99.999%
비쌈. PlanetScale 2025년 비교에서 r7i.2xlarge+io2 16K가 월 1,514달러
인스턴스 스토어 NVMe
읽기 26만 8천 IOPS, 지연 수십~100µs
m6id.4xlarge는 m6i.4xlarge보다 시간당 약 0.18달러(월 약 132달러) 비쌈. 같은 비교에서 i7i.2xlarge가 월 551달러
재미있는 사실이 하나 있습니다. 원문의 EBS 그룹도 m6id 인스턴스를 썼습니다. 즉 NVMe 값을 이미 내고 있으면서 그 NVMe를 쓰지 않은 것입니다. m6id가 m6i보다 비싼 차액(월 약 132달러)이면 gp3를 16,000 IOPS로 올리고도 남습니다. 공정한 비교를 원했다면 "같은 돈을 쓴 EBS"와 붙였어야 한다는 지적이 나오는 이유입니다.
ClickHouse 자신의 다른 벤치마크가 이 질문에 간접적으로 답합니다. 2026년 4월 공개한 PostgresBench(pgbench TPC-B 유사 부하, 클라이언트 256개)에서는 RDS 쪽에 16,000 IOPS gp3를 줬고, 그때 격차는 9배가 아니라 3.5~5.2배였습니다(부하와 조건이 달라 직접 비교는 안 됩니다). PlanetScale도 2025년 벤치마크에서 부하가 CPU에 묶이는 구간에서는 gp3 1만 IOPS나 io2 1만 6천 IOPS가 "로컬 디스크 성능에 훨씬 가까워진다"고 적었습니다. 정리하면 IOPS를 사면 격차는 크게 줄지만, 지연(네트워크 왕복)은 돈으로 살 수 없어서 완전히 사라지지는 않습니다. 지연이 곧 처리량인 부하(동시성이 제한된 OLTP)에서는 그 잔여 격차가 여전히 의미 있습니다.
반론 2. "가장 가혹한 부하를 골랐다"
482GiB 테이블에 무작위 UPDATE, 메모리는 데이터의 8분의 1. 개발자 우메시 말릭은 비평 글에서 이를 "의도적으로 적대적인 사례"라고 불렀습니다. 대부분의 서비스는 접근이 고르지 않습니다. 최근 주문, 활성 사용자, 오늘의 게시물처럼 일부 데이터에 접근이 몰립니다(핫 데이터). 작업 집합이 메모리에 들어가면 저장장치 차이는 급격히 줄어듭니다. 계산기에서 메모리를 512GB로 올려 보면 확인할 수 있습니다.
원문의 수치 안에도 이 반론의 근거가 있습니다. 순서대로 훑는 VACUUM은 2.6배, 단일 스레드로 도는 논리 디코딩은 1.7배밖에 차이가 나지 않았습니다. 발표 초록에는 "넓은 스캔과 반복 집계처럼 NVMe가 도움이 안 되는 곳… 빠른 저장장치는 병목을 CPU로 옮긴다"는 내용도 예고돼 있었는데, 발표자는 25분 시간 제약으로 이 부분을 건너뛰었습니다.
반론 3. "느린 건 스키마와 쿼리다"
해커뉴스에서 가장 큰 토론 가지를 만든 반대 댓글은 이것이었습니다. "Postgres가 느린 게 아니라 여러분의 스키마와 쿼리가 느린 것이다. 고쳐 줬다." 작성자는 "문제가 정말 저장장치였던 경우는 한 손으로 꼽을 정도"라고 덧붙였습니다. 다른 사용자는 "좋은 저장장치도 충분히 나쁜 스키마와 쿼리는 구하지 못한다"고 받았고, 또 다른 사용자는 "Postgres가 느린 게 아니라 데이터가 캐시에 없을 뿐"이라고 정리했습니다.
이 반론은 원문과 충돌하지 않습니다. 순서의 문제입니다. 인덱스가 없어서 테이블 전체를 훑는 쿼리는 NVMe에서도 느립니다. 블로트가 테이블을 세 배로 부풀렸다면, 저장장치를 바꾸기 전에 블로트부터 치우는 게 싸고 빠릅니다. 원문의 주장은 "쿼리와 스키마를 다 고쳤는데도 여전히 느리다면, 저장장치를 의심하라"로 읽는 게 정확합니다. 실제로 원문의 마무리도 "데이터베이스와 저장장치를 함께 들여다보라"입니다.
반론 4. "로컬 디스크는 운영을 여러분의 일로 만든다"
네트워크 저장장치의 진짜 가치는 성능이 아니라 운영의 외주화입니다. 해커뉴스의 한 사용자는 "그러면 복제, 장애 조치, 백업을 직접 챙겨야 한다. 복제되는 블록 저장장치를 쓰면 그 문제를 대부분 밖으로 넘길 수 있다"고 썼고, 다른 사용자는 "EBS라면 호스트가 죽어도 볼륨을 다른 호스트에 붙여 부팅하면 끝"이라고 했습니다.
인스턴스 스토어의 성질을 정확히 알아 둘 필요가 있습니다. AWS 문서에 따르면 인스턴스 스토어의 데이터는 재부팅에는 살아남지만 중지(stop), 최대 절전, 종료, 인스턴스 타입 변경, 호스트 퇴역, 자동 복구, 디스크 고장 때는 사라지고, 그때 모든 블록은 암호학적으로 지워집니다. EBS 스냅숏 API도 쓸 수 없습니다. 용량도 인스턴스 타입이 정합니다. 데이터가 950GB를 넘으면 더 큰 인스턴스로 옮겨야 합니다. 그래서 원문은 후반부를 통째로 이 문제에 씁니다. 다음 절에서 봅니다.
한편 EBS도 완벽하지 않습니다. PlanetScale의 닉 반 위게런은 「EBS의 진짜 장애율」(2025)에서 AWS가 gp3에 약속하는 것이 "프로비저닝 성능의 90%를 시간의 99% 동안"이라는 점을 짚었습니다. 거꾸로 말하면 하루 14분, 1년 86시간은 성능이 떨어져도 약속 위반이 아닙니다. 그는 쓰기 지연이 200~500ms까지 튀는 사례를 보여 주며, 볼륨 768개짜리 대형 클러스터라면 "어느 순간이든 최소 한 노드가 성능 저하를 겪고 있을 확률이 99.65%"라고 계산했습니다. 물론 이 글 역시 로컬 NVMe 상품을 파는 회사의 글입니다.
반론 5. "파는 사람이 쓴 글이다"
공정하게 짚어야 할 맥락입니다. 발표자는 ClickHouse의 Postgres 총괄이고, ClickHouse는 2026년 1월부터 NVMe 기반 관리형 Postgres를 팔고 있습니다. 발표의 마지막 장도 이 서비스 소개입니다. 해커뉴스에는 "책임 전가처럼 들린다"는 댓글도, 요약글 문체가 AI로 쓴 것 같다는 불평도 있었습니다(반대로 "요즘은 AI라고 불평하는 댓글이 콘텐츠보다 더 피곤하다"는 반박도 있었습니다).
사례 인용도 확인이 필요합니다. 발표는 Instacart와 Datadog을 "미션 크리티컬 워크로드를 NVMe 기반 Postgres에서 돌리는" 공개 사례로 소개했습니다. 그런데 원문이 링크한 자료를 직접 읽어 보면 근거가 생각보다 얇습니다.
Instacart의 검색 인프라 글에서 NVMe는 한 문장입니다. "계산을 데이터 계층으로 내려보내 Postgres 기반 검색이 두 배 빨라졌고, 이 접근이 NVMe 위의 Postgres와 결합되어 데이터 조회 성능을 더 높이고 지연을 줄였다." 두 배라는 숫자는 계산 내려보내기의 효과이고, NVMe의 효과를 따로 잰 숫자는 없습니다.
Datadog의 링크는 「Datadog이 클라우드 관리형에서 자체 관리형 Postgres로 옮기는 방법과 이유」(2025년 9월 pgconf.nyc) 발표 자료입니다. 쿠버네티스 + Patroni + WAL-G 구성이고, NVMe 관련 내용은 슬라이드 한 장의 "기본은 원격 저장장치… 필요할 때 로컬 NVMe 인스턴스 — I/O가 높은 경우 — 극단에서는 더 싸다" 정도입니다.
두 회사가 로컬 NVMe Postgres를 쓰는 것 자체는 사실이지만, 둘 다 "필요한 곳에 골라 쓴다"는 이야기이지 "모든 걸 옮겼다"는 이야기는 아닙니다.
반론 6. "고가용성 비용이 빠져 있다"
원문이 제안하는 운영 구조(다음 절)는 커밋마다 다른 AZ의 대기 서버가 WAL을 받아 디스크에 썼다는 확인을 기다립니다. AZ 사이 왕복은 대개 1ms 안팎입니다. NVMe 쪽 커밋 fsync가 1.5ms였으니, 동기 복제를 켜면 커밋 지연이 꽤 늘어날 수 있습니다. 해커뉴스의 필 이턴은 "쿼럼으로 동기 복제하는 것은 fsync보다 훨씬 비싸다"고 지적했습니다. 발표는 벤치마크 클러스터에 대기 서버가 있었는지 밝히지 않았고, 단일 노드로 읽힙니다. 다만 ClickHouse가 7월 공개한 다른 벤치마크(r8gd 인스턴스, ANY 1 쿼럼 동기 복제를 켠 상태)에서도 16 vCPU에서 2만 5천 TPS 수준이 나왔으므로, 동기 복제가 NVMe의 이점을 지우지는 않는 것으로 보입니다.
그래서, 무엇을 믿을 수 있나
반론을 다 걷어 내고 남는 것을 정리하면 이렇습니다.
✓
믿어도 되는 것
작업 집합이 메모리를 넘고 무작위 접근이 많은 부하에서, Postgres의 시간은 대부분 저장장치를 기다리는 데 쓰인다. 영수증·대기 이벤트·CPU 프로파일 세 가지 증거가 서로 맞아떨어진다. 이 상태에서는 쿼리 튜닝보다 저장장치가 더 큰 지렛대다.
!
에누리해서 들을 것
9.24배라는 크기. 상대가 가장 싼 EBS 설정이었고, 부하가 가장 가혹했고, 동기 복제가 빠져 있었다. 돈을 낸 EBS나 메모리 증설과 비교하면 격차는 몇 배 수준으로 줄어든다.
→
실무 결론
원문 스스로 말하듯 “결론은 제목보다 일부러 좁다.” 저장장치가 한계인 부하라면 로컬 NVMe가 I/O의 대가를 크게 낮춘다. 단, 다른 운영 모델이 따라온다.
12. 디스크가 사라지는 세계의 운영 구조
원문의 후반부는 당연히 나올 반론에 답합니다. "인스턴스 스토어는 기계와 수명을 같이 한다. 노드가 사라지면 데이터도 사라진다. 그런데 어떻게 운영 환경에서 쓰나?" 원문의 답은 한 문장입니다. "가능하다. 내구성을 개별 Postgres 노드가 아니라 클러스터 수준에서 제공한다면."
EBS에 익숙한 사람에게는 사고방식의 전환이 필요합니다. EBS 세계에서는 디스크가 믿을 만하다고 가정하고(볼륨 안에서 이미 복제되니까), 서버는 갈아 끼우는 부품으로 봅니다. 로컬 NVMe 세계에서는 어떤 디스크도 믿지 않습니다. 디스크는 서버와 함께 언제든 사라질 수 있는 것으로 보고, 대신 같은 데이터를 여러 기계와 여러 장소에 둡니다. 10절의 RAID가 디스크 여러 개로 하던 일을, 이번엔 서버 여러 대로 하는 것입니다.
원문이 제시하는 구조는 세 가지 요구 사항으로 정리됩니다.
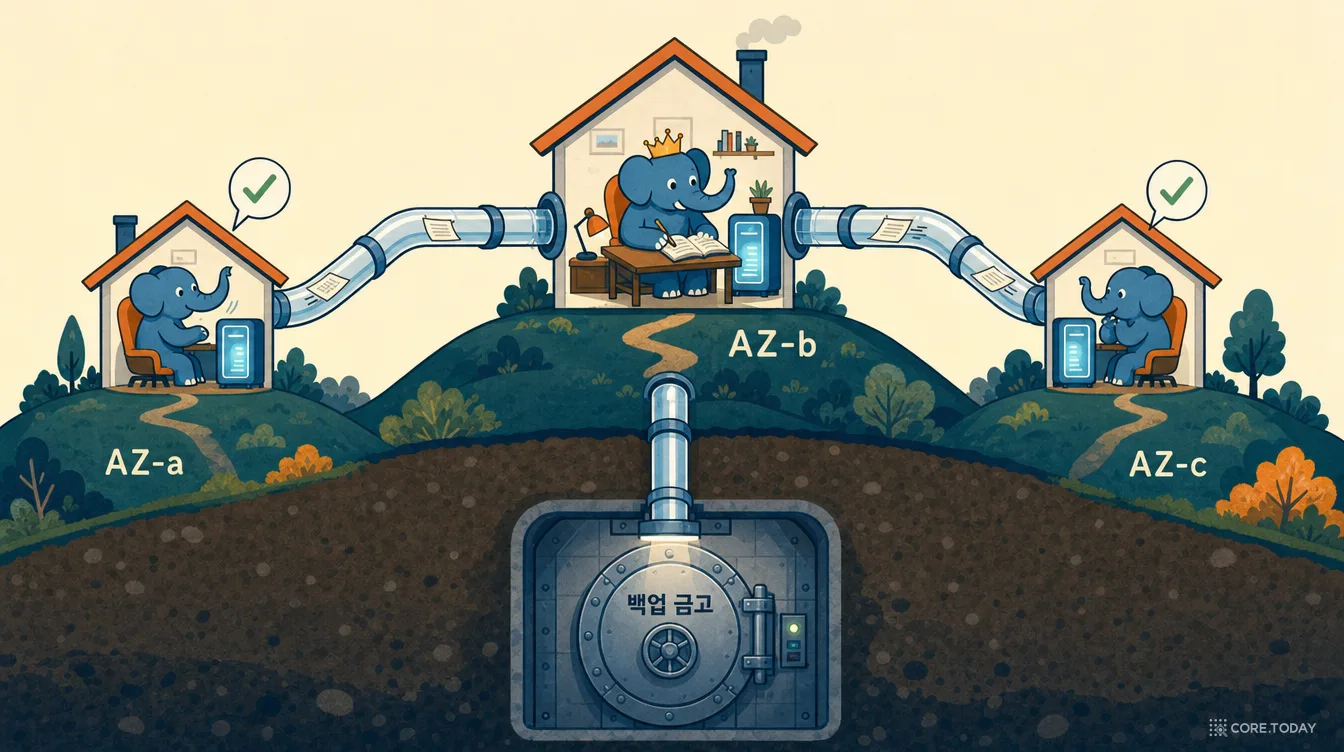
① 복제로 노드 손실을 견딘다쿼럼 동기 복제 ANY 1 (s1, s2)대기 서버 둘을 서로 다른 AZ에. 둘 중 빠른 쪽 확인만 기다린다
② 노드 밖에 백업과 WAL을 둔다WAL-G · pgBackRest · Barman → S3베이스 백업 + 연속 WAL 아카이브. 다른 실패 영역, 필요하면 다른 리전
③ 용량을 미리 계획한다인스턴스 타입 = 디스크 크기볼륨만 따로 늘릴 수 없다. 데이터·인덱스·WAL·여유분까지 계산
① 쿼럼 동기 복제: 둘 중 빠른 쪽만 기다린다
Postgres의 스트리밍 복제는 주 서버의 WAL을 대기 서버로 실시간 전송해 똑같이 재생하게 합니다. 기본은 비동기라 주 서버가 대기 서버를 기다리지 않습니다. 빠르지만, 주 서버가 갑자기 죽으면 아직 건너가지 못한 마지막 몇 건이 사라질 수 있습니다.
동기 복제는 "대기 서버가 WAL을 디스크에 썼다고 답할 때까지 커밋을 끝내지 않는다"는 약속입니다. 그런데 대기 서버를 하나만 동기로 두면 그 서버가 느려지거나 죽을 때마다 주 서버의 모든 커밋이 멈춥니다. 이 딜레마를 푸는 것이 2017년 Postgres 10에 들어온 쿼럼 커밋입니다.
ANY 1 (standby1, standby2)는 "두 후보 중 아무나 한 대가 받았다고 답하면 커밋하라"는 뜻입니다. 순서를 따지지 않으므로 두 대 중 빠른 쪽의 응답으로 커밋이 끝납니다. 한 대가 느려지거나 죽어도 다른 한 대가 쿼럼을 채우므로 쓰기가 멈추지 않습니다. 그리고 커밋된 모든 트랜잭션은 주 서버 외에 적어도 한 대에 반드시 있습니다. 세 서버를 서로 다른 AZ(같은 리전 안의 물리적으로 분리된 데이터센터 구역)에 두면 AZ 하나가 통째로 사라져도 데이터를 잃지 않습니다.
발표자는 이 구성을 업무의 중요도에 따라 조절하라고 말합니다. "은행처럼 티어 0·1 서비스라면 대기 서버 둘을 여러 AZ에 두는 게 낫다. 운영 중이라도 티어 2·3 서비스라면 대기 서버 하나로도 충분하다." 장애 조치(주 서버가 죽었을 때 대기 서버를 승격하는 일)는 repmgr, Patroni 같은 오픈소스 도구나 직접 만든 상태 기계가 맡습니다.
② 노드 밖의 백업: 시간 여행 장치
복제만으로는 부족합니다. 복제는 실수까지 충실히 복제하기 때문입니다. 누군가 DROP TABLE을 실행하면 그 명령도 WAL에 기록되어 1ms 안에 두 대기 서버로 건너갑니다. 그래서 두 번째 장치가 필요합니다. 데이터베이스 노드 바깥, 다른 실패 영역에 쌓아 두는 베이스 백업 + 연속 WAL 아카이브입니다.
원리는 간단합니다. 하루 한 번쯤 데이터베이스 전체의 물리 사본(베이스 백업)을 S3 같은 객체 저장소에 올리고, 그 뒤로 생기는 WAL 조각을 계속 올립니다. 복구할 때는 베이스 백업을 새 기계에 풀고 WAL을 원하는 시각까지 재생합니다. 이것이 시점 복구(PITR, Point-in-Time Recovery)입니다. "어제 오후 3시 14분 22초, DROP TABLE 직전의 상태"로 되돌릴 수 있습니다.
원문이 예로 든 WAL-G는 2017년 Citus Data가 WAL-E를 다시 쓴 오픈소스 도구입니다. WAL-E를 만든 대니얼 파리나는 지금 Ubicloud의 공동 창업자이고, Ubicloud는 ClickHouse의 관리형 Postgres를 함께 만든 회사입니다. 이 세계가 꽤 좁다는 걸 보여 주는 대목입니다. 발표자는 S3의 "11개의 9"(99.999999999%) 내구성을 들며, 저지연 WAL 전송으로 몇 초 단위의 RPO를 노릴 수 있다고 말합니다.
원문은 이 백업을 단순한 비상 장치 이상으로 봅니다. 같은 복구 이력으로 시점 복구, 격리된 브랜치(운영 데이터의 복사본에서 실험하기), 배포 크기 변경, 새 읽기 전용 복제본 채우기, 재해 복구를 모두 할 수 있습니다. 로컬 NVMe 세계에서는 "디스크 스냅숏 → 새 볼륨" 대신 "S3의 백업 → 새 기계"가 모든 복제의 기본 통로가 됩니다. 주 서버의 디스크에서 수백 GB를 복사해 오지 않으니 주 서버를 괴롭히지도 않습니다.
그리고 가장 중요한 문장. "복제와 백업은 서로 다른 문제를 푼다. 대기 서버는 빠른 장애 조치를, 백업은 손상·운영자 실수·클러스터 전체 장애를 막는다. 두 복구 경로 모두 정기적으로 시험해야 한다." 시험하지 않은 백업은 백업이 아니라는 오래된 격언 그대로입니다.
③ 용량 계획: 인스턴스가 곧 디스크
EBS는 볼륨 크기를 몇 분 만에 늘릴 수 있습니다. 인스턴스 스토어는 인스턴스 타입이 정한 크기 그대로입니다. 원문 실험의 m6id.4xlarge는 950GB짜리 NVMe 하나였고, 거기에 482GiB 테이블과 69GB 안팎의 인덱스, WAL, 그리고 블로트와 VACUUM을 위한 여유 공간이 들어가야 했습니다. 더 크게 필요하면 더 큰 인스턴스(디스크와 함께 CPU·메모리도 커지고 비싸지는)로 옮기거나, 디스크 비중이 큰 저장 최적화 계열(i 계열)을 골라야 합니다. 크기를 바꾸는 방법도 "볼륨 확장"이 아니라 "새 크기의 기계를 백업에서 채우고 장애 조치"입니다.
장애 훈련
이 구조가 실제 사고에서 어떻게 동작하는지 하나씩 일으켜 봅시다. 특히 "대기 서버 두 대가 동시에 죽음"과 "실수로 DROP TABLE"을 눌러 보세요. 복제가 지켜 주지 못하는 사고와, 동기 복제가 가용성 대신 내구성을 택하는 순간이 보입니다.
ClickHouse는 9월의 후속 글 「NVMe 위의 Postgres: 성능과 수렴」에서 이 구조에 Patroni·repmgr를 명시하고, 물리 WAL을 ClickHouse로 직접 복제하는 WalShadow라는 비공개 미리보기 기능까지 소개했습니다. 해커뉴스에서 "NVMe에도 원자적 스냅숏과 비동기 복제 같은 부가 기능을 얹어 달라"는 요청에 발표자가 "곧 소식이 있을 것"이라고 답한 걸 보면, 로컬 NVMe의 운영 공백을 메우는 기능 경쟁이 이제 막 시작된 것으로 보입니다.
13. 2026년에 이 이야기가 갖는 의미
이 발표가 2026년에 유독 크게 울린 데는 이유가 있습니다.
첫째, Postgres가 모든 것의 기본값이 됐습니다. 트랜잭션 처리는 물론이고 작업 대기열, 전문 검색, 벡터 검색(pgvector), 시계열, 이벤트 로그까지 "일단 Postgres에 넣자"가 기본 전략이 됐습니다(우리 블로그의 Postgres 하나로 작업 큐 만들기와 OpenAI의 PostgreSQL 확장기가 이 흐름을 다룹니다). 한 데이터베이스에 다양한 부하가 몰릴수록 작업 집합은 커지고, 메모리에 다 들어가지 않는 순간이 빨리 옵니다. 원문의 다섯 증상은 "Postgres로 다 하는" 시대의 성장통입니다.
둘째, AI 에이전트와 벡터가 무작위 접근을 늘렸습니다. 임베딩 벡터는 행 하나가 수 KB이고, HNSW 같은 벡터 인덱스 탐색은 그래프를 따라 페이지를 이리저리 건너뛰는 전형적인 무작위 읽기입니다. 인덱스가 메모리를 넘는 순간 성능이 저장장치 지연에 그대로 묶입니다. 에이전트가 사람보다 훨씬 자주, 훨씬 고르지 않게 데이터를 읽고 쓰는 것도 같은 방향으로 작용합니다.
셋째, 클라우드의 하드웨어 진화가 고르지 않았습니다. Cloudspecs 논문이 보여 줬듯 네트워크 대역폭은 달러당 10배 좋아졌지만 클라우드 NVMe는 2016년 수준에 머물렀습니다. 그런데도 그 정체된 로컬 NVMe가 네트워크 디스크보다 IOPS 단가에서 수십 배 앞섭니다. "기본값을 다시 따져 볼 때가 됐다"는 신호입니다.
넷째, 운영 도구가 성숙했습니다. 2008년에 EBS가 혁명이었던 것은 디스크 장애를 다룰 도구가 마땅치 않았기 때문입니다. 2026년에는 Patroni, CloudNativePG, WAL-G, pgBackRest 같은 도구가 10년 넘게 다듬어졌습니다. CloudNativePG 문서는 아예 "로컬 저장장치는 아무것도 공유하지 않는 구조를 가능하게 하고, 더 높고 예측 가능한 성능을 보장한다"며 로컬 디스크를 권합니다. 로컬 NVMe의 약점이던 "내구성은 여러분의 일"이 예전보다 훨씬 쉬운 일이 됐습니다. (덧붙이면, 오픈소스 생태계의 취약함도 함께 드러났습니다. 대표적인 백업 도구 pgBackRest는 2026년 4월 후원 부족으로 보관 처리됐다가 5월 후원사 연합의 지원으로 개발 재개를 발표했습니다.)
다섯째, 그럼에도 분리 아키텍처는 사라지지 않습니다. 에이전트가 실험용 데이터베이스를 수천 개 만들었다 지우고, 운영 데이터를 브랜치해 테스트하는 시대에는 Neon이나 Aurora 같은 분리 구조의 장점(즉시 생성, 0으로 줄이기, 저장소 공유 복제)이 오히려 커졌습니다. 그래서 2026년의 그림은 하나의 승자가 아니라 부하별로 다른 정답입니다. 무작위 쓰기가 많은 대형 OLTP의 주 데이터베이스는 로컬 NVMe로, 수많은 작은 데이터베이스나 들쭉날쭉한 부하는 분리 구조로, 그리고 그 사이에 io2나 Xata의 NVMe-oF처럼 "빠른 네트워크 저장장치"라는 중간 지대가 있습니다.
한국의 상황은 어떨까요. 조사한 범위에서는 이 발표를 다룬 한국어 기사나 국내 기업의 "Postgres를 로컬 NVMe로 옮긴" 공개 사례를 찾지 못했습니다(공개되지 않았을 뿐 쓰는 곳은 있을 겁니다). 대신 반대쪽 경험담은 있습니다. 한 국내 스타트업의 기술 블로그는 피크 시간 장애의 원인을 gp2 볼륨의 IOPS 크레딧 소진에서 찾고, 볼륨을 2TB로 키워 6,000 IOPS를 확보하는 것으로 해결했습니다. 용량이 필요해서가 아니라 IOPS를 사려고 디스크를 키운 것이죠. 원문의 다섯 증상이 한국 운영 현장에서도 "저장장치를 의심하지 않으면 보이지 않는" 형태로 이미 나타나고 있다는 방증입니다. 국내 클라우드(NCP, KT Cloud, NHN Cloud 등)도 로컬 NVMe 인스턴스와 네트워크 블록 스토리지를 함께 제공하므로, 같은 질문을 던져 볼 수 있습니다.
14. 내 데이터베이스 진단 체크리스트
원문의 마지막 조언은 진단입니다. "Postgres가 확장을 멈춘 것처럼 보일 때, 데이터베이스와 저장장치를 함께 들여다보라." 구체적으로 무엇을 보면 될지 정리했습니다.
① CPU가 놀고 있는데 느린가
가장 강력한 신호입니다. 처리량이 한계에 닿았는데 CPU 사용률이 낮다면 Postgres는 무언가를 기다리고 있습니다. 원문의 EBS 서버는 16코어 중 1코어만 일하면서 한계에 있었습니다.
② 무엇을 기다리는지 직접 물어본다
sql
-- 지금 이 순간, 접속들이 무엇을 기다리는가 (몇 초 간격으로 여러 번 찍어 본다)SELECT wait_event_type, wait_event, count(*)
FROM pg_stat_activity
WHERE state ='active'AND backend_type ='client backend'GROUPBY1, 2ORDERBY3DESC;
-- track_io_timing = on 이 필요하다 (오버헤드가 작아 켜 두는 경우가 많다)SELECT backend_type, object, context, reads, read_time, writes, write_time, fsyncs, fsync_time
FROM pg_stat_io -- Postgres 16 이상WHEREreads>0OR writes >0ORDERBY read_time + write_time DESC
LIMIT 10;
read_time ÷ reads로 읽기 하나의 평균 시간을 볼 수 있습니다. 로컬 NVMe라면 0.1ms 안팎, 네트워크 디스크라면 1ms 안팎이 정상이고, 그보다 훨씬 크다면 대기열이 길어진 것입니다. 특정 쿼리가 의심되면 EXPLAIN (ANALYZE, BUFFERS)로 shared hit(메모리에서 찾음)과 read(디스크에서 읽음)의 비율을 봅니다.
④ 운영체제와 클라우드 쪽 숫자를 함께 본다
리눅스 iostat -x 1: r_await·w_await(요청 하나의 대기 포함 시간), aqu-sz(대기열 길이), %util.
AWS라면 CloudWatch의 EBS 지표 중 VolumeQueueLength, VolumeReadOps/VolumeWriteOps, 그리고 IOPS·처리량 상한 초과를 알려 주는 지표(VolumeIOPSExceededCheck, VolumeThroughputExceededCheck)와 인스턴스 쪽 EBSIOBalance%. 읽기·쓰기 횟수의 합이 프로비저닝한 IOPS에 평평하게 붙어 있다면, 원문의 EBS 그룹과 같은 상태입니다.
⑤ 다섯 증상 중 몇 개가 동시에 있는가
하나만 있다면 그 증상 고유의 원인일 가능성이 큽니다. 우메시 말릭의 표현을 빌리면 "셋 이상이 동시에, CPU가 놀고 있는 상태로 나타난다면 저장장치를 시험해 볼 만한 패턴"입니다.
2메모리. 작업 집합이 메모리에 들어가면 저장장치 차이가 거의 사라진다. 메모리가 더 큰 인스턴스가 가장 단순한 해법일 때가 많다.
3EBS 사양 올리기. gp3 IOPS·처리량을 사거나 io2로. 인스턴스의 EBS 상한도 함께 확인. 운영 모델을 바꾸지 않고 얻는 가장 큰 개선.
4파티셔닝·분할. 핫 데이터와 콜드 데이터를 나누거나, 데이터를 여러 서버로 쪼갠다.
5로컬 NVMe. 위를 다 해도 저장장치가 한계라면. 단, 쿼럼 복제·노드 밖 백업·복구 연습·용량 계획이라는 다른 운영 모델을 함께 산다. 관리형 서비스(PlanetScale, ClickHouse 관리형 Postgres, Ubicloud 등)로 그 운영을 외주화하는 선택지도 있다.
맺으며: 코끼리는 건강하다
이 글의 영수증을 다시 떠올려 봅시다. 37ms 중 Postgres가 일한 시간은 2ms. 트랜잭션 하나에 드는 CPU는 EBS에서도 NVMe에서도 똑같이 0.6ms. 원문의 제목이 과장처럼 들려도, 그 숫자들이 가리키는 방향은 분명합니다. 많은 경우 Postgres는 느린 게 아니라 기다리고 있습니다.
동시에 원문은 스스로 말하듯 "제목보다 일부러 좁은 결론"을 냅니다. 저장장치가 한계인 부하에서, 로컬 NVMe는 I/O의 대가를 크게 낮춘다. 그리고 그 대가로 다른 운영 모델을 요구한다. 9배라는 숫자는 가장 싼 네트워크 디스크와 가장 가혹한 부하가 만난 결과이고, 실제 격차는 여러분의 데이터 크기, 접근 패턴, 그리고 EBS에 얼마를 쓰고 있느냐에 달려 있습니다.
50년 전 데이터베이스 설계자들은 하드디스크의 10ms를 피하려고 B-트리와 버퍼 풀과 WAL을 만들었습니다. 2008년 클라우드는 디스크를 네트워크 너머로 보내며 운영의 짐을 덜어 주었고, 그 대가로 지연을 받아 갔습니다. 2026년 우리는 그 거래의 조건을 다시 읽고 있습니다. 하드디스크 시절에는 거의 공짜였던 네트워크 왕복이, 플래시 시절에는 영수증에서 가장 큰 항목이 되었기 때문입니다.
의사의 말을 빌리면 이렇습니다. 코끼리는 건강합니다. 신발이 맞는지 한번 확인해 보세요.
참고 자료
원문과 발표
Sai Srirampur, 「Postgres Isn’t Slow. Your Storage Is」, POSETTE 2026 발표 — 영상 · 발표 페이지
J. Gray, F. Putzolu, 「The 5 Minute Rule for Trading Memory for Disc Accesses and the 10 Byte Rule for Trading Memory for CPU Time」, SIGMOD 1987
J. Gray, G. Graefe, 「The Five-Minute Rule Ten Years Later, and Other Computer Storage Rules of Thumb」, SIGMOD Record 26(4), 1997
R. Appuswamy, G. Graefe, R. Borovica-Gajic, A. Ailamaki, 「The Five-Minute Rule 30 Years Later and Its Impact on the Storage Hierarchy」, CACM 62(11), 2019
D. Patterson, G. Gibson, R. Katz, 「A Case for Redundant Arrays of Inexpensive Disks (RAID)」, SIGMOD 1988
R. Bayer, E. McCreight, 「Organization and Maintenance of Large Ordered Indices」, 1970 (Acta Informatica, 1972)