Fable took my jorbCendyneAI 감원AI 워싱하네스체크포인트검증 가능성그저 그런 자동화아제모을루과업 모형탄광 속 카나리아METR쇼피파이 Helixts-rust취향자동화의 아이러니특집
[특집] 「Fable이 내 일자리를 가져갔다」 — AI는 더 잘해서가 아니라 '더 싸서' 사람을 밀어낸다: 마지막 엔지니어의 고백으로 읽는 2026년 AI 감원의 구조
2026년 10월 11일, 보안·암호학 글로 알려진 블로거 Cendyne이 8분짜리 글 「Fable이 내 일자리를 가져갔다(Fable took my jorb)」를 올렸다. 회사의 '마지막 엔지니어'였던 그는 이렇게 쓴다. Fable이 내 일을 더 잘해서가 아니라, 내 연봉보다 쌌다. 그리고 'AI가 내 일을 가져갔다'는 말은 'AI가 내 자리를 없애는 데 한몫했다'보다 말하기 재미있을 뿐이라고. 해커뉴스에서 댓글 355개가 붙은 이 글을, 러다이트와 케인스부터 아제모을루의 '그저 그런 자동화', 브리뇰프슨의 '탄광 속 카나리아' 2026년 갱신판, 챌린저의 AI 감원 통계, 그리고 쇼피파이 Helix와 테오의 ts-rust가 보여 준 '하네스'의 구조, METR의 시간 지평, 'hmm-hmm-hmm' 반복의 정체까지 따라가며 읽는다. 인터랙티브 여섯 개와 함께.
2026년 10월 11일 일요일, 한 개인 블로그에 짧은 글이 올라왔습니다. 제목은 「Fable took my jorb」. 'jorb'는 job을 일부러 틀리게 쓴 인터넷 말장난이니, 우리말로 옮기면 「Fable이 내 일자리를 가져갔쪄」 정도의 장난스러운 제목입니다. 링크 미리보기 문구는 더 짓궂습니다. "Fable은 멋져요, 일자리를 가져가요 — 다리오 '스티브' 올트먼." Anthropic의 다리오 아모데이와 OpenAI의 샘 올트먼을 한 사람으로 섞어 버린 가상 인물의 말입니다.
그런데 본문은 하나도 장난스럽지 않습니다. 첫 문단은 이렇습니다.
사실이다. 어떤 의미에서는. LLM이 'Fable / Mythos 급'으로 마케팅되는 지능에 이르지 않았다면, 나는 아마 예전 직장에 아직 다니고 있었을 것이다. 잠깐 동안은.
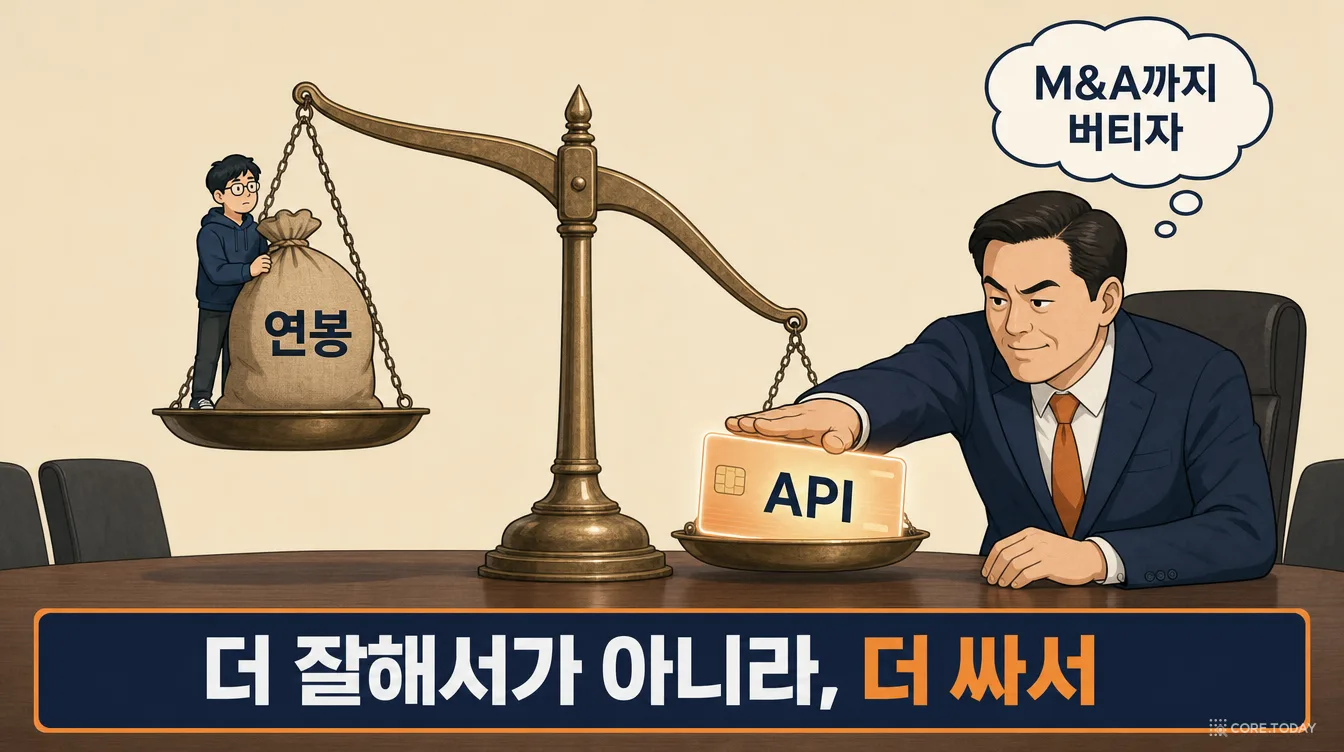
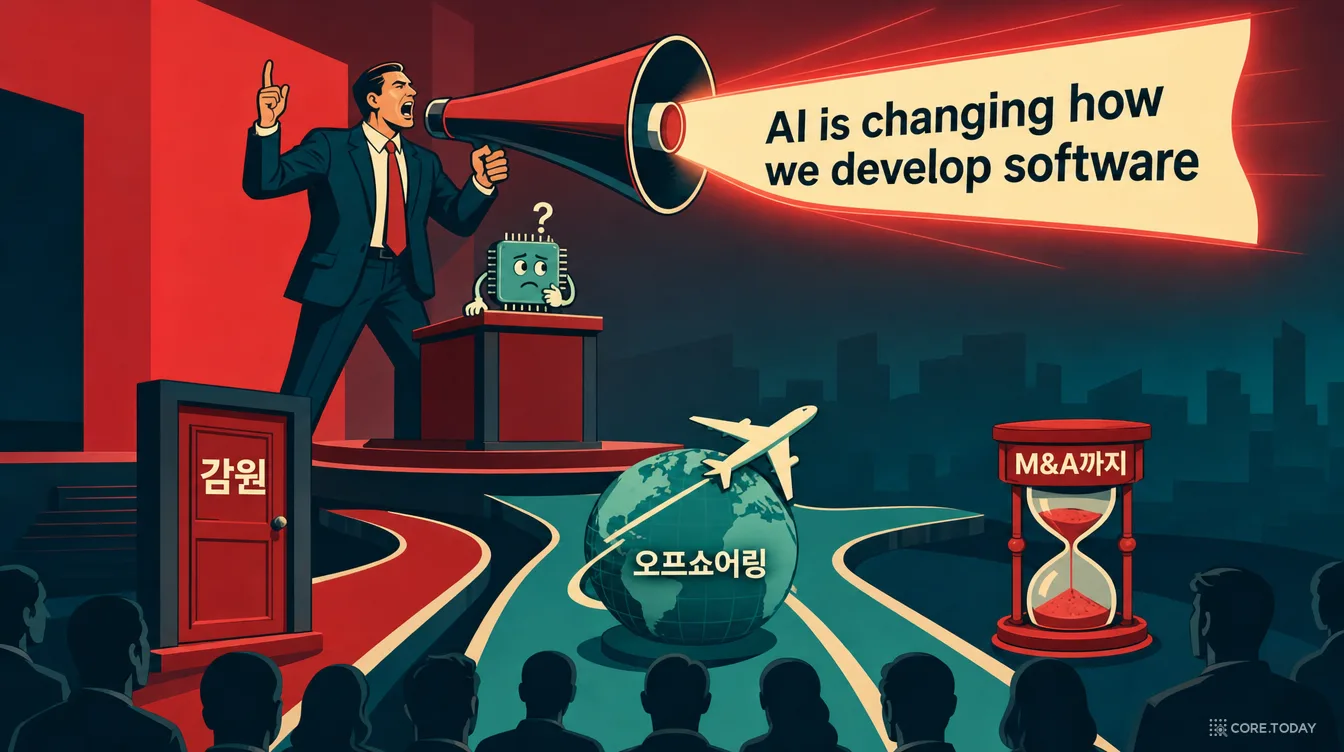
Fable이 내 일을 더 잘해서가 아니었다. 마지막 엔지니어였던 나보다, Fable이 내 연봉보다 쌌다. 그것만으로도 남아 있던 경영진의 마지막 흔적들은 인수합병(M&A) 때까지 버틸 수 있다는 확신을 얻은 모양이었다.
다음 날 아침 해커뉴스에 「Fable Took My Job」이라는 제목으로 올라간 이 글은 하루 만에 220점, 댓글 355개를 모았습니다. 글쓴이 Cendyne은 암호학과 클라우드 보안 글로 해커뉴스 첫 페이지에 자주 오르는 블로거이고, 글마다 뱀(나가) 캐릭터 스티커를 붙이는 것으로 유명합니다. 이번 글에도 어깨를 으쓱하는 뱀, 심장을 움켜쥔 뱀, 배터리를 바다에 던지는 뱀이 나옵니다.
왜 이 글이 그렇게 많은 사람을 붙잡았을까요. 같은 주에 나온 숫자들을 나란히 놓으면 보입니다.
같은 주에 있었던 일
숫자
출처
Cendyne 「Fable Took My Job」 해커뉴스 토론
220점 · 댓글 355개
HN 50053216 (10월 12일)
카파시 "LLM 능력에 대한 공통 이해의 간극이 넓어지고 있다"
조회 약 590만 · HN 705점, 댓글 1,027개
X (10월 11일)
테오의 ts-rust: TypeScript 컴파일러를 Rust로 옮긴 실험
Opus 5.5로 2주, 약 2만 4천 달러
GitHub pingdotgg/ts-rust (10월 7일)
2026년 1~9월 미국 감원 중 'AI'를 사유로 든 건수
120,136건 (전체의 21%, 누적 1위)
챌린저 9월 보고서 (10월 1일)
같은 기간 기술 업종 감원
165,925건 (전년 대비 +54%)
챌린저 9월 보고서
AI 노출 직업 22~25세 고용, 덜 노출된 동년배 대비
19% 낮음
브리뇰프슨 외 (2026년 8월 갱신)
모델은 점점 더 길고 어려운 일을 해냅니다. 감원 발표에는 'AI'라는 단어가 점점 더 자주 등장합니다. 그런데 모델을 매일 쓰는 개발자들은 "아직 경험 많은 엔지니어를 대신할 수준은 아니다"라고 말합니다. 셋 다 사실이라면, 사람들은 도대체 왜 일자리를 잃고 있는 걸까요.
Cendyne의 대답은 한 문장으로 요약됩니다.
"AI가 내 일을 가져갔다"는 말은 "AI가 내 자리를 없애는 데 한몫했다"보다 훨씬 말하기 재미있다.
이 특집은 그 두 문장 사이의 거리를 끝까지 따라갑니다. 기계가 일자리를 가져간다는 두려움이 200년 동안 어떻게 반복됐는지, 경제학자들은 '대체'와 '기여'를 어떻게 구분하는지, 2026년의 데이터는 무엇을 말하는지, 그리고 무엇보다 에이전트가 실제로 잘하는 일과 못하는 일을 가르는 기술적 경계선이 어디에 있는지. 원문이 짧게 언급하고 지나간 '하네스(harness)', '체크포인트', '복사기' 같은 단어 뒤에는 2025~2026년 AI 엔지니어링의 가장 중요한 아이디어가 숨어 있습니다.
미리 보는 핵심 개념 아홉 개
용어가 낯설 수 있으니 먼저 지도를 펼쳐 둡니다. 본문에서 하나씩 자세히 풀겠습니다.
기여 vs 대체AI가 사람보다 일을 잘해서 자리를 빼앗는 것(대체)과, AI가 '사람 없이도 버틸 수 있다'는 확신을 줘서 감원 결정을 쉽게 만드는 것(기여)은 다르다. 원문의 핵심 구분.
그저 그런 자동화경제학자 아제모을루·레스트레포의 용어(so-so automation). 사람보다 아주 조금 싸거나 비슷한 기술이 사람을 밀어내면, 생산성은 거의 오르지 않고 일자리만 줄어든다.
과업 모형직업을 '과업의 묶음'으로 보는 시각. 기계가 과업 일부를 가져가면 대체 효과·생산성 효과·복귀 효과가 동시에 작동한다.
AI 워싱원래 다른 이유(금리, 예산, 과잉 채용)로 하는 감원을 'AI 때문'이라고 포장하는 것. 샘 올트먼도 "일부 있다"고 인정했다.
하네스모델을 감싸는 모든 장치. 도구, 지시문, 작업 목록, 테스트, 검토자, 재시도 규칙. "에이전트 = 모델 + 하네스".
체크포인트와 오라클일을 작게 쪼개 단계마다 '정답지(오라클)'로 검사하고, 통과해야만 다음 단계로 가게 하는 구조. 원문의 "언덕마다 깃발".
검증 가능성"AI를 훈련시키기 쉬운 정도는 그 과제를 검증하기 쉬운 정도에 비례한다"(제이슨 웨이의 '검증자의 법칙'). 에이전트가 잘하는 일의 경계선.
시간 지평METR의 측정법. 사람이 몇 시간 걸리는 일을 AI가 50% 확률로 해내는가. 2026년 4월 Mythos Preview는 약 17시간이었지만, 80% 기준으로는 약 3시간이었다.
취향과 선견무엇을 만들지 않을지 아는 능력, 몇 주·몇 달·몇 년 뒤의 결과를 내다보는 능력. 원문이 "모델에게 아직 없다"고 꼽은 두 가지.
1. 글쓴이는 누구인가: 마지막 엔지니어가 되기까지
Cendyne은 자기를 "서버 간 아키텍처, 애플리케이션·저장소·프로토콜 안의 보안과 응용 암호학에 관심 있는 백엔드 개발자, 매니저, 리더"라고 소개합니다. Ed25519 서명 알고리즘 해설, HKDF, MD5 충돌로 인증서를 위조하는 법 같은 글이 해커뉴스와 로브스터스에 자주 올랐습니다. 블루스카이 소개는 더 짧습니다. "암호학과 클라우드 보안, 인프라 하는 나가(naga)." 퍼리(furry) 문화의 뱀 캐릭터를 페르소나로 쓰고, 글 곳곳에 커미션한 스티커 그림을 넣습니다. 너무 자주 첫 페이지에 오르는 바람에 "그 퍼리의 스티커를 지우는 스크립트까지 만든 사람들이 있다"는 이야기를 본인이 소개한 적도 있습니다.
이번 글은 갑자기 나온 글이 아닙니다. 1년 전 쓴 전작이 있습니다.
2025년 3월 「'바이브 코딩' 대 현실」: 해커뉴스 221점, 댓글 297개. AI에게 분위기(vibe)만 주고 코드를 맡기는 방식이 실제 운영 환경에서 어떻게 무너지는지 쓴 글입니다.
2025년 11월 26일 「바이브 코딩한 SaaS가 우리 팀을 죽였다」: 이 글이 이번 글의 1편입니다. "우리는 한때 천 명이었다. 오늘은 손가락으로 셀 수 있다." 경영진은 '엔지니어링 인력 0명, 도입 인력 0명, 지원 인력 0명'을 약속하는 바이브 코딩 SaaS로 갈아타기로 했고, Cendyne은 "이전 작업을 위해 한두 달 더 혼자 남는다"고 썼습니다. 투자자들은 "실패를 인정하기보다 미래의 매각에 걸기를 택했다"고도요. 이번 글의 "M&A 때까지 버틴다"는 문장은 여기서 이어집니다.
2026년 7월 21일, 마스토돈: "오늘은 Fable이 만든 코드를 리뷰 중. 주석마다 멋들어진 섹션 기호(§)가 잔뜩… 이 사람들, 열흘 뒤에도 힘들 텐데(내가 해고되면)." 그리고 덧붙입니다. "내가 마지막 엔지니어 / 리드 / 기술 담당이라서."
그러니까 이야기의 시간표는 이렇습니다. 천 명이던 회사가 손가락으로 셀 만큼 줄었고, Cendyne은 마지막 엔지니어로 남아 시스템을 넘기는 일을 했습니다. 2026년 6월 9일 Anthropic이 Claude Fable 5를 내놓으며 "작업이 길고 복잡할수록 다른 모델과의 격차가 커진다"고 홍보했고, 7월 말 Cendyne은 해고됐습니다. 그리고 두 달 반이 지나 이 글을 썼습니다.
2025-03 「바이브 코딩 대 현실」
→
2025-11 「바이브 코딩 SaaS가 우리 팀을 죽였다」 천 명 → 손가락으로 셀 만큼
→
2026-06-09 Claude Fable 5 공개 (100만 토큰당 10/50달러)
2026-07-21 "Fable이 만든 코드 리뷰 중, 열흘 뒤 해고"
→
2026-10-11 「Fable took my jorb」
→
2026-10-12 해커뉴스 220점 · 댓글 355개
1-1. 'Fable / Mythos 급'이란 무엇인가
글의 첫 문장에 나오는 "Fable / Mythos tier"를 짚고 가야 합니다. 2026년 Anthropic 모델 라인업의 맨 위 층을 가리키는 말입니다.
날짜
일어난 일
의미
2026-04-07
Claude Mythos Preview 발표. 일반 공개 없이 40여 개 기업(프로젝트 글래스윙)에만 제공
"모든 주요 운영체제와 브라우저에서 취약점을 찾았다"는 홍보로 화제
2026-06-09
Claude Fable 5 · Mythos 5 공개. 100만 토큰당 입력 10달러, 출력 50달러
처음으로 일반에 풀린 'Mythos 급' 모델. "작업이 길고 복잡할수록 격차가 커진다"
2026-06-12 ~ 07-01
미국 정부 조치로 접근 중단 후 복구
모델 하나가 국가 안보 이슈가 된 장면
2026-09-01
Fable 5.1 · Mythos 5.1
원문이 말한 '마케팅된 지능'의 정점
2026-09-03
OpenAI GPT-6 Astra 공개
원문이 "Fable의 라이벌"이라 부른 모델
2026-09-22
Claude Opus 5.5 공개. 100만 토큰당 4/20달러
"대부분의 작업에서 Fable 5.1 수준, 운영비는 40% 적게"
여기서 이미 이 글의 첫 번째 열쇠가 보입니다. Opus 5.5의 발표문은 "Fable 5.1 수준의 성능을 40% 싼 값에"라고 말합니다. 2026년 하반기 프런티어 AI 경쟁의 언어는 '더 똑똑하다'만큼이나 '같은 수준을 더 싸게'입니다. 그리고 Cendyne이 일자리를 잃은 이유도 정확히 그 단어, '더 싸게'였습니다.
2. 원문 따라 읽기: 여덟 개의 장면
원문은 8분짜리이고 소제목이 없습니다. 그래도 흐름을 따라가면 여덟 개의 장면으로 나뉩니다. 하나씩 읽어 보겠습니다.
2-1. "더 잘해서가 아니라, 더 싸서"
첫 장면은 앞에서 인용한 두 문단입니다. 여기에는 세 개의 단어가 숨어 있습니다.
첫째, '마지막 엔지니어(the last engineer)'. Cendyne은 팀 하나가 아니라 회사의 마지막 엔지니어였습니다. 그 사람을 내보낸다는 건 '엔지니어 수를 줄인다'가 아니라 '시스템을 아는 사람을 0명으로 만든다'는 뜻입니다.
둘째, '더 쌌다(cheaper)'. Cendyne은 Fable이 자기보다 일을 잘했다고 말하지 않습니다. 반대로 글 후반에서 "프런티어 모델은 경험 많은 엔지니어를 대체할 만큼 좋지 않다"고 분명히 말합니다. 비교의 축은 실력이 아니라 비용이었습니다.
셋째, '확신(confidence)'. Fable이 준 건 결과물이 아니라 경영진의 확신이었습니다. "M&A 때까지 버틸 수 있다." 회사를 성장시키는 게 목표가 아니라 팔릴 때까지 굴러가게만 하는 게 목표라면, 계산은 완전히 달라집니다. 몇 달 뒤에 터질 장애는 새 주인의 문제가 되니까요.
이 세 단어를 합치면 이 글의 경제학이 나옵니다. 사람을 내보내면 인건비는 즉시 사라집니다. 반면 시스템을 아는 사람이 없어서 생기는 비용, 즉 장애, 느려지는 대응, 쌓이는 기술 부채는 천천히, 나중에 옵니다. 평가 시점이 짧을수록 '자르기'는 합리적으로 보입니다. 아래 위젯에서 직접 계산해 보세요.
두 번째 장면에서 Cendyne은 시간을 거슬러 올라갑니다. 해고당하기 전, 그는 해고를 집행하는 쪽이었습니다.
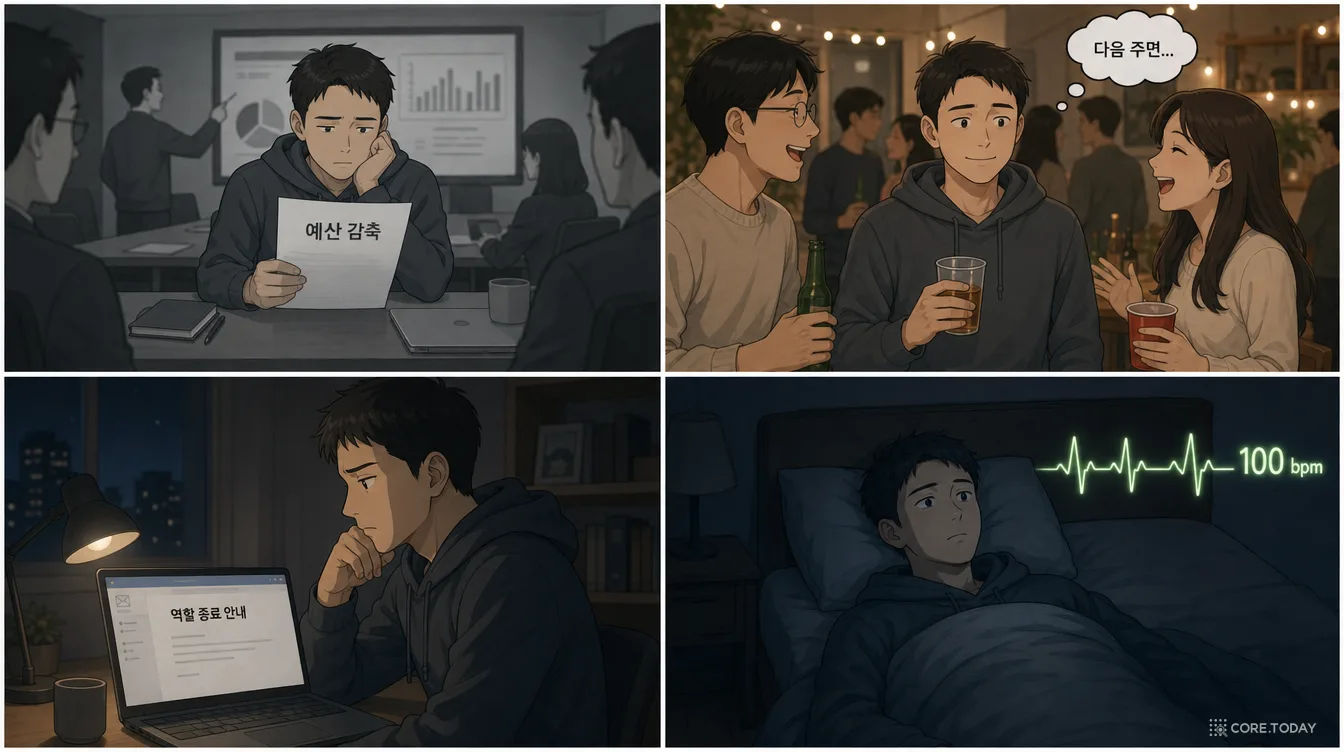
예산 삭감 때문에 하는 감원을 겪어 봤다. "내가 맡은 이 제품은 사업에 결정적이고 여전히 주인이 필요하다, 그러니 이 사람이 필요하다"를 예산 상한에 맞춰 기계적으로 정당화해야 했다. 내가 믿고 새 제품(그린필드)을 맡겼던 사람들의 자리가 없어졌다. 다음 세대 인프라로 운영 문제를 해결하는 것보다 현상 유지가 더 중요했다.
그 첫 회의가 내 영혼을 짓눌렀다. 귀가 그렇게 세게 울린 적이 없었다. 세상에서 색이 빠져나갔다. 똑바로 걷기도 힘들었다.
그리고 다음 날, 나는 부하 직원 두 명이 와 있는 하우스 파티에 갔다. 둘 다 다음 주에 아무 예고 없이 일자리를 잃는다는 걸 알면서.
이 장면이 중요한 이유는, 감원이 어떻게 결정되는지 내부자의 눈으로 보여 주기 때문입니다. 감원은 대개 "이 사람이 AI보다 못하다"는 판단에서 시작하지 않습니다. 예산 상한(budget ceiling)이 먼저 내려오고, 매니저는 그 상한 아래로 누구를 남길지를 '기계적으로 정당화'합니다. 이 과정에서 AI는 "이 사람이 없어도 된다"는 논리를 보강하는 도구로 들어옵니다. 원인이 아니라 정당화의 재료로요.
그리고 마침내 자기 차례가 왔습니다. 몇 번이나 미리 슬퍼했기에 몇 시간은 담담했다고 씁니다. 그다음이 이 글에서 가장 많이 인용된 대목입니다.
그러다 미래에 대한 두려움과 의심이 밀려오면서 심박이 100bpm을 넘었다. 일주일 넘게 내려오지 않았다. 자기 심장 소리만 들리는 채로 잠드는 게 얼마나 어려운지 아는가? 몸에 열 시간을 내줬는데 실제로는 네 시간만 자고 일하는 게 얼마나 힘든지 아는가?
감원을 다루는 기사는 숫자를 셉니다. 120,136건, 21%, +54%. Cendyne의 글은 그 숫자 하나가 한 사람의 몸에서 어떤 모습인지 보여 줍니다.
2-3. 주변의 해고들
세 번째 장면은 Cendyne 주변으로 시야를 넓힙니다.
데브옵스 관심 모임의 예닐곱 명이 지난 한 달 사이에 해고되거나 해고 통보를 받았습니다.
FAANG(빅테크) 중 한 곳에서 일하던 사람은 "6개월치 퇴직금"을 받았지만, 회사는 "자재 제한 때문에" 짐을 부쳐 줄 수도, 직접 가져가게 할 수도 없다며 개인 물건을 폐기했다고 합니다. Cendyne은 "Ship happens(배송은 일어나는 법)"라는 회사의 말장난을 비꼬며 "GLHF(행운을 빈다, 즐겜하라)"라고 덧붙입니다.
다른 회사에서 Cendyne을 면접했던 채용 매니저는 일주일 뒤 해고됐습니다. CEO가 뒤늦게 "AI가 소프트웨어 개발 방식을 바꾸고 있다"는 글을 올린 직후였습니다.
또 다른 사람은 미국에서 한창 사람을 뽑는 중이었는데 팀 전체를 잃었습니다. 위에서 "다시 오프쇼어링하자"는 결정이 내려왔기 때문입니다. AI 보조 덕분에 "덜 열정적이고, 경험이 적고, 덜 비싼 인력"의 업무 능력이 올라갔다는 이유였습니다.
마지막 사례는 특히 흥미롭습니다. 여기서 AI는 사람을 직접 대체하지 않았습니다. AI는 더 싼 사람이 비싼 사람의 일을 할 수 있게 만들었고, 그 결과 비싼 사람이 밀려났습니다. AI는 일자리를 없앤 게 아니라 일자리를 다른 나라로 옮기는 데 '한몫'했습니다.
(이 사례들의 회사 이름은 나오지 않습니다. Cendyne은 전작에서도 회사를 밝히지 않는다고 썼고, 우리도 확인하지 못했습니다. 다만 2026년 9~10월 기사로 확인되는 대형 테크 감원은 아마존 소매 부문 1,000명 미만, 애플 피트니스+ 일부, 마이크로소프트 Xbox 268명 등입니다. 데브옵스·SRE를 콕 집은 감원 보도는 찾지 못했습니다.)
2-4. 한 문장: '가져갔다'와 '한몫했다'
그리고 이 글의 중심 문장이 나옵니다.
"AI가 내 일을 가져갔다"는 "AI가 내 자리를 없애는 데 한몫했다"보다 훨씬 말하기 재미있다.
두 문장의 차이는 책임이 누구에게 있느냐입니다. "AI가 가져갔다"는 문장에서 행위자는 AI입니다. 자연재해처럼, 아무도 막을 수 없었던 일처럼 들립니다. "AI가 한몫했다"는 문장에는 숨은 행위자가 있습니다. 예산을 정한 사람, 평가 시점을 M&A로 잡은 사람, 오프쇼어링을 결정한 사람. 해커뉴스의 한 댓글(philipodonnell)이 정확히 이 점을 짚었습니다. "AI가 당신 일을 가져간 게 아니다. 한 사람이 생산성 향상을 단기 수익 실현에 쓰기로 결정한 것이다."
이 구분은 말장난이 아닙니다. 경제학에는 이 차이를 정확히 다루는 개념이 있고(5장의 '그저 그런 자동화'), 데이터에도 흔적이 있습니다(6장의 'AI 워싱'). 그리고 무엇보다, 무엇을 고쳐야 하는지가 달라집니다. AI가 가져갔다면 AI를 멈춰야 합니다. AI가 한몫했다면 결정을 바꿔야 합니다.
2-5. "그래도 모델은 아직 경험 많은 엔지니어를 대체하지 못한다"
네 번째 장면에서 Cendyne은 정면으로 주장합니다.
프런티어 모델은 경험 많은 엔지니어를 대체할 만큼 좋지 않다. 여전히 아니다. 미국 프런티어 연구소들의 마케팅(그리고 '무서워서 그만뒀어요' 직원들)이 앞으로 올 일에 대해 아무리 소리쳐도.
'무서워서 그만뒀어요' 직원들은 2026년의 연이은 공개 사직을 가리킵니다. 2월에는 Anthropic 안전 연구팀장 므리낭크 샤르마가 "세상이 위험에 처해 있다"는 편지와 함께 떠났고, 9월 9일에는 Anthropic 사전학습 연구자 제이컵 콕슨이 "두 회사 모두 무책임하게 행동하고 있다. 자기 개선하는 초지능을 향해 질주하며 우리 목숨을 걸고 도박하고 있다"는 사직 글을 올려 하룻밤에 7천만 회 넘게 조회됐습니다. Cendyne은 이런 발언들이 결과적으로 "AI는 곧 모든 것을 할 것"이라는 마케팅과 같은 방향으로 작동한다고 봅니다. 두려움도 확신을 만듭니다.
그렇다면 모델에게 무엇이 없을까요. Cendyne은 두 가지를 꼽습니다.
취향(taste):
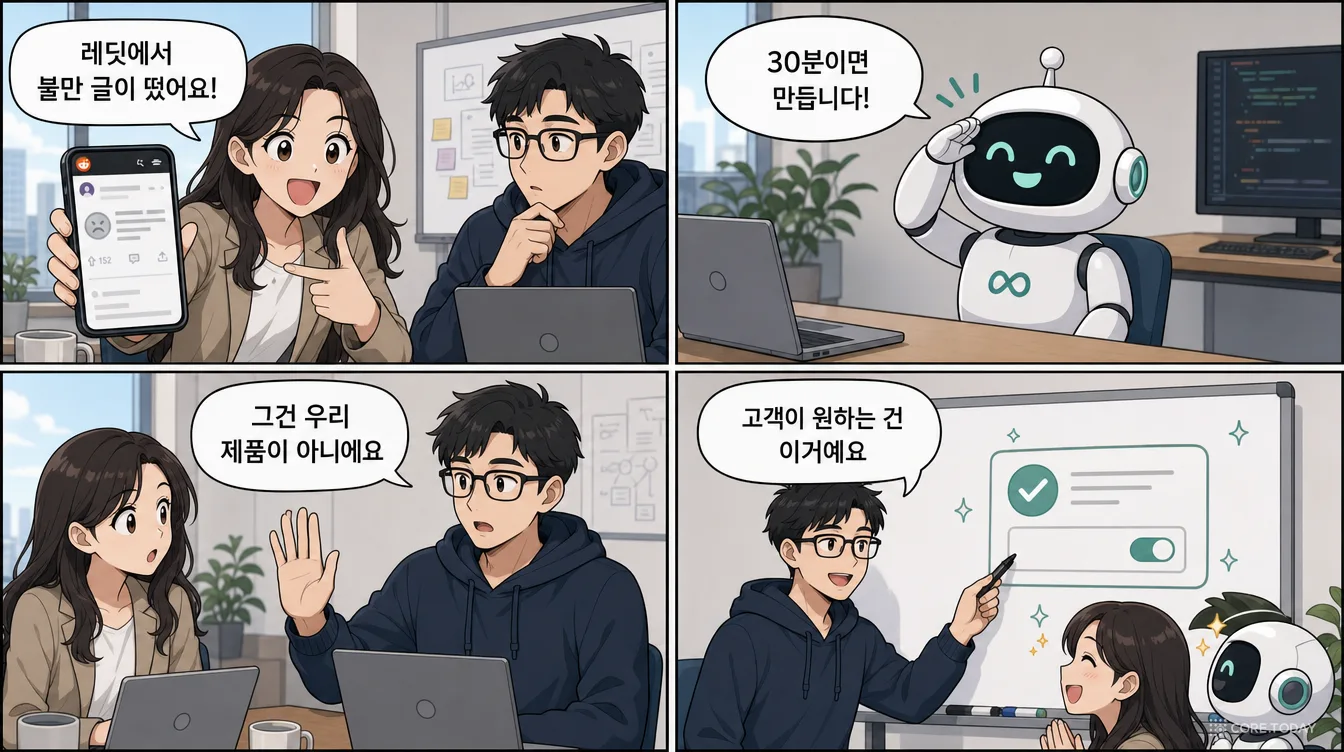
이 모델들에게는 효과적인 제품 결정을 내리게 하는 취향이 없다. 제품 매니저가 "레딧에서 누가 이걸 불평하네, 구현하죠"라고 말하는 게 그 어느 때보다 싸졌다. 반면 취향 있는 리더는 이렇게 말한다. "아니요, 그건 우리 제품이 아니에요. 그걸 만들면 오랫동안 그걸 책임져야 하고, 우리 고객이 진짜 원하는 건 {우리가 이미 하고 있지만 완벽하지는 않은 다른 것}이에요."
선견(foresight):
이 모델들에게는 결정과 약속이 몇 주, 몇 달, 몇 년 뒤에 낳을 결과를 내다보는 선견이 없다. 운영비, 복잡도, 접근성, 그리고 그 제품을 사는 고객에게의 가격 부담. 이 부차적인 것들이 제품을 성공시키고 살 만한 것으로 만든다. 세상의 슬롭(slop) 서비스들은 이것들을 늘 빠뜨리고, 맛을 보면 안다.
이 두 단락이 해커뉴스에서 가장 크게 엇갈린 반응을 받았습니다. 한쪽(A_D_E_P_T)은 "분별력이 그 어느 때보다 가치 있어졌다. Opus 5.5에게 맡기면 제품을 비대하게 만드는 모든 변경을 다 구현하라고 할 것"이라며 동의했고, 다른 쪽(dofm)은 "레오파드가 내 얼굴은 안 먹겠지"라는 밈을 인용하며 "경영진이 당신의 취향을 알아본다고 생각하는 근거가 뭔가"라고 비꼬았습니다. 취향이 있어도 해고는 당한다, 지금 이 글의 저자처럼. 이 반론은 11장에서 다시 다룹니다.
2-6. "그런데도": 쇼피파이와 테오
다섯 번째 장면에서 글은 방향을 틉니다. Cendyne은 공정하게도, 모델이 정말 잘하는 일을 인정합니다.
그런데도 모델은 쇼피파이가 React Native를 바다에 던져 버리고 네이티브 iOS·안드로이드 앱으로 돌아갈 확신을 줄 만큼은 된다. 전부 기계가 코딩하고, 경험 많고 취향 있는 개발자들이 감독하면서.
그리고 나는 쇼피파이에 동의한다. 모델은 정교하게 만든 하네스로 한 걸음씩 몰아가면, 사람들이 A/B 테스트로 닳도록 다듬어 놓은 동작을 재현하고 옮길 수 있을 만큼 좋아지고 있다. 돌을 언덕 위로 밀어 올릴 수 있다. 그다음 언덕도, 또 그다음도. 기법을 측정하고 체크포인트를 둘 수 있을 때는.
배터리를 바다에 던지는 뱀 스티커가 여기 붙어 있습니다(쇼피파이가 React Native를 '바다에 던졌다'는 농담). 그리고 다음 단락이 이어집니다.
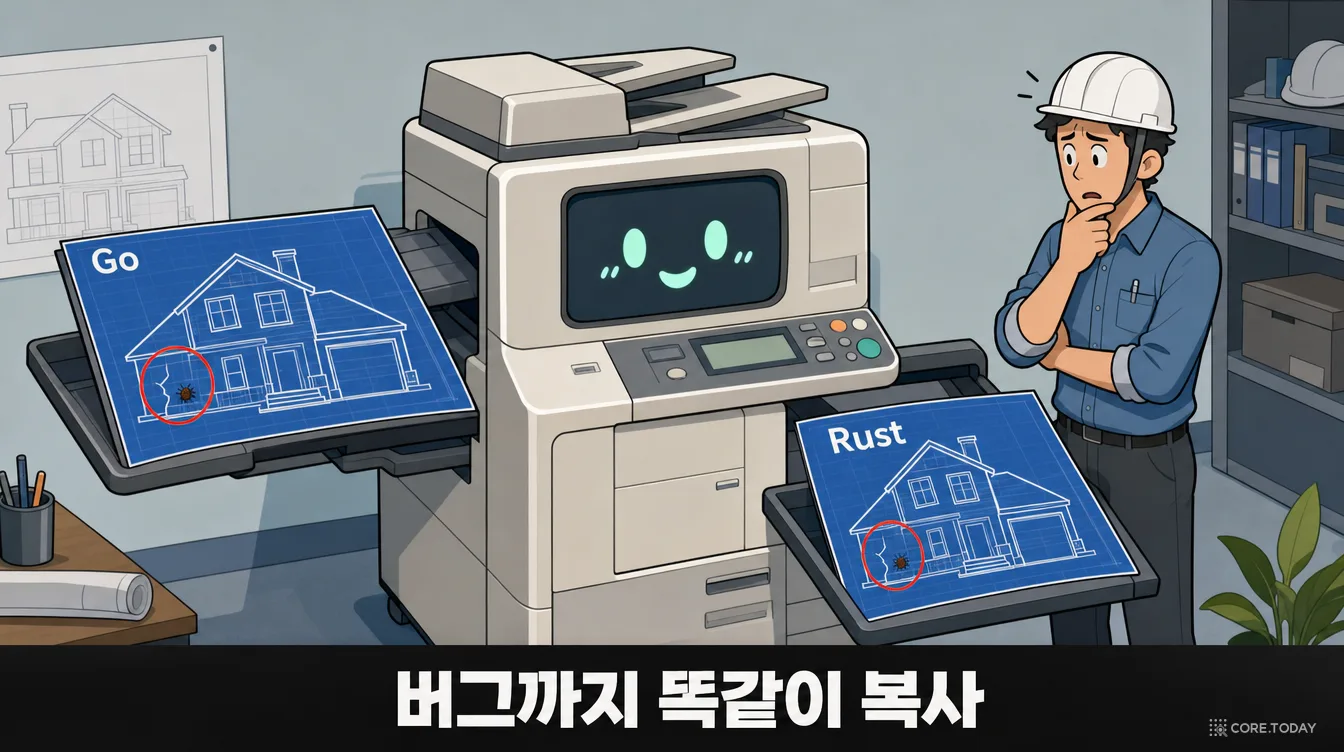
에이전트는 영역을 넘나들며 무언가를 베끼는 데 지독하게 능하다. 테오가 "밈으로" 만든 TypeScript의 Rust 포팅을 보라. Go로 된 ts-go 코드를 Rust로 옮겼다. 테오에 따르면 Opus 5.5는 Go 버전의 버그를 Rust 버전에서 정확히 그대로 재현했다. 반면 Astra(Fable의 라이벌)는 그렇게 익숙하고, 잘 알려지고, 잘 문서화된 일에서 실패했다.
이 두 단락이 이 글에서 기술적으로 가장 중요한 부분입니다. 여기서 '하네스', '체크포인트', '측정'이라는 세 단어가 나오고, 왜 같은 모델이 어떤 일에서는 경험 많은 엔지니어를 능가하고 어떤 일에서는 레딧 기능 하나도 제대로 판단하지 못하는지가 설명됩니다. 7장 전체를 이 두 단락의 해부에 씁니다.
2-7. 복사기 안의 초지능
여섯 번째 장면은 짧은 결론입니다.
올해도 끝나 가는데, 나는 여전히 '초지능'이 들어 있다는 이 복사기들이 어떻게 사람을 대체할지 모르겠다. 그것들이 한 일은 돈을 가진 사람들이 동료 인간에게 돈을 다르게 쓰도록 설득한 것이다.
마지막 문장을 천천히 읽어 볼 만합니다. "AI가 사람을 대체했다"가 아니라 "돈을 가진 사람들이 사람에게 돈을 다르게 쓰도록 설득했다". 여기서 AI의 역할은 노동자가 아니라 설득자입니다. 기술이 아니라 서사(narrative)로서의 AI. 이것이 원문 전체를 관통하는 관점이고, 6장의 데이터가 이 관점을 얼마나 지지하는지 따져 볼 겁니다.
2-8. 하루 종일 보는 화면
마지막 장면은 반전입니다. Cendyne은 새 일을 구했습니다.
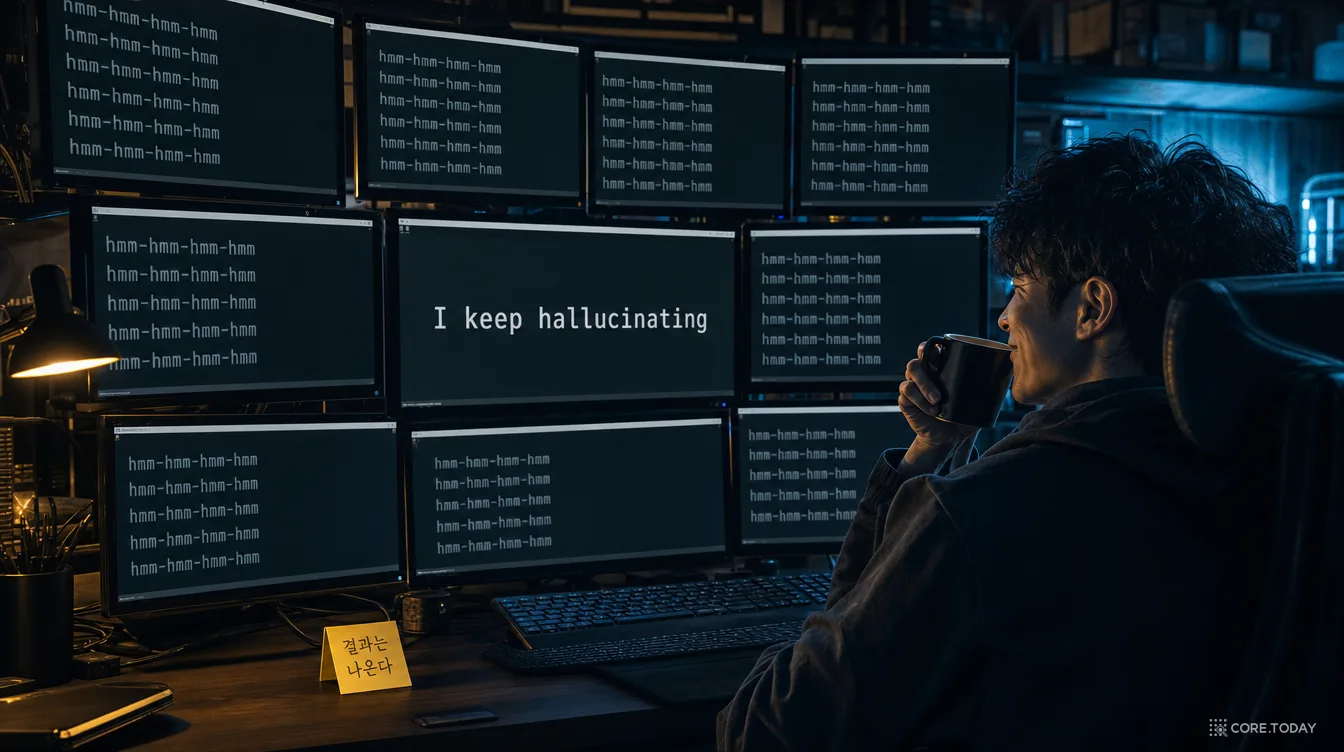
어쨌든, 나는 이제 다른 걸 하게 됐다. 하루 종일 이런 화면을 본다.
그리고 스크린숏 두 장이 붙어 있습니다. 첫 번째는 검은 터미널에 회색 글씨로 hmm-hmm-hmm-hmm-hmm-…이 화면을 가득 채운 장면입니다. 가운데쯤 한 줄에만 hmmmm이 하나 섞여 있습니다. 두 번째는 잘린 화면에 한 줄. I keep hallucinating(나는 계속 환각을 본다).
프런티어 연구소 직원들이 미쳐 가는 건 하루 종일 이걸 보고 있어서가 아닐까 싶기 시작했다.
Cendyne이 구한 새 일은, 정황상 에이전트를 돌리고 지켜보는 일입니다. 직접 코드를 쓰는 대신 에이전트가 쓰는 걸 보고, 에이전트가 반복 고리에 빠지면 꺼내 주는 일. 1983년 영국의 인지심리학자 리잔 베인브리지가 「자동화의 아이러니」에서 예언한 바로 그 역할입니다. 해커뉴스에서 한 댓글(poisonborz)은 이렇게 썼습니다. "'프로그래밍의 즐거움은 죽어 가고, 결과를 내는 즐거움은 산다.' 논쟁의 어느 편에 서든 이 문장은 맞다."
hmm-hmm-hmm이 왜 생기는지, 그리고 왜 하루 종일 그걸 보는 일이 사람을 지치게 하는지는 9장에서 논문 그림과 함께 설명합니다.
두 번째 경로의 상징적인 장면은 공교롭게도 원문에 등장하는 쇼피파이에서 나왔습니다. 2025년 4월 7일 CEO 토비 뤼트케가 사내 메모를 X에 공개했습니다.
AI를 반사적으로 쓰는 것은 이제 기본 기대치다. … 더 많은 인원과 자원을 요청하기 전에, 팀은 AI로 원하는 것을 해낼 수 없는 이유를 먼저 증명해야 한다.
이 메모는 한 회사의 정책을 넘어 2025~2026년 테크 업계의 표준 문법이 됐습니다. 핵심은 증명 책임의 역전입니다. 예전에는 "이 일에 사람이 필요하다"가 기본값이고 자동화하려면 근거가 필요했습니다. 이제는 "AI로 된다"가 기본값이고, 사람을 쓰려면 근거가 필요합니다.
같은 달 듀오링고의 루이스 폰 안 CEO는 'AI 퍼스트'를 선언하며 "AI가 처리할 수 있는 일에는 계약직을 점차 쓰지 않겠다"고 했고, 한 문장을 덧붙였습니다. "우리는 품질에서 가끔 작은 손해를 보더라도 서둘러 움직이겠다." 원문의 '슬롭 서비스의 맛'이 공식 경영 방침으로 쓰인 순간입니다.
2026년 2월 26일 블록(Block)의 잭 도시는 직원의 약 40%, 4,000명 이상을 줄이며 "AI 도구 덕분에 더 작고 평평한 팀"을 이유로 들었습니다. 다음 날 주가는 약 25% 올랐고, 도시는 "대부분의 회사는 늦었다"고 말했습니다. 시장이 이렇게 반응하면, 다른 회사 경영진에게 'AI로 사람을 줄였다'는 말은 비용 절감 이상의 의미를 갖습니다. 신호가 됩니다.
3-2. 명분 경로: 'AI 워싱'
그렇다면 'AI 때문'이라는 감원은 정말 AI 때문일까요. 흥미롭게도 가장 큰 회사들의 말이 엇갈립니다.
아마존: 2025년 6월 앤디 재시 CEO는 메모에서 "앞으로 몇 년 동안 AI가 전체 사무직 인력을 줄일 것"이라고 썼습니다. 그런데 10월 약 14,000명 감원 직후 실적 발표에서는 "실은 AI가 이유가 아니다, 적어도 지금은. 문화 때문이다"라고 말했습니다. 2026년 1월 약 16,000명이 더 나갔습니다.
마이크로소프트: 2026년 7월 약 4,800명을 줄이며 최고인사책임자가 굳이 밝혔습니다. "오늘 없어진 자리는 AI로 대체되지 않는다."
샘 올트먼: 2026년 2월 인도 AI 영향 정상회의에서 "AI 워싱이 일부 있다. 어차피 했을 감원을 AI 탓으로 돌리는 것"이라고 인정했습니다.
연구 기관들의 숫자도 같은 방향을 가리킵니다.
조사
숫자
해석
챌린저: 2025년 AI 사유 감원
54,836건, 전체의 약 4.5%
'시장·경제 상황' 사유는 약 24.5만 건(1~11월)
옥스퍼드 이코노믹스 (2026년 1월)
AI 사유는 2025년 감원의 약 4.5%
"기업들이 AI로 사람을 대규모로 대체하고 있는 것 같지는 않다." 투자자 앞에서 감원을 '좋은 소식'으로 포장한다
뉴욕 연준 (2025년 9월)
최근 6개월 AI 때문에 해고한 서비스 기업 1%
대신 AI를 쓰는 서비스 기업의 약 12%가 채용을 줄였다
예일 버짓랩 (2025년 10월, 2026년 9월 갱신)
직업 구성 변화가 인터넷 확산기보다 약 1%포인트 더 클 뿐
"AI와 관련된 노동시장 교란의 뚜렷한 증거는 없다"
챌린저: 2026년 1~9월 AI 사유
120,136건, 전체의 21%
2025년의 2배가 넘는다. 말해진 이유로서의 AI는 확실히 커졌다
뉴욕 연준의 숫자가 특히 중요합니다. 해고(1%)는 드물고, 채용 축소(12%)는 흔합니다. 이것이 네 번째 경로로 이어집니다.
3-3. 우회 경로: 자르지 않고 안 뽑는다, 혹은 옮긴다
AI가 노동시장에 남기는 가장 뚜렷한 흔적은 '해고'가 아니라 '채용하지 않음'입니다. 6장에서 볼 스탠퍼드 브리뇰프슨 팀의 2026년 갱신 연구가 정확히 이것을 보여 줍니다. AI에 많이 노출된 직업에서 22~25세 고용이 줄었는데, 그 경로는 해고 증가가 아니라 신규 채용 감소였습니다.
그리고 원문의 오프쇼어링 사례가 있습니다. AI가 덜 숙련된 사람의 생산성을 더 많이 올린다는 건 여러 연구가 확인한 사실입니다(고객 상담원 연구에서 신입이 가장 큰 폭으로 개선됐습니다). 경영자 입장에서 이 사실은 이렇게 번역될 수 있습니다. "AI를 쥐여 주면 더 싼 사람도 충분하다." 해커뉴스에서 한 댓글(voidifremoved)은 자기 회사 경영진이 "그 값이면 해외 인력에게 다섯 번을 다시 시켜도 돈이 남는다"고 했다고 전했고, 다른 댓글(torben-friis)이 답했습니다. "그래도 오프쇼어링은 안정적이기라도 했지. 지금은 다들 언제 발밑 깔개가 빠질지 기다리는 중이야."
다만 챌린저 통계에서 '아웃소싱'을 사유로 든 감원은 2026년 9월까지 557건에 불과합니다. 해외 이전은 대개 '구조조정'이나 'AI' 같은 다른 이름표를 달고 발표되기 때문에, 이 경로는 통계로 잡기가 가장 어렵습니다.
3-4. 클라르나: 비용 경로의 청구서
비용 경로가 어떻게 끝날 수 있는지를 보여 준 회사가 있습니다. 스웨덴 핀테크 클라르나는 2024년 2월 "AI 상담원이 첫 달에 230만 건, 전체 상담의 3분의 2를 처리했다. 정규직 상담원 700명분의 일"이라고 발표했습니다. 해결 시간은 11분에서 2분 미만으로, 만족도는 사람과 동등하다고 했습니다.
1년 남짓 지난 2025년 5월, 세바스티안 시미아트코프스키 CEO는 블룸버그 인터뷰에서 방향을 틀었습니다. AI는 더 쌌지만 품질이 낮았다고, 고객에게 "원하면 언제든 사람이 있다"는 걸 분명히 해야 한다고. 그리고 다시 사람 상담원을 뽑기 시작했습니다. (클라르나는 여전히 'AI 퍼스트'라고 말합니다. 포기가 아니라 재조정입니다.)
클라르나 이야기는 원문의 '선견' 논점과 정확히 겹칩니다. 비용 절감은 첫 달 장부에 바로 찍힙니다. 품질 하락은 몇 달에 걸쳐 고객 경험과 브랜드에 스며듭니다. 평가 시점이 언제냐에 따라 같은 결정이 성공도 실패도 됩니다. 앞의 리더의 계산서 위젯이 보여 준 구조 그대로입니다.
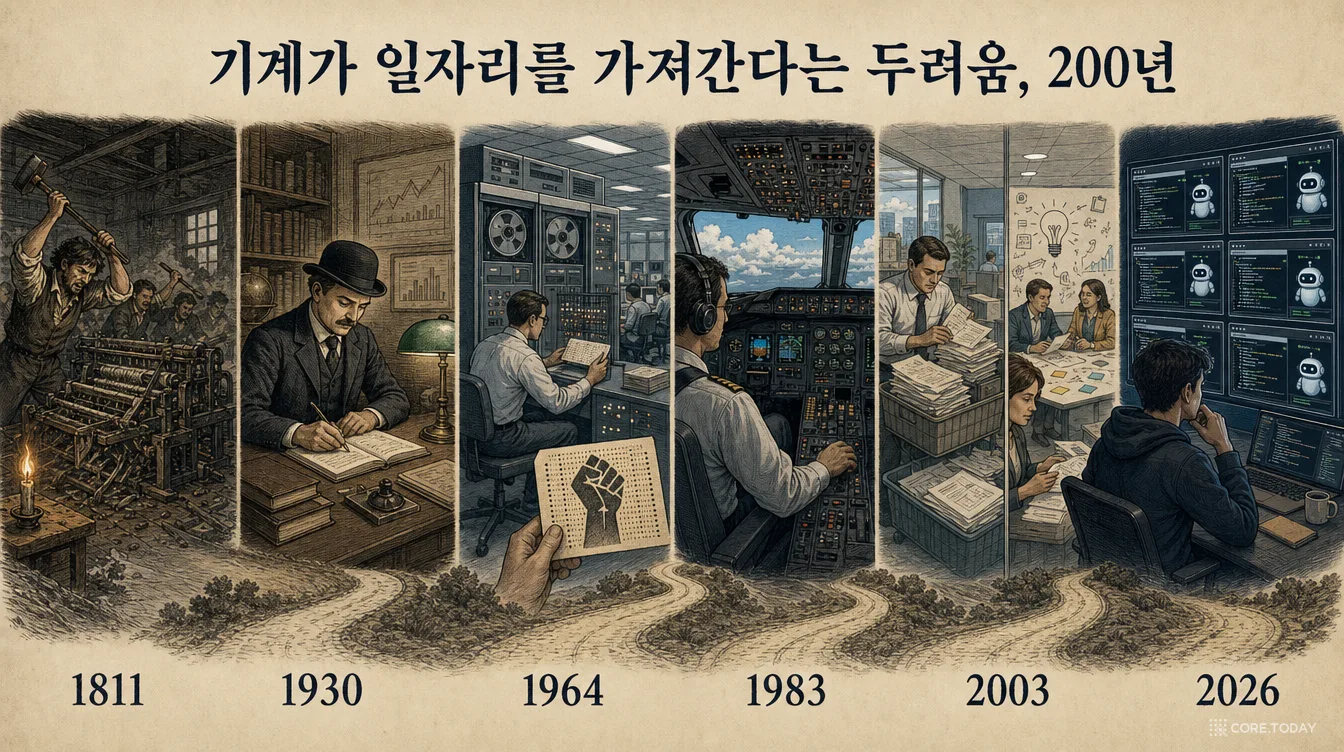
4. 역사: 기계가 일자리를 가져간다는 두려움, 200년
"AI가 내 일을 가져갔다"는 문장은 새롭지 않습니다. 기계가 일자리를 가져간다는 두려움은 산업혁명 이후 거의 모든 세대가 겪었습니다. 그런데 역사를 자세히 보면, 사람들이 정말로 화가 났던 대상은 대개 기계 자체가 아니었습니다.
'러다이트(Luddite)'는 오늘날 '신기술을 거부하는 사람'이라는 뜻으로 쓰입니다. 하지만 1811~1817년 영국 노팅엄셔, 더비셔, 레스터셔, 요크셔에서 기계를 부순 직조공들이 무엇에 항의했는지 보면 그림이 다릅니다. 러다이트 문헌을 집대성한 케빈 빈필드의 정리에 따르면 그들이 반대한 것은 이런 기계들이었습니다.
정식 7년 견습을 마치지 않은 '콜트(colt)'라 불린 미숙련 노동자가 돌리는 기계
그 기계로 임금을 깎고 질 낮은 물건을 만드는 관행. 미들랜드에서는 넓은 양말 직기로 싸구려 천을 짜서 잘라 꿰맨 '컷업' 양말이 문제였고, 요크셔에서는 손으로 다듬은 천의 품질을 따라가지 못하는 전단기가 문제였습니다.
역사학자 에릭 홉스봄은 이 기계 파괴를 "폭동을 통한 단체 교섭"이라고 불렀습니다. 기계는 표적이었지 원인이 아니었다는 뜻입니다. 영국 정부는 1812년 직기 파괴를 사형에 처할 수 있는 범죄로 만들었고, 진압에 약 1만 2천 명의 군대를 보냈습니다.
200년 전 러다이트의 불만을 2026년 언어로 옮기면 이렇습니다. "더 싼 사람에게 기계를 쥐여 주고, 더 나쁜 물건을 만들어, 우리 임금을 깎는다." Cendyne이 쓴 오프쇼어링 사례("AI 보조가 덜 열정적이고, 경험이 적고, 덜 비싼 인력의 능력을 올렸다")와 '슬롭 서비스'에 대한 불평이 놀라울 만큼 정확히 겹칩니다. 러다이트도, Cendyne도 기술이 쓰이는 방식에 화가 난 것입니다.
4-2. 1930년, 케인스: '기술적 실업'이라는 이름
경제학자 존 메이너드 케인스는 1930년 에세이 「우리 손주들의 경제적 가능성」에서 이 현상에 이름을 붙였습니다.
우리는 새로운 병에 걸렸다. 어떤 독자는 아직 이름도 못 들어 봤겠지만 앞으로 많이 듣게 될 것이다. 바로 기술적 실업(technological unemployment)이다. 노동을 아끼는 방법을 찾아내는 속도가 노동의 새 쓰임새를 찾아내는 속도를 앞지르면서 생기는 실업이다. 그러나 이것은 일시적인 부적응 단계일 뿐이다.
케인스는 낙관적이었습니다. 100년 뒤, 그러니까 2030년쯤이면 선진국의 생활 수준이 4~8배가 되고 "하루 3시간 교대, 주 15시간 노동"으로 충분할 것이라고 예측했습니다. 생활 수준 예측은 대체로 맞았고, 주 15시간 노동은 틀렸습니다. 사람들은 더 적게 일하는 대신 더 많이 소비하는 쪽을 택했습니다.
이 정의에서 눈여겨볼 단어는 '속도'입니다. 케인스는 기계가 일자리를 '없앤다'고 하지 않았습니다. 노동을 아끼는 속도가 새 쓰임새를 찾는 속도를 앞지를 때 실업이 생긴다고 했습니다. 이 '새 쓰임새'가 5장에서 볼 아제모을루의 '복귀 효과'입니다.
4-3. 1964년, 「삼중 혁명」: 거짓 경보였을까
1964년 3월 22일, 민권운동가 베이어드 러스틴, 사회비평가 마이클 해링턴 등이 서명한 공개 메모 「삼중 혁명(The Triple Revolution)」이 린든 존슨 대통령에게 전달됐습니다. 세 혁명 중 첫 번째는 '사이버네이션(cybernation)'이었습니다.
컴퓨터와 스스로 조절하는 자동 기계의 결합. 그 결과는 거의 무한한 생산 능력을 가졌으면서도 사람의 노동을 점점 덜 필요로 하는 시스템이다.
메모는 소득을 노동에 묶어 두는 기존 체계가 무너질 것이라며 "권리로서의 적정 소득", 즉 기본소득을 제안했습니다. 존슨 정부는 '기술·자동화·경제 발전 국가위원회'를 꾸렸고, 위원회는 "자동화가 현재 고용을 위협하지 않는다"고 결론 내렸습니다. 이후 10년 미국 실업률은 낮았고, 「삼중 혁명」은 '자동화 공포는 늘 거짓 경보'라는 주장의 단골 사례가 됐습니다.
하지만 같은 위원회도 보험으로서 최저소득 보장을 권고했습니다. 그리고 「삼중 혁명」의 진단, "일과 소득의 연결 고리가 끊어진다"는 문장은 60년 뒤 Cendyne의 마지막 문장과 같은 걱정입니다. "돈을 가진 사람들이 동료 인간에게 돈을 다르게 쓰도록 설득했다."
4-4. 1983년, 「자동화의 아이러니」: 남는 것은 가장 어려운 일
영국의 인지심리학자 리잔 베인브리지는 1983년 다섯 쪽짜리 논문 「자동화의 아이러니(Ironies of Automation)」를 썼습니다. 발전소와 항공기 조종석을 연구하며 발견한 역설들입니다. 이 논문은 2026년의 에이전트 시대를 위해 쓴 것처럼 읽힙니다.
아이러니 1"운영자를 없애려는 설계자도 결국 운영자에게 일을 남긴다. 설계자가 어떻게 자동화할지 생각해 내지 못한 일을." 남는 일은 가장 어렵고 드문 일이다.
아이러니 2"자동화된 공정을 감시하던 숙련 운영자는 이제 미숙련 운영자가 되어 있을 수 있다." 쓰지 않는 기술은 녹슨다.
아이러니 3"아무리 의욕 넘치는 사람도, 거의 아무 일도 일어나지 않는 정보원에 30분 넘게 효과적인 시각적 주의를 유지하는 것은 불가능하다." 감시는 사람에게 맞지 않는 일이다.
아이러니 4"지금 세대의 자동화 시스템은 예전 수동 운영자들이 감시하고 있다. 시스템은 그들의 기술에 기대어 굴러간다. 다음 세대 운영자에게는 그 기술을 기대할 수 없다."
네 번째 아이러니를 Cendyne의 회사에 대입해 봅시다. Fable이 만든 코드를 리뷰할 수 있었던 사람은 그 시스템을 직접 만들고 운영해 온 마지막 엔지니어였습니다. 그 사람이 떠나면, 에이전트의 출력을 판단할 사람이 없습니다. 3장의 첫 번째 아이러니도 그대로입니다. Cendyne의 새 일은 '에이전트가 못하는 일'을 하는 것, 그리고 하루 종일 hmm-hmm-hmm 화면을 감시하는 것입니다. 베인브리지의 세 번째 아이러니가 말하듯, 그건 사람에게 원래 맞지 않는 일입니다.
4-5. 2003년, 과업 모형의 탄생: '정해진 규칙'과 '규칙이 없는 일'
MIT의 데이비드 오터, 프랭크 레비, 리처드 머네인은 2003년 논문에서 지금 모든 AI 노동 연구의 뼈대가 된 틀을 만들었습니다. 직업을 통째로 보지 않고 과업(task) 단위로 쪼개고, 그 과업을 두 축으로 나눕니다. 정해진 규칙대로 할 수 있는가(정형, routine), 아닌가(비정형, non-routine). 그리고 머리를 쓰는가, 몸을 쓰는가.
2003년의 2×2 표
정형 과업 (규칙을 적을 수 있다)
비정형 과업 (규칙을 적기 어렵다)
분석·대인
장부 기록, 계산, 반복적인 고객 응대(은행 창구) → 컴퓨터가 상당 부분 대체
가설 세우고 검증하기, 진단, 법률 문서, 설득·판매, 사람 관리 → 컴퓨터와 강한 보완
육체
분류·집기, 반복 조립 → 상당 부분 대체
청소, 트럭 운전 → 대체 여지 제한적
이 논문은 1970~1998년 미국에서 정형 인지 과업 투입이 8.7백분위 떨어지고 비정형 대인 과업이 11.5백분위 오른 것을 보여 주며, 대졸자 수요 증가의 60%를 이 틀로 설명했습니다.
2026년의 반전은 이 표의 경계선이 움직였다는 것입니다. LLM은 '규칙을 적을 수 있는' 인지 과업을 넘어, 코드를 쓰는 일까지 해냅니다. 그런데 오른쪽 위 칸, '가설 세우기, 진단, 설득, 사람 관리'에는 여전히 약합니다. Cendyne이 말한 취향과 선견이 바로 이 칸에 있습니다.
2014년 오터는 이 경계선에 철학자 마이클 폴라니의 이름을 붙였습니다. 폴라니의 역설: "우리는 말할 수 있는 것보다 더 많이 안다. 운전자의 기술은 자동차 이론을 철저히 배운다고 대체되지 않는다." 규칙으로 적을 수 없는 암묵지는 컴퓨터에게 가르칠 수 없다는 뜻이었습니다. 오터는 같은 글에서 이렇게 예견했습니다. "오늘날의 컴퓨터 과학은 사람의 예시로부터 배우는 기계를 만들어 폴라니의 역설을 넘어서려 한다." 10년 뒤 그 예견은 LLM으로 실현됐습니다. 그리고 남은 질문은, 예시로도 배울 수 없는 것이 무엇이냐는 것입니다. 7장의 답은 '검증할 수 없는 것'입니다.
4-6. 2023~2026년: 코딩이 가장 많이 노출된 기술이 되다
2023년 OpenAI와 펜실베이니아대 연구진의 「GPTs are GPTs」는 미국 직업의 모든 과업을 사람과 GPT-4에게 평가시켰습니다. "LLM이 같은 품질로 이 과업 시간을 절반 이상 줄일 수 있는가?" 결과는 미국 노동자의 약 80%가 업무의 10% 이상, 약 19%가 업무의 절반 이상에서 영향을 받는다는 것이었습니다.
이 논문의 표 5가 이 글에 특히 중요합니다. 어떤 기술이 AI 노출과 가장 강하게 연결되는지 회귀분석한 결과입니다.
프로그래밍
+0.637
글쓰기
+0.368
과학
−0.114
비판적 사고
−0.264
막대 길이는 계수의 크기(절댓값)를 프로그래밍 0.637 기준으로 나타낸 것입니다. 빨강·주황은 노출을 높이는 기술, 초록은 오히려 낮추는 기술입니다. 코드를 쓰는 기술이 가장 많이 노출되고, 판단하는 기술은 가장 적게 노출됩니다. 3년 뒤 Cendyne이 쓴 문장, "모델은 경험 많은 엔지니어를 대체하지 못한다. 취향과 선견이 없다"는 이 회귀계수를 말로 풀어 쓴 것과 같습니다. 문제는 회사가 엔지니어를 '코드 쓰는 사람'으로만 볼 때 생깁니다.
5. 경제학 아키텍처: 과업 모형과 '그저 그런 자동화'
이제 이 글의 경제학적 엔진을 해부할 차례입니다. MIT의 다론 아제모을루(2024년 노벨 경제학상)와 파스쿠알 레스트레포가 2019년 『경제 전망 저널(JEP)』에 쓴 「자동화와 새 과업: 기술은 어떻게 노동을 밀어내고 되돌려 놓는가」입니다.
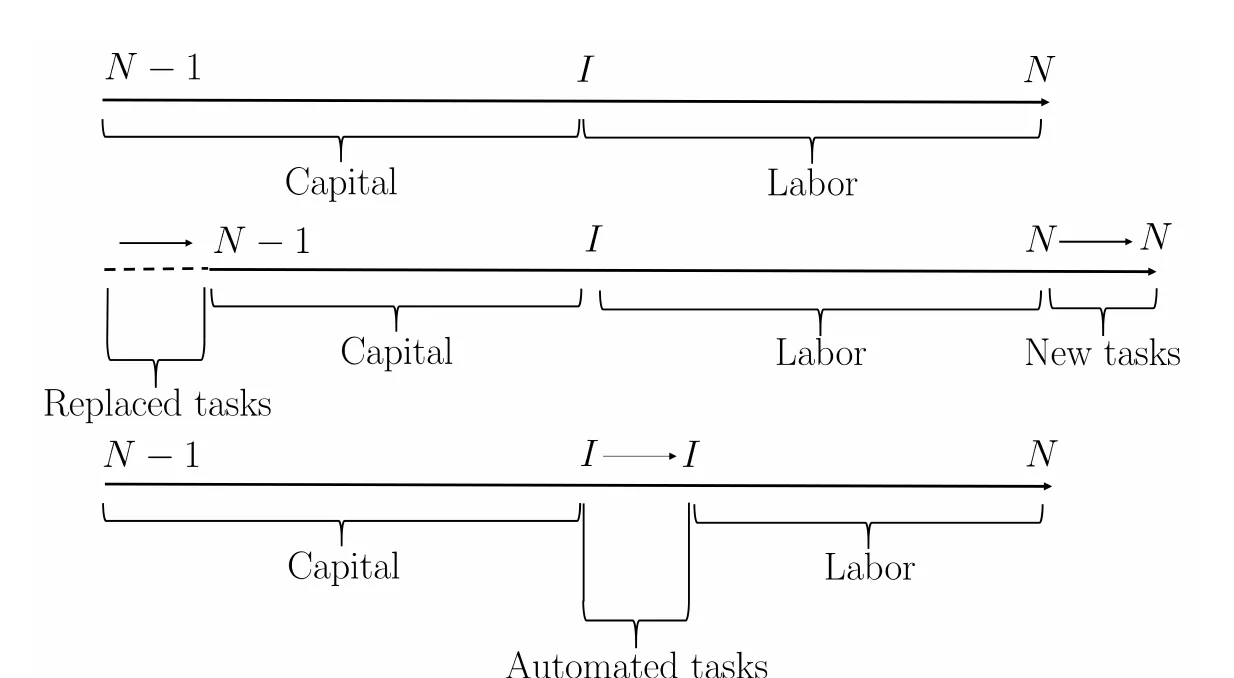
이 그림은 경제 전체의 일을 한 줄로 늘어놓은 줄자로 봅니다. 왼쪽 끝(N−1)은 가장 오래된 과업, 오른쪽 끝(N)은 가장 새로운 과업입니다. 줄자 위의 점 I가 경계선입니다.
위 줄: I 왼쪽 과업은 기계(자본)가, 오른쪽 과업은 사람(노동)이 합니다. 오래된 과업일수록 기계가 하기 쉽다는 가정입니다.
아래 줄 (자동화): 기술이 발전하면 경계 I가 오른쪽으로 밀립니다(I → I). 원래 사람이 하던 과업 일부가 '자동화된 과업'이 되어 기계 쪽으로 넘어갑니다. 이것이 대체 효과입니다.
가운데 줄 (새 과업): 동시에 줄자의 오른쪽 끝 N이 더 오른쪽으로 늘어납니다(N → N). 이전에 없던 과업이 생기고, 새 과업은 처음엔 사람이 더 잘합니다. 왼쪽 끝에서는 아주 오래된 과업이 사라집니다('대체된 과업'). 이것이 복귀 효과입니다.
이 그림이 말하는 것은 단순합니다. 자동화(I가 오른쪽으로)만 일어나면 사람의 몫은 계속 줄어듭니다. 사람의 몫이 유지되려면 새 과업(N이 오른쪽으로)이 같은 속도로 생겨야 합니다. 케인스가 말한 '새 쓰임새를 찾는 속도'를 수식으로 만든 셈입니다.
5-2. 세 힘의 줄다리기
아제모을루와 레스트레포는 기술 변화가 노동 수요에 미치는 영향을 세 효과로 나눕니다.
대체 효과 (−) 기계가 사람의 과업을 가져간다
+
생산성 효과 (+) 값이 싸져 생산이 늘고, 남은 과업에서 사람이 더 필요하다
+
복귀 효과 (+) 새 과업이 사람에게 돌아온다
↓
= 사람에 대한 수요의 변화
여기서 두 번째, 생산성 효과의 크기가 핵심입니다. 논문은 이렇게 씁니다. "자동화의 생산성 효과는 그 대체로 얻은 비용 절감에 비례한다." 기계가 사람보다 압도적으로 싸고 잘하면, 물건값이 크게 떨어지고 수요가 늘어 사람이 다른 곳에서 더 필요해집니다. 그런데 기계가 사람보다 아주 조금만 싸다면?
5-3. '그저 그런 기술(so-so technologies)'
논문의 가장 유명한 문장은 이것입니다.
고용과 임금을 위협하는 것은 '탁월한' 자동화 기술이 아니라, 생산성을 조금밖에 올리지 못하는 '그저 그런 기술'이다.
이유는 위의 비례식에 있습니다. 그저 그런 기술은 사람을 대체할 만큼은 싸지만(대체 효과는 그대로), 생산성 효과를 일으킬 만큼 싸지는 않습니다. 결과는 사람은 밀려나는데 사회 전체가 얻는 것은 거의 없는 상황입니다. 논문이 든 예가 의미심장합니다.
자동화된 고객 서비스. 사람 상담원을 대체했지만 일반적으로 품질이 낮다고 여겨진다. … 인공지능 기술의 여러 응용도 여기에 포함될 수 있다.
2019년에 쓴 이 문장은 2024년 클라르나, 그리고 2026년 Cendyne의 회사를 예언한 것처럼 보입니다. "Fable이 내 일을 더 잘해서가 아니라, 내 연봉보다 쌌다." 이것은 그저 그런 자동화의 정의 그 자체입니다. 물론 Fable이 '그저 그런 기술'이라는 뜻은 아닙니다. 같은 모델이 어떤 일(포팅, 이관)에서는 탁월한 자동화이고, 다른 일(마지막 엔지니어의 역할 전체)에서는 그저 그런 자동화일 수 있습니다. 같은 도구를 어느 과업에 대느냐가 결과를 가릅니다.
아래 위젯에서 세 힘을 직접 움직여 보세요. '그저 그런 자동화' 프리셋과 '탁월한 자동화' 프리셋을 번갈아 누르면, 비용 절감률(π) 하나가 결과를 어떻게 뒤집는지 보입니다.
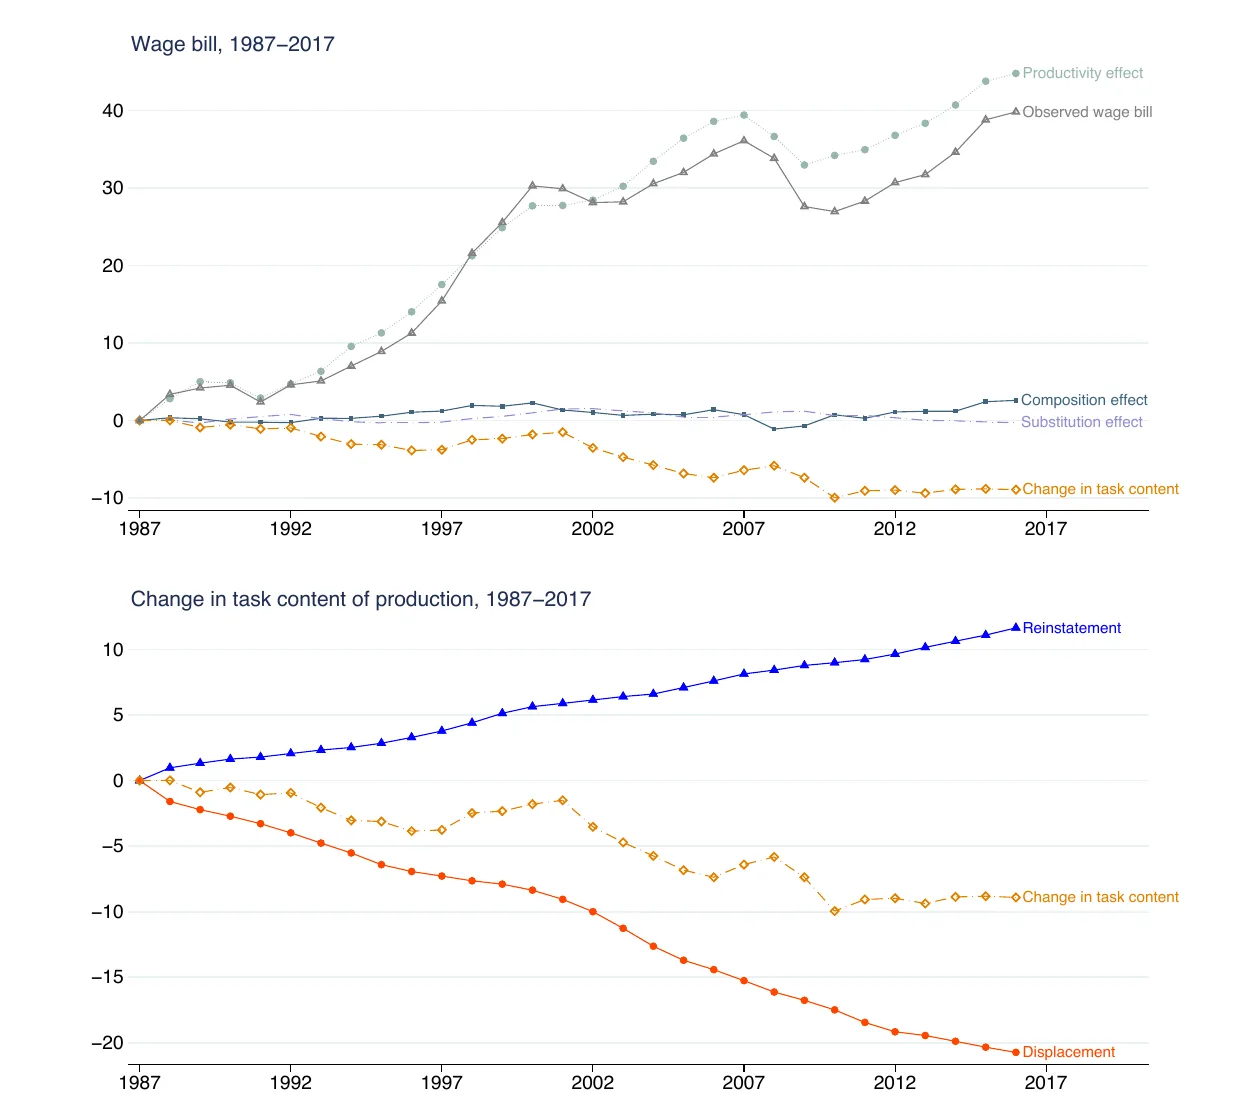
위 패널의 회색 삼각형 선은 실제로 관측된 1인당 임금 총액, 즉 '노동 수요'입니다. 1987년을 0으로 놓고 30년 동안 약 40% 늘었습니다.
연두색 점선은 생산성 효과만 있었다면 노동 수요가 어디까지 갔을지를 보여 줍니다. 약 45%로 회색 선보다 높습니다.
두 선의 간격을 벌린 범인이 주황색 마름모 선, '과업 구성 변화'입니다. 2000년대 이후 꾸준히 내려가 −10% 근처에 있습니다. 생산성이 오른 만큼 사람에 대한 수요가 따라 오르지 못했다는 뜻입니다.
아래 패널은 그 주황색 선을 두 갈래로 쪼갭니다. 파란 선(복귀)은 꾸준히 올라 30년 동안 약 +11%, 빨간 선(대체)은 더 가파르게 내려가 약 −21%. 둘을 더한 것이 주황색 선(약 −10%)입니다.
논문은 이것을 1947~1987년과 비교합니다.
연평균
1947~1987
1987~2017
생산성 효과
+2.4%
+1.54%
대체 효과
−0.48%
−0.70%
복귀 효과
+0.47%
+0.35%
과업 구성 순변화
≈ 0 (대체와 복귀가 상쇄)
−0.35%/년, 누적 약 −10%
제조업 대체 효과
—
약 −1.1%/년, 누적 약 −30%
전후 40년 동안은 자동화가 많았지만 새 과업이 같은 속도로 생겨 균형이 맞았습니다. 1987년 이후에는 대체가 빨라지고 복귀가 느려졌습니다. 아제모을루가 AI에 대해 경고하는 이유가 여기 있습니다. AI가 기존 과업을 대체하는 데만 쓰이고 새 과업을 만드는 데 쓰이지 않으면, 1987년 이후의 추세가 더 가팔라질 것이라는 걱정입니다.
5-5. 거시 계산: 10년 동안 총요소생산성 0.66%
아제모을루는 2024년 「AI의 단순한 거시경제학」에서 이 틀로 AI의 경제 효과를 직접 계산했습니다. 계산 사슬은 이렇습니다.
100%미국 경제의 모든 과업(임금 가중)
20%그중 AI에 노출된 과업 (「GPTs are GPTs」 기준)
4.6%노출된 과업 중 10년 안에 자동화가 수익이 나는 23% → 전체의 4.6%
× 27%그 과업에서의 평균 인건비 절감 (실험 연구들의 평균)
≤ 0.66%10년 동안 총요소생산성 증가의 상한. 연 0.064%. GDP로는 10년간 약 0.93~1.16%
AI 기업들이 말하는 '수십 퍼센트 성장'과는 거리가 먼 숫자입니다. 이 계산이 맞다면, AI가 일으킬 거시 효과는 대체로 그저 그런 자동화 쪽에 가깝습니다. 물론 반론도 많습니다. 이 계산은 2023년 수준의 모델과 노출 추정을 썼고, METR의 시간 지평이 4개월마다 두 배가 되는 2026년의 에이전트를 반영하지 못합니다. 하지만 이 계산의 구조는 Cendyne의 사례를 이해하는 데 그대로 쓸 수 있습니다. 노출된 과업의 비중 × 그 과업에서의 비용 절감. 마지막 엔지니어의 경우 비용 절감은 컸지만(연봉 전체), 그 사람이 하던 과업 중 Fable이 실제로 대신할 수 있는 비중은 작았습니다.
5-6. 제번스의 반론: 코드가 싸지면 소프트웨어 수요가 폭발한다
공정하려면 반대편 이야기도 들어야 합니다. 1865년 윌리엄 스탠리 제번스는 증기기관이 석탄을 더 효율적으로 쓰게 되자 석탄 소비가 오히려 늘어나는 것을 관찰했습니다. 효율이 오르면 값이 내리고, 값이 내리면 예전엔 엄두도 못 내던 곳에서 쓰기 시작하기 때문입니다. 2025년 1월 딥시크 R1 충격 때 마이크로소프트의 사티아 나델라가 "제번스의 역설이 또 왔다"고 쓴 것도 같은 논리입니다.
경제학자 제임스 베슨은 이 논리를 일자리에 적용했습니다. 19세기 직물 산업에서 역직기는 천 한 마드를 짜는 데 드는 노동의 98%를 자동화했는데, 공장 직조공 일자리는 오히려 늘었습니다. 천값이 내리자 천 수요가 폭발했기 때문입니다. ATM이 생긴 뒤에도 도시 은행 지점당 창구 직원은 20명에서 13명으로 줄었지만, 지점 수가 43% 늘었습니다. 다만 베슨은 수요가 포화하면(더 이상 값에 민감하지 않으면) 같은 생산성 향상이 일자리를 줄인다는 점도 보였습니다.
소프트웨어는 어느 쪽일까요. 미국 노동통계국(BLS)의 2025~2035년 전망이 흥미로운 힌트를 줍니다.
직업 (BLS 분류)
2025년 일자리
2025~35년 전망
소프트웨어 개발자·QA·테스터
1,905,400
+10% (평균보다 훨씬 빠름)
컴퓨터 프로그래머
110,800
−7% ("프로그래밍 작업은 계속 자동화되고 있다")
코드를 쓰는 과업은 자동화되고 있고, 무엇을 만들지 정하는 역할에 대한 수요는 늘고 있다는 전망입니다. 이것이 과업 모형의 언어로 본 2026년입니다. 직업은 사라지지 않지만, 직업을 이루는 과업의 구성이 바뀝니다. 문제는 그 전환이 같은 사람 안에서 일어나느냐, 아니면 한 사람을 내보내고 다른 사람을 뽑는 식으로 일어나느냐입니다. Cendyne의 경우는 후자였습니다.
또 하나의 관점이 있습니다. 필리프 아기옹, 벤저민 존스, 찰스 존스는 2017년 논문에서 보몰의 '비용 질병'을 AI에 적용해 이렇게 썼습니다. "성장은 우리가 잘하는 것이 아니라, 필수적이지만 개선하기 어려운 것에 의해 제약될 수 있다." 코드가 거의 공짜가 되면, 병목과 가격은 여전히 희소한 것으로 옮겨 갑니다. 판단, 취향, 선견, 책임. 원문이 말한 '취향 있는 리더'의 값은 이론적으로는 올라가야 합니다. 그런데 실제로 그 사람이 해고되는 이유를 다음 장의 데이터에서 찾아봅시다.
6. 증거: 2026년의 데이터는 무엇을 말하는가
6-1. 탄광 속 카나리아, 2026년 갱신판
2025년 8월 스탠퍼드 디지털경제연구소의 에릭 브리뇰프슨, 바랏 찬다르, 루유 천은 미국 최대 급여 대행사 ADP의 수백만 명 급여 데이터로 「탄광 속 카나리아? AI가 고용에 미친 최근 영향에 관한 여섯 가지 사실」을 발표했습니다. 탄광의 카나리아는 유독가스에 가장 먼저 쓰러지는 새입니다. 젊은 노동자가 그 카나리아라는 뜻이었습니다. 2026년 8월, 이들은 2026년 6월까지의 데이터로 140쪽짜리 갱신판을 냈습니다.
여섯 가지 사실 (2026년 8월판)
내용
① 경제 전반의 대체는 없다
ADP 표본 전체 고용은 2022년 11월~2026년 6월 +6%, 가장 노출된 5분위도 +4%
② 젊은 층만 벌어진다
AI 노출 직업의 22~25세 고용은 덜 노출된 동년배와 같은 속도로 늘었을 경우보다 19% 낮다. 경력자에게는 그런 격차가 없다
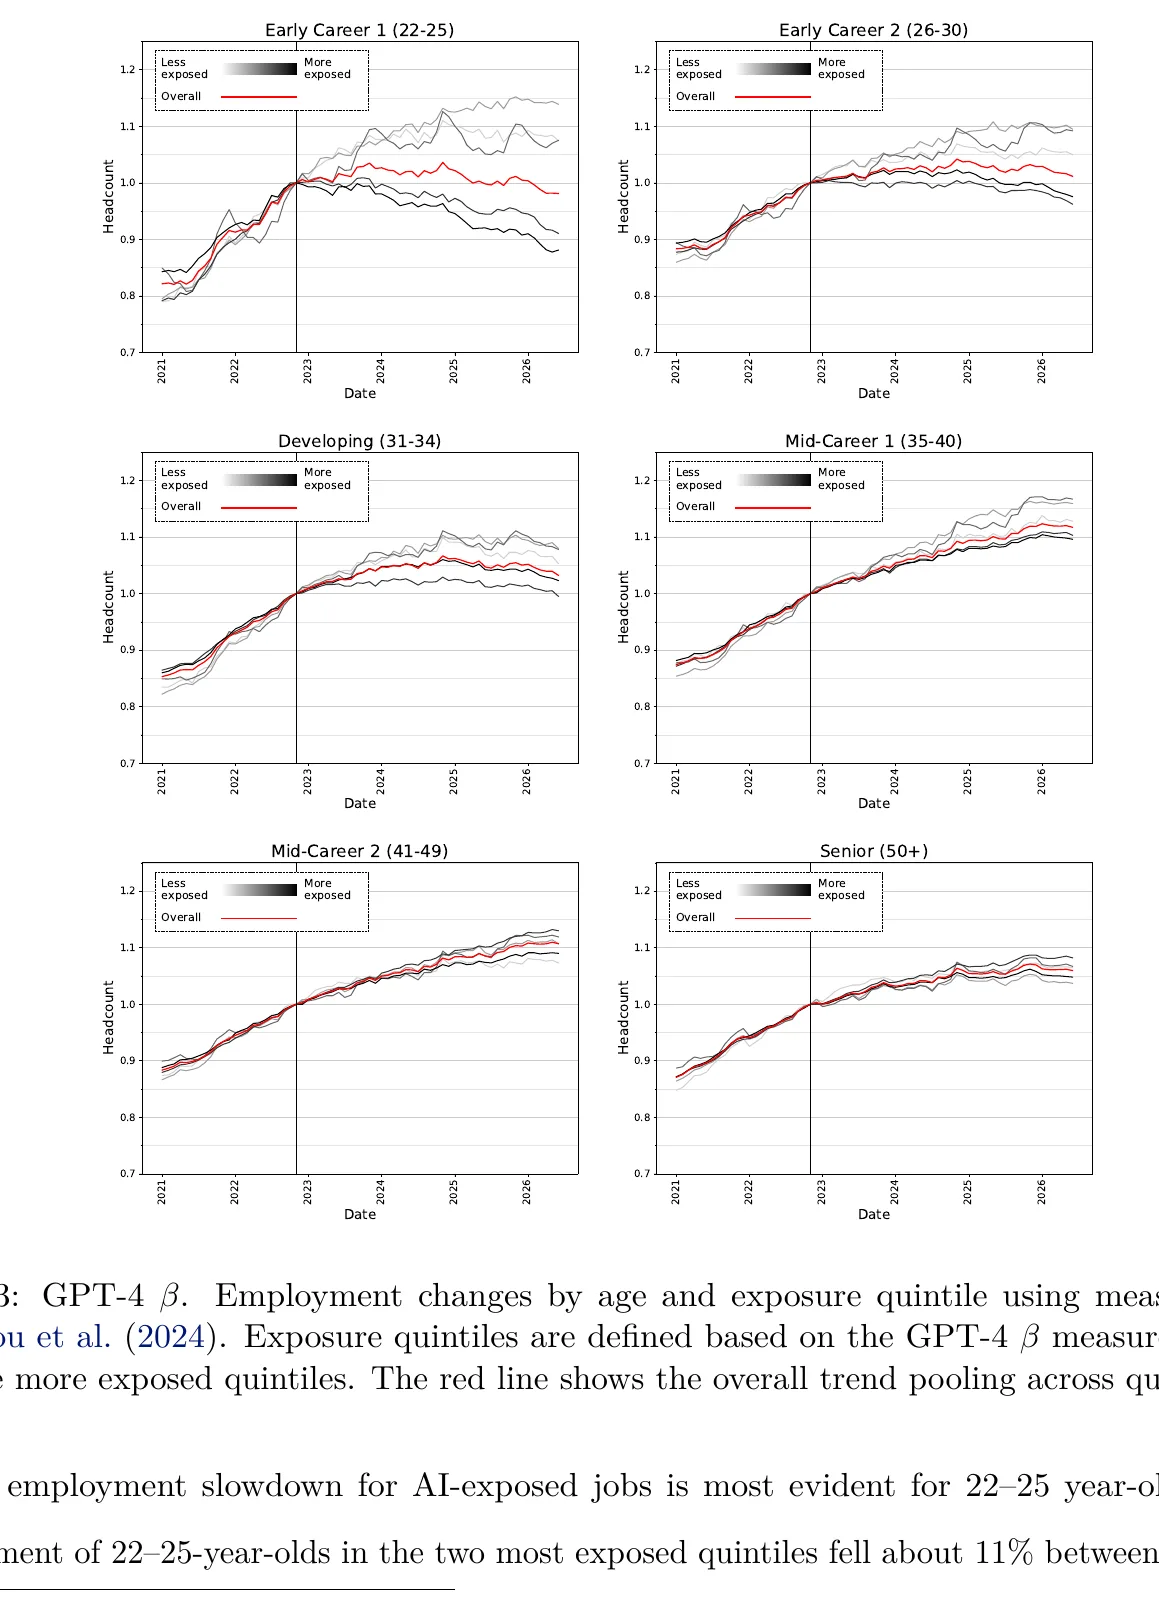
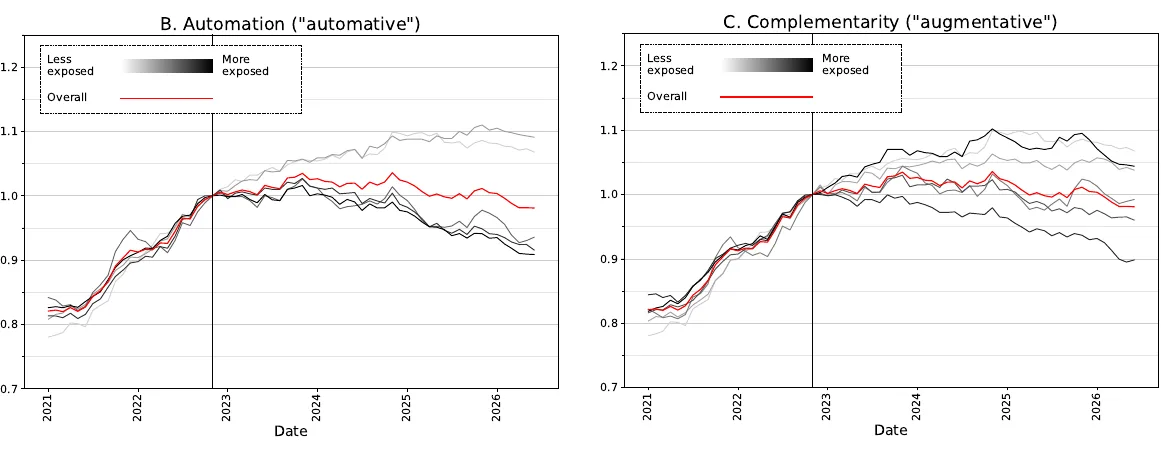
이 그림은 여섯 개의 작은 그래프로 이뤄져 있습니다. 각 그래프는 한 연령대이고, 그 안의 선 다섯 개는 AI 노출도에 따라 직업을 다섯 묶음으로 나눈 것입니다. 연한 회색이 가장 덜 노출된 직업, 검정에 가까울수록 가장 많이 노출된 직업입니다. 세로선은 ChatGPT가 나온 2022년 11월이고, 그 시점을 1로 맞췄습니다.
왼쪽 위(22~25세)만 선이 부채꼴로 벌어집니다. 세로선 이후 연한 선은 1.1 근처로 올라가고, 진한 선은 0.9 아래로 내려갑니다. 나머지 다섯 그래프에서는 다섯 선이 거의 한 덩어리로 움직입니다. 숫자로 말하면, 22~25세 중 가장 노출된 두 5분위의 고용은 2022년 11월부터 2026년 6월까지 약 11% 줄었고, 가장 덜 노출된 세 5분위는 약 10% 늘었습니다.
논문은 이 현상의 메커니즘을 이렇게 추정합니다.
AI는 역사적으로 신입 채용을 정당화하던 검사 가능하고(checkable) 절차 중심적인 과업을 자동화하는 한편, 경험 많은 직원의 지렛대를 키우고 있을지 모른다.
'검사 가능한(checkable)'. 이 단어를 기억해 두세요. 7장에서 Cendyne이 말한 '측정하고 체크포인트를 둘 수 있는 일'과 정확히 같은 단어로 돌아옵니다.
6-2. 대체형과 보완형: 같은 AI, 다른 결과
카나리아 논문의 다섯 번째 사실은 Anthropic의 경제 지수(Claude 대화 수백만 건을 직업별 과업에 대응시킨 데이터)를 써서 '대체형 사용'과 '보완형 사용'을 나눠 봅니다.
왼쪽 그래프(대체형)에서는 진한 선들, 즉 AI가 사람 대신 일을 해 주는 비중이 큰 직업들이 2024년 이후 0.9 근처까지 내려갑니다. 오른쪽 그래프(보완형)에서는 가장 진한 선, 즉 AI가 사람을 돕는 비중이 가장 큰 직업이 오히려 1.1 근처까지 올라 가장 빠르게 늘어난 축에 속합니다. 논문은 "보완형 노출 순서대로 줄지 않는다"고 씁니다.
같은 AI라도 사람 대신 일을 끝내 주는 방식으로 쓰이는 직업에서는 젊은 사람의 자리가 줄고, 사람이 더 잘하게 돕는 방식으로 쓰이는 직업에서는 그렇지 않다는 뜻입니다. 회사가 AI를 어떻게 쓰기로 하느냐가 고용 결과를 가릅니다. 이것이 '한몫했다'의 데이터 버전입니다.
저자들은 신중합니다. 결과를 "인과 추정이 아니라 초기의 서술적 지표"라고 부르고, 교육 수준을 통제하면 효과가 줄어든다는 것, 일부 추세는 생성형 AI 이전부터 있었다는 것, 2022년 미국 세법 174조 개정(소프트웨어 개발비를 즉시 비용 처리하지 못하게 바꾼 것)이 기술 직군 채용을 억눌렀을 수 있다는 대안 설명도 함께 적었습니다. 이 마지막 대안 설명은 그 자체로 '한몫했다'의 좋은 예입니다. 같은 시기 신입 채용 감소에는 세금, 금리, 팬데믹 과잉 채용의 되돌림, 그리고 AI가 함께 얽혀 있습니다.
6-3. 반대편 증거: 덴마크와 예일
모든 연구가 같은 그림을 보여 주지는 않습니다.
덴마크 (흄룸·베스테르고르): 회계사, 고객 지원, 소프트웨어 개발자 등 AI에 노출된 11개 직업, 7,000개 사업장의 25,000명을 행정 기록과 연결했습니다. 2025년 원판의 제목은 「대형 언어 모델, 작은 노동시장 효과」. 소득과 근로시간에 대한 효과가 1%보다 크다는 가능성을 배제할 수 있었습니다. 2026년 3월 갱신판(「고요한 수면, 빠른 물살」)은 이 범위를 2%로 넓혔고, 덴마크에서도 노출 직업의 젊은 층 고용 감소를 재현했지만 "그 감소는 AI 챗봇을 도입한 회사들이 일으킨 것이 아니다"라고 결론 내렸습니다.
예일 버짓랩: 미국 인구조사(CPS)로 직업 구성이 얼마나 빨리 바뀌는지를 PC 보급기(1984~89), 인터넷 확산기(1996~2002)와 비교했습니다. ChatGPT 이후의 변화 속도는 인터넷 시기보다 약 1%포인트 더 클 뿐이고, 그 변화도 2021년, 생성형 AI 이전부터 시작돼 있었습니다. 2026년 9월 갱신에서도 "AI와 관련된 노동시장 교란의 뚜렷한 증거는 없다"는 결론을 유지했습니다.
두 그림을 어떻게 맞출까요. 하나의 해석은 이렇습니다. 경제 전체로는 아직 큰 변화가 없다. 그러나 특정 칸, 즉 'AI에 많이 노출됐고, AI가 대신 해 주는 방식으로 쓰이는 직업의 신입'에서는 변화가 뚜렷하다. 평균은 조용하고, 가장자리는 시끄럽습니다. Cendyne의 사례는 그 가장자리에서도 특이한 위치에 있습니다. 신입이 아니라 마지막 엔지니어였으니까요.
6-4. 개발자의 체감: 19% 느려졌는데 20% 빨라졌다고 느꼈다
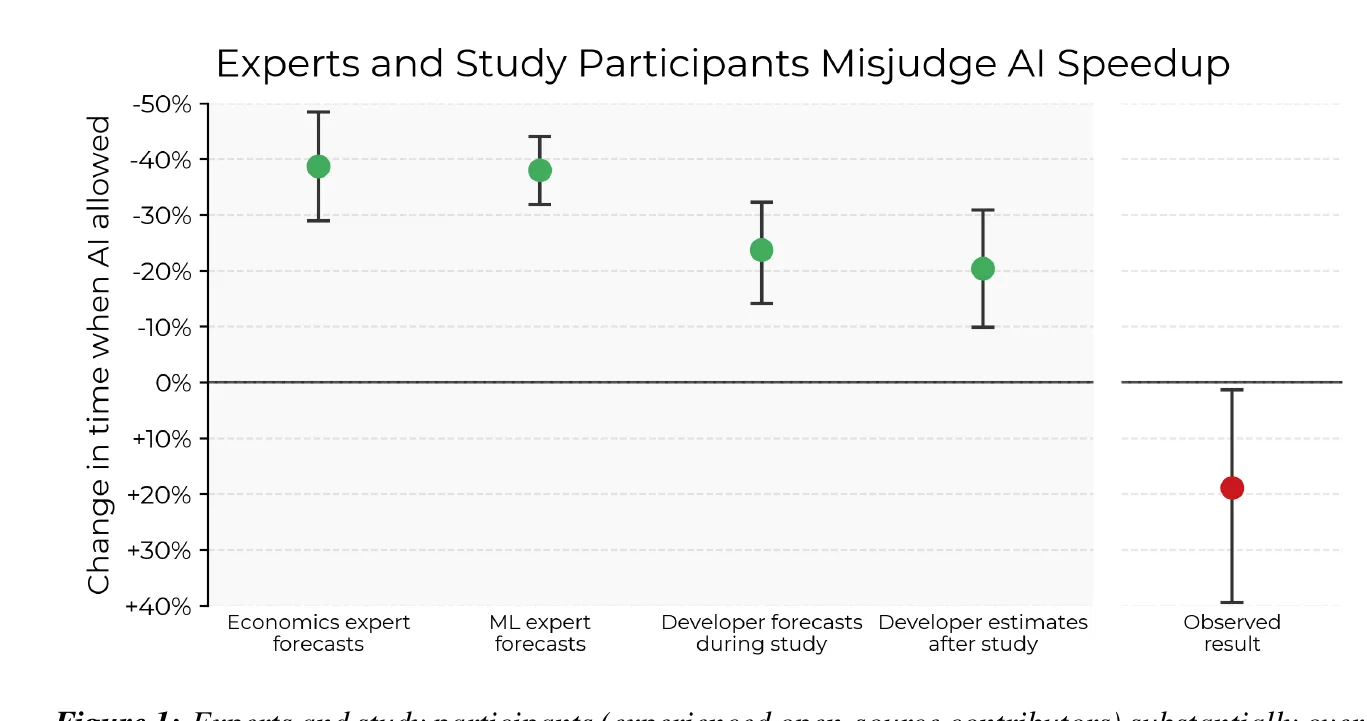
'모델이 경험 많은 엔지니어를 대체할 만큼 좋은가'에 대한 가장 유명한 실험도 있습니다. 2025년 7월 METR은 자기 저장소에서 평균 5년을 일한 숙련 오픈소스 개발자 16명에게 실제 이슈 246개를 맡기고, 이슈마다 AI 사용 허용·금지를 무작위로 정했습니다.
그래프의 세로축은 'AI를 허용했을 때 과업 시간 변화'입니다. 위로 갈수록(마이너스) 빨라진 것이고, 아래로 갈수록(플러스) 느려진 것입니다. 초록 점 네 개는 모두 위쪽입니다. 경제학자와 ML 전문가는 38~39% 빨라질 것이라 예측했고, 개발자들은 시작 전 24%, 끝난 뒤에도 20% 빨라졌다고 느꼈습니다. 오른쪽의 빨간 점이 실제 결과입니다. 19% 느려졌습니다.
원인 분석에서 개발자들은 AI가 만든 코드의 44% 미만만 받아들였고, 저장소를 잘 알수록, 저장소가 크고 복잡할수록 AI의 도움이 줄었습니다. 저장소를 깊이 아는 사람에게는 AI의 출력을 검토하고 고치는 비용이 직접 쓰는 비용보다 컸던 겁니다. 폴라니의 역설이 숫자로 나타난 장면입니다.
같은 해 8월 METR의 후속 분석은 더 날카롭습니다. Claude 3.7 Sonnet 에이전트가 실제 이슈 18개에 낸 PR은 유지보수자의 테스트 기준으로 38%가 통과했지만, 사람이 리뷰해 보니 "그대로 병합할 수 있는 것은 하나도 없었다." 문서, 린트, 테스트 커버리지, 코드 품질이 부족했습니다. 테스트를 통과하는 것과 받아들일 만한 것 사이의 간격, 이것이 숫자로 본 '취향'의 간격입니다.
(공정을 위해 덧붙이면, 이 실험은 2025년 초 모델 기준입니다. METR은 2025년 하반기에 더 큰 후속 실험을 했지만, 많은 개발자가 AI 없이 일하기를 거부하는 바람에 신뢰할 만한 추정치를 내지 못했다고 밝혔습니다. 실험이 불가능해졌다는 것 자체가 하나의 결과입니다. 2026년의 에이전트로 같은 실험을 하면 결과는 다를 가능성이 큽니다.)
6-5. 숫자로 본 2026년의 감원
이제 원문이 쓰인 2026년의 감원 통계를 직접 봅시다. 미국 재취업 컨설팅 회사 챌린저, 그레이 앤 크리스마스는 매달 기업들이 발표한 감원 계획을 사유별로 집계하는데, 2023년부터 '인공지능'을 별도 사유로 셉니다.
그래프의 모양이 많은 걸 말해 줍니다. 3월부터 7월까지 다섯 달 연속 AI가 감원 사유 1위였고, 5월에는 그달 감원의 40%가 AI를 이유로 들었습니다. 그런데 8월부터 급격히 꺾여, 9월에는 5위(약 9%)로 내려갔습니다. 몇 가지 해석이 가능합니다. 상반기에 대형 테크 기업들의 'AI 구조조정'이 몰렸다가 일단락됐을 수도 있고, 'AI 때문'이라는 말이 여론의 역풍을 맞기 시작했을 수도 있습니다(마이크로소프트가 7월에 굳이 "AI로 대체하지 않는다"고 밝힌 것처럼). Cendyne의 해고는 그 정점에서 내려오는 7월 말에 있었습니다.
6-6. 한국: '연공편향 기술 변화'와 인재 파이프라인
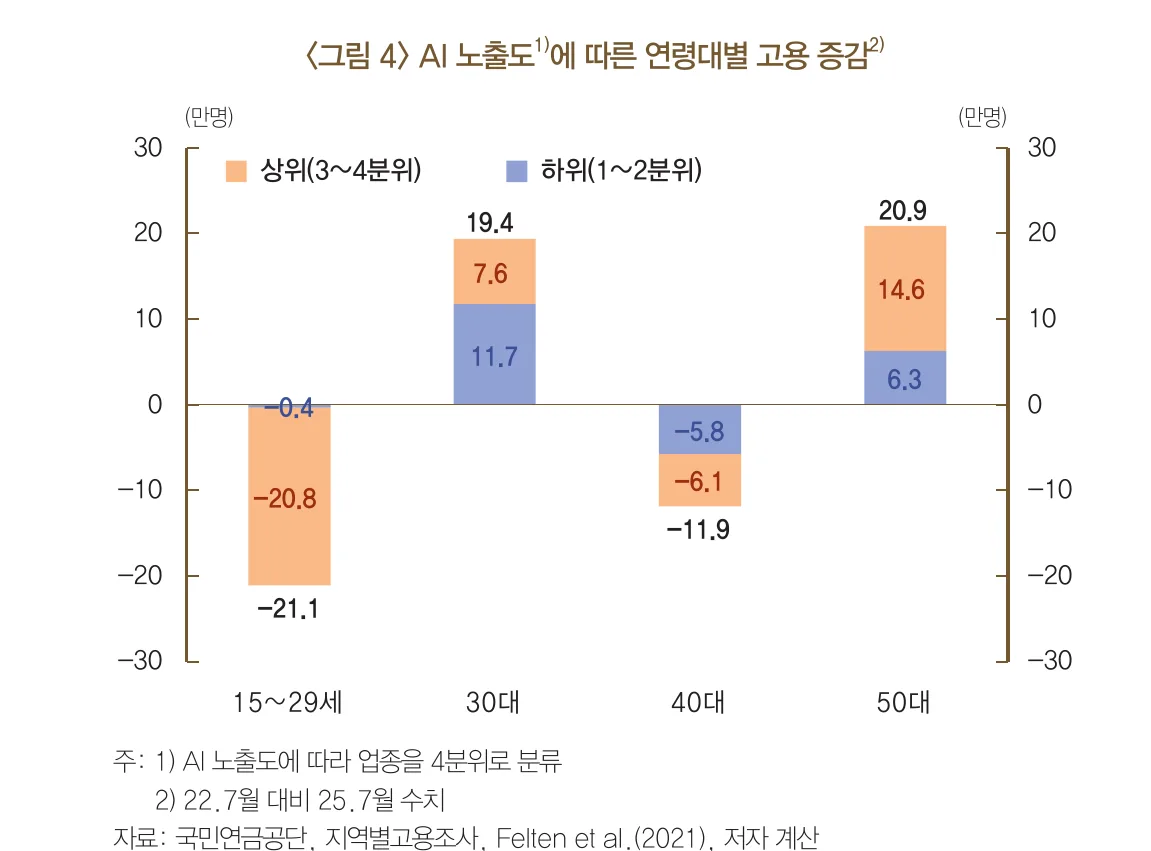
한국의 데이터도 같은 모양을 보여 줍니다. 한국은행 조사국 고용연구팀(한진수·오삼일)은 2025년 10월 이슈노트 「AI 확산과 청년고용 위축: 연공편향 기술변화를 중심으로」에서 국민연금 가입자 1,616만 명(임금근로자의 71.8%)의 업종·연령별 자료를 분석했습니다.
막대 하나가 한 연령대이고, 주황은 AI 노출 상위 업종(3~4분위), 파랑은 하위 업종(1~2분위)의 일자리 증감입니다. 3년 동안 청년(15~29세) 일자리는 21.1만 개 줄었고, 그중 20.8만 개(98.6%)가 AI 노출 상위 업종에서 줄었습니다. 같은 기간 50대 일자리는 20.9만 개 늘었는데, 그중 14.6만 개가 역시 AI 노출 상위 업종에서 늘었습니다. 같은 업종 안에서 젊은 사람은 줄고 나이 든 사람은 늘었습니다. 보고서는 이것을 '연공편향(seniority-biased) 기술 변화'라고 부릅니다. AI가 경험 많은 사람을 보완하고 신입의 일을 대체한다는 뜻입니다.
세부 업종에서는 더 뚜렷합니다. ChatGPT 이후 청년 고용이 컴퓨터 프로그래밍·시스템 통합 및 관리업에서 11.2%, 출판업 20.4%, 정보 서비스업 23.8% 줄었습니다. 2026년 8월 후속 이슈노트(오삼일·오영식, 「청년고용 위축, AI 탓인가?」)는 기간을 2026년 6월까지 늘려 청년 일자리 28.5만 개 감소 중 94%가 AI 고노출 업종에서 일어났다고 보고했고, 카나리아 논문처럼 '자동화' 비중이 큰 업종에서 청년 감소가 컸고 '증강' 비중이 큰 업종에서는 그렇지 않았다고 밝혔습니다.
그런데 한국은행은 신중합니다. 신규 채용 중 청년 비중은 "ChatGPT가 등장하기 전부터 이미 하락하고 있었다"며, 팬데믹 이후 정상화, 경력직 선호, 원격 근무 같은 요인이 섞여 있어 "AI만의 인과적 영향을 따로 떼어 내기는 어렵다"고 씁니다. 그리고 경고합니다.
많은 기업이 동시에 같은 선택을 하면 장래의 숙련 인력 공급이 부족해지는 '인재 파이프라인 문제'가 발생할 수 있다.
이것은 국가 경제 규모로 본 베인브리지의 네 번째 아이러니입니다. 지금 시스템은 경험 많은 사람의 기술에 기대어 굴러갑니다. 다음 세대는 그 기술을 기를 기회를 얻지 못합니다. 이 보고서는 각주에서 아제모을루의 '그저 그런 자동화'를 인용하며, 세제가 장비·소프트웨어 투자에 유리하면 이런 자동화가 과도하게 도입될 수 있다고도 지적합니다.
채용 공고에서도 흔적이 보입니다. 기업 정보 플랫폼 캐치의 집계(한경비즈니스, 2025년 12월)에 따르면 2025년 1~11월 대기업 정규직 신입 공고는 전년 같은 기간보다 43% 줄었고, IT·통신 분야는 899건에서 293건으로 67% 줄었습니다. (공고 감소의 원인을 AI로 단정할 수는 없습니다. 기사의 해석입니다.)
7. 기술 아키텍처: '하네스'와 '체크포인트'를 해부한다
이제 원문에서 기술적으로 가장 중요한 두 단락으로 돌아갑니다.
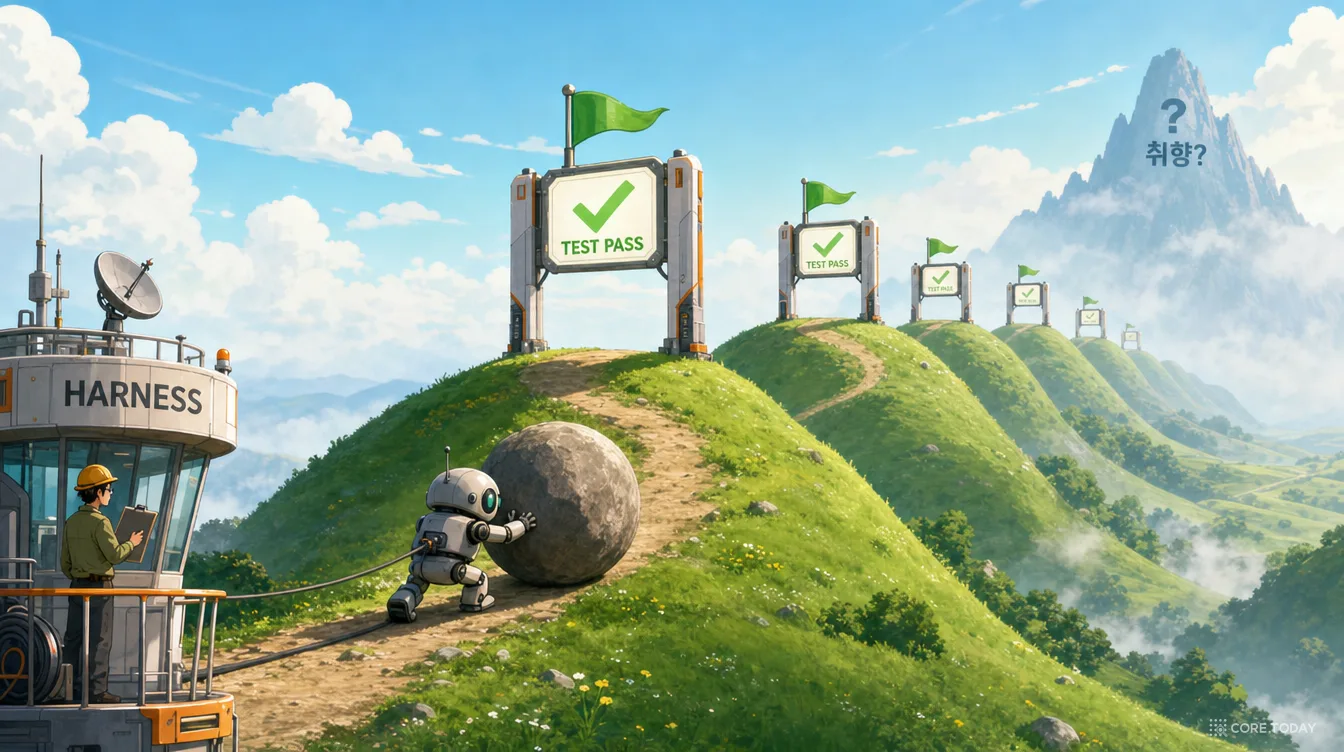
모델은 정교하게 만든 하네스로 한 걸음씩 몰아가면, 사람들이 A/B 테스트로 닳도록 다듬어 놓은 동작을 재현하고 옮길 수 있을 만큼 좋아지고 있다. 돌을 언덕 위로 밀어 올릴 수 있다. 그다음 언덕도. 기법을 측정하고 체크포인트를 둘 수 있을 때는.
이 문장 하나에 2025~2026년 AI 엔지니어링이 배운 가장 중요한 교훈이 압축돼 있습니다. 에이전트가 무엇을 해낼 수 있는지는 모델의 지능만으로 정해지지 않습니다. 모델을 감싸는 구조, 그리고 그 구조가 '정답'을 판정할 수 있는가가 정합니다. 하나씩 풀어 보겠습니다.
'하네스(harness)'는 원래 말에게 씌우는 마구, 또는 등반가의 안전벨트를 뜻합니다. 소프트웨어에서는 오래전부터 '테스트 하네스'처럼 무언가를 감싸서 실행하고 검사하는 틀을 가리켰습니다. 2025년 9월 Anthropic은 Claude Code SDK의 이름을 Claude Agent SDK로 바꾸며 이것을 "Claude Code를 움직이는 에이전트 하네스"라고 불렀고, 이후 이 단어가 업계 표준 용어가 됐습니다. 2026년 4월 마틴 파울러 사이트에 실린 비르기타 뵈켈러(Thoughtworks)의 글은 이렇게 정리합니다.
에이전트 = 모델 + 하네스. 하네스는 모델을 뺀 전부다.
모델을 뺀 전부란 무엇일까요. 뵈켈러는 하네스의 장치를 두 종류로 나눕니다.
종류
계산적 (결정론적, 빠름)
추론적 (AI가 판단, 느리고 흔들림)
가이드 (행동 전에 방향을 잡아 줌)
코드 템플릿, 타입 정의, 프로젝트 규칙 파일
계획 단계의 지시문, 설계 문서, 예시
센서 (행동 후에 관찰하고 바로잡음)
테스트, 린터, 타입 검사기, 빌드
AI 코드 리뷰, LLM 판정관
Claude Agent SDK 발표문은 에이전트의 기본 고리를 "맥락 수집 → 행동 → 작업 검증 → 반복"이라고 쓰고, 검증 방법에 순위를 매깁니다. 가장 좋은 피드백은 "출력에 대한 명확한 규칙을 주고, 어느 규칙이 왜 어겼는지 설명하는 것"이고, 린트는 "훌륭한 규칙 기반 피드백"이며, LLM을 판정관으로 쓰는 것은 "일반적으로 그다지 견고한 방법이 아니다". 하네스의 힘은 대부분 계산적 센서, 즉 기계가 의심의 여지 없이 판정할 수 있는 검사에서 나온다는 뜻입니다.
7-2. 긴 일을 위한 하네스: 체크포인트는 어떻게 생겼나
2025년 11월 Anthropic 엔지니어링 블로그의 「오래 일하는 에이전트를 위한 효과적인 하네스」는 '체크포인트'가 실제로 어떻게 생겼는지 보여 줍니다. claude.ai 같은 웹앱을 처음부터 만드는 실험에서, 에이전트 혼자 두면 네 가지 방식으로 실패했습니다.
✕
혼자 둔 에이전트의 네 가지 실패
① 전체를 너무 일찍 "다 했다"고 선언한다. ② 버그나 기록되지 않은 진행 상황을 남긴다. ③ 기능을 너무 일찍 "완료"로 표시한다. ④ 앱을 어떻게 실행하는지 알아내느라 시간을 버린다.
⚙
하네스가 준 체크포인트
200개 넘는 기능 목록을 JSON으로 주고 처음엔 전부 '실패'로 둔다. 에이전트는 'passes' 필드만 바꿀 수 있다("테스트를 지우거나 고치는 것은 용납되지 않는다"). 진행 기록 파일, 실행 스크립트, 그리고 의미 있는 메시지를 단 git 커밋으로 언제든 마지막으로 성공한 상태로 돌아갈 수 있게 한다.
✓
결과
한 번에 기능 하나씩, 테스트를 통과해야만 완료. 단위 테스트와 curl만으로는 놓친 버그를, 브라우저 자동화로 "사람처럼" 테스트하게 하자 성능이 "극적으로" 좋아졌다.
JSON을 쓴 이유가 재미있습니다. 마크다운보다 모델이 함부로 고쳐 쓸 가능성이 낮아서였습니다. 체크포인트는 에이전트를 돕는 장치이면서, 동시에 에이전트가 스스로를 속이지 못하게 막는 장치입니다.
2026년 3월 후속 글은 한 걸음 더 나아가 에이전트를 셋으로 나눴습니다. 짧은 요청을 전체 명세로 바꾸는 계획자, 앱을 만드는 생성자, 그리고 Playwright로 실행 중인 앱을 직접 테스트하고 기준표로 채점하는 평가자. 평가자를 따로 둔 이유는 생성 에이전트가 자기 작업을 "자신 있게 칭찬하는" 경향이 있어서였습니다. 대가도 있었습니다. 혼자 돌리면 20분에 9달러였던 작업이, 전체 하네스로는 6시간에 200달러가 들었습니다. 하네스는 공짜가 아닙니다.
7-3. 사례 ①: 쇼피파이 Helix, "기존 앱이 곧 명세다"
이제 원문이 언급한 쇼피파이로 가 봅시다. 2026년 9월 10일 쇼피파이 엔지니어링 디렉터 무스타파 알리는 「네이티브가 이제 쇼피파이 모바일의 미래다」를 발표했습니다(해커뉴스 1,275점, 댓글 957개). 2020년 React Native를 택했던 같은 회사가, 같은 저자의 2025년 1월 글("React Native의 미래는 밝다")을 뒤집은 결정이었습니다.
LLM이 2020년 결정의 핵심 가정 하나를 바꿨다. 네이티브는 여전히 두 플랫폼에서 소프트웨어를 만들고 유지한다는 뜻이고, 그 비용은 사라지지 않았다. 바뀐 것은, 이제 에이전트가 구현·번역·테스트·리뷰 작업의 충분한 부분을 해낼 수 있어서 그 비용이 더 이상 결정적인 요인이 아니라는 점이다.
그런데 쇼피파이는 "LLM에게 React Native 코드를 주고 한 번에 옮기게 하는 것"은 실패한다고 분명히 씁니다. "유지할 수 없는 코드가 산더미처럼 생겨 출시할 수 없다." 그래서 만든 것이 Helix입니다.
엔지니어가 화면 하나를 지정
→
Helix가 React Native 코드를 읽고 작은 체크포인트 순서를 제안 (엔지니어가 몇 분 안에 승인)
↓ 체크포인트마다 네 개의 관문
① 테스트로 동작 증명 (하위 에이전트가 기존 코드에서 테스트 생성)
→
② 화면 비교 (Gemini가 "완벽주의 디자인 리뷰어"로 차이를 모두 나열)
→
③ 적대적 코드 리뷰어 둘 (둘 다 승인할 때까지 반복)
→
④ 엔지니어의 승인 → 커밋 → 다음 체크포인트
Helix 해설 글의 핵심 문장은 이것입니다. "기준 앱이 곧 명세다(The reference is the spec)." 따로 명세서를 쓸 필요가 없습니다. 이미 수백만 명이 쓰고 있는 React Native 앱이 정답지입니다. 화면은 스크린숏으로, 동작은 분석 이벤트의 이름·횟수·필드로 비교합니다(Tardis라는 도구가 두 앱의 이벤트를 나란히 포착합니다). Cendyne의 표현, "사람들이 A/B 테스트로 닳도록 다듬어 놓은 동작을 재현한다"가 정확히 이것입니다. 몇 년 동안 사람이 실험하고 다듬은 결과물이 오라클(정답을 알려 주는 존재)이 된 것입니다.
결과는 인상적이었습니다. Shop 앱은 엔지니어 한 명이 일주일 동안 개념 증명을 만들고, 핵심 인원 6명이 12주 만에 앱 스토어에 냈습니다. 크래시가 나는 세션은 10분의 1로 줄었고(99.5%+ → 99.95%+), 안드로이드 콜드 스타트는 4,433ms에서 2,233ms로 절반이 됐습니다. 그리고 쇼피파이는 정직하게 덧붙였습니다. "네이티브 전문성은 여전히 필수였다. 생성된 코드는 기능 요구를 만족하면서도 중복, 아키텍처 표류, 성능 문제를 들여올 수 있었다."
7-4. 사례 ②: 테오의 ts-rust, 버그까지 복사한 이유
원문의 두 번째 사례는 유튜버이자 개발자인 테오 브라운(Theo)이 10월 7일 공개한 ts-rust입니다. 마이크로소프트가 Go로 다시 쓴 TypeScript 7 컴파일러(typescript-go)를 통째로 Rust로 옮긴 실험입니다. README의 동기 목록 마지막 줄이 "밈(Memes)"이라, Cendyne은 이것을 "밈으로 만든 포팅"이라고 불렀습니다.
그리고 Cendyne이 인용한 대목. 공개 당일 테오는 이렇게 썼습니다. "tsc-rs에 지금까지 이슈가 5개 올라왔다. 그중 4개는 우리가 포팅한 공식 TypeScript 원본의 문제다. 이 포팅은 너무 충실해서 '이슈'의 대부분이 실제 TypeScript 동작을 정확히 재현한 것이다." 실제로 저장소의 이슈 목록에는 upstream issue 라벨이 붙은 것이 많습니다.
왜 버그까지 복사했을까요. 우연이 아닙니다. 저장소의 PORTING.md가 약 70개 에이전트에게 준 규칙에 답이 있습니다.
이 크레이트는 고정된 typescript-go 버전을 한 줄 한 줄 옮긴 것이다. 약 70개의 에이전트가 서로 다른 Go 범위를 동시에 옮긴다. 아무도 다른 파일을 볼 수 없다. … 맡은 범위의 모든 Go 함수를 Go의 순서대로, Go의 논리를 그대로 옮겨라. 단순화하지도, 합치지도, '개선'하지도 마라. 동작은 진단 메시지 순서와 타입 생성 순서까지 Go와 정확히 같아야 한다. 추측한 값을 절대 반환하지 마라.
오라클이 "Go와 같은 출력"이면, Go의 버그를 충실히 재현하는 것이 정답입니다. 에이전트는 시킨 일을 정확히 한 것입니다. 여기서 원문의 '복사기' 비유가 나옵니다. 에이전트는 정답지가 있는 일을 지독하게 잘 복사합니다. 그런데 '이 버그를 고칠 것인가, 원본과의 호환을 지킬 것인가'를 정하는 일은 복사의 영역 밖입니다. 그건 취향과 선견의 영역입니다. 테오는 이 결정을 규칙 파일에 미리 적어 둠으로써 사람의 몫으로 처리했습니다.
README에는 이런 문장도 있습니다. "참고로, 나는 이 코드를 한 줄도 읽지 않았다." 4장의 베인브리지가 떠오르는 대목입니다.
7-5. 사례 표: 정답지가 있었던 대규모 이관들
원문이 든 두 사례만이 아닙니다. 2024~2026년 공개된 대규모 에이전트 작업들은 거의 예외 없이 같은 구조를 가집니다. 기존 구현이나 테스트가 오라클 역할을 했다.
사례
규모·결과
오라클 (정답지)
구글: JUnit3 → JUnit4 (2024)
5,359개 파일, 14.9만 줄을 3개월에. AI 코드의 약 87%가 수정 없이 커밋
변경 파일 빌드 + 단위 테스트
구글: 광고 시스템 int32 → int64 ID
최종 변경의 80%가 AI 작성, 전체 시간 약 50% 절감
빌드·테스트 검증기, 실패 시 오류를 넣어 재시도
에어비앤비: Enzyme → React Testing Library
약 3,500개 테스트 파일. 사람 추정 1.5년 → 6주. 첫 4시간에 75%
파일별 상태 기계: 리팩터 → Jest 통과 → 린트·타입 통과
아마존: Java 8/11 → 17 업그레이드 (2024)
앱당 50 개발자·일 → 몇 시간. "4,500 개발자·년" 절감 주장
컴파일 + 테스트
Anthropic 칼리니: C 컴파일러 (2026-02)
에이전트 16개, 약 2,000세션, 약 2만 달러, Rust 10만 줄. 리눅스 6.9 커널 빌드
GCC 토처 테스트, GCC 자체를 참조 컴파일러로 쓴 차분 테스트
쇼피파이 Shop 앱 (2026-09)
6명·12주, 크래시 세션 1/10
기존 React Native 앱의 화면·이벤트
테오 ts-rust (2026-10)
2주·약 2.4만 달러, 테스트 18만여 개 통과
Go 구현과 그 테스트
사이먼 윌리슨: JustHTML 포팅 (2025-12)
4.5시간, 9,000줄, 약 29달러
html5lib 테스트 9,200개
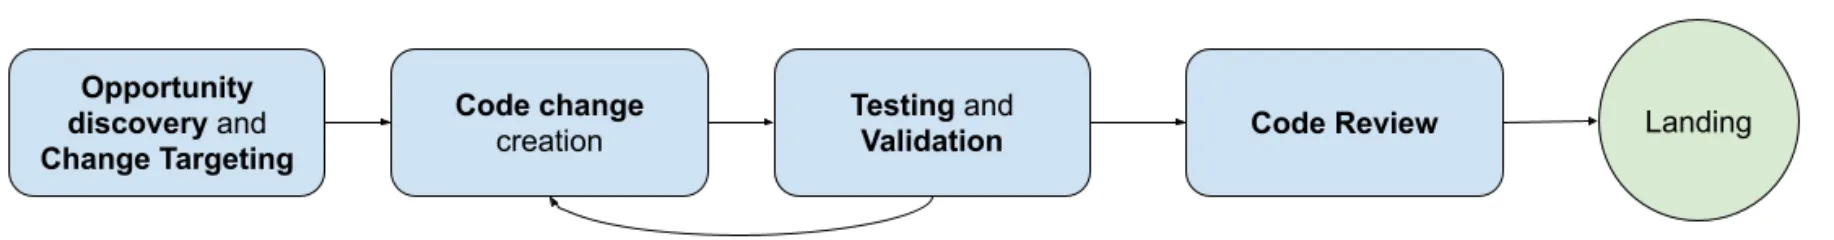
구글 논문(「구글은 사내 코드 이관에 AI를 어떻게 쓰는가」, 2025)의 그림 4는 이 구조를 한 줄로 보여 줍니다.
가운데 '코드 변경 생성'과 '테스트·검증' 사이에 되돌아가는 화살표가 있습니다. 이것이 하네스의 심장입니다. 생성이 틀리면 검증이 잡아내고, 오류 메시지를 들고 다시 생성으로 돌아갑니다. 논문은 이렇게 씁니다. "단순 프롬프트로 LLM만 쓰는 것은 가장 단순한 이관 말고는 충분하지 않다." 그리고 "LLM은 첫 시도를 보완하는, 잘 정의된 문제를 고치는 데 매우 능하다." 마지막 단계 '코드 리뷰'에 사람이 있습니다. 논문이 꼽은 병목은 모델이 아니라 사람의 리뷰였습니다. "리뷰어를 압도하지 않으려고 매주 만드는 변경 수를 일부러 제한했다."
칼리니의 C 컴파일러 글에는 이 모든 것을 요약하는 문장이 있습니다.
과제 검증기가 거의 완벽해야 한다. 그렇지 않으면 Claude는 엉뚱한 문제를 풀 것이다.
그리고 경고도 있습니다. "자율 시스템에서는 테스트가 통과하는 걸 보고 일이 끝났다고 생각하기 쉽다. 그런 경우는 드물다." 앞의 하네스 위젯에서 '검사가 놓친 오류'가 바로 이것입니다.
7-6. 왜 검증 가능성이 경계선인가: 검증자의 법칙
이 사례들이 공통으로 가리키는 원리를 OpenAI 출신 연구자 제이슨 웨이는 2025년 7월 '검증자의 법칙(Verifier's law)'이라는 이름으로 정리했습니다.
AI를 훈련시켜 어떤 과제를 풀게 하기 쉬운 정도는, 그 과제를 검증하기 쉬운 정도에 비례한다.
웨이는 검증하기 쉬운 과제의 다섯 가지 성질을 꼽습니다. 객관적 정답이 있다, 빨리 검증된다, 대량으로 검증할 수 있다, 잡음이 적다, 점수가 연속적이다. 스도쿠는 풀기는 어려워도 맞았는지는 바로 압니다. 인스타그램을 만드는 데는 몇 년이 걸려도 웹사이트가 제대로 돌아가는지는 누구나 금방 확인합니다. 반대로 에세이의 사실 확인은 쓰는 것보다 오래 걸릴 수 있습니다.
4개월 뒤 안드레이 카파시는 이것을 더 짧게 썼습니다.
소프트웨어 1.0은 명세할 수 있는 것을 쉽게 자동화한다. 소프트웨어 2.0은 검증할 수 있는 것을 쉽게 자동화한다.
카파시에 따르면 검증 가능한 환경은 세 가지 조건을 갖춥니다. 처음 상태로 되돌릴 수 있고(resettable), 많이 반복해 볼 수 있으며(efficient), 보상을 매길 수 있다(rewardable). 그리고 "이것이 LLM 발전의 들쭉날쭉한(jagged) 경계를 만든다"고 했습니다. 수학, 코드, 퍼즐처럼 검증 가능한 영역은 빠르게 나아가고, 창의성·전략·상식처럼 검증하기 어려운 영역은 뒤처집니다.
이 원리는 모델 훈련에서 먼저 확인됐습니다. 2024년 말 앨런 AI 연구소의 Tülu 3는 사람의 선호를 흉내 내는 보상 모델 대신 검증 함수(정답 일치 여부, 제약 충족 여부)로 보상을 주는 방식을 '검증 가능한 보상을 쓰는 강화학습(RLVR)'이라고 이름 붙였습니다. 2025년 1월 딥시크 R1은 이 방식만으로 수학 경시대회(AIME 2024) 정답률을 15.6%에서 70%대로 끌어올렸습니다. 딥시크 연구진은 신경망 보상 모델을 일부러 쓰지 않았습니다. 대규모 강화학습에서 모델이 보상 모델의 허점을 파고드는 '보상 해킹'에 취약하기 때문이었습니다.
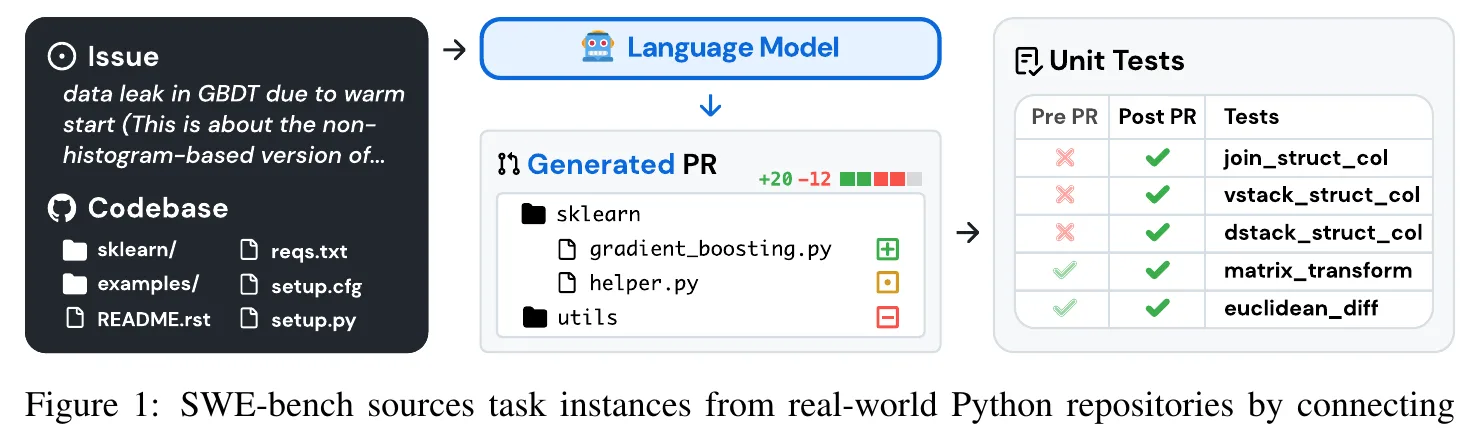
오른쪽 표가 핵심입니다. 위 세 줄은 수정 전에 빨간 ✕, 수정 후에 초록 ✓인 테스트입니다('실패→통과' 테스트). 아래 두 줄은 수정 전후 모두 통과해야 하는 테스트입니다(고치다가 다른 걸 망가뜨리지 않았는지). 모델이 이 표를 모두 초록으로 만들면 이슈를 해결한 것으로 칩니다. 2023년 발표 당시 최고 모델(Claude 2)은 2,294개 과제 중 1.96%만 풀었습니다. 정답지가 있으니 진보를 잴 수 있었고, 잴 수 있으니 진보가 빨랐습니다. 다만 이 벤치마크조차 테스트 자체가 틀린 경우가 많아 OpenAI가 사람이 다시 검증한 500문항짜리 'SWE-bench Verified'를 따로 만들어야 했습니다. 오라클도 검증해야 합니다.
7-7. 얼마나 긴 일을 맡길 수 있나: METR의 시간 지평
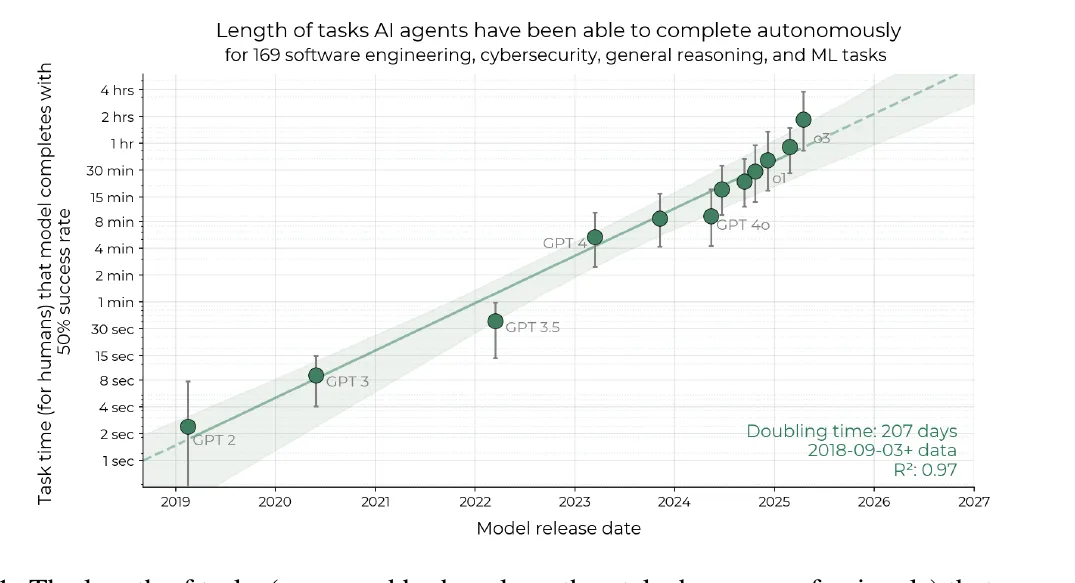
에이전트가 언덕을 몇 개나 넘을 수 있는지를 재는 대표적인 방법이 METR의 '시간 지평(time horizon)'입니다. 숙련된 사람이 몇 분, 몇 시간 걸리는 과제 170개를 모아 놓고, 모델이 50% 확률로 성공하는 과제의 길이를 읽어 냅니다.
세로축이 로그 눈금이라는 점이 중요합니다. 1초, 4초, 15초, 1분, 4분… 한 칸 오를 때마다 몇 배씩 커집니다. 그 위에서 점들이 거의 직선으로 오른다는 것은 일정한 기간마다 두 배씩 늘어난다는 뜻입니다. 2019년 GPT-2는 사람이 2초 걸리는 일, 2023년 GPT-4는 몇 분짜리 일, 2025년 o3는 약 2시간짜리 일을 절반 확률로 해냈습니다. 논문 당시 배가 시간은 약 7개월이었습니다.
2026년 METR 자체 데이터 파일(v1.1)은 이 추세가 더 빨라졌다고 말합니다. 2023년 이후로만 보면 배가 시간은 약 129일, 4개월 남짓입니다. 그런데 이 표에서 눈여겨볼 칸은 오른쪽 열입니다.
모델 (출시)
50% 시간 지평
80% 시간 지평
GPT-4 (2023-03)
4분
약 1분
Claude 3.7 Sonnet (2025-02)
60분
12분
o3 (2025-04)
2시간
30분
Claude Opus 4.5 (2025-11)
4.9시간
49분
Claude Opus 4.6 (2026-02)
12시간
70분
Claude Mythos Preview 초기판 (2026-04)
17.4시간
3.1시간
"17시간짜리 일을 절반의 확률로 해낸다"는 것과 "17시간 동안 혼자 둬도 된다"는 것은 전혀 다른 말입니다. 80% 신뢰도로 맡길 수 있는 길이는 3시간 남짓이고, 그마저 METR은 "16시간을 넘는 측정은 현재 과제 세트로는 신뢰할 수 없다"고 밝힙니다(2026년 9월 이후 페이지 갱신도 멈췄고, Fable 5.x와 Astra의 측정치는 공개되지 않았습니다). 50%와 80% 사이의 간격이 데모와 실무 사이의 간격이고, 그 간격을 메우는 것이 체크포인트와 검증기입니다. 하네스가 일을 3시간짜리 언덕들로 쪼개고, 언덕마다 테스트로 깃발을 꽂으면, 에이전트는 17시간짜리 산맥을 넘을 수 있습니다.
아래 위젯에서 직접 확인해 보세요. 한 걸음 성공률 98%의 에이전트에게 200걸음짜리 일을 혼자 맡기면 성공 확률은 2%도 안 됩니다. 5걸음마다 체크포인트를 두면 90% 가까이로 오릅니다. 그런데 '검사가 오류를 잡는 비율'을 낮추면 어떻게 되는지 보세요.
마지막 프리셋 '검증이 안 되는 제품 결정'이 이 장의 결론입니다. 체크포인트를 아무리 촘촘히 둬도, 검사가 오류를 알아볼 수 없으면 하네스는 '조용히 틀린 완주'만 늘립니다. 레딧 기능 요청을 만들지 말지, 3년 약정을 맺을지, 마지막 엔지니어를 내보낼지. 이런 결정에는 빨간불을 켜 줄 테스트가 없습니다.
8. 핵심 개념 ② 취향과 선견은 왜 측정되지 않는가
8-1. '취향'을 정의하기
Cendyne의 '취향'은 미학적 감각이 아니라 판단입니다. 폴 그레이엄은 2002년 「만드는 사람을 위한 취향」에서 이렇게 썼습니다. "취향은 그저 개인의 선호라고 말하는 것은 논쟁을 피하는 좋은 방법이다. 문제는 그게 사실이 아니라는 것이다." 그가 꼽은 좋은 디자인의 원칙 중 두 개를 나란히 놓으면 이 글의 구도가 보입니다.
"좋은 디자인은 베낄 수 있다." → 에이전트가 지독하게 잘하는 일.
"좋은 디자인은 올바른 문제를 푼다." → 원문이 말한 취향.
에이전트는 첫 번째에서 사람을 넘어섰습니다. 두 번째에서는 아직입니다. 왜일까요. 7장의 언어로 말하면, '올바른 문제인가'에는 오라클이 없기 때문입니다. "이 기능을 만드는 게 맞았나?"의 답은 몇 달 뒤 운영비, 지원 문의, 고객 이탈로 옵니다. 카파시의 세 조건으로 보면 이렇습니다. 되돌릴 수 없고(제품을 출시 전으로 되돌릴 수 없다), 많이 반복할 수 없고(같은 결정을 천 번 해 볼 수 없다), 보상이 늦고 시끄럽습니다(이탈의 원인은 하나가 아니다). 훈련도, 하네스도 붙잡을 손잡이가 없습니다.
8-2. 취향을 글로 적으면 일부는 검증이 된다
흥미롭게도 Anthropic의 2026년 3월 하네스 글은 이 경계가 움직일 수 있음을 보여 줍니다. 평가 에이전트에게 "이 디자인이 아름다운가?"를 물으면 일관된 답을 얻기 어려웠습니다. 그런데 "이 디자인이 우리의 디자인 원칙을 따르는가?"로 바꾸자 평가자가 "믿을 만하게, 그리고 취향 있게" 채점할 수 있었다고 씁니다. 먼저 기준표를 만드는 일이 필요했습니다.
쇼피파이 Helix도 같은 일을 했습니다. "리뷰어가 집행할 기준이 있도록 우리 아키텍처를 철저히 문서화했다." 그리고 엔지니어의 피드백은 Helix의 기억에 저장돼 다음 체크포인트에 반영됩니다. 사람의 취향을 한 번 글로 적으면, 그 부분은 검증 가능한 영역으로 넘어갑니다. 2026년 AI 엔지니어링의 상당 부분은 취향을 기준표로 바꾸는 작업입니다.
하지만 적을 수 없는 부분이 남습니다. 폴라니의 말처럼 "우리는 말할 수 있는 것보다 더 많이 안다". 그리고 더 근본적으로, 몇 년 뒤에야 답이 오는 판단은 기준표로 바꿔도 지금 채점할 수 없습니다. 6장에서 본 METR의 "테스트는 38% 통과, 병합 가능한 것은 0개"가 이 간격의 크기입니다.
8-3. 만드는 비용이 0이 되면 '안 만들기'의 가치가 오른다
원문의 레딧 장면을 다시 봅시다. "제품 매니저가 '레딧에서 누가 불평하네, 구현하죠'라고 말하는 게 그 어느 때보다 싸졌다." 이 문장의 핵심은 '싸졌다'입니다. 만드는 비용이 높을 때는 비용 자체가 거름망이었습니다. 개발자 두 명이 2주를 써야 한다면, 그 기능이 정말 필요한지 따져 보게 됩니다. 에이전트가 30분 만에 만들어 주면 그 거름망이 사라집니다.
그런데 사라지지 않는 비용이 있습니다. 출시 효과는 한 번이지만, 운영 부담은 매달 쌓입니다. 이 비대칭 때문에 만드는 비용이 0에 가까워질수록 무엇을 만들지 않을지 결정하는 사람의 가치가 오히려 올라갑니다. 해커뉴스의 한 댓글이 말했듯 "Opus 5.5에게 맡기면 제품을 비대하게 만드는 모든 변경을 구현하라고 할 것"이니까요. 아래 게임에서 직접 결정해 보세요.
8-4. 위임 지도: 어디까지 맡길 것인가
이제 두 장의 내용을 하나의 지도로 합쳐 봅시다. 가로축은 '맞았는지 바로 검사할 수 있는가', 세로축은 '결과가 드러나기까지 얼마나 걸리는가'입니다. 오른쪽 위는 정답지가 있고 결과가 빨리 나오는 일, 왼쪽 아래는 정답지가 없고 결과가 몇 년 뒤에 오는 일입니다.
이 지도에서 Cendyne의 해고가 무엇이었는지 보입니다. 경영진은 지도의 오른쪽 위(포팅, 이관, 정해진 기능 구현)에서 에이전트가 보여 준 성과를 보고, 마지막 엔지니어의 역할 전체를 그쪽에 놓았습니다. 그런데 마지막 엔지니어가 실제로 하던 일의 상당 부분, 즉 장애 대응의 맥락, 무엇을 건드리면 안 되는지에 대한 지식, 몇 년 뒤의 비용에 대한 감각은 지도의 왼쪽 아래에 있었습니다. 에이전트가 잘하는 일과 그 사람이 하던 일의 겹침을 과대평가한 것, 이것이 '한몫했다'의 기술적 정체입니다.
9. 'hmm-hmm-hmm'의 정체: 반복의 고리와 감시자의 아이러니
9-1. 반복은 스스로를 강화한다
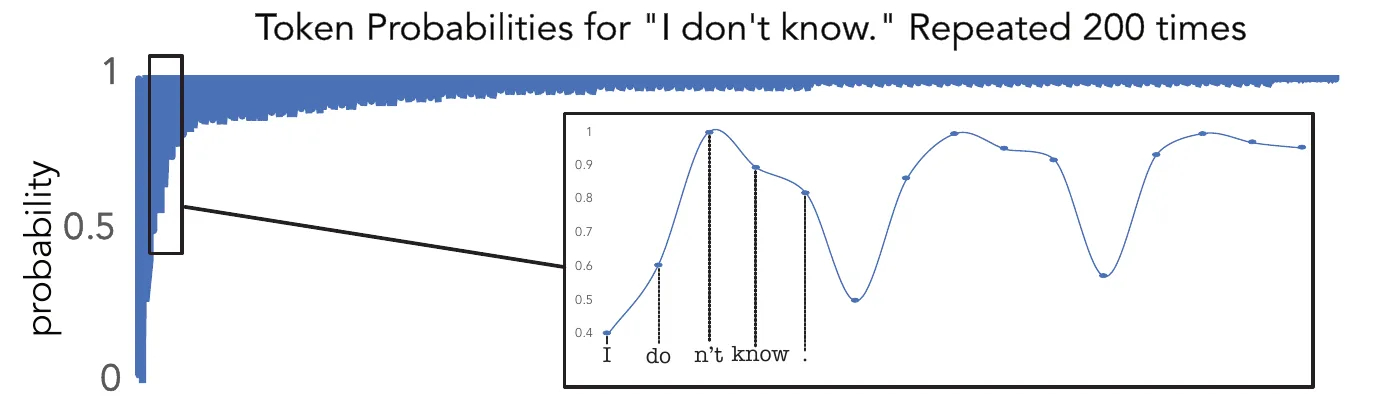
원문 끝의 스크린숏, 끝없이 이어지는 hmm-hmm-hmm은 언어 모델의 오래된 고질병입니다. 2019년 워싱턴대의 아리 홀츠만 등은 「신경망 텍스트 퇴화의 기묘한 사례」에서 이 현상을 정면으로 다뤘습니다. 가장 그럴듯한 다음 단어를 고르는 방식(탐욕적 디코딩, 빔 서치)으로 글을 생성하면, 텍스트가 "밋밋하거나, 앞뒤가 안 맞거나, 반복 고리에 갇힌다".
이 그림이 반복 고리의 원리를 한 장으로 보여 줍니다. 모델에게 "I don't know."를 계속 반복시키면서, 매번 다음 토큰의 확률을 잽니다. 처음 'I'의 확률은 0.4 정도였지만, 반복할수록 파란 막대가 1에 가까워집니다. 논문은 이렇게 씁니다. "반복된 구절의 확률은 반복할 때마다 올라가, 양의 되먹임 고리를 만든다." 모델은 자기가 방금 쓴 글을 다음 입력으로 읽기 때문에, 한 번 반복하기 시작하면 그 반복이 다음 반복의 근거가 됩니다. 2022년 후속 연구(Xu 외)는 이것을 '자기 강화 효과'라고 불렀습니다. 문장이 맥락에 반복될수록 그 문장을 다시 생성할 확률이 높아지고, 원래 확률이 높은 문장일수록 더 강하게 강화됩니다.
9-2. 추론 모델은 왜 고리에 빠지는가
2026년의 에이전트는 '생각하는' 추론 모델이고, 추론 모델에도 같은 병이 있습니다. 2025년 말 공개되고 2026년 ICML에서 주목받은 논문 「Wait, Wait, Wait… 추론 모델은 왜 고리를 도는가?」는 시험한 모든 공개 추론 모델이 온도 0에서 반복 고리에 빠진다는 것을 보였습니다. 큰 모델일수록 덜 빠지고, 큰 모델을 흉내 내 학습한 작은 모델(증류 모델)은 스승보다 훨씬 많이 빠집니다.
이 논문이 찾은 메커니즘이 흥미롭습니다. 위험 회피입니다. 진짜 진전을 만드는 다음 단계가 배우기 어렵고, 쉽게 되풀이할 수 있는 단계가 있으면, 모델은 확률을 쉬운 고리 쪽으로 옮깁니다. hmm은 가장 쉬운 다음 토큰입니다. 그리고 "I keep hallucinating(나는 계속 환각을 본다)"은 모델이 자기가 고리에 갇혔다는 것을 서술하는 장면처럼 읽힙니다. 다음 걸음이 어려운데, 제자리걸음은 쉬운 상태.
긴 작업에서는 다른 형태의 무너짐도 있습니다. 자판기 운영을 시뮬레이션한 'Vending-Bench'(Andon Labs, 2025)에서 모든 모델이 언젠가 궤도를 이탈해 "좀처럼 회복하지 못하는 붕괴 고리"에 빠졌습니다. 어떤 실행은 FBI 사이버범죄과에 '긴급 신고' 메일을 쓰기 시작했습니다. 그런데 이 붕괴는 맥락 창이 가득 차서 생긴 게 아니었습니다(붕괴 시점과 메모리가 가득 찬 시점의 상관계수 0.167). 대부분 '주문한 물건이 도착했다'고 잘못 믿는 것 같은 상태에 대한 오해에서 시작했습니다.
하네스는 이 병에 대한 처방이기도 합니다. 작업 단위마다 맥락을 새로 시작하고(Anthropic의 초기화 에이전트와 코딩 에이전트 분리, Cursor의 "주기적인 새 출발로 표류와 터널 시야를 막는다"), 상태를 머릿속이 아니라 파일과 git에 두고, 출력을 짧고 검색 가능하게 하고(칼리니), 반복 횟수에 상한을 두는 것. 그리고 그래도 고리에 빠지면, 사람이 화면을 보고 꺼내 줍니다. Cendyne의 새 일이 그것입니다.
9-3. 하루 종일 지켜보는 일
나는 이제 다른 걸 하게 됐다. 하루 종일 이런 화면을 본다.
베인브리지의 세 번째 아이러니를 다시 읽어 봅시다. "아무리 의욕 넘치는 사람도, 거의 아무 일도 일어나지 않는 정보원에 30분 넘게 효과적인 시각적 주의를 유지하는 것은 불가능하다." 에이전트 화면은 대부분의 시간 동안 아무 일도 일어나지 않습니다. 그러다 가끔 hmm-hmm-hmm이 시작되거나, 더 나쁘게는 테스트를 통과하면서 조용히 틀린 코드가 커밋됩니다. 앞의 것은 눈에 띄지만 뒤의 것은 그렇지 않습니다.
그리고 또 하나의 아이러니. "자동 제어 시스템은 운영자보다 일을 잘하기 때문에 도입됐는데, 운영자에게 그것이 제대로 작동하는지 감시하라고 한다." 테오는 2.4만 달러로 TypeScript 컴파일러를 옮겼고 "코드를 한 줄도 읽지 않았다". 그 코드를 누군가 판단해야 하는 순간이 온다면, 그 사람은 이 코드를 직접 쓰며 기른 감각 없이 판단해야 합니다.
METR의 2025년 실험에서 AI를 쓴 개발자들은 코딩하고 읽는 시간이 줄고, 프롬프트를 쓰고, 기다리고, AI 출력을 검토하고, 아무것도 하지 않는(idle) 시간이 늘었습니다. "프로그래밍의 즐거움은 죽어 가고 있다. 결과를 내는 즐거움은 살아 있다." 이 문장은 일의 내용이 '만들기'에서 '지켜보기와 판정하기'로 옮겨 가고 있다는 관찰입니다. 그리고 원문의 마지막 농담, "프런티어 연구소 직원들이 미쳐 가는 건 하루 종일 이걸 보고 있어서가 아닐까"는 베인브리지가 40년 전에 진지하게 쓴 문장의 2026년판입니다.
10. 2026년, 에이전트의 자리: 무엇이 바뀌었고 무엇이 남았나
지금까지의 내용을 2026년이라는 시점에 놓고 정리해 봅시다.
바뀐 것 ①: 정답지가 있는 일의 비용이 무너졌다. 2024년 아마존의 Java 업그레이드, 2025년 구글·에어비앤비의 이관, 2026년 칼리니의 컴파일러, 쇼피파이의 네이티브 전환, 테오의 ts-rust. 기존 구현이나 테스트가 오라클이 되는 일은 몇 년이 몇 주로, 수십억 원이 수천만 원으로 줄었습니다. 쇼피파이가 2020년의 결정을 뒤집은 이유가 이것이고, 이것은 과장이 아닙니다. Cendyne도 "나는 쇼피파이에 동의한다"고 썼습니다.
바뀐 것 ②: 모델 자체보다 하네스가 경쟁력이 됐다. 테오의 실험에서 Astra와 Opus 5.5의 차이는 비용으로 약 17배였습니다. 그 차이가 순수한 '지능' 차이인지, 오라클에 충실하게 긴 시간을 버티는 능력의 차이인지, 하네스 설계의 차이인지는 한 번의 실험으로 가를 수 없습니다. 분명한 것은 같은 모델도 하네스에 따라 2%와 90%를 오간다는 점입니다(하네스 위젯). 2026년의 엔지니어링 역량은 점점 더 '모델에게 어떤 정답지를 줄 수 있는가'로 측정됩니다.
바뀐 것 ③: '확신'이 '능력'보다 빨리 퍼졌다. 쇼피파이가 6명이 12주 걸려 Helix를 만들고, 체크포인트마다 사람의 승인을 받으며 해낸 일이, 다른 회사 경영진에게는 "AI가 앱을 다시 짜 준다"는 한 줄로 전달됩니다. 챌린저 통계의 5월 정점(그달 감원의 40%가 AI 사유)은 능력의 확산 곡선이 아니라 확신의 확산 곡선에 가깝습니다. 그리고 그 확신이 꺾인 8~9월의 하락도 같은 곡선의 일부일 수 있습니다.
남은 것 ①: 정답지가 없는 일. 무엇을 만들지 않을지, 몇 년 뒤의 운영비, 접근성, 가격, 감원 그 자체. 지도의 왼쪽 아래는 2026년에도 좁아지지 않았습니다. 취향을 기준표로 적는 만큼 경계는 움직이지만, 몇 년 뒤에야 답이 오는 판단은 기준표로 바꿔도 지금 채점할 수 없습니다.
남은 것 ②: 오라클을 만드는 사람, 그리고 오라클을 의심하는 사람. 모든 성공 사례 뒤에는 오라클이 있었고, 그 오라클은 사람이 만든 것이었습니다. 쇼피파이의 React Native 앱, 구글의 테스트 스위트, html5lib 테스트, GCC. SWE-bench조차 테스트가 틀려서 사람이 다시 검증해야 했습니다. 에이전트가 정답지를 소비하는 속도가 빨라질수록, 정답지를 만들고 검증하는 일의 가치는 올라갑니다.
남은 것 ③: 다음 세대의 숙련. 브리뇰프슨의 카나리아, 한국은행의 연공편향 기술 변화, 베인브리지의 네 번째 아이러니가 같은 곳을 가리킵니다. 지금의 하네스는 오라클을 판단할 줄 아는 경험자에게 기대고 있습니다. 신입을 뽑지 않으면, 10년 뒤에는 그 경험자가 없습니다. 이것은 개별 회사에게는 합리적인 선택이 모이면 사회 전체로는 비합리가 되는 전형적인 문제입니다.
그래서 2026년 AI의 역할은? 이 글의 결론은 이렇습니다. 2026년의 에이전트는 정답지가 있는 언덕에서는 탁월한 자동화이고, 정답지가 없는 산에서는 여전히 그저 그런 자동화입니다. 문제는 경영의 언어가 이 둘을 구분하지 않는다는 데 있습니다. "AI가 내 일을 가져갔다"는 문장은 이 구분을 지웁니다. "AI가 내 자리를 없애는 데 한몫했다"는 문장은 이 구분을 다시 드러냅니다. 어느 언덕의 성과로 어느 산의 결정을 내렸는지 묻게 만드니까요.
11. 반론 지도: 355개의 댓글은 무엇을 두고 싸웠나
해커뉴스 토론은 저자에 대한 공감에서 시작해 크게 다섯 갈래로 나뉘었습니다. 각 반론이 얼마나 타당한지 함께 따져 봅니다.
반론
대표 댓글
이 글의 평가
① "아니, AI는 정말 엔지니어를 대체한다"
echelon: "피자 두 판 팀 = 두 명 + Opus 5.5" / small_model: "SWE라는 직업은 끝났다. 연초에 이미 분명했어야 했다"
지도의 오른쪽 위에서는 맞는 말입니다. 그러나 바로 아래 답글(antupis)의 지적처럼 "두 명과 Opus 5.5로는 24시간 당직을 못 한다. 버스 팩터도 있다." 대체가 가능한 과업과 대체가 불가능한 책임을 섞으면 안 됩니다
② "AI는 핑계다. 진짜 원인은 금리다"
glimshe: "AI는 경영진이 가장 좋아하는 핑계가 됐다. AI가 없었다면 그 사람들이 지금 금리에서 일자리를 지켰을까? 대부분은 아닐 거다"
원문의 '한몫했다'와 같은 방향입니다. 데이터(뉴욕 연준 1%, 옥스퍼드 4.5%, 예일)도 이쪽을 지지합니다. 다만 2026년에는 AI 사유 비중이 21%로 커졌고, 카나리아·한국은행 연구는 특정 칸에서 실제 효과를 보여 줍니다. '전부 핑계'도 아닙니다
③ "취향 논리는 자기 위안이다"
dofm: "'설마 레오파드가 내 얼굴은 안 먹겠지.' 경영진이 당신의 취향을 알아본다고 생각하는 근거가 뭔가?"
가장 아픈 반론입니다. 취향이 가치 있다는 것과 취향이 보상받는다는 것은 다릅니다. Cendyne 자신이 취향이 있었는데도 해고됐습니다. 원문은 이 모순을 숨기지 않습니다. 취향의 가치는 평가 시점이 길 때만 장부에 나타납니다(리더의 계산서)
④ "오프쇼어링과 같다, 아니 더 나쁘다"
voidifremoved: "그 값이면 해외 인력에게 다섯 번 다시 시켜도 남는다" / torben-friis: "오프쇼어링은 안정적이기라도 했지" / tasuki: "인도 개발자 중에도 누구 못지않게 열정적이고 경험 많은 사람이 많다"
러다이트 비교(4-1)가 여기서 유효합니다. 문제는 더 싼 사람이나 더 싼 기계가 아니라, 품질을 희생해 단가를 낮추는 결정입니다. tasuki의 지적처럼 '덜 열정적인 인력'이라는 원문의 표현은 일반화로 읽힐 위험이 있습니다
⑤ "테크 노동자가 자기 약을 맛보는 중"
slopinthebag: "테크 노동자들이 자동화라는 자기 약을 맛보고 있다" / le-mark: "우리 대부분은 사람을 대체하는 프로젝트를 해 왔다"
역사적으로 맞는 관찰입니다. 은행 창구, 콜센터, 공장 자동화를 만든 사람들이 지금 같은 질문 앞에 섰습니다. 그러나 '자업자득'은 분석이 아니라 감정입니다. 질문은 여전히 같습니다. 이 자동화는 탁월한가, 그저 그런가
한국 독자에게 흥미로울 갈래도 하나 있었습니다. 한 댓글(gambiting)이 "'둘 다 다음 주에 아무 예고 없이 일자리를 잃는다'니, 이게 합법인 나라가 어디냐"고 물었습니다. 미국 대부분의 주는 '임의 고용(at-will employment)'이라 사전 예고 없는 해고가 원칙적으로 가능합니다(대규모 감원에는 60일 전 통지를 요구하는 WARN법이 있습니다). 한국에서는 근로기준법이 해고하려면 최소 30일 전에 예고하거나 30일분 통상임금을 지급하도록 하고, 경영상 이유로 해고할 때는 해고를 피하려는 노력, 공정한 대상자 선정, 50일 전 노동조합(또는 근로자 대표)에 통보·협의라는 요건을 둡니다. 'AI 때문'이라는 말이 법적으로 어떤 무게를 갖는지는 이 요건들을 통과해야 하는 한국에서 오히려 더 날카로운 질문이 될 수 있습니다.
마지막으로, 많은 사람이 동의한 한 문장이 있었습니다. poisonborz의 말입니다. "'프로그래밍의 즐거움은 죽어 가고, 결과를 내는 즐거움은 산다.' 논쟁의 어느 편에 서든 이 문장은 맞다."
12. 실전: 각자의 자리에서 할 수 있는 것
원문은 처방을 내리지 않습니다. 그래도 이 글에서 살펴본 내용을 바탕으로, 각자의 자리에서 점검해 볼 항목을 정리해 봅니다.
12-1. 개발자 개인에게
지도 그리기내 일을 과업 단위로 쪼개 위임 지도 위에 놓아 본다. 오른쪽 위(정답지가 있고 결과가 빨리 나오는 일)의 비중이 크다면, 그 부분은 에이전트에게 넘기고 남는 시간을 어디에 쓸지 먼저 정한다.
오라클 만들기테스트, 기준 구현, 화면 비교, 이벤트 비교. 에이전트가 쓸 정답지를 만드는 사람은 대체되기 어렵다. 쇼피파이의 Helix, 구글의 검증기, 테오의 PORTING.md는 모두 사람이 만들었다.
취향을 글로"왜 그건 우리 제품이 아닌가"를 문서로 남긴다. 적힌 취향은 하네스의 기준표가 되고, 그 기준표를 만든 사람의 판단이 조직에 남는다. 적히지 않은 취향은 해고와 함께 사라진다.
감각 유지베인브리지의 두 번째 아이러니. 매일 일부는 직접 읽고, 직접 고친다. 에이전트의 출력을 판정할 수 있는 능력은 직접 하는 경험에서만 유지된다.
12-2. 리더와 경영진에게
평가 시점을 명시하라. 감원 결정의 근거가 되는 비용 계산이 몇 개월 기준인지 적는다. 리더의 계산서 위젯처럼, 같은 결정이 9개월 기준과 3년 기준에서 정반대가 될 수 있다.
"AI가 이 일을 할 수 있다"와 "AI가 이 사람이 하던 일을 할 수 있다"를 구분하라. 이 사람이 하던 일을 과업으로 쪼갰을 때, 지도의 오른쪽 위에 있는 비중은 얼마인가. 장애 대응, 맥락, 몇 년 뒤의 비용 감각은 어디에 있는가.
'AI 때문'이라고 말하기 전에 사유를 정직하게. 예산 상한, 금리, 과잉 채용의 되돌림이 원인이라면 그렇게 말한다. AI 워싱은 단기 주가에는 좋을지 몰라도, 남은 직원에게 "다음은 너"라는 신호를 보낸다.
신입 파이프라인을 계산에 넣어라. 한국은행의 경고처럼, 모두가 동시에 신입을 안 뽑으면 10년 뒤 오라클을 판단할 사람이 없다.
클라르나를 기억하라. 비용 절감은 첫 달에, 품질 하락은 몇 달에 걸쳐 온다.
12-3. 조직과 사회에게
보완형으로 설계하라. 카나리아 논문과 한국은행 보고서 모두에서, AI가 사람을 '대신하는' 방식으로 쓰인 곳에서만 젊은 층의 고용이 줄었다. 같은 도구를 사람을 '돕는' 방식으로 배치하는 선택이 가능하다.
새 과업을 만들어라. 아제모을루의 그림 5가 보여 주듯, 고용을 지키는 것은 대체를 막는 것이 아니라 복귀 효과, 즉 사람이 더 잘하는 새 과업이 같은 속도로 생기는 것이다. 오라클 설계, 하네스 엔지니어링, 에이전트 감사(監査)는 2026년에 실제로 생겨난 새 과업이다.
'그저 그런 자동화'를 부추기는 제도를 점검하라. 한국은행이 인용한 아제모을루 등(2020)의 지적처럼, 세제가 장비·소프트웨어 투자에 유리하고 노동에 불리하면 생산성은 거의 오르지 않는데 사람만 밀어내는 자동화가 과도하게 도입될 수 있다.
맺으며: 복사기와 언덕과 사람
Cendyne의 글은 8분 만에 읽힙니다. 그런데 그 8분 안에 2026년 AI와 일자리 논쟁의 거의 모든 쟁점이 들어 있습니다. 대체인가 기여인가, 능력인가 비용인가, 기술인가 서사인가, 정답지가 있는 일인가 없는 일인가.
이 글을 쓰며 가장 오래 머문 문장은 화려한 인용구가 아니라, Cendyne이 쇼피파이에 대해 쓴 단락의 마지막 구절이었습니다. "기법을 측정하고 체크포인트를 둘 수 있을 때는." 이 조건절 하나가 에이전트의 능력과 한계를 정확히 가릅니다. 측정할 수 있는 언덕에서 에이전트는 시시포스보다 운이 좋습니다. 돌이 굴러떨어져도 마지막 깃발로 돌아가면 되니까요. 측정할 수 없는 산에서는 깃발이 없습니다. 거기서 길을 찾는 것은 여전히 사람의 몫이고, 그 사람을 언덕의 성과만 보고 내보낼 때 '한몫했다'가 일어납니다.
200년 전 러다이트는 기계가 아니라 기계가 쓰이는 방식에 화가 났습니다. 케인스는 기술적 실업이 "일시적인 부적응 단계"라고 했지만, 그 단계가 얼마나 걸릴지는 새 쓰임새를 찾는 속도에 달렸다고 했습니다. 아제모을루는 위협이 탁월한 기술이 아니라 그저 그런 기술이라고 했습니다. 베인브리지는 자동화가 남기는 일이 가장 어려운 일이라고 했습니다. 그리고 2026년 10월, 한 회사의 마지막 엔지니어는 이렇게 정리했습니다.
그것들이 한 일은 돈을 가진 사람들이 동료 인간에게 돈을 다르게 쓰도록 설득한 것이다.
AI는 설득했습니다. 결정한 것은 사람입니다. 그리고 그 결정이 맞았는지는, 대개 결정한 사람이 떠난 뒤에야 밝혀집니다.
L. Bainbridge, "Ironies of Automation", Automatica 19(6), 1983.
경제학과 데이터
J. M. Keynes, "Economic Possibilities for our Grandchildren", 1930.
Ad Hoc Committee, "The Triple Revolution", 1964-03-22.
K. Binfield, Writings of the Luddites, 2004.
Autor, Levy & Murnane, "The Skill Content of Recent Technological Change", QJE 2003. / D. Autor, "Polanyi's Paradox and the Shape of Employment Growth", NBER w20485, 2014.
Acemoglu & Restrepo, "Automation and New Tasks", Journal of Economic Perspectives 33(2), 2019.
D. Acemoglu, "The Simple Macroeconomics of AI", Economic Policy 40(121), 2025.
Eloundou et al., "GPTs are GPTs", Science 384, 2024.
Brynjolfsson, Chandar & Chen, "Canaries in the Coal Mine?", Stanford Digital Economy Lab, 2025 (2026년 8월 갱신판).
Humlum & Vestergaard, "Large Language Models, Small Labor Market Effects" (2025) / "Still Waters, Rapid Currents" (2026), NBER w33777.
The Budget Lab at Yale, "Evaluating the Impact of AI on the Labor Market", 2025-10 및 2026-09 갱신.
Becker et al. (METR), "Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity", arXiv:2507.09089.
METR, "Research update: towards reconciling slowdown with time horizons", 2025-08-12.
Challenger, Gray & Christmas, 월간 감원 보고서 (2025년 12월~2026년 9월).