PostgreSQLPostgres 하나로 어디까지작업 큐Job QueueSKIP LOCKEDLISTEN/NOTIFYMVCCVACUUM파티셔닝PGliteGraphile Workerpg-bossRiverProcrastinateSolid Queuepgmq백엔드
Postgres 하나로 어디까지 ① 작업 큐 — SKIP LOCKED로 Redis·RabbitMQ 없이 시작하기
메일 발송·썸네일 생성·외부 API 호출처럼 '나중에 해도 되는 일'을 맡길 큐가 필요할 때, Redis나 RabbitMQ를 새로 띄우기 전에 이미 쓰고 있는 PostgreSQL로 충분한지 따져 봅니다. 큐 테이블 하나와 쿼리 세 개로 시작해 SKIP LOCKED로 여러 워커가 겹치지 않게 일을 나누고, 리스(lease)로 죽은 워커의 일을 되살리고, 재시도·백오프·데드레터를 붙이고, LISTEN/NOTIFY로 즉시 깨우는 법까지. 큐 테이블이 부푸는 MVCC의 함정과 파티션으로 피하는 법, 언어별 라이브러리, 그리고 언제 전용 브로커로 떠나야 하는지도 다룹니다. 데모 두 개는 여러분의 브라우저 안에서 진짜 PostgreSQL 18을 띄워 실행됩니다.
새 서비스에 기능이 하나 붙을 때마다 인프라도 하나씩 늘어납니다. 작업 큐가 필요하니 Redis나 RabbitMQ, 검색이 필요하니 Elasticsearch, 벡터 검색이 필요하니 벡터 DB, 캐시가 필요하니 또 Redis. 각각은 좋은 도구지만, 운영할 시스템이 늘면 배포·백업·모니터링·장애 대응·보안 패치도 그만큼 늘어납니다. 작은 팀에게는 이것이 가장 비싼 비용입니다.
이 시리즈는 질문 하나에서 출발합니다. "이미 쓰고 있는 PostgreSQL 하나로 어디까지 할 수 있을까?" 그리고 같은 무게로 반대 질문도 다룹니다. "어디서부터는 전용 도구로 떠나야 할까?"
① 이번 글
작업 큐 — SKIP LOCKED, 리스, 재시도, LISTEN/NOTIFY, 그리고 큐 테이블이 부푸는 문제
②
검색 — tsvector·GIN, pg_trgm으로 한국어 부분 일치, BM25
③
벡터 — pgvector와 하이브리드 검색
④
캐시·잠금·문서 — UNLOGGED 테이블, advisory lock, JSONB
마무리
언제 Postgres를 떠나야 하나
모든 편의 실습은 PGlite로 여러분의 브라우저 안에 진짜 PostgreSQL 18을 띄워 진행합니다. 설치할 것은 없습니다. 버튼을 누르면 약 5MB를 내려받아 이 탭 안에서 Postgres가 뜹니다.
✅
이번 글 요약.
· 초당 수백 건 정도의 '나중에 할 일'이라면 Postgres 큐로 충분합니다. 가장 큰 장점은 업무 데이터와 같은 트랜잭션으로 작업을 등록할 수 있다는 것입니다.
· 워커 여러 개가 같은 작업을 집지 않게 하는 열쇠는 FOR UPDATE SKIP LOCKED(9.5부터). 잠금은 작업 내내 쥐지 말고, 가져올 때만 짧게 잡고 리스(locked_until)를 남깁니다.
· 실패는 재시도 + 지수 백오프 + 최대 횟수 후 데드레터. 리스 방식은 '최소 한 번' 실행이므로 작업은 멱등하게 짭니다.
· LISTEN/NOTIFY로 즉시 깨우되, 끊기면 놓치므로 폴링을 함께 둡니다.
· 큐 테이블은 MVCC 때문에 죽은 행이 쌓여 부풉니다. 긴 트랜잭션을 막고, autovacuum을 테이블별로 조이고, 보관이 필요하면 날짜 파티션 + DROP.
· 직접 만들기보다 언어별 라이브러리(Graphile Worker·pg-boss·River·Procrastinate·Solid Queue·Oban·pgmq)를 먼저 보세요.
주문이 들어오면 영수증 메일을 보내야 합니다. 메일 발송은 느리고 가끔 실패하니 요청 안에서 처리하지 않고 큐에 넘깁니다. 큐가 Redis에 있다면 코드는 "DB에 주문 저장 → Redis에 작업 등록"이 됩니다. 지난 백엔드 실전 팁의 7장에서 본 이중 쓰기 문제가 그대로 생깁니다. 주문 저장 후 등록 전에 프로세스가 죽으면 메일이 안 가고, 등록 후 주문이 롤백되면 존재하지 않는 주문의 메일이 갑니다.
큐가 같은 Postgres에 있으면 이 문제가 사라집니다. 주문 INSERT와 작업 INSERT를 한 트랜잭션에 넣으면 둘은 함께 커밋되거나 함께 사라집니다. Go의 River는 README에서 이렇게 설명합니다. 작업은 "트랜잭션이 롤백되면 함께 제거되고, 커밋될 때까지 워커에게 보이지 않는다." 지난 글의 트랜잭션 아웃박스를 따로 만들 필요 없이, 큐 자체가 아웃박스가 되는 셈입니다.
2. 큐 테이블 하나와 쿼리 세 개
Postgres 큐의 뼈대는 단순합니다.
sql
create table jobs (
id bigint generated always asidentityprimary key,
queue text not nulldefault'default',
payload jsonb not null,
status text not nulldefault'ready', -- ready · running · done · dead
priority intnot nulldefault0,
run_at timestamptz not nulldefault now(), -- 지연·재시도 시각
attempts intnot nulldefault0,
max_attempts intnot nulldefault5,
locked_until timestamptz, -- 리스(워커가 죽으면 이 시각 뒤 다시 보임)
last_error text
);
create index jobs_ready on jobs (queue, priority desc, run_at) where status ='ready';
등록은 INSERT 한 줄이고, 가져오기가 핵심입니다.
sql
update jobs
set status ='running', attempts = attempts +1,
locked_until = now() +interval'30 seconds'where id = (
select id from jobs
where (status ='ready'and run_at <= now())
or (status ='running'and locked_until < now()) -- 리스가 끝난 작업 되살리기orderby priority desc, run_at
forupdateskip locked
limit 1
)
returning id, payload, attempts;
완료는 상태를 바꾸거나 행을 지웁니다. 아래 실험실에서 이 쿼리들을 실제로 실행해 보세요. 시계는 버튼으로 돌리는 가상 시계라서, 지연 작업과 리스 만료를 기다리지 않고 볼 수 있습니다. 특히 ②번(도중 실패 → 롤백)을 눌러 주문과 작업이 함께 사라지는지 확인해 보세요.
실험실에서 확인할 수 있는 동작은 다음과 같습니다.
트랜잭션 등록: 롤백한 트랜잭션의 작업은 없고, 그 안에서 보낸 NOTIFY도 도착하지 않습니다.
우선순위: 우선순위가 높은 작업이 먼저 나옵니다.
재시도: 실패한 작업은 백오프 시각이 지나야 다시 나오고, 최대 횟수를 넘기면 데드레터(dead)로 갑니다.
리스: '워커가 죽음'을 누른 뒤 시계를 30초 넘기면 그 작업을 다른 워커가 다시 가져갑니다. 이때 늦게 깨어난 옛 워커의 완료 처리는 attempts 조건 때문에 0행이 되어 무시됩니다.
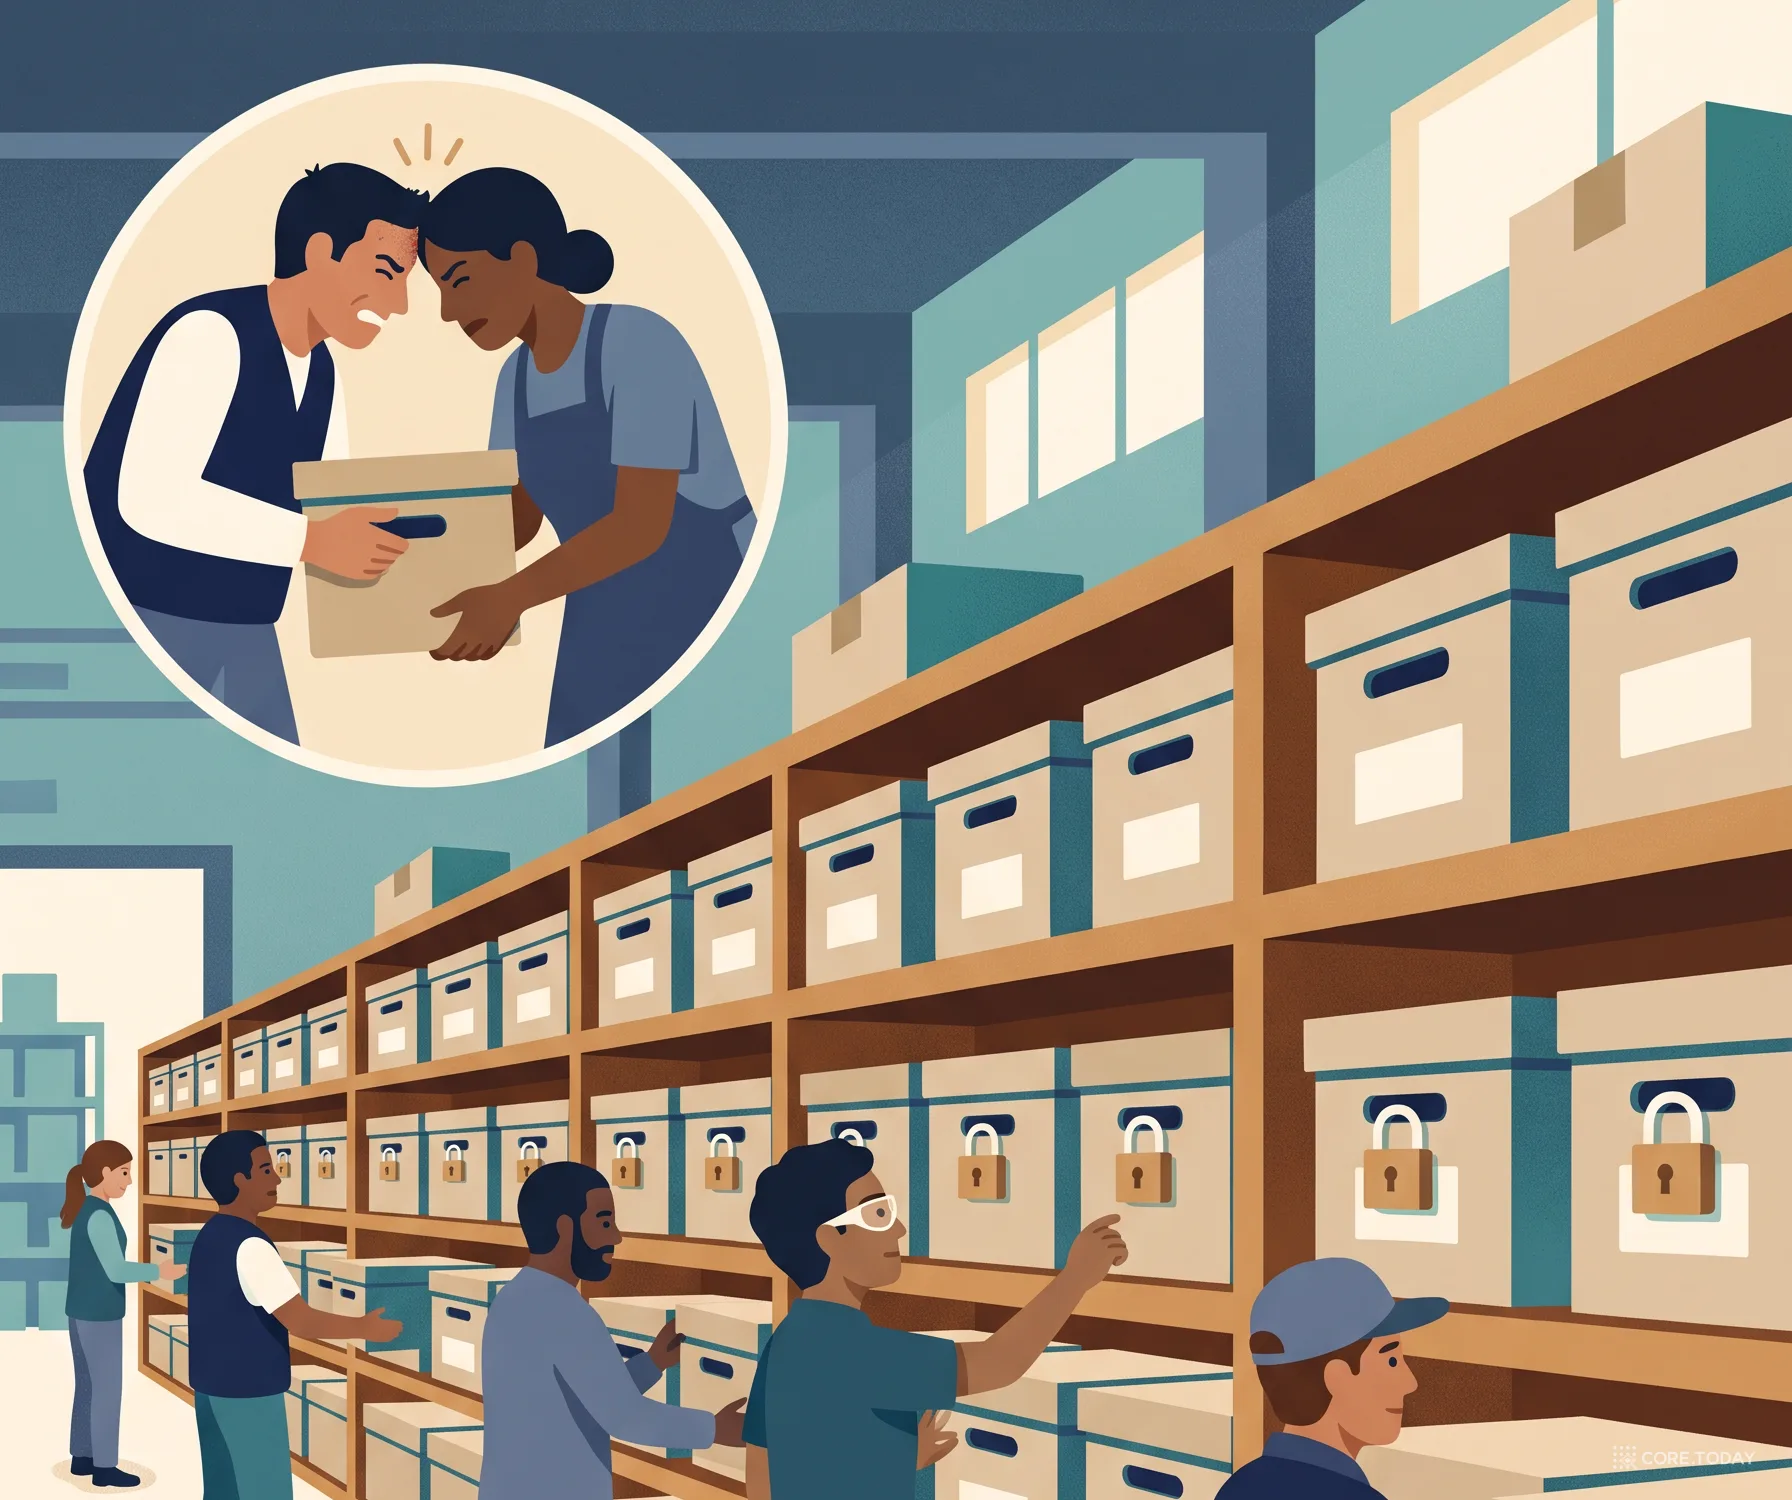
순진한 방법: SELECT로 고르고 UPDATE로 표시하는 두 문장 사이에 다른 워커도 같은 행을 읽으면 같은 작업이 두 번 실행됩니다.
FOR UPDATE: 중복은 사라지지만, 모든 워커가 맨 앞 행의 잠금을 기다리며 줄을 섭니다.
FOR UPDATE SKIP LOCKED(PostgreSQL 9.5, 2016년 1월): 이미 잠긴 행은 건너뛰고 다음 행을 가져갑니다.
PostgreSQL 문서는 이 옵션을 이렇게 설명합니다. "잠긴 행을 건너뛰면 데이터의 일관되지 않은 모습을 보게 되므로 일반 용도에는 맞지 않지만, 여러 소비자가 큐 같은 테이블에 접근할 때 잠금 경합을 피하는 데 쓸 수 있다." 바로 이 용도를 위해 있는 기능입니다. PGlite는 세션이 하나뿐이라 동시성을 진짜로 재현할 수 없어서, 아래는 시뮬레이터입니다.
워커 8개 · 작업 200개 · 각 50ms
끝나는 시간
처리량
중복 실행
① SELECT 후 UPDATE (잠금 없음)
2,348ms
85건/초
138건
② FOR UPDATE를 작업 내내 쥠
10,479ms
19건/초
0
③ FOR UPDATE SKIP LOCKED
1,338ms
150건/초
0
④ SKIP LOCKED + 리스(짧은 트랜잭션)
1,362ms
147건/초
0
③과 ④는 처리량이 같지만 큰 차이가 하나 있습니다. ③처럼 작업이 끝날 때까지 트랜잭션을 열어 두면, 연결 하나가 작업 시간 내내 묶이고, 긴 트랜잭션은 5장의 VACUUM을 방해합니다. ④처럼 가져올 때만 짧게 잠그고 locked_until을 남긴 뒤 트랜잭션을 닫는 편이 운영에 유리합니다. 그리고 워커가 여럿이면 완료 순서는 엄밀한 선입선출이 아닙니다(시뮬레이터 기본값에서 인접한 65쌍의 순서가 뒤바뀌었습니다). 순서가 중요한 일이라면 큐를 나누거나 순서 키로 직렬화해야 합니다.
배포·OOM·스팟 인스턴스 회수로 워커는 작업 도중에 죽습니다. 상태를 running으로만 바꿔 두면 그 작업은 영원히 running으로 남습니다. 그래서 리스(lease)를 둡니다. 가져갈 때 locked_until = now() + 30초를 쓰고, 그 시각이 지나도록 끝나지 않은 작업은 다시 가져갈 수 있게 합니다(위 쿼리의 두 번째 조건). AWS SQS의 가시성 타임아웃도 같은 개념입니다. 메시지를 받으면 기본 30초 동안 다른 소비자에게 안 보이고(최대 12시간), 그 안에 지우지 않으면 다시 보입니다. 작업이 리스보다 오래 걸리면 중간에 locked_until을 연장하는 하트비트를 보냅니다.
여기서 중요한 결론이 하나 나옵니다. 리스 방식은 '최소 한 번(at-least-once)' 실행입니다. 워커가 메일을 보낸 직후, 완료 표시 직전에 죽으면 그 메일은 다시 갑니다. 그래서 작업은 멱등하게 짭니다. 이미 보냈는지 확인하는 키를 두거나, 외부 API에 멱등성 키를 함께 보냅니다.
실패 처리는 세 단계가 표준입니다.
재시도: attempts < max_attempts이면 status = 'ready'로 되돌립니다.
지수 백오프: run_at = now() + 10초 × 2^attempts처럼 갈수록 늦춥니다. 외부 서비스가 쓰러졌을 때 재시도로 두들기지 않게 하려는 것입니다(지난 글 1장의 재시도 폭풍).
데드레터: 최대 횟수를 넘기면 status = 'dead'로 옮기고 알림을 보냅니다. 사람이 원인을 고친 뒤 다시 넣습니다.
5. LISTEN/NOTIFY: 폴링 대신 즉시 깨우기, 단 폴링도 함께
워커가 1초마다 큐를 조회하면 작업은 최대 1초 늦게 시작되고, 빈 큐에도 쿼리가 계속 나갑니다. Postgres의 LISTEN/NOTIFY를 쓰면 작업을 등록하는 트랜잭션에서 NOTIFY jobs를 보내고, 기다리던 워커가 즉시 깨어납니다. 위 실험실의 'NOTIFY로 깨어남' 표시가 그것입니다. 문서에서 확인한 성질은 이렇습니다.
트랜잭션 안의 NOTIFY는 커밋될 때만 전달됩니다. 롤백되면 알림도 없습니다(실험실 ②번). 큐와 궁합이 좋은 성질입니다.
페이로드는 기본 설정에서 8,000바이트 미만입니다. 작업 내용은 테이블에 두고 알림에는 ID만 보냅니다.
알림 대기열은 표준 설치에서 8GB이고, 가득 차면 NOTIFY를 부른 트랜잭션이 커밋에서 실패합니다.
세션이 끝나면 LISTEN 등록도 사라집니다. 연결이 끊긴 동안의 알림은 받을 수 없습니다. 그래서 워커는 재접속하면 테이블을 한 번 훑고, 평소에도 30초쯤 간격의 폴링을 안전망으로 둡니다.
⚠️
NOTIFY의 규모 한계. Recall.ai는 2025년 7월 글 「Postgres LISTEN/NOTIFY does not scale」에서, NOTIFY를 포함한 트랜잭션은 커밋 단계에서 데이터베이스 전체에 걸리는 전역 잠금을 잡아 그런 커밋들이 사실상 한 줄로 선다고 보고했습니다(동시 쓰기 수만 건에서 장애 세 번). 이 글은 나중에 "핵심에서 고쳐졌다"고 갱신됐지만, 연결된 커밋(PostgreSQL 19에 포함)은 알림과 무관한 백엔드를 깨우지 않게 한 개선이고, 전역 잠금 자체는 PG19와 개발 브랜치에 여전히 있습니다. 초당 쓰기가 아주 많다면 모든 INSERT마다 NOTIFY를 보내지 말고, 묶어서 보내거나(DBOS는 버퍼링으로 우회) 폴링 위주로 설계하세요.
여기가 Postgres 큐의 진짜 함정입니다. PostgreSQL은 MVCC 방식이라 UPDATE와 DELETE가 옛 행을 바로 지우지 않습니다. 큐는 행 하나가 등록 → running → done(또는 삭제)으로 짧은 시간에 여러 번 바뀌므로, 처리량만큼 죽은 행(dead tuple)이 쌓입니다. 이것을 치우는 것이 VACUUM이고, 자동으로 돌리는 것이 autovacuum입니다. 아래 데모에서 같은 일을 세 방식으로 처리하며 테이블 크기와 죽은 행 수를 보세요. 역시 브라우저 속 진짜 Postgres입니다.
Node에서 같은 SQL로 잰 값(라운드당 작업 2만 건, 3라운드)입니다.
완료 처리 방식
3라운드 뒤 힙 크기 · 죽은 행
VACUUM 뒤
정리 비용
① UPDATE status='done' (보관)
50.8MB · 12만 개
죽은 행 0, 크기는 50.8MB 그대로(다음 INSERT가 재사용)
VACUUM 42ms
② DELETE
33.9MB · 12만 개
힙은 비지만 부푼 인덱스 3.5MB가 남음
VACUUM 18ms
③ 날짜 파티션 + DROP
하루치만 부풂
파티션을 통째로 지워 24KB
DROP 약 1ms, VACUUM 불필요
죽은 행이 쌓이면 작업을 가져오는 쿼리도 느려집니다. 인덱스가 아직 옛 버전을 가리켜 더 많은 페이지를 읽어야 하기 때문입니다. 데모에서 1라운드 뒤 가져오기 쿼리는 723페이지를 읽었고, VACUUM 뒤에는 2페이지만 읽었습니다(1.9ms → 0.09ms). 실서버의 대응은 네 가지입니다.
긴 트랜잭션을 막습니다. 열려 있는 트랜잭션이 하나라도 있으면 그 이후의 죽은 행은 치울 수 없습니다. 2015년 Brandur의 글 「Postgres Job Queues & Failure By MVCC」는 긴 트랜잭션 때문에 작업 테이블에 죽은 행이 10만 개 가까이 쌓인 사례를 보여 줍니다. PlanetScale도 2026년 4월 글에서 "이 문제는 2015년의 유물이 아니다"라며 초당 800건 큐가 분석 쿼리와 겹쳐 무너지는 테스트를 공개했습니다. idle_in_transaction_session_timeout과 분석용 복제본 분리가 기본입니다.
autovacuum을 테이블별로 조입니다. 기본값은 '50행 + 테이블의 20%'가 죽으면 청소합니다. 큐 테이블에는 너무 느슨하므로 alter table jobs set (autovacuum_vacuum_scale_factor = 0.01, ...)처럼 테이블 단위로 낮춥니다. PostgreSQL 18은 테이블이 아무리 커도 이 문턱이 1억 행을 넘지 않게 하는 autovacuum_vacuum_max_threshold를 추가했습니다.
보관이 필요하면 파티션을 씁니다. PostgreSQL 문서도 파티션을 DROP TABLE이나 DETACH로 떼는 것이 "대량 DELETE보다 훨씬 빠르고, 대량 DELETE가 만드는 VACUUM 부담을 완전히 피한다"고 적습니다. 완료 작업을 날짜별 파티션에 두고 보관 기간이 지나면 통째로 지웁니다.
VACUUM FULL은 운영 중인 큐에 쓰지 않습니다. 테이블 전체에 가장 강한 잠금을 걸어 그동안 큐가 멈춥니다. 꼭 필요하면 pg_repack을 검토하세요.
🔎
PGlite에 대한 단서. PGlite는 설정상 autovacuum이 켜져 있지만, 단일 프로세스 WebAssembly라서 데모 중에 자동 청소가 돌지 않았습니다(4초를 기다려도 기록 0). 그래서 데모에서는 죽은 행이 버튼을 누를 때까지 쌓입니다. 실서버에서는 autovacuum이 1분 간격으로 돌며 문턱을 넘은 테이블을 청소합니다.
7. 직접 짜지 말고 라이브러리부터
위의 쿼리는 원리를 보여 주기 위한 것이고, 실제로는 이미 다듬어진 라이브러리가 있습니다. 재시도·백오프·스케줄(cron)·동시성 제한·대시보드까지 들어 있습니다. 버전은 2026년 10월 3일 각 레지스트리에서 확인했습니다.
언어
라이브러리
최신 버전 · 라이선스
메모
Node.js
Graphile Worker
0.18.0 (9월) · MIT
LISTEN/NOTIFY + SKIP LOCKED
Node.js
pg-boss
12.36.0 (10월 2일) · MIT
"SKIP LOCKED에 기대는" 큐, 스케줄·재시도 내장
Python
Procrastinate
3.10.0 (9월) · MIT
Python 3.10+, PostgreSQL 13+. README에서 유지보수자를 더 찾는 중이라고 밝힘
Python
Oban for Python
0.6.6 (9월) · Apache-2.0
엘릭서 Oban의 파이썬판, 아직 베타
Go
River
v0.48.0 (10월 1일) · MPL-2.0
트랜잭션 등록을 전면에 내세움
Ruby
Solid Queue · GoodJob
1.7.0 · 4.19.4 · MIT
Solid Queue는 Rails 8(2024년 11월)의 기본값. Postgres·MySQL·SQLite 모두 지원
Elixir
Oban
2.24.1 · Apache-2.0
PostgreSQL 외에 SQLite·MySQL도 지원
언어 무관
pgmq (확장)
v1.13.0 (9월) · PostgreSQL 라이선스
"SQS처럼 쓰는 Postgres 큐". Supabase Queues의 기반(Supabase Queues는 아직 Public Alpha)
내구성 실행
DBOS · Hatchet · Absurd
—
큐를 넘어 '여러 단계 작업을 중단 후 이어서 실행'. 모두 Postgres를 저장소로 사용
자주 인용되는 "HEY에서 하루 2,000만 건"이라는 Solid Queue 숫자는 MySQL 위의 숫자입니다. 37signals는 2023년 글에서 "우리는 PostgreSQL을 쓰지 않는다"고 밝혔습니다. 다만 같은 SKIP LOCKED 방식의 관계형 DB 큐가 그 규모를 감당한다는 근거로는 읽을 수 있습니다.
Postgres 큐의 처리량 한계는 생각보다 높습니다. Graphile Worker는 성능 문서에서 로컬 고성능 PC, 아무 일도 안 하는 작업 기준으로 초당 약 18만 건 실행을 측정했고, River는 2022년형 M2 맥북에어에서 초당 약 4만 6천 건을 보고했습니다. 둘 다 "그대로 믿지 말라"고 덧붙입니다. Hatchet은 초당 1만 건까지 부하 시험을 했지만 Redis·RabbitMQ 기반보다 자원을 더 쓴다고 적었습니다. 처리량보다 먼저 오는 한계는 대개 다른 데 있습니다. 아래 도구로 여러분의 상황을 넣어 보세요.
떠날 신호는 이렇습니다.
autovacuum이 못 따라갑니다.n_dead_tup이 계속 늘고, 가져오기 쿼리가 점점 느려집니다.
큐가 본 DB를 잡아먹습니다. 큐의 쓰기·연결·I/O가 주문·결제 같은 핵심 쿼리를 느리게 합니다. 먼저 큐 전용 DB 인스턴스로 떼어 보고, 그래도 부족하면 떠납니다.
여러 서비스가 같은 이벤트를 각자 구독합니다(팬아웃). 작업 큐는 '한 명이 처리'하는 모델입니다. 여러 팀이 같은 이벤트를 받아야 하면 Kafka·Redpanda 같은 로그나 SNS+SQS 같은 발행·구독이 맞습니다.
지난 이벤트를 다시 재생해야 합니다. 새 소비자가 처음부터 다시 읽는 일은 로그 기반 브로커의 영역입니다.
초당 수천 건 이상이 꾸준히 이어집니다. 관리형 큐도 비교해 볼 만합니다. 참고로 SQS FIFO는 고처리량 모드를 끄면 파티션당 초당 300건(배치로 3,000건), 고처리량 모드에서는 지역에 따라 초당 9천~7만 건입니다.
떠날 때를 대비해 처음부터 큐 접근을 작은 인터페이스(enqueue, dequeue, ack, fail) 뒤에 두세요. 그러면 Postgres에서 SQS나 RabbitMQ로 옮길 때 바꿀 곳이 한 군데로 줄어듭니다.
마치며
작업 큐는 "Postgres 하나로"가 가장 잘 통하는 영역입니다. 같은 트랜잭션으로 등록할 수 있다는 장점은 전용 브로커가 따라 할 수 없고, 초당 수백 건까지는 운영 부담도 거의 늘지 않습니다. 대신 MVCC로 테이블이 부푸는 성질만은 처음부터 알고 설계해야 합니다. 다음 편에서는 검색을 다룹니다. LIKE '%검색어%'에서 출발해 tsvector·GIN, 한국어 부분 일치를 위한 pg_trgm, 그리고 BM25까지, 역시 브라우저 속 Postgres로 실험합니다.