
#ICLR 2026
5개의 포스트
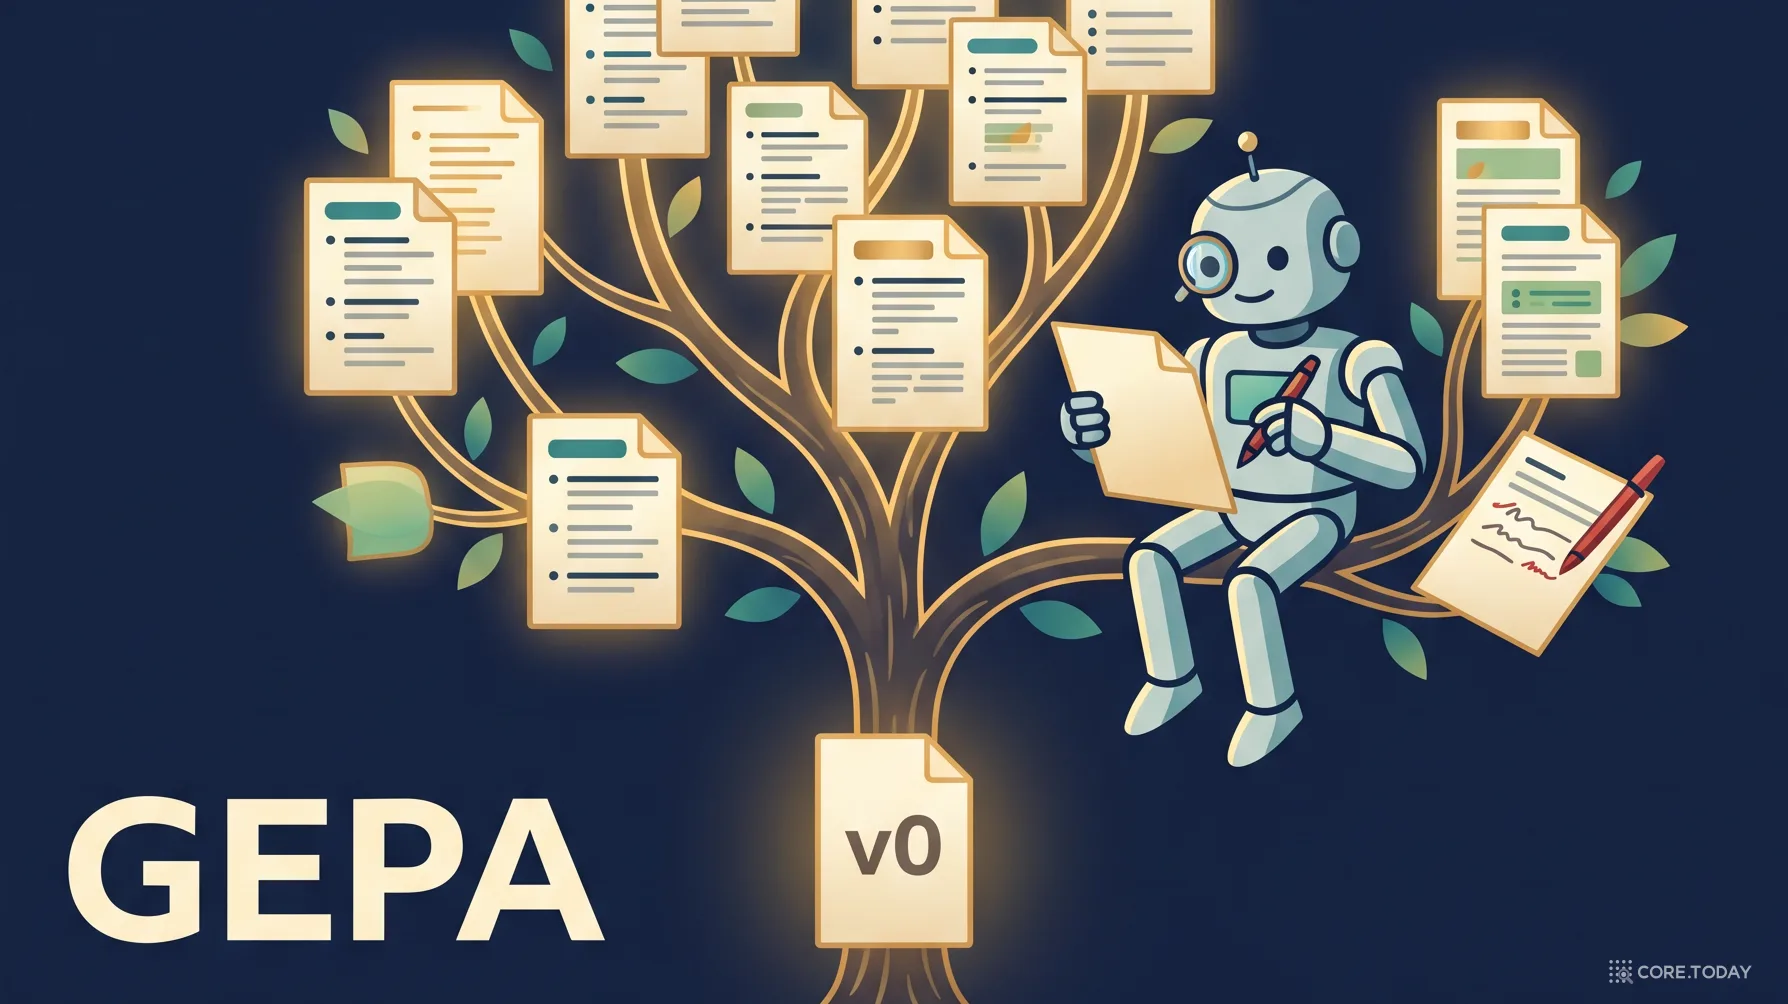
[특집] 점수 대신 첨삭으로 배운다 — GEPA, 프롬프트가 스스로 진화해 강화학습을 이긴 방법
강화학습은 시도 한 번에 점수 하나를 받는다. 그런데 AI가 일한 흔적은 전부 글이다 — 생각의 과정, 도구 호출, 컴파일러 오류 메시지까지. 그렇다면 점수 대신 그 글을 읽고 배우게 하면 어떨까? UC 버클리·스탠퍼드·MIT 등 17명이 쓴 GEPA(ICLR 2026 구두 발표)는 이 질문에 답한다. 실패한 기록을 언어 모델이 직접 읽고 반성해 프롬프트를 고치고, 고친 프롬프트들을 '문항별 1등'이라는 파레토 기준으로 살려 두며 진화시킨다. 그 결과 여섯 과제에서 가중치를 고치는 강화학습(GRPO, 24,000 롤아웃)보다 평균 6점, 최대 20점 높았고, 롤아웃은 최대 35배 적게 썼다. 이 글은 '생각해 보자, 차근차근'이라는 주문에서 시작한 프롬프트 최적화의 역사, 반성·진화·파레토라는 세 기둥, 논문의 표와 그림, 수학 문제에서는 강화학습에 진 이유, 그리고 에이전트가 경험을 글로 쌓아 가는 2026년에 이 아이디어가 맡는 역할을 인터랙티브 6개와 일러스트 13장으로 풀어 본다.
GraphRAG는 정말 효과적인가? — ICLR 2026 논문이 밝힌 9가지 진실
그래프가 RAG를 377배 비싸게 만든다면, 언제 쓸 가치가 있을까? ICLR 2026에서 발표된 GraphRAG-Bench 논문이 9개 시스템을 체계적으로 벤치마킹하여 밝혀낸 9가지 핵심 발견을 깊이 있게 분석합니다.
TurboQuant 특집: AI의 기억을 6배로 압축하는 수학의 마법
Google Research가 ICLR 2026에서 발표한 TurboQuant — AI 모델의 메모리를 6배 줄이면서 정확도 손실은 제로에 가까운 압축 알고리즘의 원리를 역사적 맥락부터 수학적 증명까지 풀어본다.
Vision-R1 특집: AI에게 '눈으로 보고 생각하는 법'을 가르치다 — 과잉사고의 함정부터 점진적 훈련까지
DeepSeek-R1이 텍스트에서 '생각하는 법'을 배웠다면, Vision-R1은 이미지를 보면서 생각하는 법을 배웠다. 하지만 그 과정에서 AI가 '쓸데없이 오래 생각하는' 과잉사고 문제에 빠졌다. ICLR 2026에서 발표된 이 논문이 제시한 점진적 사고 억제 훈련의 원리를, 일러스트와 인터랙티브 요소로 쉽고 깊게 풀어본다.
GraphRAG는 언제 써야 할까? — 그래프가 RAG를 이기는 순간과 지는 순간
GraphRAG가 만능이 아니라면, 정확히 언제 써야 할까? ICLR 2026 논문이 7개 GraphRAG 시스템을 벤치마킹하여 밝혀낸 '그래프가 빛나는 순간'과 '오히려 해가 되는 순간'을 깊이 있게 분석합니다.