
#GraphRAG
14개의 포스트
여덟 갈래를 한 장으로 — 2026년 9월 RAG 스택 선택 기준 (RAG 특집 총정리)
여덟 편에 걸쳐 2026년 하반기 RAG의 변화를 따라왔다. 검색은 파이프라인에서 에이전트가 되었고, 검색의 목표는 청크의 관련성에서 부족한 증거 집합으로, 라우터는 분류기에서 예산 배분기로, 인덱스는 산출물에서 운영 대상으로, 그래프는 하나에서 넷으로, 멀티모달은 페이지에서 토큰으로, 한국어는 한 점에서 토큰 단위 비교로, 보안은 명령문 검사에서 출처 신뢰도로 옮겨 갔다. 이 총정리는 그 여덟 갈래를 한 장의 참조 아키텍처와 한 장의 의사결정표로 접는다. 시리즈가 인용한 논문 18편을 근거 수준 세 층으로 나눠 무엇을 결정의 근거로 삼을 수 있는지 가르고, Docling·OpenSearch·Qwen3·KURE-v2·LightRAG·RAGFlow 같은 오픈소스를 2026년 9월 기준으로 어디에 쓰고 어디에 종속되면 안 되는지 판단하고, 지금 당장·3개월·6개월의 도입 순서와 하지 말아야 할 것 12가지를 적는다. 마지막으로 공고·보도자료·행정·의정·고객지원 티켓·키오스크 장애라는 우리 문서군에 이 구조를 대입해 본다. 인터랙티브 위젯 5종.
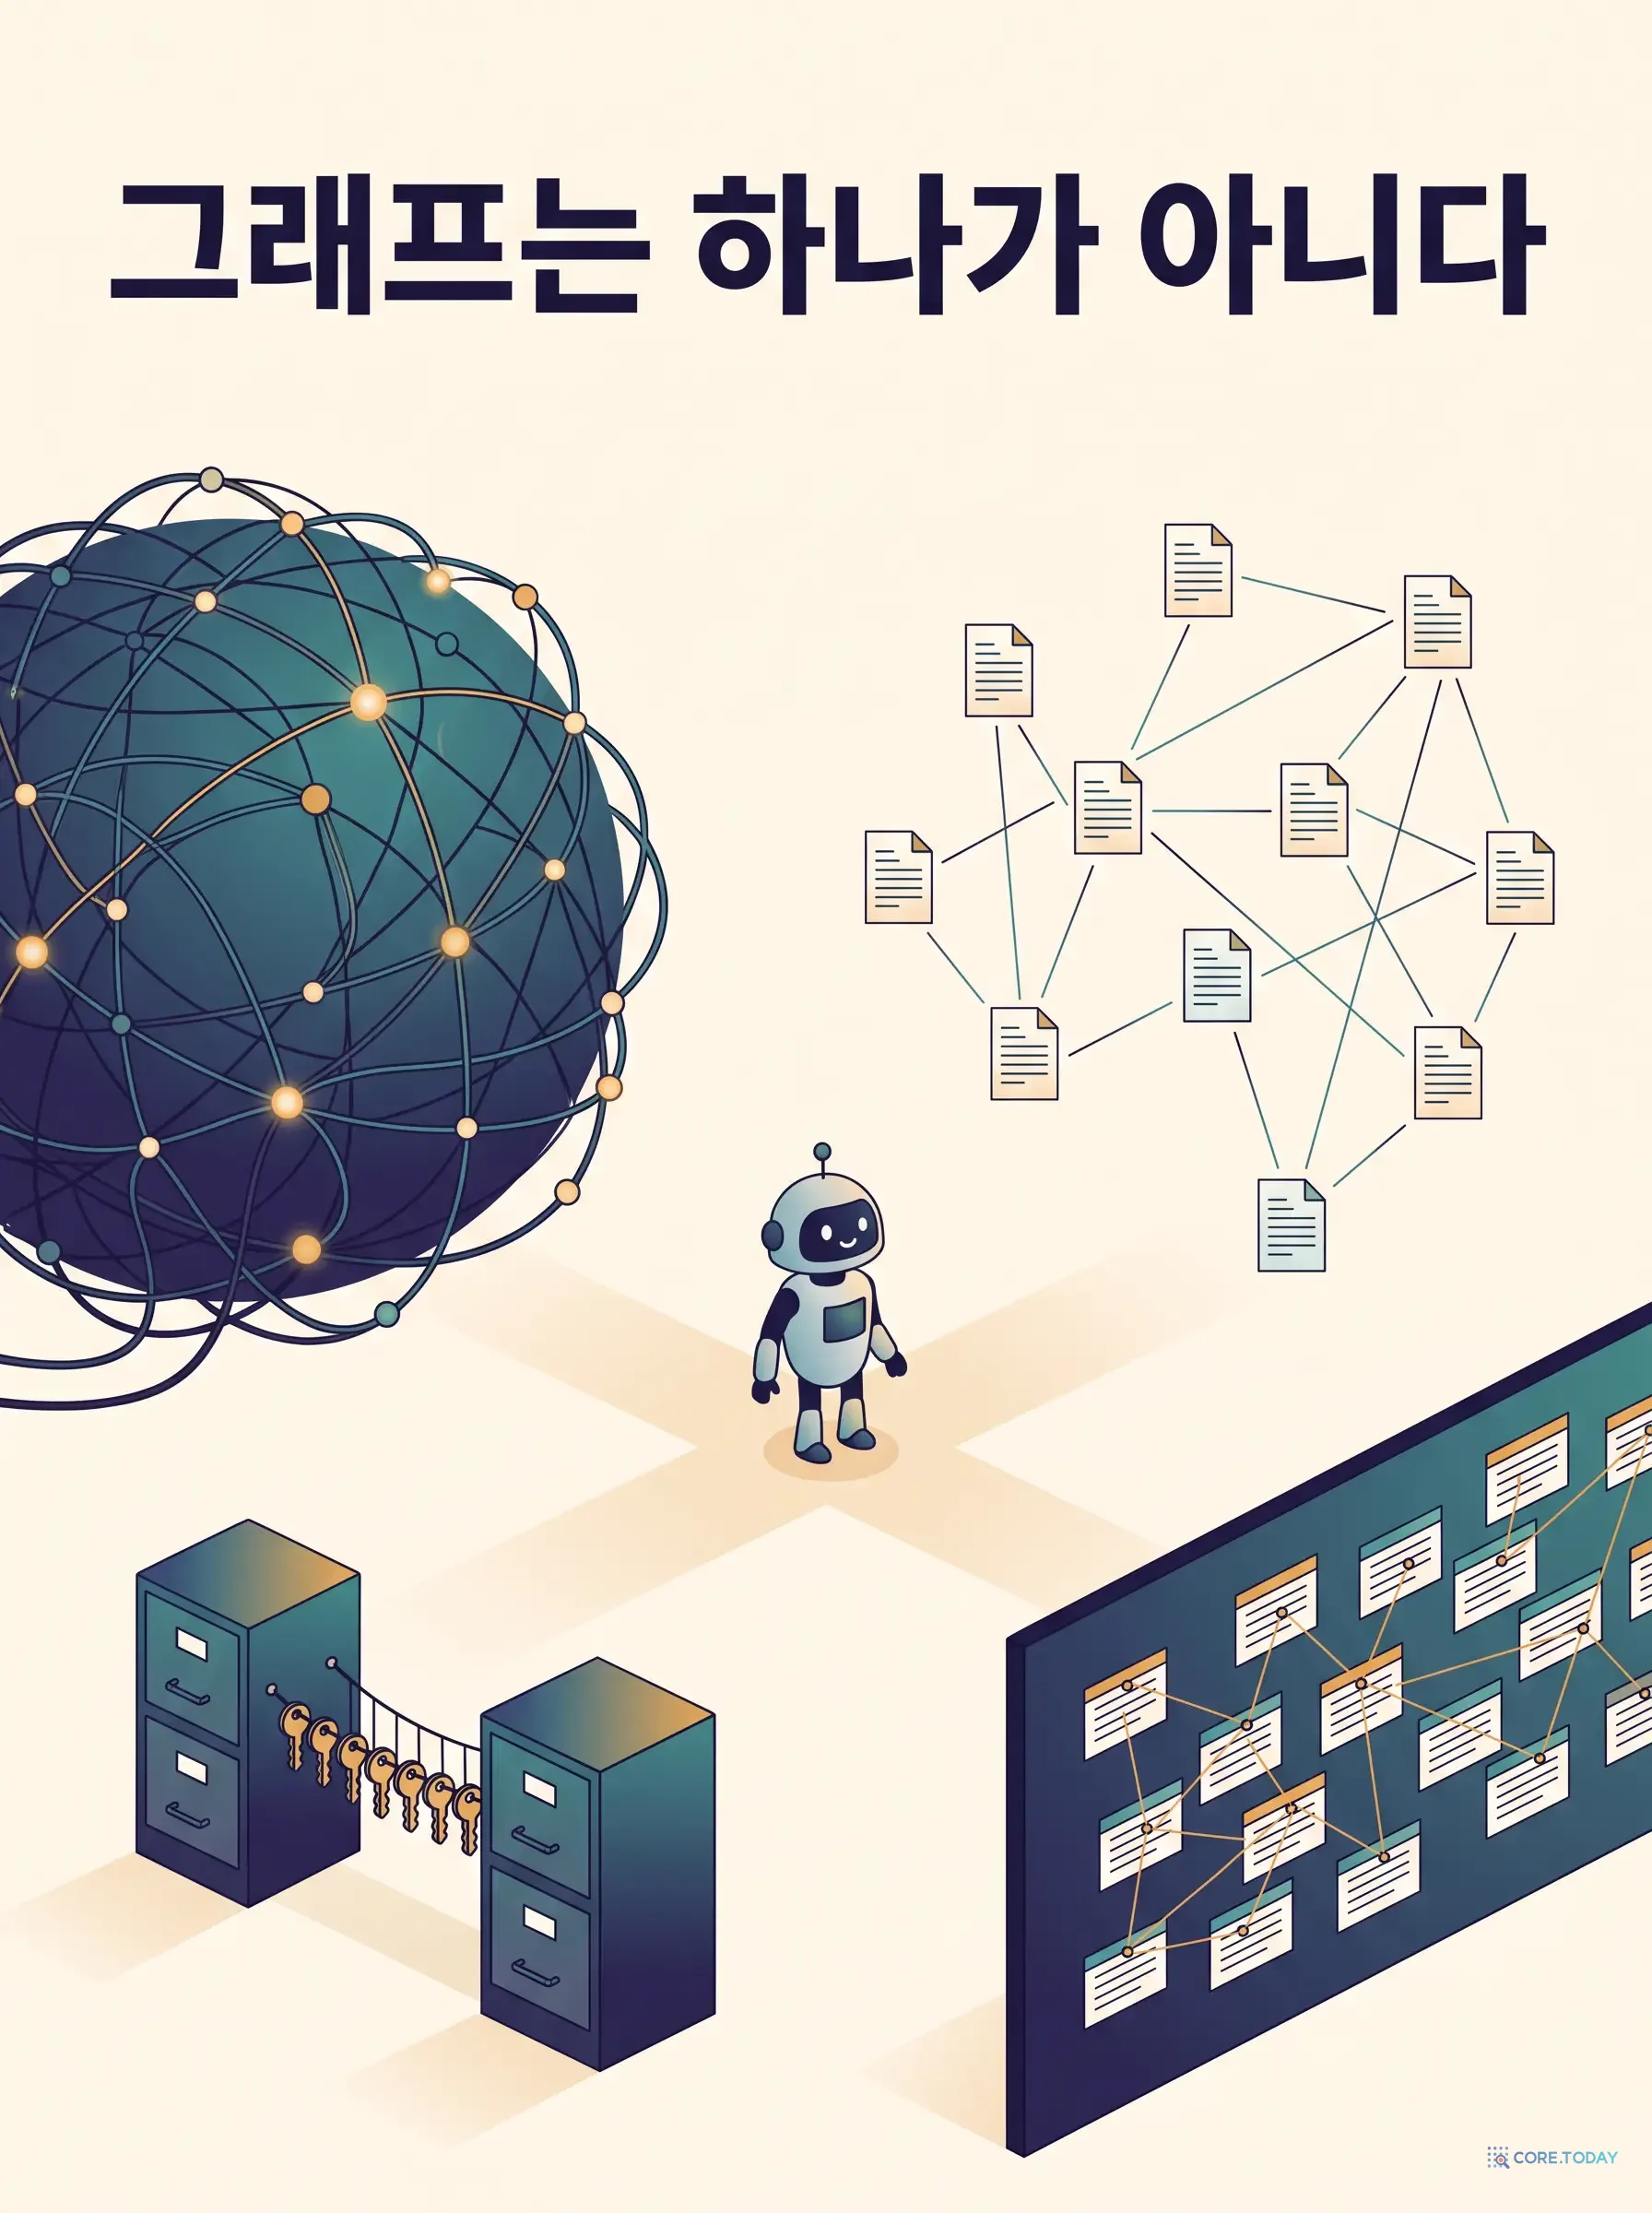
그래프는 하나가 아니다 — GraphRAG의 다변화, 거대 지식 그래프 하나에 종속되지 않기 (RAG 특집 5편)
Microsoft GraphRAG 저장소는 이제 스스로를 ‘대부분 유지보수 모드’라고 적는다. 새 기능도 PR도 받지 않는다. 그렇다고 그래프가 끝난 것은 아니다. 끝난 것은 ‘모든 문서를 LLM으로 엔티티·관계로 쪼개 거대한 전역 그래프를 만들고 모든 질의를 그 위에서 처리한다’는 공식이 무조건적 기본 선택이던 시대다. 2026년의 그래프는 네 갈래로 갈라졌다. 활발히 확장되는 LightRAG, 임베딩 각도만으로 토큰 0에 그래프를 짓는 G³RAG, 전역 그래프 없이 질의 시점에 SQL 조인으로 잇는 SAG, 그리고 위키 링크 구조. 이 특집은 왜 정적 지식 그래프가 비싸고 깨지기 쉬운지를 시뮬레이터로 보이고, cosθ·sinθ 한 식으로 엣지를 만드는 법과 공유 엔티티를 JOIN 키로 쓰는 법을 직접 만져 보고, 내 데이터에 맞는 구조를 고르는 진단 도구까지 간다. 위젯 6종. RAG 특집 시리즈 5편.
사건은 문서가 아니라 궤적이다 — Microsoft RAFT와 '어느 단계에 와 있는가'로 검색하기
Apache Jira에서 사람이 직접 '이건 저것의 중복'이라고 링크한 30쌍을 펼쳐 보면, 그중 14쌍은 제목에 공통 단어가 하나도 없다. 「NPE가 납니다」와 「2.2와 3.0의 페이징 상태가 프로토콜 v4에서 호환되지 않는다」가 같은 문제다. 사건의 유사성은 첫 화면이 아니라 조사가 도달한 지점에 담긴다. EMNLP 2026 Industry Track에 채택된 Microsoft의 RAFT는 종결된 사례를 문서 한 장이 아니라 상태의 사슬로 색인하고, 그 사슬의 중간 지점을 검색 대상으로 삼는다. 이 특집은 실제 Jira 티켓 한 건을 상태로 쪼개 보고, 여섯 단계 파이프라인과 Algorithm 1을 직접 돌려 보고, 무관한 대화 한 턴이 기존 RAG를 49%p 무너뜨리는 실험을 따라가고, 이 발상을 장애 대응·영업·법무·에이전트 메모리로 옮기는 법까지 간다. 인터랙티브 위젯 6종과 공개 데이터 분석을 함께 싣는다.
뉴럴 그래프 데이터베이스: AI가 '관계'를 이해하는 시대의 데이터 관리 혁명
Freebase 인물의 94%는 출생지 정보가 없고, Wikidata 건물의 99.6%는 높이가 기록되지 않았다. 현실의 데이터는 불완전하다. 뉴럴 그래프 데이터베이스(NGDB)는 이 빈 곳을 AI로 채우겠다는 도전이다. HKUST 연구진의 NGDBench 논문을 중심으로, 그래프 데이터 관리의 과거·현재·미래를 특집으로 다룬다.
그래프 데이터베이스의 모든 것: RedisGraph의 종말에서 FalkorDB의 부상까지
관계형 DB의 한계를 넘어선 그래프 데이터베이스의 역사부터 핵심 개념, RedisGraph EOL과 FalkorDB 마이그레이션, 그리고 2026년 AI 시대의 GraphRAG까지. 풍부한 사례와 인터랙티브 시각화로 그래프 DB의 세계를 탐험합니다.
GraphRAG는 정말 효과적인가? — ICLR 2026 논문이 밝힌 9가지 진실
그래프가 RAG를 377배 비싸게 만든다면, 언제 쓸 가치가 있을까? ICLR 2026에서 발표된 GraphRAG-Bench 논문이 9개 시스템을 체계적으로 벤치마킹하여 밝혀낸 9가지 핵심 발견을 깊이 있게 분석합니다.
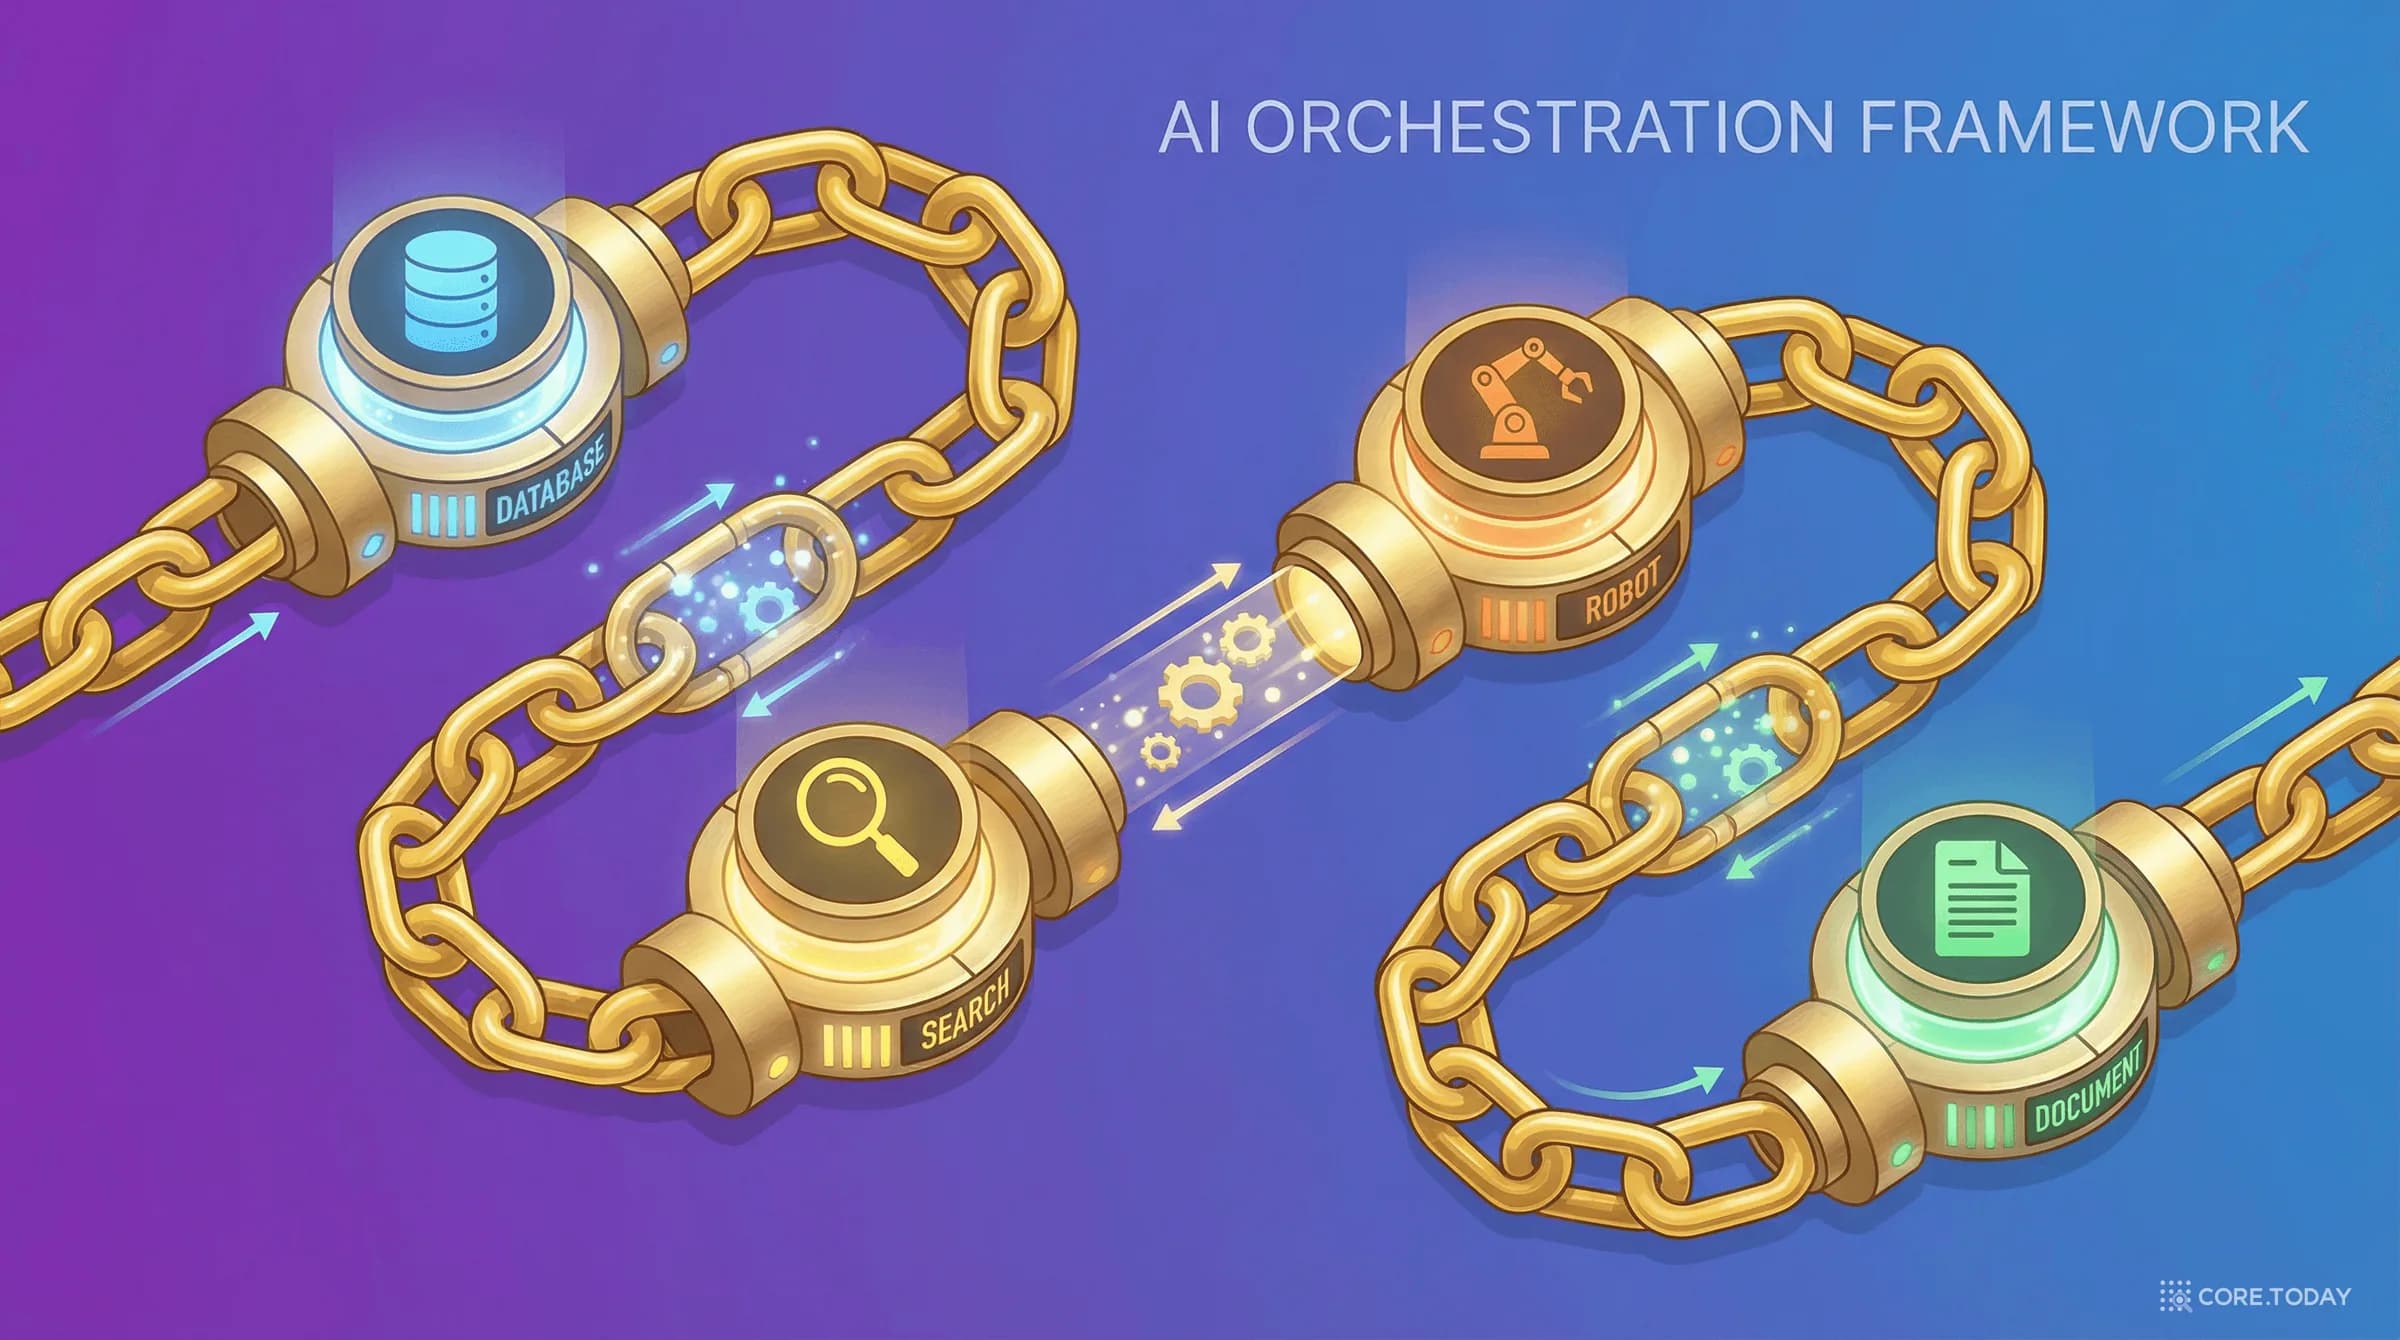
LangChain 완전 가이드: AI 앱의 레고 블록부터 GraphRAG 구축까지
LLM 애플리케이션 개발의 사실상 표준이 된 LangChain — 800줄짜리 사이드 프로젝트에서 유니콘 기업까지의 여정과 핵심 개념을 정리하고, LangChain으로 GraphRAG를 구축하는 실전 패턴을 단계별로 풀어본다.
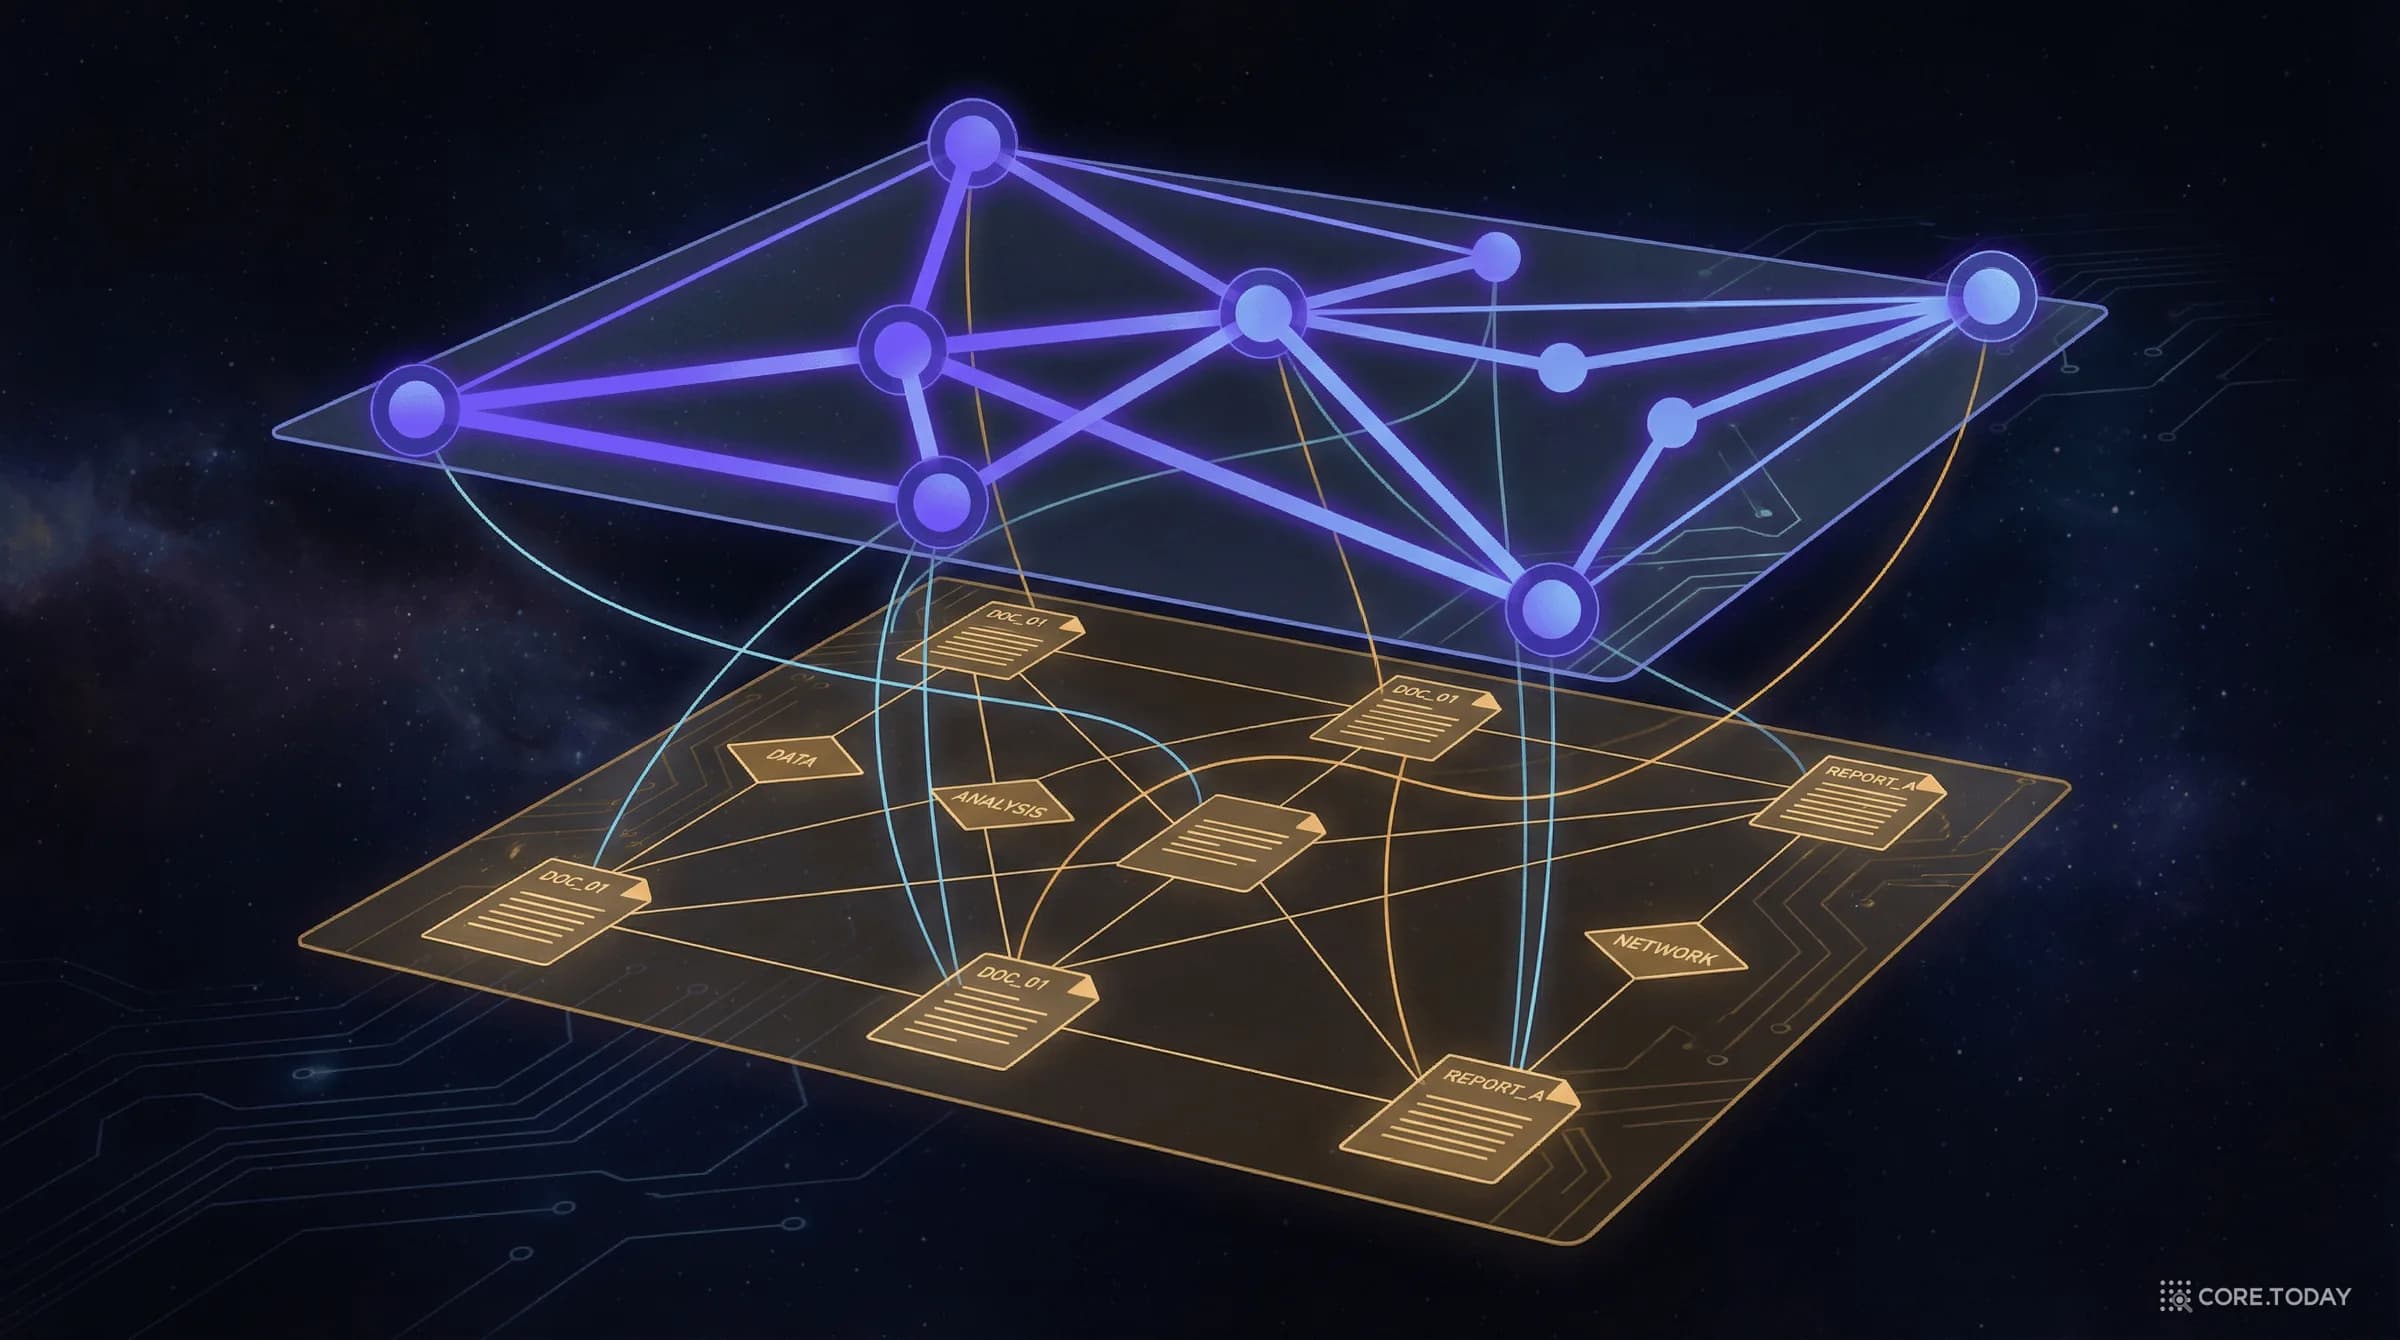
KET-RAG: GraphRAG의 품질을 1/10 비용으로 — KDD 2025가 주목한 다중 해상도 인덱싱
GraphRAG는 강력하지만, 5GB 법률 문서 인덱싱에 $33,000이 든다. KET-RAG는 '모든 청크에 LLM을 돌릴 필요가 없다'는 통찰로, KG 스켈레톤과 키워드 이분 그래프를 결합해 비용을 한 자릿수 이상 줄이면서 더 나은 품질을 달성한다. KDD 2025 논문을 해부한다.
LightRAG 완전 가이드: GraphRAG의 1/100 비용으로 지식 그래프 검색을 실현하다
GraphRAG는 강력하지만 비싸다. LightRAG는 커뮤니티 계층을 없애고 듀얼 레벨 검색을 도입하여, 쿼리당 토큰 사용량을 6000배 줄이면서도 유사한 품질을 달성한다. 왜 이런 접근법이 나왔는지, 어떻게 작동하는지, 언제 써야 하는지를 논문과 사례로 풀어본다.
GraphRAG 완전 가이드: 문서를 그래프로 바꾸면 AI가 보지 못하던 것을 본다
기본 RAG가 놓치는 '전체 그림'을 어떻게 볼 것인가. Microsoft Research의 GraphRAG 논문을 중심으로, 지식 그래프가 왜 필요한지부터 실전 비용 분석, 선택 가이드까지 — 논문과 실무 사례로 풀어본다.
GraphRAG는 언제 써야 할까? — 그래프가 RAG를 이기는 순간과 지는 순간
GraphRAG가 만능이 아니라면, 정확히 언제 써야 할까? ICLR 2026 논문이 7개 GraphRAG 시스템을 벤치마킹하여 밝혀낸 '그래프가 빛나는 순간'과 '오히려 해가 되는 순간'을 깊이 있게 분석합니다.
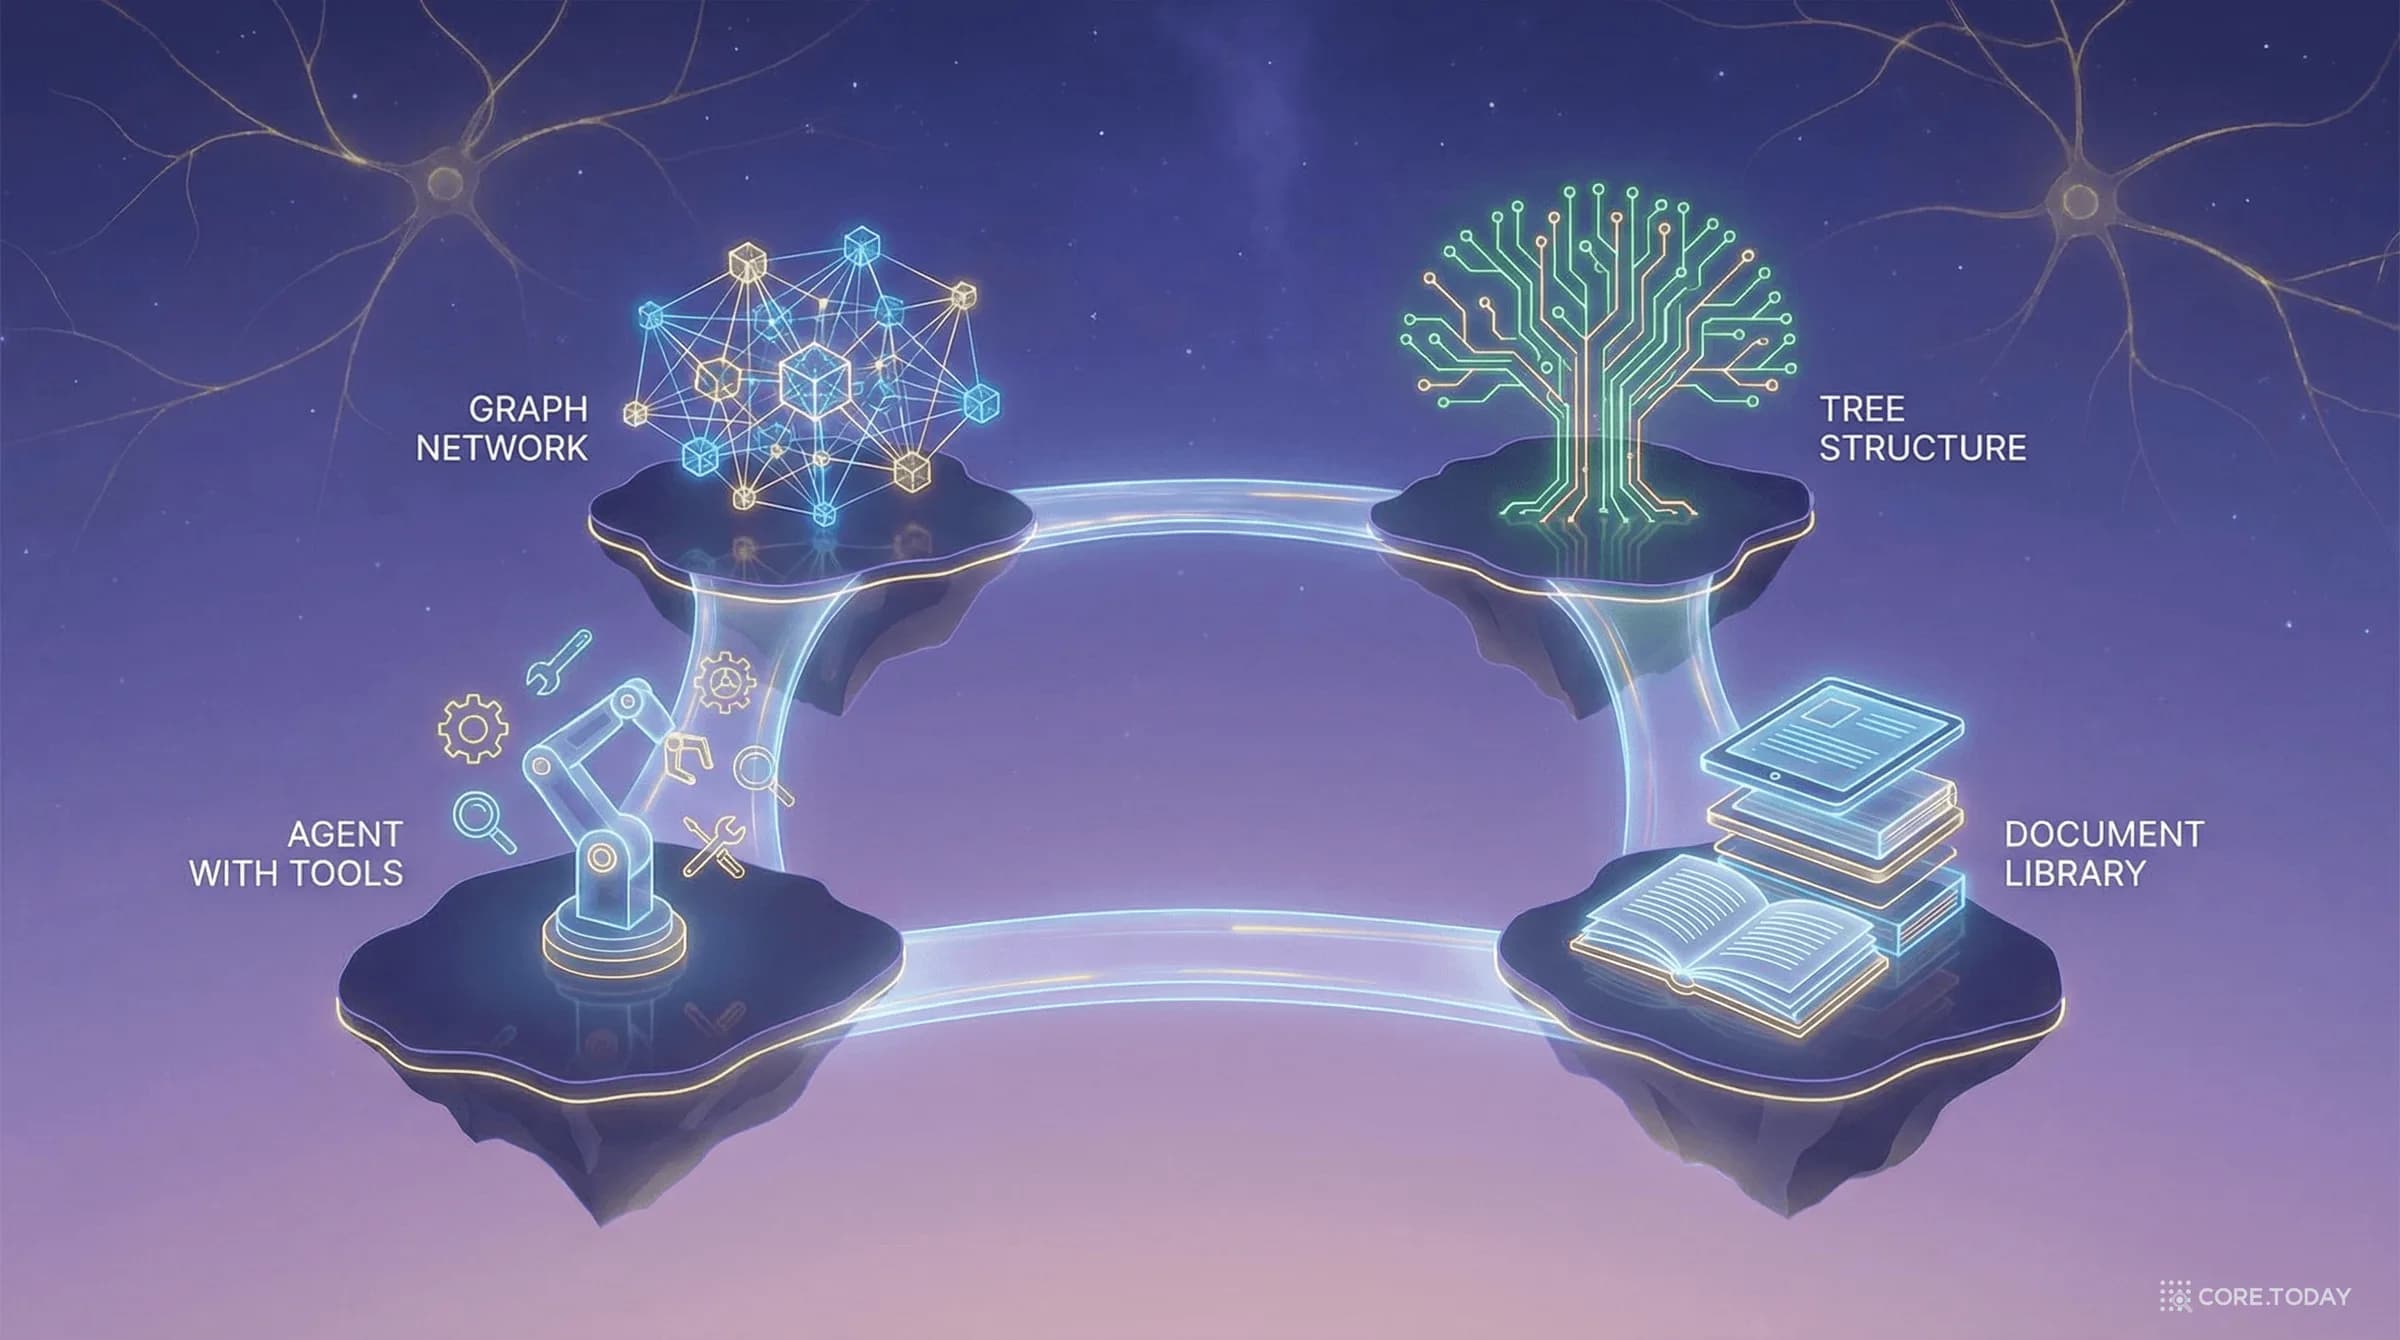
RAG 생태계 완전 가이드: Naive RAG에서 Agentic RAG까지, 언제 무엇을 선택할 것인가
RAG는 이제 하나의 기술이 아니라 하나의 생태계다. 지식 그래프를 활용하는 GraphRAG, 스스로 판단하는 Self-RAG, 에이전트로 진화한 Agentic RAG까지 — 각 접근법이 해결하는 문제와 선택 기준을 논문 기반으로 정리한다.