
#EmbeddingGemma
5개의 포스트
‘롯데 홈구장 새로 짓는 거’를 찾아라 — 부산 공적 기록으로 잰 한국어 임베딩 모델 14종
사실탐색기가 질문 속 바꿔 말한 이름을 찾을 때 쓰는 임베딩 모델을 고르려고, 부산 공적 기록 362건에서 만든 네 과제로 임베딩 14종(설정 28가지)을 맥과 A100에서 쟀습니다. 한국어로 다시 학습한 1.1B 모델 KURE-v3가 8B 모델들보다 앞섰고, 300M짜리 EmbeddingGemma 1세대가 그 바로 뒤에 붙었습니다. 그러나 과제마다 1위가 바뀌었고, 권장 접두사를 빼면 1위 모델이 글자 검색보다도 못해졌으며, 열네 모델 가운데 여섯은 ‘7월 1일’과 ‘7월 8일’처럼 숫자 하나 다른 값의 절반 넘게를 같은 값 쪽으로 봤습니다. 무엇을 고를지와 함께, 임베딩에 맡기지 말아야 할 일을 정리했습니다.
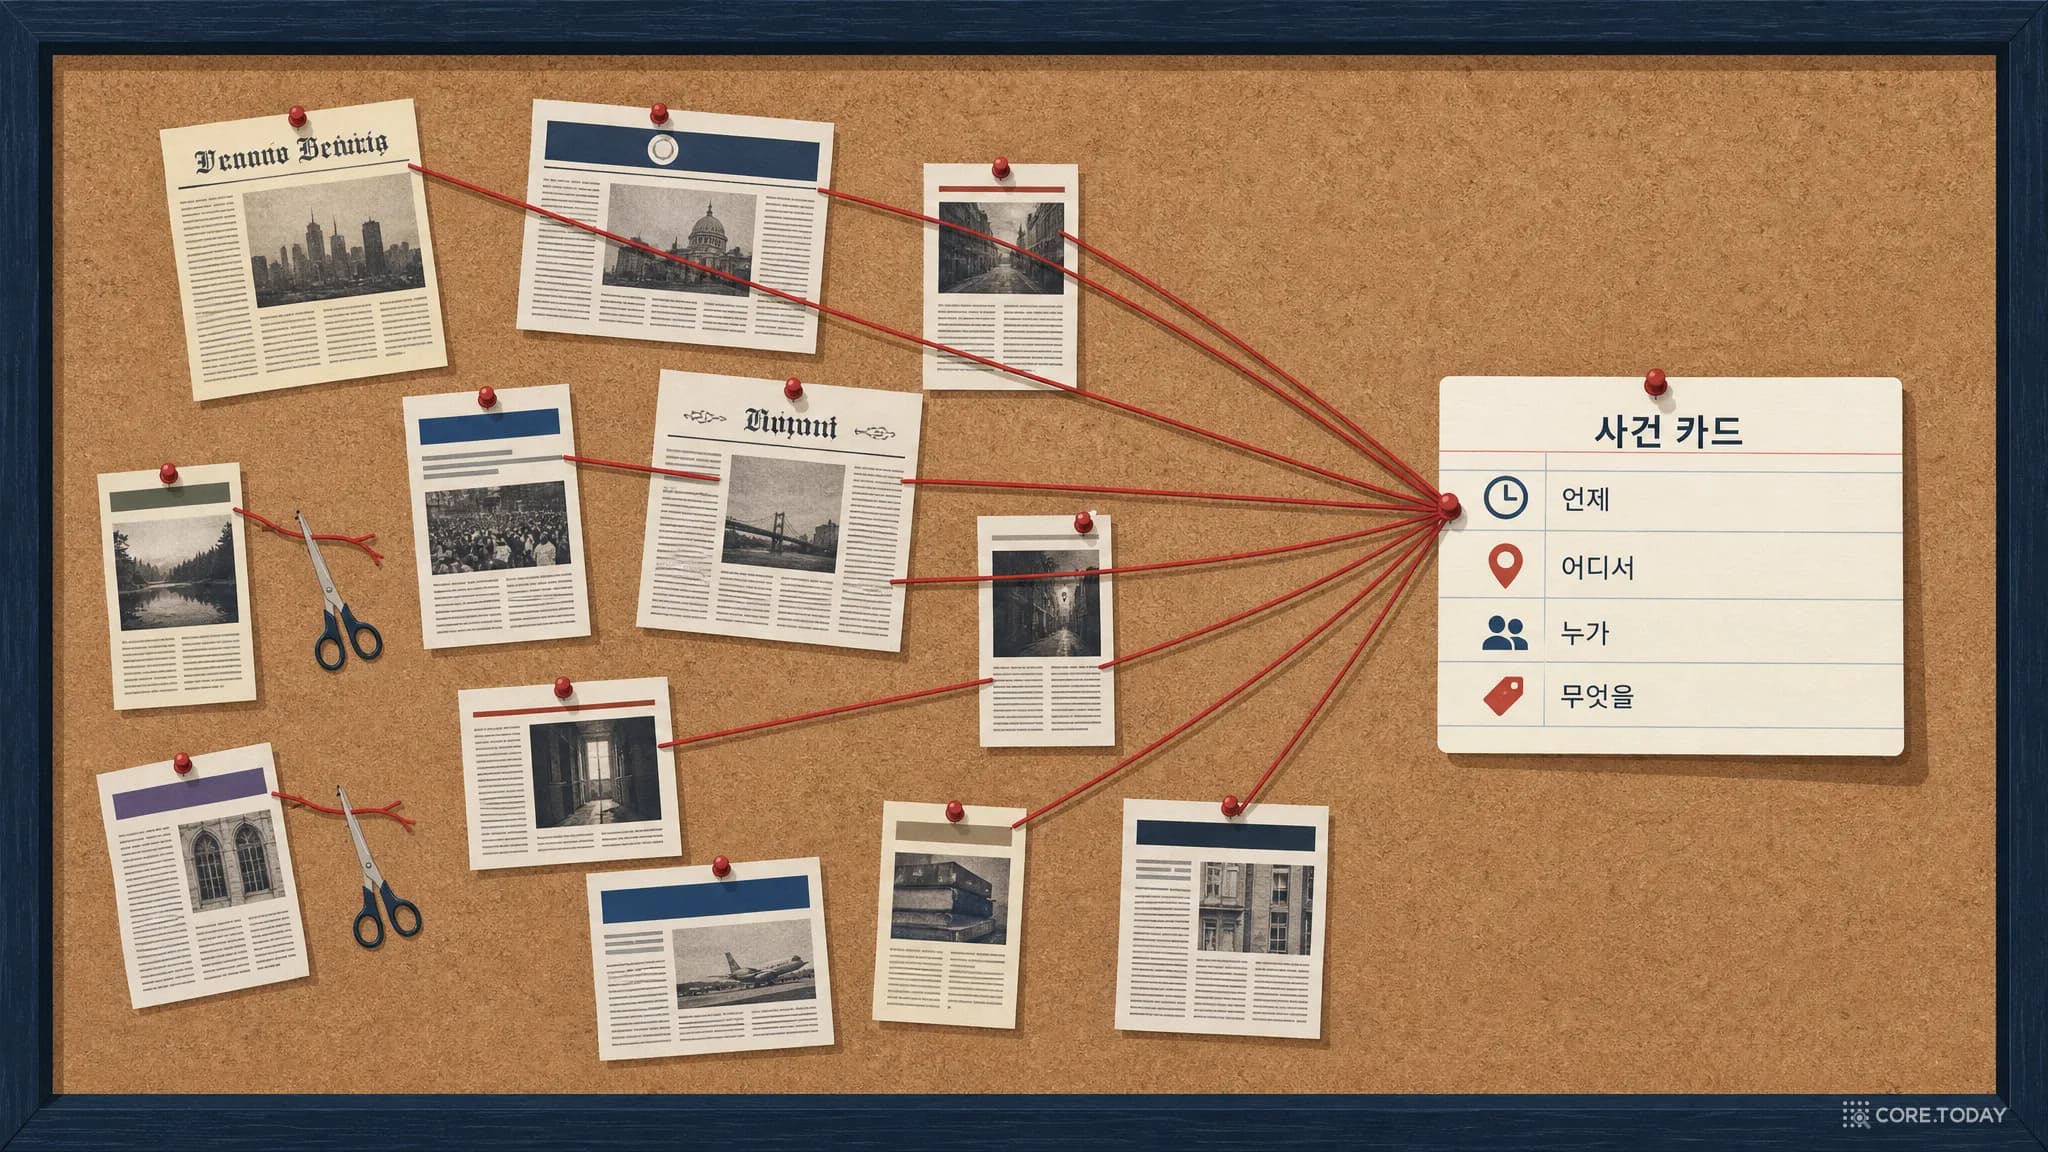
같은 사건 묶기 2편 — 25개 언론사 하루치 2,766건, 시간·장소·사건 레코드는 어디까지 도와주는가
1편은 연합뉴스 하루치 603건에서 '육하원칙 칸 일치 규칙'이 같은 사건 쌍의 3분의 1도 못 찾는다고 끝났습니다. 그러면 육하원칙은 어떻게 써야 하고, 시간과 장소는 정말 도움이 될까요. 이번에는 통신사·방송·전국지·지역지 25곳의 2026년 10월 21일 기사 2,766건을 모아 후보 쌍 20,259개에 정답을 달고(LLM 판사 셋의 다수결과 직접 검수), 기사마다 Gemini로 '사건 레코드'(유형·행위·역할이 붙은 참여자·정규화된 날짜·시군구)를 뽑아 네 가지로 썼습니다. 후보를 찾는 블로킹 키로, 임베딩할 요약으로, 판정 모델의 입력으로, 그리고 '다를 수 없다'를 잘라내는 거부 조건으로. 결과는 선명하게 갈렸습니다. 참여자 이름 블로킹은 임베딩 이웃이 놓친 같은 사건 쌍 13.5%를 건졌고, 사건 요약 임베딩은 제목 임베딩보다 쌍 F1이 0.78에서 0.81로 올랐습니다. 그러나 시간·장소 거부 조건은 처음 설계대로면 같은 사건의 25%를 잘라 버렸고, 고친 뒤에도 좋은 판정 모델 위에서는 14쌍을 바로잡고 75쌍을 잘못 자르는 손해였습니다. 가장 잘 가른 것은 역시 판정 모델이었습니다. Jev 원문 입력 AUROC 0.982, 1편에 없던 OpenAI Decisions는 사건 레코드 입력에서 쌍 F1 0.848·묶음 F1 0.956으로 가장 높았습니다. 그리고 묶음을 가장 크게 망친 것은 모델이 아니라 '오늘의 8뉴스 예고' 같은 다이제스트 기사였습니다. 점수표·묶음 게시판·문턱값 탐색기·거부 조건 분해·원문 대 레코드·파이프라인 설계기 위젯 6개.
같은 사건 묶기 — 하루치 기사 603건에서 '같은 일'을 찾는 법
2026년 10월 13일 하루 연합뉴스 기사 603건 중 같은 사건을 다룬 기사끼리 묶으면 몇 묶음이 나올까요. 인천 흉기난동 하나에만 기사 아홉 건이 달렸습니다. 이 글은 후보 쌍 5,379개를 Claude·GPT로 '같은 사건 / 같은 이야기의 다른 사건 / 다른 사건'으로 판정하고, 둘이 갈린 73쌍을 직접 검수해 정답을 만든 뒤 임베딩 다섯 가지, 문자열 규칙 두 가지, 판정 모델, LLM을 비교했습니다. 육하원칙으로 묶으면 될 것 같지만 그렇지 않았습니다. 같은 사건을 다룬 기사도 같은 사람을 다른 이름으로 부르거나 주인공이 달라서, 육하원칙 칸 일치 규칙은 같은 사건 쌍의 3분의 1도 찾지 못했습니다. 임베딩은 같은 이야기의 다른 사건(유사도 0.86)과 다른 각도의 같은 사건(0.50)을 가르지 못했습니다. 이 둘을 가장 잘 가른 것은 판정 모델 Jev였고(AUROC 0.998), 다만 0.5가 아니라 0.9를 문턱값으로 써야 했습니다. 로컬 판정 모델(Nimble·Clef-Flash·tev1)은 확률이 과감해 오히려 묶음을 망쳤고, 로컬만 쓸 수 있다면 EmbeddingGemma 하나가 가장 나았습니다. 문턱값 탐색기·사건 각도 표·방법 비교표·함정 목록·묶음 게시판 위젯 5개.
지도와 심판 — 임베딩과 판정 모델, 언제 무엇을 쓰나: 업무 12가지와 조합 실측 (로컬 모델 실측 3편)
1편에서 임베딩 모델 아홉 개를, 2편에서 판정 모델 세 개를 같은 맥에서 한국어로 쟀습니다. 3편은 그 둘을 한 자리에 놓고 묻습니다. 어느 일에 어느 쪽을 쓰나. 임베딩은 지도입니다. 수백만 건 중 어디를 볼지 알려 주고, 좌표를 저장해 두고 재사용합니다. 판정 모델은 심판입니다. 눈앞의 후보 몇 개 중 무엇이 맞는지, 규정에 비춰 되는지 안 되는지를 확률과 함께 말합니다. 이 글은 네 가지 질문으로 두 자리를 가르는 진단표, 고객 문의 라우팅·환불 규정·감성 점수·인젝션 탐지·도구 호출 가드·민원 배정·LLM 라우팅 일곱 업무의 실측(판정 모델 세 개 대 임베딩 유사도 대 27B 채팅 모델), 코어닷투데이가 실제로 만나는 업무 열두 가지의 추천 조합·예시·함정, 그리고 '작은 임베딩 + 판정 모델이 큰 임베딩을 따라잡는가'를 1편의 모델 다섯으로 확인한 조합 실험을 담았습니다. 마지막은 메모리·지연·비용·데이터 반출을 한 표로 놓은 운영 체크리스트입니다. 인터랙티브 4개와 삽화 6장.
맥 한 대에 임베딩 모델 아홉 개 — Qwen3·BGE-M3·Nomic·Arctic·EmbeddingGemma 1·2를 한국어로 다시 재다 (로컬 모델 실측 1편)
10월 1일 다섯 모델을 쟀던 글 뒤로 열흘 사이에 많은 것이 바뀌었습니다. 구글이 EmbeddingGemma 2를 냈고, Ollama 0.40이 애플 실리콘에서 MLX 러너를 기본으로 켰고, 같은 맥에 올라 있는 임베딩 모델이 아홉 개가 됐습니다. 이 글은 그 아홉 개 — Qwen3-Embedding 8B·4B·0.6B, BGE-M3, Nomic Embed v2 MoE, Snowflake Arctic Embed 2.0, EmbeddingGemma 300M, EmbeddingGemma 2 740M·440M — 를 코어닷투데이 문서 660건과 한국어 질문 85개로 같은 조건에서 다시 쟀습니다. 모델마다 '무엇을 하려고 만든 모델인지'를 뼈대(인코더·디코더·온디바이스) 기준으로 쉽게 풀고, 결과에서 가장 놀라운 한 줄 — 308M짜리 1세대 EmbeddingGemma가 4B 모델과 같은 점수를 냈고 2세대는 그보다 낮았다 — 이 왜 나왔는지, 접두어 한 줄이 0.08을 바꾸는 이유, 같은 문서를 토크나이저가 얼마나 다르게 쪼개는지, 벡터를 256차원으로 잘라도 되는지를 실제 값으로 보여 줍니다. 인터랙티브 7개와 삽화 6장. 2편은 글자를 쓰지 않는 판정 모델 tev1·Nimble, 3편은 두 종류를 언제 어떻게 쓰나입니다.