
#로컬 LLM
4개의 포스트
포트는 8080이 됐는데 AI는 아직 8000이라고 한다 — 낡은 사실 오류와 '시간 유효성' 기억
RAG는 사실이 바뀌면 옛 값과 새 값을 둘 다 꺼내 오고, 어느 쪽이 지금 값인지 가릴 방법이 없습니다. 2026년 6월 arXiv에 올라온 MemStrata 논문은 이것을 '낡은 사실 오류'라 부르고, 유사도로는 바뀐 값을 가려낼 수 없다는 것(AUROC 0.59)부터 보인 뒤 (주어, 관계, 값) 열쇠로 옛 값을 지우지 않고 퇴역시키는 기억을 제안합니다. 1969년 프레임 문제부터 SQL:2011 시간 테이블까지 '바뀌는 세계를 기억하는 법'의 역사를 따라가고, 한국어 시나리오 30개로 논문의 핵심 주장을 로컬 모델에서 다시 재 보았습니다.
[특집] 에이전트가 CPU를 먹는다 — GPU 한 장에 CPU 몇 개? 코딩 에이전트로 재 본 대기 시간
2026년 프런티어 연구소들은 강화학습에 쓸 CPU가 바닥나 클라우드 회사와 범용 서버를 놓고 다투고 있고, Microsoft의 OpenAI용 Fairwater 데이터센터는 295MW GPU 클러스터 옆에 48MW CPU·스토리지 건물을 붙였습니다(전력 약 1:6). 코어닷투데이가 Claude Code 로그 26일치(모델 응답 6만 2,600번, 도구 호출 7만 7,197번)를 세어 보니 메인 세션 활성 시간의 42%가 도구를 기다리는 시간이었고, 10초 넘는 도구 호출 8.6%가 도구 시간의 83%를 만들었습니다. 맥 한 대에서 로컬 모델로 코딩 에이전트를 돌려 테스트 수를 50개에서 6,410개로 늘리자 모델 시간은 그대로인데 모델 1초당 CPU초가 0.09에서 8.37로 커졌고, 병렬 실행은 기다림을 줄였을 뿐 CPU초를 줄이지 못했습니다. 이 비율로 계산하면 GPU 한 장 옆에 필요한 CPU 코어는 일감에 따라 10개 안팎에서 수백 개까지 벌어지며, 그 식과 계산기, 2026년 CPU 열 종의 정리를 함께 실었습니다.
4B를 Flash로 가르치기 — 육하원칙 추출, 선생님 답 1,623개로 로컬 모델을 키우다
이 시리즈의 첫 글에서 클라우드 Gemini 3.8 Flash는 육하원칙 추출 0.86, 로컬 9B는 0.69였습니다. 그 0.16을 지식 증류로 좁혀 보려고 Flash에게 기사 1,709건의 답을 쓰게 하고(5.6달러), 그 답으로 Qwen3 4B를 맥 한 대에서 LoRA로 가르쳤습니다. 결과는 실패였습니다. 아무것도 가르치지 않은 Qwen3 4B 2507이 이미 9B와 같은 0.686이었고, 1,623개를 다 본 학생은 0.656으로 오히려 내려갔습니다. 학생은 선생님의 판단보다 버릇을 먼저 배웠습니다. 예제 200개 지점에서는 이유가 없는 기사 44건 중 42건에 이유를 지어냈고, 끝까지 배운 뒤에도 학습 전(0건)보다 많은 12건을 지어냈습니다. Flash와 Flash-Lite가 함께 채운 이유만 남긴 '보수적 교재'는 버릇을 고치고 같은 예제 수에서 점수를 0.04 올렸지만, 학습 전 모델은 넘지 못했습니다. 교훈은 하나입니다. 증류보다 먼저, 같은 크기의 최신 모델을 정의서만으로 재 보세요. 학습 곡선·칸별 비교·버릇 상속·전후 비교·손익분기 위젯 5개.
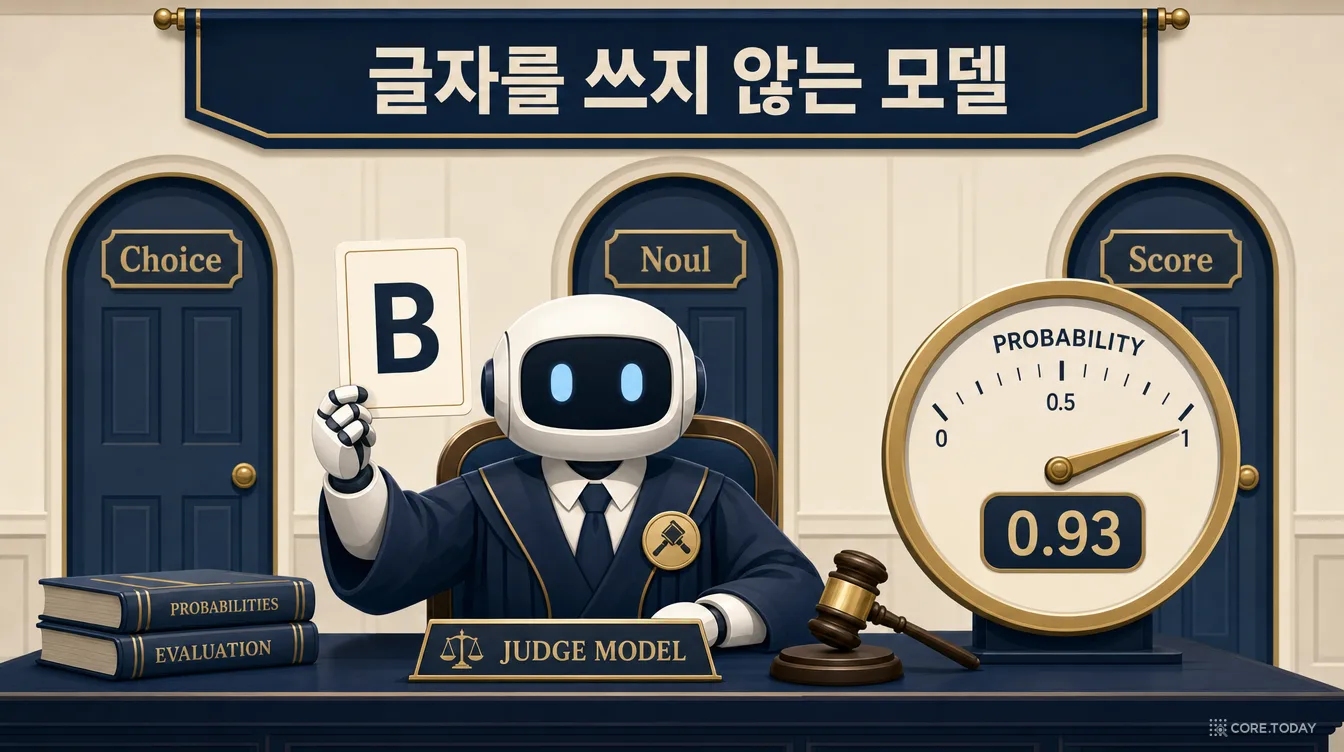
글자를 쓰지 않는 로컬 모델 — Ollama 판정 모델 tev1·Nimble을 한국어로 시험하다 (로컬 모델 실측 2편)
ollama list에 낯선 이름 둘이 있었습니다. tev1:4b와 nimble. ollama show를 쳐 보니 Capabilities에 embedding도 completion도 아닌 'decision'이 적혀 있고, 시스템 프롬프트는 '선택지 중 하나를 고르고 글자 하나만 돌려줘라'였습니다. 9월 15일 TypeSafe가 Jev를 내놓은 뒤 2주 만에 Bespoke Labs(Nimble 9B)와 Together AI(tev1 4B·0.8B)가 열린 가중치로 같은 모양의 모델을 냈고, 9월 29일 Ollama가 /v1/systemone 엔드포인트로 그것을 받아들였고, 10월 1일 클라우드플레어가 27B짜리 Clef를 보탰습니다. 이 글은 그 판정 모델이 무엇이고 왜 빠른지(한 번의 전방 패스에서 선택지 글자의 확률만 읽는다)를 그림으로 풀고, 세 모델의 출신과 학습 레시피를 뜯어본 뒤, 1편과 같은 한국어 코퍼스로 리랭커 자리(85문항 × 10문서)와 분류 자리(625건)에 세워 TypeSafe의 Jev(4편에서 같은 조건으로 직접 실측), 임베딩 이웃 투표, 27B 채팅 모델과 비교했습니다. 결론은 '9B Nimble은 한국어로도 Jev의 자리를 대신하고, 0.8B는 아직 아니다'입니다. 확률이 얼마나 믿을 만한지, 한 번 호출에 몇 ms인지, 한국어 문의 라우팅·규정 적용·감정 점수 같은 실무 과제 7종의 성적도 함께 적었습니다. 인터랙티브 6개와 삽화 7장.