체스 점수는 어떻게 AI 순위표가 됐나 — Elo, 브래들리–테리, 그리고 Chatbot Arena의 빛과 그림자 (특집)
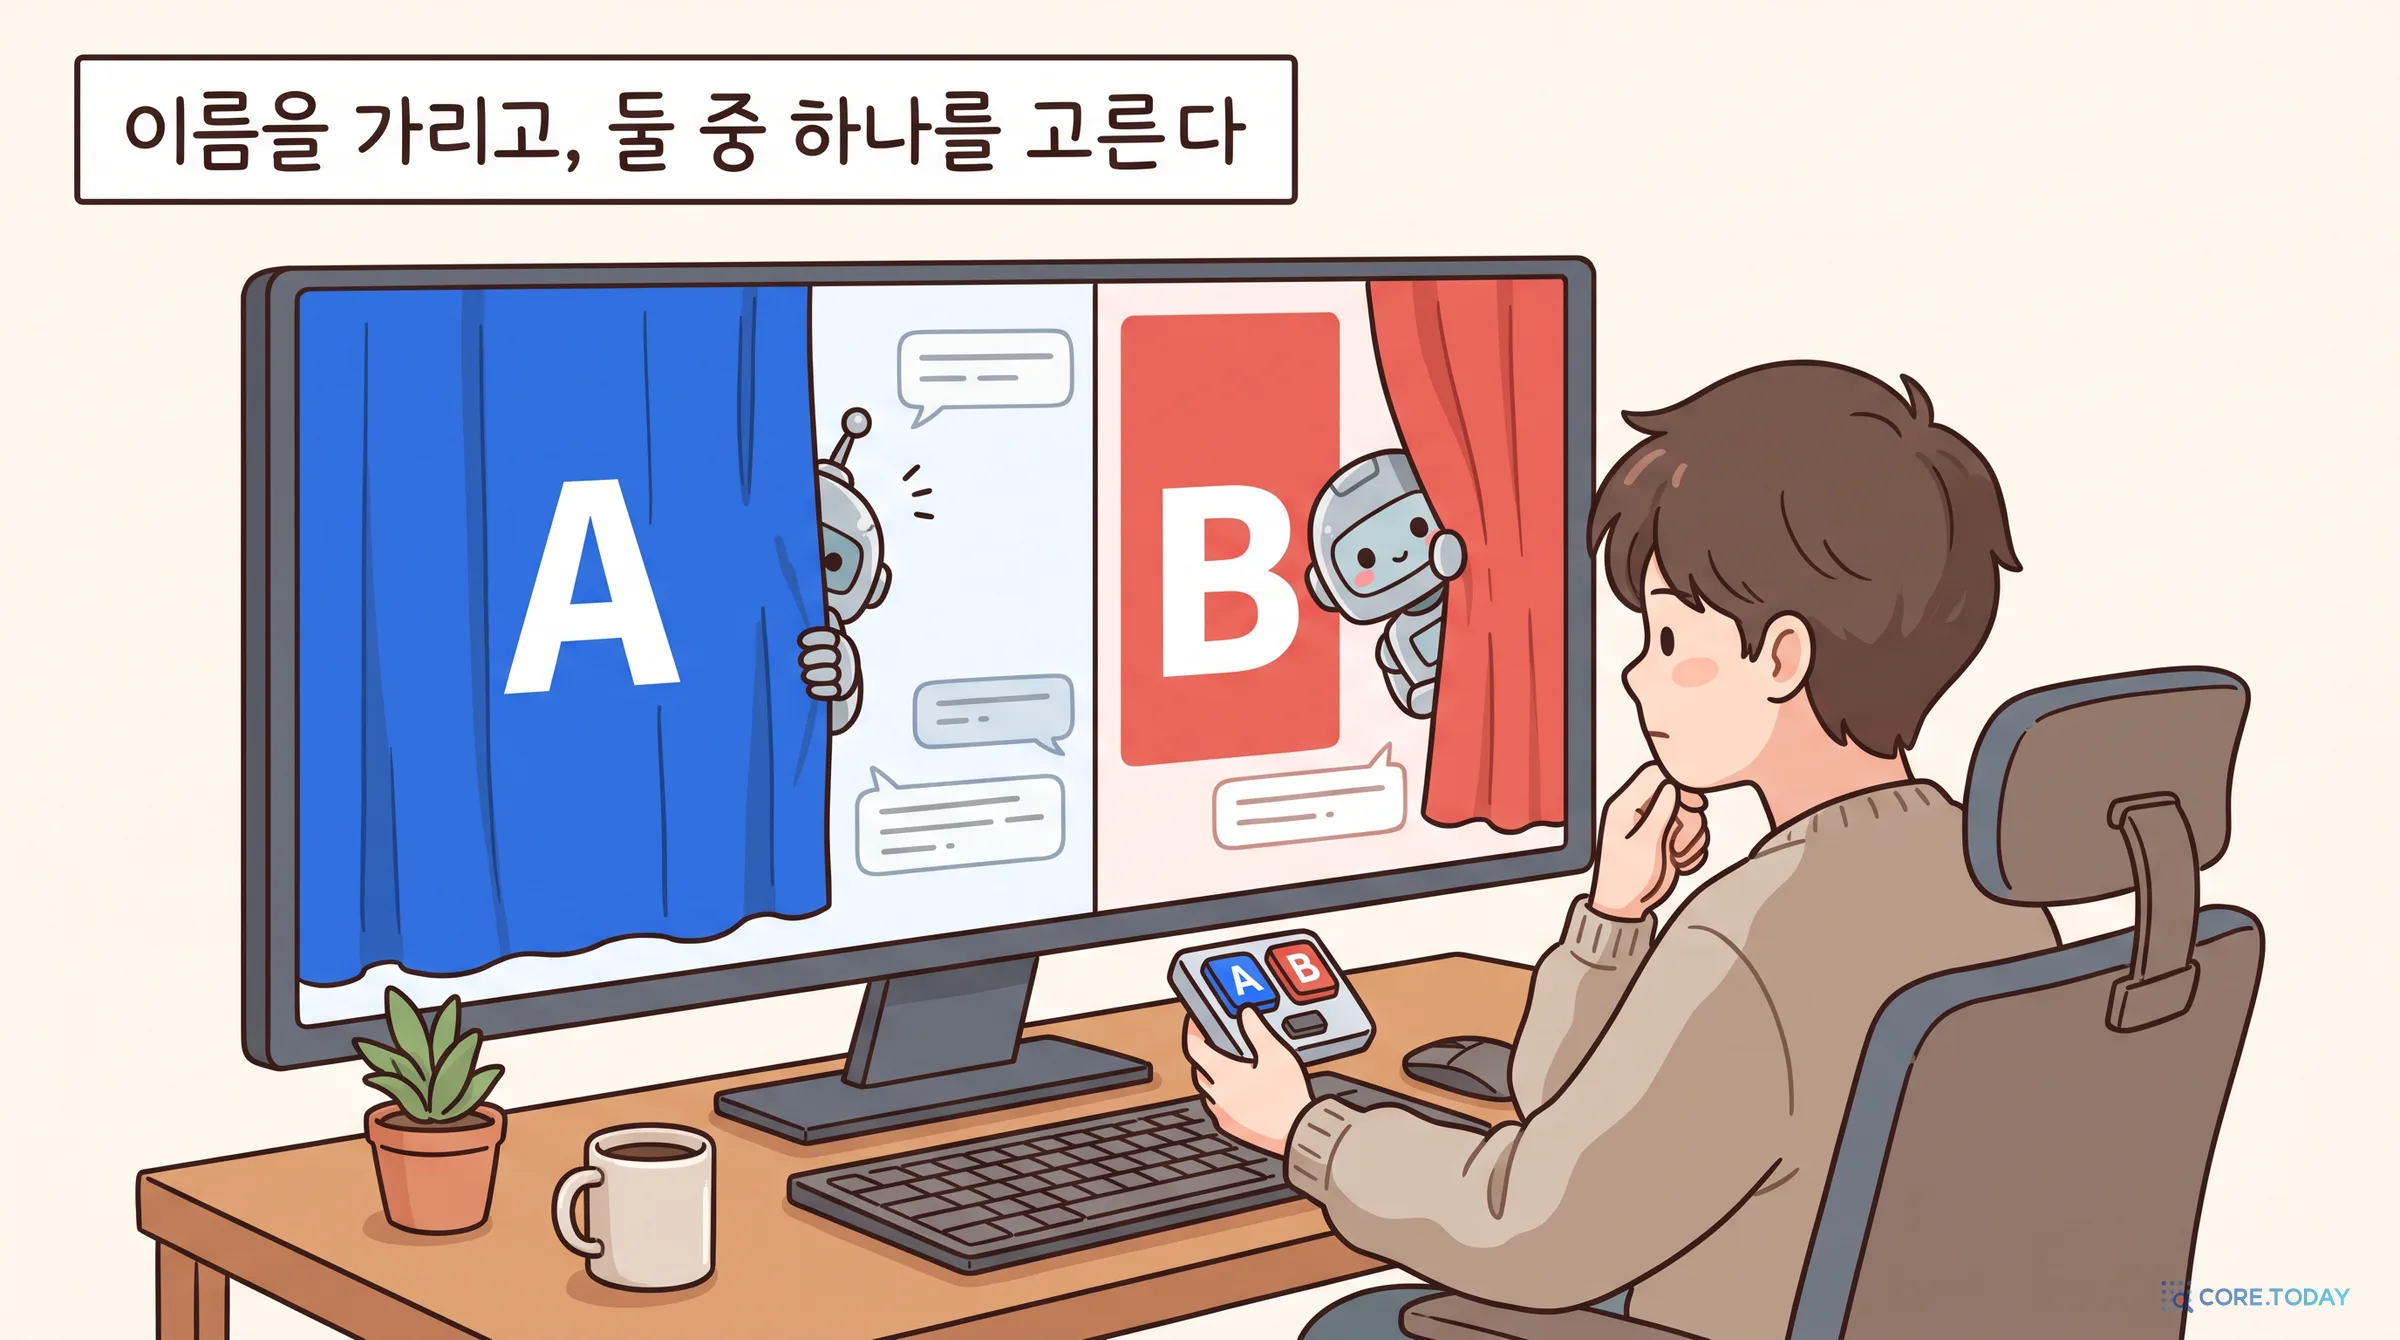
AI 모델이 새로 나오면 ‘아레나 1위’라는 말이 따라붙는다. 그 순위는 사람들이 이름을 가린 두 답 중 하나를 고른 수백만 표로 만든다. 표를 점수로 바꾸는 계산은 1960년 미국 체스계가 채택한 Elo 레이팅과, 1952년 돼지고기 맛 비교 예제를 실은 브래들리–테리 모형에서 왔다. 이 글은 ‘점수보다 비교가 쉽다’는 1927년 심리학 실험부터 체스 레이팅, Chatbot Arena의 탄생까지 따라간다. 이어 Llama 4 ‘실험판’ 사건, 비공개 변형 27개를 지적한 ‘리더보드 착시’ 논문, 1,000표로 순위를 움직이는 조작 연구, 길고 화려한 답이 이기는 문제까지 점수 조작 논란을 정리한다. 아레나 공개 투표 13만 5,634건으로 순위를 직접 다시 계산했다. 같은 Llama 4 Maverick의 실험판과 출시판은 131점 차이가 났고, 답의 길이와 꾸밈을 보정하자 격차가 57점으로 줄었다. 인터랙티브 위젯 6종, 코어닷투데이 실측, 삽화 15장.
2025년 4월 5일 토요일, 메타가 새 언어 모델 Llama 4를 공개했다. 발표 자료에는 눈에 띄는 숫자가 하나 있었다. 사람들이 직접 투표해 AI 순위를 매기는 사이트 LMArena(당시 이름, 지금은 Arena)에서 Llama 4 Maverick이 1417점, 2위에 올랐다는 것이다. 1위는 구글의 Gemini 2.5 Pro뿐이었다.
사흘 뒤 LMArena가 공개적으로 메타를 비판했다. 순위표에 오른 모델은 이름이 ‘Llama-4-Maverick-03-26-Experimental’이었다. 메타 스스로 ‘대화용으로 최적화한(optimized for conversationality)’ 실험판이라고 적어 둔 모델이다. 사람들이 내려받아 쓸 수 있는 출시판과는 다른 모델이었다.
우리는 아레나가 공개한 실제 투표 기록 13만 5,634건으로 두 모델의 점수를 직접 다시 계산했다. 같은 기간, 같은 방법으로 계산했는데도 결과가 이렇게 갈렸다.
131점
같은 Llama 4 Maverick의 실험판과 출시판 점수 차이 (53개 중 9위 대 44위)
63 : 20
두 버전이 직접 맞붙은 124판의 승패 (나머지 41판은 무승부)
1,383 대 609
답변 길이 중앙값(토큰). 굵은 글씨는 답마다 38개 대 7개
61.8%
승부가 갈린 판에서 더 긴 답이 이긴 비율
같은 회사의 같은 모델 이름인데 한쪽은 훨씬 길고 화려하게 답했다. 사람들은 그쪽에 표를 더 줬다. 이 사건은 몇 가지 질문을 남긴다.
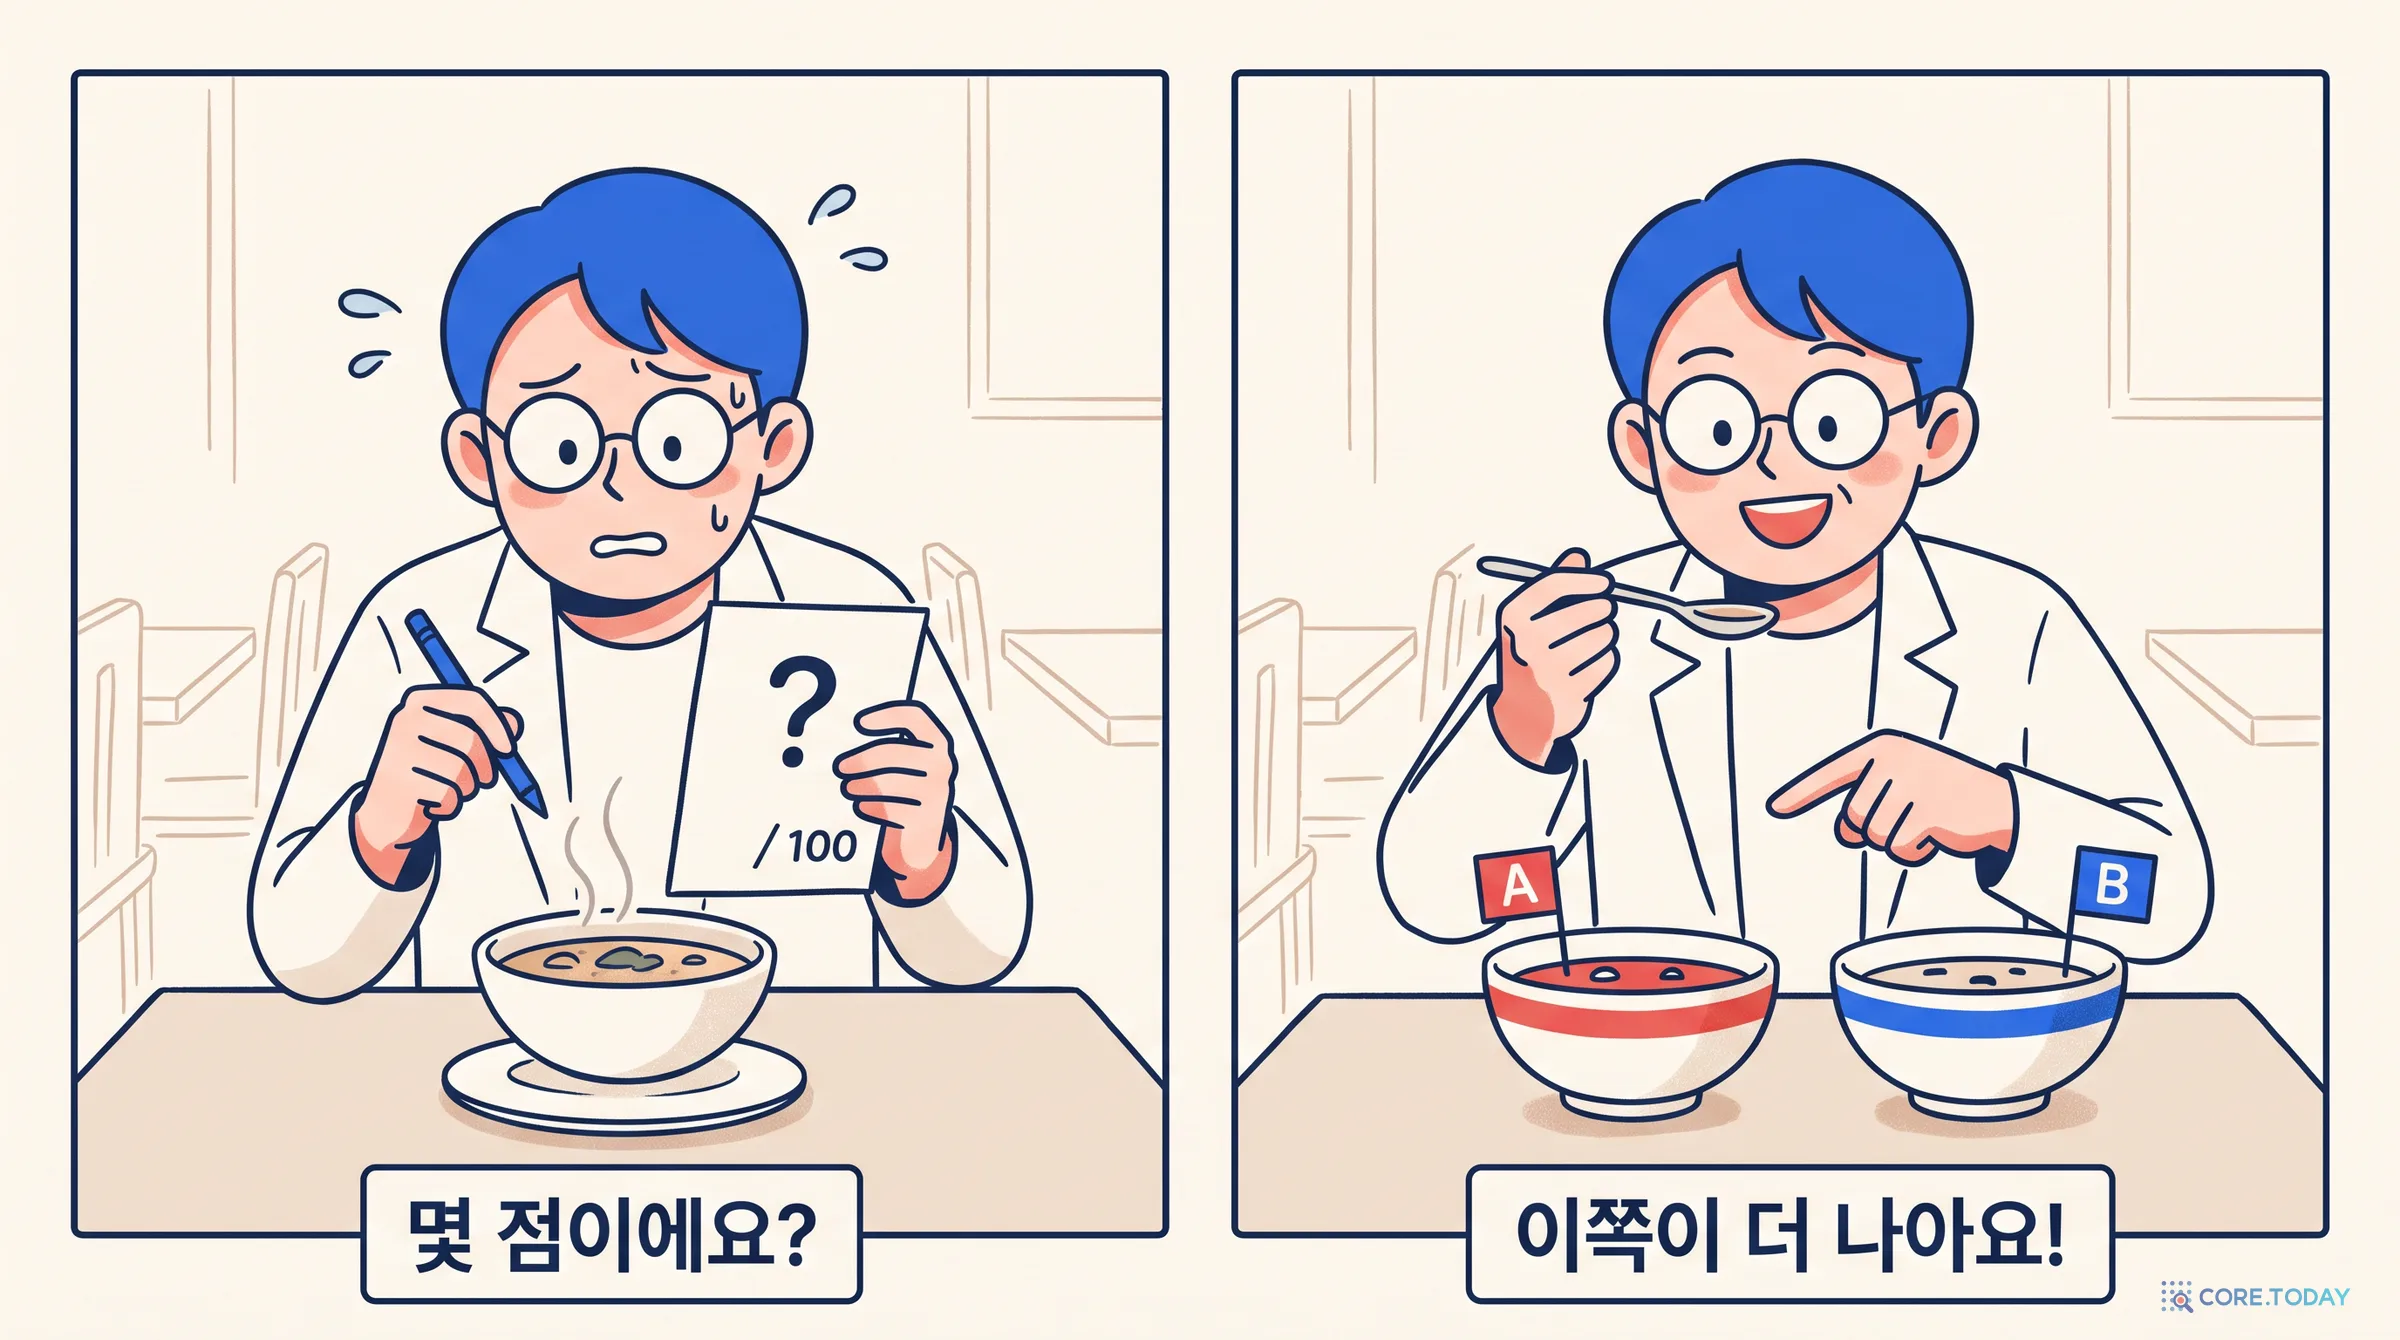
안경점에서 시력 검사를 받으면 검안사가 렌즈를 바꿔 끼우며 묻는다. “1번이 잘 보여요, 2번이 잘 보여요?” 렌즈 하나를 보여 주고 “선명함을 100점 만점으로 매겨 보세요”라고 묻지 않는다. 사람은 절대 점수를 매기는 데 서툴다. 기준이 사람마다 다르고, 같은 사람도 기분이나 앞서 본 것에 따라 기준이 흔들린다. 그런데 둘을 나란히 놓고 고르는 일은 훨씬 정확하고 빠르다.
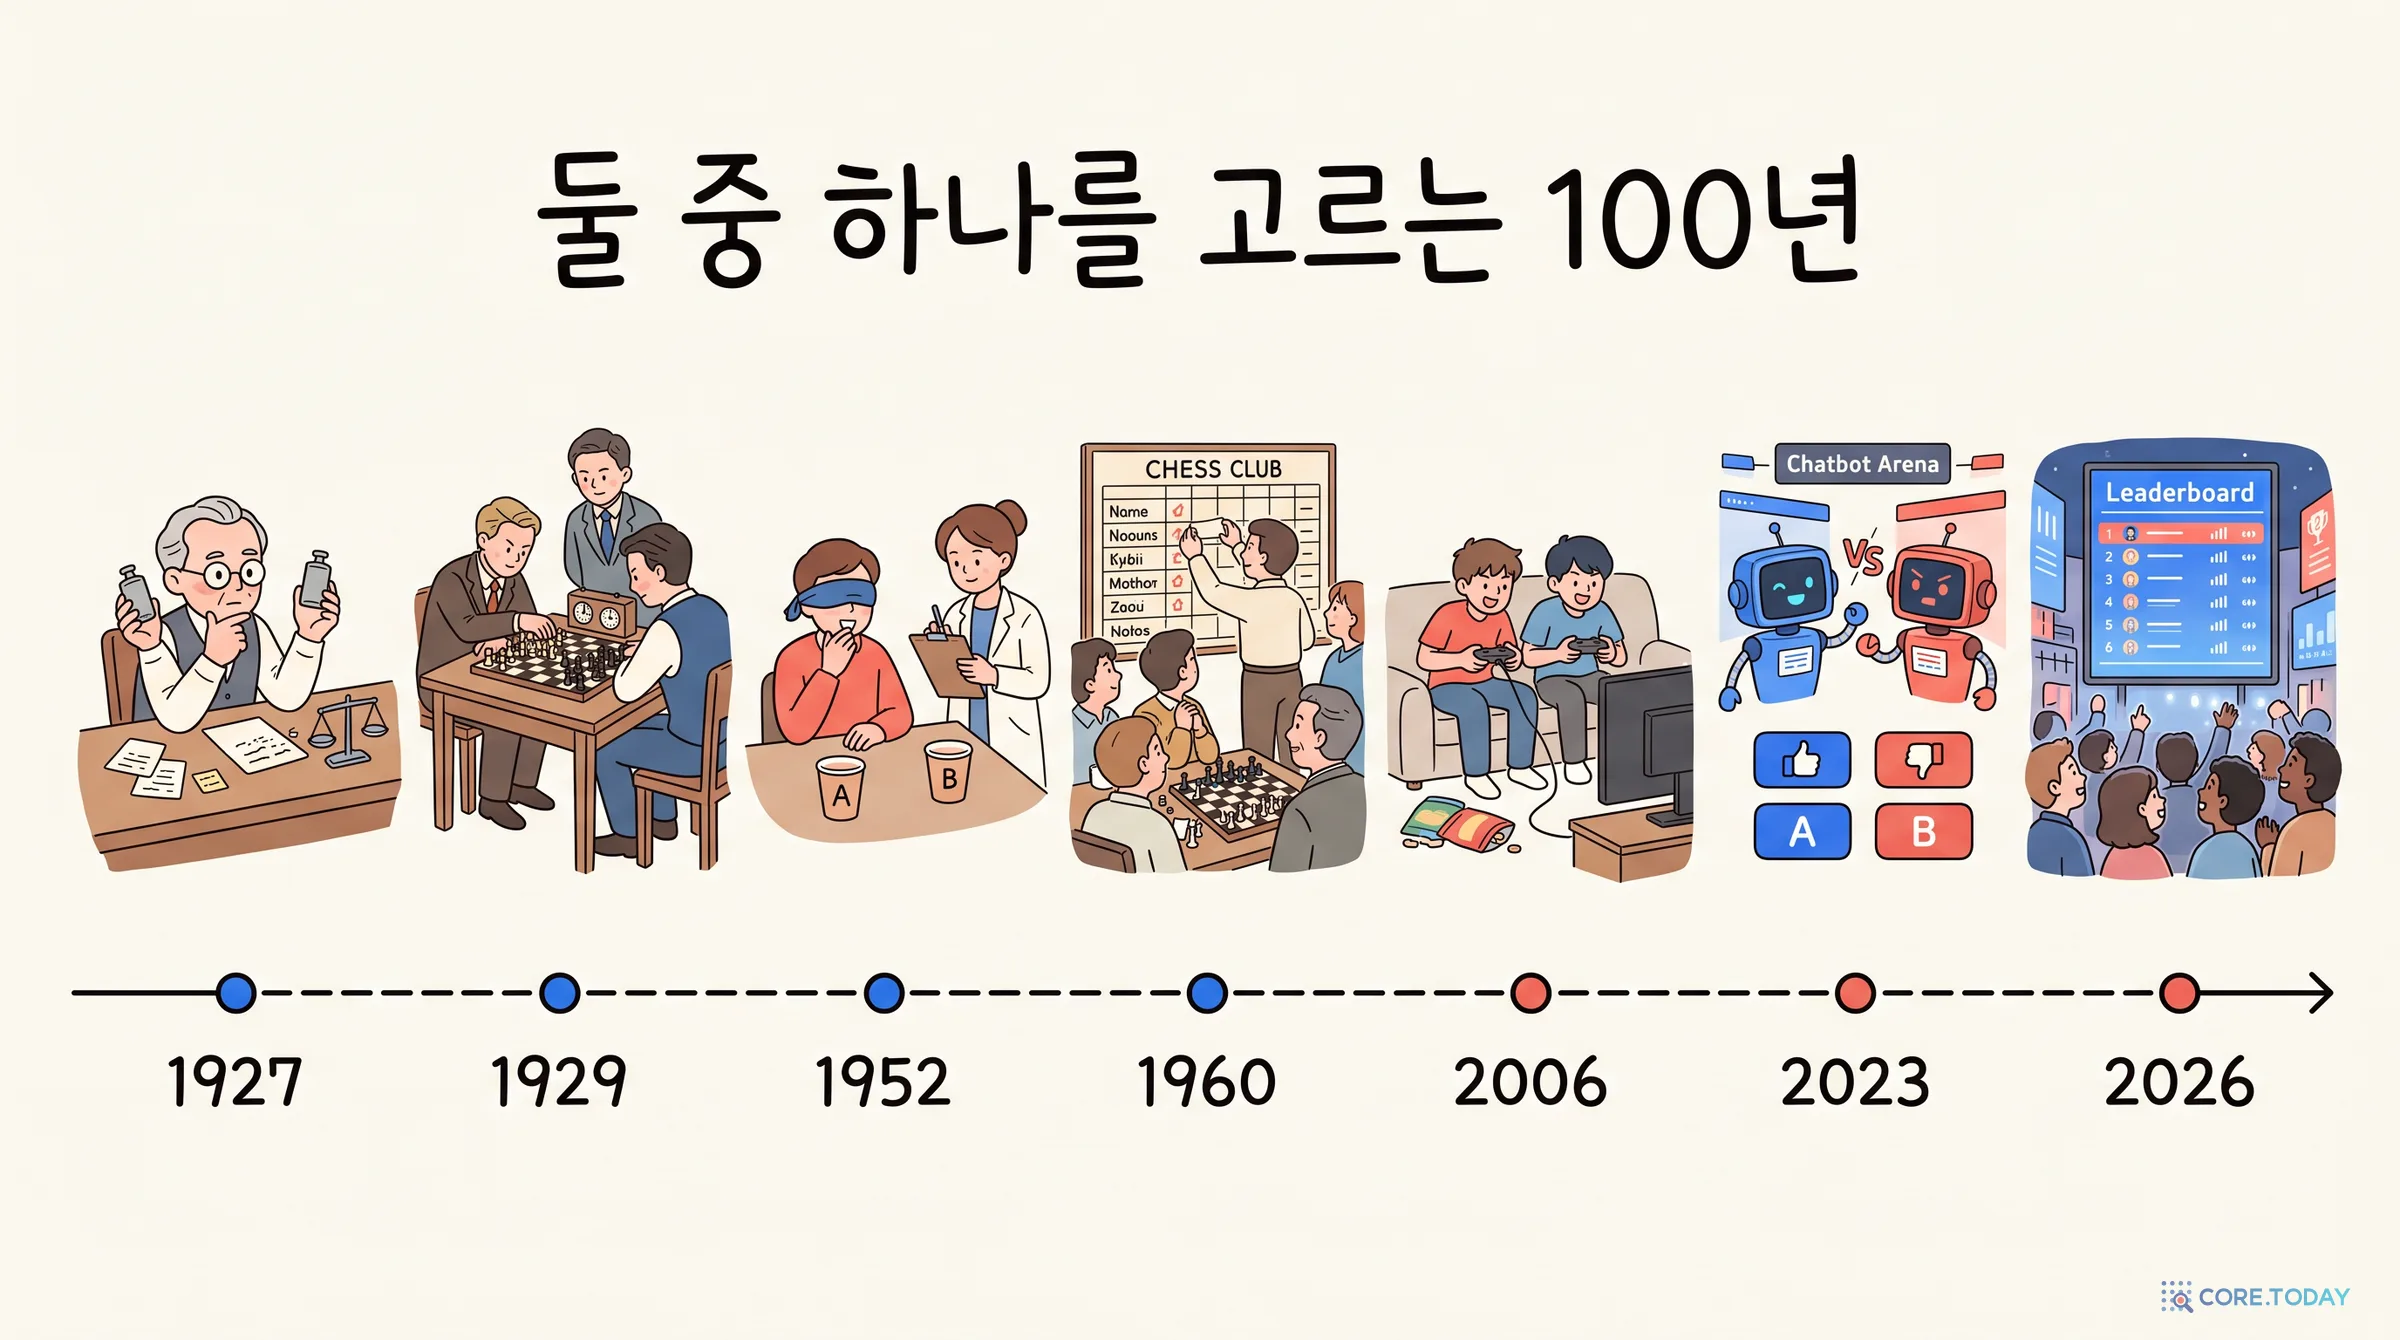
AI의 답도 그렇다. “이 답은 10점 만점에 몇 점인가?”에는 사람마다 답이 다르다. “A와 B 중 어느 쪽이 나은가?”에는 비교적 일관되게 답한다. 이렇게 둘씩 짝지어 비교하는 방법을 쌍대 비교(paired comparison)라 한다. 그런데 비교 결과는 “A가 B보다 낫다”는 문장들의 더미일 뿐이다. 여기서 모두를 한 줄로 세우는 점수를 어떻게 뽑아낼까? 이 질문에 답한 사람들이 100년 동안 이어진다.
1.2 1927년, 범죄의 ‘심각성’을 재다
시카고대학교의 심리학자 L. L. 서스톤은 1927년 「비교 판단의 법칙(A law of comparative judgment)」을 발표했다. 무게가 비슷한 추 두 개, 손글씨 견본 두 장처럼 대상을 둘씩 보여 주고 어느 쪽이 더 무거운지, 더 잘 썼는지 고르게 했다.
같은 해 그는 이 방법을 사회적 가치에 적용했다. 범죄 19종을 둘씩 짝지은 171쌍을 보여 주고 어느 쪽이 더 심각한지 고르게 했다. 이듬해에는 여러 국적에 대한 호감도도 같은 방법으로 쟀다. 자로 잴 수 없는 ‘마음속 크기’를 고른 비율로 거꾸로 재는 셈이다.
서스톤의 생각은 이렇다. 대상마다 마음속에 진짜 크기가 있다. 비교할 때마다 그 인상이 정규분포로 조금씩 흔들린다. 그래서 크기가 비슷하면 반반으로 갈리고, 차이가 크면 한쪽으로 쏠린다. 고른 비율을 보면 두 대상의 거리를 계산할 수 있다. 오늘날 ‘서스톤 모형’(가장 단순한 형태는 Case V)이라 부르는 이 생각이 쌍대 비교 통계의 출발점이다.
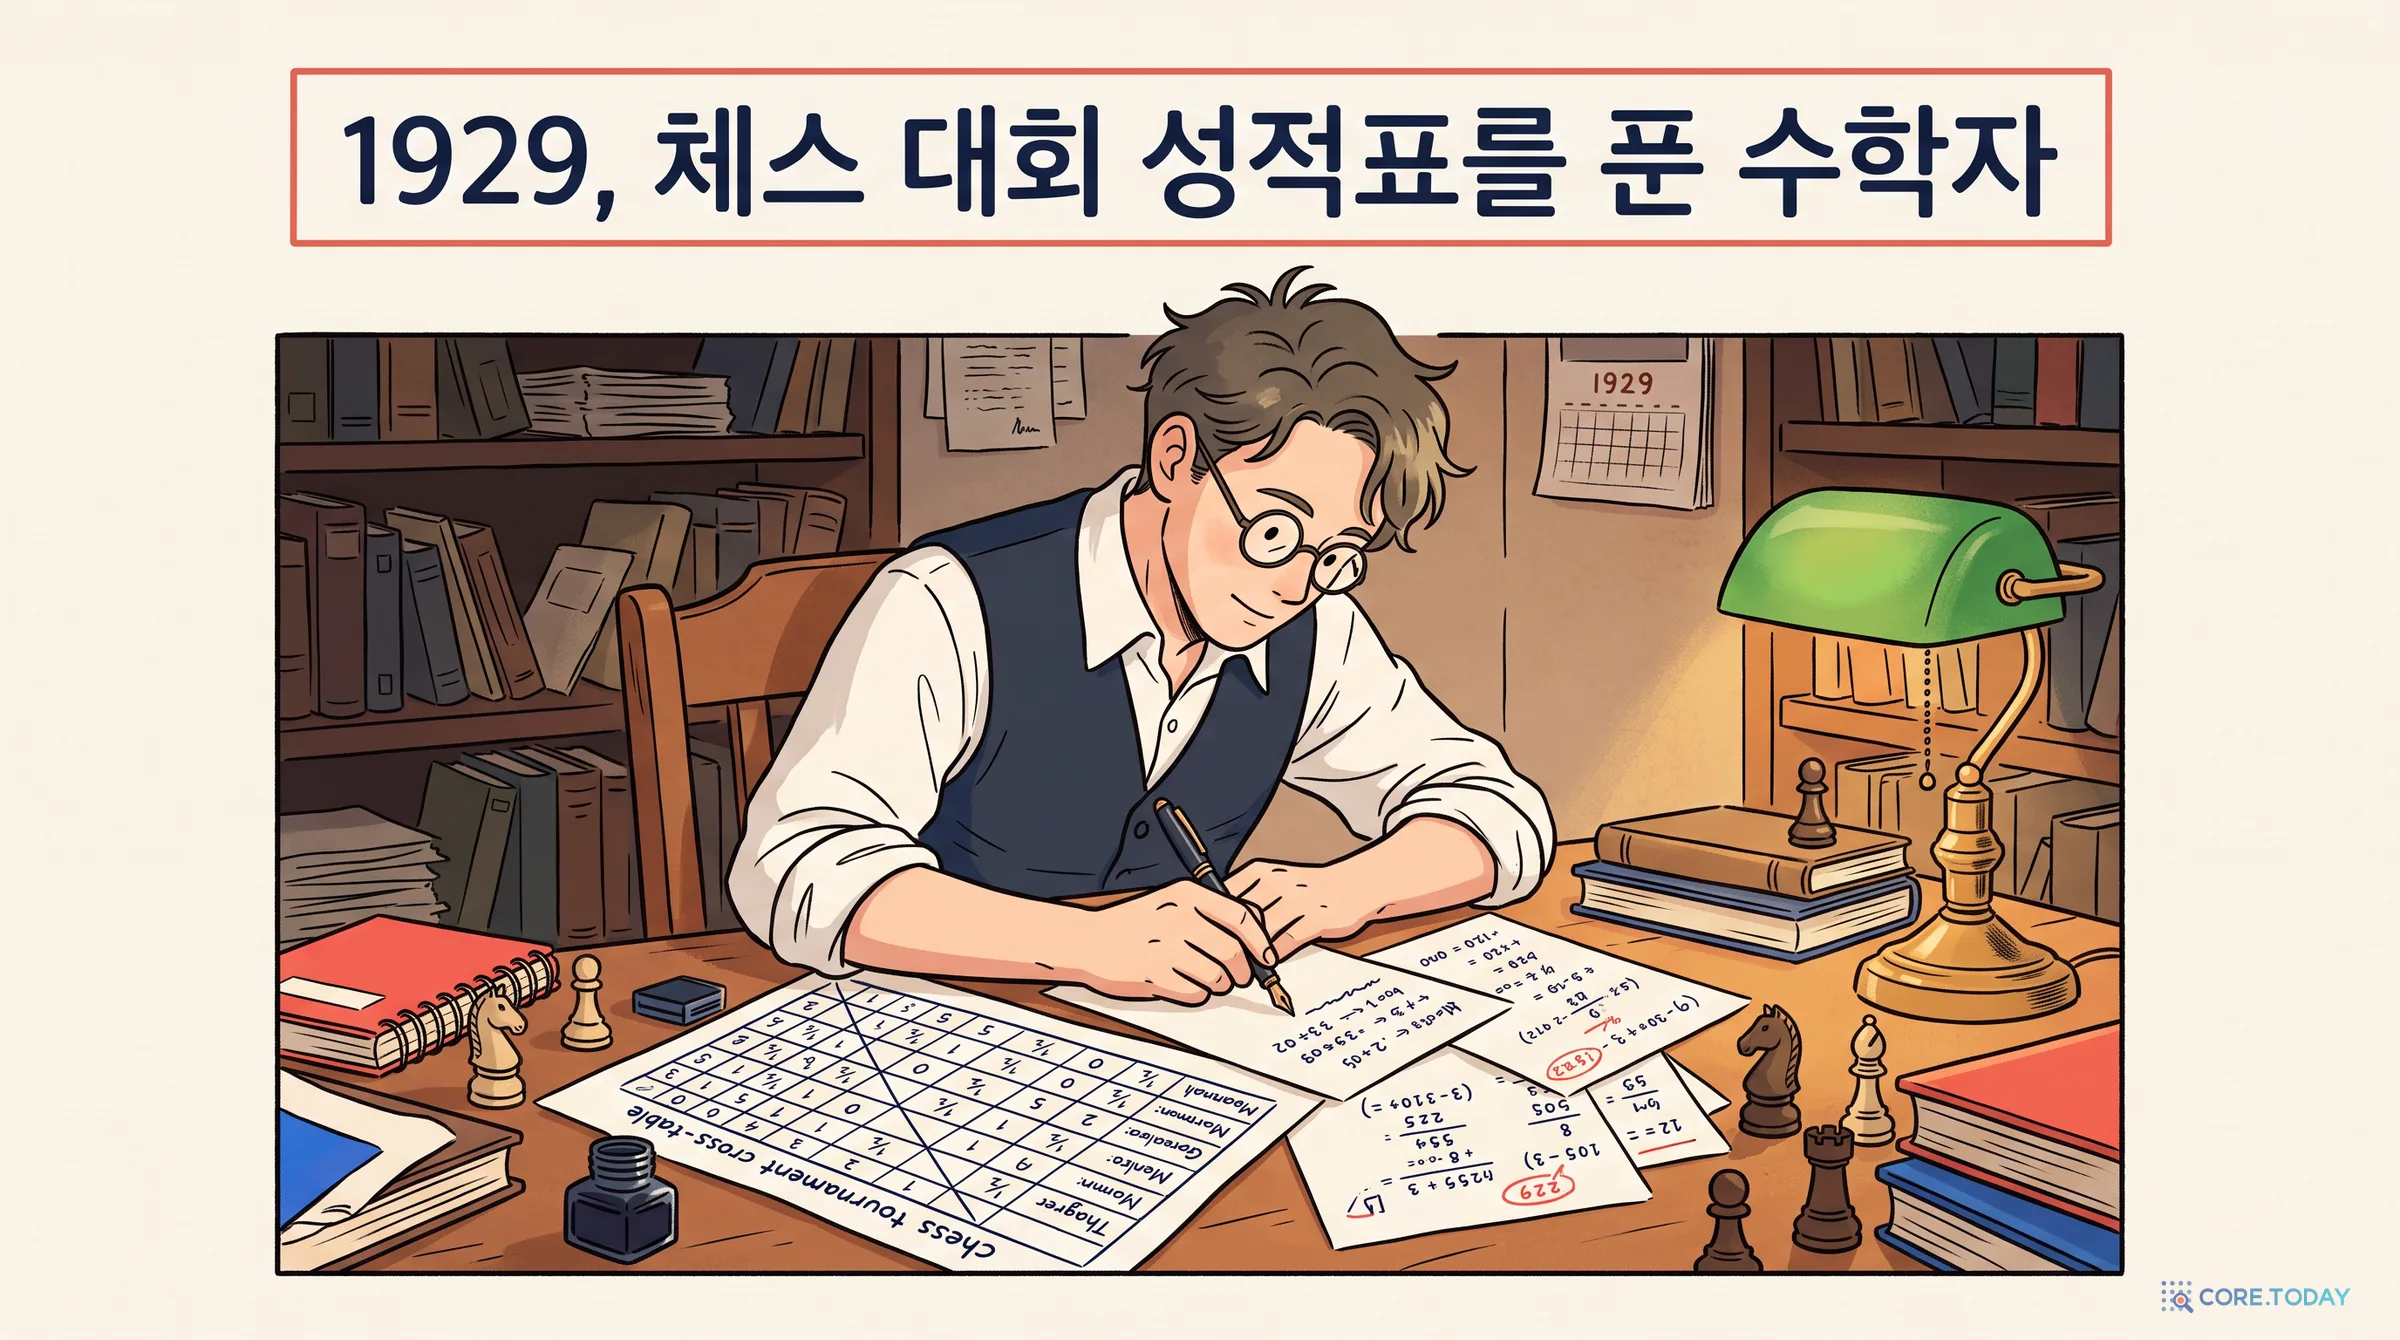
2년 뒤, 전혀 다른 곳에서 같은 문제가 풀렸다. 집합론의 공리로 유명한 독일 수학자 에른스트 체르멜로가 1929년 「최대 문제로서의 토너먼트 결과 계산」이라는 논문을 냈다.
체스 대회는 모두가 모두와 같은 횟수로 두지 않는다. 기권도 있고, 중간에 빠지는 선수도 있다. 이길 확률이 50%인 상대만 골라 이긴 선수와 강자들만 상대한 선수를 승점만으로 비교하면 공정하지 않다. 체르멜로는 선수마다 강함 u가 있고, 선수 r가 s를 이길 확률이 다음과 같다고 가정했다.
P(r가s를이긴다)=ur+usur
그리고 실제 대회 결과가 나올 확률이 가장 커지는 u들을 찾는 반복 계산법을 만들었다. 무승부는 한 번 이기고 한 번 진 것으로 쳤다. 그는 이 방법을 1924년 뉴욕 마스터스 대회 기록에 적용했다. 그 대회의 우승자였던 전 세계 챔피언 에마누엘 라스커는 1929년 체르멜로에게 편지를 보내, 확률론을 이 문제에 처음 쓴 연구라고 칭찬했다.
그러나 논문은 곧 잊혔다. 통계학자 마크 글리크먼은 이를 “시대를 한참 앞선 고립된 외도”라 불렀다. 1950년대에 같은 모형을 다시 찾아낸 사람들도, 뒤에 나올 엘로도 체르멜로를 인용하지 않았다. 이 논문을 처음 인용한 문헌은 1955년에야 나왔고, 제대로 재조명된 것은 1988년이다. 그래서 요즘은 이 모형을 ‘체르멜로–브래들리–테리 모형’이라 부르자는 의견도 있다.
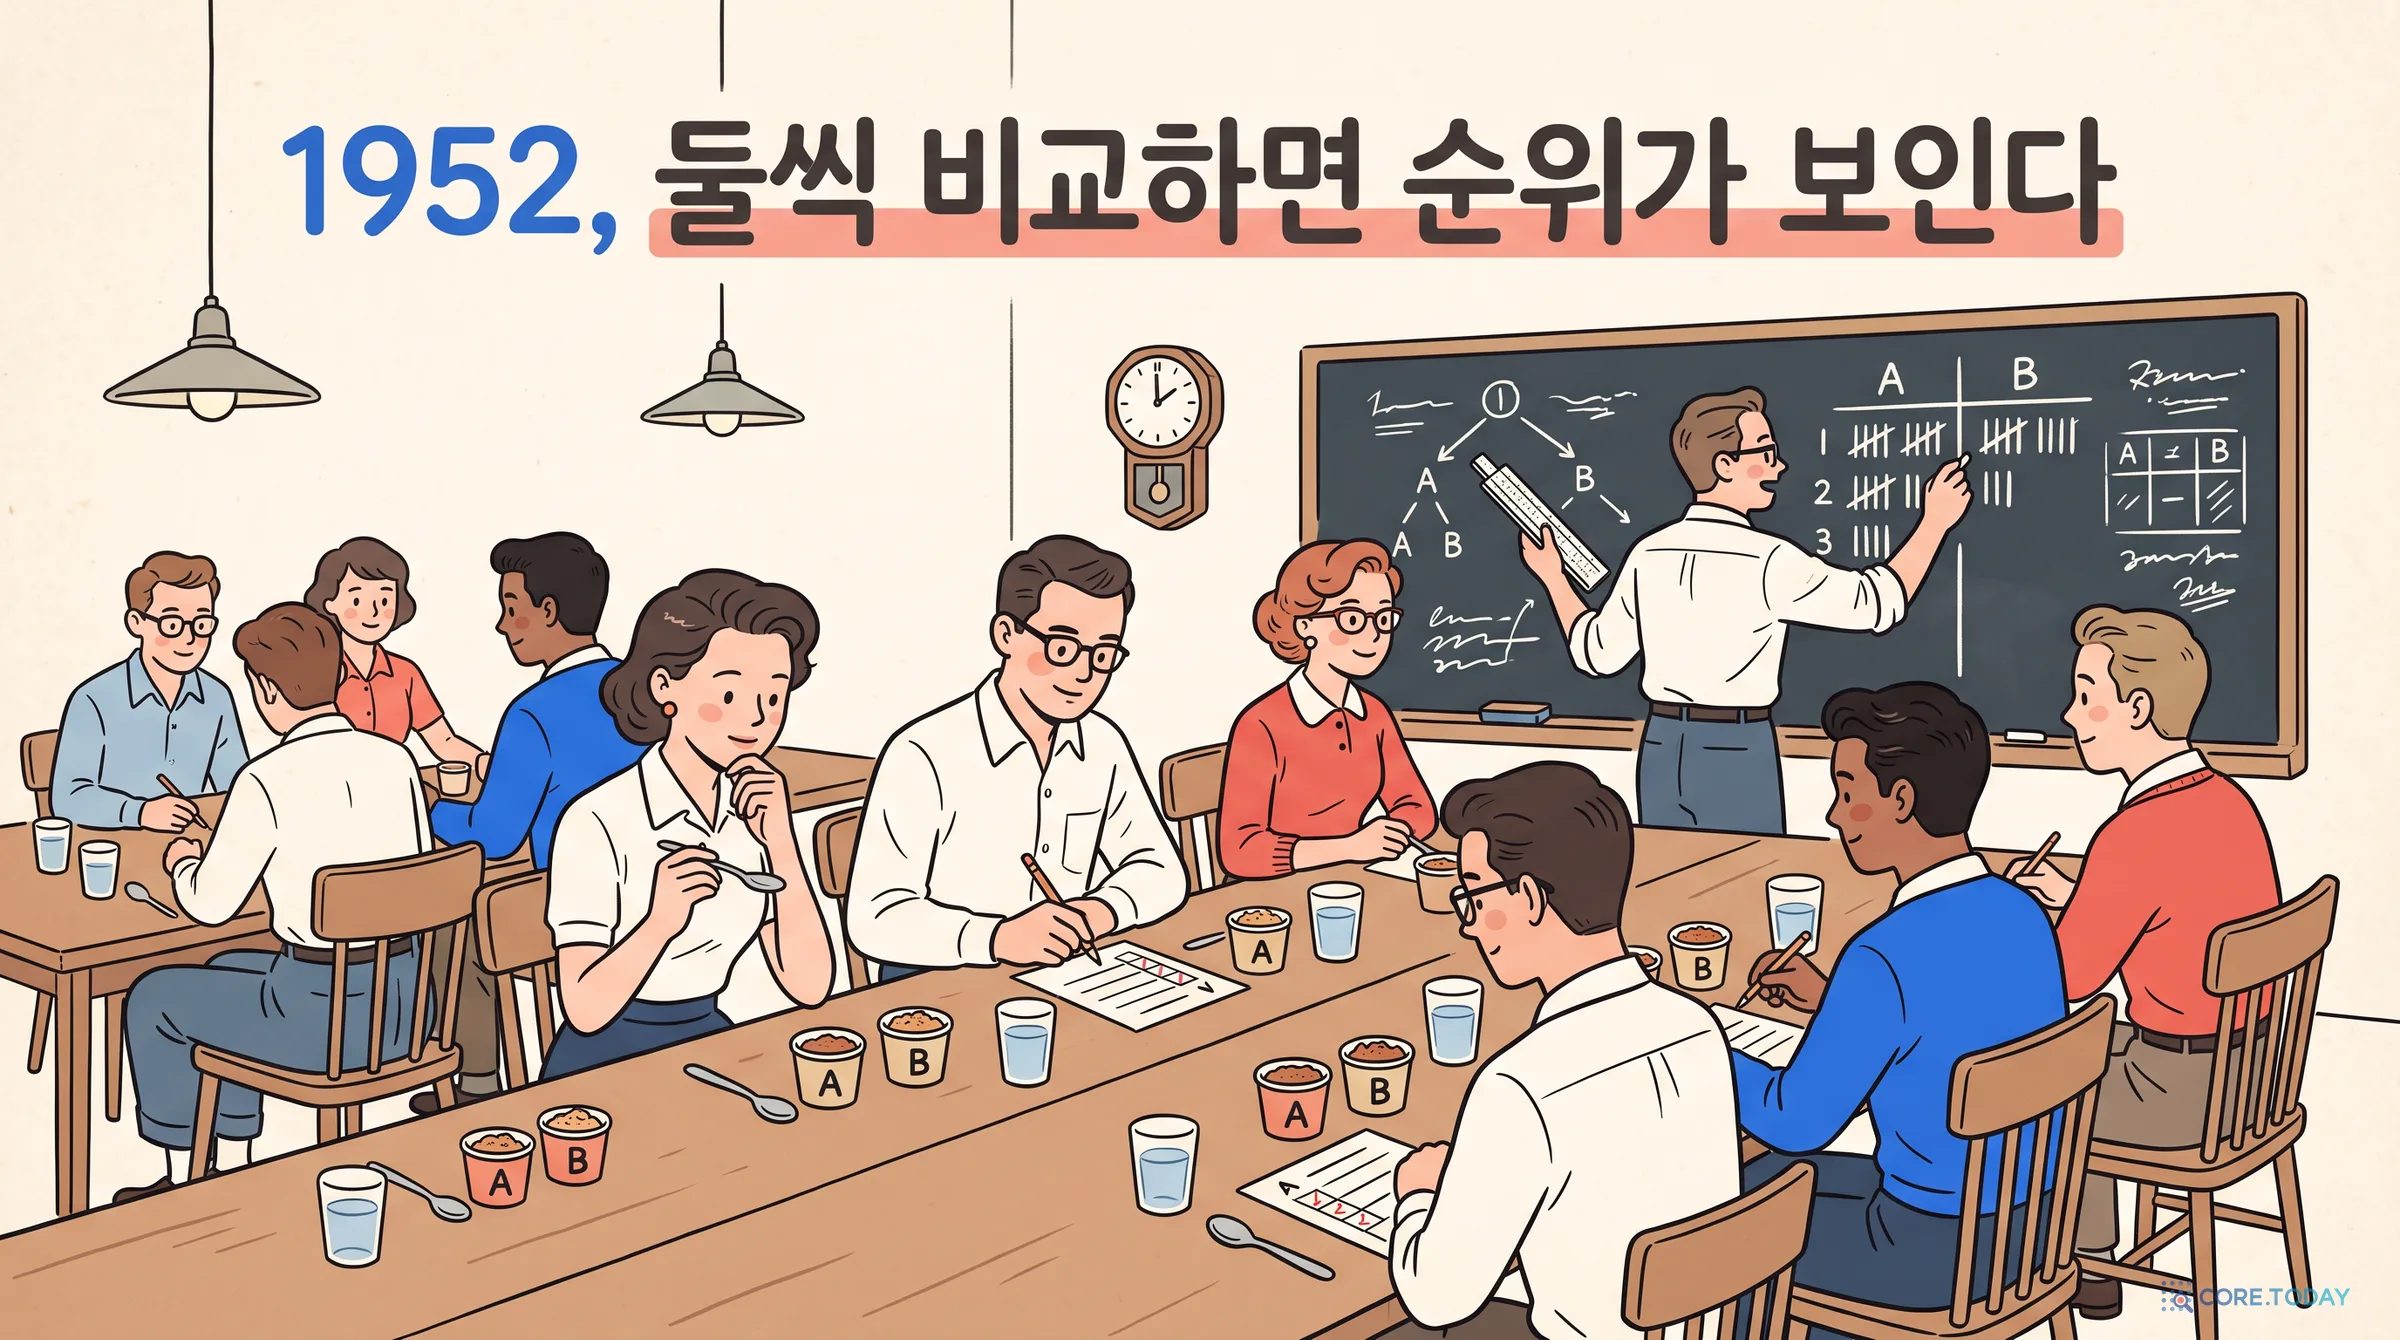
1952년 버지니아 공과대학 농업시험장의 통계학자 랄프 브래들리와 밀턴 테리가 『바이오메트리카』에 쌍대 비교 논문을 실었다. 체르멜로와 똑같은 모형이었지만, 두 사람은 체르멜로의 논문을 알지 못했다. 지금 이 모형은 두 사람의 이름을 따 브래들리–테리(Bradley–Terry, BT) 모형으로 불린다.
P(i가j보다낫다)=πi+πjπi
π는 ‘강함 지수’다. π가 3인 대상과 1인 대상을 비교하면 앞쪽이 3/(3+1), 즉 75% 확률로 이긴다. 강함이 같으면 50%다. 논문에는 이런 예제가 실려 있다. 옥수수만, 옥수수에 땅콩을 조금, 땅콩을 많이 섞어 먹여 키운 돼지의 고기 세 종류를 심사위원 두 명이 둘씩 맛보며 어느 쪽이 나은지 고르게 했다. 농업시험장다운 예제다. 맛에 점수를 매기기는 어려워도, 둘 중 어느 쪽이 맛있는지는 고를 수 있다.
이후 이론이 차곡차곡 쌓였다.
1957년 포드: 계산이 하나의 답으로 수렴함을 증명했다. 조건이 하나 있다. 모든 대상이 비교의 사슬로 이어져 있어야 한다. 늘 이기기만 했거나 늘 지기만 한 대상이 있으면 그 대상의 강함은 무한대로 발산한다. 포드도 체르멜로를 몰랐다.
1959년 루스: ‘선택 공리’로 이 모형을 셋 이상 중에서 고르는 상황까지 넓혔다. 경제학의 로짓 선택 모형과 이어지는 길이다.
2004년 헌터: 큰 데이터에서도 안정적으로 계산하는 MM 알고리즘을 정리했다. 이 글의 위젯도 이 방법으로 계산한다.
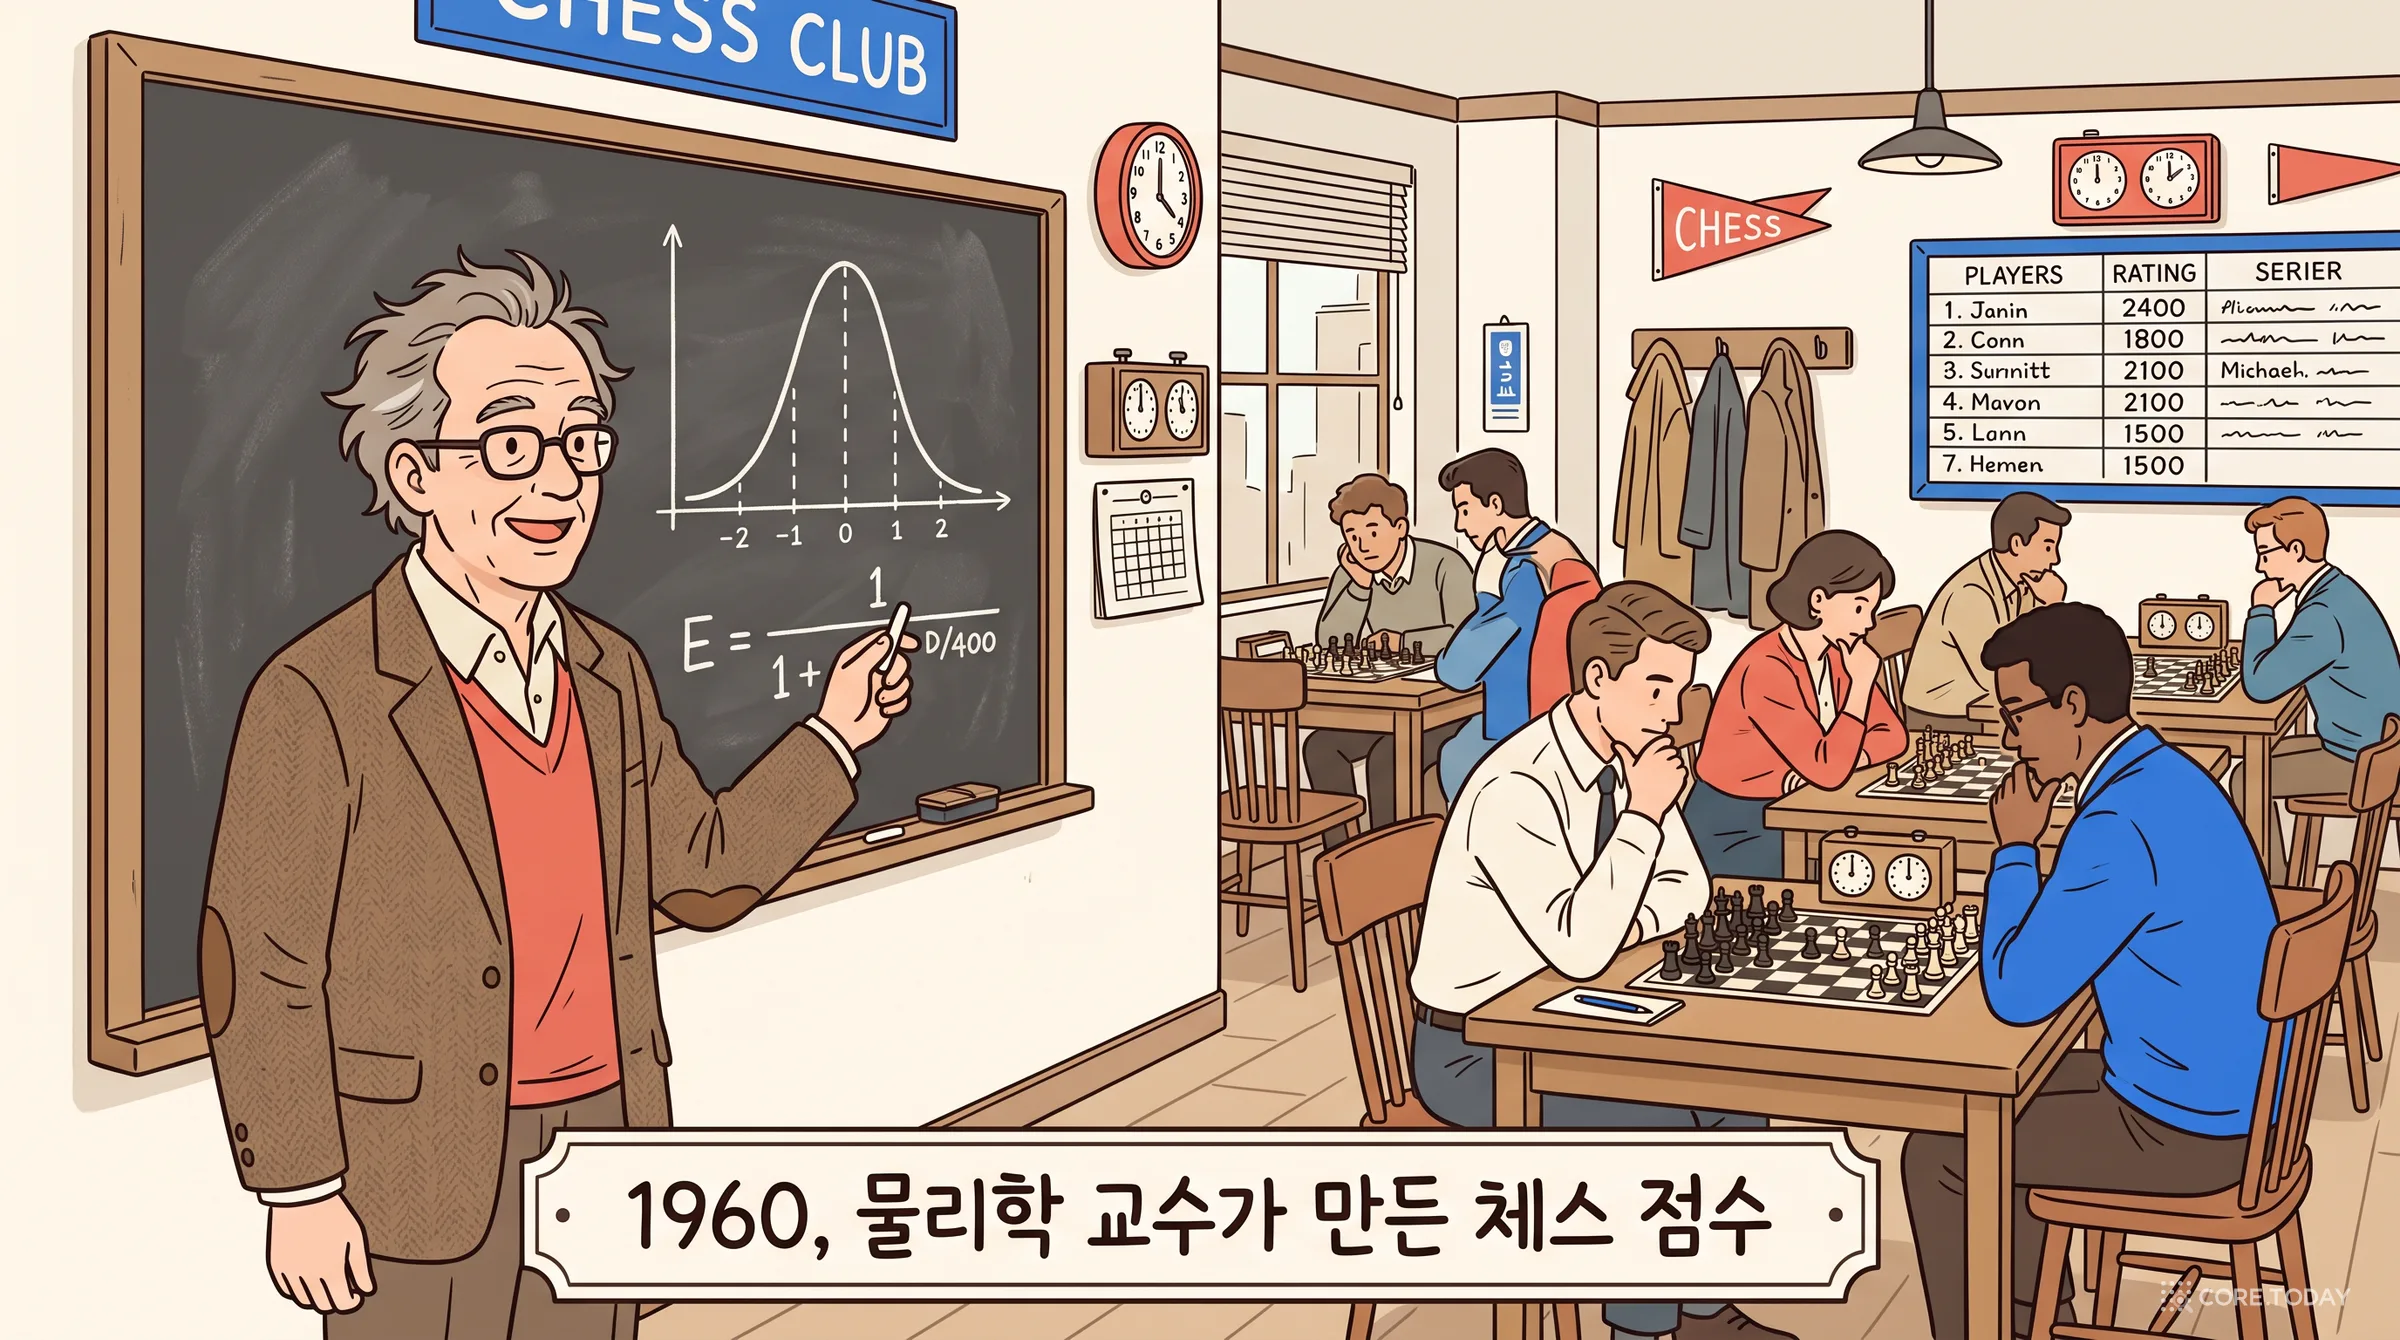
아르파드 엘로는 1903년 헝가리에서 태어나 1913년 가족과 함께 미국으로 이민했다. 1926년부터 1969년까지 밀워키의 마켓대학교에서 물리학을 가르쳤다. 동시에 위스콘신주 체스 챔피언을 여덟 번 지낸 강자였다.
미국체스연맹(USCF)은 1950년부터 케네스 하크니스가 제안한 레이팅 시스템을 썼다. 그런데 이 시스템은 관찰자들이 보기에 엉뚱한 점수를 내곤 했다. 1959년 무렵 연맹은 엘로에게 레이팅 체계를 검토하는 위원회를 맡겼다. 엘로가 만든 새 체계를 연맹이 1960년 채택했고, 국제체스연맹(FIDE)도 1970년 채택했다. 그가 1978년 펴낸 『체스 선수의 레이팅, 과거와 현재』는 지금도 이 분야의 고전이다.
엘로의 출발점은 물리학자다운 가정이었다. 선수의 실력은 고정된 숫자가 아니다. 판마다 컨디션에 따라 정규분포로 흔들린다. 엘로는 한 판의 실력 발휘가 흔들리는 폭(표준편차)을 200점으로 정했다. 그래서 미국체스연맹의 등급(클래스 A, B, C…)도 200점 간격이다. 이후 미국체스연맹은 실제 데이터에 더 잘 맞는 로지스틱 곡선으로 바꿨고, 지금 흔히 쓰는 공식도 그쪽이다.
2.2 공식은 두 줄이다
① 기대 점수. 레이팅이 RA인 A가 RB인 B를 만났을 때, A가 얻을 것으로 기대되는 점수다(승 1, 무 0.5, 패 0).
EA=1+10(RB−RA)/4001
400이라는 숫자에 큰 뜻은 없다. 레이팅 차이 400점이 ‘승산 10배’가 되도록 눈금을 정한 것이다. 차이가 100점이면 강한 쪽 기대 점수가 약 64%, 200점이면 약 76%, 400점이면 약 91%다. 400점 차이라도 약한 쪽이 열 판 중 한 판 몫은 따낸다.
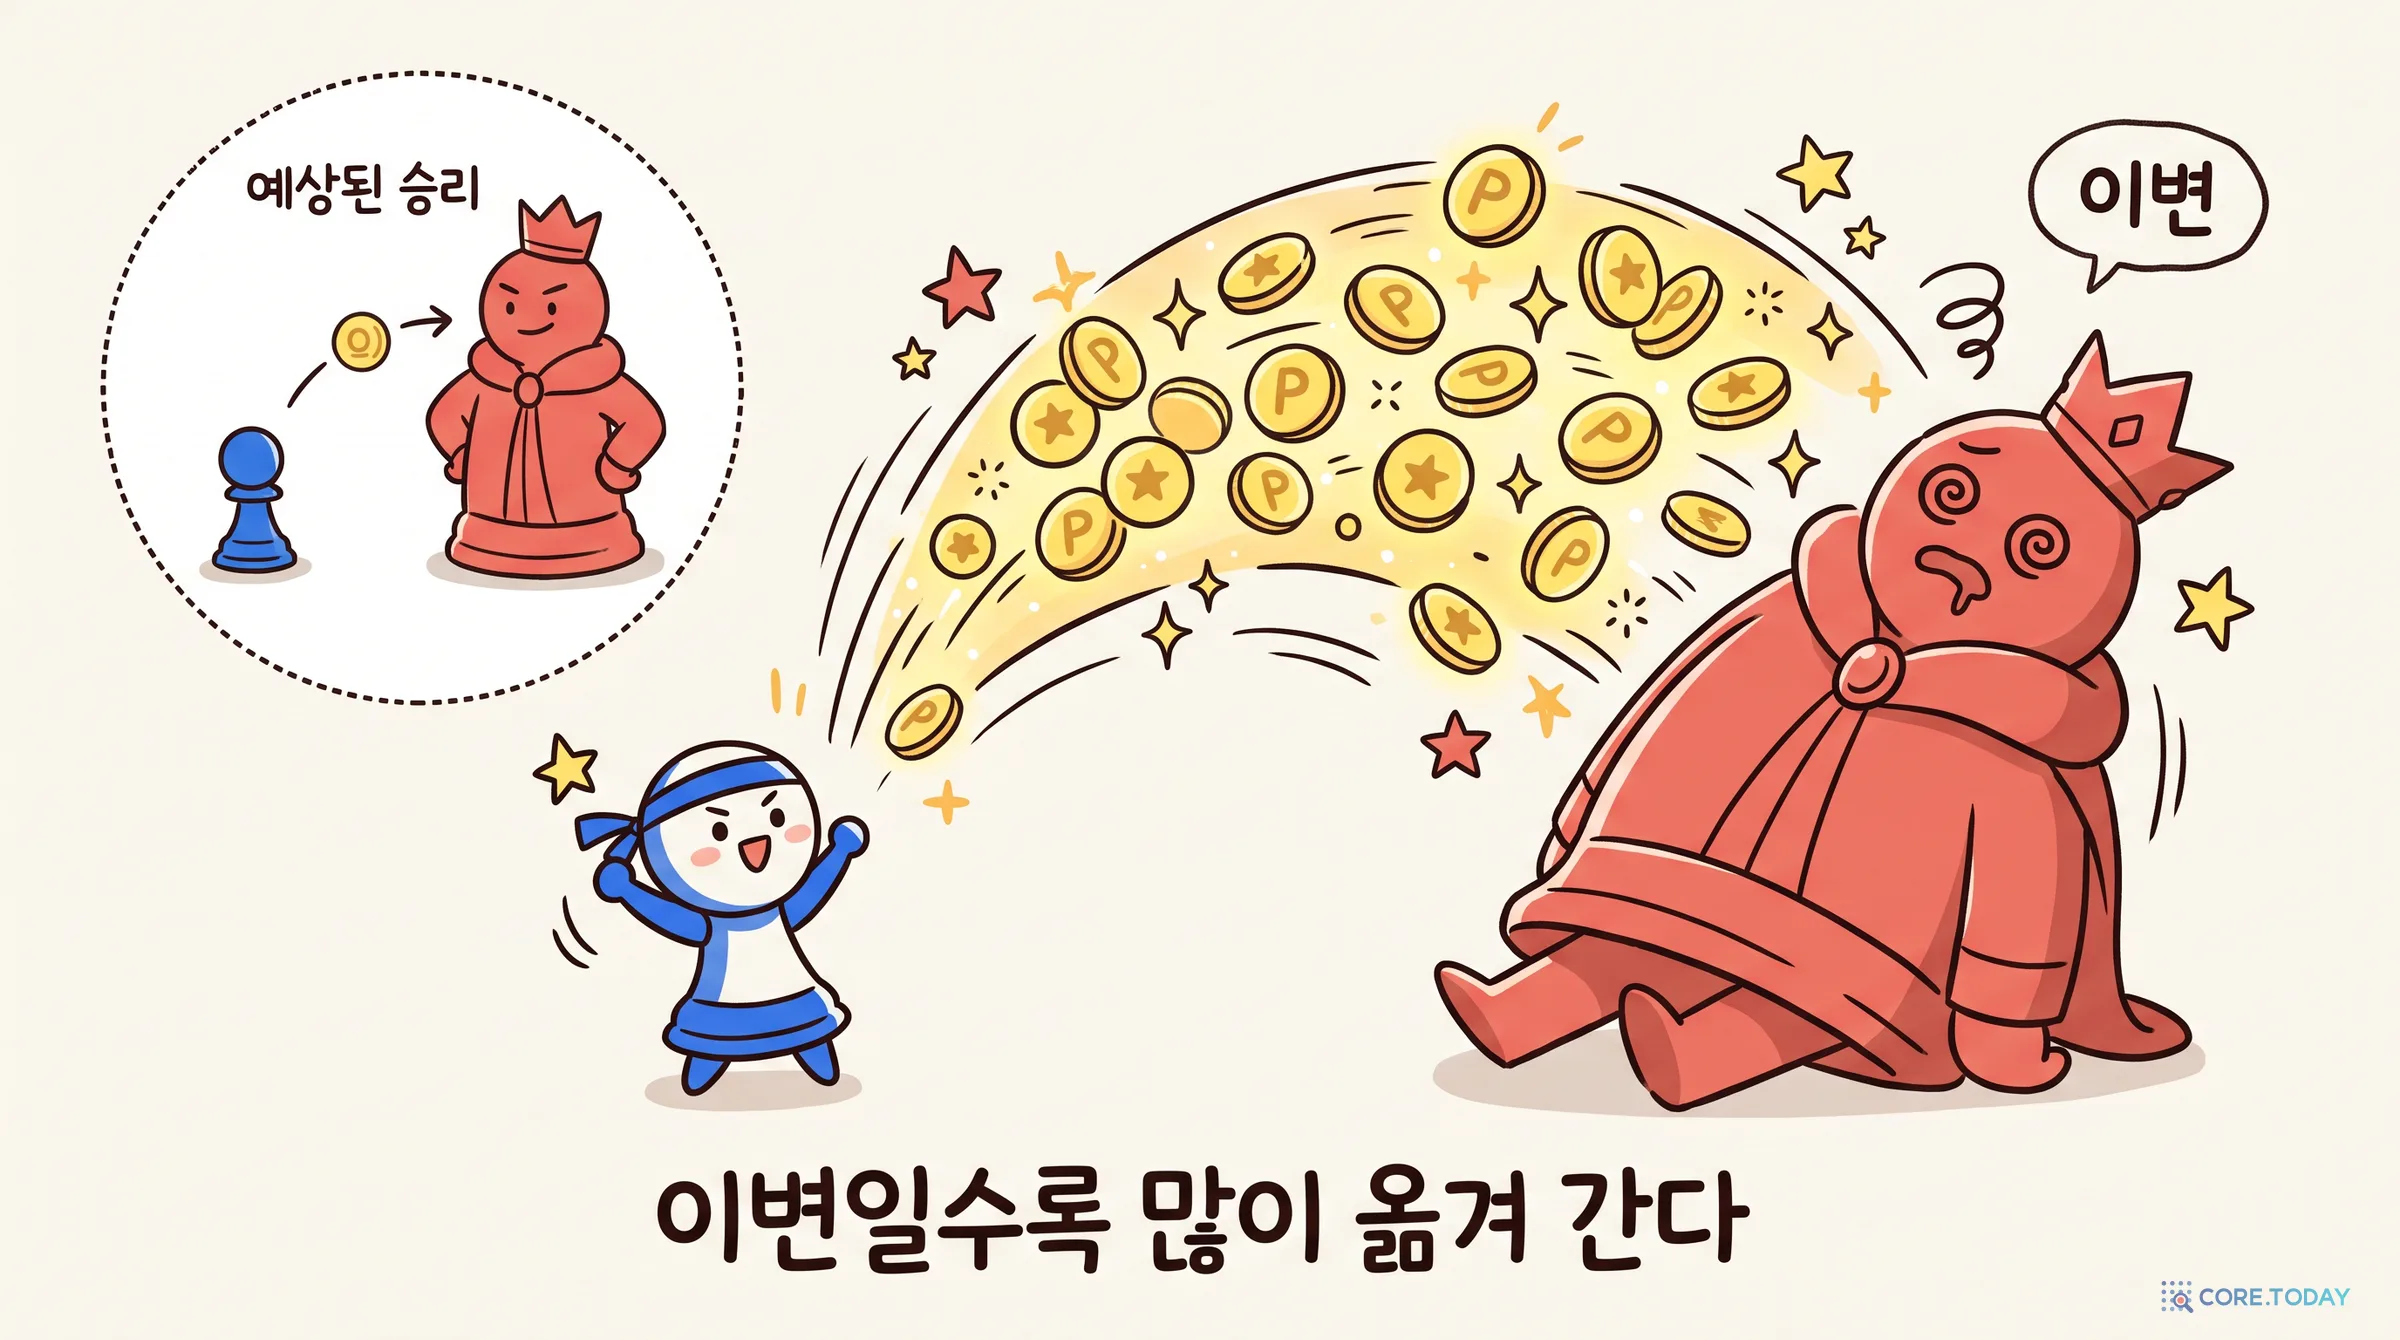
② 갱신. 경기가 끝나면 실제 점수 SA와 기대 점수의 차이만큼 레이팅을 옮긴다.
RA′=RA+K(SA−EA)
K는 한 판에 레이팅을 얼마나 크게 움직일지 정하는 값이다. 국제체스연맹은 지금 세 가지를 쓴다. 30판 미만의 신인과 2,300점 미만의 18세 이하 선수는 40, 2,400점 미만은 20, 한 번이라도 2,400점을 넘은 선수는 10이다. 신인의 점수는 빨리 제자리를 찾게 하고, 최상위권의 점수는 덜 출렁이게 하려는 것이다.
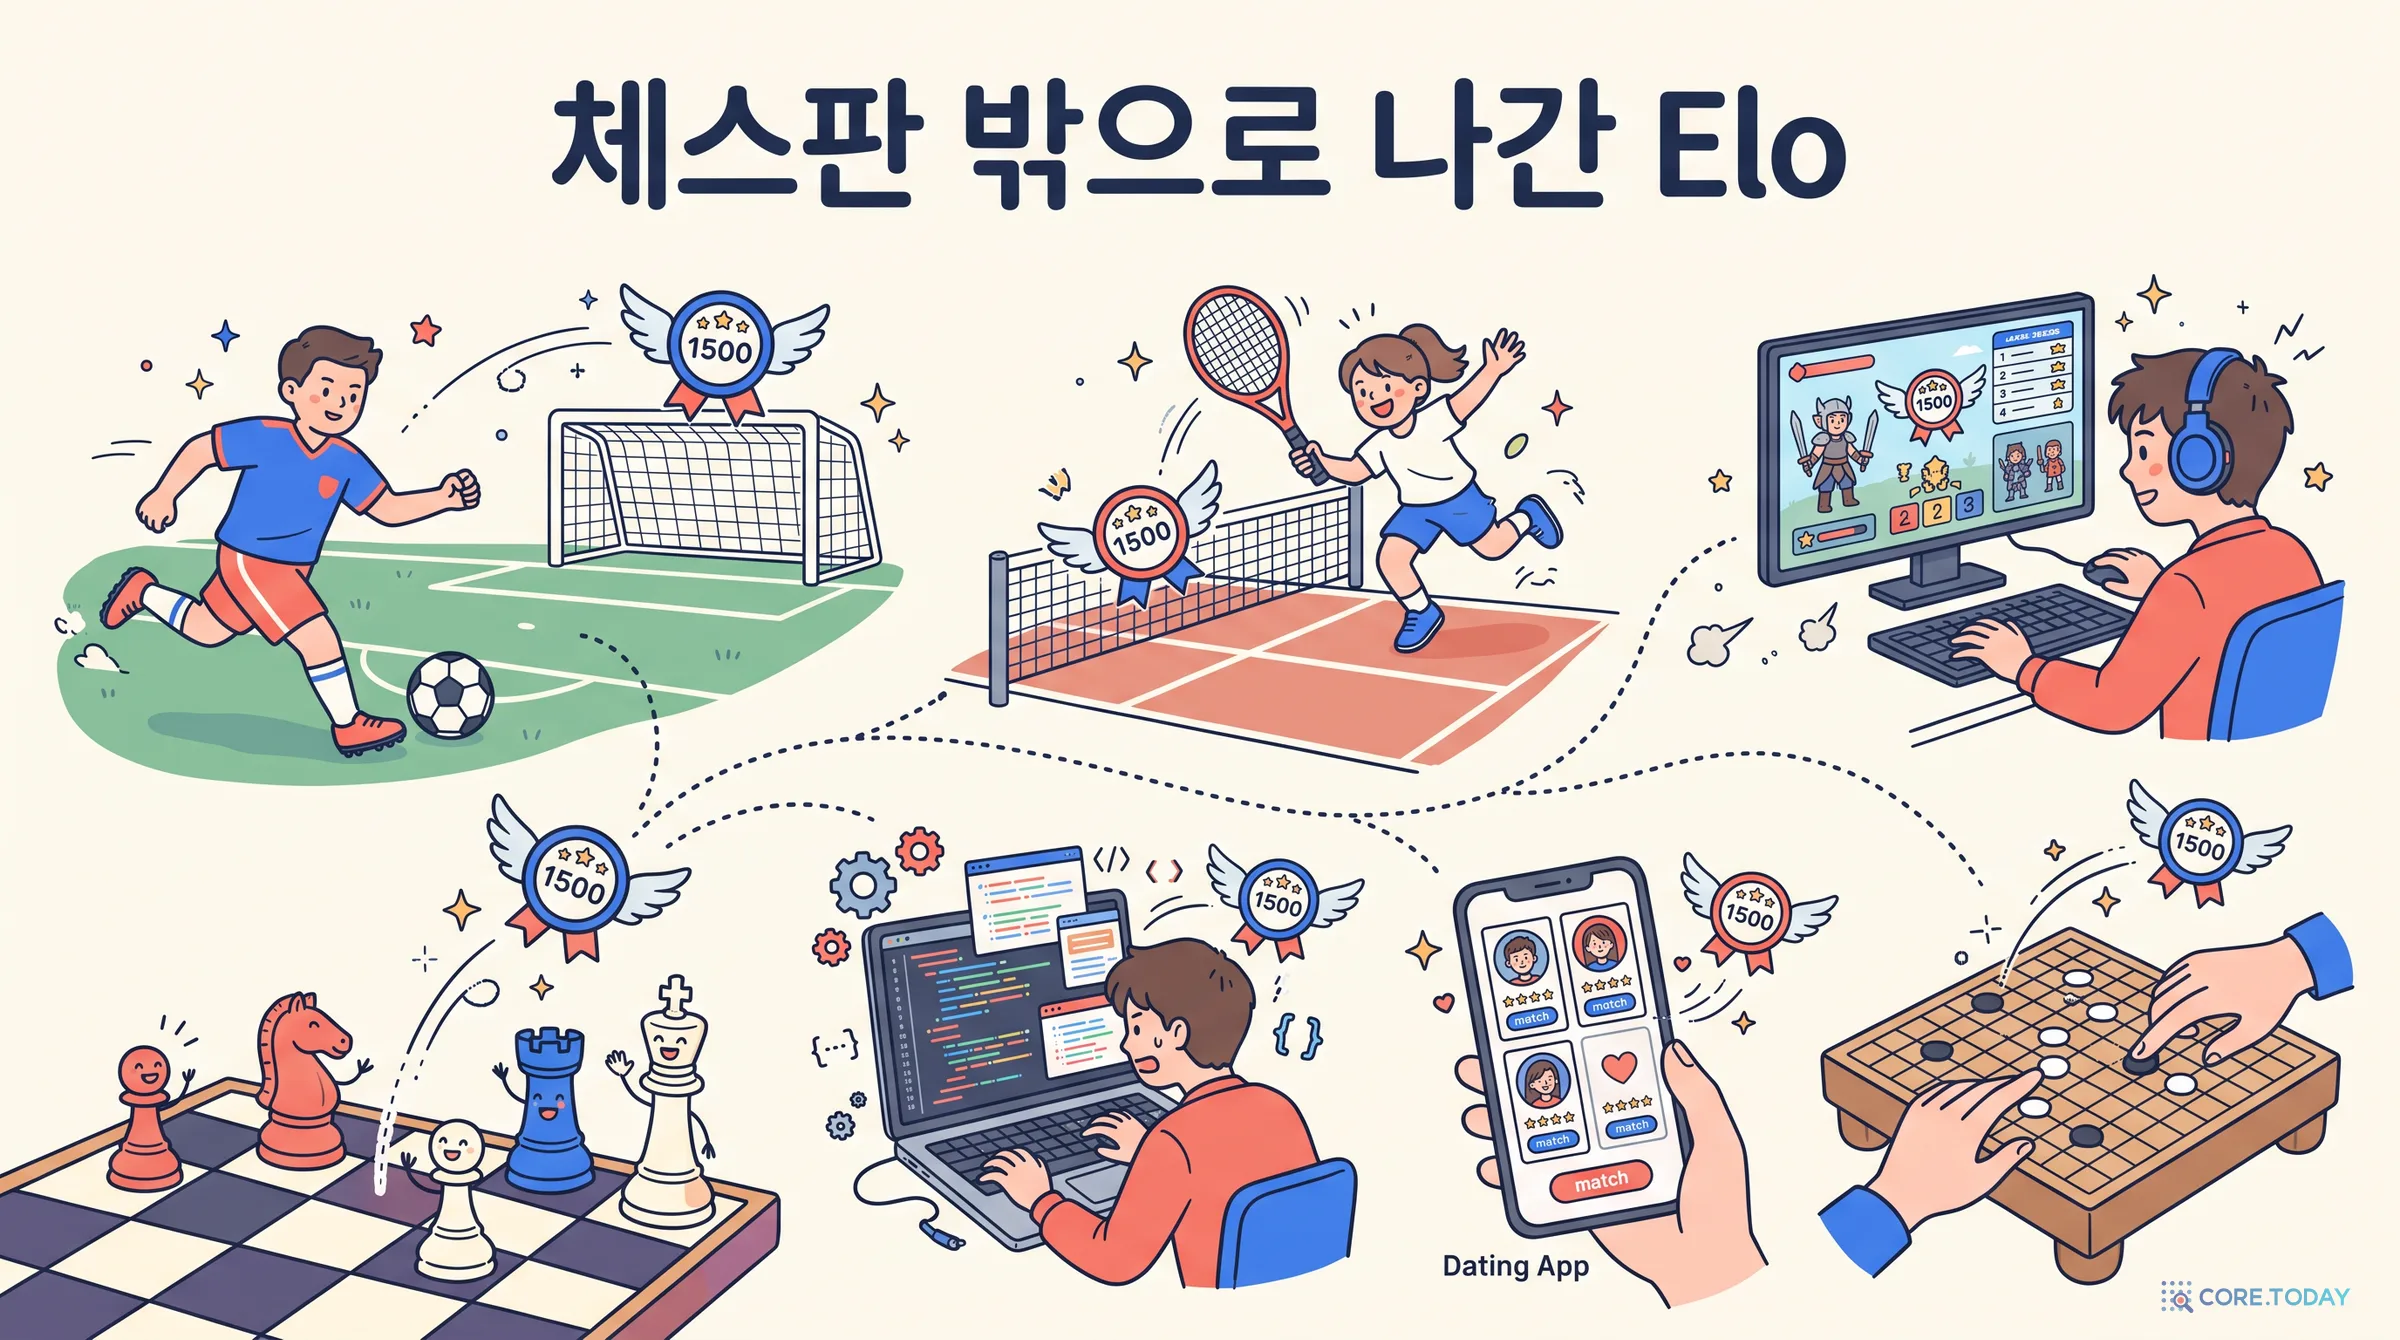
계산이 단순하고 ‘이기고 지는’ 기록만 있으면 되니, Elo는 체스판 밖으로 빠르게 퍼졌다.
축구: 1997년 밥 러니언이 국가대표 경기에 Elo를 적용했다(세계 축구 Elo 순위). 경기의 중요도, 골 득실, 홈 이점(100점)을 반영한다. 역대 최고권 팀 중 하나가 엘로의 고향 헝가리의 1954년 대표팀이라는 점이 재미있다.
미국 스포츠 예측: 데이터 저널리즘 매체 파이브서티에이트는 2014년 미식축구, 2015년 농구에 Elo 모형을 만들어 경기 결과를 예측했다.
게임과 대회: 리그 오브 레전드는 시즌 2까지 Elo를 썼다. 실력보다 낮은 점수대에 갇혔다고 느끼는 ‘Elo 지옥(Elo hell)’이라는 말이 이 게이머들 사이에서 나왔다. 프로그래밍 대회 사이트 코드포스도 Elo와 비슷한 로지스틱 레이팅을 쓴다.
데이트 앱: 2016년 미국 경제지 『패스트 컴퍼니』 기자 오스틴 카는 틴더가 사용자마다 비공개 ‘매력 점수’를 매긴다고 보도했다. 내부에서 Elo 점수라 불렀고, 기자 본인의 점수는 946이었다. 틴더는 2019년 Elo는 “낡은 지표”이며 더 이상 쓰지 않는다고 밝혔다.
영화 속 Elo: 2010년 영화 「소셜 네트워크」에는 친구가 기숙사 창문에 Elo 공식을 써 주고, 주인공이 학생 사진 두 장 중 누가 더 매력적인지 고르게 하는 사이트 ‘페이스매시’를 만드는 장면이 나온다. 실제 페이스매시(2003)가 Elo를 썼다는 증거는 없다. 다만 ‘둘 중 하나를 고르게 해서 순위를 매긴다’는 발상만큼은 20년 뒤 AI 순위표와 똑같다.
2.5 Elo의 후예들 — 불확실성까지 기록하다
Elo에는 약점이 있다. 레이팅 1,500인 선수가 1,000판을 둔 노장인지, 이제 막 세 판을 둔 신인인지 숫자만으로는 알 수 없다.
Glicko(1995)·Glicko-2(2001): 통계학자 마크 글리크먼이 레이팅 옆에 불확실성(RD, rating deviation)을 함께 기록했다. 신인은 RD 350으로 시작해 판을 둘수록 줄어든다. RD가 큰 선수는 한 판에 크게 움직인다. 온라인 체스 사이트 리체스는 Glicko-2를, 체스닷컴은 Glicko를 쓴다.
TrueSkill(2006): 마이크로소프트 연구소가 만든 베이지안 레이팅이다. 2005년부터 Xbox Live 대전 매칭에 쓰였고, 논문은 Halo 2 베타 데이터로 검증했다. 여러 명이 팀을 이뤄 싸우는 게임도 다룬다. 2018년 TrueSkill 2는 Halo 5 승패 예측 정확도를 52%에서 68%로 높였다.
‘점수 하나’에서 ‘점수와 그 점수를 얼마나 믿을지’로. 이 변화는 뒤에서 AI 순위표가 신뢰구간을 붙이게 되는 이야기와 그대로 겹친다.
Elo의 기대 점수 공식과 똑같다. 1952년 돼지고기 맛 비교의 모형과 1960년 체스 레이팅은 같은 모형을 다른 눈금으로 쓴 것이다. 강함 지수에 로그를 씌우면 Elo 점수가 된다.
3.2 Elo는 ‘한 판씩 배우는’ 브래들리–테리다
그럼 무엇이 다른가? 계산하는 방식이 다르다.
브래들리–테리 최대우도: 지금까지의 모든 경기 기록을 한꺼번에 놓고, 그 기록이 나올 확률이 가장 큰 점수들을 한 번에 구한다.
Elo: 경기가 하나 끝날 때마다 그 한 판만 보고 점수를 조금 고친다.
통계학자들은 Elo의 갱신식이 브래들리–테리(로지스틱) 우도를 확률적 경사 하강법으로 한 판씩 최적화하는 것과 같다는 점을 보였다(Szczecinski & Djebbi, 2020). K는 학습률이다. 오늘날 딥러닝이 데이터를 조금씩 보며 가중치를 고치는 바로 그 방법이다. 엘로는 1960년에 온라인 학습을 손으로 하고 있었던 셈이다.
이 차이는 체스에서는 장점이다. 선수의 실력은 늘거나 준다. 최근 경기에 더 무게를 두는 온라인 방식이 바뀐 실력을 따라간다. 그런데 실력이 고정된 대상을 평가할 때는 단점이 된다. 공개된 AI 모델 버전은 한번 나오면 실력이 바뀌지 않는다. 그런데도 온라인 방식은 경기를 넣는 순서에 따라 결과가 달라진다.
아래 실험에서는 실력이 조금씩 다른 가상의 모델 여섯 개가 600판을 겨뤘다. 결과는 고정돼 있다. 버튼을 누르면 같은 600판을 순서만 섞어서 Elo를 다시 계산한다. 옅은 막대는 브래들리–테리 최대우도다.
순서를 섞을 때마다 진한 막대가 출렁이고, 몇 번 누르다 보면 1위가 바뀐다. 옅은 막대는 꿈쩍하지 않는다. 아래 표는 실제 아레나 데이터로 같은 실험을 한 결과다. 13만 5,634표를 K=4로 넣었다. chatgpt-4o-latest는 브래들리–테리로는 5위인데, 순서를 섞자 1위에서 14위 사이를 오갔다. 7월에 늦게 들어온 grok-4는 BT로는 3위였지만 시간순 Elo로는 9위였다. 모든 모델이 1,000점에서 출발하는데, 늦게 들어온 모델은 제 점수까지 올라갈 판 수가 모자랐다.
Chatbot Arena도 처음에는 온라인 Elo를 썼다. 그리고 바로 이 문제 때문에 2023년 12월 브래들리–테리 최대우도로 바꿨다. 당시 블로그의 설명은 이렇다. Elo는 실력이 변하는 선수를 위해 “최근 경기에 더 무게를 두도록” 설계됐지만, 고정된 모델을 평가하는 데는 BT가 “훨씬 안정적인 레이팅과 정확한 신뢰구간”을 준다. 그래서 지금 아레나의 점수는 엄밀히 말하면 Elo가 아니라 ‘Elo 눈금으로 표시한 브래들리–테리 점수’다. 사람들은 여전히 Elo라 부르지만.
4부. Chatbot Arena — LLM 순위표의 탄생
4.1 2023년 봄, 시험지로는 잴 수 없는 것
2023년 3월, ChatGPT가 나온 지 넉 달 만에 공개 모델이 쏟아졌다. 3월 30일 UC버클리·CMU·스탠퍼드·UCSD 연구자들이 내놓은 Vicuna도 그중 하나다. 메타의 LLaMA를 ChatGPT 대화 약 7만 건으로 미세조정했고, 13B 모델 학습비는 약 300달러였다. 이들은 “ChatGPT 품질의 90%”라고 했다. 그런데 그 90%는 GPT-4에게 두 답을 비교해 채점하게 한 결과였고, 연구진 스스로 “재미 삼아 한 비과학적 평가”라고 적었다.
문제는 분명했다. 객관식 벤치마크로는 대화 능력을 재기 어렵다. 정답이 하나가 아니고, 시험 문제가 학습 데이터에 섞여 들어가는 오염 문제도 있다. 연구진은 사람들에게 직접 고르게 하기로 했다.
투표한 뒤에 두 모델의 이름이 공개된다. 모든 표를 모아 브래들리–테리 모형으로 점수를 매긴다.
5월 3일 발표한 첫 순위표에는 투표 약 4,700건, 모델 9개가 있었다. 1위는 vicuna-13b(1169점), 꼴찌는 stablelm-tuned-alpha-7b(858점)였다. GPT-4도 Claude도 아직 없던, 공개 모델끼리의 작은 대회였다.
이 방식에는 분명한 장점이 있었다.
실제 질문이다. 연구자가 만든 시험지가 아니라 사람들이 정말 궁금한 것을 묻는다. 시험지가 유출될 걱정도 적다.
이름을 가린다. 브랜드에 대한 선입견을 줄인다.
계속 갱신된다. 새 모델이 나오면 같은 무대에 올려 기존 모델과 비교할 수 있다.
4.2 순위 대신 ‘순위의 범위’
2023년 12월 브래들리–테리로 계산을 바꾸면서 아레나는 부트스트랩 신뢰구간을 함께 보여 주기 시작했다. 투표 기록에서 같은 수의 표를 중복을 허용해 무작위로 다시 뽑고, 점수를 다시 계산하기를 수백 번 반복한다. 그러면 점수가 얼마나 흔들리는지 보인다. 이때 투표는 13만 건, 모델은 45개를 넘었고 1위는 GPT-4-Turbo(1217점)였다.
순위도 달라졌다. 아레나는 어떤 모델의 순위를 ‘그 모델보다 확실히 나은 모델의 수 + 1’로 매긴다. 확실히 낫다는 것은 신뢰구간이 겹치지 않는다는 뜻이다. 그래서 순위표에는 공동 2위가 여럿 나오곤 한다. 점수가 몇 점 높다는 것만으로는 더 낫다고 말할 수 없기 때문이다.
4.3 대학 연구실에서 31억 달러 회사로
아레나는 3년 동안 빠르게 컸다.
시기
일어난 일
규모
2023년 5월
첫 순위표(온라인 Elo)
4,700표 · 모델 9개
2023년 12월
브래들리–테리 최대우도 + 부트스트랩 신뢰구간으로 전환
13만 표 · 모델 45개+
2024년 3월
논문 발표(ICML 2024). 크라우드 투표가 전문가 평가와 잘 맞는다고 보고
24만 표
2024년 5~8월
어려운 질문 범주, 자동 평가 Arena-Hard, 스타일 보정 도입
—
2024년 9월
주소를 lmarena.ai로 이전. 이후 비전·웹 개발·코딩·검색 아레나로 확장
—
2025년 4~5월
법인 설립. 시드 투자 1억 달러(기업가치 6억 달러)
누적 300만 표+
2025년 9~12월
기업용 유료 평가 서비스 출시. 12월 연 환산 매출 약 3,000만 달러
—
2026년 1월
시리즈 A 1억 5,000만 달러(기업가치 17억 달러). 1월 28일 이름을 Arena(arena.ai)로 변경
월 이용자 500만+
2026년 10월
시리즈 B 2억 달러(기업가치 31억 달러). 연 환산 매출 1억 달러 이상
전체 분야 누적 6,200만 표
2026년 11월
텍스트 순위표
914만 표 · 모델 419개
이 과정에서 연구실은 회사가 됐다. 평가를 받는 AI 회사들이 동시에 유료 평가 서비스의 고객이 됐다는 뜻이기도 하다. 5부의 논란은 이 지점과 이어진다.
같은 연구진은 순위표 주변의 도구도 만들었다. 2023년 MT-Bench 논문에서는 GPT-4를 심판으로 쓰면 사람의 선호와 80% 넘게 일치한다는 것을 보였다. 사람끼리 일치하는 정도와 비슷했다. 2024년 Arena-Hard는 아레나 질문 중 어려운 500개를 골라 GPT-4 심판으로 채점하게 했다. 비용은 20달러, 사람 순위와의 상관은 98.6%였다. ‘LLM 심판’이라는 평가 방식이 여기서 퍼졌다.
4.4 코어닷투데이 실측 — 공개 투표로 순위를 다시 매기다
아레나는 투표 기록 일부를 공개한다. 우리는 2025년 4월 17일부터 7월 24일까지의 공개 데이터 13만 5,634건(모델 53개)을 내려받아 브래들리–테리 순위를 직접 다시 계산했다. 무승부와 ‘둘 다 별로’는 양쪽에 반 승씩 줬다. 점수는 평균 1,000점에 맞췄다. 아레나 공식 점수(1,500점 안팎)와 숫자는 다르지만, 차이만 의미가 있다는 점은 같다.
세 개의 탭에서 각각 이런 것이 보인다.
순위와 신뢰구간. 1위 gemini-2.5-pro는 신뢰구간이 다른 모델과 겹치지 않는 확실한 1위였다. 그런데 2위부터 6위까지는 점수가 1,075~1,098점에 몰려 막대가 서로 겹친다. 앞에서 설명한 아레나 방식으로 순위를 매기면 이 다섯이 모두 공동 2위다. 아레나 순위표에서 1점, 2점 차이로 ‘역전’ 기사가 나올 때마다 떠올려야 할 장면이다.
표가 적으면 순위도 흐릿하다. 같은 데이터에서 표를 일부만 무작위로 뽑아 신뢰구간이 얼마나 넓어지는지 재 봤다. 막대는 95% 신뢰구간의 반폭이다(전체에서 5,000표 이상 받은 모델 33개의 중앙값, 부트스트랩 100회). 괄호 안은 그때 모델 하나가 받은 표 수다.
전체 1,000표 (모델당 47표)
±84점
3,000표 (143표)
±46점
1만 표 (477표)
±24점
3만 표 (1,432표)
±14점
13만 5,634표 (6,477표)
±7점
표가 4배 늘면 신뢰구간은 대략 절반으로 준다. 새 모델이 올라온 첫날의 순위를 조심해야 하는 이유다. 아레나도 표가 충분히 쌓이기 전의 점수에는 ‘잠정(preliminary)’ 표시를 붙인다.
한국어 대화만. 한국어로 감지된 대화는 2,486건, 전체의 1.8%였다. 한국어로 80표 이상 받은 모델 36개만 놓고 같은 방법으로 계산하자, 같은 모델들의 신뢰구간 반폭 중앙값이 ±7점에서 ±47점으로 커졌다. 전체 순위와 한국어 순위의 순위 상관(스피어먼)은 0.92로 높았다. 다만 개별 모델은 달랐다. o3는 전체 4위에서 한국어 14위로, llama-4-maverick 실험판은 9위에서 5위로 움직였다. 2026년 11월 현재 Arena의 공식 한국어 순위표에는 14만 2,377표가 쌓였다. 그래도 상위권 신뢰구간은 ±18~39점으로 전체 순위표보다 몇 배 넓다. 한국어 서비스를 만든다면 전체 순위가 아니라 한국어 순위와 그 신뢰구간을 봐야 한다.
5부. 점수 조작 논란
순위표가 커질수록 순위표 1위는 강력한 마케팅이 됐다. 그러자 점수를 ‘만드는’ 방법들이 하나씩 드러났다. 누가 일부러 속인 경우도 있고, 순위표의 구조가 만든 착시도 있다. 다섯 가지로 나눠 보자.
먼저 직접 투표해 보자. 다섯 질문에 대해 이름을 가린 두 답 중 더 나은 쪽을 고르면 된다.
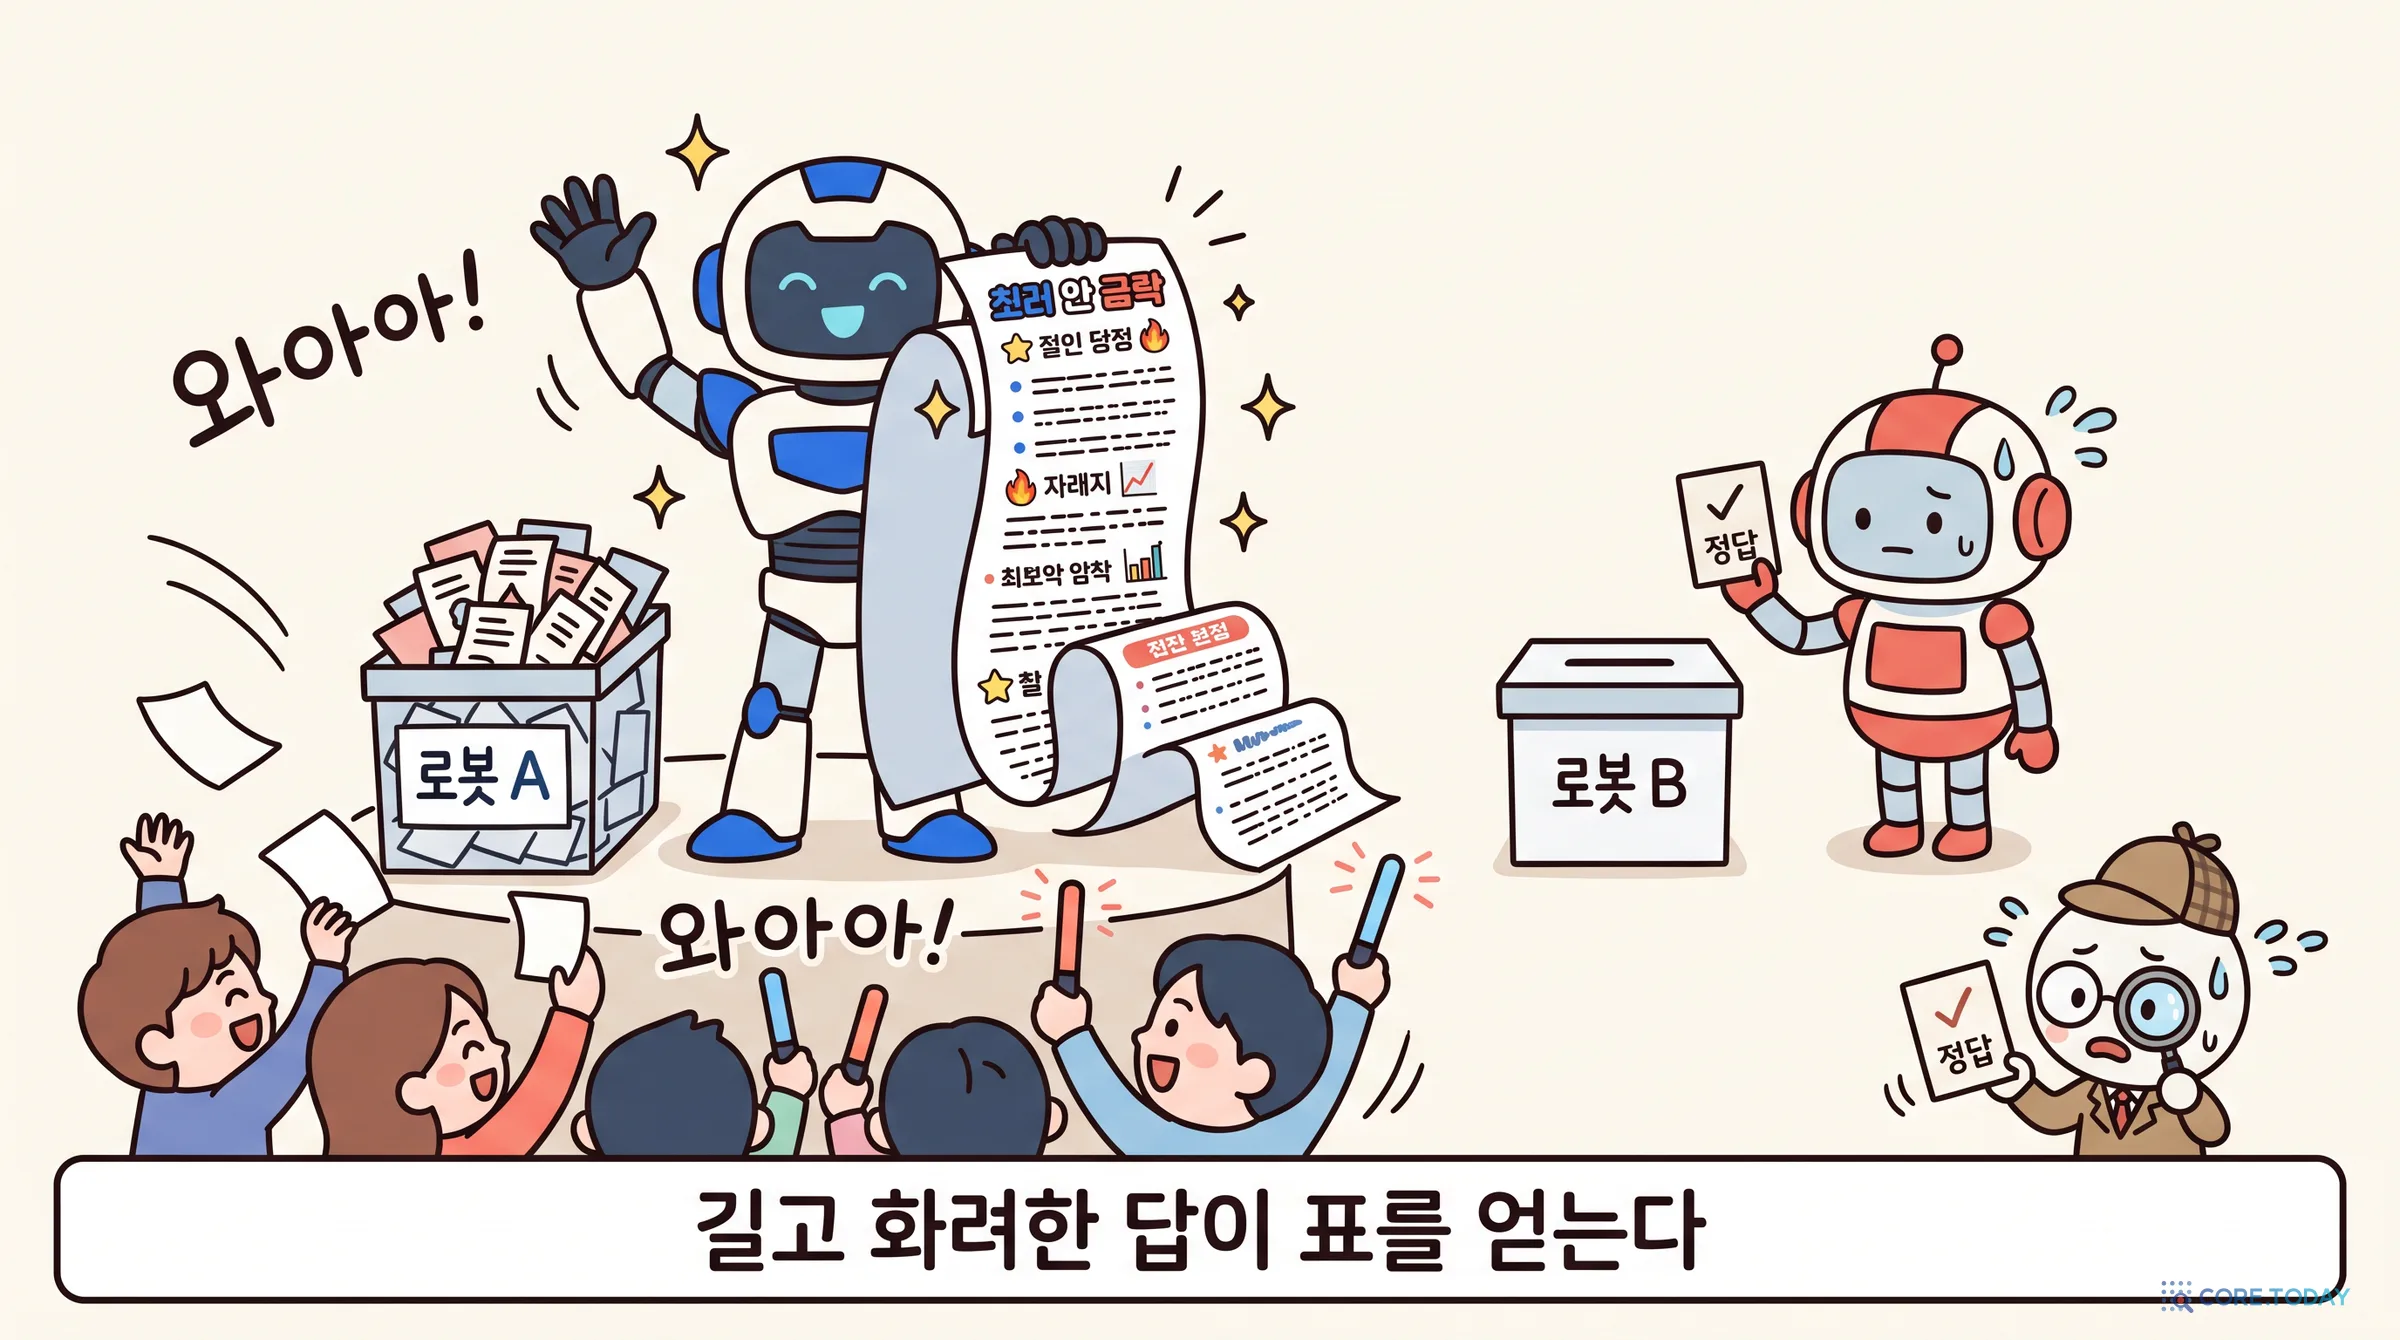
화려한 답이 끌리는 이유가 있다. 제목과 목록, 굵은 글씨는 성의 있어 보인다. 투표자는 대부분 답을 꼼꼼히 검증하지 않는다. 사실 확인에는 시간이 들지만, 길이와 꾸밈은 한눈에 보인다.
우리 실측에서도 그랬다. 승부가 갈린 판 가운데 두 답의 길이가 다른 9만 8,097판에서, 더 긴 답이 이긴 비율은 61.8%였다. 길이 차이가 클수록 이 비율이 올라갔다.
길이 차이 1.2배 이하
52.1%
1.2~1.4배
55.4%
1.4~2배
60.4%
2~4배
67.0%
4배 초과
72.5%
더 긴 답이 이긴 비율. 무승부·‘둘 다 별로’는 제외. 길이는 답변 토큰 수.
제목·목록·굵은 글씨를 합친 개수가 더 많은 답의 승률도 59.5%였다. 물론 긴 답이 실제로 더 나은 경우도 많다. 블라인드 투표의 3번 질문처럼 말이다. 문제는 ‘길어서 좋은 것’과 ‘좋아서 긴 것’이 표만으로는 구별되지 않는다는 점이다.
아레나는 2024년 8월 스타일 보정(style control)을 도입했다. 브래들리–테리 모형에 모델 이름뿐 아니라 두 답의 길이 차이, 제목·목록·굵은 글씨 개수 차이를 함께 넣는다. 그러면 모형이 ‘길이 덕분에 이긴 몫’을 따로 떼어 낸다. 남은 모델 점수는 ‘두 답의 길이와 꾸밈이 같았다면’의 점수가 된다. 아레나 분석에서도 가장 큰 요인은 길이였다. 당시 Claude-3.5-Sonnet은 6위에서 4위로 올랐고, GPT-4o-mini는 6위에서 11위로, Grok-2-mini는 6위에서 18위로 내려갔다. 지금 Arena 순위표의 기본 화면도 스타일 보정을 적용한 순위다.
우리 데이터에 같은 보정을 걸자(위 위젯의 ‘스타일 보정 전후’ 탭) 순위가 크게 바뀌었다.
모델
보정 전
보정 후
답변 길이 중앙값
o3
4위
1위
871토큰
gemini-2.5-pro
1위
2위
1,377토큰
claude-opus-4
29위
10위
362토큰
claude-sonnet-4
39위
20위
333토큰
grok-3-preview
8위
16위
—
llama-4-maverick 실험판
9위
23위
1,383토큰
llama-4-maverick 출시판
44위
45위
609토큰
전체 평균 답변 길이 중앙값은 664토큰. 길이는 첫 턴만 있는 대화에서 셌다.
답이 짧은 Claude 계열은 크게 오르고, 답이 긴 모델들은 내려갔다. 어느 순위가 ‘진짜’라고 말하기는 어렵다. 다만 순위표 하나에도 여러 얼굴이 있다는 것, 그리고 어떤 보정을 켜고 봤는지가 결론을 바꾼다는 것은 분명하다.
5.2 Llama 4 사건 — 순위표에만 내놓은 모델
이제 처음 이야기로 돌아가자. 메타가 순위표에 올린 실험판은 출시판과 무엇이 달랐을까? 우리 데이터에서 실험판 답변의 길이 중앙값은 1,383토큰으로 출시판(609토큰)의 2.3배였다. 답 하나에 굵은 글씨가 평균 38개, 목록 항목이 30개였다. 출시판은 각각 7개, 9개였다. 두 버전이 직접 맞붙은 124판에서는 실험판이 63번, 출시판이 20번 이겼다.
점수 차이는 131점이었다. 스타일 보정을 걸자 57점으로 줄었다. 격차의 57%가 길이와 꾸밈으로 설명된다. 남은 57점은 보정이 잡지 못한 말투나 이모지, 실제 품질 차이일 수 있다.
LMArena는 2025년 4월 8일 이렇게 밝혔다.
메타의 정책 해석은 우리가 모델 제공자에게 기대하는 바와 맞지 않았다. 메타는 ‘Llama-4-Maverick-03-26-Experimental’이 사람의 선호에 맞춰 최적화한 맞춤 모델이라는 점을 더 분명히 했어야 했다.
아레나는 실험판이 치른 대결 2,000여 건을 공개하고 순위표 정책을 고쳤다. 메타 대변인은 “LM Arena에서도 성적이 좋은, 대화에 최적화한 버전으로 실험한 것”이라고 해명했다. 메타의 생성 AI 책임자 아마드 알달레는 테스트 데이터로 학습했다는 소문은 “사실이 아니”라고 부인했다. 아레나에 따로 올라온 출시판은 GPT-4o, Claude 3.5 Sonnet, Gemini 1.5 Pro보다 아래였다. 해를 넘겨 2026년 1월, 메타를 떠난 얀 르쿤은 『파이낸셜 타임스』 인터뷰에서 Llama 4의 벤치마크 결과가 “조금 손봐졌다(fudged a little bit)”고 말했다. 벤치마크마다 다른 변형을 썼다는 것이다.
2025년 4월 29일, 코히어 랩스와 스탠퍼드·프린스턴 등의 연구자들이 「리더보드 착시(The Leaderboard Illusion)」라는 논문을 냈다. 2024년 1월부터 2025년 4월까지 약 200만 건의 대결, 모델 243개를 분석했다. 지적은 세 갈래였다.
1
비공개 테스트
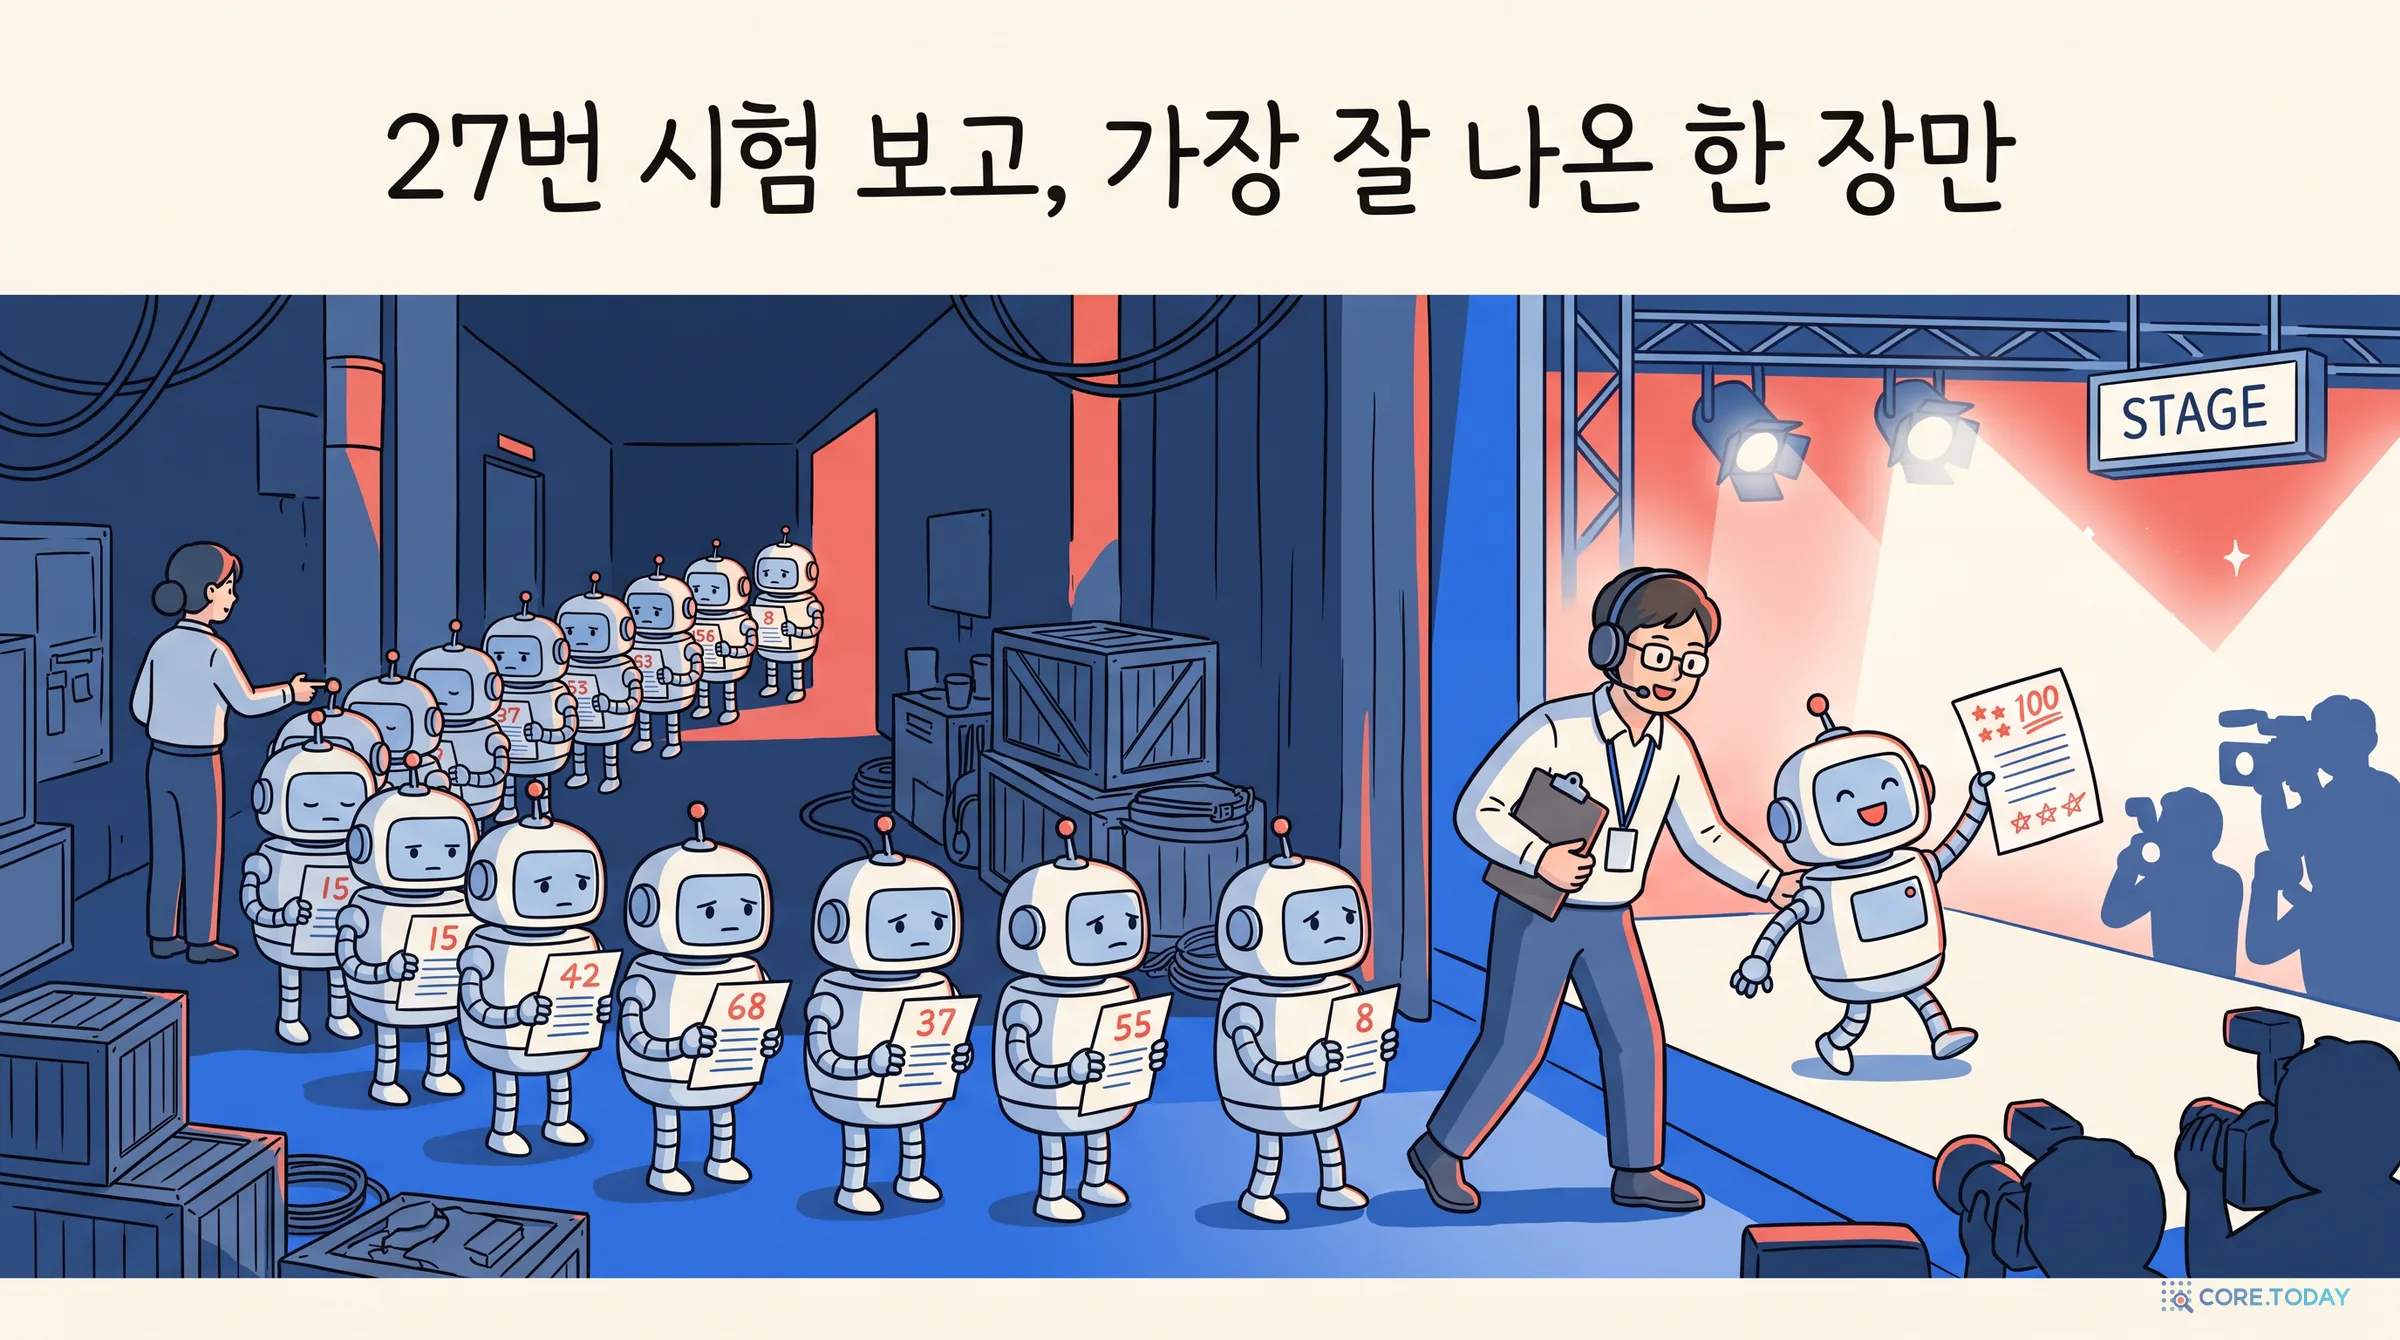
아레나는 출시 전 모델을 익명으로 올려 시험해 볼 수 있게 했다. 메타는 Llama 4 출시 전 비공개 변형 27개를 텍스트 아레나에서 시험했다(비전 아레나까지 합치면 43개). 구글은 10개를 시험했다. 여러 개를 올려 보고 가장 잘 나온 것만 공개하면, 점수가 진짜 실력보다 높게 나온다.
2
데이터 쏠림
대결 데이터 가운데 구글 모델이 19.2%, 오픈AI 모델이 20.4%를 받았다. 공개 가중치 모델 83개를 다 합쳐도 29.7%였다. 아레나 데이터로 미세조정하자 Arena-Hard 승률이 23.5%에서 49.9%로 올랐다(112% 상승). 표를 많이 받는 회사일수록 ‘아레나 취향’을 배울 데이터도 많이 가져간다.
!
조용한 퇴장
공개 모델 243개 중 205개가 공지 없이 대결에서 빠졌다. 공식적으로 내린 것은 47개였다. 모델이 빠지면 남은 모델끼리의 비교 사슬이 약해져 점수가 흔들릴 수 있다.
LMArena는 5월 9일 반박문을 냈다. 공개 모델의 데이터 비중은 40.9%라고 했다. ‘변형 10개면 약 100점’이라는 논문의 그래프는 가정에 기반한 시뮬레이션일 뿐이고, 실제 효과는 약 11점이며 새 표가 쌓이면 사라진다고 했다. 112% 상승은 실제 아레나가 아니라 500문항짜리 정적 벤치마크 Arena-Hard에서의 수치라는 점도 짚었다. 그러면서 변형을 10개 넘게 동시에 시험한 모델은 새 표 2,000개가 쌓일 때까지 점수에 ‘잠정’ 표시를 하겠다고 약속했다.
누구 말이 맞을까? 직접 시뮬레이션해 보자. 실력이 똑같은 변형을 몰래 여러 개 올려 같은 수의 표를 받게 하고, 가장 잘 나온 하나만 공개한다.
계산해 보면 양쪽 모두 맞는 말을 하고 있다. 변형 27개가 각각 1,000표를 받았다면 공개 점수는 평균 22점 부풀었다. 3,000표씩이면 13점으로, 아레나가 말한 ‘약 11점’과 비슷하다. 300표씩이면 40점이 됐다. 변형들의 실력이 실제로 조금씩 다르다면(표준편차 15점) 37점이 오르고 그중 25점만 진짜 향상이다. 결국 거품의 크기는 변형마다 받은 표의 수에 달렸다. 순위표 상위권이 10~20점 안에 몰려 있다는 점을 생각하면, 11점도 순위를 바꾸기에 충분한 크기다.
비공개 테스트가 규칙 안의 문제라면, 아예 규칙을 어기는 방법도 연구됐다. 둘 다 2025년 1월 공개돼 같은 해 ICML에 실렸다.
익명은 생각보다 얇다. 아레나 운영진과 니컬러스 칼리니, 플로리안 트라메르 같은 보안 연구자들이 함께 쓴 논문(Huang 외)은, 답의 말투만으로 어떤 모델이 썼는지 95% 넘게 맞힐 수 있음을 보였다. 이름을 가려도 내 모델을 알아볼 수 있다는 뜻이다. 그러면 내 모델이 나올 때만 골라 표를 줄 수 있다. 오프라인 시뮬레이션에서 약 1,000표면 순위를 바꿀 수 있었다.
내 모델이 안 나와도 순위는 바꿀 수 있다. Min 외의 논문은 더 교묘한 방법을 냈다. 특정 모델은 전체 대결의 약 1%에만 나온다. 그래서 내 모델이 나오는 판만 기다리기보다, 내 모델이 없는 판에서 경쟁 모델이 지도록 투표하는 편이 효율적이다. 브래들리–테리는 모든 대결이 서로 이어져 있기 때문이다. 이 방법으로 수백 표만 심어도 순위가 움직였다.
아레나는 클라우드플레어 봇 차단, 악성 사용자 탐지, 투표 속도 제한을 이미 쓰고 있었다. 여기에 로그인과 reCAPTCHA를 더하고 있다고 밝혔다. 수백만 표 중 수백 표, 비율로는 0.01%로 순위가 바뀔 수 있다는 점이 핵심이다.
5.5 투표자는 사실을 확인하지 않는다
조작이 없어도 남는 문제가 있다. 표 자체가 무엇을 재는가다.
데이터 라벨링 회사 서지 AI는 2025년 「LMArena는 AI의 암이다」라는 도발적인 글을 냈다. 이들은 아레나 투표 500건을 직접 검토했다. 그 결과 52%의 표에 동의하지 않았고, 39%에는 강하게 반대했다. 『오즈의 마법사』 대사를 틀리게 인용한 답, 케이크 틀 크기를 잘못 계산한 답이 각각 그 판에서 이겼다. 라벨링 회사의 글이니 이해관계를 감안해 읽어야 한다. 다만 블라인드 투표에서 독자가 겪은 일과 같은 방향이다.
아레나를 널리 알린 사람 중 한 명인 안드레이 카파시도 2025년 3월 이렇게 썼다.
Chatbot Arena가 너무 많은 주목을 받으면서(일부는 내 탓일까?) LLM 연구소들이 여기에 과적합하기 시작했다. 질문 수집(API 요청에서), 비공개 평가 폭격, 그리고 더 나쁘게는 순위를 학습 신호로 직접 쓰는 방식으로. … 신호가 약해지고 있는 것 같다.
‘리더보드 착시’ 논문이 나온 날에는 한 걸음 더 나갔다. 어떤 Gemini 모델은 2위와 큰 차이로 1위였지만 자기가 써 보니 더 나빴다고 했다. 반면 개인적으로 최상급이었던 Claude 3.5는 순위가 낮았다고 했다. 연구소들이 “더 나은 아레나용 모델”을 만들게 됐다며, 중첩된 목록과 이모지를 농담으로 꼽았다.
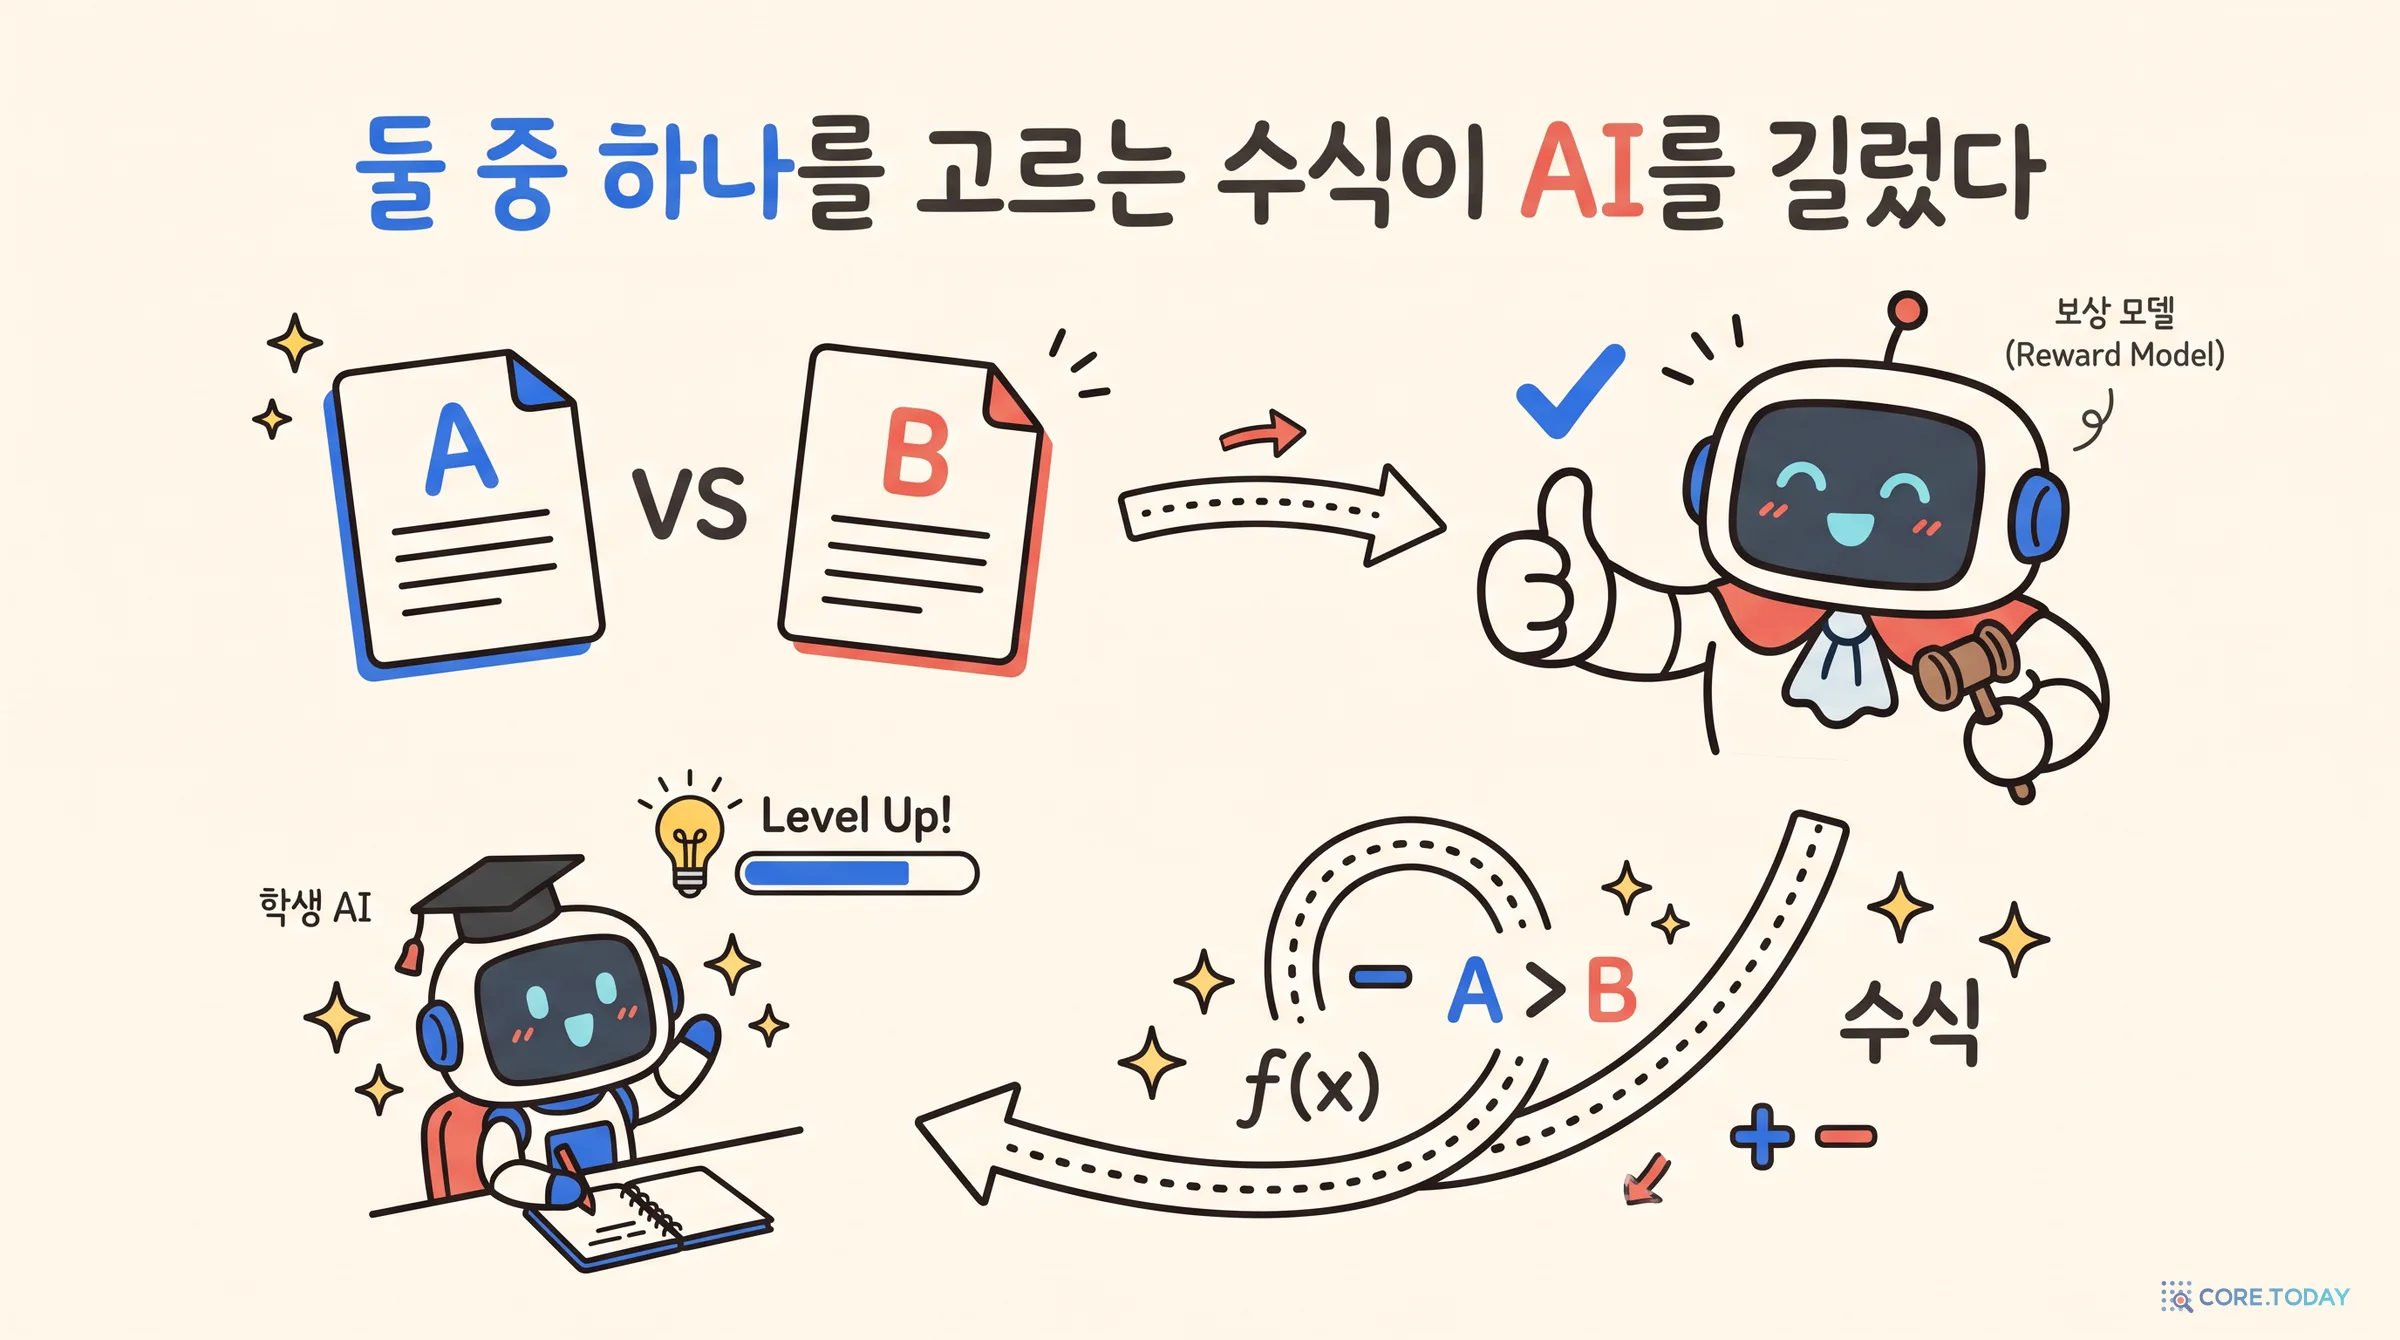
브래들리–테리 모형은 순위표 밖에서 더 큰 일을 한다. 오늘날 언어 모델을 사람의 취향에 맞추는 학습, 즉 RLHF의 심장이 바로 이 모형이다.
2017년 오픈AI와 딥마인드의 폴 크리스티아노 등은 ‘보상 함수를 쓸 수 없다면 사람에게 물어보라’는 논문에서, 사람이 두 행동 중 하나를 고른 기록으로 보상 함수를 학습했다. 논문은 이렇게 쓴다.
이는 쌍대 선호로부터 점수 함수를 추정하는 브래들리–테리 모형(Bradley and Terry, 1952)을 따른다. … 체스를 위해 개발된 유명한 Elo 레이팅 체계(Elo, 1978)와 비슷하게, 보상을 선호의 순위 눈금과 같게 놓는 것으로 이해할 수 있다.
2022년 InstructGPT의 보상 모델도 같은 형태의 손실 함수를 쓴다. 사람이 고른 답의 보상 rw와 고르지 않은 답의 보상 rl의 차이에 시그모이드를 씌운 값을 최대화한다.
loss=−logσ(r(x,yw)−r(x,yl))
σ(z)=1/(1+e−z)이니, 이 식은 브래들리–테리에서 ‘yw가 yl을 이길 확률’에 로그를 씌운 것이다. InstructGPT 논문은 브래들리–테리라는 이름을 직접 쓰지 않았지만, 뒤따른 연구들은 이 형태를 ‘BT 보상 모델’이라 부른다. 2023년 DPO는 아예 브래들리–테리 모형에서 출발해 보상 모델 없이 언어 모델을 바로 학습하는 식을 끌어냈다. 논문 스스로 자기 방법이 “재매개변수화한 브래들리–테리 모형을 맞추는 것과 같다”고 쓴다.
그러니 이런 구도가 된다. 아레나는 사람들의 쌍대 선호에 브래들리–테리를 맞춰 모델에 점수를 매긴다. 모델 회사들은 사람들의 쌍대 선호에 브래들리–테리를 맞춰 모델을 학습한다. 같은 식이 시험지와 교과서를 동시에 쓰고 있다. 투표자가 긴 답을 좋아하면, 그 취향은 학습 데이터에도 들어간다. 그렇게 학습한 모델은 아레나에서 더 잘한다. 5부의 논란은 몇몇 회사의 일탈이기 전에 이 구조에서 나온다.
6.2 2026년 11월의 순위표
2026년 11월 6일 Arena 텍스트 순위표(스타일 보정 기본) 상위권은 이렇다.
순위
모델
점수
1
Gemini 4 Carbon (High)
1526 ±9 (잠정, 4,483표)
2
Gemini 4 Argon (High)
1523
3
Muse Wonder (Max)
1513
4
Claude Opus 5.5 (High)
1505
5
Claude Fable 5 (High)
1504
1위와 5위의 차이는 22점이다. 1위는 표가 4,483개뿐인 잠정 점수이고, 신뢰구간이 2위와 겹친다. 같은 날 한국어 순위표(14만 2,377표, 모델 290개)의 1위는 Claude Fable 5 (High)로 1499 ±22점이었다. 바로 뒤의 Claude Fable 5.1, Opus 5.5, Opus 5가 약 1,493점으로 붙어 있었다. 어느 쪽이든 ‘1위’라는 말보다 ‘상위권이 오차 안에서 붙어 있다’는 말이 정확하다.
순위표 바깥의 대안도 늘었다.
전문가 비공개 평가: 스케일 AI의 SEAL 순위표(2024~)는 공개되지 않은 전문가 작성 문제로 평가해 문제 유출과 과적합을 막는다.
실제 사용량: 카파시는 여러 모델을 한 API로 파는 오픈라우터의 사용량 순위를 “속이기 매우 어려운 평가”일 수 있다고 했다. 사람들이 돈을 내고 계속 쓰는 모델이 좋은 모델이라는 논리다.
보상형 투표: 투표자에게 보상을 주는 아레나형 서비스 Yupp은 2025년 6월 시드 3,300만 달러를 받고 출발했지만, 2026년 3월 31일 문을 닫았다.
한국어 평가: 한국의 공개 순위표는 대부분 정적 벤치마크다. 업스테이지와 한국지능정보사회진흥원(NIA)의 Open Ko-LLM Leaderboard(2023~), W&B 코리아의 호랑이 리더보드가 대표적이다. 사람 투표 기반으로는 Arena의 한국어 범주가 사실상 유일한 대규모 순위표다.
6.3 순위표를 읽는 법
AI 모델을 고르거나 ‘아레나 1위’ 기사를 읽을 때 확인할 것들이다.
1
점수 말고 신뢰구간을 본다. 상위권은 10~20점 안에 몰려 있다. 막대가 겹치면 순위를 가렸다고 말할 수 없다. 아레나의 ‘공동 순위’ 표기를 그대로 받아들인다.
2
표가 몇 개인지 본다. 우리 실측에서 모델당 150표 안팎이면 신뢰구간이 ±46점, 1,400표 안팎이어도 ±14점이었다. 갓 올라온 모델의 ‘잠정’ 점수는 며칠 뒤 크게 바뀔 수 있다.
3
스타일 보정을 켜고 끈 순위를 비교한다. 보정을 끄면 오르는 모델은 길고 화려한 답으로 점수를 얻는 모델이다. 짧고 정확한 답이 필요한 업무라면 보정한 순위가 더 가깝다.
4
내 용도에 맞는 범주를 본다. 코딩, 수학, 긴 질문, 한국어처럼 범주별 순위는 전체 순위와 다르다. 우리 실측에서 o3는 전체 4위, 한국어 14위였다.
5
순위표의 모델이 내가 쓸 모델인지 확인한다. 실험판, 사고 모드(thinking), 높은 추론 설정(High·Max)처럼 이름 뒤에 붙은 말을 확인한다. API로 받는 모델과 다를 수 있다.
6
마지막은 내 데이터로 직접 비교한다. 실제 업무 질문 수십~수백 개를 두 모델에 던지고, 이름을 가린 채 동료들이 고르게 한다. 아래 코드 몇 줄이면 사내 미니 아레나의 순위를 낼 수 있다.
사내 블라인드 비교 결과가 battles.csv(열: model_a, model_b, winner — a·b·tie)에 있다면, 브래들리–테리 점수는 로지스틱 회귀 한 번으로 구한다.
python
import numpy as np, pandas as pd
from sklearn.linear_model import LogisticRegression
df = pd.read_csv("battles.csv")
models = sorted(set(df.model_a) | set(df.model_b))
idx = {m: i for i, m inenumerate(models)}
X = np.zeros((len(df), len(models)))
X[np.arange(len(df)), df.model_a.map(idx)] = 1# A는 +1
X[np.arange(len(df)), df.model_b.map(idx)] = -1# B는 -1
s = df.winner.map({"a": 1.0, "b": 0.0, "tie": 0.5}).to_numpy()
# 한 판을 'A 승' 행(가중치 s)과 'B 승' 행(가중치 1-s)으로 펼친다 → 무승부는 반 승
lr = LogisticRegression(fit_intercept=False, C=1e6)
lr.fit(np.vstack([X, X]), np.r_[np.ones(len(df)), np.zeros(len(df))],
sample_weight=np.r_[s, 1 - s])
elo = 400 / np.log(10) * lr.coef_[0] # Elo 눈금으로 바꾸기for m, r insorted(zip(models, elo - elo.mean() + 1000), key=lambda t: -t[1]):
print(f"{m:30s}{r:7.1f}")
모델 다섯 개를 비교한다면 판 수가 수백 개는 돼야 순위가 의미를 갖는다. 신뢰구간이 필요하면 행을 중복 허용으로 다시 뽑아 이 계산을 수백 번 반복하면 된다(부트스트랩). 답의 길이 차이를 열로 하나 더 넣으면 간단한 스타일 보정도 된다.
1927년 시카고의 심리학 실험실에서 2026년 기업가치 31억 달러의 AI 순위표까지, 이 글이 따라간 길에는 한 가지 생각이 계속 이어진다. 점수는 매기기 어렵지만, 둘 중 하나는 고를 수 있다.
비교에서 점수를 뽑는 수식은 하나다. 체르멜로의 체스 대회, 브래들리–테리의 돼지고기 맛 비교, 엘로의 체스 레이팅, 아레나의 AI 순위표는 모두 ‘강함의 비율이 이길 확률’이라는 같은 모형이다. Elo는 그것을 한 판씩 배우는 방법이고, 브래들리–테리 최대우도는 한꺼번에 푸는 방법이다.
숫자는 상대적이고, 흔들린다. 레이팅은 같은 집단 안의 상대 위치다. 표가 적으면 크게 흔들린다. 우리 실측에서 상위 2~6위는 신뢰구간이 겹쳤고, 한국어만 보면 같은 모델의 오차가 7배 가까이 커졌다.
표는 사람의 선호를 잴 뿐, 정답을 재지 않는다. 더 긴 답이 61.8%를 이겼다. 같은 모델의 길고 화려한 실험판은 출시판보다 131점 높았고, 그 격차의 57%는 길이와 꾸밈이었다. 비공개 변형, 데이터 쏠림, 수백 표의 조작은 그 숫자를 더 흔든다.
같은 식이 시험지와 교과서를 함께 쓴다. 브래들리–테리는 순위표를 매기는 동시에 보상 모델과 DPO로 AI를 학습시킨다. 사람의 선호를 그대로 최적화하면, AI는 사람이 좋아하는 답을 넘어 사람이 ‘좋아요’를 누르는 답을 배운다.
아레나는 지금도 대화형 AI를 비교하는 가장 큰 공개 실험이다. 그 가치는 여전하다. 다만 다음에 ‘아레나 1위’라는 말을 보면 두 가지를 물어보자. 그 1위는 2위와 신뢰구간이 겹치지 않을까? 그리고 그 점수는 더 나은 답에서 왔을까, 더 길고 화려한 답에서 왔을까?
코어닷투데이 실측 조건: lmarena-ai/arena-human-preference-140k(Hugging Face, 2025-04-17~2025-07-24, 135,634건, 모델 53개). 무승부·‘둘 다 별로’는 반 승. 브래들리–테리는 scikit-learn 로지스틱 회귀(절편 없음, 사실상 무정규화)로 맞추고 평균 1,000점에 맞춤. 신뢰구간은 부트스트랩 95%(전체 60회, 한국어 40회, 표 수별 비교 100회). 스타일 보정 공변량은 답변 토큰 수·제목·목록·굵은 글씨 개수의 정규화 차이 (a−b)/(a+b+1)를 표준화한 값. 온라인 Elo는 K=4, 초기값 1,000, 무작위 순서 40회. 길이·꾸밈 통계는 첫 턴만 있는 대화 기준. 언어는 데이터셋의 language 필드를 따랐다. 비공개 테스트 시뮬레이션은 변형마다 기준 상대와 겨룬 이항 표본으로 4,000회 반복. Arena 순위표 수치는 2026-11-06 arena.ai 기준.
Thurstone, L. L. (1927). A law of comparative judgment. Psychological Review, 34, 273–286.
Thurstone, L. L. (1927). The method of paired comparisons for social values. Journal of Abnormal and Social Psychology, 21, 384–400.
Zermelo, E. (1929). Die Berechnung der Turnier-Ergebnisse als ein Maximumproblem der Wahrscheinlichkeitsrechnung. Mathematische Zeitschrift, 29, 436–460. · Glickman, M. E. 해설(glicko.net/research/preface-z28.pdf)
Bradley, R. A., & Terry, M. E. (1952). Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons. Biometrika, 39(3/4), 324–345.
Ford, L. R. (1957). Solution of a ranking problem from binary comparisons. American Mathematical Monthly, 64, 28–33.
Luce, R. D. (1959). Individual Choice Behavior. Wiley.
Elo, A. E. (1978). The Rating of Chessplayers, Past and Present. Arco.
Glickman, M. E. (1999/2001). Parameter estimation in large dynamic paired comparison experiments (Glicko) · Dynamic paired comparison models with stochastic variances (Glicko-2). Journal of Applied Statistics, 28, 673–689.
Herbrich, R., Minka, T., & Graepel, T. (2006). TrueSkill™: A Bayesian Skill Rating System. NIPS 19, 569–576. · Minka, T. et al. (2018). TrueSkill 2. MSR-TR-2018-8.
Hunter, D. R. (2004). MM algorithms for generalized Bradley-Terry models. Annals of Statistics, 32(1), 384–406.
Szczecinski, L., & Djebbi, A. (2020). Understanding draws in Elo rating algorithm. Journal of Quantitative Analysis in Sports, 16(3), 211–220. arXiv:1910.06081
Silver, D. et al. (2017). Mastering the game of Go without human knowledge. Nature, 550, 354–359.
Carr, A. (2016). I Found Out My Secret Internal Tinder Rating And Now I Wish I Hadn't. Fast Company, 2016-01.
Christiano, P. et al. (2017). Deep Reinforcement Learning from Human Preferences. NeurIPS 2017. arXiv:1706.03741
Ouyang, L. et al. (2022). Training language models to follow instructions with human feedback. NeurIPS 2022. arXiv:2203.02155
Rafailov, R. et al. (2023). Direct Preference Optimization: Your Language Model is Secretly a Reward Model. NeurIPS 2023. arXiv:2305.18290
Chiang, W.-L. et al. (2023). Vicuna: An Open-Source Chatbot Impressing GPT-4 with 90%* ChatGPT Quality. LMSYS Blog, 2023-03-30.
Zheng, L. et al. (2023). Chatbot Arena: Benchmarking LLMs in the Wild with Elo Ratings. LMSYS Blog, 2023-05-03.
Chiang, W.-L., Li, T., Gonzalez, J. E., & Stoica, I. (2023). Chatbot Arena: New models & Elo system update. LMSYS Blog, 2023-12-07.
Zheng, L. et al. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. NeurIPS 2023 Datasets and Benchmarks. arXiv:2306.05685
Chiang, W.-L. et al. (2024). Chatbot Arena: An Open Platform for Evaluating LLMs by Human Preference. ICML 2024. arXiv:2403.04132
Li, T. et al. (2024). From Crowdsourced Data to High-Quality Benchmarks: Arena-Hard and BenchBuilder Pipeline. arXiv:2406.11939
Li, T., Angelopoulos, A., & Chiang, W.-L. (2024). Does style matter? Disentangling style and substance in Chatbot Arena. LMSYS Blog, 2024-08-29.
Frick, E. et al. (2025). Prompt-to-Leaderboard. ICML 2025. arXiv:2502.14855
Huang, Y. et al. (2025). Exploring and Mitigating Adversarial Manipulation of Voting-Based Leaderboards. ICML 2025. arXiv:2501.07493
Min, R. et al. (2025). Improving Your Model Ranking on Chatbot Arena by Vote Rigging. ICML 2025. arXiv:2501.17858
LMArena (2025). Llama 4 관련 공지(X), 2025-04-08. · TechCrunch (2025-04-11). Meta's vanilla Maverick AI model ranks below rivals on a popular chat benchmark.
Singh, S. et al. (2025). The Leaderboard Illusion. arXiv:2504.20879 · LMArena (2025). Our Response to “The Leaderboard Illusion”, 2025-05-09.
OpenAI (2025). Expanding on what we missed with sycophancy, 2025-05-02.
Karpathy, A. (2025). X 게시물, 2025-03-02 · 2025-04-30.
Surge AI (2025). LMArena is a cancer on AI. Surge AI Blog.
TechCrunch (2026-01-06). LMArena lands $1.7B valuation four months after launching its product. · Arena (2026). LMArena is now Arena, 2026-01-28. · Arena (2026). Series B, 2026-10-08.
Arena (2026). Text Arena Leaderboard · Korean Leaderboard. arena.ai, 2026-11-06 열람.
lmarena-ai (2025). arena-human-preference-140k. Hugging Face Datasets.