[특집] 종이를 빼앗기면 생각이 작아진다 — 무랏 데미르바스의 「생각의 도구로서의 글쓰기」, 유한 오토마톤에서 사고의 사슬까지
2026년 11월 7일, 분산 시스템 연구자 무랏 데미르바스가 「생각의 도구로서의 글쓰기」를 올렸다. 핵심은 마누엘 블럼의 일곱 줄이다. 유한 오토마톤과 튜링 기계의 차이는 종이와 연필 하나뿐이고, 종이를 빼앗기면 사람은 복잡도 클래스 하나를 통째로 내려간다. 이 글은 그 주장을 기계 위에서 직접 돌려 본다. 튜링이 1936년에 기계를 만든 재료가 '종이 위에서 계산하는 사람'이었다는 사실에서 출발해, 외부 메모리 알고리즘, 작업기억 4덩어리, 플라워와 헤이스의 글쓰기 인지 모형, 베라이터와 스카다말리아의 '지식 변형'까지 글쓰기의 아키텍처를 뜯어보고, 같은 정리가 2024년 사고의 사슬(CoT) 이론에서 다시 증명된 과정을 따라간다. 로컬 모델에게 종이를 주고 빼앗는 곱셈 실측(종이를 빼앗자 4자리부터 무너졌지만, 길게 쓰게 해도 나아지지 않았고 짧게 쪼개 쓰게 하자 7자리에서도 8문제 중 7문제를 맞혔다), 6쪽 메모가 더는 생각의 증거가 아니게 된 2026년의 사정, 인지 부채 연구, 그리고 데미르바스의 다섯 규칙과 맥피·엘보·보이스·스트렁크의 글쓰기 노하우까지 — 일곱 개의 인터랙티브 도구와 함께 정리했다.
1980년대 후반 터키의 한 중학생은 긴 글을 끝까지 읽어 내지 못했습니다. 한 쪽을 다 읽고 나면 머리에 남은 것이 없었습니다. 그래서 그는 절박한 마음에 노트를 하기 시작했습니다. 마침 토니 부잔의 마인드맵이 터키에 막 들어온 참이었고, 소년의 공책은 거미줄처럼 생긴 그림으로 몇 장씩 채워졌습니다. 읽은 내용이 마인드맵의 어느 가지에 매달려야 하는지 고민하는 동안 내용이 이해됐습니다. 소년은 그때 깨달았습니다. 이 공책은 정보를 저장하려는 것이 아니라 처리하려는 것이었다.
그 소년이 무랏 데미르바스(Murat Demirbas)입니다. 뉴욕주립대 버펄로 교수로 분산 시스템과 형식 기법을 가르쳤고, AWS를 거쳐 지금은 MongoDB 리서치의 수석 연구원입니다. 2011년부터 「Metadata」라는 블로그에 논문 읽기, 분산 합의, TLA+ 이야기를 꾸준히 써 왔습니다. 2026년 11월 7일 그가 올린 짧은 글 「생각의 도구로서의 글쓰기(Writing as a thinking tool)」는 그 40년 가까운 습관의 이유를 한 문장으로 설명합니다. 그 설명은 수필이 아니라 계산 이론의 정리입니다.
종이를 빼앗으면 당신은 복잡도 클래스 하나를 통째로 내려간다.
이 글은 그 한 문장을 끝까지 따라가 봅니다. 정말 정리인지, 비유인지. 왜 하필 2026년에 이 이야기가 다시 필요해졌는지. 그리고 어떻게 써야 하는지.
먼저 지도를 펼쳐 두겠습니다.
1부종이 한 장의 차이 — 블럼의 일곱 줄, 튜링이 기계를 만든 재료, 덧셈은 되고 곱셈은 안 되는 이유
2부글쓰기의 아키텍처 — 아웃오브코어 실행, 작업기억 4덩어리, 플라워와 헤이스의 인지 모형, 지식 말하기와 지식 변형
3부생각을 바깥에 두는 오래된 기술 — 점토판에서 제텔카스텐까지, 그리고 증거가 말하는 것과 말하지 않는 것
4부기계에게도 종이가 필요하다 — 사고의 사슬 이론과 코어닷투데이의 곱셈 실측
5부6쪽짜리 증거가 무너진 해 — 아마존 6페이저, 인지 부채, 고기 대리인
6부어떻게 쓸 것인가 — 데미르바스의 다섯 규칙과 맥피·엘보·보이스·스트렁크의 노하우, 실천 체크리스트
1. 블럼의 일곱 줄
데미르바스가 박사과정 시절 공부를 미루다가 읽은 글이 있습니다. 1995년 튜링상 수상자 마누엘 블럼이 대학원 신입생에게 남긴 조언 「Advice to a Beginning Graduate Student」입니다. 그 안에 이런 대목이 있습니다.
마누엘 블럼, 「대학원 신입생에게 주는 조언」 중에서
여러분은 모두 컴퓨터 과학자입니다.
유한 오토마톤이 무엇을 할 수 있는지 압니다.
튜링 기계가 무엇을 할 수 있는지 압니다.
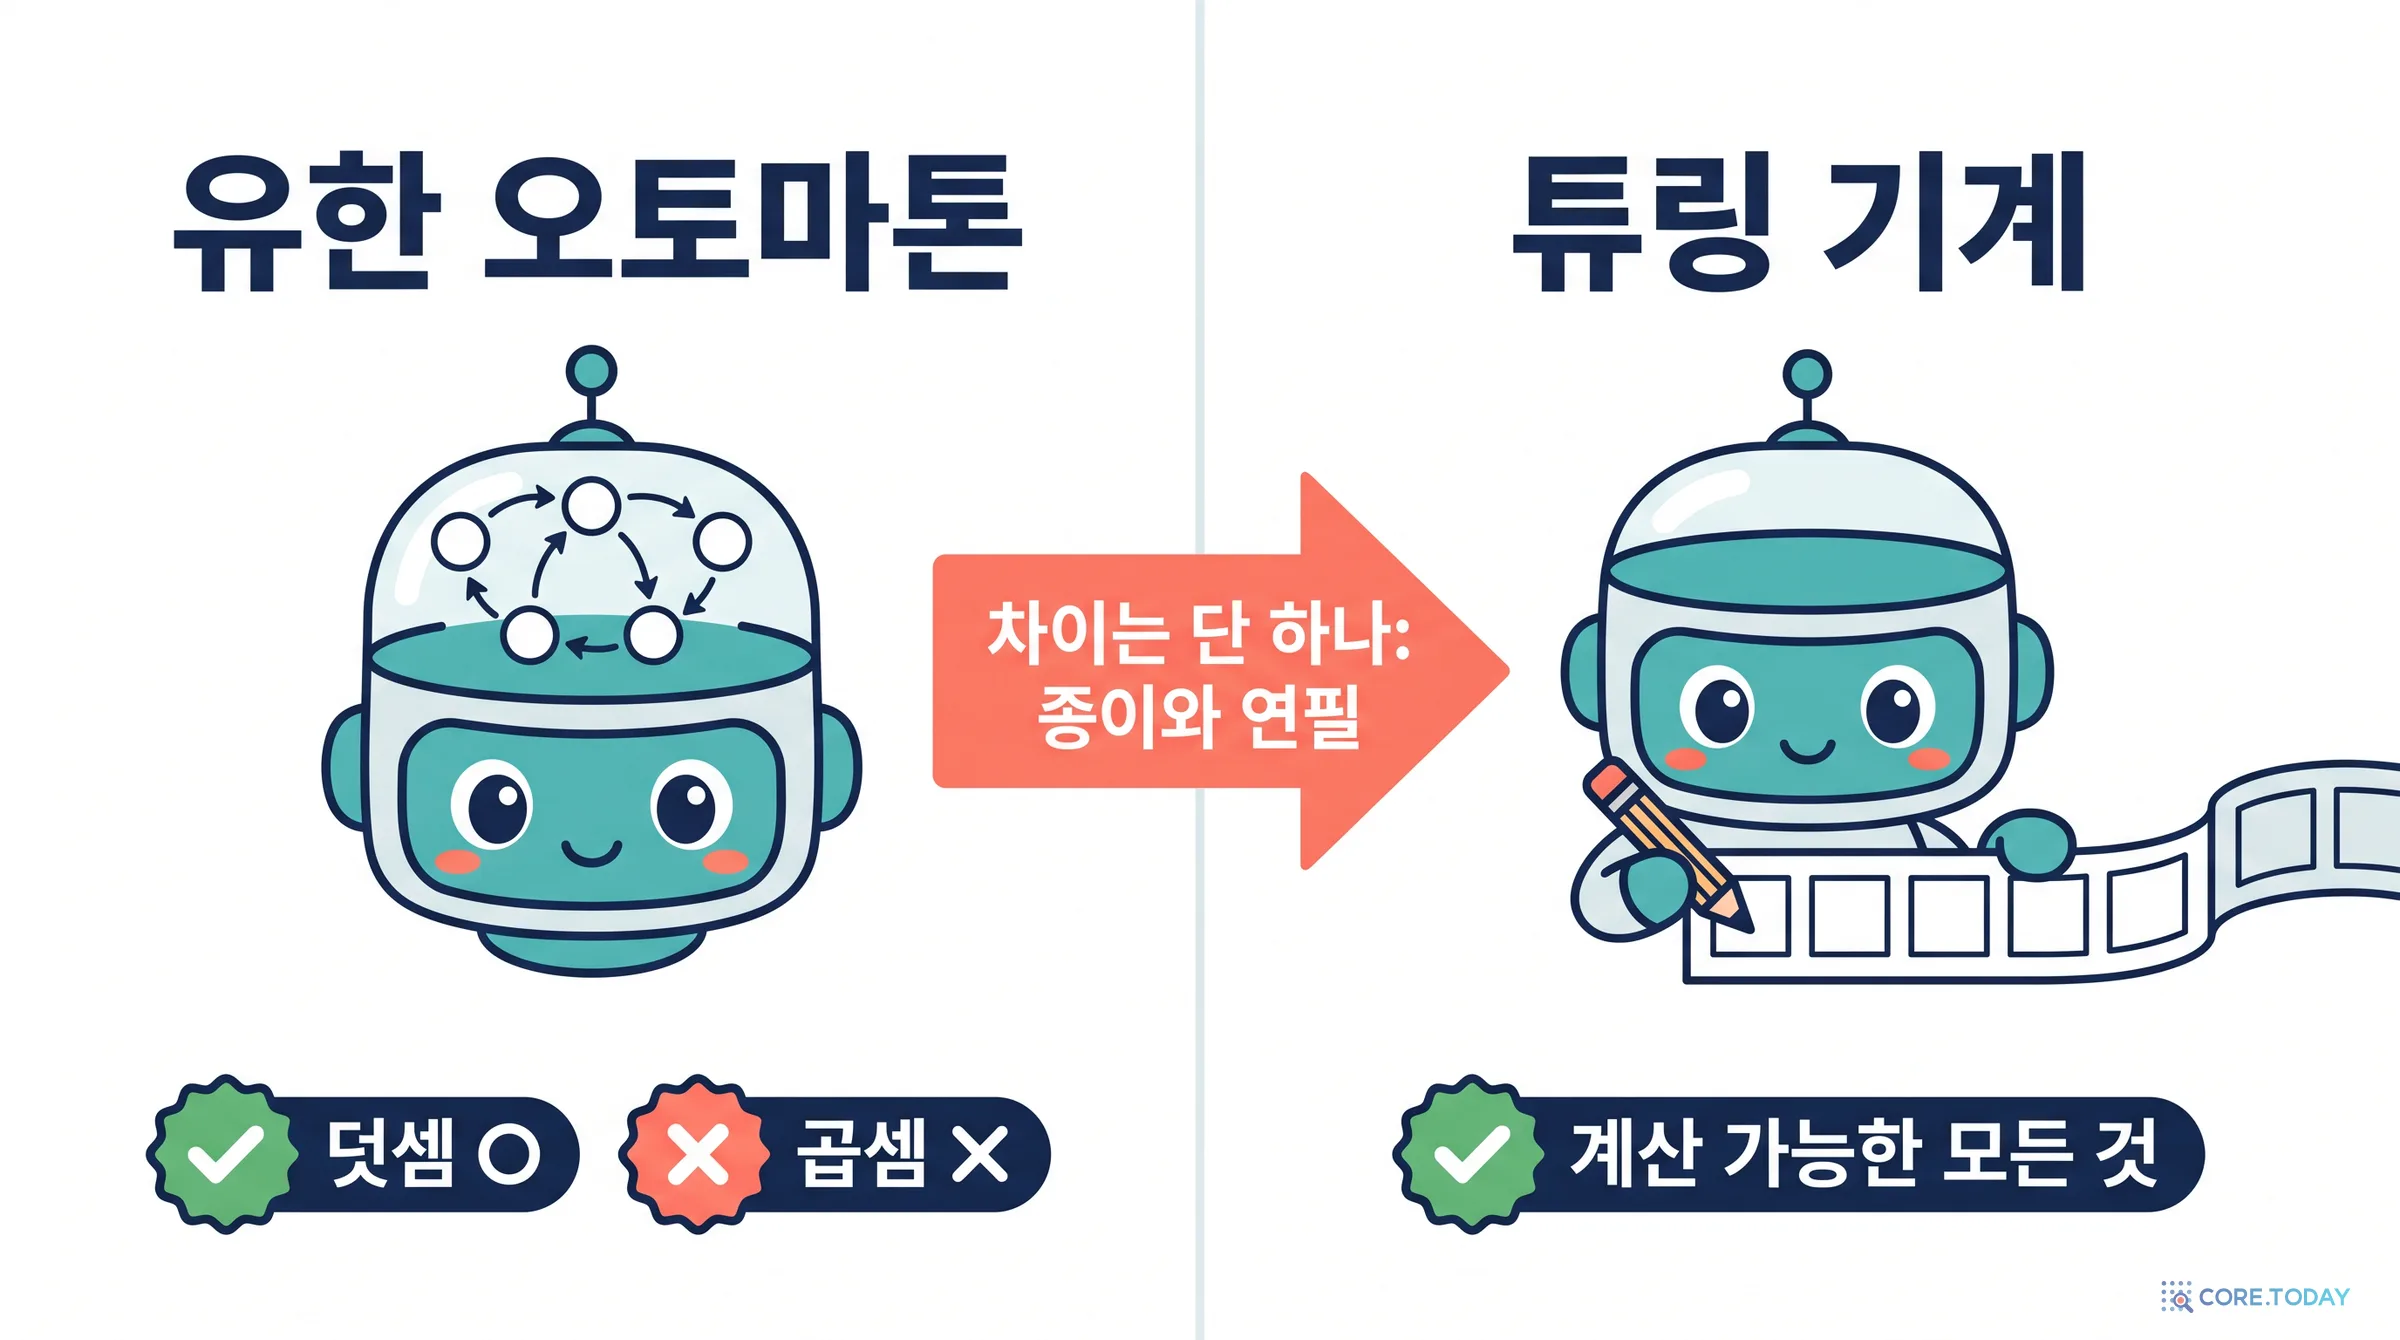
예컨대 유한 오토마톤은 더할 수는 있지만 곱할 수는 없습니다.
튜링 기계는 계산 가능한 함수라면 무엇이든 계산합니다.
튜링 기계는 유한 오토마톤보다 비교할 수 없이 강력합니다.
그런데 둘의 유일한 차이는
튜링 기계에는 유한 오토마톤과 달리 종이와 연필이 있다는 것입니다.
생각해 보세요.
이것은 글쓰기의 힘에 대해 무언가를 말해 줍니다.
글을 쓰지 않으면 여러분은 유한 오토마톤으로 줄어듭니다.
글을 쓰면 튜링 기계의 비범한 힘을 갖게 됩니다.
데미르바스는 이것을 이렇게 읽습니다. "이건 글쓰기로 어떤 문제를 풀 수 있는지에 대한 깔끔한 기술적 주장이다. 종이를 빼앗으면 당신은 복잡도 클래스 하나를 통째로 내려간다!"
유한 오토마톤(finite automaton)은 상태가 정해진 개수만큼 있는 기계입니다. 자판기를 떠올리면 됩니다. 자판기는 '0원 넣음', '500원 넣음', '1000원 넣음' 같은 몇 가지 상태 사이를 오가며, 동전이 들어올 때마다 다음 상태로 옮겨 갑니다. 지난 일을 기억하는 방법은 오직 '지금 어느 상태에 있는가'뿐입니다. 상태가 다섯 개라면 기억할 수 있는 것도 다섯 가지뿐입니다.
튜링 기계(Turing machine)는 이 자판기에 끝없이 긴 종이 테이프와 그 위를 오가며 읽고 쓰는 머리를 붙인 것입니다. 머리 안의 상태 수는 여전히 유한합니다. 똑같이 멍청한 기계입니다. 다른 점은 단 하나, 기억해야 할 것을 바깥에 적어 둘 수 있다는 것입니다.
이 작은 차이가 만드는 격차는 어마어마합니다. 유한 오토마톤이 알아볼 수 있는 패턴을 '정규 언어'라고 부르는데, 괄호의 짝이 맞는지조차 판정하지 못합니다. 반면 튜링 기계는 지금 우리가 쓰는 어떤 컴퓨터가 할 수 있는 일이든 할 수 있습니다. 처치-튜링 논제에 따르면, '계산'이라고 부를 수 있는 모든 것이 여기에 들어갑니다.
괄호 문제가 왜 어려운지 직접 확인해 보겠습니다. 아래 위젯의 왼쪽 기계는 머릿속에 칸이 몇 개뿐이고, 오른쪽 기계는 똑같이 단순하지만 종이를 가졌습니다. 칸 수를 아무리 늘려도, 그보다 한 칸 깊은 괄호를 넣으면 왼쪽 기계는 반드시 틀립니다.
이것이 블럼이 말한 '복잡도 클래스 하나'의 감각입니다. 머리를 키우는 것으로는 해결되지 않습니다. 머리가 아무리 커도 그보다 큰 문제는 언제나 있습니다. 해결책은 머리 밖에 쓸 곳을 두는 것입니다.
덧붙이면, 데미르바스의 '복잡도 클래스'라는 표현은 엄밀하게는 조금 겸손합니다. 유한 오토마톤과 튜링 기계의 차이는 같은 문제를 얼마나 빨리 푸느냐(복잡도)가 아니라 애초에 풀 수 있느냐(계산 가능성)의 차이입니다. 등급이 하나 내려가는 정도가 아니라, 풀 수 있는 문제의 세계 자체가 쪼그라듭니다. 반대 방향의 단서도 하나 있습니다. 현실의 공책은 무한하지 않습니다. 유한한 종이를 가진 사람은 엄밀히는 튜링 기계보다 '선형 유계 오토마톤'(입력 길이에 비례하는 만큼의 테이프만 쓰는 기계)에 가깝습니다. 그래도 그 차이는 유한 오토마톤과의 차이에 비하면 작습니다. 종이는 모자라면 한 장 더 꺼내면 되니까요. 이 단서는 4부의 실측에서 뜻밖의 모습으로 다시 나타납니다.
2. 튜링이 기계를 만든 재료는 '종이 위에서 계산하는 사람'이었다
여기서 한 가지 역사적 사실을 짚고 가면 블럼의 말이 더 이상 비유로 들리지 않습니다. 앨런 튜링이 1936년 논문 「계산 가능한 수에 대하여(On Computable Numbers)」에서 튜링 기계를 정의할 때 모델로 삼은 것은 기계가 아니라 사람이었습니다. 당시 '컴퓨터(computer)'는 계산을 업으로 하는 사람을 가리키는 말이었습니다.
논문 9절에서 튜링은 이렇게 씁니다.
앨런 튜링, 「계산 가능한 수에 대하여」(1936) 9절
계산은 보통 종이 위에 어떤 기호들을 적는 방식으로 이루어진다. 이 종이가 아이들의 산수 공책처럼 칸으로 나뉘어 있다고 생각해 보자. (…) 그러니 계산은 1차원 종이, 즉 칸으로 나뉜 테이프 위에서 이루어진다고 가정한다. (…) 계산하는 사람의 행동은 매 순간 그가 보고 있는 기호들과 그 순간의 '마음 상태'로 결정된다. (…) 고려해야 할 마음 상태의 수 또한 유한하다고 가정하자. (…) 더 복잡한 마음 상태를 쓰는 일은 테이프에 기호를 더 적는 것으로 피할 수 있다.
마지막 문장을 다시 읽어 보세요. 튜링은 1936년에 이미 이렇게 말했습니다. 머릿속에 더 많은 것을 담아야 할 것 같으면, 대신 종이에 더 적으면 된다. 같은 9절에는 이런 대목도 있습니다. 계산하는 사람은 언제든 일을 멈추고 자리를 떠나 다 잊어버렸다가 돌아와 이어서 할 수 있는데, 그러려면 표준적인 형식으로 '지시 메모'를 남겨야 한다. 그리고 튜링은 덧붙입니다. "이 메모가 '마음 상태'의 대응물이다." 마음 상태와 종이 위의 메모는 서로 바꿔 쓸 수 있다는 것, 이것이 계산 이론의 첫 페이지에 적힌 생각입니다.
튜링은 종이 위에서 계산하는 사람을 관찰하고, 그 사람에게서 필수적이지 않은 것을 하나씩 걷어 냈습니다. 종이는 2차원일 필요가 없으니 1차원 테이프로 바꿨습니다. 한 번에 볼 수 있는 칸 수는 유한하다고 했습니다. 마음 상태의 수도 유한하다고 했습니다. 그렇게 남은 것이 튜링 기계입니다. 유한한 마음 + 종이.
그러니 블럼의 말은 비유라기보다 정의를 거꾸로 읽은 것에 가깝습니다. 튜링 기계는 처음부터 '종이와 연필을 가진 사람'의 추상화였습니다. 종이를 빼면 남는 것은 유한한 마음 상태들, 곧 유한 오토마톤입니다.
구성 요소
튜링이 관찰한 사람
튜링 기계
종이를 빼앗긴 사람
마음
유한한 '마음 상태'
유한한 상태 집합
유한한 상태 집합
보는 범위
한 번에 몇 칸
머리 아래 한 칸
입력을 한 번 훑음
기록
산수 공책의 칸
무한한 테이프
없음
풀 수 있는 문제
계산 가능한 모든 것
계산 가능한 모든 것
정규 언어뿐
물론 사람은 유한 오토마톤이 아닙니다. 사람의 뇌에는 장기기억이 있고, 연습으로 암산 능력을 크게 키울 수 있습니다. 블럼의 주장은 '사람의 뇌가 정확히 유한 오토마톤과 같다'는 신경과학적 주장이 아닙니다. 한 번에 머릿속에 붙들 수 있는 양이 고정돼 있다면, 그보다 큰 문제는 바깥 기록 없이는 풀 수 없다는 구조적 주장입니다. 그리고 2부에서 보겠지만, 사람이 '한 번에 붙들 수 있는 양'은 놀랄 만큼 작습니다.
3. 덧셈은 되고 곱셈은 안 되는 이유
블럼의 문장 중 가장 구체적인 것은 "유한 오토마톤은 더할 수는 있지만 곱할 수는 없다"입니다. 처음 들으면 이상합니다. 둘 다 초등학교에서 배우는 계산인데 왜 하나만 될까요?
손으로 덧셈을 할 때를 떠올려 보세요. 오른쪽 끝자리부터 두 숫자를 더하고, 일의 자리를 쓰고, 올림이 있으면 기억합니다. 그다음 자리로 넘어가 같은 일을 합니다. 이때 머릿속에 들고 있어야 하는 것은 올림 하나, 0 아니면 1입니다. 자릿수가 3이든 300이든 마찬가지입니다. 상태 두 개짜리 기계로 충분합니다.
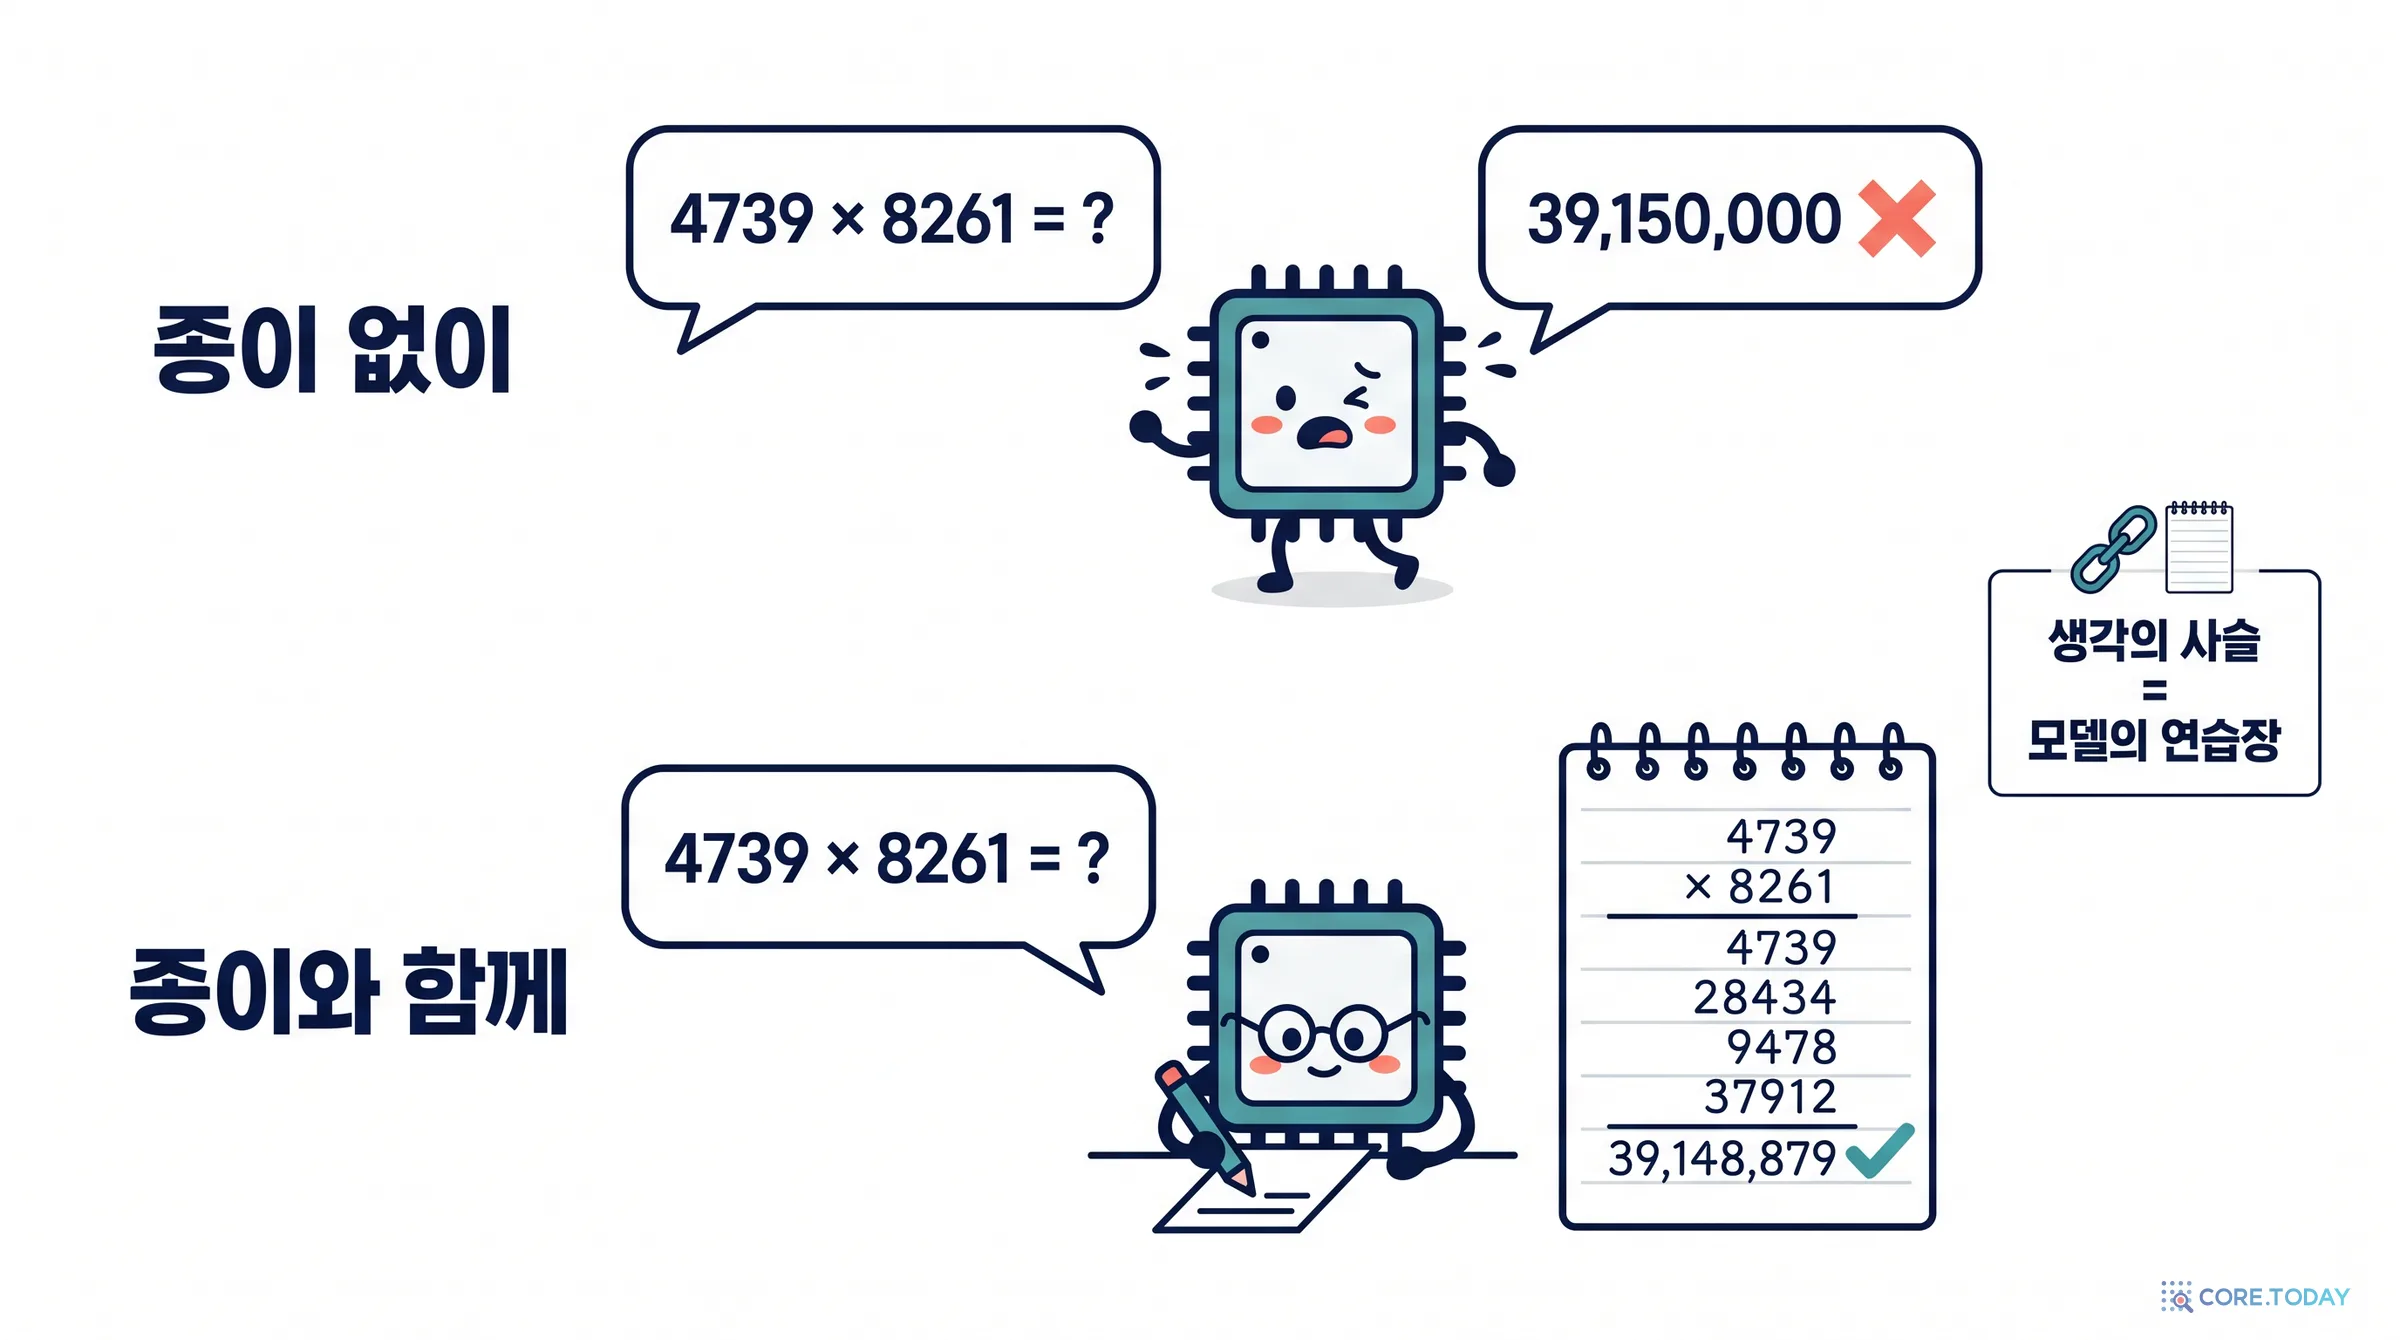
곱셈은 다릅니다. 4,739 × 8,261을 종이 없이 해 보면 곧 알게 됩니다. 4,739 × 1을 하고, 4,739 × 60을 해서 앞의 결과에 더하고, 4,739 × 200을 해서 또 더하고… 그 사이 내내 지금까지의 중간 합 전체를 머리에 붙들고 있어야 합니다. 그 중간 합의 자릿수는 문제의 자릿수와 함께 자랍니다. 상태 수가 고정된 기계는 언젠가 반드시 넘칩니다.
한 가지 단서가 있습니다. 유한 오토마톤이 덧셈을 할 수 있는 것은 두 수의 자릿수를 아래 자리부터 한 쌍씩 받을 때뿐입니다. 첫 번째 수를 다 읽고 나서 두 번째 수를 읽는 방식이라면 첫 수 전체를 기억해야 하므로 덧셈조차 못 합니다. 손으로 덧셈할 때 두 수를 위아래로 맞춰 적는 이유가 바로 이것입니다. 종이 위의 배치 자체가 머리의 짐을 덜어 주는 설계입니다.
종이가 하는 일은 늘어나는 부분을 머리 밖으로 빼내는 것입니다. 부분곱을 종이에 적어 두면, 머리가 매 순간 하는 일은 다시 '두 자리 곱하고 올림 기억하기'라는 고정된 크기의 일로 줄어듭니다. 문제는 커졌는데 머리가 할 일은 커지지 않습니다. 이것이 종이의 본질적 기능입니다. 저장이 아니라, 머리의 일을 다시 상수로 만드는 것.
데미르바스가 중학생 때 깨달은 것, "공책은 저장하려는 것이 아니라 처리하려는 것"이라는 말과 정확히 같은 이야기입니다.
4. 언어가 생각을 밖으로 꺼냈고, 그때마다 우리는 똑똑해졌다
데미르바스는 블럼의 정리를 인류사로 넓힙니다. "언어는 생각의 일부를 바깥으로 꺼내게 해 줬고, 우리 종은 더 똑똑해졌다. 문자는 그보다 더 많은 것을 꺼내게 해 줬고, 우리는 다시 똑똑해졌다." 그리고 한 걸음 더 나갑니다. "LLM이 지금처럼 유능한 이유도 이것이라고 본다. 우리 지능의 아주 많은 부분이 이미 언어 속에 쌓여 있어서, 그것으로 훈련한 모델은 상당한 지능을 공짜로 물려받는다."
이 가설은 3부와 4부에서 다시 다룹니다. 문자가 사람의 생각을 바꿨다는 주장은 플라톤부터 월터 옹까지 2,400년 동안 논쟁거리였고, 언어로 훈련한 기계가 '종이'를 받으면 무엇이 달라지는지는 2024년에야 수학적으로 증명됐습니다.
그 전에, 종이가 사람의 머릿속에서 정확히 무슨 일을 하는지부터 들여다보겠습니다. 데미르바스가 쓴 컴퓨터 공학 용어, '아웃오브코어 실행'에서 시작합니다.
5. 아웃오브코어 실행: 작은 메모리로 큰 문제를 푸는 법
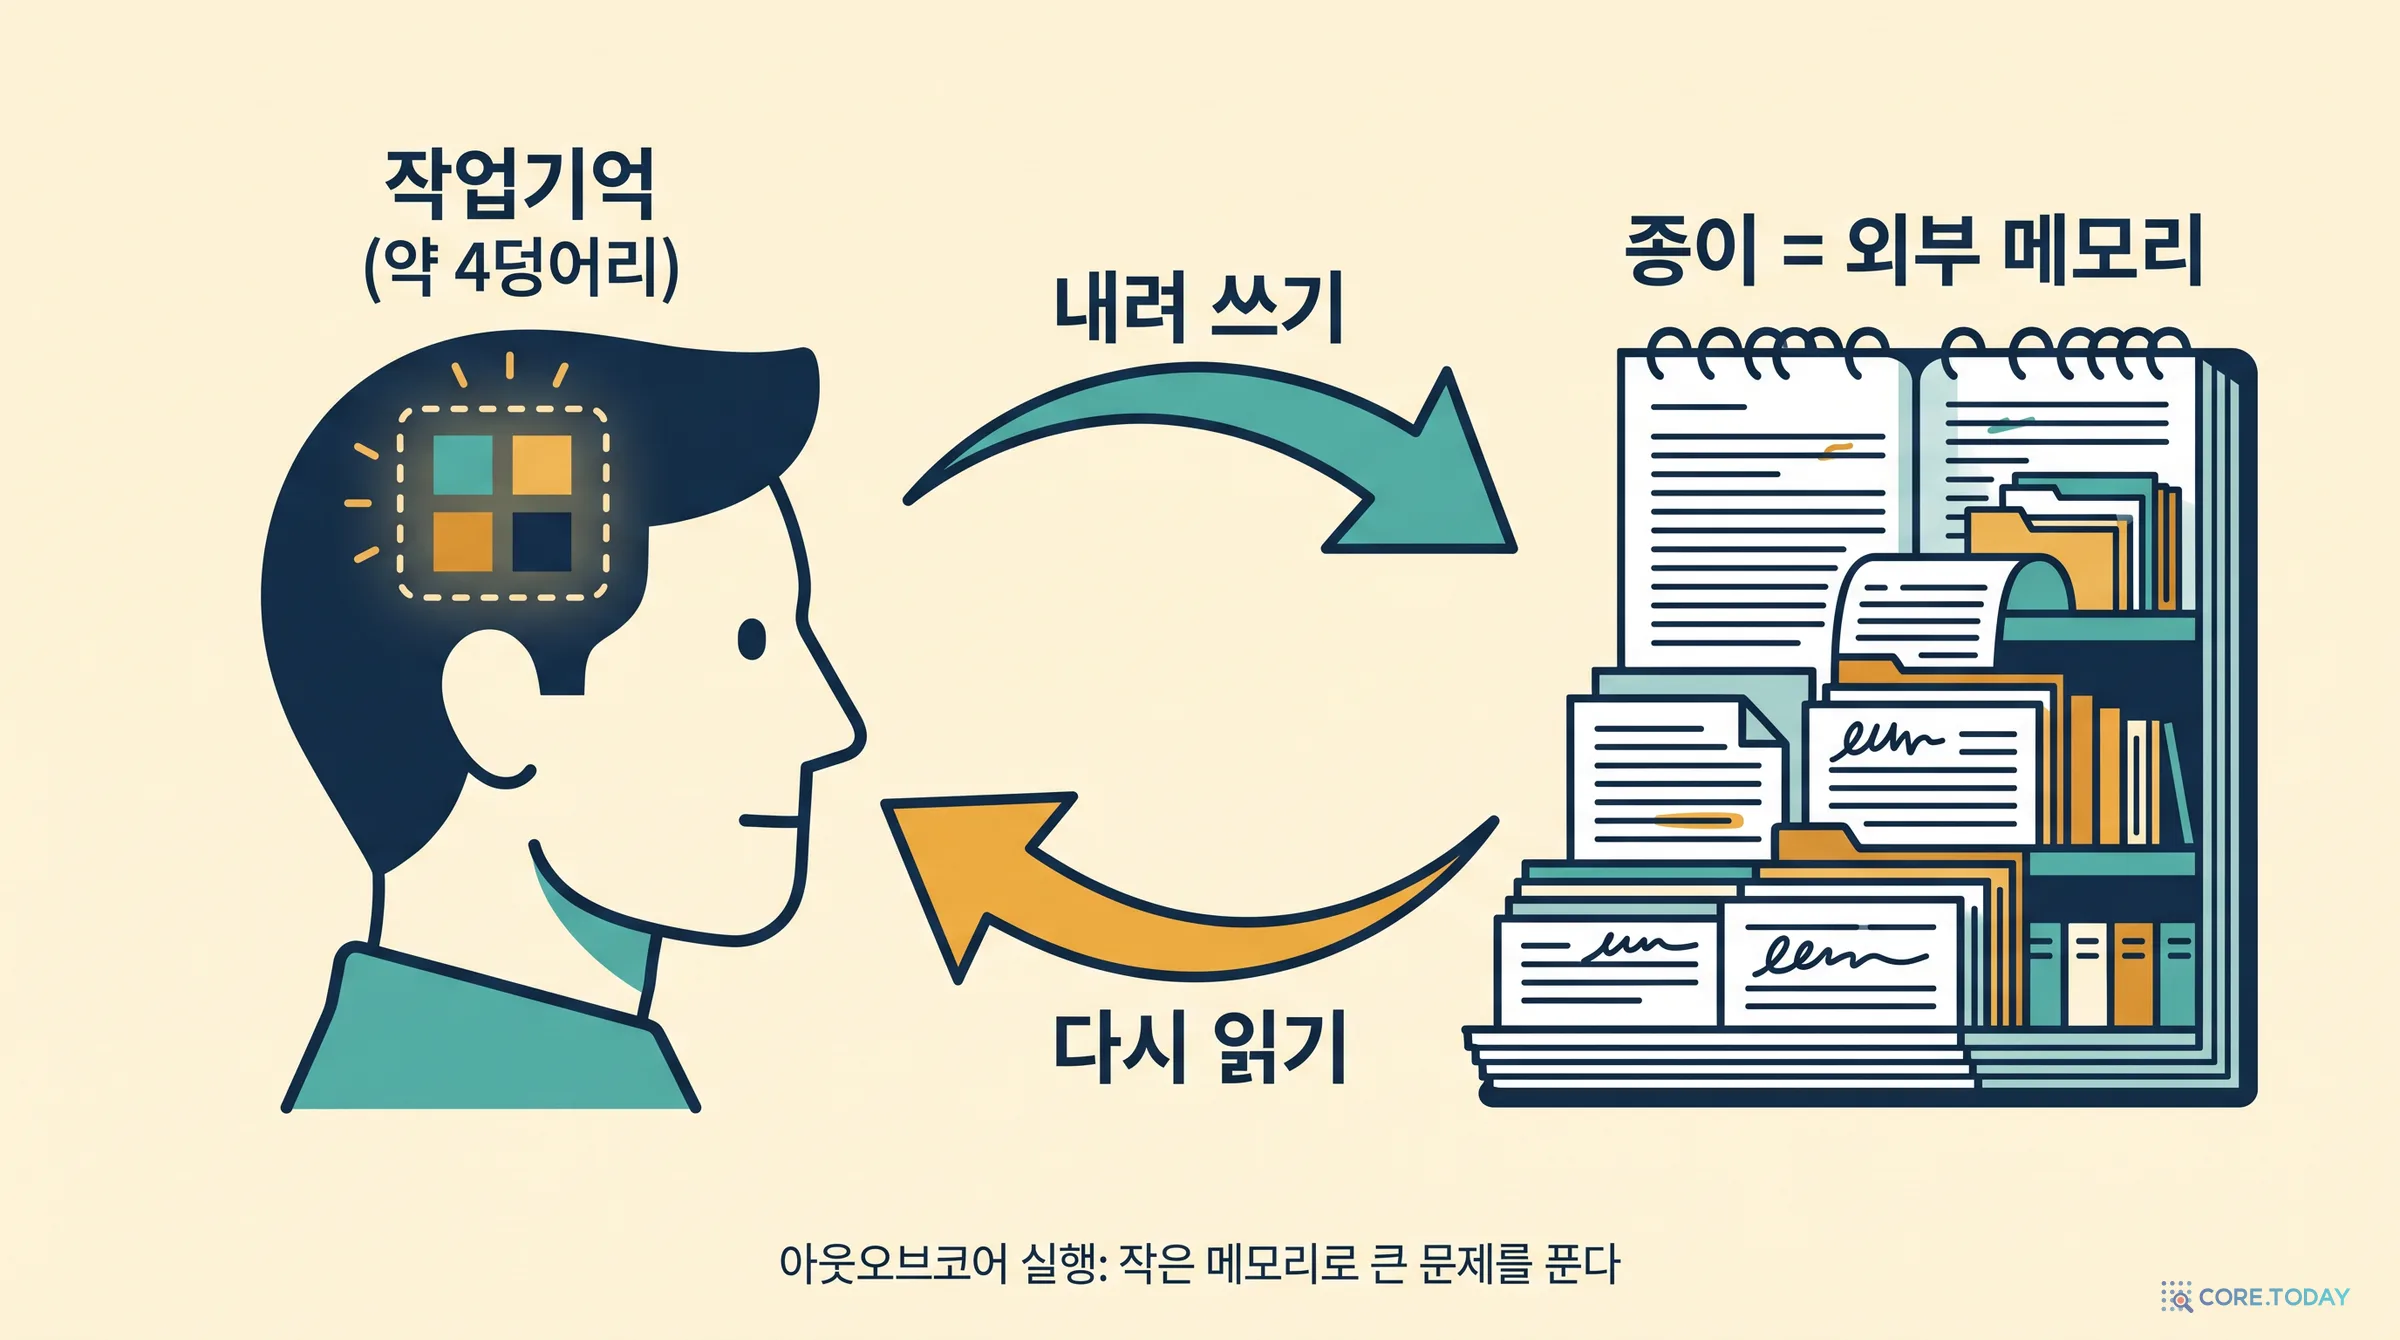
데미르바스는 글쓰기를 컴퓨터 공학의 한 기법에 빗댑니다. "글을 쓸 때 우리는 생각을 종이 위로 꺼내 놓는다. 그것이 더 큰 생각을 할 수 있게 해 준다. 나는 이것을 아웃오브코어 실행, 혹은 외부 메모리 알고리즘에 빗댄다."
'코어(core)'는 옛날 컴퓨터의 주기억장치를 부르던 말입니다. 1950~70년대 컴퓨터는 작은 자석 고리(코어)로 메모리를 만들었습니다. '아웃오브코어'는 데이터가 주기억장치에 다 들어가지 않을 때, 디스크를 작업 공간으로 쓰며 계산하는 방식을 말합니다.
컴퓨터의 메모리는 층층이 쌓여 있습니다. 위로 갈수록 빠르고 작으며, 아래로 갈수록 느리고 큽니다.
레지스터·캐시수 KB~수십 MB나노초 단위
↓ 더 크고, 더 느리게
주기억장치(RAM)수 GB~수 TB약 100나노초
↓ 수백~수만 배 느린 벽
디스크·SSD수 TB~수 PB마이크로초~밀리초
1988년 알록 아가르왈(Alok Aggarwal)과 제프리 비터(Jeffrey Vitter)는 이 상황을 수학 모형으로 만들었습니다. 이른바 외부 메모리 모형입니다. 모형에는 숫자가 셋뿐입니다. 풀어야 할 데이터의 크기 N, 빠른 메모리의 크기 M, 그리고 느린 저장소와 한 번에 주고받는 덩어리(블록)의 크기 B. 이 모형에서 비용은 계산 횟수가 아니라 블록을 몇 번 옮겼는가로 셉니다. 느린 저장소를 오가는 일이 압도적으로 비싸기 때문입니다.
이 모형의 대표 문제가 정렬입니다. 메모리에 100개밖에 안 들어가는데 100만 개를 정렬해야 한다면? 답은 '외부 병합 정렬'입니다. 먼저 100개씩 잘라 메모리에서 정렬한 뒤 디스크에 써 둡니다(이 조각을 '런'이라 부릅니다). 그다음 써 둔 런 여러 개를 조금씩 읽어 들이며 합쳐서 더 긴 런을 다시 써 둡니다. 이것을 런이 하나 남을 때까지 반복합니다. 아가르왈과 비터는 이 방식이 사실상 최선임을 증명했습니다. 블록 이동 횟수는 대략 (N/B) × logM/B(N/B)에 비례합니다.
직접 숫자를 바꿔 보세요. 데이터를 메모리의 수천 배로 키워도 정렬은 끝납니다. 대신 데이터를 여러 번 훑어야 합니다.
사람의 '코어'는 놀랄 만큼 작습니다. 1956년 심리학자 조지 밀러는 「마법의 수 7, 더하기 빼기 2」라는 유명한 논문에서 사람이 단기기억에 붙들 수 있는 항목이 대략 일곱 개 안팎이라고 했습니다. 2001년 넬슨 코완(Nelson Cowan)은 여러 실험을 다시 검토해, 되뇌기나 덩어리 짓기 같은 요령을 막으면 실제 용량은 약 4덩어리에 가깝다고 정리했습니다. 전화번호를 외울 때 010-1234-5678을 세 덩어리로 끊는 이유가 이것입니다.
그 '덩어리(chunk)'가 열쇠입니다. 1973년 윌리엄 체이스와 허버트 사이먼은 체스 고수와 초보에게 실제 대국 중의 판을 5초 보여 주고 다시 놓게 했습니다. 고수는 말을 훨씬 많이 정확히 놓았습니다. 그런데 말을 무작위로 흩어 놓은 판에서는 고수와 초보의 차이가 거의 사라졌습니다. 고수의 기억력이 좋은 것이 아니었습니다. 고수는 익숙한 배치를 한 덩어리로 묶어 기억했던 것입니다. 전문성의 상당 부분은 더 큰 덩어리를 만드는 능력입니다.
데미르바스의 문장에 이 둘이 함께 들어 있습니다. "글쓰기가 생각에 그토록 잘 듣는 이유는, 글쓰기가 우리를 느리게 만들면서도 문제 위에 머물게 하기 때문이라고 생각한다. 그 남는 시간에 통찰과 연결이 떠오를 여지가 생긴다. 덩어리 짓기와 추상화는 뒤에서 일어난다."
컴퓨터 쪽 표현으로 옮기면 이렇습니다.
외부 메모리 알고리즘
글 쓰는 사람
데미르바스의 문장
메모리 M이 작다
작업기억 약 4덩어리
"종이가 없으면 유한 오토마톤으로 줄어든다"
정렬된 런을 디스크에 써 둔다
초고·노트에 생각 토막을 써 둔다
"노트는 저장이 아니라 처리를 위한 것"
런을 다시 읽어 합친다
써 둔 것을 다시 읽어 잇는다
"써 나가면서 연결이 점점 또렷해졌다"
병합 패스를 여러 번 돈다
퇴고를 여러 번 한다
"맥피: 서너 번에 걸쳐 쓰는 것이지 한 번이 아니다"
블록 입출력이 비싸다
쓰기는 느리다
"느리게 만들면서 문제 위에 머물게 한다"
디스크는 계산이 끝나도 남는다
블로그는 외부 기억이 된다
"블로그가 내 외부 메모리가 됐다"
마지막 줄이 흥미롭습니다. 데미르바스는 자기 블로그를 끊임없이 다시 찾아 읽는다고 합니다. "그 글들을 쓰느라 머리를 쥐어짰기 때문에, 다시 읽으면 같은 뉴런이 다시 발화하고 이해가 빠르게 재구성된다." 반대로 "적어 두지 않은 생각은 잘 남지 않는다. 애초에 끝까지 생각된 적이 없기 때문이다."
인지심리학에는 이것과 닿는 오래된 발견이 있습니다. 1978년 노먼 슬래멕카와 피터 그래프는 같은 단어 쌍을 그냥 읽게 한 집단과, 단서를 보고 스스로 만들어 내게 한 집단(예: '빠르다-느?' 를 보고 '느리다'를 떠올리기)을 비교했습니다. 스스로 만들어 낸 쪽이 훨씬 잘 기억했습니다. 이것을 생성 효과(generation effect)라고 부릅니다. 남이 쓴 글을 읽는 것과 내가 애써 쓴 글을 다시 읽는 것은 같은 '읽기'가 아닙니다. 후자는 한 번 만들어 낸 길을 다시 걷는 일입니다.
6. 리뷰를 쓰고 나서야 60%만 알았다는 것을 안다
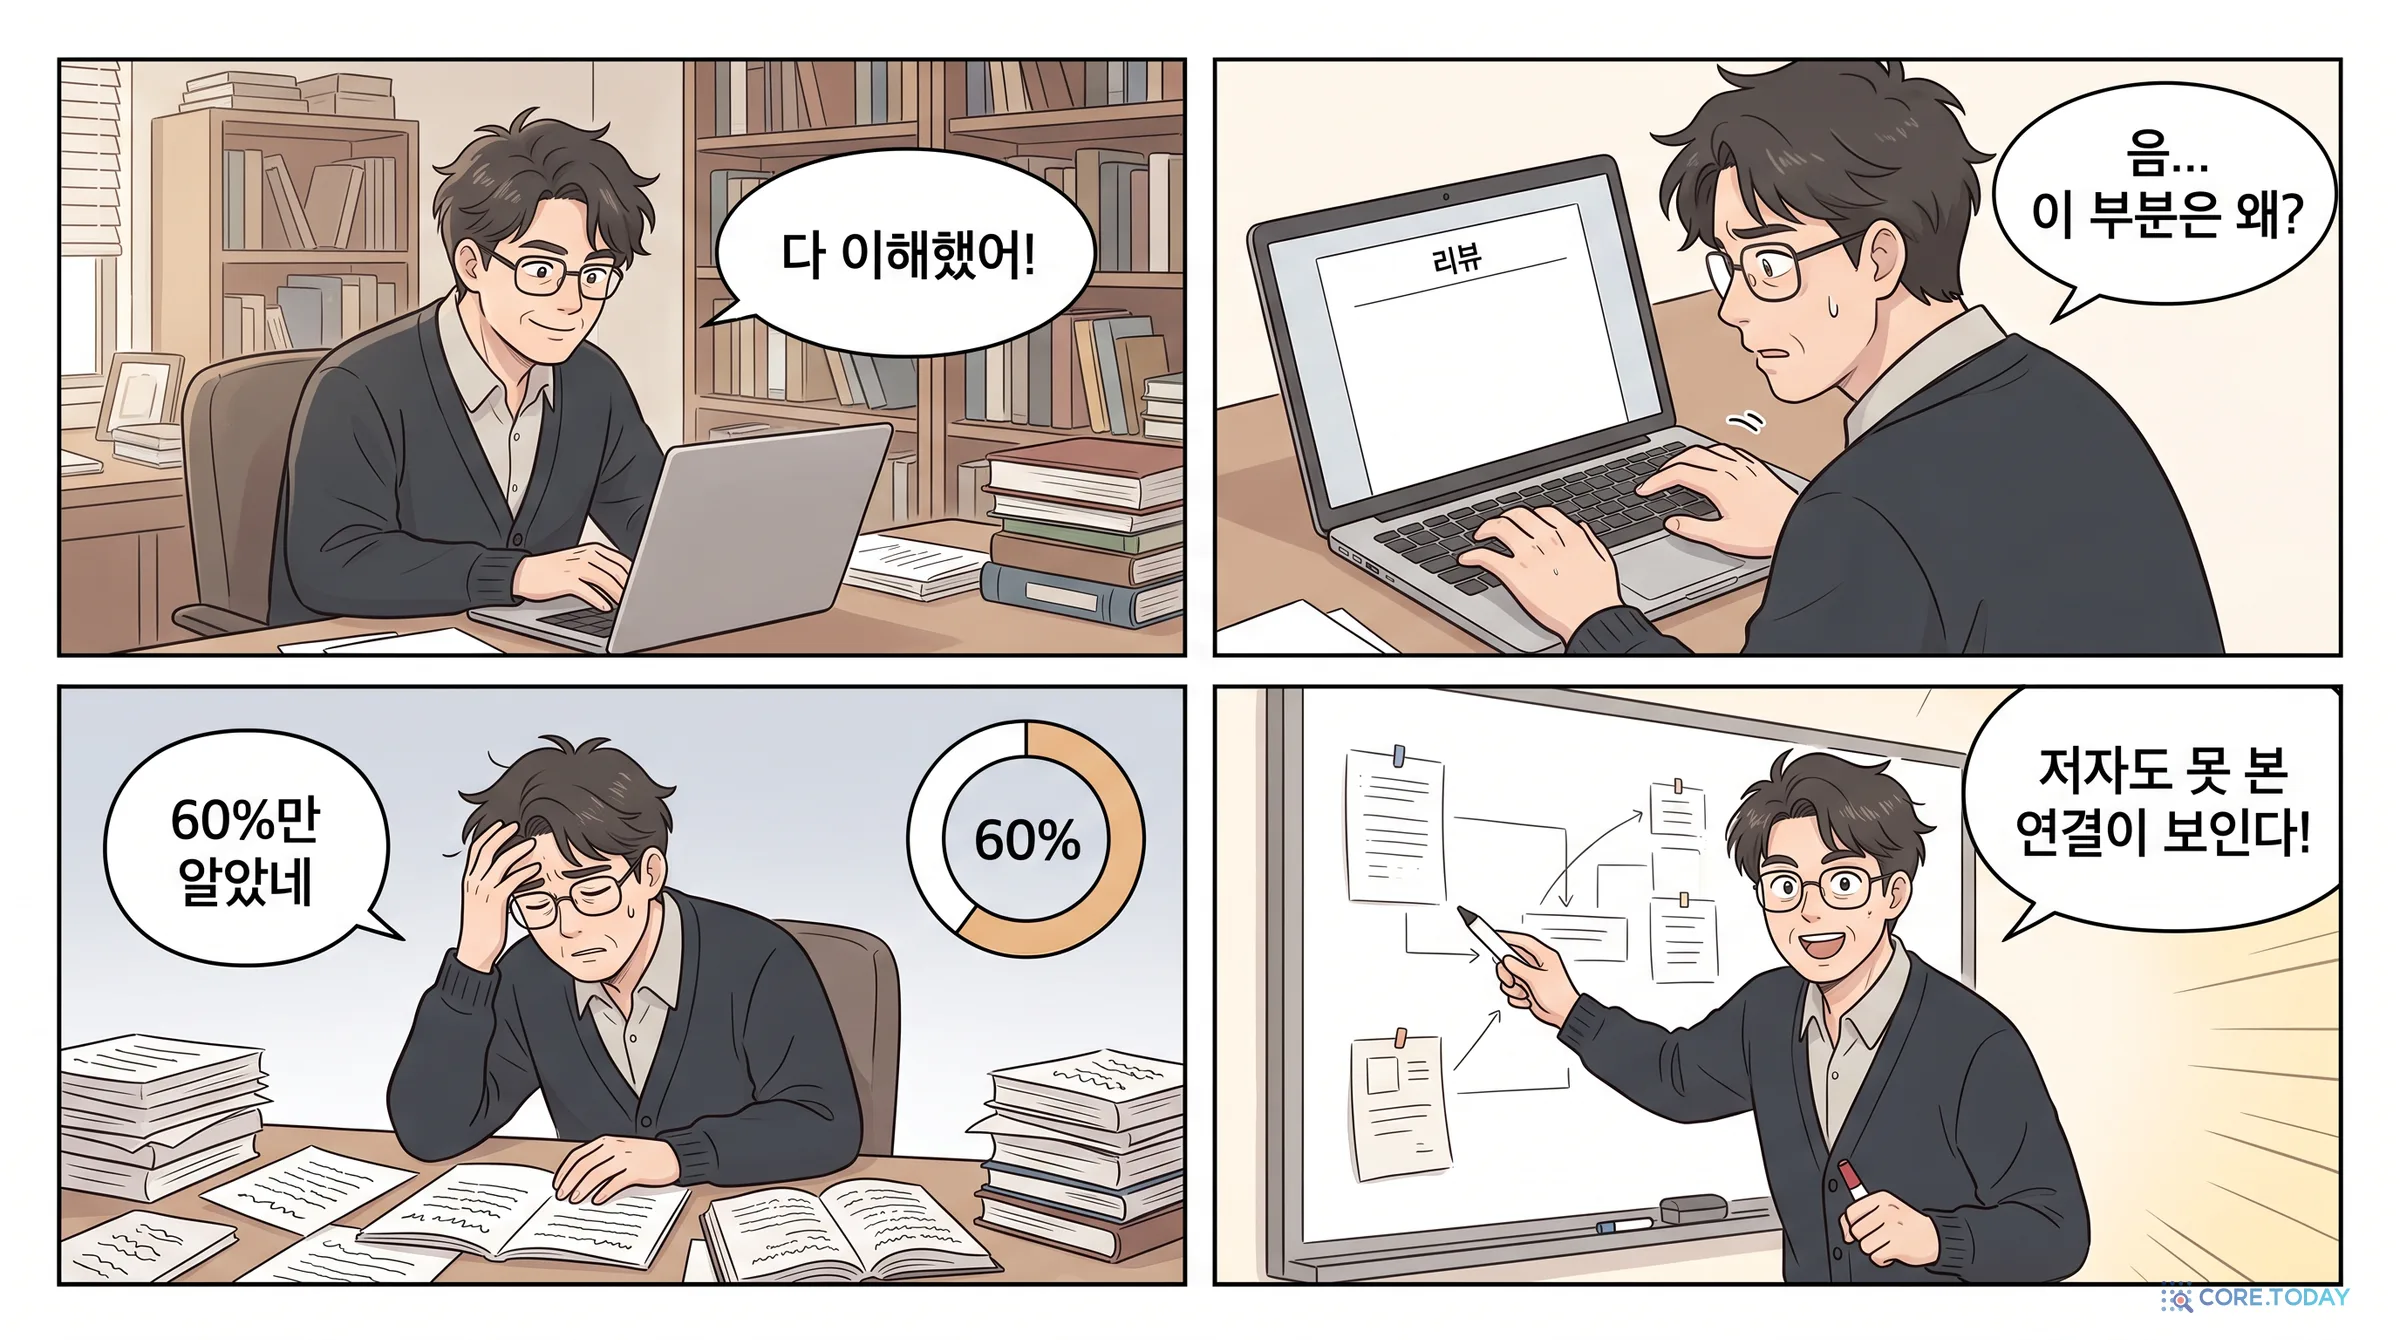
데미르바스가 드는 가장 생생한 사례는 논문 심사입니다. "논문을 읽으면 이해했다고 생각한다. 그러다 리뷰를 쓰려고 앉으면 내가 이해한 건 60% 정도였다는 걸 알게 된다. 리뷰를 쓰는 동안 논문을 더 넓은 맥락에 놓게 되고, 그제야 완전히 이해한다. 때로는 그 아이디어가 저자들이 알아챈 것보다 크고, 다른 많은 것과 이어진다는 걸 깨닫기도 한다."
이 '60%'에는 이름이 있습니다. 2002년 예일 대학의 레오니드 로젠블릿과 프랭크 케일은 사람들에게 지퍼, 수세식 변기, 자물쇠 같은 일상 물건의 작동 원리를 얼마나 잘 아는지 7점 척도로 매기게 했습니다. 그다음 실제로 작동 과정을 한 단계씩 글로 설명하게 하고, 다시 점수를 매기게 했습니다. 설명을 써 본 뒤 사람들의 자기 평가는 뚝 떨어졌습니다. 연구자들은 이것을 설명 깊이의 착각(illusion of explanatory depth)이라고 불렀습니다. 우리는 '익숙함'을 '이해'로 착각합니다. 그 착각은 설명을 써 보기 전까지 드러나지 않습니다.
읽기는 익숙함을 만들고, 쓰기는 그 익숙함을 시험합니다. 문장을 이어 가려면 A에서 B로 넘어가는 이유를 실제로 알아야 하고, 모르면 손이 멈춥니다. 손이 멈춘 자리가 내 이해의 구멍입니다. 리뷰를 쓰는 동안 데미르바스는 그 구멍들을 하나씩 메우고, 메우는 과정에서 다른 논문과의 연결이 보입니다.
때로는 쓰다가 아예 새로운 생각이 나옵니다. 2018년 데미르바스는 팍소스(Paxos)와 나카모토 합의(비트코인의 합의 방식) 사이의 '해부학적 닮음과 차이'에 대한 짧은 글을 썼습니다. 처음부터 그런 주장을 품고 쓴 글이 아니었습니다. 쓰기 시작하자 연결이 점점 또렷해졌고, 그 글은 나중에 그의 연구실 논문의 씨앗이 됐습니다. 그는 이렇게 덧붙입니다. "이건 드문 일이 아니다. 이것을 프리라이팅이라고 부른다. 기계에게 테이프를 주면 일어나는 일이다."
?
읽었을 때
익숙하다는 느낌. '다 이해했다'는 자기 평가. 사실은 60%.
✎
쓰려고 할 때
A에서 B로 넘어가는 이유를 문장으로 만들어야 한다. 손이 멈추는 곳이 이해의 구멍이다.
!
다 쓰고 나면
구멍이 메워지고, 메우는 과정에서 다른 지식과의 연결이 생긴다. 때로는 저자도 못 본 연결까지.
7. 글쓰기의 인지 모형: 플라워와 헤이스의 설계도
'쓰는 동안 생각이 바뀐다'는 경험을 처음 과학의 언어로 그린 사람들은 카네기멜런 대학의 린다 플라워와 존 헤이스입니다. 두 사람은 1970년대 말 작가들에게 글을 쓰는 동안 머릿속 생각을 소리 내어 말하게 하고(발화 사고 프로토콜), 그 녹취를 분석했습니다. 1981년 발표한 「글쓰기의 인지 과정 이론」은 지금까지도 글쓰기 연구의 기본 설계도입니다.
그들의 모형은 세 구역으로 이루어집니다.
과제 환경수사적 문제(주제·독자·목적)+ 지금까지 쓴 글
작가의 장기기억주제 지식·독자 지식+ 글쓰기 계획 지식
↓ ↑
계획하기생성 · 조직 · 목표 세우기무엇을, 왜
옮기기생각 → 문장언어로 바꾸기
검토하기평가 · 고쳐 쓰기다시 읽기
↑ 셋 사이를 언제든 오가게 하는 '모니터'
이 모형에서 중요한 발견은 세 가지입니다.
첫째, 글쓰기는 단계가 아니라 되돌이(재귀)다. 학교에서는 '개요 짜기 → 초고 → 퇴고'를 순서대로 배우지만, 실제 작가들은 한 문장을 쓰다가 계획으로 돌아가고, 검토하다가 새 목표를 세웠습니다. 세 과정은 서로를 언제든 불러냅니다. 그 전환을 조율하는 것이 '모니터'입니다.
둘째, 이미 쓴 글은 과제 환경의 일부다. 작가는 머릿속 계획만 보고 쓰지 않습니다. 방금 쓴 문장이 다음 문장을 제약하고, 때로는 계획 자체를 바꿉니다. 종이 위의 글이 생각의 입력으로 되돌아오는 것입니다. 튜링 기계의 머리가 방금 쓴 칸을 다시 읽는 것과 같은 구조입니다.
셋째, 좋은 작가는 목표를 쓰는 도중에 만든다. 플라워와 헤이스는 숙련된 작가와 미숙한 작가의 가장 큰 차이가 문장력보다 목표의 질에 있다고 봤습니다. 숙련된 작가는 쓰는 동안 '이 독자에게 이걸 납득시키려면 먼저 저걸 보여 줘야 한다' 같은 하위 목표를 계속 새로 만들었습니다. 생각이 글보다 먼저 완성돼 있는 것이 아니라, 글을 쓰는 과정에서 생각의 목표가 생겨납니다.
1996년 헤이스는 이 모형을 고쳐 작업기억을 한가운데 놓았습니다. 그리고 같은 해 로널드 켈로그(Ronald Kellogg)는 계획하기·옮기기·검토하기가 모두 작업기억이라는 같은 좁은 통로를 놓고 다툰다는 모형을 내놓았습니다. 문장을 만드는 데 머리를 다 쓰면 계획할 여력이 없고, 계획에 머리를 다 쓰면 문장이 꼬입니다. 켈로그의 실험에서 미리 개요를 써 둔 사람들의 글이 더 좋았던 이유도 여기서 설명됩니다. 개요를 종이에 내려 둔 만큼, 쓰는 동안 작업기억이 덜 붐볐기 때문입니다.
5절의 아웃오브코어 비유가 여기서 다시 맞아떨어집니다. 작업기억이라는 작은 코어 위에서 세 과정이 다투고 있고, 종이는 그 다툼을 덜어 주는 외부 메모리입니다. 계획을 종이에 내려놓으면 문장에 집중할 수 있고, 문장을 종이에 내려놓으면 다시 계획을 볼 수 있습니다.
8. 지식 말하기와 지식 변형: 쓰는 동안 생각이 바뀌는 이유
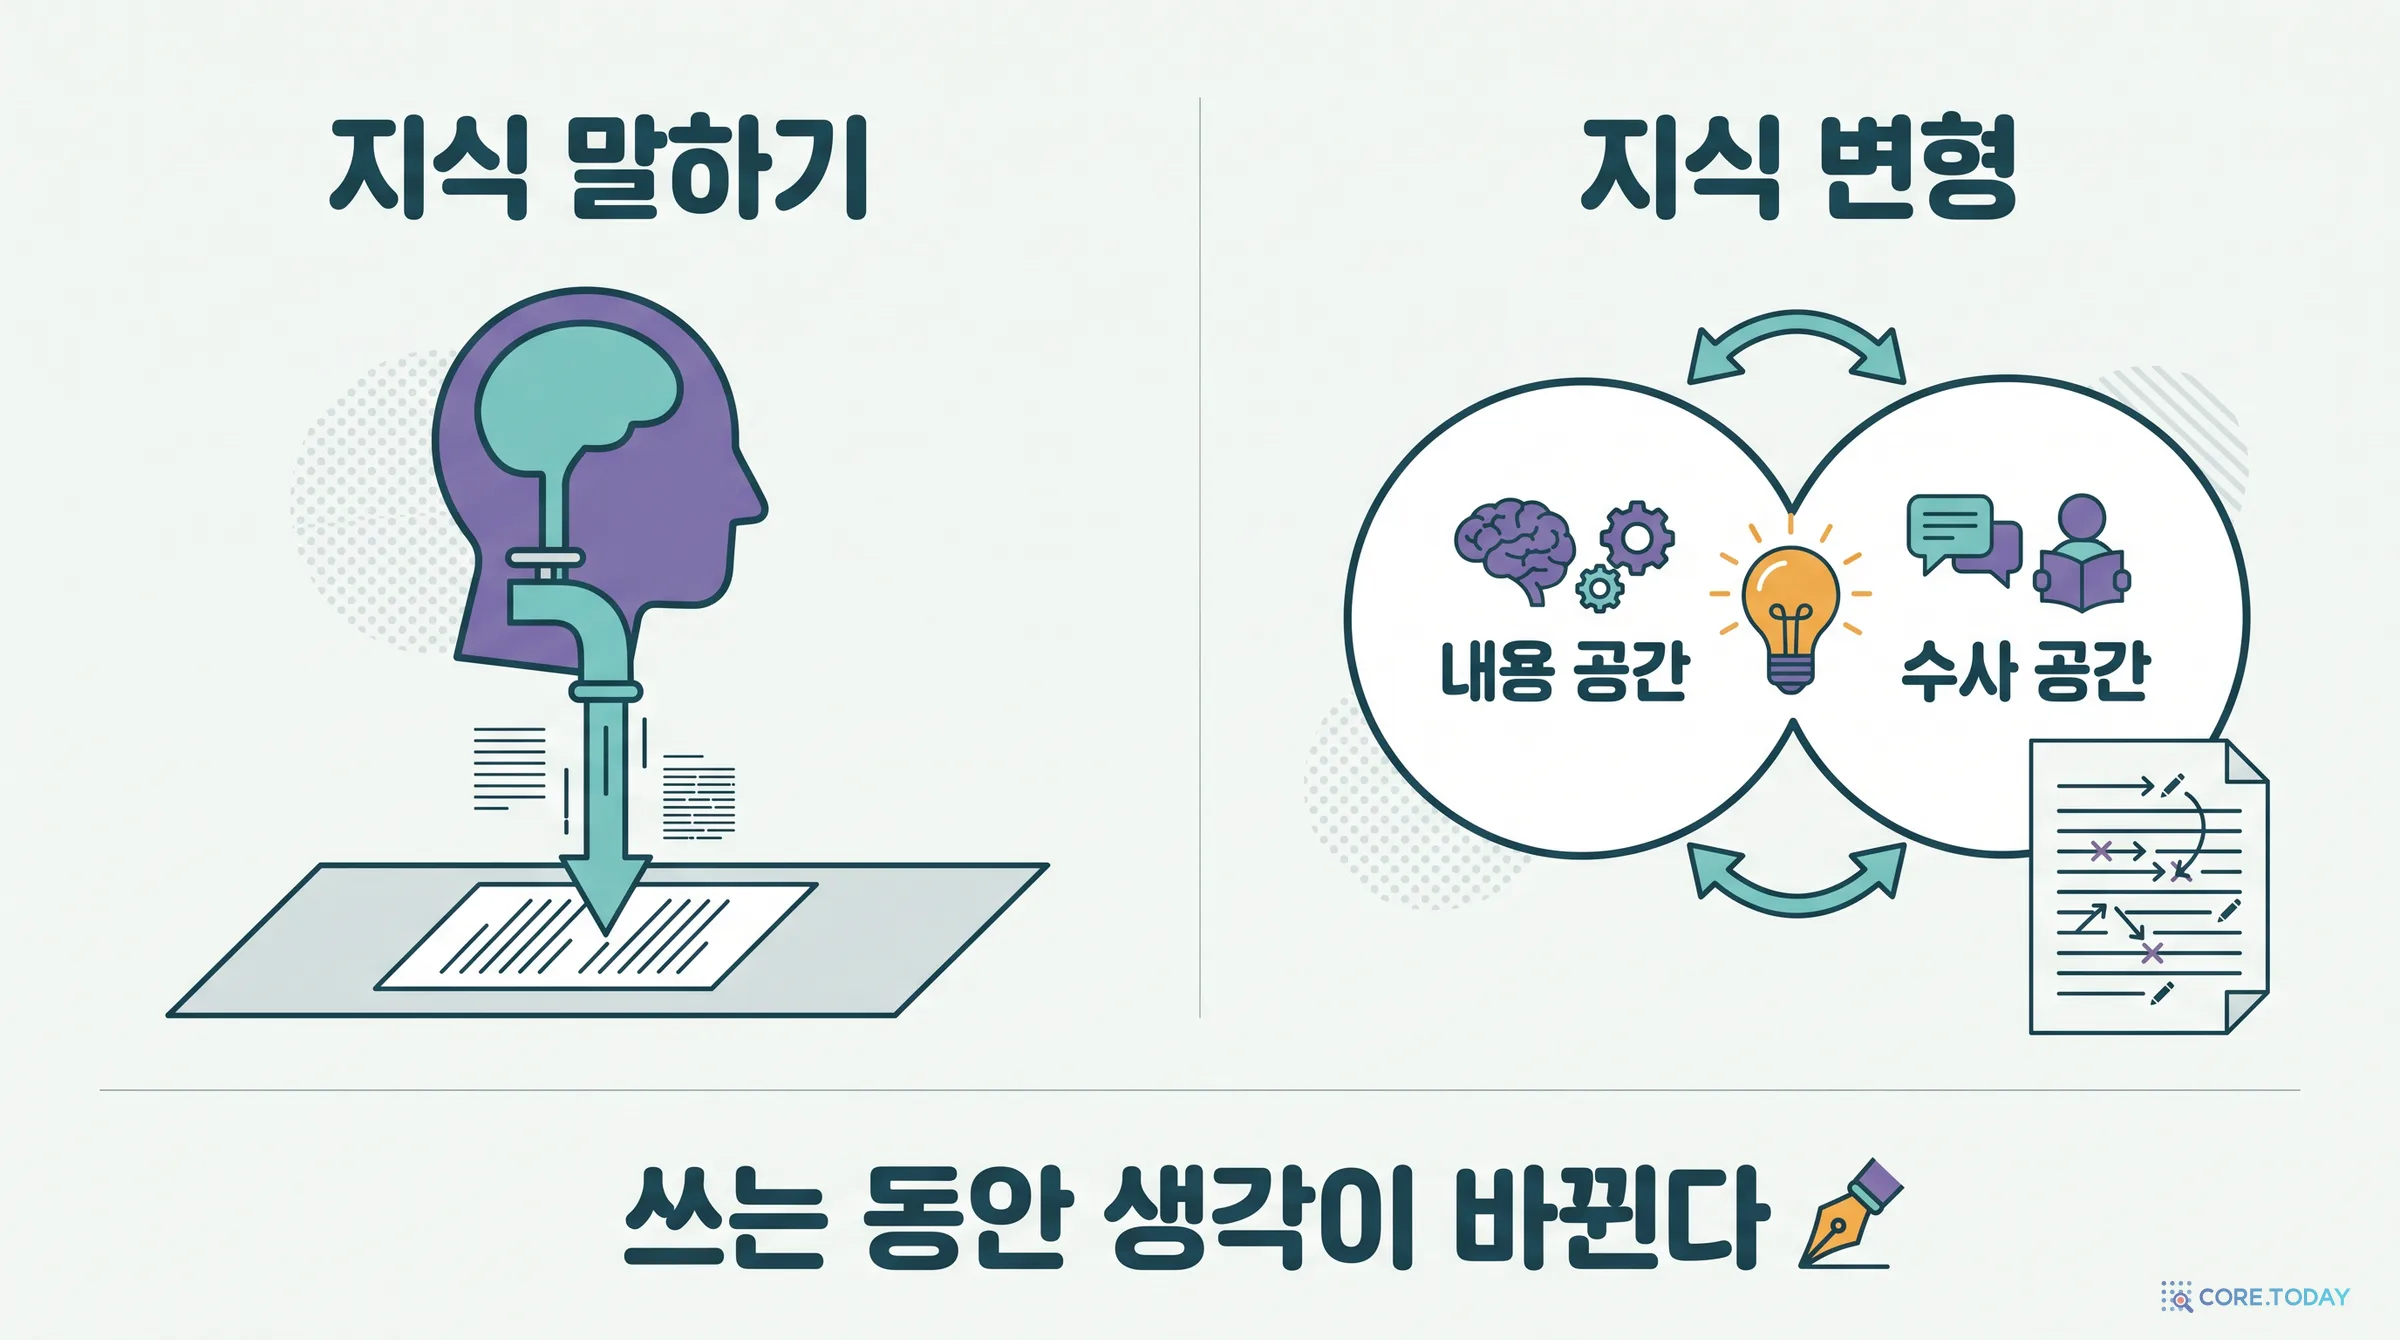
같은 1980년대, 토론토 대학의 칼 베라이터와 마를렌 스카다말리아는 아이들과 어른의 글쓰기를 비교하다가 두 가지 전혀 다른 방식이 있다는 것을 발견했습니다. 1987년 책 『글쓰기의 심리학』에서 두 사람은 이를 지식 말하기(knowledge-telling)와 지식 변형(knowledge-transforming)이라고 불렀습니다.
지식 말하기는 주제를 보고 떠오르는 것을 떠오르는 순서대로 적는 방식입니다. "우리 가족에 대해 쓰시오"라는 과제를 받은 아이는 엄마, 아빠, 동생에 대해 생각나는 대로 씁니다. 다음 문장의 단서는 방금 쓴 문장입니다. 이 방식은 쉽고 빠르며, 머릿속에 있던 지식을 그대로 옮깁니다. 쓰기 전과 쓴 뒤에 작가의 생각은 달라지지 않습니다.
지식 변형은 두 개의 문제 공간을 오가는 방식입니다. 하나는 내용 공간, 즉 '무엇이 참인가, 나는 무엇을 아는가'의 문제입니다. 다른 하나는 수사 공간, 즉 '이 독자에게 이것을 어떻게 전할까, 어떤 순서가 설득력 있나'의 문제입니다. 수사 공간에서 생긴 문제("이 독자는 이 전제를 받아들이지 않을 텐데")가 내용 공간의 문제("그럼 이 전제는 정말 참인가?")로 넘어가고, 거기서 얻은 답이 다시 수사 공간으로 돌아옵니다. 이 왕복 속에서 작가가 쓰기 전에는 몰랐던 지식이 만들어집니다.
수사 공간 "독자가 이걸 받아들일까?"
⇄
내용 공간 "그럼 이건 정말 참인가?"
왕복할수록 새로 생기는 것: 빠진 전제, 새 연결, 더 정확한 주장
데미르바스가 리뷰를 쓰다 저자도 못 본 연결을 찾고, 팍소스에 대한 짧은 글이 논문의 씨앗이 된 것은 지식 변형의 전형입니다. 반대로 지식 말하기만 하는 글쓰기는 생각을 만들지 않습니다. 이미 있는 생각을 옮길 뿐입니다.
켈로그는 2008년 글에서 이 구분을 발달 단계로 정리했습니다. 대부분의 사람은 어릴 때 지식 말하기를 익히고, 청소년기 이후 지식 변형으로 넘어가며, 일부 전문 작가는 그 위에서 독자의 머릿속에 무엇이 그려질지까지 조율하는 지식 공예(knowledge-crafting) 단계에 이릅니다. 켈로그는 지식 말하기에서 지식 공예까지 가는 데 "적어도 20년의 성숙과 교육과 훈련"이 든다고 봤습니다. 열네다섯 살이 될 때까지 아이들은 맞춤법과 문장 같은 기본기를 익히는 데만 10년을 씁니다. (켈로그 자신도 마지막 단계는 "더 사변적"이라고 단서를 달았습니다.)
이 구분은 5부에서 다시 중요해집니다. AI가 대신 쓰는 글은 형식상 지식 변형의 산물처럼 보이지만, 그 왕복은 작가의 머릿속에서 일어나지 않았습니다. 6쪽짜리 문서는 남지만, 그 문서를 쓰며 바뀌었어야 할 생각은 어디에도 없습니다.
9. 최초의 글은 장부였다: 생각을 바깥에 두는 오래된 기술
데미르바스는 "언어가 생각의 일부를 바깥으로 꺼냈고, 문자가 더 많이 꺼냈다"고 했습니다. 문자의 출발점을 보면 이 말이 얼마나 문자 그대로인지 알 수 있습니다.
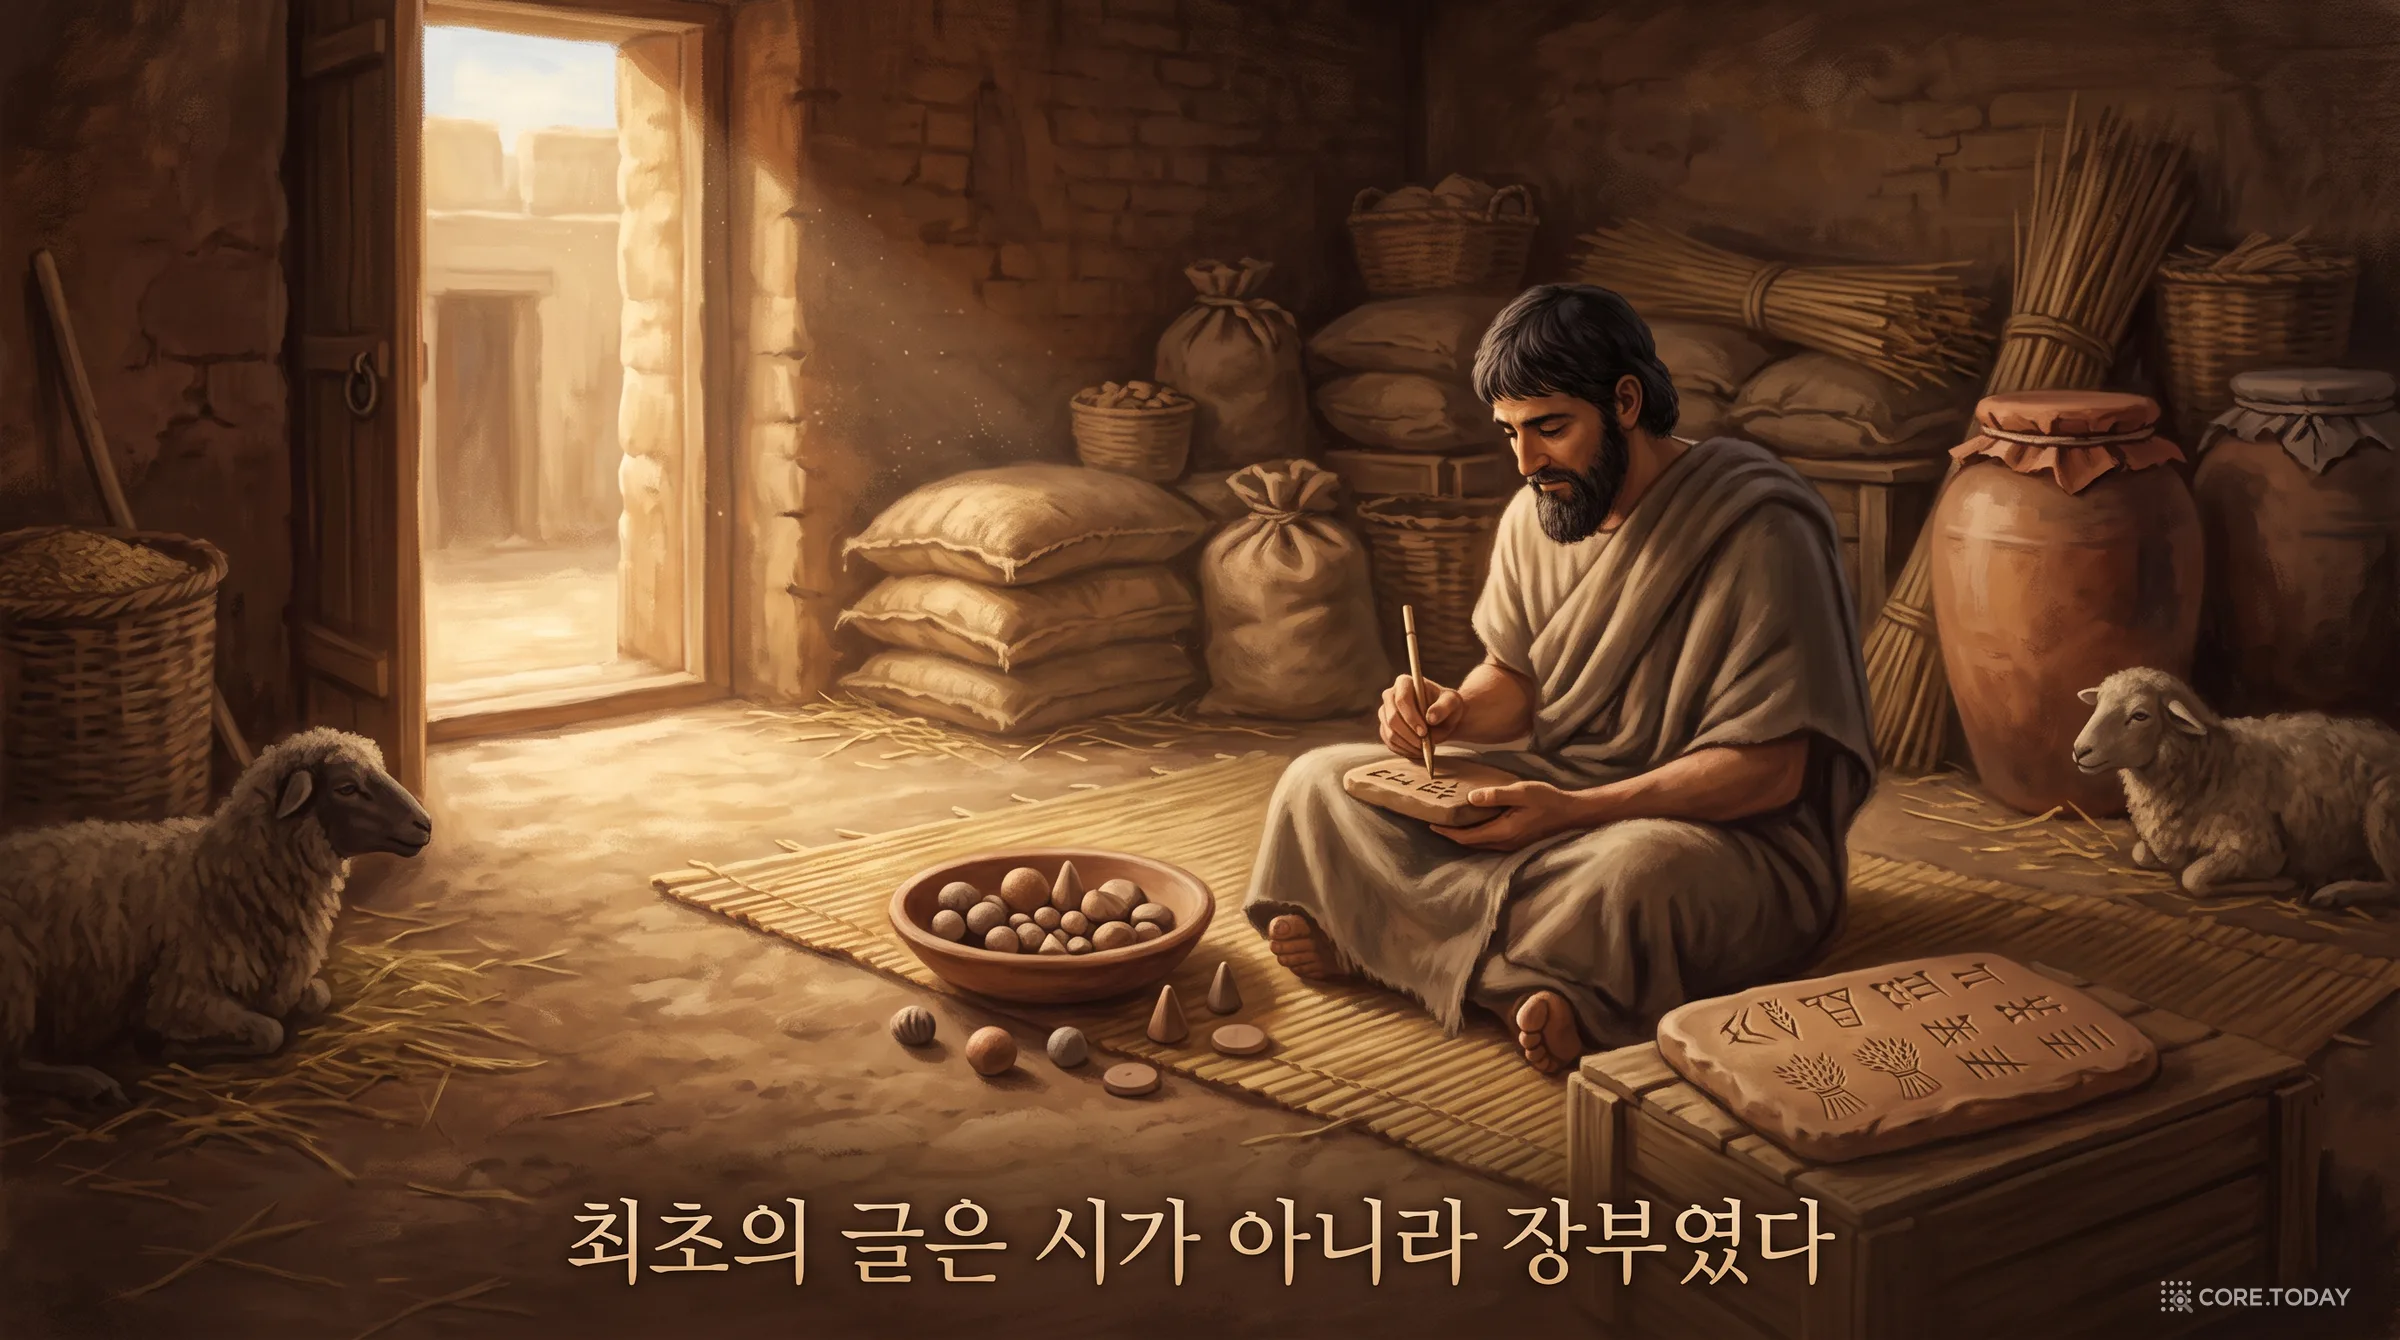
텍사스 대학의 고고학자 드니즈 슈만트베세라(Denise Schmandt-Besserat)에 따르면, 메소포타미아 사람들은 기원전 8000년경부터 곡식이나 가축을 세기 위해 300여 종류의 작은 점토 토큰을 썼습니다. 기원전 3500년경에는 거래를 증명하려고 토큰들을 점토 봉투에 넣어 봉하고, 봉투 겉에 토큰 모양을 눌러 찍었습니다. 그는 이 자국을 "최초의 문자 기호"로 봅니다. 기원전 3200년경 봉투 대신 점토판에 직접 눌러 적기 시작했고, 기원전 3100년경 그림 문자가, 기원전 3000년경 소리를 나타내는 기호가 나타났습니다. 토큰에서 문자가 나왔다는 그의 이론에는 반론도 있지만, 최초의 글이 무엇이었는지에 대해서는 이견이 적습니다. 도시 우루크에서 나온 원시 설형문자 점토판 약 5,000장 가운데 약 85%가 행정 기록, 곧 장부입니다.
최초의 글은 시도, 역사도, 편지도 아니었습니다. 머리로 다 기억할 수 없는 거래를 바깥에 맡기는 장부였습니다. 도시가 커지고 거래가 늘어 한 사람의 기억으로 감당할 수 없게 되자 사람들은 기억을 점토에 꺼내 놓았습니다. 블럼의 말로 하면, 문명의 규모가 유한 오토마톤의 상태 수를 넘어선 순간 종이(점토)가 나타난 것입니다.
그리고 거의 곧바로 걱정이 시작됐습니다. 기원전 370년경 플라톤은 『파이드로스』에서 소크라테스의 입을 빌려 이집트 신화를 전합니다. 문자를 발명한 신 테우트가 왕 타무스에게 문자를 바치며 "기억과 지혜의 묘약(파르마콘)"이라고 자랑하자, 타무스가 답합니다.
플라톤, 『파이드로스』 275a
이것은 그것을 배우는 이들의 마음에 망각을 낳을 것이오. 그들은 기억을 쓰지 않게 될 테니까. (…) 그대가 발명한 것은 기억의 묘약이 아니라 상기의 묘약이오. 그대는 제자들에게 참된 지혜가 아니라 지혜의 겉모습을 주는 것이오.
2,400년 전의 이 경고는 2026년의 AI 논쟁과 놀랄 만큼 닮았습니다. '지혜의 겉모습'은 생각 없이 만든 6쪽짜리 메모를 떠올리게 합니다. 역설적인 점은 이 경고가 문자로 기록되었기 때문에 지금까지 남았다는 것입니다.
1982년 월터 옹(Walter Ong)은 『구술성과 문자성』에서 정반대 방향의 결론을 냈습니다. 그 책 4장의 제목은 「글쓰기는 의식을 재구성한다」입니다. "다른 어떤 단일한 발명보다도 문자는 인간의 의식을 바꿔 놓았다." 옹은 구술 문화가 "목록이나 도표나 그림을 모른다"고 썼습니다. 인류학자 잭 구디(Jack Goody)는 1977년 『야생의 마음 길들이기』에서 목록과 표라는 형식 자체가 분류와 비교라는 사고방식을 가능하게 했다고 주장했습니다. 목록은 말로는 할 수 없는 일을 합니다. 항목을 위아래로 늘어놓고 빠진 것을 찾고, 순서를 바꾸고, 같은 것끼리 묶을 수 있습니다. 옹은 플라톤의 네 가지 반론이 현대인이 컴퓨터에 대해 하는 불평과 똑같다는 점도 짚었습니다.
아래 연표는 이 오래된 흐름을 네 갈래로 정리한 것입니다. 문자·기록 도구, 마음과 글쓰기 연구, 계산 이론, AI가 결국 같은 질문을 다른 언어로 물어 왔다는 것이 보입니다.
10. "이건 기록이 아니라 작업이다": 노트는 생각의 일부인가
물리학자 리처드 파인만에게는 유명한 일화가 있습니다. 과학사학자 찰스 와이너가 파인만의 연구 노트를 보며 "매일의 작업을 기록한 것"이라고 하자 파인만이 정색했습니다. 제임스 글릭의 전기 『천재』(1992)에 실린 대화는 이렇습니다.
파인만과 와이너의 대화 (글릭, 『천재』)
파인만: 저는 실제로 그 작업을 종이 위에서 했습니다. 와이너: 글쎄요, 작업은 머릿속에서 하신 거고, 그 기록이 여기 남아 있는 거죠. 파인만: 아니요, 이건 기록이 아닙니다. 정말로 아니에요. 이건 작업입니다. 종이 위에서 작업해야 하고, 이게 그 종이입니다. 아시겠어요?
흔히 인용되는 "이 노트는 내 사고 과정의 기록이 아니라 내 사고 과정 그 자체다"라는 문장은 이 대화를 다듬은 의역입니다. 하지만 뜻은 같습니다. 데미르바스가 중학생 때 깨달은 "노트는 저장이 아니라 처리를 위한 것"이라는 말과도 같습니다.
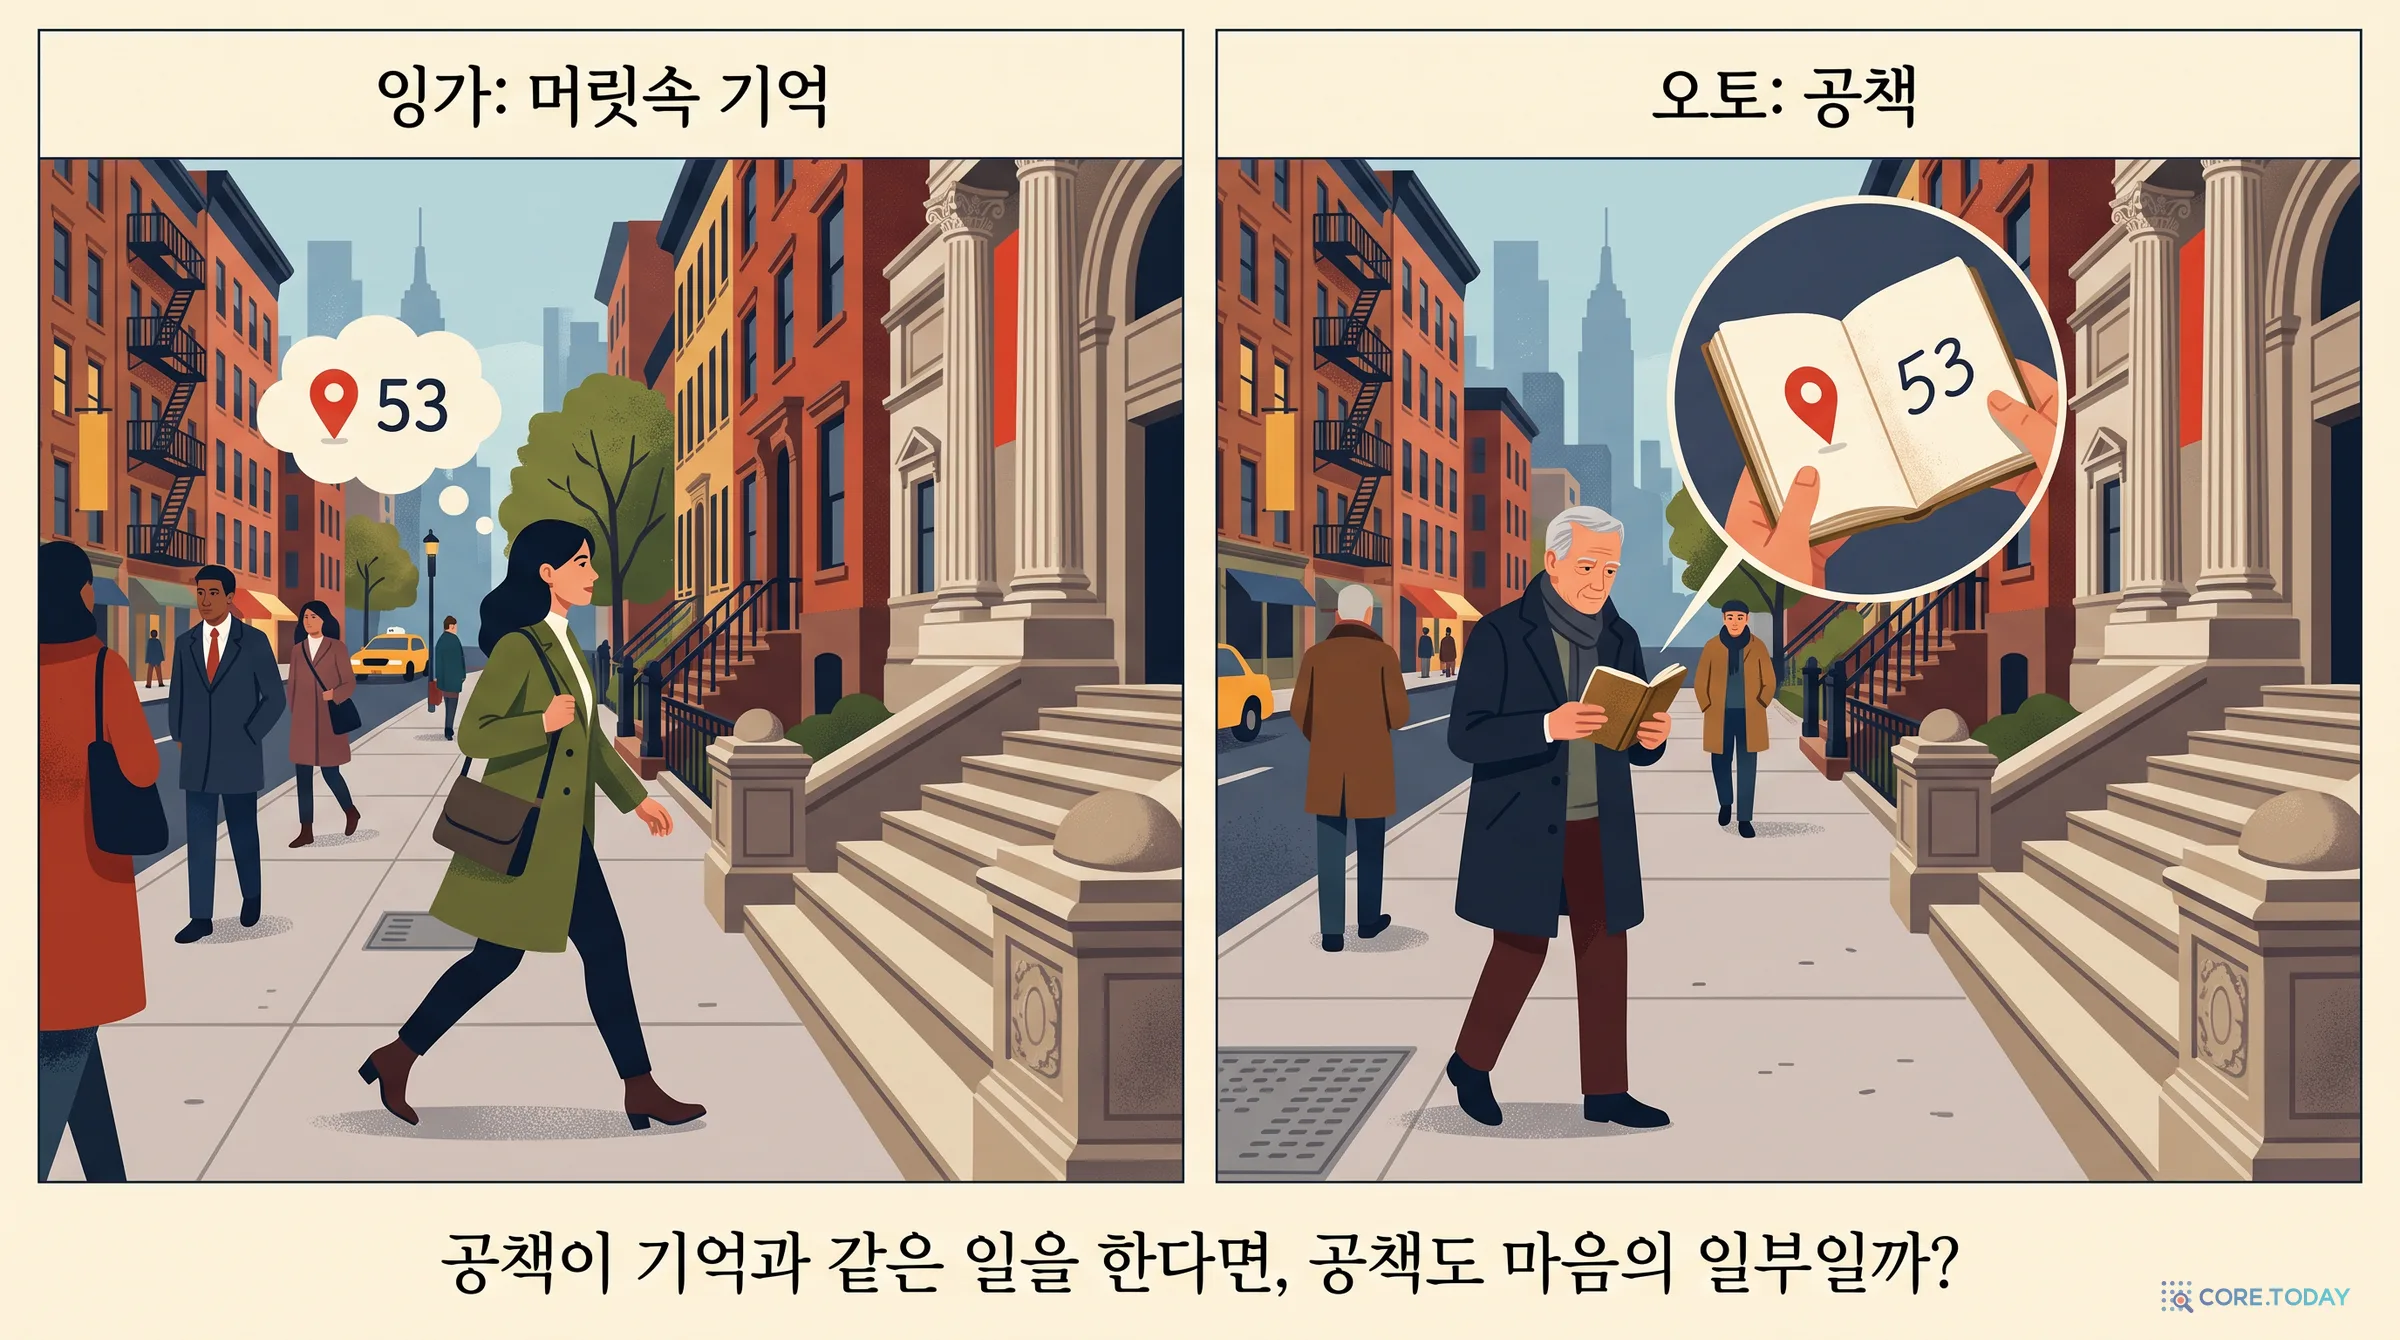
1998년 철학자 앤디 클라크와 데이비드 차머스는 이 직관을 철학 논문으로 만들었습니다. 「확장된 마음(The Extended Mind)」에는 두 사람이 등장합니다. 잉가는 뉴욕 현대미술관(MoMA)에서 전시가 열린다는 소식을 듣고, 미술관이 53번가에 있다는 것을 기억해 냅니다. 알츠하이머를 앓는 오토는 늘 공책을 들고 다니며 새로 알게 된 것을 적어 둡니다. 그는 공책을 펴서 미술관이 53번가에 있다는 것을 확인하고 걸어갑니다. 클라크와 차머스는 묻습니다. 공책이 오토에게 하는 일이 기억이 잉가에게 하는 일과 같다면, 왜 공책은 마음의 일부가 아니라고 해야 하는가? 이것이 그들의 '동등성 원리'입니다. 머릿속에서 일어났다면 인지 과정이라고 부르는 데 주저하지 않았을 일을 세계의 일부가 하고 있다면, 그 부분도 인지 과정의 일부다.
철학자 리처드 메나리(Richard Menary)는 2007년 「생각으로서의 글쓰기」에서 한 걸음 더 나갔습니다. 글을 만들고 고치고 다시 배열하는 손의 작업 자체가 인지 처리의 일부이며, 그래서 글쓰기는 우리의 인지 능력을 바꾼다는 것입니다. 파인만의 "이건 작업이다"를 철학의 언어로 쓴 셈입니다.
이 생각을 평생의 방법으로 만든 사람들도 있습니다.
니클라스 루만의 메모 상자. 독일 사회학자 루만은 1951년경부터 1996년까지 약 9만 장의 메모 카드를 만들었습니다(빌레펠트 대학 루만 아카이브 기준). 그는 1981년 글에서 이 메모 상자를 '대화 상대'라고 불렀습니다. 카드마다 번호를 매기고 서로 연결해 두면, 메모 상자가 그가 잊은 연결을 되돌려 주며 놀라움을 준다는 것입니다. 아카이브에 따르면 그는 40권이 넘는 단행본을 포함해 600편 가까운 글을 냈습니다. (흔히 도는 '책 70권, 논문 400편' 같은 숫자는 공식 집계가 아닙니다.)
버니바 부시의 메멕스. 1945년 「우리가 생각하는 대로」에서 부시는 개인의 모든 책과 기록을 담고 연관 경로로 잇는 책상 크기의 기계를 상상하며, 그것을 "기억을 크게 확장한 친밀한 보조물"이라고 불렀습니다. "두 항목을 서로 묶는 과정이 중요한 것이다."
다산 정약용의 초서(抄書). 조선 후기 학자 다산은 책을 읽으며 중요한 대목을 뽑아 적고 자기 생각을 덧붙이는 방식으로 공부했고, 유배지의 아들들에게도 그렇게 하라고 거듭 편지를 보냈습니다. (다산의 독서법은 6부에서 다시 다룹니다.)
블럼 자신. 데미르바스가 인용한 일곱 줄이 실린 블럼의 글에는 이런 조언도 있습니다. "책은 두루마리가 아니다. 책은 아무 데나 펼칠 수 있다." "여백에 쓰라." "읽으면서 읽은 것을 써 보라." 그는 MIT의 수학자 버트럼 코스탄트가 늘 무언가를 쓰고 있었는데, 알고 보니 "읽으면서 읽는 것을 쓰고 있었다"고 회상합니다. 자기 연구에 대해서는 이렇게 썼습니다. "그것을 글로 쓰고 나서야 우리는 무엇을 발견했는지 진짜로 이해했다."
데미르바스가 인용한 레슬리 램포트의 말도 이 계보에 있습니다. 분산 시스템의 기초를 놓고 2013년 튜링상을 받은 램포트는 2014년 마이크로소프트 리서치 강연 「코드 위에서 생각하기(Thinking Above the Code)」에서 이런 슬라이드를 띄웠습니다.
레슬리 램포트, 「코드 위에서 생각하기」(2014) 슬라이드 '생각하는 법'
"글쓰기는 당신의 생각이 얼마나 엉성한지 알려 주는 자연의 방식이다." — 귄던 생각하려면 써야 한다. 쓰지 않고 생각하고 있다면, 당신은 생각하고 있다고 생각할 뿐이다.
앞 문장은 만화가 딕 귄던(Dick Guindon)의 말입니다. 데미르바스의 글에는 램포트의 문장이 "If you think without writing…"으로 조금 다르게 옮겨져 있는데, 원래 슬라이드는 "If you're thinking without writing, you only think you're thinking"입니다. 폴 그레이엄도 2024년 10월 글 「쓰는 자와 못 쓰는 자」에서 같은 문장을 인용했습니다.
11. 증거가 말하는 것과 말하지 않는 것
여기까지 읽으면 글쓰기가 만능처럼 보입니다. 그렇지 않습니다. 실험 연구가 말하는 것은 더 차분하고, 그래서 더 쓸모가 있습니다.
글쓰기로 배우기의 효과는 '작지만 분명하다'. 학습을 위해 글을 쓰게 하는 수업(writing-to-learn)의 효과를 모은 메타분석들이 있습니다. 2004년 뱅거트드라운스 등은 48개 프로그램을 분석해 "작지만 긍정적인 효과"를 보고했고, 학생에게 자기 이해를 점검하게 하는 질문(메타인지 프롬프트)이 있을 때 효과가 더 컸습니다. 2020년 그레이엄 등은 1~12학년 학생 6,235명이 참여한 실험 56개를 모아 효과 크기 g = 0.30을 얻었습니다. 과학·사회·수학 어디서나 비슷했습니다. 2010년 카네기 재단 보고서 『읽기 위한 쓰기』는 읽은 글에 대해 쓰게 하는 활동이 독해력을 높인다는 것을 보였습니다. 특히 길게 응답을 쓰게 하는 활동의 효과가 컸습니다.
읽은 글에 길게 응답 쓰기 → 독해(그레이엄·허버트 2010)
0.77
요약 쓰기 → 독해
약 0.52
노트 하기 → 독해
0.47
생성 효과(버치 등 2007, 86개 연구)
0.40
글쓰기로 배우기, 교과 전반(그레이엄 등 2020)
0.30
막대 길이는 효과 크기 1.0을 100%로 잡았습니다. 교육 연구에서 0.3~0.4는 작지 않지만, 마법도 아닙니다. 그리고 효과는 어떻게 쓰느냐에 크게 달려 있습니다.
펜이냐 키보드냐는 핵심이 아니다. 2014년 팜 뮬러와 대니얼 오펜하이머는 노트북으로 필기한 학생이 손으로 쓴 학생보다 개념 문제를 못 푼다는 연구로 큰 화제가 됐습니다. 노트북 사용자는 강의를 받아 적기만 했기 때문이라는 설명이었습니다. 그런데 2019년 모어헤드 등의 재현 연구에서는 그 차이가 나오지 않았고, 2021년 어리 등의 재현에서도 노트북 필기가 더 받아쓰기에 가깝긴 했지만 시험 점수는 다르지 않았습니다. 남는 교훈은 '손글씨가 마법'이 아니라 받아 적기가 아니라 처리하기가 중요하다는 것입니다. 데미르바스의 마인드맵도 마찬가지입니다. 마인드맵 형식 자체의 효과를 잰 연구들은 생각보다 약한 결과를 냈습니다(2002년 의대생 50명 실험에서 일주일 뒤 회상 차이는 통계적으로 유의하지 않았습니다). 소년에게 효과가 있었던 것은 거미줄 모양이 아니라 "이 내용이 어느 가지에 매달려야 하나"를 고민한 처리 과정이었을 것입니다.
표현적 글쓰기의 효과도 작다. 1986년 제임스 페니베이커는 대학생들에게 나흘 밤 15분씩 힘든 경험에 대해 쓰게 했고, 그들이 이후 몇 달 동안 보건소를 덜 찾았다는 결과로 '표현적 글쓰기' 연구를 열었습니다. 하지만 146개 연구를 모은 2006년 메타분석의 효과 크기는 r = 0.075로 작았습니다. 데미르바스가 말한 "쓰고 나면 생각이 내 몸 밖으로 나가 홀가분해진다"는 느낌은 많은 사람이 공감하지만, 그것을 치료 효과로 과장해서는 안 됩니다.
정리하면 증거는 이렇게 말합니다. 쓰는 일 자체가 아니라 쓰면서 하는 처리가 생각을 만든다. 받아 적기, 베끼기, 남이 쓴 것을 붙여 넣기는 쓰기처럼 보여도 그 처리를 하지 않는다. 이것은 5부에서 볼 AI 시대의 문제를 정확히 예고합니다.
한국의 상황도 짚어 두겠습니다. 문화체육관광부의 국민독서실태조사에서 1년에 책을 한 권 이상 읽은 성인의 비율은 2023년 43.0%였고, 2026년 3월 발표된 2025년 조사에서는 38.5%로 더 떨어졌습니다. 2024년 12월 발표된 OECD 성인역량조사(PIAAC) 2주기에서 한국 성인의 언어 능력 점수는 249점으로 OECD 평균 260점보다 낮았고, 2012년 1주기보다 23점 떨어져 하락 폭이 가장 큰 나라 가운데 하나였습니다. 읽기와 쓰기는 같이 움직입니다. 읽은 것을 써 보지 않으면 읽기가 남지 않고, 읽지 않으면 쓸 재료가 없습니다.
12. 기계에게도 종이가 필요하다: 사고의 사슬
데미르바스는 LLM이 유능한 이유를 "우리 지능의 많은 부분이 이미 언어 속에 쌓여 있기 때문"이라고 봤습니다. 그런데 2021년부터 2024년 사이, AI 연구는 블럼의 일곱 줄을 기계 위에서 거의 그대로 다시 발견했습니다. 언어 모델도 종이를 주면 훨씬 똑똑해집니다.
시작은 2021년 구글의 맥스웰 나이(Maxwell Nye) 등이 쓴 「풀이를 보여 줘: 중간 계산을 위한 스크래치패드」였습니다. 연구진은 모델에게 답만 내놓게 하지 않고, 답에 이르는 중간 계산을 '스크래치패드(연습장)'에 적은 뒤 답하게 했습니다. 1~8자리 덧셈으로 훈련한 모델에게 9~10자리 덧셈을 시키자, 연습장 없이 답하던 모델은 완전히 실패했고 연습장을 쓴 모델은 크기가 커질수록 정확도가 올랐습니다. 파이썬 프로그램의 실행 결과를 맞히는 과제에서는 퓨샷 정확도가 11%에서 26.5%로, 미세 조정한 모델은 20%에서 41.5%로 올랐습니다.
이듬해 제이슨 웨이(Jason Wei) 등은 같은 생각을 더 간단하게 만들었습니다. 예시 문제에 풀이 과정을 함께 보여 주기만 하면 모델도 풀이를 적으며 답한다는 것, 이른바 사고의 사슬(Chain-of-Thought)입니다. PaLM 540B의 초등 수학 문장제(GSM8K) 정확도가 17.9%에서 56.9%로 뛰었습니다. 같은 해 고지마 다케시 등은 예시조차 필요 없다는 것을 보였습니다. 질문 끝에 "단계별로 생각해 보자(Let's think step by step)" 한 줄을 붙이자 MultiArith 정확도가 17.7%에서 78.7%가 됐습니다.
GSM8K · PaLM 540B · 바로 답
17.9%
GSM8K · PaLM 540B · 사고의 사슬
56.9%
MultiArith · 바로 답
17.7%
MultiArith · "단계별로 생각해 보자"
78.7%
처음에 이것은 '요령'처럼 보였습니다. 왜 풀이를 적게 하면 똑똑해지는지 아무도 정확히 몰랐습니다. 답은 계산 이론에서 나왔습니다.
13. 2024년의 증명: 블럼의 일곱 줄, 트랜스포머 버전
트랜스포머는 입력을 받아 정해진 층수만큼 계산하고 다음 토큰 하나를 내놓습니다. 층수는 고정돼 있습니다. 문제가 아무리 어려워도 토큰 하나를 내놓기 위해 쓸 수 있는 계산의 '깊이'는 정해져 있다는 뜻입니다. 이 점에서 바로 답하는 트랜스포머는 머리 크기가 고정된 기계, 블럼의 유한 오토마톤과 닮았습니다.
그런데 사고의 사슬은 모델이 방금 내놓은 토큰을 다시 입력으로 읽게 합니다. 방금 적은 것을 다시 읽고, 거기에 이어 적습니다. 튜링 기계의 머리가 테이프에 쓰고 다시 읽는 것과 같은 구조입니다.
이것을 정확한 정리로 만든 사람이 앨런 AI 연구소의 윌리엄 메릴(William Merrill)과 아시시 사바르왈(Ashish Sabharwal)입니다. ICLR 2024에 발표한 「사고의 사슬을 가진 트랜스포머의 표현력」의 결론은 이렇습니다.
중간 단계 0개바로 답하는 트랜스포머는 TC⁰라는 좁은 회로 클래스 안에 갇힌다. 일부 간단해 보이는 문제(예: 여러 순열을 차례로 합성한 결과 맞히기)도 풀지 못한다(복잡도 이론의 표준 가정 아래).
로그 길이만큼입력 길이 n의 로그만큼 중간 단계를 적게 하면 로그 공간(L) 정도까지만 늘어난다. 조금 적는 것으로는 크게 달라지지 않는다.
입력 길이만큼n+1개의 중간 단계로 모든 정규 언어, 곧 모든 유한 오토마톤이 할 수 있는 일을 해낸다.
다항 길이만큼다항 길이의 중간 단계를 쓰면 정확히 P, 곧 다항 시간에 풀 수 있는 모든 문제를 푼다. 저자들은 이것을 "표준 복잡도 클래스로 트랜스포머의 한 유형을 정확히 특징지은 첫 결과"라고 불렀다.
핵심 보조정리는 이것입니다. 트랜스포머 디코더는 튜링 기계의 t단계를 t개의 디코딩 단계로 흉내 낼 수 있다. 모델이 적는 토큰 한 줄 한 줄이 튜링 기계의 테이프 한 칸이 되는 것입니다.
같은 시기에 비슷한 결과가 잇달아 나왔습니다. 펑구하오(Guhao Feng) 등은 NeurIPS 2023 논문에서, 표준 가정 아래 깊이가 고정된 트랜스포머는 산술식 계산이나 연립방정식 풀이를 바로 답할 수 없지만, 사고의 사슬을 쓰면 깊이 4~5층짜리 작은 트랜스포머로도 풀 수 있음을 보였습니다. 리즈위안(Zhiyuan Li) 등은 ICLR 2024 논문 제목을 아예 「사고의 사슬은 트랜스포머가 본질적으로 순차적인 문제를 풀게 한다」로 지었습니다. 중간 단계 T개를 쓰는 트랜스포머는 크기 T인 불 회로가 계산하는 모든 것을 계산할 수 있습니다.
그보다 앞서 2023년 초, 구글의 데일 슈어먼스(Dale Schuurmans)는 더 직접적인 실험을 했습니다. 540B 모델에 읽고 쓸 수 있는 외부 메모리를 붙이고, 가중치는 하나도 바꾸지 않은 채 상태 15개·기호 2개짜리 범용 튜링 기계(U15,2)를 정확히 흉내 내게 한 것입니다. 그는 논문에서 이렇게 썼습니다. 길이가 제한된 문자열만 보고 답하는 언어 모델은 유한 오토마톤과 같다. 메모리를 붙이면 계산적으로 범용이 된다. 블럼의 일곱 줄을 LLM의 언어로 다시 쓴 문장입니다. 슈어먼스는 정직하게 단서도 달았습니다. 모델의 동작은 "깨지기 쉬웠고", 더 복잡한 튜링 기계(U6,4)는 흉내 내지 못했습니다.
블럼(사람)
트랜스포머
근거
머릿속 상태가 유한하다
층수가 고정돼 토큰당 계산 깊이가 유한하다
바로 답하면 TC⁰(메릴·사바르왈)
종이에 적고 다시 읽는다
내놓은 토큰을 다시 입력으로 읽는다
사고의 사슬 = 자기회귀 디코딩
종이가 있으면 튜링 기계
다항 길이 사고의 사슬이면 P
메릴·사바르왈 ICLR 2024
외부 기록을 무한히 쓸 수 있다
외부 메모리를 붙이면 범용
슈어먼스 2023
블로그가 외부 기억이 된다
대화 밖 저장소를 페이지처럼 오간다
MemGPT 2023
마지막 줄의 MemGPT는 데미르바스의 '아웃오브코어' 비유를 LLM에 그대로 적용한 시스템입니다. 2023년 UC 버클리 연구진은 모델의 문맥 창을 운영체제의 주기억장치(RAM)처럼, 대화 밖 저장소를 디스크처럼 다뤘습니다. 문맥 창이 약 70% 차면 '메모리 압박' 경고를 띄우고, 모델이 스스로 중요한 내용을 바깥에 써 두었다가 필요할 때 다시 불러오게 했습니다. 긴 대화의 앞부분을 기억해 답하는 시험에서 GPT-4의 정확도는 32.1%에서 92.5%로 올랐습니다.
2024년 9월 OpenAI의 o1 이후 '추론 모델'의 시대가 열리면서 이 생각은 산업의 중심이 됐습니다. o1은 답하기 전에 긴 사고 토큰을 적고, 그 길이를 늘릴수록 성능이 오르는 '테스트 시간 계산' 곡선을 보여 줬습니다. 2024년 미국 수학 경시대회(AIME)에서 GPT-4o는 평균 12%를 맞혔고, o1은 한 번 시도에 74%를 맞혔습니다. 2026년 지금 대부분의 최신 모델은 답하기 전에 '생각'합니다. 그 생각의 정체는 종이에 적는 일입니다.
14. 코어닷투데이 실측: 모델에게서 종이를 빼앗으면
블럼의 문장을 직접 확인해 보고 싶었습니다. 코어닷투데이는 로컬에서 도는 Qwen3.5 9B 모델에게 같은 계산을 두 방식으로 시켰습니다.
종이 없이: "최종 숫자만 답하라. 단계·말·풀이를 쓰지 마라."
종이와 함께: "먼저 종이에 풀어라. 곱셈이면 부분곱을 한 자리씩, 그다음 올림과 함께 자리별 합을 모두 적어라. 마지막 줄에 답을 적어라."
모델의 내장 '생각' 모드는 두 조건 모두 껐습니다. 차이는 오직 답 앞에 풀이를 적을 수 있느냐뿐입니다. 곱셈은 2~7자리 자릿수마다 무작위 문제 12개씩, 덧셈은 10·20·40자리 8개씩, 온도 0으로 풀게 했습니다. 곱셈에는 조건을 두 개 더 붙였습니다. 풀이의 '형식'을 정해 준 조건(누적합 형식)과, 모델의 내장 생각 모드를 켠 조건입니다(각 8문항).
결과는 예상과 달랐고, 그래서 더 흥미로웠습니다.
곱셈 자릿수
종이 없이
자유 풀이
누적합 형식
생각 모드
2자리
12/12 (4토큰)
12/12 (769토큰)
–
–
3자리
10/12 (6토큰)
11/12 (1.5k토큰)
6/8 (184토큰)
8/8 (3.3k토큰)
4자리
2/12 (8토큰)
4/12 (2.8k토큰)
7/8 (237토큰)
6/8 (10.9k토큰)
5자리
1/12 (9토큰)
1/12 (4.5k토큰)
8/8 (368토큰)
0/8 (14.0k토큰)
6자리
0/12 (12토큰)
0/12 (5.4k토큰)
7/8 (494토큰)
0/8 (14.0k토큰)
7자리
0/12 (12토큰)
0/12 (6.0k토큰)
7/8 (628토큰)
0/8 (14.0k토큰)
첫째, 종이를 빼앗으면 무너진다. 답만 말하게 하자 2자리 곱셈은 12문제를 다 맞혔지만 4자리에서 2문제, 6자리부터는 하나도 맞히지 못했습니다. 블럼의 말 그대로입니다. 머릿속(한 번의 계산 깊이)에 다 들어가지 않는 문제가 오는 순간 기계는 틀립니다. 틀린 답을 들여다보면 특징이 있습니다. 곱셈에서 틀린 답 47개 가운데 46개는 앞 두 자리가 맞았고, 39개는 끝자리가 맞았습니다. 틀린 곳은 가운데였습니다(20개는 자릿수까지 틀렸습니다). 대략의 크기와 끝자리처럼 '한 번에 알 수 있는 것'은 맞히고, 올림이 길게 이어지는 가운데는 그럴듯하게 지어냅니다.
둘째, 종이만 준다고 되는 것은 아니었다. 놀라운 것은 '자유 풀이' 조건입니다. 부분곱을 한 자리씩, 자리별 합을 올림과 함께 모두 적으라고 했더니, 모델은 성실하게 적었지만 4자리에서 12문제 중 4문제, 5자리에서 1문제만 맞혔습니다. 답만 말할 때와 거의 차이가 없습니다. 실패한 풀이 하나(7,654 × 2,023)를 열어 보니 부분곱 네 줄(22,962 / 153,080 / 0 / 15,308,000)은 모두 맞았습니다. 틀린 곳은 그 네 줄을 자리별로 맞춰 열마다 더하는 단계였고, 답은 15,384,402(정답 15,484,042)가 됐습니다. 사람으로 치면 부분곱은 잘 구해 놓고 마지막 세로 덧셈에서 실수한 셈입니다. 자릿수가 늘수록 풀이가 6,000토큰 한도를 넘겨 답에 이르지도 못하는 경우가 늘었습니다. 5자리에서 12문제 중 6문제, 6자리에서 9문제, 7자리에서는 12문제 모두였습니다. 종이가 모자랐던 것입니다. 1부에서 말한 '유한한 종이'의 단서가 여기서 나타났습니다.
셋째, 종이에 '어떻게' 쓰느냐가 결과를 갈랐다. '누적합 형식'은 같은 모델에게 다른 쓰기 방식을 준 것입니다. 곱하는 수를 자릿값으로 쪼개고(671,434 = 600,000 + 70,000 + …), 각 자릿값과의 곱을 한 줄씩 쓴 뒤, 두 수씩만 차례로 더해 누적합을 적게 했습니다. 이렇게 하자 4~7자리 곱셈 정확도가 88~100%로 뛰었습니다. 쓴 토큰은 200~600개로, 자유 풀이의 10분의 1도 안 됐습니다. 한 줄 한 줄이 모델이 확실히 할 수 있는 작은 일(한 자리 수 곱하고 0 붙이기, 두 수 더하기)로 쪼개져 있었기 때문입니다. 반대로 3자리에서는 이 형식을 잘못 따라 자릿값을 곱하지 않고 그냥 더해 버린 경우가 두 번 있었습니다. 형식이 생각을 대신해 주지는 않습니다.
넷째, 오래 생각한다고 되는 것도 아니었다. 모델의 내장 '생각 모드'를 켜고 답만 요구하자 3자리는 다 맞혔지만, 5자리부터는 생각 토큰 14,000개(글자로 2만5천~3만 자)를 쓰고도 끝내 답을 내지 못했습니다. 9B 모델의 생각은 같은 계산을 확인하고 또 확인하며 맴돌았습니다. 많이 쓰는 것과 잘 쓰는 것은 다릅니다.
다섯째, 모델에게는 덧셈도 공짜가 아니었다. 블럼은 유한 오토마톤도 덧셈은 한다고 했습니다. 그런데 이 모델은 답만 말할 때 10자리 덧셈 8문제 중 6문제, 20자리 4문제, 40자리 1문제만 맞혔습니다.
10자리 덧셈 · 종이 없이
6/8
20자리 덧셈 · 종이 없이
4/8
40자리 덧셈 · 종이 없이
1/8
20자리 덧셈 · 자리별 풀이
0/8
40자리 덧셈 · 자리별 풀이
0/8
이유는 3절의 단서에 있습니다. 유한 오토마톤이 덧셈을 할 수 있는 것은 두 수를 아래 자리부터 한 쌍씩 읽을 때뿐입니다. 그런데 언어 모델은 답을 앞자리부터 씁니다. 앞자리를 쓰려면 뒤에서 올라올 올림을 미리 알아야 하고, 그 올림은 수십 자리 뒤에서 시작될 수도 있습니다. 모델에게 덧셈은 자판기의 덧셈이 아니라 끝까지 내다봐야 하는 문제입니다. 틀린 답 13개 중 8개는 첫 자리부터 어긋났고, 그중 4개는 자릿수부터 틀려(자리 하나를 빠뜨리거나 더해) 전체가 밀렸습니다. 나머지 5개는 뒤쪽이나 중간의 몇 자리에서 틀렸습니다.
자리마다 올림을 적으며 풀게 하자 결과는 오히려 나빠졌습니다. 20자리와 40자리에서 16문제를 모두 틀렸고, 그중 12문제는 6,000토큰 한도에 걸려 끝까지 가지도 못했습니다. 한 자리에 여러 줄씩 쓰는 장황한 풀이는 덧셈에서도 종이를 다 써 버렸습니다. (덧셈에 맞는 짧은 형식, 예컨대 아래 자리부터 결과를 적고 마지막에 뒤집는 방식은 이번에 재지 않았습니다.)
이 결과는 블럼의 정리를 확인하는 동시에, 6부의 글쓰기 규칙을 미리 보여 줍니다. 종이를 빼앗으면 생각은 작아집니다. 하지만 종이를 준다고 저절로 커지지도 않습니다. 어떤 단위로 쪼개 적느냐, 한 줄에 무엇을 담느냐가 결과를 가릅니다. 데미르바스가 규칙 3에서 "단순하고 평이하고 간결하게"를 말한 이유를, 9B 모델이 곱셈으로 보여 준 셈입니다. 짧고 확실한 문장을 차례로 쌓은 '누적합' 풀이가 길고 빽빽한 풀이를 이겼습니다.
실측 조건
모델: Qwen3.5 9B (Ollama, 로컬 맥, 온도 0) · 문항: 자릿수마다 무작위 시드 고정, 곱셈 12문항(누적합·생각 모드는 8문항), 덧셈 8문항
한도: 종이 없이 64토큰, 자유 풀이·누적합 6,000토큰, 생각 모드 14,000토큰 · 채점: 마지막 'ANSWER:' 숫자가 정답과 정확히 같을 때만 정답
한계: 모델 하나, 문항 수가 작아 한두 문제 차이는 우연일 수 있음. 더 큰 모델은 직접 곱셈에서 훨씬 오래 버틴다(드지리 등 2023: GPT-4는 3×3자리 59%, 4×4자리 4%).
15. 6쪽짜리 증거가 무너진 해
이제 데미르바스의 글에서 가장 날카로운 대목으로 갑니다. 그는 묻습니다. "모든 것을 읽은 모델과 무엇이든 토론할 수 있게 된 지금, 생각하기 위한 글쓰기는 쓸모없어지고 있는가?"
먼저 그가 '글쓰기로 생각하기'의 대표 사례로 든 아마존의 6페이저부터 보겠습니다.
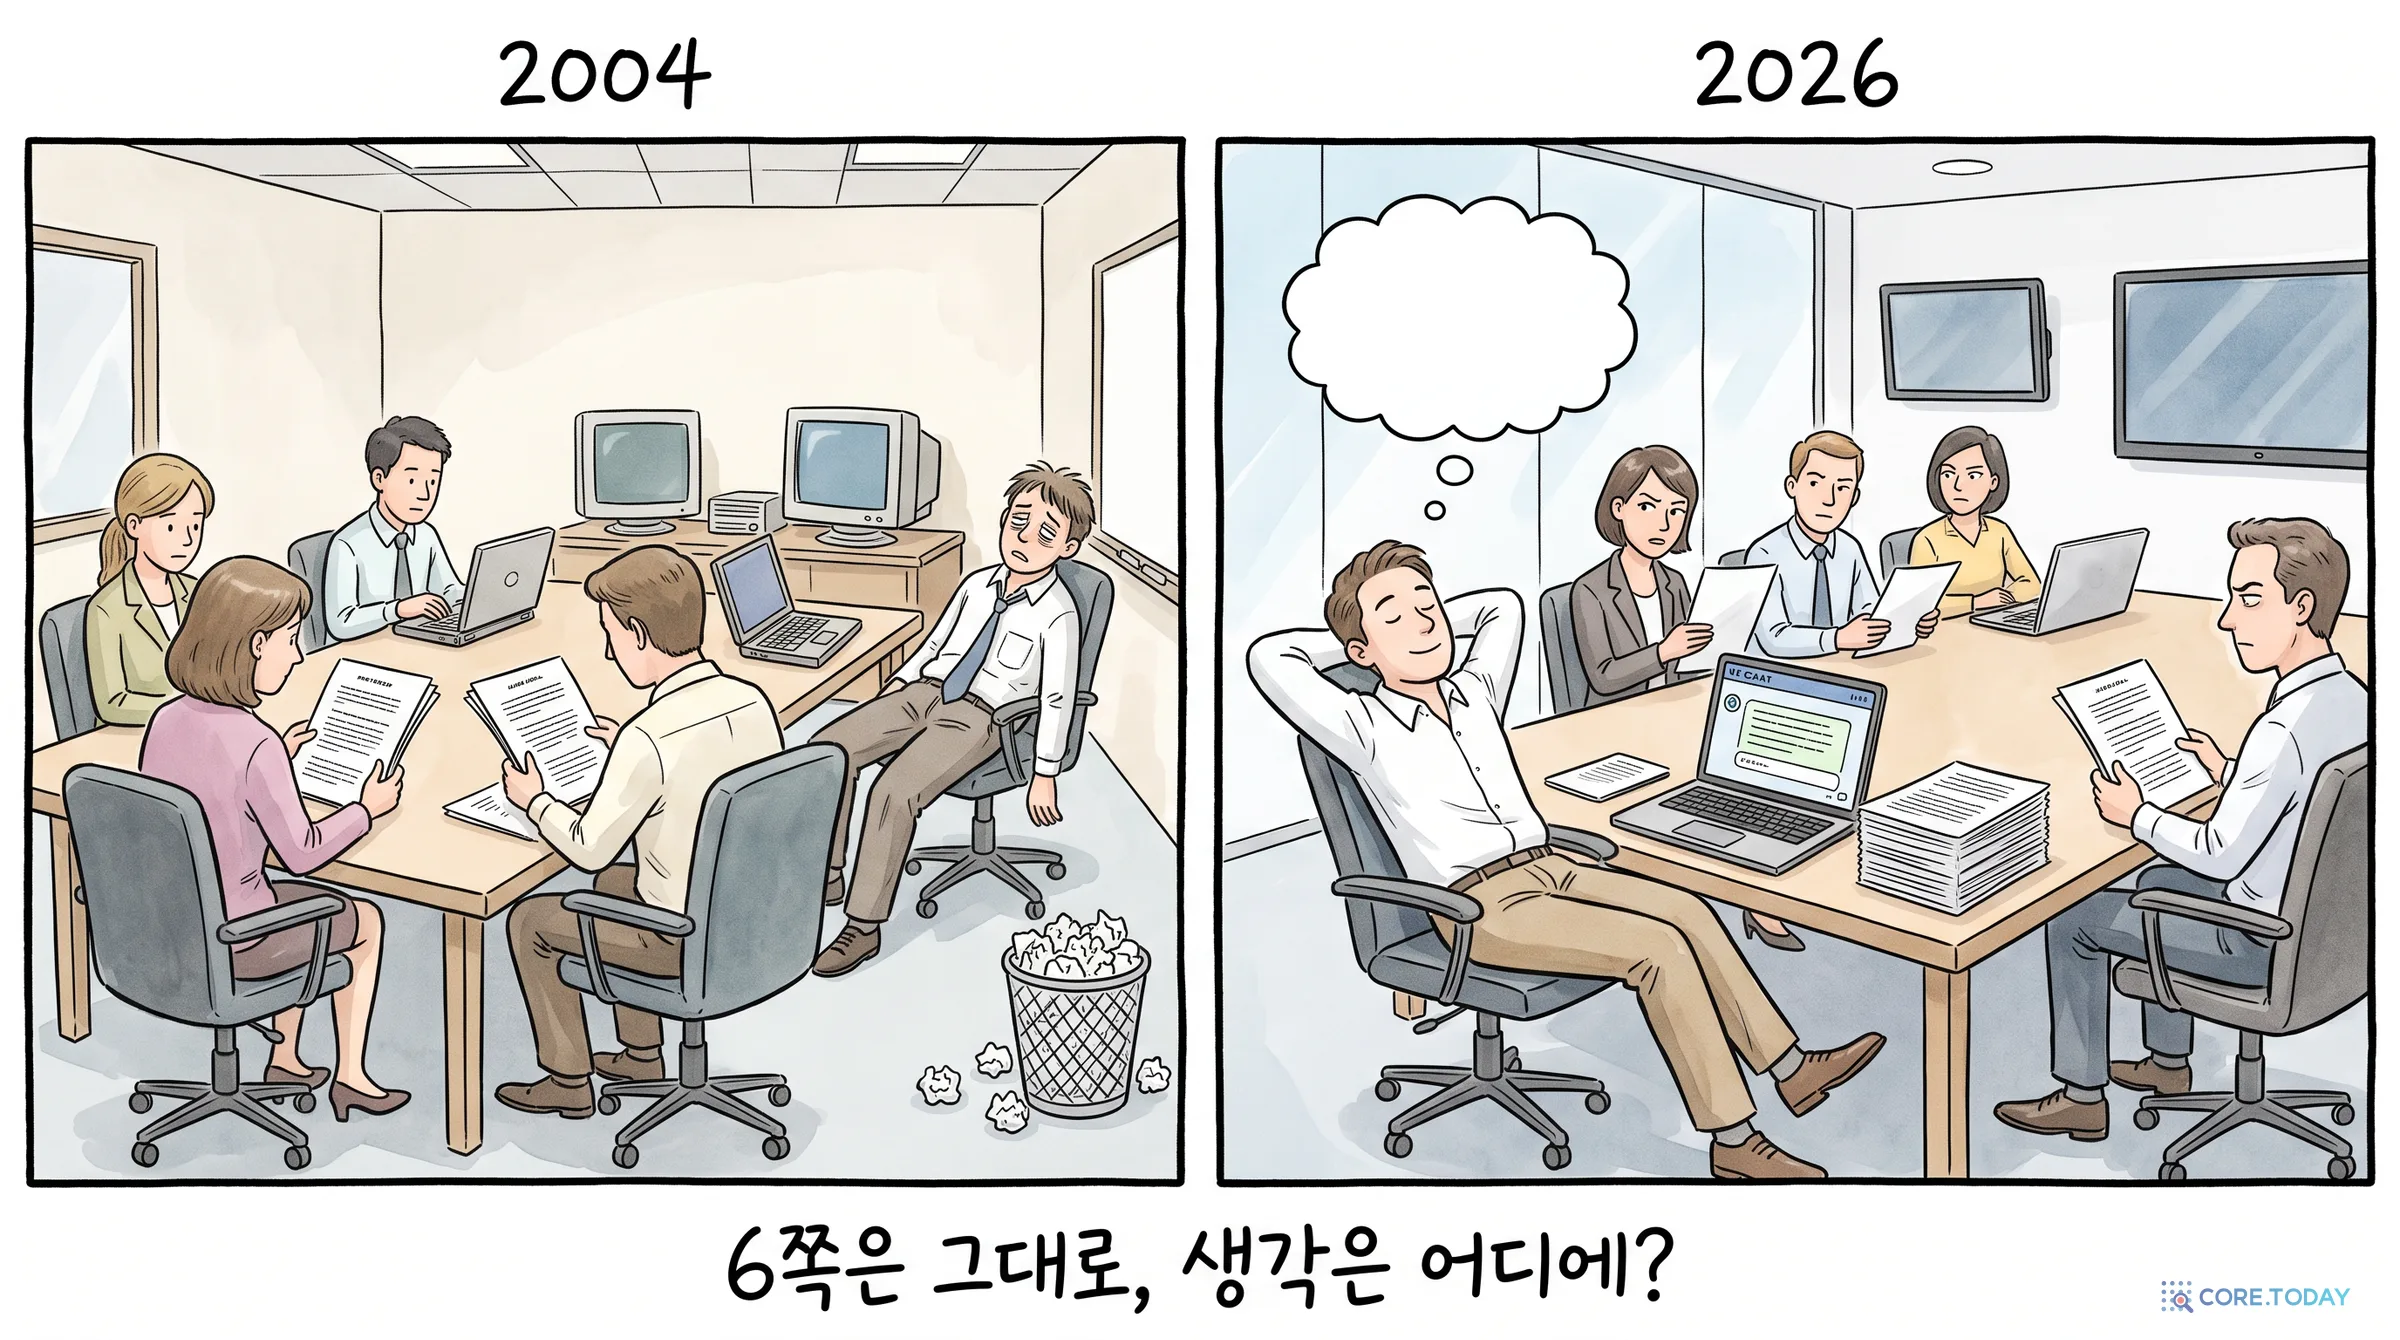
2004년 6월 9일 저녁 6시 2분, 제프 베이조스는 아마존 임원진(S-팀)에게 제목이 "앞으로 S-팀 회의에서 파워포인트 발표는 없다"인 이메일을 보냈습니다. 본문은 이렇습니다.
제프 베이조스, 2004년 6월 9일 이메일
우리가 원하는 것은 그냥 글이 아니라 구조가 잘 잡힌 서술형 글입니다. 워드로 글머리표 목록을 만든다면 파워포인트만큼 나쁩니다. 4쪽짜리 메모를 쓰는 것이 20쪽짜리 파워포인트를 '쓰는' 것보다 어려운 이유는, 좋은 메모의 서술 구조가 무엇이 무엇보다 중요한지, 생각들이 서로 어떻게 이어지는지를 더 잘 생각하고 더 잘 이해하도록 강제하기 때문입니다. 파워포인트식 발표는 어쩐지 생각을 대충 넘기고, 상대적 중요도를 납작하게 만들고, 생각들의 상호 연결을 무시해도 된다고 허락합니다.
처음에는 4쪽이었습니다. 나중에 6쪽이 표준이 됐고, 회의는 참석자 모두가 20~30분 동안 말없이 메모를 읽는 것으로 시작하게 됐습니다. 2012년 포춘 인터뷰에서 베이조스는 데미르바스가 인용한 그 문장을 남깁니다. "완전한 문장은 쓰기가 더 어렵습니다. 동사가 있어야 하니까요. 문단에는 주제문이 있어야 합니다. 6쪽짜리 서술형 메모를 쓰면서 명료하게 생각하지 않을 방법은 없습니다."
2017년 주주 서한(2018년 4월)에서 그는 좋은 메모가 어떻게 만들어지는지도 설명했습니다. "훌륭한 메모는 쓰고 또 다시 쓰이며, 동료들에게 더 낫게 만들어 달라고 돌리고, 며칠 묵혔다가, 맑은 정신으로 다시 고칩니다. 하루이틀에 될 수가 없습니다." 6쪽짜리 고품질 메모가 한두 시간에 써질 것이라 믿는 사람들이 있지만 "실제로는 일주일 이상 걸릴 수도 있다"고 했습니다.
이 제도의 핵심 논리는 이것이었습니다. 문서는 생각의 증거다. 6쪽짜리 서술형 메모가 책상 위에 있다는 것은, 누군가 그 문제를 일주일 동안 붙들고 지식 변형의 왕복을 거쳤다는 뜻이었습니다. 문서를 읽는 사람은 문서뿐 아니라 그 뒤의 생각을 믿을 수 있었습니다.
데미르바스는 단호하게 씁니다. "불행히도 LLM과 함께, 그 문장은 더 이상 참이 아니게 됐다. 이제 생각 없이도 6쪽을 만들 수 있고, 그 6쪽은 여전히 생각이 일어났다는 증거처럼 보인다."
경제학에 굿하트의 법칙이라는 말이 있습니다. 측정치가 목표가 되면 더 이상 좋은 측정치가 아니게 된다는 것입니다. 6쪽짜리 메모는 생각의 측정치였습니다. 그 측정치가 공짜로 생산되는 순간, 측정치와 생각 사이의 연결이 끊어졌습니다.
이 이야기는 가설이 아닙니다. 아마존에서 20년 가까이 일한 스티브 후인(Steve Huynh)은 2026년 10월 14일 「아마존 글쓰기 문화의 죽음에 대하여」라는 글을 올렸습니다. 공개된 앞부분에서 그는 한 장면을 전합니다. 리뷰 회의가 시작되고 30분쯤 지났을 때, 방에서 가장 직급이 높은 L7 수석 PM이 6페이저를 처음 읽고 있는 것이 눈에 보였습니다. 아무도 말하지 않았습니다. 후인은 베이조스의 포춘 인터뷰를 인용한 뒤 이렇게 씁니다. 그 말은 "더 이상 참이 아니다. AI로 6쪽은 너무 쉽게 만들 수 있고, 비판적 사고는 필요 없다." 데미르바스의 글은 바로 이 글에 링크를 겁니다.
한 가지 짚어 둘 점이 있습니다. 같은 2017년 서한에서 베이조스는 이렇게도 썼습니다. "팀의 누군가는 그 기술을 가져야 하지만, 그게 꼭 당신일 필요는 없다." 그리고 아마존의 메모에는 저자 이름이 없고 "팀 전체의 메모"라고 했습니다. 베이조스 자신도 글쓰기를 위임할 수 있다고 본 셈입니다. 다만 그때 위임받는 쪽은 그 문제를 함께 붙든 동료였고, 생각은 팀 안 어딘가에서는 반드시 일어났습니다. 2026년의 위임은 다릅니다. 받는 쪽이 문제를 붙들지 않아도 6쪽이 나옵니다.
16. 인지 부채: 2025~2026년의 증거들
생각을 기계에 맡기면 머리에서는 무슨 일이 일어날까요? 최근 몇 년 사이 이 질문에 답하려는 연구가 쏟아졌습니다. 결론부터 말하면, 증거는 한 방향을 가리키지만 아직 단단하지는 않습니다. 하나씩 보겠습니다.
MIT 미디어랩, 「ChatGPT를 쓴 당신의 뇌」(2025). 나탈리야 코스미나(Nataliya Kosmyna) 등은 보스턴 지역 대학생과 직장인 54명을 18명씩 세 집단으로 나눴습니다. ChatGPT를 쓰는 집단, 검색 엔진을 쓰는 집단, 아무 도구 없이 머리만 쓰는 집단. 넉 달 동안 세 번, 20분씩 SAT 형식의 에세이를 쓰게 하고 32채널 뇌파(EEG)를 쟀습니다. 결과는 꽤 선명했습니다.
알파파 유의미 연결 · 맨머리 집단
79개
알파파 유의미 연결 · ChatGPT 집단
42개
첫 회기, 자기 글 정확히 인용 실패 · ChatGPT
15/18
첫 회기, 자기 글 정확히 인용 실패 · 다른 두 집단
2/18
넷째 회기에서 연구진은 일부 참가자의 조건을 바꿨습니다. 내내 ChatGPT를 쓰던 사람이 머리만으로 쓰자, 9명 중 7명이 자기 글을 인용하지 못했습니다. 반대로 내내 머리만 쓰던 사람이 처음 ChatGPT를 쓰자 기억 회상과 뇌 활성이 높게 유지됐습니다. 먼저 스스로 생각한 다음에 도구를 쓰는 것과, 처음부터 도구에 기대는 것은 다른 일이라는 신호입니다. 연구진은 이것을 인지 부채(cognitive debt)라고 불렀습니다. 당장은 편하지만 나중에 갚아야 하는 빚이라는 뜻입니다.
단, 이 연구는 2026년 11월 현재 동료 심사를 거치지 않은 사전 공개 논문입니다. 집단당 18명은 작고, 2025년 말에는 표본 크기와 뇌파 분석 방법, 보고의 일관성을 지적하는 반론 논문도 나왔습니다. '83%가 자기 글을 인용하지 못했다'는 숫자도 논문 안에서 '인용할 수 있었나'와 '정확히 인용했나'가 섞여 있어 조심해서 읽어야 합니다. 그래도 '내가 쓰지 않은 글은 내 머리에 남지 않는다'는 방향은 데미르바스의 말("적어 두지 않은 생각은 남지 않는다")과 정확히 겹칩니다.
마이크로소프트·카네기멜런, CHI 2025. 리 등은 지식 노동자 319명에게 업무에서 생성형 AI를 쓴 사례 936건을 받아 분석했습니다. AI를 믿을수록 비판적 사고를 덜 했다고 답했고, 자기 능력을 믿을수록 더 했다고 답했습니다. 비판적 사고의 노력은 사라지기보다 자리를 옮겼습니다. 정보를 모으는 일에서 검증하는 일로, 직접 문제를 푸는 일에서 AI의 답을 끼워 맞추는 일로. 모두 자기 보고라는 한계가 있습니다.
와튼·펜실베이니아대, PNAS 2025. 바스타니 등은 튀르키예 고등학생 약 1,000명에게 수학 연습 시간에 GPT-4를 쓰게 했습니다. 답을 바로 알려 주는 'GPT 기본' 집단은 연습 점수가 48% 올랐지만, AI를 빼고 본 시험에서는 AI를 안 쓴 학생보다 17% 낮았습니다. 정답 대신 힌트만 주도록 만든 'GPT 튜터' 집단은 연습 점수가 127% 올랐고 시험에서의 손해도 대부분 피했습니다. 같은 도구라도 생각을 대신하는지, 생각을 돕는지에 따라 결과가 갈렸습니다.
도시·하우저, Science Advances 2024. 작가 293명이 여덟 문장짜리 짧은 이야기를 쓰고 600명이 평가했습니다. GPT-4의 아이디어를 다섯 개까지 받은 작가의 이야기는 신선함이 8.1%, 쓸모가 9.0% 올랐습니다. 특히 원래 덜 창의적이던 작가가 크게 나아졌습니다. 그런데 AI의 도움을 받은 이야기들은 서로 더 비슷해졌습니다. 개인은 나아지고 집단의 다양성은 줄었습니다.
연구
대상
발견
한계
코스미나 등 2025
54명, 에세이, 뇌파
ChatGPT 집단 연결 최저, 자기 글 기억 못 함
사전 공개, 소표본, 반론 있음
리 등 2025(CHI)
지식 노동자 319명
AI 신뢰 ↑ → 비판적 사고 ↓
자기 보고
바스타니 등 2025(PNAS)
고교생 약 1,000명
답 주는 AI: 연습 +48%, 시험 −17%
수학, 단기
도시·하우저 2024
작가 293명
개인 신선함 ↑, 집단 다양성 ↓
짧은 이야기
게를리히 2025
영국 666명 설문
AI 사용 ↔ 비판적 사고 음의 상관
횡단 설문, 표 사이 수치 불일치
한편 글은 이미 크게 바뀌었습니다. 스탠퍼드의 량웨이신(Weixin Liang) 등은 ICLR 2024 학회의 동료 심사 의견 중 약 10.6%가 LLM으로 상당 부분 고쳐 쓰인 것으로 추정했습니다(2023년 이전에는 1.6%). 심사평에서 'meticulous(꼼꼼한)'라는 단어는 34.7배, 'commendable(칭찬할 만한)'은 9.8배 늘었습니다. 2024년 펍메드 초록의 최소 13.5%가 LLM을 거쳤다는 추정도 있습니다. 논문을 심사하는 일은 데미르바스가 '쓰면서 60%를 100%로 만든다'고 한 바로 그 일입니다.
17. 고기 대리인: 쓰기가 상대적 우위가 되는 이유
데미르바스의 결론은 이렇습니다.
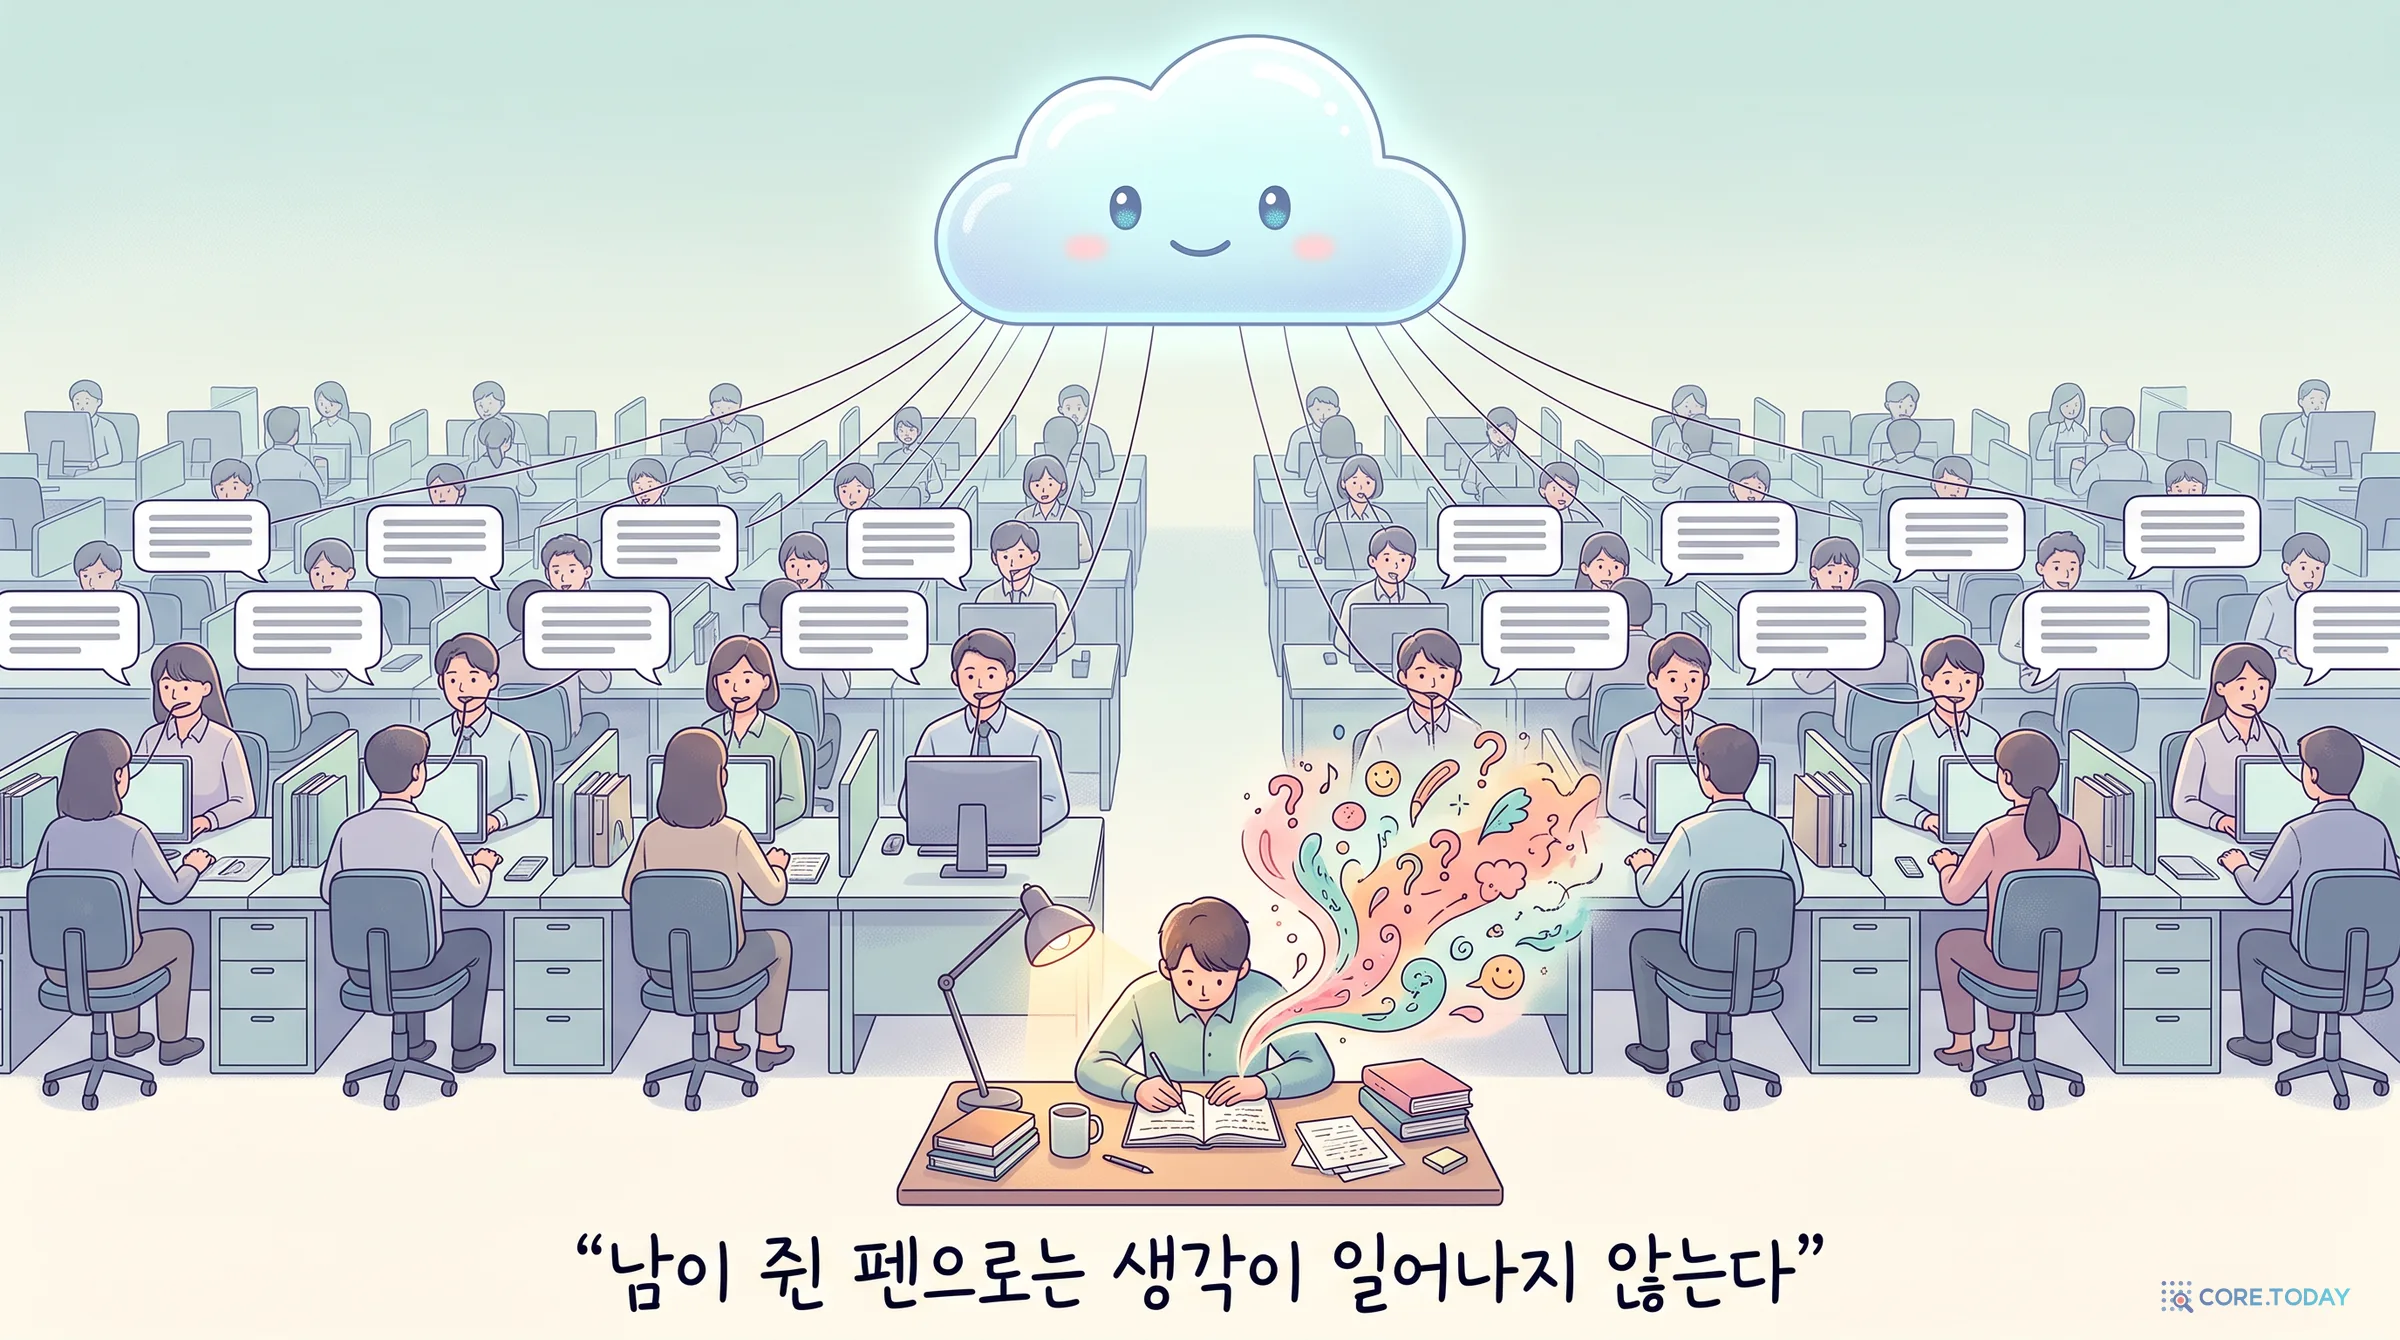
다음 토큰 확률을 최적화하는 모델은 당신의 생각을 대신해 줄 수 없다. 모델에게 펜을 쥐여 주면 생각은 일어나지 않는다. 모두가 생각을 꺼 두고 생성된 텍스트의 고기 대리인(meat-proxy)이 되어 갈 때, 여전히 직접 쓰는 사람은 여전히 스스로 생각하고 있을 것이다. 그러니 글쓰기는 이제 상대적 우위다. 그리고 그 우위는 점점 커지고 있다.
'고기 대리인'은 거친 표현입니다. 사람이 기계가 만든 문장을 옮기는 살덩이 중계기가 된다는 뜻입니다. 그런데 이 말은 1~2부의 이론과 정확히 맞물립니다. 생각은 지식 변형의 왕복, 곧 손이 멈추고 다시 고치는 과정에서 일어납니다. 그 과정을 기계에 넘기면 문서는 남지만, 그 문서를 쓰며 바뀌었어야 할 작가의 머리는 그대로입니다. 4부에서 본 것처럼 기계는 종이를 받아 똑똑해졌는데, 사람은 그 종이를 기계에게 넘겨주고 있는 셈입니다.
'상대적 우위'라는 말도 계산해 볼 만합니다. 모두가 같은 모델로 같은 6쪽을 만들 수 있다면, 6쪽 자체는 더 이상 차별점이 되지 않습니다. 도시와 하우저의 실험이 보여 준 것처럼 AI의 도움을 받은 글들은 서로 비슷해집니다. 그 속에서 남는 차별점은 모델이 모르는 것, 곧 데미르바스가 말한 "당신 머릿속의 반쯤 된 직관"을 끝까지 생각해 낸 결과입니다. 그것은 직접 써 본 사람에게만 생깁니다.
물론 반론도 있습니다. 데미르바스는 LLM이 창의적 도약을 해낼 것이라 믿지 않는다고 했지만, 이것은 2026년의 판단이고 다음 돌파구가 오면 바뀔 수 있다고 그 자신도 인정합니다. 또 '쓰기'와 '타자 치기'는 다릅니다. AI와 길게 논쟁하며 내 주장을 다듬는 사람은 손으로 쓰지 않아도 지식 변형을 하고 있을지 모릅니다. 중요한 것은 도구가 아니라 왕복이 누구의 머릿속에서 일어나느냐입니다. 아래 위젯으로 그 선을 그어 보세요.
18. 데미르바스의 다섯 규칙
"왜 써야 하는지는 이쯤 하자. 이제 어떻게 쓸지에 대한 조언이다." 데미르바스의 다섯 규칙은 짧지만, 각각 뒤에 수십 년 된 글쓰기 전통이 있습니다. 규칙마다 그 전통과 함께, 바로 써먹을 수 있는 요령을 붙여 정리합니다.
규칙 2정리하라 — 이제 비평가가 되어 가혹하게 자른다. 서너 번에 걸쳐 쓰는 것이지 한 번이 아니다.
규칙 3단순하고 평이하고 간결하게 — 복잡한 문장은 엉성한 생각이 숨는 곳이다.
규칙 4기대 없이 써라 — 독자는 나. 보상은 쓰기 자체에서.
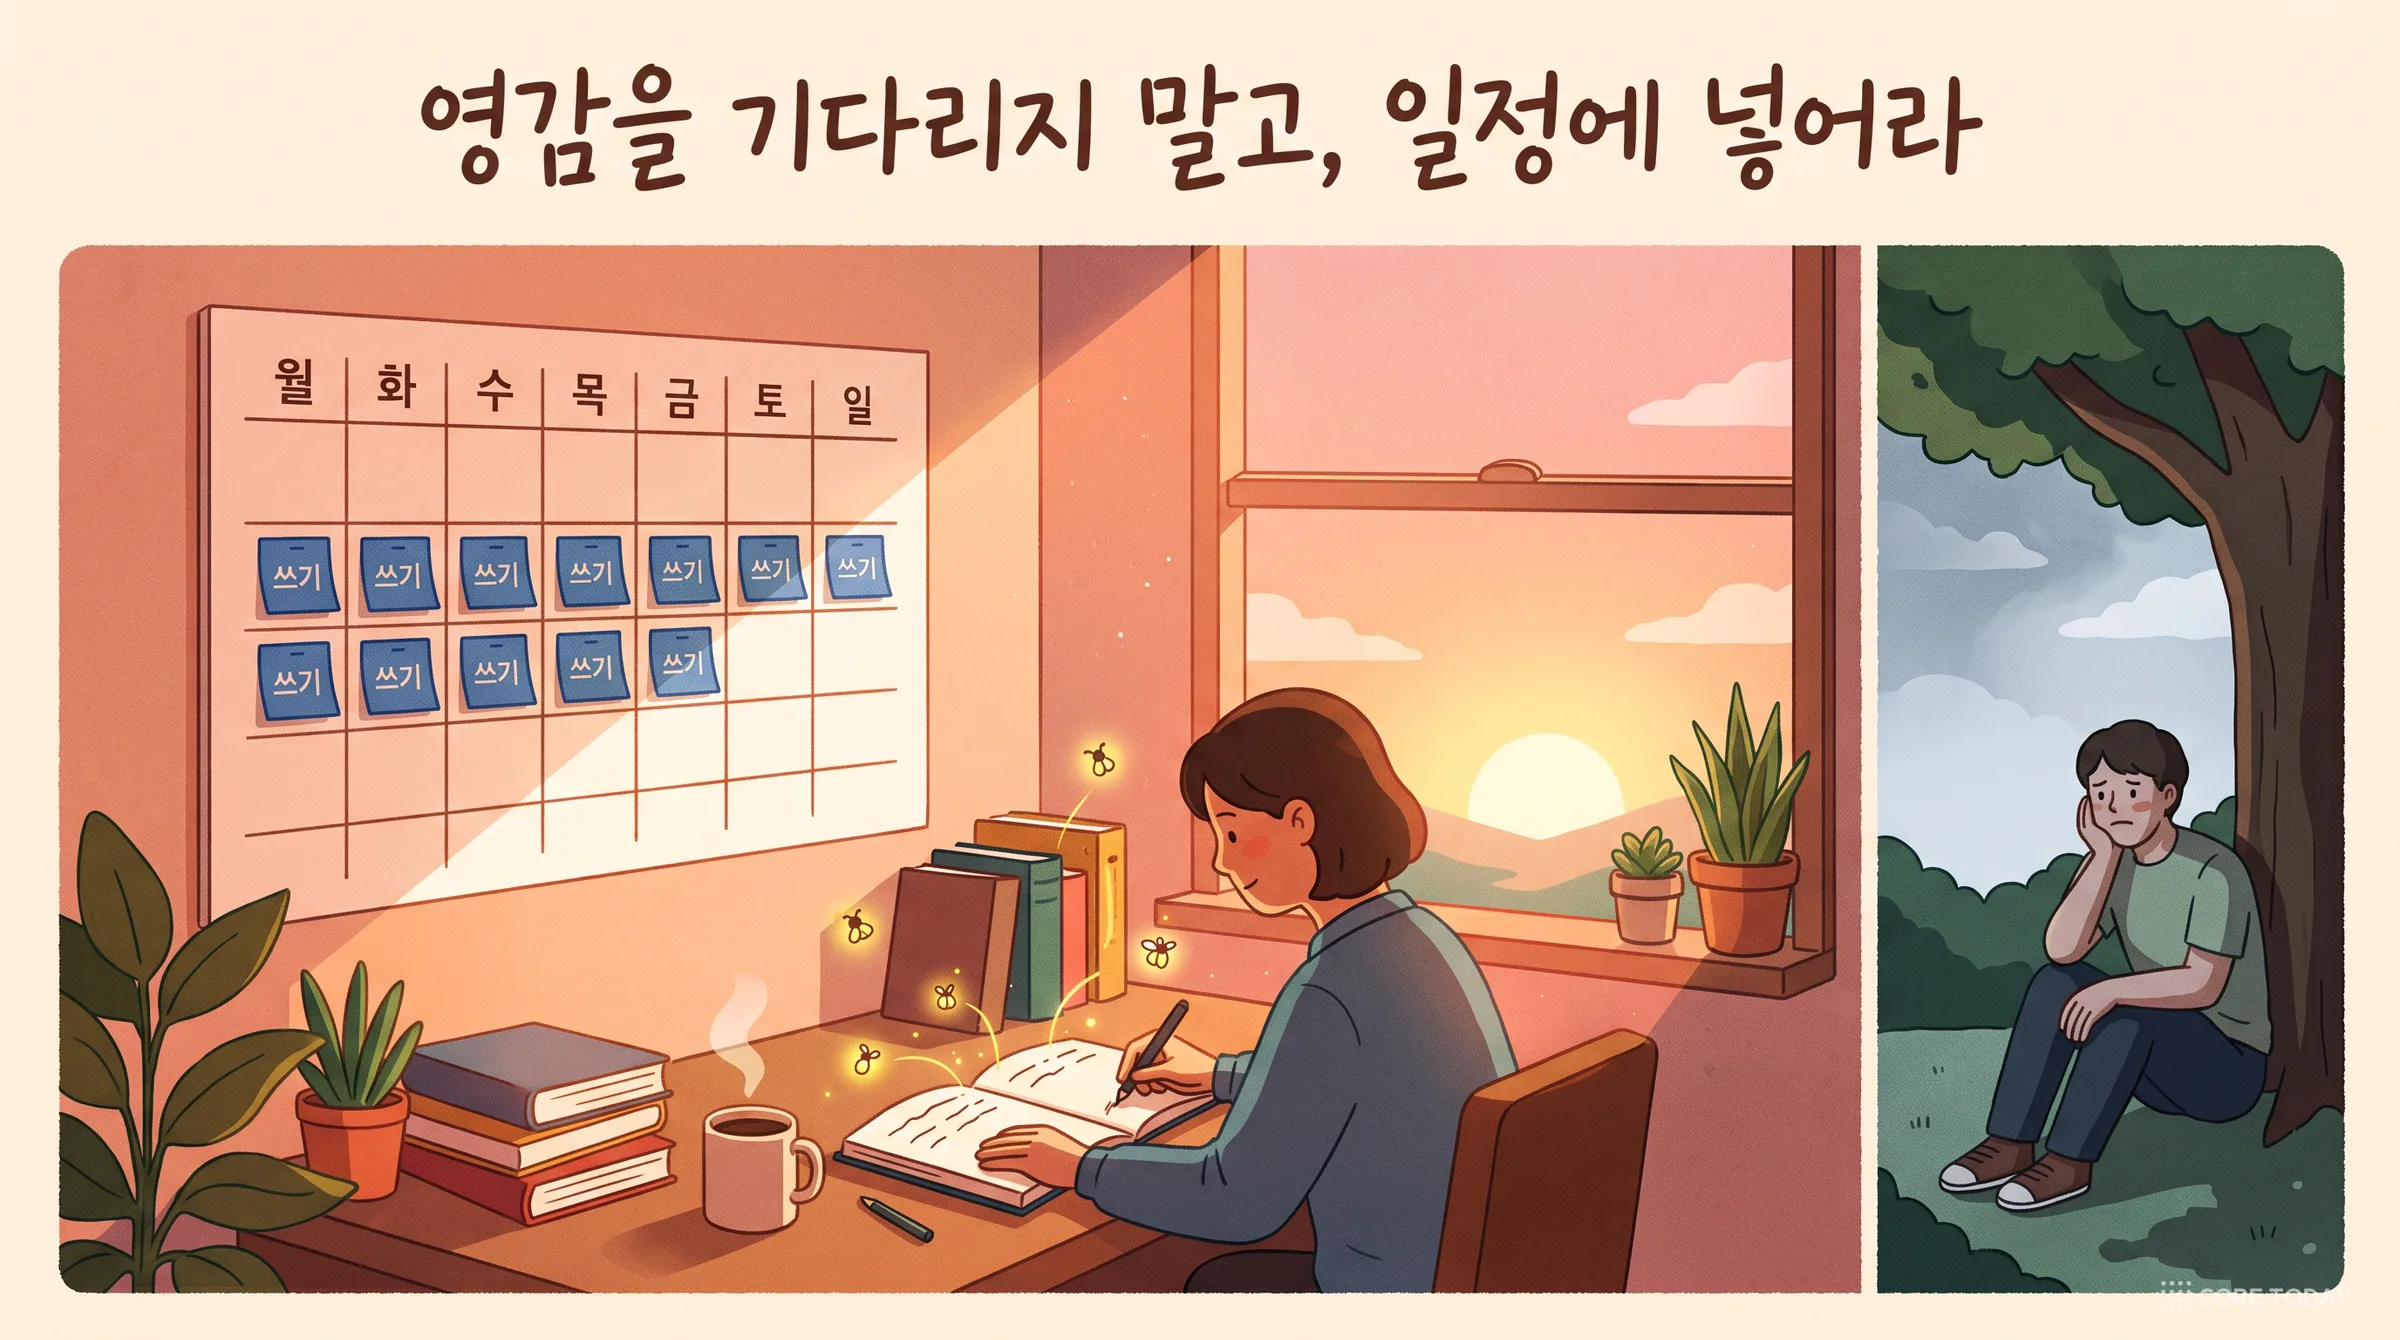
규칙 5일정에 넣어라 — 영감을 기다리지 말고 엉덩이를 의자에 붙여라.
19. 규칙 1. 엉망으로 써라
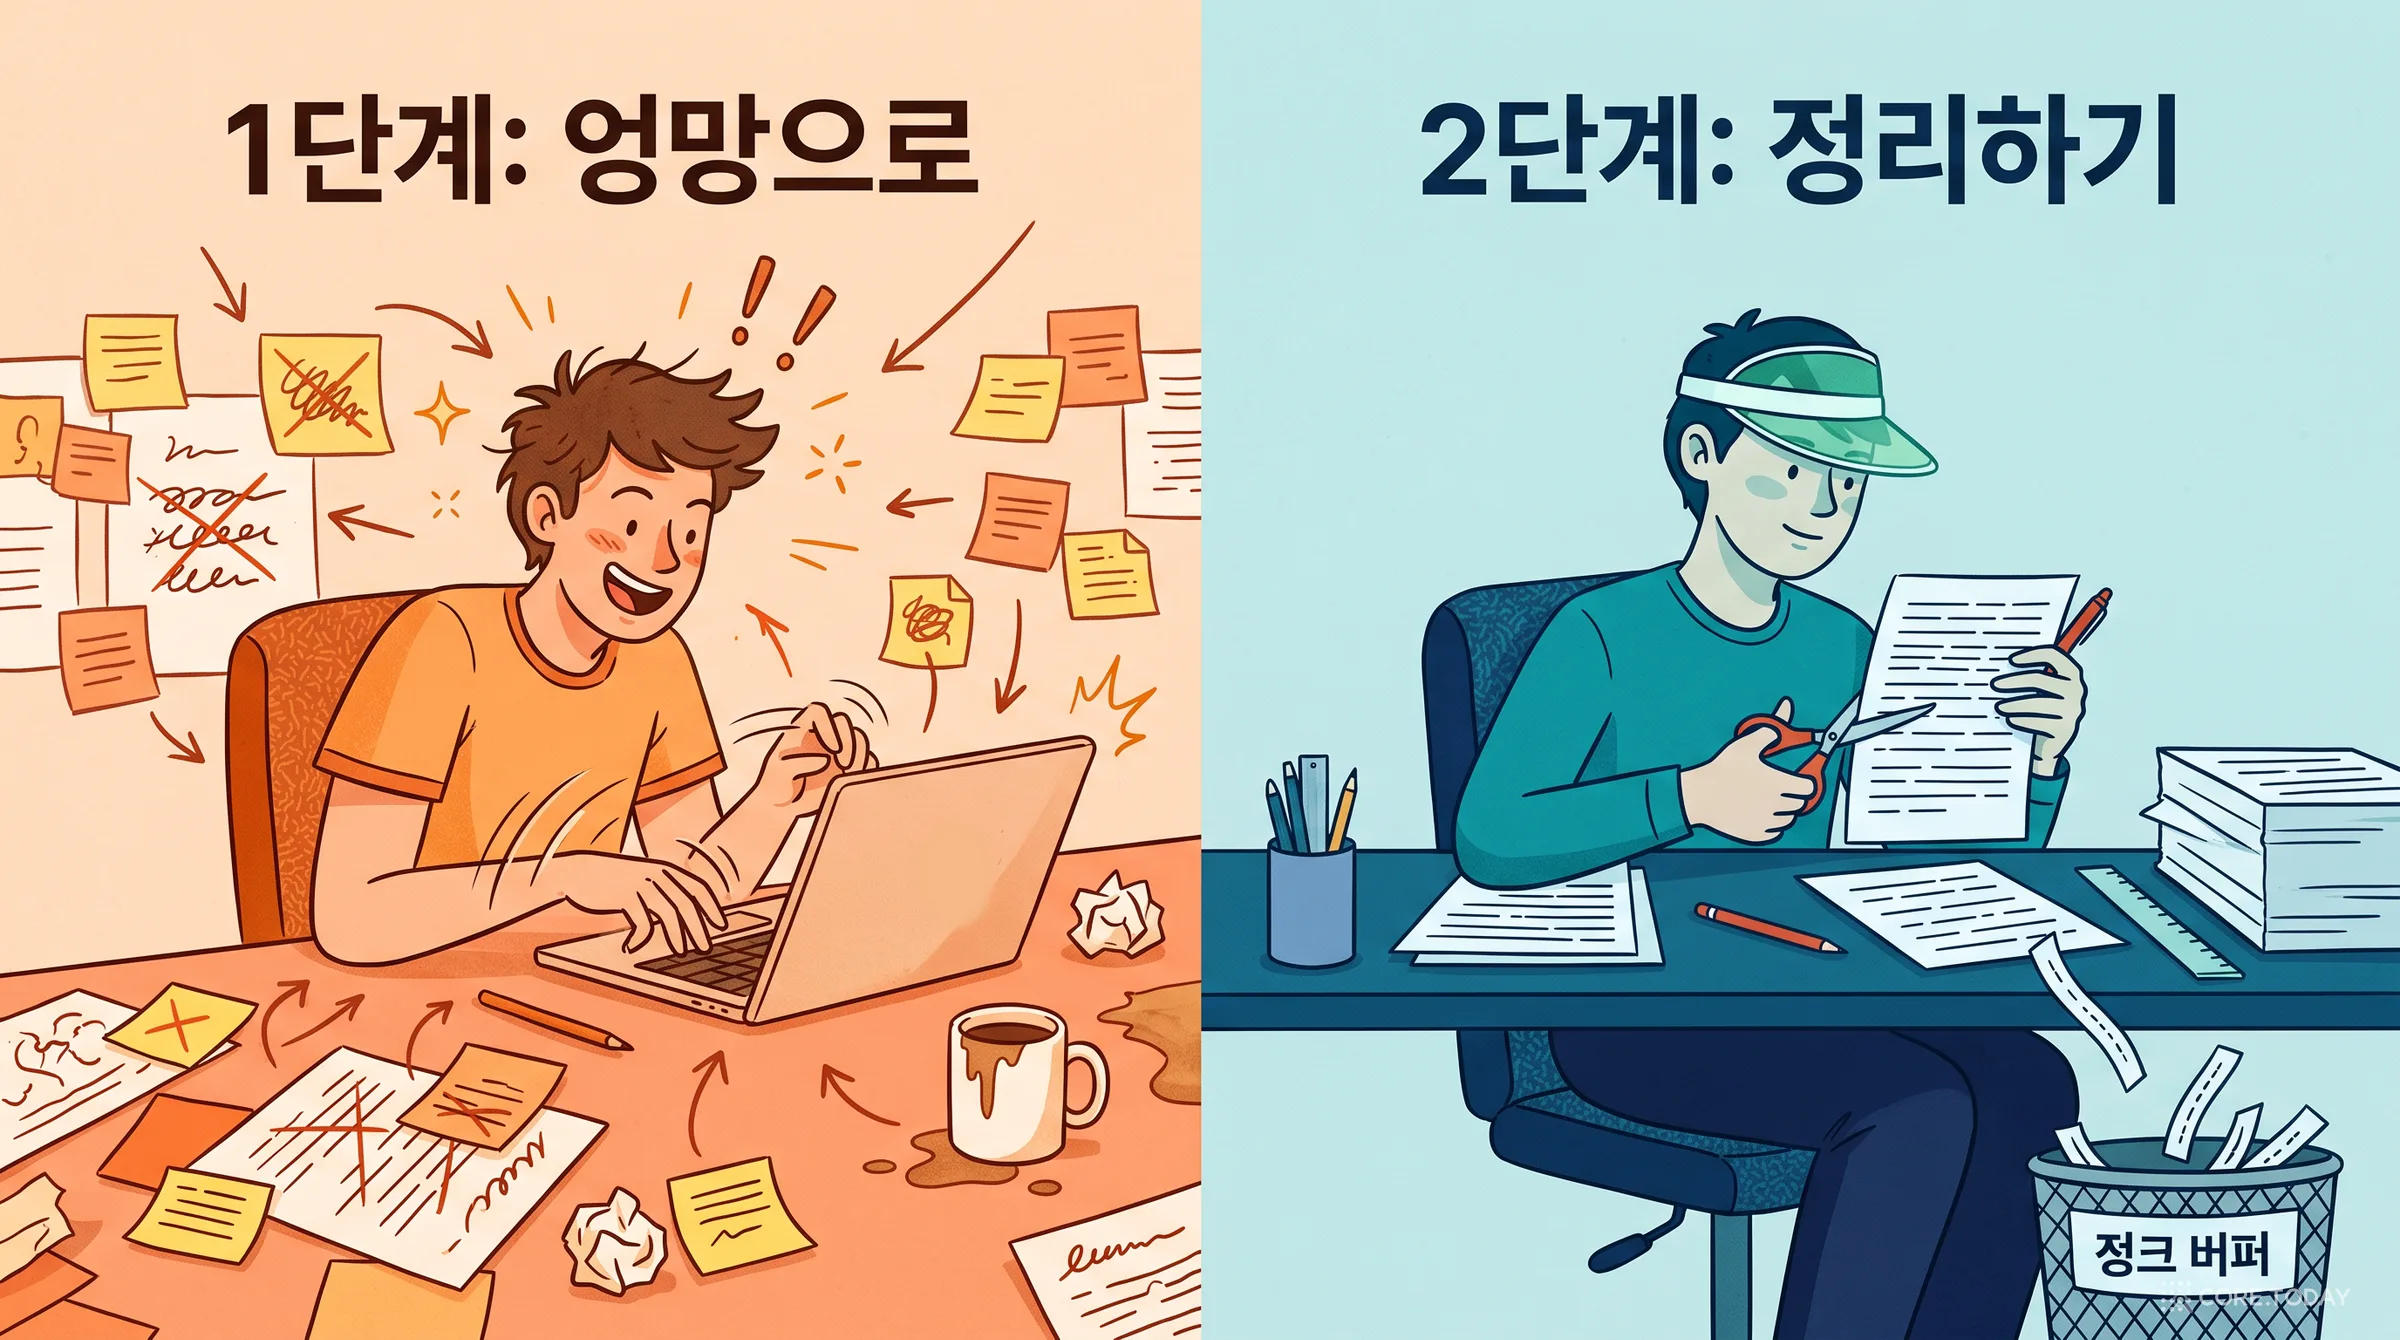
"글쓰기 클럽의 첫 번째 규칙은 아무 제약 없이 대량으로 생산하는 것이다. 비판하지 말고, 오타도 고치지 말고, 내키지 않으면 완전한 문장으로 쓰지 않아도 된다. 이 단계의 목표는 그냥 텍스트를 쌓아서 손볼 수 있는 0번째 초고에 이르는 것이다."
이 규칙의 가장 좋은 변론자는 데미르바스도 말하듯 존 맥피(John McPhee)입니다. 『뉴요커』에서 50년 넘게 논픽션을 써 온 맥피는 2013년 에세이 「초고 4번(Draft No. 4)」에서, 자신이 고쳐 쓰기를 해야 한다는 사실 때문에 무능하다고 느끼던 고등학생 딸 제니에게 보낸 편지를 공개합니다.
존 맥피가 딸 제니에게 보낸 편지 (「초고 4번」, 2013)
제니에게. 글은 서너 번에 걸쳐 쓰는 것이지, 결코 한 번에 쓰는 것이 아니란다. 나에게 가장 어려운 부분은 맨 처음, 무언가를, 뭐든지를 내 앞에 꺼내 놓는 일이야. (…) 그것이 존재하기 전까지 글쓰기는 정말로 시작된 게 아니란다.
맥피는 같은 글에서 이렇게도 씁니다. "첫 초고로 무엇이든, 뭐든지 내뱉고, 토해 내고, 지껄여라." 그리고 그 이유를 이렇게 설명합니다. 실제로 쓰는 시간은 하루 두세 시간이라도 머리는 하루 24시간, 잠자는 동안에도 그 글을 붙들고 일한다. 단, 어떤 형태로든 초고가 이미 존재할 때만. 2부의 언어로 하면, 종이 위에 무언가 있어야 머리가 그것을 입력으로 삼아 지식 변형의 왕복을 시작할 수 있습니다. 빈 화면은 반응할 거리를 주지 않습니다. 맥피에게 캘리포니아 지질학에 관한 글의 첫 초고는 "우울한 2년"이 걸렸고, 2·3·4번째 초고는 다 합쳐 6개월이 걸렸습니다. 첫 초고가 전체의 80%입니다.
같은 생각을 다른 사람들도 저마다의 말로 했습니다.
피터 엘보의 프리라이팅(1973). "10분 동안 쓰라(나중에는 15분, 20분). 무엇 때문에도 멈추지 마라. 서두르지 말되 빠르게. 절대 돌아보지 마라. 유일한 규칙은 절대 멈추지 않는 것이다." 일주일에 적어도 세 번.
앤 라모트의 「엉터리 초고」(1994). "좋은 글은 거의 모두 끔찍한 첫 시도에서 시작한다." 첫 초고는 아이의 초고이고, 그냥 다 쏟아 내는 것이다.
마크 레비의 『우연한 천재』(2000). 데미르바스가 서평을 쓴 책입니다. "느긋한 90%가 핏대 선 100%보다 효율적이다." "당신의 최고의 생각은 최악의 생각 덩어리들 속에 박혀서 온다."
유시민의 '초초고'. 2018년 국립국어원 인터뷰에서 그는 이렇게 말했습니다. "제 초고는 아주 형편없어요. 저는 그것을 '초초고'라고 불러요. 그것을 한참 손봐야 초고가 돼요." 데미르바스의 '0번째 초고'와 똑같은 말입니다.
데미르바스는 연구 논문도 이렇게 쓴다고 합니다. notes.org나 notes.txt 파일 하나를 열어 실험 노트처럼 씁니다. 일을 하면서 쓰고, 모든 곁가지를 탐색하고, 보여 줄 만해야 한다는 압박 없이 생산합니다. 그리고 2014년 글에서 이 단계를 터키 민담 「쾨르오글루」의 한 장면에 빗댔습니다.
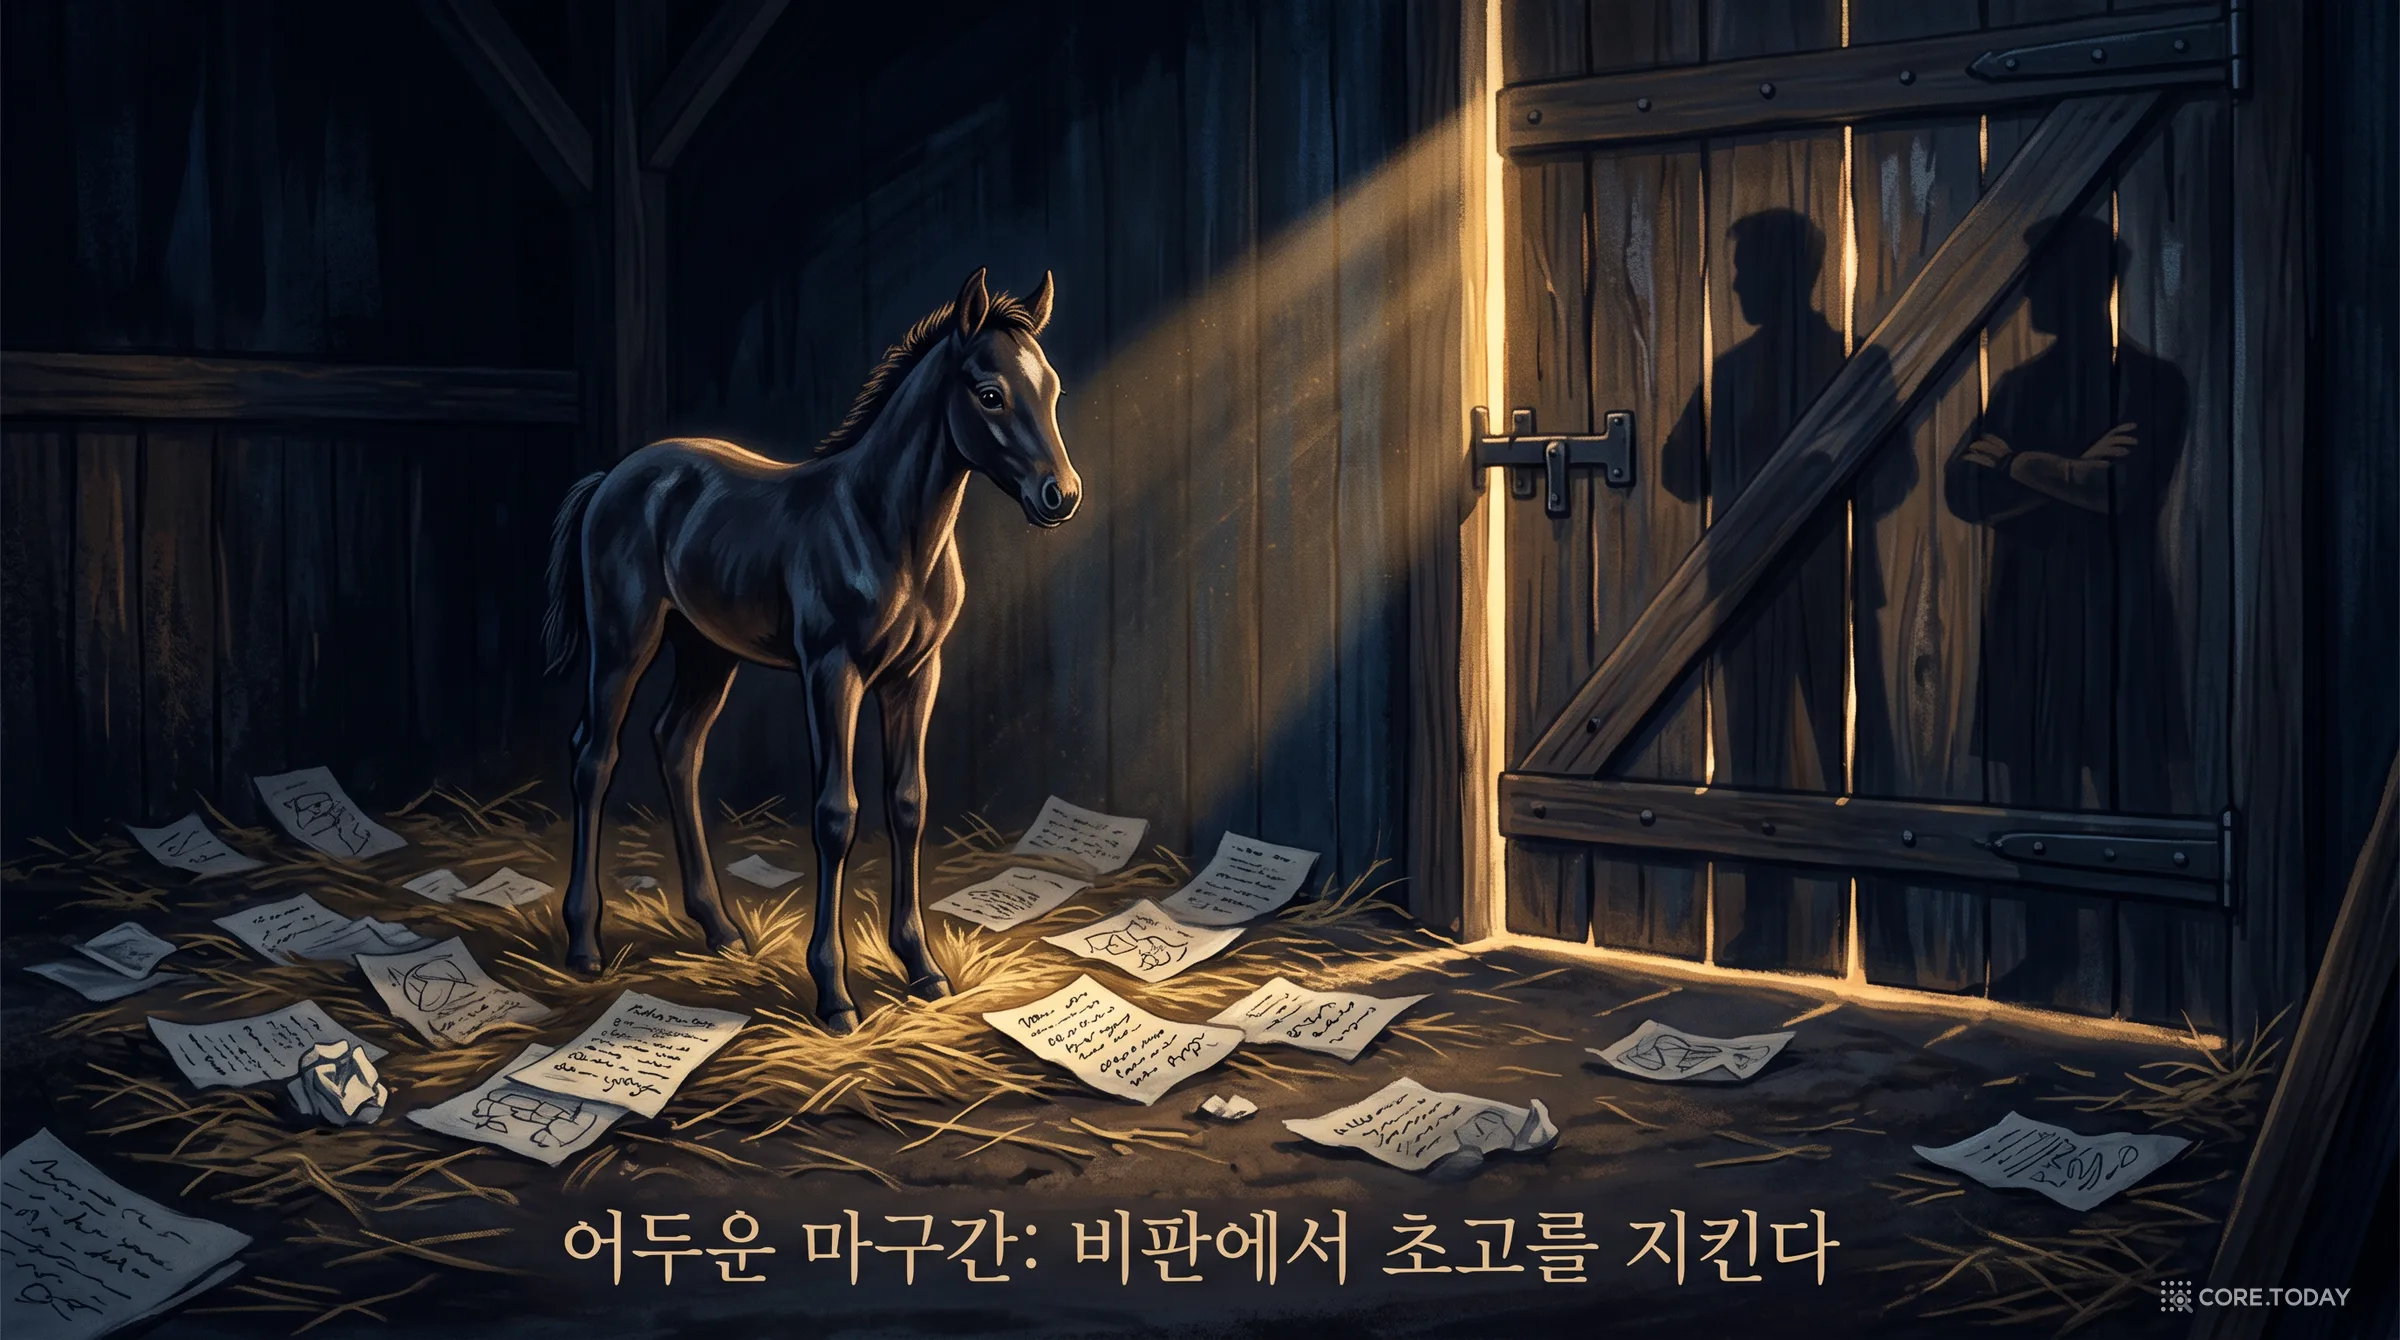
전설의 영웅 쾨르오글루는 망아지를 칠흑 같은 마구간에 넣고 몇 달 동안 아무 훈련 없이 살만 찌웁니다. 그런 다음 혹독하게 훈련시키자 "살이 금세 근육으로 바뀌었다". 데미르바스가 강조하는 것은 마구간입니다. "이 단계에서는 비판자들로부터 아이디어를 지켜야 한다. 특히 그리고 무엇보다 당신 자신으로부터. 아이디어는 연약하게 시작해서 쉽게 짓밟힌다." 그가 인용한 조니 아이브의 말처럼, 아이디어는 "연약하고 거의 형체도 없는 생각"으로 시작합니다. 그는 20쪽짜리 엉망진창이 금세 10쪽짜리 그럴듯한 초고로 다듬어지는 것을 여러 번 봤다고 합니다.
바로 써먹는 요령
타이머를 켜고 지우기를 끈다. 10~20분 동안 백스페이스를 쓰지 않습니다. 고치고 싶으면 줄을 바꿔 새로 씁니다.
모르는 것은 'TK'로 남긴다. 언론계에서 '나중에 채울 것(to come)'을 뜻하는 표시입니다. 숫자·이름·인용을 찾으러 검색창으로 가는 순간 흐름이 끊깁니다.
완전한 문장이 아니어도 된다. 화살표, 질문, "여기 뭔가 이상함"도 초고입니다.
AI 없이 쓴다. 이 단계가 5부에서 본 '생각이 일어나는 자리'입니다. 반쯤 된 직관은 모델에게 말하는 순간 표준 틀로 덮입니다.
막히면 막힌 이유를 쓴다. 맥피가 한 제자에게 보낸 편지에는 이런 처방이 있습니다. "어머니께"로 시작해 무엇이 안 풀리는지 하소연하는 편지를 쓰고, 나중에 "어머니께"만 지우면 된다는 것입니다.
아래 편집기로 직접 해 보세요. 1단계에서는 지우기가 막혀 있습니다.
20. 규칙 2. 정리하라
"이제 비평가, 편집자가 되어야 한다. 이걸 내가 썼다는 사실을 잊어라. 다른 사람이 썼다고 상상하고 가혹하게 심사하라. 무자비하게 잘라라. 코드를 지울 때처럼 글을 지우는 데서 기쁨을 찾아라."
데미르바스의 요령 중 가장 사랑스러운 것은 정크 버퍼입니다. "좋은 문장을 차마 지우지 못하겠으면 파일 맨 아래의 정크 버퍼로 옮겨라. 나중에 다시 가져올 수도 있다고 스스로에게 말할 수 있게. 스포일러: 안 가져온다."
200년 전 다산 정약용도 비슷한 요령을 아들에게 일렀습니다. 유배지에서 둘째 아들 학유에게 보낸 편지에서 그는 초서(鈔書), 곧 책에서 필요한 대목을 뽑아 적는 법을 설명합니다. 먼저 자기 뜻을 정해 만들 책의 규모와 차례를 세운 뒤에 뽑아야 일관된 묘미가 있다. 그런데 세워 둔 틀 밖에서도 꼭 뽑아 두고 싶은 것이 나오면, "모름지기 책 하나를 따로 갖추어 놓고 얻는 대로 기록하라. 물고기를 잡으려고 그물을 쳐 놓았는데 기러기가 걸렸다고 해서 어찌 버리겠느냐." 본문에서는 과감히 빼되 따로 모아 두는 것, 정크 버퍼의 조선판입니다.
데미르바스는 첫 초고가 형편없어도 낙담하지 말라고 합니다. 맥피의 '서너 번'은 오히려 좋은 소식입니다. "여러 초고에 걸쳐 생각하면 압박이 사라진다. 첫 번째에 즉흥적일 필요도, 탁월할 필요도, 오늘 끝낼 필요도 없다." 그리고 이렇게 덧붙입니다. "편집은 처음부터 정리된 생각을 하고 있었던 척하는 마술이다. 그것은 제품의 포장이다."
바로 써먹는 요령
하룻밤 묵힌다. 베이조스가 말한 좋은 메모의 조건, "며칠 묵혔다가 맑은 정신으로 다시 고친다"와 같습니다. 남의 글처럼 읽으려면 시간이 필요합니다.
소리 내어 읽는다. 숨이 차는 문장은 깁니다. 걸리는 곳은 독자도 걸립니다.
문단 첫 문장만 이어 읽는다. 그것만으로 글의 논지가 통하지 않으면 구조가 틀린 것입니다.
잘라 낸 분량을 잰다. 데미르바스는 20쪽의 엉망이 10쪽의 초고가 되는 것을 봤다고 했습니다. 절반을 자르는 것이 이상한 일이 아닙니다.
맥피의 '초고 4번'처럼 마지막에는 단어를 사냥한다. 맥피는 마지막 회차에서 마음에 안 드는 단어에 연필로 네모를 치고 더 나은 단어를 찾습니다. 그는 사전에서 처음 보는 단어보다 이미 아는 단어를 찾아보는 일이 "적어도 99대 1"로 많다고 했습니다.
AI를 쓴다면 여기서, 비평가로. "이 글에서 가장 약한 논증 세 개는?", "독자가 막힐 곳은?"처럼 묻고, 고치는 손은 내 것으로 둡니다.
파스칼은 1656년 『시골 친구에게 보내는 편지』 16번째 편지 끝에 이렇게 썼습니다. "이번 편지를 길게 쓴 것은 그것을 짧게 만들 여유가 없었기 때문입니다." 정리에는 시간이 듭니다. 그리고 그 시간이 생각하는 시간입니다.
21. 규칙 3. 단순하고 평이하고 간결하게
"나는 『문체의 요소』파다. 스트렁크와 화이트가 옳았다." 데미르바스는 커트 보니것도 사랑한다며, 그의 글이 "끝내주게 단순하면서도 완벽하게 유려하다"고 씁니다. 그리고 이 규칙의 핵심 문장이 나옵니다. "문장의 복잡함은 대개 엉성한 생각이 숨는 곳이거나, 입장을 정하지 않고 빠져나가는 방법이다. 평이하게 말할 수 없다면 아마 아직 끝까지 생각하지 않은 것이다. 그리고 끝까지 생각하는 방법은 쓰고 고치는 것이다."
4부의 실측이 보여 준 것도 같은 이야기입니다. 9B 모델에게 길고 빽빽하게 풀이를 쓰게 하자 5자리 곱셈에서 12문제 중 1문제만 맞혔지만, 한 줄에 한 가지 작은 일만 담는 짧은 형식을 주자 7자리에서도 8문제 중 7문제를 맞혔습니다. 기계에게도 사람에게도, 평이한 문장을 차례로 쌓는 쪽이 복잡한 문장보다 생각을 더 멀리 데려갑니다.
코넬 대학의 영문학 교수 윌리엄 스트렁크 주니어가 1918년 학생들을 위해 자비로 찍은 『문체의 요소』의 13번 규칙(화이트의 개정판에서는 17번)은 이렇습니다.
스트렁크, 『문체의 요소』 규칙 13 "불필요한 단어를 빼라"
힘 있는 글은 간결하다. 그림에 불필요한 선이 없어야 하고 기계에 불필요한 부품이 없어야 하는 것과 같은 이유로, 문장에는 불필요한 단어가, 문단에는 불필요한 문장이 없어야 한다. 이것은 모든 문장을 짧게 쓰거나 세부를 다 빼라는 뜻이 아니라, 모든 단어가 제 몫을 하게 하라는 뜻이다.
제자였던 E. B. 화이트는 1959년 이 책을 개정해 내놓으며, 스트렁크가 강의 시간에 "규칙 17번. 불필요한 단어를 빼라! 불필요한 단어를 빼라! 불필요한 단어를 빼라!"라고 세 번씩 외쳤다고 회고했습니다.
보니것이 1980년 한 제지 회사 광고로 쓴 「스타일 있게 쓰는 법」의 요약은 일곱 줄입니다. ① 관심 있는 주제를 찾아라 ② 그래도 횡설수설하지 마라 ③ 단순하게 써라 ④ 자를 배짱을 가져라 ⑤ 당신답게 써라 ⑥ 하고 싶은 말을 하라 ⑦ 독자를 가엾게 여겨라. 네 번째 규칙의 설명이 데미르바스의 규칙 2와 그대로 이어집니다. "아무리 훌륭한 문장이라도 주제를 새롭고 유용하게 비추지 못한다면 지워 버려라." 단순함의 예로 그는 『햄릿』을 듭니다. "사느냐 죽느냐(To be or not to be)? 가장 긴 단어가 세 글자다."
조지 오웰의 1946년 에세이 「정치와 영어」의 여섯 규칙도 같은 방향입니다. 짧은 단어로 될 때 긴 단어를 쓰지 마라. 단어를 뺄 수 있으면 빼라. 능동태로 쓸 수 있으면 수동태를 쓰지 마라. 그리고 오웰은 이 규칙이 문체의 문제가 아니라 생각의 문제라고 봤습니다. "생각이 언어를 타락시킨다면, 언어도 생각을 타락시킬 수 있다."
한국어 글쓰기에도 같은 전통이 있습니다. 이오덕은 『우리글 바로쓰기』(1989)에서 "말하듯이 쓰는 글이 가장 좋은 글"이라 했고, 일본식 '-의'와 '-적'의 남용을 경계했습니다. 유시민은 자기 글쓰기의 가장 큰 스승으로 이오덕을 꼽았습니다. 김대중·노무현 두 대통령의 연설문을 쓴 강원국도 "좋은 글쓰기는 철저하게 말하듯이 쓰는 것"이라고 했습니다.
공정하게 말하면 반론도 있습니다. 언어학자 제프리 풀럼은 2009년 『문체의 요소』 50주년에 「50년 동안의 멍청한 문법 조언」이라는 칼럼을 썼습니다. "불필요한 단어를 빼라" 같은 규칙은 쓸모가 없다는 것입니다. 어떤 단어가 불필요한지 아는 학생에게는 그 규칙이 필요 없기 때문입니다. 그는 책이 수동태의 예로 든 네 개 중 세 개가 실제로는 수동태가 아니라는 점도 지적했습니다. 이 비판은 데미르바스의 규칙 3을 뒤집는다기보다 보완합니다. 간결함은 규칙을 외워서가 아니라, 무엇을 말하려는지 알게 될 때까지 생각한 결과로 옵니다. 그래서 데미르바스도 규칙 3의 끝을 "끝까지 생각하는 방법은 쓰고 고치는 것"으로 맺습니다.
바로 써먹는 요령 (한국어 판)
'~에 대한', '~에 있어서', '~적인'을 찾아 다시 쓴다. "글쓰기에 대한 생각" → "글쓰기를 두고 한 생각" 또는 그냥 "글쓰기 생각".
'~것 같다', '~할 수 있다', '~라고 할 수 있을 것이다'로 끝나는 문장을 의심한다. 데미르바스 말대로 입장을 정하지 않고 빠져나가는 표현일 때가 많습니다. 확신이 없다면 "확실하지 않다, 왜냐하면…"이라고 쓰는 편이 정직합니다.
이중 피동(~되어지다)과 번역투(~를 통해, ~에 의해)를 줄인다.
한 문장에 한 생각. 80자가 넘는 문장은 둘로 나눌 수 있는지 봅니다.
오웰의 질문을 붙여 둔다. 나는 무엇을 말하려 하는가? 어떤 말이 그것을 표현하는가? 더 짧게 말할 수 있는가?
22. 규칙 4. 기대 없이 써라
"나 자신을 위해 써라. 내가 염두에 둔 독자는 나다. 다른 사람이 읽으면 덤이다. 동기는 내면에서 와야 한다. 바깥의 보상은 너무 늦게, 너무 무작위로 와서 그것으로 방향을 잡을 수 없다." 아무도 보지 않는 것처럼 쓰면 자유로워지고, 얼마나 공유할지는 나중에 정하면 됩니다. "도파민은 쓰는 일 자체에서 얻어라. 사람들이 읽거나 공유하는 데서 얻지 말고."
데미르바스는 2011년부터 블로그를 썼고, 2016년 무렵부터 학회에서 그의 블로그를 읽는다는 사람들을 만나기 시작했습니다. 처음에는 우연이라고 생각했지만 계속 그랬습니다. 2024년 글 「나는 왜 블로그를 하는가」에 따르면 14년 동안 650편 넘는 글을 썼고, 누적 조회수는 400만 회입니다. 그는 역설을 이렇게 요약합니다. "청중을 위해 하지 않았을 때에만 청중이 생기는 것 같다."
2부의 이론으로 보면 이 규칙에는 실용적인 이유도 있습니다. 독자를 의식하는 순간 플라워와 헤이스의 '검토하기'가 너무 일찍 켜집니다. 남이 어떻게 볼지 걱정하는 마음이 작업기억을 차지하면, 계획하고 옮기는 데 쓸 자리가 줄어듭니다. 독자는 규칙 2에서 불러오면 됩니다. 또 같은 글에서 데미르바스는 꾸준히 쓰는 습관이 "글쓰기 기준을 낮추는 데 도움이 되고, 역설적으로 그것이 기준을 유지하고 높인다"고 했습니다.
바로 써먹는 요령
비공개 저장소부터. 노트 앱, 개인 위키, 비공개 블로그. 공개는 다 쓴 뒤에 결정합니다.
조회수 알림을 끈다. 바깥의 보상은 늦고 무작위입니다.
'나에게 보내는 설명'으로 쓴다. 1년 뒤의 내가 다시 읽고 바로 이해할 수 있게. 데미르바스의 블로그가 그의 외부 메모리가 된 방식입니다.
23. 규칙 5. 일정에 넣어라
"영감을 얻어 쓰려는 시도를 멈추고 일정을 잡아라. 영감을 기다리는 것은 효과가 없다. 대신 엉덩이를 의자에 붙이고 쓰는 것이 쓸거리를 낳는다."
데미르바스는 매주 글을 올리는 일정이 자신을 "글쓰기 상태"에 머물게 한다고 말합니다. 그리고 그것은 사실 "알아차리기 상태"라고 합니다. 이번 주 주제는 재미없다고 생각하면서도 일단 쓰기 시작하면, 놀랍게도 흥미로운 것들이 샘솟듯 떠오른다는 것입니다. 일주일 동안 글을 올리지 못하면 "막힌 기분"이 들고, 쓰고 나면 생각이 몸 밖으로 나가 홀가분해져 새로운 생각을 할 자리가 생긴다고도 했습니다.
이 규칙에는 실험이 있습니다. 1983년 심리학자 로버트 보이스는 글이 막힌 대학 교수들을 조건별로 나눠 지켜봤습니다. 정해진 시간에 쓴 사람은 내킬 때만 쓴 사람보다 훨씬 많이 썼고, 새로운 아이디어도 더 자주 떠올렸습니다. 영감이 쓰기를 낳는 것이 아니라, 쓰기가 영감을 낳았습니다. 폴 실비아는 이 연구를 바탕으로 『많이 쓰는 법』(2007)에서 이렇게 썼습니다. "쓸 시간을 찾지 말고, 쓸 시간을 배정하라." "자제력의 가장 좋은 형태는 자제력이 필요한 상황을 피하는 것이다."
19세기 소설가 앤서니 트롤럽은 우체국 공무원으로 일하면서 47편의 장편을 썼습니다. 그의 『자서전』에 따르면 그는 매일 새벽 5시 30분에 책상에 앉았고(깨워 주는 마부에게 1년에 5파운드를 더 줬습니다), 시계를 앞에 두고 15분마다 250단어를 쓰도록 자신을 다그쳤습니다. 그는 "영감보다 구두장이의 밀랍을 훨씬 더 믿는다"고 했습니다. 강원국은 같은 말을 한국어로 했습니다. "대통령 연설문은 머리로 쓰는 게 아니라 엉덩이로 쓴다."
바로 써먹는 요령
시간을 고정한다. 같은 시간, 같은 자리. 결정을 매일 다시 하지 않게.
분량보다 시간을 목표로. 보이스의 벌칙 집단은 분량은 가장 많았지만 쪽당 아이디어는 가장 적었습니다.
쓰기 전 5분, 어제 쓴 것을 다시 읽는다. 외부 메모리를 불러오는 시간입니다. 헤밍웨이가 다음에 무슨 일이 일어날지 알 때 멈추라고 한 것도 다음 날 다시 시작하기 쉽게 하려는 요령입니다.
주제가 시시해 보여도 일단 쓴다. 데미르바스의 경험상 그런 날에 의외의 것이 나옵니다.
24. 2026년을 위한 실천 체크리스트
다섯 규칙과 앞의 이론을 합쳐, 2026년에 생각하는 도구로서 글쓰기를 지키는 방법을 정리합니다.
상황
이렇게
이것은 피하기
근거
논문·보고서를 읽었다
덮고 나서 5줄 요약과 '이해 안 된 곳'을 쓴다
AI 요약을 읽고 이해했다고 믿기
설명 깊이의 착각, 블럼 "읽으면서 써라"
새 아이디어가 있다
AI 없이 10분 프리라이팅
바로 채팅창 열기
데미르바스, 도시·하우저
기획서·6페이저
0번째 초고는 내 손으로, AI는 비평가로
AI 초안을 다듬어 제출
코스미나 등, 베이조스 기준의 붕괴
팀의 문서 문화
결정 기록·검토 회의에서 저자가 직접 설명
문서 분량을 생각의 증거로 보기
굿하트의 법칙, 후인
공부·학습
힌트만 주는 AI, 답은 내가
답을 바로 주는 AI로 연습
바스타니 등(PNAS 2025)
복잡한 문제
노트 파일에 실험 노트처럼 계속 쓴다
머릿속으로만 붙들기
블럼·튜링, 아웃오브코어
지난 생각을 다시 쓸 때
내가 쓴 글을 다시 읽는다
매번 처음부터 AI에게 묻기
생성 효과, 데미르바스 "블로그는 외부 메모리"
습관
주 3~5회, 같은 시간 20~30분
영감 올 때만
보이스, 트롤럽, 실비아
한 가지를 덧붙이면, AI는 이 체크리스트에서 금지 대상이 아닙니다. 4부에서 봤듯이 기계도 종이를 받아 똑똑해졌습니다. 문제는 우리가 우리의 종이를 기계에게 넘겨주는 것입니다. 기계에게는 기계의 연습장을, 나에게는 나의 연습장을.
에필로그: 테이프를 가진 유한 오토마톤
데미르바스의 글은 블럼의 일곱 줄로 시작했습니다. 이 글도 그 문장으로 돌아가겠습니다. 유한 오토마톤과 튜링 기계의 유일한 차이는 종이와 연필입니다. 그리고 이 글에서 따라온 이야기들은 모두 그 한 줄의 변주였습니다.
튜링은 산수 공책에 계산하는 사람을 보고 기계를 만들었고, 그 기계가 "더 복잡한 마음 상태는 테이프에 더 적는 것으로 피할 수 있다"고 적었습니다. 메소포타미아 사람들은 머리로 다 기억할 수 없는 거래를 점토에 꺼내 놓았고, 그것이 문자가 됐습니다. 플라워와 헤이스는 작가가 방금 쓴 문장을 다시 읽으며 목표를 새로 만든다는 것을 발견했고, 베라이터와 스카다말리아는 그 왕복 속에서 쓰기 전에는 없던 지식이 생긴다는 것을 보였습니다. 그리고 2024년, 언어로 훈련한 기계에게 종이를 주자 그 기계의 계산 능력이 정확히 블럼이 말한 만큼 올라간다는 것이 증명됐습니다.
2026년의 역설은 여기에 있습니다. 기계는 종이를 받아 튜링 기계가 되어 가는데, 사람은 그 종이를 기계에게 넘겨주며 유한 오토마톤으로 돌아갈 위험에 놓였습니다. 6쪽짜리 문서는 여전히 책상 위에 쌓이지만, 그 문서가 증명하던 생각은 점점 드물어집니다.
데미르바스의 처방은 거창하지 않습니다. 엉망으로 쓰고, 정리하고, 평이하게 쓰고, 기대 없이 쓰고, 일정에 넣으라. 그는 글의 마지막 줄에 이렇게 썼습니다. "쓰기를 달력에 넣어라. 그리고 더는 달력에 있을 필요가 없어질 때까지 거기 두어라."
코어닷투데이도 이 글을 쓰면서 같은 경험을 했습니다. 블럼의 일곱 줄을 처음 읽었을 때는 재치 있는 비유라고 생각했습니다. 그런데 튜링의 원문을 다시 읽고, 메릴과 사바르왈의 정리를 따라가고, 모델에게서 종이를 빼앗는 실험을 돌리고 나서야 그것이 비유가 아니라는 것을 알았습니다. 아마 60% 정도만 이해한 상태에서 시작했던 것 같습니다. 나머지 40%는 쓰면서 왔습니다.
Murat Demirbas, "How to write your research paper"(2014), "Anatomical similarities and differences between Paxos and blockchain consensus protocols"(2018), "Book review: Draft No. 4"(2019), "Why I blog"(2024), "The safest job from AI may be writing"(2026). 같은 블로그.
Leslie Lamport, "Thinking Above the Code," Microsoft Research Faculty Summit, 2014(슬라이드).
John McPhee, "Draft No. 4," The New Yorker, 2013-04-29.
Steve Huynh, "On the Death of Amazon's Writing Culture," 2026-10-14.
Jeff Bezos, S-팀 이메일(2004-06-09); 2017 Letter to Shareholders; Fortune 인터뷰(2012-11-16).
계산 이론과 LLM
A. M. Turing, "On Computable Numbers, with an Application to the Entscheidungsproblem," Proc. London Math. Soc. 42, 1936, §9.
S. C. Kleene, "Representation of Events in Nerve Nets and Finite Automata," 1956; M. O. Rabin & D. Scott, "Finite Automata and Their Decision Problems," IBM J. 1959.
A. Aggarwal & J. S. Vitter, "The Input/Output Complexity of Sorting and Related Problems," CACM 31(9), 1988.
M. Nye et al., "Show Your Work: Scratchpads for Intermediate Computation with Language Models," arXiv:2112.00114, 2021.
J. Wei et al., "Chain-of-Thought Prompting Elicits Reasoning in Large Language Models," NeurIPS 2022.
T. Kojima et al., "Large Language Models are Zero-Shot Reasoners," NeurIPS 2022.
W. Merrill & A. Sabharwal, "The Expressive Power of Transformers with Chain of Thought," ICLR 2024.
G. Feng et al., "Towards Revealing the Mystery behind Chain of Thought," NeurIPS 2023.
Z. Li, H. Liu, D. Zhou & T. Ma, "Chain of Thought Empowers Transformers to Solve Inherently Serial Problems," ICLR 2024.
D. Schuurmans, "Memory Augmented Large Language Models are Computationally Universal," arXiv:2301.04589, 2023.
C. Packer et al., "MemGPT: Towards LLMs as Operating Systems," arXiv:2310.08560, 2023.
N. Dziri et al., "Faith and Fate: Limits of Transformers on Compositionality," NeurIPS 2023.
OpenAI, "Learning to Reason with LLMs," 2024-09-12.
인지과학과 글쓰기 연구
G. A. Miller, "The Magical Number Seven, Plus or Minus Two," Psychological Review 63(2), 1956; N. Cowan, "The Magical Number 4 in Short-Term Memory," BBS 24(1), 2001.
W. G. Chase & H. A. Simon, "Perception in Chess," Cognitive Psychology 4(1), 1973.
N. J. Slamecka & P. Graf, "The Generation Effect," JEP: HLM 4(6), 1978; S. Bertsch et al., Memory & Cognition 35(2), 2007.
L. Flower & J. R. Hayes, "A Cognitive Process Theory of Writing," CCC 32(4), 1981; J. R. Hayes, "A New Framework for Understanding Cognition and Affect in Writing," 1996.
C. Bereiter & M. Scardamalia, The Psychology of Written Composition, 1987.
R. T. Kellogg, "A Model of Working Memory in Writing," 1996; "Training Writing Skills: A Cognitive Developmental Perspective," Journal of Writing Research 1(1), 2008.
L. Rozenblit & F. Keil, "The Misunderstood Limits of Folk Science: An Illusion of Explanatory Depth," Cognitive Science 26(5), 2002.
A. Clark & D. Chalmers, "The Extended Mind," Analysis 58(1), 1998; R. Menary, "Writing as Thinking," Language Sciences 29(5), 2007.
R. L. Bangert-Drowns et al., Review of Educational Research 74(1), 2004; S. Graham, S. Kiuhara & M. MacKay, RER 90(2), 2020; S. Graham & M. Hebert, Writing to Read, Carnegie, 2010.
P. A. Mueller & D. M. Oppenheimer, Psychological Science 25(6), 2014; K. Morehead et al., Educational Psychology Review 31(3), 2019; H. L. Urry et al., Psychological Science 32(3), 2021.
J. W. Pennebaker & S. K. Beall, Journal of Abnormal Psychology 95(3), 1986; J. Frattaroli, Psychological Bulletin 132(6), 2006.
P. Farrand, F. Hussain & E. Hennessy, Medical Education 36(5), 2002.
역사
Plato, Phaedrus 274c–275b.
W. J. Ong, Orality and Literacy, 1982; J. Goody, The Domestication of the Savage Mind, 1977.
D. Schmandt-Besserat, How Writing Came About, 1996; UT Austin 해설 페이지.
J. Gleick, Genius: The Life and Science of Richard Feynman, 1992.
N. Luhmann, "Kommunikation mit Zettelkästen," 1981; 빌레펠트 대학 루만 아카이브.
N. Kosmyna et al., "Your Brain on ChatGPT: Accumulation of Cognitive Debt when Using an AI Assistant for Essay Writing Task," arXiv:2506.08872, 2025(사전 공개).
H.-P. Lee et al., "The Impact of Generative AI on Critical Thinking," CHI 2025.
H. Bastani et al., "Generative AI without guardrails can harm learning," PNAS 122(26), 2025.
A. R. Doshi & O. P. Hauser, "Generative AI enhances individual creativity but reduces the collective diversity of novel content," Science Advances 10(28), 2024.
M. Gerlich, "AI Tools in Society," Societies 15(1), 2025.
W. Liang et al., "Monitoring AI-Modified Content at Scale," ICML 2024.
글쓰기 노하우
W. Strunk Jr., The Elements of Style, 1918/1920; Strunk & White, 1959; G. Pullum, "50 Years of Stupid Grammar Advice," 2009.
K. Vonnegut, "How to Write with Style," 1980; G. Orwell, "Politics and the English Language," 1946.
P. Elbow, Writing Without Teachers, 1973; A. Lamott, Bird by Bird, 1994; M. Levy, Accidental Genius, 2000.
R. Boice, Behaviour Research and Therapy 21(5), 1983; S. Krashen, Education 122(3), 2002; P. Silvia, How to Write a Lot, 2007.
A. Trollope, An Autobiography, 1883; B. Pascal, Les Provinciales, Lettre XVI, 1656.
P. Graham, "Putting Ideas into Words"(2022), "Writes and Write-Nots"(2024).