
#RL 환경
4개의 포스트
[특집] 에이전트가 CPU를 먹는다 — GPU 한 장에 CPU 몇 개? 코딩 에이전트로 재 본 대기 시간
2026년 프런티어 연구소들은 강화학습에 쓸 CPU가 바닥나 클라우드 회사와 범용 서버를 놓고 다투고 있고, Microsoft의 OpenAI용 Fairwater 데이터센터는 295MW GPU 클러스터 옆에 48MW CPU·스토리지 건물을 붙였습니다(전력 약 1:6). 코어닷투데이가 Claude Code 로그 26일치(모델 응답 6만 2,600번, 도구 호출 7만 7,197번)를 세어 보니 메인 세션 활성 시간의 42%가 도구를 기다리는 시간이었고, 10초 넘는 도구 호출 8.6%가 도구 시간의 83%를 만들었습니다. 맥 한 대에서 로컬 모델로 코딩 에이전트를 돌려 테스트 수를 50개에서 6,410개로 늘리자 모델 시간은 그대로인데 모델 1초당 CPU초가 0.09에서 8.37로 커졌고, 병렬 실행은 기다림을 줄였을 뿐 CPU초를 줄이지 못했습니다. 이 비율로 계산하면 GPU 한 장 옆에 필요한 CPU 코어는 일감에 따라 10개 안팎에서 수백 개까지 벌어지며, 그 식과 계산기, 2026년 CPU 열 종의 정리를 함께 실었습니다.
GLM-Legal 완전 해부 — 가벼운 모델이 법률 에이전트 시험에서 프런티어를 이긴 방법: 중간학습, 하네스 공진화, 그리고 19.2%의 의미
2026년 10월 12일, 중국 Z.ai가 법률 특화 모델 GLM-Legal을 공개했습니다. 활성 파라미터 18B짜리 가벼운 모델(GLM-5.3-Flash) 위에 법률 중간학습과 수만 개의 법률 과제 환경 강화학습을 얹었더니, 로펌 실무 과제를 끝까지 해내야 하는 Harvey LAB에서 전 항목 통과율 19.2%로 Claude Fable 5(11.3%)와 GPT-6 Astra(5.4%)를 앞섰습니다. 과제당 비용은 0.15달러로 Fable 5의 약 130분의 1입니다. 그런데 19.2%는 열 건 중 여덟 건을 '불합격'했다는 뜻이기도 합니다. 1970년대 규칙 기반 법률 AI부터 가짜 판례 사건, LegalBench에서 Harvey LAB으로 바뀐 시험지, 중간학습과 하네스 공진화라는 아키텍처, 시연 세 장면, 순위표에서 빠진 모델과 퇴보한 지표까지, 이 발표를 둘러싼 모든 것을 쉽게 풀어 씁니다. 인터랙티브 6개, 논문·벤치마크 그림 11장, 삽화 10장.
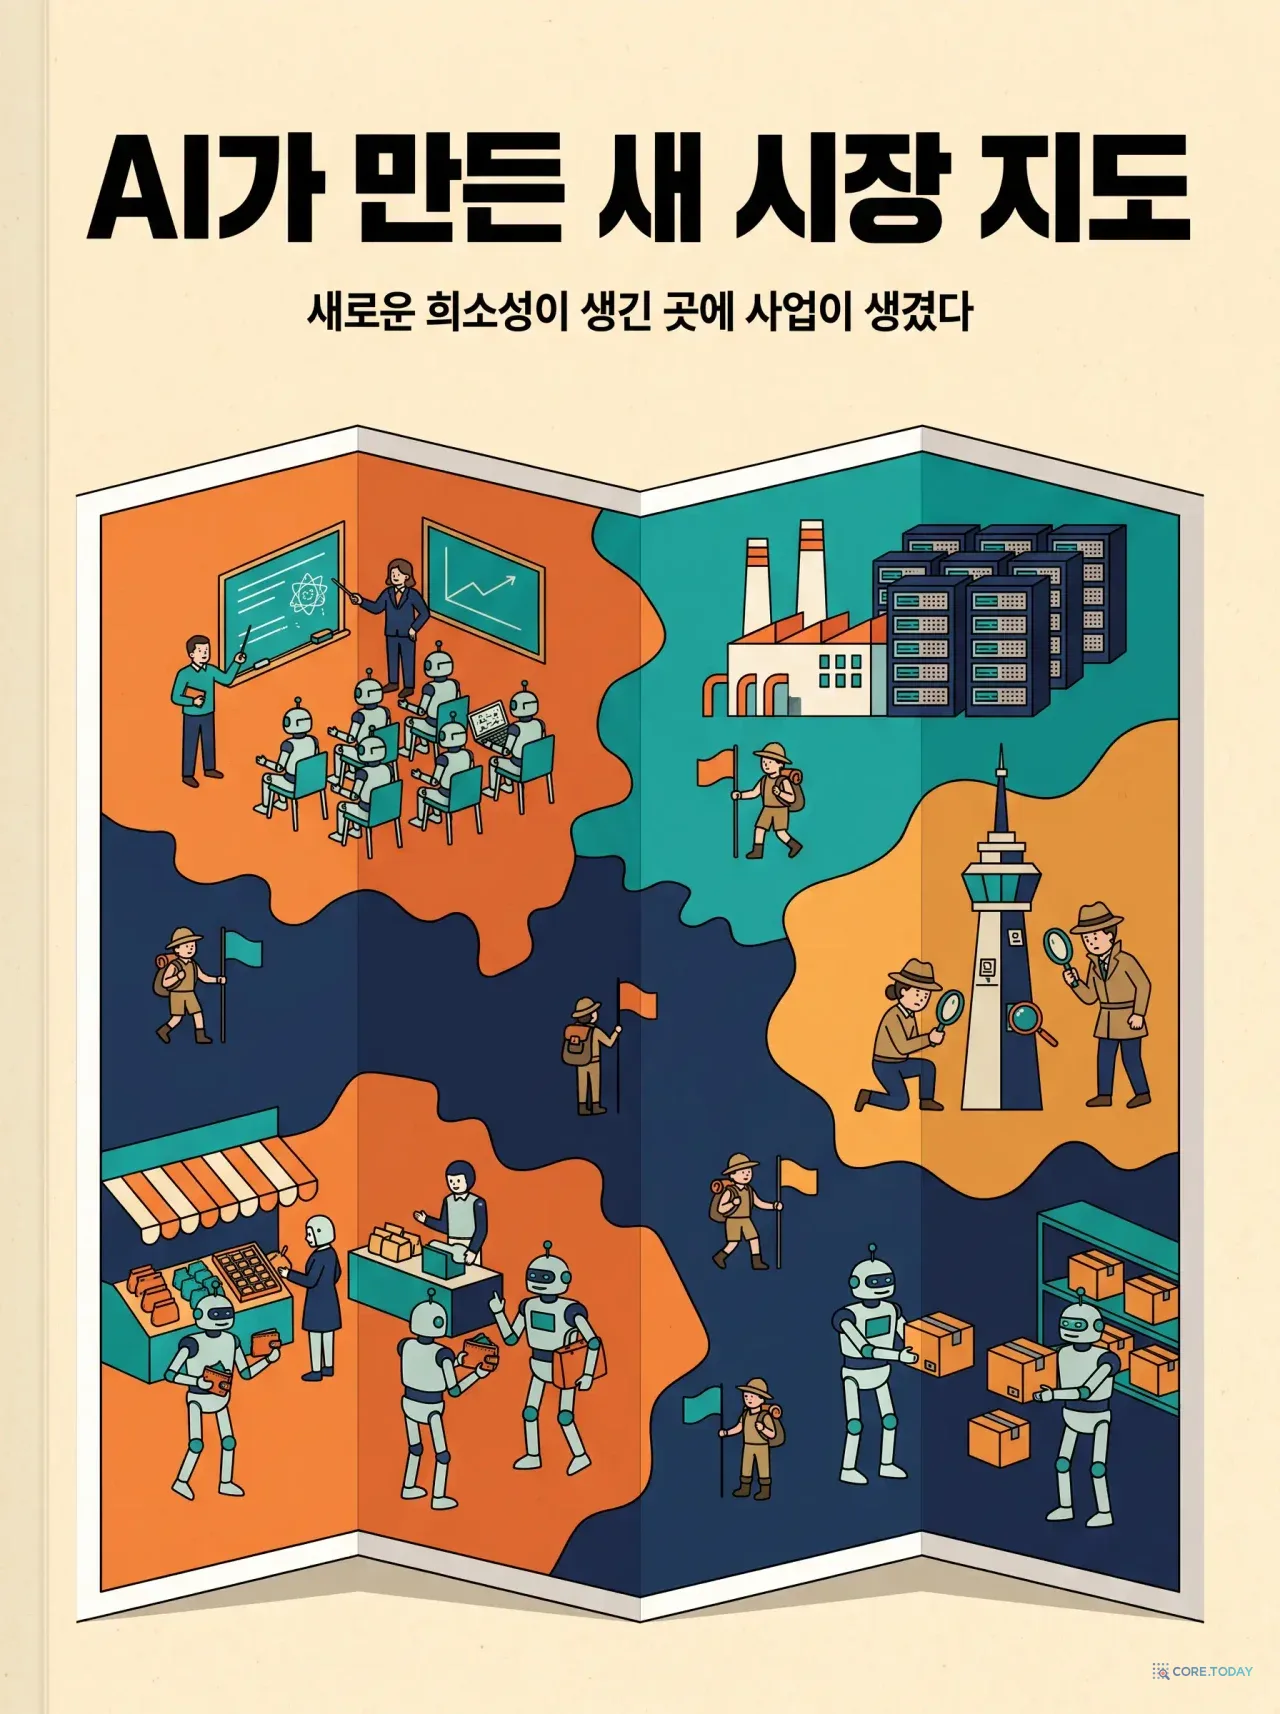
[특집] AI가 만든 새 시장 지도 2026 — 판단·연산·신뢰·새로운 고객·결과, 다섯 가지 희소성이 낳은 비즈니스
2022년에는 없던 회사들이 2026년에 수십억 달러 매출을 냅니다. 의사와 변호사를 시간제로 모아 AI를 가르치는 Mercor는 연환산 총매출 20억 달러를 넘겼고, 말로 앱을 만드는 Lovable은 출시 2년이 안 돼 연 6억 달러, AI가 문의를 끝까지 해결할 때만 돈을 받는 Sierra는 기업가치 158억 달러가 됐습니다. 이 글은 이런 새 시장 열 개를 조사해, 모두 AI가 만든 '새로운 희소성' 위에 서 있다는 공통점을 찾았습니다. 모델을 가르칠 사람의 판단, GPU와 전력, 믿고 쓸 근거, AI라는 새로운 손님, 그리고 '끝낸 일'이라는 새 과금 단위입니다. 그리고 가장 빨리 크는 시장이 가장 오래 가는 시장은 아니라는 것도요. 랩에 납품하는 시장은 고객이 몇 곳뿐이고 그 고객이 직접 만들 수 있습니다. 결과를 파는 시장은 느리지만 넓습니다. 숫자를 읽는 법(총매출과 순매출, 거래 건수와 실제 돈)과 한국에서의 기회까지, 인터랙티브 5개와 삽화 5장으로 정리했습니다.
가장 쓴 교훈 — 계산량보다 데이터, 데이터보다 '올바른 과제'
2026년 9월 10일, ChatGPT를 만든 사람 중 하나가 900단어짜리 글을 올렸다. 리치 서튼의 '쓴 교훈'(계산 > 알고리즘)은 빙산의 일각이며, 진짜 위계는 '올바른 과제 > 데이터 > 계산 > 알고리즘'이라는 주장이다. 그리고 그 증거로 자기가 만든 InstructGPT의 논문 그림 한 장을 내놓았다 — 100배 작은 모델이 100배 큰 모델 위에 통째로 올라앉은 그림. 이 글은 왜 이 개념이 나왔는지를 1997년 딥블루부터 2026년의 에이전트 시대까지 따라가며, 과제를 잘못 고른 여덟 건의 값비싼 실패와 잘 고른 다섯 건의 성공을 함께 본다. 인터랙티브 위젯 8종과 삽화 14장.