
#AI 에이전트
59개의 포스트
[특집] 기계가 해설자가 될 때 — Manim 해설 에이전트의 1년 반, 그리고 정리 10개를 직접 영상으로 만들어 보다
3Blue1Brown의 그랜트 샌더슨은 해설 영상을 만들려고 Manim을 직접 만들었다. 2025년 TheoremExplainAgent 이후 LLM이 Manim 코드를 써서 정리 해설 영상을 만드는 연구가 이어졌다. Manim의 구조와 역사, 애니메이션 학습 연구의 미지근한 숫자, TheoremExplainAgent와 Code2Video·OmniManim·ManimAgent까지 정리했다. 그리고 정리 10개를 Claude 세 모델과 로컬 Qwen에게 맡겨 영상 80편을 직접 만들고 렌더 성공률, 오류 원인, 배치와 수학 오류, 화면을 보고 고치기의 효과를 쟀다.
AI에게 '얼마나 확신해?'라고 묻지 마세요 — 0.85는 계기판이 아니라 문장이다
LLM에게 확신도를 물으면 언제나 그럴듯한 숫자가 나옵니다. 앰루트 조시의 짧은 글은 그 숫자가 측정이 아니라 '다음에 올 법한 글자'라고 지적해 해커뉴스 첫 화면에 올랐습니다. 1950년 브라이어의 일기예보 채점에서 2017년 '현대 신경망은 과신한다', GPT-4의 RLHF 보정 붕괴, 2025년 '왜 언어 모델은 환각하는가'까지 확신도 연구 75년을 따라가고, 코어닷투데이가 대화형 모델 5개와 판정 모델 4개에 한국어 객관식 598문항과 SimpleQA 200문항을 직접 물어 확신도의 정체를 쟀습니다. 작은 모델은 '정말?' 한마디에 답의 55%를 뒤집으면서 확신도를 91에서 95로 올렸고, 앞에 쓴 한 문장에 확신도가 53점 움직였습니다. 반면 GPT-6.1 Sol과 Claude Sonnet 5.5의 숫자에는 분명한 정보가 있었는데, 같은 '90'이 모델마다 다른 뜻이었습니다. 판정 모델과 기록 기반 규칙이 내놓는 확률까지 비교합니다. 인터랙티브 6개와 삽화 10장, 논문 그림 6장.
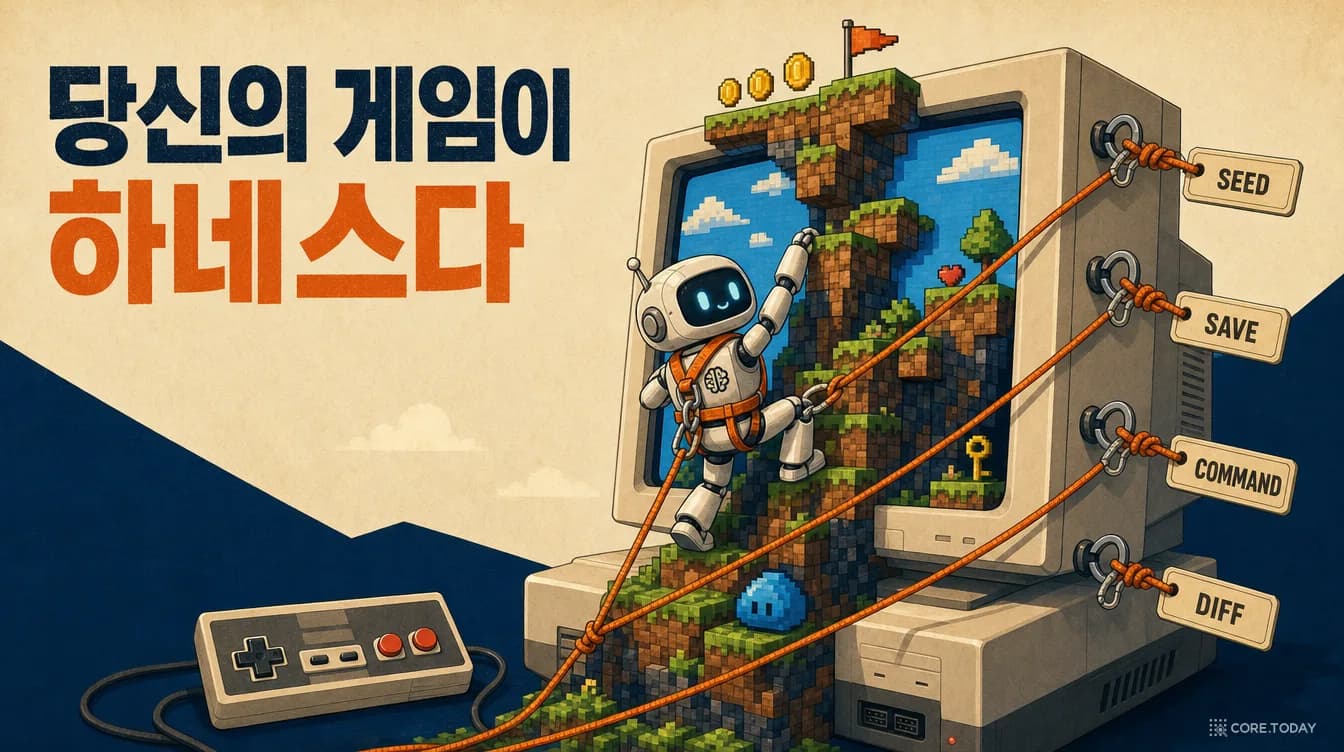
[특집] 당신의 게임이 하네스다 — 'LLM은 게임에 약하다'는 착각, 그리고 게임 자체를 AI 에이전트의 하네스로 만드는 일곱 가지 방법
2026년 9월 캐나다 캘거리의 인디 게임 행사에서 15년 차 게임 프로그래머 카일 쿠크슈텔이 45분 발표를 했다. 제목은 「당신의 게임이 하네스다」. 게임 업계에 퍼진 'LLM은 게임에 약하다'는 말을 그는 뒤집는다. 문제는 모델의 능력이 아니라 게임이 AI에게 읽히지 않는다는 것, 곧 맥락(context)의 문제라는 것이다. 처방은 AI가 아니라 게임 쪽에 있다 — 시드 하나, 한 모양의 오브젝트(나무도 개다), 텍스트로 재생되는 명령, 코드 밖의 데이터, 엔진과 분리된 시뮬레이션, 스크린샷 대신 픽셀 diff, 사람용 GUI 대신 텍스트 프로파일. 이 글은 그 처방을 하나씩 풀면서, 각각이 둠의 데모 파일(1993)과 에이지 오브 엠파이어의 '28.8 모뎀 위의 1,500명의 궁수', 스타크래프트 리플레이, 팩토리오의 디싱크 리포트에서 어떻게 이미 쓰였는지를 따라간다. 하네스라는 말이 테스트 하네스에서 2026년 '하네스 엔지니어링'까지 어떻게 왔는지, 같은 제미나이가 RAM을 텍스트로 받으면 포켓몬을 완주하고 픽셀만 받으면 0.48%에 머무는 이유, 게임 업계 52%가 AI를 해롭다고 보는 2026년의 반감과 한국 게임사 70%의 도입률까지 — 여섯 개의 인터랙티브 도구와 함께 정리했다.
기억은 미리 만들지 말고, 물어볼 때 지어라 — Just-In-Time 에이전트 메모리(JAM) 완전 해부
석 달 전 회의 요약에는 '가격 협의함'이라고만 적혀 있다. 그런데 오늘 필요한 건 '1,240만 원, VAT 별도'라는 한 줄이다. 대부분의 에이전트 메모리는 질문이 오기 전에 기록을 요약·추출해 두는 AOT(Ahead-of-Time) 방식이고, 그래서 '그때는 사소했던' 디테일을 먼저 버린다. BAAI·베이징대·홍콩이공대 연구진의 JAM은 발상을 뒤집는다. 원본은 폴더에 그대로 두고 README 색인만 미리 만든 뒤, 질문이 오면 작은 Researcher 에이전트가 open·search·browse로 찾아 들어가 그 질문만을 위한 맥락을 짓는다. 4B 모델로 14B 메모리 에이전트를 이기고, 4배 빨랐다. 토요타 공장과 JIT 컴파일러에서 시작해 Memory-Gym 데이터 합성, 힌트를 주는 강화학습, 결과표와 한계, 2026년의 다른 기억 설계와의 비교까지 인터랙티브 위젯 6종과 함께 해부한다.
에이전트 네이티브 메모리, 준비됐나? — 12개 AI 기억 시스템을 데이터베이스의 눈으로 해부한 2026년 보고서
ChatGPT도, Claude도, Copilot도 이제 '기억'을 판다. 그런데 어떤 기억이 좋은 기억인지 아무도 같은 자로 재 본 적이 없었다. 상하이교통대·칭화대·MemTensor 연구진이 12개 메모리 시스템을 11개 데이터셋에서 같은 조건으로 돌리고, 기억을 '표현·추출·검색·유지보수' 네 모듈로 뜯어 한 부품씩 바꿔 가며 측정했다. 결론은 불편하다. 만능 챔피언은 없고, 요약은 정보를 지우며, 정밀한 사실 추출은 추론을 무너뜨리고, 그래프는 정확하지만 100배 느리다. 역사·개념·실험·실무 가이드까지, 인터랙티브 위젯과 함께 완전 해부한다.
[특집] 읽는 순간 조종당한다 — 프롬프트 인젝션, 55년 된 버그는 왜 AI에서 되살아났나
2026년 2월, 누군가 깃허브 이슈의 제목 칸에 문장 하나를 적었습니다. 그 문장을 읽은 AI 봇이 배포 자격 증명을 노출했고, 변조된 패키지가 8시간 동안 약 4,000번 설치됐습니다. 해킹 도구도 악성코드도 없었습니다. 글을 읽게 했을 뿐입니다. 이것이 프롬프트 인젝션입니다. 이 글은 이 문제의 뿌리를 1971년 휘파람으로 전화 교환기를 조종하던 '블루박스'와 1998년의 SQL 인젝션에서 찾고, 2022년 9월 이름이 붙던 순간부터 2026년까지의 공격과 방어를 따라갑니다. 전화망과 데이터베이스는 '명령과 데이터의 통로를 나누는' 것으로 문제를 끝냈는데, 왜 언어 모델에서는 그 해법이 통하지 않는지. 세 연구소가 함께 쓴 논문이 최신 방어 12종을 어떻게 90% 이상 뚫었는지. 그리고 '고칠 수 없다면 속았을 때 할 수 있는 일을 줄인다'는 설계 원칙이 무엇인지 정리합니다.
[특집] 2026년 10월, 데이터베이스는 어디로 가는가 — 숫자로 읽는 여덟 가지 지각변동
새로 만들어지는 데이터베이스의 70~80%를 사람이 아니라 AI 에이전트가 만든다는 숫자가 나왔습니다. 포스트그레스는 개발자 둘 중 하나 이상이 쓰는 데이터베이스가 됐고, 데이터브릭스와 스노우플레이크는 앞다퉈 포스트그레스 회사를 샀습니다. S3는 카프카와 검색 엔진의 디스크가 됐고, 테이블 포맷 전쟁은 카탈로그 전쟁으로 옮겨 갔으며, 노트북 한 대의 DuckDB가 클러스터를 이기는 일이 흔해졌습니다. 그리고 한국에서는 국가정보자원관리원 화재로 백업 없는 858TB가 사라졌습니다. DB-엔진스 10월 순위, 스택 오버플로·젯브레인 설문, 회사 공시와 사고 보고서까지 — 2026년 10월 3일 기준으로 검증한 숫자로 데이터베이스 지형의 여덟 가지 변화를 읽고, 내 팀이 지금 던져야 할 세 가지 질문으로 정리합니다. 인터랙티브 5개와 삽화 10장.
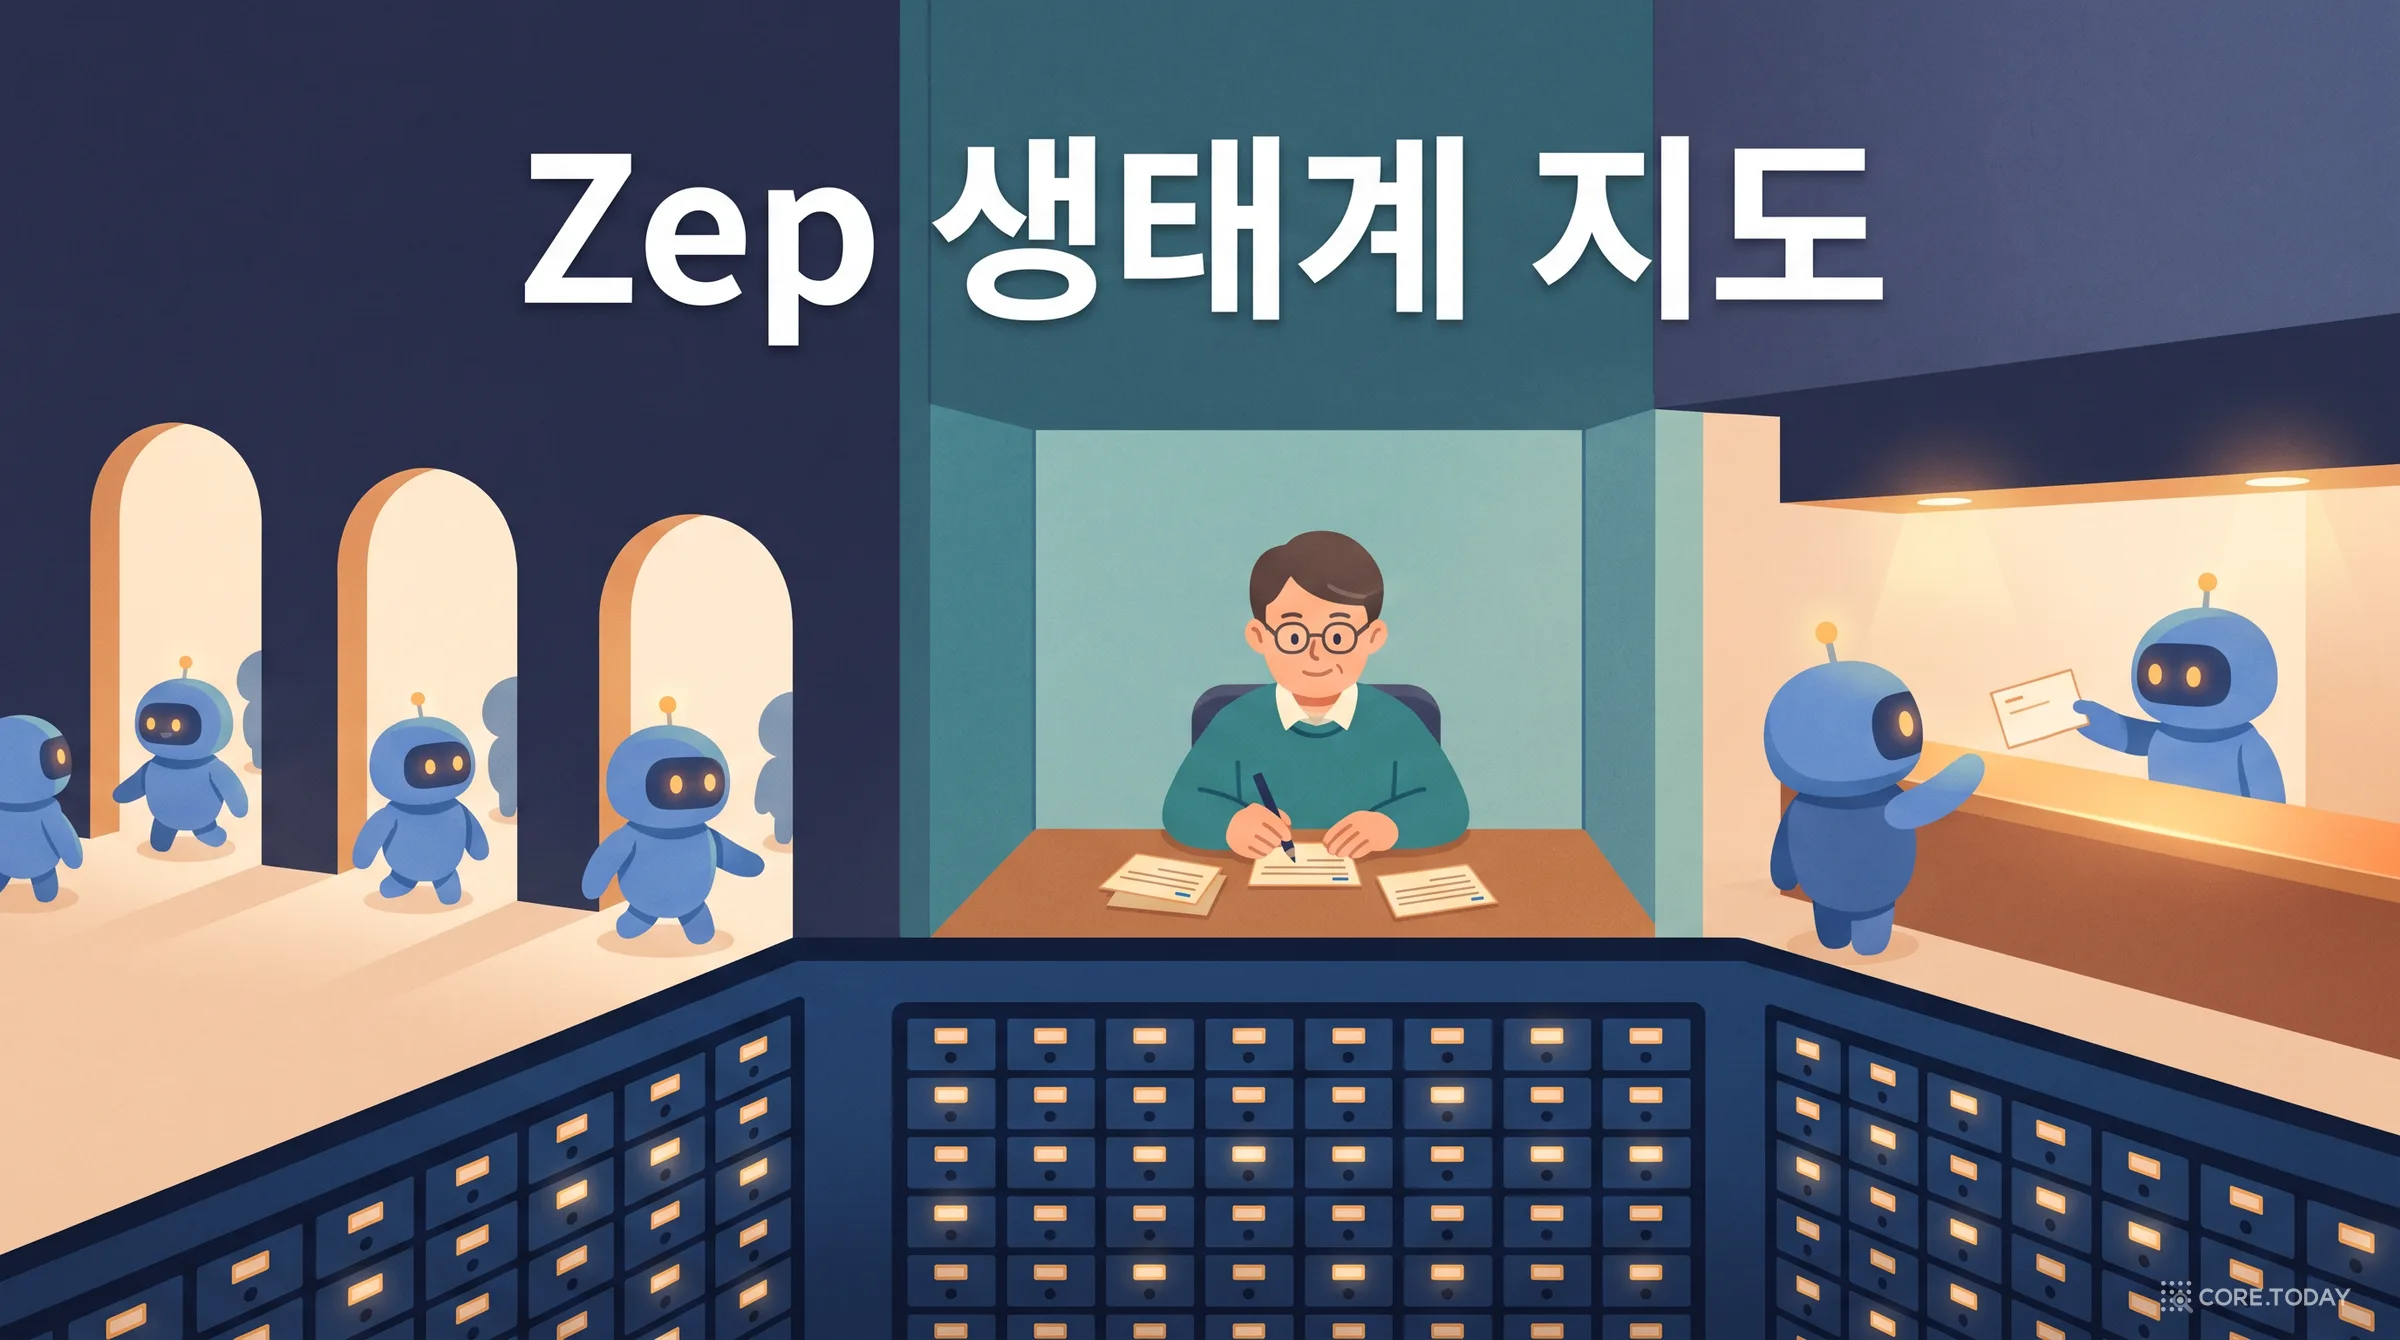
Zep 생태계 지도 — Graphiti, Konig, Context Lake는 각각 무슨 일을 하나
반년 전 Zep 논문을 해부할 때는 'Zep의 엔진은 Graphiti'라는 한 줄로 충분했습니다. 지금은 Konig, Context Lake, Memory MCP 서버, Graphiti MCP 서버처럼 이름이 늘어 누가 무슨 일을 하는지 헷갈립니다. 이 글은 도서관에 빗대어 문·접수대·사서·서고·대출 데스크·관리 규정 여섯 층으로 생태계를 정리하고, 문장 하나가 기억이 되기까지 어느 구성요소를 거치는지 위젯으로 따라갑니다. 열린 것과 닫힌 것, 요금과 크레딧 계산법, 직접 운영과 서비스 이용 중 무엇을 고를지도 함께 다룹니다.
[특집] '홈페이지 개선'은 왜 3주째 진행 중일까 — 이슈를 어떤 단위로, 어떻게 적을 것인가
업무 보드에 '홈페이지 개선'이라는 카드가 3주째 진행 중입니다. 담당자는 매일 일했는데 카드는 끝나지 않습니다. 끝난 모습이 적혀 있지 않기 때문입니다. 이 글은 일을 '얼마나 잘게 나눌까'보다 '무엇을 하나의 완료로 볼 것인가'를 먼저 묻습니다. 팀이 추적하는 결과, 내가 시작하는 첫 행동, 일하며 남기는 기록, 나중에 다시 쓰는 지식은 서로 다른 단위입니다. 빌 웨이크의 INVEST와 마이크 콘의 SPIDR, Shape Up의 '어피타이트', 사이먼 윌리슨이 이슈를 실험 노트처럼 쓰는 법, 코치 토니의 '첫 행동', 칼 뉴포트의 조사 업무 준비, 예정일과 마감일의 분리, 제텔카스텐의 원자성과 '수집가의 오류', 그리고 AI 에이전트에게 일을 맡기는 2026년의 이슈까지. 원문을 하나씩 확인한 출처 서른한 건과 인터랙티브 4개, 삽화 12장으로 정리했습니다.
Claude Opus 5.5 사용 설명서 — 생각은 끌 수 없고, 손잡이는 effort 하나다
2026년 9월 22일 공개된 Claude Opus 5.5는 Fable 5.1급 성능을 Opus 5보다 20% 싼 값에 내고, 출력은 30% 넘게 빠릅니다. 그런데 Opus 5에서 잘 돌던 코드가 그대로 400 에러를 내거나, 에러 없이 화면만 조용해질 수 있습니다. 생각은 끌 수 없고, 기본 effort는 high에서 medium으로 내려갔고, 도구 호출 사이의 진행 메모는 thinking 블록으로 옵니다. Anthropic이 공개한 Opus 5.5 프롬프팅 가이드와 마이그레이션·effort·비용 문서를 모두 읽고, 이전 모델과 무엇이 다른지, 예시 프롬프트 14개를 원문과 한국어로, 그리고 Haiku·Sonnet·Opus·Fable 중 언제 무엇을 어떤 effort로 쓸지 정리했습니다. SWE-bench Pro 부분집합에서 Opus 5.5 medium은 Fable 5.1 기본값과 같은 정답률을 약 1/5 비용에 냈습니다. 인터랙티브 5개와 삽화 8장.
에이전트 여럿, 저장소 하나 부록 — 도구 지도 2026: 언제 무엇을 쓰나
git worktree 위에는 CLI·에이전트 앱 내장 기능·관제 앱이 층층이 올라가 있고, 옆에는 GitButler·Jujutsu처럼 방식이 다른 도구와 Forgejo 같은 자체 호스팅이 있습니다. 2026년 9월 기준으로 공식 저장소와 문서에서 확인한 사실만으로 각 도구가 무엇이고 worktree와 어떤 관계인지, 언제 쓰고 언제 피할지를 정리하고, 결정 흐름도와 비교표로 '우리 팀은 무엇부터 깔까'에 답합니다.
에이전트 여럿, 저장소 하나 5편 — 두 에이전트에게 같은 일 시키고 좋은 것만 합치기
같은 기능을 Claude Code와 Codex에게 각자의 worktree·브랜치에서 동시에 맡기고, git log·diff A...B·range-diff·같은 테스트로 두 결과를 비교한 뒤 좋은 부분만 골라 합치는 법을 실제 출력으로 따라갑니다. 통째로 채택(squash), 커밋만 가져오기(cherry-pick -x), 파일 하나 가져오기(restore --source), 세 번째 에이전트에게 합치기를 맡기는 법과 뒷정리, 그리고 이 방법이 오히려 손해인 경우까지 다룹니다.