
#형태소 분석
3개의 포스트
판결문의 이름을 지우는 AI — Thunder-DeID로 읽는 비실명화의 역사, 729개의 꼬리표, 그리고 2026년
한국의 판결문은 공개가 원칙이지만, 공개 전에 사람 이름과 주소, 가게 이름까지 지워야 합니다. 이 일은 지금도 대부분 사람 손으로 이뤄지고, 법원의 자동 프로그램은 2019년 자료에서 정확도 15%, 2025년 자료에서 처리율 8%로 보고됐습니다. 서울대 연구진의 Thunder-DeID(EMNLP 2025 Findings)는 이 문제를 토큰 분류 모델로 풉니다. 원본 판결문을 구할 수 없다는 제약을 뒤집어, 이미 지워진 판결문 6,700건에 사람이 종류 꼬리표 48,306개를 붙이고 그 자리에 진짜 같은 이름을 채워 넣어 학습 데이터를 만들었습니다. 그 과정에서 나온 2단·16갈래·80가지·729개 라벨의 분류 체계, 조사를 떼어 내는 토크나이저, 에폭마다 이름을 갈아 끼우는 증강, 처음부터 사전학습한 DeBERTa 계열 모델(이진 F1 0.98, 종류 F1 0.91)을 그림과 표와 함께 하나씩 풉니다. 스위니의 87%에서 2026년 9월 법원 홈페이지 사고까지 재식별의 역사를 따라가고, 코어닷투데이가 로컬 모델로 직접 돌려 본 ‘다시 쓰게 하기’와 ‘가리킬 곳만 말하게 하기’의 차이, 논문이 말하지 않는 한계, 형사 판결문 공개 확대를 앞둔 2026년에 이 기술이 놓인 자리를 정리했습니다.
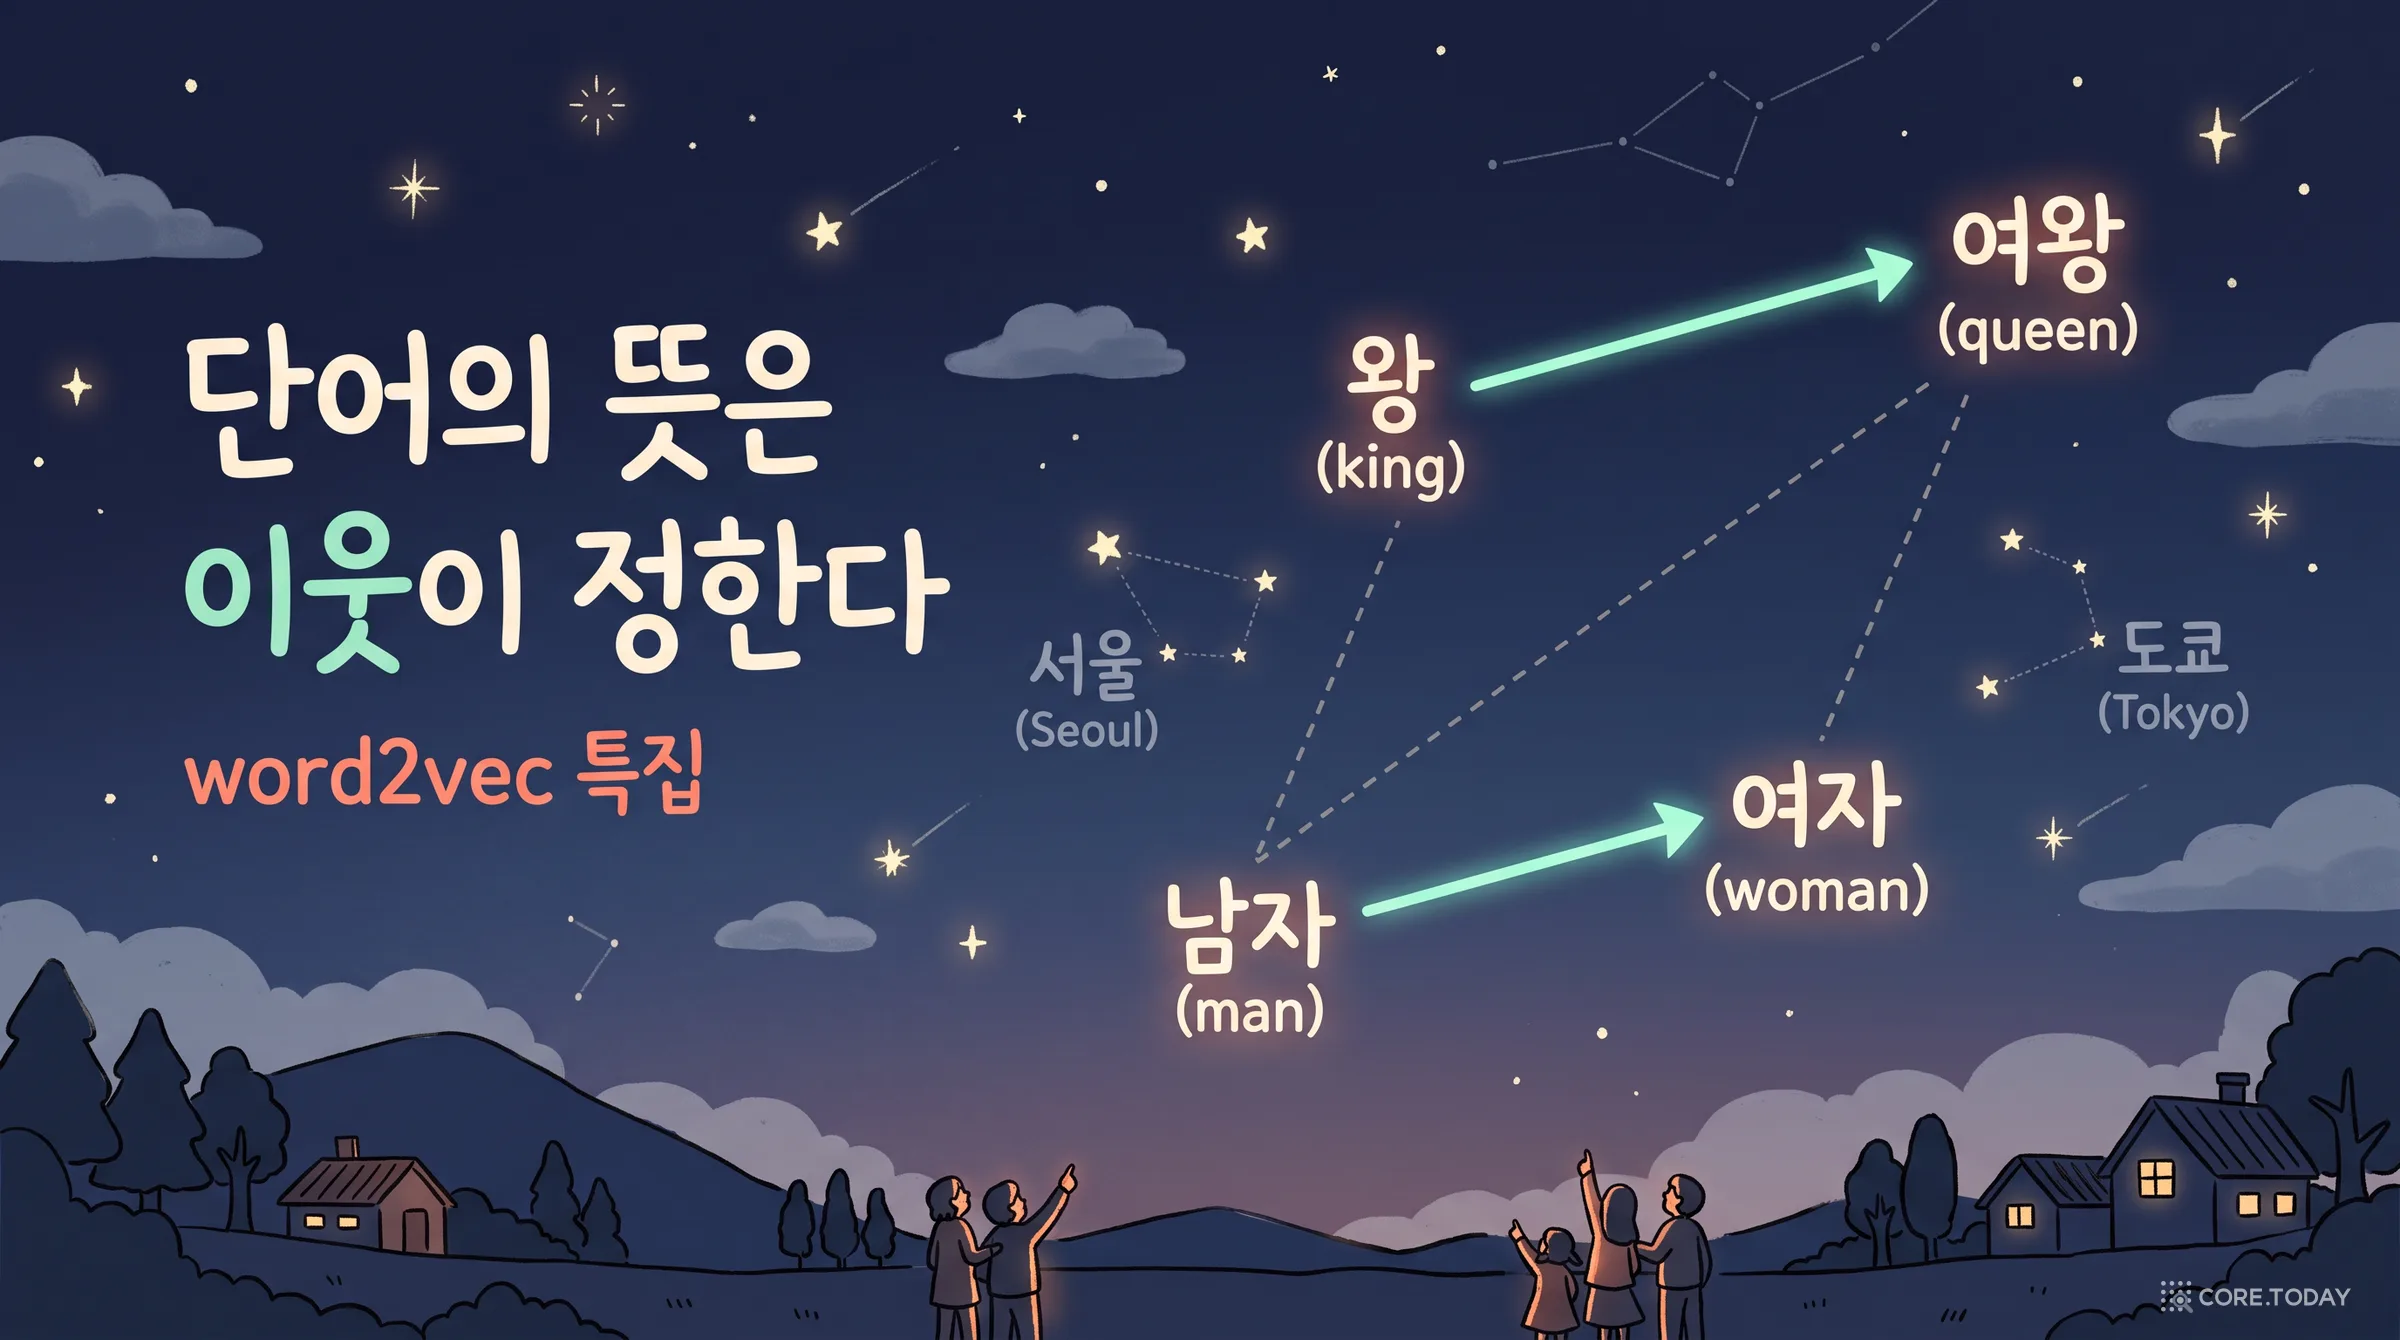
‘왕 − 남자 + 여자 = 여왕’은 정말일까? — word2vec과 분포 가설, 이웃이 단어의 뜻을 정하기까지 (특집)
1957년 영국의 언어학자 퍼스는 ‘단어는 함께 다니는 이웃을 보면 안다’고 썼다. 56년 뒤 구글의 word2vec은 이 문장을 계산으로 옮겼다. 16억 단어를 하루 만에 읽고 단어마다 수백 개의 숫자를 붙였더니 ‘왕 − 남자 + 여자’가 ‘여왕’ 근처에 떨어졌다. 이 글은 처음 보는 단어의 뜻을 문장만 보고 맞히는 놀이에서 시작해, 세는 방법(LSA)과 맞히는 방법(word2vec)이 사실은 같은 일을 하고 있었다는 발견, 유명한 벡터 산술에 숨은 규칙, 임베딩이 배운 고정관념, ‘배’처럼 뜻이 여럿인 단어의 한계까지 따라간다. 한국어 위키백과로 word2vec을 직접 학습한 실측, 최신 LLM의 입력 임베딩 표에서 여왕을 찾은 실측, 문장마다 달라지는 ‘배’ 벡터 실측을 담았다. 인터랙티브 위젯 6종, 코어닷투데이 실측, 삽화 12장.
BM25는 한국어를 어떻게 쪼개나 — 조사·복합명사·영한 혼용, 토크나이저가 검색을 결정한다 (한국어 검색 스택 5편)
2편에서 BM25는 '약한 고리'였습니다. 왜 약했을까요. 이 글은 그 질문을 파고듭니다. 같은 문서, 같은 질문, 같은 BM25 공식에 토크나이저만 여덟 가지로 바꿔 보니 nDCG@10이 0.42에서 0.62까지 벌어졌습니다. 띄어쓰기로 자르면 '청년취업을'과 '청년취업'이 다른 단어가 되고, 형태소 분석기로 조사를 떼면 같은 단어가 되며, 글자 2-gram을 겹쳐 색인하면 사전에 없는 말까지 받아 줍니다. 한국어에서 어휘 검색이 어려운 세 가지 이유(교착어의 조사와 어미, 복합명사, 영한 혼용)를 예시 문장의 실제 토큰으로 보여 주고, 엘라스틱서치 nori의 decompound 모드와 불용 품사 기본값, Kiwi의 사용자 사전, BM25의 k1·b 다이얼을 실측으로 짚습니다. 결론은 BM25 자체가 약한 것이 아니라 한국어를 잘못 쪼갠 BM25가 약하다는 것입니다. 인터랙티브 4개와 삽화 8장.