
#코사인 유사도
3개의 포스트
포트는 8080이 됐는데 AI는 아직 8000이라고 한다 — 낡은 사실 오류와 '시간 유효성' 기억
RAG는 사실이 바뀌면 옛 값과 새 값을 둘 다 꺼내 오고, 어느 쪽이 지금 값인지 가릴 방법이 없습니다. 2026년 6월 arXiv에 올라온 MemStrata 논문은 이것을 '낡은 사실 오류'라 부르고, 유사도로는 바뀐 값을 가려낼 수 없다는 것(AUROC 0.59)부터 보인 뒤 (주어, 관계, 값) 열쇠로 옛 값을 지우지 않고 퇴역시키는 기억을 제안합니다. 1969년 프레임 문제부터 SQL:2011 시간 테이블까지 '바뀌는 세계를 기억하는 법'의 역사를 따라가고, 한국어 시나리오 30개로 논문의 핵심 주장을 로컬 모델에서 다시 재 보았습니다.
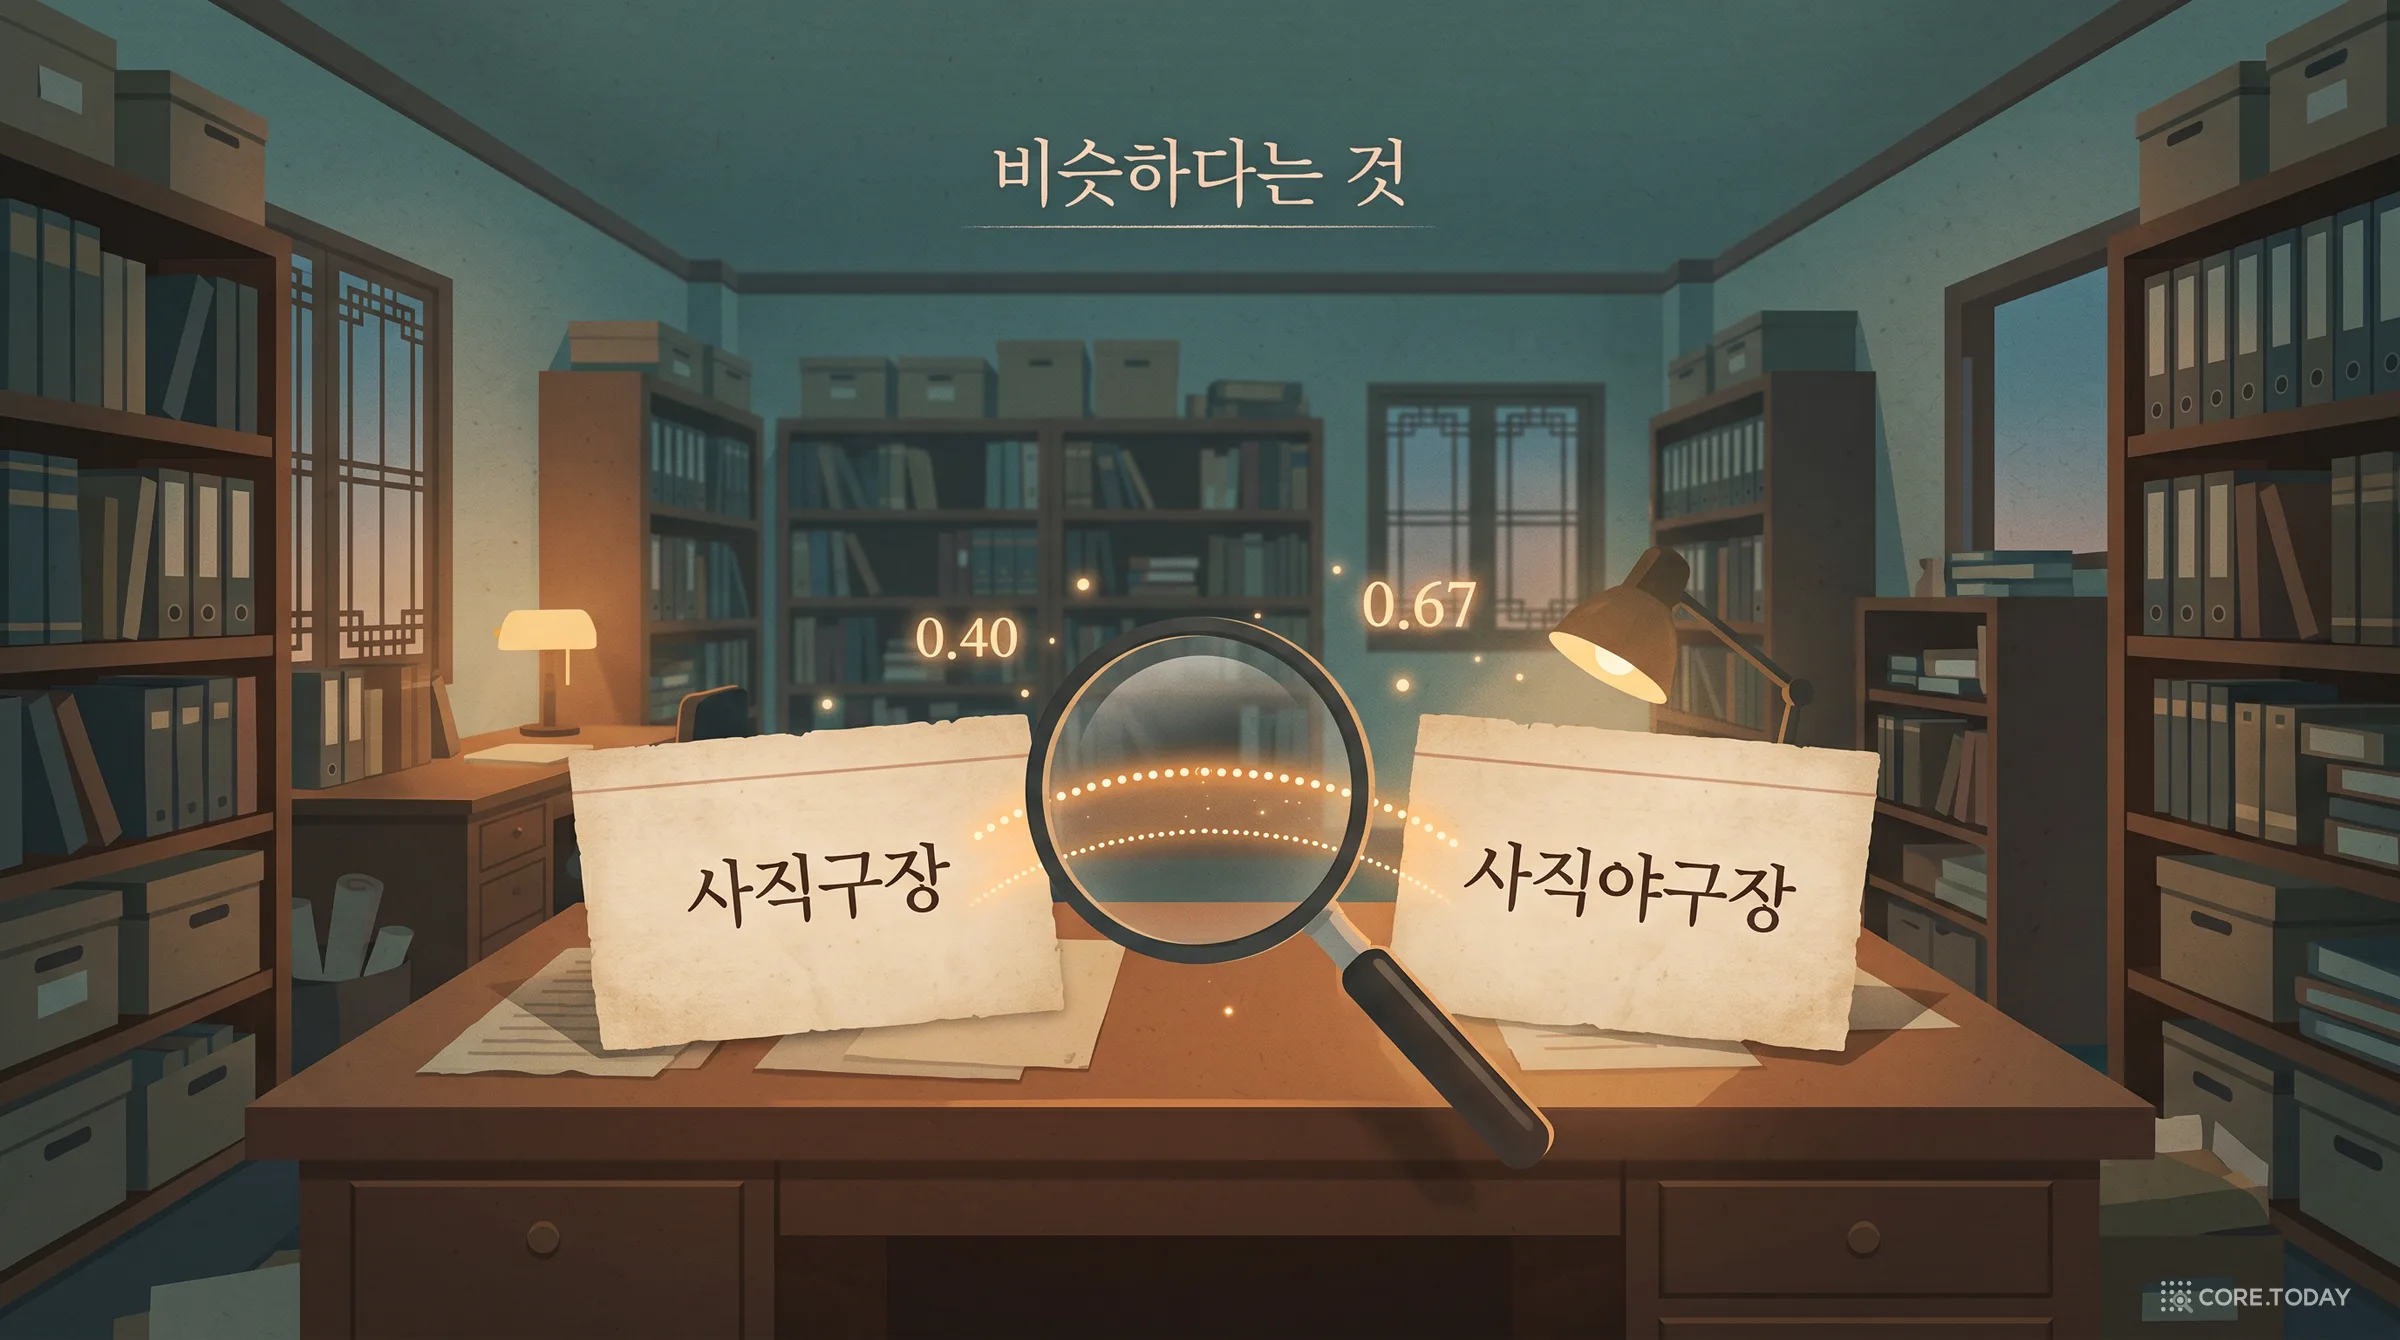
‘비슷하다’는 네 가지 질문이다 — 알프스 꽃밭의 자카드에서 2026년 한국어 사실탐색기까지, 유사도 125년
2026년 10월, 코어닷투데이 사실탐색기는 부산 조례 부칙의 '1981년 1월 1일부터 시행'과 '1984년 1월 1일부터 시행'을 같은 값으로 묶었습니다. 두 문장이 71% 비슷하다는 계산 때문이었습니다. 이 글은 '비슷하다'를 재는 기술이 왜 생겨났는지부터 시작합니다. 1901년 알프스 식물 목록을 비교한 자카드, 인구조사 이름을 소리로 묶은 사운덱스, 단어를 벡터로 바꾼 설턴과 IDF의 스파크 존스, 뜻을 좌표로 만든 임베딩까지요. 그리고 같은 기술이 한국어 공적 기록 앞에서 어디서 미끄러지는지, 2026년 임베딩 14종 실측과 최신 논문으로 따라갑니다. 결론은 하나입니다. '비슷하다'는 같은 대상·같은 값·같은 사건·비슷한 사안이라는 네 가지 다른 질문이고, 질문마다 도구가 다릅니다.
한국어 임베딩 모델, 우리 문서로 직접 재봤다 — Qwen3-Embedding 8B·4B·0.6B, BGE-M3, Nomic v2 MoE 실측 비교 (한국어 검색 스택 1편)
RAG를 만들 때 가장 먼저 부딪히는 질문이 '임베딩 모델은 뭘 쓰지?'입니다. 이 글은 그 질문에 남의 벤치마크가 아니라 우리 문서로 답합니다. 코어닷투데이 블로그와 뉴스 589건을 코퍼스로, 사람이 일부러 다른 말로 쓴 질문 22개와 로컬 LLM이 바꿔 쓴 질문 45개, 키워드 질문 18개를 만들고, 맥 한 대의 Ollama에서 Qwen3-Embedding 8B·4B·0.6B, BGE-M3, Nomic Embed v2 MoE 다섯 모델을 같은 조건으로 돌렸습니다. 임베딩이 무엇인지, 코사인 유사도가 왜 각도인지부터 시작해, '청년 일자리'라는 말이 없는 문서를 각 모델이 어떻게 찾는지 실제 값으로 보여 주고, 지시문 접두어 한 줄이 점수를 어떻게 바꾸는지, 같은 한국어 문서를 토크나이저가 얼마나 다르게 쪼개는지, 8B와 4B의 차이가 어디서 나는지를 따져 봅니다. 결론은 순위표 하나가 아니라 '어떤 환경에서 무엇을 고르나'이고, 인터랙티브 6개와 삽화 8장으로 함께 읽습니다. 2편은 BM25·RRF·리랭커, 3편은 마트료시카 임베딩입니다.